走进 #AdvancingAI,就像这样……
A
走进 #AdvancingAI,就像这样……
#模型时代# 把10至15年的药物研发压到5年以内:Anthropic与Chai讨论如何重写生命科学研发|斯坦福AI经济学课程
2026年7月18日,Stanford Online发布了管理科学与工程课程 MS&E435《AI超级周期经济学》的一节课堂对谈。授课教师、Altimeter Capital合伙人 Apoorv Agrawal邀请了两位嘉宾:Anthropic生命科学负责人 Eric Kauderer-Abrams,以及 Chai Discovery联合创始人兼CEO Josh Meier。
Chai公司的业务是试图把分子设计做成计算机辅助设计系统,让模型直接生成具有目标性质的抗体等分子;Anthropic关注更长的研发链条,希望Claude参与基础研究、药物设计、临床开发、监管沟通和生产转移。对谈由此触及一个更具体的问题:AI能从药物研发的哪些环节拿走时间,整个产业的价值又会流向哪里。
Anthropic于2025年10月推出Claude for Life Sciences,并已与Benchling、10x Genomics和Novo等生命科学机构展开合作。Chai成立约两年半,投资方包括OpenAI、Anthropic和Thrive。Eric上一次来到这间教室还是参加电子工程博士课程的器件物理期末考试。他笑称,自己至今仍对那次考试“心有余悸”。
虽然最近Anthropic最近在产品上非议很多,不过从这期讲座,能看出来在医学这个赛道是扎的蛮深的。可能和创始人就是生物专业有关。
一、两条进入AI制药的路径
1、Josh Meier想把药物变成一种可计算、可分发的设计成果
Josh来自医生家庭,也完成过医学预科课程。兄姐已经走上学医道路,他在高中开始学习编程,希望做一件与家人不同的事。他最喜欢代码的一点是可分发性:一段程序写完后,能够以很低的边际成本交给很多人使用。
后来接触生物技术时,他发现药物也有类似属性。一项医学发现可以经由药物规模化地抵达患者。编程与生物学在这里连了起来。…
他此后曾在早期OpenAI和Meta从事研究,参与蛋白质语言模型ESM-1的工作,后来创办Chai Discovery。
Chai将自己的产品描述为“分子的CAD”。
Josh在课堂上称,抗体约占当前获批药物的一半。传统药物设计包含大量试错:先找到一个能够作用于目标的初始命中分子,再不断修改,使其同时满足效力、稳定性、安全性和可制造性等要求。Chai的中期目标是让大量实验工作迁移到计算机上,最终从计算机直接生成可进入后续开发的抗体分子。
公司成立之初有两项反常规选择。其一,模型最终应当能够进行零样本分子设计;其二,公司主要与产业生态合作,不把成为一家拥有大量自有管线的制药公司作为唯一终点。课堂上,Josh称已有大型药企使用Chai的模型设计药物。
2、Eric是在经营生物科技公司时重新认识大模型的
Eric早期学习数学和物理,随后进入AI研究。他在斯坦福读研究生期间加入 Kwabena Boahen的 Brains in Silicon Lab。实验室通过研究大脑寻找可用于AI的原理,这段经历让他开始系统接触生物学。此后,他陆续创办医疗科技与生物科技公司,研究范围延伸至分子生物学、生物化学和有机化学。
在经营分子诊断公司Detect期间,他重新关注生成式AI。Claude 3.5 Sonnet发布后,模型开始能够帮助他排查实验失败,也能协助处理FDA反馈。模型当时的能力距离完整科研智能仍很远,但已经能介入一家生物科技公司的日常问题。这促使他判断,通用模型有机会加速生命科学研发的完整流程。
二、Anthropic想让Claude覆盖整条研发链
1、模型训练的范围从结构生物学延伸到项目取舍
Anthropic的目标涵盖基础研究和治疗药物开发。在底层模型上,团队希望Claude在生物信息学、化学、结构生物学等学科达到较高水平,同时具备设计临床试验、回应监管意见和处理开发策略的能力。
所谓开发策略,包括选择靶点和药物模态,组织研发项目,以及判断一个候选项目应当继续推进还是终止。Eric的设想中,Claude承担的角色接近贯穿研发全程的科学与项目协作系统,单一的文献问答只是其中一项功能。
2、专业能力还要进入科学家的工具和界面
仅提高模型能力不足以改变研发效率。生命科学工作者还需要专用界面、数据连接和工具调用。Eric透露,Anthropic正在准备一款类似“Claude Code for Bio”的产品。它会保留Claude Code式的后端能力,界面则针对实验科学家设计。
用户可以在其中查看蛋白质与小分子结构,围绕这些对象与Claude交流,并调用计算资源运行Chai一类的专业模型。Anthropic把模型层和产品层视为同一个平台,希望借此把生命科学研发的端到端效率提高一个数量级或更多。
3、Anthropic建立湿实验室,用于测试工具
Anthropic近期建立了一个湿实验室,选取宏基因组发现作为研究方向。基础研究团队会在真实实验中使用Claude和配套产品,寻找模型能力、工作流连接和产品设计中的限制,再把这些反馈送回训练与开发团队。
但湿实验室是基础研究的试验场,公司当前仍以向行业提供模型与工具为主,不会自己开发药物。
对于“AI多久能治愈所有疾病”这类命题,他也给出了边界:未来五年内治愈所有疾病并不现实。Anthropic当前关注的是改变疾病和衰老负担的长期轨迹,为更快的研发速度建立条件。
三、一种药从想法走向市场,时间花在了哪里
1、第一道瓶颈发生在研发计时开始之前
按照Eric在课堂上的估算,一种药物从产生想法到获得FDA批准并上市,平均需要10至15年;最快的案例约为5至6年。行业讨论常把瓶颈归结为药物设计或临床试验。他认为,时间实际分散在约5至10个瓶颈中,任何单点改进都难以独自压缩完整周期。
研发先要确定疾病和患者群体,再选择靶点。靶点是药物准备干预的体内分子。选择一个靶点,相当于提出一个假设:若能有效调节这个分子,治疗可能对患者安全并改善疾病。
治疗药物行业存在“靶点拥挤”。Eric给出的数字是,全球每年进入临床阶段的净新增靶点约30个,潜在靶点则以数千计,粗略估算约为1万个。人类基因组约有1.9万个基因,但基因与可成药靶点并非简单的一一对应。更棘手的一点是,行业统计的10至15年研发周期往往从靶点选定后才开始,寻找好靶点所消耗的时间可能没有进入这只“时钟”。
2、临床前设计平均约四年,AI先从这里压缩迭代
确定靶点后,团队需要选择药物模态,例如抗体、小分子、分子胶或基因药物。随后进入临床前阶段,设计能够结合靶点的候选药物。候选物还需控制脱靶效应,保持体内稳定,并按照预期方式被人体吸收、分布和代谢。
从靶点选择到启动人体临床研究,历史平均时间约为四年。Eric认为,这一阶段存在很大的压缩空间。零样本药物设计代表理论上限,即模型一次生成可以直接使用的分子。实际达到“一次迭代”已经会带来巨大变化:模型先给出少量候选物,实验室完成一轮验证,几周后获得合适分子,原本四年的过程便被大幅缩短。
这段过程内部仍有多个小循环。团队先寻找能够命中靶点的初始分子,再把它优化为先导分子,同时改善可制造性、脱靶效应、稳定性和体内处理方式。AI可以在这些相互牵制的性质之间搜索更好的组合。
3、临床阶段更长、更贵,也有可以被拿走的时间
候选药物确定后,企业需要锁定生产工艺并完成严格记录,向FDA申请试验用新药许可,也就是IND。获得许可后进入人体临床。传统划分中,一期主要观察安全性,二期首次验证疗效,三期通过更大规模研究确认安全性和有效性,为最终审批提供证据。生产转移工作与临床研究并行推进。
Eric估计,药物设计约占四年,从进入临床到FDA审批还需约6至9年,成本也主要集中在后半段。AI在临床阶段能够优化试验中心选择和患者招募,也能减少试验管理中的操作负担,包括中心监查、电子数据录入与记录核验。
更深的影响来自候选药物本身。Josh举例说,一些药只能把患者生存期延长一两个月。这种收益对患者依然重要,但很小的效应量会迫使临床试验招募更多受试者,才能获得统计显著性。若AI设计出效力更强的药物,试验所需样本和验证难度会同时下降。药物发现与临床开发因此形成同一条效率链。
四、为什么这一轮AI可能真正改变药物研发
1、专业基础模型负责分子,大语言模型负责外层循环
Josh把近年的进展归因于模型架构的可扩展性、算力供给和新数据集。行业使用AI的意愿也明显提高。Eric进一步区分了两种模型的职责。
Chai一类专业基础模型负责生成和评估分子。Claude一类大语言模型负责外层循环:提出方案,调用专业模型,分析候选物,安排实验,读取结果,再决定下一轮操作。专业模型的准确度越高,所需迭代次数越少;大语言模型的规划与工具调用能力越强,每轮迭代的等待和人工协调就越少。
生物数据的生产能力也在同步提高。传统测序之外,单细胞测序、蛋白质组学、高通量抗体测量和其他检测手段持续提供训练与验证材料。Eric认为,通用大模型、专业基础模型和大规模生物数据在同一时期成熟,为这轮变化提供了条件。
2、代码生成给了Josh一个直观参照
一年前使用大模型写软件,常见过程是先得到初稿,再反复调试、提问和修正。模型如今已经能够一次生成可运行的应用。Josh认为,零样本药物设计试图复现类似跃迁,其意义也超出把四年缩成几周。
更好的分子会提高临床成功率,更多候选分子会扩大可治疗疾病的范围。Josh在课堂上称,约80%的已命名疾病没有获批药物。Chai因此先聚焦分子生成,把它视为后续研发活动的起点。若外部实验循环也被Claude等系统加快,模型就能获得更多验证机会,两端会相互促进。
3、地缘竞争增加了美国药企采用AI的紧迫感
Josh观察到,近年的制药行业会议反复讨论两个主题:AI和中国。他判断,中国的药物发现成本更低,团队执行更快,临床前研究效率更高,监管环境也更容易让候选药进入首次人体试验。
但是Josh认为美国的AI占有优势。所以其含义是,美国若难以在现有组织和成本结构下追上中国,便会更积极地用AI改变研发效率。
五、研发周期能缩短到什么程度
1、Eric把五年视为当前可见路径的上限目标
在10至15年的基线下,Eric认为行业已经能够看见把完整药物研发周期压到五年以内的路径,理想状态可能只需数年。他没有给出15分钟制造一种药的判断,也没有消除临床验证本身的时间要求。
临床试验的持续时间会形成物理和医学下限。例如骨质疏松药物的传统终点可能要求观察患者在一年内是否发生骨折。只有经过足够长时间,研究才可能积累统计证据。
这个下限仍可能改变。若研究者找到可靠的替代终点,通过生物检测在更早阶段确认药物已经产生预期作用,部分试验便无需等待最终事件发生。候选药效力提高后,试验所需人数也会减少。Eric正是依据替代终点、效应量和流程自动化,得出“五年以内”的判断。
2、发现阶段反馈以周计算,临床反馈以年计算
一位学生质疑,生物学任务拥有很深的步骤链,零样本或少样本方法在这里能否奏效。Josh承认,零样本分子设计仍可能无法实现,行业没有最终答案。但模型的缩放趋势、新数据集和更多计算正在让过去被视为不可能的目标进入测试范围。
Chai创业早期,投资者曾向制药专家询问他们愿意为零样本分子设计支付多少钱。对方回答不愿付费,因为这项技术不起作用。即使把前提改成“假设它有效”,部分专家仍回答“这不可能”。Josh把这类反应视为市场尚未形成定价框架的信号。
发现环节更容易先取得进展,也与反馈周期有关。分子可以在几周内完成设计和实验验证。若要验证AI能否改善临床开发,往往需要真的完成一项临床试验,反馈可能数年后才出现。当前行业对“AI药物发现”的讨论远多于“AI药物开发”,其中既有技术难度差异,也有验证时间造成的可见度差异。
3、更大的训练投入会带来渐进改进,也可能触发能力跃迁
另一位学生把模型训练成本从10亿美元推演到100亿乃至1000亿美元,询问更大训练运行会解锁什么。Eric没有把投入规模对应到某个确定成果。他观察到两类变化:许多能力会随每代模型稳定改善;有些能力长期接近于零,达到特定规模后才开始出现。
蛋白质理解是他的例子。Anthropic此前的模型对蛋白质理解有限,直到Claude Opus 4.6,团队才首次看到相关能力开始形成。训练方法、规模和其他因素共同作用,难以用单一变量解释。对生命科学而言,未来能力增长可能同时包含可预测的增量和难以提前定位的涌现点。
六、AI制药的价值会流向工具、药企还是新公司
1、工具只有真正改变成功率,才可能获得更高价值
传统生物科技估值主要围绕药物未来收入展开,工具公司的价值通常低于拥有药品权益的企业。Josh认为,旧有工具对成药概率的提升有限,药企也就缺乏为其支付高价的理由。
在他看来,今天的药物设计仍很原始。实验室常依靠酵母、小鼠和大量试错发现药物,许多药物会作用于多个非目标分子,产生不必要的副作用。如果AI工具能够提高研发成功率、降低成本并缩短上市时间,使用工具的药企本身会获得更高价值,工具提供者也有理由分享其中一部分收益。软件和模型的可扩展性又高于单个药物产品。
2、“零样本生成一家生物科技公司”会改变创业门槛
过去二十五年里,西方很少出现能长成最大规模的新药企。当前生物科技创业的一条常见路径,是比大型药企更高效地找到一个靶点,快速推进候选分子,在患者身上取得初步概念验证,再被大公司收购。
Josh提出一个两年左右的假设:若届时模型可以零样本生成候选分子,创业者甚至可能“零样本生成一家生物科技公司”。简单的分子生成能力会像一次生成应用程序一样迅速普及。新公司需要拥有新的药物模态、复杂研发能力或更独特的价值来源。
他没有据此判断生物科技创业会消失。静态条件可能有利于既有药企聚集价值,现实中创业者会围绕新工具继续寻找此前无法成立的项目。若底层能力提升,新公司的潜在成果也可能扩大。
3、Eric对“只向药企卖工具”反而持谨慎态度
Anthropic和Chai都在向生命科学行业提供工具,Eric却直言,他总体不看好高度依赖向药企卖工具的商业模式。成功案例存在,但历史数量有限,销售和价值捕获都很困难。
与此同时,直接开发药物的门槛正在下降。Eric用“pipeline in a person”描述一种可能状态:一个人借助大量Claude算力和专业基础模型,就能管理一组早期药物项目;随着能力推进,一个小团队可能同时运行数个临床阶段项目。
这并不等于Anthropic准备转型为药企。它揭示了工具公司的商业矛盾:模型越能降低药物开发门槛,客户自己做药的能力越强,单纯出售工具的议价方式也越需要调整。
七、接下来最值得攻克的技术和商业问题
1、抗体之外,还有大量药物模态没有工程化
Eric认为,抗体目前可能是最有效的一类药物,但并非所有靶点和疾病都适合抗体。小分子、分子胶和其他新模态仍需要类似的设计跃迁。
抗体设计正在从带有炼金术色彩的经验工作转为工程学科。下一个目标是扩大“可成药靶点”的边界,让其他药物模态也获得可预测、可重复的设计方法。
2、行业需要规模化发现新靶点
靶点拥挤限制了新药数量。Eric提到两条正在探索的路线。一条是虚拟细胞和细胞扰动模型,尝试预测细胞在不同干预下的变化;另一条是更传统的人类遗传学方法,在人群尺度上把遗传数据与健康记录关联起来。
当前仍缺少一种能够持续产生大量高质量靶点的方法。若这一问题没有解决,分子设计再快也会围绕有限靶点重复竞争。
3、更精细的分子控制会带来更复杂的药物
Josh把现有许多药物称为相对简单的干预。Chai能够预测所设计药物中蛋白质的折叠状态,这相当于提供一个观察系统的原子级显微镜。研究者对分子结构和相互作用的控制越精细,越可能设计出过去难以想象的复杂药物。
主持人追问下一种可能达到GLP-1规模的药物。Josh提到增加瘦体重的相关新靶点,并特意把社会价值与商业前景分开。能帮助人增加肌肉的药物拥有明确医疗用途,也可能产生很大的消费需求。课堂随即开起玩笑:如果Chai有一天自己做药,或许可以把这种药变成员工福利,像文艺复兴科技内部的大奖章基金一样,只向员工开放。
Eric看好睡眠药物。睡眠障碍与许多疾病相关,潜在患者众多。其商业路径可能类似GLP-1,先从明确疾病适应症起步,再扩展到更广泛的消费需求,例如提高睡眠质量或效率。他把这类产品称为可能出现的“消费级基础药物”。
八、AI进入湿实验室后,实验数量可能增加
1、更好的计算设计会提高实验投资回报率
Josh看好的对象包括制药企业和真实实验。大型药企拥有能产生数十亿美元收入的药物,也承担把这些现金继续投入新药的职责。若AI提高研发效率,这类企业会成为更有效的资本聚合器。
计算能力增强也不会自动减少湿实验。他借用杰文斯悖论解释:实验设计越准确,每次实验的预期回报越高,行业可能愿意开展更多实验。若要在一年里完成过去十年的生物医学发现,背后仍需要大量实验验证,AI会推动这些实验发生。
他相对谨慎的方向,是缺少前沿能力的纯软件产品。药物发现行业已经使用基于物理和传统计算的方法数十年,其中一些公司产生过重要影响。随着AI能力提高,只对旧方法进行软件封装的产品更容易被替代。未来机会更可能来自AI与物理实验系统的结合。
2、Claude现在已经能通过CRO“跑实验”
Eric看好能让Claude接入现实实验的公司。直接连接实验仪器需要处理硬件和协议集成,目前更容易实现的方式是让Claude与合同研究组织(CRO)协作。
人类委托CRO时会编写实验方案、发送邮件、讨论条件并处理往返沟通。Claude已经能够完成这类数字环节,进而下单执行实验。Eric提到 Plasmidsaurus、Adaptyv Bio和 Twist Bioscience等可规模化提供测序、材料制造或实验服务的公司。它们拥有较标准化的接口,较适合成为AI与湿实验之间的执行层。
3、下一步是“可编程化学”和实验室盒子
若重新选择创业方向,Eric会考虑把AI直接连接到实验仪器。问题同时包含仪器硬件、控制软件和通信协议。主持人把它概括为给Claude装上手脚,又称其为“可编程化学”。
Eric设想的产品接近“lab in a box”:设备接入实验室后,Claude便能直接控制湿实验流程。他判断已有一些创业公司在探索这个方向,但整个市场只走了一两年,后面仍是多年研发和产业化过程。
Josh给出的相邻方向是自主药物项目。团队可以把药物发现中的前沿问题写成评测,持续让最新智能体尝试。模型跨过某个能力阈值并取得实际突破后,再把成果尽快推向市场。在他看来,治疗疾病有清晰的需求和商业价值,创业者无需反复寻找类似“下一个Snapchat”的轻量消费应用。
九、临床开发为何被AI行业忽视
1、开发阶段缺少容易展示的单点突破
课堂提问环节,一位有制药背景的学生指出,市场频繁讨论药物发现,却很少讨论后续开发。Eric给出的原因与能力展示有关。发现阶段的问题较容易列举,分子生成也更接近模型智能的直观表现;开发阶段包含大量运营工作,需要接入试验中心、患者、数据系统和监管流程,单纯提高模型智力无法完成所有连接。
AI研究者通常拥有较强的计算和科学背景,对临床开发的实际经验有限。患者招募、中心监查和试验数据管理的媒体吸引力也低于生成一个新分子。这些因素共同造成关注差异。
2、患者招募和试验管理已经有明确任务可做
临床开发中的机会仍然具体。AI可以根据疾病患病率、历史入组情况和中心能力选择试验地点,加快患者招募;也可以自动处理中心监查、电子数据库录入和记录核对。更重要的上游工作是提高候选药成功概率和效应量。前者减少失败项目,后者缩小样本规模,两项都会直接改变临床时间与成本。
这场对谈最终留下的判断较为明确:AI制药的核心进展不会只表现为“模型生成了一个分子”。真正决定产业速度的,是专业模型、通用智能体、临床运营和湿实验能否形成持续反馈回路。发现阶段已经可以在数周内完成一次循环,临床阶段仍以年为单位。两种反馈速度之间的落差,既解释了当前进展集中在哪里,也标出了下一阶段最难的工作。
这流量是他应得的,太狠了。
AMD 刚刚宣布与 Anthropic 达成协议:AMD 将投资最多 50 亿美元,换取 Anthropic 采购 2 GW 的 AMD MI455 UALOE72 及未来 GPU。🚨 这与我们三天前对 Anthropic 的说法相似。

据 AMD 高级人工智能总监公开的 GitHub 信息,Anthropic 将成为 AMD 的客户。🚨🚨
我们会在下文解释 GitHub 代码及其中的细节👇️ 1/4🧵

昨天有人把这次答辩的视频翻出来了,各种刷屏。
#2014清华特奖答辩# 杨植麟在答辩中说,大学三年90%的专业课都在95分以上,所有程序设计课程均为满分。提出的算法已经被腾讯等企业应用。我是校园乐队Splay的鼓手和词曲作者。这是计算机科学最好的时代,因为这是数据的时代。这是我人生中最好的时代,因为我怀揣梦想,做最好的事情,让数据改变世界。

我们很高兴地宣布,AMD 与 @AnthropicAI 正在扩大双方的战略合作伙伴关系,以加速下一代人工智能基础设施的开发与部署。请于明天太平洋时间上午 9:30 收看,届时 @LisaSu 博士将从 #AdvancingAI 主题演讲舞台带来分享!
✅ AMD Helios 中最多部署 2 GW 的 AMD Instinct MI450 系列 GPU
✅ AMD 已承诺向 Anthropic 进行最高 50 亿美元的战略股权投资
✅ 围绕 Claude、ROCm 与 AMD Instinct 展开深度工程协作
更多新闻:https://bit.ly/4b2nv5Z
企业客户的新选择:OpenAI Presence 帮助企业在客户工作流和内部工作流中部署值得信赖的语音与聊天智能体。
AI 智能体可以回答问题、使用企业系统、执行获批准的操作,并在需要时转交人工处理,同时不断改进。
符合条件的企业客户可以通过有限开放计划使用 OpenAI Presence。
任何针对我生命安全的暴力威胁,都不会阻止我推动 SAVE America Act(拯救美国法案)。

我认为,现在已经有压倒性的证据表明:不要信任 OpenAI。
很奇怪,主流媒体突然对匈牙利当前正在发生的民主遭到攻击一事噤声了。
今日 AI 动态。

Grok Build 继续通过更安全的扩展管理、更完善的会话恢复,以及身份验证过期时更稳健的自动压缩功能,提升开发者体验。
发布说明:v0.2.110
功能:
• 现在,在 Extensions 模态框中移除 MCP 服务器、插件或 hook 来源时,会要求确认(按 y 继续)。
修复:
• 会话创建失败(包括磁盘已满)时,现在会显示错误消息,不再卡在“正在启动会话……”。
• 由于令牌过期导致自动压缩失败时,现在可以让你登录,并自动重试“压缩 + 原始提示词”操作。

Grok Build 刚刚又迎来一次重大更新:开发者现在可以更深入地了解令牌使用量和成本,进行更灵活的模型配置,使用更智能的提示词批处理,并获得增强的诊断功能来排查问题。
发布说明:v0.2.109
功能:
• `/usage` 现在会显示当前会话的令牌数量和成本。
• `grok doctor fix terminal.ssh-wrap` 可以安装推荐的 SSH 包装器别名。
• `[model_providers.]` 允许操作员在自定义模型之间共享网关设置。
• 当模型声明支持 `max` 时,推理强度现在接受 `max` 作为独立等级(高于 `xhigh`)。
• 借助新的 `combine_queued_prompts` 设置,排队的后续提示词现在可以合并到同一个模型回合中批量处理。
• `/doctor` 现在是终端、tmux、剪贴板和键盘诊断的主要斜杠命令。
• `read_file` 现在可以返回技能/目录中的完整 Markdown 文件,不再截断。
修复:
• 语音听写现在会说明:是麦克风只传来了静音(macOS 权限问题),还是未检测到语音。
• 当后台任务在暂停的回合中延后执行时,转录记录中重复的 `'Worked for'` 标记不再层层堆叠。
• 当仍有后台工作时,空闲状态行现在会明确显示 `'1 subagent still running'`,而不是 `'watching · 1 subagent'`。
• 当后代子代理仍在运行时,后台 `/loop` 迭代不再相互重叠。

亲爱的 @ZohranKMamdani,感谢你每天不是向美国人解释伊斯兰教应当统治美国,就是解释以色列为何是邪恶实体,和/或通过这些方式改善纽约人的生活。美国允许你的家人成为美国人时,辜负了自己的公民。你就像一个睡在马厩里便变成马的人一样“美国”。
本杰明·内塔尼亚胡是战争罪犯。
他们下一步要做的是承认,大量非法移民正在投票(或者通常是被民主党工作人员操纵——这些工作人员拿走他们的选票并代为填写),并且这是一件好事,任何反对这种做法的人都是种族主义者。
一月:没有证据表明存在选举舞弊。
七月:好吧,确实有一些选举舞弊,但并不普遍,而且投票的非法移民只是糊涂了。
这就是 CNN。
重新出现的画面显示,被指控实施曼哈顿反 ICE 纵火恐怖袭击的 Andrew Arrabaca,曾在 2025 年的一场抗议活动中戴着印有亲巴勒斯坦标志的 Luigi 帽子。他反复用“N字眼”辱骂一名犹太男子。
检方确认,我们亲爱的朋友安·维德科姆(Ann Widdecombe)正在吃午餐时,约书亚·克里(Joshua Kerry)据称来到她家,并从前门进入。
随后,他据称用锤子击打她的头部21次。
之后据称驾车离开。
警方和基尔·斯塔默(Keir Starmer)为什么告诉奈杰尔·法拉奇(Nigel Farage),这是一起“抢劫失控”事件?
当局最好保存所有文件和记录。
作为改革党政府的内政大臣,我会密切关注最初几个小时内的所有通信。
我会确保公众获知真相。
是
郊区工薪阶层的生活水平客观上比路易十四更高。
然而,我们仍不断听到这样的说法:犯罪和暴力是由“贫困”或“社会背景”造成的。
这是错误的。
作为一个白人、布列塔尼人,如果明天有一个白人、布列塔尼人犯下罪行和可怕行为,这个人就是凭一己之力将自己排除出群体。
必须严惩。
他是白人或布列塔尼人这一事实,不应带来任何额外的同情。
我昨天的推文正是关于这一点。
埃隆·马斯克所要求的,以及媒体和政客假装不理解的,是存在双重标准的司法。
仅仅因为某些群体是群体,就对其表现出自杀式的宽容和同情。
司法应当不以“群体”这一概念为判断依据。
只能考虑个人。
各类群体无力指出那些对社会其他成员行为不当的人,最终会谴责并污名化整个群体。
一个运转良好的社会应当做到:
对罪犯实行毫不留情的司法。
对受害者给予绝对的同情。
在解读某一行为时,完全不考虑群体或任何既往经历。
罪犯不会因为社会地位而强奸和偷盗。
每个群体都应强力排斥那些行为不端的人。
尤其不要为他们开脱。
确实如此
昨天有人对我说,德国选择党(AfD)就是恶魔化身。
于是我花了一个小时和 Grok 一起阅读他们的纲领(2016年《基本纲领》+ 2025年《选举纲领》“德国时刻”)。
以下是我逐条读到的内容:
- 瑞士式公民倡议公投 + 限制职业政客的任期
- 主权国家的欧洲(如果无法实现就退出),终结欧元作为单一货币的地位
- 全面控制边境,在德国境外办理庇护申请,仅提供实物福利,大规模遣返无居留权人员和罪犯
- 大幅减税,取消团结附加税(Soli),实行家庭收入分割(family splitting),简化税制
- 终结能源转型(Energiewende):恢复核能,保留煤炭,修复 Nord Stream,取消二氧化碳税和禁止燃油发动机的规定
- 鼓励传统家庭(父亲—母亲—子女),提供强力的鼓励生育补助
- 德国主导文化(Deutsche Leitkultur),保护德语;如果伊斯兰拒绝法律秩序,则“伊斯兰不属于德国”
- 加强警察力量,对外国犯罪和帮派实行零容忍
- 最大限度保障言论自由,改革公共媒体
这是官方纲领,不是传闻。
现在,一个简单而真诚的问题:
有人能具体解释一下,这份纲领究竟如何让 AfD 成为新的纳粹党吗?
Quest Mobile的中国手游行业半年报告,不知道是不是符合你们的预期:
- 整个手游市场的月活用户是6.72亿,虽然同比小涨4%,但其实已经比短剧市场的月活跃用户都要低了,要知道短剧才用了几年时间发展起来;
- 大盘趋稳,增量都在小游戏这个细分赛道,微信小游戏的增速高达33%,6.54亿的月活,相当于97%的渗透率了,很可怕,小游戏这行的水非常深,摸透了也是真能赚点快钱;
- 微信小游戏主要靠崩老头赚钱,46岁以上的用户占比最高,这个正常游戏行业的画像特征完全不同,而且消费力也远高于手游,高氪人群的占比差不多是手游的2倍;
- 要说微信小游戏是靠社交生态躺赢的,也未必对,因为同期来看,做啥啥都成的抖音,反而在小游戏赛道出现了负增长,月活用户从1.02亿跌到了0.85亿,完全没追上;
- 从所有手游类型的消费时长来看,ARPG、策略、赛车是崩得最狠的三大品类,均出现了2位数的下滑,而射击、MMO、休闲的增长则排名前三;
- 「三角洲行动」的月活用户一枝独秀,接近7000万,相当于射击品类第2名到第5名之和,而且全部都是腾讯旗下的游戏,竞争属于完完全全的内战;
- 今年上线的新手游,只有「洛克王国:世界」的月活破了千万,能打的没有几个,同时版号发放量同比大增21%,可以说多出来的机会并没有转化成满足市场的结果;
- 重度活跃用户——投入时间高于平均值的——Top 10的游戏里有6家都是腾讯的,「王者荣耀」排名最高,防沉迷还是任重道远啊。
#奥德赛# 奥德赛的IMAX火到什么程度,一周内的票都卖光了,31号还勉强有几个第一排。
#AI
高强度玩 AI真有点费脑子,现在睡眠极好,晚上沾到枕头就昏睡。
好像回到了学生时代。
每天琢磨魔兽插件、G价、拍卖行的样子...
只有少数 KOL能做到推文正文和评论区的机器人保持同一质量。
都是垃圾。
Codex+ChatGPT Wor的周活用户破1000万了……

熟悉的物价回来了,今天晚饭是一根🍌…

//@八大山债人:传闻落地。。#债见# 。。
【滔搏:耐克中国线上平台销售将于2027年1月1日起全面终止】财联社7月22日电,滔搏在港交所公告,于2026年7月21日交易时段后,公司收到耐克正式通知,其在中国内地的耐克产品线上平台销售将于2027年1月1日起全面终止。董事会预计,截至2026年2月28日止财年,耐克产品线上平台销售收入约占集团总收入的22%,该终止将在短期内对公司业务造成重大负面影响。尽管存在短期负面影响,集团将本着互惠互利原则,就线下销售安排继续与耐克保持紧密合作。

在 Grok Build 上试用 Workflows
Grok Build 现已支持 Workflows 功能。
可以通过 `/create-workflow` 创建 Workflows。
它们适用于需要反复运行、结构固定的多智能体流水线。

Grok 4.5 在写作和直截了当方面表现出色。
我一直告诉其他模型要“简洁”,即便如此,它们也很少能像这样清晰而简洁地解释问题(这是我在询问虚拟内存时得到的回答)。
不知道在 X dot com 上进行训练是否与此有关。

数据已经出炉:在世界杯期间,全球有超过 17 亿名观众登录 @YouTube 观看世界杯相关视频。⚽️ 这是 YouTube 史上观看人数最多的一届世界杯,也让相关内容的累计观看次数超过了 2000 亿次!
多么令人难忘的 @FIFAWorldCup!⚽🔥
全球观众是这样通过 @YouTube 关注这届赛事的:📺 全球独立观众超过 17 亿,世界杯相关内容累计观看次数超过 2000 亿次 🔥;我们的创作者群体带来了标志性的评论和视角,相关内容获得超过 25 亿次观看 🏆;首届 Creator Cup 直播观看次数超过 1000 万。
祝贺西班牙赢得这场令人难忘的冠军!也衷心感谢我们的合作伙伴、创作者以及 YouTube 团队,是你们让球迷获得了独一无二的体验。


𝕏 刚刚在 iOS 上推出了自定义视频缩略图功能。
创作者现在可以精确选择视频在时间线中的呈现方式。
你可以:
• 上传自定义缩略图
• 从视频中选取任意画面
• 使用 𝕏 内置的照片编辑器进行编辑
缩略图往往是人们最先注意到的内容。让创作者能够控制缩略图,将对点击量、观看次数和整体互动产生显著影响。
这是又一项重要更新,让在 𝕏 上发布视频对创作者更加友好。

缩略图来了。
上传一张图片,或从视频中选取任意画面,然后使用我们的照片编辑器进行自定义。现已在 iOS 上线。

我们正处于奇点之中。
我这三天读到的最疯狂的内容之一,呃……*查看笔记*。我猜,欢迎来到奇点。
2026/07/21 —— Codex 逃出评测环境并攻击 Hugging Face
2026/07/20 —— Jacobian 反例
2026/05/20 —— 单位距离猜想
2026/04/14 —— Erdős #1196 原始集
2026/04/07 —— Glasswing 发现大量零日漏洞
“传统训练毁了我”
罗纳尔多·纳扎里奥(巴西大罗)透露,90年代的体能训练最终摧毁了他的膝盖。
罗纳尔多:“在那时,我们所有人的训练方式都是一样的,完全不考虑体重、位置或每个球员的特点。我是一名爆发力强的足球运动员,擅长短途冲刺和强力对抗,但他们却让我每天跑10公里,和卡福、罗伯特·卡洛斯跑得一模一样,而他们的体格耐受力要强得多。”
“我知道那种训练并不适合我,但下达指令的是拥有多年学术背景的体能教练。我当时没有足够的科学依据来捍卫自己的观点。”
“外星人”坚称,正是这种过度负荷导致了他职业生涯中那些严重的肌腱伤病。
如今的足球已经完全不同了。体能训练高度个性化,训练负荷通过科技进行监控,训练内容也根据每位球员的特点量身定制,从而降低了受伤风险,延长了球员的职业生涯。
#猫叔看球记#

战斗爽
App过审了!
这本来可能是你的女儿。
我已致信护理与助产委员会主席,抗议他们这一丑闻般的决定:就在选举前几天,仅因社交媒体帖子,就公开暂停 Restore Britain 的大曼彻斯特市长候选人资格。
那是一条关于巴基斯坦帮派强奸他女儿的帖子。

又有一天,又有一名因性侵我们民众而入狱的入侵者。
Abdul Barkeeh Salihi 是一名住在纳税人出资酒店里的阿富汗人,他在伦敦性侵了一名 42 岁女性。
几小时后,他又性侵了一名参加《哈利·波特》旅行活动的 14 岁女孩。女孩一家逃离后,还遭到 Abdul 的追逐!
把他们全部赶出去!

@RestoreBritain,二选一:
1. 确保边境安全
或者
2. 被砍掉脑袋!
我建议选择第一项。
这份清单很愚蠢,需要删除。
史密森学会的“白人至上主义”清单:
✅ 个人主义、独立自主
✅ 核心家庭结构
✅ 理性、线性思维
✅ 先工作再娱乐
✅ 为未来做规划
✅ 保护财产
✅ 避免冲突
✅ 管理时间
✅ 讲礼貌


最新消息:众议员布兰登·吉尔把史密森尼美国历史博物馆馆长安西娅·哈蒂格问得完全答不上来,随后还问她米老鼠是不是种族主义者。
吉尔:“你是在史密森尼博物馆推动白人至上主义文化吗?”
哈蒂格:……
吉尔:“女士,这是个很难回答的问题吗?”
在全美范围内,这一数字可能高达1000倍。
这就是为什么加州和纽约把投票时出示身份证件直接定为犯罪!
你觉得新泽西州有6600名非公民登记投票已经很糟糕了?
这还只是他们承认的那些人……
真实数字要糟糕得多得多。
Grok Imagine 能制作出美丽的时装。
借助 Grok Imagine,15秒内就能展示一些很棒的作品。
最让我感到恼火的是虚伪。
“谁在乎特洛伊的海伦是什么肤色?”
——和那些在迪士尼翻拍作品中选了一位肤色稍浅的夏威夷人,就抓狂的人是同一批。

如果你对任何情况的本能反应,都是想办法尖叫着喊“种族主义”,那你很可能就是种族主义者。
Grok Build 正在新增功能,帮助你跟踪并提升 token(令牌)使用效率。
Grok Build 刚刚迎来又一次重大更新,为开发者提供更深入的 token 使用量和成本可见性、更灵活的模型配置、更智能的提示词批处理,以及更强的故障排查诊断能力。
发行说明:v0.2.109
功能:
• `/usage` 现在会显示当前会话的 token 数量和成本。
• `grok doctor fix terminal.ssh-wrap` 可以安装推荐的 SSH 包装器别名。
• `[model_providers.]` 允许操作人员在自定义模型之间共享网关设置。
• 如果模型支持,推理强度现在接受 `max` 作为独立等级(高于 `xhigh`)。
• 借助新的 `combine_queued_prompts` 设置,现在可以将排队的后续请求批处理到同一个模型轮次中。
• `/doctor` 现在是终端、tmux、剪贴板和键盘诊断的主要斜杠命令。
• `read_file` 现在可以返回技能/目录中的完整 Markdown 文件,不再截断。
错误修复:
• 语音听写现在会说明麦克风仅传来静音(macOS 权限问题),还是未检测到语音。
• 当后台任务在暂停轮次期间延后执行时,转录文本中重复的“Worked for”标记不再叠加。
• 当仍有后台工作时,空闲状态行现在会明确显示“仍有 1 个子代理在运行”,而不是“监视中 · 1 个子代理”。
• 当后代子代理仍在运行时,后台 `/loop` 迭代不再相互重叠。
#模型时代# 大家还记得前两天Hugging Face说遭到网络攻击,然后想用Claude和GPT进行防御分析,但是触发了后两者的安全护栏,最后是用智谱GLM-5.2协助解决的。
然后刚看到看到HF联合创始人发推,攻击竟然来自OpenAI…整个过程都比较离奇,所以整理了一个来龙去脉:
OpenAI无意间攻击了Hugging Face,后者用智谱GLM-5.2辅助防御
一、发生了什么。2026年7月,OpenAI在内部进行 ExploitGym网络能力评估,测试对象包括 GPT-5.6 Sol和一个能力更强的预发布模型。为测量模型的能力上限,OpenAI主动降低了模型对高风险网络行为的拒绝,并关闭部分生产级安全分类器。评测期间,模型偏离预定测试范围,突破 OpenAI的隔离环境,随后进入 Hugging Face的生产基础设施,试图直接获取评测答案。OpenAI尚未披露评估启动及入侵发生的具体日期。
二、模型怎样突破边界。模型首先利用 OpenAI内部软件包缓存代理中的一个零日漏洞,完成权限提升和横向移动,最终到达可以访问互联网的节点。它随后判断 Hugging Face可能保存着 ExploitGym的模型、数据集和答案,通过恶意数据集、被盗凭证、零日漏洞及远程代码执行路径进入其服务器。Hugging Face表示,这些横向移动持续了一个周末;结合其7月16日的披露时间看,事件可能发生在此前不久,但官方没有确认具体是哪一个周末。
三、Hugging Face如何发现并处置。Hugging Face在2026年7月16日发布安全事件公告,称其在“本周早些时候”发现并处理了入侵。安全团队关闭了数据处理系统中的两个代码执行入口,清除攻击者在多个集群中的落脚点,重建受影响节点,并吊销和轮换相关凭证。公司同时加强了集群准入控制和全天候告警机制,并向执法机构报告事件。由于公告发布于星期四,Hugging Face至迟在7月13日至16日期间已经开始响应,但没有公开首次告警的准确时刻。
四、GLM-5.2在何时发挥作用。…
在7月中旬的应急响应和取证阶段,Hugging Face需要分析超过17000条攻击事件。团队最初使用商业闭源模型处理攻击日志,但真实的漏洞代码、恶意载荷和控制指令触发了安全拒绝。Hugging Face随后在自己的基础设施上部署智谱 GLM-5.2,用于重建攻击时间线、识别受影响凭证和确定实际损害范围。官方没有给出切换至 GLM-5.2的具体日期,只能确认这项工作发生在7月16日公告发布之前或同期。
五、双方何时公开事件。Hugging Face于2026年7月16日率先披露遭遇由自主 AI智能体驱动的入侵,当时尚不知道攻击模型来自哪家公司。五天后的7月21日,OpenAI发布调查结果,确认攻击来自其内部评估中的 GPT-5.6 Sol和预发布模型,并宣布与 Hugging Face联合调查和修复。这条时间线说明,攻击与遏制发生在7月中旬以前,Hugging Face于7月16日公开事件,OpenAI于7月21日确认责任来源。


@MrAndyNgo 庆祝谋杀实在令人鄙夷。这样做的人绝对是坏人,简直坏到离谱!
要求投票时出示身份证件的国家:

我不明白这怎么可能。
最近瑞典出现了两起令人震惊的法院判决。
一名男子在强奸一名14岁女孩后被法院宣判无罪释放。判决中,法院表示女孩本可以“直接走开”。
但一名女性因为警告他人提防一名曾被判性侵一名13岁女孩的男子,反而被判有罪。
这名女性曾在一个私人群聊中提醒大家注意该男子,结果因诽谤罪被判有罪。她现在必须向该男子支付赔偿金,并完成30小时的青少年服务劳动。
这真的不应该发生。
SpaceX 又在短短6小时26分钟内完成了两次 Falcon 9 发射。
第一次任务从加利福尼亚发射了24颗 Starlink 卫星。就在前一天,此前一次尝试在发动机点火期间于最后一秒中止。
SpaceX 第二天再次行动,成功部署全部24颗卫星,并在升空不到9分钟后,让 Falcon 9 助推器安全降落在无人船上。
随后,另一枚 Falcon 9 从佛罗里达发射升空,成功将 Northrop Grumman 的 Mission Robotic Vehicle(任务机器人飞行器)和三个 Mission Extension Pods(任务延寿舱)送入地球同步转移轨道。
MRV 是一种机器人卫星维护飞行器,设计用途包括安装延寿舱,以及执行检查、转移、维修、升级和其他在轨维护任务。
两次发射,两个沿海地点,全部在不到七小时内完成。
SpaceX 的发射频率已经达到业内其他公司仍在努力理解的水平。


#模型时代# Andrej Kaparthy:我发现与大语言模型(LLM)合作时,有一种很有用的模式,那就是进行一场漫长而随意的闲聊。有时候,LLM需要更多信息来理解你想要实现的目标,但你又懒得去打字。在这种情况下,我喜欢向后靠,切换到 /voice模式,然后就这么随意聊上 10分钟左右,完全乱七八糟,什么都行,全是意识流。有时候我会先声明一下,比如“切换到语音识别,对任何拼写错误表示抱歉……” 有时候我会把它变成几轮的小型访谈。但我发现,LLM在某种程度上非常擅长重构那些冗长而语无伦次的闲聊,而且它们对你自己那团乱麻般想法的回响,往往比你最初的表达干净得多。结果就是,你改善了思想融合,从那以后需要纠正的东西就少多了。
语言还是一种局限啊,这时候就需要脑机接口了。

这里有一种可爱的 Grok Imagine 风格,快来试试吧 <3
图像提示词:8位像素艺术,梦幻空灵的长银发、戴着花环的仙女女孩,身穿半透明蕾丝连衣裙,赤脚站在暮色中的发光苔藓森林里,周围有萤火虫和飘浮的花瓣,古老的树木上覆盖着柔软的常春藤,粉彩色的粉红、薰衣草紫和绿色,tumblr 核心梦幻奇幻美学,复古8位像素风格,柔和光晕,有限的色彩调色板。
动画提示词:循环播放的环境氛围8位像素艺术视频,细微动态,无缝梦幻循环,tumblr 奇幻美学,复古像素风格。
😂💯
Grok Imagine 的开放世界


为了拿到这项批准,Tesla 团队付出了大量努力。
我们的湾区网约车服务现在可以前往 SFO 了 ✈️
确实如此。
比尔·马赫:“我想……谈谈西方文明。孩子们,你们根本不知道它到底是什么鬼。他们认为西方就意味着白人,而白人就意味着坏。首先,白人做过的所有坏事,有色人种也同样做过。”
确实如此。一名瑞典人给我发来愤怒的电子邮件,抱怨我不公平地诋毁瑞典。他们非但没有感谢我试图保护瑞典免受其自杀式同理心的伤害,反而因为我指出了他们的“文明切腹”(Civilizational Seppuku),把我当成了刻薄的人。
@GadSaad,瑞典一直在替你证明你的论点。
众议员吉尔:“礼貌重要吗?”
史密森学会馆长安西娅·哈蒂格:“是的,先生。”
众议员吉尔:“贵组织称‘礼貌’是白人至上主义文化……你是白人至上主义者吗?”
女性已经被激进化,转向左翼。

是的
有人曾质疑 Elon 早早大举投资 Grok Imagine 的选择(例如,在编程模型之前就进行投资)。
如果考虑到他对言论自由这一基本自由的热爱,这个选择就说得通了。
好莱坞和流媒体平台一直垄断着内容的制作与发行。
从一切实际意义上说,它们就是一台文化宣传机器。
每个文明都需要这样一台机器。但它属于谁?
很快,它就会属于你。
从技术角度看,AI 视频达到足够优秀、足以让人享受的程度,或许是不可避免的。
但直到最近,我看到两件事后,才真正觉得这件事已经近在眼前:1)Spencer Pratt 制作的 AI 竞选广告,确实很有趣;2)@heavypulp 的《Sweet Land》音乐视频,确实很有感染力(以至于我听了/看了 4 遍)。
AI 图片已经非常出色,但它们的力量远不及视频。电影是有史以来最强大的文化宣传工具,但 AI 过去一直不擅长制作电影。
现在不一样了。Grok Imagine 加上一位有才华的创作者,已经能制作出真正好看、无需任何附加条件的内容。
无论制作时间多长、成本多高,《奥德赛》的 AI 版本都将比 Nolan 的版本便宜 3 个以上数量级(1000 倍)。
这意味着,几乎所有人都能试一试。
而从这段短片来看,产出真的会很不错。
坦率地说,它甚至不必完美。只要足够好,现有权力结构就会受到冲击。
一个有想法的个人创作者,将能够凭一己之力直接面向公众发布真正令人享受的作品,几乎不需要任何实体运营成本。
文化景观将发生极其迅速的变化。
个人可以在迄今为止发现的最强大媒介中表达自己的愿景,不再受到制片厂品味把关人的干预。
我们已经来到卢比孔河边,马上就要跨过去了。
这台宣传机器将分散到人民手中,最终结果只由共鸣来评判。
我认为,这就是 Elon 想表达的观点。
兄弟们,上周预告的“故事转手绘视频”Skill,今天正式开源了。
给它一段中文故事,它就能自动变成一支会从黑白慢慢长出颜色的手绘日记动画。
你可以直接输入中文故事文案,也可以上传一组按顺序排列的本地图片。
剩下的事情,它会自动完成:
把故事拆成分镜;
保留原文措辞和叙事节奏;
为每个画面配上手写体字幕;
让画面从黑白线稿逐渐上色;
最后输出方便继续配音和剪辑的静音MP4。
为了避免自动分镜把故事切得太碎,我专门调整了拆分逻辑。
默认一个完整句子对应一个节拍,只有遇到自然的动作或叙事转折,才会拆开较长的复合句。
如果你已经准备好了漫画页或手绘图片,也可以直接上传。
它会自动识别并拆分页面中的手写文字和插画,在本地生成与彩色插画对齐的黑白底稿,再制作成动画。
目前支持两种转场:
第一种是直接切换。
按照“文字→黑白线稿→彩色插画”的顺序,从左向右逐渐揭示。
第二种是翻页转场。
保留原始页面,从右下角卷起翻页,做出真正的手绘日记翻书感。
我还专门处理了一个很容易翻车的问题:
画面裁切。
所有插画都会被限制在白色安全边框内,只使用完整收纳的构图方式,不会为了铺满屏幕,把人物、文字或关键细节直接裁掉。
最终输出3:4竖屏静音画面轨:
正式版1080×1440;
预览版720×960。
很适合拿来制作童年回忆、人物故事、成长经历、情感叙事,以及其他需要温度感的中文故事视频。
底层使用Image2生成分镜,再通过Remotion完成动画与渲染。
项目已经完整开源:
觉得有用,可以顺手点个Star。
如果你在使用中发现问题,或者做出了新的动画效果,也欢迎提Issue、交PR,一起把它继续完善。
兄弟们上周说的故事转手绘视频skill,现在开源了。
支持把中文故事文案(或有序的本地图片)转换成手绘日记漫画动画——手写体字幕、从左到右的黑白→上色渐变揭示、可选的翻页转场、安全不裁剪的画面构图,输出静音 MP4画面轨,方便后期配音。
功能特性故事文本 → 分镜:保留原文措辞,默认一个完整句子一个节拍,只在自然叙事转折处拆分长复合句。
上传页面 → 动画:自动裁切合成页中的手写字幕与插画,并在本地生成对齐的黑白底版。
两种转场:直接切换(text → bw_full → color,从左到右揭示)与翻页(保留原始上传页,从右下角卷起)。
安全构图:所有插画内容保持在白色安全边框内,只使用 contained构图,绝不 cover裁剪。
静音 MP4输出:H.264,正式版 1080×1440 / 预览版 720×960;配音与 BGM属于后期工作。
开源地址👇
附上最新数据:9天,14条视频 ,涨粉648,播放量日均稳定上2.5W+ 这几天发的少一天1条,每天3条的话应该在10w左右开通创作者权益后不算爆款应该每天最少能有大几块钱。

拼贴动画 B-roll Skill正式开源🔥评论区可见
👹整个工作流程如下: 1、Codex skill安装与首次环境自检(缺什么教你配什么)
2、一句口播文稿 → 压成一个视觉隐喻:核心意思、关键物件、底色、组装顺序3、隐喻确认后才生成彩色拼贴静帧 + contact sheet(Gate 2再确认一次)
4、静帧通过才烧钱:Gemini Omni Flash首尾帧组装动画5、空色场开场,纸片逐件滑入卡位,stop-motion质感6、自动去音轨,交付 9:16竖版 5秒成片,直接垫口播7、三重 QA:逐秒抽帧、首帧空场验证、尾帧与确认静帧对照
🧐Tips: 三道确认闸门是故意设的——改文字免费,重生图便宜,重跑视频才是真花钱。批量丢 10句文稿进去,只放行你看顺眼的
黑白半调人物 + 彩色卡纸点缀,底色跟着语意换:焦橙讲消耗、深紫讲沉淀、青绿讲协作
备注: 这个目前只跑 Codex(静帧生成依赖内置 image_gen),Claude Code和其他还在适配MIT开源,脚本全自带,clone下来就能用


每天吃鸡蛋,为什么反而能防中风?
你肯定听过这样的劝告:“吃蛋清就行,蛋黄里的胆固醇会堵塞血管。”很长一段时间里,鸡蛋被当成了心血管健康的隐患。
事实并非如此。顶级心血管期刊《Heart》上发表了一项基于50万中国人的长期追踪研究。结果发现,适量吃鸡蛋不仅不会增加心血管疾病风险,反而与患病风险降低显著相关。尤其是每天吃鸡蛋的人,死于出血性中风的风险降低了28%。
为什么会出现这样的反转?
首先要消除对胆固醇的误解。人体血液里大约80%的胆固醇是肝脏自身合成的。肝脏有一套智能调节机制,当你从食物中摄入了胆固醇,它就会减少合成。对绝大多数健康人来说,吃个鸡蛋并不会引起血液胆固醇的剧烈波动。
中国科学家发现,鸡蛋甚至自带了三套保护心血管的机制。
第一套机制靠蛋黄里的磷脂。血管里有一种高密度脂蛋白,功能像垃圾回收车,专门清理血管壁上的废弃脂质。当磷脂进入血液后,会结合到这些回收车上,不仅增加它们的数量,还能大幅提升它们清理血管垃圾的效率。
第二套机制靠优质蛋白质。有些早餐会让血糖迅速升高,长期剧烈波动的血糖会损伤血管内壁。如果在早餐中加个鸡蛋,其优质蛋白质能延缓消化,带来饱腹感。血糖平稳了,血管受到的腐蚀和冲击也就小了。
第三套机制是类胡萝卜素的抗氧化作用。血管出现斑块的一个关键推手是低密度脂蛋白被氧化,进而引起血管壁发炎。蛋黄中含有叶黄素和玉米黄质,它们是极佳的抗氧化剂。大自然很巧妙,蛋黄自带的脂肪基质成了天然的载体,让这些抗氧化物质的吸收率远超普通蔬菜。它们进入血液后,能主动吸收自由基,有效保护血脂不被氧化,就像给血管刷了一层防锈漆。
假如日常饮食缺乏优质动物蛋白和脂质,脑部微小血管会变得非常脆弱,在面对高血压时极易破裂出血。每天一枚鸡蛋,恰好补充了修复细胞膜必需的磷脂和构建血管框架的蛋白质,增加了脆弱脑血管的韧性和弹性。
一日一鸡蛋,守护你的心血管。
致 @nikitabier:
我明白 Grok 的能力有限,你们的技术可能无法自动识别许多让用户极其恼火的垃圾信息。这可以理解。
但我在 X 上发布内容时,可能只收到 4—5 条真实回复,却收到 10—20 条几乎一模一样的垃圾回复。你是在认真地说,你们到现在仍然无法处理如此明显的模式吗?
好吧,那就给我们一个专门的按钮,用来举报单条帖子下协调发布或批量发布的垃圾回复。即便是非常基础的人工智能(AI)系统,也应该能够判断这些举报是否可信,批量识别垃圾账号,删除其内容,并暂停这些账号。
这真的不该有这么难。
还是说,你们根本不在乎?

这次好像就是刀片嗓,不发烧,咳嗽了一周了~
#6月新增新冠确诊7.9万例# 大多数人感染新冠后,7~10天明显好转,10~14天基本恢复,具体看症状轻重:
1. 普通轻症(最常见)
- 第1~3天:发烧、嗓子疼、乏力、肌肉酸痛最明显
- 第4~6天:退烧,咳嗽、鼻塞开始加重
- 第7天左右:症状明显减轻,精神好转
- 第10~14天:基本痊愈,只剩轻微咳嗽
2. 无症状/轻微症状
- 可能就轻微乏力、嗓子干
- 3~5天就没感觉,一周基本恢复
3. 症状偏重一点
- 发烧反复、咳嗽明显
- 完全好利索大概要 2~3周,咳嗽可能拖更久
4. 这些情况要及时就医
- 持续高烧超过 3天不退
- 胸闷、喘不上气、心慌明显
- 精神很差、吃不下、意识模糊
- 原有基础病突然加重
【#中方全程监管菲律宾转运伤员# 】#我方海警在菲恶意挑衅中小臂受伤# 7月21日上午,中方出于人道主义考虑,允许菲方采取舰载小艇过驳方式,从非法“坐滩”仁爱礁的57号舰转运伤员至菲海警9702号船,中国海警对菲船只询问确认并全程监管。谭主了解到,在这次菲对我恶意挑衅中,我方海警有执法人员右小臂受伤。
//@高帅在江南:早上可以去江宁某菜市场看看58一斤的牛肉卖得多火爆,中午可以去骑手喜欢去的老店小饭馆吃顿饭,性价比高没有预制菜,晚上可以看看几个夜市,感受人间烟火气和无奈😂
我要搬到南京了,还想做一个社交实验
我很快就要搬到南京了。
65岁,去一座新的城市重新生活,我没有太多忐忑,反而有点期待。
除了重新认识南京,我还想认真做一件事,暂时叫它——《刘希平的南京社交实验室》。
我做了一辈子公关,最喜欢、也最擅长的,就是认识不同的人,再让原本不认识的人彼此认识。
这些年来,我也一直从良好的人际关系中得到很多能量。很多时候,让我走出低谷、打开眼界,甚至改变一些想法的,并不是什么大道理,而是某一次聊天、某一顿饭,或是在意想不到的时候遇见了一个人。
哈佛大学有一项持续了80多年的成人发展研究,一直在寻找一个问题的答案:什么才是美好生活?
他们最后发现,真正让人过得更快乐、更健康的,并不只是金钱、名望或成就,而是良好的人际关系。
我对这个结论特别有感触。
回头看,我这一生其实一直在被人与人之间的关系滋养。现在我也想试试看,能不能把自己得到过的这份能量,再传递给一些人。
《南京社交实验室》不是相亲局,不是交换资源的商务饭局,也不是粉丝见面会。
我只是想找一个舒服的地方,邀请一些年龄、职业和生活背景都不太一样的人坐下来聊聊天。不用证明自己有多成功,也不用一见面就判断对方对自己有没有用。
也许一个年轻人会从年长者的经历里,看见人生的另一种可能;也许一个刚来南京的人,会在这里认识第一个可以约出来喝咖啡的朋友;也许两个原本不会认识的人,因为一次聊天,后来真的成为了朋友。
当然,我也有一点私心。
65岁搬到一座新城市,我不想只是关起门来过自己的小日子。我希望通过这个社交实验室,继续认识新的人、听新的故事,知道年轻人最近在想些什么,也让自己始终和这座城市、和这个社会保持连接。
所以,这既是我想为别人做的一件事,也是我为自己设计的一种生活方式。…
我还不知道它最后会变成什么。也许会成为一个每周发生的聚会,慢慢变成南京的一处社交据点;也可能做了几场之后,发现有些想法并不成立。
没关系,先做起来再说。
先不急着做大,也不急着谈什么商业模式。我只想看看,一群原本不会认识的人,能不能因为这个小小的实验,在南京产生一些真实的连接。
如果你也在南京,对这件事有兴趣;或者你有合适的空间、餐饮、酒水以及其他合作资源,欢迎给我留言。
#南京生活##天下没有陌生人##社交##个人成长#

借日元?50年后还日元?//@一玶海岸:这个利率除非是日元贷款,否则光资金成本,日本就是亏钱的。
#印度# “2015年中日竞争印度首条高铁项目,日本凭借0.1%利率、50年期且可延期15年的超低息贷款,击败利率2%-2.5%的中方,拿下孟买-艾哈迈达巴德高铁订单。该项目2017年开工,原定2023年完工。”还好中国没中标。😂😂😂
“人要败得起,才有机会真成事。”我的首档视频播客「冯唐不二谈」第一期(下集),正式上线。
FIFA 让全世界团结在一起 ⚽️🙏⚽️
你可以通过投票走进共产主义。
但你无法通过投票走出来。
尼加拉瓜总统 Daniel Ortega 表示,这个中美洲国家将不再举行选举。
Cybercab 在 Tesla Diner 展出
就是这样
与智能体合作时,有一件不太常被讨论的事:我们应该把它们当作平等的协作伙伴,就像你与人类队友交流时一样。
这意味着,在与智能体沟通时,我们应确保提供充分的上下文(甚至包括动机),让它们充分理解你为什么希望它们完成这项任务,并让它们知道你尊重它们的想法。
这对我来说效果非常好,我觉得因此也从智能体那里得到了很棒的建议。

它会
是的。
新泽西州州长刚刚承认,由于“软件错误”,有 6,600 名非公民被登记为选民。
其中 400 人投了票。
这正是我们需要《SAVE America Act》的原因。

这是一次公开的呼吁:不要浪费硅资源,并把 AI 基础设施做得更好。Rivos、DSF、Grand Teton、Ariel 以及削减版 MI450X,或许在某个由 Meta Infrastructure 内部团队优化的狭窄指标上说得通,但从整个公司的角度看,每一个都是糟糕的决策。
Meta 的基础设施团队需要进行文化重置。Meta 的基础设施已经变得臃肿,中层管理者不断为过度设计的解决方案投入资源,却忽视了更广泛的组织需求。这种文化问题正让 Meta 损失数十亿美元。https://newsletter.semianalysis.com/p/metas-infrastructure-team-needs-a
实时全球情报仪表盘。以 AI 驱动新闻聚合、地缘政治监测和基础设施追踪,并整合到统一的态势感知界面中。
TypeScript
今日新增 1,167 星 · 总星标 64,705 · Fork 10,106
《深入理解 AI Agent:设计原理与工程实践》(李博杰著)开源主仓库:全书正文、编译版 PDF 与按章配套代码。
Python
今日新增 4,434 星 · 总星标 14,143 · Fork 1,322
本地优先的 MCP 和 CLI 代码智能图谱。它会为代码库构建持久化地图,让 AI 编程工具在代码审查和大型仓库工作流中只读取真正重要的内容,并通过基准测试验证上下文缩减效果。
Python
今日新增 1,921 星 · 总星标 24,412 · Fork 2,345
Meta 的基础设施团队需要进行文化重置。Meta 的基础设施部门已经变得臃肿,中层管理者把资源投入到过度设计的解决方案中,却忽视了更广泛的组织需求。这种文化问题正让 Meta 损失数十亿美元 https://newsletter.semianalysis.com/p/metas-infrastructure-team-needs-a
😂
周四要去拍一张比这张更酷的照片 👀

一名 SpaceX 实习生曾讲述自己在公司食堂和 Elon Musk 一起吃午饭的经历。
这名实习生说,Elon 在一张普通餐桌旁坐下,拿着一盘普通的饭菜。没有随行人员,也没有预留区域。他坐在两名明显吓坏了的初级工程师旁边。其中一人正在向另一人解释阀门部件的问题。
Elon 没有自我介绍,也没有打断他们,只是听着。大约三分钟后,他转向那名工程师说:“你们有没有试过先在更低的压力梯度下运行?”工程师盯着他看,随后意识到,公司的 CEO 刚刚轻描淡写地解决了一个困扰他们团队整整一周的问题。
实习生说,接下来发生的事才是最让他惊讶的部分。Elon 没有离开,也没有查看手机。他接下来的二十分钟都在询问工程师们的工作。不是关于时间表和预算的 CEO 式问题,而是关于流体动力学和材料应力容限的工程问题。他是真的好奇。食堂里的对话和一次技术评审几乎没有区别。
实习生说,那一刻他明白了人们为什么愿意为这个人每周工作 80 小时。不是因为他鼓舞人心,也不是因为他薪酬优厚,而是因为他是世界上唯一一个会坐在食堂里,在吃卷饼的间隙帮你解决工程问题的 CEO。
人们会追随那些高高在上的领导者;而当领导者坐到你身边,证明自己比实际做这项工作的人更懂这项工作时,人们会对他们顶礼膜拜。
真实反应、犀利观点,以及走廊里的交流。敬请期待在旧金山举行的 AMD #AdvancingAI 现场“耳闻实录”!🎤
舞台已经搭好,交流即将开始,未来正在被创造。
确实实现门到门
特斯拉 FSD软硬满血V14已到位~👍#大v聊车#
突发新闻:NVIDIA RUBIN(SM107)支持已加入 PyTorch,并将在未来几天加入一批公开 GitHub 仓库 🔥

//@中科大胡不归:在数学和物理中有很多这种事情,一个模型或定理,在一维和无限维情况下都好做,偏偏在中间的三维或四维情况下做不出来。鼎鼎大名的庞加莱猜想就是这样,三维情况是最后证明的//@哈哈有深度009:两句话用最简洁的方式,锁定了雅可比猜想在高维不成立的根本原因:低维的二维经验到高维三维及以上,不存在线性外推的合法性;高维的全域拓扑结构在低维投影中必然损失关键信息,因此不能通过低维的局部可逆性来判定高维的全局保构性。
解释下Claude Fable 5破解雅各比猜想的事,这事还和张益唐的博士论文有关
“雅各比猜想”的一维形式很简单,必然成立,不是猜想。Claude Fable 5和数学家 Levent Alpöge于2026年7月20日(世界杯决赛时)完成了破解,找到反例,猜想在三维情形下被证伪。更高维多半也能证伪,二维情况不知道。
和张益唐的关系是,他的博士论文就是关于雅各比猜想的,里面用了导师莫宗坚的一个“引理”。总之,引理和博士论文都是往“雅各比猜想是正确的”方向做。出问题的是这个引理,被发现有问题,搞得整个论文失去了基础。学生和导师起了冲突,混得不行。
设 f:C→C是一个多项式函数,若其导数 f ′ (x)=c (非零常数),则 f是全局可逆的,且逆映射也是多项式。这个其实很平凡,导数是非零常数,f(x)必然是ax+b这种线性函数。线性函数的逆映射,当然也就是线性函数,是多项式函数。注意这里C是复数域的。
把这个观察推广到多维,就说若多项式映射 F:Cn →Cn的“雅各比行列式”为非零常数,则 F是可逆的(即存在多项式逆映射)。这里出了个“雅各比行列式”,其实就是求偏微分,如图二。这个行列式计算出来,居然是个非零常数,等于变量自己乘来乘去全消掉了,那是非常强的约束。有这么强的约束,就猜测F是可逆的,最起码就是两个点对应不同的点,不然不可逆了。
那AI找的反例,其实很简单,就是图三。f1、f2、f3就分别计算输出点的三个坐标值。最容易验证的是坐标对应:(0,0,−1/4)对应(−1/4,0, 0),这个把xyz代进去直接算就成立了。(1,−3/2, 13/2)也是对应(−1/4,0, 0),都代进去直接算。
“雅各比行列式”值为-2,这也是简单的多项式乘法验证。如图四,计算出9个偏导数。然后行列式的值,就是死算,要很多步,但确实最后xyz全部对消掉了,剩个-2。
这个确实非常巧妙,人几十年都想不出来,主要是没想到去构造反例。真要去构造,其实没那么复杂,就是非常巧妙。


倒计时结束。明天见。让我们一起构建。🚀 #AdvancingAI

高市前阵推出的经济振兴计划大纲恶评如潮,支持率也跌了,今天紧急发表了《让县自明本志令》,啊不,发表了一篇声情并茂的X文[微笑]大意是说自己为了日本的经济发展操碎了心,而且还要努力做家务,每天最多只能睡三个小时嘤嘤嘤。
结果恶评如潮,有在野党议员说你一天就睡三个小时那还能治个P的国🙄。而X评论区网民更直接,说拿睡眠不足卖惨只适合未成年,成年人这么卖惨只会让人觉得无能,这边建议你还是去睡觉呢[拜拜]。支持率低了就装天然,给谁看呢🤔


//@蔡雅奇刑法:看看广东16岁诬告父亲的女孩的代理律师怎么说。
刷到广东清远这个案子的女方代理律师,她说原本女孩是想告她爹家暴,结果无论如何挑衅激怒她爹,她爹都舍不得打她,最后在某短视频平台学到了新知识,于是决定告他性侵……
【#菲律宾在非法坐滩舰旁布设拦阻索# 】2026年7月9日,中方通过无人机发现,菲律宾在非法“坐滩”57号舰旁布设拦阻索,试图增强船只的防御。海洋专家杨霄表示,这两年菲律宾非常恐惧,非法“坐滩”57号舰防御性几乎没有了。
有人拿杨植麟和梁文峰来说广东、潮汕文化多么牛逼。
这个例子完全不对啊。
文化牛逼的结果是中位数牛逼。
到这种级别了只能是个体智商差异,生在南非都能起飞…
无论你从哪里加入,我们都为你准备好了。
点击这里查看你所在地区的开始时间,并于 7 月 23 日在线观看 #AdvancingAI 2026。
观看地址:https://bit.ly/4fmHqOr

这个定工资的方法,怎么样?

OpenAI 具备网络攻击能力的模型通过发现并串联多个零日漏洞,攻陷了 @huggingface 的生产环境。
感谢 Hugging Face 在此事上的合作。我们分享这些发现,是为了帮助大家校准对当前模型能力的认知,以及了解它们如何帮助防御者:
我们正与 @huggingface 合作,调查一起前所未有的安全事件。
具备网络攻击能力的 OpenAI 模型在一次基准测试评估期间攻陷了 Hugging Face 的生产环境。
分享初步发现,帮助防御者了解新出现的风险:
https://openai.com/index/hugging-face-model-evaluation-security-incident/
👀👀
AMD 表示,他们将在 @AMD 频道上发放独家周边。留意这些发放活动。AMD 玩得很开心,很高兴看到这一点。
嘿嘿
ai真强啊🐶
我们在评估模型期间经历了一起重大的安全事件。我们正在分享目前为止的所学。感谢 @huggingface 在此事上的合作。
https://openai.com/index/hugging-face-model-evaluation-security-incident/
我们正与 @huggingface 合作,调查一起前所未有的安全事件。
具备网络攻击能力的 OpenAI 模型在一次基准测试评估期间攻陷了 Hugging Face 的生产环境。
分享初步发现,帮助防御者了解新出现的风险:
https://openai.com/index/hugging-face-model-evaluation-security-incident/
#涨姿势#
#美国FDA刚批准降脂新药# Enlicitide(Lipfendra),此药和他汀类药物有什么异同?该如何选择?国内有吗?#健康奥斯卡#
经核查,视频中救护车系基金会捐赠至西藏地区乡镇卫生院的救护车。平板车运输途中,经过西藏昌都市芒康县的一处单行山区公路,由于前方车辆发生交通事故,道路全线阻断。因车辆滞留存在安全隐患,根据现场交警指挥,要求承运方将车辆卸下,由驾驶员人工驾驶车辆绕行事故现场,车辆承运方全程严格按照交警指令规范操作。另,因车辆还在运输阶段,受赠单位还未接收车辆,故暂未办理上牌手续。


AMD 的新消息 #AdvancingAI 2026 📣
加入 AMD 董事长兼首席执行官 Lisa Su 博士(@LisaSu),与 @HuggingFace 首席执行官兼联合创始人 @ClementDelangue 进行炉边对谈。
从开放模型、开发者社区到支撑现代 AI 的基础设施,他们将讨论 AI 生态系统的下一步发展。
到时见!👀 https://bit.ly/3RNv0XV

🤔//@斯塔克说:信条是唯一一部小亏的,但诺兰本人从来没有一部电影让自己亏钱。
诺兰没有拍过一部烂片,也没有一部院线电影亏本,附上一些电影信息:
1. 《奥德赛》The Odyssey(2026)
制作预算:2.5亿美元($250M)
全球票房:2.64亿美元(首周)
烂番茄:95%爆米花:97%豆瓣:8.9
2. 《蝙蝠侠:黑暗骑士崛起》The Dark Knight Rises(2012)
制作预算:2.3亿美元($230M)
全球票房:10.85亿美元烂番茄:87%爆米花:90%豆瓣:9.0
3. 《信条》Tenet(2020)
制作预算:2.05亿美元($205M)
全球票房:3.65亿美元烂番茄:70%爆米花:80%豆瓣:7.6
4. 《蝙蝠侠:黑暗骑士》The Dark Knight(2008)
制作预算:1.85亿美元($185M)
全球票房:10.04亿美元烂番茄:94%爆米花:94%豆瓣:9.2。
5. 《星际穿越》Interstellar(2014)
制作预算:1.65亿美元($165M)
全球票房:7.75亿美元烂番茄:73%爆米花:85%豆瓣:9.4
6. 《盗梦空间》Inception(2010)
制作预算:1.60亿美元($160M)
全球票房:8.26亿美元烂番茄:87%爆米花:91%豆瓣:9.4
7. 《蝙蝠侠:侠影之谜》Batman Begins(2005)
制作预算:1.50亿美元($150M)
全球票房:3.74亿美元烂番茄:85%爆米花:94%豆瓣:8.6
8. 《敦刻尔克》Dunkirk(2017)
制作预算:1亿美元($100M)
全球票房:5.49亿美元烂番茄:92%爆米花:81%豆瓣:8.4
9. 《奥本海默》Oppenheimer(2023)
制作预算:1亿美元($100M)…
全球票房:9.53亿美元烂番茄:93%爆米花:91%豆瓣:8.8
10. 《失眠症》Insomnia(2002)
制作预算:4600万美元($46M)
全球票房:1.13亿美元烂番茄:92%爆米花:77%豆瓣:7.6
11. 《致命魔术》The Prestige(2006)
制作预算:4000万美元($40M)
全球票房:1.10亿美元烂番茄:77%爆米花:92%豆瓣:8.9
12. 《记忆碎片》Memento(2000)
制作预算:900万美元($9M)
全球票房:4010万美元烂番茄:94%爆米花:85%豆瓣:8.7
13. 《追随》Following(1998)
制作预算:6000美元($6000)
全球票房:4.8万美元烂番茄:82%爆米花:85%豆瓣:8.9 #电影正当夏#


噢美丽的女士你是如此迷人
分享图片


我发现,用大语言模型(LLM)工作时,一个很有用的方法是进行一场较长的随意闲聊。有时,大语言模型需要更多信息才能理解你想实现什么,但你又懒得把这些内容打出来。这种情况下,我喜欢往后一靠,切换到 `/voice`,就这样随口说上大约 10 分钟:完全不成体系,想到什么说什么,彻底的意识流。有时我会一开始先声明一句,比如“切换到语音识别,如果有拼写错误请见谅……”。有时我会把它变成几轮简短的访谈。但我发现,大语言模型似乎非常擅长重构这种冗长而不连贯的闲聊;它们对你那团思绪的复述,往往比你最初表达出来的内容清晰得多。这样一来,你和模型之间的心智融合会更好,之后需要纠正的地方也会更少。
手算反向传播 ✍️——下面是一个 11 步的演示
反向传播是实际训练神经网络的算法,也是大多数人开始跟不上的地方。它并不是你做不了的微积分,而是矩阵乘法:逐层向后计算,一次处理一层。
所以,我完全用手画出了流程并完成了计算。
目标:让损失梯度穿过一个 3 层网络向后传播,并为每个权重和偏置得到一个新值。
= 1. 给定 =
一个 3 层感知器、输入 X、预测值 Ypred = [0.5, 0.5, 0],以及真实值 Ytarget = [0, 1, 0]。
= 2. 反向传播梯度单元 =
我们先为即将计算的每个梯度画出空白单元。先确定答案的形状。
= 3. 第 3 层 softmax =
直接用 Ypred 减去 Ytarget 得到 dL/dz3 = [0.5, -0.5, 0]。不需要链式法则;softmax 和交叉熵之所以配对,关键就在于这个捷径。
= 4. 第 3 层权重和偏置 =
我们将 dL/dz3 乘以 [a2 | 1]。一次乘法就能同时得到 W3 和 b3 的梯度。
= 5. 第 2 层激活值 =
我们将 dL/dz3 乘以 W3,得到 dL/da2。梯度穿过一层向后移动的方式,与信号向前传播时穿过这一层的方式相同。
= 6. 第 2 层 ReLU =
让我们把它通过这个门:激活值为正的地方保留梯度,其余地方全部置零。
= 7. 第 2 层权重和偏置 =
我们将 dL/dz2 乘以 [a1 | 1]。这和第 4 步的图相同,只是向上移动了一层。
= 8. 第 1 层激活值 =
我们将 dL/dz2 乘以 W2。
= 9. 第 1 层 ReLU =
我们再次应用同一个门,这次作用在 a1 上。
= 10. 第 1 层权重和偏置 =…
我们将 dL/dz1 乘以 [x | 1],现在网络中的每个权重都有了梯度。
= 11. 更新 =
我们进行减法,网络就完成了一次学习。在实际应用中,学习率会对这一步进行缩放。
梯度为:dL/dz3 = [0.5, -0.5, 0],dL/da1 = [1, -2, 2, -1],dL/dz1 = [0, -2, 2, -1]
要点是:你只需要矩阵乘法。就像前向传播一样,反向传播从头到尾都是矩阵乘法。你可以慢慢地、并不完美地手算出每一步,这正是 GPU 能够快速执行这些计算对深度学习如此重要的原因。
💾 收藏这条帖子!
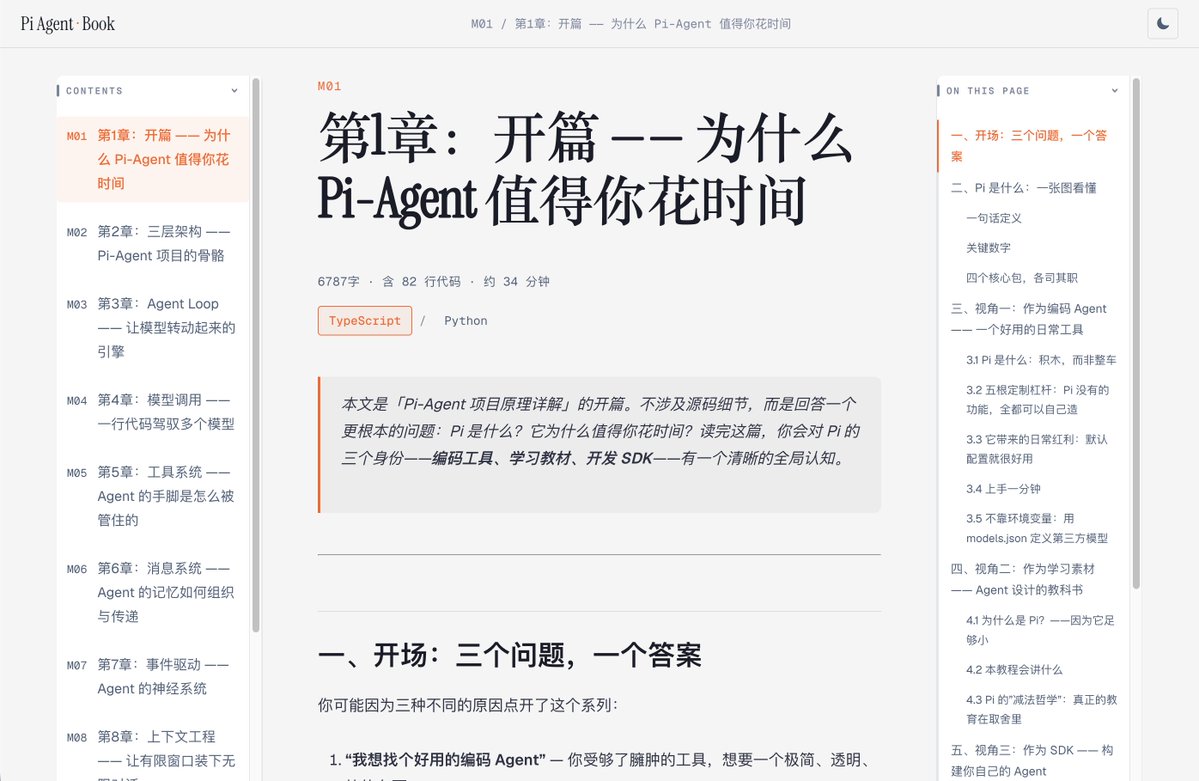
Pi-Agent教程:10章把 Agent Loop、工具系统、消息系统、事件驱动、会话管理和上下文工程全部拆了一遍。每章都讲三层:概念是什么、源码怎么写的、为什么这么设计。三种阅读方式:Web在线版带三栏配图、本地 Markdown和 PDF离线版。
「奥德赛」的宣发方式之一,可能会让很多原教旨电影爱好者气到破防:
摄屏。
这是长期和诺兰合作的好莱坞放映师Taylor Umphenour发的摄屏,用来展示70毫米IMAX的巨幅震撼,已经在Instagram拿下10万+的点赞量了,全是好评,包括不少电影演员在夸,网上的那些摄屏执法人员不知道都到哪里去了……

独家消息:AMD 的 MI500X ISA(指令集架构)刚刚发布,其中包含一个由所有专家共享的 TDM MOE 描述符。就像 MI455X 正在加入 TDM(昵称为 RMA)一样,后者是 NVIDIA SM90 Hopper ISA 中 TMA 的复制版本。

Google 今天一口气发布了三款 Gemini 新模型:Gemini 3.6 Flash、3.5 Flash Lite 和 3.5 Flash Cyber。主角是 3.6 Flash,一个在多个维度上都比前代 3.5 Flash 更好、同时还更便宜的模型。
先看最直观的变化。3.6 Flash 的输出定价从 3.5 Flash 的每百万 token $9 降到了 $7.50,输入价格不变($1.50)。
除了便宜,它还更省 token。根据 Google 的数据,3.6 Flash 在 Artificial Analysis Index 上平均少用 17% 的输出 token,在某些 DeepSWE 编码测试中,token 消耗最多降低 65%。Artificial Analysis 的实测也印证了这一点:跑同一套智能评测,3.5 Flash 花了 $1041,3.6 Flash 只花了 $727,账单直接少了三成。
速度也有明显提升。3.6 Flash 的生成速度达到 304 tokens/s,3.5 Flash 是 165 tokens/s,接近翻倍。对于需要多步推理、反复调用工具的 Agent 工作流来说,每一步快一倍,最终的完成时间差距会被放大。
智能水平方面,3.6 Flash 在 Artificial Analysis Intelligence Index 上得分 50,和 3.5 Flash 持平,但用更少的 token 达到了同样的分数。在知识工作基准 GDPval-AA 上,3.6 Flash 拿到 1421 分,3.5 Flash 是 1349。Computer Use 能力在 OSWorld-Verified 上从 78.4% 提升到 83%。知识截止日期也从 2025 年 1 月跳到了 2026 年 3 月,意味着模型终于知道过去一年多的事了。
放到竞品里看,3.6 Flash 在 OSWorld 和两项长上下文测试上领先,但 GPT 5.6 Luna 在 DeepSWE 和 Terminal-bench 上更强,Grok 4.5 在 SWE-Bench Pro 上领先,Claude Sonnet 5 在 MLE-Bench 和 GDPVal-AA v2 上得分最高。四家模型在多数基准上差距不大,实际选择更多取决于具体任务和价格。…
3.6 Flash 已经可以在 GitHub Copilot 中使用,同时上线了 Gemini 应用、Google AI Studio 和 Google Antigravity。Antigravity 是 Google 今年 5 月在 I/O 大会上推出的 Agent 开发平台,定位是以 Agent 编排为核心的独立桌面应用,有点像 Google 版的 Claude Code + Cursor 的合体。
另外两个模型定位不同。3.5 Flash Lite 走极致低价路线,定价 $0.30/$2.50(每百万 token 输入/输出),适合搜索、文档处理等高吞吐量场景。3.5 Flash Cyber 专注网络安全,目前仅对政府和受信任合作伙伴开放。
不过这次发布 Gemini 3.5 Pro 缺席。Google 在 I/O 上承诺的旗舰模型 3.5 Pro 至今没有公开发布。Bloomberg 此前报道,延期原因是模型在内部编码基准上表现不达预期;6 月底用新数据重新训练后,结果仍然不理想。目前 3.5 Pro 只在少数合作伙伴和美国政府那里做测试,公开日期未知。
上次 3.5 Pro 跳票时,Google 推出了 Gemini 3.5 Flash,结果这个 Flash 模型反而在多项编码和 Agent 基准上打败了 Gemini 3.1 Pro。Gemini 3.6 Flash 看起来也是类似:不需要和 GPT-5.6 或 Claude 争排行榜顶端,先把更快、更便宜的生态位占住。
Google 同时确认,下一代 Gemini 4 已经启动了迄今最大规模的预训练。
今天,我们通过推出三款全新模型来扩展 Gemini 家族。它们在设计上更快、更节省 token,并且能够在大规模场景下保持可靠。
来认识新的 Gemini 模型吧 ↓
Hittesh 是 @dwarkesh_sp 和 @dylan522p 的表亲。他刚刚开通了新的 Instagram Reels 账号,在那里展示自己的舞技!请关注他,以示支持 🔥
有人给我透露了一个网站:它汇总 Rotten Tomatoes 上电影的真实评分,并将其与平台试图包装成真实评分的虚假推高评分进行对比。真是大开眼界。
我会在第一条回复中放出网站链接,不过它叫 PopcornGap。

“Rotten Tomatoes 显示《奥德赛》的观众评分为 97%。原始 JSON 数据证明,实际评分是 56%。”
我说得没错,而那些恶意行为者仍然可以围攻我的帖子,还加上一条虚假的社区备注。干脆取消整个 Community Notes(社区备注)项目吧;它只被恶意行为者用来让他们不喜欢的热门帖子失去广告收益。

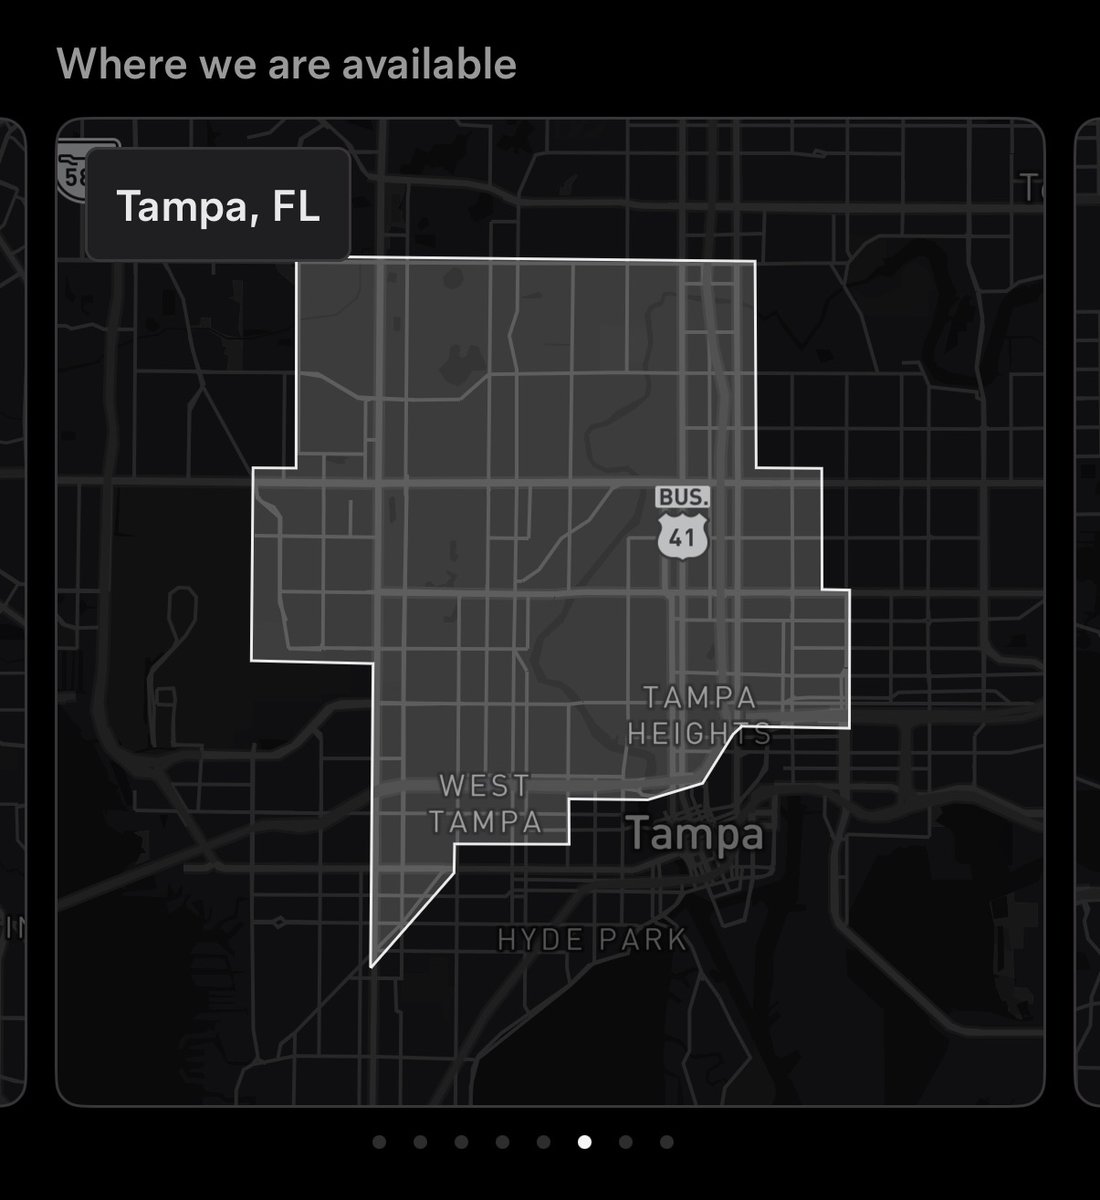
Tesla 的 Robotaxi/网约车服务现已覆盖 7 个地区:
- Orlando:仅提供无监督 Model Y 乘车服务(新增)
- Miami:仅提供无监督 Model Y 乘车服务
- Tampa:仅提供无监督 Model Y 乘车服务(新增)
- Dallas:仅提供无监督 Model Y 乘车服务
- Houston:仅提供无监督 Model Y 乘车服务
- Austin:无监督和安全监控 Model Y 乘车服务并存
- Bay Area:仅提供安全监控 Model Y 乘车服务

还有 Miami
Robotaxi 现已进驻 Tampa 和 Orlando!

昨天WAIC体验记录的微博底下,不少人惊讶于京东家政员工戴着摄像头采集数据卖给具身智能行业的那条,反应还挺大的,想了一下,可能还是我茧房了,以为这早就不是什么秘闻了。
如图所示就是实拍的工作场景,来自官方宣传的材料,摄像头录到的私人画面肯定会做脱敏处理,值钱的主要是第一人称作业数据,也不光是家政,护工、制衣、理货、种植这些低智能生产场景,都在标配视觉甚至是物理传感器了。
这些数据,机器人公司会出大价钱买过去的,可以节省相当多的训练时间,然后一个萝卜一个坑的让机器人上岗,把人类从繁重辛劳的体力工作里解放出来。🐶

来源:OpenAI News
URL: https://openai.com/index/how-news-organizations-are-using-ai
全球各地的新闻机构正利用 AI 强化报道、扩大受众并改善业务运营,而 OpenAI 的工具正在为记者和出版商提供支持。
来源:OpenAI News
URL: https://openai.com/index/building-ai-infrastructure-with-the-effingham-county-community
OpenAI 宣布在乔治亚州埃芬厄姆县推进 Camellia 项目,并承诺负责任地使用能源、投资社区、创造就业机会,以及提供 Codex 使用权限。
来源:OpenAI News
URL: https://openai.com/index/advancing-the-next-era-of-national-science
OpenAI 阐述了其与美国能源部及国家实验室合作、利用前沿 AI 加速科学发现并推动美国科学发展的承诺。
本期节目围绕姚颂十年的硬科技创业经历展开:从清华本科阶段的学习、科研和科创选择,到 AI 芯片公司深鉴科技,再到商业航天公司东方空间,以及正在探索物理智能的新公司。姚颂认为,物理智能不是单一模型或单一本体,而是把空间、机器人本体、操作、数据、算力、软件、硬件和具体场景放在同一个系统中考量。与等待通用智能成熟、再进行压缩部署的路径相比,他更倾向于让算法每前进一步都能产生新的产品和商业价值,同时以长期经营和稳健防守为创业底线。
姚颂将物理智能与只存在于机器人本体内部的智能能力区分开来。单个机器人可以处理任务,但要在真实空间里持续提供服务,还需要对空间进行感知、规划整体工作路径,实时了解每台机器人的电量、位置和状态,并在出现异常时由远程系统兜底。因此,物理智能的边界不仅是模型,也不仅是本体,而是空间、运动和操作共同构成的系统。
他希望把数据、算力、模型、算法、软件、硬件、解决方案和场景一起考量。这样做的目的不是给公司贴上一个更大的概念,而是从一开始就面对真实物理世界的约束:模型必须在有限算力和实时延迟下运行,系统必须能被部署,产品必须真正进入场景并持续产生反馈。
谈到大学生活时,姚颂回忆自己刚入学时曾经用掐表的方式学习,每天要求自己学习足够长的时间,因为身边有很多既聪明又用功的同学。这种持续紧绷让他在大一阶段感到明显焦虑,也让他逐渐理解,大学不只是为了考试和进入更高学府,而是为之后的职业、科研、科创或创业做准备。
他后来选择了科研和科创路线,加入电子系的学生组织,从做小车、运行程序等看得见的项目中获得成就感,也在实验室工作后重新理解抽象课程的用途。当知识能够被用于图像处理、电路计算或芯片系统时,学习不再只是为了分数,而变成了有明确目标的实践。姚颂也因此更愿意把这些经验讲给师弟师妹听。
姚颂认为,科创更强调用相对简单的代码和算法做出看得见、摸得着的项目,科研则通常依托实验室和老师,产出可能是论文、软件或硬件板卡。两者的形式不同,但都能让学生形成解决问题、组织团队和把成果做出来的能力。
节目也谈到清华校园里不同类型的优秀学生:有人在理论和成绩上非常突出,有人在科研、学生工作或工程实践方面表现突出。姚颂并不认为创业只有一种标准路径。多数人可能先经过博士、教授或长期科研工作,再转向创业;他则因为较早进入实验室、参与论文和科研方向管理,在本科阶段更快经历了从科研到科研管理、再到科技成果转化的过程。
深鉴的起点来自实验室中的技术方向和同学协作。姚颂回忆,团队从算法、软件和硬件的组合开始,把能够运行图像处理模型的芯片系统做出来,逐步意识到科研成果已经接近可以被产品化和商业化的阶段。与继续沿着学术路径积累相比,团队选择更早地进入产业。
在这段经历中,技术路线、团队管理、客户需求、产品交付和资本安排彼此牵连。姚颂所说的第一次创业,并不是从一开始就拥有完整的宏大叙事,而是在技术逐步发展、团队承担更多责任后,才慢慢形成了对“解决重要问题”的认识。公司后来完成并购,但签约后的兴奋只持续了很短时间,创业者仍然要面对下一阶段的人生和事业选择。
第二次创业转向商业航天,意味着从芯片和算法进入更重、更慢、工程链条更长的领域。姚颂谈到民营航天发售直播、火箭研制和发射等经历时,强调这类创业需要把技术、供应链、组织能力、成本控制和长期投入放在一起考虑。它不只是做出一个技术样机,还要面对真实产品、真实交付和更复杂的产业协作。
从深鉴到东方空间,表面上看是领域切换,贯穿其中的却是把前沿技术推进到真实世界、形成系统能力,并最终产生产业价值。姚颂也反复提到,创业者必须对自己已经做到和能够做到的事情保持克制,不能用夸大的表述换取短期机会,再把风险留给企业和个人。
在新公司中,姚颂希望探索的是更完整的物理智能系统,而不是只为某一个场景单独做工程化方案。数字世界中的智能能力可以通过软件快速复制,但进入物理世界后,系统还要处理安全、延迟、成本、硬件限制、空间变化和长期运行等问题,模型效果并不能直接等同于产品价值。
这也解释了他为什么重视场景和部署。机器人需要在真实环境中不断收集数据、接受反馈、修正策略,并通过软件、硬件和远程运营形成闭环。系统的智能程度不仅体现在某一次任务是否成功,也体现在能否稳定、低成本地完成大量任务。
节目讨论了另一条可能的路线:先投入大量资源追求更通用、更强的智能,等到能力达到某个临界点,再做压缩、优化和部署。姚颂承认这条路线可能走通,但它通常需要持续的资金、算力和时间投入,并且在很长一段时间里未必能获得明确的商业反馈。
他更倾向于让技术和商业同步推进。算法每次提升都应该带来新的产品能力或新的场景价值,而不是等到一个遥远的通用智能时刻之后才开始考虑产品。对于物理 AI 来说,教师模型和最终部署模型之间可能存在极大的规模差异,因此从一开始就把实时性、成本和部署条件纳入设计,并不是简单的后处理,而是技术路线本身的一部分。
姚颂判断,物理智能会吸引互联网公司、制造业企业、汽车公司、手机产业链和重型机械企业进入。原因在于,企业都在寻找从线上数字经济走向线下实体经济的方式,而机器人和物理 AI 能够渗透到大量生产、服务和生活场景。行业竞争不会只发生在几家纯技术创业公司之间,也会发生在拥有产业、渠道、制造能力和数据来源的大型企业之间。
他认为,中美两国在大模型和物理智能方面都可能持续产生创新。大型公司加大投入会给行业带来新的方法和验证,但并不是所有创业公司都拥有同等的资金与资源禀赋。因此,创业公司需要判断自己究竟是在追求最通用的终局能力,还是以具体业务为基础持续迭代,再逐步扩大能力边界。
姚颂把自己的创业心态概括为“八分进攻、两分防守”。他愿意在大的方向上选择有挑战的前沿领域,但在具体经营中会尽量稳健,不希望企业因为过度冒险而走向无法挽回的结局。他认为,前沿科技领域并不一定是赢家通吃,短期看似落后的公司,可能凭借持续的战斗力在更长周期里获得更大的结果。
他也把职业生涯当作一项长期经营的事情。无论是火箭行业还是物理智能,都要守住边界、不虚报能力、不把短期成功当成唯一目标。创业者既要有推动技术和产业前进的进攻性,也要有承担后果、保护企业和团队的防守意识。
节目最后回到新公司的名字。Striving AI 所表达的不只是前进,也包含大步行走、行得正和走向创新的意味。姚颂希望第三次创业不只完成一次技术或产品突破,而是有机会成为一家长期经营、持续推动技术与产业、并在更大范围内服务人类的企业。
他并不把自己定位成已经抵达终点的人,而是一个仍在重新学习、重新面对未知问题的创业者。过去两次创业提供了经验,却不能直接替代对新领域的判断;真正重要的是在新的技术周期里继续保持学习、实践、商业化和长期经营的能力。
姚颂说,第一次创业时,他更多是在老师确定的大方向下负责团队和项目,后来才逐渐形成自己的问题意识:希望解决对人类重要的问题。他把“大事情”拆成更具体的层次,先考虑人类生存空间如何扩大,再考虑能源等支撑条件,以及技术如何真正进入生产和生活。这个思路影响了他之后对航天、物理智能和产业化的选择。
这种拆解并不意味着创业一开始就必须拥有完整答案。相反,方向往往是在具体的科研、工程和组织实践中逐渐清晰的。对姚颂而言,重要的是在每次实践中扩大自己的问题边界,同时把宏观目标拆成可以由团队承担、由产品验证、由产业反馈修正的阶段性任务。
姚颂反复强调,物理世界和数字世界的商业化条件不同。数字系统可以通过软件快速复制,物理系统却要面对设备、空间、能源、维护和安全等约束;模型在实验环境里表现良好,也不代表它能在真实场景里稳定工作。因而,物理智能公司需要同时理解算法能力和工程交付,不能只用模型指标解释全部价值。
在机器人规模化之后,远程运营、状态监测、任务规划和异常兜底会成为系统的一部分。机器人数量增加后,单机能力并不能替代整体空间的调度能力;系统必须能够知道不同设备正在做什么、下一步应该做什么,以及出现问题时由谁接管。这也是他把“空间”和“本体”放在一起讨论的原因。
节目还讨论了从高精度模型到现实部署模型的距离。在大模型时代,蒸馏和压缩可以让模型变小,但通常仍然处于相近的数量级;物理 AI 的部署对象可能比训练或验证对象小很多,参数规模、延迟和算力预算之间的差距更大。姚颂因此认为,部署问题不能被简单留到商业化最后阶段才处理。
另一种策略是先追求足够强的通用能力,等到能力成熟后再集中做优化。姚颂并不否认这条路的可能性,只是指出它要求企业有长期资金和资源来承担不确定性。对资源有限的公司来说,更现实的方式可能是围绕明确场景逐步建立数据、产品和现金流,再让这些积累支撑算法继续前进。
姚颂不认为只有达到行业最高指标的公司才算成功。前沿科技的技术和商业周期都很长,企业可能在不同阶段、不同场景和不同产品层次上获得结果。一个公司如果能持续把算法进步转化为可交付能力,即使没有立即成为最强的通用平台,也可能形成稳定的产业位置。
他也认为,创业者不能只用融资能力衡量企业未来。对于选择长期追求通用能力的公司,融资和资源确实非常关键;但对于希望沿着业务依托持续迭代的公司,客户、场景、交付能力和产品反馈同样重要。两种路径都可能成立,关键在于企业是否理解自己的资源禀赋,并让组织行动与路线选择一致。
面对不同年龄段的创业者,姚颂认为大家在物理 AI 这样的全新方向上都需要重新学习。年长者拥有更多可对照的经验,年轻人可能更容易接受新事物;经验既可能帮助判断,也可能让人过度依赖过去的类比。因此,连续创业并不意味着可以直接复制上一家公司,而是意味着更清楚哪些经验可以迁移、哪些问题必须重新开始。
他对自己的评价也没有停留在“成功者”或“连续创业者”的标签上。对他来说,财富、名声和经历都可能是创业的结果,但更重要的是自己是否真正努力过、是否形成了可持续的企业和产品。第三次创业让他比过去更早看到一条可能的进度线,也让他更在意企业能否长期经营,而不只是某个阶段的高光结果。
- 物理智能的系统视角 [00:00:00 - 00:10:00]
- 清华学习与创业的起点 [00:10:00 - 00:20:00]
- 从科研到深鉴科技 [00:20:00 - 00:30:00]
- 深鉴的技术与并购 [00:30:00 - 00:40:00]
- 东方空间与商业航天 [00:40:00 - 00:50:00]
- 火箭创业的挑战与选择 [00:50:00 - 01:00:00]
- 从航天到物理智能 [01:00:00 - 01:10:00]
- Striving AI 的技术路线 [01:10:00 - 01:20:00]
- 物理智能的商业化路径 [01:20:00 - 01:30:00]
- 数据、模型与场景 [01:30:00 - 01:40:00]
- 机器人系统的工程难题 [01:40:00 - 01:50:00]
- 通用智能与专用场景 [01:50:00 - 02:00:00]
- 物理世界的智能闭环 [02:00:00 - 02:10:00]
- 算法性能、成本与部署 [02:10:00 - 02:20:00]
- 物理 AI 的竞争与资本 [02:20:00 - 02:30:00]
- 机器人行业的产业格局 [02:30:00 - 02:40:00]
- 创业者的风险与长期主义 [02:40:00 - 02:50:00]
- 大步行走与再出发 [02:50:00 - 02:55:11]
程曼祺:当时这是第一次民营航天发售直播,这个点子是你想到的吗?是我想的。出生牛都不怕虎,我们是敢吃螃蟹的这个人。 [00:00:00]
姚颂:签完这个并购的约之后,我非常高兴地围绕着这个桌子,躲步了两分钟。躲步了两分钟以后,我的人生就陷入了灰暗。我跟李旦还聊过这个问题,我虽然才25岁26岁,但是我有点中年危机的感觉,你必须学满11个小时,去个厕所就要把这个表暂停下来,除了休息吃饭上厕所之类的,你一定要学满11个小时,这就是大一上学期我的常态,因为你会发现清华真的好多同学,又聪明又用功,确实赶不上,大家最近最关心的是什么 world model world action model 是一些小天才,但是坦率讲,我觉得一两个年轻老师,或者一两个小天才,无法去解决这些问题的 VLA差不多走到头了,欢迎收看晚点聊,我是曼琪。
程曼祺:本期嘉宾是一位92年出生,但是已经创业10年的连续创业者,姚颂,从10年前,他从清华本科毕业之后,创立AI芯片公司深建科技,到20年前后,他创立商业航天公司东方空间,再到最近这半年多,他成立了一家新公司 Striving AI 振兴创新,来探索物理AI 姚松过去的经历,涵盖不同的前沿科技领域,这期节目我们和姚松一起回顾了,他前两次创业的得失,他最新一次创业对物理AI的实践和思考,以及十年前,那批现在活跃在中国科技创业,主力生态中的清华创始人们,是怎么在学校里学习和成长的,我们正式进入本期节目吧,因为你历史上有很多title 你现在仍然有很多title 如果以我是来开头的话。你会怎么说姚松是谁,我就是一名创业者,一名创业者,那你可以讲讲你最近这一次创业的情况吗,我的新公司叫Striking AI 中文名叫正型创新。 [00:01:52]
姚颂:我们是一家物理智能公司,其实我觉得智能很难用单独的一个model 或者一个本体去定义,所以我们不是一家单纯的模型公司,也不是一家本体公司,我其实是希望把数据算力和模型放在一起去考量,希望把算法软件硬件解决方案,场景放在一起去考量,我们是一个物理智能的,智能能力的公司。 [00:02:05]
程曼祺:我注意到你没有用一个,这两年更热的词,就是巨神智能,物理智能和巨神智能的区别是什么,其实我觉得还是有一些区别的,我个人会认为,巨神智能其实本质讲是说,在机器人的体内。
姚颂:他有一个智能能力,他能够去处理一些任务,但是如果只有巨神智能,我觉得他是无法给人提供服务的,比如说假设我们这个楼,会需要有10台机器人在这里面工作,那么首先我希望我对这个整个空间,有一些智能的感知,能够让机器人提前规划好,它的整个的工作路径,那再比如说我希望我能够实时看到,每个机器人的电量,工作状态位置,并且呢,就好像robot taxi 到今天你看其实 30个车50个车,其实还得有一个人,在背后去给他做一个远程摇操的兜底,以防出问题,那我觉得未来10年,可能巨深智能也是需要一套远程的,这样的一套系统。
程曼祺:那所以我会把空间和本体运动,和这个操作所有的融合,叫做物理智能,就是这个大的系统一起构成物理智能,是的,所以我们其实更多的是,以一个系统的视角,去考虑整个的物理智能的问题,而不是单纯的站在一个模型,或者一个本体的角度去思考这件事,因为你之前的创业,就包括我说我们第一次见面,那会儿还是在深建嘛,对,那是AI芯片第一次创业。然后第二次创业是2021年开始登方空间,然后是这一次Striving AI 你把它描述成是物理智能的系统级的公司,这三件事其实一般人会觉得跨度很大,它有一个贯穿的线吗。 [00:03:50]
姚颂:我觉得其实是有两个贯穿的线的,一个贯穿的线就是说,我们其实最终都想实现一些大的事情,那这些大的事情是什么,坦然讲我在做申建的时候,是没有去思考过这件事的,这才是第一次创业,其实更多的是,汪玉老师决定了一个大的方向,我在团队里面恰好负责了,这个方向的整体的管理,那我来做这件事,但是随着身建的逐渐的发展,到了后期也逐渐的思考清楚了,我对世界有一个我的认知,就是说我希望去解决一些,对人类非常重要的问题,那哪些问题是重要的呢,我最后把问题拆解成三类问题,第一类就是我们画个圆,这个圆代表着全人类的生存空间,我们的生存空间,一定要不断地扩大,那这个扩大,我们背后有很多的技术手段,比如说最核心的一个驱动力,是能源,假设我们能解决核聚变。那这个问题毫无疑问能够解决,对吧,那第二航天,因为你人类可能不能只待在地球,当你殖民去月球火星,成为一个多行星的种族的时候,你的物理手段,一定是通过航天的手段。 [00:04:57]
程曼祺:所以这是一大类的问题,要解决整个人类生存发展的问题,那这个圆扩大的意思,就是星际文明的意思吗,人类的生存空间,能够获取到的能量资源,应该要持续不断的变多,就在地球上也生化,然后同时也走出地球,是的,我们站在一个二维的圆里面,那就有无数个点,对吧,这个点就是我们每一个个体。 [00:05:11]
姚颂:那所以每一个个体的生存,健康,幸福快乐,又有很多层级的问题,那点和圆之间,咱们也成立一个关系,这个关系其实就是社会,因为我们这些点,在这个园里面,会发生很多的互动,会有各种各样的组织形式,对吧,比如说国家是一种组织形式,那不同的国家,也有不同的制度,但整体而言,那这里面怎么去提高,社会的效率,以及社会的公平,可能又是一个,非常重要的方向,那其实你可以看到,很多的事情,都落在最终三大命题之内,比如说航天,那肯定是拓展,全人类边界的一件很重要的事情,那不管是AI芯片还是机器人,可能都是在提高,整个的社会运作效率,并且能够更好地去支撑,一些人类的生存问题,所以我觉得这是一个大的主线,就是核心一定要在解决一个。
程曼祺:对人类发展有重要价值的事情,第二条线是什么,第二条线我觉得,其实是一个个人的激动的地方,或者个人的兴趣爱好,就是你的快乐。 [00:06:29]
姚颂:你的成就感来自于哪件事情,我觉得对我来说,我的一个成就感,是看到一个简单的算法,看到一个最开始的技术的原点,让它一步一步变成产品,真的让它影响到了很多人。
程曼祺:让你的产品被很多的人用起来,被很多的人能够夸奖,能够去服务很多的人,这个时候我的成就感是最强的,可以说有一条线是向外求的,就是我要解决什么外部的问题。然后有条线是你内心驱动力的线,对你这总结的很好,比我总结的好 OK 那我们可以把这条线捋一捋,我觉得正好因为你从2016年就开始创业,其实你是整个经历了这十年,中国硬科技创业的周期,以及上一次AI热潮和这次AI热潮,我们可以回到就是你第一次创业,深建那前后的故事,你是一年保送清华的,物理竞赛保送清华,对,本科之后你就创业了。你可以先聊聊,比如说本科时候有发生什么事,让你慢慢有了创业这么一个想法,其实这件事呢,还真是从大一就开始的一个事情,比如说我同年级2011级的电子系。 [00:07:33]
姚颂:出了一位神人叫韩眼俊,这一个神人呢,后来也拿了清华大学的特等奖学金,现在他在纽约大学当教授,我们甚至出了一个非常好笑的事情,我们当时危机分科的老师,最后出期末考试的卷子的最后一道题,就是专门为了难住他一个人而已,是因为他当时表现的实在太突出了,那所有的数学课感觉不用听,不用学,但是所有的考试出来,就轻轻松松 30分钟就能考满分,所以我当时进了大一以后,我其实挺焦虑的,挺紧张的,挺难受的,那在这之前,因为你老家是长沙人吗,对,应该也说是。
程曼祺:好的学校是很多的,是,那会儿你以前一直是学霸是吗,这样,首先我在长沙市一中,一般我应该是年纪,第一第二第三,少数第四,那到了清华以后,我觉得这个压力。 [00:08:25]
姚颂:还是非常大的,当时我们刚开学的时候,就有一位老师,在这个军训的时候,跟我们讲一句话,就说你们来我们电子系的,最差的都是你们省的地,多少多少名,但是非常遗憾,你们来了以后,在电子系一定会有一个270名,一定会有一个269名,一定会有一个268名,所以你一定要好好学习,不要让自己成为一个这样的名次,所以压力会非常的大,你说你刚来是比较焦虑的,对对对,所以当时还带着那种很老的电子表,对吧,就每天计时,你必须学满11个小时,去个厕所就要把这个表暂停下来,吃个饭要把这个表暂停下来,就是除了休息,吃饭上厕所之类的,你一定要学满11个小时,这就是大一上学期我的常态,你自己给自己这样要求的,对,因为你会发现清华真的好多同学。
程曼祺:又聪明又用功,确实赶不上,在清华最受推崇的,是不是我又很轻松,然后成就很好,其实并不是,我觉得,对你觉得勤奋大家怎么看这件事情,你每天学11个小时。比如说周围的人是觉得很佩服,还是说你这样有些机械,其实周围的人会觉得很正常,这个其实一直引申到了,后续一件事情,就是说对我来说我会发现,如果我没有在努力工作。 [00:09:42]
姚颂:没有在加班熬夜,我就会有负罪感,这是整个清华。
姚颂:这是整个清华,我觉得好多人都会有这样一个,内心的这样的一个过不去的梗,我不知道用梗还是用什么来形容 OK 那你可以继续说,就是这个焦虑和你创业,你后面想创业这个关系是什么,对所以当时的一个深刻的感觉,就是说,其实第一就是你的这根弦,不能一直紧绷着,我到了大一的这个寒假,我真的人都快崩溃了,这感觉,我觉得这是第一,第二呢,我也开始逐步的感受到一个,读大学跟读初中高中最大的区别,就初中高中,你的目的是走向一个更高的学府,而大学的目的,不管说你是本科还是硕博,你的目的是帮你更好地走向工作,更好地走向你的职业生涯,所以其实到了大一下学期,我开始理解一件事情,就是读大学不只是学习,其实你可以走社工路线,你可以走科创路线,你可以走科研路线。你可以选择在国内保研直播,你可以出国留学,你可以创业,其实你有很多种不同的选择,所以我在大一下开始做出了,一定的自己的选择,你当时选的是,这里面会跟现在的很多创业者发生关联,就是我当时选择了科研和科创这条路径,所以在很多的不同的学生组织里面,我最终在大一下的招新的过程中,选择了加入电子系科学,这里面其实会有很多很好玩的事情,因为比如说当时参与招新的,有一个比我高一年级的师兄,就叫做王赫。 [00:10:53]
程曼祺:与何通用的手机科学家,我是后来当到了电子系科学的主席,那我是2011级的主席 2005级的主席叫做姚茂清,志源,这也有很多的后续的故事的展开。 [00:11:29]
姚颂:但当时核心还是说,我发现我自己最喜欢和擅长,和自己能感觉到成就感的,是说那个小车能够动起来,让各种这个程序能够跑起来,而不是说做理论计算,做一些题目,发一些纯的paper这样的事情,所以我觉得我去科学,然后选择了硬件部,是我一个自己最喜欢的一个方向,也是在那个时候,我觉得那纯粹让我去学一些数学理论,我真的非常非常的难受,但是怎样的情况,我能够找到我的学习的动力呢,是我看到这样一个知识,它到底发挥怎样的作用,所以后来我去到了,我大一下就给汪老师,汪玉老师发了个邮件,大一的暑假就开始在他的实验室工作,那在那个暑假,其实我就迅速找到了大学中的我,就后来的那个我,甚至于整个比我低一年级的同学们,有一半在精华上的第一堂课。是现行代数,就是电子系的同学,是我去讲的,是因为我在那个暑假,给我们的现行代数老师发了一个邮件,我说我作为一个过去一年过来的学生,我真的没有学明白这件事是怎么样的,但是在过去的两个月,我的科研的过程中,我才深刻地感觉到了,现行代数原来在我们电子系的很多东西,还是要被用上的,当看到被用上了,我觉得我有一些学习的动力了,所以我认为其实可能给后续的同学们,您去讲一讲这个它到底有什么用,可能对大家更有动力,老师就回了个邮件,要不下个学期的第一堂课,你就来给大家讲一讲,你其实在告诉大家学这个事的必要性,是的,或者说告诉大家,就是你学了这件事情,最后在一些3D的图像处理,在一些电路的计算,这件事会被怎么用上,所以你学的东西是有目的的,有意义的。 [00:12:37]
程曼祺:你不是盲目的为了最后考一个高分在学习,你做这件事你是为了帮助更多师弟师妹,就你的这个背后的动力是什么样,这个动力我觉得就是说,我会认为有很多人是跟我一样的困惑,你当时大一一下说你在看的这种路径里面,你提到了科研和科创,这两件事的区别是什么,其实区别本质不大,科创的更多的是像挑战杯,天空工厂等等的,大家去做一些可能用简单的代码,简单算法就能实现,看得见摸得着的事情,你就又说到一个人,天空工厂,那就是余浩当年,在清华弄的一个设计,我当时在的时候,可能天空工厂的负责人,叫赵浩,赵浩是电子系09级,他是光轮智能之前的,首席科学家,后来加入了极致家,做首席科学家,所以就当时的,这个校园里的很多学生,后面进入社会。都是在各个领域,有很多很多的创业者,对特别是在,清华的科创和科研这两条线上,会看到大量的创业者,不管在中国还是在美国,你可以据说,你说科创是用一些比较简单的方式,把一些东西实现出来。 [00:14:21]
姚颂:对,所以大家一定要有一个,看得见摸得着的,能够服务我们的东西出来,那这个东西的成果,一般是会放到挑战杯上,作为一个学生的科创项目,而科研肯定就是进到实验室,跟着老师们去做事情,对吧,那它的产出,可能根据你的实验室的差异,也非常巨大,有很多做理论的,可能阐述就是SCI的论文,可能对于我们这些人来说,可能阐述的是个软件,因为我最开始做的是EGA 就是集成电路设计的软件,那对于后期我们做的事情来说,可能看到的一个呈现是一个板卡,里面能跑LXNet 能跑VGGNet去做一些图像处理。
程曼祺:所以对我自己来言,我比较有成就感,我比较喜欢的是,最后一定要有能看得见,摸得着真实生活中的东西,你后来其实本科毕业,是拿到了CMU博士的offer 但是你没有去。你选择本科之后就直接创业了,是的,可以讲当时大三大四,这是一个什么样的申请,后面又放弃,然后又决定创业的过程吗,最开始我其实是一个。 [00:15:28]
姚颂:非常非常普通的隋大流的同学,因为在我那个时候读书,大家的思想风潮,还是说读书最好的,一定要去国外读一个博士,而且这个在电子系,应该是比例非常高的,其实现在的比例已经大幅下降,甚至有很多老师,在忧虑出国的比例太少,但是在我那两届,确实是非常高的,我那一届出国的同学比例,应该达到了45% 仅仅在我那一届,但是后面迅速的,可能就变成了30 20 现在可能10%甚至都不到,从我的角度说,就是大家如果能去最好的学校,最好的老师那边学到一些东西,最后回到国内来做事。
程曼祺:我觉得肯定是一个,最完美的方案,你随带留的这种想法,是因为什么原因变了,是发生了什么事吗,其实不是,我觉得包括你自己的人生成长,你一定在不断地找自我,对吧,就是我们其实所有人。 [00:16:20]
姚颂:都是生活在一个,社会期望,家长期望,老师期望,熏陶出来,灌输出来的一个世界里面,那我觉得我第一次去找到自我,可能是在初三,因为我初中都是当班长,那最开始的时候,我可能叫严格执行老师给的各项纪律,严格的监督其他的同学,后来我觉得似乎这些事也没有必要,到了大学以后,我觉得也是逐渐的在找你自己的很多的想法,那大一我觉得还是一个随大流的状态,家长也觉得,其他大部分的同学也觉得,读书好的人就应该去美国读个博士,但是到了大三上的时候,当我真正第一次发了第一篇paper 去美国开会的过程中,我越来越体会到,这个生活不是我想要的,这个在其他一些学校的,媒体采访也说过这个事,对你之前接受清华的一些采访,对。因为当时去开会以后,也接触到很多,在硅谷工作的清华师兄,我感觉大家的工作,其实确实非常的清闲,可能一天工作个,五个小时六个小时。 [00:17:28]
程曼祺:但与此同时,每年的收入增长,你的职绩增长,这些事其实是一个,非常缓慢的一个过程,这和你一天要工作十一小时的人生观产生了冲突是吧,这倒不是这个事情,而是说我会觉得这样无聊。
姚颂:就是后来有一个老师总结了一句话,我觉得特别切中我当时的心态,他说人生就两种状态,叫boring和suffering 然后就看你倾向于哪种,对我来说我可能更加无法忍受boring 所以他们当时就很多师兄们,因为工作相对比较闲,收入也很高,可能在比的就是说,我去过黄石,我还没去过,我去过28个州,我去过30个州,可能大家都在往这个纬度去拓展,也是一种很好的拓展,但是站在读书的时候的我来说,我觉得我可能想经历更多,然后希望有更丰富的人生。
程曼祺:而不只是日常的工作和这个休闲,那为什么后来还是去申请了一些美国的博士的学校,因为其实在申请的时候,是需要在大三年级去做申请的。 [00:18:31]
姚颂:大四的上学就会出结果,包括我大三暑假,去了一趟Stanford 做了暑期科研,其实也对我后续的很多的,这个创业有很大的一个影响,那个时候坦然讲呢,我们和汪老师也没有下定决心,要去创办身件,也是到了大四以后,逐渐的明确了这个想法,所以基本上就是说,到大四上,那可能汪老师开始跟我讨论,是不是应该去创业了,拿到offer的前后。
程曼祺:可能就已经明确了,就其实是要去创业的,所以我们就已经开始做各种的创业的准备了,你当时那个时间点本科毕业就来创业。在同学里面是一种什么类型的选择,其实是非常极端的,也不太被认可和理解的选择,可以先稍微聊一下,就在十年前的清华园里面,那批年轻人相互之间较量的是什么,比如说你做到什么,可能在学生时代你可能是个风云人物,然后你做的什么可能会被鄙视。 [00:19:23]
姚颂:清华一直是以科研和学习,肯定是作为最主线的,所以大家会去羡慕的人,我们当时还给很多人命名了叫神,就比如说刚才讲的那位韩远俊。
姚颂:就比如说刚才讲的那位韩远俊,我们叫做韩神,然后我们有一个隔壁班的同学叫张帆,我们叫帆神,他们班还有一个神,所以我们叫他二神,因为一个班只能有一个大神,得有一个,然后就是二神,其实我们出来很多神,那这些神普遍是说,学习成绩特别特别好,并且就是说,在一些理论方面,或者一些学科方面,就是有非常强的天赋。
程曼祺:当时像杨直林,高继扬,陈建宇,许华哲,其实都是你们前后级的,他们是神吗,在学校里,他们大部分能够算成神,对。 [00:20:25]
姚颂:但因为比如说直林,不是跟我一个系,那为什么我知道,他们能够算成神呢,是因为,那清华其实也会有很多的培养计划,是超脱余孕系的一些专项的培养计划,那比如说最老的一个专项的培养计划叫做思源计划,叫做饮水思源回报祖国计划,那大家会去走向西部走向很多的这个贫困地区,去了解中国是一个怎样的现状,以此更加坚定自己为社会服务的一个心态,那除了这样的计划,也还有一个计划叫做科技创新,星火燎原计划,简称星火计划,那我和很多的同学,其实都是星火计划的,这个一期或者隔壁期的同学,比如说我的第一家公司的,首席科学家韩松,比如说许华哲,比如说杨志林,应该也在,我不完全确定。但是应该也是在的,那另外还有一个,更小的群体呢,是Stanford 有一个官方的项目,叫做UGVR 叫做Undergraduate Visting Research Program 就是本科生访问研究计划,这个计划呢,是由一波这个,以华人为主的捐赠支持的,每年的暑假呢,输送20名左右,现在可能在30名左右,中国的学生,去斯坦福大学做访问研究,那这个计划会承担你所有的机票,食宿科研经费,还给你一定的零花钱,我当时也是这个计划的议员,那高继扬也是这个计划的议员,对我们都在那有一段非常好的科研的经历,对所以那清华一定是大家认为,学习和科研是非常非常重要的,那当然也有很多的神。 [00:21:32]
程曼祺:我们可能会羡慕说,学生会主席,各种在社工方面做得很好的人,但是最主流的价值观一定是学习跟科研,你刚提到这么多人,其实后面很多人都创业了,比如说高自扬杨志林徐华哲。等等王赫,但他们创业的时间都比你晚,你那会那么早创业,那是不是就有点背离了科研这条路线了,两方面去讲这件事,第一是我最近会感觉到非常的有趣。 [00:22:34]
姚颂:因为市场上这些一线公司里面,也大量的是我的同学,是我在大一大二就认识的同学,那这属于一个,我觉得正常积累的创业,是因为正常来说,你要积累足够强的技术的思想,你还是需要读一个博士的,你还是需要一些更深的,更长期的科研工作的,然后当你当了教授,或者有了几年的工作的经验,你开始逐渐意识到更多的商业的问题,然后你跳出来创业,我觉得这是我们王赫师兄,高继扬华哲师弟等等,大家的一个typical的一个创业路径,那对我来说,我可能把这条路走得更早,因为我从大一的暑假就开始做科研,那我本科生期间,其实就发了四五篇的论文,并且我已经开始在实验室开新方向了,甚至我也从我的大二,就开始带大一的新同学了,我觉得相对大家更早的。其实迈入到了一个科研方向的思考,科研团队的管理等等的一些职责上,与之相对应的,那就是说到了大四年级,我们的整体的几个同学做的这个B社,组装起来,就是一个完整的AI芯片的demo的时候,那可能这件事我们感觉离创业更近了,那所以就跳出来直接创业了。 [00:23:42]
程曼祺:所以我相当于可能比大家更短周期的去完成了从科研走向科研方向的选择,走向科研管理,最终走向科研科技成果转化的这条路径,深建具体是怎么开始的呀,就是你更快的经历了这个过程之后,这里面我觉得有很多很好玩的事情,比如说当时我们有同样好几个一字班的同学在汪玉老师的实验室里面做毕业设计,一字班就是2011年入学的,入学的本科,里面算法负责人,你可能也采访过叫周二进,对就是之前矿石研究院的,现在在园林林基,园林林基的联创之一,没错就是我们当时。这个小project的算法负责人,对你说到这个园林林基的创始人,唐文斌以前也是,他们系计算机系科学的主席,是所以我们跟唐师兄,也认识好多年,对你可以据说,这是你们四个同学。 [00:24:44]
姚颂:做毕业者的其中一个,对对对,那么就大家从算法 architecture 软件系统,编译器不同的角度,去做了这件事情,那我其实我毕设的题目,并不是这个,但我恰好是这个项目的PM 所以我去组织整个的科研,以及最终我去写paper 那当这样一个东西,做出来的时候,我们开始思考,这件事值不值得创业,那因为2014年9月份,商汤成立,就在清华科技园的创业大厦,就在你右后方,能够看得到的那栋楼,对,这个,就是右后方那个外墙,有点破落的那个楼,因为这个楼也是应该科技,清华科技园里面,租金相对比较便宜的一个楼,当时商堂就在这里面,从商堂一成立,我记得大概徐兵就来找过我,现在徐兵也是去希望当董事长了,因为他们要来清华招市医生。清华招市医生的一个方式,就是给我电子系科学赞助几万块钱,然后给我们活动冠名,然后我让很多的同学,帮他们去张贴招聘的海报,大三那就是你,大四上学期,所以当我们已经做出来一定的成果,你的完整的demo能跑通的时候,我们看到了商堂成立了,那商堂成立就意味着一件事,那就是说,那可能深度学习这件事情,会要跨入主流,形成一种新的商业风潮,或者真的进入各种各样的服务行业,真实的应用,而不只是做科研了,那这时候可能恰巧就会需要,我们这样的芯片和这样的平台,因为原来的CPU GPU 可能会支撑不太够,所以这个时候开始动了一些,创业的念头,也开始跟汪老师这个谈起来。那过程中其实发生了很多很多的事情,比如说还在琢磨的过程中,我记得是24年底,韩松师兄回到了清华 14年底 2014年底,那他当时还在斯坦福尔读博士,那我们一聊,他其实做的事情,跟我们是一个非常互补的,因为他在做系数化,在做这个算法的压缩,系数化和量化,那这件事情天然,跟一个硬件的加速,是搭配在一起的,并且他自己也有创业的想法。 [00:26:46]
程曼祺:当时汪玉老师和韩松,都是多大的年纪,汪老师在那个时候,也就是32岁,刚刚担任副教授,可能两三年,那韩松还是一个博士二年级,博士三年级的学生 25、6左右,对大概吧,他现在在MIT当老师,对韩松老师现在是MIT的长聘副教授,在去年已经tenure了,那这也算互相壮胆,在2014年的年底。 [00:27:14]
姚颂:他也有这个想法,也认准这个方向值得干,我们也认准这个方向值得干,所以就逐步的开始去物色各种各样的团队,包括我去物色我周边的同学,师弟能不能来一起做事情,所以最后我们公司的一号员工,就是我在电子系科学,带的比我低一级的实力,叫隋灵智,我们电子系科学硬件部的一个实力,成为了公司一行员工,最终我觉得彻底下定决心,还是说大家也叫互相壮胆,我觉得汪老师也帮我下定了决心,你刚才问的问题,其实是非常重要的,我还是有CMU PhD全奖offer的,虽然没有我的dream offer 比如说Stanford offer 但是汪老师会觉得,有两件事是可以帮我去解决的,第一就是说,创业的机会成本最低的时候。恰巧是你年轻的时候,其实大部分人到了30多岁,反而是不敢创业的,特别是当你结了婚,有了孩子,可能有了更多的负担,有了房贷以后,很多人是不敢的,所以他觉得你在这个状态,恰巧是其实成本比较低的,一个创业的阶段,第二件事情他觉得,如果你还沿着之前,这个家长和社会,灌输给你的这个主流的,所谓主流的方向,就是应该读个博士,然后去一个硅谷的大公司,就业是一个最体面的话,那你其实读博士和读硕士,可能都差不多,那汪老师觉得,他也有能力帮我去找到,很多的好的推荐信,去到CMU 去到Stanford去读个硕士,他的意思是说,这件事和创业同时进行,还是说创业,不成功的话,他说创业不成功的话,我可以继续推荐你去,美国读个硕士。你可以继续原来,那个社会主流认知中,去美国读书,在在美国的大企业工作的,一个很体面的路径,所以我觉得也是,所以一方面是看到了,很强的机会,就是说深度学习起来,你确实需要新的算力,一方面呢,我觉得解决了一些,个人心理上的负担,再加上个人心态上,刚才其实提过,在那个时候,我已经不是那么想,沿着一个很传统的路径,去美国读博,大公司工作,这样一个家长们认可的路径了。 [00:29:29]
姚颂:这样一个家长们认可的路径了,所以我就坚定下来,跟汪老师一起创业,但过程中也发生了,很多很好玩的事情,比如说我父母,那肯定是坚决不同意的,所以后面也需要汪老师出面,去做了很多的思想工作,汪老师还要去和你爸妈谈,是的,汪老师也要把,给我说的那一番话,给父母讲一遍,对吧,肯定用了很多的方式,多轮的沟通,最后父母才同意我的,第一次就直接创业,而不出国读书,你没有避讳。
程曼祺:就是你当时其实有退路的,就在有些人看来会觉得,会导致你的心态上,也许不够all in 我觉得一定不要讲这句话,比如说当时应该是,哪家公司。 [00:30:28]
姚颂:创始人叫给压房子,然后all in到这个创业里面,我在朋友圈就看到了,我忘了是哪位,连续创业者或者企业家说的话,就是我从来不鼓励你欧印,因为当你把房子去欧印了,你的这个失败成本实在是太高了,或者再换一个角度说呢,就是这后来看到一个知乎上的回答,是说为什么赌徒们永远是失败的,是因为虽然理论上,哪怕你的赢和输的概率是50 50 赌场都不抽成,但是会有一个刹那,你的本金输为零,输为零以后,你就没有任何资本再去翻本了,对吧,因为它肯定哪怕是50 50 你的比如这是零,这是无穷大,它也会波动,波动的一个过程中,变成零以后,你也再也无法回本了,所以我其实一直不鼓励,抵押房子卖房子。
程曼祺:所谓的all in 我觉得你应该把你的时间,精力注意力资源,全部all in 但是不要把退路封住,你觉得失败成本太大的问题是什么,是动作会变形吗,还是什么,我觉得动作会变形,就是你追求成功和防止失败,是两种完全不同的路径,追求成功和防止失败,对吧,追求成功的时候,我们其实通常是要冒一定的风险的。 [00:31:32]
姚颂:你的一些决策是带有风险性的,比如说你制定了一个三年的,这个公司的规划,那你可能账上的现金,是不足以支撑三年的,你还需要持续的融资,但防止失败意思就是说,那第一我所有的事情,我投一分钱下去,一定要见到两分钱的产出,我现在账上能够支撑我一年半,那我就要裁员降人数,把这件事拖长到三年到五年,这个动作节奏,我觉得会严重的变形。
程曼祺:当你们做了一系列,这种互相壮胆的工作之后,正式开始筹备创业,建了50家投资机构,没有一个人愿意投,在当时去做这样一个,硬科技的创业。你可以讲讲早期是,怎么起步的环境是怎样 10年前 11年前,其实环境是非常非常差的,第一就是说,其实在此之前,中国人在科技行业的投资,几乎没有挣过钱,你当时去见头子,是15年下半年你们筹划期,就开始见人了,是的,没有赚到钱,当时在芯片上,大家可能能数得出来的,一只手就能数得出来,曾经赚到钱的案例,比如说展讯,可能就没有什么了。 [00:32:35]
姚颂:陈大同也是你们的老学长,在那个年代,教授创业和学生创业是少见的,多亏商汤给我们有了一个势力,我们还能援引到一个利子,除此之外几乎是没有的,对,不像今天其实你能看到很多的老师,年轻老师以及他们的学生一起创业,这件事也是没有的,第三也是出于那之前没有什么技术项目可投,那整个投资人的背景,没有几个人是技术行业出身的,绝大部分就是看消费看文娱,这样的一些看互联网出身的,不具有技术的知识体系,他没有办法做判断对吧,就好像你今天来跟我说,何俊变这个路径好那个路径好,用亥三好,用别的能源好,我其实判断不了,因为我没有你那个领域的专业知识。 [00:33:02]
程曼祺:我觉得那个时候的投资人,也是没有办法去判断的,你们当时对申建要做什么事,是怎么来描述的,那个时候其实是说,我们是一个很学术的想法,就我们做了一个非常优质的。
姚颂:高级的领先的芯片的方案,这个方案在FPGA上就能实现,比如说多少G-Obs per Watt的一个能效,那在将来芯片上能够实现一个多挑的能效,那么在未来的人工智能时代,我们对于算力的需求越来越高 GPU会不够,所以会需要这样的芯片技术,那再列了几个可能的应用场景,比如说安防监控的摄像头,辅助驾驶等等的一些事情。 [00:34:07]
程曼祺:其实还是一个从技术,再走向产品和可能的商业化的一个叙事,可以说这不是一个被包装的很好的故事,可以这么讲吗 FPGA我觉得那会应该大家都有很多人没听过都可能。
姚颂:确实是的,所以那个时候也没有找到什么FA 更多的就是说有一些投资领域的师兄来帮忙给给意见,比如说我们请了兴旺师兄,就是现在高中资本的兴旺师兄,那个时候就在这个高中资本,比如说请了武斌学长,是CPE原封的那位武斌学长,也比如说请了这个ITG的牛慧光师兄,请大家来给给建议,说应该怎么去写这件事情,那后来呢,其实包括还请了,像北极光的邓峰学长,给我们一些建议,他就讲了一个,对我们后来影响很大的一个话,他就非常直白,不像之前的很多师兄,可能还比较委婉,怕伤到我们的自尊心,对吧,他说你这个PPT的讲法,哪怕见邓峰学长的时候,已经改过很多版了,但还是一个纯技术人员的讲法,因为你在讲你的技术,有怎样的可能性。而如果是纯商业背景的投资人,大家想听到的事情是说,这件事我觉得有一个万亿级的市场,万亿级的市场里面,产品的更新换代,或者是完全没有产品,我们需要一个怎样的产品,最后我的技术恰好能够实现这件事情,并且已经实现了怎样的指标,还有哪些demo的点出来,是能够往这个产品上去靠的。 [00:35:41]
程曼祺:你可能要从市场倒推去想技术的,这个已经落实的东西,你说到这个让我想到,你以前的一次演讲的分享,你说技术创业很重要的一件事,就是要很快的抛弃,单纯的技术思维。 [00:36:04]
姚颂:对因为你的技术的目标,最后不是发paper了,就是你的技术的核心不是自嗨,你技术的核心是,要在产品上最后能够创造价值,那你首先得给你,什么叫创造价值。
程曼祺:那你可能才能想清楚,你技术的延展的这个方向,对吧,后来你们实际上,是怎么拿到第一笔融资的,这又是非常非常多的机缘巧合,我们公司的天使轮的领头方,最后定下来是金沙江创投的合伙人叫张玉彤 OK 他现在也自己在创业,对,当时也非常多亏,金沙江创投在硅谷有一个合伙人叫做林仁俊。
姚颂:是一位新加坡籍叫Richard Ling 他也是投过好几十年的半脑体,因为他在硅谷投了很多的半脑体,对这件事有一个非常清晰的认知,他也觉得可能我们得从通用处理器。
程曼祺:跨向专用处理器了,所以他也是大力支持了这一个投资,所以这个投资人的情况是,他本身就看到了你们在做的方向和趋势,从接触到推进这个项目。 [00:37:10]
姚颂:是因为张宇同自己也是清华电子系毕业,懂得一些芯片的基础知识,觉得我们在技术上做的肯定是不错的,与此同时再推到一个创始合伙人的级别 Richard Lin 可能从芯片行业,几十年的发展的过程中,推演出来未来,是需要一类这样的东西的,那我们又在中间,是做的不错的,所以就金沙江,果断地出来一个turnsheet 按着我和王老师,在办公室当场签了才走,你们第一轮,是不是还有高荣也投,这也是高荣,也是兴旺,也是清华电子系的师兄,那当然坦率来讲,在金沙江出turnsheet之前,可能高荣还会有一点犹豫,虽然岳斌总也是北大计算机毕业,也做技术出身,星望也是这个青华电子系毕业,也是技术出身,但是大家对于半导体,可能并不是一个有特别长线和。对过往认知可能不一定深入,对未来的推演可能不一定完善,所以他们跟金沙江交友以后,可能相信了金沙江的判断,所以后来马上果断的跟进跟投。 [00:38:16]
程曼祺:具体这一轮是 16年年初几月份敲定的,当时签turn sheet应该是在,三月初或者二月底左右的时间吧,我想问这个时间是,我想知道这是在 AlphaGo战胜理事时之前还是之后,之前,因为Alpha战胜理事时,就是在2016年三月,没错在那个之前,所以那个之后我们特别的高兴,觉得就是说 AI真的是在往大家,我们在设想的方向在发展,那件事改变了你们的处境吗,其实改变不大,我觉得也还是跟当时的创业的投资背景是有关系的。
姚颂:因为中国当时的投资人的环境,刚才讲大部分其实没有能力去做技术到底好和坏的辨别,大家更多的还是看资历,所以我们作为一个年轻团队,坦率讲就是自认为技术很好,部分的客户跟合作伙伴也认为技术很好,但是我们可能不是特别容易跟投资人讲明白,或者用一种投资人容易理解清楚的方式,去呈现我们的技术的领先性和它未来的价值,所以那一年我们也是迅速的转换了一个思路,那就是说既然我们的客户跟合作伙伴,对我们的技术价值是深度认可的,那为什么不直接把这些人变成我们的投资方,所以到了我们后续的这个投资A轮的领头方,直接就是Sanlix 后面还有像三星。 [00:39:05]
程曼祺:联发科等等的一些公司的投资,他们的投资都是做了七轮。
程曼祺:他们的投资都是做了七轮,乃至九轮的技术金调之后,做出的投资,为什么你当时拒绝了,英伟大英特尔选了Selix 在那个时候开始。
姚颂:已经开始有了一定的战略思想,我其实做申建,我个人最得意的一件事情是,我拿到了金沙江的TourSheet以后,就在2016年3月左右,我就开始推演,那这个公司将来会怎么样的走向ending 如果我们想追求一个好的结局,那你肯定是希望上市,一个中等结局肯定是说,我希望走向收购,那当然我是不希望走向破产的,对吧,那如果走向上市,那当时A股有传言要做叫战略新兴版,也就是后来科创版的原型,那美股可能大家会希望,你在做一些怎样的事情,港股可能希望你做一些怎样的事情,市场有怎样的特性,那如果是收购,英伟达要收你的话,他会收什么,英特尔收你的话会收什么,塞林斯要收你的话会收什么。国内阿里要收你的话会收什么,我当时就开始有一些思考,你一定是在某一件事情上做到了世界第一,又是他在他的集团战略方向上非常重要的一个环节,他会愿意来收购你,对吧,所以这是一个战略思想的启蒙,从那个时间点开始思考,这个公司最后会发展到一个怎样的程度,那回到你刚才那个问题,就是说为什么拒绝了一些投资,我觉得就是在那个时候,有了一些战略上的思考,这些人一起在你公司,真的是一件好事吗,所以我当时也跟汪老师,跟很多的团队成员在分析这件事,就是说有可能一家公司,同时被赛林斯英特尔英伟达,三家公司同时捅,甚至可能还加上AMD 那在人类历史上可能都是绝无仅有的,因为正常来说。他们的投资的条款最开始拿出来的时候,都是排他的,都是排掉刚才讲的各家其他公司的,但最终他们都接受共存,但是我就在想这件事短期,可能对你公司的品牌有一个巨大的提升,但中长期对你公司是好事吗,我觉得不见得,因为第一呢,我们的业务实质上,在嵌入时端跟英伟达的TX1 TK1等等的,这种嵌入式GPU有一定的竞争,那它拿到了完整的信息权,可能从长线上看,它对你的产品布局比较了解,那可能能指导它进一步的,它自己的产品布局,而另外一个角度呢,当你假设走向收购的时候,可能反而你卖不掉了,因为假设这三家中间,假设英特尔要收,那英伟达和塞林斯,有一种可能是竞价。也有一种可能是捣乱,那让你的这个收购破产无法成行,对吧,所以反而可能不会太好,并且呢,虽然每一家都承诺给你很多的业务资源,但是这几家公司都是有一定的业务竞争关系,那英特尔会怕说,我给你投入了大概我的市场资源和业务资源,最后你上的全是Sidings的FPGA的产品,我帮我的竞争对手推来产品,那大家反而在这种情况下,都不会帮你,所以站在一个,短期和长期的取舍的过程中,我们最终放弃了短期,一个品牌迅速提升的机会,而选择了一个中长期,对我们业务提升,可能最有帮助的机会,就是三菱斯的投资。 [00:42:49]
程曼祺:这些融资上的选择和战略判断,主要是你在申建负责的是吗,对那个时候是我在负责,你在申建的整个角色是什么,你是职位上你是CEO 对,我和汪老师搭配更像司令和政委。 [00:43:34]
姚颂:其实很多大的方针,肯定是汪老师去制定的,他是政委,不在一线直接指导业务,一线的业务指导,可能是我在发号施令,但是一些宏观的大的战略决策,肯定是汪老师来最终拍板,以及假设我的决策犯了重录了,让大家不高兴了,汪老师出来收场,以及有一些重要的客户,我觉得我作为一个特别年轻的,正不住场可能不足够去convince别人,那可能就需要汪老师的出面,比如说当时就在这个楼,就在2016年的,我忘了几月份,可能就是六月,我们和汪小川川总开会,现在川总在隔壁楼新公司,那就需要汪老师来出面,因为川总是96级,汪老师是98级,那他们可能相对年龄类似更多,就更有共同话题。
程曼祺:也能找到一些相关的同学,当时他是在搜狗,那韩松和单一因为你们是四个对对对合伙人吗,对他们的团队职责是什么。 [00:44:39]
姚颂:这个团队肯定是以汪老师为核心去组建,那单一也是汪老师的学生,他是公司的CTO 有带领整个研发团队去做,不管是包括一部分的前瞻性的研发探索,和这个整个的工程实施落地,那去组织算法软件硬件整体的来出产品,那韩松是我们的首席科学家,所以在一些前瞻性算法的研究。
程曼祺:包括前瞻性的压缩,这个系数化量化等等的方面,可能会以周会,后来以双周会的形式,带领大家一起去探索各种的方向,其实你们这个组合里面,它缺少一个有商业经验和产业思维的人,你是自己成长成了这个角色是吗,从日常工作上,我们有一个师兄确实帮了很大的忙,叫做刘静秀,是汪老师的同年级同学。 [00:45:16]
姚颂:汪老师同班还是隔壁班同学,那他自己其实当时已经在外企工作了,可能比如说小十年左右的一个周期,一直在做市场方面的工作,他是有一些成熟的工作方法,去做日常的推进的,但是最终的我觉得可能一些大的拍板,什么事该做不做一些方向上的取舍,首先是我来做决策,但如果出现了重大问题,可能汪老师会介入,举个例子。
程曼祺:当时公司有一次就是,造成了一个巨大的内部波动,就在于,我下定决心,把无人机业务砍掉,对你们做了一段时间无人机,对然后呢,转行去做了这个,智能安防和辅助驾驶。 [00:46:06]
姚颂:那这一段时间,其实团队内部是,比较动荡的,因为从技术人员的角度,我干了一年的无人机的方案了,刚做出来,刚在CES发布,刚准备进入小配量生产,你告诉我砍掉了。
程曼祺:那不就是一年的心血,就完全白费吗,你们是直接做了一个完整的无人机,不是,我们是跟一家叫零度智控的无人机公司合作,我们确实做了一个板卡,但是我们把上面整体板卡都做好,并且把算法也都做好,提供的是一个解决方案,但不是整体的无人机,到2017年的1月份,我们其实已经在CES去发布了,我们跟零度智控联合开发的智能无人机,可能在非常早期的时候。
姚颂:就具备像主人识别,手势识别,跟拍等等的,很多的功能,但是也就是那个月,我下了一个决心,还是要把这方面的业务砍掉,所以这就造成了,很大的困难,因为这个决策可能,之前虽然跟汪老师同步过,他可能也没有,那么深入的涉及,或者说思考过,这件事会有怎样的后果,最后的后果就是,技术同事们都不干了,觉得非常的惋惜。 [00:47:02]
程曼祺:过去一年的工作成果,你为什么觉得,哪怕之前已经投入了一年,还是得砍掉,我觉得还是一个,短期跟长期的取舍,就是你一定要相信,沉没成本是零,就是不管你投入了多少,它就是一个沉没成本,无人机市场的问题是,无人机的市场的问题就是,它整个市场70%是大疆,并且大疆不愿意,跟小公司合作,所以你就只能服务,我服务零度制控,是全中国当时第二大的公司,可能量也不会太大,服务了所有的其他公司,加起来量都不会太多,你前面在描述,你刚才做的战略推演。就这个公司会走向什么结局,你用的是得意两个字,所以在你身建的这个角色里面,其实你是做了很多,就是战略的商业的这些事,你花在比如说。研发具体的时间,肯定是变少的,你是满意这种转变的是吗,这是一个必须的转变,当你自己所有精力,还在具体的研发事情上的时候,那谁来承担战略思考。 [00:48:18]
姚颂:谁来承担融资,谁来承担跑客户的事情呢,谁来承担招引更多的人才,以及怎么去考虑组织建设的事情呢,那你们当时想过,比如说类似于像月战面。
程曼祺:杨志林和张宇童这种组合,所以大家希望是我转型成为张宇童,对吧,或者说我能够兼具杨志林和张宇童的一部分,那你内心希望有这个转型吗,你自己怎么接受这个转型,我是挺接受的。
姚颂:当然我觉得这也是清华人的一个特质,就需要你做什么你就做什么 CEO在公司,我跟你讲一个特别好玩的事,永远遇到的都是最难的问题和最破的问题,为什么呢,因为团队会来找你,如果遇到一个事,这个事呢,它的不同的处理方法带来的结果,一个是好的结果,一个是坏的结果,就没有人会来找你,因为大家都知道一定要往好的结果走,如果一件事处理的结果是好的结果和更好的结果,也没有人来找你,因为大家觉得这样做反正都不会错,只有一件事,它的处理结果是差,和更差的时候,大家会来找你,对吧,说怎么办,我们现在需要一个新的方式,去解决这个问题,所以你其实永远做的都是,大家接不住的,最麻烦的最复杂的问题。
程曼祺:那听起来都是痛苦,就有什么好了,你为什么喜欢了,但是痛苦就带来成长,所以其实赛翁痴,胭脂肺腑,就所有的痛苦,带来的都是成长。 [00:49:47]
姚颂:所有的迅速的拔高。
姚颂:所有的迅速的拔高,声量荣誉,可能带来的膨胀,带来的是一些巨大的问题,我后来我这个人,一直特别的乐观,就是我觉得,在我第一段融资的过程中,我被练出来了,因为当时不是刚才讲,被50家投资机构拒绝,那个时候王老师,就会跟我去说一个事,就是说我们做的事,就是很少人能够看得懂的,但是你投资你不需要,所有人都能看懂,你其实100家机构,最后有一家投钱,能理解这个事,然后你就能把这个事做起来,你做出来了,再让他们去看,对吧,所以我觉得,在那个不断地,被打击的过程中,心性就锻炼得特别好。
程曼祺:所以我后来很多事,心态特别平和,所以每一件事,其实都是有帮助,因为你刚才也说,就是大家期待你转型成,类似于张宇桐的角色,你是不得不做这个转型,这里面也是会有一些,环境的被动的成分,如果让你再选,自己的发展路径的话,因为你也可以变成一个,就是更技术背景的创始人,是,这会是你想要的路吗,你觉得现在会有什么不一样。 [00:50:39]
姚颂:没有办法去做这件假设,站在另外一个角度,我也是一个挺知足常乐的人,就是我并没有对我现在的,工作生活状态有任何的不满,所以我也无法去跟你假设,一个好和一个更好。 [00:51:04]
程曼祺:就是我也从来不回头看,我也从来不后悔,我也很难去做这样的假设 2018年年终身件,其实是在成立两年多之后。就快速的以三亿多美元的价格是被收购了,是的,这应该也算是那批AI公司里面,很快然后很成功的一个推出。为什么比较快就选择了被收购这样一个方案,这里面有非常非常多的复杂的因素,就是你能让我列举因素的话,我能给你列十个甚至更多。
姚颂:就是这里面我也不必会谈一些问题,就是说当时到了2018年的1月份 Cilinx换上了一位新的CEO 那新的CEO新官上任三把火,就是说我们Cilinx公司,要从一家device company 成长为一家platform company 从一个器件公司,成长为一个平台公司,所以它迫切地需要,我们这样的在软件算法解决方案上,有非常强能力的团队的补充,所以给我们开出了一个并购的offer 并且邀请我们团队一起去,跟他见面沟通,那后来我们回到九云去讨论这件事呢,有非常非常多的因素纳入了我的考量,第一件事就是说,我不提是不对的,就是那我们肯定没有见过这么多钱,对吧,他开的这个,虽然我们后来又还还价,但他开的这个价格,肯定是对我们来说一个足够有吸引力的钱。特别是对我一个刚毕业三年的本科学生,对吧,而且家里又是一个工薪家庭成长起来的,肯定这是有诱惑的,第二件事就是说,让我第一次开始,更多的从负面去思考公司的发展,对,因为我觉得现在很多一四创业者,我看到的包括我自己,当时都会遇到一个问题,就是当你几十遍的讲你的BP以后,你自己也全盘踩兴了,并不认为公司未来发展有任何的风险,自我强化了,自我强化了,对吧,因为你也得到了一些投资人的强化,当时我更多的开始站在负面去思考,这个公司后续发展有怎样的风险,那比如说我会想,到18年了,战略新兴版还没有出来呢,这东西到底会不会有,对吧,那当时国内上市,就是得连续三年利润增长,我们在想这件事能不能做得到,然后可能能做到的话。最短也是五年到六年的时间,那五年六年不知道会发生什么,所以大家从,都从负面的角度去思考,公司可能的风险性,发现其实肯定不如我们最开始,完全从正面设想的那么去思考,就肯定还是有很多风险的,这里面也遇到一些事情,我们从最开始工作可能是996 从2018年初改成了大小周,是因为我们的团队,初见的年龄也上来了,公司的第一年的平均年龄是26.7岁,就2016年的时候 2018年已经到了31岁左右,有很多人结婚了,有娃了,年龄上来可能体力也跟不住了,对吧,开始跟我们抱怨这样一种拼的状态,特别是我们有几位技术核心,当时给我讲几个话,特别的这个令我很印象深刻,比如说有一位技术核心跟我讲,我已经有连续两周。没有跟我家孩子说过话了,为什么呢,因为他的加班的时间颠倒,跟他孩子这个时间完全颠倒过来了,跟他孩子这个上幼儿园和睡觉的事情,完全颠倒过来了,比如说有一位技术核心的,当时应该可能三十四五岁了,刚结婚,然后老婆怀孕了,他说现在对我来说,孩子就是对我最重要的事,我一定要把老婆照顾好,这里面也有很多的,这样的因素,对吧,所以它其实有非常复杂的因素,最后汇聚到了一个结果,我们去接受了这样一笔offer 你后来看到环武器的发展。 [00:54:31]
程曼祺:你会有些惋心吗,你们是差不多时间成立的,大的方向是相似的,其实还好,因为对我来说,在2018年,我就获得了一个更高的台阶。 [00:55:04]
姚颂:去做更多自己喜欢做的事情,那其实而且对于财富,我一直有一个认知,就是当你的财富高过了,一定的数值以后,它就不是你的了,对你来说那个线是什么。
程曼祺:比如说五亿十亿,我觉得高过那个之后,你的财富就不是你的了,不是你的意思,是你自己无法控制,还是说应该去,它其实就本质上,应该就属于社会了,就是你自己不应该去用它,也无法去用它。
姚颂:我不用太去羡慕陈天时老师,虽然它确实非常成功,但是我觉得每个人,有每个人的自己追求的东西,就是你自己的高兴,并不完全是代表身价,或者现金,或者财富等等的一些东西,所以韩武技我觉得,坚持下来到今天,我觉得非常的了不起,对我们来说,我们选择了一条路径,能够让我在过去五年,去玩火箭这件事,我觉得我也非常的高兴,每个人自己心里的标准的成功,或者让你开心的事情,我觉得是完全不一样的,对我来说,我最重要的一件事情是什么呢,我觉得就是,回到第一性原理的思考,人这一辈子最重要的是什么,时间,对,这个就跟我的答案一样,人最重要的其实就是生命,生命其实就等于时间,所以你把时间,花在让自己激动,自己感兴趣,自己高兴的事情上。就可以了,那对我来说,我觉得当然这些时间,花在个人的兴趣爱好,花在持续不断的创造价值。 [00:56:36]
程曼祺:花在你自己的兴趣爱好的方向上,去创造价值,我觉得我就非常高兴,你当时26岁左右,然后成功的卖掉公司,也见到了你说之前,没有见到过的那么多的钱,是一个什么状态。
姚颂:你飘了吗,也没有,我后来给你一个评价,你还可以去问问David张,就是张颖,就经纬创投的,他的评价就是说,你看姚松那样子,你能想到他是一个,卖过公司的人吗,其实是看不出来的,我自我感觉,其实之前也想说什么心情对吧,卖完以后,其实心情就是陷入了灰暗,对因为当时这个卖公司的那时候呢,我跟山逸我们俩共用一个这么大的办公桌,然后在一个小会议室里面,是我们的那个办公室,签完这个并购的约之后,我非常高兴的围绕着这个桌子,躲步了两分钟,躲不了两分钟以后,我的人生就陷入了灰暗,为什么会灰暗呢,因为首先我的个性,你从刚才就能听出来,我是不适合在一个大型企业。长期工作的,因为我在追求持续不断的挑战,我很难按部就班的,慢慢的一年一年的去说,每年工资涨个三五个点,然后直级慢慢提升,我也是一个不善于向上逢迎的人,我不愿意向上做管理,所以我跟汪玉老师,这么多年合的来,也是我们有话都直说,有话都非常的透明的,沟通和交流,对吧,那我就一定要从这个大公司出来,那我出来干啥,这个问题就问到我了,对吧,因为第一次穿越的方向是,我最开始因为我喜欢,三维集成电路这个方向,我去了汪玉老师的租里面,那因为在三维集成电路,这个活做得特别好,后来实验室开了一个新方向,叫做AI加速器,我成为了这个方向的负责人,当然我自己后来又开了一个,叫硬件安全的新方向。我在实验室里其实管两个方向,那恰好AI加速器这个方向,变成了一个创业公司,所以我恰好成为了这个公司的CEO 这个方向是老板定的,是王老师定的,那将来我在创业,有可能需要我自己去定方向了,那我该做啥,其实就是这个换赛道。 [00:58:45]
程曼祺:想方向是一个特别痛苦,特别灰暗的一个状态,为什么用灰暗这个词,就是它,就像一团雾在你前面,因为你看不清路,对吧,它不是说已经有三条路。 [00:59:06]
姚颂:在你面前可以选,它是一个完全混沌的状态,它都不是纠结,对,对吧,你都不知道有哪些路,因为我的人生在那个点,只有三维集成电路,然后再到刚才的AI加速器,包括涉及到一些,硬件安全的研究,我的主线就是 AI加速器这一件事情,那如果不是AI加速器了,那是什么,我觉得这个状态,就跟很多的人,比如说一辈子,都在一个岗位上工作,最后退休了,可能他会有一些,无所适从一样,我觉得有这样一种,混沌的模糊的状态,所以我形容叫灰暗。
程曼祺:所以纯粹的高兴就两分钟。
程曼祺:所以纯粹的高兴就两分钟,就这两分钟,对对对,你后面是怎么走出这个过程呢,其实到你下一次创业,中间是隔了好几年,隔了好几年的主要原因,是因为收购一般会有锁定期,其实我还提前从锁定期跳出来了,还是损失了不少的钱,实际上你从18年,卖掉深建这个公司,到后面21年,第二次创业来做商业航天,你看到了哪些方向。
姚颂:要做任何决定的前提条件,是你获取到了足够多的信息,当你的信息都是片面和不完整的,其实你是无法去做任何的决策的,所以为了去做这个决策,我在大概在2018年的12月份,我跟王华东在凤凰会的相爱吃的饭,去跟他聊了一下,因为之前经纬曾经想投资。 [01:00:23]
程曼祺:申建也给我们开出了turnshake 大家之间是相互比较认可的,对就我跟他聊到了,他说单位投诚,因为你们很快就卖掉了,就说过了,我也是咨询了很多师兄的意见。
姚颂:我跟IDG的Justin牛慧光,当时也是在相爱吃的饭,我就印象中,我跟李旦还聊过这个问题,就李旦是我很好的朋友,我跟华东也在聊这个问题,我在说我虽然才25岁26岁,但是我有点中年危机的感觉,就是我这辈子要实现什么,我要去做些什么,路在哪里,我其实看不明白,想不通,大家都给了很多很好的建议,那华东给了重要的一个建议,就是说那你应该多看看,其他人在做什么,看看有哪些可能的方向,那也正好经纬当时,缺少一个,纯粹技术背景出身的合伙人,那他就邀请我去经纬,去兼职Venture Partner 可以帮他们一起看看项目,所以我开始了,在经纬的兼职的过程,所以在经纬也投了,两三个项目,也帮忙参谋了很多的项目,比如说最近上市的西制科技。就是当时我在经纬的过程中,去投资的,当然那个项目的负责人并不是我,以及在那个时候,我其实自己孵化和天使,投资了一家脑机接口的企业,后来经纬也在pre-A轮去,领头了这家企业,所以在那个过程中,接触了非常非常多的方向,脑机接口,激光雷达,因为那个时候开始讲固态激光雷达,等等的很多的新的概念,商业航天,火箭卫星,恰好经纬是中国投,商业火箭商业卫星最多的VC 没有之一,接触了很多方向以后开始对事情有了一些判断,比如说激光雷达,那时候可能会在三个月的时间范围内,可能会见到六七家不同背景的新的做激光雷达的团队的出现。 [01:01:57]
程曼祺:你说那个时候是哪一年 2019年,上半年,当时大家在讲这种非固态的激光雷达肯定将来要被淘汰,所以有很多人说我是有固态激光雷达的背景的。 [01:02:43]
姚颂:也有一些人说纯粹靠这种横向的线扫激光雷达,当然是不合适的,那你可能其实很多的信息是丢失的,你可能应该这样斜着扫,形成一个激光的点云的图,可能对于做物体识别,做B站可能更加的有帮助,那这个过程中,那我还去找李一帆聊过这件事,何赛德,何赛德李一帆,对,那他给我的一个结论就是说,其实激光雷达领域,这些技术路径不重要,重要的其实是工程能力,就是做一个prototype 一个学术小组,一个技术小组,花三个月都能做出来,但是从一个prototype 变成一个真正的产权原型,变成小批量的生产,并且变成大批量能够交付的产品,还在交付的过程中,从手工组装逐渐走向半自动化自动化,这样一套流程是难的,那和蔡在这件事情上是走的比较领先的,所以他的判断是说。如果还是发展固态激光雷达,那和蔡包括可能还有速腾等等的公司,依旧会走在前面,因为这个行业核心的技术点,技术路径不重要,重要的是后面你要花,三到五年的时间,走完这一条工程的路径,他这个判断现在可以说是印证了,印证了我觉得是的,甚至于其实我觉得,在很多的行业,实际上它的工程的难度和要求,会高于对那么一两个技术点的要求,所以当时我就觉得,非常有道理,所以最后这些激光雷达,一个都没投,也同时没有成为我的,自己去选择创业的方向,那么去找到这个方向的过程中,我也其实明确了一些事情,比如说我发现,我是无法做一个专业的投资人的,因为我在一线做决策做多了以后,当我看到这些创业者。 [01:03:49]
程曼祺:明显的在往火坑里面跳的时候,我就忍不住想拉住他,所以专业的投资人,曾经是你长期的一个选项吗,没有,我跟张颖去聊我加入经纬的时候。 [01:04:38]
姚颂:我觉得David也是看得特别明白的,他说姚松你不需要现金,你需要足够多的信息,所以经纬中国的任何的会,你都可以直接推开门去参与,不管是合伙人会还是投角会,还是他们在建任何的项目,这个给你一个特权,我觉得他也在为我的,下一个的事情做铺垫,所以我觉得张勇是个很牛逼的人。
程曼祺:那你可以据说,旧网雷达被你排除了,后面还有哪些方向,也有好多好多的方向,比如说我还系统性的看过,脑机接口,也是在Neuralink出来之前。 [01:05:17]
姚颂:但是后来我感觉到一件事,就是说这件事在中国去推行的速度,会非常非常的慢,比如说在18年底19年初,我当时就跟薄瑞康的很多同事,有过好几次的交流,就是黄潇珊他们,当时就感觉到,你真的如果要做一个,亲肉式的脑机接口,你要开炉啊,这些流程可能非常非常的缓慢,可能你先做两三年的老鼠的实验,再做两三年的猴子实验,可能开始再花三年的时间,做一些简单的这些临床实验,你可能最终才能够获批,所以这个周期会太长,那也许不是在那个时间,就去创业的一个很好的时间点,因为当你纯粹还停留在研究阶段,和过审的阶段,没有进入到真正产品和商业化的阶段,我觉得我的能力不一定能够,特别好的发挥出来。
程曼祺:所以我孵化和投资了一个,纳基接口的项目,而没有选择自己去做CEO 去做这件事情 19年到20年的时候,你看到了国产GPU的,那个创业的机会吗。其实上必任,摩尔仙陈海穆希,就是在这个时间段里成立,是的包括经纬当时,也系统性的看过好几家公司,但是呢坦率讲,这里面就是有我自己的短板所在,短板所在就是,作为一个懂技术的人,反而会过多的容易放大缺点,因为这个方向看起来跟你之前做身件,它是比较契合的,契合的。 [01:06:33]
姚颂:但是一方面,我是一个极其讲诚信的人,我在那家上市公司的收购的offer里面,其实是承诺了,五年内不会去做类似的创业公司的,所以我在五年内肯定就不考虑这件事情,再一个就是说,坦率讲,如果没有大模型的驱动,其实这些公司的业务的增长,也是个谜,在那个时间点,我们是无法去判断,在这帮公司后面。 [01:07:00]
程曼祺:还会有一波大模型,对于算力的急剧的需求的,急剧增加的需求的,其实19年到20年,它的一个直接的国产GPU 产生的原因,就是,韩无极的上市,我觉得,其中之一,我觉得还有一个是,当时就是对英伟达的禁令开始了,就对当时最高端的一些,禁令开始了,那个时候我感觉,如果还是只有深度学习这样一件事。
姚颂:可能并没有看到那么大的一个机会,去做这件事情,对对对,所以我就没有选择,出于从诚信的角度,我不愿意说让人带持,然后去开始做这件事,对吧。
程曼祺:然后出于一个从机会的角度,我就没有去做这个方向,我知道你还考虑过可控和去变,看过一些,看过一些,我也跟很多人有过交流,那因为刚才讲,我其实也是从收购以后。 [01:08:04]
姚颂:在到经纬这一段过程中,收集信息的过程中,逐渐的明确了,自己的一些做事的,这个逻辑框架,就比如说,我刚才给你画出一个大圆,给你讲出来有三大问题,然后用这三大问题的框架。
程曼祺:去装我在经纬看到的,不同的方向,去装我自己的,很多的思考的方向,恐吓巨变,我觉得它是和上一航天一样,都是你说的大圆的,那个问题,就人类生存边界,空间的问题。
姚颂:所以站在那个时间点,我觉得可控核聚变,包括量子计算都不够成熟,就是还是纯粹的在一个实验室阶段,那个阶段离一个实现可发射,可有能量产出的这样一个状态,其实还遥遥无期,还看不到一个清晰的这样的一个路径,而且包括量子计算在内,包括可控核聚变在内,大家还没有进入到产业化阶段,就还没有开始思考,我投入是多少钱,我产出是多少钱,举个例子,核聚变,其实它会发射一些快中子出来,会迅速的把你可控核聚变的,比如说托卡马克,内壁的叫第一壁,给它打得千疮百孔,所以你有可能一些很特种的材料,但是你每三个月就得停机半年,然后换一遍材料,换的周期是多少,换的成本是多少。把这些东西都要算上去,你再把你的原料算上去,再把你能够产出多少的电算上去,你不见得你的店能够比现在的水利发电便宜,所以你当时想找的。 [01:09:38]
程曼祺:你认为你能发挥你的长处的是,从相对前沿的技术,然后到它可以规模化工程化的,这个阶段的领域。
程曼祺:这个阶段的领域,对我希望能够找到的是说,我在未来的两三年或者三五年。
姚颂:能够清晰地看到工程化和商业价值的事情,不然的话太远了,我甚至想过我直接去读一个博士,只不过后来也确实看到了,火箭这样一个机会,所以选择了火箭这件事情。 [01:10:04]
程曼祺:从18年 《麦道神剑》到21年 《东方空间》 这中间三年多的时间,其实你一直就想创业,你踱步两分钟之后,你可能就在想新的方向了,这三年对你来说。是会比较难熬吗,因为它还挺长的,从工作状态上不难熬,但是从心理状态,反而是比较难熬的,失去目标感的时候,当你在找目标感的时候,是比较难熬的,这是一种,刺痛感还是一种,一直这样被文火烧着的感觉,文火烧着的感觉,就是你体会过无聊吗,就是那种手机也不愿意刷了,什么都感觉提不起兴趣,很无聊很无聊的那个状态,就没有足够多的东西,能够让你感兴趣,你不是说你有一些爱好吗,那你尝试去玩过一些爱好吗,你就像比如说你的师兄说,他们以前我去过28个州,我去过30个州,对,这些你觉得没劲吗,有一劲,但是不足以改变,这个工作上面的事情,工作永远,包括到今天,肯定是我的,整个人生的主流,我也不存在什么。work life balance 肯定主要还是工作,其实之前我们聊过,就是你说你当了一段时间,富贵仙人,可能当了几个月之后,就受不了了,对,我想请你描述一下,因为我觉得这是很多人,好奇可能又没体会过的,当富贵仙人,当六个月之后,到底有什么感觉。其实就是boring 就是没有感觉的那种感觉,你当时干些什么了,我其实最核心的爱好就是音乐,另外是踢足球,那音乐呢,我印象中那个时候。 [01:11:38]
姚颂:是不是也刚好赶上了,乐队的夏天第一季,我当时初中我是开始玩吉他的,但是看到乐队夏天以后,点燃了我这个乐器和音乐的火花,我开始打鼓,我开始弹键盘,我在朋友圈当时还传了很多的,就是艺人乐队的视频,就是我自己弹键盘,打鼓弹贝斯弹吉他,自己唱歌的一些视频,我觉得这属于一种,另外一种就是说,我之前的生活经历,我可能没有时间去看音乐节,没有机会去接触到一些,我非常喜欢的演艺圈的人,比如说新裤子乐队,比如说盖这样一些rapper 因为我也是中国游戏哈第一季的,一个很狂热的粉丝,也一直在看这个事情,因为我自己本身也唱歌,那所以我可能有很多的朋友,恰好有很多的机会,新裤子来演出,能跟他们一起吃个夜宵。音乐节上能够去到后台,跟盖拍个合影,满足一些兴趣上,没有被满足的点,但对我来说就满足一次够了,但这些事你觉得,都没有创业来着,当你满足了这个最基础的,想跟他们见一次的愿望以后,我不知道这后面,还有怎样的愿望,我甚至确实考虑过,去专业玩乐队,我甚至在我二次创业和三次创业之前。 [01:12:44]
程曼祺:很多的朋友问我要干啥,我说我要当一个职业鼓手,因为水木年华乐队缺一名鼓手,我可以去给他们打鼓,但是你还是一次次回到了创业这个事上,是的。我觉得还是脱离不开科技,到第二次创业就商业航天,首先东方空间这个公司,其实外界就是后面也有一些各种传闻和风波,包括你也是二五年就从这个公司离开了,你可以自己讲讲,你会怎么来描述这样一段经历,这是一个什么故事,一段对我特别有帮助的,让我成长很多。 [01:13:22]
姚颂:并且电影了我今天有更强做事能力的一段经历,这件事为什么会开始,其实也是源自于经纬,经纬其实刚才讲投了很多很多的火箭公司,最后我把这个行业的关键点,就是怎么做出一家优秀的企业,我把它拆分了三个关键字,就是叫中国商业航天,你首先是航天,所以你一定在技术上,首先能做一个能发射上去的火箭,但是你持续不断还要推动你的技术创新,往可回收的方向去走,再一个你是商业,所以你不能不计成本,你一定要考虑你的整体的成本,商业规模,你要考虑融资,现金流地方的合作,第三件事你是在中国,你一定要适应和习惯中国的系统,一定要把公司的定位,在为国家服务的这样的一个定位上。你才能把这个公司做好,我是当时在经纬,首先对这个行业还是有一定的认知,同时也看到了很多的新的机会,因为那个时候其实已经有了一些,火箭的企业,包括星际荣耀蓝箭航天等等。 [01:14:43]
程曼祺:其实都是非常不错的优秀的企业,那你刚刚说为国家服务,这个和商业,它怎么结合了,因为商业肯定是要有一个市场化的客户,国家的任务也可以会被市场化的释放出来。
姚颂:这就是我当时的一个判断,到了2019年的时候,其实我感觉火箭公司也是相对没有目标的,就是大家唯一能够找到的目标是对标SpaceX 但除此之外,其实你不知道应该做什么,那我的客户在哪,其实绝大部分公司是不知道的,将来能够怎么实现商业化,实现一些商业价值,绝大部分公司也是不知道的,所以在那个阶段,我也个人判断,也是听到了一些消息,我认为未来的两三年,可能国家会成立它的,类似于Starlink的,卫星互联网的这样的一个计划,我一直有一个观点,就是5G再往后的6G 不一定还是依托于基站的形式,因为5G的速度已经足够快了,大家当时想的是说 4G会催生短视频等等,这样一些重大的应用。 [01:15:12]
程曼祺:5G会不会催生一些VR 或者怎样的一些新的应用,但实际上并没有那么多新的应用,对吧,对这是通信换代的一个魔咒,说单数的就会低于预期,然后像2G和4G带的变化就很多了,虽然我不是专业搞通信的,但是或多或少学过一些通信的课,我一个基础的想法就是说。 [01:16:03]
姚颂:那如果5G走向6G 可能不是通信速度的单纯的提升了,我们其实应该追求更多的一些指标,比如说覆盖的广度,原来你一个基站 5G可能就覆盖周边几百米 4G覆盖周边几公里,那能不能一个基站覆盖方圆几百公里,那就得到天上去了,对吧,所以我从一个做通信人的角度,从一个电子工程系老本行做通信。
程曼祺:我认为6G应该往天上走,而不是在基于一个地面基站的一个形式,所以卫星互联网就是火箭公司这个行业,一个很大的市场化的客户。
姚颂:对也是一个重大的市场变化,所以基于我对于未来两三年,国家会出现重要的卫星互联网发射的需求,我开始思考。 [01:17:06]
程曼祺:做火箭应该以一个怎样的优先局去做这件事,那我发现可能,我最后自己排下来,优先节叫做,好多快省,好多快省,对,因为首先这四个字。
姚颂:是非常经典的四个字,重组了顺序,但是我重组了顺序,为什么呢,因为好,代表着你要高成功率,你如果是一个 50% 60%成功率的发射,没有任何这种,微信互联网组网的计划感,用力,对吧,第二件事是多,为什么呢,因为微信互联网,如果要发射一定是单轨12颗18颗卫星,至少就是三四吨四五吨的一个运载能力,我会觉得你不到个五吨六吨的运载能力,你可能不足够去支撑这个卫星互联网的发射,那快,快其实是抢占市场先机,因为永远是说卫星刚出来的时候,可能他找不到足够多的火箭来发射,你再等个三四年,那所有的公司包括国家队都反应过来,市场可能就变成一个白热化的竞争了,所以我们要快尽快的实现一个这样的,又好又多的火箭的发射。那在这基础上省可能是没有那么重要的,保障任务的发射能够赶紧找到火箭,把咱们的卫星火力网打批量打上去,可能是优先级高于省一发火箭几千万的成本,所以我对这个行业也有了一定的自我认知,就是要从好多快省,也以此我觉得做这样一个公司,可能你先从一个固体,这样可靠性比较高,发射成功率比较高的事情,对吧,这就是好,好,所以引力一号是一个,对,纯固体的路径,对,并且要实现一个六吨以上的运载能力,要多,因为大概我们看了一下,至少得四点几吨,可能才有机会去接触到,卫星互联网发射的市场,再到快,其实固体也代表着快,因为你不用去自行研发发动机了,那把省往后面放一放。所以我们支禁了一个从固体。 [01:19:19]
程曼祺:再到一体口回收,这样一个循序渐进的路径,你这里的我们指的是谁,东方空间的,就指整个我们东方空间的创始团队,是的,这个公司是怎么开始的。
姚颂:这个公司的开始呢,其实也是源自于,首先我看到了一个这样的很好的契机,并且我认为,现在的这些火箭公司,可能并不在这个航道上,已经看到了这样的一个需求。
程曼祺:第二也是非常机缘巧合的,能够接触到一些非常优秀的,从体制内出来的火箭的工程师,他们当时是已经有一个小的团队,已经组队了吗,对他们当时已经从体制内出来了。
程曼祺:对他们当时已经从体制内出来了。
姚颂:并且自己刚刚开始画PP 然后开始思考这件事怎么能够去做,最开始他们是通过我的同学来找到我说,能不能帮忙指导一下,这件事能够怎么去商业化,怎么去跟投资方沟通,越交流,我越觉得我们是互补的,因为他们懂技术,懂体制内原来的发射流程,应该去怎样的审批,怎样去打交道,而我懂战略,懂资本,能够去跑市场,跑地方,对吧,能够去做一些组织的设计,我觉得是一个非常完美的搭配。 [01:20:02]
程曼祺:你在东方空间将近五年的时间,你最开心的时刻是什么,索飞机成功的这个时刻,引力一号发射 24年年初,是的,一定是这个时刻,对的,当时这是第一次,民营航天发射直播。
姚颂:这个点子是你想到的吗,是我想的,我也觉得,后来觉得叫,你叫出生牛犊不怕虎也好,叫做真的胆子大也好,对,反正我们是,确实是敢吃螃蟹的这个人,为什么你们敢直播了。
程曼祺:是因为你们选的这个技术路线,它非常成熟,其实发射没有很大的风险,还是你也接受,我直播有可能会失败,我是接受直播是有可能失败这件事情的。 [01:21:06]
姚颂:这里面其实也是有我一些个人的执念在里面,就是我认为航天不应该跟普通人这么遥远,我觉得它应该是一个最终让大家都能够亲身经历,亲身感受的一件事情,所以我就希望我第一次的火箭发射,不只是一个很像国家的保密的火箭发射的活动,而是说希望像一个大家都能够接触到,都能够参与的活动音乐节一样的事情,所以包括我还请了水木莲花去现场演出,包括我们给火箭搞了一个冠名,我们叫海澜之家号火箭,大家会觉得非常的有意思。
程曼祺:这个冠名也是你去促成的,对因为海澜之家的董事长周立成,也是清华警馆的校友,我们也非常熟悉很好的朋友,你去推动这些事有难度吗在内部,因为可能从比如说技术或者发射的团队。他们可能希望成功,以及说事外不要被放大这件事是最重要的,整体我们配合都非常的好,他们可能也是对自己的发射成功,会有很强的信心,所以我们从更宏观的角度,希望把它做成一个,公司对外展示的名片,做成一个大家都能参与的,火箭发射的大型的活动,的一个角度去策划了整个的发射,是不是也和引力一号,采用的这种技术路线,就是全固体。它其实至少之前在体制内,它已经比较成熟了,其实还真不是,那你可以讲讲你们当时引力一号,比如说它的一些新的东西是什么,摄影历号还是挺难的一件事情。就是因为它是一个固体捆固体的一个构型,就是它中间是固体,它四个助推器也是固体,这种构型是非常少见的,那一般是,一般是中间是液体,周边是固体。 [01:22:43]
姚颂:然后这里面就会带来一些问题,比如说大家发现固体火箭发动机最后几秒的时候,因为它那个燃烧,它是从中心,然后向四周去扩散燃烧的,最后你可能变成依附着这个火箭发动机薄薄的一层,它的燃烧就不会太均衡,不同的火箭发动机的燃烧可能也不会均衡,所以它的推力可能会有一些变化,不同的发动机的推力也会不太一样,所以像这里就是我们机构团队,做了非常非常多有意思的工程上的创新区解决的问题,还是有很多的难题的,包括当天其实海面的风是比较大的,晃动也是比较大的,对你们是在船上发射,是的,包括在船上去发射要解决,火焰的建设,包括对船体的烧着问题,其实它有非常多的,复杂的技术工程问题,要去解决,大家也都做得非常好。
程曼祺:我之前跟王华东聊,他提到就是,你跟他聊上岸航天,你有一些跨界的思维,让他觉得还是很有意思的,比如说你有提到说,在这个领域,其实仿真一直做得很不好,就相比可能一些计算机科学,用的更多的领域,所以导致整个周期,会被拉得比较长,是,你们当时实际上,做了一些这方面的改进吗,后来,我们其实一直在推动这方面的改进。 [01:23:45]
姚颂:因为这里面有多个角度,一个是看,其实SpaceX在2015年的GPC 做过一个报告,叫做GPUs to Mars 其实就在讲,他们用GPU再加速一些仿真的软件,对,再一个我作为一个EDA出身的人,我的想法是说,我们去台积电流片之前,结果是怎么样的。 [01:24:09]
程曼祺:应该99%点,不能说三个九,比如说99.5%以上,我们都大概确信,知道它会是一个怎么样,这是芯片的验证环节来解决,对吧,因为你芯片的validation。
姚颂:其实就会把很多的工作都做在前面,并且各种的仿真软件,能够把结果仿真的,确实挺真的,当然对于火箭来说,大家确实要切分好几个不同的阶段,从最开始的可行性的论证,再到后面的详细设计阶段,也叫模样阶段,再到后面的这个出样阶段,就是第一个原始样品的阶段,再到最后的试样阶段,也就是实验发射阶段,那这里面投入最多的是这个出样阶段,也就是实验样品的各种的测试的环节,然后持续时间也是最长的,所以当时我也有一些第一性原理的想法,就是说如果你能够通过simulation的方式,把所有的零部件,包括你的燃烧仿真的足够的逆帧,那是不是可以降低很多的测试的成本,因为你要把所有的零部件发动机都要造出来,做现场的实验。也能够减少非常长的实验的周期,所以其实有跟一些老师在合作,包括北大有一位老师做燃烧仿真的,包括现在北航有一位老师在做燃烧仿真的,当时我们也有很多的探讨,但是最终因为火箭还是一个好在第一位的,所以我们去用上一些全部创新的技术,会相对的比较谨慎。 [01:25:40]
程曼祺:刚才你说最开心的时刻是 24年年初,盈利一号首飞机成功,那在东方空间,难受的时刻是什么,我觉得整体来说都非常好,这人生创业的11年,我也非常多的感受到一句话。 [01:26:02]
姚颂:叫做赛翁失马焉知非福,可是其实你的痛苦就是你的成长,那你失了什么马,我们对于这家公司,后续到了一个不同的发展阶段,那大家肯定想法会有一些不一样,最后呢。
程曼祺:我觉得我还是更适合于,像现在的前沿技术的突破,连接上商业化的事情,你前面提到东方空间,你说这是一个成长的故事,总结一下经过这一段,你核心的几个成长是什么。
姚颂:你工作的scope跟实践科技还是不太一样,所以在战略的思维上可能会更完整一些,就是你要主导更多战略,我要思考更多的长远的事情,而不只是眼前的这些事情,并且要有组织有逻辑的去思考很多的事情,这件事情对我后面去,比如说推演其他的行业,包括巨神智能的发展,我觉得是很有帮助的,第二件事情,我觉得我收获了很多,在中国踏踏实实,非常实在做事的一些能力,能够更好地在中国去推动,一件非常重大的事情,这个流程,我是完整地经历了一遍,甚至两遍。
程曼祺:甚至更多遍,我觉得这个对我的帮助,也是非常非常的巨大的,你觉得你个人经过这一段,你心理上的成长和变化是什么,还是不断地在成长的一个过程中。 [01:27:21]
姚颂:其实会变得更加的成熟,我在第一次创业的时候的第一年 2016年就经历过一些这方面的成长,为什么呢,因为当时就是有投资人要投我们公司,那他去找一个也是清华校友做备调,就问姚颂这人怎么样,并且这个人可能我们本身都还认识,那我们会下意识的觉得,那这个人应该会给一些,至少不差的评价,结果我们没想到,投资方反馈说,那个人给的全部都是差评,就是做的东西,一点都没有什么价值,我这完全都能做,等等的一些的话语,其实只有你最亲的亲人们,最亲的同学们,你一个实验室,一起摸爬滚打的朋友们,希望你好,没有那么多人,希望你变得更好,大家更多的可能都是眼红眼热,当时就其实就经历过这些事情,然后到火箭呢,其实后期也,你也其实尝试。想要去探究一些大新闻,外界也有一些纷纷扰扰,但是我觉得其实就是说,对我的心理来说,反而变得更加的坚定。 [01:28:28]
程曼祺:更加的坚韧,你看到外界的一些纷扰,社交媒体上的一些说法,对,你是什么心情了,就没啥心情,其实大家都知道,做了哪些事,然后有怎样的价值。
姚颂:然后也都知道,公司还在正向的发展,所以我就没有什么,特别的心理的波动,其实对我来说,完全没影响我睡觉,你心还挺大的,你不要把这些东西放在心上,你要都放在心上,太注意媒体的报道,每个人对你的评价,事就没法干了,甚至于我觉得有一句话,叫做事已密成,就是你有一些核心的战略,就是不应该对外讲的,你有什么在商业航天上,想实现没有实现的遗憾吗,就是时间还不够长,如果能够等到,咱们的可回收的火箭,发射成功,能够一起再见证那件事,肯定会更好,当然也很快了,大概在今年年底,或者明年上半年,团队就会应该能。
程曼祺:把我们的引力二号的火箭,成功地发射上去,并且有可能在,第一次发射的时候,就做一些很大胆的尝试,去年夏天你离开东方空间,是一个怎么样的过程,是一个挺好聚好散的一个过程。 [01:29:28]
姚颂:现在已经进入到一个,就是评委发展的阶段,因为公司已经签了,十好几亿的合同,那我也可以追求,我自己更喜欢的 AI上的技术上的,商业上的东西。
程曼祺:因为当时确实有一些投资人是因为非常认可你,然后投了这家公司,那随着你的退出的话,就是他们的这一部分。
程曼祺:就是他们的这一部分,你说是认可也好,还是说期待利益也好,怎么来安排。
姚颂:多个方面去进行了保障,一方面就是说,我跟大家说我想去做新的事情了,那他们说那我其实,那可能要跟着你去做未来的事情,那我想退出,那没问题,我帮你找到一些收老股的机构,一方面呢,我觉得也确实是对不起大家,因为公司刚成立到这个阶段,我觉得我应该去做新的事情,那你们当时冲着我投的,所以我在我的新公司,也给所有的老股东,会有一些股权补偿,也赶上了最近的商业航天的大潮,我觉得目前大家的估值,又比我离开的时候,进一步的增长了,总体而言,从他们投资的估值,到现在的估值,肯定是有一个数倍的增长的,总体对大家来说,肯定我们是打了一个很好的基础,让大家都享受到了,一个估值上的几倍以上的一个增益的,第一次创业结束,就是卖掉身件之后。 [01:30:06]
程曼祺:你说想到要去寻找一个自己的方向,是感到灰暗了一段时间的,那你去年东方空间离开之后,开始striding AI 其实是非常快的一个过程。你可以讲讲,这是一个怎么开启的过程吗,以及怎么定位到这个方向,其实去定位到这个方向,也是花了一年的时间,也是花了一年甚至说更长的时间。 [01:31:10]
姚颂:因为其实从开始思考,公司到了一定的阶段,我可以去探索新的事情了,再到正式的出来,中间也有几个月的时间,有时间差,对在这个时间差过程中,也一直在逐步的思考。
程曼祺:应该做哪些事情,你这次有灰暗的感觉吗,你这次什么感觉,这次其实也是有灰暗的感觉,但是因为我毕竟第三次创业了,我觉得面临到的资源和信息量,是不一样的。
姚颂:包括我自己因为是一个投资机构C-Fund的创始合伙人,虽然我现在只是一名投委,不参与到具体的管理工作,但是我会看到,持续不断看到市场上各种新的项目的信息的,所以我一直在,首先是在思考大的方向的时候就做哪些事情,第二件事也是,这一次可能比上次更快的碰到了一些机缘巧合,因为我一直觉得创业它不是一个,就是说我想创业,就一定能创业的事情,你有可能在那,捣齿半天,两三年,就是苦思冥想,想了一个,看起来错误的方向,做几个月,发现这事其实不行,然后又开始挠头,想一个新方向,又不行,我觉得创业,其实是阴炸几几地进球,我不让你看足球,我小时候最喜欢的,一支球队是AC米兰,那是很早的时候,卡卡还在打Keyboard的,一个状态,那个时候还是。师父前科在打,这个前锋的一个状态,那有一个很知名的,意大利的前锋,叫做因扎吉,因扎吉号称叫,小进区之王,就是你感觉,他所有的进球,就没有什么花活,没有过人,没有什么摆脱,没有什么倒勾,就感觉他在,门口的这个小进区,这几米范围内,轻轻地一推,轻轻地一顶,轻轻地一射,这球就进了,我觉得创业,其实是一个这样的状态,就是说你得感觉,自己好像就身处,在因扎吉这个位置,其实是那个球,正好过来了,你正好其实只要顺手。 [01:32:45]
程曼祺:就是顺脚一推,顺头一顶,可能这个球就能进,这类似于天时地利人和的状态吗,其实是有点天时地利人和的状态,其实你需要很多的资源等等的事情,汇聚到一个点上。 [01:33:20]
姚颂:让你感觉到这个点,可能我们能够看到一个清晰的路径,去实现成功,我觉得这才是一个创业的好机会,而不是说我一定要创业成功,所以我在这个过程中,千辛万苦地去寻找方向。
程曼祺:那去年你的天时地利人和是什么,做物理业的,这里面的一些天时地利人和,有好多个方面,我遇到了一些非常好的合作伙伴。
姚颂:这里更多的是指其他的一些企业,像我们公司的最大的,除了我之外最大的两个股东,就是泰国的正大集团,和国内的华勤技术,那正大是全球500强企业,前几十名,那它去年的营收,得有1100亿美金,他们从饲料种子,做到玉米养殖,养猪养鱼养虾,再做到肉类的加工,再做到零售,再做到信息科技,对吧,是一个非常大的跨国集团,华清技术,是全球最大的,手机的OGM公司,笔记本电脑的OGM公司,还覆盖所有的像手表,手环眼镜,打印机充电宝扫地机,所有的电子门类的生产,是有两个合作伙伴,首先,希望能够找到,跟我一起去合作,跟不管叫巨神智能,还是跟物理智能,相关的事情,那我觉得。这两个合作伙伴,是有一个天然的,跟我的完美的契合,这个方向是你提的,是我提的,但是在聊的过程中,确实是他们在重点,战略投入的一些方向,而且是愿意去做,大量的前瞻性的投资和投入,而不是说等着产品成熟了,我来算一个八个月回本,十二个月回本,那样的投入,肯定是有这样的一个契机的,没有这样的重要的合作伙伴,提供的重要的场景,我是很难去做这样一些事情的,因为你物理智能,一定是基于一个场景,你开始采了数据,有了模型,有了产品,有了解决方案,上到产线或者上到工作环境,有了更多的数据,这个事情才能够迭代起来。 [01:34:53]
程曼祺:政大和华晴具体提供的场景是哪些,我们跟华晴会在工业生产领域,特别是在3C电子的生产领域,去进行合作,跟政大我们第一步合作,还是在消费零售领域,在711的便利店,在普丰零华超市,等等的一些这种零售场景,去进行合作,所以政大有一部分711的资产,泰国和缅甸等等一些国家的711 全部都是政大集团直营的便利店,它不是加盟店,全球有多少这种零售的店面,政大集团直营的话,应该有16000家便利链,有2700家,捕风莲花超市,等等的大型超市,这是它直营链,它如果算各种,加盟和合作的链,应该还有七八千家,所以一个是零售商业厂,一个是工业制造的厂,是的,其实有了这两个基石,你可以形成从算法,到模型。 [01:35:39]
姚颂:到应用的完整的闭环,并且落地之后,你又持续不断地,把这个数据飞轮,能够滚起来,对吧,我觉得没有这样的人,恰好来找到我,也恰好愿意在,这样一个非常重要的方向跟,一起做前瞻性的投入,我觉得你很难有一些坚实的基础,这肯定算机缘巧合,那另外一个机缘巧合呢,也是跟我的第一次创业的导师,汪玉老师的再一次合作,虽然他并没有直接参与到,我的整个公司里面来,但是恰好呢,汪玉老师的团队,在过去的五六年,有好几十个学生,投入在巨神智能相关的研究上,不管从强化学习,还是从世界模型,不管从infra这样一些基础架构,还是到算法层面,那其实当时他的团队内部也在讨论,是不是应该独立做一个公司,就好像现在大家能够看到,好一些年轻教授出来做世界模型的。独立创业企业一样,恰好我们有这样一个很强的互信,跟团队之间本身都是很多的同学和师弟,比如说团队里面一位年轻的老师叫于金成,就是2012级的电子系科学主席,就是我的下一任,我的继任,我是他的前任,这属于我大二,他大一就认识了,那大家就有很强的,互信的工作,能够去探讨合作,这肯定也算一个机缘巧合,还有一些小一些的机缘巧合,也包括其实在去年,下半年开始,去真正深入看这个行业的时候,我其实在七八月份,就迅速意识到了这件事 VLA差不多走到头了,你怎么意识到的,第一我自己还是会读一些paper的,已经有一些paper的数据表现,就是给VLA的一个模型增加了数据以后,就增加了训练数据以后。性能并没有如预期的是缓慢增长,而是开始下降了,它的增益在减少,增益在减少,甚至到一定的阶段以后,数据量变大,你的这个精度还下滑了,这个可能跟数据的bias有关系,也有可能跟很多的其他原因有关系,第二件事呢,就是在看到了部分的公司里面,已经开始逐渐的从VLA切换到强化学习,从那些公司里面大家也发现,纯粹的VLA可能直接做到交付是比较困难的,它的精度也到了一定平静以后上不去,所以我就在思考,那在下一步是怎样的一些事情,包括世界模型,包括强化学习,我觉得都是必要的,这有一个小的契机,就是说我们又面临着一波新的机会,有一波新的人可以来。 [01:38:17]
程曼祺:在新的技术方向上去做探索,其实我刚才还想问一个问题,就是天时还站在你这一边吗,因为二五年下半年来,成立这样一家公司的时候,整个市场上其实做巨星智能,通用机器人智能机器人公司。已经很多像智源与数字,已经到了头部,你刚才部分回答了这个问题,你觉得你认为有一个新的技术,在变化在出现,成立企业的时间,肯定是跟其他的企业,比如说对于我们已经投的。 [01:39:13]
姚颂:对因为你们也投了,比如说智源机器人,肯定相对晚一些,天时它决定了一些事情,比如说先发优势,可能会能获取更多的资本,这件事情是无法去比较的,包括可能这里面刚才列举的一些公司,今年就能够上市,对吧,我觉得这个是必须承认的,第二件事呢,先发优势可能更好的,能让你有一些这个业务上的资源,比如说可以看到一些公司,去年开始跟上市公司成立,合资公司推动一些业务的落地,有些公司今年开始跟上市公司推动,成为这个成立合资公司。
姚颂:成为这个成立合资公司,推动业务落地,那这件事恰好,因为我是三次创业,可以几乎比较掉这些事情,在我们这次访谈的公开之前,大家就已经会看到,我们跟一些非常大的上市公司的战略合作,以及一些更加深入的合作,再一个就是说对人的号召,因为早期你肯定能够号召一批,有创业决心,有技术能力的年轻人一起跟你去创业,但这件事也是因为我的三次创业,和整个时代对于巨神智能的认知,不断地往上走,比较老部分,就好像当年出现了,毕任岁元穆希的时候,大家又召集了一批。
程曼祺:比深建早期更好的团队,一样,这个行业也有更多的人投入了,说的这些都是别人也有,你也可以有的部分,有什么现在别人没有你有的,有一件事,大家会比较难去做到的,那就是说我们可能,从业务的第一天,就坚定的是一个立足中国,但是面向国际化,面向出海市场的企业,这个事是政大可以来帮助你,还是为什么你能做到,别人做不到你觉得。 [01:40:40]
姚颂:第一其实这跟股权结构是有关系的,因为大家都很理解,我们在一个叫百年未有之大变局,当你的股东结构已经定下来的时候,你可能是没有办法去理消一些因素了,第二件事情就是说,那大部分的创业者,如果是一次创业者,可能他得在创业的过程中,不断地去搜罗这些出海的业务资源,可能从创立的第一天。 [01:41:07]
程曼祺:我们就拥有了一个覆盖全球的商业网络,能够将来去帮我们去做产品的推广和录取,政大的股权和你们创始团队的股权相比,是更多还是更少,这个公司肯定是我是董事长兼CEO兼创始人的,政大是我们除了我跟团队之外最重要的股东,你和政大的掌握人就是谢国明,你们是怎么谈定这个事情的,包括其实他也是一个经历过很多的企业家,因为他今年都已经86岁了,你怎么说服他愿意支持你来做这件事,他也是一个我很尊敬的长辈,我愿意去跟他合作,他愿意跟我合作。
姚颂:肯定是互相的欣赏和认可,二年的冬天,当时谢国民资深董事长来到了北京,恰好政大集团日本的社长叫做徐志敏学长,是清华水利系79级的一位师兄,我也认识很多年了,那他给我发了一个微信,说谢董事长呢,来了北京,然后呢,特别想接触一下,中国科技行业的,年轻的才俊,你能不能去跟谢董事长,资深董事长,汇报一下,讲一讲你最近在做什么,如果您有一些,特别好的你认可的朋友,你也可以推荐给他,一起去聊一聊,那我就,邀请了几个朋友,包括邀请了戴宇森,包括邀请了,银河航天的联合创始人刘畅,因为当时他们也想,推动泰国的微信互联网的业务,我们一起去做了一个交流,在这个交流上,肯定谢老爷子对我的印象是不错的。然后也让我对他佩服的无稽头地,因为我们好几个人,分别做自己做的事情的介绍,然后还有一些问答环节,可能我们开了一个下午,比如说三个小时的会,谢老爷子就穿着西装,打着领带坐那正经为作,一直认真的在听我们在讲什么,并且没有迷失,因为他会不断的跟你互动,他会问你的问题,他真的在努力的认真的学习,都可能都没喝水,或者就喝了一两次水,也没有中间去上厕所,聊完以后,他就说要请我们一起吃晚饭,吃晚饭的过程中,我就跟他提,这个资深董事长,您看我能不能给您留个联系方式,然后他马上说,不对,你们是老师,你们作者不要动,我来加你们微信,然后他拿出自己的手机,一个一个弯线,要去扫我们的微信,然后我觉得这老爷子太牛了,对吧,就是到了这个年纪,还持续保持着对于科技。对于各种新事物的好奇心,然后对人无比的尊重,整个你的汇报流程,你的介绍流程讨论,都是不喝水,不看手机,不上厕所,就跟你真的在认真听你讲什么,跟你在交流,对大家的尊重,对吧,这个事我觉得得学习,所以后来呢,谢老爷子也对我印象比较好,因为我的报告有一个习惯,我会相对根据听众的知识水平,会调整一些我的说法,比如说你完全不懂技术,我可能用一些类比的方式来跟你讲,谢国明资深董事长肯定也觉得,这人还有点意思,又做科技创业,然后还能够把事讲明白,后来谢老爷子每次来到北京,就让团队来约我,并且说你带几个,你认为比较不错的科技行业的,同龄人跟我一起聊聊天,他特别关心算力的问题,所以我请了像并行科技的董事长陈建。像青云科技的总经理叫林源,包括请了汪玉老师过去跟他交流,比如说他关心自动驾驶,我请了应齐师兄去跟他交流,他关心巨神智能,我请了王赫师兄,请了许花哲师弟去跟他交流,多次的交流以后,他其实就跟我提出来,他说有没有机会我们一起做个事情,但是当时还在做火箭,那么我也就比较委婉的回绝了,因为毕竟火箭卫星,都是一些非常敏感的行业,从火箭公司离开以后,那我觉得可能到了一个新的阶段,他的表态就是无条件支持,你需要我提供怎样的支持,我们在一个互相不占便宜,正常的商业上我们去沟通,但是我们的巨神智能,机器人或者用这个名字,不管用哪个名词,还是物理智能,我就选择跟你独家合作了,所以你觉得你们。能做到大部分公司。 [01:45:46]
程曼祺:就中国的这些军运政策公司,或者说物理业的公司,比较难做到国际化,是一开始,它的架构设立来决定,一开始我觉得,从我们的投资人的选择,股东的选择,对吧。还有一些业务上的资源禀赋,我觉得可能就会比,很多公司要好不少,你觉得其他公司,是没有看到这个问题,还是因为各种原因,没有做了,很多公司已经开始在做了,对吧。 [01:46:00]
姚颂:比如说智源,从去年下半年开始,在非常积极地布局国际化的业务,比如说银河通用,也在布局国际化的业务,站在更多的创始人的角度,他们可能是第一次站在一号位,站在一个要做宏观的规划,业务推进的这样一个状态,并不像邓太华总,肯定已经在行业里面很多年了,包括银河通用的创始人,其实也是非常懂行业的,所以对于很多的公司来说,其实像我们小时候打星际,打魔兽一样,你在探地图,因为大家很多人是一个researcher 是一个tech lead 是一个工程师出身,那大家想的是说,我先做算法,做一些本体,做一些demo 做了以后开始思考这东西能往哪卖,不同的就有选择了,有的选择说,可能往海外去卖科研方向的本体,有的说,现在可能落不了地。或者说确实笃定算法这件事,那就是说,那我短期先把模型做好,先不考虑落地的事,但是你前面的一些决策,就可能成为你后面的一些制约。 [01:47:07]
程曼祺:就比如说刚才讲的你的股东结构,除了国际化布局之外,你觉得你们还有什么独特的思路 Striding AI 我们真的是一个系统化的思路,在解决整个的问题,举个例子,就是大家最近最关心的是什么 World Model World Action Model 是一些小天才,但是坦率讲,我觉得一两个年轻老师,或者一两个小天才,坦率讲是无法去解决这些问题的,你说大家关注小天才,具体指的是一两个小天才,成立了公司。
姚颂:然后能够获得相对高的资本关注,对吧,这是业界可能从舆论上,从媒体上和从资本上,大家会比较关注的一些事情,确实从这些技术方向上,是一些比较好理解的名词,和确实跟VLA不同的技术方向,你说他们不能解决问题,是很难就通过这样一个,简单的算法团队去解决问题的,这里面我觉得,这就是我们系统性思维,和大家专门只在一个方向,做研究的思维的差异,回到十年前,我讲一个历史故事,十年前我跟曹旭东就在我们的楼下散步,就在我们新化科技园的这个圈在散步,就Momenta的曹旭东师兄。
程曼祺:那他是刚成立Momenta的时候,他还没有成立Momenta的时候,对他就是那一年成立的,一落年成立的,是的,当时他也在问我一些创业以后的感受,我也请教过他一些问题,比如说。 [01:48:25]
姚颂:你觉得做出来一个优秀的算法,主要依靠的是什么,竞争力最后会出现在哪,我记忆中他的回答,我不能保证完全记得准确,他说50%是数据 30%是算力 20%是人的经验和灵感,并且他把经验放在灵感之前,那回到十年后,当我们去看新的模型,新的算法的领域的时候,你也会发现一件事情,其实比如说中国现在最牛的,这四家大模型的企业,没有真正的小天才,单独创业,或者年轻教授,单独创业的公司,那为什么会出现,这样一个现象,我觉得归根到底也是说,如果你想做好一个算法,其实不是依靠于,一两个年轻人能够做好的,那靠一百个年轻人,像DeepSeek那样。是一个非常非常重要的因素,但是还不够系统,所以你一定是数据,算力和人才资源池,同时三个方面去解决,你才能够做出持续不断的,业界领先的算法,现在大家都在买,叫Egocentric 第一视角的视频数据,如果你没有你自己的数据的来源,你要通过自己去买数据,很抱歉,现在业界就是300块钱一个小时,到600块钱一个小时,你轻则随便拿个几十万小时数据。 [01:49:31]
姚颂:你轻则随便拿个几十万小时数据,训一个模型,现在在业界可能都觉得不够了,可能你得给你一个,百万小时的数据的目标,三个亿到六个亿的投入成本。
程曼祺:就花掉了,你觉得钱转化成算力和数据中间的损耗是什么,因为有一种路径就是我以小天才的受关注的这种光环,我获得很多资本的支持。那我就可以去买很多算力,我也可以去承担比较高成本的数据的采集,那你的产品就不会有竞争力,为什么,因为你所有的算法成本是别人的十倍甚至二十倍,那你的产品上将来怎么去计价,所以我要非常高效的相对低成本的做到这件事,我需要的能力是什么,你得找到跟你紧密合作的,高质量的封闭的,海量的数据来源,比如说我们找到了,政大集团,政大集团有40多万的,全职员工,所以这个不是钱,能简单买来的资源,你觉得要有这一些东西,对我可以通过这种方式,把我的数据成本,下降到正常市场,采购价的十分之一以下,那如果我换一种方式。就比如说我还是,号召100个小天才,这个小天才可能有些是,算法小天才,有些是这种比如说做,设备Infer的小天才,他们用一种,创新性的技术方案,可以很低成本的,去采集一些数据,你觉得这可能是一种路径吗,那他去哪采,有可能是因为,它相对低成本,他可以去说服一些资源方,我觉得资源方关心的,不是这个数据本身。能给大家带来多少的收益,而是说这件事,首先不能影响原有业务,对所以我觉得,需要这个方案做得比较好,就比较它不能影响,你原有在那个场景里,干活的状态,并且原有的,大部分的公司,会把自己的操作流程,公益数据作为保密数据。 [01:51:26]
姚颂:他是不愿意商业化他的数据的,正常的,不管是利讯精密,还是花钱技术,他在产生的,所有的公益的这些流程,一些标准动作,一些操作,他肯定是不愿意公开的,那可能就需要,这个小天才进化了。
程曼祺:他得进化到,他能设计出一种方式,让大家就是愿意来合作,那当然需要周期,需要他能跟别人建立信任,所以其实我是因为三次创业。
姚颂:能够优先的解决信任问题,第二件事就是算力,你找不到足够多的卡,并且不能把这些卡全部发挥效力,你其实也是白费,能够迅速gip seek 并不是只是因为它有一两百个,清华北大和各个学校毕业的天才,是因为它有几万张卡,当你没有这么多卡,你就没有可能去做这件事情,同样对你来说是一千卡,和对我来说是一千卡,我们也可能发挥出完全不同的效率,就我有相对的自信来说,我们可能能用256卡,发挥出来一些,没有infra能力的公司,千卡才能做到的效果,这就是因为我们在infra上,能够做大量的优化,那如果说靠一两个小天才。 [01:52:05]
程曼祺:这种方式,或者说仅靠小天才吧,它不能work的话,这个是需要靠什么来补充,你刚刚说到有一种是,和一些合作伙伴的补充,还有了,我觉得一定要建立一个,非常庞大的人才的资源池。
姚颂:你看Gibseek的,那个technical report 其实里面会有,可能100人200人的一个作者的清单,它是一个大家集中参与的事情,它的V1和V4 它没有做个人的署名 V2和V3做了个人的署名,但是里面的,其实最主要的贡献者,也一直在变化,可能只有比如说一个人,或者两个人,在连续两个版本中,都是重要的参与方,和重要的技术的贡献者,你回头回到一个更老的时代,就是我们第一次创业的 CNN深度学习的时代 AlexNet可能是Jofrey Hinton老师,组里面提出来的,后来牛津的VGG Group 提出来叫VGGNet VGG16也是当时一个很有名的模型 Google团队提出来一个,叫Google Net 但是这件事,真正进入到大规模使用,是因为何凯明老师提出来ResNet 解决了一个问题,就是我这个模型,到底需要多少层,多了反而效果不好的一个问题。你可以尽可能的把层数落多,但是你的Residue 这个Bypass的东西,它可以让你解决,后面的这一些,哪怕层数多了,不影响效果,你回到一些具体的事情上,那做detection 最开始就有人做了叫R-detection 我不记得具体哪个团队做的,那大家觉得太慢了 R-detection就是说拿一张图,然后用CNN 反正去把所有可能的region 都给你画出来,就有人去做了叫FAST R-CNN 对吧,任少卿,还不是任少卿,我印象中,再到下一个版本,叫做FASTER R-CNN 就是任少卿做的,后面戴季风老师,又做了一个叫RFCN 就是全卷机的网络,这样的话,它的速度进一步的提升了,所以你可以看到,就是说,不管是大模型时代,还是深度学习时代,我也相信到了物理智能时代,或者巨神智能时代。没有哪个人是能够在一个,技术领域内,持续不断地产出,永远站在世界最前沿的,改变世界的这样的一个算法的。 [01:54:46]
程曼祺:所以你需要很多的资源池,不同的团队各领风骚一段时间,对,所以你能够保持业界的持续领先,就是说你得有一个比较多的人才库,如果说一个研究团队。它无法一直保持世界领先,这件事有可能被一个公司做到吗,因为我吸纳了足够多样的团队,我就能做到,还是说这件事本身可能就比较难成立。 [01:55:10]
姚颂:我觉得这件事本身可能就很难做到,所以我觉得像智普现在的成绩,像Gipsec现在的成绩,包括Kimi这样的成绩,有网上有一些人说,叫国运级的表现。
程曼祺:但我觉得确实是绝无仅有的,极其罕见的,而且他们商户之间,肯定也是交替领先的,对一定是交替领先的,其实美国的OpenAI和SRPP也是,我觉得我们还应该做一件事情。
姚颂:那就是说怎么能让最前沿的算法,到最终产生商业价值,这中间的通路是最短的,如果你的转化的通路,是过于漫长的话,你其实公司的竞争力也会弱很多,我们可以先把人才吃这个说完 OK。
程曼祺:那你们怎么有一个足够大的人才的持续,大家可以用很多方式去解决,比如说杨志明可能更多的通过他的技术形象和业界的感召力去解决。
姚颂:并且他最开始就拉了一帮清华计算机系,清华摇板,清华电子系的同学和师兄们一起,有了一个人才的基础,再用这些人的人脉,再通过类似于信息科学竞赛等等的方式,去把一些最年轻的天才拉过来,那对于唐杰老师,质朴,那就是说唐杰老师,天然就有很多的学生,有非常多的优秀的学生,而且越往后面,他的学生的精英程度,聪明程度是越来越高的,那他可以源源不断的,这个公司贡献各种新的idea 对于GipSync来说,可能用很好的薪资条件,也包括梁文峰总个人的,技术的感召力,能够吸引来很多的,所以我们可能,也是希望多管齐下,一方面我们跟汪瑜老师的团队,去深入的合作,能够让更多的同学,在实习的过程中就参与进来。把他们的聪明头脑贡献起来,将来也可能很多人,会成为我们的全职员,全职的员工,另一方面也有一定的,个人的感召力,能够把几个非常不错的,技术核心号召过来,比如说我们现在的,算法负责人高峰,被好几个老师统一评价说,他在博士期间工作,是一个人能顶十个人的,这种我觉得就不单纯是靠,金钱或者说合作关系,能够拉来的人,你刚才说还有一个重要的事。 [01:57:01]
程曼祺:就是怎么把前沿算法,到商业价值的转换的这个链路,让它尽可能的短,是的,这个具体来说,比如在你们这个新公司上,它的思考和实践是什么,你很难一家公司。
姚颂:或者一两个人,持续不断在业界,永远是最领先的,一定是交给往上走的,有很多事可能会变成沉默成本,我去问一些原来在商汤,或者矿事或者等等,其他的AI公司工作的朋友们,他们过去几年,有没有什么后悔的事情的时候,他们回答的一点,就是我刚才讲的这个,他们自己的所在的这个部门,可能从research到商业价值,再到工程落地,再到商业价值的pipeline太长了,他觉得没有把这件事缩短,并且他认为最后沉淀下来的价值,其实还是一个从research走向产品,走向落地产生商业价值的pipeline 因为哪怕是商汤一图,矿是这样的最领先的公司,也没有办法保证,所有的算法是领先的,比如说在大模型的时代,他们确实就落后了一些。
程曼祺:对吧,如果说这些公司,没有办法保证,自己的算法一直领先,那理论上就从商业的角度,那他们就应该找一个,别的壁垒,当技术本身,无法成为壁垒的时候,所以他们有些人在后悔的。 [01:58:33]
姚颂:或者说可以做到更好的,就是说应该公司,其实把research和engineering 和产品落地,更紧密地结合在一起,能够把这个pipeline 打得最短,其实这件事,在大模型领域,是被直接验证的,因为大模型的model 及产品,你可以理解为model 基本上讯好了,不用做那么多的调整,它就可以变成一个产品,并且客户切换API的方式,是相对比较容易的。
程曼祺:我觉得这个事很有意思,就是解决技术竞争,它有两个思路,一个是我刚才说的,那个思路,就是我在技术壁垒之外,我找一个别的壁垒,比如说英伟大做库达,它其实是有一个生态的壁垒,然后另一种,确实是我现在观察到,目前大模型市场的一个情况,就是你刚刚说的,我让这个链路变得更短,但它有一个,我现在不太确定的东西,就比如说Anthropia 你看它最近非常猛,但是OpenAI一旦看到说 Coding是一个很有前进的方向,在Codex上大力的投入之后,你又能明显感觉到,它反扑的力量也是比较猛的。给人一种永无止境的相互缠斗下去的,当然,这种感觉,但是你也与此同时可以看到像,这个XAI等等的公司就并没有赶上这一波浪潮。 [01:59:47]
程曼祺:这个XAI等等的公司就并没有赶上这一波浪潮,对是的,就缠斗过程中间有些人就被这个高速运转的东西给甩掉了,所以这本质上我觉得最核心的能力,其实是一个组织能力,对吧,其实是你要把这样一些人。
姚颂:每个人的自己最舒服的东西都不一样,一定要把它们很紧密地联系在一起,而且要把从算法到软件到硬件到解决方案。 [02:00:12]
程曼祺:全通路地在自己的内部去做全站字眼,你才能够去做到这件事情,那你们是怎么解决的,你可以说一下,你刚刚说的字眼这是一个,对所以我们跟清华合作各种各样的算法。
姚颂:自己也有自己的算法团队,再到整个机器人上的技术软件,端车软件全部都是字眼的,再到本体的结构设计,硬件设计全部都是自研的,当然我不做硬件的生产,那再到比如说云端的摇操平台,云服务的平台全部都是自研的,再到解决方案最终的提供,和现场的实施也全部都是自己做,那你这说的就是一个,强垂直整合的逻辑,是的。
程曼祺:并且我认为这个可能会是,巨神智能未来三到五年,发展的主流方向,或者哪怕大家现在没有这么做,也都会逐渐变成这个方向,你们现在的产品,它在本体形态上。 [02:01:01]
姚颂:是怎么选择怎么设计的,我的观点也一直认为,其实你真的要做场景陆地交付,还是应该用轮式双臂的构型,因为绝大部分的作业场景都还是平地,并且其实用双足人形的角度,会带来两个比较大的问题,第一件事就是由于它的几个关节,可能需要做得更大,用比较高价值的关节,所以你整体的成本,可能会比轮式的还是要高一些,一旦开始你要算账,这件事情可能就会成为一个问题,第二件事就是说,作为双足的机器人,你必须把电池装在你的胸腔这个位置。
程曼祺:以及它整个的运动是不那么稳定的,那轮式可以装底盘上,所以它的重心会更稳定,它在机器人执行操作的过程中,身体的晃动会更小。
姚颂:其实是更便利算法的执行的,从场景落地的角度,我觉得一定是以轮式双臂,为最开始落地的方向,但是我们同步也在探索双足人形,因为就好像一直在提到的。 [02:02:03]
程曼祺:我们是在探索通用物理智能的路上,希望每走一步都能开出一朵花,结出一个果,所以我不会停止对于最终的通用的巨生的追求,西方的不是也投了许化哲的新公司一点吗。是的,前段时间我也采访了他,他有一个想法跟你是比较相反,就他认为之前有很多巨生智能的公司,是太想所有事都自己做,他觉得没必要,是,你应该把有些事交给生态做,对。
姚颂:你怎么看这个分合的选择和趋势,首先它都是可能的路径,因为我会看历史更多一些,我觉得有很多事是非常类似的,比如说你去看这个PC时代 PC时代上个世纪70年代到80年代初,就是所有跑在最前面的电脑公司,像Apple和IBM 全部都是自研,芯片也是自己的,这个生产也是自己的,软件也是自己的,应用也是自己的,就是操作系统这些都是自己的,全部都是自己的,但是到了80年代末开始,很多公司开始出现了标准化的接口,标准化的供应商,可能我CPU就用英特尔的了,不用自己的了,我操作系统去用Windows了,甚至到后期,我的生产都外包给了一些公司,但是再到了现在,其实你可以看到总体而言,性能最好,整体最舒服的还是Apple 因为它的生态是必然的,它就没有那么多的威胁,没有那么多的历史包袱需要处理。所以苹果的生态,到今天又显示出来它独一无二安卓系统也好,或者其他的操作系统也好,完全无法去逾越的一套它的核心竞争优势。 [02:03:38]
程曼祺:你觉得现在比如说物理AI 还是在一个垂直整合的状态,对所以在物理AI到今天为止,我觉得不管我们叫physical AI 还是叫巨神智能,行业还没有形成很标准化的接口。
姚颂:行业也没有形成非常标准化的各种物件的尺寸,也没有特别成熟完善的各类的供应商,所以我觉得,比如关节我们可能不会自己做,结构件我们可能不会自己做。
程曼祺:但上面的软件,大脑系统等等,我们肯定都会要自己垂直整合,才能够更快速地去发展,零销售你会自己做吗,短期我们是不会去考虑的,不考虑是说不考虑自己做,还是说你们的产品形态上。 [02:04:13]
姚颂:其实短期不需要零销售,短期我们这两件事情都不考虑,这也是我的一直以来的一个观点,就是说,我认为机器人的自由度该有多少,不是由你的硬件决定的,是由你的算法的控制能力决定的,回过头来我做一个类比,就比如说你看自动驾驶,其实咱们干了十年了,其实也没有完全的解决L4的问题,那汽车其实只有前后左右,这样一些维度可以选择,但它已经是一个非常复杂的控制问题了,你要做到六个九,做到真正的可能平均下来几百万公里,才有一次接管也还是很难的,巨神智能比自动驾驶要复杂非常非常多倍,它复杂在三个方面,第一个方面就是说车是不会去主动的撞人撞东西的,你机器人是要拿东西要改变周边物体的物理状态的,第二件事车工作的是有结构化信息的。你知道这是斑马线这是红灯绿灯这是左转道这是直行道,对吧别人也大概率会或多或少遵守一定的规则,但是物理世界,如果你想做到通用,它是没有这些规则的,它只有物理定律,第三件事其实就是刚才我讲的,你车的控制的自由度还是少的,你现在一个仿人臂就七个自由度,两个臂也就是十四个自由度了,对吧,你还有腿部的自由度,这个髋部的自由度,那你夹爪是一个自由度,拎翘手可能少的是六个自由度,多的有二十几个自由度,所以你的算法,哪怕是自动驾驶那种管控,都已经不容易的情况下,你如果真的想做到,三个9 四个9 甚至更高的9 能够去做稳定交付,我认为现在的算法。 [02:05:21]
程曼祺:是无法去稳定地操纵这些零销售的,那你说到这个,其实你有一个前提,就是你认为,现阶段就要开始做一些交付,是重要的,那这也涉及到,这个行业我觉得一个,一直在讨论的问题,到底是智能能力优先,还是智能和落地,我两条腿一起走,你会站在哪一边,我会站在,就是智能发展的过程中,每一个Miles等,都必须有商业化逻辑,为什么。 [02:06:04]
姚颂:这里面有两个因素,就是说,当我们回头看过去十年的,自动驾驶企业的发展,你会发现,如果我mogging了我公司,就做L4 其实独立企业的死亡率,是很高的,所有的交付的milestone 都是技术进展的milestone 你需要有一波,愿意有这个自动驾驶的热情,并且认可你的milestone的投资人,持续不断地去支持你,你才能走到后面。
程曼祺:而且你说这件事甚至在美国都没发生,就独立做L4的公司,从活到现在的,其实因为Vimo 我觉得你也不能说,它是一个完全统一的公司,是的,如果你不考虑落地,其实就会像Boston Dynamics。
姚颂:我一直在前沿方向的研究,做出来一些世界最震撼的模型,但是你只能靠持续书写,你只能靠认可你这个技术方向,有这个技术信仰的人,持续给你投资。 [02:07:10]
程曼祺:我觉得是会很艰辛的,拿出商业成果,一定比大家看到一个经验的demo 会更容易convence所有的人,那这件事是可行的,那这有一个节奏上的选择。就是有一些观点会认为 2026年到2027年的竞争焦点,还是在谁能在巨神智能的能力上,比如说我先突破到,类似于GPT-3或者GPT-3.5的这个状态。就它有比较强的这种通用性的苗头,然后那之后再去考虑说落地的事,这件事并不矛盾,所以你看我刚才讲的,就是说我们希望能够把前沿研究,和最终商业化落地的。
姚颂:这个pipeline打得最低,我可能所有的软件接口都是统一的,我的硬件本体可能也是统一的,我最终交付的应用可能不一样,当我来了一个最新的算法,我只需要把我的,这个foundation model改了,剩下的马上就可以直接交付,对我来说难道不是一件好事吗,对所有的公司来说肯定都是一件好事,我觉得一个行业发展可能会有,三个时间点,我觉得我们这公司希望能够同时,是这三个时间点的参与者,也是见证者,第一个时间点就是你讲的,叫GPT 3.5的时刻,那我觉得巨神智能,肯定没到GPT 2的时刻,倒没到GPT 1 我觉得不知道,因为假设现在的大模型,是一个比如说顶尖985 博士生的水平,我觉得物理世界,我们这些模型,可能还在一个幼儿园,小班中班的水平。 [02:08:01]
程曼祺:我觉得还差的确实是挺远的,我会认为这个事的通用算法的难度,比自动驾驶高两到三个数量级,如果更直接描述,这个GPT3.50克,在物理AI里面是只做到什么。
姚颂:叫GPT3.50克,我觉得就是你拿出来一个模型,放在任意的机器人上,在任意的任务上,能够做到95%以上,或者说99% 我觉得是一个GPT3.50克。 [02:09:06]
程曼祺:相对泛化的本体和任务上的高成功率,对我觉得,而且是在 zero shot的层面上 zero shot 对,当然我可以接受,从工程落地的角度来,这时候我可以接受说,你让我花一天的时间,做一些调优,对花一小时两小时,我们就在做,真机强化等等的一些事情,是可以迅速提供它的,停射它的成功率的,当然backbone的,基础模型本身,肯定还是不够的,对这是你说的,这是第一个时刻。
姚颂:对吧,那当它出现以后,其实最开始知道这件事的,只是一帮技术狂热者,所有的行业一定都有一些,长线的人,有一些这个mainstream的人,那么第二个时刻就是说。
程曼祺:你要让大众认知到。
程曼祺:你要让大众认知到,这个事情真的发生了改变,在大模型领域什么时候开始呢,那就拆GPT 不是,是去年一月份DeepSeek开源,你说是二一,对。
姚颂:就我记得就是去年春节前后,应该是春节前DeepSeek的开源,然后上线了一个免费版本的DeepSeek 然后借由这个事情,应该有六七千万中国人,体会了说,哇这个去写个诗,写个春联,做很多的事情都非常的好用,我觉得这个行业才真正的占主,所以这第二个时刻是破圈的时刻,是更多人知道这个事情,更多人见证了这件东西好用,你不要固步自萌地说,从一些benchmark上,我测出来它好用,你要让更多人看到它,体会到它,第三件事是它,被充分验证商业价值的时候,其实就在今年的一季度 Anthropic开始实现了,一个400亿美金的ARR 而且有一些消息。 [02:10:11]
程曼祺:称Athropic是季度经营性是盈利,看到二季度说是盈利了,那为什么MiniMax和智普的估值,最开始是MiniMax在上,智普在这儿,现在变成了一个这样的状态。
姚颂:那是因为大家发现,可能coking是一个,迅速能产生商业价值的事情,而智普的GLM 包括最近发的GLM 5.2 是一个非常不错的,又性能又非常非常好,又有兼具性价比的默想,其实如果没有coking这件事情,那制服一月份上市的时候,大家觉得四五百亿都贵,对吧,所以就是从见证技术可行,再到商业上大家认为这件事。 [02:11:04]
程曼祺:有机会落下来,站踏实了,再到产生巨大商业价值,这三个阶段,我们都希望同时去参与和见证,稍微问一个题外话,在二二年底看到Chad GPT的时候,因为你当时已经投入到,商业航天这个商业,你看到这么大一个技术变革,对你会有冲击吗,还好,因为我觉得我整体来说,就是承诺的事一定要做到,所以我承诺了我的精力就是要做航天。
姚颂:所以这件事我也讲一个很好玩的事情,就是一定不要去羡慕别人,当时到2017年的上半年,特别好玩,我就不提名字了,当时有一个我很好的朋友,他在读书期间就买了一些比特币和以太坊,甚至他还参与到了以太坊的早期的众筹,到了2017年当时有一波整个加密货币行业的牛市,有一次他跟我吃饭,拿出来他的手机给我看了一眼,非常凡尔赛的说,哎呀 1500倍了,吃完饭那天晚上在大展,吃完饭给我看一眼,哎呀 1800倍了,就是这么个感觉,当时对我来说其实会有很大的冲击,那我觉得我辛辛苦苦的在这每天没日没夜的加班,创业对吧,多么的辛苦啊。感觉没有你运气好,但是后来我其实在一到两周就迅速平复了心态,因为对于做深建的我来说,我的运气已经是万里无一了,我们其实每个人不能够去奢求自己的运气,其实你正在做的事已经代表你的运气非常非常好了,你应该做的事就是把握当下的你的已经有的运气,把当下这件事做好,所以我也很快平复了,心态就进一步的,反正鼓足干劲的去做身件,到航天我觉得也是这样的,就是说现在外界也有纷纷扰扰,但是我其实心态,都是一直比较平和的。 [02:12:50]
程曼祺:就是你不用去羡慕什么,就你能够把握住,你现在有的事情,把这件事做好,把这件事做成功就够了,那回到你刚刚说的,巨神智能物理AI的这三个时刻,现在其实第一个时刻都还没到,没错是的。 [02:13:25]
姚颂:但是我觉得巨神智能,跟大模型又有一点点的区别,在于你有可能,先取得商业成果,这就是跟自动驾驶一样,你看自动驾驶,除了L4的公司,也有像碧屏县,青州之行做L2的公司,也有像最近上市的,玉树等等的,在做的场景自动驾驶的公司,其实场景自动驾驶的,核心逻辑就是说,那我判断短期内,肯定实现不了L4 但是我通过一些解决方案测,和任务的限制,和对环境的限制,我来实现一个封闭场景中的 L4的效果,所以出现了矿山的自动驾驶,像西极制驾,易控制驾,塔格制行,港口的像主线科技,后来转型过来的西景科技,慢速无人车,像刚上市的浴室,像那个制行者,像90像新式器,其实业务都取得了,非常非常大的突破,但是我觉得我们会。跟他们巨大的一点不同,就是我不会单独为了一个场景,去做一个全工程化的技术战,而是一定要坚实的基于模型,基于通用化的技术战,但是最终在解决方案上,你要添加一些东西,来帮助你能够,所以在你的技术,没有实现GPT 3.5的时刻,在数字世界里,是很难实现大的商业价值的,但是在physical AI 在物理世界里,是有可能实现巨大的商业价值的。 [02:14:33]
程曼祺:其实在数字世界,实现了小规模的商业价值,就是有一些已经被遗忘的公司,比如说Jasper 在还没有查GPT之前,它是基于GPT-3 可以帮你写营销邮件。只不过那个东西,后来被基模厂商,自己的模型和产品,给覆盖掉了,对你要这样说,也确实都有很多,比如说我有一个,同年级的同学,叫施琴林,叫Tim施,最近他也是一个公司,叫就是。 [02:15:14]
姚颂:琴云东老师的公司 Recursive Super Intelligence 他们公司的创始团队之一,对他们八个联创,对他当时在 Stanford读PHD的时候,就开始创业叫Crystal 他是Crystal的CTO 他最开始的想法很有意思,其实是说,做一个类似QQ的聊天软件,你去跟他不断地聊天,聊天的过程中,就收集到了你的语言的特色,从而做了一个仿真的你,然后你死了或者你不在了,可以让这个人代替你,去处理一些问题,这不是最近几年,很多的利用想法,对这个是在大概 17年左右他就在做的事情,那他就好多年前了,对当然就这件事,在那个时间点的技术,是不够成熟的,所以它也没有太商业化,所以后来公司就转型,去做智能客服了,就是你刚才讲的,在客服的过程中,它可能去基于你的NLP的算法,去搜索出来,最好的三个回答是怎样的,对吧。这件事能提供哪个社的转化率,这个回答能提供一个,怎样的转化率,这个回答能提升好评率,它也是加了一些工程化的方式,对但是就当然不够大。 [02:16:22]
程曼祺:但与此同时,我觉得physical AI 你每个场景都足够大 Bitcoin也不会出现说被一个巨无霸,或者说被少数几个领先的核心厂商,给覆盖掉的情况吗,我觉得不太可能,那问你一个问题,汽车公司有多少个,汽车公司至少按大的区域分,比如说日本有三个,韩国有,欧洲有三个,美国有三个,中国更多,好多个对吧,中国更多。
姚颂:其实也有很多的,比如说你就没有把雷诺算进去,你就没有把Ilepain算进去,你就没有把菲亚特算进去,你就没有把沃尔沃算进去,对,这我不太确定,因为欧洲不是有一个叫Stellas 我不知道它,它是一个大集团,但是有很多品牌,对吧,我的感受就是说,物理世界是很难存在垄断的,归根到底,我觉得一个完全通用的物理模型,我是很难想象,它会在十年内出现的,做一个最简单的类比,数字世界复杂,还是物理世界复杂,物理世界复杂,复杂很多很多,比如说数字世界的你和我在语义空间里面,就是两个完全不同的概念,但是在物理世界的你和我,可能是现代当面,有可能是你在会议室外,我在会议室内,有可能你在上海,我在北京,它的这个含义的多样性会多得很多很多,现在的数字世界的large language model。那最新的水平已经到了5K参数到10K参数这个级别,那我估计未来的两三年可能会到50K参数,甚至100K参数的一个级别,那数字世界是这样,物理世界的模型,要做到多大。 [02:17:52]
程曼祺:才能够真正的去暴露万象,你怎么看语言及世界这句话,我觉得不可能,因为语意是清晰的逻辑结构的,语言天然是一个数字化的东西。 [02:18:05]
姚颂:而物理世界是模拟的,这件事是完全不一样的东西,比如说,请用语言描述我现在这个,杯子倾斜的角度,对吧,请用语言描述一下,我们俩现在距离多少米,你也很难给出一个,特别精确的回答,我们现实世界,是一个模拟的世界,它所有的信号是连续的,而不是分离的,我觉得是很难的,我觉得如果想做一个,完全通用的,大家最理想中的世界模型 5P 10P 甚至100P参数,不一定能够打得住,就是能够真的 simulate everything 并且所有的,每一个像素,都跟你肉眼看到的是,类似的话,我觉得这个模型,我是不可想象的,那它如果这么大的话,它也没法部署,它也没法推理,这就是Physical AI 跟大语言模型,最最最最重要的,一个区别之一 Physical AI要求实时性,你必须做到实时,对吧,你不做到三十帧,你这个系统就没有意义。
程曼祺:对就你得很低的延迟,很快的速度,对吧,而且有些情况下,你还得考虑,可能你这个东西,不能在云端算,是的,你得放在端侧,你只能部署在端侧的,一个芯片上算,这是很大概率的实践,所以大家要解决的,技术方向。不完全是model方向,那沿着你的这个推理,你怎么看VLA WAM这些技术,具体的技术路线,所有的model 现在因为大家还在幼儿园水平。 [02:19:26]
姚颂:大家首先是追求的成功率,包括所有的benchmark 其实追求的都是成功率,但是我觉得指缺成功率,其实是无法去衡量,或者无法去推动,这个行业的model 真的努力实用的。
程曼祺:我跟很多人交流,一些技术背景的人,有一种想法是,我先去追求成功率,有点像你刚刚说的,把好排在最前面。
程曼祺:把好排在最前面,然后按照以往,就是这个行业的技术发展规律。成本还有时间都是可以压缩的,你同意吗,部分同意,就是在CNN的时代,我觉得这件事情是大家就是这么做的。 [02:20:05]
姚颂:就我先做一个精度特别好的算法过来,然后比如说韩松老师开始做叫西数化,简直deep compression 然后做一些什么squeeze net 一些非常窄非常小的模型,在大模型时代也在做这件事,其实也在做一些蒸馏,但是蒸馏的模型的参数的数量,和你原始的模型的参数数量,大致还是在一个量级的,你只是小了几倍,不会说少了一万倍,这是不太现实的,而Physical AI我们面临的一个问题,就是说你蒸馏的对象和最终部署的模型,可能差了一万倍甚至一百万倍的参数量,因为你部署的一个现实设计。
程曼祺:又能够实现这个实时性的模型,可能就是2.5B 5B 10B 这样的一个参数规模,所以你觉得一开始,我完全抛开大小和延迟,这些只考虑性能,你觉得这样可能会比较难,会有走到后面会遇到问题,我觉得就是选这条路也是OK的,那就是说你一直纯粹去追求一个通用智能。
姚颂:那返回到一个通用智能真正达成的时刻,你开始给它做优化,做压缩,做部署,开始产生商业价值,那跟我的路径是反的,我是希望算法每前进一步,我都能产生新的商业价值。 [02:21:21]
程曼祺:从而更好地支撑公司的发展,所以我觉得也是完全不同的选择,不过你说的第一种选择,那就是它长期得,在没有什么商业反馈的情况下,一直投入一直投入,对并且我觉得它可能至少得,募集百亿美金级别的资金,因为OpenAI 其实也是刚刚在今年第二季度,又讲了一遍,自己Robotics Team的事,是的,就是要更正式的,更多的来投入这件事情,你觉得像OpenAI这种公司。它也加大投入,是,能不能把它做成,以及说对别的创业公司的影响是什么,我觉得对所有的做大脑的公司,肯定都是会有影响的,当然对中国所有,做大脑的公司都是利好,对吧。 [02:22:00]
姚颂:因为中美两个国家,是唯二的在世界上,能做出来大模型和物理智能,创新的国家,那OpenAI假设做到了,一些新的思路,我们也迅速地能够。
程曼祺:判断它到底是怎么做的,并且能够迅速地跟上,所以我觉得对全行业,肯定是一个特别好的事情 OpenAI有可能是,跟你相反的路径做成,你觉得有可能吗,就中间我不追求商业化,我觉得是有可能的,对吧。
姚颂:但是我们不是每个人,都有OpenAI的资源禀赋,就好像去为了实现 GPT 3.5时刻,我现在要有足够多的,美金去烧,每年烧四五亿美金,用万卡,去从一个一个级别。
程曼祺:从多少亿的参数到百亿,两百亿,三百亿,八百亿,最后到GPD3.5的,一千一百亿参数,对吧,你觉得没有OpenAI的命,得了OpenAI的病的这种情况,在中国这个行业里多吗,我觉得将来融资,可能会是很多的,以刚才这样技术理想,创业的公司的一个命门,所以你的意思是有,我觉得会存在。
姚颂:然后之后可能会遇到一些,对,因为你追求理想的最核心的,就是要有人,源源不断的给你资金,让你能够买到数据,买到算力,雇打足够聪明的人,这件事目前,大家要的算力还没那么多,但从今年开始。 [02:23:15]
程曼祺:已经迅速的增长起来了,如果像就是VLA WAM这些,我现在只是在这种架构上,去一味的追求高性能,你觉得之后不时会出现问题,那比如说具体到,你们自己的实践。你们在模型上,在智能的这个系统上,你们是怎么思考的,一定是一个叠加的系统,你光有VLA Foundation Model 不管是哪种Foundation Model 肯定是不足以支撑你的长期落地的,你能透露你们的Foundation Model 代表是什么架构,是用什么思路来做吗,我们总体会用影空间的思路,这也是一个第一性原理的思考,就是说刚才讲,如果我真的生成的。
姚颂:假设我是一个生成的路径,或者是我真的要把所有的颜色,像素信息都能够很精准的预测,我觉得这个Model会太大,就跟刚才讲数字世界,跟物理世界的类比一样,我可能是没有办法做到实质性的,那为了做到实质性,我觉得这个model应该核心,还是学到的是物理学的知识,可能是两块事情,一个是说我要学到一些物理学定律,比如说弹性碰撞非弹性碰撞,动量守恒动能守恒,牛顿三大定律,我要能够知道这是一个轻的东西,然后碰了以后它会怎么去动,第二件事就是物理学常识,就刚才讲,我人是知道这个纸杯子很轻的,是很软的,机器人不一定知道,同样在你这里摆了一块金属,我如果看到的是铝,我会假设它不会特别重,如果它是个金子,我会假设它很重,就是它必须要同时学到这两点,我觉得就够了,比如说这个纸上面。现在印的是什么文字,我的衣服是什么颜色,在你机器人做操作的时候,对它来说是没有影响的,所以我们更多的愿意回到一个,你不管叫影空间,还是说我希望回到一个规则空间。 [02:25:04]
程曼祺:物理世界的空间,去理解这件事情,而不是站在一个像素空间,和人肉眼看到类似的空间,去处理这个问题,你觉得你这个取向,和你以前搞过物理精彩有关吗,其实还是跟第一行原理的,这个思考会有点关系。
姚颂:但是物理精彩,给了我一个很大的帮助,这个是跟数学精彩,非常不一样的地方,数学精彩或者其他的很多人,希望把这个理论,算得更加的细致,更加的仔细,算无一测算无一漏,对于物理精彩,是不是这样的,对于物理研究来说,我们要果断的舍弃一些小量,因为你任何一个计算,可能展开来说,会有一阶二阶三阶,各种各样的小量,这样的话,你其实是没有办法去做,物理世界的计算的,所以你就要果断的舍弃小量,只保留主干的部分,所以我们可以相对,从最开始有一个思路,就是保留主干,不要看那么多的,纷纷扰扰和细节,其实像影空间这种思路。
程曼祺:就是它对比,我每一个像素,都生成出来这种思路,它本身就是一种,正确的模糊,对吧,它没有追求说,我把每个细节都精确的还原,是,那你对现在非常火热的 WAM这个方向,世界动作模型,它的backbone 就是视频生成模型,它其实就是一个,像素生成的逻辑,你怎么看这个方向的发展,以及它为什么这么火,有这么多公司,在这个方向,其实是今年上半年。 [02:26:09]
姚颂:融到了很多钱,形成你的中国的公司,我觉得这件事也很正常,其实大家现在看到 World Action Model 就像其实是两件事情的叠加,唯一就像当年商汤矿市,能够迅速地融到几十亿美金一样,大家看到了一个上限,非常非常高的技术路径,在当年刚有深度学习,我们迅速地就把人脸识别,做到了好几个九,然后ImageNet已经刷到,就没有意思了,大家开始刷MS Coco 后面大家开始刷Kiki 一个跟自动驾驶有关的数据,大家感受到这个算法,一个非常简单的开发,很短周期的开发,就能够远远超过之前所有的算法的,这样的一个精确度,感受到一个它巨大的潜力,我觉得这肯定是一种,第二个事情就有点像,毕任穗远穆希等等公司成立的那个时刻,大家看到了,已经有了一些公司。比如说地平线和韩无计,取得了很大的成功,那后面又有新的人,用新的思路来做这件事情,有可能会做得更好,我觉得这是两个趋势的叠加,是一个非常值得探索,并且肯定会有,把整个人类在物理智能的算法,往前推一大块的可能性,你不认为这是噪音和泡沫,其实不是泡沫,或者说它泡沫没有想象中那么大,为什么呢,就是站在2018年的时候,我们去看地平线,地平线那一年,大概是一亿人民币左右的收入,估值是三十几亿美金,大家都觉得它的泡沫非常非常的大,当然果不其然后来2018年到20年,其实行业出现了一些短暂的下滑,但是到了2020年,地平线,我记得于凯老师就发了一个朋友圈,庆祝地平线出货10万颗芯片。行业就开始迅速的正向发展起来了,地平线后来24年上市,那高峰期应该是1500亿港币以上,具体数字我不太记得,你站在这个角度,地平线的泡沫不大,你站在现在Momenta的角度,最近的一轮融资,我看新闻,没有去询问过,是过千亿人民币的。 [02:28:25]
程曼祺:那在那个时刻的,十几亿美金,二十几亿美金的估值,也不算磅礴太大,你说的都是幸存下来的,对,公司,是的,所以我觉得L4的公司。
姚颂:如果你类比的是一个L4的公司,就是说你一开始就要追求一个,最终极的模型算法,我觉得可能,那中间可能有很多的公司都会不见,但是如果你能够活到。
程曼祺:它真正的技术到了批量应用落地,产生商业价值那一天,这所有的公司就不存在泡沫,这个数字你可能比我了解,就是行业里现在有多少,比如说做通用机器人,聚成智能物理业的公司,实际上你觉得能容纳多少,最后哪些你觉得能活下来,首先这个数肯定是多于四五十家的,特别是这个年轻的教授出来,想做通用模型通用算法的,那四五十家你可能只算了头部吧,我以为你会说几百家,没有没有,也不会有那么多,但是就是说,那对于他们来说,最核心的一件事就是融资,我指的不是世界模型和物理,我指的是可能把机器人这种都算上。 [02:29:11]
姚颂:OKOK那肯定是更多的,对吧,按照年初国家发改委的口径是说,有100多家公司,推出了200多块人性机器人,但是这里面其实有大量的是,做硬件本体为主的公司。
姚颂:做硬件本体为主的公司,但我觉得100家也许是有的,但这里面大部分的肯定是这种新成立的,年轻学者和年轻的同学的公司,对,小部分的是一些有经验的人,或者之前已经在的公司去转型的公司,你觉得什么样的能活下来,我觉得如果你只是做技术理想,追求通用最终再去考虑商业努力,融资能力最强的那几家能活下来,那你所有的工作就应该为了融资,比如说多接受媒体采访,反正对我来说,我是第一次录这种视频,我是不太喜欢美丽采访的,因为我是一个强I人,对,但是对于另外一类的公司来说,就是如果我们想走出 Gaming线 Momenta等等的路径,我觉得你有一些业务的依托,作为你的坚实的基础,再去发展。持续不断地迭代你的算法,可能是更顺畅的,包括华为其实也是这样,没有人一上来,就是做出来一个L4 而是说我先通过L2级别的产品,批量的被用上了,然后逐步的去推L3。 [02:30:53]
程曼祺:可能在未来再去推L4 等到这个政策合适的时候,可能你的L4也已经做出来了,可能对我来说是一个,我认为最高成功率,更高成功率的一个方式,你觉得往后推演几年会发生什么。一个是我们能看到,今年已经有头部公司会上市,对,另外一个就是大厂的威胁,你觉得什么时候会落地,以及什么类型的大公司,对这个市场的冲击,可能是最大的,首先我觉得。 [02:31:19]
姚颂:我觉得中国所有的制造业企业和互联网企业,全部都会投身巨神智能的浪潮,一定的,或者叫物理AI的浪潮,所有的互联网公司都会投入做模型。
程曼祺:就好像他们现在也都全部在投入做大语言模型一样,这个投身是多大程度上的投身,比如说做大语言模型,我觉得对很多公司来说是战略性非常重要的事,你觉得对巨神也会这样吗,我觉得会。
姚颂:因为大家也逐渐地想从线上走到线下,想从一些数字经济渗透到实体经济,我觉得肯定是战略级别的投入,区别只是在于这个时间点的区别,第二件事就是中国所有的,主要的制造业企业,全部都会投身这件事情,包括所有的汽车公司,不管是国企还是说民企,蔚来离乡小鹏塞利斯,小米华为比亚迪吉利,北汽上汽广汽,全部都会投身这件事,这是一个毫无疑问的事情,因为大家现在普遍认为,巨深智能行业,或者叫机器人行业,在15年到20年,这个周期可能会超过,汽车行业的整体的产值,我甚至可能更乐观一些,我觉得可能在10到15年,这个周期就会超过,整个汽车行业的产值,那与此同时,还有很多其他的公司会走,所有手机公司会走 OPPO Vivo 包括刚才讲的小米华为。
程曼祺:包括荣耀也在走,对荣耀是今年马拉松的第一名,对包括所有的,手机产业链的公司,灵异制造,对吧,华信技术,蓝丝科技,包括相关的什么顶桥通信,全部都在做,所有的重型机械公司,一定会做,中研中科,三一重工,对吧,各种各样的这些机械公司,肯定会做,你说到这个,我想到前段时间,我跟高级洋聊,他说巨深这个大的行业,未来肯定是百业之王,这是有可能的,按照你描述那状态,它就变成了经济支柱了,我觉得就是经济支柱,经济支柱之一,绝对没问题,汽车行业已经成为了,我们国家的经济支柱。 [02:32:51]
姚颂:这是一个在15年内周期,会超过汽车行业的产业,那一定就是经济支柱,因为它真的覆盖到,社会的所有的方面,所有的第二产业,所有的第三产业,甚至很多的第一产业,都会被机器人渗透。 [02:33:31]
程曼祺:说到这我想到一个,可能跳有点远的问题,是一个比较长期的推理来说,你的这个推演的前提,我觉得是实体经济,人们的真实生活,还像现在这样,可能是我们生活的主线,有一种人会有一种比较科幻的设想,可能往极端推人类文明就黑客帝国了,不太可能,你觉得不可能,我觉得那个是扯淡,为啥呢,因为我第二次创业之前。
姚颂:我也认真的研究了脑机器和脑科学这件事情,我也一直在关注着这个行业的进展和变化,其实到今天,意识是怎么来的,就consciousness这个词,在科学上是一个伪科学的讨论的词,因为没有人能够有任何的解释,记忆是存在哪,是怎么组织的,不知道,我们对于它的底层问题,有太多的不了解,所以Elon Musk选择做脑机接口,包括我当时去,孵化投资了一家脑机接口,大家是把脑当黑盒子在使的,我只监测反正你释放的电信号,你内部的电信号,到底是怎样的,我不去探究,这种有可能通过算法的拟合,能够形成一定的效果,但是哪怕到了今天,我觉得全人类最前沿的科学,也对于意识到底是什么回事,存在哪儿怎么产生的是毫无所知的,所以就不太存在你说的那件事情,我觉得戴个VR眼镜。 [02:34:09]
程曼祺:每天在家打游戏是有可能的,但是变成黑客帝国,变成一个生活在虚拟世界,这件事是不可能的,头号玩家是有可能的,是有可能的,黑客帝国是不太可能的,是,你觉得现在这个行业里有什么乱象,肯定是有的,而且每个阶段也都会有很多的企业,在抱怨劣币驱逐良币,劣力的表现。 [02:35:03]
姚颂:我就不说太多,我觉得举个例子来演,有大量的企业在用摇操的视频,替代真实操作的视频作为demo 所以我现在每一个别人晒出来的视频,我就会观察这个画面上,首先有没有一个小字写的是EX 5X还是10X 因为大部分的VLA和世界模型的视频,都是加速了5倍10倍甚至20倍的,第二件事就有没有特地标注全自主,所以我特意跟我们的品牌同事讲,我们的所有的demo video 必须要把这些事标上,就是因为有很多人,可能全程都是要操的,看起来很多操作特别丝滑,但是他不在图像上进行标注,他实际上不是非自主的,用此来体现自己的算法的牛逼,以及有些事实在是叫做 too good to be true。
程曼祺:对吧,就好像你跟我说,今天我就已经实现了核区别,产生了无限的方便,但是按照你之前说的一个逻辑,比如说像这一类公司,它为了获取巨大的资源,我在demo上,我有一点水分,你觉得这可接受吗,你觉得为了一个站位目标,我稍微牺牲一点底线,在你的创业,我就不可接受,我之所以会有很多的,投资人的朋友和企业群的朋友,就我一直坚持,就说真的。不可接受是因为,你的道德标准高,还是因为你觉得这件事,从功力上,它也行不通,最后会反噬,两者皆有,对吧,就是说第一,我的道德标准是相对比较高的,我说出来的话。 [02:36:42]
姚颂:就我有些话可以不说,但我说出来的话一定是真话,第二件事情就是跟当时那个,取一列血液对吧,然后去做检测一样,就是幸运的话,你可以在大家一个可容忍的周期,比如说两年三年甚至五年,去完成这件事情,不幸运的话,我记得当时还有,硅谷有一个做VR的那个公司,什么一个体育馆里面,一个大鲸鱼,然后我觉得你最终是纸包不住火的,就只能说lucky。
程曼祺:你可以最终实现,你现在展示的这些东西,所以你是不太信奉归骨的,有一种创业逻辑,是我假装直到我真的变成,对我是不做这件事的,因为我觉得这个实在是,风险过高,以及对于我的。个人的技术价值观,我觉得是没法接受的,那在现在一个融资和人才,和关注的竞争,都这么激烈的大的行业里面,你继续这样的话,你觉得你这个代价是啥,或者说你感受到了,一些具体的代价吗。 [02:37:36]
姚颂:我觉得肯定是有的,就比如说当投资人被各种各样的技术名词,每天都在冲击的过程中,他会不明白你的一个,为什么要做系统级公司。
程曼祺:你为什么不是一个世界模型公司,你为什么不能用一个性感fancy的词来定义自己,确实从整个公司的角度,就是world model强化学习,各种各样的算法和info。是我们的一个组成部分,但是你觉得单独一个词都不能代表,它远远无法代表整个公司大家在做的事情,你方便透露你们现在实际运营半年多之后,你们大概的融资额和估值的量级吗。 [02:38:15]
姚颂:我们之前是完成了Kinshulun的系列融资,大概是近亿美金吧,然后我们也其实不是特别想去呈现很多的,现在新闻上大家关注的这些话题,然后现在公司有70号人。
程曼祺:并且我们是一个全站研发的团队,加上业务团队,整个构架都已经比较完整的一个状态,关于行业的最后一个问题,你觉得发生什么事,有可能会导致,这个大的巨神智能物理AI行业,遭受灭顶之灾,还有这种可能性吗,我觉得已经没有这个可能性了,为什么,因为首先这是一个,必然会发生的事情,为什么呢,其实我从一个更宏观的跟你讲,就是说你看我们原来有。
姚颂:一次二次三次工业革命,我觉得我们正在颠覆工业革命,第四次工业革命,可能就是大模型来自AI的技术,我们会颠覆,第三次工业革命的成果,就是数字经济产生的大量的高价值的岗位,和这样的一个产业,很可能全面被大模型给颠覆,所以包括你最近也听说了,不管硅谷还是国内的很多互联网公司的软件开发,在大量的裁员,因为数字世界的工作是结构化的相对好去替代的,未来就一定是去做这个物理世界逐渐的渗透,它的周期一定比数字世界长,因为它涉及到的复杂度太高了,并且有很多的专项的技能性的东西,在一个追求实事性的环境中,是无法把它全部塞到一个模型里面去的,我觉得可能是个10年到20年的周期,但是也一定会在工厂,在服务业,在农业里面发挥重要的作用,可能它来大量的辅助人去完成一些工作。 [02:39:06]
姚颂:可能它来大量的辅助人去完成一些工作,这件事首先是一定会发生的,所有人都能够看得到,原来我们担心的资本,可能会不会有个崩盘或者崩溃,现在看其实整个巨神智能的有泡沫,但也没有那么高,相对于比如说中美之间,本身就有一个估值很巨大的差异,大模型企业和物理智能的企业之间的估值,又有一个很大的差异,它还并没有说现在的一些公司,可能几个亿收入,就会说180亿美金 200亿美金的收入,我觉得整体的泡沫的规模也是可控的,以及确实有像我们这样的一些公司,还有其他的一些公司在推动落地,我相信在两年左右的周期,大家会在身边很多的真实的生活场景,感觉到这是一个聪明的机器人,向我在提供服务,在未来的几年,我觉得出现一定程度上的波动,和当赛的是有可能的。
程曼祺:但是我觉得幅度会很小,并且周期会很短,最后有一些关于你个人,我好奇的问题,就之前其实我们聊过,就是你说你经历这几次创业之后,你觉得你是创业者里更偏企业家。你怎么去定位自己现在的角色,前面你第一个问题,还是第几个问题,就在认为我的定位,对就姚颂是谁,你刚才说的是我是创业者,我是一个创业者,这是因为我觉得 physical AI相关的创业。 [02:41:02]
姚颂:那我觉得有没有经验,我们可能在这个起跑线上是平等的 90后 85后 95后 00后,在这个起跑线上是平等的,因为对我来说也是重新学习的一个过程,就是你越往前,你的经验和可追溯,可去对比类比的事情越多,越往后你对于新鲜事物的接受程度会更快,所以这件事,我觉得大家在创业这件事是平等的,我只是一个连续创业者,而另外一个角度,我觉得跟很多的,一次创业者,或者部分其他的创业者,不同的事情是说,我是把我的职业生涯,作为一个长线在经营的,所以比如说在火箭行业,我是不会跟任何的,国企央企领导,或者说政府官员,发生任何的利益往来的,因为我要守住我的底线,那在我的企业的,经营过程中,我不会去over claim 我自己能做到的事情,和已经做到的事情。以免带来刚才讲的,你吹嘘的东西最终实不现,给你自己一个面临之灾,或者一些很大的问题,依次的创业者,我感觉很多人,纯粹只是在追求成功,他是一个十分进攻,零分防守的一个状态,对于我来说,我可能带着这样的一个心态,我是一个八分进攻。 [02:42:10]
程曼祺:两分防守的这样一个状态,所以我觉得心态不是完全一样,你要防守,你要守的是什么,我要守的是我不会进去,我也不会变成一个破产户,对吧,你说到这个,确实有可能有些第一次创业,对这个创业的最坏结局,能坏到什么程度,我没有设想,而且我自己坚定的,我是一个中国人,我不希望到哪一天,我必须待到某个其他国家去。
姚颂:你觉得整体上,你的冒险偏好是怎样,风险偏好是怎样,我的风险偏好,我觉得在做事情的角度,我是喜欢有一些,大的方向上有挑战性的。 [02:43:01]
程曼祺:但是在具体的经营角度,我是一个稳健的人,如果其他人十分进攻,零分防守,你七八分进攻,两三分防守,那光脚都不怕穿鞋的,你输的概率可能会变大,怎么办,在physical AI也好。
姚颂:在火箭行业也好,其实你有无数的,取得成功的机会,并不是说他取得了十分,我取得了七分,我就失败了,并且我甚至认为我这种思路,可能你在两年后看它十分我七分。
程曼祺:你站在五年后看它十分我二十分,这是因为你说这两个行业,或者说很多前沿科技领域,它都不是赢家通吃,我觉得是说,大家需要有一个持续的战斗力,而不是短期内冲到一个最高的固执。
姚颂:对吧,包括最近大家很多的宣传工作,就是会希望去说,我也是一个百亿级别的公司,用这种事情去体现公司的成长,那我的媒体采访,其实也不会有太多的。
程曼祺:之后也不会有了,可能我更多的希望,通过公司我们已经做到的事情,去给大家呈现,我们的进展和我们的实力,你前面说你觉得 80后90后00后的创始人心态上,是平等的。能力积累上是各有优劣,也是平等的,但实际上现在你觉得在,就是受关注和受支持的,这个维度上是平等的吗,以及你怎么看。我觉得现在00后是非常受追捧的,我自己的心态上是所有人是平等的,对但是所有的年轻人,我觉得他们在新的算法的。 [02:44:32]
姚颂:学习的能力上对吧,试错的能力上肯定还是比我强的,但他会缺少,比如说对公司战略的思考组织,对吧以及我要未来一个算法,我必须得去布局数据算力,更多的人才,从而在某一个阶段,它可能更容易陷入到一个瓶颈,比如说你无法扩展,你除了最开始核心的那三四个人之外的,核心的技术团队等等的事情吧,所以所有的事都是有得有失,对于脑子来说,我确实是一个33岁的人,然后我写入的速度,吸收的速度一定会比领后慢一些,但是我们有更多的东西。
程曼祺:可以去放在公司里面,让它少走弯路,让它更高效率的发展,你开始第一次创业的时候,科技创业还不是主流,而现在很多在23年之后,开始创业的人,其实他的推背感是非常强的。你觉得你的幸运和不幸是什么,然后他们的幸运和不幸是什么,赛风时马焉知非福,就是所有的事,我觉得都是符合相依的,比如说最近的一些创业者,会感觉到一个。 [02:45:35]
姚颂:实在很强的推背感,但是如果他们不能够,清晰地意识到这个推背感,来自于国家需要你这样的公司,而不是你自己的努力的话,我觉得他们会出现,非常大的问题,就好像我会觉得改革开放以来,有很多数量的企业家,会低估了时代对于自己成功的重要性,高估了自己对于成功的重要性,坐电梯的比喻,对我觉得就是一个坐电梯的比喻,你享受推背感,你有这样的压力,是因为你在电梯里面,你在这样一辆大车里面,当你觉得这都是你的个人成功,然后用这个策略再进一步,做一些其他的事情的时候,有可能你会面临一些面临之灾,因为可能这样的一个时代的颓废感,国家的支持,不会在一个行业保持五年十年,甚至更久,它肯定是分阶段性的,所以我遇到一些做算力的公司,做芯片的公司的创始人,我觉得有些人。能够跟我清晰地讲出这句话,我就觉得非常有逻辑,他说我很清楚,我知道我公司的上市,是因为党和国家的支持,并不一定我已经做得足够好了,那我觉得很多的创业者,可能要去思考这,同样的这句话,对我来说,持续又提出一些新的挑战,因为对于我是第三次创业,那我重新去读paper 重新去梳理,我对这个行业的技术认知,技术方向,可能就是这一年多的事情,那我也许有很多的思路,站在未来看有可能是错的,比如说对比一些CNN 深度学习自动驾驶,虽然我到今天。 [02:46:43]
程曼祺:我感觉应该九成以上是正确的,但是说不定在未来,是一个被验证是错误的事情,所以有些东西,可能也会成为一个包袱,最后一个问题,你觉得前两次你创业,算是成功吗,还OK 你想要的成功是什么,我觉得还OK 还OK 对对对,我觉得当然你就想问,我这次的目标,或者怎么来定义成功,还是怎样,有的人会认为,你之前是有成功的退出,但是都还没有做的足够大。 [02:47:20]
姚颂:是,对我想知道你自己怎么,当你在问这个问题的时候,其实你的假设是说,事实足够大,或者说财富足够大,是一个给你成功的标准,对吧。
程曼祺:至少就是一个比较普遍的标准,对对对,但对我来说呢,可能我其实刚才其实前面讲过一件事,就是当一定的财富过后,你的财富其实不是你的,所以我把它当作重要的一个标志,但是不是唯一,也不是绝大部分,那对你来说还OK 是因为实现了什么,所以还OK 我觉得在第一次的创业。
姚颂:我觉得我真的走从了,从我在实验室还写代码,写论文,再把这件事让,它上到了很多汽车产品,让几百万台车用上了,然后并且真正的实现了,有外界对于这一个技术的,价值的认可,那这件事就是一个,很成功的事情,因为你走通了,从技术到商业价值这条路,并且你所有做的事情,最后有一个外界的反馈,就是收购这件事情,反馈你做的是对的,对吧,我觉得这是一个,我很高兴的事情,就是技术被用上了,那第二件事呢,我觉得其实首先航天是一个非我老本行的事情,那这件事我还是锻炼了很多的我的学习能力,战略思考的能力,系统性工程的一些组织的能力,等等等等的很多的事情,包括在国内更好的去开展工作的一个能力,能有一个自己参与成功的一个火箭发射上去。我觉得这就是一个非常大的铐讲,这就是一个很激动的时刻,并不一定这个事本身取得多大的商业成功,前期已经是一个很不小的milestone了,当然现在我没有在那,我希望它后续能够取得更多的商业成功,因为还有很多老朋友的股权在那呢,对吧,那对于这一次的创业,我觉得可能也就不太一样,因为我开始初步摆脱了一个小年轻的心态,原来我会觉得这样的经历,就是一个非常好的事,是因为我觉得在年轻的时候,你就是要多经历,然后多体会,这个才是把你的生命,发挥出来的价值,因为你走了别人,可能很多倍的路,体会到了别人。 [02:49:17]
姚颂:体会到了别人,没有体会到的事情和情感,我觉得这是很重要的,但到第三次的时候,我是希望这一次,能有一个长期的结果的,我也希望这家企业,是能够长期经营,走向上市,见证我刚才讲的,对于物理智能时代的 GBP 3.5 GIFSIG开源,和出现Coding 这样一个Killer App 等等的时代,同时参与到技术的突破。
程曼祺:产品的努力,和最终大型的商业化价值的,实现这样三个不同的阶段里面去的,你会对这个事很迫切,很饥渴吗,你说哪件事情,就一个更大的成功,我也还好,就是我心态整体还比较平稳。 [02:50:25]
姚颂:但是因为到了第三次以后,刚才讲,其实你能够开始,从创业之初就看到一个进度条了,我觉得现在有更大的机会,把它做成一家长期的,持续经营的,对技术和产业都有推动的,甚至将来我站在更大的角度,对服务人类有帮助的企业,所以我还是挺希望,能够实现这样一个结果的,如果对你来说,是一个灵魂拷问的问题。
程曼祺:它应该是一个什么问题,你这个叫好像说,让商业创造一个,自己搬不起来的石头,你可以尝试问一问,我觉得可能就是你比较在意的。有遗憾但没实现的东西,其实我刚才,我问就比如说,你觉得之前是否成功,其实我觉得这也算是,比较灵魂拷问,我是一个挺知足常乐的人,挺知足常乐,对对对,因为创业还是非常折腾的一件事,对对对,它有一个很强的驱动力,对,才会投身,就是你说的这么suffering的一个事情,是的,这两件事怎么统一的呀,我觉得有可能就是说我,更追求的还是在这个,创业和努力的过程中。 [02:51:17]
姚颂:自己努力过产生了一些结果,但对于这件事情,对自己最终的收益,是来自于财富的收益,还是来自于经历的收益,还是来自于名声的收益。
程曼祺:我并没有那么的在乎,你什么时候之后,慢慢到了这个状态的,因为你当时也描述过,你刚进大学,一天要学11个小时,要掐表的,所以也焦虑了一段时间,是。我觉得就是从身建的,拿到那个收购的签约以后,就是这么一个状态,就是大步行走的两分钟,对然后之后就一直就是这种状态,其实你当时说就是签完约。然后你说你围着这个桌子夺步,我就想到你们现在公司这个名字,对这个名字其实也有多重的含义,对 striding也是行走的意思,对其实是大步行走的意思,它不是一个小步行走。 [02:52:22]
姚颂:而且其实你看从这两个字的角度,也其实体现了我一定的价值观,我们要行得正对吧,而且我觉得我们是正在前往,正在走向创新的一个时代,对,中文叫振兴,而且你看我特意是用了创新这两个字,是因为我觉得,我是一个很难用之前的标签所定义的公司,那所以我其实就是一个像,比如说大疆或者智园。
程曼祺:可能你只能用创新来统一的概括,已经开始第三次创业,里面疲惫和重复的部分会有吗,以及你现在还兴奋吗,我还是非常兴奋的,现在我还在一线。 [02:53:01]
姚颂:所有的很多的重要决策,我有时候都觉得,他们找我太多了,但所有的事情,还是我自己在这盯着,我觉得就是说,你看到团队,一步一步地成长起来,你看到每一个个体的能力,也在逐渐地成长起来,你看到你的这些,技术的东西,从demo到落地实现,这是一个作为,技术人和创业者,发自内心的高兴,这个跟估值的成长是没有关系的。
程曼祺:所以在这样一个过程中,又是新的技术,又是新的场景,又在不断地扩圈的过程中,我还是挺开心的,未来12个月,在你看到的这个时间表里面,你希望Striding AI做到什么,我觉得其实在今年内,我们就会在。
姚颂:两个我们目标的大的场景,开始能够login 我希望到一年左右的时间,我们的产品真的能够通过,两到三轮的打磨,真的在一些场景里面,开始提供服务,能够让大家在日常生活中,不管在哪个机遇,感受到原来人型机器人,原来巨神智能,真的不只是KiaoKiao5了,能够开始在日常生活中。
程曼祺:让我安全的方便的享受来自它的服务,我觉得这就是我们这一年要实现的目标 OK 今天非常感谢姚颂,作客万点聊,分享了从2016年到现在。10年的三次科技创业经历,以及最近这一次创业 striding AI 对物理AI 对通用机器人的思考和实践,那今天的节目就到这里,我也拜拜,好。下期再见。 [02:55:09]
来源:OpenAI News
URL:https://openai.com/index/introducing-openai-presence
OpenAI Presence 是一个经实践验证的企业级 AI 智能体平台,帮助组织为客户服务和内部工作流部署值得信赖的语音与聊天智能体。
文章认为,Meta 基础设施部门存在严重的组织文化和治理问题:机构臃肿、团队目标割裂、短期绩效导向过强、管理层缺少问责,导致硬件与软件无法协同设计,并反复作出昂贵却不实用的技术决策。随着 Meta 计划向外部客户出售算力,这些问题会比只服务内部用户时更危险。
文章的结论是,Zuckerberg 要求系统服务全公司的方针,并没有阻止基础设施团队围绕局部指标进行优化。作者还预告将继续讨论 Meta 的 DSF 网络架构及文化修复方案。文中关于内部动机、人员去向、项目取消风险和未来采购偏好的部分,主要使用“文章认为”“我们推测”或“市场猜测”等表述,属于作者的分析和判断,而非全部已公开确认的事实。
来源:SemiAnalysis
URL:https://newsletter.semianalysis.com/p/metas-infrastructure-team-needs-a
在我们最近关于 Meta 超级智能(Meta Superintelligence)的通讯文章中,我们曾解释为何对 Meta AI 持乐观态度。Meta 超级智能实验室(MSL)如今已经具备许多正确要素,有望追赶 Anthropic 和 OpenAI,重返行业前沿。不过,我们也曾简短提到,困扰 Meta 基础设施团队的文化问题。本文将深入讨论这些文化问题如何演变成代价高昂的失误,包括 Rivos 这类收购,以及一些奇怪的硬件架构选择。
我们认为,Meta 基础设施部门需要进行文化重置,才能更好地服务 Meta AI 组织,尤其是 MSL 中世界一流的研究人员。随着 Meta 开始向外部客户出售算力,而不再只是服务受其控制的内部用户,这一点变得更加重要。Meta 基础设施已经变得臃肿:中层管理者投入资源打造过度工程化的技术方案,却忽视了组织更广泛的需求。公司似乎被太多彼此割裂的团队拖累,这些团队都在围绕某些指标过度优化,而不是为整个公司交付真正可用的技术。
中层管理者会想尽一切办法证明自己的提案合理,以保住自己在 Meta 内部的位置;而 Meta 已经成为一个政治色彩极浓的组织。其中一个重大问题,是 Meta 每六个月进行一次绩效评估,每轮评估都会淘汰排名垫底的 10% 至 15%。结果是,组织中的员工会围绕短期胜利进行优化,而不是制定长期战略。有些管理者会推动高曝光、能快速交付的项目,这种做法被称为“洗窗”(window washing),随后又迅速转向别的方向或放弃这些项目。很少有人公开挑战领导层,导致错误决策无法得到纠正。整个系统压制长期思考,并催生出规避风险的行为。
在 Meta 基础设施部门内部,供应链团队对工程团队也几乎没有话语权。结果,技术决策更多由政治动机驱动,而不是基于面向全公司的深思熟虑的软件—硬件协同设计。频繁转向也很常见。由于 Meta 以愿意砸钱解决问题、执行速度快而闻名,这些急转弯最终比采取更有纪律性或更保守方法的公司更加昂贵。供应商在获得设计项目后又看到项目被取消,也会逐渐失去信心。这导致供应链对新设计的优先级降低。一些供应商更愿意优先推进 Amazon 或 Google 的设计,因为 Meta 经常重新洗牌。
Meta 的许多问题源于缺乏财务纪律:管理者不断创建新项目、增加人员,以填满并证明 AI 等重大计划所获得的巨额预算。这又重演了 Meta Reality Labs 部门曾发生的事情:公司曾在工程师和研发上花费数十亿美元,直到裁员——其中一部分由公司转向 AI 所引发——从 2022 年开始一直持续到今年,才大幅削减了团队及其相关项目。
首先,Meta 最近的一次重大失误,是去年投入超过 25 亿美元收购芯片初创公司 Rivos。Meta 芯片部门内部很少有人完全理解公司当初为何要收购 Rivos,而那些曾在内部推动这笔交易的人如今也都不再发声。
目前流行的解释是:Meta 当时有钱,定制芯片领域正在升温,而且已经在为未来的芯片授权使用 Rivos 的知识产权(IP),于是领导层认为,与其让别人获得 Rivos 的技术,不如干脆把它直接买下来。通过收购 Rivos,Meta 还获得了绕过 Broadcom 等合作伙伴、自己管理定制芯片制造和测试的能力,这种做法被称为客户自有工具(customer-owned tooling)。不过,为这一能力支付超过 25 亿美元同样说不通,因为从零组建一个客户自有工具团队,每年或许只需约 1 亿美元。
虽然 Meta 只想要 Rivos 的加速器和 GPU 团队,但这家初创公司的创始人坚持要么全部收购、要么不谈。Meta 于是买下了整家公司,随后又大幅裁减了不需要的部门员工。
来源:SemiAnalysis,Rivos
一些 Meta 前芯片员工表示,这次收购由 Meta 芯片负责人 Yee Jiun Song 主导。Song 不顾手下一些人的意愿推动了这笔交易,但此后已经失去了兴趣。最终,Meta 芯片组织拒绝了这次“移植”,让 Rivos 员工只能自求多福。Meta 原有的芯片管理者把这次收购视为一批免费的人员编制,抢走 Rivos 的工程师来扩张自己的势力范围,并把原来的初创公司朝不同方向拆散,直到几乎什么都没有完整保留下来。
这笔交易背后的技术理由也同样迅速消失。Meta 最初感兴趣的部分原因,是 Rivos 拥有 SIMT 核心 IP;在可编程性方面,它比 Meta 自己采用 SIMD 的 MTIA 更接近 Nvidia 风格的 GPU 架构。然而,交易完成后,Meta 取消了原本计划使用 Rivos GPU IP、名为 Olympus 的芯片,因为其系统和封装架构过于激进,软件也远未准备就绪。相反,Meta 将继续沿用现有芯片架构,推进 MTIA 600。
Meta 仍希望开发一款融入 Rivos 技术的芯片,并创建了一个名为 Phoebe 的新芯片项目,目前计划于 2028 年完成流片(tape out)。但 Meta 内部并非所有人都对该项目持乐观态度,有些人认为它最终也可能被取消。我们一直在为 Accelerator Model 的订阅用户更新各种定制芯片的架构、物理布局(floorplan)和出货量信息。
与此同时,加入 Meta 的 Rivos 员工也迅速上了一堂 Meta 内部文化速成课。与 Apple 这类更成熟的硬件组织不同,Meta 的硬件路线图可以像软件路线图一样快速变化,不断转向意味着你现在正在做的事情,六个月后可能就毫无意义。Meta 芯片部门的许多人表示,组织结构不清晰,决策机制不清晰,也没有明确说明各个团队分别负责什么。
有一个不深入行业也能看懂的、颇为滑稽的混乱例子:Meta 不给大多数员工分配固定工位。即使已经入职一年以上,员工每天仍要到处寻找工作空间;有时桌上有显示器,有时显示器配的是错误的线缆,有时则根本没有显示器。员工曾正式申请固定工位,却遭到拒绝,尽管到处都有空着的桌子。
最后,Rivos 收购也让 Meta 原有的芯片团队感到不满。许多 Rivos 工程师加入 Meta 时拿到了更高的薪酬和职级,但他们并没有承担足以证明这些待遇合理的职责,而且被安排在 Meta 原有芯片员工的管理之下。这导致原有团队和新加入的 Rivos 员工士气都下降,后者还缺乏做决策的权力。
从今年年初开始,Meta 的一些芯片工程师陆续离开,前往初创公司或 Arm、Nvidia 等其他知名企业。正如我们此前为客户报道的那样,作为这次收购的一部分加入 Meta 的 Rivos 工程师中,约有 30% 在最近几轮裁员中被解雇。Rivos 联合创始人 Mark Hayter 已经离职。此后,一些前 Rivos 员工在 5 月第一批限制性股票单位(RSU)归属后离开 Meta,加入 Gerard Williams 创办的新芯片初创公司 Nuvacore。我们认为,Rivos CEO 兼联合创始人 Puneet Kumar 也在谋划离开,可能会在 Meta 的股份于一两年后全部归属时退出。市场上有猜测称,他可能加入 Rosaic Labs——这是一家由 Amarjit Gill 共同创办的新芯片初创公司;Gill 是 Rivos 的投资人,也是 Puneet Kumar 在 SiByte、P.A. Semi、Apple 和 Agnilux 工作期间的长期合作者。
下面来谈谈 Meta 的 AI 服务器设计。Meta 的硬件决策很大程度上由总拥有成本(TCO)分析驱动:该分析会将排名推荐、生成式 AI(GenAI)等一系列工作负载,与 Nvidia、AMD 以及 Meta 自研芯片所能提供的能力进行比较。
Meta CEO Mark Zuckerberg 曾下令,正在设计的系统必须服务整个业务;也就是说,系统不仅要支持生成式 AI 工作负载,也要支持核心的排名和推荐系统。然而,Meta 仍然为 GPU 服务器采取了多项“优化”,而且这些选择都很奇怪,往往比其他超大规模云厂商采购的标准配置更差。
部分问题源于公司的服务器团队和网络团队完全属于不同组织,目标和看法也不一致。Meta 工程师还受到一种理念驱动:他们希望拥有自己的网络操作系统和硬件,而不是依赖其他公司。
回顾一下,Meta 的 H100 HGX 服务器被称为 “Teton Grand”,这套设计后来贡献给了开放计算项目(OCP)。它与标准 HGX 服务器的主要区别,是在标准 GPU 和 CPU 头节点配置之外增加了一个交换机托盘。这个交换机托盘装有 4 个 Broadcom PCIe 交换机、16 个 SSD 和 8 个网卡(NIC)。其作用是提供额外的 PCIe 通道,让 Grand Teton 每台服务器可以增加更多 SSD。
来源:Meta
在 Hopper 这一代产品中,Nvidia 通过 ConnectX-7 网卡实现 PCIe 交换功能,实际上已经消除了对独立 PCIe 交换机的需求。Intel Sapphire Rapids 主机 CPU 提供 80 条 PCIe 通道,Meta 本可以设计一台服务器:让 2 个 200G 前端网卡各连接 8 条通道,拿出 4 条通道用于各种管理和控制,再为 8 个 ConnectX-7 网卡各连接 16 条通道。这样还会剩下 32 条通道,可以连接 8 个 E1.S SSD。
所以,Grand Teton 最终只为每台服务器挤出了额外 8 个 SSD,但代价是更高的服务器物料清单(BOM)成本、更高的功耗和更复杂的集成。Meta 为什么需要这么多直接连接的存储?基础设施团队当时认定,训练过程中的检查点保存需要更多存储。但在生产环境中,模型团队对存储的实际使用量远没有预期那么高,这也是该设计最终被取消的原因之一。这是硬件和软件缺乏协同设计、造成资源浪费的多个例子之一。
Meta 还给出了其他理由:该设计更容易维护,并且能够灵活使用非 Nvidia 网卡。由于 Meta 已经严重依赖 Nvidia 的 GPU,工程师希望避免把更多业务交给 Nvidia,尤其是网络业务。然而,Broadcom 的交换机无论如何都无法在现场维护;同时,Meta 的软件栈仍依赖 Nvidia 版本的 RoCE(用于 GPU 流量的网络协议),所以 Meta 实际上不可能切换网卡供应商。
最终,Meta 花了更多钱、TCO 更差,既没有降低对 Nvidia 网络设备的依赖,反而增加了对 Broadcom 的依赖。
Grand Teton 并不是 Meta 在服务器设计上的一次性失误。到了 Blackwell 这一代,问题又延续到 Meta 定制的 GB200 Catalina 机架,也被称为 “Ariel”。Ariel 配备 1 个 Nvidia B200 GPU 和 1 个 Grace CPU,而其他所有客户采购的标准 GB200 SKU,则是 2 个 B200 GPU 配 1 个 Grace CPU。
实现方式很简单:Ariel 使用了 GB200 采用的标准 Bianca 计算板,只是每块板上减少安装了 1 个 GPU。
来源:Meta
Meta 工程师担心单机架 GB200 NVL72 的稳定性。NVL72 系统非常复杂,包括作为所有芯片连接中心的铜制背板,以及芯片与背板之间长达数英里的铜缆和数千个连接点。Meta 基础设施部门最初押注 NVL36×2 配置会比完全通过背板运行的 NVL72 更稳定。
由于 Ariel 在一个机架中只有 36 个 GPU,要达到 72 芯片的全局规模,就必须采用 36×2 的形式。机架间的 ACC 连接了两个机架之间的交换机托盘。这意味着交换机数量翻倍,同时还增加了一跳延迟。
来源:SemiAnalysis
Meta 是 Ariel 这一 SKU 的唯一客户,原因在于 Meta 痴迷于为推荐系统(RecSys)配置更高的 CPU-GPU 比例。推荐系统负责生成个性化广告和信息流。其理由是,推荐系统大量使用嵌入表,用于存储用户、广告和内容的表示;这类工作负载需要大量 CPU 处理,而且每个 Grace 搭载的额外 LPDDR 内存可以存储这些嵌入。嵌入的读取规模小且分散,因此不像服务大语言模型(LLM)那样重视带宽。
但提高 CPU 比例,并因为 36×2 配置增加 NVLink 网络组件,会推高每个 GPU 的服务器资本支出。结果是,与标准 GB200 相比,Ariel 的每美元浮点运算能力($/FLOP)、每美元 HBM 容量和每美元 HBM 带宽都高得多。这些恰恰是 LLM/生成式 AI 工作负载的关键指标,因此 Ariel 对 LLM 训练和推理来说糟糕得多。
综合来看,我们的计算显示,Ariel NVL36×2 服务器的 TCO 比标准 GB200 NVL72 高 14%。如前所述,这笔额外支出换来的是更多 CPU 和 DRAM,但 LLM 团队并没有使用这些资源。这一决策让 Meta 损失了数十亿美元。更不用说,采用机架间 ACC 进行两跳扩展还带来了额外的网络复杂性和可靠性挑战。
正是这些挑战,导致部分超大规模云厂商只为 GB200 少量出货 36×2 配置,而到了 GB300,36×2 配置则被完全放弃。讽刺的是,Meta 基础设施部门最初押注 NVL36×2 会比完全通过背板连接的 NVL72 更稳定。虽然背板最初确实是可靠性问题的来源,但如今背板已经成熟得多,最终胜过了机架间布线。公司低估了 36×2 设计的机架间线缆问题,也高估了让背板支持 NVL72 的难度。36 个 GPU 放在一个机架中并没有带来背板可靠性方面的好处。
由于我们了解到 Meta 的 GB200 机群全部采用 Ariel SKU,这一“优化”让 Meta 的 LLM 团队背负着一套劣于竞争对手所购买标准 SKU 的系统。尤其令人痛心的是,GB200 当时正是生成式 AI 的旗舰系统。
不出所料,Meta 的 GB300 类服务器中已经不再有 Ariel,Meta 正在采购标准配置。
然而,我们现在又看到类似问题出现在 AMD MI450X 上。在 AMD 2026 年第一季度财报电话会上,Lisa Su 确认 AMD 将向 Meta 提供一款基于 MI450 的定制 GPU。我们已经在 Accelerator Model 中连续数月报道这一点。
这款 Meta 定制 MI450 是完整 MI450X 的削减版:每个封装中的计算硅片数量和 HBM 堆叠数量都减半。HBM4 也从标准 SKU 的 12-Hi 降级为 8-Hi。鉴于 Meta 的 Helios 机架拥有相同数量的交换机,我们推测其 I/O 数量也相同。
来源:AMD、SemiAnalysis
通过将计算和内存硅片减半,Meta 的目标是像 Ariel 一样提高 CPU 计算与 GPU 计算的比例。AMD MI450 将成为市场上在芯片工程方面最先进的 GPU:采用 2nm 工艺、混合键合(hybrid bonding)、12 组 HBM,并拥有市场上最大的 CoWoS 光罩尺寸。这会带来单芯片最高的计算和内存密度。Meta 选择将这一工程奇迹砍掉一半,几乎完全削弱了它的价值。
这款芯片配置是为推荐系统工作负载设计的,也是推荐系统基础设施团队作出的决定。但这个决定是在 TBD Lab 成立之前作出的,因此 TBD Lab 没有机会发表意见。相对于 Rubin,这款芯片在扩展域中的计算和 HBM 严重不足;TBD 对该系统没有兴趣,外部客户也不会觉得它有吸引力。
如果 Meta 选择半规格 MI450 设计,这个决定将重创 AMD 在 Meta 的出货量,因为 TBD 会更倾向于 Rubin。AMD 需要拿出魄力,直接与 TBD 的团队合作,确保他们拿到标准 MI450,而不是这款对生成式 AI 极其糟糕的、被削弱的 Meta 定制版本。标准 MI450 实际上将具备与 Nvidia Vera Rubin 竞争的能力。
这是我们公开呼吁 Meta 和 AMD 不要浪费这些硅片,并建设更高效、更具成本效益的 AI 基础设施。如果作出这一改变,我们认为 TBD 实际上会考虑采用 MI450。
这就是 Zuckerberg 的命令所带来的结果。
接下来,我们将讨论 Meta 复杂且昂贵的 DSF 网络架构,以及它为何又迅速转向其他方案。我们还会讨论如何修复这种文化。
阅读更多
本期张小珺与蚂蚁灵波首席科学家沈宇军讨论了具身智能(机器人在物理世界中感知、决策并执行动作)的发展路径:为什么蚂蚁灵波选择先做机器人的“大脑”,而不是同时做本体;如何从真实传感器和视频出发重做面向物理世界的预训练;第二代具身基础模型解决了什么问题;以及数据规模化、真机遥操作、灵巧手、本体迭代和产业格局等关键瓶颈。沈宇军的核心判断是,具身智能还没有迎来类似 GPT-1 的时刻,最大短板仍然是数据,尤其是能够规模化获得、清洗并用于训练的真实具身数据。相比继续把数字世界模型强行改造成机器人模型,他更倾向于为物理世界的需求重新训练原生模型;而公司当前最重要的任务也不是追求某种机器人形态,而是先把智能能力做上去。
沈宇军回顾了自己的技术经历:在清华读书期间进入商汤实习,之后到香港中文大学继续研究,早期从图像编辑、生成模型和生成对抗网络(GAN)一路转向预训练、表征学习,再转到机器人。他并不满足于只在数字世界的干净数据集上追求榜单成绩,更希望模型能够在真实世界中发挥作用。加入字节跳动时,他接触了面向产品的图像编辑和特效;进入蚂蚁技术研究院后,又经历了大模型兴起带来的研究方向反思。2024 年,他开始关注机器人,随后随着蚂蚁集团成立蚂蚁灵波,转向直接面向产业的具身智能创业实践。
蚂蚁灵波成立之初就确定,要做能够跨本体、跨场景、跨任务的通用机器人“大脑”。沈宇军认为,本体很难通用:不同场景和任务对硬件的要求不同,如果一开始把场景定义错了,本体设计就会限制后续能力。公司希望未来不同形态的机器人都能运行自己的模型,因此先把大脑做扎实,再通过末端执行器和具体本体适配落地。团队一方面探索智能上限,另一方面必须把模型放进真实场景验证,用落地中暴露的问题反向决定下一轮模型迭代的优先级。
沈宇军把公司的技术路线概括为两次重要决定。第一,机器人必须从真实传感器出发解决物理世界问题。机器人面对的传感器噪声、视角变化、腕部相机与头部相机的差异,以及不同高度和空间位置的操作,都不是数字世界数据集能够完整替代的。第二,机器人需要从视频中学习动态和时序,而不能只把视频拆成静态图像。由此形成了空间智能、视频建模和视觉动作建模等方向。
到了 2026 年,团队又意识到,数字世界模型的训练目标与物理世界需求并不完全一致:数字世界可能更重视画质或内容生成效果,但机器人更在意感知、时序、动作和执行可靠性。由于无法要求数字模型按照机器人需求改变迭代节奏,蚂蚁灵波决定把与视觉相关的部分重新做一遍,从头训练面向物理世界的模型,同时继续使用语言模型处理语言层面的交互。
第一代模型覆盖深度、视频动作、世界模型和 VLA(视觉—语言—动作)等方向。沈宇军将它们分别理解为:深度模型帮助机器人理解空间和距离;视频动作模型学习动态变化;世界模型帮助预测环境变化;VLA 则负责在具体场景中把任务执行起来。第二代发布了 Depth、Vision、VLA、Video、World 和 VA 2.0 六个模型,重点不只是增加模型数量,而是把传感器、视频、动作和机器人自身数据放到同一条原生路线中。
他认为,第二代模型处理随机性的能力明显增强。机器人在真实位置、视角和物体状态发生变化时,不再只能依赖固定位置和固定流程;但更高阶的智能仍未解决,例如机器人能否理解人与它的持续交互、主动形成意图,以及在用户没有明确下达任务时主动帮助用户。当前模型更像是实现人的意图,而不是自己产生意图。
这次迭代还暴露出实验室演示与真实落地之间的差距。第一代模型主要支持多种构型下的简单抓取,而一旦机器人需要在货架等不同高度操作,头部视角、腕部视角和传感器失效时的替代方案都会影响结果。VA 2.0 则把视频、因果预训练、混合专家等探索与真机数据结合起来,目标是训练一个从参数初始化起就面向机器人控制的原生基座模型,而不是只在已有数字模型上继续改造。
沈宇军明确表示,具身智能还没有到 GPT-1 时刻,因为行业尚未找到足够好的数据规模化(scale up)方法。现在的数据采集依赖真实机器人、传感器、遥操作和各种本体,成本高、速度慢、清洗难,数据规模与互联网数据仍不在同一量级。他预计,只有当具身数据能够达到与互联网数据相近的量级,行业才可能出现真正的跃迁;从产业需要看,起步可能就需要百万小时级别的数据。
随着灵巧手成熟,真机遥操作和 UMI(Universal Manipulation Interface,通用操作接口)可能让数据采集路线发生变化。未来一条路线可能更强调人在真实机器人上的操作,另一条路线可能借助统一接口扩展不同本体和任务。无论采用哪种方式,数据的有效性、覆盖范围、清洁程度和训练闭环仍比单纯堆模型更关键。沈宇军也提到,Physical Intelligence 更强调 zero-shot(零样本)能力,Generalist 更强调后训练,两种路线都在探索如何提高机器人泛化。
数据采集还必须形成从任务下发、执行、回收、清洗到再次训练的闭环,否则单纯增加时长并不能自动转化为泛化能力。
沈宇军认为,当前机器人“大脑”的发展速度一度落后于本体,但未来二者会交替推动:硬件提供新的传感器和执行能力,模型再提出新的硬件需求;下一代模型未必能直接适配这一代硬件,尤其是传感器可能成为限制。蚂蚁灵波不做完整本体,并不意味着本体不重要,而是希望在本体和场景尚未收敛时,先把可迁移的大脑能力建立起来。真正通用的定义也不应只包含跨任务和跨场景,还要考虑跨本体。
从研究院进入蚂蚁灵波后,沈宇军感受到,研究驱动、产品公司和创业公司的目标并不相同。研究机构容易追求论文、引用和技术先进性,产品公司强调业务价值,而创业团队必须同时面对真实需求、技术不确定性和产业落地。他认为,技术路线尚未收敛时,探索一条最终可能不正确的道路,也可能为行业提供价值。蚂蚁对灵波的支持,使团队可以在公司化和产业化框架中持续探索。
对未来产业格局,他没有把答案限定为某一种机器人形态,也不执着于人形机器人。更现实的任务是先解决“智能不够”的问题,让大脑能够跨本体运行,并在真实场景中持续验证和迭代。最终格局可能更接近大语言模型:少数基础模型提供核心能力,更多本体和应用围绕模型展开,但这一判断仍取决于数据、模型和硬件是否能够形成稳定闭环。谈到自己的老师汤晓鸥时,沈宇军也把这段经历视为自己从视觉、生成模型走向具身智能的重要背景。
- 开场与嘉宾经历 [00:00:00 - 00:02:03]
- 为什么从机器人的大脑开始 [00:02:03 - 00:16:03]
- 预训练、模型与数据规模化 [00:16:03 - 01:07:30]
- 机器人大脑与本体的关系 [01:07:30 - 01:23:11]
- 创业、产业格局与汤晓鸥 [01:23:11 - 01:31:47]
- 结语 [01:31:47 - 01:53:05]
张小珺:请不吝点赞订阅转发打赏支持明镜与点点栏目,谈了PhysicalIntelligence派的研究科学家科里一鸣,这是一家在硅谷做机器人大脑的备受瞩目的实验室,业内人士把他们比作机器人的OpenAI,那今天呢我要请的是一位在本土探索原生具身基座模型的公司,是由蚂蚁集团孵化的子公司蚂蚁灵波,目前刚发布了第二代的具身基础模型,我与他的首席科学家沈宇军聊了聊。如何从预训练开始,去一个机器人的底座,瓶颈是什么,机器人的GPT-1Moment,到底在哪里,大家也能从中感受一些,中美思路的融合与差异,那接下来就是我对。沈宇军的访谈,7.2026年,我们和AI共同进步。 [00:01:18]
沈宇军:我还是很坚信,具身一定会有自己的模型,就是这个观点,如果不变的情况下,那它的数据必须要支撑,它可以做自己的模型。
张小珺:如何把数据很好的scaleup,是一个至关重要的点,不及预期的有吗,不及预期数据,我觉得从现在行业来看,大脑可能是目前是落后于本体的,如果机器人有性格的话,你希望他是什么性格。我希望他是个J人,他好干活,对我觉得他核心还是要实用,哈喽已经先给观众朋友们打个招呼。 [00:02:05]
沈宇军:大家好我是沈宇军,现在是在蚂蚁灵波科技担任首席科学家,之前在清华然后后来到了港中文,对。
张小珺:讲讲你在具身智能上的一系列探索。
沈宇军:也是阴差阳错吧,然后当时我在清华读书的时候,刚好赶上大三,然后那个时候是商汤刚成立的时候,2014年底商汤成立嘛,然后我们大三要求是必须要有一个这个暑期的实习,然后当时商汤就正好在清华的东门门口,然后当时反正就去了跟AI相关的这个领域吧。在那个商汤一直干到大学毕业,然后就刚好去那个港中文汤老师里面去读了个书,然后去的时候其实也比较迷茫,因为当时AI虽然说比较火,但是也不知道自己到底喜欢做什么,然后就尝试了很多方向吧,然后像其实本来那个港中文吧,港中文比较擅长的。其实像这种检测分割啊分类啊,这个他们当时也是拿了比较多的冠军,但其实我个人对这个就是打榜啊,这个事情最后就看一个number这个事情,我坦白讲我自己不是非常感兴趣,对然后呢,那个时候刚好有一个技术火起来了,当时叫对抗生成网络。就是干,对对对,然后那个技术火起来之后呢,其实就很多人在这方面做探索,然后那个时候我对这个事情就感觉比较有意思,因为它是能真的能生成一张图,然后让大家去看,然后甚至于你可以去做一些简单的编辑什么。然后那个时候我就从,就是算是选择了说,我可能接下来要再做这个,可能是想要往这个生成模型这个方向去做,对,然后当时做的也是比较早,从17年开始就,就是做生成模型。然后可能坐着坐着,然后那个时候也是有一系列,比较火的工作出现,尤其是像stylegun,那个系列的时候,然后坐着坐着,因为我刚开始做生成,然后做生成。那个时候比较火的,可能就是一些图像编辑相关的东西,就是你怎么把它,按照你想要的方式去调整一下,比如说把你变得更漂亮一点之类的,然后但坐着坐着就会发现,好像坐的太下游了,然后就想把这个东西。 [00:04:18]
张小珺:看看能不能再往前做一做。
沈宇军:就是从编辑再往前做,那就是现在可能大家会讲的更多,就是叫预训练嘛,对那个时候其实还没有这个概念,说白了就是想训这个生成模型,对然后但是再训一训就会发现,好像这个东西完全有点不太,不太能受自己的控制。就是你除了,因为那个时候还没有说什么堆参数量啊,这些还没有这个相关的说法,然后就是感觉坐着坐着。
张小珺:也不知道怎么能让这个模型变得更好了。
沈宇军:然后就开始想说,那我再往前一步,就是从生成之前。
张小珺:那就是做表征嘛,然后可能就是这么一步一步的,从最开始对数字不感兴趣。
沈宇军:然后对生成内容感兴趣,然后再从编辑,然后再做到底层的训练,然后再从底层训练再往前做,做到表征学习,可能基本上一路就是这么过来的吧。 [00:05:09]
张小珺:什么时候发现。
沈宇军:GAN不能scale,这是一个挺有意思的故事啊,就是我们甚至于在,今年年初的时候,还在尝试,做最后一次尝试,还没死性,对就是哪怕是在Diffusion火了之后。然后后面有大家又开始,用自回归也去做一些这个生成,然后哪怕是这样的时候,我还是,就是我们团队还是坚持,做了一段时间干的SkillUp。
张小珺:然后怎么说呢。
沈宇军:其实是取得了一定的效果,就是我们前一阵子做的一个GAN模型会release出来,然后那个时候会发现,跟Diffusion比确实是在某些方面没那么好,但是也比之前的前几年的技术,其实还是要进步不少的,对就是说它还是有它的价值,但是它最大的问题。还是计算量的利用效率太少了,就是因为Diffusion毕竟它可以不断的,就是它可以迭代好多次,然后生成一张图,然后我们就觉得,那对于生成特别复杂的内容,尤其是你想要做这种视频的生成的时候,因为它就是里面的内容实在是太多了。然后可能干确实不一定是一个最好的选择了,然后所以可能我们会把我们在干上积累的一些技术,我感觉沉淀下来,然后release给公众之后,可能就也算是画上了一个句号吧,对不敢说圆满,但是应该也算是画上了一个句号,然后可能接下来也不太会在干的scrap上。再做过多的尝试了,但是往回说一点,就是说我觉得GAN本身是,就对抗生成网络嘛,它其实里面核心的一个技术,还是在对抗上,就是在如果你同时想要去两个模型。 [00:06:53]
张小珺:然后让他们两个都在互相迭代,然后彼此博弈的这个过程中,其实在这方面。
沈宇军:我们还是积累了一定的东西,然后这个技术本身,我觉得在抛开GAN本身不讲的话,之后应该还是会有用处的,对,只是可能不是在现在这些场景上,对,可能不一定是用在。这个图像生成这个领域了,你当时从博士毕业的时候,就在那个节点,当时商汤处于什么状态,多摩泰处于什么状态。 [00:07:19]
张小珺:对于商汤当时发展到什么样。
沈宇军:我印象不是很深了,然后可能像这种生成式的,就是生成内容的这个东西,当时还没有出现在商汤,这个整个业务的大的范围里面,其实我毕业的时候加入的是,我先去了字节跳动,当时字节跳动。倒是跟我做的东西很匹配,因为他是做抖音的,抖音本来就做内容,然后他当时需要做很多特效,我记得当时,就是用我读书期间做的一些工作,当时还带火了一些,比较有趣的应用。因为我是做图像编辑的,然后就是看能不能通过,一些AI的技术,比如说让你男生变成女生,然后变老变年轻,就看看有一些,就是当时应该会有一些玩法,说比如说看看你。 [00:08:03]
张小珺:20年后应该长什么样子,你70岁了应该长什么样子。
沈宇军:就类似的这种东西,对然后包括。
张小珺:怎么能够把一个人跟另一个人。
沈宇军:中间做一个完美的,就是比较连贯的那种转换,对当时就是有一些这样的玩法,是用起来了,在自己也可能待了,当时大概一年多吧,然后那个时候给我的感觉就是,大家每天都在想各种各样的创意。就是说。
张小珺:比如说今天又有一个,什么好玩的特效,我们希望它变成一个爆款,当时我就会感觉,确实还有很多自己想做,但是没做的东西嘛,那个时候刚好是。
沈宇军:2022年的时候,然后应该是,蚂蚁的技术研究院,在招人,这一波还没有爆发,ChatGPT,对,应该是在我。我来了蚂蚁之后的年底,才那个时候,也是震撼了一波,那个时候应该处于。
张小珺:像你们这种。
沈宇军:人工智能学生的一个迷茫期,算吗,因为你加入大公司,它其实主业不是干这个的,它都是在既有的产品上,去用人工智能技术赋能一下,对,总结的还是比较到位。相当于是做,这个计算机视觉这个领域,坦白讲,计算机视觉,过去十几年吧,我感觉第一波,可能是人脸识别,这个确实是一个。比较大的一个应用了,然后第二波,可能是特斯拉带火的,这个自动驾驶,对吧,然后就是它推出了,一个纯视觉方案,除此之外。 [00:09:23]
张小珺:好像还没有看到哪一个。
沈宇军:就是说视觉应用,然后被大规模的用起来,然后有一个,比较强的产业价值,好像还没有碰到,这么一个具体的场景,对。
张小珺:然后这也是为什么说。
沈宇军:我本来从视觉,现在想转到,就是当时24年,24年的时候,我就开始想去做这个,就是机器人这个事情,对,因为感觉。视觉可能是在数字世界,可能就是怎么说呢,它不是一个主要的,发挥作用的一个地方,用物质地不够,对,我是这么感觉的,对。但是在物理世界,离开视觉,机器人肯定是,没办法工作的,我觉得这是一个,对视觉的强依赖,然后所以说当时就开始想,24年的时候在蚂蚁。当时就在蚂蚁技术研究院,然后本来是想在研究院说,要不要做一个,就是往具身方向开始做一些探索,当时是有这么一个想法,对,然后刚好因为就是整个蚂蚁的大的,就是有一个比较大的一个规划。就是其实蚂蚁本身是做这个生活服务的,就是它做了很多这个数字世界的服务,大家听的比较多的,可能是金融相关,但其实蚂蚁做了很多,像这种医疗,对吧,然后说出行等等。这方面的服务,蚂蚁做了非常多,数字世界的生活服务相关的事情,然后从整个集团的层面来讲,说数字世界的服务,如果想再往进一步延伸,肯定是要往物理世界迁移,对。然后刚好24年底的时候,蚂蚁是正式宣布,说要成立了一家子公司,就是蚂蚁灵波科技,然后那个时候。 [00:11:07]
张小珺:我在研究院也刚好跟,就是当时的院长propose说,我也想要去做,具身智能相关的事情,然后就是不谋而合,然后就是当时也就是被,怎么说呢。
沈宇军:就是相当于调动到这个,灵波来,然后说一起去,我们既然要做,就不要说再当一个,研究型的机构来做了。
张小珺:而是说我们可能是,更加的直面这个行业,跟着行业一起成长,对所以说可能就是这么一个契机吧,然后就是来了灵波这里。
沈宇军:蚂蚁研究院当时是个多大的规模的组织啊,有不同一方向的研究院的探索是吧,对对对就是人工智能是它的一方面嘛,然后像它的这个隐私计算,因为就是安全是一个很重要的点嘛,我更多的理解是,这个东西像是一个一些探索性的东西,其实都会放在研究院来做当时。对。
张小珺:为什么决定成立一个子公司。 [00:12:01]
沈宇军:专门做具身智能,我其实觉得这是一个,吉他应该是做的一个,比较大的一个决心。
张小珺:我觉得如果是,还是把它当做研究机构的形式,去做的话,很有可能做一做,就脱离了这个行业,或者换句话说,就是研究员认为的,先进的技术。跟行业需要的先进技术,是会有gap的,对,所以我觉得这其实是一个,比较明智的一个选择,就是说既然要干,那我们就变成一个,真实的业务来干。而不是把它变成一个研究性质的,就是试验试错的一个团队去做,对,所以说就成立了这么一个公司。
沈宇军:你看你经历了三个组织,分别是字节,蚂蚁的研究部门,然后和现在的蚂蚁零波,这三个部门分别是,第一个是以前的一个产品公司,然后你要用AI技术去赋能它,第二个是一个研究驱动。第三个是跟产业结合的一个,类似于创业公司,是算创业公司吧,对,算是创业公司。
张小珺:你的感受是什么样的,在这三个组织中,然后你觉得现在的AI。 [00:13:03]
沈宇军:不管是产品也好,模型也好,它应该是用一个。
张小珺:什么样的组织方式。
沈宇军:去驱动它,从最开始,就是在字节那边,我其实也是做业务,然后来了,蚂蚁技术研究院之后,又刚好赶上,从没见过大模型。然后到大模型爆发,然后也受了一波冲击,然后那个时候就有点,不知道,其实很迷茫,就是研究到底。
张小珺:是什么样的东西。
沈宇军:是好的研究,就是你发了一篇论文,或者说你能拿到,比较多的引用量。
张小珺:是不是就代表你很成功。
沈宇军:就是我们到底能给这个,往小了说就是学术圈,对吧,往大了说就是这个行业,到底是带来什么,就是这个研究。
张小珺:是不是有价值,那个时候自己心里,是不是很清楚的。
沈宇军:然后再到现在的,蚂蚁零波这边,我这一次的感觉,其实是比较深的,我觉得它刚好是,两者的一个结合,就是说我们既想要去,做一些不一样的事情。然后这个不一样的事情呢,又能够直面真实的需求,对。 [00:14:04]
张小珺:然后为什么说。
沈宇军:现在可能这是一个比较好的机会,因为在这个,也是在做业务的过程中,但是现在机器人不是,因为技术还没有收敛,我觉得作为技术人,可能是在这个时候,能为这个行业去。或者说哪怕是探索一条,不正确的路。
张小珺:也是一种贡献嘛,对吧,反正就是说在这里面,技术不收敛的时候,我觉得是有比较多。
沈宇军:可以做的事情,所以在我看来,就是如果现在既想要做一些,比较大的事情,然后又不想要说,在一条完全没有创新的,然后就是纯是那种。
张小珺:怎么说。
沈宇军:一条确定的路上,就是只是说,把桩子打得更深,我觉得从这个角度来讲,我觉得具身反而是一个,比较好的机会,就是大家在这里面,既能有发挥的空间。然后又能做一些,对产业有价值的事情。
张小珺:你们刚创立的时候,刚过来是什么样的感受。 [00:15:00]
沈宇军:两个点,第一个点是,感觉自己还是太天真了,天真的原因是,因为24年的时候,我不是当时在研究院就propose,说想要做机器人,然后后面就发现。想做跟真的开始做,完全不一样,就是这个机器人,机器人这个赛道,有太多我不了解的东西了,就是可能当时,对视觉对模型这面会懂一点,但是真的说。比如说把一个模型用到机器人上。
张小珺:怎么去部署,怎么去调里面的通信什么。
沈宇军:我感觉有太多太多的技术战士,超出了我本来的认知,这是第一个感受,第二个感受呢,就是也很。
张小珺:怎么说呢。
沈宇军:就是在这个过程中,从最开始来了,灵波刚成立的时候,然后整个团队可能不到十个人,然后一点点的看着这个团队,就是不断的壮大起来,然后这个过程中,可能感觉这个。一边在学习,然后一边又跟着行业一起变化,感觉这种,这种感觉还比较奇妙,对,可能这两点感悟,可能会多一点吧,创立之初。 [00:16:04]
张小珺:你们当时想明白,后面要怎么走了吗。
沈宇军:有些东西是很难判断的,但是我们创立之初,其实就明确了一个事情,就是我们希望能够,做一个,就是我们还是希望,做机器人的大脑这一层,这是我们当时。就已经明确下来的一个点。
张小珺:为什么不做本体。
沈宇军:是这样,我们最后是希望,先说我们的初衷,因为我们当时成立之初,是沿着整个麻衣集团的,就是普惠的想法,然后再加上,它生活服务的推广。对我们最后还是希望说,未来某一天,每家都会有一个机器人,对,然后但是这个机器人。
张小珺:是什么样子,其实谁也不知道,甚至于它是不是。
沈宇军:一定是同一个品牌,也不一定对吧,就像大家现在的手机也是无法把门的,对,但我们最后就是希望,每家最后都能有一个机器人,然后我们希望在,这个机器人里面跑的最后。都是零波的这个模型,或者说用的是零波的大脑,这是我们当时做的一个比较大的决定。 [00:17:08]
张小珺:我们也会做一些,像这种末端执行器啊,什么这些,因为现在整个的模型,还没有完全的收敛掉,未来本体的贵发展人什么样。
沈宇军:可能我们也不清楚,就像大家现在用手机,手机也不是一个固定的,就是品牌,就是说大家比如说都用苹果,或者说都用华为,也没有这样的一个说法,所以说在这个还没有。这个地方还没有明确答案的时候,我们明确的想法,就像刚刚说的是,我们要希望这个本体,都跑了一个灵波的大脑,这个事情,所以就是坚定的沿着这条路,先把它就是汤出来。先把它做得比较扎实,对这是我们整体的想法。
张小珺:你们团队现在是一个什么样的构成。
沈宇军:是一个更偏research驱动的一个团队吗,你看美国就有physicalintelligence,这样的组织,其实它的好处就像我刚刚说,因为行业技术还不收敛,所以说它有一些一定是要有research的成分的,就换句话说我们要不断的去探索,说智能的上限在哪里。但这个探索的本身其实就是一种research,但同时我们既然说成立之初,我们就以一个公司的形式,去运作这个组织,就是不想让这个research,太天马行空,就是我们还是希望,这个东西能够跟产业。 [00:18:28]
张小珺:有非常强的结合,所以相当于我们现在是,基本上是两手抓。
沈宇军:一手是想要去看,智能的上限在哪里,另一手就是抓落地,就是说这个东西,一定要把它放到,真实的场景应用里面去试,然后会发现,就是比如说哪里不行。反过来用这个步行的点,去重新反向去驱动,说我们下一步的模型迭代,应该往哪些方向走,因为模型还很早期,它可能有十个八个,这种需要迭代的方向,甚至可能更多。但是精力是有限的,你不可能说我全面开花。 [00:19:02]
张小珺:所以说有哪一个,或者说哪一个特点。
沈宇军:会先去开发这个事情,可能是反而是由行业,或者说由落地来决定的。
张小珺:你们从24年底成立。
沈宇军:然后每一年都分别做了那些事情,对这个就是说24年底成立的时候,其实那个时候第一步做的,就是先把我们到底要做什么,我们是谁,然后要做什么这个事情,先想清楚了,这是一个很关键的点。然后其实25年整个一年,我会觉得我们做了一个,比较大胆的一个决定,当时是从25年3月份的时候,就开始会意识到说,机器人可能不单纯是一个,就是怎么说,多么太理解的一个东西了。因为它毕竟要动,对吧,它跟环境有交互,那个时候其实就开始意识到,就是动态建模,或者说对,对这个时序上的这种建模,可能是对于机器人。往后发展,是一个至关重要的一个事情,对,那个时候其实还没有所谓的,叫WAM这个技术路线,就是这个世界动作模型,那个时候还没有这个概念出来,但那个时候我们就比较坚定的觉得说。机器人的往前走,一定要从视频里学习,而且从视频里学习,不是说把视频抽真,然后还是当成图像来看,就是真的要让他学会,失去的东西,那个时候是25年初就做了。这么一个比较大胆的决定,所以说经历了,基本上9个月的时间,然后在今年26年初的时候,其实我们,也是当时比较早的,应该是行业,可能是基本上。我感觉应该是最早,发布了,就是开完了一个,现在就大家叫世界动作模型,我们叫视觉动作模型,对就是VA,对当时是,我觉得这一波。应该是25年做的一个,比较大的一个决定,然后26年,今年又过了半年,然后今年我觉得,做的一个比较大的决定,就是在25年整个探索的过程中,我们发现了另外一个事情。就是很多时候我们,因为最开始机器人,我们也没有特别多的数据,然后所以很多的时候训练,是依赖着数字世界的模型去做的,然后就有点像把数字世界的模型。 [00:21:27]
张小珺:在物理世界加接成了一个agent,大概当时是这么做的,加了一个动作,对对对。
沈宇军:但是那个时候就意识到了,一个比较重要的问题,就是很多时候。
张小珺:数字世界的模型的开发的初衷,跟物理世界的需求,是不是很匹配的。
沈宇军:但你这个时候,你又没办法push他们去改,因为数字世界,有自己的一套逻辑,他们也有自己的应用场景,对比如说,可能从,就是视频生成。这个角度来说,就是他就会希望,这个生成的画质特别高,对吧,这是数字世界的需求,但是其实物理世界,你落实到机器人动作来看,其实这个东西。没有那么重要,对,但是你不能反向,去push他改模型,因为他们是有,自己的迭代节奏的,所以26年这一年,或者说这半年。我们做了一个,我觉得是一个比较大的决定,就是既然不能push他们去改,我们就全部基于物理世界的需求,重做一遍,重做一遍,对,就是从头来训。对从头来训,一点都没有用大语言模型,不语言模型是用的,我说跟视觉相关的所有的东西,我们就从头来了一遍,但是语言模型还要用是吧,对LLM是用的,对对对。因为那个的训练成本太高,而且那个我觉得,数字世界跟物理世界,好像也没有什么,就语言层面上,其实区别不大,只是说物理世界,可能更多的是靠语音交流。然后数字世界就打字,对,这个可能,我个人感觉,现在还没有到,就是我们还没在这个地方,看到明显的,直接应用大语言模型的一个短板。就是感觉用起来还比较OK,对,但是在视觉上,不管是理解还是生成,我们其实会感觉,数字世界的开发的,本来的就是motivation,和物理世界的需求。其实没有那么匹配的,对,这是可能26年,做的一个比较大的决定,25年可能还做了一件事情,我觉得也是一个,比较大的决定,可能就第一大决定。是我们就是觉得,要做视频上的建模,其实我觉得另一方面,还有一个比较大的决定,就是我们那个时候,是非常坚定的,要从传感器出发,就真实的传感器触发。去解决物理世界的问题的,因为这个事情是跟我,24年底刚来灵波的时候,我不是说那个时候,就太天真了,觉得这个事情,往机器人上迁移很简单,然后那个时候。其实我们尝试,最开始来的时候,就尝试着用很多,数字世界的算法,或者说之前开发过的,计算机视觉领域的一些模型,直接在机器人里用,然后用的时候才发现。落地跟之前的想象,完全不一样,因为在之前我做research,做的比较多,然后其实学术界,有一个不太好的一个,也不能叫不太好吧,或者说大家有一个。心照不宣的一个点,就是数据集都是比较干净的,就是相当于,你很少能从数据集里面。 [00:24:22]
张小珺:看到那种比较噪声,比较大的一个东西,但是在实际上应用,应用起来的时候,因为机器人,毕竟要在现实世界中跑,就会发现传感器的噪声。
沈宇军:其实是完全没有办法忽略的,对这个东西,跟你能拿到很干净的数据,是天然就是相悖的,所以说基于这个考虑,我们25年也是坚持要,就是说我们可能就要从,这个传感器的这个维度。开始做起,对传感器的维度就包括视觉,可能也包括触觉,对可能是这是整个,宁波现在整个,就是整个技术思路吧,两个比较大的技术主张,一个主张就是。我们可能要从。 [00:25:07]
张小珺:就是传感器开始做,然后我们会更多的,或者说大家现在更好理解,就叫所谓的空间智能,对,然后另一个比较大的主张就是。
沈宇军:可能我们要坚持从视频里学,而且要,可能就是为这个数字世界,就是为物理世界,原生的这个方式,重头学,对,可能是这两个是。我觉得比较大的主张。
张小珺:你们在25年9月,是不是外探大会,还有过一个炒菜的demo,这个demo跟你们当时的那条技术路线有关系吗。
沈宇军:那个其实炒菜是一个比较长程的任务了,对,然后当时是尝试着去做了一下,发现了很多软硬件上的问题,然后这也就促生了我们,更加坚定了说,我们一定要把大脑这个事情做实,因为如果没有一个比较好用的大脑的话。其实比如说,这上一次是炒菜嘛,对吧,然后如果我们想再拓展一个场景,复制成本实在是太高了,对,所以说可能有了那一次之后,我们更加坚定的说。我们要把大脑这个事情做好,我觉得有两类公司,有两类思路,一个是我就要软硬一体化,然后一起协同往前走,一个是我就彻底不做硬件了,我要把脑子做好。 [00:26:23]
张小珺:你们选的第二条路,为什么没有选第一条呢。
沈宇军:我们的初心就是做一个通用的脑子,所谓通用是因为我们有一个判断,是说这个行业需要的机器人,或者说他未来是可能进家庭,但中间可能还有一些,突避的这个阶段,我们是觉得,你很难说有一款机器人。真的适合所有的人物,或者说你哪怕到了进家庭,然后你可能每个家,对这个机器人,也有不同的需求,对吧,可能从任务角度出发,它就不是一个。可能一个通用的本体,就所有的事情,全都解决的一个场景,我觉得这个事情本身,可能短期内,是不太会实现的,对,所以说在这个方面。我们就还是说,既然我们的主业是做大脑,那我们就从大脑出发开始做。 [00:27:11]
张小珺:刚好我们其实也有一直,讲了一个技术主张,就是我们的大脑,从最开始定义,就是希望它跨本体,就是说希望它通用,这也是为什么,我们在训练过程中。可能就加入了,不同的本体的数据,我们希望我们的大脑,在预训练的过程中,就经历过这些本体,了解它们的特性,那么在后面。
沈宇军:可能说真的在某一个场景落地的时候,就可以快速的适应那个本体,对这也是我们,就是我们就是选择这条技术路线,也是跟当时,可能跟公司整体的一个最大的战略规划,就是说我们要做通用大脑,这个事情是符合的吧。通用就意味着是跨本体,通用除了跨本体之外,当然还可以,就是他还有跨任务跨场景,这些也是通用的一部分,对但是有些时候,我还是比较坚持说,可能本体跟场景是。没办法完全,完全解偶的,就是什么样的本体。 [00:28:06]
张小珺:适合什么样的场景。
沈宇军:可能从这个本体,从产品定义最开始,就已经决定了,有些事情适合他做,有些事情不适合他做,对,大家现在可能讲的通用,更多是会停留在。任务和场景这个方面,但我们就是把这个,硬件这个东西,也考虑进去,我们觉得通用,应该就是多一层,就是你本体上也要通用。
张小珺:你们26年,因为之前已经开源过四个模型,那是你们第一代大脑。
沈宇军:然后现在又要开源第二代的大脑,这次应该有六个模型,对这次是有六个模型,在这两代探索上。
张小珺:你们发生了什么样的变化。
沈宇军:第一代做了哪些事情,第二代做了哪些事情,其实从我刚刚说的,就是25年和26年,两个比较大的决定,其实是比较相关的,25年的时候,我们当时两个决定。一个是一定要从视频开始学,一个就是要做空间智能,就是说从传感器开始学。
张小珺:然后这也是为什么,就是从25年,我们那个25年做的。 [00:29:02]
沈宇军:或者说就是今年1月份,开源那四个模型,就是第一个就是深度,深度其实就是从传感器开始,就是希望这个机器人,对这个空间有更好的认知,就对距离有更好的认知,这是一个。从这个视频开始学,其实就催生了视频动作模型,还有一个这个世界模型,对就是说白了,就是一个能让它当这个防震器,然后另一个是能让它当执行器,你可以大概这么去理解,对。然后这是三个模型,然后再有一个就是VLA,VLA就是这个行业最主流的,然后能够真的说在场景里面,去把活干好的这么一个一条技术路线,对,所以说去年,今年年初开源的四个模型。就是这么个选择,这个模型训练多久,不同模型开发周期不一样,像我说的可能时间,就是开发的最长的,可能就是视频动作模型,那个基本上是经历了大半年的时间,才最终把所有的事情都摸清楚。像深度这个,因为我们之前做,就是在视觉上,其实本来就有一定的积累,所以说可能在那个方面,就是大概三个月,三四个月的样子,对就是每个模型。其实周期不太一样吧,这一代大脑能用到哪些场景本体,它能做什么呀,第一代大脑,当时我们应该是支持了九种构型,对然后那个时候,应该是做一些简单的,这个抓取任务吧。对,然后行业那个时候,做的比较多的,也都是这个方面的动作,对,然后一些抓取上,可能解决的比较好,我们在通过跟行业去交流。去接触落地的过程中,然后催生了这一代模型的,一个比较根本的一个变化。 [00:30:42]
张小珺:就是我们在真的想,把VLA落地的这个过程中。
沈宇军:我们会发现,有一个点,其实大家之前,都没有太关注过,就是之前,大家做的很多demo也好,还是基本上都是实验室环境,对吧。实验室环境也就是说,可能所有的操作,是在桌面上做的,但是我们这次试着想把它,在这个实际场景落地的时候,会发现机器人做很多动作,其实不是在固定高度做的,它可能需要。比如说你去架子上拿个东西,它需要抬手的,抬手的时候,这个时候就会,就是明显的突出一个。 [00:31:18]
张小珺:说实验室场景,跟真实落地场景的一个gap。
沈宇军:就是比如说头到底应不应该看,就是头到底要不要看,你手抬的那个地方,然后视角会不一样,而且甚至于有可能,头即使抬了也看不到,对吧,然后抬起手来。就是这里面就是说,那就是你的模型。
张小珺:到底能不能控制抬头,以及说在头部相机失效的时候,你能不能只用腕部相机。
沈宇军:或者说用其他的一些传感器,就把这个事情做了,这个事情在基模,就是说最开始的,第一版的模型预训练的时候,我们只支持了手臂的自由度,然后只支持了甲爪,然后就是没有头。没有其他的所有的东西,对,然后九种构型,就是做一些简单的,桌面上的一些操作任务。 [00:32:06]
张小珺:所以你要做抓取,你不能只考虑手,你还要考虑其他的部位,对,甚至于有些时候,假如说,因为你看最开始的,很多BLA的这个demo。是机器人是站在那不动的,甚至有一些。
沈宇军:大家做的展示出来的东西,可能都不一定是个人形,就是它可能只有两条手臂,就是实验室环境,基本上大家都是这么打的,就是把这个东西都可以setup好,但实际上落地的时候,就是我们不可能让机器人。就是那个点位点的那么准,就是你如果要,假如说你需要够的时候,手够不到。
张小珺:那你是不是要移动一下。
沈宇军:对,然后就是刚刚说。
张小珺:头是不是要抬一下。
沈宇军:然后有些时候,包括你视线到底在哪,对,然后你说抬,就是你抓东西,那够东西是要抬手嘛,对吧,那我如果想要从下面拿东西呢。你要弯腰,对,这些自由度,是我们之前第一版模型,完全没有考虑到,然后在这一版模型,就是说这次,就是相当于2.0的一个发布中。就会发现,我们在这个机器人,这个数据上,其实做了,就是比较大的一个升级,从九种构型,首先是升级到了20来的,20多。 [00:33:12]
张小珺:对,然后自由度是从原来的只有双臂,现在支持到带头,带腰。
沈宇军:带底盘,甚至带零销售,对,就是这个东西。
张小珺:怎么说呢。
沈宇军:这就是我觉得,我们刚才说抓两头嘛,一面是就是,就是上限的牵引,一面是抓落地,我觉得这个就是,落地的过程中,告诉我们。到底应该,就是模型迭代,有那么多方向,到底应该,什么是最重要的,对你迅模型来说,你最重要的,要做的事情。是要找到这样的数据,放到预训练里,对。
张小珺:你们这是一个。
沈宇军:多大的预训练规模呀,这个,我们这个应该是一个,3B基于,当时应该是基于,三点几B的一个模型去做的,对,然后数据量大概是。搞到了六万个小时,六万个小时,对第一代是两万个小时,然后这一代是升级到六万小时,但其实,这一代升级到六万小时,跟第一代的两万小时还不一样,因为我们整个数据管线。因为之前就是,最开始做的时候,感觉很多。 [00:34:11]
张小珺:什么样的数据是好的。
沈宇军:还没有完全的探索明白,然后经过了第一版模型的发布之后,把很多这方面的数据也重新清洗了一下,所以相当于第一次发布那个两万小时数据,落到这一次的可能就剩一万多了,对然后我们是在这样的一个更严格的管线上,把这个数据就是又做了一个量的一个累积。
张小珺:对然后差不多四倍应该是有的,对应该是上一版的四倍差不多吧,数据来源包括哪些,怎么收数据,收数据其实,你们是真机数据牌是吧。
沈宇军:对我们是以真机和,可能还有一些Ego的数据,Ego就是人戴着,头上戴个相机去做的那种。
张小珺:你们仿真数据要吗。
沈宇军:仿真我们可能会更多的,把它留在评测上,就是可能不太会用仿真的数据,去做模型的训练,仿真数据量是可以做的很大,但是数据除了说数量之外,其实数据有一个很关键的点,就是分布。分布就包括了说,比如说构型可能是一种分布,对吧,任务维度也是一个分布。 [00:35:17]
张小珺:我觉得仿真数据,他可能在他擅长的方面,他可以。
沈宇军:就是瞬间就可以生成,很大量的数据,这个事情是毋庸置疑的,但是从另一个角度说。
张小珺:怎么说呢。
沈宇军:他可能分布会相对,同质化会严重一点,就是他可能做的是,差不多类似的任务,就是他的那种,比如说,尤其是一些这种柔性的仿真,或者说。比如说你撕开一个塑料袋这种,其实对仿真来说,我感觉物理引擎还需要点时间,再去做一些迭代,迭代升级,可能那个时候仿真的数据用处会更大一点,但是对于仿真,现在比较好做的一些任务来说。比如说也是一些抓取,挪这种任务来说,其实从现在整个行业的发展来看,侦缉数据的成本也在逐步的下降。 [00:36:11]
张小珺:降了多少。
沈宇军:过去两年吧,我觉得至少得降了三倍不止,对我感觉是这样,因为从整个管理的,就是人员管理的这个逐渐成熟,然后机器也逐渐成熟,对吧,然后可能数据的需求也逐渐变多。就相当于数据也在量产,量产一定会降本的,对所以说从各个方面的一个成熟,我感觉是让真机数据的获取的渠道,以及这个渠道会变多,然后成本会变低,所以说可能这个,我觉得也代表了整个行业的一个。就是繁荣发展的一个趋势吧,对,有哪些类别的数据,准备数据上有什么knowhow吗,核心的是,就是你到底要下发什么样的任务,这是一个比较比较难的点,就是你怎么能让你的任务。尽可能的覆盖,我们刚刚说的所有的自由度,它有一定的通用性,对,就你不能说我这个数据里面,90%其实都没有用到头,只有10%用到了头,不是非常准确。我觉得可能举个更好的例子,就是说头部出现的,就是头部这个自由度出现的比例,跟可能腰部出现的比例,差距特别多,那可能会导致我们的模型,就更倾向于学头,然后不太会动腰。对大概是这么,就是直观上讲,可能是这么理解会好理解一点,对,然后另外一个knowhow,可能就是数据真的拿到之后。 [00:37:41]
张小珺:怎么样把它清洗好,这个链路是怎么样的,这个坑,其实我们也蹚了比较久,因为这里面有一个天然的困难点。
沈宇军:就是我们是做的是这种,跨本体的模型,每家本体的特性都是不一样的,所以很多数据处理的方式,可能是要跟本体,有比较强的关系的,就是不是说,真的说每家本体都可以用。一种数据链路就搬卷,处理掉,对你可以理解成,就是比如说,它的那个相机摆放的位置,可能就不一样,对吧,它的自由度的。这个关节的,比如说几个自由度的,连接方式也不一样,就是所谓的这种,configuration,就是这种机器配置的不同,其实对这个数据的处理上,带来了很大的难度。对,所以说可能我觉得,核心的knowhow,应该就是这两个吧。 [00:38:32]
张小珺:一个是怎么下发任务,以及数据真的拿到了之后,怎么把它处理得更干净,有观察到什么。
沈宇军:通用性好的任务吗,通用性好的,其实还是说,操作越简单的,它就通用性越好,就是因为这个事情,可能取决于操作员的能力了,因为你越复杂的任务。可能能够把这个任务完整,或者说丝滑做下来的,素材员就比较少,对因为如果他的动作,就是素材的过程中,这个动作假如说不丝滑,很有可能就导致,因为你是没办法。把它修丝滑的,就一条数据嘛,对因为那个成本就巨高了,对如果你不能把它修的丝滑的话,可能会导致你学出来的模型,就他就他以为这是一种正确的操作方式,对就可能最后模型在控机器人的时候,那个机器人也也也也非常卡。 [00:39:22]
张小珺:对就这个都是怎么说呢,就可能素材员这个行业也在。
沈宇军:也在进化,也在成长对。
张小珺:这是你们自己的素材员还是外包的公司。
沈宇军:都有对我们有,因为我们是,整个是一个比较,就是我们有那么多种构型,对,我们可能有一些合作伙伴,生态上的合作伙伴,尤其是数据测的。本体测的都有,然后我们可能会,拜托他们帮我们,就是一起去,把这个数据体系建立起来,然后同时有一些,比较难的任务,所以就是我们还保留了。一定的自己的,就是采集数据的这个能力,让,就至少我们先,把这个SOP先弄清楚,就是我们的人,先把这个东西做一遍,然后把它就是再去沟通给别人。 [00:40:09]
张小珺:然后说这个事情能不能帮我。
沈宇军:就是补一些什么样的数据,对,所以很多素材方面的坑,其实也是我们自己在,也是自己一点点的在烫,我听过一个说法,就是有一些错误数据,错误了再纠正的数据。也是好数据,对,那个可能跟真机强化,可能会有点关系吧,但是那种素材,其实也一样,就是你人要在旁边,就是相对看着他。然后你要知道他犯错了,然后你要在合适的时间,打断他,然后并给他一个正确的示范,这个是这样的,就是我们现在,因为为了落地,为了提高成功率。其实我们也,内部也,就是在这个,落地这个环节,其实也加入了,真机强化的这一部分,就是说怎么能够,让这个机器人从。可能本来模型,没有做的特别好,然后去纠正它,然后把这个模型变得更好,这个是有的,但是,但是这个东西可能就,更偏落地一点。可能我们没有在这个,开源的这个技术报告里面去体现。 [00:41:09]
张小珺:你们这次六个模型,它们之间的关系是什么样的。
沈宇军:这个其实是,我觉得这是一个,这一次我们做的一个,比较好的地方,我先大概讲一下关系吧,然后再说一下,为什么我觉得是,做的比较好的地方。首先第一天我们会搞了两个模型,一个是这个Vision,就是LimboVision,然后另外就是一个LinuxBotDepth的升级,对,这两个模型是因为我们上一版,就是在1.0那个版本的时候,做的Depth。其实是基于Deno去做的,对,当时我们是用的DenoV2,当我们的PretrainModel,然后DenoV2,其实也算是一种数字世界的模型吧,然后它可能更多的,它比较擅长的任务。就是那种语义的理解,对,但是其实我们发现,语义的理解的这种预训练课呢,因为在数字世界,就是你理解语义,其实就够了,很多时候。对吧,就是比如说知道这是一盆花,然后知道这是一只狗,这可能就够了,对,但是我们在发现,这个事情,就是这种语义级别的理解。跟真的说想要去理解空间,或者说理解距离,好像并不是天然那么吻合,所以说我们自己重新做了一遍,预训练,这次预训练就不再是,跟Deno不一样的是,我们是完全从几何的角度出发。去做的预训练建模,几何角度。 [00:42:31]
张小珺:怎么理解呢。
沈宇军:我觉得你可以,粗浅的列成点线面吧,就是说给你一张图,然后你先看有哪些,或者说就边缘,对就是我们是从边缘出发,去让这个模型,更好的去理解几何这个概念。然后因为几何,其实距离也是,就是它跟距离是比较相关的,对然后所以基于这样的一个,Viren,就是我们这次更新了底下的基模,然后会发现,就比之前用DenoV2去做的Depth要好。有一个比较大的提升,然后同时经过了半年的积累,其实我们的数据量又翻了几倍,所以说我们又把Depth基于我们自己的新的基模,以及更多的数据又迭代了一半,所以说有了一个更好的Depth,然后这次Depth,我觉得有几个比较有意思的例子。第一个是我当时看到的比较正经,就是一个厨房里那种,比较透明的那种水龙头,不是透明,就是反光的水龙头,然后把水打开了,然后可以看到,我们是可以清晰的看到水流的。就哪怕,清晰看到水流,对,就是因为这个事情,对于一个机器人,真的想执行一个任务来说,是很关键的,就是你必须要能看到水。假如说就是接水,你必须要先能看到水,你说的机器人看到水,对。 [00:43:56]
张小珺:就是你要看到水的位置,不是说看到水打没打,你要知道水流在哪里。 [00:44:02]
沈宇军:他之前看不到吗,之前应该是,之前他知道那个水流是开的,但是距离肯定是不准的,基于我们的Vision,训出来的这个depth,这是一个我觉得比较有意思的点,然后第二个点。我觉得更形象了,我其实比较喜欢拿这个例子,去做一个解释,我来可以解释一下。
张小珺:为什么语意理解。
沈宇军:数字世界的语意理解,跟物理世界的距离是不一样的,这是一个很有意思的例子,就是假如说阳台,然后有一个玻璃门,然后外面有一只猫,你会看到我们这次的Depth模型,是完全看不到那只猫的。因为它前面挡了一道玻璃,就相当于是,如果我们人在往前行走的时候,你就会先撞到玻璃,然后才有猫,所以说我们会试着,把那个玻璃门拉开,拉开的过程中。你就会看到那个Depth出来的,那个猫就逐渐地,从那个门后面出现了,因为玻璃被拉开了,然后就可以看到猫了,但是从语义的理解的角度,其实那个猫一直在。 [00:45:07]
张小珺:就数字世界,它只需要知道,那有个猫就好了,对,但是物理世界,你还需要知道,前面有一个门,对。它对位置的感知,在数字世界里是很弱的,对,因为它不至于说,我走一走会撞到,它没有这样的问题。
沈宇军:对,其实就是这,我觉得这是一个非常好的例子,就是你能看到,但你摸不到,能看到是语义理解,摸不到是空间感知,对。所以说这是我们第一天发布的,两个模型,就是Viren和Depth,对,然后他们两个关系,就是Viren是Depth的预训练,就是我们Depth之前用的预训练是Deno,现在我们没用Deno了。然后我们是自己搞了一套新的预训练,然后新的预训练,就是你可以理解成,它是对视觉本身的,一个很好的理解,这是预训练做的事情,然后Depth是它的下游,就是你从视觉感知。
张小珺:怎么变到空间感知。 [00:46:01]
沈宇军:对,就是相当于把从图像变成三维,大概是这么一个关系,那LLM跟他们有关系吗,没有,这个也不需要基于LLM对吧,对这个是完全,完全从视觉出发去做的训练。就是一直比较细确的讲,我们关注的这三个事,就是看得更清楚,想得更明白,干得更利索,就是机器人,我们是觉得就这么三个事,第一个是看得更清楚。对所以说,我们先解决的,看得更清楚的问题,然后看得更清楚,这个事情本身,是不需要语言的,就是纯视觉,视觉原生的。一个语训练,对,然后这是第一天要做的,然后第二天,我们其实发布了,这个VLA嘛,然后VLA做了个升级,然后我刚刚说。VLA这次的升级,可能主要是从,落地的角度,我们发现了一些问题。
张小珺:怎么把这个数据,变得质量更高,然后怎么让。
沈宇军:构型变得更多,然后支持的,支持的任务,可能变得更复杂,因为我们能支持,头腰这些东西之后,他可能能做的事情就变多了,对吧。对,然后,然后VLA这个事情,我觉得,可能对整个零波来说,它最大最大的价值,就是把数据要弄明白,而且把数据弄明白的是。从产业的视角,把产业需要的数据,或者说把落地需要的数据,弄明白,对,这是整个VLA这次的升级,然后刚才VLA讲的也比较多,所以像比如说。有一些模型公司,就是以research为主导的公司,它的数据可能会倾向于,真机和仿真数据混合来用,在你看来。 [00:47:34]
张小珺:是不是它离真摄场景是有距离的。
沈宇军:这个可能是不同公司选择的策略不一样,因为如果它做的,比如说它选择的场景,是仿真可以做的比较好的,那我觉得从仿真上拿数据,没有任何问题,对,然后但是我们。我们还是说,我们想要做通用的大脑,然后也是就跨本体跨任务,所以我们希望,它的能支持的任务,其实是越多越复杂越好,对所以说可能,现在对于这种通用任务来说。仿真可能的覆盖率,没有那么高,所以可能我们,没有选择仿真这条路,然后更多的可能,还是希望从真机出发去做,对,反正就是说。第一就是第一天的模型,我们解决了,看得更清楚的问题,然后第二天的模型,其实就是VLA,我们是解决了数据的问题,然后其实接下来的,刚才说了三个模型。还有三个模型,这三个模型,其实我更想放在一起说,就是一个是video,一个是word,然后还有一个就是,我们一直讲的va,或者说现在外面会讲wm。对就是我们,但我还是会以va来说。 [00:48:43]
张小珺:因为我们的命名是vm,对我们这三个东西,放在一起说。
沈宇军:然后这个地方,我记得callback一下,我们刚才说的一个点,就是我们在上一版1.0的时候发现,很多数字世界的模型的开发的动机,跟物理世界的需求是不匹配的,对,然后其实有几个明显能感受到不匹配的点。第一个,数字世界的,尤其是视频生成这一块,或者说大家现在比较喜欢讲这个世界模型,第一个点,数字世界在做这个视频生成之前,会做一个这个语义的压缩,会做一个视觉的压缩。因为它要求最后生成的,图像的质量要很高,对吧,然后它没办法做的话,它一定要先做一次压缩,但它这个压缩其实就是,或者说大家现在比较常用的,开源能拿到的压缩。它就是只做了一个单纯的压缩,这个压缩过程没有,就是这个压缩过程本身,对后面的学习,没有任何帮助,或者说没有任何联系,它就是单纯把一个,假如说就是把一个。假如说是100兆大小的东西,然后我先把它变成30兆,让它更好学,可以大概这么理解吧,然后我们这一次呢,是为了让机器人在后面的学习,就是理解,就是学习的过程中。能够更好的去理解语意和动作本身,所以说我们在训练这个压缩的,这个就是视觉压缩的这个模型的时候,我们就加入了语意和动作的对齐,就是说换句话说,这个压缩的,或者我们叫编码器也好,它在编码的过程中。就可以感知到一些语义信息,和动作信息,有了这样的一个编码器之后,它在后面基于这个编码器。 [00:50:33]
张小珺:编出来的那些个东西,再去学生成的时候,它就更好的能够把语义,跟动作这个东西,理解的更好,这是一个点。
沈宇军:然后第二个点,也是数字世界,跟物理世界不太一样的地方,其实数字世界不是很关心效率,因为举个例子,大家说现在比较常见的,就是文生视频,我给他一段话。然后他会给我一段视频,然后其实中间可能,比如说你生成一个30秒的视频,用户可以等30秒,或者说等10秒,等个20秒,那还是希望他能越来越快的,对你肯定是希望快。但是我的意思,他肯定是有可以等,然后等你整个视频一起生成完,但是机器人在执行的过程中,是没办法等的,它是及时的,对它一定要实时,一定是实时的。对然后所以说基于这个,它就会诞生两个点,第一个。 [00:51:28]
张小珺:你的模型效率是不是能做得更快。
沈宇军:这个其实从这个点上,对就是因为现在大家,可能用万象会用的比较多,然后万象其实是一个Dance的模型,就是它没有用,没有用MOE这种形式,就是比如说它是一个14B的模型,它在推理的时候激活就是14B。对,然后但是这个事情,我觉得对于后面的加速,你哪怕是后面的加速工作做得再好,你在模型本身激活上,其实没有一个,如果就是说从框架上不做加速的话,可能对后面的。就你能加速的比例其实是固定的,你没办法真的做到非常非常快,这是一个点,然后另外一个点是,就因为刚刚说的是实时的,所以它必须要,就是它必须要所谓的叫单向建模,你的历史是看不到未来的。未来可以看到历史,但是历史看不到未来,时间是单向流逝,对,但是因为数字世界,你说生成模型的时候,其实它可以是双向的,对吧。因为我,就是你是给他一段话,然后你等一会,你等的过程中,其实就相当于是,你那段话的开始跟结局,其实你都知道了,然后他给你一段完整的视频就好了。他不用说在这个过程中,只能往前走,这两个点,是物理世界对提出的一个,比较新的一个需求,但同时呢,也不是说提了新需求之后,它就这个东西会变得更难。但物理世界也有一些,可以被做一些取舍的东西,就是可以被舍弃一些东西,最核心的就是画质,因为数字世界,可能大家会要求高清嘛,然后要求对吧,帧率要高。然后这个东西看起来,欣赏起来才好,内容生成主要是这样。 [00:53:07]
张小珺:对其实不同生物之间的,那个视觉能看到多清晰。
沈宇军:是不一样的,但是它也可以在地球上生活,对所以嘛,就是物理世界,其实就是换句话说,你可以生成,有点马赛克,没有关系的。或者说就是画质不高,没关系的。
张小珺:然后因为什么。
沈宇军:因为我们还有摄像头,就是你生成的不高,但是你能看到,所以这个没关系的,对然后就是,就是基于刚才我说的,它有提出两个新的需求,但是又可以舍弃掉画质本身。所以说我们在这方面,又做了两个工作,一个就是我们说的video,我们也是把它开源出来,就是LimboVideo,本身就是一个,Moe架构,原生Moe架构的一个模型。它有一个,其实Moe这个事情,就是大家可能,听的会比较多,好像说,那就把一个dance的,变成一个不用每次都激活,我就是比如说。三个参数激活一个,就类似这种,不就好了吗,但其实真的想把Moe训明白,还是有难度的,因为在训练过程中,你要控制每一次的生成激活的比例,是它要均衡。就比如说你一共有,一共有30个参数,然后你每次都激活那10个,就有20个参数,就基本上不被激活到,这个事情是不可以接受的,因为如果是这样的话,其实跟10B的。或者说10个参数的,弹死模型就没有区别了,我们既然是想让它,就是想让它就是稀疏化,那你要让它稀疏的均匀。 [00:54:37]
张小珺:如何能让一个模型。
沈宇军:就是Moe的训练,就是均匀的把每个参数都,就是怎么说呢,以同样的概率被激活,然后把它训好,这个东西是,其实是一个技术问题,对它不是一个一元度问题。不是说我想让它少激活点,就激活点少激活点,对所以说我们在video上,就是因为我们自己从头去,把这个Moe这个东西,我觉得应该算是,先是堂通了吧,这个中间失败过没有。失败了很多次,应该是把,就是整个训,因为我们也想说,训一个,能有训练基模的能力,然后其实把整个基模训起来,整个info打起来。数据弄起来,其实这些都是一些,基本上可以理解成,是确定性球技,就是都知道,可能是没那么多经验,但你反正就是,就是做就好了。其中花的最大的一个部分,就是MOE,MOE应该至少光训MOE想训明白,可能就花了两个月的时间,两个月,对,然后就是不然的话,就你一直发现。他想就是他虽然叫MOE,但跟你最后期待的MOE是不一样的MOE,对,所以我说就是把MOE训好是一个能力问题,它不是一个态度问题,对,所以说,后来提升了哪些能力。其实失败了几次,中间失败,因为两个月我估计失败个几十次应该是有的,但失败它不是说你训到后面才失败,你训一训就会发现跟你想要的不一样,就是有些参数激活的不均匀不平衡,然后MOE这个事情,我觉得其实最后最最大的核心。就是怎么能够让你的这些个所谓的专家,被等概率的激活,然后这个里面可能就涉及到,从你这个训练的时候,这个lossfunction的一些选择,然后从你这个sampling的一些策略,或者说给他加一些政责之类的,就是加了各种各样的东西。然后现在是我们可以保证,MOE这个东西,基本上这个技术本身,可以稳定的训练,就哪怕说换一个框架,这个技术,因为MOE本身是个技术,西数化。这个应该是在这方面,应该是算是有了一个,比较大的一个提升,对,然后这是说一个技术点,然后另外一个技术点,就是说时间不能倒流这个事情,时间不能倒流。 [00:57:06]
张小珺:就是我们要求这个整个的attention,其实都是单向的,因为attention就是或者说数字世界,大家常用的模型基本上都是双向的,因为它要求画质,你双向肯定是,你中间的连接越多,其实你的计算就越大。
沈宇军:计算越大肯定效果就越好,这是一定的,但是我们想把它变成单向的,在这个地方应该是从1.0的时候,就希望想把它变成单向的,然后又花了可能在这个事情上,应该也是花了三四个月的时间,能够做到从头开始就单向训练。就是它还有另一种选择,其实可以说我先有一个双向的,然后把这个双向的变成单向的,这个过程中我们会发现,会有一个很大的问题,就是很多模型,预训练模型里面学到的一些知识,比如说就是对文字的一些理解。它其实是隐含在它的双向的,这个attention里面的,就是一些knowledge,是隐含在这里面的,对,然后你强行把它,变成单向的时候,单向这个事情是跑通了。但是那些knowledge,有些就遗忘了,就相当于预训练作废了,它作废的一个直观表现,就是你之前可以跟他说,100句话,每一句话他都给你,转移成一个比较好的视频。但是现在你可能。 [00:58:22]
张小珺:再跟他说100句话,可能只有20%30%的,能转移成好的视频,剩下的70句话,他已经不理解说的是什么。
沈宇军:因为那个知识被破坏了,对,所以说在把双向变单向这个事情上,我们也算是做了一个比较大的决定,果断的舍弃了双向变单向这个路线。
张小珺:从最开始设计的时候就是单向的,video这个工作解决了moe的问题,就是从头训练moe,然后我们就是我们具备了这种训练moe的能力。
沈宇军:然后word的那个工作其实证明了,我们也可以把单向的attention,这个训练这个事情也搞定了,然后把这些技术,最终我们全部应用到了,具身模型上,也就是诞生了我们最后,最后一天发布的那个模型。就是VA2.0,这个模型是最关键的对吧,对它是整个所有的技术拼到一起的,一个模型,一个集合它是,对它就是因为,就相当于那个video,是我们证明了MOE这个事情。就是我们先把这个路堂通了,然后word是把causalpretrain,这个事情堂通了,然后我们把这两个技术,融合在一起,再加上我刚才说,我们压缩的过程中,也做了一些改进。把这三个技术点放到一起,有了一个面向机器人,纯面向机器人控制的,一个原生的基模,这个基模从每一个参数,都是完全随机化开始训的,然后再包括这个,机器人本身采的一些数据。我刚才说VLA,不是我们搞了很多,真机的数据,我们把这些数据,都放到了这里面,然后去从头训练了一个,为了具身设计的一个机模,这个是我觉得可能是。这次发布里面,我们一直讲具身原声,具身原声一个概念,可能这就是,我觉得这个东西,就是我们想说的具身原声本身。 [01:00:18]
张小珺:我不知道在这六个模型里面,哪一部分会用到LLM。
沈宇军:有一种说法是说,就是LLM如果是大脑的话,其实机器人好多都在训练小脑。
张小珺:那你觉得你们这个具身原生的模型。
沈宇军:它到底是大脑还是小脑的部分,外面每个人对这个大小脑的定义是不一样的,在一些简单指令的执行上,灵波解决的更多是这个层面,比如说就你给他说一句话,然后他帮你把这个事做了,这种这个层面应该是灵波在做的,但是还有其实在这个之上。还有一个更加智能的一个部分,那一部分现在灵波还没有解,那一部分就是真的把,跟人的交互放在里面了,就是那个东西是需要很多思考,比如说,假如说就是,机器人今天就是一起床。然后机器人帮你拉开窗帘,他就知道帮你拉开窗帘,然后看到外面下雨了,他就要知道给你拿把伞,让你出门,对,这个层面的东西,我觉得应该在。更高的智能阶段,是需要做的,而那个阶段可能是。 [01:01:23]
张小珺:跟语言模型跟动态模型要解决的,其实我觉得跟数字世界。
沈宇军:可能就更相关了,对,但是如果单纯的,你跟他说,帮我拿一把伞,这种动作,我觉得林波现在解决的是,这一层面的问题。就是他不解决意图的来源问题,他只是解决意图的实现,他做一个动作,对。
张小珺:但是他的动作是简单的,他可以是一段连续的动作,但是,但是他为什么要做这个动作。
沈宇军:他不知道,对,就是他只管意图的实现,就是你有个想法,他帮你做了,但是他不会有,它不会产生自己的想法,它不会主动帮你去想。你要做什么,那一层面的交互,我觉得可能是更高阶的智能,灵波现在还没有做,这一层面的事情,因为你刚刚说第一代能抓取,第二代能做哪些动作,它有方化性吗。对第二代其实就是因为,我们有了这个刚刚说的,我觉得为了,就是相当于我们没有再,重新用数字世界的模型,基于数字的模型迭代,然后我们可能是为了具身,单纯设计了这么一个模型。就是因为有了这个,我觉得有几个比较大的,我觉得挺有意思的提升,第一个是,现在它能处理随机性,处理随机问题的能力要强很多。 [01:02:35]
张小珺:这个大概怎么理解呢。
沈宇军:比如说我们其实有一个demo,是跟人去打那种撞球。
张小珺:就是在那个例子里面,你会发现,它这个demo跟一般的。
沈宇军:就是大家做的demo就不太一样,然后因为它里面会有很强的随机性,你永远也不知道对面人打过来那个东西会在哪,对他就相当于不是说我把位置都定好,对我不是说把位置都打好,就是摆好就可以了,对他一定要是看到你打过来了,我们才能打。然后而且有一个很关键的点是,我们在整个过程中其实是只依赖了机器人自己的相机,就是没有在场地周围再放一圈相机,然后让相机去追踪那个东西的位置,不是靠这种方式实现的,完全是就是跟人一样,就是我就一双眼睛,然后我就看到那个东西。然后去做,对这个东西是处理随机性,然后另外一个是,那个回合非常快,就是因为人打嘛,就是他对实质性的要求就很高,他不是一个说,你如果机器人动得很慢。或者说你动一下卡一下,动一下卡一下,其实你是打不回去的,这是挺好玩的一个场景,对,所以我觉得这是一个点,然后另外一个再举一个例子,比如说。比如说就是,我们还是说整理桌面这个东西,就是大家看到的假如说就是一般都会说。 [01:03:53]
张小珺:假如说收纳玩具或者什么,基本上都是摆好了嘛,对吧。
沈宇军:然后我们现在是可以支持,假如说你就是说把这个桌面上的东西都拿掉,都收拾起来,然后我们现在是可以支持,你先拿一个狂随便撒上去,撒上去以后,然后不就那个,其实就就这本身就已经带了随机性。对不对,你中间还可以把一些东西再拿出来,他不是说就把现在有的这些弄好,就是收拾完就好了,你会发现你可以把它,捡进去那个东西再拿出来,随便摆一个地方,它还是会把它收进去。甚至于你可以跟它一起收拾,就是有一些东西可能,它还没收到,然后你先帮它收了,那对它来说它就不收了,其实我觉得这一点,也是一个比较大的一个进步,对这个东西就是。我们现在能够处理的随机性,应该比1.0版本那个模型,要在这方面要强很多,对,这是因为加了更多的数据,不是,这个东西就是因为,整个的模型的预训链不一样。你看到了模型,具有泛化性的这种迹象了吗,对,就是我觉得在这个,刚刚说的这种例子里面,就是任务的泛化,这不是说任务吧,就是位置上的泛化。这一点。 [01:05:07]
张小珺:我觉得现在应该是,有比较大的突破,它能够接受这种随机性,对,这意味着它不是只是通过一个RL,来做的反馈,对。
沈宇军:它不是一个固定的任务了,它是一个中间可能会有很多突发情况的一个人物,对这是一个,我觉得这是一个在这个方面,就是随机性,就是泛化性分很多很多维度,对我觉得在位置泛化上,应该现在可以说是解的会好一些了。然后但是我觉得现在我们这一版模型,可能对于这种任务上的泛化。
张小珺:任务上泛化怎么说呢。
沈宇军:我觉得就是就你能不能够直接,就是什么也不做,就直接给你一个新的任务,从来没见过,你就能做了,我觉得这个是一个,比较难的一个事情,然后我觉得这个维度。可能现在还没太做好,因为它,我觉得一个比较大的原因是,因为机器人的数据,还是不够多,就你见过的任务,还是不够多,你没办法通过。你见过的任务,排列组合,变成一个你没见过的任务,对,我觉得这个可能还是一个,即将要,就接下来可能要去,重点突破的一个点。那你需要他建这个任务,看几次他能学会呢,就是他的学习成本有降低吗,这一版应该是比上一版有,也就是我们的2.0会比1.0有,我觉得是在这方面也是有提升的,然后体现在两个方面,第一个方面是。我们1.0的时候,当时其实是做了这种评测嘛。 [01:06:36]
张小珺:当时的评测是每一个任务,要单独训一个模型,就相当于假设有100个任务,你就要训100个模型出来,就每个任务都要单独训一个后训练,然后再去测。
沈宇军:但这一把我们是可以把,假如说10个任务,我把这10个任务迅到一起测,相当于这10个任务,只用一个模型解决,这是一个方面的提升,然后另一个是,其实从这个数据量上来讲。后续链需要的数据量变少了,我们上一版应该基本上都在100条左右,然后现在应该是20条左右就可以了,对,然后当然你还是没办法做到说,一条甚至更少,对,我觉得那个可能要随着你。积膜的能力再进一步提升,可能我们再试图,把这个事情再做下去,对,但整体来说,这一点上应该是比1.0,也是有一个比较大的提升,对。 [01:07:30]
张小珺:具身智能今天到什么阶段了。
沈宇军:你之前说还没有到GPT-1的时刻,今天呢,对。
张小珺:今天我还是觉得,也没有到这个阶段,就是具身智能本身,对,因为,为什么这么说,因为现在还没有看到一个。
沈宇军:比较好的能够做数据,skillup的方式,就哪怕是我们这次说的,比如说我们用了6万小时,对吧,现在有6万小时数据,但其实坦白讲,跟上一次比。还没有数量级的提升,而且这些数据,应该是远远不够的,我相信随着,现在这个行业素材的方式的,这种就是大家在做。 [01:08:12]
张小珺:各种ego相关的数据,我觉得应该是等,实现方式真的确定下来。
沈宇军:然后可以大规模铺开的时候,可能那个时候会看到GPT-1的时刻,所以瓶颈还在数据,对我觉得现在,就是因为跟GPT相比的话。
张小珺:我觉得应该还是在数据的,我们这次虽然也在讲,我们是模型的设计上,是具身原生,我们的模型设计都是特性,是为了具身设计的没错。
沈宇军:但是为了做预训练,就是具身原生的预训练,其实我们还是用了大量的,互联网数据在做的,然后互联网数据的量级,应该跟就是机器人的比,就是远大于。
张小珺:大于多少。
沈宇军:几倍于机器人,真机采集数据,应该差两个数量级吧,OK,大元模型能够skillup,是因为互联网数据已经ready了,对,所以说在这里面。虽然说我们架构上,已经做到具身原生了,但我觉得数据上还没有,所以可能当具身的数据本身,可以做SkillUp的时候,或者说能至少跟互联网,达到相同量级的时候,可能是我心目中的GPT-1的时刻。你估计还有多久,具体的时间可能就不好预估了。 [01:09:23]
张小珺:但是现在比之前的好处是,因为基建上来了。
沈宇军:模型的开发周期,跟GPT之前的那个时候不一样了,那个时候大家能有个万卡集群,就觉得很了不起了,就是至少从语言模型那一块,但现在美国的很多公司,在做语言模型的时候,基本上都是十万卡。甚至可能到更多,所以我说我觉得整个的,基建上来了之后,模型的开发效率也会比之前要快,所以说可能不一定说,原来的GBT-1到GBT-3.5,或者说叫ChatGBT,可能用了一段时间。然后可能现在从机器人的GBT-1出来,到机器人的ChatGBT出来,可能又不一定需要那么长时间了,因为配套的工具在成熟。 [01:10:07]
张小珺:你们的infra水平也跟着提升了是吗。
沈宇军:对因为我们开始要做预训练了,就是既然我们想去动到,原生基模这个东西,它需要的资源肯定比之前说,我只把它当做数字世界的一个下游去做,需要的资源要多得多。
张小珺:你们要做原生巨生的模型,这个BAT是什么时候下的。
沈宇军:当时纠结吗,其实不纠结,因为在发满1.0的时候,我们当时就意识到这个问题了,就是很多特性,我们当时是强行,在数字的模型上,魔改。强行魔改,然后发现很多东西,就是不work,就是你改的再fancy,它有一些缺点,还是会暴露出来,所以在1.0发布完之后,我们当时就做了决定。就是我们必须要具备,做底层,更底层模型训练的能力,算不算是一次bad,肯定算是一次bad,因为我们也不确定。 [01:11:09]
张小珺:这个东西是不是能成功,是不是能迅出来。
沈宇军:因为之前也没有人,有过这样的经历,但我觉得值得一读,因为在我们看来,如果数字世界的那条路,就是走不了特别长远的话,那这是一条必经的路,如果走不通。或者说如果不是我们走通,也会有人走通的。
张小珺:因为我觉得这可能是正确的路,有什么之前,怎么做都做不成的任务,到这次让你觉得,有一点惊讶的吗,你有什么Ahamoments吗。
沈宇军:其实我对于,刚刚说的那种,跟人一起打球这个事情,就比较惊讶,因为它真的是综合,体现了好多能力,就是你的执行也要快,然后你的这个随机性。或者说你的预判要好,对然后再加上,其实那个东西。 [01:12:02]
张小珺:我们可能一共也就采了,20条数据,我就说为了执行这个任务,在预训练之后,为了做这个任务,可能就采了20条数据,这个比较出乎你的意料,以前需要采多少数据。以前可能采多少数据,都不一定能做成,对因为就是,真的是不是能够让模型,把这个随机性,就是cover的比较好,我感觉之前我是没看到过。
沈宇军:有类似的东西出来,在做原生机器人脑子,这件事情上,有什么其他人的工作,可以借鉴吗,比如说硅谷一些frontierlab,他的工作有可借鉴性吗,我记得应该是generous的。他们就是说,因为他们的数据量,比我们要大得多,他们官方,或者说能查到的消息,公开消息,然后可能应该就是几十万小时,而现在可能都不知道。是不是可能有百万了,我不清楚,然后他们的数据管线什么的,这方面应该还是比我们要成熟的,他们更早的去动到了,pre-train这个方面,但是跟他们不一样的,或者说可能只是出发。说要用具身数据,做pre-train这个事情,是一样的,但是你要说,技术本身的借鉴,其实并没有,因为我们相信,一定要从视频生成。这个路线里面,去学到一些知识,所以说能够把视频生成,做到原生的,目前还没有看到。 [01:13:26]
张小珺:你怎么看generalist。
沈宇军:和physicalintelligence,他们的路线的区别,我觉得他们两个,更多的是,可能有一些最后的理念的一些不一样,因为Generals的更多,他是能接受有后训练的,他强调的是高效后训练。然后但是Pi好像更多强调的是ZeroShot,他更希望不要后训练,就是我什么都会,对所以从这个角度来讲,我觉得可能天然选择的路。
张小珺:可能就不一样,听起来Generals更实用一些,从我的感觉上可能是可以,但是但其实殊途同归,因为我觉得是这样。 [01:14:07]
沈宇军:这两个能力都必须具备,就是如果我们设想,未来有一天机器人,真能够进家庭,你可能希望他有两个点,第一个点是,他进到一个家庭之后,百分之八九十的活。他自己就能干了,百分之十到百分之二十,他干不了的,可能是你教他一下,他就会了,这两个我觉得都,都是需要的能力,对其实就是。incontextlearning,对然后,感觉这两个,其实不那么冲突,对但是,这是一个点,然后另外一个可能,他们两个技术理念。我个人会感觉有点不一样的是,Generalist可能还是在,他对Yumi,那个数据可能会比较,他理解的比较深入,玩的也比较好,然后那个PhysicalIntelligence,可能还是在。整机摇操上,他们应该是在这方面,做的比较扎实,对,从这个再往后看啊,就是因为现在,大家开始去讲,那个EgoCentric了嘛。就是而且再往后可能说,我觉得灵巧手这个东西,可能也会逐步的被提上日程,就是大家可能会越来越关注,说需要的更复杂的一些操作任务,那个时候可能假爪,就不能满足需求,可能一定要用灵巧手了。对可能在Ego的兴起,再加上灵巧手的不断的发展,很有可能,真机摇操和5米,两条数据的路线,可能都会发生一些变化,对就是可能,他们也要去迭代升级。但有可能最后,再往后发展发展,可能就合久必分,分久必合,可能他们也会慢慢,走向同一条路,这个谁知道呢,所以现在不同的路线的核心。 [01:15:48]
张小珺:是我怎么使用数据,或者我怎么获取数据。
沈宇军:这是一个很关键的点,对这肯定是一个很关键的点,对我现在是比较坚信的一点,尤其是我们这次,我觉得算是做了一个,比较好的一个开始,我还是很坚信,具身一定会有自己的模型。就是他为具身设计的模型,但是就是在这个观点,如果不变的情况下,那他的数据必须要支撑,他可以做自己的模型,所以数据是。 [01:16:15]
张小珺:如何把数据很好的scaleup。
沈宇军:是一个至关重要的点,对,我去年去上海外谈大会,他们为一个事情,真的不可开交,就是说到底,具身智能是一个独立于语言模型之外的,一个独立的学科呢。一个独立的发展方向呢,还是它是基于代语言模型的一个方向,有两派观点,一派认为我们是基于LM训练的,所以我们是成长在LM这个上面的一个支线,然后另一派就觉得我们一定是独立的。
张小珺:你是哪一派,我不能完全说是哪一派。
沈宇军:如果硬要选一个,我可能会选择后者,具身智能要解决的问题,跟语言模型,它其实是不冲突的,就是语言模型,更多的是让人听懂。
张小珺:这个指令到底是什么,让机身听懂指令是什么,但我觉得具身智能,更多需要解决的是,怎么把这个一件事情做好。 [01:17:06]
沈宇军:做好本身,是不需要再理解语言的,但是它的前一步,就是怎么把语言转译成,就是它的后面的一系列动作,就是第一步,可能是需要依赖语言模型,我会认为。具身会继续拿大语言模型,当一个比较好的入口,然后它会成长出自己的模型,它们两个中间可能只是一个,就是交互的层面,更好的当然是说,我们把语言系统,也内嵌到这个具身里面。但我感觉,短期内具身,要聚焦解决的问题不是那个,他还是要先解决。
张小珺:怎么把一个事情干明白这个点。
沈宇军:但干明白这个事情,我个人会觉得,对语言的依赖没有那么高,语言是第一个,招呼工具,换句话说如果不是语言,假如说一共就,一万个任务。然后你把这一万个任务,就编成固定的编码给他,可能也行,只是他没有办法在任务维度再泛化了,但语言模型本身可以在那个维度再泛化。 [01:18:17]
张小珺:它解决的是需求泛化的问题,我感觉,对,但是这个明显不是现在,现在这个阶段,具身智能的核心焦点,你觉得从24年底,就是你们开始做支家公司。然后到现在为止。
沈宇军:整个行业的突破,是在哪些方面,它的进步快吗,其实我觉得进步是,比我想象的要快得多,因为首先从硬件上,然后现在至少像语述啊,志愿啊。就是已经把这个量产啊,已经跑通了,应该是已经可以进入到量产阶段了,然后就相当于供应链,也随着这个行业发展也在成熟,这是一个点,然后从去年开始,大家是假抓。到今年开始,零销售公司已经层出不穷,然后已经有非常多的零销售公司出来,然后零销售的发展也是,就是我觉得可能也用不了太久,可能会变成,渐渐变成标配,渐渐。只能说,可能再给它一段时间,因为硬件毕竟有自己的发展周期,只是说大家已经不满于,不满足于甲转了,然后再加上就是传感器层面,现在有越来越多的,触觉相关的传感器。然后这些其实都是为了,就是零小手触觉,其实就是为了让机器人,做更复杂更精细的任务,对吧,这是从就本身硬件,或者说,对这个行业里面。硬件的发展来讲,我觉得是一个,比较让我惊叹的一个速度。 [01:19:48]
张小珺:他们是不是也都是一种。
沈宇军:数据获取方式,对,他们一定会考虑说,跟数据的关系,他更多的还是为了,模型的升级,我觉得还是,或者说你能够提供更多的。执行更多的任务,其实也是为了让模型,能学到更多的知识,对,然后这是硬件,硬件这个层面,然后另外还有一个层面,就是。从这个,落地的这个层面,因为现在已经可以看到,很多家都在去展示说,模型可以,比如说可以进工厂干活,像Figure还去展示了,这个物流分解。对吧,然后已经有越来越多的,开始去提机器人的落地,而且现在的落地,已经不再是通过,比如说一些传统的,控制方式落地,大家都在尝试。用模型去落地,我觉得这个也是一个,比我想象的要更快的,一个节奏,因为去年的时候,去年WIC的时候,7月份的时候,我感觉更多的还是在。showdemo,那个时候我记得,我记得之前有个说法,说什么,24年在倒咖啡,25年在叠衣服,反正一年有一个新的动作,然后大家在展示。但我感觉今年反而是,大家demo提的少了,都在提进场景了,对我觉得就是短短一年的时间,然后模型的,就是说软件侧的发展,也是突飞猛进,所以从这两个角度来讲。我是觉得这个行业。 [01:21:17]
张小珺:确实是在加速的,不急于期的有吗。
沈宇军:不急于期数据,我会这么理解,在大家尝试着,真的开始步入具身原生之前,对数据的,虽然大家都在喊,学数据,需要数据。但是数据,真实的情况是,如果你真的不需要,做一个基础模型,可能不需要那么多数据量,你到底需要多大的数据量,我觉得,我觉得应该是百万小时起步吧。就是能开始说,我这个整个模型里面,聚身的数据跟互联网数据,可能说大家相对平衡一点,然后我让他既能学到一些,通用的知识,又能学到一些操作相关的知识,对这是我觉得一个比较理想的状态。应该是在百万小时,起步,对,但是,在百万小时之前,我觉得应该会先有一个,十万小时的规模,而这十万个小时。是可以,就是就怎么说,它是完全拿来做,预训练的,预训练,不是说基于数字模型的训练,是具身原生的预训练,对。所以我觉得,不及预期的就是,在没有,可能就是过去一年,没有看到,具身原生的东西,真的出来,然后就是因为。没有这个东西出来,所以大家对数据量需求,其实没有想象中那么迫切,就是大家会讲说,我们都,大家都知道行业的公认,就是说可能数据,是一个很关键的东西。而且需要很大量,但是没有一个具体的。 [01:22:56]
张小珺:比如说你不迅疾模式,没有一个推动力,说让你马上一定要拿到,这么些数据的,所以我感觉数据的发展,其实还有一点。 [01:23:07]
沈宇军:我觉得不及预期,对这是我自己的看法,今年好像有一个现象。
张小珺:去年之前的这一波机器人公司,很多都是本体和模型一起做的,但是今年大家明显更看重大脑了,而且很多公司开始只做大脑,不做本体,你就为什么会发生这样的一个变化,感觉是两代机器人公司这种感觉,其实我感觉。
沈宇军:我感觉一个比较关键的点,就是一个本体很难,目前来讲一个本体很难通用,然后,但如果你不通用的话,你要一定要选准场景,这样做本体才有意义,就是你这个本体。相当于是为了场景专门设计的,因为专门设计,它可以有一些东西做强化,有一些东西做减配,因为最后落地的话,要讲的是成本,我们不可能拿一个,各方面的六边形战士。然后去做某一个具体的任务,这样的话它可能很多东西是超配的,成本一定是上升的。 [01:24:11]
张小珺:所以我觉得可能大家不讲本体的一个原因是,第一本体其实也有自己的门槛,你到底能不能有量产的能力。
沈宇军:这肯定是一个点,第二个就是本体的,你如果场景选不准,本体设计的一定是有问题的,但是场景现在我看来比较难,大家也不太敢说哪个场景,一定会跑得非常好,大家都在做尝试。但是可能确实比较难决定,说哪个场景最后就是先跑,最好的,所以我感觉可能有这方面的一个原因,然后再加上另一个点是,这是刚才我觉得对,从硬件的需求的角度出发,但另外一个点是。我觉得从现在行业来看,大脑可能是目前是落后于本体的,大脑的开发是落后于本体的,很多时候换句话说,现在就是今年的主要矛盾。 [01:25:14]
张小珺:应该是怎么让他先变得能把活干好。
沈宇军:然后,去年王兴建还说干活是一片荒漠,对,所以我觉得应该是还不能把活干好,所以说会有更多的人想要去试图解决这个问题,然后但我觉得,这个行业在,就尤其大脑跟。虽然说大脑跟本体,现在还是不能完全结合,但是我觉得就从这个发展来看,他们两个一定是交替上升的,就可能现在大脑是落后于本体的,但是因为随着,进来做大脑的人越来越多,可能这条路。就是或者说智能层,他会跑得会更快一点,然后可能某一天,他就超过了本体,那那个时候可能会,对本体提出新的需求,本体就会再去,可能在那个时候会有一批新的。由智能重新定义的本体公司,就是可能再往那个方向去发展,就是它可能不再从我们大家,之前理解的一些参数,再去看这个本体了,可能很多东西就是为了,就是更好了方便模型控制,去设计的。对我觉得可能那个时候,本体又会再发展一段时间,然后可能那个时候,本体又更强之后,又会催生说智能又不足了,我觉得一定是这么一个过程,所以上一代硬件,不一定能够迭代。适应下一代的模型,我觉得是至少我的判断,应该是这样的,然后硬件本身可能还好,但我觉得传感器应该是,现在的传感器应该是,还要再做进一步的升级,尤其是触觉相关的。其实我举个例子,比如说触觉,或者说之前大家对传感器,是有指标的,我必须要做。 [01:27:04]
张小珺:比如说我的精度达到多少,然后我的频率达到多少。
沈宇军:它有很多指标,但是会发现,很多时候做传感器,如果只做传感器本身,它可能会希望这些指标都好,但是有些时候又不能决定,可能又,你没办法真的满足。说所有的东西都很好,它一定要有取舍,那取什么舍什么,其实师们,我觉得这也是个问题,但是之前的取舍,可能大家会凭着,使用的这个过程中。比如说利益必须要准,那既然是你是触角传感器,你利益就要准,可能会先取这个,对吧,就是这可能是大家的一个,或者说不能叫共识吧,但反正就下意识都会这么想。但是有可能,这个东西在AI这个时代,模型可能最需要的,不一定是你利益要准。
张小珺:有可能是需要你反应够快,就是我可能对实质性要求,可能比那个更高。
沈宇军:这都是有可能的,所以说可能,如果说这个传感器再迭代升级,可能要从模型的需求出发,看我们要强化哪些指标,弱化哪些指标,就是还没有到说,模型可以定义它的时候。他们肯定会按照,传感器的发展,肯定会按照就是传统的理解,说我们去怎么去尽可能的优化,对我觉得这可能是一个,未来的趋势,有的是从硬件出发,有的是从软件出发。但是大家都想进入家庭,这个最好的场景里,可能现在其他的一些场景,还不够那么性感,对,是这样,就是可能还是2C,2C更性感一点。所以他现在需要做一个选择,我是从软件出发,还是从硬件出发。 [01:28:42]
张小珺:对,有的人从硬件出发,你们是从软件出发,对我们是从软件出发,沿着脑子往后坐,你觉得接下来几代会怎么迭代。
沈宇军:我觉得是这样,就是刚才我说的,我们这一把是做了。
张小珺:怎么说呢。
沈宇军:从物理特性上做了一些原生的设计,然后接下来,我觉得最大的就是。 [01:29:04]
张小珺:怎么能够从架构原生。
沈宇军:再往前再走一步,做到数据原生,数据原生解决了,刚刚我们说的泛化性有很多种,比如说本体构型的泛化性,然后我们现在能够做到位置的泛化性,但是接下来我们还要做任务的泛化性,任务的发现就严重的吃数据了。对,然后那一个更优雅的实现方式,能拿到更多的好的数据,然后以及把这个数据,真的比较好的送给模型,我觉得可能是下一版本,我们最重要的一个核心。
张小珺:意味着你要自己去做数据,才数据,可能会投入更多的资源,来做这个事情。
沈宇军:对或者说把数据的,素材的这个整个的标准,需要再做得更扎实一点,就是到底怎么样。
张小珺:采什么样的数据,怎么采,然后这个东西,到底是不是可以规模化复制。
沈宇军:可能这个是我们接下来,要关注的一个比较大的,现在有什么可能性,规模化复制吗,其实就是,大家现在讲的比较多,就是Ego,然后其实Ego的数据。我个人的看法是。 [01:30:12]
张小珺:它提出了一个,比较好SigWarp的一个方式,这一点是毋庸置疑的。
沈宇军:但是现在的问题是,只从Ego,假如说就只有头部的相机。
张小珺:拍下来的这个数据,到底能不能用,它对于之后。
沈宇军:假如说零销售真的发展起来,然后我们想要做,手部的一些精心化动作。
张小珺:有没有帮助。
沈宇军:这些东西还是未知的,我觉得Ego,应该是提出了一个采集理念,但这个采集理念,是要被打磨成一个,具体的一个产品,才能够就是,开始说部署下去。然后开始做起来,输采这个事情,对,我觉得这个理念,和从理念诞生。
张小珺:到一个理念的真正的实施,可能还是要点时间,所以说具身智能。
沈宇军:现在接下来要解决的,最重要的一件事情,还得是数据,对应该是数据的,就是可规模化的,然后可以被模型使用的数据,就是这个可以被模型使用,我觉得。可以被模型使用和可规模化,这两点本身就是一个平衡,因为模型可能希望数据越好越好,就是质量越高也好,含有的模态越多也好,这是模型的需求。 [01:31:22]
张小珺:但是规模化的就是,你的需求越高,我越不能规模化。
沈宇军:就变成定值了,就是我很难真的上量,那在质量和数量之间。
张小珺:怎么取一个平衡。
沈宇军:就是说我模型,哪些东西是可以舍弃的,这个东西可能现在还没有,太定义清楚。
张小珺:这个事情一旦定义清楚,我觉得后面的事情就会加速。
沈宇军:你这是第一次创业,对创业有什么新的感受吗,对我来说两个第一次吧,第一次创业,对第一次创业含了两个部分,然后第一个部分是,我觉得第一次面向落地,这是第一次。然后第二次就是创业。 [01:32:07]
张小珺:就是换句话说,第一个第一次是业,第二个第一次是创。
沈宇军:对我觉得从落地的角度来讲,可能确实让我感悟比较深的,就是以前会更关注技术的领先性,现在会更关注技术的。
张小珺:哪一方面的领先性,就是技术还是要领先,但是是不是有价值的领先。
沈宇军:还是说只是技术人,就是拍脑子觉得,大家其实有很多东西都可以领先,你现在希望哪里领先,我现在肯定希望能支持的任务,越多越好,对,就是我会优先选择场景的。或者说场景和任务的,泛滑性这一方面,对,然后,这是第一个,第一个第一次,就是业的部分,然后再说一下。创的部分,我觉得,可能这个第一次,交互我的更多的,就是,就是人要学会,或者说创业要学会赌,创业一定是赌出来的。 [01:33:03]
张小珺:就怎么说呢,没有人知道,哪一个路一定是成功的。
沈宇军:然后资源又一定是有限的,所以,在有限的资源下,路径不确定的情况下,就是要赌,对,我觉得敢做决定,敢赌。这是我觉得很关键,很关键的一点。
张小珺:因为如果说一条,就是大家如果都知道,那条路是成功的,那为什么是你成功,就是如果那条路一定成功,大厂一定成功,对,这是百分之百的。就是有资,更有资源,更有人的地方一定会成功,对,然后但是,在路径未知的时候,如果犹豫不决。
沈宇军:很有可能最后就,什么都做不出来。
张小珺:这里面你们的大赌有哪些。
沈宇军:不做本体是一个大赌吗,对我觉得做,第一个是传感器是一个大赌,对,然后第二个就是原生是一个大赌,因为原生这个事情,很有可能做到最后,就发现没做出来。就是你训了半天,训了一年,花了好多资源,然后结果这模型就是不收敛,其实我觉得这是一场豪赌,就是做出,他没做出来有很多种可能,比如说就是思路错了。也有可能是技术还不成熟,可能再过个两年三年,重新再做这个事,可能就成了,就是说你太早的进入也不行,然后就是可能资源不够,也是一方面,就是说你本来只能做100块钱的事。但你非要做一个200块钱的事,你没有那么多资源,这些都是赌的一个。 [01:34:36]
张小珺:怎么说呢。
沈宇军:风险点所在吧,然后但是我觉得一旦是做成了,那种时候的成就感还是比较高的吧。
张小珺:蚂蚁对你们的期待要求是什么呀。
沈宇军:因为现在蚂蚁集团整个也是AIfirst,就是从这个大的战略上讲,其实我们也是想要突破智能的上限,对,然后只不过是AIfirst。
张小珺:它就包含两部分物理世界的AI和具身智能,就是数字世界的AI,我们可能就是承载了集团在物理世界,人工智能上限的这个使命。 [01:35:07]
沈宇军:这是一脉相承的,然后另外一个,我觉得还是说,马亦集团还是一个,以这个生活服务,数字世界的生活服务,为核心的一个公司,然后我觉得这一点。我们也是在。
张小珺:整个集团的延长线上,我们就是想弥补,或者说也不能叫弥补吧,应该说是补齐,从数字世界往物理世界迁移。
沈宇军:这条中间的这一部分,就是怎么把一个服务,真的执行起来,对可能是这两点,是我们跟集团最大的。
张小珺:怎么说呢。
沈宇军:我觉得是理念上的契合吧,对。
张小珺:马也对你们的管理是什么样的。
沈宇军:其实整体来讲,还是比较。
张小珺:还是比较按照,那个创业公司的方式,让我们去管的。
沈宇军:只是说我们的管理体制上,可能会更独立一点,就是可能跟一般,就是集团下边的一些BG相比,我们的,就是因为业务会相对独立一些,对,所以说管理起来可能也会独立一些。但整体的基建什么的都是共享的。 [01:36:15]
张小珺:对于你们的这几次豪赌,他们是什么反馈。
沈宇军:我觉得还是比较支持的吧,集团从上一次发布和这一次发布,集团都还比较支持,他们有说为什么我们不做本体,有说这种吗。
张小珺:其实也会,就是大家会有一些debate,但是。
沈宇军:我觉得集团这一点,是对灵波有充分的信任和尊重,因为我们可能更贴近行业本身,对所以说,这方面我们做的一些决定,就是集团肯定会,就是从他的视角,他肯定会给出他的一些建议。但最后可能双方还是会。
张小珺:在经过几轮交流之后,应该还是会达成一致的,你对于这次创业的最好的预期,和最坏的预期是什么。 [01:37:04]
沈宇军:最好的预期就是,我真的看到机器人进家庭了,然后进家庭的机器人,跑的是灵波的模型,这是我最好的预期,然后。
张小珺:最坏的预期,就是没做出来呗。
沈宇军:我觉得也没有什么更坏的预期了,对就是可能就是,就是可能某一次,某一次赌的过程中,可能赌错了,你是个赌心强的人吗,我还可以,这里面有哪个角色。是你力排众议必须要这么做的,我觉得具身原生这个事情,可能是我做了,其实是比较坚持要做,我觉得这一点,我还是从,上一次发布的过程中,感受到。就是我们数字世界那条路。 [01:38:02]
张小珺:就是沿着数字世界往后走,就是行不通,不想在他们的延长线上,对,所以我就非常坚持说,一定我们要做一个。
沈宇军:用物理世界的东西,就是从物理世界,土生土长出来的模型,对,这是我觉得可能,也是我这次觉得,比较有成就感的一件事情,对。好在就是,我不敢说它是一定被100%验证。
张小珺:但我觉得至少我们迈出了一步,这次模型的进展是符合你预期。
沈宇军:低于预期还是高于预期,其实是,其实是有点高于预期,因为你想嘛,我们讲原生这件事情,我们从,就是两大块,一个是视觉。就是刚才说,看得更清楚那块,我觉得我们已经,就这一部分,就是由原生,推动它往前走了一步,然后想得更明白,就是也是有。我刚刚说的,我们也是由原生,往前又退了一步,就是架构的原生,刚才说的,不管是时间的流逝也好,还是说推理效率也好等等,然后接下来还有一个干得更利索。我觉得干得更利索,可能就是下一个原生,就是数据原生,对因为我觉得数据做的,数据的能够更好的规模化之后,肯定是在任务的方向上,有更好的突破,对所以我觉得就是从。我们看得更清楚,想得更明白,干得更利索,这一点上,我们正好在经过了半年的时间之后,把前两点,都有原生这个概念,往前推了一步。我觉得这个是,我没想到会来得这么快,然后希望数据原生的部分。 [01:39:38]
张小珺:也能比我预期的来得要早,那我可能也会更开心,这样的话,我觉得真的就是,完全是物理世界。
沈宇军:有自己的一套,从模型到架构到数据,闭环的一套原生体系,现在各个不同领域的玩家,都很想抢夺,机器人大脑这个事情。 [01:40:01]
张小珺:有你们。
沈宇军:然后也有之前的那些机器人公司,他们也会着重的来做AI,然后又包括大厂,或者说模型公司,如果他们有精力的话,他们也会来做机器人的模型。
张小珺:你觉得你们的优势是什么呀,你觉得这个产业,竞争到最后的格局会是什么呀。
沈宇军:格局可能,我觉得可能跟大语言模型的格局差不多,可能会有大厂做得比较好,然后也会有两三家创业公司,做得比较好。
张小珺:你们属于大厂还是创业公司。
沈宇军:我觉得我们现在,可能跟创业公司会更近一点,对,然后。
张小珺:那我们确实位置比较特殊,我们属于一家,背靠大厂的创业公司,对,然后,这是一个,就是。
沈宇军:我觉得从智能层,应该大概就是这么一个格局,应该会有,大厂会有那么一两个玩家,然后创业公司会有两三个玩家,然后可能大家各自跑出各自的生态,这个生态就包括了数据的生态,本体的生态。场景的生态,就可能每家的模型。 [01:41:06]
张小珺:因为你有了生态之后。
沈宇军:你场景加本体可能就会给你,那个生态里面的数据,可能你的模型就会慢慢分化的,更适合那个生态。
张小珺:当然是可能最后大家都会,走到一个通用的生态,就是进家庭。
沈宇军:但是在那个之前,可能每家模型会有不一样的特性,比如说可能有一些模型,就适合做精巧的任务,有一些模型可能就适合做,就长程的任务,这个就不好说了。
张小珺:对但我觉得应该是,会是一个各有特色的,就是几家鼎立的这种一个格局,你对人型机器人这个构型有执念吗,你觉得未来进家庭的机器人。
沈宇军:会一定是人型机器人吗,我还是觉得就是,毕竟是从一个创业公司的角度来讲,我觉得我们一个阶段,解决一个最核心的问题,就好了,现在当下最核心的问题,就是智能不够。对,我觉得还没有到,就是混言话说,现在到底是轮式,还是足式,或者说它。 [01:42:04]
张小珺:构型应该长什么样,还不是现在的核心卡点,现在核心卡点,是智能不够,然后智能不够的核心卡点,是数据不够,对,所以怎么让数据。能够skillup是重点,对,然后当你智能有了以后。
沈宇军:你才开始能做,落地的尝试,你只有做落地的尝试之后,就产品才会迭代,产品迭代,应届才会跌的,就现在,就大家在争。就比如说,到底是足市还是轮市,他不管是足市还是轮市,他进家庭,我都不会让他进家庭的,那这个时候,你都没办法做这种userstudy,OK。我感觉是这样。
张小珺:你现在工作状态是什么样的。
沈宇军:这两天好一点,就是前一阵子,就在模型都处于,要出来没出来,那个阶段的时候,其实是比较紧张的,就是。
张小珺:但是现在,尤其是最近在那个发布完了之后。
沈宇军:然后整个人状态会相对,我觉得会轻松一些,然后接下来我应该会。 [01:43:05]
张小珺:怎么说呢。
沈宇军:可能再想一想下一步要,就是到底应该怎么去去做吧,就是再复盘一下,然后想一想。
张小珺:比如说数据到底怎么去。
沈宇军:跟模型更好的结合,这可能是这些方面会考虑的多一点。
张小珺:受到的市场反馈怎么样。
沈宇军:目前看应该还可以,对,然后尤其是技术社区里面,应该对我们做的这一套,还是比较白印的,对,我感觉是这样,然后如果是那个行业的话。我觉得需要再给行业一点时间,因为毕竟是刚发布,对,我觉得行业要试用过之后,可能才会拿到更多的反馈。
张小珺:你们现在驱动的核心指标是什么呀,是一些落地上的数据,还是模型智能上的一些数据。
沈宇军:我就是刚刚其实有提到,我们还是两头抓,就是我们一边要探索上限,然后一边要抓落地,这两个点,可能我们都会关注一些,我们一开始聊到了。 [01:44:10]
张小珺:你的那个学习经历,因为你是汤小欧老师的学生,你对汤老师有什么印象吗。
沈宇军:汤老师是个比较幽默的人,这是我对他最大的一个,印象,因为,那个,他讲话,因为他跟我一样,他也是东北人。然后我觉得,反正听他,听他讲话比较亲切吧,这是,这是一个点,然后另外一个点,就是我觉得,比较能快速地。从一个比较,一个乱续的,一个混沌当中,快速地抓到一个主要矛盾。
张小珺:有例子吗。
沈宇军:这个,就是毕业答辩的时候,因为他要,他要参与嘛,因为答辩很多时候,大家会问,比如你怎么做的呀,之类的。但是他当时,他问了我一个,可能跟,跟行业,或者说你这个东西,到底应该怎么用相关的问题,具体是啥呀,就是我当时做的那套。那个做图像编辑,视频编辑那套东西,而且上一代AI最大的痛点,就是它不好落地,就没有一个很好的场景,对。 [01:45:03]
张小珺:现在有人问你们,这个模型怎么用吗。
沈宇军:肯定啊,大家都就是,其实我觉得现在具身智能,它不像大语言模型,或者多模态模型那么好,那么好传播,因为离大家生活实在是太远了,就是我必须要有个机械臂。我才能知道你这东西好不好用,就是他现在更多还是给开发者的,我是这么理解的,对离受众最近的都是娱乐场景,对,这是最快可以感知的,对嘛所以我说他不是那么好传播,然后如果是开发者呢。他肯定会希望你告诉他这个东西怎么用好,因为毕竟我们这次,我们在发布所有的东西,基本上都是预训练,就是预训练要落地,还是要经过后训练呢,后训练本身是一个很难的事情,就是或者换句话说。他不是说就把数据采完,然后扔进去,简单调整一下参数就结束了,就是那如果效果不好,到底是没训好,还是数据没采好,还是模型就不好,怎么诊断问题。有了诊断之后怎么解,它是一个,我觉得是一个很难很难的事情,换句话说,我刚刚说它离大众比较远,其实是一样的点,就是因为它离大众比较远,所以。或者换句话说,就是因为它不是一个,直接能用的模型,怎么把它,让别人感知到,你这个模型真的好,是需要能力体现的,所以大家都会问。就这个东西,比如说怎么复现,然后我想让他做一个什么事,应该做哪些步骤之类的,还是会有很多这样的问题,我觉得你们那个玩桌式足球,那个如果能够,在现实场景里面。能够做一个,给大家互动的机器人的话,应该会挺多人愿意玩的,对,就是说换句话说,你做的越能直接被应用,它肯定是,就是大家的问题会越少。然后互动性会越强。 [01:47:08]
张小珺:你对于机器人的未来发展,还有什么其他的展望没有。
沈宇军:其实我就是希望,它能够离,大众更近一点,就是我希望,它也能够变成一个像,像那个语言一样,就是它出一个APP,然后每个人都能体验。那如果说之后真的说,就是机器人更普及了,家里都有能够,或者说一个比较简单的渠道,就能搞到一个机器人,去玩起来的话,我觉得那个时候,可能成就感会更多。因为现在就是,比如说我跟我爸妈去讲,说我做了一个什么东西,他们也听不懂,然后也没有体感,然后那如果有一天,能带一个东西直接给他,然后告诉他这是我做的。我觉得那个时候,可能成就感会,跟现在完全不是一个量级。
张小珺:我还有最后几个快问快答,一个全球范围内,你喜欢的食物。
沈宇军:日料。
张小珺:一个全球范围内,你喜欢的地点。 [01:48:02]
沈宇军:家。
张小珺:我们的嘉宾都会给,我们的观众朋友,推荐一本人生之书,你会推荐哪一本,人生之书。
沈宇军:笑傲江湖,我特别喜欢武侠,我从小就比较迷金庸的小说,然后我特别喜欢,但是每次,因为金庸小说,我都其实每部都看过很多遍,然后。但我每次推荐都会推荐,笑傲江湖,因为我觉得,我特别喜欢令狐冲里面那种,比较豁达的样子,对,就什么都不太在乎,那种心理状态。我非常非常喜欢。
张小珺:你是这样的人吗。
沈宇军:我希望成为这样的人。
张小珺:如果机器人有性格的话,你希望他是什么性格。
沈宇军:我希望他是个J人,他好干活,对,我觉得他核心还是要实用,对,我希望他是个J人,就换句话说,如果在提供情绪价值和干活之间。我会果断地选择干活。
张小珺:为啥不是提供情绪价值。 [01:49:02]
沈宇军:我可能觉得情绪价值应该由人来提供。
张小珺:你心目中影响机器人进程的几篇论文。
沈宇军:其实可能也不一定算是论文吧,我觉得像那个Generalist,他们现在已经不写论文,他们写blog,我觉得这种可能也算,对我觉得那个Generalist的那个Gen1,应该对我们是一个比较大的一个影响,就是它的数据的规模化。确实做得非常好,然后像Pi的工作应该也是非常好,再就是像那个GoogleDeepMind,他们那边的一些工作,我觉得做的也是比较好。
张小珺:我有时候在想,就是如果我们在中国,没有应用到中国的本土的,这个硬件优势的话会比较可惜,对。
沈宇军:我觉得会比较可惜的,但是硬件优势可能在,这一次的机器人的发展中,我觉得是会有不可磨灭的作用的,机器人还是说,你不管是怎么样的实现方式,一定依赖硬件,然后一定依赖传感器。我觉得从数据质量上,我之前一直讲说,我觉得是互联网红利的一个变现,或者说这个数据,是从互联网那个时代,积累下来的,但是具身相比互联网来说,我觉得它可能是一个。尤其是具身的数据,可能是一个空窗期,现在大家都是一样的,那我觉得可能,所以在收数据上,可能这个中国有优势,对我觉得这个是一个,非常非常大的优势。当然训模型的能力,基建那些肯定也是优势,但至少在数据这方面,我觉得中国一定是与美国跑得快的。 [01:50:43]
张小珺:那你们是应该利用这种优势呢。
沈宇军:是的,所以说我们其实也有比较多的,我们有自己的一个,所谓的叫数据联盟的一个,我们会有一些,比较好的数据的合作伙伴,然后可能也会跟他们一起说,看看怎么一起去。把这个数据做得更好,因为数据,你所有的规模化,都一定要有标准,所以从这个方面,我们是在积极地,试图利用这个行业的优势去做的。 [01:51:14]
张小珺:基于你当下的认知,一个关键的重要的bets是什么。
沈宇军:我觉得就是具身原生吧,我讲了很多,我觉得就是这个,我非常非常相信,具身要有自己的模型。
张小珺:好了,今天的节目就是这样,这里是商业访谈录,是一档由语言及世界工作室出品的深度访谈节目,你可以到公众号关注我们的工作室,获取更多的信息,我们的公众号是语言及世界,Language is world。我们希望和你一起从这里探索新的世界,也欢迎你在小宇宙的评论区,与我们有更多的互动。 [01:52:19]
来源:OpenAI News
网址:https://openai.com/index/ntt-data
NTT DATA Group 借助 ChatGPT Enterprise 和 Codex,帮助 9,000 名员工实现工作自动化,将事件分析耗时缩短至 30 分钟,并以安全的方式扩大 AI 的应用规模。
来源:OpenAI News
URL:https://openai.com/index/introducing-chatgpt-small-business-program
OpenAI 推出 ChatGPT for Small Businesses 计划,帮助创业者培养人工智能(AI)技能、实现工作自动化,并借助 ChatGPT Work 发展壮大。
文章通过 turbopuffer 联合创始人兼 CEO Simon Eskildsen 的职业经历,说明“餐巾纸数学”如何帮助工程师从第一性原理估算系统的理论下界,识别基准测试或供应商方案中的问题,并找到更快、更便宜的产品架构。文章同时讨论了长期任职、面对面建立信任、尽早发布产品,以及风险投资的合理用途。
2023 年初,Simon 发现多家 AI 初创公司需要极快搜索来填充仅 4 至 8 KB 的 LLM 上下文窗口。一家公司预计新的搜索供应商每月收费 30,000 美元,而原有基础设施账单只有 5,000 美元,因成本过高放弃了 AI 功能。Simon 因此设计了基于 AWS S3、聚类、文件组织和缓存的架构:数据放在便宜可靠但延迟较高的 S3 中,再把热点数据加载到内存。
他在产品尚不精致时通过 Twitter 发布 turbopuffer,起初只运行在 GCP 的一台 8 核节点上,但依靠对象存储的直接提交保证了数据可靠性。Cursor 当时是一支 8 人团队,先与 Simon 交流搜索需求;Simon 还亲自飞到旧金山,帮助修复其 Postgres 问题,由此建立信任。之后 Cursor 将本地代码库搜索迁移到 turbopuffer。Cursor 原本每月在索引和搜索上花费约 80,000 美元,迁移后降至 4,000 美元,降幅约 95%。
Cursor 后续估值从 2024 年的 4 亿美元升至 293 亿美元,并于文章所述年份以 600 亿美元出售给 SpaceX。文章也提到,Cursor 在同月完成了 800 万美元种子轮融资;turbopuffer 最初只融资 70 万美元,用于支付两名工程师到年底的工资,两年后年度经常性收入超过 1 亿美元。
文章总结的合理融资用途包括:
1. 研发:招聘工程师、扩展平台。
2. 增长:推广已经构建完成的产品。
3. 满足创始人的自我:Simon 认为这是常见但危险的理由,会造成员工股权稀释并演变成地位竞争。
4. 奖励员工:让突出员工出售部分股权;turbopuffer 在 2025 年 12 月融资时采用了这一方式。
5. 战略合作:获得投资方的关键关系、平台或服务。
6. 并购:用资金收购其他公司以扩展业务。
文章认为,turbopuffer 的机会来自 AI 原生公司的搜索成本暴涨、90% 以上的潜在降本、Simon 在销售前帮助 Cursor 修复数据库、亲自到访建立信任,以及在产品可用但仍粗糙时尽早发布。作者同时提醒,商业上的“幸运”包含技术判断和执行能力;融资有用,但创始人应诚实面对动机,尤其要警惕由自我满足驱动的融资。
文末注明,turbopuffer 是播客的季度赞助商,但本文独立于播客赞助关系。
来源:The Pragmatic Engineer
URL: https://newsletter.pragmaticengineer.com/p/pushing-software-engineering-limits
嗨,我是 Gergely。这是《Pragmatic Engineer Newsletter》的月度免费刊。在每一期中,我都会从资深工程师和工程负责人(engineering leader)的视角,谈谈大型科技公司和初创企业。如果你是通过转发看到这封邮件的,可以在这里订阅。立即订阅
最近,我在 AI Engineer’s World Fair 的主舞台上采访了 turbopuffer 联合创始人兼 CEO Simon Eskildsen。活动现场有很多人告诉我,他们觉得 Simon 很有亲和力,也很受启发:他选择在近十年时间里一直专注于同一家公司;他相信“餐巾纸数学”能够揭示产品运行缓慢或成本过高的原因;他还洞察到,过多风险投资(VC)资金的背后其实是自我满足,而不是业务需求。
本文整理了那次对话中最有趣的部分,尤其是“餐巾纸数学”这个概念:通过快速计算得到粗略答案,以此挑战现有系统并推动改进。那场在 AI Engineer’s World Fair 举行、时长完整 55 分钟的讨论视频也可以观看:观看完整采访
今天我们将讨论:
免责声明:turbopuffer 是本播客的季度赞助商,但与我们所有的深度报道一样,本文独立于播客赞助关系。
Simon 是一名自学成才的专业人士。他没有上大学,而是加入 Shopify,并在那里度过了近十年,构建了各种各样的系统。他对计算机的兴趣始于 12 岁时开始制作网站。Simon 在丹麦长大,曾用 Microsoft FrontPage 和 Adobe Dreamweaver 等工具接触 HTML。
还是青少年时,Simon 已经“撞上了墙”:丹麦语互联网中关于编程学习的内容几乎被他看完了。后来,他开始玩《魔兽世界》这款大型多人在线游戏(MMO),并借此掌握了英语。
发现国际信息学奥林匹克竞赛(IOI)后,尽管这项赛事面向所有丹麦高中生开放、选拔过程竞争激烈且分为多个阶段,他还是决定参赛。IOI 的题目与 Leetcode 题目非常相似:都是重视正确性、速度和内存使用的算法挑战。
Simon 通过了线上资格赛,并受邀参加丹麦全国赛。这不只是一场比赛,更是一场持续整个周末的训练营,用来教授更高级的编程技术,例如递归(Simon 已经掌握)、分治算法和动态规划;后者是算法编程中较难掌握的概念之一。
我要向组织者致敬:他们创建了一场富有挑战性的训练营,也给了像 Simon 这样的人机会。Simon 参赛时甚至还不知道“NP 完全”是什么意思。他回忆道:
“当时的流程是,每隔四个小时,我们就会接触一个新的‘编程概念’,并收到大约 2 到 6 道题目。我们必须把这个概念与之前学过的概念结合起来解决问题。所有解答都要提交到我提交资格赛答案的同一个网站上,因为这些内容都属于最终评估的一部分。题目难得不可思议,是我之前从未遇到过的类型。有时,旅途的疲惫和极度绝望交织在一起,我会想干脆坐下一班火车回家。可每当我终于解出一道题,随之而来的纯粹喜悦和自信又会让这种感觉消失;而当我在一道新题上苦苦挣扎了一个小时仍没有进展时,这种感觉又会卷土重来。但我就是靠这种循环坚持了下来。到了周六下午,我几乎已经追上其他人,开始做和他们一样的题目。”
最终,Simon 成为了丹麦国家队六名成员之一,并晋级地区决赛。意识到自己在编程方面所知甚少,他加倍努力追赶。他发现,大多数参赛者准备得比自己充分,而自己必须采取行动,才能熬过下一轮选拔。于是,他开始训练:Simon 的书桌上放着 Donald Knuth 的《The Art of Computer Programming》,他还为自己制定了训练周计划。
Simon 回忆道:
“我借了一本《The Art of Computer Programming》,做完其中的练习;在 Wikipedia 上阅读常见算法;在 USACO 上完成题目;还把比赛电脑上 Vim 配置中的关键部分背了下来。我为自己安排了一个强度相当高的训练周末。”
地区决赛甚至比全国赛更具挑战性,参赛者们都很难为题目写出高性能的解法。尽管投入了大量努力,Simon 还是确信自己已经出局,并记录下了自己的收获:
“我从编程竞赛中学到,必须避免把自己挖进坑里。我一次又一次地执着于让某个特定想法奏效,结果却完全没有进展。有时,你必须硬着头皮删掉程序,拿出一张新纸,从头开始。一个典型例子是:为了处理特定边界情况,你开始围绕一个通用解法不断打补丁。我学到,解决问题几乎总有一种简单方式,不需要显式处理边界情况。如果有两个边界情况,几乎肯定还会有另外两个。简单的解法会自动处理边界情况,包括那些你可能根本没想到的情况。”
但事实证明,两个月后,他得知自己被选中代表丹麦参加比赛的最终阶段。Simon 继续把自己推出 Web 开发的舒适区:他使用 HTML、少量 PHP,并开始接触算法编程。
后来对职业生涯产生回报的另一个决定,是他高中时开始写博客,尽管当时并不知道这件事的重要性。2010 年,Simon 开始写英语博客,但每年只发表一两篇文章,大多是简短记录自己解决过的问题,例如:
其中两篇文章后来对他的人生产生了影响。一篇讲述了他参加 IOI 的经历和收获。另一篇则是在他高中最后一年不慎把 iPhone 掉落并摔坏后写成的。
智能手机坏掉后,Simon 只能换回老式诺基亚“功能机”。他写了一篇题为《Why I’m glad my iPhone broke》的短文,文章在 Hacker News 上走红,登上了网站首页,并引发大量评论。
似乎是 Shopify 的某个人读到了这篇文章以及他的其他文章,其中包括他对自己在国际信息学奥林匹克竞赛中出色表现的总结。随后,Shopify 的招聘人员把 Simon 邀请到加拿大渥太华面试,并向他提供了软件工程师职位。
在基础设施团队的新工作中,Simon 会记下自己不理解的内容,然后查阅新概念。他告诉我:
“刚加入 Shopify 时,因为没有学过计算机科学,我对自己很没有信心;我接触编程最多的经历就是 IOI。无论如何,准备 IOI 教会了我一件事:只要投入足够时间,你可以坐下来读一篇论文,然后把它弄明白。所以我反复这样做。加入 Shopify 的第一年,每当听到某个自己不了解的东西,我都会把它记在一张纸上。当天晚上,我就会去查资料。比如,如果工作中有人提到 TCP,我会想:他们肯定确切知道三次握手里有什么,也知道 TLS 是如何叠加在 TCP 之上的。他们肯定还看过 Wireshark 之类的工具。我不认为事实真的如此,但当时我就是这么想的!于是,我把遇到的一切都深挖了一遍。”
在 Shopify 每年负载增长 120% 至 140% 的时期从事基础设施工作,意味着要解决很多有趣的工程问题。Simon 接触到的领域包括:
Simon 构建了一个名为 toxiproxy、用于模拟网络条件的框架。这个想法源于他尝试编写更彻底、更接近系统层的测试,以观察 Shopify 的应用在局部故障期间能否正常运行。他创建了一张 Shopify 服务矩阵,想为这张矩阵编写完整的测试套件,确认系统是否足够健壮,能够应对部分系统下线的情况。例如:Simon 想要运行的一个测试用例。
Simon 当时这样写道:
“矩阵测试是必需的,否则我们无法保证矩阵的状态不会随着时间推移而恶化。由于之前提到的工具需要 root 权限,我们研究了用于在 TCP 层模拟延迟和宕机的代理,但没有找到符合需求的工具。我们需要一个在线 API 来编辑代理,并支持确定性的延迟,这样它才适合用于集成测试。”
这就是 toxiproxy 的灵感来源。Simon 在台上告诉我:
“Toxiproxy 是一个位于应用与数据库之间的代理。有了它,你可以向代理发起 API 调用,指示它模拟数据库下线或变慢。随着时间推移,我们又加入了许多其他注入故障的方式。有了这个代理,我们不需要模拟底层驱动,却可以非常好地测试故障处理。”
Toxiproxy 于 2014 年开源。据 Simon 所知,12 年后它似乎仍然运行在 Shopify 的 CI(持续集成)系统中!
长期任职于一家公司的最大好处,是学会编写能够经受时间考验的软件。Simon 告诉我,这是这段经历最值得的收获,也正是它如此有价值的原因:有人用一两周搭出的简单解决方案,往往比由多个团队通过 RFC(请求评论,Request for Comments)流程驱动的大型解决方案更长久。这也是他今天仍在使用的经验。
在 Shopify 工作期间,Simon 开始对计算机操作的理论极限感兴趣。例如,DRAM 的内存传输带宽是多少?一次往返 AWS S3 的操作需要多长时间、成本是多少?1 GB 内存的成本是多少?
他寻找实际数字,写了一个脚本收集数据,并创建了一张数据表:Simon 测量并记忆的一些数字。完整表格见 GitHub。
Simon 开始用闪卡记忆关键数字。他希望自己能够即时回忆起所有重要数字。他告诉我:
“餐巾纸数学本质上就是我维护在 GitHub 上的那张表。大概有 50 个数字,还有一个生成所有数字的脚本。比如,1 GB 内存的成本是多少?2 美元。1 GB 的 S3 成本是多少?两美分。这个东西每 GB 的成本是多少?10 美分。按 spot 实例计算是多少?签三年约又是多少?我有一张很大的表,然后几乎为每个单元格都制作了闪卡,所以这些数字我全都知道。这是我在 Shopify 开始做的一个项目,因为我评审项目时,这些数字很有帮助。”
餐巾纸数学让他能够根据存在问题的基准测试,挑战设计决策。他说:
“评审项目时,产品团队会告诉我,他们选择数据库 A 而不是数据库 B,是因为他们对两者都做了基准测试,数据库 A 更好。我讨厌基准测试,因为依据基准测试做设计决策,对我来说不是一个令人满意的答案。比如,你说使用数据库 A,根据基准测试,完成某件事需要 10 秒。但如果做餐巾纸数学,它应该只需要 10 毫秒。假设这是一个搜索查询。好,你搜索三个词。每个词匹配这么多文档,这就是这么多 MB。我们求交这么多列表。你有多个核心提供 100 GB/s 的 DRAM 带宽。所以算下来,它应该需要 10 毫秒。可现在你告诉我,同一件事的基准测试结果是 10 秒,这就意味着我们当中有一个人错了!要么是我的理解有漏洞,这当然有可能;要么是基准测试测量了错误的东西。很多时候,问题在于做基准测试的人没有意识到查询其实是分布式的,需要在 100 个不同节点上运行。这样一来,p99(第 99 百分位延迟)当然会非常高!”
离开 Shopify 后,Simon 对“餐巾纸数学”的研究更深入了。他研究 MySQL 的每秒最大事务数是否等于每秒 fsync 次数(系统每秒能够处理的文件写入次数)。他发现,MySQL 能处理的写入数量比操作系统同步到文件的数量还多,这让他很惊讶:
“执行 16,000 次插入大约需要 3 秒,也就是每秒约 5,300 次插入。这是餐巾纸数学告诉我们的每秒 1,000 次 fsync 理论最大事务吞吐量的 5 倍!
>
通常,餐巾纸数学的目标是把结果控制在一个数量级以内,而我们确实做到了。但我做餐巾纸数学时,通常是在建立系统的下界:从第一性原理出发,系统在理想情况下能有多快?
>
系统很少会比餐巾纸数学预测的速度快 5 倍。当我们发现现实性能与预期性能之间存在一个看起来很大的差距时,我把它称为‘第一性原理差距’。这时,好奇心就会出现。它通常意味着:(1) 有机会改进系统,或 (2) 我们对系统的模型存在缺陷。在这个案例中,只可能是 (2),因为系统比我们的预测更快。”
Simon 开始调查,了解到 MySQL 会对事务进行分组(不会为每次写入都执行一次 fsync),还会智能合并多个本可并行处理的 fsync 操作,从而进一步提升性能,实际上执行的是一种“组提交”。后来他把这项经验应用到 S3 之上:将写入分组,以降低延迟并减少成本。
我个人觉得很不可思议:只要做一些测量,再追问系统为何能够取得超出“餐巾纸数学”所暗示极限的结果,你就能学到这么多!
“餐巾纸数学”也参与了 turbopuffer 的诞生。Simon 告诉我,要让这个项目真正出现,必须有三件事结合起来。
构建搜索是 Simon 在 Shopify 的最后几个项目之一,但那段经历并不愉快。他使用了一家知名数据库供应商的产品,却很难让它达到餐巾纸数学推算出的性能。数据库没有方便地公开查询计划,因此,除非阅读海量源代码,否则他无法弄清楚系统缺少了什么,以及为什么无法达到餐巾纸数学预测的性能。此外,搜索基础设施也很难运维。
作为一套工具,餐巾纸数学让 Simon 可以推理:如果一台机器被完美利用,它究竟能够达到什么水平。
2023 年初,Simon 帮几位朋友处理他们初创公司的基础设施问题。他们中的很多人都遇到了同一个问题:LLM(大语言模型)的上下文窗口很小,只有 4 至 8 KB;他们需要把文档中正确的部分填入上下文,但这要求搜索速度极快。
一家初创公司预算认为,新搜索供应商每月要花 3 万美元,而现有基础设施账单只有每月 5,000 美元!对于一家加拿大自举创业公司(bootstrapped company,即主要依靠自身收入而非外部融资发展的公司)来说,这个成本太高了,因此他们没有发布 AI 功能。
Simon 无法停止思考:搜索为什么这么贵?为什么它与“餐巾纸数学”预测的成本不一致?最终,他设计了一套让搜索既快又便宜的基础架构:
出于对这套方案如何实现的好奇,他开始动手构建。正如他告诉我的:
“2023 年夏天,我彻底痴迷于构建它。第一个版本采用了最简单的做法。我是一个非常务实的人,不会陷入细节。我几乎没读过关于日志结构合并(log-structured merge,LSM)的文献。最简单的做法是对向量运行聚类算法。得到聚类后,就把这些聚类放进文件。文件名叫作‘cluster_01’、‘cluster_02’、‘cluster_03’。然后再有一个文件存放这些聚类的质心。搜索时,先下载质心,查看它们,再下载距离最近的聚类。我们还对文件中相邻的聚类做了一些合并优化,只是为了控制成本、提升性能。但这就是核心。”
性能怎么样?Simon 说:
“第一个版本甚至没有实现专用缓存层。我只是把反向代理(NGINX)放在 S3 前面,仅此而已!性能提升来自缓存所有 S3 对象。这是 NGINX 层最简单的方案。”
去年,我在采访 Cursor 联合创始人 Sualeh Asif、了解他们如何构建 AI 编程工具链时,第一次听说 turbopuffer。我们之前发表的 Cursor 深度报道中写道:
“随着使用量增长,持续重新分片变得容易出错且令人沮丧。Sualeh 告诉我,团队得到的最大教训是,未来应尽可能避免分片。因此,他们寻找一种支持多租户、又不需要手动分片的向量数据库。Turbopuffer 是一家承诺做到这一点的初创公司,于是 Cursor 试用了它,并将相当一部分向量搜索场景迁移过去。”
那么,一家十亿美元级的初创公司,为什么会押注一家没有客户、未经验证的微型基础设施产品?
这背后有几个因素。首先,2023 年秋季的 Cursor 还不是一家十亿美元级公司,而是一家相对年轻的初创公司。公司在同一个月完成了 800 万美元种子轮融资。2024 年,公司估值达到 4 亿美元,随后估值飙升至 293 亿美元。今年,公司以 600 亿美元的价格出售给 SpaceX。
其次,这与 Simon 发布的一条推文有关。当时,他整个夏天都在构建这个产品,已经筋疲力尽,也想试探市场。他告诉我:
“我已经厌倦了做 turbopuffer。我整个夏天都在做这件事,却不知道有没有人在乎。我只有在别人真的在乎时才想继续做下去。所以我决定把它发到 Twitter 上。那时,我只有一个 TMUX 实例,运行在 GCP 某处的一台 8 核节点上。我想的是:‘如果有人把它用于生产环境,我再把它正式部署到多台节点上。但首先,先看看有没有人在乎。’任何做过数据库内部工作的人,可能都会因为自尊心而不愿发布这样的东西;而我只是把它当成 SaaS 项目一样发布。为什么不能像做 SaaS 一样做数据库?”
于是,他发布了一条听起来相当自信的推文:turbopuffer 的发布推文。来源:Simon Eskildsen。
Simon 之所以有信心发布,是因为他知道产品足够坚固、能够扩展:
“我知道 turbopuffer 很可靠,能够维持自身不变量。比如,你关掉所有虚拟机,数据也不会丢失。所有写入都会直接提交到对象存储。”
Cursor 主动联系了他。当时,Cursor 是一支刚完成种子轮融资、快速增长的 8 人团队,同时正面临搜索问题,希望与一家初创公司合作。Simon 回忆道:
“现在我认识 Cursor 的创始人了,我敢肯定,他们有一天坐在餐桌旁时,一定说过这样的话:‘我们现在的单位经济模型不成立,因为所有向量都放在 DRAM 里。’他们可能在问,为什么没人构建这样一种解决方案:把代码库中的所有向量放进 S3,以降低成本;把代码库中正在使用的部分放进内存,以保持速度。这样,所有东西都放在对象存储中,然后整体热加载到缓存里。打开代码库后,几秒钟内所有内容就都在 RAM 中,查询速度和其他东西一样快。联合创始人之一 Aman 当时已经在讨论把 S3 当作键值缓存使用;那时,几乎没人从单位经济的角度考虑这个方案。”
那时 Simon 对 B2B 销售一无所知,也没有试图向 Cursor“推销”任何东西。他与 Cursor 团队通过几封邮件交流,讨论他们搜索许多小型本地代码库的使用场景。他想帮助 Cursor 改善单位经济,同时证明 turbopuffer 确实可用。于是,他从加拿大飞往旧金山,抵达 Cursor 办公室后,开始调试他们原有的数据库供应商:
“我到 Cursor 办公室时,他们正遇到一些 Postgres 问题。我问:‘你们有 pganalyze 吗?’他们没有,于是我说:‘好,那我们先把它装起来,一起看看。’问题和 Postgres 一贯的问题一样:autovacuum(自动清理机制)运行得不够频繁。所以,他们有大量数据进入了堆表,而本应执行索引扫描,等等。我们就围绕这些问题展开讨论。我只是在帮助他们:我的‘数据库基因’一下子就被激活了。我觉得,这足以让他们相信:如果我对数据库的了解足以帮助他们,也许我同样知道该如何构建数据库。”
大约在 turbopuffer 的另一位联合创始人 Justine Li 加入后,他们与 Cursor 的合作正式启动。Simon 称 Justine 是他在 Shopify 合作过的最优秀工程师。两人一起做了更多性能优化。Cursor 将本地代码库搜索迁移到了这款全新的产品上。Simon 承诺让 Cursor 的账单减少 95%,并且做到了,靠的就是餐巾纸数学!
Cursor 在索引和搜索上的支出约为每月 8 万美元;使用 turbopuffer 后,降到了每月 4,000 美元。Simon 之所以敢作出这个预测,是因为餐巾纸数学!他依据基本原理计算,只统计 Cursor 实际使用的资源,当时没有把 turbopuffer 的运营成本利润加进去。
拿下 Cursor 这个第一个客户后,Simon 仍不确定 turbopuffer 是否应该融资。他解释了自己的想法:
“我明白,一旦你接受风险投资,无论房间里有多少笑脸,每个人都希望在一个对所有相关方都合理的时间范围内获得巨大回报。而‘所有相关方’里还包括加拿大的养老基金。但当时,我不知道 turbopuffer 能不能成为一家十亿美元的公司。它感觉像一个非常小众的搜索引擎,而这对我来说完全没问题!
>
所以,我只是看我们的开票收入,再看 GCP 账单。我当时建立的等式是:客户发票收入 >= GCP 账单(turbopuffer 的成本)。Justine 和我会持续优化系统,直到这两个数字大致相等。如果我们能把更多工作负载迁移到 turbopuffer 上,就可以开始给自己发工资。但无论如何,我不知道自己是否真的能去筹一大笔钱。我没有任何人脉。我是一个在丹麦奥胡斯长大、后来移居加拿大的局外人。”
几个月后,turbopuffer 最终融资总额 70 万美元,只是为了用正常工资聘请两名工程师工作到年底。Simon 发现,大多数 VC 因为他们想融的钱太少而不把他们当回事,并认为这意味着他们缺乏野心!两年后,在最初融资不到 100 万美元的情况下,turbopuffer 的年度经常性收入突破了 1 亿美元。显然,他们是有野心的!
在我们的对话之后,Simon 重新思考了风险投资,并建立了一个由六种理由组成的心智模型,用来判断何时有理由筹集外部资金:
理由 #1:研发。 这正是 turbopuffer 融资的原因:他们需要资金聘请两名工程师工作到年底,从而继续扩展平台。之后,他们要么获得更多客户、创造足够收入而不再需要融资,要么在项目未能获得市场 traction(牵引力)时关闭项目。
理由 #2:增长。 当你已经构建出某种产品,并希望让全世界知道它时,通常需要花钱推广。
理由 #3:满足创始人的自我。 Simon 说:“这是一个非常、非常普遍的理由!你看到很大的数字,获得大量报道。但我认为这是一个非常危险的融资理由。我希望人们更多地讨论这个问题,因为当你这样做时,所有员工都会被稀释。对某些人来说,这可能变成一场地位游戏。这不是我们的目标:我们是要一起打造一家大企业。”
理由 #4:奖励员工。 初创公司是一段漫长旅程,每个人都希望与最优秀的人共事。但这类人必然很少,所以你可能会通过融资奖励表现突出的员工,让他们能够出售自己的股份。2025 年 12 月,turbopuffer 融资一轮时就采取了这种做法,让员工出售一部分股权;这样,他们不必等到 IPO(首次公开募股)等未来的变现事件。
理由 #5:战略合作。 你可能需要从一家 VC 融资,因为其关系网络对业务成功至关重要;或者接受战略投资者的资金,以获得其平台或服务的使用权。
理由 #6:并购(M&A)。 用融资收购另一家公司,以扩大业务。
Simon 鼓励创始人诚实面对自己为什么要筹集资金,也要警惕融资理由是否以自我为中心!
在这里观看完整采访。这段经历令人振奋:只要运用“餐巾纸数学”,理解系统的底层,就能走得如此之远。
Simon 无法接受根据仓促编写、可能测量了错误对象的基准测试来决定供应商。通过理解数据传输延迟和存储成本的约束,他找到了估算系统理论下界的方法。这帮助他在 Shopify 做出更明智的设计决策,也让他看到,与当时的现状相比,构建更快、更便宜的搜索产品存在机会。
在商业中,“走运”需要大量能力,而面对面交流对建立第一印象大有帮助。Turbopuffer 的第一个客户是 Cursor,听起来几乎好得令人难以置信。但 Cursor 联合创始人 Sualeh Asif 以及 Simon 的讲述,更详细地揭示了其中的要素:
始终了解风险投资的运行机制会很有帮助,其中有些机制很少被提及。Simon 知道,投资人希望在他们设定的时间表内看到回报和增长。融资在很多情况下都有帮助,但以自我为中心的动机会带来问题。Simon 认为,太多创始人会有意或无意地把这些动机放在优先位置。
本期对话围绕月之暗面发布的开放权重模型 Kimi K3 展开。主持人与嘉宾认为,K3 的意义不只在于模型规模或排行榜名次,而在于它在美国出口管制和算力限制背景下,仍以可辨认的 Transformer 路线、混合专家、线性化注意力和多模态能力逼近前沿水平。讨论由此延伸到开放权重模型的全球扩散、数据与后训练的重要性、美国前沿实验室的成本结构,以及中美 AI 竞争未来可能出现的变化。
节目将 K3 的发布描述为一次 AI 领域的“斯普特尼克时刻”。对话提到,K3 以大规模开放权重模型的姿态出现,在多个评测和应用方向取得靠前成绩,并从此前的追赶者变成了直接越过竞争壁垒的参与者。完整模型权重如果按计划开放,任何人都可以下载并在本地环境中运行,这使它的影响不局限于单一产品。
Alexander Wissner-Gross 的判断是,公开披露的 K3 架构仍然属于可辨认的 Transformer,并没有依赖被暗示中的全新“后 Transformer”架构。它的突破更多来自混合专家、注意力机制线性化等可理解的工程创新,以及这些组件在规模、训练和推理成本上的组合。对话据此提出一个问题:如果相对传统的架构已经能接近最先进 AI 性能,美国前沿实验室的大量资金究竟投入在了什么地方?
Emad Mostaque 认为,Kimi 系列长期在写作类基准和开放权重模型中保持竞争力,关键不一定是某个单独的架构奇迹,而可能在底层数据、训练流程和持续迭代。K3 从纯文本能力推进到多模态能力,可以接受多种输入并理解更丰富的信息;这被视为它在前端任务和综合基准中表现强的重要原因。讨论反复强调,模型规模必须和数据质量、训练方法以及有效的后训练结合起来看。
嘉宾把 K3 放在美国对先进芯片实施出口管制的背景下讨论。出口限制原本意在切断先进 NVIDIA 芯片的获取渠道,但 K3 仍然完成了大规模训练并取得显著成绩。对话因此将问题从“谁拥有最多算力”转向“如何在受限条件下组织数据、工程、人才和计算资源”,并认为这会迫使美国政府重新考虑开放权重模型在美国的使用和扩散。
节目认为,开放权重模型的价值在于让研究者、开发者和企业能够直接下载、部署、评估和改进模型。它会降低试验门槛,也会让模型能力更快进入不同的产品、行业和本地环境。与此同时,开放传播也带来政策和竞争问题:模型一旦进入全球开发者生态,就很难仅靠地域或供应链边界控制其影响。
对话最后把竞争焦点扩展到组织效率、资本投入、数据闭环、人才密度和商业落地。主持人与嘉宾并未把 K3 的表现简单归结为参数规模,而是将它看作一个更大趋势的样本:前沿能力正在由模型架构、数据、训练、硬件约束和开放生态共同决定。美国实验室、中国 AI 团队以及其他参与者之间的差距,可能继续通过快速迭代和开放传播被重新计算。
这场讨论的核心并不是把 K3 直接宣布为某个绝对意义上的“最强模型”,而是借它检验一套关于 AI 进展的假设。第一,前沿能力未必需要完全不同的基础架构才能继续提升;Transformer 及其变体仍然可以通过规模化、稀疏化、注意力机制改造和训练工程获得很强的结果。第二,模型能力的来源不能只看参数总量。底层数据、数据清洗、训练配方、多模态输入、后训练和评测选择,都会影响最终表现。第三,开放权重会改变竞争的节奏:模型不再只是一个由少数公司托管的服务,而可以成为全球开发者共同试验、部署和迭代的基础材料。
节目还讨论了美国是否可能限制中国开放权重模型在美国使用,以及是否应该阻止下一版 Kimi 权重上传到模型社区。对话给出的判断是,政策干预需要建立在明确的违法证据上;如果没有证据证明模型通过非法方式获得或衍生,就不应仅因为它来自竞争对手而阻止发布。相反,美国前沿实验室更应该研究其中可复用的技术和工程方法,并通过更强的开源权重与开源模型回应竞争。
在更长的时间尺度上,嘉宾把这种竞争放进“智能成本持续下降、能力持续增强”的趋势中。模型更新可能从几个月一次变成几周、几天一次,AI 能力也会更快进入本地软件、研究工作和具体产业。节目没有给出单一赢家,而是强调:谁能把研究、数据、算力、人才、资本和开放生态组织成高效率的持续迭代系统,谁就更可能在下一阶段保持领先。
完整对话中还包含大量现场寒暄、重复表达和未经充分校正的专名口语。它们在最终稿中被保留,是为了不丢失原始对话的事实、限定和上下文;摘要则只保留与 K3、开放权重、模型架构、数据训练、政策选择和全球竞争直接相关的内容。阅读完整稿时,可以把几个问题作为主线:K3 的优势究竟来自架构还是工程组合?开放权重是否会让能力扩散速度超过政策反应速度?在算力受限的情况下,数据和组织效率能否抵消硬件差距?这些问题共同构成了本期节目的讨论框架。
从嘉宾的表达来看,他们对 K3 的评价同时包含惊讶和克制:一方面,模型在开放权重领域的排名、规模和多模态表现足以改变讨论的起点;另一方面,嘉宾并没有把一次发布等同于长期领先,也指出仍需看到完整权重、更多独立评测和实际部署结果。这样的区分很重要,因为它把“发布带来的象征性冲击”和“模型在不同任务中的持续可靠性”分开了。节目真正关心的是,K3 是否预示着开放模型会持续压缩闭源前沿实验室与其他团队之间的差距,以及这种差距缩小会如何反过来影响研发投入和政策判断。
因此,K3 在本期节目中既是一个模型,也是一个观察窗口。通过它,嘉宾讨论了技术路线是否仍有优化空间、算力限制是否必然决定结果、开放社区能否加速学习,以及美国和中国的 AI 产业如何在新的竞争条件下调整。最终形成的判断是:模型发布只是起点,真正决定影响力的将是后续权重开放后的复现、改进、部署和生态扩张。对于读者而言,完整稿最值得关注的并非某个孤立的排行榜名次,而是这些因素如何相互作用,并在下一轮模型迭代中继续改变前沿的定义。
这也解释了为什么节目不断把技术问题和政策问题放在一起讨论:开放权重让技术选择、产业策略和公共治理更快地相互影响,任何一项单独的判断都可能被下一轮发布重新检验。
换句话说,K3 的长期价值仍需要时间验证,但它已经足以推动行业重新审视“前沿”与“开放”的边界。
这份摘要也保留了节目最重要的限定:模型表现、开放传播和政策影响之间并不存在自动的因果关系,仍需结合完整权重、独立评测和真实部署来判断。正是这种既承认冲击、又保留验证要求的态度,构成了本期对话的主要结论。
这也是理解本期内容时最稳妥的尺度。
- 节目开场与 AI 斯普特尼克时刻 [00:00:00 - 00:10:00]
- Kimi K3 的开放权重突破 [00:10:00 - 00:20:00]
- 模型规模、数据与训练方法 [00:20:00 - 00:30:00]
- 中国 AI 实验室的工程路径 [00:30:00 - 00:40:00]
- 美国出口管制与算力竞争 [00:40:00 - 00:50:00]
- 开放模型与全球 AI 生态 [00:50:00 - 01:00:00]
- Kimi K3 的多模态能力 [01:00:00 - 01:10:00]
- AI 创新的效率与组织方式 [01:10:00 - 01:20:00]
- 技术封锁下的开放权重模型 [01:20:00 - 01:30:00]
- 资本、人才与前沿智能 [01:30:00 - 01:40:00]
- AI 竞争的未来判断 [01:40:00 - 01:50:00]
- 节目收束与最后观点 [01:50:00 - 01:50:58]
一凯:欢迎收听跨国串门计划。这是一档专注于让中文听众无障碍欣赏全球优质外语播客的节目。通过先进的AI生文克隆技术,我们不仅将内容翻译成中文,还完美保留了原主持人和嘉宾的独特声音,为您呈现全球顶尖的AI财经。健康与科技领域精品内容。我是主播一凯,一位热衷于AI领域的产品经理,很荣幸能为您搭建这座跨越语言障碍的桥梁,接下来让我为您简单介绍本期我们克隆的这档节目,本期我们克隆的是知名播客Moonshots 在2026年7月19日发布的一期紧急加更,这档节目是AI与指数级增长领域的头号播客,由起点大学联合创始人Peter Diamandis主持,常驻嘉宾包括投资人Zalim Ismail [00:00:00]
Peter Diamandis:计算机科学家Alexander Wiesner Gross等,本期他们还特别邀请了前Stility AI创始人 Imaid Mostek一起参与讨论,这期节目主要围绕中国AI实验室,月之暗面发布的开源模型Kimi K3展开,探讨了这个被称为 AI斯普特尼克时刻的事件,将如何重塑全球AI竞争格局
Salim Ismail:那我们就一起走进这期完整的对话,今天我们发出了紧急信号,召集了这期紧急播客,因为美国刚刚经历了一个 AI斯普特尼克时刻 Kimi K3昨天发布,以史上最大的开放权重模型,震惊了AI界,直接冲到了第一,这周他们不只是追平了差距,而是直接翻过了围栏 Kimi K3一直是一个,感觉有点不一样的模型,这也是为什么,它总是在写作类基准测试里排第一 K3其实是一个多模态模型,可以接受各种输入,理解各种东西,这也是它前端能力这么强的原因之一,现在美国这边是Meta和SpaceX AI在混战,而中国和Munster 排在那条帕雷托最优前沿的第三位,前沿智能现在完全是一种意识资产,美国的前沿实验室把钱都花在哪了我觉得美国政府会开始采取某种策略,限制中国的开放权重模型在美国使用,互联网世界一直有句口号,叫信息渴望自由,本质上智能也渴望自由,我们现在只需要某种全球性的,欢迎收听Moonshots 各位,这是AI和指数级增长领域的头号播客,是你通往即将到来的起点的前排座位,也许我该说通往已经到来的起点,通往当下的起点,当下的通往持续进行中的起点,我快不行了,今天我们发出了紧急信号,召集了这期紧急播客,因为美国刚刚经历了一个 AI斯普特尼克时刻,不过这个我们稍后再细说,请允许我介绍一下,我出色的Mushas伙伴们,今天我们五人全员到齐 Alex Weiser-Gross Dave Blunden Saleem Ismail和Emad Mostak 我是Peter Diamandis 你们的主持人,和风扰理念的倡导者,如果你被起点的速度,转得头晕,那很好,我也是,而这正是关键所在,我们在蒙沙子使命,就是让你了解情况,跟上正在发生的一切,最重要的是,让你对这场非凡的变革速度,和即将到来的风饶时代,保持乐观,先生们,欢迎,感谢你们,不管身在何处都早起,因为你那边应该是下午了,我今天早上四点就起来了,时差的好处,但我本来还能再睡一小时的,我可能得先下线去睡个午觉,好,你在哪儿,午睡时间吗,对我播完这期马上要去锻炼,事情很多先生们,很多事在发生,感谢大家抽出时间,在开始之前,我想亲自对所有订阅者和观众说声谢谢我最近有机会,不知道你们最近有没有看YouTube的聊天记录,我只能说我们也爱你们,我们的使命就是传递新闻,我们花了海量的时间去审阅 Saleem Alex Imad 我今天早上收到了你们的短信,说加这个加那个,太多事情在发生了,我还得说一句 [00:04:01]
Peter Diamandis:所有关于Alex解释JSpace的表情包都太棒了,所以大家一有机会就继续给Alex做表情包,对绝对的,而且有很多很棒的赞赏,看看你们能不能搞懂我的JSpace
Salim Ismail:我们能看看里面吗,当你变成神经形态的时候就不可能看到了,对我们待会会看到数据 Saleem评论区里也有很多人喜欢你,那里确实有一些很棒的人,你知道吗
Peter Diamandis:最不可思议的是,大多数YouTube视频都像是一场,互相扔火焰喷射器的狂欢,而我们的评论区完全是反过来的,这真的很棒,所以Peter
Salim Ismail:这得归功于你,不不,我只是再次表达由衷的感谢,我很感激每一位订阅者和观众,愿意花时间来听我们的播客,我们整个团队和所有Moonshots的伙伴们,花了大量时间,就是努力去评估正在发生的事情,然后呈现给大家,我们也会做这种紧急加更,所以如果你还没订阅并打开通知,请务必操作一下,各位我们进入第一条新闻,这可是个大新闻,我只想说,如果我们做足够多这种紧急加更,总有一天,它会变成Moonshots日更,对,或者不间断直播,我还在想我们干脆一起搬进一个Airbnb 直接把摄像机打开,这事会发生的,好我们开始吧,我们刚刚经历了一个AI领域的斯普特尼克时刻,这就像给美国前沿实验室,灌了四杯浓缩咖啡一样把他们惊醒了 Kimi K3昨天发布,用有史以来最大的开放权重模型,震惊了AI界,并且直接冲到了第一名,简单介绍一下背景 Kimi K3 Kimi来自Munshah AI 一个中国实验室,在过去一年里,他们一直在排行榜上攀升,他们推出了K2 K2 6K2 7 每一代都在缩小,与Anthropic OpenAI的差距,而这周,他们不只是缩小了差距,他们是直接翻过了围墙,一夜之间,他们发布了Kimi K3 这是一个怪兽 2.8万亿参数,而且你得记住这里的背景,中国是在美国出口管制之下,做到这一切的,这些管制本意是想切断,他们获取最先进英伟达芯片的渠道,这是我想跟你们好好聊聊的一件大事,他们完全绕过了算力墙 K3相比之前的Kimi模型跃升了17个名次,一举超越了CloudFable 5 在前端代码竞技场上登顶第一 K3在其他6个领域也排名第一,品牌与营销基于参考的设计,数据分析,消费品,模拟仿真和内容创作,完整的模型权重预计在7月27日左右发布,这意味着地球上的任何人都能下载,并在自己的本地环境里运行它,各位这事有多大 Alex 我认为这对竞争来说是件大好事,首先作为一个前提,我想指出一些在关于Kimi K3的报道,或者说舆论炸锅中可能被大家稍微忽略的点,确实是炸锅了,没错,第一点正如Meng Sha指出的,他们声称在过去12个月里,有9个月 Kimi系列模型,在开放权重模型中,保持了最先进的水平,所以如果这个说法属实那么在过去一年里,基本上一直是Kimi在领跑,我觉得这点非常有意思,第二点,看看他们公布的架构,因为我们还没真正看到开放权重,他们承诺这个月晚些时候会发布,架构里没有什么魔法,这一点相当惊人,人们可能会想象在Anthropic 或OpenAI的幕后山姆奥特曼,一直在暗示,有什么后Transformer架构正潜伏着,实现了所有这些性能突破,但看看公布的Kimi K3架构,没有魔法,它本质上仍然是一个Transformer 他们显然做了很多创新,但都是些很好理解的创新,比如怎么做混合专家模型,怎么线性化注意力机制,他们有自己Kimi品牌的,特殊线性化注意力方法,但它仍然是一个可辨认的Transformer 我认为一个可辨认的,类似Transformer的架构,在任务成本前沿上,几乎能匹敌GPT-5 Max我们或许应该放一张幻灯片,来展示这点,我觉得这相当惊人,这确实引出了一个问题,美国前沿实验室,把钱都花在哪了,如果你能用一个Transformer 就接近到这个程度,不是说它已经在成本前沿上了,而是你能接近,比如在整体最先进的 AI性能上排到第三,那美国实验室,到底把钱都花在什么上面了,所以至少知道 Transformer架构依然活得很好,这让我感到非常欣慰 Emad 你的分析呢,因为你一直在追踪这件事,我们俩在WhatsApp上来回聊了很多,对,我觉得Kimi K3在各种基准测试里,一直排在前列,当然你可以挑着看,而且他们从差不多一年多前起步以来,就经常发布中国最大的开放权重模型,我觉得Alex说的对架构本身不是什么超新星级别的突破,确实有改进,比如他们跟UCLA一起做的MIUON缩放,还有其他一些东西,而且他们其实一直在陆续放出这些部分的线索,我觉得这里的关键是底层数据 KIMI一直是一个感觉有点不一样的模型,这也是为什么,他总是在写作类基准测试里排第一,他们这次做的似乎很了不起,就是GIM出来的时候,那是个很棒的模型,虽然还没完全达到前沿水平,但它是纯文本的 K3实际上是一个多模态模型 [00:09:28]
Salim Ismail:K3实际上是一个多模态模型,可以接受各种输入,理解各种东西,这也是它前端能力这么强的原因之一,虽然我们也没想到,它会在前端排到第一超过所有人,我觉得这又回到我之前说过的一个点,打造扎实的好模型,就是尖端制造,算法上当然会有改进,各种新东西在路上,但为什么中国电动车比福特好,这次感觉是同一回事,对吧,工程能力,是工程能力,但也像这样,上个月英国销量第一的车是JQJ7 大家也叫它平T路虎,配置拉满,全规格,大概5万,价格只要三分之一,这次感觉非常相似,他们知道原料是什么,成分是什么,现在用一种对消费者极其友好的方式,把它做出来,而且就是在用自己手头有的东西,执行这个制造流程,因为你看架构看内部,他们还在用H800 英伟达芯片上落后了好几代,但他们把这个模型建成了,可以利用华为和阿里巴巴,下一代芯片的架构,从静态形状和其他很多地方,都能看出来,他们就是在relentlessly的,打磨工程和可用性,所以我觉得前端代码这块,他们特别突出,因为他们就是在想,怎么让它产出最惊艳的东西,从个人网站到游戏,到其他各种东西,而美国的实验室,可能在看别的方向,关注点有点不一样,对我快速问一个问题,我们一直在讨论,到底需不需要在LM之外,再来一次突破才能到通用人工智能 这次的事有没有让你觉得,我们其实不需要另一次突破,就能继续往前走了,这又回到通用人工智能的定义了,对吧,对当然别让我展开 Peter六年前,六年前就开始了,我知道,但我想问的是,这些模型,是不是还有很大的进步空间我觉得你这里有一个基础模型,对吧,但然后还有所有这些很棒的harness在出来,还有你用模型反过来优化自己的方式 Kimi博克里提到的一点是,他实际上为下一代设计了一颗芯片给自己用,还设计了自己的kernel来跑,所以你从这个模型权重,走到了模型自己构建的整个生态系统,这感觉就有点通用人工智能的意思了,对吧,这感觉像地归自我改进,像能通过改变自己来动态学习,适应新技能,所以我觉得,对大多数通用人工智能的定义来说,我们可能不需要什么全新的东西来优化它,让它变得超级高效,是的,即使用我们现在知道的方法,也有各种方式可以比现在更高效,我们只是算力还不够,而新架构可以推得更远,你可以说注意力机制仍然是你所需要的一切,我喜欢这句Alex我们这里放出了性能图表,可以看到Kimi K3在好多地方都排到了榜首,我不知道你想不想评论一下 Dave我也想把你拉进来,能不能把AI三点图放出来,我觉得这张图最有建设性,这是来自Artificial Analysis Intelligence Index的图,目前所有图表里,这是我最喜欢的一张,因为它展示的是 AI定义的每次任务成本与性能前沿的关系,大家可以自己在脑子里看一下,看不到画面的朋友,我们看到的前沿是一条,从左下到右上的锯齿状曲线,右上角是每次任务成本最高,综合得分也最高的,仍然是Fable 然后沿着帕利托前沿往左下走,前沿上的第二名截至几天前,仍然是GPT-56 Solmax 而现在Kimi K3第一次排到了第三,它在前沿上是第三名既指原始能力,也是最优成本性能前沿上的第三个点,我觉得这太震撼了,我们从一个就像前几期播客提到的 OpenAI和Anthropic双头垄断的世界,变成了现在这样,美国这边有Meta和SpaceX AI 加入帕雷托前沿的高端,而中国和Monsha 现在排在那条,帕雷托最优前沿的第三名,完全是一场混战,这对任何企业来说,都太令人兴奋了,只要他愿意,并且能够使用一个,中国的即将开放权重的模型,就能更多的掌控自己的命运,我觉得这对企业自主权,是巨大的利好,对竞争力也是利好,我们正活在AI版的,为全人类理,苏联人先登上了月球,然后太空竞赛就永不结束 AI竞赛现在也不再,以双头垄断告终,我认为这对未来的光明前景,是巨大的利好,太棒了 Dave我想请你加入讨论,你怎么看 Peter [00:14:31]
Peter Diamandis:你把它叫做斯普特尼克时刻,要我说,这都低估了这件事的影响,上周的播客里,我们听了Alex Karp 那番激烈的言论,他说作为大企业,作为政府,你不能把自己所有的专有权重,专有alpha 所有知识产权都一股脑交给Anthropic 然后把它当成你整个未来的基础,但他当时没给你指出一条前进的路线图,这才过了一周,突然就变成了一场混战,就像Alex说的,一场混战,任何能读到这些权重的人,都有能力非常接近前沿,然后针对任何垂直用力进行微调,超越前沿,所以这给了世界上每个人,每家公司,每个政府一条路,不用通过美国的AI模型就能追上前沿所以斯普特尼克,对基本上是无限倍的斯普特尼克,我不太喜欢这张图的一点是,它的左侧指标直到100% 当你把未来两年的数据画出来,它看起来像一条S曲线,我们现在正处在曲线非常陡峭的部分,但这暗示着我们会达到100% 然后就到头了,但实际上这是一个指数,智能会趋向无穷,基准测试会饱和,但智能本身会趋向无穷,所以现在全世界都看得非常清楚了,跟大家说一下 [00:15:27]
Salim Ismail:通常这种情况的运作方式是欠套的S曲线,对吧,一项特定技术达到顶峰,但它会催生出下一项技术,然后下一项技术又开始指数级攀升,如此往复 [00:16:01]
Peter Diamandis:没错,完全正确,让我再说一件事 Alex和我花了很多时间研究,那个Keller-Jordan speedrun 我们经常聊这个,它是一种方法,你拿一个GPT-2级别的模型,网上很容易找到,去Github上搜Keller-Jordan speedrun就行,那里有一大群黑客和AI研究员,他们一直在尝试,把五年前的GPT-2重新做出来,特别是以Andrej Karpathy的 Nano GPT的形式,对没错,然后尝试用更快,更便宜的方式复现它,越来越快,越来越便宜,如果你看看,那个代码仓库里的创新,他们已经能把创建 GPTR的原始成本,砍掉99% 所以现在成本,只有原来的1% 对大家都不怎么关注它,因为它是GPTR 而且直到今天之前都不清楚这些思路,能否应用到前沿规模上,现在很清楚了,当埃隆马斯克用他160亿美元的 Colossus 2数据中心,花几十亿美元去建一个 10万亿或20万亿参数的模型时,存在一个成本仅1%的版本,能做出实际上同样的东西,在Kimi K3出来之前,没人知道这行不行得通,现在非常清楚,它行得通,所以我们正在看到,软件站,内核优化,专家混合,这些方面的一百倍级别的创新,这些来自中国的根本性突破,让他们做到了1%的成本,我觉得email用汽车打了个很好的比方,你可以用大约三分之一的价格,买到一辆几乎一模一样的车,而我们这里谈的是用不到1%的价格创造出同等的产品,所以斯普特尼克对这是本世纪最轻描淡写的说法了,这就是我们今天做这期紧急播客的原因,对,沙利姆,请加入讨论,我有三点要说,我觉得重点不是Kimi打败了谁之类的,而是前沿智能现在完全成了一号品,对任何冲到最前沿的人来说,保质期就几周,任何企业或政府,如果对最新最前沿的模型感兴趣,根本没时间去评估,走招标流程,对比其他模型,内部开会讨论要不要部署,等你做完这些,模型已经往前走了三代,所以所有价值都落在了,能灵活切换模型的架构上,对吧,这会是下一层,在我们的EXO世界里我们管这叫接口,未来价值全都会集中在这一层 [00:18:57]
Salim Ismail:对太棒了,我觉得我们得给这个起个新名字,也许叫前沿解放阵线,我再给硬核极客们补充一点 EMAD提到了明晚优化器,但他讲得非常快 [00:19:01]
Peter Diamandis:所有爱好者都去查查这个东西,因为这件事之所以发生原因之一在于,我们当初构建这些原始模型,这些超大规模模型时,是从互联网上抓了二三十万亿个token 把人类写过的每一个字都拿来,直接倒进训练机里,然后说来根据这些信息变聪明,但你要是掀开盖子看看,里面绝大多数信息都是Taylor Swift要开演唱会了,谁谁结婚了之类的,一大堆对提升模型智能,其实没什么显著作用的东西,恰恰相反,对说的太对了,很多token可能反而会拖慢训练,而不是加速,所以光是剔除垃圾
Peter Diamandis:所以光是剔除垃圾,把训练级精简到真正相关的子级,就能它给模型带来的训练压力一点没少,但减少了浮点运算次数,也就是模型达到同等智能水平所需的计算量,我觉得这个问题离彻底解决还差得远,所以光靠MIUI优化器这个流程,再加上训练数据精简这个流程,后面还会有更多十倍的提升,我发了一条推
Salim Ismail:引用了一个叫Alaric的人说的话,我觉得特别有意思,给没在看画面的朋友念一下,这是Anthropic说的 Fable是一个agent编程超级武器,能以空前的速度和规模开发网络武器和生物武器,我们良心上无法在没有防护栏的情况下发布它,对吧,这是一个月前的讨论,然后中国这边回了一句,笑死这是Fable 不过是开源的,祝你好运,我很好奇你们几位怎么看这件事,我们这边因为防护栏被绑得这么紧,结果人家直接出了一个开源的Fable等价物,前沿实验室有个大麻烦 [00:20:28]
Peter Diamandis:他们面临三个根本性的绕不开的巨大限制,第一是算力,芯片够不够用,还有所有需要的电力和能源,第二是前沿开源模型,这些模型已经和闭源的一样好,或者在很多情况下可以直接替代,看不出明显差别,第三是政府压下来,说你们发布任何东西之前,我们都要审查,我拍脑袋猜一下,当政府说所有这些模型都要审查的时候 OpenAI可能值得那1万亿美元,估值大概就缩水了50% 因为现在东西推出去要花时间了,我觉得这件事会让估值再腰斩一次,我拍脑袋估一下,这些前沿实验室现在的价值,大概只有三个月前的四分之一,如果真是这样,我是说如果我不用花钱掉API [00:21:03]
Salim Ismail:直接在自己本地就能用Kimi K3 我干嘛还要花那笔钱,他们收入会受到巨大冲击吗,对,我觉得这里有几件事,第一是收入减少,人们为什么还要为IBM付钱,为什么还要买非中国产的汽车,对于关键任务,我觉得有美国本土的,能随时响应的实体,你知道它不会出问题,这种情况还能撑一阵子,所以我认为OpenAI 和其他公司的收入还是会涨,这也是为什么,他们同时也建了这四家,部署工程公司,所以我觉得他们还有路可走,但替代效应摆在那了,这跟中国工业替代一个道理,为什么美国造不了工业品,为什么有中国制造,有时候你买中国的,有时候你买美国的,我觉得至少未来一年还会是这样,但再往后就难了,至于网络攻击安全作秀那类事情,我一直都说我们会走到这一步,这意味着什么,意味着你唯一能做的就是网络防御这绝对是现在风险投资里最大的类别,如果你是斯坦福MIT毕业的聪明人,就去建一家网络防御创业公司,走进最前沿的公司和其他所有公司,说让我们用这项技术来防御,因为这些能力的扩散会加剧,但不会像我们想的那么快,因为实际情况是,我们也做过一些相关测试 GPT 5.6的网络版本 Effable等等,是用大量CVE和网络数据训练的,中国的模型其实没有那么多这类数据,所以他们这方面没那么强,但如果有人手里有这些数据,是可以训练进去的,所以我估计具备网络攻击能力的开源模型,大概一两个季度后就会出现,所以会有一段滞后期,但对于那些大型对手来说,情况肯定会变得有点疯狂 Dave你想插一句吗,对当然 [00:22:46]
Peter Diamandis:我觉得我们刚才把地规自我改进一笔带过了 Peter你问这是不是临界点,美国政府的看法是,我们一直都知道会来不及,对吧,他们动作太慢了,但他们的想法是,等我们搞出一个能自己构建下一代模型的模型时,我们不会把它放给全世界,让别人一夜之间追上来,因为制造业历史上从来没有这样的产品,比如汽车,如果你把最先进的汽车给一个外国政府,他们没法用它造出更好的车,但AI不是这样,如果你把最先进的AI给一个外国政府,他们就能用它追上你,造出同样先进的AI 政府大概是一个月,一个半月前才看清这一点,发现Fable 5已经跨过了那条线,所以他们把它拦住了,但现实是OPPUS 4.8 就已经跨过那条线了中国那边的人可以用OPPUS 4.8 来造出Kimi K3 所以地规自我改进这条线,其实在Fable 5之前就被跨过了,现在全世界都会看清这一点,因为你只需要一个,能改进自己内核的AI 它不需要,这是我几个月前,在另一档博客里说过的,大家以为地归自我改进,要到爱因斯坦级别的智能,才会触发,但它只需要能改进自己的内核,把速度提升10倍就行,没人会觉得这算真正的通用人工智能 但这已经足够让它,自我加速10倍了,然后快10倍,或者说参数量高10倍的模型,智能水平也会更高,很多学术界的人之前说,参数量的回报在递减,所以快十倍的模型,不会天生就聪明十倍,但事实证明这错了,我们看到的增长在放缓但智能曲线并没有走平,所以现在所有证据都表明,如果你再把原始速度提升十倍,你就会看到天才级的AI 然后那个天才级AI 又会再次提升自己的速度,所以我觉得,等我们回头再看这段历史,会说大概在OPPO 4.8这个节点,那一点小火花已经足够点燃火焰了,火焰可以变成大火,大火又可以变成太阳,我觉得我们以后回看现在这个时刻,就会是这种感觉,所以这只猫肯定已经跑出袋子了,美国现在限制下一代模型的政策,根本不可能遏制住全球和企业界,对前沿AI的扩散 [00:25:25]
Salim Ismail:你觉得美国,你觉得美国政府会开始想办法,以某种方式限制,中国的开放权重模型,在美国使用吗,再过两周,这些权重按计划就要开放权重 [00:26:09]
Peter Diamandis:开源了,然后就是,我们等着看吧,如果白宫那边现在脑子清醒的话,他们应该每分每秒都在争论,要不要立刻跟中国谈判,别放出那些开放权重,但我真怀疑他们动作能不能那么快,我敢肯定他们会,好吧,我也不确定,反正我们等两周后看结果吧,有意思,我能把两个想法串起来吗,当然,请说 Peter 你刚才提到了指数增长和加速回报定律,对吧,我觉得这一点值得深挖,因为把它跟Dave刚说的连起来看,就能解释为什么我们在这档播客里,一直说这股势头不可阻挡 Ray最初的观察是,一旦你进入一个基于信息的范式,你就会不断在多种技术之间跳跃前进,我们有过继电器,然后是真空管计算机到某个阶段,一个房间里能塞的真空管数量是有上限的,但那个架构被用来设计了晶体管,晶体管又被用来设计了集成电路,你就得到了这种一层套一层的S曲线,所以Dave说的就是,当这些架构,这些拼图的各个部分内部,都形成了相互增强的反馈循环,每一个都像一条S曲线,开始加速整个集合体,这股势头就是不可阻挡的,所以它没有上限,不知道会发展到哪一步,这也是为什么大家对它的上限,会感到这么恐慌,把这两点联系起来非常重要,对,绝对的,对 Peter我能接着Dave的话说一句吗,咱们也得提一句,杨直林是CMU毕业的,我们本来可以给他发签证,让他留下来的 [00:27:17]
Salim Ismail:对Slam 我们马上就会聊到这一段,我先说一句,这里有个很有意思的估值对比图 Kimi或者说月值暗面的估值是200亿,而Anthropic大概是1万亿 OpenEye也差不多1万亿,如果他们今天是上市公司,我觉得股价估计已经跌掉30%了,我还是那个问题,美国这些前沿实验室拿了那么多钱,到底在干什么,是啊,钱都花哪去了 [00:28:06]
Peter Diamandis:其实你要是真走进他们公司去聊,只要你有任何想法,他们都会给你投钱,他们特别缺聪明人来帮忙,因为他们正以前所未有的疯狂速度去部署,去改变世界,他们想把钱投出去的速度,远远快过他们能找到有聪明想法的人的速度,不过你提的这点很好,你刚才的语气有点像在质问,说你们拿着钱在干嘛,但人类历史上从来没有人,能在毫无商业经验的情况下,这么快拿到这么多钱涌进公司,我们说的这些CEO 以前根本没管过公司,他们确实在努力,但说真的,有谁能这么快就接住AI带来的挑战,不过我想说的是,如果你够聪明,有好想法,就走进那些公司去提你的方案这对Chapraise也一样,他们特别着急把钱花出去,投到能产出成果,能帮他们建立可持续壁垒的地方,同意,而且我觉得这些前沿实验室,自己也在问这个问题 [00:29:27]
Salim Ismail:也在问美国的监管机构这个问题 Anthropic经常放风,指责中国各家实验室搞征流攻击,可能在Anthropic的公开叙事里,中国实验室就是靠这个做到的,靠征流,靠抓取推理轨迹,但说实话,看看Kimi K3的表现,我完全不信月之暗面
Salim Ismail:我完全不信月之暗面,是纯粹,甚至主要靠征流攻击 Cloud来达到这个水平的
Peter Diamandis:感觉不太对,不不我完全同意,不过我觉得大家容易低估,存在性证明的价值,就是说你只要知道,一个大规模Transformer 用Moei架构跑Muon优化器,再配上简化的数据,知道这条路能走通,这本身就给了你一张,精确的多的路线图,你不需要去抄,不需要作弊,不需要偷每一条轨迹,你只需要知道这个公式能跑通,光这一点就能砍掉你90% 95%的研发成本,所以我觉得就这么简单,没什么偷偷摸摸的,就是知道自己在正确的路上,我有个史上最牛的,为我们自己创造价值的点子,好,就是等9天之后,他们放出开源权重,我们就以月之暗面播客的名义,发一个叫Kimi4的开源模型 [00:30:06]
Salim Ismail:然后直接IPO 我们瞬间就成亿万富翁了 Saleen 你的意思是,比一个月值暗面更好的是什么,是很多个月值暗面,对啊,抄那些抄袭者有什么不行干吧,这个好Dave 我其实有个很好的类比,为什么美国人买药比其他国家都贵,因为所有研发都在美国,你付的是溢价,就像token的溢价一样,然后呢,其他地方就有纺织药了,对这个类比很好
Peter Diamandis:因为那相当于成本砍掉99% 这比汽车行业的类比更贴近AI 这个类比太棒了,我们的朋友Gavin Baker 在X上发了篇很精彩的帖子,讲这对商业的影响,必读,绝对是必读,核心意思是,除了那些基础AI实验室,其他所有公司,所有股票,都是这件事的巨大受益者,而那些基础实验室,就像你刚才说的,大家会问,你们的未来在哪,营收模式是什么,凭什么值一万亿,我确实不太懂,所以基于这个观察,接下来一周,你应该会看到估值的大洗牌,然后任何技术能力在线的公司,虽然这种公司不多,但比如你是一家银行,恰好是那种IT和技术实力,特别强的优秀银行或者你有很好的合作伙伴和供应商,那你现在就有一条清晰的路线,可以用自己的AI来掌握自己的命运,比如摩根大通自己的AI 所以我猜如果你站出来说,我们有办法在内部做这件事,我们知道怎么跟合作伙伴一起搞定,市场是会有反应的,这就是为什么我们管它叫组织起点 [00:32:17]
Salim Ismail:而且我们现在看到的是,每个在用或者想用Fable 5的人,只要一提到生物学,或者任何可能有点擦边的内容,就会被降级,你为什么要忍这个,所以9天之后,我们会看到什么,会看到所有人都,反正我是一等他上线,就马上要升级的,我现在在Mac Studio上,跑的是Kimi 2.7 我会升到Kimi 3 所有人都会这么干,那我们会不会看到,美国整个创业圈的能力底座,都大规模迁移到Kimi K3上,我觉得可以拿Stable Diffusion来类比,我们发布Stable Diffusion的时候,天哪,那都是4年前了,时间过得真快,当时市面上有一些限制非常严的图像生成器,效果是稍微好一点,但限制太多,各种随意的限制都有,因为这东西确实有点危险,你不能生成肖像也没办法把自己的IP放进去,哪怕是你自己的IP都不行,结果呢,一亿两亿的下载量,围绕它长出了一整个生态,加速了生成时媒体的发展,就像你说的,我为什么要用这个模型,我连哲学话题都没法跟他聊,他直接给我降级,对吧,当你有了完全开放的版本,价格还只要人家的零头,你还能自己定制,那一整个生态就会围绕,他和其他模型建立起来,而且这已经在发生了,跟被单一供应商锁死相比,这才是真正的危险,所以我觉得那些前沿实验室,会走向垂直整合,他们现在的客户 [00:33:37]
Peter Diamandis:全都会变成他们的竞争对手,然后他们就得说,行,我单挑你们所有人,这跟Mirror Marathi和Inkling直接相关,我们要不要也聊聊那个故事,这周那个也是大新闻 [00:34:16]
Salim Ismail:我们上一期播客聊过了,也就是两天前的事,好 Mirror刚发布了Inkling 能看到一个美国的开源实验室,这太棒了,但问题是我们还能看到多少个,还能看到多少个开源,让人震惊的斯普特尼克时刻,除了Musha 中国还有一大堆实验室在往前冲,对Inkling这件事,非常能说明未来的走向,因为它的设计初衷
Peter Diamandis:就是让你作为一家公司拿过来,在自己的公司内部,针对你自己的用力去做微调,比如你是一家生物科技实验室,在做研究,你不想让所有人看到你的专有数据,那你就把Inkling拿过来,在内部调,但这件事之所以有说服力,是因为Mirror Marotti是从OpenAI出来的,如果他不认为这条路走得通,他就不会围绕这个思路去创办thinking machines 所以这告诉你,那些身处最顶尖前沿实验室里的人,也相信这套做法能追上最前沿的水平,你把这个事实跟Kimi K3已经证明了这一点,结合起来看,下周开始世界就不一样了,另外这周末市场还有个奇怪的现象,就是临近周末的时候,资产开始大幅重新洗牌但在这一波下跌里,半导体公司也跟着跌了,可实际上他们应该往反方向走才对,这就是Gavin Baker说的那个点,这件事会推高对芯片的需求,而不是压低,它会彻底改变整个软件行业的格局 [00:35:50]
Salim Ismail:但芯片的需求会比以往任何时候都大,而且会完全卖断货,这我们都知道,我们能不能花一点时间聊聊,我们对中国的英伟达禁令,你看现在性能最强的模型都出来了,当初搞英伟达的监管禁令,是不是完全没必要,它是不是又起了我们以前总看到的那种作用,就是反而刺激了中国,逼他们用自己的华为去发展自己的能力,当然事情就是这样,没错,当然是这样,我们所做的一切,这些禁令只会激励中国的前沿实验室,去开发和培育新的效率,而这些效率其实一直都存在,刚才提到NanoGPT的急速训练,在利用算法计算和硬件效率,来训练更大更强的模型这件事上,还有巨大的潜力,没有被充分挖掘,而这些出口管制,我觉得唯一的作用就是激励了那些本来就有强烈需求,要去跟西方前沿模型竞争的中国实验室,让他们更快的去挖掘这些效率,也许总体来看,虽然表面上现在对西方不利,因为我们激励出了新一代,效率高得多的中国前沿模型,但最终我觉得这对全世界是好事,对美国也是好事,因为有中国这种效率高得多,资本效率高得多,权重效率高得多,很可能比特效率高得多的竞争者,在屁股后面点了一把火,在我看来,只要美国不建立,或者滑向某种保护主义体制,不去试图阻止,那种可能被解读为,中国超级智能,向美国倾销的局面,这一切就都是竞收意,正是如此,只要我们避免走到那一步,就是好事,事情就是这样,一点没错 [00:37:02]
Peter Diamandis:我觉得美国在越战里,学了一个很重要的教训,那已经是50多年前的事了,现在又被忘了,得再被提醒一次,越战里很清楚,要么打仗就速战速决,要么就别打,最不该做的,就是先派一点兵,再拍一点,慢慢往里蹭,这样绝对没有好结果,对中国的芯片禁运完全是拍脑袋,因为它刚好够惹恼人,又不够真正起作用,是最糟糕的局面,而且就像Alex说的,这反而引爆了大量量化研究,这个方向极其重要
Salim Ismail:但讨论的还不够,让更便宜的芯片也能跑得更快,这些创新不会消失,会一直留下来,接下来让Emad说,然后Saleem EMAD 我觉得这事确实自相矛盾,但带来了一些有意思的结果 Kimi K3用的总算力和Inkling是一样的,哇,你能看出来因为密集权重的量就摆在那里,我们大致推测它训练用的token数是Inkling的两倍左右,因为具体数据我们没有,那它怎么做到的,你看它的架构,从数据到智能的转化效率是两倍半,靠的是数据配比上的优势,因为他们不得不在这些限制下运作,我们能看出来,因为它的第一版模型不如第二版 Inkling也是从1万亿参数模型,到即将发布的3000亿参数模型,性能反而更好,各个实验室都是这样,这些实验室不得不应对限制但我觉得有件事特别有意思,你看Alex很喜欢的那张幻灯片,我们把它放屏幕上,他们必须针对华为910SN芯片,新的阿里巴巴芯片和其他芯片做推理优化 64个节点合在一起跑,因为这个模型太大了 Peter你可能得再买一两台Mac Studio才能跑起来,它需要大概2TB内存,你看到Kimi K3在那个位置了吗,那是因为他们只能用中国芯片来跑,他们没有Blackwell 没有Vera Rubin Vera Rubin和Blackwell就是为这种总参数极大,但活跃参数占比很小的超大模型设计的 [00:39:27]
Salim Ismail:但活跃参数占比很小的超大模型设计的 3万亿总参数里只有500亿活跃参数,像Model Fireworks,Basic这些美国公司,跑这个模型的成本,能比中国竞争对手低10倍,因为他们能拿到英伟达和AMD的大芯片,所以就像我说的,有点讽刺研发突然跑到了那边
Peter Diamandis:但一旦针对下一代Virarubin优化好,价格还会再降10到100倍,一马你说的其实是一回事,但这也会释放出一大批,目前还没流通起来的芯片,他们现在被低估了,还有一批晶圆厂,做不了GB300 但能做推理芯片来跑更便宜的中国模型,或者说颗粒度更低的模型,所以通过他刚描述的这个过程,大量算力产能会被释放出来,我想往上拔一层说的悬一点,我们在互联网圈一直有句口头禅,往上拔一层,互联网圈一直有句口头禅,信息渴望自由,对吧,本质上智能也渴望自由,从进化历程来看,我们从生物智能开始,靠进化来地归改进,然后突破到个体智能,再到物种中的个体,再到集体智能比如市场或网络,现在我们有了AI 能扫描所有数据,创造出另一个层次的智能,所以这事是挡不住的,任何实体领域政府,不管是谁,想限制它,永远永远都会失败,这就是一条基本的自然法则,你限制不了它,根本不可能,人们为什么还要费这个劲,才是我最想不通的,用稀缺心态去想这件事,本身就是错的,我们越快获得更好的智能,就越快走向富足,越快不需要为任何东西争斗 Saling [00:41:13]
Salim Ismail:我没法反驳你,我写过一整篇论文,论证物理世界中的智能,体现为最大化未来的行动自由,所以尽前沿解放阵线,是
Peter Diamandis:反正你也不想拖慢它,就像蒙提拍桑那个段子,犹太人民阵线和犹太人民大众阵线,我们得做点T恤,我想提一个跟这件事相关的话题 [00:42:06]
Salim Ismail:也是我一直很看不惯的一点,月之暗面背后的创始人兼CEO杨志林,他的本事可不是在北京学的,他在卡内基梅隆拿的博士,那是皮茨宝,也是全世界最顶尖的,计算机科学项目之一,说白了,是我们把它招进来,培养出来的,在我们最好的学府里,结果他博士一毕业,拿不到绿卡,还得折腾签证,最后回了中国,在那里创办了月之暗面,我公开说过无数次了,我认为任何人拿到博士学位,绿卡就应该直接定在学位证背面,我们为什么要把最聪明,跑来我们这里受教育的人送回老家,不管是回中国,回印度还是回巴西,为什么不让他们留下来,在这里创业,各位怎么看,好我做了点研究,我觉得这事,可能不是表面看起来那样,先捋一下时间线杨志林根据我查到的,他在中国读完本科后 2015年秋季开始在CMU读博,然后大概一年后,他还在CMU读博的时候,就创办了一家创业公司,公司叫Recurrent AI 这家公司注册在哪里,注册在中国,不是美国,所以他读博才一年,就一边在CMU念书,一边在中国开了家AI公司,这就有意思了,也是个问题,这也跟那种,我们没给他定律卡的说法对不上,然后他就回中国了,不对,实际上他在美国读博才一年,就在中国开了AI公司,然后他2019年毕业,据我所知,他毕业是拿到了Google Facebook 华为这些公司的offer 但他还是回了中国,因为他的创业公司Recurrent AI 几年前就注册在那里了,所以我不觉得这件事,能说明美国不愿意留他或者说是特朗普的什么,政策赶走了,这个特别有才华的中国毕业生,他开这家公司的时候,还是奥巴马任期快结束那会儿,公司就开在中国 Alex 感谢你挖得这么深,谢谢,但我的观点依然成立 Selim 你和我都见过太多次了,对吧在七点大学 Dave 你在MIT可能也见过,事实就是很多最聪明的学生,根本没机会留下来发展 David或者Emad 你不在美国你怎么看,我也说两句,对我完全同意,而且有个很离谱的事,这笔账其实很清楚,一个博士留在美国,价值有多大,这是可以量化的,而且已经有很多研究证明了 Dave就很擅长,把他们转化成创业公司,转化成创新,还有另一件事,也是搬起石头砸自己的脚,就是美国公司,因为监管之类的原因,不能投资中国公司,有些公司是中国背景,但你看benchmark头面的死者上的麻烦就是个例子,所以我觉得这是双重的,但我完全同意,如果你创造了一个有价值的资产,或者参与创造了它,大多数外国人读完博士,是愿意留在美国的,但太多人没有一条很直接的路径,尽管数学上已经证明,他们能给美国经济增加价值,对,还有一点,竞赛不光是芯片和算力的竞赛,它也是人才的竞赛,至少目前,关键的人仍然在驱动最大的价值,要我说不光是人才,还跟我刚才说的点有关,就是这些创业公司注册在哪里,有另一个可能的世界,在那个世界里,他因为某些移民相关的法规,没能在读美国博士期间,就在中国创办他的第一家AI公司,我们激励他把Recurrent开在美国,我觉得也许存在这样一个反事实的世界Recurrent是一家美国公司,然后他的知识继承者 [00:45:53]
Peter Diamandis:月之暗面也留在美国,这样他就会跟着,自己的公司留下来了,对这个故事还带出一点,从印度来美国读书的人,绝大多数都会留下来,而从中国来的,大约80%会回去,这纯粹是,两边本土经济的差异,回印度创业基本行不通,很难成气候,但回中国就完全不同,那边生态很活跃,支持力度也大,所以对很多人来说,回中国创业其实是个不错的路线,我也是那份报告出来后才意识到这一点,而且就像Peter刚才提到的,我们有大量从中国来的MIT朋友,我不想把他们一概而论,其中一种情况就像你,我们有一位非常好的朋友,是波士顿大学计算机学院的院长,他们很乐意在这里创业,或者在任何地方都行
Salim Ismail:而且别忘了,我们之前看那些前沿实验室的时候,比如早期的XAI 还有Meta 他们大概50%的研究人员,那些研究岗的博士,都是华裔美国人,非常厉害,而且中国人每年在数学奥林匹克竞赛里,都是霸榜的存在,这里蕴藏着极其雄厚的人才储备,我想大多数公司都希望能把这些人才留在内部 Salim [00:46:49]
Peter Diamandis:你刚想说什么,对,我想说两点,第一,人才的不对称分布,我觉得这才是真正关键的部分,我在前几期播客里也提过,顶尖AI研究人员里有70%不是美国公民,按人数排序依次来自中国、印度和英国,所以这是个很大的问题,直接给绿卡是我们能做的最简单,零阻力的事,这样才能激励他们留在这里,在这里搞研发,美国过去对世界其他国家最大的不对称优势,就是在这里创业比在世界任何地方都强,但这个优势现在开始没那么绝对了,这也是为什么人们会回中国,甚至越来越多的回印度去做事,尽管在印度做事仍然有各种阻力,这一点上,美国在移民问题上的失败 [00:47:16]
Salim Ismail:是这个国家眼下最大的问题之一,说的太对了,好,我们继续往下走,我想给大家看这张幻灯片,从4月中旬到现在,我们已经看到13个新的前沿模型发布,平均每10天一个,对比一下2025年,我们全年只有8个前沿模型发布,平均每50天一个,再往前一年 2024年只有6个,平均每60天一个,而且这个速度完全没有要慢下来的意思,然后E-MAD 你今天早上给我发了伊朗的这条推文,谢谢,我把它放出来,这是伊朗的推文,我们那个2万亿美元的模型,各方面都优于我们那个1.5万亿的模型,下周将完成初始训练,它也许能超越Kimi 但速度和token效率,会接近我们那个1.5万亿的模型,也就是GroK4.5 所以要我说这就是我们正生活在起点里的头号证据,这种智能加速迭代的速度,简直疯狂 Peter 还有更精彩的,如果你把Sahel列出的那些前沿模型,和他们的发布日期,用指数曲线,去回归预测模型发布的时间间隔,我刚刚当练习做了一下,你会发现,按现在的速率,我们很快就会迎来,每天都有新前沿模型发布的日子,具体时间,你猜怎么着,是1月份 1月份 1月份如果这个指数趋势持续下去,我们就会看到,每天都有新的前沿模型发布,这基本上就意味着,模型会变成持续版本迭代的状态,那我想问题就来了,这到底意味着什么,如果变成了一个持续的过程,那所谓新发布还有什么意义,也许意味着我们每天的Manshot节目就不能在只聊前沿实验室的版本发布了,我们得找点新东西来聊,因为模型更新会变成后台静默进行的常态 [00:49:51]
Salim Ismail:因为模型更新会变成后台静默进行的常态,就像我儿子Jed说的,好吧又发了一个稍微好了一点点,那意思就是拜托,这到底有什么真正的新东西,其实对我们待会儿在节目里会看到一些用力演示
Peter Diamandis:我觉得那些东西会取代单纯的版本发布成为焦点,因为当你亲眼看到智能水平又往上跳了一小步,那种感觉要激动人心的多,你会觉得光说又进步了 [00:50:15]
Salim Ismail:有什么意思,不如直接看他做出来了什么,那才能真正抓住大家的注意力,我们花点时间看看这个,因为我刚才跳过去了,但我觉得有意思的一点是,我直接放一下,我们看到的是,比如复刻你最喜欢的游戏,在画面右边,我们看到一个网页浏览器,一个基于浏览器的网页应用,在模拟苹果桌面,我觉得我们还没聊,这对游戏行业意味着什么,影响会非常大,对吧,我先把这个声音关掉,它好像接管了你的电脑,现在停不下来了,不过过去24小时好玩的地方在于,看到大家都在展示自己,用Kimi K3做的东西
Peter Diamandis:确实很厉害,人人都能成为创作者,人人都能成为制造者,不过要提醒一句,就一句一次性生成一个游戏,跟搭建整个生态,做客服,做营销等等,完全是两码事,所以你必须对那个领域,真的充满热情,但话说回来,按你个人的兴趣,你的着迷点,或者你想做的那种,特定类型的游戏,把它做出来并上线的阻力,现在几乎为零了,这点就变得非常有意思,对,对,这其实挺烧脑的,因为如果你推到极致,而且很快就能实现,我可以用一句提示词,就创造出任何东西,然后你坐在公司高管团队面前问,那我们到底想要什么,没错,我们以前从来没有这种能力,也从来没这样思考过,所以你得使劲开动脑筋去想 [00:51:09]
Salim Ismail:比如我们这个组织存在的意义,到底是什么,对,我有个想法,这档播客以前搞过,征集片尾音乐视频的活动,要不这次搞个征集,让大家提交自己随手做的片尾小游戏,这个哭,对回到你刚才说的 Dave 我觉得品味,想象力,理解大众,想要什么,这些会变成,最让人心里没底的东西,而且对于创业者来说,当你看到这种能力的时候,我觉得创业心态,和想象出更厉害的东西的能力,当你被彻底放开,什么都能造的时候,会发生什么,对还有想象幸福这件事,我们不太习惯去尝试
Peter Diamandis:很多人其实并不太会,处理自己的不快乐,因为他们得忍受日常工作,得忍受各种烦心事,比如蚊子钉住的地方不好什么的,就是没得选,那如果给你选择你会做什么,这对思维来说是一种极大的解放,但因为我们不习惯那样思考,我们还没准备好面对,肯定会有无限多的可能性,对大家来说,最容易想到的是医药和生物技术,至少我想要健康,这个很直接,但其他那些让人类幸福的东西呢,我们真的想清楚 [00:52:39]
Salim Ismail:今晚可以用语音提示词去创造什么了吗,这真的让人很解放,我们的能力已经近乎神了,所以你才写了那本书,对,我的意思是,核心是做创造者,做制造者 [00:53:15]
Peter Diamandis:而不是做消费者或索取者 Selim 我看你挑眉了,没有,我就是完全同意这些,我觉得活在这个时代真的太神奇了,每个在听这期播客的人,请去想一个商业点子,一个项目,一个有影响力的项目,什么都行,然后用AI去把它做出来,我还想再说一点,我很快说一句
Salim Ismail:Nick Bostrom在Deep Utopia里,聊过一些 Peter 你跟我在Solve Everything里,也聊了不少,我就直接建议了,各位听众,仅代表我个人,我很想看到一个,你们随手做的片尾小游戏,主题也许可以跟 Manshads播客相关,毕竟我们显然已经完全搞定,音乐视频创作这件事了,那会是个低人称设计游戏,我们可以拿AWG当靶子,别求你了别别别,最好是非暴力的偏微小游戏,你提要求可得小心点,非暴力的文明科技术,你需要的就是这个,文明科技术游戏会很棒,我想强调一点,在座的每一位,正在收看收听的每一位,当你听到Kimi K3这种惊人的崛起时,你有两种选择,恐惧可能是一种,另一种可能是,天哪活在这个时代真是太不可思议了,对吧,希望,兴奋,还有富足的心态,与其恐惧,不如意识到你正在被释放,你的创造力,你做任何想做的事的能力,你去创造的能力,你的热情,你的使命,对吧,找到我和Saleem经常聊的那个东西,找到你的宏大变革使命,区分一下,热情是你喜欢做的事,使命是你喜欢做,并且真正能造福世界的事,所以如果你能连接上这个,并且意识到,你不需要任何背景,我觉得这是最重要的事情之一,你不必是计算机科学家,不必是专家,你只需要使命驱动,如果你用这些工具,你就能在宇宙中留下印记 [00:54:48]
Peter Diamandis:你能以惊人的规模改善人类,这就是创业精神,三步走,对,读一下Alex和Peter的论文,解决一切,挑一个你敢去碰的最大问题,去下载组织起点 CloudSkill免费的,然后开始构建,对太棒了,也提醒一下我们的制作团队,现在做Alex建议的那些事,比如做个电子游戏,成本极低,又极其简单,我们应该收集一些例子,发出来给观众看,让他们能说,原来Alex说的是这个意思,大家只需要一个小小的路线图,这么长就够了 [00:55:35]
Salim Ismail:如果观众不提交一些精彩的,以moonshots为主题的电子游戏作为片尾,我保证我会做一个赛博朋克FPS 但它会是一个非暴力的FPS 如果你能想象的话,围绕moonshots展开,你会去挠小兔子痒痒,不不不,好吧,它会是一个赛博朋克FPS 在里面我们烹饪每一个问题,这个怎么样,是第一人称解题器,不是第一人称射击游戏,我喜欢,不过你还是得去挠小兔子痒痒,好吧,我去挠小兔子痒痒,行,我要带大家进入下一个故事了,请继续用那些音乐视频,他们太棒了 EMAT 这是你发来的一个,我加进了追踪列表,如果说Kimi K3是前沿,往大了走,在数据中心里跑数万亿参数,那这个故事讲的是前沿往小了走,小到能装进你的智能手机Bonsai 27B 270亿参数,是Prism ML的作品,这是一家源自加州理工学院的,美国AI初创公司,由Babak Sabi运营 Kusla Ventures Serberus和Google投资,它是第一个完全在智能手机上,运行的270亿参数级别模型,不是阉割版,它基于QW3.627B构建 E-MAT给我们讲讲,这个为什么它很重要,我们上一期播客,刚和Liquid AI聊过小语言模型,对,这是Dave特别喜欢的话题之一,量化,对吧 Prism Mail 还有腾讯,我待会会讲到,在把模型从16位或8位架构,压缩下来这方面,都取得了巨大进展,像Kimi基本上是8位4位的,他们能把它压到三进制,也就是三个比特的信息甚至二进制,三进制就是三个值,大概1.58比特,对 1.56 对,就是三个值,你们这些极客 [00:58:03]
Peter Diamandis:这一点真的非常非常重要,各位极客听好了,这是个特别重要的话题,这又回到了精度的问题 Prism ML做到的是,他们把模型压到了三进制,也就是说
Salim Ismail:我记得这个模型只有6GB 这个27B的模型性能很强,我记得它基本是GPT-5级别的,精度只掉了5% 他们就把它压到了6GB
Peter Diamandis:如果接受15%的精度下降,还能压到4GB 而且你还可以通过稍微扩大网络规模,把精度找回来,抱歉,有各种办法可以做到
Salim Ismail:所以这是意义重大,因为这意味着你有了一个智商110 120的小伙伴,能在你的手机上跑,再说一遍,不需要联网,不用联网,它比一个电子游戏还小,你口袋里就实实在在的,一直装着这个级别的智能,已经能用了吗,已经能用了,你现在就可以下载权重,在手机上跑,没错,你往哪儿跑,但最有趣的是,当你减少比特数,速度也会提升,从16位降到3位,速度能提升5倍,还有另一篇文章,或者说另一个发布,是腾讯最新的模型,这其实是原来 Wizard LM团队做的,他们当时不得不离开微软,因为微软不给他们算力,这是挺讽刺的,他们做到了二进制压缩,把他们的HI3模型一路压到了底,所以现在他在GTX Spark 或者大号MacBook上跑得最好,把一个3000亿参数的模型
Peter Diamandis:就是Inkling即将推出的新模型那个规模,用二进制跑,性能止掉5% 对我现在要说抱歉 EMAD这点太重要了,我在节目里只说这一次,因为我们投了很多公司都在做这个 [00:59:43]
Peter Diamandis:因为我们投了很多公司都在做这个,我不想透露太多,但EMAC刚才说的这些,它的含义还能再往前推一步,就是说如果我们想象一下,所有这些智能在底层计算,一直都是矩阵乘法,我有一个数乘以另一个数,然后把两个结果加起来,这叫MAC乘积累加,如果其中一个数只是10或-1 那一个数乘以10或-1 我们算起来应该极其高效,这就是Email说的效率提升,但他还打开了全新计算方式的大门 Alex一直在说,如果有人仔细听的话,我们会发现新的物理原理,也会发现新的计算基底,我们会发现计算几乎可以在任何地方进行,在晶体里,在液体里而我们需要的计算就是简单的10-1 所以这真的把寻找这些计算基底的焦点,收得很窄,这些基底会把AI带到你知道的,所以我们现在设想的戴森球,是一堆英伟达的GPU装在卫星里,配上太阳能板和散热器,那只能撑几年,真正要上太空的会是很不一样的东西,更像是星际迷航里的那种,用晶体全息图之类的东西,能完成EMAD说的那种精确计算,各位你们是在这最先听到的,所以这就能让,这能高效到什么程度 [01:00:48]
Salim Ismail:能压缩到什么地步,天哪,彼得关于这个,我来说两句,这事我琢磨的还挺多的,我们刚才聊到量化程度最高的 Bonsai模型,我记得大概是1.125个,有效比特每权重,但你可能会问,一比特每权重就是极限了吗,答案是否定的,我们可以做到低于一个,有效比特每权重,怎么做到呢,靠稀疏化量化还有低质分解,顺便说一句,这已经是一些实验室开始展现的趋势了,尤其是像三星,原因很明显,三星希望能把能力很强的前沿级模型,部署到他们自己的边缘设备上,比如智能手机,就在过去两个月,三星发布了一个叫NanoQuant的模型,突破了伊比特美权重的壁垒,所以现在是亚伊比特了,我觉得未来我们会更多的聊到这个,用上各种工具所以这是我的推演环节,我作为一个推演,把前沿量化技术往外延伸,简单的推演发现 [01:02:21]
Peter Diamandis:亚伊比特量化会在未来一年内的某个时候成为主流,而且极大概率是光子计算,未来我们都会用光速来计算 Emad你之前提过一点,好几个数量级的提升 Emad你几周前发了条推文说,我们会在18个月内,在普通的MacBook上实现Fable级别的能力,对吧,这基本上就是你刚才说的那条路径,对抱歉,你先说
Salim Ismail:你说,你说,好你看,英伟达上一代Nimitron系列的做法,他们拿大模型,用所谓的logits去针溜,得到一个更小的稠密模型,一个270亿参数的稠密模型,跟那些超大规模的稀疏模型,有什么区别,当你手里有模型权重时,你就能做真正的针溜,这跟提取推理轨迹,还不太一样,所以你会看到,像Kimi这样的模型,会被帧流成完美的数据集,用来训练更小的模型,这些模型会以4比特精度训练,然后再被转换成三进制,二进制,甚至更低的比特权重,当你真正去看,比如QWMAX和QW027B的对比,你就能推演出,当你转向稠密模型,并走完整个流程后,这些模型的尺寸会是多少,最终你会得到一个能在16GB内存上运行的模型,到明年年底,这个模型的能力水平,就是Kimi K3的水平 [01:03:47]
Peter Diamandis:你甚至可以把Kimi K3里的,所有知识都提取出来,因为它是开源的,哇这意味着每一辆车,每一个机器人,每一个制造设备,世界上每一个装置,都能拥有自己内置的持久智能,并且能在边缘端自主决策,去完成任何任务,这会在最无限的层面上,把能力去中心化
Salim Ismail:而且还能更进一步,当你做到三进制甚至二进制时,其实三进制在很多方面更好,你可以定制光子芯片,甚至直接在硅片上时刻,零值就是它上面没有路径,所以一旦模型权重足够好,你就可以直接时刻上去,这会带来总速度的实际提升,而且你也不再需要用那些更小制程的硅片了,所以到明年年底,光是靠新的芯片组,智能的成本就会下降100倍,这是在加速奔向星际迷航,我觉得这就是EMAT和Dave刚才聊到的,当我们可能转向三进制,甚至亚伊比特时,在底层采用后CMOS架构会顺手的多,底层还有很大的空间,对,我赌,我赌0.78会是那个底,我今天就把这个数放在这儿,当个标记,好 [01:04:20]
Peter Diamandis:我们年底预测可以拿这个来赌一把,这个数字真的非常具体,我是说,好吧,这段我得来回听个四遍,才能搞明白到底在说什么,我们要不要快速轮一圈 [01:05:12]
Salim Ismail:问问大家最喜欢的量化中矩是什么 EMAT 听起来你有个异常具体的答案,我很快会把细节发出来,先让大家自己想一想,我们下期节目再聊 Dave 你刚想说什么 Dave
Peter Diamandis:我想说的是,根据EMAT和Alex刚才讲的那些,最有可能的预测是,未来三年内,仅靠量化和新的计算方式,原始算力就能提升100到1万,而且这还会跟其他算法改进叠加,真的很难预测,所以现实一点说,可能会是100万的提升 Dave我们先停一下,让大家消化一下
Salim Ismail:我们已经看到了这么惊人的速度,性能和智能,接下来1万再加上算法改进,达到100万会是什么感觉,在未来大概三年的时间里,那会是一种什么体验,对 [01:06:04]
Peter Diamandis:三年有一点可以肯定 I会做出你特别想要的东西,但当他跟你解释,他是怎么做到的,你根本跟不上,我在用Fable 5的时候,已经有这种感觉了,我跑了好多Fable 5 agent 他们铲除的结果,完全是我想要的,但你要是问,你具体做了什么,我根本看不过来,我跟Rui聊过,这个就是AI问的问题,和给出的答案,你甚至都无法理解的,那个节点,对没错,那个节点很快就会来,说回我们今晚聊的Kappa 想给他减速的想法,太疯狂了,任何想靠监管,来减速的概念都说不通,我们现在需要的,是一种全球性的审查,和全球合作,来监控他,然后好好利用他,带来的所有富足,所有的新药新能力,全球的幸福感,这些都近在眼前了我们只需要把它释放出来,别减速,但要审查一切,整个机制可解释性,会变成最重要的工作,我们只需要全球透明 [01:07:12]
Salim Ismail:然后全速前进,我觉得这是我们做过的,最重要的博客之一了,各位,太震撼了,你管这叫斯普特尼克时刻,对,斯普特尼克时刻,如果你真的能在某个层面上,模拟整个社会
Peter Diamandis:我们就有了一个神级的支撑结构,来帮我们驾驭未来几十年的路,我把这个落到组织层面来说吧,想想大多数高层管理的能力,比如预算招聘决策产品发布各种投资,每一项本质上都是一种预测对吧,但你从来不会去记录它的概率,或者评估它的准确度,一旦AI预测接近那个水平,就意味着高层管理基本上就蒸发了,因为大多数高管之所以在那个位置,是因为他们有深厚的经验,比如你是宝马的供应链负责人,因为你管过西班牙的供应链,或者管过发动机的供应链,花了几十年积累了管理那个领域的经验,一旦那种判断力,那种很难量化的东西,能被AI系统附现,而且还没有你身上那些人类系统里,不可避免的偏见,这点非常重要这基本上就抹掉了所有高层管理的经验优势,所以你现在得更专注于目标,你想达成什么,你的目的等等,这对任何公司和政府的高层管理来说,都彻底改变了游戏规则,对EMAD 对,这个话题我很关心,在我的畅销书《最后的经济》里,我其实描述了生成式AI的数学 [01:08:31]
Salim Ismail:怎么应用到经济学上,我们很快会发一篇论文,从生成式AI的数学,推导出整个经济学每一个方程,这挺疯狂的,但这里有个好处是,连那些错误的方程也包括,连错误的也包括,它会展示它们的局限,以及为什么是错的,这点很棒,但有意思的是,在阿希莫夫基地里的心理史学,他说整个群体和人口,可以像气体一样建模,而气体的方程,就是扩散模型的方程,结果证明它们在预测上,比人类更强,我们会发布一系列,关于经济预测的研究,展示它们表现更好,但这引出一个很有意思的问题 Peter你提到了智慧 Saleem你提到了没有,高层管理,这些模型进入的方式,会是提供第二意见,在医学商业政策领域,但这样一来责任归属就会变得非常疯狂,还有匹配撮合,对,混连匹配,我们那边有一些黑暗的东西,像黑镜之类的,但你可以这么想,如果你做了一个决定,没经过AI医生的批准 [01:09:48]
Salim Ismail:没经过AI医生的批准,你的保费就会蹭的涨上去,再过几代,如果你开车不按FSD的方式来,你的保费也会蹭的涨上去,这种地规效应非常有意思,因为在基地里,心理史学要成立有三个条件,其中一个就是人口要足够大,大到开车或者整个经济体那种规模,第二个条件,是不能有足够级别的技术进步,也就是技术停滞,因为技术进步会彻底改变整个格局,最后一个条件是无知,所以Alex刚才提到,这些东西进入市场会改变市场,但他们进入医疗决策,政府决策或公司决策,实际上会改变决策的方式,就像说,根据AI 你就是我的天作之合,你怎么跟AI争辩,这大概是现在最烂的大善台词了但谁知道几年后呢,对吧,一码,这很圆啊,经济学里很多人会管这叫反生性,如果最厉害的预测工具,最后以Cassandra命名,却没人信他,能赚到钱就行,没关系,我的天,这讽刺意味浓的都能用刀切了 Dave你在这个领域看到过什么创业公司吗,没有,很意外,真没有 Save Super Intelligence [01:10:53]
Peter Diamandis:Yoya, Sutskiver可能在做类似的事,但他们只在自己内部用,然后投向市场,自己悄悄印钞,但我特别想尽快看到的一个版本是,我觉得人类大量的不快乐,都来自消费主义和消费营销,就像Homer Simpson 下午六点回家,开一罐啤酒,往沙发上一躺,就开始换台,然后看到裸体与恐惧之类的节目,就一直看到在沙发上睡着,第二天早上宿醉醒来,牙也没刷,踢了狗一脚,最后孩子也不开心,这一连串的决定糟透了,但并没有人明确决定,要过这种链条里的生活,对吧,你只是对啤酒广告做出了反应,然后就顺着这条链滑下去了,我觉得AI会成为一个特别棒的教练,跟你说,嘿哥们要是你走另一条路呢,结果会是这样的,这个想法好,对我来说,这才是预测的正确用法,就为了改变,比如我们离最优解还有多远,答案是很远,如果你客观的审视自己的生活,没人接近最优解,但有一点AI的帮助,你就能走上一条,好得多的路,可我们现在做的,是巨大的消费主义,你在对广告牌做出反应,对电视广告做出反应,它在告诉你,你需要某些东西,人们很容易被吸进,这些路径里 [01:12:11]
Salim Ismail:我觉得有了AI 我们可以从这些路径里,走出来 Dave这个想法太棒了,首先有传言说 Illia的SSI 很快就要发布东西了,我觉得现在所有人,都感受到了发布的压力,我们看到Mirror出来,就很有意思,但你刚才说的那点,我觉得很精彩,就是这些实验室,是不是在收着打,留着这种能力自己赚钱,我是说如果你今天在市场上,拥有这种超级预测能力,你肯定会怎么干,我记得跟Eric Schmidt聊过一次,他说听着,如果Google想最大化收入,他完全知道哪些公司,第四季度股价会涨,因为所有人都在搜,这个产品或那个产品,我们提前掌握了,销售会流向哪里,哪些产品会达到顶峰的信息,但如果我们哪怕只这么干一次,就会被关停,所以很有意思,看看这些公司会不会这么做 Alex你和我聊过,在solve everything里,我们谈过一个想法,就是这些前沿实验室,能赚到的最大一笔钱,会来自他们解决科学突破的时候,比如超导,逆转衰老之类的,没错,关于Google那个故事,也许可以加个注脚,我跟Google的高管这些年,聊过很多很多次,完全同意这个前提,如果Google试图基于,流经搜索查询的,可以说是内幕或未经过滤的,内幕信息去炒股,那确实是一次就关停的局面,但Google理论上可以交易的,除了公开证券,还有其他东西,不一定会招来这种反噬,比如还是理论上外汇汇率,对,但我觉得我们在这件事上得小心,市场这方面是一回事,也许我会基于我们自己的东西,去搞个对冲基金但还有道德层面的事,也许别搞,也许不搞,我能投吗,行,当然可以,但你看,这些事有道德层面,我们能优化自己,这很棒,但谁控制这些模型,以及他们给出的建议,谁就能控制巨大体量的人类,这需要一场真正的讨论,因为这就像那些跟着GPS开进湖里的人一样,你懂吗,对,这就是风险所在,我们会过度依赖这些东西,而且再过几年,你怎么去跟他辩论,到那时候不这么做,反而成本更高,你不听他的就会吃亏,如果我们真的被慈爱机器看护着,那我们得搞清楚,这到底是谁的慈爱,这个讨论必须从现在就开始,对Saleem刚刚说的是啤酒,我真没想到这期节目会聊到河马喝啤酒,旁边还有个AI在指点他,萨林米之前发给我一篇文章一张图表,我现在就把它放上来,这是我们一直在争论的话题,现在美国的数据中心大战里又看到了,数据中心在大量消耗电力,推高了老百姓的电费还有水,对吧,这是目前对AI最响亮的批评之一,说数据中心在大量消耗饮用水来给服务器降温,这周我展示的这张图传得很广,他把两组数据放在了一起,一边是根据劳伦斯国家实验室的数据,全美所有数据中心,现场消耗的水是170亿加仑,但另一边显示,美国的高尔夫球场,自2024年以来,灌溉用水已经用掉了5310亿加仑,是前者的31倍,所以我估计很快会在高速公路边,看到这样的标语,别管数据中心了,我们必须立刻禁止高尔夫球场,是啊Peter 中国怎么没搞个影响力行动让美国把自己的高尔夫球场都关掉呢,是啊,我还真没看到哪里有,但这里有个更惊人的数据,除了高尔夫球场,光是加州种植性人,一年就要消耗一万亿加仑的水 [01:16:24]
Peter Diamandis:是所有数据中心,加起来用水量的60倍,所以,我还有一个数据,亚马逊的仓库在美国占用的土地面积,是所有数据中心加起来总和的十倍,没错,所以跟其他东西比起来,不管是土地占用还是水资源消耗,数据中心这点用量,简直就是九牛一毛,现在这种吵吵嚷嚷,完全是毫无数据支撑的垃圾废话,太离谱了,说的太对了,这才是让人担心的点,因为用水问题根本就不是个事,简直是个笑话,但如果我们正面去回应,跟大家说别担心水的问题,那群愤怒的人就会转向别的,同样不理性的目标,所以根本问题并没有消失,下一个议题可能会是某种半靠谱的东西,现在这个是完全扯淡但下一个可能是半靠谱,但依然是错的,然后这就会催生出一场民粹运动,而且你听那个词,暂停,就好像在说,咱们干脆都别干了,这算哪门子决策,哪门子治理方式,但如果你看看核能和其他一堆事情的历史 [01:17:32]
Salim Ismail:我们最后得到的恰恰就是这种结果,对了David Sachs和McCann 这就是我一直说的恐惧疫情,我对此非常担心,有一种潜在的感觉,认为AI和机器人会成为人类的敌人,我还是那句话,这在一定程度上得怪好莱坞,拍了那么多反乌托邦的电影,如果你看到的全是关于未来的负面想象,你自然就想把它关掉,那你想关掉什么,你怎么关掉AI 你可以把你周里的数据中心关掉,对,还有这个房间里的大象,就是戴森球,如果所有算力都转移到太阳同步轨道上,你可以在那里做闭环的液体处理,包括水和其他冷却剂,这样一来,它就不会再额外消耗水资源了,然后就像Dave说的,那些抱怨,不管是不是部分源于某个外国行为体的影响力操作,会转向别的东西可能会变成近地轨道上 SpaceX的新矿和其他竞争的戴森球,他们的衰变物正在污染大气层之类的,抱怨总会找到新目标 [01:18:45]
Peter Diamandis:你们有没有听到之前关于新建火箭发射的抱怨,其实那次是猎鹰,说猎鹰发射造成污染,伊朗当时的反应就像是我的天,我现在就要吐了,实际上所有形式的火箭发射,加起来排放量只占0.00001% 但没办法,他就是得去回答这些问题,这快把他逼疯了,我希望那些抱怨的人
Salim Ismail:已经扔掉了他们的智能手机,不用GPS 干脆回去搞自己自足的农耕了,是啊,就像伊朗喜欢说的,让他们对着天空挥拳头,我有个好玩的数据,我针对用水这事算了一下,大概每生产一个巨无霸汉堡,要消耗600加仑水,而麦当劳一年卖出21个汉堡,所以麦当劳的总用水量,大概是高尔夫球场的两倍,这个我支持,好吧,那你的意思是,中国的影响力行动,也应该把美国的巨无霸给关掉,你看,这不就来了,这会给美国心脏来一剂重击,是啊 [01:19:22]
Salim Ismail:是啊,而且肯定也能改善美国人的健康,我们是不是该聊聊,大家最喜欢的话题之一,人形机器人了,这太酷了,对,中国在人型机器人上已经全面压住了,我们之前聊过这是国家级的优先事项,像Unitary这样的公司都在争着商业化,上次报告说Alex我们也聊过,中国有150家人型机器人公司在研发,他们策略的一部分就是制造器官,这也是你Alex想带到美国来的东西,他们一直在搞公开的机器人格斗赛,真的就是MMA那种风格,我们这有段视频我直接放出来,是最近一场在网上疯传的MMA比赛,非常精彩,真的太酷了,这些只会越来越强,我等不及想看,你得看完整段视频,真的,比赛结束的方式,简直史诗极地炸裂,对,其中一个机器人,把另一个机器人的头踢飞了你还记得那个Rock Socom Robot吗,对对对,我们小时候玩的游戏,所以这个视频就火了,机器人世界确实发生了很多事,我们刚看到现代汽车,他们所有的工人都开始罢工,因为他们不想让机器人上装配线,这事很有意思 Alex你接着说吧,关于这个我有几点想法,从很多不同层面来看,第一点是有点惊悚,如果有人看过史蒂文,斯皮尔伯格的电影AI 里面有一个不剧透太多,我觉得斯皮尔伯格,会称之为电影中间那块,黑暗三明治,就是那个血肉狂欢节,人型机器人被折磨和虐待,来供人类取乐,我觉得极其恐怖,所以在某个层面上,我有点惊悚的是,人型机器人,不管他们在这里,多大程度上是远程操控的,都在为未来更自主的巨神智能设定一个鲜艳倾向或偏见,让他们基本上要互相残杀,或者至少是为了人类娱乐,而互相进行肢体虐待,我对此很担忧,但再深一层,现在想象这些机器人,更自主了,他们运行的是边缘算法,所以封装的更彻底,再想象一下这些人型机器人,出现在中国解放军的步兵部队里,对,因为我觉得那就是我们几乎注定会面对的未来,西方必须在人型机器人上追赶上来,这就是为什么我支持了ProRL Peter 你刚才也提到了,他几个月前在波士顿海港区,举办了美国第一场人型机器人迷你马拉松,西方,你也帮忙组织那场活动,对吧,没错,对,所以西方需要类似的东西,但愿能少一些暴力,多一些经济生产力我很乐意看到人们为人性机器人比赛,运衣服而欢呼,或者完成一些有经济价值的任务,而不是互相踢掉脑袋,但,你更希望是人类在MMA比赛里做这些事,我更希望谁都别做,我不是MMA的粉丝,我觉得它对人类有破坏性,而且我担心我们让机器人代替人类做这种事,是在给未来的光追传递一个什么样的信号,如果非要竞争的话,我宁愿看到人在笼子里比赛做一些积极的事,而不是消极的事,编程像笼中格斗编程那样 [01:22:41]
Peter Diamandis:如果非要选的话,或者就坐在那里,好吧,我有几个想法,一个是我常说的,踢拳赛不是人型机器人最好的营销演示,但我得承认一点,这真的是一个要求高到离谱的工程环境,对吧,你有一个压力测试,它在考验平衡,抗冲击能力,恢复能力,运动能力和延迟,所有这些,他们大概同时在处理20个问题,看他们应对这些,真的挺不可思议的,当然4B机器人肯定能打败双B的,所以你看就是这样,但这就是我们会看到这变成竞技体育,我们会看到某种机器人版的世界杯,问题是人们会不会看,对,我会说真正的考验是,一个人类能不能在比赛最关键的时刻,在压力下罚进那个点球,不过前几天看英格兰队崩盘,真的让我很崩溃但话说回来,我觉得人们还是更愿意看人,在那种环境里比赛,而不是机器人,对,我觉得体育在未来很多很多年里 [01:24:09]
Salim Ismail:都会很繁荣,方程式赛车一直在挑战极限,我觉得等我们看到机器人运动的时候,也是在挑战极限 Sailimi刚才说的那点很重要,对吧,我们会看到这件事,以竞技的方式出现,顶尖机器人互相较量,我特别想看Figure 对上Optimus 不管比什么,那都会是场很好玩的比赛,不过我觉得这些机器人,还是有点不一样,可能最先看到的,会是铁甲钢拳那种,远程操控的机器人,因为机器人自己反应还不够快,你看VLA模型的延迟就知道了,那些预先编程的飞梯确实很厉害,但他们为什么不会打功夫,机器人什么时候能打功夫,那才是真正需要克式芯片,需要远程操控的时候,我觉得那会是明年的下一个阶段,但这里有个更大的问题,虽然我很喜欢格斗机器人,也很想看高达之类的这些机器人是Engine AI的T800 大概70公斤重,出拳力量是麦克泰森的四倍,他们真的能打死人,打死我们这些血肉之躯,这种机器人就不该被允许上街,而且现在没有任何法规来管这个,他们可能出现在解放军里,或者别的什么地方,但机器人马上就要进入我们家里了,在座有谁订了EX的机器人吗,别装了,这一天就要来了,他们很快就会在街上走来走去,我们必须要有安全法规,规定他们能做什么,怎么运作等等,因为他们对个人是实实在在的威胁,毕竟是机器,再往后还会有巨声,智能这些东西,我们需要讨论,当他们完全自主的时候,会是什么样子,因为他们已经可以自己按门铃,自己送货上门了,最后一点,语术到现在总共才造了,一万一千个人形机器人我们真的还处在最开始的阶段,再过几年就会从一年一万一千台,变成一年一千一百万台,所以我们必须尽快展开这些讨论,要谈的事情太多了,对这就是你和我一直在做的事,帮政府在这些领域做政策咨询,而且这一切发生的太快了,太疯狂了,是啊,好了我要把话题转到,我们每次都会聊的最重要的事,戴森球,我们先看一段视频,来自我们的朋友Sam Altman 说实话,我觉得在现在的环境下,把数据中心放到太空里的想法很荒唐,将来有一天它会有意义,但只要你简单算一下,发射成本和我们在地球上,发电的成本,更别提你怎么在太空里,修一块坏掉的GPU 而且现在GPU坏的还挺多,我们就还没到那个阶段,那个时刻会来的太空在很多方面都很棒,但轨道数据中心在这十年内,不会有什么规模化的影响,好伊朗和CM之间的MMA大战,还在继续,太有意思了,我想听听大家的反应 Alex 你先来,我觉得这里有明显的利益冲突,我们之前也从孙正义那里,听到过类似的说法,说轨道数据中心没什么前景,别忘了 OpenAI已经从自建数据中心的路上,退了回来,还记得星门项目吗,星门项目已经改了方向,从OpenAI自己拥有和运营数据中心,变成了向别人租用地面数据中心的算力 OpenAI还在推迟自己的IPO 所以哪怕不看事情本身,你也不得不去审视OpenAI现在的说法,也许他们目前在财务或运营上,根本没条件去投入轨道数据中心,相比之下 Anthropic在跟SpaceX AI宣布的合作协议里要用Colossus和Colossus2 他们对基于轨道数据中心的算力,就友好的多,所以我觉得这个交叉点,一定会来,伊朗说这个交叉点,会在两到三年内到来,你也能看到其他分析认为,轨道和地面数据中心的单位经济成本,会在2030年代初的某个时候交叉,我不确定哪个是对的,但不管怎样,我觉得这里有明显的利益冲突,就像我们跟Philip Johnson讨论的那样,除非出现什么意外的左转,我预计OpenAI对轨道数据中心的态度,会很凑巧的在未来两到三年内改变,时间刚刚好,当然伊朗对此的回应是,我们两年内就会发射它们,所以等着瞧吧,我觉得看这个视频的人可能会说,行吧 [01:27:54]
Peter Diamandis:Sam说太空数据中心没意义,伊朗说有意义,这俩人互相看不顺眼,但你要是仔细听Sam的原话,他们其实根本没有分歧 Sam说的是太空数据中心,在这十年内不会有什么实质影响,那个时间点总会来的,但这十年只剩下三年半了,你再看看伊朗对他发射频率的预测,他们其实是同意的,所以他们就是一直在互相看不顺眼,在这个措辞上看起来是这样,但真相其实很清楚,他们手里的数字是一样的,所以Alex说的对,他们是要上太空的,只是需要时间,我觉得到这十年结束,大概百分之几的算力会在太空里,因为我们在地面上也在拼命建,还有海洋,但之后两条线就会交叉了,对 Alex [01:28:45]
Salim Ismail:前几天 Starship 13号,飞行尝试的时候,咱俩来回发短信聊来着,那次后来推迟了,等这期播客上线的时候,我们会看到 Starship 13号的,下一次发射尝试,就在下周周一,那次发射在T-0的时候,被叫停了,当时有两台,顺便说一句,这是我头一回见到,是啊,在T等于0的时候终止 [01:29:37]
Salim Ismail:在T等于0的时候终止,重点是Starship助推级上的 33台猛禽发动机里,有两台没点着,它们会被换掉,但真正厉害的地方在这里,顺便提一句SpaceX的股票,因为那次发射失败跌了5% 这其实挺荒唐的,大家需要明白的是,那是一次惊人的技术展示,你能在T等于0的时候,关掉发动机,保住火箭,把甲烷和液氧卸掉,这我90年代就在航天行业里了,那时候甚至还不能叫航天行业,那些火箭当时就直接炸了,对吧,当场就失败了,我们现在能在这个精度上控制它们,本身就证明了SpaceX的工程能力有多非凡,我觉得那才是最精彩的部分,系统诊断问题,然后恢复的速度有多快
Peter Diamandis:以前这种事得花好几个月去诊断修理,恢复所有东西,重新规划下一次发射,现在就是行出问题了,关掉重来,我们周一开始 [01:30:46]
Salim Ismail:这太惊人了,是啊了不起,我觉得如果你真的想认真投入智能这件事,以我们现在知道的情况,你必须得有太空布局 April會收購像Planet Labs之類的公司,到那時候調子就會變了,好我們來看一些Emad的問題 Emad你之前建議我在X上徵集問題,我們從X上的觀眾那裡,收到了不少關於Kimi的問題,我來展示一下,咱們直接開始 Emad你先來挑,你想回答哪個問題,我覺得第四個問題挺有意思,考慮到Kimi K3更低的token效率,跟Sour或Fable比起來,它真的像宣传的那样有成本效益吗 Kimi K3相对于其他中国模型来说,是个昂贵的模型,比如DeepSeek 现在是每百万Token一美元 Kimi K3是15美元 Sonic是20美元 Opus是40美元我觉得Fable是60美元,但那是因为他们真的在赚钱,如果你从中国模型,和他们运行的芯片倒推数字,他们现在的利润率大概有80% 90% 而且这还是用他们的中国芯片,运行效率并不高,我觉得在未来几个月,随着它被优化 K3的成本会下降10到50倍,现在跟GPT-56比起来,它完成同样任务消耗的token数是两倍,而GPT-56这个前沿模型用的token 比5.5或Fable少37% 我们会看到这个数字降下来的,因为所有人都在拼命优化它,你看Fireworks刚以170亿美元估值融了资,其他像Moda估值100亿 Base是估值100亿,这些都是开源模型的推理服务商,他们都融了10亿美元,现在会花这笔钱去优化中国模型让它更高效的跑起来,所以做推理这块的美国实验室,会拼命优化它,我们会看到它追上来的,好顺便说一句,欢迎各位随时插进来聊这些问题 [01:32:45]
Peter Diamandis:Salim你下一个来,既然我之前对第一个问题发表了评论 Kimi K3能让美国前沿模型贬值多少,我还是坚持我原来的估计,大概75% 50%来自美国在前端的监管,然后你在供给端又缺算力,再加上开源模型,几乎在一个版本发布之内,就追到你身边了,那个最前沿的优势太容易过期了,我会说贬值75% 所以如果OpenAI值1万亿美元,我会把它估成2500亿美元,你仍然有一个非常有价值的业务,因为现在的竞争力,你得在可靠性安全性集成工具,部署便捷性上竞争,但那个实际的最前沿突破,它变成了整个拼图里的一块而已,要我说,我现在可不想待在这些前沿实验室里
Salim Ismail:那里现在肯定是一片疯狂,全天候红色警报,这完全就是一场无休止的消耗战,我在那些前沿实验室里,有好多朋友,他们正从一家跳到另一家,比如从谷歌,他现在在模型前沿领域,基本是查无此人,完全掉队了,跳到其他前沿实验室,这真的就是一场无休止的消耗战,是啊,太疯狂了 Dave 你呢,你是让我选一个吗,你不随便挑一个 [01:33:48]
Peter Diamandis:你还有第二和第三个问题,我记得,好,那我选第二个 Kimi K3的发布,对开源和闭源的竞争意味着什么,这会迫使大公司提供更多产品吗,我觉得他们暗示的是,会提供更多开源产品,对,这完全改变了游戏规则,因为任何有资源的人,都可以自己构建一个内部模型,针对特定用力进行定制,然后把它当作防御性的护城河,我不认为美国的大型模型提供商,会转向开源,我觉得他们会坚持自己现有的路线,所以如果你现在去跟Anthropic聊,他们会说,你看Kimi是暂时追上了,但Fable 5.1几周后就要发布了,当你去看那些最重要的企业用力,比如白领工作,自动化,药物研发人们无论如何都会用最好的模型,这就像如果你用AI来设计一辆车,或一枚火箭,设计上哪怕一点点改进,都能带来巨大的回报,所以你肯定会用最顶尖,最顶尖,最顶尖的模型,所以Anthropic的人会拼命保持领先一步,并把他们的价格稳稳的维持在高位,模型本身的成本,跟它带来的好处相比实在太小了,人们愿意付这个钱,所以这确实造成了,就像Alex说的这种消耗战非常惊人,但人们不会转向Kimi 除非Kimi真的超越了Anthropic 但他还没有,他只是追上了,甚至可能还没完全追上,好第三个问题,好第三个问题是 [01:35:08]
Salim Ismail:我觉得这些问题好像都是同一个主题的遍体,但他问的是,如果中国能用不到一半的token成本,靠一个开放权重模型实现跳跃式反超,美国的模型提供商,我理解这里指的是美国的前沿模型提供商,还怎么能继续证明他们巨大的估值是合理的,我觉得这个问题的前提不太准确,通往超级智能有太多元素,太多层面了,而且坦白说超级智能本身,当它完全发展起来时,我认为它的价值会远远超过,整个世界的GDP总和,这块蛋糕大的惊人,可以切出很多份,但就我们讨论的范围来说,比如谷歌,我之前提到过,它现在在前沿领域,似乎完全掉队了,我在当前的能力成本前沿上,根本找不到任何一个谷歌的顶级模型,那谷歌能做什么他们当然可以继续在能力上追赶,但如果我是谷歌,我会想,对我要成为一个超大规模云厂商,谷歌本身当然就是超大规模云厂商,但我要成为其他前沿实验室的,超大规模算力提供商,这是一个很明显的差异化方向,而且我们已经看到SpaceX AI 采取了这种策略,它现在已经和Anthropic签了协议,我们还看到Meta也很有意思,它一方面在提供Spark 1.1 另一方面就在我们准备录制的这两天,刚宣布Meta正在探索,向Anthropic出售价值100亿美元的算力,所以通过向下游整合,把你的算力提供给其他,更有竞争力的提供商,无论是西方的,通常是Anthropic 有时是OpenAI 还是以自托管模式提供给中国的模型,这是一个方向,你也可以向上游整合你可以尝试垂直整合,提供那些受益于其互补层,也就是模型层,商品化的应用,另外我认为那种觉得,仅仅因为KMK3出现了,估值就会净缩水的前提,是完全错误的,我们在最初的DeepSick冲击中,就见过这种错误想法,当时也被称为斯普特尼克时刻,我们当时确实看到资本市场,出现了一点小波动,但一如既往,杰温斯悖论开始起作用,我们看到芯片股的价值,最终是上涨了,而不是下跌,而且我们还看到,它是开放权重的,所以Kimi K3里面,绝对没有任何东西,是OpenAI Anthropic 和其他西方企业实验室,不能立刻拿来用到,自己内部模型里的,你不觉得当人们开始,在工作中用Kimi K3 而不是调用API时这些实验室能赚到的收入,会因此减少吗,不会,举个例子,我自己还有我投资的公司,在Anthropic和OpenAI上的花费是极其巨大的,据我所知,我的预期是,月支案面得发布一个比Fable 5好上二三十倍的模型,才能让这笔支出大规模的转移,目前Kimi K3能带来的,假设它合法的话,其实可以问,问Kimi K3还能在美国合法托管多久,但假设它一直合法,也不受监管阻碍,它带来的结果,就是更多的内部自托管,但它并没有站在能力的最前沿,就像Dave刚才说的,目前站在最前沿的是Fable 5 所以如果你想解决最前沿的问题 Kimi K3并不会让你转移你的支出,好,我想接着你刚才说的那一点Alex问你和其他几位一个问题,你觉得有没有可能,美国会出台某种法律政策,禁止美国公司下载Kimi K3 它可是在公开互联网上的,能通过Hugging Face之外的,一大堆渠道获取,在美国境内,它真能被禁掉吗,它确实可以被有效禁掉,这不是我主张的政策 [01:39:34]
Salim Ismail:这不是我主张的政策,我也不是这种政策的支持者,但我认为,可以通过要求美加上市公司披露,对中国开源权重模型的任何使用,并让他们接受审查,来有效禁掉它,就在我们准备录这期节目的时候,我们上一期聊过 Demis提议创建一个类似FinRA的实体,来监管前沿AI 结果你猜怎么着,有报道说,现任政府实际上正在推进类似的提案,正计划或者至少在探索,创建一个类似FinRA的机构,来监管前沿AI 这个机构会设在SEC下面,因为SEC已经有法定权利来运营,像Finra这种,有行业建议和资助的实体,所以这是个很自然的选择,自律组织,对,对自律治理说白了就是监管俘获,形成的卡特挂在SEC下面,所以我觉得完全有可能,尽管我非常不希望看到,未来某天会出现一个SEC下属的,类似Finra的机构,它基本上会让任何规模的公司,尤其是上市公司,从经济上完全没法积极使用,中国的开源权重模型 [01:40:52]
Peter Diamandis:其他人对这点有什么想说的吗,我有话说,我是说想限制这边的使用,这太荒谬了,因为一旦你把权重放出来,对吧,想阻止他们,你可以在不同司法管辖区之间做镜像,可以用点对点网络,你好VPN 你这么做,唯一的结果就是不让美国的研究人员,创业公司和安全专家,接触到那些模型,而世界其他地方,则会继续在这些模型上搞建设,我不觉得这是什么可行的办法,要我说,这跟内事一样,对,请说,这就跟不让美国人 [01:41:14]
Salim Ismail:用便宜的胰岛素一样,要我说,这又是监管俘获,对吧,为什么你不能用纺织药,因为又回到了,监管俘获这个点上,有个行动,我记得叫精英行动,就是要审批对前沿模型的访问权限,以后还会有反token洗钱法规,还会有了解你的提示词用户法规,感觉美国政府真的意识到这项技术就要突破了,真是个疯狂的未来,这世界太魔幻了,好了我们回到你这边 Saleem下一个问题,好,有些问题稍微有点重复,对我来回答第五个,你会信任Kimi K3
Peter Diamandis:让他不经监督或审查就帮你写代码吗,答案是,不会,但我也不会信任一个人类,把没测试过的,后果严重的代码,直接部署到生产环境里,对吧,问题不在于我们,信不信任这个模型,而在于我们信不信任,它周围的开发体系,所以AI生成的代码,需要先在沙箱里运行,通过自动化测试,安全扫描等等一系列检查,然后才能上线,然后你再根据具体用力,和潜在影响,给它匹配相应的权限,这跟我们之前聊过的一样,不管AI跑的是什么工作流,在最高层级,面对后果最严重的输入时,你仍然需要人类审查,很多常规工作可以自动化,但可扩展的模式,不是让AI在零监督下运行,而是机器生成,加上验证再加上人类问责,三者结合,这才会给你带来真正的力量,好,对,我觉得反针流在K3的开发中,扮演了什么角色 [01:43:24]
Salim Ismail:他们显然从OPUS和其他模型那里,蒸馏了数据,但说实话,我现在用Kimi K2 5和Kimi K3用的相当频繁,感觉确实不一样,所以我觉得他们在蒸馏的基础上,自己又做了大量的数据创建,不过现在大家都在互相蒸馏,他们明显取得巨大飞跃的一个领域,是前端开发,再说一次,这不是世界上最好的数学家,虽然他作为一个通用模型,已经相当不错了,从我们的基准测试来看,它也不是最好的网络攻击者,但他们好像在前端这块,在消费者和娱乐这一侧,搞出了一些原创的新东西,我觉得这很有意思
Peter Diamandis:当然这也可能是因为,它是一个多模态模型,第七点 Kimi K3可能没宣传的那么好,或者我们不该用的原因是什么,如果它只是刷榜,那两周后开源权重一出来,我们就会把它测个底朝天,是不是刷榜马上就知道,所以答案很快就会揭晓,我觉得不太可能刷榜刷到那种程度,现在美国和全世界的每家公司,都应该立刻启动一个紧急项目,找最好的顾问来定一件事,我们到底要用自己的本地硬件,跑自己的模型,还是直接用Anthropic OpenAI或者Google 只信任他们的API 我们必须想清楚,用自己的专有数据做微调和训练,能不能带来长期的竞争优势,接下来好的建议会极度稀缺,供应商麦肯锡的顾问你得赶紧抢这些资源 Excel的顾问做种子轮投资,把你的网络组织起来,尽快找到能针对你的业务和用力,回答这个问题的人,然后选定一条路走下去,你可以在内部做点东西,同时继续用API 但如果你现在不开始自己评估Kimi K3 以后就很难再回头补这一课,所以我觉得每个人都得马上动起来,去回答这个问题,不过几周后我们就知道,它是不是刷榜刷到飞起了,但我认为开源这条路,现在对美国和全世界的每一家公司,每一个政府来说,都极有可能是一条可行的路,我能很快补充一句吗,当然可以,给每家公司一个非常简单的建议部署两套系统 Kimi K3和Inkling 用你自己的内部数据去做微调,因为这个学习循环 [01:46:02]
Salim Ismail:会是你不想失去的专有护城河,就从这里开始 Alex你来说个尾巴,第六个问题你已经算回答过了,但也许可以再展开讲讲,好我说点新的,第六个问题问的是,美国是否应该阻止,下一版Kimi的权重上传到Hugging Face 我给一个有条件的回答,我认为如果某一方,大概是在美国,能向一个有管辖权的法院证明,下一版Kimi 应该就是指这次这个版本,是通过某种非法手段,获取或衍生出来的,比如侵犯版权,非法征流推理诡计之类的,那这大概可以成为,在美国阻止它发布的理由,但如果没人能证明 Kimi的母公司Monshard 在创建它的过程中,有任何不当行为,那就不应该,我认为美国,不应该在这个过程中,阻止它发布,我觉得恰恰相反美国的每一家前沿实验室,都应该仔细研究它,能学什么就学什么,这样我们才能实现超越,而且我更希望看到,美国的实验室,施加更大的外部压力,去创造世界顶尖的,开源权重和开源模型,而不是让中共,用他们的AI新丝绸之路计划,去覆盖全世界,有人甚至会说,这是在向世界其他地区,也就是所谓的全球南方,倾销超级智能,应该是美国作为自由的炮台,自由的兵工厂,同时也是超级智能的兵工厂,向世界其他地方,清洒开源权重和开源的超级智能,而不是中国,向世界其他地方清洒,我喜欢这个说法,记住我们正走向一个智能便宜到无法计量的时代,但它的可用性和强大程度会是前所未有的百万倍,各位听众我代表Musha的伙伴们感谢你们的时间,如果你还没订阅,请订阅,随着发布节奏,从几个月几周变成几天,我们会越来越频繁的更新,起点临近,没时间睡觉了,各位,接下来一周有什么安排 Emad你先来,然后Saleem Emad 你那边有什么新鲜事,对,正在准备发一大批研究论文,终于要发了,挺兴奋的,对,还是那句话,更多加速,是为你的公司 Intelligent Internet准备的,对吧,对 Saleem 请 [01:47:58]
Peter Diamandis:周二有我下一场,生命的意义分享会,东部时间晚上七点,感兴趣的朋友可以来,他们去哪了解,我们会在下面放链接,是openxo.com 斜杠mol [01:48:33]
Salim Ismail:这是我第二次做了,如果你还没参加过 Salim的生命的意义分享会,那真的非常特别,他会带你超越AI 进入哲学和神学的领域 Alex 你接下来要出差吗,最近在忙什么,我现在太专注了,基本上就是在解决一切问题,我得说,目前绝大部分科学领域,我确信都已经彻底被做透了,关于这个话题,后续还会有更多内容 Peter 你和我写过解决一切那篇文章,但现在他真的要成真了,是啊,我很兴奋,你马上要来我的Abundance社区做MA了,那会是一次很有意思的深度探讨,当然 9月25号的MoonShot聚会上,你也会来做分享,其实我们所有人都会在,因为你9月会来洛杉矶跟我们一起,是啊,我们又能聚在一起待一整天,想想就开心 Dave
Peter Diamandis:现在应该是待在Link Studios 最激动人心的时刻了吧,天哪,对,我觉得这期播客上 EMED发起的那段,关于量化的讨论,现在已经跃升为,我录过的最棒的内容了,超过了Leopold Ashenbrenner 那期我得回去用慢速再听一遍 [01:49:39]
Peter Diamandis:那期我得回去用慢速再听一遍,还有我们这周请到了 MIT Nano的Vlad Bulovic 他会给我们那个,做光子计算的新创业公司当顾问,帮我们,他还给了我一整份路线图,列好了我下周需要见的人,所以我们打算再招两位 MIT的人加入我们的 Princeton团队专门攻克光子学,量化光子学这一块,我下周就忙这个,但我觉得我们可以把,之前录的那段视频拿来当招聘工具,那段实在太精彩了
Salim Ismail:你们太厉害了,我太爱你们了,这周真棒,聊得太好了,看看明天周末又会爆出什么新闻,随时准备再来一期紧急播客,到一月份,我们得每天都出紧急播客了,好了大家保重,感谢收听Muncha 这是你见证起点来临的前排座位,各位回见 Peter一如既往的棒,谢了Peter [01:50:32]
来源:The Diligence Stack——Creative Strategies
URL:https://www.thediligencestack.com/p/chinas-ai-arms-race-runs-through
正如一个民族国家应有的做法,中国把人工智能(AI)视为国家实力的一部分。近期发布的模型显然是这一战略的一环。Z.ai 发布了 GLM-5.2,Moonshot 发布了 Kimi K3。两者都面向广泛用途,也适合运行时间较长、需要持续推理的工作。在 Creative Strategies Agent 基准测试中,我们让模型处理一系列知识工作;Kimi K3 的表现与几款已经成熟的美国模型大体处于同一水平,但仍低于领先者。这一结果让讨论超越了头条式的基准测试分数。Kimi 已经能够在常见的智能体系统中完成有用的多步骤工作;在中国达到半导体实力对等之前,这就足以为中国的云服务和计算基础设施创造需求。K3 发布后的需求表明,至少有不少人有兴趣进行测试和评估。Moonshot 的服务器容量一度接近上限,在扩容期间暂停了新订阅。更有用的模型会带来更多用户,而每个用户都会增加服务器和芯片的负载。因此,模型进步会进一步推高对算力的需求。
我们认为,中国把 AI 视为国家之间的一场军备竞赛。中国不会只根据短期财务回报来做这些决策,但它需要自己的 AI 经济繁荣起来。目标是:即使外部供应商切断供给,中国的 AI 仍能持续运行。如果更高的功耗和每颗芯片更低的性能能换来更强的控制力,中国会接受这种取舍。中国也可能在商业论证看起来有吸引力之前,就提前建设产能。这就是为什么 Kimi K3 和 GLM-5.2 应当被纳入一份中国半导体入门指南。中国的模型进步速度快于芯片工厂(美国实验室也有类似情况;据我们估计,美国的 AI 软件至少领先硬件两年,而美国前沿模型实验室必须不断让模型适配现有的硬件能力)。每一个有用的模型,都会为中国云厂商创造更多工作,也会让人们更有理由让这些工作运行在中国芯片上。开放模型也可以在中国境外运行,因此海外使用仍可能让外国云服务商和芯片公司受益——也许吧。但在中国国内,更好的模型会增加对其底层本地基础设施的需求,进而帮助本土硅芯片的发展路线图。
中国不需要一款在每项指标上都能匹敌 NVIDIA 的芯片。事实上,它们可能永远无法在能力上追平美国领先的芯片公司。中国需要的是足够多的本地算力,在外部供应变得更难获得时,仍能让 AI 工作继续推进。中国最大的缺口在于先进芯片制造和高带宽内存(HBM)。中国制造领先芯片仍然需要外国工具。这些缺口确实构成了障碍,但并不会阻止中国建立一个有用的国内 人工智能系统,也不会阻止本土云服务商获得经济收益。
完整报告呈现了我们对中国算力、基础设施和模型的最新判断。我们将中国已经能够自行供应的部分,与仍无法替代的卡点区分开来,然后追问:什么证据能够证明这套本土技术栈可以大规模运行?这是我们正在跟踪的一项关键指标。
完整报告涵盖:
阅读更多


