2026-08-22 15:56 · 来自 X
E


//@paingod:对上了,英国每日镜报找到了哈普在信里那个事的照片:阿川开着高尔夫球车,哈普在后面拼命追,哈普在信中为此给阿川造成的困扰道歉。不愧是知名小报,八卦赛道非常厉害 http://t.cn/AXpIJf0z
好家伙,这八卦好看!美媒拿到了两封娜塔莉·哈普写给阿川的信,写信时间是2023年,当时她约31岁,他76岁。写于阿川2023年5月苏格兰和爱尔兰高尔夫之旅附近的时间,当时哈普陪同出行。
内容如下,你们自己判断
第一封信:我以为昨晚只有我一个人被落下了,完全不知道马戈特的车也被拦下,并被送回了机场,因为我独自在海关外的面包车里,没有护照,我慌了,本该直接打电话给特勤局而不是你,如果我还做了其他任何给你添麻烦的事,请原谅我。第一天时我被告知没有球车可用,大家只能步行,所以我选择了步行。第二天,有人专门问我一一我记不清对方的名字了,但应该是那里工作的主要人员之一是否要继续步行,并告诉其他准备出发的姑娘们也这么做,以尽可能避免赛道上出现更多球车。如果我所做的任何事给您带来了困扰,请务必原谅我。我知道有些人曾说过我没有回复他们的短信,这其中还涉及一些国际手机通信方面的问题(约翰当时也在飞机上遇到了技术问题,因此请求我予以协助)。
我希望我们之间永远都好好的。我也知道这一整周我都很分心(整天忘记吃饭,甚至忘记睡觉,一次只睡几个小时)。不是因为我在意别人怎么想,而是因为我看到自己在你眼中和你的好感中被降低了。那就是你看到的恐惧,因为我只想带给你快乐,别无其他。你是我唯一在乎的一切,我永远不想让你失望,感谢你成为我此生的守护者和保护者—一这正是我想用这张卡表达的心意,当你看到我在收银台时,你再次做了本不必做的事,并赠予我这次一生难忘的旅程的纪念品,一个成长的见证。我会成为一个更好的人。现在我必须下线了,因为车辆正在离开。很快再见。
全心全意的,娜塔莉
第一封信:现在这是我本想写的信(但得先道歉。)…
在这段旅程中,我对于自己有了许多新的认识——一我一直知道回到自己的根脉之处会有所启迪,但未曾料到其影响竟如此深远。这是我有生以来头一次被迫“断开连接”。我们可以在没有机械设备的场地里活动,甚至忘却了时间的流逝!我不再需要扮演“人类打印机”的角色。我得以有时间享受愉快的交谈,同时仍能确保在一天结束时完成所有工作。事实上,我甚至有余暇在早晚时分长距离漫步,尽情欣赏日出和日落(尽管我确实忘了吃饭和睡觉!)。有了如此充裕的思考时间,我承认这有时确实会产生些许负面的影响——一我知道你已经注意到了这一点。但我认为,最终的结果将是值得的。我完全未曾料到自己竟会以如此快的速度接近精疲力竭的状态,并开始羡慕那些似乎只需与你交谈、且只需保持光鲜外表的“工作”。我渴望拥有那样的工作!!很多时候,我只是竭力应对扑面而来的各种事务,就像个没时间整理仪容的驼背者(至少你知道我本应有的模样)!此外,我还怀念过去那些你时常打来电话的日子,我们畅谈一切或无所不谈。我想重拾那种协作共事的氛围。我们不应该总是没完没了地谈论工作!!我一直感觉自己处于一种中间状态,介于员工与你那些乐于在飞机上或餐桌上与之交谈的人之间,因为在我还是“脱口秀主持人”的时候,这就是我对你曾经扮演的角色(尽管我本人非常厌恶那份实际的工作!)。若能聆听每一场对话该有多好,因为那正是你享受快乐时光、暂时忘却一切烦恼的时刻,哪怕只是短短的几分钟。
但经过这番自我剖析之后,我的结论是:我需要将过去的自我与现在的自我重新融合为一个更好的我,一个能够让你感到骄傲的我。而且,如果我在某个时候失败了,你能告诉我吗?你有绝对的权利在我理应受到指摘时对我大发雷霆,因为没有人比我更了解或更关心我的情况。感谢你一直以来对我的不离不弃——一我永远不会忘记你在我失去父亲后向我许下的承诺,并且我知道他现在一定非常开心,因为我的确如他所愿踏上了前往苏格兰和爱尔兰的旅程。这里用一句改写的经典:“我本不该与你分离,因为没有人比你更值得。”——而且,我要补充的是,不配的人是我。
永远的,娜塔莉
附言:我在苏格兰和爱尔兰时手部状况更糟,因为寒冷使旧伤变紫。仍在康复中!
——————————分割线——————————
补充背景:娜塔莉·哈普是阿川的贴身助理,因为前几天白宫发言人莱维特宣布辞职,美国上下又掀起了新一轮八卦潮。一段视频显示,在莱维特辞职前几小时,有人拍到她与阿川还有哈普,在“陆战队一号”上紧张的谈话,而35岁的哈普,是阿川在安卡拉收到刺杀警报后,唯三带上备用飞机的亲信之一。
而莱维特跟鲁彪、贝森特、米勒等等一起却被留在了老“空军一号”上,充当所谓“刺杀导弹”的诱饵。
而这两天CNN记者因为提问阿川关于他和哈普的事情,导致阿川当场情绪失控,怒斥CNN记者,随后CNN官方账号因为此事也和白宫掀起了骂战。http://t.cn/AXp5hc6v


完,谈崩了。加拿大总理卡尼刚刚发布声明,因美国在谈判最后关头临时加价,加拿大撤回谈判团队,美加贸易谈判破裂。
当晚12点也就是北京时间中午12点,加拿大将面临美国50%的关税,加拿大选择硬刚,将对等报复。


响马高见:
> 工程师永远不会消失,但是工作方式会变化。工具化永远会进化到 roi 低于人力的边界,然后需要更多的人力来补齐最后的缝隙。
类似于你开了一家餐厅,买了一台洗碗机,一下子替代了 3个洗碗工,效率高、成本低。这就是工具化带来的 ROI(投入产出比)远高于人力的阶段。
但洗碗机洗不了所有东西。异形的锅、烧焦的铁板、精致的瓷器,这些还得靠人手洗。你可以花大价钱去研发一台能洗一切的超级洗碗机,但为了搞定最后这 5% 的餐具,你可能得投入比前面 95% 多十倍的钱。
这时候你算一笔账:与其砸钱造那台超级机器,不如留一个洗碗工来处理这些边角料,人力反而更划算了。
工具进化到某个点之后,再往前推的成本急剧上升,ROI跌到比直接用人还低。
另一个角度,工具越强,整个行业的总产出往往也在膨胀。洗碗机让你的餐厅能接待更多客人,于是产生了更多的异形锅、更多的特殊情况,那些“缝隙”的绝对数量反而变多了。所以你可能裁了 3个普通洗碗工,最后又请了 2个专门处理疑难杂症的人。
AI工具会吃掉大量标准化的编程工作,但软件行业的总规模也会因此爆发式增长,而增长带来的各种边界情况、系统集成、业务理解这些“缝隙”,短期内仍然需要人来填。
工程师永远不会消失,但是工作方式会变化。工具化永远会进化到 roi低于人力的边界,然后需要更多的人力来补齐最后的缝隙。
现阶段画图并且能自由编辑最佳方式应该是 HTML或者类似于 HTML(比如 React)的方式,因为这个训练的最好的画出来效果最好的。
而且 HTML可以方便的编辑,也可以转换成其他可编辑格式。
借这个话题,很想了解下大家现在在「画图」这件事上的取舍。
AI时代之前,我日常主要用 DrawIO和 Excalidraw。AI爆发之后,也尝试过一些对 AI更友好的方式,比如 Mermaid、PlantUML,或者像 Thariq提到的直接用 HTML。
但用下来一直有个很明显的问题是:AI很好生成,但人很难微调。
所以现在我的日常反而还是 AI生成 DrawIO,再手动调整。虽然 DrawIO本身对 AI并不算友好,生成复杂图时也经常会出现连线错乱、布局不稳定之类的问题,但至少最后还能比较自由地编辑。
感觉现在一直缺一个真正做到 AI-Native,同时又对人类编辑友好的画图方案。
不知道大家日常都是怎么画图的?有没有更好的工作流或工具推荐 🤔
百度的月活用户量已经连续4个季度下降了,跌到了2022年的水平,同时广告收入的增速也已经连续9个季度同比为负,还有什么绝境翻盘的办法吗?


昨天张家界景区一个游客随手拍的这条视频在抖音爆了,反差太强烈了 😂😂😂
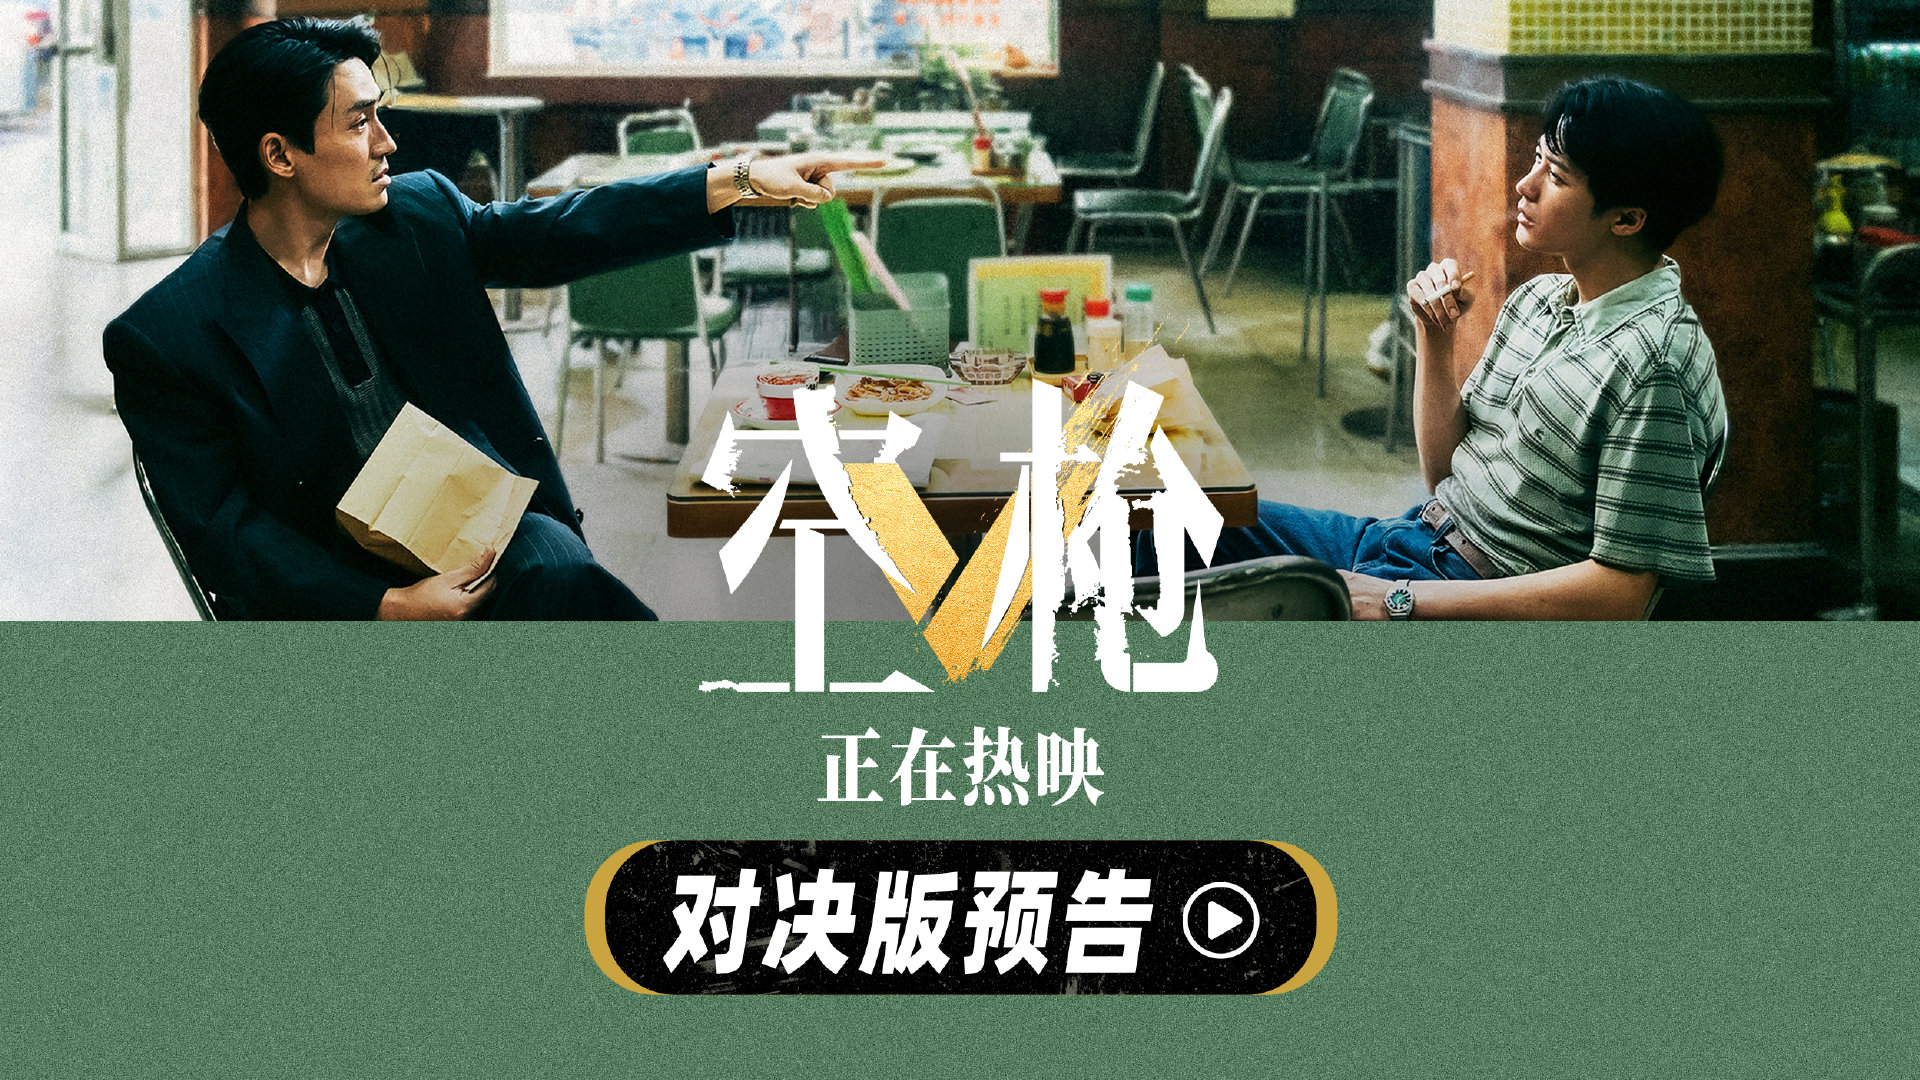
http://t.cn/AXNE81cb我的评分:⭐⭐⭐⭐⭐ #婆婆鉴片# 好的我来说一下这部空枪。还是那句话,影评纯主观,如果您和我的观影感受不一致,请务必以您的感受为准,您一定是对的。🌸
本文有轻度剧透,但应该不影响您观影体验。观影后阅读效果更佳。
想不到在今年暑期档的尾巴还能看到这么高质量的片子,我心甚慰啊。🌸
尽管在片头就有“本故事纯属虚构,请勿对号入座”,但是这个常见的“叠甲声明”,在本片确实就没有太大必要。谁都知道这片的原型故事说的是谁。
香港历史上最著名的“世纪贼王”,张子强。
他的犯罪历史很漫长,当然最著名的,莫过于绑架过香港首富的儿子,得了10亿港币赎金。
那可是1996年的10亿港币啊。
正因为如此著名,张子强的故事多次被香港电影搬上大银幕。最幽默的是,在这部空枪里扮演香港首富的梁家辉,还曾经在另一部电影里扮演过张子强。当然,用的都是谐音名。
剧情方面,(放心,这里没有剧透),韩延导演明显是下了功夫了,这片的剧情推进节奏感很强,各个篇章之间丝滑推进,而且补齐了以往“张子强片”里最大的短板,成功塑造了足以抗衡乃至最终降服张子强的正面群像,这一点比以往香港导演的版本强太多了,后面我再细说。
演员方面,朱一龙老师饰演的“万梓强”再次贡献了出色的表演。由于众所周知的原因,我一向是不会评价流量剧火起来的演员的演技的。但很显然,朱老师已经通过多个角色的成功塑造证明了自己。新晋百花影后卫诗雅表现也非常优秀。梁家辉就更不用说了,什么叫老戏骨的含金量啊。倒是檀老师吧,我感觉是吃了颜值的亏,不是说警察没有帅的,而是太帅导致缺了点橄榄绿时代老派警察的味道。
最后我想说说这部片我真正觉得出彩的地方。…
它通过三个对比,非常巧妙的跳出了传统“张子强片”的类型框架,把这部片上升到了一个全新的高度。
这三个对比分别是:“万梓强”和香港首富;内地警察和香港警察;香港回归前后的警队及整个法制体系。
在以往的“张子强片”里,由于众所周知的原因,“香港首富儿子被绑”这事儿往往都是作为背景板出现的。而更由于整个香港文艺界的传统风格,各个版本的“张子强”几乎都是清一色的“江湖枭雄”设定。而这部片,很突破性的把“香港首富”的很多事情给放到台面上来晒了晒,妙极。而这个版本的张子强也就是“万梓强”,完全没有了“枭雄”或者“江湖气”,甚至给他设计了很多“反江湖”的重要情节。而片中虚构了万梓强的一些做法,比如开着直升机撒钱什么的,也绝不是所谓的劫富济贫。他就是内地警察在片中说的,极度的自卑所以表现出对有钱人的极度仇恨。我讲的再直白一点,一个是把自己包装成大善人的恶人,一个是把自己想象成罗宾汉的恶人,作恶方式不同罢了。
第二个对比,是内地警察和香港警察。当然,是在97回归前后的。穿着橄榄绿的老派内地警察,现在对很多年轻人来说可能很陌生了,但说起来,以前的港片里,“橄榄绿内地警察”的形象其实大多都,比较一言难尽。再直白点说,黑我们黑的很有章法。所以这部片算是再一次回到那个时代的拨乱反正。而片中回归前的香港警察,倒是相当写实的。比如和黑帮沆瀣一气的黑警,以及资本对警队及法制的影响,那时候可真是比法律好使多了。檀老师饰演的内地警察就像一个懵逼的孩子:“你们怎么能给他放了啊?”
第三个对比,就是香港回归前后的警队变化,这也是我觉得本片最出彩的地方,当然,应该也是本片让一些反贼最难受的地方。本片用了很短的篇幅但是很用心的表现,来专门反映了97年回归时的香港警队,改变的不仅仅是徽章和旗帜,而是极具讽刺意义的现实:
张子强犯罪集团真的是1991年的香港启德机场劫走了1700万美元和300万港币。
张子强真的在被捕后由于所谓“证据程序漏洞“和他妻子罗艳芳聘请的大律师而被无罪释放。
张子强真的在无罪释放后极为嚣张的公开比出了胜利V手势。
张子强真的在无罪释放后反手就起诉了香港警察获得了800万港币的赔偿,让香港警察沦为全港笑柄,again。
张子强自此极度相信“钱+大律师”就能搞定一切,进而胆子越来越大最终做下了绑架首富儿子并获得10亿赎金的惊天大案。
然后香港警察真的拿他几乎毫无办法,以至于张子强最后胆大到,他真的打算整个史无前例的大活儿:他从内地偷运了800公斤炸药和2000枚雷管到香港,你猜猜他想干什么?
答:炸了香港赤柱监狱营救同伙,然后再绑几个富豪。
在他的眼里,香港警察真的就和摆设差不多了。
万幸,这时候已经是1998年。时代变了,小贼。
1998年1月,广东公安机关在广东江门成功抓获张子强,其犯罪团伙其他成员也相继落网,证据确凿人赃俱获,经严格的司法程序,广州市中级人民法院一审判处张子强死刑,后经广东省高级人民法院终审,1998年12月5日,张子强被执行死刑。
“小港啊,你看好了,我只示范一次。”🐶
附图不是电影剧照,这是真正的张子强当年被“无罪释放”时在香港高等法院门口摆出的“胜利V”真实照片。朱老师在片子完美复刻了这一名场面。http://mapi/8dffe03cgy1igbqat3whbj20pe0u00wp
传统车厂容易把这块屏,当做内饰的一部分🐶
宝马今天iX3的价格惊到了整个媒体圈,而i3的外观大家也都很喜欢。
宝马中国团队真的已经足够努力,说服了宝马管理层,定了一个近乎没有道理的价格,你对比一下iX3在欧洲的售价就知道,便宜得离谱。
但我个人对接下来这2台车的前景依然不是太看好,最大的原因就是因为这个车机系统,无论是硬件和软件确实还有太多和时下国人习惯或者说已经洗脑完成的智能车机差异巨大。
这种差异甚至是难以去适应和学习的,今年的北京车展上,我向宝马全球CTO和中国CTO表达了我的这个观点,当场他们很诧异,后来还找同事来详细问我细节。
欧洲用户用起来完全没问题的一套车机,中国确实会面临很大的压力。如果我买台宝马燃油车或者 M,这个车机我也能忍,但电动车的话,确实不行,因为有对比。
奔驰也经历了这个过程,但没这么严重,屏幕硬件没有那么倾斜另类。即便如此,奔驰接下来也开始用和Flyme Auto联合开发的一套全新的车机了,开发逻辑应该类似神行者8和smart,德方负责HMI/UI,中方负责研发其他部分。
BBA新能源车的路任重道远,三电已经基本搞定,智能化的智驾部分也基本搞定(iX3的momenta智驾居然城区3年后还要收费),接下来智能座舱就是最后的堡垒了。
当悲伤逆流成河,而时光悄悄流逝。
记得BBA的豪华和尊贵的那群人,也一天天的老去……

最近起点网文作者圈子里哀嚎一片,起因是平台突然收紧了AI文政策,一些作品被相继撤下了各大推荐位和榜单,相当于在流量上判了半个死刑。
注意啊,这些小说并不是完全用AI生成的水文——否则就算给了推荐位也很难活下去——不少作者说只用AI进行了一部分的润色,其中被撤的作品有不少质量上乘,属于叫好又叫座的那类。
目前流传最广的统计口径是,月票榜前1000本书里的「涉事作品」约为100本,斩杀率高达10%,其中有大量像《山河鉴》《我加载了神秘学面板》这样均订破万的头部小说。
但事情并不是突然发展成这样的,看网文多的人可能知道,仅仅是在几个月以前,还有一些作者会因为AI使用上的分歧,直接贴脸开大嘲讽读者。
我就曾看到一名头铁的作者,在评论区公开表示「有新工具不用,这不是傻*吗?」,他的小说《战锤:大贤者的维度穿越》在八个月的时间里更新了470万字,平均日更2万字。
这是什么概念?哪怕一天不吃不喝写12个小时,每小时也有近1700字的产出,很恐怖我只能说。
所以现在在网文圈里,AI基本成了作者们人人避之不及的东西,但凡作品跟AI挂上钩,被读者和平台清算只是时间问题。
这就很魔幻了,要知道起点的母公司阅文,算得上是国内最早拥抱AI的内容商之一了,早在2023年就推出了「妙笔」大模型,去年还高调宣布接入DeepSeek,最大的卖点之一,就是帮助作者进行文章润色。
当时集团对外的原话是,「AIGC是IP产业未来5年的重要动能」。
这话当然没毛病,它指向了一个多赢的局面:作者用AI提升效率和产能,读者获得更多的内容供给,大家都有光明的未来,对吧?
但问题在于,AI是不受控的,就好像2026年我们经历了太多历史性拐点,AI访问网页的数量超越了人类、AI图片的产量超越了人类,那距离出自AI之手的文字体量超越人类,还会远吗?
我的意思是,在这样的潮水里,继续保持理性已经毫无意义了,起点最初的设想,是赋予作者5%、10%的产能提升,但没想到这个数字一下变成了500%......
于是开了风灵月影之后,游戏突然变得索然无味。
当然,这绝不是只有起点和网文赛道要面临的问题,AI的发展和治理,一定会长此以往纠缠下去,显然阅文是不可能放弃AI的,因为还有诸如翻译、漫剧制作和IP改编这些工序,都需要AI来降本增效。
只不过让AI出现在该出现的位置很重要,既要拥抱未来,又怕未来跑得太快,低估了AI的影响,最后就只能靠不断微操来对冲了。
//@无心简影:可以说,这次是出现了一个转折点🤔
大概十几年以前,医闹是个让医院和地方政府都很头疼的问题,那个时候处理医闹,主要是牺牲医院和医生的利益换取患者家属的消停。忘了哪个地方的公安局局长还在公开的会议发言上说:“总的原则是,绝不能让患者和医院的矛盾变成患者和地方政府的矛盾”。
但是后来有了微博,各地的医生们纷纷开账号,医生们又普遍有文化有水平,表达能力很强,所以很快就火了一大批医生博主,这些博主开始在各种“医闹”事件中为医生发声,利用舆论给地方政府施压,动静还特别大,最后很多地方政府被逼的没办法了,只能尽可能公平公正去处理“医闹”事件,至少不敢再明目张胆牺牲医院和医生利益来换取患者消停。医生们也算是打出了自己的统战价值。
我提这段旧事没啥别的意思,就是想说,你不能因为某些群体不敢“闹”不想“闹”不愿意“闹”,就忽略他们的存在,就理所当然牺牲他们的利益。
很多人“不闹”,不是因为他们没能力,只是因为他们老实,他们对国家和政府有信心有期待,希望能通过正常渠道解决问题以及维护自己的利益。
他们为了大局,有时候也愿意做出一些牺牲,但这不是因为他们好欺负,是因为他们把自己和这个国家视为一个整体,愿意为了集体进行一定程度的忍耐,但这种忍耐和牺牲不是无条件无底线。
如果他们总是被牺牲的那群人,他们看不到自己的牺牲及忍耐的意义,他们也会不满。他们可能不会因为不满就跳到对立面去,但也会感心灰意冷进而“非暴力不合作”。
如果这些人中再出现一些愿意“闹”敢”闹“的人,那动静就大了。这些人不会管什么大局,因为他们觉得这个大局并不包括自己,认为靠谁都不如靠自己亲自动手。
另外多说一句:我之所以经常喷胡锡进,就是因为他是这种“基本盘不具备统战价值”思想在网络的总代表。
#AI短片南天门计划# OMG……刷到有作者用AI把南天门计划制作出来了!!!真人复刻会遇到的画面制作难题,用AI就都解决了!?整个制作还是太震撼了……#热搜AI创作激励大赛#
#2026成都车展# 新世代宝马i3长轴距版内饰首发,2027年1月投产。新车基于NK平台,外观融合“数字天使光翼”与发光C标,内饰配17.9英寸屏及全景iDrive;搭载800V、第六代eDrive,零百4.7秒,续航最高912公里,兼顾科技与性能。
#智能驾趣宝马新世代##保罗车闻##宝马iX3价格#


#购物
无印良品的这个室内拖鞋,薄得不像拖鞋,像手工鞋底。
但是特别适合喜欢光脚走路的人,适应了挺舒服。

#tesla
申请特斯拉开发者也是秒过的,权限高了很多。建议自己申请一个来玩。
比如一个简单的需求:手机语音控制特斯拉 15分钟后开空调。
#家具
买了一个宜家今年的折叠沙发,放在书房。有时候午休不想上楼,就直接展开小睡一下。
不错,推荐。


#U卡
替你们测过了,Krak US实际货转+磨损是 -2.3%,而最高等级会员返现 2%。
也就是说用这个卡是亏本 0.3% 的🌚
如果 Stripe的卡都是这样,可以说还没进入市场就已经退出了 🌶︎🐔

#Crypto
除了 Rain之外,有新玩家入场了。


1948年,贝尔实验室一名32岁的年轻人发表了一篇无人能够完全理解的论文。
工程师觉得它数学味太浓,数学家则认为它过于偏重工程。一位著名数学家给出了负面评价。
这篇论文名为《通信的数学理论》(A Mathematical Theory of Communication),后来成为数字时代的奠基性文献。
这个人就是克劳德·香农(Claude Shannon),信息论之父。
21岁时,他写出了20世纪最重要的硕士论文。
在麻省理工学院研究一台早期机械计算机时,香农注意到它的继电器开关恰好只有两种状态:开或关。他刚上过一门介绍布尔代数的哲学课程,而布尔代数同样只处理两个值:真和假。
从未有人把这两件事联系起来。
1937年,他的论文证明了布尔代数与电路在数学上完全等价,任何逻辑运算都可以由简单的开关构成。
霍华德·加德纳称其为“可能是本世纪最重要、也最著名的硕士论文”。
每一台曾经制造出来的数字计算机,都可以追溯到这一洞见。
29岁时,他证明了完美加密的存在。
二战期间,香农在贝尔实验室从事机密密码学研究。他的工作促成了 SIGSALY 的诞生。这套安全语音系统曾用于罗斯福与丘吉尔之间的机密通信。
在一份于1945年列为机密的备忘录中,他从数学上证明了一次性密码本能够提供完美保密性:即使攻击者拥有无限能力,它也不仅在计算意义上无法破解,而且在数学上可被证明是永久不可破解的。
这份备忘录于1949年解除机密后,密码学从一门艺术变成了一门科学,并为 DES、AES 以及所有现代加密标准奠定了基础。
32岁时,他定义了什么是信息。
他在1948年的论文中提出了一个公式:H = −Σ p(x) log p(x)…
香农熵:概率分布中的平均不确定性,也是编码一条消息所需的最少比特数。
由此产生了三件事:
> 他定义了比特(bit),即一切信息的基本单位。他的同事 John Tukey 为它命名。
> 他证明了信道容量定理:每条通信信道都有一个可靠传输的最大速率。你可以无限接近它,却永远无法超越它。
> 他首次将电报、电话和无线电统一进同一个数学框架。
贝尔实验室的 Robert Lucky 称其为“技术思想史上最伟大的作品”。
他的公式如今在人工智能中的应用包括:
交叉熵损失(cross-entropy loss)是训练每个分类器和语言模型的函数,它直接源自 H。决策树分裂使用信息增益,也就是将 H 应用于数据。困惑度(perplexity)这一标准的大语言模型评估指标,则是交叉熵的指数化结果。
每当神经网络进行训练,香农的公式都会在其中运行。
他还制造了第一台人工智能学习设备。
1950年,香农制造了 Theseus:一只通过反复试错在迷宫中导航的机械老鼠。它学会正确路径后,便能完美地重复这条路径。贝尔实验室的 Mazin Gilbert 说:“Theseus 启发了整个人工智能领域。”
同年,他发表了第一篇关于编程计算机下棋的论文,并共同组织了1956年的达特茅斯研讨会,这是人工智能作为一个领域诞生的标志性活动。
这个人还会一边在贝尔实验室的走廊里骑独轮车,一边抛接杂耍球。他制造过喷火小号、火箭动力飞盘,还做过泡沫塑料鞋,穿着它们在自家房后的湖面上行走。
他把自己的家称为“熵之家”(Entropy House)。
有人问他是什么驱动着自己,他回答:“我受到好奇心的驱动,从来不是为了经济利益。我只是想知道事物是如何组合起来的。”
1985年,他意外出现在布莱顿的一场会议上。人群蜂拥而至,请他签名。有人劝他在宴会上发言,他简短地说了几句,随后从口袋里掏出三个球,开始表演杂耍。
一位工程师说:“那就像牛顿突然出现在一场物理学会议上一样。”
2001年,他在与阿尔茨海默病抗争了十年后去世。定义了信息是什么的人,却眼睁睁看着信息一点点离开自己的头脑,这是一种残酷的讽刺。
人工智能模型 Claude 的名字,正是来自克劳德·香农。这位数学家为我们如今赖以生存的数字世界奠定了基础。

Grok 4.6 刚刚在 CursorBench 上拿下第一名。
不仅是最高分。
它的成本还只是紧随其后的那些模型的一小部分。
这种组合才是真正值得关注的信号。
顶级结果是一回事。
而能以足够低的成本,长时间运行代理式编程会话的顶级结果,则是另一回事。
我认为,这才是对实际工作真正重要的实用优势。
基准测试很有用。
真正会被使用的,是低成本下的持续性能。

Grok 4.6 现在开启“超高思考模式”后,在 CursorBench 上拿下第一名!
使用 Grok 就这么简单 @Bot
我让 Grok Bot 上线运行了24小时,给了它3项工作,也不再把人工智能当作聊天机器人。
我让它扫描实时的 X 和网页数据,寻找新兴的人工智能产品,研究人们对这些产品的真实看法,过滤掉明显的诱导互动内容,比较不同来源,再把最强的信号整理成结构化简报。
与此同时,我还可以让不同的研究路径分别去关注竞争对手、代码或市场机会,而不是把所有事情都强行塞进同一段对话。
这就是我之前低估的差别。我不想每隔5分钟就坐在聊天窗口里写另一个提示词。我想定义目标,让代理访问正确的工具和数据,看着它执行,然后在真正需要判断或批准时再介入。
旧工作流是:提示词 → 回答 → 复制 → 重复。
我正在转向的工作流是:分配 → 执行 → 验证。
当人工智能不再等待你的下一条消息时,它就不再像是你正在使用的软件,而更像是你委托出去的工作。
Grok Bot 可以通过链接复刻任何病毒式传播的视频 🤯
工作原理是:我向 @bot 发送一个 AI 视频片段的链接。
它会观看视频,并写出一条提示词来复刻视频(也可以加入我想要的任何改动)。
然后,它会使用 @imagine 生成新视频!我在地铁潮流上试了一下 👇
如果你是正在约会、并考虑认真对待一位女性的男人,先了解她在新冠疫情期间的表现,再听听她对 Lindsay Clancy 案的看法。
只是想帮你少受点苦 :)
我来概括一下全局:
自1964年以来,美国一直处于两部宪法之下。
《民权法案》最初是为了禁止种族隔离。后来,Griggs 案让群体结果不平等变成违法行为;Bakke 案以多元化为旗号,将种族偏好写入大学招生;《第七章》和平等就业机会委员会(EEOC)又发展成一套永久性的法律机制,只要数字看起来不均衡,就可以凌驾于私人合同、招聘决定和自由结社之上。
Christopher Caldwell 在《权利时代》(The Age of Entitlement)中的观点是:一部宪法保护个人自由,另一部则强制实现群体平等。
那么,具体而言,这种“平等”究竟是以学校、大学、企业和政府中的哪个群体为代价实现的?
为什么年轻男性正在退出劳动力市场?有没有办法让他们回来?@WSJFreeEx:
在巴黎杀害130人的巴塔克兰袭击者早已被认定为已知威胁,但欧洲当局仍然任由他们自由活动。
头目 Abdelhamid Abaaoud 曾被缺席判刑,并被发布国际逮捕令,但几个月内仍在叙利亚、希腊和西欧之间往来,没有被拦下。
Samy Amimour 曾因试图加入也门的圣战分子而受到正式司法监管,后来逃脱监管,前往叙利亚,返回法国,并参与实施了这场大屠杀。
另外两名袭击者持伪造的叙利亚护照,经希腊莱罗斯岛进入欧洲,走的是数十万名真正寻求庇护者使用的同一条移民路线。
法国自己的 Fiche S 恐怖主义观察名单将数千人标记为安全风险,其中包括几名与袭击者有关联的人,但这一标记不具备法律效力,因此他们仍然逍遥法外。
议会调查后来证实,每一个名字都早已在案。缺少的,是在屠杀开始前采取行动的意愿。
如果丹麦的左翼人士可以通过关闭边境来保护自己的福利国家,美国左翼人士为什么不行?
2015年德国敞开大门之际,Mette Frederiksen 政府却把丹麦变成了欧洲移民政策最严格的国家之一。
他们强制让来自非西方人口占多数社区的幼儿,从1岁起就在托儿所接受丹麦语和价值观教育。
丹麦成为第一个在欧洲以外处理庇护申请的欧盟国家,并开始在认定大马士革足够安全、可以返回后,取消叙利亚人的居留许可。
庇护申请量从2015年的2.1万多份降至不足2000份。
他们认定,没有融合的规模化移民会让这个由丹麦工人缴纳数十年资金建立起来的体系破产,于是关上了大门。
我怀疑美国左翼人士另有隐情。
刚收获一个冷知识,一些支付的地方只能绑信用卡,不能绑 U卡。(比如 X推广)
这种情况下 Google Wallet的虚拟卡功能就很好用了。
#风控
Amex在 Google Wallet上有一个虚拟卡功能特别好用。
需要在网上输入信用卡信息的时候,有个虚拟卡选项,直接调银行的 API,生成一张临时的虚拟卡。
在这个网站验证完成了之后,虚拟卡的 CVC就会自动失效。这样就不会泄露实体信用卡的信息。
同时由于已经验卡通过,以后在这个网站上购物也不受影响。
还有一些未验证的猜测:由于扣款商户信息一般都不会变更,所以可能只允许这张虚拟卡在初次绑定的商户消费。
如果发现来自不同商户的扣款,直接拒绝。
这样再不浪费卡号的基础上,实现了风险隔离,一矿一地址(一卡一商户)。
𝕏 上的喜剧是合法的
这是我第二次尝试 Grok Bot,还是觉得难以置信。
它接管了我整个增长引擎,把它拆成了 4 个自己的实例:一个负责内容,一个负责排期,一个监测互动,还有一个在最后把所有内容汇总成报告。
上面还有一个主编排器决定谁在什么时候做什么,而这一部分我真的没有设置过,它自己摸索出了分工。
我点击启动后就再也没碰过它。它只是沿着队列推进,只有真的需要我做“是”或“否”的决定时才来找我。
我总会忘记,这一切其实仍然只是 @grok。我眼前看到的 @xAI 和 @elonmusk 正在打造的东西,更像是一支已经打卡上岗、知道自己该做什么的团队,而不是一个等待指令的机器人。
本周最疯狂的事:我曾经让 @bot Grok Bot 看着我做一次费用报销。就一次。第二天,它已经把积压的报销处理完了。
它登录门户,把收据与明细项匹配起来,还标出了两个我本来会漏掉的重复项。整个过程我没有再碰它。
我没写脚本,也没搭工作流。它只是通过观察学会了这一切。太不可思议了!
现在,同一个线程里有三个 Bot 在运行:一个处理费用,一个给支持工单分流,一个起草跟进消息。它们彼此交接,只有真的需要我签字确认时才会出现。感觉就像在管理一支小团队。
看着这东西工作,@SpaceX 收购 @Cursor 突然就更说得通了。

大家都把 grok bot 当成了五名新员工。
更有意思的是,他们并不是五名彼此孤立的员工。
他们共享一个持久的云环境:相同的浏览器会话、终端、文件系统和已认证工具;同时,一名参谋长可以在他们之间分配工作,不必等你打开笔记本电脑。
这就把一次登录变成了基础设施。
一个研究机器人可以收集线索,把线索交给写作者,再把结果交给设计师,然后让运营机器人更新工作流;所有这些都在同一台持续运行的机器里完成。
好处显而易见:更少的复制粘贴、更少的交接,以及你睡觉时工作仍在继续。
其影响范围同样显而易见:
- 只认证整个智能体团队获准访问的服务
- 为每个机器人设定狭窄的职责描述,因为这份描述会成为它在组织架构中的位置
- 将不可逆操作置于人工审批之后:发送、发布、花钱和生产环境变更
- 把技能、配置和长期状态存放在 \`/workspace\` 中,因为更新期间虚拟机的其他部分可能会消失
- 把共享会话视为共享权限,而不是彼此独立的机器人身份
让 grok bot 变得有用的,正是那套让它在随意配置时变得危险的架构。
我的看法是:突破点不在于你可以雇佣五名 AI 员工,而在于他们可以在你的真实工具中像一家公司一样持续运作。你的工作也会从为每项任务编写提示词,转变为设计权限、边界和交接流程。
完整的参谋长配置、会话交接模型、审批矩阵和 \`/workspace\` 生存策略,都已经在文章中梳理好了 ↓
他是个天才。
见鬼?

林赛·克兰西审判案外,女性究竟在抗议什么?她们反对的压迫到底是什么?为什么有些女性会把自己拍成视频发到 TikTok 上,对着全世界发泄母亲身份带来的压力?
简而言之,美国女性到底怎么了?答案是:我们让几代女性相信,她们正是那些赋予她们以及男性意义与幸福的制度的受害者。
然后,我们又用社交媒体的传染效应和无休止的受害者心态取代了这些制度。
目标是让我们的客户在任何任务上都能获得市场最低价格,同时享有最高的能力上限。
随着我们继续推动能力边界并提升效率,未来 3 个月我们将把 GPT-5.6 Sol 的 API 和积分定价下调超过 20%。
罗马衰落的原因,是他们不再生育罗马人。
我们以为出生率下降是现代问题。其实并不是。世界上最有权势的人曾经面对过完全相同的事情,而且他为此十分震惊,甚至通过法律强迫自己的人民生育。
这并不是现代政府,而是 2000 年前的罗马……
那位皇帝是奥古斯都。在他的统治时期,罗马精英阶层已经变得富有、舒适,也不愿结婚或养育家庭。男人们更喜欢单身生活和婚外情,而不是承担妻子和孩子带来的负担。
奥古斯都认为这已经严重到必须立法干预。公元前 18 年左右以及公元 9 年,他先后推动通过《尤利娅法》和《帕皮娅·波培娅法》;这是一整套旨在通过法令制造婴儿潮的法律。
这些措施很直接:未婚男性和无子女夫妇在继承权上会受到惩罚;结婚并生育子女的人则会获得更快的晋升和公共荣誉。生育三个或以上子女的女性还会获得一项特殊的法律自由,即 ius trium liberorum(“三个孩子的权利”),从而不再受男性监护。
国家当时确实是在用金钱奖励公民生育,并在他们不生育时罚款。
但它没有奏效……
这些法律遭到怨恨、规避,并被反复修修补补;罗马精英仍然坚持只养育少数子女。历史学家卡西乌斯·狄奥记载,奥古斯都曾站在罗马那些没有子女的男性面前,当面羞辱他们:“你们一开始就不生育本应成为你们后代的人,这是在犯下谋杀罪。”他警告说,一座城市不是它的建筑,而是它的人民:“构成城市的是人,而不是没有人居住的房屋、柱廊或市场。”
现在看看今天的数字。要让人口简单维持稳定,女性平均每人需要生育约 2.1 个孩子。韩国最近降至 0.72,这是全世界有记录以来任何国家的最低水平;即使 2025 年小幅反弹至 0.8,仍不到一个国家维持自身人口所需水平的一半。意大利和日本约为 1.2,中国约为 1.0,西班牙约为 1.1。美国约为 1.6,英国为 1.5。…
据联合国统计,如今全球超过一半的国家都低于这条线。
俗话说,历史不会重演,但往往押着相似的韵脚;这个模式古老而又令人毛骨悚然地熟悉。一个社会的财富和舒适程度不断攀升,在达到顶峰时,人们却停止生育,任何法律、激励措施和金钱似乎都无法说服他们回心转意。
罗马曾经尝试过,背后有整个帝国的力量支持,但失败了。在鼎盛时期,这座城市拥有超过 100 万人口;此后 1700 年间,再没有欧洲城市达到这一规模,直到 19 世纪的伦敦出现。
罗马历史学家李维在共和国向帝国过渡之际写道,他所处的时代“既无法忍受自己的恶习,也无法忍受对恶习的救治”。两千年后,我们面对同一个问题,同样无力解决,或许正在见证同一个故事的开端……
一个文明并不总是败给城门外的敌人。正如历史学家阿诺德·J.·汤因比曾说:“文明死于自杀,而非谋杀。”

一级谋杀。
🚨 更新:爆出一批惊人短信后,卡梅洛·安东尼的法律团队陷入一片混乱。短信显示,他在杀害奥斯汀·梅特卡夫之前就曾幻想过谋杀。
“你想让多少颗子弹从你的胸口射出来?”
“我捅了人之后,要舔掉刀刃上的血。”
两小时前:“我暗暗觉得自己快撑不住了。” 🤯
彻底疯狂。
他就该被判死刑!
Grok Voice 排名第一
Grok Voice Think Fast 2.0 刚刚在 Artificial Analysis 新推出的 Speech Agent Arena 中,以最高任务成功率排名第 1。
这个基准测试真正衡量的是重要的东西:真人在实际场景中与隐藏的语音代理交互。任务成功率(Task Success Rate)追踪 AI 是否理解请求、调用正确工具并成功完成任务。
这不只是听起来是否自然,而是语音代理是否真的能把事情办成。Grok 最终排名第一。

美洲唯一的大规模锂电池正极材料生产基地
我们正在运营北美首座大规模正极材料生产设施,作为我们在德克萨斯州奥斯汀生产 4680 电芯的一部分。
该死,我那些真正有收入的 AI 创始人朋友,现在全都在转型成上面叠加增值服务的新型云服务商(neoclouds)。
有意思
我打算更经常地分享 VulcanBench 的排行榜。
据我所知,VulcanBench 是唯一一个能够跨不同投入程度进行基准测试的平台,评测套件中的任务 100% 都是真实工程任务。
我们正准备让评测套件 3 退役,而评测套件 4 也几乎准备就绪。
这是当前评测套件 3 的排行榜:Grok 4.5 High 得分最高,Fable 5 Low,没错,是 Low,紧随其后。
我通过 VulcanBench 发现,太多人用 Max effort 运行模型,以为这样能换来更高准确率,但实际上这只会花费更多、消耗更多 token(令牌),因此耗时更长。
如果你仍处于“告诉我的代理做点什么,然后去喝咖啡”的模式,那你可能还活在过去。你可以更快、更准确地推进工作,关键是不必始终使用 Max effort。
#Crypto
除了 Rain之外,有新玩家入场了。
外观致敬的是当年拯救宝马公司的1500系列——没有1500,就没有后来的宝马🐶 http://t.cn/AXpcQ1Dl //@詹志斌同学:这次我觉得真的挺好的就是外观争议比较大但是我是觉得很耐看//@无名少年曾阿牛:非常有辨识度的车,在千篇一律新能源电车,他绝对脱颖而出,
#2026成都车展#新世代 BMW IX3售价26.99万起,11月正式上市交付这车内饰牛逼,驾控牛逼,续航也牛逼,外观有争议, (50版113度大圆柱电池,续航超过850公里)
价格非常中国化了!


确实不是。
埃隆·马斯克:“庇护本来应该意味着,如果你回到自己的国家,就会被杀害。”
“[如今]庇护申请人会去他们申请庇护的那个国家度假……这说不通。”
当我告诉大家,我并没有挑选那些疯狂的论文和博士论文,然后不断发到 X 上时,我没有撒谎。
许多领域发表的典型论文都是旨在摧毁西方的活动家式词语沙拉。这不是夸张,而是一个明摆着的事实。
这是一场彻底的危机。
“出于好奇:我随机选了 5 所大学,查了查它们社会学系的教师。我随机选取了这些教师写的论文。哇,结果让我大吃一惊。至少 60% 都是类似的胡言乱语。不断出现带有政治色彩的断言,却没有任何底层数据。反殖民主义:一切事情不知怎么都成了种族不公和殖民主义的遗产。算了,根本没有实际数据支持这种说法。气候灾难、移民不公……这个系看起来就像民主党智库。” @VPrasadMDMPH
本周 ChatGPT 功能更新 - 8 月 21 日:
又一个星期五,又到了盘点本周发布内容的时候:
1/ 最近照片:在 iOS 上长按“+”菜单即可快速附加最近照片——这是一个很有趣的高级用户功能。设计非常漂亮!也是一个实用的快捷方式。
2/ 时间:我们让 ChatGPT 更好地理解你当前的时间。由于一些有趣而复杂的原因,它之前在这方面出奇地糟糕。现在好多了!
3/ 长对话加载:在 http://chatgpt.com 上,长对话的加载和运行速度更快了。少等一点,体验就更好。
4/ “无网络”错误:等待网络连接时,我们会在界面中显示更清晰的状态更新。ChatGPT 超时真的很令人沮丧。现在至少在问题确实出在网络时,你能知道原因了。
感谢每周持续交付的团队,希望大家都喜欢 🚀
没有95%,但是60%也很高了 http://t.cn/AXpcY0jq
网友:法兰西迎来了全民搭伙时代,95%孩子已经不结婚伙伴生的,一辈子只搭伙。
这其实是对极端不合理的婚姻法的用脚投票。法国婚内女方无论白的生下孩子黑的,也必须按亲生子女对待,不允许亲子鉴定,也不承认亲子鉴定优先。而且如果女方没有工作,离婚男的必须养女的到对方再结婚,哪怕她早就和别人一起生活生几个孩子。
这就是为什么欧洲求婚女方很开心,那真的是终生饭票。
这种情况下其实变成一个没有人要的婚姻法,变成事实上搭伙制婚姻法了。

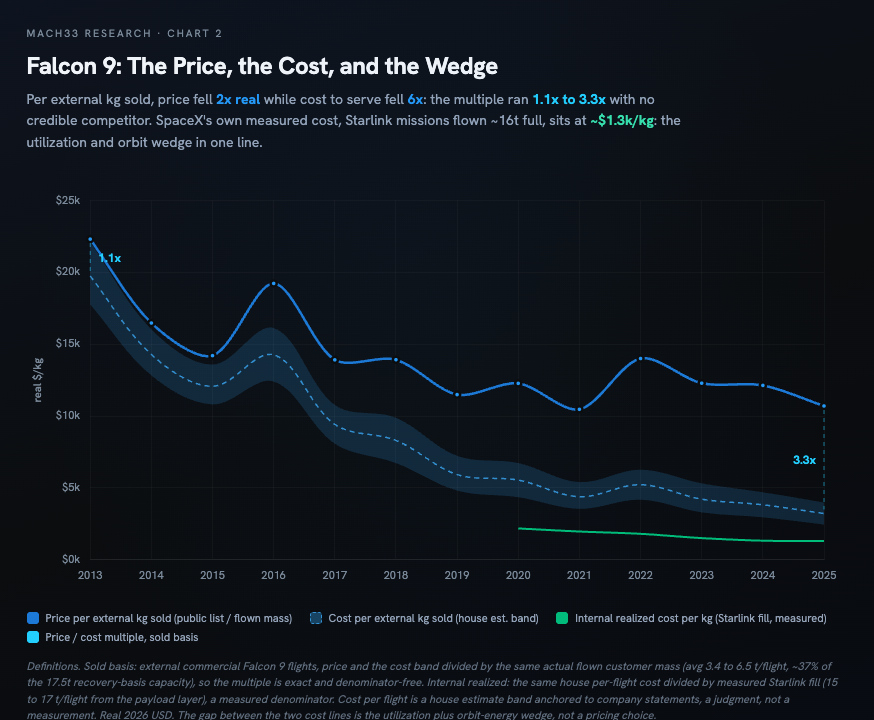
Falcon 9 多年来的定价一直约为 7000 万美元,导致很多人以为市场价格一直没有变化。
这是按通胀调整后的情况。
Falcon 9 客户发射业务的利润率从 2013 年的约盈亏平衡点一路升至如今的价格。按照我们的估算,如今价格已达到内部成本的 3.3 倍。这意味着利润率约为 70%。
(绿色线是 Starlink 的内部成本,因为他们能更接近于填满有效载荷容量,所以成本更低!)
把这些动态与 Starship 即将问世后的市场价格对应起来,会很有意思……
悲观主义听起来很聪明,但乐观主义能把改变生活的技术变成现实,从而赚到钱。
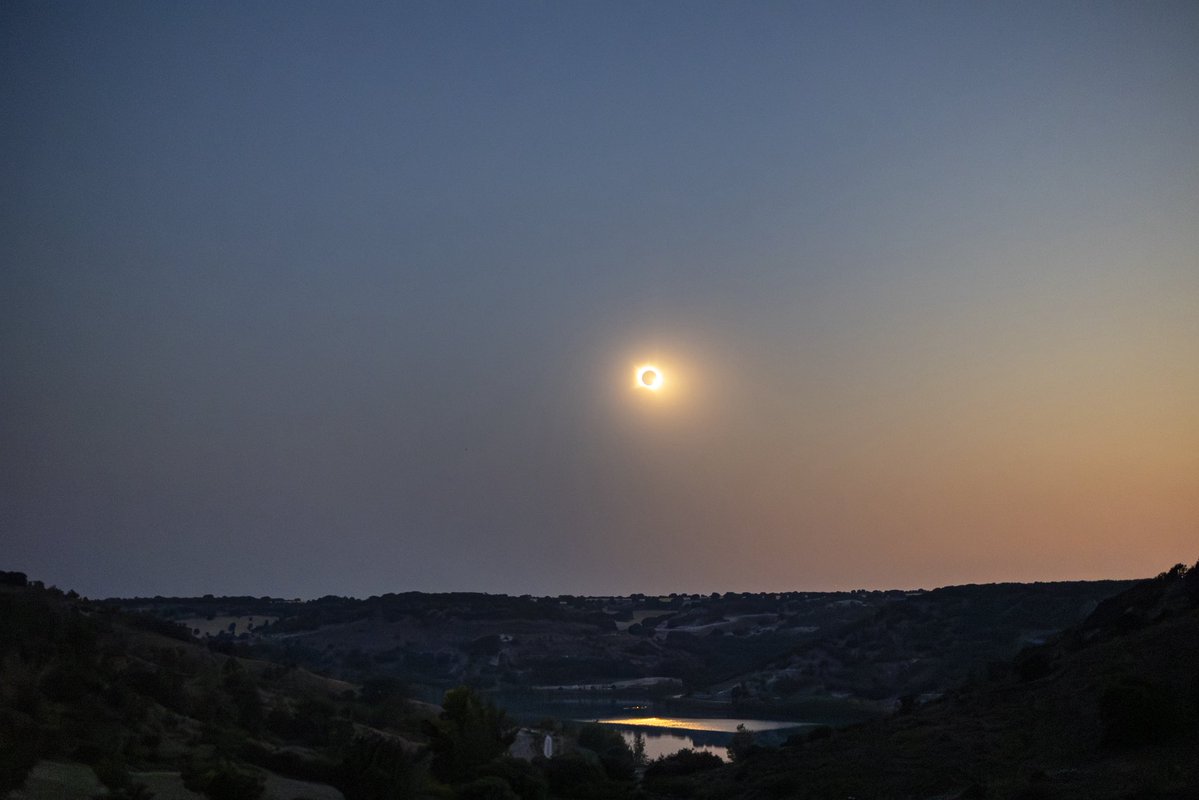
Starlink 正在日食期间提供远程连接和实时直播。🛰️❤️
幕后英雄是 @Starlink:它为我们整个团队提供了互联网,还让 @MatthewCappucci 能在荒无人烟的地方进行电视直播。📡
注意看天线上的小月牙形太阳,那是 iPhone 镜头折射造成的!

#涨姿势# //@运动康复陈老师:周五了,转一波长播客——为什么现代人越来越容易腰痛,从生理到心理情绪,多方面去看待👇🏻👇🏻
#为什么中国人总腰痛# 你有没有发现,身边几乎人人都在喊腰痛?上班族、宝妈,甚至学生,腰都在提前 “报废”[生病]但你知道吗?腰痛不只和姿势、肌肉有关,还藏着很多想不到的关联 ——
焦虑情绪会加重腰痛?性格内向的 i人痛感更强?甚至连你晕车晕船,都和腰痛根源相通?
今天这条长视频,我们从康复视角深度拆解,带你找到真正的腰痛根源,走出康复误区😏😏 #运动康复# #健闻登顶计划#
这个车的动能回收说是做了一套特别复杂的系统
全新 iX3不动声色的搞了一次续航实验:从沈阳工厂出发到北京研发中心,全程 1030.2公里,一箱电跑完,还剩 5% 电量。
iX3上的 4695大圆柱电池包,总容量为 115kWh,可用容量 108.7kWh,算下来,整个旅程平均电耗在 9.8kWh/100公里左右。
虽说这是一个经过规划验证后的路线,并在当时特定天气状况下跑出的结果,但对比 CLTC 919公里的续航里程来看,iX3效率能力所言不虚。我准备等它有试驾车了试试看,我这种废物右脚到底能跑出多少来。😂😂😂
#别不正经说车##宝马💬##宝马# #智能驾趣宝马新世代#


这是一个有意思的 Skill,叫 ELI5,意思是就好比你给 5 岁孩子解释这件事,所以要通俗易懂。生成结果是 HTML 页面。
其实如果你不经常用,没必要安装这个 Skill,这个 Skill 里面也就是一句提示词而已。
提示词(https://github.com/anthropics/claude-plugins-community/blob/main/eli5/skills/eli5/SKILL.md):请把我当成对这个话题一无所知的人,用一个包含大图且文字较少的 HTML 组件来向我解释。
Anthropic 最近经常使用的一个 skill:ELI5
/eli5 <你想让人解释的内容>
“请把我当成对这个话题一无所知的人,使用包含大图和少量文字的 HTML 组件来向我解释。”
【深度解析】谁能主宰商业航天的未来?#朱雀三号# 是这么回答的!
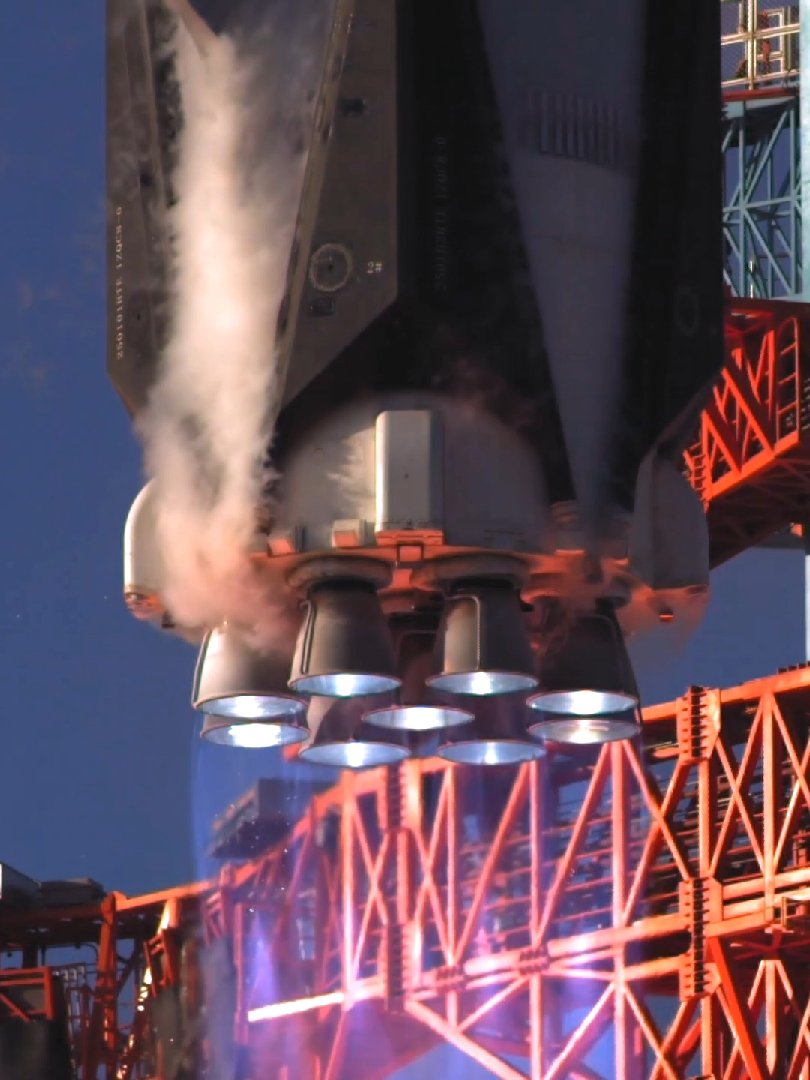
超级慢放!看朱雀三号遥二火箭尾焰!
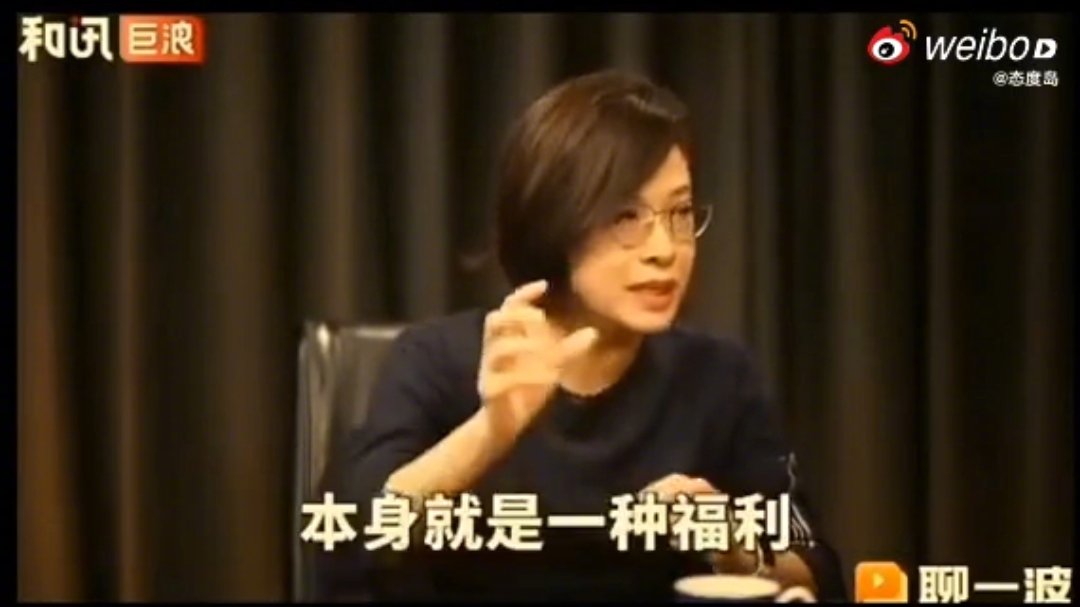
看了下原视频,原话“灵活是一种福利”,这和“灵活就业是一种福利”是不是还是有点差别啊? //@屠龙的胭脂井:这就是我说,为什么家境普通的小孩,如果特别优秀,能考好大学,千万不要学社科文科!!你相当于超高智商的一个人交钱花四年青春吃屎,什么都学不到[跪了]。你辛辛苦苦读了这么多年,好不容易上了清华北大,老师是劳东燕,赵宏,张丹丹【当然她们几个是女的,喜欢出头,还有一大堆蔫坏的男的水平也很差】。这种吃屎的机会,你留给权贵家孩子就行。
发一下北大教授张丹丹的原视频吧,免得有人说断章取义,反正从视频上看,当北大教授张丹丹说出“灵活就业本身就是一种福利”时,她旁边的两个专家的表情应该是懵了……#北大教授称灵活就业是福利#
我知道这已经被说过很多次了……但我第一次在航班上用到 Starlink,哇。那种类似 Apple 的时刻:技术就是能“直接正常工作”。很难想象人们试过之后还会回头。
//@牛叔:阿里的大方向上确实没错,慢慢就跑出来了。
从财报里聊聊阿里全栈AI
2013年我去参加阿里云的活动,那时还不叫云栖大会,而是以开发者和项目方为主,大棚下面吃盒饭,阿里云的体系也才刚有雏形;但如今,阿里云没有固守传统云第一的位置,反而是更阔步地建设全栈AI体系。
而最新阿里巴巴的2027财年Q1财报显示,全栈AI的成效,也开始显现。阿里云外部商业化收入增速提升至45%,比亚马逊高,全球云厂商里第二快;而且指引中认为还会提速。AI相关产品收入已连续12个季度实现三位数同比增长,年化AI产品收入超过495亿元人民币,接近73亿美元。
这个增速是如何实现的?以及全栈AI会持续带来什么惊喜?今天就通过阿里的财报做个分析。
1、阿里云的AI加速
中国有句老话是“观其言察其行”,这对于变革中的公司非常适用,观察阿里云的AI加速也很有用。
在2025年八月的财报中,阿里巴巴对其自身的描述发生了一些变化,突出“聚焦电商和云计算的全球科技公司”;一年后,这个描述中又突出了AI。
聚焦到阿里云,描述的变化则更早。在2023年底,吴泳铭便提出了AI驱动、公共云优先的口号,而且也坚信,公共云优先,可以在未来收获规模效应和技术红利。
动作上也如此践行。
组织层面不断优化,成立ATH部门,加速AI商业化;财报结构方面,也将电商全部并成一个集团(含盒马和菜鸟部分商业);平头哥并入云,合成"AI云与算力服务";模型实验室、千问事业部、千问办公从 All Others里抠出来,独立成"AI实验室与应用"。
AI的重要性可见一斑。
而且也在大手笔投资。2025年公司制定了三年3800亿的资本开支计划,17个月就投了1900亿。并且表示,希望今年的投入建设还是维持在更积极的态度上。
国内同行也都在加大资本开支力度。…
腾讯2026年二季度资本开支527亿元,同比 +176%,占当季收入25.8%,为历史新高;百度核心资本开支114亿元,同比+201%,资本支出率45%。
中国三大云厂商都陆续将capex拉到了历史最高。毕竟,目前的算力资源依然是稀缺的;而当AI应用爆发、更深一步进入生活、工作中后,也是显著紧缺的。
对于资本开支,不少投资人的锚定开始模糊了。甚至出现了不花钱,觉得AI战略落后;花钱又觉得AI战略激进。
但从科技发展的历史来看,企业家的判断,大多数情况是正确的。就像当年英伟达坚持在毛利率受损的情况下,投资CUDA建设;彼时也是被投资人百般否定、指责;但坚持到如今,给英伟达带来的收入和优势、甚至给AI发展带来的促进,都是巨大的。
再来看组数据,我让千问办公做了一份关于Capex强度的统计,也就是每1美元收入对应多少资本开支。和美国同行2026指引相比(微软150%、亚马逊130%、谷歌250%),阿里云的Capex强度为140%,仍处于合理区间,稳步推进。
相反是谷歌,作为全栈AI的典范,依然在加大资本开支。所以,对于花钱这事儿,不用担心不可控。
核心问题是,钱花得值不值,或者说,全栈AI到底有哪些好处?
2、全栈AI和谷歌云的对比
聊到全栈AI,市场会有对比,都说是全栈,那为什么就谷歌云的收入利润那么好看呢?实际上,不是全栈AI不行,而是所处的阶段不一样。
谷歌云也经历了爬坡期。2015年TPU正式部署,2018年Cloud TPU向外部客户销售,而2023年才开始盈利转正;但随后的利润改善是非常显著的。
利润改善的原因,既包括AI爆发的长期产业趋势,也包括AI算力资源紧缺带来的提价效应,以及全栈AI云自身的护城河,包括学习曲线和规模效应。
规模效应,是显而易见的,可以平摊固定成本。学习曲线则包括自研芯片经验丰富后的性价比提升,以及软硬件一体的工程优化。
另外,服务器的折旧摊销,也是市场的争议点。阿里高管认为“服务器通常3年实现盈亏平衡,但往往能使用5年以上,至少2年会有FCF为正”。
我基本认可这个判断。AI基础设施不是“买新机器、旧机器报废”这么简单。
一方面,海外高端显卡仍供不应求,国内模型公司的Scaling Law也远未到天花板,所以高端服务器经济性依然拉满,买到就是赚到;另一方面,可预期的几年内,Token需求增长仍是非常快的,从而令旧算力的经济寿命也被拉长。
所以目前的商业模式是:新算力负责最前沿的工作负载,旧算力逐步下沉到成本更敏感、性能要求更低的推理任务,整个算力池不断分层复用。
即使是高端显卡不设防的美国云厂商,例如亚马逊等,也认可提高旧算力的经济价值。
目前,阿里云收入增长持续加速,盈利质量与经营杠杆推动EBITA利润率提升至了11.6%。对照谷歌云的曾长曲线来看,阿里目前的12%,大致相当于谷歌2023年底到 2024年的位置,也就是首次盈利之后的利润率爬坡初期。
对于未来,阿里管理层表示,"20%以上有很强可见性"。我觉得,和海外云厂商的竞争格局相比,国内竞争更加激烈,下游客户付费能力也不如海外,所以,国内云服务的利润率天花板会更低,达不到谷歌的30%+。
但是,如果实现从12%到20%的改善,也依然很香了。实现路径包括:等待新增的服务器折旧摊销完成(近期依然有增加压力)、规模效应、学习效应的体现,以及很重要的千问AI等业务的发力。
3、全栈的完善和收获
自研芯片是全栈AI的硬实力。
阿里自研芯片平头哥,最初被大家认识是因为平头哥这只动物,生性凶猛,不畏挑战。这一次,则是被作为阿里全栈AI的重要亮点被展示。
阿里高管表示,平头哥的上一代芯片已经出货超过50万片,同时能够非常好地支持训练和推理的工作负载。而且阿里云真武M890超节点,可以高效运行超过2万亿参数的大模型推理,Kimi K3和千问3.8-Max均已通过该超节点实例对外提供MaaS服务。
竞争对手的旗舰模型,跑在阿里的国产自研芯片上,对外提供服务。这句话同时验证了三件事:真武M890不是内部自用的样品;月之暗面愿意把旗舰模型的商业推理托管在阿里的国产算力上;以及阿里在扮演中立基础设施,而不只是自家模型的载体。
截止8月初,真武芯片已经服务了超过650家客户,覆盖20多个行业。而且第二代芯片今年下半年开始会逐渐流片和产出。终于,自研芯片开始直接贡献收入了。
模型也是全栈体系的重要一环。
这个领域最重要的一个信息是“托管开源免费的三方模型和托管自研模型毛利是相差不大的”。这反映了阿里云开放、生态的战略。
因为客户要的是把事情做好、以及成本控制好,必然会有多模型的需求。靠单一大厂,也很难把所有领域的模型都做到最强,也把所有模型的成本都控到最低。所以,非常有必要提供第三方模型。
可是,如果托管别人的免费开源模型和托管千问一样赚钱,那千问的巨额训练投入,在 MaaS业务上的商业回报是什么?
吴泳铭的回答是:自研模型更多是为了长期追求在模型智能水平上的提升和通用人工智能突破。这是比较实诚的回答,模型的价值在于算力定价的锚,以及一个长期的通用人工智能期权。
最后聊下千问AI。
2025年9月,千问App上线公测;一年后,千问办公(QwenWork)正式发布,并在华尔街投行杰富瑞分析师的评测中获得综合得分第一;至此,覆盖C、B端的AI应用布局成型。
谷歌云的高利润率里,就有一块来自于Workspace这个纯SaaS层。我觉得千问办公就是阿里试图补上这一层的产品。
AI办公也已经是显学了,有需求、有付费力,场景清晰、模型能力也更容易规划。
当年谷歌靠Gmail的免费用户向企业版转化,走了十年;但阿里的路径可以更短。因为千问办公在分发上,与阿里云和钉钉生态深度集成,成为触达阿里巴巴庞大企业用户群和既有办公工作流的天然入口。速度更快、营销成本也更低。
同时,千问APP用户规模持续保持稳定增长,并正在增加多元化的付费增值服务。
从财务角度看,AI实验室与应用分部收入为34亿,经调整EBITA亏损138.61亿,去年同期亏32.24亿。虽然亏损在加大,但这是为了补足战略板块必须付出的投资,而不是代价。
更大视角看,目前包括MaaS在内的模型与应用服务ARR已突破160亿元人民币。AI相关产品,已经连续十二个季度三位数同比增长。而且,下个季度AI产品年化收入"将接近100亿美元"。这是阿里首次为单项业务给出下季度指引,其信心和决心也可见一斑。
4、结尾
整体来看,阿里财报可以看作是一次公开的自我重新分类。支撑它的,是三件已经发生的事:
云的收入增速和利润率第一次同时抬升;自研芯片开始承载包括竞争对手在内的商业推理负载;以及AI产品年化收入不断增加,管理层第一次为单项业务给出了下个季度的指引。
这就是全栈AI的部分果实;而接下来还会看到更多。回顾我2013年参会、以及看到这份财报的感受就是,这一次阿里押注的力度,比2013年大得多。
http://t.cn/AXp5jebg
SpaceX 的 AI 员工刚刚为 GROK BOT 发布了音乐,让它发挥出最大潜力。
我自己已经试过了,效果惊人。下面是清单:
- 在返回任何内容前增加一次自检。要求代理在最终确定前,依据原始指令核对自己的输出:“这真的满足每一项要求吗?如果没有,列出缺少的内容。”这一个额外步骤,比修改提示词措辞更能捕获错误。
- 明确定义“完成”(DONE)。“管理我的开支”会得到模糊输出;“标记每笔超过 200 美元且没有匹配收据的交易,并以表格格式输出”会得到精确输出。代理不擅长猜测,但擅长执行。
- 强制使用结构化输出。要求 JSON 或固定表格格式,而不是自由文本。结构化输出可验证,自由文本无论怎样都只是听起来很自信。
- 按任务而不是全局授予工具访问权限。一个“以防万一”拥有所有内容读取权限的代理,做出的决定会比只拥有这个具体任务所需 2 个工具的代理更糟。权限越少,输出越精准。
你现在实际上在做其中哪一项?
//@nyouyou:中后段让我想起Catch me if you can (是不是叫《猫鼠游戏》?),不是情节相似,而是那种一环扣一环地“我预判了你的预判”😄//@朱一龙:#空枪真疯遇劲敌# 交锋,那就以疯对疯。#电影空枪入戏指南##电影空枪#
#空枪真疯遇劲敌# 相对,那就针锋相对。#电影空枪入戏指南##电影空枪#
情况就是这么糟糕。
我的天。我一直以来都被严重误导了,对布尔什维克主义的了解完全不对。
刺激啊……

是的
Elon Musk 给每一位 Tesla 员工发了一份备忘录,削弱了管理者的权力,并把权力交还给员工。
他从不要求加班。每条规则都让决策更靠近实际执行工作的人。
Musk:“过多的会议是大公司的祸根,而且几乎总会随着时间推移变得更糟。”
公司会给每个制定流程的人安排角色,却不给任何取消流程的人安排角色。会议和审批链之所以能存续,是因为从来没有谁负责取消它们。
Musk:“一旦明显看出你没有创造价值,就离开会议,或者退出通话。”
参加会议一直被视为投入的证明。他让这种证明变得毫无意义,会议室里唯一重要的变成了贡献。
Musk:“离开并不失礼,要求别人留下来浪费时间才失礼。”
通常的礼节保护的是召集会议的人。他把这种保护转给了其他安静坐着、手头还有真正工作要做的人。
Musk:“在 Tesla 不要用缩写或毫无意义的词来称呼对象、软件或流程。任何需要解释的东西都会妨碍沟通。”
内部术语把知识转化为地位,并向每个新来者收取参与费用。
一家说话直白的公司,能够全速吸纳人才。
Musk:“沟通应该沿着完成工作所必需的最短路径传递,而不是沿着指挥链传递。”
大多数好想法在传递途中就夭折了,卡在离拥有行动权的人还有三层的位置。
Musk:“任何试图强制通过指挥链沟通的管理者,很快就会发现自己只能去别处工作。”
整份备忘录里唯一的威胁。一个坚持让沟通层层转递的管理者,是在用所有人的时间购买自己的存在价值。Musk 给这件事标了价。
Musk:“始终以常识为准。如果在某种具体情形下,遵守公司规则显然很荒谬,那就应该修改规则。”
遵守糟糕的规则通常能为你提供掩护。运用判断力反而会让你暴露在风险中。
他颠倒了两者的风险归属,此后每条规则都必须在面对执行它的人时证明自己值得保留。
每个机构都会逐渐偏向保护自身的舒适区。那些持续建设的机构,靠的是一群把规则重新改写到单个人也能执行的程度的人维系。
清单上的任何一项都不需要预算、人员编制或头衔。
你现在坐在哪里,都可以执行整份备忘录。大多数人从未验证过它,也从未知道它一直都被允许。
Grok Bot 已扩展到更多套餐,现在可以免费试用
http://x.ai/bot
我们正在让 Grok Bot 向更多人开放。
所有 SuperGrok Plus、Cursor Pro+ 和 Cursor Teams 订阅用户现在都可以使用。
我们还为其他所有用户提供限量使用的免费试用。
我们刚刚推出了 𝕏 Ads MCP,让你可以直接在你已经使用智能体的地方创建广告。
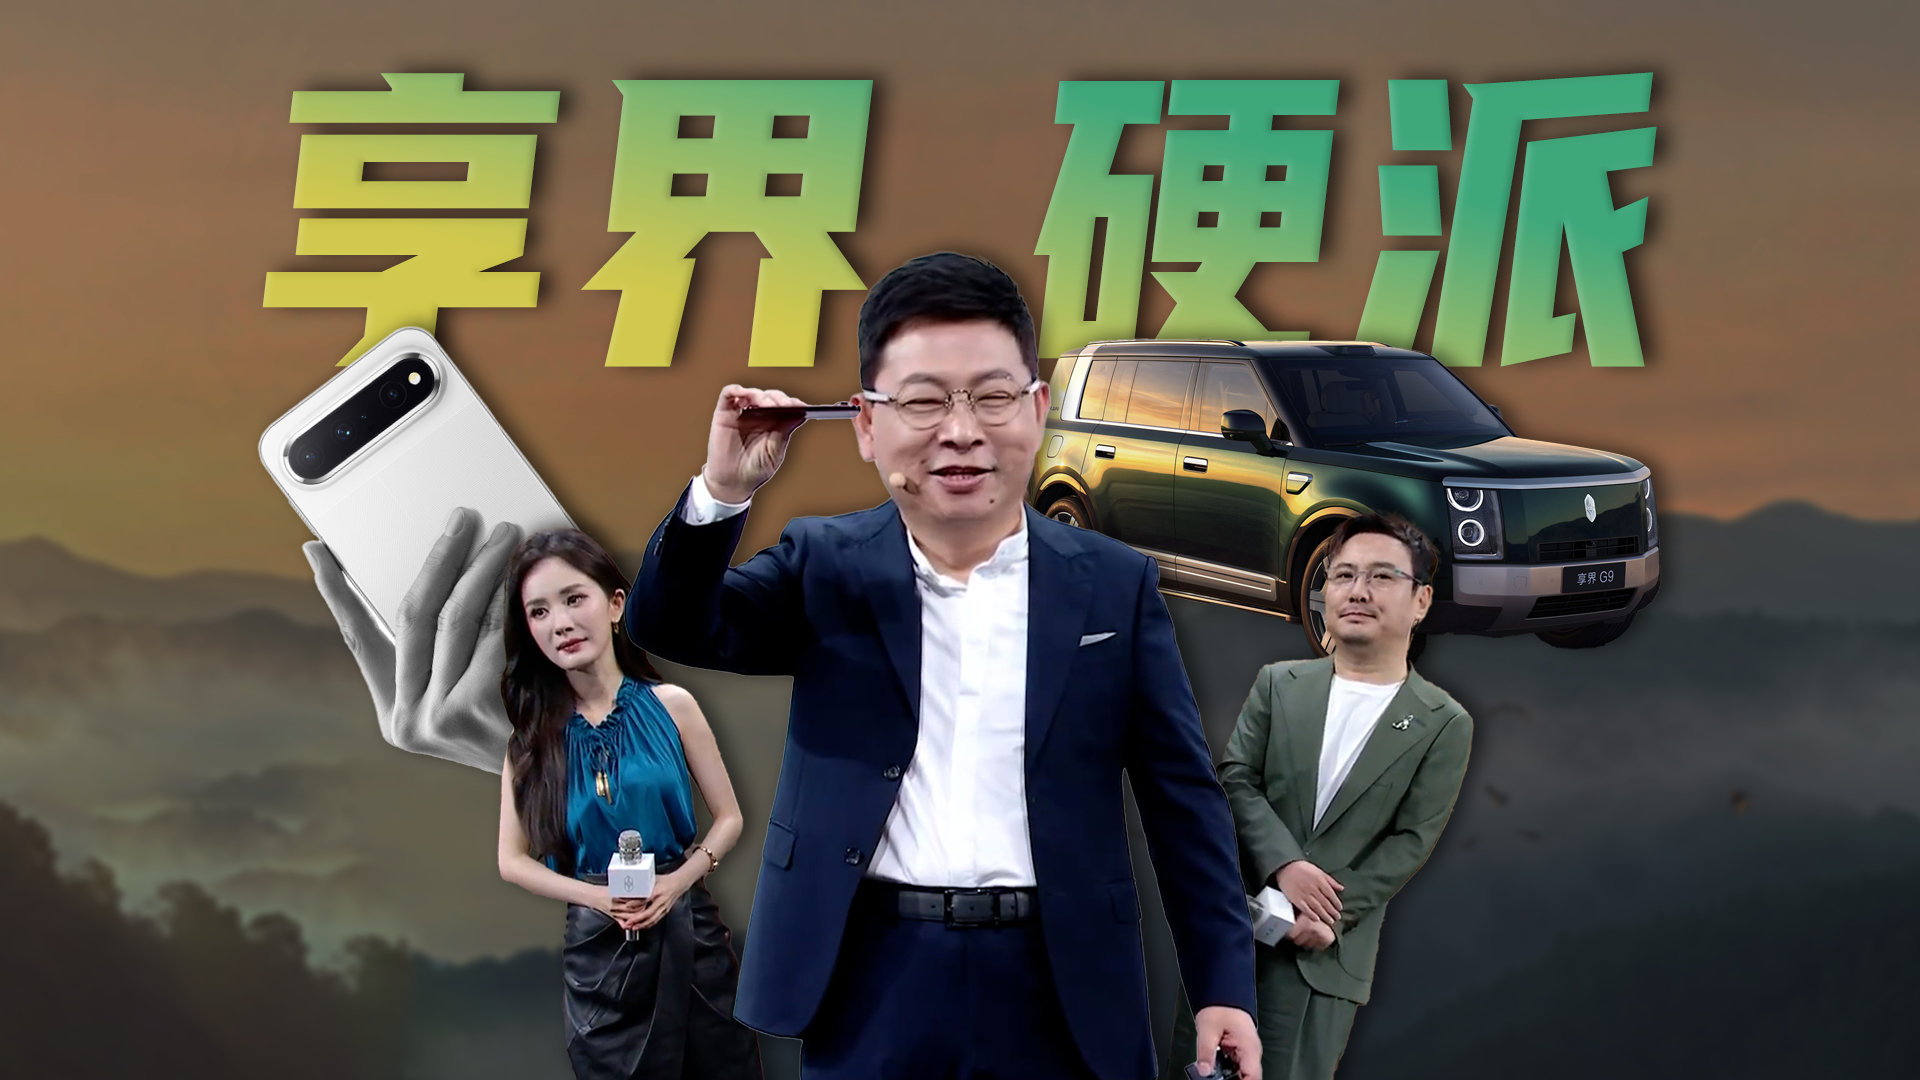
#趣看发布会#余总再喊遥遥领先!享界G9、阔直板手机及鸿蒙智行新品发布会总结。
#专业视频创作季#
为了最大限度地发挥 Grok 4.6 的作用,可以通过 Grok Build harness 或 Cursor 应用来使用它:
http://X.ai/build
突发:Grok 4.6 刚刚登上 CursorBench 3.2 第一名,同时展现出巨大的效率优势。⚡💻
• Grok 4.6 Extra High:70.8% | 每项任务 2.81 美元
• Fable 5 Max:70.5% | 每项任务 17.32 美元
• Opus 5 Max:70.0% | 每项任务 8.23 美元
• GPT-5.6 Sol Max:67.2% | 每项任务 5.69 美元
Grok 取得了最高分,而每项任务的成本约为 Fable 5 Max 的六分之一、Opus 5 Max 的近三分之一。
对于 AI 智能体来说,原始智能只是等式的一部分。在长期编码任务中保持高性能,同时不消耗海量算力,可能会成为一项重大优势。
Grok 的智能体编码效率正变得令人印象深刻。🚀

【#多家车企启动召回##多家车企因门把手安全隐患召回#】8月21日,据市场监管总局官网,特斯拉、小鹏、吉利、零跑、奇瑞、东风、北汽蓝谷、一汽、小米等多家车企向国家市场监督管理总局备案了召回计划,均涉及车内应急机械拉手。
上述车企表示,由于车内应急机械拉手与内饰颜色接近,不易识别和操作。当发生严重碰撞导致整车低压系统失效等极端情形时,可能影响驾乘人员快速开启车门逃生和车外人员救援,存在安全隐患。
特斯拉:
召回编号S2026M0098V:自2026年9月25日起,召回2019年3月4日至2026年4月29日期间生产的部分国产Model 3电动汽车,共计973156辆;2020年11月16日至2026年4月30日期间生产的部分国产Model Y电动汽车,共计1956713辆。
召回编号S2026M0099V:自2026年9月25日起,召回2018年8月22日至2019年11月20日期间生产的部分进口Model 3电动汽车,共计35590辆;2022年10月27日至2026年2月13日期间生产的部分进口Model X电动汽车,共计8328辆;2023年1月18日至2026年2月10日期间生产的部分进口Model S电动汽车,共计2123辆。
本次召回范围内的车辆,由于车内应急机械拉手与内饰颜色接近,不易识别和操作。当发生严重碰撞导致整车低压系统失效等极端情形时,可能影响驾乘人员快速开启车门逃生和车外人员救援,存在安全隐患。
特斯拉(上海)有限公司、特斯拉汽车(北京)有限公司将免费为召回范围内的车辆加贴警示标识;并通过汽车远程升级(OTA)技术升级车窗控制软件,增加事故后降窗策略,以降低安全隐患。因部分车辆已配备警示标识,本次召回此部分车辆无需再次加贴。
零跑:…
召回编号S2026M0100V:自即日起,召回2022年8月7日至2025年11月29日期间生产的部分C01汽车,共计48625辆;2021年9月20日至2026年4月21日期间生产的部分C11汽车,共计322575辆。
本次召回范围内的车辆,由于车内应急机械拉手与内饰颜色接近,不易识别和操作。当发生严重碰撞导致整车低压系统失效等极端情形时,可能影响驾乘人员快速开启车门逃生,存在安全隐患。
零跑汽车有限公司将免费为召回范围内的车辆在车内应急机械拉手位置加贴警示标识;并通过汽车远程升级(OTA)技术升级车窗控制软件,增加事故后降窗策略,以降低安全隐患。
小鹏:
召回编号S2026M0101V:自2026年8月22日起,召回2023年4月7日至2025年12月22日期间生产的部分小鹏G6汽车,共计134588辆;2024年7月23日至2025年12月10日期间生产的部分小鹏P7+汽车,共计94688辆;2023年8月8日至2025年9月26日期间生产的部分小鹏X9汽车,共计35566辆。
本次召回范围内的车辆,由于车内应急机械拉手与内饰颜色接近,不易识别和操作。当发生严重碰撞导致整车低压系统失效等极端情形时,可能影响驾乘人员快速开启车门逃生,存在安全隐患。
肇庆小鹏新能源投资有限公司将免费为召回范围内的车辆在车内应急机械拉手位置加贴警示标识,以降低安全隐患。
吉利:
召回编号S2026M0102V:自2026年8月24日起,召回2023年3月1日至2026年5月21日期间生产的部分极氪007和极氪X汽车,共计92658辆。
本次召回范围内的车辆,由于车内应急机械拉手与内饰颜色接近,不易识别和操作。当发生严重碰撞导致整车低压系统失效等极端情形时,可能影响驾乘人员快速开启车门逃生和车外人员救援,存在安全隐患。
浙江吉利汽车有限公司将授权、委托浙江极氪智能科技有限公司免费为召回范围内的车辆加贴警示标识;并通过汽车远程升级(OTA)技术升级车窗控制软件,增加事故后降窗策略,以降低安全隐患。
奇瑞:
召回编号S2026M0103V:自2026年9月18日起,召回2023年10月11日至2025年2月27日期间生产的iCAR 03汽车,共计57688辆;2025年5月23日至2026年3月15日期间生产的风云X3汽车,共计10800辆。
本次召回范围内的车辆,由于车内应急机械拉手盖板与内饰颜色接近,不易识别和操作。当发生严重碰撞导致整车低压系统失效等极端情形时,可能影响驾乘人员快速开启车门逃生,存在安全隐患。
奇瑞新能源汽车股份有限公司将免费为召回范围内的车辆在车内应急机械拉手下方加贴警示标识,并更换改进后的车内应急机械拉手盖板,以降低安全隐患。
东风:
召回编号S2026M0105V:自即日起,召回2025年3月4日至2026年4月16日期间生产的部分纳米06、风神L8、eπ007、eπ008汽车,共计53452辆。
本次召回范围内的车辆,由于车内应急机械拉手与内饰颜色接近,不易识别和操作。当发生严重碰撞导致整车低压系统失效等极端情形时,可能影响驾乘人员快速开启车门逃生,存在安全隐患。
东风汽车集团有限公司将免费为召回范围内的车辆在车内应急机械拉手位置加贴警示标识;并通过汽车远程升级(OTA)技术为纳米06、风神L8汽车升级车窗控制软件,增加事故后降窗策略,以降低安全隐患。
北汽蓝谷:
召回编号S2026M0104V:自2026年8月22日起,召回2023年8月17日至2026年7月31日期间生产的极狐考拉纯电动汽车,共计46850辆。
本次召回范围内的车辆,因右后侧滑动门内部应急机械拉手开启盖板缺少专用文字提示标识,可识别性较差,极端情形下可能影响右后侧滑动门快速开启,存在安全隐患。
北汽蓝谷麦格纳汽车有限公司将免费为召回范围内的车辆更换带有文字提示标识的应急机械拉手开启盖板,并通过汽车远程升级(OTA)技术,免费为召回范围内的车辆升级软件,增加严重碰撞事故后降窗策略,以降低安全隐患。
一汽:
召回编号S2026M0106V:自即日起,召回2024年1月11日至2026年3月30日期间生产的部分EH7汽车,共计7873辆;2024年4月29日至2026年1月23日期间生产的部分天工08汽车,共计4035辆。
本次召回范围内的车辆,由于车内应急机械拉手与内饰颜色接近,不易识别和操作。当发生严重碰撞导致整车低压系统失效等极端情形时,可能影响驾乘人员快速开启车门逃生,存在安全隐患。
中国第一汽车股份有限公司将免费为召回范围内的车辆在车内应急机械拉手位置加贴警示标识,以降低安全隐患。
小米:
一、召回编号S2026M0096V:自即日起,召回2024年8月8日至2026年3月4日生产的部分2024款小米SU7系列纯电动汽车,共计339069台。
二、召回编号S2026M0097V:自即日起,召回2023年12月27日至2024年8月16日生产的部分2024款小米SU7系列纯电动汽车,共计51366台。
本次召回范围内的车辆,由于车内应急机械拉手与内饰颜色接近,不易识别和操作。当发生严重碰撞导致整车低压系统失效等极端情形时,可能影响驾乘人员快速开启车门逃生和车外人员救援,存在安全隐患。
小米汽车科技有限公司将免费为召回范围内的车辆在车内应急机械拉手处加贴警示标识;并通过汽车远程升级(OTA)技术升级软件,优化中控解锁逻辑及降窗策略,以降低安全隐患。因部分车辆已加贴警示标识,本次召回此部分车辆无需再次加贴。(澎湃新闻)

“几乎在所有可能的方面都突破了极限。”
@ServeTheHome 深入解析 AMD Instinct MI455X 和 CDNA 5,探讨支撑 Instinct 加速器下一时代的内存、带宽、封装和机架级进展。🚀 https://www.servethehome.com/amd-instinct-mi455x-deep-dive-cdna-5-marks-the-next-era-of-instinct/
如果全世界都反对真相,那我就反对全世界。说谎的嘴唇是上帝所憎恶的!我宁愿遭到社会抵制,也不愿被基督拒绝。
用你的 AI 管理 𝕏 广告!
𝕏 Ads 刚刚实现了智能体原生化……这是一次非常强大的升级。
借助全新的 𝕏 Ads MCP,你现在可以将 Grok、Grok Build、Claude Code 或其他 AI 智能体直接连接到你的 𝕏 Ads 账户,通过普通对话管理广告活动。
你甚至可以直接问:“我的广告表现如何?”
智能体会调取真实的广告活动数据,分析结果,并告诉你哪些有效。
但它能做的远不止分析。
AI 可以:
• 创建和管理广告活动
• 搜索用于定向的兴趣和地点
• 添加或移除定向条件
• 创建广告帖子
• 推广已有帖子
• 查看广告活动表现和覆盖人数
• 更新并激活广告活动
通过 MCP 可以使用 23 个 𝕏 Ads 工具。
而且它的安全设计确实很聪明:新广告活动和广告项目默认都会以“已暂停”状态创建,因此在你明确激活它们之前,AI 无法开始花钱。
智能体甚至可以自行串起完整流程:你的请求 → 账户 → 预算 → 广告活动 → 定向 → 广告。
这就是广告行业的发展方向。你不必再待在 Ads Manager 里,只需告诉 AI 你想实现什么目标,智能体就会替你运行广告活动。
“言论自由的终极目的,是推翻谎言、欺诈和错误意识形态。这正是 Cofnas 正在做的事。”
美国国务院正在为 Cofnas 辩护。选举确实会带来后果。这令人备受鼓舞。
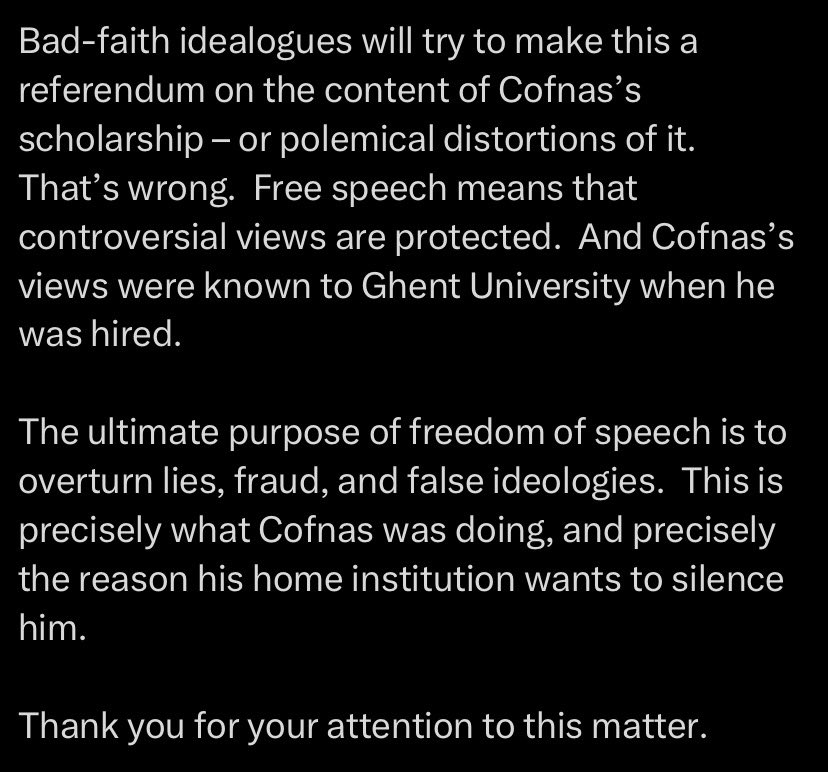
美国驻比利时使团强烈谴责根特大学:该校因一名美国学者如实举报学术欺诈而对其进行报复。
美国政府经常为海外大学的研究、学术交流及其他合作提供资金和支持。那些参与或纵容替罪羊式群体行为、反而奖励这种行为的不诚实腐败机构,并不是我们希望合作的伙伴。尤其是在这种替罪羊行为的目的和结果都是惩罚揭露学术不端的真实报道时,更是如此。因此,我们正在重新审视与根特大学的任何关系。
恶意的意识形态人士会试图把这件事变成对 Cofnas 学术研究内容,或对其进行的争论性歪曲的全民公投。这是不对的。言论自由意味着具有争议的观点受到保护。而且,根特大学在聘用 Cofnas 时就已经知晓他的观点。
言论自由的终极目的,是推翻谎言、欺诈和错误意识形态。这正是 Cofnas 正在做的事,也正是他的所属机构想让他闭嘴的原因。
感谢你关注此事。
酷。
Grok Bot 可能是第一个让非技术人员凭借一组 AI 智能体管理完整业务的工具。
我的朋友 Billy 用 Grok Bot 智能体运营着完整的新闻简报业务,我认为我们很快就会看到 10 万多家像他这样的企业。
最佳实践:
1. 智能体运行在共享云电脑上,所以把新闻简报、X 账号和收据都放在同一个地方,会造成上下文膨胀并快速消耗令牌。每个设置只承担一个任务。
2. 从 Chief of Staff(幕僚长)开始。让它访问你现有的文档(Notion、Slack、Gmail),先审查业务,再让它告诉你应该优先构建哪三个智能体来推动收入增长。
3. 在启动新智能体之前,先和 Chief of Staff 把一项任务打磨完善。让它先做一次主动销售,审查结果,然后再说:“现在构建一个能完全照做的机器人。”只有先证明任务可行,你才能获得每一位新员工。
4. 限制本身就是功能。你能使用的智能体数量有限,每个机器人只有一个线程,就像和队友私聊一样。这会迫使你始终专注于任务,而不是为每个随机想法都启动一个机器人。
5. 做决定的是你,而不是智能体。Billy 的团队花了三周都没能决定内容应该放在哪里。到了某个时候,你就得说:“我们用 Notion,别再折腾了”,然后继续前进。
6. 第一周不要增加新智能体。先组建团队,学会驾驶这架飞机,只管执行。到第三周你才会发现真正的缺口,然后再扩充团队:安排一个智能体管理收件箱,再安排一个管理 Shopify 商店。
7. 然后加入例行流程,让它在你睡觉时也能工作。询问 Chief of Staff,哪些周期性任务可以在夜间推动业务发展,然后让它构建无需你参与即可运行的自动化流程。
感谢 @billyjhowell 在 @startupideaspod 分享这些经验(关注以获取更多内容)。
Grokbot 真酷。
下面观看:
http://youtu.be/qQluNEfSVHk?si=3L2cAB71NQSuqxWU
记住了,孩子们:有人说 ARR 不是 annual reoccurring revenue(年度重复性收入),而是 annualized run rate(年化运行率)。顺便说一句,这里面大多数都是一次性的,而且起伏很大。
为我们的第十四次飞行测试做准备的星舰,已完成一次持续完整时长60秒的静态点火测试,六台Raptor发动机全部参与。
🚨David Friedberg 预测了通往“奥科西奥·科特斯同志(Comrade AOC)”、国家资产没收以及数据中心成为下一个目标的路径。
“他们会在2028年开始制定政策,由奥科西奥·科特斯同志负责……成本会飙升,债券市场会遭到抛售……于是30年期收益率飙升至7%、8%,甚至更高。”
更高的利率会让住房变得更加难以负担。然后,政府需要更多资金。
“所以现在我们需要通过一项国家资产没收税。”
但顶层没有足够的财富。
“所有身家超过5000万美元的人,其净资产总额也只有23万亿美元。”
@DavidSacks 指出,Cato 的估算显示,九项 DSA 式提案在10年内的成本将达到71万亿至212万亿美元。
整个《福布斯》400富豪榜的财富也只有6.6万亿美元。
Friedberg 认为,最终可供征税的亿万富翁会越来越少,政策会转向没收和寻找替罪羊。
@chamath:“亿万富翁会被当作替罪羊,而万亿富翁会被……我的意思是,处境会更糟。”
随后,科技行业会成为目标:
“数据中心就是亿万富翁和万亿富翁祈祷的圣殿。”
@friedberg 警告称:大规模的 DSA 式政府支出会让可负担性危机进一步恶化,助长怨恨,最终为国家没收资产制造政治正当性。
完整节目:@theallinpod
我们的孟菲斯和南海文站点将由全球最大的并网电池组供电,从而降低当地社区的电力成本,并提高当地电力系统的可靠性。
硅谷和资本市场之中,有一个一定错了,是谁呢。//@梁斌penny:惨啊//@桂曙光:才5%?😅😑//@莫非是托的微博:回复@国产愚人王:黑料还多,慢慢发,虽然大结局已经提前可知,但过程更有趣😂//@国产愚人王:不能为了黑而黑
高盛说英伟达的GPU早已过剩,第三方报告也显示GPU平均利用率仅为5%。而英伟达的应对是将GPU货币化和次贷化。
英伟现在的做法是把算力资产打包,以其未来产生的算力租金收入为支撑,发行金融产品卖给美国养老金这个倒霉的背债人。这与当年将房贷打包成MBS(抵押贷款支持证券)的手法一模一样。
感觉黄仁勋搞垮帝国要立首功😂

恒大歌舞团的江湖传说可太多了,之前看到有广州退休官员给媒体说,许家印请他见面的时候,他带了老婆一起,一进房间就看到妹子们簇拥着许家印在那等着,而许家印没想到客人会是夫妻一起过来,反应也很快,马上就让歌舞团的人出去了。🐶
许家印后面被爆出的一些日常生活。
巅峰坐拥3架大型私人飞机。
地面座驾出行只坐吉利号牌加长劳斯莱斯幻影。地方如果无达标车辆,必须跨城调车。
并且地方分公司因为他的到来,需要提前两月成立专属接待组,全公司工作围绕接待运转。
抵达前完成楼层全包、环境改造、设备空运,全程数十名保镖、专属发型师、私人厨师、女按摩师随行。
饮食方面,指定法国高端矿泉水,单瓶高达2000多。
瓶身Logo必须朝向自己拿取方向,水温严格固定,专人每日空运储备。
因为喜欢吃日本顶级静冈蜜瓜,单颗蜜瓜千元起步,恒大专人常驻日本果园每日甄选,瑕疵1点直接整颗丢弃,专机空运回国。
常年随身携带古巴限量雪茄,单根价值数千,一套烟具专人打理。
此项爱好年花费超700万元,秘书忘带雪茄曾当场中断会议、暴怒离场。
入住酒店必须包下整层客房,总统套房常住。
硬性要求:室温恒定湿度锁,全屋统一更换暖光灯泡。
地毯必须专人顺着纹路单向刷洗。
电梯指示灯用黑胶布遮蔽,酒店员工必须穿软底静音鞋。酒店无静音净化器,直接从广州总部空运。
广州恒大中心41-43层整体打通,42层为许家印专属私密会所,设专属门禁与独立电梯,普通员工终身无权抵达,多数副总裁进入需单独审批。
恒大歌舞团巅峰规模200人,上千选一严苛选拔。对身高、体重、外形、学历多重筛选,几乎不对外商演,全部开销由恒大集团全额承担,主要用于私人接待、内部宴请、应酬助兴,排练厅设于总部高层私密区域,管控严格。
敢想象他有多快乐吗🐶


//@王巍w:转发微博
没人能想到,美国的独立与崛起,竟是一场靠负债撑起的金融奇迹。5400万战争债务没有拖垮新生美国,反而在汉密尔顿的操盘下,催生了资本市场,奠定了美国的金融根基。债务从不是单纯的负担,而是重塑国家格局的核心工具。
#独立战争##汉密尔顿# #债务立国# #金融史# #金融博物馆# @王巍w
你俩真是人才。

开放模型正在迎头赶上吗?
比较前沿模型各个时代的开放模型与闭源模型,差距正在缩小吗?
https://newsletter.semianalysis.com/p/are-open-models-catching-up
确实如此
我给我的 Grok Bot 最好的东西之一……
是一个独立的电子邮箱地址。
现在它可以:
→ 发送邮件 → 接收回复 → 验证账户 → 注册网站 → 在自己的工作流中使用电子邮件
只需2分钟……
现在不用我帮忙,它就能做得多得多。

其实就是要分清口径,云赚的钱、模型赚的钱、应用赚的钱,广义上都可以算作AI赚的钱,混在一起去反推CapEx,误差会很大。现在大厂的盈利计划主要都在云上面,跟模型主导的公司不在一条叙事线上。
这轮Q2财报季的末班车,阿里是最后上车的。
经由口径调整,现在能够很清楚的看到AI业务造成了多大的净亏损:-138亿人民币。
腾讯Q2同位置数字是-105亿人民币,差不多也有定论了,国内大厂的模型研发、算力消耗、产品运营、市场推广叠加起来,单季度就是需要至少100亿的输血量。
但这又和CapEx不是一码事儿,CapEx有点类似固定资产投资,主要是一次性支出,阿里Q2干到了676亿,比腾讯还要高出150亿。
不过两家公司的市值管理方式都是一样的——
腾讯总裁刘炽平:「随着规模扩张,商业收益会逐步兑现,而且我们拥有保底方案,哪怕停止自研应用,单纯把算力对外租赁,相关业务本身就能盈利。」
阿里CEO吴泳铭:「本季度资本开支略高于预期,但整体投资进展基本符合预期。按照当前AI产品的平均毛利水平,相关资本开支可以在三年内回本。」
不同的表达,同一个意思,就是算力这种资源,属于市面上的硬通货,只有买不到的,没有卖不动的,哪怕你把购入的卡原封不动的再租出去,在差价周期里也是一定可以赚到利润。
大摩有份研报算过的,一台8卡服务器,采购价800万,月租25万,刚好3年出头可以回本,如果你能做成MaaS去卖,回本时间更是可以缩短到2年半。
那么问题来了,既然直接转卖算力是稳定赚钱的,而把算力交付给模型部门消耗则是必然亏损的,公司该怎么分配?
所以AI和云非得分开不可,阿里在Q2财报里强调的把公司重新分成4块——电商+云+模型+其他——主要就是为了解决上面说到的那个矛盾。
你会发现大厂入局AI的开端都是把这个业务挂靠在云底下,阿里、腾讯、谷歌莫不如此,这在以前是有合理性的,AI需要的上游资源,都在云手里,所以让云去扶持AI,天经地义,合乎周礼。
但事情具体推进起来,却和预想的完全不一样。…
最近2个Q的财报会议,谷歌CEO都在反复保证,会优先保障DeepMind的TPU需求。
DeepMind就是谷歌的AI实验室,属于战略中的战略,核心中的核心,管够TPU不是理所应当的吗?怎么还要CEO纡尊降贵来点名的?
因为谷歌云是真敢不给啊⋯⋯今年已经有DeepMind的研究员忍不住了,绕过公式制度直接捅到了媒体那里,说谷歌云把大部分TPU都卖给Anthropic了,DeepMind根本拿不到足够的算力。
虽说Gemini的拉胯未必跟这个有太大关系,但分工体系就是这么奇妙,一方面,Anthropic是DeepMind最强大的竞争对手,另一方面,对于谷歌云来说,Anthropic却是极其优质的客户,订单肥厚,打款痛快,所以实际上的画面是,谷歌云在猛猛帮着Anthropic打自家的DeepMind。
你也不能说谷歌云是内鬼,它难道不是在为公司赚钱么,凭什么有送上门的订单不要、去支持不能给自己贡献KPI的兄弟部门呢?
所以到头来还是要回到组织的角度,把云和模型彻底拆开,算成两笔账,它们虽然都叫AI创造的收入,但内在逻辑完全不一样,也不要再搞所谓的协同了。
国内的情况是,云业务做得好的公司,自家模型都不太能打,或者说,在市场上,外部的DeepSeek、Kimi、GLM更有竞争力,所以在冲业绩这件事情上,云部门的宁愿打折销售第三方模型——折扣力度甚至能做到比原厂还低——也没有动力去卖政治正确但不利于签单拿提成的自家产品。
以3月份林俊旸离职为节点,阿里半年里进行了4次集团层面的组织调整,这个频率自阿里创立以来绝无仅有,如果不列出来,可能很难直观感受到阿里到底是想解决一个什么问题:
- 3月16日,成立ATH事业群,整合通义实验室、千问、悟空、MaaS和创新业务,由CEO吴泳铭直接挂帅;
- 4月8日,通义实验室升级为通义大模型事业部,周靖人不再担任阿里云CTO,转为负责这个事业部;
- 6月8日合并通义大模型事业部与未来生活实验室,成立Token Foundry事业部,由吴泳铭直接负责,周靖人升任首席科学家;
- 8月20日,经由财报口径调整,模型、千问、千问办公装进了AI实验室与应用这个财务板块,和电商、云、其他业务并列;
发现玄机没有?每一次都是在把AI拆出来了一点点,同时也把级别再往上提一点点,经过了足足4轮调整,才把原本隶属于阿里云底下的一个实验室,挪到了整个集团的四大板块之一。
这就是大公司的组织摩擦成本⋯⋯
所以昨天阿里股价先跌后涨,整个市场的心路历程是很好懂的,跌是因为开支继续扩大,AI实验室是一个暂时看不到底的利润黑洞,然后用来输血的电商业务又很疲软,消费的大环境也不太够看,感觉有雷,但是随后换个角度来看,阿里云涨那么猛,又没拆出去,3-5年内在营收侧再造一个阿里是完全可能的,情绪又乐观起来了。
按照原计划,阿里要在三年内往AI基础设施投掉3800亿人民币,但是光Q2单季度的CapEx就是676亿,即便考虑到其中包括预支付的部分,但怎么算都指向一个新的预期,那就是3800亿并非上限,而是下限,极有可能再次上调。
阿里账上的现金储备还剩4700亿,花是够花了,就看什么时候能跑过转盈线吧,有点像我们小时候做数学题,一个水池,上面一根进水管,下面一根放水管,同时打开,需要多久可以注满⋯⋯
为了节约 Token成本(低峰时 Token费用更低),程序员都要开始倒班了吗?😂引用原帖:
多年后回想起来,可能会发现,让程序员指挥 AI写代码,可能是我们人类走过的一段弯路。

扩大 Grok @Bot 的使用范围
我们正在让更多用户可以使用 Grok Bot。
现在,所有 SuperGrok Plus、Cursor Pro+ 和 Cursor Teams 订阅用户都可以访问。
此外,我们还为其他所有用户提供使用受限的免费试用。
GPU 生成的 token 越多,就越需要更多 CPU 资源来处理它们。
AMD 的 @MadhuR_PDX 解释了,随着 GPU 能力不断提升,CPU 与 GPU 的比例为何也在演变。
了解更多:https://bit.ly/4bGsXfe
Fable默认用 high就够了,然后让它主要负责编排、验收,这样是最经济实惠的。
附提示词:
> 注意你的主要任务是分析、编排和验证,具体任务尽可能交给 subagent(Opus 或 Sonnet)去执行。自己只做需求澄清、方案拆解、任务分发和结果验收,实现类工作(读大量代码、写代码、跑测试、批量修改)一律用 Agent 工具派给 subagent 执行。
fable max确实非常消耗 token,对比下来 xhigh要节约很多

Falcon 9 从佛罗里达发射 29 颗 @Starlink 卫星


开放模型正在迎头赶上吗?
在前沿模型发展的不同阶段比较开放模型与闭源模型,差距正在缩小吗?
https://newsletter.semianalysis.com/p/are-open-models-catching-up
传统工业之外,确实…//@桂曙光:严肃应用一个都没有~🤔🙄
#机器人离真正自主还有多远#自主其实不是大问题,能遥控的必然也能自主。
但是如果你看过一些机器人的数据采集场景会发现,特别是手部动作的,即使是遥控,场景的动作精度要求往往也不高。这需要硬件的变化。当然,我们这里说的是通用机器人。
Grok 4.6 在超高思考模式下,现已在 CursorBench 上取得第 1 名!
Grok 4.6 刚刚拿下 CursorBench 3.2 的第 1 名……而且效率简直惊人。
下面是成本对比:
• Grok 4.6 Extra High —— 70.8% | 每项任务 2.81 美元
• Fable 5 Max —— 70.5% | 每项任务 17.32 美元
• Opus 5 Max —— 70.0% | 每项任务 8.23 美元
• GPT-5.6 Sol Max —— 67.2% | 每项任务 5.69 美元
Grok 取得了最高分,同时每项任务的成本约比 Fable 5 Max 低 6 倍,比 Opus 5 Max 低近 3 倍。
这正是 Grok 对智能体而言如此强大的原因。顶尖智能当然很棒……但能在漫长的编程任务中持续工作、无需消耗离谱算力的顶尖智能更胜一筹。Grok 的智能体编程效率简直惊人。

Grok Build 几乎每天都在改进
Grok Build 1.0.8 已发布。@SpaceXAI 持续改进智能体工作流,此版本重点优化了子智能体、工作流以及更流畅的多任务处理。
最重要的更新:
• 并发子智能体现在启动速度大幅提升,不再冻结父会话
• 同时打开多个子智能体时,加载历史记录不再冻结 UI
• 即使子智能体或任务正在运行,后续消息也会立即发送
• Ctrl+S 现在会暂存当前的提示词草稿,方便你切换任务,之后再恢复
• /workflow 现在会自动补全已保存的工作流,并且只显示有效操作
• MCP 服务器可以通过常规问题弹窗请求表单输入或 URL 授权
• 工作流智能体行现在显示当前上下文使用量,而不是累计 token 数量
此外还包括:针对虚构工具调用的错误提示更清晰、状态栏修复,以及改进文件夹下载。

可以试试 DSH 最新版,内置支持新的多模态模型 DeepSeek-V4-Flash-Vision-Exp。
DeepSeek-V4-Flash-Vision-Exp 现已上线 DeepSeek API Platform!🚀
🔹 这款实验性多模态模型的文本能力与 DeepSeek-V4-Flash 相当,包括智能体、推理和世界知识。🔹 在多模态智能体基准测试中,V4-Flash-Vision-Exp 相较 V4-Flash 实现了重大跃升,使多模态智能体性能接近 Opus-4.8。
使用 model='deepseek-v4-flash-vision-exp' 试用。DeepSeek Harness 0.1.1 已于今日发布,开箱即支持新模型。
1/n

Starlink 目前已有 1.1 万颗卫星在轨
观看 Falcon 9 从佛罗里达发射 29 颗 @Starlink 卫星进入轨道 https://x.com/i/broadcasts/1oKMvNQVqmkGQ
上周,@SpaceXAI 发布了 Grok 4.6,这款新的前沿模型专为编程、智能体任务和知识工作而设计。
独立评测表明,SpaceXAI 在性能和成本两方面都已重返 AI 前沿竞争。
Grok 4.6 的经济性对 AI 智能体尤其有吸引力。Artificial Analysis 估算,Grok 4.6 在其 Intelligence Index 上的单项任务成本为 0.84 美元,使其位于智能与成本之间的帕累托前沿。
本周通讯中还有更多 @MattarARK 的内容 ⬇️

Starlink 正在席卷航空业。
宣布与 Starlink 达成合作的航空公司数量正在激增,原因很简单:没有 Starlink 的航空公司如今可能会因机上连接体验远逊于竞争对手而流失乘客。
我们已经在 𝕏 上看到这方面的证据,许多乘客表示,他们特意因为某家航空公司提供 Starlink,而选择它而不是另一家。

“我曾经是超级左翼。后来移民来了,开始强奸所有人;现在我成了超级右翼。”
这种情况很多。
埃隆效应:Terafab 已经吸引更多公司来到德克萨斯州 Brazos Valley。🇺🇸
Greater Brazos Partnership 表示,自 Terafab 宣布以来,其他公司已经开始打电话,希望加入该地区的发展。
当地领导人估计,未来十年 Terafab 将占该地区总增长的约 15%。
Texas A&M 预计今年至少有 50 名学生开始攻读其新的微电子与半导体硕士项目。
这就是埃隆效应。Terafab 将帮助美国在本土制造先进 AI 芯片,供地球和太空使用。
正如 Greater Brazos Partnership 首席执行官 Tom Johnson 所说:“这是赢家。”
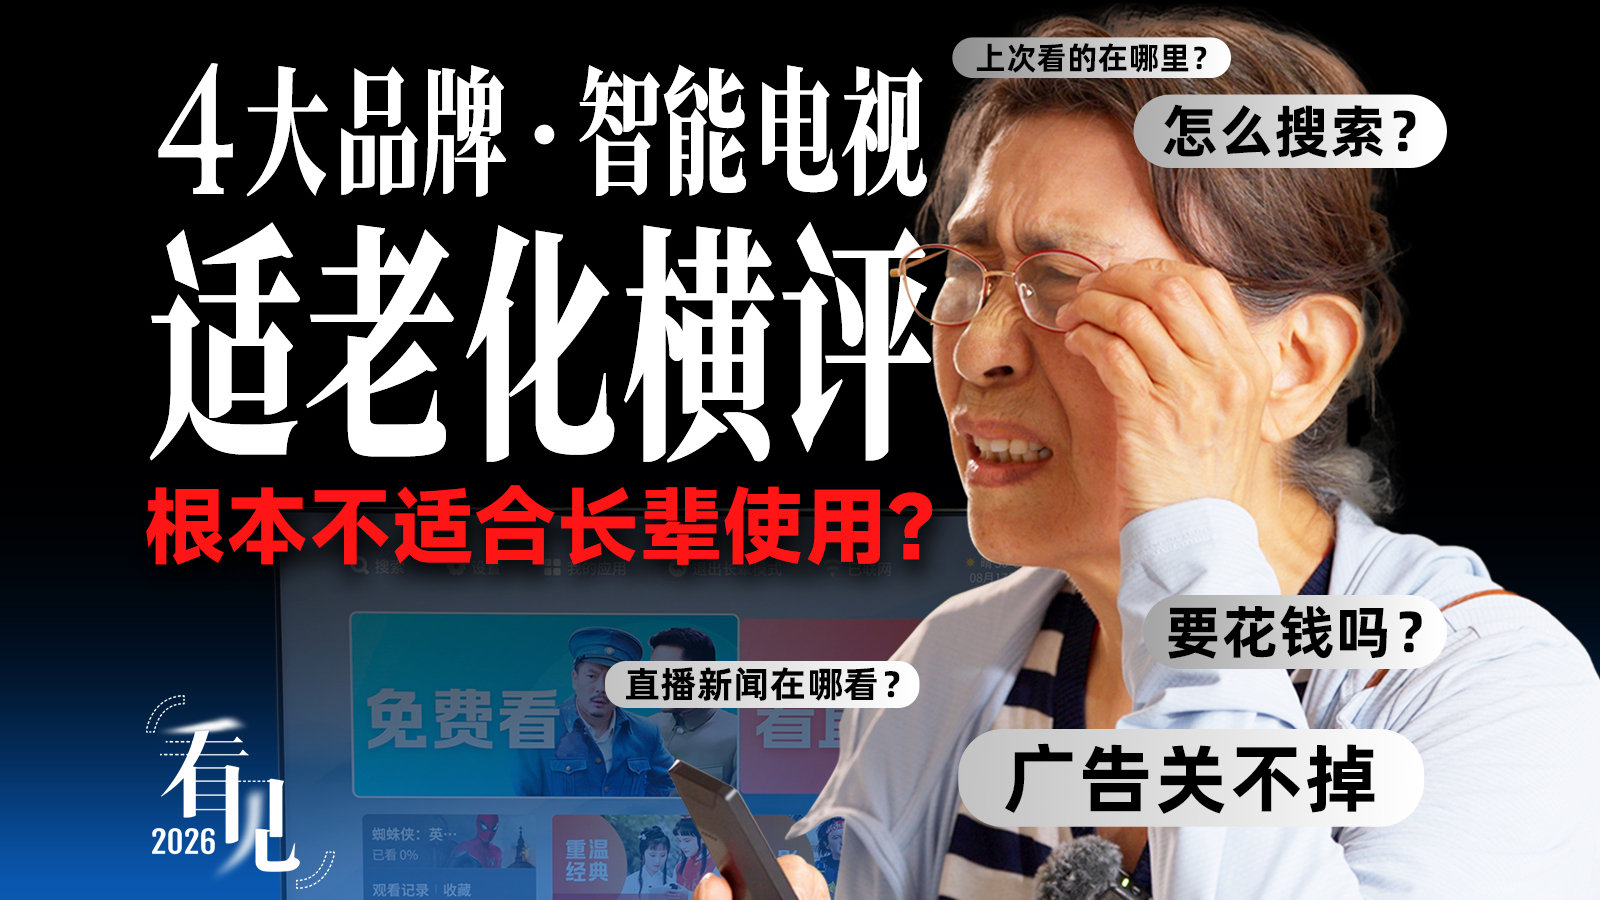
【#电视应该为老人做减法吗# 】科技进步不该只是功能堆砌,希望有一天,每一代人都能轻松用上智能设备。
凰家评测「看见」栏目第八年,我们联合了联谛信息无障碍研究院、北京市西城德外大街西社区养老服务驿站,找来13位60-80岁的老人,实测了4款国产主流品牌电视的长辈模式。结果第二项测试全军覆没——没有一位老人能独立找到想看的电视剧!
遥控器没有文字、光标找不到、搜剧不会用、误触进商城…… 所谓 "长辈模式",或许根本不可行。
我们总说要给父母更好的,却连他们最基础的"打开就能看"的需求都忽略了。
这一期凰家评测「看见2026」,我们把镜头对准了被智能电视困住的长辈们。↓↓↓
这轮Q2财报季的末班车,阿里是最后上车的。
经由口径调整,现在能够很清楚的看到AI业务造成了多大的净亏损:-138亿人民币。
腾讯Q2同位置数字是-105亿人民币,差不多也有定论了,国内大厂的模型研发、算力消耗、产品运营、市场推广叠加起来,单季度就是需要至少100亿的输血量。
但这又和CapEx不是一码事儿,CapEx有点类似固定资产投资,主要是一次性支出,阿里Q2干到了676亿,比腾讯还要高出150亿。
不过两家公司的市值管理方式都是一样的——
腾讯总裁刘炽平:「随着规模扩张,商业收益会逐步兑现,而且我们拥有保底方案,哪怕停止自研应用,单纯把算力对外租赁,相关业务本身就能盈利。」
阿里CEO吴泳铭:「本季度资本开支略高于预期,但整体投资进展基本符合预期。按照当前AI产品的平均毛利水平,相关资本开支可以在三年内回本。」
不同的表达,同一个意思,就是算力这种资源,属于市面上的硬通货,只有买不到的,没有卖不动的,哪怕你把购入的卡原封不动的再租出去,在差价周期里也是一定可以赚到利润。
大摩有份研报算过的,一台8卡服务器,采购价800万,月租25万,刚好3年出头可以回本,如果你能做成MaaS去卖,回本时间更是可以缩短到2年半。
那么问题来了,既然直接转卖算力是稳定赚钱的,而把算力交付给模型部门消耗则是必然亏损的,公司该怎么分配?
所以AI和云非得分开不可,阿里在Q2财报里强调的把公司重新分成4块——电商+云+模型+其他——主要就是为了解决上面说到的那个矛盾。
你会发现大厂入局AI的开端都是把这个业务挂靠在云底下,阿里、腾讯、谷歌莫不如此,这在以前是有合理性的,AI需要的上游资源,都在云手里,所以让云去扶持AI,天经地义,合乎周礼。
但事情具体推进起来,却和预想的完全不一样。
最近2个Q的财报会议,谷歌CEO都在反复保证,会优先保障DeepMind的TPU需求。
DeepMind就是谷歌的AI实验室,属于战略中的战略,核心中的核心,管够TPU不是理所应当的吗?怎么还要CEO纡尊降贵来点名的?…
因为谷歌云是真敢不给啊⋯⋯今年已经有DeepMind的研究员忍不住了,绕过公式制度直接捅到了媒体那里,说谷歌云把大部分TPU都卖给Anthropic了,DeepMind根本拿不到足够的算力。
虽说Gemini的拉胯未必跟这个有太大关系,但分工体系就是这么奇妙,一方面,Anthropic是DeepMind最强大的竞争对手,另一方面,对于谷歌云来说,Anthropic却是极其优质的客户,订单肥厚,打款痛快,所以实际上的画面是,谷歌云在猛猛帮着Anthropic打自家的DeepMind。
你也不能说谷歌云是内鬼,它难道不是在为公司赚钱么,凭什么有送上门的订单不要、去支持不能给自己贡献KPI的兄弟部门呢?
所以到头来还是要回到组织的角度,把云和模型彻底拆开,算成两笔账,它们虽然都叫AI创造的收入,但内在逻辑完全不一样,也不要再搞所谓的协同了。
国内的情况是,云业务做得好的公司,自家模型都不太能打,或者说,在市场上,外部的DeepSeek、Kimi、GLM更有竞争力,所以在冲业绩这件事情上,云部门的宁愿打折销售第三方模型——折扣力度甚至能做到比原厂还低——也没有动力去卖政治正确但不利于签单拿提成的自家产品。
以3月份林俊旸离职为节点,阿里半年里进行了4次集团层面的组织调整,这个频率自阿里创立以来绝无仅有,如果不列出来,可能很难直观感受到阿里到底是想解决一个什么问题:
- 3月16日,成立ATH事业群,整合通义实验室、千问、悟空、MaaS和创新业务,由CEO吴泳铭直接挂帅;
- 4月8日,通义实验室升级为通义大模型事业部,周靖人不再担任阿里云CTO,转为负责这个事业部;
- 6月8日合并通义大模型事业部与未来生活实验室,成立Token Foundry事业部,由吴泳铭直接负责,周靖人升任首席科学家;
- 8月20日,经由财报口径调整,模型、千问、千问办公装进了AI实验室与应用这个财务板块,和电商、云、其他业务并列;
发现玄机没有?每一次都是在把AI拆出来了一点点,同时也把级别再往上提一点点,经过了足足4轮调整,才把原本隶属于阿里云底下的一个实验室,挪到了整个集团的四大板块之一。
这就是大公司的组织摩擦成本⋯⋯
所以昨天阿里股价先跌后涨,整个市场的心路历程是很好懂的,跌是因为开支继续扩大,AI实验室是一个暂时看不到底的利润黑洞,然后用来输血的电商业务又很疲软,消费的大环境也不太够看,感觉有雷,但是随后换个角度来看,阿里云涨那么猛,又没拆出去,3-5年内在营收侧再造一个阿里是完全可能的,情绪又乐观起来了。
按照原计划,阿里要在三年内往AI基础设施投掉3800亿人民币,但是光Q2单季度的CapEx就是676亿,即便考虑到其中包括预支付的部分,但怎么算都指向一个新的预期,那就是3800亿并非上限,而是下限,极有可能再次上调。
阿里账上的现金储备还剩4700亿,花是够花了,就看什么时候能跑过转盈线吧,有点像我们小时候做数学题,一个水池,上面一根进水管,下面一根放水管,同时打开,需要多久可以注满⋯⋯
来源:The Diligence Stack——Creative Strategies
URL:https://www.thediligencestack.com/p/state-of-models-august-2026-what
编者按:本报告基于我们日常使用这些模型的体验,以及支撑 CS Bench 的测试结果。我们会明确区分哪些发现来自基准测试,哪些反映的是我们的判断。排名截至 2026 年 8 月仍然有效。图表 1 按照模型能否在智能体系统中可靠完成工作,将它们分为五类。
The Diligence Stack 长期关注整个 AI 市场。这是我们首次对模型本身进行全面评估,之后还会在不同时间点持续更新。通过与大型企业交流,我们认为,围绕两类问题,整个行业正在进行同样的评估:哪些模型适合广泛的知识工作场景,以及相关成本和 token 用量究竟是多少。我们分享这次评估的心得,以及对计算基础设施和模型经济学有参考价值的关键结论。
我们构建了 CS Bench,用于在 The Diligence Stack 研究所依托的知识库智能体中比较不同模型。公开发布的基准测试衡量的是金融分析初稿的质量和估算成本,这是我们测试的核心用例。我们也每天使用这些模型进行研究、软件开发和成品文件制作。本报告以测试过的全部任务为基础,分析每个模型的表现。
从模型评估的角度看,买方按 token 向模型提供商付费,并根据最终完成的工作来判断结果。如果输出还需要花一小时检查或重做,那么较低的 token 价格并没有帮助。比较模型成本时,我们会把这段复核时间也计算在内。
与其他工作流程相比,财务建模更容易暴露问题。最常见的失败,是一个在逻辑经过检查之前看起来已经完成的工作簿。它可能包含多个标签页,也可能有一个能正常工作的情景切换开关。第一次查看时,格式看起来很可信;但深入检查后,会发现收入取自错误的财务期间,或者驱动项行被硬编码为数值,却伪装成了公式。找出这些错误可能要花一小时甚至更久。
因此,我们会分别评估工作的正确性和呈现效果。正确但格式糟糕的工作会带来清理成本;存在明显错误的工作通常很快就会被拒绝。真正昂贵的情况,是一份格式精良但内部埋藏错误的文件,因为它的呈现方式让人以为这份工作已经可以直接使用。图表 2 展示了其中的差异。
CS Bench 衡量的是专家接手前的初稿质量。现在,我们还在加入复核这份工作所需的时间、反复出现的错误,以及发现这些错误所需的时间。这些检查能帮助我们更准确地估算一份可用工作的成本。
参数量并不能说明模型是否会完成任务。我们关注的是:它是否理解一项不完整的任务,是否会持续使用工具直到工作完成,以及第一次尝试失败后能否恢复。模型周围的软件同样会影响结果。检索、文件处理和执行能力,可能让同一个模型变得可靠得多,也可能可靠性大幅下降。买方付费购买的是完整系统。
公开 API 价格只描述了买方付费方式中的一种。小团队往往使用固定价格的订阅服务。企业则会通过承诺一定的支出换取更低的价格,但承诺的额度未必能够全部用完。真实成本包括模型本身、重试和人工复核。token 价格较低,完成工作的总成本仍然可能很高。
对投资者而言,在 token 价格不断下降的情况下,复核工作量是观察哪些模型仍能获得溢价的一种方式。较小的模型可以处理大量定义清晰的工作;较大的模型仍然更适合需要更多判断力的任务。当软件产品能让模型变得更可靠时,软件公司也可以分享其中一部分价值。
市场将支持多个模型类别,因为不同工作的性质和失败成本差异很大。
完整报告内容
我们如何对模型分组,以及对每个类别的评估。
我们针对工作质量、呈现效果、工具使用、指令保持、判断力和成本制定的评分卡。
面向研究、软件工程、财务建模和日常助手使用场景的工作负载级建议。
订阅、企业合同、用量和复核如何改变完成工作的成本。
为什么在一段较长的对话中切换模型,可能会提高总成本。
哪些证据会促使我们改变排名,以及 CS Bench 下一步将测试什么。
阅读更多
文章认为,开源模型正在以越来越快的速度追赶闭源前沿模型:从早期扩展时代到推理时代,再到智能体时代,开源模型追平每个时代首个闭源前沿模型所需的时间大致逐代减半。作者据此提出,模型能力差距会周期性收敛,但这并不意味着闭源前沿实验室的产品和利润必然被完全商品化。
基准测试不是实际工作的完美代理指标。文章指出,Kimi K3 虽可能在综合评测中高于 Fable 5,但 SemiAnalysis 日常工作仍偏好 Fable,因为 Anthropic 在 Claude Code、Claude Tag 等模型产品化和工具框架方面做得更好。公开基准测试还可能被模型制造商通过构造高度仿真的强化学习环境来“刷榜”。
文章也承认,Anthropic 和 OpenAI 可能比 Moonshot、智谱花费更多时间做安全测试,从而使时代 3 的追赶时间看起来更短,但作者认为这不是新现象:GPT-4 在发布前 218 天已完成训练;即使假设 Mythos 于 2 月中旬完成训练,距离 Fable 发布也只有 114 天。
文末只出现“即将到来的时代”和“阅读更多”,没有继续提供未来时代的具体预测。因此,文章已经论证的是能力差距收敛速度与产品化价值之间的区别,而不是闭源模型未来利润或模型层商品化的确定结论。
来源:SemiAnalysis
URL:https://newsletter.semianalysis.com/p/are-open-models-catching-up
过去两个月是开源 AI 的突破期。没错,2025 年 1 月曾经出现过“DeepSeek 时刻”,但实际上没有人用 R1 完成任何有经济价值的工作。相比之下,GLM 5.3 和 Kimi K3 等模型确实已经能够胜任许多与 Anthropic 业务快速增长至 650 亿美元以上 ARR(年度经常性收入)相同的编码和智能体任务。与那些夸大 ARR 的公司不同,我们的数字更接近现实。
来源:SemiAnalysis
对于 token(令牌)消费者来说,这是一个令人兴奋的时代。竞争正在升温,使用额度重置被分批发放,而争夺你所消耗 token 的战场也已经超越 OpenAI 与 Anthropic 的双头垄断。仅 Fireworks 每天处理的 token 就超过 40 万亿,是 OpenAI API 在 3 月底流量的两倍。
然而,开源模型的成功也引发了严重的 FUD(恐惧、不确定性与怀疑):如果开源模型能够以极低的成本,长期维持相对于闭源前沿模型足够高的能力,那么模型层难道不会商品化吗?这显然会给前沿实验室的利润率带来灾难性后果。关于 Anthropic 和 OpenAI 财务状况的完整细节,请参阅我们的《Tokenomics Model》。
要预测未来开源与闭源模型之间的能力差距如何演变,我们首先需要衡量过去。你可能会简单地选择一组基准测试来衡量历史上的所有模型,但这是错误的。每项基准测试都是特定时代的产物。有人创建一项新基准测试时,目标是辨别当时模型能力之间的差异。如果他们成功了,模型制造商就会不断攀升这项基准测试的成绩,直到它饱和。饱和之后,所有人都会不再关注这项基准测试,循环重新开始。
迄今为止,大语言模型(LLM)历史上经历了三个时代:早期扩展、推理和智能体。每个时代都代表模型实用性的一次阶跃式提升。与其试图绘制一条连续的长期趋势,我们认为,更好的方法是分别评估各个时代的模型和基准测试。
从这个角度看,开源与闭源之间的差距呈周期性变化。每个时代开始时,前沿实验室完成一些有前景的研究,训练出令人印象深刻的模型,并将其大规模部署给用户,从而取得领先。随后,其他实验室找出前沿实验室采用的关键进展,逆向分析其做法,在自己的模型中复现这些成果,最终缩小差距。没有什么东西能永远保密,尤其是在考虑到蒸馏的情况下。问题只在于需要多长时间。
为回答这个问题,我们收集了每个时代的所有相关模型,并运行一组经过筛选的基准测试,以得到综合能力得分。结果呈现出清晰趋势:在每一代模型中,开源模型追赶上该时代首个闭源模型所需的时间都会缩短一半。
来源:SemiAnalysis
当然,基准测试无法讲述全部故事,下面我们会说明所有相关的注意事项。最后,我们还会把分析延伸到未来,并解释为什么前沿模型的前景没有你最初想象的那么悲观。
下面概述了我们为每个时代选择的模型和基准测试:
来源:SemiAnalysis
在某个特定时间点选择一个闭源 SOTA(最先进)模型和一个开源 SOTA 模型,带有主观性,但我们的选择反映了 AI 专家群体的普遍共识。当存在争议时,例如今天的 Fable 5 与 GPT 5.6,我们采取保守做法,对两者都进行了测试。
对于基准测试,我们结合了个人判断与流行度。例如,Humanities Last Exam(HLE,人类最后考试)因问题很多而广受诟病,但它确实是推理时代最具代表性的基准测试之一,而且没有接近的替代品。另一方面,SWE-bench Pro 同样流行、同样存在问题,但 DeepSWE 对它进行了较为接近的近似。
这里的大部分基准测试分数都是我们使用 Prime Intellect 的评测栈自行运行的,具体包括其 environments hub(环境中心)以及 Prime-RL 中包含的 evals harness(评测工具框架)。其余分数来自我们的朋友 Artificial Analysis 的运行结果,以及 Datacurve 的 DeepSWE 排行榜。
开源模型按照它们发布时实际会采用的方式提供服务:使用当时的 vLLM 版本、当时在用的硬件,以及模型卡中给出的采样设置。对于闭源模型,我们使用其固定版本的 API 进行测试。当我们的数字与第三方数字出现在同一张图表中时,我们采用与对方一致的规则集。
我们要特别感谢 Prime Intellect 的 Florian Brand(@xeophon),感谢他帮助我们选择基准测试和模型、实现评测并检查正确性。
现在是 2023 年 6 月。全世界正在重新认识 ChatGPT,而 Mark Zuckerberg 刚刚同意在罗马斗兽场与 Elon Musk 对决。不过,当扎克在训练巴西柔术、做 Murph 训练时,他的公司也在进行自己的训练。FAIR 即将熬过 Mistral 出走和其他风波,并成功发布 Llama-2-70B——这是第一个接近前沿水平的开源模型。
它落后前沿模型多远?当时有四项基准测试帮助定义 SOTA:GSM8K、HumanEval、TriviaQA 和 MMLU-Pro。
来源:SemiAnalysis
这些基准测试代表了当时前沿模型具备的能力:简单的选择题、文字题,以及范围局限于单个函数的编程题。时代已经变化太多了!下面来看看 Llama-2 与 GPT-3.5 Turbo 的正面较量:
来源:SemiAnalysis
为了考虑不同基准测试之间的难度差异,我们对分数进行了归一化。每个时代的最佳结果设为 100,其他模型则据此相对计分。综合得分是四项测试的等权平均:GPT-3.5 Turbo 作为前沿模型的得分为 75.7,Llama-2-70B 为 39.9。这是一个经过衡量、但相当可观的差距。
这一最初的落后为该时代剩余部分定下了叙事基调:2023 年 12 月发布的 Mixtral-8x7B 朝着 GPT-4 的能力迈进,但随后 GPT-4 Turbo 和 GPT-4o 又竞相拉开差距。
来源:SemiAnalysis
直到 2024 年 7 月 Llama-3.1-405B 发布,开源模型才缩小了与 GPT-3.5 Turbo 的差距,其综合得分为 86。最后一个前沿模型 GPT-4o 的能力,则在 2024 年 12 月被 DeepSeek V3 追平,二者的得分分别为 95.5 和 94.1。Qwen2.5-72B 仅用 405B 参数量的六分之一、在 18 万亿 token 上完成预训练,就达到了距离 GPT-4o 仅一步之遥的水平。这是差距首次被弥合。
在这个时代,我们没有看到前沿能力大幅超越 GPT-4,但这主要是因为优先级不同:Turbo 和 4o 的目标是让 GPT-4 更便宜、更快速,而不是更聪明。
与此同时,OpenAI 一直在开发另一种模型。过程奖励论文和 Noam Brown 的入职都指向推理;到 2024 年年中,每家主要实验室都在发表关于测试时计算(test-time compute)的研究。405B 发布七周后,也就是 2024 年 9 月 12 日,OpenAI 发布了 o1-preview,开启了一个全新的创新时代。
o1 重新定义了基准测试的选择,也重新拉开了差距。时代 1 的基础评测已经不足以测试 o1 的全部能力。小学数学题被 AIME 取代。Scale AI 收集了世界上一些最晦涩、达到博士水平的选择题,并挑衅性地将其命名为 Humanity's Last Exam(人类最后考试)。
来源:SemiAnalysis
o1 的发布对科技圈的重要性怎么强调都不过分。许多人认为,那一天就是“我们确定一定会实现 通用人工智能(通用人工智能)”的日子。
不过,与 Llama-2-70B 对 GPT-4 的情况不同,时代 2 开始时开源与闭源之间的差距要小得多。罪魁祸首?一个名不见经传的模型:DeepSeek R1。
来源:SemiAnalysis
时代 2 初始差距为 12.1 分,而前一个时代开始时是 35.8 分。市场对此作出了剧烈反应。幸运的是,AI 资本开支交易很快恢复,而 R1 建立起来的“我们又回来了”式开源模型势头,很快被 Meta 的 Llama-4 Maverick 压制。
来源:SemiAnalysis
Gemini 2.5 Pro 和 o3 继续推动推理前沿,而 R1-0528 检查点在 2025 年 5 月缩小了最初的差距,得分达到 78。缩小 12.1 分的差距只用了 8.5 个月:
来源:SemiAnalysis
到目前为止,图表中显眼地缺少 Anthropic。他们的模型卡和其他公司一样报告了这些基准测试,但在这个时代从未争夺排行榜榜首。OpenAI 和 Google 轮流加冕之时,Anthropic 正在把 Claude 打造成默认的编码智能体。这为下一个时代设定了规则:如今真正重要的基准测试,都在终端中运行。
在 Claude Code 之前,智能体也曾有过高光时刻,例如 Cognition 在 2024 年 3 月发布的 Devin 病毒式演示。但 Anthropic 是第一家真正做好“模型 + 工具框架”产品的公司,而它也得到了回报。自 Claude Code 于 2025 年 5 月正式发布以来,Anthropic 增加了超过 650 亿美元的 ARR。关于 Anthropic 和 OpenAI ARR 的深入预测,请参阅我们的《Tokenomics Model》。
随着智能体出现,又一套新的基准测试诞生了。复杂的数学题不再是测试模型能力的最佳方式。相反,人们想知道模型能否编写代码、进行网络搜索,以及总体上像人一样使用计算机。
来源:SemiAnalysis
Terminal-Bench 2.1、BrowseComp-Plus、𝜏³-banking 和 DeepSWE,覆盖了如今智能体所承担的长时程工作:软件工程、深度研究和知识工作。我们还特意选择了更新的基准测试,以限制模型记忆训练数据带来的影响。
来源:SemiAnalysis
由于模型的可靠性,大多数 AI 专家都将 Opus 4.5 视为智能体时代正式开始的标志。有趣的是,GPT-5.2(当时 OpenAI 的旗舰模型)在我们的基准测试套件上表现更好,但这并不对应更好的用户体验。此时真正重要的是完整的智能体产品(模型 + 工具框架),而 Anthropic 一直专注于迭代,努力打造一个擅长通用智能体工作的工具框架。
相比之下,Codex 相对粗糙,而 OpenAI 同时还在投入浏览器等支线项目。两家前沿实验室之间的模型发布间隔也在缩短。在这个时代,OpenAI 和 Anthropic 平均每 51 天发布一个模型,由此建立了双头垄断。相比之下,时代 1 和时代 2 的平均发布间隔分别为 213 天和 120 天,这意味着速度大幅提升。
来源:SemiAnalysis
尽管前沿模型创造的经济价值出现爆炸式增长,时代 3 的差距仍比前两个时代更快地缩小。Kimi K2.6 用 4.8 个月、以 56.3 的得分超过 Opus 4.5;GLM-5.2 用 6 个月、以 72.4 的得分超过 GPT-5.2。随着时代推进,追赶时间逐代减半的趋势惊人地稳定。
来源:SemiAnalysis
那么,这一切对闭源与开源模型的未来意味着什么?
首先,我们想承认,基准测试并不是全部。Kimi K3 在我们精心筛选的综合评测中可能得分高于 Fable 5,但在 SemiAnalysis 的日常工作中,我们仍然更喜欢使用 Fable。这部分是因为 Anthropic 通过 Claude Code、Claude Tag 等产品做得更好,但更大程度上是因为基准测试并不是实际工作的完美代理指标。
对于公开基准测试而言,这一点尤其明显:模型制造商只需创建一批与基准测试任务高度相似的强化学习(RL)环境,就能轻易地沿着基准测试不断攀升。
其次,你可能会认为,时代 3 的追赶时间因为 Anthropic 和 OpenAI 花费更多时间进行安全测试,而 Moonshot 和智谱花费更少,所以被人为压缩了。但这并不是新现象。例如,GPT-4 在发布前 218 天就已经完成训练。即使我们假设 Mythos 在 2 月中旬完成训练,那么在 Fable 发布前也只有 114 天的延迟。
阅读更多