2026-09-13 23:21 · 来自 iPhone 17 Pro Max
晚安。

产品自述:从需求到上线,全程由智能体推进。
团队成员详见原始页面
Product Hunt 页面没有明确问题陈述;可先参考产品自述和官网。
开发者工具 / API
Open Source、Developer Tools、Artificial Intelligence、GitHub
产品自述:把任意 AI 智能体接入 Slack、Teams 和 Discord
团队成员详见原始页面
Product Hunt 页面没有明确问题陈述;可先参考产品自述和官网。
开发者工具 / API
Open Source、Developer Tools、Artificial Intelligence
产品自述:通过与智能体对话,构建并完善 B2B 名单
团队成员详见原始页面
Product Hunt 页面没有明确问题陈述;可先参考产品自述和官网。
开发者工具 / API
Sales、Marketing、Developer Tools
在你现有的硬件上运行前沿混合专家(MoE)模型:纯 C 语言实现、零依赖,专家模块从磁盘流式加载。引擎小巧,模型能力强大。🐦
C
今日新增 960 星 · 总星标 29,430 · Fork 3,209
Ever® Gauzy™——开源业务管理平台,涵盖企业资源计划(ERP)、客户关系管理(CRM)、人力资源管理(HRM)、申请人跟踪系统(ATS)和项目管理(PM)。https://gauzy.co
TypeScript
今日新增 58 星 · 总星标 4,866 · Fork 927
一款运行在浏览器中的间谍卫星模拟器,不过使用的是真实数据。在逼真的 3D 地球仪上实时呈现开源地理空间情报。
JavaScript
今日新增 2,898 星 · 总星标 31,510 · Fork 6,323
晚安。
根据各种实拍爆料,iPhone Duo的折痕确实浅到基本可以忽略不计了,这我是高低得尝尝咸淡的。
其实这两年抢首发的意愿已经没有以前那么高涨了,翻了下去年在Apple Store的订单,发现我是在预购开启后半个多月才下的单,已经没有一点科技博主的样子了。
所以今年支棱起来的计划,是18PM和Duo我全都要,目前18PM已经在拼多多下单了,如果不出意外,下个月的Duo也会在上面买,因为它给的实在太多了......
简单来说,拼多多上商品券和积分券叠加使用是可以立省1000块的,而且领券很痛快,不存在套路,同机型价格基本跟去年持平,万元以内能拿下18PM的,目前好像只有它一家。
虽然最火的勃艮第红还在等补货,但对于等等党而言,这点忍耐力还是有的。
就是不知道下个月Duo开售的时候,会是一场怎样的腥风血雨。
#拼多多iPhone18pro直降1000元#


闺蜜机是什么赛道?🤔

#模型时代# 刚在X上刷到一个十五万访问量的帖子,但是观点过于绝对,怀疑是假新闻。于是用右上角的Grok做了个确认,确实是假的。
不过,过程耗时大约1分钟,订阅费平摊算1毛钱吧。这就是你得到真相是需要付出的代价。
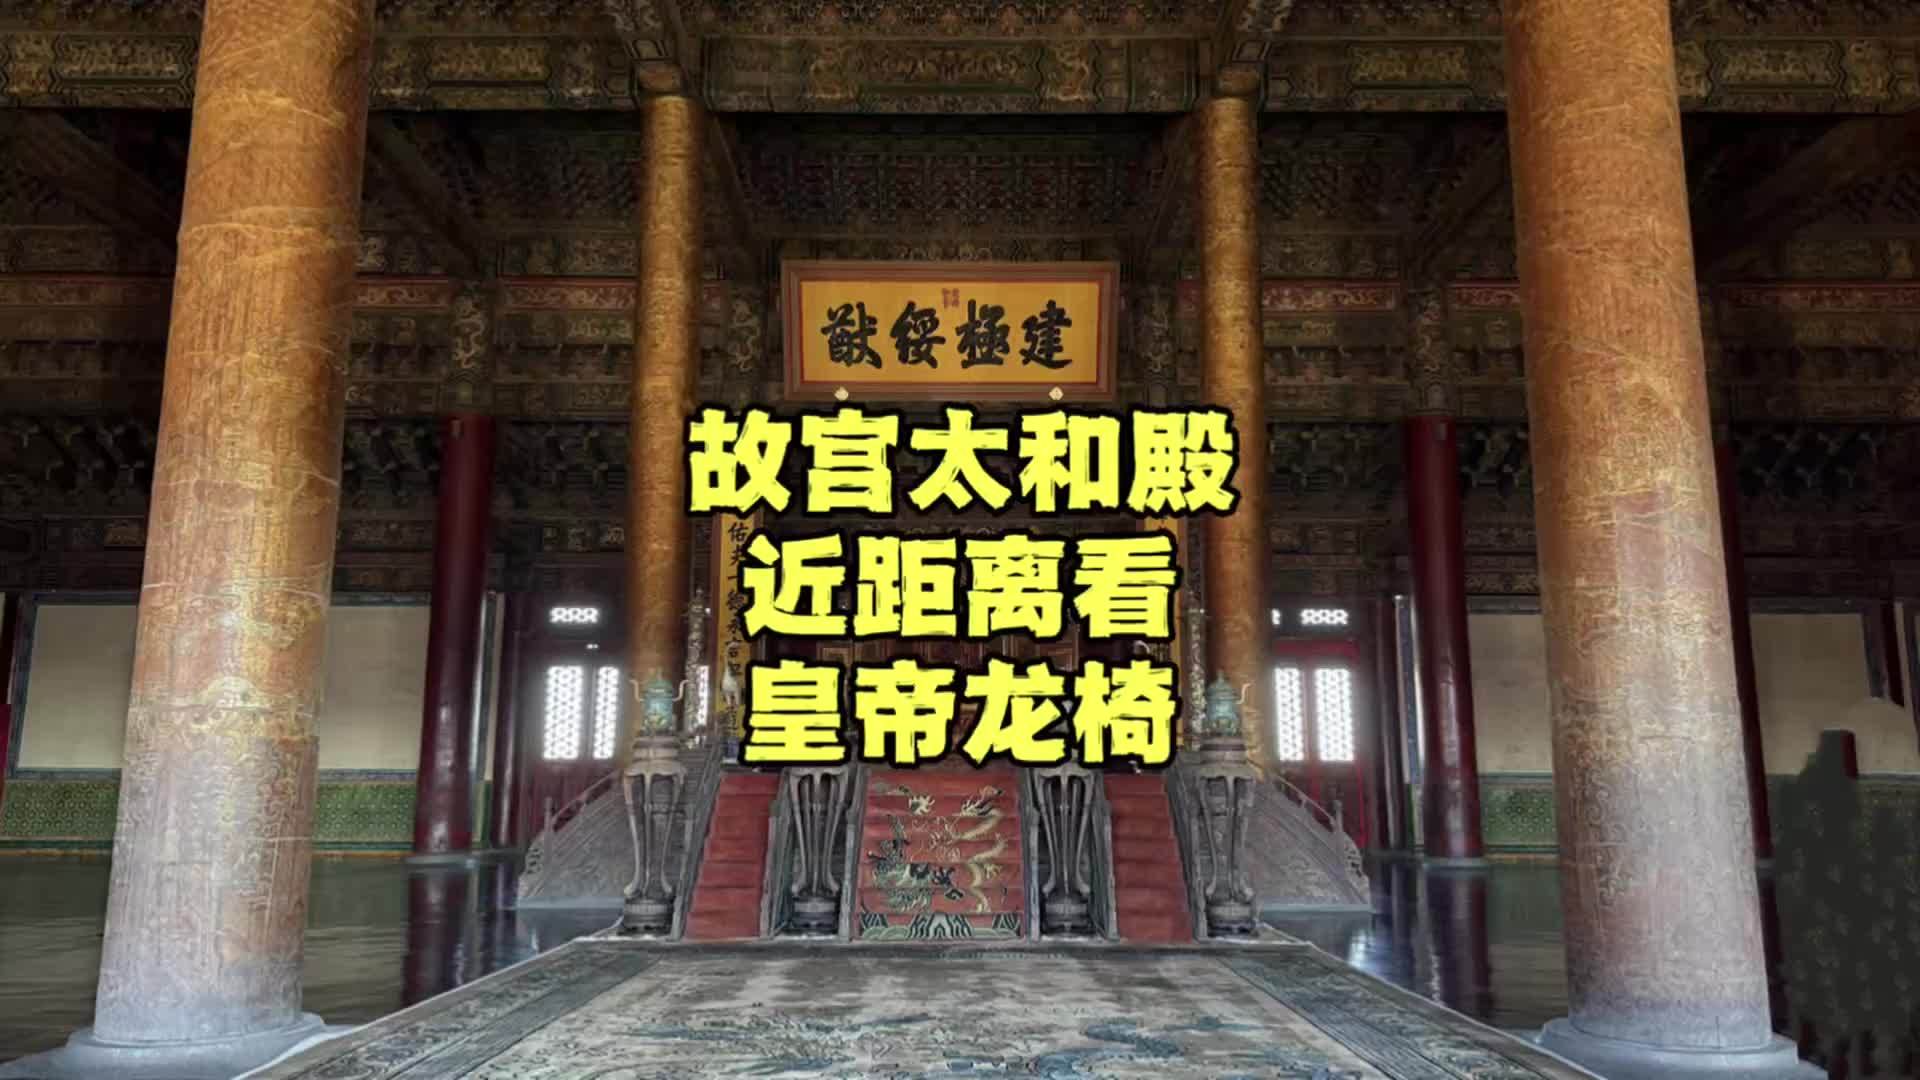
北京故宫好消息,太和殿前的围栏撤了,终于看到龙椅了,大开眼界#微博旅行家##带着微博去旅行##北京范儿##故宫#
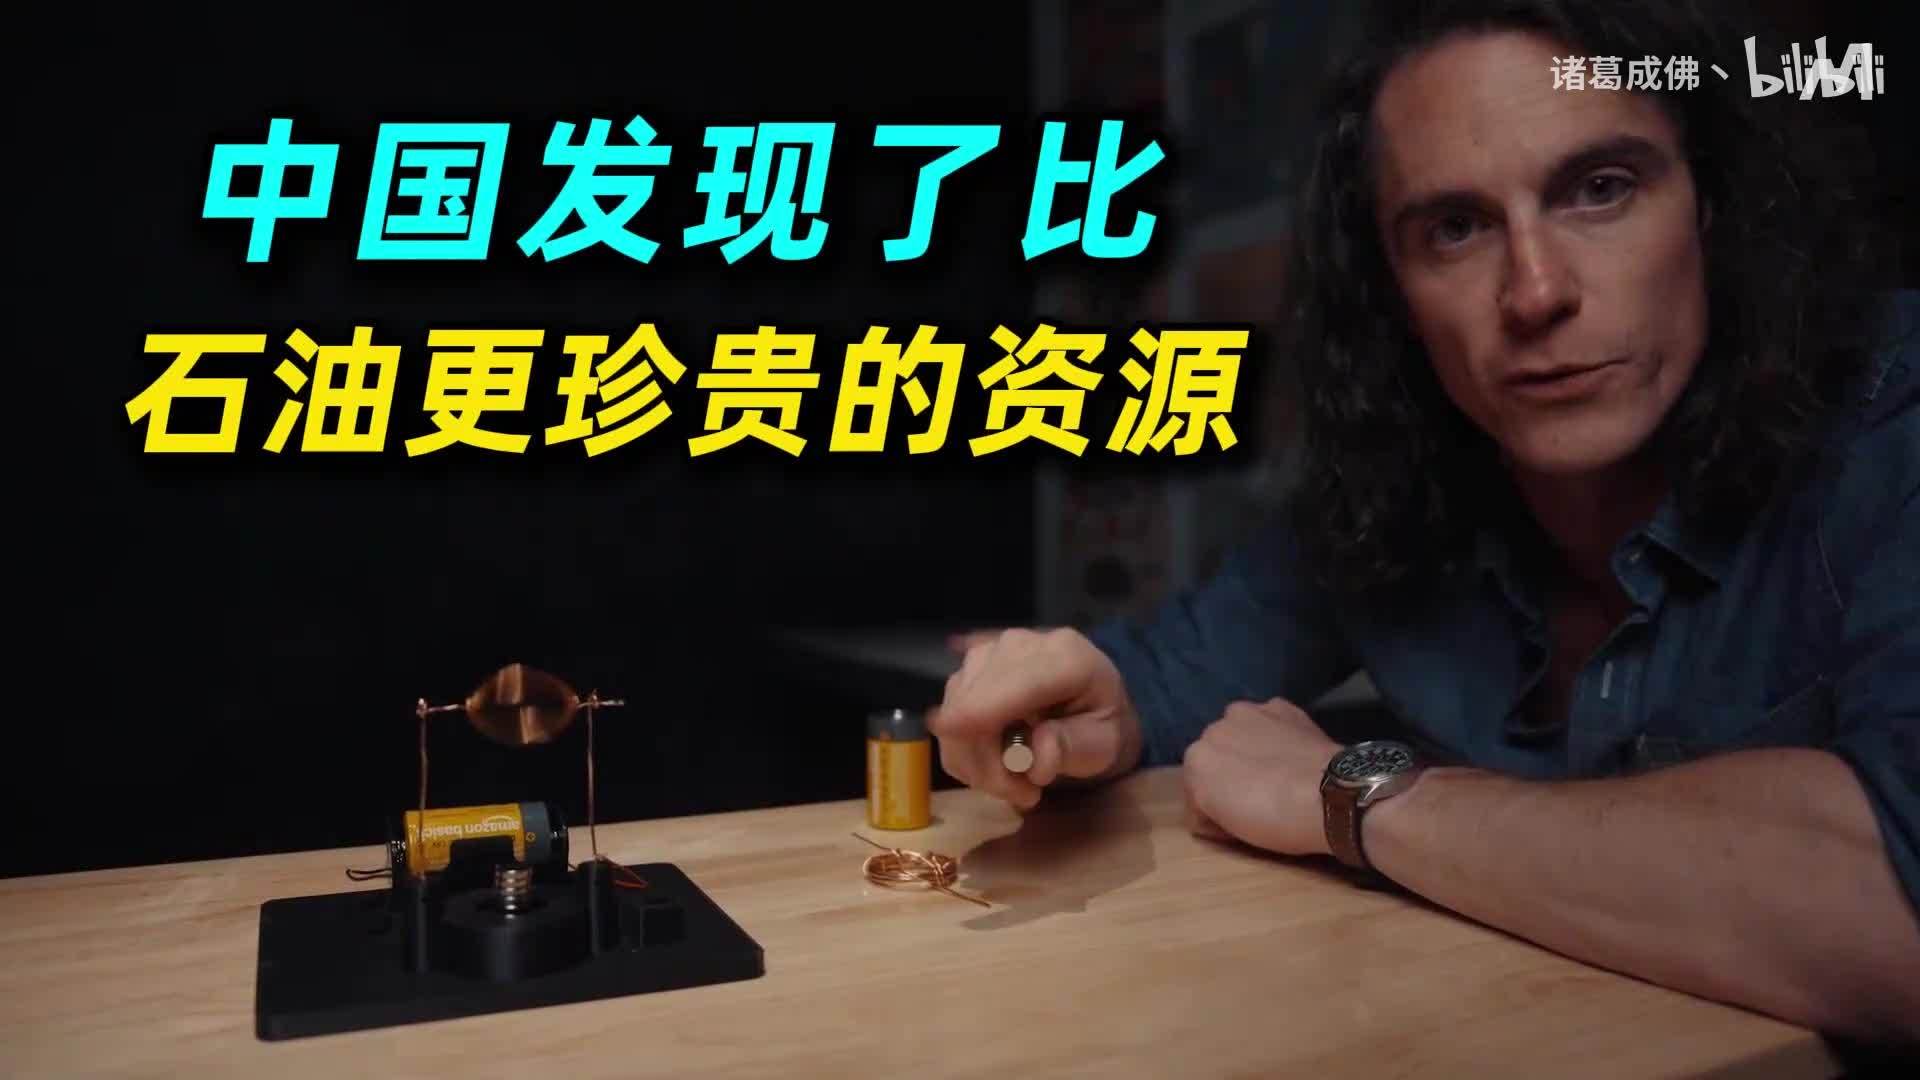
外网博主:中国发现了比石油更珍贵的资源
胖东来又在做什么实验

矮堆叠之王万岁:为何4层堆叠HBM能实现带宽不变、裸片更少:4层堆叠HBM如何降低推理成本,让稀缺DRAM发挥更大作用
https://newsletter.semianalysis.com/p/long-live-the-short-king-why-4-hi外链:
- https://newsletter.semianalysis.com/p/long-live-the-short-king-why-4-hi
「关广告挑战」的视频这几天彻底🔥了⋯⋯
#模型时代# 关于Anthropic的最新段子:我们需要第三方监管,我们组建了第三方监管。
第 1天:Anthropic的一名员工离职,转投 METR工作。
第 2天:Anthropic提名 METR为“第三方评估机构”。

【非洲第三大湖马拉维湖隐藏的危险】
在湖边小镇安卡塔贝,步行25分钟到了一个非常惬意的沙滩,虽然遇到了三个一直像苍蝇一样骚扰我的小贩,风景还是不错的。
下图,如果我不跟大家说,是不是大家以为这里会是大海?
这就是马拉维湖,非洲第三大湖泊,一个狭长的淡水湖,最深处达700米,由于湖太大,以至于形成了“潮汐现象”,下图,这个沙滩的浪比大海的浪还大。
我给大家介绍一下马拉维湖的情况:马拉维湖,在尼扬贾语里“马拉维”是燃烧的湖水,指日落时整片湖面火红。
1️⃣基本概况它是位于东非大裂谷的南部,是东非大裂谷最南端的断层地堑湖,约在450万年前由地壳撕裂行成。
它南北长度为580公里,宽度在25~80公里,平均水深273米,最深处706米,湖底低于海平面,湖面海拔为468米,总面积29600平方千米。
(对比贝加尔湖的31500平方千米,马拉维湖跟贝加尔湖的面积相当)
再对比新加坡的总面积734平方千米,马拉维湖的面积相当于40.3个新加坡的大小。
典位于湖的西岸,面朝东,完全望不到东岸的莫桑比克,足以见得其面积之大。
2️⃣生物资源湖中有800~1000中慈鲷,90%是马拉维湖特有的。马拉维湖的慈鲷比整个欧洲加上北美的全部淡水鱼种类还多!
为什么有这么多种类的淡水鱼?因为其地理演化过程,它是一个半封闭的湖,上百万年经历了几十次剧烈的水位涨落,大湖反复分裂成小湖再合并,导致爆发式的鱼类分化。
由于马拉维2000多万人口,70%的蛋白质来源于这个湖泊(主要吃小银鱼,大型慈鲷),湖边有几十万艘独木舟(图8),导致湖里过度捕捞严重。
3️⃣危险的动物马拉维湖里还有少量的鳄鱼和河马,有一定的隐患。
鳄鱼品种为尼罗鳄,分布在浅水区,泥岸,河流入湖口等位置,数量大概在6000~8000只。
平均每年有30~60人因鳄鱼死亡(上报数量),受伤达80~150人。
湖里的河马数量8000~10000只,位于河流入湖口,浅水区域,沼泽地带,河马不喜欢进入深湖区。他们喜欢待在有泥滩,水草,河口,封闭湖湾等安静有遮蔽的场所。
平均每年有8~20人因河马死亡(上报),受伤几乎没有,因为碰到河马发飙基本上没有概率幸存。


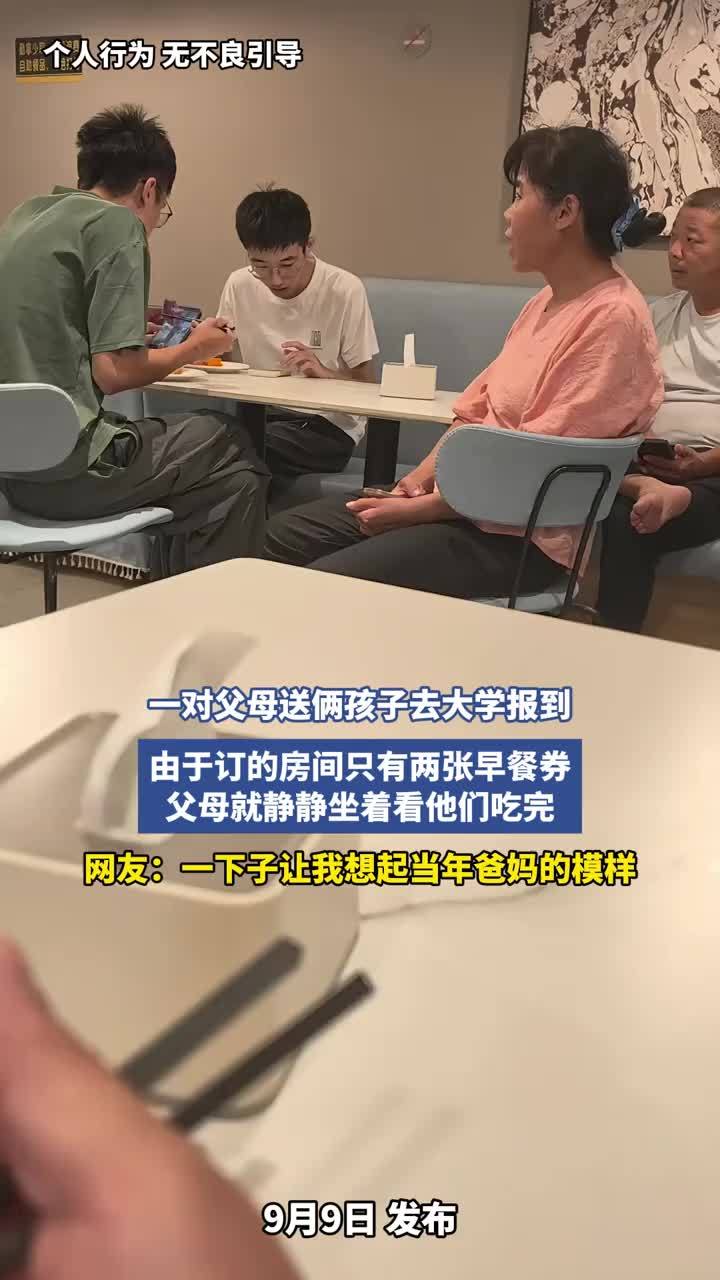
哈哈哈//@北漂民工的日常:作为尊贵的亚朵/华住会双铂金会员,我有一堆早餐券,不知道何时能用完 http://t.cn/AXOAYUkh //@知名在家做饭也把号炸了博主:纯属大病//@蓝紫青灰:四个人得订两间房吧,一个房间有两张早餐券吧?难道一个标间住四个人?酒店不让入住啊。//@李子的围脖:好烦这种自我感动式的。第一,订了房间想多要张早餐券可以直接和前台商量。第二,真舍不得买早餐券就不去餐厅啊。而且有些酒店是只让有早餐券的客人进去。所以大概率是摆拍。//@丛虫时移事往:…非要省这个钱,就自己出去吃早饭,或者买了早餐在房间里吃…😞
一对父母送俩孩子去大学报到,由于订的房间只有两张早餐券,父母就静静坐着看他们吃完!!!
この先で出会うすべての人も、すべての出来事も、あなたがこの壁を越えてくるのを静かに待っている。
来源:OpenAI News
URL: https://openai.com/index/perplexity-improving-accuracy-with-astra
Perplexity 使用 Astra 撰写沟通内容、修改软件并监控生产系统。与早期模型相比,团队如今需要更少地介入跟进。
文章认为,AI 推理的主要瓶颈越来越偏向内存带宽,而非容量。只要系统有足够 HBM 容纳模型权重和必要的用户 KV Cache,继续增加堆叠层数带来的收益就会递减。HBM 堆叠从 12 层降至 4 层,容量随之下降,但单堆叠带宽不变;在 HBM 昂贵且供应紧张的情况下,4 层因此可能带来更低的每令牌成本、更高的每片 HBM 晶圆吞吐量,并缓解 DRAM 供应压力。
文章使用 16 颗 GB300 GPU、分别由 8 颗 GPU 组成预填充池和解码池的分离式系统,对 Kimi K3 进行测试。HBM 使用率从通常的 92% 降到 85%,每 GPU 的 KV Cache 空间减少 20 GB。聚合服务 KV 预算从 53 GB 降至 34 GB(减少 36%);分离式配对从 44 GB 降至 24 GB(减少 44%)。
多数测试点的吞吐量与高 HBM 配置相近;并发超过 70 后,受限配置的吞吐量低近 30%,此时 GPU KV 占用达到 100%,抢占、重复加载和排队开始造成影响。在相同并发下,低 HBM 配置读取 DRAM 中 KV Cache 的次数超过高 HBM 配置 10 倍以上。测试说明,把较冷的 KV Cache 卸载到 DDR DRAM 能缓解 HBM 容量压力。文章还提到,DeepSeek v4.1 Flash 相比 v4 Flash 可将活跃 KV Cache 缩小约 75%;缓存缩减后,系统可能转而受计算或网络限制。
若未来模型及每用户 KV Cache 都达到 Kimi K3 的 3 倍,12 层比 4 层多提供 47% 的令牌总量,8 层多提供 36%,尽管速度只有前者的一半。在这一场景下,较低交互速度下的 8 层吞吐增幅可能超过 TCO 增幅;但 12 层仍无法以吞吐增益抵消相对 8 层的 BOM 增幅。
文章提出三点反驳:模型能力不再只靠增加参数,强化学习和更多推理时间也在发挥作用;循环变换器可通过增加深度而非权重扩展模型;如果 4 层加速器成为主流,研究者可能会让模型适配这类硬件。前沿实验室硬件团队支持 4 层,也被视为软硬件协同设计将降低容量需求的信号。服务器服役超过 5 年、未来模型增长仍是 4 层方案需要面对的风险。
文章把“每片 HBM 晶圆可服务的令牌数”视为与每瓦令牌数、每单位 TCO 令牌数并列的优化目标。相同晶圆用于 4 层而非 12 层,理论上可获得三倍带宽;相较 8 层则可获得两倍带宽,且 4 层封装良率更高。更多可用堆叠最终仍受逻辑晶圆、基板、PCB、封装集成能力和电力等环节约束;但释放的 DRAM 晶圆也可用于服务器内存等同样短缺的领域。
4 层 HBM 并非对所有训练、模型规模和延迟要求都最优。文章的主要论据针对内存价格高、容量已经足以容纳权重的推理场景;其屋顶线模型按峰值带宽估算,实际测试只覆盖特定模型和系统配置。是否采用更高堆叠,最终取决于未来模型与缓存规模、交互速度、并发需求、真实可用带宽,以及额外吞吐量是否足以抵消更高系统成本。
来源:SemiAnalysis
原文:https://newsletter.semianalysis.com/p/long-live-the-short-king-why-4-hi
高带宽内存(HBM)是推动人工智能革命的关键技术。尽管 HBM 相比其他内存形式价格高昂,芯片设计者仍不断在 AI 加速器中集成更多 HBM。客户既要求采用新一代 HBM,也不断通过增加堆叠数量、提升单堆叠密度和高度来扩大每颗 XPU 的容量。结果是,HBM 消耗了越来越多的动态随机存取存储器(DRAM)晶圆产能,造成了眼下极其严重的 DRAM 短缺。
如今,这一趋势即将转向,背后既有技术原因,也有供应链因素。新一代加速器正把 8 层堆叠作为标准,而当前标准是 12 层。英伟达已在 Rubin Ultra 上采取这一做法:与标准 Rubin 和 B300 每颗 GPU 配备 288 GB 相比,Rubin Ultra 降至 192 GB。SemiAnalysis 最早报道了这一变化。供应链目前正为 8 层堆叠成为新标准做准备;而就在不到一年前,行业还预计会转向 16 层甚至更高堆叠。正如我们在《Memory Model》中讨论的那样,我们认为这一趋势还会进一步发展。
对于最看重内存带宽的推理工作负载,4 层 HBM 的单位带宽成本最低,因此每个令牌(token)的成本也最低。容量的重要性有一个上限:达到一定门槛后,增加 HBM 容量带来的收益递减,但新增容量仍会带来同样的物料清单(BOM)成本。这正是大型实验室的硬件团队希望从下一代 HBM4 开始,在自研专用集成电路(ASIC)项目中采用 4 层堆叠的原因。正如硬件设计者在数据中心供电受限的环境中力求提高每瓦令牌数一样,4 层堆叠能提高每片 HBM 晶圆产出的令牌数,而晶圆同样是稀缺资源。
本文将解释容量需求的变化,说明 HBM 容量为何常常闲置,并展示这种转变如何同时改善实验室的总拥有成本(TCO)和内存供应商的盈利能力。
HBM 一直是 AI 工作负载的主要工作内存,因为它在容量和带宽之间取得了良好平衡,适用于训练和推理中的通用芯片。静态随机存取存储器(SRAM)速度很快,但容量有限,因此价格高昂,能承担的任务也有限。传统 DDR DRAM 每美元能提供更多容量,但带宽太低。AI 是高度依赖内存的工作负载,因此每代加速器配备更多 HBM 并不意外:加速器上的堆叠数量增加、单个堆叠密度提高,堆叠层数也越来越高。
来源:SemiAnalysis、英伟达
每颗芯片搭载的 HBM 越来越多,也是成本持续上涨的重要推手。不过过去几个月里,这一趋势已经转向。下一代 Rubin Ultra 每颗加速器只配备 192 GB HBM,而标准 Rubin 甚至 Blackwell Ultra 都有 288 GB!这与不到一年前的预期相差甚远,当时人们认为 Rubin Ultra 每颗 GPU 会配备 1 TB HBM。公平地说,那时 Rubin Ultra 预计采用 4 颗计算芯粒,如今则只有 2 颗。即使按计算芯粒数归一化,单颗 GPU 芯粒的 HBM 也从 256 GB 降到了 96 GB。
来源:SemiAnalysis、英伟达
降低 HBM 密度的决定很大程度上是出于供应考虑。HBM 晶圆供应稀缺,根本没有足够晶圆生产所需数量的 12 层堆叠,以满足英伟达明年已锁定的 N3 逻辑芯片和 CoWoS 封装产能。改用 8 层堆叠,有限晶圆就能产出更多堆叠,有助于弥补缺口。明年 HBM 成本大幅上升也无济于事,尽管英伟达拿到的价格比其他大客户更优惠。即使 GPU 需求远高于供给,英伟达也不得不接受部分利润空间被上涨的零部件成本挤压,而内存是其中占比最大的项目。
HBM 密度一路上升的趋势如今正在逆转,原因不仅是供应,也包括架构变化和工作负载需求改变。供应和成本固然重要,但如果新增容量确有必要、能明显改善性能与 TCO,英伟达不会做出这种取舍。本文重点要说明的是,在许多场景中,每颗 GPU 增加 HBM 容量并不值其成本,未来常常以 4 层 HBM 为最佳配置。
需要提醒读者的是,降低堆叠高度、减少每颗 GPU 的容量,并不会牺牲带宽。无论堆叠有多高,每个 HBM 堆叠可用的带宽都相同。HBM4 或 HBM4E 每个堆叠有 2,048 条数据输入/输出(I/O)通道,这些通道由堆叠中的 DRAM 核心裸片平均分配。每层最多可用 512 条 I/O,因此 4 层是能用满全部 2,048 条通道、实现最大带宽的最低堆叠高度。
但无论供应商还是终端客户,成本主要由每个堆叠内 DRAM 的容量决定。HBM 定价主要依据每堆叠的 GB 数,而客户看重的往往是带宽。因此,较低堆叠高度能为终端客户带来更低的单位带宽成本,选择低层数几乎等于白得好处。
来源:SemiAnalysis
不同 AI 工作负载都需要容量和带宽,但两者的相对重要性因工作负载而异。AI 计算大致可分为三类:预训练、后训练/强化学习、推理。强化学习与推理非常相似,所需架构也近似。在这三类计算中,推理的解码阶段主要受带宽限制:生成每个令牌,都要读取所有活跃模型参数,以及存放在内存中的用户键值缓存(KV Cache)。强化学习也类似推理,整体仍偏向带宽受限,但由于侧重较大的批次,需要比推理更多容量。预训练则对容量更敏感,因为训练期间 HBM 要存放权重、梯度和激活值,而推理前向计算通常只需存放权重和用户 KV Cache。
近来,一个重要变化是:随着最终令牌需求上升、后训练技术成为扩展模型的重要途径,分配给预训练的计算资源占比大幅下降。因此,如今大部分计算资源的需求更受带宽影响,而不是受容量影响。
来源:SemiAnalysis 的令牌经济模型
这并不是说推理完全不需要容量。容量仍然重要,但只重要到一定程度。Cerebras 和 Groq 的 SRAM 机器有一个主要弱点:尽管 SRAM 带宽充足、能快速提供令牌,容量却不足。简而言之,系统必须达到一个容量门槛:推理系统的高带宽内存必须足以存放模型权重和用户 KV Cache。超过这个门槛后,容量再增加,收益就会递减,后文将对此展开说明。
还有一点很重要:应该看整个系统的总内存,而非单颗芯片的内存。前沿模型早已大到无法装进单颗芯片的内存,必须分散存放在多颗芯片上。这也是网络互联成为 人工智能系统设计核心环节的原因。如今所有前沿模型都采用混合专家(MoE)架构。通常,最佳系统是在一个纵向扩展域内实现快速、低延迟通信(例如整机架内部的 NVLink),以支持大规模专家并行;每颗 GPU 只加载少数几个专家。这样,每个专家就能处理更大的令牌批次,提高计算和内存带宽利用率,代价则是 GPU 之间需要承担更多全互联通信。
来源:SemiAnalysis、英伟达、Hugging Face
模型权重和用户 KV Cache 的容量需求都在增长,但纵向扩展域规模的巨大增长,使节点总内存足以跟上需求。Hopper 时代,一套 H100 HGX 系统共有 640 GB HBM。当时最强的开源模型 Llama 3.1 405B,其权重会占用其中 63%,留给 KV Cache 的空间有限但尚可。这就是 H200 每颗 GPU 多出的 61 GB 如此重要的原因:每台服务器拥有 1,128 GB 内存,带来更多余量,可容纳更多 KV Cache、服务更多并发用户。
在 GB300 NVL72 机架级方案中,英伟达把纵向扩展域规模扩大到原来的 9 倍,同时通过采用 12 层 HBM、增加每颗 GPU 的 HBM 堆叠数,将单颗 GPU 的 HBM 容量翻倍。因此,与 H200 HGX 相比,系统总 HBM 容量提升了 18 倍,远超当今最大开源模型 Kimi K3 从当年 4050 亿参数增长到 2.8 万亿参数的近 7 倍增幅。将精度从 16/8 位量化为 4 位四分之一精度,也大幅降低了容量压力。以 MXFP4 格式存储的一份 2.8 万亿参数 Kimi K3 仅占 1,561 GB,不到 GB300 NVL72 近 21 TB HBM 容量的 8%。纵向扩展域规模还会继续增长:Rubin Ultra 的重大升级是转向 NVL576,规模再扩大 8 倍,足以抵消每颗 GPU HBM 容量减少三分之一的影响。
来源:SemiAnalysis、Moonshot、英伟达、AMD
进入机架级服务器时代后,可用内存容量远超存放模型权重所需,因此还能为用户 KV Cache 留出充足余量。系统现在可以轻松支持超长上下文推理请求,并保持足够并发,从而实现很高的推理利润率。这缓解了大量 HBM 容量压力,也让单芯片的 HBM 密度可以降低。这与过去较小规模的服务部署截然不同:当时模型权重会占总内存的很大部分,增加每颗 GPU 的 HBM 密度是获得宝贵容量余量的关键方式。
降低堆叠高度、以更低成本获得同等带宽的论据早已成立;只是直到最近,单芯片所需的最低 HBM 容量门槛才显著降低,所以我们现在才看到高堆叠逆转。我们认为这一趋势还会继续。前沿实验室的硅片和硬件团队认为,对于许多推理工作负载,4 层 HBM 是性能/TCO 最优的产品规格。下面将深入说明原因。
带宽与容量之间存在一个最佳比例。很多时候,容量会过量配置、闲置在那里,因为每个令牌获得的带宽不足以读遍 HBM 中全部容量。先看一个简单例子。假设每个 HBM4E 堆叠的标称峰值带宽为 3,328 GB/s(假设有 2,048 个引脚,每个引脚速率为 13 Gbps)。HBM4E 每个核心裸片为 32 Gb,因此 4 层、8 层和 12 层堆叠的容量分别为 16 GB、32 GB 和 48 GB。假设单路生成速度为每秒 100 个令牌,那么每个令牌可用的内存带宽为 3,328/100=33.28 GB。用每令牌可用带宽除以堆叠容量,可以得到每个令牌能够读取堆叠总容量的次数。
如果每个令牌能读取整堆叠一次,容量与带宽就完美匹配:一个令牌恰好拥有足够带宽,能读取 HBM 中全部工作数据,不多不少。比值高于 1,说明相对容量而言带宽“过量配置”,因为一个令牌只需读取一次工作集(也就是一次前向计算)。不过,这些带宽通常并非真正“多余”,还可以通过提高每秒令牌数来利用。比值低于 1,则表示一个令牌的带宽不足以读遍 HBM 容量。在给定吞吐速度下,工作集不能大于每令牌可用带宽,因此必须小于总内存容量,结果就是一部分内存容量闲置。
来源:SemiAnalysis
如上方示意表所示,每秒令牌数越高,每个令牌可用的带宽越低,堆叠读取次数与令牌数之比也越小,因此容量过量配置的可能性越大。这形成了一种不对称:相比容量,更充足的带宽通常更有价值。带宽一般能充分利用,闲置容量却未必用得上,同时它的成本还在不断升高。
当然,这个简单分析没有考虑通过批处理同时服务多个并发用户。批处理对推理经济性至关重要:它能在给定交互速度下最大化总令牌吞吐量。批处理带来的主要节省,是把读取权重的成本分摊到多个用户请求上。并发越高,内存中需要加载的各用户 KV Cache 也越多。因此,提高批次大小通常会让推理工作负载从带宽受限转为容量受限。当 HBM 容量足以容纳模型权重时,增加 HBM 容量的价值在于提高令牌吞吐量;也正因如此,额外的内存位元有时值得其 BOM 成本。
来源:SemiAnalysis
把批处理因素纳入后,就得到上方的通用曲线。其他条件相同的情况下,更高的 HBM 堆叠可提高吞吐量,但只会持续到某个每用户延迟服务等级目标(SLA);超过该点,额外容量就不再有用。图中不同曲线相交的点正代表这一情况。这里的“每用户延迟 SLA”表示最低交互速度假设,而非实际交互速度下限。当并发受容量限制时,仍有多余带宽可用于提高每用户令牌生成速度。因此,即使 4 层堆叠能支持的并发用户较少,更快的每用户生成速度也可以全部或部分抵消批次变小对总令牌吞吐量的影响。
并发数取以下两种上限中的较低者:一是容量受限时的最大并发数,也就是内存能容纳多少组用户 KV Cache;二是带宽受限时,在满足最低交互速度的前提下最多能服务多少用户,计算中会考虑上文的每令牌可用带宽。用户数乘以每用户每秒令牌数,即为每秒生成的令牌总数,也就是吞吐量。这些曲线展示了额外容量对推理性能的价值:更多容量可能通过更大批次带来更多令牌吞吐量,也能显示在什么最低交互速度下额外容量已无助益。
结果很大程度上取决于模型大小,换句话说,也取决于 HBM 容量中有多少必须分配给模型权重。通常,模型越大,曲线就越向右移:更高堆叠在更快的交互速度下也能带来更高吞吐量,峰值吞吐量的提升幅度也会更大。这仍然是批处理的经济性使然:无论批次大小如何,每一步都只需读取一次权重;权重占用越大,每多一个并发用户所能解锁的吞吐量就越高。
下面以当今最大的开源模型 Kimi K3 为例,代入实际数字。这里做的是屋顶线分析;现实中实际内存带宽远低于峰值,因此实际结果中的最低交互速度门槛会向左移动,但总体结论不变。分析只针对分离式预填充/解码(PD)架构中的解码池;实际交付表现可参考我们的 InferenceX 和 AgentX 基准测试。我们采用 Rubin Ultra NVL576 系统,因为它更能代表 HBM4E 时代的纵向扩展域规模。假设 HBM4E 速率为 13 Gbps;每颗 GPU 的 HBM 容量分别是:4 层 128 GB、8 层 256 GB、12 层 384 GB。Kimi K3 在这套 NVL576 系统上每颗 GPU 承载 16.8 GB 权重,也就是每个 HBM 堆叠 2.1 GB。
最低 SLA 为每用户每秒 105 个令牌时,12 层 HBM 的吞吐量并不高于 8 层。交互速度再翻倍、达到每用户每秒 213 个令牌时,堆叠超过 4 层也没有好处。就最大吞吐量而言,8 层比 4 层最多提升 8%,12 层最多提升 10%。但如果接受 4 层能达到的最大吞吐量,交互速度可以提高到两倍以上。还要再次强调,现实中无法利用全部原始内存带宽,所以曲线会向左移;高容量达到收支平衡的交互速度门槛会更低,甚至可能低到用户无法接受。
来源:SemiAnalysis、Moonshot
由此可见,对这些模型而言,增加容量只能带来有限的令牌吞吐量提升(暂且不计更快令牌本身的价值)。那么,额外吞吐量是否值得为更多内存支付额外 BOM 成本?HBM 在加速器 BOM 中占比很大,而且 HBM 供应紧张,明年每 GB 的价格将大幅上涨。我们以 HBM4E 4 层 Rubin Ultra 为基准,估算终端用户在 Rubin Ultra NVL576 系统上要承担的 BOM 增幅。8 层方案的整机成本比 4 层基准高 12.1%;12 层则高出 26.3%。整机成本占 TCO 的绝大部分,因此本文以整机成本近似 TCO。接下来,我们比较不同最低交互速度下的令牌吞吐量增幅与成本增幅,判断更多内存能否降低每令牌成本。
来源:SemiAnalysis
总体来看,12 层或 8 层 HBM 带来的吞吐量提升低于更多内存增加的系统成本。按照这里的内存价格(再加上英伟达的利润加成),12 层和 8 层 HBM 的每令牌成本都高于 4 层。此处还未计入更多节省 HBM 的技术,例如把 KV Cache 卸载到较低层级的内存。下一节将展示我们进行的一次生产环境实测,观察减少内存对实际吞吐量的影响。
只要模型权重仍能装入 HBM,降低 HBM 容量就会减少可留在其中的 KV Cache 数量。不过,第二层 DRAM 可以存放不那么“热”、但仍需快速取用的 KV Cache。在智能体工作负载中,这种做法越来越常见:上下文很长,会给 HBM 容量造成压力,但不同轮次之间又常有较长停顿,因此把 KV Cache 移到 DRAM 甚至存储设备,往往比完全重新计算更划算。在我们近期的 AgentX 基准测试中,许多工作负载在超过某些并发水平后,帕累托最优结果都采用了 KV Cache 卸载。
为测试减少 HBM 对真实工作负载的影响,我们在 HBM 容量受限的条件下,对 Kimi K3 运行了 InferenceX 基准测试。系统有 16 颗 GB300 GPU,采用分离式架构:8 颗 GPU 组成预填充池,另 8 颗组成解码池。受限内存测试的 HBM 使用率为 85%,通常情况下则为 92%。没错,HBM 使用率只降低了 8%,远低于从 8 层改为 4 层时容量减少 50%;不过 Kimi K3 只用 8 颗 GPU 服务,权重占用了大量内存。最终,每颗 GPU 可用于存储 KV Cache 的空间减少了 20 GB。具体来说,聚合服务的 GPU KV 预算从 53 GB 降至 34 GB,减少 36%;分离式配对的预算则从 44 GB 降至 24 GB,减少 44%。这已经是相当显著的 KV Cache HBM 预算削减。
从结果看,在曲线上的大多数点,HBM 受限的测试仍实现了非常接近的吞吐量(图中以红色虚线表示)。但并发数超过 70 后,吞吐量骤降,相比 HBM 较充裕的测试低了近 30%。此时受限内存版本的 GPU KV 占用率达到 100%;抢占、重复加载和排队开始影响吞吐量。请注意,这发生在并发较高、交互速度却很低的区域。我们也发现,在相同并发数下,低 HBM 配置读取 DRAM KV Cache 的次数超过高 HBM 配置的 10 倍。
来源:SemiAnalysis
这项真实工作负载测试表明,把 KV Cache 卸载到 DDR DRAM 能有效缓解 HBM 容量压力。这里测试的是 Kimi K3,尚未计入 DeepSeek v4.1 Flash 最新引入的一些更激进缓存缩减技术;与 v4 Flash 相比,这些技术可将活跃 KV Cache 大小减少约 75%。在 KV Cache 已大幅缩小的情况下,为充分利用 HBM 容量而提高并发,很可能会让工作负载转为受计算和网络限制,而不是受容量限制,因此进一步削弱高层数 HBM 的价值。
我们用 HBM4E 和 NVL576 对 Kimi K3 做屋顶线分析,显而易见的局限是:用当前工作负载证明未来系统只需 4 层 HBM。一年后,更大的纵向扩展域和 HBM4E 才会上市,而那时前沿模型只会变得更大。此外,AI 服务器的部署寿命超过 5 年,在整个期间都必须能继续提供令牌服务。若未来工作负载的模型规模大幅增长,减少容量可能会低估最佳容量需求。
例如,假设未来模型的规模是 Kimi K3 的 3 倍,而且每用户 KV Cache 也增至 3 倍,那么更高堆叠带来的吞吐量提升就大得多:12 层比 4 层多提供 47% 的令牌总量,8 层多提供 36%,但速度只有前者的一半。在这种情形下,额外容量开始更有理由,最终要看更快令牌的价值有多大。
来源:SemiAnalysis
把成本纳入分析后,在这个场景中,当每用户速度低于每秒 180 个令牌时,8 层方案带来的吞吐量增幅超过了 TCO 增幅。
来源:SemiAnalysis
但从 8 层再升至 12 层仍不划算:曲线上的任何位置,12 层增加的令牌吞吐量都不及相应的 BOM 成本增幅。
来源:SemiAnalysis
对此有几项反驳理由。第一,扩大参数规模、增加模型权重,已不再是提升模型能力的唯一关键。大幅增加强化学习,以及投入更多推理/思考时间,已成为提高效率、改进模型架构的重要路径。另有消息实际上已确认 GPT-6 Astra 使用循环变换器,也有大量猜测认为 Anthropic 的最大模型同样如此。循环变换器会让输入多次经过变换器层,通过增加模型深度而非权重数量来扩展模型。
第二,如果 4 层加速器成为 AI 服务器装机量的重要组成部分,研究人员会调整模型,使其能在这类硬件上高效运行。此外,据我们了解,最支持 4 层 HBM 的正是前沿实验室硬件团队。这些团队极为重视软硬件协同设计;他们呼吁采用 4 层堆叠,反映出未来模型的发展方向并不需要那么大的容量。
最后,从大局看,所有模型构建者和服务提供商都希望最大化令牌服务量。采用 4 层堆叠才能做到这一点……
最佳硬件架构应当让稀缺资源产出最大化。建设 AI 基础设施面临多种短缺,其中电力是关键之一,因此提高每瓦令牌数是推理服务商和硬件架构师努力优化的重要指标。当然,资金也有限,所以性能/TCO 一直是硬件决策中重要的衡量标准。正如前文所述,另一项主要约束是 HBM 晶圆供应。虽然不常被提及,但优化每片 HBM 晶圆能产出的令牌数,可以与优化每瓦令牌数、每单位 TCO 令牌数相提并论。做法很简单:采用 4 层 HBM。
4 层堆叠与 8 层或 12 层堆叠能提供相同带宽。简单来说,如果一片晶圆用于生产 12 层 HBM,改用 4 层可从中获取三倍内存带宽;若原本用于 8 层,则可获取两倍带宽。考虑到 4 层封装良率更高,实际收益还会更好。内存带宽通常直接关系到令牌吞吐量,因此在 HBM 供应有限时,4 层是提高其利用效率的最佳选择。与 8 层相比,改用 4 层后可产出的 HBM 堆叠数量可能超过两倍。
不过,只有与加速器共同封装、装入系统的 HBM 堆叠才有用。这意味着瓶颈会从 HBM 晶圆转移到供应链其他环节,例如逻辑晶圆(包括加速器和 HBM 基础裸片)、基板、印刷电路板(PCB)、下游集成产能,以及其间的许多其他组件。也不能忘记部署更多系统所需的电力。总体而言,我们认为未来几年其他供应链环节扩产的速度会超过 DRAM 供应增长。即使 AI 服务器供应链无法满足翻倍 HBM 堆叠所需的产能,释放出来的晶圆也能用于生产传统 DRAM,供应其他同样缺内存的应用,缓解 HBM 挤占整体 DRAM 供应的影响。首先想到的就是服务器 DRAM:为了充分利用有限供应,每路处理器配置的 DRAM 已被大幅削减。这也与支持智能体工作负载密切相关,因为这类工作负载往往有大量时间花在等待 CPU 相关执行,而不是等待 GPU 解码令牌。
付费内容部分将讨论这对内存供应商的影响、4 层 HBM 如何使他们受益,以及他们正在如何应对。我们的《Memory Model》中还包含更多洞见、产品规格/供应商决策和供需细节。
阅读更多