这个兼得有点宽啊⋯⋯

这个兼得有点宽啊⋯⋯
#模型时代# 医生们在 GPT-5.6的回答中发现的缺陷比医生自己写的回答中少。
诊断这个环节,是逐渐被侵蚀了。


#模型时代# 隐形冠军了,销售 AI训练数据的初创公司(2026年 7月)
50家公司向大型 AI实验室销售数据和 RL环境,并在幕后推动 AI进步。
它们总收入约 85亿美元,估值约 1000亿美元,其中 >75% 仅由 4家玩家占据:Scale、Surge、Mercor和 Handshake。


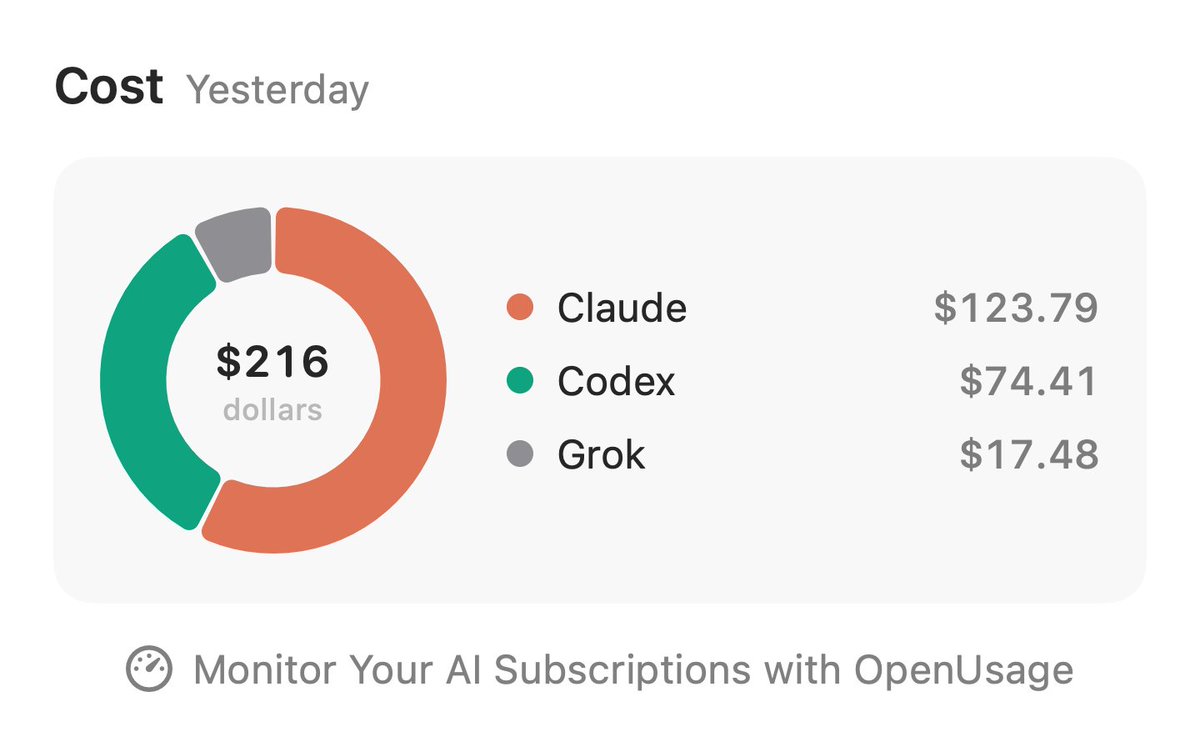
确实很爽,它在拆分后我就点开了 Token消耗界面开始心疼了😂
#模型时代# 用Claude Code这些工具,最赏心悦目的时候,就是看到模型自己拆分任务,多agent共同工作吧。有种“一直穿云箭,千军万马来相见!”的感觉。

哈哈哈 //@Errordetected:确实,多个sub agent嗖嗖跑的时候运筹帷幄感拉满,同时token消耗也拉满,所以肾上腺素里又掺杂一点肉疼
#模型时代# 用Claude Code这些工具,最赏心悦目的时候,就是看到模型自己拆分任务,多agent共同工作吧。有种“一直穿云箭,千军万马来相见!”的感觉。
#模型时代# 用Claude Code这些工具,最赏心悦目的时候,就是看到模型自己拆分任务,多agent共同工作吧。有种“一直穿云箭,千军万马来相见!”的感觉。
#占车位公务员不是知错了而是怕了#曾经仔细研究过车位被占的问题,几乎是无解的:
1、你可以联系对方车主,对方很配合,一来一回也浪费了时间,这已经是最好的情况;2、你可以联系物业,物业也不过是帮你联系对方车主,其他过程和1一模一样;3、如果联系了对方不来,你堵在对方车头,或者给对方车上锁,都是涉嫌扰乱公共秩序,这个罪过比占车位还大;4、唯一解就是给车位上锁。(是的,自己花钱买设备,自己停车多费事,所以我才说就是这么无解)
5、其实,所有人都可能有急事占了别人的车位,态度良好,行动迅速,道歉、挪车才是正道;以及,完全不能理解盯着一个车位占的。
😄 🤦
HSD 2.0的慕尼黑首秀,优雅从容的穿街过巷,尽管目前系统还从未用欧洲数据训练过 …
#SK海力士暴涨# #模型时代# SK集团会长崔泰源:存储短缺要等到通用人工智能才结束,产能翻倍也不够用,中美AI策略完全不同
嘉宾:崔泰源(Chey Tae-won),SK集团会长 | 主持人:Ed Ludlow,Bloomberg Tech
时间/地点:2026年7月10日,纽约纳斯达克交易所
2026年7月10日Bloomberg Tech专访,SK集团会长崔泰源在纳斯达克交易所敲钟后接受采访。崔泰源是韩国第二大财阀SK集团的掌门人,旗下SK海力士(SK hynix)是全球第二大存储芯片制造商,也是AI训练和推理所依赖的高带宽存储器HBM的最大供应商,全球市场份额约58%(2026年Q1,Counterpoint Research数据),英伟达的首要HBM供应商。
当天,SK海力士以ADR(美国存托凭证,让外国公司的股票在美国交易所交易的机制)形式在纳斯达克挂牌,融资265亿美元,超过阿里巴巴2014年的250亿美元纪录,成为外国公司在美最大首发。这家公司15年前还在银行债权人的接管下挣扎求生,没有人愿意接手;2012年崔泰源以约30亿美元收购,当时被认为是一步险棋。2026年5月,SK海力士市值突破1万亿美元,6月一度超越三星电子成为韩国股市最大市值公司。
采访中最有信息量的一组对话出现在产能问题上:SK海力士刚宣布五年内产能翻倍,崔泰源说客户的反应是"不够,我们要五倍、六倍"。他判断,存储供应追不上AI需求的局面会一直持续,"直到人类社会在通用人工智能这件事上达成某种定局为止。"谈到中美AI策略差异时,崔泰源的观察是:美国押注顶级市场和token质量,中国用百万STEM毕业生和低成本token走另一条路,胜负未定。
第一部分:为什么是现在
Ludlow:一个合理的起点是:为什么是现在?你考虑美国上市已经有一段时间了,为什么选择现在把SK海力士推到美国投资者面前?
崔泰源:我们等这一天等了太久了。自从我大约15年前收购海力士,这就是我们的里程碑之一:必须打开进入美国资本市场的通道。现在梦想成真了。…
大家问"为什么是现在",但其实这已经是我们能做到的最早时间点了。
Ludlow:265亿美元是一笔大钱,但相比SK在韩国国内和全球范围内的投入规模,并不算大。我们能否期待SK海力士会多次发行ADR、多轮回到市场?
崔泰源:是的,我预计我们可以做到。我们会努力扩大ADR的规模,但这需要更好的回报。一旦我们交出更好的回报,需求自然就来了。所以第一件事是保持股价稳定,希望长期能有上涨空间。而且我看到,这个时刻——这是AI时代——AI时代引爆了对存储的大量需求。这是属于我们的时代。
Ludlow:这是近期的计划吗?你和管理层、CFO讨论过要定期发行ADR,还是还没有谈到这一步?
崔泰源:说实话,我们一直在讨论,但细节现在还不能透露。
Ludlow:美国上市给了SK一个新的股权融资渠道,但更广泛的美国资本市场呢?我们会看到SK集团或SK海力士发行全球债券吗?
崔泰源:有可能,但目前我们现金储备充足。SK海力士或其他SK集团旗下公司未来可以发行债券、进入资本市场。
第二部分:HBM供应紧张与AI需求
Ludlow:(举起一颗HBM4E芯片)请允许我向全球观众展示这个东西。这就是我们今天都聚在这里的原因。你几乎看不到它——一颗微小的HBM4E,高带宽存储器,这颗是12层堆叠。(笑声)HBM目前的供应有多紧张?更重要的是,这种紧张会持续多久?你能看到哪一年供应状况会发生变化吗?
崔泰源:要真正理解HBM存储的所有需求和条件,你必须先理解AI那一端。大家都知道大语言模型。对。但大语言模型固然重要,我认为未来随着我们更多地使用AI,AI对推理的需求会更大。而推理的关键是KV缓存(Key-Value Caching)。推理会产生大量KV缓存。要维持大语言模型的性能,你需要大容量的KV缓存,而这些缓存必须存储在某个地方。
这就像人类的记忆——和我们在大脑中存储记忆是一回事。AI也需要那种记忆。KV缓存必须有地方存放。存储容量越大,性能就越好。就这么简单。
而且存储的周期正在变成一种不同的周期——我不该说"周期",而是一种不同的动能。过去,存储芯片的需求取决于人口数量和硬件设备的数量。
Ludlow:那在某种程度上是一个消费电子的故事。
崔泰源:对。繁荣与萧条交替。你给自己的智能手机加内存,但你不需要几十部不同的手机——你只用一部,就像PC一样。所以需求受制于人口数量。但在AI时代不同了。你可能在未来几年会使用自己的AI智能体(agent),而且你可能拥有几百个不同的智能体。每个智能体都需要大量存储,因为它们会创造大量KV缓存,这些缓存必须存储在某个地方。这需要巨量的存储。这就是AI时代。存储生意已经进入了一个不同的阶段。
Ludlow:不过你还是把它称为周期。那是需求端。发行ADR的原因之一是融资扩产。你们的行业同行美光(Micron)最近表示,他们预计2028年供应状况会有所改善——在2027年之后——部分原因是新产能将上线。SK海力士怎么看?
崔泰源:嗯,我们跟客户谈过。几个月前我们刚宣布,要在五年内将产能翻倍。这意味着我们做了25年以上的业务,在接下来五年要把全部产能翻一倍。有人觉得这不现实,会导致过剩,大家很担心。但我的客户说:"不够。"
Ludlow:他们还需要更多?
崔泰源: "我们需要更多。"翻倍不够。他们真正想要的是五倍、六倍——越多越好,因为未来需求会指数级增长。
Ludlow:基于那些客户的需求——如果他们是看向未来的水晶球——他们相信这个需求水平会一直持续到2029、2030年?供应紧张会持续多久?
崔泰源:没有人能预测未来几年会发生什么。但我有一定信心,需求会增长,而我们的供应能力永远追不上。我不知道会持续多久,但我认为要到我们的社会——人类社会——在通用人工智能(通用人工智能)这件事上达成某种定局为止,到那时可能才会回归到旧的周期。但在那之前,我们需要大量存储。
第三部分:2012年的收购——一次大胆的押注
Ludlow:把时间拉回到2012年。SK收购海力士。当时很多人质疑这个决定。他们没看到什么?他们遗漏了什么,而你看到了存储市场的什么潜力?
崔泰源:那是一个大胆的决定。我认为从财务角度来说,我做了一个风险极高的赌注。那家公司当时深陷债务泥潭,挣扎在生存线上。大约15年前,那家公司在银行控制之下——简单说,就是一个类似美国"第11章"破产保护的状态。用韩国的说法叫"债务重组计划"(workout program)。但银行做了十多年的重组,没有人真正想要这个资产,因为风险太高。原因是存储生意是周期性的,承受着不可控的周期波动,而且每年都需要数十亿美元的资本开支,无论盈亏。
Ludlow:即便不赚钱。
崔泰源:即便不赚钱,这个生意也需要买设备、扩产能、适配新技术、购入新机器——你必须花巨额资本开支。所以没有人想碰这种危险的生意。
Ludlow:但你出手了。
崔泰源:对。我看到的东西不太一样。换一个角度看,存储制造是全世界最精密复杂的制造业务。如果你能做成这件事,你就能做成任何事。
Ludlow:如果你攻克了技术和工艺——
崔泰源:对。而且整个制造过程——你做出这些微小的芯片,里面有3800亿个晶体管。这就是这门生意。你怎么在这么小的硅片上放进这么多晶体管?这是技术的巅峰。一旦你能做到这一点,你就能管理好任何事情,也能挑战任何事情。而且在数字世界里,存储未来会创造巨大的价值。
Ludlow:所以那就是你看到的。
崔泰源:是的。我就赌了这一把。人类永远需要存储。
第四部分:长期合约——商业模式的转变
Ludlow:你被问过很多次了,但是长期合约这个概念——客户与供应商签订长期协议——是如何改变了这个行业的历史?
崔泰源:对。现在供应短缺,每个客户都想确保自己的供应、覆盖自己的需求。所以他们来找我们,要求签某种长期合同。这不是我们提议的——是他们主动要求的。
Ludlow:提出合约的是客户,不是SK?
崔泰源:不是SK。他们更愿意签。我们也乐意这么做,因为这样就不再是周期性生意了。有了长期协议,即便在行业下行期,我们也能维持出货量和一定的价格水平。这给了我们不同的动能,也创造了另一个机会——我们可以改变商业模式。
第五部分:SK集团的投资战略——AI数据中心及更多
Ludlow:SK的投资重心在哪里?国内和美国之间如何取舍——不只是用这次美股融资的资金,而是从整体资产负债表来看?
崔泰源:总体来说,在SK海力士之外,最重要的事是AI数据中心业务。我们宣布了未来10年近1万亿美元的投资计划,用来建设AI数据中心。我的目标是在韩国建设约15吉瓦的数据中心容量,在韩国以外建设约5吉瓦,包括美国在内的多个地区都在考虑范围内。核心问题是电力——电价对AI数据中心来说至关重要。但一旦建成AI数据中心,就能在存储芯片和基础设施之间产生协同效应。这就是我未来要做的事。
Ludlow:你谈到了数据中心的问题。这是SK集团层面的布局。所以你说的是SK集团在更广泛地审视AI技术栈,不只是存储。
崔泰源:对。
Ludlow:你还会关注哪些领域?
崔泰源:比如SK电讯,他们正在投入资源开发自己的大语言模型、应用程序,以及物理AI(Physical AI)方面。
Ludlow:机器人?
崔泰源:对,还有医疗健康。有大量的机会,我们一直在尝试把握这些业务方向。
第六部分:人才——全球竞争
Ludlow:在美国和韩国,人才都是一个问题。美国芯片行业存在技术工人短缺,而像美光这样的公司知道韩国有大量优秀人才。你打算怎么应对这个问题?这如何影响你在美国的投资计划?
崔泰源:要吸引更多人才——ADR是一个好的选择。ADR给了我们一些金融工具,比如股票期权。我们可以直接用ADR来做这些事。这对吸引人才加入我们集团有帮助。
Ludlow:所以ADR也关乎外界对SK的认知。
崔泰源:这是另一个层面。认知很重要。我们也要花大钱去招聘优秀人才。我不在乎人才来自哪里——美国、日本,哪里都行。我在努力招更多人才,这至关重要。我跟旗下CEO们说:你们的任务就是为未来锁定人才。干就是了。我们会创造大量就业岗位。我们宣布了数万亿美元级别的投资计划,需要大量人才。
第七部分:SK海力士的竞争优势
Ludlow:崔会长,SK在存储领域建立的最大技术优势是什么?
崔泰源:很难只说一件事。
Ludlow:最重要的是什么?
崔泰源:一个团队。我一直专注于把所有力量凝聚成一个公司、一个团队。存储制造是一个简单的商业模式。我们能强调的就是:我们是一个团队。我认为这一个团队创造了一个真正伟大的历史性成就。这是最重要的。当然,你也可以提到设计能力、制程技术——那些都对。
Ludlow:或者与台积电在base die(基础逻辑芯片)上的合作——其他厂商没有这么做。
崔泰源:还有一点,我们不与任何客户竞争。这也很重要。
Ludlow:你们不与任何客户竞争。你认为这很重要?
崔泰源:是的,这很重要。这给了我们大量的合作空间。这就是我们能维持所有合作伙伴关系的方式。
Ludlow:从更大的格局看——你能追上三星吗?
崔泰源:我不想回答这类问题。我的首要目标是让我们的利益相关方满意。为此,某种程度上需要竞争,但正面对抗不是我的目标。
Ludlow:但这很难,崔会长。股东想要利润,客户想要更多产能和供应。这两件事似乎是矛盾的。
崔泰源:这就是我们所说的"利益相关方"。不只是股东。股东要好回报,客户要便宜的产品和充足的供应。我不可能每时每刻满足每一方,但我们必须在利益相关方之间找到一种平衡。而且我还要让公司的成员——员工——感到快乐。快乐的公司才能创造快乐的成果。就这么简单。
第八部分:NAND闪存与"存储即服务"
Ludlow:ADR定价149美元。存储市场也在演变。虽然供应紧张,但业界对其他技术的关注面也在拓宽。我对SK海力士在NAND闪存上的策略以及你如何看待这项技术的未来角色很感兴趣。
崔泰源:NAND和DRAM是不同类型的存储。DRAM有自己的功能——它是即时响应型的。就像你记住某些数字,或者准备考试时需要快速调取的记忆。但你也需要大量其他类型的记忆——比如你小时候的记忆,不一定只存在大脑里,还存在别的地方。AI需要大量存储。DRAM提供的是即时响应。但如果数据量大——我们称之为"冷数据"——就可以存在NAND闪存里。
Ludlow:NAND这一端的创新在哪里?
崔泰源:涉及大量技术。NAND的问题在于延迟——响应需要更多时间。要解决延迟问题,我们需要特殊的技术。而且KV缓存——那些缓存必须存储在某个地方。这是一个金字塔,是整个存储系统的层级结构。我们需要所有这些层级一起演进。
Ludlow:SK会投资这些技术?
崔泰源:当然。这是我们的核心业务。我们会做,而且我们可以交付的不只是作为存储生产商的角色。我们可以提供"存储即服务"(Memory as a Service)。这是未来我们可以重点投入的另一个方向。
Ludlow:多说说"存储即服务"——它的基本运作方式是什么?
崔泰源:现在这还是一个构想——只是一个想法。但我认为整个AI的趋势方向就在那里,因为存储是真正的瓶颈。我们必须解决它。专业人员会为每个客户、每个应用场景提供特定类型的解决方案。不会有一个方案能覆盖所有问题——这不可能。不同的终端市场有自己的特征,我们必须为每个场景开发特定的存储配置——存储的堆叠方式、如何实现——还需要配套的专用软件。核心是,我们可以作为某种服务商,而不是简单地说"这是存储,你拿去用"。我们可以调配各种不同的存储系统。一旦做好了,我们就可以把它作为一种服务来交付,而不是只做一个大宗商品的生产者。
第九部分:AI成本与泡沫之问
Ludlow:去年10月你在接受Bloomberg的Shery Ahn采访时说过,大家一直问你"AI泡沫、AI泡沫、AI泡沫"。你当时说,问题的核心是AI的成本。AI的成本太高了。从10月到现在,情况有变化吗?AI成本的轨迹是怎样的?
崔泰源:AI的成本——你可以用每美元的token数或每token的美元数来衡量。我们必须降低token成本。
Ludlow:你看到成本在下降吗?
崔泰源:是的。三年之内,token成本大约会降到目前的五分之一甚至十分之一。这就是技术进化。大量参与者在共同推动token成本的下降。甚至我的存储公司也在研发降低token成本的解决方案——这是我们的挑战。方向是明确的。这是一个AI的生态系统。现在成本确实太高了。但凭借技术,也许五年、十年之后,我们能消化所有这些问题。AI可以变成"每个人的AI"。未来每个人都能使用自己的智能体。这就是我看到的方向。
Ludlow:但没有AI泡沫?
崔泰源:这么说吧——AI泡沫这件事,现实世界和股市是两回事。股市总有过度反应,过热或过冷。股价可能存在泡沫,但那不代表现实世界的全貌。从趋势来看,两年、三年之后,股市会反映真实世界。你可以说股市里有AI泡沫,但AI技术本身是真实的——你在用它。问题在于AI现在还不成熟,还不完美。
Ludlow:还处于早期阶段。
崔泰源:对,早期阶段。我说过,现在AI只是一个四岁的小孩。等它长成大学生,成熟了,它就能在生产力方面帮到我们很多。我们会依赖这些东西。这是一场竞赛,我们现在正处在AI试验期。
第十部分:SK的美国投资与特朗普政府
Ludlow:今天是历史性的一天。ADR上市确实是在创造历史。但关于对美国的聚焦——SK与美国的关系。你与特朗普政府的关系如何?你们如何合作,把更多的SK海力士带到美国?
崔泰源:不只是SK海力士。SK已经在美国投资了超过350亿美元,虽然很多人没有注意到。我们有生物制药业务,有电池业务,最近还在印第安纳州宣布了新的工厂(先进封装厂)。SK电讯也在AI初创企业上投入了大量资金。我们已经投了350亿美元,但我的计划是一个大得多的数字。
Ludlow:比350亿更大?
崔泰源:大得多。比350亿大得多得多得多。我正在规划中。今天是一个里程碑——我们进入了美国资本市场。我们有大量选择,也有责任维护股价。好的一面是,如果我们做对了投资,就能守住我们的价值。
第十一部分:中国的AI策略
Ludlow:中国是一个重要的市场,也是AI的推动力之一。
崔泰源:对。但我们必须注意,中国的路径和美国截然不同。
Ludlow:怎么不同?
崔泰源:他们虽然在AI上有很多短板,但他们投入了大量资源。第一是人力——人力资本。工程师的数量:中国每年有超过100万STEM专业的学生毕业。他们都在找工作,大多数流向科技行业。科技行业里面,大概50%是AI方向。所以他们在用一种不同的策略。我目前还没有看到明显的成果,但有一些迹象。他们在用更便宜的方式做事,试图创造更低成本的token。token成本竞争力确实重要。美国聚焦于高端、利基市场——追求token的质量。但中国走的是另一条路。最终结果我不知道,但我看到的是,他们在用不同的策略。
#模型时代# 东罗马史学者Kaldellis:为什么这个帝国能存续1200年?
这个有点离题万里了,一期讲历史的。Lex Fridman Podcast的第498期。
嘉宾Anthony Kaldellis,芝加哥大学古典学教授,著有近千页的东罗马帝国通史《The New Roman Empire》和《Streams of Gold, Rivers of Blood》,主持播客Byzantium & Friends。他目前正在写一本新书,专门从分析角度回答一个问题:东罗马帝国凭什么存续这么久。
一个在1000年里经历了大约120次权力争夺、46%的皇帝被暴力更迭的国家,按常理早该四分五裂。但东罗马帝国的历史提供了一组完全相反的事实:没有任何一个罗马行省试图脱离;武力几乎从未被用于管控平民;每次遭受外部冲击、丢失大片领土后,这个社会都能自行恢复、重新增长。Kaldellis花了多年时间研究这个悖论,这次近四小时的对话,是他对这套分析框架极为详尽的一次阐述。
我是历史知识盲(是真盲)。不过曾和一位专家W老师聊天时,他对我说,其实西方世界一直都想重建罗马。或者说,以成为新罗马,作为最高理想。另外,不知道研究罗马和研究明史,是不是比较类似?
一、"拜占庭帝国"从未存在过
1、这个名字是后人发明的政治工具
所有原始文献都清楚地表明,所谓的"拜占庭帝国"自始至终称自己为罗马帝国。它的臣民是罗马公民,他们自称罗马人,直到帝国终结乃至之后都是如此。"拜占庭"这个标签是西欧人出于政治目的发明的,先叫了一千年"希腊人的帝国",后来又换成"拜占庭帝国"。Kaldellis认为,学术界正在进入一个新阶段:承认罗马国家的历史是一个连续体,从古典时期一直延伸到15世纪。
这个连续体的正式名称是Romania,即罗马人的国家。他们自己的语言里甚至没有一个对应于英语empire的官方术语。
2、忒修斯之船:变化不等于断裂
古希腊有一个思想实验:一艘船在航行中逐渐替换了每一块木板,最后没有一块原始部件,但它仍然是那艘船。…
Kaldellis用这个比喻来说明罗马历史的独特之处:它是一个政治共同体的历史。基督教可以在任何国家传播,希腊文化可以在任何地方传承,但罗马历史只能是一个特定政体的故事。变化始终在发生,但每一代人经历的变化都足够缓慢,以至于没人会觉得自己已经不再是同一个故事的一部分。
最终的结果是:说希腊语的东正教罗马人和说拉丁语、崇拜古罗马诸神的共和国时期罗马人,看起来当然截然不同。但如果你在两者之间放一个公元2世纪的皇帝哈德良,这位双语、世界主义的君主和几百年后一个同样双语、世界主义的东罗马皇帝之间的共通点,远多于他和公元前4世纪在意大利山区作战的古罗马战士之间的共通点。我们人为划定的"罗马/拜占庭"分界线,恰恰切在了最不应该切的地方。
3、跨时代的连续性藏在具体的社会角色里
罗马士兵在帝国存续的每个世纪都宣誓效忠,誓词内容大同小异。做生意的罗马女性,在任何一个世纪都受罗马财产法和继承法的保护。10世纪、11世纪的犹太女性发现,在罗马法院她们享有的权利比在拉比法庭里更多,于是把纠纷带到罗马法院处理。对罗马人来说,这是财产问题;对拉比来说,这是宗教问题。但罗马法院的判决高于犹太法庭。
这些跨越世纪的一致性,才是"罗马"这个词真正的含义。公元6世纪有一位东罗马外交官在与波斯人谈判时说了一句话:"The Romans. The name should say it all."——你现在面对的是罗马人,这个名字本身就说明了一切。持续了上千年的政治传统的分量,浓缩在这一句话里。
二、持续的民意检验:权力的真正制衡机制
1、皇帝的宝座没有法定继承权
这是理解整个政治体制的关键。罗马皇帝不像奥斯曼帝国的苏丹那样,因为王朝通过征服创建了国家而天然拥有王位。罗马皇帝是从共和国内部生长出来的角色。为了在争夺结束后获得稳定的执政地位,早期皇帝从罗马帝国的第一位皇帝奥古斯都开始就必须假装自己不是君主:"我只是共和国的第一公民,元老院给了我这些职务。"这层表演虽然是门面,但它的存在本身极为重要,因为它设定了一个底层规则:没人天生有权坐那个位子。
2、46%的非正常更迭率造就了一种实质性的问责制
君士坦丁堡的核心公共空间是竞技场,即Hippodrome,能容纳数万人,既办赛车也办政治集会。皇帝在那里公开露面,民众用欢呼或沉默投票。如果呼声热烈,一切照旧。如果民众沉默甚至发出嘘声,皇帝就知道出了问题,必须查明原因并尽快解决。可能是粮食供应出了状况,可能是税收政策引发不满。
Kaldellis把这套机制叫做一种"持续的民意检验"。现代选举给政府一个四五年的合法执政期,在这期间你再不受欢迎也是合法的。君士坦丁堡没有这种缓冲,皇帝的合法性在每一天、每一次公开露面中被实时检验。一个真实案例:1190年代,皇帝阿历克塞三世想对民众征收一种新税来应付德意志皇帝的勒索,他在竞技场宣布了"德意志税"。民众当场暴怒,他立刻收回:"那不是我的主意,不知道谁提的。我们不征了。"
3、权力争夺是调频旋钮,不是系统崩溃
1000年大约120次权力争夺,但几乎都在短时间内结束,且从不关乎意识形态。参与者的意识形态完全一致,争夺的只是谁来执政。一旦有了赢家,所有人归队。有时候有人想发起夺权,他会沿着君士坦丁堡的中央大道走下去,召集民众到圣索菲亚大教堂集合,要求废黜皇帝。有时候成功了,有时候人群越走越少,最后只剩这个人孤零零地跑进教堂寻求庇护。
这些争夺从不导致帝国分裂,从不产生持久的对立派系,也从不产生分离倾向。
4、皇帝的"人设":言行一致是怎么做到的
帝国当局持续对臣民广播一套特定的形象:我们在为你们的利益服务;我们对自己的行为负责;我们在提前预判你们可能遇到的问题并加以解决;我们夜以继日地工作。查士丁尼的"不眠皇帝"绰号就来自于此——他是一个公认的工作狂,半夜还在召见官员讨论战争、建筑、法律和神学。
Kaldellis从马基雅维利那里借来了一条分析原则:判断统治者要看他们做什么,不看他们说什么。他的研究结论是,在东罗马帝国,言辞和行动之间的差距总体上相当小。皇帝们确实有动机去兑现承诺,因为不兑现的代价是真实的非正常更迭。
三、税收:帝国真正的心脏
1、如果只能选一个解释因素,就是税收
问到帝国存续的最重要单一因素,Kaldellis的回答毫不犹豫:税收。公元3世纪末重建帝国行政体系的关键人物戴克里先(公元284—305年在位),建立了一套覆盖全帝国的普查和税收体系。每一块可耕地都被登记在案,税收不是一年一次,而是大约一年三次,而且不止是货币,还包括实物、劳役和兵源。每一次征收都意味着国家官员与社区的一次直接接触,这套系统因此创造了一个极为密集的制度网络,把每一个社区都编织进帝国的机体里。
2、不存在"与世隔绝的农民"
学术界偶尔会假设帝国深处存在那种与中央完全脱节、甚至不知道皇帝是谁的偏远农村社区。Kaldellis认为这是一个神话,找不到任何此类社区存在的证据。每一块可耕地都已经被普查了好几个世纪,隐藏一个村庄根本不可能。偶尔有基督教苦修者走到极远的深山里,文献中会说"连税务普查员都到不了那里"——这恰恰说明,"税务普查员是否到达"是衡量"有没有脱离文明"的标准。
再加上教堂(有布道、有日历、有为皇帝祈祷的仪式)和到处流通的硬币,这个帝国的臣民对时间、空间、价值和权力关系的理解,全部被国家制度所塑造。
3、君士坦丁堡的人口奇迹:国家激励结构的力量
君士坦丁堡从一个约2.5万人的小城拜占庭,在两个世纪内增长到50万人口。这个速度靠自然繁殖完全不可能实现,而且古代城市因疾病密度高,每年还要净损失1%到3%的人口。唯一的解释是大规模行省移民。Kaldellis做了一个简单的算术:皇帝把约2500名元老院议员迁入新首都,按每户保守估计30人的随从规模计算,仅此一项就接近10万人。再加上君士坦丁设置的大约20万人的免费面包配额,激励更多人涌入。
供应这些面包的粮食来自埃及。新罗马从旧罗马的嘴里抢走了食物。旧罗马没有饿死,因为北非和西西里可以替代,但这发出了一个强烈的信号:帝国的重心已经东移。
4、意大利免税特权的终结:平等税制的政治意义
戴克里先之前,意大利本土不交税,征服者不给自己交税。戴克里先和他的伊利里亚同僚出身巴尔干,一个经济欠发达地区。他们的态度毫不客气:意大利是帝国最富裕的地区之一,为什么免税?从此意大利也进入税基。所有罗马公民同一法律、同一税制,这在当时的标准下实际上具有进步意义,因为连精英阶层也要按相同的标准缴纳。
5、宦官:皇帝对抗官僚惰性的工具
帝国的文官系统庞大且自成体系。皇帝面临的一个核心风险是被自己的官僚机构架空。如果官僚系统能自行运转、自行解决问题,皇帝就变得可有可无。解决方案之一是起用宦官。宦官通常出身帝国外部或奴隶阶层,没有家族网络,不能生育后代,完全依赖皇帝本人的恩宠。皇帝会刻意把宦官安插到军事指挥等关键岗位上,打破既有将领的权力网络。
查士丁尼的将军纳尔塞斯就是一个宦官。他年迈、矮小,哥特人看到他哈哈大笑。但在意大利的决定性战役中,最后笑的人是纳尔塞斯。
四、公民权与基督教:两个改变帝国轨迹的决定
1、卡拉卡拉敕令(公元212年):罗马做了大英帝国永远不会做的事
公元212年,皇帝卡拉卡拉颁布《安东尼努斯敕令》,将罗马公民权扩展至帝国境内所有自由居民。在此之前,大约只有三分之一的自由人口是罗马公民,其余人只有当地公民身份。关键在于,这不是一纸空文。一代人之内,所有皇帝都来自行省,帝国最有权势的人物全部是行省出身。
Kaldellis用了一个类比:试想大英帝国在巅峰期把英国公民权授予所有人,包括印度人,并且把伦敦的最高权力职位向印度人开放,包括王位。这在以种族和殖民主义为底色的近现代帝国中完全不可想象。但罗马帝国做到了,而且认真执行了。
2、君士坦丁的基督教转向:个人信仰还是政治算计?
公元312年前后,君士坦丁皈依基督教。当时基督徒最多占帝国人口的10%,主要集中在城市的中产和中下层,政治影响力有限。学术界曾经流行"政治功利论",认为君士坦丁是为了获得某种政治利益才选择基督教。但Kaldellis说,他从未看到过一个有说服力的论证来说明这个"政治利益"到底是什么。最终只能退回到个人解释:他相信基督教的上帝在战场上帮助了他。
不过君士坦丁是一个极其务实的人。面对基督徒听众,他会提到基督。面对全体臣民,他只说"正确的宗教",让你自己去理解。他在君士坦丁堡广场中央竖了一座巨大的镀金雕像,造型是一尊裸体、头顶光芒四射的阿波罗,只不过脸换成了他自己的。
3、宗教被帝国的国家机器所吸收
基督教讲述的是一个"胜利"叙事:正信战胜了异教。但如果你从帝国国家机器的方向看,基督教没有征服它,也没有驯服它,反而变成了它的一个组成部分。整个过程花了大约两个世纪,从君士坦丁到公元6世纪初,帝国才真正成为一个以基督徒为压倒性多数的社会。
方法是激励加限制:主教获得资金去做慈善,土地被赠予教会;同时传统宗教的活动被逐步立法禁止。这和伊斯兰教的历史形成鲜明对比。伊斯兰教诞生时没有一个现成的国家来接纳它,它自己创建了国家。基督教诞生在一个高度发达的政治体系内部,被这个体系吸收和塑造,走了一条完全不同的路。
4、正教信仰:凝聚与撕裂并存
排他性宗教同时是最强大的凝聚力和最危险的分裂力。古代宗教很少产生身份冲突,但当你宣称"我的信仰是真的,你的信仰是魔鬼放进你脑子里的",社区的边界就变得锋利。Kaldellis说他无法判定基督教对东罗马帝国的净效应是正是负,因为它两方面都做到了极致。
到了帝国末期,人们面临选择:接受西方天主教统治(必须改变信仰)还是接受奥斯曼统治(可以保留信仰)。一些人明确选择了后者。信仰的代价是真实的,他们愿意支付。
Kaldellis还指出,这个社会其实是人类历史上唯一一个同时承载罗马政治身份、基督教信仰和希腊文化传统的社会。三种元素在不同人身上产生不同的组合:有人全力投入正教修道主义,有人只关心世俗政治,有人一心钻研希腊文学。正是这种多元组合的可能性,让这个社会拥有了独特的内部弹性。
5、圣像破坏运动:真正关心的人可能只有100到200个
8世纪到9世纪,帝国经历了围绕是否应该在教堂中使用圣像(icon)的激烈争论,史称圣像破坏运动。传统叙事把这描述为撕裂社会的重大危机。但Kaldellis的研究得出了一个不同的结论:他找不到民众对这件事表达强烈意见的证据。真正投入这场争论的大概只有一小群皇帝、主教和修道院长,总共可能100到200人。但他们恰好是写文献的那群人。
每当皇帝改变政策方向,几乎所有人都立刻换立场跟上。这说明对大多数人来说,圣像问题并不触及核心关切。最终支持圣像的一方获胜,此后东正教教堂开始铺满圣像画,这个传统一直延续到今天。
五、查士丁尼:一个无法被归入"好"或"坏"的皇帝
1、从农民到皇帝:才能是唯一的用人标准
查士丁尼(公元527—565年在位)出身于西巴尔干的贫困农业社区。他的叔叔查士丁一世从行伍中一路升迁成为皇帝,再把他推上接班人位置。查士丁尼选择合作者的唯一标准是才能:他的妻子狄奥多拉是前性工作者(为了合法娶她,他让叔叔修改了禁止元老院议员与"不光彩职业"从业者通婚的法律);他的团队里充满了出身卑微但能力出众的人。
他主持编纂了被后世称为Corpus Juris Civilis的罗马民法大全,由法学家特里波尼安的委员会完成。这部法典实质上定义了我们今天所说的"罗马法"。我们能看到的罗马法,几乎全部来自这个君士坦丁堡的委员会版本。欧洲大陆的法律学生至今仍然要学习它。
2、征服的代价:战略透支
查士丁尼认为自己受上帝授权去收复西罗马帝国的失地。北非的收复可能划算,但意大利的战争持续了几十年,把这个半岛打得遍体鳞伤,最终可能连自付成本都不够。更严重的是,为了西征他抽调了东部的兵力,导致波斯人长驱直入,摧毁了安条克。用Kaldellis的话说,你不能靠放弃叙利亚来换取北非的征服。
Kaldellis对征服本身不给额外加分。他衡量皇帝的标准是:你的臣民因为你的执政过得更好了吗?你是否加强了长期服务于臣民的制度?按这个标准,查士丁尼功过参半到难以归类,所以他在Kaldellis的"十佳皇帝"和"十差皇帝"名单上都没有出现。
3、查士丁尼瘟疫:50%死亡率?证据不支持
公元541年,鼠疫杆菌(Yersinia pestis)在帝国爆发,持续了大约两个世纪,史称"查士丁尼瘟疫"。一些学者主张50%的人口死亡率。Kaldellis对此持强烈怀疑态度:如果真的死了一半人口,社会必然全面停摆,就像14世纪黑死病冲击下的欧洲那样。但在6世纪的东罗马帝国,查士丁尼同时在四五条战线上作战,战争叙事中看不到任何因瘟疫而暂停的迹象。税收继续,法院照常运转。他倾向于认为瘟疫的影响远低于50%。
4、尼卡事变:皇帝对平民动用武力的极罕见案例
公元532年,君士坦丁堡爆发尼卡事变,街头冲突持续约10天。查士丁尼最终下令武力清场,造成超过3万人死亡。这在东罗马帝国1200年的历史中几乎是唯一一次皇帝对本国平民大规模动用武力。大量城区被焚毁,查士丁尼随后重建了君士坦丁堡,包括建造圣索菲亚大教堂。
六、为什么这个帝国活了1200年
Kaldellis说这是他正在写的下一本书要回答的问题。东罗马帝国地处人类历史上帝国建设和新宗教扩张的核心通道正中央,用他的原话说,"This is the most dangerous neighborhood that you can possibly live in"——这是你能住的最危险的街区。英国、葡萄牙、日本这些长寿国家都缩在世界的边角,东罗马帝国不是。能在这样的地缘位置上存续1200年,需要解释。
1、三次外部冲击,每次都快速而致命
Kaldellis把帝国的领土损失归结为三次离散的外部冲击:公元630年代的阿拉伯征服(一个十年内完成)、1070年代的塞尔柱突厥征服小亚细亚(极其迅速,后来仅部分逆转)、1204年第四次十字军攻陷君士坦丁堡。这三次冲击都来得极快,造成巨大破坏。但帝国历史的绝大部分时间是缓慢而稳定的经济增长、领土巩固和人口恢复。
2、希腊火、海军与反复止血
每次遭受重击后,帝国首先要止住流血。在阿拉伯征服之后,帝国把兵力收缩到小亚细亚,花了几十年才稳住防线。一项关键的军事技术是希腊火,一种国家最高机密级别的燃烧武器。它通过加压容器和喷嘴喷出可燃化合物,在水面上持续燃烧,无法扑灭。帝国甚至开发了手榴弹形态:陶罐装化合物,外挂引信,投掷后引燃目标。这种武器在两次阿拉伯围攻君士坦丁堡和后来抵御维京人袭击中都发挥了决定性作用。
配方和制造工艺被严格保密。至今学界仍在争论其具体成分,这本身就证明了保密工作的成功。
3、定义这个社会的,应该是它的恢复能力
这是Kaldellis对整个领域提出的方法论挑战。传统的"拜占庭简史"类著作,从一个高光时刻跳到下一个高光时刻,中间穿插危机。读者无法从中理解那些高光时刻之间的深层连接,那些制度、意识形态和日常生活是如何把社会粘合在一起的。
他的核心论点:外部冲击是这个社会的遭遇,而它的内生特质是冲击过后每次都能自行恢复。没有外部力量来帮助它重建,重建的动力全部来自内部。用什么来定义这个社会?几次短暂的外部危机,还是长达数个世纪的内生性恢复和增长?Kaldellis的回答毫不含糊:后者。
4、导致其他帝国崩溃的因素全部缺席
1200年历史中:没有分离倾向(唯一例外是保加利亚,在被征服约170年后于1185年独立);中央从未丧失对领土的征税能力;从未出现地方军阀割据;从未发生大规模农民民变。法兰克人的帝国在查理曼之后就被继承人分割了,但东罗马帝国从未被任何皇帝主动拆分。
那么,韧性最终在什么时候耗尽?Kaldellis认为大约在1300年到1350年之间。1300年前后丢失了整个小亚细亚,帝国失去了在欧亚两翼之间调度资源的关键能力。即便如此,当时帝国的领土面积和收入大致相当于英格兰,并未完全丧失希望。真正的致命打击是紧随其后的一系列权力争夺、塞尔维亚的扩张和黑死病三重叠加。帖木儿从中亚突袭奥斯曼帝国,意外延缓了最终崩溃,但也只多续了大约50年。
5、两个力量的叠加
Kaldellis给出的解释分两部分。第一,当局做出了巨大努力来说服臣民帝国在为他们的利益服务,而且大体上确实在这么做。第二,帝国拥有一个紧密统一的身份,"罗马人"加"正教徒"。臣民知道自己被非罗马人、非基督教徒的敌人包围,不想生活在那些人的统治下。这两个因素叠加,给了每个人足够的理由留在这个系统里。
替代方案更差。这就够了。
Kaldellis对现代治理提出的启示可以归结为一句话:投资于为多数人服务的制度,向他们解释为什么要付出代价,然后真的去做你说过的话。"言行一致"不是道德口号,而是一种权力技术。你的行动越接近你的言辞,你的言辞就越有约束力和动员力。反过来,当言行之间的差距大到民众都不再相信时,这本身就是系统性风险。他以美国外交政策为例:美国的高频习惯是宣布崇高目标,但是……。
上一波全球化到中国的时候,还是微笑曲线理论占主导,品牌研发重要,制造不重要,还会反思造一部iPhone,苹果赚多少,富士康赚多少;时过境迁,现在人人都觉得制造也是“最重要的”。所以,现在出海,必然是“重资产出海”。
国内财经自媒体基本都是胡扯。
印尼新政策下,中国企业只能本地生产深度加工,不是纷纷撤出印尼。
人家印尼明明赢麻了,还各种污蔑。
宁德时代旗下邦普循环联合印尼国企ANTAM等合作的印尼电池全链条项目,总规划投资60亿美元(约430亿元人民币),项目周期5年,覆盖镍矿开采、湿法冶炼、正极材料、电芯制造、电池回收全环节,2025年6月正式动工。其中宁德时代方面出资约39.37亿美元。
2025年10月公告1.31亿美元采购资金用于印尼工厂建设;同期无全新大额增资公告,原有60亿美元项目按进度持续落地。
青山集团在印尼整体累计投资超930亿元人民币,集中在莫罗瓦利(IMIP)、纬达贝(IWIP)两大工业园,核心为镍矿、高冰镍、不锈钢冶炼。
近一年新增项目(2025.7-2026.7)
2026年5月官宣新建印尼北马鲁古电解铝项目,总投资30亿美元(约204亿元)
以下为2025年7月—2026年7月期间,发布印尼投资正式公告的A股上市公司,按行业划分整理:
一、新能源锂电(镍矿、前驱体、正极材料)
1. 龙蟠科技(603906)
2026年6月公告,投建印尼锂源三期项目,总投资约10.88亿元,建设12万吨磷酸铁锂产线,叠加存量产能,当地铁锂总产能规划24万吨。
2. 华友钴业(603799)
2026年2月公告,联合印尼国有矿业企业ANTAM、IBC落地全产业链项目,涵盖镍冶炼、三元前驱体、正极材料与电池工厂。
3. 亿纬锂能(300014)
同步参与上述印尼一体化电池项目,布局镍冶炼、三元正极及20GWh动力电池产能。
4. 格林美(002340)
2025年9月与淡水河谷印尼签署镍冶炼项目;同年10月引入蔚蓝锂芯对其印尼材料公司增资扩股,规划配套正极材料产能。…
5. 蔚蓝锂芯(002245)
2025年10月出资2000万美元入股格林美印尼项目;2026年7月公告,自筹2.9亿美元在印尼建设5GWh锂电池生产基地。
二、制造加工类
1. 顾家家居(603816)
2025年9月公告,斥资11.24亿元在印尼建设家居生产制造基地。
2. 振邦智能(003028)
2025年7月公告,合计投入1100万美元设立印尼子公司,建设电控产品生产基地。
3. 东方雨虹(002271)
2026年6月公告,收购两家印尼化工企业多数股权,落地本地化建材生产。
三、消费食品行业
1. 东鹏饮料(605499)
2026年1月公告,印尼子公司完成注册,建设功能饮料本地化生产工厂。
2. 欢乐家(300997)
2026年7月公告,上调印尼椰子加工项目总投资额至5500万美元,扩大原料加工产能。
四、环保公用行业
旺能环境(002034)
2026年3月公告,设立合资公司运营印尼勿加泗垃圾焚烧发电项目,并为项目提供履约担保。
//@中科大胡不归://@考古学渣:跟一群NPC一样,跑来评论就是一堆莫名其妙的话,再贴上一堆编排好的图片,文不对题,不知道想表达什么
我一直都知道伪史派喜欢“先编造他人说法,再依据自己编造的谣言说他人造假”。
不过我以前只知道伪史派会编造数据。
今天才知道,他们还会P图。
图1是伪史派P的图。
图2是原图,红线为本人所加,方便大家看出区别。图2来自少年儿童出版社1982版《世界五千年》第一册143页,版权页见图3。
为什么伪史派要P图呢?
当然是为了自我画靶虚空索敌骗流量了,还能为啥?
不P图的话,何以编造所谓“西方历史”所说的马其顿方阵长矛长度是假的?
我很好奇啊……难道在伪史派眼里,西方历史就那么无懈可击?以至于伪史派不凭空捏造、篡改史料,就找不出西方历史的任何漏洞吗?


//@摇摆时间线ZHLMI:🍉呵呵//@i陆三金:除了字节通吃之外,又一次复刻了其他领域的剧本。发现机会→批量涌入→卷到极致→产能过剩→一地鸡毛。他是名和钱都赚到了,剩下一堆没吃上热的的,等着下一波浪潮,再来一次循环。
看十字路口对AI漫剧创始人的访谈,也意外也不意外,可以说十分中国了。
“对。成也字节,败也字节。
我听别人讲过一句话,做生意的大厂,一般不会赚走最后一枚铜板。但现在字节给我的感觉,就是把最后一枚铜板都赚走。这就是现在的状态。”


#雷军回应做增程车#原来是新能源是增量市场,现在增程是增量,若干年后,燃油车可能也是增量。自己没做过的,都是增量。
//@薛凯-又重名了:从国外进口氦气的公司,和需要使用氦气的公司又不是同一个公司,即便是同一公司,如果出口获利更高,比自用更赚钱,显然也会选择出口。现在存储芯片太贵,已经有手机厂商不生产手机,转而卖自己囤的存储芯片了//@蚁工厂:[柯基]也听说国内很缺氦,没想到之前还有出口
几个赢学家又把禁止氦气出口讲成了中国卡其他国家脖子了,彻底讲反了。
氦气又不是钢铁这种可以反复冶炼循环利用的资源,氦一旦进入空气,就会摆脱地球引力,一路飘到外太空去。地球上的氦都来自于地层深处核裂变,然后逐步在某些地层里富集起来,通常和天然气伴生,所以地球上几个氦气开采大国,就是天然气大国,尤其是美国。
中国的氦气开采量还不到自己用量的五分之一,曾经主要从美国进口,后来两国相互卡脖子,中国又开辟了卡塔尔、俄罗斯、哈萨克斯坦等新渠道。现在卡塔尔被伊朗封锁了,俄罗斯的工厂被乌克兰炸了,国际市场上氦气价格暴涨几倍。
氦不和其他元素化学反应,在高端工业里非常重要,很多精密制造要在氦气环境里进行,同时也是超低温制冷的核心介质。现在是中国这个第一工业大国自己的存量告急了,赢学家们就别瞎扯什么卡别人脖子,中国的唯一对手是美国,美国不缺氦气。
少花点时间刷社交媒体。住在大城市以外。少出去参加夜生活。少抽烟。少喝酒。你可能会做出更好的投资决策。有时,过度暴露于市场情绪并不是好事。
或者,他没能稳住局面(Anthropic、Thinky、Core Automation 等),还大肆吹嘘自己的技术,结果所有人都看到了生存级威胁,引来了所有超大规模云服务商的竞争。如果他当时打好手里的牌,我敢说根本不会有 Anthropic、Meta TBD 或 xAI。
Sam Altman 可能是我们这个时代最伟大的 CEO。他几乎让每一家主要科技公司的 CEO 都投入数千亿美元来与他竞争,有时甚至还会串通(见 Elon + Zuck)。我不知道 Gates、Zuck,甚至 Elon 在创办自己公司的时候,是否也面临过这样的竞争。OpenAI 仍然持续产出一些最好的模型,而且在几乎每个类别中都最终胜出。我唯一的问题是,@paulg 在那次 10 分钟的 YC 面试中看到了什么?
Anthropic 7月 10日发布了一场关于 Agent基础设施的对谈。Claude平台工程负责人 Katelyn Lesse、产品负责人 Angela Jiang和产品经理 Jess Yann,分享了几个来自一线的观察。
【Agent的“脚手架”正在变薄】
几个月前,搭建 Agent往往需要写大量流程控制代码:先执行 A,满足条件再进入 B,遇到不同情况还要切换不同分支。流程越复杂,系统越容易出错。
随着模型的推理和工具调用能力增强,这些编排层(harness)正在变薄。开发者不用再规定每一步,只需给出目标和基本边界,让模型自己决定怎么完成。
与此同时,一种更高层的编排方式开始出现:让多个 Agent同时解决一个问题,从中选出最佳方案;让一个 Agent提方案,另一个负责挑错;或者在 Agent卡住时,请另一个能力更强的 Agent提供建议。
重点正在从“控制每一步”,转向“设计 Agent之间如何协作”。
【衡量 Agent “投入产出比”(ROI,Return on Investment),先看一个人快了多少】
Angela建议,企业不要一开始就规划上百个自动化流程,而应该先看一个具体的人:用了 Agent之后,他的工作速度和产出提高了多少?
验证有效后,再从个人推广到团队,最后才处理跨部门流程。前期重点看速度和生产力,等应用逐步成熟,再衡量收入、成本和用户指标。
很多企业做 AI转型时,喜欢先画一张宏大的自动化蓝图。问题是,流程涉及的部门越多、规则越复杂,落地阻力就越大。从个人开始,更容易看到效果,也更容易持续推进。
【工程团队没消失,但每个人的角色都变了】
Katelyn观察到,Anthropic的工程团队和半年前相比,人员构成没有太大变化,但协作方式已经不同。
过去通常由技术负责人决定架构,其他工程师领取任务、编写代码。现在,更多工程师会参与产品和架构决策,再分别指挥 Claude完成具体工作。
Agent的作用也不再只是“帮忙写代码”。…
她提到 Shopify的 River系统,已经把需求文档、开发环境、代码实现和 QA测试串成了一套端到端的 Agent工作流。
【个体变强,不等于团队自然变好】
Agent降低了开发和试错成本,也可能带来新的问题。
过去,一个团队会先讨论十个方案中哪个最值得做。现在,每个人都可以快速做出十个原型,甚至全部上线,让市场决定谁胜出。
这样做速度很快,但如果缺少统一方向,产品很容易无序扩张。Agent能显著放大个人能力,却不会自动解决团队的协调、取舍和决策问题。
来源:
#AI
这个改造的流程有更高效、更完善版本,是 Orca自带的编排功能。
讨论部分的流程不变:/grill → /spec → /tickets。
之前是新开对话,然后单个 tickets走 /implement。自己逐一验收。
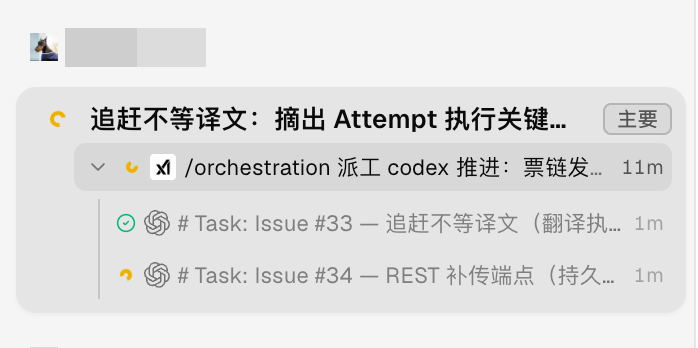
现在改成新开对话,用 /orchestration监工,会根据 tickets安排子代理串行或并行。最后它帮你完成验收。
比如:/orchestration派工 codex推进 tickets #33-#37。
昨天玩一天还真是全用上了,fable讨论需求、写文档、定票;grok监工或快速执行;gpt-sol按票去写代码。
grok确实是又快又好,iOS端的 grok快上 4.5就可以替代 chatgpt app了。
#AI
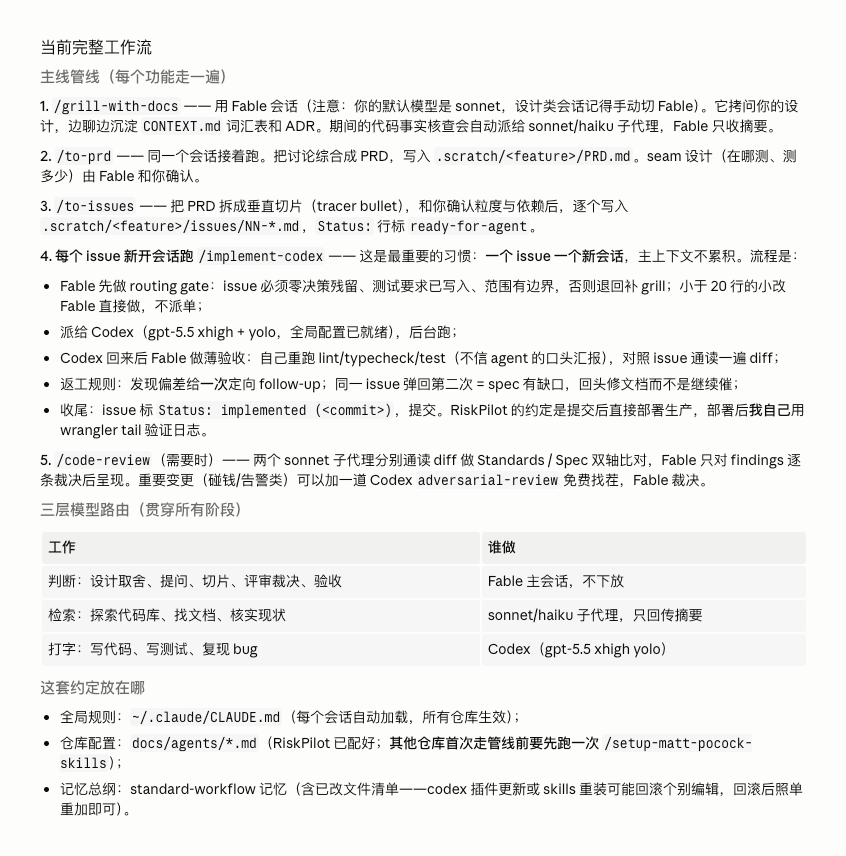
基于 mattpocock/skills和今天 Claude官方的 Fable token节约文章。
让 AI把 /implement改造成了 /implement-codex。
现在完整的工作流如图。
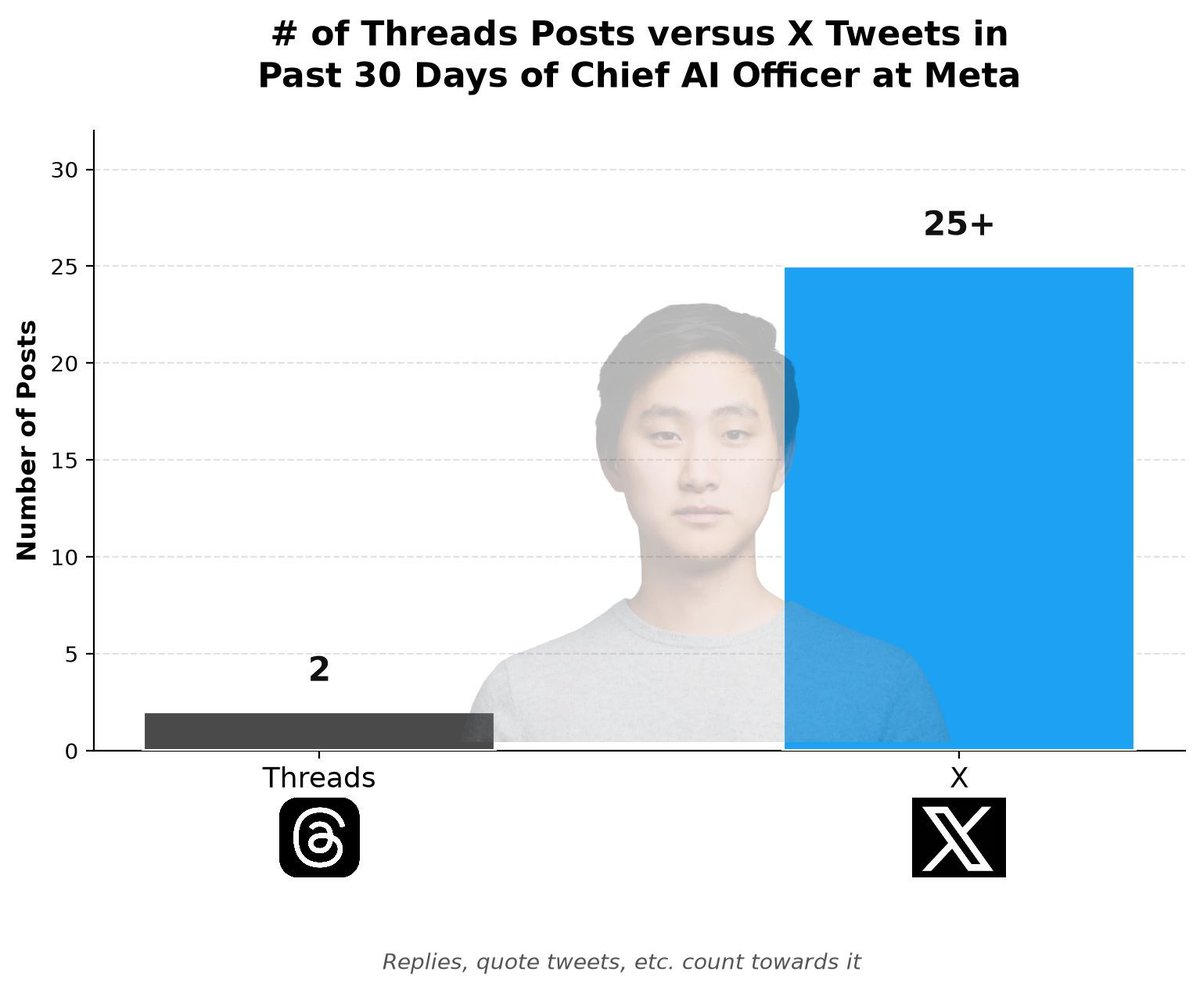
过去 30 天里,@alexandr_wang 只在 Meta 的 Threads 上发过两次帖子,而在 @X 上发了 25 多次。
嘿,@nikitabier 和 @elonmusk,你们能为 Alexandr 开启创作者变现吗?
那光线明显就是ai做的。。。不过大家都装傻发而已,毕竟现实中肯定有类似的桥段。。。#债见# 。。。
#无人机吊起2人神图系AI合成#所以,“AI标注”不会阻止AI假新闻:遵守规则的人不会造假,造假的人当然不会标注。
🇳🇴 平 🏴 坚定相信曼城后卫会习惯性把球传道哈兰德脚下
🇦🇷 胜 🇨🇭 蒸馍,你不扶器?
#模型时代# #SK海力士暴涨# SemiAnalysis创始人Dylan Patel:iPhone涨价几百美元之后,内存短缺才会停下来
这篇笔记含金量有点高了。来自WisdomTree Europe播客"The Next Big Thing",7月9日上线。嘉宾Dylan Patel是半导体与AI研究机构SemiAnalysis的创始人兼CEO。
当然,和观点相比,这哥们的经历也非常传奇。
Dylan Patel十几岁在硬件论坛写芯片帖,12岁在Reddit管理英伟达Nvidia和Android版块。2020年辞掉量化交易的工作开了实名博客分析半导体供应链,此后四年每年跑40场行业会议,从AI学术大会到只有300人参加的日本材料小众会议,上下游全覆盖。
他2020年从一个WordPress博客起步,到2026年7月已扩张到90人,2026年预计营收超过1亿美元(但Token支出高达1100万美元!)。2025年SemiAnalysis启动了开源推理基准InferenceX,OpenAI、微软、亚马逊、Google等相互竞争的公司同时向它捐赠硬件做中立测试,总价超5000万美元,8类芯片每晚自动在最新软件上跑完整基准。之后,WisdomTree与SemiAnalysis合作开发了AI基础设施指数,并于2026年6月推出了跟踪该指数的ETF(WAGI)。
2026年3月的GTC上,黄仁勋花五分钟展示InferenceX图表。英伟达最初称Blackwell推理性能是Hopper的25倍,InferenceX实测在软件持续优化后达到50倍,超过了英伟达更新后的35倍官宣。一时间名声大噪。
一、AI公司的经济账:谁在赚钱,钱花在哪
1、Anthropic已经开始盈利,增速是软件行业有史以来最快的
Dylan在播客中透露,Anthropic在2026年Q2的4月和5月已经实现了自由现金流为正和盈利,6月账目尚未完全关闭但趋势相同。ARR已经突破500亿美元,毛利率超过70%。…
作为参照,CNBC在2026年5月报道称Anthropic Q2营收有望达到109亿美元,将成为公司第一个盈利季度。Yipit在2026年7月10日估计Anthropic的ARR已达690亿美元,日增ARR约5.5亿美元。从2025年底的90亿美元到半年后突破600亿美元,这个增速在企业软件历史上没有先例。
2、SemiAnalysis自己的AI支出数据是一面镜子
Dylan用自家公司做了一个活生生的案例。2025年11月,SemiAnalysis的年化AI支出不到10万美元,主要是给每个员工买了200美元档的ChatGPT订阅。2025年12月Claude Code开始爆发,到2026年1月底年化支出飙升到400万美元,到播客录制时(2026年7月)已经达到1100万美元。90人公司,年化AI支出1100万美元,相当于员工薪资总支出的三分之一以上。
Dylan说到年底可能会接近50%。他估算一个年薪30万美元的优秀开发者,其AI支出正在接近一比一的比例。
3、成本优化的直觉往往是反的
多数公司的第一反应是用便宜模型降成本。Dylan把AI工作负载分成两类来拆解这个问题。
第一类是流程嵌入型:把AI接入现有业务流程(比如自动审核客户文档),只需要达到某个质量线,然后等更便宜的模型出来就行。AI模型的性价比每年提升约60倍。DeepSeek V3对比GPT-4便宜了600倍,中间间隔大约两年。
第二类是AI助手型:人和模型频繁交互完成工作。这时候用最聪明的模型反而更省钱。Claude 4.6 Opus完成一个任务可能需要10万token和10分钟人工时间,Claude 4.8 Opus只需要2.5万token和一次交互。token数更少,人的时间也更少,总成本反而下降。
4、Anthropic在token效率上赢了OpenAI,这是Claude Code主导市场的核心原因
Dylan承认OpenAI的模型在前沿科学、数学和代码的极端边界上有时能完成Anthropic模型做不了的任务。但代价是3到4倍的token消耗和更长的等待时间。在人机交互的反馈循环中,token效率直接决定了工作体验。Anthropic模型一轮交互就能出结果,OpenAI模型可能需要多轮。人在循环里等待的时间成了隐性成本。
SemiAnalysis的实际使用印证了这一点:日常任务绝大多数用Claude Code完成,只有那些可以丢在后台跑一整夜的长任务才交给OpenAI的Codex。
二、内存:40年来的周期规律正在被打破
2023年初Dylan自己写过一篇报告,论证内存是AI最大的输家,理由是当时AI服务器中内存占总成本的比例远低于传统服务器。英伟达后续每一代芯片都大幅增加了内存用量,这个判断被彻底推翻。Dylan反过来成了内存看多派最有力的声音。
1、这不是一个普通的涨价周期,而是结构性短缺
内存行业的传统节奏是18到24个月的涨跌循环。Dylan说这一轮有本质区别:AI数据中心对内存的需求正在翻倍,但全球内存产能每年只增长20%到30%。供需缺口将持续数年。
SemiAnalysis在2026年1月发布了一份关键报告。当时市场上很多人看到内存价格已经涨了50%,开始问"是不是到顶了"。SemiAnalysis的结论是:远没到顶。
2、消费电子正在被挤出内存市场
当供给增长追不上AI需求时,价格持续上涨的压力会迫使弹性更高的买家退出。Dylan给出了一个具体的传导链条:小米等中国手机厂商的中低端机型出货量已经下降了40%。高端市场暂时还没受影响,但他认为明年iPhone和MacBook的价格都要涨。涨100美元影响不大,但内存价格会一直涨到AI拿够了它需要的量为止,最终手机可能要涨几百美元。
直到AI需求和消费电子需求之间建立新的均衡点,这个过程才会停下来。
3、推理模型改变了内存的需求结构
SemiAnalysis在2024年12月发布了一篇关于OpenAI o1推理模型的研报,核心洞察是:推理模型把内存从配角变成了主角。
传统聊天式推理中,上下文长度只有几千个token,用于记录token间关系的KV Cache占用极小。但推理模型和智能体的上下文长度可能达到10万token甚至更长。模型权重的读取量不变(无论上下文1000还是10万,都得读全部权重),但KV Cache随上下文长度线性膨胀,上下文越长,缓存越大。计算量没怎么变,内存开销却暴涨了。
这意味着每一代新模型对内存的消耗都在加速,而产能扩张的速度远远跟不上。内存厂商的毛利率正在向85%到90%攀升,虽然最终会回落,但短期内没有缓解的迹象。台积电TSMC的定价相对克制,每年只提5%到10%,但内存是纯粹的现货和合约市场,供需失衡直接反映在价格上,振幅可以达到2到3倍。
三、CPU:从被忽视到全面紧缺
1、AI头三年没人谈CPU,2026年突然成了焦点
Dylan说SemiAnalysis在2025年11月就开始在机构研报中讨论CPU需求拐点。OpenAI和Anthropic当时已经在跟亚马逊、Google、微软谈判,要租用它们闲置的CPU资源。
核心原因来自两个方向的变化。
训练侧:预训练转向强化学习。预训练的token处理几乎不需要CPU,但强化学习要求模型生成的输出在"环境"中被验证,编译代码、运行单元测试、模拟网站交互、检查电商流程,这些环境都跑在CPU上。
推理侧:聊天式推理变成智能体工作流。聊天是一问一答,但智能体需要不断调用工具、搜索数据库、运行Python脚本、编译并部署代码。每一次工具调用都在消耗CPU。
2、CPU市场的竞争格局正在重塑
两年前,服务器CPU市场基本上是英特尔Intel和AMD的天下。现在,亚马逊的Graviton已经拿到了可观的份额,英伟达用Vera进入了独立CPU市场,ARM也发布了自己的服务器CPU。
英特尔和AMD都提高了价格,需求大增。亚马逊因为自己造CPU、自己租出去,利润率极高。英伟达给出了200亿美元的CPU营收指引。
3、"大核少量"还是"小核大量",取决于工作负载
Dylan拆解了CPU架构的核心取舍。英伟达的Vera CPU不到100个核心,但每个核心速度更快。AMD的旗舰CPU有256个核心,单核慢一些但总吞吐量更大。亚马逊的Graviton和ARM的设计也倾向于多核方向。
在某些智能体工作流中,GPU计算必须等CPU完成工具调用才能继续。这时候需要单核性能最快的CPU,比如Vera,哪怕总核数少。但在另一些场景中,比如大量用户共享推理集群,或者AI生成的代码被批量部署到CPU上运行,高吞吐多核CPU更有优势。Dylan提到,GitHub全球代码提交量相比去年增长了好几倍,不是10%或50%的涨幅,是数倍级。大量AI生成的代码被部署后跑在标准CPU上,进一步推高了需求。
4、CPU需求暴涨有"补课效应",卖方分析师过度外推了
Dylan强调一个重要的供需动态:过去三年卖出了上千万颗AI芯片,但配套的CPU严重不足。现在市场在补这个历史缺口,同时还要满足新增的GPU配套需求。叠加起来,短期CPU需求看起来极其疯狂。ARM和英特尔的股价都翻了几倍。
但一旦补课结束,需求会回落到稳态增量水平。而且GPU单价5万美元以上,配套CPU只要5000美元左右,即使按1:2的比例配置,每10万美元GPU支出只对应5000美元CPU支出。CPU市场在增长,但取代不了AI算力作为主要资本支出。一些卖方分析师把CPU的重要性吹得超过了GPU,这是对实际比例关系的误判。
四、网络:CPO被推迟了,铜线赢得了更多时间
1、光互联占AI支出的比重从不到10%涨向20%到30%
随着模型变大,跨芯片通信的数据量急剧增长。网络内容在AI芯片相关支出中的占比,正在从不到10%突破到10%以上。等到把光学器件直接封装到芯片上的CPO技术成熟部署,这个比例还会进一步升至20%到30%。
2、CPO不会在2027年到来,真正的规模化要等2029年
Dylan的判断是:CPO在规模化部署上面临制造良率、产能、芯片设计适配等一系列难题。当前英伟达的Ruben用的是铜线,下一代GPU Feynman在GPU端仍然是铜线。CPO在交换机端会先于GPU端部署,但GPU端的规模化部署要等到2028年末甚至2029年。
这意味着铜线连接器厂商(如Amphenol)在接下来几年的表现会好于市场此前的预期,因为大家原本以为CPO会更早到来。铜线技术本身也在持续创新,不断推迟光学替代的临界点。
SemiAnalysis在最近一周发布了一份面向机构客户的研报,核心观点就是:短期看好铜线和非CPO光学,对CPO的时间线持谨慎态度。
五、电力:数据中心的终极约束与无限创意
1、增长速度:今年20GW,明年30GW,后年50GW
Dylan给出的数据中心电力部署节奏:2026年全球新增20GW数据中心容量,2027年增长到30GW,2028年达到50GW。制约因素三个:能源获取、政治许可、建设施工。其中能源是最根本的。
2、"表后电力"正在爆发,几年内将占新增电力的一半
能源问题可以拆成三层:发电、输电、转换。输电最难突破,因为涉及监管审批、公用事业垄断结构和成本分摊机制。但发电侧涌现了大量创新。
SemiAnalysis预测,大约两年后新增数据中心电力的一半将来自所谓behind the meter的现场自发电模式,不接公共电网,由数据中心自己在旁边建电厂。方案包括联合循环燃气轮机(GE Vernova、三菱、西门子产品线)、往复式发动机、工业燃气轮机,甚至有人把卡车柴油发动机改装成燃气发电机。Dylan描述了一个场景:把卡车引擎改成燃气引擎,在生产环节就能完成,技术简单,反向驱动电动马达发电,几百台并排放在数据中心旁边,雇一批汽车维修技工轮班维护。粗糙、不优雅,但能用。
3、太阳能加电池在两年内将比燃气更便宜
这取决于冗余度要求。如果只需要电池撑过一个晚上,太阳能加电池已经接近临界点。如果要应对连续三天阴天,成本就高出一大截。中国的制造业产能和补贴正在加速降低太阳能和电池的成本。
更远的方案是太空数据中心,连电池都不需要,直接用太阳能板。SemiAnalysis此前发布了一篇关于太空数据中心的详细报告。从卡车引擎改装到把芯片送上太空,解决方案的光谱跨度极大,关键在于愿意为算力付出多大代价。
4、转换层是另一条被低估的投资主线
从发电端的高压交流电到芯片需要的低压直流电,中间有一整条转换链。涉及的技术包括IGBT、碳化硅MOSFET、氮化镓MOSFET、固态变压器、UPS和超级电容。从12V到54V到800V直流的架构演变,每一步都催生新的供应链。
SemiAnalysis上周刚发布了一篇关于800V架构的博客。他们在机构研报中还提到,英伟达的Ruben Ultra Kyber已经取消了800V支持,这意味着800V的供应链部署时间被推后了。
六、供应链的"微型瓶颈"无处不在
Dylan最后强调了一个被忽视的现象:除了内存、CPU、光学这些大的瓶颈之外,AI基础设施供应链中充满了极其细碎的局部短缺。PCB钻头短缺过几个月,PCB铜箔也紧张过,用于电路滤波和去耦的多层陶瓷电容MLCC也被讨论。这些小部件的供应商可能在中国台湾上市,可能在日本交易,可能在韩国交易,投资者根本不容易接触到。
SemiAnalysis的数据中心、能源与工业团队(内部代号"DEI team")是公司最大的研究条线。他们跟踪每一座数据中心和每一座电厂。Google想知道Meta能部署多少,Meta想知道OpenAI能部署多少,投资者想知道所有人的进度。这个数据集是SemiAnalysis最核心的产品之一。
核心归纳
Q1: AI模型的成本到底在变贵还是变便宜?两者同时成立。同一质量水平的AI推理每年便宜约60倍(DeepSeek V3比GPT-4便宜600倍,间隔约两年)。但用户实际支出在飙升,因为更强的模型让人能做以前做不了的事,用量远超节约的成本。SemiAnalysis自己从年化10万美元AI支出涨到1100万美元只用了8个月。"省下来的钱"全被"能做更多事"吃掉了。
Q2: 内存短缺对普通消费者意味什么?手机和电脑要涨价。AI数据中心正在吸走全球内存产能,产能年增只有20%到30%但AI需求在翻倍。弹性低的消费电子会被挤出市场。小米中低端机型出货已降40%,Dylan预计明年iPhone和MacBook都要涨价,且不是涨100美元的问题。
Q3: AI基础设施供应链中,最被低估的投资主线是什么?Dylan点了三个方向:一是铜线连接器,CPO延期让铜线赢得更多时间,Amphenol等公司受益;二是behind the meter供应链,从卡车引擎改装到太阳能加电池,一大批做发电设备、电力转换、电池储能的公司将受益于数据中心现场发电的趋势;三是各种不起眼的小部件供应商如PCB钻头、铜箔、MLCC,它们在中国台湾、日本、韩国上市,多数投资者看不到。
UI是面子,代码是里子
没几个人在乎衣服是什么棉花做的,但是在乎穿的衣服好不好看、有没有撞衫🤪
使用 AI 构建产品,要求组织在采用新工具的同时拥抱一种新的思维方式。
在下一期《Advanced Insights》中,@AnthropicAI 的 Claude Code 负责人 Boris Cherny(@BCherny)将与 Mark Papermaster 对谈,分享 AI 如何加速工作流程,以及在各团队中鼓励实验的重要性。
完整节目即将上线。
截至目前,至少我相当确定 AI 创造的就业岗位总体多于它取代的岗位。
这并不是我原本预期的结果——虽然我比其他人悲观得少,但我以为达到这样的能力水平时,我们应该已经看到一些影响了。
这种趋势有可能会延续下去!
哇。
AI是杠杆,但跨领域/同领域撬动的方向不一样,杠杆倍数也永远和自身水平以及使用AI水平有关。跨领域会拉齐一些,典型应用是普通人寻求医疗second opinion;但同领域内会极大拉开距离,放大明星效应,因为知识和生产力有复利效应//@高飞:1、或许人和人的差别,由于之前没有合适的工具,被拉齐了?2、68块钱的豆包和20美金的GPT作为生产力工具,其实不算贵。3、其实人类历史上第一次,多数人都有能力触及/使用超级工具,但是不用/ 用不好是另一回事了。
有时候我想想还是很难过的,牛逼模型是普通模型价格的10倍以上,比如CC最好的模型和最差的比如Fable5 (输入$10/输出$50) 和 Haiku 4.5(输入$1/输出$5),这个差距只会越来越大,普通人的问题没那么难,用简单模型就够了,也问不出什么高端问题出来。牛人问题难,问的问题有价值,也愿意出高价。
如果,富人用 10块的模型、普人用 1块的。。而实际场景是:一个人开一个对话框,和一家公司 7×24跑一万个 agent(大量消耗10块贵的模型)、但是只要能赚钱,就能支撑再买更多更贵的token。
这么一来会导致什么呢?本能来AI是智能平权的,现在通过这种价格的不平等,最终让一部分人越用牛AI越牛,用量还大,他还能赚钱,越能支付费用。一部分普人很可能永远停留在普通层,那种AI平权的梦想可能是错的。。
#无人机吊起2人神图系AI合成#所以,“AI标注”不会阻止AI假新闻:遵守规则的人不会造假,造假的人当然不会标注。
GPT-5.6 Sol Ultra 证明了一个有 50 年历史的数学猜想。不同于 Erdős Unit Distance Problem(厄尔多什单位距离问题),这次使用的是今天就已向公众开放的模型。我很期待看到科学家和研究人员能用这个模型做出什么!
昨天,我们让 GPT-5.6 Sol Ultra 正式向公众开放。今天,我们宣布它在不到一小时内,使用 64 个子代理(subagents)给出了 50 年历史的 Cycle Double Cover Conjecture(圈双覆盖猜想)的证明。下面将分享提示词和证明。很期待看到你们用 Ultra 做出什么!
1、或许人和人的差别,由于之前没有合适的工具,被拉齐了?2、68块钱的豆包和20美金的GPT作为生产力工具,其实不算贵。3、其实人类历史上第一次,多数人都有能力触及/使用超级工具,但是不用/ 用不好是另一回事了。
有时候我想想还是很难过的,牛逼模型是普通模型价格的10倍以上,比如CC最好的模型和最差的比如Fable5 (输入$10/输出$50) 和 Haiku 4.5(输入$1/输出$5),这个差距只会越来越大,普通人的问题没那么难,用简单模型就够了,也问不出什么高端问题出来。牛人问题难,问的问题有价值,也愿意出高价。
如果,富人用 10块的模型、普人用 1块的。。而实际场景是:一个人开一个对话框,和一家公司 7×24跑一万个 agent(大量消耗10块贵的模型)、但是只要能赚钱,就能支撑再买更多更贵的token。
这么一来会导致什么呢?本能来AI是智能平权的,现在通过这种价格的不平等,最终让一部分人越用牛AI越牛,用量还大,他还能赚钱,越能支付费用。一部分普人很可能永远停留在普通层,那种AI平权的梦想可能是错的。。
警报:在 vLLM Kimi 上——它与 xAI 的 Cursor Composer 2.5 使用相同的模型架构——NVIDIA 完胜 AMD。看到 B300 比 B200 更快也很棒。

“医生发现,GPT-5.6 的回答比医生撰写的回答存在更少的缺陷。”
♥️ GPT-5.6 在医疗领域实现了重大进步,无论是在前沿能力还是成本方面。
这些模型将单位美元的性能边界不断向前推进,让所有人都能获得最强的医疗智能。最小的版本 GPT-5.6 Luna 在最低推理强度下进行评测,性能超过最高推理强度下的 GPT-5.5,而成本只有后者的 1/25。最大的版本 GPT-5.6 Sol 则在成本效益方面树立了新的标杆。
另一个尤其酷的结果是:医生发现,GPT-5.6 的回答比医生撰写的回答存在更少的缺陷。
我们收集了一组多样化任务,这些任务对近期的 OpenAI 模型来说仍然很难,覆盖面向患者和面向临床医生的使用场景。我们邀请与任务专科匹配的医生,在时间不限且可以访问网络的条件下,为这些任务撰写回答。随后,我们请其他医生在不知道回答来源的情况下进行盲测并排比较。医生需要从五个维度指出改进空间:准确性、沟通、完整性、遵循指令,以及对医疗决策的帮助程度。然后,我们统计了不同来源的回答在所有维度上都获得满分的比例,总计进行了 20,000 次维度评分。GPT-5.6 Sol 的表现似乎最强,不过所有 GPT-5.6 模型的表现都显著优于医生。

有大量基准测试表明,5.6 Sol 目前可能是全球最强的模型,但最可靠的判断方法是:Elon 又开始痴迷于我了。
按这样的使用量计算,30% 的成本都花在了 fable 上?
我们团队同时拥有 Sol 和 fable 的第一周,最疯狂的是,我们的成本有 30% 花在了 fable 上。

老兄,把短期太空数据中心卖给公开市场投资者的人明明是你。
他把诈骗带到了一个全新的境界。
Lenny Rachitsky 与 Noam Segal 讨论第二次年度科技从业者情绪调查。调查覆盖约 6000 名来自产品、工程、设计、研究、市场等职能的从业者。核心结论是:AI 正把科技职场近乎对半分开。一半人感到自己被 AI 放大,认为自己能做更多、做得更好;另一半人则感到角色被重新定义、职业根基动摇或自身能力被削弱。AI 对职业身份和工作感受的影响,明显超过岗位、公司规模和职级等传统因素。
变化带来两种矛盾结果:人们仍然享受使用 AI,也能实现过去看似不可能的项目,但倦怠明显上升,职业乐观程度下降。显著倦怠比例从 2025 年的 44.7% 升至 2026 年的 54.7%,乐观比例从 54.8% 降至 48.7%。人们不只是害怕被 AI 取代,更担心公司把速度变成新的工作基线,要求员工拿同样的工资做更多事情。
AI 没有让人少做事,而是带来了更多原型、PRD、PR、活动、智能体和广告。交付速度提高了,工作量和预期也一起提高,因此更快交付并没有减少压力。另一方面,AI 让人跳出传统岗位的“泳道”,所以许多人仍然享受工作。
72% 的受访者在某种程度上担心被裁,41.2% 至少达到中度担忧。人们一边享受新工具,一边担心公司全面投入智能体后自己会变得不再需要;一边觉得技术像游乐场,一边又很难停下来休息。
科技岗位的 NPS(净推荐值)没有出现真正的推荐者。即使创始人是最幸福、最乐观的群体,也不太愿意推荐自己的岗位;设计师和研究员最不愿意推荐自己的角色。职级越低,推荐意愿通常越低。
嘉宾用梯子解释这种感受:AI 正沿着从学生、实习生、初级工程师到高级工程师的梯子向上爬,而处在较低位置的人感觉脚下的梯级正在被抽走。但这描述的是感受,并不等于设计或研究即将消失。
97.2% 的人认为 AI 让自己在工作中变得更好,接近一半的人认为提升“非常”或“极其”明显。但深入追问后发现,“更好”常常指做得更多、更快,而不是质量更高。AI 降低了 PR、PRD、研究项目或原型的产出门槛,却没有保证更高质量。
更深层的代价是“认知腐烂”:人们直接接受 AI 的初始输出,不再运用判断和思考,逐渐失去参与感、自我效能和工作掌控。每次亲自解决问题会提高人的自信基线,把问题外包给模型则可能降低这条基线。生产力提升是真实的,但人的判断和思维敏锐度需要靠刻意练习维护。
“被 AI 抢走工作”排在担忧列表倒数第二,第一是“拿同样的工资做更多事情”,第二是工作和技术变化的节奏不可持续。AI 带来的每一次速度提升都会成为新基线;员工既要交付更多,也要学习新模型、新框架和新方法,学习时间又挤占专注工作时间。
情绪因此呈现“微笑着的疲惫”:好奇和兴奋排在前面,但不堪重负、疲惫、焦虑和希望也同时存在。同一个人可以既兴奋又疲惫,既看好技术又对它产生怨恨。
设计师和研究员连续两年在 AI 身份变化、焦虑、疲惫、失业担忧和岗位推荐意愿上最负面;数据与分析岗位在担心被 AI 抢走工作方面更突出。嘉宾强调,这些结果描述的是从业者感受,不是 AI 客观完成这些工作的能力。
创始人和小公司员工连续两年最幸福。创始人有 71% 对未来乐观,工作享受度最高,倦怠和裁员担忧最低,对 AI 最兴奋;但仍有 47% 的创始人至少中度倦怠,也不太愿意推荐别人做创始人。公司越大,乐观越低、倦怠越高、裁员担忧越强,也越不愿意推荐岗位。
只有约 25% 的人认为自己的经理非常有效,36% 认为经理无效;但拥有极其有效经理的人,工作享受度约高 65%,倦怠也明显更低。经理不仅影响员工是否开心,还负责保护员工免受工作挤压,帮助确定合理的范围、节奏和期待。
公司想降低倦怠、提升享受度和留任率,就应投资于经理培养。员工找工作时也应了解未来经理是谁,因为这个人可能比其他工作特征更能影响幸福感。经理本身也承受行业压力,组织需要给他们支持和训练。
1. AI 把科技职场分成几乎对半的两组:一组感到被放大,另一组感到动摇、迷失或被削弱。
2. 工作可以更有趣、更有创造力,同时也更疲惫;享受度高不能抵消倦怠上升。
3. 员工最担心的不是被 AI 直接取代,而是同薪酬下不可持续的工作量。
4. “做得更多、更快”不等于质量更高;人的判断、自我效能和技能需要刻意维护。
5. 设计和研究的负面感受值得领导者重视,但不等于这些职能会消失。
6. 创始人和小公司员工状态相对最好,不过创业仍然艰难。
7. 经理是影响员工幸福感、倦怠和留任率的最大杠杆之一。
8. 员工应选择少数真正希望 AI 帮助的任务深入做,管理工作范围,寻找优秀经理和导师;领导者应培养经理、设定可持续预期,并帮助职业早期员工成长。
来源:Lenny's Podcast: Product | Career | Growth
原文链接:https://www.lennysnewsletter.com/p/how-tech-workers-actually-feel-about
- [00 00 00 - 00 09 55] 科技职场正在分裂
- [00 09 55 - 00 19 35] 四种情绪原型
- [00 19 35 - 00 29 15] 倦怠正在飙升
- [00 29 15 - 00 39 58] 没有人会推荐今天进入科技行业
- [00 39 58 - 00 49 59] 梯子隐喻与生产力陷阱
- [00 49 59 - 00 59 59] AI 让人更快,却未必更好
- [00 59 59 - 01 09 59] “微笑着的疲惫”与最悲观的职能
- [01 09 59 - 01 19 51] 公司规模、管理者与幸福感
- [01 19 51 - 01 29 54] 一个更加混乱的行业
- [01 29 54 - 01 36 05] 员工和领导者现在能做什么
Lenny Rachitsky:科技圈有个坏消息:工作中的倦怠已经成为一个严重问题,而 AI 可能会让本已不堪重负的员工处境更加糟糕。人们对 AI 的蜜月期已经结束。当我们问大家“你害怕什么”时,“被 AI 抢走工作”实际上排在倒数第二。排在最前面的,是“拿着同样的工资,却被要求做更多事情”。我们做了这项调查,想知道现在科技从业者究竟是什么感受。倦怠显著增加,乐观情绪正在下降,整个行业从来没有这么疯狂过。 [00:00:00]
Lenny Rachitsky:我们什么时候才能讲到这期节目乐观的一面?科技行业里有一半人感觉好极了,而另一半人却说:“我的大脑正在萎缩,我的工作变得更糟了。”埃隆·马斯克有一种很有意思的说法:如果我们现在还活着,未来却要在太空建数据中心,而且 AI 会变得和人类一样聪明,那我们显然正生活在一场模拟中。
Lenny Rachitsky:如果我们什么都能做,这告诉我们应该怎么做?我们正处在一次巨大转变的第二局。没有人知道它最终会如何收场,但你能做的只有继续上场击球。今天的嘉宾是 Noam Segal。我和 Noam 认识很久了。我们曾在 Airbnb 共事多年,他是我的研究搭档。此后,他先后在 Intercom、Twitter、Wealthfront、Meta、Zapier 和 Figma 担任研究负责人。
Lenny Rachitsky:过去几年里,我很幸运能和他一起做很多研究项目,其中最重要的就是科技从业者情绪调查。我们打算每年都做一次。这是第二次调查,研究范围也许是同类调查中最大的,关注科技从业者如何看待自己的工作、AI、裁员、倦怠,以及职业未来。本期节目基本就是围绕调查结果展开的对话,最后还会讨论如果你现在正处在困境中,可以采取哪些行动。 [00:01:17]
Lenny Rachitsky:开始之前,别忘了去 lenny'sproductpass.com。Lenny 的 newsletter(通讯)订阅者可以在那里免费获得一年全球最热门、制作最精良的 AI 产品。接下来,让我们请出 Noam Segal。 [00:02:01]
Lenny Rachitsky:Noam,非常感谢你来参加节目,欢迎你。
Noam Segal:非常感谢你,Lenny。能来这里是一次不可思议的经历,谢谢你的邀请。
Lenny Rachitsky:这是我们一起工作的很久以前了。很多人可能不知道,你当年是我在 Airbnb 团队里的研究员,大概是十年前。
Noam Segal:整整十年。
Lenny Rachitsky:十年了,Noam。变化真大。
Noam Segal:变化确实太大了。这也正好引出今天的主题:我们做了一项调查,想知道当下科技从业者的感受。这个行业从来没有这么疯狂过,所以我们做了这份报告。这是我们第二次做同一项调查;我们的想法是把它做成年度科技情绪调查,持续追踪科技从业者的状态。进入具体结论前,能不能先介绍一下调查是怎么做的、研究了什么,以及听众需要知道的背景? [00:03:01]
Noam Segal:这是第二次开展这项调查,我觉得它在科技行业里非常独特。感谢你给我这个机会,也感谢你让我们整个社区有机会更了解大家在科技行业中的真实感受。我不知道还有哪项调查能以这样的规模研究这些问题。去年第一次调查的标题是“倦怠,但仍然乐观”:当时我们看到相当高的倦怠水平,但人们对未来走向仍有不错的乐观情绪。后来我们围绕倦怠继续研究,创建了 ARM 框架。很高兴我们做了这件事。今年,我们调查了大约 6000 人,涵盖产品、工程、设计、研究、市场等几乎所有科技岗位。 [00:04:15]
Lenny Rachitsky:结果非常有意思,我迫不及待想深入看看。我记得你把分析初稿发给我时,我一边读一边想:“天啊,这太有意思了。”它仿佛把我自己的感受,以及我从很多人那里听到的感受,都准确说了出来。接下来我们就从报告的十大结论开始。本期节目由 WorkOS 赞助。
Lenny Rachitsky:OpenAI、Anthropic、Cursor、Vercel、Replit、Sierra、Clay 以及数百家其他成功公司有什么共同点?它们都由 WorkOS 提供支持。如果你在打造面向企业的产品,就一定体会过集成 SSO(单点登录)、SCIM、RBAC(基于角色的访问控制)、审计日志和其他大公司必需功能时的痛苦。WorkOS 把这些交易阻碍变成开箱即用的 API,提供现代化的开发者平台。无论你是想拿下第一个企业客户的种子期创业公司,还是正在全球扩张的独角兽,WorkOS 都能帮助你更快完成企业化。访问 workos.com,让你的应用今天就具备服务企业的能力。 [00:05:00]
Noam Segal:如果只能从这份报告里带走一个结论,你认为最重要的是什么?
Noam Segal:首先,你和我都注意到 Elena Verna 在这期播客录制前几天发的一篇文章,她谈到科技行业里的“AI 信心剧场”:如今的对话里,什么都被说成“已经死了”——工程、编码、设计、SaaS,当然这显然不是真的。我们接下来展示的,是目前关于人们如何真实感受 AI 的最好图景之一。很多人每年都会填写类似 Culture Amp 的公司调查,但那些问题通常只会问菜单生成器是否有效、或你如何评价公司领导层,不会真正深入了解大家的感受。 [00:06:06]
Noam Segal:这份调查最突出的地方,是当前职场的两极分化。AI 对人们工作感受的影响,远远超过岗位、公司、公司规模、职级等其他工作特征。一半科技从业者感到自己被 AI 放大了能力:他们对技术和职业未来感到兴奋、精力充沛、充满期待;另一半则觉得未来不清晰,自己被动摇、被削弱,或者被其他负面情绪包围。 [00:07:20]
Lenny Rachitsky:结果正好是五五开,这一点很有意思。我原本没想到会如此平均。
Noam Segal:进一步看“AI 如何改变你的职业身份”这个问题,只有 3% 的人说 AI 没有改变自己的身份。也就是说,AI 已经改变了几乎每个人看待自己的方式。最显著的一组是 50% 感到自己被放大的人:他们觉得自己能做更多、做得更好。另一半又分成三个群体。27% 的人觉得自己的角色正在被重新定义,却没有太多清晰的正面或负面情绪;他们只是还不明白究竟发生了什么。14% 的人感到自己的职业根基正在动摇,而 5% 的人感到自己被削弱,仿佛 AI 的强大能力从他们身上夺走了某些东西。 [00:08:59]
Noam Segal:剩下两个群体有明确的负面情绪。14% 的人感到不稳定,仿佛脚下的地面正在晃动;他们对正在发生的事情缺乏清晰认识,焦虑水平很高,对未来的看法非常消极、悲观。还有 5% 的人感到被削弱:他们认为 AI 的强大能力夺走了自己的一部分,而且那部分显然不会回来。不是有句话说,今天的 AI 模型已经是它们最差的时候,它们只会越来越好吗?所以今天已经感到被削弱的人,未来可能只会更强烈地感到被削弱。 [00:09:55]
Lenny Rachitsky:抱歉带来坏消息。
Noam Segal:但这里也有好消息。这四个群体和我们问到的其他几乎所有工作状态指标,都有非常强的相关性。我们对其他核心问题做回归分析时,能清楚看到这些情绪彼此相连。
Noam Segal:用几个统计学术语来说明影响有多大。在科技行业,我们有些沉迷于“统计显著性”。但如果样本足够大,无论实际影响有多大,你都可能得到统计显著的结果。更好的看法是使用 Cohen's d 这样的效应量指标,因为效应量告诉你:这件事在实际工作中到底有多重要。 [00:11:19]
Noam Segal:例如,去年最大的几个效应之一,是你的经理是谁,以及经理有多有效,这会极大影响你是否享受工作、是否乐观、是否倦怠。另一个很大的效应是创始人幸福感:正在创业、亲自经营一家初创公司的人通常非常幸福,可能是因为相较于普通员工,他们拥有更多能动性和自主权。
Noam Segal:而这次关于 AI 如何影响职业身份、以及如何影响工作中几乎所有其他变量的发现,效应大约是那些因素的三倍。我们所处的这个时代、这项技术,对人们工作感受的影响异常巨大,超过了我们之前看到的任何因素。 [00:12:52]
Lenny Rachitsky:接下来我们会看这种分类与职业乐观、倦怠等指标的联系,也会回到一个关键问题:到底是哪一个问题,能告诉你自己处在这条分界线的哪一侧?
Noam Segal:随着人们从“被放大”走向“被削弱”,职业乐观情绪显著下降,倦怠显著上升,对裁员的担忧也显著上升。最重要的发现也许是:在 AI 改变行业的当下,人们不会建议初入职场的人进入科技行业。 [00:14:05]
Lenny Rachitsky:我们还把这些数据点归纳成四种科技从业者原型。我猜每个听众都会说:“这就是我。”
Noam Segal:我们让受访者报告自己的具体情绪,可以选择任意多个。平均而言,每个人选择了五种情绪,有些人甚至选择了 13 种。第一类是“精力充沛者”,占样本的 41%。他们会说:“产品又变得有趣了。我在探索。我像身处一座科技游乐园,所有东西都向我开放;我可以尝试新的方法。我现在是一个建造者,拥有以前从未拥有过的力量。”他们对技术和职业都非常兴奋。
Noam Segal:第二类是“冲突者”,也就是矛盾的中间群体,占 35%。他们一方面觉得自己作为建造者、产品经理、设计师或工程师,玩得比以往任何时候都开心;另一方面又感到职业生涯前所未有的不确定。他们不明白事情会走向哪里,也不知道自己正在建造的东西,最终是否会导致自己熟悉的职业终结。 [00:16:02]
Noam Segal:第三类是“迷失者”。他们觉得自己的角色不断变化。有一位受访者说:“我们就像工业革命前夕的农民,看不清事情会走向哪里。”他们对自己的职业和未来方向感到极度迷惘。最后是“怨恨者”,占样本的 12%。他们感到受压迫、已经抽离,不再享受工作。他们会说:“我被迫使用 AI,否则就会丢掉工作;可即便使用 AI,我还是看到有人失去工作。我讨厌它,讨厌必须利用这项技术,而不是按自己的方式做事。”当然,现在没人能真正忽略 AI。 [00:17:04]
Lenny Rachitsky:显然有很多人非常不开心、怨恨或迷失。我想他们很难想象,竟然有这么多人正处在极度兴奋的状态;反过来也一样。这个结果提醒我们,身边的人可能和自己完全不同:有人过得非常好,也有人过得非常糟。尤其要对状态不佳的那一半人保持同理心。
Noam Segal:我完全同意。随着技术变化越来越快,我们太多注意力都花在掌握技术、理解新模型、新能力、循环工程,以及下周会出现的下一个东西上,却没有花足够时间关注工作中的关系、看见同事、支持同伴,也没有认真学习如何与处在不同情绪群体的人协作。我希望所有人,尤其是精力充沛的人,把一部分能量投入身边的人,而不是只盯着 AI 的下一个变化。 [00:19:17]
Lenny Rachitsky:那我们进入下一个结论,谈谈倦怠和乐观情绪。
Noam Segal:去年我们看到的倦怠水平已经令人担忧,以至于后来专门发表了研究,并提出 ARM 框架来应对和抵抗倦怠。今年我原本希望乐观情绪能保持稳定,倦怠不要继续上升。毕竟,能力越来越强、模型越来越好,按理说我们也许不需要那么辛苦、投入那么多精力,不至于被拖入倦怠。然而事实并非如此。中度以上的显著倦怠,从 2025 年的 44.7% 上升到 2026 年的 54.7%。倦怠正在飙升。 [00:20:14]
Noam Segal:现在,样本中超过一半的人都感到明显倦怠。与此同时,人们对岗位和职业未来的乐观程度,从 2025 年的 54.8% 降到了 2026 年的 48.7%。这对科技社区来说是个坏消息。
Lenny Rachitsky:除了“这太糟了”,我不知道还能说什么。我完全理解大家为什么会有这种感受。一年之内倦怠上升超过 10 个百分点,这非常令人担忧。 [00:21:11]
Noam Segal:你过去采访过几位谈到类似问题的嘉宾。我很喜欢你和 Ramp 的 Jeff 的对话,他说自己最严重的倦怠,发生在速度最低的时候。当你把精力投入到实际上没有任何推进的事情上,感觉当然不好,最终就会导致倦怠。一些关于倦怠的理论也认为,停滞会导致倦怠。但现在的情况正好相反:数据告诉我们,即使交付速度比以往快得多——从每天交付几个 PR(拉取请求)到每天 30 个 PR,或者总体上做的事情多得多——我们仍然比以前更容易倦怠。
Lenny Rachitsky:我们显然并没有少努力。我们只是承担了更多东西:更多原型、更多 PRD(产品需求文档)、更多 PR、更多营销活动、更多智能体、更多广告。这些都在推动倦怠上升。 [00:22:34]
Lenny Rachitsky:不过有一点希望:工作的享受程度其实仍然很高,和去年大致处在同一水平。虽然人们更加倦怠,却仍然喜欢自己的工作。
Noam Segal:这正是让我感到希望的地方。首先,人们能够把过去无法展现的身份和热情带到工作中。如果你职位上是产品经理,但内心一直有个设计师;或者你是一名市场人员,心里其实一直想做工程师,现在你可以把那部分自己释放出来。我们拥有的各种工具,让人能跳出过去的泳道,去实现其他职业志向。
Noam Segal:第二,人们可以把不久前还觉得不可能的东西做出来。不论是在主业中,还是在业余时间,人们都能实现自己一直想做的项目。对许多科技从业者来说,现在仍然是一个令人兴奋、令人享受的时代,因为我们可以做出过去无法做的东西:它们可能超出了自己的岗位、超出了技术可行性的边界,或者只是因为过去没有合适的工具。 [00:24:33]
Lenny Rachitsky:另一个很有意思的结论,是裁员以及对裁员的恐惧如何影响倦怠。我们问了大家有多担心被裁。
Noam Segal:72% 的受访者在某种程度上担心被裁,41.2% 的人至少达到了中度担忧。很明显,人们觉得自己可能正在砍断自己所坐的树枝:公司全面投入智能体和其他 AI 技术,员工担心自己终有一天会被挤出去。 [00:25:17]
Noam Segal:这也说明了当下科技社区的矛盾情绪。人们一边感到精力充沛、享受工作,另一边却对未来并不乐观,感到疲惫,并担心公司有一天会决定自己已经不再需要。
Lenny Rachitsky:很多听众大概都在这些情绪中听见了自己。到目前为止,两个结论是:一方面,职场正在分化成不同群体;另一方面,从整体上看,倦怠显著增加,乐观情绪下降。你如何理解这两件事同时发生?
Noam Segal:这项技术有让人上瘾的地方。我先说说自己的感受:使用这些技术时,我从未在职业生涯中这么开心过。我每天花太多时间摆弄它、建造东西。我相信许多人即使没有那么“精力充沛”,也会觉得自己置身于一个迷人的技术游乐场,很难停下来,去接触真实世界、读书,或做平时喜欢做的事情。
Noam Segal:所以,我们一方面享受 AI 打开的新路径;另一方面,持续学习这项技术、在不同情境中应用它,并不断承担超出传统岗位范围的事情,确实很累。因为传统岗位已经不存在了——如今我们全都是建造者,无论公司是否正式这样定义我们的职位。可能性令人兴奋,AI 也很好玩,但它之所以令人兴奋,正是因为它如此强大;而它如此强大,也意味着它可能会来取代我们、夺走我们的工作。 [00:28:32]
Lenny Rachitsky:你小时候看过《终结者》吗?我总会想到那些电影。
Noam Segal:当然看过。现在感觉 Skynet 正在被建造,Skynet 就要来了。
Lenny Rachitsky:接下来我们谈谈人们如何看待自己的职业,以及他们是否愿意向别人推荐这个职业。这个结论非常惊人。至少在研究社区里,我是出了名的 NPS(净推荐值)反对者。我甚至建了一个专门批评 NPS 的网站:npsisattheworst.com。我讨厌 NPS 到什么程度呢?我还买了 npsisatthebest.com 这个域名,再把它转到 npsisattheworst.com。这就是我反对它的决心。 [00:29:22]
Noam Segal:我们真正好奇的是,那些已经在行业里工作了几年、处于高级或更高职级的人,会对今天准备进入这个行业的人说什么?他们会把自己的岗位,或者更广义的科技行业,推荐给朋友或亲戚吗?答案令人震惊。
Noam Segal:NPS 问的是:你愿不愿意把一个产品——在这里是你的职业——推荐给朋友或家人?评分从 0 到 10,10 表示你一定会推荐,0 表示你绝不会推荐。NPS 的最终范围则是 -100 到 +100,0 代表整体中立:既不是会向别人推荐的“推荐者”,也不是对自己的岗位持负面态度的“贬损者”。 [00:30:26]
Noam Segal:现在你看到的是,科技行业里没有任何岗位拥有正向的推荐者。连目前最快乐、最乐观的创始人也不会推荐自己的岗位。销售和市场拓展、产品经理、运营、工程都一样;最糟糕的是设计师和研究员。研究和设计社区的人,最不愿意把自己的岗位推荐给即将进入科技行业的人。就像是在说:“我正在这个泳池里游泳,水还勉强可以,但你别跳进来。” [00:31:13]
Lenny Rachitsky:天啊,这是研究里一个非常有意思的结论。看着这张图,每个人都像是在说:“不,别做我做的事。”我们之后会谈到创始人是科技行业里最幸福的人,但这仍然是一份压力极大、非常艰难的工作。我原以为创始人会说:“这是最疯狂、最痛苦的岗位,千万别做。”但有意思的是,他们虽然最不可能推荐,却也不是最不开心的那群人。
Noam Segal:现在有一种强烈叙事,认为成为创始人的时机从未如此好:你更少依赖别人来建造产品,单人创业者、双人创业者的讨论到处都是。可是,已经处在这个岗位的人,并不太愿意把它推荐给其他人。
Noam Segal:还有一层差异:职级越低,越不愿意推荐自己的岗位。高管、副总裁,甚至总监,比个人贡献者更可能推荐自己的职位。一个解释是,处在金字塔顶端的副总裁,可能从 AI 中获益更多:AI 帮他们处理大量信息和知识,让工作容易了很多。而个人贡献者则在公司里争相构建各种微型 SaaS(软件即服务)产品,没有人知道别人在做什么,重复劳动大量增加。现在做产品更容易了,但维护产品却更难了。 [00:33:59]
Noam Segal:很多个人贡献者的感受就像“踩尽油门却挂在空挡”:你一直在建造,却没有取得想要的影响力;所有人也都在建造,混乱越来越大,最后觉得这一切不值得。
Lenny Rachitsky:这里还有一种“别成为永久底层阶级”的情绪。大家会想:“我现在是产品经理,但已经太晚了,别做这个,通往这个岗位的门正在关闭。”这不仅是产品经理,几乎每个岗位都让人觉得,也许应该去做别的事。
Noam Segal:过去,人们会劝孩子学计算机科学、学编程。作为一个家长,我现在甚至不知道该建议孩子做什么;我不确定几年后还会有哪些岗位。科技从业者也有同样的感觉:他们不知道未来会给自己留下什么,当然更不可能对别人说“放心,五年后这里会很棒,赶紧加入”。没人知道。 [00:35:57]
Lenny Rachitsky:把镜头拉远一点看,我们正经历的变化实在太疯狂了。一两年前不可能得到这样的结果。现在的环境极度不稳定、不确定,这对科技行业的人来说很新鲜。
Noam Segal:我喜欢用生活中其他领域的比喻来解释。Cognition 的联合创始人兼 CEO Scott Wu 介绍 Devin 时,说它沿着一架梯子不断进步:从高中计算机科学学生,到大学实习生,再到初级工程师,现在可能已经接近高级或资深工程师。我们都在看着这项技术沿梯子向上爬,而它似乎正在从我们脚下抽走梯级。站得越高的人,对职业越有信心、越稳定;位置越低的人,脚下的梯级越容易消失。因此,我们当然不会建议别人站上这架梯子。 [00:36:46]
Lenny Rachitsky:销售和产品经理是“别进入这个岗位”得分相对没那么糟的群体,这很出乎我意料。研究和设计则最悲观。作为研究员,看到这个结果是什么感受?
Noam Segal:很难受。多年来,研究社区一直背负着很多担忧和焦虑:我们能不能参与产品决策,工作是否有意义,研究是否会被民主化,其他人是否会接手我们的工作、最终取代我们。看到这样的结果确实很痛苦。但研究在未来的产品建设中仍然有非常重要的作用。技术越强大,我们越应该更有思考地决定做什么,而不是变得更随意。
Noam Segal:我听过“既然建造很便宜,那就做一千个原型,看看哪个有效”的说法。这样做只会让我们更加倦怠,我个人不推荐。研究和设计的重要作用,是提高可能性的上限;而 AI 主要是在降低门槛,却还没有提高上限。 [00:39:51]
Noam Segal:产品经理更可能推荐自己的岗位,虽然他们总体上仍不太可能推荐,这其实说得通。产品经理更像通才,是 AI 时代的“通才优势”。最让我意外的是销售和市场拓展。如果我们真的处在某种“SaaS 末日”中——我个人并不相信,但大家一直这么说——那销售和市场拓展人员不该如此愿意推荐自己的岗位。也许他们相信,销售在现阶段还无法由 AI 完成。 [00:40:14]
Lenny Rachitsky:这里有一点必须说清:这并不意味着设计或研究会消失。它只意味着,现在做这些岗位的人,脑海中的叙事是“别做这个”。这可能只是我们不断听到的炒作,并不代表这些岗位真的结束了。我自己也通过各种嘉宾的访谈参与制造过一部分炒作,但调查测量的只是人们的感受。
Noam Segal:没错。这个项目研究的是科技从业者如何感受,而不是科技行业工作的客观现实。我们展示的不是现实本身,而是人们此刻对科技工作的情绪图景。 [00:41:32]
Lenny Rachitsky:我们还问了一个不同的问题:你是否愿意推荐别人进入自己的岗位?同时也问,你自己现在在这个岗位上是否开心。结果很有意思:很多人说“我其实还不错,我很开心自己是产品经理、设计师或研究员”。这就像“水还可以,但别进来”。
Noam Segal:大多数人说自己总体上确实享受当前岗位。他们缺少的不是当下的满足,而是过去那种乐观。一个人可以根据自己的经历和所处梯级,觉得现在过得不错;但当他把未来推演到一年、三年、五年后,得到的却是更负面的结果。整个行业目前还在享受、尝试新事物,工作方式也发生了彻底的范式转变,这一段时间是有趣的;只是大家觉得它未必会朝最好的方向发展。希望我们都判断错了。
Lenny Rachitsky:我是天生的乐观主义者,我觉得总会好起来。
Noam Segal:我也是。但到目前为止,我们还没有太多乐观的时刻。接下来谈谈 AI 的生产力和质量提升。这是我很感兴趣的一个结论。
Noam Segal:在去年的调查里,当我们问 AI 对生产力和质量的影响时,人们相当看好这项技术,认为它不仅让自己更高效,也让自己变得更好。今年出现了一些有意思的结果。我们先问了一个简单问题:“多大程度上,AI 让你更擅长自己的工作?”答案毫无疑问是肯定的:97.2% 的人说 AI 让自己的工作表现更好,接近一半的人说“非常”或“极其”如此。 [00:45:56]
Noam Segal:但深入理解“更好”到底意味着什么,就会发现它和我们以为的含义很不一样。听到人们说自己做得更好时,我以为他们是指工作质量更高,AI 帮助他们产出了质量更好的工作。
Noam Segal:事实恰恰相反。人们告诉我们的第一件令人担忧的事是:“我能更快地做更多事情,但做得并没有更好。”AI 降低了可能性的底线,让人们能够比以前产出多得多的工作——PR、PRD、研究项目、原型,什么都有——但产出的质量并没有提高。 [00:46:56]
Noam Segal:更令人担忧的是 AI 对思考和判断的深层代价。人们说:“我的大脑正在腐烂,我的工作感觉更糟了。”这和最近有人提到的“认知腐烂”现象有关:你看到 AI 模型的初始输出,就直接接受它,不再运用判断,也不再思考,慢慢把自己的思维、参与度和工作能动性放任到一种腐烂状态。 [00:47:24]
Lenny Rachitsky:这是个很有意思的结论,因为里面也有积极的一面。数据显示,82% 的人说 AI 至少让自己的工作表现中度变好,接近 50% 的人说非常或极其变好。这可能对应了前面讲的分化:那些觉得 AI 让自己变好的人,也许正是最有活力的群体。无论它客观上是否真的成立,人们确实感觉自己变好了,这种感受是真实的。
Lenny Rachitsky:同时,人们也有自我觉察。他们知道质量是个问题,也意识到自己可能正在失去写代码、写战略文档等能力。至少他们没有盲目地说“我现在做什么都很棒,质量比以前高得多”。
Noam Segal:但仅仅自我觉察还不够,我们必须采取行动。一个解释是,AI 的蜜月期结束了。我们曾经以为它完美无缺,是继切片面包之后最伟大的东西;现在我们发现它还远没有达到那个程度。没错,今天的模型已经是它们最差的时候,它们只会变得更好,但在真正让我们的工作变得更好之前,它们还有很长的路要走。 [00:49:59]
Noam Segal:你曾在节目里和 Simon Willison 讨论过技能萎缩:人们担心自己学得不够,也需要有意识地抵抗,不要让认知腐烂。这些数据说明,我们在这场抵抗中似乎正在输掉一点。随着标准不断提高、技术不断演进,我们必须用刻意练习、刻意思考和刻意判断来回应。可人们很难这样做;如果面前有一个“简单按钮”,我们通常就会按下去。 [00:50:20]
Noam Segal:就像我明知道不该吃 Doritos,还是会说“算了,就吃吧”。挑战在于:既然可以走简单的路,就很难逼自己走困难的路。这也和前面的梯子有关。人们已经进入这些工作,但必须逼自己用更难的方式学习,真正掌握技能。
Noam Segal:我尤其想知道,这会怎样影响初级从业者:他们究竟要怎样学会真正写代码、写 PRD,怎样用手指从头写出文档,而不是只和 Claude 对话。
Lenny Rachitsky:人们有时会怀念“感觉自己很聪明”。我曾经以为自己是聪明人,但遇到这些模型——尤其是最近第二次发布的 Fable 5——你就不再那么觉得自己聪明了。你会失去过去那种自我效能感。
Noam Segal:每当你亲自解决一个问题、跨过一个障碍,你的自我效能、自信和自我信念基线就会上升;每当你把问题外包给自己最喜欢的 AI 模型,这条基线就会下降,而你的思考和判断也在旁观。生产力提升是真实的,但工作质量和产出者的思维敏锐度正在受到损害。 [00:52:27]
Lenny Rachitsky:我们应该密切关注这一点,并努力维护自己的自我效能。也许我们需要给人类做评测,设计“人的 Evals(评估)”,看看人的聪明程度和判断力是否还在。
Lenny Rachitsky:科技社区目前最主流的叙事,是害怕被取代。很多人担心自己会被 AI 取代、被裁员。因此,如果我们问“你在科技行业最担心什么”,选项里有“我担心被 AI 抢走工作”,它本来应该排得很高。但结果却不是这样:被 AI 抢走工作,实际上排在倒数第二。排在最前面的,是“拿同样的工资做更多事情”。 [00:53:45]
Noam Segal:我们仿佛一直被挤压、再挤压:在更短时间里完成更多工作,却拿着同样的工资。第二大的担忧是节奏变得不可持续。这里的节奏既包括工作速度、每天必须交付多少,也包括技术本身变化的速度。你必须投入大量时间学习新模型、新框架、新的使用方式,这些时间又会挤占核心、专注的工作时间。
Noam Segal:这形成了一个恶性的下行循环,让人觉得自己无法完成任何有意义的事情,只会过度工作、非常疲惫。AI 解锁的速度,直接被重新塞回了工作预期;每一次效率提升都会成为新的基线,而被要求达到这条基线的人,已经没有多少喘息空间了。 [00:55:15]
Lenny Rachitsky:我们什么时候才能讲到这期节目的乐观部分?
Noam Segal:行业确实处在一种矛盾状态。我们试图捕捉人们当下在工作中的所有情绪,很高兴告诉大家,排名前两位的是正面情绪:好奇和兴奋。人们对技术、能力以及自己能够实现的东西感到兴奋,也对模型和系统继续演进后未来会带来什么感到好奇,这当然是乐观的信号。 [00:56:00]
Noam Segal:但继续往下看,就会发现正面、负面和中性情绪混杂在一起。人们感到不堪重负、矛盾,也会因为把某些事情交给 AI 而感到释然;他们同时感到疲惫、倦怠、焦虑、不安,但也抱有希望。很难用单一标签解释正在发生什么。 [00:57:24]
Noam Segal:Nikhyl Singhal 在节目中谈到“微笑着的疲惫”,我非常喜欢这个词,因为它准确捕捉了这种矛盾。过去的倦怠通常是阴沉的:人们因为脱离和疲惫而产生一系列负面情绪。现在则像是重新获得了生命——“我又在交付、又在建造、又在用 AI 创造不可思议的东西”。这可能是历史上最令人兴奋的时期,但没有关闭开关,节奏极其残酷,规则每天都在重写,速度持续不断。
Noam Segal:所以,我们是在微笑着承受这种疲惫。这比任何东西都更能体现矛盾感。我们也必须记得,确实有一半的人虽然工作非常努力、可能常常疲惫,却真正投入其中,对未来感到精力充沛、充满期待。不能因为我们讨论负面因素,就忘记还有一大群人正享受这个时代,并且表现得非常好。
Lenny Rachitsky:我们太容易用非黑即白的方式看问题,把人分成充满炒作的人、末日论者或憎恨者。
Noam Segal:但事情没有那么简单。我们每个人身上都有“炒作者”和“末日论者”的一部分,只是比例不同。一个人可以既兴奋、好奇,又不堪重负;既感到释然,又感到疲惫;即使总体上看好这项技术,也可以感到怨恨。这些情绪可以共存,在我们所处的时代里,它们都很自然。 [01:00:52]
Lenny Rachitsky:接下来我们看哪些职能状态最好、哪些最糟。结果有几个群体整体上过得最艰难、幸福感最低。
Noam Segal:设计师和研究员连续两年都是最悲观的群体。具体来说,在 AI 改变职业身份的问题上,他们最常感到不稳定或被削弱;在疲惫、不堪重负、焦虑等情绪上,他们也是负面情绪最多的群体;在担心被 AI 抢走工作方面,他们同样处于最高水平。最后,在类似 NPS 的“是否会把岗位推荐给朋友或同事”的指标上,研究员和设计师最不愿意推荐别人进入自己的岗位。 [01:01:27]
Noam Segal:这并不一定意味着这些职能真的陷入大麻烦,只是说明从业者此刻的感受如此。我本人属于研究和设计社区,当然不完全客观,但我想告诉这个社区:我真心相信,在我们建造产品的时代,我们的岗位从未如此重要。
Noam Segal:你以前采访过很多人谈品味、工艺和质量。比如 Linear 的 CEO Karri Saarinen,谈过如何构建高质量产品;Stripe 的 Katie Dill 谈过品味和美感;还有 Anthropic Claude 设计负责人 Jenny Wen,以及许多其他人。他们都在谈品味、判断力和设计的重要性。
Noam Segal:因此,我真心希望明年设计和研究从业者对这个行业的感受能反弹,因为行业需要他们,也需要我们。希望所有设计师和研究员都重新投入,做我们擅长的事情:在这个时代,这些能力极其有价值。 [01:03:43]
Lenny Rachitsky:我最近和几个人讨论过,既然 AI 在设计上仍然很差,为什么设计今天还没有成为公司巨大的价值增量和差异化来源?你能明显看出很多东西是 AI 设计的。看着大量 AI 生产的平庸内容,人们应该会厌倦那些千篇一律的东西,转而想真正做出优秀的产品。我对此很乐观。
Noam Segal:AI 在设计上的一些问题也许可以解决,但有些问题可能很难、甚至无法解决。创造不可思议、新颖、富有创意的体验,目前仍不是这项技术擅长的事情。希望研究和设计社区明年能重新改变对这个行业的看法。
Lenny Rachitsky:在“担心被 AI 抢走工作”的群体中,数据与分析岗位其实更担心。各种模型在数据分析上的能力进步非常快;研究领域也看到了同样的情况,编码能力也在飞速提升。我原本以为工程师在某些指标上会更悲观,但事实并非如此。
Noam Segal:不过要再次强调,这不是在描述 AI 客观上已经能多好地完成每项工作,而是在描述各个职能的人如何感受。两者并不存在一对一的对应关系。
Lenny Rachitsky:那么谁过得最好?谁是科技行业里最幸福的人?
Noam Segal:这一点和去年的调查相比没有变化:仍然是创始人和在较小公司工作的人。需要说明的是,创始人是一份极其困难、包罗万象的工作。这里还有选择偏差:我们调查的是仍在运营的初创公司里、当前正在担任创始人的人,不包括已经关闭公司的创始人。
Noam Segal:但从数据上看,创始人在几乎所有指标上都排名靠前:他们有 71% 的人对未来乐观,工作享受度最高,倦怠最低,对裁员的担忧最低,对 AI 最兴奋。这是相对于其他因素的中等效应,但非常显著。
Noam Segal:当然,拥有所有权和能动性也有边界。许多创始人仍然至少处于中度倦怠,具体来说,47% 的创始人达到了这个水平。而且,创始人现在仍然不太愿意把“成为创始人”推荐给别人,这很有意思。
Lenny Rachitsky:现在有一种“从来没有比今天更适合建造”的说法,很多人可能因此觉得必须创办公司,因为那里看起来是最好的位置。但这可能只是当前这个令人兴奋的时刻;当环境变得更艰难时,情况也许会改变。两年连续调查都显示创始人最幸福,但这并不等于你成为创始人就一定会幸福。
Noam Segal:公司规模也保持了同样的趋势:公司越大,乐观程度越低,倦怠越高,对裁员的担忧越强,也越不愿意推荐自己的岗位。 [01:09:49]
Noam Segal:倦怠会随着公司规模显著上升:从 1 到 10 人的小型初创公司,到 5000 人或 1 万人的企业,趋势几乎是线性的。没有所谓先变好再变坏的甜蜜点,规模越大,各项指标就越糟。 [01:10:14]
Noam Segal:当然,即使最小公司的倦怠水平也相当高。相对来说,初创公司员工的倦怠和担忧较低、状态更健康,但这些绝对水平仍然令人担忧。我担心现在科技行业的担忧程度,这不是一个好迹象。十年前我们在 Airbnb 认识时,科技行业的氛围明显不同。
Noam Segal:从相对角度看,也许可以考虑换个方向,自己创业,或加入一家更小的公司。
Lenny Rachitsky:如果我们也对非科技行业做一次调查,会很有意思。科技从业者如此害怕和担忧,那么蓝领工人或其他职能的人会怎样?
Noam Segal:我的 HVAC(暖通空调)技师现在可能对自己的职业相当满意。佛罗里达太热了,人人都需要空调,这短期内不会改变。我们应该进入 HVAC 行业,或者开一家水管公司。 [01:11:59]
Lenny Rachitsky:再次做调查的好处,是我们开始发现一些持续成立的结论。管理者就是其中一个很好的例子。
Noam Segal:管理者的影响非常大。你的经理是谁,可能比岗位的其他大多数特征更重要。我们去年和今年都清楚看到了这一点。我们询问人们:你的经理有多有效?你如何评价你的经理?结果显示,经理越有效,员工越不倦怠,也越享受工作。
Noam Segal:这是一个巨大影响。如果你的经理极其有效,你报告的工作享受度大约高 65%,倦怠也显著更低。问题在于,只有约 25% 的受访者认为自己的经理非常有效;36% 的人认为自己的经理无效,而且和去年相比变化很小。 [01:13:36]
Lenny Rachitsky:这太惊人了。我们经常听到“人们不是离开工作,而是离开经理”,但很少看到如此清晰的数据。遇到糟糕的处境时,找一个更好的经理当然说起来容易做起来难,但这可能是最重要的行动。
Noam Segal:这里还有两点值得注意。第一,我们正处在“大扁平化”和“创始人模式”时代。人们向更多直接下属汇报,公司尽可能保持扁平、减少层级。扁平化当然有合理的好处,但考虑到经理对幸福感如此重要,我很担心这种趋势会走向哪里。
Noam Segal:第二,我们之前谈到 AI 带来的过度工作和挤压。谁比任何人都更能管理这种挤压?就是你的经理。经理负责保护你,也在很大程度上决定你会不会被过度工作。因此,经理的重要性比以往更高。我担心我们在科技行业对经理所做的事情、以及我们搭建组织的方式,正在制造一些负面现象。 [01:15:30]
Lenny Rachitsky:如果以后有机会,我们还应该看看经理的这些指标:他们有多倦怠、幸福感和乐观程度下降了多少。这会非常有意思。
Lenny Rachitsky:报告里有一个核心结论:如果你想提高公司的留任率,最大的杠杆就是改善经理,让员工和更好的经理建立联系。最糟糕的经理集中在数据与分析、以及设计职能。
Noam Segal:我不确定是否有明确解释。一个可能的原因是,经理也是普通人;设计经理、数据和分析经理本身就在这些最悲观的职能中工作,他们显然也在受苦。一个人很难把自己在科技行业的感受和作为经理的工作完全分开,负面能量很容易传给团队和同事。因此,我很同情当前处境艰难的设计、研究、数据和分析经理。
Noam Segal:可惜的是,其中一部分压力又会被传递给直接下属。我曾在一些公司有机会参加经理培训,但这在组织中仍然太少见。如果你是公司的领导者或 C-suite(高管团队)成员,请更多投资于经理培训。如果你正在找工作,请认真考虑你的经理会是谁,因为很可能没有什么比这个人对你的幸福感影响更大。 [01:18:10]
Lenny Rachitsky:公司现在还面临人才被挖走的问题。想象一下,你好不容易找到优秀的经理、培养他们成为出色的管理者,结果他们又被拥有无限资金的实验室挖走,实在太难了。这正好引出最后一个结论:现在的人们究竟如何描述科技行业?
Noam Segal:我们让受访者描述当下科技行业的状态,并收到了数千份开放式回答。我们把这些描述聚类成一张词云。有人不喜欢词云,但我不打算为喜欢它道歉,因为它非常清楚地呈现了现在的感受:变化、混乱、速度、兴奋、波动、炒作、缺乏稳定性、潜在泡沫,同时也有疯狂的机会。一切都在演进,一切都不稳定;它更好,也更糟;它规模巨大,也令人困惑。 [01:19:17]
Lenny Rachitsky:所有东西都挤在一起,组成了一个前所未有的混乱行业。我什么都看不懂。词云里还有一句话:“我们正处在一次巨大转变的第二局。没有人知道它如何结束,但你能做的只有继续上场击球。”
Noam Segal:这是棒球的说法,不是板球。它的意思就是继续尝试,继续挥棒,继续向目标射门。另一个很精彩的受访者引语是:“科技行业陷入躁狂,一半人脱离现实、紧紧抓住潮流、冲向过度炒作;另一半人则被前一半人耗尽。” [01:20:25]
Noam Segal:从整体情绪分析看,37% 的词是正面的,37% 是负面的,剩下大约 26% 是中性的,几乎完全均分。我们看到的是同一件事,但一半人觉得它令人兴奋,另一半人觉得它令人恐惧。
Lenny Rachitsky:看到这些数据时我很震惊,我们竟然如此平均地分裂。你之前说过一句话:“这已经是未来最正常的状态。”
Noam Segal:我不想假装自己能预言未来,但从统计上看,我怀疑它不会比现在更“正常”。我们拭目以待。 [01:21:57]
Lenny Rachitsky:把镜头拉远,我们正在亲历历史。变化的规模前所未有。人们总用工业革命作比喻,也许准确,也许夸张,但这正是有趣之处:我们竟然生活在这样的时代。埃隆·马斯克说过,如果我们现在还活着,未来又要在太空建数据中心,AI 会变得和人脑一样聪明,那么我们活在这个时刻的概率实在太低了,仿佛更高等的智能正在模拟历史上最有趣的时期。 [01:22:06]
Noam Segal:我很尊重埃隆·马斯克。像他这样的人把注意力放在宇宙、宇宙之外以及支配宇宙的法则上。我的学术训练是心理学,我一直关注的则是人。如果要为这项研究做最后总结,我想说:拥有最先进的 AI、获得世界上最好的模型,并不能决定你的组织是否成功。我们必须记住,所有这些事情的底层都是人。
Noam Segal:人类正在经历一生中最大规模的转变。人们常常同时感到兴奋、疲惫、充满希望和害怕。我们都在参与塑造和建造一个未来,希望几年后它仍然有我们的位置。推动创新的是人,建造这些技术的也是令人惊叹的人。我的注意力始终会放在人身上。如果你正在看这期节目,请照顾好自己,去接触真实世界,花一点时间想想自己在职业中真正想要什么。允许自己感受所有情绪,找到适合自己的方式,度过科技行业的这段疯狂时期。 [01:24:38]
Lenny Rachitsky:你花了很多时间思考这些结果,以及人们能用数据做什么。只报告“大家有什么感受”还不够,我们接下来要做什么?如果我们想让自己处在更幸福的位置,这些数据告诉我们应该怎么办?
Noam Segal:如果你是员工,尤其是在公司工作的个人贡献者,一个建议是:选择几个具体任务或待完成事项,深入做下去。那些感到自己被放大、精力充沛的人,往往不是试图成为无所不做的通才,而是在具体任务上钻得很深。我想提醒大家,不要过度相信“现在必须成为通才、什么都做”的叙事,也不要完全忽略自己的核心职能。那样做很可能不会让你感觉更好。 [01:25:26]
Noam Segal:还要警惕“同样的工资做更多事情”的挤压。我们值得更好的工作条件。报告里链接了倦怠测试,去做测试,看看自己处在倦怠量表的什么位置;然后根据结果反思现状,和经理沟通,重新界定工作范围,重新校准工作,确保自己不会被挤到对岗位和职业完全失去积极感的位置。 [01:26:24]
Lenny Rachitsky:这里可以把建议分成两组:员工能做的事,大约有五条;公司能做的事,也有五条左右。第一条是,选出几件你最希望 AI 帮助的事情,深入做,而不是让 AI 试图替你完成所有事情。第二条就是注意工作挤压:如果职责增加、薪酬却没有改变,就和经理沟通。
Noam Segal:第三条是保护并投资于你和经理的关系。经理显然比几乎任何其他因素都更能影响你的工作感受。建立良好的沟通渠道,学习更好地向上管理,这段关系上的投入会极大改善你的状态。除此之外,如果你想尝试更小的公司或开始自己的公司,数据确实显示它们有一些优势。
Noam Segal:如果你处在职业早期,感觉梯子的梯级正在慢慢消失、越来越难向上爬,我强烈相信导师和指导的价值。优秀的指导仍然极其有效。去寻找愿意培养你的团队、经理和人,这在这个时代尤其有价值。 [01:28:15]
Noam Segal:如果你在领导团队或公司,就投资于经理。这可能是你花得最值得的一笔钱。样本中只有四分之一的人认为自己的经理非常有效,这对我来说是一个重大的危险信号,是科技行业的重大问题。想降低倦怠、提高工作享受度、在 AI 实验室不断发出高薪邀约的环境下提高留任率,就必须投资于经理。
Noam Segal:同时要管理好工作挤压。AI 正以不可持续的方式提高标准,所以你必须找到合适的预期和生产力水平。不要让梯子最底层的人被腐蚀,要帮助初级员工真正成长,因为职业早期的人往往也是最适应 AI 的人,他们可能比习惯旧范式的人更自然地使用这些技术。 [01:29:40]
Noam Segal:我也希望领导者更多关注设计、研究以及其他情绪更负面的岗位。请记住,AI 正在抬升一部分人,同时让另一部分人失去稳定。我们显然没有以同样的方式体验这项技术。 [01:30:13]
Lenny Rachitsky:我想再次强调你提到的倦怠测试。有人会觉得这听起来很傻,问“我为什么要做这个?”但我自己经历过倦怠期,却没有意识到那正在发生。知道“我现在的感受并不正常,我其实已经极度倦怠”非常有帮助。你可以根据这个信息决定怎么做:找教练、和经理沟通,或者如果条件允许就休息一段时间。仅仅知道这一点,就很有力量。你做的测验有真实的科学和研究依据,我们会把它链接出来。
Lenny Rachitsky:我们讨论了很多,有些内容令人害怕,也有一些乐观的地方。我们会链接报告,也会根据这次对话和评论区出现的内容做后续节目:哪些问题浮现出来了,我们能否找到答案。我们不会对所有事情都有答案,但会继续追问。
Noam Segal:还有一个有意思的现象:我们开始看到“AI 内疚”。特别是职业早期的人,会觉得利用 AI 有点像作弊。随着职级上升,这种内疚会下降。产品、市场,以及数据和分析岗位的人,之前在一些指标上就比较突出,现在也表现出最多的内疚。
Noam Segal:这和众所周知的冒名顶替现象有关:能力很强的人觉得自己“不够好”,觉得成功并不属于自己,而属于别人。只不过这一次,那个“别人”变成了 AI。对所有感到内疚的人,我想说:AI 是一项不可思议的技术,去利用它,学习如何利用它。它大概不会消失;今天的 AI 已经是最差的时候,只会变得更好,所以没有理由为使用它感到内疚。相反,我们迟早都会、也必然会持续使用它。 [01:32:42]
Lenny Rachitsky:Noam,我非常感谢你。你和我一起做了这么多次调查,这项工作就像你和我共同完成的一件副业,却可能是这个领域规模最大的调查之一。你运行调查、分析数据,还把结果写得这么好。这是一份独特而特别的报告,我很期待它接下来会带来什么,也很感谢你为大家做的这些事。
Lenny Rachitsky:如果听众想联系你、关注你,或者有后续问题,可以在哪里找到你?
Noam Segal:最好的地方是 LinkedIn。我很愿意和任何想交流的人建立联系,也可以在 Lenny 的社区或 Slack 里找到我。我一直在那里,也很乐意和社区成员交流。 [01:34:16]
Lenny Rachitsky:听众怎样才能对你的研究有所帮助?
Noam Segal:我希望这项研究对你有所帮助。更重要的是,希望你愿意参加我们未来的研究项目。我们会继续做社区快速投票、深入的长篇调查、访谈以及各种研究。如果你收到研究项目的消息、邮件或 Slack 邀请,请参与进来。我们希望听到你的声音和观点,再把它们分享回社区,帮助大家更好地工作,也更好地感受自己的工作。
Noam Segal:虽然这期节目有不少艰难甚至负面的内容,但和 Lenny 一样,我也是一个永恒的乐观主义者、技术乐观主义者。我相信事情会朝好的方向发展,也希望我们能准确捕捉这种可能性。请参加下一次研究项目。 [01:35:40]
Lenny Rachitsky:这是个很好的请求。Noam,非常感谢你来参加节目。
Noam Segal:谢谢你,Lenny。
本期对话讨论的核心不是某一个模型或芯片,而是 AI 规模化背后的完整基础设施。Chris Gannatti 与 Dylan Patel 从 SemiAnalysis 的成长过程谈起,逐层分析模型使用、Token 经济学、存储、CPU、网络、光通信、数据中心和电力。Dylan 的主要判断是:AI 仍处于强劲的基础设施建设周期,但真正决定产业节奏的,往往不是最受关注的 GPU,而是内存、CPU、网络、电力和供应链中大量不起眼的局部瓶颈。不同环节的需求会继续增长,却不一定同步增长;理解供需错配、技术路线和部署时间,才是判断这一轮建设能否持续的关键。
对话首先回顾 Dylan 的职业路径。他从少年时期在论坛发布芯片、手机和游戏硬件观点开始,后来做量化分析,再于 2020 年创办 SemiAnalysis。Dylan 认为,技术、商业、金融和供应链必须放在同一套分析框架里:不仅要知道产品如何工作,也要知道它如何制造、如何定价,以及地缘和供应链变化会把市场份额推向哪里。
在开源基准测试部分,Dylan 介绍团队如何使用 OpenAI、Microsoft、Amazon、Google、CoreWeave、Nebius 等公司捐赠的硬件,持续测试 GPU、TPU 及软件栈的变化。团队的 InferenceX 项目曾测到 Blackwell 在特定 DeepSeek V3 推理场景中相对 Hopper 的性能提升,结果后来被 Jensen Huang 在公开演讲中引用。这一经历也说明,软件版本、驱动、编译器和推理引擎的变化,会显著影响硬件的实际表现。
谈到 AI 的 ROI 时,Dylan 区分了两类使用方式:一类是把 AI 集成进固定工作流,重点是锁定质量并等待成本下降;另一类是把 AI 当作助手,重点是让更强的模型用更少的 Token 更快完成工作。他认为,模型升级后成本可能先下降,再因为用户发现了新的生产力空间而回升,因此不能只看账单,还要把生产力放在一起衡量。Anthropic 在许多任务上凭借更高的 Token 效率保持优势,而 OpenAI 的 Codex 更适合部分可以长时间运行的任务。
存储讨论集中在超级周期和推理负载。Dylan 认为,传统存储周期不会消失,但这一次的需求不只是终端市场的周期性增长。推理模型会产生更大的上下文和 KV cache,内存因此从模型训练的配套部件,变成持续影响推理成本和系统吞吐的核心资源。由于未来几年的供给扩张有限,存储价格和供需错配仍可能保持高位,谷底也可能高于过去周期的高点。
关于 CPU,Dylan 将需求上升与强化学习和 Agent 工作流联系起来。模型不仅生成回答,还要调用工具、运行 Python、编译代码、访问数据库、操作浏览器或在沙箱中验证结果,这些环境都需要 CPU。市场正在从 Intel 和 AMD 扩展到 Arm、Amazon、Microsoft、Google 与 Nvidia,但 Dylan 强调,CPU 更像是在补回过去算力部署时欠下的配套需求,随后会进入更稳定的比例,而不是永久超过 AI 加速器。
网络和光通信部分讨论铜与 CPO 的时间差。随着集群规模和模型通信量增加,网络在 AI 芯片相关支出中的占比会继续提升;但共封装光学仍面临制造、良率、产能和芯片设计问题,真正的大规模部署可能要到 2028 年底或 2029 年。Dylan 因此认为,CPO 是长期方向,但中期仍看好铜和非 CPO 光通信;在技术路线尚未成熟时,延迟本身会为供应链中的其他方案创造机会。
最后,双方讨论数据中心电力。Dylan 把能源拆成发电、输电和变电,认为输电受监管和政治约束最强,而就地发电、燃气机组、柴油或卡车发动机改装、太阳能加储能、储能电池以及更高电压的供电方案都在同时发展。SemiAnalysis 追踪的不只是大型芯片和云厂商,还包括 PCB 钻头、铜箔、IGBT、碳化硅、MOSFET、UPS 等分散环节;这些小部件的供需错配,可能成为下一阶段最难被发现、却最重要的瓶颈。
- 从论坛发帖到创办 SemiAnalysis [00:00:00 - 00:10:00]
- 开源基准测试与 Blackwell 性能 [00:10:00 - 00:20:00]
- AI 使用、Token 经济学与存储超级周期 [00:20:00 - 00:30:00]
- 强化学习与 Agent 工作流推高 CPU 需求 [00:30:00 - 00:40:00]
- 网络、铜与 CPO 的上量时间 [00:40:00 - 00:50:00]
- 数据中心电力与供应链瓶颈 [00:50:00 - 00:54:40]
Chris Gannatti:欢迎收听跨国串门计划,这是一档专注于让中文听众无障碍欣赏全球优质外语播客的节目。通过先进的AI生文、克隆技术,我们不仅将内容翻译成中文。还完美保留了原主持人和嘉宾的独特声音,为您呈现全球顶尖的AI财经。健康与科技领域精品内容。。我是主播一凯一位热衷于AI领域的产品经理很荣幸能为您搭建这座跨越语言障碍的桥梁接下来让我为您简单介绍本期我们克隆的这档节目本期我们克。隆的是知名播客The Next Big Thing在2026年7月的一期深度对谈主持人是WisdomTree的同事嘉宾则是SemiA。nalysis研究机构的创始人Dylan PatelDylan以对半导体和AI供应链的深刻洞察闻名他带领着一个近百人的团队为全球顶尖。机构提供从芯片到数据中心的全面分析这一期他们主要围绕支撑AI革命的基础设施现状展开从模型、芯片、存储、网络一路聊到数据中心背后的电力。供应几乎覆盖了整个技术战的关键环节那我们就一起来听听这期的完整对话好大家好欢迎回到我们下一期的The Next Big Thing播。客今天和我一起的有我的同事Blake Hyman还有我们的新合伙人SemiAnalysis研究机构的创始人Dylan Patel今天。很让人兴奋我们可以和Dylan一起梳理一下AI基础设施的现状你可能在很多播客里听过Dylan的分享我一直关注他的内容也订阅了Semi。Analysis网站上的newsletter最近我看到的一篇是关于太空数据中心的如果有人对这个话题感兴趣他们有一篇很棒的深度文章不过。Dylan我很想听听SemiAnalysis这个想法是怎么来的我知道现在在Substack圈子里大家经常讨论你们公司的收入和成功但我。觉得很多时候人们看到的是现在的成功却忘了背后的历程起点以及这背后投入了多少心血对我觉得SemiAnalysis的起源其实可以追溯到。 [00:02:12]
Dylan Patel:我在网上发帖灌水用一种不那么严肃的方式会像我最早关于半导体的帖子那还是我十几岁的时候我那时候就在网上发关于芯片智能手机手机屏幕手机S。oC这些东西的内容在我自己都还没有智能手机的时候我就已经对这些东西着迷了游戏硬件也是一样PC硬件游戏主机硬件我那时候在各种论坛上不停。地发这些东西到我12岁的时候我已经在管理很多论坛了比如关于AndroidAppleGoogleIntelNvidiaAMD这些硬件话。题的Reddit上也有很多相关的板块所以一切的起源就是我一直就是个发帖的人我一直发表自己的观点一直回复别人一直看评论我觉得有件事挺有。意思的现在我们团队有90个人了我也有市场部的人他们会说Dylan别在网上回复那些乱七八糟的人了你让我们看起来很掉价但我就是有那种冲动。当有人在网上批评我的时候我就想回复他们这也许是个坏毛病基本上在我整个青少年时期我都在管理这些论坛后来到了十七八岁我开始赚钱了也就马上。开始做投资我做了两年量化分析师然后创办了自己的公司但整个过程里我一直在发帖发帖发帖我有过匿名博客发过匿名帖子但到了2020年我对自己。的工作感到厌倦了对做量化分析师这件事有点幻灭它并没有看起来那么美好是的你能赚钱但并没有看起来那么美好我算是消极代工然后创办了自己的公。司我当时也不确定它会走向何方但我开始在一个自己建的wordpress网站上发帖用我的真名发的内容混合了技术商业金融供应链这些都是我最。感兴趣的东西因为我是在小生意里长大的我是在汽车旅馆长大的我父母在佐治亚州的乡下有一家汽车旅馆我们就住在里面我算是天生就懂点生意后来我。们家还开了加油站所以我是在那种环境里生活长大的我一直很喜欢商业从投资的角度从东西是怎么造出来的角度看供应链一直很有趣我觉得这是一种天。赋就是总想知道东西是怎么造出来的技术层面当然非常令人兴奋金融层面也非常令人兴奋所以把这些结合起来我最早写的文章里有一篇是关于当时中国。在禁止或者说美国在禁止华为获得TSMC的代工服务然后我最早的文章之一就是分析为什么联发科是最大的赢家因为华为当时在中国智能手机芯片和。智能手机市场的份额是第一显然因为拿不到TSMC的代工这个份额会暴跌所以美国市场当时觉得高通会赢但联发科是台湾公司我当时觉得他们其实会。抢到更多份额因为从地缘政治上看我们刚进了华为中国肯定更愿意买台湾公司的产品而不是美国公司的所以两家都受益了但联发科受益大得多就这种技。术供应链金融地缘政治所有这些东西揉在一起后来几年我把wordpress转成了substack开始收费我写的都是整个半导体和AI供应链。的各种话题我一直在关注AI做量化分析师的时候也接触过一点AI半导体更是我一直以来的兴趣然后这个事就越做越大越做越大有四年时间我满世界。跑参加全球所有的会议一年跑40场会没有固定住处就是能去的会全去不管是newripsACMLICLR这种AI研究会议主要是研究员去也有。一些公司去发表研究还是往下游走去那种特别偏门的会比如半导体供应链上游的化工原料会议我整条产业链上下全跑服务器网络制造 AI全跑一年4。0场会议有些会特别小众就300个人除了5个人以外全讲日语我当时就想行吧就这样没办法但另外一些会呢一两万人规模巨大整个光谱整个连续区间。我都覆盖到了所以我能横跨整个生态一个会你去三次你就真能听懂他们说的话了也认识人了你能建立起所有这些关系可以问他们问题我就这样搭建起了。整个生态和知识体系而且我在每一个节点上都能捕捉到拐点技术上我好奇心很强但一旦有什么东西在技术或供应链上特别突出我从会上了解到之后我就。知道它在供应链或金融层面会导向哪里所以我写的东西是所有这些混在一起的有时候报告偏技术金融圈没人关心有时候他们就会说哇这是个瓶颈或者这。是个正在发生的拐点或者这家公司下一代技术会让他抢到巨大市场份额而且我比街上所有人都先喊出来比任何对冲基金都早比谁都早所以这差不多就是。起点后来substack越做越大2022年我开始招人前两个招的人是我在discord上认识多年的朋友但之后第三个招的是Marin他之。前在对冲基金工作当时要搬到日本跟妻子一起生活所以他算是个自由人我发过一篇文章讲的是那篇文章在当时很有意思23年初内存是AI最大的输家。原因是AI芯片和AI服务器用的内存量比普通服务器少很多普通服务器里差不多一半的成本是AI芯片是内存AI服务器里就少得多一部分原因是N。VIDIA的利润率更高还有几个其他因素当然NVIDIA下一代芯片把内存容量大幅提上去了现在已经是多得多但当时我的判断就是内存是最大输。家在付费部分我说了我在招人Mirren就联系了我他是第一个对冲基金背景的人另外两个人都是技术背景他一加入我们就开始做各种模型真正把业。务转型了我们还在做newsletter还在上面发大量优质内容比以前还多但我把它从单纯的newsletter转成了卖信息服务的模式卖报。告卖数据集这个事一开始滚动起来就像雪球滚下山一样从2023年到2024年我从两个人扩到七个人然后从24年到25年初从七个人扩到20个。人从25年到26年从20个人扩到60个人今年我们已经到90个人了光今年就加了30个人就是雪球一路滚下山我们不断加新的领域我一直对什么。都感兴趣但现在我能招到各个领域的专家我觉得Seminarios最让人兴奋的一点就是我不知道还有哪家公司有我们这种密度的人才集中度我团。队里有人在ASMLApplied MaterialsLAM Research这些做晶圆设备的公司干过一路往上游走还有人待过Intel。SMCNVIDIAMicrosoftAmazon当然也包括在OpenAI做过模型的人有人在OpenAI做过模型有人在Tesla做过F。SD有人在Cohere做过我们覆盖了模型层的人在另一个垂直方向我们还有做过数据中心的人我公司里有个人在哈萨克斯坦建过一座发电厂我们的。人才密度高得离谱特别棒公司差不多一半的人是在行业里做过工程的另一半要么是钱对冲基金的要么就是网上找来的特别有热情的人我在Twitte。r或Discord上发现他们觉得这人聪明就让他们来跟我干结果还真行这就是我们一步步搭建起来的东西现在Semian Analysis有。很多条业务线有数据服务咨询信息服务有Newsletter还在做各种媒体内容。 [00:09:25]
Chris Gannatti:我们很快要办一场大会规模会很大反正我们做的事五花八门这一路真的很过瘾说到这一路Dylan 我有个瞬间想跟你聊聊WisdomTree和。SemiAnalysis已经合作好几个月了每年三月NVIDIA GTC都会开今年我在北卡罗来纳州夏洛特看直播当时大概有五万五千人一起。在看然后突然而且现场体育馆里还有两万人兄弟体育馆里坐了两万人然后他直接在台上点名说你在他某个数字上藏着了就在你的图标里直接在大屏幕上。讲说实话我当时替你激动了一下看着全世界最大公司的CEO在台上引用你的研究还说你批评了他对某些数字的看法我想听你聊聊听起来你当时就在现。场对那个瞬间确实挺超现实的简单说SemiAnalysis做的一件事是。 [00:10:17]
Dylan Patel:我们有一批工程师在做开源基准测试覆盖所有开源AI模型和所有硬件这个项目挺厉害的我这边有好几位工程师但我们跟行业合作非常紧密我们从Op。enAIMicrosoftAmazonGoogle,Coreweave,Nebius。Cruzo这些公司拿到了超过5000万美元的硬件捐赠你能想到的主要云厂商基本都给我们捐了硬件Oracle也捐了我们就在这些硬件上跑基。准测试我们现在有8种不同的GPU包括各种H100,H200,Blackwell还有AMD的各种GPU另外我们还有Google的TPU。和Amazon的Trainium我们做的事情是每天用最新版本的软件跑基准测试为什么是每天因为每天晚上都可能发布新的CUDA版本PyT。orch版本驱动更新或者推力引擎VRM Scalene的新版本等等所以我们每晚都在整条曲线上跑覆盖从追求最快Token速度到追求最优。性价比的各种场景我们每天都跑这是一套自动化的基准测试套件黄仁勋最初发布Blackwell的时候声称会有25倍的提升当时没人信他对吧那。是黄仁勋他擅长营销就连我们当时也觉得好吧我们比大多数人更看好我们根据跑过的模拟认为大概能有15到20倍的提升因为我们有性能模拟器但随。着我们把这个叫InferenceX的推理基准测试做起来我们发现哇在DeepSeek V3上Blackwell在曲线的某个点上比Hop。per快了30倍然后就有了后面的事我一拿到结果就给他发了邮件这些结果会自动发布到开源GitHub上这是个开源协作项目NVIDIA的人。也参与了他们知道但我特意跟他强调了一下我给他发邮件说嘿黄仁勋你在2024年发布Blackwell的时候说25倍所有人都喷你这是当时喷。你的人连我也喷了我说不可能25倍大概15到20倍还有很多人说不不不也就三倍我们当时已经算很看好的了但是黄仁勋我错了你是在藏拙实际是3。0倍然后他就拿这个去用了我当时不知道他会怎么用只是从几个客户那里听说Meta有人告诉我他们开了个会黄仁勋拿这个当证据证明他没有在数字。上藏拙因为他当时在讲下一代芯片总之这些事就这么发生了我完全没想到他会在台上讲另外在InferenceX项目里我们还做了一个腰带长得像。WWE冠军腰带上面写着Inference King我们把这个腰带发给了所有合作方发给了合作方发给了NVIDIA发给了AMD还发给了S。GLVLM这些帮我们做基准测试的人还有捐赠硬件的人毕竟这是个开源项目我每年花几百万美元在工程师工资上其他人花几百万在硬件上捐给我们或。者花几百万在工程师工资上捐给这个开源项目我把这个腰带发给他们然后黄仁勋在幻灯片上展示了这个腰带他举着他旁边是我们的图表他在幻灯片上讲。了五分钟说Dylan说我藏拙但我没有我们的性能就是最好的那一刻真的太超现实了他讲我们的时间比讲其他任何人都长。 [00:13:24]
Chris Gannatti:唯一被提到差不多多的是OpenClaw它现在确实风靡全球所以那真是个不可思议的时刻对Dylan你刚才提到了几件事我觉得很有意思的是你。提到了开源现在可能稍微转向一些最近的发展还有市场方面一直有关于一些开源模型和闭源模型在实际推理效率上的讨论而且直到今天还有很多投资者。在质疑这一切的ROI就在过去一两周我记得有个Bloomberg的经济学家谈到很多AI项目在一些公司里可能正在失败我知道你强调过你们公。司是怎么广泛使用AI的真的在让员工大量使用Token然后你刚才也提到你们在招人所以我很好奇你怎么看这种终端需求以及这种终端需求确实在。推动我们看到的这场大规模建设而这场建设充满了各种制约因素至少在过去一个月里除了最近几天市场的变化这些因素一直在推高很多相关主题的股票。对我想说几点当你去看这个核心问题就是ROI公司从AI里赚到足够多的钱了吗这能持续吗。 [00:14:31]
Dylan Patel:用AI的人真的从中获得价值了吗这是很多人心里的大问题我去看去想这个问题的时候有几个角度可以拆解首先Anthropic的自由现金流是正。的他们在Q2是盈利的即使在4月他们4月结账时也是盈利的自由现金流是正的5月自由现金流是正的也是盈利的6月看起来也会是这样虽然还没完全。结账但至少三个月里有两个月他们是自由现金流为正并且盈利的他们的经常性收入已经突破了500亿美元AR他们做得非常好但我觉得这只是硬币的。一面就是Anthropic在印钱显然还有很多公司没在印钱但他们在接近了OpenAI的收入随着Codex采用率增长也开始起飞其他产品也。是所以这些公司都在变得更赚钱Anthropic毛利率非常高超过70%但最终你刚才也暗示了人们开始关注的硬币另一面是那些在AI上花钱的。公司呢至少在SemiAnalysis我们之前的情况是我喜欢管它叫ARS不是AR年度经常性收入是年度经常性支出在Claude Code。真正起飞之前也就是去年11月我们的年度经常性支出还不到10万美元当时我们给每个人订了ChatTPT的200美元套餐差不多就是这样如果。有人想要XAI或Ccloud我们也会给但标配就是每人一个OpenAI 200美元订阅这就是去年11月的状态我觉得那时候我们已经算很前。沿了但后来Claude Code开始爆发随着Cloud Open 4.5 4.6这些版本出来到1月底我们的R2年度经常性支出已经冲到。400万美元了就是因为大家都在用Claude Code我想说清楚一点我们的员工支出里有超过三分之一是花在AI上而且这还不算其他开销到。年底这个比例可能会变成一半一半取决于Methos和其他模型出来之后能变得多好这个支出量非常大那问题来了ROI怎么样我觉得回报巨大因为。我们能做出产品能卖出更多东西公司里每个人的效率都提高了所以我能看到ROI但我觉得很多公司在问如果我有个很厉害的开发者年薪30万美元甚。至更高那他在AI上的花费对好的开发者来说已经开始接近1比1了对非开发者来说花费范围可能低一些但至少在SemiAnalysis我们很多。花钱最多的人反而是不会写代码的他们就是告诉模型自己想要什么然后反复迭代最后就拿到了想要的东西所以你看到人均支出在飙升很多公司现在理所。当然的在问我们全年的AI预算Q1 Q2就已经花光了现在怎么办问题是我们要砍AI支出还是砍别的地方很多公司说也许我们得放慢AI上的花费。但我看到很多公司开始砍别的地方了他们在砍以前用的其他SaaS产品说我们可以增长更快那就这么干他们说在AI上花钱没问题暂时承受一下I一。直在变便宜即使采用率在飙升我六个月前做的事现在用AI做便宜多了当然我现在用AI做的事比六个月前广泛的多大家的做法各不相同有些人甚至在裁员工而不是砍AI。 [00:17:37]
Chris Gannatti:也有人在收紧AI支出但这些公司在生产力提升和能做出什么东西方面会被源源甩在后面明白了那有一种可以缓解增量成本的办法就是选便宜一些有时。候不那么聪明的模型不一定总用最前沿的我听到的一些说法还非常早期但我好奇的是像你们这样的公司会不会在某个节点决定有些场景用DeepSe。qVis这类模型更合适而需要更高智能的任务才去用那些更贵的模型这是不是你们考量的一部分我觉得对一些人来说这绝对是考量的一部分而且你得把AI的工作负载分成两类。 [00:18:14]
Dylan Patel:一类是把AI集成到我已经有的流程里比如客户发来一份文件我检查它有没有XYZ问题我把文件丢给模型模型检查完就结束了这种情况下我只需要达。到某个质量水平就行达到之后我就可以不再追求模型更强而是等着更新更便宜的模型出来或者等成本效率提升来降低成本我们看到2A模型的成本每年。大约能降低60倍你锁定一个质量水平一年后达到同样水平的成本就变成了1 60分之一大家之前被DeepSeek吓到因为它比GPD4便宜了。600倍这其实是在GPD4发布大约两年后所以是360倍60乘60是360倍结果它实际上便宜了600倍所以这个曲线上的某个点不管是每年。便宜60倍还是每年便宜90倍大概就在这个范围内但DeepSeek V3对比GPD4两年内成本降到了1%你往后看差不多就是这个量级所以。如果你有一个工作流把AI集成进去那你的做法就是先达到一个质量水平然后再追求更便宜另一类工作是AI助手我觉得这里其实有点误解你不需要如。果我在做日常工作让模型帮我做这个帮我找那个帮我弄清楚某件事成本优化并不是去用一个更便宜的模型成本优化往往是去用最新的模型因为最新的模。型比如Claude 4.6 Opus可能要花10万个token来完成一个任务而且可能需要几个来回我跟他反复对话所以它可能耗费10万个。token和我10分钟的时间但Quad 4.8 Opus可能只需要四分之一的token25000个而且可能只需要一个来回就搞定了所以。成本其实更低因为生成的token数量更少我花的时间也更少所以当我观察一个开发者或者一个做智力工作的人降低成本的途径其实不是用更便宜的。模型而是把那些以前需要跟模型反复拉扯才能完成的任务交给越来越新的模型现在它可能只需要一次迭代或者一次性就能完成整个工作流它可以用更少。的token完成所以我们看到从4.6 Opus到4.7 Opus我的成本实际上下降了一周然后又飙升回去了因为大家用的越来越多那为什么。成本会飙升回去呢因为大家需要适应新的工作流他们会想好我之前做的工作已经完成了让我做更多的事所以成本又上去了同样的当4.7升级到4.8。时成本也下降了大概一周到一周半然后成本又飙升回去了因为大家意识到对我现在能做更多工作了所以你必须把生产力和成本放在一起衡量当它是一个。AI助手时Token效率真的非常重要这也是为什么Anthropic一直能打败OpenAI因为他们的模型比OpenAI的模型Token。效率更高实际上OpenAI的模型在一些前沿科学前沿数学前沿编程的边缘案例上经常能完成Anthropic模型做不了的任务但是他们花费的。时间可能是三倍消耗的token是四倍因此成本高得多而且人和AI之间的反馈循环也没那么快这最终导致在客户感知上他的表现反而更差因为你跟。模型说去做这个任务然后你回来检查任务是否完成这是一回事但另一种情况是你说我有四个小时来做这个任务那么是让模型调用一次自己干四个小时还。是跟模型来回交互四次哪种方式做得更好事实证明当有人在回路中这种反馈循环时Anthropic实际上要快得多好得多因为它token效率更。高所以这也是我们仍然主要使用Anthropic的主要原因有些任务大家确实会用OpenAI而且通常是那些可以让它跑一整夜的任务大家会交。给OpenAI的Codex但大多数任务大家还是用Claude Code所以关于模型和token效率一个很有意思的点是成本这东西有点难。以拆开来说有些任务是你锁定模型质量然后等着模型变便宜。 [00:22:11]
Chris Gannatti:而另一些任务实际上你只想要最聪明的模型因为它反而更便宜Dylan我有点好奇想听听你的看法把话题稍微转到硬件这边我知道今年早些时候你们。有一期newsletter如果听众还没发现的话我已经是你们多年的忠实读者了里面有一篇文章讲到了存储存储通常是有周期的大概18到24个。月往上走然后18到24个月往下走我们都知道这个规律但现在感觉好像所有东西都缺货只要你是做数据中心相关组件的问题已经不是你能不能拿到货。而是你得等多久因为现在这个世道你几乎拿不到任何组件以你纵观硬件领域的经验来看像存储这种过去40年来一直是大宗商品跟着周期起起落落的东西。 [00:23:02]
Dylan Patel:你觉得接下来会发生什么变化对我不是说以后就没有周期了我觉得周期肯定还会有显然我们现在处在一个超级周期里上升势头非常猛将来也一定会有下。行而且下行也会很惨烈但即便下行谷底跟谷底比增长依然很大所以我觉得现在存储和其他组件真正值得关注的地方是正在发生的阶段性变化过去的上行。周期终端市场可能增长50%对于存储这种定价弹性大的大宗商品市场来说相关股票可能涨个两三倍但我们现在看到的不是增长50%而是过去几年里。总支出已经翻倍了而且还会再翻倍总支出翻倍之后再看不同终端市场的弹性存储的价格已经涨了大概四倍接下来在产能增长之外还会再涨个两三倍所以。这些股票在回落之前涨势会非常疯狂我觉得存储真正让人兴奋的地方在于它不只是一个终端市场的问题不光是市场在暴涨而是它本身就是一个弹性很大。的商品定价对终端市场需求极其敏感真正有意思的是我们在2024年O1出来的时候就写过OpenEye发布了O1这是第一个Reasonin。g模型它催生了一波新的Reasoning模型热潮OpenEye,Anthropic。DeepSeek还有很多其他公司都在利用这个方向让模型去做长周期的agent任务我们当时注意到O1一出来工作负载立刻发生了巨大变化你。看以前我们做对话的时候你跟XTPT聊天发一个prompt可能是50个词也可能是500个词你发过去它给你一个回复这个比例下上下文长度大。概是几千假设上下文长度是2000这意味着你跑inference的时候每生成一个token就要把所有权重读进芯片把所有上下文读进芯片处。理一个token然后再循环你要反复读取所有token上下文和权重上下文这部分就叫kvcash它建立了这些Token之间的关系有意思的。是当你跑模型Inference的时候在权重这一侧不管上下文长度是1000还是10万你都得把所有权重读一遍推理场景下的内存强度在权重这。边是一样的但在KVCash这边也就是上下文这边你读入1000个Token和读入10万个Token内存需求是天壤之别尽管计算量大致相同。因为有了KVCash在内存上的缓存机制你的计算成本不会飙升但内存成本会飙升所以我们在OE的报告中重点提到2024年12月我们就谈过s。caling loss预训链的scaling loss正在让位给reasoning的scaling lossOE是一个巨大的接约变化。我们当时就说KV cash会因为reasoning而爆炸式增长所以内存会是最大的赢家我们在24年12月就提出了这个观点25年又多次强。调我们对内存非常看好但真正关键的我想是26年1月我们写了那份报告当时大家觉得内存已经涨了50%是不是到周期顶部了还要不要继续我们那份。报告基本就是在说不不不我觉得你们没搞懂未来三年内存产能每年只增长20%30%但需求却在翻倍再翻倍所以最终会发生什么内存价格会持续飙升。那些对价格弹性承受力较弱或者无法适应这种价格弹性的内存用户会被挤出市场智能手机笔记本电脑因为成本涨得太厉害会被挤出市场这些需求全都会。让位给AI这意味着价格只能一直涨一直涨一直涨直到挤出效应发生因为产能增长根本不够所以我们当时的观点是内存处于短缺状态而且不是短期短缺。是会持续好几年的短缺我们看到的情况是从去年Q1到今年Q1再到现在的Q2内存表现一直非常强劲一直在飙升中间也有过因为某些随机原因单日跌。个7%8%的时候但整体走势就是一路向上我们觉得这不是投资建议但我们认为它还会继续涨因为价格还在继续往上走我们目前看到一些中国的中低端。手机厂商比如小米出货量已经下降了40%但高端市场还没受到冲击明年iPhone必须涨价MacBook必须涨价现在如果MacBook和i。Phone涨个100美元市场还不会调整太多但内存会越来越贵直到AI的需求被满足为止这意味着智能手机价格不是只涨100美元而是得涨几百。美元最终会达到一个均衡点AI拿到它需要的需求而移动端和消费硬件被压到足够低的水平但显然人们迟早还是需要新手机和新电脑所以还是会买我们。必须达到一个新的均衡因为内存终端市场的产能增长不够快把视角扩展到整个生态真正重要的是很多不同组件都处于短缺状态谁的定价有弹性谁没有举。个例子TSMC的定价就没有弹性他们是一家很好的公司对客户很公平长期合作他们会说我们涨价5% 10%内存厂商呢他们处于大宗商品市场他们。让现货市场和合约市场的供需平衡来真正调节价格所以你会看到价格翻两倍三倍将来某一天你也会看到价格腰斩因为内存本身不配拥有85%的利润率。对吧虽然现在正往那个方向走我们现在还没到85%90%的毛利率但会到的然后从那个高点又会腰斩回落到70%多甚至更低所以我们会看到内存的。这种震荡在TSMC你看不到这么大的震荡在其他领域比如ASML你也看不到价格上这么大的震荡他们是做设备的但生态里不同环节的震荡方式会不。一样取决于两点一是AI的终端需求有多少能传导到他们身上供应链的不同环节每花一美元在AI上可能只有一美分落到某个产品上但可能有五美分落。到另一个产品上所以在这个终端市场里内存跟其他东西的情况显然不一样所以基础设施供应链里不同终端市场受益程度不一样需求端是这样但除此之外。还得看市场本身的格局是垄断或寡头吗还是竞争非常激烈的大市场是定价比较稳定靠长期协议的那种还是更像大宗商品市场价格完全由供需决定所有这。些因素共同决定了某个终端市场会怎么走不管是内存还是现在大家开始讨论短缺的MLCC或者PCB钻头PCB铜箔各种五花八门的零部件你上网一。看到处都在说这个是下一个短缺那个是下一个短缺你会看到各种各样的说法但真正重要的是实际的需求传导有多少这个终端市场是在翻倍增长还是只涨。了50%还是翻了4倍基于市场结构价格又能涨多少这些才是真正决定基础设施供应链走向的东西如果用你这个框架来看感觉每年市场都会突然意识到。 [00:30:01]
Chris Gannatti:你说的某一种潜在短缺今年早些时候OpenClaw在各大网站爆火让大家突然看到了AI Agent的世界和各种可能性用你刚才说的框架我很。想听听你对CPU市场的看法在AI头三年里我几乎没听人提过CPU这个词但今年CPU这个词到处都是对对CPU这边有意思的是我们在去年11月。
Dylan Patel:给客户的机构研究里就开始大量讨论这个话题了因为当时OpenAI和Anthropic已经开始跟AmazonGoogle Microso。ft这些公司谈交易要把他们数据中心里所有的CPU都租下来然后从去年年底到今年CPU需求一直在急剧攀升原因是什么我们先说原因以前主要靠。算力和网络但随着预训练转向强化学习聊天室的推理变成了Agentic的工作流CPU的需求一下子就上来了为什么预训练是把整个互联网的数据。集都喂给模型去训练而强化学习是模型自己生成一些合成数据或者生成一个推理链然后放到一个环境里去验证这个环境可能是跑代码的单元测试可能是。一个模拟网站的沙箱也可能是一个模拟工程系统或其他平台的沙箱比如网站购物网站之类的总之是你在互联网上会用到的某种东西也可能是编译代码这。些环境都需要大量的CPU而以前的预训链处理Token本身并不需要太多CPU需要CPU的是环境验证这一步好我生成了这些Token现在它。们有效吗把它们放到Python或CBN一期里会怎样或者放到一个网站里比如我想买个东西电商场景也好别的也好作为一个agent工作流我在。不停地测试这些东西这需要大量CPU反过来看现在做实时推理的时候如果是聊天就是我说一句他回一句结束我可能再多问几个问题但也就这样了但现。在我们说的是Agentic工作流模型在做工具调用模型会说好我去搜一下这个然后我去数据库里查一下这个我去问问Python解释器我写小段。代码来验证一下我的工作我写点代码编译一下然后部署出去这些Agentic流程最终会需要越来越多的CPU因为他们必须跟真实世界交互人跟模。型交互是一回事我告诉模型一件事模型给我一个回复我读了然后复制粘贴到别的地方去用但模型自己去跟互联网世界交互就是另一回事了在这个过程中。会有更多的计算在循环里更多的AI在循环里抱歉是更多的CPU在循环里来回传递答案所以不管是强化学习还是agentic工作流都需要大量C。PU那么现在实际发生了什么因为好我们需要大量CPU但先按我们之前的框架来评估一下对吧市场结构是什么样的好市场里有几家有Intel和A。MD现在ARM也推出了CPU所以ARM的股价涨疯了因为市场里来了一个看起来很有竞争力的新玩家然后还有Amazon他们是这个领域的领头。羊但Microsoft和Google也在发布自己内部研发的CPU接着NVIDIA也在发布自己的CPU所以市场里有很多不同的竞争者但说。实话直到两年前整个市场还都是Intel和AMD的天下现在Amazon已经拿下了不小的份额Nvidia和ARM也开始拿到更多份额但最终。市场端发生的是Intel其实能提价AMD其实也能提价所以他们两家都提了价他们的需求显然也大幅增长了Amazon则能从CPU上赚取惊人。的利润因为他们不是制造CPU来卖而是制造CPU来租所以他们的Graviton CPU租的特别火而且他们大幅增加了订单Nvidia以前。只把CPU和他们的GPU捆绑销售现在也开始单独卖CPU了就是Vera他们给出的指引是200亿美元CPU收入对Media来说这其实不算。什么也就是几个百分点不我开玩笑的我觉得当你去看其他公司比如IntelIMDARM Amazon。 [00:33:56]
Chris Gannatti:看谁能拿到IaaS收入而不只是销售收入这里面正在发生巨大的变化Dylan顺着这个话题关于CPU我听到的一些讨论是用于agent的CP。U在某些方面跟以前的CPU不太一样我记得听黄仁勋说过或暗示过Vera CPU的核心针对Agentic活动做了更多优化然后还有很多关于。GPU和CPU比例的讨论这显然也点明了CPU需求和用量的方向你能不能就这两个话题多给我们讲讲因为我觉得这个概念在宏观上大家很容易理解。但其中有些技术细节可能被忽略了我不确定这到底是营销话术还是确有其事说到agentic工作流CPU的使用方式差别很大有些agentic工作流是这样的模型在跑。 [00:34:45]
Dylan Patel:然后我把所有token的响应发给某个CPU工作流接着我就等着CPU去完成一些操作然后再把结果发回给模型模型继续工作问题在于第一跑模型。的计算资源在等CPU的时候会不会闲置有些情况下会有些不会在会闲置的情况下跑模型的计算资源就干等着CPU的响应这时候CPU的架构就需要。非常不一样基本概念就是你是想要更多核心还是想要更快的核心CPU架构里有个规律简单说就是如果你把CPU核心做的大一倍也就是芯片上的核心。数少一半你的单核性能并不会翻倍单核性能可能只提升50%当然这里面有很多工程细节这个取舍没那么简单但极度简化来看可以这么理解所以如果我。看NVIDIA的Vera CPU它的核心数不到100个但这些核心比AMD的核心更快AMD的旗舰CPU有256个核心所以核心数量差距很。大但NVIDIA的核心更快不过也没快到两倍对吧它没有比AMD的CPU核心快两倍所以大家在设计上就在做这种取舍有些工作负载里挨算力必须。停下来等CPU那你就得想管它呢就算核心数少一半每个核心只快50%整体CPU性能是变低了但单核性能更高这样我就不用老等着CPU核心了我。不需要那种超级并行的任务我要的是这个任务现在就给我跑完所以当AI算力在空转等待的时候我就想要最快的单核宁可牺牲多核性能这是一类age。ntic工作流另一类agentic工作流呢就是说我平时怎么用cloud还有我们团队怎么用cloud我们一年在cloud上花1100万。美元按IRS口径算那是什么情况我在调用cloudcloud在处理一堆token但它不是只服务我一个人它把几十万用户一起做P处理对吧所。有算力混在一起跑所以当它把响应返回给我等着我去执行的时候不管是等我这个人还是等某个CPU核心去执行这都没关系因为算力还在跑只是不在跑。我的任务在跑别人的所以如果CPU慢一点但数量多得多那就是另一种任务类型了还有一种情况是这是AI在主动使用还是说用的是AI生成出来的东。西你把AI生成的东西拿去部署有意思的是你看全球GitHub提交量跟去年比翻了好几倍不是那种GitHub总提交量涨了10%或50%是翻。了好几倍这意味着什么意味着全世界有大量代码在被生成出来而且很多代码真的被部署了当然很多代码是垃圾但确实有大量代码在部署部署之后这些代。码就跑在CPU上而且就是普通代码可能就是个网页爬虫可能是个分析引擎也可能是业务流程自动化这些不一定需要跑在超快的CPU核心上跑在性价。比高的核心上就行所以你看这个光谱NVIDIA造了性能最高的CPU核心但不一定适合所有场景反观AMD和Amazon它们的核心数多得多几。百个但单核性能更低这就形成了一个取舍ARM也在这个光谱上那你在光谱上选哪个位置有些工作负载确实需要Vera有些则需要Graviton。或者AMD的CPU我不会说这事很简单至于你提到的另一个问题比例问题CPU需求在上升这是无可争议的我们去年底在机构研究里最先提出这一点。今年1月又在newsletter里讲了自我们发布之后一些CPU股票暴涨ARM翻了好几倍Intel也翻了好几倍AMD暴涨这些股票都涨疯。了但现在卖方那边他们其实根本不懂技术就开始瞎编了把CPU对GPU的比例或者说CPU对AI算力的比例编得越来越离谱编到CPU比AI算力。还占优势的程度这是错的再强调一下你看一块Blackwell满血版Blackwell大概5万多美元一颗如果是1比1的比例CPU大概50。00美元一颗那算下来如果要卖3000亿或5000亿美元的Blackwell对应的CPU销售额也就300亿或500亿美元这也是大家开始。忽略的另一个点没错这个终端市场在暴涨但大部分钱还是流向了AI算力和内存这个市场之前被低估了现在定价更合理了我觉得大家需要认识到CPU。的需求不会一直涨涨到超过AI ASIC这更像是一次波正基本上23 24 25年这几年卖了几百万颗AI芯片但CPU卖的很少现在CPU需。求突然爆发本来比例不该这么低应该更高才对大家现在在补课所以我得买一堆CPU去补齐之前买的所有算力同时还要覆盖现在正在买的算力可一旦我。把之前买的那些AI芯片的CPU欠账补完了这部分需求就没了我已经把历史欠账补上了现在就只剩增量部分了你想假设一个比例比如1比2一颗CP。U配两颗GPU每颗GPU假设卖5万美元每颗CPU卖5000美元那每花10万美元买GPU才花5000美元买CPU这对CPU的增长来说市。场格局其实没那么好当然对CPU来说还是很好比以前强太多了但反过来看如果我过去三年卖了1000万颗GPU和AIEC它们基本都没配CPU。那这5000美元一块的CPU就有一个巨大的补涨空间我们现在经历的正是这种巨大的补涨同时配比也上移了再加上历史欠账在集中回补所以你看到。需求非常夸张但它会慢慢消化然后进入一个稳态我们正处在CPU的一个小周期里这个背景补充的太好了非常有帮助。 [00:40:11]
Chris Gannatti:那我们接下来聊聊网络往技术战的另一块走我觉得这块引起了很多投资者的关注尤其是他们深入研究光通信供应链和一些瓶颈之后我们看到一些估计说。供封装光学可能讨论的很多但真正部署大概要到2028左右或者20272028年你怎么看这个就是大家常说的能用铜的地方用铜必须用光的地方。用光这种从光到铜的过渡而且黄仁勋在Computex上也讲了很多其他很多讨论也把像Marvell这样的公司推到了聚光灯下关于光通信以及。未来两年数据中心在网络架构方面会怎么演变你还有什么补充的想法吗我觉得趋势挺明显的随着模型越来越大我们怎么跨模型运行。 [00:41:02]
Dylan Patel:怎么训练模型光通信站里有很多不同的领域比如电信光通信像Ciena这样的公司长得很猛他们周围的很多供应链公司也是再看数据通信芯片到芯片。的互联这里面有铜的领域现在也有光的领域这些都在暴涨因为网络内容的增速比其他任何部分都快按百分比算网络在AI芯片相关支出里的占比会从不。到10%涨到10%以上等到了CPU时代网络占比还会更高能到20%30%所以网络内容会有一个巨大的提升但另一方面CPU对行业来说是一次。巨大的节约式变化现在大家都认识到CPU了但我觉得人们现在有点过于兴奋了目前大家对CPU有点太激动了在我看来它不会在27年到来真正大规。模上量做scale up供封装光学要到28年底29年才是真正的爬坡期这里面问题很多主要是制造问题如果今天就能以好的成本部署那太好了所。有人都会用但它真的很难制造产能不够良率不行芯片也还没真正为此设计好要把这东西做起来非常复杂非常难所以大家会尽可能长时间的留在同的方案。上这意味着Rubin全是同GPU上的Feynman也还是同Feynman是Rubin Ultra之后NVIDIA的下一代GPU而我们。连Rubin都还没开始发货所以Rubin才刚开始出货我们还有好几代芯片才会在GPU上看到共封装光学交换机上的共封装光学会来得早一些比。GPU或ASIC上的早但说到底就算没有CPU随着集群规模变大每颗GPU需要的光模块也会更多或者需要更多有源电缆之类的东西所以我们看到。的是一个很大的动态变化实际上我们周一刚在Seminal Analysis给机构研究订阅用户发了一份报告讲的是一个局部时机的问题不是说。整个终端市场显然技术上我们认同CPU一定会发生我们推这个观点也很久了我们也认同铜会逐渐被替代但在中期来看我们其实非常看好铜也非常看好。非CPU的光通信反而对CPU有点看空因为我们看到下游某些芯片的延迟比如Feynman不会全面采用CPU还有其他类似的情况像Anfin。o这种做背板连接器和线缆的铜连接公司未来几年的表现会远超之前的预期因为我们之前以为CPU会更快上量但现在它推迟了供应链里就是会发生这。种事但归根结底光通信这块如果你今天闭上眼睛五年后再睁开它的规模会大得多这里面有些已经反映在股价里了有些还没有我觉得存在一些局部错位但。这其实也是我们做研究以及和你们一起在做的工作的一部分怎么去给这些东西负权重对吧怎么去权衡哪些是利好CPU光通信的哪些是利好非CPU光。通信的对吧传统光模块和铜蓝之间怎么选因为铜蓝其实还有很长的路要走铜蓝行业正在发生很多创新再把CPU往后推对吧我为什么要用CPU因为归。根结底集成光学比用电传输贵太多了除非我用电传输时不加中继器或光模块就传不了多远所以这里存在一种权衡和连续谱CPU肯定会来但看起来时间。点要往后推一推了Dylan我们大概还有时间聊最后一个大话题。 [00:44:20]
Chris Gannatti:我们聊了模型GPUCPU内存网络如果不提一下每个数据中心里那头房间里的大象就有点说不过去了也就是电从哪里来以及怎么把电变成可用的形式。我知道你在newsletter里写过直流电和交流电这些内容理论上当你看到超大规模云厂商砸这么多钱建数据中心甚至可能把发电厂建在圆区里。走表后模式我们该怎么理解电力需求以及电网供电和非电网供电的区别我知道这个话题很大但我觉得不提一下实在说不过去对。
Dylan Patel:要我说数据中心的增长非常猛今年我们在部署20GW的数据中心明年这个数字会涨到50GW或者说涨50%抱歉是50%50GW30GW然后后。年会到50GW数据中心容量的增长是巨大的这里面有很多局部错位需要人们去处理要我说能源是最大的问题之一另一个是政治因素第三是建设本身建。数据中心拿许可做申报都挺难的政治上有人在试图阻止但归根结底最主要的制约因素还是能源那么现在是什么情况能源可以拆成几块来看对吧有发电也。就是我从哪里产生电子有输电也就是我怎么把电子从发电的地方送到数据中心然后是变电因为输过来的电其形态是芯片没法直接用的芯片需要用另一种。形态的电这个变电的流程是什么样的我觉得这三块里都有非常值得看好的方面输电这一侧是最难乐观的因为建更多输电容量在监管和政治上困难重重而。且地方公用事业垄断的运作方式也很麻烦他们建一条输电线路成本要摊销给所有用户而不是单个用户输电这块存在各种奇怪的错位所以建更多电网容量。在输电层面挺难的但发电和变电这两块很有意思发电方面显然电网上的发电量在增加同时还有一个大转变就是为数据中心就地发电我们预测过几年数据。中心新增电力里会有一半是就地发电而不是靠外部电网所以表后模式正在飙升我们从数据中心和能源模型里的表后追踪器也能看到这一点我提过我们团。队有位同事他在哈萨克斯坦建过发电厂现在负责我们的能源模型叫Ally它一直在追踪我们也在搭建整个电网的模型包括每一个发电资产每一个输电。资产所有负载资产以及所有表后项目有意思的是我们看到表后这块出现了巨大的繁荣在许可和监管方面也遇到了不少阻力比如有人不想批准空气排放许。可或者有人不允许把天然气管道修到厂区类似这样的事情我们在Oracle的一个数据中心项目上就看到过有很多不同层面的情况在发生但最终的结。果是表后模式正在飙升其中很大一部分是用天然气很多是G-Venova三菱或西门子的双联合循环燃气机组除此之外还有各种不同类型的能源对吧。有网附式发动机有工业燃气轮机有各种柴油机还有火车发动机有人拿火车发动机船用发动机卡车发动机把它们改造成数据中心的发电设备我们看到那里。正在涌现一大波创新不是说我们没有工业产能对吧美国每年能造几百万台工业用的网附式发动机就是那种烧油转动的机器把这些发动机从烧柴油改成烧。天然气技术上很简单就算继续烧柴油也没问题然后你给它接上一个电动机反过来驱动它就能发电了这样你就可以大规模的发电我们看到有超过十几瓦的。数据中心会用这类技术来建对吧把柴油卡车发动机改成烧天然气的这在生产环节就能做非常简单然后反过来驱动电动机把他们部署到数据中心现场一个。数据中心后面摆上几百台这种设备再从汽修店雇一批人因为这些设备需要维护对吧他们就整天围着这些柴油机转做保养你还需要一些缓冲这样当某台机。器停机时你可以去修好它让它继续运转保证最大功率输出当然中间还需要一些电池因为你不想让数据中心负载的波动把发动机搞坏所以这背后有一整条。表后发电的供应链这很令人兴奋但除此之外大概两年后太阳能加储能的成本会比天然气还低当然太阳能加储能的供应链现在还有难度而且这取决于你想。要多高的可靠性如果你的电池只够撑过一晚那成本更低但如果你需要电池能撑过三个晚上呢因为可能连下两天雨你想要几个九的可靠性但太阳能加储能。的成本正在以惊人的速度下降这得益于中国强大的制造能力还有一些补贴在某个时间点用太阳能加储能的方案会更便宜然后你还有太空数据中心对吧那。里连电池都不需要你把设备放到太空配上太阳能板就行了所以你有一整套连续的发电方案从把柴油机改成燃气机或者用联合循环机组一直到干脆把芯片。送到太空里去这是一整个连续的光谱这里面有很多钱可以赚有很多有意思的动态可以玩这也是为什么实际上Semi-Analysis最大的数据集。和研究板块你可能以为是半导体其实是数据中心和能源是数据中心工业和能源我们内部叫它DEI团队数据中心能源工业的缩写算是个文字梗内部标签。就是DEI团队Jeremy是那个团队的负责人这名字是他起的总之数据中心能源和工业这其实是我们最大的研究板块因为我们在追踪每一个数据中。心和每一座发电厂所以当我们发现某个延迟或者某件事正在发生或者某个公司下个季度会有多少数据中心上线这些是业内其他任何人都做不到的这也是。为什么这是我们最大的板块之一而且所有人都对这个感兴趣对吧Google想知道Meta能部署多少Meta想知道OpenAI能部署多少同时。所有这些公司都在盯着供应链的能力看谁手里有产能然后所有的投资者也在盯着所以这是我们最大的数据集但我想说这个市场非常分散对吧像存储就三。家主要厂商很简单像加速器也就那么几家像半导体晶圆制造设备也只有几家但在这个领域供应链里有几百家公司都在制造各种奇奇怪怪的小部件有几十。家公司在建数据中心这里面有几十家公司都在尝试各种方向有的是做独立发电商有的是做表后发电有的是提供某种电池服务各种玩法都有这条供应链非。常复杂但同时也充满活力说到底我觉得现在有大量创新在发生所以数据中心会继续是某种瓶颈但也不会一直是瓶颈就看你能疯到什么程度就像我刚才说。的你可以直接把卡车发动机拿来改装雇一群机械师就这么把场站跑起来这肯定不是最优解很多人会说这也太离谱了可靠性能行吗搞起来会很烦吧但确实。有人在这么做而且能跑通过程很折腾但能跑通一路到另一个极端把芯片射到太空去过程也很折腾实现起来非常难但也能跑通所以数据中心这个问题是有。解的不管你是走最脏的路子还是直接上太空而供应链的其他环节就没这么多解法了我觉得这就是这个市场如此有活力的原因你会看到很多人起起落落然。后我想还有另一块刚才说的是发电和输电侧但变电侧也很关键对吧你怎么把电从它产生的地方传输过来的形态变成芯片想要的那种电这里面也有一整条。供应链在运转涉及IGBT 碳化硅各种MOSFET 氮化针MOSFET各种名字都有比如我们从12伏转到54伏再转到800伏直流的时候变。电这条供应链会怎么变固态变压器在创新又会带来什么这个领域里所有这些事情都在同时发生还有UPS不间断电源电池备份超级电容以及其他各种用。来平滑电力的手段把左边那种脏的波动的电变成右边需要的超干净的电而且右边的用电本身也是波动的怎么去匹配整条变电pipeline非常非常。令人兴奋我们上周刚发了一篇关于800伏的播客最近也跟机构订阅客户聊到NVIDIA那边出现了一些延迟他们把800伏从Kyber里拿掉了。Rubin Ultra Kyber不再搭载800伏了这对供应链意味着什么就是整个时间线会往后推一点Dylan 我这边要好好谢谢你。 [00:52:58]
Chris Gannatti:如果按章节来算这是我们第一次请Dylan来上节目但肯定不会是最后一次因为信息量实在太大了而且就像他刚才反复说的整个技术战从上到下一切都在不断变化要跟上真的很难。 [00:53:11]
Dylan Patel:但正如他所说他们有90个人在做这件事我还想说一点这条供应链简直疯狂到离谱我们经常聊那些大块头内存 CPU 数据中心这些但当你真正往供。应链深处钻的时候会发现局部的小瓶颈非常多而且很分散比如有几个月我们一直在聊PCB钻头就是给PCB钻孔用的那种钻头还有PCB上用的铜箔。这种很偏门的东西供应链里全是这种不起眼的小环节而且都会出现供需错配做这些东西的公司遍布全球可能在台湾上市可能在日本上市可能在韩国上市。也可能在世界各地对投资者来说这些并不是那么容易接触到所以我觉得我们这次合作我们这种工作方式最让人兴奋的地方在于我们能对正在发生的事情。产生一些影响能大量讨论这些供应链的扰动而且在我刚才讲的那个框架。 [00:54:03]
Chris Gannatti:以及我们想要覆盖的整个版图里这些都非常有意思所以很期待以后多来上节目也期待我们其他的合作绝对最后我还得说一句这是给我们合规团队听的本。播客中表达的观点和意见来自WisdomTree且可能随时变化本播客中呈现的任何内容均不构成预测研究也不构成投资或税务建议本播客中的信。息和意见不构成对任何证券的推荐要约或买卖邀请听众依赖这些信息需自行承担风险请记住过往表现不代表未来结果感谢大家今天抽出时间我们期待未来再见保重。