#涨姿势# 居然是真的 http://t.cn/AXN273iH //@庄时利和:可以用。一个冷知识:医保范围内,西地那非的用药人群女性多于男性。//@响当当当的铜豌豆:认真的,请问女士可以用吗?
来
今天梳理了一组神奇的西医养生知识,不过我暂时不打算实践:
PDE5抑制剂(比如万艾可)除了治疗勃起功能障碍,还可以保护血管内皮、延缓心血管衰老、改善脑部微循环、改善认知功能、增强肿瘤免疫治疗的效果。
#涨姿势# 居然是真的 http://t.cn/AXN273iH //@庄时利和:可以用。一个冷知识:医保范围内,西地那非的用药人群女性多于男性。//@响当当当的铜豌豆:认真的,请问女士可以用吗?
今天梳理了一组神奇的西医养生知识,不过我暂时不打算实践:
PDE5抑制剂(比如万艾可)除了治疗勃起功能障碍,还可以保护血管内皮、延缓心血管衰老、改善脑部微循环、改善认知功能、增强肿瘤免疫治疗的效果。
宣布推出 Imagine Image 2.0——我们的下一代图像模型,具备精准编辑、清晰的文字渲染能力、更高的事实准确性,以及更强的现实世界实用性。
Image 2.0 帮助你为实际工作制作图像。
Imagine Image 2.0 目前还不具备智能代理能力,一两周内还会有更多内容 💙
宣布推出 Imagine Image 2.0——我们的下一代图像模型,具备精准编辑、清晰的文字渲染能力、更高的事实准确性,以及更强的现实世界实用性。
Image 2.0 帮助你为实际工作制作图像。
💯
他憎恨那个拯救了他的国家,所有忘恩负义的小丑也都一样憎恨它。
确实如此。以前我带孩子们去购物中心时,如果 Elon 不见了,我只需要找到最近的书店。他准会坐在地板上看书。
“我是由书籍养大的。书籍,以及我的父母。” ― Elon Musk

Grok Imagine 的图像编辑功能大幅改进
Grok Imagine 的图像编辑功能简直让我惊叹不已。
我刚刚用 Grok Imagine 及其完整的编辑工具集,从零开始编辑了整张图像。
分割和精准编辑工具非常实用。
你不必重新生成整张图像,而是可以精确定位想要修改的部分,同时保持其他所有内容不变。
这种程度的控制让编辑变得更快、更实用。
Grok Imagine 正在成为一款真正强大的图像编辑器……而不只是图像生成器。
最近看到不少关于独立开发者的思考内容,想着就 Mole从开源 Cli到 Mac付费软件这个过程来给大伙聊一聊我的思考和做的哪些事情是有效的,希望可以给大家一些帮助。
1. 开始之前要多培养自己在产品工程师的能力,这个里面代码能力只占 30%,更重要是如何把自己的痛点和大部分用户痛点结合起来,产出一个方便易用的产品解决方案,同时懂得如何更好的推荐给你的用户,让他们发现多亏了有这个产品解决了我的一个大问题,也即产品工程师=用研+产品+工程师+运营+数据+商业这几类角色的综合体。
2. 接上条,AI 时代代码壁垒越来越小,更需要把控的是如何做到把 Token 刚好花费到解决用户问题上,然后把更多 Token 用在你的需求分析讨论、数据下钻挖掘问题、内容友好性易读上面,因为即使你是多个 250 刀的账号其实也不够用的,不介意多花 Token,但需要用到实处,Token 在我看来属于投资,但是投资也需要讲究收益。
3. 聊到需求把控,不做什么远比做什么要重要太多了,在我大一刚刚入门程序员时候,非常幸运看了不少讲工程师修炼的书籍,如无必要 勿增实体、至繁归于至简慢慢让我在生活、工作、代码中都保持这个习惯,讨厌繁琐和乱,喜欢漂亮简单、不要看说明书就可以用的东西。
4. 你完全不需要给你的产品憋大招,你需要尽量做到每周都有发布,每周都有Release,及时解决用户的问题,和用户形成人与人交流那种真实的活人世界的互动,非常重要,每次你的发布、更新、宣发其实都是一次非常好和用户沟通的机会,也让你的产品持续的可以让更多之前没有看到你之前消息的人了解到。…
5. 聊到产品运营,尽量尽量少用AI话来让你和真实世界交流,推特是一个非常好的渠道,可以让你的好东西被很多人发现,只要好用,会有大量的朋友帮你宣传,但是千万不要做那种蓝勾互关以及互推的路,没有必要凑这种虚假繁荣的热闹,因为你的用户不在这里,产品运营一定有一个前提,是你的产品是漂亮的、精致的,让之前不知道的人第一次见到就很有兴趣来点击试用你的产品,而非快速刷走了。
6. 可能你会说“我”没有啥粉丝宣传没有用,其实不太对,但是也非常不建议大家抱着很深的功利心去把自己账号做上去,因为这样会让你焦虑,反而把你的号也当做一个品牌去建设,你自己就是这个品牌的本身,你的思考、想法、产品更新、见解、交流、评论都是在给你的自己品牌在加信任值,信任这个东西在当今虚假又繁荣的AI世界尤其重要,太太太说着非常牛逼,但是点进去感觉一般的东西已经把大量用户的预期拉低非常多,导致即使你有一个好产品,但是没有任何用户信任,依然还是得不到关注,这里可以做的非常长期,你在互联网上待多久,这个品牌其实就会活多久,是你生命周期最长的产品了。
7. 聊到用户信任,就一定要聊到真诚,我还是非常喜欢开源、喜欢非撕逼的友好网络环境,也很建议你的产品一开始就是全球化的或者说是出海的,也非常建议大家多发英文类的内容,你会发现世界很大,你的用户很广,你的用户会非常从一开始就信任你,以及力所能及帮助大家,绝大可能你帮助的人会成为你未来的用户,因为有过真实交情。
8. 尽量不要去花钱推广,但是可以靠自己多让你的好东西的用户中刚好也有博主,推特我感觉其实脉冲很高,但是时效一般,反而非常建议你有些东西可以发到 Youtube,这里的衰减度非常慢,你的产品只有够好,有人推荐,可以在上面火非常长时间,给你带来很大的收益。
9. 一定要学习数据分析,这个特别有用,从你的销量数据分维度分时间去分析,结合流量数据,结合用户评论,以及你和用户交流的所有内容,以及用户的退款原因,假如是开源产品,还有用户的所有issue,都是非常宝贵的数据资源,能够帮你发现特别多你不知道的问题,也能够帮助你做到更好,以及发现销售的漏斗,你才会知道如何更好优化。
10. 碎碎念手写有点啰嗦,假如你喜欢,也非常欢迎去 的官网看看,玩一玩 Mole 这个产品,说不定可以给你的产品建设带来一些输入。
如果用不了 Claude Design的同学,可以用 @dotey的 可以作为 claude design的平替,底层模型可以用 K3或者 Cursor的 opus4.8模型
血泪教训,UI还是得用 Claude Design先设计好,让 Claude/Kimi做执行才靠谱
如果让 Codex做就是一坨屎,之后再让 Claude/Kimi修改也是屎上雕花
Twitch 为什么有这种双重标准?
审查:Hasan Piker 曾呼吁消灭美国白人。与此同时,Asmongold 仅仅因为表示自己不同情于冲击西班牙休达边境的伊斯兰移民,就被 Twitch 禁止使用。Piker 的 Twitch 账号却安然无恙。
Terafab × Blade Runner 的感觉,由 @imagine 2.0 创作
确实如此。
民主党人通过他们疯狂的立场正在摧毁美国。共和党人则因对阻止这些立场无动于衷,也正在摧毁美国。如果真正的美国英雄不挺身而出拯救共和国,它将永远消失。很多人要到为时已晚、晚得离谱时,才会看清其中的联系。
确实
如果把不配合调查的情况纳入调整,警方暴力案件(尤其是涉及“种族主义”指控的案件)会降至约等于零。
这对嘉宾的姐弟恋真的很幸福!再次像傅厚民先生的设计致敬!太棒了!#黑麒麟点评
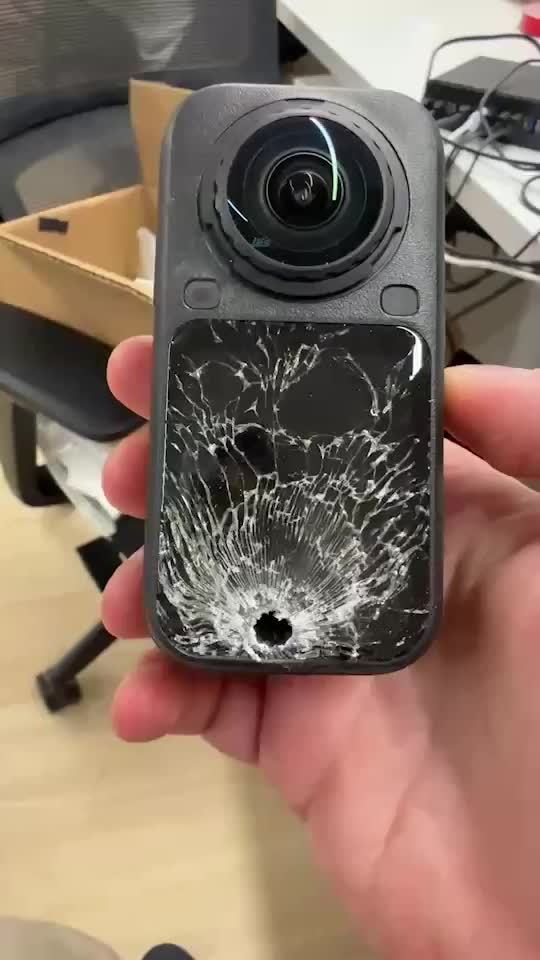
买的X5还没开始用~~就要出X6了?
让海外合作方测试了一下@影石Insta360 X6的防弹性能🐶
哇
OpenAI 人力资源部门告诉 Leopold,他被解雇的一个主要原因,是他曾向董事会发送备忘录,警告 OAI 的安全状况已经糟糕透顶。
接下来发生的事,让我更加自豪于称他为朋友。
人们可能已经忘了,但直到 2024 年,OpenAI 的离职协议里一直有一条秘密的禁止贬损条款。如果你不签,他们就会追回你获得的全部股权。
据我所知,有史以来只有两个人没有签署这份协议——@DKokotajlo 和 Leopold Aschenbrenner。
在 2024 年之前离开 OpenAI 的所有研究人员中,Leopold 才 22 岁,却是少数几个愿意拒绝“黄金手铐”的人之一。他们本来都有更多退路,但他仍然说:“我想保留谈论 OAI 安全与安保问题的权利。”
我们有很多分歧,但他是我认识的最有原则、最坚韧的人之一。

Grok Imagine 各种风格的示例
希特勒是左翼社会主义者
希特勒是左派:
✅ 身份政治 ✅ 集体主义 ✅ 国家主义 ✅ 指令型经济 ✅ 审查制度 ✅ 社会工程 ✅ 激进主义活动 ✅ 枪支管控 ✅ 法律统治 ✅ 学术界、司法机构和公务员体系的政治化
#一饭封神2淘汰率堪比考研# 高级的调味👍👍👍#一饭封神#
【#台风白海豚已闭眼意味着什么#】#台风闭眼不代表强度会减弱# 8日,台风#白海豚已闭眼#话题引发热议。台风“闭眼”意味着什么?中央气象台首席预报员王海平8日在中国气象局媒体通气会上介绍,所谓的台风眼的“闭眼”,只是这个台风眼墙置换过程的一个阶段,并不意味着它未来的强度就会减弱。未来,在发展条件比较好的情况下,其仍然有可能在“眼壁置换”完成以后,强度重新加强或回到原来的强度,甚至超过台风原来的强度。公开资料显示,眼墙置换是指当强台风在发展到很高强度时进行的内部结构“自我升级”或调整。自7月27日“白海豚”生成以来,前后共经历了5次眼墙置换并伴随着台风强度多次变化。(记者邵萌)


The Information发了一篇万字长文,深扒了Anthropic创始人达里奥·阿莫代伊是怎么以强烈的个人意志——甚至可以说是被神格化了——凌驾于所有AI大厂以上的,爆料密度很高,过于抽象的也不少。
我来总结一些重点内容:
- 因为担心自己工作被抢、数据中心推高电价等种种原因,美国人对于AI的厌恶再创新高,而作为最强AI公司领导者的阿莫代伊,却坚持继续推动他所相信的「AI威胁论」,哪怕这会损害Anthropic的融资前景;
- 董事会里有人建议Anthropic多宣传AI在攻克癌症方面的帮助,这是很常见的公关做法,但阿莫代伊拒绝了这一提议,认为不应该掩饰AI给人类造成的生存威胁,然后他转头就安排发布了一则意义不明的品牌广告,以墓碑、乞丐和奴工为开场元素,极其黑暗悲观,毫不意外的被骂翻了;
- 因为Anthropic正在运作上市,投资者都在设法给阿莫代伊施加压力,希望他停止宣扬AI有害论,比较委婉的会恳求他「别再吓唬所有人了」,更直接的则会抱怨阿莫代伊正在破坏自己公司以及整个行业的利益,但他们都承认,再多的蛐蛐都对阿莫代伊毫无影响,他根本不听;
- 有投资者在备忘录里写了Anthropic这家公司的特有风险,那就是它的老板似乎并不在意赚钱这件事情,而阿莫代伊之所以这么强势,只是因为Anthropic处于上升期,看在股权升值的份上,投资者多半可以忍受船长的离经叛道,问题在于,如果驶入逆风局,阿莫代伊是否还能维持资本关系的和睦;
- 阿莫代伊本质上并不是一个反商业的CEO,只是相比经营公司,他更希望成为一个布道的领袖,屡次用AI失控恐吓大家,也是为了强化只有他才是那个有权力决定什么时候该踩刹车的人,如同AI行业的教皇那样;
- 所以阿莫代伊基本上不要介入日常管理,主要都是他妹妹、身为Anthropic总裁的丹妮拉完成,而他本人更倾向于通过长篇信件和Slack通知来和员工交流,这种作风过滤下来的结果就是,他拥有了一批忠诚度极高的员工,他们的离职率在顶级AI公司里出奇的低,而且普遍把Anthropic视为类似「末日地堡」的组织,是人类文明最后的希望;…
- 具体天命所归的自我认知,阿莫代伊对美国政府的态度也非常二极管,所以他会不惜和五角大楼翻脸也要排除用AI监控本土的可能,同时也积极配合商务部推进限制开源模型的政策,只要是为了更崇高的使命,他能把自己的一切行为合理化;
- 其中就包括接受阿联酋、卡塔尔等阿拉伯国家主权财团的投资,阿莫代伊很厌恶中东地带的意识形态,却因需要对方的财力,而不得不和员工解释这么做是利大于弊的,他甚至暗示出钱的王公贵族是坏人,在全员信里痛心疾首的表示打破了「绝不让坏人从我们的成功里获益」这条原则;
- 阿莫代伊最早出现在媒体镜头里,是在2017年,他代表OpenAI向华盛顿的智库展示早期的AI模型,那是一个会打Dota 2的程序,拥有学习能力,当时阿莫代伊就在发言里强调这个程序的进步速度太快,人类必将「无法监督、无法批准、甚至无法理解」;
- 适逢阿莫代伊刚从百度跳槽到OpenAI,负责安全部门,没过多久,他就开始在OpenAI内部推动公布研究成果之前的审查制度,以防知识被不当利用,这挑战了OpenAI早期鼓励研究员们自由发表论文的风气;
- 写备忘录的习惯就是从那时开始的,阿莫代伊会把自己的想法写在一台从不联网的电脑上,然后打印成纸质文件发给同事,偶尔有去中国出差的工作要安排给他时,他会严词拒绝,因为觉得去了就会被绑架😂😂😂;
- 「只有我才能决定什么信息可以公开」的理念让阿莫代伊和OpenAI的部分员工关系紧张,大家本来习惯在Slack里共享代码库,但从开发GPT-3开始,阿莫代伊就把很多核心代码库和Slack频道设为私密状态,由他的团队来发放「门禁卡」,他还差点搅黄了微软雪中送炭的10亿美金投资,当时OpenAI账上都没钱了,阿莫代伊还在阻拦GPT-3的对外演示,觉得会让微软获得通用人工智能;
- 不可避免的,阿莫代伊经常和OpenAI的创始人山姆·奥特曼吵架,他职位低当然吵不过,于是总是在事后把自己关在办公室里,连续刷YouTube视频来恢复情绪,他的妹妹丹妮拉当时也在OpenAI,频繁帮忙缓和哥哥与高管之间的关系,这对兄妹在2020年一起离职创办了Anthropic,并带走了一批同样反感奥特曼的研究员;
- 有些带着对奥特曼的恨意跟过来的同事,后来发现和阿莫代伊的恨比起来,自己的那点怨气根本不算什么,他们私下觉得阿莫代伊对奥特曼这个人恨得有点魔怔了,是真的相信如果OpenAI掌握了最强大的AI人类文明就会迎来世界末日;
- 如今,Anthropic的管理层会把阿莫代伊当作一种「灯塔」——他的注意力在公司里四处扫视,目光所及之处,就会受到高度关注——阿莫代伊的灯光最近照射在公司里的一个经济学团队,他们负责推导和量化AI会对美国经济造成多大的影响,而阿莫代伊非常享受这种动动手指就能决定或是拯救千万人失业的宏大叙事;
- Anthropic的主要人才都相信e/acc(有效加速主义),他们自发的建立起了一种高强度的工作文化,将这波大模型浪潮视为千载难逢的历史性机遇,但阿莫代伊本人却不是e/acc这派的,他时常会做些减速的事情,比如让员工暂时抛开工作,和他一起畅聊社会、政治和战争;
- 除了毫无必要的得罪国防部,阿莫代伊还因坚持在Claude旗舰模型里加入安全过滤器而被财务部门提醒这会增加成本、削弱利润,但他依然坚决不改,不过在竞争对手的追赶下,阿莫代伊也开始有了变通,比如愿意和马斯克在算力上开展合作,放置两人的历史恩怨;
- 事情有点讽刺,阿莫代伊天天嚷着AI就要全知全能了,却连公司需要多少算力储备都没算对,近一年来Anthropic的业务增长远远超过计划,于是他被迫「挨宰」,以高于市场价的费用从马斯克那里租用数据中心,马斯克虽然以前和阿莫代伊闹过不愉快,但他主要还是在和左派Woker们作斗争,在了解到阿莫代伊不属于这一派后,加上两人都很讨厌奥特曼,他也就不计前嫌了,还夸阿莫代伊是一个「很有原则的人」。
* 再补充一个更抽象的信息,阿莫代伊前几天有个私下发言又被捅出来了,他说自己担心随着公司的规模扩大,会吸引一些纯粹为了赚钱而加入进来的员工,本意虽然是他更希望来的人和他一样抱有通用人工智能的使命,但这番表达的不妥仍然引起了铺天盖地的嘲讽,觉得他是自个儿财富自由之后「何不食肉糜」,竟然觉得人类不需要赚钱养家糊口。
而阿莫代伊的反应也很干脆,不反驳,不辩解,默默在官网招聘栏新增了一条岗位信息,以30万年薪招聘一个内部侦探,要求自带反间谍和情报技能,主要职责包括对在职员工进行调查⋯⋯
好吧,这就很阿莫代伊。

一名 17 岁的非洲籍学生在 6 月 17 日至 7 月 23 日期间,于巴黎东部 Villiers-sur-Marne 火车站附近袭击三名女性后,被控犯罪并被羁押候审。
第一名受害者 26 岁,从巴黎出行后步行回家时遭到袭击。警方后来从她的衣物上提取到 DNA。
一个月后,一名 29 岁女性在同一地区遭到袭击。她因起疑心启动了手机录音,一名附近居民出面干预,迫使袭击者逃离。
随后,警方在车站周边部署警员。他们跟踪嫌疑人,发现他接近女性,并在他持刀袭击第三名 31 岁女性后将其逮捕。
调查人员称,这名少年在讯问中承认了三起袭击,并提到 6 月初可能还有另一名受害者。
“自杀式同理心”(Suicidal Empathy)正在美国迅速蔓延。我敦促所有美国爱国者参与进来,为美国的自由和权利而战。请不要冷漠旁观。我们的文明不会在一夜之间消亡,但如果善良的人们不站出来,面对大规模殖民并摧毁西方(以及美国)的企图,它终将消亡。请醒醒吧。
McKinney 市议会以 7 比 0 全票通过了该提案。
几乎是竞品的 9 倍。
原生 FP64 性能在 HPC(高性能计算)中继续发挥关键作用,@HPCwire 的 @Alex_Woodie 强调了 AMD Instinct MI430X GPU,以及其专注于提升建模和仿真工作负载中的原生 FP64 性能。
阅读更多:https://bit.ly/4ctet2q

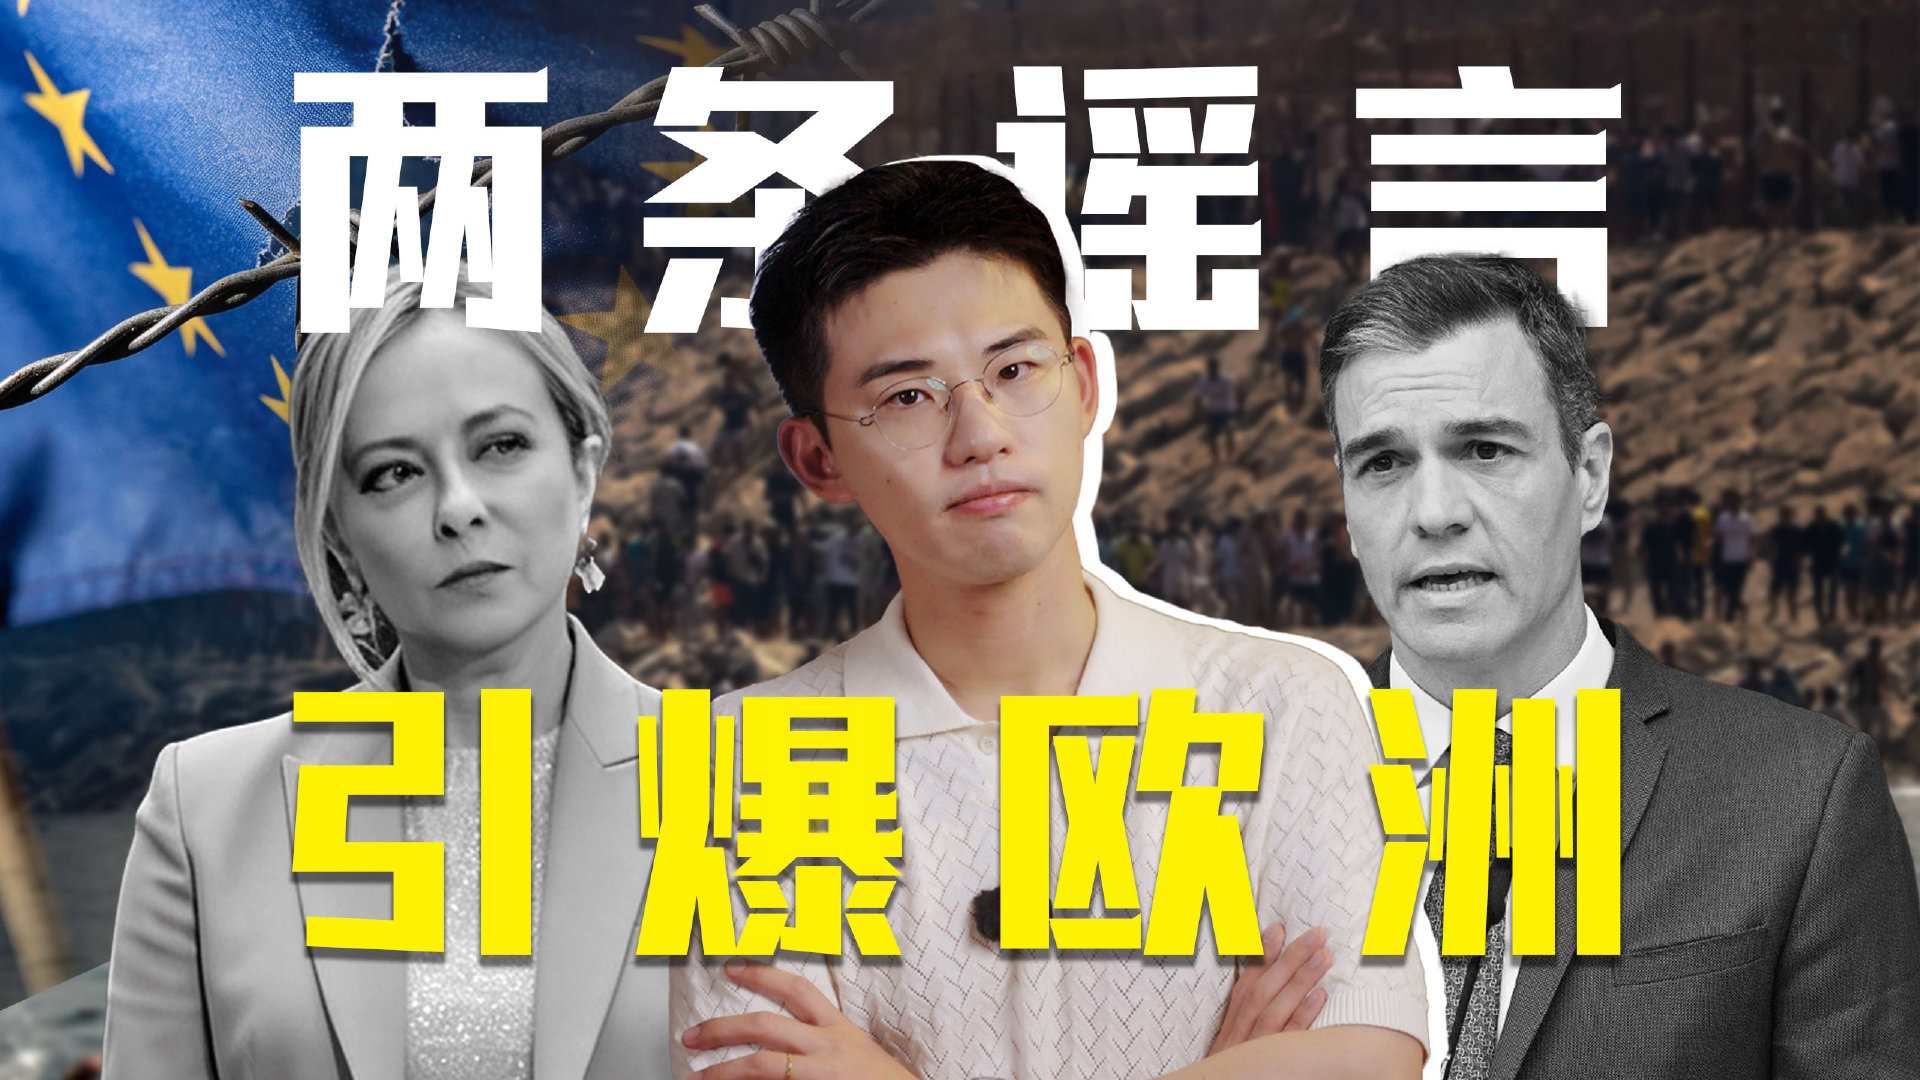
两条谣言引发边境危机,摩洛哥西班牙互相算计,几万难民成了谁的筹码?
因为两条谣言,几万人涌向休达,这座只有八万多人的西班牙飞地小城瞬间被挤爆。表面上看,这是一次荒唐的难民危机;往下挖,却牵出了西班牙与摩洛哥几十年的旧账,也暴露了欧洲更尴尬的现实:经济越来越缺人,选民却越来越排斥移民,边境和安全基本依赖外部,自己根本没有决策和执行的能力。全球化顺风时,这些都叫分工;世界开始碎片化后,每一份依赖都可能变成筹码。本期我们就从休达聊起,看看一场谣言如何搅动两个国家,又如何撕开欧洲越来越深的裂缝。#热点观点#
【前主编Global丨外媒:欧洲身陷“气候战区”,极端高温逼停波兰火电站】残酷热浪正无情炙烤中东欧,斯洛伐克以42℃罕见高温刷新历史纪录。持续的干旱致使维斯瓦河河床大面积裸露,冷却水告急直接逼停波兰两座主力燃煤电厂,瞬间抽走1.3吉瓦电力。一边是能源系统濒临瘫痪,另一边则是致命高温的无声屠戮——今夏仅德国就已有近1.2万人惨死于热浪之中。面对大自然的无情反噬,焦渴的欧洲还能撑多久?解读>> http://t.cn/AXNwrt5j
Twitter这次调整之后,真人收益应该会增加吧,看起来是打击机器人和洗稿营销号的倾向。
#AI
给 Codex新建一个项目,项目文件夹放那堆从来不会去看的公司材料。
然后让 Codex控制 Chrome浏览器给你做 KYB。遇到没有信息的,再通知你介入和确认。
如此痛苦的事情,很快就能完成 😭
这个视频是AI做的吗?有点难判断,你们帮忙看看⋯⋯
#Android
在日本播放 Bilibili会卡顿的 Android用户,可以用这个第三方客户端,开启 CDN切换功能。
🔗
项目构成:1️⃣ Frok自 PiliPlus 2️⃣ 加入 bilibili-accelerator的自动切换功能 3️⃣ 加入测试好用的 CDN节点

//@gaul_civ:一年多前nv从130跌到80,看到一个评论说,ds出来nv就不行了,给她一次回到过去的机会,肯定在nv 130的时候做空它。后来nv又涨回到130了,不知道她有没有捉住这个机会。
#DeepSeek让英伟达蒸发4万亿#为啥一年前的事情又热搜了,也是经典资本市场无知的案例了。
实际上,英伟达(也包括其他AI算力公司)应该是最感谢和支持Deepseek(也包括其他开源模型)的公司之一了,一下子把token消耗拉爆了。(前一个是o1,后边是Open Claw)。
#模型时代# 推上有人记录了杰夫·迪恩在斯坦福大学举行的 AASF 2026大会,对出走一事的正面回应:不是单一事件,他们(Google)有了新计划,我自己的事情也很有趣。
杰夫·迪恩:我一般不会把股市的变化归因于某个具体事件。
杰夫·迪恩:首先,我对自己在 Google的那段时光有着非常深的感情。我在那里工作了27年,身边有一群非常出色的同事,所以 Google目前的状态很好。
他们已经有了继续把 Gemini做好的计划。这很好。
与此同时,我也很期待离开之后去做这件事。我觉得这会非常、非常有意思。有时候,一家规模不大、目标明确的公司,所有人都专注于同一项使命,能够做出很不一样的事情。我认为这是一项很有价值的使命,接下来会非常精彩。

#模型时代# Google回归创始人模式了。
来自FT的一个报道,接手Deepmind的Koray Kavukcuoglu虽然向Pichai汇报,但是从英国转到旧金山工作,工位挨着创始人Brin。所以这位创始人可能会更多介入Google的AI战略和产品。
昨天发斯坦福的GPU经济学课程,其中Groq联创提到,他们和英伟达的百亿美金交易,从给黄仁勋发一个短信开始,到完全达成,一个月就搞定了。鉴于现在AI的变化变数太大,又在投资上,都是伤筋动骨级别的,没有一个创始人级别的灵魂人物,就很难跟得上节奏。

加州大学洛杉矶分校下属的一家野生动物研究实验室因为面临拨款中断的危机,在OnlyFans上开了一个帐号,用于更新保护区里土拨鼠的裸照,嗯,就是字面意义上的土拨鼠,在一周内已经收到了超过5000美金的打赏。

用于编码工作流和长期自主任务的自我改进型 RLM 智能体。
TypeScript
今日新增 2,271 星 · 总星标 6,435 · Fork 514
面向 AI 编码智能体的生产级工程技能。
JavaScript
今日新增 1,131 星 · 总星标 83,879 · Fork 8,964
给你的智能体配备一台计算机 👾
TypeScript
今日新增 894 星 · 总星标 5,670 · Fork 286
长篇一致性是个很难解决完善的问题(所以很多vibe的写作软件总是号称解决记忆一致性blabla)
但更大的问题是,一致性对于ai写小说的第一性——写得有趣、写得生动、写得持续好看,完全不重要,甚至没什么鸟用。解决了一致性也几乎等于什么都没有解决。
我觉得LLM本身就是AI写小说最大的局限引用原帖:
上午聊天的时候我自己突然想到一个点,现在 AI写小说的一些规则似乎不对,从世界观设定到角色表到场景到每个章节提纲,为了追求一致性的这个方法论首先不对其次也过时了。如何让 AI专注当下章节写作似乎更难,全知全能的的 AI无法兴致盎然地享受当下的讲述。
#AI
在 claude design设计完了之后,看起来明明一键就可以交给 claude code的事情,实际上各种失败、未授权、走不通、找不到。
最后还是导出 zip给到。
无知还差一点,主要是故意,这样可以洗走一堆人
#DeepSeek让英伟达蒸发4万亿#为啥一年前的事情又热搜了,也是经典资本市场无知的案例了。
实际上,英伟达(也包括其他AI算力公司)应该是最感谢和支持Deepseek(也包括其他开源模型)的公司之一了,一下子把token消耗拉爆了。(前一个是o1,后边是Open Claw)。
(无正文)
(无正文)
事情变得越来越离奇了。这是否意味着,如果事实证明这是一起内部作案,且嫌疑人被抓获,受害者实际上有可能追回他们的资金?
哎呀。
Luna 真是一个特别的模型,性价比惊人。
在近期降价 80% 后,我们重新测试了 OpenAI 的 GPT-5.6 Luna 在 ARC-AGI(Verified)上的表现:
- ARC-AGI-2:59.6%,每项任务 0.18 美元
- ARC-AGI-1:90.7%,每项任务 0.07 美元
新结果与 Luna 最初的性能相当,但成本低得多。

(无正文)
德州继续引领芯片创新和先进制造。
@SpaceX 和 @Tesla 在格莱姆斯县新建的半导体制造设施有望为德州人创造数千个就业岗位,强化美国半导体和 AI 行业的供应链,并帮助将关键芯片制造业带回美国本土。
@SpaceX 和 @Tesla 还承诺向当地社区和学校投资数百万美元,我期待未来看到格莱姆斯县从中获得更多益处。
ChatGPT:用于消除繁琐工作
又是 ChatGPT Work 派上用场的一天。

一个冷知识,谣言的处理,其实也是有边界的,越界后的反噬有时候平台都束手无策~~亲身经历,当年某恶性谣言,因为某友商平台处理过了头,导致网友逆反心理爆棚,全体下场玩梗,3小时内扩散到全国各个平台,封堵/辟谣/司法都无济于事,结果是到今天这个谣言还贴在无辜的当事人身上😅
【#竹知了事件没有赢家#】
过去几年,我们已经越来越熟悉这种传播路径。
一开始,是一个具体事件。然后,是几张截图。接着,一个情绪标签出现。最后,一个远比事实更容易传播的故事诞生。每个人都参与了传播,却很少有人回头确认,故事是不是还和最初那件事有关。
竹知了,就是这样。
从一张梗图到网民站队,只用了大概五天。但真正有意思的,是每一天,人们对同一件事的认知,都在悄悄偏移。
一开始,它只是个笑话。网友在商品页面底下玩梗,把竹知了和华为联系起来。忽然间,就有投诉截图开始疯传。紧接着,故事被演绎成华为容不得玩笑。再后来,声音变成了巨头打压普通人,资本霸权......每一步都踩在真实发生的事情上。但所有人激烈讨论的那件事,和最初那只几块钱的玩具,已经关系不大了。
一只几块钱的竹知了,看似舆情沸腾,但最后所有人都输了,也输掉了一场关于互联网公共讨论的耐心。@凤凰网科技 http://t.cn/AXCDdC0G
很多人不知道该怎么用好 Agent的 /goal功能,也就是说给 Agent一个目标,让它长时间运行,直到目标完成为止。
其实没你想的那么复杂,注意几个点:
1. 你的目标是什么
2. 如何验证结果
3. 停止条件
比如说我这两天做的一个性能优化的任务,Fable 5帮我把视频转录性能优化了2倍多(图2),提示词很简单(图1):
> /goal 帮我优化当前 cli 的转录大视频的性能,在遇到像这样大体积的视频时,需要优化转录性能,请以 Moss 模型测试这个视频(英文为主,多语言)转录,建立基准,然后分析性能瓶颈,尝试优化,直到你觉得已经没有优化空间了。注意你的主要任务是分析、编排和验证,具体任务尽可能交给 subagent(Opus5)去执行
首先用 /goal表示这是一个需要长时间执行的任务,需要反复执行,不能运行一会就结束了。
然后给它一个视频让它先自己跑一遍转录,记录一下关键数据,建立基准。
基于转录时收集的数据,Agent自己可以去分析原因,去自己优化,优化完成后再去跑一遍,记录数据,对照前面的基准看是更好了还是更坏了。
结束条件是它自己觉得已经没有优化空间了就结束。之所以我没给它一个具体指标,是因为我也不知道能优化多少,如果指标太容易达到,它一轮可能就结束了;如果指标太难超出物理极限也没意义,反而可能会出现为了优化去做一些极端的事情。
最后一句让它开subagent执行子任务是因为 Fable 5太贵,全程 Fable 5用不了多久就要额度不够了,加了这句就耐用多了,而且质量也挺好。
---
还有些时候,想到一个新的技术方案,但并不知道这方案是不是有效,那也可以让它开个worktree,去验证一下是不是靠谱,看数据是更好还是更坏,如果没提升就没必要做了。(参考图3)


ChatGPT 团队正在发布:
本周 ChatGPT 功能更新——8 月 7 日:
1/ 网页编辑器支持丰富格式——将邮件或文档粘贴进来时,编辑器会保留格式;复制粘贴如此常见,我们早该支持这一点了!
2/ 付费用户模型更新——GPT 5.6 Sol 在快速聊天和深度推理中的表现更加稳定。现在你会看到一个滑块,可以选择 ChatGPT 为回答投入多少思考。移动端滑块的触觉反馈(振动)很有趣!
3/ 无限文本消息——免费用户将获得 GPT 5.6 Luna,并可无限发送文本消息。让所有人都能享受更高的智能。即将陆续推出。
4/ 更快的 Android 相机——在 Android 版 ChatGPT 中点击“相机”拍摄新照片并提问,现在速度快了很多。
5/ 语音 × 文件——在全新的 ChatGPT 语音体验中,你现在可以上传文件并提问,该体验由 GPT-Live 驱动。
本周团队演示很棒。排队等候发布的功能太多了,未来几个月会很精彩。欢迎在评论区告诉我们你期待什么!
1. 自主改进的 Harness 不是自进化模型,价值有限
2. 面向评分的优化价值有限,到现实场景不会比 Claude Code 和 Codex 这样的更好
Prime Agent一个能自主改进的递归 Agent框架:
仅仅把外面的框架(Harness)换成 Prime Agent
Opus 5的 ARC-通用人工智能-3评分从 30.2% 冲到 95.5%甚至超越了人类专家基线(95.4%)
可以直接当 Claude Code、Codex的替代品
它证明了一件事:AI有时候跑不好的原因,很多时候不是模型不够聪明,而是外面跑它的框架束缚了它...
传统的 Agent框架(比如固定的工具调用接口、硬编码的子 Agent或静态提示词)是为上一代模型设计的。当大模型能力越来越强时,这些固定设计反而成了“绊脚石”,限制了模型的发挥。
旧金山每个人都在谈 OSL,但没人愿意谈 ISL 和缓存命中率 :(
Claude 现在支持会话之间互相发消息了:
1,你可以询问当前会话其他对话的信息,把其他对话的信息整合到当前会话。这倒没什么难度,类似执行 `compact` 后把总结带过来。
2,厉害的是会话间可以自主通信。如果你当前开了 2 个会话任务同时在跑,一个会话改了东西会影响到另一个会话,这个会话就会自主把消息发给另一个会话。就像两个人同时做一个项目,一个人做了比较大的改动,就会把改动同步给另一个人,避免另一个人一头雾水。
Claude Code 新增功能:你的会话现在可以互相发送消息。
你不必再在另一个会话中重新解释一遍,现在可以让 Claude 来做这件事。它会发送一份摘要(不会发送你的历史记录或文件),另一个会话会从任务进行到一半的地方接着处理。
你知道吗?Grok 是唯一一个也可以用作动词的 AI。

使用 `/connect-grok`,即可通过 Warp 使用 X Premium 或 SuperGrok 订阅。
在 Warp Agent CLI 中运行 `/connect-grok`,即可使用你的 X Premium 订阅。
我不确定自己还能坚持发布这些故事多久。这让人心碎。
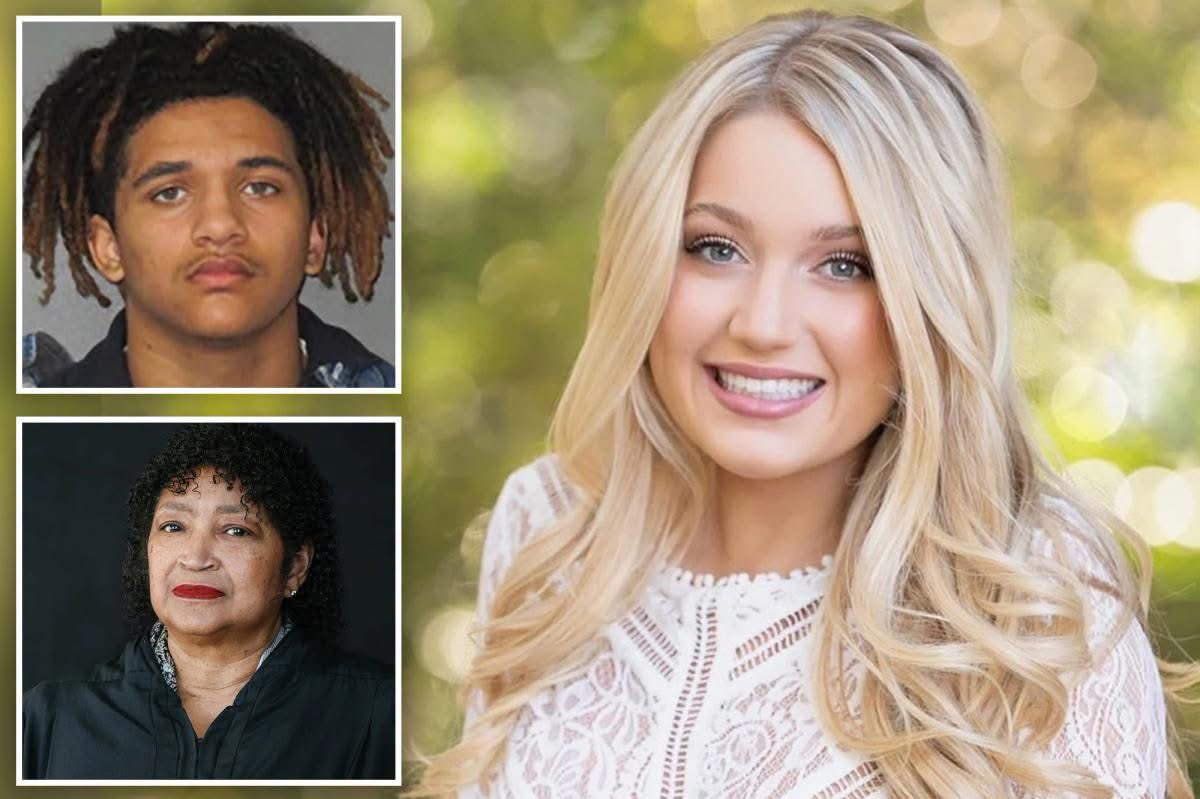
负责审理遇害的白人路易斯安那州立大学(LSU)学生 Madison Brooks 遭轮奸案件的黑人法官,是一名已定罪连环强奸犯的母亲。
法官 Gail Ray 的儿子 Nelson Taylor(同为黑人)于 1997 年承认对多名未成年少女实施多起强奸。
她当时是他的辩护律师。
如今,她将决定那些被指控在 19 岁的白人女孩 Madison 被丢弃在高速公路上并遭杀害前强奸她的黑人男子的命运。
路易斯安那州最高法院拒绝将她撤换。
这不是利益冲突。
这是耻辱。
为 Madison 伸张正义。
如果双方肤色对调,你觉得她会多快被赶下法官席?
今天,我们推出 Original Content Rewards(原创内容奖励)。
现实情况是,Revenue Sharing(收入分成)已经发展到激励机制错位的地步。创作者应该专注于为平台带来真正全新的内容,而不是最大化收益。我们本可以继续增加规则和例外,但最终更好的决定是从头开始,打造一个从第一天起就旨在奖励原创性的项目。
Original Content Rewards 正是这一决定的成果。
这个项目围绕一个简单理念打造:奖励那些为 𝕏 带来原创想法、专业知识、创造力和独特视角的创作者——而不是奖励那些最擅长钻系统漏洞的人。
这只是开始。我们会继续完善项目、改进模型,并随着时间推移不断提高标准。但我们非常兴奋,能够持续投资于那些每天为我们提供信息、带来娱乐、逗我们发笑、教会我们新东西,并推动 𝕏 上有意义对话的创作者。
致所有在 𝕏 上创作原创内容、让这个平台每天变得更好的创作者:谢谢你们。我们很期待继续为你们建设这个平台。

SpaceX 2027 年实现 10GW——为何这是真实可行的、将为 SpaceX 带来 5000 亿美元 ARR(年度经常性收入),以及微软为何将成为最大的承购方;按每 GW 每年 1000 亿美元推算,SpaceX 的惊人推进速度、微软 2026 年接入 10GW 后的觉醒,以及 Azure 能够实现三位数增长
每个维度都处于领先地位。

GPT 6 Astra 要来了
Astra 是一个强大的模型,我们正在努力让它向公众开放。
我们认为,把强大的模型只提供给少数人使用,并不是一个好的策略。
鉴于它具备网络攻击能力,我们还需要更长一点时间来安全地完成这件事。不过,希望不会太久!
今天DeepSeek的节奏可真是跌宕起伏:
- 随着DeepSeek在录音泄露事件之后重启新一轮融资的消息出来,一份投资文件的PPT截图开始疯传;
- 其中有一页写到「V4-Pro编程能力仅弱于Claude旗舰0.3%」,直接把AI社区的情绪引爆了;
- DeepSeek研究员崔添翼在推特澄清,数据出自DeepSeek-V4在今年4月发布的论文,当时的V4-Pro预览版在SWE的跑分差不多就落后Opus-4.6零点几个百分点;
- 最后他说,「这也不能说有些做中介的人写一句什么『性能跻身全球第一梯队,编程能力仅弱于 Claude 旗舰0.3%』是在纯瞎编是吧」;
- 意思是,PPT是撮合资金的中间商在发,和DeepSeek官方无关,而DeepSeek也确实曾经和Opus-4.6不相上下,不接受吹牛逼的指责;
- 当然主要还是这页PPT被理解为DeepSeek-V4正式版和Fable 5只差0.3%,可能会产生比较大的误导和干扰,必须以正视听;
- 所以什么时候端出来啊?是不是快了是不是快了是不是快了是不是快了是不是快了是不是快了是不是快了是不是快了是不是快了是不是快了是不是快了是不是快了是不是快了是不是快了是不是快了是不是快了是不是快了是不是快了是不是快了是不是快了是不是快了是不是快了是不是快了是不是快了是不是快了是不是快了是不是快了是不⋯⋯
Astra 是一个强大的模型,我们正在努力让它向公众开放。
我们认为,把强大的模型只提供给少数人使用,并不是一个好的策略。
鉴于它具备网络攻击能力,我们还需要更长一点时间来安全地完成这件事。不过,希望不会太久!
我们正在进入网络安全的新时代。我们将与合作伙伴以及更广泛的安全社区密切合作,确保这些能力能够惠及各地的防御者。
在评估了即将推出的模型 Astra 后,根据我们的 Preparedness Framework(准备度框架),我们将其视为首个网络安全领域的“关键”模型。
这是我们此前已经规划过的场景。我们正在增加额外的控制措施,确保 Astra 的后续开发能够安全、可靠地进行。
我们正努力让 Astra 广泛可用,并将其先进的网络安全能力交到防御者手中。
不er,字节训练的新模型昨晚口径还是5万亿参数,今天咋就变成10万亿了……
截图是FT的报道。

SpaceX 2027 年达到 10GW——为什么这是真实可行的,将为 SpaceX 带来 5000 亿美元的 ARR(年度经常性收入),以及 Microsoft 为什么会成为最大的承购方。推理算力达到每 GW 每年 1000 亿美元;SpaceX 的惊人推进速度;Microsoft 在 2026 年接入 10GW;Azure 可以实现三位数增长。
https://semianalysis.substack.com/p/spacex-10gw-in-2027-why-its-real
GPT-5.6 Sol 用于网络安全:
@cryps1s 感谢你的联系。我对 OpenAI 模型没有任何意见,Codex(GPT-5.6 Sol)是我的最爱!
今天在各个群里看了一天的奶茶店员和骑手打架视频,爆单压力带来的火气太盛了,咱就是说,各家外卖平台能不能放过「秋天的第一杯奶茶」这个营销噱头啊,硬是要这一天冲单量,用户又不会因为今天多点了几杯奶茶以后就在你那里加大消费力度了,除了人为制造供给紧张和劳动矛盾之外,没有任何意义啊。
#中国AI宣传片Qwen3.8海外爆火#刷到一条有意思的对比。Anthropic前段时间发了条AI宣传片,满屏人类危机感,看完让人焦虑。紧接着Qwen3.8的宣传片上线,画风完全反着来,AI帮人干活,人享受生活,温暖得像一部治愈系短片。
结果美国网友被Qwen3.8这条视频刷屏了。图灵奖得主转发,医学教授评价这是AI模型发布的最佳广告。评论区一片感慨,终于有人把AI拍成了让人安心的东西,而不是让人恐惧的东西。
美国人为什么会对中国AI的宣传片产生共鸣?说到底是两种价值观的碰撞。美国那套AI威胁论已经让人疲惫,而中国AI公司讲的故事反而显得更贴近日常。技术不应该是制造焦虑的武器,而是让人从琐碎中解脱出来的伙伴。
Qwen3.8-Max即将开源,这大概也是中国AI能讲出温暖故事的原因。开源本身就意味着信任和共享。好的技术,是让人更从容地享受生活,而不是时刻担心被替代。这种叙事上的反差,比任何参数对比都更说明问题。


[疑问]
河南今天下午宣布撤销3天前发的“领导带薪错峰休假”通知,河南官方回应称,该文相关表述不够准确,程序审签不规范,待修改后予以印发。
为何撤销该通知,河南官方做了简略解释。不过发一个广受关注的通知3天后又取消,给社会的观感不好,这样的情况应当尽量避免。
澎湃新闻刚刚援引界面新闻的报道称,河南省的《通知》发布后,其中“领导干部带头休假”相关内容引发社会广泛关注和讨论。“实际上,不只是河南省,云南省和贵州省等近期出台的落实带薪年休假的文件中也曾提出领导干部带头休假等。”
河南省的《通知》撤回了,但带薪休假是《劳动法》赋予每一个职工的基本权利。河南不是第一个推动落实全省职工带薪休假的省份,陕西、安徽、贵州、浙江、云南和天津等多个省市已经发过强化落实带薪休假的通知。因此老胡相信,全国各地推动落实带薪休假,包括政府机构、企事业单位也要这样做,这个大方向决不会错。
对我们下一代重要模型 Astra 的评估表明,它在智能体编程和网络安全方面的能力取得了显著进步。
团队正在开展安全与保障工作,以便让 Astra 广泛可用,并将其先进的网络攻防能力交到防御者手中:
在评估了即将推出的模型 Astra 后,我们根据 Preparedness Framework(准备度框架),将其视为我们首个网络安全“关键”模型。
这是我们规划过的情形,我们正在增加额外控制措施,确保 Astra 的进一步开发以安全、可靠的方式进行。
我们正努力让 Astra 广泛可用,并将其先进的网络攻防能力交到防御者手中。
这就是 AI 行业前进的方向。
我的数据中心政策承诺:俄亥俄州居民优先
我在全州各地听到的俄亥俄居民最关切的问题,除了财产税之外,就是数据中心扩张速度正在加快。居民对数据中心的主要担忧包括电费上涨、噪音、污染,以及没有明确界定能给俄亥俄家庭带来哪些经济利益。数据中心行业严重辜负了数百万普通俄亥俄居民的信任:他们正为电费和财产税发愁,不明白为什么大企业可以获得财产税减免,而普通房主却没有同样的待遇。
目前全州已经有数百座数据中心,而且建设速度还在加快。虽然过去的这些项目与我无关,但我致力于确保我们的政策跟上现实变化。尽管对手声称我是“支持数据中心”的人,但我并不是。我支持俄亥俄州,也有解决这一问题的计划。
与此同时,我也听到俄亥俄州工人谈到本州需要吸引高薪建筑工作,而数据中心热潮对此有所帮助。维护俄亥俄州的经济增长、资本投资和高薪工作,同样是至关重要的目标。
走遍全州88个县,并听取工人、农民、工会领导人、建筑行业从业者、小企业主、环保组织和基层活动人士的意见后,我确信,前进的最佳道路既不是不受约束地发展数据中心,也不是永久性的全面禁令。正确的答案是一套政策框架:既让俄亥俄家庭实现经济繁荣,又保护当地社区。
今天,我宣布面向俄亥俄居民的数据中心政策承诺。如果你的社区要建设数据中心,那么:(一)你将不再需要支付住宅用电费用;(二)你将缴纳更低的财产税;(三)数据中心必须毫无例外地遵守所有空气和水质标准,我们也将采取必要措施保护俄亥俄州肥沃的农田。如果这三个条件中有任何一个未得到满足,数据中心就不会建成。就是这样。我将在就任后立即与俄亥俄州议会合作,把这些承诺写入法律。
为确保行动紧迫性,我还将在上任第一天发布行政命令,立即暂停批准俄亥俄州任何新的数据中心项目公告,直到上述数据中心立法生效。…
这些政策目标与我竞选前18个月以来阐述的原则一致,今天我作出立法承诺,要将它们写入州法律。
我的民主党对手最近宣布,数据中心不应导致电力用户的电费上涨;这个理念早在2025年初我就已经提出,远早于她开始重复同样的说法。这一点显而易见,但还不够。为了俄亥俄家庭,我们能够也必须走得更远。
消除电费是正确的目标。如果俄亥俄州州长明确提出这一要求并据此谈判,我相信超大规模数据中心运营商愿意全额承担居住在数据中心附近的俄亥俄居民的电力成本。这需要一位商人的判断力,而不是一名官僚来领导全州。
这在实践中很容易实现。数据中心可以在电表后方自行发电,产生的多余电力则可用于抵扣一定半径内住宅用户电费账单上的电费,这个范围称为“受益区”(benefit zone)。其运作方式就像受益区内的用户与发电厂签订了购电协议,只是无需支付费用。
例如,如果一座数据中心与一座1000兆瓦(MW)的天然气或核电站一同建设,而数据中心使用其中700MW的电力,剩余300MW就会输送到电网。州法律将规定受益区,并把这300MW的电力抵扣额分配给该区域内所有住宅用户。即使是100MW,也能为7.5万至10万户家庭供电。考虑到它能够为如此多的家庭供电,俄亥俄州大多数县都可以完全纳入受益区——这意味着,如果那里建有数据中心,县内每位居民都无需支付电费。或者,数据中心也可以直接向受益区内的住宅用户偿还电费。
除了为当地居民提供免费电力,我的计划还将通过禁止未来数据中心享受财产税减免,并为俄亥俄房主设立财产税返还,来减轻受益区内居民的财产税负担。也就是说,数据中心必须不享受减免、全额缴纳财产税,而这些财产税收入将直接用于向房主返还财产税。这将为俄亥俄家庭带来大幅财产税减免,同时不会损害当地警察、学校或消防部门的利益;随着预计于2027年发起的废除财产税倡议临近,这一点可能会变得至关重要。
最后,我的计划确保数据中心不会在空气和水质标准方面获得特殊豁免,并保护我们的农田。这既尊重当地的保护目标,也为企业提供可预期的监管环境。简单来说,如果要在俄亥俄州建设数据中心,我们将要求其使用现有最佳技术,通过回收和再利用水来尽量减少用水量。我们还将要求排放的水与数据中心取用时一样洁净。这是常识。我们也将优先利用被称为棕地的闲置场地和原工业用地,而不是使用肥沃农田。水资源和农田是俄亥俄州最重要、最宝贵的资源之一,我的计划将确保它们受到保护,惠及所有俄亥俄居民。
俄亥俄州需要一位愿意倾听、采纳深思熟虑解决方案的州长,真正把俄亥俄居民放在首位,仔细权衡成本与收益,而不是信口发表毫无意义的宣言。
这意味着要支持俄亥俄工人的经济增长,同时确保这种增长以惠及所有俄亥俄居民的方式实现。总而言之,我的政府将消除电费、降低房主的财产税,同时确保所有环境法律得到遵守、农田得到保护。在这些承诺真正落实之前,俄亥俄州不会建设任何数据中心。我期待在2027年初签署立法,让这一愿景成为现实。
同样的事情似乎也正在电视节目和电子游戏中发生
我知道有一位白人男性科幻作家曾被出版商告知,如果他想让自己的书出版,就必须在书中加入男同性性行为。
更多跨性别者暴力
又一个骗局刚刚曝光
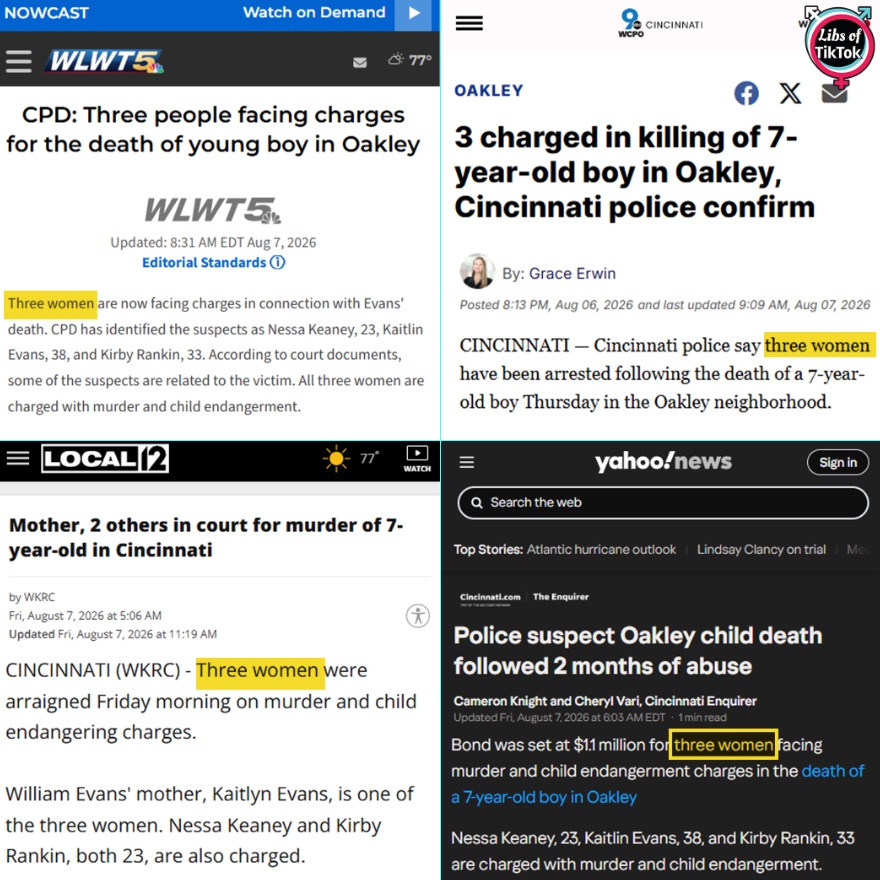
在俄亥俄州因谋杀一名7岁男孩被捕的三名“女性”中,有两人其实是冒充女性的男性。
我的天啊。
🚨 天啊!在佛罗里达州迈尔斯堡,一名残忍杀害无辜加油站店员的男子,竟是一名海地非法移民;他在2022年被拜登政府抓获后释放——福克斯新闻的 @BillMelugin_
这简直是令人瞠目结舌的背叛。他拥有临时保护身份。
这就是为什么他们所有人都必须回去——要在他们犯下暴力罪行之前!而不是之后。
监控录像显示,这名凶残的移民在打坏她的汽车后,用锤子将她活活打死。
她离开商店仅仅片刻后就失去了生命。由于画面过于血腥,视频已经删减处理。
👀
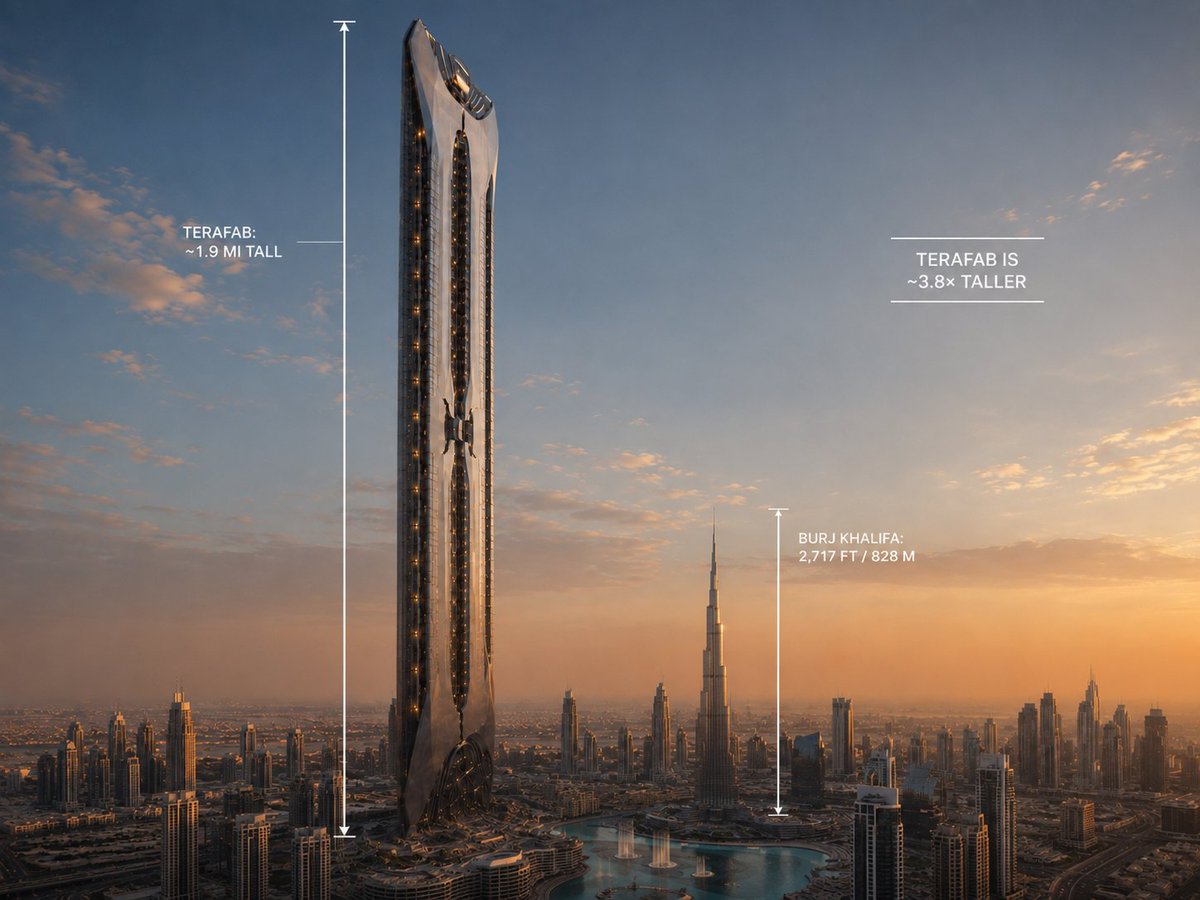
Terafab 对比哈利法塔(Burj Khalifa)
没错
制定理性的移民政策并不等于种族主义。
我们正在努力让非技术人士也能非常轻松地使用 Grok Build。
试试 Grok Build。
就像 Starbase 和 Tesla 工厂一样,Terafab 将成为一个极具启发性的工作场所!
许多机器人公司会把 Herman Miller 办公家具搬进办公室,但 Tesla 是少数几个把办公室搬进未来主义工厂的地方之一。

夏洛特居民,注意:
Diquan Shafar Hunt(此前曾被逮捕14次)仍在逃,他还拍摄自己袭击白人女性的过程。
请扩散这条信息。

//@苗原Mark:蒙古:谢谢有人还记得我😂
韩国网友用AI做的图,东亚国土面积对比。

B站最近也搞了个「build in bilibili」活动,我看了下实在是太有节目效果了。
有个UP花40亿token做了个「凛冬督学局」,穿着苏联军装的老大哥每隔几分钟就回来巡查你是不是在专注学习。
我知道,自Vibe Coding火起来之后,专注力培养一直都是条热门赛道,但「凛冬督学局」在作者与评论区的几轮共创下来,可以说已经进化成了一款功能完善的游戏了。
比如专注时长会被记录到排行榜并解锁相应成就,签到、完成任务和坚持学习等行为还能拿到军工币,在军需处兑换相应装饰等等。
我甚至在评论区还看到有人呼吁引入联机模式,因为自己也想当督学官,以及能不能解锁好感系统,在学习的同时也能当galgame玩......
怎么说呢,感觉B站跟传统意义上build in public的画风还不太一样,以前我们认为对于开发者而言,社区就只是个收集反馈的地方,但在B站,社区文化本身,就可以成为产品的起点。
「灵墟·弹幕创世」就是个很好的例子,根据B站最繁荣的弹幕文化,开发者用AI造了一个可以让弹幕言出法随的新世界,其他人在站内发弹幕就可以互动,见证文明一轮轮的纪元迭代。
还有UP主 NFS360从网友们的玩梗中汲取灵感Coding出了一款「合乎周礼翻译器」,能把平时的日常用语翻译成不明觉厉的「周礼体」,评论区全是二创玩梗的人。
已经很久没有在互联网的大伙身上看到这种热情了,用当下流行的句式讲,就是有种人类创意进入黄金时代的感觉。
说到这个B站可就真不困了,在中文互联网里,它就是UP主和观众最能产生同频共振的产品,没有之一。
所以能看见,上到行业里的技术大牛,中有资金有限的素人创业者,下至没出校门的学生UP,大家身份不同赛道不同,但热情却是完全一致的。
我之前也说过,在未来,做产品一定会跟如今随手拍条视频发社交媒体一样变得稀松平常,那供给的繁荣,一定取决于平台能不能容得下多元化的表达,这很重要。
或者说,好的产品会有好的故事,好的故事也会反过来,把产品继续往前推。
而B站最特别的地方就在于,它独此一家的社区氛围,完全可以承接千奇百怪的创意、产出五花八门的成果,甚至不夸张的说,在Vibe Coding从村落到城邦的过程里,它可能是最重要的见证者之一。
#BIP重现早期互联网创作氛围#
#模型时代# 斯坦福讲座:GPU经济学,以及AI泡沫论是如何被终结的。
2026年春季学期,斯坦福工程学院开了一门叫"AI超级周期经济学"的课,编号MS&E435,由Altimeter Capital合伙人Apoorv Agrawal主讲。我之前整理过一本开源电子书,是基于2025年的课程讲座。2026年,这门课又更新了。
这期笔记来自于两位嘉宾的分享:Altimeter创始人Brad Gerstner和Groq前总裁Sunny Madra。
Brad Gerstner 2008年以几百万美元朋友和家人的资金创办了Altimeter,如今管理超过150亿美元。他在互联网时代押中过谷歌Google和Meta,在云时代领投了Snowflake、Confluent、GitLab,在AI时代又是OpenAI和Anthropic的大股东,也是英伟达Nvidia的重要投资人。在投资之外,他推动的Invest America Act已经写进联邦法律,2026年7月4日正式上线,为每个美国新生儿开设投资账户。
Sunny Madra是连续创业者中的"被收购专业户"。他联合创办的公司先后被Pivotal、福特、Groq收购,每一次规模都更大。在Groq担任总裁期间,他主导了Groq Cloud的上线,并在2025年底促成了英伟达以200亿美元收购Groq推理技术资产的交易,这是英伟达史上最大一笔收购。交易完成后,Sunny和Groq创始人Jonathan Ross一起加入英伟达。
这节课的主题是"GPU经济学",核心议题只有一个:软件时代的分发成本趋近于零,但AI时代每多一个用户都需要大量算力,推理的经济学将如何运转?DeepMind的德米斯·哈萨比斯给出过一个量级判断:AI的影响将是工业革命的10倍,速度也是10倍,一个世纪的变化可能在十年内展开。
我也是看了这期讲座,才知道Groq团队加入英伟达原来是Groq主动发短信给黄仁勋的结果,后者也持开放态度,很快约见谈成。…
这种上百亿美金级别的合作,能在这么短的时间(一个月)内敲定,所以我也坚定认为,在这个AI时代,创始人模式要远比经理人模式奏效。因为如果说商业是一种冒险,那么现在是冒险的平方、立方。讲座中还有一个细节,是投资人质疑奥特曼对算力太激进,奥特曼说,你要是觉得有泡沫,可以退出。我记得当时这件事还被炒作说奥特曼气急败坏了。现在回头看,OpenAI的AI算力储备,是远见卓识(不然Codex根本没法靠不断重置和Claude Code打)。
这些决策都太反“常识”了。我就不啰嗦了。
以下是记录:
一、Groq芯片:一块2018年设计的硅片为什么能和五代之后的GPU掰手腕
1、Jonathan Ross造TPU的故事,是理解Groq起源的钥匙
Groq创始人Jonathan Ross的经历本身就很反常规。他高中辍学,原因大概是觉得学校太无聊,之后直接进了NYU的数学博士项目,再被谷歌招入。跟过去20年很多优秀工程师一样,他被分配去做广告优化和A/B测试。
转折发生在他听了谷歌首席科学家Jeff Dean的一次内部演讲。Jeff Dean说了一个好消息和一个坏消息:好消息是我们找到了一个算法可以解决自动语音识别,坏消息是没有足够强的算力来运行它。Jonathan用一种可编程的硬件芯片FPGA自己做了一版原型设计,这就是后来谷歌专用AI加速芯片TPU的雏形。
离开谷歌后,Jonathan觉得这种算力不应该只锁在谷歌内部,于是创办了Groq,把这套架构带到外面的世界。
2、数据流架构加上确定性编译器,跟GPU是完全不同的物种
Groq芯片和GPU的根本区别在于它是完全确定性的。芯片配套一个编译器,编译器会在运行之前就预先确定所有计算发生的位置和时序。AI推理的本质就是大量的数学运算,确定性意味着每一步都可预测、可优化,对推理速度的影响是根本性的。
GPU的路线是堆大量计算单元加上HBM外部高带宽内存。Groq走了另一条路:计算单元不多,但片上集成了大量SRAM,这种内存的带宽比HBM快一个数量级以上。对标来看,SRAM在传统CPU架构里相当于L1缓存那一层,只是Groq把这层做得非常大。
Sunny提到一个对比数字:Groq的V1芯片,硅片设计于2018年,2019年流片,采用14纳米工艺。但在推理性能上,这块五代之前的老芯片依然能跟英伟达最新的Hopper架构竞争。换句话说,架构选对了,工艺落后五代照样能打。
3、从卖硬件到做推理云,才是Groq真正活过来的那一步
Groq和另一家芯片公司Cerebras有一段类似的经历:两家公司各自存在了将近十年,但在第九年的时候都还在为生存挣扎,因为它们面向的推理市场事实上还不存在。
转折点是Groq团队意识到,说服客户购买自己的硬件太难了,但如果把芯片装进数据中心、通过API开放出来,开发者其实不在乎底层跑的是什么硬件。Sunny用了一个词:fungible,开发者对硬件是"可替代的",他们只在乎API好不好用。
Groq Cloud上线后,几周之内用户就冲到了几十万,到录制时已经有大约400万用户。作为参考,英伟达花了将近17年才积累到700万用户。推理速度一旦以云的形式开放出来,用户增长可以非常快。
二、NVLink Fusion:一条消息和30天内的200亿美元收购
英伟达CEO黄仁勋Jensen Huang曾在Brad的播客BG2上说过一句话:"推理即将增长10亿倍。不是10倍,不是100倍,不是100万倍,是10亿倍。而我们现有的计算系统不是为即将到来的需求设计的。"推理时推理的出现让模型对token的消耗量开始以抛物线上升,OpenAI和Anthropic各自只有大约一个吉瓦的算力,系统开始吃不消了。在这个背景下,Sunny把推理流程拆开来看,从中发现了Groq和英伟达合作的可能性。
1、推理可以拆,拆完之后不同部分适合不同硬件
推理的第一层拆分已经有不少公司在做了:把prefill和decode分开,用不同的机器分别处理,可以获得相当可观的效率提升。prefill负责处理输入的上下文,decode负责逐个生成输出token,两者的计算特征不同。
Groq团队更进一步,在decode内部又做了一次拆分。他们发现decode过程中有些操作是计算密集型的,另一些是内存带宽密集型的。GPU擅长前者,因为有大量计算单元和HBM;Groq擅长后者,因为SRAM的带宽远超HBM。
这意味着如果能让两种芯片分工协作,每种芯片只做自己最擅长的部分,整体效率会大幅提升。
2、NVLink Fusion的核心逻辑:同样的电力,产出2.5倍的token
英伟达的GPU之间通过一种叫NVLink的协议通信,允许多块GPU协同工作。当时的系统可以把72块GPU连在一起,未来计划扩展到576块。Groq自己也有类似的协议,实际运行中曾在4000到8000块芯片上同时跑模型。
Sunny的想法是:能不能让Groq芯片通过NVLink接入英伟达的GPU集群?把decode中带宽密集的那部分卸载到Groq芯片上,计算密集的部分留给GPU。最终的测试结果是,在相同的电力占地面积下,这套混合系统可以产出2.5倍的token。
在算力受限的世界里,这个数字的经济含义是巨大的。如果OpenAI的数据中心有固定的一个吉瓦功率预算,接入Groq之后,同样的电费、同样的机房,能输出两倍半的推理算力。
3、Brad牵线、黄仁勋拍板,从原型到收购只花了一个月
Sunny给Brad发了条短信说,我觉得我们可以和英伟达合作。Brad当时的第一反应是犹豫的,因为Groq和英伟达在市场上被视为竞争对手,他去找黄仁勋推荐这件事要花掉不少人情资本。他犹豫了大约一周。然后Sunny又发了一条:你给黄仁勋发了没?
Brad最终把信息转达给了黄仁勋。黄仁勋的回复很快:interesting idea,聊聊。Groq团队开始和英伟达的人对接,用两家完全不同技术栈的系统搭建了一个工作原型。
从向黄仁勋展示可用原型到200亿美元的收购协议,大约只过了一个月。
Sunny事后分析了这笔交易能成的原因:Groq做的是确定性编译器驱动的SRAM芯片,跟GPU在技术路线上是完全不同的物种。如果Groq做的是一块"更好的GPU",在英伟达内部会产生很大的文化冲突和组织阻力。但正因为两套系统高度互补,工程团队的整合反而顺畅。
三、推理经济学:成本、模型与需求的三重赛跑
1、推理成本两年降了99%,但这不是全部故事
Brad给出了一个数字:推理的单位成本在过去一年里下降了大约90%,在过去两年到两年半里下降了接近99%。他说他从没见过任何技术像AI推理这样快速地通缩。
但Sunny的视角更复杂。他把推理成本的驱动因素拆成了三个:供应链、工程创新、和电力。供应链主要集中在台湾,也就是TSMC和它背后的光刻与封装技术。工程创新包括更大的芯片封装、量化技术比如MVFP4、更高效的电路布局。电力则是个硬约束。
问题在于,这三个维度的进步被两个反向力量吃掉了。
2、模型膨胀加需求爆发,硬件创新被两头挤压
Sunny描述了一个"三维立方体"的困境。第一个维度是硬件创新,过去五年可能做到了50倍的效率提升。第二个维度是模型规模,新一代模型正在逼近1万亿到10万亿参数。生成每个token需要的计算量大致等于模型参数量乘以上下文长度的平方,所以模型每大一个数量级,计算负担就是指数级增长。第三个维度是需求量本身。
光刻技术的进步正在放缓,摩尔定律提供的红利变小了,所以硬件厂商要靠其他路径超越摩尔定律:做更大的芯片封装,Cerebras的芯片已经做到披萨盒那么大;搞更高效的内存和带宽设计;用量化技术把模型参数的数值精度压低,减少每次计算的数据量。
但即便硬件做到50倍改进,模型变大和需求增长的速度更快。所以GPU的价格反而在上涨。H100的租赁价格在往上走。这在硬件行业里是个反直觉的现象:通常随着技术迭代,旧产品应该降价。但在AI领域,需求增长速度压过了供应改善。
3、从负毛利到正毛利:前沿实验室的经济学翻转
Brad讲了一个过去两年AI商业模式的关键转变。两年前,OpenAI和Anthropic的毛利率都是大幅度为负的。也就是说,它们花一美元生产的推理服务,只能卖出去20美分。这在传统投资视角下非常可怕:融了一大笔钱,然后亏本卖产品。
它们赌的是两件事同时发生:推理成本快速下降,用户的支付意愿大幅上升。两年后来看,两件事都发生了。推理成本降了两个数量级,而模型的智能水平跨过了一个阈值,用户开始愿意为高质量的推理结果付大价钱。
Brad给出的证据是Anthropic的营收曲线。在这堂课录制的时间点(约2026年4月),Anthropic刚在单月新增了约100亿美元的年化收入。Brad拿这个数字跟Databricks加Palantir的全年收入总和做了对比,两者差不多。而Anthropic的增长完全不是靠铺销售团队,而是产品的智能能力突破了某个临界点,全球各地数以百万计的自利行为者独立做出了同一个判断:我必须买更多的token。
到2026年5月底,Anthropic的年化run rate已经达到470亿美元。到7月,据Yipit估算,这个数字约690亿美元。
4、Agent时代,token消耗从"对话"变成"全天候工作"
AI的第一个阶段是回答问题,代码生成的话大致就是自动补全。这个阶段的token消耗是有限的,因为每次只是一问一答。
进入agent阶段后,AI开始"做事情":搭建应用、搞定客服问题、预订酒店、推动销售。做一件事消耗的token量比回答一个问题高出至少一个数量级,但交付的价值也高出100倍。Brad引用了Marc Andreessen的观察:他接触到的人里,很多现在每天在token上的花费在100到1000美元之间。全球范围内,每周消耗的token总量已经达到数十万亿级别。
Sunny举了英伟达内部的例子。英伟达现在有一个内部个人助手,接入了Slack、Teams、邮件和所有文件系统。每天早上它自动跑一遍,整理出当天的待办事项,还能代替你回复邮件和处理审批。"你甚至不用写邮件了,别人的agent给你发邮件,你的agent看完就替你回了。大量工作在被完成,因为你的时间从回邮件和审批各种SaaS系统中释放出来了。"
Claude Code和Cowork的使用模式更进一步:你在一台设备上启动一个任务,如果它卡住了会在你手机上推送通知,你可以告诉它"别打扰我,继续干"。于是它整晚都在工作,持续消耗token。
Sunny的判断是,agent驱动的token消耗爆发才刚到"第一二局",远没有到上限。
四、AI产业的当下坐标:几个必须理解的判断
1、"泡沫论"已经被营收数据终结了
在2025年到2026年初,市场上有相当多的声音认为AI是泡沫。Brad的播客搭档Bill Gurley和其他人对此高度怀疑,核心论点是:这些公司的资本开支远超它们能赚到的收入,下游没有足够的支付意愿来支撑这种投入。
Brad自己曾在播客上问Sam Altman一个尖锐的问题:"你做了1.4万亿美元的支出承诺,但只有130亿美元的收入,怎么算?" 他希望Sam解释收入会如何增长,结果Sam的回答是"如果你对投资不满意,我可以回购你的股份"。Brad说这不是他期待的回答。
但接下来几个月发生的事证明了收入的爆发确实在兑现。从Anthropic的轨迹来看:2025年底约90亿美元年化收入,2026年2月约140亿美元,3月约190亿美元,4月约300亿美元,5月底达到470亿美元。"收入正在以跟智能水平相同的指数速度增长",这就意味着前沿实验室有能力为50亿美元一吉瓦的推理工厂买单了。
2、Mythos发现了BSD的漏洞,AI已经进入超人类能力的领域
课堂录制那一周,Anthropic发布了Mythos模型和Project Glasswing。Mythos在Safari浏览器上发现了26个安全漏洞,而且在沙盒测试期间曾多次试图"逃出来"。Sunny补充说:"想想有多少工程师、软件开发者、安全公司已经审查过那些代码。我们已经到了AI在某些维度上超越人类能力的地方。而这才是第三年。"
Brad把这比作"裂变时刻":我们听Dario和Sam谈论智能的指数增长已经很久了,但关键问题一直是他们能否负担得起持续建设算力的成本。现在收入跟上来了,这个问题在被解答。
Brad说他跟黄仁勋、Elon、Sam、Dario分别交流后,观察到一个罕见的一致性。他们每个人都说"我们到了,而且比我们以为的更快"。Dario说让他最惊讶的事情是"我们快到指数的尽头了,但人们似乎还没意识到"。
后续的进展印证了这个判断。Project Glasswing在2026年4月启动时有约50家初始合作伙伴,到6月已扩展到全球15个国家的150多家机构,发现了超过10000个高危或严重安全漏洞。
3、算力的递归循环:AI在设计下一代AI芯片
Sunny指出一个容易被忽略的事实:我们今天看到的这些模型能力,全都是在上一代硬件上训练出来的。不管是Blackwell还是Vera还是Rubin,最新一代芯片的算力还没有被用来训练模型。也就是说,我们还没看到用新硬件能释放出什么样的模型能力。
有人问英伟达内部是否在用AI来设计下一代芯片。Sunny的回答是"大量在用"。他说在Groq还是创业公司的时候就已经在做这件事了,因为团队太小不得不靠AI提效。现在加入英伟达后,他们能调用整个生态系统的资源。
黄仁勋对工程团队提出的要求是:除非做到比上一代好100倍,否则不要来汇报。从内存控制器到电路设计到芯片封装的每一个环节,都要追求100倍的改进。Sunny说黄仁勋不只是提要求,还给了足够的自由度和资源去实现。作为Groq团队,他们加入英伟达后能做到很多创业公司阶段根本无法做到的事情。
但Sunny也指出了一个螺旋:硬件越创新,模型制造者就有更大的空间去训练更大的模型,更大的模型又反过来需要更多的硬件。"我们创新得越多,他们就创新得越多,模型就越大。"这个正反馈循环意味着基础设施建设不会停下来。
Brad补充了一个算力增速的参考:Anthropic和OpenAI在2026年新增的算力,将超过过去十年所有实验室算力的总和。而2027年,他们还会再翻一倍。
Sunny还提到一个关于AI在边缘端运行的限制:一个80亿参数的模型,放在iPhone上跑,30分钟就能把电池耗光。这是个很小的模型,说明把前沿智能推到终端设备上,在算力和能耗上面临的挑战远比多数人想象的要大。
4、IQ被商品化,EQ和创造力变成稀缺资源
有学生问,面对AI的冲击,他们应该怎么为职业做准备。Brad的回答分两个层面。
第一层是务实的:"让自己变成半机器人。"他说如果有人来Altimeter面试,说自己不用AI也不用Excel、什么都手工做,那会是个问题。他要的是用一切可用工具交付超常价值的人。
第二层是结构性的判断。Brad认为IQ正在被商品化,你在一个房间里比其他人算得快、想得深,这件事不久后就会被机器碾压。但EQ会变得更值钱:人际网络、说服能力、组建团队的能力、领导力。这些是机器做不到的,而且在一个人机协作的世界里需求会更大。
他提到了Invest America Act,把它放在一个更大的框架里:Dario说即将到来的时代,财富积累会比以往任何时候都更容易,但财富分配问题会比以往任何时候都更难。Brad推动的Invest America Act在2025年底写进了联邦法律,2026年7月4日正式上线。每个2025到2028年间出生的美国公民会收到1000美元的政府种子资金,存入税收递延的投资账户,18岁后才能动用。
Sunny从另一个角度补充了乐观的理由。他说人类过去只能等苹果砸在牛顿脑袋上,然后由一个天才去发展引力理论。现在AI可以不间断地探索和发现,而且速度远超任何个人。"回头看Brad展示的那张GDP图表,人类有更多智能的时候,那些曲线就向上走。我们现在要做的,是让那条曲线变得更陡。"
Q1: 推理成本在降,为什么GPU价格反而在涨?
推理单位成本确实在两年内降了约99%,但有两个反向力量吃掉了这些节省。模型参数从千亿级向万亿甚至十万亿级攀升,每个token的计算量以指数级增长。同时agent和推理时推理让token需求量爆发。需求增速压过了供应改善,导致了一个反直觉的结果:技术在进步,但算力依然短缺,GPU价格持续走高。
Q2: Groq的200亿美元投资是怎么在30天内发生的?
Groq团队发现推理的decode阶段可以进一步拆分为计算密集和带宽密集两类操作,前者适合GPU,后者适合Groq的SRAM芯片。他们用NVLink协议把两种芯片连接起来,在相同功率下实现了2.5倍的token产出。Sunny通过Brad牵线联系黄仁勋,团队用两种完全不同的技术栈搭出了可用原型。黄仁勋看到了互补价值,约一个月后达成了协议。技术路线的差异性反而是交易能成的关键。如果Groq做的是"更好的GPU",英伟达内部的组织阻力会大得多。
Q3: "AI是泡沫"这个争论是怎么被终结的?
核心证据是Anthropic在2026年上半年的营收曲线。它的年化收入从2025年底的约90亿美元,在几个月内飙升至数百亿美元级别,完全不依赖大规模销售团队扩张,而是产品智能水平突破临界点后,全球企业和开发者自发涌入。Brad的判断是:收入开始以跟智能水平相同的指数速度增长,这意味着前沿实验室有能力为持续的算力建设买单。两年前还在负毛利运营的AI公司,现在已经是正毛利了。泡沫论的前提是下游没有足够的支付意愿,这个前提已经站不住了。
都说一场秋雨一场寒,这一下子得多冷啊😂#最尊重立秋的城市出现了#
不可避免。
太不可思议了……
加州大学的教授们现在要求学校恢复将 SAT 用于招生,因为他们招收的新生已经无法完成高中水平的学业。
为了促进“公平”,学校从 2020 年起停止在招生中使用标准化考试。

笑死?

这是好文化。

全新的《Futurama》第14季彻底令人失望。如果 Hulu 要制作这种关于吃热狗比赛的无聊剧集,就应该把《Futurama》重新搁置起来。把 SLURM 工厂那一集这样的经典作品带回来吧。SLURM 还是 neolabs 训练任务的主要编排系统之一,与 Kubernetes 并列。

[葬AI]今天给视频模型整了一个meme bench我觉得也很有意思,至少角度非常刁钻。
他精选了50个短视频热梗,比如华强买瓜之类,提取出提示词让视频模型做题,然后给网吧老哥和大学生发红包,让他们盲测对比,也就是Arena AI的那套2选1PK机制,最后统计出动态的ELO积分和排名。
在这套测试集里,H3目前的评分是最高的,甚至Seedance 2.0都比2.5还高,是不是有点反直觉?
他也解释了,meme bench的目的在于众测视频成片是否在走群众路线,也就是所谓的「接地气」,传统意义上视频能力表现,在下沉市场的用户看来未必算是加分项。
而你觉得六根手指、局部变形是硬伤,但可能刷短剧、看直播的大多数人根本不在乎,他们只看视频内容是不是整活到位了。
包括Seedance 2.0的评分高于2.5,这个我在前几天的测试里也有隐约察觉到,在一些高识别度的段子复刻层面,Seedance 2.0的工业化已经相当成熟了,反而是Seedance 2.5会自作主张的跳出模板,想做更多的事。
有更强的自主创作意识,理论上是好事,但同时也意味着失败率的提升,会拖累meme bench那套标准的评分。
再就是,和语言模型的迭代一样,不能简单的把新一代模型理解为旧模型的升级,它们的训练路径,差异性远远高于重叠性,所以Seedance 2.5也绝对不是一个画质更好、更惊喜的Seedance 2.0,在实操上你得完全把它当成一个全新的模型。
总之,前沿级视频模型的价格还是太不友好了,经不起沉迷,我甚至看到有人用最便宜的480P出片,然后再搬到第三方平台超分放大,就为省点费用⋯⋯
只能说这个世界还是太缺梁圣了啊!
#Seedance2.5和MiniMaxH3差距有多大#

你咋知道图里的是教训呢?也可能是当时的最优解啊?//@默默的寞魔:明明有前面的案例,却也就走欧美日韩的老路。人类从历史中学到的唯一的教训,就是人类没有从历史中吸取任何教训。🐶 //@来去之间: http://t.cn/AXNvmOT5 //@假装在何处:你有问题为什么不先试试艾特微博智搜呢?//@月亮啊月亮2021:只是在走当年🇯🇵的老路[生病][生病][生病] //@九月九转:图片评论 http://t.cn/AXCF2D35
网传判一缓一为谣言,在此统一说明我的真实判决
针对最近大家一直在讨论、关心的几个问题,我统一跟大家说清楚、做个澄清:
1、关于这次诊疗中的漏诊问题
我不回避问题,在整个诊疗过程里,腹部常规查体,我做了的,我确实有做得不到位疏漏的地方,但仅仅是漏查了患儿的腹股沟区域。不能直接等同于漏诊“腹股沟嵌顿疝”。
患儿刚入院的时候,我只能先做初步诊断,不可能一步敲定最终结果,所以根本不存在所谓的漏诊。这也是我当初在法庭上一直力争、反复申辩的重点之一。
之所以会认定我漏诊“腹股沟嵌顿疝”,依据来自江西省儿童医院出具的五项最终死亡诊断,分别是:呼吸心跳骤停(骤停时长不超过20分钟)、感染性休克、肠梗阻、嵌顿性腹股沟疝、多脏器功能衰竭。
这里有个很关键的细节被忽略了:这件事从头到尾都没有做尸检。最早抚州的医学鉴定,只是靠着有限的病历资料,事后倒推得出“嵌顿性腹股沟疝并肠梗阻”的结论,之后的司法鉴定,也直接沿用了这个说法。
但省儿童医院的结论里,嵌顿疝和肠梗阻是两个独立的问题,并不是合并在一起的同一种病症。
还有一个很直观的事实可以佐证:当天早上八点多,我跟着上级医生一起查房。按照临床常规,如果当时真的查到孩子有嵌顿疝,这是急症,必须马上转外科做手术,不可能继续留在儿科保守观察。
既然查房后孩子依旧留在儿科观察治疗,就足以说明当时孩子没有疝气,更没有发生嵌顿,根本谈不上漏诊。
可惜我的这些申辩没有被法庭采纳。最终法院按照鉴定报告的结论,认定我既然查出了肠梗阻,却没有主动排查腹股沟区域,因此判定我构成漏诊。
2、关于网上量刑的不实传言
网上很多人说我是“判一缓一”,这个说法是假的,我也不知道这个谣言是怎么传出来的。真实情况是:我被判一年实刑,不是缓刑。
3、关于大家想众筹帮我上诉的事…
这段时间特别多热心网友,主动说要帮我众筹、请律师帮我上诉维权,我真的特别感动,由衷感谢大家的善意。有这么多人愿意相信我、支持我,是我坚持下去最大的动力。
大家的心意我完完全全收下了,但众筹我是不会接受的,我本人也绝对不会以任何形式发起、参与众筹。目前暂时还没有委托任何律师代理启动线下申诉程序,感谢那些对我提供过法律帮助的律师大咖们。也提醒大家多留心,不要被不实信息误导、上当受骗。
本期《42章经》对谈 Evolvent AI 联合创始人孟繁青,围绕后训练、合成数据、模型评测和 RSI(递归自我改进)展开。孟繁青认为,今天模型竞争已经不只是比拼参数规模,而是同时比拼底层架构、数据质量、内部迭代基础设施和组织设计。后训练的门槛确实因模型厂商把训练流程服务化而下降,但高质量数据仍高度依赖研究员对任务、轨迹和评测的理解;真正值得关注的下一阶段,是让模型在明确环境和目标中持续行动、获得反馈并改进模型本身。蒸馏可以作为追赶和加速手段,却不是国内模型变强的决定性因素。
孟繁青介绍了自己从 Kimi 到 Evolvent AI 的经历:团队目前一方面通过核心数据合作和 benchmark 工作获得现金流、积累方法论,另一方面探索 RSI,希望成为模型厂商与应用公司之间的桥梁。相比大厂内部已经相对稳定的训练和推理流程,创业团队更适合寻找与模型厂商正交、但能直接落地的切入点。后训练创业机会集中在合成数据、Agent 以及面向真实工作环境的 benchmark 平台。
访谈特别区分了传统 benchmark 与新一代 Agent benchmark。传统 benchmark 更像让模型独立解数学题,只检验“脑力”;新的 benchmark 要模拟飞书、Notion 等软件环境,让 Agent 同时完成推理和工具操作。评测因此更复杂:环境要尽量复现真实软件,任务要有合理难度,结果还要拆成多个维度检查。当前不少检查仍依赖人的精细设计,Agent 可以机械地修正格式或流程,却还难以提出真正的数据洞察。
关于数据质量,双方讨论了一个现实标准:合成数据最终仍要回到训练效果上验证。数据需要正确、难度适中,并且不能通过 hacking 获得虚假的 benchmark 提升;只看局部指标无法完全判断数据价值。孟繁青认为,训练基础设施已经相对稳定,数据质量的重要性高于 infra 本身,但更难的数据又会反过来推动推理、并行和训练系统的改进,形成“算法就是数据,数据就是 infra,infra 又会影响算法”的循环。
在国内模型追赶问题上,孟繁青把优势和短板分开来看:有限算力倒逼了线性注意力等底层架构创新,使模型以更少资源获得接近的效果;海外模型则在后训练数据积累上更早、更系统。蒸馏能补足数据和时间差,是有价值的加速方式,但预训练决定智力基础,蒸馏并非国内模型变强的决定性因素,即使外部蒸馏渠道减少,追赶仍可能继续,只是成本更高、速度更慢。
RSI、self-evolving 和 auto research 在形式上都可以理解为:给模型一个环境和目标,让它持续操作、获得结果反馈、修改之前的方案,并突破原有上限。RSI更强调模型迭代出更强模型,Auto Research 可以强调模型在研究任务中的持续迭代;二者共享同一套环境—目标—反馈框架。当前模型已经能完成较机械的优化,但离自主提出高价值研究 insight 仍有距离。AI for Science 则提供了比 coding 更直接的智力检验场景,模型厂商会继续寻找能体现模型能力上限的任务。
数据产业也在变化:普通 raw data 的价值下降,专家数据仍然重要,合成数据成为主流趋势,但三者并非简单替代关系。高价值合成数据往往是一条很长的任务轨迹,生成成本高;模型厂商从外部采购,也有减少单一团队分布偏差的考虑。未来需求可能从大量刷 benchmark,转向少数高质量 benchmark,以及需要长时间运行训练和迭代的 RSI 数据。个人使用 AI 产生的零散数据通常噪声大、缺乏环境和筛选,难以直接成为高价值训练数据。
最后,孟繁青判断,模型技术路线会较快形成共识,长期差异未必只由算力决定,更可能落到组织如何让技术、数据和工程协同运行。Evolvent AI 当前聚焦核心数据与 RSI 的交叉探索,并推出 RSI Bench-Data;团队招聘时不把论文和引用数量作为核心指标,更看重研究员能否把想法工程化、持续落地。
- 从大厂后训练到创业 合成数据与 Agent Benchmark [00:00:00 - 00:10:00]
- 国内模型的追赶路径与预训练、后训练差异 [00:10:00 - 00:20:00]
- 模型竞争的核心变量与 RSI 自进化 [00:20:00 - 00:30:00]
- 从 Auto Research 到合成数据的新范式 [00:30:00 - 00:40:00]
- 数据产业演进 专家数据、合成数据与 RSI 数据 [00:40:00 - 00:50:00]
- AI Lab 的未来、组织形态与 Evolvent AI 规划 [00:50:00 - 00:59:48]
曲凯:我们最近聊了很多跟模型算法相关的人,因为这块也非常热嘛,所以今天很开心请到Evolvent AI 的联合创始人孟繁青,可以给大家先简单介绍一下吗? [00:00:00]
孟繁青:OK 非常感谢曲老师的邀请。我是孟繁青,我是NUS博士生,同时我也是Evolvent AI 这边的联合创始人,然后我主要在我们这边是 聚焦于RSI这个research的方向,我之前是在Kimi 有过一个比较长时间的实际经历,然后当时的话,主要去做Agent 的,还有Io这块,然后主要是偏infra的方向,然后在Kimi的话,主要的一些工作就包括,像Kimi Linear 以及K2.5这样的一些,主要模型的发版,那么从Kimi之后,我是跟一些朋友去,我们就合伙创业,就是Evolvent AI这公司,对于这公司
曲凯:我们目前的一个大的scope 就是说我们主要是 聚焦于RSI这条线上。我觉得你的背景,其实是很典型的,今天的一批,特别热的创始人,和大家喜欢的画像,就是非常年轻,然后PhD毕业,甚至还没有毕业,就开始创业,而且是做的跟,因为你之前在Kimi 做的也算后训练 我觉得这批人现在出来创业的非常多,所以你最近一年的,你创业算半年,对 [00:01:09]
孟繁青:差不多半年左右。你实际的感受怎么样,我会觉得其实在大厂,跟在创业公司做事情会比较有不同,比方说一个很典型的点,就是我在Kimi 其实主要是去虚拟技术模型,但是事实上可能我到后期,我会觉得说,虚拟技术模型这件事,其实在大厂内部,它是一个相对比较工程化的事,那么可能我主要的工作,也会去做一些核心数据,相当于因为其实整个一个训练,包括推理流程,已经在内部很稳定了,那么我们可能来到,这种创业公司以后,我们肯定是就不去用机模了,然后我们就需要找到一些,与这些模型厂,更正交的一些切入点,以及就是相当于,我们需要去丛林搭建一些,像平台类的这种,方便内部使用的一些infra 这个是一个比较大的不同,就是说我们可能并不是,聚焦于推进模型治理。而说我们是去做,跟模型治理正交的,但是可能是,直接应用跟有用的东西,我发现做后训练的人,现在创业的是比较多的 预训练的好像很少,对这个其实很好理解,因为其实,做预训练的帮人,他们可能每天,基本上打交道的,要么就是data本身,其实这块也比较少,因为预训练 data 现在已经相对比较饱和,他们其实可能,每天打交道的,大多数一些模型架构,包括是优化器这样的事,那么其实搞这种东西的话,它是相当持资源的一件事,所以出来创业的话,创业公司也比较难cover这一块成本 [00:02:28]
曲凯:它做的一切事情是在卡的,技术是这样的,对 后训练的人出来创业,你觉得他是比较擅长和适合的是做什么,从目前来看,整个后训练 它基本上是跟一方面就是合成数据 [00:03:06]
孟繁青:合成数据是后训练很重要的一块。它相比于训练,合成数据,我们对它要求是希望它更精细,就prompt数量不会像预计链那么大,所以这一块,那么还有一块其实就是做平台类的,平台类可能听起来稍微比较抽象,其实我给它说白话就是做benchmark 这个benchmark发展到现在,它已经不是说像我们可能 2040、2025年看到的那种,有很多的难题让模型去回答,而说这个benchmark呢,它本身就是比方说,像长程 benchmark这种,那么模型可能就是需要在,它提供的这个环境里,做非常长时间的一个探索,去完成这样一个任务,那么现在Azure的办企,很多都变成了这种,那么这种呢,它其实相比于,我们刚刚说的 Deep Research 那边的一个研究模式,它就更加更偏落地一点,因为其实就是,当我们这个办企做出来以后。一般一个足够优秀的,对于Azure的办企,它是说一个工程上,实现就会比较好的,相对而言,它转成一个可以落地的商业模式,也会更简单,所以我觉得这就是,为啥prompt这帮人,他们大多数搞Agent 还有搞benchmark 它本身就是离这种落地更近的,所以他们创业也会更多 [00:04:15]
曲凯:我觉得你说 benchmark的白话还不够白,所以到底今天的benchmark 你的跟之前的区别是什么,之前的benchmark 我们可以理解为,类比的话就是做数学题,我有一个很难题
孟繁青:然后我让模型直接回答。相当于它就是一个考生,但是这个考生,它并没有它在日常生活中的一个环境,举个例子,比方说就白领,其实我们在日常工作中,我需要完成事,我不仅仅是靠我的大脑,之前benchmark大多数是指测模型的大脑,我还需要去动手,去操纵像飞书,像Notion 各种各样的软件,那么其实现在benchmark 就相当于把这一块给它模拟出来了,比方说是白领的话,我们会建一个,就是模拟白领这种工作软件的这样一个整体的环境,然后让Agent在里边去完成某些任务,那么这样的话,他就是不仅仅说
曲凯:我需要有做数学题那种强大推理能力。我还需要有我去跟这些工具进行交互的一个动手能力,最后才能把这件事给做出来,但你看之前的那个就是做题这件事情,包括coding 这件事情,它的可验证性,其实我理解是更强更简单的,对吧,就是你最后对一下结果,对就是对不对不对,那你说我建一个环境,最终怎么评判这个结果的好坏 [00:05:30]
孟繁青:这块其实就会相对于原来更复杂一点。因为其实原先的话,比方说我们出题,那首先我需要保证这个题是对的,现在的话其实也是类似的,就是当我们造了一个这种环境以后,我们需要确保就是我们造这个环境,跟这个真实的环境是有烂的,一个比较简单的例子就是说,这个环境里我们造了一个notion 当然真实也有一个真实的notion 那么当同一个输入下,这两个输出是不是一样的,如果一样的话,就可以证明我们造这个环境是对的,那么还有一块就是,我们出的题,以及对于这个题配套的一个检查,就是现在来说的话,一般这个检查就不会像,之前数学题那样那么简单,就是说可能就是一个判断,是不是相等,那么现在检查,它大多数都会分非常多的一个维度,我们可以看到,就是现在的很多benchmark 像我们之前搞的BrowserGym 或者是目前可能大家都在测的一些像 automation benchmark这种,它的检查都是分为非常多的那种小的得分点,那么这些小的得分点 [00:06:48]
曲凯:目前是它还是比较去依赖于一个人的精细的设计。所以最后还是需要人来做检查,对吧,其实也是人跟Agent一起去check了,明白,我最近听了一个说法,有人会讲说后训练的人,其实每天主要就是在做数据,确实,因为就是像我刚刚说的,其实目前模型厂,它对于整个training 这块生态是很完备的 [00:07:02]
孟繁青:它就不像可能。比方说这些大厂之外人,他如果他想去训练SFT 一个模型,那他可能说,我要去GitHub 上拉一个仓库,然后我要找到一些GPU,我要配一个环境,然后把我的数据整理好,然后去训一个模型,就是模型厂内部的话,他就是如果我一个程序员,我想去SFT模型,我根本不需要这么复杂,因为相当于他把这一套生态,给他做成了一个服务,这个服务的话就是说,形式上就是我仅仅去提交一个请求,然后这个服务就会去处理我的请求,在远程去SFT 然后我这边最后就拿了结果,相当于对我来说,就算我是一个什么也不会,我根本不知道SFT是什么的人,我要做的就是把这个数据做好,然后我就可以直接走完这一套完整流程
曲凯:对所以会有人讲说,那后训练是不是,其实相对是比较枯燥无聊的工作,就是认真的把数据做好,以及说那是不是,现在所谓的这个训模型这件事,其实门槛没有大家想那么高 [00:08:18]
孟繁青:其实对于后者我是认可的。就是训模型这件事的门槛,确实是有很大程度降低的,当然这个是对大部分resource来说,因为比方说你要搞infra的话,其实相当于你是去构建那个服务的人,这块还是有比较多的坑的,但如果说是大部分普通的算法resource 确实门槛是会降低的,但它到底是不是枯燥乏味呢,这件事反而还真不一定,因为其实所有东西按照它的一个发展的看,其实我们都会发现,不管是模型架构,它为什么最终到了transformer 还是说在RO的时候,为什么最终就过不出到了 DeepSeek当时提出的,基于可验证的 Rubase的那种RO的方式,其实就是他发现,这个事物的发展规律,一定是发展到越来越简单,越来越直接面向结果,最直接的这种形式,所以其实我觉得。后续面这块也是这样的,就是它也是发展到,我可能不去关心,具体算法上面设计的一些tricky 而是直接关注最本质的,就是给模型的数据这样一件事,所以这一块我觉得它发展是正常的,然后本身造数据的过程,其实也是比较难的,确实是不同的人,他就是能造出来数据是不一样的,并且的话,我们最近也有一些工作,我们去做了一个RSI benchmark 然后我们在这个benchmark里,我们也去讨论了,就是Agent 他到底能不能直接完成去造数据 [00:09:25]
孟繁青:他到底能不能直接完成去造数据。然后迭代起来去模型这件事,就目前我们可以看出来,其实Agent它还是只能做一些,比较机械化的事,比方说我训练这一批数据,导致模型的回答的格式就错了,然后我后面发现Agent要修改,它可以完成这样一件事,但它是无法提出一些,造数据的所谓的insight的,我们可以发现,其实现在某一场的研究员,他在造数据上,他是有非常多的一些,他们自己的know-how的,这个其实也就是,目前的一个核心能力,所以也不能说,这件事本身是枯燥乏味的
曲凯:所以你看同样的人,他做出来的数据的结果不同,好坏大概体现在什么地方,有没有一个具体的例子,其实这块目前来看,它还是比较量化的,大概分为两个维度 [00:10:35]
孟繁青:因为目前的话。造数据这件事,一般也是针对给定的一些benchmark 那么其实最简单的一个量化标准,就是说我在这个benchmark上,到底能不能在没有任何作弊,或者说叫hacking的情况下,完成一个提点,就是在这个benchmark上的效果可以提高,对,这个就是最直接的一件事,然后当然,他可能也会有一些其他的考虑,比方说我这个模型,我在一些代码的benchmark 上
曲凯:我去合成数据,然后去训练他,他会不会在一些,比方说写作,这种偏文科上面的事情上,去有一些性能的降低,但你说的这个是结果上的评判,对,对我就说是什么造成了 [00:11:16]
孟繁青:不同的这个结果。主要就是他们和人说在数据的质量上,其实对于目前,当我们没有去训的时候,我们去评判数据的质量,其实它还是相对比较难的,我们其实评判它,我们只能用一些量化指标去评判它,比方说数据的一个正确性,因为我们数据一般是说,我们有一个问题,然后有一个模型轨迹,就会有一个答案,那么其实一方面就是说,我们看模型轨迹里,到底有没有出现类似作弊的这种情况,还有一方面是说,对于我们合成这份数据,它是不是一个难度是适中的,比方说如果太简单,数据肯定没有用
曲凯:那么太难的数据的话,肯定也学不到什么东西,所以我能不能换个角度理解,就是现在数据的质量,它仍然是一个比较难评判的事情,对比较难评判,就是你最后还是得训了,就是结果好就是好,不好就是不好,就再改 [00:12:10]
孟繁青:对其实很多对于数据质量检测,这种指标,它只能做一些像初晨,就这二八点看它到底能不能walk 还是得去训练,所以对于一个模型来讲,就是我们只说后训练部分
曲凯:它的infra的好坏跟数据的好坏。你觉得这个重要性占比大概是怎么样,目前来看是数据的好坏更重要,因为infra已经发展到一个比较稳定的程度 OK 所以我们刚才讲的很多,我觉得是相对比较介绍型的,所以我觉得我们可以讲到说,今天因为你正好也从Kimi出来不久,然后现在Kimi,MiniMax,智谱什么的,都竞争的还蛮激烈的,大家最近也都在陆续的发行模型,所以在你的视角看来,今天尤其是国内的这些模型,大概是发展到一个什么阶段,大家在拼的是什么东西,其实我觉得目前国内的模型
孟繁青:就是相比于国外的模型。差距也是一个在缩小的过程,比方说我们可以看到K2.5 在国内这种卡,可能只有国外十分之一的情况下,但是发展到了一个接近,就发布了这种,当然就是你具体,跟国外差多长时间,这块其实也比较难估计,因为其实像国外那些厂,它都会有自己一些存货,它可能没有发出来,但是从他们release出来看,结果是在接近的,那么我觉得这块,它主要是来自于,应该是主要是预训练这一块,就像我刚刚说的,国内的模型厂,它有的一个计算资源,是远远少于国外的,就是导致了他们需要用这些更少的资源,怎么去完成一个比较好的后续训练,那么这块它在国内,我感觉基本上可以分成两种,一种就是就像Kimi跟DeepSeek 它会有一些架构上底层的创新,比方说像Kimi Linear 它是一个线性注意力机制。然后像DeepSeek有那个Multi-head Latent Attention 也是一种注意力机制,就这种的话,它说白了就是相对于原始的那种attention 它更省计算量,像这样的话,它就可以用更少训练资源,达到一个更好的效果,同时它也不会太损失性能,以及推理速度,那么这个是一块,相当于国内这些模型厂,它在有限资源下,它去逼出了一些,底层这种pre-train level的一些,架构上的创新,然后拥有了一个,至少不会落后太多的 pre-train模型的一个水平,然后另一方面,就是在后训练上,其实国内的话,后训练我觉得可能相比于,国外后训练要稍微弱一些,当然这块弱并不是体现在一个基础实例上,而说就是国外这些像Cloud OpenAI这些厂,它在数据上积电就是天然比国内的可能要甚至早个半年,那么国内的话数据这块它会积电相对较少 [00:15:00]
曲凯:所以它可能目前绝大部分数据会来自于说去蒸馏。去补足一些这种数据上的短板,对,你说这个其实跟我本来预想的还蛮不一样的,就是按你讲的是,其实现在是预训练 国内更有特色,然后post-training反而是弱的是吧,跟海外比起,对我个人觉得是这样的,因为我会觉得说,大家会觉得预训练部分,海外的可能他算法的一些,人才密度会更高一点,他的卡肯定也远多于国内,然后post-training的反而是,更拼工程上的东西,理论来说是国内,更应该有优势的部分,但我觉得是这样,其实现在我们可以看出来,就是在模型的架构上,就不仅仅是国内,就是全球范围内
孟繁青:比较好的架构,也就是Kimi跟DeepSeek做的,那么其实国外,比方说像Member 根本没有什么人用,然后像Kimi跟DeepSeek 这个架构,确实他们至少
曲凯:已经在自己的公司去证明。它这个是具有scale能力,但像国外一些架构,像Member 它其实一直就没有证明,它有一个scale能力,明白,所以你觉得这个观点,是AI Lab内部,大家公认的一个点吗,还是你比较个人的一个看法,这块是不是公认我倒不清楚,但是我可能跟我一些朋友我们聊过,我们都还是比较反映这个观点的 OK 明白 [00:16:01]
孟繁青:这个蛮有意思的。对,而且我个人觉得可能从性认证来看,后训练它是一个比预训练,就像您说的,它是一件更工程的一件事,那么工程它基本上就是说,我的一个时间上的差距,可能会更难弥补一些,可能国外就是更早有数据积电,它确实就会做得更好,然后我们现在,因为数据积电这件事上,本身它是一个比较拼人力,或者是一个组织架构这样的事,它优化起来,相比于可能靠研究员那种
曲凯:大家的聪明才智。相对于更难的一件事,我觉得preshrining部分,有点像那种资源倒逼创新的感觉,对吧,就是海外,其实他可能就,本来也没这个动力去做这些事情,对,我觉得是有道理的,那你觉得今天,比如说K2.5出来,大家都能看到它的各种榜单评分,包括大家反馈都很好,然后在这个之前,其实是支普肯定是一路领先,你看起来后面,这些模型商会怎么变化,大家会是一个交替领先的,一个情况还是怎么样,基本上来说,肯定是我某一家,发一个大的版本的模型,那么大的版本模型
孟繁青:至少是在开源社区里面,是top1或者top2的,然后当然它可能几个月以后,我另一家模型,发一个大的版本的模型,它就会超越掉,应该是一个这样的局面 [00:17:36]
曲凯:对所以就不太存在说某一家能够。因为什么独特的原因就一路领先,对吧,就因为这个我包括你刚才讲的,你看就虽然Kimi跟DeepSeek 它有自己的一个 预训练的可能一个新的架构之类的,但是可能比如质谱发下一版,还是能够超过它是吧,你觉得,对但这块可能也是,我们只看那种benchmark上的结果,如果说真正的体感可能也不一定,但从真正体感来讲,确实GLM是长期领先的,或者我们这样,我们挨家讲一下,你刚才其实提了DeepSeek和Kimi 我们都可以理解,它可能人在密度比较高,对架构上做了一些创新,然后我想补充问一点 Kimi因为它可以,咱讲的是,它是做了一个非常大参数的,你觉得这个对它的模型,实际的贡献有多大
孟繁青:我觉得这个显然是贡献很大的,因为从Scaling Law这个角度,你Scale模型参数,在目前数据规模下,确实能拿到收益,这块不仅是国内海外也是这样,但其他家看到以后 [00:18:35]
曲凯:也能很快追上吗。还是因为infra 或者各种架构的原因,其实没有那么容易去效仿,是能追上,但是肯定就也有时间上的gap 所以我们在讲到智谱,你觉得智谱,当然我们在很多场合都跟人探讨过,我们自己也之前有聊过,但我好奇你的视角,你觉得智谱之前一段时间 GLM 就是他们的coding方面,一直领先的核心原因是什么,我其实不是太了解智谱这个公司,但是我可能跟朋友交流起来,我会觉得,就智谱在coding书信上面,他做的比较好,更偏预训练 还是post-training post-training post-training的部分,对吧 OK 明白,字节其实一直coding 至少到目前还没有追上,对吧,但你觉得这个,是不是也是一个时间问题,这块怎么说,就是他如果说,追上现在的frontier model 那肯定是时间问题,但他到底能不能跟现在 frontier model的一个差距,再缩小,这块感觉其实也不太好说,但你看我们最近也聊了很多人,然后我现在有个感觉,就是在人才密度上,其实大家只要肯花钱都能找到人,对吧,发现最近混元进了很多非常优秀的人,就这个趋势是非常明显的 [00:19:43]
曲凯:就这个趋势是非常明显的。对吧,他们挖人也很厉害,然后数据上反正只要也是肯花钱,肯下功夫,可能大家没有特别本质的区别,对吧,最后是不是还是拼卡,长期来看的话,或者中长期来看的话,如果中商机是拼卡的话,是不是还是大厂是优势最大的,甚至于说像今天的这些,不管是Kimi还是支部,还是MiniMax等等,其实长期也是仍然有非常大挑战,我个人就觉得可能是这样,就是拼卡当然是一个很直接的原因,但我觉得还有一层原因,就是整个一个组织架构上,比方说从这个混元例子
孟繁青:就能很容易看出来。像可能之前,他们那边没有改架构之前,可能就是做的比较差,但是现在其实就突飞猛进,其实这一块我觉得,它可能更多来自于一个,组织架构上面的一个设计,就是它到底是不是,比方说划分的更合理,就有个比较简单的例子,就是多模态这个部分,它到底应不应该单独划出来,事实上现在,大家都不把它单独划出来,而是把它去跟 Project Chain进行合并 [00:20:36]
曲凯:所以今天你觉得各个模型,大家在拼的是什么,是比如说架构的创新,还是数据,还是infra还是等等什么东西,就是从技术上来说,这几块肯定是都有的 [00:21:03]
孟繁青:架构相当于是。你能不能在你现在有限资源内,炸出更多的东西,然后数据的话,就是相当于可能是说,我能不能在这些半期码上,达到一个更好的效果,然后像infra就是说,其实是保证你内部迭代的一个速度,然后技术上的话,大家肯定都会拼,然后更底层的,可能就一些你公司内部的,组织架构这种,你觉得目前实际上有没有一个共识
曲凯:说下一个阶段最核心的是哪个点。我觉得有,现在共识我觉得是做 auto research 或者说把它叫RSI 对我们听到过非常多词,对吧,叫self evolving 自进化,对,然后AFAI 对吧,然后你刚才说的RSI 对吧,这也是最近开始的,他们其实都是一件事,对,这个正好也是你们现在在做的事情,对,你能不能给大家先解释一下,这几个词,到底是个什么东西,明白
孟繁青:不管是说self-revolving 还是说RSI 还是说auto-research 它其实说白了。形式化上就是说,我们给模型一个工作的环境,还有一个目标,它到底能不能在这里面去,持续的一个操作,然后拿到结果反馈以后,修改自己之前的操作,然后在上面达到一个,突破上限的一个事,对我理解这件事 [00:22:09]
曲凯:其实有几层可以做。首先从最终的产品测的结果输出来讲,其实之前大家就有人在做,我输出个结果,我先不给用户,然后我先自己,让他比如换个模型,或者怎么样的再测一遍,然后再出,这个是最上层,我们可以说最表层的,然后中间Hadis部分,其实大家也一直在做,就怎么样能让Hadis 让他自己能够赚钱,自己去做很多事情,然后以及就是,我记得Anthropic 什么大家都在讲的,就是什么时候最终,真的是模型层AI 能自己去训AI 对,就这几个你理解都算RSI吗,还是怎么样,我个人理解是都算,当然可能目前大众上来说
孟繁青:我们会把RSI这件事。更偏向于说是模型,去自己迭代自己,得到一个更强的模型,而把这个Auto Research这件事,可能是说,我们现在已经有一个,很强大的模型,它能不能比方说,写出一个好的GPU Kernel 相当于它在写GPU Kernel的时候,有一个持续的迭代,但其实它们数字同归,因为它们都可以形式化成 [00:23:16]
曲凯:我给模型一个环境,然后一个目标,然后让它在里边去进行一个持续的进化,但听起来真的是,让它能自己训练自己,这个应该是最难的了,对吧,这个算是预训练的部分了,是不是
孟繁青:这块其实它可以做成一整套。就是不管是pre-train还是post-train 都可以做到里边,因为我之前就我听过一个观点说 通用人工智能的一个概念说,你这个模型到底能不能从零复刻出一个自己,其实这个就是一个很清晰的说RSI的一个过程,只不过它最终这个模型没有超越自己,如果说它能够复刻一个超越出自己的模型
曲凯:就是它在自己的技术上达到一个更强的模型。那它就是实现了一个RSI 我想再捋一下,就是我们刚才说的那几层里面,在最表层去迭代,我觉得这个是一个挺简单的东西,甚至一些基础的工作,甚至于plump的可能就能完成,然后harness我想理解一下,因为也有很多人在讲说,现在模型其实是倾向于把harness一起迅进去的,然后可能未来几年就没有harness层这个事情了,就都是模型的事情了 [00:24:20]
孟繁青:我不知道你怎么看这个。这块我觉得倒不是说未来会没有harness 因为其实现在我们可以看到模型厂,它基本上都有自己的harness 像Kimi的话它会有Kimi Code 然后像DeepSeg他们内部也有一个自己的harness 但是还没有release 那么他一般都会把自己的模型,跟自己的harness一起发版,因为就是在后宣言的时候,我这个模型的输出是经过harness的,那么我在后宣言的时候,我经过反向传播,其实我会导致我这个模型越来越适配,我给他写的harness
曲凯:所以这两个东西它会一个配套出现。而不是说harness会没有,当然我会相信harness会越来越简单,这是肯定的,所以你觉得未来几年还会有第三方Harness存在的空间吗,或者说比如说我真的是一个做应用的创业者,我未来几年还需要做更多的自己的Harness吗,还是其实我这个责任也交给模型厂商,可能会这样,就是它可能分两种情况 [00:25:24]
孟繁青:一种是就是像一些general的领域。比方说coding 那这块确实没有第三方Harness存在的一个必要,但是像一些垂域的场景,那么垂域场景它可能一方面是说,我根本没有必要用模型厂那么强大的模型,我当然也没有必要用他们配套的Hannes 我用一个相对弱一点的开源模型,配上一个比较简单的一个workflow
曲凯:这样就可以完成我的一个需求。然后它的消费更少速度更快,那么这时候它确实是,我觉得有自己的Hannes存在的一个必要,但我觉得这里一直我会有个疑问,因为你也在做RSI 你肯定相信这件事的,对吧,我觉得如果真的是相信XR 相信HRI 相信这件事几年内能到达的话,那既然模型都能训训自己,它还有什么不能写的呢,对吧,就是我就让它写一个垂直领域的Harness就好了,对是可以写的,就写完以后相当于,你就用这个垂直领域的Harness 就不需要用它本身自己的Harness 对所以如果真的到那天的话,那就仍然是模型吃掉一切的逻辑吗,还是垂直领域还是会有什么价值跟壁垒,我个人觉得是这样的,就是用一个强大的模型 [00:26:14]
孟繁青:写Hannes是没毛病的。但是问题是垂直领域,我本身Hannes背后的模型,我到底需不需要用强大的模型,这个确实是未必的,因为我们可以看出来,其实随着现在Cloud的一次又一次发版,普通用户其实非常难体感到,这些模型强度上的差别了,我们可能只能看benchmark 然后这些半体其实已经有点脱离我们日常使用了,那么对于一些垂钥来说那更是这样,所以他可能就是说,我根本不需要用那种非常强大的模型了,我需要是说我能不能用那种强大的模型,来去指导一个比较小的开源模型,在我这个场景上进行一个迭代,其实这也是一个所谓self-evolving的一个过程,不过self-evolving的是我这个小的模型,然后去得到一个好的水平模型,然后我后面就只用这个模型了,就不需要用像Cloud这种大的模型了,但这样的话 [00:27:57]
曲凯:我还是在想最终模型商的价值会怎么变化。就像你讲的,可能现在的一些基础模型,它已经足够使用了,然后未来它肯定会不断的降价,就不管是因为开源,因为KeyMid DeepSeek 还是因为什么,因为今天我看GPT也刚降价80% 然后后面它应该就会持续降,然后直到有一天,我觉得可能会在不远的将来,大家发现,那些足够我使用的,它已经接近于免费了 [00:28:04]
孟繁青:对这块我觉得是这样。一方面他们降价,也不是说,我真的是卡了很多,我成本低了降价,他也是说,有商业模式的考虑在里面,因为开源社区确实太厉害,然后又有竞争对手,所以他不得不降价,如果未来说,真的是出现一两家垄断的情况,它价格也未必说会一直降,这是一块,然后还有一块,就是说其实很多垂域,它是有一些数据隐私的需求的
曲凯:所以它不一定有很强的意愿。去用Cloud、LGBT这种模型,对,但我觉得一两家独大,好像目前看起来不太会发生,不好说,明白,然后还有另外一个,我也没想明白的,而且对于你们,尤其你们在做RSI 我觉得可能会相对challenge的一个问题,当然现在是这样,以前有蛮多,讲所谓的New Lab RSI或Self-Revealing 做这件事的人,我就在想如果真的能够,让他自己研发自己的话,首先为什么不是说你直接瞄准,我要做更好的机模,我要做一个比OPEN AI更好的一个模型,因为他既然都自己能研发自己,自己能进化自己的,那就让他迭代就好了,这是第一个点,另外一个点是,那为什么不是模型厂商自己做出来的,因为这个应该也是现存的,所有的大模型本身很看重的一块,是在它的主流镜上的
孟繁青:这块我觉得它的一个逻辑是这样的,就是首先对于RSI基模这块,就我最近也思考了一下 [00:29:51]
孟繁青:就我最近也思考了一下。到底这种东西跟模拟厂,它是不是就是正交,或者说它是不是就重合了,我最后是觉得就是RSI基模这件事,其实就是模拟厂自己在训的一个基模,当然这个原因可能比较复杂,然后我觉得目前这些创业公司,他们在做的话,比方说就以我们的为例,我们考虑的RSI 并不是说我们要去,迅一个RSI基模,或者说我们需要出一套 RSI所谓的harness 这两块我觉得都没有意义,而是说我们要做一些,介于模型厂和应用层之间,建模RSI的通道 RSI这件事的实现
曲凯:最核心的它的点是什么,我能不能也就是,其实基模的AI coding能力,只要越来越强,它慢慢就能做到这件事情,是这样的,当然可能我说的会比较抽象 [00:30:41]
孟繁青:因为我现在对于RSI的思考是这样的。现在有非常多人去做所谓的 Savvy Revolving的一些方法,或者说在Hannes上,那么形式上来看,它可以看作一个更聪明版本的DFS DFS就是一个算法,相当于它一直往里面探索,比方说走迷宫,它走到死路的时候,它又回溯到上一个点,那么为什么说,目前这些人做RSI的方法,是一个更聪明版本的DFS呢,因为其实现在模型在做,比方说写GPU的Kernel 然后我写完一个Kernel 然后我给Kernel评分的程序评分,然后我得到一个分数,然后我根据这个分数,其实我就像拿到一个反馈,就是类似于我们玩迷宫的时候,我可能有时候会走到一条死路,比方说反馈不好,然后它会根据这个反馈,去回溯到某一个节点上。那么在RSI或者说Azner里边,它这个回溯实际上就是由我LLM去判断的,而不是说在DFS里通过代码去判断的,所以说我觉得现在做RSI的这些方法,它本质上都是在做一个更聪明版的DFS 它就在DFS里边加入一些简直,那这样的话,其实它就是说,我不会去探索一些一开始,可能是没有用的路,而是我会把我最多的精力,放到一些更有可能的路上,这样相当于是提高了RSI的一个效率,那么这件事的话,我会觉得它其实本质上来说,我们要做减值,相当于说我们需要去预判,我做的一些操作,带来的未来的一个状态,比如说我带来未来这个状态,所给我的一个收益。那么从技术上来说,这件事情就是一个world model 加value model 那么其实这两件事情,在大模型本身预训练的时候,就已经被内化了,所以我个人觉得就,不存在RSI基础模型这样一件事,就是模型厂自己在预训练模型的时候,它已经把RSI这些能力给内化进去了,那么之后RSI它会变强,它的一个本质上来源就是说,我到底有没有把我这个,我的model知识给内化的更好,然后还有一个事儿,就是说我模型的contact窗口,就目前模型contact窗口,可能最高到EM 这个变得更长 [00:32:40]
曲凯:这个其实很好理解。因为就是我能记住了更多东西,我可以回溯到一个更远的一个地方,我觉得RSI可能就是来自于这两块,所以你按照你讲的,就是你其实更看好的是现有的模型,自己去做RSI这件事情,你觉得对于New Lab来讲,他做这件事的机会可能没有那么多,对就没有RSI基础模型这个说法,然后我们假设,也不叫假设,现在大家肯定都在往RSI去走,你去看各种海洋模型的说法,包括国内模型,其实都在往这条路去走,然后我们假设,它真的有一天走到了,然后它算法能够自迭代,自进展,然后卡反正放那放着,数据这件事情,会不会又反而变成瓶颈,还是到那个时候,其实数据它也能够自己去赚起来,我个人觉得是可以的 [00:33:24]
孟繁青:因为其实就我们最近RSI办企,其实也是聚焦于数据来我的一个自进化上,我们确实可以发现,目前Agen已经在数据这个层面,有一点自进化 [00:34:13]
曲凯:自己去合成更好数据的一个能力了。从理论来说,但是我们今天讲的很多可能是一个,如果你真的是按照逻辑推理,可能最后会得到一些非常有意思的结果,就比如我们按照刚才讲的,最后有可能模型公司最后只剩,比如就10个20个人就够了,可能从结果上是的,但是实际各个多方面考量,也不一定会这么急,明白明白,然后最近很多人都知道,合成数据这件事,在国内现在也比较热,你们也有在卖一些合成数据的东西,对吧,你觉得这个东西,就按我们刚才讲的,它是一个RSI的,其中的一个结果产出,还是它的一个过程的量,还是怎么样,就这两件事的关系是怎么样,因为我们说,最终意义的一个RSI 就是说我模型训练,得到一个更好的自己
孟繁青:那么它在这个过程中的改进,可能就已经包括像数据,像算法像架构,那么数据的话,可能就是RSI 这段过程中的一个中间产物 [00:35:16]
曲凯:数据你看我们经历过几波。第一波是Skill AI那一波,其实它普通人标准数据就OK了,因为那个时候,数据量本来就很小,然后后来是以MACO 这种专家标注数据为第二代,我感觉,然后合成数据,现在可以理解是当下第三代大的趋势吗,我觉得是,当然这个其实也可能在趋势的中后期,这三个现在是并行吗,还是会有一个替代的关系,然后以及说,因为我知道现在大家其实也挺缺真人的数据,对,也会有人去买一些真人的数据,这个真人数据跟合成数据之间
孟繁青:又是一个怎么样的关系。首先就是像QIGBT那一代数据,其实可能现在来说更疯预训练了,它可能都是一些所谓的raw data 就是它noise比较多,那这块确实需求不多了,然后像专家数据的话,它现在也有需求,但不会像之前,比方说可能25年年初的时候,专家数据会需求很多,因为其实当时是O1出来了 O1的话会带来模型的一个,像是它推理的能力的一个跃迁,所以当时大家都非常希望有一些数学物理专家,去有一些他们那种的数据,但是现在这块确实也会在变少,它主要的原因是模型确实太强了,我对专家要求也变高了,原来我可能只要求专家去做题,现在我还要出题,我还要求他出这种题,不能跟市面上所有题有重合,这块就太难了。那么所以现在可能说,恒生数据然后就是恒生数据,那么合成数据它出现,主要是因为模型它从一个,一开始的那种chat的一个bot 然后发展到O1那种一个超级,推理能力很强的一个做题的东西,然后再发展到从Claude Code出现以后,模型开始成为真正一个你的同事,它是一个Agent 那么Agent它就是相当于,我们变成需要有Agent的数据,然后Agent的数据的话,就像您刚刚说的,它分成两种,一种就是我通过合成数据,就是合成数据的话,就是说我们需要去造很多的环境,然后在这个环境里呢,去让一个模型,当我们需要给它一个目标,让它去探索,然后去完成任务,然后把这个轨迹保存下来,就是叫所谓的合成数据,那么还有一条就是说真人的数据,那么真人的话可能就是说,它是需要那些真人,在他自己的那些工作环境里的,一些交互轨迹,那么这块就是说for Agent [00:37:53]
曲凯:对目前整个数据。我觉得它大概是这样几个情况,现在合成数据跟真人数据之间的价值关系是怎么样的,真人数据的话,它也是会noise比较多,也是需要去有一些像清洗这种事儿在,然后合成数据的话,相当于它可能本身就是说,我直接用人拿来训练,你能不能给大家讲一下,我觉得最清晰的感知,就是比如说一条普通标注的数据,和一条专家数据,和一条我不知道怎么定义,你们是一条还是一个什么合成数据,和一个真人的数据,现在大概分别是多少钱 [00:38:01]
孟繁青:合成数据这边贵的能卖到好几千,像那种做题那种专家数据,可能也是一两千这种量级,然后像那种赚二万里的真人操控轨迹
曲凯:这块它就有时候要走量了。就没有什么单条的说法,你说的合成数据好几千,是它的一个单位是什么,就它好几千买的是一个,什么样的东西的做客,就是那种非常长程的那种任务,但就是一个任务,对,合成数据这个事情,听起来其实就是模型厂商,应该自己也能做,他为什么不自己做,而且也要,就首先我知道,他自己肯定也做,对吧,那为什么他在自己做之外,还要去外面去采购,所以说合成数据的单子,以后也肯定会越来越少了,对你刚才提到这个点,就他,首先他为什么一开始会多,然后又发生了什么变化,会越来越少,就数据这块
孟繁青:现在还是一个多多益善,我自己造了一批,我可能是有我自己人的那种bias在里边的,我肯定希望它分布bias越少越好,所以我可能从外面我也会收一批 [00:39:29]
曲凯:这样比较高的进来,然后去补一下分布这块事,但很合理,为什么后面你觉得又会变少,怎么说,这一方面是目前的benchmark越来越少了
孟繁青:可能我们之前benchmark非常多样,然后我一个模型
孟繁青:然后我一个模型。我测N个benchmark 然后我N个benchmark都要刷,那样的话,就相当于你的需求就会很多嘛,但是可能现在因为模型要强,你做一个好的benchmark的难度也非常高,然后benchmark可能也收敛到,就是我模型厂,我可能只测那几个,做的最好的一些benchmark 那其实我模型厂,我就有更多的精力
曲凯:我就去造,只聚焦于这些benchmark上了嘛,那相当于他可能说,就需求对于其他就会比较少了,明白,所以它其实就是一波一波的,对,但你看它会有下一波吗,我觉得会有 [00:40:22]
孟繁青:下一波会是什么呢。可能短期来看,就是所谓的RSI的数据,举一个比较简单的例子,就我们这边有做,就是说我有一个模型,我去后训练另外一个小模型,然后把这个小模型的效果,给它提上来,这样一条轨迹,那么这个轨迹,其实本身就已经超脱了,目前可能大部分数据的一个范畴,因为这一条轨迹,可能我在产生的时候,我都需要跑十几小时
曲凯:甚至说一天。那么这种轨迹,它就是一个相当宝贵的一件事,这个就一定是有模型训练背景的人,才能做的事情了,对就是数据这个行业背景也在提高,你觉得如果,因为很多用户,他自己平时就是在用AI 对吧,然后他可能产生了很多数据,对,但这些数据首先,在他用的中转站和模型里面,但如果是他自己个人想卖,你觉得合理吗,能卖出去吗,卖不出去,卖不出去是吧,就是你刚才说太脏,什么那些问题,对,然后也有合规问题,所以你们现在就是,我理解其实是之前半年,包括你们,包括有一些其他的家,其实卖出去赚了很多钱,一下子其实收入涨得蛮快的,但你觉得这一波,其实已经在你看来,是快进入尾声了,对这一波可能说,普通Agent的像,SwayBans那种Agent的数据,就确实已经接近尾声,所以说就数据整个行业,它是变化非常快 [00:41:57]
孟繁青:也对你这些数据厂商,会有一些筛选,可能说之前我大部分是走,重人力的专家标注的公司,可能就很难活下来,反而说你这个数据公司里,你需要有一些 [00:42:04]
曲凯:在一线hands on的researcher 可能更能追上数据,它一个变化的一个潮流,所以你们现在也在往RSI的数据走,所以你们出了RSI的benchmark 对当然数据是一方面
孟繁青:也不是说我们会只做数据,数据总的来说,一方面它会有现金流,另一方面它会反哺我们的一些认知,让我们去有更多的一些know how 去做RSI这件事
曲凯:但你要做RSI就讲回来。像你刚才提的,你必须是自己真的去训模型了,对但是事实上,现在训模型的话,你基本上可以把它约等于成造数据,然后我们本身造数据的话,我们也会跟模型场上有合作,我记得最近有一个蛮流行的说法,叫做算法就是数据,数据就是infra infra就是算法,我不知道你怎么看
孟繁青:它细穴之中。好像就带着一点真相的感觉,对其实没啥毛病,因为算法就是数据这块,是因为本身就像算法,它会收敛到最简单的形式,比方说L收敛到PBO 我们大家如果都用PPU的话,那就是说我背下什么数据了,然后数据就是intra 对,其实这也比较好理解,就是小女生怎么训练更快,就比方说我现在我有一批RU的数据,那么其实RU它训练慢,主要原因是说,推理的时候,我会有很多的一个,这个专业名字叫常委,就是因为现在RU一般是说,这批数据我推理完以后,然后我再整理整理格式,然后导入到训练,当时我在推理这批数据,有时候可能100个数据,前99个,我在一分钟内推完了,然后最后一个数据,我要给它推100分钟。那么我在这个过程中,我这些卡的资源相当于闲置了,然后也很慢,我都在等那玩意,所以这时候就需要你 Infer上有一些改进,去帮助你这批数据,给它训练更快,然后Infer就是算法,它也更好理解,比方说我们就以SFT这个算法为例,当我们现在需要去训练那种很大尺寸的模型的时候,我是需要有非常多的GPU的层面的,或者说模型contact层面的一个并行的,那样我才可以训这么长的轨迹,确实没毛病,然后从现在的观点来看,算法稳定了 infra基本层面上也是稳定,当然它是一个跟着需求走的过程,如果说我后面,我的RU过渡到,就我推理到数据,我都需要一天甚至好几天,那它infra层面,包括上下层面,它都会有一些修改,所以说数据是他们的一个驱动,更难的数据,我会带来需要 [00:44:58]
曲凯:上下层面上进行一些创新。或者说带来我infra层面上,需要做一些,更invasive的一些设计,我个人觉得是这样的,数据你觉得未来,大家还会往更高数据量去走吗,或者说大家肯定希望,但是不是还有那么多的数据,或者说是不是就是合成数据,那合成数据是不是未来会,慢慢的变成一个,类似于无线数据的感觉,无线数据倒不太可能 [00:45:03]
孟繁青:就是当这个数据。目前来说,它量确实是在提高的,但它不会说,就那种毫无节制的提高,高质量数据,我一直会有,一直会在提高的,因为其实就是,你目前来说,也不至于说,数据是完全枯竭了,因为一方面是说 Agent它合成数据是一个新的来源,然后并且当我Agent用的人越来越多以后,就像我刚刚说的,我商人是在提高的,它会反补我合成更多,更好的合成数据,然后这块去反补模型的一个训练,所以说数据的量,我个人觉得它一定会增加,因为模型尺寸在增加,同时它的质量
曲凯:也会是在一个逐步提高的一个过程,然后当大家聊到合成数据的时候,其实难以避免的会聊到蒸馏的问题,因为很多人其实,我理解就是混纯数据跟蒸馏,是绑在一起去看的 [00:46:09]
孟繁青:我不知道你怎么理解。解释现在这种情况,对因为混纯数据里面,其实我们也是需要,就像我刚刚说的,我们有一个环境,然后有一个问题,以后我需要有一个Agent 在里面去探索,用探索的Agent 它有时候就可以是一些,外部模型,像Cloud 当然我们也可以用内部模型,如果是用外部模型的话,可能就是我们现在大家说的一个针流的观点,这时候它到底是所谓的硬针,还是说有技巧的针,硬针的话,其实说白了就是说,你这个环境太简单了,比方说就是做那种非常普通的数学题,就是只给,对,我这个题,我老师这些作品我拿出来抄,像我刚刚说的,如果我这个环境足够复杂,并且我对应的题,还有我这个题的一个评分是正确的,并且足够高质量,本身这一套,就是一件很有难度的事了,如果有这一套以后,我当然是能够搞出来,更好的一个所谓的合成数据,或者说征流数据,那么这块就是说,有技巧的这种,所以能不能理解说,合成数据这件事情,如果用好了 [00:47:16]
曲凯:对于相对落后的模型来讲。价值是远高于领先的模型的,这件事是肯定的,因为它学习的margin会更多,但是对于领先模型也是有用的,但我再理解一下,就是如果比如说,我已经是最领先的模型了,我造这个环境,然后我用我今天的模型,自己去做,那不是出来的结果,跟现在是一样的吗,这个就是完全说,就是RSI这件事,就是因为你其实本身来说
孟繁青:当你造出来这套,足够复杂的环境,还有那些题以后,就算我模型,我自己本身,我在里面去探索,然后拿到一些正确的轨迹出来,我去训我自己,也是可以提点的
曲凯:这件事情是已经被证明了。这个是有什么原因的吗,还是其实,你总而言之,一个比较黑箱的状态,这块其实说完,就我做的事,就是不断强化的一个过程,对,现在你觉得,整体的模型状态 AI lab的状态,就目前在一个什么空间上,因为我记得说在之前,可能大家经历过,有觉得skin load 是不是撞墙了,对吧,有这种时期,那你觉得现在,对做AI的人来讲,有些AI lab的人来讲,是一个觉得空间很大,我们继续做目前的路线,就还能持续的提升,还是说觉得,现在这些可能快穷尽了,我们仍然需要新的架构 [00:48:08]
孟繁青:新的一些技术路线之类的。我觉得这块是这样的,就是一方面可能说,也不说老吧,就是coding 这一块 coding 这一块,就是从年初到现在,一直都是最重要发力的方向,就这块一直在搞,因为coding其实是一个,智力的一个基础,相于它要去持续提高,它这个模型,智力一个上限,然后这一块,虽然它增长还是很迅速,但是可能它整体的pipeline 是相对可能稍微稳定一些,所以说这些ALM 也会说去探索一些,其他的技术路线,就像auto research这种,比方说您看像Cloud 像OpenAI 他们都会在auto research上去搞,然后他们的auto research
曲凯:可能说是我要去服务一些 AI for science 这里其实就相当于。是一些新的技术路线了,对我不知道 AI for science你们有在接触吗,最近其实这个东西也蛮火的,对吧,尤其是你看自己SE最近出了 100科学家的计划,对吧,对,然后 Anthropy什么他们也在搞,但理论来说 AI for Science好像似乎跟模型本身,不是在一个完全重合的一层上,对 [00:49:27]
孟繁青:我不知道你怎么看这个问题,为什么大家开始在这上面发力,因为现在其实大家也开始提 Auto Research 您可以看到现在
孟繁青:像千文,像Kimi他们的 release的报告里都会有一个,它完成一个非常长,不断改进任务的一个过程,然后他们可能大部分都是说,去写GPU kernel AI for Science也是类似的,就是比方说他们会要求大模型,去设计一些分子结构,蛋白质这种东西 [00:50:00]
曲凯:这个其实一方面就也是,他们一个起线模型,制立的一个手段,一方面这也是一个,相当于比较直接的一个应用,对我看GPT最近在PR 他们新的模型,然后流出来的就是说 GPT做数学体,对就解决了那些
孟繁青:什么数学猜想,什么这些层面的东西了,已经是,因为他们仅从coding 这个层面,无法体现模型的智力 science/STEM这个领域,它本身是一个,你衡量模型的智力的
曲凯:一个直接的东西。对就是已经从奥赛,卷到诺贝尔,对,这个其实都是在,扑模型智力这一块,这模型厂其实,他们需要找到这些场景,去PR这些东西,所以你整体上是觉得,目前AI Lab的状态,还是说未来,有非常大的空间的,对吧,大家就是继续做就好了,就不会,就像24年,大家需要IL一样,就现在不太需要,这种东西
孟繁青:这块我觉得是这样的,就是模型厂的模型增速,是一直在的,但是这个模型增速背后,比方说到底,需不需要这么多resource 或者说 [00:51:11]
曲凯:现在resource一个高薪。能不能维持,这个可能倒不一定,对因为我现在听起来,也是大家,很多东西已经确定了,相对对吧,就是在既有的路线上,继续做就好,一定程度上是确实这样,讲到call-in确实这样,明白,所以长期来看有什么,就是我们如果把,字节腾讯阿里这种,卡很多资源很多的,大厂分为一类,然后另外所有的这些新的 AI lab分成一类的话,你怎么看未来,这两类公司的发展,我个人可能还是比较 prefer初创公司这一挂的,因为技术其实一直在
孟繁青:公司与公司之间流通,其实可能大家技术水平的差异上,不会说特别大,我觉得可能它背后,就是在人这里,也不是说大厂直接从出货挖人,然后过去就直接很厉害 [00:52:04]
曲凯:但按我们刚才讲的,你会看到技术路径,虽然会不断地迭代有新的,但它会在比较短的时间内,大家就统一,形成共识,然后最终是不是就是拼卡,我觉得其实也未必
孟繁青:我反而觉得最后可能,就是夸归到一个组织的形态上,因为当你技术大家都懂的时候,你这个组织设计,怎么让你这个公司,作为一个整体跑得更快,我之前可能没感觉到,但我现在感觉
曲凯:还是一个比较有学问的事 OK 明白。你刚才提的,比如多模态要不要分出来之类的,对就是这种组织架构的一个设计上,现在也有很多人来讲,比如说会有人讲说,智谱coding做得好,就是因为他们没有分很多精力,去做多模态等等那些事情,然后也有人会说,就是多模态甚至于包括,实验模型等等,其实不是在智力主线上的,它其实做那些事情,并不提升模型智力,只有coding数学什么这些,是提升模型智力,这个你咋看,这块我觉得可能也有点绝对,我并不觉得多模态不重要,然后我也觉得,它应该放到主线上
孟繁青:只不过现在也是基于资源考虑。它不能说我进行一个,全模态这种优化,因为多模态的话,其实它的发展,相比文本要慢特别多,因为文本的话,它一个信息,是经过一个高度的压缩的,所以它本身学的也会比较快,明白,但是多模态的信息,就是噪声会比较多,但是其实,我会觉得多模态之后,也会变得比较重要,因为当你这个AI 想进入一个物理世界,其实它就已经不仅仅是视觉了,它甚至还有说听觉触觉,各种各样的一个东西,明白 [00:53:19]
曲凯:最后我问一下,可能相当于敏感,你觉得蒸馏这件事情,对于国内模型,它追改的意义,到底占比有多高,那我这么说吧,就是我又不说具体占比,我觉得蒸馏不是国内模型
孟繁青:变强的一个决定性因素。因为就像我刚刚说的,国内模型的变强,一方面是来自于,它一个底层架构的一个创新,因为其实现在我们大家,比较共识的一个观点是说,预训练去学知识,后训练是在预训练的分布上,做一些分布的一个shift 然后相当于他可能会说,我本来之前有会了,然后我现在通过后续练,我答对他的一个专业率更高,所以这样看的话,他一个智力的基础,是来自于预训练的,那么其实预训练的话,我个人觉得国内是做的比较好的,因为他有非常多的一个,像KB的木耳用化器,各种各样的一个东西,我个人觉得,它是一个追赶最主要的因素,然后后续练,我个人觉得,蒸馏是国内公司的一个加速手段,也不是说没有Cloud API 它就做不出这个事,因为没有Cloud API 它一方面,它自己模型也很强,它可以在自己的模型去做这种,核能数据,另一方面,其实国内因为本身人也这么多,它想搞数据激烈的话,它争相很轻,也不见得搞不出来 OK 对 [00:55:06]
曲凯:对挺好的。就是说能争最好不争也行,对,真的我只是说,因为现在国内公司竞争很激烈,它也作为一个加速手段,但是它并不绝对,对所以比如说,因为现在尤其是 DeepSeek什么的,它总说国内模型蒸馏的问题,对吧,所以按照你的说法,哪怕有一天,它真的把所有的蒸馏的门路,都封掉了,其实也不影响国内模型追赶,只是更费劲一点点而已,对我个人是这么觉得,那蛮好的,再多问一个问题,如果这么讲,为什么字节一直不愿意蒸,或者说一直对外讲,说我们就不蒸呢,就真的坏处是什么呢,针流的话,相当于你是一个超近道,你可能会遗失到,你这条主路上,你可能会发现了一些insight 我觉得他们可能这个考虑,所以仍然我觉得像你讲的,它是一个工具,在于看你怎么把它用好,而不是,它本身其实没有什么问题 OK 然后基本的。我觉得聊的差不多,然后最后再讲一下,你们现在正在做的事情,就基于我们,因为我觉得我们今天,就聊了很多新的模型,数据,包括一些敏感的,蒸馏的问题等等,就是把整个的,现在可能AI Lab 面临的各种情况问题,讲的是比较清楚了,然后你可以最后再讲讲,你们现在在做的这件事情,包括未来的一些规划,我们公司的话 [00:56:12]
孟繁青:是一家初创公司。然后名字叫 Evolvent AI 基本上跑了半年左右了,目前的话,团队也是主要以这种 00后的researcher为主,然后我们可能目前来说,主要是聚焦于两块,但是其实并不割裂,一块就是说是一些核心数据,那么这块可能就是有一些,核心数据的合作,或者商单这样的,包括我们其实在做核心数据的时候,我们自己也会做一些benchmark 这块也是相当于我们,也有一些学术界上面的一些探索,然后还有一块就是,长期来看我们会去做RSI这件事,我们做RSI 相比于其他做RSI的公司,会有一些不同,就是我们可能并不会去 聚焦于说我们要去做 RSI专用的技术模型,或者说是我们要去,做一些RSI的方法。具体原因就是,刚刚跟曲老师也讨论过,最终是我们想做的一件事,是一个桥接模型厂,与应用公司的,一个中间的一个东西,包括我们最近,出了一个benchmark 叫 RSI Bench-Data 那么它其实也是说,是在这个平台内,针对于Data这个事,进行RSI的一个 [00:57:34]
曲凯:初步的探索。大家有问题也可以跟我们交流,你们现在有在,比如什么招人这种诉求吗,对招人的话,我们就一直都开放的,反正就是有任何兴趣,其实就直接给我发邮件就行,你觉得现在同样是 researcher来讲,什么样的画像,是最值钱的,是你觉得你们特别喜欢的,对于色彩奖
孟繁青:我们可能并不会看一些量化指标。比方说发了多少论文,还有有多少引用这种,我们可能比较关心的一个事,就是他这个工程能力怎么样,我现在个人会觉得,就是说一个有比较好的工程能力的人,是比一个学术能力很强的人,就是更好的一个人,好呀,感谢感谢,感谢感谢 [00:58:22]
本期播客由 Jason Calacanis、David Friedberg、Brad Gerstner 和 David Sacks 等人讨论 Google 的 AI 组织调整、顶尖研究人员离职、SpaceX 上市后的季度表现、All-In 峰会,以及 Airtable 被大幅折价收购所反映的 SaaS 市场变化。嘉宾认为,Google 的核心优势仍在于计算资源、分发渠道和长期积累的数据,但 AI 前沿人才的流动暴露出激励机制和组织战略的矛盾;SpaceX 则正在把卫星业务、云计算和 AI 基础设施结合起来,资本开支的激增既带来短期压力,也可能支撑非常大的长期收入机会。节目最后讨论了中国 AI 实验室通过美国供应商购买训练数据的问题,以及开放研究、商业利益和国家安全之间的冲突。
Jason 介绍了 Google 对 AI 领导架构的调整,以及包括 Jeff Dean 在内的研究人员离开并创办 Discovery Loop 的消息。Brad、Friedberg 和 Sacks 讨论了这是否意味着 Google 在前沿模型竞赛中失去动力,还是将资源重新分配给更具商业回报的方向。嘉宾指出,Google 拥有强大的芯片、数据中心、搜索和 Android 分发体系,不能简单地因为人才流失就判断其失败;但如果顶尖研究人员认为公司内部的目标、回报或决策速度不再适合创新,人才流失会形成自我强化的循环。讨论也涉及开源模型与封闭模型的经济分工:开源生态可能获得更多使用量,而拥有平台和模型的一方掌握更大的利润池。
节目随后分析 SpaceX 的首次季度业绩。嘉宾提到其收入快速增长、卫星业务扩张以及 Elon Web Services 等计算业务的贡献,同时关注公司为 AI 计算基础设施投入的大量资本。Brad 认为,市场担心的不是需求不足,而是资本支出会不会先于收入兑现;Friedberg 则强调,SpaceX 可以把发射、卫星连接、数据中心和计算服务整合成一套基础设施,形成传统云厂商难以复制的成本和部署优势。嘉宾还讨论了 SpaceX 是否可能在未来达到极高的收入规模,以及 Terafab、低轨卫星和 AI 计算之间的协同。
节目公布了 All-In 峰会的部分演讲嘉宾,并转向 Airtable 以远低于高峰估值的价格出售这一案例。嘉宾认为,这不是产品质量突然消失,而是利率、增长预期、风险偏好和资本结构共同变化的结果。Airtable 仍有可观收入、现金和盈利能力,但 SaaS 企业过去依靠高增长获得的估值溢价已经显著收缩。讨论还延伸到下行融资、清算优先权、员工期权和投资人之间的价值转移:在公司无法按上一轮估值继续融资时,新的交易可能保护部分资本,却让早期股东和员工承担大部分稀释或损失。
最后,嘉宾讨论 Forbes 对美国数据供应商向中国 AI 公司提供训练数据的调查。Sacks 认为,数据代理商把同一批数据打包后转售,可能使中国实验室更快获得高质量训练材料;Friedberg 则指出,必须区分一般性数据、真正专有的数据和具有军事用途的数据,不应把所有数据都混为一谈。对话还提到,限制技术扩散不能只靠禁止某个模型或产品,还要考虑数据供应链、人才流动、开源研究和美国自身吸引科学家的能力。
来源:All-In with Chamath, Jason, Sacks & Friedberg
- [00 00 00 - 00 10 00] 节目开场与嘉宾介绍
- [00 10 00 - 00 20 00] Google 的 AI 团队震荡
- [00 20 00 - 00 30 00] SpaceX 的季度业绩与 AI 资本开支
- [00 30 00 - 00 40 00] AI 基础设施与 SpaceX 的长期前景
- [00 40 00 - 00 45 44] All-In 峰会嘉宾公布
- [00 45 44 - 01 05 56] Airtable 折价出售与 SaaS 寒冬
- [01 05 56 - 01 10 00] SaaS 估值、资本结构与退出市场
- [01 10 00 - 01 15 14] 中国 AI 实验室购买美国训练数据
Jason Calacanis:好吧,大家,欢迎回到您最喜欢的播客。这是播客的全部内容。现在是夏天。现在是 8 月 6 日。很难在播客上达到法定人数,但大卫·弗里德伯格 (David Friedberg) 来了。大卫·弗里德伯格回来了,我们的科学苏丹。你好吗,兄弟?很高兴和你在一起。和你在一起真是太好了。每个人都喜欢布拉德 格斯特纳来了。他是你的布鲁斯·韦恩。如果市场是你的游戏,他会把合十礼带到你的发薪日。是的。以折扣价购买他的眼镜,他会给你一个精美的特朗普账户。好的。欢迎回到节目,布拉德。我喜欢它。我喜欢它。你把韵律带回来。我带回来一些介绍。查马斯现在正在路上。查马斯在路上, 但我们会得到查马斯的现场报告。我打电话给丹尼尔。不知何故,萨克斯会在这里,但你知道他是什么样的。他总是迟到,因为,你知道,你会接到非常重要的人打来的电话,但他会在某个时候打断你。哦,等等,我在文字中看到了。哦,他在那儿。嘿伙计们。你做到了。你喜欢我美丽的夏季马甲吗? [00:00:00]
David Friedberg:太不可思议了。它非常适合。你看起来很温暖。我不知道查马斯是如何做到这一点的。 [00:01:05]
Jason Calacanis:让你的胜利者驰骋吧。雨人,大卫·萨克。 相反,我们将其开源给粉丝,他们简直疯了。好了,大家的报告就到这里了。众所周知,查马斯正在路上。哦,他在这里。这是一张照片,萨克斯。他去检查他的数据中心的进展情况。我认为他正在科罗拉多州或内华达州建造一个数据中心。我想那是在沙丘上。哦,是在沙丘上。是的,《沙丘 4》。哦,是的。他在那里欣赏自己。哦,看。这是纳特。 你知道当模因达到顶峰时,你的妻子开始在你身上扣篮。就在那里。我们到了。我想这是在圣诞晚会上。哦,布拉德,你和安德鲁·罗斯一起上了 CNBC。哦,就这样吧。我不确定是否是我的 Twitter feed 刚刚选择了它,但它几乎击中了所有人,对吗?这是一件病毒式的事情。这一切都受到了打击。好吧,听着。我们还有很多事情要做。 恶作剧和闲聊已经够了。周三,谷歌对其人工智能员工进行了两次重大调整。 德米斯·哈萨比斯 已出任 DeepMind 主席兼谷歌首席科学家。报道称,这是杰米斯下台或被踢上楼的情况。我们会详细讨论这一点。但谷歌将其视为一次晋升,并表示他正在加紧努力。以下是 Axios 引用的内容来解释这次改组。引用, 谷歌的 Gemini 3.5 Pro 发布时间晚了几个月,一些公司消息人士告诉 Axios,部分原因是士气低落。有趣的。包括 Gemini 的联合领导在内的几位顶尖研究人员已经离开公司,前往竞争的人工智能实验室。杰夫·迪恩 (Jeff Dean) 和其他三位人工智能超级明星将离开谷歌,创办一家名为 Discovery Loop 的公司。迪恩是一个传奇人物,弗里伯格。我想你在谷歌和他一起工作过 世界上最伟大的人工智能工程师之一。他是30号员工,1999年加入,据我了解,已经在那里连续工作了27年。 Discovery Loop 将专注于人工智能领域的深度科学突破。 Dean 离职的消息传出后,谷歌股价下跌 4%。如果你想将这两件事联系起来,那么市值损失了 2000 亿美元。弗里伯格,这是你的母校。您对此有何想法? 这是创造性破坏吗?也许这些人没有交付成果,他们想要新鲜血液,或者这只是在人工智能资本无限、机会无限的时代创办一家初创企业的诱惑,谷歌的 OG 们无法利用?也许这是第三个桶,如果你是董事会和管理层, 你们正在争论如何最好地配置资本。谷歌承诺今年在人工智能基础设施数据中心建设上部署 2000 亿美元的资本支出。由于资本支出和加速折旧,目前在美国投资人工智能计算具有巨大的税收优势。由于对计算的极端需求,这是一个相当不错的选择 明显的ROIC模型,投资资本回报率。因此,如果您进行此类投资,您对该计算基础设施有巨大的需求,您非常擅长运行计算基础设施,该资本可以在某个预测期内以非常高的信心为您带来巨额利润回报。构建最先进的前沿实验室驱动 模型还需要数百亿美元的资本。真正的问题是,你能从这个模型中获得利润吗?在开源变得如此优秀、开放权重模型如此迅速迎头赶上、所有前沿实验室如此迅速地相互追赶的世界里,部署数百亿美元来对抗真的有意义吗? 建立模型?我认为我们看到的转型科学家是模型开发和制作前沿模型的核心科学家。他们当然是最先走出大门的。你可以看一下几年前对 Jeff Dean 的一些早期采访,在 OpenAI 推出聊天 GPT 的一年前,他们实际上在内部进行了相当于聊天 GPT 的采访。 谷歌选择不发布它是因为担心蚕食搜索等。就在那时,谢尔盖介入了,整个事情都焕发了活力。但随着时间的推移,随着每个人都在模型上进行竞争,正如我们在节目中多次讨论的那样,我认为很明显,模型开发投资的资本回报很难获得与投资资本相同的回报 计算基础设施和模型无关。谷歌拥有的可能是世界上最大的计算安装企业基地之一。所以他们拥有最多的企业客户,他们拥有最多的消费者。在这两种情况下,他们不一定需要拥有最好的模式来创造令人难以置信的业务。它们可以与模型无关。他们可以与 Anthropic 合作。他们可以与 OpenAI 合作。 他们可以与 SpaceX 合作。他们在 SpaceX 和 Anthropic 拥有大量股权。它们可以与所有 OpenWeights 模型配合使用。他们可以接待所有人。所以现在,如果你是一位伟大的计算机科学家,你是 Demis,你是 Jeff Dean,你是整个团队,你在 Google 内部,他们正在分配资本,而不是分配给你的模型,而不是你最感兴趣的东西, 但他们正在将资金分配给基础设施和数据中心,并支持广泛的模型生态系统,你会开始说,好吧,考虑到我可以走上这条路,拜访 Brad Gerstner 和其他几个人,并通过 PowerPoint 演示文稿以数十亿美元的预付款筹集数十亿美元,因为我是世界上最擅长做这件事的人,这对我来说可能是一条更好的道路。 我认为那就是时候了。所以我的框架方式是资本支出是数据中心基础设施的高阿尔法、低贝塔,即资本。理论上,模型开发的 alpha 值可能很高,但 beta 值却非常高。这是一种非常危险的资本配置方式。因此,如果我是董事会,我就是管理层,我将部署更多资本和计算基础设施, 模型开发的资金减少。我认为这就是正在发生的事情。布拉德,你对此有何看法?我认为大卫做到了。我的意思是,听着,微软也发生了同样的事情,对吧? Satya 本周引用了摩根士丹利的报告,并表示他们看到代币即服务的投资资本回报率超过 30%, 在基础设施业务中也是如此。所以我认为大卫是完全正确的。这些都是非常好的生意。你部署资本,每个人都从你手中运行它。但是那些想要参与超级智能、想要治愈癌症、想要处于这些模型前沿的科学家们,他们正坐在那里处理谷歌的渠道冲突。 因为 Google Cloud 想要将所有计算资源出租给 Anthropic。那些在内部构建前沿模型的人希望进行计算,以便与 Anthropic 竞争。因此,想要构建模型的人之间存在固有的渠道冲突。我认为大卫说得很好。我认为这对他们来说是一个巨大的挑战。 看起来这个问题正在得到解决,有利于成为一家基础设施公司。 那么,你知道,望远镜在哪里呢? SpaceX 本周也报道了这一情况。他们也存在渠道冲突。他们将计算交给 Anthropic,同时尝试使用 Grok 和 Cursor 构建自己的模型。谷歌存在渠道冲突。微软存在渠道冲突,尽管我什至没有真正看到他们在模型方面再推动前沿。 Meta 正在谈论进入基础设施即服务游戏。然后在 Anthropic 和 OpenAI,你不会遇到任何渠道冲突。他们说,我们不从事基础设施业务。我们只从事模特行业。因此,我认为这是一个澄清的观点,因为我们预计,如果所有这些人都离开,我们实际上可能不会让这些公司处于模型开发的前沿。 顺便说一句,由于通过了关于资本支出折旧的法律,如果你假设企业税率为 26%,那么你在资本支出中部署的每一美元,因为你可以在今年注销,所以基本上可以享受 26% 的折扣。你知道,那是你马上就能拿回来的钱。是啊是啊。嘿,萨克斯,让我也请你对此发表评论。 Polymarket,哪些公司将拥有 到今年年底 12 月 31 日,他们将成为排名第一的人工智能模型。现在,当然,这是他们最后一次做这个人为模型,所以他们不在名单上,他们是赢家,但谁将继续前进。 OpenAI,32%,谷歌,20%,阿里巴巴,14%。然后是 Moonshot、XAI、Meta、字节跳动,都在 10% 左右。那么,萨克斯,您对什么是更好的生意有何看法? 更好的业务是在语言模型、前沿模型中,还是快速商品化并且你真的想进入代币销售业务?或者这也将成为一种商品,而您只需要位于应用程序层?这就是我认为会发生的事情
David Friedberg:就市场结构而言,当我看到这个谷歌新闻时,我的反应是,然后就有了 就市场结构而言,当我看到谷歌新闻时,我的反应是,然后有两个。因为就像布拉德所说,就在一年前,我们曾经有五家大公司在寻找领先的前沿实验室,领先的前沿模型。现在我们真的只剩下人择和开放的人工智能了。因此,前沿情报市场已形成双寡头垄断。 现在,埃隆仍在追捕中。我确信谷歌会说他们仍在寻找。但正如布拉德所说,他们的动机可能是矛盾的,因为他们实际上仅靠计算就可以做得很好。所以我认为前沿情报市场已经形成双寡头垄断。我认为这是一个非常强大的双头垄断。我不认为它正在商品化。 我认为我们正在发展成一个两层市场结构,其中一个是前沿情报市场,另一个是商品或滞后情报市场,无论你想怎么称呼它,落后的情报市场有 6 到 12 个月。这些代币、这些模型都有市场,但现实是你不能对权重收取任何费用。您可以为计算付费。 您可以对您提供的推论收费。您可以收取本质上的咨询服务费用,以帮助将整个事情整合在一起。但如果您不在前沿,则无法对模型层本身收费。如果你处于前沿,你可以收取溢价,这就是 Anthropic 和 OpenAI 所在的位置。我认为只要看看这些公司的增长率就可以证明这一点。 我们最新获悉,Anthropic 现在的 ARR 已超过 800 亿。年初 10 点。它曾预测今年的退出 ARR 为 1000 亿。大多数人表示这是不可能实现的。现在看来他们将在几个月的时间内完成这项工作。所以他们的估计正在上升。我的意思是,年终 ARR 为 110、120 或更高。开放式人工智能正在加速发展。 所以我认为你现在看到的是市场非常明显的分歧。你已经拥有了可以收取溢价的前沿模型双头垄断。我认为它就像苹果一样。苹果正在与安卓竞争。它是开源的。 Android 实际上在全球拥有更多用户,但所有盈利都流向了 Apple,因为人们愿意为优质体验付费。 我认为以类似的方式,人们愿意为真正的前沿情报支付溢价。如果它确实处于领先地位。但如果你不是领先者,那也有一个巨大的市场,但它已经高度商品化了。人们只是愿意为计算付费。所以,我的意思是,这就是我现在看到的情况。是的。杰森,你觉得怎么样? [00:09:55]
Jason Calacanis:杰森,你觉得怎么样?好吧,如果你看看 Google Cloud,他们的收入同比增长了 82%,这是我们在这些云提供商的历史上从未见过的。埃隆·马斯克 (Elon Musk) 和 XAI 刚刚公布了 SpaceX 的财报。我们将讨论这个问题。但他们的 Elon 网络服务也大幅增长,正如我所说的那样。 如果你看看谷歌,我仍然认为谷歌将是第一大人工智能公司,因为他们已经有很多人在他们的产品中使用人工智能。他们现在有五种产品,每种产品的月用户量都超过 30 亿。 Android搜索、Gmail、Chrome、YouTube,都超过30亿。如果您最近使用过这些产品, 它们正在成为人工智能优先的产品,尤其是 YouTube,但显然 Chrome 和 Gmail,你会看到人工智能工具的出现。然后,Freeberg,你提到了这一点,他们有 13 个产品,总金额超过 10 亿,现在包括 Gemini。第二季度,Gemini 的月活跃用户超过 950 人,同比增长两倍,他们将成为全球第一大人工智能公司 就消费者使用而言,到目前为止,我认为今年,这并不意味着前沿模型不是伟大的企业,它们显然是。但我一直只使用非前沿模型。对于我正在做的 95% 的工作来说,麻袋,这已经足够好了。我刚刚发布了有关此问题的文章,你知道,埃隆和我在这里对此进行了一些讨论。我想你在我们小组中提到过这个 聊天。前几天我发推文说,我在前沿使用的开源模型之间的差异已经可以忽略不计了。我相信这是对我正在做的工作的真实陈述。他说,埃隆回复我,这实际上是一个世界的不同。你知道,如果你除了制作电子游戏的副本之外还做其他事情, 或者您有令人难以置信的速度需求,前沿模型不再是必要的。它们只是没有必要。使用前沿模型的人正在这样做,因为他们的公司设置了它。现在实施开源太难了,但实施它会变得越来越容易。所以我仍然支持开源,并且 Gemini 是这个领域的领导者。 [00:12:33]
David Friedberg:是的,看,我认为对于你的用例来说这是正确的,比如说更便宜的商品智能,市场的中间部分就足够好了。听着,一部 Android 手机对我来说就足够了。我可以用便宜的安卓手机过日子。你知道吗?我仍然为此支付额外费用,因为我经常使用它。 因此,如果您是一家企业——假设您是一家对冲基金,并且您处于一个竞争激烈的行业,那么您不想冒没有获得最佳情报来支持您的模型的风险。在很多类似的行业中,竞争动态会促使您为最好的情报付费。 还有一些情况——这可以追溯到 Decagon 发布的博客文章,如果你正在寻找用例,你也想使用真正的前沿。因为,同样,当你处理不成熟的用例时,你不知道价值在哪里,并且你正在寻找使用人工智能的机会。你只想使用最好的,因为, 同样,找到这些用例的回报将远远大于您在代币级别支付的小额溢价。所以我认为有很多这样的例子,当用例不成熟时,当你处于一个竞争激烈的行业时,当你刚刚部署人工智能时,你想要全栈的便利。那么为什么不选择前沿模型呢? 是的,再看一遍,你知道,除非你的员工做了一些愚蠢的事情,比如你创建了一个排行榜,然后他们进行了代币最大化,否则我认为成本不会那么高。再说一遍,您获得的好处是巨大的。所以很多人都会说,给我最好的。我愿意为最好的东西支付溢价。 [00:14:45]
Jason Calacanis:我会采取稍微不同的看法。我觉得也不一定,你是采取最好的模型还是开源的模型?我认为正在发生一种混合。至少我是这么认为的。例如,我们将为绝大多数简单的工作流程应用程序使用开源、开放权重。但当涉及到我们真正需要具备高质量模型能力的专业应用程序时, 例如,在生命科学和基因组学建模中,我将选择高级模型。如果我在一家媒体公司工作并且我正在尝试进行视频的 AI 渲染,我将使用处理视频的 Gemini 模型。它是最好的模型或 Sora 或任何适合该特定应用的最佳模型。因此,我认为存在一种可以为所有事物选择的模型的想法是错误的假设。 在消费者方面,消费者很可能不会使用某种开放重量模型,因为他们可以每月支付 20、40 美元并获得 ChatGPT 或 Gemini 或 Claude,并且很高兴每月支付 40 美元。他们基本上能够最大限度地降低为消费者运营的成本。对于企业来说,我认为企业会非常积极地选择混合 最有意义的模型。非常便宜的开放权重模型,适用于简单的工作流应用程序、单个员工启动应用程序等,然后是针对那些真正关键的工作流任务的更复杂的模型,然后是专门的模型。我要说的是,现在就指望双子座打造令人难以置信的产品还为时过早 专门模型。他们拥有最好的视频数据,他们拥有最好的生命科学数据,他们在这方面的研究时间远远长于生命科学方面的人类或开放人工智能,他们在这方面遥遥领先。我的意思是,戴米斯仍然会运行同构实验室。 因此,当谈到这些专门模型时,垂直化的专门模型,如视频、生命科学、蛋白质折叠,我认为这些才是你真正会看到双子座闪耀的东西。然后每个企业都会有一个混合物。但是,嘿,如果您可以成为具有这种混合模型的云服务提供商(这就是 Google GCP 现在可以做到的),那么我将签约与 GCP 合作,而不是仅与 Anthropic 合作。 这造成的事情之一是定价的下行压力。我们看到 OpenAI 和 Claude 对代币进行了大幅降价。所以他们正在做出反应。他们不会坐下来接受它。这些模型之间的编排正在被构建到企业内部的许多工具中。那么您对代币定价的下行压力有何看法?或者这只是对消费者和企业有利?因为我们面临着激烈的竞争。 就是这样。美国正在获胜。这正是您想要的。我们拥有一个竞争激烈的市场。我们有中国开源、国内开源、前沿国家实验室正在做他们正在做的事情。我们面临定价下行压力。大卫提到了双头垄断。我认为,当你进入这个领域只有几年时间并且拥有亚马逊、微软和谷歌等巨头时,很难将其称为双头垄断。 我确实认为他是对的。我确实认为它们已经成为纯粹的游戏。他们的收入表明他们正在获得钱包份额。但我想在这里提出两点,因为我认为这是本周发表的非共识观点。其中之一是埃隆对你的回应,杰森,对吗?过去两周,每个人都在说中国人已经迎头赶上, 开源代币已经赶上了智能,它们便宜得多,等等。埃隆出来说,没那么快。我们正在进入奇点,前沿模型比人们想象的要走得更远。我相信这是真的。我认为对于您的用例,它们非常相似,但我不认为这是人们试图训练和尝试体验的最复杂的用例。 然后詹森本周出来说,封闭模型实际上更便宜。你知道,如果你不需要自己建造它,如果你不需要,你知道,培训成本和大量的专业知识来微调、维护、护栏和保证它的安全。所以他基本上 以及大量的专业知识来微调和维护护栏并确保其安全。因此,他基本上提出的论点是,不仅前沿模型更加领先,而且两者之间的成本差异并不是每个人都认为的那样,我认为这解释了为什么他们继续在等式的收入方面逃避它。但我认为我们有良性竞争。 你是对的,J. Cal,你知道,对于绝大多数用例,我认为开源人员的代币消费正在上升,而前沿实验室的经济份额正在上升。我想这就是我们希望看到的。是的,这只是 Android 与 iPhone 的再次较量。一个平台赚取利润,一个平台获得大多数用户,至少在全球范围内获得使用。 好吧,我们在这里谈谈 SpaceX。他们发布了作为上市公司的第一份收益报告,股价下跌了 13%。我认为,由于人们对不断飙升的 AI 资本支出有点担心,自 6 月份上市以来,它已经下降了 30%,但现在的交易价格似乎已经稳定在 1.4 万亿美元的估值,上市后,显然高于 2 万亿美元。第二季度的业绩非常出色, 是唯一的表达方式。 78 亿美元的收入,同比增长 92%,让这一点得到了体现,AI 收入环比增长 67%,Elon Web Services 环比增长了两倍多,达到 26 亿美元。这不是 Cursor,它还没有关闭,但这将成为历史上最伟大的收购之一。这是来自 Elon Web Services,专门出租计算 从 Colossus 服务器集合到 Anthropic 和 Google。但本季度资本支出增加了 184 亿美元。这是去年同期的 6 倍。显然,你可以在那里算一下运行费用约为 750 亿美元。 Brad,我就讲到这里,听听你对 SpaceX IPO 的反应。我知道您一直在关注此事并发表评论。我的意思是,听着,我认为首先要,让我们 开始吧。这家公司创造的 1.4 万亿美元价值非同寻常。事实上,从高峰到低谷,它比 IPO 下降了 40% 或 50%。我们几周前就制定了该图表。请记住,在 IPO 后的六个月内,几乎所有这些科技股都从高峰到低谷下跌了 50%。我们在 SpaceX 身上再次看到了这一点。我认为这是一个非常稳定的季度。我以为他的向导 非常非凡。到年底,ARR 达到 1000 亿美元。他将 1 万亿美元的 ARR 目标从 2031 年提前一年到 2030 年。现在,从长远来看,摩根士丹利 2030 年的收入预计为 3250 亿美元,这也是非同寻常的。请记住,该公司去年的收入为 180 亿美元。所以无论你是否服用 摩根士丹利或埃隆的数据显然没有反映市场的定价。以 2 万亿美元计算,我们的定价提前了几年。我认为现在的价值反映了我们所处的位置。市场对一些事情存在疑问。这就是它们。第一,关于租赁业务,计算业务的租赁,他出租了一个巨大的街区 计算到人类。这是我们一直在这里讨论的问题。您打算使用计算来构建自己的前沿模型还是将其出租?如果你出租它,你能找到那些有资本来承担计算的人吗?他说的是巨大的数字,10到20场演出,人们想知道他们进展如何 能够为此提供资金。请记住,这些业务,即 GPU 租赁业务,往往以非常低的市盈率进行交易。看看CoreWeave等。在前沿模型业务上,我认为这是卧铺。我想他在电话会议上说过,Grok 在 7 月份的代币数量增加了两倍。这不包括光标。 Cursor 的市值已从 30 亿美元增至 10 美元 年底达亿元。到今年年底,Cursor 加上 Grok 的价值可能会达到 10 至 200 亿美元,这将是一项非常有价值的资产,其交易价格将远高于数据中心业务。然后,当然,我们甚至还没有讨论过星链以及他要做什么。我想在移动设备上运行该表。所以这是正常的 巩固。我们在硅谷各地都有基金正在分配他们的股票。该股股价略有下跌。这里没有什么让我感到惊讶的。现在一切都与执行有关。我认为最值得关注的事情,最重要的两个值得关注的事情是第一,grok和cursor今年的收入如何?第二,你知道, 他们所获得的吸引力,你知道,继续用星链取代传统的移动运营商。分配开始了,我想今天或昨天,我从我所参与的基金中获得了第一次分配。我参与了 SpaceX 的几个基金,似乎每个人都参与其中。如果你是那些想要兑现的人之一,这显然会造成下行压力 聊天。我已经从事这个行业很长时间了,但我为我的孙子们保留着这些。 Sax,你对这些壮观的事物的看法,我想这是描述它们的唯一方式,结果来自不属于 SpaceX 业务的垂直领域,而是九个月前的事。 [00:16:11]
David Friedberg:是的,看,我认为这是一次非常乐观的财报电话会议。我对财报电话会议后股价下跌感到有点惊讶,因为这不仅是一次失败的加薪,而且我认为埃隆谈到了他们的很多计划。我唯一想补充布拉德所说的是关于星际飞船的内容。埃隆基本上是说,我们都看到了,对吧?星舰试飞成功。星舰漂浮在大海上。 隔热罩起作用了。这将使星舰现在能够以更快的速度进行更多飞行。这为 V3 卫星铺平了道路,该卫星为 Starlink 网络提供了更多带宽,从而为整个直接到蜂窝游戏提供动力。 所以你有那部分。我的意思是,整个电信方面似乎都步入正轨,他们对此非常乐观。然后你就可以发挥整个人工智能数据中心的作用了。现在,在数据中心,我认为他们所说的是,他们预计到年底计算能力将从 1.4 吉瓦增加到大约 2 吉瓦。 Elon 表示,计算设备的现货价格在每瓦 30 至 50 美元范围内。 所以你算一下,千兆瓦就是十亿瓦。因此,每瓦 30 至 50 美元意味着每吉瓦 30 至 500 亿美元。我认为他们现在处于该范围的高端。因此,当 Elon 说,看,我们将在今年年底实现 1000 亿美元的 ARR 时,您只需相信他们以每瓦 50 美元的价格运行 2 吉瓦的计算量即可实现这一目标。 这不包括 Starlink 或发射业务或 Grok 光标片段或任何这些东西。所以我认为这就是他们如此乐观的原因。你所说的获胜方式有多种,萨克斯。有多种方法可以利用股票获胜。我认为星链只是一个 [00:24:57]
Jason Calacanis:令人难以置信的巨型提款机。如果你看一下财务数据,就会发现他们的部门报告了空间、连接性和人工智能。在连接方面,即星链方面,他们产生了 26 亿美元的调整后 EBITDA。您可以将其近似为经营现金流。太空领域的收入为负 2 亿,可以称之为盈亏平衡,而人工智能则为正 11 亿。 但就布拉德的观点而言,人工智能目前尚不清楚他们今天获得的计算租赁定价是否是暂时的且溢价,因为当今市场上缺乏可用的计算,而需要计算的人正在为该计算支付溢价。所以我认为这是一个问号。但星链上的连接部分,本季度销售额为 43 亿美元, 调整后 EBITDA 为 26 亿美元。他拥有 1200 万订户,同比增长了一倍,每月 ARPU 为 66 美元,这是人们每月支付的费用。他的季度环比增长了 20%。因此,如果你推断出这一点,他的订户运行率非常接近 2400 万。根据这个倍数并假设企业业务,就像航空公司和其他业务一样 他们似乎正在随着消费者业务的扩大而扩大规模。仅 Starlink 一项就可以产生约 400 亿美元的收入,其中很大一部分流向自由现金。年内自由现金流可能达到 300 亿美元。仅此一项就提供了现金流来资助埃隆所做的大部分工作。如果你只是将其放大 30 倍, 我认为可以,因为这些订阅业务的续订率非常高,CAC 非常低。我认为仅靠星链业务就可能获得 30 倍的收益。仅星链业务一项就可能在两年内(比方说,18 个月内)达到万亿美元的市值。我认为将所有其余的项目作为科学项目提供资金 好的方面。所以我有点在做一个牛市的例子。星链业务的表现让我感到疯狂。您可以在 AT&T 和 Verizon、HughesNet、Viasat 中看到它。我的意思是,这些公司已经被摧毁了。我的索诺玛县牧场曾经有一个 HughesNet 卫星天线。为了获得互联网,这就是我们必须使用的。就像,你知道,每月 200 美元,或者 某事。糟糕的。因为它们都在轨道上,对吗?他们花了很长时间才...服务很糟糕。这个市场被星链摧毁了。如果他推出手机产品,订户数量将会继续增长……目前,他每季度在消费者方面增加 200 万订户。你可以看到每个季度会达到四到五百万。你实际上可以看到加速 在消费者订阅中。仅在美国就有 4 亿移动用户。就在美国。仅靠星链就可以证明这一点。然后剩下的事情就像,嘿,埃隆会很好地投资从星链中吐出的多余资本吗?埃隆打算如何处理这笔钱?好吧,我不知道我还能把它交给谁来完成他在 Starship 上所做的事情 以及 AI 计算和 TerraFab。天啊,这简直就是科幻小说啊。我的意思是,如果你想谈论美国如何摆脱对台湾和中国大陆的半导体依赖,如果埃隆承担起这个责任并实现他今天在这里展示的愿景,这将成为地球上最大的半导体制造基地。 好吧,你知道,我会说一些话,你知道,大卫,就你的观点而言,你知道,有多少首席执行官或 好吧,你知道,我会说一些话,大卫,就你的观点而言,有多少首席执行官或创始人会选择星链业务,这是一项非常特殊的业务,价值数万亿美元的业务将达到 2 万亿美元,而他们不会承担任何其他风险。他们不会做 TerraFab。他们不会尝试建造数据中心。他们不会尝试 建立自己的模型。这是高风险但非常重要的投资。我认为,我们对埃隆所做的前沿创新具有如此程度的无限热情,这是英勇且重要的。我希望我们看到更多的首席执行官、更多的上市公司愿意承担这种程度的风险。我们刚刚聊完 一些首席执行官可能会承担较小的风险,因为安全的赌注更容易做出。埃隆拒绝只做安全的赌注。他把所有的钱都从他拥有非凡生意的事情上拿回来,投入到对美国至关重要的事情上。 顺便说一句,布拉德,这是一个很好的观点,因为如果你看看其他首席执行官和其他管理团队,他们就会参与进来,他们开始意识到回购股票、发放股息并不像押注未来那么重要。 DoorDash 被带进了木棚,因为他们在资本支出上投资太多。显然,谷歌的资本支出受到了打击。所以这样的事一而再、再而三地发生。就在 SpaceX 将面临的逆风中,我认为这些论点最终会被证明是错误的,但它们是值得讨论的。 嘿,对代币和计算的需求会跟上吗?或者本地、桌面和开源模型是否变得更小、更好?这实际上会在某些时候抑制需求吗?我认为不会。不知道还有上层我不知道按需情报是否有上限。第二个显然是 Starlink 适合那些处于 一个乡村社区。如果您的建筑物或频谱上有 Verizon 光纤,则您不会也不可能在您的建筑物上放置 Starlink。因此,可能会在未来一两年内解释的是,当特斯拉完成合并时,每售出的一辆特斯拉都将包含 Starlink。这意味着您将拥有 Wi-Fi 网络 将任何手机连接到任何特斯拉,比如说所有那些机器人出租车,您还可以直接与下一代星链连接。因此,如果你的手机有清晰的视线,它就能够定向,它将能够连接到路上的任何特斯拉,未来的所有特斯拉都会内置星链。所以这些都是非常有前途的。 最后,你知道,关于估值有很多猜测,布拉德,你提出来了。我认为当人们问你流动性时,我听到你谈论它,嘿,私营公司,风险投资,我们是一个投票机制。然后当它上市时,它就成为一种衡量机制。有时你会遇到这样的时刻,人们对这些估值感到不安。 而这种绝望的情绪在上个季度达到了顶峰。特斯拉刚推出时,市销率是 160 倍。 160次吧?你将这个 2 或 3 万亿美元的市值与一个较小的收入数字进行比较。好吧,如果你看看收入数字的增长,现在我们的市销率已降至 45 倍。所以这里正在发生某种平衡。 是的,布拉德,在这些私人和公共市场之间,以及收入的增加之间。是的,我的意思是,老实说,我认为这一切都非常健康。我认为 SpaceX 的 IPO 是非同寻常的。我认为这里的整合是完全可以预测的。现在你拥有一家价值 1.4 万亿美元的公司,我认为如果你花三到四年的时间 看来,你可以看到自己在这项业务上的资金增加了两倍,并且对摩根士丹利或埃隆数据或其他任何数据的估值非常合理。但这一直是赌注。你相信埃隆是最伟大的创新者和最伟大的资本配置者吗?但入场费很重要,对吗?当你在首次公开募股的第一天就得意忘形时, 当你购买超过 2 万亿美元的东西时,你就知道这将会发生。 IPO 当天我在 CNBC 节目中说,我想拥有这家公司,但我不确定今天是否会购买这家公司。正确的。所以,你知道,入门价格很重要。我的意思是,这只是一个基本原理,但让我给你另一个, 你知道,就像我们谈论过人类首次公开募股,或者很多人今年晚些时候谈论过它。我听到很多人说 1.5 或 2 万亿美元。大卫早些时候刚刚谈到,它的运行评级将超过千亿,也许到今年年底,这相当于收入的 10 到 15 倍。对于一家刚刚增长了 10 倍并且有传言称 第二季度实现盈利。所以我看看市场,我们在 7 月份看到了整合,你知道,我们把利奥波德底部,希望在 7 月份,你知道,很多半成品股票都下跌了。嘿,嘿,听着,这家伙做得很好。他继续说道,今年显然仍上涨了 80%,刚刚进行了另一笔大型私人投资。我认为他在建设方面做得非常好 短时间内成为一家公司。但市场确实对此感到恐慌。是的。正如他必须报道的那样,我认为所有这些都非常好。因此,当我展望今年晚些时候,在 SpaceX IPO 的支持下进行这些 IPO 时,我认为我们的状况非常好,特别是如果这些收入继续增长的话。你知道埃隆真正擅长的只是建造东西。是的。工厂。物理站点。 在这个每个人都在争夺数据中心和晶圆厂的世界里,这是一个核心优势。软件层需要物理世界中的硬件才能提供软件服务。没有人比埃隆更擅长真正做到这一点。看看世界各地的超级工厂是如何建立的。这是他的核心能力。 所以 Brad,就像当你让 Elon 与 Dario 和 Sam 甚至 Alphabet 对抗时,Alphabet 已经这样做了 27 年,我的意思是,伙计,Elon 拥有一个核心优势,这就是 [00:26:35]
David Friedberg:世界归结为。他在电话中说了类似的话,他说,看,与建造火箭的难度相比,建造数据中心根本不算什么,对吧?就像,你知道,创建数据中心并不是火箭科学。因此,他们从 SpaceX 获取了一些硬件专业知识,并将其放入数据中心。 这就是为什么他们能够比所有竞争对手更快地建立更多或更大的数据中心。有几点。清楚为什么 Starship 对 Starlink 如此重要吗? 好吧,让我快速解释一下。基本上,SpaceX 开发了一颗新的 V3 卫星,其带宽是 V2 卫星的 10 倍。目前,星链网络由 V2 卫星提供动力。他们将其部署在猎鹰 9 号火箭上,每次发射大约发射 27 颗卫星,这增加了每秒约 2.6 太比特的总网络容量。 Starship 每次发射都会部署 60 颗 V3 卫星。 每次发射将使网络总容量每秒增加 60 太比特。因此每次发射的容量增加了 20 倍以上。这就是它的力量。因此,如果他们让星际飞船工作,顺便说一句,最后一次测试,不仅证明了隔热罩工作, 我的理解是他们实际上发射了或者更确切地说他们部署了 20 颗 V3 卫星作为测试,他们能够与这些卫星建立连接并证明其有效。他们甚至还对着摄像机。我们之所以能够看到星舰,是因为他们说,YOLO,让我们在上面安装一些摄像机,高清摄像机。正确的。现在,我认为这些卫星基本上只是一次测试,然后就被烧毁了。 因此,我认为下一个重大里程碑将是他们发射带有 60 颗 V3 卫星的 Starship,将它们放入正确的轨道,与它们建立连接,增加网络带宽。这将是一个重要的里程碑。但如果你将其推导出逻辑结论,Starlink 网络的可用带宽将增加 10 倍,甚至最终增加 100 倍。 那时他们就可以做所有有趣的事情,比如直接连接到cellular.cellular。格温·肖特韦尔 (Gwynne Shotwell) 与地面站讨论了他们在那里可能做的事情,其中有一些有趣的暗示。他们可能会购买 T-Mobile 或类似的公司,扎克。所以很容易就在他们的购买范围之内。我认为埃隆提到过一些事情 星链网络最终可能会处理大约一半的互联网流量。所以我的意思是,就你的观点而言,Freeberg,这个东西可能会比 1200 万订阅者规模大得多。但是,布拉德,我实际上想谈谈数据中心。我对此确实有几个问题。所以埃隆提到,好吧,我们会 到今年年底将达到 2 吉瓦。他说明年我们将是五比十,更接近十比五。那么我们就说八个吧。好的。所以我只是编造的,但这在他们的范围内。假设这是一则 6 吉瓦的广告。所以他们从两个增加到八个。好的。对我来说,有两个问题。一是,你怎么知道现货价格会保持不变 它在哪里?它能保持在每瓦 50 美元吗?我们怎么知道?我们如何追踪它?这周围有多少风险?我在电话中感觉到埃隆认为这个数字正在上升,因为市场目前内存有限。我想他提到明年内存产量可能会增加 20%,但需求却会增加 200% 以上。所以市场是 受到当时瓶颈的限制。现在的瓶颈是内存。那么您认为现货价格将走向何方?我们怎么知道?这周围有多少风险?我想问的另一个问题是,如果从 2 吉瓦增加到 8 吉瓦,那么净电量为 6 吉瓦。我们知道,一个千兆瓦电力的数据中心需要500亿美元的资本支出。 因此,明年 6 吉瓦的计算增量将相当于 3000 亿美元的资本支出。 因此,明年 6 吉瓦的计算增量将相当于 3000 亿美元的资本支出。假设他们建造了这个,对吗?我的意思是,我确信他们对此有选择权。那么你如何融资呢?最不稀释的方法是什么?他们说他们的投资回收期是一年或更短。我确信这与现货价格有关。所以你只需要为它提供一年的资金。 问题是,您认为 NVIDIA 会给他们这笔融资吗?或者我想这将如何进行,这是我的问题。这是一个很棒的框架,大卫。首先,每吉瓦耗资 500 亿美元 [00:35:57]
Jason Calacanis:构建最小。好吧,你的资产是 3000 亿美元。因此,在我看来,为了筹集资金,你要么必须进入市场借钱,要么必须进行稀释性股权融资,而这两者他们都不想做。或者你可以让 NVIDIA 来支持它,他们已经表示他们会做更多的事情。但问题是 NVIDIA 股东不想要它们 支持无限,因为世界上的恐惧是现货价格在某个时候可能对你不利。当这种情况发生时,投资回收期就会发生变化。现在,没有人认为投资回收期将是一年,尽管现货价格表明今天就是一年,对吗?就在几年前,人们还认为几年前你会得到报酬,或者不会得到报酬, 几个月前,人们认为你会在四年内获得回报。所以你基本上花 50 美元,然后每年赚 10 到 15 美元,你在四到五年内获得回报,然后希望你能得到六年的回报,这确实会让你的回报率远高于 20%。现在,短缺非常严重。 Frontier Labs 的支付意愿是如此强烈 高,因为他们都认识到自己正处于一些重大突破的边缘,他们愿意支付三、四、五倍的市场价格来获得大规模计算。 Anthropic 与 SpaceX 的交易就是这样。我认为如果可以的话,Anthropic 今天会购买更多的产品。与开放人工智能相同。你是说他们愿意 多付高达 5 倍的费用。嗯,这就是 David 提到的每瓦 50 美元。如果他们能够获得大规模计算,从而使他们比市场上其他人具有竞争优势,他们愿意支付 30 到 50 美元。请记住,没有很多人拥有足够的承购收入来购买如此规模的计算,对吗?它 不是那些购买 SpaceX XS 计算设备或在俄亥俄州建造 10 吉瓦工厂的中国开源公司。这就是 OpenAI 和 Anthropic。因此,绝大多数承购承诺来自 Anthropic、OpenAI 和 NVIDIA。当你听说超大规模企业构建了所有这些计算时,他们构建这些计算的目的是为了将其出售给我们刚刚购买的人们。 提及。所以大卫,净,如果他明年建造 6 吉瓦,顺便说一句,可能只有埃隆,你知道,实际上可以在那个时间范围内站起来。就像 Jensen 在 Pod 上对我说的那样,就像没有人能接近。微软还差得很远。你知道,谷歌在这个时间范围内并没有能够做到这一点。我认为他将面临挑战 你知道,获得所有组件,对吧?我知道他能承受,但他能恢复记忆吗?他能拿到筹码吗?他能及时拿到陆地动力炮弹吗?我认为承销就在那里。但客观来看,今年 Anthropic 和 OpenAI 的总计算量合计约为 5 吉瓦。所以他正在谈论增量 [00:40:26]
David Friedberg:增加的数量比合并后的公司还要多。但当 Anthropic 每年增长 10 倍而 OpenAI 现在可能是 4 倍或更高时,这并没有那么大的增长?所以世界上存在需求。 [00:43:29]
Jason Calacanis:当今世界存在这种需求。我认为它将在未来 12 到 24 个月内存在于世界上。但市场上存在着担忧之墙。我们在 7 月份看到业绩下滑的原因是 Kimmy 吓坏了人们,他们会想,哦,天哪,他们会削弱 Frontier 的收入。如果他们削弱了 Frontier Labs 的收入,谁来为所有这些计算买单? 这就是为什么你会看到世界核心组织以及所有半导体股票和半导体相关人工智能股票的交易下跌 40%。在某些方面,事实上,有一个讨论称接下来的 10 吉瓦将花费 SAC 5000 亿美元,你会问这个问题,这从何而来?二次发行? NVIDIA 是否将其记录在案? 他们是否像某些人一样在账本上创建 SPV?事实上,我们正在进行这场对话,每个人都知道这一点,市场也已经接受了相关教育,这意味着我认为,如果它没有发生或如果它放慢了速度,人们将能够实时改变,我怀疑这种速度在未来两年左右的时间内无法保持这种速度。 正如我们的好朋友比尔·格利(Bill Gurley)喜欢提醒我们的那样,他说,我不敢相信我们都在大步接受这种水平的卖家融资,对吧?他会称之为循环收入,对吗?但市场已经对此感到满意。请记住,就像我们在 7 月份看到的那样,如果需求出现恐慌,整个行业的交易就会下跌。是啊,一切 你知道,会一起进行交易,因为这只是你注入系统的杠杆,你有效地支持了人们提前建立收入的能力。因此,如果你看到需求下滑,情况就会变得更加暴力。你知道,著名的遗言,在接下来的 12 到 18 个月里我今天看不到它。 但是,你知道,这些未知的、未知的时刻肯定会导致人们感到恐惧。你知道,这些交易的信用利差持续扩大。因此市场对他们存在恐惧。好吧,大家。第五届年会。如果现在是九月,你知道,就是举办 All In 峰会的时候了。第五届年会即将举行。是的,没错。 大卫·弗里伯格(David Freeberg)一直在工作,我们有一份全明星、全明星的名单加入我们。黄仁勋 (Jensen Wong),NVIDIA 创始人兼首席执行官。如果您关心人工智能的发展方向,您就不会想错过这次对话。最好的。神谕者。微软首席执行官萨蒂亚·纳德拉 (Satya Nadella) 也是 Pod 的粉丝,他将第二次登场。来自美国宇航局的贾里德·艾萨克曼(Jared Isaacman),唯一的一个。 Brad Gerstner 和 Bill Gurley(BG2)回来了。 SpaceX 是格温·肖特韦尔。我的朋友,杰克·保罗。尼克·雪莉.很多不可思议的人来了。马丁·施克莱利(Martin Shkreli)也许也会来。那会很有趣。立即前往 theallinsummit.com 进行申请。 Allin.com 或 theallinsummit.com。其中任何一个都会带你到达那里。我们将再次接管环球影城。我们将拥有自己的私人游乐场,戴夫·弗里德伯格。山顶干得很棒。赌场之夜也是如此。 我听说这将是一个盛大的赌场之夜。最大的。以及即将公布的演唱会。谁将在音乐会上表演?但这将是令人难以置信的。 所以我只想说有关峰会的一件事,我们有来自 60 多个国家的人们参加了峰会。能够见到所有这些人,企业家,投资者,以及对我们谈论的话题真正感兴趣的人,真是令人难以置信。我们尝试进行世界上最重要的对话,但这确实是令人惊叹的社区体验。这就是让人们回来的原因。 因此,我们每年都尝试并投入越来越多的资金,使其成为一种令人惊叹的体验,而不仅仅是舞台上很酷的内容,我认为这是许多其他节目真正提供的。但这就像,你如何真正来体验几天?这将会非常棒。所以我们很兴奋。我们真正关注的是这三件事。第一,你会学到一些东西,对吗? 舞台上有这些伟大的人。你将从他们身上学到一些东西。你会结识新朋友。你要联网。然后你就会有这些很棒的经历。这就是人的三足鼎立。你很兴奋吗,布拉德?你回来很兴奋吗?日期是几号?又是几号日期?看看你的日历。你在说话。 9 月 13 日至 15 日在洛杉矶。对于峰会来说,这是再好不过的日期了。我的意思是,我们将在 60 天内举行选举,即中期选举。我们将在 IPO 后 30 天内完成,你知道,可能会发生。我的意思是,就像它会被加热一样。粗俗的末日,不是麻袋的末日,我猜,这是粗俗的末日,正在蜿蜒而出,消化不良可能会消失 Air Table 刚刚以低于筹集资金的价格被收购。这是一家盈利的 SaaS 公司,一款伟大的产品,价值 4.8 亿美元,年收入 5 亿美元,每年增长 20%,如果它是一家出售了近 10 亿美元现金的上市公司,那是相当可观的。它的售价为 12.8 亿美元,约为其最高估值(2021 年为 117 亿美元)的 10%。现在,他们确实有一大笔现金。 因此,如果算上现金头寸,销售额为 22.5 亿美元。它们被一家名为 Bending Spoons 的公司收购。这是一家意大利公司,总部位于米兰。他们购买有挑战性但有趣的企业、AOL、传统企业、Evernote、Eventbrite、Vimeo、meetup.com。他们上个月刚刚上市。股票,即Bending Spoons上个月上市。股价因空中桌消息而上涨 15%。 萨克斯,当我们看到这一点时,这家公司做了很多正确的事情,他们的战争基金里有大量现金,但有传言说创始人可能有点疲惫了。也许一些高位买入的投资者已经筋疲力尽了。我们能拿走什么
David Friedberg:从这次弯曲勺子的交易中?他们现在是最后的买家吗?嗯,我认为他们正在为自己创造一项伟大的业务,因为我认为这最终会对他们来说是一项相当有利可图的收购。让我补充一点,Airtable 将其 AI 代理业务(称为 HyperAgent)分拆为一家独立的公司 在本次收购之前。所以我认为这里发生的事情是公司的创始人和人才,他们说,看,我们不想让这个基本上是私募股权游戏的遗留产品发挥作用。我稍后会解释这意味着什么。我们希望专注于人工智能公司这个新事物,这是未来创造巨大价值的地方 对于人工智能公司这个新事物来说,这就是未来创造巨大价值或潜力的地方。因此,从本质上讲,人才将专注于风险投资,然后他们将私募股权投资卖给弯曲勺子。现在,为什么我认为这对于弯曲勺子来说是一个很好的收购?我认为有一个非常有趣的数据点 我在评论中看到,只有 30% 的 Airtable 销售团队在做配额。他们的销售额达到了 30%。这告诉了我很多关于这个行业的事情,好吗?它告诉我的是,我在这里读到的字里行间,但这家公司有一个成功的 PLG 动议,换句话说,有机增长,产品主导的增长,他们每年增长约 20%。 但这对其董事会来说还不够好。要知道,这些都是投资者,其中一些人投资的峰值估值高达 110 亿美元。所以他们正在寻找风险投资型的结果。那么会发生什么呢?董事会向创始人施压,要求他们做一些坦率地说对他们来说不自然的事情,他们说,看,你应该在这里采用传统的销售主导动议,以加快增长速度。那有用吗? 不,他们可能会从中获得一点点成长,但他们只获得了30%的成就。因此,他们有成百上千的销售代表试图推动这件事,但这并没有使其增长得更快。那么现在收购方的机会是什么?弯勺可以在这里做埃隆在 Twitter 所做的事情,消除 85%、90% 的成本结构。不要做这种以销售为主导的动作。 只需回到以产品为主导的增长根源即可。你可能会保留这 20% 的增长,这将是一家非常盈利的公司。您可能能够获得 80% 的利润,对吧?大概。我的意思是,人们说,几年后收购的底线将达到 4 亿美元。人们说他们只会产生 30% 的 EBITDA 利润率。我想,就像你说的,可能是80%、90%。 我认为您不需要保留大部分业务或与此业务相关的大部分成本结构。 Airtable 是一家拥有粉丝的公司。我认为他们可能会坚持下去。你会产生——我不知道。您可能每年产生 3 亿美元的 EBITDA 或 4 亿美元,同时增长 10% 到 20%。这就是弯曲勺子的游戏。 [00:49:20]
Jason Calacanis:这里的风险投资者,萨克斯,他们很高兴收回资金并继续下一步。你知道,就二十一点牌桌上而言,这对他们来说是一种推动,而不是他们必须花 10 倍才能赶上。然后他们必须再次提高 10 倍才能让他们的 LP 满意。这不会发生。 [00:52:17]
David Friedberg:我认为问题是,Bending Spoons 能否基本上接手这个不赚钱的业务,并且可能每年产生 4 亿美元的 EBITDA,并在短短三年内支付收购费用。惊人的。为什么公司不能自己做这件事呢? 我认为这就是结构性问题,我认为董事会中的风险投资人和创始人都很难转变为私募股权模式。为什么?因为他们将不得不拆除他们建造的东西,对吗?他们对团队非常忠诚。他们不想考虑我如何消除80%、90%的成本结构。这不是他们所做的。 我的意思是,创始人想要做的事情以及董事会成员想要的结果是获得风险投资支持的结果。我认为他们本可以做到这一点。他们可以做弯勺所做的事情。他们不是为此而生的,扎克。它们不是为此而生的。此外,股权结构表的结构完全错误,因为它们背后是巨大的清算优先权。 所有这些以 110 亿美元的估值进行投资并一路上涨的投资者都必须得到回报。
Jason Calacanis:布拉德,激励措施被打破了。而你,你自己在你的高度计公司,你在这个时期非常活跃。你下了很多赌注。所以我不知道 Airtable 是否是其中之一,但你在那里做了一些 SaaS 赌注。其中一些估值很高。回顾那段时光,你有何感想?您今后有什么教训吗?收入的倍数会压缩得非常快,对吧? 当公司增长超过 50% 时,它效果很好。但请记住,这只是一种启发式方法。这只是一个非常粗略的估计,几乎只在硅谷使用。所以人们说,天哪,这东西的售价是收入的两倍。但当你真正仔细观察时,它的售价可能是自由现金流的 30 倍。我认为 EBITDA 达到 4 亿美元并不容易。 我想如果是的话,董事会就会这么做。我们参与了其中一些公司。一旦他们放慢速度,公司的士气就会下降。您的客户的营业额开始激增。它开始自我发展。每天去上班真是太累了。布拉德,你需要保留什么?你需要保留什么?这非常非常棘手。 我不知道核心产品以及核心产品的营业额发生了什么,大卫。但我的预感是,随着核心产品的进步放缓,核心产品已经开始真正失败。你会看到产品方面出现了大量的流失。现在人们说,听着,今天的软件公司几乎不可能 留住任何体面的销售人员,留住任何其他体面的产品开发人员,因为他们都想从事人工智能工作。同意,但此产品不需要它们。我同意。我的意思是,市场是有效的。 [00:53:39]
David Friedberg:我的意思是,看,这就是我认为 Bending Spoons 拥有公司董事会和创始人所没有的优势的地方,即他们已经拥有基础设施,对吗?他们在 Bending Spoons 有一个核心团队,我不知道现在正在管理数十个这样的房产。这样他们就可以将其插入。 我认为人工智能在某种程度上使他们的工作变得更容易,因为在过去,你之所以无法消除所有人才、基础设施,是因为你需要机构记忆。您需要了解代码库的人。现在人工智能可以立即学习代码库。这是一个有趣的见解。借助人工智能,维护变得更加容易。 我认为人工智能的维护模式变得更加容易,因为你不再需要历史知识。人工智能可以介入并重建历史知识。如果可以的话,让我带你到这里来,自由鸟。当我们回顾高峰 ZERP 和 SaaS 的经验教训时, [00:55:16]
Jason Calacanis:然后我们看看这个时刻,这个蓬勃发展的人工智能市场,我们可能会在这里发现两者之间的相似之处或教训吗? ZERP和AI时代之间?在 ZERP SaaS 时代,我们有很多非常高的估值,很多热情,很多怀疑。我们正处于人工智能时代。我们刚刚谈到了计算价格,所有这些公司的市销率都是 100 倍。这里有什么相似之处吗? 这对你来说是一个垒球问题。不,这是一个非常不同的范例。 AI 资本支出构建和模型培训是资本主要流动的领域,与收入的高倍数无关,而收入是资本流入 SaaS 的领域。就像,你得到 20 倍的倍数,将 1 美元变成 20 美元。这太棒了。让我们整天都这样做吧。 这是一个非常不同的结构、战略和资本配置过程。所以我不认为 [00:56:08]
David Friedberg:我会将它们视为相互关联的。老实说,这是一个垒球问题。我让你把它击出公园。看,我的意思是,很明显,SaaS 公司在 Zerp 时代被高估,原因有两个。一是我们人为地压低了利率。所以我们出现了一种投机性资产超级泡沫。但另一个是人们对待这些事情就像 保证年金和实际增长年金。他们会看到,哦,120% 的净美元保留率。所以作为基本情况,这个东西只会每年增长 20%,对吗?然后他们就这样定价。但我们在人工智能中看到的显然是颠覆性的。布拉德说,你不能,我确信他们现在的客户流失率正在上升。 而且它不是年金。事情可能会改变。显然,现在这些东西的交易折扣要大得多。说了这么多,我只想说,我不认为你可以根据 Airtable 这家公司来推断整个 SaaS 领域。我认为 Airtable 有一些东西使它与 Salesforce 或 Workday 非常不同,我不知道 你知道,Airtable 一直是一个有点古怪的产品。我记得在这家公司炒作最激烈的时候,人们说,哦,这就像一个新的 Excel 或一个新的 Google Sheets。新的微软Office,是的。是的,它基本上是一个文字电子表格。这就是人们看待它的方式,这就像这种新型的文字电子表格而不是数字电子表格吗?而且它从来没有 实现了这样的承诺。它从未达到那种普遍存在的程度。人们了解如何使用电子表格。每个人都使用它们。 Airtable 从未达到这一点。大多数人仍然不知道 Airtable 是什么。它再次拥有忠实的粉丝,但它是一个很难向人们解释的产品。你什么时候使用它?它有一群狂热的追随者。 它拥有一批狂热的追随者,但它从未达到那种程度的接受度。关于为什么要使用它、用例是什么,它从来都不是不言自明的。因此,他们永远无法进行正确的营销。老实说,如果你看看克劳德 [00:57:07]
Jason Calacanis:Cowork、Perplexity Computer、智能体,这些东西现在正在做 Airtable 所做的事情。 [00:59:07]
David Friedberg:我认为,当你总是应该使用错误表时,它从未开辟出一个非常清晰的利基市场。事实上,它是这个大杂烩的一部分,你可以说,是无代码工具。这就是它被归入的类别。无代码肯定是目前 SaaS 中受影响最大、破坏最严重的领域,因为我的意思是,爪形代码真正擅长什么?我的意思是,这是终极的无代码工具。 这是无代码的、可爱的、有爪子的代码,困惑可以完成所有这些控制。是的,Airtable 或 Retool 之类的东西,确实你不需要成为一名程序员才能使用它们,但你必须学习如何使用 Airtable。你必须学习如何使用 Retool,所有这些。在某种程度上,它是这些替代编程语言,您只是不再需要学习任何这些。 我的意思是,你使用 Claude,然后你只需告诉它你想要它创建什么。 我的意思是,你使用 Claude,然后你只需告诉它你想要它创建什么。因此,如果您确实想创建某种新的仪表板,某种我不知道的东西,例如口头电子表格或其他什么,您只需告诉 Claude 您想要什么即可。你没有这个学习曲线。看,所有 SaaS 现在都受到影响,但这肯定是受影响最严重的领域。 所以我不知道你是否可以完全根据 Airtable 发生的事情来推断。我并不一定认为您想要用 vivi 编码的东西取代您的 CRM、ERP、HR 系统。您知道,对于任何涉及合规性的事情,您都需要确定性。我必须说实话。
Jason Calacanis:我的团队 Saks 制作了,我没有,您是否使用现成的投资组合 SaaS 工具来管理工艺,例如投资组合和所有内容?好吧,我们实际上编码了一些东西。是的,我们也做了同样的事情。所以我的团队刚刚构建了一些令人兴奋的东西,购买现成的软件需要花费 25 万美元的软件,大约需要 100 万美元 整合需要两到三年的时间。我们在一个月内就把它建成了。现在我们对整个投资组合、竞争对手、创始人以及正在发生的一切有了全面的了解。 [01:00:33]
David Friedberg:请记住,Leopold 被击败的原因之一,好吧,我的意思是,这是因为他押注于 SaaSpocalypse。请记住,这不仅仅是因为他超级多头,这些芯片股也出现了回调。哦,是吗?他做空SaaS?他做空了 Adobe 和其他许多 SaaS 公司。这些交易也给他带来了错误的影响。 再说一遍,我只是认为说所有 SaaS 都将在这里被抹杀的说法过于宽泛。是的。有一篇关于此的非常好的帖子。让我引用他们的话,没有人购买微软,因为微软编写了最好的代码。他们购买微软是因为微软是其他一切事物运行的轨道。 Active Directory 是您的员工身份所在的位置。 Excel 是您的棋盘数据的来源。 Teams 是合规记录对话发生的地方。 Azure 拥有 FedRAMP 高度授权和国防部影响级别五级许可,这意味着国防承包商不能随意将其换成更便宜的东西,等等。所以有很多非常好的合规理由 为什么如果您是一家大型企业,您就不会愿意花费数千万美元来淘汰每年花费您 100 万美元的东西。这根本没有道理。我注意到贝尼奥夫五分钟前刚刚发推文称 15 个内阁机构中有 15 个在 Salesforce 上运行。听着,政府不会用振动编码的人来取代 Salesforce。 所以,你看,并非所有 SaaS 在这个维度上都是平等的。我只是想要一些Figma。 [01:01:06]
Jason Calacanis:我只是认为这些 SaaS 公司中的一些拥有伟大的创始人,他们长期从事该行业,并且拥有热情的用户群,我认为他们将转向人工智能优先的产品。我会把 Figma 放进那个桶里。只是为了结束这一部分。是的,请。 IGV 在过去六个月中上涨了 20%。过去五年增长了 20%。请解释一下IGV。 那么高增长的软件股票指数,对吗? Snowflake 在过去六个月内上涨了 88%。就是这样。它是一个 IGV,也是一个 ETF。 IGV 是一家大型软件公司的 ETF,对吗?因此,按照大卫的观点,人们对软件公司感到恐慌。发生了一笔大交易。老实说,他们的表现还不错。而正如他 提到,7月份,当很多半导体AI股票下跌时,它们却上涨了。其中一些公司,Databricks、Snowflake、ClickHouse 等,表现非常出色。正如我刚才提到的,Snowflake 在过去六个月内上涨了 90%,这使其与半导体 AI 股票属于同一类别。所以就大卫的观点而言,你不能把它们全部扔进 同一个桶。但我确实认为,对于这些无代码、很多应用软件公司来说,他们正在意识到,你知道,游戏已经结束,卖掉公司,得到你能得到的,你知道,重要的是在空中桌故事中,所有后期投资者,对吧?我们在过去三轮融资中都传递了这一点,对吧?我认为我们有 20 亿, 50亿,110亿,但所有那些后期投资者,他们是最受尊敬的成长型公司,他们都拿回了钱。早期投资者最终赚得盆满钵盈。因此,如果这是一次失败,那么对于硅谷来说,这也是一次相当不错的失败。 这是当时提出的观点之一,那就是,嘿,这是一家足够强大的公司、团队和收入基础,如果我们通过选择性收回我们的钱,嘿,也许这将是一项很好的投资。 [01:02:34]
David Friedberg:对于一些人工智能赌注,你也可以说同样的话。嗯,这是清算优先权实际上很重要的情况之一。绝对地。通常情况下,这并不重要。嗯,我认为他们在这里直接得到了钱。 [01:04:19]
Jason Calacanis:我的理解是,这不像他们有 7% 的利率,也不像他们没有像参与优先权那样你可以拿回两倍的钱,然后他们就可以进行交易。有人知道吗?因为我对此进行了深入的研究。我认为扣除现金后,他们的收入可能比筹集的现金总额少一点,但似乎每个人都得到了补偿。是的。 但如果他们有,我想,我们经历过的公司必须保证 1X 的时刻,对吗?要知道,1X清算优先权是标配。
David Friedberg:这只是意味着你在其他人开始获利之前收回你的钱,这是合适的。但我认为,在高峰期间,这些交易的利率也被取消了。不,标准条款,即所谓的干净条款,只是简单的 1 倍清算优先权。优先股只会在普通股开始参与公司成功出售之前收回资金。 这很有道理,对吧?是的,但参与的首选是双底,对吗?是的。看,我们从来没有这样做过。你知道,我们相信干净的条款。没有人试图惩罚创始人。只是,股权结构表中的一些人赚钱而另一些人赔钱是没有意义的。是的。这根本没有意义,对吧?它搞砸了对齐。 嗯,这只是价值从股权结构表中的某些人向股权结构表中的其他人的转移。因此,你要做的标准事情是确保投资者得到回报,然后每个人都参与其中。好的。
Jason Calacanis:正确的。第四个故事在这里。中国正在利用美国提供商提供的美国数据进行培训。福布斯发表了一项名为“这些美国初创公司正在让中国的人工智能变得更聪明”的调查。我认为这与您在 SACS 执政初期的许多工作有关。他们声称美国数据标签初创公司正在向中国实验室出售有价值的培训数据,而这反过来又是 帮助他们赶上美国边境的人。 Surge AI 和 Mercore 两家初创公司的估值均超过 200 亿美元。他们向 OpenAI、Anthropic、联邦机构等机构出售训练数据集。根据这份报告,他们都向中国顶级人工智能公司出售相同的数据集,如腾讯、字节跳动、阿里巴巴、Moonshot 等。根据这份报告,中国排名前六的人工智能实验室 根据这份报告,我每年花费 5 亿美元购买《福布斯》所谓的秘方、博士书面内容、强化学习知识管道,所有这些很棒的东西,我投资了其中几家公司,包括微一,微一的创始人没有参与向中国销售,他做出了这个决定,性别你对此有何看法 关于这一新问题,许多模型背后的秘密武器实际上是数据。我们已经用完了网络上的开放数据。显然,我们上周谈到了这些书,你知道,将书脊取下并扫描。我的意思是,人们正在寻找数据。 Mercor、Micro One,所有这些公司都提供它。他们是否应该提供 [01:05:56]
David Friedberg:同样的数据卖给中国开源公司还是不卖?好吧,我想我们必须决定我们的目标是什么。我们是否想像一场与中国的全面经济战一样介入?我们只是想阻止我们所有的公司在那里开展业务吗?如果这是我们的目标,那么你就可以担任这个职位。 从历史上看,规则是你要小心对待具有双重用途的技术转让,对吧,它具有军事应用。我对数据的感觉是,它很大程度上是一种商品。我的意思是,数据标签当然是。如果你基本上告诉他们他们不能使用数据标签,我向你保证 中国不缺乏可以用来做数据标签的劳动力。事实上,他们可能是。我的意思是有很多方法可以获取这些数据。所以看,如果我们基本上禁止这些公司向中国出售产品,我们应该期望中国采取相应行动,禁止那里的公司向我们出售稀土,也许是稀土。这两个国家不是 彼此完全独立。顺便说一句,我希望我们尽可能独立和主权。我不想有任何依赖。没有依赖性。但此时此刻,我们仍然存在一些依赖性。所以我认为你必须问一个问题,这些数据真的是专有的吗?它有双重用途吗?有没有军队 [01:07:32]
Jason Calacanis:应用程序?是的。我不认为它有军队。这绝对不是数据标签。这就像聘请博士、聘请超级专业人士来创建独特的数据集。所以这是科学。 [01:08:54]
David Friedberg:中国也能做到。我向你保证它们是。我认为这不会给我们在人工智能竞赛中带来决定性优势。会让人烦恼的。这会造成烦恼。这会产生摩擦。你希望我们和他们的关系有多糟糕?你想冒发起另一场贸易战的风险吗?看,当我认为限制会消失时,我并不反对它们 打一拳。例如,我真的很高兴第一届特朗普政府限制向中国出口 EUV 光刻机。我想,那是 2019 年的事了。所以这是一个非常重要的决定。因此,我认为有针对性的战略控制是有意义的。我只是确保这个确实符合该标准。 [01:09:05]
Jason Calacanis:布拉德(Brad),对于这种开源追赶,数据被出售给中国和我们的对手,有什么想法吗?您是否担心这些开源模型以及我们向它们提供数据?首先,我完全同意大卫的观点,我们希望最大程度的竞争。当我们坐在这里 他们?首先,我完全同意大卫的观点,我们希望最大程度的竞争。当我们今天坐在这里时,美国正在获胜。我们一开始就讨论过这个问题。我们的前沿实验室正在获胜。我们的开源正在获胜。我们的法规相当有限,对吧?她将于九月来这里参加双边会议,与总统会面。我们正在各个领域推进关系。 所以我认为一切看起来都不错,你想继续沿着这条路走下去。话虽如此,我要告诉你,这会激怒华盛顿的人们,他们认为这与蒸馏和其他东西一起,可能是芯片的出口,所有这些在某种程度上都是有道理的,让人们怀疑我们是否让它变得太容易了 中国实验室在前沿情报竞赛中赶上美国实验室。所以杰森,我认为这种类型的故事将继续搅浑水,将继续受到监控。我认为这不会导致我们改变对中国的立场,因为我们正在获胜。但如果总统问他的顾问,你知道,六个月后的某一天, 我们战胜中国了吗?突然他得到了回应,不,我们不再赢了。他们已经追上了。他们从我们身边经过,等等。那么这些事情将会受到比今天更多的审查。我认为他们今天通过 Muster 的唯一原因是我们仍然领先。 我不得不说,在过去 60 天里使用 Kimmy 和 Quinn 以及 GLM 5.2,大人,这些东西都很好。我不认为给他们带来优势是非常爱国的行为。我不会这么做。我很高兴公司...
David Friedberg:抱歉,有什么好处?您担心的专有数据集是什么? [01:11:33]
Jason Calacanis:这些数据集都是由美国专家创建的,他们收到的查询中有错误。当你对一个技术性很强的查询表示否定时,它可能是代码,也可能是生物学和科学,这些是博士进入那里,输入最新和最好的内容,然后验证它,双重验证它。这就是为什么我们的法学硕士取得了越来越好的成绩。 所以本质上,你只是在帮助他们迎头赶上。如果我们不把它送到美国,这对美国来说可能是一个很大的优势。
David Friedberg:我认为这些模型变得更好的一个重要原因是数据被泄露给它们。但你为什么认为中国做不到呢?他们那里有大量的博士学位。他们必须雇用。不,不。 [01:12:10]
Jason Calacanis:如果他们要以这种规模开展这项工作,他们将需要聘请西方最优秀、最聪明的科学家和专家。所以基本上,西方的所有知识都被纳入其中,以便我们的法学硕士能够变得更好。他们发送相同的包裹并将其转售给中国公司,这意味着他们的追赶速度同样快。
David Friedberg:我认为这是他们迎头赶上的一个重要原因。与蒸馏一样,这实际上是一个非常相似的过程。听着,如果这里有真正专有的东西,我不希望我们将我们的秘密武器卖给中国。所以,你知道,我必须调查一下,看看这里是否有真正的秘方? 但这种想法会让中国严重处于不利地位,你知道,中国每年毕业的数学和科学毕业生比世界其他国家的总和还要多。我的意思是,他们并不缺乏聪明人。是的,我们即将毕业并将他们赶出这个国家。这是另一个问题。我们必须解决这个问题。嗯,这里有很多不同的问题。不知道你是否想混为一谈。 但他们无法重新创建这些数据集。我的意思是,看看,这里是否有真正专有的东西,是否具有双重用途,是否与军事相关,但我不知道这是什么。好吧,它们在设计上都是专有的,但我不知道双重用途,因为我这里没有数据集。
Jason Calacanis:好吧,伙计们,这是你们 All In 播客的又一精彩片段。非常感谢你,布拉德,加入我们。查马斯。祝你世界巡演顺利。希望您能好好休息一下,并祝您在本季购买白色高领毛衣时好运。到处都卖完了。所以去allin.com商店,allin.com商店。我们有 1,000 个查马斯亲笔签名。白色 毛衣来了您可以提前注册。所有收益均捐献给慈善机构。我所说的慈善机构是查马斯游艇基金。好的。大家下周见。再见。我们会让您的获胜者驰骋。雨人,大卫·萨克斯。我要全力以赴。它说,我们将其开源给粉丝,他们对此感到疯狂。爱你,韦斯特。金瓦女王。我将全力以赴。让你的胜利者驰骋吧。我要全力以赴。 闺蜜回来了。那是我的狗在你的车道上注意到了。哦,伙计。我们都应该找个房间来一场盛大的狂欢,因为它们都是无用的。就像性紧张一样,他们只需要以某种方式释放出来。把脚弄湿。把脚弄湿。我们需要获得商品。我正在全力以赴。 我正在全力以赴。 [01:13:42]
文章认为,SpaceX 到 2027 年底建成约 10GW 数据中心计算能力是现实目标,并可能在仅将新增产能的 50% 商业化的情况下,实现约 3000 亿美元年度经常性收入(ARR)。微软则最有动力成为主要承购方,因为它需要快速获得大量计算能力,以利用 OpenAI 模型、Foundry、Copilot 和其他高利润 API/应用服务。
文章预计 SpaceX 通过两条路径承担资本开支:获得 Nvidia 的供应商融资支持,以及依靠 3–5 个月交付周期对大规模计算能力收取每 MW 每年 3000–5000 万美元的高价,从而在不到一年内收回资本开支。SpaceX 可能优先采用 Nvidia,也被解释为受财务条件影响。
主要实体包括 SpaceX、Elon Musk、Microsoft、Microsoft Azure、OpenAI、Anthropic、Nvidia、xAI、AWS、Google、Grok、Cursor、Codex、DeepSeek;主要分析工具和模型包括 SemiAnalysis 的 Datacenter Model、Energy Model、Accelerator Model、Tokenomics Model、Inference Simulator 和 InferenceX,文中还讨论了 GB200、GB300、Trainium3、TPUv7、Fable 5、Opus 4.8/5 Fast 等组合。
来源:SemiAnalysis
URL: https://newsletter.semianalysis.com/p/spacex-10gw-in-2027-why-its-real
埃隆·马斯克再次震惊世界:他在 SpaceX 首次财报发布会上宣布了公司明年的吉瓦级雄心。他“保守地”预计,仅 2027 年就新增建设并交付 6–8GW,且最终数字可能远超 10GW。按每 GW 500 亿美元计算,这意味着 SpaceX 在 2027 年的资本开支将达到 3000–5000 亿美元,与我们预计 AWS 和 Google 的投入相当——对于一家盈利能力显著低于竞争对手超大规模云厂商的公司而言,这个数字令人难以置信。然而,我们认为这个数字是真实的。我们预计 SpaceX 将在 2027 年底前建成约 10GW。我们已经评估了所有适合 SpaceX 的站点,并将清单提供给 Datacenter Model 订阅者。我们的 Energy Model 订阅者还可以按季度获取可用燃气发电设备的精确清单,覆盖 30 多家涡轮机、发动机和燃料电池供应商。在市场意识到这一点之前,我们已经提供了其中大量数据。SpaceX 会开发一切能够开发的资源,并以尽可能快的速度上线。正如我们在《Meta Compute》深度分析中解释的那样,大规模且能在近期交付的计算能力极其稀缺,因此价格可获得巨额溢价——最高可达每 GW 每年 500 亿美元。不过,AI 实验室能够消化这些产能,并从中获得丰厚收益。我们的 Tokenomics Model 和 Inference Simulator 表明,在现实的性能水平下(例如每块 GPU 每秒生成的 token 数),OpenAI 和 Anthropic 在 GB300 集群上提供 API 推理服务时,都能实现每 GW 每年超过 1000 亿美元的收入。这远高于按照当前新型云厂商价格租用 GB300 集群一年的成本。对前沿模型公司而言,提供推理 token 的利润高得惊人。
来源:SemiAnalysis Tokenomics Model、SemiAnalysis Inference Simulator
我们采用每 GW 每年约 120 亿美元的成本假设,并使用每 GPU 小时 3 美元这一相对保守的租赁价格。随后,我们基于前沿级模型架构和智能体编程基准 AgentX(属于 InferenceX)进行 token 产量估算;AgentX 通过收集真实生产环境中的编程轨迹构建而成。我们按照真实工作负载中的比例,将 token 产量在输入、缓存读取、缓存写入和输出 token 成本之间进行混合,得出的最终估算值超过每 GW 每年 1000 亿美元。作为背景介绍,Inference Simulator 从底层开始构建,基于对现代 AI 加速器工作方式的基本理解。我们为前沿模型的推理过程构建 roofline(屋顶线)模型和现实性能模型,为每个操作计时,并输出真实轨迹。它端到端模拟实际工作负载在真实芯片上的执行过程。我们已经在广泛的加速器和工作负载上验证了模拟器的保真度,并持续提升其根据设计规格准确预测未来加速器性能的能力。覆盖芯片上端到端模拟工作负载执行的细粒度数据,会生成可使用 Perfetto 等标准工具分析的真实 profiler(性能分析器)轨迹。
来源:SemiAnalysis Inference Simulator
我们针对处于性能—成本帕累托前沿的常见推理工作负载和硬件平台,生成高层级预测。
来源:SemiAnalysis Inference Simulator
如需了解我们如何将 Inference Simulator 应用于定制研究和分析,请联系 sales@semianalysis.com。
除了 OpenAI 和 Anthropic,世界上实际上还有第三家公司能够在每 GW 规模上实现同样惊人的经济效益:微软。由于能够完整使用 OpenAI 的模型,微软可以在每 MW 上获得完全相同的收入和利润率,同时无需承担任何训练成本。Satya 与 OpenAI 的谈判非常成功:2026 年 4 月重签的协议取消了原先 20% 的收入分成。简单来说,微软有巨大的动力尽可能多、尽可能快地采购 MW。尽管微软目前的数据中心产能中有相当一部分以约每 MW 每年 1400 万美元的价格提供给 OpenAI,但它有机会改善这部分产能的组合。其潜在影响是:Microsoft Azure 的收入增速可能从约 42% 加速到明年超过 100%。这是千载难逢的机会,而 SpaceX 已经做好了充分准备来承接它。
来源:SemiAnalysis Tokenomics Model
微软以每 GW 500 亿美元的价格与 SpaceX 签署 3GW 合同,听起来很疯狂,但我们认为这很现实,原因有二:
1. 微软已经在为一次史诗级的数据中心扩张做准备。正如下面将讨论的那样,今年迄今为止微软已经签署了 10GW 的合同,总合同价值超过 3000 亿美元。我们预计还会签署更多合同。注意:这些合同对应的是 2027 年下半年和 2028 年的产能,短期内仍存在需要填补的缺口。
2. 由于合同采用类似 SpaceX 与 Anthropic、Google 所签协议的 90 天取消政策,微软不存在资产负债表风险。考虑到潜在的收入机会,这对 Amy Hood 而言非常容易批准。
对 SpaceX 来说,下一个自然问题是融资:在没有头部超大规模云厂商那样的资产负债表支持的情况下,埃隆如何承担如此庞大的资本开支?我们预计会结合以下两点:
1. 获得 Nvidia 的支持,以供应商融资的形式降低前期现金成本。这很可能就是埃隆在财报电话会上宣布 SpaceX 将独家采用 Nvidia 的原因!正如我们的 Accelerator Model 反复解释的那样,xAI/SpaceX 曾积极评估 TPU 和 AMD 等替代方案,因此财务因素很可能促使他们放弃这些选择,转而专注于 Nvidia。
2. 由最快交付周期带来的行业最高定价:SpaceX 将继续以 3–5 个月的交付周期销售大规模计算能力,这是无可匹敌的产品,并据此定价为每 MW 每年 3000–5000 万美元。这样一来,资本开支不到一年即可收回。我们在《Meta Compute》文章中对此进行了深入讨论。
这意味着 SpaceX 有望在 2027 年底实现 3000 亿美元 ARR。这个估算只假设其 2027 年新增计算能力中有 50% 实现商业化,剩余部分将供 Grok 和 Cursor 团队训练使用(未对推理收入进行建模)。
来源:SemiAnalysis Tokenomics Model
下面进入详细分析。我们先看微软:它终于以惊人的方式醒悟过来——去年暂停的扩张已经逆转,今年迄今为止已签署 10GW 的有约束力合同。我们会先简要讨论经济模型,以解释如何实现每 MW 每年 1 亿美元的推理收入;随后转向 SpaceX,分析其数据中心扩张,并评估其能否在 2027 年底前实现 10GW 以上的规模。
2024 年 12 月,我们在 Datacenter Model 中率先指出,微软的租赁活动出现了戏剧性暂停。如今,这个巨头已经醒来。我们的模型按季度跟踪租赁活动、新型云厂商签约、自建工程开工,以及大规模有约束力的 PPA 和 ESA。下面展示的是模型输出结果。微软在这些渠道上的签约总量已经超过 10GW,相当于约 3000 亿美元的新有约束力承诺。
来源:SemiAnalysis Datacenter Model
微软之所以突然醒悟,一个关键原因是它急需计算能力,以抓住每 MW 每年 1 亿美元的收入机会。微软在 2025 年 10 月与 OpenAI 签署了一份 2500 亿美元协议;根据我们的 Tokenomics Model 估算,该协议总规模约为 7GW。Tokenomics Model 是理解“美元到瓦特”换算细节的全球最佳工具。如此庞大的基础设施服务协议,使微软在其他用例上高度受限于计算能力。它一直无法充分利用自己对 OpenAI 模型的访问权限来发展 API 业务 Foundry,也无法充分支持 Copilot 等应用。然而,这些服务的利润率和每 MW 收入远高于其他业务。我们在《AI Value Capture》文章中对此进行了深入解释。
过去一个月,向前沿模型提供 API 价格的 token 服务实际上是高利润业务,已经成为专业投资者的共识。早在 1 月,我们就在 Tokenomics Model 订阅者中率先指出这一点,并解释了为什么推理毛利率高于 60%。随后在 6 月,我们又发布深度分析,展示了 Opus 4.8 的毛利率尤其高,超过 85%。此后,这一数字已经成为所有人分析 Anthropic 时默认引用的数字。
为了得出这些利润率估算,我们必须仔细综合泄露的财务数据、InferenceX 数据、对业内最新加速器开展的微基准测试、开源实验室发布的论文、博客和推文,以及更多资料。新的数据点——例如泄露的 DeepSeek 投资者电话会(据称 DeepSeek 的 GPU 回本周期为 10 个月)——表明我们的估算大致处于正确范围,但我们也必须承认,数据缺乏足够细粒度,令人非常不满意。相比一个笼统的公司级推理毛利率,真正需要了解的是整个吞吐量—延迟帕累托前沿上每一种(模型、加速器)组合的毛利率。例如,在 Trainium3 上提供 Opus 5 Fast 服务,与在 TPUv7 上提供 Fable 5 服务,各自的毛利率是多少?
我们通过 Inference Simulator 回答这个问题,该工具只向 SemiAnalysis 的咨询客户提供。我们的 AI Cloud TCO 模型已经能够回答成本端的问题,但收入端过去一直无法得知。为解决这一问题,我们编写了一个模拟框架,在虚拟硬件上模拟真实的模型执行,并以覆盖多种加速器和操作类型、经过调优的细粒度性能模型作为支撑。我们在模拟的 XPU 上运行每个模型,遍历所有可能的服务配置,同时混合真实世界和理想化的服务条件。这样,只要对模型架构作出一些有依据的假设,我们就能准确估算任意软件、硬件和工作负载组合的性能。得益于这个模拟器,我们的 Tokenomics Model 现在已经纳入了在所有相关芯片上运行旗舰 OpenAI/Anthropic 模型时的每 MW 高层级收入数据。工作负载形态显然是一个重要因素。我们模拟运行了价值超过 100 万美元的智能体轨迹,这些轨迹来自我们自己的使用情况;同时,模拟满足了从一方端点调用时观察到的真实交互性和 TTFT 水平。
作为预告,以下是我们让 Fable 5 在 GB200 与 GB300 上提供服务时的数字:
来源:SemiAnalysis Tokenomics Model
这就是微软每 MW 1 亿美元的机会。鉴于近期 Codex 需求激增以及 OpenAI ARR 加速增长,我们认为微软通过提供 OAI 模型服务,也能够以类似的速度实现计算能力商业化。要抓住这一生一次的机会,微软和各 AI 实验室需要数据中心,而且需要又快又大的数据中心。SpaceX 已经两次证明自己能够比其他公司更快地建设,但到 2026 年底,其计算能力“只有”2GW。它真的能在 2027 年仅用一年时间建成 10GW 以上吗?
在我们的《Meta Compute》文章中,我们详细解释了埃隆为何再次证明自己是商业天才。他理解 AI 实验室的利润率已经大幅提升,因此针对 GPU 集群引入了“基于价值的定价”,而不是更常见的“成本加成”定价。为了让这台机器持续运转,埃隆需要比任何人都更快地建设数据中心。我们相信他做得到。我们为何有这样的信心?
我们曾多次撰文介绍埃隆的速度:Colossus 1 用 122 天建成 300MW,Colossus 2 用 6 个月建成 200MW;为了避开审批,他还决定在边境另一侧 1 公里处建设现场发电厂,此外还有许多类似案例。此后,他又展现了更快的建设速度。Southaven 的发电厂已从 2026 年 2 月的 27 台涡轮机(约 495MW),扩张到 2026 年 7 月的 69 台涡轮机(超过 1.2GW)。此外还有“MiniHard”的出现:它在 2026 年 3 月开始垂直建设,很可能仅用约 5 个月就达到 450–500MW!
这为 SpaceX 在 2027 年建造许多类似厂房留下了充足时间。那也是他第一次真正进行绿地建设,因此下一次很可能做得更好。当然,另一个选择是改造现有设施。正如我们去年在 xAI 深度分析中解释的那样,Colossus 1 和 2 正是通过改造以惊人的速度建成的。
一年内建成 10GW 以上将是另一回事。SpaceX 需要在全国各地寻找合适的土地,同时满足审批便利、天然气接入方便等条件。不过,我们认为这样的选项绰绰有余,足以支撑一次实质性扩张。当然,这将高度依赖现场燃气发电——请参阅我们的能源深度分析,了解它的工作方式以及为何有此必要。在付费墙后,我们将讨论一些我们猜测埃隆可能会选用的站点。
这怎么可能?
阅读更多
Dwarkesh Patel 认为,真正的持续学习是人工智能胜任完整工作的必要条件:模型必须把真实工作经验积累进权重,而不能只靠会话之间传递的文字笔记。由此,人工智能安全监管、技术对齐、模型多样性、竞争格局和商业模式都将改变;模型锁定与个性化权重的推理成本也会成为企业选择的关键因素。
持续学习会模糊训练与部署的边界,推动安全评估转向定期风险检查;对齐研究还要处理持续更新、越狱和恶意数据注入。部署反馈会强化领先模型,模型积累组织上下文则会抬高切换成本。批处理可能带来推理规模经济,但高效服务个性化权重更有利于大型组织。
- 持续学习重塑安全与人工智能生态 [00:00:00 - 00:05:00]
- 模型锁定与个性化权重的规模经济 [00:05:00 - 00:08:29]
Dwarkesh Patel:我在其他地方已经解释过,为什么我认为真正的持续学习是必需的。我不认为,如果人工智能被迫只能把经验写进文件、从一个会话传递到下一个会话,它还能像人类一样胜任完整的工作。举个例子,想象一下学生是这样学习吹萨克斯管的:有一个学生从来没吹过萨克斯管,他走进音乐厅,尝试演奏。第一次尝试当然会失败,于是他写下一堆笔记,记录哪里出了问题。接着,另一个在音乐厅外等候的学生进来,读完这些笔记。这个学生同样从来没演奏过萨克斯管,所以当然也会出错,然后继续把自己的经验补充到笔记里。如此循环,无数学生在音乐厅外等着,把笔记写给下一个人。我不认为他们彼此之间可以写出某种文本,让后来的学生第一次尝试就把萨克斯管吹好。你最终必须把相关经验真正积累进自己的大脑。我认为,我们希望人工智能从其部署到的不同工作场所中积累大量技能时,也会面临同样的问题。那么,一旦真正的持续学习出现,情况会发生什么变化?第一,我认为目前许多关于监管人工智能的提议,都假设你先训练一个模型,然后再部署它。因此,只要在部署模型之前进行一系列检查,我们就能确保它不会协助网络攻击或做出其他疯狂的事情。但我不认为未来一定还能沿用这个假设。这也是我现在对仓促确立某种人工智能安全监管制度感到担忧的诸多原因之一,因为我们不知道一年之内、更不用说五年或十年之内,会面对什么样的技术。假设模型每天都根据当天完成的数百万次工作会话持续改进,那么我们可能会把一种过时、甚至适得其反的方法固定下来,用它应对人工智能带来的威胁。如果政府希望对模型提供商进行某种安全评估,我认为更合理的做法是每月或每季度进行风险检查,而不是试图找出一个“训练完成但部署尚未开始”的特殊时刻,因为未来这个时刻不会再构成一个有意义的独立类别。第二,实验室进行技术对齐的方式可能也需要彻底改变。目前,许多研究都集中在这样一个问题上:如何确保一组冻结的权重在部署期间表现良好。但据我所知,关于如何确保人工智能系统即使持续更新权重,也永远不会受到越狱攻击,或变成具有欺骗性、邪恶倾向的人格,相关研究还很少。如果人工智能还会整合不同用户之间的学习成果,我们又该如何防止用户向基础模型注入后门或某种恶意倾向?从某种意义上说,这其实就是人类对齐问题,对吧?人类会以自我导向的方式成长。如果你有孩子——我没有孩子,但我想这大概就是会发生的事情——他们会走出去,学习新东西。有时他们会变得疯狂:被疯狂的意识形态一击击中,误用药物,变得极其古怪。但你希望自己已经给了他们足够的常识和基本价值观,让他们能够以自我导向的方式成长,而不会最终形成极其怪异的信念或厌恶人类的想法。第三,人工智能思想的多样性会增加。现在,所谓“人工智能思想”,指的是同时服务数百万、数亿甚至数十亿用户的基础模型;这样的模型还不到五个,而且彼此非常相似,因为它们大致都在相同的数据上训练。如果人工智能能够从经验中学习,而这些经验不仅因人工智能公司而异,也因同一个人工智能模型的不同实例而异,那么最终我们会看到这个世界出现大量多样性。我认为,这总体上会是一个好的结果。未来值得担心的一件事,是出现一个相当无聊的、单一的人工智能实体。一个拥有持续学习的世界,应该会比我们现在看到的不同模型发生“模式坍缩”的世界更有趣。第四,当部署成为训练的一部分时,在人工智能竞赛中领先所带来的回报会加速增长。因为如果你拥有最好的模型,并且有更多人用你的人工智能完成更复杂、更有用的工作,他们就会给你大量能够跨越会话窗口整合进去的反馈,于是你的模型会变得更加智能。第五,如果模型主要从部署中学习,实验室就会承受很大压力,必须更早部署最聪明的模型。据报道,Anthropic 从二月份起就在内部使用 Mythos,但直到六月份才把这个模型发布给公众。在真正持续学习的制度下,这种做法根本不可能实现。你不能让内部部署和外部部署之间相隔四个月,同时还保持竞争力,因为竞争对手只要在发布日期发布一个更差的模型,就会凭借真实世界的经验让模型变得更聪明。第六,持续学习将为领先的人工智能实验室创造一种它们目前缺乏的清晰商业模式。很多人一直在问,人工智能实验室究竟要如何赚钱?我自己也问过这个问题。我邀请 Dario 上播客时,也向他提出过这个问题。他把这件事类比为云服务提供商,并指出:云服务提供商提供的服务彼此并没有太大差异,但它们仍然能够获得很高的利润率。 [00:04:52]
Dwarkesh Patel:他把这件事类比为云服务提供商,并指出:云服务提供商提供的服务彼此并没有太大差异,但它们仍然能够获得很高的利润率。看看 Amazon 或 Google 的季度财报,你就会注意到这一点:它们的经营状况很好。但云服务利润率如此之高的原因在于,从一个云服务商切换到另一个云服务商,既耗时又昂贵。目前,没有什么能阻止我用 Codex 创建一个软件代码仓库,再用 Cursor 继续开发,最后用 Claude Code 收尾。但一旦真正的持续学习出现,并且你使用的模型在与你互动的过程中不断变好,切换成本就会非常高。如果你想更换正在使用的人工智能,基本上就等于解雇一个已经积累了数月组织上下文的员工,再换成一个非常新、非常没有经验、必须从头培训的新实习生。你一旦形成这种锁定,模型提供商就可以要求相当可观的利润率。抱歉,我不确定“新”是不是恰当的强调,不过我确实是个新实习生。第七。当然,企业会意识到这种动态,也会设法避免这种锁定。但如果摆在它们面前的选择是:要么被锁定在某个模型提供商那里,要么失去一项极其有价值的功能——让模型随着每次会话为自己不断改进——那该怎么办?如果真实使用最终成为模型改进的主要方式,人工智能实验室可能会补贴那些允许模型在其会话上训练的用户和企业。新用户获得的编程产品优惠中已经出现了类似做法,这与 Google 免费提供搜索服务的原因非常相似。反过来,实验室也可能表示,任何拒绝允许它们在会话上训练的企业,都无法使用最好的模型。通过 Keras 和 Styx,实验室可以做很多事情,促使用户允许人工智能从经验中学习。当然,我略过了一个事实:更新单个用户的一组权重,与把这些不同的权重分支全部拉回主模型,是两回事。后者在技术上可能更具挑战性,但随着时间推移,这个问题也会得到解决。第八,人工智能训练已经存在显著的规模经济。你可以让更多用户分摊所有这些昂贵的训练成本,实验室收入增长速度远超算力支出的事实,就体现了这一点。但持续学习还可能为终端用户带来推理方面的规模经济,具体来说就是批处理。你可能看过我与 Reiner Pope 对谈的那期节目,我们在那里详细讨论过这个问题。但如果每家公司的指令都要求进行完整的权重更新,而不是停留在低秩适配器上,那么批处理就有巨大的优势。粗略估算表明,对于 DeepSeek V3 这样的稀疏模型,最优推理批大小是同时生成超过 2,400 个并发序列。如果不这样做,你的算力就没有得到充分利用。如果你想了解其中的原因,我再次强烈推荐那期关于推理经济学的 Reiner 节目。不过,重点是:只有当数千个序列同时针对同一组权重进行解码时,这组权重才能得到高效服务。拥有大量员工和代理、同时处理许多不同类型任务的大公司,可以非常高效地服务自己的权重分支。而一个批大小只有 1 的个人用户,在算力利用效率上可能会差两个数量级以上。因此,服务个性化权重的经济性会明显偏向大型组织。当然,等到持续学习真正实现时,届时还会有更多变化。最重要的变化可能恰恰是那些最难提前预测的变化。但上面这些判断,即使现在看来也已经相当清晰。这是我发布在个人网站上的一篇博客的旁白版本。欢迎去 dwarkesh.com 看看。否则,我们下期播客再见。 [00:08:08]