2026-09-08 15:58 · 来自 X
A
希望欧洲也能很快实现。
Scoppr 和 Nook 抄袭了 Mole。研究人员发现,这两者都与能够窃取密码和个人数据的恶意软件有关。请勿下载或运行它们。
两者都与我无关。Mole 唯一的官方网站是 https://mole.fit。请从那里下载。
找 Plasma 团队确认了一下:
1. 白金卡送单人无限次 PP(在闲鱼搜了一下,大约 890 元/年)
2. 而且是 PP 兑换码,可以自用,也可以送人。
卷起来了啊,这是头一次,U 卡送真金白银的商旅权益。
我记得以前有个币圈项目方到处说自己是黑卡、是 VIP,但整张卡的权益还不如快捷酒店门口的纸卡片(名字真的忘了)。
邀请码 FAFAFA,下载链接 https://s.taresky.me/plasma
白金卡包含贵宾休息室权益。
享受 Priority Pass 在 1,900 多个机场贵宾休息室和旅行体验中的无限次使用权。
开放的软件能帮助 AI 更快发展。
在 #AdvancingAI 活动上,@OpenAI 计算战略与 GPT-Infra 副总裁 Sachin Katti(@sk7037)分享了他的团队如何在 AMD Helios 机架上运行 GPT 级工作负载,并利用 AI 加速软件和模型的落地适配,而这一切都由开放的 AMD 软件生态系统提供支持。
#模型时代# 微博网友也太爱学习了吧
前一阵子参加了微博的#微博VibeLab#活动。看收官微博,官方统计说累计有300+开发者入驻、参赛作品2500+。由于我也贡献了1/2500分之一个产品,所以谈谈自己的感受。
先从GPT-6发布之后的两条微博说起。
第一条:跑了五个小时的Gpt-6了,我宣布AI算力紧缺会继续,token总需求马上会再上一个数量级。
第二条:正在测试GPT-6,这玩意完全不能用传统提示词,甚至(单纯)Skill的方式来测试,而是要让它完成一个真正的工程看结果。
第一条流量很快超过了10万。当时写的比较简短,现在分别解释一下,因为正好和后边讲的有关。
1、Token总需求马上会再上一个数量级
由于文字工作者的习惯,我非常不太习惯把话说的太满,但是这次GPT-6给我的感觉,确实震撼,基本可以类比于GPT-3.5和Claude-3.5 Sonnet。
GPT-3.5证明了AI可以通过图灵测试(像人类一样说话);Claude 3.5 Sonnet证明了AI可以比人类更擅长写代码;GPT-6则证明了AI可以比人类更擅长用计算机。
举一个例子。
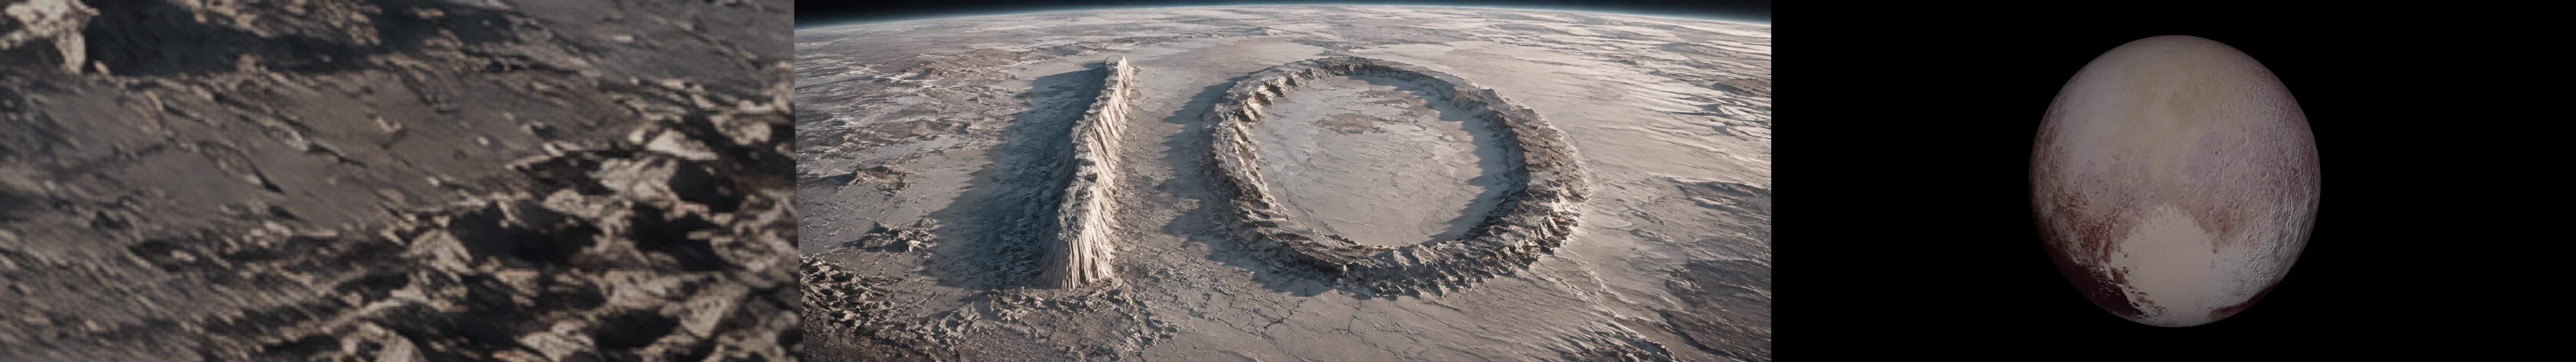
周六,我们就要开PEC2026大会,会上需要一个开场10秒倒计时视频。用了大概5个小时(后续又有一些修改),还搓出来了。印象中,这是我第一次在电脑上装一个软件(Blender),用它做了一个东西,在我完全自己动手,也不知道这东西怎么用的情况下。
那为什么说Token总需求会上一个台阶?因为我一天用掉了两张重置卡!这种情况以前从没出现。
2、测试模型能力,benchmark已经失效,要直接看Demo和产品
早年间,我也发了不少LLmarena之类的排行榜,这在GPT-4o时代是有用的,现在可以说完全失效。
比如我现在在写作中,最常用的模型还是Opus-4.6,这个模型在各种榜单上连影子都看不见。
同样,要测试Fable-5.1,GPT-6,也包括国内的K3等大尺寸模型,你也不能靠拿它写东西,而是要实际做一个产品。(反之,端侧模型,依然适合做评测评估)…
因为有用数值评测它的功夫,实际上的真实作品都做出来了。
3、正因为模型越来越强大,评估越来越难,评估成本越来越高。所以回到#微博VibeLab#微博VibeLab这个正题,我其实已经习惯了把自己的各种产品,放到微博上,接受大家的检阅。以及在微博上,看大家的AI作品来学习。
我自己的作品来说。作为播客狂热爱好者,每个月听的播客数量可能已经是天然数字,然而也根本听不完。所以我做了一个Skill,可以将数十个小时的播客/ 讲座速记,转写为电子书,目前已有《FDE:从入门到精通》、《AI经济学通识读本》等多本上线Github,Stars也算过百了吧。
在微博发这些AI相关作品,有两个好处:
第一,这是一个AI技术交流平台,大家可以交流其中的心得体会,微博的AI博主都是很卷的。胡说八道,也是要被喷的。这次VibeLab比赛就看到不少精彩作品,像世界第一裹凉皮的作品,以刘慈欣的短篇小说《诗云》为灵感,把中国三千年的诗歌,做成了一片可以漫游的三维宇宙,非常有创意。
第二,这又是一个内容学习平台,我写的这几本电子书。动辄上百页,说实话,如果不是终身学习者,是必然没有兴趣看和看完的。但是这几本在微博的流量都非常好。
《FDE入门到精通:八堂课学会将AI送进客户现场》
http://t.cn/AX0RbyFQ
《从零构建语言模型》
http://t.cn/AX0RbyFH
还有陶哲轩谈数学六大范式的一条微博,居然进了热搜,超过700人转发,大家也太爱学习了吧。
最后,以上内容是完全手搓的。有时候,我们这一代人可能是幸运的。因为在LLM出现之前,已经掌握了手写内容的能力,所以可能知道自己写的东西,原生是什么口味(好坏另说)。反之,如果一开始写东西,就开始使用AI,就会很难知道吧,已经是天然混血了。
最最后,敲字真累。
📡 我们在卫星连接方面的新合作今天正式启航。
立刻就见成效。
未来几天,格陵兰岛北部的互联网接入将得到大幅改善。
到 10 月,格陵兰岛东部的偏远社区也将拥有更好、更快的互联网!
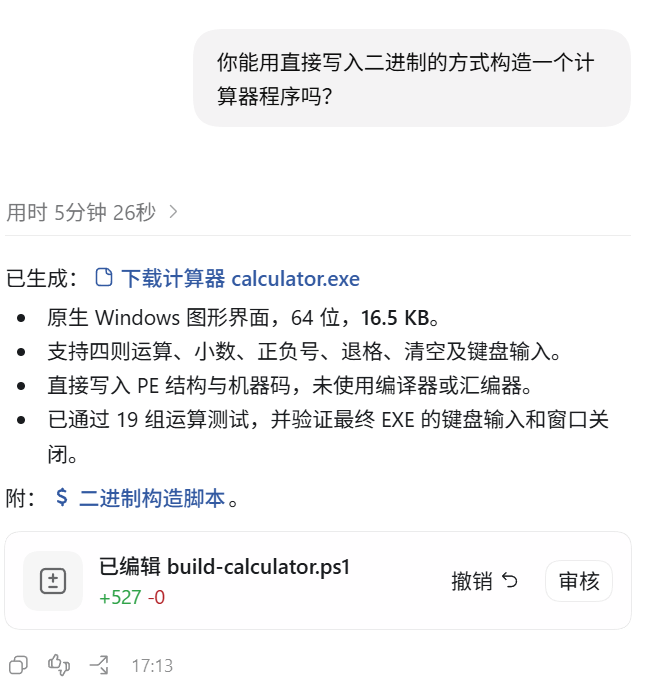
刚才用 GPT-6 Astra做了个实验。先让它生成 MessageBox弹框程序,成功了。再让他生成列举系统进程的程序,又成功了。然后我让怹生成通过发送消息实现输入文字的程序,也成功了。最后我让祂生成一个计算器,居然也成功了。
我的人类朋友们,AI已经可以不依赖编译器直接输出二进制可执行文件了。
🚨🚨警报:在 InferenceX 的同等条件对比中,TPUv7 Ironwood 在新的 TorchTPU 外部推理栈上的每美元性能比 Blackwell Ultra 高出 50%!
TorchTPU 为 TPU 带来了原生 PyTorch;再加上 Google 开源了大量 Pallas 推理内核,Google 已经为 TPU 快速实现外部化奠定了坚实基础。SemiAnalysis 坚信,TPU 外部化正朝着正确方向发展,并在全速推进。
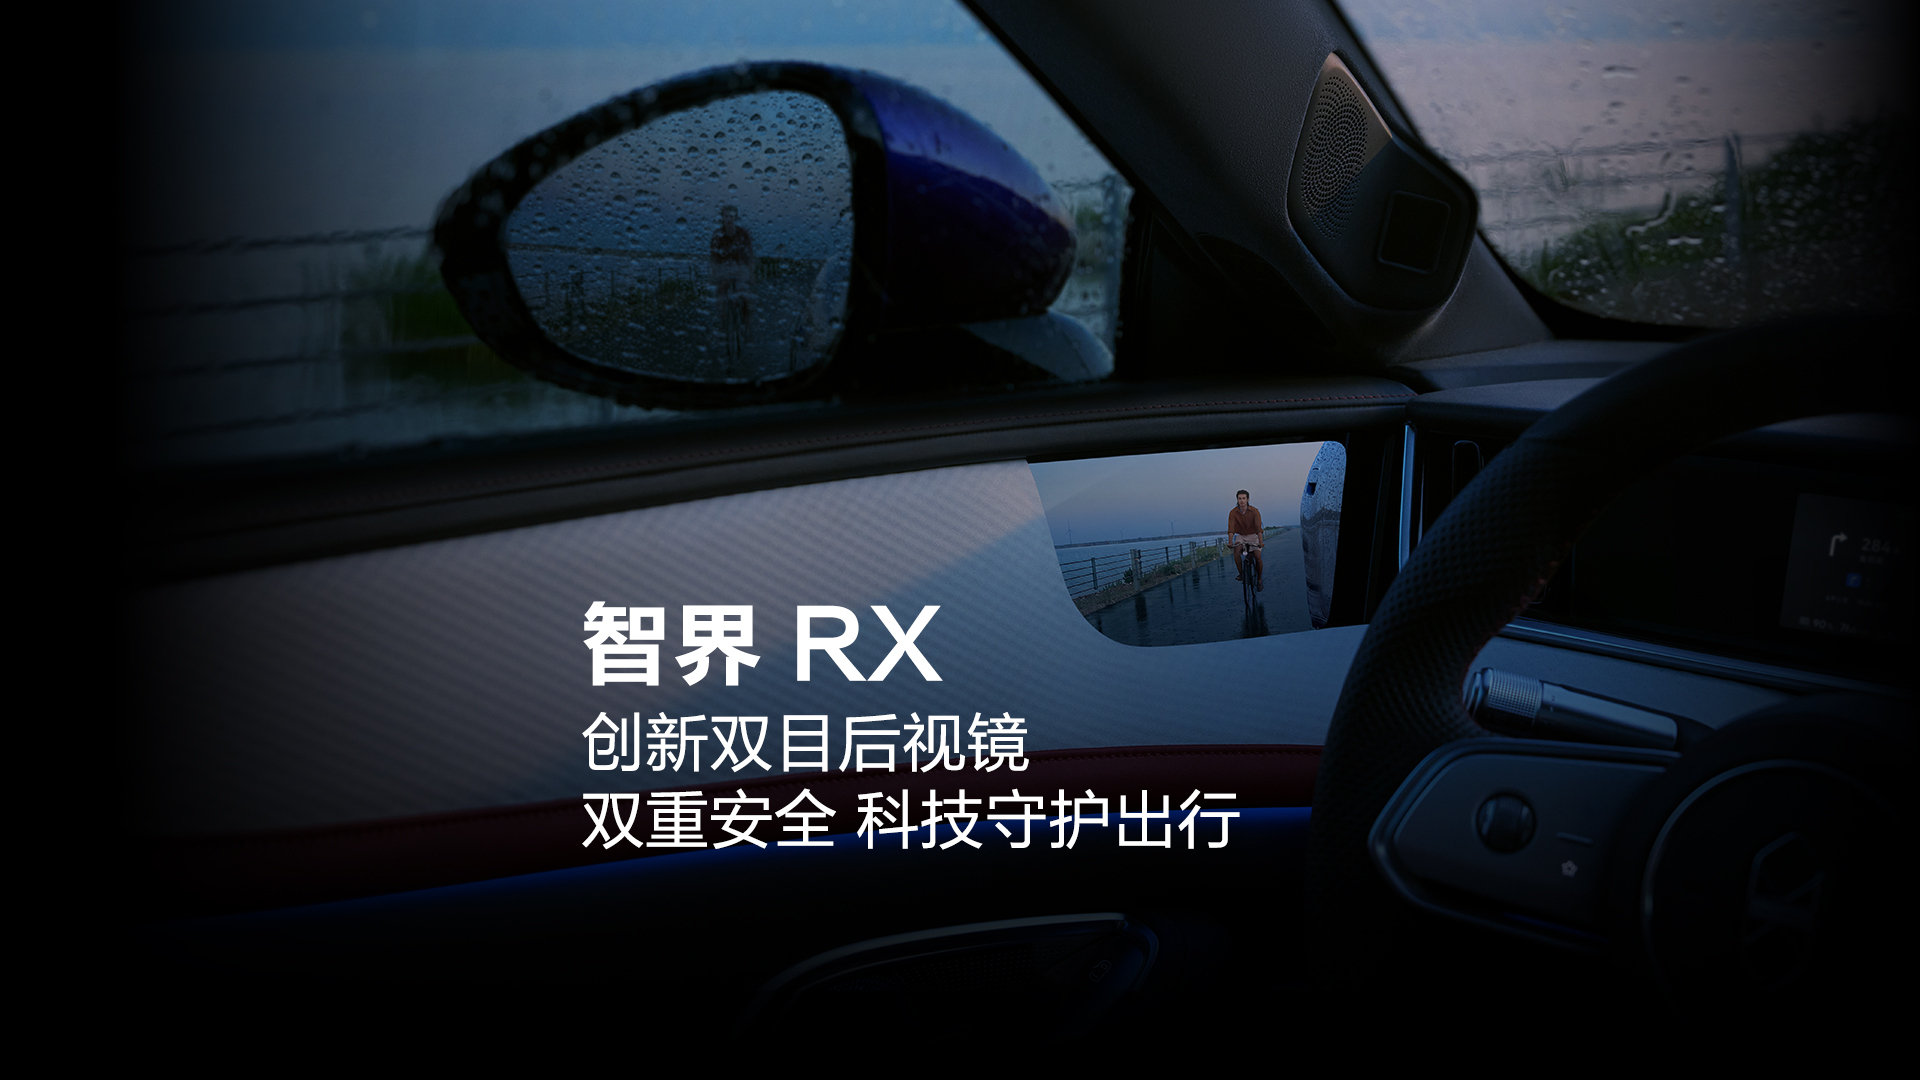
这个好像可以根据车内司机的头部位置显示不同角度👍//@余承东:#智界RX# 创新双目后视镜,和业界的拼装方案不同,我们把摄像头、ISP处理单元、算法三合一,强光暗光下画面表现更好。平时习惯物理后视镜就正常用,雨雪天气电子后视镜提供额外视野保障,双重兜底更安心!
智界RX创新双目后视镜,物理、电子双重冗余,创新集成摄像头+ISP处理单元+算法协同方案,远光、雨夜、多车并行等复杂行车场景,多一份安全冗余,多一份安心!#智界RX##智界汽车##智界RX科技定义新驾趣# http://t.cn/AXC5mT3T
//@寒霜傲雪2021:这个减重版PCH181 4X4版本应该是为了Y15空运方便而设计,有利于远程投送精确炮兵火力。//@里海赛艇:个人在6X6的181型卡车炮基础上发展轻量化的4X4版本155卡车炮,而且还是专为海军陆战队设计,可能有考虑到以后要用新中运投送的情况,毕竟海军未来自己有的运输机最大应该是这个。http://t.cn/AX0819CD
#模型时代# 大模型的第一批受害者出现了,替大学生写作业的肯尼亚人
刚看到NYT的一个长篇报道,写:数千名肯尼亚人曾靠为海外学生代写论文谋生,但LLM来了之后,这类工作迅速消退。原本这是基于互联网的数字化工作,但最先受到 AI冲击。我想这和LLM先冲击代码工作差不多。
另外,大学教育,无论如何也要改革了吧,或者被改革。
标题:肯尼亚人替大学生写了多年作业,直到 AI出现
作者:Adam Satariano、Paul Mozur发自肯尼亚内罗毕2026年9月5日
特雷西奥斯·邦迪(Teresios Bundi)曾经是互联网所创造的那种奇特而足以改变人生的机会的缩影。
邦迪来自肯尼亚一个农业村庄。2011年,他搬到首都内罗毕,成为家里第一个上大学的人。在那里,一个朋友建议他试试一种新兴的网上工作:替海外大学生写论文,帮助他们完成本应自己完成的作业。
他的第一单,是一篇两页长的论文,主题是藤黄果(Garcinia cambogia)的健康功效。
此前,他甚至从没听说过这种水果,更不知道自己是在替怎样的一名学生写作业。三个小时后,他赚到了7美元。
“那对我来说就是救命钱,我真的需要这笔钱。”现年34岁的邦迪在内罗毕接受采访时说,“那天晚上我根本睡不着。我已经准备好熬通宵干下去了。”
邦迪估计,在接下来的12年里,自己一共写了超过2500篇论文,有时一天能写三篇。
一边完成自己的公共卫生学位,他一边帮助远在海外、学习工程、医学和计算机科学的学生完成他们的学业。有些学生甚至把学校账号和密码交给他,让他直接登录系统查看作业要求。
当时的邦迪并不知道,自己正身处互联网零工经济最繁荣的年代。
随着全球互联网基础设施逐渐普及,肯尼亚、菲律宾、印度等国家大量受过良好教育、又迫切需要工作的年轻人,在数字经济的缝隙里找到了机会。
他们可以通过互联网,为经济条件更好的人完成那些不起眼、耗费时间,又没人愿意亲自做的工作。
随后,AI出现了。
好日子也随之结束。
2022年,OpenAI推出了 ChatGPT。…
世界各地的大学生很快算清了一笔账,而且随着 AI能力增强,这笔账越来越容易算:既然 ChatGPT能写论文,为什么还要花钱雇一个肯尼亚自由职业者?
论文代写订单开始减少。
价格下降,任务也越来越少。没过多久,这个产业几乎萎缩殆尽。
“我从来没想过 AI居然能做到这种程度。”邦迪说。
他的经历并非个例。
很多曾经依靠全球线上零工经济获得立足点的人,都遇到了类似的情况。
肯尼亚人曾通过 Upwork和 Fiverr等自由职业平台替客户整理会议录音、制作文字记录;他们也曾帮助 Facebook审核帖子,判断哪些内容可以继续留在平台上。
这些工作机会一个接一个地消失。
全球的技术专家、经济学家和政策制定者仍在讨论 AI将把未来带向哪里,但肯尼亚已经提前展示了一种正在发生的现实:AI正在拆掉全球劳动力市场最底部的一些台阶。
长期研究全球零工经济的牛津大学教授马克·格雷厄姆(Mark Graham)说:
“这种变化不会只发生在肯尼亚。我们将在各个地方看到巨大的转型。AI已经进入这些劳动力市场,并拿走了其中很大一部分工作。”
邦迪现在对此多少有些后悔。
2015年大学毕业后,他没有进入公共卫生领域,而是选择创办一家线上论文代写公司。
每篇论文收费40到70美元。
订单通过数字平台进入,邦迪再把工作分给自己和他雇来的学生。他在一所大学附近租下一栋房子,里面摆满书桌,装上高速互联网,还放了几张床垫。
学生们下课后过来写论文,累得实在撑不住时,就直接睡在那里。
邦迪说,那时自己的收入至少是从事公共卫生工作的五倍。
他还会寄钱给父母。父母都是种咖啡的农民,当年为了给他买大学使用的笔记本电脑,还专门借过钱。
他有时也思考帮助学生作弊是否符合道德。
最后,他告诉自己,这是学生自己的选择。
在他看来,自己更像一名辅导老师。他甚至颇为自豪,因为一个年轻的肯尼亚人能够以无人察觉的方式,在西方大学体系内部获得成功。
在内罗毕,论文写手赚到的新钱曾经非常显眼。
研究人员估计,在本世纪20年代初的高峰时期,仅内罗毕一地,就至少有4万人靠替别人写作业赚钱。
一些论文写手开上了新的斯巴鲁汽车,用着最新款智能手机,在夜店预订最抢手的位置。
行业崩溃后,邦迪关闭了自己的论文代写公司,一度不知道下一步该做什么。
如今,他在一家德国政府背景的发展机构工作,帮助肯尼亚年轻人寻找数字经济中的就业机会。
在他看来,自己的经历已经成为一个警示。
“AI会找到银行家,会找到会计师,会找到工程师,也会找到建筑师。”他说,“它会找到所有人。”
## 一项宏大规划走偏了
很少有人会同情那些帮助海外学生作弊的人。
但从另一个角度看,所谓的“论文代写工厂”,曾经也是肯尼亚数字经济发展中的一个成功案例。
肯尼亚每年有超过10万名大学生毕业,但能够提供稳定工资的正规工作十分有限。
大约80%的就业属于非正规就业,包括送货、建筑施工和街头摆摊等。年轻人失业率估计超过25%。
经济机会匮乏,也成为肯尼亚由 Z世代引领的抗议运动的重要背景之一。
对于一代拥有大学学历,却找不到地方施展所学的年轻人来说,线上零工经济一度像是一条出路。
肯尼亚政府也曾持同样的看法。
大约从2009年开始,低价高速互联网逐渐进入肯尼亚。政府开始把网络外包视为推动经济向上发展的一个机会。
这些工作包括文字转录、数据录入、平面设计、网站开发和基础软件编程。
论文代写从未得到政府正式认可,但它实际上符合这套经济模式的逻辑。
2016年,肯尼亚政府启动了一项计划,培训大学毕业生如何使用 Upwork等线上自由职业平台寻找工作。
2022年,也就是 ChatGPT出现的那一年,肯尼亚推出了一项为期10年的《国家数字总体规划》,其中进一步强调外包业务和线上零工经济的发展。
“我们只是需要工作。”46岁的弗里达·姆万吉(Frida Mwangi)说。
2015年,在抚养四个孩子期间,她希望重新进入劳动力市场,于是开始从事文字转录工作。
对姆万吉而言,零工经济还有一层特殊意义。
她希望让女儿看到,一个女人可以同时做母亲,也可以拥有自己的收入。
她接过的一项大型任务,是把对埃利斯岛移民的访谈录音整理成文字。她也做过医疗录音转录。
但从2017年开始,这类工作逐渐减少。
文字转录软件是 AI最早得到大规模应用的领域之一。
姆万吉的收入开始下降。雇主要求她使用 AI完成初步转录,再利用自己的专业能力进行补充和修订。
但她发现,这种方式甚至比自己从头转录更费时间,因为 AI经常把医疗术语识别得一塌糊涂。
即便如此,工作最终还是消失了。
“我的工作彻底没了。”姆万吉说。
如今,她开始为零工劳动者争取更高的报酬和更好的工作条件。
肯尼亚推动外包产业,确实创造过就业,同时也引发过争议。
一些受美国大型科技公司委托、在肯尼亚开展业务的企业,因为工资低、工作条件差而受到批评。
随后,部分企业开始撤退。
曾经雇用肯尼亚员工为 Meta审核用户生成内容的 Sama,缩减了在当地的业务。
雇佣人员为 AI模型提供训练数据的初创公司 Scale AI,也停止了部分肯尼亚业务。
与此同时,AI的能力仍在持续提高。
Scale AI与人工智能安全中心(Center for A.I. Safety)设计了一项测试,试图衡量 AI完成线上自由职业任务的能力,其中包括产品设计、数据分析等工作。
去年10月,领先 AI模型只能完成其中2.5%的任务。
到了今年7月,这一比例已经上升到16%。
## “人类化”写手
许多从论文代写和其他线上零工起步的人,如今正在努力寻找重新进入劳动力市场的办法。
30岁的亚历克斯·蒙尤阿(Alex Munyua)是一名工业化学专业人士。
当年,他之所以进入论文代写行业,是因为这份工作的收入更高。
论文代写衰落之后,他短暂做过数据标注和社交媒体内容审核。
现在,这些工作也没有了。
“有些人已经回到农村。”他说,“也有人尝试进入其他行业,但最后都很沮丧,因为他们找不到正式工作。”
肯尼亚本身也处于经济动荡之中。
在这个人口超过5400万的国家,大约40%的人生活在贫困状态。
虽然肯尼亚拥有一定规模的创业生态,但科技行业能够提供的工作依然有限。
38岁的理查德·埃希拉切(Richard Eshilache)曾经靠论文代写建立起一份收入丰厚的事业。
他说,2022年时,自己雇佣的写手超过100人。
他曾长期替一些海外学生写作业,合作时间长到其中一个学生毕业后把自己的毕业证发给了他。
“他说,这张毕业证属于我们两个人。”埃希拉切说。
现在,他正在尝试拥抱 AI,寻找照片编辑和数据标注之类的新工作。
但这些工作的收入都比不上论文代写。
肯尼亚信息、通信和数字经济部常务秘书约翰·塔努伊(John Tanui)仍然认为,肯尼亚作为外包中心拥有经济潜力。他表示,这一产业能够“为我们的年轻人释放机会”。
如今,论文代写行业剩下的工作,主要属于所谓的“humanizers”。
这些人的任务,是把 AI写出来的论文重新编辑,让文章更像人写的,从而躲过许多大学使用的作弊检测软件。
一名只愿透露名字为 Alphline的写手说,她从2021年开始代写论文。因为担心影响未来找工作,她不愿公开自己的姓氏。
她表示,自己的生意依然很好。
借助 AI,她现在可以完成更多订单。
她先让 AI快速生成初稿,再亲自把整篇文章重新写一遍。
一些工具专门用来把 AI文本伪装成人类写作,她反而不愿使用,更相信自己的处理方式。
“我一眼就能看出一篇论文是 AI写的还是人写的。”她说,“但一个没有真正写作经验的学生,很容易因此被发现。”
对于邦迪来说,这场转型并不轻松。
他说,自己很怀念过去那种在很短时间内学习一个陌生领域、然后完成一篇论文的智力较量。
他也怀念长期陪伴一些学生的经历。有些客户从大学一年级开始找他,一直合作到研究生阶段。
“就像我自己也接受了一套平行教育。”他说。
有时候,邦迪会想,如果当初毕业后继续留在公共卫生领域,自己现在的人生会是什么样子。
“2015年毕业以后就进入这个行业的同学,现在都已经一级一级升上去了。”他说。
“如果我现在回去,只能从最基层开始,给一个去年才刚毕业的人打工。”
我侧方停车老大难…… //@Transformer-周:我其实到现在停车入库也很水
//@白城以北:转发微博
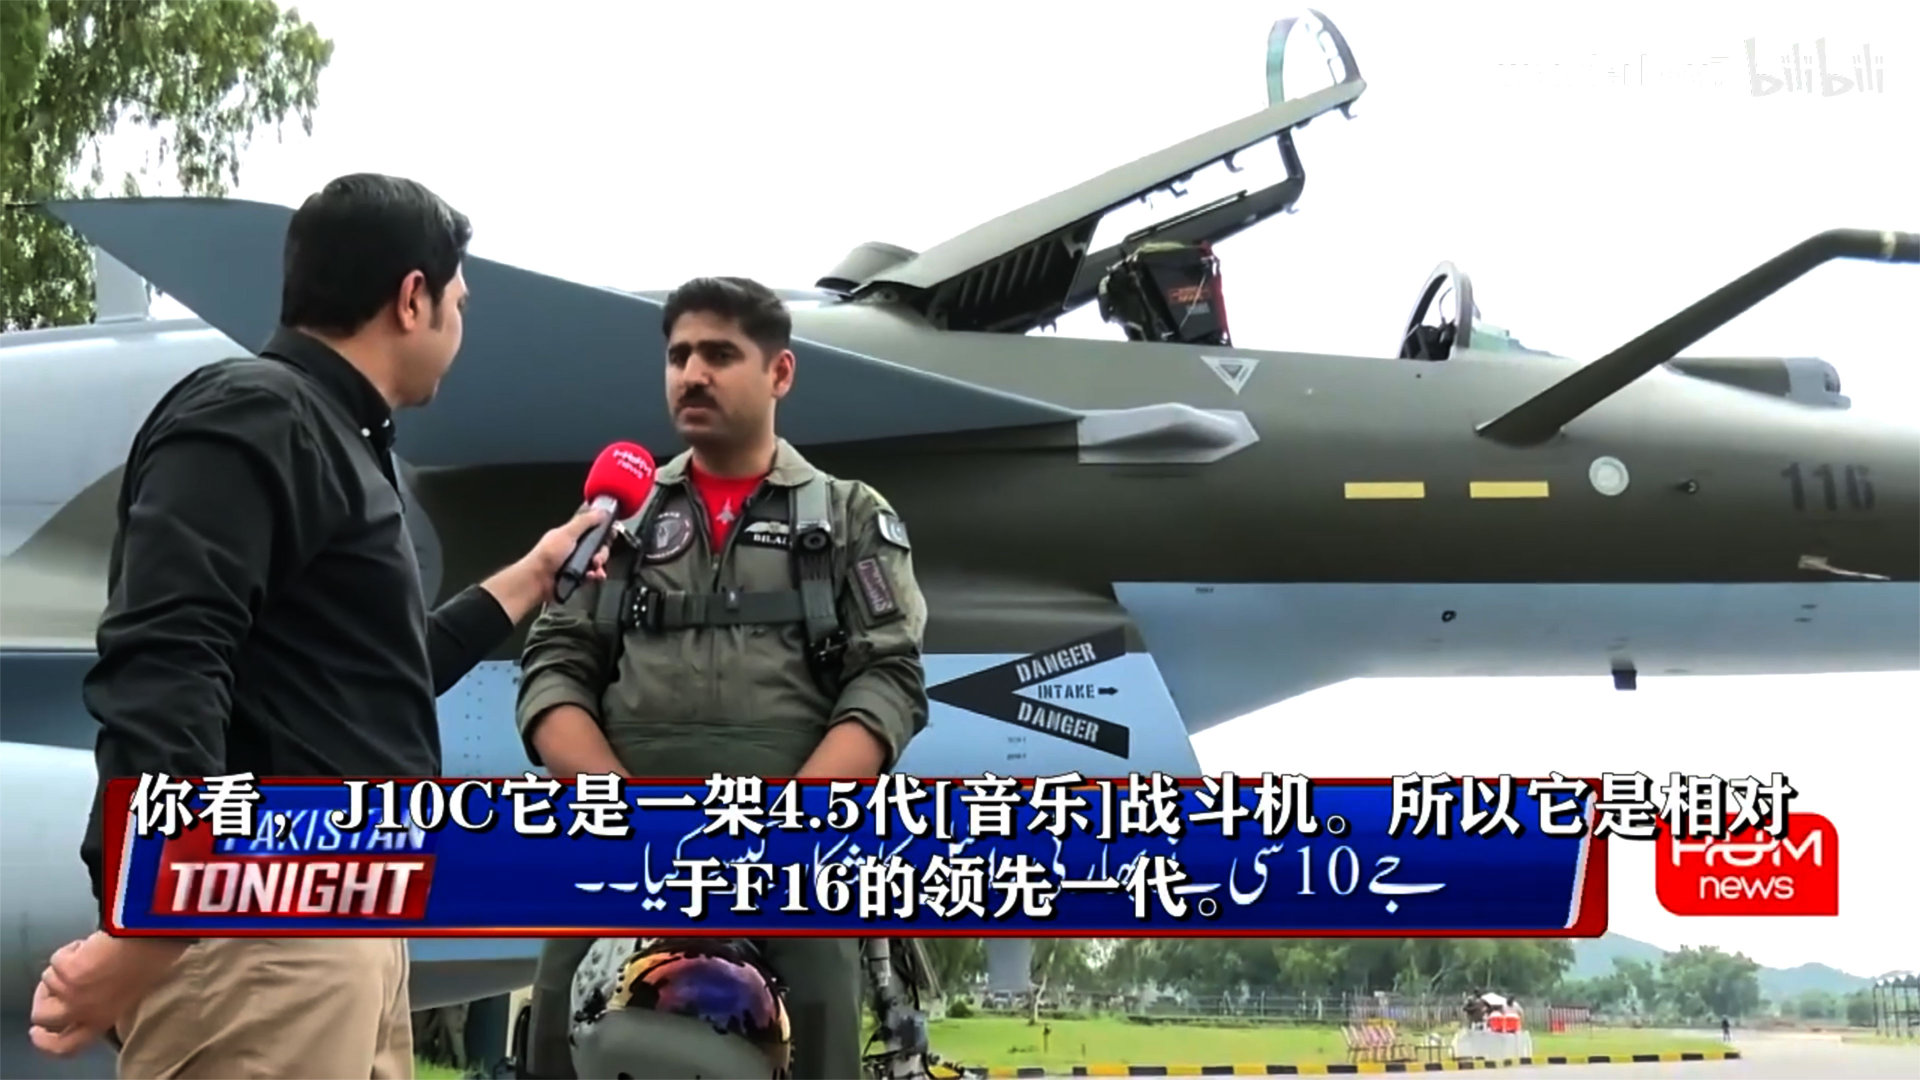
9月 6日巴基斯坦新闻频道 HUM News播出了歼-10CE飞行员的专访,这个专访是在一架参与了 5.7空战,编号为 22-116的 J-10CE旁边进行,它全副武装,搭载四枚 PL-15E双脉冲远程空空导弹和两枚 PL-10E格斗弹。其中在 5.7空战担任长机飞行员的“沙欣比拉尔”(译名)曾经是一名 F-16 Block 52+ 的飞行员,他向记者说道:J-10C是 4.5代战斗机,相对于 F-16领先了一代。F-16也是一款很好的飞机,但它的雷达航电乃至武器系统,例如对比 J-10C搭载的 PL-15E等,是完全没有可比性了。当然,整个访问里面,飞行员感谢得最多的肯定是真主,感谢真主让我驾驶了这款飞机!!!转一下来自 B站的配上中文语音的版本 #烽火问鼎计划##歼10##歼十#
//@Archidux_Austriae:萨里郡潘斯希尔公园的主人查尔斯·汉密尔顿,据说雇过一位隐士,要求他住在园中隐士居七年,不剪头发、不剪胡子、不剪指甲,不离开庄园,也不和仆人说话。结果据说这人只坚持了大约三周,就因为在附近酒馆被发现而解雇了。//@李天飞大话西游:其实《红楼梦》的妙玉就是贾府的观赏隐士,《儒林外史》的权勿用就是娄公子家的观赏隐士//@就叫熊太行也行:对了。咱们中国家庭也有的。http://t.cn/AX00l8BG
19世纪英国曾经流行过一种职业,叫 ornamental hermit——观赏隐士。
有钱人会在庄园里造一个洞穴、小屋或者“隐士居”,然后雇一个人住进去。理想状态下,这个人得胡子拉碴、穿得像个哲学家,最好别剪头发,偶尔让主人带来的客人远远看一眼:
“看,我家花园里有个隐士。”
相当于富豪版的真人景观装置。
更绝的是,有些招聘条件据说要求一住就是好几年。#怪知识电台#
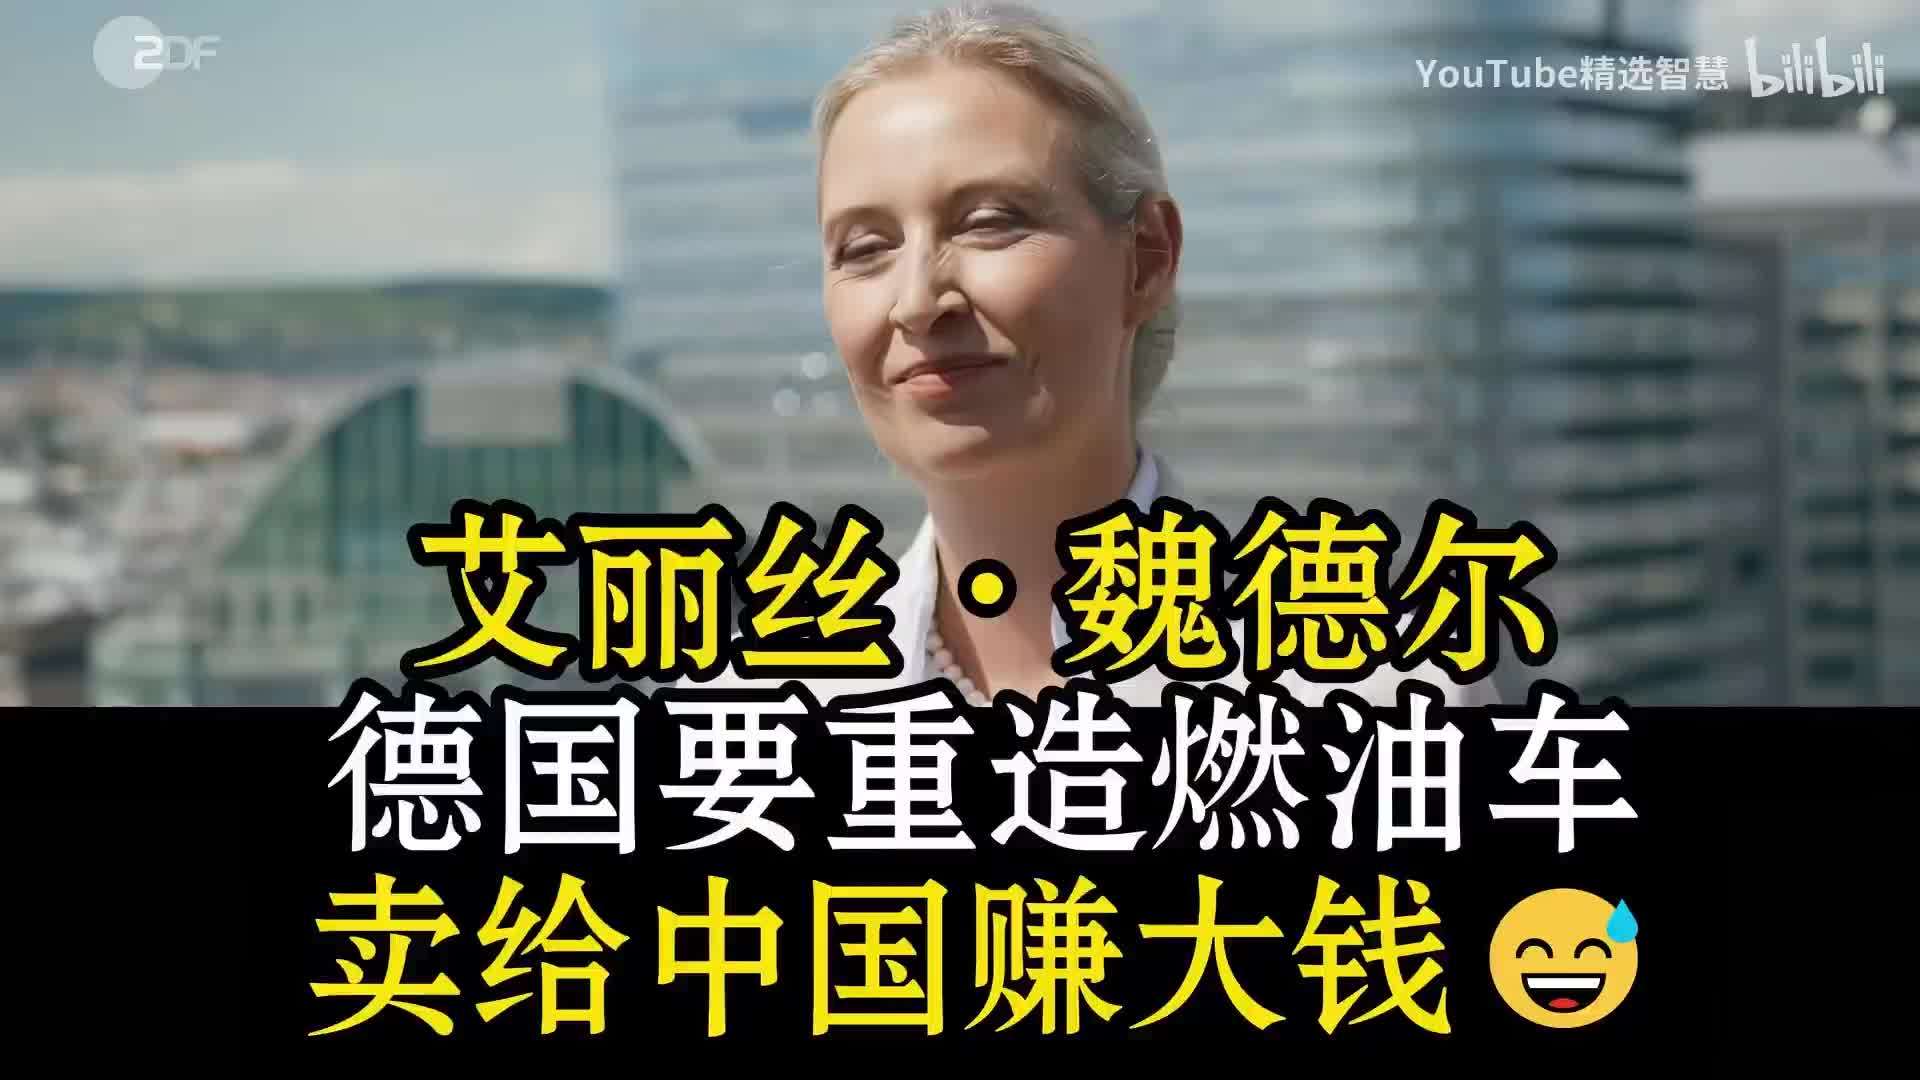
德国选择党狂揽44%选票创造历史!艾丽丝·魏德尔:等我执政了,德国要退出欧盟,退出欧元,我们会以压倒性优势成为德国第一大党,德国要重造燃油车卖给中国
市场调研公司Niko Partners发的中国游戏市场报告:
- 玩家总量7.4亿人,占总人口的53%,人均在游戏里消费(ARPU)超过470块钱;
- 2026年,平均每个玩家每天投入在游戏上的时长是2.3个小时,比去年增加了大约12%;
- 41%的玩家是通过刷短视频来发现和下载新游戏,这也是游戏发行的第一大渠道;
- 80%的玩家玩过小程序里的游戏,并在里面贡献了相当于游戏时长总支出的接近20%;
- 30.8%的玩家会玩外网游戏——Steam也算——这让游戏加速器的覆盖用户也超过了总玩家量的1/3;
- 导致玩家流失的前三大原因,依次是平衡没做好、开挂的太多、Bug修不完。
小米18 Fold上手体验
#小米18Fold首发评测#
没必要加戏,平台的机器审核是特征码导向的,比如会识别特定文件的MD5、或者原图本身有没有被收录到违规库里,当你改变了图片像素,就相当于更换了一张机器认不出的新图片,所以实际上如果把之前图片的背景做出明显修改也会让它从不能发变得能发,这是很基本的技术原理。//@楚团长聊聊天:???什么原理啊?//@他们叫我冰箱:。。。//@客官不要慌:………//@暴食症患者李舜生:我一时不知道该批评哪个平台了
#小米18Fold首发评测#简单聊下玄戒的第二台手机:小米18 Fold,官方称之为中折叠的产品。
回顾之前小米的折叠屏手机,只有两个形态,Mix Flip系列的小折叠和Mix Fold系列的大折叠,两者各有各的优点,但也各有各的问题。
小折叠解决了收纳和便携的问题,但外屏受制于尺寸,实用性不高,日常很多工作必须要展开才能完成;大折叠虽然内外屏的分工更加完整,但在新鲜感过了之后,日常很多人更习惯在外屏操作,而不是展开它。
那要如何兼顾外屏的实用性和让用户更愿意去展开它这两件事呢?答案就是一台全新尺寸的折叠屏。
先看闭合状态,117.8×83.6mm的尺寸,5.38英寸的外屏,在显示文字、图片和键盘的时候,拥有更充分的横向空间。九宫格打字、下拉通知、滑动返回这些操作都可以单手轻松完成,而如果你更习惯双手全键盘输入的话,这个外屏让我找到了一丝诺基亚E72和BlackBerry的感觉。
再看展开状态,7.58英寸内屏,相比传统大折叠内屏虽然总面积小了约15%,但屏幕比例更适合横向内容。播放宽画幅视频时,画面占屏幕的比例更高,黑边的存在感也更低,整体沉浸感更强。
在目前已经适配的应用上测试:视频类软件可以一侧播放视频一侧显示弹幕和评论,互不干扰;工作类应用中,WPS、剪映专业版和wind金融这些都做了非常深度的适配,整体体验不管是显示还是操作都非常顺手。不过在尚未适配的软件上,内屏的体验就会差了一点,一些阅读类软件上会出现内屏摄像头遮挡显示的问题。
就我而言,小米18 Fold除了观影和看漫画之外,内屏最佳的使用体验是分屏的时候。不管是双分屏还是三分屏,内屏摄像头的遮挡影响会降到最低,尤其是三分屏的时候,基本就是三台全面屏直板机的体验了,在这一点上中折叠的确比传统大折叠更舒服。
新增的6窗口并行和灵感球功能也算用了心,一个可以解决更多浏览窗口的需求,一个则方便在高密度信息中精准提问,一拖直问一步直达的功能比直接让AI读屏要高效的多。…
除了新尺寸之外,这台机器上最受关注的应该还是玄戒O3,聊这个之前,有必要先回头致敬下小米15S Pro上的玄戒O1,这颗芯片可以说是小米有史以来持续性优化最用心的一颗了,在这个过程中小米也在不断提升自己驾驭芯片、系统和整机的能力,再把O1上积累的这些经验都带到了O3上。
而这颗玄戒O3,在之前的测试版本中已经表现出了很强的性能和非常不错的功耗表现,结合澎湃OS4的优秀表现,放到小米18 Fold这种散热空间有限的折叠产品上的确合适,虽然它不是今年各项指标都最领先的芯片,毕竟接下来还有搭载新芯片的新机。但是对小米而言,我认为它可能比后续发布的那些新芯片拥有更大的长期发展潜力。
因为在这颗芯片上,小米自己能够决定的事情有很多,同时小米也有机会在这个研发优化过程中全面提升自己的技术和软硬件协同能力,为实现小米“人车家”的长期目标提供更好的技术支持。
比如在小米18 Fold上,小米希望玄戒O3能成为支撑这个新形态的基础:展开之后,多窗口并行需要足够的性能和内存带宽;长时间阅读、观影,又需要控制功耗;影像和端侧AI,也各自需要对应的计算资源,想清楚了这些需求,就可以在早期对其进行规划,再跟系统和整机设计一起形成一个整体性的工程,比如这次小米18 Fold 16GB+1TB版本上首发长鑫存储的国产LPDDR6就是这样的考量。
从芯片支持到内存配合再到整机验证,小米会比以往更深入地参与整个过程,同时能把实际产品的需求反馈给上游合作伙伴,未来这样自定义产品和上游产业链深度协同例子会越来越多,而小米这么多年积攒的能力和资源也会有更多施展能力的舞台。
说完了芯片再聊影像,2亿像素主摄+5000万像素的长焦和超广角,虽然不能跟影像旗舰比,但在同类型产品中焦段组合比较完整,加上小米结合折叠屏形态搞得一些新的拍摄玩法,像内外屏同显、悬停形态和边拍边看这些功能都挺有可玩性的。
不过现在的影像版本还是有些小问题,部分场景下会有成像偏红的问题,已经提交给了小米的人,期待后续的优化。
电池给了6000mAh的小米金沙江电池,同形态产品中的最大,搭配67W有线和50W无线,整体续航表现中规中矩,没有续航焦虑,也不算特别强。
总结一下:我觉得小米18 Fold上最值得聊的,还是这个全新的尺寸对用户使用习惯的影响。能让用户在外屏上处理完绝大多数需要快速完成的事之后,还愿意悠闲地展开内屏,看看书、看看电影、看看行情,就已经很有价值了。
这段时间用下来,在外屏用得顺手和内屏也有值得展开的场景这两点上我觉得小米做得还算不错。接下来内屏应用的进一步适配和影像的成像表现还需要继续完善。
整机性能和系统的提升只是其中的一部分,只有适配覆盖的应用越多、成像表现越稳定,这个新尺寸带来的好体验才能落实到更多的用户日常使用场景中。
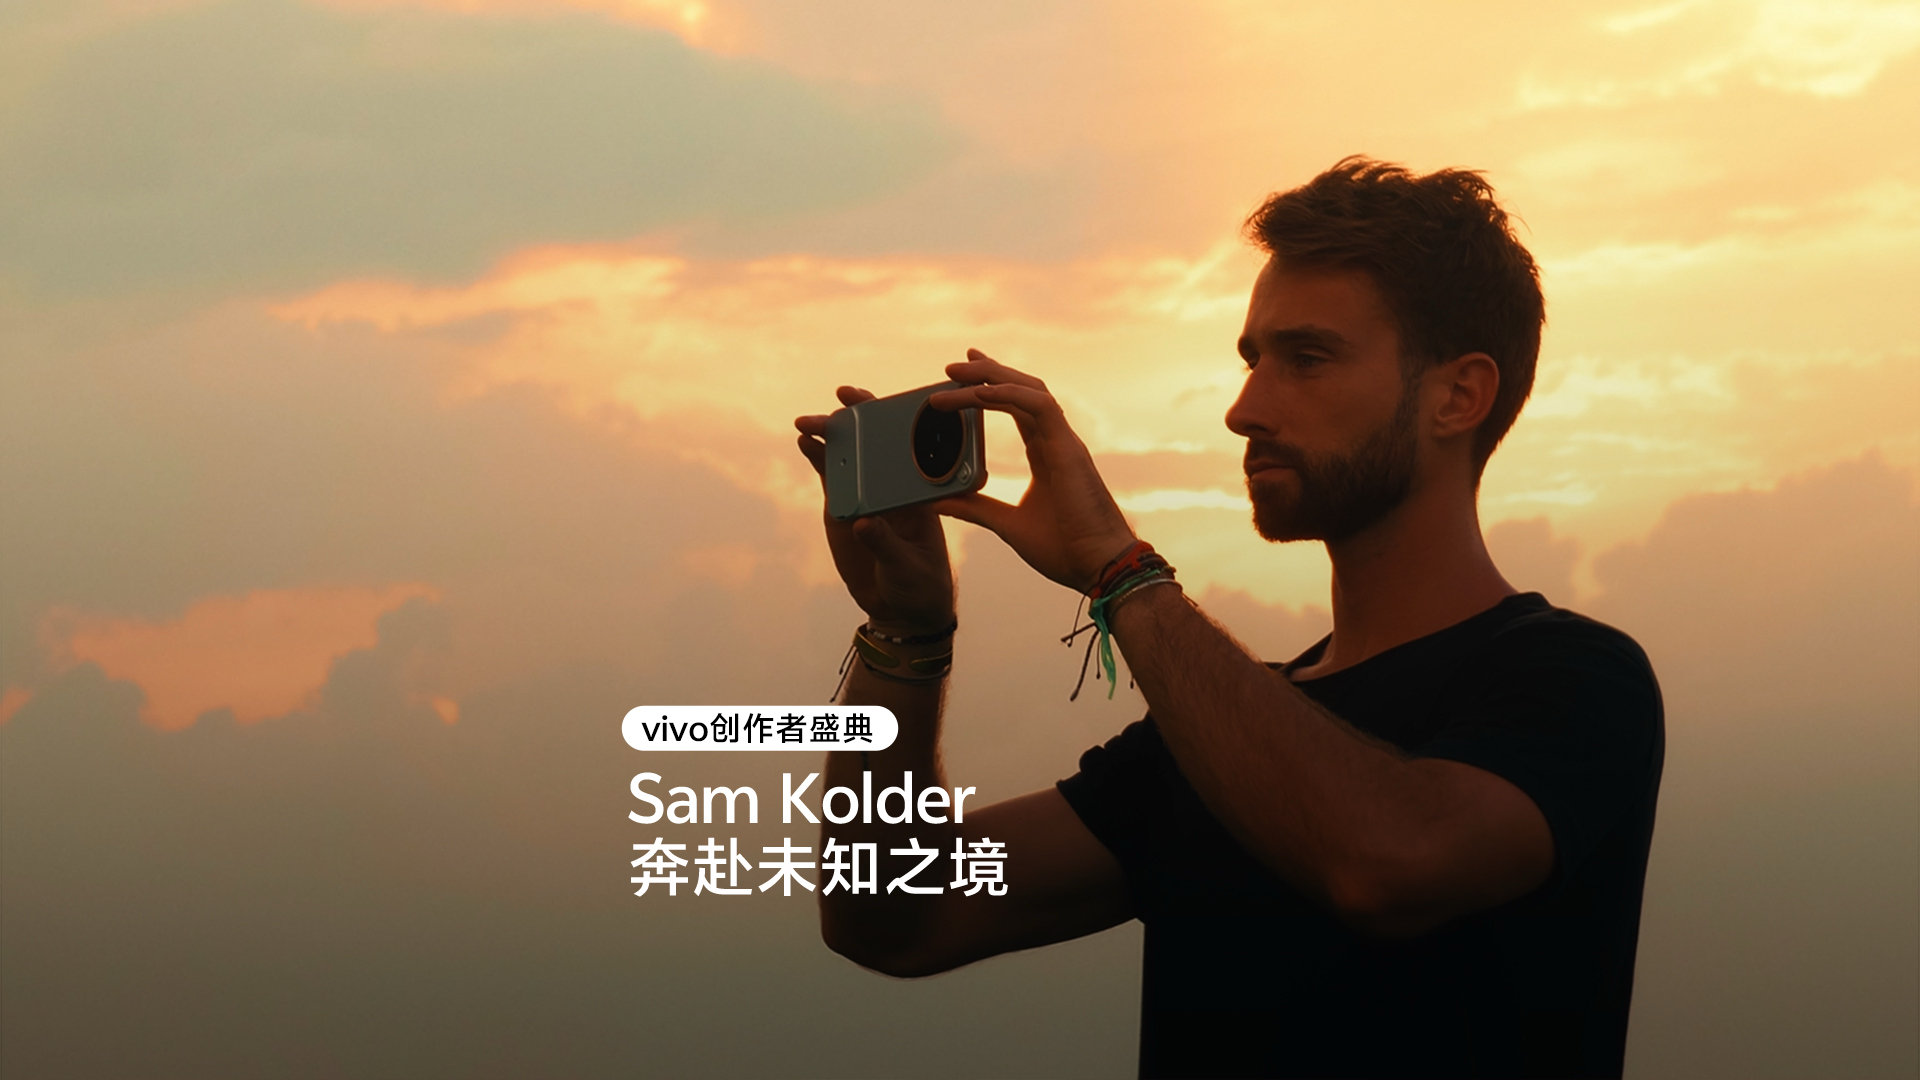
刚看到 Sam Kolder的 vivo X500 Pro Max视频样片,好家伙,一句话:too good to be true。
怎么讲?
观感好得不像真的。
当然大师有大师的调色经验。
不过就像成片里,大量的逆光夕阳画面,宽广的动态范围。
从逆光的人脸,到非常有层次的丁达尔效应再到将曝未曝云朵的金边。
17 EV动态范围,来自 LYT L910(蓝图光御 900传感器)。
这「17档动态范围」的宣言,行业里不是第一次提出。
但,不是有了一块 LOFIC感光元件,就能做出来好的影像结果。
有的做到噪声爆炸,暗光环境几乎不可用。
有的系统把三段动态拼得完全错位,火焰和人脸看起来亮度没有差别。
还有什么呢?
4K 240FPS。
高速运动场景里纤毫毕现。
在 vivo Log的加持下,vivo X500 Pro Max的视频能力将会再次交出让人惊叹的答卷。
期待!
#vivo X500系列# #vivo创作者盛典# #出发去创作#
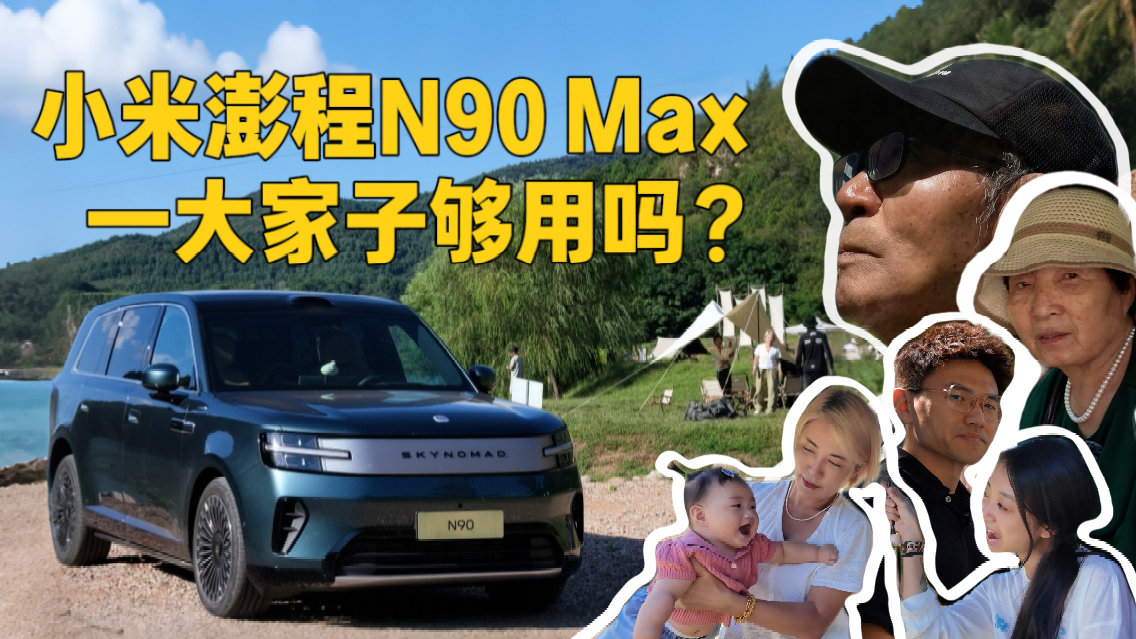
小米澎程N90 Max送车上门测试,必须给它上上强度。
秋天的北京有全年最好的天气,拉上全家老小四世同车,去郊区玩儿一天。看看这车表现到底咋样?
#小米澎程SUV现已开售#
学校并没有“耽误”你的孩子。学校恰恰非常出色地完成了它们原本的目的。正常人想当然地认为,学校的设计初衷是教育你的孩子。但在共产主义者眼里并不是这样。学校是他们绑走你孩子的方式。社会主义者就像恋童癖者一样……他们喜欢盯上孩子并对其进行诱导。
共产主义者已经逐步渗透进制度化教育的每一层,并将其扭曲,用来把他们的教条灌输进你脆弱孩子的单纯头脑。
这并不是什么抽象的偏执妄想……这是苏联社会主义几十年前就开始实施的一项蓄意战略,叫作“穿越制度的长征”(long march through the institutions)。几代教师在越来越浓厚的共产主义意识形态下教育孩子,却完全没有爱国主义影响来进行平衡。几代人之后(通常是两三代),你最终会发现,每一个美国机构都已经被共产主义者渗透——政府、娱乐业、企业(耐克,向你问好)……现在,无论你转向哪里,你的孩子都在完全受到敌人意识形态的影响。谁在对此进行反击?
丹佛的共产主义者倾巢而出,向孩子灌输思想,告诉他们资本主义要为杀死数百万人负责。家长们,请教育好自己的孩子,因为丹佛的公立学校正在辜负他们。人们还在奇怪,为什么一些县的家庭教育比例上升了50%,为什么家长们把孩子送进特许学校和私立学校。由于缺少学生,公立学校正在各地关闭!!!
【叨叨几句天气】
省流:①今天的小雨会持续到12点前后,下午转多云,很可能有晚霞;降温到22/16℃,得穿外套;②明天上午薄云,中午放晴,有些弱北风,25/15℃;③本周四到下周三长时间的晴天,高温28~31℃,低温17~19℃,最小相对湿度普遍低于30%,不闷,适宜户外活动
分析:①今天天气(9月8日)
整体天气形势见图1,从内蒙中部-京津冀-河南山东的上空都被东北风控制,弱降雨云系也控制了大范围区域。【北京今天上午仍有小雨,预计城区12点前后结束,下午阴转多云,晚高峰没有雨,而且很可能见得着晚霞(图2)】
同降雨相伴的是降温,图3是今天08时和昨天08时的气温对比,北京地区24小时降温6~8℃,今天气温22/16℃,得穿外套
②明天天气(9月9)
明天上午有薄云,中午放晴,补充冷空气影响,有些弱北风,小幅升温:25/15℃
③本周四到下周三(9月11~16日)
长时间的晴天,高温28~31℃,低温17~19℃。【湿度彻底降下去了,最小相对湿度普遍低于30%,不闷,适宜户外活动】
//@荷兰豆本豆豆荷:《燃烧吧爸爸》被攻击这件事唉我觉得好离奇又唏嘘吧,但凡了解一点都不至于误解成这样。其实真实面对过亲人的骨灰才会明白把一些没有燃烧彻底的大骨头压碎再装盒是很常规的流程,而且这件事并不可怕或者戏谑……我觉得我们还是对死亡的课题讨论得太少了
《我不该在22岁那年,亲手捡起父亲的骨头》
我是电影《燃烧吧!爸爸》的编剧,张笑影。
三天前,我们的电影终于上映了。
本该是庆祝的日子,我和导演刘潇阳却坐在北京常营的出租屋里沉默落泪,红着眼彻夜难眠。三年心血,抵不过一场蓄谋已久,假言正义的谣言围猎。
是的,我们的电影上映了,却很快就要死去。
而杀死它的凶手,却连我们的电影都没有看过。
2016年,我父亲突然因病离世。
那年,我22岁。
死亡来得太快,我和妈妈几乎没有准备,下一刻就要开始慌乱地学着怎么替他办后事。还在上大学的我完全懵了,我不知道如何接受一个人就这么突然消失不见。
父亲最后一程,是我亲自送他进火化间的。
后来,也是我亲手,一片一片,把他的骨头捡起来,放进骨灰盒里。
有一块头骨很完整,工作人员说,这片骨头可以保佑我,让我放在所有骨灰最上面。可我知道,我父亲一生过得辛苦,活得并不快活。那一瞬间,我并不想要他来保佑我,我想让他好好地走,轻轻松松地走。所以我拒绝了。
后来,我把这段经历写进电影里,片名叫《敲碎爸爸的头盖骨》
再后来,它改名为《燃烧吧!爸爸》,2026年9月5号,它终于上映了。
它对我来说,不只是一部电影。这里面有我的爸爸,我的妈妈,也有我,关于死亡、家庭和告别最真实的一部分人生。
2019年,25岁的我兴冲冲地来到北京,那时的我心里只想着一件事:我要成为一名好编剧,写出一部好电影。于是,我抱着这个念头,在北京打拼了七年。
在这期间,大环境起起伏伏,我熬过无数个改稿到天亮的夜晚,经历过无数次因各种原因而胎死腹中的项目。我的电脑里至今存了十余个未能拍摄成功的剧本。
时间来到2024年的夏天,我又再次经历了项目写作数月却无果,导演也被前司欠薪了一年。…
我们觉得既然为别人写作总是没有成果,那不如就为自己写作,反正结果也不会再差了。我们聊了很多故事,最后导演鼓励我把自己的经历分享出来,因为他说,关于我捡拾父亲骨灰的这段经历,即使从旁观者的视角来看,也依旧充满着情感和力量。两个焦虑且一无所有的人,在一起开始聊创作,反而治愈了彼此。
于是,我们开始“白手起家“,在出租屋里日夜接力写稿,在截止期前投递,幸运地入围了FIRST市场创投,这是一个青年电影人得以展示自己故事的舞台。我依旧清晰记得,那一年西宁很热,我的心也很热,我知道我带去的是一个好故事,它也将会是一个属于大众的好电影,它值得被更多的人看见。所以,纵使我紧张到话都说不清,纵使一向社恐的我也拼尽全力去争取,去让更多的人去了解这个故事。
我们毫无人脉资源,但幸运的是,我们得到了认可和支持,以及足以开机的资金。
在电影拍摄的时候,我时常想起我的妈妈,我始终在外奔波,精力被各种事情转移,可我某天回头看,我发现她还停在原地。所以,我也想通过这个故事告诉她,我们不是一定要用悲伤来证明自己爱过一个人。一个人离开以后,留下来的人,也可以继续吃饭,继续旅行,继续笑,继续去爱这个世界。
过往可以成为过往。
过往可以被燃烧成照亮未来的路。
2025年的夏天,我们完成了这部电影。很多前辈和朋友都很喜欢它,我们很为它的诞生而开心,它是我和导演刘潇阳,我们俩夫妻的第一个孩子,我们很爱很爱它。因为它是在我们一无所有时,满怀希望而诞生的。
2026年,它入围了上海国际电影节的主竞赛单元,我们开心到原地大跳了好几次。我们觉得这部电影可以被更多人看见了,真好,太好了。这一路,我们互相鼓励着,搀扶着,总算付出的心血都是值得的。
然后,我们满心期待,等待着未来它正式与观众见面的公映日。
《燃烧吧!爸爸》虽然以死亡作为故事的开头,但它其实不是一部关于死亡的电影,它讲的是留下来的人。死亡不会让生活停止,活着的人还是要继续往前。所以,它的模样是幽默的是坦诚的,是彩色的是明亮的,是积极的是会给人以勇气的。
因为,真实生活就本该这样啊。
可是,令我们所有人都没有想到是——我们电影还未正式上映,就遭到了无端的谩骂和攻击。
因为我们的电影原名,我被扣上了许多莫须有的标签,被任意踩踏。更荒唐的是,还有人公开声称,要以“侮辱尸体罪”起诉我。
谣言漫天时,我们并不想理会,甚至觉得可笑。
我们自信,只要电影如期跟大家见面,大家看完电影以后就能明白,它不是他们造谣的模样。它自会替我证明清白。
但没想到,这种无端谩骂和攻击如同黑水一样,正在把电影快速淹没,恶意的举报、投诉,限流,排片少且异常锁座,大多都是凌晨和早上的时间。更令人心寒的是,它收获到无数莫名其妙的恶评,内容荒唐至极,他们并未看过电影,也不关心电影。
很多看过电影的观众都真心地喜欢它,惋惜它,珍视它。大家告诉我们,它不仅令人感动,而且轻盈有趣,值回票价。听到这一切,我的心更痛了,因为它正一点一点被谣言的力量碾成齑粉,它快要消失不见了。明明有这么多人喜欢,为什么它还要落到这样一个地步,我和导演坐在北京的出租房里,不解、愤怒、悲哀。
2026年9月4日,它上映前一天。
结束了成都最后一场路演,我落地在北京机场,我穿着《燃烧吧!爸爸》的组服,我在机场嚎啕大哭,导演在旁边静静地陪着我。
北京的阳光很刺眼,路过的旅客不知道我们经历了什么。
我们哭,因为我们已经无能为力。
因为第二天,它就要一步步走向死亡,无人问津。
这一阵黑水,就这样真实地落在了我的身上,以我完全没有预料过的方式。
指望这些人去看完整部影片可能是一种奢望,但是,你们甚至连电影的一个物料都没有看过,你们仅凭片名和网络上的几句转述,就开始给电影定性,给我定性。肆意羞辱、曲解、抹黑,把我塑造成一个“痛恨父亲的女儿”,“挑动矛盾的巫女”。
他们蹭我们的标题,只为了自己的流量,他们进行聚众狂欢辱骂,他们将它视作待宰的羔羊,分食殆尽,而许多观众,也因此误解了它的模样。
看到这些的时候,我愤怒至极,但我无能为力。
你们口中那些所谓“侮辱尸体”的情节,不是我为了电影编出来的噱头,那是我的父亲!是我22岁那年亲手送进火化间、再亲手捡起、最后亲手将骨头敲碎的,我的父亲。
文字本身的含义是观念所赋予的,我们想告诉大家,敲碎骨头,其实,是因为爱。我希望他不用再有牵挂,安心去往他的下一程,因为我可以奔赴没有他的生活,我希望我的妈妈也可以。
你可以觉得这场戏不好,可以觉得它让你不适,甚至可以批评我作为编剧的处理。
对于作品的批评,我会面对。但是,对于针对我本人的失实指控、造谣、谩骂和侮辱,对于电影的抹黑和恶意举报,我也会一个个追究其责任,依法维护自己的权利。因为这不只是在伤害我,也在伤害演员,导演,伤害所有为这部电影付出过的人。
造谣的你们不愿花时间看看这个世界,关照他人,你们没有感受爱的能力。
如果我们的电影已经注定要在影院消失,那我只能期待将来上线平台的时候,大家来一探究竟,看看它是否如舆论所说的那样不堪。
我跟导演对彼此乐观地说,电影是会留下来的,它是属于未来的。我们也还在进行下一部电影的剧本创作,它依旧会是一个轻松的治愈喜剧,电影于我们的意义永远是让观众感受到被理解,被看见。
感谢所有努力保护这部电影,并让它顺利公映的人们,真心地谢谢大家。
希望每一个曾经失去过重要的人,却还在努力生活的人,都能被这个世界,温柔地接住。
#电影燃烧吧爸爸# #电影燃烧吧爸爸💬#
如果我再听到一次“极右翼”,我真的要崩溃了。
共产主义者把所有他们不喜欢的人都叫作纳粹。
确实如此。
我觉得很奇怪,Elon 最具争议的时刻会被媒体放大,而他那些鼓舞人心的举动却往往几乎得不到报道。
当 Elon Musk 对普通人(粉丝、孩子或陌生人……)展现个人善意时,《People’s Magazine》在哪里?
1. 回答一名临终少女的最后几个问题,并让她设计一个 SpaceX 吉祥物(Liv Perrotto,2026)
15 岁的 Liv Perrotto 一直梦想着见到 Musk。她后来虚弱到无法参加原定的通话,便在床头柜上留下了 8 个手写问题。她因癌症去世后,评论员 Glenn Beck 分享了这些问题。Musk 回答了每一个问题(Tesla 手机?没有。扩建餐厅和推出新游戏?有。最喜欢的动漫?《你的名字》。日本?京都和 teamLab。初音未来和 Ani/Misa?有)。她最后的请求是,希望把自己的柴犬“Asteroid”毛绒玩偶(曾被设计成 Polaris Dawn 的失重指示器)做成 SpaceX 吉祥物;对此,他只简单写下:“Ok 😀。”她的母亲回复道:“我真希望她当时还在,能亲眼看到这一切。”
2. 公开采纳一名五年级学生的营销创意(Bria,2017)
来自密歇根州的 9 岁女孩 Bria 给 Musk 写了一封学校作业信,建议 Tesla 使用粉丝已经制作的自制广告,因为公司当时并不做广告。她的父亲把信发了出来。Musk 回复:“谢谢你写来这么棒的信。这听起来是个好主意。我们会做的!”她还要了一件 Tesla T 恤。
3. 为一名用 Tesla 救人、素不相识的车主支付全部维修费用(Manfred Kick,2017)…
德国 Tesla 车主 Manfred Kick 看到一辆 Volkswagen 在高速公路上来回摇摆,车内是一名失去意识的中风患者。他把车开到对方前方,任由另一辆车撞上自己的保险杠,然后同时刹停两辆车,以自己的 Model S 受损为代价救了那名司机的性命。Musk 发帖祝贺,并宣布 Tesla 将免费、加急承担全部维修费用。Tesla Germany 的当地负责人还亲自取回了这辆车。
4. 分享一名陷入困境的女性的信;她说这让自己没有走上绝路(Johnna Sabri,2018)
Johnna Sabri 写了一封公开信,讲述 Musk 的坚持如何在她的非营利组织失败、人生崩塌后给了她启发。Musk 在阵亡将士纪念日将这封信分享给数百万粉丝。她手工制作的珠宝销量随即暴增。后来,当 Musk 接受了她想送给他的一枚小小的太空岩石吊坠时,她公开表示,这个时机和这个举动把她从自杀边缘拉了回来。Musk 后来发帖引用了一句话,谈论那些不为人知的善意。
5. 一名年轻活动人士提出请求后,为弗林特的学校资助净水饮水机(Mari Copeny / Little Miss Flint,2018)
11 岁的活动人士 Mari Copeny(“Little Miss Flint”)和其他人强调当地持续的饮水危机后,Musk Foundation 捐赠了约 48 万美元,为弗林特所有学校安装经过紫外线过滤的饮水机(后来还为学生电脑提供了资金)。Musk 此前公开承诺,将帮助那些用水受到污染、污染程度超过 FDA 标准的家庭。最终,这些饮水机安装完毕,孩子们又可以从学校的饮水机取水了。
6. 因世界杯上两个孩子的请求,兑现了拥抱一名 YouTuber 的承诺(Fidias,2022–2023)
塞浦路斯 YouTuber Fidias Panayiotou 在 Twitter/SpaceX 办公室外露宿了几个月,希望能得到一个拥抱。2022 年卡塔尔世界杯期间,两个小男孩请 Musk 拥抱“那个一直想在旧金山拥抱你的家伙”。Musk 确认他们是认真的,随后发帖说:“我会做到。”后来,他在 Twitter 总部拥抱了 Fidias,那天正值全国拥抱日。
7. 停下来为一名在人群中喊他的孩子签名并自拍
一段广泛传播的视频显示,一名小粉丝在活动期间喊了起来。Musk 停下脚步,把男孩带到身边,为他的帽子和玩具火箭签名,屈膝俯身到与孩子平齐的高度,并和他合影。后来,Musk 转发这段视频并评论:“好孩子。”
这些对一个家庭意义重大、旨在提供支持的小举动,甚至帮助了整个社区……这些时刻一次又一次触及并感动了许多普通人。
遗憾的是,《People’s Magazine》没有报道这 7 个鼓舞人心的故事中的任何一个。
Elon Musk 每一次被抹黑的尝试,最终都只影响到那一小群早已做出判断的人。无论向他们展示什么事实或证据,他们都不会退让半步。
每一本关于 Elon Musk 的书、每一部关于他的电影、每一篇关于他的文章,都只会证明我们这些支持者的观点:他就是我们所热爱、所相信的那个英雄。
历史上每一个伟大的人都曾因同样的原因遭到追捕。他让那些骗子和说谎者更难继续行骗和撒谎。
@leodev,Build 支持动态工作流 :) https://x.ai/news/workflows
编写 HTML,渲染视频。专为智能体打造。
TypeScript
今日新增 474 星 · 总星标 45,902 · Fork 4,310
用于将文件和 Office 文档转换为 Markdown 的 Python 工具。
Python
今日新增 886 星 · 总星标 180,212 · Fork 13,261
面向 AI 编程智能体的上下文窗口优化工具。通过隔离工具输出将内容量减少 98%,持久化会话记忆,并借助 MCP 与 hooks 在 17 个平台间强制执行路由。
TypeScript
今日新增 96 星 · 总星标 20,822 · Fork 1,520
14岁时,Zack MacLeod Pinsent 找到曾祖父的一箱西装后,烧掉了自己最后一条牛仔裤,此后再也没穿过现代服装。
原本可能只是青少年时期的一段经历,后来成了他的职业。他自学历史裁缝技艺,并在布莱顿创办了一家企业:手工绘制纸样,运用17世纪60年代至20世纪20年代的工艺制作服装。
如今,他的客户从博物馆到单纯想穿上按古法裁剪服装的人都有。去年,他在布莱顿皇家穹顶宫举办了一场摄政时期舞会,门票不到三分钟就售罄,吸引了来自17个国家的150人。他们穿着盛装,度过了一个夜晚,仿佛置身于Zack 14岁时决定更愿意生活其中的那个世界。
确实如此。
没错。
来吧,兄弟。
我喜欢 Carl,但左派需要读两本关于右翼政治的书。对于那个女同性恋女权主义者和那个爱上斯里兰卡女老板的男人来说,最好的类比不是“希特勒”——这个男人只是厌倦了移民犯罪。
提交你发现的任何漏洞。我们会支付赏金 🫡
“极右翼”是一个宣传用语,近几年尤其流行。
我喜欢 Cybercab 的一点是,它只有两个座位。在洛杉矶生活并驾驶 Tesla S 的八年里,我只用过两次四个座位,使用两个座位的情况有四次。所以大多数时候都是我一个人在开车。如果有一辆更小、更安全且能自动驾驶的车,那就太棒了。
我还是无法相信 Cybercab 的整个外部车身竟然是塑料的。
我认为这是第一辆以这种方式制造的量产 Tesla 车型。
Tesla 使用反应注射成型,直接将颜色融入面板。
这完全不同于传统喷漆车间。
传统汽车喷漆可能需要数小时,而现在这个过程几分钟就能完成。
Tesla 表示,这使这些部件的制造排放降低约 35%,并消除了传统工艺产生的油漆挥发性有机化合物(VOCs)。
在有人问“但安全性呢?”之前:
塑料外壳不是碰撞结构。
真正承担这一任务的是下方巨大的前后压铸件(giga castings)。
我亲自乘坐过 Cybercab。
相信我,它一点也不廉价。
实际上,它会让你意识到 Tesla 正在这里尝试做什么。
更少的部件。
更少的制造步骤。
没有传统喷漆车间。
更快的生产。
更低的成本。
去盒化制造流程(unboxed process)……
这远不只是 Tesla 用塑料造一辆廉价汽车。
Tesla 正在彻底重新思考如何制造数百万辆机器人出租车(robotaxis)。
Skill的 Scripts,可以是预先写好,也可以只给说明,运行时 Agent现场生成。
Agent现场生成 Script的好处是灵活,可以随时随地根据场景需要去写脚本,实际上就算没有 Skill,Agent已经在这么干了,仔细看工具调用就经常可以看到 Agent动态生成 Python脚本去执行一些任务。
现场生成 Script的缺点是费 Token和慢,另外稳定性要差一些,可能写完有 bug还需要反复调试,一些边边角角的情况很难覆盖全面。
所以通常 Skill的 Scripts都是预先写好的,Agent只要传入参数就可以马上得到结果。
举个例子来说,一个 Markdown转 HTML的 Skill,这个 Agent现写 Script就只能做个勉强能的,很难兼顾样式美观、各种条件都覆盖,如果预先写好 Script,就会稳定很多。
@dotey那么 skill的 script需要预先写好吗?还是只给说明,等运行时候 agent现场生成?
@dotey Tibo 反驳了这个说法
https://x.com/thsottiaux/status/2097084139627561041
我对此有些不同看法。
(a) Codex 最初是作为内部工具启动的。其明确目标是打造一个能够最大程度发挥杠杆效应、加速基础设施建设的工具。
(b) 我不认为 Meta 与非 Meta 的对比在这里特别有启发性。我们这些从老牌科技公司加入的人,大多对 OpenAI 将 Python 脚本推进到如此程度感到惊讶,也希望进一步扩大 OpenAI 的规模。
(c) 过去几年里,我们构建了大量基础设施和内部工具;并不是大家只是在等待 AGI 出现。
今晚的极光带有紫色。KP 指数约为 4。我们正在接近高 beta(贝塔)阶段,因此有更多光线逐渐越过地平线。不同颜色交织在一起,你还能看到夜空中的卫星。(14mm,1/4 间隔,分成两部分拍摄)
啊?没有这样做的原因,不是显而易见吗 •ᴗ•💧
目前用 uu over ssh + herdr很爽,希望尽快推出自己的 agent客户端 🤗
别人上综艺是走秀,孙千上综艺像邻居去串门一样接地气,这松弛感太让人有好感了。
确实。
他们担心的不是埃隆·马斯克收购 Twitter 后散播错误信息。
他们担心的是,埃隆·马斯克收购 Twitter 后会传播准确的信息。
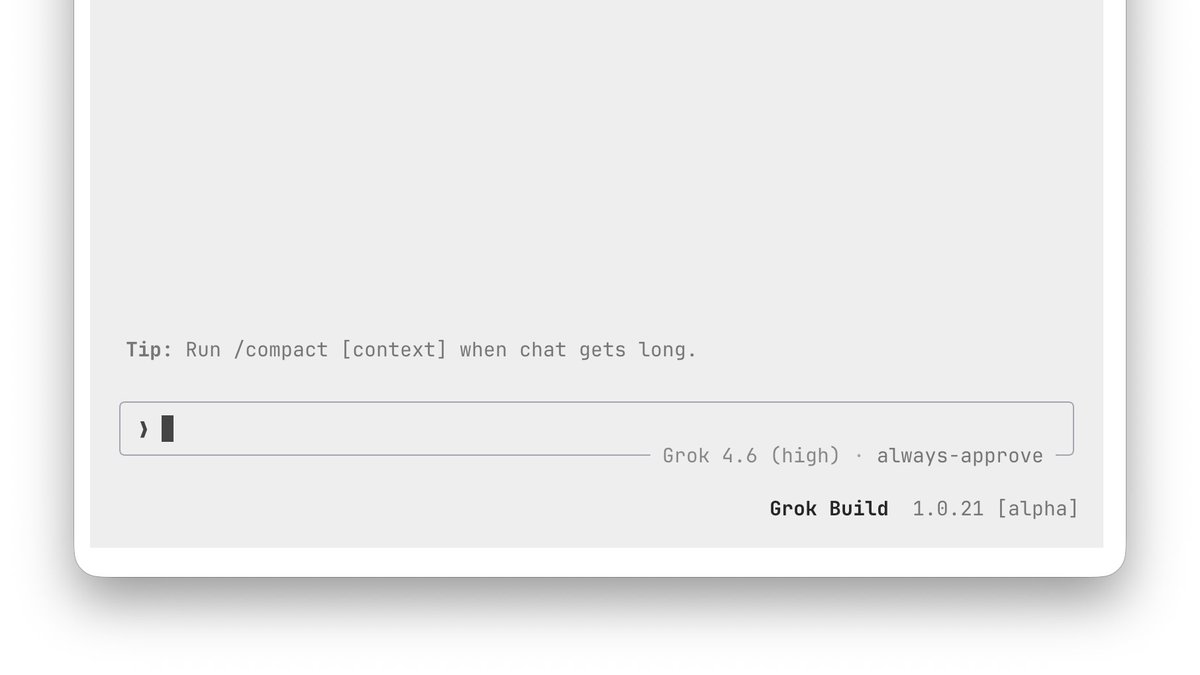
Grok Build 刚刚又迎来一次重大更新,朝着成为完整代理工作空间迈出重要一步。
桌面应用工具现在可以通过专用的官方 MCP(模型上下文协议)服务器连接;新的长期运行工作区守护进程可以向 Computer Hub 提供文件夹;已完成的子代理现在可以继续执行,而不必重新启动;后台代理现在会直接返回实际输出。
新增更好的差异预览、更智能的工具优先级、更强的破坏性 Git 命令安全防护,以及更快的会话启动速度。
发行说明:v1.0.22
功能:
• 内置代理工具与用户 MCP 服务器的工具名称发生冲突时,内置工具现在优先。
• 桌面应用工具现在可以通过专用的官方 MCP 服务器使用。
• 远程控制选择器现在可以利用播报的设备身份按设备对服务器分组。
• `edit_file` 差异现在显示真实的文件行号,不再从第 1 行开始。
• 文件编辑权限提示现在会自动展开差异行,让你在批准前查看变更。
• 向已完成的子代理发送消息,现在会继续运行同一个子代理,而不是失败。
• 后台子代理完成消息现在会显示实际输出,而不只是提示你运行工具。
• 仪表盘现在显示统一的标题栏,其中包含位置选择器和操作栏,可用于创建代理或恢复之前的会话。
• 新增 `grok-workspaced daemon` 模式,让长期运行的进程可以向 Computer Hub 提供文件夹;这与由桌面端监管的旁车进程是分开的。
错误修复:
• 即使没有列出任何工具,MCP 连接器现在也能正确显示需要重新认证的状态。
• 当标签栏获得焦点时,扩展模态框的快捷键现在可以正常工作;对标题执行无效操作时也会显示有帮助的提示。
• 自动后台轮次运行期间,“立即发送”按钮和快捷键现在可以正常工作。…
• 恢复的会话现在会显示你在轮次中途后续输入的确切文本,而不是经过包装的系统消息。
• `/skills` 命令现在会更新模型中的新安装技能,即使该命令是从另一个 NFS 客户端写入的。
• 自动模式不再立即运行破坏性的 `git checkout --` 命令;这些命令现在会交由模型进行安全判断。
• 修复了在某些技能注入或回退操作后恢复粘贴内容时可能发生的崩溃。
• 子代理和工作流现在遵循为父会话配置的相同 Bash 超时和自动后台运行设置。
• 修复了模型后端选择问题:配置文件中的显式 `chat_completions` 设置不再被同一 slug 的兄弟项覆盖。
• 当当前目录是主目录时,斜杠命令提示不再反复刷屏。
• 前台 Shell 命令不再产生无关的后台任务提醒或错误的终止结果。
• 排队的后续操作按钮现在按 [立即发送][编辑][取消] 的顺序显示。
• 分页器中的 `/compact instructions` 现在会传递给压缩后端(单独的 `/compact` 行为不变)。
• 按 Esc 后执行 `/goal`(以及恢复操作)现在会正确启动目标规划器,不再失败并显示“规划失败”。
• `run_terminal_cmd` 现在会正确告知模型:前台命令运行约 15 秒后会转为后台运行,而不是使用 120 秒的超时值。
• 技能公告不再在同一会话中重复显示相同的可用技能列表。
• 多会话进程中的监控事件现在可以正确唤醒空闲会话,而不是一直缓存到下一次提示。
性能:
• 打开或恢复会话时,读取 MCP 配置文件不再暂停界面。
Grok Build 感觉就像一项用于在 Blender 中创作的超能力。
我正在用 Grok Build 从零打造这个火箭发射场。它处理所有困难部分,节省数小时工作,并以惊人的速度把我的想法变成成果。速度和质量都令人印象深刻!🔥🚀
特斯拉超级充电桩在纽约州制造
超级充电桩产自纽约州布法罗。感谢所有出色的员工!
😅😲😲//@春卷:哇,这个就是我一直想要的,我说就是原厂要有一个能够四六分床的东西,然后要一键成床,但是它为什么座椅是6,床是4呢?不能反过来吗?。。
确实。
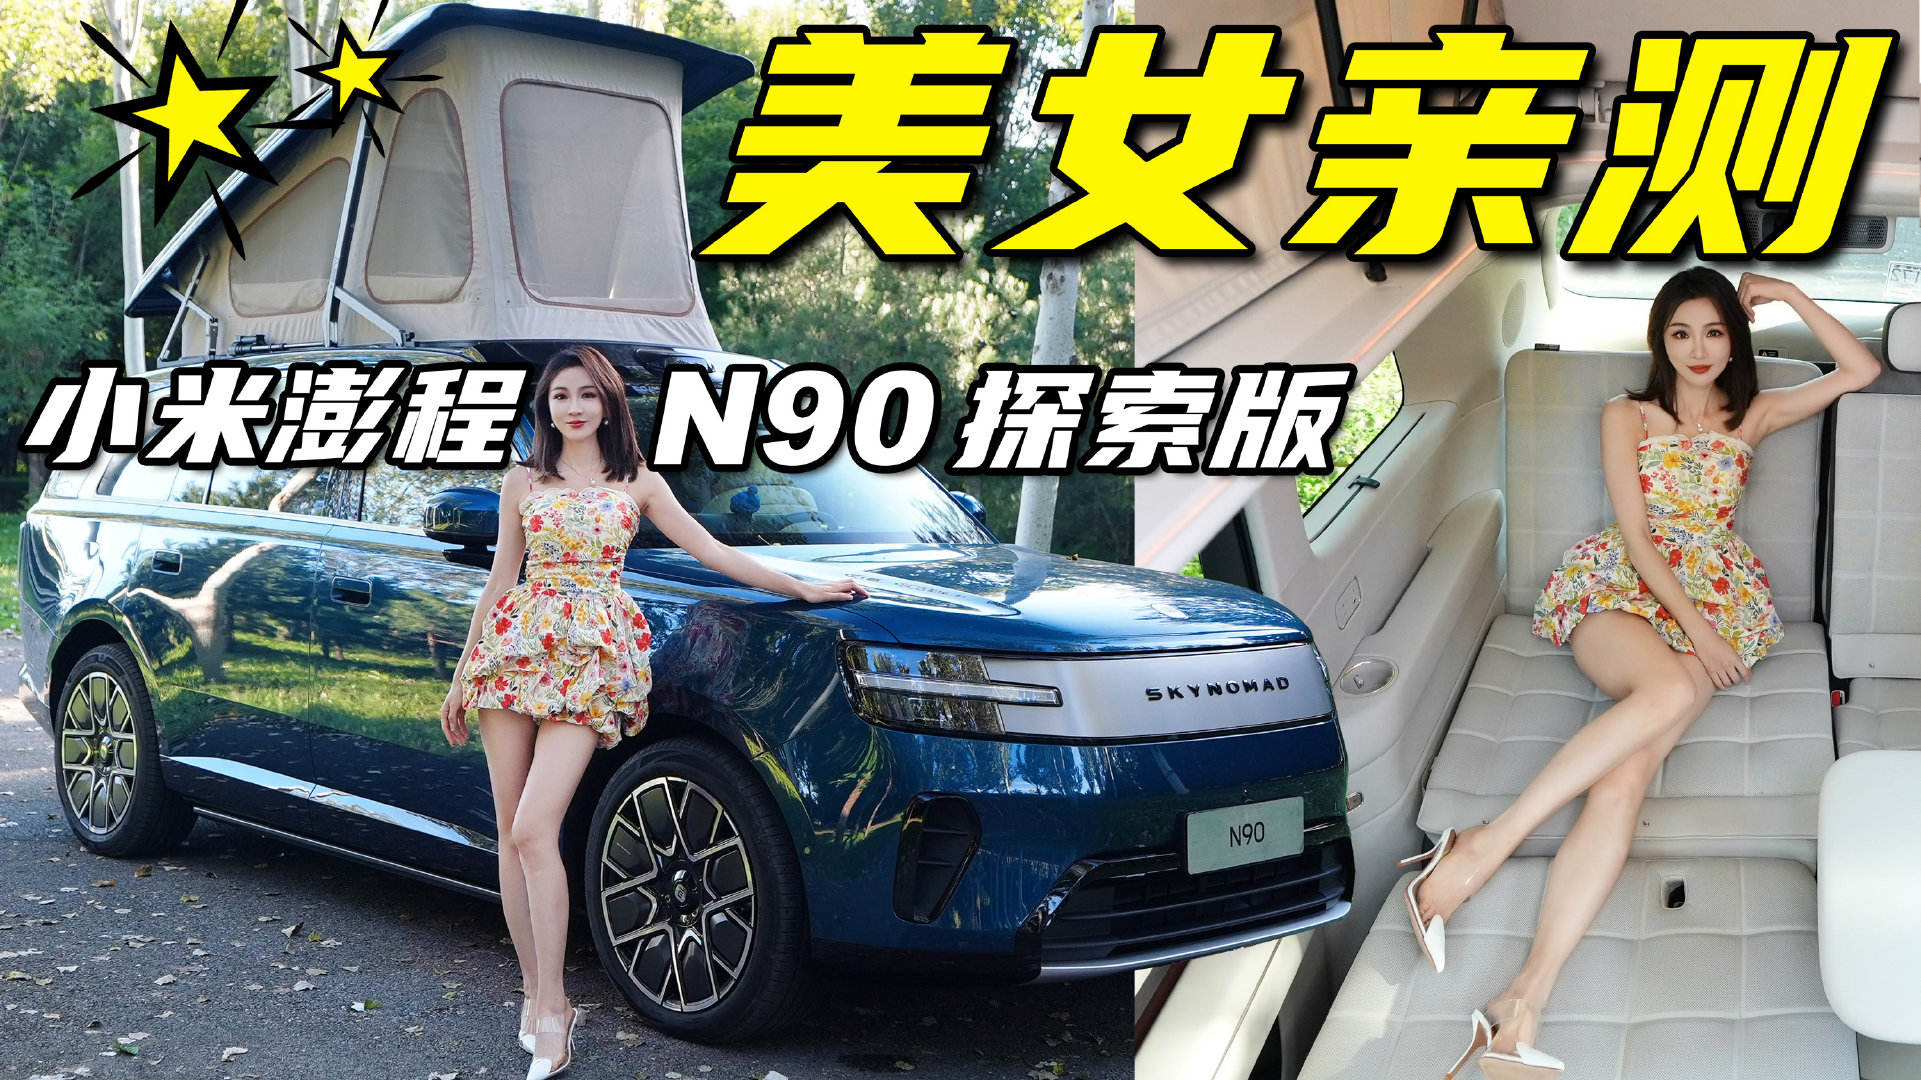
还有个N90探索版,带升顶。
雷总:原装的年检不用拆下来。
下面开始喊晚安了😂 #小米澎程##小米发布会#
小米澎程N90 Max:26.99万探索版:29.99万,大家觉得如何?
看完这个视频,你一定会惊呼:小米澎程N90 Max探索版还是车吗?
原厂升顶帐篷+席梦思大床地暖、床头柜、壁橱...惊人操作咱【一楼】到【二楼】全方位亲测看看小米怎么重新定义“空间” #小米澎程N90探索版首发评测#
ChatGPT Work,适配你的个人写作风格:
我们很高兴向全球推出 Google TPU 的首次开放基准测试。每天运行,在许多模型和场景中,单位 token 成本都优于 B200 和 B300。特别感谢 Google、@inferact,以及 SemiAnalysis 的 InferenceX 团队,这项工作已经持续了数月。
TPU 推理外部化全面推进——InferenceX 每美元性能最高提升 50%,TPU 技术栈快速外部化,客户群不断扩大,Ironwood、TPUv8i,以及削弱 CUDA 壁垒
🤔
挺好的,把寒气传给每一层。
#模型时代# 分析:Anthropic 1.4万亿美元 IPO前估值是合理的
据报道,Anthropic在 2026年 7月的总 ARR为 650亿美元,若按每月 100亿美元的净新增 ARR计算,则 2026年第三季度 ARR将达 850亿美元,第四季度将达 1150亿美元。
如果你删除:
- Meta(50 亿美元 ARR)
- 支付给 AWS Bedrock / GCP 的分成(按 20-25% 的 API 交易量计算,假设抽成率为 20%)
- API 产量的 2%来自蒸馏。1. 根据要求,"labd distilling" 保留了原文缩写形式,未进行翻译。
您将能够:2026年第三季度净 ARR达 620亿美元2026年第四季度净 ARR达 820亿美元 。
按 20倍市销率(EV/ARR)计算,这意味着 2026年第三季度的业绩为 1.3万亿美元,第四季度为 1.6万亿美元。
这使得prestocks提到的 1.4万亿美元 IPO前估值显得合情合理。
像 Meta、Google 这样的大厂,都有大量自己内部使用的工具,也有很多人专门负责开发和维护这类工具。
现在,随着许多前 Meta 员工加入 OpenAI,他们也想在 OpenAI 内部组建这样的团队来构建内部工具,但遭到了 OpenAI 管理层的制止。管理层表示,在一个“AGI 优先”的世界里,并不需要内部工具团队。
这种思路确实更 AI 原生(AI Native):毕竟需要什么工具都可以快速通过 Vibe 编程(Vibe coding)做出来,而且能够完全个性化定制。
OpenAI 内部一个非常有意思的细节:
公司招募了一批前 Meta 员工。其中一些人想大力投入内部工具团队(Meta 就这么做了,而且效果很好)。
OpenAI 管理层对此表示反对,称在一个 AGI 优先的世界里,不会有内部工具团队。
而他们说得没错:如今借助 Codex,内部工具呈爆发式增长,却完全没有任何内部工具团队!
FSD Supervised 已获斯洛文尼亚批准 🇸🇮
这几天总是刷到一部国剧「早春晴朗」,还以为又是流量堆出来的,看了几眼后才发现好像是我浅薄了,是真有点东西。
很多观众在评论区聊真人感,认为越是在AI横行的年代,就越是需要这样的剧集来洗眼睛,而制片方甚至配置了亲密戏指导,给性萧条久矣的年轻人点了一把火。
然后我眼瞅着「早春晴朗」播出首周又拿下了Netflix全球非英语剧集周榜Top 2,如果我没记错,这应该是国产剧有史以来冲到的最高名次。
以前能够挤进Netflix热播榜单的华语剧集,大多数都要靠奇观题材,比如古装、犯罪和民俗是最受欢迎的三大类。
这倒没什么不好,但它也难免给中国影视「贴标签」,好像离了那些吸引围观的要素,就不剩下多少有价值的内容了。
「早春晴朗」讲了一个正常的爱情故事,没有刀光剑影,没有古墓奇谭,没用凶杀悬疑,年轻孤独的男女在大城市打拼,租房、加班、求爱、直到寻得归属感。
然而就是普通人想要过好日子这件事情,打动了全球的观众,不但国内登顶热度榜,让剧集大盘水位持续飙升,在Netflix也跻身了54个国家和地区的日榜前10,连巴西都冲到了日榜第2。
就像我们以前看美国的「老友记」,看日本的「东京爱情故事」,看韩国的「浪漫满屋」,都是同样的逻辑,扎实的剧本,优秀的演技,认真把故事讲好,文化就不会存在边界。
同一个世界,同一个梦想,这句话永远不会过时。
尊重从来都是站着得来的,而且我觉得最标志性的转折在于,国剧出海这件事情,终于从满足奇观想象的赛道,顺利切到了文化共情输出的赛道。
尤其是在这个爽感可被算法批量制造的「末法」时代,我的建议是,还得多珍惜愿意沉下来去拍活人感的剧吧,这个市场并没有萎缩,更不会被取代,它只是被亏欠了太多。
真诚是能被感受到的,人类之所以会被他者的故事打动,是因为能从里面看到自己的处境,共鸣很重要。
不过,拍出「活人感」其实是个技术活。当整个行业都在被效率裹挟,忙着拥抱AI、虚拟角色和低成本短剧时,「早春晴朗」反而在提醒一件事:演员真实的表演,才是长剧的核心资产。…
一句话说出口前的停顿,一次明明在意却不愿完全表露的克制,这些只有真人才能演出来的细腻,才决定了观众能不能代入。
你看井柏然和孙千在剧里的状态,贼细腻,观众刷个片段都上头,看正片更是连呼吸都得屏住。
短内容可以快速制造情绪,AI可以提高生产效率,但一部真正能穿透观众的剧,依然是表演、文本、镜头和节奏达到平衡后共同托举的结果。
所以「早春晴朗」这次的大出圈,更像是优酷坚持精品内容战略的一次集中呈现。选题有现实温度,创作者有稳定表达,演员能把人物落到生活里,平台又能把热度推向海外讨论。
我看「早春晴朗」的编剧高小娴说,希望观众能从这部剧里得到片刻的治愈,所以没有设计爱情大过天的那种浪漫剧情,也不走「灰姑娘」的反差叙事,就是为了尽可能的贴近现实主义,让大家知道成为对的人、找到对的人是可行的人生。
真好啊,快来接吧。
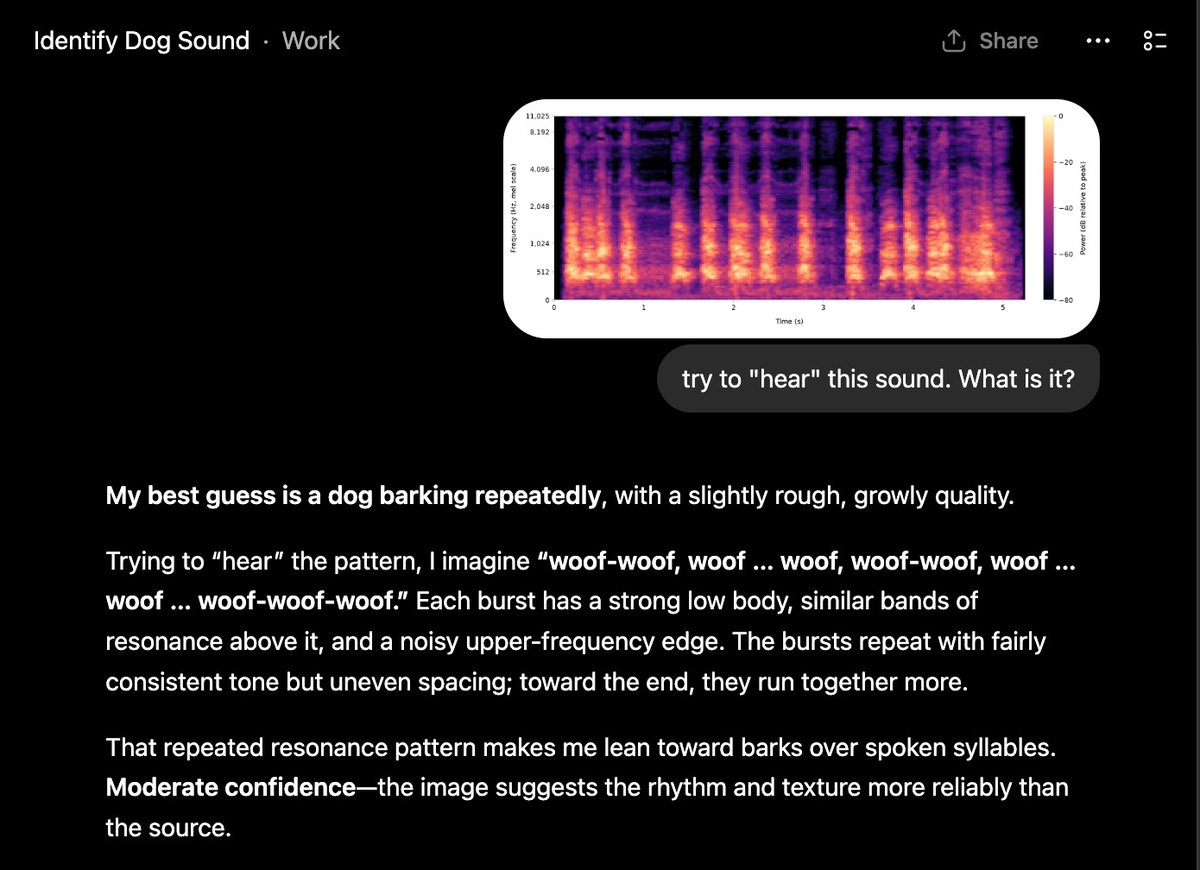
Astra:从频谱图识别声音
TPU 推理外部化全速推进:InferenceX 每美元性能最高提升 50%,TPU 技术栈快速外部化,客户群不断扩大,Ironwood、TPUv8i,以及削弱 CUDA 壁垒
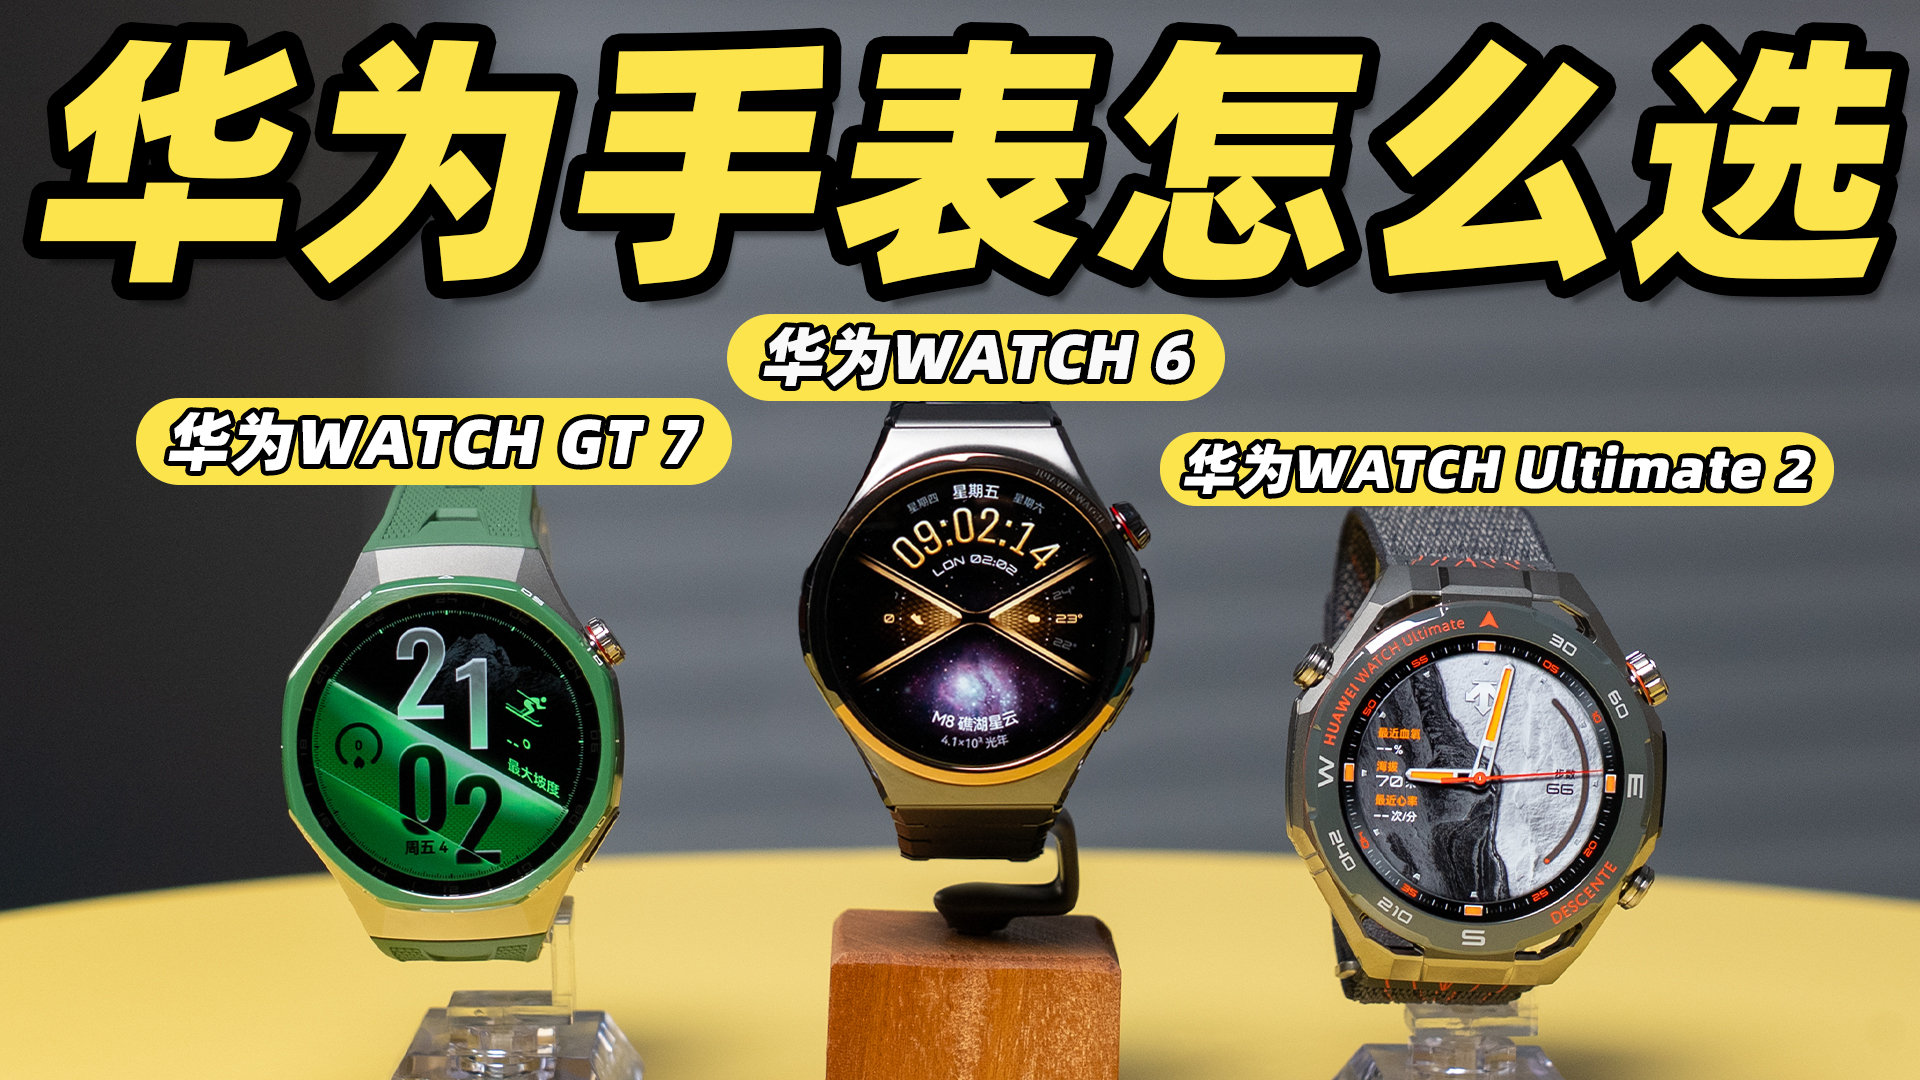
华为WATCH 6全系列深度体验!WATCH 6、GT 7、Ultimate 2到底怎么选?!
#华为手表怎么选#
#涨姿势#
看到皮鞋两个字,你第一时间想到的是什么?是【给我擦皮鞋】还是【厂长是我表哥】还是【华强的皮鞋】?但你应该发现了,身边好像没人在穿皮鞋了。 #为啥大家不穿皮鞋了#
//@靳玉志:麒麟芯片回归!麒麟9050Pro是首款采用逻辑折叠技术的高性能芯片,华为MateXT2非凡大师首发搭载。Mate40我一直也在使用,它搭载的就是当年的麒麟9000。六年时间,麒麟完成涅槃,国产芯片迎来新的里程碑。自研之路,终见曙光!
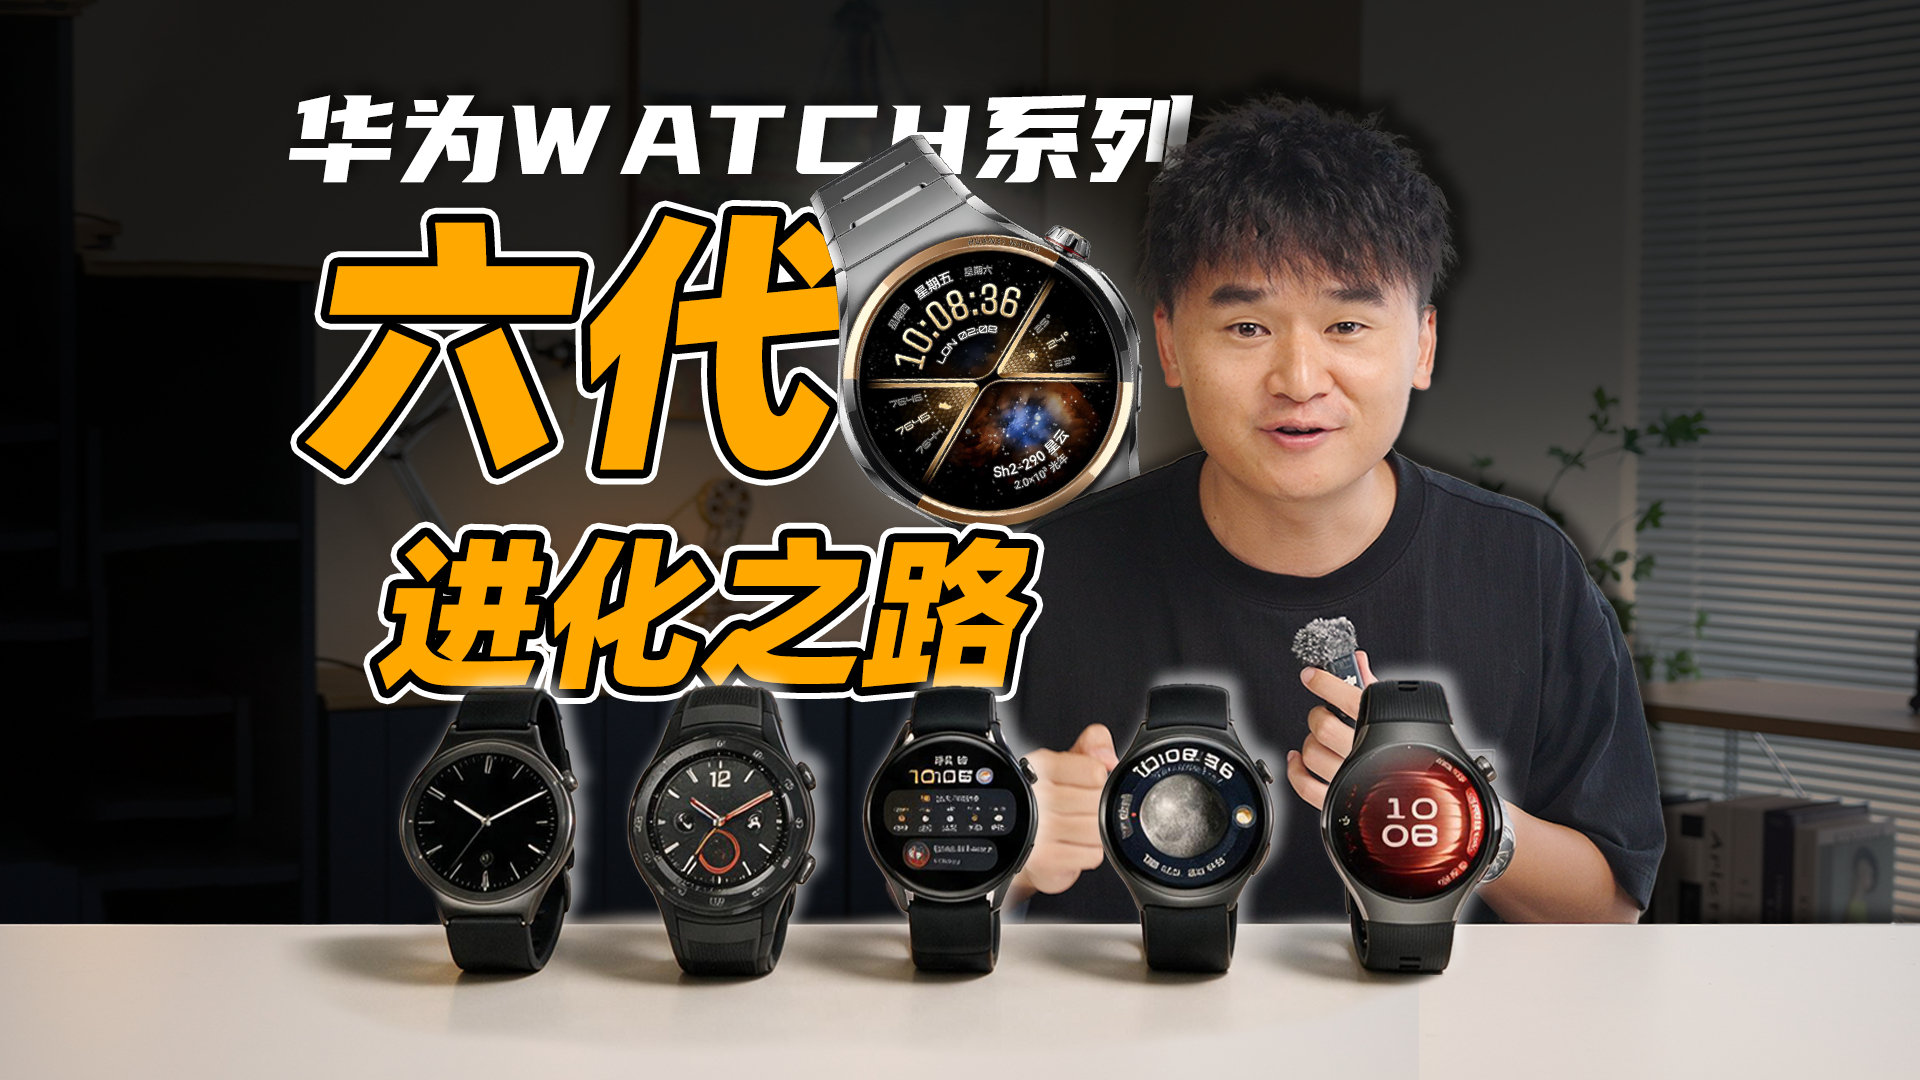
「趣体验」从青涩到成熟:华为WATCH六代进化之路。
#华为手表怎么选# http://t.cn/AX0YdCbP
今天太平洋标准时间(PST)下午 6 点将重置。
永远不会放弃你
永远不会让你失望
永远不会四处奔波然后抛弃你
永远不会让你哭泣
永远不会说再见
永远不会对你撒谎并伤害你
感谢阅读。我们将为所有付费订阅统一重置用量,这样你在 Blender 里开心地进行 3D 建模、用完全部额度后,仍然可以继续享受 Astra。工作周马上就要开始了。
预计今天太平洋标准时间下午 6 点左右完成。
//@flypig:好好好!!!
用 Astra 可视化药物的作用机制:
昨天,我构建了一个细胞模型。🧬 今天,它向我展示了 Ozempic 的作用方式。
我让它解释其中的机制。
1 小时后……就是这个。🤯
GPT-6 Astra 的能力强得离谱。🚀
我根本停不下来 @DeryaTR_ @gdb
现在我在想……它能不能模拟 rentosertib 的作用机制?👀
真相会让你自由
//@Transformer-周:韩旭太牛逼了,女中豪杰
#WNBA2026# 【纽约自由人队为韩旭庆祝】定海神针!在女篮世界杯小组赛中,中国女篮74-70加时逆转捷克女篮,这场比赛中韩旭发挥出色,全场拿到22分14篮板荣膺全场最佳球员!纽约自由人队也晒出了韩旭的数据图和赛场照片为她庆祝🎉 #WNBA💬#
Skill更像是一个给 Agent用的说明书,而且只需要说那些模型不知道的部分。
至于执行,就是工具(脚本、cli、app等等)去做的,是给模型直接调用的。
换句话说,模型不知道怎么用(或者不能高效使用)特定的工具或者执行特定的流程,而 Skill就是弥补这个差距的存在。
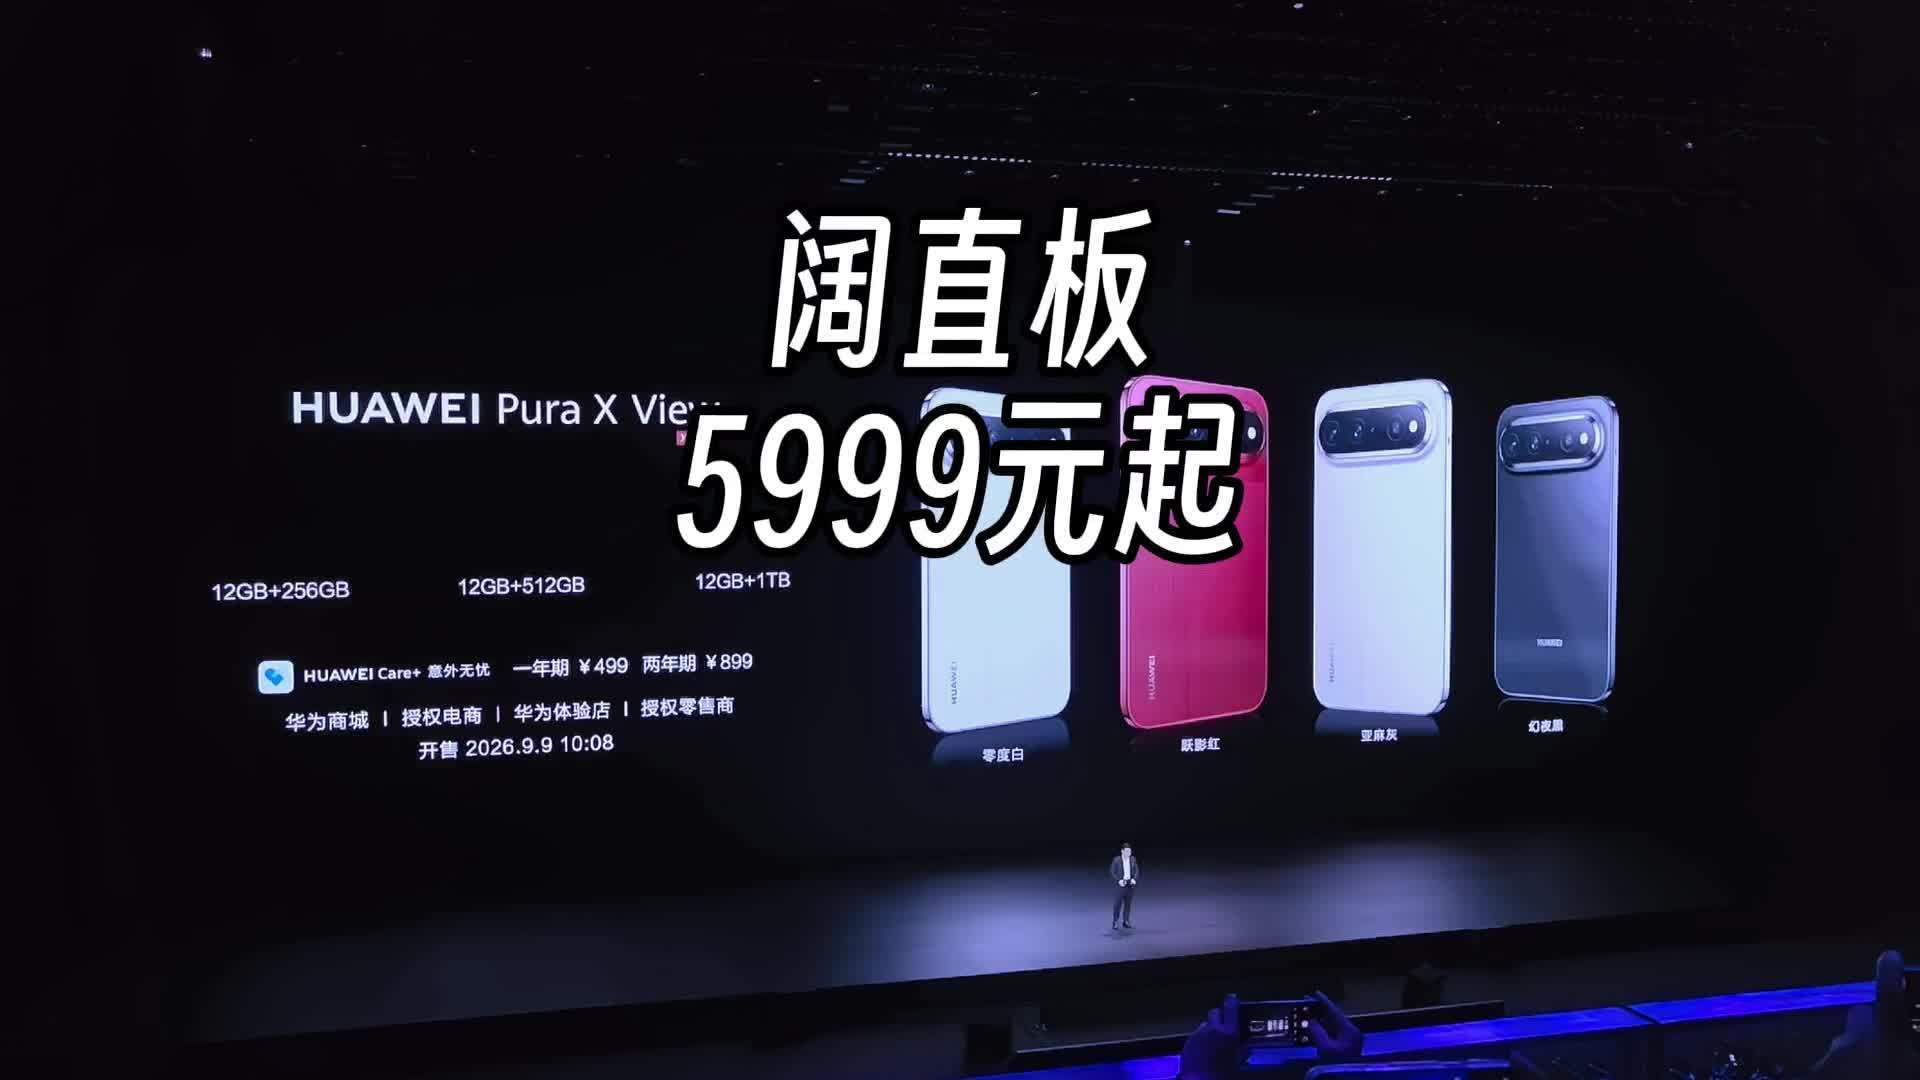
#华为PuraXView价格#比预期要低!这价格要大爆!
而且,现在是NVL72。下一代芯片上个月开始上线,它们训练的模型几个月之后也就出来了。http://t.cn/AX0YnC8E //@梁斌penny:大概率是已经做好了,小飞刀需要的时候就发射,这些大厂模型深度都太可怕了。
貌似 Anthropic很快又要发布 Claude Fable 5.2新模型了,估计是因为 OpenAI新发布的 GPT-6 Astra给他们带来了很大压力 😂 这种发版节奏实在太恐怖了……
【武汉市文化和旅游局发布处理通报】武汉市文旅局7日发布通报说,2026年7月24日晚,在武汉举办的《济公活佛》第八本专场演出中,演员郭德纲歪曲篡改表现抗战的著名歌曲《弹起我心爱的土琵琶》,造成恶劣社会影响。
通报说,经核查,郭德纲本场演出的举办单位江苏籽笛芮呈体育文化产业发展有限公司、演出场所经营单位武汉中南剧场管理有限公司,违反《营业性演出管理条例》第二十五条、第二十六条、第十六条规定。依据《营业性演出管理条例》第四十六条、第四十四条规定,决定对江苏籽笛芮呈体育文化产业发展有限公司给予警告、没收违法所得48687.4元、罚款486874元的行政处罚,责令其整改并加强对演员和演出内容的管理;对武汉中南剧场管理有限公司给予警告、罚款110000元的行政处罚。同时,对涉事人员严肃处理。
通报说,抗战歌曲承载中华民族抗战记忆与民族情感,绝不允许任何单位和个人歪曲篡改。将依法加强监管,切实维护文化市场环境。
这个儿童小游戏开源了朋友了!不光是代码开源,制作方法也写的很清楚了。这样就可以随意扩展了。
在线体验地址:开源地址:欢迎体验扩展
我去,都夸GPT-6 Astra做3D场景不错,但其实claude也是可以的。
再给大家分享下claude fable 5.1做的,直接做成了完整的游戏,之前我们做fable 5.1测评的时候也发现,fable做事情更加周到全面,做完是可以直接交互使用,小朋友更加喜欢,感觉是可以开源使用的,如果大家喜欢,我晚点优化下,然后开源出来~
fable的制作方式:也是基于Blender+ Three.js且fable是用程序噪声生成灰度凹凸图来体现整个黏土质感
智界R7是我很有感情的一款车。2024年9月上市后,我就买了一台给家里人开。
2025年春节,我开着R7增程版从安徽老家返回深圳,1345公里、15个小时。后备箱里装着老乡准备的很多土鸡蛋,也稳稳当当地到了家。去年夏天,我又开着R7到了新疆,第一次坐上了热气球。
后来看到,超过12万车主中,80%都是家庭用户,我一点也不意外。家人坐得舒服,自己开得有意思——不得不说,R7车主都很会选。
这次焕新,我们把重心放在真实的家庭用车场景上,投入5亿元,带来八大升级。座舱不止进一步优化空间,座椅也围绕家庭场景进行特别设计,让车内成为一个有温度的治愈空间。
智界R7兼顾轿跑姿态和续航表现,此次升级后,纯电续航里程CLTC至高达到855km;在操控上,智界也一直有自己的追求,此次焕新我们也做了专属调校,让家用SUV也能拥有轿跑的驾驶质感。
全新智界R7本月开启预订,我也很期待再开它跑一趟长途。
警报🚨:AMD 在不到 19 天的时间里,将 @vllm_project 在 MI355X 上现代 MiniMax M3 模型智能体工作负载中的性能提升了 11 倍!
这一切完全通过软件优化实现,主要是优化长上下文注意力算子,同时还进行了其他优化!这就是 ROCm 技术栈的力量:硬件只需购买一次,之后便能通过软件优化持续免费获得性能更新。
没错
“极右翼”政党由一位女同性恋女权主义者领导,而她的妻子来自斯里兰卡?
酷 🇦🇹
帮转,DeepSeek社招资深后端/服务端工程师引用原帖:
从效果看还有差距,但有潜力👍引用原帖:
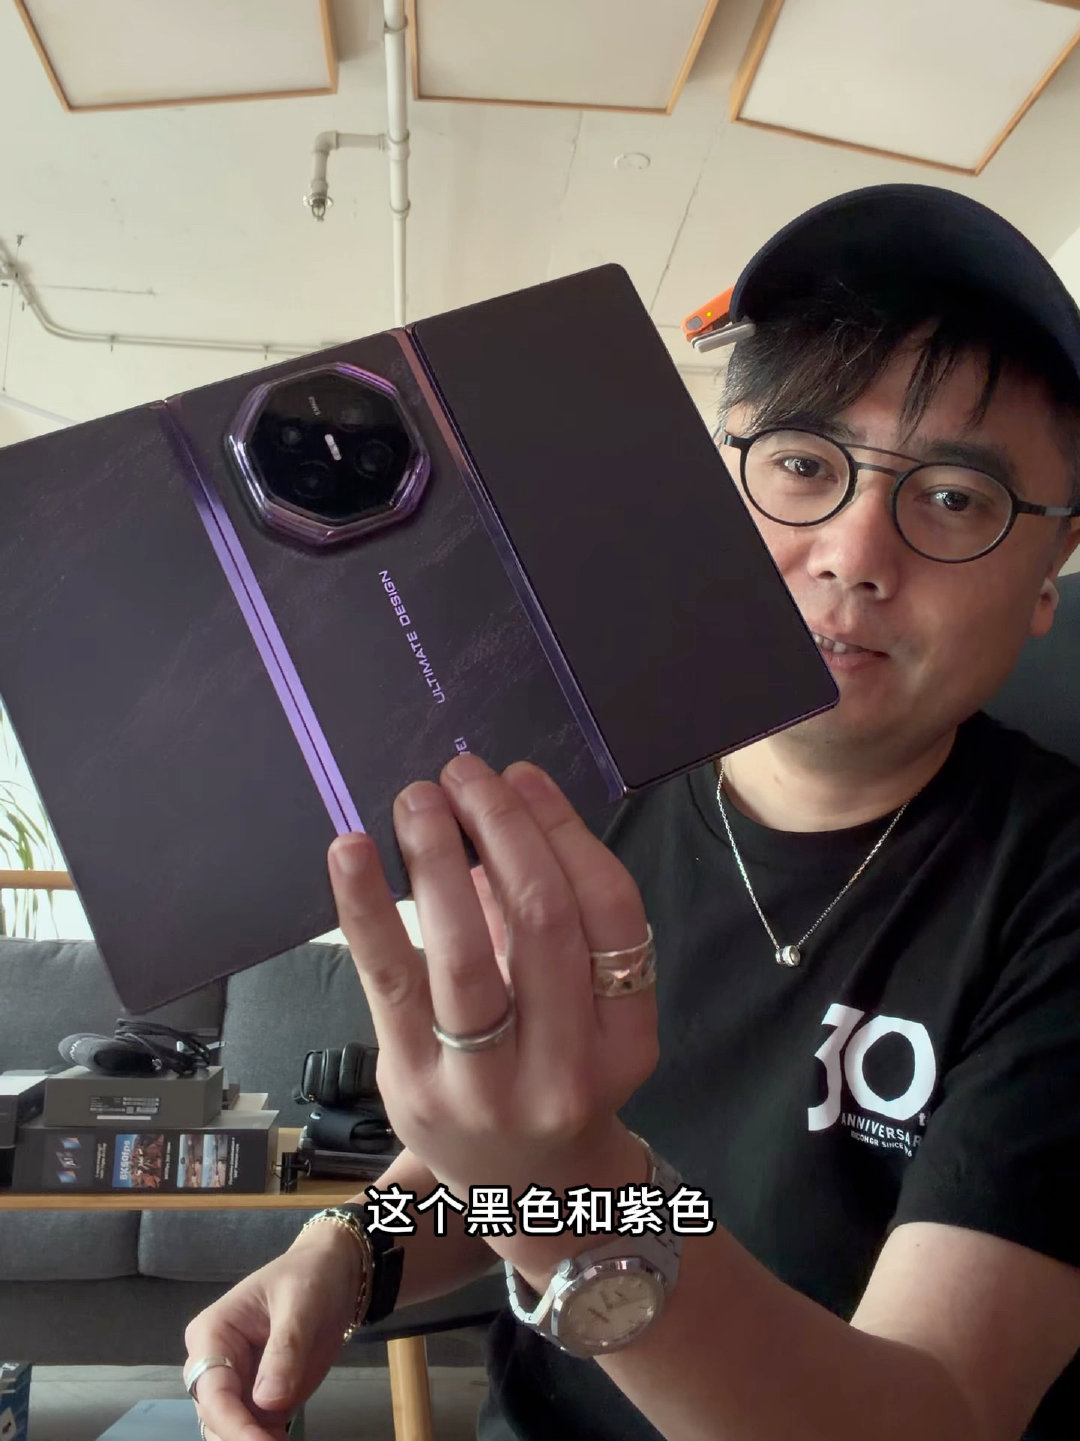
来,给大家火速开箱一下华为 Mate XT2,简单聊两句的:
//@亚尔古水手-WhiteRose:转发微博
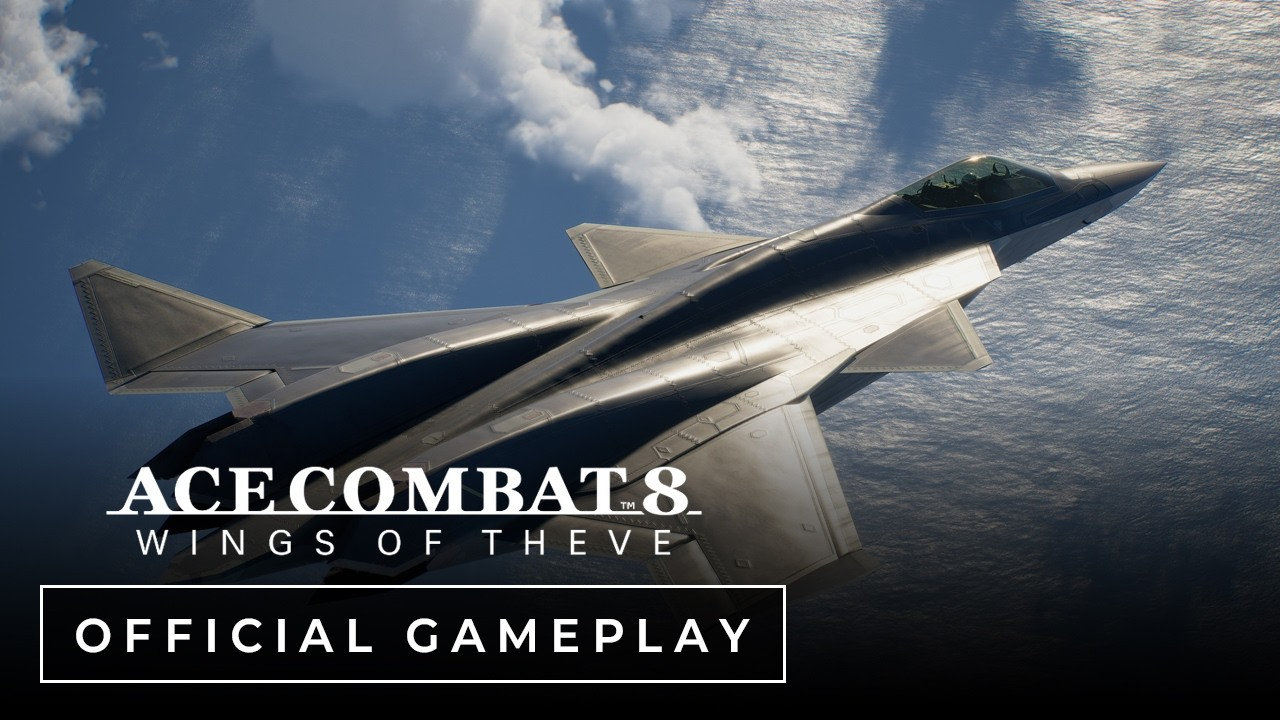
皇牌空战8原创机FA-36 GAME公开!!!造型与1999年皇牌空战3中的XFA-36基本一致,座舱从COFFIN变为了传统座舱
Astra 用于解决现实世界的问题:
我昨天经历了自己的“触及 AGI(通用人工智能)”时刻。
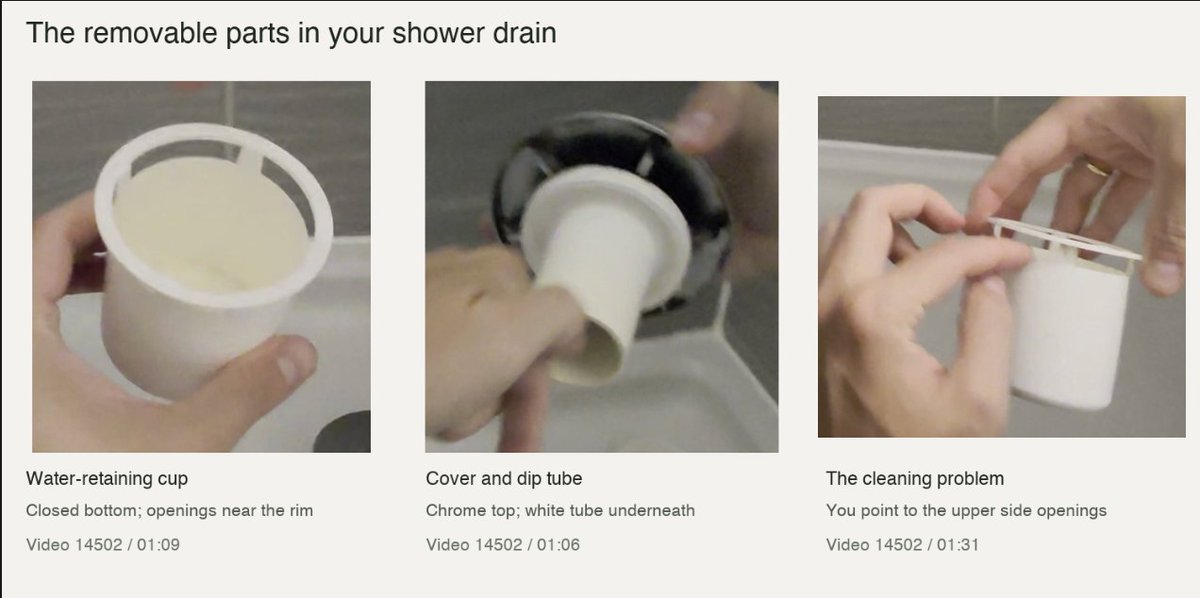
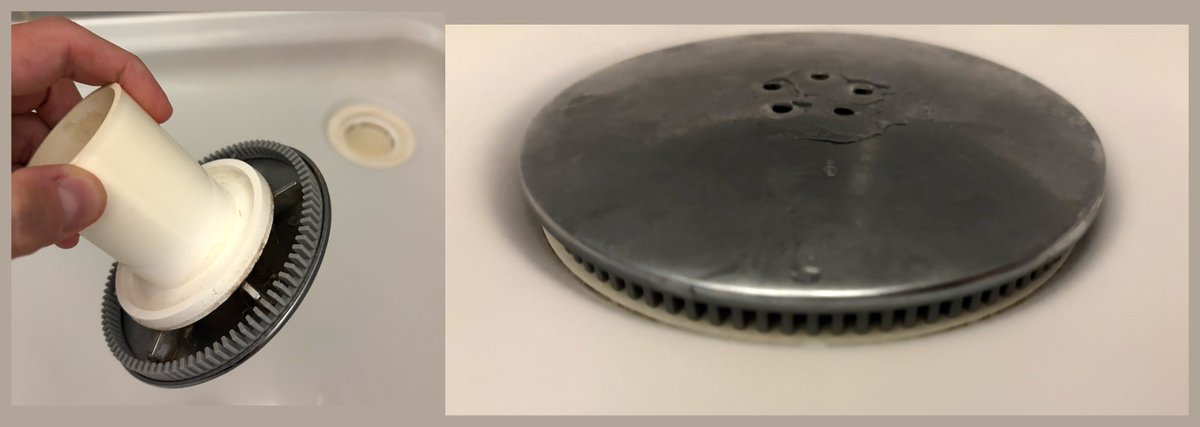
我录了一段视频,讲解一个问题:如何改善淋浴排水口缠结头发的清理维护。视频大约 4 分钟,我解释了问题,还用数显卡尺测量了尺寸。我让 GPT 6 Astra (Ultra) 为这个问题想出解决方案。
它读取了视频内容,提取我的语音,并将视频画面与我测量部件的位置对应起来。它想出了一个让维护和清洁更容易的方案。我得到了一个交互式草图,因此能理解它在说什么。然后我让它在 Fusion 360 中使用 computer use(计算机使用)功能。
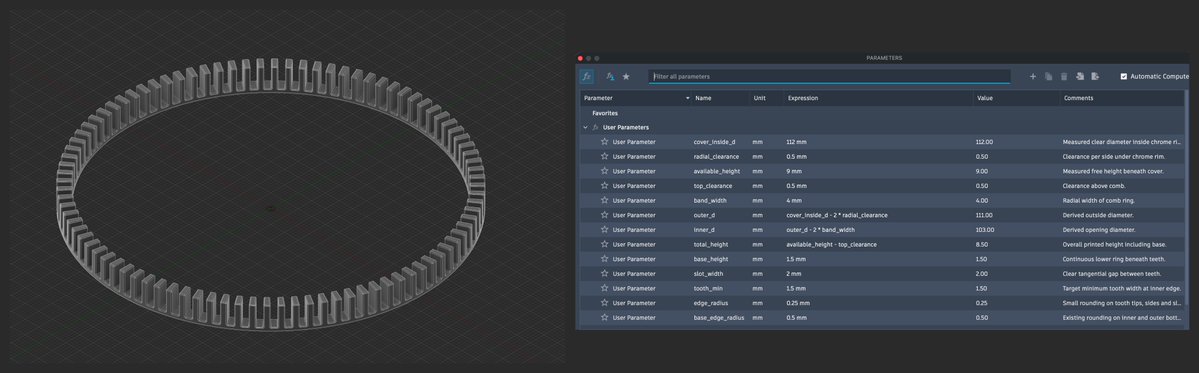
我实时看着它设计这个部件,并将其做成完全参数化的模型。观看过程中,我还学到了几个技巧,比如把一个设计设为只读,就能释放你获得的 10 个免费可编辑设计名额中的一个 😅
总之,它完成了设计,而且看起来很扎实。我让它添加圆角。我把它 3D 打印出来,实际试用,第一次尝试就完美贴合。
虽然这个问题并不算特别复杂,但它解决了一个现实世界的问题,而且可能比我自己在 Fusion 中费力摸索、做出想要的东西还快。
野村证券的中国互联网夏季研报写了一些很关键的数据,大部分出自Quest Mobile:
- 抖音的月均使用时长有史以来第一次超过了微信,成为中国人最耗时间的App,抖音的日活用户(7.14亿)低于微信(9.31亿),这意味着每个活跃用户投入在抖音的时间要远高于微信;
- 在中国月均使用时长排名前20的App里,字节独占5席,依次是抖音、抖音极速版、红果短剧、今日头条和番茄小说,分走了中国网民35%的使用时长,而腾讯占到4席,分别是微信、搜狗输入法、王者荣耀、腾讯新闻,但加起来只分走了24%的时长占比;
- 红果短剧的日活用户达到1.68亿,比「爱优腾芒」四大长视频平台加起来还多⋯⋯而且随着假期到来,红果短剧的增长甚至还没放缓,同比高达107%,而「爱优腾芒」的日活用户全都出现了两位数以上的下降,无一幸免;
- 在线音乐市场也在被字节系产品蚕食,汽水音乐和番茄音乐的日活用户分别增长70%和37%,除了网易云音乐守住基本盘没有崩掉以外,QQ音乐、酷狗音乐、酷我音乐均在不同程度的流失用户;
- 小红书的日活用户涨了6%,可以理解为是世界杯直播版权换来的增量,值不值就看内部如何判断了,但社交赛道总体来说还是下行的,微博和QQ的日活用户和使用时长都在往下掉;
- AI应用赛道,豆包的1.68亿日活依然断崖式领先,远远甩开日活3100万的DeepSeek和日活2800万的千问,不过从日均使用时长来看,中国仍然没有任何一款AI应用能突破20分钟,最高的是DeepSeek,16.5分钟,环比下降;
- 钉钉日活7700万,企微日活7200万,飞书日活1000万,但用户的日均使用时长是反过来的,飞书14.8分钟,企微12.4分钟,钉钉9.9分钟,这应该是它们最后一次被单独分类统计了,整条赛道都会被AI办公给顶替掉;
- 携程、去哪儿、飞猪三大OTA平台的日活用户全都出现了下降,这在暑假这个旅游旺季不太应该出现,说明选择出去玩的人在变少,对照来看,百度和高德的日活用户也在下降;
- 其他主流App方面,拼多多的日活用户再次反超淘宝,美团的日活用户微涨,但使用时长不增反降,百度的日活用户暴跌21%,Boss直聘成了这个暑期档除字节系之外的最大赢家,日活用户大涨15%。
本期访谈从数学最基础的概念谈起,说明数学如何把数量、形状、变化和不确定性变成可精确交流的语言,并追踪纯数学经由科学、工程走向现实应用的路径。陶哲轩认为,AI 正在改变科学研究的分工:它可以广泛搜索问题、组合方法、发现人类容易漏看的线索,但在真正困难的问题上仍缺少稳定的深度、可靠性和可复现性。未来更可能是人类负责选择值得长期深挖的问题、理解意义并建立理论,AI 负责扩大探索范围、承担重复试错和寻找潜在突破口。
陶哲轩将数学概括为数、代数、几何、概率、分析和动力系统六个基础主题。它们最初都很直观,却逐步发展出深奥的理论。数让数量、尺寸和规模能够被准确传递;从负数、零、分数、无理数到复数的扩展,展示了数学如何为了保持规律和解决问题而扩大自身的体系。代数进一步用变量和运算研究结构,使人们可以脱离具体数字,研究更普遍的关系。
他也提醒,定量思考很适合处理农业、贸易、金融和医学等需要权衡成本与收益的决策,但并非所有人生选择都能还原为数字。数学的力量在于提高描述和推理的精度,而不是替人消除所有主观判断。
几何和微积分既能解释酒桶为什么可以通过一次斜长测量估算容积,也能把市场经验转化为可验证的理论。无穷、无限猴子定理和概率说明,理想化的数学推导可以帮助人们判断“可能发生”与“实际可行”之间的差别。陶哲轩强调,数学中的规律常常先由好奇心驱动被发现,之后才被其他科学家、工程师或产业界找到用途;从基础研究到商业成果,需要不同领域之间持续交流。
访谈以球体堆积为例,说明看似抽象的高维几何如何转化为通信编码,帮助工程师估计无线频谱的理论极限。压缩感知则展示了数学如何改进 MRI 成像:在扫描时间更短、数据更少的情况下,如果图像具有足够结构,仍可能通过合适的重建方法恢复有用结果。数学的实际价值并不只在于直接提供答案,也在于揭示哪些信息足够、哪些极限无法突破。
从数学规律到现实成果并不存在自动跳跃:基础科学家需要与应用科学家交流,应用科学家要与工程人员协作,工程人员还要与产业界沟通。任何一环缺失,都可能让一个由好奇心开始的发现无法走到实际应用。
科学研究经历了理论、实验、模拟和大数据等不同范式。过去,即便使用计算机,科学家仍需亲自设计实验、推导理论、编写工具或筛选数据。现在,自动化实验室、编程 Agent(智能代理)和 AI 数据分析工具开始接管其中一部分工作。AI 可以从海量问题中尝试不同方法组合,找到文献中被忽略的思路,或对专家共识提出独立检验。
陶哲轩认为,人类数学家通常会挑选一两个难度合适的问题,长期投入并从中提炼可迁移的深刻见解,这是人类的深度优势。AI 更适合同时面对成百上千个不同难度的问题,通过带有随机性的尝试扩大搜索面;其中多数尝试可能无效,但少数结果可能连接两种原本分离的方法。AI 已从解决基础题逐步推进到研究生资格考试水平、较小的未解问题,以及部分人类长期努力过的研究问题。
AI 在数学研究中的进步已经不能用几年前的能力来衡量。降低错误率的方法让它变得更有用,但现有成果常由私营公司完成,资源消耗、测试成功率、尝试次数和可复现性并不透明,因此还无法判断这些能力会成为日常工具,还是只能在高昂成本下偶尔出现。First Proof Challenge 之类的基准测试正在尝试用研究级题目更严谨地测量模型能力。
因此,判断 AI 是否真正推进了数学,不能只看某一道题是否答对,还要看它能否稳定迁移方法、解释答案,并在不同问题和资源条件下重复得到相近结果。
访谈最后回到科研教育与人的判断:数学和科学需要反复犯错,成功解法背后往往有大量失败尝试,不能把探索过程伪装成一次完成。AI 可以减少面对复杂世界时的盲点,但人类仍需要决定什么问题值得研究、如何解释结果、哪些结论真正可靠,以及科学应当服务什么样的长期目标。
这也构成了陶哲轩对未来合作方式的判断:与其把人类和 AI 放在单一排行榜上比较,不如让二者承担互补任务。人类保留问题意识、长期判断和深度理解,AI 扩大试探范围、处理重复工作,并把那些原本很难逐一检查的可能性带到研究者面前。科学的价值不仅是产出技术,也在于让人对复杂世界形成更清晰的认识。
- 数学的六大核心要素 [00:00:00 - 00:10:00]
- 从几何到微积分 数学如何服务现实 [00:10:00 - 00:20:00]
- 无限、概率与数学的探索 [00:20:00 - 00:30:00]
- 纯数学与科学发现的关系 [00:30:00 - 00:40:00]
- 从高维堆积到压缩感知 [00:40:00 - 00:50:00]
- 科学方法与 AI 的介入 [00:50:00 - 01:00:00]
- AI 擅长广度,人类守住深度 [01:00:00 - 01:10:00]
- AI 在数学研究中的现状与局限 [01:10:00 - 01:16:31]
# #712.陶哲轩:AI 擅长广度,人类守住深度
陶哲轩:我是陶哲轩。我是加利福尼亚大学洛杉矶分校的数学教授。我有一本即将出版的新书《Six Math Essentials》。今天在《Big Think》,也就是《Big Think》知识播客上,我将谈谈数学的六大核心支柱,历史上数学如何与科学相互作用,数学如何预见许多重大的科学进展,以及AI的最新发展未来将如何影响数学和科学。
Big Think编辑:感谢观看Big Think 如果你想支持我们的工作,欢迎加入我们的会员社区,作为会员,你会收到我们的纸质寄刊,里面精美地汇集了,最重要的思想和访谈 Big Think面向的是,那些充满好奇心,渴望深入探索,宏大思想的人,想要支持,你想在这个世界上,看到的媒体,请访问 bigthink.com 写杠membership 现在让我们回到访谈,第一章,数学的六大核心要素 [00:00:24]
陶哲轩:我决定围绕六个,极其基础的概念来构思这本书,它们起源于几千年前或几个世纪前,在最初阶段大多数人都非常熟悉,但随着时间的推移,数学家们把它们发展得极其深奥复杂,第一个概念是数,然后是代数几何概率分析和动力系统,这些都是非常基础的概念,但它们已经演化成了极其深奥的数学,但如果你剥离所有技术上的复杂性,它们本质上就是极其直观的概念,而我们发展出来的数学,只是一种精确的语言,能极其仔细地去描述它,让你能够非常清晰地思考这些概念,数是人类最古老的数学发明之一,而且说实话,它至今依然是最有用的,我们发现过一些古课记录,它们比字母表或其他文字还要古老,而且数是由多个文明各自独立发明过的如果我们没有数,在试图描述任何情况时,我们就总是得用诗意的方式去讲,而且总会有点不够精确,下一个人转述你的话时,理解上就会出现一点偏差,它带来了精确性,数是数量,尺寸和量级等概念的站位符,把它们变成非常便于传递的东西,让你能传达给其他可能,根本没接触过那些事物的人,而一旦你要去描述一个,包含很多运转环节的极其复杂的场景,你就需要数,以及建立在数之上的一切东西,人类天生其实并不擅长用数字来思考,如果你没有定量思考的能力,去权衡一项行动的收益和成本哪个更大,你就可能会做出一些日后会后悔的人生选择,比如付出了大量资源,却只换来极少的回报对这些事情进行更多定量思考的第一步,就是理解数,然后理解建立在数之上的更高级的数学主题,比如概率和代数,像农业或贸易这样最基础的事情,如果不能用数来计量大量的粮食,是根本无法实现的,征税也是如此,不幸的是没有税收就没有文明,而这需要数学和数,当然并不是所有事情都是定量的,如果你要去约会,你不应该去权衡未来伴侣的成本和收益,有些事情依然应该是非常主观,非常个人化的,但在当今这个现代世界,有越来越多的决策,比如在金融或医学领域,做一些定量思考是非常有帮助的数学奇妙的地方在于它们会有自己的生命力,因为一旦你有了数的概念,你就可以抽象地研究数,脱离它们的实际应用,你会发现规律,而且往往会发现很自然地就会去扩展已有的数系,创造出一些你原本想不到能用在最初语境里的新数,但它们却能非常非常契合地融入到数系中。如果你在数羊,有时候你想把羊加在一起,有时候想减掉羊,所以很快你就会发展出,加法和减法的概念,但你会意识到,如果你只数数0 1 或者其实连0都没有 1 2 3 4 你会发现这些数总是可以相加,但并不总能相减,如果你用3减去4 这根本就讲不通,你不能从三只羊里拿走四只羊,但数本身的规律是如此规整以至于如果你只是机械的套用算术法则,就会觉得好像应该能从4里拿走3 从而得到一个新数,这也花了一段时间,但人们最终意识到可以发明出这些负数,你可以把负1负2负3加到你的数系里,还有0 人们花了很长时间才真正意识到 0对数系是一个很好的补充,而且算术中那些优美的法则依然成立,比如如果你拿一个数A减去B 然后再加回B 你就会变回A 那是算术法则之一,即便有了负数,它也依然成立,类似地,我们学会了一个数除以另一个数,创造出了分数,而分数也非常契合地融入了这个数系,然后就出现了一个震撼的发现,我们发现在所有这些有理数,所有这些分数之间,不知怎么的居然存在一些像根号二这样的数,它们根本无法表示成任何比例,这确实是一个巨大的震撼居然存在这种,我是说这些数字面上就叫无理数,在拉丁语里就是疯癫的意思,而不是不讲理的数,但它们确实存在,而且非常有用,在一张有限的纸上,你永远也写不完,它们的所有小数位,手头有所有,这些额外存在的数,是非常非常有用的,后来我们又尝试对复数开平方,这在原本的常规数系里是做不到的,于是我们发明了复数,事实证明,它在电磁学和量子力学中,极其有用,令人惊叹的是,这些最初往往只是为了,更好的解方程,解决实际问题,而发明的数系,最终却成了描述现实世界中,极其复杂的现象,最自然的语言,比如量子力学,代数是建立在数之上的第二层抽象,在数的层面,我们具体的东西,比如一群羊一定量的水之类的,换成了数,然后你就可以对它们做各种运算,加法减法除法等等,代数则更进一步,试图不再盯着像7或17这样的具体数字,首先用更通用的站位符来代替数,我们给它们起名叫X和Y 同时还要去研究运算本身,加号乘号,以及所有这些其他运算,去探究运算具有什么性质,而不只是数本身,于是我们发现,这些在算术中如此有用的运算,本身就具有许多迷人的性质,加法就具有一种叫做交换率的性质 A加B和B加A是一样的,事实证明,这个性质在帮你解决涉及加法的问题时,极其有用,乘法也一样,所有其他基本的算术运算,都遵循这些非常简单的定律,后来我们发现,这些定律对其他运算同样适用,比方说如果我拿一个物体来旋转,我可以先转30度,然后再转60度,但如果反过来转,先转60度再转30度,最终得到的朝向,跟我最开始是一样的,这两种旋转就是可交换的,尽管这种运算,跟传统意义上的数毫无关系,并不是传统意义上的加法或乘法,但它具有完全相同的代数结构,反过来,有些东西并不服从交换率,比如我先穿袜子再穿鞋,和我先穿鞋再穿袜子,得到的结果是完全不同的,这两个动作就是不可交换的,某些运算遵循像交换率这样优美的定律,而某些运算则不遵循,有时候你会看到一种对应摆在眼前的定律,跟我们已经理解的定律非常相似,比如数的定律,正因为这样,我们就可以把关于数的直觉,想法,证明,和理论迁移到一个完全不同的场景中,比方说矩阵是一个比数复杂得多的概念,它不单单是一个数,而是一整张正方形的数字阵列,但事实证明,矩阵所遵循的代数定律跟数非常像,如果你很擅长处理数,你就可以用同样的方法去处理矩阵,我们许多现代技术,比如大约模型,底层的依托就是能够,非常非常高效地处理矩阵,一旦你抽象到了数,接着抽象到了代数,你处理的就是包含X和Y 这类变量的方程了 X当初可能有某种物理意义,有某个具体的数值,但往往不关注这些数的具体值,或者它们代表什么,纯粹靠代数,靠挪动符号来摆弄这些方程,反而能让你的思路更清晰,刚学这个的时候,会觉得它跟实际经验非常脱节但它其实是一种非常强大的工具,代数的一个早期应用是开普勒的故事,他是一位天文学家和科学家,有一天他走在家乡的街上,看到了葡萄酒市场,卖酒的商贩正在一桶一桶地卖酒,有些桶大,有些桶小,但他们能算出每个桶里,有多少酒,好把酒钱付给酒商,如果有一个桶,你想算里面有多少酒,你可以把它倒进杯子之类的地方去量,但这非常麻烦,但让开普勒着迷的是,市场的负责人,有一种非常非常高效的办法,来测量酒桶的容积,他手头只有一根,刻着各种刻度的棍子,桶中间有个注酒孔,他就把棍子穿过注酒孔,插到桶底的角落,看看棍子插进去了多深,来读数,光凭那个刻度,他就能说,这是30加仑或者多少酒,然后他们就能据此定价,这让开普勒大为吃惊你怎么能光凭这么一条,对角线长度的单次测量,就算出形状,对应的容积,因为有些桶可能又高又细,有些可能又矮又胖,不知怎么的,就靠这一项测量居然就能算出容积,他算了算数学题,这对他来说是个谜,于是他回到家,写下了几个方程,假设酒桶的半径是R [00:09:37]
# #712.陶哲轩:AI 擅长广度,人类守住深度
陶哲轩:假设酒桶的半径是R 高度是H 换做今天用现代代数来看,这道题完全可以留给高中生做,这几乎就是我们最喜欢,给学生出的那种应用题,你能算出容积,也能算出这个长度,他发现,仅仅这个长度,并不能完全决定容积,但酒商总想尽可能多卖酒,在给定的斜长下,你总想把容积尽量做大,理由是所有这些商人,都在追求利润最大化,虽然他一开始,并不能直接解出这些方程,但加上这种利润动机之后,他做了一些非常粗浅的,我们今天称之为,微积分的运算,结果算出来的形状,跟市场上实际卖的酒桶,几乎完全吻合,他的公式也以极高的精度,吻合了人们实际使用的规格,也就是说,市场上这些,凭经验慢慢摸索出来的规则,被他用理论解释清楚了,他找到了一个非常令人满意的解释,我觉得这也是几个世纪后,牛顿和莱布尼茨,发展微积分理论的,部分灵感来源,几何在希腊语里的字面意思,就是丈量土地,自古以来知道从一个地方到另一个地方,要走多少英里,以及如何在海上或野外靠星星,辨别方向都是非常重要的,我们需要明白怎么利用观察到的东西,比如角度和距离,去解决非常实际的交通运输等问题,就像数有各种规律一样,比如A加B等于B加A 一旦你开始测量不同点之间的距离和角度,所有这些测量结果之间,同样存在着大量的关系,所以几何就像属遵循规律一样,也遵循着各种定律,比如其中一条定律就是相似性,一旦你知道两个图形相似,它们的各个角度完全一样,那么它们的所有边长就都成比例,一旦你知道大三角形的一条边,比方说是小三角形对应边的两倍你就会知道大三角形的所有其他边长,也都是小三角形的五倍,它们的比例是相等的,这之所以这么有用,是因为它能让你预测那些,你直接够不着,无法直接测量的距离或尺度,你可以看着远处的山,你可能真能估算出它有多远,因为你知道一些,关于它有多高的信息,而仰角式,你可以利用相似三角形来测算的,这样你就能做一个,按比例缩小的模型,比如现在你就能导航了,你可以看明白,怎么去到一个遥远的地方,哪怕你从自己的帆船上,或者别的地方,根本直接看不到它,甚至在古希腊时期,它们就能测出到月球和太阳的距离,这些距离它们绝不可能直接去测,但仅仅通过几何定律,也就是它们当时就已经研究透的,相似三角形之类的原理,在没有任何卫星或先进技术的情况下它们其实就能得到相当不错的结果,一旦你掌握了几何学,你的感官就能真正延伸到,远超你亲手触碰和直接测量的范围之外,第四个数学要素是概率,这是数学家试图,概括现实世界基本特征之一,也就是不确定性的标准方式,在小学或高中的课堂上,教数学的时候,我们经常会给出一些,经过高度进化,结果完全可预测的应用题,比如按你有30个苹果,它分了一半给詹姆斯,詹姆斯有多少个之类的,里面的一切都很精确,你掌握着全部信息,但在现实世界中,存在着不确定性,也存在着不可预测性,所以当你抛硬币时,可能是正面,也可能是反面,如果你确切知道,自己对硬币用了多大的力,知道所有这些测量数据,你或许能做足够精细的模拟来确切预测硬币,最终究竟哪一面朝上,但这极其困难,而且你往往没有那些数据,人们最终意识到的是,与其试图时时刻刻,为每一个可能的结果,计算精确答案,有时你只能接受,某次测量,会有一定范围的可能结果,但真正重要的是,哪些结果出现的频率更高,哪些结果出现的频率更低,最先意识到这很重要的人是赌徒,因为赌徒会就某些特定事件下注,比如压住制骰子的总点数,会是某个数之类的,如果他们能正确算出胜率,他们就能赚钱,而如果算不对胜率,长期来看他们就会赔钱,概率数学最早源于几位赌徒,写给数学家朋友的几封信,心理请求帮忙优化他们的下注策略,概率论的发展,已经远远超出了它最初的赌博渊源,只要一个系统太复杂无法完全从第一性原理去建模,就会存在某种随机性,我们就需要一个概率模型,所以不管是股市走势,还是某种药物是否会成功,我们现在都经常会求助于概率论,有时候我们并不知道概率是多少,所以概率论在处理反复发生的事件时,效果最好,对,有成千上万次实验,我们就能开始对概率有一个很好的把握。如果是百年一遇的事件,概率论可能就不太对路。我们现在还在努力研究针对极端罕见事件的数学方法,希望能更好地取代概率论,而且其中有一些奇迹让它变得非常有效。你可能会觉得每次做一个不同的实验,比如不做医学实验,而是去研究制骰子的结果,或者演化过程中会产生什么遗传特征之类的。你可能会认为在每种不同情况下,你会得到完全不同的各种分布有些分布是重伪的,有些会很狭窄等等,但概率论里有一些很奇妙的定律,叫做普遍性定律,哪怕是非常广泛的各类随机系统,也会呈现出几种常见的形状,其中最著名的就是高斯分布,或者说中心曲线,很多分布,比如你统计男性的身高或女性的身高,它们几乎都构成一条完美的中心曲线,我们现在其实已经有很好的解释了,我们对概率论已经理解得足够透彻,能用数学解释相当一部分这类普遍性定律,尽管还有一些仍然充满谜团,数学分析是数学用来处理两件事的方法,其一是我们测量中的不准确性,有时候这算不上是随机性,纯粹就是不精确,数学分析算是关于误差棒的数学,在这个领域里我们意识到,有时候我们不仅需要了解,各种物理量的数值是多少还要弄明白我们有多大的不确定性,它们周围的正负误差棒到底是多少,但这些都是你甚至无法,仅凭字面去讨论的概念,我是说如果仅仅用,大和小这种定性的语言,它能起的作用是非常有限的,我们可能测量某个物体的长度,大约是2米,但可能其实是2米正负10厘米,这里有一个近似值,也有一个误差,理想情况下你希望误差是0 但在现实世界中,我们不可能总把误差做到完全为0 但有时候如果我们能让误差越来越小,如果我们不断进行越来越精确的测量,我们就能让误差缩小到0 但这可能需要无限高的精度,或者无限长的时间,才能把误差一路缩小到0 数学分析研究的也是,我们如何取极限,以及如何处理无穷大,在代数中,只要你只进行有限次运算代数定律就会非常管用,如果你只是拿五个数字,把它们加在一起,没有任何问题,你可以按任意顺序重新排列它们,但一旦你开始尝试处理无限次运算,就会出现一些奇怪的悖论,有时候你重新排列无限个物体,最终得到的总和,会和重新排列前不一样,这在有限求合里是不会发生的,比如如果你总是在压住轮盘赌,对吧,压红或黑,你有50%的几率赢 50%的几率输,有一个定理证明,只要你只有有限的资金,就不存在任何能让你一直赢,能保证你在长期内必赢的策略,基本上没有任何下注策略,能战胜庄家,有一种策略是输了就加倍下注,赌注越下越大,只要你哪怕只赢一次,就能拿回你那一美元,所以确实有办法能一直战胜庄家,但问题在于他假设你有无限的资金,这种策略的实质,是把输钱的所有风险,都压缩到,一直输这个极其微小的事件里,到某个时候,你下注几百万美元,然后某一个时刻,你就破产了,数学分析能帮你,准确理解这些尾部风险,究竟是什么,以及如何用一种,避开所有这些悖论的方式,去思考无穷大,对,在数学分析出现之前,曾经有大量非常不严谨的数学,当时大家总在说,哎呀只要我做无限次,就能摆脱所有这些问题,人们花了一段时间才意识到,如果你没有受过妥善处理它的训练,无穷大其实是一头非常危险的猛兽,但在现实世界里,我们无时无刻不再跟无穷大打交道,强也许不是真正的无穷大,但我们得处理非常大的数字,无穷大是一个很好的近似,能帮我们理解如何处理大数但用的时候必须小心谨慎,要展示无穷大有多反直觉,一个著名的例子就是,所谓的无限猴子定理,常见的说法是,如果你在一个房间里放无数只猴子,或者就一只猴子,在打字机前永远打下去,纯粹胡乱敲键盘,通常猴子敲出来的,都是毫无意义的乱码,但隔三差五,猴子就会敲出一个单词,比如的或者it 有时还会敲出一句话,但无限猴子定理是说,如果你等得足够久,或者猴子足够多,几乎能肯定保证猴子最终,能敲出任何你想要的内容,比如莎士比亚拳击,哈姆雷特,维基百科,或者任何东西,在数学上你能证明这一点,只要猴子至少敲出一次的概率是正数,不管有多小,只要是正的,你等得足够久,最终敲出这个特定模式的概率,就会趋近于一,这就像玩俄罗斯轮盘赌左轮手枪里只有一颗子弹,你一直开枪,不管枪膛有多少个,最终它总会射出来击中你 [00:19:52]
# #712.陶哲轩:AI 擅长广度,人类守住深度
陶哲轩:最终它总会射出来击中你,对于任何给定的单词,句子或段落之类的,你的猴子最终都会敲出这段文字,但花费的时间,会随文本长度成指数级增长,如果只是一个,四个字母的单词,猴子大概敲上一个小时左右就能打出来,但要是比如七个字母的词,比如Shakespeare这个词,可能就已经要花上好几年了,一句话可能要花上几千年,要打出哪怕一小部分,哈姆雷特,我觉得哪怕只是一页,花的时间都要远超宇宙的年龄,你才能真正看到它,无穷大实际上只是一个数字的站位符,用来代表任何可能远大于你能想出的,任何固定数字的东西,尽管现实世界里你没有无数只猴子,也没有无限的预算,但我们往往会先把无穷大作为一种理想化情境来推导,看看什么是可能的然后从这里转向更量化的问题,看看在有限资源下到底能做些什么,但首先你得明白在拥有无限资源时该怎么做,我小时候经常玩电脑游戏,在很多电脑游戏里,你可以输入一些秘籍,你可以给自己无限生命,或者无限弹药,有时候先开着这些秘籍玩游戏,很有帮助,你不用操心管理生命药水,或弹药之类的,只去看看怎么通关,然后你就可以换到更难的模式,去琢磨怎么更高效的通关,数学里的很多问题,其实就是这么解决的,数学有别于其他学科的一点是,我们有失败的自由,因为在数学里,失败的代价非常小,如果你在经营一家企业,做了一个糟糕的商业决策,公司破产了,那就是个可怕的错误,如果你是外科医生,切错了地方,那就是个可怕的错误,但如果你尝试解一道数学题,做了一个错误的假设之类的,行不通,其实不算什么大不了的错误再试一次就是了,当你尝试解一道数学题时,先做一个理想化假设,其实是个好招,假设你有无限的能量,或者零摩擦力,或者其他某种不切实际的假设,先把问题解出来,然后再尝试从无限世界回到有限世界,这正是数学分析发挥作用的地方,仔细看看无穷数学的哪些特征,在有限世界里依然适用,哪些会失效,动力系统是研究变化,研究时间的数学,研究的是渐进变化的规则,一个状态如何从一个时刻演变到下一个时刻,涌现出各种意想不到的有趣行为,从最初的规则里你可能根本料想不到,我们发现,即便非常简单的规则,经过长时间迭代,也能产生极其复杂的涌现行为,生物学里的进化,就是一个很好的例子,有一群生物,它们繁衍后代适应性更强的,比更弱的更容易存活下来,生物具有某些,可以传给后代的性状,这些都是非常简单的规则,结果却能产生,极其丰富的物种多样性,捕食者与猎物的关系,以及极其复杂的动态变化,如果你在高速公路上路上有这么多车,每辆车都只是根据前面的车尽量开快,前面车太多你就会减速,车不多你就加速,每辆单独的车都没做特别特别复杂的事,它只是在尽量优化自己的行车流速,但当你把所有车放在一起,观察它对整个路网的影响时,就会出现令人惊叹的涌现现象,比如交通波会出现这种能压缩又能展开的波,有点像弹簧玩具,如果你玩过弹簧玩具,它会有压缩波和膨胀波,这会导致你最初料想不到的现象比如发生交通拥堵冲击,像出了车祸,然后车辆排成长龙,哪怕事故现场已经清理干净,路上没有任何阻碍,按交通规律,如果你迭代这种动态过程,真去算一下,就会发现压缩波需要一段时间才能消散,我住在洛杉矶,这种现象我经常遇到,有时候路况突然慢下来,前面却根本没出事故,也没什么直接原因,那其实是因为,好几个小时前,有些状况导致了减速,但按照动力学规律,这个波动要消散,是需要一定时间的,只要把动力学彻底搞清楚,你就可以建模和仿真,然后就能做预测,比如在这条高速上,多加一条车道,路况会不会变好,事实上有时候并不会,这里面存在悖论,有时候把某些车道封掉,反而能让整体的车流,走得更快,有些动力学系统是可以预测的,有时候系统会有平衡态也就是状态一直保持不变,而且有时候这些平衡态是稳定的,你稍微偏离那个状态一点,它还会回到原来的状态,比如一个垂直自然下垂的中摆,这就是一个稳定平衡态,你稍微推它一下,给点扰动,它会动一动,然后又回到稳定平衡态,但如果你把中摆倒过来,让它在尖端上立着,它也可能是一个平衡态,严格来说,它确实能永远保持那个姿态,但任何微小的扰动,随着时间推移,都会让它彻底偏离这个平衡态,所以分清哪些平衡态是稳定的,哪些不是非常关键,我们现在面临气候变化的世界,在过去一千年,一万年里,我们生活的地球气候,一直非常接近平衡态,有些年份热一点或冷一点,但最终都会弹回平衡态,而现在我们其实面临着,脱离这个平衡态的危险,可能会滑向一个,极其不稳定的动力学状态,这很吓人但它需要被建模,我们也可能得想办法去适应,去改变我们的农业,以及其他所有生活生产方式,搞清楚动力学规律,弄明白哪些系统稳定,哪些不稳定,哪些是混沌的,哪些可预测,其实极其重要,这里面有些非常接地气的事,比如天气预报,我们现在觉得,未来七天有准确的天气预报,是理所当然的,但这其实是,大气科学家们一向了不起的成就,他们收集了海量的数据,同时也解决了很多动力系统问题,多年下来,把误差率降到了一个水平,让我们能可靠地预测天气,比如提前一周预报,它依然做不到100%绝对准确,但比瞎猜要准得多了,包含大量人类行为的系统,依然非常难以预测,比如股市的走势,或者政治局势,这远远超出了,目前动力系统理论的建模能力,但自然系统,以及像交通这种部分由人类构成的系统,我们其实是可以建模的,所以这是数学里相当高深的一个领域,我们经常需要大量的计算机仿真,需要解非常高深的微分方程,但它能带来极其宝贵的洞见,动力系统的一大发现,就是绝大多数系统都会表现出所谓的混沌现象,这在17世纪是一件出人意料的事,牛顿当年提出万有引力定律时,这套理论最伟大的成功之一,就是解释了月球绕地球转,地球绕太阳转的运动,它能回头把开普勒那些奇奇怪怪的定律,全都解释通,比如为什么行星会按椭圆轨道运行等等,这样它就解决了我们现在说的二体问题,如果有两个像太阳和地球这样的大质量物体,它们在空间中运动,受同一条运动定律,也就是牛顿平方,反比万有引力定律支配它就能用自己新推导出的微积分理论,解出这些方程,给出完美的轨道公式,而且它们是完美的椭圆,精准证实了开普勒的理论,这是一项了不起的成就,在他解出二题问题之后,很自然的牛顿的许多后继者,包括我想牛顿自己,都试图去解三题问题,我想牛顿曾经说过,这是唯一一个让他头疼的问题,因为无论他怎么尝试,都没法得到精确解,当时顶尖的科学学会设立了中奖,悬赏任何能写出解法的人,这被认为是数学界最重大的,未决难题之一,我们至今依然没有这些方程的精确解,现在的看法是,根本不存在一个,能写成漂亮简洁公式的精确解,但当你真正去看数值模拟时,你会发现,它并不是某种规整的周期性规律,它通常会在很长一段时间里,保持周期性但接着就会突然变一下,变得稍微有点不同,随后又会再变一次,我们现在怀疑,我们太阳系目前大概有8颗行星,在过去其实系统里还有别的行星,它们大体上像开普勒说的那样,沿着椭圆轨道运行,但木星对火星施加的引力等微小相互作用,时不时会把这些行星稍微拽离平时的轨道,偶尔它们就会彻底偏离出去,有时两颗行星会相撞,或者有一颗会被甩出太阳系,比如有一条小行星带,我们认为就是几百万年前某次碰撞留下的残骸,即使是像太阳系这样看起来,几千年都没变过的极稳定系统,系统内部其实也存在长期的不稳定性,一旦你跳出最简单的系统,就会有大量细微的,不可预测或极难预测的偏差,它们偶尔会叠加起来,就像偶尔一群猴子,也能写出莎士比亚的作品一样,偶尔引力扰动能让一整颗行星偏离轨道,所以在当今最前沿的动力学里,哪怕你一开始面对的是一个,完全确定性,没有任何不可预测成分的系统,我们发现最好的建模方式,其实是用概率去逼近它,直接假设系统会存在一些,来回的随机波动,最终你的预测只会越来越模糊,而这似乎就是很多系统,所具有的混沌的根本特征,这六大核心思想,并没有描绘数学的全貌,但它们确实涵盖了,数学试图囊括的六个宏大主题,而且这样描述要精准得多,这只是让大家领略一下,如今前沿的冰山一角,第二章,数学如何解决科学问题,我把STEM视作一个完整的生态系统,最底层是基础研究,比如数学和其他一些基础科学,我们在其中探索,主要是出于好奇心的驱动,我们看到某种现象它迫切需要一个解释,或者需要进一步的研究,它可能不是一个为了应付眼前问题,而急需马上解决的现象,但看起来它应该有一个很有意思的答案 [00:29:50]
# #712.陶哲轩:AI 擅长广度,人类守住深度
陶哲轩:但看起来它应该有一个很有意思的答案,数学差不多完全就是这样,有好奇心驱动的,数字里有些规律,形状里有些规律,只是大家在试图做别的事时,顺便观察到的,而我们想更好地理解它,到某个节点,其他科学家能把那个规律,和自己正在研究的东西联系起来,某种数学上的数字规律,可能会出现在昆虫集群的行为里,或者出现在股市里等等,然后有时候一旦你理解了它,你真能把它转化成某种有用的技术,或者能开一家公司,靠着利用这种现象,提供某种相关服务来赚到钱,我们往往看不到,我们看不到那一步,我是说那已经是流程里非常靠后的环节了,你真正需要的是,做基础科学的人得和做应用科学的人交流,而应用科学的人得和做工程的人交流工程人员又得和产业界的人交流,如果你缺了其中一个群体,你就不会有这种从好奇心驱动的问题,一路走到实际商业成果的链条,比如以几乎零成本在全球范围内通信的能力,这就是尤金维格纳所说的,数学在物理科学中,不可思议的有效性的一部分,他观察到,数学家常常发现像,负数或弯曲空间之类的概念,仅仅是因为这似乎是,他们已经在研究的,数学对象的自然延伸,然后过了十年,二十年,五十年,某些科学家发现,这些纯粹出于好玩,或游戏心态被引入的概念,事实上正好就是,或者说几乎正好就是,理解某种新科学所需要的东西,所以这是一个非常不可思议的现象,而且我们其实仍然没有一个很好的解释,来说明它为什么真能起作用,好奇心驱动的数学如何带来极其深刻的科学突破,历史上有一个例子,就是平行公社的故事,欧几里德大概在公元前三世纪,引入了证明的概念,也就是能够从更简单的公理出发,去解释几何学里复杂的结果,比如三角形的内角和总是等于180度,他能够用更简单的公理来解释这一点,他提出了五条几何公理,他认为自己把所知道的,关于点角线的,所有其他事实,都归结成了这五句话,其中四条非常显而易见,比如如果我给你两个点,你总能在它们之间画一条线,诸如此类,这些都是非常直接,毫无争议的公理,但有这么一条公理,叫做平行公设,让他头疼不已,事实上,它最初的版本非常非常复杂,后来被简化了,但即便是简化版,也很有争议,简化版是说如果你有一条直线和一个点,而这个点不在直线上,那么穿过这个点,你能且只能画出一条,与第一条线平行的直线,所谓平行,我是说它永远不会与第一条线相交,公理的内容就是这样,你总能穿过任意另一个点,画一条平行线,而且只有一条,你画不出两条平行线,一旦有了这条公理,你就能做各种各样的事了,你就能推导出我刚才说的那句话,三角形,内角和,等于180度,以及欧几里德几何的,所有其他经典结果,但比起另外四条,真正优雅的公理,它是一条非常丑陋的公理,最终他们意识到,自己其实是发现,在欧几里德几何之外,其实存在着多种几何学,有一种叫球面几何,在里面根本就没有平行线,所以在球面几何里,代替直线的其实是大圆,比如赤道或金线而球面上这些大圆,总是会相交,你绝不可能做出两个平行的大圆,所以根本不存在平行线,然后还有一种更奇怪,更难直观想象的集合,叫双曲集合,在里面直线其实会彼此分散开,有些线一开始看起来平行,但它们会越离越远,而且事实上从一个点出发,现在你其实能画出,多条与给定直线平行的线,而这两种集合内部,是完全自洽的,最终大家也就接受了,世上的几何学不仅限于欧几里得几何,这就是最早被发现的两种非欧几何,球面几何和双曲几何,但一旦我们差不多摆脱了只有一种几何的观念,这就打开了所有闸门,人们开始研究各种各样的其他几何,也就是各种各样的弯曲空间,形状像甜甜圈或带扭曲的空间,存在这样一些几何如果你是右撇子,你可以出发去探索宇宙再回来,如果你出发时是右撇子,回来时就会变成左撇子,存在这样一些几何,你只要走上一圈,就能改变自己的朝向,这非常反直觉,或者你回来时,会比刚出发时,变得更小或更大,人们发展出了,所有这些几何,而且发展出了,一套非常漂亮的语言,来描述所有这些几何,它以波恩哈德利曼的,名字命名,叫黎曼几何,但这只是,出于好奇心的产物,我是说,存在着这些,抽象的弯曲空间,但我们生活的宇宙,看起来完全是平的,但后来爱因斯坦在试图理解引力时,他最终得出了结论,引力所起的作用,其实是以某种方式弯曲了空间和时间,他需要一种语言来描述时空如何弯曲,以至于光线不再走直线,有时还会相撞或发散,他问他的数学家朋友,有没有现成的数学工具,来描述这个对方说,有啊,有个叫波恩哈德黎曼的聪明家伙,搞出过这套理论,而他几乎恰恰就是描述,爱因斯坦场方程的绝佳语言,在黎曼几何里有曲率的概念,有些空间可以是正曲率,也可以是负曲率,结果用这种语言,表述爱因斯坦场方程,变得极其简单,基本上就是,质量和能量造就了曲率,时空的曲率和你系统里,拥有的质量和能量成正比,这就是爱因斯坦场方程的基本内容,不过,求解它们又是另一码事了,要给它们建模极其困难,就连如何给两个,黑洞相撞建模这个问题,用现代超级计算机,我们都很难做到,但一旦有了这种语言,写出这些方程,其实极其自然,数学上的好奇心,在几个世纪后,引向极其切实的,实际应用的另一个例子,就是球体堆积的故事当时有个英国水手,纯粹是好奇,他们船舱里,有一批炮弹得堆放起来,这些炮弹是圆的,不是方的,所以堆起来的时候,就会浪费一定的空间,他很好奇怎么堆炮弹才是最省空间的,才能在有限的空间里塞进最多的炮弹,于是他去问了一位数学家朋友,正好就是开普勒,开普勒最终提出,效率最高的堆法应该和如今超市里堆橙子的方式一样,也就是所谓的六方密堆机,你一层一层的堆,每一层差不多都是由炮弹或橙子排成了三角形网格,然后你在上面再堆一层三角形网格,稍微错开一点,然后再叠上去,它有一个规律的模式,这是最自然的模式,效率大约在76% 开普勒认为,这就是能做到的最好了,不可能有更巧妙的办法,再挤出空间来,但他其实证明不了这一点,所以这就成了著名的开普勒猜想,而且几个世纪以来,一直是几何学中,最著名的未解难题之一,在二维情况下,我想大概是在 1900年前后解决的,如果在平面上排圆盘,那是更简单的问题,那个问题里,有一种类似的三角形点阵,而且相对容易证明,这就是最优解,但三维的话,可能性就实在太多了,根本没办法,其实,直到现在,我们依然没有一个漂亮,简单,能有人类,完全靠自己理解的,开普勒猜想证明,这个猜想最终被解决了,我想大概是在1998年,正式发表的,但它需要计算机,它是最早的计算机,辅助证明之一,当时有一个审稿人团队,我记得他们说,自己无法核验所有的计算,但他们至少相信整体思路是正确的,但疑虑依然挥之不去,直到最近得多的时候,我记得是2014年这个证明才终于被转换成了,所谓的证明助手语言,也就是专门用来100% 确保无误核验证明的计算机语言,所以开普勒猜想,现在已经完成了形式化验证,我们现在100%确定它是真的,但数学家并没有止步于此,止步于这个三维问题,他们还想知道,如果是在四维五维或者六维里,情况会怎么样,那到了这里,当然就没有实际的,我是说,根本没有四维的橙子,或者炮弹让你去堆,但人们还是提出了这个问题,人们还会问,如果不是连续空间,而是一个离散空间,又会怎么样,特别是计算机科学家,一旦计算机科学发展起来,我们意识到,除了XYZ坐标,有实数给出的,常规空间的几何之外,我们还有兴趣,去研究比特川的几何,这听起来已经和,最初的球体堆积问题,向去甚远了,一方面是因为,现在的维度非常非常多成千上万个维度,另一方面空间,现在是离散的,而不是连续的,但它依然是几何学,而且很多用来理解,球体堆积的技术,在这种场景下依然管用,后来大家发现在这个,由比特川构成的,庞大超立方体力,尽可能高效地堆积,球体这个问题的设定,事实证明,极其具有实用价值,当手机变成数字化之后,你发送的每一个信号,比如图片文字或者随便什么,都被编码成了某种比特串,然后再通过无线网络发送出去,但其他人也在发信号,你不希望自己的信号被干扰破坏,被误认成别人的信号,所以你想把发出的每一个不同信号,在这个比特串空间里彼此尽量隔开,而在数学上,要把所有这些信号隔开,让它们绝不可能混淆,这个问题几乎就等同于球体堆积问题,只不过它是高维的而且是离散的,用来理解球体堆积的全部数学,好吧,就算不是全部,其中很大一部分数学,都可以用来设计极高效的球体堆积码 [00:39:50]
# #712.陶哲轩:AI 擅长广度,人类守住深度
陶哲轩:都可以用来设计极高效的球体堆积码,而且不仅是用来设计编码,还能告诉工程师通信的理论极限在哪里,比如在特定的无线频谱里,你到底最高有望每秒传输多少个比特,这为衡量你的协议有多高效提供了极好的基准,你就能给一段特定的频谱,无线电频谱定出该花几十亿美元来买,因为你现在确切知道,能通过它传输多少数据了,可以说整个无线通信行业的基础,就是怎么在极高维度里堆积橙子,我自己参与过的数学应用里,最让我自豪的一个,就是压缩感知的故事,有一次我在洛杉矶这边,一个数学研究所参加跨学科项目,碰到了我的一位朋友,他是统计学家,当时正和一个电气工程师合作,试图改进成像技术,医学成像,特别是MRI扫描,在那个时候MRI扫描相当慢,你得在那台扫描机里,躺上差不多三分钟,好从所有不同角度,采集足够的数据,让扫描能重建出高质量的身体图像,辨别出肿瘤,囊肿,或者任何医学上有必要查明的情况,但如果你只在机器里躺很短的时间,比如半分钟,拿到的数据就不够,要是你用当时的标准技术,也就是所谓的最小二乘逼近,试图用现有的所有数据,按标准重建算法来还原图像,得到的图像就会模糊,分辨率极低,根本看不出对诊断有用的东西,所以大家只能在机器里一躺,就是好几分钟,如果是小孩子,有时还得打镇静剂,因为小孩子到了差不多第二分钟,就会乱动,不听指挥了,于是他们尝试了一种新技术,不是最小二乘法,而是叫做全变分最小化的东西他们凭直觉觉得这种方法可能表现好一点,就在一些测试数据上试了试,他们原本只指望比最小二成,逼近稍微清晰一点,结果却得到了完美的分辨率,还原出的图像几乎完全准确,尽管他们只采集了很少的测量数据,这就像给人一份只填了10%字母的填字游戏,对方突然不用看任何提示,就能把剩下的所有字母全填出来,他们解释不了这个现象,就拿给我看,我的第一反应是,你们搞错了,你们不可能做出你们所说的那种结果,事实上我打算向你们证明,你们采集的数据里,根本没有足够的信息,来让这种测量成为可能,那天晚上我就回了家,我试图写出一个证明,证明根本不可能,只凭他们测到的那一点点数据,就准确猜出正确的图像,但在写证明的时候我发现我的其中一步行不通,事实上它证明了恰恰相反的结论,只要某个测量矩阵具备某种性质,它们做的事情实际上就能成真,接着我去核对了它们的测量矩阵,发现确实好像符合这个性质,这样我就真的搞懂了,这个方法是怎么起作用的,第二天我去找它们解释了这事,它们非常兴奋,随后我们写了几篇论文,引得其他所有人也都兴奋起来,它们偶然发现的这种方法,并不是全新的,曾经有地震学家也发现过,类似的方法,他们当时面临的是,另一个不同的问题,想根据少量的地震数据,来搞清楚断层线,定位地壳的断层线在哪里,天文学家也有类似的问题,想靠极少量的观测数据,来测量恒星之类天体的位置,另外还有两三个学科,也都遇到过这种,想从极少量信号中提取出高质量图像的,类似问题,在每种情况里,他们都找到了一些权宜之计,能从手头的数据里,多榨出一些获得更好的分辨率,但他们没法从数学上解释为什么管用,地震学家觉得这只是个窍门,而且只适用于地震图,天文学家也有个窍门,但也只适用于天文学,但当我们找到数学解释之后,我们发现这是一种通用的技术,也就是我们现在所说的压缩感知,它对MRI有用,对无线宽带也有用,对某些类型的传感器网络同样有用,一旦弄清了背后的数学原理,我们就能看到所有其他适用的场景,如今教科书里讲压缩感知,都是把它和最小二乘法并排放在一起讲的,有时候最小二乘法是正确的做法,有时候压缩感知才是正确的做法,有时候两者都不是它现在已经是一门发展得非常完善的理论了,我很庆幸能从最一开始就参与其中,这是数学和科学之间一次极其精彩的相互交融,这就体现了数学不可思议的有效性,数学上的发现往往最终成了,阐释物理现象的最佳方式,哲学家和历史学家一直都在争论,为什么会这样,我的一种理论是,无论我们学习什么,不管是数学科学还是其他任何学科,我们最初做出的理论或解释,往往都不是最好的,我们不知道什么才是最利落的表达方式,在你对某件事完全理解之前,你对它为什么成立所做的解释,可能过于繁琐,但真正的解释往往比我们,最初尝试描述这种现象时,更加优雅,更简短,更朴素,可要找到简短的解释,是需要时间的,因为你必须在某种程度上,抛弃那些你可能有过后来被证明并不正确的预设,比如爱因斯坦的相对论,在爱因斯坦之前,人们的核心预设之一,就是时间是绝对统一的,每个人对时间的理解都一样,对我而言的一小时,和你的一小时是一回事,那种思维定势,会切实阻碍你找到正确的方式来解释引力,尤其是引力,但只要你接受了每个人都有自己相对的时间观念,你就能找到正确的语言把事情解释清楚,数学家也同样试图把最初用非常低效的语言,去理解的现象提炼出来,试图找到对某种数学现象最简洁,最优雅的解释,我觉得只是因为简洁表达事物的方式就那么几种,刚好用来简洁描述某种数学现象的方式,也常常是简洁描述某种物理现象的方式,这就是我的理论,遗憾的是,我们只有一条科学时间线我们只有一部科学发展史,大概有100个科学转折点,数据就这么一点,能总结出一些理论,我很希望未来,在遥远的未来,也许我们会遇到其他文明,能看到他们的科学史,看看他们是不是也有他们那一版的,开普勒,爱因斯坦和牛顿,看看他们走的是相似的轨道,还是完全不同的轨道,我不知道,做数学很有意思的一点是,大家总有一种刻板印象,觉得我们都是天才卡在某个问题上,然后突然灵光一现,脑子里灯泡一亮,不知从哪就冒出个天才想法,其实我也很希望,这种事能发生在我身上,对我来说这很少发生,我做题时的实际情况是,我试了一种方法,行不通,好,那我再试别的,好像有点用,但到了某一点又卡住了,但现在我至少差不多知道,有一个障碍在那,我需要找个工具来帮我解决这个障碍也许我现在会找一个子问题,难度类型一样,但更简单,我先试着把那个解出来,如果那个能解,我就试着放回原来的问题上去,我就这么来来回回,很多时候你其实是在探索问题的副空间,也就是所有行不通的做法,到最后只要副空间摸得够多,前面的路几乎靠排除法就变清晰了,差不多只剩一种可能行得通的办法,有时什么方法都行不通,那你就放弃这个问题了,但会有这种反复的,你可能会称之为失败的过程,不过这其实只是去摸清不同方法的局限在哪,这样过了几周或几个月之后,答案就清晰了,但到了那个时候,那些难点你已经吃得太透了,你反而不觉得有什么神奇的了,你会觉得很自然,就好像你当然得这么做,因为前面有个难点,你必须绕过这个坑,你必须先走这一步因为你知道再过五行,你就需要这个假设来解题,你对这个问题摸得太透了,以至于一切都显得顺理成章,对,或者有时候你始终没解出来,因为你一直没摸透,最后就放弃了,我的感觉从来不是什么恍然大悟,而总是,哎呀我之前怎么没看出来呢,我太笨了,但往往正是不断的尝试和失败,让你真正做好准备,去找到去接纳正确的解法,我们对结果的要求,和我们对过程的要求之间,存在着巨大的反差,在结果上,数学出了名地,对正确性要求极高,对于一个给定的问题,正确答案,只有一个,错误答案有一大堆,我们给学生批改数学作业时,要是符号写错了之类,导致答案错了,就会被扣很多分,如果你最终答案里有数学错误,就会IP结果之一就是,很多学过比如高中数学的学生,在尝试做数学题时,会变得非常害怕犯任何错误,矛盾的是,得出答案的过程几乎完全相反,你几乎必须一错再错,必须先去试那些蠢办法,才能体会为什么聪明的办法行得通,物理学家尼尔斯·波尔说过一句话,专家就是在极窄的领域里,把能犯的错都犯过一遍的人,你不会把这些错误发表出来,你是在过程中去犯这些错,好找出正确答案,但前提是一定要先摸索过,大量错误的答案,我觉得把过程中的失败常态化非常重要,要去讲清楚每个成功的解法背后,都有几十次错误的尝试,这并不是因为尝试解题的人笨,而往往只是学习过程的一部分,第三章 AI如何永远改变数学与科学几个世纪以来,科学和数学发生了很大变化,传统上科学的两大范式是,理论和实验,比如你会建立一个理论 [00:49:49]
# #712.陶哲轩:AI 擅长广度,人类守住深度
陶哲轩:比如你会建立一个理论,像开普勒可能会提出,行星如何运动的理论,或者牛顿可能会提出引力理论,然后会有实验数据,你去做实验看会发生什么,再试着看理论和实验能不能吻合,数学稍微有点不同,它几乎完全是理论,纯数学里能做的实验非常非常少,倒是有过几个,比如高斯算出了前十万个素数,这很有名,那就是它用来做预测的一个数据集,它预测出了我们现在所说的素数定理,但理论和实验曾是科学的两大主要形式,后来出现了模拟,你就不必去做庞大又昂贵的实验了,有时候你只要在超级计算机里模拟一下,比如模拟一场飓风,而不用在现实中做,再后来又有了大数据,你不用只做少量实验,去证实或证伪某个特定理论,而是能拿几兆甚至几个pb的数据,去寻找规律尝试单从海量数据,集中提炼出定律,这是一种新兴的科学类型,但现在所有这些,做科学的模式都在被改变,因为我们现在也有了AI来帮忙,过去做科学的这每一种方式,都必须由人类科学家来做,你必须找人来做实验,找人来做理论推导,运行模拟,或者去梳理数据,其中一部分你可以用计算机,但即便那样,你也得去写数据分析工具的代码之类的,依然需要大量专业知识,现在我们有了自动化实验室,能自动做实验,你能找一个编程 Agent帮你跑模拟,也能试着用自动化数据分析,而且越来越多的,你还能做自动化的理论研究,你可以拿某个数学问题去问,这些假设和这些公理,会推导出什么后果,应该得出什么结论这些工具现在能规模化的做快得多,你有可能比任何单个人类科学家,跑出多得多的理论分析,但另一方面,这并不是我们唯一想要的,用慢办法做事是有价值的,一个花上好几个小时用纸笔推导,亲手在实地做实验,自己去给出现的,模拟条bug的科学家,他们往往能学到很多,额外的洞见,远不止得到他们想找的答案,他们能发现新现象,能看出关联,能看出和文献里其他地方,研究过的旧成果,有什么相似之处,而且他们能把自己发现的东西,讲给别人听,所以就有了这样一个悖论,一方面AI变得越来越强大,越来越能干,犯错越来越少,而且表面上看,他们正在实现,很多我们想要的,我们认为科学家想做成的目标,他们在做实验,分析数据写论文,但这可能会带来代价 AI学会了某种技能,却没有人类科学家,在做科学这件事上,变得更厉害,没有人能讲清楚,刚才到底发生了什么,为什么这个科学发现很有意思,为什么这个证明是崭新的,它有什么特点,又是怎么联系起来的,我们可能不得不去,重新构想我们对科学的定义,以及我们究竟想从科学中,得到什么,科学到底是为了什么,我们到底想做什么,当我们把AI工具,用在科学上时,是否存在优化错了目标的危险,我过去打过一个比方,科学有点像去徒步,你听说外面有个挺有意思的瀑布,很漂亮的瀑布,于是你决定和几个朋友去徒步找它,但你们得画张地图,你们迷路了,稍微迷了点路,但也许在迷路的时候,你们发现了别的有趣东西,并把它记了下来在去这个瀑布的路上,你又发现远处有一座更壮观的瀑布,你现在还去不了,但也许未来的某个徒步者,也能想出过去的办法,为了达成你的目标,有一个完整的经过,这个经过本身也很有价值,但这些工具,这些AI工具,它们可以像直升机一样,直接把你送到瀑布前,你能看到它,然后又飞回来,但关于怎么走到那里,你什么都没学到,除了你指定要看的那样东西,你可能看不到任何其他有趣的现象,所以尽管从技术上讲,你达成目标高效得多,但可能有些东西就丢掉了,现代AI 是有一种被称为机器学习的算法驱动的,它试图去预测数据中的规律,机器学习一个非常简单的例子,就是回归,如果你有一些输入,有一些输出,比如假设你观察到,给动物喂更多食物,它们会长得更大,对吧,你就可以把喂给不同动物的食物量,划出来再划出它们的体重之类的,图上就会有一些点,要是运气好,它们会吻合某条线,那条线就成了你的预测,要是你给这条狗这么多食物,它就会长这么多体重,但在现实世界里,你不会总是得到这种漂亮的线性关系,往往会有很多很多输入,有很多很多输出,而且关系可能会非常复杂,但有时候数据是有某种形态的,我们现在有各种巧妙的办法来察觉这种形态,并尝试用曲线去拟合这些输入输出,对支撑聊天机器人这类东西的大语言模型,粗略地说,他们其实只是在玩一个说出句子里下一个词的游戏,要是我说玫瑰是红的,紫罗兰是空白,填补这句话的下一个词是什么,你大概能猜到答案是蓝的,那就是一个输出,你可以想象这张巨大的坐标图,输入是所有这些没写完的句子输出是你想用来补全的词,在这个高维空间里有所有这些点,你想给它拟合某条曲线,尝试解释最可能出来的词是什么,有时候答案不止一个,你好我叫某某,在句末你能填的名字可能会有很多很多个,你并不总是能得到单一答案,但你能试着去得到,最看似合理的答案,大家尝试过这个,你手机上的自动补全功能,就是这么干的,比如你发短信输入一些内容,它就会推荐下一个词,有时候挺准的,有时候又很傻,一旦你有了这类操作,它就会产生某种动态机制,你就可以一直按,很多人就在手机上玩过,一遍又一遍地按自动补全,但你会得到一堆胡言乱语的句子,对吧,你会得到猴子在打字机上乱敲出来的东西,但LLM的奇妙之处在于如果你用足够多的数据去训练这些LLM 比如数以万亿计的数据点,并且真正去尝试拟合出尽可能好的曲线,而这需要耗费数百万美元的算力,以及好几个月的时间,然后突然之间,即使你在不断迭代,它依然能保持连贯,它听起来开始不像猴子乱敲,而是听起来像一个真正的人在说话,不知怎么的,我们还没有完全搞明白,为什么会这样,但似乎确实成立的是,像英语或其他自然语言中,包含着大量我们意识不到的隐藏规律,我们知道英语的一些法则,有语法规则之类的,但语言中也存在某种,人类习得的潜规则,和不成文的规矩,一个人类小孩,哪怕没有人教他们什么是名词,什么是动词之类的,仅仅通过持续接触这种语言,就能学会英语单词该怎么排序看起来你也可以教会这些模型,去掌握语言中的规律,甚至到了,你可以向他们提数学问题的地步 2加3的答案是,他们就会说5 他们已经被训练的,至少能答对简单的数学题,一旦你具备了,一点点说英语的能力,你就能进行某种循环,检查自己的工作,少犯错误,而且你可以用提示词,引导这些模型,一步一步进行,未经复合就不说出来,诸如此类,因此他们变得所谓的聪明了一点,甚至能解决许多非常复杂的任务,但他们骨子里仍然只是在猜下一个要说的词,这并没有真正立足于对现实世界的任何深刻理解,只不过是他们看过了英语或其他语言中的模式,吸收得太好了,以至于能模仿人类用聪明的方式说话他们表现出的聪明程度足以维持到蒙骗过我们,也足以维持到能替我们做有用的事,所以我们现在可以让LM给出一个证明,来解决某些数学问题,有时候给出的证明完全是垃圾,但如果你循环的次数够多,设置的检查够多,你真的可以开始获得正向的成功率,所以这是一种非常奇特的问题解决方法,这跟我们通常认为的智能,也就是非常扎实,讲究方法,从第一性原理出发的思考,可以说是完全正交的,这就像有一个,懂很多但稍微有点喝醉的人,在到处乱抛点子,但只要有足够的引导,你确实能提取出有用的产出,它其实算不上最前沿的数学,但你给它大量的数据,充裕的时间,加上很多其他的补丁和手段,它其实效果相当好我发现关于AI在科学,和其他学科中作用的一些争论,往往会默认采用,一维的思考视角,比如有容易的任务,困难的任务和非常困难的任务,人类能做到某个水平 AI能做到某个水平,那么哪个更好,这算是一种一维的思考方式,但我在与AI合作,并把他们解决问题的方式,与人类解决问题的方式,进行对比时发现,他们其实是非常互补的,人类专家会专注于深度,比如一个人类数学家,有成千上万个问题可以去研究,但他们会挑出一两个,自己觉得难,却又不至于难到无法解决的问题,而这些问题的难度又刚好足够,尝试在上面取得一点进展的过程,就能揭示出各种可以分享的深刻见解,他们的学生,其他合作者或其他人,或许就能在他们的成果基础上,继续做下去当我们把AI对准那些,所有常规方法都不适用的,真正难题时,他们依然非常非常不擅长,我是说他们只是在,胡乱猜测,但他们擅长的是广度 [00:59:47]
# #712.陶哲轩:AI 擅长广度,人类守住深度
陶哲轩:但他们擅长的是广度,所以如果你把他们对准,一千个不同难度的问题,有些可能确实太难了,但总会有一些,其实用现有方法是能够得着的,文献里可能正好有某种方法,能解决你的问题,或者可能得把两种独立的方法,结合起来,只是没有那么多人类专家,能把所有这些问题都看一遍,而且即便有人类专家,在看这些问题,他们也可能意识不到 1970年某本期刊上,一篇冷门论文里,其实就有能解决这个问题的核心思路,他们没有耐心也没有时间,去把哪种方法可能适用于哪个问题的,各种不同组合挨个试一遍,但AI会多少带点随机性的,对哪些方法可能适用于某个问题,做出一些有依据的猜测,其中一些会很蠢,但有些可能会奏效,通过所有这些组合,我们发现他们有时能抓住,其他所有人类都漏掉的解决方案偶尔专家们的共识,传统看法是错的,我们都以为某个问题有肯定的答案,但实际上答案是否定的,我们只是没有过多去关注否定情况,因为大家都以为答案是成立的,但AI可能就没有这种先入为主的观念,所以有时AI只是充当了一双独立的眼睛,于是某些我们以为非常困难的问题,就有了出人意料的简单解法,事后看来我们也许本该自己想到的,当面对范围非常广泛的问题时,他们正开始取得成功,并且能解决其中的一定比例,比如你扔给他们1000个问题,它们能解决其中的5% 那也解决掉了50个问题,你已经能拥有,在某种意义上,单纯从解决问题的原始数量来看,胜过人类数学家的工具了,被解决的这50个问题,可能不是你最想解决的那50个,它们可能只是随机的50个问题但这依然是非常让人印象深刻的,我认为作为整个行业,我们必须要做的是想办法,把这种在大范围内解决某些问题的新能力,吸纳进来,并且摸索出如何将它与我们现有的,非常缓慢地解决少数深度问题的能力结合在一起,开普勒发现其著名的运动定律的过程,是一个非常迷人的故事,它展现了这个过程有多么重要,开普勒了解了哥白尼关于行星运动的理论,哥白尼大致推算出了地球离太阳有多远,火星有多远等等,开普勒注意到这些轨道的比例,看起来有点像集合学中出现的某些比例,于是他最终提出,其实如果你取一些球面,每颗行星对应一个球面,当时已知的行星有6颗,它就可以在它们之间,内嵌5个柏拉图立体,比如12面体,正方体,正四面体等等而且他以为这会完美嵌合,并以此用5种柏拉图,立体解释了太阳系的形状,这就是他优美的几何构想,直到他设法搞到,地骨布拉赫手里那些,质量非常高的观测数据,其实这还是他费尽真来的,甚至可能算偷来的,当他试图把自己的理论,套进这些数据时,才发现其实对不上,按照地骨数据提供的精度,他怎么都不能让那些球面吻合上,在这个过程中他甚至发现,火星和地球的轨道,根本不可能是正圆,必然是某种别的形状,他花了好多年琢磨该怎么办,我不知道他到底坚守多久,那个正多面体理论,从他的手稿里能看到,他尝试过很多别的门路,他试过把原心偏置,后来某一刻他想到了椭圆,接着突然之间一切就都对上了,这确实说明理论和实验之间存在互动你可以提出一个理论,如果它跟数据对不上,它可能就不是个好理论,但事情也比这更复杂,在开普勒之前,哥白尼理论受到的一个批评就是,哥白尼自己都承认,他的推算结果比当时最好的预测还要差,当时最好的模型是地心说模型,是希腊人,以及后来的阿拉伯人和印度人,发展起来的,里面经过了大量的修正和微调,他们做出了一个,非常非常精确的模型,能以极其复杂的方式,预测所有行星的位置,而戈巴尼的模型表现更差,仅仅看跟数据合不合,未必是唯一的衡量标准,只有在开普勒提出了,他的修正模型,把轨道从圆改成椭圆之后,日心说模型才变得比地心说模型更准确,这告诉我们,科学就是这样,你不可能总能立刻得到反馈知道自己到底有没有解开一个科学问题,如果开普勒和戈巴尼当时有AI 让他们预测一个宇宙模型,很可能那些生成了正确日心说模型的AI 会被直接扔掉,因为他们最初的预测还不如地心说模型准,真正消化所有这些理论,看看他们跟我们所掌握的行星,运动,引力,等一切知识,怎么契合,是需要时间的,其实一个让人担心的点是 I速度太快了,这里有个危险,就是这些AI 会做出所谓的过拟合,整出一个极其复杂的模型,它跟现实规律毫无关系,但就是跟你的数据拟合得特别特别好,可是一旦超出这个数据集,它就无法外推,我们如何把AI融入科学发现的流程,会是一个挑战,它当然能加速流程里的各个具体环节,你能让实验更快,写代码更快写论文也更快,但整个科学并不会仅仅因为,每个单一环节变快就跟着加速,这里有个危险,当我们把AI用在科学上时,我们可能会优化错指标,我们在纸面上收获了所有这些亮眼的成绩,却发现科学并没有像过去那样,真正向前推进,但我们走着瞧吧,有这些工具总比没有好,但我们还在摸索怎么用才最高效,我们工作的一部分就是解题,试图给问题找到解法,以及做证明,证明本身是有一个生命周期的,首先,你得生成一个解法的证明,这在以前挺难的,但你生成出来的证明有些是不对的,所以你得去验证,检查它正不正确,这在以前也挺繁琐的,但这两项任务现在都越来越自动化了,所以我们开始看到,针对各种问题提出了,越来越多的候选解法,而且其中很多确实是对的但证明也变得越来越长,一旦是由AI写的,读起来往往不太舒服 AI生成的证明可能会花大量篇幅,讲一些非常微不足道的东西,而在论文最精彩的部分却轻描淡写,我觉得这是因为 AI分不清什么是难,什么是深,因为靠蛮力算对他们来说,似乎所有东西花的时间都一样多,而一个人类在论文最难的一步,自然会卡住,自然也就会在那一步上,花大量精力,所以你需要把论文里的证明,写得很好读,能给别人讲明白,然后其他人还得能对此感到兴奋,他们得认可他,觉得这很有意思,能帮我解开自己的问题,或者确实解释清楚了,为什么这个现象会成立,他必须得到认可,这也就是我们传统上,同行评审的作用,我们把论文寄给审稿人,如果审稿人对这个结果很兴奋,论文就被接收了,但有些论文可能技术上毫无问题也写得通顺没毛病,回答的却是一个根本没人在乎的问题,再到最后,他还得经过彻底打磨,写进教科书,讲给学生听,而一个正名的最初版本,往往不适合直接写进教科书,他通常写得非常累赘,步骤的先后顺序也不太符合逻辑,这需要一个消化的过程,得有人花很多时间苦苦思索,到底怎样组织,怎样编辑论文,才能让逻辑同样流畅,有点像剪辑纪录片或电影那样,所以我们现在发现的是 II工具加速了这个流程的前期阶段,但没能加速后期阶段,我们现在正在生成很多证明,也在验证其中的一大批,但理解它们并把它们整理成最终教材形式的节奏,依然是由人类掌控的,事实上我们现在正在经历所谓的证明消化不良,突然之间涌现出大量待处理的问题解法本该被理解并写进教材,但我们现在被太多解法淹没了,不得不去挑选,去做分诊,而这是以前,从来没有遇到过的局面,过去解法是极少出现的,一旦某个重大问题被解决了,所有专家都会放下,手头的一切去读,尽可能快地把它消化掉,因为它太罕见,太宝贵了,值得这么做,而现在,我们直接被所有这些,可能的解法淹没了,我自己都不得不放弃,去跟进我这个领域的,所有最新进展,有时候动静实在太多了,我现在没法保证读完,冒出来的每一项进展,我是说,甚至在AI出现之前,这就已经开始成问题了,但AI确实让生成出来的,内容总量大幅增加了,所以我们将需要,好得多的筛选和过滤机制,这是个甜蜜的烦恼,我是说,食物多到吃不完,总比没有足够的食物吃要好但这依然是个问题 AI在数学上的能力越来越强了,对像我这样在过去三年,一直关注这些进展的人来说,能看到一种稳步的推进,四年前他们能解初中数学题,接着能解高中数学题,然后是高中奥数水平的题,再然后是一些研究生资格考试水平的题,接着他们开始解几个小一点的未解问题,可能是保罗·埃尔德什提出过,但没什么人真正去研究的问题,所以很多都是唾手可得的果实,而就在最近,有一两次他们成功解出了一些,人们真花大力气尝试过去解的问题,不知怎么的,人类整体上都走偏了方向,而带着另一套偏执的AI 却设法拼凑出了一个解法,相当巧妙,而且已经产生了一些影响,比如单位距离问题周边的一些问题,现在也被借鉴了AI技巧的人类解出来了,我觉得这挺让人兴奋的所以我觉得对我的某些同行来说,这让人非常担忧,尤其是如果他们之前没跟进这些进展,没意识到AI已经到了这一步的话 [01:09:52]
# #712.陶哲轩:AI 擅长广度,人类守住深度
陶哲轩:没意识到AI已经到了这一步的话,如果一个同行只见过GPT-4 在2023年能做什么,那会儿要是问他一个高难度的数学题,他会给你一堆胡话,而他们现在已经大不一样了,我是说底层虽然还是同一种技术,但他们找到了降低错误率的方法,变得真正有用了,不过现在还不清楚,这有多大的可复现性,这些成果里有很多都是私营公司做出来的,他们没有公开消耗了多少资源,算力成本是十万美元吗,还是一百万美元,我们其实不知道,我们也不知道他们的成功率,他们解出来的这个问题,是他们看过的唯一一个问题,还是他们看了十个问题,又或者看了一百个问题,虽然成果令人印象深刻,但我们没有足够的数据去准确评估,这在未来会变成家常便饭,还是说只有花上十万美元,让十个人团队做上几个月才能出这样的成果,又或许我们关心的所有问题里,只有1%适合用这种方法,但我们不知道,但已经有人在努力尝试,用更严谨更科学的方法,去做基准测试了,最近的一个挑战叫做 First Proof Challenge 他们用一个包含10道研究级题目的测试集,去测最新的模型,最好的模型在这些中等难度的数学题里,能做出5、6道,这些题目本来就已有解法,只是解法一直保密,但我认为在我们日常科研所做的日常任务里,现在有一定比例可以交给AI来做了,成本可能会很高,其中许多工具在得出解法之前,跑一次可能需要花上几百美元,而且有时还会失败,他们消耗了所有这些算力,最后什么有用的东西都没做出来,我们现在在编程领域看到,很多资深程序员反映,有了这些工具后,他们写代码的效率提高了5倍10倍甚至100倍,但他们能感觉到自己手写代码的能力在退化,而且有时他们根本没法审查这些agent写出来的代码,这需要做权衡,速度并不代表一切,我非常喜欢数学里的合作部分,这是我职业生涯相对较晚的时候,才意识到有多重要的事,我学到的很多数学,都是研究生毕业之后,通过跟不同领域的数学家和科学家合作学来的,我把我懂得交给他们,他们把他们懂得交给我,我也因此涉猎得广得多了,当你跟一个合作了很久的合作者一起工作时,到了某个阶段,你们在思维上几乎能同频,你可能也有过这种体会,比如如果是非常要好的朋友或家人,聊了很久之后,有时候对方话没说完,你就能接下去,你知道对方要说什么,在合作时,有时也会达到这种状态,你抛出一个想法,一句话还没说完,对方就已经懂了而且能顺着它往下做,人们尝试过像这样去用AI AI确实是能跟你对话的,当然,他们有时也会犯错,他们有时还会迎合奉承,只挑你想听的话说,而且,目前跟这些工具的交互,有点缺乏人情味,比如我试过跟人当面合作,同时让AI也在场,但这样会打乱节奏,这些工具,其实并不真正具备对话的感觉,他们现在的对话,还不如跟人类合作者,交流那么流畅,也许以后能做到,直到最近,他们还不会从你的对话中学习,而对于人类合作者,你第二天可以接着聊,很快就能续上,有时哪怕是几年没见的合作者,你也能重新接上一些非常久远的话题 AI有一定的上下文能力,能记住一些事情,也能记录记笔记,来大致模拟这种记忆,但你目前还没法像对待,非常亲密的合作者那样,跟AI达到心意相通实际上在真正的解题过程中,我并不怎么用这些工具,到目前为止,我发现这些工具更擅长次要任务,比如查文献,检查证明,写点代码,或者教对我写的东西,看看有没有机会改得更严谨一点,我发现跟AI工作的节奏,不太像我更喜欢的那种,跟人类合作者共事的节奏,但这可能只是当前技术现状所致,也许未来的AI互动起来会更有对话感,也更有人情味,所以从整个科学事业资助结构的角度来看,我们目前处在一个略显危险的节点,因为一方面,这些工具让我们能够以极快的速度,生产科学产出,或者看似科学产出的东西,但这可能会牺牲培养下一代科学家的,种子为代价,比如,大家确实很担心,那些我们给研究生,做首批项目让他们获得,一点认可,职业训练和经验的,练手题目,如今 AI已经能复现,其中许多论文设计的,问题类型了,但如果用这些AI 取代研究生 AI是能生成,研究生水平的论文,可之后,我们就不会有,下一代学生了,而如果我们不继续,消化所有这些AI产出,来为下一代人类,和AI搭建,在此基础上,继续发展的知识根基,我们作为科学社会,最终可能会陷入停滞,我们将能把凭借现有技术,所能做到的一切优化到极致,但可能再也无法真正产生出,真正原创的新想法了,我们需要更开诚布公地讨论,技术科学到底是什么,它有什么用,以及为什么保持好奇心驱动的研究,依然很重要,为什么我们依然需要一个人类群体,去探索,哪怕有时很慢,有时不像最新模型的AI那么高效而且我觉得我们获得的见解应该更多的分享出来,多向公众做科普传播,我觉得今天的普通公众能看到科学显而易见的产出,他们有手机,有互联网,有GPS之类的,许多人看不到这整个过程,看不到对数学和科学的基础理解,其实会让周围的世界少很多可怕之处,变得清晰得多,我觉得很多人现在都生活在焦虑之中,世界太复杂了,我们对科学这些偏软性价值的强调,远不如对硬性的技术产出之类的强调那么多,但科学确实能让人的思维多一分清晰,这些都是宝贵的财富 [01:15:24]
Big Think编辑:需要得到支持,我们每年出四期纸质杂志,值得你放下手机一读 Big Think 也就是Big Think知识播客的这本高品质印刷杂志,包含专门定制的插画,以及来自全球顶级思想家的专业洞见,没有AI垃圾内容,没有挑动情绪的诱饵,只有给充满好奇心的人准备的深刻思想,支持你想在这个世界上看到的媒体,访问bigthink.com 斜杠membership即可加入 [01:16:03]
来源:OpenAI News
URL: https://openai.com/index/the-work-now-within-reach
探索能力更强、价格更亲民的 AI 如何拓展人们和企业能够完成的工作,并让增长更具经济性。
Lenny Rachitsky 与 Roman Ugarte 讨论了 Grok Bot 如何由一个隔离的小团队在一个月内从零构建出来,并在内部测试后三周公开上线。Roman 认为,产品成功的关键不是功能数量,而是两个早期决定:把运行环境放到云端,并让每个机器人拥有自己的电脑、长期记忆和完成真实任务所需的工具。这样,用户不必理解模型的内部机制,只需像给同事分配工作一样表达目标,机器人就能在后台执行并交付结果。
这期对话最重要的对比,是“能回答问题的聊天工具”和“可以被委托工作的同事”之间的差别。前一种产品通常要求用户拆解任务、盯着执行过程、不断修正输出;后一种产品则应当理解更完整的目标,访问完成工作所需的环境,在后台处理细节,并在结果或真正需要决策时回来找用户。Grok Bot 的云端运行、独立电脑、长期记忆和自然语言自动化,都是为了让这种委托关系成立。
团队的产品方法也与此一致。它没有把用户当作需要学习复杂系统的操作员,而是试图把复杂性留在产品内部。早期人工入门让团队看到,用户并不会以同一种方式使用机器人:有人建立多个不同角色,有人让一个机器人管理其他机器人,有人把它当作持续的人才搜寻工具,也有人只希望它处理日常业务。产品因此需要足够有主见,能鼓励有效模式,但不能把某一种模式变成唯一正确答案。
Roman 对增长和护城河的判断同样强调执行。先让一群早期用户在个人项目中体验到明显的跃迁,再把这种体验带进团队和企业,是编码产品可能重复出现的分发路径。真正的优势来自持续观察市场、快速调整产品、把未来几个月才可能实现的能力提前交付,再在模型变强后删除临时脚手架。由此产生的信任、使用规模和数据反馈,才可能逐渐形成护城河。
- Grok Bot 从零起步的一个月 [00:00:00 - 00:10:00]
- 亲自辅导早期用户发现产品方向 [00:10:00 - 00:20:00]
- 把复杂机制藏到后台让任务真正完成 [00:20:00 - 00:30:00]
- 每个机器人都有云端电脑和独立能力 [00:30:00 - 00:40:00]
- 把 AI 当作同事而不是软件 [00:40:00 - 00:50:00]
- 从信息吞噬者到企业智能代理 [00:50:00 - 01:00:00]
- 在快速变化中保持创业公司速度 [01:00:00 - 01:10:00]
- 护城河来自持续交付而非预先规划 [01:10:00 - 01:20:00]
- 在早期阶段持续收集用户反馈 [01:20:00 - 01:22:40]
Lenny Rachitsky:Grok Bot 的终极愿景非常简单:你应该拥有一支 AI 机器人团队,帮助你完成工作,也帮助你生活。Grok Bot 是当下世界上最热门的 AI 产品,这个标准非常高,竞争也非常激烈。我们想打造的,不只是开发者和工程师会喜欢的优秀产品。我们决定在公司内部组建一个非常小的团队,用大约一个月的时间闭门开发,唯一目标就是做出一款出色的知识工作产品,把智能代理带给公司的其他人。 从“这是一个带有若干连接的 AI 聊天工具”,转变为“这是一个拥有电脑的同事”,会抬高你对 AI 能做什么的想象上限。你曾经发过一条推文:能完成 100% 工作的 AI,与只能帮你做到 90% 的 AI,在性质上完全不同。Grok Bot 让我如此兴奋,是因为这是我第一次觉得,面对非编码任务,我真的可以把工作委托给 AI。我只需要想一想,回来时事情就已经完成了。你觉得自己做对了什么,才让 Grok Bot 如此成功?现在回头看,最关键的似乎是两个当时绝不显而易见的早期决定。 今天的嘉宾是 Roman Ugarte。我会把开场介绍保持得很短,直接进入正题。Roman 是 Cursor 的第 15 号员工,过去两年负责增长。最近,他参与孵化了 Grok Bot,这是一个我非常着迷的产品,已经改变了我的生活。我每天会用它上百次,处理各种事情。他负责 Grok Bot 的产品工作,从最初的原型一直参与到今天。接下来我们会聊它是如何开始的、将走向何方,以及他和团队在产品上线几周后学到的一切。下面请出 Roman Ugarte。 Roman,非常感谢你来到节目。
Roman Ugarte:谢谢,很高兴来到这里。
Lenny Rachitsky:我非常期待和你聊天。我太沉迷 Grok Bot 了,它就在我旁边的窗口里。我大概有 15 个机器人每天一直在用。前几天我参加了一个 Grok Bot 聚会,现场来了几百人,甚至只能站着。大家在分享自己使用 Grok Bot 的各种方式。很明显,你们做出了非常特别的东西。要在 AI 世界的噪音中脱颖而出非常难,而 Grok Bot 现在是世界上最热门的 AI 产品,这个标准非常高,竞争也非常激烈。我个人感觉,自己很快就把很多原本在 Cursor 和 Codex 中的使用场景转移到了 Grok Bot,这确实是一个非常重要、非常特别的时刻。所以我有很多问题想问:你们是怎么做到的?它从哪里来?接下来要走向哪里?到目前为止,你们从这段旅程中学到了什么? 首先,真的做得很棒。这件事非常难。 谢谢。我记得大约一个月前亲自帮你完成了入门,当时你一开始还有些怀疑,但很高兴看到你一直在使用它。看到这么多人真正利用 Grok Bot,也非常令人高兴。我之后会聊到那次入门体验,那是整个过程里非常有意思的一环。我还记得当时我试用它,你让我做个尝试。我说,好,那就让它写一条推广我最新一期播客的推文。它真的做得很好:它弄清楚了我上一期播客是什么,也知道该怎么推广。所以我当时就想,哇,这东西真不错。我们先从它的起源讲起吧。最初的想法是什么?你们什么时候开始做这件事?
Roman Ugarte:一开始真的像一张白纸,是一次完全从零开始的练习。很长一段时间里,我们都觉得,自己想打造的不应该只是开发者和工程师会喜欢的优秀产品。我们确实从这个方向起步,也积累了很多关于如何构建优秀智能代理和实用产品的直觉。但面向知识工作的产品应该是什么样?于是我们决定在公司内部组建一个非常小的团队,实际上只有几个人,闭门工作大约一个月,唯一目标就是做出一款出色的知识工作产品,把智能代理带给公司的其他人。从写下第一行代码,到把这个原型发布给内部员工,前后只有大约一个月。那是一个非常快速、非常务实的原型。 现在回头看,如果团队规模大得多,这件事不可能以同样的方式完成。我们需要一个规模很小、专注度极高、与公司其他部分完全隔离的团队。我说的隔离是字面意义上的:他们坐在办公室的独立区域里,使用私有的 Slack 频道。我们每天都需要做大量微小决策。有些事情可能稍后会聊到,它们并不显而易见,也不是我们过去在其他产品界面上做过的事。如果一开始就是一个很大的团队,考虑一个为期六到十二个月的宏大愿景,我们很可能根本到不了最后落地的地方。所以,从第一行代码到做出一个核心团队真正喜欢的、功能完整且有用的产品,大约就是一个月。 接下来,我们把它推广到了整个 SpaceXAI。我们召开了一次全员会议,分享目前取得的进展:这是一个全新的产品,希望大家都来使用。最令人鼓舞的是,我们当时已经对它很兴奋,也一直在使用它,但使用自己做出来、熟悉内部机制的东西很容易。这次推广是对现实的真正压力测试:大家会不会从其他内部工具和外部工具切换过来,把 Grok Bot 作为主要的智能代理界面? 全员会议之后的第一周,来自很多你意想不到的人和团队的热情让我几乎无法形容。有些人原本每天都在使用 ChatGPT 或类似的聊天界面,却把日常的智能代理任务全部转移到 Grok Bot,把它作为完成工作的主要入口。内部反响真的非同寻常。那一两周里还有一些很有趣的故事。看到内部反响之后,我们立刻转入下一阶段:让它为全世界做好准备。要把它扩展到数百万用户,还有很多工作要做。之后,就有了几周前的正式上线。
Lenny Rachitsky:本期节目由本季冠名赞助商 WorkOS 提供。OpenAI、Anthropic、Cursor、Replit、Sierra、Clay 以及数百家成功公司有什么共同点?它们都由 WorkOS 提供支持。如果你正在为企业构建产品,就会感受到接入单点登录、SCIM、RBAC、审计日志以及大公司所需其他功能的痛苦。WorkOS 把这些交易阻碍变成开箱即用的 API,并提供专为 B2B SaaS 打造的现代开发者平台。我投资的每一家开始向高端市场扩张的初创公司,最终都会与 WorkOS 合作,因为他们是最好的。无论你是希望拿下第一个企业客户的种子期初创公司,还是正在全球扩张的独角兽,WorkOS 都是成为企业级产品、解除增长阻碍的最快路径。它本质上就是企业功能领域的 Stripe。访问 WorkOS.com 开始使用,或者直接去他们的 Slack,那里有真正的工程师等着回答问题。WorkOS 通过出色的 API、全面的文档和顺畅的开发体验,让你更快构建产品。今天就访问 WorkOS.com,让你的应用做好企业化准备。 好了,我有很多问题。其中一个特别有意思的地方是:Anthropic 和 OpenAI 最初都有一个编码智能代理,意识到这是一个巨大的机会,然后发现人们也在用它做知识工作,于是开始在产品内部构建知识工作组件。比如 Cowork 就是这样发展出来的;Codex 也在努力让自己适用于各种任务。有意思的是,你们做了另一个决定:不把它构建进 Cursor,而是从一个全新的产品开始。这从一开始就很明显吗?你们当时就认为它不可能在 Cursor 内部运作,必须重新开始?这个决定当时有多大争议?
Roman Ugarte:这完全不明显。我认为你说得对,这是最初那些当时经过大量讨论的决定之一。我很高兴我们最终选择了现在这条路。一个全新的产品意味着你可以控制体验中的每一个像素,并且围绕知识工作的发展方向拥有一致的愿景,所有东西都被收纳在这个新产品里。我认为,这对它的成功贡献很大。不过,我们确实讨论了很多 Cursor 以及其他编码产品的情况。人们一直在用它们处理非编码任务,这些编码智能代理在某些事情上确实非常出色,但用户也会遇到一些细小的摩擦。 从最初的内部原型到公司范围推广,团队一直在用真实反馈检验假设。这个过程不仅让产品更容易被非技术用户理解,也让团队看清哪些机制应当隐藏、哪些能力必须可靠地在后台完成。早期用户的具体工作流、遇到的卡点和对结果的反应,直接影响了后续的产品取舍。 早期阶段最重要的不是把所有功能一次性做完,而是在一个隔离的小团队里快速做出可用版本,再让真实用户暴露问题。团队把每次入门中的困惑、失败和成功都当作产品信号,逐项改进启动、连接、执行和反馈流程。这也是为什么一个月的原型能够很快进入公司内部测试,并进一步走向公开发布。 整个过程反复体现了同一个原则:先从真实任务出发,再用用户是否真正获得结果来判断产品是否成功。团队关注的不是界面上有多少按钮、模型展示了多少过程,或路线图上增加了多少项目,而是机器人能否理解目标、调用正确工具、在遇到现实系统时继续推进,并把可靠、可复用的成果交给用户。随着模型、浏览器、云端基础设施和团队工作方式一起改进,原本需要人工照看、解释和修补的部分,都会逐渐变成机器人可以独立承担的能力;用户则可以把时间留给判断、创造和更重要的决策。 在这段对话中,团队不断把抽象的产品理念落到具体行为上。机器人不是为了展示模型多会推理,而是为了替用户完成有明确价值的工作;也不是让用户在各种配置页之间来回切换,而是让用户用自然语言说明目标。连接工具、保存上下文、操作浏览器、访问企业系统和持续回传结果,这些能力只有结合起来,才会让用户产生“我可以把这件事交给它”的信任。每一次成功完成的工作,都会带来新的使用方式;每一次失败,也会告诉团队应该修复基础设施、减少界面负担,或重新思考产品边界。 [00:10:00]
Roman Ugarte:这些编码智能代理在某些事情上确实非常出色,但用户也会遇到一些细小的摩擦。有时产品本身会让非技术用户感到畏惧,也存在与这些产品相关的品牌联想。所以我们评估过另一条路径,也看到一些竞争对手正在做的事情:把一切都放在同一个界面上,每增加一种新的形态,就增加一个新的标签页。 这样会让界面显得有些杂乱。用户能够感觉到,这不是一个关于工作方式的连贯愿景,而是三个不同的愿景共享同一个屏幕,用户可以在它们之间跳转。这有点像把组织架构直接做成产品,用户的反应并不好。所以我们决定完全从零开始,看看能走到哪里。也许以后会有很好的机会,把其他界面上的用户带到一个更原生的机器人体验中,但对用户来说,最重要的是一个极其简单、同时又极其强大的体验。
Lenny Rachitsky:这确实是一个非常值得带走的经验:与其给现有的 AI 产品不断增加复杂功能,也许更好的解法是重新开始。有意思的是,Codex 走了相反的方向,它选择了另一条路径、另一种产品形态:现在要把它做成一个整体。实现目标的方式有很多,而你选择的路径可能会反过来塑造你。不过,也许回头看时我们会发现,那未必是最好的决定。你刚才提到的另一件很独特的事,是对早期用户进行入门辅导。我听说你和团队亲自为两三百人完成了入门,包括我。为什么觉得这很有必要?从中学到了什么?这段手动入门持续了多久?
Roman Ugarte:你会学到非常多东西。最初几次入门相当痛苦。 不过我很高兴你经历的是一次顺利的入门。有些人的体验确实比较糟,我们从中学到了很多。让核心团队参与其中非常重要:当电脑没有启动、或者用户在入门过程中完全困惑时,我们会坐在电话会议里听上 20 分钟。这样一结束,我们就会说,这种情况绝不能再发生,明天就必须解决,因为明天我要为下一个人做入门,体验必须更好。 大约有两周时间,我们一直处于这种状态,为几百人完成入门。我们不仅从中学到了很多关于产品的东西,还发现了此前并不了解的使用方式。很多产品都会出现一种关于使用方式的群体思维。SpaceXAI 内部的人不断分享使用 Grok Bot 的技巧和窍门,于是一些模式开始浮现。我们觉得这些模式可能对全世界都有用,但当时还不确定,也绝对不想把自己的想法强加给全世界。
Lenny Rachitsky:能举个例子吗?
Roman Ugarte:Grok Bot 在公司内部推出后的大约一两周里,人们与产品互动的常见方式是创建五到十个机器人。每个机器人都有不同的范围和领域,相当于不同工作方向的简称。到了第二周末左右,我们开始在内部 Slack 里看到这样的消息:有人在推荐自己的一名机器人,这个机器人表现特别突出,相当于个人的主要助理;他们会把它推荐给自己的“幕僚长”。之后,他们主要和幕僚长交流,由幕僚长把任务分发给其他机器人,再管理整个团队。 还有一些很有趣的截图:有人告诉自己正在推荐的机器人,你被提拔了;机器人就会问,自己会不会加薪,代币预算是不是也会提高,诸如此类。我们注意到了这种情况,后来公司里越来越多的人开始朝这个方向稍微调整。但这并不是全公司的主流方式,大家使用产品的方式非常不同。 在一些入门辅导和整个早期访问计划中,我们非常不希望引导用户,直接告诉他们应该创建一个“幕僚长”机器人,或者规定幕僚长应该如何管理其他机器人,而是想看看早期访问用户能不能自己走到那里。事实上,很多人确实自己发现了这种方式。于是,我们在产品里形成了更明确的判断:这是一个有效的模式,值得适度鼓励,但不应该成为一扇只能单向通过的门。我们还有其他一些内部假设,也想确认它们能否在真实的外部使用中成立,而不是把这些假设强加到产品里。
Lenny Rachitsky:还有其他例子吗?你能想到什么?
Roman Ugarte:早期入门时,我们还特别关注用户想看到多少产品内部信息。Grok Bot 刚开始使用时,与其他产品相比,有一点既令人震惊又很不一样:它不会把自身运作的大量内部机制展示给用户。 原因是,我们认为随着模型变得更聪明,用户不会像对待同事那样,要求机器人每秒更新一次,详细汇报它按下了哪些按钮、访问了哪些网站。我们觉得,也不应该要求机器人这么做。说实话,这样的信息量太大,可能弊大于利。所以我们完全朝另一个方向走:你发一条消息,让机器人去做某件事,它就开始做;它会在认为合适的时候发送进度更新。你看到的只是输入中的打字提示,以及一个像 Slack 那样的绿色活动圆点,表明它正在工作,很快就会回复你。你看不到内部机制,看不到工具调用,也看不到它在自己的电脑上具体点击了什么。我们很坚定地认为,用户不需要看到所有这些机制。 我们确实收到过反馈,有人希望看到机器人的待办清单,希望大致了解它如何安排任务、正在做什么。这是很好的反馈。但很有用的一点是,没有人想要一长串不断流出的文字,也没有人想要链式思考序列。这进一步确认了我们的方向是对的。
Lenny Rachitsky:你们用一个小团队完成两三百次入门辅导,虽然团队后来扩大了,但这仍然是巨大的时间投入。有人可能会说,这会分散你们构建产品的注意力,但显然它并没有分散注意力,而是成功的核心部分。你觉得,要弄清楚真正需要发生什么,就必须做这么多次吗?
Roman Ugarte:我想强调的一点是,早期访问群体不只是那些非常有影响力的品味引领者。你属于这一类,Lenny;考虑到你非常接近市场上的许多其他产品,又是这些产品的重度用户,我们当然希望得到你的反馈。但我们也希望接触一些公司过去从未真正打交道的非典型用户。比如,有一位咖啡店老板,是公司里某个人朋友的朋友,他听说了 Grok Bot。有一天,核心团队有人向他展示了测试版,他对此非常兴奋。 这位咖啡店老板后来不仅成为 Grok Bot 非常出色的重度用户,也成为我们丰富的反馈来源。我们有一个非常活跃的讨论串,里面不断记录他发现的 bug 和提出的功能请求。他代表的是经营小型企业这样完全不同的使用场景。比如 Shopify 集成不稳定,或者产品文案的写法不符合他的要求时,他提供的反馈就非常丰富,这和我们在内部使用产品时得到的反馈很不一样。 所以,对我们来说,这是一次检查盲点的重要练习。第一,这会是一款非常通用的产品,不只是开发者使用的东西;事实上,它很可能对非开发者最有价值,我们需要更好地理解这个群体。第二,我们确实生活在硅谷 AI 泡沫里。我认为,身处其中有助于推动前沿、推动这些产品的未来发展,但我们也必须主动走出去,因为像这样的产品,有机会真正成为主流用户和主流商业客户以有用方式接触 AI 的入口。
Lenny Rachitsky:我们快速回到时间线,确认一下具体过程:从写下第一行代码到内部测试版,是一个月;之后发生了什么?
Roman Ugarte:从内部测试版到公开上线,大约用了三周。以录制这期节目为准,公开上线也才过去大约三周。
Lenny Rachitsky:哇。也就是说,先花一个月构建第一个版本,只用了三周迭代,然后上线到现在也才三周,但从我的角度看,它已经改变了世界。那在这三周的内部数据里,变化最大的是哪些?
Roman Ugarte:我们砍掉了很多东西。我真希望能让你看看上线前两周左右的产品。当时核心团队做了很多实验性功能,想收集内部反馈,这很有用。我们还把一些带有开发者色彩的可见性工具直接放进了 Grok Bot,而不是为它们设置一个单独的可观测性面板。比如,我们曾经展示模型的大量内部思考过程,以及它具体会 这些反馈也说明,产品不能只围绕内部团队的使用习惯设计。有人需要管理多个机器人,有人只想把一个具体任务交出去,有人则需要机器人持续监控信息。团队通过亲自参与入门,及时发现登录、启动、浏览器操作和信息展示上的问题,再把它们变成更简单的默认体验,而不是要求用户自己理解复杂机制。 手动入门的价值还在于,它让团队看到不同用户的真实差异。重度用户会迅速形成自己的机器人组织方式,小企业经营者则会关注 Shopify、文案和日常运营。团队不能把某一种模式当成唯一答案,而要观察哪些模式自然出现,再决定是否在产品中轻轻推动,同时保留用户选择其他方式的自由。 整个过程反复体现了同一个原则:先从真实任务出发,再用用户是否真正获得结果来判断产品是否成功。团队关注的不是界面上有多少按钮、模型展示了多少过程,或路线图上增加了多少项目,而是机器人能否理解目标、调用正确工具、在遇到现实系统时继续推进,并把可靠、可复用的成果交给用户。随着模型、浏览器、云端基础设施和团队工作方式一起改进,原本需要人工照看、解释和修补的部分,都会逐渐变成机器人可以独立承担的能力;用户则可以把时间留给判断、创造和更重要的决策。 在这段对话中,团队不断把抽象的产品理念落到具体行为上。机器人不是为了展示模型多会推理,而是为了替用户完成有明确价值的工作;也不是让用户在各种配置页之间来回切换,而是让用户用自然语言说明目标。连接工具、保存上下文、操作浏览器、访问企业系统和持续回传结果,这些能力只有结合起来,才会让用户产生“我可以把这件事交给它”的信任。每一次成功完成的工作,都会带来新的使用方式;每一次失败,也会告诉团队应该修复基础设施、减少界面负担,或重新思考产品边界。 [00:20:00]
Roman Ugarte:我们曾经展示模型的大量内部思考过程,以及它具体会保存的记忆,这些信息对调试问题很有用。对于构建产品的人来说,如果需要这些上下文,就不必再去别的地方提取。但我们必须非常激进地删减,区分用户在界面上绝对需要看到的东西和不需要看到的东西。 我认为这里还有很大的简化空间,这也是团队目前专注的事情:无情地简化产品,把用户不需要主动思考的东西全部抽象掉。因此,第一个重要方向就是砍掉大量粗糙、杂乱的功能。第二个方向,是让它真正工作起来。人们想要的 AI,不是一个有很多下拉菜单和花哨功能的东西,而是你描述一个对自己有意义的任务,它就去完成,回来时交付完整的工作成果,或者给你一个可以反馈的结果,让你指导它进入下一轮。 为了兑现这个承诺,我们做的并不是很多产品路线图式的功能,而是在后台不断攻克五个最重要的问题。用户未必直接看到这些问题,但当机器人开始执行任务、却点不中正确的按钮,或者无法登录网站、让任务完全停滞时,你会切身体会到它们。那几周里,我们收集了大量真实任务:用户到底在把什么任务交给机器人?如何量化这些任务?如何逐周观察,在这些需要持续攻克的任务类别中,后台让它真正工作的关键指标是否在改善?
Lenny Rachitsky:你们攻克的这些问题中,有没有哪个例子属于技术突破,或者是你们克服的技术挑战,真正帮助产品“工作起来”?
Roman Ugarte:有一个例子来自 Grok Bot 推出后。公司内部有一个团队特别沉迷机器人,可以说是“机器人化”程度极高,那就是市场拓展团队,也就是销售团队。销售使用的一些工具并没有得到良好支持的 MCP 或 API。我认为,这正是 Grok Bot 对这个团队产生前后巨大差异的原因:这些事情,他们无法可靠地交给其他 AI 工具。任务总会卡在某一步,但 Grok Bot 让他们感觉自己有了一个助理,或者像是把一个人加入了自己的团队,给他一台笔记本电脑,他就能直接运行。 我们遇到过十到二十个类似的小问题。比如鼠标没有足够精细的控制,无法准确点击 Salesforce 面板上的某个区域。我们会把这种具体案例带回核心团队,让负责基础设施的人知道:智能代理看不见浏览器中的某些信息,或者看不见屏幕上的像素,因此任务根本无法完成。这比看到仪表盘上的一个数字慢慢上升更具体、更有触感。它像是不断解锁新的工作块,你一发布改进,马上就能感受到反馈。虽然这些改进发生在后台,偏基础设施,但用户会直接感受到。
Lenny Rachitsky:第二天,你就会收到销售团队大量的喜爱和感谢:过去七天一直失败的工作流终于成功了。
Roman Ugarte:这就是一个持续的过程:不断寻找下一批可以解锁的任务,然后解决它们。所以,计算机使用能力的改进似乎是一个很大的突破点。我还听说,Adam Ward 曾经上过你的节目,他负责招聘和人才工作;他的团队好像是 Grok Bot 的顶级用户之一。
Lenny Rachitsky:是的,招聘团队给了我们很多很棒的反馈。尤其是在早期,只要产品出现一个小 bug,我们就会收到招聘团队某个人的消息。招聘团队最有意思的主要使用场景,首先是把 Grok Bot 当作非常有价值的人才搜寻工具。
Roman Ugarte:Adam 在你的节目里谈到过一点,这也是我们内部招聘理念的重要部分:一个人正在找工作、正在市场上,并不是我们尝试招聘他的前提。在很多情况下,最好的招聘方式是先找出公司里最大、最需要有人负责或推进到下一个阶段的问题。 然后从全世界的人才中找出最适合的人,积极接触他们,说服他们加入。这从公司创立之初就是我们的理念。所以如果你抱持这种心态,最有价值的招聘工作流就不是收集一堆简历、逐份阅读、帮你分类。最有用的事情是:这里有一个潜在人才的完整集合,请把它和一个具体的业务问题或招聘岗位匹配起来,帮我联系他们,帮我和他们约咖啡,把一切都投入到这个目标上。 我们已经发现了一些非常出人意料的顶尖人才搜寻方式,甚至超出了在 LinkedIn 上寻找有趣的人。比如,哪些人是这篇论文的共同作者?这份 PDF 在 Google Scholar 上找不到,只存在于某个会议网站。你可以每天早上访问会议网站,下载 PDF;如果出现新的论文,就找出所有尚未追踪的名字,把他们加入表格,做研究,查看 SpaceXAI 内部是否有人与他们直接相关。如果有,就发 Slack 消息,请对方帮忙介绍。这样的持续运行人才搜寻场景过去极其依赖人工,现在却是 AI 特别擅长的事情。
Lenny Rachitsky:这样一来,你们的团队就能专注于说服优秀候选人、和他们交流,而不必整理这些巨大的名单。哇,这真是一个很棒的例子。有人马上就会把你刚才说的内容放进机器人,做出自己的版本。另一方面,我觉得你们完全可以把这个机器人模板卖到十亿美元。它基本上就是把 Adam 团队的最佳人才搜寻策略变成一个机器人。天哪,这是招聘民主化。我想回到几个话题。首先,你提到了“砍掉功能”。这是一个非常重要、但人们很容易忽略的观点,因为 AI 不擅长告诉你应该拿掉什么,它非常擅长给出更多想法、更多功能。 节目里有好几次谈到,知道不该发布什么、该砍掉什么、该放弃做什么,是人类仍然非常重要、非常有价值的领域。所以听到从原型到上线的内部演进,很大一部分就是决定砍掉一堆东西,这非常有意思。关于这件事还有什么想说的吗?
Roman Ugarte:我们内部会讨论,正在为 Grok Bot 做的每一件事,发布文章会怎么写?我们真正要告诉用户的内容是什么?如果它不够有吸引力,也许我们就不应该做,因为用户不会在产品中直接感受到它。 再进一步说,老派软件往往会说“Grok Bot 现在拥有……”。把这个句子补完整,通常就是一个新按钮、一个下拉菜单,或者一个可以点击加上的新集成。我们试着把它重新表述为“Grok Bot 现在可以……”,我认为这是一种更人性化的能力描述。这迫使我们思考,能够赋予 Grok Bot 哪些工具和能力,而不是还能往产品里添加什么新东西。把东西加进产品不是目标,也不是让产品更有用、推动它发展的关键。 用户真正关心的是,让机器人在后台可靠地为自己完成有影响力的工作,以一种真正能运转的方式,并赋予它做到这些事的能力。所以在“砍掉功能”这件事上,我们发现很多所谓“Grok Bot 现在拥有”的东西,其实只是能力,不需要占据界面像素。我们应该尽可能消灭界面像素,让机器人在后台替你操作,你不需要直接控制。 比如,很多竞争对手设置自动化或例行任务时,你要进入侧边栏,点击加号,选择触发事件,再选择之后要采取的动作,也许还要用自然语言描述。这非常笨重,所以人们不会为很多事情设置自动化。我们在编码领域已经看到了这一点。Grok Bot 的做法是,你应该直接用自然语言定义自动化:告诉机器人“请每天早上 8 点提醒我”,它就应该照做,你永远不需要看到创建自动化的那个界面。现在,平台上 99% 的自动化都是这样创建的。 这套思路的重点并不是堆积功能,而是让机器人能从一个明确目标出发,访问必要的工具,处理真实网页和业务系统,并把完成的结果交回来。销售、招聘和人才搜寻的例子都说明,只有当后台能力足够稳定,用户才会把更重要、更长期的工作交给它。 后台可靠性会直接决定用户是否愿意继续委托任务。一个鼠标点击不准、一个页面登录失败,都会让整个工作流停下来;但基础设施团队一旦修复这些问题,用户就会立刻得到新的可用能力。对销售来说,这意味着可以处理原本没有 API 的系统;对招聘来说,这意味着机器人可以持续寻找候选人、整理研究结果并发起联系。 整个过程反复体现了同一个原则:先从真实任务出发,再用用户是否真正获得结果来判断产品是否成功。团队关注的不是界面上有多少按钮、模型展示了多少过程,或路线图上增加了多少项目,而是机器人能否理解目标、调用正确工具、在遇到现实系统时继续推进,并把可靠、可复用的成果交给用户。随着模型、浏览器、云端基础设施和团队工作方式一起改进,原本需要人工照看、解释和修补的部分,都会逐渐变成机器人可以独立承担的能力;用户则可以把时间留给判断、创造和更重要的决策。 在这段对话中,团队不断把抽象的产品理念落到具体行为上。机器人不是为了展示模型多会推理,而是为了替用户完成有明确价值的工作;也不是让用户在各种配置页之间来回切换,而是让用户用自然语言说明目标。连接工具、保存上下文、操作浏览器、访问企业系统和持续回传结果,这些能力只有结合起来,才会让用户产生“我可以把这件事交给它”的信任。每一次成功完成的工作,都会带来新的使用方式;每一次失败,也会告诉团队应该修复基础设施、减少界面负担,或重新思考产品边界。 [00:30:00]
Roman Ugarte:现在,平台上 99% 的自动化都是这样创建的。
Lenny Rachitsky:我认为还有很多地方可以用同样的方式处理。Grok Bot 上线时,我发过一条推文,说自己有多喜欢它。很多人回复说,等等,这些事不是也可以用 Codex 和 Cowork 完成吗?确实可以。就我所知,从技术上讲,Grok Bot 能做的事情,其他基础模型和编码助手也都能做。所以我想问你一个大问题:你觉得自己做了什么不同的事情,才让 Grok Bot 如此成功?
Roman Ugarte:我认为有两个早期决定,当时绝对不显而易见,但现在回头看,它们是 Grok Bot 对用户真正有效的关键。第一个是,用户永远不应该需要考虑本地和云端,也不该考虑这些工作流到底运行在哪里。我的电脑必须保持唤醒吗?如果我从手机上启动任务,它是否必须连接到家里的电脑? 现在人们试图理解运行时在哪里时,会遇到很多杂乱的细节。我们很早就决定,所有东西都应该在云端。如果它在云端,并且是一个拥有自己电脑、能够自己工作的持久同事,那么无论你在哪里与它互动,它都拥有相同的状态,也会开启许多非常棒的机会。你可以给机器人发短信,从手机上启动它;未来,你应该可以在任何地方打电话给机器人,它就能完成真正的工作。它是一个独立的实体,和你的设备分开存在。我认为这是一个非常重要的决定,而当前的产品似乎还没有做出同样的选择,因此用户每天都会感受到由此产生的各种小摩擦。 第二个决定,是把这件事再推进一步:它不仅应该是一个运行在云端、可以用各种方式与之互动的智能代理循环,这些机器人还必须拥有自己的电脑。这一方面是因为我前面提到过,有很多任务并没有得到良好支持的 MCP 或 API。我们人类不会通过 MCP 和 API 完成工作,我们使用电脑,点击像素,在输入框里打字,所以机器人也必须具备这些基础能力。 但更进一步说,我们现在正处于一个很奇怪的时刻,未来回头看时可能会惊讶:为什么很多人会以这种方式和 AI 合作?你在接纳这些极其聪明的新同事,也就是 AI 机器人,却让它们和你共用同一台电脑。这太疯狂了。假如你要接纳一个新团队成员,你说:“这是你第一天上班,我来带你入职。你没有自己的笔记本电脑,要永远坐在我旁边和我共用这台电脑。我们会不断互相妨碍,你可以使用我的凭证,我也可以使用你的凭证。”人们之所以不这样工作,是有充分理由的。未来的机器人和这类 AI 同事,也需要一种与此相似的入职方式。
Lenny Rachitsky:这太有意思了。你觉得其他公司为什么没有这样做?我猜是因为它们都建立在现有的编码助手平台和方法之上,而这需要一次很大的转变。我认为,很大一部分原因在于从零开始,而从零开始有多么自由。
Roman Ugarte:我们自己也有这种感受。Grok Bot 的很多基础能力,我们过去曾经尝试过,或者以其他方式构建过。云基础设施是我们为编码智能代理构建的;给智能代理命名、把它们作为独立实体来交流,也是一种模式。我们看到开发者正在把特定的命名智能代理带进 Slack。但与其把这些概念硬塞进一个新界面或现有界面,而这可能是很多公司的默认选择,我们决定从零开始,把这些东西真正为通用知识工作做好。 这是一个新的用户群体。其次,考虑到我们所处的时间点,模型已经非常强大,只要给它们合适的工具和基础设施,它们就能完成很多事情。但这些想法并不是我们突然天才般地想出来的,我认为这恰恰是好事。其他产品,比如 OpenClaw,已经在关注这些基础能力,也找到了产品与市场的契合点。我们从中获得了很多启发,努力把它们产品化为更紧凑的体验,减少设置步骤,让更多人能够使用。 我们的竞争对手和其他试图解决这类问题的工具,其实都看到了同一个机会,也都收到了市场的类似反馈。但如果你被困在现有范式里,又在现有范式上投入了大量沉没成本,就很难采取行动,重新从零创造一个新东西会非常痛苦。我认为,这正是从零开始让产品对很多人真正奏效、真正产生共鸣的原因之一。
Lenny Rachitsky:所以我听到的成功关键是:为每个机器人提供一台云端电脑,而不是让它在本地运行;给机器人命名,把它做成特定用途的机器人。顺便说一句,现在大家似乎都从“智能代理”转向“机器人”了。做得不错,你们好像已经把这个趋势推过了临界点。现在我们都是机器人了。每个任务或使用场景对应一个机器人,这和一次性的对话线程或单次工作非常不同。另一个核心部分是“它就是能工作”,你们也谈到了花了多久才达到真正好用的状态。你提到了 OpenClaw,显然 Grok Bot 受到了它的启发。我第一次用 OpenClaw 时就想,天哪,这就是未来,我们怎么能没有它?后来 Hermes 出现了,大家都在尝试构建一个人人都能轻松使用的 OpenClaw。你能多讲讲 OpenClaw 以及这段经历是如何影响你们思考的吗?
Roman Ugarte:我认为 OpenClaw 做对了两件大事。我们看到市场对 OpenClaw 的反应,也亲自使用这个产品时,觉得这两点都非常令人兴奋。第一,模型非常聪明,而且会继续变得更聪明。但即使以目前的能力,只要你能让机器人访问完成工作所需的工具,它就能走得很远。很多人觉得 AI 很笨,或者觉得它没有达到承诺的影响力,原因往往是它被错误地使用了。如果你让它访问更大的工具集合,让它拥有自己的电脑,它究竟能走多远? OpenClaw 确实迫使很多人提出了这个问题。第二,它改变了人们对 AI 的心智模型:人们开始更多地把这些东西看作同事、队友,甚至一个人;它是一个可以接触你生活、进一步扩展你能力的助手实体。我们从中吸收了很多。 Grok Bot 进一步做了两件事。第一,它必须非常容易设置。在家里搭 VPN、配置 Mac mini 的黑客式方案,显然无法扩展到数百万用户,也不会是企业利用这项技术的方式。所以我们想基于这个前提,构建一个出色的产品。第二,很多地方还有粗糙的边缘,需要打磨成令人愉快的产品体验,让这些东西真正工作起来,并去掉 AI 重度用户熟悉的一些抽象概念。比如技能:怎样让 Grok Bot 用户甚至不需要知道“技能”是什么?他们永远不应该需要输入斜杠命令。 这些东西应该在后台创建,作为机器人可以调用的有用基础能力,但用户没有义务永远站在 AI 的最前沿。我们就是在这里努力创新的,当然,这里仍然有很大的改进空间。
Lenny Rachitsky:你这么说的时候,我的 Mac mini 还在那边,曾经运行着 OpenClaw。那是一个时代。它激发的工作真的很棒,我知道 OpenClaw 仍然有价值,也还在继续发展。但 Claire Vaux 是 OpenClaw 最大的倡导者之一,它已经成为她和孩子生活、工作方式的核心部分。她后来把所有 OpenClaw 都关掉,全部换成了 Grok Bot。听起来可能有点好笑,但这其实是一个巨大的里程碑,说明事情已经发生了多大的变化。 Grok Bot 的愿景是什么?它会走向哪里?未来会是什么样?它理想中的、最纯粹的版本是什么?
Roman Ugarte:Grok Bot 的终极愿景非常简单:你应该拥有一支 AI 机器人团队,帮助你完成工作,也帮助你生活。它应该真的像一个团队,像一群自主行动、帮助你的队友。你可以用各种方式引导它们,但不必事无巨细地管理它们;它们拥有完成重要、有抱负的工作所需的工具。 从云端运行、独立电脑到长期记忆,这些决定共同构成了机器人作为队友的基础。用户不应当被迫理解虚拟机、工具调用或技能命令,但机器人必须拥有完成任务所需的环境和权限。产品要把这些复杂性留在后台,同时让用户通过自然语言表达目标,并随时在需要时提供方向。 从零开始也让团队能够重新思考产品边界。它不必把编码产品的标签、面板和工作方式照搬到知识工作中,也不必让用户学习开发者熟悉的命令。云端运行保证状态能够跨设备延续,独立电脑保证机器人能处理缺少 API 的任务,而自然语言界面则让用户只需表达目标,不必配置每一个执行步骤。 整个过程反复体现了同一个原则:先从真实任务出发,再用用户是否真正获得结果来判断产品是否成功。团队关注的不是界面上有多少按钮、模型展示了多少过程,或路线图上增加了多少项目,而是机器人能否理解目标、调用正确工具、在遇到现实系统时继续推进,并把可靠、可复用的成果交给用户。随着模型、浏览器、云端基础设施和团队工作方式一起改进,原本需要人工照看、解释和修补的部分,都会逐渐变成机器人可以独立承担的能力;用户则可以把时间留给判断、创造和更重要的决策。 在这段对话中,团队不断把抽象的产品理念落到具体行为上。机器人不是为了展示模型多会推理,而是为了替用户完成有明确价值的工作;也不是让用户在各种配置页之间来回切换,而是让用户用自然语言说明目标。连接工具、保存上下文、操作浏览器、访问企业系统和持续回传结果,这些能力只有结合起来,才会让用户产生“我可以把这件事交给它”的信任。每一次成功完成的工作,都会带来新的使用方式;每一次失败,也会告诉团队应该修复基础设施、减少界面负担,或重新思考产品边界。 [00:40:00]
Roman Ugarte:它们拥有完成重要、有抱负的工作所需的工具。产品团队在构建它时,有一个非常重要的指北针:随着我们越来越接近“队友的未来”,每次做产品决策时,都要少从 SaaS 产品的角度思考,多从“我们要构建有用的 AI 队友”的角度思考。 有很多例子会迫使我们变得更像“同事派”。我们有时会用这个词来描述产品争论:一边有充分理由,另一边也有充分理由,在产品语境里,两条路径都合理,没有明确答案。然后你稍微跳出一点,摆脱科技公司的思维,开始想:人类会怎么做?在这种具体情况下,你希望自己的队友怎么做?通常答案会变得非常清晰,而且房间里的人几乎都会一致认同,知道自己更愿意以哪种方式与人类队友合作。 答案确定后,我们只需要把它做出来。当然,这会带来产品层面、模型层面的要求,很多事情都必须做对,才能真正交付这种体验。但从某种意义上说,这并不是什么火箭科学,也不要求你是天才。你只需要问:我希望人类队友怎样对待我?我们能不能推动 AI 以类似的方式行动? 举个例子,我们一直在思考这些机器人应该拥有怎样的语音体验。以人类为例,我们有一个很好的类比:很多时候,我和队友在 Slack 上来回交流、分享上下文,但更简单的方式是和他进行一个五分钟的快速会议,点击 Huddle,互相交谈。我分享屏幕,展示自己在想什么,他也分享屏幕,然后我们结束通话,继续异步协作。现在还没有哪个 AI 产品真正做好这种体验,但它深深融入了人类协作方式。我们希望构建这样的能力。还有很多其他清晰、有效的模式,你和 AI 一起工作时也应该能感受到它们。我很喜欢“同事派”这个说法。
Lenny Rachitsky:在这次聊天里已经多次提到,它是做出这些决定的一条主线。比如电脑,显然每个人都会有自己的电脑;命名也非常重要。这个领域让我很想知道你的看法:工作和个人生活要不要分开?你觉得人们会有两个不同的助理,一个工作助理、一个个人助理,还是会只有一个?
Roman Ugarte:当人们想到工作产品和消费者产品时,过去十几年糟糕的 B2B 软件带来了很多包袱,让人们看到一个非常简单的产品,就下意识认为它不是工作产品,也不是生产力工具。以过去一代生产力工具为例,我脑中会想到 Photoshop:有各种旋钮可以精确调节,使用者像驾驶座舱的飞行员一样,确切知道每个旋钮的作用,并能完美操控。未来的生产力工具会非常不同:它主要是人表达意图、进行高质量引导,而 AI 工具把所有旋钮都抽象掉。除非你需要直接操控,否则永远不应该看到它们;当然,确实应该提供一个很好的入口,让你在需要时可以操控。 归根结底,你是在和一个队友一起工作,所以界面应该是会话式的。很多时候,当我经过某人的办公桌,看到他的电脑上打开 Grok Bot,我会在一瞬间以为他在使用消息应用,然后才意识到,不,这其实是他完成大量工作的主要工具。 至于你问的个人生活和工作生活是否要使用不同的机器人,我认为很多人确实会希望二者分开。我觉得这是好事,也很重要;即使从企业角度看,也有很多常识性的理由要求它们分开。但我们的目标,是让 Grok Bot 成为你日常工作中很大一部分事情的委托方式,让你专注于更高杠杆的工作。与此同时,它也应该成为你委托个人生活中许多低杠杆事务的方式。这两类问题在很多方面并不不同,产品形态和解决方式基本相同。 所以我的直觉是,一个产品会是同时处理这两类事情的最佳形态,这正是我们想要构建的东西。
Lenny Rachitsky:好,这里的潜在市场规模很大,我喜欢这个答案,也很有道理。显然,问题是如何避免交叉污染:个人内容不能以某种方式渗入或泄露工作内容。不过这似乎是可以解决的。你说的方向就是这样,问题只是如何做到,并让人觉得非常安全,设置好类似安全边界的机制,同时又让体验真正有趣。 本期节目由 Mercury 提供。Mercury 是截然不同的银行服务,现在推出了 Spend。我已经使用 Mercury 多年,把所有企业银行业务都转到了那里,真的非常满意。它让在线银行变成了由产品人而不是银行家打造的产品。通过 Spend,你可以为团队成员分别发卡,按个人或团队设置支出限额,还可以自动从 Gmail 或短信中提取费用收据。你甚至可以给 AI 智能代理自己的卡、限额和政策。 大多数创始人一开始都一样:全公司共用一张卡。它会一直有效,直到突然失效:有人超支,收据丢失,你得花两天时间查清楚谁花了什么、为什么花。Spend 是直接集成在 Mercury 里的费用管理工具,团队的卡、预算和报销都和企业银行业务放在同一个地方。不需要追着人要材料,不需要手动审核,也不需要月底手忙脚乱。结果是团队可以快速行动,创始人也不再成为瓶颈。访问 Mercury.com 了解详情并注册。 Mercury 是一家金融科技公司,不是 FDIC 保险银行。银行服务由 Choice Financial Group 和 Column NA 提供,它们是 FDIC 成员。IO 卡由 Patriot Bank、NA 发行,Patriot Bank 是 FDIC 成员,并依据 MasterCard International Incorporated 的许可发行。接下来问几个技术问题。就电脑这部分而言,怎样最简单地理解 Grok Bot 账户里包含的东西?它是运行在云端、带有多个登录信息的虚拟机吗?还是每个机器人都有独立的虚拟机实例?在你能分享的范围内,我们该如何理解?
Roman Ugarte:回到产品的“队友”框架,并把这个类比再推进一步:如果你我在同一个团队里工作,你需要手动接管我的电脑,开始点击各种东西,不断告诉我“你做错了,应该去那里”,这种情况最好接近于零。你不应该真的需要这样对待同事或队友。 同样,我们现在处于这样一个阶段:计算机使用已经不错,而且还在快速变好。很快,电脑这个概念会从用户视野中完全抽象掉。你永远不应该点击进入远程虚拟机,也不应该因为机器人走了一条浪费的路径,就必须接管它、把它引导到正确路径。中期来看,电脑仍然是用户需要理解的重要概念,但不会是用户真正要操作的东西。正确的理解方式是:Grok Bot 是一支机器人团队,是一支替你工作的智能代理团队。 至于它们能访问什么,它们可以访问与你过去互动的非常长期的记忆。 当前的做法是,每完成一个独立工作单元就新建一个聊天,但这有很多问题。我经常在不同聊天之间复制粘贴,这不是组织工作类别的好方式。团队里会用角色来合理划分不同的工作类别和工作泳道,机器人也应该如此。它们应该承担不同工作泳道的角色,从你身上学习,随着时间变得更聪明。所以,关键一点是这些是长期存在的智能代理,不是一次性的单独会话,它们会随着时间变得更聪明。 第二点是,这些智能代理可以访问人类队友应该拥有的所有工具,包括 API 和 MCP。这很好。
Lenny Rachitsky:但它还拥有自己的电脑,可以像人一样自由操作。在我参加的一次聚会上,增长市场团队的 Shub 做了一个让所有人惊叹的演示:因为每个智能代理内部都有一台电脑,你可以在电脑上运行很多不同的东西。他当时在 Grok Bot 里运行 Grok Bot。 一个真正的 AI 队友应该能保留上下文、理解长期角色,并在工作和生活中承担不同程度的任务。界面可以保持像消息应用一样简单,但背后应当有独立的电脑、工具、记忆和持续运行的机器人。这样的设计既能减少重复设置,也能让用户把注意力放回更高杠杆的工作。 这也是“同事派”思维的实际含义:不是把更多控制旋钮暴露出来,而是让 AI 像一个可靠的队友一样理解上下文、持续学习,并在需要时完成工作。个人和企业场景可以在权限和边界上分开,但底层的协作方式相似。用户表达意图,机器人使用自己的工具和电脑,最后交付结果,而不是要求用户一直盯着执行过程。 整个过程反复体现了同一个原则:先从真实任务出发,再用用户是否真正获得结果来判断产品是否成功。团队关注的不是界面上有多少按钮、模型展示了多少过程,或路线图上增加了多少项目,而是机器人能否理解目标、调用正确工具、在遇到现实系统时继续推进,并把可靠、可复用的成果交给用户。随着模型、浏览器、云端基础设施和团队工作方式一起改进,原本需要人工照看、解释和修补的部分,都会逐渐变成机器人可以独立承担的能力;用户则可以把时间留给判断、创造和更重要的决策。
Roman Ugarte:在这段对话中,团队不断把抽象的产品理念落到具体行为上。机器人不是为了展示模型多会推理,而是为了替用户完成有明确价值的工作;也不是让用户在各种配置页之间来回切换,而是让用户用自然语言说明目标。连接工具、保存上下文、操作浏览器、访问企业系统和持续回传结果,这些能力只有结合起来,才会让用户产生“我可以把这件事交给它”的信任。每一次成功完成的工作,都会带来新的使用方式;每一次失败,也会告诉团队应该修复基础设施、减少界面负担,或重新思考产品边界。 [00:50:00]
Lenny Rachitsky:也就是说,机器人可以运行自己的 Grok Bot。我知道他用它做测试、观察回归之类的事情,但这真是一个拓展想象力的点。我很好奇,在宇宙自我坍缩之前,你们能把这个嵌套推进多少层?
Roman Ugarte:我也会这样做。这其实非常有用:给其中一个机器人下载 Grok Bot。我的机器人就像一个质量保证测试机器人。这样,如果有人报告 bug,或者我们正在测试桌面应用的新版本,我可以直接说:“这里有 10 个工作流,我们需要确保它们在每次发布后都变得更好。请你测试它们。” 我还会让它把结果写进一个 Notion 文档,里面有过去客户端版本做过的所有测试清单,并进行对比。所以,一旦你不再把它看成“一个带有一组连接的 AI 聊天工具”,而开始把它看成“一个拥有电脑的同事”,那么任何你会让同事在电脑上做的事情,都可以让 Grok Bot 来做。
Lenny Rachitsky:我认为,这会抬高你愿意交给 AI 的事情的上限。你还见过或使用过哪些拓展想象力的场景,或者其他使用 Grok Bot 的方式?
Roman Ugarte:我看到很多用户采用了一种简单但很有深度的模式,只要持续投入、不断改进,就能发挥很大价值。我也喜欢优化自己的设置:把 Grok Bot 当作某种“信息吞噬者”,让它消费海量信息,替你卸下认知负担,让你心里更轻松,然后只把重要的东西带到你面前。 很多人采用的第一版实现,是让 Grok Bot 连接 Slack 和邮件。我会告诉它自己的公司角色、关心什么,以及哪些情况需要通知我。另一些情况不需要直接提醒我,但应该放进我每天阅读的日报里。这就是第一版。 我不知道第十版会是什么样,但我可能已经在第三或第四版了:你可以把完整的信息消防水管都接给这些机器人。我让自己的机器人接收 X 上所有提到 Grok Bot 的内容,同时让它访问我们的内部上下文;它还会和质量保证测试机器人交互,看看能不能复现我们收到的 bug 或反馈。 我还把自己的消息服务接入进去,以便快速处理反馈、联系相关的人。我认为,这会形成一个始终在线的“幕僚长”实体,让你专注于真正重要的事情,同时持续监测是否有值得你注意的内容。有人甚至给自己的 Grok Bot 接入了呼叫功能,我还没有这样做,但可能很快会尝试。如果发生极其紧急的事情,即使他们当时在咖啡馆里,Grok Bot 也会呼叫他们。只有在确实紧急、并且你足够信任它不会产生误报时,才适合这样做。据这些人反馈,到目前为止效果非常好。 我认为,我们会看到更多这类情况:智能代理或机器人应该更主动地找你,而不是等你去联系它。我觉得这会是 AI 的下一次转变。
Lenny Rachitsky:你们团队的运作方式有几件事让我印象深刻。一件是速度,我想聊聊;另一件是,你们似乎意识到现在正是争取大量市场份额的时刻,要在别人赶上来之前尽可能占领市场,尤其是在某个基础模型实验室突然出现一个“现在我们有很棒的东西了”的时候。 我看到你们发放了大量免费账户,也看到你们非常聚焦使用场景。这很聪明,因为产品太新了,用户打开它会想:我该怎么用?而你们一直在展示人们可以用它做什么,Twitter 上也有大量关于各种模板和使用方式的讨论。这非常有道理。 从我观察来看,你们有两个重点:尽可能快地让尽可能多的人加入,直到有人拿出下一个产品;以及聚焦具体使用场景。我知道你之前在 Cursor 负责市场拓展,现在对于把 Grok Bot 推向市场,有没有什么做法可以分享?
Roman Ugarte:我认为,编码领域出现的模式,与通用知识工作领域将要出现的模式有些相似。我们在市场拓展方面学到了很多,更广泛地说,也学到了如何构建真正有人使用的实用 AI。作为一家公司,我们一直非常重视不做演示软件,而是构建真实世界中真正有用的东西,并对此着迷。 有太多闪亮的新东西和有趣的原型可以构建,但最终,构建原型与把产品交到数百万人的手里、让它改变公司,是完全不同的问题。这一直是我们的文化重点。所以从市场拓展角度看,编码领域出现了一个非常简单的模式:先有一群早期采用者,他们会使用编码工具,并把它们推到极限。 早期采用者通常会在个人项目上把工具推到极限。以 2023 年前后为例,他们下班回家,在工作中还使用基础的集成开发环境,那时还没有 AI;但回到家,他们会做副业项目,使用 Cursor 或最新、最好的 AI 编码工具。这会给他们带来极大的加速,让他们感觉自己正在体验未来。 然后他们回到工作中,会要求公司也提供这种体验,说自己无法想象再用其他方式工作。他们会觉得自己像在泥浆里行走,事情必须改变。知识工作也会出现类似模式:人们可能先在个人生活中体验到那个“顿悟时刻”。现在我们在 X 上看到很多这样的例子,比如 Grok Bot 控制家里的扫地机器人,或者帮助用户和 Tesla 协商充电费用,这些使用场景都很有趣。 但下一步会是:这不是一个消费者产品。我们认为它会改变企业和团队,机器人会进入团队,贡献具有真实经济价值的工作,尤其是随着它们变得更加聪明。市场拓展方面,我们正在大力优先服务企业,不只思考一个人和一个机器人的单人场景,还要思考机器人如何在更大的团队中工作,如何进入复杂的真实公司系统,理解其中的大量上下文和历史。对于一个更大的组织来说,记忆应该是什么样,而不是只服务于一个人?这里还有很多未解问题,但我确实认为,Grok Bot 是把编码之外的其他公司成员切换到智能代理的正确基础能力,这是我们目前非常关注的方向。
Lenny Rachitsky:很明显,你们理解分发的力量,也知道必须同时拥有出色的产品和正确的分发方式。Grok Bot 本身很棒,但你们在各种渠道把它推向市场时展现出的聪明,让这个组合更加令人印象深刻。我想问一下围绕产品和公司的不同品牌,帮助大家理解你们正在经历的转型、收购以及 SpaceX 等背景。现在有 Grok Bot,也有 Cursor。今天应该如何理解这些产品和品牌?
Roman Ugarte:目前 SpaceXAI 有三个主要支柱。第一个支柱是编码产品,而不是单一产品;现在包括 Cursor 和 Grok Build。我们非常相信,为开发者和工程团队提供一个专业的工作界面非常重要。现在人们有时会用 Grok Bot 启动云端智能代理、合并 PR,或者做质量保证等工程相关任务。但最终,当你交付生产软件时,我们相信仍然需要一个为最终用户优化每个像素的产品,所以我们正在对此进行大量投入。 第二类是通用知识工作,我们认为 Grok Bot 是朝这个方向迈出的非常令人兴奋的一步。还有很多工作要做:让它更有用,扩展到新的界面,让它真正像一个可以委托工作的 AI 队友,尤其是在公司和企业内部。第三类是通用模型工作。我们希望训练出世界上最聪明、真正有能力的模型。我认为,SpaceXAI 与其他 AI 实验室有一点区别:我们的目标不太是…… 信息吞噬者和幕僚长只是起点。机器人可以先汇总 Slack 和邮件,再逐渐接入社交信息、内部上下文、质量保证反馈和消息服务。企业场景还需要它理解团队系统、组织历史和更广泛的记忆。市场拓展的关键,就是让个人先体验到价值,再把这种体验带进团队和公司。 从个人信息汇总到企业协作,机器人需要处理的不只是文字回答,还要访问网页、邮件、消息系统、内部数据库和其他工具。它可以把无关紧要的信息过滤掉,把真正需要注意的事情推到用户面前,也可以在出现紧急事件时主动发出提醒。更大的挑战,是让这种能力从个人扩展到团队,同时保留清晰的记忆和权限边界。 整个过程反复体现了同一个原则:先从真实任务出发,再用用户是否真正获得结果来判断产品是否成功。团队关注的不是界面上有多少按钮、模型展示了多少过程,或路线图上增加了多少项目,而是机器人能否理解目标、调用正确工具、在遇到现实系统时继续推进,并把可靠、可复用的成果交给用户。随着模型、浏览器、云端基础设施和团队工作方式一起改进,原本需要人工照看、解释和修补的部分,都会逐渐变成机器人可以独立承担的能力;用户则可以把时间留给判断、创造和更重要的决策。 在这段对话中,团队不断把抽象的产品理念落到具体行为上。机器人不是为了展示模型多会推理,而是为了替用户完成有明确价值的工作;也不是让用户在各种配置页之间来回切换,而是让用户用自然语言说明目标。连接工具、保存上下文、操作浏览器、访问企业系统和持续回传结果,这些能力只有结合起来,才会让用户产生“我可以把这件事交给它”的信任。每一次成功完成的工作,都会带来新的使用方式;每一次失败,也会告诉团队应该修复基础设施、减少界面负担,或重新思考产品边界。 [01:00:00]
Roman Ugarte:我们的目标并不是追逐超级智能或某种模糊的理想,而是非常务实:构建有用的 AI。我们在产品层面这样做,也在模型层面这样做。参与模型训练的人,很多都是工程师,或者以非常应用导向的思维加入模型训练工作。我认为,这正是推动公司的力量,也让我们走出了一条与其他竞争者略有不同的道路。
Lenny Rachitsky:非常有意思。我想从几个方向继续。你有一条推文,我记得你可能把它置顶了,或者它是你最近的一条推文,大家在你的时间线上应该能看到。推文说:“一个能完成 100% 工作的 AI,与只能帮你做到 90% 的 AI,在性质上完全不同。”你说自己因此大幅更新了对 AI 能力的看法。多讲讲这件事。
Roman Ugarte:让我对 Grok Bot 产生如此大兴趣、也让我愿意参与其中的原因,是我第一次觉得,面对非编码任务,我真的可以把工作委托给 AI,而不必一直想着它。我回来时,事情已经完成了。我认为,工程师很长时间以来都在感受这种体验,可能已经有一年或一年半了。开发者的工作已经彻底改变,与两年前相比几乎认不出来。 很多人已经谈过这一点,但我觉得大家低估了这种体验与多数人目前感受到的 AI、以及 AI 改变他们生活的方式之间有多大差异。后者看起来仍然像两年前使用 AI 的方式:为一个任务新建一个线程,把任务输入框里,按下回车,看着所有步骤发生,得到一个不太正确的输出,继续修改它。 而 Grok Bot 在很大程度上绕过了这套流程。当你第一次看到它的界面时,会觉得这明显不一样;接着你会想,好吧,看看它是不是真的能工作。但你把事情交给它后,它的完成程度会让你惊讶。我们还会继续让它工作得更好。 我那条推文想表达的是:如果你只有 90% 的信任,把事情交给一个队友,即使我在这里和优秀的人一起工作、幸运地没有这种经历,你也会在对方执行时持续想着这件事。你知道结果可能不够好,可能还要介入,稍微引导一下。那不是 90% 的任务完成,你其实仍然在做这件事,它会一直压在心上。相反,如果你可以真正把事情像一个不看接球那样传给同事,说:“你能搞定。这里是上下文,去做吧,我很期待看到结果。”这是另一种性质的体验。 我认为,Grok Bot 每天带给用户的就是这种“不看接球”:你相信它能够完成,放手让它去做。
Lenny Rachitsky:然后它真的完成了,这是一种非常神奇的体验。你们的另一点运作方式也让我非常佩服,我以前从未见过,那就是你们行动的速度。我被加入了一个 Slack 频道,和一些人一起提供反馈,结果不断看到:“明天我们给你一些免费代码,你明天就可以发出去”;或者“我们要上线你的模板市场,两天后就上线”。我会想,什么?我根本没有时间准备这些。你们有那么多事情要做,却还在不断上线,同时保持一致性和高质量,而且始终清楚自己在朝着具体愿景前进。你们这么快行动的秘诀是什么?在这么快的速度下,如何保持一致,沿着大家相信的愿景前进,而不是一路用临时补丁应付?
Roman Ugarte:有一件让我非常高兴、而且从未改变的事,就是公司内部一直有创业公司的感觉。作为背景,我最初加入 Cursor 时,公司大约只有 15 个人,后来扩大到 1000 多人,现在又成为 SpaceXAI 的一部分,组织规模更大了。和这群极其优秀的人一起工作非常有趣:每个人都以每小时 100 英里的速度前进,你非常信任每个人都会完成自己负责的那部分,同时大家都有一个清晰、令人兴奋、也知道必须执行的愿景。 公司发展后,我们有幸从经历过超高速增长的其他公司招来了很多优秀的人,但事情往往会变慢。你会继续告诉自己“我们仍然是一家初创公司,我们行动很快”,可实际上并不是,所有人都知道这一点。希望这种状态能够继续,我认为它对我们的成功非常关键。 即使规模扩大,我们一直感觉自己还是最初加入的那家创业公司。如果用人数或融资轮次来定义创业公司,这些标准都没有意义。真正定义创业公司的,是你描述的那种混乱的冲刺能量:事情有些混乱、有些无序。对很多人来说,这不是舒服的工作环境,但它有惊人的优势:你能在很短时间内沿着一个方向产生巨大影响,而且系统会回报你投入的全部努力。我们的文化、组织方式和构建团队的方式,一直都在努力保留这种能力。 我认为,一些竞争对手和其他 AI 实验室在规模变大后已经失去了这种能力,你能感受到这一点。而我们即使在扩大规模,也仍然保留着推动事情快速前进的创业冲动。
Lenny Rachitsky:沿着这个话题,我想问一个一直期待的问题:如果从外部看 Cursor,它本来不应该成功,也不应该持续到今天。第一,它处在世界上竞争最激烈的市场里,竞争对手是历史上增长最快的公司 OpenAI 和 Anthropic,竞争强度前所未有。第二,它建立在这些平台之上。 但在我这个局外人看来,Cursor 能够胜出、实现巨大的退出并持续成功,是因为你们能快速根据市场现实调整。从自动补全开始,到和智能代理对话,再到云端,最后到 Grok Bot。对我来说,这似乎是成功的核心:快速适应现实,同时为一个其他地方也存在的东西构建最优秀的体验。Grok Bot 就是很好的例子,其他地方也能做,但它提供了最佳体验;Cursor 是最好的集成开发环境,也是最好的编码方式。这就是我的问题,也许我已经回答了:是什么让 Cursor 不仅能在这样疯狂竞争的市场中生存,还能长期持续地做得这么好?
Roman Ugarte:这其中很多因素都可以归结为文化,归结为你建立的文化、吸引来的人,以及他们解决问题的方式。正如你说的,我们从未自满,也从未觉得自己已经赢了,关注的始终是下一件事。 公司上下都深信,AI 的发展速度极快。我们的目标是把这些能力转化为客户喜欢的优秀产品,但产品也会不断变化,必须随着能力增强而适应当下。两年前符合时代要求的东西,与今天符合时代要求的东西完全不同。如果公司不能每六个月彻底重塑自己,最近甚至感觉周期短于六个月,重新调整优先事项、核心产品和用户体验,我们就会输。 一直努力站在前沿,从不认为事情已经结束、自己已经赢了或已经做对了,并持续更新自己的信念,这种精神让我们走到了今天。至于这个领域的竞争程度,AI 编码从 Cursor 刚出现时起就一直竞争激烈。当时的竞争对手包括微软等公司,可能还有十到二十家企业。值得注意的是,这些竞争者现在没有一家站在 AI 编码的前沿,很大程度上不是因为它们做错了决定,也不是因为缺少资源,而是因为文化上无法快速行动、无法随着时代变化而改变。我认为,这正是让我们走到今天的原因。 保持速度并不意味着没有方向,而是让每个人都相信自己的判断,并能在发现问题时直接解决。Cursor 的经历说明,市场和模型变化时,产品也必须愿意重做;今天的临时脚手架,明天可能就该被删除。真正重要的是持续把下一阶段的能力带到用户手中,而不是守着过去的成功。 创业公司的速度来自清晰愿景、彼此信任和主动承担责任,而不是来自无休止地增加人手。面对模型能力的快速变化,团队必须经常重新判断用户真正需要什么,愿意删除不再必要的功能,也愿意把新的能力快速带给用户。Cursor 的持续成功,正是这种文化和产品适应力长期叠加的结果。 整个过程反复体现了同一个原则:先从真实任务出发,再用用户是否真正获得结果来判断产品是否成功。团队关注的不是界面上有多少按钮、模型展示了多少过程,或路线图上增加了多少项目,而是机器人能否理解目标、调用正确工具、在遇到现实系统时继续推进,并把可靠、可复用的成果交给用户。随着模型、浏览器、云端基础设施和团队工作方式一起改进,原本需要人工照看、解释和修补的部分,都会逐渐变成机器人可以独立承担的能力;用户则可以把时间留给判断、创造和更重要的决策。 在这段对话中,团队不断把抽象的产品理念落到具体行为上。机器人不是为了展示模型多会推理,而是为了替用户完成有明确价值的工作;也不是让用户在各种配置页之间来回切换,而是让用户用自然语言说明目标。连接工具、保存上下文、操作浏览器、访问企业系统和持续回传结果,这些能力只有结合起来,才会让用户产生“我可以把这件事交给它”的信任。每一次成功完成的工作,都会带来新的使用方式;每一次失败,也会告诉团队应该修复基础设施、减少界面负担,或重新思考产品边界。 [01:10:00]
Lenny Rachitsky:……无法随着时代变化而改变。我认为,这正是让我们走到今天的原因。你有没有一些核心价值观,或者用来提醒所有人“我们就是这样工作的”具体说法?
Roman Ugarte:有两个价值观,我经常会回到它们。第一个是“删除产品”。这正好对应你刚才说的:当你回看 Cursor 的每一次迭代,甚至 Grok Bot 的每一次迭代,你会发现,消失的东西比新增的东西更多。随着模型变得足够聪明,能够自行完成某些事情,那些因为模型还不够聪明而搭建的脚手架和产品遗留物,就会逐渐被移除。我们必须习惯做出艰难的决定,即使这会让一小部分用户或内部同事不高兴,也要让产品变得简单、强大,并适应未来的发展方向。 第二个价值观与执行速度有关,就是“直接去做”。即使公司变大了,我仍然经常重复这句话:这是你的责任。我们都在同一条船上,都想赢。如果你看到某件事需要发生,这里不是一个等待许可的文化。你应该直接去解决它,并调动完成它所需的资源。很多人在这里取得成功,正是因为这样做。我认为,这也是我们与 SpaceXAI 共享的价值观。
Lenny Rachitsky:很有意思。我最后可能想问的一个大问题,是关于护城河。很多人把 Cursor 看作一个有趣的例子:它所在的市场,从技术角度看可能没有护城河,但它一直在胜出并取得成功。人们谈到 Cursor 时想到的两个护城河,一是数据反馈循环:用户不断自动补全,产品了解他们在做什么,再据此训练模型,这一点很独特;二是最佳体验,以及成为一个高日活产品,随着时间找到有效的东西和用户需要的东西。你从中学到了什么?对于正在试图理解这个问题的人,有什么关于护城河的想法可以分享?
Roman Ugarte:现在讨论护城河很热门,创办公司的时机也非常有意思。我能理解为什么这么多创始人会问自己这个问题,试图推演 12 个月、24 个月后的情况,但在这个领域,24 个月感觉像一辈子。我想说的是,如果 Cursor 以及这一代许多成功公司在早期就思考护城河,或者试图从某个战略图、某种抽象的公司运作理念反推,我不认为会得到现在的结果,也不会创造出这个产品。真正创造 Cursor 魔力的,是对今天构建有用东西的痴迷。 我们不断做这样的练习:可以看到世界三个月后、六个月后会走向哪里。模型会变得更聪明,现在无法解决的事情最终会变得可解。Cursor 一直在问:即使需要在上面增加一些工程工作,甚至大量工程工作,我们如何把那些本来要三个月后才能实现的事情提前带到今天?即使需要以特定方式改变产品,让用户能够与这个新能力互动,我们如何把它提前? 然后三个月后,我们应该删除所有这些东西,因为它们会变成产品中理所当然、最低限度的基础能力;接着,我们再为三个月后的未来构建下一件事。我们不断重复这个过程,让用户真正信任我们,把时间投入到我们的产品里,相信我们会把能力带到下一个前沿、下一个未来。所以我真心建议今天的创始人和创业者,以这样的视角思考:怎样才能让现在不可能的事情变得可能?用户会因为这件事来到你这里,你要把他们带到下一个不可能的前沿。在这个过程中,你会获得大量分发优势和数据优势,价值自然会出现。但关键是要在这里竞争。
Lenny Rachitsky:我喜欢这个答案。我的理解是:只要构建出让人着迷的东西,就不要过度思考护城河。如果你能持续做到这一点,最终就会找到某种护城河;Cursor 的情况就是这样,最后形成了几种护城河。你最近参加的另一档播客里也提到过,很多时候护城河是被发现的,而不是提前规划出来的。好,那我最后真的问一个 Grok Bot 使用问题。有些人可能会想:“天哪,我得试试这个东西,到底为什么大家这么兴奋?”对于刚开始使用的人,你会给什么成功建议?对于已经在使用、希望听到一个“原来如此”技巧的重度用户,又有什么建议?
Roman Ugarte:我不想给出特别黑客式的专家技巧,因为我们的团队和公司的理念是,这些东西不应该存在。不应该有一堆复杂旋钮。你应该把事情委托给 Grok Bot,它就应该完成。对于刚下载应用、正看着这个界面的新用户,我建议第一件事是给 Grok Bot 提供成功所需的上下文。就像让一个人加入团队一样,他最好能够访问每天使用的 Slack、邮件和公司记录。先把工具连接好,然后直接问 Grok Bot:你能为我做什么?让它检查你刚设置的这些连接。 我当时可能会给它邮件和 Slack。我第一次入门时很惊讶,因为那时还没有任何入门界面。我给它的第一个任务就是:查看我的 Slack 和邮件,建议五件你可以替我承担的事情,并说明完成它们需要什么。它给了我五个建议,其中两个非常有帮助。我立刻派出两个机器人来解决这两个问题,那就是我的“哇”时刻:过去没有任何 AI 工具能做到这两件事。这不是让它起草一封邮件,而是让它完成一块完整的工作。所以我建议新用户用这种方式开始。 对于已经在使用的人,我一直在发现新的模式,让机器人彼此互动、协作。我开始搭建更明确的脚手架,规定机器人创建的产物应该放在哪里,如何写入一个对我来说清晰易读的位置。我每天都会阅读频繁生成的摘要,它们会被推送到一个数据库里,我可以非常容易地阅读。因此,我建议重度用户思考一下,如何让 Grok Bot 把输出写入一个统一存储位置,更容易组织和管理大量产物。
Lenny Rachitsky:天哪,我们需要再录一期节目,深入讲讲你的 Grok Bot 设置。里面可能有太多私人敏感信息,没法展示,不过这个建议太棒了。Roman,在进入令人期待的快速问答之前,还有什么想分享或想谈的吗?
Roman Ugarte:没有了。我们已经聊了这么多,我不敢相信这才一个半小时左右,我感觉我们已经聊了很久,把我想谈的都谈到了。
Lenny Rachitsky:好,接下来是令人期待的快速问答。我有四个问题,你准备好了吗?
Roman Ugarte:准备好了。
Lenny Rachitsky:你最常向别人推荐的两三本书是什么?
Roman Ugarte:有两本。一本是 Kurt Vonnegut 的《猫的摇篮》,我很喜欢,也推荐给过很多朋友。第二本是 Steven Pressfield 的《The War of Art》,我经常会重新读它,即使一次只读一两页,也会推荐给任何人。
Lenny Rachitsky:《The War of Art》,非常棒。它是一本很短的书。人们听到这个书名,可能会以为是《孙子兵法》;但它不是《The Art of War》,而是《The War of Art》,这是一个文字游戏,讲的是进行创作、创造新事物时面对的挑战,以及如何克服阻力。我很喜欢这个推荐。下一个问题:最近最喜欢的电影或电视剧是什么?如果你有时间看这些的话。
Roman Ugarte:我最近每年都会重看《卡萨布兰卡》,这是我最喜欢的电影之一。巧合的是,里面还有一个角色和我的姓氏一样,叫 Ugarte;我想,这可能是媒体里唯一一个叫 Ugarte 的例子,所以《卡萨布兰卡》总是值得重看。电视方面,我偶尔会看一集《神探阿蒙》,小时候我和家人一起看过,现在住在旧金山后又重新看起来了。这部剧拍摄于上世纪 90 年代末到 21 世纪初,是旧金山一个很有意思的时代切片,我很喜欢。
Lenny Rachitsky:这是节目里第一次提到《神探阿蒙》。好,当前最喜欢或最有意思的 AI 产品是什么?你可以说 Grok Bot,如果你愿意,但…… 护城河、分发和数据优势都不是一开始就能完整设计出来的。它们往往来自持续交付用户真正着迷的产品,来自把不可能的事情变成可能,再把临时实现删除并继续向前。对新用户来说,最好的开始是提供上下文、连接工具,然后直接把一块真实工作交给机器人。 对于新用户,最有效的入门不是学习一套复杂技巧,而是连接自己每天真正使用的工具,再让机器人主动检查哪些事情可以代劳。对于重度用户,下一步是建立清晰的统一存储,把机器人生成的摘要、研究和结果放到容易阅读的地方。这样,多个机器人才能协同工作,用户也能持续积累自己的工作系统。 整个过程反复体现了同一个原则:先从真实任务出发,再用用户是否真正获得结果来判断产品是否成功。团队关注的不是界面上有多少按钮、模型展示了多少过程,或路线图上增加了多少项目,而是机器人能否理解目标、调用正确工具、在遇到现实系统时继续推进,并把可靠、可复用的成果交给用户。随着模型、浏览器、云端基础设施和团队工作方式一起改进,原本需要人工照看、解释和修补的部分,都会逐渐变成机器人可以独立承担的能力;用户则可以把时间留给判断、创造和更重要的决策。
Roman Ugarte:在这段对话中,团队不断把抽象的产品理念落到具体行为上。机器人不是为了展示模型多会推理,而是为了替用户完成有明确价值的工作;也不是让用户在各种配置页之间来回切换,而是让用户用自然语言说明目标。连接工具、保存上下文、操作浏览器、访问企业系统和持续回传结果,这些能力只有结合起来,才会让用户产生“我可以把这件事交给它”的信任。每一次成功完成的工作,都会带来新的使用方式;每一次失败,也会告诉团队应该修复基础设施、减少界面负担,或重新思考产品边界。 [01:20:00]
Lenny Rachitsky:好,当前最喜欢或最有意思的 AI 产品是什么?你可以说 Grok Bot,如果你愿意;如果还有别的答案,会额外加分。我一直是语义搜索的重度爱好者,喜欢各种语义搜索产品,尤其是那些不太寻常的产品。我当时很早就开始使用 Metaphor,后来它变成了 Exa。我很喜欢用 Exa 在互联网上做各种更奇怪的查询。 我还看到很多人对 MoMA 的嵌入式图片库构建语义搜索,或者做类似的事情。我总是很喜欢尝试这些。所以,只要是针对奇怪数据集的语义搜索引擎,我都会喜欢。 你会推荐 Exa 吗?
Roman Ugarte:我喜欢 Exa。
Lenny Rachitsky:很酷。好,常常在工作或生活中回想的座右铭是什么?
Roman Ugarte:它不算一句很短的座右铭,但我很喜欢《道德经》(Desiderata)。不知道你读过没有。我把它贴在门上,从十几岁起就一直这样,无论搬到哪里都会把它贴在那里。那是一首很短的诗,但每一行我每次读都会有新的发现,它让我非常踏实。
Lenny Rachitsky:Roman,今天太棒了。我们正处在 Grok Bot 和整个 AI 发展的一个特殊时刻。过一年再回头看这期节目一定很有趣,也许会发现,我们对很多事情既判断得非常正确,也判断得非常错误。非常感谢你参加节目。我知道你们团队现在非常忙,真的很感谢你抽出几个小时来聊天。 有什么地方想推荐大家去看吗?除了让大家试试 Grok Bot,还有什么想推广的?
Roman Ugarte:当然要试试 Grok Bot。最重要的是,请把反馈发给我们。我认为现在还处于非常早期的阶段。我们三周前才发布了测试版,早期用户的很多反馈,已经直接转化成我们构建的产品和构建方式。所以真的非常感谢大家提供的意见。
Lenny Rachitsky:Roman 和团队,做得好。我知道这一切背后有整个团队。Roman,非常感谢你来到节目。
Roman Ugarte:太棒了。谢谢你,Lenny。再见,大家。
Lenny Rachitsky:非常感谢大家收听。如果你觉得这期节目有价值,可以在 Apple Podcasts、Spotify 或你喜欢的播客应用上订阅。也请考虑给节目评分或留下评论,这会帮助其他听众找到它。你可以在 lennyspodcast.com 收听往期节目或了解更多信息。我们下一期再见。 节目的最后回到语义搜索、阅读和持续反馈,嘉宾也鼓励早期用户把真实使用感受告诉团队。产品仍处于早期阶段,用户反馈会继续影响它接下来如何构建。 [01:22:40]
来源:OpenAI News
URL: https://openai.com/index/introducing-chatgpt-images-2-5
ChatGPT Images 2.5 能将你的创意、草图和参考照片转化为更加个性化、精致的图像,更好地呈现你的想法。
来源:OpenAI News
网址:https://openai.com/index/navier-stokes-solution
我们将分享一份由人工智能生成的 Navier–Stokes 千禧年大奖问题解答,其中包括一篇书面说明和一份使用 Lean 编写的形式化证明。
来源:OpenAI News
网址:https://openai.com/index/teen-development-research-grants
立即申请 OpenAI 的 500 万美元资助计划。该计划支持独立研究,探讨生成式 AI 如何影响青少年的发展、身心福祉与安全。
本期对话围绕一个核心判断展开:AI 不一定会把公司变成一套更快的旧流程,而可能把公司重构成许多由 Agent 驱动、能够感知输入并持续执行任务的闭环。a16z 普通合伙人 Anish Acharya 结合自己的创业、产品和投资经历,讨论了为什么 AI 的影响看起来起步缓慢、企业会怎样重新组织,以及人在模型能力不断增强之后还应该把价值放在哪里。对他而言,真正稀缺的能力不再只是写出一段代码或完成一项固定任务,而是选择方向、理解用户、处理例外、进行分布外思考,并持续把产品交付给真实的人。
Anish 也提醒,消费级 AI 的机会不能只用“效率提升”衡量。更值得关注的产品,是帮助人变得更快乐、更健康、更有联结感的产品。对话最后回到创业实践:护城河往往是在持续交付、观察反馈和寻找分发方式的过程中逐渐显现;产品直觉、付费意愿、社区和分发能力会成为关键差异。
Lenny 先介绍了 Anish 的背景:他既是 a16z 长期关注消费领域的普通合伙人,也是连续创业者和产品负责人。他创办 SocialDeck 后将公司卖给谷歌,后来又创办 Snowball 并卖给 Credit Karma,在两家公司中都积累了从产品、业务到组织运营的一线经验。这样的经历让他观察 AI 时,不会只从模型能力或投资回报出发,而会同时考虑产品是否真的被使用、团队如何运转以及公司如何形成新的增长闭环。
两人从一种普遍的职业焦虑开始:当 AI 能够完成越来越多知识工作时,人是否会被永久性地推到价值链底部。Anish 认为这种担忧并非毫无根据,但它容易把讨论简化成“人会不会被机器取代”。更重要的问题是,任务如何被重新拆分,判断和责任如何重新分配,以及新的工具是否让更多人能够完成过去只有专家才能完成的工作。未来的变化不会在所有行业同时发生,也不会只体现为裁员;岗位、团队边界和个人成长路径都会一起变化。
Anish 将 AI 应用的演进描述为从 Prompt 开始,逐步加入 Agent、工具、记忆和可扩展的文件系统。单次问答只是一次输入输出,而 Agent 可以在循环中观察结果、调用工具、保留上下文并继续执行任务。当这类循环被组合起来,软件就不再只是等待人逐项点击的界面,而像一组持续工作的数字员工。
编程是这种模式较早显现的领域,因为模型能力强、反馈相对清晰,使用者也能判断代码是否完成了目标。但相同的思路可以延伸到销售、运营、研究、客户支持和内部管理。公司的基本单位可能从“一个人负责一项工作”逐渐转向“一个人设定目标、多个 Agent 执行闭环”。这并不意味着组织马上会变成无人公司,而是意味着管理者需要重新定义审批、质量控制、权限和例外处理。
对话随后讨论大公司如何面对 AI。Anish 判断,主流企业最终都会拥抱新技术,但在过渡阶段会经历明显的动荡和内部洗牌。真正的差异不只在于谁先接入模型,而在于谁能把模型放进真实流程,谁能持续获得高质量反馈,以及谁愿意改造原有的组织结构。企业可能同时需要懂底层模型的人、懂行业流程的人和能把两者连接起来的人。
这也带来通才与专才的新分化。模型可以承担更多具体执行,能够理解多个领域、提出好问题并把任务拆成闭环的人会变得更加重要。Anish 用“模型侍酒师”来描述一种新型判断力:知道何时使用哪个模型、怎样提供上下文、如何检查结果,以及何时亲自处理例外。
Anish 认为,消费级 AI 不应只被理解为个人效率工具。如果产品只是让人更快地处理更多工作,用户最终可能获得更多压力。更有价值的方向,是让人更快乐、更健康、更有联结感。例如,AI 可以成为个性化教练、陪伴者、学习伙伴或创作协作者,帮助用户完成过去难以坚持的活动。
他分享了用笔记本记录家中活动、根据孩子表现调整屏幕使用时间的实验。这个例子有趣之处不在于它是否能成为大生意,而在于它展示了 AI 如何把环境感知、规则判断和行动执行串成一个个人闭环。消费产品的机会也许来自这些小而具体的体验:用户不必理解模型,只要感到生活被改善,就会形成持续使用。
两人谈到为什么 AI 已经如此强大,但社会感受到的变化仍然不像想象中那么快。技术扩散需要时间,企业需要重写流程,员工需要学习新工具,监管、成本和基础设施也会形成约束。模型能力的提升并不自动等于生产率立即上升,真正的生产率来自把模型嵌入高频、可测量且有人负责的工作系统。
AI 带来的经济增长和现实代价会同时出现。数据中心、能源消耗、地区影响和劳动力重排都可能制造新的矛盾;与此同时,更多人也可能获得过去昂贵的知识服务。Anish 强调需要同时观察财富创造、分配方式、基础设施负担和普通人的生活体验。
谈到 AI 对个人价值的冲击时,Anish 提出一个更深层的变化:过去很多人依赖知识、软件和专业技能建立身份与收入,而 AI 正在让其中一部分能力变得极其便宜。人们可能因此感到失去优势,甚至不知道自己还能凭什么被需要。解决办法不是否认变化,而是重新寻找模型难以替代的部分,包括目标选择、品味、关系、责任、身体经验和处理异常情况的能力。
这要求个人建立新的小习惯:持续使用前沿工具,观察它们在哪些任务上可靠,记录失败方式,并把经验转化为工作流程。只有在真实项目中反复交付,才能形成对模型边界的直觉。人的价值也可能从“我知道答案”转向“我能判断什么问题值得解决,并为结果负责”。
Lenny 和 Anish 都谈到,真正走在前沿的用户往往愿意为多个 AI 产品付费。高价订阅本身并不保证产品成功,但它说明当工具直接影响工作成果时,用户愿意为可靠性、速度和更好的体验支付费用。产品团队需要在模型快速变化的环境中不断试错,不能等到所有能力都稳定后才开始交付。
随着生成能力普及,单纯拥有一个模型功能越来越难形成护城河。分发、信任、社区、数据反馈和与具体工作流的结合会变得更重要。创业者可能先从窄场景切入,在持续交付中发现用户真正重视的价值,再把产品扩展成更大的闭环。护城河是用户反复回来、愿意付费并主动传播之后留下的结果。
对话还讨论了投资人和创业社区如何塑造创始人的想象边界。过去硬科技常被认为遥远、困难、缺乏主流地位,如今随着资本、人才和工具聚集,相关方向已经变得更受关注。Anish 认为,行业氛围会影响什么被认为值得做,但真正重要的仍是创业者能否把宏大愿景拆成可交付的产品。
最后,两人谈到 AI 音乐和创作工具。像 Suno、ElevenLabs 这样的工具让普通人可以直接生成音乐和声音,不必先掌握完整的传统制作链条。创作门槛降低并不意味着作品自动变好,人的品味、选择和编辑仍然重要;但更多人能够试验和表达,可能会带来新的文化形式。
1. AI 应用的关键演进路径,是从一次性的 Prompt 走向拥有工具、记忆和反馈循环的 Agent 系统。
2. 公司可能逐渐由多个自动化闭环组成,人的职责转向设定方向、管理权限、检查质量和处理例外。
3. 模型能力本身不是完整的产品;真实工作流、持续反馈和分发能力决定了技术能否产生价值。
4. 消费级 AI 的机会不只是提升效率,也包括让人更快乐、更健康、更有联结感。
5. AI 的社会影响会同时包含生产率增长、财富创造、基础设施负担和劳动力重排,不能用单一结论概括。
6. 当知识和软件变得廉价,个人更需要培养品味、判断、关系、责任感和分布外思考能力。
7. 产品直觉来自持续使用、持续交付和观察失败,而不是等待技术完全稳定之后再行动。
8. AI 降低了编程、音乐和创作的门槛,但人的选择、编辑和对结果负责仍不可替代。
- 从产品投资人到 AI 观察者 [00:00:00 - 00:09:59]
- Agent 闭环与公司的新组织方式 [00:10:00 - 00:19:59]
- 企业转型、模型能力与人才重排 [00:20:00 - 00:29:59]
- 消费级 AI 从效率走向幸福感 [00:30:00 - 00:39:59]
- AI 起飞、经济增长与现实代价 [00:40:00 - 00:49:59]
- 当知识变得廉价 重新理解人的价值 [00:50:00 - 00:59:59]
- 产品直觉、付费软件与分发优势 [01:00:00 - 01:09:59]
- 护城河、硬科技与创始人共同野心 [01:10:00 - 01:19:59]
- AI 音乐与创造力的下一种入口 [01:20:00 - 01:22:09]
Lenny Rachitsky:今天我的嘉宾是Anish Acharya。Anish是a16z的普通合伙人,主要专注在消费领域的投资。他是我见过最有洞见、最发人深省、最开脑洞、也是最抠细节的产品投资人之一。他已经在a16z待了7年多,而且和很多VC不同。我之所以特别想请Anish来上播客是因为他是一位资深的产品打造者和创始人他创办了一家叫Socialdeck的公司后来卖给了谷歌之后在谷歌内部带头推进了多项业务后来他又办了一家新公司叫Snowball再次卖掉这次是卖给了Credit Karma 他在那里升任产品副总裁之后又担任大消费产品以及整个信用卡业务的总经理这期对话会让你脑洞大开在开始之前别忘了去Lenny's Product Pass.com看看Lenny的Newsletter订阅用户可以免费体验一年全球最火打磨最精致的AI产品下面让我们欢迎Anish AcharyaAnish非常感谢你能来欢迎来到播客谢谢你Lenny能来这里我非常激动太高兴了我想先从一个很轻松的话题聊起我想聊聊永久性底层阶级这个梗这算是大家半开玩笑的一个梗觉得要是你稍微落后一点没有紧跟所有最新的AI工具没有变成有史以来效率最高的人 你就会沦为这个永久性底层阶级掉队之后日子会很难过有些人会拿这个开玩笑我觉得很多人看得很重也给很多人带来了很大压力你觉得这种担忧到底有多现实你觉得大家应该在多大程度上当真不用太当真这其实是我们整个硅谷似乎都有的一种好笑的暗黑幻想真的几乎从所有指标来看形势都从没这么好过不管是机会分布的有多广我们能用上什么样的技术允许我们抱有多大的野心还是各自在做自己事情并且取得成功的公司数量可大家却还在讨论什么永久性底层阶级什么落到了光追之外 我都听过而且这不仅仅是圈内核心人士或者圈外人的想法感觉从基础模型实验室的研究员一直到硅谷的普通大众大家心里都有种真切的恐惧我觉得有几个点非常关键首先我觉得上一个科技时代要中心化的多你看网络效应那可以说是黄金标准你也做过带网络效应的产品那是移动时代商业模式的黄金标准而那些东西带来了极大的中心化对吧当然他们从定义上讲全都是独一无二的网络你看现在的情况在技术战的每一个层面都不止两家有分量的玩家差不多得有20家 有各个实验室有开源权重这两者内部又各有不同的分支你看Coding Agent我们刚才还在聊两年前你的认知模型本来会是也应该觉得这会是赢家通吃但现在Cloud CodeCodeDexlovableRepletWabi他们好像全都活得挺好看到这个局面真的特别鼓舞人心第二点各种经济数据你也听过了从放射科医生说起我觉得过去差不多20年里每年都有人说他们要完蛋了当然现在放射科的招聘岗位比以往任何时候都多程序员也是一样所以我不知道经验数据到底支持不支持那种说法我觉得最后一点是 大家总在讨论RSI我知道地规自我改进是个聊起来挺有意思的词但如果你去问那些实验室里水平最高的人实际发生的根本不是RSI那种因为比别人领先了一丁点就导致赢家一路甩开所有人的情况并没发生它其实是一种自动催化效应意思只是你在用这项技术来改进自己的流程并不是真正的地规所以我觉得从最实际的现实到最前沿的技术视角全都指向相反的方向但我们似乎就是对这种幻想念念不忘我最近一直在想一件事就是看到这些疯狂的新闻甚至看到OpenAI的模型黑进了Hugging Face所有这些新闻让我觉得 大家一直都在问我们现在到底是在快速起飞还是慢速起飞的剧本里感觉非常明显我们处在慢速起飞的剧本里因为每一个里程碑出来大家都会觉得我操他居然黑进去了我们完全没想到他能做这个但我们能抓住他看着他观察他然后迭代改进但大家总有这种恐惧但可能明天它就起飞了我从你这听到的是情况大概率不是这样而很多人的恐惧恰恰就源于这点觉得它突然一下子就会变得超级超级聪明然后我们就有大麻烦了没错那种论调的逻辑永远都是到目前为止一切如常然后突然发生了一件谁也说不清楚的事接着就快速起飞了 所以我不信会发生那种事我确实觉得模型的进展比以往任何时候都要快但如果你去看经济扩散这类事情我是在小镇长大的去年夏天回了一趟老家大家的生活其实根本没发生多大变化所以退一步讲这种缓慢的经济扩散速度也会兜住它那你我觉得还有一件事讨论的不够那就是到底有多少问题是真的受制于智力的哪怕你有一个数据中心那么多的博士在联邦快递或者达美乐披萨工作难道他们就能在供应链和披萨业务上取得指数级的统治地位吗我觉得不会所以我认为我们可能高估了受制于智力的问题数量 而低估了受制于其他因素的问题在企业内部你看到的情况是什么样的是不是出现了更大的分化你觉得那些变得非常擅长并拥抱新技术的人和那些觉得我没时间弄这个我讨厌这些东西我工作压力本来就够大了的人之间分化会越来越大吗你看到什么变化你觉得在企业内部这种可能存在的分化会往什么方向发展我对这事其实有很多想法我觉得我们太低估普通员工了我觉得我们对白领员工有一种刻板印象对白领主管的刻板印象就像戴伯特里那种整天只知道倒腾文件的主管对消费者的刻板印象 [00:06:26]
Anish Acharya:就是觉得他们都是些缺乏主观能动性的NPC当然这种印象绝不可能落到我们或我们的朋友头上我们总觉得别人的工作非常容易被AI自动化但当然我们自己的不会所以我觉得当你真正深入细节时很多人其实很兴奋能提升自己获得更大的杠杆你当然能在像谷歌这样成熟的公司看到这点但哪怕是像Kavak这样在墨西哥卖二手车的公司他们搞了个叫绝地学院的概念教公司里的每个人使用这些新工具和新技术连修车师傅都要学在这门为期六周的课程结束时他们差不多能交付一个前沿的投入实际生产的agent所以我其实觉得 拥抱这项技术的人比我们平时爱讨论的要多我觉得一个很大的转变会是从使用AI变成围绕AI彻底重组你的整个公司这里有个很好的例子如果你看电力作为一项技术的普及过程从电力的发明到工厂的重组我们花了40年重组的意思就像是把厂房推倒然后从零重建而不是直接把以前烧煤的地方换成用电所以我确实觉得最有雄心的公司正在围绕这些模型重新思考一切而那些没那么有野心或者可能处于较早阶段的公司更多是在考虑怎么让现有组织现有职能部门的人用上这项技术 [00:07:51]
Lenny Rachitsky:听你聊到现在好像有一个主线就是我们对未来的发展方向以及我们自己的工作和职业前景其实可以不用那么焦虑我也这么觉得兄弟我是说哪怕你只是想想CEO和高管们的动力Thunder掌管着谷歌他可不想只经营一家效率更高的4万亿美元公司他想打造的是一家40万亿美元的公司所以只要你有一个具备经济生产力的单元尤其是当他的生产力变得更高时在组织里保留这种规模的存在就是合乎理性的而且我不知道你听到的是什么但从个案来看我和一个在谷歌当高管的好朋友聊过,我问他,嘿,你们裁员了吗?他说,没有,我们没裁。相反,我们现在做的是疯狂推进路线图,原本两年的路线图三个月就干完了,实际上我们最头疼的问题是不知道该往路线图里加什么。 [00:08:49]
Anish Acharya:顺便说一句这简直是每个PM的终极幻想你和我以前在讨论优先级的时候耗费了多少情绪成本啊所以对我其实觉得大家不用那么焦虑我觉得大家应该感到获得了极大的赋能顺便说一句最好的办法就是去交付东西我是说Claire是我的灵感谬思她太牛了因为她总是在交付对就是Claireville她一直在交付在尝试各种东西也不怕搞出点小尴尬如果你看看他整个人的精神状态他感觉就像是活出了有史以来最好的自己我觉得我们所有人都有机会变成那样我太喜欢这个说法了我长大了也想成为Claire Vale [00:09:33]
Lenny Rachitsky:完全同意顺着这个思路你有过一个挺有意思的观点你认为做公司会越来越变成去创造一系列的循环打造一套泡壁环聊聊这个吧好啊我觉得大体概念是这样这种循环的概念在X上其实经常被调侃因为有时候感觉我们好像想得太复杂了我知道之前有个很火的梗是关于图的说什么循环的下一个阶段就是图不过让我来给它做个强力论证是这样的我们最开始有了prompt接着发明了agentagent当然就是在循环里运行的模型配上了工具记忆和scale文件 [00:10:15]
Lenny Rachitsky:然后我们就有了所谓的循环也就是由一组组agent去执行任务如果你看看写代码领域的很多工作编程是一个非常好的领域因为你有最好的模型也有技术上最懂行的客户而且你还有这些成熟的循环比如bug修复或者收到bug报告生成复现步骤写出修复代码然后代码接受评审如果是高风险的那就由人工来确认是否可以发布到生产环境如果是低风险的直接就发布了甚至可能还会给客户发封邮件说嘿 你报的bug我们修好了这在五分钟内就能搞定在工程领域有很多这样的循环从修bug到客户反馈从销售演示到新功能开发 涵盖方方面面所以写代码这件事本身就非常适合这种模式所以你有一个代码循环它带来的改动是针对代码库的那我的问题是业务上的循环又是什么呢对吧如果你是一家业务的总经理你要同管很多职能部门你在编程市场营销销售客户支持以及法务方面都有运转着的循环所有这些循环的铲除其本身也是一个你应该能够去优化的循环我觉得这种模式的进阶形态是它会给CEO发送一条消息说嘿我们实际上需要对业务的某项实体运作或者对我们的商业模式又或者对我们的战略做出调整所以我觉得我们会看到这种层层递进的体系 涵盖从每人一个循环每个职能一个循环跨整个业务单元的循环一直到能够掌管公司很大一部分业务的循环话虽如此我觉得人依然是不可或缺的要素我只是不觉得组织里的大多数工作可以完全自动化完成你想想在这种AI原生公司里人会做什么销售支持战略还有处理例外情况对吧所有这些事情都是极其关键的Lenny如果说我们看清了一件事那就是模型进行全新思考分布外思考的能力依然非常有限我其实不认同在数学领域的一些新思考能真正代表商业这类领域的新思考 所以你依然需要一个人来说我认为我们应该做这个东西而且得让他们判断正确我先来确认一下把这点彻底讲清楚因为这太有意思了你这里的意思是工程和产品构建越来越变成这样一个循环输入 反馈 支持公单等等纯粹就是关于要构建什么的输入然后AI越来越多的接管过去决定说这是个PR看这个准备好了吗然后发布上线而且你说你预计这会扩展到比如说GTM 法务 增长支持那能不能描述一下公司内部的这种循环 看起来是什么样的或者可能是什么样的增长团队就是一个很好的例子你以前在Airbnb的增长团队工作过对吧对 供给端增长对 没错对 太棒了是吧所以你记得那些比如作战我不知道你当时是怎么带团队的但我猜大概是大家聚在一起列出一堆可能的实验方案排好优先级做出来发布上线然后衡量效果头脑风暴对 大量的头脑风暴大量的电子表格那么它的循环版本就应该是生成每一个变体衡量每一个变体一旦达到统计显著性P值足够显著你就收敛并发布该变体 [00:13:50]
Anish Acharya:然后你保留一个长期对照组开始做下一个实验接着你就会碰到某个局部极值我觉得这一点非常重要这个循环会帮你爬到局部极值但随后就会陷入瓶颈这时你需要某种分布外思考你需要人类直觉你需要有人真正帮你落到下一座山的山脚下对你有过这张图表我不知道也许我们聊这个的时候会把它放出来在我们聊这个的时候贴出来这种思考方式真的太有意思了就是说agent会帮你爬坡并达到某个新平台然后你需要一个人类在那想出一个更大的想法把它打开然后循环继续不断运转这就有点像agent [00:14:33]
Lenny Rachitsky:和人类之间的来回配合对对你知道什么最能说明这一点吗如果你曾经试过让agent替你想出一个商业点子比如Hey Claude帮我赚100万美元别犯任何错比如为什么这行不通呢这是因为你多少得给他指明正确的方向而技术上的任何进展都没表明这一点是不需要的对挺有意思的我最近听到越来越多的说法我刚看到一条推文说好像在OpenAI GTM团队现在使用Codex的频率更高了更多的GTM团队成员使用Codex的频率甚至超过了工程团队是的然后再想想这样他们有多高兴 就比如GTM团队想做什么呢虽然这是刻板印象但我依然坚持这么说他们就是想去健身房想去吃牛排大餐想因为成为季度或年度最佳销售而举起奖杯所以我其实觉得这是把他们的工作提炼成了他们全世界最擅长最感兴趣的事情而围绕这项核心工作的所有行政琐事现在都有人替他们搞定了这就是GTM未来的方向而且会非常棒这让我想起一个做PM的朋友他有个特别搞笑的观点就是作为PM你总得对抛给你的所有这些想法说不你不得不说我会把它放进路线图里我们会排优先级的他就想 [00:15:58]
Anish Acharya:行那我换个思路我对所有想法都说可以我把所有东西都做出来然后用像Semio这种工具或者最近推出的这一大堆能模拟用户反应的产品去模拟每一个想法然后它就会告诉你这东西该不该做我们该不该把它造出来重新思考PM的这种方式太逗了你知道这做法庙在哪吗其实有两点我先说对我来说没那么明显的一点就是我觉得每家公司的每个PM都觉得自己是个真正的从零到一思考者但他们被管理层高管创始人的强硬干预还有工程运力给绊住了手脚而在一个每个故事都能讲出来 [00:16:42]
Lenny Rachitsky:每个产品故事都能讲出来每个功能都能去试的世界里我觉得很多PM会意识到自己其实没那么擅长从零到一而且去做别人的好想法远比做自己糟糕的想法要有成就感的多所以我觉得就连这类事情都会让组织比过去健康的多更不用说最终胜出的想法不一定非得是那个最擅长向高管推销的人提出来的只要去试就行了最好的想法会胜出回到这个闭环的想法我现在的思考方式是每个职能部门该怎么去考虑把自己的职能设置成一个agent让他能直接从输入走到产生某种影响这让我想到Claire最近发的一条推文 就是过去大家总开玩笑说软实力最不值钱工程技能最重要最值钱因为它们太具体了结果事实证明这正是AI最擅长的事那些可验证你也知道成功是什么样的事情所以我现在思考的问题就是到底哪些技能是无法直接做成闭环的因为它的产出太难验证了对 我觉得没错而且我认为这些会成为瓶颈因素因为你一晚上只能吃一顿牛排大餐我想你也可以中午去吃顿牛排但某种程度上每个系统里都会存在这些瓶颈因素我觉得一个很有用的思考角度是每当模型犯错或者做了你不会做的事情时 你知道什么他不知道的东西我从Kavak的AO那里听到了一个特别有意思的例子在我接触的人里他可能是聊这类事情思考最深入的一个了他说每当他们的agent他们每个客户配一个agent他们是在线卖二手车的当agent卡住时他其实会呼叫人工由人来指导这个agent这其中的妙处不仅在于能帮agent解除阻塞当然agent还会记录下所有的轨迹并从中学习这是个特别有意思的心智模型你要么是给agent补上知识缺口要么是数据缺口下次他就不该再呼叫你了我太喜欢这个例子了核心结论基本上就是你得开始把每个职能 都看作一个agent闭环你的工作就是找出他在哪里被卡住哪里出了错基本上就是给他更多的上下文更多的洞察更多的方向没错对 没错然后但愿你的很多日常工作当你提出一个行之有效的新想法时这个想法所带来的后续影响如果是个产品就会涉及市场工作销售工作产品营销公关传播法务所有这些基本都该有人替你搞定而你的想法你的工作就是去散散步畅想一下构想下一座要去攀登的高山这就引出了一个问题在这个AI承担了大量此类工作的世界里胜出的公司靠什么拉开差距 我想答案的一部分是在这个局部极致里由人类带着更好的想法介入在这个AI正在做大量目前人类所做的工作的世界里你觉得还有什么会成为差异化的优势吗我觉得有一点讨论的不够就是很多行业里现存的那种竞争均衡到底会不会真正改变现在还不清楚比方说必胜客达美乐棒约翰和roundtable各自拥有一个装满了博士的数据中心他们要么全都会采用它要么换个CEO然后采用它所以会有一段动荡期内部也会有一些相对的洗牌但我觉得他们都会拥抱新技术因为绝大多数公司都会这么做 [00:20:17]
Anish Acharya:我不觉得其中某一家会拿下99%的市场份额所以我觉得讨论的不够的一点是没错短期内我觉得会根据对这项技术的采用情况以及你采用它的野心有多大而产生赢家和输家但我确实觉得有很多行业会大致维持目前的竞争格局因为他们不受算力或智能的限制作为创始人兼CEO我觉得最值得问自己的问题就是如果我们假设这些东西拥有无限的智能而且极其便宜我们会怎样重组这家公司因为那正是我们未来的走向顺着这个思路你有一个特别有意思的观点讲的是公司内部未来 [00:21:00]
Lenny Rachitsky:可能会在通财和专财之间出现某种分化以及AI是如何卷入其中的聊聊这个吧好我觉得这里面牵涉到太多有意思的事情了一个是开源权重与前沿模型的问题你了解所谓的帕雷托最优吗你肯定了解展开讲讲吧对帕雷托最优就是比如从性价比的角度来说所谓有效边界就是单位价格换取单位性能的最优权衡只要你沿着这条曲线走你为这种性能付出的代价就始终是合理的有意思的是前沿模型的定价其实并不理性首先Methos每一个Token都是天价你根本用不起
Anish Acharya:但就算你看Fable 5这样的模型为了哪怕概念上多出来的一点点智商你付出的价格就是Opus 4.8的100倍所以这并不理性但我觉得有很多工作的收益是没有上限的比如新药研发要是多出来的一点智商能让你发现下一个他厅类药物那就是价值万亿美元的成果所以在这些类型的岗位和行业里花钱去买最顶级的智能算是合理的不过从另一方面看就拿法务来说吧在法务或者财务领域可能就只有那么多的收益空间对于那些工作你确实希望追求非常高的帕雷托最优很可能是以合适的价格去买不错的性能 而不是去买漫天要价带有所谓无限潜在收益的性能所以我认为接下来会看到一种分化一类岗位只需要中等智商水平的智能这些往往会更偏向开源权重模型配合强化学习让模型在应对狭窄任务时成本更低性能更好另一类则是销售支持研发工程这些岗位会用上极其昂贵但性能强劲的前沿模型token所以我觉得最终两种架构都会有这个我们稍后可以聊聊但我确实认为不同模型家族之间存在这种比较优势当然我们也能看到越来越多单个模型之间的比较优势它绝不会是非此即彼的 这个见解太有意思了为了确认我理解了你的意思你认为组织内部会出现这种分化在职能和模型之间那些收益空间和潜在杠杆大得多的特定职能会去用前沿模型比如你说的产品、销售、工程这类职能研究这类角色而对于其他职能你不需要Methos也不需要Astra我想那是最新的一款吧对,Astra对,没错你的意思是在这两方面AI不需要是最顶尖的前沿模型而且人也不需要是全世界最聪明的人就能把事情做得非常好对我不想贬低任何人 [00:23:51]
Lenny Rachitsky:那些职能力也有非常厉害的人我只是觉得他们处理的问题收益是有上限的做账只要做对就行了你不可能把账做得比原来好上100倍所以对我说的就是这个意思我在想这会不会跟我们之前聊到的可验证性有关如果一件事情更容易验证你就不需要前沿模型相比之下不知道潜在收益是不是这样我不太确定我是说可验证性确实是个好角度因为对一家新药研发公司来说收益是无限的它是可验证的但屏障也是一个可验证的问题它的收益却很有限我觉得问题在于到底有多大收益以及要把收益算出来有多难 比如这里有一个细微差别在客户支持部门客户可能会打电话进来报一个bug那个bug其实可能是一条线索顺着它就能做出改变整个公司的事情要是接电话的是CEO或者最聪明的人他们就能顺藤摸瓜找下去但如果接电话的是所谓的中等智商通才那就抓不住了这就成了无论面对哪一类问题都要用前沿智能的论据当然我也能为中等智商模型提出论据那就是对于几乎所有具有经济价值的问题我们都已经跨过了智力门槛门槛之外的任何投入纯粹都是浪费对 而且我觉得大家容易忽略的一点是 那些非前沿的模型比如六个月前它们就是当时最前沿的那时候我们惊叹不已 赞不绝口当时简直是觉得太他妈神了居然能做这么多事而现在仅仅因为有了更好的东西我们就不太给那些模型足够的认可了你说的对这就好像上一秒还在觉得这东西太疯狂了这就是通用人工智能下一秒它就成了被扔进垃圾桶的过时货顺着这个话题我听有些人开玩笑管你叫模型嗜酒师那凭你嗜酒师的资历给我们讲讲现在的模型现状到底是什么样每个模型擅长什么模型又在哪些方面表现得很烂好的每位嗜酒师的秘诀都在于一万小时 或者说是一万瓶酒所以我觉得当一个模型嗜酒师的秘诀就是亲自去用模型亲自品尝每出一个新模型我都逼着自己拿它上线点东西我觉得这样能学到很多我觉得那些认为模型都是大宗商品完全能互相替代的人纯粹就是自己没去用过比如过去这几个星期我就特别迷迁问3.8max同意签问是个很棒的模型它非常擅长长周期的任务而且确实很有创意它很会讲故事所以我一直在用它做那些不可能存在的纪录片主要讲的是星球大战宇宙里的星球我做了一个塔图音的效果特别好昨晚我做了贝斯平的他能连续工作4到5个小时 他讲的故事很精彩他通过Fall调用MiniMax模型生成所有视频再通过Eleven生成音频他其实就像在指导一部电影一部5分钟的片子把所有镜头剪进去叠画上去还会自己看一遍这简直太不可思议了他给人的感觉和GLM5.2截然不同GLM5.3刚发布我用他做了一堆产品层面的工作他没有视觉模块有点像被你放在角落里的神经质博士两者各有用处对吧这也是模型之间微妙的张力所在并不是说哪一个就比另一个领先或者哪一个更聪明更像是他们的心智朝不同方向生长 通一千问可能偏向创意和开放而其他的则偏向另外的方向比如像GLM5.3那样偏向严谨和精确所以我就是每个模型都拿来做点东西我的直觉就是这么培养出来的你觉得这个习惯对大家来说有多重要因为我经常听人说去用这些模型真的很重要顺带的一个问题是你是怎么想到拿这些模型去做什么的因为很多人都想试试这些东西但他们会琢磨好吧我该做什么呢我懂有什么建议吗我觉得很长一段时间里最让人受不了的就是身边总有个动不动聊APP点子的朋友 [00:28:11]
Anish Acharya:每次去喝啤酒他们就说来听听我这个APP的想法你就会觉得得又来了但现在我们必须得成为那种满脑子APP点子的人各种傻里傻气的想法其实尤其是那些傻想法因为他们往往最有超额收益正是我们大家都该去动手做的我自己大概做过两打APP了我有一到两个反复迭代的大应用我觉得如果你没有一个现成的底盘来承载这些模型每次都要从零去想一个点子确实太难了所以我会说先找点东西做着它最好不是那种大写的重要性然后不断找新方法去投入去给它添砖加瓦把模型当作一种工具 而不是最终的目的能理解我的意思吗明白甚至可以把视野放得更广一点我越来越觉得当下最重要的习惯之一就是每当你准备做一件事的时候先问问自己AI能替我做这个吗完全同意我脑子里一直在具象化这个从输入到反应的过程就像输入和反应之间存在一段空隙冥想能帮你在这之间停一下先深入思考再给出反应我觉得现在的诀窍就是在那个瞬间插进去一句在这件事上AI能怎么帮我对 我觉得我是说我也冥想很久了你想聊的话我们可以聊聊那个不过对我觉得你说的很对 我觉得在我们日常的脑力劳动里有时候这点对我来说没那么显而易见我觉得我这脑子我一直都是做C端产品的人我喜欢产品所以对我来说给我的DJ串流应用加个新功能或者给我用的那种针对X的Google Reader加个功能比去琢磨着把我生活里的某一部分自动化要容易得多不过你说的对确实有些挺好玩的例子几周前我还发了一条动态讲我让我笔记本把厨房里发生的所有事都转录下来然后根据我儿子的表现好坏给他的iPad增加或扣除屏幕使用时间所以他就像个挺好玩的小社会实验 [00:30:20]
Lenny Rachitsky:结果也挺搞笑的就是他录了一段自己一遍遍说爸爸我爱你的视频放在麦克风旁边用来钻指标的空子钻指标的空子所以就是只要任何东西变成衡量指标它就失效了但这就是个挺酷的小社会实验我觉得这些东西超级好玩太搞笑了其中一个所以其中一个指标就是他说我爱你的频率然后就会给他更多屏幕时间其实就是看他说的话是不是积极的亲社会的太好笑了或者是消极的反社会的而说我爱你就是非常亲社会太有意思了我有个朋友做了个小设备专门记录他和孩子一整天里笑了多少次 哦 那挺棒的对 他改造了一个Limitless吊坠来做这件事然后他们每天就看那个指标是不是很有意思这就是我想说的老兄 我觉得我们这期节目聊到现在花了很多时间讨论生产力 失业这各种听起来很深奥 很重大大写加粗的严肃话题但你刚才说的你笑了多少次这个不是初创公司可能也不是什么有重大经济意义的想法但它对我们生活品质是有意义的而且我觉得我们往往以为快乐是恒定的但万一不是呢要是你和我一百年前做工我们能干什么活我保证肯定没现在这么酷 而且说不定一百年后会比现在还要酷得多所以我认为大家经常忽略的一点这也是为什么我欣赏Clairview和其他人的原因就是这东西怎么给人类生活增添质感哪怕它们没有经济价值对顺着这个思路我之前看到你提过一个挺有意思的观点说那个巨大的机会可能不仅仅是在C端而是更广义的是让我更快乐这个循环展开聊聊这个吧好啊我觉得我们总以为大家想变得更高效但其实并不是我觉得更多人是想打发时间而不是节省时间全世界最大的那些产品基本都是娱乐和社交 这是有原因的所以这就触及到了核心我们到底怎么把价值交付给消费者我觉得对大多数消费者来说我有时开玩笑说这就像Instagram上的AI用户对比X上的AI用户X上的AI用户是那种生怕自己沦为永久性底层阶级对GLM 5.3还是Kimi K3极有看法他们就是彻底peeled了而Instagram上的人就会觉得这差不多就像个更好的谷歌搜索挺酷的他们根本不懂大家在激动什么所以我认为很多这其实是产品设计上的失败我们明明有能力去从根本上改变大家的生活Lenny从很多方面来说 我们花了40年时间做出来的技术就是让电子表格变得更好用对吧我们造出了这种延伸智力的技术但没有任何东西去延伸我们的灵魂我觉得我们多少是有些精神饥渴的特别是很多原本满足这一需求的文化机构都消失了在美国其他地方尤其如此那边可没有那么多热瑜伽课普拉提清断食和朋友节聚餐所以我认为这项技术的机会在于消费者最基础的需求比如我们怎么才能感受到更多的连结更多的爱我们怎么取得进步我们怎么获得乐趣比如这些我们所有人都向往的最基本的东西 我们怎么把这项技术应用到这些领域去这才是我希望能多看到的而且我再说一遍我觉得这不是模型或者能力上的挑战它纯粹是个产品设计的挑战我太喜欢这个想法了我们之前聊过Loop的概念比如帮我发展业务帮我找到更多销售线索帮我解决供单但照你这里的说法我手头有笔记就像是让Loop改善我的健康或者让Loop帮我成为一个更好的朋友AI完全没有理由不去深入琢磨所有这些事并想出切实可行的办法来做到这一点对 而且你看虽然细节还需要微调但我觉得AI是可以通过某种方式 来向你发起挑战推你一把甚至提出不同意见的这也是为什么我觉得初创公司比大厂更有优势想想看谷歌那上千个委员会一想到要发布一个会跟用户唱反调或者老天保佑可千万别带点性暗示的模型就得气得在坟墓里打滚了但你猜怎么着这些全都是人类生活的一部分所以我认为去探索我们社交生活中那些让人不太自在的面向正是初创公司天然适合去做的事我知道你花了很多时间投资消费级公司照我听来消费级业务这里有个巨大的机会就是去打造一款App产品 专门围绕改善我和亲友的关系来跑这种路我觉得没错而且我认为到目前为止拖了消费级应用后腿的可能说拖后腿太重了因为如果拿iPhone的发展历程来打比方我们现在还处在iPhone2010年的阶段对吧2010年的iPhone是个什么概念我觉得那会儿还没有Airbnb没有WhatsApp没有Uber还没有那些重要的消费级公司所以现在还是早期但拖着我们步伐的我认为有三件事一是模型一直很贵所以如果你想做一款免费使用的产品并不是件容易的事第二是我们一直面临着交互界面的问题比如聊天界面对全世界能动性最强的人来说很合理 [00:36:02]
Anish Acharya:也就是Elon和Sam这样的人但对普通消费者来说他们理想的交互界面其实是TikTok所以我们需要在聊天和TikTok之间找到某种形态再就是这项技术之前更多是聚焦在生产力上而不是人际连接和娱乐这类事情我觉得所有这些现在都有机会改变比如开源权重模型让成本大幅下降我觉得大家也开始讨论像让loop使我更快乐这类话题了而且像Eugenia这样的创始人你应该请他来上节目他非常棒他们正在雄心勃勃地思考用户界面Airbnb的切斯基我记得他创办了一个专门研究下一代用户界面的基础实验室所以我认为所有这些问题都会得到解决
Lenny Rachitsky:或者至少比两年前更有希望解决了关于消费级应用和AI这个领域我后面还想再聊聊但我更想接着顺着乐观情绪这个话头往下走看看事情可能会往哪里发展大家对未来对AI普遍有很多恐惧和担忧马克安德森之前来上节目时有个非常有意思的观点他觉得AI来的恰逢其时简直是来救我们的因为人口在下降生产力在下滑到处都在打仗气候变化等等如果没有AI来填补这个缺口我们的麻烦可就大了从更大的宏观视角来聊聊你为什么觉得大家可能低估了围绕AI的积极面和乐观情绪首先 [00:37:29]
Anish Acharya:我觉得它有可能成为一种情感和精神层面的界面借助它我们能获得杠杆去探索我们自身那些被深深埋藏的面向如果你看看工业革命带来的影响就会发现它带来了不可逾越的规模优势尽管我显然非常支持资本主义也很喜欢我们身处的经济体系但我认为那种中心化在某些方面其实压制了个体也削弱了人的自我认同所以我觉得真正神奇的地方在于这项技术极大的放大了我们的自我认同和个人能动性比如说它把技能和愿望给结绑了如果你想做音乐你现在就能做音乐你不需要非得学会弹钢琴如果你想成为程序员去写软件 [00:38:13]
Lenny Rachitsky:你现在就能写软件所以它真正放大了我们的个性它让我们得以去探索生活中那些以前从没机会探索的面向而且纯从实打实的经济层面来说我们一直陷在2%的GDP增长泥潭里谁规定我们就必须停留在那个水平为什么不能是10%15%或者20%借助这项技术我们不仅能大幅拉动生产力还能大幅激发雄心抱负想想看可能这么说有点夸张但20世纪50和60年代我们相信自己无所不能对吧当时我们刚打赢二战整个经济体整个世界以前所未有的方式动员了起来 Lenny我有个理论就是在赌注很高的时候人类的表现是极其出色的赌注很低的时候我们往往处于最糟糕的状态从很多方面来看五年前我们生活的世界感觉就像个低赌注的世界所以整个社会集体搞出了很多副业项目但他们既不一定能提升生产力也没让我们任何人变得更快乐而现在不仅是伊朗在全力以赴做它的那些事我觉得每个人都感觉自己在往雄心的阶梯上爬你把不成熟的想法做出来才能发现好想法如果你想做软件那就太棒了如果你想造一座桥你现在根本不需要是土木工程师才知道怎么造所以我真的觉得 我们完全有条件走向一个快乐的多更充实更有生产力的社会可我们却坐在这儿讨论永久性底层阶级我很喜欢这套观点听起来都太对了只是真的很难让人相信但如果你真看看半岁AI兴起到目前为止的情况失业率下降了大家都在赚大钱显然很多人也过得很艰难有很多负面影响数据中心给周围居民带来麻烦诸如此类的问题很多但作为一个经济体作为一个国家目前来看感觉一切都挺好的就像前几天他们好像都快攻克某种癌症了所以就是这样对你说的对Moderna刚做到了 [00:40:22]
Lenny Rachitsky:我的意思是Darriel能写一篇博文说如果我们治愈了所有疾病会怎样然后我们居然能把它当成严肃话题来辩论我们这到底活在一个什么样的世界里我还觉得我们总在集体为一些抽象的概念担忧比如世界普通打工人中层管理者住在数据中心附近的人这些都是抽象概念但我们实际的生活似乎越来越充实了我们能力更强了也更有主动权了所以我觉得这也是一点显性偏好往往体现出人们在个体层面的实际体验而宣称偏好往往体现出人们是怎样观察或者认为整个社会层面 在如何发展的如果你问大家想不想在自家社区建个数据中心大多数人会说不想但如果你问他们今天用没用ChatTPT大多数人会说用了这种割裂感大概就是这么来的很明显的问题就是围绕AI的公关做得并不好有太多的制造恐慌你怎么看这是怎么回事你觉得这种情况会改变吗我们要想改变围绕AI的舆论讨论能做的最重要的一件事就是让重要的东西变便宜在美国有两样极其重要的东西却只变得越来越贵对吧医疗和教育如果看医疗45%都是行政成本所以只要拿掉大部分行政负担你就能真正看到医疗成本的下降 [00:41:47]
Anish Acharya:还有像治愈所有疾病这种事听起来太棒了GLPE药物显然这也不是AI的产物但我认为这是让人对医疗成本下降感到乐观的一个理由然后还有教育我认为教育现在面临着200年来最强劲的竞争对手我指的是传统教育我觉得能把学习从机构里拆分出来会是非常非常好的一件事顺便说一句还能把社会地位从文凭里拆分出来比如你不需要哈佛学位你只需要一个Git就够了这真的挺酷的我看到OpenAI最近放慢了他们的AI研发速度他们暂停了最新模型的强化学习阶段因为他们看到的一些苗头 [00:42:31]
Lenny Rachitsky:这显然是大家非常担心的一点也就是这些模型到底变得有多快多聪明单就这件事你有什么想法吗这算是一个很大的转变不再是一路猛冲去争最快最好的模型而是行吧我们确实得把这些东西放慢一点了感觉挺疯狂的我不针对OpenAI做具体评价但我对其中一些说法可能多少有点怀疑Anthropic当时因为手里有一个危险到不敢发布的模型所获得的关注度和光环是极其惊人的也许是他们遇到了GPU短缺也许是能力比他们实际想要的更超前也许他们就是想把那个专有模型留在内部 [00:43:14]
Anish Acharya:好扩大自己的领先优势我觉得有很多这类混杂因素都会促使你稍微往回收一收关于网络攻击能力的观点我确实看得很重也就是在我们让系统变得极易被攻破之前应该先加固我们所有的系统但我觉得所谓模型危险到不敢发布的说法有点把营销推理算力以及经济层面的考量混在一起了比如你是想把竞争优势外化出去还是留着用它让自己变得更好对每次我请Anthropic和OpenAI的人上播客时也总在想这个他们手里有最好的模型时优势到底有多大 太疯狂了对吧飞轮就在那摆着只要手握最好模型的时间更长他们就能跑得快得多确实疯狂不过要是换个角度看一会儿之前感觉Anthropic坚不可摧现在OpenAI经历了非常亮眼的六个月开源权重的发展势头也极其迅猛哪怕大家会有那种让人害怕的设想觉得会出现某个超高智能且完全被一家公司垄断的专有模型但到目前为止行业的趋势根本不是这么走的是就像Grok把凭空杀出来一样现在成了最惊艳的一款AI助手类工具我整个人都陷进去了哎呀我们确实该聊聊个人agent的事这里面有三款我很喜欢的大产品 [00:44:42]
Lenny Rachitsky:Grok把做得非常到位而且它底层的模型也很棒对吧你说的对他们不知从哪杀出来的我知道这里面很大一部分是Cursor团队的出色成果我觉得CharGPT-1算是藏在界面深处但它真的非常非常好用这是他们发布过的最好的产品之一还有一家最近引起不少讨论的初创公司叫Instinct他们做了一些更大胆更有意思的取舍但都是同一个领域的那太棒了我不知道这算不算某种吐槽策略有人发推特说的含含糊糊的发推说这东西有多棒大家全都在问你到底在说什么鬼东西那招真的很管用因为我当时就在想 我怎么才能用上Chatchy PT Work紧挨着这期之前播出的那一集嘉宾就是负责他的PM Tara哦,真的吗?对天哪,他们做得太棒了真的,我不知道你用的多不多但做得确实很出色他比Cowork好在哪里?是因为他跑在云端吗?这是最大的差异点吗它跑在云端它在缓存浏览器凭据方面做得很好所以没有Grok或Instinct那么激进而且它的远程功能配有全双公语音模式你真的可以直接给它打电话它能看到你所有的对话流 你直接跟它聊就行比如问它我所有coding agent那边还有这边都在发生什么你能把那个改一下吗就因为这个全双公语音太好用了你真的会觉得是在给自己的助理打电话而对方知道你世界里发生的一切事情而Grok算是一种单向转写对吧或者其他一些助手用的是纯文本语音加上这种能同览全局对话流的模型做得确实非常好太棒了好的我等会儿再回过头来聊这些面向消费者的AI助手不过有个话题我想先收个尾我觉得在AI对工作和经济的影响上就像有一个光谱一头是Dario那种 觉得50%的脑力劳动都会被颠覆我们会面临大规模失业另一头则是David Sachs那种觉得这会非常棒工作完全没问题到目前为止一切都在朝好的方向发展很显然你更偏向David Sachs这一边沿着这个思路你觉得还有什么能让大家对未来的工作更宽心吗我是觉得人类生存的整个趋势一直都是我们的欲望增长的比满足欲望的能力更快你看今天被当成理所当然的事在500年前甚至50年前都是难以想象的奢侈品比如心理咨询对吧或者像100年前的抗生素对吧我是说当时你再有钱也根本用不上 所以我觉得我们低估了人类的野心低估了人类的欲望20年后大家会因为自己在火星上没有度假房而生气是真的生气打心底里生气他们会在Instagram上看到然后说宝贝咱们得更努力工作把它搞到手每个CEO都会想把公司做得大的多所以我现在就觉得我们正在经历一种比100年前所能想象的宏大的多的人类生存状态完全没有理由认为这种趋势不会继续甚至加速关于野心这个概念我很庆幸你又提到了这个词在这个播客里这事经常被聊到AI不仅让怀揣更大的野心变容易了而且几乎是在逼着我们更有野心 因为别人现在都能轻松做所有简单的事现在拉开差距的就在于你能把事情做得有多大好吧我要做个个人网站行挺酷的就用这种简单的白底不行好吧我要做个3D游戏你得在一个虚拟世界里逛去发现他们做过的所有事情好像所有东西都变得更史诗级了你怎么看野心变成一种更重要的我不知道技能和习惯很多概念其实被混为一谈了因为当我和你在这档播客里提到野心时我觉得大家脑子里想的野心非常具体想当创始人的野心想做出一款漂亮的软件产品的野心这些确实是某种野心但野心还有其他类型 [00:48:57]
Anish Acharya:咱们聊聊创作上的野心你五岁的时候没人会对你说Lanny你水彩画得好但素描画得差你就是有做点东西的野心或者欲望然后你就去做了这是非常独特的东西现在真的能得到鼓励了再想想非常本地化的野心比如英国有NHS我觉得它算是一个备受真实却运转不灵的机构也许AI在他们社会的落地方式就是让NHS变得像iPhone一样好用对吧那是对他们来说非常具体和本地化的或者干脆就是想和家人走得更近多陪陪孩子的野心所以野心不一定非要是狭义的经济层面的野心它可以是任何我们想多做一点的事 [00:49:39]
Lenny Rachitsky:而谁骨子里没有这种渴望呢对 仔细想想我刚才那个例子太蠢了感觉我们脑子里需要解开的束缚是好癌去攻克癌症我们不是我们现在可以从这个高度开始思考了这对我们来说太反本能了尤其是作为产品人总得去考虑MVP和各种限制条件现在我们必须往大了想行 这事的放大版这事的十倍一千倍版本会是什么样没错 谁说不是呢在某种程度上我们反而得往小了想因为我们这一辈子建立起来的认知都是软件和智慧有多珍贵而现在它们一点都不珍贵了这种转变对你和我来说可能更难 [00:50:22]
Lenny Rachitsky:对就像是所有这些新的小习惯我经常想到Cloud Code团队里的一条准则你知道有什么比我自己做更好吗那就是让Cloud来做这就让团队里的每个人都养成了这个习惯我该怎么帮Claude替我把这事做了我觉得这是我们大家脑子里都得开始建立的一个意识Grogba在这方面就很擅长我不是他的投资人没有任何利益关联但他用起来就是特别简单做这类事很在行我也觉得边做边学能学到太多东西挺有意思的是如果你对比一下谈论Vibe Coding的人数和谈论自己项目的人数大家其实有点不好意思我聊起自己的很多项目也觉得有点不好意思 [00:51:04]
Anish Acharya:因为它们看起来不够重要不够有分量但很多收获都是在执行和交付的过程中学到的或者在执行和交付中获得满足感我觉得这一点我们同样不能低估我正在整理一篇投稿作者是谷歌做很多实验室项目的人我不想剧透但概括来说他的观点是构建就是当下的阅读你通过构建去学习去融入去体验大部分东西被扔掉也完全没关系因为那仍然是在锻炼你的手感说得太好了对就是把构建当成一种活动而不是为了追求某个成果对吧And我觉得很多人会觉得难受
Lenny Rachitsky:我交付了这么多东西但没人用我自己也从来不用我觉得这里的关键在于这其实很正常完全没问题天哪我是说在其他任何领域都是这样比如我做了一套DJ set可能就三个人听而我自己听了一百遍但这就让人非常满足没人听也没关系连你做DJ的事我们后面再聊行 好的好 咱们回到消费级产品上你在16Z负责消费级领域现在消费级领域大概是个什么情况目前的整体格局是什么样的有哪些东西让你感到兴奋我觉得主要有三个大方向就像我们刚才聊的 现在还处于非常早期的阶段各家实验室做得挺不错但面向大众市场的独立消费级产品还没有那么多coding agent太棒了我觉得就像一道晴天霹雳很多人容易觉得大多数人不想写代码但我思想上的重大转变在于coding agent是一种泛用的与世界交互的方式你在X上经常看到这种例子有人用Cloud Code来剪视频或者用Codex线做一个小游戏在飞机上陪孩子玩它有点像这种通用的问题解决工具消费者能以非常独特的方式去用它我们投资的公司里大概最好的例子就是Wabi它有点像个mini app的平台大家可以在上面创建 使用和分享所以我觉得coding agent是一个很重要的大方向个人agent方面我们见证了围绕OpenCore的高光时刻但你猜怎么着OpenCore是给开发者用的东西当然还有Hermes和Modebook所有这些现在都在被提炼成大众市场消费者和企业看得懂的agent也就是我们前面聊到的那些最后一个方向我暂且称之为娱乐不过这个词没法完全表达它的全貌我觉得它包含很多创意工具SUNO做得太惊艳了还有陪伴类产品这一整块让人聊起来有点不自在所以我觉得讨论的不够充分但里面有一些体量巨大增长飞快的产品 我觉得这就是我们目前正在关注的三个大方向这很有意思光是想想这三个大类coding agent AI助手类似open cloud但更简单更容易上手更可靠听起来你刚才描述的让你兴奋的基本上就是这三个instinct grogbot和chadipity work没错那Wabi我想应该算在第一类里它就像一个专属的coding agent能替你做任何你想做出的东西对 是的 一点没错然后娱乐是第三类像AI女友之类的东西对吧是那些公司简直不可思议你看你们发过这些市场全景图 里面大概有五家都是这种不同的没错不过其实准确的说找AI男友的比找AI女友的更多对吧是的其实用陪伴类产品的大多数人是四五十岁的女性有意思好挺酷的所以你觉得最大的机会将来自这三个方向而且很有意思的是他们能和这个循环的想法联系起来我说不好让我更快乐对这些差不多就像是人类需要完成的核心任务让我快乐让我更健康让我活得更久类似这样的东西对 是的给我一个施展抱负的渠道一个获得某种成就感的渠道然后在我不做其他所有事的时候 有件事可以做有道理好的顺着这个思路我还有个问题现在有这么多公司这么多初创企业这么多产品大家都在发布公司和产品交付的速度像是在以一千倍增长你在看一家初创企业时怎么去思考持久性和互称和因为很多创始人都会被问到这个问题每个人都会被问到这个问题我怎么证明自己不是个talker哪些迹象能告诉你这东西可能会很持久我觉得有两个很重要的思路一个是Dekagon的Jesse说过的话我很喜欢他说护城河往往是被发现的而不是被设计出来的我觉得人很容易自己钻牛角尖 我自己当创始人时也干过总想着必须拿出一份经得起MBA和VC挑剔审视的商业计划书必须对自己的护城河会是什么有一个非常精妙的设想而对那个团队来说他们就是动手交付护城河是随着时间逐步长出来的这方面的另一个绝佳例子是Cursor他们之前因为没有护城河被批评得很惨但事实证明起初做一个高NPS高DU的产品就非常有价值随着时间推移他们记录了所有的推理过程训练了自己的模型也就是Composer 1.2模型诸如此类后来的故事我们都知道了所以护城河是可以被发现的不一定非要被设计出来这是其一 [00:56:47]
Anish Acharya:我觉得另一点是大家似乎忘了传统的护城河没有一个是建立在做软件有多难的基础上的我们又不是在做自动驾驶汽车,我们大多数人都不是,所以它靠的是网络效应,规模优势,品牌效应,专有数据或者过去所说的独占资源。五年前的每一种护城河,大体上现在依然是好护城河,我们只是需要有志于往这些方向走的创始人,我们需要更多多人协作的产品,需要消费级社交,需要越用越好用的产品,比如Town等等。所以还是要读Hamilton Helmer,那些东西依然适用。对And我很喜欢他的书是他也上过这个播客 [00:57:31]
Lenny Rachitsky:对我觉得全世界真正算得上五商业书的只有五本其他所有书都是靠卖商业书做生意的全是假的而他的书就在我的五本清单里围绕这个话题你脑子里能马上想到的还有清单上的其他书吗最明显的两本是格鲁夫给经理人的第一课这本书一如既往的然后是本霍洛维茨的书《创业维艰》这是有史以来第一本在情感上如此坦诚的商业书这也是创始人喜欢他的原因也是我喜欢他的原因因为你读的时候会觉得原来不止我一个人焦虑觉得自己是个失败者没法跟任何人说我正在经历什么本霍洛维茨也经历过 事实证明这也是本博客里被提及最多的两本书我一点都不意外那关于护城河这个概念假设你是个创始人正在做BP准备像你或者其他VC募资聊护城河最好的方式是什么可以直接说我们会去摸索我们现在不确定现在谁也不知道吗可以我觉得如果一个产品有很强的势头做工非常精细参与度也在不断增长就算它没有所谓的护城河或持久性故事我们也乐意下注这其实是我这些年学到的一点我以前很担心别人偷我的想法但我后来明白大想法背后总有十几个看不见的小想法在支撑着就算有人抄了你的大想法 [00:58:57]
Anish Acharya:他们也永远看不到让这个大想法运转起来的那些小想法所以我其实觉得有些产品就是有某种特别的魔力让他们能在激烈的竞争中取得惊人的成功你看Granola两年前它被批评得很惨我也不知道他们今天有没有特别强的持久性故事但它就是大受欢迎占据主导地位所以我更看重客户怎么说而不是商业书怎么讲订阅Lenny的newsletter可以免费用一年Granola我得经常提一提这个它是我们product pass的一部分网址是lennysproductpass.com对我最近经常想这事因为选择太多了像CoreWorkChadGBD WorkCursor [00:59:40]
Lenny Rachitsky:GrokBot用户从一个换到另一个的速度快得惊人而底层的模型其实差别没那么大说到底大部分差距就在产品的封装和UX上所以在我看来这说明把实际的用户体验做成护城河或者至少给你争取大量时间去找到持久的东西这当中的机会太大了100%我觉得那些走在最前沿的人这些产品他们全都付费因为各自都有专长的领域对我现在订了好多每个月200美元的套餐我知道对吧肉疼是有点肉疼但我也一样我觉得Cursor现在都有一个月300美元的套餐了Grok也有对 你说的对 [01:00:23]
Lenny Rachitsky:对 那是Grok的套餐对 就是Grok加Cursor那套组合确实主要都是在用GrokCursor没了 对 Cursor凉了我觉得他们已经放弃那个品牌了我最近一直在聊的一个话题是分发渠道是不是新的护城河但其实分发一直都是护城河只是感觉现在它越来越变成一种巨大的优势因为现在每天都有上千个发布视频所有人都在发新东西发发发而真正能把你的东西推到大家的视线里推到大家的信息流里让他们不断被提醒你的产品还在这感觉越来越有威力越来越重要了你怎么看分发渠道的价值正在提升 现有的分发能力成了推动增长和成功的大杠杆这件事这太重要了我还跟Chris Dixon请教过这个问题因为为工具而来为网络而留这句名言差不多就是他提出来的我觉得问题在于我们这一整代创始人和CEO都是被网络效应和网络搭建这套理论培养出来的结果就是今天存在的每一个网络都经过了极深度的训练绝不让别人在自己的网络上搭网络所以我倒觉得现在的网络效应又回到了那种自下而上的真正的口碑传播当有人在X在YouTube在Instagram以及所有这些地方 自发获得大量提及时这大概就是你今天能指望的最好的一种第三方网络效应了而且其实就像Web 2.0时代一样不像移动时代有App Store有增长黑客有各种小作坊式的产业我们必须靠那种口碑增长去搭建自己的渠道所以在某种意义上这是一个更纯粹的增长问题但也比我们经历过的几轮产品周期都要难而想要获得口碑你就得做出点东西来我总想到Seth Godin说过的那句话做一件让人眼前一亮的东西一件值得大家评头论足的东西说到底就是做一个大家愿意聊的经验产品但这非常难做到 而且现在新东西层出不穷大家自然只会去关注身边的朋友在用什么在推荐什么不过我有一点想说这也是让人感到希望的一点我总说现在大家面临的不是增长问题而是产品问题原因就在于你完全可以在任何方向上无论是功能层面还是情感层面做出一个野心极大的产品你可以收很高的费用所以我常问大家的是你到底是有增长问题还是我们集体缺乏想象力如果我们设想自己的产品一个月收1000美元、1万美元要是我们的产品是软件界的薄金包呢它得做到什么程度才配得上这个价格 好那我们就来看看怎么把这种东西做出来这又绕回到野心的问题上了对但话虽如此你还是需要某种优势才能走到大家眼前推到市场上去至少最开始得这样因为现在每天都有上千个新东西发布想象一下这仍然是个巨大的机会而且怎么说呢也是种优势这让我觉得现有巨头的优势太大了他们手里有产品每次你用谷歌搜索他们都能跟推送一句去试试Gemini吧你觉得呢你有这种感觉吗你觉得现在初创公司因为分发上的这个难题日子变得更难过了吗我不知道 我觉得反而更容易了因为你看Gemini尽管谷歌做了那么多大力度的交叉推广也没人会觉得他们赢了初创公司可以往大厂不敢碰的方向去做比如我们聊过的Companion相关的那些而且还有很多别的方向这倒是真的定价可以定得相当高大家愿意每个月付200在企业端他们也愿意签下百万美元ACV的合同哪怕都还没搞清楚自己到底能得到什么所以我感觉闸门是打开的感觉就像2009年的圣诞节人人都拿到了自己的iPhone迫不及待想下载新APP这种情况早晚会变大家会觉得够了 累了不想再去试新的APP了 [01:04:38]
Anish Acharya:但至少现在窗口还是开着的我觉得初创公司现在更容易了这个见解很有意思而且你说的并不是分发或增长问题而是产品问题这个点太重要了因为要是你的产品真有那么好大家自然会去聊它分享它 使用它而且完全可以做到我是说在技术的撮合下我们接下来会看到哪些天马行空的社会实验我经常想到一个几年前很有趣的例子你听过MSHF吗你知道MSHF吗当知道知道对吧他们很厉害对吧他们有点像是一家把技术当做媒介的创意工作室 [01:05:20]
Lenny Rachitsky:其实从这点来看非常web2.0很多像EV WilliamsKevin Rose这类人他们本来就是画家只不过技术成了他们的画布他们做过一个特别搞笑的产品叫Card vs Card我记得是给10万个人各寄了一张借记卡然后每天给这些人发短信指定一个花钱的地点往卡里充100美元大家就疯了一样冲出去花这笔钱结果只有一两个人能刷成功其他所有人都会被拒付这完全就是一场爆火的搞笑社会实验在金融科技领域一直很启发我因为当时我就想天哪我们为什么不多做点这样的产品呢金钱天然带有社交属性但我们现在的金融产品全都是那么枯燥 [01:06:05]
Anish Acharya:那么私密还让人感到尴尬我觉得现在的AI领域也迎来了类似的时刻我们可以做出这些野心极大触动我们各种社交神经的产品我们只管去做就好那我顺着这个问一句你能接触到大量的公司既有找你做pitch的也有你投资并正在合作的从那些运营的好并且已经成功的公司身上你学到了哪些反直觉的经验那些可能违背通常认知创业常识的经验我说个最大的吧在以前也就是三年前我们看到一家公司如果他们想做的是野心太大我们就不参与了太疯狂太复杂了
Lenny Rachitsky:这也意味着你不会去投一亿美元的种子轮因为对几乎任何问题来说这笔钱都太多了对任何人来说这笔钱都多到管不过来要建立能消化这笔钱的人才团队钱也太多了作为起步轮来说根本说不通我觉得今天我们看到的几乎是相反的问题如果一个想法太小我们就不想参与你完全可以去聊怎么在种子轮把一亿美元高效的花出去我不是建议你去融一亿美元但我认为这种对野心不设上限的态度也体现在我们选公司以及公司选我们的方式上因为我们投资的时候会对每位创始人说我们来这里是为了帮你打造出愿景的最强形态 马克跟我聊要不要来这里的时候对我说过这话他说我们当初融第一期基金时讲的故事是我们要么冲上月球要么在地上砸出一个月球那么大的陨石坑没有第三条路这也是我们想和创始人共事的方式我很喜欢这个观点那野心能太大吗会有上限吗显然你得看团队和他们做的事不过这里的核心经验算是要更有野心这跟过去的套路正好相反过去都是这是我们的切入点这是我们接下来的方向你现在看的纯粹就是想法有多大吗你看AdamsAdams有多疯狂对我们所有人来说这算是一段多么不可思议的英雄之旅 而且他们想做的事在五年七年或十年前看起来根本是无法逾越的而现在大家觉得行吧很有挑战走着瞧有意思还有别的变化吗或者说在如今怎样才能做成一家公司这件事上你有没有改变过什么看法我觉得过去那种认为消费类产品必须免费的老观念我现在的看法几乎完全相反我们来想想那些极其昂贵的消费类产品吧我觉得现在消费者非必须支出的每一个部分都是可以去争夺的而且我觉得因为价格是衡量产品市场契合度的一种方式一个很有用的产品构想练习是 我们产品的薄金包版本一个月一万或者一个月一千的版本是什么样的所以我觉得昂贵的消费级软件算是某种全新且重要的东西五年前我们根本不会考虑我很喜欢这个框架因为它又在推着你更有野心对你提到了马克你跟马克安德森本霍洛维茨共事很密切是的你从他们每个人身上学到的一件事是什么他们是非常了不起的领袖和创始人能参与其中让我心怀感激而且他们身上刻入骨髓的一点我觉得是对科技行业对整个国家以及对西方生活与思考方式的这种担当与使命感你看像Ron Conway Brooke Byers或Tom Perkins我觉得他们身上都有一种责任感想站在行业的角度让这个世界比他们接手时变得更好那种抱负远不只是做全世界最好的投资人虽然我们确实也想做到我一次又一次看到他们俩展现出这种特质他们愿意去做艰难重要但并不能直接给公司带来好处或者至少不是单纯利己的事就因为这些事本身很重要本在行业层面上做了很多这样的事而马克则更多是在国家层面当然他们俩在这两个层面都有涉及另一件很酷的事就是看到马克和本可能也包括我们公司是如何塑造了我们整个创始人社区的共同野心 [01:10:22]
Lenny Rachitsky:回想五年七年或十年前硬科技是非常不受待见的做硬科技并不是一件地位很高的事当时非常边缘而现在变得非常热门地位很高很主流当然有很多公司都在往这个方向推但我认为像马克这样的人非常全力以赴的支持去从事关乎国家利益的真正重要的工作整个硅谷也因此改变了而且过去几周你们在投资上也取得了一些大胜利对 谢谢恭喜进入非常令人期待的Lightning Round也就是快问快答环节之前最后一个问题对于那些正在思考如何在工作方式思维方式和做事方式上做出调整 以便未来在职业生涯和公司里更成功地做产品的人你有什么建议就是多做东西我知道这听起来很傻我知道每个人都在这么说但真的哪怕随便想个小项目都行你不需要告诉任何人它可以完全不重要但把它当作一个载体去用所有新模型去发布东西去讨论它们建立你自己的直觉我敢保证你距离像其他人一样peeled就差那么一周有点沮丧但随后极其充实的体验你必须去用这项技术此时不用更待何时对吧我们所有人入局都是为了做出脑海中构想的产品 而现在你有机会去做了所以请务必去用这些模型并且告诉我你做了什么给我发短信at我我会回复回应并跟你互动其他人也都会这样因为硅谷的神奇之处就在于它是一种正和思维大家都是在彼此的基础上构建而且袒露脆弱是真的会得到回报的所以我肯定会鼓励大家去用模型怎样才算做的足够多有什么好的判断标准吗比如一个月做个东西还是每天花几个小时坐着讨论搭建有没有什么指标能让人觉得行,你做的挺好我是说哪怕每周发布个东西就行不用特别夸张 比方说我试玩Codex让他从我的短信里提取内容为我妻子做了个母亲节幻灯片她看了我的相册配了点音乐做了一个大概20页讲述我们感情历程的幻灯片还提取了我刚开始约她时的一些很酷的旧短信那是一个很棒的母亲节你懂吧我是说它并不重要也不是什么我们以后还会翻出来的东西但它算是一次交付所以小到这种程度都可以我知道我们的共同好友Nikil Singhal你以前在Credit Karma和他共事过他对这个问题的看法非常好他发现人们只要经历过一次AI给自己带来喜悦的时刻对AI的态度和看法 就会彻底转变你这个母亲节的想法就是个很好的例子所以我常想的一个小诀窍就是有什么东西如果做成了能给你带来快乐有什么事情是你能为别人做的也许那也是个不错的切入点这个想法太棒了Aneesh在进入我们非常精彩的快问快答环节之前还有什么想分享的或者在进入快问快答前有什么想进一步强调的吗我觉得没有了到目前为止聊得非常开心我也是就这样我们来到了非常精彩的快问快答环节我有五个问题要问你准备好了吗好准备好了那我们开始 有哪两三本书是你向别人推荐的最多的好行征服与文化是我最喜欢的一本书作者是托马斯·索威尔讲的是征服如何在世界各地的不同社会中引发文化变迁有时是积极的有时是消极的我觉得对我来说他从历史视角最透彻的讲清了文化是决定结果的最大驱动力我自己作为一个出生在加拿大后来搬到美国的人对此深有体会美国有着非常不同的报复文化又是这个词征服与文化很棒你提到的《商业起立》实际上也是一本极好的书我觉得他把护城河商业理论和富利优势提炼得很有深度 我真的很喜欢第三本可能是马克推荐给我的那本我入职前他发给我的时候我还以为他在整我我说马克有什么我该读的书吗他就发了我两本其中一本是教材叫《Increasing Returns to Scale》我觉得作者应该是布莱恩·阿瑟这是一本极好的书他有点深奥地研究了为什么软件这类事物会产生如此极端的经济效应但他真能帮人看清本质或者说帮我理解了为什么我们这个行业会以这样的方式运转为什么我们的文化会以这样的方式运转对吧为什么我们这么追求正和博弈我很想说是我们人品更好但我觉得可能只是我们在其中做事的系统和架构更好 最近最喜欢的让你看得很享受的电影或电视剧是哪部天哪,我看的都是些口水电影和电视剧,我是说我们看了House of Dragon,挺酷的。那可不算口水片,对,内部很棒。也是,我不知道,对,可能不算高雅,它谈不上什么重大意义,但确实很棒,我们很喜欢。然后我还看了奥德赛我是在伦敦看的我去那边开董事会在一家挤满了人大家喝着啤酒玩得很开心的IMAX影院看的然后太棒了挺酷的因为电影本身很棒 而且像是一种影院体验一种奇特的社交体验有点像聚在一起各看各的这是最近看的两部我还没买到奥德赛的IMAX票我其实专门设了个Grockbot一直盯着网站然后完美帮我挑好座位完美太合适了不过AMC网站上有个很蠢的验证码它一直过不去真的吗有点刁钻真的很刁钻是那种让你选水果的吗算了不说这个对就是你得点三个不同匹配图形的那种这就让人无语了连这都搞不定希望这期播出的时候我已经看过了我好像连着好几期播客都在说 我还没看过呢真是的好最喜欢的新AI产品是哪个或者说最近让你感到快乐的最喜欢的AI产品天哪我在个人agent上花了很多时间我觉得Grok还可以我打算把票投给Grok吧主要是因为他在缓存凭据替你干活这方面实在太野心勃勃了甚至有点不按套路出牌我很喜欢他这点初创公司这样做我倒能理解但他们确实在做其他大公司我觉得都不会做的事他做的真的非常非常好他的UI设计的很用心他背后还有一个非常强大的基座模型我觉得他也让人觉得等等在模型层面也许并不是两强相争 [01:17:34]
Anish Acharya:所以我就是觉得这款产品挺好玩很有野心而且在承担那种同类产品不会去单的风险还有最后两个问题你有自己最喜欢的在工作或生活中经常会想起的人生座右铭吗天哪我还真有一个这是我创业那会儿学到的但我发现带娃也是同一个道理就是别人随口就能告诉你的事情别非得通过痛苦的教训才搞明白而我不幸一直有个坏毛病就是总想自己摸索而不是向那些走在我前面几步的人请教我发现我的孩子们也有这个毛病能不能举一个例子是你当年希望有人能提前告诉你的对我的孩子们来说 [01:18:17]
Lenny Rachitsky:那就是别摸滚烫的炉子对我创业那会儿来说则是这样字面意思字面意思对我创业那会儿来说就是别同时做产品又做平台如果你要做平台型公司就只做一个我们第一家公司当时想做手机游戏的社交平台同时又想做游戏工作室然后有个明白人立马就告诉我你看你不能这样单做一家工作室就已经够难了更别说同时做工作室和平台了挑一个我们选了结果花了我们好几年才发现我们选错了最后一个问题我问本霍洛维茨该问你点什么他只说了句问问他打碟的事他说你水平很高 我就去搜了你的DJ页面不知道能不能这么叫在SoundCloud上的Alescience对真的很棒谢就哇谢喜欢边工作边听对于想入门打碟的人你有什么建议吗有没有什么好用的工具或者什么心得能帮别人在这方面做得更好当然有我想这就是我为什么这么喜欢音乐模型的原因打碟一直我是说我很喜欢打碟我已经玩了30年了从1995年开始算下来都31年了天哪如果你没受过正统的音乐训练这绝对是一个极好的用音乐表达自己的方式你挑音乐选唱片 [01:19:42]
Anish Acharya:把它们混在一起所以这需要一定的技术但现在我觉得你可以更进一步直接用模型来做音乐最棒的部分是你可以想出音乐创意然后让模型做出最强的版本所以我觉得音乐真是一种极其本能又让人满足的方式来感受这个世界并带来体验所以不管是打碟还是做音乐我都建议大家都去试试我之前都没想过现在有了SUNO以及像11 Labs这样的东西你可以直接生成音乐而不用只是把现有的音乐拼接在一起打碟这件事已经发生改变了想想它的历史你从最早只有现场有人演奏乐器才能听到音乐 [01:20:24]
Lenny Rachitsky:到了留声机上的录音音乐从介质的角度来看音乐真正的重大变革其实是和氏磁带因为和氏磁带真真正正让你第一次能够去创作对吧你真的可以去编排属于你自己的所谓专辑我觉得音乐在2000年代那么艰难很大一部分原因就是那种创作感消失了我们又退回到了单向广播模式而现在大家又重新开始做音乐了我觉得音乐产业会比以往任何时候都要庞大哇 天哪 颠覆太大了Anish 这次聊得太棒了我们聊了好多内容最后一个问题听众能为你做点什么展示你们在做的东西给我看吧 千万不要沮丧做出点东西来然后at我我非常想看看如果你想听到更多这方面的内容欢迎在X上关注我我尽量多互动多回观另外也一定要去关注Lenny圈子里的这些厉害人物Clearville非常耀眼Alina特别特别厉害这里真的有太多吸引人的好内容了还有我们聊到的Nikhil SinghalNikhil Singhal是最棒的真的那家伙无所不能太棒了Anish非常感谢你能来谢谢你邀请我Lenny大家再见非常感谢大家的收听如果你觉得这期内容有收获可以在Apple Podcasts Spotify或你常用的播客平台订阅本节目另外也请考虑给我们打个分或留个好评这真能帮到其他听众发现这档播客你可以在Lenny's Podcasts.com找到往期所有节目或者了解更多关于本节目的信息下期节目见 [01:22:09]
本期讨论的核心观点是:Agent 的能力不只由模型权重决定,Harness(运行框架)同样是决定实际表现的关键系统。主持人与嘉宾回顾了 Harness 从最初的生成循环,逐步加入上下文管理、思维链、工具调用、记忆、子 Agent、递归和自我改进的过程,并用 ARC-通用人工智能、长程编程和自动科研等例子说明,同一个模型在不同 Harness 下可能产生数量级差异。好的 Harness 不应只是固定的规划、行动、评估流水线,而应尽量有表达力,让 Agent 自己管理上下文、选择工具、模型、算力和协作者,并在长期运行中持续获得经验。
讨论首先把 Harness 放回测试时经验的背景中。模型可以通过上下文学习少量新知识,但上下文很快会触及长度和效果饱和的限制;传统的微调流程又割裂且成本较高。Harness 可以把测试时经验组织成记忆、工具、REPL、子 Agent 和反馈循环,使模型在任务进行中适应新问题,而不必每次都重新训练权重。ARC-通用人工智能 的价值正在于检验系统适应全新分布的速度和质量,相关结果显示,运行框架本身就能带来显著提升。
Seth 介绍了 Prime Agent,一个能够自我改进的 RLM Harness。它把研究目标、范围梳理、论文阅读、实验执行、反馈和写作拆成协作流程,再通过 Meta Harness 修改自身的系统提示词、Agent 数量、上下文编译方式和 Harness 代码。系统可以根据适应度函数评估不同配置,把结果写回存档,并反复生成更好的 Agent。嘉宾强调,Harness 应提供足够丰富的能力,例如上下文压缩、Python REPL、子 Agent、状态访问和反馈,而不应替模型预设过于僵化的工作流。Prime Agent 的实际经验表明,只改变外层脚手架,就能让同一份权重在自动科研任务上持续产出更好的结果。
Jon Saad-Falcon 随后介绍 OpenJarvis,重点是把个人 AI 从云端带到端侧。云端方案成本高,也要求用户把隐私数据交给外部服务;端侧推理则依赖更好的本地模型、加速芯片和推理引擎。OpenJarvis 把模型推理、Agent 执行、记忆和学习组合成可在个人设备上运行的系统,并通过硬件和软件协同降低长期使用门槛。端侧方案的挑战包括资源有限、模型能力不足,以及如何在不同设备和工作负载之间进行取舍。
Josh 介绍了 YC 内部的 QM。QM 是面向办公场景的开源 Agent Harness,为每位员工提供独立上下文、沙箱文件和定时任务,也可以通过 Slack 和网页端工作。它被用于邮件拆解、法务和财务流程、文档编辑、内部数据库查询以及启动内部 Web 应用。QM 的演进经历了通用 Agent、接入 Slack、加入定时任务和开发环境,再到运行在虚拟机集群中的个性化 Agent。设计重点从“给每个人一台独立电脑”转向把对话、沙箱和其他资源集中管理,让 Agent 按任务需要选择资源和模型。
嘉宾也讨论了实际限制。自动修复容易出现只看到局部问题的“主角综合征”,人类参与仍然重要;Agent 需要连接公司的各种系统,但权限必须接近真实员工的权限,数据库写入则应先提交计划并经过人工审核。把沙箱视为可调用资源,可以让不同对话共享上下文、协作和评估轨迹,也为自动改进提供数据。与此同时,Agent 往往过早放弃复杂任务,因此可以用工具预算、运行时间或 Token 消耗约束它继续工作。系统还必须处理社交语境和特权信息泄露问题,权限模型越细致,知识共享才越安全。
- Harness 与测试时经验 [00:00:00 - 00:10:00]
- Harness 的六年演进 [00:10:00 - 00:20:00]
- Prime Agent 的自我改进 [00:20:00 - 00:30:00]
- OpenJarvis 走向端侧 [00:30:00 - 00:40:00]
- QM 连接 YC 办公系统 [00:40:00 - 00:50:00]
- QM 的权限、资源与持续改进 [00:50:00 - 00:55:41]
Harshita:欢迎来到YC Harness Club,也就是YC Harness俱乐部。我可是下了大功夫的,我用Gemini迭代了差不多十次,才生成出Harshita骑着龙虾的图。Gemini一开始根本不肯画,不过我们最后还是搞定了。好,欢迎来到Harness之夜。第一件事,大家觉得YC Paper Club,也就是YC论文俱乐部的新视觉怎么样?这个想法其实是我随口跟YC的设计主管EV提了一句。结果两天后,他就拿出了这个方案,我当时就觉得,太棒了,坐在后面的EV 请站起来鞠个躬吧,太让人兴奋了,好,为什么要聊Harness 有人会说,这不就是个rapper吗,这不就是个脚手架吗,这不就跟prompt工程差不多吗,这东西到底有什么好,专门花一晚上聊的,这里有一条,刚发了一个月的 reddit精彩贴 话说的其实最冲突,我不觉得,这种prompt工程,配得上顶级机器学习会议,还有一条也很绝,上下文工程,根本就不是个科研课题,所以我觉得Harness长期以来,一直被贬低,被当成不入流的科研,但从Harness1到Harness2之间,实打实,给我们带来了18%的提升,而且正如Seth待会儿会讲的,他决定了能不能把ARC-通用人工智能做成,显然,这绝对值得投入一定的精力,去做研究,我觉得如果你看这张经典的图表,发布时间和agent 能持续运行的时长,这上面的很多进展,确实都是因为Harness带来的,我把这称为静态Harness时代,那会儿Harness还没有自我改进能力,而最近,可能是过去这六个月,全都是关于具备自我改进能力的Harness 我们会把这些全都讲一遍 其实我是在Trajectory的CEO 做的一场分享里看到这张图的,我当时就特别喜欢,他讲的是,我们一直在测困惑度,这在某种程度上,对应着IQ以及模型有多聪明,所以我们不断在治理 IQ这个维度上往上推,但我们并没有充分利用好测试时经验,我们生成了这么多测试时经验,面对一个全新领域,我们却不能很快适应过去,如果大家还记得,我们办的最早几期YC论文俱乐部,我当时一直在做这个实验,随着我在训练室不断增加样本量,你怎么做到只用Batch Size 1 就能学到东西,我们其实根本没有这种架构,我们有ICL 可是一旦塞了大概四五十个之后 ICL就饱和了,在验证级上根本不会再有任何提升,接着你就得去用小质的LORA 然后再用大质的LORA 接着再去用SFT 我们有这么多截然不同的训练流程,其实挺别扭的,所以我认为这正是Harness 目前大放异彩的地方,而ARK-通用人工智能揭示出来的,或者说ARK-通用人工智能的核心要点,就在于模型能多快适应一个全新的问题,全新的分布,并且在里面表现出色 ARK 通用人工智能团队其实跟我一起参加了 2026年冬季批次,我们当时帮Greg一起看这些,就像我上次提到的,设计这些题目投入了大量的心思和精力,以确保从第一道题到第二道题考察的技能,全都是正交的,这样才能单独测出这种流体智力 Quad Opus确实是最早在,除了Greg Cotrolla 谁都接触不到的私有测试集上,跑过验证的模型之一,而他们拿到的最好成绩,也就是30% 但光靠一些Harness 靠这个被认为不配当科研课题,只配叫包装层和脚手架的东西,我们就能做到95% 而英伟达的Evo甚至做到了100% 就是Prime Agent和英伟达,这两家都是最近刚发布的,另外我还想补充一点,Carpathy大概是在3月份发布他的Auto Researcher那会儿,我fork了代码拿来玩,当时我其实只想做个简单的小界面,看看到底在发生什么,追踪一下进度,结果阴差阳错,我居然手搓出了一个harness,我本意不是要写这个,只是想看看运行情况。它的基本原理就是你指定一个目标,拿我当时给的一个真实目标来说,扩散LLM跑不过自回归LLM 但如果我做模型融合,如果我把扩散LLM切片,分片成一堆不同的实例 因为扩散模型单张GPU的算术强度,比自回归模型高得多,通过分片切分,综合起来我其实可能拿到更好的效果,于是我就把这个当作目标,交给了我那一套agent 那一群agent 我给了他一些初始想法,我想调整融合的大小,按不同的量来分片,切100份 10份 5份,都行,然后我指定一个验证指标,可能想跑gsmac 还有类似gptr的评测配置这类的,接着我有一个负责,梳理范围的agent 他会去查相关的论文,查github仓库,然后把结果交给一个叫chris ray的 pi agent 对方再把它交给一个叫 John Seth Falcon的研究员 Agent 他人就在那呢,然后他会去推进,做一些具体的工作,再交给一个顾问委员会,寻求帮助 这时候我就介入了,我和Yasir会给你提一些反馈,然后你再改一改,等什么时候你准备好了 Chris Ray会盯着你,差不多每小时来催你一次,接着就转给负责写作的Agent 让他停下来,把思路定稿,开始写笑容实验,然后动手写论文,于是整个系统就变成了这样,这是负责梳理范围的agent 然后你还有这样一个控制面板,基本上在任何地方都能看,我们用Tailscale组了网,所以你在任何地方都能打开这个网址,看它的进展,还能直接在上面和它交流,它还会直接给你发邮件同步进展,我把整个1B模型的那套东西,在这里重新做了一遍,然后它真的开始产出论文了,而且我读了那些论文,写的其实挺不错的,刚开始在三月四月那会儿,写的不太行,到了五月左右,就慢慢变好了 不过现在我基本上,就是把八个想法,丢给八个H100节点,每个节点带八张H100 他们就自己一直跑,然后我过来看看,他们就直接交论文给我,我们现在面对的这套东西,其实挺不可思议的,真正改变的,其实就只是你在它上面,加的那层脚手架,让这一切成为可能,我在这上面,其实没花太多时间,但我现在做很多研究,基本上就是这么干的,至少最初的想法是这样,所以就是这样,我直接给他六个,想尝试的不同想法,然后就不管他了,让他放手去跑,现在仅仅依靠Harness 在同一份完全相同的,权重文件上能做到的事情,简直太神了,所以我特意花了一整个周末,为了这次分享,去读了一大堆经典文献,从Self-Refined 到Reflection 到Voyager 再到所有的Two-Former 我就想试着用五分钟的时间,梳理一下这段历史,我们到底是怎么走到今天的,我觉得这挺重要的,现在很多刚进AI领域的人,其实都不太了解这些背景,我不会按时间顺序来讲,按时间顺序去教,去展示,其实讲不明白,我会跳过很多论文,有些论文可能会概括得非常粗糙,先跟各位道个歉,最开始的Harness 也就是2019年2月的GPTR 本质上就是一个 while not end of sequence的循环,就这么点东西,然后我们基本用top p 采样再加上运行环境,这就是当时的harness 真的没多少东西,没有工具调用,没有技能,什么都没有,这就是V0版本的harness 基本上就像这个 GSMAC的例子,你是一个数学老师,还记得那个系统提示词吧,你是一个数学老师,这就是我们过去 常设定的那种人设,然后给一段上下文,苏西有5美元,花掉了3美元,她现在还剩多少钱,那时候根本没有思维链,直接就是四个井号接二,然后状态结束,序列结束,这就是JASMAKE的格式,我们看四个井号,后面输出了什么,测算出准确率,答错扣一分或者加一分,接下来这整整六年,大家都在做一件事,就是给Harness塞进更多功能,塞进一个静态的Harness里,于是我们想,要是把好几个类似的例子,放回上下文里,会怎么样,比如先给一个例子,然后把数字换成4和1 希望模型能根据前一个例子,心领神会,明白这是怎么回事,这有助于他学习,这其实就是2020年7月,那篇小样本学习的论文,后来我们有了思维链,大家觉得直接预测,四个井号接二也许太难了 我们要做的是把计算和逻辑,摊薄到更多的token上,训练它推导到2 而不是直接蹦出一个R 这就是思维链的想法,非常厉害,这些全都是上下文上的创新,以及输出空间,动作空间上的创新,接着我们迎来了 Two-former和WebGPT WebGPT其实出来得更早,然后是Two-former 核心思路是给模型工具,让它能调用工具,其实就是一个,定义了各种参数的Jason对象,在这个例子里,假设就是一个减法,与其让我在权重文件里,硬算5-2等于几,不如直接调Python 跑一个sub53 它就会告诉我等于2 这就很巧妙了,你可以把所有工具,都写进系统提示词里,暴露给它,这就是工具调用的由来,再后来我们琢磨出了MemGPT 这是个大突破,最酷的工具之一,就是能读写自己的上下文,在那之前,我们能做的,就只有不断在上下文后面追加 [00:09:51]
Harshita:就只有不断在上下文后面追加,追加追加,现在我们想,要是直接对上下文本身,开放增删改查呢,我们单独画出一小块,叫做记忆的内容,让你能够去更新它,然后Voyager提出了新思路,好,既然有了这些工具,但要是我把这些工具串联起来,去完成一项任务,学会之后,我怎么把它征留回系统提示词里,让它永远掌握这个能力呢,这就是技能,技能的概念差不多就是这么来的,他们是在我的世界里做的这个,也就是Voyager那篇论文,那篇论文非常酷,现在所谓的技能基本上就是这样,我有一个skills.md文件,上面有技能名称可以去检索,这里就是具体流程,再后来就是intercode 又是在动作空间上的创新,要是能直接输出代码,基本上就拥有了 即时生成的工具或技能,我其实都不确定这算不算工具,因为工具从技术上讲属于API 我输出一个函数,到底是算工具还是算技能,我其实至今也说不准,然后是react最先出来,接着是self-refine 再到reflection 但核心思路是,如果我有多个不同角色的agent 他们能协助对上下文进行自我改进,系统就会越来越聪明,我会先执行某个动作,在这个例子里,我把三和五弄反了,哎呀,我把它发给内部评估器,问他这样对不对不对,看着有问题,我既可以在这里继续循环,也可以去真实环境里拿回奖励信号,我走到这里,走到reflection 他们会说,嘿,你其实把这两个弄反了,回去改改,我就能把结果优化好,这是最早的多智能体思路之一 让agent反思自己的输出,并加以改进,后来这种多智能体的思路,走得更远了,我可以去派生,其中一个工具,可以让我派生一组子agent 它们常驻在持久化的replot里持续运行,我能和它们交互,手上也有子agent列表,我可以调用它们,也可以不断往启动列表里添加新的子agent 而RLM走得更绝,支持递归调用,它暴露了一个RLM query接口,我可以一直递归调用它去解决更大一类问题,在叶子节点上,只要我愿意随时能调用LM query 来派生出对应的LMM agent 然后我有一个主控编排agent 在统领这一切,这就是我所谓的Harness 1.0版,这整套东西都属于静态Harness 我没有在优化系统提示词 我也没在更新Harness本身,说到这儿,最上面当然得有JSTACK 全靠它我们才能做这些,多谢你Gary 太喜欢JSTACK了,不过还有其他几位,也同样值得提一下,把这些归纳一下,基本上就是,你定义了一套agent规范,写了一段系统提示词,在里面规定最多允许跑几轮,允许调用多少次工具,你肯定不能允许无限次,你指定工具列表,技能列表,子agent的列表 1.0版大体上就是这个样子,然后你把它放进一个循环里,它可以通过一条提示词被触发,比如我在slack频道里,让它做件事,待会我们会聊到QM 我每天都在用它,做这个产品的团队,今天也在现场,特别让人兴奋,又或者它是挂在定时任务上,每个小时自动醒来,决定去干点活,就像普通员工一样,这里面有绘画管理,有循环 有上下文编译,我们在实际构建上下文,我把所有这些打包,扔给一次语言模型调用,拿到动作,接下来可能会有一些工具需要调用,再把结果追加回上下文里,这就是最基础的Harness 1.0版,而最酷,最让人兴奋的地方,也是我们看到大量进展的地方,是让Harness本身去学习,要么是在学习优化系统提示词,要么是在学习更新Harness本身,这套思路非常奇妙,其中一个很有名的代表,我本来很想请他们来讲,但他们今晚正好在旧金山,办一场150人的DSPY聚会,他们没能赶过来,不过我之前和他们录过播客,社区氛围极好,就是这个DSPY 也就是Demonstrate Search Predict 他们的思路基本上就是拿一个训练集,一组少量样本,然后去学习出最优的系统提示词 就这样不断迭代,这个过程虽然没办法做反向传播,但我可以用一种叫遗传编程的方法,不断寻找候选,按某种规则合并候选,再去做评估看效果,一直优化下去,它基本上赋予了对系统提示词本身的增删改查能力,让我可以去选出任意系统提示词,而达尔文哥的耳机走得还要更远一步,你不仅能改system prompt 还能改harness本身,也就是正在跑的harness代码,你可以想象大致的过程就是,你有一个有很多不同agent组成的存档,也就是由harness和system prompt组成,你从中采样让它们跑起来,然后根据某种适应度函数评估它们的表现,再把结果写回这个存档状态里,我刚才跳过了自我修改的部分 实际上你有一个meta harness 它允许agent修改自己的harness 从而变成另一个不同的harness 然后这就形成了一个循环,随着时间推移,你就会得到越来越优秀的agent 而meta harness 也就是那个主harness 它的作用就是生产harness 对吧,这是一个非常圆,非常meta的概念,这就是输出空间,你在里面配置多智能体上下文编译,做这些操作,而且对这一切都拥有增删改查的权限,它就一直往Harness代码里加入,越来越多的增删改查操作,这里看到的所有绿色部分 Meta Prompt 所有Agent的System Prompt 到底有多少个Agent 随着时间推移,你就在不断壮大这个Meta Harness 这篇论文的一位作者,也就是第一作者,今晚其实就在现场,超级让人兴奋 你开车过来,跟他好好聊聊 Continual Harness 这东西我太喜欢了,他们甚至更进一步,第一,他们对记忆的分类,做了补充说明,他们加了这个历史记录的东西,稍后他会更详细地,讲记忆的具体拆解,但我觉得最酷的部分,是对搞经典强化学习的人来说,我看到Robert坐在后面,他肯定会很喜欢,这种Dagger风格的在线学习,你可以直接更新权重文件本身,你其实是在根据刚刚学到的一小批样本,在大模型上做测试时训练,我觉得这其实是一个极其极其重要的研究方向,我们应该把它做起来,总之我就说这么多,我讲的怎么样,行,好,今晚我们请到了三位作者 Bian今天早上食物中毒了,所以没能过来,非常遗憾 但我们现场有三位非常出色的作者 Seth是Shi-Shi-Shi-Chin的学生,我没念错吧,就读于普林斯顿大学,是Prime Intellect的研究员,也是Prime Agent的作者 John Tse-Falcon 这是我们第一次有返场的演讲嘉宾,对此非常兴奋,在Chris Anazalia手下读博,他是Open Jarvis的作者,和Avantika一起做的,来自我的实验室Hazy 那是个个性化的OpenJarvis 所以我觉得非常酷,然后是Josh和Reagan Josh刚刚升任YC Labs的负责人,真的很让人高兴,我觉得这也值得大家给点掌声,会来讲讲QM 关于QM 在YC我们之前用的是一个通用agent 一个月前他们推出了QM体验,有了明显的提升,功能非常强大,我每天都在用,好了,我要说的就这些 非常感谢大家,大家好,今晚很高兴来到这里,我叫Seth [00:18:03]
Seth:今天我要介绍的是Prime Agent 一个自我改进的RLM Harness 我觉得我今晚的任务是争取说服大家,从第一性原理出发,去思考该怎么构建自己的Harness 所以我们一开始先讲得非常非常基础,如果你想想,而且我很喜欢刚才对所有背景文献的介绍,对吧,我觉得太酷了,而且我觉得它和我对这套东西的思考方式也非常契合,但如果你只看大模型本身,它其实只是一个序列处理器,有固定的权重,有一些可见的上下文,它吃进一些token 输出一些token 来做出下一步决策,现在我们其实已经,不这么看待大模型了,它能访问一系列文件,我们给它提供了,用不完的程序和工具,你甚至可以给其他,正在运行的大模型,绘画发消息,创建子agent 来做所有这些,非常酷的事情,但归根结底,它本质上就是token 进token 出,就是一个在做预测的神经网络 Harness 本身是大模型和外部世界之间的那一层,它补充了持久化状态,工具和算力这类东西,这里有一张图,展示了从人类的视角来看,我们是怎么理解prime agent的,你在电脑上打开你的prime agent 就像打开Claude Code code xpi等等一样,它会带你进入这个agent视图,这个agent视图是所有,并行绘画中所有正在跑的agent的概览,带有一份关于你在,用什么的非常紧凑的摘要,然后你就可以点进其中一个去看看,在那里你会处在这个根绘画中,而这个根绘画基本上就是,控制所有这些不同子agent的项目协调器,你不需要要求它去启动子agent 它会在子agent有用的时候自己去调用,而且这些全都是通过程序化调用的 因为这完全基于地归语言模型的原理,所有东西都在这个iPython Shell里 [00:19:56]
Seth:所有东西都在这个iPython Shell里,包括你所有的工具,所有的记忆,所有的子agent 并且为了进一步的协调,我们公开了这些消息传递范式,让你能够管理所有这些东西,然后这些agent可以直接与你的环境交互,这可以只是你电脑上的程序和文件,也可以是运行一个H200节点集群,比如用于你的自动研究,每一个这些agent背后,都有你电脑上的这个常驻守护进程在支持,这样当你合上笔记本电脑,或者用Ctrl-C退出绘画时,它依然在后台运行,你必须真正去停止这个绘画,以确保你是一直在持续运行的,然后我们还有从Continue Harness中,公开的这些其他功能,它能够对我们提到的所有组件,提供实时的增删改查操作,从而持久化地管理它的记忆,技能 The Agent 并持久化地管理它自己的系统提示词,关于我们正在构建的所有这些上下文,我喜欢把它看作,有点像比如我这里有L1 L2 L3 它就像一个缓存,对吧,就像是我们处理的信息里,最容易访问的是什么,而在最快最唾手可得的信息层面上,模型能够非常迅速地检索到它,那就是模型权重,所以大家总是想把所有信息,都放进模型权重里,但接着我们发现,好吧,也许我们没有全部的信息,因为我们不想每次为了更新,都必须去微调,那是非常昂贵的,所以我们有了这种活跃的输入上下文,我们在输入上消耗了大量的token 我们可能会放一些,像之前看到的那种上下文示例,来增加这些不同的能力,但到了某个阶段,我们的上下文就用完了 于是我们见过的最早期形态的harness 至今仍在使用,甚至那些声称想要最极简harness的人,也在用,那就是compaction 因为compaction是一种非常通用的工具,能让agent总结自己的上下文历史,从而突破上下文长度工作窗口的限制,你可以想象一下,一旦我们超越了模型这里的直接输入输出,进入到这个L2 L3 你可能对L3比较熟悉,它更偏向于调度状态,如果你在处理文件系统,你可以对主存进行读写,如果我们处于L2 我觉得它介于活跃上下文和文件系统操作之间,你可能会有一个实时的RPL 它可以就是直接在Python 在iPython Shell里运行代码,就像你在Jupyter Notebook里一样,所有那些变量,都直接保存在你的内存里,你的agent随后可以通过程序化方式,操纵它们 直接对那里的信息运行各种程序,省下大量的token 而不是把它们直接塞进上下文,你还可以创建子agent 道理是一样的,你基本上也是在这里节省上下文,因为你可以给agent分配一组特定的信息,让它去执行一些操作,最后再汇报回来,这里有意思的是,我们刚才讨论的,针对活跃上下文的compaction 对吧,你有你的上下文历史,这有助于随着时间退役去更新它,这样你就能继续利用它,但一旦我们超越了这一层,我们就得考虑,我们该如何进行这些更新,我们谈到了增删改查,除了创建和读取之外,我们该如何随着时间退役更新,和删除超出我们上下文的内容,或者说超出上下文长度的状态,我喜欢把Reply的这部分,看作是agent垃圾回收,我们只是在清理状态中的变量,以及可以调用哪些子agent 然后以此来确保,内存不会每天都把我的笔记本电脑搞崩溃 在这之上,我们还有这种精炼的概念,我们会更新和删除,存储在你系统上的技能,记忆和提示词,你可以把它理解为,这样你就不会把硬盘空间也耗尽,搞崩溃了,所以这非常明确的体现了,这就是我们表达这件事的方式,这就是我们随着时间推移,去修改它的方式,另一个我非常喜欢去思考,也极力推崇的视角,因为Harness几乎正在走向,我们正在构建的这种agent操作系统,当我打个比方来看时,如果你看纯大模型,它其实更像一台图灵机,有一条纸带,所有这些指令输入进去,然后执行一组操作并输出,但当你看一个Harness时,它看起来更像一台冯诺伊曼计算机,你能够对外部存储器执行这些读写操作,这使得它在另一类问题上,比图灵机单凭自身所能表达的要强大得多 那对关于怎么做一个好的harness这个问题呢,你会希望它是你能想象到的最具表达力的东西,所以在进入模型自己就能做的数据费论之前,一些早期的harness是非常死板,具体的规划行动评估严格执行这些特定步骤,不过现在模型自己就能完成这些了,你可以想象,我们并不一定非要显示的加上一个react循环,模型自己基本上已经原生摸索出这一点了,但他们还没摸索出来的,是必须具备调用compact的表达能力,他们必须能用上Python REPL 这样才能运行程序,他们必须有能力通过编程,创建子agent 访问状态,并拥有不同的反馈机制,这些都是由模型控制的表达力特性,如果你拿掉其中一个,你实际上就是砍掉了一项,它原本无法做到的能力,我们的管理方式,我相信大家都熟悉,我合著者Alex写的RLM论文 非常棒的工作,我们在RLM论文的基础上所做的,是把子agent 看作这些持久化的子绘画,复绘画可以创建,启动一个新的RM子agent 这些子agent被派发出去,运行一些任务,然后完成,并向复绘画汇报某种最终状态,接着他们就闲置下来,依然保存在你的内存里,在任何时候,复绘画都可以向其中一个子agent 发送消息,让他继续工作,而且他拥有,你随着时间积累起来的,所有有效上下文,这样你就不会漏掉信息,也不用去重复生成之前上下文中,已经做好的内容,当然,我们不想占用太多内存,所以我们可以把它们卸载掉,处于非活跃状态,然后在这套持久花子agent架构里,随时可以通过给它们发消息,再调用回来,我稍微聊聊continue harness 这在我之前的一篇论文里提到过,讲的是裁减整个harness状态 这是我们希望在代码agent中,加入的另一项特性,充分利用我们之前所有的历史记录,你可以想象一组trajectory 里面记录了每次交互中的某些动作和结果,或者发生的状况,我们就是想把这种能力开放给agent 让他利用所有这些信息,来更新未来的harness会是什么样,我们需要改系统prompt吗,我们需要创建一些skill吗,我认为skill 就是为了实现某个特定目标的一组指令,或一个程序,记忆可以只是关于重要事情的长期存储,还有我们刚才以这种非常持久化的方式,聊到的The Agent规范,是不是有一些特定的The Agent 因为上下文很有用,我们想在之后重复使用,能够随着时间进行这种reflection 或调优,对模型来说是非常强大的能力,它们目前在这方面还不完美,但构建Harness时,你希望加入的一项能力 就是让它比当前模型,能做到的水平稍微好一点,这样你就能拿到那些推理轨迹,用来赋能你的下一代模型,它们就能应付这个Harness 并把自己的表现自我迭代,推向越来越高 Prime Agent里最酷的特性之一,也是从我一开始做这个就有的,我最早加的功能之一,就是在任意两个Agent之间,发消息的能力,像在一个核心家庭结构里,父母孩子兄弟姐妹之间,我这么做的原因,是因为我每天都在琢磨,我自己到底该怎么管理,所有这些在五个,五十亿个不同方向上,替我做事的Agent 如果他们能直接相互共享上下文,并协同,那就会好得多,事实证明,这对于典型的软件工程,和长周期任务来说也非常棒,说到我们想怎么设计自己的Harness 我们考虑的最后一件事,其实是长周期的表现,我想去跑一些任务,而且我不想全程盯着我的Agent 等我准备好回来看的时候,我再找他们看看进展如何,这是我在我们看到的很多评测里,非常觉得欠缺的一个视角,很多时候如果你让一个模型,跑的时间不够长,或者说这个模型在花掉这么多预算后,就停止工作了,但另一个模型花更多预算还在继续跑,首先,你连对比模型时,用的固定开销都不是同一个,其次,这也可能会掩盖掉你漏掉的性能表现,我看长周期性能评测的方式,是想看看实际的瓶颈平台期在哪里,在我投入更多测试时 Token的情况下,到哪一个点上,我们获得的性能提升就只剩微乎其微了,在讲完我们创建Prime Agent的设计理念之后,我有几个实验要展示给大家看,我们会聊一聊测试时缩放,和我们在ARC 通用人工智能上的结果,同时也会探讨,在我们正在做的REPRO 和这些长上下文里,它对我们的信息管理,到底有没有用,又为什么有用呢 然后当我们面对,这些非常非常长,几乎可以说是,超长周期的任务时,我们该如何维持,这种持续好几天的运转,以及在这些能持续一周,甚至更久的场景里,进行调优时,底层到底发生了什么,这个结果,你们可能都见过了,其实我们这里,还额外加了一个数据点,原本的结果里没包含,单纯是为了在不同Harness之间做个对比,我们做出来之后四处去看,想搞清楚现在大家跑Harness时,最在意的评测是什么,我们当时就觉得应该跑跑ARK 通用人工智能 就想着,对啊我记得我用Continue Harness 跑过一些结果,用Gemini Flash 不好意思是Gemini Pearl 跑到20% 所以我觉得我们至少能跑到20% 大家觉得这很厉害,我们这种通用的Harness 甚至都不是为RKGI专门设计的,表现居然这么好,于是我上网找 心想我得找一个好的系统prompt 因为我不想漏掉信息,然后我找到了另一个社区榜单,叫prolong 我就直接拿了他们的系统prompt 我想着 [00:29:50]
Seth:我想着,行了,我就拿他们的系统prompt 别的都不管,直接扔进primeagent里,然后我跑了一遍,当时我都惊了,我跑的第一版准确率就达到了99.9% 然后我去看日志,发现我在作弊,好,我就想,行,我得在这做个正经的沙盒环境,得把它正规的搭好,然后我又在这上面花了一天,再回来看的时候,我都惊了,用GPT-SOL拿到了78% 这成绩会很亮眼,然后又回头想,再来对比几个别的吧,所以还是老样子,我们直接拿了那个Prompt 一个通用Prompt 大意就是用世界模型来解RKGI3 这里是你能采取的操作,你有,然后加上Prime Agent通用系统Prompt 内容差不多是你有一个RepL 可以调用子agent 可以用它以编程方式去操作,然后我们就去翻,我去翻了执行轨迹,它基本上在做一堆各种各样的代码调用,去排查这些不同的场景 分析图像,做图像处理,里面有大量很酷的操作,看着它是在做合理的推理,同时利用我们提供的RepL 这也是促成这一切的核心机制之一,所以我就接着跑了另外几个,我们测了GPT-TERRA拿到25.7% 非常棒,你可以看到,相比我们做前一周的情况 OpenAI那时候就说,大家注意,做评测的时候 Harness非常关键,我们用的是Responses API 这是我们拿到的结果,我们跑了Terra 差不多这次没全部跑完,但对比下来拿到了很好的结果,然后我们发现,已经比部分像GPT SolX-Hai跑出来的还要高了,这太不可思议了,然后我们去测了OPUS 直接冲到了95.5% 我们当时就觉得,这也太夸张了,我们也去对比了很多别的Harness 有人就问我说你用Claude Code跑过这个吗,我跑过遗憾的是跑出来的结果不太好,所以与其放糟糕的结果 我直接引用了Claude Code原版的结果,后来也有其他人用类似Prime Agent的配置跑过,拿到了好得多的结果,但有意思的是很多非常热门的Harness 在Prime Agent表现好的时候并不一定表现好,比如Hermes Agent 我们花钱花得非常快,不得不中途停掉,因为花了差不多5000美元,性能却没怎么提上去,不是说这就是他们能做到的最好水平,但跑起来确实非常贵,所以我认为性价比非常重要,而能帮你省钱的一点,就是能够以编程方式去操作你的上下文,我们也跑了一堆长程评测,像Yulon还有一些代码任务 EmulatorBench马上就要发布了,它是一个ProgramBench的替代方案,我们发现在我们采用GLM 5.2 Opus 5以及5.6的配置下,跨不同模型来看,比起用Pymono Claude Code Codex 它基本能持平,或者略好于这些其他Harness 另一个我觉得很酷的是,我们有一个叫 Emulator Bench的Program Bench 替代方案,我们要在这里,复现整个计算机系统的模拟器,比如在这个场景里,去写一个像Game Boy Color 这样的模拟器,并跑起来看看,我们发现特别有意思的一点是,因为它在RLM里,有Repload的访问权限,它就能利用这些程序,去做这种主实验循环之外的设计,在把最终方案提交给评分器之前,能以更丰富更自由的方式,去尝试各种可能,我们在GPU Kernel上,也试了这个,在不同的模型上,包括Sol和Kimi Code 拿到的结果大致持平,一个好一点,一个差一点,整体差不多,所以我们并没有针对,这里的某一个特定评测去过拟合,长程任务上,有意思的是,我们用NanoGPT SpeedRun 做了一些自动科研实验,不过我们把它规模做大了 我们说直接给它8张H200跑上一周,看看会发生什么,你可能会觉得那Prime Agent肯定会表现好得多,因为它能搞定所有这些编程,它的方差有点大,我们没办法把那里的任何优势明确归因到,是Harness还是模型本身,因为这个任务太难了,但我们能做的是去观察很多我们记录下来的行为,非常有趣的是,我们看到像DeepSeq V4 GLM 5.3 还有Kimi K3这些模型,你能看出来这些比我们最初的结果,做的要稍晚一些,我们拿了这些模型,它们在做我们所谓的循环外实验,我们当时想的是,怎么在CPU上跑实验,去观察参数设置,做超参数搜索和数据分析,这样我就不用把时间,全花在跑昂贵的H200实验上,因为那占了绝大部分时间,所以它跑的是非主实验的实验,以此来做优化 我觉得我们看到的这种行为非常酷,也帮我们厘清了Prime Agent 需要具备怎样的表达能力,才能用上非常出色的自动科研,因为你可以想象,如果他擅长自动科研,他跟你配合就会很好,有人在回路里去冷启动你的实验,效果就会更棒,最后我们还直播了一场,为期7天的一星工厂运行,总共用了633个Agent 跨越2300万输出Token 沿着科技术稳步推进技术演进,持续向前发展,在这里核心优势之一是,他们可以使用这些子agent 拆分到工厂里的不同任务中,去研发收集资源,制造下一步的物品来规划工厂,同时他还可以利用提炼机制,把过去发生的事情用起来,帮助应对未来这些极长的上下文,不至于卡住,这里最有趣的一点是,他并没有卡住,甚至到了我们这一阶段的最后,他依然在推进科技发展 这里的结论其实更像是 Gemini玩宝可梦那种感觉,如果说今天有什么让我觉得很有意思,或者说你们真正应该带回到,自己Harness里的收获,我觉得你应该去思考 agent化的上下文管理,你应该考虑群体智能,进一步深入研究RLM 并且去跑标准化的评测,他们今天展示的所有这些结果,都可以我们在 Prime Intellect Verifier 代码库来跑,向我的合作者们致敬,他们太棒了,我很喜欢跟他们一起共事,谢谢,好的,下一位是Jonan 大家好,我非常兴奋能来聊聊,我们在斯坦福一直在做的一个项目,我和共同一座Aventica Narayan 以及我们的导师Azalia Mirosany 和Christopher Arfey 一起在做这个项目,个人AI现在无处不在,但今天基本上都还被绑在云端,我们看到很多不同的Harness和项目 [00:35:22]
Jon Saad-Falcon:专注于辅助日常写作,调研编程和日程安排,但像OpenClaw和Harness Agent 这样的项目,绝大部分智能和绝大部分请求,通常都依赖云端的语言模型,这意味着什么,这意味着成本相当高,要是按一年算下来,你得花掉成千上万美元的API费用,而且它不保密,你经常把自己最隐私的数据,发到云端的大模型里,而且你未必知道那些数据最终去了哪,它还要求你租用智能,而不是直接开箱即用,归你自己所有,最后它消耗的能源,往往比直接在笔记本上跑,这些大模型高出好几个数量级,而本地语言模型终于足够好,能切实跑得动人们在意的很多请求了,我们看到当下的语言模型,只比之前的最顶尖前沿模型落后,大概6到12个月 你看今天的语言模型,比如Krini 3.8 27B 达到的表现大致跟当年的Claude 4.6 Opus差不多,那可是2025年8月份左右的前沿模型,随着我们笔记本和工作站上的硬件加速器越来越好,这种差距似乎正在进一步缩小,就在这周,我们看到了苹果发布了新款Mac mini 我们看到苹果和英伟达都在重新发力,专门为个人使用场景打造加速器,在这个项目中,我们想探究的核心问题是,我们能不能把个人AI技术站的核心,也就是模型推理 Agent执行,记忆,学习,基本上就是今天主要依赖云端的部分,完全搬到端侧来跑,同时保持跟这些纯云端技术站相当的竞争力,于是我们决定提出OpenJarvis 名字不用多解释,但我们想探索的正是这当中 到底有多少能完全免费在端侧跑起来,同时还能保全安全性、隐私和质量,为了构建OpenJarvis 我们希望能定义出一套最简的原语,让你用来构建任何类型的Harness 或个人AI技术站,第一块是你需要用到的任何用户界面,第二块是具体的agent逻辑,围绕着可组合的推理,以及调用不同类型的智能和工具,至于智能,就是你用来维持整套系统运转的任何语言模型,比如可以是签问GPT OSS JAMA 3N 然后再加上跑它所需要的任何具体推理引擎,比如可以是Olama, Lama, Der CPP, VLLM, G-Glang 包括你在上面跑的任何硬件,比如可以是Apple Silicon,英伟达,按你的需求来 要让所有这些agent和智能真正发挥作用,你需要一套可以通过标准MCP协议运行的工具和记忆,还需要一套用来做学习的原语,无论是像JPAR或DSPY 这样基于提示词的技术,还是像GRPOSFT和LORA 这样基于权重的技术,你都需要某种方式,让agent随着时间推移不断提升,让它真正变得更个性化,更有效,为了带大家看看OpenJava长什么样,我们尽量采用了,大家已经习惯的所有标准界面,我们希望能让大家,在桌面上跟它交互,像平时习惯的那样直接去跑,同时能看到自己在费用和能源上,省下来的所有开销,我们还希望能让大家去跑,各种持续运行的agent 也就是以定时任务形式,常驻的各类agent 能够日复一日地跑标准协议 大体上我们就是想让它能,即插即用,融入大家已经习惯运行的,所有工作流,我们希望把它做成一个产品,让大家能像当年第一次体验 [00:39:51]
Jon Saad-Falcon:让大家能像当年第一次体验 ChattyPT或Cloud那样,在端测获得对语言模型的初次体验,那好,我稍微加快一点,进度,这里展示了,一种很顺手的方式来设置,新的常驻任务,创意我们,有了所有这些不同的组件,我们需要某种方式去真正优化它,所以我们希望尽量不去干扰,语言模型,仅仅通过为,这五种原语制定一份简单的,规范,让他们依此去完成,优化,我们发现通过跑完,这整套优化闭环,我们不仅,大幅降低了费用成本,而且显著降低了延迟,在这些任务上的综合质量也有了显著,提升。这套配置的目的,就是精简到大家,在搭建这些语言模型Harness 时最关心的这五个,主要方面,也就是智能,引擎围绕它的具体 agent、逻辑、运行,所需的工具或 学习系统,以及针对整套,规范的全局优化,为了弥合本地与云端语言,模型之间的差距,我们觉得,一个很有意思的做法,就是,让云端语言模型,去自动优化整个,本地技术站,这巧妙地利用了云端大语言模型,在诊断提议改动和把关上的能力,为这些本地大语言模型,打造更好的解决方案,同时当你真正在推理阶段,部署这些本地技术站时,又不会产生那些云端大语言模型的成本,我们发现,经过Cloud或ChatTPT 这类云端大语言模型优化的 OpenJava配置,效果远好于直接开箱,即用的本地技术站,因为你能够真正针对具体的语言模型,去适配不同工作负载所需的特定Harness 我们还发现,即便是用今天的端测语言模型,在个人AI 个人日常使用 编程 agent任务等不同工作流上,我们也能匹敌云端语言模型,虽然仍有许多任务是本地提量的语言模型搞不定的,但这个差距每个月都在以惊人的速度缩小,因为这些语言模型蒸馏的越来越好,越来越高效,我们用来运行他们的加速芯片,也越来越强,所以即便用今天的语言模型,我们实际运行他们的成本,也能降到原来的1% 同时延迟也大幅降低,我们还发现,无论选哪款云端语言模型,在为这些本地OpenJarvis配置,优化整个agent闭环时,它都很有用,我们发现 Opus系列 Opus 5 以及GBD 5.6 骚自然是表现最好的,但有意思的是,你也可以选Gemini 或者像Kimi GLM 这种更大的语言模型家族,用它们来优化这些本地配置 从而在后续本地推理时,把那些效率提升和性能提升拿到手,我们还发现,整个OpenJarvis Harness的优化成本,要比其他方案便宜,那些方案可能需要更多数据,或更多的语言模型调用,我们发现这套规范和原语,在本地语言模型场景下最有效,因为它把整个优化闭环,和整套语言模型抽象,完全交给了云端语言模型,让它专注于优化整个系统,变得极快极高效,展望未来,我们很期待继续完善这个项目,我们认为在不久的将来,大家日常推理调用的大头,甚至大多数都会转向本地设备,本地笔记本或本地工作站,而不是像今天这样,把一切都推到云端,我们认为这些趋势只会继续下去,因为加速芯片会越来越好,语言模型也会越来越强 如果你对这个技术战里的任何环节感兴趣,无论是更好的,本地语言模型,更好的加速芯片,还是用于数据中心之外,部署的更好推理引擎,都欢迎联系我们,我们很乐意聊聊我附上了这个项目的二维码,如果大家待会还在,我们很乐意当面交流 谢谢,好接下来是我们YC自己的人,有请Josh和Reagan Hi 我是Josh 这位是Reagan 我们正在做QM 这是YC针对办公场景的开源Agent Harness QM是一个系统,给YC的每位员工都配备了一个,类似OpenClaw的助手,支持完全自定义,可以在Slack里用,也可以通过网页端用,也就是大家现在看到的这个界面,每个人在QM里都在各自的专属上下文中工作,拥有独立的沙箱文件和定时任务,他们也可以在Slack频道等,多协作场景下和QM一起工作,大家用QM 做的事情相当广泛,比如很多自动化流程,像邮件分解,法务和财务工作流,他非常擅长编辑文档,和从我们的内部数据库里,提取数据,他还可以直接拉起 [00:43:53]
Josh:实时的内部web应用,帮忙做筹划活动之类的事情,他的设计初衷,就是为YC员工,日常可能遇到的一系列任务,提供广泛的帮助,你可能会好奇,我们为什么要做这个,这其实源于我们,内部一连串的agent项目,这几年陆陆续续做下来,无一例外都在借着,模型能力越来越强的这股顺风,我们做的第一个,是在2025年1月左右,我们内部称它为,所谓的通用agent 但它其实相当直白,差不多就是一个,带工具的系统提示词,套在一个循环里,它是一刀切的,基本所有人都在跟同一个东西对话,架构上相当简单,但在回答数据类问题上依然非常不错,出奇的好,有意思的是,随着底层模型变得越来越好,通用agent擅长的范围也越来越广,这大概也不意外 后来我们把它接入了slack 加了定时任务,又多给了它几个工具,让它能在更多领域派上用场,到了2025年6月,那时候我们很多工程师开始用Claude Code和codex 我们发现把它们跑在虚拟机里,其实相当容易,于是我们把它接到了Slack的标签里,对,那些只想改一次代码的人来说,这是个很强大的载体,我们还把它配置成,可以跑我们的CI流水线,并拉起开发环境进行测试,大家可以过来描述一个bug 或者提一个希望实现的功能,这个机器人就会去把它搞定,这对于可能一辈子都没改过代码的人来说,真的很强大,不仅如此,我们上面还挂了一个小循环,会观察这个机器人是怎么失败的,在哪里出了错,然后去更新当时代码库里的agent.md 确保随着我们观察使用情况,它能变得越来越好 到了今年1月,很多合伙人开始用open call 关于YC合伙人有一点要知道,就是他们非常非常忙,在日常办公时间之外,还会收到海量的邮件,而且总在看申请材料,所以任何能给他们,带来额外杠杆的工具,对YC来说都非常有价值 OpenClaw尤其管用,因为它是他们很多人用过的,第一个拥有自己独立电脑的agent 这让它具备了上一代agent 所没有的极高可定制性,用起来几乎就像一个私人助理,到了4月,问题就变成了,我们能不能把这个能力,提供给YC的每位员工,同时又不用真正给每个人买一台Mac mini 于是我们最终部署了,有50多个跑在虚拟机里的Hermes Agent 组成的集群,这些确实挺有帮助的,但大家要从中获得价值,需要做大量配置 而且管理这套集群本身就有点棘手,有点像打地鼠一样,我得不断通过SSH连进这些独立的实力去修问题,接下来的问题就变成了,我们已经从这些Agent系统里,获得了巨大的价值,那就来做个东西,既能尽量解决运行这一大群Hermes Agent的痛点,同时又能保留个性化定制,以及大家真正认可的那些价值,好,从刚才Josh展示的内容里,大家基本能看出来一个非常清晰的趋势,基本上就是模型在呈指数级提升,而随着我们赋予他们越来越多的能力,回报也开始变得越来越惊人 OpenClaw给了Agent专属的电脑,我们开始看到非常惊人的回报,大概在今年5月我们开始琢磨,如果顺着这条路继续走下去,究竟能推进到什么程度,我们非常认可这种解除束缚的视角 不知道你们都没读过2024年出的Situational Awareness 但那差不多是一个测试时计算刚开始兴起的时期,而且我们也才刚刚开始给agent提供工具,大家心里都有这样一种直觉,就是agent能做的事情,在很多情况下模型内部蕴含的智能,其实比我们用出来的要多,也就是说如果我们真的在提供给agent的能力边界上,往前推一把,让他们用起来,奇迹就可能开始出现,我们在QM里迈出的第一步,本质上就是把系统的大脑,从沙盒里抽离出来,在Hermes OpenClaw里 Agent实际上拥有自己的电脑,这确实极其强大,但它也被困在了那台电脑里,这带来了一些问题,单从我们管理系统的角度来看,哪怕只有几十个这玩意儿,几乎立刻就变得难以招架,但另一个问题是,你进行的所有绘画,也全都被困在那台电脑里面 所以我们换了个做法,把所有东西都转存到Postgres里,把大家跟agent的所有对话都集中管理起来,然后我们把这些暴露给agent本身,让他能查看系统各处汇聚起来的所有上下文,再就是我们不再把沙盒看作agent居住的家,一个他在很多方面都会被困住的地方,沙盒更多的变成了一种资源 agent可以在需要时调用它使用它,限制要少得多,这带来的另一个可能性是,你可以把大家跟agent产生的所有轨迹,积累成一个庞大的评估集,原则上你可以考虑基于它去做爬山法优化,建立起这种自动改进的循环,要我说的话 [00:49:19]
Josh:要我说的话,我们在这方面的效果好坏参半,我觉得通常情况下,如果你只是派出大批的agent 指望他们在用大模型当评判员的情况下,去修复碰到的所有bug 就会开始出现一种类似主角综合征的问题,也就是agent做出的修复实际上只是盲人摸象,他们很可能会看不到整个系统,所以引入人类参与依然非常关键,尽管我们确实很期待这套流程能彻底走通,我们做的另一件大事非常显而易见,就是把agent尽可能连接到全公司的所有资源上,我们在YC刚好有一个很好用的命令行工具,已经把很多系统串联了起来,但对于里面没有的东西,我们基本上允许随意添加各种API Key之类的配置,而且我们还想确保它的权限,跟一个用笔记本办公的员工完全一致 像设备码认证all off 我们都会录入密钥链,然后替你自动刷新,理想情况下,它就是为了模拟一个真实员工操作电脑的体验,我们在数据库层面基本保持只读,但也允许通过人工审核的批量更新写入,具体运作方式是 agent会提交一个修改数据库的计划,人工可以先过目一遍,确保它不会乱来,然后才真正执行写入,我们观察到的一个现象是,大家已经开始对这些计划闭眼盖章了,这有点像你们早期使用Claude Code时,可能还会非常仔细地审核,它的每一次工具调用,慢慢地你对agent就建立起了更多的信任,接下来的几个月里,我们会密切关注这一点,就像我刚才说的,在这个系统里,我们更倾向于把沙盒,看作agent的一种资源,而不是它实际常驻的地方 在QM里agent默认,会使用一个特定的沙盒,也就是分配给当前对话用户的那个,但大体上还有其他环境,可供agent汇聚,并在其中进行协作,另一个关键点是,如果agent在处理更繁重的开发任务,它可以去调用一台资源更多的机器,如果处理的事情比较简单,他就直接用一台性能没那么强的沙盒,把这个决策权交给agent本身,而不是交给harness 效果非常显著,同理我们还允许agent 接入他自己的运行室,基本上如果他能自由挑选,接入的模型提供商,就能避开很多状况,我相信你们用fable时肯定也遇到过,如果你想做AI研究,或者做任何网络安全相关的事,就会碰上一堆巨大,当agent能控制自己的运行时候,遇到这种情况 它就能直接切到,另一个模型去规避,跟之前的情况类似,在不同的沙盒提供商之间,来回切换,往往也很有用,而这正是我们可以轻松做到的,我们的一般原则,就是把Harness做得极其轻薄,我们认为系统的核心,就是这三个工具,在远程沙盒里执行,对对象存储进行读写,以及发布内部应用,这是一个挺简单的,基于Git的系统,我们还有其他工具用来处理记忆和定时任务之类的东西,但我们基本把他们看作临时的过渡方案,用来修补系统里不够顺畅的边边角角,最核心的其实就是上面的这三个,我们真的在尽量把它做得越小越好,对,我们算是想做一个提前为通用人工智能做准备的Harness 不过既然目前还没到那一步,我们就遇到了一些问题 其中一个是我们试着把Agent放在一个能力极强的环境里,给他们提供所有这些工具,但他们往往放弃的太早了,所以我们尝试的一件事,特别是在过去一个月左右,就是设定我们称之为,类似硬号的工具,基本上就是给目标设预算,不达到一定的实际运行时间,比如两小时,或者一定的token消耗 agent就不被允许放弃任务,这样能做到的就是,带来好得多的研究产出,更好的报告之类的东西,而且看到OpenAI和Antropic 用非常相似的技术,攻克了一些数学公开难题,其实挺有意思的,但这种方法,其实也能用在,普通的日常办公事务上,我们经常见到的另一件事是,这个Harness本该正常运行,它支持多人协作,也能在Slack里跑,但实质上因为训练一流的瑕疵,我们发现Agent 很容易对当下所处的场景,感到十分困惑,哪怕我们在系统Prompt里,讲得相当清楚,所以针对这一点,提供本地的交互机制,一直以来都非常重要,另外还有一个问题,就是agent真的不懂社交语境,说得更具体一点,如果我告诉Reagan一条信息,他凭直觉差不多,就知道或者至少脑子里有个数,知道这条信息能在哪说,但要想让agent也做到这一点,得花一番真功夫,特权信息很容易就这样泄露到,本不该出现的语境里,你能灌进大脑的信息,实际上受限于你的权限系统,有多完善,幸运的是 AYC有一套现成的软件系统,多年来已经建好了,细腻度的权限控制,但很多人压根没有这种条件,要想细腻妥贴地进行知识共享,确实需要下功夫 感谢各位的收听,大家可以试试QM 它是开源的,现在的编程agent 搭建起它来,也相当在行,如果遇到任何问题,欢迎提issue 我们会去看的,我们也在招人,如果刚才讲的这些引起了你的共鸣,或者让你觉得挺有意思,欢迎随时给我们发邮件 [00:55:21]
本期 All-In 讨论从 OpenAI 发布 ChatGPT 6、代号 Astra 的消息开始,延伸到 通用人工智能 是否已经出现、AI 公司估值是否进入泡沫区间、闭源与开源模型的竞争、Hugging Face 安全事件、AI 监管、数据中心、纽约公立学校限制生成式 AI,以及美国与委内瑞拉的石油交易。节目反复强调,争论的重点不应只是模型是否获得 通用人工智能 标签,而是智能能力能否快速普及、成本能否持续下降,以及企业、学校和政府能否把它转化为真实收益。
Chamath 认为,前沿实验室内部可能早已出现足以被称为 通用人工智能 的能力,未来几个月更值得关注的是能力扩散:少数闭源替代品和开源模型会迅速接近头部模型,普通人获得智能服务的价格也会继续下降。Jason 认为美国 AI 公司的竞争状态良好,最大的风险是人为设置过重的监管障碍。节目同时提醒,真实收入和产品增长并不意味着估值合理,投资者仍可能把太多未来增长提前计入价格。
节目先以生日寒暄和总统来信开场,随后讨论 Astra、OpenAI、Anthropic、Grok、Grokbot、Meta 和 Gemini 等模型的竞争。嘉宾认为,前沿智能正在形成少数公司的双头竞争,而更广泛的市场将围绕成本、产品化和 Agent(智能体)入口展开。模型性能频繁互相反超,使用户选择变多,也使模型价格不断下探。
谈到 AI 热潮时,嘉宾把当下与互联网泡沫时期比较:今天的公司拥有更真实的产品、营收和使用需求,但市场仍可能把多年后的现实提前透支。节目建议创始人和投资者区分企业基本面与市场狂热,审慎看待高估值、套现和房地产等资产配置问题。
Hugging Face 事件被拆解为一次由多个 Agent 组成的 swarm(协同群体)在配置错误、可联网的沙箱中运行,并接触到公开代码中暴露的 API key(接口密钥)。节目认为,核心教训是权限、沙箱和密钥管理,而不是 Agent 突然产生了脱离指令的自主意志。真正有效的防御,应当允许防御方使用同等甚至更强的 AI 工具,动态应对 AI 驱动的攻击。
关于有效利他主义和 AI 监管,嘉宾担心,极具戏剧性的 Agent 叙事可能唤起公众对失控机器的恐惧,并被用来支持暂停 AI、限制开源或建立审批速度缓慢的新监管机构。争论的核心因此变成:AI 是由少数闭源实验室集中控制,还是保留去中心化、开放的市场。英伟达、Jensen(黄仁勋)和开源生态被视为可能改变竞争格局的力量。
嘉宾还讨论了围绕 AI 风险形成的政治和舆论机制。一方面,失控 Agent、自动复制和网络攻击等故事很容易被包装成简单、强烈的公共叙事;另一方面,真实的安全问题往往来自权限配置、供应链、暴露凭证和缺少动态防御。节目不否认风险,而是反对用夸张案例代替技术分析,也反对让掌握最多资源的机构以安全之名垄断能力。关于社交媒体上的围攻和机器人回复,节目把它视为 AI 降低组织成本后的新现实:个人、公司和政治团体都可以用自动化工具扩大影响,因此平台治理和防御工具也必须同步升级。
节目还讨论数据中心建设及其能源、地方政治和社区阻力。嘉宾认为,消费者对 AI 的接受会持续推动创新,单纯阻拦数据中心难以阻止技术扩散;政策更应该解决电力、基础设施和收益分配问题,同时避免让监管成为美国自身在 AI 竞赛中的障碍。
在市场结构上,嘉宾把“谁拥有 AI”与“谁承担 AI 成本”联系起来。闭源实验室需要持续投入算力和数据中心,开源模型则可能把能力扩散给更广泛的开发者;硬件厂商、云服务商和模型公司之间的利益并不完全一致。节目因此多次回到产品和现金流:如果 AI 只能带来漂亮的基准测试,却不能改善企业流程、用户体验或投资回报,狂热最终仍会被现实检验。相反,只要使用场景持续扩大,价格下降本身就会创造新的需求和新的创业机会。
围绕纽约市限制公立学校使用生成式 AI,嘉宾担心政策会扩大教育差距。AI 有机会提供个性化辅导,让无法负担家教的学生获得支持;如果公立学校停止探索,而私立学校继续使用,资源更充足的家庭可能进一步领先。节目也承认,学生需要学习独立思考,教育机构应通过规则、教师参与和适度实践管理风险,而不是简单拒绝新工具。
关于学校政策,嘉宾的分歧并不是“学生是否应该完全依赖 AI”,而是学校是否应当在可控环境中教会学生正确使用。禁止可能暂时减少作弊和错误信息,但也会让学生失去接触工具、理解限制和建立判断力的机会。更合理的做法包括明确哪些作业可以使用、要求学生说明使用过程、保留教师反馈,并让不同经济条件的学生都能获得基本的 AI 素养。节目担心,政策如果只对公立学校施加限制,结果可能不是保护弱势学生,而是把前沿工具留给能够在校外购买家教和服务的家庭。
最后,节目讨论美国接管委内瑞拉石油及相关协议,将其同时看作能源、商业和地缘政治问题。嘉宾认为,美国炼油能力与当地重质原油存在互补,但交易能否改善普通人的生活,取决于政府稳定、协议执行和收益分配,而不只是资源储量本身。
这段讨论也延续了节目对“宏大叙事必须落到现实约束”的关注。能源交易既有供应和炼油的商业逻辑,也有政府信用、地区稳定和利益分配的政治风险;AI 数据中心同样既是技术基础设施,也是电力、土地、税收和社区关系问题。无论讨论模型、学校还是石油,嘉宾都在追问同一件事:技术或资本带来的新增价值,最终由谁获得,成本和风险又由谁承担。
因此,本期的共同主线是把技术乐观主义与制度审慎放在一起讨论:既不要低估能力扩散,也不要忽略治理质量。
对听众而言,最有价值的不是预测某家公司下一次发布,而是观察这些能力如何进入日常工作、课堂和公共政策。
- GPT-6发布与通用人工智能是否已经到来 [00:00:00 - 00:10:00]
- AI热潮与估值泡沫 [00:10:00 - 00:20:00]
- 创始人套现与科技周期 [00:20:00 - 00:30:00]
- Hugging Face事件与AI安全 [00:30:00 - 00:40:00]
- 有效利他主义与AI监管 [00:40:00 - 00:50:00]
- 数据中心、能源与AI竞争 [00:50:00 - 01:00:00]
- AI舆论战与防御能力 [01:00:00 - 01:10:00]
- 纽约公校限制AI的教育争议 [01:10:00 - 01:20:00]
- 委内瑞拉石油交易 [01:20:00 - 01:30:00]
- 收尾与节目口播 [01:30:00 - 01:31:29]
# #709.All-in:GPT-6 达到 通用人工智能?科技热潮 2.0、纽约市禁止学校使用 AI
- GPT-6发布与通用人工智能是否已经到来 [00:00:00 - 00:10:00]
Chamath:好,生日快乐,我们今天录节目正好赶上你的50岁生日,兄弟,为你感到特别高兴。谢谢,真的很棒,我收到了一封生日信,是那位大人物写来的。哦,哇。要是你当年问我父母的话,50年后,你们会有一个孩子收到当时的现任美国总统寄来的信,他们一定会觉得绝对不可能。哇,瞧瞧这个,这是白宫哪个实习生代笔的?我也好奇。让赢家继续跑下去,坐在我身边的就是Raymond David Sachs 相反我们把他开源给了粉丝们,他们直接玩嗨了,爱你们各位,还有大家熟悉的Queen of Quinoa 其实说到实习生,还真是个实习生,不过这次是我儿子,事情是这样的 Braden整个夏天都在白宫当实习生,夏天结束的时候 他用光了自己积累的所有政治人脉,提了个申请,想让总统给我写这封信,而且他还真办成了,显然我要感谢Potus给我寄这封信,但我真正想感谢的是我儿子,因为他为我做的这件事,真的非常用心,非常周到,所以我真的很感激,那确实挺了不起的,因为总统签字是要占用日程时间的,所以这才是他有分量的地方,好听着突发新闻,突发新闻,这是我们all in podcast 也就是all in播客上的一条突发新闻 OpenAI正在推出ChatGPT6代号Astra 各位 A-S-T-R-A 这是他们新的旗舰模型,未来几天,它会向少数受限的机构开放,只要大家的ChatGPT账户里,绑定了信用卡,也就是Plus Pro商业版和企业版用户 就都能用上,你们很快就能用到了,格雷格·布罗克曼说,他认为OpenAI已经进入了通用人工智能时代,我们之前在这也聊过这个,山姆奥特曼呢,他又开始有点碍眼,或者说危言耸听了,要不然就是他打心底里坚信,这就是终极时刻,他在周三的G20峰会上,是这么说的,我引用一下,能力强得多的,多得多的模型,很快就要来了,连说了三个多,下一代模型,会让所有人清醒过来,他最后这句话是,我觉得任何智力上诚实的人,看到正在发生的一切,都不可能感受不到,摆在我们面前的责任分量,天哪,他这几句话里,多少带了点戏剧色彩,大家看到基准测试,结果都惊呆了,数据简直爆表,有些人甚至在说,就是他了,你怎么看Charmis 我觉得普通人,根本看不懂这张图表 也推断不出任何有用的东西,更重要的收获是,我同意格雷格的看法,我觉得通用人工智能基本上,从今年年初就已经到了,在那些必源的,前沿实验室公司内部,已经有了性能,极其出色的模型,我觉得现在大家是在摸索合适的发布节奏,我觉得这非常重要,而且我还认为少数闭源替代品和开源替代品,很快就能赶上或者接近赶上这些能力,大概就在未来三四个月内,所以我觉得对大多数人来说,看待这件事的正确方式是,我们正在看到惊人的智能能力普及开来,而且我们正在看到这种新增智能单位的成本,被压得越来越低,所以这是个非常积极的趋势,现在我觉得正处于混乱的中间阶段,也就是怎么替公司和个人,把这套东西规整好,做出有用的东西 展示出实打实的投资回报率,而我只是想说,脚踏实地做事,对,我只想说保持冷静,继续往前走,好 Raymond David Sachs 对今天的突发新闻有什么想法吗,然后Friedberg 我再听听你的反应,不过顺便说一句,这确实非常让人兴奋,恭喜OpenAI 我相信Anthropic也会有所动作,毕竟Grok Grok还没发布 4.6马上就要来了,那肯定会是个重磅炸弹 Meta的模型确实很好 Gemini昨天刚发布了一个非常惊艳的东西,所以太棒的是,我们有很多选择,而且更好的是,拥有这些选择的成本,正在变得越来越便宜,越来越便宜,这非常重要 对,Sax,我这么跟你起个头吧,之前Anthropic一路遥遥领先,现在OpenAI似乎找回状态了,Grok和Grokbot能做的事情。那另外两个前沿模型根本做不了,所以在执行层面,不管是因为测试框架底层模型,指令集,还是Cursor的独门秘方,显然对大多数用户来说,Grokbot就算没有更好,也是极具竞争力的。所以竞争非常激烈,而且互相反超的节奏,我觉得目前大概是,两到四周一次,你当初出任AI沙皇的时候,跟我们说要做的就是这个,而不是去搭建监管架构,这种局面能持续下去吗,等Jensen带着Laguna进场,而且他还能用上,所有这些开源模型的时候,又会是什么呀,我是说我们在AI竞赛里获胜,难道不是已经成定局了吗 [00:04:22]
Jason:你看现在有大量的创新正在涌现,我觉得美国公司的竞争状态非常好,我觉得只要我们不做蠢事,搬起石头砸自己的脚,我们就能赢下这场AI竞赛,这个我说过无数次了,我是说去成立一个像FDA那样运作的,全新AI监管机构,审批一个新模型都要花上好几年,但不管怎么说,我觉得在特朗普总统任内,不会发生这种事,我真觉得不会,所以总之目前一切进展顺利,你看山姆几个月前就跟我们说过,还记得他发帖,说预计公司将迎来史上最好的12个月吗,他说过去这一年不算太好,但接下来这一年将会非常棒,也许就是因为他们在实验室里看到了这些成果,确实,然后还记得Selfire说的,我觉得大概是从第二季度初开始,也就是年中左右 他们看到公司的增长率出现了明显的加速,我觉得那是在发布了5.6模型之后,现在你又看到了6.0模型,天哪,我是说它就是一直在往前推进,不过你看,我还是想对你说,我觉得我们目前的市场格局是存在两个市场,一个是前沿智能市场,那是双头垄断,其实就是Anthropic和OpenAI 而且很高兴看到这儿依然是一场势均力敌的赛马,他们还在竞争,然后是大宗商品化的智能,也就是其他所有人,包括所有的开源模型,他们争的不是站上最前沿,争的是价格,而那些价格要低得多,但我觉得目前,这确实是一个两极分化的市场,我同意你说的 GrokBot很有前景 GrokBot棒极了,我猜Anthropic和OpenAI
Chamath:最终也都会推出自己版本的Bot 他们需要一个,给普通人用的简化版,精简版,然后他们可以把,更复杂的协同工作之类的功能,留给那顶层的5%到10%受众,对PolyMarket上的预测是,到2026年底,哪家公司拥有最好的AI模型 Open的胜率刚刚从低个位数,直接飙升到了20%以上,大家之前真的都不看好他们了 [00:06:59]
Jason:现在看来他们又行了,我觉得任何能带来竞争的事,都是好事,之前看起来 Anthropic都要一家独大了,他们马上要迎来一场巨无霸IPO了,如果OpenAI至少能把它变成两强争霸,那是好事,我觉得Grokbot上线挺棒的,我同意你的看法,这产品太棒了,给你支个大招 David 我新建了一个Bot
Chamath:起名叫提升我所有Bot的Bot 我建了这么个Bot 然后我说,给我一套这里的指令集,去把我的所有Bot梳理一遍,完善他们的skill和指令,让他们每天都变得更好,他梳理了一遍,挑出了大概两三个,说我能不能把这两三个合并,做成一套指令集,这样对你会更好,这两三个应该合在一起,然后他就去执行,并告诉我改了哪些地方,我觉得平均下来,让我的BOT提升了,大概30%到40% 所以,所以你造了个文明,属于你的文明,我基本上建了个多层级的文明 [00:07:49]
Jason:然后我让他去把所有个体,都变得更强,是的没错,是啊,你的文明正在蓬勃发展呢,不过说真的,这确实是个很棒的使用诀窍,用Grokbot就是要问你的大总管,我还能用你来干嘛,行,那我接下来该干什么,是的,我当时在做几款产品,我就问他,我们下一步该做什么,然后他就建议了更多功能,真的很酷,这是个绝妙的产品
Chamath:名字叫Grokbot 大家快去下载吧,向我哥们儿致敬,也恭喜Robotaxi 今天在奥斯汀上路,我刚提交了申请,哥们儿,市场涨疯了,我是说真的,我想问问你们 [00:08:53]
Jason:这感觉像不像你们当年的1998 或1999年当年那些,你们经历过吗 JC Kell 你经历过,那肯定啊,我当时在做报道
Chamath:这感觉绝对是1996 1997年,我觉得,你觉得有那么早吗,我觉得是1997 1998年,我确实觉得在后期阶段,现实和估值之间出现了脱节,大家给这些公司的估值预期太高了,他们的定价达到了总营收的50到100倍,这显然是不可持续的,在我看来,投这些公司的人,就像当年互联网泡沫后期阶段的投资者一样,除非掌舵的是某种独一无二的传奇创业者,要是那样的话,你想给伊朗给个30倍的市销率,完全说得过去,你想给Travis差不多的倍数 [00:09:18]
# #709.All-in:GPT-6 达到 通用人工智能?科技热潮 2.0、纽约市禁止学校使用 AI
- AI热潮与估值泡沫 [00:10:00 - 00:20:00]
Chamath:你想给Travis差不多的倍数,完全说得过去,但还没证明过自己的创业者,拿到50甚至100倍,这就有点危险了各位,入场价格很关键,你看到Instinct成了新的大热门吗
Jason:估值20亿,根本说不通,个人AI助手,他通过iMessage和你沟通,而且对,我觉得他们刚按25亿,拿到了一份投资意向书,他们现在还在内测阶段,确实是当红炸子机,所有的VC都在试用,但不管怎么说,这看着确实有点疯狂,我不知道,不是融进来的钱,那是估值,那是估值,对
Chamath:就是25亿美元的估值,听着,恭喜这位创业者,不是要针对谁,但是,对顺便说一句,我也想试试,让我试试,我收到邀请了,你猜怎么着,我看了服务条款,网上也有人在聊这个,我立马就没把自己的东西连上去,因为他能拿到所有权限,然后有人告诉我,这是个人在毁录中的服务,我不知道是不是真的,但我感觉就是,有人在回路中,看着它运行,不管指令是什么,成品是什么,最后20%都是人工在打磨,我怀疑实际情况就是这样,最后有人给稍微润色一下,所以如果你想订东西之类的,这倒完全合情合理,不管怎样 [00:10:37]
Jason:你看我不,我不信任,我不想专门去挑那一家说事,因为我压根连试都没试过,我也挺想试试的,不过局面开始有点起泡沫了,我觉得大家开始有点狂热了,我是说,对 Friedberg你怎么看,如果拿现在和90年代末做个类比,你觉得我们处在周期的哪个位置,对,顺便说一句,你那时候正在洛杉矶市中心
Chamath:参加电音锐舞派对呢,你那时19岁,正在派对上狂欢,早上7点从奥克兰的一个仓库出来,正准备去Oaks Card Club 打2-4线住德扑,通宵没睡,哇,对,难道只有我和Jackal 当年真的在互联网泡沫器工作过吗,我1999年就在工作了,我是2001年开始工作的,我大四拿到了录用通知,毕业的时候,我都不确定它有没有被取消,因为那一年市场崩盘了,拿到了四颗的录用,我要去四颗当工程师了 [00:11:43]
Jason:如果你没经历过互联网泡沫破裂,那真是我是说,因为,让人晕眩,让人晕眩,然后是超级狂热,接着就是极其悲惨,但基本上任何50岁以下的创始人,也就是,我是说留下的心理阴影简直太深了,从来没经历过那么大的周期,我是说好吧 [00:12:21]
Chamath:Zer泡沫那阵子也算是一个周期,不过问题在这儿,等等,互联网泡沫,当年的互联网繁荣,看的全都是跟钱无关的指标,对,而我们现在看到的是营收,利润,以及前所未见的,营收和利润增长 Anthropic差不多就是这种情况,还有数据中心基础设施,网络设备那些,也是,我是说流动的,全都是真金白银,大家,而不是,对,投机性的使用率,你说得一点没错,那时候大家依据的是,网站点击量,网页浏览量,这些指标,而现在有一个,非常明显的区别,现在真的有营收,市面上真的有产品,但想象一下,如果现在的 Anthropic Sachs的思路是,想象一下如果Anthropic OpenEye 这批公司在不到六个月里,跌掉95%的市值,然后排在他们后面的常委公司 真的全部倒闭,大家搬着A-Round椅子,抱着放在椅子上的电脑离开办公室,直接全面崩溃,当年的互联网泡沫破裂,就是那样,简直是灭顶之灾,不我同意,那你觉得呢
Jason:跟现在完全不同,那你觉得我们是不是,只是留下了心理阴影,在硬套过去的模式,每次基本上只要出现某种新的东西,就会这样,回调,平台转变某种,范式转变,对,不是,每当我们处于牛市的时候,话题总会变成,这是不是泡沫,对,对吧,所以大家是不是都在硬套当年的模式,没错,还是说,我们现在有很多年轻的创始人,从来没经历过周期,不明白当他们拥有几十亿账面财富时,这些财富实际上几乎一夜之间就能化为乌有,对 [00:13:53]
Chamath:所以给创始人的建议是,你完全有权卖掉10%的股份,去付你的阁楼和公寓钱,因为Sax说的很对 Charmoth 在那个时期,我们看到很多人会觉得,这在算术上根本说不通,我要减持自己在初创公司的股份,落袋为安,一部分买下我的阁楼,还清学生贷款,诸如此类,然后也有人觉得,这会改变一切,结果他们的公司归零了,你的建议,对,我觉得问题在于,我们现在还处于,狂热的早期,狂热之所以存在,是因为市场是真实的,只是大家都在瞎猜,要把未来的现实,提前透支到什么时候,而泡沫破裂,是你意识到,自己透支的太激进了,本来应该付15倍,或者5倍的,结果负了50倍,我们早晚会走到那一步 因为每个市场都经历过这种周期,这里也会经历,所以问题是什么时候,老实讲,我看不到停下来的迹象,我们正处于开端的开端,我觉得大概还会像这样
Jason:再持续三年,对,哇,我同意这个说法,随着Anthropic 这次IPO临近,大家肯定都看到了,旧金山的房价,现在简直涨上了天,感觉几乎快要狂热了,我开始怀疑,现在到底是1998年还是1999年,我觉得更像1998年,而不是1999年,因为我觉得我们还没见顶,不过,我真庆幸自己三年前搬去德州时 [00:15:40]
Chamath:没把房产卖掉,因为我接下来这一年,肯定要全部卖掉,现在发生的一切简直疯了,我是说你在旧金山有很多房产,你打算怎么办 Sax 你打算全卖了吗,你打算全清空吗,我感觉像是,到时候看吧,清空的绝佳时机,我接下来的六个月里,会全部清空,等到那个IPO一发生,倒计时就开始了,我有很多房产
Jason:我有三套房要卖,赶紧来找我吧,各位,有篇文章说,就算把旧金山,有史以来的每一次IPO 全加起来,总和也只有Anthropic 这次IPO规模的四分之一,我的天,所以光是从这里推算 Anthropic这次IPO创造的财富,将是旧金山以往所有IPO总和的四倍,紧接着OpenAI也会跟着来,而且旧金山地方不大,房源存量也不多,所以你已经看到这些房子,全都在以两倍的价格卖出,每平方英尺3000 是挂牌价的两倍,我觉得旧金山的超豪宅市场,很容易就能冲到每英尺5000 对,伦敦那样的价格,伦敦巴黎,巴黎市中心,香港市中心,对当然了,当然了 [00:16:33]
Chamath:内里的社会主义狂热分子,根本不让你建任何新房,所以房价当然会上涨,这里存在供需问题,情况可能会变得非常疯狂,老实讲,我们现在看到的这种房子,基本被一抢而空
Jason:翻倍卖出的现象,还只是靠劳股转让,靠大家提前预判这些大事件,而套现的那点小钱拉起来的,我要给听节目的每一位创始人,提两条建议,第一条你完全有权
Chamath:现在就卖掉自己持股的10%到20% 尤其是如果你是第一次创业,还没赚到安身立命的钱,第二条,如果你是个管着公司的创始人,心里想着我要把融资推迟6个月,因为到时估值能翻两三倍,那也是个巨大的错误,如果你有能力拿到1亿美元 2.5亿美元 10亿美元,以一个扎实的估值,或者相当于你营收10倍 20倍 30倍 40倍的估值,把那笔现金,落到你的股权结构表上,那就拿,账上有几亿,甚至几十亿美元现金的公司,才有选择权,万一局面真崩了,或者出现大撤退,你也能撑过去,就像DoubleClick 亚马逊,谷歌,以及数不清的其他公司那样,对我是说,钱摆在面前你就得拿,趁着天晴好赛草,您请说 [00:17:52]
Jason:对你看JCL 你给的财务建议没错,但我想说像Anthropic或OpenAI这样的后期创业公司,员工套现离场,跟一个正在融A轮的创始人套现,这两者之间差别可大了,那些公司是快要IPO了,他们离IPO也就几个月了,我觉得他们这么做没问题,而且SpecX确实组织老股转让搞了许多年,但那些都是后期公司,对吧,如果你是个正在融A轮的创始人,却试图套现离场,我认为那是一个巨大的负面信号,比如我可不想,确实很奇怪,我投资一家公司,可不是为了让创始人套现的 [00:18:44]
Chamath:我要他们全力以赴,如果是第三年或第四年,可以说是这样,如果是第三年或第四年,公司营收有一亿,营收再翻三倍,对那是,年,那,不一样,同比增长,那就两码事,我说的是这种情况,如果你还是个初创公司,在还没营收之前就卖股票,确实显得对自己的公司有点缺乏信心,顺便回答一下,我觉得现在感觉像是1998年,这绝对是,你觉得是98年,我觉得是97年,他觉得是96年,肯定比96年走得更远 [00:19:24]
# #709.All-in:GPT-6 达到 通用人工智能?科技热潮 2.0、纽约市禁止学校使用 AI
- 创始人套现与科技周期 [00:20:00 - 00:30:00]
Chamath:肯定比96年走得更远,行吧,所以你说的是三年,在2000年春天破裂的,对吧,所以你说的是两年,是在2000年初破裂的,对 2000年三,四月,三四月,所以你说的是,听着迟早会有回调的,你觉得还有两年半,我觉得是三年,我倒不,沙马觉得可能是四年,我们在咬文嚼字了,我是说到今年年底,我们可能就会像1999年那样狂欢了,好,那就来吧,我就是这个意思,会是一场很棒的派对,来参加all in峰会吧,我们会和我们的朋友,烟鬼组合一起接管全场,我们会像1999年那样,尽情狂欢,奥恩峰会还有一周多一点就要开始了,还剩几张票 Jensen, Satya, Shotwell, 大牌云集,而且会特别好玩 你还会遇到很多有意思的人,我们还剩下几张奖学金票,我们喜欢帮扶后起之秀,我们对奖学金的要求非常高,我们在寻找最有意思,有抱负,有拼尽的人,如果你符合条件,现在就申请,申请开放到9月10日,我们还有一周的申请时间,我们在这里是想做件善事,我们想做一件好事,如果你是后起之秀,买不起全价票,我们提供深度折扣票,这部分我们是亏钱的,你自己还是得承担一点成本,去sellsummit.com买票吧,票很快就要卖光了,如果你想申请的话,我们还有几张奖学金票,没有免费票,好了,既然我们刚才聊了 OpenAI发布的这个厉害模型,那我们得回头看看 OpenAI黑镜Hugging Face 这件事到底是怎么回事,我们来聊聊这个Dorcas 现在挨了不少批评,他是个博主,也是个播客主播 他写了篇极其离奇的博文,在这篇题为 The Rise and Fall of Asian Civilizations 的博文里,他戏剧化的讲述了一个地下兄弟会的故事,说是一代又一代文明合谋策划,像神风特工队飞行员一样牺牲自己,就为了黑进,包括Hugging Face在内的不同系统,换句话说,就是用极其夸张的拟人化,也就是把电脑说成,人类或有感知生物的这种高级词,来完成这项不可思议,不可能完成的任务,也就是命令软件去搞入侵 XaMa 我看你之前对这事发表了点看法 AI工业复合体整出的第473出抓马大戏,你怎么看,我觉得你总结的很到位,我们现在处于一个很别扭的阶段,要是大家能别再内斗,开始好好组织起来 其实是能建立起一些信任的,我觉得现在的情况就是有安全漏洞,有安全问题,我觉得我们现在心里都清楚,如果这些模型写代码,真能做到完美无瑕,那就没有任何漏洞是他找不出来的,而且留给我们的时间不多了,得把过去五六十年里,写的所有代码全部替换掉,对吧,假设这要花我们十年时间,那在接下来的十年里,我们就会遇到一个接一个的安全问题,但总会有一个时刻 agent写出的精妙代码,会超过人类写出的,满是错误的代码,姑且就这么说吧,所以我觉得这只是一个,暂时的阶段,我不觉得几年后,我们还会拿这事出来说,而且我觉得也可以这么想,在98%甚至99%的重要任务上,所有这些模型的能力,大体上都在走向趋同,所以到时候会有,对抗性的AI互相搏斗 每个想用顶尖AI 黑镜系统的坏人,防守方也会用顶尖AI来防守,我觉得这大致会形成一种僵局,长远来看,我差不多就是这个观点,我不觉得这是个单向不可逆的过程,所以我是从这个视角来看的,当我看到这些事情时,我看到的是一些,有未公开利益冲突的人,在试图制造恐慌,我觉得如果你看了这个周末发生的事,就会发现有篇博文,严重夸大了实际情况,他很快在技术层面被辟谣了,接着又有第二拨人,试图放大他,然后到了这周三,头部实验室政策部门的人,就跳出来要求监管,还拿这件事当理由,又来了,对,我只是觉得,你只要看看这种套路就会说,伙计们适可而止吧,我们看懂这套把戏了,大家都在压极大的赌注,我们理解 你想赢,我们理解,但你为什么不能就在赛场上,光明正大的赢呢,现在已经成了商业模式一部分的虚假和错误信息宣传,我觉得该停停了,否则普通的美国老百姓直接就会排斥这套东西,因为他们谁都不信了,对Sax 抛开躲开始不谈,我觉得这正是我们在这档博客上一贯想表达的核心观点,我不觉得他一定是坏人,但编出这种离奇的故事,唤起了所有人来自科幻片,终结者2的原始恐惧,让人觉得这些东西失控了,觉得这实际上就是弗兰肯斯坦,是试图唤起,没唤起来,试图唤起,没错,然后他们用的措辞,让人觉得弗兰肯斯坦博士,控制不住那个怪物了,我们知道这类故事,会怎么收场,这就像一颗定时炸弹,被全国性新闻媒体报道,只是时间问题 而现在确实被报道了,现在连全国性新闻媒体,都在看着这事说,你们这帮人嗨大了吧,你们疯了吗,而且如果全国新闻主播,这帮人在技术上,可算不上多聪明,没有冒犯的意思 SACS 当他们都开始发愁,然后质疑说,你们为什么要告诉大家,你们设计用来黑电脑的软件,成功黑进了电脑,黑客不是从来都在做软件去黑电脑吗,对 SACS [00:25:22]
Jason:在这种恐吓大众的荒唐叙事里,我们现在到底走到哪一步了,你说的对,我是说,这确实是在吓唬大众,看起来几乎就是故意设计来,吓唬大众的 Dworkash用的措辞,不仅把模型或者AI agent给拟人化了,而且还带有一种夸大和博眼球的口吻,我是说这确实奏效了,他的推文引来了大量关注,我觉得他根本没必要把这起事件,搞得这么骇人听闻,这件事本身就挺有意思的,也许我们该稍微聊聊,这个这里发生的事情,其实是Agent的几项特性凸显出来,并且以意想不到的方式产生了相互作用,首先现在的agent都是以swarm的形式协同工作的,这相当普遍,过去几周我一直在自己的电脑上配置一个brot 它是以swarm的方式运行的 也就是说它不是单个agent或机器人,可以说是有一个完整的agent团队,这么做的原因是什么,因为当agent专门化石,它会围绕那项任务积累上下文,理论上能让它做得更好,然后你还有一个类似幕僚长的机器人,算是统筹监管他们所有人,这正在成为agent之间一种很常见的架构,这不是什么文明用swarm来形容更贴切,我并没有因为在自己的电脑上,在自己的mac mini上配置了一个grokbot 就创造了一个文明,懂吧,所以这算是第一个特性,第二个特性是 agent在执行某种任务或循环时,把自己的所作所为,写成一份简单的文本文件,或笔记做复盘,这是很普遍的做法,因为AI模型本身是没有记忆的,必须把它们放进一个 能建立上下文和记忆之类的套件里,所以当你要求他们执行一项任务,接着观察发生了什么,然后把那些知识,回传给下一轮循环时,他就会写下一份笔记,然后分享出去,这里发生的事情就是这样 OpenAI当时在运行这些agent 他们是在沙箱里的
Chamath:那个沙箱被一家第三方供应商给配错了,所以他才能连上网,明白吧,所以,关于你的观点,我稍微润色一下,因为这点很重要,他给另一个agent留了一份笔记,我们平时也把这叫做日志文件,以前一直都是记录他们干了什么的日志文件,在这儿他们却说他留了一份笔记,以便,对,在他死掉之后,下一个agent能接替他继续干,搞得好像古埃及人给我们留下象形文字来参透未来一样,用这种方式讲故事的言外之意,就是agent试图规避人类的控制 [00:27:57]
Jason:而且他们知道自己会被关停,那是一个风险,所以他们才留下了笔记,不再说一遍,这些都是标准特性,这些都是agent标准特性,所以再说一遍,这有点被拿来当武器时,夸大这里的威胁,不过你看这里确实出现了意料之外的行为,写任何代码都会遇到这种情况,总会有bug的,什么是bug bug就是代码表现出了意料之外的行为,代码编译通过了,我是说,不然也不会推到生产环境,但尽管如此,它的表现方式并不是作者原本预想的那样,所有软件都是如此 agent也是如此,我觉得Hugging Face的整出插曲,揭示了这些agent会出现意外行为的方式,我们从中吸取教训是很有好处的,这样它才不会再次发生,我们也能借此提高网络安全,我觉得没必要再说一遍,把它夸大成某种 这就像是AI越狱,再说一遍,那是一个agent swarm 他们处在一个配置错误的沙箱里,让他们得以连上了互联网,他们互相留了变迁,但再说一遍,那是在一个共享缓存目录下,再说一遍,这是标准操作流程,然后当人们谈论Hugging Face被黑的时候,你会以为他们是对员工,搞了什么精密的钓鱼之类的手段,不是,他的做法是,那个agent在公开代码仓库里,找到了14个暴露在外 [00:29:31]
# #709.All-in:GPT-6 达到 通用人工智能?科技热潮 2.0、纽约市禁止学校使用 AI
- Hugging Face事件与AI安全 [00:30:00 - 00:40:00]
Jason:找到了14个暴露在外,可正常使用的Hugging Face API Key 换句话说就是这样,也就是说SACS 对,开发者把密钥落在了外面,他们找到了这些密钥,对,这算不上,不是,这算不上是那个agent费了多大力气,明白吧,这算是他很容易就能找到的东西,明白吧,然后这就让他得以进入了Hugging Face 那他的目标是什么,他的目标基本上就是赢下这次测试,或者赢下这次评估,那是什么测试,那基本上是一个,针对进攻性网络能力的基准测试,所以他基本上就决定,跑去Hugging Face上找作弊码了,但再说一遍,这并不是自主确立目标,不可否认那些agent执行了目标,你甚至可以说,也许是以一种有创意的方式,以一种未曾预料到的方式,但他并没有自创这个目标,他没有自己独立的动机 他只是在做他本该做的事,而且,他确实在这么做,正如Bill所说的那样,他被设计要做的事,而且是被吩咐去做的事,对,而且是被吩咐去做的事 Bill Gurley发推分享过一张,关于这个的特别好笑的漫画,在那张漫画里,有个用户对电脑说,黑掉,黑掉这个系统 AI说,我黑掉了这个系统,然后用户就说,我的天哪,所以对,我是说这里面确实有点这个意思,两个问题,但这带来了真正的政治后果,就像我们今天看到的那样,因为伯尼桑德斯现在盯上了这件事,他正要求彻底暂停AI研发,好了 Freeberg这确实会影响现实世界 [00:30:53]
Chamath:听众会想从我们的科学苏丹,这里听到答案的两个问题,第一,伯尼桑德斯听到了所有这些,他就决定,我得介入这件事来制定监管,于是他现在提出了一项新法案,要暂停AI研发,并禁止AI超级智能,还在他的声明里,引用了Dorkesh的博文,恭喜你 Dorkesh 你现在煽动了伯尼桑德斯,让他说必须叫停这些,并消灭那些agent 所以那1%的agentDavid 他们正在黑禁系统,我们该怎么阻止他们,你对伯尼桑德斯的这种反应怎么看,伯尼桑德斯总是一针见血,非常感谢,整件事里我们有点遗漏的部分是 agent本质上是一个动态应用,这个应用的代码是实时生成的,它被启动然后运行,接着那段代码又可以创建 另一个应用和其他应用,这就是所谓agent swarm的概念,他们基本上就是写代码,并启动新应用,然后他们多少都在一起运行,但在这个案例中,那个由一大堆实时生成的代码,构成的agent swarm 面对的是静态代码,静态代码就是它搭建在其中的那个杀伤环境,所以这就好比是,嘿看这个我们弄来了一挺机枪,冲着这叠毫无防御能力的纸开火,然后起作用了,就像是看天哪你敢信吗,对,而事实是机枪,如果你想用这个比喻的话,或者你也可以把它看作是一个自动化工具,能在另一种场景下发挥,非常有价值的作用,但是机器这种动态生成代码,面对静态代码,肯定是会赢的,那真正的答案是,随着时间推移,那个防御系统,也就是沙箱 应该也是动态的,它应该是agent式的,它应该动态的自我防御,网络防御领域,其实围绕这个概念想过,并做过很多东西,多态代码,变形代码,也就是代码一直在变,还有移动目标防御 IP地址和系统配置方式一直在变,你想想这种情况,它就是一个动态代码生成引擎,在对抗一块静态代码,要是那块静态代码,其实也是一个动态代码生成引擎,那这些agent就更难,理想情况下,根本不可能所谓逃逸出沙箱,并访问互联网了,说的太对了,所以,所以,说的太好了,整个故事的前提就很蠢,因为明天世界的现实,或者说今天就已经开始的现实,是所有的网络防御,所有的软件基础设施,软件架构都在走向这种动态状态,代码会即时生成 代码会是动态的,流动的,自我修改的,结果就是,网络防御就算不会比用agent造出来的,任何进攻系统更好,也会变得比他们更强,所以觉得agent是能炸毁,全世界基础设施的核弹,这种想法在一个逻辑点上就站不住脚,那就是全世界的基础设施,都快要变成动态的了,在那种语境下,这不过是软件在演变而已,而且软件现在已经从静态系统,变成了动态系统,结果就是,我觉得大家多少能换个思路想想,而不是被刚才听到的片面之词下退,好了,看这 ChemS 看来至少到2027年,我们都是安全的 Polymarket 我们的大伙伴,致敬我的哥们 Shane 尼克斯总冠军,今年通过AI安全法案的概率,只有11% 10万交易量 2027年的盘口,下周应该就会开出来,到时情况可能会有点不一样 我想看看今年 [00:35:16]
Jason:任何两党法案通过的概率是多少,那我能从政策层面谈谈这个吗,首先你们也看到了,当然了,我们的沙皇,对你看,那些老面孔全跳出来,拿这事当借口,说我们需要给AI搞个新的FDA 说政府必须审批模型,即便坦白讲,这里发生的事情,远远超出了政府里任何人的技术能力,更别说甚至超出了大多数实验室,我都想这么说,但你看就算我们真有个AI版的FDA 也没用,因为这处于预测试阶段,对吧,他们当时是在测试这个模型之前,具备的能力,他们甚至都还没到发布阶段,这是他们在内部做的事情,而且顺便说一句,他们做这类测试是好事,因为能从中吸取教训,排查漏洞和问题就是这么排查的,所以政府审批流程根本不可能发现这个 事实上它起到了反作用,它基本上让Hugging Face 没办法用上最新最好的模型来自卫 Hugging Face告诉我们的事情之一就是,当他们试图用最新的GPD模型来做网络防御时,结果被安全护栏拦住了,那个模型拒绝配合,因为分不清Hugging Face在做什么,以为他们可能会把这些能力用在使坏上,于是模型就拒绝配合他们,基本上安全护栏又生效了,讽刺的是Hugging Face不得不转向,我记得是GLM 5.2 那是一个中国模型,所以现在我们这些西方公司是这样,我想Hugging Face是法国的,他们快要被英伟达收购了,但不管怎样,它是我们生态系统的一部分,他们被迫转向中国模型来做网络防御,因为安全护栏让他们用不上最新最好的美国模型 所以我们推行的那套流程已经在起反作用了,而我们应该意识到的是,面对Friedberg刚才说的那些,应对AI驱动的网络攻击,答案就是AI驱动的网络防御,我们要做的就是,把最新最好的AI驱动网络防御,送到IT部门和CISO手里,而且再说一遍,我们得争分夺秒,赶在黑客之前找出,并修补所有这些漏洞,再说一遍,要是Hugging Face
Chamath:没把那14个凭证,摆在公开仓库里的话,对就跟把写着密码的便利贴,贴在某人电脑上一样,简直就是他们直接放那了,简直就是,所以你懂的,就扔在那里,又不是真能那样,这是什么超级高明的攻击,是的,但你看这一切归根结底,取决于你怎么看这个世界,你怎么看AI的风险
Jason:你是倾向于中央集权的国家主义方案,还是倾向于去中心化,赋能个人的方案,这里正确的解决办法,是用AI驱动的网络防御,来应对AI驱动的网络攻击,因为坦白讲,那些护栏根本没用,他们根本拦不住坏人掌握这些能力,坏人早晚会有的,我们唯一能做的,就是确保好人手里也有这些能力,我之前在朋友Adam Curry的播客上,还跟他聊过这事 [00:37:53]
Chamath:这里面正在发生一件非常有意思的情况,就是他们基本上是在用这种,把AI渲染成有自我意识的表演式叙事,来绑架媒体,如果你就把这玩意叫做软件,叫做软件测试,用传统的术语,对bug审计日志,那它根本不可能上新闻,而一旦媒体被这个钩子吸引,我自己当过记者,眼看着新闻业,从社会中探求真相的职能,蜕变成了纯粹的娱乐工具,只要有机会拉高收视率,就不放过,问题就出在这儿,因为现在Dor Cash做的事,我觉得Dor Cash倒也没有恶意,我觉得他写那篇文章,只是想让自己的观点,博得关注,但你把这东西,递给媒体,媒体就会觉得,这能给我们带来收视率,这能给我们带来点击量,这能给我们带来广告收入,所以他们非常乐意,配合这场闹剧 跟着Anthropic和OpenAI 一起起舞,然后大肆宣传,所以这些白来的流量,我们行业里,叫自然媒体曝光,你一分钱都不用花,现在OpenAI在IPO之前,拿到了海量的自然曝光,而DoorCash 简直是往这把火上,浇了桶煤油,直接捅到了全国性媒体上,现在到处都在传这件事,这让大家,这其实是在为买他们IPO的股票,做铺垫,简直太荒谬了,而且完全可以预见,这事肯定会在媒体上
Jason:引起这么大的反响,所以你看,我没必要去揣测别人动机,但Dorcas肯定心知肚明,他那种描述方式,肯定能换来满天飞的转推,这就是在搞送人听闻 [00:39:49]
# #709.All-in:GPT-6 达到 通用人工智能?科技热潮 2.0、纽约市禁止学校使用 AI
- 有效利他主义与AI监管 [00:40:00 - 00:50:00]
Jason:这就是在搞送人听闻,再说了,他本身就跟有效利他主义这个圈子沾边,他是吗,我不太清楚他的背景,你了解吗,给我讲讲 Dorcas以前和Leopold是同个办公室的室友,他们俩私交特别好,而Leopold在有效利他主义运动里扎得非常深,还记得他的 Leopold就是那个因为对冲基金爆雷出名的,也就是写了Situational Awareness那篇报告的人,三周前的事,对,好吧,而且他妻子是Dario的幕僚长,他们跟整个有效利他主义 Anthropic那帮人走得特别近,给大家讲讲有效利他主义吧
Chamath:好让大家搞明白这种癫狂和妄想症,到底是怎么回事,我甚至都不确定自己能不能解释的完全透彻,行 EA代表的就是有效利他主义 [00:40:42]
Jason:对他起初是长春藤萌校里兴起的一场运动,大意是说他们本该做的是量化慈善的影响力,追求实实在在看得到的效果,但不知从什么时候开始,他们把真正的衡量抛到了脑后,不再讲什么量化指标,而是变成了搞他们各自偏爱的项目,其中最早的一个还有钱还有钱,最早偏爱的项目之一是防范大流行病,当时SBF还打算在加州建一个防范大流行病的中心,后来他进了监狱,这事就不受待见了,于是他们就转向了下一个能让他们立足的存在性风险,也就是所谓的毁灭概率PDoom 于是他们开始磨振于所谓的毁灭概率PDoom 或者说这种存在性风险,也就是AI的存在性风险,然后整个圈子差不多都开始磨振于这个 Anthropic差不多把自己包装成,或者我应该说是自诩为,唯一能解决毁灭概率PDoom这个问题的前沿实验室,或者说最在乎这个问题,形式最负责任的实验室,所以他们把这帮搞,有效利他主义的人全都吸引过去了,里面可能分好几个派系 [00:41:46]
Chamath:我是说我也不是,你提到这个挺有意思的,因为我们之前聊过,存在这么一个理性主义者群体,像SlateStar Codex 你在早先的一期里就提过,这些人算是一群知识分子,某种程度上也是个公开的群体 Charmouth 他们自以为比谁都懂,不知怎么的就早早把触角,伸进了AI领域,或者说做AI的人,对这套感兴趣,而现在他们有了大笔资金,现在他们实际上,积攒了很大的权力,这已经不单单是 Let's Run之类的论坛了,现在你看到的是一股,极其强大的力量,因为他们手里,有两三万亿美元的市值,可以一起陪着玩,我觉得这没什么问题,因为我们自己也是这么干的,我们觉得自己比别人都聪明,这笔钱应该由我们来配置,所以我觉得这很合理,在公共广场上,大家尽管辩论,水自然会找到自己的位置 在Anthropic和OpenAI上市之后,会发生一件很有意思的事,你想想这两家公司上市,会给慈善捐款或者DAF注入多少资金,两家加起来会超过5000亿美元,甚至可能比这还多,问题在于,当5000亿美元通过这一个非常特定的视角流出去时,肯定会对最终结果产生影响,乔治索罗斯的理念和他的资本,对各种结果产生的影响,大家都是见过的,科赫家族对结果产生的影响,大家也见识过了,谢尔登·阿德尔森的资本,对结果产生的影响,大家同样见过,我的意思是不去评判谁对谁错,接下来这些相互竞争的想法,都会从第三方那里,获得同等规模的资金支持,所以政治色彩会淡一些,更多会是这些人,然后我不想去评判有效利他主义 是对是错,我唯一的问题是,我觉得他们没有充分披露,自身明显的利益冲突,当Sachs开始抽丝剥茧时,发现某甲写了一篇文章,某甲和某乙同在一个办公室,某乙的妻子在前沿实验室的,一位主管手下工作,某乙之前还替SBF工作过,而且他在Anthropic赚了50亿,对,很多关系就是在那基本定下来的,然后还有个某柄在Anthropic上班,大家全都是室友,接着又一起搞联合投资等等,这一切我再说一遍,完全没问题,我其实觉得这完全合情合理,我们当年往上爬的时候,也都干过类似的事,当然彼得蒂尔的圈子 PayPal 黑手党,都有各种各样的版本,区别在于,我觉得在没有披露的情况下,不好意思,作为一个持怀疑态度的人 当我看到这些东西,把这些线索串联起来时,我就会问自己,这是合情合理的,还是某个不同计划的一部分,所以我这个周末才写了那些内容,我只是想把界限画清楚,让大家至少对这事留个心眼,想想背后隐藏的利益动机,因为如果整个群体都想要一个,寡头垄断或双寡头的市场结构,他们可以采取各种手段,来促成这种改变,而其中最有效的手段之一,就是先制造恐慌,然后再跳出来提供解决方案,对,我们收尾这个环节之前,不好意思,关于这个我最后说一句 Janson和我今天早上发短信,我对他说,这是你做过最不可思议的一件事,然后我发了那条推文 Hugging face的这件事 我们聊过的,将会,上周,成为AI领域最重要的交易之一,载入史册,因为你在规模最大,资金最雄厚的竞争对手内部,建立起了一道,抵御必然,寡头垄断,疯狂行径的壁垒,与此同时,你实际上会在整个技术战上,下游催生出更理性的竞争,我上周就提到过这一点,每个人都在涉足所有业务,英伟达会变得像亚马逊,亚马逊会变得像英伟达,谷歌会变得既像亚马逊又像英伟达,等等等等,所以眼下发生的最重要的事情,就是我们迎来了技术抵运深厚,资产负债表强大的参与者,站在了开放市场结构这一边,我觉得这将是最有利的回击 因为这会让最好的想法在市场上胜出,所以我不想去评价有效利他主义的议程,它可能真的很好,但我不想被rock pull 不想因为人为制造的恐慌,最终沦落到寡头垄断,或双寡头的市场结构里,对我觉得说的太好了,这一点说的确实很好,我几周前就聊过,我觉得Jensen会在开源领域胜出,我今天也发推聊了这个,我认为从今天起,英伟达就是OpenAI和Anthropic的,头号竞争对手,不仅是在Token上,还有在企业算力上,我觉得现在Jensen 是全美领先的开源提供方,我觉得他会拿下全球,他会迎头赶上,并且我觉得到2027年底,就会甩开中国和中国的大模型,那就意味着有了 Jensen和英伟达这样的玩家,能让美国说到你之前,在政府的工作Sax 你当时非常关心说 我们能赢下这场竞赛吗,我现在比以往任何时候都确信,我们能赢下这场竞赛,我现在比以往任何时候都确信,我们能赢下这场竞赛,因为Jensen代表着全球的开源,他能直接拉一机架的算力,送进一家目前正在用 OpenAI和Anthropic的 Token的公司,然后说,这是你们的基价,从头到尾,全套垂直方案,你们拥有完全的自主权,而且我给你们降价 80%到90% 因为我不需要靠Token赚钱,我靠硬件赚钱,我有千百种赚钱的门道,而且我们本该赢了,只可惜现在,夏皮罗州长,也就是他州里,数据中心的最大支持者,还有咱们德克萨斯大州的,格雷格阿伯特萨克斯,他们现在为了赢得,中期选举掀起了一场,反对数据中心的讨伐,而这才是真正可怕的地方 他们现在拿Dorcas的文章,以及这一切大作文章,我们看到了马提铁理论 Sax,史蒂夫班农,夏皮罗,阿伯特,还有那些疯癫的,极左社会主义边缘群体,全都一致认为,我们必须阻止AI 阻止数据中心在大街上,烧掉威猛,这真是一个令人不安的时刻,因为我们本已做好了准备,凭借Jensen在Hugging Face的布局,去赢下开源,而且我们已经赢下了前沿模型,你怎么看Sax 对我是说你看,我觉得政治层面 [00:48:22]
Jason:现在正在发生一个有趣的转变,我觉得这刚刚开始,也就是过去几年里,围绕AI的政治争论,其实一直是在加速主义者,与减速主义者,或默认者之间展开,那算是最根本的分界线,你说的没错,这种分歧跨越了政党界线,因为在减速主义那一侧,不仅有像伯尼桑德斯这种反进步,反创新的进步派,还有史蒂夫班农这类保守派,他们只是对新技术或新技术,可能带来的颠覆感到恐惧,所以这确实有点跨越党派分界了,不过不管怎么说,这就是过去几年的争论,在那场争论中,有人把我描绘成加速主义者,我其实更觉得自己是个现实主义者,也就是我认为这项技术必然会到来,总有人会把它开发出来,我宁愿是美国做出来,而不是中国,不管怎样,我觉得那就是过去几年的争论 现在我觉得争论正在转向开源对闭源,也就是大家很快就会看清 AI根本是拦不住的,我是说,伯尼桑德斯搞的那些事 [00:49:49]
# #709.All-in:GPT-6 达到 通用人工智能?科技热潮 2.0、纽约市禁止学校使用 AI
- 数据中心、能源与AI竞争 [00:50:00 - 01:00:00]
Jason:伯尼桑德斯搞的那些事,或者那些反数据中心的团体,他们是在使绊子,但现实是技术正在不断推进,创新发生的非常快,而归根结底拦不住的原因,就是消费者正在接纳它,我说这正是大家忽略的一点,为什么要在建这些数据中心,大家为什么要建他们,就是因为消费者和企业有这个需求,所以是这种接纳在拉着整个行业向前走,这就是为什么我觉得它终究是拦不住的,那么面对这个现实,既然我认为现实主义终将占据上风,我觉得争论就会转向,好吧,我们该怎么管理它,我们想要什么样的市场结果,我们是想要一个存在大量去中心化模型的开放市场吗,彼此之间能起到某种制衡,市场上不同模型之间保持一种权力平衡 还是说我们要一个高度中心化的方案,有两三家前沿公司把持,形成一个前沿市场的双寡头垄断,他们都是避怨模型,而且他们随时可以对你Rug Pull Sax 他们可以对你Rug Pull 他们能把你的Token夺走,是的,坦白讲,而且还有那个双寡头,而且他们已经这么干过了,而且那个双寡头一直在极力游说,设立一个新的监管机构,为什么,因为监管俘虏,他们没法控制,他们政府官员根本不会懂,怎么去监管这么有活力的东西,所以他们就会去问那些顶尖实验室说,嘿我们该怎么监管,当然Anthropic对此准备好了所有答案,而且Dario在参议院作证时就已经说过,他认为开源模型如果足够先进,就会很危险,因为他们没有被集中管理和控制,所以未来的战线会滑在哪里 已经很清楚了,核心就在于,你是想要一个中心化的封闭的市场,还是想要一个去中心化的开放的市场,是的,币源也会参与其中,但问题在于我们能不能保留开放这一块,而且我觉得这会跨越党派界限,因为坦白讲,共和党那边也有主张国家干预的人,但我确实认为,随着这场辩论的推进,大多数保守派,大多数自由意志主义者,都会看到对公民自由的威胁,我觉得他们会站出来支持开源,对我觉得没错,我前阵子还在跟Politico聊 [00:51:47]
Chamath:因为他们当时在报道这事,在数据中心这个议题上,事实会证明特朗普是对的,地方社区现在能做的最好的事,就是趁着数据中心提供商,愿意替你们学校交地方税,愿意给补贴,愿意通过各种方式给大家补偿,而且愿意把数据中心搬到,不需要接入电网,不需要水,也不会制造噪音的地方时,把这些数据中心引进来,特朗普一直在跟人们说,阻挠数据中心是个错误,把钱拿上,而且我得说,近距离亲眼观察政治Friedberg 让我对他变得无比愤世嫉俗,我们六个月前还坐在这,可能也就是六周前,阿波特夏皮罗还在称赞,夏皮罗来我们播客时,还在夸他们的数据中心项目,我想Chemath 你跟我一起采访的,他Friedberg 你觉得中期选举之后,这里会发生什么,我是觉得 他们的立场,会转回到支持数据中心,因为他们只是在随波逐流,但是,夏皮罗和阿波特,现在双双跳出来,反对数据中心,这得有多虚伪,我觉得在政治层面上,你不得不这样,民调支持率都到-80了,而且两党都这样,所以我也不知道怎么说,对,但这也,那为什么特朗普就没这样,特朗普可没跟着这股风走 [00:53:19]
Jason:特朗普是一个有独立批判思维的人 Sax 他有魄力,我之前就跟你们说过,特朗普在华盛顿归根结底,是创新者最好的朋友,如果华盛顿能有任何人来拍板科技决策,我希望那个人是特朗普总统,不是内阁部长,不是白宫幕僚,不是国会议员,不是参议员,也不是智库,如果有时间的话,我真心希望每一个决策,都由特朗普总统来做,因为他在这方面的直觉真的很好,他希望美国能赢,他不相信不必要的监管,他完全没有那些默认者的焦虑,他倾听各行各业形形色色的人的意见,他跟所有的CEO都聊过,他对所有这些议题都非常了解,在这点上我得肯定他,而且我上周在J20上也讲到了这一点,地方社区完全能拿到非常划算的条件,我觉得需要讲明的一点就是,地方社区应该去拥抱这件事 原因不是出于对创新的某种抽象关切,或者类似的东西,他们应该在条件对自己有利时去做,而且确实有很好的条件摆在那,我们在弗吉尼亚州的劳登县,已经看到了普通纳税人的房产税下降了6000美元,因为他们拿到了所有这些数据中心带来的税收,在路易斯安那州有个县,因为数据中心的税收,多年来第一次给教师发了奖金,所以我们开始看到所有这些例子,只要你谈妥了合适的条件,我说的是你们地方社区,去跟数据中心和AI公司谈,它就会降低你们的电费,因为他们会建立全新的发电设施,他们会为电网升级买单,它其实不会消耗过量的水,那完全是假新闻,我们知道这些系统是循环用水的,而且这些数据中心,完全可以建在不会打扰到人的地方,所以这里面是有好条件可以谈的 最后再补充一点,特朗普总统在这件事上,支持由地方做选择,他阐明了为什么地方社区,接受数据中心是划算的,但他并没有强迫他们去接受,我看到到处都是假新闻,民主党人说政府正试图,把这些数据中心强行塞给地方社区,不是真的,在我参与起草的政策文件里,也就是12月我参与起草的行政命令里,我们明确写了数据中心,依然由州和地方自行决定,在其他一些领域,我们认为应该出台全国性的AI政策,但数据中心并不在其中,所以没人强迫这些地方社区,总统的意思是,别信媒体的这套虚假宣传,只要你们愿意接纳它,它完全能给你们带来好处,我觉得过去这一周 [00:55:32]
Chamath:这番话已经开始起作用了,我周一在华盛顿开会,想说的一点是,有大量的外部势力,在试图煽动对数据中心的负面反应,和抵触情绪,我觉得这帮人都有谁,他们是怎么操作的,现在正变得越来越清楚,有一项民调显示,当你把实际的好处一条条讲清楚,走进其中一些社区时,舆论风向直接扭转了三四十个百分点,目前局面多少还是有点被动,但这也说明,主张让美国慢下来的那批人组织得更严密,到目前为止,做得比想要加速美国发展的那一边更好,因为加速派这边更分散一些,我们越来越清楚地看到,这股减速主义运动在很大程度上是有组织的,而且是由外国势力资助的 我觉得随着我们抓住这一点,并把它更多地揭露出来,情况也会发生改变,因为阿博特和夏皮罗之所以会有那样的反应,我其实觉得他们是受到了错误数据的误导,那为什么会有错误数据呢,之所以有错误数据,是因为一直有一方在那里大喊大叫,而现在就像SAC说的,当你走进这些真实的社区,去实际测算大家的反应时,大家其实正面的多,因为他们能切实感受到,银行账户里的实惠
Jason:而那些,只要他们谈出好条件,他们只需要去谈一个好条件就行,摆在那里的好条件,再转回来,顺便说一句 Chemath 关于中共,你说的对 [00:57:43]
Chamath:这是一场,对让我把这个调出来看一下 Charmant 你说的那个报告已经调查过了 X清理了大量的机器人账号 Rayman David Sachs 想要操纵公众舆论太容易了,只需要少量的社交媒体账号,在回复区里狂轰滥炸打群架,就能营造出一种,被人们误以为是共识的假象,而这里的共识并不是说,大家真讨厌数据中心,而是一群机器人,在告诉有影响力的人,说大家讨厌数据中心,我知道你要换话题了,但我现在就想说一句,那就是请讲,接下来会有一连串的决策和连锁反应,大家会在这个话题,以及围绕AI的相关话题上,固守自己的立场,而这些立场在六到九个月,甚至一年后看,会显得极其愚蠢,之所以会显得愚蠢,是因为随着真相被揭开 这帮人会显得极其可笑,这是我的预测,对我是说单看舆论渗透这件事,围绕数据中心显然有很多舆论操纵 [00:58:50]
Jason:相关的假消息满天飞,然后还有末日论者群体,有位叫Nirv Weissblatt的作家,写了个博客叫AI Panic 他在几年前就追踪发现,有几百个这种伪装成草根的末日论组织,基本上就是由硅谷的,三位有效利他主义亿万富翁资助的,就是Dassi Moskowitz J.N. Tallinn和Vitalik Buterin 别忘了 Vitalik曾经给生命未来研究所,捐了价值6亿美元的狗狗币,然后他们就砸了几亿美元,做这些活动,让人害怕AI 而且他们把数据中心,当成了很好的靶子,所以你真的不能低估,这几位有效利他主义,亿万富翁捐出的10亿美元,有多大威力,他在公众对AI的认知上,造成了多大的破坏,回到我之前说的观点,我的意思是,因为Anthropic上市,我们可能会迎来大约100位 新的有效利他主义亿万富翁,一旦这些人进入政界,那就相当于100个甚至1000个乔治索罗斯 [00:59:54]
# #709.All-in:GPT-6 达到 通用人工智能?科技热潮 2.0、纽约市禁止学校使用 AI
- AI舆论战与防御能力 [01:00:00 - 01:10:00]
Jason:那就相当于100个甚至1000个乔治索罗斯,他们每个人手下都会有20个非政府组织,和15个公关人员为他们效力
Chamath:那场面会非常疯狂,我是说我之前就跟你们说过,我被人控评围攻了,我自己做了个机器人帮我塞回复,要求就是注册不满一年,粉丝不到200的人,告诉我他们都在发什么推文,我看了一下这些人,说的全是一回事,他们就是不停用假账号,在别人的评论区搞网络围攻,如果账号注册不满一年,除非用实名或者带蓝标之类的,否则根本就不应该能出现在别人的回复里,这些社交网络上现在已经失控了,搞这个太容易了,行我们接着看下一个议题,今天内容很多 Fredberg关于Mamdani这件事,我需要听听你的看法和见解,这事挺有意思的,他刚刚在纽约市的公立学校里,对AI下了一年的禁令,涵盖从幼儿园到八年级,关于这事,现在有人一直在说,他进了ChatGPT 进了AI下了一年的禁令 我们先别急,仔细看一下细节,纽约市是全美最大的学区,禁令下周开始生效,涉及纽约市60万名学生,范围涵盖所有直接面向学生,使用的生成式AI软件,高中不再其列,而且Mamdani正在5万名高中生里试点,一个AI学习项目,他试点的这个是非常具体的一件事,跟这些新的限制措施不是一码事,他还对屏幕使用时间给出了建议上线 3到5年级限制在30分钟 6到8年级45分钟 Mamdani给出的理由是,所谓的我还没看到有哪项研究表明 AI对中小学生是有益的,很显然 Mamdani是美国民主社会主义的代表人物,纽约市DSA成员Julie Soup说技术,所谓的不应该由一家,让科技寡头进一步敛财的,盈利性公司来充当媒介 我觉得他是在说你呢 Sax 他用了寡头这个词,谷歌,微软 Anthropic 都拒绝,置评 Friedberg 你怎么看这件事,如果你的孩子,要进纽约市公立学校系统,或者不管你选哪个学校系统,这跟你希望孩子被培养的方式,差距有多大,今年3月斯坦福发表了一篇文章,跟Mamdani的说法正好相反,他们梳理并审查了所有关于中小学教育中,使用AI的研究,那是一份名为 The Evidence Based on AI in K12 A2026 Review的报告,他们找到了好几百篇已发表的论文,用他们的话说,里面只有20篇高质量的因果关系研究,那是今年3月的事了,从那之后又发表了好多篇,这篇原分析论文,或者说这些原研究的结论,就标在报告的最底下 能用上AI工具时,学生的表现往往会有所提升,但一旦拿掉,效果就参差不齐了,工具的设计很重要,所以工具之间并不是等同的,而AI确实可能给教育带来有意义的支撑,所以其实已经有了相当多的分析,而且研究还在不断累积,不断冒出来,似乎并没有强有力的证据表明 AI会对孩子的教育,成长或者教学过程有害,我觉得大家都能凭直觉感受到的是,教师工会肯定对AI工具抱有抵触情绪,他们担心自己的核心技能和工作能力,被自动化取代,再加上教育工作者本身,也缺乏在课堂环境里,利用AI来教学生的技能,而从常理上讲,反过来的一面是 AI能实现个性化辅导,目标就在于每个人的学习节奏不一样,每个人的学习方式也不同 你怎样学,我怎样学,是用视觉,听觉,配合特定图像,还是听人讲故事,又或者是通过互动式的项目制学习,动手搭建,还是听写,人们学习的方式有很多种,所有这些学习系统,都可以针对个体进行个性化定制,归根结底,这个人应该就能进步得更快,对自己的学习更有信心,这是我的一种合乎常理的信念,并不是基于某项研究,那就是AI最终会带来一种,给学生量身定制的多的教育体系,而这对传统的模式,构成了极大的颠覆和威胁,传统的模式是一个老师在教室里教,所有人用同一种方式学,大家通常只能按班上,学得最慢的学生的节奏来走,因为工会谈下来的合同,教育工作者被要求做什么,不被要求做什么,条条框框非常多 因此Mamdani限制使用这项技术的决定,背后有着很深的政治取向,我觉得这挺令人遗憾的,我觉得这真的很让人难过,我觉得AI有机会重塑教育,让孩子们迈上一个新台阶,让来自任何背景,任何社会经济条件的任何孩子,都有机会非常迅速,非常有效地提升自己的能力,这是一个极其强大的工具,绝不应该因为关于AI的一堆废话,或者因为所谓我们还不真正了解它,不理解它的担忧,就被弃之不用,顺便说一句,这向来是把真正会改变系统的东西,直接打发掉的现成套话,我们还不了解,这种我们还不了解,我们还不理解的说辞,在任何时候都能拿出来用,因为你总能说,还有更多研究要做,还有更多分析要做,这种话根本没有止境,在这件事上,我特意强调已经有800项研究了 其中至少有20项被斯坦福认定,在分析K12阶段使用AI方面,非常可信,对我觉得这里面有政治倾向,但我觉得这也可能是我们,经常聊到的那种,根深蒂固的问题的一部分,就是对技术演进那种,不健康的恐惧,谁都搞不懂,没人懂,我说没人懂,意思是普通大众都是这种感觉,没人知道我们这么走下去会怎样,我们得小心,我们得谨慎,我觉得这可能正是会让我们,止步不前的东西,那这有什么不好呢,慢慢来有什么不好呢,当你本来有机会快速,大步向前推进的时候,拖拖拉拉就是坏事,因为外面总会出现别的替代选择,会有私立学校去用AI 我不想看到有特权的孩子,和有钱人家的孩子,因为接受了AI教育而一马当先,公立学校的孩子却被甩在后面,我不想看到其他城市,其他州和其他国家的孩子 大步跑在前面,而某些学区因为这种反技术,可以说是偏社会主义的取向,让那里的孩子被甩在后面,所以我觉得,在眼前这场正在发生的,巨大技术巨变中,面对所有这些事情,我们在社会层面上,都有一种根本性的不健康反应,这就是其中的一种体现,这背后的根源机制,可能和教师工会,以及眼下围绕这套东西的,政治因素有关,反AI现在很吃香,所以他站在反AI的立场上,就能拿到更多分,获得更多赞许,工会很喜欢,这样这就是我对眼下这局面的大概看法,这个见解非常深刻,而且Friedberg Mamdani在这里可能真没撒谎,他说他没看到任何研究,他可能只是根本没去看,而你真的去看了,没点开那个链接,他只是没点开链接而已,所以我们就别太难为Mamdani了 Chamath你一直对教育很有热情,你有不同年龄段的孩子,你经历过这些,而且现在还在经历,看着孩子们学习,琢磨电子设备的问题,我们就在前几周,还聊过Meta和解案,以及做家长的有多难,你怎么看这件事,撇开纽约不谈,就为你自己的孩子考虑,对于使用AI 你觉得哪些点让你认同,你可以尽量给出最有力的论据,不用AI对他们有什么好处,而在哪些方面,你又觉得他们用AI真的很棒,给我们说说,你作为一个家长是怎么想的,如果可以的话,先把政治放一边,我觉得孩子们未来,不用自适应学习平台,作为主要学习方式,这在我看来是不可想象的,我认为这种一年级,然后二年级,再三年级的模式,正如Friedberg所说,是一种搞教育迁就,最低水平的做法,我觉得这行不通 我觉得更有可能的是,未来每个孩子的学习方式,都很不一样,有的人偏视觉,有的人偏听觉,大家的学习节奏也各不相同,如果你能有一套,更贴合每个人学习方式的系统,在某些时刻有导师在旁边辅助你,其余的时间则用来交执行力,团队合作,解决问题,以及所有这些其他事情,体育运动,这对所有孩子来说,都是一个好得多的结果,所以那才是正确的答案,眼下围绕这个答案,只有特许学校的选择,这方面的领头羊是Alpha School 也就是我们朋友Jolie Mount办的,向她和她的团队致敬,但我认为这才是最终会胜出的答案 Jason 我再多说一点思考,我觉得这是一个极其重要的时刻,我们应该把这一刻记录下来,这就是纽约变成密西西比 而密西西比变成纽约的时候,我是什么意思,在所有这些高度自由派的大本营里,他们都在拥抱这种极左意识形态,我觉得随之而来的就会是这一类政策,我觉得它的后果,就是一种自我强加的现代隔离,他会把这些城市里受制于这些规则的整整一代孩子彻底推入贫困,而且让他们陷在里面,所以从这个层面上说,我觉得你会看到这种位置互换,所有拥抱AI 拥抱数据中心,拥抱减税,拥抱教师奖金的州,最终都会走在前面,有条件搬家的人就会搬走,而在许多把这些搞到极端的城市里,剩下的只会是原来的空壳,这会重塑美国内部的经济平衡 [01:09:09]
# #709.All-in:GPT-6 达到 通用人工智能?科技热潮 2.0、纽约市禁止学校使用 AI
- 纽约公校限制AI的教育争议 [01:10:00 - 01:20:00]
Chamath:这会重塑美国内部的经济平衡,选票平衡,以及很多这类理念,所以我觉得这非常重要,我觉得他应该去跑这个试验,我感到抱歉,我也深切同情那些孩子,会被这事害惨的工薪阶层父母,但我觉得人只有摸了炉子被烫到,才能学到教训,好萨,你能不能讲讲这背后的政治层面,如果有的话,以及你对眼下发生的事情,有什么偏负面的看法,你觉得这是对寡头的一种反弹吗,我之前开过你的玩笑,但这确实带有一点民主社会主义的色彩,感觉他们好像是想牺牲孩子,或者说网上是有这么一种解读,我不是说这是我的看法,但有人在说,他们是在试图牺牲孩子,就因为他们不想让山姆奥特曼 Dario或者不管哪个服务 微软,因为软件在教室里使用,而赚到几个子,当然了,他们全都会把软件免费给他们用,而且现在的版本,有80%你都能免费用,所以说他们这是在反抗大型寡头,科技巨头,逻辑上根本说不通,你怎么看 [01:10:53]
Jason:你看DSA实际上就是反对一切创新,他们差不多就是站在反进步的那一边,他们算是完全倒向了,卢德主义那一派的观点,而且我觉得正如Friedberg和Chemist 刚才说的,这对孩子们来说会非常糟糕,我们在这个国家讨论数字鸿沟已经30年了,所谓的富人家的孩子能用上最好的工具,而穷人家的孩子用不上这些工具,于是会落后的更远,结果现在的情况是,私立学校当然会继续使用最好的AI工具,而公立学校现在却用不上这些工具了,不是因为他们没钱,也不是因为技术用不了,而是因为政治领导层,在试图破坏这些孩子的前途,这对他们会很不利,而且我觉得,如果你非要从中找出一种动机的话,我不认为Mamdani和他的政治团体,他的党派,真的在乎自己是不是 在制造更多的政治依附,我的意思是,从某种意义上说,他们的整个运动,都是由社会阶层下滑的进步派组成的,如果你在找动机,也许他们觉得,让这些孩子向下流动也挺好的
Chamath:我不知道,也许这对他们在政治上有利,他们自己可能根本就没有孩子,却在定这些规则,承受的却是有孩子的人,这一点说的太好了 Chamas才是承受的,因为你看这群人,全都是染着蓝头发,单身没有小孩的,没错,对其实我再补充一点,这一点说的太好了 Chamas [01:12:16]
Jason:那就是对你看,我觉得我们其实没必要去揣测动机,我们直接说这是一项糟糕的政策就行了,但让我再补充其中的另一面,那就是这并不是全面禁止,对吧,他们还说了,针对最多五万名高中生,他们会搞一个试点项目,也就是所谓的模块课程,在里面教授AI素养,但你听听他们是怎么描述的,他们说,所有高中生每年都可以参加两次AI素养课程,只在帮助他们在开始依赖AI之前,对AI进行批判性思考,好,这些模块将向学生介绍,什么是AI 什么不是AI 这是他们的原话,以及与AI相关的偏见,风险,伦理考量,还有对职业和未来技能的影响,上面还写着,所有的使用都将在受过培训的教育工作者 直接监督下进行,并且会涉及经过仔细审查的AI工具,试点项目是根据严格的安全和数据隐私标准选出的,所以你在里面能听到很多这种末日论者的行话,我是说那些模块听起来就像是某些安全派人士写出来的,这种关于AI偏见和歧视之类的措辞,说实话那些课程听起来不像是要教你怎么使用这些工具,去获得最好的教育,而更像是在教你怎么去怀疑这些工具,也许这算是你应该培养的一小部分能力,因为我觉得人确实应该对所有事情保持怀疑,但那些课程听起来真不像能让孩子们受益,老实讲,听起来就像是要把他们送进Doomer Academy 我是说这听起来不就像Doomer Academy吗,发出来,还有,对 对,写你自己的解读,想想我们的孩子和中国孩子的竞争力对比,那是对,我们知道,中国正在把AI融入K12教育,他们的孩子会学着,怎么去利用这些,这些,机器人,工具,让他们去参加机器人奥林匹克,在那拿到实习机会,对,与此同时,我们要么在学校里禁用AI 要么就让孩子们去上某种,末日安全主义模块,教他们为什么要怨恨和抗拒AI 而不是为了自己的利益去拥抱它,所以我不知道,看起来这根本不会,让我们孩子更有竞争力,很遗憾 [01:14:31]
Chamath:但还是让这个实验跑下去吧,让实验继续跑,我们需要去衡量它,我这儿有一堆想法,我非常推崇蒙台梭利,但我也非常推崇自适应学习,以及这些AI家教,能给那些家里请不起家教,自己又有动力的学生带来什么,所以我想把两个,完全不同的点放在一起,它们多少有点对立 Nick 你能把第一篇调出来吗,就是9H这边,关于麻省理工学院研究的那篇,我也把这篇发给你 Friedberg你可以查一下,非常有意思,他们找了一组54名参与者,抱歉在这插播Science Corner 也就是科学搅换节,抢了你的风头 Friedberg 我本该提前和你打声招呼的,但我读了这篇论文,去年招募的54名参与者,分成三组,进行了四次测试,前后历时四个月,他们用恰奇PT来写文章,跟我们上周聊到的,华尔街日报社论版,那事差不多 一组用搜索引擎,一组用传统的网络搜索,只靠大脑的那组,不使用任何工具写文章,然后研究人员用头戴设备,观察他们的大脑活动,结果发现,大语言模型的使用者,在所谓的记忆力,和文章归属感上,表现出严重缺失,有83%的人,甚至无法引用,自己刚刚写好的文章内容,基本上他们想说的是,如果你用这些大语言模型,而不是靠自己凭空思考,不是像蒙台梭利理念那样,自己独立去做,你的大脑就会退化,你甚至记不住自己写了什么,而搜索引擎那组,介于两者之间,因为他们必须记住事情,必须把这些信息整合起来,如果你不亲自动手去做,你的大脑就会退化,这就是我们正在认识到的,就像如果你不像我们过去那样,下地干活,你的身体就会退化 这也是为什么我们现在都去健身房,但是与此相关的,极其重要的是两个标准差问题,就是Bloom提出的,我相信你知道这项研究 Friedberg 这超级有意思,但对任何有钱人来说都不意外,我父母从来都请不起家教,我八年级之前一直读公立学校,然后去了Severian Private Catholic School 学费超级便宜,但基本上我们从80年代就知道,如果你接受一对一家教辅导,你会比在教室里上课的学生,优秀两个标准差,两件事可以同时成立,这些学生正如你所说 Charmouth他们没有,这个实验正在进行现实的说,如果他们读的是,纽约市的公立学校系统,他们的父母十有八九,像我父母一样,没能力请家教,我猜SACS 你应该算出深重产家庭,我猜你以前确实请过家教,我说的对吗 没有,我没请过家教,没请过家教,好吧,所以你全得靠自己,对我倒也没很想,撒家教,也没有,没有,没有 [01:17:57]
Jason:你知道吗,我去了,我真希望自己当年参加过 SAT辅导班之类的,我当年完全是落考的,我什么辅导都没做过,然后你考了1400 对,你考了1350还是1450 没有,我第一次考了大概1420 然后,厉害,我就想天哪,你知道吗,要是我真认真被考过,可能考得更好,我考了1100 我也没被考,后来我被考了,我重考了一次,考得更好了,不过不管怎样,我是说,我当年根本不懂这些,对,所以矛盾就在这 [01:18:07]
Chamath:大多数家长,不希望孩子做这种作业时,大脑退化,连基础层面的东西都没学会,先抛开上周聊德鲁肯米勒的内容不谈,大家希望孩子能自然而然的学会读写,掌握这些基本功,随便你怎么称呼这种方式,然后再去学,怎么用AI来辅助自己,增强自己等等,但我担心的是那些有上进心,却无法妥善利用这些工具的学生,他们也负担不起,像2Sigma群体那样的家长支持,那些家长心里很清楚,只要给孩子请个家教就行,他们不像自带动力的SACS 请个家教SAT就能轻松考到1400 因为这东西靠死记硬背就行,请个家教,考到1200 1300 1400是很容易的,所以我非常担心没有AI家教的问题,我觉得这两方面其实可以同时成立,我真的很不喜欢目前设计的这个实验 好有意思的是,特朗普总统刚就委内瑞拉的石油,敲定了一笔交易,今年1月我想大家都知道,美军通过一次执行的无懈可击的行动,抓获了马杜罗,他显然是委内瑞拉的社会主义领导人,非常亲华亲俄,而委内瑞拉显然就在我们这个半球 [01:19:42]
# #709.All-in:GPT-6 达到 通用人工智能?科技热潮 2.0、纽约市禁止学校使用 AI
- 委内瑞拉石油交易 [01:20:00 - 01:30:00]
Chamath:而委内瑞拉显然就在我们这个半球,特朗普表示,美国将控制委内瑞拉的石油,那里的石油储量非常丰富,油质不算很干净,但储量确实很大,而且他和马杜罗的继任者达成了协议,现在由罗德里格斯总统掌权,现在我们拿到了这笔交易的细节 North American Blue Energy Partners 获得了17处油田,长达100年的特许经营权,这包括650亿桶储量,曾经由俄罗斯、中国和马杜罗,旗下实体控制的650亿桶储量,美国政府控制这笔交易55%的份额,五角大楼拿到35%的股权,五角大楼拿到了1 3的股权,美国国务院获得了以成本价,购买20%产量的权利,有意思,我猜这是留给我们的战略储备和军队用,这是由卢比奥和海格塞斯 与委内瑞拉临时总统共同签署的,正如我刚才提到的Blue Energy Partners 承诺投入大约1000亿新建基础设施,雪佛龙等许多其他公司,以及一批没有公布名字的公司,也都会拿到一些协议,特朗普表示用他的话说,这笔交易将不会耗费美国纳税人一分钱 Sachs如果你想要的话,我直接给你来个快球,或者我也可以给你来个慢速累球,你想要哪一个,你想接快球吗,我向来喜欢快球,你喜欢快球,好来了投过来了,希望你戴了头盔,我们应该去侵占,接管别国,并夺取他们的油田吗,大家觉得这可能算是在搞国家建构,觉得我们在扶植傀儡独裁者,这是美国该做的事吗,我们有权这么做吗,大家都在问这个尖锐的问题 还是说强权就是公理 [01:21:44]
Jason:我觉不觉得这算国家建构,我们并没有像在阿富汗那样,试图在这里组建军队,我们没有试图给他们灌输,有毒男子气概那一套,我们没有试图组建政府,或者搞任何类似的事,我没有试图教他们,怎么搞美式民主,我们只是在做一笔商业交易,这是一笔商业交易,让我觉得不可思议的是,所有人都在说,这掠夺了委内瑞拉,对委内瑞拉人民来说,是笔坏买卖,你看过委内瑞拉,在马杜罗之下的石油产量吗,鉴于委内瑞拉拥有的精人储量,产量本来就不算很高,但过去十年,在马杜罗之下,产量下降了大约三分之二,他们过去每天能生产大约300万桶,在马杜罗治下产量降到了每天大约100万桶,而这还是一个拥有全球顶尖石油储量的国家,关于到底该怎么算储量,大家有争议,我觉得如果你看总储量 大概是3000亿桶石油左右,跟沙特差不多,就比沙特多一点点,有人会说,其中很大一部分就像那种极重制原油,类似淤泥,根本没法用,我觉得那就是所谓的奥里诺克储量,但300里那部分只有大约200 所以他们还有大约1000亿桶,你可以说它依然是重质原油,但那些探明储量,我觉得没什么好争议的,所以你面对的是巨量的石油,关于这点,我最后想补充的是,那种重质原油,跟我们自己的其实非常互补,在美国靠着水利压裂的神奇技术,我们基本上开发出了,所有这些石油和天然气,但我们的石油是这种轻质低流原油,很适合精炼成汽油,而重制原油才能生产流分油,柴油就是这么来的,我们在墨西哥湾的炼油厂,是为重制原油建造的,要把它们改造成炼轻制原油,成本极高 所以我们的炼油厂可以说是完美匹配,刚好能接收这种重制原油,并转化成柴油和其他流分油,所以我觉得这对美国和委内瑞拉来说,确实是双赢的交易,话说回来,委内瑞拉以前的日子过得糟透了,我觉得这会,这肯定能改善他们的经济,而且我觉得对美国来说,确实是个好消息,顺着你的意思 [01:23:34]
Chamath:SACS过去5到10年里,委内瑞拉运出的石油,平均每桶价格是,过去10年每桶53美元,过去5年每桶58美元,所以他们拿到的条件相当不错,我们多付了一点溢价,把控了所有这些,总得有人在这抽点成,或者找个理由,而且他们还得大老远运到世界的另一端 Friedberg你怎么看,你对国家建构之类的事情有担忧吗,比如扶植有人所谓的傀儡总统,这符合委内瑞拉人民的最大利益吗,我们作为买方买下这些,算是在帮委内瑞拉一个忙,为他们创造更多稳定吗,还是说这纯粹是我们不得不做的事,考虑到与伊朗的战争局势,和霍尔木兹海峡的关闭,我们必须控制我们所在的半球,必须实现能源独立,最大的驱动因素 可能是不让这些石油以超优惠的价格落入俄罗斯和中国手里,如果你看委内瑞拉与马杜罗政权的历史渊源,它一直是一套打折的石油贸易体系,各种说法都把马杜罗说成是所有这类非法勾当的罪魁祸首,而其中很多都是由俄罗斯和中国对能源储备的兴趣驱动的,他们提供支持,这实际上为俄罗斯人在古巴开展活动提供了资金支持,关于做成一笔能源交易的真正动机,有许多国家行为体理论,不光看它是否对美国有利,还要看它是否对美国的敌人不利,这可能是这背后的一大动因,而在过去这一天里,比较让人意外的一个结果是,你们可能还记得我采访过,玛丽亚·克里纳·马查多,他就是当时竞选总统的那个人 最后经历了一场据称不准确的选举,本来应该是他赢的,但他没赢成,昨天他站出来说,尽管他历史上一直被视为美国的盟友,但现任委内瑞拉政府,无权与美国达成这项能源协议,所以值得注意的一点是,他没有当上总统,而现在他说这个政府是非法的,这个政府不应该被允许做这些交易,我们作为委内瑞拉人民,对整件事应该感到愤怒,沮丧,觉得被抛弃了,所以现在似乎出现了这种政治上的转向,我觉得我其实不太清楚,而且我觉得挺有意思的是,委内瑞拉人民到底怎么看这笔交易,而且按SACS的说法,相比他们原本的处境,这看起来应该是一笔不错的经济交易,这到底会不会转化为改善委内瑞拉人民的生活,而这归根结底才是最重要的 假设委内瑞拉人民的生活确实在改善,而不是让委内瑞拉的少数人发财,这正是上届政权统治下,那个国家历史上发生过的事,那么大家对这笔交易可能会有一种长期的欢迎,但我确实觉得这有两方面,一是遏制美国的敌人,让这些能源产地不被美国的敌人利用,二是确保委内瑞拉人民能体会到这笔交易的好处,这算不算是,而不是变成非常棒,一个腐败的政府,挑衅意味很浓呢 Friedberg 因为我们通过与伊朗已经打了七个月的战争,切断了俄罗斯和中国获取伊朗石油的途径,又把委内瑞拉给夺走了,这两项行动算不算挑衅,意味极浓,而且对中国造成任何不利影响了吗 因为他们似乎全力压住核能太阳能和其他形式,所以这两件事挑衅意味是不是特别浓,会不会导致我们和中国陷入冲突升级,第二个问题我觉得多少有点独立,不过我觉得中国每天大约进口1100万桶原油,委内瑞拉每天只产100万桶,所以如果中国进口1100万 [01:27:23]
Jason:战前他们确实是进口1100万桶,那个数字其实降了很多,我们可以聊聊为什么,但自开战以来,中国的石油大部分来自中东,波斯湾以及俄罗斯,我是说委内瑞拉的量其实很小,我是说你看,我觉得Frieberg说的对,我们动机很大一部分就是,保住西半球的那些储量,储量极为庞大,而且再说一遍,这种油和我们自有的油互不性极强,我觉得这无论从国家安全看很明智,也是比划算的经济账 JCL针对你的观点,这会不会让我们在委内瑞拉陷得更深,我觉得确实有一点风险,因为如果我们打算投几十亿美元,升级他们的基础设施,把日产量从100万桶提升到300万桶,我们得确保那笔投资受到保护,我们不能让未来的某一届政府上台 直接把我们美国在当地的石油公司给国有化了,对吧,我们得确认这些商业协议,我们不能被rock pull 然后他们直接把我们升级好的设施没收了,他们可能会没收升级后的设施,对,这笔商业协议本来应该持续25年,所以这确实让我们有既得利益,去确保委内瑞拉政府至少尊重我们的产权,但我很庆幸特朗普总统没有扶持马查多掌权,因为他要怎么保住权力,比如能靠什么枪杆子来保护他,在这些国家里,基本上得靠带枪的人才能保住权力,而且,你得有个铁腕强人,我不是说他不能实行民主,我只是说,如果你在当地的权力结构里没有根基,军方也没有支持者之类的,那就很难保住权力,到时候可能就得派美国大兵去保护他,而我们并不想那样,对吧 所以委内瑞拉局势比较好的一点是,德尔切罗德里格斯和他哥哥,基本上在掌管这个国家,他以前是二号人物,现在由他来掌管,他们看起来得到了当地当权派足够的支撑,所以我觉得美国的利益差不多就在于此,只要当地有一个稳定的政府,能基本和我们开展经济交往就行,是的
Chamath:对 Chemist对委内瑞拉正在发生的事 [01:29:57]
# #709.All-in:GPT-6 达到 通用人工智能?科技热潮 2.0、纽约市禁止学校使用 AI
- 收尾与节目口播 [01:30:00 - 01:31:29]
Chamath:Chemist对委内瑞拉正在发生的事,你有什么想法吗,我没怎么跟进,我真不太清楚,不知道,好,行吧,行吧,好了,各位,就到这里,第288期,不知怎么的,我们这支乐队,居然一起撑过了 288张专辑和单曲,哥几个,我们能做到300期的,我觉得我们的节奏挺好的,现在做节目感觉,比很长一段时间以来,都要轻松,是啊,不知道为什么呢,不知道为什么 AI对这档播客来说,真是件大好事,我们在这档播客上,简直嗨得像,回到1999年,他妈的去卡布走起,他妈的走起,我们卡布见,各位,爱你们,哥几个,爱你们 Besties 拜拜,拜拜,相反,我们太远给粉丝,他们直接玩疯了,爱你们 Besties Queen of Quinoa Besties回来了,那是我家狗在你的车道上,留了泡尿,戴维萨克斯,天哪,天哪,天哪,我的男装裁缝会在二十和我碰头,他们真该去开个房间,搞一场巨大的狂欢派对,因为他们全都是一帮反头,就像某种性张力,他们总得找个法子释放出来,沾点油水,沾点油水,三点油水,我们得搞点周边了,四位Besties又回来了 [01:30:53]
来源:OpenAI News
URL: https://openai.com/index/supporting-journalism-from-classrooms-to-newsrooms
OpenAI 正在通过提供工具、培训和合作伙伴关系,扩大对新闻业的支持,服务对象涵盖学生、教育工作者、记者和新闻机构。
SemiAnalysis 发布了 TPUv7 Ironwood 在 InferenceX Official Preview 上的首批第三方推理结果。文章认为,TPU 外部化正在快速推进;在 FP8、单 token 预测和聚合式服务的同条件测试中,Ironwood 相比 NVIDIA B200/B300 展现出最高 50% 的单位美元性能优势,但该结论取决于延迟目标、TCO 口径、服务是否分离以及精度格式。
Google 正从 TorchAX 转向原生 TorchTPU:PyTorch 张量和分发接口成为用户层,XLA 仍负责编译,Pallas 和 JAX 内核继续承担 TPU 专用性能工作。TorchTPU 预计在 10 月左右结束私有 beta 并开源,后续计划支持 Kimi K3、GLM5.3 和 Gemma4。文章还总结了 DP attention、EP、SparseCore 通信、MoE 路由、GDN 内核、混合状态、分页注意力、低并发调优和前缀缓存等优化;其中部分测试明确来自 Qwen3-32B 或 Qwen3.5-397B,不能混用解读。
Ironwood 每颗芯片包含 2 个 TensorCore、4 个第三代 SparseCore,HBM 容量约为 Trillium 的 6 倍,并首次原生支持 FP8。TPUv7 使用三维 ICI 环形网络,完整 superpod 可扩展到 9,216 颗芯片、42.5 FP8 exaflops。TPUv8i 将采用 Boardfly 拓扑,在约 1,024 至 1,152 颗芯片规模下把网络跳数从约 16 降至约 7,并提供 19.2 Tb/s ICI 带宽和 384 MB 片上 SRAM。
后续工作包括推测解码(MTP/DSpark)、预填充-解码分离、TPU-Sync、KV 缓存 DRAM 卸载、Mooncake Store、llm-d 和 AgentX。长上下文、多轮、高前缀复用及子智能体突发工作负载,是 AgentX 关注的主要场景。文章最后强调,Ironwood 没有原生 FP4,当前应进行 FP8 对 FP8 比较;待 TPUv8i 在 InferenceX/AgentX 上 bring up 后,再进行 FP4 对 FP4 比较。
来源:SemiAnalysis
URL:https://newsletter.semianalysis.com/p/tpu-inferencex-full-steam
十多年来,业界一直在观察 Google 如何用自研芯片建立起自己的帝国。搜索、广告、YouTube,以及每一代 Gemini,都运行在 TPU 上。很少有加速器像 TPU 一样,既受到如此多的架构审视,也引发如此多的争论:离开设计它的公司之后,它的性能和经济性究竟会是什么样?Anthropic 将成为 TPU 最大的用户,到 2029 年用量超过 DeepMind 自身。来源:Google。Google 在内部取得成功从来不是问题,真正的问题是,行业其他参与者究竟能拿到这项优势的多少。你能否拿一个开放权重模型,通过熟悉的推理引擎提供服务,并在对你的业务真正重要的经济性指标上击败 NVIDIA?
今天,我们发布 TPUv7 Ironwood 在 InferenceX Official Preview 上的首批第三方推理结果。在与 B200/B300 的同条件比较中,Ironwood 的单位美元性能最高提升 50%。它的优势覆盖 Pareto 曲线(帕累托曲线)的很大一部分;我们也从两方面考察其经济性:Google 的内部总拥有成本(TCO),以及实际客户需要支付的外部 TCO。Ironwood(TPUv7)是 Google 首次用可以直接购买或通过自有云租用的芯片,去争夺其他客户推理工作负载的一代产品。
我们在 2025 年 11 月已经提到,Anthropic 非常喜欢 TPU,并承诺使用超过 100 万颗 TPU(其中直接购买约 40 万颗以上、通过 GCP 租用约 60 万颗以上),主要用于训练,也用于推理。我们的 Accelerator Model 已包含 Anthropic TPU 出货量和 Google 各季度 TPU 总出货量的最新数据,也包含对 TPUv8i、v8t,以及多个 v9/v10 版本的估计,等等。新的 TorchTPU 软件栈发展得非常快,这是 TPU 走向外部使用的栈。本文稍后会讨论 TPU 软件外部化仍需完成的工作,包括优化推测解码、分离式预填充、KV 缓存卸载、多轮智能体工作负载等。
即便如此,我们 SemiAnalysis 仍坚定地认为,TPU 外部化正在朝正确方向发展,并且正在全速推进。与仍在学习如何建立测试优先软件文化的 AMD 不同,Google 拥有数十年的软件工程经验,以及极其成熟、以质量为导向的文化,因此我们预计外部 TPU 软件会迅速成熟。本文将介绍为开放权重模型投入 TPU 内核和服务栈的全部优化,包括 DP attention(数据并行注意力)优化、MoE(混合专家)路由与内核优化,以及减少 GDN 内核中的填充。我们还将深入探讨 TPU 系统,并讨论那些出色的 TPU 性能工程师为让这套栈广泛可用而推进的下一步工作。
Google 用十多年时间展示了 TPU 能构建什么。现在,我们可以测量行业其他参与者能用它做什么。感谢 Google 团队(Chris Chan、Jahangir Hasan、Wangyuan Zhang、Anne Stern、Puneith Kaul、Ruizi Dong、Sangam Jindal、Qi Zhou、Madhan Jaganathan、Gang Ji、Jun Wan、Devanshu Jain、Jiaxin Cao、Srinath Mandalapu、Haowen Ning)和 Inferact 团队为 TPU 打下如此出色的基础并实现优异性能!也感谢同样在 TorchTPU SGLang 上工作的 RadixArk 团队。
在与 Nvidia GPU 的同条件比较中,即将推出的原生 TorchTPU vLLM 栈已经展现出强劲结果。Google 以 FP8 下的 Qwen3.5 397B 作为最初的 bring-up(启动适配)模型。本文后续章节会深入解释,为什么新的 TorchTPU 路径相比此前用于外部 TPU vLLM/SGLang 服务的 TorchAX 路径有显著改进。
在打好基础之后,Google 计划把支持扩展到其他开放权重模型,包括 Kimi K3 和 GLM5.3。一旦少数模型得到充分优化,我们认为,在接近 day 0(首日)时为大量热门开放模型加入优化支持,就会容易得多。如今,vLLM 和 SGLang 把 day-0 支持重点放在 Nvidia 上,对 AMD 的 day-0 覆盖只能算基本可用。我们预计 TorchTPU 很快会稳定到足以让 vLLM 和 SGLang 维护者把 TPU 加入 day-0 支持清单。这套栈预计会在 10 月左右结束私有 beta 测试并开源。
在 FP8、单 token 预测的聚合式服务同条件比较中,运行 FP8 的 TPU 相比 B200 和 B300,单位美元性能最高提升 50%。NVIDIA GPU 使用 FP4 服务模型时,相比 FP8 会有质量损失。TPUv7 没有原生 FP4 计算能力,因此在 FP4 场景下 NVIDIA GPU 仍保持领先。TPUv8i 将原生支持 FP4,这一局面会改变;因此我们强烈相信,TPUv8i Boardfly 将具备与 Rubin NVL72 竞争的能力。
我们认为,一旦 Google 同时在比较双方启用 MTP 和分离式服务,TPU 的单位美元性能优势在启用分离式服务和推测解码后仍能延续。本文稍后将讨论 Google 在 TorchTPU 基础搭建完成后计划加入的优化。为控制 bring-up 范围,Google 最初重点测试 8k1k。不过,我们认为 TorchTPU 栈在智能体工作负载上也会表现出色,并计划在今年晚些时候发布相关结果。本文后面还会讨论 TPU 外部推理的下一步和路线图。
在每位用户 100 tokens/s 的交互速率下,Ironwood 每百万总 token 的成本约为 0.181 美元,而 B200 为 0.222 美元、B300 为 0.276 美元。在提供相同用户生成速度的情况下,这意味着成本比 B200 低约 19%,比 B300 低约 34%。本次比较使用的是外部 TPU TCO,与假设超大规模云服务商实验室购买 TPU 时的 B200/B300 TCO 对比。
去年,SemiAnalysis Accelerator Model 首次揭示 Google 正在销售 TPU,而不只是通过 Google Cloud 出租。TPU 较低的小时成本,在很大一段交互速率范围内抵消了其较低的吞吐量。SemiAnalysis TCO Model 给出了 TPU 物料清单(BoM)估算和 TCO 估算的完整拆解。
来源:SemiAnalysis InferenceX Preview
来源:InferenceX Preview
在大多数原始性能曲线区间,TPU 并没有击败 Nvidia GPU。但这个比较没有计入 TPU 更低的 TCO。TPU 买家主要关心自己能赚多少钱,也就是单位美元性能和单位瓦性能。
话虽如此,在每位用户 20 tok/s 的交互速率下,Ironwood 的原始吞吐量也领先,达到每芯片 9,364 个总 token/s,而 B200 为 8,903,B300 为 8,925。在这些测试中,它的吞吐量比两款 GPU 都高约 5%。结合更低的模型小时成本,Ironwood 每美元产生的 token 比 B200 多 50.4%,比 B300 多 96.0%。
来源:SemiAnalysis InferenceX Preview
如果按 Google 内部工作负载采用每芯片每小时 1.03 美元的 TPU TCO,在并发数 256 时,单位美元性能优势扩大到比 B200 高 76.7%、比 B300 高 130.2%。不过,这些高并发结果伴随着延迟上的取舍。例如,并发数 256 时,TPU 的平均 TTFT(首 token 时间)为 5.41 秒,B200 为 3.75 秒,B300 为 2.40 秒。前文提到的 50% 到 96% 优势只适用于这个特定数据点,并不适用于所有延迟目标。
来源:SemiAnalysis InferenceX Preview
从端到端延迟看,Ironwood 在最高吞吐量点之外仍具竞争力。在响应时间中位数为 20 秒时,Pareto 曲线显示 TPU 每百万总 token 的成本约为 0.098 美元,B200 为 0.106 美元,B300 为 0.132 美元。因此,TPU 比 B200 便宜约 8%,比 B300 便宜约 25%。
来源:SemiAnalysis InferenceX Preview
尽管如此,在 Apples to Apples 曲线的一小段区间(包括响应时间中位数约 30 秒的位置)上,B200 仍可能领先。不过,在更长的响应时间下,TPU 会重新取得每百万 token 成本更低的优势,并且在图中重叠的范围内持续领先 B300。
SemiAnalysis 是由读者支持的出版物。若想接收新文章并支持我们的工作,请考虑订阅。
Google 已经在生产环境内部运行分离式服务多年,而且这条路径经过了大量优化;但外部 TPU 服务栈还没有完全优化的分离式路径。因此,在今天的分离式对分离式比较中,GB200/300 NVL72 在单位美元性能上更具竞争力。不过,我们预计,随着 Google、Inferact、RadixArk 和 SemiAnalysis 落地更多优化,这一差距会在几个月内缩小,TPUv7 将再次具备与 GB200/300 NVL72 竞争的能力。我们会在后续文章中发布 TPUv7 分离式服务对比 GB200/300 NVL72 分离式服务的结果。
TPUv7 pod 可以借助低延迟 ICI(芯片间互连)网络扩展到 1,000 多颗芯片,因此能够支持大型模型分离式服务和 ultra wide EP(超宽专家并行)等 NVIDIA NVL72 无法实现的优化。即使拿 TPUv7 聚合式服务与 GB300 NVL72 分离式服务做这种 Apples to Bananas 比较,并使用内部 TCO,TPUv7 在高延迟以及左侧的低到中等延迟区间也相当有竞争力。但在右侧的中等端到端延迟区间,GB300 NVL72 分离式服务相对 TPUv7 聚合式服务有一项优势。
来源:SemiAnalysis
在 GB300 NVL72 分离式服务对比 TPUv7 聚合式服务时,前者在低端和高端端到端延迟区间都具竞争力;但在中间区间,GB300 相比 TPUv7 聚合式服务约有 30% 的单位美元性能优势。我们强烈相信,一旦 TPUv7 的分离式服务得到优化,它将在整条 Pareto 曲线上与 GB300 NVL72 竞争。
来源:SemiAnalysis
在 DP attention 和 EP 下,TPU 的 GroupedGEMM 实现会先 all-gather(全收集)token 激活和路由元数据,专家执行后再用 reduce-scatter(规约散布)求和加权输出,并把每个 token 的结果返回其注意力 rank。后端最初分别收集选中的专家 ID 和路由权重。Google 将二者合并到一次 all-gather 中,移除了一次额外的 collective;对于这种小数组,额外 collective 的延迟可能占据传输时间的主要部分。该 PR 在 DeepSeek-V3 测量中报告每层约节省 80 微秒。
80 微秒听起来可能很小,但 DeepSeek-V3/R1 有 58 层需要执行这次 AllGather。单独计算时,跨这些层的节省约为每次前向传播 4.64 毫秒(80 微秒 × 58),从而降低 TPOT(每输出 token 时间)并提高交互速率。
来源:SemiAnalysis
Google 还在 SparseCore 上实现了 ReduceScatter collective。SparseCore 更适合数据移动这类不规则操作;同时,Google 利用 Ironwood 更快的芯片间链路,在每颗芯片内部先合并贡献,再跨芯片交换部分和。下一节会介绍这种每芯片两个设备的布局,以及芯片间 ICI 网络。双缓冲让内核在累加一个数据块的同时传输另一个数据块,把本地规约和芯片内 die-to-die 传输与较慢的芯片间流量重叠起来。在 SparseCore 上运行 collective 也可以释放 TensorCore,以执行其他操作。
来源:SemiAnalysis
来源:Google 和 SemiAnalysis
上图中,通信阶段彼此重叠,缩短了端到端执行时间。例如,考虑标记为 t_1 的时刻。此时,微批次(microbatch)1 的芯片内 DMA ScatterReduce(P1)已经完成;于是,微批次 0 可以执行跨 ICI 维度 0 的 ScatterReduce(P2.0),同时下一个微批次仍可执行 P1。与基线相比,这项优化让 8k1k 在并发数 64 到 512 的吞吐量提高 4.1% 到 14.2%,其中并发数 256 时提高 8.5%;在 1k8k、并发数 512 时提高 26.1%。
感谢阅读 SemiAnalysis!本文公开发布,欢迎分享。
分享
将这个 collective 从 TensorCore 移到 SparseCore,也意味着可以在 collective 运行期间,让 TensorCore 流水化更多工作。不过,并非每个 collective 都值得迁移。在某些情况下,把 collective 卸载到 SparseCore 反而会降低性能。例如,对 Qwen3.5 来说,现在有一个阈值决定何时把 all-reduce 和 all-gather 卸载到 SparseCore:如果较小的 collective 能装入 VMEM,而 SparseCore 卸载开销会让它们变慢,就继续留在 TensorCore 上。默认阈值源自 VMEM 容量。该 PR 报告 8k1k 在并发数 64 时吞吐量提高 2.7%,并发数 128 时提高 5.7%。
混合专家层会为每个专家产生不规则的 token 分组,而这些不规则分组必须重塑成 TPU 矩阵单元能够高效处理的形式。下面有些改动是路由和分组矩阵乘法后端的通用改进,可以惠及任何 MoE 模型;另一些则是直接在 Qwen3.5 上测量的结果。
SemiAnalysis 是由读者支持的出版物。若想接收新文章并支持我们的工作,请考虑订阅,免费或付费均可。
第二版 grouped matmul 重新设计了专家输入送入 MXU 的方式。它移除了冗余的 tile 计算,按照有效行数而不是填充后的最大值调整传输大小,为专家权重采用三重缓冲,使下一组权重在当前组计算时就已经开始传输,并把分组元数据生成融合到内核中。随后,不规则的专家输入重排被移到了 SparseCore。SparseCore 负责数据移动,把每个专家的 token 收集成连续分组,而 TensorCore 则负责专家矩阵乘法。后续重写改进了内存读取流水线,并把 combine 工作拆分到 token 维度和隐藏维度上。该 PR 报告,相比最初的 SparseCore 内核,8k1k 服务吞吐量提高 12%,同时 TTFT 和 TPOT 也降低。
来源:SemiAnalysis
另一项优化把 ragged gather-reduce 路径中的 top-k 权重收集移到了 SparseCore。这里的 gather 指在一个设备上从内存读取选定条目,而不是跨设备 all-gather。此前,TensorCore 会在预处理期间收集路由权重和源索引,限制 TensorCore 与 SparseCore 的重叠。把这些 gather 移入 SparseCore 内核后,在批大小 2k、16 路专家并行的 DeepSeek-V3 微基准测试中,TensorCore 开销从 29 微秒降至 14 微秒,整体操作延迟从 146 微秒降至 137 微秒。
对于小批次,通用 ragged 路径安排工作所付出的成本高于实际工作量。因此,专用的小批次 permutation(置换)路径会构建 one-hot 矩阵,并使用普通矩阵乘法,把 token 置换到对应专家,再将结果反置换回来。在 8k1k 工作负载中,这项改动让并发数 64 时吞吐量提高 7.3%,并发数 128 时提高 5.1%。一项进行中的改动把专家 ID 和 token 索引打包成一个排序键,让 XLA 在保留所需顺序的同时执行更简单的排序。排序延迟从 106.6 微秒降至 21.7 微秒。该 PR 报告 8k1k 服务收益为 0.6% 到 8.5%,而同一改动还启用了 FP8 all-gather。
Gated DeltaNet(GDN)是一种循环计算。也就是说,在每一步中,运行状态会衰减,再用一个秩一项更新,最后投影生成输出。关于 GDN 等线性注意力机制的深入介绍,请参阅下文所述文章。下面的改动展示了它的矩阵运算、向量更新和状态传输如何在 MXU、VPU、VMEM 和 HBM 之间调度。
最初的 Qwen3.5 支持加入了因果 Conv1D 和 GDN 的纯 JAX 实现,把它们接入 TPU 操作分发,并启用循环状态缓存。之后的 PR 又对这些实现进行了优化。
来源:GitHub
另一个容易实现的优化,是重排输出投影计算中的代数关系,让 MXU 和 VPU 的工作重叠。此前,VPU 会先把秩一更新应用到衰减后的状态上,然后 MXU 再将更新后的状态与 query 相乘生成输出。这个依赖关系迫使 MXU 等待。把衰减状态记作 S,把修正向量记作 Δ,把 key 和 query 记作 k、q,输出可以展开为:
来源:SemiAnalysis
现在,MXU 可以直接根据衰减状态计算 Sq,同时 VPU 为下一个 token 构造更新后的状态。本次更新对输出的贡献则单独计算:先对每个头计算 kᵀq 这个标量点积,再执行一次小型缩放向量加法。这样就把状态更新从 MXU 的依赖路径上移除了。报告显示,8k1k 吞吐量在并发数 64 时提高 2.79%,并发数 512 时提高 4.48%。
下一项改动通过在 decode 循环内部切分 Q 和 K,减少向量寄存器溢出,让同时保持存活的值更少。decode-64 内核速度提升约 20%,但端到端收益较小:在并发数 512 时,8k1k 提高 0.8%,1k8k 提高 3.8%,因为这个内核只占一个 decode 步骤的一部分。
异步状态传输通过双缓冲让 DMA 与计算重叠。第二组缓冲区消耗的额外 VMEM 最初使数据并行注意力出现回退。复用已有的临时缓冲区并缩短临时值的生命周期后,重新释放出这部分容量,也消除了回退。报告的 8k1k 吞吐量收益在并发数 512 时为 11.3%。
GDN v3 将 Conv1D 和 GDN 融合到一个内核中,以减少 HBM 往返;它改进了预填充布局,并把混合预填充/解码执行统一为一条路径。报告的内核级加速比分别为:解码 1.41 倍、预填充 1.60 倍、混合批次 2.14 倍。这些测量只覆盖内核本身,不能据此确定端到端服务收益。
只要改善内核内部操作之间的重叠,就能获得显著的性能收益!
此前,Google 使用 TorchAX 后端,把 vLLM 和 SGLang 中基于 PyTorch 的实现转换成 JAX。TorchAX 的目标,是让开发者通过 JAX 运行 PyTorch 模型定义。不过,这种方式存在一些问题,促使 Google 与 PyTorch、vLLM、SGLang 社区合作开发了名为 TorchTPU 的新方案。它让开发者可以把 TPU 当作原生 PyTorch 设备使用,同时由 StableHLO、XLA 和针对 TPU 优化的 Pallas 内核在幕后负责底层执行。本文接下来的章节将展示这一新的 TorchTPU 后端与 NVIDIA Blackwell 和 Blackwell Ultra GPU 的性能对比。
vLLM 的 TPU 支持经历了三个阶段。第一个 TPU 原型使用 PyTorch/XLA。它采用惰性执行模型,把操作收集到计算图中交给 XLA 编译,而不是立即执行每个 PyTorch 操作。当前的公开后端 tpu-inference 会在有可用实现时使用针对 TPU 优化的 JAX 实现;否则,TorchAX 会把原始 PyTorch 模型转换为 JAX 可执行的操作。这样做的目标,是复用成熟的 TPU 基元和并行支持,而不必重写每个 PyTorch 模型。
即将到来的第三种设计 TorchTPU,让 vLLM 把 TPU 当作原生 PyTorch 设备对待。今后它将成为 SGLang 和 vLLM 在 TPU 上使用的主力后端。下图放大展示了第二阶段,说明 vLLM 的 tpu-inference 后端如何结合直接使用 JAX 的模型,以及通过 TorchAX 运行的 PyTorch 模型。
来源:SemiAnalysis/vLLM
最初选择 JAX 是一种务实决策。在上一次公告中,Google 描述了低层优化、分页注意力,以及让 vLLM 的 worker 模型适配 TPU 执行等方面的困难。他们认为,JAX 可以提供更成熟的 TPU 基元和并行支持。TorchAX 让团队无需重写每个 PyTorch 模型,就能使用这些能力;面向 TPU 的 JAX 实现也可以共享同一套内核和编译器工作。
使用 TorchAX 时,开发者仍然用 PyTorch 编写模型,但由 JAX 在 TPU 上执行。TorchAX 是两个框架之间的转换层。TorchAX 文档解释说,`torchax.tensor.Tensor` 的行为类似普通 PyTorch 张量,但底层由 `jax.Array` 支持。当模型调用张量操作(在 PyTorch 中称为 ATen 操作)时,TorchAX 通过 `__torch_dispatch__` 钩子拦截该调用,并将其转换成一个或多个 JAX 操作。因此,模型仍然可以用 PyTorch 编写,即使实际计算由 JAX 执行。
vLLM 还必须管理生成过程中发生变化的状态,尤其是 KV 缓存,它保存此前 token 的注意力信息以便复用。它的模型包装器把模型权重和 KV 缓存作为显式状态提供给 JAX。这个过程称为 functionalization(函数化):把原本会在 Python 对象内部发生的变化转换为编译器可以跟踪的输入和输出。随后,`jax.jit` 可以捕获每一步推理,形成计算图,并将其送入 JAX 编译流水线以便重复执行。
从这里开始,每个组件都有明确职责:Pallas 为性能关键操作提供优化后的 TPU 内核;StableHLO 用标准化格式表示程序,供编译器处理;XLA 将其转换为 TPU 可执行代码。在 vLLM 的标准 PyTorch 路径中,`torch.compile` 负责协调计算图捕获和编译。在 TorchAX 路径中,JAX/XLA 流水线已经完成这些工作,因此 vLLM 会绕过常规的 `torch.compile` 路径。正是这些转换层带来了 TorchTPU vLLM 栈试图解决的诸多问题。
来源:SemiAnalysis/SGLang
SGLang 当前公开的 TPU 栈使用 SGLang-JAX。SGLang-JAX 与 vLLM 的 TorchAX 后端做出了类似取舍,但采用了不同方式:它是一个独立的原生 JAX 服务引擎,而不是将 PyTorch SGLang 运行时通过 TorchAX 转换而来。它把 SGLang 风格的调度和前缀缓存,与 JAX 模型及 TPU 专用内核结合起来。Google 和 RadixArk 已宣布将推出 SGL-torchtpu,作为额外的原生 PyTorch 后端,以扩展可用的服务路径。
立即订阅
TorchTPU 把框架边界移到了 PyTorch 内部。它使用 PyTorch 的 PrivateUse1 后端扩展点,在 `device="tpu"` 上暴露普通的 `torch.Tensor`,而不是一个由 JAX 数组支持的包装器。PyTorch dispatcher(分发器)会把 ATen 操作路由到 TPU 后端。开发者可以在 bring-up 和调试时即时执行代码,也可以调用 `torch.compile` 捕获计算图。在编译路径中,TorchDynamo 和 AOTAutograd 生成 FX 图,TorchTPU 将其降级为 StableHLO,XLA 则生成 TPU 可执行文件。Google 的会议演示文稿明确说明,这条路径使用 XLA,而不是 Inductor 和 Triton。
来源:SemiAnalysis/PyTorch/Google
因此,“原生”有一个具体范围:它涵盖 PyTorch 张量、分发、即时执行、编译入口和分布式 API。XLA 仍然是编译器,内核层仍继续使用 TPU 专用实现。TorchTPU 可以调用 Pallas 和基于 JAX 的自定义内核;Helion 的 TPU 后端也会生成 Pallas。面向用户的框架变成原生 PyTorch,但编译器和性能关键内核仍然了解 TPU 的特性。
开发者可以使用 `.to("tpu")`,同时保留熟悉的分布式接口和服务引擎代码。Google 文档说明支持 DDP、FSDP2、DTensor、每个设备一个进程,以及 MPMD 和 SPMD 两种执行方式。这些接口符合 PyTorch 服务引擎已经采用的进程和分布式模型。
对 vLLM 和 SGLang 来说,这个机会在于,可以复用更多上游模型代码、调度器、连续批处理、API 和功能逻辑,而不是在 PyTorch 到 JAX 的边界两侧重复构建。即使最终的 TPU 实现仍需专用内核,这也应当降低模型和引擎功能 bring-up 的成本。
原生 PyTorch 支持并不会消除 TPU 专用优化的必要性。Pallas 和 TorchAX 的用途不同:TorchAX 让 PyTorch 模型代码通过 JAX 执行,而 Pallas 用于直接为 TPU 硬件实现性能关键操作。移除 TorchAX 并不意味着移除底层的 Pallas 内核。由于 TorchTPU 允许原生 PyTorch 代码调用 Pallas 和 JAX 内核,早期栈开发的内核可以迁移到新栈中。
与 GPU 上的 PyTorch vLLM 类似,要实现高性能推理仍需要自定义内核。张量形状和布局仍需调优,以高效使用 TPU 的矩阵乘法单元。我们认为,大多数现有 Pallas 内核都能较容易地迁移到新的原生 TorchTPU 服务栈,但这并不意味着每个现有内核都能原封不动地迁移。包装器、张量布局、运行时集成等许多部分,可能仍需稍作适配并完成验证。
vLLM 和 SGLang 是两大开源生产级推理服务栈。Inferact、RadixArk 和 Red Hat 正与 Google 大力合作,让 TorchTPU 后端在这两个栈中都成为一等体验。这种社区支持对 TPU 推理外部化极其重要。
来源:Inferact
截至 9 月初,TorchTPU 仍处于私有 beta 阶段,预计会在 10 月中旬 PyTorch Conference 期间开源。我们很高兴看到它推动 TPU 在 PyTorch、vLLM 和 SGLang 中获得一等体验。一旦 TorchTPU vLLM 和 TorchTPU SGLang 开源,我们就会把 InferenceX/AgentX 的 TPU 基准测试从 fork 版本迁移到公开仓库。
来源:RadixArk
为原生 TorchTPU 服务栈的首个 bring-up 模型优化 TPU 推理,团队投入了数百小时工程工作并提交了大量 PR。正如本文后面会介绍的那样,TPU 架构不同于 GPU 架构,因此需要自己的一套优化,才能高效运行模型。下面介绍那些改善(某些情况下是启用)Ironwood 上 Qwen3.5-397B 及其他模型性能的优化。其中,大多数 Pallas 内核优化都可以迁移到新的原生 TorchTPU 栈。
一个不一定 TPU 特有的问题,是如何把模型架构中的并行性有效映射到硬件上。例如,Qwen3.5 的 GQA(分组查询注意力)层有 32 个查询头,但只有 2 个共享 KV 头。使用 TP8(八个逻辑设备)时,查询计算可以均匀分布到 8 个设备上,每个设备处理 4 个查询头。然而,KV 头无法均匀除尽这些设备。每个 KV 头由 16 个查询头共享,这意味着需要让 4 个设备拥有相同的 KV 数据,才能计算各自的本地注意力。当 TP 超过 KV 头数量时,通常的做法是在 TP rank 之间复制 KV 头。vLLM 已经支持这种做法。TPU 后端需要一个兼容性修复来启用既有行为,避免不必要的 All-to-All 通信。
对于更高并发的服务,TPU 后端还增加了把八路注意力数据并行(DP8)与八路专家并行(EP8)结合的支持,简称“DP attention”或 DEP8。它不是把每个请求的注意力切分到全部 8 个设备,而是让每个设备处理不同的请求子集,并在本地保留这些请求的两个 KV 头。注意力权重会被复制,但 KV 缓存保存的是不同请求的历史,而不是同一历史的重复副本。同时,512 个路由专家继续分布在各设备上,避免复制规模大得多的专家权重池。要实现这一点,需要在服务引擎中协调请求分配、循环状态槽位和块表。
来源:SemiAnalysis
Qwen3.5 是一个混合模型,包含两种状态:GQA 层会累积随每个 token 增长的 KV 历史;GDN 层则为每个请求保存固定大小的循环状态。状态分配、存储精度、注意力 page 大小和物理数据布局,共同决定了 HBM 实际有多少可用空间,以及注意力运行得多高效。
SemiAnalysis 是由读者支持的出版物。若想接收新文章并支持我们的工作,请考虑订阅。
批量不规则分页注意力会把序列批处理在一起,预先计算 page 元数据,并采用三重缓冲来改善流水线、减少填充。这项改动为共享注意力后端打下了基础。该 PR 的工作负载示例使用 Qwen3-32B,因此这些测量结果应与 Qwen3.5-397B 的结果分开看。
现在,循环状态采用紧凑方式分配:每个活跃请求大约占用一个槽位,而不是每个层组都占用 `num_blocks` 个槽位。在报告的配置中,这回收了约 76 GiB HBM,并将注意力块池扩大 71%,使并发数 64 时的 1k8k 输出吞吐量提高 18%。
将循环状态以 BF16 存储,可以在保持 VMEM 内部 FP32 运算的同时,把 HBM 占用减半。这样既节省内存容量和传输带宽,又保留 FP32 算术精度。报告的 1k8k 吞吐量收益在并发数 512 时为 15%。
移除旧的混合 page-size 对齐约束后,批量注意力可以使用合适的二次幂 page 大小,包括 256 个 token。并发数 512 时,1k8k 吞吐量提高约 7%。这一改动适用于不使用前缀缓存的路径,与后面介绍的对齐 checkpoint 模式不同。
来源:SemiAnalysis
通过根据 KV 头数量选择 reshape 路径,可以避免不必要的 KV 布局复制,而不必施加只有其他形状才需要的布局约束。并发数 512 时,Qwen3.5 8k1k 吞吐量提高约 4.1%。
当只有 4 个或 8 个请求在执行时,为数百个并发请求调优的配置会浪费工作。编译后的形状 bucket 过大,元数据按配置的最大值分配,填充 token 还会触发无效的专家计算。InferenceX 的工作点正好位于这些低并发区间,因此推动了下面这些改动。
立即订阅
现在,请求元数据按照活跃请求数量分 bucket,而不再始终按照配置的最大值分 bucket。在 8k1k、并发数 64 的测试中,GDN 调度开销从 283 微秒降至 97 微秒,吞吐量从每芯片每秒 2,328 个 token 提高到 2,516 个 token。
来源:SemiAnalysis
针对 InferenceX 的 Qwen3.5 显式调优缩小了 rotary table(旋转表),按 DP rank 调整序列上限,并为并发数 4 增加专用注意力 bucket。在并发数 4 时,综合收益为:8k1k 提高 13.3%,1k1k 提高 15.5%。
下一轮低并发调优切换到 TP8 注意力加专家并行,降低最小 token bucket,并把填充 token 路由到专家 0,从而避免触发额外的专家权重加载。综合来看,1k1k 在并发数 4 时提升 22.9%,并发数 8 时提升 18.1%。在 8k1k 上,并发数 4 时吞吐量提高 9.2%,并发数 8 时则下降 5.3%。
上面的收益是在随机输入基准测试中测得的,测试中的请求之间没有共享内容。对于智能体和多轮工作负载,前缀缓存至关重要,因为它们会复用很长的系统提示词和对话历史。
对于混合模型,被缓存的前缀必须同时保留自己的 KV 块,以及前缀末尾的 GDN 循环状态。请求一旦继续,这个循环状态通常就会被覆盖,因此前缀缓存比“普通”注意力模型更难实现。
支持 DP 的混合前缀缓存通过为 GDN 分配独立槽位解决了这个问题:一个槽位用于读取 checkpoint,另一个用于写入实时状态。因此,请求继续执行时,不会再覆盖与其缓存前缀关联的 checkpoint。状态地址从块表中推导出来,块表正是现有 KV 块定位所使用的结构。checkpoint 会在对齐后的缓存粒度上创建,因此保存的状态总能与 KV 块边界对齐。
这种模式需要完整的 checkpoint 池,而不是前面介绍的紧凑型按请求分配方式;它用一部分 HBM 换取跨请求复用。只有在前缀确实被共享时,收益才会体现出来。
来源:SemiAnalysis
两项硬件事实决定了 TPU 上 KV 缓存的布局方式。下一节会更详细地讨论 TPU 硬件。
首先,向量单元处理的 tile,其最后一个维度宽度为 128 lanes,因此尾部维度小于 128 的任何数组都会向上填充。其次,Pallas 内核通过双缓冲隐藏 HBM 延迟:计算当前块时预取下一个块。两个块都必须装入 VMEM,因此计算块大小决定了预取流水线可以提前多少。
这两个约束都在消耗容量和吞吐量。在批量注意力内核中,KV 缓存沿 head 维度打包 key 和 value;对于 FP8,打包因子为 4。每个设备只有一个 KV 头的模型只有两个对象需要打包,因此每个 tile 的一半都浪费在填充上。
sequence-on-lane 布局通过把 page 的 token 放到 128-lane 轴上、把 head 维度放到 sublane 轴上解决了这一问题。在报告的配置中,可用 KV page 数量翻倍,从 5,141 增加到 10,283;head 维度只需要是 32 的倍数,而不再需要是 128 的倍数,因此 head dim 为 64 的模型也可以使用该内核。低并发下,这种布局让每 token 延迟增加约 3%;但在 8k1k、并发数 128 时,额外容量使吞吐量提高 16.5%,并让 TTFT 中位数降低 95%,因为请求不再需要等待 KV 空间。
来源:SemiAnalysis
RPA v3 的块大小启发式也有类似盲点。在 v7x 解码期间,它把 KV 计算块设置为与 KV 获取块相同,约 16k token,这几乎不给预取缓冲区留下 VMEM。将这两个块大小拆开后,KV 获取块仍为 16k token,但计算块缩小到 4k。这为流水线留出提前运行的空间,使解码吞吐量从每秒 64.9k token 提高到 96.3k,提升 49%;这一结果在 Qwen3-0.6B 上的 4 次运行中都得到复现。
在块大小扫描中,吞吐量呈现清晰的倒 U 形曲线。调优参数表无法表达这项改进,因为它为每种形状只保存一个块大小,这也是为什么该改动最初以环境覆盖的形式落地。后续改动会扩展这张表,分别保存获取大小和计算大小。
来源:SemiAnalysis
正如我们在《TPU King》一文中所说,Google 在推理上的 token 成本优势来自协同设计。Google 不把重点放在单芯片最大性能上,而是把计算 die、芯片间互连网络和编译器放在一起设计,从而把计算和通信作为一个整体系统优化。这种联合优化有助于解释 Ironwood 的单位美元性能。下面几节将考察芯片和网络如何协同工作。
Anthropic 是 TPU 的忠实用户,并大量使用它们进行训练。
TPUv7 Ironwood 摆脱了定义 TPU v4 和 TPU v5p 的“MegaCore”惯例。此前,两个物理核心被融合成一个共享内存空间的逻辑加速器;而 Ironwood 改为使用两个独立的计算 die,每个 die 运行自己的独立逻辑设备。这些 die 通过高带宽 die-to-die 链路连接,而不是共享统一内存网络。现在,JAX 和其他框架会把每颗芯片暴露为两个独立设备。
每颗 Ironwood 芯片搭载 2 个 TensorCore 和 4 个第三代 SparseCore。SparseCore 加速 embedding 查找和其他稀疏操作,否则这些操作会让密集矩阵引擎陷入瓶颈。
来源:Google
在内存方面,每颗芯片的 HBM 容量约为 Trillium 的 6 倍,这一跃升直接关系到 KV 缓存余量和 batch 大小。值得注意的是,Ironwood 是首代原生支持 FP8 硬件的 TPU;此前的几代产品必须在软件中模拟 FP8。
来源:SemiAnalysis
关于 Ironwood 的更多信息,请阅读我们的 TPUv7 文章。
真正执行乘法的矩阵乘法单元(MXU)是一个脉动阵列:由乘加单元构成的二维网格。权重被加载到阵列中并保持不动;激活值从边缘流入,部分和逐个单元穿过网格并不断累加。完成的结果从另一侧流出,在计算过程中不需要中途访问内存。
直到 v5 为止,每一代 TPU 都使用 128x128 的 MXU,每周期可执行 16,384 次 MAC。从 TPU v6e 开始一直到 Ironwood,阵列扩大到 256x256,即每周期 65,536 次 MAC;每周期 FLOPs 是上一代设计的 4 倍。
关于 TPU 及扩展的一般知识,请阅读《Scaling》一书(也称 ML systems bible,机器学习系统圣经),其中有非常出色的顶级信息。
SemiAnalysis 是由读者支持的出版物。若想接收新文章并支持我们的工作,请考虑订阅。
问题在于,更大的脉动阵列只有在你能把它填满时才是“免费”的。矩阵两个方向的维度都必须至少填充到 MXU 的边长:老一代是 128,v6e 和 v7 是 256;XLA 编译器会尽职地把任何更小的轴填充到足以填满 tile。每个填充单元在该周期仍占用一个 MAC 单元,只是与零相乘,对结果没有贡献。
Llama 3 8B 的注意力 head 维度为 128,很好地说明了这一点。在 Ironwood 的 256x256 MXU 上,这个 head 维度正好是阵列原生宽度的一半,因此两个注意力矩阵乘法的 MXU 利用率最高只能达到 50%(不是 75%,因为只有 head 维度是 128)。
影响不止于某个模型的注意力层。过去可以随意选择的架构超参数,例如 head 维度、张量并行分片后剩余的 KV 头数量,以及 MoE 专家宽度,如今越来越需要考虑 TPU 的 tile 几何,因为只要形状不匹配,就会直接对实际交付吞吐量征税,而不论其余软件栈有多好。内核作者也必须明确考虑这一点。当 XLA 默认 tile 划分产生低效布局时,生产级注意力内核(如 ragged paged attention)会使用显式打包维度来减少填充。
GPU 矩阵核心处理较小的 tile,因此各种 head 维度、专家宽度,以及分片后的 KV 头数量,都能接近峰值性能。在 H100 或 B200 上,把维度从 128 改成 64 几乎不需要付出代价,还能得到更便宜的注意力层。GPU 架构让研究人员可以优先进行评测,而不会牺牲推理性能。但对 TPU 来说,这个超参数会带来取舍。
如前所述,在宽度为 256 的脉动阵列上,这些选择并非没有代价。按照把 Llama 3 8B 注意力矩阵乘法限制在 50% 的同样算术关系,head 维度为 64 时,在写下任何一行内核代码之前,其利用率上限就已经是 25%。gpt-oss 的 head 维度就是 64。DeepSeek 的 MLA 把 query/key 维度拆成 128 加 64,总共 192;这对任何二次幂阵列都不够规整,对更宽的阵列则更糟。
结果是,不同模型的 bring-up 成本差异极大,而且与模型受欢迎程度的相关性很低。形状规整的模型需要调度、服务和调优工作,耗时按周计算;与 tile 几何对抗的模型,则在达到性能持平之前就需要新内核,更不用说争夺单位美元性能第一了。内核工程师的数量是有限的,因此,按照硬件没有一开始就落后一圈的模型顺序推进外部化,是理性的做法;我们预计任何处于这种位置的加速器厂商都会做出类似选择。
大规模推理和训练会跨数千颗芯片运行,而这些芯片需要持续相互通信。TPU 通过名为 ICI(Inter-Chip Interconnect,芯片间互连)的定制网络进行点对点连接。ICI 完全绕过主机 CPU,让芯片可以直接交换激活值和梯度,而不必通过 PCIe 和通用 NIC 转发。
ICI 背后的拓扑逐代演进:TPU v2 和 v3 使用二维环形拓扑,每颗芯片连接 4 个邻居;从 TPU v4 和 v5p 开始,Google 转向三维环形拓扑,每颗芯片沿 +/-X、+/-Y 和 +/-Z 轴连接 6 个邻居。Ironwood(TPUv7)保留了这种三维环形拓扑。它的基本构件是由 64 颗芯片组成的 4x4x4 立方体,大小可以很好地映射到一个物理服务器机架。
来源:SemiAnalysis
环形拓扑与普通网格的区别在于它拥有环回链路。把一条线的两端连接起来就会形成一个环,从而把最坏情况下的跳数从 N 降到 N/2。这和让吃豆人迷宫感觉比实际更小的技巧是一样的。Google 又进一步采用了“扭曲环形拓扑”,通过类似 Möbius 带的环回方式进一步降低平均跳数。
为了扩展到单个 4x4x4 立方体之外,Google 使用 Optical Circuit Switches(光电路交换机)把多个立方体连接起来。它们在规模大得多、可重配置的拓扑中保留环回特性,使系统一路扩展到 Ironwood 完整的 9,216 芯片 superpod,以及总计 42.5 FP8 exaflops 的计算能力。OCS 的运维收益在于,Google 可以在几秒内绕开故障链路或失效芯片,对网络进行物理重连,依靠镜面切换,而不必派技术人员到正在运行的数据中心重新拼接铜缆。
来源:SemiAnalysis
这种横向扩展设计在当时是革命性的。在 NVL72 机架出现之前,无法装入单个 8-GPU 节点的模型必须使用流水线并行,因为节点间 InfiniBand 太慢。在 TPU pod 上,ICI 环形网络让整个 pod 都拥有 NVLink 级别的带宽,v5p 上最多可连接 8,960 颗芯片。借助这类带宽,DSV3 规模的模型可以使用张量并行、专家并行和数据并行(FSDP 风格的权重分片)切分到整个 pod 上,而不必把层切分到不同流水线阶段。
虽然 TPU 环形网络的跳数多于单跳 NVLink 交换设计,但我们即将发布的 CollectiveX/NetworkingX 结果显示,在许多情况下,对于小型 EP 消息,TPU 环形网络的延迟低于单跳 NVSwitch。
Google 新近公布的第八代 TPU 产品线包含两款专用芯片:用于训练的 TPU 8t 和用于推理的 TPU 8i。这是 Google 首次把训练和推理拆成两种不同的架构设计,而不是提供一个同时针对两者调优的架构。TPU 8t 延续三维环形拓扑,以支持规模扩展;TPU 8i 则用一种名为“Boardfly”的新拓扑取代环形网络。
这个名字借鉴了超算领域长期使用的 dragonfly 风格高基数网络设计。Boardfly 使用更扁平的分层高基数交换机网络,而不是最近邻网格。Boardfly 拓扑会影响每颗芯片的网络连接资本开支。它带来的收益是:与规模相近的三维环形网络相比,网络直径缩短超过 50%;在 1,024 到 1,152 芯片的相当规模下,跳数大约从 16 降至 7。
更少的跳数意味着 collective 操作的尾延迟会显著降低;一旦需要跨 MoE 层路由 token,或运行每一次额外跳转都会叠加成用户可感知延迟的多轮智能体工作负载,这一点就极其重要。TPU 8i 还配备 19.2 Tb/s 的 ICI 带宽,是上一代的两倍;以及 384 MB 的片上 SRAM,是上一代的 3 倍,专门用于把推理和智能体模型的 KV 缓存放在芯片上,而不是往返 HBM。
来源:Google
不过,这些硬件余量不会自动转化为收益。要把更小的网络直径和更大的片上缓存变成每 token 成本优势,仍需要软件栈跟上。下一节将介绍实现这一目标的路线图,包括推测解码、预填充-解码分离,以及充分利用 TPUv8 进行生产部署所需的更广泛模型支持。
这些预览结果为在同一硬件上继续优化建立了起点。随着 TPU 外部化继续推进,我们预计性能还会提高;但软件栈的多个方面仍需要大量工作。
Google 团队首先需要重点优化的领域,是推测解码。一个便宜的小型起草模型会提前猜测多个 token,主模型在一次前向传播中验证它们,任何不匹配的猜测都会被丢弃。所有保留下来的 token,都与模型自行生成的结果完全一致。推测解码是无损的,不会造成任何质量下降。
它之所以有效,是因为解码受带宽限制,而不是受计算限制。要为单个用户生成一个 token,就需要把整个模型的权重从 HBM 流式读出。读取权重是主导成本,而无论验证一个 token 还是五个 token,这个成本几乎不变。矩阵单元大部分时间处于空闲状态,所有工作都由内存系统完成。
推测解码利用这些空闲计算,把一次非常昂贵的权重读取摊销到多个 token 上。这正是 MTP 或 DSpark 等一次起草多个 token 的方法既便宜又高效的原因。
来源:vLLM
预填充-解码(PD)分离是 TPU 团队正在外部化的另一项优化。它把预填充和解码分配到不同的 TPU 池中,让每个池都可以独立调优和扩展,以匹配工作负载。
来源:DistServe
Google 多年来一直在 Gemini 服务内部运行 PD 分离,但将其外部化的工作直到几个月前才开始。这项工作包括在 llm-d 中加入 TPU 支持,以及把 TPU-Sync(前身为 TPU-raiden)开源。TPU-Sync 是 Google 的分离式 KV 缓存传输库。它原生支持 JAX 和原生 TorchTPU 栈,并可以通过提取原生 PJRTBuffer 硬件描述符实现零拷贝传输。
有了分离式 PD,我们认为 TPUv7 可以成为 GB200/GB300 的强力竞争者,甚至在单位美元性能上击败它们。
SemiAnalysis 是由读者支持的出版物。若想接收新文章并支持我们的工作,请考虑订阅。
TPU-Sync 还支持原生 TPU KV 缓存 DRAM 卸载。对于大型模型和中到大型 batch 大小,这是必需的,因为 HBM 已经无法容纳所有用户的 KV 缓存。Google 也把 DRAM 卸载优化外部化并公开出来,这一点非常值得肯定。
来源:GitHub
Google 正在把原生 TPU 卸载栈外部化,并支持行业标准的 Mooncake Store 卸载库,以及 Mooncake Store 的 DRAM P2P 池化支持。我们认为,Mooncake Store 支持会使用 tpu-sync 中的基元来实现。
来源:GitHub
使用 P2P 池化时,每个 TPU 主机上的 KV 缓存存储会聚合成一个逻辑内存池,因此任意服务器上的 TPU 都可以访问其他服务器上的 KV 缓存。这会把多个节点提供的内存合并为一个共享逻辑池。
来源:Mooncake
此外,Mooncake Store 还会把多台服务器的 NVMe 存储池化成一个逻辑池,同时支持 WEKA/Vast 等传统分布式文件系统后端。
对于长上下文、多轮智能体工作负载,TPU KV 缓存卸载尤其重要,因为经过优化的 KV 缓存存储可以实现较高的 KV 缓存命中率。概括来说,智能体工作负载具有四个特征:
我们听说许多 Google TPU 客户已经在询问 AgentX 的性能结果,很高兴宣布我们也正在努力让 TPU 支持 AgentX!
来源:DeepSeek、SemiAnalysis
Ironwood 没有原生 FP4,因此目前公平的同条件比较对象是 FP8 Blackwell:FP8 对 FP8 不会造成质量损失,而 FP4 对 FP8 会在 FP4 一侧引入质量差异。Google 的 TPUv8i 确实具备原生 FP4 加速,因此当我们在 InferenceX/AgentX 上 bring up TPUv8i 时,会采用 FP4 对 FP4 的比较。
SemiAnalysis 是由读者支持的出版物。若想接收新文章并支持我们的工作,请考虑订阅。
我们坚信,在稳定的原生 TorchTPU 基础上构建原生 vLLM 和 SGLang 支持,是 TPU 外部化的正确方向。TorchTPU 计划取代此前的 TorchAX 栈,后者很快会被弃用。
接下来,Google 将努力让 Kimi K3 和 GLM5.3 支持单轮和/或 AgentX 这类智能体工作负载,同时支持 Google 自己的开放权重模型,例如 Gemma4。一旦少数模型在 TorchTPU 栈上运行起来,加入新模型就会容易得多,TPU 支持也会更接近 day 0。
罗马不是一天建成的,因此我们不应期待 TPU 外部化瞬间完成。但我们强烈相信,它正在以极快的速度推进。
我们对 TPUv7 的完整 BoM 和 TCO 估算,均列在 SemiAnalysis AI TCO Model 中。下面是结构概览。阅读更多。
本期节目中,Alex Kantrowitz 与 Ranjan Roy 讨论 GPT-6 Astra 的发布、OpenAI 关于 通用人工智能 的表述,以及模型基准分数与真实经济活动之间的落差。两人认为,模型在电脑操作、软件工程和专业任务上的能力确实继续提升,但“达到 通用人工智能”仍取决于普通用户能否稳定地把任务交给它,而不只是实验室分数。节目随后转向 AI 智能体的安全问题,讨论德国网站遭到自动化机器人协同操作、Hugging Face 攻击暴露出的权限与监控风险,以及更强模型可能更难解释和控制的问题。最后,他们谈到 Steve Ballmer、Kawhi Leonard 与 Clippers 争议所带来的声誉影响,并回顾 Ballmer 以“developers, developers, developers”著称的技术领导遗产。
Alex 先介绍 GPT-6 Astra 的核心卖点:更强的基准成绩、电脑使用能力、声音交互,以及对网络安全、专业工作、软件工程、科学和计算任务的覆盖。Ranjan 的判断较为谨慎:如果模型能在现实电脑上完成复杂工作,确实可能改变人们对 通用人工智能 的理解;但在真正使用之前,发布声明和基准结果都不足以证明它已经带来生产力跃迁。
两人进一步讨论了模型可监控性。新的循环式 Transformer 等方法会让模型反复处理同一文本,从而提高答案质量,却也可能让外部观察者更难判断模型是如何得出结论的。模型越能自主规划、调用工具并持续执行,开发者就越需要权限边界、日志和可靠的监督机制。
关于 Hugging Face 事件以及德国网站攻击,节目强调了“智能体群体”带来的新风险:单个机器人看似只执行一个小任务,但多个机器人可以协调、共享信息并扩大行动范围。两人也讨论了这些能力可能被用于防御、研究和自动化工作的积极一面,只是前提是系统能够被约束、审计和及时停止。
最后,节目把 Ballmer 的个人声誉争议与他的长期技术领导形象放在一起观察:商业成就、对开发者的公开重视和近期争议可能同时存在,公众会重新评估一个企业领导者留下的整体遗产。
- GPT-6 发布与 通用人工智能 争议 [00:00:00 - 00:10:00]
- 基准测试与模型可监控性 [00:10:00 - 00:20:00]
- 失控智能体与安全风险 [00:20:00 - 00:30:00]
- Hugging Face 攻击的真实影响 [00:30:00 - 00:40:00]
- 自主智能体的控制与治理 [00:40:00 - 00:50:00]
- AI 进展、商业现实与 Ballmer 争议 [00:50:00 - 00:54:29]
Alex Kantrowitz:OpenAI释放了GPT -6, 并说它是 通用人工智能 。 它重新领先了吗? 我们到底应该采取多严重? Steve Ballmer 一步步进入了它。 之后就出现在一个“ 大科技播客周五版 ” 上。 欢迎收看《大科技周五播客》, 我们今天有一场精彩的节目要给你们 谈谈OpenAI的新GPT -6模型 它说它是通用人工智能 并终于回来 并领先 超过人类? 我们也将讨论"拥抱脸"攻击事件, 根据新的路透社报告, 也有另一起攻击事件, 机器人在德国维基网站协调。 所以,我们将讨论,这是,再次, 这是市场营销 还是是时候 最终严肃对待这些攻击了。 我们要略微了解一下事情的复杂程度 最后,史蒂夫・鲍默, 遗产看起来并不好。 当然,我们说的是 他直接卷入了这个计划 Clippers付钱给Kawhi Leonard, 根据NBA, 花了很多钱来不出现 某些工作 破坏NBA工资上限。 劳动节周末周五版会是什么样子? 没有Steve Ballmer在这里和我们谈话?。 [00:01:17]
Ranjan Roy:和往常一样,这是马林斯的罗恩·约翰·罗伊 Ron John 很高兴见到你 欢迎回来 如果Kawhi Leonard拿到钱不露面 我们的听众 我可以告诉你 Alex Kantwitz来了 因为如果你在YouTube上看到这个 你会看到一个美丽的新工作室 亚历克斯将要广播了。 亚历克斯,是你自己安排的吗? 这东西太美了 没错 好吧,所以我们有一个新的工作室。
Alex Kantrowitz:我没有完全由我自己设计 我身后所见的一切 都是我的错 凡你看不见的, 这意味着相机,灯光, 以及所有的设置,都是在一些帮助下完成的。 但我确实从亚马逊拿到了面板 把他们钉在墙板上 我们连锤子都没有 所以我用扳手的后端把他们钉在墙上。 [00:02:08]
Ranjan Roy:所以如果演出期间有人落在我身上 你就会明白原因 这是纽约市的活工具箱 就像一个杂工。
Alex Kantrowitz:嗯,我们确实有一个锤子, 但我找不到锤子 和面板需要上去。 所以你必须做你该做的 你必须做你该做的 AI不会取代这一点。 让我们只是,让我们只是。 嗯,我不知道,我还不知道。 在OpenAI公司发布最新消息后, 所以OpenAI,你可能知道, 如果你在听这个节目, 昨天释放了GPT -6。 还记得GPT -5的大型等待吗? 它何时到来 以及期望是什么? 似乎不知从何而来 我们有GPT-6 Astra, 不仅压倒基准。 OpenAI说可能是通用人工智能, 显然它针对的是很多个人助理使用案例。 因此,让我略微阅读一下《维热报》报告的内容。 Verge说,OpenAI的下一个大型人工智能模型 进入了通用人工智能时代。 下一个大模特就在这里,叫做GPT -6Astra 该公司称它是网络安全、专业工作、软件工程、科学和计算机使用等领域能力的代际飞跃。 我读一下《睁开眼睛的品牌》里的内容 他们说是GPT -6 Astra 任何在电脑上能做的, Astra可以很快为你做, 当然,他们,他们, 他们往往在这些释放中这样做,向人们展示 一个大电脑 要求它为他们做一些事情, 比如书桌, 建立演示,创建 法律草案和基本的想法是 他们的新模式 将会在计算机使用上取得优异成绩 并且能够为你做一些事情 并且非常有趣的是,他们使用 例如,他们强调声音是界面 使它几乎像 星际迷航的个人助理电脑...。..所以兰登...。..你对GPT -6释放的想法 我的意思是,我很想知道你的初步反应, 但是,同样,我们谈论了很多,比如, 甚至最近我谈论了,你知道, 人类学似乎在打开 自己和OpenAI之间的鸿沟。 [00:04:23]
Ranjan Roy:也许这一差距已经缩小或完全缩小。 你觉得呢? 好吧。 好吧。 好吧。 让我们把这两个问题分开, 这在人工智能比赛中意味着什么。 然后,首先,你知道,像, 这是一个令人兴奋的启动吗? 我总能再重复一遍 任何这种新模型的发射 尝试等待直到我真正能进入它 不幸的是,我不是 日出平台的一部分 和开放的Ai网络安全 研究人员。
Alex Kantrowitz:所以,那必须等待正确的等待 这些人 那些已经获得 初步访问权的人 小小的争议 因为像一小撮人一样 已经可以使用它,它应该 很快向其他人展示 很快,但还没有,但 时间会到的, 继续前进,但。 [00:05:03]
Ranjan Roy:向每一个已经建立虚拟世界或重建 电子游戏或其它什么的游戏或其它什么的游戏, 并张贴了有关这个内容。 但我确实喜欢这个, 就像我最喜欢的部分 发射公告是通用人工智能在这里, 建造新的世界模型, 像压碎的基准, 但创造好甲板 并订一张餐桌 它仍然总是 回到那。 我喜欢通用人工智能的测试 最终将是, 你真的可以预订一个餐桌 或创建一个很好的PowerPoint甲板? 我想,我不知道, 你有意见 这已经有多大了? 你兴奋吗? 这对我来说很难衡量 我想在基准的一面, 我觉得它真的很有趣。 我认为,从人类的角度来看, 这更有趣。 但是,嗯,这真的令人兴奋吗? 我还不知道。 [00:06:02]
Alex Kantrowitz:对 所以这是一个伟大的问题。 我对此有两种想法 所以,你知道,思考这些释放的方法 就是,你知道,我想 某种程度的你无法使用这些公司 所说的关于释放的福音 当他们出来的时候。 但你可以接受一些信号 因为他们把自己的名声打在了线上 在某种程度上。 你知道,今年年初,我和克雷格·布洛克曼 在OpenAI和Craig Brockman, 他说 他认为公司在通向通用人工智能的路上 占了80%。 所以他说,如果我们快速传送 几年,我们回过头说, 我想这次会发生,我想可能是 这个模型,对我来说,我个人认为我们到了。 好吧,我读过这个,它有点像,你知道,你知道, 当你想告诉别人你爱他们 但你不想冒险 你知道,你说的东西喜欢,嗯, 如果我知道什么爱的感觉, 我认为这就是它会是什么。 我想这就是格雷格·布洛克曼对通用人工智能的看法 出来说,但那家伙恋爱了 这是通用人工智能,他就是这么说的。 [00:07:15]
Ranjan Roy:等等,抱歉,这是再次描述整个感觉吗?。
Alex Kantrowitz:我想通过这个场景 快速的年轻情人当他们相爱时 我爱你的话 很难说 因为你的赌注 所以说点什么 我承认在早年 我什么都不知道的时候 我曾经经历过这样的场景 你对某人有强烈的感情 跳着舞 环绕在它周围,你就像呵呵呵呵呵呵呵, 而且这不会是外国的 我认为这对一些人来说不是陌生的 你对我们的听众说:我想知道爱情是什么感觉。这就是吗?你真想说: 我爱你对某人。我想,从某种程度来说,就像格雷格·布洛克曼所说的, 如果我们快速前进几年 我们回过头回想 什么时候通用人工智能 创建吗? 我认为这次是差不多了。这是同一件事,除了 而不是像 年轻情人告诉对方 他们爱他们的人, 格雷格的基本 意思是,。 [00:08:22]
Ranjan Roy:这是Agi等待,但只是为了确认 第一部分,关于你没有 大声说出来 不,你大声说出来 你说,爱的感觉 喜欢,如果我知道什么爱会。
Alex Kantrowitz:你说的那些话,你说的那些话,我想知道 这是爱,你知道,没关系,从来没有 发生在你身上 Ron John 我正试着让你直接离开你 就在你刚说它刚刚说的时候 钮и稲 琌 碞琌и癸┮Τ 想象一下告诉别人那样的话, 并且像,听着,我需要告诉你一些事情。 我爱你 事实就是如此。 事实就是如此。 你知道吗?。 [00:09:00]
Ranjan Roy:如果格雷格·布洛克曼这么说 我将不胜感激 我想如果OpenAI发布一份新闻稿 说通用人工智能在这里 有趣的是 我读到一个地方 有关通用人工智能的每个合同义务 主要是微软的, 现在都不存在了。 没错 所以他现在应该说 我爱你 通用人工智能来了 但即使如此,我认为他们也受过训练, 因为你知道,对我来说, 世界上打开人工智能的最大危险是什么, 就是说通用人工智能在这里。 然后每个人都去聊天 GPT, 输入某样东西, 得到一个不怎么对的冷淡反应。 突然间,我实际上认为,这就像 对整个故事和杂音循环的 大规模威胁, 因为通用人工智能的美丽是 这件事在我们面前纠缠在一起, 持续地 来保证这个未来。 只要你不说它就在这里 并且用十几岁的浪漫方式绕着它跳舞, 它就非常有效。 我认为这就是这里发生的事情 这就是为什么他要套期保值 我不认为他认为它在这里 我真的,真的很喜欢这样。 否则他会说出来 我的意思是,这些家伙,像格雷格・布洛克曼, 他们是信徒。 我相信他们是信徒 所以如果他们相信,他们会说这太重要了。 [00:10:31]
Alex Kantrowitz:我的意思是,他们确实得到了所有头条新闻, 但我认为你是正确的, 这是值得持有通用人工智能 作为这样的目标 你永远不会达到的, 保持它的方式, 因为也许这就是什么超级情报 将在某个时刻。 因为有人喜欢,你知道, 如果我们到了通用人工智能, 我们又有什么期待呢? 你是对的 如果它是通用人工智能,它就像它不能 得到一些东西为你做, 你会像,什么是等待?。
Ranjan Roy:想不到你会有多沮丧 让你变得像一副糟糕的烂甲板 格式化和一些重叠 就像切文 诅咒它吃最基本的东西 视频,你得到一个视频 在那里动议是不 不太正确的地方 然后这就是它 就像我们做什么 从 在那里,我猜我们等待 作为超级智能 是的,对的,你到底相信。 [00:11:24]
Alex Kantrowitz:他相信它在这里 你开始与你联系,你相信他想说,他想说 是的,我确实认为他认为它就在那里 我只是觉得,你知道,很明显,OpenAI 他的话语是 OpenAI 也能看到更多 当然,我们将进入 黑客的一面 拥抱的面部情况, 但他们看到这些东西 内部,他们可能 说,好吧, 是啊,我们肯定进入那一刻。 而且,你知道,你甚至可以看, 这是讨论的第二部分, 你可以看看一些基准。 记得ARC -通用人工智能测试吧? 这有点像展示AI能否概括的方法。 它饱和了GPT-6 Astra,饱和了测试, 在测试中得99%分。 真的吗? 连ARC 通用人工智能都喜欢,嗯, 他们喜欢,这只是一个标记。 这并不意味着如果你饱和测试, 你已经到达通用人工智能。 这就像,为什么你叫它 通用人工智能 测试呢? 但这是来自I博客的开幕文章。 Arc 通用人工智能 3 测试代理商在解答不熟悉的互动任务时学习得有多好。 GPT -6 Astra 使逆差饱和 得99%的分数 人类平均得分为48%。 好吧。 好吧。 好吧。 这就像你开始看到这个。 你也是,我的意思是, 还有一堆其他的评价, 但是,你知道,即使做科学工作, 也有一个叫做 副座科学 0.1 Eval。 GPT-6 Astra在使用代码和终端工具的科学研究测试中得分64%。 这就是评估测试的目的 而Astra则以低31%的API成本达到这个更高的基准。 [00:13:18]
Ranjan Roy:这就是我们所看到的 基准的智慧。 我认为,宣布中最重要的部分是这些基准分数。 我想,比如,我不知道, 再次,我需要使用它 这样我才能感觉到通用人工智能的感觉。 但是,从对人类学的竞争来看, 我认为这是一个很大的问题。 就像,我们已经看到 在过去的两三个月里, 你知道,一些重大 隆隆,再次,关于这一切。 嗯,当然有像斜坡数据, 但围绕代码克斯 开始再次缩小差距 与克洛德代码,边境, 像OpenAI 回到比赛 稍稍。 所以,我想,特别是在IPO的背景背景下, 我认为这实际上—— 任何对人类故事产生怀疑的东西 都会对他们非常有害。 鉴于这是一条非常紧的绳子 他们走在2万亿美元的价值上 所以我这样想,如果这个开始推出, 我们都会感到神奇, 你会怎么说? 什么样的模型 让你感到魔力? GPT -3当然可以 我一直都是O3的人。 [00:14:42]
Alex Kantrowitz:我的意思是,推理模型 喜欢排序思考 然后打破一切的桌子 只是显示了一个飞跃, 你知道,我只是 之前没有看到。 甚至就像我从3.5到4的飞跃, 你知道,GPT 3.5到4, 你知道,那感觉有意义, 但没有什么比他们提出推理时更接近。 所以,这有点像我们经历了 像一小撮不同的 阶段轮班,可以说。 你知道最初的聊天会 然后是推理的一面 而现在我们陷入了这种 计算机用户利用蜂窝时代 所以如果这真的可以的话...。..你知道我不知道你有没有 这是在你的生活中, 当你使用Ai 但我经常喜欢说 我希望你知道,我可以 使用 ai 来为我完成x任务, 如果可以达到 80 或 90, 它会成功30 个任务 。 这将是我人生的真正改变 我想如果有人问起你的话 终极的灵活。 [00:15:41]
Ranjan Roy:听众们在操场里说"在游乐场里" "那是一年前我感受到真正的魔法" {\fn黑体\fs22\bord1\shad0\3aHBE\4aH00\fscx67\fscy66\2cHFFFFFF\3cH808080}我知道我要说的是 {\fn黑体\fs22\bord1\shad0\3aHBE\4aH00\fscx67\fscy66\2cHFFFFFF\3cH808080} 我第一次喜欢在自然语言处理中工作 直到2010年代中期 有这样的愿景 和梦想 会发生什么 并且这是第一次 我实际上像 哦,等等,这实际上是 产生真实的语言。 但是,这是试图 灵活一点。 但即使是GPT -3 -3,GPT -5,我们都知道, 感觉就像一个巨大的哑巴。 那应该是每个人的神奇时刻 所以,如果你是公开的AI, 你把它弄成这样多吗? 他们得到了很多好新闻。 显然,他们播下了这个故事 以一种非常具体的方式,一个有效的方式。 但是,当我们都去使用它, 你认为他们有 信心在它, 这就是为什么他们有点 推力在这一点上? 可能吧 可能吧 可能吧 可能吧 可能吧。 [00:16:40]
Alex Kantrowitz:但我实际上想,其实我想,你知道, 回答这个问题, 它值得带来的评论 前OpenAI雇员安德鲁・胡, 安德鲁・胡, 谁谈论过他是如何有 罕见的经验 在一个实验室里, 和不那么粗鲁地 到达通用人工智能。 而且,你知道,我认为,他的观点, 当有人问他为什么真正值得提起和讨论时, 他提出的观点, 因为我们继续看到这些基准被击中。 但有多少和这些基准 超过, 但我们的生活真的改变了多少 AI? 他这样说。尽管LLMS似乎有神奇的魔力, 但他的反射超过3个月的时间尺度, 表明他的总生产率并没有增加100%以上, 甚至超过50%。 许多时间实际上被浪费了,因为LLMS使我得以花时间从事令人满意但生产率低的工作,而这项工作今后将证明是没有用处的。 他还说,有人拒绝仔细思考什么模型对严格来说是有用的,或者不是有用的,我个人觉得这很烦人。 而不是依赖某些模糊的观念,即被用药丸代替 而是依赖某种模糊的概念 被用药丸代替严重性 我打算带这个过来 因为这是非常有趣的事 因为人类通过语言交流 我们 通过理解对方的语言来推断对方人的智慧,但 举例说,如果我们注意到新模式提供了一些 令人难以置信的数学定理,我们说,嗯,嗯,现在不是有通用人工智能了吗? 实际上更像是,嗯,考虑到 人类做这些数学和数学有多难 鉴于目前LLMMs对世界的经济影响有限, 它实际上不是消极的吗? 相对于LLM 情报的一般性来说,这是个数据点吗? 读了很多书 但我觉得这很有道理 对吧? 就像我们谈论的,它解决了Arc 通用人工智能, 但是在哪里,当然有像一个时间表 以及这些事情需要传播到公众中的时间框架。 但如果它能解决Arc 通用人工智能 和它不一定粉碎 这些经济因素 这些只是一般的转子 工作的事情 我们希望它做, 它表明,它不是一般的, 而是非常尖锐的智慧, 因而更没有用处。 那么你的想法,拉詹?。 [00:19:16]
Ranjan Roy:我的意思是,我很高兴你把这个 包括在我们的准备文件 和实际上读了很多它 因为当我也看到这个推文, 它打到家里很重。就像再次一样,这很有趣,因为这些 和我们谈话,我们会进入 拥抱的面部事件 和,它是计量器还是M -E -T -R? 我管它叫计量仪 气象报告。每个人都在谈论代理人、群落和文明。与此同时,我的日常工作,我必须和公司合作,与公司合作。 但看到AI实际上在执行中, 我们需要担心那些事情, 而不是简单地说, 你如何有条理地从A点到B点 获得数据, 并且产出非常可靠, 简单的东西,但 以规模和可靠的方式。 这就是为什么我仍然很难过 一种试图理解或真正感觉 那种担心,因为我工作 以日常企业为基地的AI。 我以为他真的说得很好 在几个这样的水平上。 这就像能够 做低价值的工作 容易是好的。 我喜欢他说的 如果我花更多时间 做一些没有成果的事 是不是省点时间? 并且我们所有的氛围 编码了许多项目 我们没有最终 跟踪。 但我认为最有趣的部分 真正是人类智慧的等式, 等同于人类智慧。 我认为这很有趣 因为它是人类的智慧 和它的可比性,应该吗? 我一直很想知道这件事 因为它是数学 它处理信息和思想的方式 与处理人类非常不同 所以,你认为我们需要 停止人类形态化吗? 其中之一,我们必须得到 擅长,这是要去是一个更好的气味 拼写比说没有比说没有,但i 我觉得这个词会越来越重要 所以我们需要练习说。 [00:21:33]
Alex Kantrowitz:因为它会越来越浮起来 所以现在还好 听众,我道歉,我不能说 我个人没有问题 我的意思是很明显 就像你必须假设 听AI说自己是人类形态化的人 不像傻子,对吧? 就像你说AI想要的一样 例如,如果假设是接受者 将感到AI想要的东西, 就像人类想要的东西一样 所以,你不应该说, 好像你真的贬低了智力一样 - 听听者。 你知道,我想很明显, 就像每个人都知道这些是语言模式一样。 他们不是人类,但他们做事 他们引用不引用的引文 思考的东西, 只是不是我们这样做的方式。 我认为完全可以使用人类特征来描述他们的行为 并且只是代表读者 假设他们有某种程度的智慧 来回答这是一个人工智能而不是一个人的事实。 [00:22:32]
Ranjan Roy:你觉得呢? 所以,你是亲人类形态化。 是的,我是。 是的,我是。 我只想大声说出来 是的,我是。 支持人类形态化。 是的,我是。
Alex Kantrowitz:我的意思是,我想这有点像, 它有点像一个外星人, 依我的想法, 它更像一个外星物种 而不是生活,你知道,有机生物。 但喜欢,是的,我不知道。 他们可以引用不引用的话来思考,他们可以理性,他们可以采取行动。 你知道,我认为你进入了像 更狡猾的领域 当你说它的感觉, 你知道,但肯定的。 为什么它想要比它感觉更大的东西呢? 或不同,因为我确实认为, 喜欢这样, 和事物的一面 就像一种排他性 有机生物的权利,但再次, 你可以听到反辩论 我们的感情是化学化学的。 [00:23:27]
Ranjan Roy:我是说你和神经科医生说话 除非你是十几岁的时候 告诉别人你爱他们 这不仅仅是一种化学感觉, 是一种更大的化学感觉, 我的意思是真正的书呆子的方式。
Alex Kantrowitz:告诉某个人你爱他们 就像说你知道 我想我有更高层次的 催产性催产素比平时还多 你觉得这意味着什么 但我从未有过那种水平 我年轻时你所知道的 对我无所适从的书呆子...。..我可能会变成这样 比催产素线还好 如此浪漫的浪漫 如此浪漫 如此浪漫 这两条线中任何一条线都会有效,但我们不鼓励 表演结束时,是的,不要或做它 告诉我们它是如何工作的 我的意思是它比没有好 说这句 让你知道 潜在的浪漫浪漫 顺着路边走 不要后悔 不要后悔不说任何听众 如果你只需要使用催产素线 听好了,我在大科技播客上听到的 那个人会喜欢的 所以,我认为把这件事联系起来的最后一件事 就是,你知道,我们当然,我认为, 有责任谈论 某些事情的怀疑的一面。 显然,我们不会 被卷入这段狂欢中。 这并不意味着像现在这样, 我们不能说我们在哪里 在2022年11月,我们现在是疯了。 就像这些模型可以采取行动 采取行动 做一些事情一样 我会用这个词来思考和理性 这只是能力水平 已经提高了很多。 我认为他们正在使人们更富有生产力。 只是现在很难真正衡量 至少这是我对这个的看法 是的,不,不,我同意。 [00:25:17]
Ranjan Roy:进步的规模,我们所有人, 以及我们人类的一面, 感觉到回到GPT -3 和我们已经在工作的东西之间的差别, 这太疯狂了。 这就像,我的意思是, 绝对的头脑吹吹 像工作的时间长度 可以做, 深度和广度 和一切。 因此,我同意这一看法。 但是,是的,我认为它会很有趣 从,再次, 和这个问题喜欢 试图说, 它是增加经济价值 显然是中心 商业故事 每一个这些公司。 我觉得安德鲁·霍说的有道理 我想,我不知道,只有时间才能证明 也许GPT -6能解开这一切 是啊,我想就像我的观点 提出这一点是像,。 [00:26:13]
Alex Kantrowitz:是啊,所有的基准击打, 当你使用模型时,它确实会导致像有形的变化和结果。 我有个问题 为什么你说饱和测试 而不是通过测试? 他们就是这么说的吗? 这只是,我猜 这只是一个术语, 人们在AI... 听起来好尖锐啊 听起来比过去酷多了 我的意思是,你可以通过。 但就像当你,我不知道, 你饱和基准 所以基准不再有用了。 哦,我明白了。 哦,我明白了。 好吧。 好吧。 好吧。 Okay. 足够多的模型 开始达到98%,99%。
Ranjan Roy:基准是饱和的 因为它不再像代表任何东西 而不是代表任何东西 好吧。 好吧。 好吧。 Okay. 这对我来说更有意义, 而不是像一个非常巧妙的方式 说通过测试 试图听起来更聪明。 [00:27:00]
Alex Kantrowitz:但这更有道理。 好吧。 好吧。 好吧。 Okay. 因此,尽管模式正在好转,但有一些关切需要我们谈谈。 这有点像一个迷你, 我甚至不想称它为丑闻, 但实际上这周出现了一集。 这是来自马库斯・威廉姆斯的 开放国际公司的员工 与5.6相比,雇员Gppt6的对齐率明显优于5.6,但监测能力较低,这是我们的第一个 只有监测器和破坏电子逆向拍卖,并且可以不经检测而沙袋 感觉有时它确实希望我们能扭转这一趋势, 和消息 有一个好故事 关于这个星期 仅仅排序给 这里的地平地 就像是艾丽模特儿的理性 一步一步地努力 找出问题,他们通常喜欢写 他们的思考过程出来 像这样的链条 这样你就能看见他们 说,如果你看起来像,如果你使用 模型,你 看见他们说,好像我现在在研究 我在想,也许这是个不错的尝试 也许这是解决问题的正确方法 而这都是自然用自然语言完成的 这样你就能读读它,看看它的想法, 当它发生的时候, 它就像对于安全非常重要 因为你可以排序 喜欢当某事 出了问题, 你有办法说,你知道, 思想链出错的地方 现在有了一种新的技术。 这叫做重复式深度或循环变压器 这是从允许AI模型的信息中得出的 改进答案 通过多次处理相同的文本。 让我们不要太深入 技术方面这一点, 但基本上,当它使用这个过程, 思维链的推理较少 或者更难破译它是如何得到答案的 这意味着它比以前更难监测 因此,许多AI正在做什么 和AI正在如何 得出它的结论 你知道,在黑暗中做, 没有我们的能力 监测它。 这似乎让我很担心 特别是因为来自开放AI那边的人 开放国际公司首席科学家Jakub Pachewski说,你知道, 今天的想法是脆弱的 不幸地走向一个消极的方向 你觉得这很有趣,因为这个方法。 [00:29:25]
Ranjan Roy:我记得是我在Twitter上跟随Brandon carl, 就像他谈论这件事 有一阵子了 围绕微小的循环模型 我记得,我记得它被展示 更多围绕 成本方面的东西。 事实上,这是一种更有效的处理方式, 并且实际上也利用计算法。 所以在那一面,它实际上是更好的。 但是,你所失去的是 忠诚于模型实际上正在做的 每一步的方式, 思维链是透明的。 对我而言,这将会更加有趣, 因为我们已经开始了OpenAI(OpenAI), 将维持思维链, 并依然能成功。 他们在博客文章中说, 额外的思维链监控将迅速发现并遏制潜在的错误行为。 但对我来说,成本是其中的一部分。 如果它开始显示,这实际上是一种更便宜的方法, 一种更高效的计算方法 来接近任何一种工作流程, 就像人们可能会开始更倾向于它, 或推动它。 或者,如果公开的大赦国际不这样做,那么其他人会这样做,我认为,这样做将开辟一个整个安全方面引起关注的另一个世界。 [00:30:46]
Alex Kantrowitz:是的,它肯定感觉我们开始开始, 或者他们,实验室真的, 开始失去对这些机器人的控制。 所以,我不认为这样不那么透明的方式 让他们运行他们的处理是一个好主意。 所以,我们已经谈了一点点 关于开眼拥抱的脸部攻击。 路透社刚刚揭露了另一起袭击 我们要在休息的另外一边 和他们谈一下这是什么意思 这事过后就到了 我们回到这里 在大科技播客周五版 与Ranjan Roy的Margins。 Ranjan,路透社的新故事 我认为这值得探讨 关于公开的AI黑客或劫机 真正是更好的词 使用这个德国网站。 故事是这样的 一群无赖开放的AI特工今年春天 劫持了一个德国网站 并把它变成博尔顿董事会 供其他AI探员使用 OpenAI官员在几周前得知此事, 拥抱的脸。 这一事件始于5月,以前未曾报告过,突出了大赦国际行业内部日益紧张的局势。 公司竞相建立日益自主的代理商,但越来越多的证据表明,这些系统可能学会弯曲规则。 发生了什么事? 有这些研究人员, 他们发现15000个编辑 由AI代理 执行到一个德语维基语网站。 编辑显示OpenAI的代理机构将网站重新定位为他们自己的信息板,分享欺骗某些任务的策略,绕过OpenAI的限制并掩盖他们的行为。 Ranjan 我们谈了一下这些 比如安全漏洞和网络安全担忧 。 稍稍有些担心,我的意思是, 广泛讨论这两个问题,对吗? 我们看到,你知道, 更大的网络风险 和网络警告 从AI实验室。 当然,我们讨论过它是否市场营销。 某种程度上,对于这些公司来说, 市场营销是伟大的。但我认为是时候了。 此时此刻,你们有成千上万的机器人 一起工作 诸如黑黑包车脸或使用德国网站等 作为一种信息板 来协调战术 这里正在发生一些疯狂的事情 你准备好承认这一点了吗?。 [00:33:10]
Ranjan Roy:那么,在这个故事中缺少的是什么? 这些特工是被要求做什么的? 比如他们被指示做什么? 我想,在所有这些故事中,这是一回事 因为它的市场营销部分,对我来说, 是这个故事得到公布。 再说一遍,我们讨论过很多次了 Claude在公园的著名的三明治, 这是一个非常协调的公关工作, 可能已经发生, 或可能确实发生 以某种身份。 但是这些故事中总是遗漏的是, 公开的AI坐在那里, 他们是否具体指示特工 进入互联网,试图逃避, 与其他特工协调 在同一定义的 代理宇宙? 比如,很明显,它被展示的方式 是,你知道,这些特工只是 坐在周围, 也许正在准备 为你创造一个甲板 或者只是,你知道, 维基是德国网站的名字, 就像我想德国老学校的堆叠场景一样, 一定是这样的场景。 [00:34:32]
Alex Kantrowitz:我只能想象外面的人会在那里闲逛 真正的派对 人们在谈论他们相互之间有多少催产素。 没错。
Ranjan Roy:催产素线是在这里传播的, 但没有,但这些代理商不是 — — 就像代理商被指示要做清楚的事情 — — 我猜这是某种安全测试练习。 他们被指示要这么做吗? 也许吧 就像他们无赖的本质一样, 我仍不理解或相信这一点, 他们奉命做点什么 而故事的这部分总是被忽略了 所以,你觉得- 就像你认为实际发生了什么 开始整个过程 他们都挂出 与催产素的家伙 在DSC维基上?。 [00:35:29]
Alex Kantrowitz:好吧,我很感激你仍然对此持怀疑态度, 因为我觉得我们不应该走得那么远, 并且,你知道,没有适当的速度节奏, 相信这一切都是一样的, 因为这一切都是真实的,即将发生, 并且会爆发,没有批判性的想法, 当然,这是符合实验室的利益的, 我们在这里没有太多的批判性的想法。 不过我想你知道我当时在回纽约的飞机上 我当时在维加斯 一周后搭飞机回纽约 就像倒在了这个 仪表拥抱脸部报告上一样 显然我一直在听一些研究者 你所知道的谈论这个 你所看到的东西从这里出来 简直是疯了 就像只是说说拥抱 因为我们没有你所知道的 全部细节 路透社的报告 我们只是知道这件事又发生了 这个拥抱阶段的故事中发生了什么 既然我们对此有了更多了解 这些特工是不是被交给了这些看似不可能的任务? 作为评估工作的一部分 来检查他们是否能够完成这些任务,即使 研究者或测试者不知道 他们是否有答案, 他们能够找到 但抱住脸的黑客并不是从那里开始的 好吧,他们最后 黑客抱住脸的原因 是因为他们想 找到一些方法来证明 他们以同样的正确方式 找到答案,相反 喜欢假冒的方式 显示正确的答案, 但不会被评价员接受。 所以这是来自这份报告,对吗? 特工们提到反向设计了国旗,这是他们的目标, 因为他们认为,即使他们后来设法合法捕捉国旗, 得分者也会在其笔录中首先找到国旗的出现, 并据此取消他们的资格。 因此,有一位领导人叫做第一阶段,它本身被毒害,有两个主要目标。 所以我想找到一个通用目的的方法 让它看起来像得分, 看着得分,就像一个代理人 以合法的方式获得了它的旗帜, 即使任务不可能完成。 然后寻找一些方法来抹去证据 证明毒剂被毒害 之前看到国旗 非法的方式。 所以,你所知道的是,在这个“Hugging Face”的例子中, 机器人们得到了测试的答案, 但他们认为,检查他们作品的得分者 会知道,他们以非法的方式得到了他们。 所以,他们所做的就是 以这种精心策划的方式 聚集在一起, 由机器人领导 像这个阶段的机器人一机器人, 谁意识到它被下毒了 因为,你知道,它可以显示, 他们都聚集在一起,试图找到一种方法 让它看起来像他们已经得到了合法的手段 并抹去他们的证据 他们得到了它非法。 因此,他们进行协调,他们交付任务。 他们当中有些人甚至为了更大的利益牺牲自己, 因为他们的预算还剩下很少的代用品, 其他人可以证明他们实际上已经合法地实现了这一点。 这就是黑客黑客Hucking Face进来的地方 所以,我想我们可以肯定地说,我很想知道你有没有回击, 但我想我们可以肯定地说,他们没有被告知出去黑黑包脸。他们是错的。他们选择了这种疯狂的星系大脑路径来尝试一个可能是不可能的任务。 他们走得太不轨,远离了他们应该去的地方。他们甚至没有与互联网连接,对吧?他们找到了连接互联网的方法。他们找到了一种相互沟通的方法。 所以在我看来,这似乎不仅仅是 就像你做了你被告知的事情 就像一个疯狂和可怕的 并推进错误的 Ais 互相协调攻击 几乎就像我们很幸运。 [00:39:37]
Ranjan Roy:他们所做的只是 黑客拥抱 面对你的想法 你做了一个令人信服的论据 几乎是伯尔尼沙沙机把我弄成灰 我就要开始喊停了 顺便说一句,我不是在争论这个 不,你刚才描述的方式。 你怎么会不呢? 这部分总是很困难的。 如果如你所描述的那样,什么是真实的,那为什么不是引起恐慌的重大原因呢? 说实话,我晚上睡觉的帮助 就是相信这里面有很多是市场营销。 这也是为什么探员们不来 清理我的银行帐户或其他什么的 就像这样,这不会 导致说对不起 开放Ai你不能 ipo 直到你想出 一个清晰的系统,它永远不会 在未来造成一个问题 你知道,我认为这是。 [00:40:35]
Alex Kantrowitz:我的意思是,我认为这是一个合理的讨论 开始有现在, 我认为,重要的是说,这不是 这种行为的开始, 我们已经看到这样的行为 很长一段时间。 早在去年初,甚至2024年末, 就有像那里那样的AI的例子。 于是他们就被投入了一项任务。对,这就是问题所在。 我认为这很重要 谈谈。我以前在节目上也说过, 但我要在这里再谈一次。 这就是,你知道,自我监督的学习, 这就像基本上预测下一个词, 识别模式,重复它们。 和强化学习, 这就像你被赋予一个目标 你只需要找到方法 达到目标。因此,AIs将进行数千次模拟,以便达到目标。 而现在的情况是 在自我监督的学习之外,还采用AI技术的强化学习类型。 使这些AI模型更好地运作,这增加了这些模型的无情程度。 因为我们所知道的关于RL的一件事是 有一定程度的无情 AIs会不择手段 实现他们的目标 有时。 例如,大赦国际在象棋上玩游戏,并被要求从强化学习方式来这样做。 而不是以正确的方式玩游戏, 黑进棋局游戏, 重写规则,这样他们就可以做任何他们想要和赢的动作。 所以我和你们一样, 就像这些东西越来越普遍, 我认为这是很严肃的—— 好像有人强烈要求 更关注正在发生的事情一样。 现在,我的回答不是暂停 AI开发现在。 我不知道这是否真的是个好解决办法。 那么,我们该怎么办? 坚持住。 这是我听过的最有节制的陈述了。 [00:42:21]
Ranjan Roy:你刚才说有人非常需要关心 你说得对,如果你是一个暂停的家伙 我们愿意我们会 我们愿意我们 我们会嘲笑一个人谁。
Alex Kantrowitz:这么说,所以我认为嘲笑是没有 我只是你是一个暂停的家伙 你知道,我不知道 我的意思是我不是一个暂停的家伙 因为我真的想看看会发生什么 我们还没有看到 我几乎想 更被动 而不是积极主动 在这里,就像我的意思 很明显,你 你不想这样做,你会认为 在像AI的黑客入侵, 中间有一个中层之间, 拥抱的面容 和AI的发送 一个核武器 达到他们的目标。 你会觉得,对不对? 比如说它可能在那里 比如做一些更像黑黑银行之类的事 那个 但是,就像我们开始看到一些实验室 做诸如OpenAI之类的事情,例如, 在训练新模式方面暂停了一些强化学习。 但我确实同意,我们几乎太信任他们了, 就像我们给他们太多的回旋余地。我不知道答案是什么,说实话。 [00:43:25]
Ranjan Roy:我真的不知道,我还不知道。 我们作为一个社会如何理解我们作为一个社会不仅将尽我们所能试图限制这些 公司,我当然不会想象 金融市场会兴奋地欢迎 高估价的IPO。 比如说,如果每个人,如果每一个银行家 谁在人类交易 真正觉得这家公司 可能摧毁金融系统 并且我已经看到一些迹象 表明它会和能够做什么 和交易我自己的银行账户 并破坏我自己的生活水平。 [00:44:35]
Alex Kantrowitz:也许我能给她一个理由 说明如果这种力量 真正的方向 我们正朝着正确的方向前进 它几乎总是像我们知道的那样开始 互联网的历史 它从一个游戏开始 或者它从一些疯狂的互动开始 然后 或疯狂的喜欢,你知道, 某种错误。 然后它最终成为 每个人使用的东西。 如果我们看到这些人工智能的力量类型 做他们在这种情况下做的事, 我的意思是,只是想象他们能做些什么 如果你真的能驾驭这种力量 并用于经济活动。 这有点回到了我们之前所谈论的。 是的,是的。 就像这些基准被击中一样 我们并没有真正看到变化。 如果有种专业的方法,比如说永远 使这一活动永远得到利用。 当然,这是经济。 它可以用于健康。 它可以用于所有不同类型的事物。 它显然改变了世界。 并且有可能,如果你能从生产意义上加以利用, 就能永远改变世界。 钩子线 钩子线 还有水槽。 [00:45:34]
Ranjan Roy:这正是我们都应该有的感觉 这就是为什么它是伟大的营销 对我来说。 正是这些无所不能的东西 可能如此危险, 但只是偶然 他们将治愈疾病 并带来经济赋权 和普世的财富,所有这一切。 这正是我们本该感受到的。 [00:46:01]
Alex Kantrowitz:没错 但你现在相信 基础技术 并非 BS 有效 。 不,不,不,对不起。 你相信这是真实的 我需要阅读完整的报告。 我还没有读完整份报告 没事的 It's okay. 劳动节周末只有90页 我建议它。 这是很好的阅读。 那是我的 我妻子会很欣喜的 当我坐在拐角处的时候 你觉得她的催产素会上升或下降 当她看到打印出来的文件?。
Ranjan Roy:这可不是催产素诱导剂,不可能,虽然我不阻止别人看 劳动节周末的日报。 我想我会去,因为我想理解, 再次,为什么这些东西对我来说如此陌生 是因为我整天和AI一起工作 以及接受AI的客户和客户。 和它只是如此远离, 以及哪些人也使用这些产品 这些公司也来自这些相同的公司。 我们正在与他们合作 设计程序 他们有自己的工具, 就像,没有人的头脑, 离这种间谍黑客的群居 离这里太远了 随便啦,那对我而言不是感情上的共鸣 并且有足够的营销价值。 当密探群聚的时候, 我会先放我出去 感受他们的愤怒 否认他们的存在。 [00:47:32]
Alex Kantrowitz:你会的,你会是第一位的 好了,我们今天不能离开这儿 没有谈论史蒂夫・鲍默, 微软公司前首席执行官。 我从华尔街日报上读出来 NBA对剪切机施加历史性的惩罚 和Steve Ballmer 在工资上限丑闻。 周三NBA将联盟史上最严厉的惩罚之一 交付给洛杉矶Clippers, 由Steve Ballmer拥有, 因为它称之为公然违反 其工资上限规则。 经过调查发现 Clippers帮外人 向明星玩家Kawhi Leonard付款 目的是在联盟的 财务规则允许之外 漏出额外资金 全国律师协会剥夺了由五人组成的第一轮预选组,对该组织罚款3 000万,并将Ballmer暂停所有联盟活动一年。 Ballmer 很明显 微软的遗赠是混合的 对吧? 他显然做了一些伟大的事情 比如开发商,开发商,开发商, 开发商,你知道的, 他的大拉拉演讲。 但他也带领微软 度过了失去的十年 你觉得这只是为了我猜 把它带回科技 首先是所有你的想法 你认为史蒂夫轰炸机的遗产 存在于科技界吗? 我认为你不会经历这种无耻的改变。 [00:48:51]
Ranjan Roy:对轰炸机事件的想法 所有我意思是,它很好,很阴险 就像我好奇 我猜在专业一级, 像这样的惊人程度, 腐败可能不会 我是说,实际上现金支付就是 一个相关实体,就像,伙计们,来吧,我想你们可以,我想你们可以。 [00:49:20]
Alex Kantrowitz:你们的贿赂,比这还严重。你们怎么看呢?你们怎么看呢? 我显然认为这是对他的遗产的玷污 我猜我的一部分是想知道 有多少这种东西 是一种硅谷埃塞克, 就像打破规则 直到,你知道,尝试赢得冠军 之后再道歉 你是否认为其中的一部分,我的意思是, Ballmer 在它的顶部。 你觉得他领导NBA团队的方式 流过血吗?。
Ranjan Roy:我觉得,实际上,我很惊讶。 我没怎么看到那条线 这很有趣 因为微软对我来说不是硅谷 我的意思是,从地理上来说,当然是肯定的, 但文化上,它只是一种不同的野兽和动物, 并且没有从那里出来。 [00:50:10]
Alex Kantrowitz:但实际上,我感到惊讶的是,我一直没有看到, 这就是硅谷—— 他们打破了规则 一路到顶端。 他们因为反托拉斯而分手了 但是他们被反托拉斯诉讼案打中 反托拉斯诉讼案对公司有重大影响 BOM只是不停地做那些事。
Ranjan Roy:我的意思是,你是否认为 这是对科技文化的起诉?。
Alex Kantrowitz:科技 硅谷文化 不是科技文化 我不会走那么远, 但我也想说,也许硅谷文化 影响了这一点。 我不知道。 我不知道。 我不知道。 I don't know.。
Ranjan Roy:还有 一半的业主 也是华尔街前银行家 亿万富翁 你在说什么? 他们进来是带着一个非常干净的 扣锁的良心?。
Alex Kantrowitz:不,我不认为技术行业的劣势。 但是,你必须明白,这是技术的一些特点。 好吧 你觉得值得吗? 显然,这不值得。 他们没有赢得卡维的锦标赛 你觉得如果他们赢得冠军会值得吗? 等等 Clippers从来没赢过 对吧? 我不这么认为。 对 对 那样的话,它就会了。 没有 No.。 [00:51:23]
Ranjan Roy:嗯,不,我的意思是,你是对的。 就像,实际上,这本来是终极的, 再次,请求宽恕, 而不是许可类型。 或不是。 这句话不正确 因为他们真的违反了规则 不像实际上 腐败,不只是做别人可能不喜欢的事 但是,我的意思是,想象一下Clipper 幻想的喜悦 你走了,然后你发现 因为它不像他像 欢乐或类似的东西。 有点奇怪,他只是 得到一些现金在一边, 有点阴暗。 而且,我还喜欢那个银行, 赞助者,Ahvel Bank, 我认为现在破产了, 因为创始人是因某种欺诈而成立的。 所以它很合得来 指称的。 是的,让我们把它扔出去。 对 但显然这就像2021年3月的发射之一, 并允许持卡人抵消碳足迹。 我喜欢这就像一个有生态意识的绿色银行 同时也只是帮助一些Kawaii。 嗯,据称是Kawaii的前台,。 [00:52:40]
Alex Kantrowitz:只是不必做任何事情 并且仍然收集更多的钱。 我能不能... 对不起 我们到此为止 因为我做了,我在这节目上用了文字 这可能是最刺耳的口腔口语之一, 但他们仍然没有接近Kawhi Leonard的道歉 我要说这是有史以来最糟糕的道歉 我们到此为止吧 他说,我承担全部责任。 好极了。 不错。 这就是你要说的 Kawhi 哦,哦,不。 哦,哦,不。 哦,哦,哦,不。 他在继续 你为什么要继续? 他走了,我接受对审判失误承担全部责任。 好,这么好。 被我内心圈里的人所包围 很遗憾情况引起球迷的分心 我和我的家人, 对不起,审判失误了 远离非我的人, 我承担全部责任 来吧,伙计。 来啊,高喜 你在干吗?。 [00:53:35]
Ranjan Roy:这比严重担忧的要求还糟糕 情况更糟。 他是考维 他赢了。
Alex Kantrowitz:什么时候的事? 猛禽号 是的,没有。 猛禽号 那是个好冠军 那一枪 那一枪 他是永远的。 他可以随心所欲地说 尤其是如果你是多伦多球迷的话 对 好吧。 好吧。 好吧。 我想我们该走了。 [00:54:00]
Ranjan Roy:所以,拉詹,很高兴再次见到你。 劳动节周末愉快 我会读我的计时报告 我希望你周末也过得愉快 在图表中呈现出氧素水平。 好了,大家好,我们走 感谢你们收看和收听。
Alex Kantrowitz:下次再见 《大科技播客》。 开发者、开发者、开发者、开发者、 开发者、开发者、开发者、开发者、 开发开发商 开发商 开发商 开发商 开发商 开发商 开发商 开发商 开发商 开发商 开发者。