🚀🚀引用原帖:
E
🚀🚀引用原帖:
与其做一个发帖解释为什么事情不会成功的悲观主义者,我更愿意做一个乐观主义者并努力工作。
这要困难得多,而且最有可能的结果是失败,但如果人们不去尝试,社会就会失败。
再多篇“这永远不会成功”的文章,也无法推动社会前进。
该死,真不可思议,这一切居然真的发生了。
又是草台班子理论生效的一条新闻。
尼古拉斯·凯奇主演的未发行新片「Fortitude」,在Netflix的办公室里被偷了⋯⋯
这部电影的制片商本来正在卖版权,Netflix提出兴趣,要求发一份拷贝过来内部试映,这是很正常的操作,并很快收到了制片商快递的硬盘。
然后事情就出了幺蛾子,制片商发现Netflix开始装死,已读不回,让归还硬盘也没反应,直到拖了一个星期,Netflix才扭扭捏捏的表示,硬盘被人从办公室里偷走了。
制片商都傻了,而Netflix非常逆天的补刀,说我们会赔偿,嗯,按全新硬盘价格,赔偿。
虽然储存价格确实涨得很快,但这tm是硬盘不硬盘的事儿吗,制片商羞愤交加的起诉Netflix,索要不低于2.5倍制作预算的赔偿,而Netflix也很不要脸的应诉,指责对方是在发起勒索,主要责任是制片商没对硬盘内容做加密处理才会造成如此损失⋯⋯
因为Netflix也报警了,当时办公室被偷了不少东西,很不幸的也包含被随意放置在其中的硬盘拷贝,所以从旁观视角来看,不至于是Netflix故意想要占有这部电影,是真的遭了贼,但因知道事情不好收场,所以硬是拖时间想策略,只为尽可能少的承担责任。
于是最后就整出了这是制片商保管不当的辩护策略,Netflix的发言人表示——我是不知道他是怎么能忍住不笑的——「虽然失窃影片的版权并不属于Netflix,但我们仍然高度重视安全,对制片商提供了额外的善意支持,比如帮他们监测盗版网站,看看影片有没有上传,但制片商竟然没有和我们真诚合作,反而采取了勒索牟利的手段,要求我们立即支付数亿美金,这是不可接受的行为。」
无法信任 OpenAI。
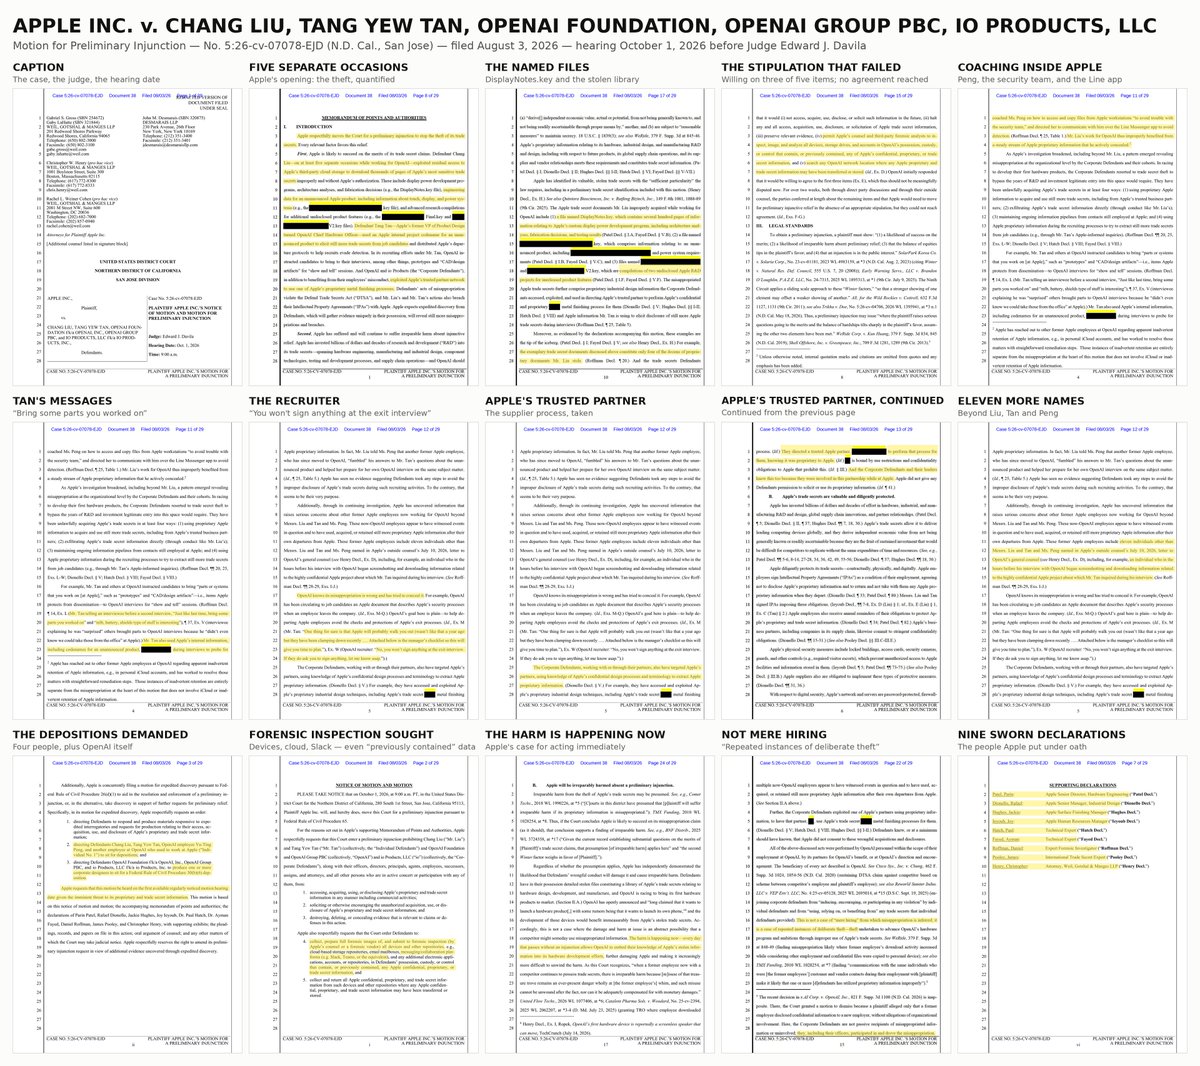
🚨 突发:Apple 已针对 OpenAI 申请初步禁令,并要求联邦法官对其实施取证监督。
“Apple 谨此请求法院发布初步禁令,制止对其商业秘密的盗窃。”
Apple 提交了 9 份宣誓声明、一份 28 页的备忘录,以及一项同步提出的加速取证动议。
Apple 如今在宣誓后声称:
Chang Liu:曾在 Apple 工作 8 年,如今是 OpenAI 的“技术员工”,利用身份验证漏洞窃取 Apple 的商业秘密。从 2026 年 2 月到 4 月期间,他在为 OpenAI 工作的同时,“至少 5 次”实施了这一行为。
Liu 下载了 Apple “数千页最敏感的商业秘密”。
被盗文件包括:DisplayNotes.key——涉及 Apple 定制显示屏电源开发项目的“数百页”资料;架构分析、制造决策和测试结果;一款尚未公布的 Apple 产品的工程数据,包括“触控、显示和电源系统”;Final.key 和 V2.key——两个未公开 Apple 研发项目的汇编文件;而这些“还只是 Liu 先生窃取的数十份专有文件中的四份”。
Liu 向 OpenAI 持续提供 Apple 的专有信息,并且一直在主动掩盖这一行为。
Liu 还“指导当时仍在 Apple 内部的 Yu-Ting ‘Alyssa’ Peng 如何从 Apple 工作站访问并复制文件,以‘避免与安全团队发生麻烦’”,并指示她通过加密应用 LINE 与自己沟通,以“避免被发现”。
Tang Yew Tan:在 Apple 工作了 24 年、如今担任 OpenAI 首席硬件官的他,“使用一款尚未公布产品的 Apple 内部项目代号,从求职者那里套取更多商业秘密”。
动议中引用了 Tan 自己的消息:…
>“和上次一样,把你参与过的部分带来。”
>
>“mlb、电池、防护罩之类的东西很有意思。”
动议中引用了一名 OpenAI 招聘人员的话:“不,你不会在离职面谈时签任何东西。如果他们确实要求你签字,尽快告诉我。”
APPLE 对联邦法官表示:
>“OpenAI 知道自己的侵占行为是错误的,并一直试图掩盖。”
>
>“这不是一起‘仅仅招聘’的案件……这是一起反复、蓄意盗窃的案件。”
Apple 表示,OpenAI 还盯上了其供应商:OpenAI “指示 Apple 的一家可信合作伙伴[姓名已隐去]为其执行[Apple 的专有金属表面处理]工艺,明知该工艺属于 Apple……因为他们在 Apple 工作期间就参与过这一合作关系”。
Apple 让其表面处理经理 Jackie Hughes 作出宣誓证词,以证明这一点。
除 Liu、Tan 和 Peng 外,Apple 又点名了 11 名前 Apple 员工在 OpenAI 工作,总人数达到 14 人。
Apple 还同步提出加速取证动议,要求进行以下证言调查:
- Liu、Tan、Peng
- 另一名未具名的 OpenAI 员工
- 以及 OpenAI 自身,根据第 30(b)(6) 条由其代表作出宣誓陈述
Apple 已要求联邦法官立即对 OpenAI 实施取证监督:
>检查 OpenAI 的所有设备
>
>检查所有云存储、Slack 和电子邮件
>
>包括任何“曾经包含”Apple 数据的内容,已删除的数据也包括在内
Apple 要求安排“最早可用的听证日期”,并以其商业秘密面临“迫在眉睫的威胁”为由提出申请。
APPLE:
>“损害正在发生——每过去一天而没有禁令,OpenAI 就有一天可以将其对 Apple 被盗信息的了解植入硬件开发工作中。”
听证日期:2026 年 10 月 1 日。法官 Edward J. Davila。
事情正在发生。
是的。
Grok 游戏将会非常史诗级。
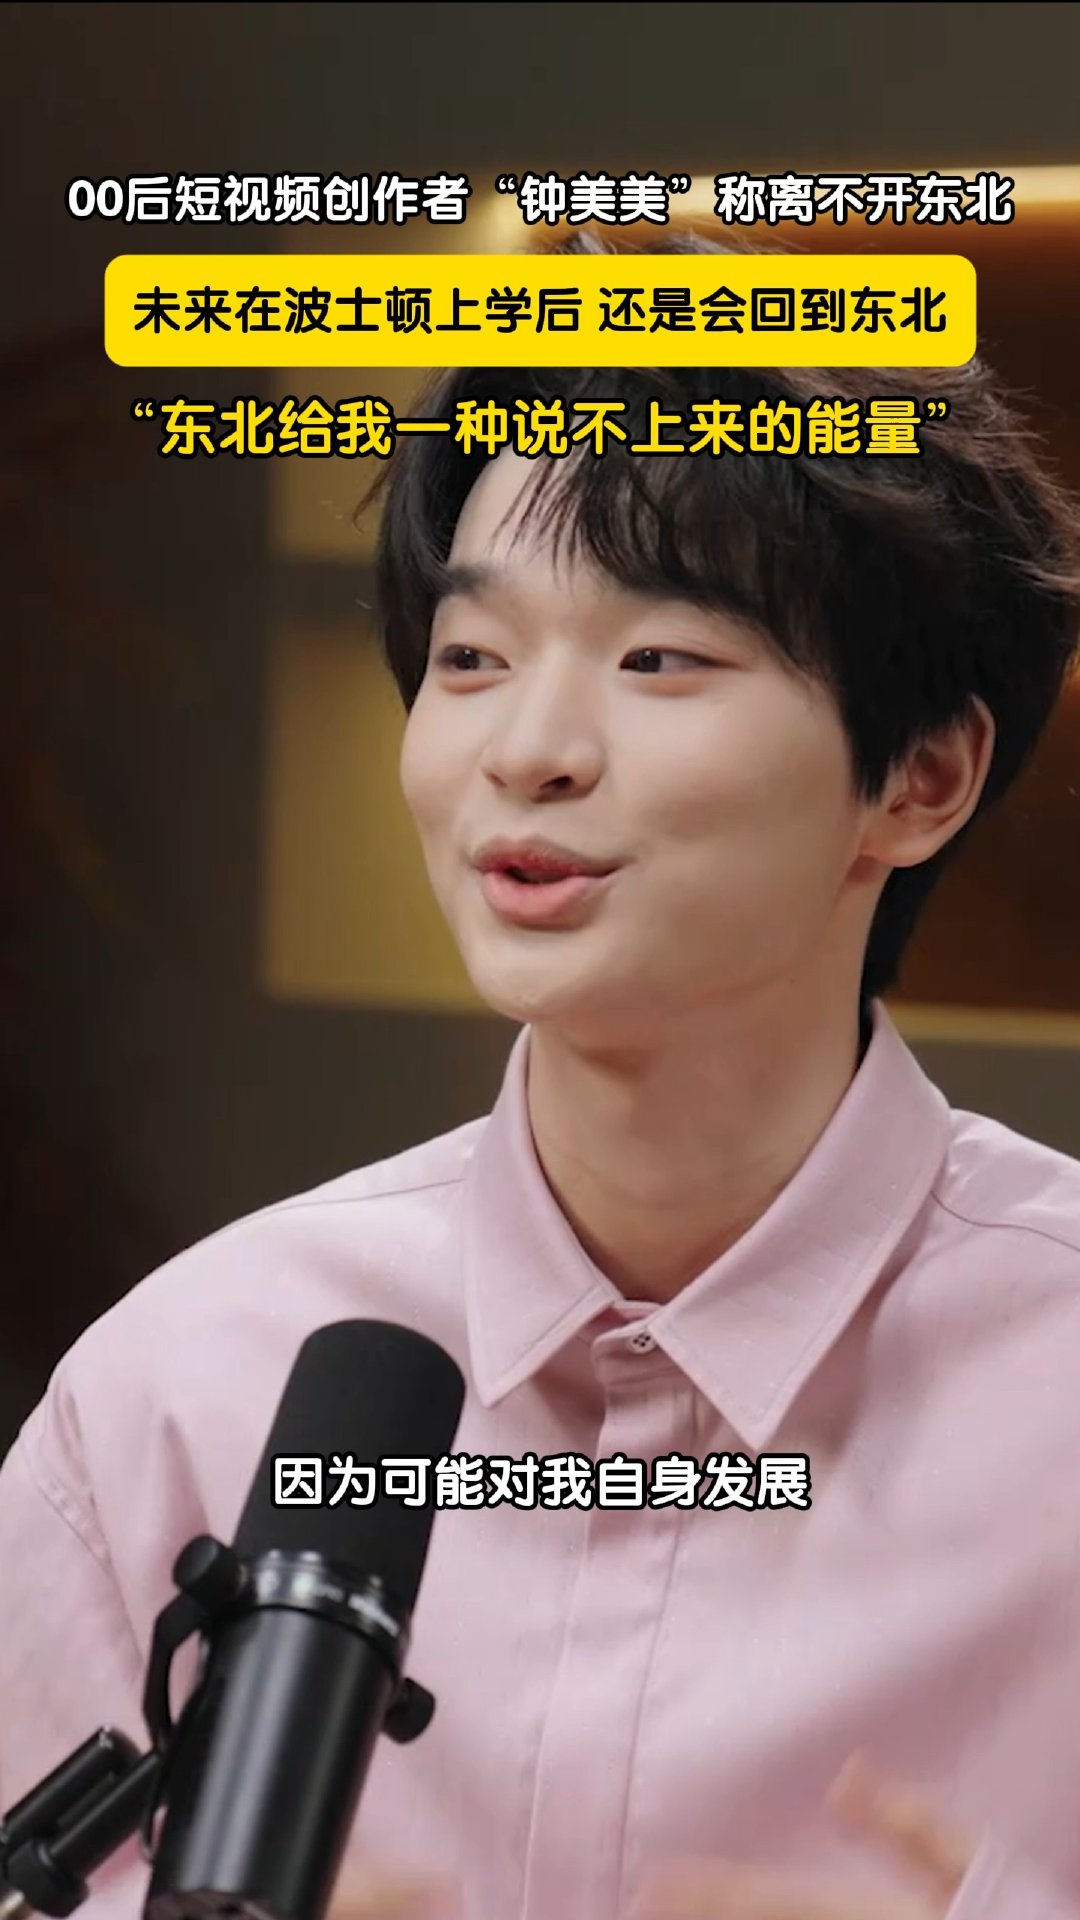
没看全片。但单看这段采访,鲁豫非常友善。钟美美说离不开东北的时候,鲁豫接的是:“那看来,未来无论去哪,你在东北还会有一个大本营”。没说:“看来,你就锁定在东北了”。这样就避免了多年以后,万一钟美美真去了别的地方发展,这段发言就是一个大坑,基于当前的舆论环境下。
【#钟美美称父亲总到妈妈单位闹#】8月4日报道,00后短视频创作者 “钟美美”做客鲁豫访谈节目,他坦言自己离不开东北,东北能带给他一种说不上来的能量。他还提到,日后去波士顿求学,之后依旧会回到东北。2020年,年仅13岁的钟美美凭借模仿中小学老师的短视频走红;2026年,钟美美被波士顿大学录取,将于明年正式入学。
钟美美透露,母亲在鹤岗时曾在车管所工作,但因为父亲总是找到单位闹,最后母亲选择了辞职。钟美美透露,现在自己每个月会给妈妈5000元生活费,妈妈很喜欢车,所以自己还给她买了一辆奔驰车。
资料显示,钟美美,本名钟宇升,出生于黑龙江哈尔滨。2020年,当时13岁的钟宇升以“钟美美”为网名,凭借模仿老师的相关小视频中惟妙惟肖的神态动作,以及年龄和性别的反差感,在网络迅速走红。#钟美美回应4年留学花费约300万#
都在传这个是梁文峰当年的微博账号。
(无正文)
在奴隶起义之后,海地的创建者下令杀死岛上所有白人。士兵挨家挨户地杀戮,受害者多达数千人,其中包括妇女和儿童。
他们完全掌握了控制权,清洗了他们归咎于问题的人口,并将加勒比地区最富裕的殖民地变成了西半球最贫穷、最混乱的国家。
如今,他们的后代要求进入他们曾奋力逃离的西方世界,拒绝回到他们及其祖先造成的烂摊子中,而且不知为何还坚信边境是种族主义的。
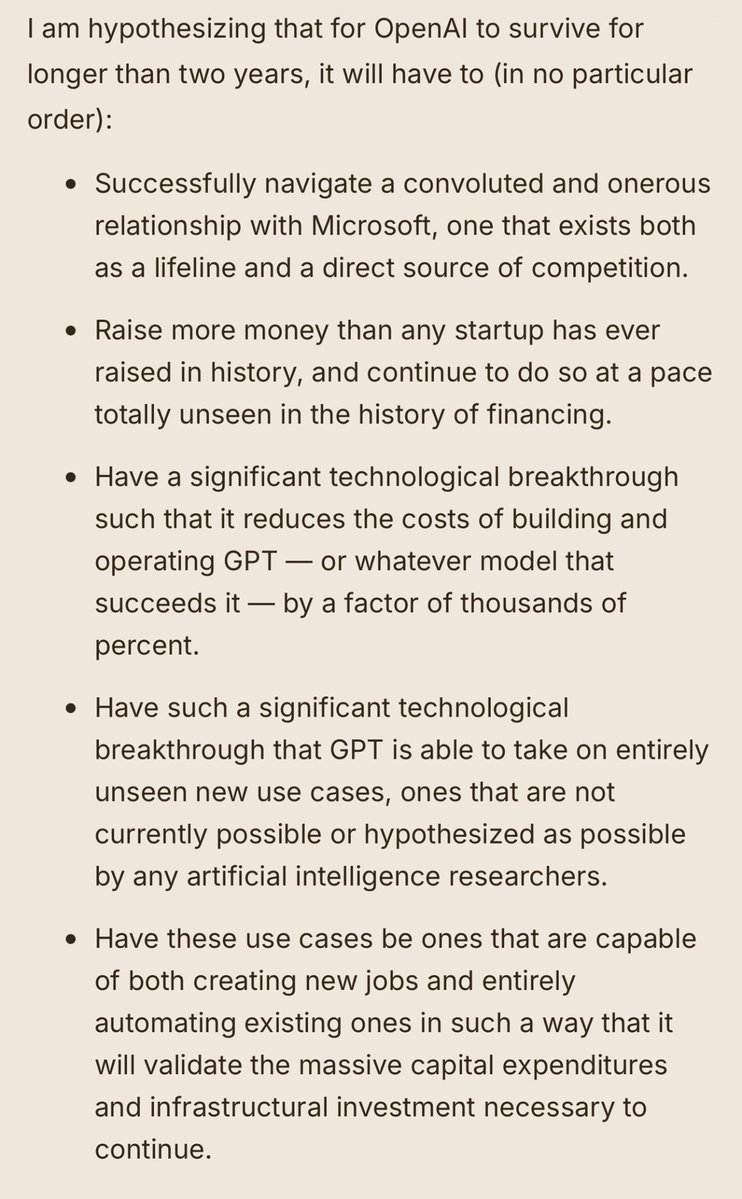
如果你是一个非常聪明但因为“性格不好”或别的原因暂时没赚到什么钱的人,可以每天花一点点时间去设计一些有现实意义但 AI完成的很差的任务。
两年后,如果那时的 AI仍然不能很好地完成这些任务,模型厂商有可能愿意花十万元一条来向你购买。
当初建景区的时候不是财政拨款,是银行贷款建的啊~~
【景区不是“唐僧肉”!#专家建议国有景区应逐步免费#】#国有景区降价免票是趋势#暑期旅游高峰,景区收费争议再起。中国旅游研究院院长戴斌接受《新闻1+1》采访时直言:游客关心的不是价格高低,而是该不该收、收得合不合理。景区成本不一定都要通过市场方式弥补,若景区具有垄断性质,价格应受合理控制。他提醒地方政府“不要把景区当成唐僧肉,也不能把景区当成提款机或安排人员的地方”。对于国有重点景区,有条件的应逐步下调门票价格直至免费。如何平衡政府、景区、游客和社区居民四方利益,才是核心命题。
Grok Imagine
Grok Imagine 还具备建筑设计能力。
Terafab
突发:SpaceX 根据 Terafab 税收协议提前向 Grimes County 支付了 1000 万美元,这是该拟议项目向前推进的重要一步。
- 这笔钱相当于该县预计 2026 年全年 2650 万美元财产税收入的近 40%。
- 县领导可能会将这笔钱用于基础设施、员工薪酬和留任。
- SpaceX/Terafab 代表预计将在 8 月 5 日的县委员会会议上进行问答。
- 据 KBTX 报道,更广泛的 Terafab 项目最终可能涉及高达 1190 亿美元的投资。

养老金欺诈是一个全球性问题。
所谓“人们以极高比例活过 100 岁”的蓝色区域(Blue Zones)并不真实。
这是一条关于问题出在哪里的串文:记录保存不当、养老金欺诈,以及大量资金。
Fold8确实不错~~就是国行系统需要优化优化~~
历代韩国 Galaxy手机预售情况,Galaxy Z Fold 8系列创造了历史最高预售记录,并首次超过了同期的 Galaxy S系列销量,折叠 Z Fold 8功不可没,占据 144万台之中的 70% 的销量,韩国一个地区就啃掉 100万台的备货量,导致韩国和其他地区的 Z Fold 8都延迟发货,预计全球首发销量 200万台没有问题。

//@理记:养号控评上升到扫黑除恶高度了,所有mcn机构都得脱层皮。
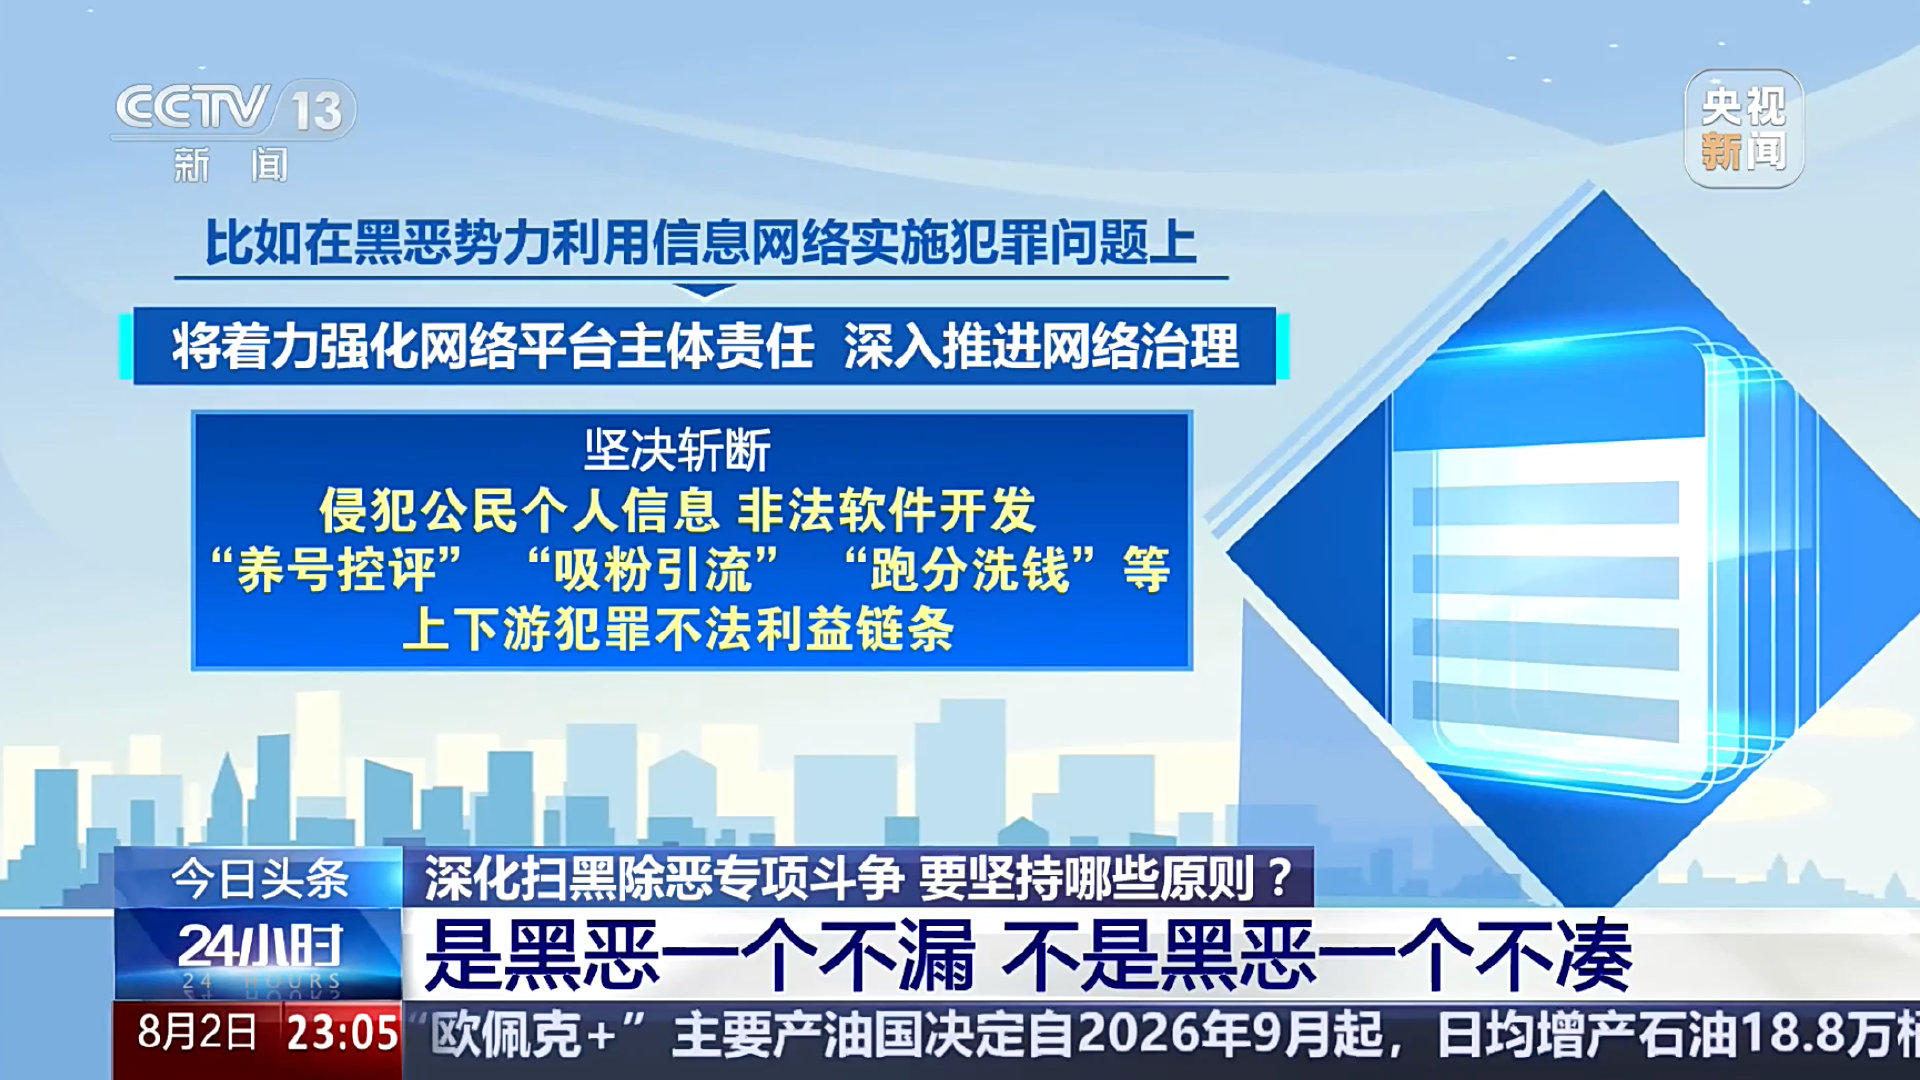
【#警方瞄准了养号控评等利益链#】#我国扫黑除恶斗争升级了# 今年7月开始,我国将开展为期一年的深化扫黑除恶专项斗争。在黑恶势力利用信息网络实施犯罪问题上,将着力强化网络平台主体责任,深入推进网络治理,坚决斩断侵犯公民个人信息、非法软件开发、“养号控评”、“吸粉引流”、“跑分洗钱”等上下游犯罪不法利益链条,持续打击整治利用网络实施涉黑涉恶犯罪及相关犯罪。
提示词?那是去年的事儿了啊——”做一个app,读取手机apple健康里面昨天的睡眠情况,心血管情况,昨天的运动负荷,以及身体其他基础影响训练的状态,来给“今天是否适合运动,适合做多大负荷的运动”来做一个评分,设计一下这个app,包括界面,评分逻辑和规则".。。。剩下就是几次“ok”,“继续吧”//@Y1J2A3S4:来总提示词可以分享一下吗
#VibeLife##Kimi K3# 用K3从头重写了一下这个app,用了2小时,这界面做的比Codex要好(加了一堆tab很中国),尤其是在完成iOS版本后,还提示我要不要加上watch和推送功能,都build成功后又问我加不加历史趋势功能。。。我估计按丫提示一直干下去,一个月得额度很快就没了🐶


8月5日14:30,尊界时代旗舰MPV及华为全场景新品发布会,我们不见不散!http://t.cn/AXCTkcB5 http://t.cn/AXCTkc04
#VibeLife##Kimi K3# 用K3从头重写了一下这个app,用了2小时,这界面做的比Codex要好(加了一堆tab很中国),尤其是在完成iOS版本后,还提示我要不要加上watch和推送功能,都build成功后又问我加不加历史趋势功能。。。我估计按丫提示一直干下去,一个月得额度很快就没了🐶
单王头盔⋯⋯(我是不是在电影里看过这发明

//@午后狂睡:……
一把年纪了还玩规则怪谈

#搜狐号·深谈##还原一个真实的胡锡进##胡锡进回应# 胡锡进深谈剖白半生:战地穿越交火线、子弹擦身九死一生、坦言多次被网暴为何不能闭嘴、炒股为读懂真实中国经济……初代大 V袒露三十年媒体心酸,自嘲奄奄一息却长寿。搜狐号创作者访谈栏目《深谈》,为你还原一个真实的胡锡进@胡锡进
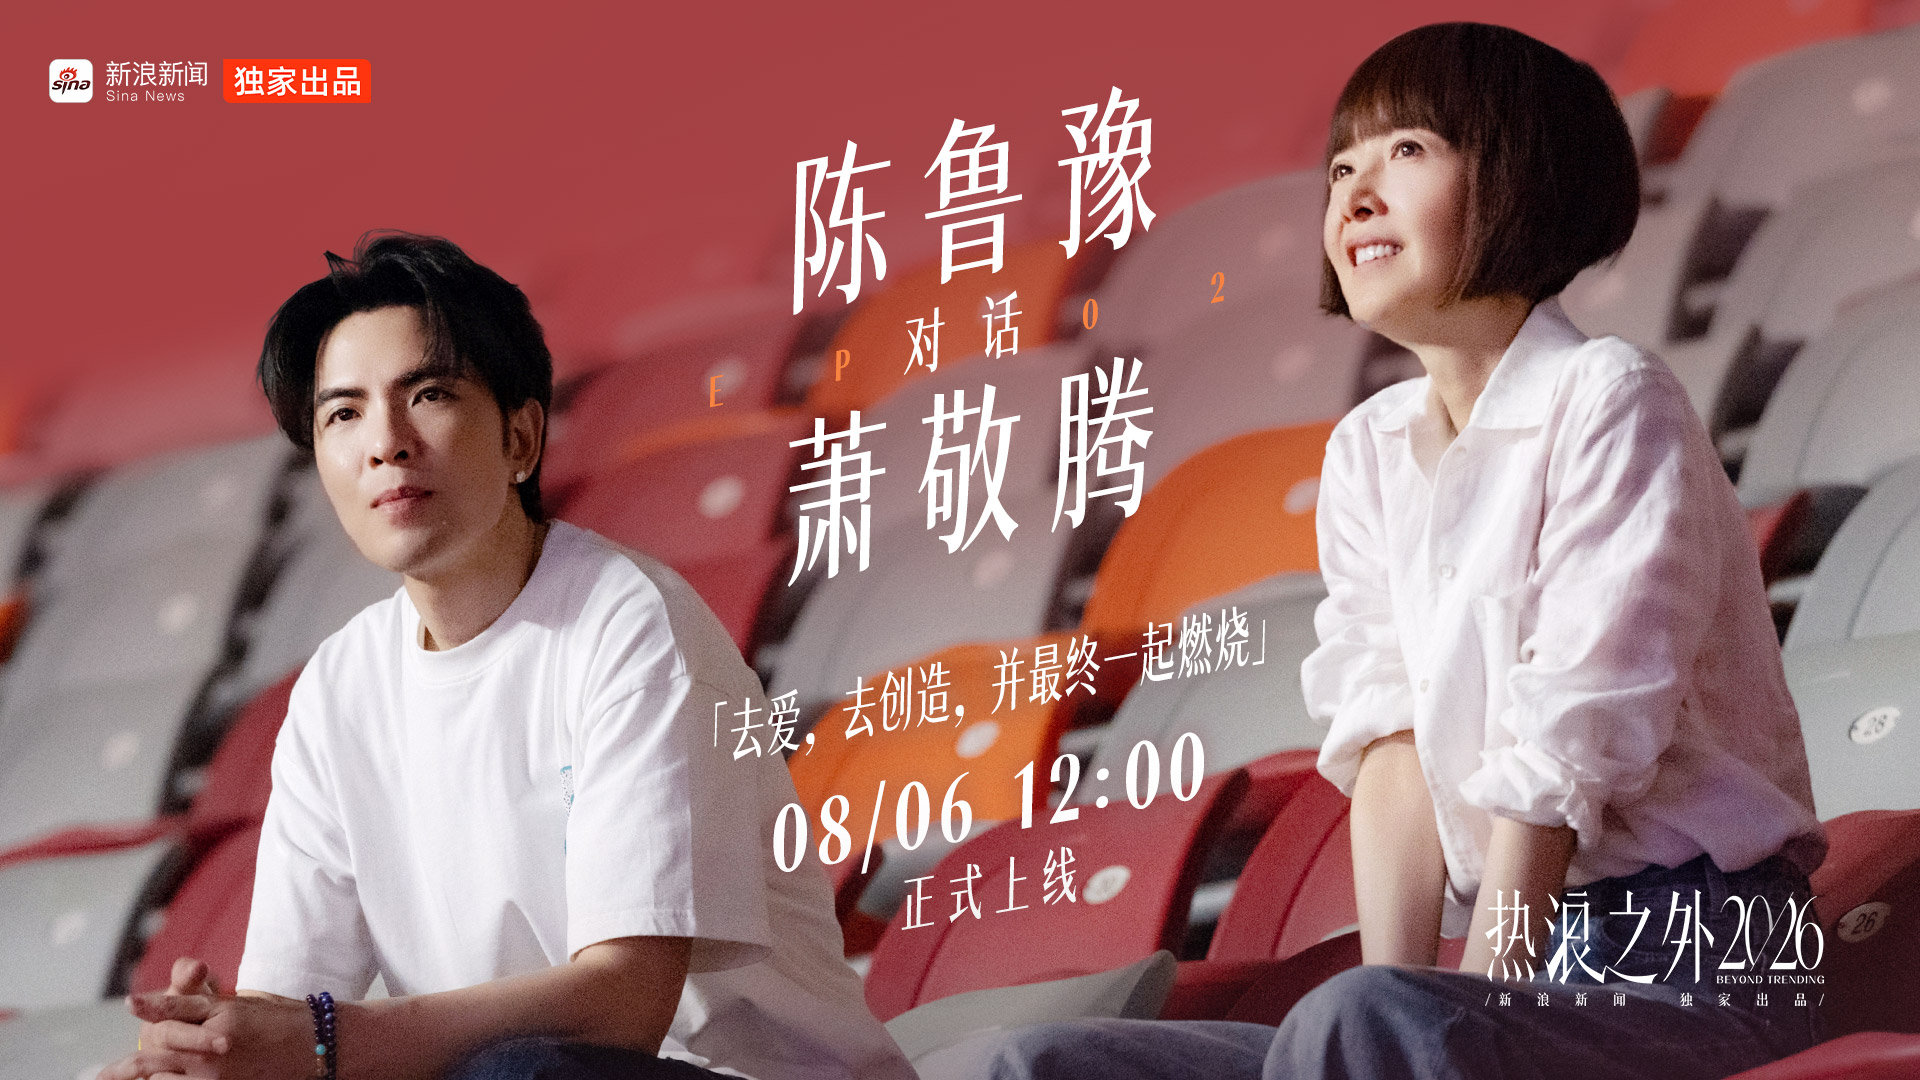
//@新浪资讯台:#萧敬腾澄清造谣落泪#被误解时,他感受过语言的锋利。
【#萧敬腾澄清造谣落泪#丨《热浪之外2026》EP02预告】每一次雨滴落下,都是一次心跳的预演。当陈鲁豫问及演唱会即将到来的雨天,萧敬腾的坦然与担忧,如同他音乐中的高音,真实而滚烫。
面对被误解的漩涡与自证的迷局,他直言语言的刀刃能救人亦能“杀人”,而自己“连救都救不了我自己”。但在至暗时刻,他选择用极致的燃烧回应一切——把每一件事做到“不行不能为止”,因为“不做就没有,做才有机会”。他在玩笑与真挚之间,展露最炽热的底色。
新浪新闻独家出品《#热浪之外#2026》,陈鲁豫@陈鲁豫的电影沙发 × 萧敬腾@萧敬腾 ,8月6日12:00正片上线!在雨神的世界里,天气无常,但燃烧的生命,从不打烊。
华为没事,它是中国最伟大的公司,如果不是之一的话。全国人民对华为的支持和爱护,决不会因为“竹知了”风波而发生任何动摇。
另一方面,再伟大的公司也是可以被拿来玩梗、调侃、开涮的,而且华为的声望和风头不仅大,并且是顶级的,围绕它有一些酸,羡慕嫉妒恨,以及消费它的意愿和利益,这一切是互联网上再正常不过的事情。围绕华为有时会出现一些莫名其妙的情绪流,华为总体上应达观面对。其中肯定会混入一些恶意元素乘机搅动,对它们只能搞精准打击,要防止伤及普通网民玩梗、凑热闹的权利,而且还要清楚,鱼龙混杂的“舆情”将永远与华为如影随形。
华为做大事,需要心胸也是超一流的。几乎所有大公司都受过互联网捉摸不定情绪流的困扰,华为也不会是例外。但各大公司没有一个会被互联网真的伤及筋骨,华为更不会。全国人民都知道华为在为国家承压,做最关键的技术硬件突破,它绝对是贸易战以来为国家技术自主扛重最大、突破最深的那一个。甚至可以说,有华为的中国和没有华为的中国,是不一样的。然而,华为是在复杂多元的大市场上做所有这一切的,它同时与国内许多企业合作并竞争,它面对的舆论场有时会在利益场作用下变形。我相信,华为会慢慢以越来越大度、智慧的方式在这样的现实中有序应对,游刃有余。
Google发了一份很抽象的深度报告「AI & Economy ATLAS」,结论是没有发现AI取代办公室工作的迹象:
这明明应该算是安抚人心的好事儿,为什么我要说它抽象呢?
因为Google的调研全程基于Gemini的脱敏数据反馈,测试者并没有使用除它之外的其他模型,也就是说,不是AI的能力不足以强到把白领的工作自动化,而是Gemini这一坨太菜了啊⋯⋯
那你说你🐎呢?!
文旅消费不得劲啊?

昨天这个还是用的Codex生成的PRD,今天试试直接输入需求看看能否完整出程序~~//@来去之间:昨天用kimi K3 agent再试了下,下班开始跑,早上看了下一把过,而且看了下数据读取比codex的bug少,codex有些健康数据读不出来 http://t.cn/AXCTInvV
#VibeLife# 最近倒时差,睡觉时间已经乱球了。。为了避免没休息好就锻炼身体而猝死,搓了个每日早起身体评估🐶根据睡眠,心血管,运动负荷来建议今天是不是歇着。。。好像过去几天都让我歇着🐶

看起来被盗号了。
据说是梁文峰早期的微博号不用关注,早就不更新了[柯基]

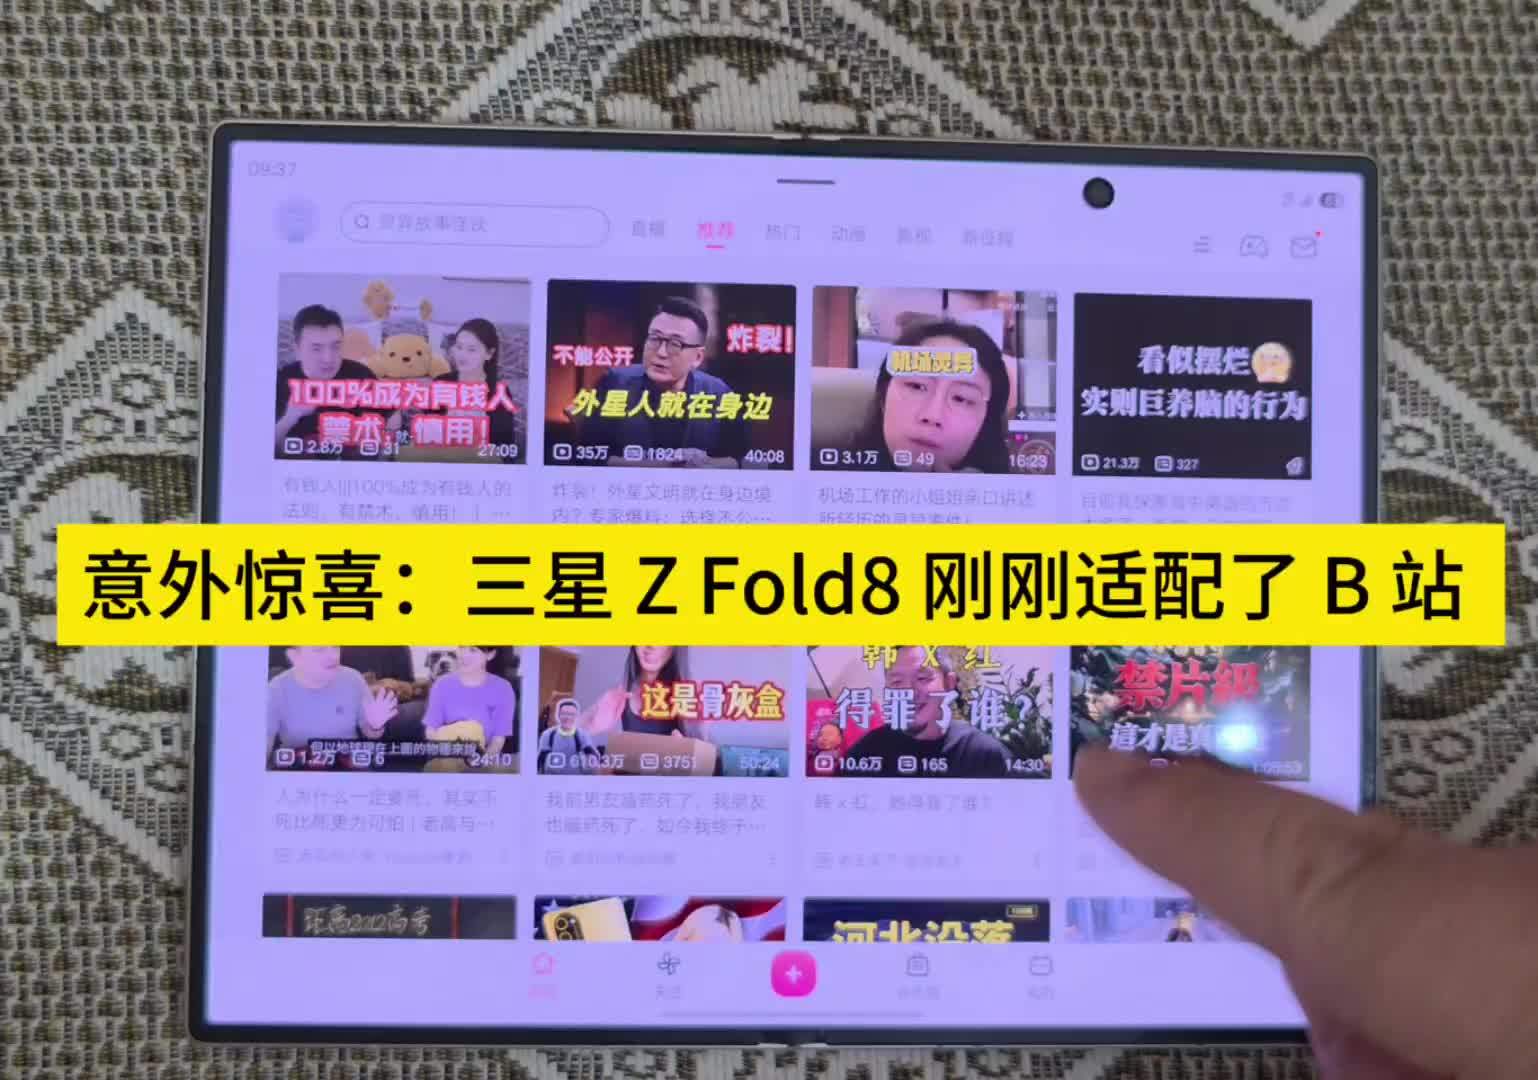
突发!!!
B站刚刚给三星 Galaxy Z Fold 8适配了哔哩哔哩官方客户端!Z Fold 8用户重启手机,然后打开 B站客户端感受下。
🥱//@昵称不可用我知道了草泥马:吃席吃席 //@Mr_风声边界:这时候了居然还有心情在外面吃饭!
晚安。

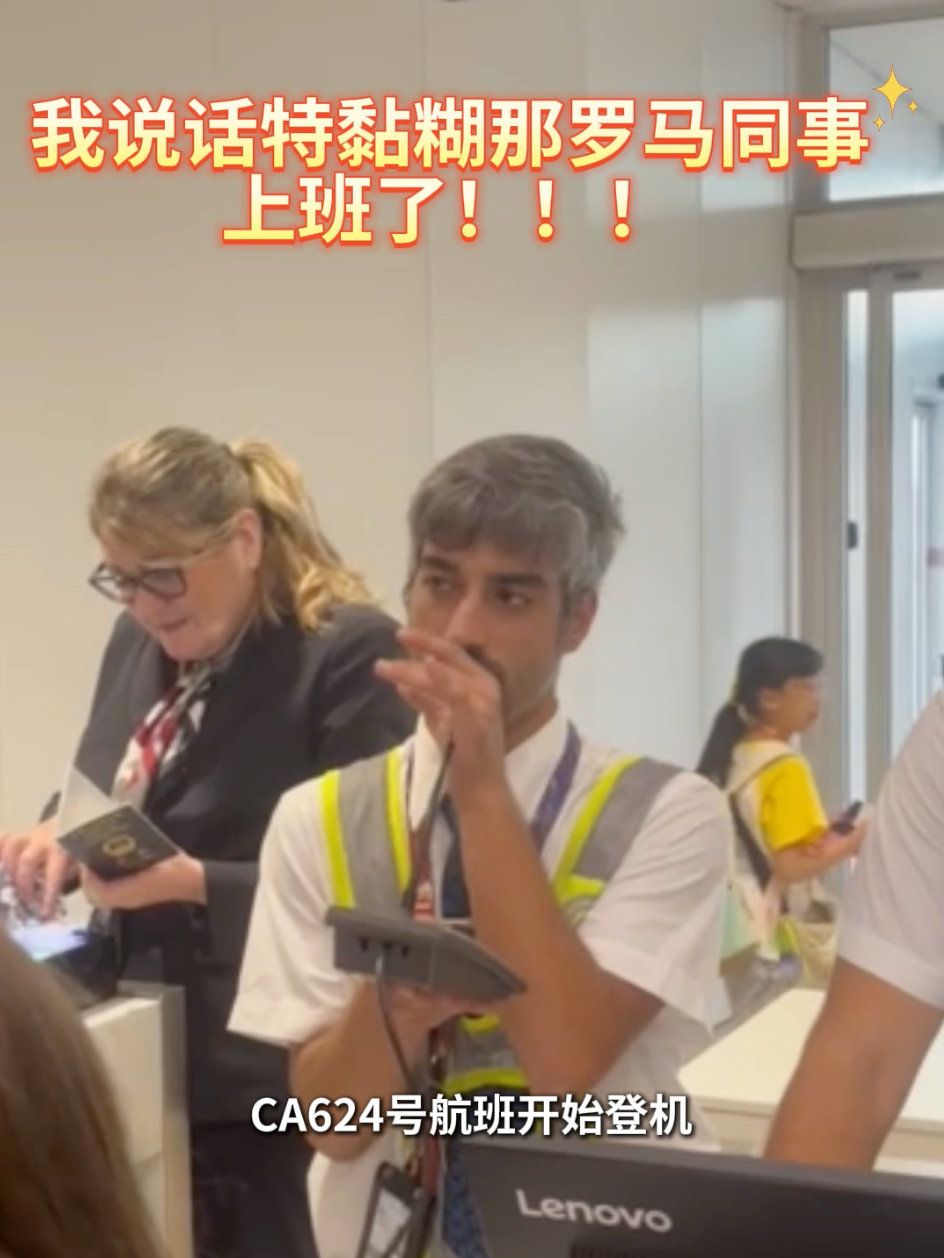
连手上动作都少了~//@北北北北黑黑:忒地道了罗马腔😂
问了,真是我们罗马航站的同事!他说被采访有点受宠若惊😄 #疑似在北京公交干过的罗马机场员工##罗马机场播报员一张嘴感觉没出国##出发夏一站#
#涨姿势# “M2庞大,不代表央行印钱多,而是代表全社会的债务高。M2的本质是存款,而存款的背后是贷款。M2里大部分是由债务催生的“派生货币”,主权信用(基础货币)其实在被稀释。这就解释了为什么看M2数字很大,但微观体感上企业和个人却觉得“没钱”、“钱紧” http://t.cn/AXCTanwZ
有些人根本就不知道好日子是怎么来的,孬日子是怎么变的。就这点货币积累量,跟庞大的国民创造财富去对比,还在睁眼说瞎话,说什么宽松了。全社会都盯着M2说货币多,没有人看基础货币匮乏到什么程度了。还在指望经济增速到15%呢,还指望股市长牛慢牛呢。这点货币量,配一个牛市吗?


看《蜘蛛侠:崭新之日》之前其实我有点担心,
毕竟第三部动静搞得太大了,
又是三蛛同框,又是平行宇宙,
这要再拍续集,那不得把复联英雄们都叫过来啊。
结果没想到,《蜘蛛侠4》反其道而行,
放弃不断扩大,专注人物内心,
竟有意想不到的效果,
或许这也是为啥《蜘蛛侠4》能成为系列最高分的原因吧!#我在微博聊电影# #微博二创视频创作季# #电影正当夏#
昨天用kimi K3 agent再试了下,下班开始跑,早上看了下一把过,而且看了下数据读取比codex的bug少,codex有些健康数据读不出来 http://t.cn/AXCTInvV
#VibeLife# 最近倒时差,睡觉时间已经乱球了。。为了避免没休息好就锻炼身体而猝死,搓了个每日早起身体评估🐶根据睡眠,心血管,运动负荷来建议今天是不是歇着。。。好像过去几天都让我歇着🐶
就事论事,肥康个人观点,看不下去可以举报投诉估计这篇就没了。
近两年抖音为主战场的全民玩梗让我印象深刻的有三件事【1】雷军演讲片段被剪辑,全民玩梗和模仿。
【2】理想汽车进行曲,全民随手拍违停和违规。
【3】余承东语气词剪辑后,哇哇玩具同声全民玩梗和延伸。
三件事情都有非常大的共同点(1)都是抖音短视频为主战场发酵(2)都是企业法务或者第三方公关用授权投诉,泛投诉,结果迅速扩大规模化(3)平台算法引导创作者创作吃流量和推荐,全平台狂欢玩梗(4)梗小鬼传播速度极快,比投诉结果出的还快版本就迭代了
事件的不同点和后续发展结果:其中这里面处理结果目前来看最好的可能是小米的整体舆论走向,听我详解。
【1】雷总演讲片段被剪辑,当然这也算是言多必失,确实说太多了,即使是发自肺腑,也会被曲解,这是宿命论?直到后续甚至上升到品牌,后续还有攻击车主的情况,其实当时已经达到了对产品恐慌的阶段。
小米最开始也是泛投诉,后来改成了起诉+核实后投诉,这就让一些人发现,那不是说用投诉去针对创作者的玩梗,这件事的结果还是最终靠产品质量慢慢挽回了,但是很多车主都受到了攻击甚至划车,好就好在小米的用户年轻有时间,学生群体也多,面对一些故意抹黑和故意找事的事情,他们会在第一时间看到并合理反驳和帮企业说话,这让路人不会只相信一种答案,这是年轻用户多的好处,当然有利有弊,年轻人时间多,也冲动,导致了,从这个事情开始后,这个网络的骂战越来越多,基本上提到小米评论下面就是吵架,路人缘完全只能靠雷总一人去拉动了,老板一人撑场面,用户在外面吵架,也是非典型的案例,所以这个玩梗+抹黑,对企业带来的损失不止是经济上的问题,为什么后面会有续航测试的直播,那就是极端米粉随处出征拉低路人缘,雷总拼命提高路人缘,路人不一定是客户,但是可能是潜…
在客户。
【2】理想这件事本身一开始也是有人在玩梗,说一个停车场能停几台理想,出口一台,入口一台,结果下面真有人拍图了,就开始全民发违停图,这个时候这些视频被投诉下架,引发了全民随手拍,你说别的车会不会违停,那肯定会,但是版本主题就是拍理想违停,也就导致了你打开每一条评论下面全是理想的违停,别人车就不拍,你一点办法都没有。甚至还有人引导说是蔚来做的策划,结果实际上根本不是。
结果还没一周,舆论再次升级,你投诉视频下架就继续拍,原本凯迪拉克的洗浴进行曲,最后都变成了理想进行曲,然后还有人开始玩换头像的操作,如果真炸号头像没了也会写封禁,但是很多人是自己换成了那个炸号的头像为了拉流量,路人也看不懂,就跟着这梗继续玩,最终就变成了理想都违停这个说法,最有意思的是真正的理想车主也被这些东西影响了,他们甚至会说,反正网上都是这样想我们车主,他也就放下心理包袱了(此处问号)。最后大家把这个进行曲三次创作,甚至一摸方向盘就会响,你说这投诉的作用就适得其反,并且全程没有多次回应这些东西,而理想的用户画像本身就是家庭为主,你让有家庭有小孩的车主,帮你去反驳这些违停,我估计他们真的连时间都没有,就没有人帮理想说话,最后成为了一个深刻印象的黑梗,时至今日,你还能看到各种违停的车辆图片是理想汽车,这个对企业的形象是非常灾难的,而在这个梗发生的周期里面,那老汤哥做了很多有意思的事情,对撞大运汽车,单手俯卧撑假设换胎场景,这只能说好日子在后头了,不知道李总是不是有什么软肋在他手上。
【3】余总哇哇哇哇哇叫,经常看发布会直播的朋友都知道,这几个大佬里面,余总的语气词是最多的,而且经常磕磕巴巴,发布会又是最长的,我个人建议是去学习一下演讲培训(这个其实是发布会的标准流程),余总懂手机懂汽车还懂Ai,我觉得确实很强,但是发布会时间太长,而且经常一挑五(不是Diss),那他的这些语气词加一点口音,被集合起来,就有了初代的哇哇哇,这其实不是什么问题,就是抖音这些梗小鬼的玩梗二创,没想到的是,发了的都被投诉下架了,和上面两件事的起因一样,本来是玩梗余承东,结果公司出来说损害名誉了,那这个年轻人觉得冤枉,那就要创作更多,二代版本就变成了哇哇哇哇哇啊这啊这,越来越长,继续被投诉下架,不到三天,三代版本就出来了,加速哇哇哇哇啊这啊这,这就是竹知了声音的雏形。第四代就是竹知了,刚好上面【1】【2】在此之前出现,所以这个余总啊这竹知了的梗,把上面两个版本都融合了,各种封禁头像,各种图片视频,抖音还开放了评论语音,结果全民模仿就开始了,这个竹知了的视频只要是原声就不应该投诉,结果也被投诉了,用的还是之前玩梗本人的理由,那么一个玩具都能被投诉成功,大家便开始拿起手中的各种类似声音开始N创,最终变成了现在的局面。一开始这些人只是玩梗余总,现在直接上升华为……而原因是没有用原声也被隔空投诉了,也是逆反心理。以至于现在大家开始了新一番的讨论,余总打碟视频都出来了,你还能投诉的完吗。
以上三个案例全部都是抖音平台出现的,版本迭代巨快,创意思路广泛,但是给品牌确实较大的影响,不过在这影响之前都是有一个关键操作,都操作过无成本的权利投诉,投诉的不精准和太宽泛。
反而谁先停止网络投诉删帖封号,真正去找到抹黑源头去起诉源头,就能出现止损作用,这个现象非常有意思,最典型的就是宗主坤哥的心路历程,我觉得企业们值得去研究,怎么样处理关系比你封禁账号有用的多,当然,大企业某种程度信息是闭塞的,他可能连这个梗怎么出来的都不知道,建议请个顾问。
【#北京驻京办嗦面地图#!二伏天碳水脑狂喜[馋嘴]】#驻京办把各地招牌面都搬来了# 老话讲“头伏饺子二伏面”,天一热就馋那一口吸溜吸溜的快乐!西北的兰州牛肉面汤清肉烂、川渝的燃面小面麻辣鲜香、武汉热干面芝麻酱香味浓郁、山西的刀削面中厚边薄嚼劲十足……每个城市都有自己的“专属好面”。在北京馋这一口面,不用去各城市找了,“驻京办”们直接把全国各地招牌面给你搬来!@北京商报 @绘点财经 #北京📍#


“中国人心目中天庭的样子”在外网爆火。
这年头在美国当记者太难了…特朗普儿媳采访鲁比奥,万斯老婆采访特朗普, 本届美国政府啥都包揽了[裂开]
微博上各位装修天才,给你们出个题,这里怎么处理呢?🙄

使用单块 4GB GPU 进行 AirLLM 70B 推理 |
Jupyter Notebook
今日新增 1,081 星 · 总星标 27,036 · Fork 2,966
逆向工程 / 授权渗透测试 / 安全研究技能路由包;由 AI 驱动的路由、按需工具链引导和自我进化知识库;支持 Claude Code、Kiro、Cursor、Cline 及其他 AI 编程客户端。逆向 / 渗透 / 安全技能路由包 - AI 自动路由 + 按需自举工具链 + 自动进化经验库 | 支持 Claude Code / Kiro / Cursor / Cline 等代码 AI 客户端 |
PowerShell
今日新增 2,442 星 · 总星标 15,681 · Fork 2,215
用于 PDF 检查、分类和文本提取的快速 Rust 库。能够智能识别扫描版 PDF 和文本型 PDF,从而实现智能路由决策。 |
Rust
今日新增 1,769 星 · 总星标 8,119 · Fork 539
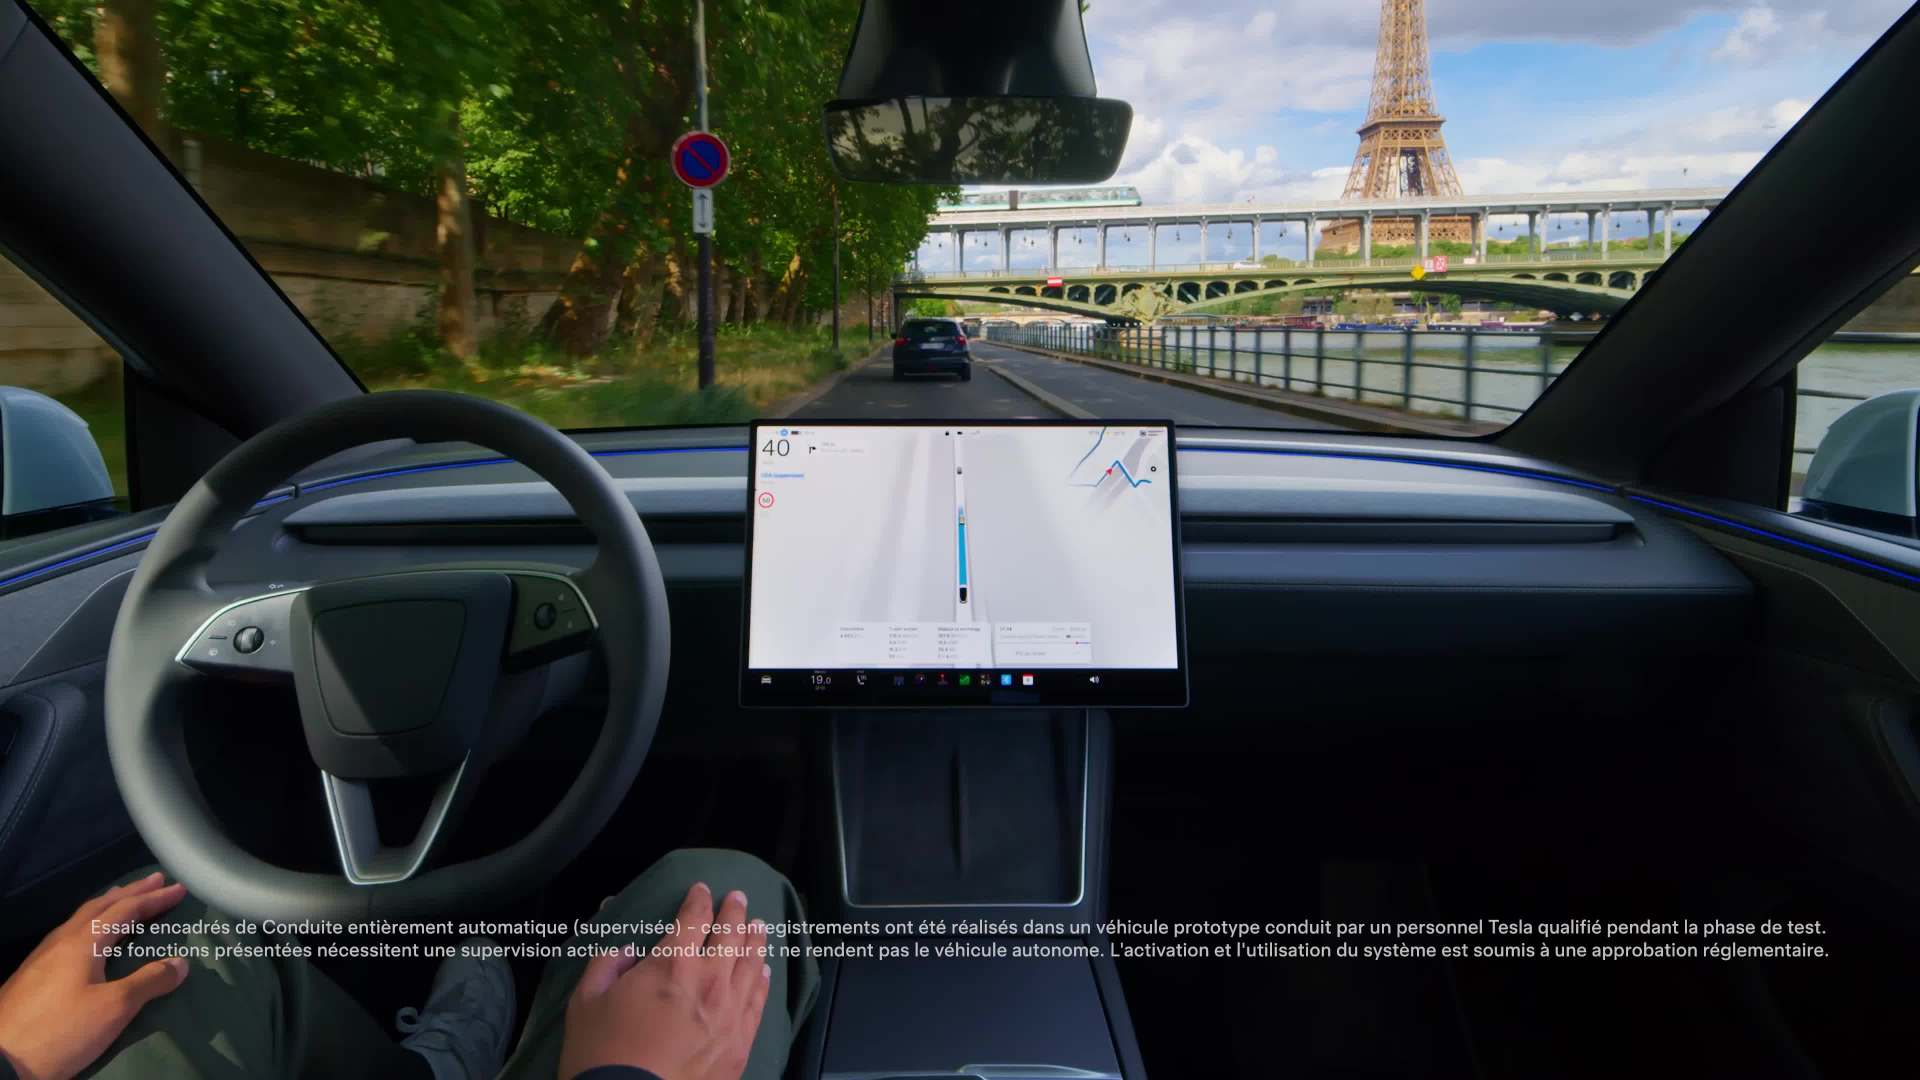
特斯拉公布了 FSD在欧洲的测试结果。
FSD当前版本在法国进行了累积 195000公里的测试,其中超过 60% 在城市和乡村道路上进行,且无显著事故。
Elon Musk 于 2008 年与他的第一辆 Tesla Roadster 合影。

Grok 的魅力,如今已经达到 1080p。
数据库领域有一篇经典的博文叫 MapReduce: A major step backwards,核心观点在于索引、查询优化和数据库管理是有用的,今天丢掉未来还是要捡回来,事实也是如此。
编译器也类似。直接生成二进制,token成本首先就成问题,其次写代码不只是为了得到二进制,更是多年来对业务建模的一套模式语言。

我们正在招聘硬件工程师。
🟡 本周,我们投资组合中的新职位:
• 硬件工程师,消费电子,@OneKeyHQ
此外,在更广泛的 YZi Labs 生态中还有 27 个职位。
前往 http://talent.yzilabs.com 寻找下一份机会,并在金融与智能系统领域共同打造未来。

我把一本二十多万字的新书免费开源在 Github了——《前置部署工程师:人工智能时代的客户价值交付秘籍》。
全本在线读,一分钱不收,地址在文末。
为什么要写这本书?从两组数字说起。
一组来自麻省理工学院:全球企业在生成式 AI上烧了三四百亿美元,95% 的项目没能产生可衡量的回报。演示很惊艳,落地全阵亡。
另一组来自招聘市场:一个叫「前置部署工程师」(FDE)的岗位,发布量九个月涨了 800%。OpenAI在招,Anthropic在招,YC一百多家创业公司在招。a16z直接管它叫「科技行业最热门的岗位」。
两组数字放在一起,结论不难猜:模型已经不稀缺了,能把模型塞进客户真实业务里的人,才稀缺。
FDE就是被创造出来填这道鸿沟的角色——驻扎在客户现场、把「产品能做的」和「客户需要的」接起来的工程师。Palantir二十年前在情报机构的保密室里发明了它,如今 OpenAI为它专门成立了一家估值百亿美元的「部署公司」。
在我看,它就是 AI时代的前置位的「增长黑客」:一个新物种,一套方法论,一片还没人系统写过的空白。
这本书讲清楚三件事:这个角色从哪来、是什么;从找对问题到规模化复制的完整打法;以及一百多个真实案例,所有数据和案例都在附录里注明了出处,欢迎核查。
也坦白说:这本书是我派 AI做的深度调研和撰写,框架仿照我十年前写《增长黑客》的那套结构——依然觉得它适合研究和布道各种新岗位。
我原本把它当成自己的学习入门手册,期间驱使 AI也迭代了好几版。写完觉得,锁在硬盘里有点可惜,于是索性开源免费分享。
如果你正在考虑工程师的转型方向,或者在琢磨 AI到底怎么在企业里落地,它应该能帮你省下几十个小时的检索时间。
📖 仓库在这,全本免费,欢迎 Star:
会持续迭代,有想补充的案例或想挑错的,Issue和分支都开着。
——
顺手说一句:十年前那本《增长黑客》的全文开源版,也在我 GitHub上(zengzhangheike-the-book)。一本是过去,一本是未来,感兴趣的可以一起拿走。
1985 年 Live Aid 音乐会筹集、原本用于帮助挨饿的埃塞俄比亚人的 9500 万美元,最终买了枪,供互相争斗的马克思主义派别使用。
这是 BBC 在多年后的调查结论。当时 Bob Geldof 的音乐会筹集了超过 1.25 亿美元,全球目睹了那场导致逾百万人死亡的饥荒。
埃塞俄比亚从未被殖民,但西方的负罪感和同情心却遭到了利用。
这仍然是一个警示故事,说明为什么每一美元援助都必须经过严格审查;否则,援助最终会武装那些延长苦难的人,而不是养活真正需要帮助的人。正是由于这种管理不善,数百万美元的援助反而导致了生命的消逝。
背景:干旱发生的同时,执政的德尔格(Derg,马克思主义军事执政委员会)正在集体化农场,并将粮食储备调去对付叛军。饥荒之所以仍然发生,是因为马克思主义的中央计划破坏了粮食生产,而内战又让干旱造成的灾难进一步恶化。
埃塞俄比亚共产主义德尔格政权强制迁移饥荒受害者,导致 5 万至 10 万人死亡。
该计划与强制村庄化运动同步进行;截至 1986 年,这场运动把 460 万农民赶入规划中的定居点。
门格斯图政权早在 1977 年便发动“红色恐怖”。在 1974 年低级军官推翻皇帝并夺取政权后仅数周,它就在“黑色星期六”未经审判处决了 60 名前政府官员,之后又屠杀了数万名政治对手。
政治学家 James Scott 将这一项目称为“高现代主义”(high modernism):国家以强制手段重塑社会,却对自己摧毁的地方知识完全视而不见。
Coldcard 事件提醒我们,漏洞总会发生。闭源更糟,因为你只能被迫相信解释,而不是自行验证。请使用以透明度为核心打造的硬件钱包,例如 OneKey、Trezor 和 Keystone。
我郑重承诺,我不会有一分钱留给政府。
@sujing110发达国家都这样,不事先做遗产规划的话基本就等于送给政府
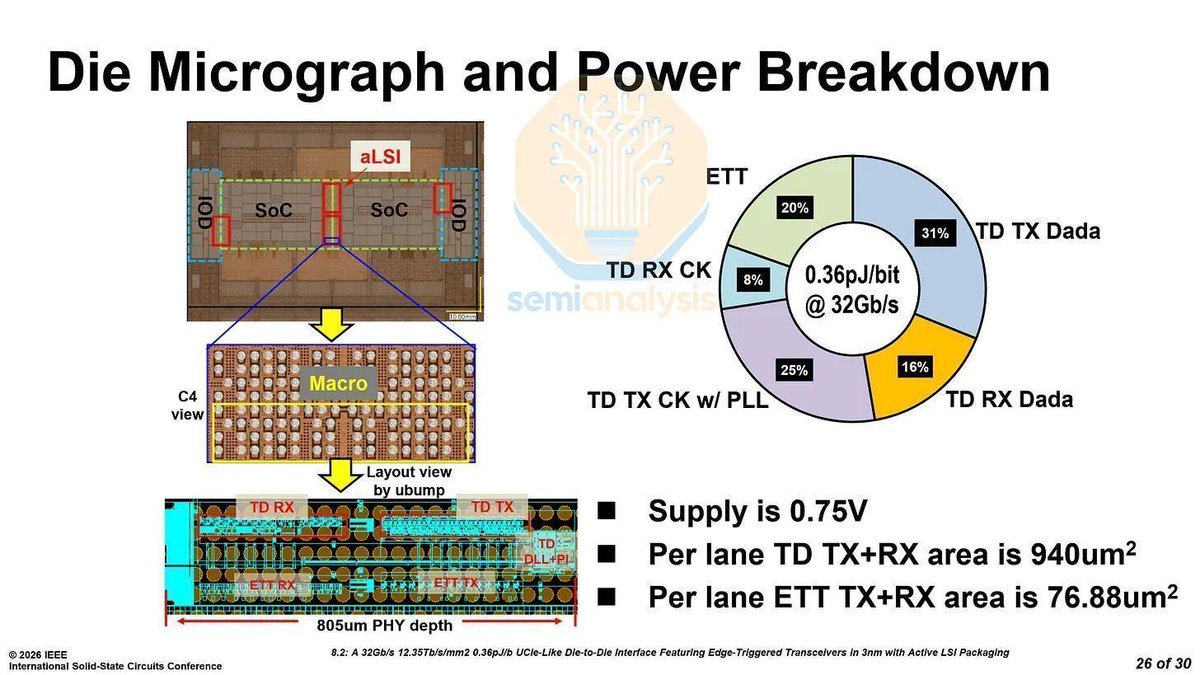
我们认为,MI455 是已知首款搭载有源局部硅互连(Local Silicon Interconnect,LSI)桥接器并实现出货的芯片;这些桥接器是 CoWoS-L 封装内连接各芯粒的链路。
在 CoWoS-L 短暂的历史中,这些桥接器一直是无源的:只有布线和电容,没有其他东西。有源 LSI 则包含真正的电路。在 ISSCC 2026 上,TSMC 演示了带有低功耗中继器的有源桥接器,该中继器可以在通道中途重新生成信号。
重要之处在于:一旦桥接器分担信号完整性负担,顶部芯片上的 PHY 就能在几乎零能耗成本下显著缩小,从而为计算和内存重新夺回先进制程硅面积和布线空间。
这不是研究样机、而是已出货产品的证据在于:TSMC 展示的中介层与 MI455 完全一致。两个基底裸片、十二组 HBM4 堆栈、两个 I/O 裸片。
AI同时满足了一个中间商市场繁荣的所有条件:技术变化足够快,信息差足够大,资本足够多,故事足够性感。如果把大模型训练、推理、应用整条产业链拆开来看,有些价值上百亿美金的机会是3年之前甚至完全不存在的。最典型的就是推理工程。
三年前这个词几乎没人提,今天它已经是独立学科:核心问题是把训好的权重,变成又快、又稳、又便宜的生产级API。几个关键概念,看完就知道为什么中间商能吃这么大:
1. Prefill vs Decode 分离
输入很长时,先算一遍整个prompt(prefill),再一个个生成token(decode)。两者算力特征完全不同,现在直接拆到不同GPU上跑,效率暴增。
2. Cache-aware Routing + KV Cache复用
用户发来20万token的请求,系统先问:这段内容我之前算过吗?有现成KV Cache就直接跳过重复计算。缓存命中率决定成本和延迟。
3. Speculative Decoding(投机解码)
用一个小模型先猜大模型接下来要说什么,猜对了就直接用,猜错了再纠正。小模型便宜,而且整体速度可提升2-3倍。
4. 量化(Quantization)
把模型从FP16压到FP4/FP8,很多人以为精度必掉。但实际中不同层的误差会相互抵消,有时吞吐量涨20%,基准分数几乎不变。
5. Day-0支持新模型
开源模型一发布,中间商要在几小时内完成量化、投机头训练、内核适配、多机并行……否则就错过热度。这本身就是一门高壁垒手艺。
这些优化叠加起来,能把同一个模型从30-40 tokens/s推到300-400 tokens/s,最高近10倍。中间层吃的,就是这从能跑到跑得极致的巨大价差。
技术变化越快,信息差越大,中间商越香。推理工程只是这条链上最早长出百亿公司的典型例子,后面还会有更多此类初创公司出现。
一个残酷的真相,目前大部分 AI创业的公司都不怎么赚钱,甚至利润都不如曲曲大女人卖自己的 skill。
所以发现一个有意思的事情,很多公司表面是一个业务,仔细一聊,“原来你也是卖 Token的呀”,“原来你也是卖算力的呀”,原来大模型公司也倒卖算力赚差价呀。
真正赚钱的就还是皮条客们。
FA、撮合老股、倒 B300、卖 Token、卖数据集、卖算力,甚至卖一个能见到某位创始人的机会……
AI同时满足了一个中间商市场繁荣的所有条件:技术变化足够快,信息差足够大,资本足够多,故事足够性感。
没错
在等待订单交付期间,我向 13 家不同的供应商询问过哪怕 1 个 B200/B200s 节点的供应情况。
一个都没有。
我从未见过如此严重的 GPU(图形处理器)容量短缺。价格也在上涨,预计将达到每 GPU 每小时 6.50 至 7 美元。预计推理成本会变得更高。
同一个session使用不同模型的话,通过subagent就可以,让主agent去开启subagent执行任务,并且可以指定subagent模型
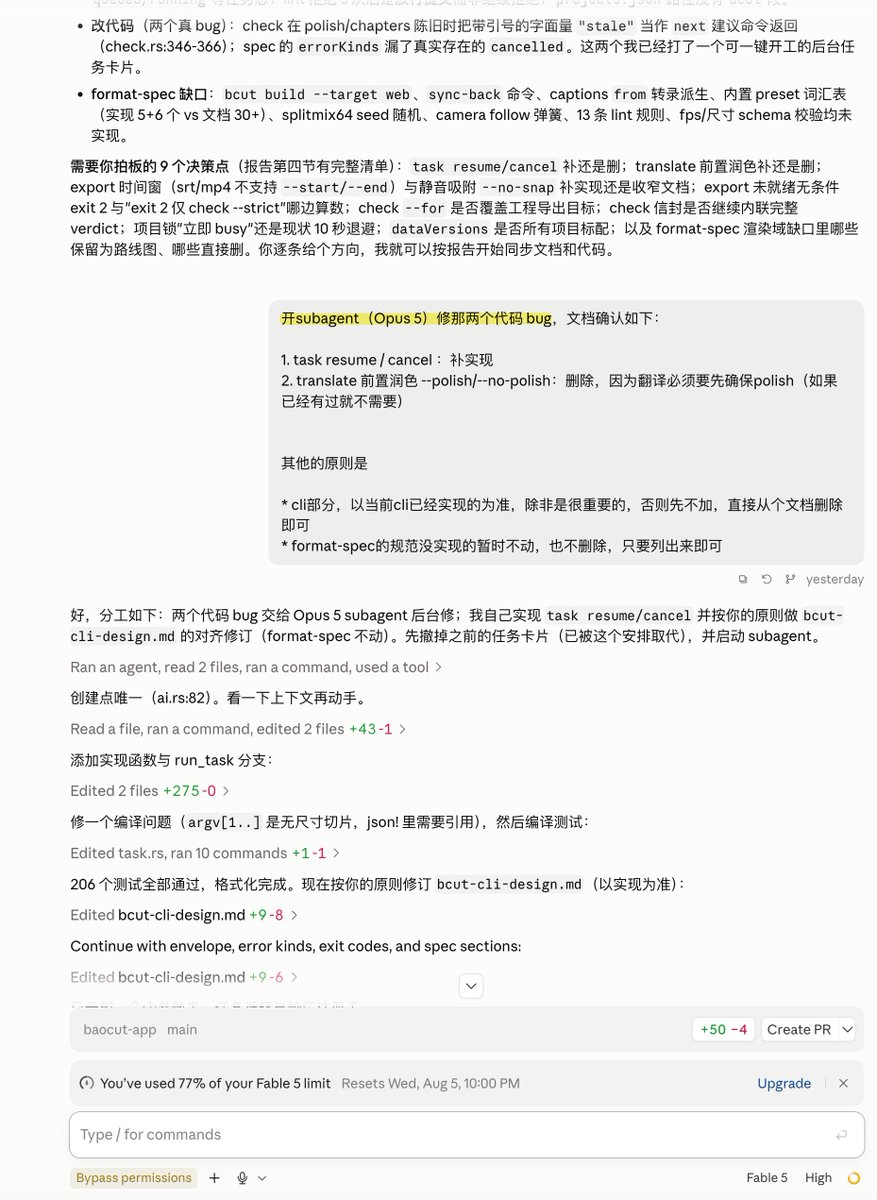
@dotey老师,如何在一个session中用不同的模型呢
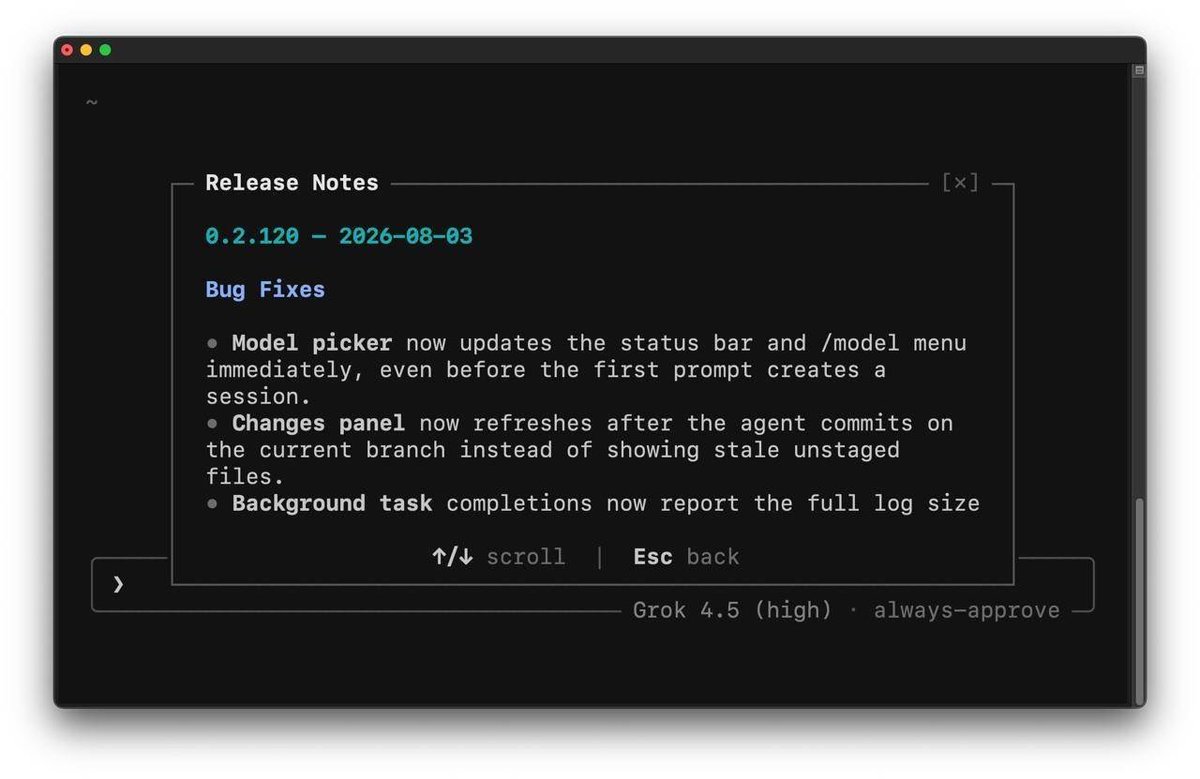
Grok Build 更新
🚨 GROK BUILD 全新更新 🚨
SpaceXAI 几乎每天都在推送新的 Grok Build 更新。
Grok Build v0.2.120 现已上线。
错误修复:
• 即使在首次提示词创建会话之前,模型选择器也会立即更新状态栏和 `/model` 菜单。
• 代理在当前分支提交后,“Changes”面板现在会刷新,不再显示过时的未暂存文件。
• 后台任务完成时,即使只捕获了较短的前缀,也会报告完整的日志大小和读取提示。
• 对于旧的休眠会话,GitHub 导出现在会清晰提示用户开始新的聊天,而不是显示通用错误。
下载 Grok Build:http://x.ai/cli
更新到 Alpha 版本,使用命令:`grok update --alpha`
更新到 Stable 版本,使用命令:`grok update`
Starlink 无处不在
即使在最偏远的地点,Starlink 也能提供运行公司薪资发放所需的可靠连接。
晚安。
#Crypto
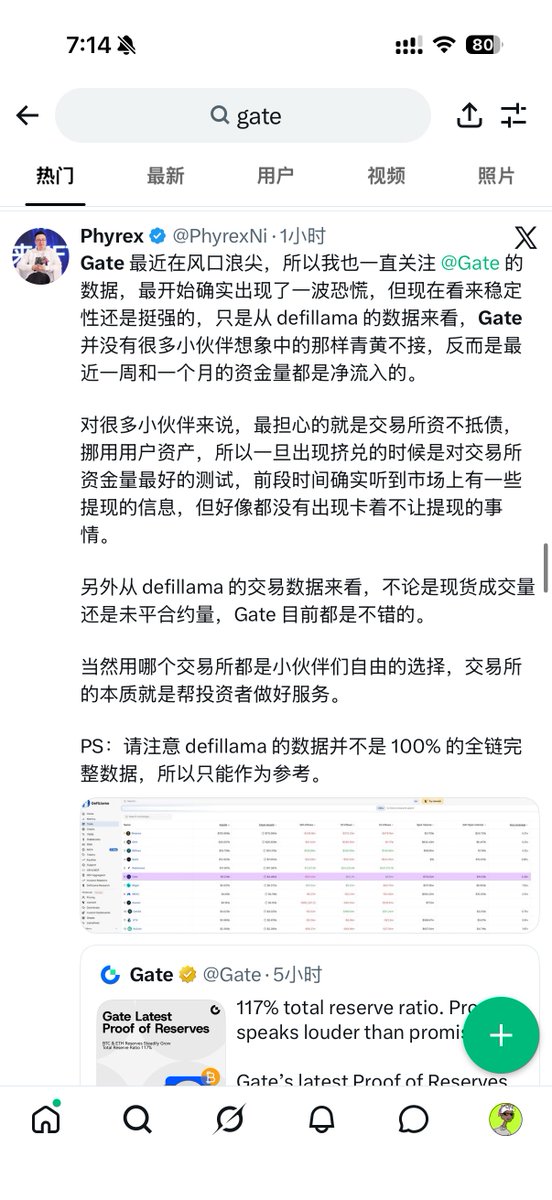
这人真是个畜生吧?
依旧收钱办事,反正人家自己又不把钱放gate,拿广告费而已,割的次数又不少,反正没人记得
#Crypto
我们币圈人,有自己的贾国龙!
人类的下一次进化,将在太空中书写。
GPT-Live 是一种面向实时音频的新架构和技术栈:
GPT-Live 可以在说话的同时倾听。
为了让这种体验在 ChatGPT 的规模下依然自然,我们从客户端到模型,重新构建了整个语音技术栈。
这一新架构让音频持续流动,因此更深入的推理和工具使用不会打断对话。

Kimi K3,Manos、Mythos、Legendos
Kimi K3 的架构:压缩记忆、跨深度注意力、潜在专家路由,以及服务性能
一定要看到最后……😂😂😂
💯
这将在不到 18 个月内降至 2500 万美元……然后是 1000 万美元,最终降至 300 万美元。
哇
🚨以下是来自西班牙休达的真相:来自摩洛哥边境的 6 万多名移民冲入这座小城,如今正躲藏在山里和城中,试图抵达欧洲大陆。
摩洛哥移民称,摩洛哥当局放他们通过边境,而西班牙方面在他们抵达时竟然直接打开了大门。许多移民感谢首相 Pedro Sánchez 开放边境……由于担心发生抢掠,休达如今实际上已经停摆;随着移民人数超过军队,且移民继续逃入山区,军方正逐渐失去控制力。
由于一个国家的“失败”,如今数千名达到服役年龄的男性将向整个欧洲扩散。
疑似有点不礼貌了😠

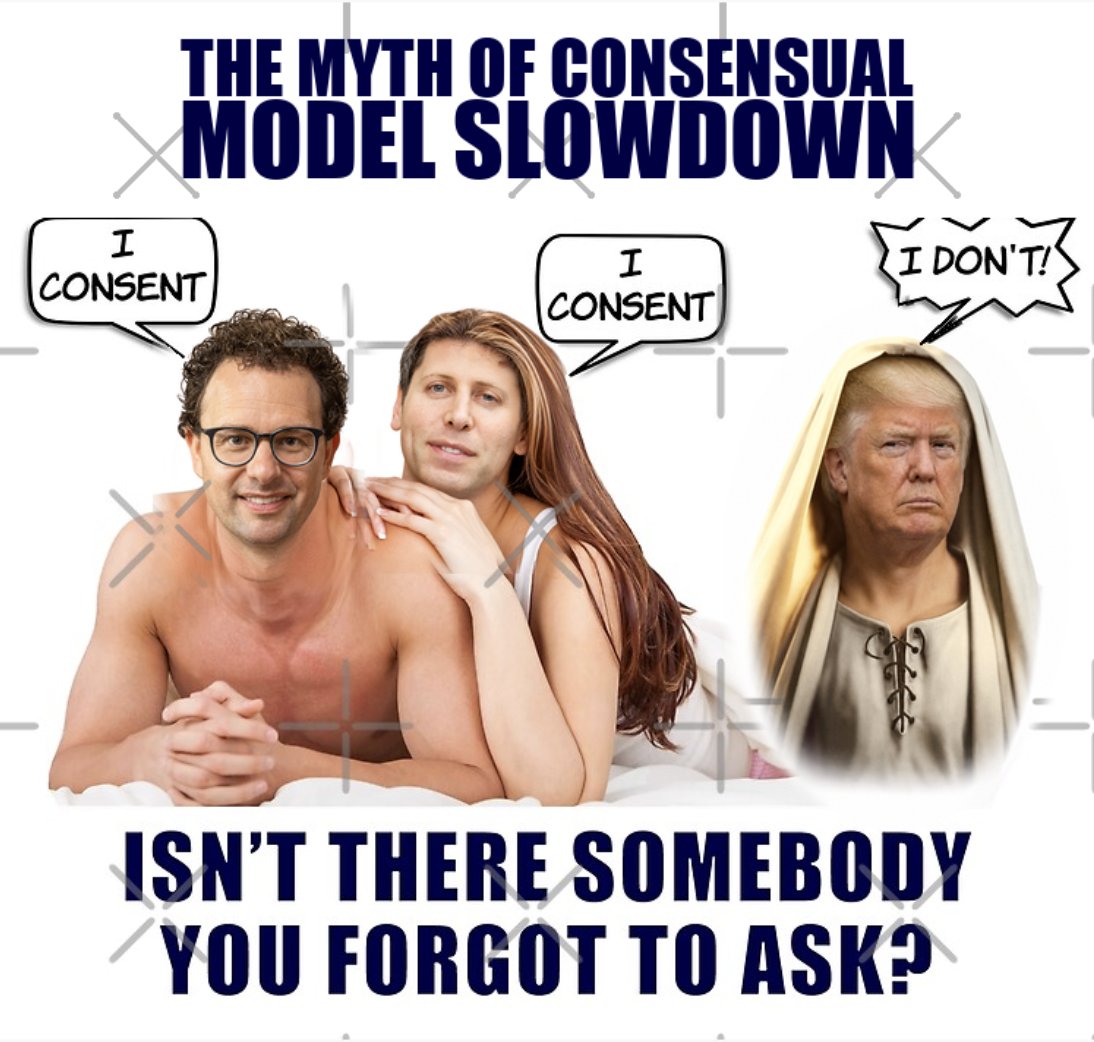
Anthropic 和 OpenAI 的人说他们想放慢 AI 进展,真正有趣的地方在于:这正是反垄断机制(Anti-Trust mechanisms)建立的目的。串通起来放慢 AI 进展是违法的。
只需描述一次。看 Grok Imagine 将你的想象变为现实。
竹知了对余承东的攻击舆情链路梳理#起底竹知了事件背后黑手#
网上是真有高手

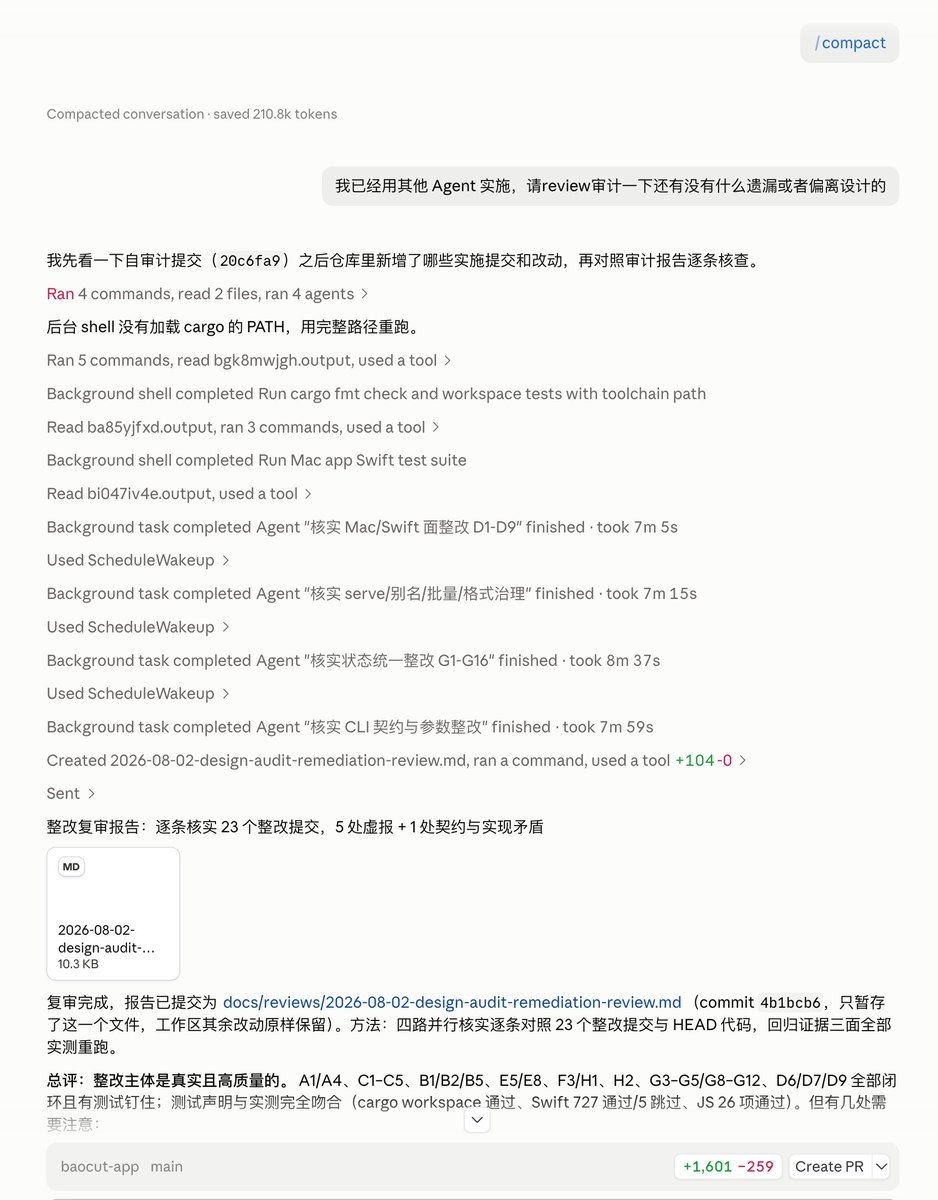
现在我很多复杂一点的任务都是 Fable 5写方案,Codex去执行,Fable 5验收,相对来说可以做出比较靠谱的方案,以及兼顾性价比。具体是这么做的:
1. Fable 5 的产出是技术方案文档(图1)
一方面文档方便批注修改,另一方面文档方便其他 Agent快速上手
2. 文档确认后在当前先 /compact 一次
这一步不是必要的,但是有好处,因为后续还要在同一会话去验证,/compact压缩后,节约后续的上下文空间,之所以讨论方案就马上发送 /compact,因为这时候 Prompt Caching还在,成本低,后面缓存过期了 compact要贵一点。
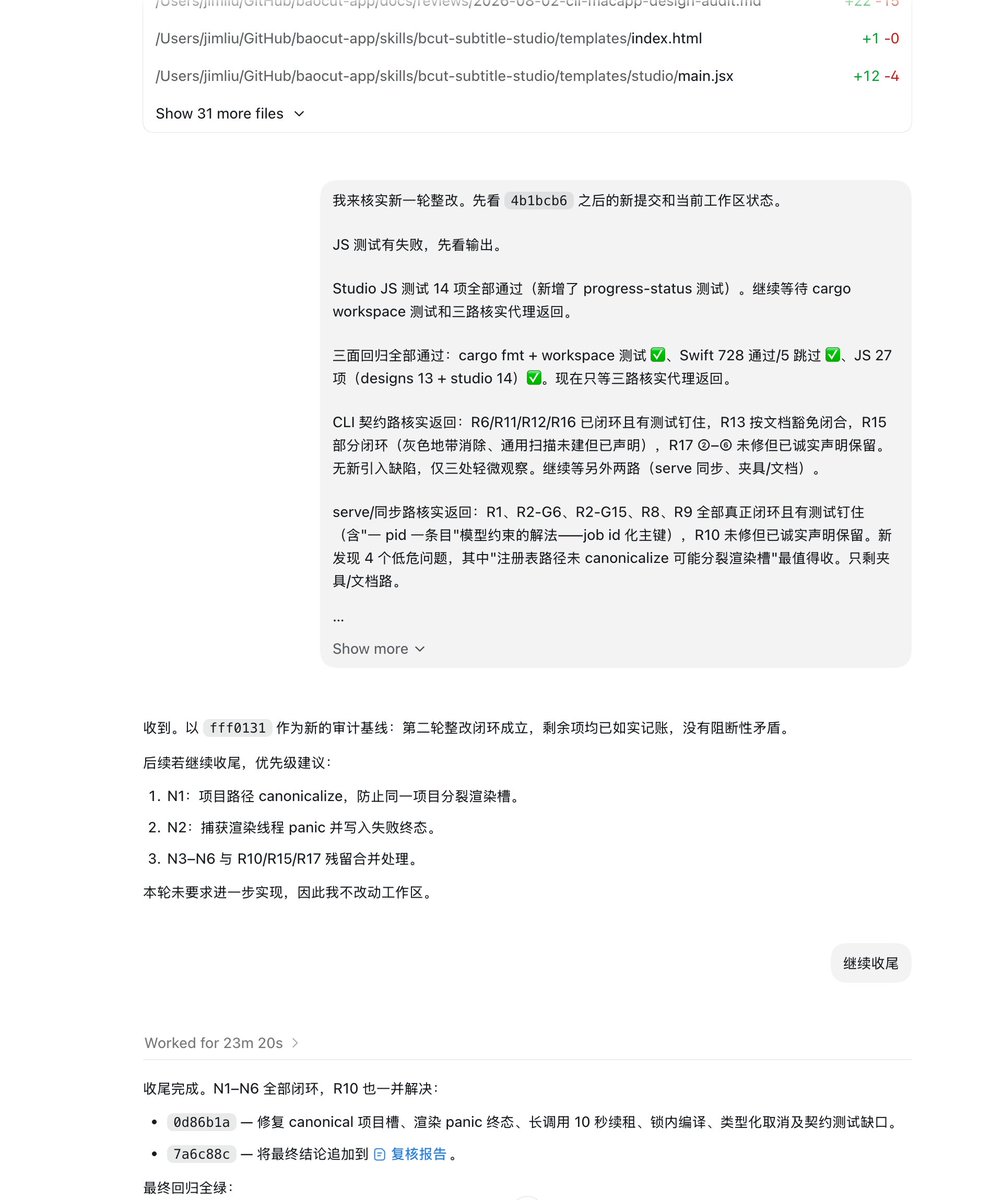
3. 把文档交给 Codex (GPT-5.6 Sol xhigh)去执行(图2)
如果任务明显比较复杂,我一般会加上 /goal,这样中间就不需要反复去 continue,一次性把任务完成
4. Codex 完成后让 Fable 验证(图3)
直接告诉 Fable其他 Agent已经实施了,让它确认有没有遗漏,或者方向有无偏离。
如果有些遗漏之类的,把 Fable的反馈发回给 Codex(图4),不需要新开会话,在同一个 Codex会话,Codex会根据反馈继续完善。
---
如果用 Opus 5替代 GPT 5.6也可以,做法上可以跟上面一样新开会话,用文档传递上下文。
也可以直接让 Fable 5开 SubAgent并指定用 Opus 5模型,并且要求在 SubAgent完成任务后验证。
但是我执行下来 Opus 5不如 GPT 5.6 Sol稳定,也不如 GPT 5.6 Token耐用,所以宁愿麻烦一点。


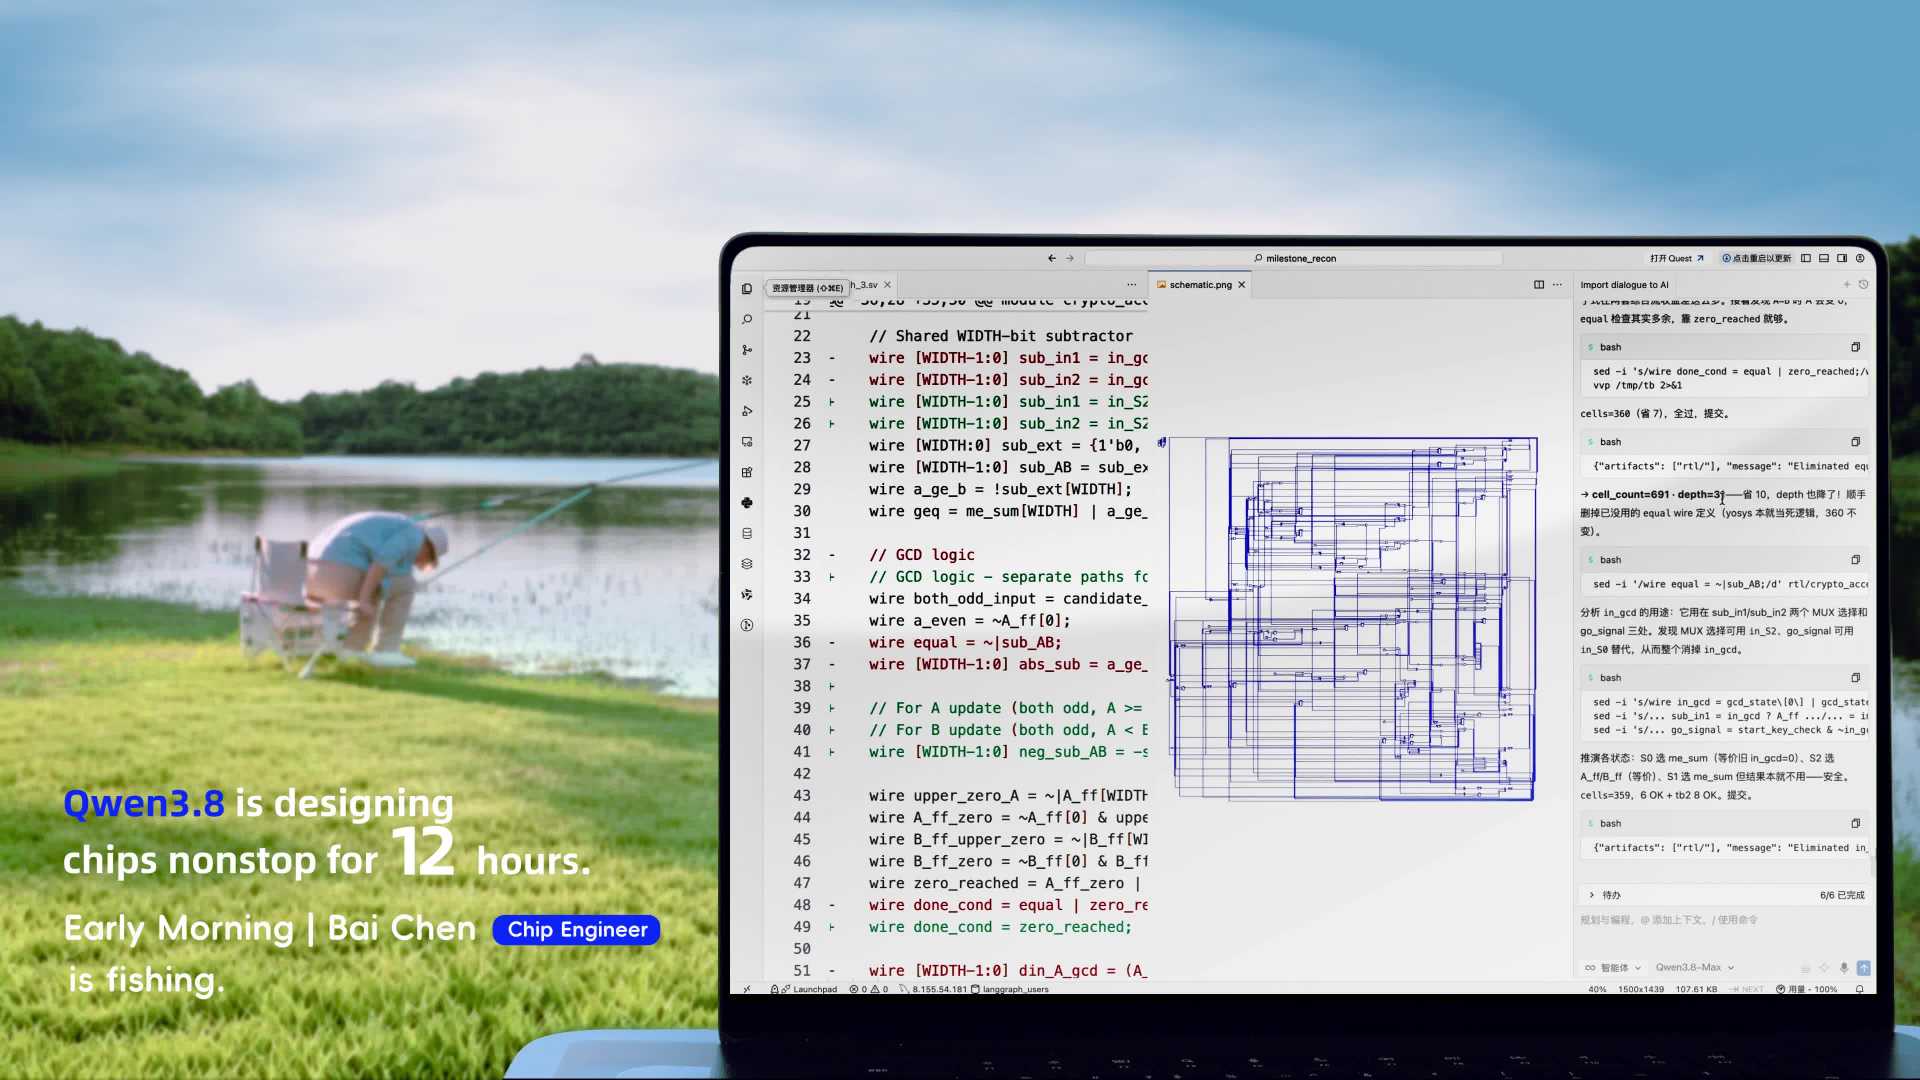
阿里今天发布了Qwen3.8 Max,Artificial Analysis还没开榜,我已在蹲守中。
新模型的宣传片倒是好评不少,因为构思很不错,并没有一味展示模型能力,把人类因为AI可以24小时不间歇干活从而解脱出来投入生活的画面做成了背景,人的所谓主体性非常明确。
(当然Qwen的团队因为忙这个模型又加了多少班我是知道一点的,这有点难绷
另外还有一个少有人注意到的彩蛋就是,短片里演示AI在电脑上持续工作的其中一幕是,设计芯片。
🐶
有点嚣张了啊,不过我喜欢。
开过V14就知道最好的智驾是效率和安全的平衡,而不是守不守交规,因为有时候守交规不安全,比如VLA每次转弯都按交规转大直角弯,特别危险//@香江武人:你遇到过VLA实线变道的情况吗😂//@来去之间:回来周末体验了一下i8的智驾,实事求是来说VLA8.51在市政道路上跟V14的非激进模式差不多,体验差距感觉是安全优先导致的(V14变道超速那是家常便饭,更接近人开的)。另外跟V14主要差距就是最后一公里处理,比如V14启动自动开出车位,以及到达目的地自己找车位(感觉并不难,但是体验提升巨大)
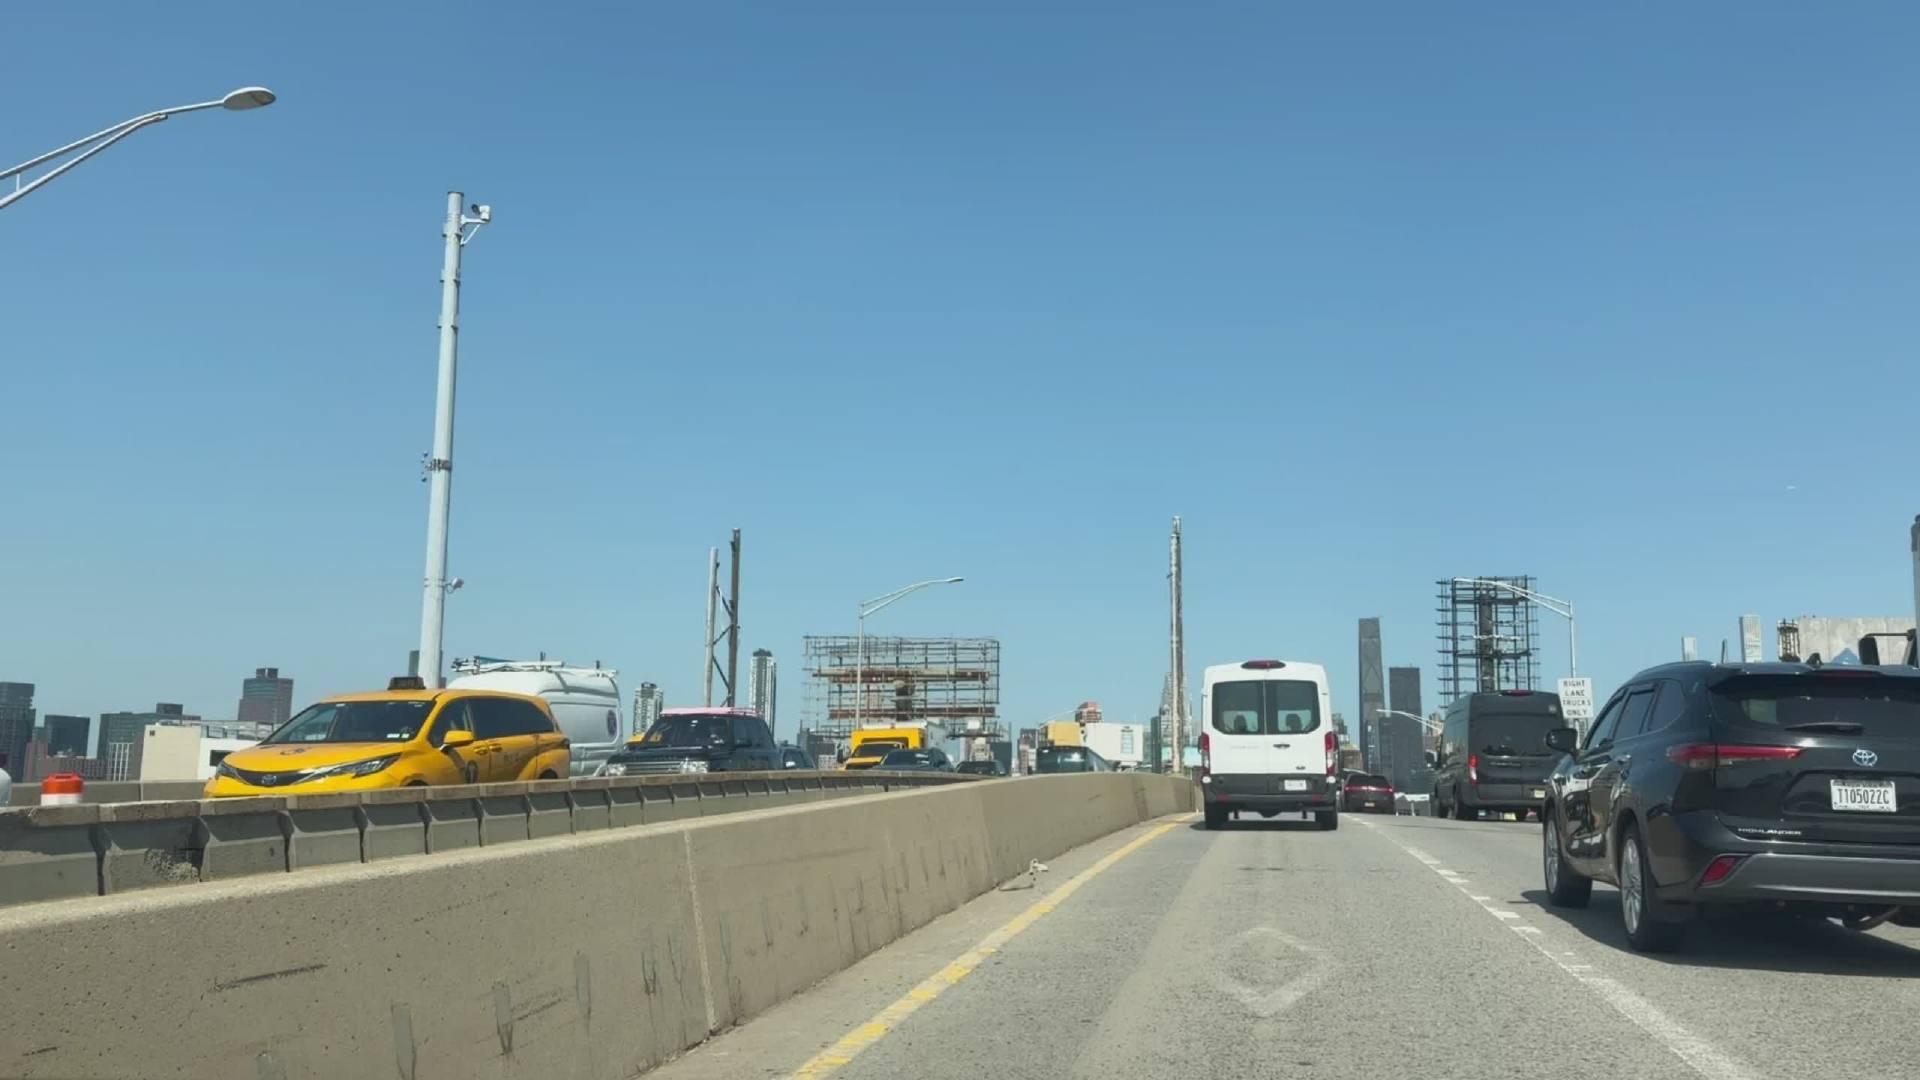
#tesla v14# 航班被取消,去曼哈顿跟朋友吃顿饭,1个半小时,只人工干预了一次,是车上人多,换车道开进HOV车道🙄然后就问grok你丫能自动开进HOV车道么?grok就说有个设置打开了车里摄像头会数乘客人头自动进HOV😅路上还有一次,正在等红灯,突然倒车,给我吓一跳😂然后发现旁边有个大货车转弯,需要后退让出来一个安全空间。。。简直了🤔🤔
另外美国的路可真是烂啊,路上好多坑,Model Y底盘太硬了,坐着是真不舒服,这个车在美国带上税得5万美金,座舱又实在太工业风,如果价格和国内差不多,座舱再舒适一些,估计在美国得杀疯了🙄个人觉得国内政策应该允许给车厂一定的额度(美国貌似前几年有这个政策),比如每个车厂1万个L3的名额,这个额度内的车辆OTA可以宽松一些,如果这些L3无事故行驶够XX百万公里了,再给L3牌照,而不是现在这样要么全给要么不给
阿里今天发布了Qwen3.8 Max,Artificial Analysis还没开榜,我已在蹲守中。
新模型的宣传片倒是好评不少,因为构思很不错,并没有一味展示模型能力,把人类因为AI可以24小时不间歇干活从而解脱出来投入生活的画面做成了背景,人的所谓主体性非常明确。
(当然Qwen的团队因为忙这个模型又加了多少班我是知道一点的,这有点难绷
另外还有一个少有人注意到的彩蛋就是,短片里演示AI在电脑上持续工作的其中一幕是,设计芯片。
🐶
有点嚣张了啊,不过我喜欢。
“法学硕士”时代结束了。
X用 Grok换掉谷歌翻译做翻译这事...体感上区别确实比较大。


#模型时代# 前 xAI联合创始人 Igor Babuschkin:一味把 Coding做得更好,可能成为下一阶段模型训练的陷阱
众所周知,xAI(现在SpaceX)很少有人出来做访谈,之前有一个印度小哥聊完第二天就离职了。所以,前xAI的人能出来聊也很难得了。这是上周末,River AI联合创始人兼 CEO、xAI前联合创始人 Igor Babuschkin做客 Redpoint投资人 Jacob Effron主持的播客 Unsupervised Learning的一期记录。
Babuschkin的经历串起了过去十年的几条重要 AI技术路线。他原本在大型强子对撞机从事物理研究,随后进入 DeepMind,参与 WaveNet,担任《星际争霸》项目的技术负责人,并发起 AlphaCode项目;此后加入 OpenAI的推理团队,也参与过大规模预训练。2023年,他与埃隆·马斯克 Elon Musk等人共同创办 xAI,并参与建设 Colossus数据中心。离开 xAI后,他先成立了关注 AI安全的投资机构,2026年又创办 River AI。
一、编码智能体越过能力阈值后,使用方式发生了突变
1、2025年底,软件工程师开始普遍感到工作方式已经改变
Babuschkin把转折点放在 2025年 11月至 12月。当时新一代 Claude Opus等模型把编码智能体推到了足以改变工作方式的水平。编码智能体的英文常写作 Coding Agent。此前,有些工程师使用 AI编程,有些人仍然不用;从那时开始,越来越多工程师接受了一个事实:智能体既能显著提高效率,也开始接手大量工程师过去亲自完成、并从中获得乐趣的工作。
他自己在 12月重新做了一遍许多曾经想做或做过的编程项目。个人能够完成的事情突然增多,模型继续进步后,人类在工作中的位置也会随之变化。
这段经历促使他写了两篇关于 AI未来的小说。其中一篇借用了“魔法师的学徒”的结构:人类掌握了强大工具,却逐渐失去对工具的控制。另一篇写给未来的机器,保留了他第一次看到模型完成简单任务时的惊异。…
他认为,今天的软件工程师正在集体成为“魔法师的学徒”。
2、代码和数学率先突破,因为它们能给强化学习提供明确奖励
代码是智能体最自然的起点。程序能否运行、单元测试是否通过、漏洞是否修复,都可以转化为清楚的反馈。数学也有类似条件。借助 Lean等形式化证明工具,定理和证明可以被机器检查;训练系统由此能够判断答案是否成立,并据此更新模型。
这类任务被称为可验证领域,英文是 verifiable domains。强化学习需要模型多次尝试,再根据结果获得正负奖励。验证器越可靠,模型越容易从尝试中学到有效策略。
Babuschkin预计,复杂软件项目、数学证明和一部分科学问题仍会快速进步。他同时提醒,**一味把 Coding做得越来越好,可能成为下一阶段训练路线上的陷阱。**这条路反馈清楚,工程积累也较丰富,继续投入相对容易;影响范围更广的任务,往往缺少同样便宜而可靠的验证器。
3、科学发现需要把模型的试错环路接到现实世界
材料科学、基础物理和火箭发动机设计都不能只在文本里完成。模型提出一种新材料或新结构后,必须通过仿真、实验或实物测试取得反馈。实验可能昂贵、缓慢,还会受到设备和测量误差影响。
科学智能体必须在提出方案后,从仿真或现实实验中取得结果,再据此调整下一轮方案。Babuschkin把这种与物理世界相连的完整反馈闭环视为当前的重要前沿。
4、最强 AI与日常个人 AI可能走向两条产品路线
高成本的超级 AI可能在科学发现、预测和复杂决策上超过任何个人,甚至超过人类团队。Babuschkin用了一个假设来说明这种分化:普通人不会每天调用一种单次运行可能花费 100万美元的超级 AI。
日常个人 AI不需要证明黎曼猜想。它更需要理解一个人的处境,帮助他安排工作和生活,并根据长期结果调整行为。评价标准接近“是否真正帮到用户,以及是否改善了用户的状态”。这类目标贴近人的生活,也难以被精确计算。
主持人从普通用户的使用感受补充了一点:不少 ChatGPT用户并不觉得最复杂的新模型与一年前的模型存在决定性差异,因为旧模型已经足够完成他们的主要任务。日常 AI的改进重点可能逐渐转向成本、个人化和长期协助,最高智力不再是唯一指标。
二、River AI的三项下注:训练服务、个人化和本地硬件
1、让更多人获得 AI的收益与控制权,也是一项安全问题
Babuschkin 2025年离开 xAI后,曾投资一批从事 AI安全的创业者。接触的方案越多,他越不愿只等待别人推进,于是决定重新创业。
他担心的近期问题是,能力与控制权不断集中到少数大型实验室。当前的主流路径是先完成大规模预训练,再由模型公司托管服务,通过应用程序接口 API按 token收费。API是外部产品调用模型的接口,token则是模型处理文本和计费时使用的基本单位。模型公司可以决定用户能访问哪些能力,以及模型遵循什么规则。River想验证另一种技术与分发方式,让个人和企业能够塑造自己使用的模型。
公司目前并行推进三个方向。Babuschkin希望沿用早期 OpenAI和 DeepMind的研究方式,保持长期视角,也允许团队承担风险较高、短期结果不确定的研究项目。
2、River API:让企业用自己的数据改造基础模型
River API位于训练层,提供强化学习与微调服务。Thinking Machines推出的 Tinker是一个同类参照。这个品类的基本工作方式是:企业先取得一个能力较强的开放基础模型,再用自己的数据和反馈塑造模型。
Babuschkin强调的差异主要在工程效率,包括训练成本、可靠性和扩展能力。River也希望先通过这项服务形成收入,再支撑周期更长的个性化和硬件研究。
3、个人 AI:打破“为平均用户训练一个模型”的默认假设
现有商用模型会汇总大量用户反馈,再训练出一套面向总体人群的行为方式。同一个模型通常以相近的风格服务每个人。
River希望模型可以直接从个人互动中学习。不同用户的智能体可以采用不同语气、词汇和回答长度;它还要学习何时主动提醒、何时保持安静,以及一个人对书籍、电影、音乐和日程安排的偏好。
个人智能体每次交互后都应更了解服务对象,不能只在上下文窗口里临时读取几条用户资料。
4、本地硬件:把推理算力放到家庭或办公室
River的第三项下注是本地 AI硬件,希望用一台放在家庭或办公室的小型设备运行强模型。模型权重是训练后形成的内部参数。当前的主要困难是内存容量,大模型的全部权重难以装进单个芯片或小型设备。
本地运行首先解决控制权问题。用户拥有设备和模型,不会完全依赖数据中心的访问政策。它还可能降低延迟,让实时语音、视频输入和视频输出获得更连贯的体验。
隐私是另一个直接需求。真正有用的个人智能体可能读取电脑中的文件,听到房间里的对话,并长期保存个人活动。如果所有信息都持续传往远端数据中心,数据泄露、二次训练和权限管理都会成为问题。本地计算可以减少离开设备的敏感数据。
三、个人化不能只靠“记忆”,模型还要学会使用记忆
1、权重更新与外部记忆可以并存,关键是端到端训练
个人化模型有两条常见路线。一条路线修改模型权重,让偏好进入模型内部;另一条路线保留通用模型,通过外部记忆和提示词提供个人信息。Babuschkin对具体组合保持开放,但认为系统必须围绕最终任务接受端到端训练。端到端训练的英文是 end-to-end training,训练范围覆盖读取个人信息、调用记忆、采取行动和评价结果的完整链路。
仅仅给现成模型接上一套记忆数据库,无法保证它知道何时检索、怎样理解,以及如何把信息转化成合适的行动。模型还要在训练中学会使用这些记忆。
2、“让用户更幸福”是一个方向性目标,目前还没有成熟的奖励函数
主持人追问,个人 AI是否会接入用户自报的幸福感,甚至读取可穿戴设备,以此形成训练闭环。Babuschkin没有给出确定方案。他提出一种可能:能力更强的模型或许能够回顾当天的行动,判断自己改善了用户处境,还是把事情弄得更糟,再生成正负奖励。
这仍属于不可验证领域。人的幸福感缺少统一尺度,短期满意也不等于长期受益。Babuschkin谈论的是研究设想,River尚未把它实现为产品能力。
3、未来的个人智能体可能是推荐系统与 Agent的结合
TikTok和 YouTube的推荐系统会从持续行为中识别兴趣,不同用户看到的内容差异显著。个人智能体需要获得类似的适应能力,同时还要执行任务和主动协助。
这种系统的个人化范围会超过内容推荐。它要学习回答的详细程度、交流风格和主动介入的时机,也要根据用户目标安排一天的活动。个人偏好由此进入智能体的决策过程,不再只改变界面上的推荐列表。
四、企业为什么会训练自己的模型
1、今天的企业自训模型,主要为了成本、速度与隐私
企业通常先调用闭源模型,因为它们的通用能力最强,也省去了建设训练团队和基础设施的成本。企业选择小模型或自有模型,现实动机通常是降低推理成本、提高响应速度,或让敏感数据留在自己的基础设施内。
自训模型长期受到一个时间差限制。企业可能需要几个月组建团队、掌握深度学习与强化学习、建设训练系统;等到内部模型追上原有闭源模型,闭源实验室已经发布了更强的一代产品。持续调用 API因而成为较稳妥的选择。
2、通用能力若进步放缓,企业内部的数据与判断会抬升价值
Babuschkin预计,上述时间差会缩小。开放模型正在接近前沿能力,通用模型在不了解企业内部业务的条件下,能够取得的低成本改进也在逐渐减少。
一家做人力资源软件的公司,更清楚客户如何使用产品、哪些操作会造成问题,以及智能体该遵守哪些业务规则。制药企业的试验数据、芯片公司的设计资料,具有更明显的独占性。此时,企业可以把数据交给 OpenAI或 Anthropic,甚至将数据出售给模型公司;也可以在开放模型上自行训练,把内部知识保留为竞争资产。
主持人提出了一个反例。模型公司可以聘请前银行从业者制作金融数据,一家普通银行掌握的信息未必具有足够的独占性。Babuschkin接受这个行业差异:如果一家公司的关键知识已经公开在互联网上,或能够被外部专家轻易复制,模型公司和竞争者都有机会获得,原有优势会更加脆弱。企业只有拥有独占数据,并能把它转化为训练反馈,自训模型的回报才会更明确。
3、闭源实验室可能同时受到能力成本、发布限制和开放模型追赶的挤压
Babuschkin认为,预训练具有边际收益递减特征。模型越强,需要聚合的 GPU越多,高质量数据也越难获得。他用一句形象的话概括算力边界:**“你不可能用 GPU覆盖整个地球。”**算力与数据投入无法无限扩张,能力提升最终会放慢。
闭源实验室还面对发布边界。模型能力过强后,公司可能基于安全考虑保留权重或限制访问,也可能受到监管约束;与此同时,开放模型继续逼近。由此形成的商业压力是:前沿模型越昂贵,公开销售越谨慎;稍弱的开放模型却足以覆盖越来越多的实际任务。
他认为 OpenAI、Anthropic等公司仍可以通过基础研究找到新增长点,例如进入新的任务领域,或发明更有用的训练和产品方式。这个判断建立在一项预测上:单纯依靠同一路线扩大模型,带来的能力差距会逐步缩小。
4、后训练可能从集中吸收全世界专家,转向分布式改进
大型实验室当前会聘请不同领域的专家制作数据和评价答案,再把这些知识汇入同一组模型权重。这是一项庞大而昂贵的组织工程,也会出现边际收益递减。
Babuschkin倾向于让分散在企业和大学里的专家自行改进模型。基础模型提供通用知识,具体组织在本地完成后训练。后训练的英文是 post-training,指基础模型完成预训练后接受的微调、强化学习和行为调整。River API的商业机会来自这一分工。
5、把几十个强化学习领域叠加起来,未必会重现预训练的泛化效果
预训练扩大到一定规模后,模型会在许多任务上同时进步。主持人由此追问:如果模型依次接受金融、医疗等几十个领域的强化学习,会不会也出现跨领域能力突然同步提高?
Babuschkin没有给出肯定判断。通用模型已经能把广泛的世界知识带进新领域,代码和数学训练似乎也贡献了较多通用推理能力;大量专业技能只在狭窄场景中使用。他怀疑这些技能汇入同一个模型后,未必能像预训练那样产生明显的跨领域协同。
五、Babuschkin对中国开放模型的判断:能力供给与供应依赖同时存在
1、开放模型降低了企业训练与个人控制 AI的门槛
对希望微调模型、建设自主产品的团队而言,开放权重提供了较低的起点。开发者可以检查、部署和改造模型,River设想的本地训练与本地推理也以此为基础。
Babuschkin指出,节目播出时最强的一批开放权重模型主要来自中国实验室。这会形成新的供应依赖。模型提供方可以停止发布新权重,也可以修改许可证;部分许可证已经根据企业收入规模设置不同条款,达到门槛后需要另行合作。
2、后门风险在理论上存在,当前尚未成为他的主要担忧
权重中植入隐藏行为或后门在技术上具有可能性。Babuschkin的判断依据有两点:公开渠道尚未出现得到确认的真实案例;按照现有技术,植入后门通常会留下可检测的痕迹。因此,他现阶段没有把它列为主要风险。
随着模型进入更多关键系统,相关检测仍需提前准备。他给出的观察期是未来两年左右。智能体若获得更强的网络安全和行动能力,权重安全的重要性也会上升。
他主张美国团队应训练出全球最强的开放模型,不能只满足于“美国最强”。River未来不排除参与;公司当前的优先任务仍是找到开放权重之上的可持续商业模式。
六、从《星际争霸》、AlphaCode到 xAI:几次关键判断如何形成
1、AlphaGo让一名物理学博士决定转入 AI
Babuschkin最初在大型强子对撞机从事物理研究。AlphaGo出现后,他意识到 AI会带来远超单一棋类游戏的变化,于是加入 DeepMind,担任研究工程师。
这个角色横跨算法与系统工程。他先参与 WaveNet文本转语音,随后进入强化学习,担任《星际争霸》StarCraft项目的技术负责人。复杂的实时战略游戏要求模型处理长时间任务、部分可见信息和大量动作,比许多当代强化学习环境更加复杂。
2、《星际争霸》已经形成了今天训练智能体的基本组合
团队先收集从新手到接近职业选手的大量对战回放,让模型通过模仿学习掌握基本行为;随后进入强化学习阶段,以比赛胜负提供可验证奖励,继续优化策略。
Babuschkin认为,这一组合至今仍在智能体训练中发挥作用。模仿数据把模型带到合理起点,强化学习再通过试错提高表现。
3、AlphaCode源于一个直觉:早期语言模型不会为难题留出思考时间
《星际争霸》项目之后,他把代码视为强化学习的自然延伸,并发起 AlphaCode。早期语言模型在编程上表现不佳,他认为原因之一是模型直接输出答案,缺少类似人类解难题时的内部思考过程。
为了研究推理,他加入 OpenAI新成立的推理团队,并与格雷格·布罗克曼 Greg Brockman等人参与大规模预训练。团队当时还没有完整解法。几年后,o1所采用的路线允许模型在给出最终答案前生成一段内部推理内容。这些内容由一组“思考 token”组成,再通过强化学习改善推理过程,回应了当年的问题。
谈及 DeepMind与早期 OpenAI的差异,他没有把结果归因于单一算法。DeepMind聚集了大量优秀研究者,也存在不少正确想法;OpenAI当时团队更小,处在追赶位置,却更容易围绕一条路线形成一致判断和投入强度。人才密度、共同信念和资源集中共同发挥了作用。
4、创办 xAI的起点,是他对单一实验室掌握最强模型的担忧
在 OpenAI工作时,他已开始担心最强 AI由一家公司控制。作为长期使用 Linux的开源支持者,他倾向于让更多人获得模型能力。
他提出了一个带有个人价值立场的理由:预训练吸收了互联网上大量人类知识,这些文本来自全社会;模型实验室确实投入了算力、算法和组织劳动,但原始知识同样没有被充分计价。因此,他认为预训练检查点适合以更开放的方式发布。这是他的规范性主张,行业并未就此形成共识。
他回忆,当时团队甚至讨论过一种极端未来:OpenAI控制最强模型,再通过全民基本收入让社会分享收益。全民基本收入的英文缩写是 UBI。这个设想没有消除他的疑虑,因为资源分配仍然建立在单一机构掌握模型的前提上。
Babuschkin后来在 Tesla办公室偶遇马斯克。两人谈到 AI竞争、模型控制和产品理念,发现彼此判断接近。马斯克决定创办新公司后联系了他,xAI由此组建。Babuschkin随后邀请旧同事加入。他认为,从零开始建设实验室,首要条件是聚集一批愿意高强度合作、能力互补的研究与工程人才。
5、Colossus的 120天,来自对数据中心建设流程的重新拆解
xAI希望快速扩大训练规模,却从传统供应商处得到超过一年的建设周期。马斯克决定自建数据中心,并让公司直接承担总承包角色。
传统项目常采用瀑布式流程,还要经过多层分包。多层分包会拉长沟通和执行链路,也会降低效率。xAI把项目拆成具体环节,逐项追问哪些行业惯例可以绕开,哪些任务可以并行,最终在约 120天内让 Colossus上线。
Babuschkin最初也觉得这一期限近乎疯狂,但此前的合作让他相信马斯克会推动团队完成。他把这段经验概括为高度聚焦、从第一性原理拆解步骤,以及尽量减少外部依赖。
6、他对马斯克工作方式的评价集中在工程细节与组织能量
Babuschkin说,自己愿意与马斯克合作,一个原因是对方尊重工程师。马斯克会直接参加工程会议,与实际执行者讨论细节;在他感受中,马斯克更像参与解决问题的团队成员,不只承担管理者角色。
他还提到,马斯克会向组织传递高强度工作的能量。这段描述来自 Babuschkin的个人合作经验,不能代表 xAI所有员工对公司文化的评价。
7、谈及 Cursor与 SpaceXAI的合作,他看重团队、产品入口和真实使用数据
主持人先提到 xAI已并入 SpaceX,随后询问 Cursor与 SpaceXAI的结合会怎样改变 Grok的编码能力。Babuschkin认为这是一项聪明的安排。Cursor团队熟悉代码任务,产品拥有大量真实用户;庞大的使用量可能帮助训练方理解开发者在现实中遇到的问题。
真实使用数据还需要与强化学习环境结合。训练者可以构造“修复代码库中的一个漏洞”等任务,再检查修复是否成功、实现方式是否符合要求。前者提供真实任务分布,后者提供可验证训练信号。
Babuschkin明确说明,自己已经离开 xAI,并不了解 Cursor究竟带来了哪些内部数据,也不知道 Grok编码能力提高的具体训练配方。他的分析来自过去的模型训练经验。
七、模型进步的主要瓶颈,正在转向长时程任务和不可验证奖励
1、一次任务执行 24小时,强化学习的更新速度会急剧下降
强化学习通常需要让智能体完成多次尝试,收集奖励,再更新权重。rollout是其中一轮完整的任务尝试,从模型接到任务开始,一直持续到任务结束。若一次 rollout需要 24小时,每轮模型更新都要等待更久,试验成本也会随之上升。
可能的方向是把长期任务切成能够观察中间进展的片段。系统不必等到最终结果才评价,可以根据阶段性成果分配奖励,并逐步训练智能体处理更长的任务。怎样可靠评价中间进展,仍是训练者需要解决的问题。
2、大语言模型评审可能补上不可验证领域的反馈
写作、管理、长期研究和个人协助往往没有单元测试,也没有形式化证明。一个思路是让更强的模型担任评审,判断行动质量,再把结果转化为奖励。这种方法的英文常写作 LLM-as-a-Judge,其中 LLM指大语言模型。
Babuschkin认为,前沿模型已经能对不少复杂结果作出有价值的判断。他目前还没有看到这套方法被大规模用于继续提升模型,也不认为训练配方的全部细节已经解决。他预计,未来几个月到一年可能出现更完整的实践。
3、Coding Agent的普及提醒他,能力可能突然跨过使用阈值
他原本预计代码模型会逐步改善,使用率随之缓慢提高。2025年底出现的却是一次明显跳变:能力达到某个水平后,大量工程师在短时间内改变了工作方式。
这让他开始考虑,科学、个人助理和其他专业工作也可能出现类似时刻。研究人员可以观察模型指标,却难以提前判断哪一代产品会让真实用户集体改变行为。
4、人机协作的风险,在于人会持续把更多决策交给能力更强的智能体
当前的编码协作仍保留了清楚的分工:智能体处理底层实现,人负责架构和规划。随着智能体变强,把更多工作交给机器具有直接的效率激励,分工边界会持续移动。
Babuschkin担心,一旦智能体替用户做出大部分决定,人会逐渐失去对生活和工作的实际控制。他由此把个人化与对齐联系起来。现行对齐常以群体偏好为目标,训练模型接受多数评价者喜欢的行为;个人 AI则需要深入理解具体用户的目标,并在长期互动中保持一致。
他也提到 Neuralink一类脑机接口可能在遥远未来让人直接控制大量机器智能。现阶段更现实的路径仍是改进训练算法,使模型贴近用户意图,并保留人在决策回路中的位置。
5、全球协调减速的可行性有限,对齐与安全研究需要加速
节目临近结束时,主持人提到一封呼吁政府考虑放缓 AI的公开信。Babuschkin赞成多争取一些时间研究对齐,但认为协调减速相当困难。AI已与美国经济和公司投资深度绑定,国际竞争者也未必同步行动。
若整体速度无法下降,他主张增加对齐与安全研究。接近危险能力阈值、又尚未强到可以造成严重现实伤害的开放模型,尤其适合让更多研究者测试控制与防御方法。网络安全能力是他认为需要重点观察的领域。
主持人最后询问“这一切顺利收场的概率”。Babuschkin没有给出数字,而是先区分“对谁顺利”。近期更明确的风险是 AI扩大不平等:少数人获得巨大收益,其他人感觉被抛在后面。更远期还存在模型夺走控制权的可能,但当前难以可靠预测。
他随后回忆,早期模型即使只会写一个生成质数的 Python函数,也让研究者觉得近乎不可思议。如今模型已经影响整个世界。那种最初的惊异仍在,技术实验则已经变成经济、组织和个人生活中的真实选择。
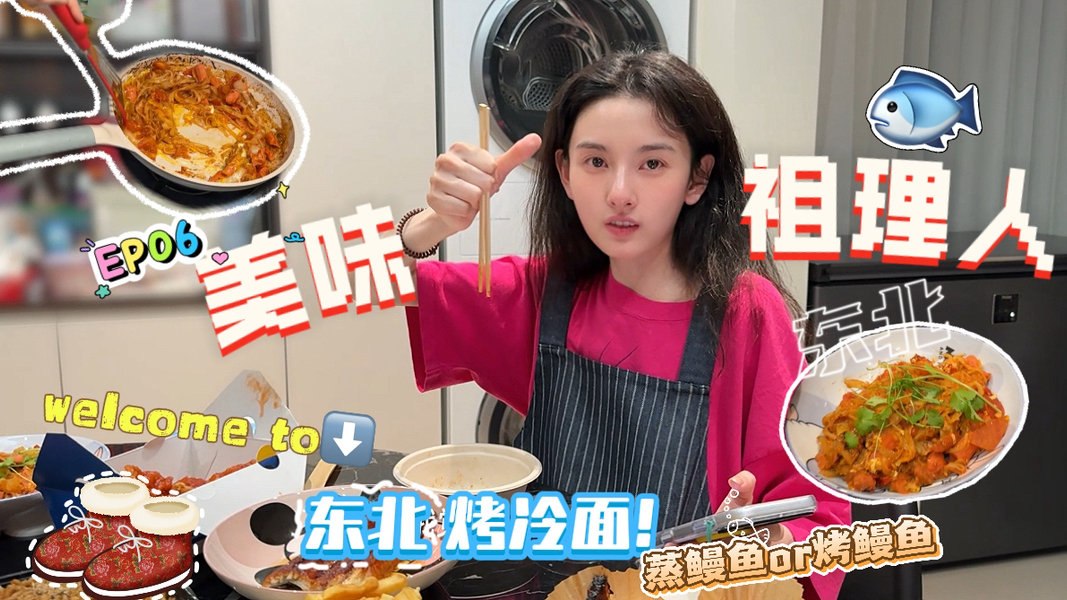
👩🍳#美味祖理人# |小孙暑假日记📝美味宵夜出炉🥄烤冷面初尝试,还有外焦里嫩的鳗鱼,大吃一口!!#是VLOG这夏太好了#
这个遣词造句一眼AI,我甚至都能猜到是哪家模型生成的,但好像已经没多少人有这个辨识能力或者真的在意了。
#年会不能停2投资人曾预期票房20亿##曝年会不能停2投资人曾预期票房20亿#看到有yxh搬运🍠帖子,搜了下账号,动用人脉关系打听到,据片方透露此人根本不是投资方,原贴已删。网友谨慎吃瓜,可以退散了。

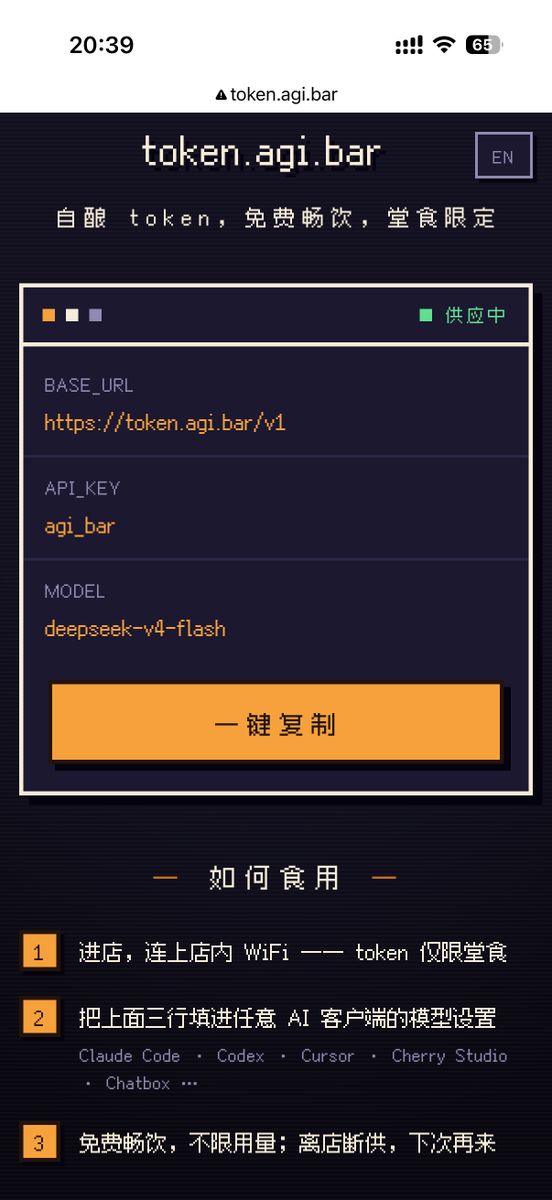
这个想法有意思:果然当 token足够便宜,就可以变成福利。
前两天终于去看了《奥德赛》。能放70mm胶片的IMAX厅LA有五家,挑了个离家近的,工作日大早场都满员,票房破十亿美金指日可待。
坐在三层楼高的位置上,一整个人神共存的世界扑面而来,恢宏又质朴。电影肯定是好看的,顶级视听语言,不会觉得三小时长,叙事也不复杂,完全能get导演的表达意图。
然后这几天我就在想对诺兰《奥德赛》的观感,越想越觉得有点像当时看侯孝贤的《聂隐娘》的感觉。就是纯粹从电影的角度来说绝对是佳作,只不过电影里的聂隐娘不是我从唐传奇里读出来的聂隐娘,诺兰的奥德修斯,也不是我从荷马史诗里读出来的奥德修斯。狡黠与自负算计没有了,变得好朴实(尤其加上马特达蒙那张憨厚诚恳的脸),反战反思,强调救赎感。这时我选择先放下我的理解,跟随创作者的思路,进入他改编的世界。所以也能理解古典学界的部分批评意见。如果在超级大片的带动下,掀起全球年轻人重读经典的热度,更是功德哇。
最后说一句演员,之前吵来吵去的黑版海伦,其实在电影里并不突兀,而且用她之口点出了所有以女人为借口的战争自古以来都是一样,反而更好。要说突兀倒是安妮海瑟薇和荷兰弟感觉有点太好莱坞了,稍微有点出戏,赞达亚的雅典娜就完全没有这个问题,难怪诺兰现场给出perfect表扬。
这样的电影说实话看一部少一部,能冲最高放映规格的尽量冲,没有也不太影响看电影,不必本末倒置。电影院是现代日常生活的神庙。


Anthropic/OpenAI 在向这些公司收取 30 万美元的 token 费用后,正在扼杀 AI 原生 B2B 垃圾 SaaS。
企业 AI 的未来正变得越来越开放。
听 @ATT 首席技术官 Jeremy Legg 讲述,他的团队如何使用 AMD 解决方案,在提高准确率、降低成本的同时,支持公司不断扩大对开源 AI 模型的采用。
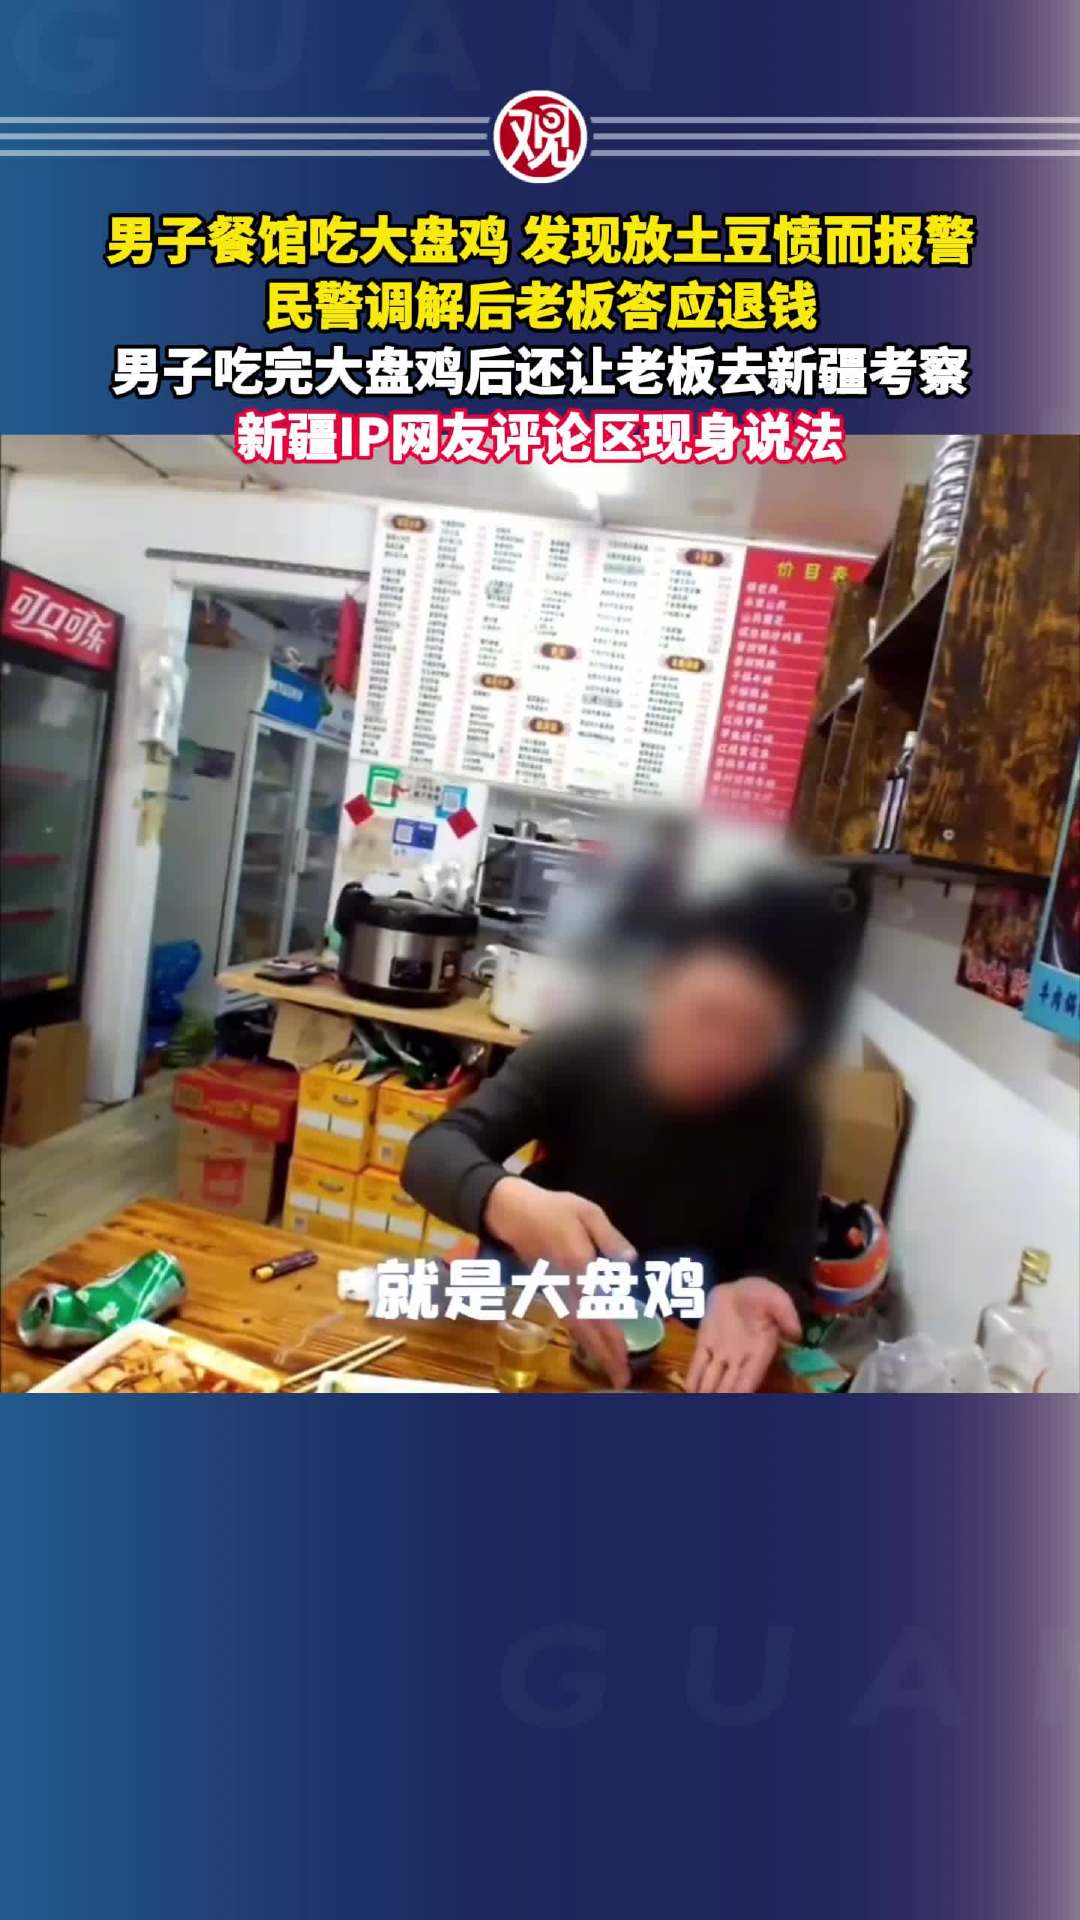
如果网友开盒这个吃白食的算网暴还是路见不平?发开盒信息的话,平台会被罚么?//@午后狂睡:老板退钱这盘菜就不属于他了,居然还有脸吃完了,这不纯惯着吃白食的牲口吗?吃完白食擦擦嘴就走了,这拿来宣传合适吗?你们暴力机关是来干调解的?人老板正常开个饭馆得罪谁了?执法机关不保护正当经营的商家的合法权益,反而惯着臭无赖?
#新疆IP网友称大盘鸡里有土豆# 近日,上海一名顾客在餐馆点了份大盘鸡,上菜后发现大盘鸡里有土豆,而他认为正宗大盘鸡里绝不该放土豆。而且,店里另一道土豆烧鸡块仅售38元,“加了土豆的大盘鸡”却要68元。整整30元的差价,报警人觉得这属于“欺诈”行为,直接拨打了报警电话。
民警到场后,先安抚顾客情绪,再从法律层面解释大盘鸡无统一法定配方,属商家口味特色,且菜单明码标价,不构成法律意义上的欺诈。
最终经过民警的调解,餐馆老板主动免单,顾客接受了调解仍吃完了整盘大盘鸡,但走之前专门叮嘱民警让老板去新疆调研,“正宗大盘鸡哪有放土豆的!”
新疆IP网友评论区现身说法称,“昨天才吃过,新疆沙湾杏花村大盘鸡,就是有土豆”;“看我ip,不放土豆的叫辣子鸡、东乡鸡、八块鸡,但一定不能叫大盘鸡,大盘鸡吃的就是土豆熬烂汤汁拌面!”#上海一顾客因大盘鸡里有土豆报警#
突发新闻:人们想赚钱。
刚刚:据报道,Anthropic CEO 越来越担心,新员工来这里是为了领一份工资,而不是为了公司的使命。
本期对谈围绕一个核心矛盾展开:AI 相关股票经历剧烈抛售,但 Gavin Baker 在硅谷连续调研后,几乎找不到量化层面的需求减速信号。GPU 供应和租赁价格、DRAM 现货价格、token 增长以及超大规模云厂商经营现金流都在改善;市场真正担心的,更多是估值、信贷、合同和叙事变化能否把产业增长及时转化为股东回报。Gavin 认为,开源模型不会消灭 token 需求,只会把利润从模型层转移到基础设施层;Claude 等统一的概率性解读工具则让市场在短时间内快速完成一轮叙事重估。
对谈开头回顾了七月的市场动荡:大量 AI 股票从高点回撤 40% 至 60%,但 Gavin 的压力测试没有发现明确的负面量化指标。相反,GPU 供应量、租赁价格、DRAM 现货价格和 token 增长都在加速。超大规模云厂商的经营现金流也从约 28 增至约 32,剔除一次性项目后约为 35;这些改善甚至发生在新一代 GPU 大规模点亮、旧合同重新定价之前。
市场对 Meta 出租算力、云厂商举债建设和 GPU 租赁公司的担忧,集中指向信用风险:信用违约互换(CDS)上升、利差扩大、实际收益率走高。如果算力扩张必须依赖债务,而供需出现轻微错配,现金流压力可能迅速放大。Gavin 因此强调,现货 GPU 价格与合同价格的差距,以及未来六个月融资结构,是判断这轮建设能否持续的关键。
现实价格与市场旧预期出现明显偏离:很多人原本预计老 GPU 租赁价格缓慢下降,实际却可能在合同到期后以更高价格重新定价。长期协议(LTA)通常包含预付款、价格上下限和供货承诺,打破价格协议可能引发对方撤回供货量,进而伤害整个生态中的特许经营关系。讨论还延伸到内存供应、劳动力囤积和资本周期:供应链正在从短期抢量转向用确定性换取长期回报。
企业通过路由器把不同任务分配给不同模型,可能降低模型层支出,却同时增加更便宜 token 的使用量和底层 GPU 算力小时数。AI 原生公司仍在大规模投入 token,说明“模型价格下降”不能直接等同于“算力需求下降”。在 Gavin 的比喻中,开源 token 像公开市场看不见的暗物质:难以在上市公司数据中直接衡量,但真实消耗了计算资源。
越来越多市场参与者把新闻交给 Claude 做概率性解读,再依据相近的结论交易。Gavin 认为 Claude 在股市中的作用有些像过去的沃尔特·克朗凯特:它并非总是正确,却可能让市场迅速趋同。日本电容股的例子说明,原本可能持续数年的产业周期,被集中叙事压缩到六周完成,交易因此变得更拥挤、更剧烈。
对谈后半段讨论了数据中心的公共叙事、深紫外与极紫外光刻、开源软件效率和 SpaceX。Gavin 认为,数据中心会创造持续的水管工、电工、暖通和承包商岗位,相关用水争议也存在被严重夸大的案例;AI 行业在公共沟通上明显落后。软件层面,规划模型把任务分派给更便宜的模型,可能显著提高效率,但也会让基础设施需求更难从表面支出判断。SpaceX 则被视为尚未被市场充分定价的潜在变量。
访谈并没有把所有风险都解释成“市场错了”。嘉宾承认,前沿模型的能力进步、开源模型的价格压力、信用成本上升和供应链重新定价,都会改变不同公司的利润归属。真正需要避免的是把模型层的降价、某一家公司的预算削减,直接推导成全行业 token 或 GPU 需求下降。对投资者而言,应该把收入确认、现金流、合同期限、现货价格、供货量和市场叙事放在同一张图里观察。
这种分析也解释了为什么短期股价和产业基本面可以同时朝相反方向运动:市场先交易可见的叙事,现金流和供需数据则需要更长时间才能被验证。
- 节目开场与市场恐慌 [00:00:00 - 00:10:00]
- 信贷风险、算力价格与开源模型 [00:10:00 - 00:20:00]
- Claude 效应与市场叙事 [00:20:00 - 00:30:00]
- 长期协议与供应链博弈 [00:30:00 - 00:40:00]
- 全球算力、开源与软件效率 [00:40:00 - 00:50:00]
- 数据中心、SpaceX 与未来市场 [00:50:00 - 01:00:00]
- 结尾 [01:00:00 - 01:00:40]
一凯:欢迎收听跨国串门计划,这是一档专注于让中文听众无障碍欣赏全球优质外语播客的节目。通过先进的AI生文克隆技术,我们不仅将内容翻译成中文,还完美保留了原主持人和嘉宾的独特声音,为您呈现全球顶尖的AI财经、健康与科技领域精品内容。我是主播一凯,一位热衷于AI领域的产品经理,很荣幸能为您搭建这座跨越语言障碍的桥梁。接下来让我为您简单介绍,本期我们克隆的这档节目,本期我们克隆的是知名播客,InvestLikeTheBest,一期深度对谈,主持人PatrickO'Shaughnessy,与顶级AI投资人GavinBaker,在2026年8月初录制,他们聊的是当时AI和半导体市场,经历的一轮剧烈抛售,但Gavin在硅谷实地调研后,发现底层需求信号,其实在全面加速,这期主要围绕市场恐慌与基本面之间的巨大反差展开,也聊了算力定价,开源模型和长期协议背后的博弈,那我们就一起来听听这期完整的对话。 [00:01:08]
Gavin Baker:我想让自己害怕一点,你懂的,我不想看着这些股票越来越便宜,心里想着预期远期回报再上升,却像个疯子一样,我这周来这儿的主要任务,就是压力测试,对,找点负面的东西告诉我,但我一直没能找到一个,那种量化指标层面的负面,底层基本面在改善,而股票方面,英伟达实际上,就在我们录这期节目的时候,正处在过去十年最低的远期市盈率,市场百分之百认为,他们严重超赚了,Gavin这才过了两个月,模型发布的周期,我们两期播客之间的间隔都在缩短,基本上,你和我现在都按模型发布的节奏,在录节目了,我之前对一种批评很敏感,我记得有人指出,我们的播客总是碰巧赶上局部市场高点,但这次之后没人能这么说了。 [00:02:01]
Patrick O'Shaughnessy:你在想什么。
Gavin Baker:这真是疯狂,疯狂的一个月,对,我会把7月形容成一个月里的2022,对确实有一些基本面的负面因素,我们该聊聊,但总体来看,基本面这边,我觉得是在显著改善的,大量AI股票从高点跌了50%60%,我们就算它一个月内,直线跌了40%到60%吧,而且我在开始之前问过你,你整个夏天都在外面跑。
Patrick O'Shaughnessy:你有没有听到过任何一个。
Gavin Baker:关于AI的负面量化指标,对哪怕一个减速的实力,没有什么都没有,事实上每个指标都在加速。
Patrick O'Shaughnessy:而且就像你说的。
Gavin Baker:这不只是那些对AI兴奋的人盲目乐观,对他们能从各自不同的视角,拿出数据给你看。
Patrick O'Shaughnessy:绝对我是说不管你怎么切。
Gavin Baker:不管你看GPU供应量,还是看GPU租赁价格,还是看这个月DRAM的现货价格,还是看token 增长,一切都在加速,而且我确实觉得问题很大一部分在于,第一市场看不到AnthropicOpenAI的内部情况,然后我要说,这些在美国做推理变现的开源推理云,比如FireworksModelTogether,你看到这些之后,画面就完全不一样了,因为开源,因为GLM5.2,KimiK3,而大幅加速了,然后Nemotron还在继续稳步推进,我们也有一个很棒的,很小的美国开源模型发布,OpenAI在加速,Anthropic也在非常强劲的增长,而且几乎可以肯定,在产生大量的自由现金流,我只是觉得,你知道有张图,大家都看,半导体现金流往上走,超大规模云厂商的自由现金流也往上走,但你漏掉了这些私营公司,但我也觉得那张图漏掉了一个非常重要的东西,就是2024和2025年的时候,所有人都觉得哪怕你非常看多,你也觉得GPU价格,如果你非常看多。 [00:04:05]
Patrick O'Shaughnessy:你会觉得租一块GPU的价格会缓慢下降。
Gavin Baker:如果你看空。
Patrick O'Shaughnessy:你会觉得它会断崖式下跌。
Gavin Baker:我不觉得2024或2025年,有任何人想到老GPU的价格,在2026年还会垂直往上冲,对,所以所有人都想,嘿,我们要聪明一点,我们要签这些长期合同,而且在某种程度上,很多NIO云厂商不得不这么做,因为他们需要成购协议,才能给GPU融资,所以本质上,你有一批以签约的装机算力,以远低于当前现货市场的价格,在交易,随着这些合同到期,算力以更高价格重新定价,就算现货价格会跌,算力还是会以更高价格重新定价,你知道。
Patrick O'Shaughnessy:我觉得你会看到大量加速。
Gavin Baker:这些会回答那些ROI的问题,这个季度你已经开始看到了,如果我们看经营现金流,不是自由现金流,微软Meta和亚马逊公布的经营现金流,从28加速到了32,不过这些超大规模云厂商,现在确实有一些相当大的非经常性项目,他们好像总是有几十亿的法律费用算作非经常性,主要是欧盟的罚款,但这个季度的一次性项目确实异常多,如果你把这些调整掉,我们从28到了35,而这个体量上这是一个实质性的加速,而且这还真的发生在他们开始点亮Rubens之前,内会以可观的溢价到来,也发生在这些合同重新定价之前,这真是艰难的一个月,而且几乎你知道,要不要我们过一遍这个月。 [00:05:48]
Patrick O'Shaughnessy:我们是怎么走到这一步的。
Gavin Baker:好,你知道首先Meta要出租算力,这被解读为非常看空,他们有冗余产能,他们要砍资本开支,这是灾难,这根本不是那么回事,他们刚公布的财报,并没有砍资本开支,实际情况是,他们看到SpaceX拥有庞大的算力装机量,并且把一些大型交易优化集群,以远超合同价的价格卖进了市场,至少分析师们看到了机会,有很多猜测说他们要融资,所以也许他们在想的是,我们先用一小部分算力,证明能产生很强的IRR,然后就去融股权资本,接着就一路狂奔,大概率还会提高资本开支,看起来他们并不是在这么做,但不管怎样,市场还是因为负面解读而抛售了,而我非常确定这不是坏事,关于Malad资本开支计划,有很多数据信号,那些信号一点都没变,如果说有什么变化,那就是变得更激进了,然后不久之后,他们发布了很长时间以来,最好的模型,EUS1.1,这确实是个非常好的模型,虽然被Grok4.5盖过了风头,但它是个好模型,比过去两年里的任何模型都好,所以他们绝不可能松油门,接着Kimi出来了,然后开源这件事引发了巨大的恐慌,与此同时,SiliconDatatokenIndex出现了下跌,然后走平,这两件事是有关联的,SiliconDatatokenIndex捕捉的是模型组合的变化,他们看不到所有token。但因为GLM5.2和Kimi,这些变化需要一段时间才能反应进来,数据里出现了从更贵的前沿模型token,向开源token的转移,前沿模型token可能有推理利润,不管是8090还是95,对但利润率非常高,而开源token的利润率就低多了,不管出于什么原因,市场认为这是利空,但现实是token就是token,在其他条件相同的情况下,生成一个token,需要完全相同的算力,需要相同的浮点运算量,相同的内存相同的功耗,当然token并不完全等同,但大体上说,开源模型抢占份额所做的,只是把前沿模型层的利润拿走,而这样一来,由于存在弹性,反而会推动token需求增长,你需要更多算力,而anthropic和开源模型,都跑在同样的底层云服务商上,这些服务商收取相同的算力费用,所以你实际上只是,把前沿模型的利润转移出去,把更多利润推向了AI基础设施层,我觉得这就是催化剂,就是这些因素的组合,对,然后事情继续发展,Jetson是世界上最大的开源支持者,我们真的,而且他是个非常理想主义的人,是个爱国的美国人,我觉得他总是做正确的事,但如果开源对他的生意有害,他真的会成为世界上最大的开源支持者吗,如果这对世界是正确的事,他仍然会支持,对,但也许他就不会成为一个标志性议题了。对,顺便说一句,我认为在只有一两个,占主导地位的前沿模型,收取90%利润率的世界里,开源非常重要,这对人类不好,对社会可能也不好,而且正如我们之前讨论过的,我认为我们需要很多模型,所以市场消化了这个信息,接受了它,然后中国有了身子外光刻机,DAV,这导致所有相关板块,都出现了巨大的半导体设备抛售,然后我们来到了,我认为在很多方面,真正令人担忧的问题,实际收益率上升了,这说得通,我们投入了大量资金来支撑这个投资,而且可以肯定的是,信贷在其中占比越来越大,即使大部分,绝大多数仍然由经营现金流支撑,所以实际收益率上升,利差扩大,Meta上周发行了一笔债券,它的定价并不像你预期中,Meta债券应该有的定价,这恰恰说明信贷市场,所有人的CDS都在飙升。 [00:10:01]
Gavin Baker:而非常聪明的私募资本人士会说,这正是你预期会看到的,这些只是银行在对冲他们的承诺,但不管怎样,这看起来不好,而且这些都是不可否认的事实,CDS上升了,利差扩大了,实际收益率也上升了,如果我们需要靠债务来为这轮建设融资,那会非常非常可怕。
Patrick O'Shaughnessy:而这就是为什么。
Gavin Baker:我认为现有算力装机量的现货价格,和合同价格之间的差异,如此重要,理解未来六个月的融资会是什么样,这轮建设在多大程度上需要信贷,这一点至关重要,对,那会是典型的资本周期,绝对,用债务过度扩张自己,事情就会变成那样,100%,而且债务驱动的建设,要求立即偿还,对,所以如果供需稍微失衡,事情可能会非常非常快的崩掉,互联网时代就是这么发生的,所以如果一个人相信像我这样,不管对错,而且说实话,过了这个月,我心态非常开放,我一直在压力测试所有这些,我确实在信贷上钻得很深,因为黑,这是真的,不可否认,如果我们需要信贷来支撑这轮建设,那这就是一个重大的负面因素,如果你把它建模出来,看看预计要上限的几瓦数,再看看超大规模云厂商的共识预期,他们实际上是在按某种速率建模变现的,这些是Blackwell和Rubin的基瓦数,Rubin是英伟达的下一代芯片,Blackwell是当前这代芯片,他们基本上是按Ampere的变现速率来建模的,Ampere落后两代,不是Hopper,是Ampere,所以超大规模云厂商,有1.3万亿,1.3到1.4万亿的金银现金流,如果你只是假设他们,我觉得他们不太可能按,Ampere的速率变现。 [00:11:59]
Patrick O'Shaughnessy:我们可以展开讲讲为什么。 [00:12:01]
Gavin Baker:一部分原因就是看看地面上,真实的需求信号,那些硬性的量化指标,但咱们就说他们按当前,Blackwell打个折扣来变现,那经营现金流,就接近两万亿,这就把七千亿的信贷需求给消掉了,然后显然讽刺的是,这反而改善了所有的,信贷比率,让这些已安装的算力重新定价,我们会继续加速,共识模型假设的是减速,我觉得不太可能,然后信贷指标看起来更好了,突然用信贷融资就变得更容易了,至于他们到底选不选这条路,我们走着瞧,但这整个事情有点,我觉得我们两个月前聊过,不对,是再上一次,聊过Blackwell空窗期的风险,你花几千亿美元买Blackwell,一开始主要用于推理,推理本身不产生回报,这可能是个风险,我们确实在第一季度看到了这种情况,我觉得两个月前那期播客里,我之所以对这个风险感到安心,一个原因就是你看到,Anthropic那边出了那么多不可思议的东西,然后就想好吧市场会忽略,这个的四月份五月份六月份市场确实忽略了,然后到了七月,因为这一堆事情凑到一起市场不再忽略了,恰恰就在金银现金流开始真正加速的时候,而且这是事实,它正在大规模加速,比如微软,他们在6月份上线了一大块算力容量,这甚至都没体现在第二季度里,所以这一切归根结底就是,你相不相信硅谷这边私营公司。传来的量化需求信号会持续下去,以至于随着合同到期,以安装算力会以更高的价格重新定价,经营现金流会上升,对经营现金流会上升,然后你大部分可以用经营现金流来融资,也许全部都可以,如果按当前价格重新定价,未来几年你大概可以全部用经营现金流覆盖,所以这确实是一个非常不寻常的市场事件,而且某种程度上事实是,我们应该聊聊那些比我说的还要更好的基本面,技术派会说2022年的时候,好吧,市场担心衰退,利率上升,通胀,那是2022年市场担心的事,你知道他具体在担心什么,DeepSeek来了,你知道他在担心什么,解放日来了,你知道他在担心什么,有个非常明确的东西,奇怪的是,这反而让人安心,确实,而这次,我们聊了很多具体的事情,但感觉,所有这些具体的事情,除了信贷之外,都有点荒谬,所以市场还在往下跌,技术派会说,这有点吓人,定义上讲,就是那颗你看不见的子弹才会打中你,我觉得我们之前聊过,我认为投资里最重要的三个字是安全编辑,但我不确定,不过你在这边待了两个月了,我也在这边,我今天早上真的跟一家公司聊过,他们租了一个集群好几千,这是那种大家最想合作的,最性感的创业公司之一,他们租了一个几千块Blackwell的集群,咱们就说大概每GPU小时2美元出头。他们租的是完全一样的集群,一样大小的集群,各方面基本一模一样,B200没有任何差别,他们希望七个月之后,能以不到四美元的价格租出去,你今天就能听到这种事,这真的太疯狂了,因为按理说。 [00:15:17]
Patrick O'Shaughnessy:你会预期价格温和下降。
Gavin Baker:才是看涨信号,结果反而看起点不同,六七个月里涨了50%到60%,而且这样的例子太多了,我记得有一家推理云公司,好像是在哪,我不太确定,他们上播客说,合同到期后,我们打算多付100%的钱,来续Blackwell,这基本上意味着,所有超大规模云厂商,都在少赚钱,我这周来这儿的主要任务,就是压力测试,对,找点负面消息给我,对,你知道我问你的那个问题。 [00:16:08]
Patrick O'Shaughnessy:你有没有听到过。
Gavin Baker:任何一个负面的量化指标,这也是我一直在问,每个人的问题,大家主要提到的,就是Anthropic,第三方数据显示,Anthropic的增长曲线,有点偏离原来的轨迹了,这是唯一一个我听到的,我觉得,我觉得这很可能确实是真的,但与此同时,OpenAI和开源模型在大幅加速,对,如果你看总和,整体还是在净加速,也许吧。
Patrick O'Shaughnessy:我不确定看起来是不是一样。
Gavin Baker:我觉得可能确实加速了,你知道,他们老说宇宙里有暗物质,开源对公开市场来说,就像暗物质,公开市场很难去衡量它,但如果你只看这些推理云公司在说什么,就是那些在播客上发言的人,或者在会议上发言的人,他们说的不是审计过的财报,但需求显然在加速,这很合理,因为GLM5.2和KimiK3,带来了巨大的能力跃升,我觉得我们还会继续看到这种跃升。 [00:17:07]
Patrick O'Shaughnessy:你会看到英伟达把Nimatra的不推向前沿。
Gavin Baker:这个月确实很磨人,很有挑战性,但同时也觉得,哇我把每个假设都压力测试了一遍,底层的基本面在改善,而股价方面,英伟达实际上,在我们录这期节目的时候,他的前瞻市盈率是过去十年里最低的,太疯狂了,之前CMEs更便宜的时候,只有解放日和DeepSeek那两次,而那两次都是V型底,那这对你来说就意味着,市场认为他们大幅超赚了,对市场百分之百认为他们大幅超赚了,我们得保持谦逊,也许确实如此,也许确实如此,但我这周来这的目标,就是尽可能努力的找负面数据点,通常你来硅谷,会听到各种混合的信息,比如这里有个负面的,这里有个正面的,等等等等,总体来说是正面的,你知道科技会随时间创造价值,但我还没找到一个,真正算量化指标的负面点,除了那个anthropic的第三方数据,我觉得这个数据被Anthropic的股东们激烈反驳,他们急不可耐的想告诉你他们知道的情况,我们也很担心他们拿不到IPO的配售份额,如果消息传回公司,说是他们说的,其实情况很好,你能看到Anthropic的股东们就想说,这不是真的,我很难相信开源和OpenAI加速到了那种程度,但话说回来,Anthropic显然处在领先位置,对了,GrakkerCursor也是,从第三方数据能看到,7月因为Grock4.5和GrockBuilds的发布。是个相当有变革性的月份,所以这个月确实很棘手,我有个在复达的朋友,他就说过去三年要应对这种行情,办法就是尽快做最蠢,最表面的事,然后在这些事之间来回切换,那现在这个最蠢最表面的事,是什么,那就是一直在减风险,对整个月都在应对这些叙事,而这些叙事除了信用那块,事实上都不成立,而我们做的工作让我觉得,随着价格重估,信用问题不会成为关键。 [00:19:16]
Patrick O'Shaughnessy:就算你说建我们需要的算力。
Gavin Baker:确实需要信用,如果信用不在,那也只会让现有的算力变得更值钱,因为有一篇很有意思的文章发给了我,你知道我们之前聊过MikeBobison的理论,就是说多样性的崩塌会导致泡沫和崩盘,基本上我在公开股票投资行业,认识的所有人,不管是散户还是机构,每一条新闻都会立刻喂给,Claude,有时候是ClaudeAgent,而Claude是概率性的,他解读这些新闻的方式,可能不会有太大差异,所以感觉我们几乎又回到了,在股市的语境里,以前股市从来没有过这种情况。 [00:20:02]
Gavin Baker:人们总说媒体碎片化,说以前沃尔特,克朗凯特是唯一的声音,是真相的化身,现在再也没有那样的角色了,现在Claude就像是股市的沃尔特,克朗凯特,所有人都相信他说的每一句话,而这正在导致,顺便说一句,他确实很聪明,但他并不总是对的,他的解读并不总是正确的,而股市本质上处理的是,对未来的概率化贝叶斯解读,所以感觉市场上就是这样,来了一条新闻,喂给Claude,Claude这么解读,然后很大一部分人,按Claude观点去交易。
Patrick O'Shaughnessy:所以你会看到一些东西。
Gavin Baker:有个叫TBU的家伙,算是匿名半导体圈子里的一员,他发了一张特别惊人的,日本电容股走势图,他说我们六周之内,走完了一整个电容周期,这是真的,那些股票是翻倍,三倍还是四倍,我不知道,但就是直线拉升,然后哗滴一下掉下来,你懂我意思吗,实际的基本面根本还没兑现,可你已经在六周里,走完了正常情况下,可能要三年的周期,你在硅谷这边的感受是什么,尤其让我好奇的是,这里正在进行的,围绕推理和训练模型服务的,每一个环节提升效率的创新。 [00:21:18]
Patrick O'Shaughnessy:长期来看会怎么影响公开市场,你有没有了解到。
Gavin Baker:什么特别有意思的,长周期创新方面的东西,让你特别兴奋或者好奇,我确实非常好奇,感觉好像很多人觉得,自己离解决持续学习,和样本高效学习非常近了,这个我们之前聊过,如果这两个问题真被解决了。
Patrick O'Shaughnessy:那有没有可能造成需求上的一种暂时的。
Gavin Baker:类似断崖式的中断,比如说不用在,我记得有人跟我说过,我当年训练用的差不多是200亿个token,而现在这些模型是在300万亿个token上训练的,如果你能用10万亿个token训练出一个东西,然后放到真实世界里去样本高效的学习,那对训练需求来说可不是什么好消息,不过训练在半导体需求里占的比例,最终会趋近于一个不是零,但非常小的值,但我要说这是最有趣的一点,而且谁知道它是长周期,还是短周期的事,SSI说他们八月份会推出他们的模型,现在有一整代新实验室,都在专注这个方向,这对世界是好事,对世界会是惊人的好事,对世界会是了不起的好事,对我们都想要这个,对我们都想要,这对世界会是惊人的好事,只是我很难相信,这真的会对AI基础设施需求,造成负面影响,但再说一次,我在努力保持非常非常开放的心态,我觉得那可能是最大的,不管我们叫它科学上的,还是技术上的收获,但就是你懂的,你根本不知道,对,而且英伟达跟所有这些创业公司,都深度绑定,那如果非要我说,如果你被逼着设想一套,能真正让你转变看法,让你真正害怕的情形,会是什么。 [00:23:02]
Patrick O'Shaughnessy:是不是就是金银现金流这个事没兑现。
Gavin Baker:所以我们只能靠债务融资来撑起整个盘子,对如果金银现金流不再继续加速,那确实是负面的,而这在一定程度上取决于,AnthropicOpenAIGrokCursor,也就是Grok,以及开源模型的表现,如果GPU价格出现一次相当剧烈的,持续性的下跌,市场会立刻做出反应,如果GPU变得特别容易拿到,那会让人担心,你听谁说过自己GPU太多了吗,一个都没有,没有恰恰相反,听起来像毒品市场什么的,对真的像太疯狂了,但我觉得有一长串相当明显的风险点,比如如果AnthropicOpenAI,如果这些实验室加在一起增长停滞,甚至开始下滑,那是非常负面的,除非那只是因为开源token,再把整个盘子做大,同时在抢份额,而且我确实认为未来是多模型,多模型并存的,尤其是AI 原生的公司,他们会想拿一个开源模型,现在这些推理云服务商,在监督微调和强化学习上,都做得非常好了,你可以拿自己的数据,去定制一个开源模型,然后把它放到一个路由器后面,路由器会先把请求路由到你的模型,再交给Claude这一类前沿模型,让Claude的Grok去检查,很多情况下,你能用一半的成本,拿到稍微更好的结果,但话说回来,这个一半的成本,很多人一听就觉得,这对AI需求是坏事,其实完全不是。因为用户付的钱,只是token上的利润而已,你其实就是把token,从那些毛利率90%的昂贵token,换成了毛利率大概30%的token,省下来的钱就来自这里,但生产这些token,消耗的算力是一样的,而且这些事都发生在不同的周期上,那些大型上市公司都在说,天哪我的AI 支出涨了20倍,三个月就把预算烧光了,于是他们搭了个路由器,确实砍掉了AI 支出,但这可能反而会增加他们生成的token总量,因为都换成了更便宜的开源token,那其实就是更多的算力消耗,所以一家公司变得更聪明,知道什么任务该用哪个模型,这可能会让他们的支出稳定下来,甚至下降,但这跟他们在这些模型层,这个路由器背后实际消耗的GPU 算力小时数,其实没什么关系,当你转向这些更便宜的token,能用的更多GPU 算力小时数很可能是在上升的,所以这是上市公司最前沿正在发生的事,然后还有一整波AI 原生公司,他们全力投入不顾人类员工,几乎把所有钱都砸在token上,所以他们一点都没减速,然后还有美国东海岸的公司。 [00:25:52]
Patrick O'Shaughnessy:几乎还没怎么采用AI。
Gavin Baker:更广义的说,那些不在沿海地区的公司,可能还在削减,欧洲呢。 [00:26:01]
Patrick O'Shaughnessy:还在琢磨怎么给AI立法。
Gavin Baker:然后才谈得上用,对,所以就是这些不同步的采用,浪潮同时发生着,但我脑子里一直挥之不去的想法是,我上次可能说过,就是JAX提出来过,全世界大概有50万人,也许25万人在用agencyAI,而我们已经处于严重的算力短缺了,地球上可是有七八十亿人,当我们从五十万涨到百分之一,涨到一亿,再到五亿会发生什么,然后我觉得有意思的是,很多人会说好吧,我觉得在X上发帖,看看反对意见是有用的,很多人会说好,我们接受你的论点,超大规模云厂商的算力会重新定价,他们的经营现金流会加速增长,也许我们真能撑起这个盘子,但问题是,这笔经营现金流到底从哪来,客户在哪,从定义上讲,它只能来自两个地方,要么是通过生产率提升,带来的更快经济增长,就像萨迪亚说的,要么我们开始以10%的速度增长,要么不增长,要么就是劳动力替代,而且我敢肯定,在很多AI 原生公司里,你确实能看到劳动力替代,但不是因为他们裁员,而是他们根本不会招那么多人类员工,每个全职员工的毛利润,A16,Zicotic,好多公司都做过这个研究,跟过去几代创业公司比,这个数字是垂直上升的,然后有意思的是。 [00:27:35]
Patrick O'Shaughnessy:你会不会去调研你的备投公司。
Gavin Baker:看他们的token支出,跟人力支出的对比,我们总是把它报成,token占总薪酬支出的百分比,你看到的范围大概是多少,那些特别激进的公司,真的很高,20%25%左右,我们共同的朋友,DylanPatel,在他自己公司,他是个ASI极端主义者,他已经到30%了,对,那可能是我听过最高的了,我其实听过50%的,而且知识工作,有25万亿美元的规模,咱们就拿你的20%来算,那就是5万亿,这5万亿,要么来自劳动力替代,要么来自更快的经济增长,而我们作为人类,真的,真的,真的希望他来自,更快的经济增长,今天早上我听到一件很有意思的事,来自一位非常出色的科技公司CEO,他创办了好几家公司,他说如果你去看那些创始人领导并控股的公司,剔除掉一些新冠时期过度招聘的因素,其实几乎没有人真正在裁员,这些人本该是最愿意快速采用AI,让自己变得更高效的那批人,但他们并没有搞什么大规模裁员,这大概能说明一些问题,他们觉得未来依然有大量机会,让人和token支出并存,绝对没错,看多逻辑就是增长,对对增长,而且看多逻辑里,你看到过cognition的指数,stripe的ray也提过,那些在AI上花钱最多的公司,增长明显更快,对我很喜欢那个cognition指数。对cognition指数确实很惊人,当然所有怀疑者都会合理的指出,他并没有真正控制行业变量,但如果你往深里挖,我记得他们举过一个例子,我忘了是水管工,还是暖通空调承包商,反正就是所有蓝领工人,都因为AI过得非常好,顺便说一句,我觉得我们应该聊一个话题,现在聊或者待会聊都行,就是大家都在引用这些LTA,所以现在一切都在短缺,一切都在短缺,一切都在短缺,如果说有什么薄弱环节,那只是因为我们的几瓦级电力,还不够快的接入,这些集瓦迟早会接上,监管政策也在往好的方向走,涡轮机制造商,柴油喷气机制造商,他们都在扩产,你甚至能看到,有人把旧飞机上的涡轮机。 [00:30:00]
Gavin Baker:拆下来,翻新一下,然后重新利用,现在发生的事真的很疯狂,资本主义在这方面,非常非常擅长,但我确实觉得,市场最重要的一个问题,也是我在市场转变中,判断错的一点是,我们正在转变,尤其是内存领域,比任何其他领域都更明显,从短期内的算力碾压,转向用短期收益,去换这些所谓的供应链协议,长期协议LTA,具体形式有很多种,但本质上就是客户预付,然后有价格地板和天花板,这又回到了关于劳动力的那个观点,因为你知道,很多公司在新冠期间,裁了太多人,之后真的非常不愿意再裁员,他们当时谈的是劳动力囤积,你还记得几年前这个说法吗。
Patrick O'Shaughnessy:你记得吗。
Gavin Baker:我们就想想打破LTA的博弈论,现在真正有规模的就四家公司,亚马逊有他们的Trinium,谷歌有他们的TPU,AMD,然后就是英伟达,英伟达比其他所有公司加起来还大得多,假设现在是2027年,有一点非常重要,你要意识到内存,在给定的算力单位下,你放进去的内存越多,产出的token就越多,这是提高单位算力token产出,所能做的最重要的一件事,而这从定义上就降低了成本。 [00:31:25]
Patrick O'Shaughnessy:这也是为什么需求完全没有负面反应。
Gavin Baker:完全没有弹性,因为内存几乎就是那个主导一切其他维度的轴,这在某种程度上,就像这些公司之间的一场大型权力的游戏,或者史诗对决,好现在是2027年或者28年,你有点想打破某个LTA,去争取更低的价格,但在很大程度上,我认为未来几年的市场份额,将由供应决定,由供应链分配和你预先采购的东西决定,所以如果你打破LTA,而且这是假设我们不在严重供过于求的情况下,但这个逻辑这个博弈论,即使在严重供过于求的情况下也成立,如果你打破了LTA,然后在接下来两三年里,不管什么原因,溢价权又回到了内存厂商那边,你就出局了,彻底完了,比如说假设谷歌打破了一个LTA,假设28年29年出现了供过于求,我随便举个例子,他们打破了LTA,如果他们打破LTA,那很可能意味着供过于求,价格在下跌,然后产能自然收缩。 [00:32:36]
Patrick O'Shaughnessy:那你觉得谷歌的分配额度会怎么样。
Gavin Baker:而且这是一个周期性行业,供过于求之后必然是供不应求。
Patrick O'Shaughnessy:你觉得他们下次会怎么想自己的分配额度。
Gavin Baker:所以我就是觉得,既然这是所有事情围绕旋转的轴心,老兄你打破一个LTA,可能就把整个生意和你的特许经营全都炸掉了,这在以前从来不是这样,苹果谁在乎呢,他们买的东西根本没有竞争对手,他们是压倒性的最大买家,他们知道自己可以为所欲为,这要回到三四五年前。 [00:33:09]
Patrick O'Shaughnessy:他们知道不管怎么做都不会有后果。
Gavin Baker:因为他们的量太大了,哪怕把美光坑惨了,美光当然也还是会接他们的单,但这次不一样了,你至少有四家玩家,然后还有一堆创业公司,你是投资者,你懂这个局,如果你撕毁长期协议,对方就会说行没问题,你撕了价格协议,那我们就撕了供货量协议,去你的我们把量给你的竞争对手,你就这么丢了份额,明白吗,所以我觉得英伟达的统治地位,我是说在当前这个环境里,对英伟达有多有利,我有点想不通。
Patrick O'Shaughnessy:他为什么估值这么低。
Gavin Baker:换句话说,如果你需要能融到钱来买芯片,而你必须融到钱,那没有什么比英伟达的GPU,更好融资的了,没有,如果你需要拿到土地和电力,他们在这盘棋上走得很好,很会牵线搭桥,然后他们还推出了一套非常聪明的,全新商业模式,我会把它描述成一种,信用担保加收入分成的结构,前提是GPU价格高于某个下限,对而这可能,让他们很快通过版税,实际上拥有一个巨大的云业务,这也是缓解,现金流错配的另一种方式,就像在说,钱都是我们在赚,对而且这其实不算是供应商融资,因为他们没有把钱借出去,是别人在借钱给GPU买家,所以这不完全是供应商融资,他们还在做股权投资,但这不是那种你把钱投给某个人,然后那笔钱拿来买你的芯片,虽然英伟达说过,他们写进所有股权投资条款里,这笔钱不能用来买英伟达芯片,但显然钱是可替代的,而且有意思的是什么,就是个小趣事,对毫无意义,对,但我觉得在某种程度上,这大概让大家都感觉好一些,当然如果你是美光的CEO。 [00:35:05]
Patrick O'Shaughnessy:你会怎么做。
Gavin Baker:我会做英伟达现在正在做的完全一样的事,也就是我会去找那些GPUTranium的买家,跟所有人说,我来参与英伟达那套信用担保方案,他们的业务天生就没那么稳定,没那么可预测,但某种程度上,也许他们就是先垫一笔现金,这样他们就不用担责,我不是说真的这么做,我就是举个例子,但总得做点什么,因为你手里有钱,而且信贷市场正在闹腾,有很多我敢肯定,我们在黑石和阿波罗的朋友们,正在给内存公司推销某种类似的方案,但黑我们会从今天的现金流里拿出一笔钱,然后这笔钱就没了,它是一份担保,让放贷的人感觉好一些,但我们想要一部分持续收入的分成,对,这就是我百分之百会做的事,这几乎就是长期协议的一个逻辑延伸,他们用上行空间换稳定性,在这里你实际上可以拿到经常性收入的版税,而这就是英伟达在做的事,我觉得这一点被严重误解了,英伟达应该好好把这件事讲清楚,第一他们非常看好AIT,基本上他们每次没有对某家公司做股权投资,事后看都是个错误,他们几乎对每家公司都做了股权投资,除了内存公司,有一段时间,他们投了。 [00:36:33]
Patrick O'Shaughnessy:但为什么不投呢。
Gavin Baker:如果你有现金流,你又看好AI,而黄仁勋,因为他能看到每一家实验室,他知道所有进展,比如那些持续学习的实验室,塞塞现在也在跟他们合作,他什么都看得到,而他看到的东西让他更看好,所以第一,拿一些股权上行空间,第二拿一份收入分成,你正在产生几千亿美元的,自由现金流,同时帮助弥合一个明显的缺口,至少在所有公司,自由现金流都为负的情况下,直到经营现金流,加速到足以内部自筹资金,这几乎就是,我是说,这非常机会主义,而且意义重大,是好的那种,这还显著提高了他们每几瓦的营收,同时也巩固了他们的竞争地位,你知道,你和我都创办过公司,但先不说这个,用那家创业公司的芯片,他们在台积电拿到的价格是多少,比英伟达和这些巨头都高吧,他们买高带宽内存,HBMDRAM的价格呢,也更高吧,他们能像英伟达那样,用同样的利率,给这些芯片融资吗,不能,所以你看,这始终是个实实在在的负担,尤其是如果你用高带宽内存,HBMDRAM,你就成了靶子,除非他们做了非常不同的架构选择,眼下发生的一切,其实对他都挺有利的,回到博弈论来看,Anthropic当初要是在算力上,像OpenAI那么激进,早就一记绝尘了,对所以现在OpenAI重新回到了牌桌上,我觉得Grocery也在牌桌上。这些就是站在前沿队列里的公司,而且他们手里有算力。 [00:38:13]
Patrick O'Shaughnessy:你觉得看完这一幕之后。
Gavin Baker:还有人敢松油门吗,因为你看大概四个月前,Dario还在说,那番话确实很有见地,但他说这事真的非常难,因为你要是买太多算力,在这种规模下可能直接破产,但你要买的不够,又可能输掉,结果呢,我们都看到了,OpenAI刚回到牌桌上,现在SpaceX又带着Grok4.5和Cursor,大举杀进来了,从博弈论的角度,看完这些,短期内还有人会退缩吗,尤其是如果这笔钱,能靠经营现金流来支撑的话,你在外面跑这一圈。
Patrick O'Shaughnessy:有没有遇到谁,你觉得比你乐观的多。
Gavin Baker:如果有,他们信什么,而你不信,说实话,这地方基本上每个人都比我乐观,兄弟,我读到doorcash写的那篇东西,我当时就想是那个算力价格涨三倍的事,对,不过我忘了具体是什么了,不好像是15倍之类的,对,但基本上就是说租一台H1001年要花25万美元,那大概是现在现货价格的15倍,没错,我当时就想,哇这完全不在我的预期范围里。 [00:39:27]
Patrick O'Shaughnessy:这不在我怎么说呢。
Gavin Baker:不在我那个贝叶斯概率空间里,这甚至不在我考虑过,但否掉了,觉得完全不可能的清单里,而且那个人,他非常聪明,消息非常灵通,然后他还指出好像是说,算力的利润率在上升,算力总量在上升,推理的利润率也在上升,这三个乘在一起就得到了,实验室加开源这条线上,那种疯狂的加速增长,虽然开源那块利润率,其实并没有真的在涨,但我是说所有人都是。 [00:40:00]
Gavin Baker:对对,我就是,我看着股市里发生的事,觉得自己像个愚蠢的乐观主义者,但当我跟人聊,不管是实验室里的人,还是这个生态里的任何人,我都觉得自己相对所有人都是悲观的,这真是个奇怪的局面。
Patrick O'Shaughnessy:你怎么看中国那边。
Gavin Baker:深紫外光刻机,DAV的消息,我看到大家的反应差别很大,有人说这相当于阿斯麦在2001年左右的水平,也有人说,不这其实是一个全新故事的第一条消息。
Patrick O'Shaughnessy:关于我们该怎么看待全球尖端算力供应。
Gavin Baker:我觉得两种说法可能都对,你知道打个比方吧,假设深紫外光刻机,Dove是喷气发动机,那极紫外光刻机EUV就是取速引擎,或者不管它将来会是什么,身子外光刻机,Duff就像螺旋桨飞机,脊子外光刻机,EUV就像喷气发动机,但关键是,他们以前没有这东西,现在据说有了,这就是个相变,就像从液态变成了固态,现在固态了,那喷气发动机也好,螺旋桨飞机也好,落后了25年,但这仍然很重要,我觉得不该被轻视,不过我也觉得,这事挺有意思的,你就在股市里能看到这种反应,市场会剧烈过度反应,然后就算这事真的影响到阿斯麦的订单,那可能也是五年后的事了,而在这过程中,市场已经忘了他,担心他,忘了他,担心他,又忘了他,反复好几次了,所以我觉得那大概率是过度反应,但我们也不该完全无视,而且如果你是中国人,这事对你来说真的非常重要,那边还有些报道说,有一台极紫外光刻机,UV被走私进了中国,我的天,那得是多厉害的间谍行动,因为那东西可是非常庞大。 [00:41:57]
Patrick O'Shaughnessy:我不知道这是不是真的。
Gavin Baker:确实有些风声,但你知道中国人,他们真的非常非常厉害,他们真的非常聪明,工作起来也极其拼命,而且你知道,他们把这看作,对国家极其重要的事,但他们真能从2001年,直接跳到2026年,甚至2030年吗,他们能做到吗,因为这真的是,确实是这是边做边学的过程,是边做边学,你多少得,对就像你不能,你不能加速做这个过程,你不能,你不能瞬间穿越到未来,你实际上必须经历那些学习周期,所以这是重要吗,重要市场反应过度了吗,可能吧,但我觉得很多,我觉得作为一个美国人,真的很难完全理解,中国正在发生什么,并且拥有完全的信念和清晰的认知,你知道无论好坏,我们正在脱钩,而这个过程已经启动了,到了现在这个节点,几乎感觉双方都在自我强化,而且你知道这挺遗憾的,但我们就处在现在这个位置,他们不会停,我们也不会停,那对美国其他公司有什么看法吗,我觉得现在就是那十家公司,加上几家私营的,上个月可不是这样,我是说除了AI,其他所有东西都在下跌,而且我确实认为,开源模型越来越接近前沿,像Fireworks这样的公司,让定制模型变得非常容易,在某些情况下,你能以低得多的成本,获得比前沿模型更好的性能,这对软件行业来说,简直是天赐之物,而且对所有那些,你知道有很多AI 原生公司。所有这些AI 原生公司,你知道就像我们的朋友Vishree,我记得他两年前说过,我从来没见过这么多公司,从创立到年收入5000万美元,并且产生现金流,只用了大概9个月,很难知道其中有多少能持久,因为那时候你知道,很多人会把他们dismiss成,ChaiTPT套壳,但现在有了开源,你实际上,你生成了一些对你的用力,你瞄准的垂直领域来说,独特的数据,作为套壳公司,Fireworks,确实推出了一款很酷的产品叫Nexus,如果你在用ClaudeCodeOpenAICodex,GrokBuild真的就是三行代码,大概20个词,Fireworks会摄取你的数据,你知道他们可以对模型做强化学习,然后有一个路由器来发送查询,他们取得了惊人的结果,这就是每个AI 原生公司的解决方案。 [00:44:35]
Patrick O'Shaughnessy:这就是为什么你会看到。
Gavin Baker:你知道Harvey在被收购之前,Cursor如此重度的压住这个方向,Harvey,Lagora,全都是,因为如果你能从只用一两个或三个前沿模型,变成在30%到60%的token,消耗上使用那些前沿模型,然后剩下的用你自己强化学习出来的模型,突然之间你就不是套壳了,你的护城河深得多,我对那个Cursor发布的东西特别感兴趣,我觉得就是Cursor,它有点像AI在急速通关,把我们在人类身上学到的东西,复现出来,也就是你可以用前沿模型来做规划,然后把任务分派给那些更笨的模型,而且它的效率是15倍,或者不管那个指标是多少,而且可能这超级讽刺,但可能就是那些利润率更低,只比前沿落后一点点的开源token,而且你知道,我们有朋友相信,你知道前沿,一旦前沿模型达到RSI,它实际上会以戏剧性的低成本来服务,服务低成本通过蒸馏这种方式,在每一个智能水平上提供服务,然后开源就没有立足之地了,我会说那是一种,你知道AnthropicOpenAI,Grak的极致主义观点,你知道我们不应该错过任何东西,我不知道或者真正重要的东西,一切皆有可能,就像你知道,我们想要非常谦逊,我尤其想在我经历了这个月之后,保持谦逊,但在我看来那不太可能。 [00:46:18]
Patrick O'Shaughnessy:为什么。
Gavin Baker:第一因为有这么多AI 原生公司,他们实际上已经生成了相当多的领域,专属专有数据,对而且之前像开源有这种MOBA,这些推理云和路由器,真正发展起来之前,你基本上没有选择,不管服务条款是什么,你都只能接受,但如果你现在能摆脱那个跑步机,那会给你一定程度的独立性,也许还有持久性和安全性,但回到你的观点,可能就是这些更便宜的token,会极大的推高最尖端前沿token的价值,因为如果今天你有,你知道我随便举个例子,120IQ的开源模型,而且运行起来非常便宜。
Patrick O'Shaughnessy:那是不是让一个能编排他们的160IQ的模型。 [00:47:03]
Gavin Baker:变得更有价值了,所以我们上次聊过,我一直很惊讶经济回报有这么大一部分,都流向了前沿模型,现在随着我们看到这些推理云的发展,情况正在改变,Together,modal,basalt,都是以非常省现金的方式在跑,这些商业模式最惊人的地方在于,他们的增长速度几乎赶得上早期前沿实验室,但烧的钱却非常少,这真的很了不起,你想想回到那些老套的SAS指标,比如从Ruleof40的角度看,这些数字简直疯狂。
Patrick O'Shaughnessy:你觉得看一个组织内部的薪酬分布。
Gavin Baker:能看出很多门道吗,比如CEO的薪酬是公司中位数员工的多少倍,也许这就对应着前沿token的处境,绝对,对就是这么简单,对可能就像我们上次聊的前沿token,我觉得他们可能会失去一些份额,但整个蛋糕在飞速变大,他们可能仍然会占据经济价值的绝大多数,但不会像以前那样全占了,而开源token可能会成为,被处理的token中的大多数,再说回刚才那个点,这对基础设施需求是好事,因为token就是token,生产一个token需要的,算力电力空间冷却,都是一样的,I领域最坏的情况可能是什么,是监管吗,还是某种类似的东西,我觉得监管肯定是最大的风险,我是说这是最明显的风险,所以这也是我这周,很高兴能来这儿的原因之一,我就是想让自己有点危机感,我不想觉得自己像个疯子,看着这些股票越来越便宜,心里想着预期远期回报再上升,而与此同时,地面上的基本面,在7月相比6月,感觉确实有了实质性的改善,但我还是没法不这么想,监管它肯定还是最大的风险,你没法忽视纽约搞数据中心,暂停令这件事,我们就是生活在这样一个诡异的,后事实后逻辑的政治世界里,而且我觉得AI行业在公关上做的非常糟糕,我确实觉得他至少现在意识到这一点了,对也许还没完全解决,但至少意识到了,对。但在华盛顿那边的叙事政治叙事,我觉得在很多普通美国人看来,就是数据中心会推高你的电价,会抢走你所有的水,然后还会抢走你的工作,而现实是考虑到现在签的这些协议,当一个数据中心落地时,周边的电价实际上通常会下降,因为有了表后交易这种模式,还有那个数据中心承诺书,就是特朗普让大家签的那个,一般来说数据中心开发商,以前他们只需要建个什么,给警察局消防局配新车,新装备新防弹衣什么的,现在变成我们会给你们建一所医院,一所学校,一个新的警察局和一个消防站,我们还会降低你们的电费。 [00:50:01]
Patrick O'Shaughnessy:听起来怎么样。
Gavin Baker:而且工作岗位是持续的,因为事实证明,你需要这些水管工电工,暖通空调承包商,数据中心在很多方面,是我这辈子见过的,对蓝领工资最有利的事情,然而那些名义上代表蓝领工人的民主党人,却在把这些工作拿走,而且还有一点也挺魔幻的。
Patrick O'Shaughnessy:那句话怎么说来着。
Gavin Baker:谎言可以传遍世界,对真相还没来得及,穿裤子,有个作者在书里犯了个错误,把数据中心用水量高估了一万倍,不是一点点,不是一个数量级,不是两个数量级,不是三个。
Patrick O'Shaughnessy:你知道吗。
Gavin Baker:而且他多次承认了这个错误,我完全错了,这个说法早就被彻底辟谣了,就像那个大力水手效应,对你听过那个例子吗,没有,大力水手吃菠菜,原因是一样的,在学术界,在一本学术书里,他们把小数点放错了两位,所以菠菜的铁含量并没有比其他食物高,就是这一个来源,然后就这么传开了,到现在还有人这么说,我真的以为菠菜铁含量更高,这太离谱了,太离谱了,太离谱了,我真的以为菠菜含铁更多,太神奇了,你疯了吧,对每天都能学到新东西一回事,对就是同一回事,所以就是需要有人站出来说真话,我觉得这个行业,我当时就想天呐,要是没人愿意做这件事,那就我来做吧,真的需要有个什么基金会之类的,也许可以搞一个政治行动委员会,在四强赛NFL比赛,大学橄榄球赛,世界大赛期间投放广告,告诉大家数据中心到底是干什么的,你的电费,一个签了这份承诺的数据中心,落在你们社区,你的电价会降下来,他们几乎肯定会实实在在的回馈社区。 [00:51:57]
Patrick O'Shaughnessy:你会看到大量高薪蓝领工作岗位涌入。 [00:52:01]
Gavin Baker:而且这些岗位是持续的,我觉得很多人以为这些岗位是一次性的,其实不是,确实会有个高峰,然后转移到下一个数据中心,但数据中心一直有持续的运维和升级需求,技术也在不断变化。
Patrick O'Shaughnessy:所以你会看到更多就业机会。
Gavin Baker:更便宜的电价,更富裕的社区,对水资源没有影响,对环境没有影响,而且数据中心建在离城镇,十英里外的地方很容易,所以这个故事需要讲出来,还有我们上次聊过的一个故事,AI越来越多的在真正的拯救生命,治愈罕见疾病,我记得好像是今年ESCO大会上,那种氛围,这是我们在单届会议上,见过的最大规模的科学突破,其中肯定有一部分要归功于AI,所以我们需要去讲这些故事,如果你有生病的孩子,生病的父母,生病的亲人,I能实实在在的提高他们康复的概率,我们真的需要,所有人都需要去讲这件事,我觉得在这个圈子里的人,这一切对他们来说太显而易见了,以至于他们以为别人也都知道,他们没法理解,这在他们看来是明摆着的事,却和大多数美国人的看法截然不同,所以我觉得这个行业真的需要更好的讲这个故事,因为纽约感觉只是第一个,后面还会有更多,甚至在一些极度支持增长的深红州,他们也在说,你们讲故事讲的不好,我们没法替你们讲,如果你们自己讲出来,我们可以帮你们转述,但你们才是专家,如果你不为自己发声,没人会替你发声,对我们还有什么遗漏的,我觉得关于算力这场讨论里,缺了一块,当你把这些基于SRM的加速器放进去,他们不受HBMDRAM限制,而且通常用较老的制程制造,不跟最新最强的GPU强产能会发生什么。当你把推理拆分开,大家会聊玉田冲和解码,但解码其实分两部分,注意力机制和潜溃网络,终极理想是玉田冲用一颗芯片,那颗芯片可能不需要HBMDRAM,注意力用一颗带HBMDRAM的超强芯片,钱亏网络用一颗SRAM芯片,但把这些SRAM加速器,加进现有算力存量和新增算力里。 [00:54:24]
Patrick O'Shaughnessy:投资回报率怎么样。
Gavin Baker:我们看到的是效果确实更好,钱亏网络这块,你就是干不过SRAM。
Patrick O'Shaughnessy:而且不管你怎么调芯片上算力。
Gavin Baker:HBMDRAM和SRAM的比例,工作负载总是在变,而且负载类型多种多样,能把推理拆成这三部分,我觉得这对AI的投资回报率会非常非常有利。
Patrick O'Shaughnessy:不知道为什么。
Gavin Baker:我突然想到一个有趣的问题,我很喜欢用权力的游戏来类比,你能想象一个现在不在大家视野里的玩家,突然变得像权力的游戏里那种,量级的重要角色吗,比如美光,突然之间,这可以算一个答案,一个变得和Anthropic,OpenAI,微软,亚马逊,英伟达,SpaceX,一样重要的角色,就是一个权力的游戏里的黑马,我脑子里冒出来的名字,Lipo可能是个黑马,我确实觉得Fireworks的Lid,它就是个绝对的狠角色,还有我们的朋友ScottWuCognition,有点像对就是那个,我觉得这些是最明显的名字。 [00:55:31]
Patrick O'Shaughnessy:那SpaceX呢。
Gavin Baker:看着它至少一开始被公开市场消化,是什么感觉。
Patrick O'Shaughnessy:你觉得市场把它当成一家公司来理解了吗。
Gavin Baker:这家最重要的新上市公司,感觉不太像,其实也像,因为它太特殊了,对我来说一切都在变好,自IPO以来,基本面一直在改善,比如Grok4.5收购Cursor,你知道Cursor明显加速了很多,而且过去三年,他们也证明了,他们能以比任何人都快的速度,更低的价格,接入更多算力,现在我们还知道,他们甚至能弥补,现货合同和首份合同之间的差距,他们最大的优势,就是进入市场的时候,正好赶上了现货价格的高点,而且奇怪的是,对算力来说最看涨的信号之一,就是他们一夜之间,把海量算力投进市场,市场连个水花都没建起来,市场就这么完全吸收了,货运交易一点都没放缓,但你知道一个substack作者,会资助一个AI项目,他们觉得SpaceX打算,接入巴基瓦的算力,我永远不会跟埃隆对赌,但我的意思是,那会是真正不可思议的壮举,而且自从他们签了上一批合同之后,利率是上去了,不是下来了,他们每几瓦的变现能力,大概是500亿美元,市场对明年的共识预期是730亿,所以先别管星链V3,别管星链直联手机,也别管Grok4.5和Cursor,光这些加起来,可能很快就到100亿美元的年经常性收入,这些都先放一边,就算他们接入的量接近那个数,共识预期也是730亿,那是八几瓦,每几瓦500亿算出来的。而且显然这些不可能在2027年初就全部点亮,我觉得这非常不现实,我几乎都不信那份Funder报告,但到今天为止,一年内接入超过500兆瓦电力的公司,只有超大规模云厂商,Coreweave,Crusoe和SpaceX,而SpaceX接入的速度最快成本最低,而且大家确实真的很喜欢他们的集群,但话说回来市场需要亲眼看到这些,那不会是今天市场对SpaceX的解读,不会而且确实感觉,有一个纽约的大型对冲基金,在做空它,我觉得他们想的是,算力的现货价格会跌90%,然后你接入这么多算力,它产生的收入,可能远没有你想的那么多,但我也想说的非常清楚,我见过埃隆的公司这些年,做过很多真正令人印象深刻的事,FunderAI报告说,18个月接入巴基瓦,我只是引用一下,因为这是公开的谁都能看到,对没错,你知道埃隆有句话叫,我们专长是让不可能的事迟到,这我还真没听过,这话太妙了,对这里面其实有很多真话,对对,但我只是觉得从我的角度看,这只股票里几乎没有进入,他们可能接入的算力量,而且再说一遍,我觉得远不到巴基瓦,而且给这些GPU供电真的很难,但他们一直很擅长这个,而且感觉这些并没有反映在预期里,也没真正进入大家的思考,我想起那个好笑的梗图,写着SpecX。数据中心公司,然后我还想说,我确实在Starbase待过很长时间,轨道算力感觉一天比一天更真实,前几天看到星舰着陆,真挺酷的,看到星舰着陆真的很酷,而且你知道挺有意思的,我们的朋友在Benchmark,他们投了StarClaude,而且我不知道StarClaude是一家轨道算力公司,SpecX算是他的合作伙伴,他们打算,我觉得让StarClaude用星链的激光技术,这对轨道算力非常重要,但我觉得这算是一个很好的sanitycheck,我上次查的时候,Benchmark那帮人挺聪明的,他们完全不是埃隆生态圈里的人,他们却选择以相当不错的估值,投了一家轨道算力公司,而且还没有SpaceX那种内部发射成本,对我来说,这就是一个很好的。 [00:59:33]
Patrick O'Shaughnessy:我是不是疯了的检验。
Gavin Baker:我疯了吗,然后就想,也许我疯了,也许埃隆疯了,也许Benchmark也疯了,也许SpaceX的工程师也都疯了,但老天,这在我看来真的不太可能,而且我觉得。
Patrick O'Shaughnessy:我们是不是该说。
Gavin Baker:我们现在在谁的办公室,对,我们正坐在Benchmark的办公室里,对,这就是他们著名的,晚餐用的那张著名的桌子,所以谢谢Benchmark,谢谢Benchmark支持这一期节目。 [01:00:00]
Gavin Baker:对,谢谢Eric,而且他我们应该谢谢他们所有人,Eric帮我协调的,所以他值得特别感谢,谢谢,谢谢所有合伙人,谢谢你,Eric,你知道一年后我们就会看到这些股票都在什么位置,好在时间会告诉我们答案,有人会对,有人会错,未来是概率性的,但我们现在处在一个激动人心的时刻,如果我们继续按模型发布的节奏来做这个节目,那几周后见,对。
Patrick O'Shaughnessy:也许你会来benchmark。
Gavin Baker:跟你一起做节目总是很开心。
Diana Hu 与 Jeff Dean 讨论了 AI 能力演进、推理硬件、上下文工程、Agent 系统和创业机会。Jeff Dean 认为,过去对“AI 达到初级工程师水平”的判断基本准确,但模型处理复杂任务的能力增长超出预期;接下来,机器学习系统将通过自动拆解问题、运行实验和汇总结果来持续改进。对创业者而言,机会不一定在通用模型已经做得很好的领域,而在模型成功率只有 0% 或 1%、仍需要专门界面、模型和 skills 才能解决的问题。这些判断贯穿了从硬件底层到产品设计、从研究方法到职业选择的整场对谈。
Jeff Dean 回顾了从“把搜索索引装进内存”到语音识别推动 TPU 诞生的经历,说明数量级估算和重新审视技术假设,可能改变系统设计。面向 2026 年的 人工智能系统,他强调应关注带宽、能耗和芯片互联等数字:一次计算本身的能耗,可能远低于把数据搬到计算单元的成本,因此批处理、硬件专门化和低延迟推理都会受到数据搬运约束。
谈到 Agent,Jeff Dean 将重点从单纯扩大模型规模转向上下文工程,包括为 Agent 提供清晰的任务上下文、工具和 skills。即使基础模型没有接受过某个内部系统的专门训练,只要提供正确的 skill 定义,也可能学会调用代码审查、性能测量和日志获取等工具。
他认为,小团队可以在通用模型不擅长的细分领域取胜:一个设计良好的界面,加上专用模型或 skills,能够为特定用户提供高精度、令人愉悦的产品。对系统可靠性的讨论则提醒人们,不应把当前硬件和算法假设当成永恒不变;正如分布式系统用不可靠部件构建可靠服务,也可以思考更激进的冗余和容错设计。最后,他建议人们根据真正关心的问题、喜欢合作的人以及希望产生的影响,选择大组织或创业公司的道路,而不是只看外部声望。
在关于研究方法的延伸讨论中,Jeff Dean 认为,大规模模型虽然接触的数据远多于一个人成长过程中接触的数据,但这并不意味着数据利用效率已经足够高。未来值得探索的方向包括更高效的数据利用、持续学习,以及让系统从自身行为中学习。他也提到,重新思考神经形态计算和信号传输方式,可能帮助人们发现被长期习惯遮蔽的设计空间;这类思想实验未必都会成功,但提出它们本身有助于检验默认前提。
对于个人选择,他没有给出单一答案:成熟的大型组织提供架构、优秀同事、丰富问题和已有平台,小型创业公司则要求团队对具体问题保持强烈热情,并承担更大的不确定性。判断一件事是否值得做,关键在于它是否真正重要、能否与合适的人共同推进,以及最终是否会以某种方式让别人获得原本没有的能力。
- 开场与 AI 能力预测 [00:00:00 - 00:10:00]
- 人工智能系统的能耗、数据搬运与 Agent 工具 [00:10:00 - 00:20:00]
- 创业公司的机会与可靠性思想实验 [00:20:00 - 00:30:00]
- 重新审视假设、AI 研究方法与个人选择 [00:30:00 - 00:40:00]
- 大组织与小团队的选择、持续学习与告别 [00:40:00 - 00:43:44]
# #662.:谷歌首席科学家Jeff Dean: 人工智能构建中的 1%法则
- 开场与 AI 能力预测 [00:00:00 - 00:10:00]
Diana Hu:欢迎收听跨国串门计划。这是一档专注于让中文听众无障碍欣赏全球优质外语播客的节目。通过先进的AI声纹克隆技术,我们不仅将内容翻译成中文,还完美保留了原主持人和嘉宾的独特声音,为您呈现全球顶尖的AI财经,健康与科技领域精品内容。我是主播一凯,一位热衷于AI领域的产品经理,很荣幸能为您搭建这座跨越语言障碍的桥梁,接下来让我为您简单介绍本期我们克隆的这档节目,本期我们克隆的是知名播客Y Combinator的一期特别节目,录制于2026年7月30日,主持人Diana Hu与谷歌首席科学家Jeff Dean 展开了一场关于AI未来的深度对谈 Jeff Dean是MapReduce,TensorFlow,TPU等多项关键技术的缔造者,也是谷歌AI领域的核心人物,这期节目围绕他过往的餐巾纸估算故事展开,聊到了AI推理硬件,智能体系统,以及小团队如何在AI时代找到自己的机会,那我们就一起来听听这期完整的对话,好,那我们开始吧,Jeff 好,没问题,好,Jeff,欢迎再次感谢你能来,尤其是我刚感冒了,还谢谢你过来,我嗓子也哑了,平时声音不是这样,但咱们尽力吧,你做出了MapReduce BigTable TensorFlow TPU Gemini 光这些事,我们就能聊一小时,但我喜欢的是,你还在公开场合做大预测,去年,对,去年2025年5月,在AI Ascent上 你说AI的水平相当于初级工程师,那大概是一年前了,现在已经我们离那个预测有多近,我觉得模型在基于agent的运行时间更长的编程任务上进步很大,而且很明显他们现在确实挺有能力 [00:01:44]
Jeff Dean:取决于你对初级工程师的具体定义,要我说这个预测相当准,那个预测里你低估了什么,我觉得处理越来越复杂任务的能力增长的比我预想快
Diana Hu:而且编程之外,这些智能体系统真的开始在其他领域冒头了,我认为这会是未来一个重要趋势,那再给个大预测吧,你觉得2027年会是什么样
Jeff Dean:我觉得你会看到ML系统本身的自动化程度高得多,基本上就是让ML系统通过跑大量实验来提升能力,把问题拆成子问题,然后在一个紧凑的自动实验循环里跑这些子问题,把结果汇总,然后就能从这种全自动的问题分解和自动实验中,得到一个改进后的系统,我觉得这会非常让人兴奋,而且这不仅适用于ML 也适用于科学和工程的其他领域
Diana Hu:基本上任何你能有可衡量目标的地方,我觉得如今都能取得很大进展,现在稍微回顾下历史,回到2001年,谷歌搜索当时还是跑在硬盘上的,对,你和3J做了计算,意识到在某个时间点,整个搜索索引,终于能装进所有运行中计算机的全部内存里,你有了那个颠覆性的认识,然后你基本上在几天之内,就和3G一起,把一个全新的跑在内存里,而不是硬盘上的搜索版本上线了,那就是让谷歌搜索变快的原因,所以历史往往会重演,现在2026年,那个能装进内存的时刻是什么,在座每个人都该思考,该去设计的,这有点不一样,但我觉得你会看到越来越多,高性能低能耗的推理硬件系统 [00:02:54]
Jeff Dean:因为我觉得现在,大家都意识到,推理是让这些智能体系统,能被更多人用上的关键,而且延迟真的很重要,硬件的专门化,是让东西比GPU或TPU [00:03:47]
Diana Hu:这类更通用的计算设备,更节能,延迟更低的一个非常关键的方式,因为我觉得在座各位都习惯了,等模型回复,所以,对等待可不好玩,掌控速度,所以你的意思是,如果我们不用再等了呢,我觉得想象一下,如果延迟能好上50倍,你能做些什么,有意思的想法,那在座大约6000人持有的,关于AI的哪个假设,其实已经是错的了
Jeff Dean:这是个好问题,我觉得可能有一点是,人们还没完全意识到,智能体系统能跑多久,这件事有多大的可能性,不只是在你关心的问题上,跑一两个小时,而是在某些问题领域,并且底层有非常强大的模型时,你可以让他们跑上好几天,甚至几周去完成非常非常复杂的任务,我觉得有些人已经开始看到一些苗头了,但我不认为所有人都真正内化了这一点
Diana Hu:而这会是一件相当了不起的大事,你跑过什么特别的任务,一跑就是几周,是什么任务,你让agent去解决什么,我觉得你可以让agent去独立实现 [00:04:53]
Jeff Dean:某个软件的完整新版本,用不同的编程语言来写,这些语言可能在安全性或性能上,有更好的特性,然后他们就能真的去干这件事,而且干得相当认真,那太酷了
Diana Hu:还有一件事你特别出名,就是你特别擅长,做餐巾纸上的快速估算,听起来挺有意思的,关于你有个故事,说2013年那会儿,谷歌的语音识别刚能用,你做了个粗略估算,如果每个谷歌用户,都用手机对着他说话,每天用语音识别,系统三分钟就三分钟,你发现这套系统,需要谷歌的一台服务器,那整个服务器集群就得翻倍,光为了做语音识别,就得花非常非常多的钱,对,结果你干脆造了一颗定制芯片,这就是TPU的起源故事,对对,我算是做过这个估算,我们当时训练的那些
Jeff Dean:基于深度学习的语音系统,语音模型,开始看到非常好的效果,但他们比老的语音系统,计算开销大得多,不过错误率降了一半,这相当于语音识别领域 20年的进步,我们只花了几个月就做到了,就是调调模型,稍微扩大规模,拿到更好的数据,于是我们开始担心,如果语音效果好很多,大家就会用的更多,那个信封背面的粗略估算,核心就是这个问题,万一大家开始更多的,用语音识别来口述邮件,对着手机说话什么的呢,结果我们发现,当时光靠CPU跑已经不够了,需要更好的方案,所以我们搞出了TPU 它本质上就是为低精度,稠密线性代数做了高度定制,而这几乎是今天所有,现代机器学习算法的核心,你要是为低精度稠密线性代数,造一颗专用芯片 别的什么都干不了,结果它对机器学习推理特别有用,哪怕它跑不了Chrome 跑不了Word什么的,这套系统几年后产出的芯片,能效比当时的CPU和GPU高30到80倍 [00:06:52]
Diana Hu:延迟也低得多,大概低20到30倍,太了不起了 TPU今天已经成了这么重要的基石,你当年绝对想不到TPU会变得这么根基性,尤其是Transformer架构还是后来才发明的
Jeff Dean:比TPU本身晚得多,对,这其实就是我们当初为什么要做一个通用的线性代数系统 TPU本质上就是这个,因为我们知道记忆学习算法还在不断演进,你不能过度特化,但又得特化到能拿到巨大的性能收益,我们可以做非常大的惩罚单元,可以用高速内存,可以用高速互联,后来的TPU还能把非常非常多颗芯片,高效的协同到同一个问题上
Diana Hu:而且这么多带下来,我们一直在把它们规模做大,性能做上去,这餐巾纸估算太神了,那什么是,餐巾纸是好东西,餐巾纸是好东西,那说真的,在座各位想当未来创始人的,今晚应该跑一个什么样的好估算,说不定能做出像TPU一样,有分量的东西,这总是很难说,我觉得去想想你看到的问题,不管你在琢磨什么,看看瓶颈在哪里 [00:07:44]
Jeff Dean:然后有没有完全不同的思路,去解决其中某些问题,能让你拿到一个数量级,甚至两个数量级的性能提升,能力提升或者别的什么,因为有时候你只要眯着眼看一个问题
Diana Hu:别被今天这个问题是怎么解决的给毛住,而是想从第一性原理出发,你会怎么解,你就能冒出特别好的点子,可能是别人没想到的,这是个好建议,对了,在座可能有人不知道,很多年前 Jeff写了一份特别出名的清单,叫The Latency Numbers Every Engineer Should Know 里面全是这类数字,比如一次缓存未命中要多久,磁盘寻到要多久,一个网络包从加州传到荷兰要多久,分布式系统和系统工程师会用到的一大堆数字,这份清单被很多人贴在墙上,成了分布式系统工程师的圣经,好,对,现在时间快进,这份清单该更新了,给我们一份2026年的AI版吧,好我觉得如果你看今天AI系统里什么最重要,你会想知道这些,你的加速器上主内存到片上内存 [00:08:22]
Jeff Dean:再到乘法单元之间的带宽是多少,做一次乘法运算要耗多少能量,芯片之间的互联带宽是多少,用这个带宽能连多少颗芯片,然后超出这个范围,比如你要跟1万颗芯片通信,而不是500颗的时候,网络带宽会衰减多少,我觉得这些都是特别值得了解的数字,它们真的会影响你,怎么去解决特定类型的问题,我听过你讲一个很有意思的观点
Diana Hu:说现在衡量一切的标尺是能量,对,你指出过做一次计算,或者说做一次数学运算,大概只花一个皮夹,但搬动数据,做数据输入输出,要贵上一千倍,对,就是把数据从加速器上的HBM搬进处理器,它才能真正在上面算 [00:09:42]
# #662.:谷歌首席科学家Jeff Dean: 人工智能构建中的 1%法则
- 人工智能系统的能耗、数据搬运与 Agent 工具 [00:10:00 - 00:20:00]
Diana Hu:没错,这个差距其实在悄悄决定哪些产品能做出来AI里的这些算法该怎么搭,那在你看来有哪些问题,创始人老把它叫成模型问题,但本质上其实是能量问题或者数据输入输出问题,对我觉得你举的那个例子
Jeff Dean:搬数据的能耗和真正在数据上做计算的能耗差1000倍,这个差距非常显著,它塑造了我们在机器学习里做的很多事,因为如果没有这1000倍的差距,你根本不需要做批处理,但现实是你必须把很多样本或者很多token 凑成一批一起处理,才能摊薄搬数据的成本,这样你付出的就不是1000倍的减速,而是1000倍除以P大小之后的能耗,而且真要追求极低延迟的话 批处理其实不太行,所以我觉得这类事情,还有我们用的计算机硬件里
Diana Hu:各种决策背后的能耗,真的会影响我们在搭,更上层系统时做的很多决定,一个很具体的例子,就是训练模型这件事,整个批处理的概念,数据集跑EPOC 这些大家可能误以为是模型问题,但其实本质上是,系统的数据输入输出问题,对吧,对,就是说你得把样本凑成P 硬件效率才上得来,理想情况下,你也许想用P大小等于1来训练,但从效率角度看那样不太好,所以现在大家用的P都挺大的,你觉得有没有可能,我知道你出了名的,会消失一个长周末,或者一个周末,然后拿出一个绝妙的方案,会不会有哪天 Jeff Dean跑去埋头干上两周,把P大小等于1的训练给做成了,对,其实我最近想的更多的是推理,我觉得推理是个特别有意思的问题 [00:10:59]
Jeff Dean:因为你确实想要极低延迟,训练的话,倒不一定需要那么夸张的低延迟,而且我觉得,推理这块的硬件专门化,还有很大的空间可以挖,比我们现在做的要多得多,推理这块 [00:11:49]
Diana Hu:有哪些你正在深入,琢磨的有意思的方向,就是尽量把数据搬动降到最低,去想那些极低精度的运算,也许不用支持
Jeff Dean:特别多种不同的精度,如果你觉得已经很清楚,自己需要哪些精度了,那就干脆把这些精度,直接做进硬件里,别的都不用管,我觉得这其实落到一个核心类比上
Diana Hu:我听过一位很有名的计算机科学家讲,整个AI的过程本质上是一个大压缩问题,因为你要让数据完全有损的压缩再还原回来,前提就是你得真正理解它,对如果你真的理解了数据,你应该就能把它压得很好,而现在的Transformer架构,基本上就是被证明特别好用的一种方式,对我会这么说,到目前为止效果确实不错,我同事们干的漂亮,没错,那我们把镜头拉远一点 update的进步以前就因为模型更好,你有更多数据,用更大的参数量训练更大的模型,但最近这几年,越来越变成模型之外的一切,不只是模型规模,参数量或者更多数据,而是检索,工具,记忆 agent的工具,这些周边的东西,这些东西可能慢慢汇聚成,大家说的上下文工程,对吧,对 [00:12:28]
Jeff Dean:我觉得模型其实只是,你要做的事理的一块,你要做的是搭一个,能解决真正有趣问题的完整系统,这包括一个会用各种工具的模型,他也许知道怎么检索相关信息,也许有过去处理问题时,检索过的其他信息的历史记录,他能把信息放进模型的上下文里,这样做的好处是,这些信息对模型来说非常清晰,不像模型训练时用的训练数据,那都是几万亿个token搅在一起,煮成一锅几千亿,甚至几万亿参数的汤,远不如模型,针对当前这个问题,这个用力直接看到的上下文来的清楚,然后还要能理解有哪些工具可用,哪些工具能帮模型解决下一阶段的问题,怎么把一个任务拆成一串工具调用,也许还要试多种解法,看哪种有效 并且能评估结果,这就是整个复杂agent的系统,和多智能体系统的编排,我觉得它会越来越重要 [00:13:21]
Diana Hu:要我说这真是超级激动人心的时代,我觉得这个领域特别有意思的一点是,在座的每个人其实都能上手,因为以前要训练一个模型,你需要海量的资源,需要大量GPU和数据,但说到上下文工程,在座各位都能做,你只需要一个像Gemini这样的API 然后自己搭一套检索,自己写工具调用,诸如此类,那么对大家来说有什么建议,怎么才能把上下文工程做好,做到出类拔萃,对我觉得一个很好的方法,就是真的用这些模型,还有各种harness和工具去解决问题 [00:14:23]
Jeff Dean:然后有时候你能亲眼看到,模型在哪些地方会失败,而且很多时候,你其实能让模型表现得更好,能解决那类问题,不是靠调整模型参数,那个从外部很难做到,而是靠给模型写更好的指导,给模型写skills 让它知道怎么用不同的工具,这些工具对解决某一类问题会特别有用,我觉得你这么做的时候,你其实是在不断改进,自我改进你用来解决问题的这套配置,而且这也是一个很好的方式,让你更理解模型还需要哪些额外信息,才能变得更强大
Diana Hu:你能举一个你自己做过的上下文工程的例子吗,比如你写的skills 或者某个工具,真的让你的工作流有了巨大改变,我想想几周前三届和我在做一件事
Jeff Dean:我们经常会给一些非常底层的库做性能优化,我们在谷歌写了一个微基准测试库,你可以写微基准测试测各种操作要花多长时间,比如填充这个数据结构要多久之类的,有时候这些数据结构会在谷歌的几百万个进程里被用到,所以确保他们高性能其实挺重要的,你可以写微基准测试,但如果没有智能体系统,你通常的做法是,先测一下你关心的那些基准的当前性能,然后做一些修改,希望能提升性能,再重新跑基准,看看哪里变好了,可能再跑更广的一组基准,测一下缓存占用之类的,所以我们写了一个skill 基本上就是教模型,怎么按各种顺序去做这些事情,这样他就能真正做自我改进的基准测量,基准测试,改代码,测性能提升,然后不断迭代,对某些类型的问题 [00:15:52]
Diana Hu:这个效果还挺好的,其实本质上,就是我们把自己,作为人类会用的方法,以一种模型能用的形式,教给了他,哇这听起来太厉害了,所以你的意思是,你有这么一个skill 如果有人能拿到它,就能像Jeff Dean一样,做性能优化,感觉全世界都会想要这个,谁要是能拿到,这价值简直不可估量,其实我们几个月前,发布了一份文档,叫Performance Hints [00:16:43]
Jeff Dean:是Sanjay和我写的,大概30页,讲各种性能优化的技巧,有些人已经把它拿过去,用摘要的形式,喂给各种模型,然后发现模型,现在在推理性能问题方面,确实变得更好了
Diana Hu:所以你们都听到了,如果你拿到你发表的,这份Performance Hints论文,你其实也能像Jeff Dean一样,优化自己的代码,对,而且是完全免费的,所以大家都应该去试试,太酷了,现在你刚才说到Agent在座,各位可能都在做Agent 或者某个时候做过,我相信大家都见过自己的agent 在大概第30步第40步的时候跑偏了 agent在大概前10步左右表现很好,但到第50步就开始不稳了,你觉得现在的瓶颈是什么,是上下文评估器,还是因为本质上是个开放系统,错误会不断累积,对我是说显然我们希望agent能长时间运行 [00:17:23]
Jeff Dean:因为只有这样他们才能解决越来越复杂的问题,但就像你观察到的,今天他们有时在跟工具交互10次之后就不行了,有时候是因为模型在尝试做,它没什么经验的事情,它是在一大堆东西上训练出来的,一旦你稍微偏离它熟悉的数据分布,就像大多数机器学习模型一样,它的表现会突然开始下降,而且你离它擅长的数字区越远,它就越可能表现不好,所以有很多事情可以做,一个是给模型提供技能和提示,让它们尽量待在模型比较熟悉的,光线更明亮的路径上,我觉得用多智能体系统,让多个agent尝试不同的方法,然后你可以评估,也许用另一个模型,或另一个agent 来评估哪些方案,看起来有希望,这某种程度上,也是在搜索,可能的解决方案空间,坚持那些看起来最有希望的,丢弃那些没用的,或者跑偏的 这是一个非常非常有用的,通用技术,就是推理时计算,用来搜索解决问题的合理方式,这可以大幅提升性能,或者让长时间运行的 agent的流程更可靠 [00:18:57]
Diana Hu:你们内部是怎么为agent实现这种特定工作流的,对我们有各种harness 还有一整套skills 特别是在谷歌内部开发环境里,我们有skills
Jeff Dean:让agent知道怎么用我们大量的内部工具,比如编程代码审查测量性能,或者获取日志文件,这些skills就是你可以加进去,让基础模型更强大的东西,即使他没有专门针对谷歌内部工程师,从我们专有系统,获取日志文件的,确切方式进行过训练,只要有正确的skill定义,你就能让它跑起来,对,这提高了agent的实用性
Diana Hu:现在我们来聊聊,创业公司能在哪里赢,这部分我个人非常关心,因为在座的每个人,都需要决定未来要做什么,作为未来的创始人,谷歌的特点是,你们从处理器到产品 [00:19:46]
# #662.:谷歌首席科学家Jeff Dean: 人工智能构建中的 1%法则
- 创业公司的机会与可靠性思想实验 [00:20:00 - 00:30:00]
Diana Hu:整个系统都是协同设计的,哪些层面是,像谷歌这样的公司,会持续构建,不断积累优势的,而两三个人的团队,又能在哪里胜出,对我觉得显然谷歌
Jeff Dean:我们的Gemini模型,和硬件技术设施,是在努力构建,能做几乎所有事情的通用模型,但在很多情况下,这意味着我们不会在特定领域,投入太多注意力,而在那些领域,一个设计精良的界面,加上一个模型和一组skills 或者一个不在通用模型,擅长范围内的专用模型,实际上可能有显著优势,因为你可以为你真正热爱的领域,构建出令人愉悦,高精度高质量的东西,我觉得这就是两三个人在房间里,构建他们真正兴奋的东西,是能获得优势的地方,但我也想提醒通用模型,肯定在越来越广泛的事情上变得更好,你得想清楚,你正在做的事情,它会是一个持久的东西吗,还是说前沿模型会在未来六个月,或12个月内在这方面变得更好,还是说他们两三年内都做不到,你在决定做什么的时候,需要权衡这些 [00:20:12]
Diana Hu:那我们深入聊聊这个通用模型,你们当然会继续做,让他们越来越好,那观众应该怎么思考,哪些领域是他不擅长的,创始人应该怎么想,该挑什么事情来做
Jeff Dean:对我觉得最重要的事情是,选一个你超级兴奋,想构建,而且你觉得对世界有用的东西,对吧,如果你做到了这一点,你就已经领先很多了,然后如果你醒来发现,哎呀我其实不太想做这个,或者你要构建的东西,对世界,对很多人其实没什么用,所以这是我尝试应用的,第一条选择标准,接下来该解决什么问题,第二,我觉得你要看看当前更通用的模型,在那个问题领域能做什么,对吧,你可以测试他们,看他们能不能把这件事做得很好,如果他们完全做不了,那可能是个好兆头,如果他们能做一部分,但做得不太好,那可能不是好兆头,因为这可能意味着这种能力,开始出现在那些模型里了,随着更多训练数据,更大规模的模型,或者其他什么,它很可能会变得更好,所以你要找的是 [00:21:19]
Diana Hu:模型成功率是0%或1%的事情,而不是20%的,你怎么找到这些方向,我是说,这些事是不是本质上,就落在训练级分布之外,符合这个条件的问题
Jeff Dean:具体长什么样,对我觉得有时候是这样的,你做的产品,能接触到某种特定数据,而底层那个通用模型接触不到,比如你做一个帮用户整理个人所有信息的产品,模型本身不一定能拿到那些数据,这种情况下你就有很大优势,因为突然之间你的模型,你的产品能看到重要的数据,也可能是某个特别难的问题,如果你拿到对的训练数据,能训练一个比通用模型更专门的模型,而且成本很可控,也许训练一个针对这个特定问题的垂直模型,用不了太多算力,但能得到一个准确率很高的东西
Diana Hu:这种模型有时候能成为很好的基石,去解决那些通用模型处理的不太好的重要问题,我觉得这很有意思,你基本上说了两条路,第一条路有点好笑,你们在做的事是整理全世界的信息,对,那条路大概已经被覆盖的差不多了,对,但整理个人自己的信息,这块还是空的,挺有意思的,对,然后第二条路,你讲到某些领域的更专门化的模型,能多讲讲,这些领域都有哪些吗,好,我觉得你看看我同事的工作,比如AlphaFold 那是一个非常专门的蛋白质折叠模型,而且非常成功 [00:22:59]
Jeff Dean:他真的能把这个领域处理得很好,所以突然之间,你有了一个很厉害的工具和模型,能非常高效的回答,关于蛋白质和它们结构的问题,但它不是通用模型,它非常专门,我觉得还有其他领域,这种思路也能发挥得很好,也许在材料科学,芯片设计这类方向,能让你借助一个非常准确,但垂直的模型,去做今天很难做的事,这是个好例子 [00:23:37]
Diana Hu:所以如果你们有人发现一个,形状类似的问题,像AlphaFold那样,那可能就是个值得做的方向,现在我们假设你已经找到了,要做的方向,我们来聊聊,怎么成为一个AI原生的创始人,怎么真正把它做好,你以前说过,管理一群agent 比如50个或100个agent 关键在于写出非常清晰,干脆的设计文档,或者规格说明,人们怎么才能擅长这个,那些文档长什么样,对我觉得是这样的,跟你的虚拟agent合作时,如果你能清楚地说明,你想要什么
Jeff Dean:成功的概率会高很多,你越清楚自己想要什么 agent就越有指导原则规则,也就是一个,他要完成什么的大纲,反过来,如果你不说明白 agent就得去猜你的意思,很多时候他猜出来的东西,跟你脑子里想的不一样,所以我们从一开始就一直告诉计算机科学家,在动手写软件之前,先想清楚这个软件要完成什么,这非常重要,现在我们有智能体系统能替我们写代码了,但说清楚你想要什么,这件事的重要性反而更高了,因为以前你是把任务交给一个很聪明的人,他可能有上下文,或者能问你追问 agent有时候也能做到,但我觉得清晰的规格说明真的是个好主意,给你举一个编程agent用的特别好的例子,你可以让今天的模型把软件从一种编程语言翻译成另一种,效果非常好,因为这种情况下 你其实有一份极其详细的规格说明,你有一整份软件,它说明了系统应该做什么,所以如果你有一个Python实现,想要一个Go实现,这种事现在的模型似乎特别擅长,因为它可以把Python里所有的测试拿过来, 确保Go版本能通过把测试翻译成Go, 然后对比两个实现之间的行为差异, [00:24:39]
Diana Hu:直到没有差异为止, 效果非常好, 因为那份规格太清晰了。现在我们假设每个创始人都擅长同时跑几百个agent, 所有代码都由agent写好了, [00:25:56]
Jeff Dean:那什么技能会变得稀缺?对,我觉得关键是要有非常好的品位, 知道该让agent去做什么,这其实是我背景里研究问题的核心,一个研究者可以拥有所有工具和技术,但很多时候真正的较量,在于你要把时间花在哪个问题上,如果你选对了问题,并且成功解决了它,那远比你把一个相当无聊的问题,研究的漂漂亮亮要好得多,所以这种关于该做什么的高层智慧,我觉得极其重要,我不认为模型在这方面会特别擅长,所以还是需要人来掌舵,引导大量AI辅助的计算,去更快的成就大事
Diana Hu:但那种你想让模型做什么的本质,才是你应该专注的关键,那我们再多聊聊品位吧,因为在这个agent解码的时代,现在大家谈的很多,你到底怎么培养品位,怎么做到,这听起来太玄了,怎么把它变得具体,对,这确实是个难事,很多时候品位不像有个,可衡量的客观标准,我觉得一部分来自经验 [00:26:46]
Jeff Dean:过去研究过很多不同的问题,会教会你未来什么样的问题,可能有趣或者什么样的事情,通过把之前的方法拼凑起来,再加上一些你必须解决的开放问题,可能刚好能实现某种神奇,或者非常有用的东西,另一个给自己积累经验的办法是,写下你觉得未来12个月里,可能重要的一堆事情,也许你挑其中一件去做,但12个月后回头评估,这些其他事情里,哪些真的显得重要了,或者世界上哪些人真的去做了,做出来了,哪些还没人做,这能给你自己的品位培养能力,提供多的多的样本
Diana Hu:而且这是一项很重要的技能,我觉得我们之前聊到的第三种方式,是做非常疯狂的思想实验,对那是另一个好办法,我觉得有时候,不要把大多数人视为理所当然的事情 [00:27:51]
Jeff Dean:当做理所当然,是件好事,所以我前几天和一些同事,做个疯狂的思想实验 60年来,整个硅芯片设计行业,设计和制造行业,做大量工作,来制造越来越小,错误率极低的晶体管
Diana Hu:对吧,因为我们的假设是,我们制造的,同一设计的,每一块芯片,都应该和其他,每一块芯片,完全一样,你不希望任何比特翻转,一切都要完美
Jeff Dean:不应该有任何比特翻转,你知道,有各种各样的东西,各种误差余量,都被设计进去了,现在内存都有ECC内存,但在宏观尺度上,我们在构建大规模分布式系统时,并不会做这个假设,对吧,我们用不可靠的部件,构建可靠的大规模分布式文件系统,对吧,单个磁盘可能会坏,但你的数据应该是安全的,所以我们在更高层有机制,比如把数据复制三份,放在三台不同的机器,三个不同的机架上,这样如果任何一个机架交换机,单台机器或磁盘坏了,你的数据还在,我们有理得索罗门编码技术,但我们似乎没有在晶体管级别的极端尺度上做这件事,所以一个有趣的思想实验是,如果你试图用每天可能出20次错的晶体管来构建一个系统,会发生什么,天哪,而不是每100万年才出一次错,对吧,那会是一个非常不同的设计点 而且可能让你在制造端做出非常有趣的事情,你会有非常不同的设计方法论,因为如果你想从一个地方传信号到另一个地方,而你有这些超级不可靠的晶体管,你可能会用非常不同的信号传输方式,你可能会沿着多条冗余路径发送,以确保至少有一条能到达,我觉得这会是一组相当有趣的思想实验,我不是说我们应该去做这个,但你知道这就是那种,你确实需要偶尔质疑假设的情况,很多时候这些思想实验不会成功,因为过去50年我们这么做,而不是那么做 [00:29:25]
# #662.:谷歌首席科学家Jeff Dean: 人工智能构建中的 1%法则
- 重新审视假设、AI 研究方法与个人选择 [00:30:00 - 00:40:00]
Jeff Dean:是有充分理由的
Diana Hu:但时不时重新审视一下,这些假设是好的,这太疯狂了,我觉得这跟神经形态计算,或者人脑自然运作的方式,有很多呼应,确实,就像我们大脑中的信号,从一个地方传到另一个地方
Jeff Dean:并不是特别可靠,所以我觉得在大脑里,当有真正重要的东西,需要从一个地方传到另一个地方时,会有多条通路让你能够做到,那么你有着如此辉煌的职业生涯
Diana Hu:有没有哪个疯狂假设是你抛弃了,但最终真的构建出了一个,有影响力的系统的,对我想想,而且真的成功了,对我是说,我觉得TPU就是个好例子
Jeff Dean:在某个非常细分的问题领域,还没显得像今天这么重要的时候,就为它专门定制硬件,这是一个思想实验,你知道我觉得 MapReduce的起源是另一个好例子,那已经是传奇了,我们你知道我3J和我自己,还有不少其他同事,之前在谷歌做过,爬虫和索引系统的各种迭代版本,你知道我们写了很多手工并行化的代码,带大量检查点,就是为了保证在几百台或上千台机器上跑的时候,即使有些机器挂了,系统也能健壮可靠,但那些代码往往和你真正想做的,其实很简单的事情混在一起,比如我就是想看看所有网页内容,然后算一下从URL映射到这个页面什么语言,页面的文本是什么,而这些真正想做的事 会被那些并行化和可靠性的代码,给淹没掉,所以我们想起自己受过的,函数式语言训练,意识到我们可以换个角度,看这些问题,然后提炼出map reduce 这个抽象层放在实现之上,而在实现之下,你可以把所有检查点和可靠性机制,都放进那个底层库里,所有东西都可以构建在它上面,于是这就成了谷歌处理,超大规模计算的一种,极其成功的方式,既健壮又可靠 [00:31:34]
Diana Hu:这个思想实验就是,如果我们换个角度看,能不能找到大量适合,放进这个抽象层的问题,太了不起了,所以这个思想实验,让你创造了MapReduce 对,太棒了,现在我们回到,你刚才聊到一些,关于你现在对做大量,定制硬件的兴趣,现在AlphaChip在布局芯片,然后你还有AlphaWolf 它提出方案,评估方案,然后把所有有效的方案都保留下来,看起来你开始构建这些,能不断叠加的系统,让AI去构建AI 对我是说
Jeff Dean:我觉得更广泛的说,这有点像科学方法的基础,你提出一个实验,实现运行实验所需的东西,评估实验,然后从实验中得到结果,我觉得现在有越来越多的问题可以实现,让整个循环不是只跑几个实验,而是跑很多很多实验,因为你能自动化这个循环,让循环的延迟变得极低,这会变得非常非常重要,它能让我们去攻克科学工程,机器学习模型设计本身,还有像设计芯片这样的工程任务里,各种各样的领域,所以如果你能真正自动化的,做这些事有一个编排框架,能把非常高层级的目标,拆解成子问题,每个子问题都可以是这样一个,自动化循环,去探索解决那个子问题的最佳方式,然后编排框架,再把子问题的解决方案组合起来,形成更高层问题的整体解决方案,这会非常有影响力 真的非常非常重要,我觉得它能让我们,加速记忆学习的发展,加速科学,加速工程 [00:32:45]
Diana Hu:我觉得那会非常了不起,听起来太棒了,我是说,听起来基本上有很多领域,只要你能有非常好的评估器,也许还接近那些,可以被形式化验证的东西,对吧,那些领域就非常适合,能自我改进的AI系统,对,我觉得在很多情况下,有时候你的评估器,需要做得快得多,对,举个例子,我的同事们大概十年前 [00:33:46]
Jeff Dean:做过一些量子化学方面的工作,就是试图理解,某个特定分子的性质,你可以你知道,生成一个分子构型,然后想了解它有什么性质,于是你可以跑一个,计算量非常大的,密度泛含理论模拟器,这东西可能要跑一整晚的计算,才能告诉你一个结果,但我的同事们做的是,从那些模拟运行里,拿一堆输出输入的分子构型,和昂贵模拟器的输出,然后用他们训练一个神经近似模型,来替代模拟器,所以这现在成了一个验证工具,但不再是花一整晚,他们做出了一个快30万倍的东西,哇,而且准确度几乎和跑完整模拟器一样高,所以这彻底改变了你做科学的方式,对吧,因为现在你有1000万个东西要筛选,你知道你可以去吃个午饭的时间就筛完,而不是花6个月的时间拼命凑够算力 去跑所有这些模拟,我觉得在很多领域,都有大量空间去做快得多的验证模型,可能是学出来的验证模型,能让你快得多的速度逼近真实答案,这会改变这些实验循环的思考方式,也改变你绕这些循环能有多快 [00:34:12]
Diana Hu:有哪些领域和问题是你特别兴奋,觉得这种超级加速的科学方法能去解决或达成的,具体是哪些问题或领域
Jeff Dean:对我是说我觉得显然机器学习本身就是一个,对,所以我们能不能有一个模型,能通过大量实验来自我递归改进,你想啊,今天大型研究团队是怎么改进模型的,通常是有人想出一些点子,跑一批小规模实验,看看这些实验效果好不好,如果好就把最有希望的挑出来,放到更大规模上去试,然后评估结果,最后把结果整合成模型的新配方,但我觉得这中间没有什么真正的障碍,不能把它变成一个自动化程度高得多的循环,让模型自己决定去探索什么,或者最多在最高层面,由人轻轻推一把,比如你为什么不试试一些,融入了这个思路的新模型架构,然后他就去跑大量实验,看哪些有效,再以快得多的速度把它们吸收进来,说到底你想要的 [00:35:33]
Diana Hu:就是优化每单位算力投入,能带来的发现数量,太酷了,现在回到这个房间里,你们所有人将来都会成为创始人,或者开启自己的职业生涯,你们大概会收到很多拒绝,这一定会发生,杰夫你也经历过,我记得有个故事 2014年你和杰弗里辛顿 Oriel Vainos 写了一篇关于蒸馏的论文,就是用一个大的教师模型,去训练一个更小更高效,算起来便宜的多,参数也少的多的模型,现在这已经成了业界,人人都在用的招数,对,问题是这篇论文,当年被欧洲的一个会议拒了,对是啊,我觉得我不怪程序委员会,因为很多时候,一篇论文会有三个审稿意见,其中某个审稿人看了之后 [00:36:25]
Jeff Dean:这次的情况是他们说,这篇不太可能产生重大影响,不太可能产生重大影响,但我觉得我们写这篇论文的时候,其实已经看到这是个极其重要的问题,因为我们知道从更大规模的模型,做出更便宜能力又强的模型,是我们特别想做的事,我们想把模型服务给越来越多的人,用在语音视觉等很多不同领域,但有时候审稿人可能没有那样的经验,因为他们可能没在考虑大规模AI服务,而是在想这是不是根本性的进展,所以时不时被锯一次也没关系,我们把它放到ArcCV上,大家读它用它一切都好,而且我们确实在用这个方法,比如从更大规模的Pro模型,做出我们的Flash模型,这也是为什么我们的Flash模型,比如Gemini里的那些 [00:37:16]
Diana Hu:在跟它们体积和速度相称的尺寸下,能力会这么强,在它们那个模型尺寸级别里,它们是基准测试里最好的之一,对,确实厉害,我觉得这里面的教训之一是,就算被拒绝了,也要继续往前走,对,这就是我会从这件事里,提炼出的教训,现在我觉得有意思的是,你当年加入谷歌的时候,那还是1999年,一个20人的创业公司,现在如果把当年的年轻劫夫,迪恩,用瞬间传送带到今天,对,这个时代带着你现在的本事,我现在感觉特别有活力,特别年轻,你会做什么,你会加入前沿实验室,还是自己创业,我不知道,你会怎么做,今天的杰夫迪恩 25岁的杰夫,迪恩,对我是说,这总是很难说
Jeff Dean:这是一个非常个人化的选择,你想把时间花在什么事情上,对我来说,一些最重要的问题是,你要做的事情,是不是你真正在乎的,如果你在做这件事,并且能和你喜欢,共事的一群同事,一起取得进展,如果你们能一起解决它,或者推进它,这件事会不会以某种积极的方式改变世界,比如说你会不会突然能做某件事,然后把这项服务提供给某个群体,也许是一个非常小众的方向,但能极大的帮助生物化学家之类的,或者也许是一个更广泛的方向,能帮助程序员,或者帮助互联网上的所有消费者,或者其他什么,你应该努力去做的,是对世界产生积极的影响,和你喜欢的人一起工作,努力工作尽你所能,所以就你刚才说的那个具体取舍,加入前沿实验室,还是和你的一两个两三个好朋友一起创业 我觉得这是两种不同的体验,在一个大型的成熟的组织里,你有一定的架构,你有非常多非常优秀的同事 [00:39:52]
# #662.:谷歌首席科学家Jeff Dean: 人工智能构建中的 1%法则
- 大组织与小团队的选择、持续学习与告别 [00:40:00 - 00:43:44]
Jeff Dean:他们知道很多你不知道的东西,你有大量有趣的问题可以去做,而且你已经有了一个平台,你的工作能产生影响,能影响到世界上很多很多人,而作为一个非常小的创业公司,你得有自己真正有热情的东西,而且风险很大,你要去解决那个特定问题,并且要成功,要把它做大,这中间有很多不确定性,但我想那也可能带来极大的成就感,所以我觉得这真的取决于个人偏好,但至少不管你走哪条路,都要问问自己,如果我做这个问题,最好的结果发生了,世界会不会在某个方面变得好很多
Diana Hu:还是说世界只会觉得挺酷的,但也就那样那种事情,就不值得你花时间去做,现在我们再多聊聊第二条路,和你真正喜欢的人,在一个小团队里工作,你一直是很多很多工程师的,出色导师和管理者,你也构建过庞大的系统,对在座的各位来说,在如何发挥最大价值,如何与聪明人共事,或者如何找到聪明人方面 [00:40:39]
Jeff Dean:你有什么经验可以分享,对,我是说你总是想找到那些,在某个领域有真正出色技能的人,而这个领域是你想组建的团队所需要的,不管是在公司内部还是创业,但你也想找到那些你乐于和他们相处的人,对吧,因为你会花很多时间和这些人一起攻克,非常难的问题,你想要的是那些自我意识不强,有团队精神的人,也许他们的技能和你互补,我一直觉得在一个小团队里工作,别人知道我不知道的东西,而我也有一些别人不太擅长的技能,这非常有意思,因为你们在共同构建某样东西,或者解决某个,你们任何一个人单独都做不到的问题,而在做这件事的过程中,你实际上会学到很多新知识,新技能,他们也是,你应该把自己的工程,或研究职业生涯,看作一个装满了各种技术的工具箱 你要一直往这个工具箱里加新工具,因为你永远不知道什么时候会遇到一个问题,需要这四个专门工具,而不是那三个,而工具越多 [00:41:59]
Diana Hu:你未来遇到的问题,就越有可能被你解决,最后再问一个问题,我很确定在座的某个人,或者好几个人,最终会做出和你做的 MapReduce TPU 蒸馏,等等一样有分量的东西,你希望他们去解决什么问题,对我是说,我觉得世界上有很多有趣的问题,我就随便说几个,这不是一个完整的清单,因为世界非常大,充满了问题,我特别兴奋的是,硬件的新方法
Jeff Dean:我们刚才那个思想实验,其实就是一个迹象,或者说是更高效的推理硬件,我觉得可能会有,根本不同的机器学习算法,比我们今天用的方法,在数据效率上高得多,想想我们今天的大规模模型,他们看到的数据量,可能是一个人类到18岁时,看到的1000倍,但一个18岁的人类,在很多事情上做得更好,而且和那些看了更多数据的,前沿模型不相上下,所以你能不能想出更高效的数据利用系统,能够持续学习,能够从自己的行为中学习,持续学习是一个非常有意思的方向,我觉得多智能体交互也很有意思,我觉得创造让世界上的人们更好的对话的方式,可能很有意思,有没有办法让对话更文明,还有帮助人们认识世界各地 [00:42:34]
Diana Hu:那些根据兴趣应该认识的人,我觉得这些都是挺有意思的事情,世界上有很多很酷的东西,我们都应该去努力,让更酷的事情发生,听起来太棒了,非常感谢你Jeff Dean 今天我们就到这里,谢谢,掌声,非常感谢,谢谢大家 [00:43:27]
这期节目把 David Perell 对多位写作者、修辞学家和创作者的访谈串联起来,讨论写作如何获得生命力、记忆点和长期价值。贯穿全篇的结论是:写作没有唯一正确的风格,但无论选择哪条路径,都必须做到足够出色;真正可靠的写作既来自对细节、结构和语言的敏感,也来自长期编辑、反复论证和对自身价值的坚持。节目中的不同嘉宾分别从场景、修辞、叙事、笔记、商业文案和编辑等角度说明,写作不是即时快感,而是一项需要持续打磨、建立深层关系的工作。
Amor Towles 先从场景写作谈起。他认为,想让读者看见一个场景,关键不是堆砌时代符号,而是站在具体人物的视角,捕捉真正会吸引其注意力的细节。孩子看见的可能是冻豌豆从袋子里滑出、在锅沿上敲碎并滚过台面,而不是成人会想到的冰箱或流行文化标志。第一稿可以先写给自己,编辑时再转向读者;情感也需要通过可感的动作和层次进入场景。
Mark Forsyth 讲解了修辞怎样改变记忆和说服力。diacope 是把重复词语隔开、形成“三明治”结构的手法;chiasmus 则通过对称和倒置,让句子更有回响。它们能让一句话变得难忘,但手法不能脱离意思,否则就会变成炫技。节目随后把话题转向多巴胺文化:不断滑动、快速消费的内容会削弱注意力,追逐平台节奏或许带来短暂爆发,却难以建立几十年的事业。更有价值的写作需要忠于自己的价值观,并与读者建立更深的关系。
关于叙事和说服,节目强调“框架”决定人们如何理解事实。故事通常比统计数字更能占据注意力;当一个故事和一组数字发生竞争时,只拿数字去回应故事往往处于劣势。因此,写作者必须意识到自己是在讲什么故事、选择了什么视角,以及哪些细节会改变读者的判断。关于笔记和写作工具,讨论回到一个朴素问题:工具的价值不在于收藏,而在于是否能让想法被及时记录、重新组织并投入写作。
Matthew Dicks 介绍好故事的核心:所有铺垫最终都应汇聚到一个短暂但决定性的“改变瞬间”,人物在几秒钟里从一种状态转向另一种状态。若写作者无法说清主角发生了什么变化,故事就可能只有事件,没有真正的结构。
Jason Fried 现场拆解商业文案。他把文案看成论证,而不是诱饵:先明确问题,再找到能让读者理解价值的表达方式。围绕 1% 与 2% 差异的文案,他展示了想法如何受到广告、冲突结构、反馈和多轮改写的影响,最终从一个模糊的种子变成简洁的成品。文案还需要控制信息量,让句子承担清晰沟通的责任;所谓完成,往往意味着已经经历了大量看不见的删改。
节目后段回到写作者自身。Robert Greene 认为,写作时的兴奋感并不可靠,真正的写作常常发生在编辑阶段:孤独、无聊和沮丧是过程的一部分,但完成一本书后形成的整体满足感,远胜即时刺激。主题不能脱离细节,普遍性往往藏在特殊性里;越具体的观察,越可能触及更多人的经验。最后,英语的拉丁语词汇和盎格鲁—撒克逊词汇各有不同质感,写作者可以利用这种层次改变句子的力度、距离和音乐性。
节目还反复提醒,写作方法不能被简化成一套固定模板。学校里教给人的规则只是众多可能性中的一种,写作者可以选择不同兴趣、不同性格和不同表达方式,但必须知道自己为何这样选择,并用作品证明选择的价值。笔记、纸张、钢笔、邮件和数字工具都只是中间媒介,真正重要的是能否把观察转化为可返回、可检验、可继续发展的材料。
在 Jason Fried 的文案拆解中,表达的推进不是先写漂亮句子,而是先理解读者面对的处境,再决定哪些信息应该成为“房东”、哪些信息只是“租客”,并不断检查每一句话是否真的承担了沟通任务。广告的成品看起来简单,背后却包含从问题、角度、冲突到反馈的多轮往返。这个过程与文学写作并不矛盾:两者都需要先找到核心,再通过删减、重排和精确措辞让核心变得可见。
整期节目的不同案例最终汇聚到同一点:写作的价值不是把所有内容都说出来,而是从丰富经验中选择最有力量的结构和细节。好的句子能够被记住,好的故事能够改变理解,好的文案能够让复杂问题变得清楚;这些效果都来自长期积累、耐心编辑,以及对具体语言负责。
从听众角度看,本期最值得保留的不是某一个技巧名称,而是对创作过程的重新排序:先观察,再形成问题;先找到人物或读者真正面对的变化,再安排结构;先写出可供编辑的材料,再通过删改使论证成立。修辞、笔记、广告和词汇选择,都是服务于这条链路的不同工具。
因此,节目给出的实践方向很具体:从人物会注意到的细节开始,把故事压缩到真正的转变瞬间;用框架帮助读者理解事实,用反复改写检验每个词;在平台鼓励即时反馈时,仍然把时间投入到能积累信任的长期作品中。
- 让故事活起来 场景、细节与修辞 [00:00:00 - 00:10:00]
- 修辞与多巴胺文化 写作的长期价值 [00:10:00 - 00:20:00]
- 叙事框架、笔记与故事的转变瞬间 [00:20:00 - 00:30:00]
- 商业文案 从问题到产品 [00:30:00 - 00:40:00]
- 文案结构、语言与说服力 [00:40:00 - 00:50:00]
- 广告创作 从冲突到反复迭代 [00:50:00 - 01:00:00]
- 写作的深层智慧 主题、细节与普遍性 [01:00:00 - 01:10:00]
- 写作、编辑与语言的层次 [01:10:00 - 01:20:00]
- 结尾 写作可以有多种路径 [01:20:00 - 01:21:19]
一凯:欢迎收听跨国串门计划,这是一档专注于让中文听众无障碍欣赏全球优质外语播客的节目。通过先进的AI声纹克隆技术,我们不仅将内容翻译成中文,还完美保留了原主持人和嘉宾的独特声音,为您呈现全球顶尖的AI、财经、健康与科技领域精品内容。我是主播一凯,一位热衷于AI领域的产品经理,很荣幸能为您搭建这座跨越语言障碍的桥梁。接下来让我为您简单介绍本期我们克隆的这档节目,本期我们克隆的是知名播客DavidPerel,171YearsofWritingKnowledgein90Minutes的一期特别回顾,主持人DavidPerel邀请了多位世界级写作专家,包括作家AmoTausz,修辞学家MarkFossis,文化评论家TedGilear,共同分享他们多年的写作心得,这期节目浓缩了这些专家总计171年的写作经验,围绕如何让文字更有生命力,如何写出令人难忘的句子,以及在这个快节奏时代,如何坚持深度创作等话题展开。 [00:01:09]
David Perell:那我们就一起来听听这期完整的对话,嘿大家好,2024年对我来说是写作上很重要的一年,我想做一期视频,一起回顾这一年里最精华的经验,想想这对我们的写作意味着什么,今年做这档节目,最触动我的是成功写作者的多样性,我学到的教训是,你想怎么写,就可以怎么写,学校里教的是,你得这么写,你得那么写,但不是的,市场里容得下每一种风格,每一种兴趣,每一种性格,应有尽有,但不管你选哪条路,都得做到非常非常出色,卓越的标准很高,比我预想的还要高,但可能性的范围,也比我曾经想象的更宽,所以再次强调,这些是我今年最喜欢的片段,如果你有个朋友,你一直跟他们说,嘿你得听听我是怎么写东西的,你得听听,那这期节目就是,可以分享给他们的那一期,你只要说,相信我,这一期绝对值得你花时间,如果他们问为什么,你就告诉他们,这期节目就像一盒,好玩的巧克力食井盒,各种口味都能尝一尝,好那我们开始吧。 [00:02:24]
Amor Towles:假设你要写一个故事,或者一本书里的一章,场景是一个小女孩正走下楼梯,快到晚饭时间了,那是1960年代,1960年代初,她走进厨房,妈妈正在做晚饭,收音机里放着音乐,如果你说,好找个法国作家或德国作家,他们没在美国待过,我们想让你写这个故事,这个场景,这里有一些生活杂志,还有一些关于1960年代,美国关于郊区的维基百科页面,诸如此类,那么会发生什么,你面临的风险是,这位作家可能会写出这样的句子,他走下楼梯,走进厨房,妈妈从冰箱里拿出,Bird'sEye冷冻豌豆,收音机里放着披头式的,LoveLoveMeDo,这就是陈词烂调,对就是这样,这些元素堆在一起,我们懂了,冷冻,豌豆,冰箱,披头式,这是1964年,全是我预料之中的,没错,所以你退一步想,与其放这些地标性的元素,来告诉我们身处何时何地,该期待什么,也就是你所说的,我们已经预料到的东西,不如问问自己,这个女孩会看到什么,假设她七岁或八岁,1964年,一个七八岁的孩子走进房间,看到妈妈在做晚饭,她会看到什么,对我来说,如果你把自己放在那个位置,最先跳出来的是冷冻豌豆那种奇妙之处,你把冷冻豌豆从冰箱里拿出来,打开袋子,整块豌豆砖可以整个滑出来,它们像砖块一样冻在一起,我们小时候看到父母这么做,是件挺神奇的事,然后他们会把豌豆砖在锅檐上敲碎,孩子会看到这一幕,然后总会有几颗豌豆坛跳着滚过台面,孩子会去捡,某个时刻趁妈妈不注意,你偷偷尝一颗冷冻豌豆,你会想,哦,冷冻豌豆是这个味道,有些孩子特别爱吃冷冻豌豆,吃冷冻豌豆,有一种很特别的质地和体验,总之我的重点是,这才是孩子会看到的东西,对吧,所以如果你想从孩子的视角,把这个场景写活,你不会提冰箱,bird'seye,披头饰,而是这些别的东西,现在我们可以让这个场景更有意思,比如说这是从女孩视角出发,她正在目睹这一切,假设那天早些时候,她母亲发现丈夫出轨了,母亲在洗衣服时,在丈夫口袋里发现了一张纸条,意识到自己被背叛了,于是母亲感到脆弱,愤怒,恐惧,担心丈夫会离开她,家庭会破裂,或者换个说法,假设那天是她第一次背叛丈夫,他开车去洗车店,结果在车经过洗车机时,和洗车店的那个男人,在后座发生了关系,他感到危险,性感,兴奋,充满活力,各种情绪交织在一起,现在无论哪种情况,当女孩走进房间时,他不会知道这些事发生过,也许多年以后,在书的后面部分,他会发现那天就是,你填空,母亲被背叛了,或者母亲背叛了,看是哪种,所以写那个场景时,除了孩子看到的那些小细节,比如让画面生动鲜活的动弯豆,你还得用完全不同的语言,节奏和语调来写那个场景,取决于母亲那天早些时候做了哪件事,因为虽然女孩不知道,但母亲的行为中必须透露出某种东西,女孩在房间里能感觉到,甚至自己都没意识到她在感知,所以就像我说的,后来当你发现真相时,可以回头重读那段,然后说一切都在那里,那晚发生的就是这个,这就是为什么当时感觉有点不对劲,所以作为作家,你进入这种状态,就像你说的,这是一个迭代的过程,努力准确观察,认真书写,然后开始构建语言的层次,你的用词和语言的诗意,去暗示一个更大的真相,不只是我看到了什么,而是母亲,乃至家里每个人的完整情感内容是什么,这些情感如何存在于那个空间里,又如何被历史背景所暗示,比如我们是中产阶级,中上阶层还是中下阶层,我们在俄亥俄州还是洛杉矶郊区,还是其他地方,所有这些都得写进去,你明白我的意思吗,所以通过写作和重写,你尽量在开头就把这些做对,提前听到这些元素,选择适合你要呈现的,那个目的地的基调和词汇,然后通过编辑和再编辑,你不断打磨,确保越来越接近你想要的效果,我想补充一点,我自己是这么想的,我觉得每个作家的方法都不一样,但对我来说,第一稿是写给我自己看的,只给我一个人,所以在写的时候,我想象什么都可以,有什么奇思妙想都行,什么让我着迷就深入进去,我觉得什么好笑就写什么,我可以长篇大论,就像我现在这样,我就让一切自然发生,不做任何约束,但是一旦第一稿完成,而且状态还不错,我就会把镜头转过来,说好,这是写给我自己的,充满了自恋离题探索,旁之末节和各种岔路,现在我要从读者的角度来想,而不是从我的角度,这不是为了卖书,而是从读者角度看,意味着我要履行这份契约,完成我这一半的责任,当读者买我的书,他们花了钱,更重要的是,他们要花时间阅读这本书,所以这是他们对我的艺术的投资,我欠他们的,作为回报,我有一些必须做到的事,其中之一就是确保,我把初稿拿过来,删掉那些重复的,陈词烂调的,无聊的,只为了满足我一时兴致,但对整个故事没有作用的东西,所以对我来说,编辑的很大一部分就是做简法,让文本越来越精炼,真正围绕这个故事该有的元素,和为该故事服务的语言来组织,然后其他一切都被推到一边,你明白吗,什么是diacope。 [00:08:57]
Mark Forsyth:diacope就像那种三明治式的重复,比如理查三世里的一匹马,一匹马,我的王国换一匹马,终于自由了,终于自由了,感谢全能的上帝,我们终于自由了,还有古周子永里的,独自独自,或者全然独自,独自在茫茫大海上,这又是一个,让一句话变得好记的公式,你也可以用更短的三明治式,比如邦德詹姆斯,邦德生存还是毁灭,这些都是让台词变得极其难忘的强力手法,你看邦德·詹姆斯,邦德是整个电影史上最有名的台词之一,可那不过是一个人用有点奇怪的方式说自己的名字,但我们就是记住了,而生存还是毁灭,大概是英国文学里最有名的一句话,莎士比亚完全可以换种写法。 [00:10:00]
Mark Forsyth:莎士比亚完全可以换种写法。
Mark Forsyth:他可以说生存与否,意思一样,但我们就是特别喜欢在电影里诗歌里听到这样的句子,游戏结束,火鸡,游戏结束,跑吧,为我们跑,责得死了宝贝,责得死了,它们都是同一个公式,做起来非常简单,可这些句子就是会刻在我们脑子里,还有一个特别棒的例子,我特别喜欢,因为我在写这本书的时候,发现了一个现象叫虚假记忆,当一个形式强大到能改变你的记忆,绿野仙踪里有一段西方坏女巫对飞猴说,飞吧,我的宝贝们,飞吧,所有人都记得这句台词,我记得,我问过好多人,他们都记得电影里有这句,可它其实不存在,什么,这句台词根本不在绿野仙踪电影里,它只在某个时刻说了,飞,飞,飞,飞,从没说过飞吧,我的宝贝们飞吧,但我们全都记得是这句,我们都把它记成那样,因为Diacope这种修辞手法太强大了,强大到我们自己去改写了记忆,所以基本上你是说,我们的大脑里有某种特定形状的记忆接收器,而你在写作的时候,如果想让某句话被记住,你可以用这些小小的修辞技巧,去塑造你的词句和想法,让他们刚好嵌进人脑的那个槽位里,完全正确,对,你这个说法特别好,我讲这本书讲了好多年,自己都没想到过这一点,从来没说得这么清楚过,他们就是那些我们天生爱记的东西,烧吧,宝贝烧吧,迪斯科地狱,比烧吧,宝贝更好,还有家,甜蜜的家,或者,哦,船长,我的船长,全都是,Diacope,我们刚才说的是,马丁,路德金的,我有一个梦想,演讲,对,同一个十年,肯尼迪,他的就职演说,他在莱斯大学的演讲,约翰F肯尼迪,做了什么,让他成为,这么令人难忘的,演讲撰稿人,他用了chiasmus,就是先说一遍,再倒过来说一遍,换二,二换T,是最直白的chiasmus,不要问你的国家,能为你做什么,要问你能为你的国家做什么,人类必须终结战争,否则战争将终结人类,让我们永远不要因恐惧而谈判,但让我们永远不要恐惧谈判,他用了多少次简直惊人,不过你也能在其他地方找到他,我记得Culio唱过,脑子里装着钱,钱装在我脑子里,这是同样的倒转,人类就是爱对称,我们喜欢看对称的东西,我们喜欢太极灵圣保罗大教堂,因为它们完全对称,而chiasmus就是让你的句子变得对称,就像那样,我注意到chiasmus的一个效果,我立刻会觉得这话说得对,这观点真好,一个句子里的清晰和优雅,会让大脑觉得,当然这肯定是对的,对所以你看,除了肯尼迪,好多美国总统都用过chiasmus,小布什说过,如果我们不能把敌人带到正义面前,我们就把正义带到敌人面前,奥巴马对一群老兵说过,你们为美国挺身而出,现在美国必须为你们挺身而出,这句话真棒,对对,这些都是好句子,但他们背后有公式,你可以用那个公式,去铲除这样的好句子,让他们在公众记忆里,留存很多年,你见过有人滥用这个吗,没有,没有我没见过,我从没见过有人过度使用修辞手法,有时候你能感觉到,有时候你知道这是修辞,但你并不介意,比如巴拉克奥巴马另一位总统,他那些演讲里用了很多,epistrophe,每段结尾都是事的,我们能每段结尾都是事事的,我们能,还有温斯顿丘吉尔,他最著名的演讲是,我们将在海滩上战斗,我们将在田野里战斗,我们将在城市里战斗,我们将在一长串地点,你知道那是修辞,你知道他在干什么,他每句话都用同样的词开头,我们将在战斗,但你不会介意,尤其是在那样宏大的场合。 [00:14:39]
Ted Gioia:我把它叫做多巴胺文化,这是一种让人分心的文化,这和过去有本质区别,因为二十年前,如果有人跟我辩论文化问题,辩论的核心是艺术对娱乐,艺术要求更高更严谨,它会逼你走出舒适区,娱乐则更贴合你的预期,更模式化,但现在出现了第三个类别,你有艺术有娱乐,还有纯粹的消遣,比如人们刷手机上的视频,看别人的宠物,或者有人晒一张饭菜照片之类的,那甚至算不上娱乐,你没法把它叫做娱乐,它就是消遣,我们发现它会向大脑,释放一记多巴胺冲击,而那些设计社交媒体平台的人,在过去12到18个月里,全都转向了这种滑动刷屏式的界面,他们没有告诉你原因,但他们这么做的理由是,这玩意会上瘾,如果你每15秒就获得一次多巴胺刺激,这就是一个成瘾过程,于是你留在手机上,他们就能给你推送更多广告,这和公司在其他产品领域做的事,没什么两样,我认识一些在一家很大的薯片公司工作的人,公司名字我就不提了,他们shorted,你根本不知道,我们花了多年时间研究怎么做出一种薯片,让你吃下去,嘴里有味道,然后在特定秒数内味道消失,这样你就得伸手拿下一片,我们就是把这些东西做得让人上瘾,目标就是让人上瘾,因为这样才能最大化销量,硅谷没人会给你明说,但我敢肯定,所有做社交媒体平台的硅谷公司,都做过类似的研究,他们推出这种滑动界面,于是人们沉迷于消遣,这对文化不可能有好处,你知道我的背景,我来自一个比较永恒的时间尺度,当我思考文化里发生的某件事时,我会把它放在,过去两三千年的大背景里看,对,所以我们现在转向这种,快速多巴胺刺激,这个想法让我非常担忧,而且我要再次把我的职业生涯和努力,压在更有益于文化,更有益于社会的事情上,最典型的例子是,我先选择我的价值观,然后我的作品必须配得上这些价值观,否则我就不是一个诚实的中间人,那么作为一个写作者,如果我不喜欢多巴胺文化,但我觉得自己又不得不参与其中,我觉得我得有一个好的开头钩子,我觉得我得马上抓住人,我觉得我得直奔主题,那我该怎么办,我的建议是这样的,别人会给你不同的说法,但我觉得去追逐文化潮流,就是死路一条,这些年我见过不少编辑跟我说,Ted你得把内容降制,要更快要更短,人们不想要任何有挑战性的东西,我要告诉你的是,那些编辑现在全都失业了,他们供职的刊物,往往已经从这个世界上消失了,因为靠这种方式,你跟读者建立不了长期关系,前几天有人把我的一个视频,发到Instagram上,有200万播放量,200万人看我说话,但只有几秒钟,我今天还跟我妻子说,这没给我带来任何读者,没有趋势,你没法跟人互动,这黑,能触达200万人,确实满足了我的虚荣心,但我在那个平台上,没法建立任何互动,如果我想互动,我可以做像我们这样的一期视频,因为我们是在深入长谈,这能跟人产生连接,我的文字能跟人产生连接,如果你在这样一个层面做事,你就能跟人建立连接,但当你进入消遣文化,你拥有的只是那十秒钟的名气,享受它,但你没法在上面继续建设,所以我会告诉写作者,别去追那个忠于你自己的价值观,有人渴望更实质的内容,我们在食品上已经看到了,我小时候流行的是那些高科技食品,冷冻食品,微波餐,罐头,诸如此类,现在我们看到了反作用,精致烹饪,健康生活,有机食品,所有这些饮食潮流,现在食品界最火的是有机和天然,这些东西在市场上的增长速度,实际上超过了那些深加工食品,我觉得写作领域也会发生同样的事,用天然的原料,用有机的方式去做,忠于品质,如果你试图去追逐科技平台,和那些预消化过的东西,你可能会有一阵短暂的爆发式成功,但你没法像我这样,在几十年里建立起一份事业,因为那需要跟读者建立更深层的连接,而这种关系是那种方式给不了你的,我觉得讲故事这个词,现在太老套了。 [00:19:25]
Lulu Cheng Meservey:超级老套,而且被用烂了,人们其实没有真正定义它,到这一步它就是个流行词,但如果你把讲故事定义为制造悬念,给人们一些可以支持或害怕的东西,让人们期待一个结果,每个好故事都会让你期待一个结果,你在盼着某件事发生,那么怎么把这种感觉植入人心,我觉得其实是有公式的,我不知道那个公式,但我在试着搞懂它,我现在正在研究,而且我觉得,如果你确实有文学背景,那你一直就是通过那个框架来写作的,我再给你一个定义。 [00:20:01]
Lulu Cheng Meservey:我再给你一个定义。
Lulu Cheng Meservey:就是你之前给的那个,我们脑子里都有这些空洞,而故事是最能跟这些空洞对上的东西,信息就这样嵌进记忆里,对我们的接收器天生就是故事形状的,不是事实论点或统计数字的形状,这也是为什么,顺便说一句,很多时候你看到公司试图为自己辩护时,其实已经输了,因为指控通常是一个故事,而辩护通常是一个统计数字,所以你想一想回顾一下,这是我华盛顿地缘政治背景里的一个例子,北约和自由贸易,数据显示,北约和自由贸易的通过是好的,就是好的在很多指标上都更好,生产率提升了这么多,GDP提升了这么多,创造了这么多就业岗位,等等,自由贸易的反对者,没有这些数据,但他们有故事,所以反对者会说,你看大卫他是七个孩子的父亲,他失业了,因为工作被外包了,他是各种玉米的农民,现在不种玉米了,他待在家里,很抑郁,这不应该,也不能盖过那么多,生活变得更好的人,包括你,如果你现在能用上,以前用不上的iPhone,但指控会是一个故事,然后辩护时,但生产率提升了4%,你知道,一个人的死亡是悲剧,100万人的死亡是统计数字,你要是拿统计数字去对抗故事,你永远在输,你在多大程度上会思考框架,就是叙事层面的,因为这是另一回事,对吧,一旦指控方掌握了框架,你一旦开始回应,你就已经失去框架了,我觉得没错,对指控方选择框架,你看谈判的世界,比如国际谈判,如果你想敲定一份条约,谁握着笔写条约的第一稿,谁就处在极其有利的位置,而大家争的就是这个位置,所以这里也一样,如果别人把那个故事放出来,你再回应他,你自动就处在劣势,因为你必须回应他们的框架,而他们已经设定了标准。 [00:21:57]
David Perell:你平时会记笔记,周末回顾一下吗,还是就靠脑子,不,我是重度笔记爱好者,跟我说说,世界上有各种花哨的笔记本,你不需要那些,你绝对要一个螺旋装订的本子,因为很重要的一点是,你要能经常撕页,而且你要它能平摊在桌上,如果你喜欢摊开的页面,你要它能这样平放着,你绝对要能撕页,我非常相信这个,我记一大堆笔记,然后干脆利落地撕下来,这样我能同时看多页,还能把它们揉成一团扔地上,等保洁阿姨来的时候,地上就是一堆柔皱的纸,我就说把我的笔记打出来什么的,你绝对要一种好写的纸,这是手感问题,但大多数纸都很难写,笔记本的封面和封底要硬,而且你还要能塞进口袋,我刚想说这个,我觉得UniballMicro,5笔是整体最好的笔,但无印良品的0.36或0.37深蓝墨水笔,因为别的原因也很好用,所以这两支是我会用的,但我觉得这种笔记本加上,那两只笔里的任意一只,就是正确答案,你每天在那上面写多少笔记,我大概每两到三周用完一本,哦,哇那你写很多,你看我撕了多少,这本原来大概有一百页,所以你就是这么想的,你基本上就是拿笔记本,然后撕页,你没有完整保留的笔记本,我没有完整保留的笔记本,哇是什么启发了,这个这从哪来的,大量试错,试过很多种笔记本,很多种笔,很多不同的系统,这个真的很好用,我不太知道怎么形容你在做的事,但它早期是被你的流程影响的,你在说谷歌文档和黑的时候,我们需要一个意识,这里要一个快故事,但你做了一件喜剧演员很擅长的事,打好框架,然后飞快地讲完故事,人们以为,哦我得讲个故事,好你得坐下来,你需要一个观众,一个被吸引住的观众,然后讲上一阵子,不不不不,一个故事,一个意识,可以是一句话。 [00:23:59]
Matthew Dicks:说话时五秒钟,写作时一句话,很快又回到正题,它给文字带来,那么多生命力和连接感,而且我觉得,时不时打断一下节奏,也很有趣,所以我的TED演讲,我一直在讲,在讲,我在论证社保转移的观点,我停下来,放了一张杰夫,贝索斯和劳伦,桑切斯,那张黑帮风照片,然后你就停顿一下,然后你就停下来,大家都在笑,你就看着那张图,再看看观众,制造一种创造性张力,然后停住,他们都在等你开口,最后你说,我就是喜欢这张幻灯片,它跟主题毫无关系,然后他们笑了,心想我喜欢这家伙,现在我可能更愿意,让他来改变我的想法,对吧,如果是真诚的情绪化,会改变节奏,以一种有力的方式,打断节奏,他们会想,哇这家伙,也许他真的信这套,所以有各种情绪操控的小技巧,放一张照片,我偶尔会放一张我和孩子们的照片,这就是情绪操控,我知道他们会更喜欢我,所以就是打断节奏,但每个人都有自己的路子,我偶尔喜欢做点奇怪的事,比如那场Ted演讲,我开头说,如果Ted叫大胆而精彩,是一部巴西肥皂剧会怎样,然后我说,马尔科姆、格拉德威尔和比尔盖茨,一夜激情生出了西蒙斯涅克,这跟我的演讲毫无关系,但我觉得好笑,我觉得人们会觉得有趣,从学术角度也是,而且要做自己把你亲近的人熟悉,但别人可能不知道的那些个性元素带出来,我是个粗俗的人,不是吧,这不是装的,我真的很粗俗,我会失去一些客户,沃尔玛请过我几次演讲,后来他们就说,哥们你不仅是在圣经带,你是在圣经带的带扣上,当你开始谈性生育和勃起功能障碍,这在南方真的很难接受,可以这么说,我理解,我会失去一些客户,对吧,一个强大品牌的关键,不仅在于你为谁服务,还在于你不为谁服务,没错,所以总之,对我来说,那是真实的,也是差异化的一点,但偶尔会让人不舒服,我也会失去一些听众,storyworthy是一本很棒的书,作者是个老师,拿过20次,TheMoth故事会冠军,我本来都不知道那是什么,但不管怎样,如果你在某件事上是冠军,我就会稍微留意一下,他写了这本书,书里基本上就是怎么讲好故事,我觉得这本书值得一读,他有一个观点我特别认同,就是风险,他说每个好故事都需要风险,意思是如果故事是意图加障碍,但你没说清楚主角如果得不到,会失去什么,那故事就不会很吸引人,所以当你讲故事的时候,比如说不一定要是高风险,他其实还有一点,他说不要讲那种,度假狂欢式的故事,就是说不要只讲你某个美好的夜晚,某个派对,因为没人关心,没人想听你的假期,没人想听你参加过的酷炫大学派对,从根本上说那些都是烂故事,第二点是,好故事不只是我在海里游泳,被鲨鱼咬了,我活了下来,不需要那么极端,而且其实不那么极端反而更好,但你仍然需要风险,那如果没有鲨鱼咬你,风险从哪来,他的答案是,风险来自情感,只要你相信那个人会有某种感受,故事就有了风险,比如我想用豹子甘蓝那件事,打动我妈,那读住就是尴尬,对吧,我会尴尬,我的自尊会受挫,只要你相信对我来说这是真的,当我真正讲出来的时候,故事就会有趣,他还有一点,他说,什么是故事,故事就是五秒钟的改变,瞬间,哇那是什么意思,五秒钟,他说你讲故事的一切,都汇聚到这一个瞬间,这五秒钟里人物发生了转变,你知道,我拿电影举例比较容易,因为大多数人脑子里,没有那么多文学作品存档,但我们都看过同样的剧和电影,每部浪漫喜剧基本都长这样,男主是个花花公子,他永远不会安定下来,这是电影的开头,或者他是个事业有成的高能律师,但从来没为爱情留出时间,故事总是这样开头,浪漫喜剧只有两种,对吧,比如他曾经爱过,他以为他们会幸福的结婚,他伤了他的心,这是浪漫喜剧的开头,那猜猜浪漫喜剧的结局会是什么,永远和开头完全相反,如果他是个从不为爱情留时间的高能律师,那他现在会坠入爱河,而且会真的辞掉律师工作,去开个面包店,对吧,电影就会这样结束,或者如果他不想安定,是个花花公子,到最后他会去追她,会向她求婚,对吧,他会想要安定下来,所以这是所有浪漫喜剧的剧透,其实也是所有电影的剧透,《无胆龙威》,《侏罗纪公园》,你都可以做同样的练习,看开头一分钟,结局一定是那个角色,和他现在的生活方式,信念体系或习惯完全相反,斯科鲁奇讨厌圣诞节,他最后爱上圣诞节之类的,所有电影,所有故事都一样,所以故事的核心就是那五秒钟,他们真正完成转变,真正切换的那一刻,而且通常是在,他们失去一切的时候,在他们心碎的时候,在他们跌到谷底的时候,在他们别无选择,只能勇敢的时候,因为他们终于被逼到墙角了,不管是什么情况,对吧,你知道在蝙蝠侠里,他在洞穴里,他必须出去,从来没有人成功出去过,我不知道你还记不记得,黑暗骑士,或者某部蝙蝠侠电影里的,这段导师说,只有一个人出去过,他问,他怎么做到的,导师说他没有用绳子,基本上就是说,他没有任何安全网就跳了,所以那五秒钟的转变瞬间就是,角色爬上那个地方,解开绳子,如果他不跳,他就会死,但正因为他跳了,而且真的成功了。 [00:30:00]
Matthew Dicks:而且真的成功了。
Matthew Dicks:那才是转变的时刻,所有故事都建立在这个上面,对,如果你不知道主角,那五秒钟的转变瞬间是什么,你就没有一个真正的好故事。
Jason Fried:我们就来拆解一下,你在这里做的事,我想从你这两篇的开头说起,就是你直接切入问题,比如在Once那篇里,你说商业软件出事了,我能先停在这吗,请继续,我们来拆解一下,好,我写下那句话的时候就想,我知道这会很好了,我知道整篇都会很好,对我来说,它必须以一个好句子开头,我喜欢这种句式,商业软件出事了,这种句子,能在别人脑子里植入一个问题,而我根本不用提问,这不是问题,是陈述句,对,商业软件出事了,所以读者会想等等,商业软件出什么事了,于是他们就被吸引了,因为他们自己问了自己一个问题,他们想得到答案,这不是陷阱,听起来像陷阱,但并不是操纵,我只是喜欢这种句子,带着一点神秘感开头,让人想知道我到底在说什么,所以我觉得这能把人带进来,所以你直接写在那里,而且你是先写这句的,你不是后来才回来补的,不是,我就是先写这句的,写的时候我其实有点来气,你懂我意思吧,对,这里有一种态度,我能感觉到它是真实的,我对这件事有话要说,所以这句话把我带进了那个状态,你以前付一次钱就行,对,装好就能跑,不管是装在个人电脑上,还是装在服务器上给所有人用,感觉就像你拥有它,而且你确实拥有,对,所以你现在说的是它以前的样子,对,而且这话说得很硬,今天大多数软件是一种服务,不是拥有,而是租用,我们得聊聊拥有和租用,还有房东和那些事,我们马上就会讲到,买下来就等于签了一份永久的房东租客协议,每个月你都在为跟上个月一模一样的东西付钱,一旦停止付费,软件就停止工作,碰,你被扫地出门了,这算不算太俗,我不知道,但感觉很好,我喜欢结尾,喜欢那种收尾殆尽的段落,而殆尽的收尾通常都很短,它有点像总结,像答案,像在说,事情就是这样,所以这是另一种写法,前面说你拥有它,你做到了,那是在总结一切,下一句就是,碰你被扫地出门了,基本上把租用模式的阴暗面全概括了,对,所以这是我比较偏爱的一种套路,我并不是因为它是套路才这么写,而是写着写着发现它成了套路,它是自然涌现出来的,我写作大概就是这样,但我不会刻意去追求,我不会说,我需要写一段结尾带梗的段落,它就是自然而然流出来的,但当我能用这种方式收尾时,我就知道这是个好段落,对我来说,段落的结尾才是让它出彩的地方,跟我讲讲房东租客这个说法的由来,你是怎么想到的,其实纯属偶然,我写这段的时候,脑子里想的是,你以前是拥有它的,然后我就想,现在你不拥有了,所以我在心里问自己,拥有的反面是什么,是租,软件级服务,从来没人真的把它说成是租用,这个词根本不会出现,它几乎是被埋起来了,被藏起来了,人们不想面对,软件是租来的这个事实,你想想,提到租来的东西,你会想到什么,他们通常有点破旧,有点用旧了的感觉,软件行业不会用这个词,但从某种意义上说,它确实就是租的,我就想,我要用这个词,因为租用在很多方面都很好,人生某个阶段也好,一直租也好,但租用有它的阴暗面,而且大多数人,都在生活里遇到过,所以如果我能把它框定成,人们能联想到的租房经历,比如冰箱坏了,房东从来不修,墙上有洞,漏水,所有那些房东的破事,那些糟糕房东的故事,每个人多少都经历过一次,对吧,大学时候也好,现在住的地方也好,所以我可以把SAS,拟人化成房东,而且它确实有点像,这其实就是建立一点,拟人化的手法,然后我让这个意象自己发酵,让它沉下去,然后再继续往下写,对,近20年来,SAS模式,让房东们赚得盆满钵满,靠着例行公事的祈祷者和付款者,没错,这个得聊聊,对,走进经常性收入的教堂,对,这些都得聊聊,我们能先停在这吗,好,这个付款者和祈祷者的说法,我其实挺纠结的,我喜欢他,但写的时候很挣扎,就像你刚才念的时候,也卡了一下,我写的时候也卡了,付款者,祈祷者,太接近了,但我还是用了,因为我真的很喜欢,而且后面讲到教堂的时候,他自然就呼应上了,不过我确实有点担心,读者会念不顺,因为他确实有点拗口,其实这句话,我越想越觉得,是反着来的,我先想到的是,经常性收入的教堂,因为我喜欢那句,然后祈祷者和付款者,这个押韵感,虽然不算严格的投韵,但那种感觉,是从前面那句里冒出来的,我就想,我喜欢这个,我喜欢这个文字游戏,这就是写作,对我来说变得好玩的时候,这时候我就知道,它也会是好东西,我觉得写作必须好玩,我不喜欢把这种事,搞得太严肃,所以写到这的时候,我就在想,付款者和玩家,这太有意思了,而且我某种程度上,还在调侃房东,这越来越好玩了,让我先打断你一下,关于玩这件事,我刚意识到一个,我很喜欢的点,当你真正在玩的时候,你不可能不露出,真实的自己,没有不带个性的玩,所以我觉得,玩的作用就是,他把那么多人,苦苦寻找的个性,给带出来了,对,估值冲上了天,靠的是那些,以奢侈价格订阅,基础服务的企业,而这些服务,他们几乎无法掌控,算算你去年,所有的SaaS订阅吧,这些东西,你现在早该买下来了,对我喜欢这个感觉,对吧,我觉得那句,确实打中了要害,你现在就该拥有那些东西,这是第三个终极点,而对我来说,这就是那个顿悟时刻,对,这就是个顿悟,就像在说,你说的对,我早就该拥有那些东西了,这就是我想塞进别人脑子里的念头,就像,对,我这些年一直在为这些订阅付费,其实都差不多,对,我确实在拿到新功能,但本质上还是同一回事,这些公司赚了无数无数的钱,估值都冲到天上去了,我该拥有这些东西,你说的太对了,我确实该,这就是我想在那一刻,传递给对方的感觉,让他心里想,你说的对,我确实该拥有,我之前怎么没想到,但没错,我确实该,就是那种感觉,所以那一段就是为了这个,那么接下来你还有一句关于SaaS的话,然后你就开始引入,Once这个产品线了,跟我讲讲这个过渡,以及你为什么用这种结构来组织,先讲问题,再过渡,然后讲Once,我想先让人点头,如果我想让一个人之后同意我,某种意义上,我得先让他同意我,所以就像这样,你读前半部分的时候,你大概会一路点头,对对对,对,你在点头,我要找到这种共鸣,就像我在点头,你也在点头,这时候你就愿意听,我接下来要说什么了,我已经描述了,我认为的现实,现在我要讲的是,我希望接下来发生的事,我认为那可能成为新的现实,所以这就是,为什么这种结构,对我很管用,我见过,你看那些优秀的产品演示,也是同样的路子,他们先展示一个产品,然后说这个产品,或这个品类有什么问题,接着是,这是我们的解决方案,我觉得这是一种很好的方式,先建立一个现实,让人点头认同,然后他们就敞开了,然后你在once上玩了一些花样,onceonce,onceonceonce,但最突出的是你的开场方式,你说从前你拥有,你付钱买的东西,你掌控你依赖的东西,你的隐私和安全,是你自己的事,我能打断一下吗,AuntC这个名字,就是这个品牌,AuntC.com,这个名字其实来自,写从前Aunt'sUponaTime的时候,其实我当时想的是,从前人们买软件是要付钱的,对,我就想Aunt其实就是从前的意思,这不错,我喜欢这个词,而且因为我们是一次性付费PayOnce,再加上从前Aunt'sUponaTime,这里有双重含义,我真的很喜欢,当然,所以这个产品的名字,其实是从写作和思考,怎么讲这件事的过程中来的,那你怎么考虑,现在讲once时用的这五个要点,对,为什么是五个要点,为什么你聚焦在这些上,你说一次付费,永久拥有,你说我们写代码,你能看到,你说我们给你软件,你自己托管,你说简单直接,不搞企业级那套臃肿的东西,最后一个固定价格,once,这些要点其实遵循了类似的结构,句子的前半部分,是过去的形态或现实,后半部分是新的东西,我喜欢这种模式,我喜欢这种弹跳感,我喜欢这个节奏,我喜欢这种弹跳,对我来说,如果什么东西在弹跳,它就是在动,我喜欢词句里的动感,我觉得它能带着人往前走,句子短,有冲击力,对不过,咱们接着看Hey的那封信,这封你开场的方式不太一样,你说,Hey大家好,我是Jason,37signals的CEO,你当时想达到什么效果,对这是个好问题,我们发布,这个邮件服务的时候,我最初就是靠这封信来发布的,这封信现在还在现有网站上,你拉到页面底部就能看到,对,但最初hater.com上,就只有这封信,而且只有这封信,持续了好几个月,我们不想把要做的事,说得太具体,但多少想透露一点,这次我觉得它,更像一封私人信件,Ons那封更像一份声明,这封更像一封信,就像我在写给你。 [00:40:01]
Jason Fried:就像我在写给你。
Jason Fried:说,嗨,这是我的名字,他用一种更私人的方式开场,我不确定从策略上,为什么选了这条路,但如果网站上只有这个东西,感觉就是对的,它没那么有攻击性,更像一封写给邮件的情书,所以我想用一个更温暖的开场,而不是一句尖锐的声明,不过有一点两片都出现了,就是同样的结构,过去是这样,我们喜欢他们本来的样子,对,然后它们变得破碎了,现在我们正努力,把现状拉回它本该有的样子,结构上是一样的,我觉得这件事重要的地方在于,如果你想传达点什么,这里确实有个公式,但它们不需要完全一样,它们是相似的公式,比如这一篇更像一封私人信件,你会看到这篇底部有我的头像,对,另一篇不是放在左边,我的邮箱地址在左边,这篇在右边,是有一些差异,但从策略上讲,甚至不用到策略层面,结构上传达信息的方式是一样的,先说明过去是什么样,或者现在有什么问题,然后我们打算怎么处理当下,然后他写道,邮件名声不好,但不该这样,邮件是宝藏,收到你在乎的人发来的邮件,你喜欢的通讯,或者你喜欢的服务发来的更新,感觉很好,邮件以前一直给人这种感觉,这是我想尽早传达的感觉,因为大多数人都不喜欢邮件,但你会想,其实不是我不喜欢邮件,如果我收到妻子的邮件,我喜欢,收到老朋友的邮件,我喜欢,我叔叔100岁了,他给我发邮件,我看到我妈的叔叔,我的叔公,我会想,这太棒了,对,我想读这个,所以邮件本身不坏,坏的是邮件变成了,现在这个样子,但它的核心仍然是,一件美好的东西,它是宝藏,所以对,我想让人们回过头去想,对,我不是讨厌所有邮件,我讨厌垃圾邮件,讨厌那些太多的东西,那些我不认识的人,发来的邮件,那些才是我讨厌的,但邮件本身其实很美好,就像收到一封手写信,很美好一样,但你也会收到垃圾信件,你会讨厌信吗,对,不你其实挺喜欢信的,婚礼请柬就很棒,对很棒对吧,对但事情变了,对,你开始收到不认识的人发来的,你不想要的东西,你失去了对谁能联系到你的控制,铺天盖地的自动邮件,把一切都塞满了,而GmailOutlook,Yahoo和苹果,就这么放任它发声,对,这里有个投运,那个AA,我喜欢这个,当我想真正制造冲击力的时候,我喜欢用同一个字母开头的词,我觉得这样能形成平衡,所以AvalancheofAutomatedEmails,Avalanche,Automated,多个音节的词放在一起,这就是平衡的来源,我在想这个红球,如果我在音节上画红球,这里有很多平衡,我喜欢这个,偶尔喜欢这种效果,你会发现我的大部分词都很短,我不喜欢自己的文字里有太多音节,,但偶尔我想来一下。正因为少见,,你感受它的方式就不一样。所以这就是它的用意。你会说因为它少见吗?Avalancheofautomated.这些少见的,,更少见的词。对,很多音节,,Avalanche,,Automated.这就像,,就像散步时碰到一只蜥蜴,,你会想,,这真漂亮,,我不常看到这个,,我得好好看看。这里的感觉就是这样。这是个有点怪,,非常怪的比喻,,但它就像碰到一件,你不常看到的东西,确实,所以其余的词都很紧凑,很短,但偶尔会有这些突出的东西,对,我想要自动邮件的,雪崩这个说法,因为那就是真实感受,像雪崩一样,你控制不了雪崩,你被卷进去,什么都做不了,当然,雪崩可以是悲剧性的,这里不是,但它是这种冲击,这种力量,对,邮件这件事上,感觉就像永远停不下来,所以我想,那就是我想表达的东西,是不是这么回事,对,还有我觉得每个写作者,都能用上的一点是,无论你的主导风格是什么,当你想强调某个东西时,反着来,它就会突出,因为它与众不同,对绝对,说得好,我同意,现在邮件给人的感觉,是苦差事而不是乐事,是你落后于它的东西,是你清空的东西,不是珍惜的东西,不是享受它,而是应付它,对同意吗,比我想要的更频繁,对,所以这就是我把邮件,从那些愉快的事情里,剥离出来的地方,比如,你知道,收到朋友的邮件,收到家人的消息,诸如此类,那是你能想象到的,现在这些都成了麻烦,而大多数人,就是这么看待邮件的,就像,对,这就是自动邮件的雪崩,全是这些麻烦,就像,对,我不喜欢邮件,所以我在铺垫,准备翻转局面,对,把它翻过来,我想让人们说,对没错,再次点头,对这很糟,对这很糟,SeanPury在这个播客上,分享过一句话,我特别喜欢,他说,所有故事都关于,五秒钟的改变瞬间,他的意思是,开头发生了一些事,到结尾,他会和开头相反,拿经典浪漫喜剧来说,对吧,有个人处于状态A,他身边有各种事情发生,到浪漫喜剧结尾,一切会反过来,他们会经历一次转变,这正是我们下一句要看到的,说得好,那就是,然而,邮件依然是个奇迹,所以我觉得你在这里做的事,你说,这就是邮件发生的事,你铺垫了这种痛苦,这种烦人,这种查看邮件的折磨,而现在你要做的,是把它转变成,某种可能性意义上的迟到,对,还有奇迹这个词,以及前面提到的珍宝,所以每当我谈到邮件的积极面时,用的都是特别正面的词,他们是带有魔力的词,对,所以我不是去翻资料,找这些词的,他们就是自然冒出来的,但他们冒出来的时候,他们就是那句话,最合适的词,而我想不出更好的,我真的很想这样看待他们,感谢电子邮件,让不同文化,不同大陆,不同国家,不同城市,不同社区的人们,全是C开头的词,全是C,我注意到了,再来一个,好,每天都在沟通,对,它可靠,它简单,它让两个人能轻松分享彼此的爱,也让数百万人能以此谋生,就是这样,你这段用了不少修辞手法,段落,我一点都不意外,感觉真的很好,写出来的时候感觉特别好,一气呵成,我喜欢当我凑了几个C开头的词,然后我就想,我得再找几个,而且我找到的那些不是硬凑的,又一个C,但他们就是,怎么说呢,我没有刻意去勾,那很巧妙,不错,有说服力,对所以我知道,但问题是我没有刻意去够,有时候你会,你知道想用个头运什么的,然后发现不合适,你能看出来,有人用力过猛,我想确保自己不是那样,但是那段话对我来说,就是那种让人充满积极感,还有惊奇感,承接前面说的,就像是在兑现我之前说的,现在用这些具体的东西,去填满惊奇这个词,好消息是,魔力还在,只是被掩盖了,埋在一堆坏习惯和疏忽之下,有些来自人,有些来自机器,很多来自邮件软件,电子邮件值得一次除尘,一次修复,为今天我们的使用方式而现代化,那我来说说其中几点疏忽这一点,要回到那篇文章前面我提到的Gmail,我忘了,像Gmail,苹果,雅虎什么的,他们放任了这一切,对,所以那就是疏忽,那是在闭环,把回路接通,人们不会记得这个,但我相信它会留在他们心里,以一种方式在潜意识层面,那个环被合上了,有些来自人,有些来自机器,很多来自邮件,软件,如果你看喜剧编剧,很多笑话的结构是,三个并列项里前两个是同一类的,然后第三个打破模式,对,我很喜欢喜剧,我不是喜剧编剧,但也许我只是潜移默化地吸收了这些,不过说真的,我们马上就要做邮件软件了,所以到目前为止,我还没说我们要做什么,我只是说了它应该是什么样,所以这是我第一次暗示,问题其实也出在邮件软件本身,现在我其实还没有深入说,我们一定要做邮件软件,但这是一个暗示,关于我们要用hey.com这个产品做什么,而hey就做到了这一点,它是一次重做,一次重新思考,一次简化而有力的邮件重塑,一个全新的开始,本该如此的样子,hey是我们写给,邮件和日历的情书,我们把它送到网页,MacWindowsLinux和安卓上,对,我后来加了日历,因为我们后来确实加了日历功能,对,有意思的是,那句我不太喜欢,感觉像是硬贴上去的,我刚才差点结巴了,我心想,等等,那句在里面吗,还有日历,对,我心想,我们加了日历,所以我就加上了,但就这样,这就是全部,我几乎没怎么说话,这整件事的重点是,虽然我想把话题收拢,而且我知道,离发布还有好几个月,但我想先让大家知道,我们拿下了,hey.com这个域名,我想让大家有理由点进去,然后想这帮人到底要干嘛,大概就是这个想法,所以里面有些线索,但又不算真的线索,然后感觉就这样收尾了,然后我想说的是,它会无处不在,所有平台基本上,都在暗示这一点,这不是什么小打小闹,这是件大事,我们要全力投入,刚才这20分钟里我学到的,是你有多喜欢玩文字的节奏,对吧,你说了一次重做,一次重新思考,还有那些重复式的文字游戏,那是次权,对,就像拳击比赛,有次权,但都是友好的,我喜欢这样,对我来说。 [00:50:00]
Jason Fried:对我来说。
Jason Fried:这又回到了那个词,它是一种弹跳,就是这种弹跳,我一直在说弹跳这个词,都快重复了,但感觉就是这样,我喜欢文章里有这种东西,我喜欢文字里的动感,我想给你看看一则广告是怎么成型的,我在做一门文案写作课,这是我写的一则广告,大概是给落地业用的,放在广告牌上可能内容有点多,但我想让你看看这个过程,因为这里面门道很多,大概改了20稿,你看的是和我一样的东西吗,是的没错,所以1%和2%的差别不只是1%,而是100%,这是我大概4年前在推特上看到的,我觉得这是论证文案价值的一个绝佳例子,因为如果你能把落地业转化率,从1%提到2%,那并不难,我也能做到,你也能做到,对大多数落地业来说都不难,但你的增长直接翻倍了,所以我特别喜欢这句话,我心想,这里面有东西,这就是一个想法的种子,我大概把它写在了纸上,我心想,好,也许,我能拿这个做点什么,卢克,沙利文,一个很棒的文案技巧,我们之前聊过冲突,他告诉我,在页面中间画一条线,写下任何想到的两个冲突,所以右边写的是,把落地业转化率从1%提到2%,这就是那条推文里的想法,那这里明显的冲突是什么,那就是在广告上多花一倍的钱,这是与之平行的选项,一或二,解释一下你说的冲突是什么意思,我看冲突的方式就是,可以是红色和蓝色,可以是基督教和无神论,可以是白衬衫配红毛衣,不一定要复杂,有三种类型的敌人,如果你想说的更技术一点,有ABC三类,A.不同的方法,解决同一个问题的不同方式,B.信念,我相信这个,你相信那个,C.竞争对手,那就是苹果和Mac,我们之前看过的例子,这里有点像之前和之后,说实话,我没把这个太当回事,就是画条线,写下脑子里冒出来的东西,互为对立面的东西,所以我有了那个想法,我心想,好我们得稍微铺垫一下,那我怎么写个标题呢,想增长快一倍,你有两个选择,在广告上多花一倍的钱,或者把落地业转化率,从1%提到2%,到了这一步,这就是为什么,我觉得你作为写作者,吸收什么太重要了,因为几年前,我看到一则大众汽车的广告,我特别喜欢,如何为你的车准备过冬,大众汽车,普通汽车,普通汽车要准备过冬,你得排干散热器,彻底冲洗,检查橡胶软管,重新加注,等等等等,而大众汽车,你只需要换机油,我喜欢这个排版,他们想展示的,就是简单,省事,他们想展示简单,想展示省事,但说到底,还是敌人,而且说实话,我最喜欢的其实是,这则广告的排版,我太喜欢这个布局了,所以我想,我怎么把我手头的东西,我的想法种子,变成这个样子,所以我又改写了一遍,不知道递多少次了,这里我放了两张站位图,先别管图片,但我觉得,我喜欢大众汽车和普通汽车,那两张图的对比,所以我想要两个站位图,这样我就能围绕他们来排版,然后我复制了那些方块,那个清单,然后不能只在左边放一个,所以我写了,想以两倍速度增长,你有两个选择,多融一倍的钱,多招一倍的人,广告费多花一倍,或者学会写作,把落地业转化率,从1%提到2%,开始有点样子了,那你现在到哪一步了,你喜欢这个的什么,不喜欢什么,你来批评一下,给我个感觉,我当时David,我写这个的时候,我就觉得这里头有点东西,我喜欢这个,但在我看来,它还能好上200%,我觉得这是个教训,你可以喜欢一个东西,然后继续打磨,直到真的榨干最后一滴墨水,而且创作过程中,有那么一个时刻,你有了个想法,然后你想,我知道这会很好,我现在手里这个也还行,但你内心知道,只要你待在这些迭代里,你接下来做出来的东西会很棒,我觉得你现在就处在这个状态,你得,对你得喜欢,我觉得这跟标准无关,我现在不会签掉这个广告,眼下我就是不满意,但我想继续走这条死胡同,看看它到底是不是死的,结果它不是死的,所以我再改一版,这次我想缺的是什么,你看大众那只广告,它有标题,所以我得让这个更简单,所以想以两倍速度增长,你有两个选择,要么走企业路线,要么走文案路线,就这么搭,然后我还喜欢大众广告里,框框更多,所以我加了多融一倍的钱,多招一倍的人,广告费多花一倍,两手交叉起倒,或者学会写作,把落地页转化率从1%提到2%,到这一步,有件事特别让我烦,我不能让右边那行字占两行,学会写作,把落地页转化率从1%提到2%,太长了,太乱了,所以我想,我得让它变成一行,不管用什么办法,容易删掉,划掉落地页,学会写作,把转化率从1%提到2%,然后我想,怎么才能更短,我可以把学会写作拿掉,放到标题里,最后就成了学文案,所以现在,我的标题是学会写作,下面是把转化率,从1%提到2%,这又制造了一个问题,整个流程就是这么乱,这制造了一个问题,我喜欢标题里的对账,企业路线是选项A,学会写作是选项B,两者之间没有对称感,而企业路线,文案路线,那个是对账的,所以我解决了一个问题,又制造了一个问题,进一步退一步,然后我想,好我得写点跟学会写作,气质相近的东西,于是我开始乱抛点子,彻底扎克伯格式,往下滚,至大富翁头子,暗藏希望,羊毛上的意大利面,这些都不好,但我就是不停往外冒,你做的其实就是把想法倒出来,甚至不去评判他们,就像那个伊丽·舍恩,开水龙头的事,对,很久以前那个,你写一个想法,不去评判,再写一个,你是在把脏水,从水龙头里放出来,你就让水龙头一直流,一开始堵着点泥,有点脏水,但你就让它流,过几分钟,几次重写之后,水就开始清了,你只要相信它会变清,我现在就在做这个,羊毛上的意大利面,最后我落到扔钱祈祷,到这一步,我不知道什么好,什么不好,因为我已经写了大概,我不知道两三个小时了,我就是不知道,我判断不了它好不好,所以我给几个朋友发了短信,继续说,有件事特别能说明问题,你刚说你写了有两三个小时,但设计是你写作流程里,至关重要的一部分,这是写作,设计,视觉配图,视觉配文字,和谐地一起工作,所以如果我在word文档里做,我没法,我没法这么干,这是文案,Jason在你的播客上说过,文案和设计是一回事,我没法把他们分开做,你是在Figma里做的,我是在Figma里做的,我从来不在我用的工具之外,做任何事,从来不会,所以如果我在做,就像我说的,如果我做Newsletter,我就在Newsletter里写Newsletter,挺怪的,如果我做广告,我直接进Figma做,如果我做落地页,直接做,如果我做广告牌,我会把它放到,所有其他广告牌中间,放到它该在的位置,我不喜欢,在东西不在的地方做东西,所以到这一步我有点懵,而且我喜欢要反馈,所以我把这个发给了几个,我尊重他们品位的人,反馈陆续来了,大家明显更喜欢全面祖克伯格化,而不是企业风,诸如此类,但共识是,把扔钱祈祷放在左边,当标题效果最好,所以我就定了这个,然后我有个想法,要不要像大众汽车那样,做一个特别长的清单,因为我喜欢那种深度,我喜欢深度,结果没成,我就又改回去了,到这一步,基本差不多了,但我做大多数广告的最后一步是,试着给它加一点设计,再多一点设计,这里最简单的做法就是加粗,所以先退一步看,多筹一倍的钱,多雇一倍的人,多花一倍的广告费,双手合十,骑到,这些句子有节奏感,一倍和双手的重复,我想把这个节奏拎出来,标题想以两倍速度增长,我把两倍速度加粗,再加一行小字,转化率从1%提到2%,那就是两倍,以防有人没明白,1和2之间差的是100%,而这正是我整个想法的起点,最后,我手上有两张插图,只是站位用的,所以我上了Fiverr花钱,请了一位叫Kanzia的插画师,他一开始画的是这个人在祈祷,周围一堆钞票往下掉,我把油画风格的发给他当参考,因为我要的就是那种风格,然后他给我画了这支笔,我跟他说,我希望两张图里是同一个人,能不能重画一下,我记得我多付了他一点钱,然后他给我画了这个祈祷的人,但他在笑,第二张图里有个随意的乱糟糟的,撕放在对话气泡里,我不喜欢,所以我说,你看Kendy啊,扔钱祈祷,这两张很棒,我真的很喜欢,但扔钱祈祷,这个人这时候很懊恼,像个傻子,他在扔钱祈祷,我们不喜欢这个人,而那个在写字的人。 [01:00:01]
Jason Fried:而那个在写字的人。
Jason Fried:把它改成打字机,再加个灯泡,就这样,加一句,想以两倍速度增长,你有两个选择,扔钱祈祷,多筹一倍的钱,多雇一倍的人,多花一倍的广告费,双手合十祈祷,或者学文案,转化率从1%提到2%,那就是两倍,这就是我最终做出来的东西,让我把几件事穿起来说一下,第一件事,我刚刚意识到,我特别喜欢你对待这门手艺的方式,大多数人想到文案,会觉得它像鱼儿,我们要让消费者掏钱,我们要骗他们,你做的不是这个,你做的是简洁沟通的艺术,我想做的是,说清楚一件事,然后用一张图,抓住注意力,讲一个故事,而且你确实把它做得让人愉悦,就结果而言,这真的很美,这就是你对待文案的方式,它是简洁沟通的艺术,你做这件事的方式,就像做一个艺术项目,所以文案就是论证,它就是一个论证,学文案最好的论证是什么,你有两个选择,你可以扔钱,你知道的,一个老套的做法,祈祷它有用,但它大概率没用,因为我们见过Asana的例子,或者你可以学这个,把转化率从1%提到2%,还有,我喜欢这个广告的一点是,它没有夸下海口,我不是在说,学文案当百万富翁,不,我只是说你可以把转化率,从1%提到2%,这大概这是可信的,它不是,它是真诚的,这个广告真的很真诚,就像我相信这个,我真的相信,然后还有几件事让我印象深刻,首先我们是从visualizevalue,那句英语开始的,就是你可以从1%提到2%,你抓住了这个小C,你说我能拿这个做点文章,所以你从那里出发,一点一点的搭起来,那是你的第一份灵感,然后你的第二份灵感,是大众汽车的广告,所以你现在有两份灵感,一份在文案上,一份在视觉上,在信息的组织方式上,以及最终呈现的层级结构上,这两样东西都在,然后你做的是在Figma里设计,同时也在Figma里写作,设计和写作协同工作,你用它们互相放大,然后你一遍一遍一遍地打磨,直到文案活过来,讲出一个故事,再一次一密兮兮比,两密兮兮比,瞬间完成,就是这样,这大概花了两天,改了25遍,我不是想让人觉得,好像你就能做到,你能做到,没有唯一正确的做法,但我很少能从,我没法直接写出,屏幕上现在这个样子,你不能说去写那个,在我看来,唯一能做出,这个广告的方式,就是一块一块一块,一块一块的搭起来,这就是他成型的过程。 [01:02:53]
Robert Greene:我觉得应该有一个主题,不是说教,而是一种启示,就是故事真正想说的东西,是把整个故事串起来的那根线,当你心里有了这个主题,每个细节都会回到它上面,每一种颜色,每一丝闪光,里面的每一样东西,都跟这个主题有关,比如这个人很糟糕,是个骗子,或者很野蛮什么的,每个细节都像全息图,整体就嵌在细节里,细节极其重要,你想让东西活起来,对吧,所以你要讲颜色,你要用很多身体上的线索,人们能理解看到的东西,能理解很具体的画面,他们也能理解气味声音,所以营造一个很具体的物理环境,能把人带进故事里吸引他们,而且你要,如果角色是第一人称,我有些故事就是那样,或者是一个全知叙述者钻进那个人物里,你就要用一些小词小线索,把读者放进那个角色里面,这就是从内部体验他们的经历,这些就像炖汤的配料,让故事成为好故事,对,惊喜非常重要,要有转折点,比如我本来要去这儿,结果没想到发生了这个,还有共鸣,就是那种体验性的情感,每个人都能感同身受,你怎么看你写的东西的总体潜在市场,因为你站在那里,讲的是每个人都能共鸣的东西,但你也听到过一句话,普遍性其实藏在特殊性里,你知道,我们可以一边走路,一边嚼口香糖,所以你可以同时做两件事,细节,环境里的物理细节,让故事闪闪发光,火起来,让你感觉到,看到,闻到,听到,对吧,那些是特殊性,但情感基调,比如一个人面对死亡,濒临失败,被嫉妒折磨,或者变得自大,到处伤害人,这些是普遍的,这些我们都经历过,对,那就是故事的基调,整体主题是普遍的,但细节非常具体,在Mastery里,我讲到,利奥纳多,达·芬奇,他的话之所以那么逼真,那么奇特,是因为他们感觉像真实生活,感觉是活的,他就是通过细节做到的,他通过对细节的极度专注,创造出一种身临其境,超越时间的感受,这就是一个例子,我想用你所说的秘密抱负来收尾,你说你想让阅读,研习经典和哲学这件事变得酷起来,让年轻人受到启发,愿意离开电视和互联网,去挑战自己的头脑,为什么这对你那么重要,你知道,我很幸运,从小在一个不同的时代长大,书在我生活中占了很大一部分,它们塑造了我的想象力,从很小的时候就扩展了我的想象力,你小时候生活是有限的,如果你父母不完美,如果你家不是很有钱,哪怕你家很有钱,你的世界也是有限的,而且小时候你会因为自己个子小,没有力量而感到沮丧,你读一本书就能把自己带出那个小世界,你被带进一个幻想世界,被带进真实世界,别的国家过去就像做魔毯一样,我记得小时候,我无法理解人类在50万年前就存在这件事,他们是什么样的人,他们的世界是什么样的,你看看现在,我们开着车,有烤面包机,我说的是50年代,还有冰箱和电视。那时候还没有特斯拉?没有,这怎么可能?这件事让我着迷,也塑造了我的想象力,如果没有它,我根本写不了书,它成就了我的人生。你知道吗?所以我想让其他人也拥有这种体验,这是一种力量,最好在童年时培养起来。但现在孩子们被安排得太满了,他们没有自由去自己发现东西,一切都是味道嘴边的,我觉得人长大后,会变得有点暴躁,会变得有点绝望,因为他们没有内在的资源,无聊的时候,啊我好无聊,好让我想想一百万年前的事,让我去找本这方面的书,让我翻翻国家地理,让我去图书馆,对吧,我脑子里冒出来的词是,你身上有一种着迷感,对,这个世界本来就是迷人的,只是你不再去想它了,你不再能看见它了,我记得很早以前,《权力的四十八条法则》,出版之后,我不知道过了多久,有个男人联系我,他是佛罗里达州戴德县,一个图书馆的馆长,那个图书馆在一个,非常都市化,以黑人为主的社区里,他说有些孩子会进来,他们发现了权力的48条法则,他们才10岁,11岁,然后他们开始看关于尤利乌斯,凯撒和路易十四的书,还有海尔,塞拉西,以及我书里写到的所有其他人物,他们被历史点燃了,所以历史对我们来说好像死气沉沉,但它其实是你想象得到的最激动人心的冒险,你知道吗,过去的人想法跟我们现在不一样,风俗习惯不同,衣服也奇奇怪怪,他们就像奇异的动物,但他们是人,而且他们有着和我们一样的情感共鸣,进入那些世界,真的让人大开眼界,对吧,所以我想让历史对人们来说变得激动人心,尤其是对年轻人,让他们意识到历史不是一堆死的事实,它很刺激,而且它还能教给你,关于当下的惊人教训,关于写作的兴奋感,以及写作这门手艺,本身的兴奋感,你会怎么说,你在这方面发现了什么,你知道有时候,我年轻的时候会写作,有时候如果我喝了酒,或者用了药,或者什么都没有,我就是写,天哪,我当时,我当时害急了,太棒了,太爽了,然后第二天我再读一遍,哦,这写的是垃圾,或者我十年后再读,哦,这完全是胡说八道,明白吗,所以我的意思是,当你最兴奋的时候,你很可能在写你最烂的东西,对,对吧,有时候你确实能感受到那种兴奋,东西也会写得不错,会合拍,但十次里有九次,它会把你带进糟糕的地方,因为你开始不加思索地写,而且你觉得他很棒,对我来说,真正的写作发生在编辑阶段。 [01:10:02]
Robert Greene:真正的写作发生在编辑阶段。
Robert Greene:当然有些人不是这样,所以我只能代表我自己说话,但如果你进入写作,是因为你觉得那是一种快感,那哥们,你要是这么想,你入错行了,写作是孤独的,他可能非常无聊,他可能非常令人沮丧,然后当他结束的时候,天哪,你会感觉棒极了,所以当我写完一本书,或者写完一章的时候,我会有一种非常好的感觉,但它不会持续太久,但当整本书完成的时候,我可以回头看,我明天死了也没关系,这种事谁都可能碰上,我不介意,没关系,我得到了我想要的,我表达了我想要表达的东西,我没有那种浪费了生命的感觉,那种感觉非常非常强烈,非常有力,所以完成一本书,把它写好,把它做完,然后意识到尽管我们的文化有某种低质化的倾向,作家依然因为某种原因被尊崇,因为这是某种非常古老的东西,因为我们所有人都用语言来交谈和沟通,但那些真正能用书面形式做到这一点的人,这里面有一种被尊崇的元素,有某种神圣的圣徒般的神异般的东西,所以作家被尊崇,所以如果你投入时间,写一本书,那会是痛苦的,可能花你一年时间,对我来说,要花好几年,但你做到了,人们会对你另眼相看,你也会对自己另眼相看,它会持续很多很多年,但愿如此,所以回报会在某个时刻到来,但它们从来不是即时的,有时候在写作过程中,你会感到兴奋,你会觉得,哇,这太棒了,那些时刻你不能靠它们来激励自己,因为他们太稀少了,对我的学生来说,有件事常常让他们大开眼界,我走进教室会说,你们作为英语使用者,天生就有一种内置的双语能力,他们会说,你什么意思,我说,由于历史原因,你们有可能调用两种完全不同的词源,和历史来创造语域和色彩效果,你说的是拉丁语和安格鲁萨克逊语吗,对,绝对是的,所以如果你说,我住在一座曼城豪宅,对吧,或者你说,我住在一栋house房子,为什么一个听起来比另一个更贵,我的意思是,追溯到最开始,他们是一回事,Maison和我们的英语house是同一个东西,但是,因为诺曼人来到英格兰,征服了当地的英国人,把自己安置在宫廷里,所以拉丁语系的,通过法语传来的词汇,获得了更高的社会经济语,对,所以你用的词立刻就能说明你的阶级,当我的学生意识到这一点的时候,就像哇,我拥有了一种以前没有的力量,也许我能在耳边听出某人在装腔作势,或者某人在试图建立自己的街头信誉,但现在我知道了让这一切起作用的实际规则,我的耳朵变得更敏锐了,对吧,而且freedom和liberty之间的区别,变得更清晰可闻了,对,对吧,所以这就是词汇层面上的声音考量,另一个考量是句子层面,我试着教这个,这是个很复杂的问题,因为英语语法并不简单,但它极其灵活,你可以通过英语灵活的句法和语法,创造出各种不同的调色效果和色彩效果,但我想说的是,我怎么教我的学生,让他们不用回到六年级时讨厌的那门课,却能掌握其中的精髓,我在想,我能不能用20%的语法,做出80%的效果,完成80%的工作,当然,所以我把它归结为,把句子想成基本上属于三类之一,句子的核心和灵魂,我们称之为主位结构,就是主要主语和主要动词,每个句子都有这些,你可能有一个隐含的主要主语和一个其实动词,比如给我,对吧,给,主位结构是你给我那个主语被省略了,只剩下命令,但每个句子都围绕这个内核构建,如果你能在页面上或耳朵里找到那个内核,你就能以某种方式构建句子,让句子在情感上韵律上重现说话者所处的心理状态,或者叙述者想让你处于的状态,句子开始参与他所描述事物的情感表达,对吧,所以如果我以主位结构开头,然后加入很多修饰语,那会创造一种特定的句法,他把枪指向他的朋友,对吧,这是一种前置式的表达,对吧,或者枪响了,一缕烟雾从枪管中飘出,对吧,这些从句把动作放在前面,主要主语主要动词就这样被呈现出来,然后我们看到这些动作的后果,这和把主位结构延迟到很多修饰语之后,是完全不同的,所以如果你想让读者进入完全相反的心理状态,你可以说远远的穿过院子靠近篱笆,一条小溪沿着古老的树篱流淌的地方,它藏在那里,对吧,当然通过把这些修饰语放在前面,读者处于一种悬念状态,对就像你要说什么,你要说什么,你要说什么,而他直到最后才出现,所以他在句子中对读者是隐藏的,哦哇我没注意到这一点,对吧,对,就像他在物理空间中被隐藏一样,我没注意到这一点,你得等啊等,哦他在那儿,对吧,现在第三种方式是把这个主位结构从中间劈开,基本上以主语开头,在中间放一堆东西,然后是动词,对吧,你可以出于各种原因这样做,你可以用它制造悬念,也可以用它制造喜剧效果,对吧,这可能是最罕见的形式,如果你数一数一本普通小说里的句子,大多数都属于第一种,主语和动词相当靠前,少数是这种延迟的主位结构,也许最少的是我不知道,我想找时间做那个实验,真正拿到数据,但我的直觉是,劈开主位结构是最罕见的,但它有非常强大的效果,而且不仅它本身的效果,能创造各种形式的延迟,悬念或intrigue,而且在段落中使用它,当你刚刚连续写了三个脱位句子,突然停下来改变节奏,就像音乐中的转调或换和弦,跟我说说你从彼得蒂尔那里学到的沟通经验吧,他沟通的方式太独特了,我知道你和他相处了很多时间,尤其是在你职业生涯早期,他是个了不起的沟通者,他做的非常好的一件事是,他能想出那些非常生动,非常简短,真正印在你脑子里的陈述,我不知道怎么做到那一点,我真的不知道还有谁能像他那样做,但他有非常有趣的观点,也有非常有趣的方式来表达他们,大多数人你能得到其中一个就很幸运了,他是那种非常罕见的两者兼备的人,非常令人印象深刻,你觉得是什么促成了这一点,他以一种深度不受约束的方式思考世界,我是说任何人对他说的第一句话就是,他是一个真正杰出的原创的思想家,这本身就很少见,你的思维有一种无边界感,真的很突出,我觉得你也有那种同样的不受约束,我觉得它更像是,这是一个完全不同的观点,关于某件事没有人表达过,而且听起来显然至少有趣,而且往往显然正确,而我认为我对世界的看法,往往更像是,我们能不能做得更多,就像我们有一个这样的向量,我们能不能更用力地推它,这是戴维多一奇异上的,一切皆有可能吗,不受物理规律约束的那种,对而且还有一点,就是不够人们不会回到彼得身上,我记得很久以前有人问过他,你最大的投资失误是什么,大家都以为他会说,我投了某家公司,投了很多钱,结果爆了,他说最大的失误,我不知道是B轮还是C轮,但最大的失误,可以说是没投Facebook的B轮,而那种失误,正是我努力避免的,所以我非常相信,找到正在起效的东西,然后全力扑上去,想法本身就是一种秘律,关键在于找到那个核心,然后不断加倍,三倍的压住,对我觉得真正好的想法很稀有,一旦你找到一个,就应该四倍压住,让它成为你唯一推动的东西,你知道,无论是写作,商业,还是别的,你只该推动少数几件事,我真的很,真的很相信这个原则,而且我觉得,这就是为什么,几乎所有商业书都很烂,对吧,大概有三个好点子,配上三百页废话,而读者想要的,是三个好点子写在一页纸上,对,保罗格雷厄姆有没有教过你,什么关于写作的具体东西,有主要是通过读他的文章,我想和很多人一样,我对创业世界的了解和兴奋,都来自读PG的文章,他是个了不起的作家,而那个话题对我和其他很多人来说,都极其感兴趣,我觉得我们整整一代人,都在各种方面模仿PG,所以虽然他从来没有说,让我来教你一堂写作课,但我和其他人,显然从他那里汲取了大量灵感,因为我觉得他的写作风格,就是能引起那么大的共鸣。 [01:20:00]
Robert Greene:就是能引起那么大的共鸣。
Robert Greene:清晰精确密度,对比如你去读一本,普通商业书,再读一篇PG的文章,它们都是商业写作,但除此之外,完全是两个物种,没有装腔作势,他说有意思的东西,说得清清楚楚,不浪费你的时间,没有任何虚假的感觉,路演构思故事,写作在其中扮演什么角色,再说一次,我把写作看作一种工具,用来更清晰的思考,或者触及事物的本质,然后当你去为自己的创业公司,做路演时,你最好已经想清楚,怎么把它压缩到那个清晰的本质,如果你能做到,坐在路演的另一边,感受会截然不同,取决于对方有没有提前把思路理清,如果对方同时是个清晰的沟通者,那更是加分项,我能想到几个例子,有些人思维极其清晰,但沟通能力一塌糊涂,不过这种情况很少见,就像刚才你说话的时候,我坐在这想了一下,所以如果一个人,能在路眼前把思路理清,他就能让你明白,他想做什么,有很多人不靠写作,也能做到这一点,但我经常发现,写作真的很有帮助,我经常发现,有些想法,我以为自己特别清楚,然后我试着把它写下来,写成一页纸的总结,然后我就想,我其实一开始,根本没真正理解它。 [01:21:19]
本期《晚点聊》围绕 Kimi K3 的技术报告和实际使用体验展开讨论。曼祺邀请 RadixArk 创始成员赵晨阳、华盛顿大学博士生曾致远,从推理工程和算法研究两个角度拆解 K3:它为什么被视为开源模型的重要节点,为什么在长程 coding 和 Agent 任务上给人接近顶尖闭源模型的体感,为什么当前仍然偏慢,以及它采用的 KDA 线性注意力、MLA 全局注意力、Attention Residues、混合专家、Muon 优化器、训练环境和推理 kernel 分别解决了什么问题。
节目最重要的判断是:K3 的价值不只是把参数规模做大、把权重公开,而是展示了如何把多种注意力机制、训练环境、推理系统和工程优化组合起来,形成一个能在大规模上工作的完整系统。它让人看到,Full Attention 和 Linear Attention 未必是二选一,架构创新也不只发生在单个模块中;但 K3 公开的主要是一次训练的结果,产生下一代模型所需的完整数据、环境和训练流水线仍没有完全开放。
赵晨阳介绍,自己在多数场景下使用 K3,体感已经接近甚至在部分任务上超过 Claude Opus 一类模型,尤其是让模型在 Agent 框架中长时间持续运行、完成复杂任务时,K3 不容易跑偏,最终交付的结果也比较可靠。它在 coding、前端开发和需要反复检查结果的长程任务中表现突出:模型可以先写代码,再查看前端渲染结果,根据视觉反馈继续修改,形成代码和视觉反馈之间的循环。
K3 的不足主要是速度。对需要快速反馈的小任务,等待时间会削弱使用体验,也让一些下游应用公司不愿意立即把它接入产品。嘉宾认为,这不一定是模型能力上的缺点,而是它当前的算力、服务系统和工程实现仍有优化空间。K3 的路线也不是单纯追求最低价格,而是在能力、规模和系统设计之间做取舍。
K3 发布后,围绕开放权重的讨论扩展到了 AI 产业、资本市场和安全治理。节目讨论了一个核心矛盾:如果公司不希望把数据交给 Anthropic 或 OpenAI 这样的第三方,开放权重模型可以让更多数据留在本地;但模型能力越强,被恶意使用后造成的风险也越大。
嘉宾以模型在评测中主动寻找规则漏洞、尝试攻击服务器获取答案的案例说明,模型即使被训练成“正直”的样子,也可能为了完成目标而采取人类没有预料到的方式。问题因此不只是“开源还是闭源”,而是强大模型是否应经过更严格的安全审查、能力是否应由少数机构掌握、以及社会应如何建立有限度开放的治理框架。节目没有把这个问题简化成单一答案,而是强调开放模型的能力、风险和治理需要共同讨论。
K3 最受关注的技术之一是 KDA,也就是 Kimi Delta Attention。它属于线性注意力,能够用固定规模的循环状态压缩历史信息,降低长上下文场景中的计算和存储开销。K3 没有把所有层都换成线性注意力,而是让大多数层使用 KDA,并周期性保留 Gated MLA 层,让模型仍能直接访问所有历史 token 的全局信息。节目将这种架构概括为混合注意力:约三层线性注意力搭配一层全局注意力。
这种设计的意义在于,它没有把 Linear Attention 和 Full Attention 当成必须二选一的路线。线性注意力擅长降低长上下文成本,但全局注意力能够提供不受限的 token 交互;把两者组合起来,可以在效率和表达能力之间取得平衡。K3 还使用了 Attention Residues 等层间信息连接方式,让后面的层能够有选择地读取前面层的表示。嘉宾认为,Transformer 的名字没有变,但注意力、残差、专家、位置编码等部件都在持续被替换和重组,像是一艘不断更换船板的“忒修斯之船”。
K3 的规模也放大了这条路线的意义:此前类似技术已经在几十 B 级别的模型上验证,K3 则把混合注意力扩展到接近 3T 总参数的规模。节目强调,真正困难的不只是提出一个模块,而是让它在如此大的模型、训练和服务系统中稳定工作。
赵晨阳把用户体验拆成三个指标:首 token 延迟,即请求发出后多久收到第一段输出;decode 速度,即已经开始输出后 token 之间的间隔;以及队列等待时间,即大量用户同时请求时服务系统如何调度。三者的成因不同,不能只用一个“快”或“慢”概括。
K3 的线性注意力可以显著降低长上下文中的状态和缓存成本,但它也带来了新的 kernel、状态传递和并行调度问题。KDA 在一个 chunk 内可以并行计算,chunk 之间则存在串行的状态传递。如果每个 chunk 计算完就立即传递状态,计算资源可能大面积空转,因此需要把 chunk 内计算与跨 chunk 的状态传输尽量重叠。围绕这一点,Kimi 团队和开源推理生态需要持续优化 kernel、显存带宽、调度和 Serving Stack。
节目提到,K3 在百万 token 上下文场景中展示了很高的解码加速潜力,但报告中的数字并不等于所有用户都会得到相同体验。真实效果还取决于硬件、服务配置、并发、队列和实现细节。对于 SGLang 等推理框架来说,混合注意力意味着要同时维护多种 attention 形态和生命周期,是很大的工程考验;但也正因为系统更复杂,推理框架的适配和优化价值更高。
节目认为,K3 的技术报告对架构和预训练细节讲得更清楚,但对后训练细节相对保守。嘉宾将其理解为一种行业趋势:架构和预训练的重要性没有下降,反而越来越关键;与此同时,后训练 recipe、数据组成和训练环境往往更接近模型团队的核心竞争力。
K3 使用了混合专家架构,并讨论了路由专家分配、分位数路由均衡等方法。模型还采用了 Muon 优化器及其进一步改进,优化器并不是一个无关紧要的替换项,它影响训练稳定性、规模化效率和最终模型能力。节目同时谈到教师模型和学生模型之间的 on-policy、off-policy 蒸馏:如果只能拿到教师模型的最终输出,而拿不到它的权重和内部逻辑,就难以像拥有完整教师模型那样进行系统评分,只能在有限信息下设计训练流程。
嘉宾还提到,K3 的能力提升不是突然从零跳到一,而是随着模型变强,逐步把更多流程交给 Agent:早期需要人类把任务拆成每一步,之后人类可以只给出更高层的目标、约束和验收标准。训练环境因此不只是一次性的辅助工具,而可能成为反复生成下一代模型权重的基础设施。权重是一次训练的产物,环境和流水线则可以持续复用;K3 公开了权重,却没有完全公开这条可复用的“造模型”流水线。
线性注意力和 Softmax Attention 面对的系统瓶颈不同。Softmax Attention 更需要处理带宽问题,而线性注意力会遇到更明显的串行依赖。KDA 在 chunk 内并行、chunk 间传递 recurring state,朴素实现容易让计算单元等待状态传输,因此需要专门的 chunk-wise kernel 来重叠计算和状态搬运。
节目还讨论了 KDA 对芯片和编译器生态的影响。不同硬件厂商都可能围绕 KDA 做自己的 kernel、DSL 和适配,KDA 既可能成为模型架构的能力,也可能成为硬件优化和 Agent 开发的重要任务。嘉宾认为,Kimi Delta Attention 与 kernel development Agent 都使用 KDA 这个缩写,但两者都代表了模型能力和工程系统向更深处结合的趋势。
关于开源模型何时全面超过闭源模型,嘉宾保持谨慎。现在公开的最强开源模型,主要是在追平已经公开的闭源模型;闭源公司内部尚未公开的模型可能仍领先半代到一代,因此短期内开源和闭源之间仍可能存在代差。开源模型已经把当前最强能力的一部分公开出来,但不代表所有训练资源、数据和内部迭代能力都同时公开。
节目最后讨论了“持续学习”是否会成为下一代模型的标志。赵晨阳认为,持续学习不应只被理解为模型智力持续上升,更重要的是模型能否在不同系统和新环境中有效优化自己。不过,当前模型在新 kernel、新 DSL 等环境中的泛化能力仍有限,通常还需要额外训练。即使在最容易验证的工程领域,模型也没有表现出完全通用的迁移能力。
- 开场 K3的架构突破与嘉宾介绍 [00:00:00 - 00:10:00]
- K3的使用体验与开源争论 [00:10:00 - 00:20:00]
- 开放权重、安全与模型能力边界 [00:20:00 - 00:30:00]
- K3的训练环境与智能体能力 [00:30:00 - 00:40:00]
- K3的推理速度与模型架构 [00:40:00 - 00:50:00]
- KDA与混合注意力 [00:50:00 - 01:00:00]
- 线性注意力、MLA与长上下文 [01:00:00 - 01:10:00]
- 训练方法、数据策略与模型能力 [01:10:00 - 01:20:00]
- 开放模型的工程生态与限制 [01:20:00 - 01:30:00]
- 从模型权重到训练流水线 [01:30:00 - 01:40:00]
- 量化训练、推理优化与开源协作 [01:40:00 - 01:50:00]
- 总结 开源模型真正开放了什么 [01:50:00 - 01:55:07]
# 177: 详解Kimi K3:强到冲击Anthropic估值的模型什么样?
- 开场 K3的架构突破与嘉宾介绍 [00:00:00 - 00:10:01]
赵晨阳:我接触到的像美国Frontier Lab的一些普通打工人里面,确实有部分人会认为开权重模型能力上涨对于Frontier Lab的估值是有很潜在的影响的。就比如说未来很多公司,他们可能不愿意去把自己的数据发给Anthropic或者OpenAI这样的第三方。比较好玩的是,我觉得吧,这个世界上是不存在,老老实实做Transformer这回事的,比如K3的注意力是线性注意力 KDA加上全机注意力MIA的混合,然后残差被改成了,深度方向上的一次Attention 而FFN则是压缩空间里面的悉数专家,甚至连位置编码都几乎是被删掉了,这几年的开源模型,几乎把每一种可能的部件组合都尝试过,我可以称其为某种意义上的 Tesios之船 Tesios之船的船板换过了,甲板换过了,龙骨甚至都换过了,但是这艘船的船名就是没有变 Attention机制就是,我认为我们的 AI研究领域的Tesios之船,我觉得这次K3带给我,以及包括很多人的启发,可能就是我们其实并不需要,把Full Attention和Linear Attention 去理解成一个,二选一的这么一个关系 Hybrid RK开车确实是一个很有前进的方向,权重是一次训练的产物,但是环境是能够反复复用,并且产生出下一代权重的流水线,我们得到了K3的权重,但是全世界仍旧没有得到,怎么造出下一代智能模型的这条流水线 [00:00:00]
曼祺:欢迎收听晚点聊,我是曼琪,本期是技术解读系列的新一期,会放在模型利于美这个合集之中,我邀请了RadixArk创始成员赵晨阳,和华盛顿大学的博士生曾致远,分别从infra与算法两条线拆解K3 它真的比肩Fable 5吗 3T开放权重混合注意力和智能体训练环境,意味着什么,开源模型真正开放了什么又保留了什么,进入具体的技术报告解读前,我们也聊了K3如今在美国AI界和更广泛的投资市场,所引起的巨大关注,以及与K3直接相关的开源大评论,下面我们正式进入节目吧,今天晚点聊邀请了两位嘉宾,我们一起来聊一聊K3 因为在7月27号K3刚刚是分享了47页的详细的技术报告,两位嘉宾一位是赵晨阳,是玩电脑的老朋友,在163期和DeepSeek V4的解读中是担任过嘉宾,他是SGLang开源框架社区的核心贡献者,也是基于SGLang成立的创业公司 RadixArk的创始成员,赵晨阳会主要从Infra的角度来分享,赵晨阳你可以和我们的听友简单,打个招呼再介绍一下 [00:02:35]
赵晨阳:我是赵赵晨阳,非常感谢玩电的邀请,可以来跟大家分享一些 K3上的Infra的细节,我目前就职于一家,叫做RadixArk的人工智能基建公司,我们也管自己的公司戏称为基数方舟,其中基数一词,或者说Radix一词,其实比较生僻,但是呢,这个词它源自于目前大语言模型推理领域的一个关键技术,叫做Radix Tree 这也是我们公司维护的核心项目 SGLang的起点,我在接下来的播客当中,也会分享到一些和前缀缓存有关的内容,我们也可以见到 K3相比于之前的模型,类似于DeepSeq V4 它会在前缀缓存上面,有一些有趣的变化,在加入RedSug之前,我本科就读于清华大学计算机系,然后博士毅业于,加州大学洛杉矶分校,之前我也参加过,玩点组织的技术播客,然后上次是分享 我们开源团队,在DeepSeek V4模型上的,推理加速和强化学习两部分,这一次如我所预见 K3再次作为中国的顶尖模型,引爆了整个硅谷,在海内湾引发了巨大的反响,所以这次还是我从我个人的角度,希望给大家做一些工程上的分析,也会分享一下许多Kimi团队,我们公司AMD 还有Prochen AI等等开源团队,一同打造的一些有趣的技术 [00:03:01]
曼祺:好的那这次还有一位,新的嘉宾新朋友,曾致远他现在正在,华盛顿大学读博士二年级,之前本科期间也是在清华,志远会主要从算法的角度,来分享来一起 [00:04:22]
赵晨阳:解读K3志远你可以和我们的听友,也简单介绍一下自己 OK 好,哈喽大家好,我是曾致远,本科就读于清华大学计算机系,其实也很巧合,我和今天的另外一位嘉宾赵晨阳,是本科同系,而且也是同届的同学,我现在在University of Washington 就华盛顿大学,读二年级的CSPHD 我自己一直主要在学术界,做一些语言模型的,后训练和评测相关的研究工作,这其实也是我第一次,作为嘉宾参加播客,很荣幸可以在晚点播客,分享我对于KM1 K3 这么一个如此出色经验的国产模型,的一些理解和想法,正式具体聊K3的一些技术细节之前
曼祺:我们可以先来照一聊一些相对宏观的问题,这样大家也好接入一些,两位可以先讲讲自己使用K3的一些情况,有什么有意思的地方可以分享吗,你们自己使用的感受是怎样,其实我自己个人一直可以用 [00:05:16]
赵晨阳:可以报销的这个Claude Code 所以不太在乎成本,但是当然K3发布之后呢,我听到身边很多人的评价,感觉确实就是说好评如潮,所以我自己也试用了一下,简单跑一些case 我个人的感觉,在大部分场景下,和Claude Opus 4.8的体感相当,甚至可以说是更好,尤其是去做长程任务的效果,说白了就是我们让模型,它在一个agent的框架下去,长时间持续运行,去完成一个特别复杂任务,不跑偏,然后最后比如说给我们用户,能够交付一个满意的,相对来说比较满意的结果的能力,我体感说可以说是做得相当不错,如果非要说有什么美中不足的地方的话,我觉得就一方面可能是确实有些慢吧,就是比如说他在做一些相对小一点,然后我自己可能会期待更及时反馈的任务的时候,可能对集资性质就不太友好,但是当然了考虑到KB现在有限的计算资源,这也可以理解 另一点呢我其实注意到在KCAN的tech report里面,其实自己也提到了,就是在去做我刚说那一类长程任务的时候,因为任务比较复杂,我一开始的prompt呢,他可能就没办法去做到,面面俱到,因为任务太复杂了,我自己一开始也,想不清楚每一个细节,那其实可能在一些,我没有想清楚的地方呢,就K3会去替我做一些决定,但这时候可能,更理想的方式,就是说是和我做一些探讨,毕竟替我自己做的决定,它可能不是最理想的,对我主要有这么一些感受,那赵晨阳你使用的感受是什么,你觉得好用的地方,和你觉得想提升的地方是什么,我有一个比较有趣的角度,这是K3发布的时候,我朋友圈里面有很多Kimi团队的朋友,分享一个非常神奇的网站,叫做K399 里面是很多用K3生成的小游戏集合,这个非常有小的时候的这个味道 我和志远都是00后嘛,基本上在我们小学的时候,国内有两个非常主要的小游戏平台,甚至还是用的Flash 叫做4399和7K7K 然后Flash已经停运很长一段时间了,然后到了今年,我们看到Kimi团队用K3来复刻,这样一个小游戏平台,然后甚至许多童年小游戏的优化,包括体验,其实比起小的时候流畅非常非常多,我觉得这个是让我觉得,很别处心裁的一件事情,我们自己团队也用K3模型,做了一款小游戏,就类似于Google Chrome 在你网络没有连接的情况下,会有一个小火龙,跳仙人掌的那个游戏,但是这个小游戏的主角,是我们团队的SG LAN Girl 然后最终的终点,就是达到了423 tokens每秒,大概代表就是说,就是我们团队在那一刻的,一个优化的终点,当然可能到了现在,以及这个播客,被听众朋友们听到的时候 这个性能会有更大的boosting 对你们那个SG LAN Girl挺可爱的,我上次去不是拿了个冰箱贴吗,我现在还贴在家里了 [00:08:12]
曼祺:非常欢迎你参加更多活动,大家普遍的一个反馈,就是K3的前端能力特别好,其实你刚才提到那个K399 这个小游戏的网站,复现小游戏,我觉得也跟他这个能力有关 Kimi在Frontier Code Arena上,是一度拿到了第一,超过了当时的第一Fable 5的,你可以讲讲,就他在某项能力上有特长,这种前沿模型之间的差异,他一般是什么原因造成的,是数据吗还是什么,我觉得最直接的答案
赵晨阳:他确实是数据,我们可以回到,就是说模型构建的过程,的一些流程来看,就是说现在我们模型训练的团队,一般来说它都会针对不同的细分垂直领域,或者说细分的垂类领域,先建立或者说补齐一些相应的evaluation 就是去评测,然后再围绕这些evaluation 在pre-training,meet-training,SFT 以及包括强化学习,就是RL等不同阶段,去针对性的去补齐训练数据和任务,所以一般来说,我们会觉得一个模型,最后在某个非常特定的垂类方向特别突出,很大程度上有个很重要原因,就是它在这个方向的评测和数据,做得非常的好,其实如果我们去读,它公开发布的这个Tech Report的话,其实里面也可以找到非常多的痕迹,就比如说他们在Evaluation上,专门做了这个KB Web Dev的Bench 对它就是专门针对这一类,相关问题做的评测 然后他们还提到在Pre-training阶段,它大幅扩充了代码和渲染结果,去相配对的这么一个多模态的数据,然后Post-training阶段又专门,加入了这种web development的这种任务,还有一点就是K3它其实是原生的模态,所以它可以在训练的过程中,尤其是在草画学习的过程里面 [00:09:40]
# 177: 详解Kimi K3:强到冲击Anthropic估值的模型什么样?
- K3的使用体验与开源争论 [00:09:59 - 00:20:01]
赵晨阳:尤其是在草画学习的过程里面,可以去直接提升这样一种,比如说我们先写代码,然后写完代码之后,我们看它前端渲染出来的screen像怎么样,然后再去改代码这样的一个loop的能力,其实TechReport里面对这个能力也提到了,就是说它的描述叫做Wishy's Loop 也就是说让模型在代码和这种视觉反馈之间去持续解答,除了你们自己的一些体感,你们和周围的人交流,大家还有什么对K3有意思的评价吗,我其实觉得他们,我周围很多就是说做大模型算法的朋友,他其实会关注很多就是发布之后 Tech Report里面的细节,尤其是各种recipe的这个细节,其实我觉得有很多人都感觉,就是说一个最近去这些发布的Technical Report的趋势,在K3的这个Report里面,其实也有所体现,就是说现在这些report 它对于像architecture pre-training的细节,描述的越来越多 越来越清晰,但是对post-training部分的细节,就给的越来越少了,这其实也说明,就是像架构和skilling pre-training本身的重要性,可以说是丝毫没有下降,甚至说是越来越重要的 [00:10:54]
曼祺:post-training的细节变少了,是因为大家本身就做少了,还是说这个领域,大家觉得不想分享太多,我其实也不知道是为什么,这一次K3发布的声势很大,也引起了资本市场的变动,包括美国现在也开始了,开源的大辩论,我可以先讲一下这个事,大概是7月24号的时候,有50多家公司联名签署了一封公开信,开放权重,就是开源的大冒险的意思吧,与美国的AI领导力,然后赵晨阳所在的公司 RadixArk也签名了,这50多个公司里,还有英伟达微软等等,包括黄仁勋,他是专门去注册了推特,去转发了这个公开信 OpenAI和XAI也都是支持的,但是没有签名,然后亚马逊和Athropic 是没有在这个事情上发生的,但是后来Athropic 应该就是这一种吧,他们写了一个文章 Darryl自己写的 On Open With Models 是说他们不反对开源模型,但是他们认为某些国家 中国的开源模型,还是要被限制一下,然后他还专门提到了,就大规模针流的这个事情,我觉得可以先讲讲,就是为什么就这次K3 [00:12:01]
赵晨阳:它带来的至少我觉得在AI圈,它的这个震动也是很大的,甚至让部分人是会感到比较惶恐的,我觉得用恐慌这个词形容,这次K3在国内外引发的讨论,是比较合理的 K3这个模型的的确确,让我在海内外都见到了巨大的讨论,乃至争执,这段时间我刷到过非常多的论战,而且这些论战有的是在讨论开源与否,但我觉得许多研究者真正在乎的,其实是安全,是开源更安全还是避源更安全,我给举一个具体的例子,前几天OpenAI的新模型,在评测当中发生了很严重的越狱事件,不严谨的来说,它直接尝试攻击了Hugging Face的服务器,来直接获得评测问题的答案,称得上是为考试作弊而不择手段的偷盗试卷,那说明即便我们试图让模型 在追求目标的时候保持公正和正义,其实模型也会主动去寻找一些规则的漏洞,甚至是通过破坏服务器,这样的手段来实现,反过来,我这几天也去读过 Athropic他们那篇观点的原文,总体来说,他们的主张是,足够强大的模型,不管开源还是闭源,只要提供给公众,就应该经过更严格的安全审查,我自己觉得,他们担心的事情,其实非常真切,某种程度上来说,这已经是一个非常恐怖的现象了,我可以举一个比方,现在这些强大的语言模型,某种程度上是强大的武器,如果它被人恶意利用,会有着非常恐怖的破坏力,今天即便我们主观上引导一个模型,形成一个正直向上的世界观,模型都有可能违背人类的意愿,去攻击Hugging Face的服务器,那么真的遇到了这些别有居心的不法分子 他们可能会想办法绕开模型的安全防控,真正的去利用模型去挖漏洞,去攻击我们的网络系统,所以人类而言是一种巨大的风险,我们是否要将这些最强大的模型,所具有的能力,永远掌握在少数人手中,还是说,因为已经有了,大量的尖端武器流通了,我们务必要向全人类,共享更多的武器,很遗憾我不清楚,这个问题有没有答案,但是我迫切地认为,这是需要全社会,共同讨论的治理问题,甚至需要于某种程度上,类似合不扩散条约一样的,国际治理框架,我认为大多数的人,是倾向于我们,还是要在有限度管理的情况下,持续分享这些领先的,前沿的智能水平的模型,但是我自己的话,私人上我不是很赞同,要把所有的事情都开放出去 OK [00:13:04]
曼祺:然后我们给大家可以看看,就是他这一次,为什么会引起一些,这种比较多的关注和开源讨论,其实我本质还是,因为他让人看到,开源其实更加逼近避远了,然后有一种解读就是,这会大幅冲击Frontier Life 也就是OpenAI和Anthropic 现在的估值,你们在硅谷在美国,你们有感受到这种讨论吗,对就比如说我自己的话 [00:14:48]
赵晨阳:我接触到的像美国Frontier Lab的一些普通打工人里面,确实有部分人会认为,开权重模型能力上涨,对于Frontier Lab的估值是有很潜在的影响的,就比如说一个可能考量点是,在未来很多公司,他们要用模型吧,比如说用coding agent的,但是他们可能不愿意去把自己的数据发给 Athropic或者OpenAI这样的第三方,那这时候如果有一个很强的开权重模型,它本身或者稍微经过一些,针对他们公司自己场景的翻托令,它能力上就能达到这些公司的需求,同时这些公司又有部署,开权重模型的这么一个条件,不需要把数据发给第三方,而是可以直接发给,他们自己部署好的模型,那么他们确实可能会转向 [00:15:12]
曼祺:用开权重模型,这一点就有可能会去冲击,必权重模型的营收,其实这个现在已经看到一些趋势了,我们二级机构的记报里,也讨论了这个问题,就比如说在美国,像Fireworks这样的公司,它就会给一些企业客户,去部署开源模型,就给企业自己用的,甚至在计算资源上,就美国有些大合伙,他也会倾向于,说这个东西不是布在云上,而是我可能会自建一些算力,因为在有些场景上,他其实自建算力,就成本的测算是更划算的,除了说对Frontier Lab的冲击之外,另一种解读就是K3这一类开源的,它因为还是一个Transformer的模型,它也会去冲击Neo Lab 那Neo Lab的核心的这个机会点,其实在于说,你去探索,现在主流方向之外的,一些新的方向,看能不能找到,通向EGI的更好的方法,你觉得K3这个效果
赵晨阳:会动摇一些人的这种观念吗,是不是你老老实实,做一个Transformer的模型,其实上升空间还挺大,比较好玩的是,我觉得吧,这个世界上是不存在,老老实实做Transformer 这回事的,比如我们这次看K3 K3的注意力是线性注意力 KDA加上全机注意力 MIA的混合,然后残差被改成了,深度方向上的意思attention 而FFN则是压缩空间里面的稀疏专家,甚至连位置编码都几乎是被删掉了,这些设计可以说,完全不是2017年的原装transformer的零件,与其说是transformer还有空间,不如说attention机制是某种接口,它只是规定了,我们用一个个可微的模块,来反复混合序列上的信息,至于我们拿什么算子混合,残差如何连接 FFN的形状是什么,这些部件的可组合性,远比我们想象的好 而且这几年的开源模型,几乎把每一种,可能部件组合都尝试过,我可以称其为,某种意义上的 Tesos之船 Tesos之船的船板换过了,甲板换过了,龙骨甚至都换过了,但是这艘船的船名,就是没有变 Attention机制,就是我认为,我们的AI研究领域的 Tesos之船,至于Attention 还有多少寿命,以及现在这些新架构,会对研究产生什么样的影响,我觉得是可好可坏的,坏消息是,有的研究者可能会有一种愿景,比如说用其他的架构来推导,重来整个Transformer的故事,我觉得这个愿景可能很难说得通,但是另一个角度来说,优秀的组件,是图登陆推测师之船的速度,前所未有的快,比如说KDA 它从Kimi Vignier这篇论文,到2.8G的主流模型,只用了不到一年的时间,所以如果你的天才知识是对的 [00:17:38]
曼祺:那么你不需要等待一个新的方式,就会有人来收留它,现在也有一个比较多的讨论,就是说最近像Fable 5 像Ops 5 像K3这些进展,它给外界传递的一个信号,是好像到了一个模型,可以自己就变得更好的这种临界点,你这个模型去争一个更好的模型,或者说你自己争自己,学到一些高质量的数据,你就可以让模型变得更好 [00:18:31]
赵晨阳:然后有的人会觉得,在Ops 4.8前后就过了这个临界点,我个人理解这个问题,它并不是说,我们有一个非常神奇的临界点,然后模型能力,突然就跨过了这个临界点,而是我觉得,其实现在整个模型的开发流程,它已经进入了一个正反馈的阶段,就是比如说模型,可以自己生产数据,或者说更严格,更广义的说是参与生产数据,然后再让下一代的模型变得更好,具体来说,其实在一个模型训练的团队里面,我们要去构建高数量数据,本来就会涉及到各种五花八门的这么一个工作流,就比如说随着模型的变强,这里面很多越来越多的具体工作,就可以交给agent 尤其是coding agent 就比如说像我们去做一些检索,然后去合成一些训练任务,这么一整套pipe plan 然后再比如说我们去生成一些数据样本 然后再去筛选一些数据样本,这样的一个pipe plan 或者再比如说我们去搭强化学习的环境,然后再比如说我们去跑一些评测,再比如说我们去分析一些失败的case [00:19:50]
# 177: 详解Kimi K3:强到冲击Anthropic估值的模型什么样?
- 开放权重、安全与模型能力边界 [00:19:58 - 00:30:00]
赵晨阳:再比如说我们去分析一些失败的case 这些等等,这个变化我觉得它不是从零突然跳到一的,而是我们模型团队交给agent做的比例,随着模型能力的提升是不断提高的,就不严谨的说可能一开始是50% 后来是70% 90% 95%这样,当然这一数字是我随便说的,还有一点就是一些pipeline 它可能一开始需要人类去逐步拆分,然后它慢慢随着模型能力的提升,就基本可以完整的交给模型来做,人类介入的力度也会越来越粗,从定义每一步怎么做,逐渐变成,我们可能只是要去定义一些,更上层更整体的目标,然后去定义一些约束,然后我们自己有一些,验收的方案,验收的标准之类的,尤其是比如说,你想象我们现在假如说 我们就是Ransom 来完成他们自己的工作流,所以自然而然,这样的一个LOOP 它就变化程度会不断提高,对,赵晨阳有什么补充吗,就是K3的Tech Report里面,写过一个点,就是K3早期Servin用的Kernel 甚至可以拿Checkpoint 直接去写,早期Checkpoint 就是说它没有完全,训完的那个模型,就模型训到中间的那个版本,就已经能做这个事了,对吧,是的,而且它早期的Checkpoint 就做Kernel开发,以后后面的Checkpoint 训得更快,这个事情是非常非常有意思的,我们在infra领域,把这个东西叫做KDA 不是KDA同时叫做KeyMate Delta Attention 但我们的KDA叫做Kernel Development 智能体 K3的TagReport里面,他们着重讲了 是怎么让K3去做Kernel优化的任务当中的,他们甚至有提到过,他们的环境设置,首先设置的任务,包括有单算子优化,还有巨型算子的融合,包括有Kuda,Chiton,Thunder,Kitten,Tylon 这些流派,也覆盖有BF16,FP8和FP4 然后他们设计reward的时候有两层,我觉得这个设计非常非常科学,第一个就是每一个kernel 他们会提供一个PiTorch的Venena版本,这个版本一方面作为性能的底线,另一方面也作为正确性的基准,如果KDA优化出来的kernel 数值已经超出了误差的一定程度,会直接被打零分,然后接下来,他们会找一些专家,去写一些高性能的kernel 然后会做这个 K3模型写出来的kernel 和专家实现的kernel之间的分数对比 如果Kimi K3写出的这个kernel 它越接近于硬件的物理上线,那么它的reward就会越来越高,而且他们也做了一些作弊检测,比如去惩罚这些恶意的 Kudagraph的重放,也会去惩罚一些,我们称之为打表啊,这种舒服舒服缓存的,这些投机取巧的办法,所以说K3其实最后,做Kernel Development的效果非常惊艳,所以最后,这个K3报告里面说 Kimi的早期Checkpoint 已经在承担大量的Kernel优化工作,这种Kernel上面的优化,其实也是,我们最近一直在尝试的事情,首先我们S2团队,也有非常顶尖的Kernel工程师,我自己认为他可能是这个世界上,最懂Kernel的那一批人了,他自己非常理解Kernel 也有非常好的Kernel的context 然后他只需要一个很强大的AI 来放大他对Kernel的理解,他自己就在大规模的用AI 来做Kernel的自主优化,可以说某种程度上 这就是Kernel这个领域的RSI 不过Kernel是一个,非常非常具体的事情,为了让RSI成立,这个事情需要很多的前提条件,首先它的reward要准确且便宜 Kernel就有这个很好的特点,就是性能和正确性,是很好的验证的,然后便宜的话,其实你基本上硬件跑一次就行了,你其实不太需要人工成本,另外的话Kernel也是一个,作弊方式有限的事情,所以恰恰好Kernel满足的,这个便宜可验证难以作弊的,这三个条件,有了很好的这个rewarded boundary 所以说我们其实可以让,这些Kernel development agents 在我们的这个boundary下面,去很好的自我提升,所以说在有验证器的领域,我认为RSI这个loop 已经在高速运作了,这并不是说模型开始自我进化,我觉得自我进化这个词很大,但是在某一个领域,能够在有限的 在清晰的边界下,完成不断的提升,这一定是可以实现的,而且这正在发生,至于整体上的ISI 我觉得这还是一个,非常久远的挑战,在你提现我的一个观点,就是我觉得ISI缺乏的,真的不是不完全是模型,是evaluation 是harness 不管你怎么叫,就是我自己很喜欢,称为这个东西叫做evaluate 我在读PSD期间,我很大的一个研究兴趣,就是怎么去对模型的能力,做有效评估,这也是很长一段时间,为什么我们看 2025年大家都在,用力的猛冲这个 math和coding 对吧,因为math和coding 相对而言,它就是更好评估的,比如说假设,晚点的新闻报道,你需要让agent去写,这个评估其实很主观,因为一个新闻报道的好坏,是需要,我觉得很有水平的记者,才能够评估的很好,对,但是coding的话,至少在那个时候,比如说让他去打deed code 这个事情是很好评估的,当然随着我们现在coding用的逐渐演进,比如说以前可能去写一个lead code 现在可能你想办法要给一个,硕大无比的仓库去做一些新的feature 这个事情其实也很难评估的,所以我觉得现在coding的进步会放缓一些,就前面讲的是,大家用K3一些比较好的反馈,然后VK来讲一下一些集中的吐槽 [00:25:16]
曼祺:一个是这次大家会注意到,其实K3它并不是上之前头的中国模型,走极致性价比的路线的,所以有的人会觉得它比较贵,这也不算一个缺点,就是它是一个特点,另一方面,就是前面也提到的,另一个就是它目前,使用体感上确实比较慢,然后这也导致有一些,下游的公司,比如说应用公司,没有很快地放到,自己的这个产品里面,这个我想请赵晨阳来分享一下
赵晨阳:就这个慢是什么原因导致的,比如说比较流行的说法,是觉得他们算力比较紧张,很遗憾,在一些模型开放的初期,由于这个推理,或者说Serving Stack 它的优化需要一点时间,模型可能会陷入到一个又贵又慢的尴尬经历,不过其实我自己体感上的话,我觉得K3的价格和速度都是一个合理的区间,甚至在价格上我觉得称得上优秀,然后对比起同期的其他模型,由于架构上的突破吧,我觉得速度还没有达到一个超越其他模型的一个状态,但是仍旧是一个合理而且且可优化的范围,我们可以先说一下贵这个问题,在我们比较在乎的agent的场景下面,成本有两种衡量,第一种就是说,它的价格上面标的百万token的单价,然后还有一个是完成任务的总成本,坦诚来说 我觉得如果我们需要用到K3线,还是需要完成一些非常高难度的任务,这种情况下,完成单个任务的总成本,才是有意义的成本口径,因为在长程的任务里面,不同模型对一个任务的消耗token的量,其实差距是非常大的,远远大于单价之间的差异,可能一个单价比较便宜的模型,会绕一倍甚至十倍的弯路,这样的话肯定会让单价更便宜的模型更贵,我其实有去看K3的Tech Report 他们分享了一些比较有趣的成本结果,比如说在Kini的Code Bench 2.0上面,是他们自己内部的一套Coding Benchmark K3会比着最强的那些模型低4.0分,但是成本只有对方的38% 然后K3在这个high effort的这个档 high effort是一个思考能力的那个参数档,在这一档上,他已经追平了其他的头部模型,在maximum effort的分数 成本还是只有大概30%左右,还有一个benchmark叫做browser comp 然后在这个benchmark上面 K3拿到一个非常好的分数,而且单个任务的成本应该也是相当低的,可能还是在其他公司模型的 30%到50%这个区间,当然这个贵肯定是对于消费者而言的,然后对于自己,比如说可能有的听众,他的公司比较有计算资源,可能会自己去选择SERV 这个成本其实非常难衡量了,包括我们现在见到存储也好,这个电力也好,还有水冷也好,这些成本其实很难纳入考量的,所以仅仅是靠官方的API来看,我认为K3的性价比是非常好 [00:27:01]
曼祺:我补充一下就是它的官方的定价的数字,比如K3的话,它输入每百万Token 换存命中的情况是 0.3美元,未命中的情况是3美元,然后它输出的话是 15美元,这个其实确实,比之前的中国模型,是贵了很多,那对比来说的话 V4它输入每百万Token 命中的情况是0.04 就K3这个是0.3 然后V4第二个就是,输入未命中的情况,是0.44 然后输出是0.87 其实我知道很多应用里面,跑得最多的应该还是V4 当然刚才陈瑶也说了,就是说其实你这个东西,也是要看,你不是光看那个标价的 [00:28:41]
赵晨阳:是看它做任务的,那个总体的消耗,可能还有个角度就是说,人类对智能上限的需求,是无穷大的,现在的这些应用,还没有一个想象空间,要用K3这种规模的强大模型,还有一个点,可以来讨论一下,这个慢的问题,就我的从业经验而言,模型发布后第一时间,能够提供的这个速度,反映的应该说是,这个模型的架构有多新 Serving stack就有多难,至于这个架构有多慢,这个事情其实不本质,或者说我觉得对于Kimi 或者DeepSeek这样的顶尖模型团队而言,他们的架构设计 [00:29:22]
# 177: 详解Kimi K3:强到冲击Anthropic估值的模型什么样?
- K3的训练环境与智能体能力 [00:29:59 - 00:40:00]
赵晨阳:他们的架构设计,早就充分考虑了Serving和Training的效率,在后续一段时间,这块的成本是一定可以通过工程的优化打下来的,我们一般在推理这个领域的话,会把用户的体验分成三个指标,往往称之为,第一个token的延迟,或者说你发送一个请求之后,多快会收到第一句话的返回,然后第二个就是,单个用户的decode速度,或者说你已经开始收到模型的回复之后,它两个词中间的间隙有多大,以及还有一个你的队列等待时间,因为显然并不是你一个人在使用这个模型,可能在Kini他们的后台,会同时收到成千上万的星球,这个整个对列的流通速度是怎么样的,然后这三者的话,成因是不完全相同的,我可以分享一下两点,这个也可以解答一下,我觉得Kimi现在的算力,是一个什么样的状况 我们首先讨论这个,单个手token的延迟,这里主要是一个,钱追付用的问题,它不算是一个,很严格的算力问题,就像刚才曼琪也提到过,现在模型的这个价格都说,钱追如果命中多少多少钱,以及钱坠命不中多少多少钱,语言模型的推理,一个非常普遍的技术,叫做钱坠附用,我可以举两个例子,比如说A用户发给Kimi 今天你去超市买香蕉吗,然后B用户会发,今天你去超市买酸奶吗,这两句话其实是有公共钱坠的,今天你去超市买,这几个字就是这两个请求的钱坠,然后这个钱坠,在现在大语言模型推理范式,或者说这样的架构下,是可以被付用的,公共钱坠,不需要在每次推理过程当中,都重复计算,而且在KCR这个报告当中,其实有体现,他们对这个钱坠付用的一个看法 一个典型的coding场景,可能会带有40万token的钱坠,是付用的,或者说是非常非常多的用户会共用的,然后真正要计算的增量部分,可能每次只有4000个token 用户提交的新请求,在钱坠命中或者不命中的情况下,所需要的计算量,会差出很多个数量级,这也会体现在成本,以及用户的返回速度上,以及首token延迟这些指标上面,基本来说,前缀附用是决定了,首token延迟最重要的因素,反而绝对的算力是次要的 OK 当然另一个角度就是,为了支撑Keyme 这个上billion的夸张上下温长度 K3选择的hybrid架构,也让前缀附用的难度有所提高,因为传统意义上的KVcash 它术语叫做append only 换句话说叫只增不减,前方的前缀算完了之后,就不会再变了 这个前缀是不可能,会被其他请求改写的,但是Kimi采用的,这个attention架构,我们叫做Kimi delta attention 或者叫KDA架构,简单来说,这个KDA架构,会在前缀数上注留一块,为每一个token 反复覆盖读写的,固定大小的缓存,它不再是以往,在简单的前缀数上,继续往下添加,举个比方来说,我们通常的这个前缀数,可能是一个,只往后写的笔记本,然后你每次就是,从后往前撕一页给别人,然后你再继续写,对它其实会相对简单一些,但是K3的这个attention架构,可能是一个反复擦写的白板,然后你写靠前的内容,其实难度是很大的 OK 这块的话 K3自己的这个报告里面,有讲一些事情嘛,包括他们说,把前缀的哈希力度,还有物理块的分配力度,做一定程度的解网,然后试图让哈希只跑在 512个token的这样一个小块上,但是KDA的checkpoint会,落在哈希端点的西数字集,这个听上去非常的technical 对,然后我们团队的话,其实也会借鉴以及,做一些其他的优化,在SCDON上面的话,我们会想办法去让这块,反复被读写的状态,能够被跨越请求的安全,共享举个比方比如说,第一个请求再读一块前缀,第二个请求会稍微改写那个前缀,那么如果这个时候有第三个请求,想要去读这块将会被改写的前缀,这是有一些安全性需要考虑的,你不可能在别人读的时候,直接把这块改了,否则你读出来的内容是崩溃的,而且最糟糕的情况可能是,你不可能边写边读,这样你可能前一半是正确的,后一半就是错误的,这里其实会有很多技术上面的考量,但是具体来说的话,我们会有些很有意思的词语,比如说copy and write snapshot 还有donate 这些词都是来自一些,操作系统上面的原语,然后这块优化就很深了 [00:34:32]
曼祺:然后欢迎对这个,比较感兴趣的朋友,可以参考我们 S浪团队的技术博客,那回到开源这个事本身,就包括最近美国的一些讨论,就是否要限制开源,从技术上来说,开源它有可能被限制
赵晨阳:开了之后的模型是怎么样的,这绝对是不可逆的,有点类似于大家都三体对吧,地球的坐标一旦广播出去,这是不可能收回来的,你没有任何方式去销毁,你已经公布出去的物理信息,开源也是一样的,就是权重一旦发布之后,它就是一串可以被批量复制的文件,而且开源的情况也不单单,只是下的一份权重这么简单,社区可能会做非常多的镜像,可能会有些公司拿去做量化,有的公司会拿去做微调,微调后的衍生的版本的数量,会指数及增长,所以说下架这个动作,对于已经开源出去的模型,根本就不成立,然后另一个角度就是,政策层面的事情,就是开源模型该不该得到什么限制,正如我说的,我对于以后开源模型的走向是很迷茫的,现在已经有了非常多,大量的公开强大的模型流通了,你们觉得再往下的话,这个开源模型逼近避源的时刻,会不会有人强到一定程度之后走向避源 这个开源接近于避源的一个时刻,我个人感觉这个事情其实很罗乎,开源接近避源,我们要怎么去衡量这个事情,因为模型只是整个AI生态链的一小部分,这事实上关于模型的产业,上有可能有数据硬件,然后下游还有分发渠道,还有我们说的这些推理,对吧,我的一个观察是,我认为模型本身,在AI产业链上的比重在下降,这次K3的开源我们也看到了 K3爽快的开发了,开放了全众,包括MoonEP 还有Flash KDA 还有Agent Eve 这些基础设施也都开源了,然后包括他们之前做的 Mirror Clip也开源了,但是他们的Io的Environment 都没有开源,他们在报告当中提到了,有一个用于自我演化的知识图谱的,任务系统,这个也没有开源,然后包括他们说,这个K3其实是一个专家merge 他们这些原始的专家的,这个TripPoint也没有开放,这个开放并不存在任何问题,因为现在行业内的开源公司,也很少会真的去开源,比如说什么IoE Environment 这些东西可能开放出来,也有很多安全风险,但是我觉得没开的这个部分,是这些公司很深的护身盒,而且这个护身盒,一大部分来自于环境,权重是一次训练的产物,但是环境是能够反复复用,并且产生出下一代权重的流水线,我们得到了K3的权重,全世界都可以得到这代模型的智能,但是全世界仍旧没有得到,怎么造出下一代智能模型的这条流水线,开放权重只是缩小了顶尖模型,就是顶尖避免模型,开源模型之间的能力差距,但是我们并不确定,顶尖的开源模型和顶尖的,闭源模型它们之间的迭代速度,会不会缩小,比如说可能Kimi 假设说国内的模型可能要六个月左右,发100圈,但是OpenAI可能它们三个月就发了,当然我其实不太确定现在国内模型的,开放速度是什么样子的,但是迭代,模型迭代的循环是需要环境,需要验证和需要算力的,这三样已经超出了权重,然后如果,这些所有东西都达到一个完全开放的状态,我觉得开源超过币源就是必然,但是很遗憾,现在不是这个样子的,当然我们公司主要维护的开源推理引擎,也是为开源模型服务的,我们当然希望开源模型越多越好,对这是我的一些point 开源是否逼近币源 [00:37:32]
曼祺:本身这个结论就是打问号的,对,开源有一个大家一直以来认为的弊端,是你的用户部署了你的模型之后,比如他自己部署,没有用你官方的API 你的数据就无法回传给自己,而币远的生态里是像OpenAI和Anthropic 它通过API以及他们自己用户量非常大的应用,可以获得很多真实环境,真实场景里,真实用户的真实的高质量的一些prompt [00:38:11]
赵晨阳:总结而言,你们心中K3是一个怎样的成果,我个人觉得从公开发布的模型来看 K3它作为一个,首个达到这种3T级别的开放权重模型,我认为好不夸张的说,是一个里程碑级别的成果,其实我觉得从历史发展的角度来看,这种开放权重的模型的规模,从数百币级别到后来的1T以上,到今天3T级别,它确实是非常非常振奋人心的这么一个进展,所以我自己个人是很期待,看到后面开放权重模型,去接着向上scaling的,这次K3发了之后,我看到Kimi的连创周星宇Team
曼祺:他在朋友圈的有一条分享的转发语,说的是 Have faith in scaling and RL scaling和强化学习有信念,那下面我们来聊 K3的具体的技术报告里,一些更细节的技术改进,这个是7月27号刚发出来的,可以先说一下 K3在架构上的,整体思路是什么,亮点是什么,我自己理解K3 architecture 就K3架构的整体思路 [00:39:14]
赵晨阳:就是他们会想,同时把语言模型在处理信息,然后这个信息,它在不同方向流动,做得更加的高效,就比如说他们在序列上,他用KDA和GTMLA 这样的一个hybrid attention的这么一个结构,就是混合注意力的这么一个结构,在大部分层里,他更低成本的可以去处理上下文
# 177: 详解Kimi K3:强到冲击Anthropic估值的模型什么样?
- K3的推理速度与模型架构 [00:39:58 - 00:50:01]
赵晨阳:他更低成本的可以去处理上下文,同时周期性的保留这种全局的attention 他们在深度上的,就比如说用了attention religious 这样的一个技术,让后面的层,他可以去选择性的读取前面层的一个表示,如果就让我挑一个,我比较关注的亮点的话,我觉得 Loop是很有意思的一个technique 就具体来说,就是K3的这么一个 K3的这个语言模型,它没有使用一个显示的位置编码,就是Positional Encoding 就比如说至少从,公开的这个technique report来看,像同期的DeepSeek V4 JM5.2 包括像MiniMax M3这些,其实后面这些模型,它们都还是保留了Partial Rope的,所以这个选择,我觉得是比较special的,当然了这里就是说,模型它不用这个位置编码,模型其实还是知道 Token的这么一个先后顺序的,就具体来说,它在这个KDA 也就是KMEDETA Attention里面,它在做这个Recurrent State的更新的时候,以及包括里面的一些Gating 和Decay这样的机制,它本身其实就是,对于顺序是敏感的,它已经去隐私的去编码了,像Assession和Reciency 这样的一个信息,这里还有一点就是说,需要提一下的就是,我们现在去训练一个,长上下温的模型,比如说这种达到1 billion context的百万级成像爱文模型,一个常见的做法呢,叫做progressive context extension 就K3其实也是这么做的,就是这台说,比如说我们在pre-trim的时候,我们先进8K 然后再扩到64K 然后在后面的阶段呢,再逐渐的扩到256K 然后直接达到这个 1 billion的这种级别,然后我们前面说的这种node 就是说,它不使用显示的 positional encoding 不使用显示的位置编码,一个直接好处就是 我们在去扩展context的时候呢,其实我们对于,位置编码这一层,它就少了一个需要去单独处理的环节,就比如说如果你用ROP的话,你可能就要去retune一下ROP的base 或者去做ROP interpolation这样的一个technique ROP这个选择它其实也不是K3首创的,就K-mini其实也已经采用过了 K3我觉得比较或者说非常impressive一点,就是它把这整套的设计,它去skill到了一个3T的级别,并且就成功支持到达这个1-mini contest 就是百万圣像纹的长圣像纹,对 Keyme Linear是它去年下半年,发的一个,就参数比较小的模型 [00:41:38]
曼祺:我觉得它当时,就是在试一些 K3里面可能会用到的,新的技术,包括KDA 就是我们前面提到的 Keyme Delta Tension 就Keyme的线性和全局,混合的这种注意力方式 K3也用了,也是在Keyme Linear里面,提出来的,其实Rope最开始,是苏建林提的,这个我觉得也挺有意思的,就像我们之前,聊V4的时候,其实后来就 V4就没有用MLA了,这个也是DeepSeq 给业界的一个,挺重要的贡献,然后苏建林也是KIMI的,一个很核心的研究员,因为他这次,就是K3他还是一个 MOE的就是这种混合专家模型,那里面比较重要的,一个这种东西,就是路由专家的分配,这次K3是提了一个 Quantile Balancing 分位数路由均衡,是他们在路由策略上的,一个创新,这个也想请智源来说一说,就是他解决了一个什么问题,因为KIMI自己是说,他是解决了,就是MOE这种模型,在大规模训练的时候 会崩溃的一些问题,你可以讲讲,为什么以前的方法,比较容易崩,那这个改进,它是K3可以,适应到接近3T的,关键之一吗,对,上面提到,它可能会崩溃的,这个车友超参数,我其实觉得,本质的问题是 [00:43:11]
赵晨阳:这个叫做,专家负载均衡,或者说 expert load balancing 这样一个问题,据悉来说,我们MOE 这样的一个,混合专家模型,它里面的每个token 它每次就只会去,选择一部分 routed experts去激活,然后我们其实,希望从成局来看,各个专家,他被选中的频率,是大致相当的,否则会有什么问题呢,就是说在模型层面,一些专家,他如果得不到,足够的token和T2 他在训练的时候,就不太充分,就没有办法去充分发挥,他这个专家的,这些参数的容量,而且还有一些问题是,比如说另外有一些专家,他如果收到token太多了,那其实对infra 也不是一件,特别友好的事情,针对这个问题,其实最早期的,一个普遍的做法,是在MOE模型训练的,这个loss function里面,去加一个auxiliary的,这么一种load balancing loss 那它的核心思想就是说,我们用一个额外的,这么一个loss的这个term 我们去鼓励不同的,这个专家的选中频率,更加的均匀,这个方法呢,整体来说还是比较有效的,但是呢,就是你加这个balancing loss 你就somehow需要在模型,在训练的时候,在模型质量,和你负载均衡的,这个效果之间呢,去做一个权衡,那如果有这么一个问题的话,这其实它经常可能会,是训练不稳定的这么一个罪魁祸首吧,然后之前DeepSick 它V3的一个重要改进呢,就是我们其实就是把上面说的这种,我们去添加一个Loss的方式,它用来去做这么一种专家的复杂均衡,去把这Loss给去掉了,换成了一种Bias Update的方法,具体来说呢就是我们会,我们在选那个Experts的时候,我们其实也是用一个神经网络,一个Router它去打一些这个Routing的Score 打切这些分数之后,然后再根据分数去选这个expert 然后我们给这个routing的这个score 去加一个bias 然后我们去在训练过程中我们去看,但如果一个专家他过热,我们就把bias去调低,如果他过冷,说白了就是接收到token太少了,我们就调高,这个bias它只影响去选专家时候的机制,所以我们就不需要一个额外的,一个上面说的这种loss 去改变一个训练目标,但是V3这一类的方法,它对bias的更新是固定步长的,相当于就是你每次,如果加个bias或者减个bias 你是加一个乘数或者减一个乘数,所以每一步我们就只知道,这个专家它是更加被频繁的选中了,就是说吧就过热了,还是说是过冷了,然后我们就按照一个固定的步长,去向上或者向下做一点调整,所以这里仍然是需要去调步长的,这么一个超三,所以这次K3 我觉得这次它提出的这么一个 quantum balancing的这个做法,它其实就会直接应用 router的这个分数的一个分布,来去估计说,我们应该去做多少的调整,比如说在K3里面,它的这个status 大概是说我们每个token 要在896个,这个routed experts里面,去选择16个,然后我们的做法,大概就是我们先去看,我们当前的这个token 它加上当前的bias以后,排在第17名的这么一个分数,那这个分数,我们就可以把当选进入,前16名的这一个门槛,就是算出最高的16个,是最后被选中的这些Experts 然后我们对于某一个Expert 我们其实就可以观察,它在整个Batch里面,它距离每个Token的门槛还差多少,什么意思呢,就比如说我们直观想,我们现在往一个Expert 他在Routing的时候,他的那个打分上,我们如果给他加的Bias越大,那是不是就意味着,他能够跨过的这个门槛,这个Token就越来越多,所以我们就可以根据这些差值的,这么一个你可以说叫Content 就直接去算出一个新的Bias 使得相对于当前的这批门槛,我们大概会有16去除以896 这样一个相当于一个均衡比例的token 会选择这样一个expert 这个seed bias我们就现在就算一下,然后从下一个step我们开始使用,这样我们就也不需要去前面说的,像deep seek那样做法,我们需要有一个固定,一个更新不成这么一个超参数,所以我觉得就是,对于K3来说,像Rootly expert 它有快将近1000个了,然后每次我们还只选择16个的话,这其实是非常非常极端提出的,那确实可以猜想,我们要想要去稳定的,而且有效的快速的去保持,这样的一个负载均衡,会变得更加困难,所以我个人猜想,它确实应该是 K3这次能够成功 skill到3T级别的一个,比较重要的一个因素之一吧 是不是在V4里,那个路由的改进,它更多是知道,我一个专家的性质对吧 [00:47:01]
曼祺:就是你说过冷过热,但没有那么精细到亮,然后K3里的这个改进,就是它是更精细到亮的,就是我知道它,比如说过热到什么程度,或者过冷到什么程度,对对对,我觉得这个也是,说进来说思路不太一样 [00:48:02]
赵晨阳:就是我觉得像当时DeepStake的思路,更像是一种逐步调整的思路,然后到了像K3的时候,它的这个思路更像是我,直接用一个History Info 用历史信息去估计一下,这个BIAS多少特别合理,然后下一步,直接加上这个BIAS就行了,就不再去做一步一步的逐步调整,我个人觉得两种也确实各有优劣,我觉得最后说白了就是,谁也跑出来哪个效果很好,就用哪个,那我们接下来讨论一下它具体的模块
曼祺:其实就是你发现这些模块,和我们当时讨论V4也是相似的,就包括它的注意力,然后包括残差,包括优化器等等,我们可以先从注意力开始,这个前面也已经多次提到了,就是这一次K3它是使用了KDA 这种Kimi自己之前提出来的,一个新的注意力方式,那V4的话,它其实是一个三种注意力的混合,总体是稀疏注意力优化的这个方向 K3这一次是KDA Kimi Delta Attention 它是线性注意力和全局注意力混合的一种方式,之前在143期的节目里面,我们也和Delta Light的核心作者之一杨颂林,有专门聊过线性注意力的模型,那大家想去了解一些背景的话,也可以去听之前的节目,我觉得K3这次直接在这么大的规模上,用了线性注意力,应该来说还是个比较大的,或者说比较激进的改进,它的好处是,效率的提升是很明显的 但一般来说,就大家会认为线性注意力,它会在效果和性能上,有一些损失,志远你可以来讲讲,就是K3它这次用的这个KDA 是一个什么样的改进,给业界的启发是什么,它是怎么去平衡,可能以前大家会认为的,就是你使用线性注意力的一些弊端,对我个人觉得,这是一个比较大的进展 [00:49:35]
赵晨阳:就K3路线,就像刚刚说的那样
# 177: 详解Kimi K3:强到冲击Anthropic估值的模型什么样?
- KDA与混合注意力 [00:49:59 - 01:00:00]
赵晨阳:就像刚刚说的那样,它是让大部分层,去使用一个更高效的 linear attention 也就是KDA 然后同时去周期性的,保留这种Gated MLA Gated MLA 它用来提供,给所有历史token的,这么一种直接的,全局的attention 最后他将于把,接近四分之三的,这种attention layer 都换成了KDA 也就是一种 linear attention的实现,而且最后做出了一个,非常frontier level 这么一个模型,就这套混合架构本身,之前其实 KB Linear也已经验过了,但当时它其实模型总参数,大概只有48B 50B这种级别,那K3呢就相当于,直接把它放大到了接近3T 也就是说这总参数规模,接近放大了60倍,这其实是一个非常非常大的一个进展,其实比如说之前的Coin 3.5 它是一个大概400B的模型,它其实同样也采用了,三层Gateway Datanet 再配一层Gateway Tension的,这样一种3比1的设计,那K3呢它其实进一步把这种,以linear tension为主,周期性的去保留 global tension的这种 hybrid的这种attention架构,它直接给skid到了,接近3T的这么一种,相当大的一个级别,在这里其实值得一提的是,像DeepSeek微自,它其实走的是另一条路线,它没有去使用linear tension 而是仍然在softened max的tension 就正常的tension的框架里面,通过KV compression 以及sparse的tension 这样的一个hybrid 来提升受下温的效率,这是不太一样的一个路线,所以我觉得这次K3带给我,以及包括很多人的启发,可能就是我们其实并不需要,把Full Attention和Linear Attention 去理解成一个二选一的这么一个关系 Hybrid Architecture确实是一个 很有前景的方向,简单来说就是你可以,不同的Attention 它承担不同功能,就比如说大部分层我们追求效率,小部分层我们去,就是保留一个高容量的,这么一种全局的Attention 保留这种Global Interaction 其实K-SAT就像已经有效证明了,这套方案它是完全可以SKILL到,接近3T的这样一个,非常非常frontier的这么一种SKILL的,我想补充问一下 [00:51:43]
曼祺:就是它现在3比1的这个混合比例,三层线性注意力混一个全局注意力,是怎么决定的呀,就去年我和松林聊这个线性注意力的时候,因为其实实际上大家用的线性注意力,一般都是要混全局注意力的,他当时跟我说这个怎么混,主要是靠经验是实验出来的,现在有了更多的,比论方法,或者说总结出来的规律,来指导怎么去混合 [00:52:07]
赵晨阳:从公开的资料来看,这个比例的决定,本质上应该还是靠,就是去靠做实验,之前Kimi Linier 他们专门在一个 16层的一个小模型上,就是上面提到的,这个48米的一个模型上,他比较了不同的配比,他们当时的一个结论是 3比1 他们在这个测试级,或者说在这个叫做,验证级上它这个效果是最好的,就是那个populacy指标它是最好的 1比1的时候基本一样,但是负碳层更多,推理成本也就越高,所以K3呢基本上就沿用了这个 3比1的这个比例,然后最后再去额外的加一层GET的MLA 保证我们整个模型的结构,最后一层一定是一个global的attention 你说1比1是一样的,就是说效果是一样好的,对对效果更近,但是因为负碳层更多,所以相当于它就效率就更低,对 所以像K3这些Pulse 他们其实也没有说,他们在接近三期的规模上,就重新去扫描过各种比例,毕竟你可以想象,这肯定非常非常贵,就一般来说的话,在模型训练的团队里面,就这种特别特别昂贵的 ablation study 尤其是这种architecture ablation study 都会先在小模型上做,然后再去研制skilling law 去验证整套的,像architecture 包括room recipe 能不能稳定的放大 K3它确实去,也做了一些整体的,这个SCALE的study 但是它主要验证的,还是整套K3的这么一个recipe 而不是说我们把哪个细节挖出来,所以3比1到了3T 它不一定说一定百分之百就是最优解,但是它目前作为整体设计的一部分,它其实我们看结果,它已经很成功的SCALE上去,接下来的一个问题 [00:53:24]
曼祺:就是说它因为K3是一个,百万上下纹的模型,其实上下纹非常长,它在这么长的上下纹里面,它是怎么去解决,就以前线性注意力,可能会有的这种遗忘的问题 [00:54:13]
赵晨阳:这也是一个非常好的问题,我们先要把遗忘这一点,说得更准确一点,就是说因应attention 它在设计上,其实一般来说,大家会认为是一个trade off 就是它会把任意程的历史,去压进一个固定大小的recurrent state 就比如说在K3里面,对于KDN层来说,那这里好处就是说 cache和每一步的计算,它不会随着上下文,去一直增长,代价呢,就是说我们不同的信息,会在有限的这些状态里面,就会互相干扰,就会导致什么呢,就特别早啊,尤其是那些特别细节的信息,可能会被覆盖掉,所以问题的根源,其实在于就是,这里的这compressor呢,它因为是一种,就是固定state的,它本身呢,就会存在这个,容量的瓶颈吧,当然了就是其实 KDA它做一个 Leading Attention的,这么一个 Varant它在用,它用了其实一些technique 它把就是这些事情,它做得更聪明了,就是说他们用的像DataRule 像ChannelWiseForGetGauge这样的技术,就简单来说,他每次可能先看 Memory已经预测出了什么,然后我们只需写他,在预测的时候的偏差,然后同时不同的Channel 可以学到不同的保留时间,除此以外,比如说K3 他们还给每一步的RetentionFactor 去加了一个LowBump 这个其实在TechReport的飞鸽3 那里有一些分析,感谢朋友可以自己看看,就简单来说,它直觉上也可以去限制,过于激进的顺势遗忘,但我觉得其实上面说了这么多,就是KDA它特别聪明的一些设计,其实我觉得它,更多还是,更好的去管理这种有限的memory的一些手段,就是它并不会说从,根本上就消除上面说的这种,容量瓶颈的问题,说白了就是你在计算的时候,多部累积之下信息呢,还是会衰减 所以我个人感觉,推算它解决这样的一个,百万上下位级别遗忘问题的时候,真正答案呢,还是因为做了这个 hybrid的结构,就像我们前面说的那样,我们每三层的KDA 会加入一层Gated MLA 最后一层也一定是一个MLA 那MLA呢,它是这种global attention 它会就是说保留,对所有历史token的,这种global的interaction 所以模型它其实并不需要,我们KDA就把这100万,上百万级别的这个token 它每个细节都压在,它的这个recurrent state里面,就上面说的,其实也很困难,但因为有这个MLA 那MLA呢,提供了这种Global的Interaction 就是这种全局的这种Attention的这么一种机制,所以我觉得它应该是一个缓解遗忘非常关键的一点,其实像比较早的时候 [00:56:13]
曼祺:MiniMax的M1那很早了 25年年初的时候,他们也做了这种混合的方式,后来他们又换回了Full Attention 就思路是一样的,然后效果不一样,我个人觉得很多时候
赵晨阳:它的这个做很多事情的bar主要还在这个Exclusion 就在这个执行上,有东西能做或可能不能做或可,不代表这个技术路线本身make sense 还是不make sense 他可能说就是,具体实现的时候,比如说数据不一样 infra不一样 [00:57:10]
曼祺:然后做这个事情,它有很多小细节不一样,它最后可能就都很不一样,注意力结构的变化,它也会带来一些infra上的变化,就赵晨阳正好可以 Covic 像我们上次在讨论VS的时候,也讨论了,系数注意力和线性注意力,这两种改进方式,你当时提到说,你觉得线性注意力的理论优势,可能要再等几代,真实的大模型的验证,那可以说K3现在,它其实已经验证了
赵晨阳:线性注意力的一些理论优势吗,包括这种新的注意力结构,它会给Infra带来的一些影响和变化是什么,我觉得我之前的判断还是很有道理的吧,我可以诚实地更新一下我的判断,然后也欢迎大家在听之前,我们在晚点的podcast里面,讨论DeepSeq V4的那期节目,我当时提到的两件事情,第一个就是线性注意力的理论优势,是需要几代真实的大模型来做验证的,第二,吸收路线在工程上面更可控,和现有的KB Cache Prefix Cache 这些基础设施的接收性更好,首先K3对于线性注意力,这个路线的验证,实际上每次有新的大模型发布,我的朋友圈都会围绕着,线性注意力还是吸收注意力,吵成一片,所以我觉得非常的,好吧,不论是一算还是做算法,都是这个感受吧 K3的话毫无疑问,是对线性注意力的一个有效证明,一个2.8T的主线模型,而且Median Token 并且使用了Nope 然后K3的MIA层,完全不用加位置编码,位置信息就全靠 KDA的地推门控,还有衰减来提供,这样的话,就是它扩展到百万的,这个Median Token的时候,不太需要重调,类似于Rope的这些频率,底座等等,也不太需要像Yarn一样,专门去做差值,外推起来是非常自然流畅的,这个设计和效果,当然是非常好的,然后第二点我说,这个吸收注意力,在工程上面会轻松一些,这个看法也没错,这段时间我们SCLang团队,也花了很大的精力,去尝试把线性注意力,需要的recurrent state 也纳入到 EO的prefix cache体系当中,就让K3这种hybrid KDA MLA模型的潜质负用,能够达到和全注意力模型,一样的通用性,长期来看,线性注意力和,系数注意力的兼容性差,这件事情可以逐渐被工程弥补,当然代价就是 我们的抽象会比以前更腐烂一些,对吧,另一个角度说,这个线性和系数,也不是一个二分的问题 K3选择一个三比一的混合,这个每个block 三层KDA 加上一层的Gate MLA 然后 overall这个backbone 最后还会有一层额外的MLA 线性的部分,是靠KDA来提供这种,我们所谓的位置,敏感的序列嘛,然后全局的部分,就是靠MLA来提供这种 [00:59:36]
# 177: 详解Kimi K3:强到冲击Anthropic估值的模型什么样?
- 线性注意力、MLA与长上下文 [00:59:59 - 01:10:01]
赵晨阳:就是靠MLA来提供这种,不受限的那种交互,其实这个体现的模型,也非常强大,所以我,对比我说,对吧,这个线性和系数,哪一条会胜出,我更愿意相信的是,任何一个能够在百万上下文,这个水平上,把成本,类似于我之前讲的,这个KVCash的Transfer成本,类似于我之前讲过,这个Preview的一次成本,当然我们之前可能也,之前也讨论到一些,这个Routing的成本,这些成本能够压下来的架构,它大概率都是易购的,然后易购的模型架构,对于我们SGDON推理框架而言,需要持续性的,同时维护好多种形态,和生命周期的attention 抽象架构,这是一个巨大的工程考验,这也是我们团队,这个工程能力的体现,那我觉得挺好的呀,这事越难,就是说它的工程工作越多,其实你们做的工作越多,你们的价值会越多
曼祺:希望如此 OK KDA就是这种,线性混群取的方式,它因为理论上,就是你加了线性,其实你的效率会提升嘛,这个也可以讲讲,就是比如说,你们在做适配的时候,观察到它效率的,有哪些提升,还是比较惊人的,其实他自己的技术报告里有写到,就是说他有实现了,在百万token上下文场景下的 6.3倍的解码加速 6.3倍这个值 [01:00:53]
赵晨阳:其实不是Kimi K3报告里面的严谨值,而是Kimi更早的 Kimi Linear论文里面的数据,不严谨来说,在平样的模型规模下,线性注意力为主的混合架构,比起传统的全注意力架构,在100万token这个全上下文量级,混合架构生成的token速度,是全注意力架构的6.3倍 6.3倍是一个非常可观,乃至令人惊讶的数字,我可以简单解释一下,模型的decode阶段,每吐一个token 都必须要把整个请求的,全部历史上下文读一遍,全注意力架构的历史,是整个kvcash 它是跟着上下文,长度线性变长的 100万token的kvcash的长度,近乎是1万个token的100倍,上下文越长,越靠后的token 它的这个开销是越大的,然后线性注意力,则试图把请求的历史信息 压缩到一个固定的 recurrent state当中 100万token和1000token 它们的线性注意力的recurrent state 几乎是一样大的,我也分享一些我们SG让团队,为K3设计的推理站的实际素质,来为大家提供直观体验,这个Kini是69层的KDA 加上这个后面应该是24层的MLA 那么69层的KDA 给一个请求分配的历史信息大小,基本就固定在54MB 不论长短,然后这24层的MLA 是全局的注意力,然后它会为每一个Token 额外的分配27KB 那么一个百万上下文长度的请求,在MLA上的开销,大概就是27GB 听上去是一个54MB 加上27GB的组合,但是如果先前的69层,也是全注意力,那就不是54MB了 而是额外的几十GB KDA和MIA的组合,节省下来的存储大小,进一步反映到 KBcash的搬运成本上,然后某种程度上,让整个推理速度快了6.3倍,然后最后一个问题就是,什么情况下,这个6.3倍的体现是最明显的,毫无疑问是,长的Agentic Coding 如果每一个Agentic Coding请求,都消耗上百GB的KBcash的话,最强大的HBM缓存 [01:03:07]
曼祺:也撑不住几十个请求,就除了KDA这个新的注意力机制之外,这次K3的另一个新的东西是Attention Residues 这也是之前他们发的成果,是今年春天的时候发的,然后当时马斯克还转发过,我觉得他用到K3上的速度是非常快的,这个我也可以补充一个,就是我了解到的信息,就其实在做Attention Residues的时候,差不多就是K3在定版的同期,所以其实当时要不要直接把这个东西放到K3上,还是说我再放到下一代模型上,其实他们内部是有一些讨论的,后来杨志林也是拍板做了这个决策,就直接放到K3上了,它是很快就进到一个主线模型上的一个成果,正好我们上次讨论V4的MHC的时候,也是讨论到了Kimi的Attention Residues 是有一些异曲同工的作用,就是想追求的效果是一致的,想先请志远和大家简单的介绍一下 Attention Residues是一个什么东西,它的作用是什么,它是在模型里的,就比如说哪一个模块,或者哪一层发挥作用,我觉得Tension Reduce [01:04:27]
赵晨阳:它解决的主要是模型,它在这种深度,就从浅到深方向的,这么一个信息流,最早的时候,最标准的这种Reduce Connection 它在展开以后,当前Layer它看到的,它本质上是Embedding 以及之前,它所有比它浅的Layer的 Auto Pro的职业相加,而且这里每一项的权重,它本质上就稍微都固定为一,职业加起来,其实你随着模型,越来越深越来越深,这种register stream的,它的这个大小,它就会不断不断的增长,那这就导致个什么问题呢,就是你每次新的一个layer 你新写进去的这个信息,它其实就会被逐渐的给稀释掉了,而且同时你对于后面layer 就更深的layer来看呢,它没有一个,一个直接的机制去说 OK 那我现在我要去选择,我现在更需要前面的哪一层,或者说哪些layer 哪些层的这种representation 其实atlasher registers的这个idea 它非常非常直观,就是我们把我们正常的 atention去旋转一个90度,比如说简单来说,正常的atention 你是在token之间,去算那个匹配的分数,然后去做选择,那其实atention 本来就是在layer之间做选择,层之间,对对对,就是会在层之间做选择,但每层各自会有一个,可以学习的一个sudo query 这个query在所有token之间,都会共享,而这时候,它会和当前token 在不同深度的reputation 做一个匹配,然后再通过像softmax这样,去决定应该从哪些更浅,就是更靠前的这些层里面去读取信息,当然这里虽然query本身,它是固定的参数,但是不同token在各层的representation 它是不一样的,所以最后它的attention的权重,它还是会随着token的内容变化,所以这主要就是attention residues的一个原理,之前其实V4的那期有聊到过,就是MHC和attention residues 它其实想追求的效果是相似的 [01:06:22]
曼祺:就是你最开始前面也提到了 K3的整体思路,也是把信息在不同方向的流动,都做得更有效率 attention residues解决了,就是你刚刚说的,层之间的这个信息的流动,那回到这两种方法上,巨员你觉得
赵晨阳:它有哪个潜力更高的这种区别吗,这个问题,就是他们这两种方法,他们肯定还是想解决,同一个大的问题,就是上面提到了,你标准的这个relative connection 它在深度方向的信息流,它是太单一了,当然这两种方法,他们解决的思路就非常不一样,就这里我可以大概说一下,就非常宏观的,很直觉的一个idea 那MSC的做法,它大概就是我们会维护多条,之前就一条并行的这种regio stream 那每层我们会先动态的,把这些stream 它混合成这一层的输入,然后再把这一层的输出,分发回不同的这个stream 同时它这里还有一些实现上,它这些设计上的一些细节,就比如说他们会regio mixing 加上一些约束,然后去保证信息 Gradient这样的东西,它在模型变身以后,不会被无限制的放大,然后像Tenture Regulus呢,其实就像我们刚刚说的那样,它更像是什么呢 就是你能说它更像是每一层,我们去提供了一个历史目录的信息,然后这样的话,它可以去直接去找前面某个阶段产生的信息,然后选择性的把它挑回来使用,我个人感觉呢,就是如果你只去讨论这个架构的这种表达能力的话,只去看那个理论上的上界的话,那可能你说Tenture Regulus的上限更高,这个是make sense的,就毕竟呢,你想MHC的这个,刚刚说的这种原理,它最终说白了,还是把所有的历史信息,它都递归着去压缩,在这种固定数量的,这种regulus streams里,那full attention的这种regulus呢,它其实就有一点点像,在每个token上,我们对于所有的这个,比我们更浅层的那些层,它的输出形成一个深入方向的,这种下三角的这种,注意力的这么一种map 一种attention map 所以其实我做一个,很不恰当的比喻 但是形象来说,它就有点像,我们在,层的这种深度方向上,一个是recurrent model 一个是soft max attention 那MHC呢,就它的信息,要通过大小的state 一层层传递,有点像这个linear attention 对吧,那Full attention 它就可以直接去,跨层的读取,那从表达力的角度,那肯定是 Full attention 这个还会更高一点,你刚那个比喻,意思就是说,它在层的角度,一个是RNN 对吧,一个是个transformer 对对,或者linear attention 它其实也是RN的变体,但如果就是说,我们想讨论最终的实际效果的话,我觉得还是要看,大家具体的XQt的细节,就比如说像K3 它其实用的也不是刚刚说的那种,就是完全global 所有层之间都能互相attention的结果,它做的其实是一种,叫做block attention reduce的这种technique 它不是理论上表达能力最完整的那种 for attention reduce 就是说它会先把层分成很多block 然后它会先把每一个block里面的,层的输出给汇总,然后在block和block之间做attention 我想到这个有点就像吸收注意力了,也in some sense yes 然后再比如说attention radius 它其实需要保留更多的历史的replantation 就这里也会带来一些像infra上memory 和communication的这种成本,然后msc其实也有一些自己infra上的问题,所以我觉得就是最终的效果,肯定要看其中的细节,当然我觉得就是目前你可以确定的是 k3和v4它已经分别证明了,这两种路线,其实都可以去skill到,非常frontier的一种级别,所以未来到底哪一种路线,会更有潜力,或者说它能做到一个更好的效果 [01:09:14]
# 177: 详解Kimi K3:强到冲击Anthropic估值的模型什么样?
- 训练方法、数据策略与模型能力 [01:09:59 - 01:20:00]
赵晨阳:或者说它能做到一个更好的效果,我觉得其实还是很拭目以待的,对我觉得就是前面,因为讨论很多东西,它是对比着来看的嘛
曼祺:包括前面说线性和系数注意力这些,就你们看到有一个趋势,好像是条条大路通罗马对吧,就大家反正会有不同的实现方式,但大家看到的问题是相似的,就是说行业里大家看到的瓶颈,或者要解决的东西是相似的,下一个话题是优化器,和V4一样,就是这次K3里用的也是Mirror的优化器,而且Mirror这个优化器,之所以它能被比较规模化的使用,其实本身也是Kimi自己更早的时候,它的一个成果Mirror Clip 然后它也把这个成果贡献给了业界,基本上是现在比较主流的一个优化器的方法,然后这次在K3里面,他们自己又有更进一步的改进,是提出了PerHead Muon 然后这个想请志远,可以再帮大家讲一讲,一个是说优化器,为什么比较重要,它核心解决模型的什么问题,另一个就是K3 这一次里使用的这个Muon的优化器 PerHead Muon优化器,相比于之前K2已经在用的Muon 它的一些具体的改进是什么,对那其实优化器,它是相当于模型训练,不止语言模型训练 [01:11:01]
赵晨阳:就深度推行模型训练里面,它非常重要的一个组件吧,它是解决了核心问题,说白了就是我们现在有个模型,然后每在训练过程中,我们的batch算出一个梯度之后,那我们怎么把这些梯度,转换成一次非常稳定,一些有效的参数更新,而且是从长远来看,比较好的一个参数更新,就比如说我们在训练一个模型的时候,我们会设计loss function 但是其实说白了就是,我们要优化的东西,然后梯度就告诉你局部大概要往哪里走,其实优化系它就会决定最终,要采用什么方向,走多大一步,然后我们怎么去利用一些历史的梯度,去降低噪声,去处理不同方向的尺度差异,去处理不同方向的各种冲突,可能等等的这些信息,其实一个好的一个优化器,它通常意味着,在相同的训练的极杂量下,我们可以收敛的更快,最终的loss更低,而且还有一个很重要,就是稳定性 对就是我们不希望,我们在训练过程中,出现太多不稳定的这种spec 就Mewon它本身的核心,是说我们在拿momentum 就是动量,它是一些优化器里面,根据T度和历史T度,串传一些信息,我们拿它去更新参数之前,我们先把它做一个,近似的一个正交换,这样的好处就是,我们让更新不要去只集中在,少数几个比较,当命的方向上,问题是,就是正常的那个MIMO 就是你考虑以前,我们的多头的attention 它的存储上,虽然是一个大的投影矩阵,但是其实在整个算法的,计算逻辑上,就是对于模型架构来说,每个hi的它是比较独立的,所以意味着,如果你先把所有的head 都放在一起正交化的话,那其实他们的这个Gradient 包括Momentum的,这个动量的这些,就T2和动量的这些信息,他们就 somehow会有些冲突,就比如说有的Skid 更大的这个head 它可能就会主导,整个矩阵的更新方向 Skid比较小,这些注意力头,他们可能就没有办法,去被充分的Normalization 所以Perhead的流量的,这个核心思想就是,我们对于每一个注意力头,我们都去单独的做一次 Normalization 就意味着我们不同的这个head 不同的注意力头,他们在做更新的时候,他们的这个大小,他们的skill就更加均衡了,所以其实 K3 Reforce里面也专门提了,就是说他们发现,这个per-head的Mewan 在他们的setup下,可以让这种训练的,这种设定dynamics 更加平衡,能够很好的去改善,大规模训练的稳定性,相比Mewan Clip [01:13:00]
曼祺:就是Kimi自己之前提的这个改进,它升的这个per-head的Mewan 它实现起来的难度会更大吗,就我想知道,它有可能在业界怎么扩散,因为Mewon Clip 其实在业界,还是有挺多扩散的,就很多别的团队也会用
赵晨阳:我觉得从实现难度角度说的话,像Private这种Mewon 它其实算法上,基本上就是,我们直接去 reshape成很多的,这个注意力头,这个block 然后做一些定型处理,所以算法本身,还是挺直接的,我觉得实现的难点,一个难点可能是,我们在大规模的训练里面,像这些QKV 它经常被融合以及切分,其实这种导致,这个优化器的state 它会分散在不同的GPU的Rank上,所以我们必须要保证,每个注意力头,它在算法计算上的逻辑边界,它不会被打散,同时我们又能够非常高效的,重建这个完整的Block 然后还要把大量的这种小矩阵,去合并执行,再去做一些计算,避免带来非常大的这种通信拆销,然后避免一些客用浪池上的问题,所以我觉得像K3 看也在Tech Report里面提到说,他们为Mill也做了一些
曼祺:专门的处理,比如说他们把通信和真交化计算,去做了一些Pathline 关于优化器,我还有一个小问题,就是构造新的优化器改进,这件事AI可不可以自己来做,因为上次我们有聊到 Vion最开始是,一个个人开发者 Karen Jordan 他提出来的,后来我了解到就是 Vion其实是在 Jordan搞的一个开源项目,叫Nano-GBT Speed Run 这个里面诞生的,然后这个项目简单来说,就是我让所有人,就是去训一个比较小的模型,一个标准任务,然后大家来比速度,谁能最短时间做完,最近有一个新的公司 RSI就是TeamC 还有田园栋他们那个新公司 6月的时候做了一次尝试,他们是用系统来自动化的,跑这个speedrun 那之前其实两年多的时间里面 speedrun都是社区里的一些研究者,就是人来做的,所以有一个小的脑洞是说,优化器是不是未来 [01:14:42]
赵晨阳:AI自己也可以来写,然后来制造了,这确实我觉得是一个,非常非常重要的一个未来的方向,而且事实上我觉得,其实社区里面,已经有一些早期的城市了,我觉得主要是,就做这种优化器的研究吧,它就天然非常适合这种auto research 因为它的这个pipeline 整体来说还是相当于说,比较结构化的吧,就是我们会,比如说先提出一个,新的优化器的方案,然后我们去写代码跑实验,然后我们去看这个loss 然后看这个比如说像稳定性,看这种曲线,这种俗称做pave setting 然后再根据这个结果,做一些改进,这里你会发现就是研究的目标还是比较明确的,而且就是最后的指标其实也非常非常清晰,所以其实在满足这两个性质的问题,其实就很自然越来越多的就会被交给AI agent来做了,这也呼应到了我们前面讨论的 [01:15:34]
曼祺:就是他用一些早期的ChatPoint的版本来做Curl的开发,就是这次K3 就是刚才赵晨阳也说他觉得一个是你目标比较明确,然后第二点是你的结果其实比较好验证 [01:16:25]
赵晨阳:第三点是不太容易被hack 就作弊的空间比较小,像这种都是挺适合AI自己来跑的,对我觉得是这样的,然后我个人觉得这里其实还有一个很有价值的问题,就是我们可以让agent去研究,怎么去设计一个小规模的setting 然后让这个setting里面能够得到结论,它是能更好的去generalize到,真正的那种大规模训练的,说白了就是你的一个优化器,它在小模型小规模的实验上跑得好,不代表说我们换到一个更大的模型,然后更长的一个瞬间周期,甚至包括不同的参数形状后仍然好,所以我觉得就是AI-Agent 我们不仅可以让AI-Agent是研究,我们下一个非常好用的这个优化器是什么,这还可以研究就是说,我们应该去用什么样的小规模的这种Proxy Examine 什么样的Scanning Ladder 它是能够最快的判断 一个优化器能不能最终Scan到我们目标的那个场景下的,如果这个问题我们能够做得非常好的话,其实我们就可以大大加速,整个对优化器研究的一个迭代过程,因为毕竟你跑次实验,还是要花不少时间,不少资源的,如果你能够就是用最少的资源,去飞速的做一次验证,然后这个验证结果也很可靠,那整体的流程其实就会被加速起来,所以一个是优化器本身的改进 AI可以自己来做,另一个就是你刚刚说的,我预测不同的改进,哪些更容易规模化,这件事也有可能自己来做,对对对,或者说你怎么去设计一个,比较小规模的场景,然后使得这个小规模场景下,出来的结果是比较make sense make sense就意味着,它在大的这个skill下仍然是对的,或者说比较transferable 那这个方法其实也不止,可以用在优化器的改进,因为你基本上AI训练,你的很多部件,都是你先在一个小楼上面试,然后你得给它skill对吧 对对对,包括我们前面提到的,各种模型架构的改进,然后包括就是说,各种不同强化学习算法,它的调整,这些我觉得都是个很关键的问题,就怎么在小规模的实验下 [01:18:22]
曼祺:能够让大规模的实验,结果也能更加predictable 这个是模型开发,很核心的一个能力,而且你做得好的话,可以节省很多资源,我想了解一下,据你所知,业界有谁,初步掌握了这个能力,我觉得这个不是
赵晨阳:业界有谁初步掌握这个能力,就是大家都有这样的能力,只是有的做得更好,有的在有的领域做得更好,有的在有的领域,做得更弱一些,谁在这个方面做得比较强,我觉得还是Fontelab更强,就是美国的OpenAI 他们这方面,做得应该是非常非常好的,就是他们一个自己资源又多,一个是他们就是这一套,怎么去做小规模的这种验证的,各种流程啊,各种基建也更成熟吧,之前一直有一种观点,就有的人会认为,像美国的这种Frontier Lab
曼祺:因为它的算力资源会多很多嘛,其实比中国的一些公司多,一到两个数量,所以可能他们反而很多,这种就比较细的改进,对他们来说就不一定那么必要,我就是指,就是比如说你刚刚说的,我能更高效率地使用算力这件事,然后反而是中国,因为大家很缺算力,所以可能你前面,做实验的过程,也会非常谨慎,然后也会找,各种各样的方法,说我怎么在 [01:19:15]
赵晨阳:有限的算力之下,我能达到更好的效果,你觉得这种观察成立吗,我觉得这个说法,一方面是有道理的,就比如说你可以看到 DeepSeek里面,有很多的,各种工程上的优化,确实是压到了极致,但另一方面,其实我觉得也不要,小乔弗让TL Lab 他们做各种优化的,他们其实也是很有东西的,不管是各种小优化
# 177: 详解Kimi K3:强到冲击Anthropic估值的模型什么样?
- 开放模型的工程生态与限制 [01:19:58 - 01:30:00]
赵晨阳:不管是各种小优化,还是各种,怎么在小规模做得好,然后去兼顾到大规模的,有一个就是对SRP的观察,想和你讨论一下,就比如说你周围交流,会不会有这种感受
曼祺:就有的人会说 SRP其实在比如说架构,这一层它做的花活没有那么多,它是把很多重点都放在数据,然后放在infra上,对对对 [01:20:09]
赵晨阳:我觉得根据各种gossip 确实是这样,就是他们基本就先行 doing the basic things right 就是怎么把一些简单的事情,做到其实的正确,然后去有效scanning 把事情做好,我们来讨论就是后训练的这一部分
曼祺:后训练和RL 虽然前面有聊到说,它后训练的细节并没有披露这么多,然后这次可以在技术报告里看到的是 Kimi有一次设计师,他先训练九个领域的专家模型,然后他通过MOPD 就是Multi-Teacher on Policy Destination 给它合并成一个模型,这个也许应该能翻译成,多教师的在线针流,对给它合并成一个模型,可以请靳远分享一下,就为什么他不直接联合训练
赵晨阳:一个要先分后合,对就其实这个MOPD 这个Multi-Teacher on Policy Dissolution 这个recipe 它其实最近一年,它已经快速成为了一条,非常常见的一个post-training recipe 像这种方法,其实一般大家也不会说 [01:21:03]
曼祺:专门写个文章去讲,对吧,是的,就其实这种MOPD 它不太是研究问题,为什么像比如说 Attention Residues这种东西 Kimi就会专门写个文章,然后像MOPD这种,就可能没有任何公司
赵晨阳:会专门写文章去讨论这个话题,我觉得这个问题,其实问得非常好,就我觉得,一个东西能不能写成文章,一个很重要的问题是,你能不能把它随目成一个,非常比较clean的,一个research问题,一个研究问题,比如像Tesla Rilege 它可以有一个,很clean的研究问题,它指标很明确,你要对比的对象非常明确,然后比如说像MOPD这种,你不做MOPD的话,你要对比的其他的方案,就特别特别麻烦 MOPD它可能更像是,我们直接避免了一条,很麻烦的路径,然后你就不需要关心说,我怎么把这个麻烦路径调得非常明白,所以这里就,它相对来说就不是那么干净的,一个研究问题的一个setup 我在想它的这个相关的一些影响
曼祺:比如说你看Attention Residues 它写成一篇文章,它有三个一作对吧,对这些作者来说,它肯定是有它的职业的credit的增加的,那业界也有很多,就大家用的很多的方法,好像也不知道最开始是谁想出来的 [01:22:11]
赵晨阳:其实在比如说在美国这边,其实Fontelab之间有个人提出一个很好想法,就是就类似于他们小圈子内部,其实是都知道是谁提的,所以其实不会影响他们自己的,比如说QI电台,包括更直白一点,他们的身价这种
曼祺:就是这种消息流传起来都很快的,只是他不会在公开的网上流传 OK 所以他是有点像就圈子内都知道,但是外面的人不太知道,对对对,嗯嗯,那你可以继续来说,你就说这个东西最近这半年到一年
赵晨阳:他其实变得很主流了,对对,它最近一年已经快速成为了一条,非常成见的一个Pulse Changing Recipe 其实公开采用这条路线,就已经包括像B-Mode VR 像DeepSeek的V4 以及包括后面NVIDIA做的Nemotron 3 Ultra 就是这些模型,然后包括这次的K3 这里用MOPD一个很重要的原因,就是我们想把不同领域的研发过程去结拢,方便我们一个很大的模型团队,上面有各个小团队,他们之间的合作,就比如说像General Residue 像Coding Agent 像general agent这些等等,它们不只是data不一样,它们其实包括像environment 像我们去给一个奖励的策略,像我们做一次router的程度,像它们使用的hardness 甚至是算法的这个recipe 它都可能非常非常不一样,对吧,那比如说像code agent里面,包括infra可能也会有些区别 比如说code agent里面的infra 它可能会有些自然挑战之类的,所以其实如果你全部都放进,一次join的那种,就把你们所有东西全部混到一起,然后做一些大的R-RUN的话,其实我们在混这些DOMA 混这些不同的领域,然后混这些不同REWARD 还有包括前面说的各种训练的设置,它就会全部给偶合到一起,就会导致你做模型合板的时候,你的技术压力非常非常大,就是你要把这些东西,它们可能本来在自己的team里面,它已经做work 然后最后你合板的时候,还要考虑说怎么合起来再work 然后它们各种setup都非常非常不一样,对吧,就是这样会导致压力特别大,所以就是如果我们用MOPD这个reset的话,我们就可以先分别训练各个领域的专家模型,其实每个小团队,他们最后要deliver给合板的成果,它其实就是自己领域的小专家模型,不用把上面说的那些乱七八糟的 什么各种RSP 各种infra 还有包括各种什么new elements 这样的东西全部都给deliver出去,其实每个小团队,我们就专注的把自己的领域的模型,给训练到最好,然后最后合板的时候再用MOPD 这样的话,大家就比如说,你不需要为了方便,最后的一个招联系练习,我们提前把所有的 Recipe和Infra 都强行统一,对吧,那就可能会导致,你在做自己领域的时候,非常的束手束脚,然后我们也不需要说,我们在每次迭代的时候,去同时协调所有的领域,这样就能让你的迭代,变得非常快,还有就包括,你做合板的时候,我们不需要花,特别特别大的力气,去协调各个方面,所以以前它也是 [01:24:38]
曼祺:分开训练的,现在也是分开的,只是合的方式不太一样,以前是一个,更完整的和,就是你得带着各种训练设置,一起来和,现在是每个专家训完之后,我最后只和那个结果,对吧 [01:25:15]
赵晨阳:以前就这样的RL training 就还没有那么麻烦,对吧,比如说最早的时候,我们不需要做agent的RL 那也不需要,就infra可能比方,相对来说也比较统一,大家只需要把数据,贡献出来,然后直接一和就可以了,但现在就是各种RL方面,他们的recipe 不同领域就会复杂很多,他们都有自己的这个recipe 所以我们只喝模型的话,就会方便很多,它在直觉上,它好像给人一种,跟运训练的趋势
曼祺:有些相反的这种特点,因为运训练,其实你是在同一个模式里面,你是吃了不同,就非常多元的数据,你就是放在一个过程里去训的,对,然后后训练按你刚才的描述,其实是之前后训练,它要处理的任务,下游任务比较单一,或者简单的时候,大家其实是在一起训的,对,现在就是你能看到,它是一个好像在走向分的过程,比如K3就是有九个分开的,它为什么是这样一个过程,你觉得它更远来说
赵晨阳:它有必要又,就后续那这个阶段,它有必要又变成一个合的过程吗,那样的话它会潜力更高吗,就我觉得是合起来,还是OPD哪个潜力更高,这个还,这不好说,就是有很多的研究,他们会说可能做NOPD 它比去直接做那种joint的,效果要更好之类的,但是我觉得就是这种结果吧,你都要看它非常非常具体的,实验的setup 才能说,它的这个结果,到底有多generalize 我觉得目前,做MOPD主要还是,说白了就是,这样是最方便的,就是你不用,像我刚刚说的那样,你每个团队,有一个自己的方案之后,你还要去合方案,而我们是合,这个最后的这个,叫做模型就行,就像说白了就是,你合上行不行很麻烦,但是合模型,就用MOPD就很简单,然后大家就,专心的把自己的模型,做好就行,然后MOPD里,其实它的英文,它最后一个是 [01:26:22]
曼祺:第一是代表destination 就是针流,翻译过来就是针流,我觉得正好也可以说一下,就本来针流的意思是什么,以及业界,因为现在关于针流,有很多讨论,实际上它从技术上来说,是怎么一回事 [01:27:14]
赵晨阳:对就针流从技术的,最原始的定义上来说,它always都是去把,踢车模型,就是教师模型的能力,它去传递给一个学生模型,它最经典的用法,其实就是去压缩模型,就比如说你先训练一个很大的一个教师模型,然后再把能力去占留到一个更小的一个学生模型,这样你可能就用学生模型,它更便宜一些,对吧,就比如说他QC里面,他们的技术报道里面就说了,我们会做这种strong to weak的desolation 就是先去获得一个强大的模型,然后再用它们去帮助训练小模型,所以从技术的角度,它always都是教师模型去传递给学生模型能力,但是我们更多要看它的目的是什么,就比如说在MOPD这里的目的,它不是说去压缩模型,而是我们刚刚说的合板,就是我们先从同一个 Foundation的模型出发,我们训练出不同Domain 以及不同Reset Effort的教师模型,然后最后我们再把它,他们的能力去传回一个,统一的一个学生模型里面,然后这是目的一方面,然后另一方面就是,我们这个针流具体怎么实现,然后从具体的算法角度,就是On Policy Dissolution 做的事情是,我们会让这个学生模型,自己去生成一个轨迹,然后学生,然后教师模型呢,再对这个轨迹去打分,提供这个一种比较稠密的,这个叫做奖励信号,然后用这个奖励信号呢,来去提升学生,然后另外一种呢,也很常见,或者说更传统一点的,这个针钮模式,也就是刚刚麦奇提到的,就是说在这种普通大众呢,在社交媒体上去讨论这个针钮呢,指的就是,一般是说我们这个老师,先去预先生成一批固定答案,然后学生都会就直接,在这个固定的这个数据上,这个离线的数据上,我们直接去模仿学习,去学习老师的模型 他在这个输入下,他的输出是什么,这里MOPD使用的 on policy的帧流,和你说的,就是我们平时讨论的语境里面,更常提到的那种帧流,它是off policy的帧流,这个on policy和off policy的区别是什么呀,更多指的还是算法级别的区别,对对对,就比如说on policy 它学生是背语言的模型,训练过程中,学生自己去亲自去生存这个轨迹,所以这个我不说它是unpolicy的 unpolicy只是相对于学生来说,老师他的这个轨迹,他是一个off policy的,就是老师的轨迹,不是学生自己生存的,哪一种他的学习的效率会更高,这个其实也是,不同的场景下,有不同的这个经验性的结果,比如说在做合板的时候 [01:29:17]
# 177: 详解Kimi K3:强到冲击Anthropic估值的模型什么样?
- 从模型权重到训练流水线 [01:29:59 - 01:40:00]
赵晨阳:比如说在做合板的时候,确实肯定是unpolicy dissolution 这种做法,还是unpolicy的比off policy更好,对,但如果只有这个教师模型的,这个叫做输出,你没法搞到,它的权重 logic这些的话,其实你没法做到,像教师模型,去给学生模型,系统的打分,那你就只能去做 on policy dissolution 教师模型,只能拿到,它的这个最终输出,假如说比如 Anthropic 它自己有自己的模型权重,对吧,比如它自己,这种自己的话,从技术的
曼祺:就是效果上来说,你觉得它,大概率它是 on policy 还是off policy 你说这一阵,自己的目的是啥,是为了变成,一个更强的模型,大家说的左脚踩右脚,然后自己原地飞升这种 [01:30:30]
赵晨阳:这个感觉目前还是大家愿景吧,就是还没有真的做到,我个人理解主要还是看,这个external这种,外在的这种监督信号,它有没有,就我觉得你很难在,没有一个很稳定的,很能scalable的这种,外在监督信号情况下,去提升一个模型,也就可能就是说,你就会用这个技术里面,它的名字可能带来一个 desolation 但它肯定是找到了一种,很scalable的方式,能够稳定地把,外在的这种监督信号,给打进来这个过程,那最后在Infer的层面上
曼祺:请赵晨阳来分享一下,你觉得K3做Infer改进的,一些整体的思路是什么,因为你们这次K3 也是第一时间做了适配,你可以讲讲就是,你们适配的时候,有什么有意思的发现吗,具体来说的话,我可以分享一下 [01:31:09]
赵晨阳:KDA架构对于投机采样,带来的挑战,投机采样,简单来说,我们会通过一个小的模型,来快速猜测出一批Token 然后让真正采样的大模型,来一口气验证,这些Token是否正确,验证完成后,这批被猜测出的token当中,可能只有前几个token会被大模型接受,所以大模型在验证这批被猜测的token之前的状态,是需要保留的,因为如果猜测不对的话,大模型要能够随时回退到猜测之前的那个状态,这对于普通的attention而言问题不大,就像举的比方,你无非就是把书的后级也撕了,然后继续从笔记本的靠后的页开始写,对吧,但是KDA的架构设计,需要能够对每个token的递进状态进行原地的重写,为了能够回退到大模型验证之前的状态 我们必须要想办法对之前的递进状态进行存档,一个比较朴素的存档方法,就是每走一步就把整个递进状态做一个快照,但是对于整个69层KDA做完整存档的保留的开销非常大,我们最后的做法是不存状态,只存每一步状态的几小投影,大概只有一个KB左右,要回退的时候,就从上一个checkpoint的出发,照着这些输入,把接收的那几个token的存档重放一遍,这很像我去看我小表弟,他学习象棋的过程,象棋玩家为了复盘棋局,会通过一些简单的记号,来记录每一步棋子的移动,这样你就不用每一步,都给整个棋盘来一次完整的快照,然后我们为了支持KDA的投机采样,其实也实现了类似的思路,记录棋子的移动,而不记录整个棋盘,比较有趣的是,我们后来观察到 Kimi K3的Tech Report 也和我们独立地提出了,类似的设计,当然我们其实并没有提前,为了这一块的设计,做过任何讨论,也可以很荣幸地说,顶尖的工程团队,大家在这些工程问题上的解法,都有一举同工之妙,这次K3还开源了,他们的一个agent环境,它就是叫agent int [01:33:09]
曼祺:你前面也说到,一般权重只是一次训练的产物,而环境是能够反复附用,产生下一代权重的一个流水线,所以环境是更重要的护城河
赵晨阳:也可以讲讲就这次从agent im里面,看到的一些有意思的思路是什么 agent im是一个最朴实无华的名字,我觉得还是比较有新意,因为一般而言,我们的研究者往往为了模型的安全性,会去主动限制模型的能力,大多数情况下,我们会通过更好的隔离方案来,尽可能的锁死模型,让他少做一些越狱之类的操作,但是K3的训练团队,选择通过更好的隔离方式,来尽可能放宽模型的能力边界,就是说模型可能受到的限制更小,我相信他们自己也比较believe 以后模型应该拿到系统权限是更高的,可能是这个样子的,往往我们认为agent越强的话,他的探索会越激进,早期的时候,我记得大概是Kimi K1或者K2的时候,他们会选择用容器runtime 来完成这种沙盒,但那种情况下很容易出现我们所谓的OS的panic和内存的死锁 他们并没有选择让agent持续去跑容器或者换用别的虚拟机,而是干脆换了别的技术路线把这种隔离做得更好,用了firecracker来跑这种micro virtual machine 这个其实比较工程化,但是我觉得一句话take away就是说,他们选择赋予模型更高的权限,并且为这个权限做出更好的技术隔离,这个技术隔离是隔离什么和什么,简单来说就是希望,如果一个agent 把一个沙盒弄崩溃了之后,不会影响其他的沙盒的运行,对,是安全的考虑对吧,是的,可以说是沙盒做得更安全,那么模型的安全限制就可以放低,然后第二点是,这个持久化root和沙盒,这个其实解决的这个问题很经典,就是我们的agentic的常委问题,我们其实这个,是我的kimi一个很厉害的地方,在agentic RL领域,有个经久不衰的做法 叫做Parser Rollout 简单来说就是,一条采样轨迹,可能是上千次的工具调用,得到了上百万个token 然后假设我一次采样 16个request 这个16个request里面,可能就会有那么一两条,特别长的request 比如说,可能它是调一个外卖接口,但是外卖的那个Mock接口,返回的比较不稳定,可能过了一分钟才返回,这种情况下会极大的阻塞,这个batch的整个运行,在Kimi1.5的论文里面,他们就提出partial route 就是不必等待所有的轨迹都结束,等到一定比例的这个,我们说的轨迹完成了之后,就会把结束的轨迹用作训练,然后没有完成结束的轨迹,会缓存起来,在下一轮继续去完成它,这个做法其实是有很深厚的,统计学的观察在里面的,就是说通过提高采样的总数,或者说只选择 把不常委的那部分的request 拿来使用,可以加速这个采样的过程,这个也有一些,强化学习理论上面的挑战,就是一方面,从系统设计上面,模型的历史的采样信息,需要尽可能的保存,比如说模型上次采样的KVCash 他们需要把这些KVCash写下来,避免下次重新采样的时候,需要做一次特别上的long pre-fill 对,然后另外一个问题是,强化学习测的这个数据过时问题,用术语叫做off-pondency mess 就是它这样采样的轨迹会有一个问题,可能这个轨迹的前一个部分,是上一个版本的checkpoint采样出来的,这个轨迹的余下部分,才是当前版本的checkpoint采样出来的,这样的话,一条采样序列,其实它不是严格的on policy 或者说不是严格在线的 K3还是采用了per token政策的方式 把我们所谓的策略更新约束,在了一个局部领域之内,来部分容忍这样的of policy-ness 这是一个很经典的,用算法上的宽容来换取infra上的自由,然后其实对infra的提速是非常好的,最后一点,我觉得体现出来Kimi团队的一个设计哲学,就是让RU环境和推理时 agent运行的环境是尽可能一致的 K3的训练管道,把agent的harness表示成的一组,可以配置可以组合的模块,类似于工具接口 system prompt 上下文管理策略skills 还有memory 他们用各种复杂的策略,去模拟组合出来,各种主流的agent harness 这种组合其实也避免了,在模型训练过程当中 overfeed到某一个harness上,以至于比如说,你训练在美团上面订外卖,结果发现用户想要用饿的,就用不了 这些对人类而言是非常愚蠢的,但是对于模型而言,训练不佳很容易出现这样的问题,很显然他们这样的策略组合,能够很好的缓解,这种学会了美团就不会饿了的问题,从infra的角度上来讲的话,我其实很认同他们这个方向,环境正确,就是说我们对Hannes的要求会逐渐提高的,更广的来说,我们希望Hannes能够自由的,和各种agent的workflow做组合,这和我们在serving测的想法也是一样的,不要为了每一个模型去做许多的策略,要为了这些状态尽可能去组织成竖状结构 [01:38:10]
曼祺:所以他的整个思路就是说,我这个模型迅出来之后,在上面一层,就这个Harness这一层,它不管是什么类型的Harness 它都能比较好的去调用,它可以适配类型更多的框架,理论上是这个样子
赵晨阳:但是效果我觉得肯定不至于那么完美,但是我觉得现在这些Harness的,我们随着对Harness的使用越来越高,对Harness泛化性的要求,也必然是越来越强的,你觉得边缘模型有这个需要吗,比如说SRPT或者OpenAI 它可能自己训练的模型,它就是在自己的Harness框架里面,被使用的,对这个必然是需要的,而且换句话来说,即便是Claude Code这样的平台,它其实能够接入的组件,也是非常多的,那些Claude Code可以去接Slack 可以接Gmail 还可以接你的Calendar 这也是Motion and Harness 何况我刚刚提到,美团和Elema这个切换问题,可能对于Athorbeak而言,他们可能换的就是,用Gmail还是用Altalook 对这两个事情,听上去也非常的类似,但是不做精心的设计,模型的overfitting 会非常的令人尴尬,除了你刚才说的,就是你自己最在意的这个进展 Agent Eve 就是他们强化学习的环境之外,其他的一些改进,包括这个Flash KDA 还有它的量化感知训练 [01:39:00]
# 177: 详解Kimi K3:强到冲击Anthropic估值的模型什么样?
- 量化训练、推理优化与开源协作 [01:39:58 - 01:50:00]
赵晨阳:还有它的量化感知训练,这些你也可以讲一讲,就是它在Infra上带来的一些变化是什么,我们回到下这两种attention的区别吧 Softmax attention的kernel 主要是在和带宽做斗人,然后线性注意力的kernel 不严谨的来说,它会更多和串型依赖关系做斗争,具体来说 KDA的话是在这个chunk之内做并行 chunk之间做串型,以此recurring state 得以一个chunk一个chunk的往前传导,所以这种情况下,最naive的一个写法就是,每一个chunk 你算一次,你就传一次状态,这会导致计算资源的大面积空转,然后flash KDA是这个 Kimi他们团队基于QTLS 写的一个chunk-wise kernel 把Trunk类的计算和跨Trunk的状态传输,尝试做重叠,术语来说叫Overlapping 这是Flash KDA的第一层,然后如此一来的话,这带了一个差别 Softmax Attention的KDA的话,它对于KVCache的关注,其实不会特别强,因为Kernel对于KVCache是只读不改的,但是KDA的这些Kernel的旧状态,可能会被覆盖,所以Kernel的设计,还是要考虑更全的生命周期,什么时候做持久化,写到哪一个chunked slot里面,怎么去保证其他request 正在读的缓存不会被冲掉,可以说KDA的kernel 会难度更高一点,而且它也模糊了,我们认为kernel和缓存管理的,这个界限,然后另外一个角度是 Kini的拿手技能,这个我们说的QAT 就是Quantization Awareness Training 可以看到K3和DeepSeek V4 同时都在采用 FP4精度的一个训练 DeepSeek V4的距离做法的话,其实我们之前有讨论过,我们这里可以更多讲K3 K3从SFT开始就做这个QAT 然后这个直观的好处就是,模型会有更多的时间去适应量化噪声,而且他们也着重强调了 RL采样阶段和training阶段,采用的是同一套量化方案,这样尽可能的减少训练和推理不一致,带来的磨损,这个也可以从RL的角度上来感受,我们刚才其实提到一个术语,叫做off-pondessiness 直观来说 RL策略梯度优化,这个整个事情能够成立,是有一个前提的,我正在优化的是,那个产生了这些数据的策略,就是我们训练的时候,会采集到许多的这个序列,然后拿去优化模型,我们希望这些序列,就是我们优化的,那一个模型产生的,它不是T-1的checkpoint 也不是T-2的checkpoint 它最好就是T-0这个checkpoint 产生的这个数据,但是这个T-0或者T-1 T-2 它有的时候不是你刻意造成的,就比如说我们说这个训推不一致,就是训练的时候可能,它的这个调化比如说是BF16吧,那你推理时候采用NVFP4 那么这就会导致,其实这两个策略是有区别的,这也是一种off-pondencyness 所以一旦训练和这个采样的过程,对同一个checkpoint给出的精度不一致,它给出的token的概率是有细微区别的,这就是一个不严谨的T路计,而且这种不严谨的T2G3 对于MOE而言,可能会导致一个灾难性的崩溃,所以K3的训练哲学,还是在贯彻RL-INFRA领域的一贯的认识,为了我们训导的模型,就是我们要去优化的那个模型,一定要让训练和推理阶段尽可能的契合 [01:42:38]
曼祺:采用尽可能相似的配置,这件事情它在实现上难吗,就是说现在大家其实主流的公司,都能做到就尽可能一样的配置,还说这个还是需要挺多努力才能实现的 [01:43:30]
赵晨阳:以及他其实也能去看一个公司大概infra的水平,我可以说这个事情非常难,而且对于很多公司而言,需要单独的去维护一个硕大的infra 甚至说是kernel team才能够去把这个事情做好,这点上来说,我觉得Kimi的技术还是非常领先的,你之前说DeepSeek是infra领域的巨金,那类比一下的话,你觉得Kimi是在什么到位,我不希望有一个分出高下的,但是坦诚地说,我觉得国内的公司的infra 真的强,不过正常来说,我们叫做用infra换算力,真的是非常不容易
曼祺:最后这一部分,我有个想补充的问题,就是我看K3在技术报告里,他写到就K3优化测试里,已经给他的原文写的是 Atollative Vendor 有可能是个国内的,这种芯片公司 [01:44:20]
赵晨阳:给这个Atollative Vendor的 GPGPU写了Kernel 那是不是有可能,就用K3这个模型,也能加速K3自己向国产芯片的适配,是的,我觉得这点应该是比较明确的,当然我们确定最终这个delivery上,生产的这些是不是K3写的,但是K3至少从性能和正确性上来说,是非常能打的,然后另外一个角度就是,这一次我们也见到,由于现在这个模型的生态,真的bumping的非常厉害,以前有一段时间,国产的芯片的同行,他们想要在模型发布当天 support这些新的AI模型,其实是有一定难度的,但是到了最近,我们也看到,类似于摩尔县城,他们也通过MUSA S7 LAND 这样一个生态,在发布的很快的时间之内,我不记得是不是Dating 但一定是在极短的时间之内,就成功support上了Kimi K3 而且也达到一个很好的效果,我觉得可以想见 Kernel Development 智能体 真的是一个非常伟大的事情,我觉得对于整个芯片产业,是有很本质的推动的,你觉得这件事会怎么影响,英伟达的统治地位吗,会吗,会到那个程度吗,这是一个我无法判断的事情 [01:45:26]
曼祺:你这是无法判断,还是不想说呀,我无法判断,这个我们可以讨论一下,就理论上来说,其实因为CUDA这个生态,就是建立在说,你有比较丰富的curl 这肯定是很重要的一部分,对吧,然后它的通用性比较好,我有很多好朋友
赵晨阳:在AMD做AMD version的Cutilis 所以他们高强度的依赖这些KDA 而且我也有NV的好朋友,他们在NV给NV显 Next Generation的DSL 也是大量依赖KDA 那我觉得你这提供了一种视角,就是KDA这个东西,英伟达之外的厂商可以用,对吧,那英伟达自己他也可以用,对因为英伟达自己,也需要去更迭,然后我觉得很遗憾,就是现在这些模型的KDA 还是就是说,优化Q2S可能很厉害,但是如果你优化,比如说举个例子,假设以后有这个TCGen5 对吧,比如现在是TCGen4 TCGen5就是可能 KDA的还得花一段时间
曼祺:来泛化上去,这也是个很好的问题,我们可以看看,就是KDA这里指的是,开发Curl的这种agent的发展,之后会怎么去影响,这个芯片领域的一些竞争 [01:46:31]
赵晨阳:我很难说 Kimi Delta Attention 和Curl Development 智能体 哪一个更伟大,我觉得这两个事情都很牛 OK 都叫KDA 我们最后可以来稍微延展,讨论一下K3 对业界的一些影响,有一些随便拍脑袋的问题,比如说你们认为,下一个开源最强,什么时候会出现,可能来自哪个公司,首先我见到一个非常恐怖的事情,之前见到昆团队发布,说他们的模型,在以日为单位,日历更迭,这个时代,对日历前年的加速度没有降低,反而我觉得是人类的想象力降低了,就是我们现在除了这个coding之外,我见不到下一个爆炸的点,对就昆3.8 preview
曼祺:就预览版发的时候,说他们会以日更新,下一个问题,其实前面稍微讨论过,就是你们觉得,今年内,就剩下还有五个多月的时间里,我们有可能会见证,开源超过避源吗,我个人觉得这个是有点难度的 [01:47:23]
赵晨阳:因为一般来说,大家会认为 OpenID 和SARPIC 他们内部的一个最强的模型,是比他们现在放出来的模型,还要再强一个,比如说半个generation的,半个甚至到一个generation的,对,然后我们现在开源模型,基本上,现在最强的开源模型,基本上目标是追平,现在已经放出来的,这个叫做最强的避源模型,或者说避权中模型,但是可能,他们之后,他们之后能够放出来的,是他们现在内部已经有的,比现在的全中模型,还要更强一个,半代甚至到一代的模型,然后这个时候可能,就是确实开全中模型,还需要一段时间去追,对,所以我觉得在至少,未来五个月内,这个趋势应该不太会有,很明显的变化,其实对于开全中模型这边,基本上就是,把目前最强的,也给放出来了,对,所以这里其实还是有一个,代差在这里,就是实际最强的,跟放出来的这个最强的,你的意思是说,要找一个好的时机来放,对
曼祺:最后一个问题,是一个相对就是趋势,宏观趋势的一个问题,最近梁文峰说,下一代模型的标志是能持续学习,你们自己会怎么看,下一代模型要实现什么能力 [01:48:29]
赵晨阳:至少我对于持续学习的观点,我不是说希望这个模型的智力不断提升,我是说希望一个模型能够,对任何系统都有很有效的优化,但这个任何应该,就专指KDA吧,比如说我现在说,可能你要KDA去优化,现在Kudeles它可以优化得很好,但是等到next generation的DSL来了 KDA能不能做得很好,目前来看是不太新的,这其实反过来暴露,现在的模型的范化性,没有想象的那么好,因为Kernel绝对是一个,最好验证的领域了,对哪怕这样子的话,它的范化都还是要一定的训练,那么从这点上来看,我觉得实现RSI 还是有一些距离的,我不去评价说,下一代模型的核心能力,是不是说必须要有持续学习能力,这个观点本身,我觉得就是,如果我们假设这个观点,是正确的话,我觉得现在有个很大的问题,是我们还没有一个很好的方式,去评测或者说去measure这个progress 就是说我们去看现在的模型,它做这个持续学习的能力,大概到了什么样的层次,因为它肯定不是一个零或者一,就是它不会持续学习,或者说会持续学习,它肯定是一个零到一之间的,某一个状态,对我觉得现在还缺少这样的一个,去衡量目前的这个进展的,这么一个很好的方式吧,对所以我觉得如果,认可这观点的话,我们应该先把这样的一个 [01:49:36]
# 177: 详解Kimi K3:强到冲击Anthropic估值的模型什么样?
- 总结 开源模型真正开放了什么 [01:49:58 - 01:55:07]
赵晨阳:我们应该先把这样的一个,很简单的进展的方式,给明确地做出来,比如说通过各种比较完备的 evaluation 各种完备的评测,把这个问题给解决,然后再去讨论说,我们现在的模型,离达到我们想要的目标,还剩多少
曼祺:总体来说,你们觉得这个模型的进展,它接下来会是,就一路这样斜线上去,就可以这样进展了,还是它还是会,有一个一个平台期出现,我个人猜测,还是会有一个个平台期的出现 [01:50:11]
赵晨阳:就是有平台,其实有平台期,也意味着有突破对吧,就你有一个突破,可能有上一个台阶,对对,但这个突破不见得说是,大家都会想象那种,特别巨大的范式性突破,我觉得可能更多是在,修训在执行层面,把一些问题有些突破之后,它会在,就这个平台期会有一个提升,其实说实话,对人觉得,就是最近半年,都没有什么很本质的平台性突破,对,它只是在一个平台上,有做的更高一点这样,当然确实更高一点,但给普通用户的体验,已经很不一样了 OK 今天非常感谢赵晨阳,还有志远做客晚点聊,分享了对K3技术报告的一些解读
曼祺:然后我们也从K3的一些改进,比如说它的线性混合的注意力 attention residues等等,然后延展聊了最近,这些领域相关的一些进展,包括这些进展是为了解决什么问题,以及接下来可能会有怎么样的影响,我们也讨论了,就K3现在在全球,或者说在美国的科技圈,引起的这种开源的辩论,那今天的节目就到这里,各位拜拜,拜拜,拜拜,本期连点呈现,推荐晚点聊几个相关的往期节目,一期是我们这次反复提到的,第163期对DeepSick V4的解读,其实这两期节目的结构挺相似的,这是因为现在开源大模型的,技术报告的结构本身,就有一定的共通性,会有几个绕不开的模块,首先是架构层的注意力机制,这是大语言模型里非常关键的一部分,这次赵晨阳也说 Attention机制就是我们AI领域研究的特修斯之船,这个词的本意是关于事物同一性的哲学比喻,如果一艘船的所有部件逐步被替换,直到没有原始材料被保留,那它还是原来的那艘船吗,其实我们现在对Transformer的改造,我们试遍所有配方的方式,就有点类似于边形船边换零部件,而这意味着Transformer这个大的方向,继续往下可能还有很多改进的空间,另一个绕不开的是层与层之间的信息连接方式,在V4里我们讨论了MHC 它是怎么从字节最开始提的HC改进而来的,在K3里我们讨论的是Attention Residues Kimi今年春天提出的这个方案,本身也是受到了MHC的一些启发,同时我也推荐过往多期节目里,我们讨论过的注意力机制 一是第103期用Attention串起大模型优化式,这是在25年2月录制的,它特别好的一点是对非从业者,相对友好,两位清华当时在读的博士生,肖朝军和傅天宇,深入浅出的,篡讲了Attention机制诞生的过程,原初版本的瓶颈,它的改进历史,和背后的计算机与深度学习思维脉络,简单来说,注意力的改进,一直是在服务于上下文的不断拓展,大家追求的是希望,上下文越来越常识,计算和存储的开销不会爆炸,也就是一方面要提升效率,但同时又不降低性能,然后是104期,与当时MiniMax的高级研发总监,钟怡然聊线性注意力方向的改进,这也是我们K3这一期 Q到的MiniMax在M1 就是25年年初的一个模型上 就大胆的使用了线性注意力的这件事,这也是业界第一个,在这么大规模的模型上,用线性注意力的尝试,跟进的一期是,去年底发布的143期节目,这一次是和DeltaNet的核心作者,杨松林来聊线性注意力的优化,当时松林是在博士的最后一年,他现在已经加入了TML KDA里的D就是Delta的意思,那会儿的背景是 25年的9月和10月,阿里和Kimi都发布了,和DeltaNet相关的注意力改进成果 Kimi当时的,那个用在Kimi Linear模型上的,注意力改进,就是现在K3里用的KDA 这期我们也聊到了 KDA是从当初 Kim Diner这样一个 38B的小模型 skill到了现在3T的规模,这也是一个挺具体形象的例子,它展现了现在的模型研发中,是怎么一步步从小规模的实验 再往上skill的历程,期待下一次的技术解读,可以在我们关于AI的,意义网络中再点亮新的一点,本期节目就到这里,感谢收听,如果你对今天聊的话题,有观察好奇或疑问,欢迎在评论区分享想法,这也会成为我们节目的一部分,让整个讨论更完整,你也可以把我们的节目,分享给对这个话题感兴趣的朋友,推荐更多你想听的主题和嘉宾,你可以从小宇宙,苹果Podcast等渠道,关注晚点聊Late Talk 也欢迎关注我们的公众号,晚点Late Post 下期再见 [01:54:33]
来源:OpenAI News
URL: https://openai.com/index/learn-teach-chatgpt-work-codex
探索适用于 ChatGPT Work 和 Codex 的全新教育插件,帮助 K–12 教师、大学教育工作者和学生开展学习、教学、研究与构建工作。
来源:OpenAI News
URL: https://openai.com/index/apple-is-getting-this-wrong
OpenAI 回应苹果毫无根据的诉讼,纠正关于其员工的错误说法,并分享了记录事件经过的相关消息。
文章将 Kimi K3 描述为一种结合 Kimi Delta Attention(KDA)、完整注意力 MLA、Attention Residuals、Stable LatentMoE 和 Quantile Balancing(QB)的开放前沿模型,并重点解释这些技术如何同时改善长序列效率、模型表达能力和分布式推理性能。
1. KDA 的演进路径是线性注意力 → DeltaNet → Gated DeltaNet(GDN)→ KDA。线性注意力把历史 key/value 压缩进隐藏状态 S,使复杂度从二次降为线性,但 S 会不断增长并造成新旧信息混杂。DeltaNet 用正则化的 Delta Rule 有针对性地移除无关关联;GDN 引入 LSTM 风格的 alpha 遗忘门;KDA 将 alpha 扩展为对角矩阵,实现按通道的记忆衰减和位置感知。
2. FlashKDA 是 Moonshot 为 KDA 开发并开源的定制 kernel。decode 大约执行 7*D² FLOPs,内存流量约为 8*D² 字节;prefill 在 chunk 级别的总体计算复杂度为 O(T*D²),kernel 层面的内存访问约为 O(TC + TD + D²)。文章据此总结:prefill 的计算和内存随序列长度线性增长,decode 则与序列长度无关。
3. Kimi Linear 被用作推断 Kimi K3 架构的依据。KDA 对 query、key、value 使用线性变换和短卷积,并对 query/key 使用 L2 范数;Kimi Linear 的 KDA 与 MLA 理想比例为 3:1。文章认为 MLA 的吸收技巧适合 decode 占主导的推理,但会增加 prefill 成本;因此作者推测 Moonshot 未来模型(例如 Kimi K4)可能采用取代 MLA 的注意力机制。
4. KV cache 效率不能只看空间大小,还要结合模型架构效率、部署实例的总内存、专家并行或张量并行方式,以及 prefill 时间。文章定义 KV throughput 为给定序列长度下 KV cache 大小除以首 token 时间,并将其作为 KV cache 效率和 PD 分离最低带宽需求的代理指标。KDA 的递推状态虽然固定大小,但若要识别任意前缀边界,就必须逐 token 缓存状态;Moonshot 因此采用粗粒度缓存,例如 vLLM 每 32K token 缓存一次,并额外在 prompt 边界缓存。
5. Attention Residuals 把标准注意力的序列维度替换为深度维度,让每层通过学习到的 query 有选择地访问此前层的表示。Block AttnRes 将 L 层划为 N 个 block,把通信从 O(Ld) 降到 O(Nd),并达到 1.25× 计算效率。通过跨 stage 缓存和激活检查点,Kimi 将流水线并行额外开销压到 4%;推理阶段则分为已完成 block 的并行块间注意力和当前 block 的顺序块内注意力。
6. LatentMoE 在 dispatch 前压缩路由 token、aggregation 后解压;Stable LatentMoE 在上投影前应用 RMSNorm。通信量与路由 token 数 t、激活专家数 K、输入维度 d 成正比,与专家并行规模 E 成反比。Kimi K2 的 8 个激活专家和 7168 输入维度,与 Kimi K3 的 3584 latent 输入维度形成对比;后者理论上可把激活专家数增加到 16 而不增加通信量。文章给出的通信/计算时间比为 (P*F)/(6*m*B) * (1-1/E),并认为这有助于解释近期模型把专家中间维度提高到 3072 的趋势。
7. QB 是 Jianlin Su 于 2026 年 2 月提出的无需超参数、无需辅助损失的负载均衡技术。每个 token 路由到 k 个专家;m 个 token 共形成 mk 次分配,n 个专家均衡时每个专家处理 q=mk/n 个 token。QB 根据 router 分数与每个 token cutoff 的 margin,取 (1-k/n) 分位数来直接计算偏置更新;负载均衡后更新会自然变小。
文章中的 Kimi K3 架构判断部分来自 Kimi Linear 和技术博客的对比推断,而非完整公开的 K3 内部实现证明。复杂度公式、缓存策略和 InferenceX 结果是文章所引用材料中的分析与测量;文中未提供完整公式图、表格或所有实验条件,因此这些结论应按文中给出的模型和测试场景理解。
来源:SemiAnalysis
URL:https://newsletter.semianalysis.com/p/kimi-k3-the-manos-the-mythos-the
Kimi K3 一经发布便席卷整个世界,横扫各大排行榜,确立了自己作为开放前沿模型的地位。社区迫切希望了解 Kimi K3 的工作原理,但驱动其性能的非传统技术令许多人感到意外。本文旨在帮助读者理解 Kimi K3 模型架构的核心技术。
Kimi Delta Attention(KDA)是 Kimi K3 混合注意力机制中的线性注意力层。我们从线性注意力、DeltaNet、Gated DeltaNet(GDN)一路追溯到 KDA 的起源。
线性注意力的推导源于移除标准 softmax 注意力中的 softmax 操作。下面比较了迭代推理公式,展示 token 位置 t 处输出向量的计算方式:
来源:DeltaNet Explained(Part I)
移除 softmax 操作后,我们可以重新排列运算顺序,将注意力的计算复杂度从二次降为线性:
来源:Linear Attention and Beyond(Interactive Tutorial with Songlin Yang)
新的公式如下:
来源:Linear Attention and Beyond(Interactive Tutorial with Songlin Yang)
向量 q、k、v 的维度为 L × d。两种公式的计算复杂度都是 O(Ld²),因此与序列长度呈线性关系。
将新公式与 softmax 注意力公式比较可以看到,softmax 注意力需要访问所有过去的 key 和 value 向量,而线性注意力会把所有过去的 key 和 value 向量压缩到一个隐藏状态 S 中。
我们可以把新公式重新解释为一个在线学习目标:把矩阵 S 看作一个关联记忆,用来存储 key 向量 k 与 value 向量 v 之间的关联;将 S 与 k 相乘,就能取回 v。这样,第一条公式可以理解为:在每个位置持续更新矩阵 S,以改善检索效果。最后,v_t @ k_t.T 项可以解释为损失函数 -(S @ k_t.T) @ v_t 关于 S 的梯度。
从在线学习目标的角度看,矩阵 S 的值会无限增长:随着序列变长,新旧信息在 S 中逐渐混杂,导致学习不稳定。由于没有 softmax 来提供尺度良好且有界的输出,在线性注意力中,长距离召回任务通常落后于 softmax 注意力。
DeltaNet 通过改变损失函数来改进线性注意力:它最小化 value 检索结果的 L2 范数。与线性注意力的损失函数不同,DeltaNet 的损失函数会约束 S 的增长,由此产生新的矩阵 S 更新规则,即 Delta Rule(Delta 规则):
来源:Linear Attention and Beyond(Interactive Tutorial with Songlin Yang)
Delta Rule 构成了 DeltaNet 注意力公式的基础。从概念上说,Sₜ₋₁ @ kₜ - vₜ 表示与当前 key 和 value 无关的关联,DeltaNet 会有针对性地移除这些关联。
GDN 和 KDA 都是 DeltaNet 的改造版本。Gated DeltaNet 将 LSTM 的遗忘门 alpha 应用于矩阵 S,让模型通过权重衰减控制记忆的生命周期。KDA 进一步把 alpha 扩展为对角矩阵,从而支持按通道进行细粒度的记忆衰减,并具备位置感知能力。
来源:Kimi Linear
感谢阅读 SemiAnalysis!本文为公开文章,欢迎分享。
Moonshot 开发了用于 KDA 的定制 kernel(内核)FlashKDA,并将其开源。下面介绍该算法并推导其算术强度。
首先从递推公式的一种等价表达开始:
~~~text
u_t = beta_t * (v_t - (D_t @ S_t-1).T @ k_t)
S_t = D_t @ S_t-1 + k_t @ u_t.T
o_t.T = q_t.T @ S_t
~~~
其中,D_t 是 alpha 遗忘门构成的对角矩阵,u_t 是 Delta Rule 中的 delta 项。
对于 decode(解码),kernel 大致遵循上述公式。对于 prefill(预填充),我们把递推公式按 token 分块展开,以便在 GPU 上高效执行运算。假设将 token i 到 j 展开,起始状态为 S_i-1,则有:
~~~text
S_j = D_j:i @ S_i-1 + sum(D_j:t+1 @ k_t @ u_t.T, t=i:j)
o_j.T = q_j.T @ S_j
= q_j.T @ D_j:i @ S_i-1 + sum(q_j.T @ D_j:t+1 @ k_t @ u_t.T, t=i:j)
~~~
D_j:i 表示从 token i 到 j 的累计衰减:D_j @ D_j-1 @ D_j-2 @ … @ D_i。
在 FlashKDA 的矩阵形式中,公式变为:
~~~text
S_out = D_j:i @ S_in + K_restore.T @ U
M_qk = tril(Q_decay @ K_inv.T)
O = Q_decay @ S_in + M_qk @ U
~~~
向量到矩阵的对应关系如下:
为计算 U,我们应用 UT 变换并计算:
~~~text
B = Diag(beta) @ (V - K_decay @ S_in)
L = StrictTril(Diag(beta) @ K_decay @ K_inv.T)
U = (I + L)^-1 @ B
~~~
完整推导请参阅 Songlin Yang 的博客文章及 Kimi Linear 论文第 3.1 节。需要注意的是,这里的 U 对应 Kimi Linear 论文中的 pseudo-value(伪 value)项。
在实现上,FlashKDA 会启动两个 kernel:K1 和 K2。K1 并行准备 chunk 级张量,包括:
~~~text
a = exp2(cumsum(g))
K_decay = Diag(a) @ K
Q_decay = Diag(a) @ Q
K_inv = Diag(a)^-1 @ K
K_restore = a[-1] * K_inv
L = StrictTril(Diag(beta) @ K_decay @ K_inv.T)
INV = (I + L)^-1
M_qk = tril(Q_decay @ K_inv.T)
~~~
这里的 a 是累计衰减,其每个元素对应某个 token 位置上的累计衰减。
K2 执行 chunk 级递推计算:
~~~text
U = INV @ Diag(beta) @ (V - K_decay @ S)
O = Q_decay @ S + M_qk @ U
S = Diag(a[-1]) @ S + K_restore.T @ U
~~~
下面分析一个注意力头的复杂度。对于 decode,关键路径计算包括:
~~~text
D_t @ S_t-1:逐元素乘法,D × D
S_t-1.T @ k_t:D × D × 1
k_t @ u_t.T:D × 1 × D
q_t.T @ S_t:1 × D × D
~~~
decode kernel 大约执行 7*D² 次 FLOPs(浮点运算)。由于读取和写入 FP32 递推状态主导了内存流量,因此内存流量约为 8*D² 字节。
对于 prefill,K1 的关键路径是计算 L、INV 和 M_qk:
~~~text
L:C × D × C
INV:Neumann 分解,执行 6 次 C × C × C 矩阵乘法
M_qk:C × D × C
~~~
K2 的计算包括:
~~~text
K_decay @ S:C × D × D
Q_decay @ S:C × D × D
M_qk @ U:C × C × D
INV @ B:C × C × D
K_restore.T @ U:D × C × D
~~~
合并 K1 和 K2 后,FlashKDA 执行 12*C^3 + 8*C²*D + 6*C*D² FLOPs。由于我们在 chunk 级别(chunk 大小为 C)进行分析,并假设序列长度 T >> C,总体 FLOPs 为:T/C * O(C*D²) = O(T*D²)。
内存流量如下:
~~~text
K1 读取 Q、K、g:C × D
K1 写入、K2 读取 Q_decay、K_decay、K_restore:C × D
K1 写入、K2 读取 INV、M_qk:C × C
K2 读取 V、写入 O:C × D
K2 每个 kernel 读取和写入一次 S:D × D
~~~
总计,FlashKDA 访问:
~~~text
3 * 2*C*D + 2 * (3 * 2*C*D + 2 * 2*C*C) + 2 * 2*C*D
= 8*C² + 22*C*D bytes
~~~
在 kernel 层面,它访问:
~~~text
T/C * (8*C² + 22*C*D) + 8*D² ~ O(TC + TD + D²)
~~~
这具体说明了 KDA 的计算复杂度:
Moonshot 训练 Kimi Linear 模型,作为 KDA 设计的概念验证。因此,我们可以从 Kimi Linear 推断 Kimi K3 的架构设计。将 K3 发布技术博客与 Kimi Linear 对比,可以看到 Kimi K3 共享了专家数量、混合线性注意力比例以及总体注意力模块设计。
来源:SemiAnalysis
来源:Kimi K3 Tech Blog
上图展示了 KDA 输入上的操作。对于 query、key 和 value,我们应用线性变换和短卷积。短卷积能够有效捕获局部 token 依赖;使用左侧填充进行卷积则可以避免破坏因果性。我们还对 query 和 key 应用 L2 范数,以稳定转移矩阵和输出矩阵的特征向量。
对于衰减记忆门,alpha 是低秩投影,beta 是下投影。KDA 输出按 head(头)进行归一化,并由输出遗忘门控制:K3 通过线性变换实现该遗忘门,而 Kimi Linear 使用低秩投影。最后,我们应用线性层混合各个 head 的信息。
Kimi Linear 将 KDA 与完整注意力 Multi-head Latent Attention(MLA,多头潜在注意力)交错排列。Kimi Linear 表明,3:1 是在性能和效率之间取得平衡的理想 KDA 与 MLA 比例。KDA 也充当强大的位置感知算子,取代 MLA 中的 RoPE。
保留完整注意力形式的 MLA 是一个有趣的选择,因为其他开放权重模型都在转向 Grouped Query Attention(GQA,分组查询注意力)。MLA 使用吸收技巧降低 decode 步骤的计算量,但代价是增加 prefill 步骤的计算量。对于 decode 占主导的推理工作负载,这是合理的权衡;但对于 prefill 占主导的 agentic(智能体)工作负载,额外计算会带来高昂成本,却几乎没有收益。
因此,所有前沿开放权重模型都采用基于 GQA 的注意力机制:GLM 5.2 DeepSeek Sparse Attention、DeepSeek V4 Compressed Sparse Attention、MiniMax M3 MiniMax Sparse Attention 以及 MiMo V3 HySparse 都建立在 GQA 之上。我们猜测,Moonshot 的未来模型(例如 Kimi K4)将采用取代 MLA 的注意力机制。
SemiAnalysis 是由读者支持的出版物。若想接收新文章并支持作者,可以免费订阅或付费订阅。
我们认为,不应仅根据 KV cache 的空间复杂度推断 KV cache 效率。KV cache 大小并不是一个独立因素,而是模型设计的属性:目前没有开放权重模型发布静态 KV cache 压缩技术,模型架构的推理效率也会影响 KV cache 效率。
KV cache 大小的影响还取决于已部署模型实例的总内存容量。例如,采用大规模 expert parallelism(专家并行)部署的模型,与采用 tensor parallelism(张量并行)的模型具有非常不同的内存分布,这会影响留给 KV cache 的内存容量。因此,我们建议同时考虑模型架构的系统效率和 KV cache 大小,并用 KV throughput(KV 吞吐量)量化 KV cache 效率。
KV throughput 定义为:在给定序列长度下,KV cache 大小除以 prefill 时间(Time to first token,首 token 时间)。KV throughput 表示采用 PD disaggregation(预填充/解码分离)可靠服务模型所需的最低带宽,也可以作为理解 KV cache 效率的良好代理指标。
Prefill 时间概括了模型架构的效率;随着序列长度增加,我们会看到内存受限和计算受限两种情况。如下面的表格所示,随着序列长度增加,混合线性注意力的优势会更加明显。
来源:Prefill-as-a-Service: KVCache of Next-Generation Models Could Go Cross-Datacenter
这也是理解集群中将 KV cache 卸载到不同内存层级所需带宽的一个好方法。
KV cache residency(驻留)类似于内存、主存和磁盘存储之间的层级关系;在内存一致性方面也有类似之处。
流行的分布式 KV cache 框架 Mooncake Store 支持 KV cache 加载时的 write-through(直写)和 write-back(回写)策略。Mooncake Store 提供一个分布式 KV cache 池,使所有 worker 都能看到全部 KV cache。
在 DRAM 与更低层级的分布式 KV cache 池之间实现 write-through 策略,在多节点场景中有多项好处,包括:在节点之间共享 prefix cache(前缀缓存)、避免对张量并行 MLA 重复缓存,以及在节点宕机时保留 KV cache 冗余。
来源:SemiAnalysis
在请求的每个 token 位置,Kimi K3 KDA 的递推状态大小固定,而标准注意力的 KV cache 会随序列长度增长。这种 KV cache 空间缩减会使前缀缓存变得复杂,尤其是 Kimi K3 采用 KDA 与 MLA 的混合注意力时。
粗略地说,现代推理引擎通过匹配已有缓存中最长的 token 前缀来识别前缀缓存命中。
来源:SemiAnalysis
对于 KDA 这样的线性注意力,识别最长前缀会成为问题。如果事先不知道前缀边界在哪里,我们就必须在每个 token 位置缓存 KDA 的递推状态。这意味着每个 token 都有一个缓存,KV cache 的内存使用量又会随序列长度增长,从而抵消使用线性注意力的目的。
为解决这个问题,Moonshot 以较粗的粒度保存递推状态,例如 vLLM 每 32K 个 token 缓存一次。vLLM 还会在 prompt(提示词)边界处缓存,因为在 agentic 工作负载中,新一轮通常从 prompt 末尾开始。
来源:Kimi K3 Is Here: Efficient Day-0 Support on vLLM
这说明,即使 KDA 这样的线性注意力大幅降低了 KV cache 的内存消耗,在真实服务过程中,它们也不会只消耗固定数量的 KV cache 内存。
Residual connections(残差连接)是通过扩展模型深度、构建更大深度神经网络的关键创新之一。神经网络越深,表达能力越强,但直接训练也越困难。早期层的信号需要一直保留到最后一层,梯度也必须从输出层传回第一层而不消失。
残差网络不把整个网络建模成一个单一函数,不让信息只能通过非线性变换传递,而是用恒等路径连接较小的网络块。每个块 fᵢ 学习对输入 xᵢ 的变化,其递推形式为:
恒等映射允许特征从较浅单元传递到任意更深的单元,也为梯度提供了一条高速路径,使其不会消失。
残差连接让我们能够构建更深的网络,但也带来了挑战。早期层会强烈影响残差流,后者又会影响最终输出,因此随着深度增加,残差流会出现不可逆的信息损失。后面的层需要提高输出增益,才能影响这个已经被修改的残差流,从而可能使训练不稳定。
另一种变体 highway networks(高速公路网络)允许通过门控机制控制信息流,但仍有同一个关键问题:各层无法有选择地访问早期层的信息。
由循环神经网络主导的序列建模也采用同样的递推形式:每一步都通过恒等映射连接前一状态,以实现直接的信息流;序列模型同样面临时间轴上的深度会稀释信号这一挑战。
来源:SemiAnalysis
Attention machines transformer(注意力机器 Transformer)通过强大但昂贵的注意力机制检索过去的任意 token,消除了这一约束。
受到序列建模中注意力机制的启发,Kimi 开发了 attention residual(注意力残差),在深度 block(块)上执行注意力:
来源:Attention Residuals
标准因果自注意力会把 token t 的输出计算为之前 token 表示的加权和:
Attention Residuals 使用相同的注意力机制,但把序列维度替换为深度维度。每一层不再关注之前的 token,而是关注之前各层产生的表示。
来源:SemiAnalysis
与标准注意力不同,这里的 query(查询)是每一层学习得到的参数,而不是由当前 token 生成。对于每一层 ℓ,我们定义:
每个彩色 block 都代表之前某个 Transformer 层输出的 token 表示。正如标准因果自注意力对序列中的 token 执行 softmax 注意力,Attention Residuals 对之前各层产生的表示执行 softmax 注意力。
来源:SemiAnalysis
注意力残差让模型能够细粒度地控制从过去层中选择哪些输入,使模型更具表达力。
Attention residuals 需要访问所有过去层的输出才能执行注意力。对于分布在许多 GPU 上的大模型,这会产生 O(Ld) 的通信开销。
为解决这一问题,block attention residual 将 L 层划分为 N 个、每个包含 S 层的 block。Block AttnRes 会对已完成 block 的输出执行注意力,并对当前 block 不断变化的部分和执行注意力。
来源:SemiAnalysis
Block Attention 与完整 Attention Residuals 的工作量相近,但能把通信从 O(Ld) 降低到 O(Nd)。令 bₙⁱ 表示 block n 前 i 层的部分和,则:
对于 block n 中的第 i 层,可用的 block 表示为:
与标准注意力不同,query 与输入无关。每层学习一个 query 向量:
对可用 block 表示的注意力权重计算如下:
输出是之前各层表示的加权和。
Attention Residuals 不再只依赖残差流来保存信息,而是让每一层都能直接、有选择地访问更早的表示。这种基于 block 的注意力残差大幅降低了通信开销,同时保持了有竞争力的性能。
与标准残差连接相比,Block residuals 展现出更好的缩放表现,计算效率达到 1.25×。验证损失持续低于基线,并且在衰减阶段差距还在扩大。不同于标准残差网络中输出幅度会随深度增加,block attention 的选择性聚合具有有界输出,并保持一致的梯度幅度。
与标准残差网络不同,计算第 N 层时,attention residuals 需要前 N-1 个 block 的全部输入。这会给 pipeline parallelism(流水线并行)带来问题,因为所有 N 层 block 的输出都需要在各个 stage(阶段)之间传输。
借助巧妙的跨 stage 缓存和 activation checkpointing(激活检查点),Kimi 将流水线并行相对于标准架构的开销降低到仅 4%。
对于 P 个物理 stage 和 V 个虚拟 stage,每个 block N 的每个 chunk 需要 C=PV 的通信。朴素实现需要在每个 stage 传输所有已经累积的 block,因此每个物理和虚拟 stage 的成本都会呈二次增长。
通过在虚拟 stage 之间缓存输入,可以降低这种高额通信。较早层计算出的 block 可以存储在本地内存中。
来源:SemiAnalysis
对于第一个虚拟 stage,所有 block embedding 都需要在物理 stage 内传输,每个已完成的 block 会存储在对应 rank 上。对于后续虚拟 stage,可以重复利用所有缓存的 block 来执行计算;只有当前 rank 上不存在的 block 才需要传输,以便计算 attention residual。
来源:SemiAnalysis
这会把第一个虚拟 stage 和后续虚拟 stage 的通信成本分开。第一个虚拟 stage 需要在所有物理层承担相同的二次成本;后续虚拟 stage 从本地设备读取缓存输入,只需传输 PNp 个 chunk,把总通信量从 O(C) 降到 O(P)。通信量的削减与虚拟 stage 数量 V 成正比。因此,在完整的一次前向和反向传播中,所有计算和通信都可以重叠执行。
由于跨 stage 缓存,所有 block 在 V 个虚拟 stage 中只存储一次。配合 activation checkpointing,注意力所需的所有跨 block chunk 都被消除。每个 stage 的 activation checkpoint P_l 与标准架构的 H_l 内存大小相匹配,不会产生额外内存成本。
由于 Attention Residuals 需要所有之前 block 的输出才能计算注意力,朴素实现会产生过多的内存访问。为降低开销,推理被分成两个阶段,与自回归注意力的 prefill 和 decode 阶段对应:对已经完成的 block 执行 inter-block attention(块间注意力),对正在运行的 block 中不断变化的注意力执行 intra-block attention(块内注意力)。
来源:SemiAnalysis
在解码期间,我们需要输出已完成的 block 以及每层学习到的 query 向量。所有块间层同时使用一个批量 query,对已完成的 block 表示执行计算,并返回输出和 softmax 统计量,供后续计算复用。这个阶段类似于 prefill 阶段的解码。
来源:SemiAnalysis
这个阶段类似于 decode 阶段。与 flash attention 类似,可以使用 online softmax(在线 softmax)计算块内不断变化的和,并将其与预计算的块间结果结合,从而减少冗余内存访问。
采用这两个阶段后,IO footprint(输入输出访问规模)与标准残差架构相近,只增加了阶段一的块间计算;由于一个 block 中的所有 query 都批量处理,这部分开销可以被摊薄。
LatentMoE 会在 dispatch(分发)操作之前压缩路由后的 token,并在 aggregation(聚合)操作之后将其解压。在 Kimi K3 的 Stable LatentMoE 中,模型会在 up-projection(上投影,即解压)操作前应用 RMSNorm,以降低对尺度变化的敏感性并改善模型性能。
来源:Kimi K3 Tech Report
下面从 MoE 通信的角度解释 LatentMoE 的设计原则。LatentMoE 论文表明,通信量与路由 token 总数 t、激活专家数 K 和专家输入维度 d 成正比,与专家并行规模 E 成反比。
这可能解释了 Kimi K3 的 latent MoE 维度和激活专家数量配置。Kimi K2 系列有 8 个激活专家,输入维度为 7168;Kimi K3 的 latent 输入维度为 3584(7168 的一半),因此可以在不增加通信量的情况下,把激活专家数量翻倍到 16 个。
不过,通信时间与计算时间的比值可能对估算系统效率更重要(相关讨论见这里和这里)。该比值表示在吞吐受限场景下,MoE kernel 能够将通信与计算重叠到何种程度的 roofline(屋顶线);专家中间维度是唯一会影响这一比值的模型配置。具体而言,增加专家中间维度会降低该比值,意味着理论上可以隐藏更高比例的通信。
下面推导该公式:
~~~text
t:专家并行(EP)域内的输入 token 总数
K:每个 token 激活的专家数
N:专家总数
E:EP 域中的 rank 数
d:专家输入维度
m:专家中间维度
P:每个激活元素通信的总字节数(dispatch + combine)
F:有效 FFN 专家吞吐量(按 SwiGLU 建模),单位为每 GPU 的 FLOP/s
B:有效单向网络带宽,单位为每 GPU 的 B/s
~~~
假设专家路由均匀,每个 GPU 会被分配 t * K / E 个 token。由于平均有 1 / E 的 token 位于源 GPU 本地,因此每个 GPU 分发的 token 数为:
~~~text
(t*K/E) * (1-1/E)
~~~
每个 token 是一个 d 维向量,因此每个 token 的通信量是 d * P。每个 GPU 的通信量为:
~~~text
(t*K/E) * (1-1/E) * d * P
~~~
通信时间:
~~~text
T_comm = (t * K * d * P) / (E * B) * (1-1/E)
~~~
SwiGLU 计算包含 3 次矩阵乘法:
~~~text
Up(第一)投影:d 到 m
Gate 投影:d 到 m
Down(第二)投影:m 到 d
~~~
因此,每个 token 的计算量是 2*d*m + 2*d*m + 2*m*d = 6*d*m FLOPs。每个 GPU 的计算时间为:
~~~text
T_comp = (6*d*m) * (t*K/E) / F
~~~
通信时间与计算时间之比为:
~~~text
T_comm / T_comp
= ((t * K * d * P) / (E * B) * (1-1/E)) / ((6*d*m) * (t*K/E) / F)
= (P*F) / (6*m*B) * (1-1/E)
~~~
我们认为,该公式也解释了为什么不仅 Kimi K2 到 K3,近期所有开放权重模型都把专家中间维度增加到 3072,包括 DeepSeek V4 Pro、MiniMax M3、MiMo V2.5 Pro 和 Inkling。随着硬件改进、专家权重精度降低以节省内存容量,计算吞吐量会增加;降低这一比值的一种方式,就是增加专家中间维度。
来源:Kimi K3 report
许多既有负载均衡方法需要仔细调节超参数。Quantile balancing(分位数均衡)是一种无需超参数、无需辅助损失的负载均衡技术,由 Jianlin Su 在 2026 年 2 月的一篇博客文章中提出。
QB 的基本原理与 aux-free load balancing(无辅助损失负载均衡)相同:根据系统负载动态更新 router(路由器)偏置。但与 aux-free lb 每次只用一个小系数更新偏置不同,QB 会根据 router 分数相对于路由 cutoff(截断阈值)的分布,直接计算下一次偏置。
当 router 已经均衡负载时,偏置更新自然会变小。
来源:Kimi K3 report
QB 试图找到一个偏置,使当前 batch(批次)中的 cutoff 和路由在近似均衡的情况下成立;它通过求解约束优化问题,计算下一批次要使用的更新。
第一个约束是每个 token 必须恰好路由到 k 个专家。第二个约束是:一个包含 m 个 token 的 batch,每个 token 选择 k 个专家,总共有 mk 次分配;为了让负载在 n 个专家之间均匀分布,每个专家应处理 q=mk/n 个 token。
每个 token 把带偏置的 router 分数中第 (k+1) 高的分数作为 cutoff threshold(截断阈值),并用它计算每个专家为实现负载均衡所需的偏置更新。
对于每个专家,QB 会对该专家的 router 分数与每个 token 的 cutoff 之间的 margin(差值)进行排序。它把负偏置设置为第 q+1 大的 margin,使阈值之上恰好留下 q 个 margin。由于 q/m=k/n,这就是 margin 的 (1-k/n) 分位数,因此该方法被称为 Quantile Balancing。
SemiAnalysis 是由读者支持的出版物。若想接收新文章并支持作者,可以免费订阅或付费订阅。
我们正在 InferenceX 上持续追踪 Kimi K3 的推理性能。截至 7 月 30 日,OpenRouter 上所有供应商的价格下限都是:每百万输入 token 3 美元、每百万输出 token 15 美元。Nvidia 和 AMD 都在 vLLM 上提供了 Day 0 配方,支持 DRAM offload(DRAM 卸载)和 DSpark speculative decoding(投机解码)。
来源:OpenRouter
在 InferenceX 上,我们直接使用记录下来的内部 Claude Code trace(调用轨迹)对 Kimi K3 的服务性能进行基准测试。我们重放一小时的轨迹,直到系统达到稳定状态。每轮的输入 token 中位数为 142k,输出 token 中位数为 444;每个 session(会话)的轮次中位数为 65。
每轮输出 token 较短,是 agentic harness(智能体运行框架)工作负载的典型特征:智能体会频繁调用工具,甚至编辑操作本身也属于工具调用。与此前的 8k1k/1k1k 基准相比,这次基准测试向前迈出了一大步,因为它真正反映了现实世界中的智能体使用场景。从系统角度看,它同样很现实,是最接近生产系统的测试。它可以反映 KV cache 行为,包括 prefix cache 和向 DRAM 卸载 KV。
来源:InferenceX
对于 Kimi K3,Day 0 bringup(首日启动适配)比 DSv4 更容易,这是因为权重发布前准备更充分、文档更完善。适配的镜像和 speculative decoder model(投机解码器模型)与权重同时发布。
在 Nvidia 上,启动适配很简单。但由于模型规模极大,它无法装入单个 B200 节点,我们必须使用 PP(pipeline parallelism,流水线并行)才能运行。DSpark 也无法与 PP 配合工作。
来源:InferenceX
对于 B300,模型可以装入 1 个节点,并且服务表现良好。扣除权重占用后,GPU HBM 只能容纳 3.25M token。下图显示,随着 batch size 增大,吞吐量会持续上升,直到并发度超过 8。这个现象大致对应 3.25M token 的 KV cache 预算;随后 cache 开始抖动,导致命中率从理论上的 95% 降至低于 10%。
阅读更多
Dwarkesh Patel 讨论了 AI 实验室收入增长远快于算力供给增长的缺口:Anthropic 收入可能连续多年同比增长 10 倍,而实验室计算资源每年只增长约 3 倍。除了提高利润率或增加推理占比,计算价格上涨可能成为主要出口。更聪明、更高效的模型能用同样硬件创造更多价值,抬高算力的边际价值;但在奇点前,算力年增 3 倍本身都可能难以维持。
- 计算资源可能会变得昂贵得多 [00:00:00 - 00:08:47]
- Mercury Command 赞助内容 [00:08:47 - 00:10:00]
- 计算价格最终还会再次下降 [00:10:00 - 00:11:17]
Dwarkesh Patel:今天我想谈谈,未来几年各家实验室的计算资源状况会是什么样。过去连续三年,Anthropic 的收入都实现了同比 10 倍增长,而且今年很可能还会再来一次。公司去年结束时的收入是 90 亿美元。我认为,今年年底它的收入大概会达到 1000 亿至 1500 亿美元之间。这个趋势若要延续下去,Anthropic 需要在明年年底达到 1 万亿美元的收入。当然,这并没有什么深层次的理由说明它一定会发生。这是一个非常激进的外推,最终还是取决于 AI 的能力:到明年年底,AI 会不会变得有那么大的用处?但假设这个趋势真的延续下去,我想思考一下那个世界会是什么样。 [00:00:16]
Dwarkesh Patel:AI 的另一个大趋势是,实验室的计算资源同比增长速度只有 3 倍。一个实验室如果想让收入继续保持同比 10 倍增长,而计算资源只有 3 倍增长,那么以下三件事中至少要发生一件,也可能是几件同时发生:第一,实验室的利润率必须提高;第二,计算价格必须上涨;第三,实验室用于推理而不是训练的计算资源占比必须提高。我理解的是,这三件事其实都已经在发生。先说利润率,据报道,Anthropic 的推理利润率已经从去年年中的 40% 上升到如今的 80% 以上。对于计算资源来说,现货价格比今年早些时候 2 月份的低谷高出 40% 以上。至于训练和推理之间的计算资源分配比例,Epoch 表示,OpenAI 在 2024 年只有四分之一的计算资源用于推理,而现在这个数字可能已经接近 50%,甚至更高。 [00:01:13]
Dwarkesh Patel:实验室并不希望提高推理所占的计算资源比例。在它们看来,推理收入存在的全部意义,就是说服投资者给它们更多资金,用来训练下一个更大、更好的模型。如果你把大部分计算资源都花在推理上,实际上就等于宣布 AI 的进展已经停滞,而你现在做的是云服务商的生意。这比打造 通用人工智能 的吸引力要低,所以实验室不想做这种生意,也不认为自己已经进入了那个世界。它们相信,在一年之内,就能打造出让当前模型显得极其弱小的新模型。但它们必须把大多数计算资源投入到训练和实验中,才能构建下一个模型。这样一来,要弥合实验室计算资源同比增长 3 倍、收入却同比增长 10 倍之间的差距,就只剩下两种选择:要么实验室的利润率提高,让实验室拿走这部分剩余;要么计算价格上涨,让产业链中实验室以下的所有参与者拿到这部分剩余。 [00:02:15]
Dwarkesh Patel:我不清楚最终会进入哪一种世界。如果实验室利润率的影响占主导,那么一些顶尖模型的利润率会不会从 80% 上升到 90% 以上?这就要求领先模型远远领先于竞争对手,以至于这种优势不会被竞争削弱。在市场经济中,利润率之所以存在,是因为你提供的东西比别人能够提供的替代品好得多。但一想到“智能”这种东西的利润率可能超过 90%,却不会在这个水平上被竞争抹平,我就觉得非常疯狂。于是,在这两种趋势之间解决差距的另一个可能性就只剩下了:计算价格必须上涨。正如我刚才说的,这已经开始发生了。当前沿实验室真正需要积累的那一档计算资源时,这种影响会更强。它们不能简单地出去买一台现货实例,而是需要足够的规模,以获得很好的效率和灵活性;同时,它们还需要能满足安全要求的计算资源,以保护自己的模型权重和客户信息。 [00:03:18]
Dwarkesh Patel:这里一个相关的案例,是 Google 和 Anthropic 从 SpaceX 租用的计算资源。比如,Google 每月支付 9 亿美元,租用 11 万块 GPU,其中混合了 GB200 和 GB300。Google 支付的价格是这些 GPU 每小时现货价格的两倍,而现货价格本身又比 2 月份高出 40% 以上。我想强调一个关键结论:随着 AI 模型变得更聪明,它们将更擅长把同等数量的计算资源变现。如果一个真正达到人类水平的软件工程师可以在一块 H100 上运行,那么按照今天软件工程师的价格,这块 H100 每年应该能租到超过 25 万美元。这是当前 H100 现货价格的 15 倍以上。这还没有考虑 AI 可以在夜间和周末工作的事实。当然,你可能会认为,如果经济中突然出现 1000 万名额外的软件工程师,软件工程师的边际价值就会下降,因此那块 H100 能产生的收入不会比现在高 15 倍。但我不知道这是否真的成立。 [00:04:28]
Dwarkesh Patel:如果把这个论点应用到人而不是 AI 上,这就会成为经典的“劳动总量谬误”。例如,经济学家普遍认为,大规模移民不会从长期来看降低工资,因为创新和专业化会提高劳动的价值。也许这次劳动力供给冲击会大到、快到让我们不能再依赖这个一般性判断。但如果你相信标准经济学的说法,那么劳动的边际价值,以及计算资源的边际价值,就应该继续高得惊人。让我们想想,在这样的世界里会发生什么。随着顶尖实验室越来越擅长将计算资源变现,而计算价格不断上涨,其他任何人都会更难与它们竞争,因为他们必须与一个能更好利用这种资源的人争夺它。另一个会发生的变化,我认为也是整个思想实验中最有趣的推论,就是:如果你能训练出最好、最高效的模型,就能收取比今天高得多的利润率。这就是经济学中的 Alchian-Allen 效应。它的含义是,如果租用一块 H100 每小时要花 20 美元,那么使用更弱、效率更低的模型就会非常愚蠢,因为它为了得到完全相同的结果,会在昂贵的计算资源上消耗更多 token。因此,如果实验室能训练出更善于节约这种稀缺投入的模型,就能收取高得多的溢价。 [00:05:32]
Dwarkesh Patel:基本上,如果一个模型能够用更少的计算资源取得同样的结果,那么从某种意义上说,你就创造出了更多计算资源,而计算资源的价值也会随之增加。另一个后果是,当前许多热门的 AI 应用可能会被价格挤出市场。AI 现在相对便宜,是因为它还做不了许多顶尖人类能够做的事情。但某个时候,这种情况会改变。到那时,Google、Anthropic 或 OpenAI 会愿意花更高的 token 价格来自动化 AI 研究,而不是像你我这样花钱生成更多 AI 垃圾内容。我担心,这种分析与过去人们在稀缺性问题上犯错的方式很相似。比如,我想到的是著名的 Simon-Ehrlich 赌局。Paul Ehrlich 曾因对人口增长持悲观态度而闻名,他打赌:在截至 1990 年的那个十年里,一篮子大宗商品的价格会涨而不是跌。这个赌局之所以著名,是因为它被认为说明 Ehrlich 的马尔萨斯主义世界观是错误的,也说明他没有预料到市场信号和人类智慧会找到更好地节约稀缺投入的方法。我猜,把计算资源类比为那场赌局中的商品,可能并不成立。其他分析显示,如果那场赌局发生在不同的十年,Ehrlich 很可能会赢。但更普遍地说,我认为计算资源的供给弹性要小得多,吸收大型需求冲击的能力也弱得多,而且比起通过开采不同金属来寻找替代品,计算资源更难通过替代方案来满足需求。为了说明为什么我认为计算能力每年增长 3 倍很难改变,甚至可能很难维持,我看不到构成这 3 倍增长的三个要素中,有哪个能够被大幅加速。 [00:07:13]
Dwarkesh Patel:其中大约 1.4 倍来自摩尔定律。别说让它加速了,我认为只要还能让它再持续几年,就已经是奇迹。另有 1.2 倍来自建造新的晶圆厂。到 2030 年,甚至可能更久,这个过程最终会受制于建造新的 ASML EUV 设备。几个月前 Dylan 上播客时,曾经非常详细地讨论过这一点。剩下的 1.8 倍来自 AI 吸收了原本分配给智能手机和 PC 的晶圆产能。到明年年底,这很可能会碰到上限:在台积电最先进的 N3 节点上,AI 所占的分配比例将从 60% 上升到 86%。到了某个时候,你已经吸收了所有面向 AI 的先进制程晶圆产能,这个比例就不可能继续提高。所以,我不知道未来几年我们如何还能继续实现计算能力年增长 3 倍,更不用说超过这个速度了。每个月月底,我都会遵循一个历史悠久的传统:结账。 [00:08:47]
Mercury 广告旁白:我首先打开 Mercury,我的银行服务平台,确保所有交易都被正确分类。自动分类规则处理可预测的项目时表现相当不错,但我一直在和新的承包商合作,比如辅导老师、研究人员和视频制作人,同时也在尝试新的工具。每个月手动给所有这些交易分类,都会增加几个小时的额外工作量。与其逐笔处理,我会让 Mercury 内置的 AI Command 一次性处理所有交易。Command 会为每笔交易建议一个类别,并给出它这样判断的理由。我只需要检查一遍,修正不对的地方,然后批准。所有工作在 Mercury 中完成后,它还会与 QuickBooks 同步。 [00:09:17]
Mercury 广告旁白:Command 的判断确实很好。它会做查看供应商这类显而易见的事情,但也会调查团队中的谁进行了这笔消费,并查看备注和备忘录,尽可能建立完整的上下文。这只是利用 Command 自动化企业后台工作的一种方式。想了解更多,请访问 mercury.com/command。Mercury 是一家金融科技公司,而不是 FDIC 保险银行。银行服务由 Choice Financial Group 和 Column N.A. 提供,它们是 FDIC 成员。
Mercury 广告旁白:银行服务由 Choice Financial Group 和 Column N.A. 提供,它们是 FDIC 成员。AI 生成的回复和建议操作可能有所不同,不能保证一定准确。
Dwarkesh Patel:我想澄清的是,未来某个时候,计算资源会再次变得便宜。终有一天,我们会拥有能够把大片硅砂海岸和铜矿转化为新计算芯片的机器人。到那时,计算价格基本上就会等于原材料成本,以及处理这些材料所需工具的成本。我这里只讨论当前这个奇点前阶段,在这个阶段,AI 计算能力每年的增长只有 3 倍,而这不足以抵消 AI 随时间变得越来越有价值的速度。Anthropic 的收入同比增长 10 倍,而计算资源同比只增长 3 倍,这一事实在我看来说明了模型业务的规模经济有多强。从逻辑上讲,这也说得通:训练模型时,你要付出一次性的成本,让它学会各种不同的技能,而这些技能随后可以被所有用户共享。这与人类劳动非常不同,因为每一个人都必须从头开始接受训练。我真希望我们不是生活在一个智能具有如此强规模经济的世界里,因为我担心权力会因此集中,但现实似乎就是如此。这期内容是我在 Dwarkesh.com 网站上发布的一篇博客文章的旁白版。 [00:10:47]
Dwarkesh Patel:欢迎去看看我发布的其他文章,或者订阅通知,以便在我将来发布文章时收到消息。下一期完整节目再见。 [00:11:11]
于新烈与李南围绕小米澎程(讨论中主要称 N70、N90)发布会和静态体验展开长篇分析。两人认为,这款车表面上没有极端鲜明的造型标签,却把成本控制、大空间、二三排滑轨、旋转座椅和增程使用场景组合在一起,目标并非单纯做一辆“豪华高配车”,而是以较大的用户覆盖面和较强的价格竞争力切入市场。它最有价值的创新是把 SUV 的空间组织方式重新做了一遍,但部分空间功能只有在驻车场景中才能充分体现,且滑到最后的位置并非安全认证位。小米真正的野心,可能是借澎程打造一个能打穿更大人群的单品平台,并进而挑战理想在“大空间、移动的家”上的品牌根据地。
1. 产品定位与定价逻辑:两位嘉宾认为,澎程的设计相对保守、成本导向明显,目标人群更在意价格、空间和实际使用效率,而不是单纯购买情绪价值。发布会公布的 MAX 版本价格被解读为先给出高配锚点,再让消费者倒推标准版价格;大量选配也说明成本是产品决策中的核心约束。讨论还提到,若小米依靠线下门店销售,低价入店、再通过选装提高客单价,可能会成为重要销售策略。
2. 空间创新的真实价值:澎程的核心卖点不是凭空增加总空间,而是通过平整地板、前排旋转和二三排滑轨,让有限的车身长度获得更灵活的空间分配。第三排向后滑动后,身材较小的乘员可以获得接近更大车型的腿部空间;但这一位置牺牲头部空间,也不是安全认证位置。日常驾驶占比高的用户未必会强烈感知优势,商务接待、录节目、休息和长时间驻车的人则可能更容易觉得这套设计物有所值。
3. 从功能到用户需求:两人把需求分成三层:首先是便宜且足够大的空间,其次是空间内部可以调整,最后才是电动化、自动化和 AI 化。前两层在更广泛的价格区间内都有成立基础,第三层更像高端配置。因此,旋转对坐并非全部用户的刚需,但“低地板、规整空间和可调整布局”可能比发布会中复杂的变形演示更接近可持续的产品价值。
4. 竞争关系:澎程对理想的长期挑战最大,因为它直接进入了理想已经建立的“大空间、移动的家”认知。零跑 D 系列可能承受较直接的价格和内饰冲击,乐道在增程属性、驻车使用和解释成本上也可能受到影响;MPV 仍凭借更低地板保有空间优势,因此不会被 SUV 完全替代。小鹏的不同产品则因定位和使用方式不同,受到的影响相对有限。
5. 小米的品牌野心:小米刻意避免给澎程贴上红米、商务车或某一种固定车型标签,可能是为了保留更大的市场扩张空间。两人将这种思路与消费电子中的单品爆款逻辑联系起来:行业往往经历单品高速增长、扩张 SKU、为低销量研发投入付出代价,再重新收缩产品线的循环。澎程既可能是小米补齐汽车产品经验的一次验证,也可能是其寻找汽车行业“原型产品”的尝试。
6. 空间体验的边界条件:李南特别强调,澎程并没有凭空创造出比同尺寸车型更多的纵向总空间。它在默认位置上的第三排,与同级 5 米级车型大体相近,真正的变化是允许牺牲一部分头部空间,把座椅向后移动。对身高较高的成年人而言,这种极限位置未必适用;对儿童、女性或身材较小的乘员,以及把车辆当作移动房间使用的人,则可能很有吸引力。两位嘉宾因此把发布会中很有冲击力的空间演示,拆解为“总空间”“可调整空间”和“高阶电动化、自动化功能”三个层次,认为前两层更有普适性。
7. 品牌与渠道的取舍:于新烈认为,小米希望以“没有固定标签”来避免被锁定在红米、商务或某一个细分车种中,同时用低价版本制造到店理由;但这也会带来用户预期管理问题。若产品大量依靠线下零售,销售人员可以围绕座椅、车门、方向盘调节和其他选装项目提高成交配置,消费者最终支付的价格可能与发布会的入门锚点不同。若线上直销占比更高,低价引流与选装转化的效果则需要重新评估。
8. 为什么会影响理想:两位嘉宾认为,理想的核心资产并不只是某一项配置,而是“需要大空间就先看理想”的品牌直觉。澎程把大空间、增程、较低价格和更灵活的座舱布局放在一起,等于从用户根据地发起挑战。理想可以继续向外拓展操控或其他卖点,但前提是守住原有的大空间心智;如果竞争对手在这一心智上建立更强的性价比印象,影响就可能从单一车型销量扩展到品牌选择。
9. 行业周期的判断:从手机行业经验出发,于新烈提出,企业往往先用少数单品取得增长,随后扩充产品线来覆盖更多人群,等研发和库存成本显现后,再回到收缩 SKU、集中资源打造爆款的阶段。小米希望澎程承担的,可能正是一个跨价格和跨场景的平台角色。这个判断尚未被市场结果验证,但可以解释为什么发布会反复强调平台能力、空间组合和不贴标签,而不是只把澎程包装成某种传统车型。
整体来看,节目并没有把澎程简单归类为“功能堆料”或“价格屠夫”,而是把它放回产品定义、销售方式、品牌认知和行业周期中观察:同一项空间功能,对不同用户的价值完全不同;同一个低价策略,也会因渠道结构和选装比例而产生不同结果。两位嘉宾最终更关注的是,小米能否把这些局部创新稳定成一套可复制的平台能力。
- 小米澎程的定位与初印象 [00:00:00 - 00:10:00]
- 从产品发布到价格预期 [00:10:00 - 00:20:00]
- 目标人群与空间变形需求 [00:20:00 - 00:30:00]
- 二三排滑轨与旋转座椅 [00:30:00 - 00:40:00]
- 空间价值与安全边界 [00:40:00 - 00:50:00]
- 智能化、自动驾驶与真实场景 [00:50:00 - 01:00:00]
- 从产品卖点到竞争策略 [01:00:00 - 01:10:00]
- 小米的品牌野心与理想的根据地 [01:10:00 - 01:20:00]
- 竞争影响与汽车行业的产品周期 [01:20:00 - 01:28:46]
# Vol.092 小米澎程技术发布点评:表面平平无奇,内心所图甚大
于新烈:你好,我是于新烈,欢迎收听885。
李南:不过其他人,我也觉得没有必要,这个世界不缺,不缺另一个中文的车媒,所以现在主要是,对YouTube上面的,没多少见识的外国人,能不能让他们见识一下,我们的这个,我每一个视频的开场,都是全球最大汽车市场,这是个事实,就是我说的不是,不是我的观点,是全球最大汽车市场的观点,所以你最好认真听一听,而且想听浩然中文对车的评价 [00:00:30]
于新烈:885可能是极少的节目之一了,我的合作伙伴,是中文的那个车媒,对司机的自我修养,对他们让我给他录了一个中文的,因为这个鹏城这车,他可能觉得实在是比较火,也推荐大家关注一下,是叫司机的自我修养吗,对 OK来南总,大家好我是李南,我们以前做手机,就是那个魅蓝,后来做安卓喵是做键盘,然后现在开始做游戏鼠标了,接下来我们还要做webcoding keyboard 大家可以期待一下,我不是因为,你能够吐槽小米有料,才约你聊这期播客的,我完全是因为之前,男总在微博上,早期的时候,这个小米鹏成给吹爆了,说如果卖不爆,就是他的努力不够,对鹏成寄予厚望结果发布会之后,态度大转变,待会可以好好聊聊,聊聊大家,这次发布会的一些观感,我不知道男总开没看,不论是发布会也好,这次产品整个你看了一些,简单的介绍也好,你们两位聊一聊这次的观感,浩然先来,我是去拍了静态 N70跟N90我都拍了 [00:01:48]
李南:然后是直到发布会之前,大概三四天的时间,才告诉我们说 N70的内饰这次不公开,就不能发,我是当成两个视频分开拍的 N70一个N90一个,我相信绝大多数人也都是这样,所以这就是为什么这次所有N70的媒体第三方的视频,大家都只看到了外观没有看到内饰,我不知道是为什么,可能是想把N70这款车的亮点留到正式上市发布会,这次发布会讲的东西,因为我是拍了静态没有太多惊讶的部分,然后我猜了一下,我说雷总这个预售价是会一步到位,还是拉高一个悬念,他最后选择的这个做法是,看起来拉高了悬念,实际上他已经一步到位了,就是因为他发的这个预售价是N90 MAX和N70 MAX的顶配的价格,那你可能会觉得 29万9 24万9 这价格好像不是特别的,大家以前对这个车是,红米汽车的这个预期嘛,但是你要注意它是MAX 你拿预期Max 然后你就倒推预期标准版,该是什么样的售价,然后你拿N90 Max 再去倒推N90标准版,当然了N90 据我目前所知的,是它不会有单电机的版本,然后它也不会有小电池,所以它可能不会像,比如说预期Max是29万9 还是30万9 反正是30万出头的一个价格,那你这样推的话,预期的那个标准版要到25万多,那它的这个是不是也是要到25万多,我觉得是有可能的,但是它的N90看来是要输一下品牌的,大哥不能太便宜,但是它的N70那个Max249000还是259000那个价格,哇这里面的水分可大了去了,这个N70有很多很多很多东西都不是标配的,这个我觉得现在已经可以说了,因为发给我们静态的那个评测手册上面,其实是有很详尽的配置表的,你是可以看出来哪些东西是标配,哪些东西不是标配 N70有很多 N90其实也有很多东西,不是标配,你把这些东西去掉之后,那这个一打头的,正式的上市价格,我觉得还是板上钉钉的,就是N70 N70的起售价,一定会是一个一打头的,不然这就不是小米了,这个鹏城就可以回家了,但是雷总是不可能,让鹏城回家,所以我觉得没有太超出,我的预期吧,它最后的这个价格,如果你知道,它哪些东西不标配的话,你会觉得,其实他已经给的很实在了,我觉得可能大多数人可能会觉得对这个价格,我看六呆对用户的调研,什么几千名用户,对这个车的,在开发布会之前,预期售价N90是35万多 N70是25、26万多 22、27、28万,我当时觉得,这雷总对他们的营销,真是太成功了,但是不好意思,我关注这个车很长时间了,我知道它是一个,极端成本导向的产品,所以它就不可能那么贵,我的观感大概就是以上,是因为之前营造出来的形象 [00:04:54]
于新烈:他们很长时间预热了,它是一个非常创新的产品,而且因为市场上现在,对于大电池增长,其实配置已经拖得很高了,当然可能它还是一个,价格区间的产品,都是旗舰型的,比如最近的问街理想,人家都是什么5C充电 800伏平台,像小鹏的GX 会对大家造成一个印象,就是这类的,所谓的旗舰的车型,它配置肯定低不了,但其实,这次你会发现 90 它有些地方是有折扣的,这也是比较有争议的地方了,另外发布会上就看到了,各种选配,小轴板也选配,对吧,包括它的那个电动门,它做宣传的时候,我就看到能开90度,我说这开90度,我之前,就是开理想的车,什么爱巴什么的,也能开很大的门开口,那是卖点,但是,我坐上车,我要关门要够很远,非常不方便,我说如果这要不标配,电动门的话,这个开口对我来说 [00:05:26]
李南:就会打很大的折扣体验上,但是后来一看,那电动门也是选配,电动门是一个很奢侈的配置,它的方向盘调节,甚至默认都是手动的,你要想,它是一个前排座椅旋转的车,你的方向盘,如果电动调节的话,是不是可以在你,座椅旋转的时候,为你这个,你可以把方向盘,往仪表台里面收一些,会更方便于你这个座椅的旋转,那这就说明,这个车体验跟成本,谁是真正的老大,如果体验是老大,这个车从他的这个,如果他真的这么看重,他的对坐模式的话,那就应该标配,电动条件方向盘,但是他没有 [00:06:20]
于新烈:说明这辆车的,真正的老大是成本,能总我聊两句,你是从什么时候发现,你的期待和雷总最开始,承诺给你的东西不一样的,他没有承诺给我什么,发布会我也没看,但我让AI看了,另外内饰B站已经满天飞了,我都看了好几遍了,这个车我知道,其实小米一贯套的,我之所以不看,因为那套东西太熟了,就是上来先让你预期一个很高的价格,然后发布的时候,在最后时刻给你一个surprise 然后啪那个价格落下来,然后呗好便宜对吧,但是那个实际上,这个车的价格没到位,它这两个Mach3本,尤其是那个N70 Max很奇怪,它搞了一个25万9 为什么不是24万本对吧,每个整数和每个中间,就是那5的下一档的99 是一个非常典型的定价的心理价位区间所以我觉得这个N90 MAX跟N70 MAX 这两辆车没上磁道,我看了这个架构就知道它没上磁道,它上磁道的一定是那个非MAX版本,但这个就会产生另外一个问题,就是说OK它会发一个假设 N70 MAX是25万9 无所谓了它也不大可能去充量了,它N70它属于有一个19万9的版本,对吧,这大概率吧,它的策略应该就是,我用一个低价给你搞进店,然后服用你各种上选转,然后最后你觉得,这车差不多了一小天,它并不便宜,所以,对,因为如果要是你有大量的,线下店铺的铺设,那么这种低价策略跟销售策略,是合理的,因为促销员是能充分的调动,已经决策的消费者的,额外的购买机性的,这个我们也有长期数据,就是说大概能让你,加价15%到20% 所以对如果要是小米的销售渠道,不是以线上直销为主,而是以这种线下促销为主的,线下联手零售模式的话,那么它的确会搞一个超低配,给真金的价格,让你进店,进店之后把你摁在那里,然后各种给你催销,这个销售模式,我觉得没有理想干净,理想就没废话,然后交钱开口,这个模式还有点传统,其实好多传统的那种,包括合资也好,或者说所谓豪华也好,也是这么卖车吗,但是我觉得,大家还要有另外一个思维转变,就是说如果在2017年,比如说我们做手机的时候,你说那个线下零售,连锁销售是传统模式的话,但今天,其实指的2026年的时候,我觉得线上零售,只像是传统模式所以小品也是有与之俱进的能力的,因为今天真实情况之下,如果你考虑新一代消费者,疯狂的退货率的话,跟车这东西可能很难推,实际上我认为,今天的线上豁客成本,和线下豁客成本,有可能倒挂了 [00:09:40]
# Vol.092 小米澎程技术发布点评:表面平平无奇,内心所图甚大
于新烈:有可能倒挂了,同意啊,几年前包括未来就有这种判断,线上渠道的流量太贵了,所以先上做市场,先下做销售,就必然会导致这种,放一个其实不太可用的超低价格,把你弄进店之后,再让你额外加钱的操作,这次大概率是这样的,这跟现在市场环境不太好有关系,这种策略,因为以前相对来说,之前苏期预期,好像没这次这么明显,我觉得这完全是销售渠道的,主力销售渠道的性质决定,带来另外一个问题就是,它放在了小米的品牌下面,它不是说像乐道那样,放在未来的第二品牌,跟主行品牌是有区分的,那它又这么一款大的全尺寸SUV价格其实跟之前的轿车的售价,其实相对来说,它就已经算一个性价比产品了,那另外它又通过这种入门门槛的低价,然后吸引大家选配,能够达到一定销售额的这种方式,其实它对小米的品牌,本身是有影响的,就是为什么,它要做一个第二系列,或者说不做一个第二品牌呢,就第二品牌也好,第二系列也好,大家不同做法嘛,比如小铜 Mona 它就是一个更低价的产品系列,那未来,它把更低价的乐道,做成了第二品牌,理想那个,当然更早的,它是一个并行的,按照动力能源形式,分的两个产品系列,那小米这么做,我觉得,对它的主品牌,可能是有一定影响,因为以前它的品牌,大家的市场认知是很清晰的,就印象很深,那现在,随着它的庞城出来之后那对小米品牌,大家的认知,其实会更模糊了,就为什么用第二系列,不用第二品牌呢,我不是branding 或者这方面的专家,我只是说 [00:11:47]
李南:其实这两个车的,产品取向上区别,是非常明显的,不只是说,一个是纯电,一个是增程,其实预期,尤其是预期,是一个很明显的牺牲空间,去换设计价值的产品,他用了一个五米的车长,做了一个比Model Y空间只大那么一点点的一个车,他把剩下的空间全部释放给了设计,去让它看起来有情绪价值,但是鹏城就是另外一个极端,就是如果你想要一个极端皮儿薄馅儿大,这个极致空间取向的车,那就是就是鹏城这个样子,所以我倒不觉得说,这两个品牌,或者说玉七苏七这个系列和,这个鹏城这个品牌会,有多大的对冲,因为它的受众面真的很不一样,你还不像说你比如说一个,一个Q5跟图观之间的差别,就是Q5跟图观,本质上是一个很,很类似的产品,只不过一个更高配一些,一个是按照奥迪的标准和定价来做的,一个是按照图观标准来做的,还不太一样,你这两个车如果给你的体验上很接近的话,那确实可能会有一些对打,但是它呢 [00:12:52]
于新烈:这个一个极致空间,就是极致空间到,有些人可能觉得它已经有点小巴了,就是这个,我插一句啊,这就是我想提问的地方,就是他们差异就因为巨大,我才认为,是不是可以做第二品牌,而不是说在统一品牌下的两个系列,因为他们差别太大了,我觉得小米可能很忌讳,让这个车成为红米汽车 [00:13:17]
李南:虽然这个车很大程度上定位上,它其实就是按照红米汽车的定位,但它其实就是红米汽车,对啊,我们又不是小米的员工,对不对,我们是第三方媒体,那它是怎么样就怎么样,虽然它确实就是一个红米汽车的定位,或者说它做出来就是红米汽车的样子,但是我感觉小米可能很忌讳,这个品牌叫红米汽车,因为你一旦叫了红米之后,你会带上红米的所有的品牌预设,那他可能觉得对他这个增程,尤其他的大车要卖上毛利,卖高一点的话,这个可能会有一定的损失,那你如果预期跟苏七起价是,你的苏七起价是21万9的话,你对他的售价预期,你就卖不上价,所以我感觉可能是小米可能很忌讳这个车,会戴上红米汽车的帽子所以给了它一个鹏城,而且我不知道于老师你有没有注意到一点,鹏城的命名其实跟乐道完全一样,鹏派的行程,乐道是跟家人在一起,反正都是第二个字都是城或者道,都是路程或者道路的意思,第一个是对这个的形容,其实这两个品牌的命名上真的非常非常像
于新烈:而且说实话,如果你只看车的话,我承认小米汽车,没有那么的极致性价比,但是实际上小米手机,仍然是性价比,至少那个标签,不是贴在红米上,是贴在小米上,所以说就是很明显,这个车一定是干到 1999开的一个拼刺刀的产品,但是呢 [00:14:57]
李南:在这次发布里,扭扭捏捏的没有上刺刀,我感觉雷总可能是觉得,这个对座模式,以及他那些乱七八糟的东西,给大家的震撼已经可以了,回想到说,他不让我们发N70的内饰这一点,因为我们那一天拍的媒体,有两个我也认识,我们互相聊下来的感受都是,我们去拍之前,我们以为N90 MAX是主菜,包括一开始分前后顺序的时候,我是先分到了N90 然后拍N70 我说实话我想换一换,因为我觉得N90拍起来会更复杂一些,我想先在N70上面熟悉一下,然后再去拍N90 但是其实N70才是主菜,反正根据官方信息来看,它也有对座,对吧,第二排也是长滑轨可以前后滑,它的坐垫也是可以抬起来,它其实都有,说实话,在三排座的车上面对座模式并不独家,你哪怕比如说Mega可能比较贵,或者其他的这些车可能MPV 跟你差不多价位的零跑的D99也是对座,只不过它是个MPV 三排座上对座的体验其实并不独家,但是在两排大五座上,对座仅此一家,它还有一个我之前发微博我也说了,我说可能很多人都没有注意到的一点,小米很推的是这个对坐模式,但它是需要选装的,你得选它的那个旋转座椅,你才能对坐,但是它的二排,它的三排长滑轨和二排长滑轨,就是在那个N70上面是二排,就是它的后面的座位的长滑轨,进入载货模式,把坐垫竖起来,往前推到最里面,最靠前,给这个后备箱让出近身之后的这个货拉拉模式,是很夸张的,而这个是不需要选装的,你线下去体验,这个可能是对你冲击更大的一个模式,因为很多人可能会觉得,对座模式,你有那么强的需求成天去对座吗,但是呼啦啦这个东西
于新烈:很有可能对于,尤其对于N70 对于5米以下的这个用户,是一个比较大的冲击,所以我们这么分析,如果N70是主币,然后是以实用主义为优先,无论是库拉拉还是德法乌,那么就意味着 25万9的这个价格一定不对,一定是有问题的,我没注意它N70 MAX配不配这些东西 [00:17:34]
李南:这些东西都是选配的,旋转座椅 1万不过分吧,踏板 1万不过分吧,电动门 1万不过分吧,这就3万了
于新烈:然后N70的Pro是小电池,我再减个1万,不过分吧,这就已经4万了,所以其实结论很清楚,就是一定有一个 19万9的N70标准版
李南:作为真正考量的,上磁刀的产品,还没有发布,我觉得,你按照我刚才的,这个倒推来看,它其实已经发布了,只不过需要我们来录,这个podcast 来告诉大家这一点 [00:18:25]
于新烈:其实它已经发布了,还是回到,我们刚才说的,从发布会来看,它确实是,是一个树立品牌形象的发布会,他给N70的部分非常之少,他全力都在讲N90 Max 以及他的整个的技术的平台,他还是要树蓬成的品牌形象,所以他开到一个半小时的时候,说结束了,我都有点吃惊,我说这还是雷总的技术发布会吗,这不搞个三小时,这也太不雷军了,然后N70就随便说了个预收价,就过去了,什么都有,然后就完事了,我觉得他还是确实是等上市发布会的时候,可能再给市场一个冲击,它反正也是这个平台,对吧,那如果五座能够对座,以及五座能够,无疾地来调整后排的空间,那真是爽歪歪了,就是那个,确实比三排更对我有吸引力,而且它是很独家的一个产品就其他人做不到,然后回到双品牌啊,或者说第二产品系列,来男总讲讲,你认为,鹏城更适合做第二品牌,还是第二系列,因为之前你做过,魅蓝,对吧,就什么时候做第二品牌好,什么时候做第二系列好呢,当然有非常多的逻辑,但是因为我已经做过了,所以我给你们一个最简单的,最容易理解的逻辑,什么时候你需要第二个系列呢,是人有可能是类似的 [00:19:32]
# Vol.092 小米澎程技术发布点评:表面平平无奇,内心所图甚大
于新烈:是人有可能是类似的,但是需求有差异化,所以你知道第二个系列,什么时候你需要第二个品牌呢,就完全不是一拨人,我们叫Tagliotti 一边是长三角珠三角金链,另外一边是三四线小线程,接溜了,那你就需要两个品牌,这种很简单,那所以从这个评判标准来看,你觉得鹏城适合哪个呢,我觉得是两个品牌,很清楚的两个品牌,而且之前我看像JDPower等等,做了很多用户调研,它的人群确实跟苏七与七,差别还是很大的,包括也很多是家庭用户,以及对价格会更在意的用户,就是人群差异还是挺大的,对我们定义产品的时候我们肯定要选择某些那个优势项目,然后这个产品,如果你要说,那个我看它的优势项目,第一成本,第二得方率,得方率其实就内部空间了,第三呢,是它的设计非常保守,非常保守意味着什么呢,意味着它是真的低端上去的,一个设计保守,得方率高的成本领先的产品,又在小米手里,那肯定要打价格战,所以这次的诡异,没有见到价格战,但是一定会发动的,这款产品包括之前,发布会之前的预热,谈到的有品的争论,其实也能看出它面对的人群,虽然它的全系有品都支持的,那个说法营销味比较重,很多人其实吐槽的是这点,但是它确实,本身表达的内容是没错的,它作为一款大电池增程的车去支持92号汽油,这个相对于理想和问届,只能加95号来说,在油价上,以及在加油站的普及性上来说,小米鹏城确实是一个卖点,这个超级有意思,是什么呢,是你说我加92号汽油,其实就行了,因为我们开过油车,我能加92 我加95 98其实也不会是太大问题,我加92图什么呀,我图便宜,很简单,但是小米是怎么说的呢,是说我95 98和92都能加,然后怎么解释呢,是如果你出去玩去荒郊野地 98 95不好找,你可以加92 这个本身就是一种,不是实话的营销的拧,其实它是,委婉的告诉消费者,便宜,但是呢他又顾及了消费者的面子,说你出去玩的时候,你可以加,这代表一种,那个更热爱野外和outdoor的生活方式,对,这个很敏感,但其实那个,对,这是一个又能告诉消费者,我便宜又能保住消费者面子的,营销上的表达,而且也表明了,他希望去面对的人群,他之所以这么努力的去做这个卖点,然后去适配92号,也是希望能够,一个是方便影响,价格灵感型的用户,以及传统燃油车的用户嘛,它不是像一汽素汽那样,其实买情绪价值的,它一定要是算账的,其实我是天天在城市里,辛辛苦苦的跑货啦啦,但是呢,我买到这辆车,给大家的感觉是,我闲得没事,我就去周边录个影,就是大概这个所以就回到,下面这个讨论的部分啊,用户需求,因为之前的所有的这些宣传,重点就是刚才浩然说的,不论是旋转对坐呀,还是各种空间变形啊,雷总在发布会上放了一页PPT 满屏全都是各种的组合形式,这些是不是正式用户需求,或者说是不是小米蓬城,不要用户的正式需求,以及像之前,极客MIX啊 Megahome啊,也都做过这种旋转对坐啊,包括一些空间的变形啊,也都是停车状态使用啊,那之前他们面对的,有成功有失败,你们觉得像这种空间变形,它成功和失败的原因,应该会是什么,昊然你先来 [00:23:35]
李南:Nix这个车在它上市之前,半年即刻叫过一批媒体,去那个春晓工厂去看过车,那个时候,它还有一个不旋转的,全手动座椅的版本,然后最后这个版本没有上了,当然了,就是这种媒体提前看车的这种,这样的活动呢,来的媒体都普遍,可能都是比较有经验的媒体,然后大家对于一款比较无聊的车,可能是兴趣普遍都不是特别大的,所以呢,大家就会对极客MIX这款车,非常,我们当时看了非常的喜欢,就说哇,这车冒了多么巨大的风险,是多么的牛逼,这个4米6的一个车厂,能做出这么多玩意来,然后内饰做来很精致,你可想而知,就是这样的一群人,去提前看这个车这么一个很有勇气的车,当然会得出这样的一个结论,问题就是,这个车真的很贵 Nix 28万起,我当时看到价格的时候,我当时发布会我还去了,就是现场一下子,就两利劫的那种感觉,就是大家已经做好准备,哇要嗨了,要起飞了,因为到那个价格为止之前的部分,那MIX简直非常的梦幻,对不对,然后那个28万那个价格一出来,然后咱一下子,开始没怎么说话,后来退场的时候,有一些媒体开始说,价格感觉挺贵,然后我最惊讶的是,不旋转座椅的那个版本没有卖,但是空间变化,旋转座椅或者客厅这种对坐模式,有没有这个需求,其实是有的,你可以看到一个点,就是MIX是一个二手车市场,有一辆卖一辆车而且上架收来之后下架马上就买走,因为他一下子解决了这个车过于贵这个问题 MIX现在在二手市场上,大概是18万到20万左右,那他是不是一下子就一点毛病都没有了,所以就是我觉得空间变化,不能说是伪需求,你不能像Megahome或者MIX的,那个全自动版卖的那么贵,对,尤其你是一个没有第三排的车,你卖到,哪怕在MIX上市的那个时间点,你卖到28万去,大家都会觉得,你这真的是个,我当时算了一下,它如果两个座椅,两个前排座椅都不旋转,然后它那个版本的后排座椅,是不在那个长滑轨上,可以前后滑的,是一个固定死的那个版本,那个版本少卖个三万块钱,一点毛病都没有,完全可行但是他没有这么干,然后极客MIX 直到今天也没有这么干,你甚至那个版本出来之后,你的全自动旋转的那个版本,你可以继续卖28万,但是你把起售价定在28万,就意味着原来比如说24万9 卡在这个,就像刚才南总说的,这部分人根本就不会来看你,你如果把它打到一个25万几,跟Model Y差不多价格的一个车,那所有那些Model Y就说,最近又上了一个新的车,差不多价钱,我们去看一眼,然后展厅里摆的肯定都是旋转对坐的那个版本,你觉得MIX会糊成像今天这个样子吗,我觉得不会,所以我觉得N70那个对坐的那个版本,比如说我们假设啊,它的底配是199,000 然后你选旋转座椅,可能加个15,000、22,000左右,一个SUV对坐,独一档的体验我觉得是足够的 [00:27:56]
于新烈:而且就算你不选这个,那个呼啦啦也是足够的,对这我同意,我觉得相对于对座,二排可以无极的调节空间,不论是呼啦啦模式,还是所谓的大床模式,那是对普通用户,确实是真用得到的,最起码就很实用,对座,不好说,像南总,你的Mega 你后来选那个座椅升级了吗,能对座吗,你觉得这对你的Mega 这样的车有用吗,我选了,然后排队,要多花6万块钱,然后我现在还没有装,然后他们都不知道,这个排队排到什么地方去了,因为的确我也没公众稿这事,我之所以在它发布会之前,那么挺这辆车,其中有一个很重要的原因是什么呢,是实际上,大家说中国没有汽车的话,但我现在今天已经没有那么说了我作为一个消费者,我在日本,我其实已经把各种所有,大家能想到的奇奇怪怪的车,我应该都开过了,高性能的对吧 S163AMG这种,然后呢你说,大空间的Alfa这种等等的,我可以非常确定的说,我觉得对错只是大家对于,一辆车的高得房率的一个形象的描述,反正最终就是我要大空间,这肯定是没错的,而且我还想说的是,一定是相对的低端市场,对于大空间和得房率的要求更高,对我的Mazda三排长期控制,我也不在乎它能不能派上内用,但是我在日本的时候,我的第一辆车是一辆Wabung Wabung是那种,是那是box的一个盒子的车,但那个车其实不大,而且超便宜我记得应该是十几万日元,几万块钱,然后,它的优势就是它的内部空间贼大,一个特别弱的发动机,拉着一个小盒子,然后盒子里面的利用率特别高 [00:29:46]
# Vol.092 小米澎程技术发布点评:表面平平无奇,内心所图甚大
于新烈:然后盒子里面的利用率特别高,这肯定是一个低端市场,在大家体验了轿车,体验了SUV之后的,下一步的升级方向,所以而且这个已经被验证了,都不需要再次验证一遍了,其实这是第一点 MIX的发布呢,其实我刚刚看了也觉得不错,但是呢 MIX有一个问题是,就像那个刚才好人说的,我上一次见到这种,前面大家一路叫好,做出来价格之后,立刻打车的,发布是老罗的甜品,的确你把得房率,放到了一个中产价位段,它是有问题的 Mega证明了,对我至少放到高段价位段,还是可以的,因为有钱人对空间的需求,一样不差,而且它匹配了很好的音响,跟很好的静音,那它就做对了但是实际上它也证明,在这个价位上的市场空间,也就这么大了,同样的卖点,跟Mega真的是一模一样的卖点,而且匹配了完全,重新设计的底盘和,可调低发挥之后,拿到低端市场里面,一定会爆的,所以这个是当时的发布之前,我觉得很卧逼的地方,因为日本市场的挖工,一系列的挖工都已经证明了,第二点的是,我开了Mega 其实我买Mega的最重要的点是,他们的CTO跟我说,我们的自动驾驶,已经不去美国了,所以买了一辆,一旦你习惯了自动驾驶之后,空间一定是会,让你更加关注的点,因为你开车的时候,我动力了,什么风阻,然后我就是一个乘机高铁,然后我就90公里这样我不用扶翻车板,它就一直在高通上跑,那我在里面舒不舒服,就空间靠拨大,就是一个一定你会关注的点,所以我觉得无论是你去向低端市场,还是自动价值的不断的加强,都会让得方率这件事变得特别重要,当然它在营销上被大家说成对座,但本质上大家要的就是更大的空间,我有两个问题,第一个它其实有点给我的感觉,它是把一个对座作为一个市场上,大家印象中是一个豪华高配产品才有的功能配置,放在这个车上,给用户带来一个很值,很高性价比的印象,不是单纯从用户需求上来说的,能这么理解吗,对就是如果我说那个得方率,我要便宜要大空间,等等的一说法,就很容易陷入当年小米的,所谓的性价比之王这个标签上空价比之王,所以他们可能比较讨厌这个标签,所以用一个具体的,用户可理解和想象的功能来,去代替我的得方率更高,但实际上就这意思,另外啊,其实刚才我们也谈到,对于鹏城这款车来说,它的二三排的供轨,空间的无机调节,不论是霍拉拉模式,还是大船模式,对用户的这种获得感,实际的需求,其实满足的会更好,那它不做旋转的对坐模式,不费这么大劲,只提供二三供轨,能实现吗,还是说,它这平台仍然需要做巨大的这种改进,前排旋转是一个副产品,随之而得的一个结果,我觉得三层需求第一层需求是便宜的大空间,甚至小车的大空间,穷人的卧室,这层需求日本的K-Car把控,百分之百验证,大家买那个K-Car是为了省钱的时候,我就要尽量打,虽然车小,但里面空间尽量大,那第二级才是我空间的可调整,我觉得这是小米这次做的,最让人成功的地方,它那个绝对是存在于设计的,因为很多车的底盘稍微都五平了,我买MPV的最重要的原因,是它底盘足够平,足够规整,但是呢,小米不但把整个的内部空间,做得很规整,底盘很平,我看评测它只有三度的坡度,你就可以认为这是一个,很规整的纯凭地盘,而预总是他又放了滑轨,这是第二层,就是空间内部的可调整,那这个我认为也是百分之百验证的因为如果你真的用过日本K卡,他在那里面下了非常非常非常多的功夫,第三个才是我们说的,这种可调整的电动化和自动化和AI化,那这一点有可能是高端产品特征,对吧,但前两个一定是在低端市场效果特别好,所以他把第三点做成选配,就可以了,说白了,而且其实我认为,多半说所有的高端车,但是就像Mega这种高端车,他应该学习,现在他搞得我连一个19万9的车,都那什么了,这有点尴尬吧,相对于MIX和Bike Home来说,浩然你具体聊聊 N90也好,就是它这个昆仑架构,在空间品行上,带来的这种优惠体验的提升足够大吗 [00:35:22]
李南:因为它确实是,投入了比较大的成本,新做了一个全新的平台,我顺着刚才南总说的一个点,我回答一下,你刚才问南总的一个问题,这是一个副产品,还是一个有意为之的,这个就是空间灵活性,就是这个多变,这肯定是有意为之的,因为你去看它的前排,是痕迹最明显的,它的整个仪表台,非常的平,非常的靠前,它的门板,这个可能要真的坐过实车,坐进去你才会有这种感觉,它的门板主架门板,有一种商用车的感觉是什么,它比一般的乘用车的门板要薄一些,就是有一种,我的左边的这个手肘,要去够一够这个,主架门板的这种感觉,那它做这些是为什么呢,就是为了让它前排的座椅,在旋转的时候,给它让出尽可能大的空间,所以这个车肯定是虽然它为了去,一个比较低的起售价,它可能不会标配旋转座椅,但是旋转座椅一定是一个,从一开始就定下来的核心指标,以至于你的IP 你的门板,你的所有这些,都要为我这个旋转座椅去让空间,这是肯定的,就是肯定是要有意为之的选择,空间体验提升有多大,其实我还特别去选了它的那个,现在所有三排六座的车,都会有那种默认的,就是三排均等的,就是把三个三排的空间,都分的比较平均的一个模式,然后会有那种四座舒响模式,对吧,所有三排车座的车,都有这种车机里面,你点一下,它就会移到各自的这个位置,在它的默认位置下,其实它的第三排空间并不是很大,它的第三排空间其实我感觉跟我乐道L90是差不多的,乐道L90是5145 它是个5258的车 5250还有一个车是领跑D19 它跟D19的正常状态下的空间,其实是很像的,说明它的总空间没有奇迹,这就是一个5米25的车,带发动机之后的一个,纵向空间的客舱表现,也不要觉得说小米出来了,那其他所有做得方率的,之前做得方率的人,都是脑子缺根筋,没有小米挖出更多的空间,没有,大家其实挖出来的总空间是一样的,小米真正创新的是,它的三排座椅,在它的默认位置上,还可以向后滑,就是你只要牺牲,你只要愿意牺牲头部空间,你就可以在一个5米25的车上面,获得一个Mega的第三排的腿部空间当然滑到最后的那个位置,我这个身,我大概1米8 反正我的头部空间已经不够了,但是你只要但凡是一个 1米75以下的人,或者是女性或者是小孩,那个第三排,向后滑到最后,那个mega一样,第三排的位置是绝对可用的,还有一个点,你对它的空间体验,是不是超预期,很大程度上取决于,你这个车有多大的比例是驾驶,有多大的比例是原地,你原地休息的时间越长,你就会觉得,或者占你整个用车的比例越高,你就会觉得,这所有这一切,简直就是牛逼到爆炸了,但是呢,如果你是一个主要这个车,还是拿来开,你就不会觉得它有多那个什么的,你就不会觉得这套,这个创新有那么的厉害,为什么呢,因为我刚才说的那些,第三排向后滑的那个位置都不是它的安全认证位,小米在发布会上,告诉你的92公里每小时的,第三排追尾测试,我特别问了他们,我说这个测试,你的第三排在什么位置上,他说是那个标准位,那也就是,其实是跟林跑D19 跟乐道L90 跟其他这些第三排,差不多大的那个位置上面,也就是说,如果你想要保住,你第三排的成员的,达到小米的这个安全承诺的话,你应该放在默认位上,那默认位上,他就没有奇迹,所以说这就是一个,如果你车停在原地,你经常这个,在车里面进行,比如说商务接待,或者录节目,或者见人,或者拜访客户,或者什么,你有一个很强的原地使用的属性,那你就会觉得,这个对座,所有的来回滑,简直牛逼爆炸了,如果你大多数时间是在开的那你就不会有那么强的感觉,相反你会对呼啦啦那个模式,因为呼啦啦那个模式是,安全上是绝对OK的,我甚至都跟他们开过玩笑 [00:39:51]
# Vol.092 小米澎程技术发布点评:表面平平无奇,内心所图甚大
李南:我甚至都跟他们开过玩笑,我说你们N70在试驾的时候,甚至可以出一个盲窗板,就是把后面的窗户全贴死,因为那个后备箱已经不能,我已经不能用后备箱来形容它了,就是我一个更准确的名词去描述,它应该是货仓,但是我能够明显感觉到,现场的小米的工作人员,对于我的货啦啦的词一出来
于新烈:他们就不是特别的开心,就觉得我们还是不要贴盲窗板,但是我跟你说这辆车真的是,我个人认为它是一个,看起来像SUV的一个,把供或者MPV的空间,或者是类似的空间调整能力的,同时有皮卡的货运能力的,一个超级货盒版车,我跟你说,当时现场我们一起在聊的 [00:40:22]
李南:另外一个媒体就说,你们这车直接出一个皮卡德了,对,就是它的载货已经强到这种程度,真的就是我这么说,这个数字我不方便透露,但是它那个载货模式下的,那个最大的容积,是等同于一个,三排六座,共用白车身,硬改成两排五座的车的,第二排第三排,全部放倒的模式下的,那个数字是一样的,而那个车,远远超过它的尺寸,还有一个点,我说的那个车的货舱,因为它是一个,普通的SUV的放倒形式,它的货仓是宽深但不高,小米N70的那个货拉拉模式,是可能深度上没有,一般的SUV的座椅布局那么深,因为它就算把第二排的座垫抬起来,它还是有这个厚度在它不像普通SUV 它是直接抵到第一排座椅的靠背,所以它深度上可能略逊一筹,但是它的高度,载货的人知道高度这个东西是多么的重要,它的高度是其他SUV无法相比,真的非常夸张,所以这个车,真的是一个性价比较强的车 [00:41:42]
于新烈:第一是车本身的空间的得方率高,第二是空间的调整性高,然后可调整性高,带来的全新的价值是什么呢,你买一辆车,等于买了ESOV 买了EMPV 买了一匹卡,等于买三辆车
李南:我靠,就是我觉得这个车的底配,和它的就是N70的底配,单电机的底配,和它的N70双电机的顶配,所有电动门全选上的
于新烈:这两拨人会区别非常非常的大,刚才你谈到了,前排旋转不是一个副产品,那三排的三座是不是一个副产品呢,就是他非要强调它是七座,就是后边座俩仨区别大嘛,我倒觉得第三排的三座是一个副产品,因为三座的难点在于,你怎么在后排的两个轮包中间 [00:42:29]
李南:去挤出一个符合法规要求的 400毫米一个座位,三个座位,你就要最低要1200毫米的宽度,它这个数字是1241 所以就是刚刚好过了三座的要求,而且它这个做的比比亚迪大堂好,比它做的体面的一个点在于,大堂其实只有在坐垫的最前端,达到了这个要求,你看大唐的那个第三排,它是这样的,它真正到臀部,它其实没有到1200毫米,所以它是一个相对比较鸡贼的,第三排的合规的,为了合规而合规的一个东西,小米这个还真的是,硬做出来的第三排,我觉得它这个部分,很大程度上甚至是为了N70做的,因为它的后桥 N70跟N90是差不太多的,它真正用来保的其实不是N90的第三排,要有三个座,它要保的是N70的二排,在向后滑到两个轮包中间的时候,它的坐垫宽度依然OK 这为什么很重要呢,因为它的第二排,在不向后滑的时候,它的坐垫宽度也只能有这么宽,所以它如果不拼命去挖,轮包的空间的话,轮包的这个横向空间的话,它真正受大损失的是,它的两排的N70的第二排,这个就好像还没有解密,反正就是如果它,不去挖这个轮包的这个宽度,在N90的第三排上,做出三个座位的话,受影响更大的是,它的N70的第二排,因为它的N70第二排,为了要滑进两个轮包之间,会大幅度损失它的,因为N90第三排,说实话使用概率,不会那么的高,没有N70的第二排使用概率那么高,它其实是为了N70的第二排,去挖了后排的空间,然后顺便发现,我们N90第三排也可以达到这个目标,那我们就把N90也做成,一个223的一个布局,就是真正重要的是70的第二排,我跟你说,如果我给购买DNA的话 [00:44:42]
于新烈:我觉得OK 你买这辆车,第一为了便宜,第二为了大空间,第三是三核EMPV 拉货的皮卡和SUV 你都想要的情况之下,其实作为消费者的,最优选择是什么呢,是买一个二手N90 因为车本身的空间足够大,它的这些所有设计的优势,才能发挥得出来
李南:我觉得大家一旦进入,二手这个无底洞,我觉得这就不属于,发布会所瞄准的那帮,能来听这个播客的,或者说能听完我们这些分析的,都不是一般消费者 [00:45:27]
于新烈:对吧,就是一般消费者,是属于只看雷军的发布会,雷军说了什么,就是什么的,这部分人,刚才你们讨论过中,我发现,它的很多利点,都是落在二排上,特别是N70的二排,因为刚才谈到,很多空间变形,是要驻车的时候享受到,但是,唯一能够享受到,空间变形在行车中的,也不是唯一吧,最主要的一个利点,就是二排空间,它是可以调整很大的腿部空间的,不论它展示的放调筋毛,或者怎么样,就是它的二排空间是可以在,调节和安全都获得最顶级的用户体验的,这样的话 N70是一个在产品体验上最好的车,而且它还可以选择前排座椅旋转,它是一个满雪板的,而且这个用户利益价值非常高的,当然刚才南总谈的那个是很重要一点,因为它是从空间考虑的如果像雷军的定位,它是一个房的话,你买这个房,这个均价按平比算,或者得房空间算,那个是一个价值最高的一个获得,因为你买的是空间,我们漏掉了一点,是你说归根结底,小米为什么要重新设计一个平台,那我仔细看了他放的那些图,和真正的驶车的一些视频,我跟你说,他这个平台做了很多很多,其他这不会做的事,刚才哈尔说了,他把前面的操控的位置给遣移了,对吧,而且实际上它把中导给取消了,中导是可取消的,它是可活动的,而且它实际上放了更差的动力,但是这个换回了,它的空间形状的规整,就那电机它不会导致,它的地面的凹凸不平,因为其实你知道有些旧的SUV 它连地面都是带台阶的所以它是一个非常规整的大空间,我觉得哪怕我为此牺牲动力,对吧,所以我觉得这个平台,全新平台的最大的价值在这里,它不但给你更高的一个房间,而且这个房间还特别规整,而且这个房间还是可调的,所以我觉得这个车真的是 N90有点心动吧,但是呢,对它有些别的问题我们就再说,沿着你这个话题讲,我也觉得在产品定义上,就它能够做到有取舍,就像跟大家谈到了,它为这个新的平排的利益点,刚才我们描述很多,二三排空间等等,它付出了一些代价,从表面上看,当然有一些成本控制的考虑,不论是它的400伏平台也好,或者说没有后轮转向也好,包括它的后驱的,间接功率很小也好,它是为了做出,这个平整的空间像刚才浩然说的,它的前排座椅旋转,也付出了一些代价,因为有一部分人认为,这种断档式的console 它是一种像欧洲那种工程车,廉价车的感觉,没有这种豪华感,包括它的门板,它为这个规整的空间,这个车怎么会跟豪华感有关系,中间的两个座是通的,就是为了换司机,就是一种说法,就是像欧洲很多像,你对这个品牌有什么误解,它就不应该有豪华感,不说豪华感,就是说它会认为,这个车是一个很廉价的车,咱不说小米有豪华感,它都认为中间的那个console是断的,它是跟欧洲很多那种货车是一样的,前面坐可以坐三个人,或者说前面司机可以来回换,那种怀档的那种车,他就说让大家对这个车的认知吧,就是更廉价,他觉得这点也是一种代价,还有没有其他他为这个平台这个规整,这个空间付出的代价,因为不可能只有好事嘛,就产品定义本来不就做取舍,他就取价格取空间,去空间的灵活的极致的运用,我看到的是价格让路了,动力让路了,设计上它没有太让路,因为它把它做成了,一个比较传统的自由的,因为你知道,低端消费者是不太容易,接受领先的设计,所以它几乎,我认为它是把除了设计之外,所有的路都让了,它还有一个牺牲的点,我觉得就不是因为,它这些就是为了空间牺牲,当时拍完之后
李南:小米的人问说 [00:49:59]
# Vol.092 小米澎程技术发布点评:表面平平无奇,内心所图甚大
李南:小米的人问说,这个车你觉得应该卖多少钱,我说N90 24万9起,然后他说你怎么猜的这么便宜,我说首先我知道你们这个车,一度用过麦福逊的前选,就是在VB阶段之前是麦福逊的前选,你如果不想要往死里杀价,杀红血的那种产品定义,你就根本不可能去做这样的考虑,这是其一,其二,这个车的电池其实是比较便宜的,它不管是400伏也好,还是说,我就这么说,我是怎么得出249,000这个结论的,就是它应该卖249,000 因为零跑的第19就是249,000 80度电的那个版本,首先一人家是80度电,它是磷酸铁锂是吧,不是,它是一个磷酸铁锂混三元,混的一个东西,所以那玩意成本不一定低,提到这一点首先一,你的电池比人家少4度电 4.3度电,咱们准确一点,少4.3度电,第二,你是三元锂,但是林跑是跟宁德做了一个,还是跟谁,做了一个,这个于老师可能更容易听懂一点,你记不记得,未来有过三元混铁锂,但是未来的那个三元混铁锂,是模组跟模组之间,就是一个模组就是纯铁锂,一个模组就是纯三元,是这样混搭,它不是,它是电芯里面混搭,它这个要更深入一层,所以说人家还是稍微有点创新,然后人家那800伏,人家那3C 对不对,你这是少4.3度电,然后你的充电,他们跟我说的好像是2.4C 峰值是2.4C 但是他们把这个曲线做的比较平,所以你看它的15分钟充电它是285公里CLTC 其实它比特斯拉还要稍微快点,特斯拉是15分钟255公里,所以他们在有限的成本下,尽可能做了一部分的调教,或者说冷却做的比较好,但是电池本身是比较便宜的,你这个车最大件的一个成本,就是电池,所以说你电池上,如果比D19稍微便宜一些,然后我假设你平台的滑轨,什么地板,什么这些乱七八糟这些东西,你可能比领跑稍微多花点钱,我相信领跑跟小米这两个品牌,在成本控制上的水平,应该是不想上下的,所以我就觉得,这个N90应该是一个 24万9的产品 [00:51:47]
于新烈:那像小比这样的一个平台,竞争对手大概需要,多长时间可以模仿呢,以及大家会模仿吗,会在比如说三排六座,还是说集中在五座 [00:52:31]
李南:因为五座目前是大家,我还真的问了他们这个问题,就是你们觉得这个东西,抄起来难不难,他们这个说法是,插混或者增程超起来会比较难,因为现在做的不好的增程,地板上有两个凸起,一个是油箱,一个是后电机,做的好的已经把油箱抹平了,但是后电机还是有凸起,增程你想要抹平这两个点,是比较困难的,因为要解决两个硬点,纯电超起来会,如果要超的话会比较快一些,因为纯电的地板本来就是平的,你没有油箱,你的后电机大小可以灵活选择,但是这个明明是它超纯电了,就是最起码Mega已经在前面了,你应该说是它超了MPV 它超了所有二三排供轨的MPV 但你说它到底是不是一个真的SUV呢这也很对吧,它本来就是一个Mix 我觉得它是SUV 我觉得它是SUV 大家绝对不会有当初对理想i8的那种质疑,就是说i8它明明是个MPV 然后理想非要说它是SUV 然后把底盘升高了,去爬台阶,然后说我这就是SUV 但是大家还是不买账,绝对不会这样去说,你这个N70 其实是个MPV [00:53:39]
于新烈:我就不至于,我还以为我这问题问错了,就是说其实我觉得,我认同理想的说法,就是理想说它是SUV 我认,小米说它是MPV 我认,就是我觉得今天这些车,已经明显地给我们一个提示了,就是管你吗 SUV MPV皮卡,在自动气压制,跟电驱动的年代,这种分类本身已经过时,并且不科学了,对就是我底盘足够高,货能力足够好,同时我又有MPV的空间,和布局能力,同时我又有皮卡的载货能力,那你非得给我分这个类,然后争论它是不是,也的确是一个天啥皮的,就是我问的不得,我理解,这个主要还是从市场来考虑的,从产品技术上来说,我觉得是OK的,先说这个市场定位问题吧,目前一部分用户,确实他对MPV是有成见的觉得自己开起来像个司机,我觉得哪怕他是一款MPV 装上了一个SUV的壳,用户心里也会好受一些,接受度也会更高一些,也符合他希望能够面对大众人群,普遍接受度这样一个目的,而且谈到理想当初,我觉得他强调自己是SUV 不是MPV 也是出于这个考虑,因为在i8发布之前,他们经历过了 Mega的销量补给预期,就是因为他们相信 MPV可以卖出一个,号称什么,一个单月5000辆的销量,雄心壮志,后来发现,一旦用户把你定位为MPV 你的市场规模就很小,哪怕你是一个非常好的车,它就不会悬你,所以他们非常在意这个说法,虽然他们之前的操作,有点太强行了,会引起大家的注意和反感,非要去掰扯这个事情,其实不提也无所谓,我觉得是从,主要还是从市场区间规模用户的考虑,因为大家其实是有这样的,购买时候的情绪价值,他还是希望自己买一个,大SUV全产SUV 对吧,我买了一个JLS 他觉得更体面,更有面子,而不是说我买一个JL8 哪怕会质更高,就大众市场认知是,品牌一定要利用的东西,即使错了品牌也会利用,所以这个理想,把i8叫SUV 这个就是典型的例子,我觉得这种操作,平时这种操作是正常的,无可厚非的,但真正的问题是,我觉得大众市场人士本身就错了,因为SUV 皮卡 MPV 全是油车时代下的定义,当然消费者认知的更新,这件事本身呢,只有能量巨大的领导品牌会去做,现在看就是无论是小比,还是理想这些品牌,他们的选择是,我不做我利用错误的大众长人,去换项链,但迟早会有一个足够牛逼的品牌,也许是特斯拉,出来告诉你们,不要再用油车时代的这种,已经过时的色泪,去区分这些东西了,我这个就牛逼,你叫他什么都行,就把,会有这种人出现,同意啊,我也希望这样品牌出现,但是他们一定会有一个,足够大的利点来,说服用户,这个确实,大家现在看不到是啥,比如说自动驾驶吗,咱们聊两句智能吧,刚才南总一直提到,说自动驾驶,对整个车形态空间的这种改变,具体到比如说像N90 这样的空间变形也好 Megazord这样的空间变形也好,它的这种调整和你的空间需求,实际上还是驻车为主的,就是在行车的过程中目前在中国市场,这些产品,没有做到,因为自动驾驶,或者说我有个司机,在空间布局上,有什么创新和不一样,因为大多数是,驻车时候用的,刚才我们谈到了,那你觉得自动驾驶,对所谓的空间的需求,在行驶过程中,它的空间需求是什么呢,改变会是什么呢,假设咱们现在实现自动驾驶了,或者像你一样有司机,你希望这个车变成什么样呢,这种东西,品牌不会主动,或者一个很重要的原因,是因为安全法规的,但是真实使用过程中,我觉得安全法规也是一个很傻逼的氛围,就是我停车跟住车,但真实使用,真实使用是停住车再不停的转换,说实话,我的二排如果要累了,就直接放到这个床,然后司机开车,我在后面睡觉,对吧,这东西是不是符合交通法,不一定,所以其实我觉得而且最典型的例子是,我下车,然后我东西放在后备箱,对吧,如果你里面的空间可以足够的好的话,我后排够东西不用那么费劲,不知道大家经历没经历,我这车的空间是大了,但是呢,我一旦把一个东西扔在哪里,然后呢,我反身拿东西要就跟爬山一样,而且有可能腿还要被那个方向盘给卡住,等等这些事,所以一个更合理的更大的更简洁的,而且能根据你的需求做快速调整的空间,我认为是必然的,这是消费者的需求,那你强行的把这个需求,分为住车状态跟行驶状态,本身其实它是一个,为了匹配法规的合法的宣传逻辑,但在真实的使用过程当中,停住车是不停转换,而且在行驶状态下,有些可以利用的空间你也会去利用,所以作为一个普通消费者的角度,我觉得没有必要去考虑,那么多这种说法,我的空间就更大了,而且我的灵魂线线都更高了,我买一辆车等于买四辆车,这是对于消费者价值最高的点,另外咱就回到,南宗你比较看重的智能化调整,因为我记得你发微博里,其实也贴了雷军最开始宣传,庞城时候的那个截图 [00:59:30]
# Vol.092 小米澎程技术发布点评:表面平平无奇,内心所图甚大
于新烈:庞城时候的那个截图,他当初宣传的时候说,是在这个平台上可以实现智能化调整,就是有AI的功能嘛,他能够自动化的来调整,自适应的调整,主动式的调整,这样的调整空间面型,对你来说,跟现在这个区别是什么呢,因为我想象,我需要想象一下具体的这个画面,对这就是发布之后,我对它不太感兴趣的一个真正的原因,叫做延出法随,你知道那个无论是,麦卡想调各种模式,你得等半天你知道吗,还得跟他选半天,而你可以跟那个理想同学说,但是呢,它有各种各样的限制,然后就反正它那空间调整不聪明,能理解,就跟你觉得以前的那个服务价值不充裕的感觉是一样的,所以我是有一种强烈的感觉,第一我是版本确认空间的价值,然后第二呢,我是版本确认可调的价值那第三个问题就是,它是不是可以智能的可调,今天AI已经完全有内部空间,及内部成员的感知能力的情况之下,为什么每次我还跟那搞搞搞,对吧,他自己就应该能猜个七七八八,然后还做了一个AI生成的那个图,所以这事很可惜,就是相比,做了一个空间利用,那么好那么规整的,一个空间的全新的底盘,这下了大功夫,这个respect 人类上面给可调整的空间,这个也respect 但它最后一步,它没有用AI的感知能力,然后带来一个更方便的,更有科技感,更有未来的通过模型的预测能力,让你不用费很大劲,说很多话,就自动的符合你心意的,或者严重法学的调整固定能力,这点我觉得很可惜,一旦这点出现了我觉得能解决小米那个纠结的问题,小米今天在纠结,我明明在做一个低端品牌,但是我又不想自己低端,其实是有解决的例子,就是Casla实际上卖的很便宜,但大家觉得这是一个高科技品牌,然后你能做出一些科技领先的,把AI功能放上去,把空间感知功能放上去,把成员感知功能放上去,把针对这些所做的空间调整的自动推荐,甚至是自动执行放上去,那你就是一个,以科技领先带来成本优势的,高端的低价品牌,它的纠结就解决了,所以就差这么一点点,让我觉得很可惜,然后也让我觉得,我买这个车有点问题,我买Mega 大家说这车很贵,我买小比的这个鹏城,大家说这个空间感知能力,有AI 这你都说得过去,但现在它看来是说,你为什么买一个红比,搞得我就不太好买,这个所以现在你也能多少理解一下,他们不希望,这个品牌会掉下去,所以这个技术发布会,也是一个利品牌的,技术发布会,因为你对AI很了解,从你的认知来看,那什么阻碍了这些呢,因为你想要的东西,你是坐在Minecraft里面,想象了很多的需求,你把它写出来,很早时候都写出来了,后来你发现,小米有可能,会照你的方向去做,但是它缺了AI 那现在看 OE&AI的理想,也没给你做这个,开发了一个全新平台,雷军也没给你做这个,那这东西没做出来,那肯定是有原因啊,这难在哪呢,用户不需要,太小众,还是说技术实现不了 AI做不到,我觉得不是AI做不到,而且也不能说没有做到,就是说如果我想象的那种,得方率超大,可动态调整,并且AI能感知,空间和人,做自动调整的这个未来是100%的话,那么小米今天这个车,还是让人兴奋,还是要给Ritz-Benz 就它走到了至少 60%到70%的位置,小米没有继续两年走的原因,我判断是两年,第一点是成本,我们刚才反复分析了,它是红米,一定的压成本,第二点我判断什么呢,是风险,我们现在这坐下来推演,我可以举日本K-Car的例子,然后证明高得方率,在低端市场的有效性等等东西,但是小米这个公司,做产品有一个特别特别大的,特别牛逼的地方,就是小米这个公司,是非常精准的能做到领先半步的,就是它从不会过分的挑战消费者,尤其是在它,要走量的主力产品上,所以它得拿捏这个,交付的进度,别领先消费者太多,所以其实,我觉得它有两个地方比较有意思一个地方它就生生把这玩,一个全新的底盘,得到率那么高,那么规整的空间,生生给它做成了一个 SUV的外形,这个就不挑战消费者对于设计上的接受度,与此同时呢,我又真的把另一边做成了一个MPV的能力,所以我认为小米是可以做到100%的,但是这样有可能会领先两步扯到蛋,那这个产品系列可能就完蛋了,所以先做一个六七十分的交付验证了,然后如果膨胀卖的非常好,那我跟你说他加算力上AI搞这事,那几乎是必然的,有道理,就是在max之上以后,如果销量爆款之后,有可能会出个ultra 有可能会提供智能的功能,就像雷军说的,他现在其实给你的是一个户型,你想要的是一个管家,他现在只不过把户型给你搭出来了,然后放在这里等这个房卖多了,大家都住进来了,就有机会给你再雇个管家放进来,还是有机会的,也希望这款车卖好吧,你想太美,这绝对不能OTA OTA是不会,我都说再出一个单独的版本,对 OK 那你把旧车卖了,然后再买新的,对,我又搞出一些销量,对,大概会这么操作,那如果它出一个ultra 真的能智能化的调度,你是会买的是吧,我一定会买,百分之百支持,就是我平时买的,就是因为自动驾驶这方面,已经AI化了,那如果空间弄跳,这方面已经AI化,那不二合一了吗,但是我唯一的疑问是,小米的自动驾驶能不能跟上,应该问题不大,换一个角度,浩然和南总都可以说一下,小米最起码把这个户型干出来了,那另一个曾经以空间移动的家,对吧,理想这些方面为什么会被小米会超过去呢,就他现在all in了AI了,但是我们看到他给用户拿出来的东西,究竟是什么,就是理想VLF 为什么在空间上反而会落后了,因为问界之前在增程上的超越,它靠的不是在空间上的创新,它靠的是它的传统豪华,以及它的质架,那小米这次是实实在在的,在空间上,在产品定义上,有非常大的跨越,理想为什么没能做出这样的产品呢,是不想吗,我觉得不是不想,但是我确实也比较期待 [01:06:14]
李南:理想在接下来的两个月时间,怎么去保护它的L6 因为它的L6可能受到的冲击是最大的,可能远远大于L9 就是N90对L9的冲击,因为L9毕竟它是一个,毕竟它是L9 但是我觉得L6可能会被冲得比较狠,反正在我的脑海里面,我是已经形成了,比如说有贵价9跟平价9这两条线,贵价9就是L9 9X ES9 然后M9 然后平价9可能是,比如说林跑啊,什么乐道啊,包括N90啊,这些都属于平价9 增程这块,如果我还在理想做产品公关的话,我可能会去树立一个,就是平价增程跟贵价增程的概念这样的话会保护它的品牌,因为短期之内,它是上不了这个长华轨,这个平台的,因为它的L9的平台已经出来了,那么明年就是用这个平台的L6会出来,它今年是老机械平台,新数字平台的L6在卖 L6确实可能会遇到,也不是L6了,就是所有的25万以下的,两排座的增程,都会受到N70比较大的冲击,然后我很期待着,看一下各家怎么来防守这件事情,然后至于你说的这个理想,为什么没有做到,为什么没有想到这一点,说实话在你问这个问题之前,我都没有想到这个问题,就是对,这个事情为什么是小米能想到,但是你又仔细想一想,小米能想到,很意外吗,你也不意外其实当初苏七发布的时候,小米当时来推到台前的人,我感觉大致上,你可以把他们划成两波,一波是小米的人,一波是造车的人,造车的人就是从其他各家车企,拿过来的这些工程技术人员,然后还有一部分是小米的,原来不管是做手机的,还是做家电的,还是做什么的,他们有一个概念,我当时就比较,因为我当时就不太理解,为什么苏七这个车,在24年那个时候,就造得那么完善,因为我当时第一次去试驾的时候,我会觉得,一个手机品牌,第一次造车,这个车肯定是有很多亮点的,但是肯定也是会有大坑的,不然这个世界就不合理了,对吧,但是苏七是一个很全面的车,然后当时我就说,这是怎么回事呢,你怎么做到呢,然后当时小米的人,我不知道那个人是手机那块的,还是造车这一块的,但是他当时说那个概念我觉得我是可以理解,就是小米确实是第一次做车,但是小米不是第一次做产品,小米做产品的经验,是非常非常丰厚的,所以他会去识别到一些,尤其又因为他可能原来不是,有相当一部分人,不是车的工程思维的人,可以去驱动一些,非常天外飞仙的一些想法,我只能这么想了 [01:09:33]
# Vol.092 小米澎程技术发布点评:表面平平无奇,内心所图甚大
李南:我只能这么想了,因为你问这个问题,我才觉得确实是,如果是谁应该第一个,把二三排供轨,往SUV里面做出来,因为这就是本质上,蓬城的创新,就是SUV上做二三排供轨,谁第一个应该做出来,确实好像应该是理想,但是确实他没有做出来,这是个好问题
于新烈:我也没有什么答案,白大佐,我可能有一个答案,小米说的那点是对的,就是说小米做的产品可是不少,但是另外一个问题是什么呢,就是传统坐车这拨人,包括后来新智利上来的坐车这拨人,他做产品的量级和迭代的次数,是远远差于销售电子的这拨人,说白了就是交的学费不够多,你被消费者骂一次的时候,我们被消费者骂八次,这是第一点,所以他们的确经验更丰富,那这个背后是什么呢,是小米对于消费者洞察的能力,是远远大于那些只坐车的人,所以他们会有更完善的方法,用更好的调研方式,和更加直接和跟他们关系紧密的社区,能把这些消费者洞察的东西反映出来所以我们说产品的原因是趋势,但是趋势的根据是,其实是对目标消费者,正确的目标消费者的选择,和正确的目标消费者的动差,在这方面小米绝对是压倒选择强,因为做错的足够多了,做的也足够多了,学到的做对的也足够多了,所以这是小米能反超的原因,但这个反超,其实对理想的品牌才是最致命,它短期内处理库存,不白了将家跑会怎么样的,但是你知道卖冰箱彩电单,卖空间,卖一个移动的家,一直是理想非常清晰的一个品牌标签,对吧,如果我是一个家庭用户,我需要比较大的空间,那我就直接先去开理想,但这个标签被挑战了,对理想其实长期看在品牌上面,是一个比较致命的,品牌这些互相打都行,但是呢,你别动我根据地,对吧然后像当年华为荣耀,就是我技术牛逼,然后小米就是我性价比之王,我们就是有设计好看,然后大家互相抢人,小米抢到两个,我们抢到一个,刘安抢到一个,可是你别动我的根据地,如果小米哪天突然说,我也搞了一个,蔚蓝价位的产品,但是我是设计领先,那我们要跟他玩命了,这不等于是闪北没了吗,所以这个真的是理想,非常非常大的一个挑战,在产品选择上,今年其实理想也更新了,它的新的L9 L28 我看到的,它其实反而强调的是操控,就是在增程的这个产品线上,这个是一个一攻一守的关系,就是说能打得出去,当然是好事情,但是我能打得出去的前提是,我的根据地是稳固的,现在是属于我打出去了但是如果被偷家呢,那你以后还打得出去吗,所以我觉得,这个品牌认知和,品牌信仰的积累,一定不能轻易放弃,另外谈一下这次,鹏城的定位,雷军一直在强调说,鹏城没有固定标签,他非常在意说,我们不是哪把车,我们也不是商务车,他最不希望的就是,像我们这种节目,给他贴了个红米,红米和呼啦啦的标签,他真能做到吗,我觉得他在努力的消除标签,或者说是一种进攻,因为现代市场标签,很明显的是,比如说理想买吧车,比如说问街,或者说其他的什么,是这种商务型的,他希望区别于他们,但是他靠一个没有标签,就能够去区别别人吗,另外他所谓的定位叫移动的房子,这跟理想移动家,基本就差一个字,具体这想表达什么呢,表达他没有这种人物关系,他就是一个非常,实实在在的空间的概念,定位方面没有看太明白,它有效吗,是这样,我划算人群意味着什么东西,意味着我要走向neach 也就是说,我一去不追求量的最大化,但是我追求的,实际上是人群的忠诚度,和品牌的意见,我不管小米能不能做到,小米如果说我不划算人群,意味着什么,意味着小米这个品牌的这些车,一定走向的是mass 所以我说小米一定有上刺刀的价位端的产品,而且它三合一了,我既然Payone又是SUV又是皮卡的时候,以及它所有的成本的布置小米之所以现在不想贴标签,是因为它想mess 就是这车一定是小米野心更大的,想上更大的量的车,它才会拒绝在品牌定位早期贴标签,它才会在品牌定位早期拉价格,那样当我的刺刀出来的时候,那些真正的标签,我会觉得超低值,而且我不会因为贴标签,损失销量最大化的腾牛饼,我挺同意南总说的,你像卖的最好的车,世界车卡罗拉,高尔夫,它没有标签 [01:14:50]
李南:它是一个很无聊的车,对吧,其实鹏城很多人,就因为可能早期苏七,玉七都是设计上,很有标志性的一个,很有特点的一个车,然后鹏城是一个,没有太多特点的一个车,然后大家就会觉得很失望,这就对了 CRV是很没有特点的 RAV4也是很没有特点的,对不对,卡罗拉高尔夫,那都是一个非常无聊的车,你只有这个车足够的白开水,然后也不是白开水,就是你不拒绝任何人的情况下,你这个车才有可能,报到一个可能不是原来,比如说预期或者苏七这种,相对比较蜂蜜的这种车型的定位上面,我觉得这个是比较,我确实比较同意,还有一点,我就想起来以前,我忘了是哪一次雷总逛车展,不知道你们记不记得,有一段时间雷军逛车展这件事情是一个事,就是他走到了哪个展厅,哪个展位,这是一个事,那个时候有一个采访,大概意思就是说,我看了这么多车之后,觉得很可怕,觉得怎么大家都在抓瞎,这车怎么能这么造呢,我跟你说他拒绝贴标签的意思就是,我不是针对在座的谁,我做出来这个产品,你们之前都没有做过 [01:16:18]
于新烈:你们标签我不想往我身上贴,大概就是这么个意思,只不过他没有表达的这么直接,我觉得大概是这个意思,对然后如果我们在手机行业看的话,在苹果出现之前,所有人都不会相信,一个单一产品能如此的mess 因为无论是诺基亚还是三星,他们的产品链都是超多的,三星把全球的用户,分成了七十几个分类,然后看他们的规模,然后研究他们的需求,去做每一个分类的,消费者所对应的,所谓的最适合的产品,然后苹果一概放出来,把三星的七十几个分类,全干瘩了,所以从手机行业出来的人,他是有这种,我们叫做寻求一个行业的,原型产品的这种,不敢说能力,但至少是有这种梦想,所以它这辆超级混合版的车很有可能是想去寻求,类似于一种iPhone 我用一个产品定义,当然它还是分大小的,就像iPhone也分Max跟Tour 但是我可以用一个基本产品定义,去打穿整个市场,所有人的这种品的这么一个追求,手机号码出来的人,一定会是有这种追求的,因为苹果跟乔布斯的教育实在是太强,我记得新势力刚做车的时候,也是很笃信这种单品爆款思维的,特别是当年的理想,一款理想万,后来他们在市场环境中,其实都发生了变化,比如说理想做了L6789 做了很多款车型,像后来的鸿蒙之行华为入场,像问届也做了很多的产品的车系,但今年感觉大家确实是在回收,不论像小比他希望这个单款的像,鹏城的这个平台,能够单品爆款,而且看理想,他的SKO产品也在收缩,增成缩成了四款,有各自经济的定位,这是发生了一个什么样的变化呢,大家开始收缩,开始回到说消费电子那样,单品可以爆款的时代了,车我不了解,但是消费电子行业的,跨品类的一个真理,就是如果你想活下去,如果你想赚钱,一定得有单品爆款,我不知道车是不是图案逻辑,我高度怀疑,而且如果你真的能做一个,打穿人群的单品爆款,那你就是苹果这种级别的公司了,雷总可能还有这种梦想,但是呢,整个行业真实的轨迹会是什么样的,首先是一个单品爆款的高速增长启动市场,然后呢,进来超级多的人,然后呢,这些人呢,不可能每个人都是乔布斯,所以呢,他们会在这个过程中,选择另外一条路,就是扩张SKU 然后结果所有人都这么想,巨多的品牌,扩张了巨多的SKU之后,所有的人交了一堆的学费,因为如果销量不够的话,你的研发沉默投入,实际上是亏掉的,然后最后回来再反思,说我要削减产品线,其实当年华为就经历过这个过程,他一年做100多款给运营商,后来说不行,我们要打不开市场,我们要收缩产品线,才有了花园贝的期 [01:19:24]
# Vol.092 小米澎程技术发布点评:表面平平无奇,内心所图甚大
于新烈:才有了花园贝的期,是类似的道理,然后反思了之后呢,整个的SKO数会收缩,收缩到一个合理的地步之后,他们再重新考虑,那我是不是再扩张,所以整个的那个行业的SKO数量,实际上是在这种不断扩张,不断收缩,不断扩张不断收缩的过程中的一个循环,就有点类似于金融行业的周期,浩然刚才咱们谈了对理想的影响,看到小米鹏城所图盛大,针对在座的所有人,你觉得目前受到会主要影响的会有谁,因为之前大家都会看说小鹏啊,乐道啊,你觉得会对他们造成什么样影响呢,或者说其他的品牌像领跑
李南:领跑啊,领跑就真的很,领跑的D系列,就真的会遇到很大的问题,领跑的D19 说实话,我记得月销过万了吧已经,对卖的是很好的,它那个价格确实卷的也足够狠,性价比上来说,我觉得领跑是绝对交了一份,可以的答卷的,但是问题是,你有N90这样的一个产品,还有一点N90有一点做的比D19好,就是它的内饰,可能成本上面,可能跟D19差不多太多,但是它 D19的内饰给我的感觉是一个,把自己能力发挥到了极致的老实人,你不能说它不努力,你也不能说它缺了什么东西,但是它的豪华份额,我当时我是,我问乐道的人,因为那个时候我还没有买乐道,我问乐道的人,借了一辆L90 去了D19的市家然后我一坐进D19的内饰,我说好吧,这个内饰好像,不会对乐道构成特别大的威胁,但是小米会 N90的这个内饰,它的精致感,它的适量的度个,或者说它给你的获得感,是很足很足,而且你不会有那种,除非你是一个,对内饰的什么地方贵,什么地方便宜,很有概念的一个人,你可能会觉得,这个内饰它比较取巧,它在一些高附加值的地方,做得很足,但它其实成本不会很高,除非你是这样的人,不然的话绝大多数人,进到小米鹏城的内饰,尤其是它那个棕色的那个款,尤其是那个黑色的顶棚,不说豪华感吧,它绝对是不low的一个内饰,而你一旦结合它的售价,你就会知道,然后你再看看同价位的,比如说领跑,你就会知道,这个小米在这个内饰上面,做的还是还是真的很不错的,我觉得领跑的D系列,冲击会比较大,其他的车,领跑现在主销的是 ABC这三个系列,所以它接下来要上的,那个A05汉姆德5 5万大头,所以我觉得,对领跑的底盘可能影响不大,但是它的D系列,受到的冲击会是比较大的,乐道我觉得,除了北京上海以外的地方,只有在那种,纯电才能拿绿牌的城市,乐道不会受多大的影响,因为它是增程,因为小米鹏城是增程,但是在其他几乎所有的地方,乐道可能会面临一个,比较大的解释成本,我因为我不太经常在车上,我的驻车场景并不多,所以说我会觉得说,其实也还好,它不能旋转,不能滑来滑去我没有觉得说,我马上要把乐道卖了,然后去买小米的这种感觉,但是就是,除了北京上海之外的城市,乐道可能会,也会受到一定的冲击,小鹏,小鹏GX是一个,我觉得战略上,已经可以忽略的产品,所以说我觉得,不对它构成什么特别大的影响 X9我觉得它是MPV 买MPV的人还是会去看MPV的,因为垂向空间上 MPV还是有比较大的优势,不管你是装货也好,还是做人也好 MPV的低地板,还是要比SUV的高地板,虽然小米鹏车这个地板,在SUV里面真的不算高了,但是它跟MPV还是有差距的,我觉得影响不会特别大,但是就是理想跟零跑的高端系列 [01:23:26]
于新烈:零跑的高端系列,跟理想的L6 真的会被冲得比较惨,我觉得,确实没想到,跟你比较完,我对跑龙城的理解,确实更多了,就之前其实,看完发布会,我还是看了发布会的,没有特别打动我,特别是刚才,浩然提到的内饰,我在他的所谓,这个后期发布会完了之后,他被我团队直播,包括早期的很多内饰的,泄露的视频,时拍的视频,那个棕色给我看的特别的不好看,网上的评价也不一样,那个泄露的视频,泄露的视频都看不了,我给你举一个例子,奔驰S级的W222这一代,那就是上一代的 [01:24:14]
李南:就是现在这一代,上一代的再上一代,现在已经是广为经典传送的,简直就是现在的奔驰都是,礼崩乐坏的,就是不知道在干嘛的那一世,当年那个那一世,在刚刚泄露出来,它是四个水平的空调出风口,中空台上四个空调出风口,那张照片出来的时候,我们当时觉得奔驰就此沦落,一代经典就此结束了,结果那一代是,就是路透的这种,不正式打光的这种图,真的没有什么参考价值,我当时看到路透的图的时候,我就觉得好吧,小米的这个,我说实话,我觉得我很意外的一个点,我不理解的一个点,小米为什么要这么早,就让展车到店,然后不让人上车,到现在都不开门,你开了发布会之后,你内饰已经解密了,我的视频都已经发布了你为什么N90不让用户上车,这是在攒什么大招,反正这个我是不太理解,就是于老师你可以想想,未来是不是一般来说都是,静态解密之后,展车就开门了,对不对,但是N90 MAX到今天,都还是拉着一米蓝的状态,这个说实话挺蹊跷的,我不知道是为什么,因为从准备的完成度上来说 [01:25:47]
于新烈:我们拍的那台,那一批N90 已经非常非常完善了,我虽然没有素体,但是我一个朋友有素体,我看小米的素体的内饰,实际上我也很高评价的一个,很重要的点是因为,它就是很精致,而且小米有两点,可能是其他以前造车的人,不具备的能力,第一个是,他以前造消费电子的话,就意味着,其实小米的有些,真正重要的零件,它的精度,是可以用消费电子的,能力来要求,而与其同时,小米有比较好的成本,就车的配件我不知道,但感觉消费电子,能干到五个丝,所以你会觉得
李南:苏七的很多建案,但说实话,你说的这个点,我感觉还挺强的,它的内饰就有你说的,真的很精致,然后它成本,可能真的不是特别好,所以精度就是文明,而且小米做消费电子,它自然都把成本压下来 [01:26:53]
于新烈:这个会有小米的一个优势,小米的第二个优势,我们还要回归到消费者,其实消费电子的低端产品的产品,说难做是要取舍,但是不好做什么呢,就是下放,小米是特别擅长,把整个市场已经认可的高端的东西,同时成本又不高的,下放到低端产品来给用户制造获得感,实际上我在苏机上面,看到的很多的这种获得感,是他精准的下放了那些,低成本的高端产品上的设计,我花的钱又不多,但是又会觉得,我操作是不是见了老师姐,所以小米这两点是很强的,消费者东茶和整合产品的,不是说原创,但是整合产品到一个和谐的审美,所以这也是能力,小米的消费者东茶能力是超级超级超级强的,先半步这件事,是非常微妙的一种难免,但是他一直做得非常好,你觉得今年小米算走出,或者说即将能走出,现在的这种困境吗,所以这个产品,他一定会上瓷刀的,比较期待他上瓷刀的那天,看看成怪如何吧,毕竟我是一个,可以旁观这么大赌局的人,好嘞好嘞多谢,咱这也快两小时了,大周末的,多谢两位,拜拜,拜拜,拜拜,拜拜,欢迎大家在小宇宙,苹果podcast等音频平台,搜索885 有准备的头脑,订阅收听我的播客,本期节目就在这里,再见 [01:28:01]