微博的2026#AI创造营# 第一季收官,除了前几名像是「丧尸清道夫」和「纸手机」这些出圈的作品,我很喜欢的@文野Bot也在获奖名单里,这次他投稿的作品「重连中...」竟然看出了一种黑镜的既视感,充满了意外和惊喜。
我一直都不愿意单纯用流量来衡量AI视频的发展,一部作品能收获上亿播放固然是好事,但类型是否丰富也同样重要。
在这次微博的AI创造营,是真的能看见那些并不为流量而生的短片题材,一茬又一茬地冒出来可以被更多人知道,海纳百川,兼容并蓄。
这很难得。

微博的2026#AI创造营# 第一季收官,除了前几名像是「丧尸清道夫」和「纸手机」这些出圈的作品,我很喜欢的@文野Bot也在获奖名单里,这次他投稿的作品「重连中...」竟然看出了一种黑镜的既视感,充满了意外和惊喜。
我一直都不愿意单纯用流量来衡量AI视频的发展,一部作品能收获上亿播放固然是好事,但类型是否丰富也同样重要。
在这次微博的AI创造营,是真的能看见那些并不为流量而生的短片题材,一茬又一茬地冒出来可以被更多人知道,海纳百川,兼容并蓄。
这很难得。
哥答应你!
以及:你找不到有Jensen名字的办公室,但他就可能出现在任何地方。
一位老哥访问了英伟达的办公室,整理一下供大家消遣:
1、零食和咖啡不是免费的:你得为它们付费。(英伟达员工指正:机器咖啡是免费的,手工咖啡是付费的。零食是有补贴的)
2、Codex和其他 AI相关初创公司设有专门的驻场办公室,在这些办公室里,员工们会为英伟达的同事们提供办公时间服务。
3、二进宫很常见:一个开发者,他在英伟达工作了1年,然后离开去创办一家初创公司,然后在6年前回来了。
4、在职时间普遍很长,切换团队也很容易。员工不需要担心裁员。这意味着无需担心为了让自己“安全”和重要而挤掉别人。所以每个人都互相帮助。
5、 "Jensen" 这个名字每个几分钟就有人提起。
链接:x.com/GergelyOrosz/status/2070210683182981206
AI 创新正在整个技术栈上发生。
加入我们在 Advancing AI 2026 的活动,探索全栈 AI(full-stack AI)的最新进展,并聆听正在帮助塑造行业未来的领导者分享观点。
注册:https://bit.ly/4oDMPoo

🤦 😄 😄 🤦 😄 🤦
今年不像 2022年,反而更像 2015年。
#模型时代# 今年高考数学压轴题,被微博AI的 30亿参数的模型做出来了
今年高考数学结束后,Hugging Face上有用户做了一件事:把几道压轴题喂给一个叫 VibeThinker-3B的开源模型,结果全部做对。这个模型来自微博 AI团队,9个人开发,6月 16日刚发布,权重文件只有 6GB,一张消费级显卡就能跑。
其实,去年 11月 VibeThinker-1.5B发布的时候,很多人就注意到了这个团队,这次 3B版本出来,在海外技术社区引起的动静比上次大得多。微博 AI团队在 Hugging Face的讨论区回复也说,发布前做过大量分布外(OOD)泛化测试,高考题这种难度的准确率确实很高。
做对高考压轴题这件事单独看可能不算稀奇,GPT-5、Gemini、Claude这些旗舰模型大概率也能做到。#微博大模型可真能省钱# 但它们的参数量从几千亿到万亿不等,训练成本以亿美元计。一个 30亿参数的模型做到同样的事,参数量只有 DeepSeek V3.2的两百分之一,就值得解读一下了。当然,最重要的,我是一名合格的微博AI博主。
对了,技术报告的排版很漂亮。
一、做到了什么,没做到什么
1、推理赛道:进入旗舰模型的性能区间
VibeThinker-3B的定位是“可验证推理”,也就是专攻有标准答案、可以自动判对错的任务。数学竞赛、编程竞赛、STEM推理是它的主场。
技术报告(arXiv 2606.16140,2026年 6月 16日发布)给出的自测数据:AIME 2026(美国数学邀请赛)得分 94.3,和 DeepSeek V3.2(671亿参数)处于同一档,高于 Gemini 3 Pro的 91.7。在 LiveCodeBench v6上拿到 80.2的 Pass@ 1。更有说服力的是 LeetCode的实战测试:团队用 2026年 4月 25日到 5月 31日期间的周赛和双周赛题目来评测,这批题目晚于训练数据截止时间,模型不可能提前见过。128道题首次提交通过了 123道,通过率 96.1%。
2、知识赛道:差距一点没缩小…
但如果拿知识密集型的任务来测,画面完全不同。GPQA-Diamond是一个研究生级别的科学知识基准,VibeThinker-3B只拿到 70.2,而 Gemini 3 Pro是 91.9,Claude Opus 4.5是 87.0,差了将近二十分。有海外用户下载模型实测后发现,它连 uv是什么都不知道,而 uv可以说是当下 Python开发者用得最多的包管理工具之一。团队也直言不讳:模型没有用日常编程和工具调用数据训练,不适合当通用编程助手。
不过,两组数据放在一起看,就有了一个结论:在有标准答案可以验证的推理任务上,30亿参数进入了旗舰模型的性能区间;在需要广泛知识储备的任务上,差距并没缩小。它不是一个“什么都会但都一般”的通用模型,恰恰是因为极度专注,才在自己的赛道上走到了这个位置。
3、高考压轴题为什么恰好适配
这也是它跟高考压轴题适配的原因。高考数学压轴题的特征正好落在 VibeThinker-3B的能力圈内:多步推理、逻辑链条长、有标准答案可以验证、不依赖课本之外的百科知识。同样的道理,竞赛级别的编程题、STEM领域的公式推导和数据分析中的逻辑推理环节,都是它可以发挥的场景。但拿它来做需要调用 API、理解项目上下文的日常开发工作,那就超出了设计意图。
二、为什么 30亿参数够用
1、站在别人的肩膀上做后训练
VibeThinker-3B不是从头训练的。基座是阿里巴巴开源的 Qwen2.5-Coder-3B,一个现成的小模型。微博 AI团队在这个基座上做后训练,通过精心设计的监督微调、多域强化学习和自蒸馏流程,把推理能力从基座水平拉到了当前的位置。
这个系列不是新出现的。前身 VibeThinker-1.5B在 2025年 11月发布,15亿参数,当时的后训练成本约 7,800美元。同期 DeepSeek R1同一环节的开销约 29.4万美元。3B是 1.5B技术路线的延续和放大。机器学习研究者 Sebastian Raschka在 6月的博客中估算,3B版本的训练成本可能在 2.5万到 6万美元之间(团队未正式公布这一数字)。花的钱不多,但关键问题不是“便宜”,而是“为什么便宜也能做到”。
2、参数压缩覆盖假设:推理像肌肉,知识像仓库
技术报告提出了一个假设来回答这个问题,叫 Parametric Compression-Coverage Hypothesis,参数压缩覆盖假设。核心判断是:不同类型的能力对模型参数的依赖方式不一样。
可验证推理的工作模式是多步推理、约束满足、自我纠错、答案验证。这些操作的模式虽然精密,种类却有限,可以在较小的参数空间里被高度浓缩。打个比方,推理能力更像肌肉纤维,可以在有限的体积里高密度排列。只要训练方法足够精准,小模型就有可能逼近大模型在这个方向上的表现。
开放域知识则完全是另一种需求。要知道世界上有哪些编程工具、各行业的常识背景、历史事件的前因后果、各种长尾场景的处理方式,这些信息本身就需要参数空间来承载,覆盖面跟参数规模直接挂钩。知识更像是仓库的货架,存储空间就是硬约束,堆不出密度优势。
这个区分解释了 VibeThinker-3B的成绩单为什么分裂成两半:推理可压缩,所以 30亿参数够用;知识不可压缩,所以 GPQA差了二十多分。不是模型有什么设计缺陷,而是这两种能力天生就以不同的方式依赖参数。
3、VentureBeat的判断:可压缩程度远超预期
VentureBeat在 6月的报道中对这个假设的评价是:它揭示了推理能力和事实知识之间存在部分解耦,而且推理的可压缩程度远超行业此前的预期。如果这个判断成立,对模型设计思路、部署成本和先进 AI能力的普及方式都会有实质性的影响。
三、一个 6GB的模型打开了什么可能
1、部署架构可能从“一个大模型”走向分工
技术报告讲到假设就收尾了,没有再往下推。
不过,如果推理可压缩这件事成立,AI应用的部署架构可能不会一直是“一个大模型包办所有事”的形态。更经济的方式也许是分工:大模型跑在云端做知识底座,负责通用对话和开放域问答;小模型跑在本地甚至终端设备上做专项推理,在需要数学计算、逻辑推导、代码推理的环节接管任务。两者通过路由机制协作。调用一次千亿参数模型和调用一次 30亿参数模型,算力开销差的是数量级。高考压轴题级别的推理能力如果能稳定地跑在消费级硬件上,教育辅导、工程计算、数据分析这些场景的产品成本结构会发生变化。
2、开源验证:条件给足了,结论还早
VibeThinker-3B采用 MIT许可证完全开源,发布第一天社区就做出了量化版和衍生版本,已经积累了 700个 likes。验证条件给足了。但要说明的是,技术报告中的基准分数是团队自测自报的,目前没有第三方独立完成复现。社区对于“benchmaxxing”(专门针对基准刷分)的质疑不是没有根据,有人指出这类数学和编程基准天然有利于专项优化。不过反过来说,LeetCode周赛那组数据用的是训练截止之后才出现的题目,这是所有成绩里最难通过刷题来达成的一项。
9个人的团队,几万美元量级的训练投入,做出一个在可验证推理方向上进入旗舰模型区间的开源模型。作为一个每天在微博上跟 AI打交道的人,我觉得这件事的价值不在于证明微博也能做 AI,而在于它触及了一个更根本的问题:我们对“推理能力需要多大的模型来承载”这件事的理解,可能还有空间可以挖掘。
技术报告:arxiv.org/abs/2606.16140
模型地址:huggingface.co/WeiboAI/VibeThinker-3B

#外设
怒喵的磁轴键盘到手了,用着还不错。
看李楠的意思还要做一个听声辨位的硬件挂,有点意思。

翻译一下,这是自动驾驶芯片第一股、自动驾驶第一股、物理AI第一股本尊
地平线的确不太会混社会,自动驾驶芯片第一股,自动驾驶第一股,物理AI第一股 … ,等“xxx第一股”从来都没搞过,是一家比较无聊的公司。
Oura ring 5不错,纤细了很多。
PPT Master确实是最好的 PPT Skill
我新的 skill写PPT也挺好,能导出可编辑版本,可以AI配图,可以在 Agent内置浏览器中标记编辑
转发一下 B站博主的锐评 PPT skills:
注意:有些 skill不是专门做 PPT的,所以评分会有点低,只是需求不同,想专门做 PPT的看最前面的。
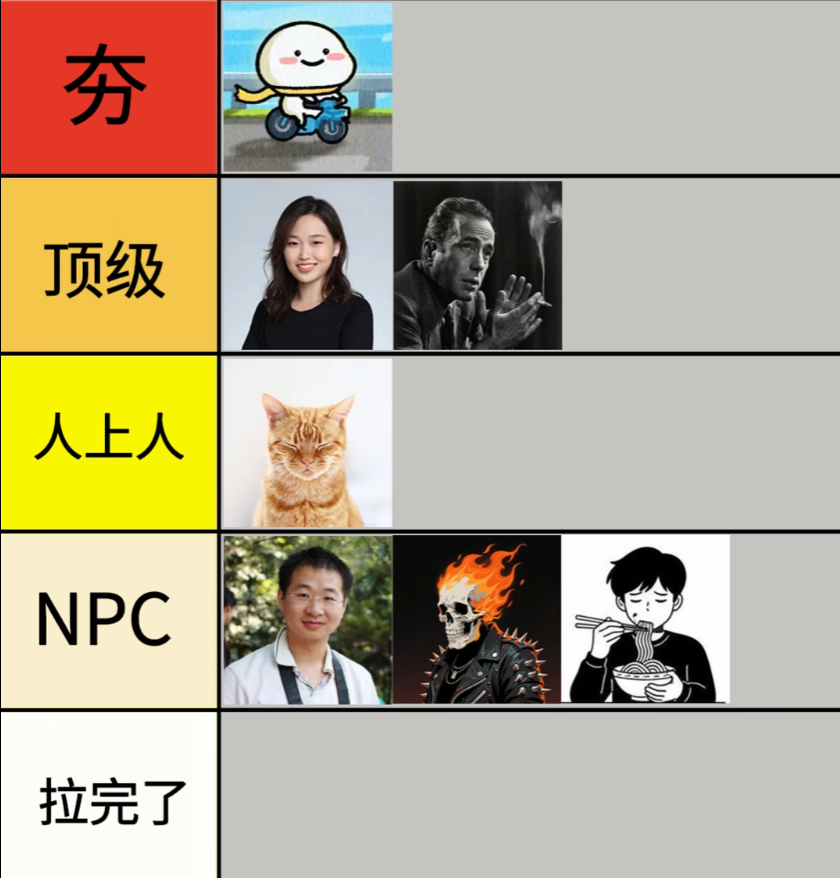
1. hugohe( 3.1万 star) | 顶级天花板 👑
全场唯一正经做 PPT的!元素全可编辑,自带音色克隆和旁白生成,纯纯降维打击。
🔗
2. 张咋啦 @zarazhangrui ( 2.3 万 star)
顶级主观审美最佳,完成度极高!目前呈现为 HTML格式,稍微考验一点使用者的基础。🔗
3. 花叔 @AlchainHust ( 1.9 万 star)
顶级审美极佳,关键是能输出可编辑的 PPTX格式!
🔗
4. 歸藏 @op7418 ( 1.5 万 star)
人上人瑞士风审美非常棒,自带快捷键,很适合线下分享。
🔗
5. Lewis ( 6500 star)
功能设计十分贴心,自带计时器和逐字稿等实用组件。
6. 宝玉 ( 2.2 万 star)
NPC风格偏可爱,主要以纯图片形式呈现。
🔗
7. 乔木 ( 5400 star)
偏向于纯图片卡片的输出,更侧重于内容的初步呈现。
🔗
是不是得把我的账号收款地区改为日本,才能把我美好的中国话翻译成英文推送给全世界啊?
在 @nvidia 度过了很棒的一天。
今天我还知道了,Jensen 最喜欢的食物是美式炸牛排(Chicken Fried Steak)。他 9 岁时作为寄宿学生来到肯塔基,不久后就吃到了这道菜;那时他还负责打扫学校的卫生间。🇺🇸 🇺🇸 🇺🇸 🇺🇸 🇺🇸

整理卡片,发现汇丰香港 APP就支持直接修改 ATM密码了🥲
这么多年,我认为真正称得上神卡、神银行的只有汇丰。

突发新闻:OpenAI 负责算力的技术负责人在 2026 年 4 月加入 Meta 后,已经回到了 OpenAI。Meta 到底发生了什么,才会让人在短短几个月后就离职?
Anuj 是不是在 Meta 的组织调整中被调去了数据标注岗位,所以才离开的?

Codex发展趋势必然是 Agent OS而不仅仅是 Agent Office引用原帖:
最近的一个观察:Codex将成为AI时代的Office,可能也会成为操作系统。来自OpenAI的研究:他们几乎全员都从ChatGPT转向Codex了,包括研发、法务、财务和招聘部门。
用 DigitalOcean 跑 Codex 远程会话:
现在,只需一个提示词,就可以通过 Codex 的 @DigitalOcean 插件启动一个持久化的云端开发环境。
它运行在你的 DigitalOcean 账户中,并且在你离开后仍会继续工作。
🇪🇨 负 🇩🇪 不会有不同意见吧🇨🇼 负 🇨🇮 臭鱼烂虾没跑,我说是就是🇹🇳 负 🇳🇱 荷兰要刷净胜球确保下一场踢摩洛哥,这场大会是比分🇯🇵 胜 🇸🇪 日本也有机会冲一下净胜球🇵🇾 平 🇦🇺 平局大家都能进淘汰赛🇹🇷 负 🇺🇸 这届土耳其烂完了
今夜将是恢复荣光的一夜,保底6中5,信我!
OpenAI CEO Sam Altman 本周三在公司内部 Q&A 上告诉员工,GPT-5.6 将以“有限预览”的方式发布,只向一小部分合作伙伴开放。原因是联邦政府的要求。
周四,Altman 在内部备忘录中进一步说明:在预览期间,政府会“逐个客户审批”GPT-5.6 的访问权限。
这种发布方式在 AI 行业没有先例。以往模型发布的节奏由公司自己决定,现在变成了政府拿着名单逐一放行。
从纸面上看,行政令说得很清楚:不创设强制许可或预审批要求。但 Anthropic 的遭遇已经给整个行业做了一个示范,不配合的后果是模型直接被下架。OpenAI 的“自愿”配合,与其说是出于认同,不如说是看清了不配合的代价。
有评论者指出了一个容易被忽视的问题:这种机制只限制了模型的发布速度,并不限制训练速度。公司内部拥有的能力和公众能用到的能力之间的差距,会越拉越大。
对普通用户来说,GPT-5.6 的传闻规格不低,上下文窗口从 GPT-5.5 的 100 万 token 扩展到约 150 万,代码能力和多步骤 agent 任务上也有改进。但什么时候能用上,现在取决于政府的审批节奏,而不是 OpenAI 的产品日历。
新消息,来自 @leomschwartz 和 @amir:
特朗普政府出于安全担忧,已要求 OpenAI 分阶段发布 GPT-5.6。
周四,CEO Sam Altman 告诉员工,政府将按客户逐一批准 GPT-5.6 的访问权限;这是一种非常不寻常的做法。

B站突然发布了一本视频播客创作手册,还特意标出这是1.0版本,大有把它做成行业白皮书的意图。
我的评价是,面对信息低质且泛滥的现状,B站的担忧之情可谓是溢于言表。
牛津词典和韦氏词典曾选用「脑腐」和「泔水」分别作为2024和2025的年度关键词,前者说的是人们已经习惯了社交媒体上短平快的内容,以致于认知和注意力都有不同程度的下降,后者则直指AI被滥用之后,几乎已经没有什么信息质量可言了。
甚至在「AI盛行的时代,还有老一辈艺术家坚持手搓」这句本该是称赞的话里,我们都能不可避免地读出一丝嘲讽的味道……
于是B站急于站出来披露一些积极信号,证明好好说话仍然有无法替代的价值:
比如全站视频播客的日均播放时长已经突破了1亿分钟,哪怕放在短视频席卷一切的当下,这个数字含金量依然十足,它意味着曾经被视为冷门赛道的视频播客,某种程度上已经彻底摆脱了小众定位;
又比如内容类型的多样性变得空前丰富,无论单口、对话还是实时连线,甚至很多拿素材填充画面,或是只用头像不露脸的播客节目,也都能找到感兴趣的人群。
当然,这一切的前提,除了表达质量,还是表达质量。
跟短视频钩子、反转、语速、剪辑这些公式化打法完全不同的是,视频播客本质上筛选的是表达者而非表演者,它允许停顿、铺垫、犹豫甚至跑题,也允许一个人在长时间说话里暴露自己的知识半径、经验褶皱和判断方式,短视频可以包装人设,但长对话很难一直演下去。
这倒不是说,视频播客会变得像短视频一样受欢迎,不过这并不是内容形式的问题,而是内啡肽刺激的人群规模,一定比不上多巴胺刺激的设定问题。
大概也是短视频兴盛叠加上AI内容泛滥的这几年,人们开始回忆起了何为人味,回忆起了篝火夜话才是人类最本真的信息传播方式,回忆起了交谈曾经也是我们生活里的必需品,所以内容的钟摆,又回荡到以质量和深度见长的视频播客这里。
再者说,一个健康的市场,也必须得容得下物种的多样性。
从这本手册的内容来看,B站开门迎客的诚意不可谓不足,从做节目的理由和技巧,到硬件准备、取景构图和扶持政策,一应俱全事无巨细,就差分析MBTI了。
B站抛出的判断是,预计到明年日均观看时长还会有300%的增长,讲真,这可能是在注意力稀缺的年代里,普通人和名人为数不多可以从同一起跑线同台竞技的机会了。


人们还不太理解,为了数据中心,现在有多少电表后侧发电资产(behind-the-meter power generation assets)正在建设。原因是美国电网太糟糕,即便成本和复杂度更高,大家也不得不这么做。
美国电网约束:到 2028 年,电表后侧数据中心是否会超过 40GW?
为什么电网跟不上,以及为什么这会推动到 2028 年每年 50% 以上的数据中心采用电表后侧供电
https://semianalysis.substack.com/p/us-grid-constraints-towards-40gw
在飞机上翻杂志,给我看沉默了⋯⋯

Agent(智能体)正在被非常快速地采用,并加速工作推进。在 OpenAI 内部,这种变化是这样的:

OpenAI 的各个部门正在被智能体改变工作方式。
在整个公司里,人们正在使用 Codex 完成更复杂、耗时更长、也越来越跨职能的工作。
我们的内部使用情况提供了一个早期窗口,让人们看到随着智能体工具能力提升并广泛可用,它们可能如何重塑工作。


非常好用,笑死我了引用原帖:
帮转,DeepSeek招多模态方向工程师研究员引用原帖:
🚀 我们组在招(全职/实习都可以): - 多模态数据工程师(属于预训练数据工程师)
-多模态理解数据/算法研究员(图像 & 视频方向)
DM已开,直接带CV发消息给我,或者带CV发邮件到 talent@deepseek.com

张雪峰已经由贫寒学子的圣徒,变成了梗小鬼们的新目标,但填报志愿这门生意,还得继续。
就像每年高考期间都有丢失准考证的新闻出现,在分数出来之后,关于花大价钱买一份志愿填报意见究竟是不是割韭菜,以及因此闹出的法律纠纷,也还是在层出不穷。
今年更魔幻的是,央视直接起底了高报机构的生意经:所谓资深名师可能是入职不久的销售,证书可以P,十年经验可以编;家长花几千上万元买来的「一对一定制」,背后是把问题丢给免费的千问,再换一套话术卖回来。
连教育部都忍不住了,今年把国家教育考试指导委员会专家组成员推了出来,给高考志愿填报服务「泼冷水」,表示对于「一次选择定终生」的期待是不切实际的:
「不要想着花几千元甚至上万元,把这个工作交给别人,这极其不负责任。」
另一方面,更大的变量则来自AI,虽然大模型的热潮已经进入了第4年,但从去年年底开始的Agent能力爆发,直接为AI赋予了行动能力,而不只是信息组织,这彻底加速了千行百业接入AI的效率。
如果说高考志愿填报也称得上是一个行业的话,它所受到的冲击,一点儿也不比其他赛道来得更加缓和。
在一次2026年高考志愿填报师AI使用情况的调研统计里,最难绷住的情况出现了:有九成以上的高考志愿填报师承认,他们会用AI来帮助完成自己的工作。
这就很经不起细想了,家长豪掷成千上万的费用,本来以为买到的是一整套围绕孩子展开的专业分析:分数、位次、专业、城市、就业、风险,全都有人仔细研究。
可现实却是,对方收钱之后,开始把学生资料输入给AI,再把生成结果换个说法、换个封面,重新包装成「专家方案」。
问题当然不在AI。
恰恰相反,AI本来可以把复杂的政策、院校和专业信息,变成普通家庭也能看懂、能核验、能讨论的参考。它应该降低信息差,而不是被一些机构拿去制造新的信息差。
我倒不是觉得高考志愿填报师这种职业就应该被淘汰了。真正专业的高报师,当然有价值。他们能结合孩子的兴趣、家庭情况、城市选择和长期规划,做更细的判断。…
但如果一项服务的核心价值,并不在于精进自身的专业水平,而只是把AI生成的基础信息转述给家长,再靠「名师」「定制」「内部经验」的包装收取高价,那它的合理性就值得重新审视了。
中国每年的高考人数,长期保持在1000万级的规模,最近几年甚至冲到了1200万以上的高位,其中愿为孩子消费专业填报服务的家庭,占比在5%以内。
这也是AI进入高考志愿场景最重要的意义:让更多普通家庭,也能先获得一份低门槛、可复核的基础参考。
当越来越多高报师也开始使用AI,普通家庭更应该意识到,AI不是别人家的资源。
上面提到的调研里还有一个信息:在高考志愿填报师常用的AI工具中,千问被频繁提及。某种程度上,这恰恰说明,志愿填报里大量信息整理、政策核验和方案初筛的工作,正在变成一种更开放的基础能力。
原因也不难理解,千问背后有夸克超过8年的学生服务数据积累,这些能力也延伸到了千问高考志愿服务里。
在友松实验室专门为高考志愿设计的AI基准测试里,千问的表现,基本持平了人类咨询师水平。这说明,查政策、核专业、做初筛、排方案这类工作,已经不再只能依赖少数人的经验和资料库。
这当然不是说人类又双叒叕输了。真正专业的咨询师仍然有他的岗位价值,比如理解考生,沟通家庭,解释风险,权衡取舍。
大部分的体验落差,其实都是可以想到的,和殷勤热忱的销售态度比起来,收钱之后的对接服务如同抽盲盒,不是每一个家长都能获得满足预期的服务。
这就更回旋镖了,高价购买的服务本身就充满了不确定性,却希望能够换来确定性的人生指南,哪里有这么好的事呢?
我一直不同意AI会削弱人类的所谓主体性,或者说,在没有AI之前,人类就非常善于让渡自身的主体性,不愿直面沉重的责任与义务,AI实际上带来了新的变数,在它的帮扶之下,人类或许有机会被赋予本不存在的能力,从而回归主体性。
放到高考志愿这件事上,就是家长和考生至少不必再从一片空白开始。他们可以先用AI完成一次信息核验和方案初筛,再带着更具体的问题去进行沟通。
现在的AI志愿工具也不再只是简单问答。它会追问分数、位次、选科、城市偏好、专业兴趣和风险承受能力,把原本散落在各处的信息,整理成一份可以讨论、可以修正的初步方案。
只能说,生在这个巨变的时代,学生们虽然苦是苦,但吃得也是真的好。
年轻人永远值得信任的原因,在于他们始终能在是有学习欲望的那段生命里,迎面遇到最先进的技术生产力,用千问填报志愿,或许就是原生AI代际的参与开端。
说到这里,我想到老编辑说,再也不可能有张雪峰了,因为那样一个名师IP,是一段特定历史的符号。
莘莘学子的下一个报考导师,又何必有一具肉身凡胎呢?


负责任 AI 并不是一个检查点,而是一种思维方式。
Kathy Pham 做客 Advanced Insights,讨论组织如何从第一天起就把信任构建进 AI 系统,以及为什么最成功的团队会在开发流程早期引入多元视角。
现在观看:https://bit.ly/4w5K55D
我们正作为创始合作伙伴加入 @raiseus_ai。
RAISE US 是一个非营利联盟,致力于通过由雇主主导的行动、AI 赋能的培训以及政策创新,帮助美国劳动力为向变革性 AI 过渡做好准备。
今天,我们正式启动 RAISE US。美国有一套面向 AI 的技术战略,但还没有一套面向人的战略。我们就是来建立它的。
RAISE US 由 @GinaRaimondo 和 Eric Holcomb 共同担任主席。我们正在与州长、雇主和教育工作者合作,帮助劳动者接受培训、完成转型并蓬勃发展。
这件事之所以可行,是因为构建 AI 的人和受其影响最深的人坐在了同一张桌子前。了解更多:http://raiseus.ai #RAISEUS
毫无疑问:
一个让十亿台机器人运行 foundation models(基础模型)的世界,不会在本地完成这些计算。
嵌入式计算不会再像今天这样。
所有嵌入式计算都会针对无线连接进行优化。
原因如下:
这期内容完整朗读并整理了杰夫·贝佐斯从亚马逊早期到交棒前的多封致股东信。主线不是简单回顾收入、客户数、员工数或产品清单,而是反复解释亚马逊如何理解长期主义、客户痴迷、自由现金流、发明、失败、运营纪律、高标准和社会责任。贝佐斯不断把“第一天”作为管理原则:公司必须像创业初期一样保持紧迫感,把资源投向能长期提升客户价值和市场领先地位的事情,即使短期利润、外部评价和失败概率并不友好。整套信件展示了亚马逊从在线书店扩展到 Marketplace、Prime、Kindle、AWS、Alexa、视频、广告、物流、员工安全和气候承诺的过程,也展示了贝佐斯对组织如何避免平庸、持续创造多于消耗的最后总结。
开篇的 1997 年致股东信奠定了全文反复出现的底层原则:亚马逊会把长期股东价值作为根本衡量标准,而长期股东价值来自市场领先地位、客户增长、复购、品牌强度和更强的经济模型。贝佐斯明确说,亚马逊会优先做有助于扩大客户基础和市场领先的投资,而不是为了短期盈利或华尔街短期反应调整方向;会用分析方法评估项目,淘汰回报不够好的投入,把资源加到最有效的方向上;也会在看到足够大的领先机会时做出大胆投资,即使其中一些会失败。
这封信同时解释了亚马逊为什么从书开始:互联网可以让客户获得实体书店难以提供的选择、搜索、浏览和便利。亚马逊全年无休,通过礼品卡、一键下单、评论、推荐和降价提升体验。信中列出 1997 年的增长:营收从 1570 万美元增长到 1.478 亿美元,客户账户数从 18 万增长到 151 万,回头客订单占比提升,战略伙伴关系扩大,配送中心和库存也显著扩张。贝佐斯把这些成果归因于客户信任、员工牺牲和高标准招聘,同时提醒股东:公司面对的竞争、增长、执行和持续投资风险都很大,必须保持警惕和紧迫感。
随后几封信显示,亚马逊从在线书店向音乐、视频、礼品、英国和德国站点以及 Auctions 等业务扩张。贝佐斯把“打造一个让数千万客户找到并发现任何想在网上买的东西的地方”作为愿景,同时强调前方机会和风险都比过去更大。1998 年信中反复出现的事实是:销售额、客户账户、回头客订单、国际和新品类收入都快速增长,而这些增长依赖于基础设施扩建、管理团队增强、配送和客户服务能力提升。
到了 1999 年和 2000 年,信件中的语气更强调“客户体验”和“长期判断”。贝佐斯承认资本市场和互联网行业环境剧烈变化,但坚持把精力放在客户能感知的价值上:更低价格、更大选择、更高可用性、更快交付和更好工具。信中不断出现的逻辑是,短期股票价格不是公司价值的可靠代理,真实的价值要看公司是否创造了可持续的客户关系和现金流能力。亚马逊在高增长中也继续扩大基础设施、类别和地域覆盖,既追求规模,也承认执行复杂性和投资压力。
2001 年之后,亚马逊开始更明确地强调运营纪律和成本意识。贝佐斯没有放弃增长,但更强调在增长、盈利能力和资本管理之间取得平衡。低价被描述为长期客户价值的重要组成部分:把效率节省回馈给客户,可以带来更强的忠诚度和更高的交易量,最终形成更健康的飞轮。信件中也反复出现“精打细算”“保持精简文化”“持续强化成本意识”等表述,说明亚马逊把节俭视为发明和长期竞争力的一部分,而不只是财务约束。
2002 年到 2004 年左右的内容把自由现金流放到非常核心的位置。贝佐斯解释,相比只看每股收益或会计利润,他更重视公司长期能产生多少自由现金流,因为这更接近股东实际拥有的经济价值。信中用资本周转、库存效率、固定成本杠杆和营运资本等角度说明,零售业务可以通过更快周转、更好供应链和更高效率创造价值,而不只是靠提高毛利率。
他强调,亚马逊会在多个指标之间做取舍,但原则是最大化未来现金流现值。当 GAAP 报表和长期现金流之间出现冲突时,公司会选择现金流。这并不意味着忽视利润,而是把利润、增长、资本效率和客户价值放进同一套长期模型里看。信件也把低价格与自由现金流联系起来:短期降价可能压低利润率,但如果它带来客户增长、复购和规模效率,长期可能增强公司价值。
中段大量内容围绕 Marketplace 和第三方卖家展开。贝佐斯把第三方卖家的成功视为亚马逊客户体验的一部分,而不是对自营业务的威胁。第三方卖家带来更大的选择、更有竞争力的价格和更多库存深度,亚马逊则通过工具、支付、配送、流量和信任机制帮助他们接触客户。信中提到第三方销售占比持续提升,卖家数量增长,Fulfillment by Amazon 让卖家的商品能够利用亚马逊配送网络并享受客户熟悉的服务标准。
这一部分体现了亚马逊“平台化”的管理方式:把内部能力拆成可复用服务,让外部卖家、开发者、作者、内容创作者和企业客户也能使用。贝佐斯多次提到,自助服务、规模化工具和长期降低门槛可以让更多参与者创造价值。亚马逊并不只把自己看作零售商,而是把许多能力建设成基础设施:卖家工具、应用商店、出版工具、物流服务和云服务,都延续了这种思路。
Kindle 相关内容强调,亚马逊愿意用数字阅读挑战自己原有的纸书业务。贝佐斯承认,技术转变可能会冲击既有模式,但如果客户更需要即时获取、便携、搜索、字体调整和大量书库,亚马逊就应该主动推动这种变化。Kindle 不只是一个硬件项目,而是围绕阅读体验重新组织内容、设备、商店和云端同步。
信中反复提到,为客户创造更好的阅读体验需要长期投入,也需要在硬件、软件、内容和出版生态上连续发明。亚马逊扩展了 Kindle 设备、Kindle Store、作者和出版相关工具,并试图让更多作品更容易被发现和购买。这里再次出现“长期”和“客户”的组合:只要客户体验明显更好,即使商业模式短期不确定,亚马逊也会愿意投入。
Prime 在信件中从快速配送服务逐步变成综合会员价值体系。最初的关键价值是让客户更频繁、更放心地购买,因为他们知道配送体验可预期。之后 Prime 叠加视频、内容、设备和其他权益,成为提高客户忠诚度和消费频率的重要机制。贝佐斯强调,Prime 的吸引力来自不断增加的客户价值,而不是一次性的营销包装。
信件中还提到 Prime Instant Video、原创内容、Fire TV、游戏、App Store、有声内容和 Fresh 等一系列业务。它们看起来分散,但在贝佐斯的叙述中都服务于同一逻辑:通过长期投入,扩大客户在亚马逊生态中的使用场景,让会员关系更深、更有用。许多尝试并不保证成功,但只要能学习、能提高客户价值,亚马逊就愿意探索。
AWS 相关内容展示了亚马逊从零售和电商经验中提炼出技术基础设施服务的过程。贝佐斯强调,AWS 的团队直接倾听客户需求,以快速迭代和持续降价的方式推出服务。他列举了数据库、虚拟私有云、Elastic MapReduce、高内存实例、预留和竞价实例、CloudFront 等服务,说明 AWS 不断增加“积木式”的基础能力,让客户能够更快构建自己的系统。
AWS 的重要性不仅是一个新业务收入来源,更是亚马逊管理哲学的延伸:把复杂能力封装成客户可自助使用的服务;用规模和运营效率不断降价;通过高速度发布和客户反馈持续迭代。贝佐斯把 AWS 与 Marketplace、Kindle、Prime 放在同一类叙事里:它们最初都像大胆赌注,但如果抓住真实客户需求、持续发明并长期投入,就可能成为新的支柱。
2015 年前后的内容集中讨论发明、失败和决策机制。贝佐斯强调,如果公司想获得超额回报,就必须允许规模足够大的试验;如果只做确定性很高的小改进,就不会产生 Marketplace、Prime、AWS 这类大赢家。失败不是目标,但它是发明不可分割的一部分。重要的是让失败发生在可承受范围内,并从中学习。
他也区分了不同类型的决策:有些是难以逆转的单向门,需要谨慎、慢一些;有些是可逆的双向门,可以用更小团队、更快速度尝试。大公司容易把所有决策都当成单向门,导致速度下降、创新变慢。贝佐斯希望亚马逊保持创业公司的决策速度,在可逆事项上快速行动,同时在真正重大的不可逆事项上保持高质量判断。
这部分还强调“客户痴迷”比“竞争者关注”更能驱动发明。客户往往不清楚未来能被发明出来的东西,但他们永远想要更低价格、更大选择、更快交付和更好体验。亚马逊从这些稳定需求出发,反复寻找长期可以成立的机会,而不是只追随竞争对手的动作。
2017 年相关内容大量讨论高标准。贝佐斯认为高标准不是天生的,它可以被学习和传播,但前提是人们必须理解某个领域里“好”到底意味着什么,以及达到好需要付出多少努力。很多低质量结果不是因为人们不想做好,而是因为误判了任务难度,以为两周能完成的事情,实际需要六个月。
他用写高质量备忘录等例子说明,高标准需要清晰的预期、具体榜样和愿意反复打磨的文化。亚马逊希望在招聘、运营、产品、客户服务、技术和内部沟通中都保持高标准。高标准的价值不是形式主义,而是减少平庸输出、提高客户体验、吸引优秀人才,并让组织持续提高自己的上限。
后段内容谈到机器学习、Alexa、Echo 和各种智能服务。贝佐斯把机器学习描述为已经深入亚马逊多个业务的能力:搜索、推荐、预测、履约、语音交互、AWS 服务和开发者工具都在使用相关技术。Alexa 和 Echo 被作为客户体验创新的重要例子:它们不是简单销售一个设备,而是在尝试新的交互方式和家庭场景。
信中还提到,机器学习能力也通过 AWS 向外部客户开放,让开发者不必从零开始建设复杂系统。这个主题继续延续“把内部能力变成外部服务”的思路。贝佐斯关心的不是技术概念本身,而是技术能否降低客户和开发者的门槛,能否让更多人更快创造价值。
在最后阶段,贝佐斯把员工体验和安全提升到更高位置。信中提到亚马逊为大量不具备计算机科学背景或高学历优势的人创造工作,也提到最低时薪、福利、培训、岗位轮换、安全专业人员和 Working Well 等项目。贝佐斯承认,仅仅对已有员工推荐率或安全表现感到满意是不够的,亚马逊需要提出更好的员工成功愿景。
他宣布亚马逊不仅要成为地球上最以客户为中心的公司,也要成为地球上最好的雇主和地球上最安全的工作场所。这个目标被放在他即将转任执行董事长的语境中:他认为自己最擅长的是发明,而员工安全和成功也需要发明。这里的重点不是用员工目标替代客户目标,而是相信二者可以互相促进;如果亚马逊能同时做好消费电商和 AWS 两个差异巨大的业务,也应该能同时追求客户中心、最佳雇主和安全工作场所。
气候承诺相关内容强调,气候行动不只是成本或负担,也可以推动效率、技术变革、风险降低和更好的未来。贝佐斯提到亚马逊与 Global Optimism 发起气候承诺,目标是比巴黎协定提前实现净零碳排放,并要求签署方测量和报告排放、通过业务变革和创新脱碳,并用高质量抵销处理剩余排放。
信中列举了可再生能源、电动送货车、Rivian 投资、Climate Pledge Fund 以及个人气候资助等内容。核心逻辑仍然是用规模发出市场信号:当大公司承诺购买和部署低碳技术,供应商和创新公司就会更有动力发明、扩产和降本。贝佐斯希望公司不只是减少自身影响,也帮助相关技术和市场更快成熟。
最后一封信具有明显的告别意味。贝佐斯引用关于生命体抵抗与环境趋同的论述,把它转化成公司和个人的比喻:世界会用许多方式把你拉向平庸,如果不持续努力保持独特性,组织就会逐渐失去差异。对亚马逊来说,独特性包括客户痴迷、长期主义、发明、愿意失败、高标准和第一天文化。保持这些东西需要付出代价,不会轻松,但值得。
他感谢 Andy Jassy 接任 CEO,表达对其标准和能力的信任,并提醒亚马逊人要与人为善、保持独创,让创造多于消耗。这个结尾把前面二十多年反复出现的主题压缩成一句管理伦理:公司不能只从世界拿走资源、注意力和利润,还必须创造出更多客户价值、员工机会、基础设施能力和社会价值。亚马逊的长期主义最终不只是资本配置方法,也是一种要求组织持续证明自身存在价值的纪律。
文稿中出现的业务清单很长,但它们并不是孤立展示成绩。图书、音乐、视频、礼品、国际站点、Marketplace、FBA、Kindle、Prime、AWS、Fire TV、App Store、Audible、Fresh、Fashion、Sunday Delivery、WebLab、Alexa 和机器学习服务,都被放在同一套逻辑下解释:先找到长期不会变化的客户需求,再围绕这些需求投入系统、基础设施、工具和人才。客户想要更低价格、更大选择和更快交付,这些需求多年不变;卖家想更容易接触客户,开发者想更快构建系统,作者和内容创作者想更低门槛发布作品,这些也是亚马逊反复服务的对象。
因此,很多业务最初看似偏离在线书店,但在贝佐斯的叙述里都是同一飞轮的延伸。Marketplace 增加选择并强化价格竞争,FBA 把亚马逊的配送能力开放给卖家,Prime 把高频购买和会员权益绑定起来,Kindle 重新定义阅读,AWS 把内部技术能力变成外部客户可使用的基础设施,Alexa 和机器学习把交互与智能能力嵌入产品和平台。每一项都需要长期建设,也都可能经历多年不确定性;贝佐斯借这些案例说明,亚马逊的增长并不是靠一次灵感,而是靠持续把能力服务化、规模化和客户化。
文稿里也多次强调,亚马逊愿意把节省下来的成本返还给客户,而不是优先留在利润率里。更低价格可能短期看起来削弱利润,但如果它提升客户信任、复购和规模,就会增强长期经济模型。配送网络、软件系统、仓储自动化、运营流程、实验平台和供应链能力,都是为了让这种低价、选择和速度的承诺更可持续。贝佐斯把这些看作难以复制的复合能力,而不只是某个单点产品优势。
整套股东信的另一个重点是管理机制。贝佐斯并不只是说“要长期”“要创新”,而是反复解释组织怎样才能真的做到:用自由现金流而不只是会计利润看价值;用客户指标和复购衡量品牌;把薪酬更多与股票期权和主人翁意识连接;坚持高标准招聘;让小团队和可逆决策保持速度;用实验平台验证产品改变;用自助服务降低外部参与者门槛;用公开给股东的方式说明战略思考,让投资者知道公司为什么做出看似不寻常的取舍。
高标准、节俭、偏好行动、愿意失败和客户痴迷在文稿中互相支撑。没有节俭,高增长会变成低效率扩张;没有高标准,规模会稀释质量;没有偏好行动,大公司会在层层审批中失去速度;没有愿意失败,发明就只能停留在小改良;没有客户痴迷,技术和平台化又容易变成自我炫耀。贝佐斯真正强调的是一整套互相咬合的组织操作系统,而不是某一句管理格言。
最后几封信把这种操作系统扩展到员工和社会议题。最低工资、培训、岗位轮换、工伤预防、可再生能源、电动货车、气候基金和个人气候资助都被放在“用规模创造更多价值”的框架下。贝佐斯承认这些目标不容易,也不可能靠口号完成;它们需要像客户体验和 AWS 一样被发明、被测量、被投入、被迭代。由此看,最终的“创造多于消耗”不是抽象劝勉,而是对公司继续证明自身长期价值的要求。
从时间线看,早期信件更关注证明在线零售的可能性:客户数、销售额、配送面积、库存、战略伙伴和复购率是主要证据。中期信件开始强调亚马逊不是单一零售业务,而是在建设可复用的平台能力:卖家服务、会员体系、数字内容、云计算和设备服务逐渐成为新的增长来源。后期信件则把组织能力本身放到前台:高标准、决策速度、机器学习、员工安全、气候承诺和保持独特性,成为贝佐斯解释亚马逊为什么还能继续进化的关键。
这种演变说明,贝佐斯并没有把长期主义理解成“坚持原来的业务不变”。相反,长期主义要求公司不断改写自己,只要新的方向能更好服务客户并创造长期价值,就要愿意投入、试错和自我替代。亚马逊从书到万货,从零售到平台,从内部系统到 AWS,从配送体验到员工安全和气候行动,都是在同一原则下发生的连续扩展。
还有一个反复出现的细节是,贝佐斯总把抽象原则落回可验证的经营事实:客户账户、复购占比、第三方卖家销售占比、AWS 服务发布数量、Prime 权益扩展、员工安全投入、可再生能源项目、电动送货车订单和气候承诺签署方,都被用来说明原则是否真的转化成行动。也正因为如此,这组信件读起来像一套连续的经营备忘录:每一年都在回答同一个问题,亚马逊是否仍然在为客户、员工、合作伙伴和股东创造比消耗更多的东西。这个问题也解释了为什么同一封信里会同时出现价格、物流、云服务、内容、招聘、安全和气候:它们共同构成亚马逊对长期价值的定义,也让这组信件从业务年表变成一套可执行的公司治理方法。
1. 亚马逊的核心管理原则是“第一天”:保持创业早期的紧迫感、客户敏感度和发明速度,避免大公司惯性把组织拖向缓慢和平庸。
2. 贝佐斯把长期股东价值建立在客户价值和市场领先之上,而不是短期利润或股价表现之上;客户增长、复购、品牌强度和现金流能力才是更重要的信号。
3. 客户痴迷在信件中不是口号,而是具体体现在更低价格、更大选择、更快配送、更好工具、更可靠服务和愿意自我颠覆既有业务上。
4. 自由现金流是亚马逊解释财务表现的重要语言。公司愿意为了未来现金流现值牺牲短期报表表现,但同时强调成本意识、资本效率和运营纪律。
5. Marketplace、Prime、Kindle、AWS、Alexa 等业务都体现同一种方法:从长期稳定的客户需求出发,持续投入基础设施,允许试验失败,等待少数大赢家变成支柱。
6. 亚马逊把许多内部能力平台化,让第三方卖家、开发者、作者、企业客户和内容合作方使用亚马逊的工具、配送、云服务和流量,这扩大了生态价值。
7. 高标准可以被学习和传播,但必须理解真实难度;组织要通过清晰样板、严肃评审和充足投入,避免把平庸误认为完成。
8. 发明离不开失败。关键不是避免失败,而是区分可逆与不可逆决策,让可逆试验跑得更快,让不可逆决策保持谨慎和高质量。
9. 后期信件把员工安全、最佳雇主和气候承诺纳入长期主义范围,说明贝佐斯希望亚马逊用规模解决客户之外的组织和社会问题。
10. 终章的核心提醒是“差异化就是生存”:无论公司还是个人,都必须持续投入能量保持独特性,并努力让创造多于消耗。
- 1997年致股东信 团队、高标准与主人翁文化 [00:00:00 - 00:10:00]
- 1998年致股东信 团队、高标准与主人翁文化 [00:10:00 - 00:20:00]
- 1999年致股东信 客户痴迷与体验提升 [00:20:00 - 00:30:00]
- 2000年致股东信 客户痴迷与体验提升 [00:30:00 - 00:40:00]
- 2001年致股东信 客户痴迷与体验提升 [00:40:00 - 00:50:00]
- 2002年致股东信 自由现金流与股东价值 [00:50:00 - 01:00:00]
- 2003年致股东信 自由现金流与股东价值 [01:00:00 - 01:10:00]
- 2005年致股东信 自由现金流与股东价值 [01:10:00 - 01:20:00]
- 2006年致股东信 Marketplace 与第三方卖家 [01:20:00 - 01:30:00]
- 2007-2008年致股东信 Kindle 与数字阅读 [01:30:00 - 01:40:00]
- 2009年致股东信 客户痴迷与体验提升 [01:40:00 - 01:50:00]
- 2010年致股东信 客户痴迷与体验提升 [01:50:00 - 02:00:00]
- 2010年致股东信续篇 Kindle 与数字阅读 [02:00:00 - 02:10:00]
- 2012年致股东信 客户痴迷与体验提升 [02:10:00 - 02:20:00]
- 2013年致股东信 Prime 与会员价值 [02:20:00 - 02:30:00]
- 2013年致股东信续篇 团队、高标准与主人翁文化 [02:30:00 - 02:40:00]
- 2013年致股东信续篇 团队、高标准与主人翁文化 [02:40:00 - 02:50:00]
- 2013年致股东信续篇 Marketplace 与第三方卖家 [02:50:00 - 03:00:00]
- 2013年致股东信续篇 Prime 与会员价值 [03:00:00 - 03:10:00]
- 2015年致股东信 发明、失败与长期投资 [03:10:00 - 03:20:00]
- 2015年致股东信续篇 Prime 与会员价值 [03:20:00 - 03:30:00]
- 2015年致股东信续篇 AWS 与技术基础设施 [03:30:00 - 03:40:00]
- 2015年致股东信续篇 团队、高标准与主人翁文化 [03:40:00 - 03:50:00]
- 2017年致股东信 团队、高标准与主人翁文化 [03:50:00 - 04:00:00]
- 2017年致股东信续篇 团队、高标准与主人翁文化 [04:00:00 - 04:10:00]
- 2017年致股东信续篇 Prime 与会员价值 [04:10:00 - 04:20:00]
- 2018年致股东信 Marketplace 与第三方卖家 [04:20:00 - 04:30:00]
- 2018年致股东信续篇 机器学习、Alexa 与智能服务 [04:30:00 - 04:40:00]
- 2019年致股东信 团队、高标准与主人翁文化 [04:40:00 - 04:50:00]
- 2019年致股东信续篇 气候承诺与可持续经营 [04:50:00 - 05:00:00]
- 2019年致股东信续篇 团队、高标准与主人翁文化 [05:00:00 - 05:10:00]
- 2019年致股东信续篇 团队、高标准与主人翁文化 [05:10:00 - 05:20:00]
- 2019年致股东信续篇 气候承诺与可持续经营 [05:20:00 - 05:30:00]
- 2019年致股东信续篇 团队、高标准与主人翁文化 [05:30:00 - 05:31:40]
杰夫·贝佐斯:1997年致股东信:致我们的股东。亚马逊在1997年跨过了很多里程碑,到年底我们服务了超过150万名客户,营收增长了838%,达到14万7800万美元,并且在竞争激烈的情况下依然扩大了我们的市场领先地位。但今天对互联网来说只是第一天,对我们亚马逊来说,如果执行到位也只是第一天,眼下线上商务帮客户省了钱,也省了宝贵的时间,未来通过个性化线上商务会加速发现,好商品这个过程本身,亚马逊用互联网为客户创造真正的价值,并希望借此打造一个持久的品牌,哪怕是在那些已经很成熟的大市场里 我们面前有一个机会窗口,因为更大的玩家正在调集资源来追逐线上机会,而刚接触线上购物的客户也愿意建立新的消费关系,竞争格局一直在快速演变,很多大公司已经带着有竞争力的产品进入线上,并且投入了大量精力和资源来建立认知流量和销售,我们的目标是快速行动,巩固和扩大我们当前的地位,同时开始探索其他领域的线上商务机会,在我们瞄准的大市场里,我们看到了巨大的机会,这个策略不是没有风险,它需要大手笔的投入,也需要在面对那些老牌领先者时,有果断的执行力,一切都关乎长期 我们相信衡量我们成功的一个根本标准,是我们长期创造的股东价值,这个价值将直接取决于,我们能否扩大和巩固当前的市场领先地位,我们的市场领先地位越强,我们的经济模式就越强大,市场领先可以直接转化为更高的收入,更高的盈利能力,更快的资本周转速度,以及相应更强的投资回报,我们的决策一直反映着这个重心,我们首先用那些最能体现市场领先地位的指标,来衡量自己客户和收入增长,客户持续复购的程度,以及我们品牌的强度,为了建立一个持久的品牌,我们已经投入并且会继续大力投入,来扩大和利用我们的客户基础 品牌和基础设施,因为我们看重长期我们做决策和权衡取舍的方式,可能会跟一些公司不太一样,所以我们想跟各位股东分享一下,我们最根本的管理和决策思路,这样你们也可以确认,它跟你们的投资理念是不是一致,我们会继续不懈的专注于客户,我们会继续根据长期市场领先地位的考量,来做投资决策,而不是看短期盈利考量,也不是看华尔街的短期反应,我们会继续用分析的方式来衡量我们的项目和投资的有效性,抛弃那些不能带来可接受回报的,并加大对那些效果最好的项目的投入,我们会继续从成功和失败中学习 当我们看到有足够可能性获得市场领先优势时,我们会做出大胆而非保守的投资决策,这些投资有些会成功,有些不会,但无论哪种情况,我们都会学到宝贵的一课,当被迫在优化GAAP会计准则下的报表表现,和最大化未来现金流的现值之间做选择时,我们会选择现金流,当我们做出大胆选择时,在竞争压力允许的范围内,我们会跟你们分享我们的战略思考过程,这样你们就可以自己评估,我们是否在做理性的长期领先投资,我们会努力精打细算,保持我们精简文化,我们深知持续强化成本意识的重要性 尤其是在一个正在产生净亏损的业务里,我们会在关注增长的同时,平衡对长期盈利能力和资本管理的重视,在现阶段,我们选择优先考虑增长,因为我们相信规模对于实现我们商业模式的潜力至关重要,我们会继续专注于招聘和留住多才多艺的优秀人才,并继续让他们的薪酬向股票期权倾斜,而不是现金,我们知道我们的成功在很大程度上取决于,我们能否吸引和留住一群有自驱力的员工,他们每个人都必须像主人一样思考,因此也必须真正是主人,我们不敢说上面这些就是正确的投资哲学,但这是我们的哲学 如果不把我们一直坚持并将继续坚持的做法说清楚,那就是我们的失职,有了这个基础,我们想接着回顾一下我们的业务重点 1997年的进展,以及对未来的展望,痴迷于客户,从一开始,我们的重点就是给客户提供有吸引力的价值,我们意识到当时的网络是,现在也依然是World Wide Web 所以我们决定给客户提供一些,他们用其他方式根本得不到的东西,于是从书开始服务他们,我们给他们的选择,比任何实体书店能提供的都要多得多,按规模算,我们的书店现在能占满六个足球场,而且是一种实用,方便搜索,方便浏览的形式呈现 全年365天,每天24小时不打烊,我们一直死死盯着怎么改善购物体验 1997年也对我们的商店做了大幅提升,现在我们给客户提供礼品卡,一键下单服务,还有多得多的评论内容,浏览选项和推荐功能,我们大幅降低了价格,进一步提升了客户价值,口碑依然是我们最强大的获客工具,我们很感激客户对我们的信任,复购和口碑加在一起,让亚马逊成了在线图书销售的市场领导者,从很多指标来看,亚马逊在1997年都走了很远,销售额从1996年的1570万美元,增长到14780万美元,增幅838% 累计客户账户数从18万增长到151万,增幅738% 来自回头客的订单占比,从1996年第四季度的超过46% 增长到1997年同期的超过58% 在受众覆盖方面,根据Media Matrix的数据,我们网站从第90名进入了前20名,我们和很多重要的战略伙伴建立了长期关系,包括America Online Yahoo Excite Netscape GeoCities AltaVista At Home 和Prodigy 基础设施 1997年,我们努力扩展了业务基础设施,来支撑这些大幅增长的流量,销售和服务水平 亚马逊的员工人数从158人增长到614人,我们也显著加强了管理团队,配送中心面积从5万平方英尺增长到28万5000平方英尺,其中包括西雅图设施70%的扩建,以及11月在特拉华州启动的第二个配送中心,到年底库存数目超过20万种,这让我们能为客户改善可及性,年底我们的现金和投资余额是一亿两千五百万美元,这要感谢一九九七年五月的首次公开募股和七千五百万美元的贷款,这给了我们很大的战略灵活性,我们的员工过去一年的成功是一群有才华聪明又勤奋的人做出来的,能成为这个团队的一员,我非常自豪 在招聘上坚持高标准,一直是也将继续是亚马逊成功的最重要因素,在这里工作并不轻松,我面试人的时候会跟他们说,你可以工作的久,工作的苦,或者工作的巧,但在亚马逊,你不能三选二,但我们正在努力打造一些重要的东西,一些对我们的客户有意义的东西,一些我们以后可以讲给孙辈听的东西,这种事本来就不该轻松,我们非常幸运,能有这样一群全心投入的员工,是他们的牺牲和热情造就了亚马逊 1998年的目标,在如何通过互联网商务和商品销售,给客户带来新价值这件事上,我们仍处在早期学习阶段,我们的目标依然是继续巩固和扩展 我们的品牌和客户基础,这需要持续投资系统,和基础设施,以支撑我们在增长过程中,提供出色的客户便利,选择和服务,我们计划在产品中,增加音乐品类,而且随着时间推移,我们认为其他产品。 [00:00:00]
杰夫·贝佐斯:我们认为其他产品,也可能是审慎的投资方向,我们也相信,在更好的服务海外客户方面,存在重大机会,比如缩短配送时间,更好的定制客户体验,可以肯定的是,我们面临的挑战,很大一部分不在于找到扩展业务的新方法,而在于如何给投资排优先级,我们现在对在线商务的了解,比亚马逊刚创立时多得多,但我们仍然有太多东西要学,虽然我们很乐观,但我们必须保持警惕,保持紧迫感,要实现我们对亚马逊的长期愿景,我们面临的挑战和障碍有好几个,激进有能力,资金充裕的竞争,巨大的增长挑战和执行风险,产品和地域扩张的风险,以及为了抓住不断扩大的市场机会 需要持续进行大规模投资,不过正如我们长期以来所说的,在线图书销售乃至整个在线商务,应该会是一个非常大的市场,而且很可能会有多家公司从中显著受益,我们对自己做过的事感觉良好,对想做的事更加兴奋 1997年确实是不可思议的一年,我们亚马逊的每一个人,感谢客户的业务和信任,感谢彼此的努力工作,也感谢股东的支持和鼓励 Jeffrey P. Bezos 创始人兼首席执行官 1998年致股东信,至我们的股东客户和员工,过去这三年半非常令人兴奋,我们累计服务了6.2亿美元客户 1998年结束时 营收run rate达到11美元,在美国上线了音乐,视频和礼品商店,在英国和德国开了店,最近还推出了亚马逊 Auctions 我们预计接下来的三年半,会更令人兴奋,我们正在努力打造一个地方,让数千万客户能来找到,并发现他们想在网上买的任何东西,对互联网来说,这真的是得宜,而且如果我们执行好商业计划,对亚马逊来说也依然是第一,考虑到已经发生的一切可能很难想象,但我们认为前方的机遇和风险比身后的更大,我们将不得不做出许多清醒而审慎的选择,其中一些会是大胆且非常规的,但愿有些会成为赢家,当然有些也会成为错误 1998年回顾 买头专注于客户帮助我们,在1998年取得了实质性进展,销售额从1997年的1亿4800万美元,增长到6亿1000万美元,增幅313% 累计客户账户从1997年底的150万,增长到1998年底的620万,增幅超过300% 尽管新客户增长强劲,回头客在亚马逊网站上的订单,占比从1997年第四季度的超过58% 增长到1998年同期的超过64% 我们的首个重大品类扩展亚马逊音乐商店,在第一个完整季度就成为领先的在线音乐零售商,英国和德国商店于10月以Amazon品牌和亚马逊技术上线后 第四季度合计销售额较第三季度增长近四倍,使Amazon.co.uk和Amazon.de成为各自市场领先的在线书商,继音乐之后 11月又增加了视频和礼品,我们仅用六周就成为领先的在线视频零售商,非1998年第四季度销售额的25% 来自Amazon.co.uk Amazon.de 以及亚马逊上的音乐视频和礼品销售,这些都是非常新的业务,非我们显著改善了客户体验,推出了一键购物gift click 全站销售排名和即时推荐等创新 1998年的营收和客户增长,以及1999年持续增长的实现 过去和现在都依赖于我们基础设施的扩张,一些亮点 1998年我们的员工规模从约600人增长到超过2100人,并显著加强了管理团队,我们在英国和德国开设了配送和客户服务中心,并在1999年初宣布在内华达州Friendly租赁一个约32万3000平方英尺的高度机械化配送中心,这个最新增至将使我们的总配送能力翻倍以上,并让我们能进一步缩短客户的收件时间,库存从年初的900万美元上升到年底的3000万美元,使我们能提高客户的产品可得性,并通过直接从制造商采购来改善产品成本 继1998年5月高收益债发行和1999年初可转换债发行之后,我们的现金和投资余额目前远超15亿美元,被考口径,赋予我们雄厚的财务实力和战略灵活性,我们很幸运受益于一种现金流友好,且资本效率高的商业模式,由于我们不需要建实体店,或为店铺被库存,我们的集中配送模式,让我们仅用3000万美元库存和3000万美元进厂房设备,就将业务做到了10亿美元的销售规模 1998年我们产生了3100万美元的运营现金流,超过了2800万美元的净固定资产增加额,我们的客户,我们打算打造世界上最以客户为中心的公司 我们奉为公理的是客户有洞察力且聪明,品牌形象跟随现实,而不是反过来,我们的客户告诉我们,他们选择亚马逊,并向朋友推荐我们,是因为我们提供的选品,易用性,低价和服务,但疲惫者无休,我不断提醒我们的员工要心怀畏惧,每天早上醒来都要感到惶恐,不是怕竞争对手,而是怕我们的客户,我们的客户成就了我们今天的事业,他们是我们与之建立关系的人,也是我们欠下巨大义务的人,而且我们认为他们对我们忠诚,直到别人提供更好服务的那一秒为止,我们必须致力于在每一项举措中,持续改进实验和创新,我们热爱做先驱,这刻在公司的DNA里,这也是件好事 因为我们需要那种先驱精神才能成功,我们为通过持续创新,和对客户体验的不懈关注,所建立的差异化感到自豪,我们相信1998年的举措反映了这一点,我们的音乐视频,英国和德国商店,就像我们的美国书店一样,都是同类最佳,努力工作,享受乐趣,创造历史,没有非凡的人才,不可能在互联网这样动态的环境中,产出成果,努力创造一点点历史本,就不该是容易的事,我们发现事情确实如他们该有的样子,我们现在拥有一支2100人的团队,聪明,勤奋,充满热情,把客户放在第一位,在招聘方式上设定高标准 一直是也将继续是亚马逊成功的最重要因素,在我们的招聘会议上,我们要求大家在做出决定前思考三个问题,你会钦佩这个人吗,回想一下你生命中钦佩的那些人,他们多半是你能从他们身上学到东西,或者能当做榜样的人,就我自己来说,我一直努力只跟自己钦佩的人共事,我也鼓励在座的各位,用同样高的标准来要求,生命太短暂,不值得退而求其次,这个人能拉高他所在团队的平均效率水平吗,我们要对抗商增,标准必须不断提高,我请大家想象一下五年后的公司,到那时我们每个人都应该环顾四周,然后说现在标准真高啊,天真庆幸我是在当年进来的,这个人在哪个维度上可能是个超级明星 很多人都有独特的技能,兴趣和视角,能丰富我们所有人的工作环境,而且往往跟他们的本职工作都没什么关系,我们这里有一个人是全国拼字比赛的冠军,我记得是1978年,我猜这对他的日常工作没什么帮助,但如果你偶尔能在走廊里拦住他,快速挑战一下,那确实会让在这,工作变得更有趣 1999年的目标,展望未来,我们相信整体电商的机会是巨大的 1999年将是重要的一年,虽然亚马逊已经建立了强大的领先地位,但竞争肯定会进一步加剧,我们计划积极投资,为一家营收达数十亿美元,服务数千万客户,并以卓越运营和高效率运作的公司打下基础 尽管这种前瞻性的投资成本高昂,并且伴随着许多固有风险,但我们相信这将为客户提供最好的端到端体验,并且实际上为投资者提供风险最低的长期价值创造路径。 [00:10:00]
杰夫·贝佐斯:并且实际上为投资者提供风险最低的长期价值创造路径,我们1999年计划的要素,各位可能不会感到意外,配送能力,我们打算建设一个规模庞大的配送基础设施,以确保能够支持客户所需的所有销售,并让他们能快速获取海量的产品库存,系统能力,我们将扩展系统能力,以支持类似的增长水平,系统团队肩负着一项重大任务,扩展以满足近期增长,为数十亿美元规模和数千万客户重构系统,为新举措和新创新开发功能和系统,并提升运营卓越性和效率,而这一切都要在一个价值10亿美元,拥有800万客户的商店 保持7天24小时不间断运行的前提下完成,品牌承诺相对于主要的线下零售商,亚马逊仍然是一家小而年轻的公司,我们必须确保在这个关键时期,建立起广泛牢固的客户关系,扩展产品与服务,在1999年,我们将继续拓展现有产品和服务的范围,并增加新的举措,亚马逊拍卖是我们最新增加的服务,如果你们中有人还没试过这样新服务,我建议你跑着而不是走着,去www.yamaha 点击拍卖标签,作为亚马逊的客户,你已经预先注册,既可以竞拍也可以出售,作为卖家,你可以接触到亚马逊的800万,经验丰富的在线购物者,人才储备与流程 随着新产品,新服务,新地域,收购,以及商业模式的增加,我们的业务已经变得极其复杂,我们打算在团队流程,沟通和人才培养实践上进行投入,以这种方式进行规模化扩张,是我们计划中最具挑战性,也最困难的部分之一,亚马逊在过去一年里取得了许多进步,但仍有大量的东西需要学习,大量的事情需要去做,我们保持乐观,但我们也知道必须保持警惕,并维持一种紧迫感,我们面临着许多挑战和障碍,其中包括激进,有能力且资金充裕的竞争,与我们自身扩张相关的增长挑战和执行风险 以及为抓住不断扩大的市场机会而需要进行的大量持续投资,我在这封信里能说的最重要的话,其实在去年的信里已经说过了,那封信详细阐述了我们的长期投资方针,因为我们有很多新股东,今年我们印了超过20万份这样的信,去年我们印了大约13000份,所以我们将去年的信附在了今年这封信的后面,我邀请你读一读标题为一切关乎长期的那一节,你或许想读两遍以确定我们是你想要投资的那种公司,正如那里所说,我们不声称这是唯一正确的哲学,我们只声称这是我们的哲学,再次向我们的客户股东以及所有在这里每天充满激情的工作 致力于打造一家重要且持久的公司的同仁们,致以最美好的祝愿和诚挚的感谢,杰弗里·贝索斯创始人兼首席执行官 1999年致股东信,致我们的股东,我们这四年半的旅程,已经取得了一些很棒的成果,我们现在服务了超过1700万客户,遍布150多个国家,并且打造了全球领先的电商品牌和平台,未来几年,随着全球数以百万计的新消费者,首次接入互联网,我们预计会从全球电商的持续普及中受益,随着线上购物体验不断改善,消费者的信任和信心会增强,从而推动进一步的普及 而且如果我们亚马逊把工作做好,我们就能占据独特优势,最好的服务这些新客户,并从中受益 1999年回顾 1999年,我们对客户的不懈专注取得了成效,销售额从1998年的6.1亿美元,增长到16.4亿美元,增幅169% 我们新增了1070万客户,累计客户账户,从620万增加到1690万,回头课订单占比从1998年第四季度的超过64% 增长到1999年同期的超过73% 全球客户现在选择在亚马逊购买种类繁多的商品 仅仅两年前亚马逊的美国图书业务还占我们销售额的100% 今天尽管美国图书业务增长强劲,其他业务已占我们销售额的一半以上 1999年的主要举措包括拍卖 Zshops 玩具,消费电子,家居装修,软件,视频游戏,支付,以及我们的无限计划Amazon Anywhere 我们不仅在我们更成熟的领域,如图书持续被认可为最佳,在我们的新商店也是如此,单看一个领域 Amazon Toys已获得多个奖项,包括在MSNBC调查中,被评为最佳在线玩具店,被Forester Research评为排名第一的在线玩具店,并在消费者报告的玩具品类中获得最高电子评分,每次都击败了许多经营更久的玩家 美国以外的销售额占我们业务的22% 总计3.58亿美元,在英国和德国,我们增加了音乐拍卖和ZipShops 事实上Amazon.co.uk Amazon.de和亚马逊现在是欧洲排名第一,第二和第三的最受欢迎在线零售域名,我们在不到12个月的时间里将全球配送能力从大约30万平方英尺提升到超过500万平方英尺,部分得益于这些基础设施,我们得以在短短三个月内实现90%的收入增长,同时超过99%的假日订单都按时送达,据我们所知,没有其他公司曾在超过10亿美元的销售基础上,三个月内增长90% 我为亚马逊的每一个人感到无比自豪,他们不懈努力 交付了已成为行业标杆的亚马逊级客户体验,同时应对了如此惊人的增长速度,如果各位股东想感谢这支了不起的全球Amazonian团队,请随时发邮件到JFAT亚马逊,在我出色的办公室同事帮助下,我会把它们汇编起来发给公司,我知道大家会感激的,附带的好处是,我也能看看有没有人读这些信 1999年,我们继续受益于一种,天生就资本效率很高的商业模式,我们不需要建实体店,也不需要为那些店备货,我们的集中配送模式,让我们建立了一个年化销售额,超过20亿美元的业务,但只需要2.2亿美元的库存和3.18亿美元的固定资产,在过去五年里 我们累计只用了6200万美元的运营现金,你拥有的是什么,最近在斯坦福大学校园的一次活动上,一位年轻女士走到麦克风前,问了我一个很好的问题,我有一百股亚马逊的股票,我拥有的是什么,我很惊讶一些没听过这个问题,至少没被这么简洁的问过,你拥有的是什么,你拥有的是领先电商平台的一部分,亚马逊这个平台有品牌,客户技术配送能力,深厚的电商专业知识,以及一支对创新充满热情,对服务客户充满热情的出色团队组成,我们以1700万客户,全球公认的客户至上深域,最好的电商软件系统,以及专门构建的配送和客户服务基础设施,开启2000年 我们相信我们已经到达了一个临界点,这个平台让我们能比任何其他公司,更快的推出新的电商业务,客户体验质量更高,增量成本更低,成功几率更高,并且能更快的走向规模化和盈利,我们的愿景是利用这个平台,打造地球上最以客户为中心的公司,一个客户能来寻找和发现,他们想在网上购买的任何东西的地方,我们不会独自完成,而是与成千上万各种规模的伙伴一起,我们会倾听客户,为他们去创新,为每个人个性化商店,同时努力持续赢得他们的信任,很明显,这个平台提供了一个异常巨大的规模机会,如果我们能充分利用它,这应该对客户和股东都非常有价值 尽管存在许多风险和复杂性,我们仍坚定的致力于此 2000年的目标 2000年亚马逊有六大目标,一是增长客户数量,同时加深我们与每位客户的关系,二是继续快速扩展我们提供的产品和服务,三是在公司所有领域推动卓越运营。 [00:20:00]
杰夫·贝佐斯:三是在公司所有领域推动卓越运营,四是国际扩张,五是拓展我们的合作伙伴计划,最后也是很重要的一点,推动我们所在的每一项业务走向盈利,我会逐一展开讲讲,增长并巩固客户关系,我们会继续大力投资去触达新客户,虽然过去五年发生了这么多事,有时很难想象,但对电商来说,今天依然是第一天,现在人事品类形成的早期,很多客户是第一次建立关系,我们必须努力去增加在我们这里购物的客户数量,他们购买的产品数量,购物的频率,以及他们购物时的满意度,产品和服务扩展,我们正在努力打造一个地方 让客户能随时随地找到并发现他们想买的任何东西,我们每推出一项新产品或新服务,都能让我们与更广泛的客户群更相关,也能提高他们访问我们商店的频率,所以随着我们扩展产品线,我们会为整个业务创造一个良性循环,客户越常来我们的商店,我们花在让他们再次回来上的时间,精力和营销投入就越少,眼不见心不想嘛,此外随着我们扩张,每家新店都有一支专门的团队,致力于让他成为所在品类的佼佼者,因此每一家新店也是一个向客户展示,我们如何专注于他们的新机会,最后每一项新产品或新服务 都会进一步撬动我们在物流客服技术和品牌上的投资,并能为我们的利润带来更高的杠杆效应,卓越运营,对我们来说卓越运营意味着两件事,在客户体验上实现持续改进,并在我们所有业务中提升生产力,利润率,效率和资产周转速度,很多时候,推动其中一件事的最好方法,就是去做好另一件,比如更高效的物流,能带来更快的配送时间,这反过来又能降低,每笔订单的客户咨询量和客户成本,而这些又能改善客户体验,建立品牌,进而降低客户获取和留存的成本 2000年我们整个公司都高度专注于,在业务的每个领域推动卓越运营 在客户体验和运营上都做到世界级,将让我们增长的更快,并提供更高的服务水平,国际扩张,我们认为美国以外的消费者,在零售方面得到的服务,比美国国内的还要不足,而凭借我们已经搭建好的平台,亚马逊完全有条件成为一家领先的全球零售商,我们在全球已经拥有显著的品牌知名度,销售额和客户基础,因为我们向超过150个国家发货已经快5年了,我很高兴的向大家报告,我们在英国和德国的商店开局强劲,他们已经进入了各自国家的前十大网站,并且是排名第一的电商网站,我们在全世界的客户和股东,可以期待在未来一年里,从这个基础上进行更广的地域扩张 拓展我们的合作伙伴计划,通过我们的平台,我们能为合作伙伴带来巨大的价值,比如drugstore.com 事实上我们迄今为止的经验表明,亚马逊很可能是我们的合作伙伴,用来建立他们业务最高效最有效的途径,在很多领域,合作是我们以客户为中心,低成本高效率的快速扩展商店的最佳方式,有一点值得强调,合作伙伴所交付的客户体验质量,是我们筛选过程中唯一最重要的标准,我们绝不会与任何不和我们一样,对服务客户充满热情的公司建立合作关系,我们热爱这类合作,因为他们让客户满意,让合作伙伴满意,而且在财务上也很有吸引力,让我们的股东,也就是你们和我们都满意 推动我们所在的每项业务走向盈利,我之前概述的每一个目标,都服务于我们的长期目标,打造最好最赚钱,资本回报率最高,能长期经营的特许事业,所以从某种意义上说,推动盈利是支撑所有这些目标的基础,在未来一年,随着我们在与供应商的合作,我们自身的生产力和效率,固定资本和运营资本的管理,以及产品组合和定价的专业能力上持续改进,我们预计将实现显著的利润率提升和成本杠杆效应,我们今年推出的每一项后续产品和服务,都应该建立在我们现有平台之上,这样我们的投资曲线就能更平缓,而每项业务实现盈利的时间 总的来说应该会继续缩短,一切关乎长期,在我们1997年之股东的信也是第一封里,我们详细阐述了长期投资策略,因为不断有新股东加入,我们把那封信附在了今年这封信的后面,我要请读一读标题为一切关乎长期那部分,因为就我所知,这是最能帮助我们确保自己,是你愿意投资的那类公司的方式,就像我们在那里写的,我们不声称这是唯一正确的理念,我们只说这是我们的理念,最后请思考这个最重要的观点,当下的线上购物体验,是它最差的时候,今天它已经足够好,能吸引1700万顾客,但它还会变得好得多,贷款提升会带来更快的页面浏览速度 和更丰富的内容,进一步改进,会实现随时在线访问,我预计这会极大推动,在家线上购物,而不是在办公室,我们还会看到,非PC设备和无线接入的显著增长,而且能参与这个,数万亿美元的全球市场,而我们在其中还非常,非常渺小,这太棒了,我们受到双重眷顾,在一个市场体量,不受限制的领域拥有机会,同时我们所依赖的底层基础技术,每天都在进步,这并不寻常,一如既往,亚马逊的我们,感谢顾客的惠顾与信任,感谢彼此的努力工作,感谢股东的支持与鼓励,非常非常感谢 Jeffrey P. Bezos创始人,兼首席执行官 2000年致股东信仰,至我们的股东,说实话,过去这一年,对资本市场的很多人来说都很残酷,对亚马逊的股东来说当然也不例外,在我写这封信的时候,我们的股价比我去年给你们写信时,跌了超过80% 但不管用什么标准来衡量,亚马逊这家公司现在的状况,比过去任何时候都要强,我们在2000年服务了2000万客户,比1999年的1400万有所增长,销售额从1999年的16.4亿美元增长到了2000年的27.6亿美元,第四季度的Proforma运营亏损占销售额的比例,从1999年第四季度的26%降到了2000年第四季度的6% 美国市场的Proforma运营亏损占销售额的比例,从1999年第四季度的24% 降到了2000年第四季度的2% 2000年平均每个客户的消费额是134美元,增长了19% 毛利从1999年的2.91亿美元,增长到了2000年的6.56亿美元,增幅125% 在2000年第四季度,将近36%的美国客户,从我们的非BMV商店买了东西,比如电子产品工具和厨房用品,国际销售额从1999年的1.68亿美元,增长到了2000年的3.81亿美元,我们在2000年第四季度,帮助合作伙伴toysruss.com 卖出了超过1.25亿美元的玩具和电子游戏,到2000年底,我们手里的现金和有价证券是11亿美元,比1999年7.06亿美元要多,这要感谢我们在2000年初的欧元可转换债券融资,而且最重要的是,我们埋头专注于客户的努力,在美国顾客满意度指数上拿到了84分,我们听说这是所有行业里服务型公司,有史以来的最高分,那么如果公司现在的状况比一年前更好,为什么股价反而比一年前低了这么多呢,就像著名投资人本杰明格雷厄姆说的,短期来看,股市是一台投票机,长期来看,它是一台称重机 很明显在1999年那个繁荣的年份里,投票的行为很多,称重的行为却少得多,我们是一家想被称重的公司,而且随着时间的推移,我们会被称重的,长期来看,所有公司都会被称重,与此同时,我们正埋头苦干。 [00:30:00]
杰夫·贝佐斯:我们正埋头苦干,努力把公司打造的越来越重,你们很多人都听我聊过,我们公司已经做出,并且会继续做出的那些大胆赌注,这些大胆赌注包罗万象,从我们对数字和无线技术的投资,到我们决定投资一些更小的电商公司,比如Living.com和Path.com 这两家都在2000年停止了运营,我们是这两家公司的重要股东,也在这两笔投资上亏了不少钱,我们当时做这些投资,是因为我们知道自己在短期内,不会亲自进入这些特定领域,而且我们当时对互联网跑马圈地的比喻深信不疑,确实从1994年开始的好几年里,这个比喻都是一个极其有用的决策辅助工具,但我们现在认为 它的作用在过去几年里已经基本消失了,回过头看,我们严重低估了进入这些领域的时间窗口有多长,也低估了单一品类电商公司要达到成功所需规模的难度。线上零售相对于传统零售来说是一个规模生意,特点是固定成本高,可变成本相对较低。这就让做一家中等规模的电商公司变得很难。如果融资跑道足够长 PathCardPump和LivingCardPump 或许能获得足够多的客户,达到所需的规模,但当资本市场对互联网公司,关上了融资的大门时,这些公司除了关门,别无选择,虽然这很痛苦,但另一种选择,也就是投入我们自己的更多资金,去维持他们的运营 会是一个更大的错误,未来房地产不遵循默尔定律,让我们把目光投向未来,为什么你们应该对电子商务和亚马逊的未来感到乐观呢,未来几年行业的增长和新客户的获取,将由在线购物客户体验的持续改善来驱动,而这些客户体验的改善,又是由可用带宽磁盘空间和处理能力的大幅提升,所带来的创新驱动的,所有这些资源都在迅速变得便宜,处理能力的性价比大约每18个月翻一翻,也就是摩尔定律磁盘空间的性价比,大约每12个月翻一翻,带宽的性价比大约每9个月翻一翻,按照最后这个翻倍速度 5年后亚马逊能为每个客户使用的带宽,将是现在的60倍 同时还能保持我们为每个客户支出的带宽成本,不变,同样地,磁盘空间和处理能力性价比的提升,将允许我们,比如说对我们的网站进行更多更好的实时个性化,在实体世界里,零售商会继续用技术来降低成本,但不会用它来改变客户体验,我们也会用技术来降低成本,但更大的作用是用技术来驱动客户获取和收入增长,我们仍然相信最终大约会有15%的零售商业转移到线上,虽然没有什么事是板上钉钉的,我们也还有很多东西需要证明,但今天的亚马逊是一项独特的资产,我们拥有品牌客户关系技术物流基础设施财务实力人才 以及在这个新兴行业里扩展领导地位,打造一家重要且持久的公司的决心,而我们会通过把客户放在第一位来实现这一切 2001年对我们来说会是发展上很重要的一年,跟2000年一样,今年也是聚焦和执行的一年,第一步,我们定下了在第四季度实现performer营业利润的目标,当然我们要做的事情非常多,也没法打保票,但我们有达成目标的计划,这是我们第一要务,公司里每一个人都致力于为此努力,我期待在接下来这一年,向大家汇报我们的进展,跟往年一样,我把1997年的信,也就是我们第一封致股东的信,附在了后面,每过一年,这封信读起来都更有意思 部分原因在于,很多东西几乎没怎么变,我特别请大家留意其中一节,标题是一切关乎长期,我们亚马逊全体同仁,依然感谢客户的惠顾与信任,感谢彼此的努力付出,也感谢股东们的支持和鼓励,非常非常感谢大家 Jeffrey P. Bezos创始人兼首席执行官 2001年致股东信,至我们的股东,去年7月亚马逊到达了一个重要的中转站,在四年一心一意专注增长,随后将近两年几乎完全投入降低成本之后,我们终于走到了一个可以兼顾增长与成本优化的节点,能够把资源和人力同时投向这两个方向 我们7月那次大幅降价,把定价超过20美元的图书打7折,就标志着这一转变,这种平衡在第四季度开始见效,我们不仅大幅超越了自身的利润底线目标,同时也重新加速了业务增长 1月份我们又降了一次价,推出了全年有效的订单,满99美元及免运费的新配送方案,专注成本优化,让我们有能力承担降价,而降价又驱动增长。增长把固定成本分摊到更多销量上,降低单位成本,这又为进一步降价创造了空间。顾客喜欢这一点,对股东也有利,请期待我们不断重复这个循环,正如我提到的,我们第四季度超越了目标 实现了5900万美元的Proforma营业利润,和3500万美元的Proforma净利润,全球数千名亚马逊员工,为实现这一目标付出了艰苦努力,他们对此成就感到自豪,也理应如此,以下是这个值得铭记的年份,离更多亮点,销售额增长13% 从2000年27.6亿美元,增至2001年31.2亿美元,并且在第四季度重新加速增长,实现了我们首个10亿美元季度 2001年我们服务了2500万个客户账户,相比之下 2000年是2000万 1999年是1400万,国际销售额在2001年增长了74% 超过四分之一的销售额,来自美国以外,我们最大的国际市场,英国和德国 在第四季度首次合计,实现了Proforma营业利润,日本站开业仅一年,第四季度年化营收,就达到了一亿美元,数十万小企业和个人,通过我们流量极高的商品详情页,直接向我们的客户销售新品和二手商品,从而赚到了钱,这些Marketplace订单,在第四季度增长到美国订单的15% 远超我们2000年11月推出Marketplace时的预期,库存周转率从2000年的12次,提高到2001年的16次,最重要的是,我们始终不懈的专注于客户,这体现在我们连续第二年,在密歇根大学进行的,广受关注的美国顾客满意度指数中,获得了84分的最高分 我们被告知,这是有史以来记录的最高分,不只是在所有零售商中,而是在所有服务类公司中,痴迷于客户,我们的承诺仍在继续,在7月之前,亚马逊主要建立在,客户体验的两大支柱上,选品和便利 7月正如我已经讨论过的,我们增加了第三根客户体验支柱,不懈的降低价格,你们应该知道,我们对前两根支柱的承诺一如既往的坚定,我们现在电子商店里有超过四万五千种商品,大约是你在一家大型电子卖场能找到的选品的七倍,我们的厨具选品增加了两倍,你能找到所有最好的品牌,我们还推出了电脑和杂志订阅商店 并通过与Target和Circuit City等战略合作伙伴合作来扩充选品,我们通过一些功能提升了便利性,比如Instant Order Update 它会在你即将重复购买同一件商品时提醒你,人们很忙会忘记自己已经买过了,我们大幅改进了客户自助服务能力,客户现在可以轻松的查找取消或修改自己的订单,要查找订单,只需确保你已登录并被网站识别,然后对你订单中的任意商品进行一次常规搜索,当你进入该商品的详情页时,页面顶部就会出现一个指向你订单的链接,我们打造了一个叫look inside book的新功能 客户不仅可以查看图书封面的大尺寸高清图片,还可以看到封底索引目录,以及相当一部分内页样张,他们可以在做出购买决定之前,先look inside the book。 [00:40:00]
杰夫·贝佐斯:先look inside the book 这个功能覆盖了我们数百万种图书中的,超过20万种作为对比,一家典型的图书大卖场,大约有10万种书,作为最后一个例子,我只想指出,我们为改善客户便利性和体验,所做的最重要的事情之一,恰好也是可变成本生产力的一个巨大驱动力,从根源上消除差错和失误,自亚马逊成立以来,每过一年我们在消除差错方面都做得越来越好,而过去这一年是我们做得最好的一年,消除差错的根源既为我们省钱,也为客户省时间,我们消费者特许经营权是我们最宝贵的资产,我们将用创新和勤奋来滋养它,一个投资框架,在每一封年度制股东信中 包括这封我们都会附上 1997年那封原始制股东信的副本,以帮助投资者判断,亚马逊是否是他们合适的投资标的,也帮助我们审视自己,是否始终忠于最初的目标和价值观,我认为我们做到了,在那封1997年的信中,我们写到,当被迫在优化该会计准则下的报表,表现与最大化未来现金流的现值之间,做出选择时,我们会选择现金流,为什么关注现金流,因为一股股票代表的是一家公司未来现金流的一部分,因此从长期来看,现金流似乎比任何其他单一变量都更能解释一家公司的股价,如果你能确切知道两件事,一家公司未来的现金流 以及他未来的流通股数量,那你对这家公司今天每股的供应价值,就能有一个相当清晰的判断,你还需要知道合适的折现率,但如果你已经确切知道未来的现金流,那该用什么样的折现率,也就相对容易判断了,这并不简单,但你可以通过研究公司过去的业绩,以及分析它商业模式中的杠杆点,和可扩展性等因素,来对未来现金流做出有依据的预测,而要估算未来的流通股数量,你就需要预测像给员工的期权授予,或者其他潜在的资本交易,最终你对每股现金流的判断会是一个强有力的指标,告诉你自己愿意为任何一家公司的所有权股份支付什么价格 我们预计即使在销量大幅增长的情况下,我们的固定成本也基本保持不变,因此我们相信亚马逊在未来几年,有望产生可观的持续的自由现金流,我们2002年的目标正体现了这一点,正如我们1月份公布第四季度业绩时所说,我们计划今年产生正的运营现金流,进而实现自由现金流,两者之间的差额是最高7500万美元的计划资本支出,我们过去12个月的形式净利润,其趋势应该会大致,但并非完全与过去12个月的现金流趋势一致,限制股份数量意味着更高的每股现金流,以及为股东带来更多长期价值,我们当前的目标是 在未来五年内将员工股票期权,授予减去注销后的金额带来的净息势率,控制在平均每年3% 尽管在任何一个特定年份,这个数字可能会高一些或低一些,对长期股东价值的不懈承诺,正如我之前多次谈到的,我们坚信股东的长期利益与客户的利益是紧密相连的,如果我们做好本职工作,今天的客户明天会买的更多,我们也会在这个过程中赢得更多客户,这一切最终都会带来更多的现金流,为我们的股东创造更多长期价值,为此我们致力于以汇集客户的方式,扩展我们在电子商务领域的领先地位,这本身也就会汇集投资者 你无法只做其一不做其二,在2002年开启之际,我很高兴的告诉大家,我对这项事业的热情一如既往,我们面前的创新比身后的更多,我们即将展现出商业模式的运营杠杆,而且我能与全球各地这群了不起的Amazon人一起工作,我感到幸运且心怀感激,我们感谢你们,我们的股东,感谢你们的支持鼓励,感谢你们与我们一起踏上这段旅程,如果你是客户,我们再次感谢你 Jeffrey P. Bezos 创始人兼首席执行官 2002年致股东信,至我们的股东,从很多方面来说,亚马逊并不是一家普通的商店 我们的选品深度不受货架空间的限制,我们的库存在一年内周转19次,我们为每一位顾客个性化定制商店,我们用技术来置换不动产,而技术每年都在变得更便宜更强大,我们会展示顾客对我们产品的批评性评论,你可以在几秒钟内一键完成购买,我们把二手商品放在新品旁边,让你可以自行选择,我们把自己最好的位置,也就是产品详情页分享给第三方,如果他们能提供更好的价值,我们就让他们来,我们最令人兴奋的特点之一,其实并没有被很好的理解,人们看到我们决心同时提供世界一流的顾客体验,和尽可能低的价格,但对一些人来说 这个双重目标即便不是完全一想天开,也似乎是自相矛盾的,传统商店面临着一个酒精考验的权衡,一边是高接触的顾客体验,另一边是尽可能低的价格,亚马逊怎么能试图两者兼得呢,答案是我们把大部分顾客体验,比如无与伦比的选品,详尽的产品信息,个性化推荐,以及其他新的软件功能,都转化成了大体固定的Fate 用当顾客体验的成本基本固定时,就更像出版模式而非零售模式,我们的成本占销售额的百分比,会随着业务增长而迅速缩小,此外那些仍然可变的顾客体验成本,比如配送成本中的可变部分,在我们减少缺陷的过程中,也会得到改善,消除缺陷既能降低成本,也能带来更好的顾客体验 我们相信我们既能降低价格,又能同时提升顾客体验的能力,是一件大事,而过去这一年也提供了证据,表明这个策略正在奏效,首先我们确实在持续提升顾客体验,今年的假日季就是一个例子,在向顾客交付创纪录数量的商品的同时,我们也交付了有史以来最好的体验,周期时间,也就是我们的旅游中心处理一个订单,所花费的时间,相比去年缩短了17% 而我们最敏感的顾客满意度指标,也就是每个订单的客户联系次数改善了13% 在现有的产品品类内部,我们一直在努力增加选品 仅在美国电子产品的选品就比前一年增加了超过40% 我们现在提供的选品是典型的大型电子产品卖场的10倍,即使是在我们已经耕耘了8年的美国图书领域,我们也增加了15%的选品,主要集中在更难找到和绝版的图书上,当然我们还增加了新的品类,我们的服装和配饰商店拥有超过500个顶级服装品牌,在开业的头60天里,顾客购买了15万3000件衬衫 16000条裤子和31000条内裤,在今年的美国顾客满意度指数中,也就是最权威的顾客满意度研究里,亚马逊得了88分,这是有史以来记录的最高分,不只是在线上,不只是在零售业,而是在所有服务行业中记录的最高分,用A-Size来说 亚马逊持续展现出异常高的顾客满意度水平,凭借88分上升了5%的成绩,他正在创造服务行业闻所未闻的满意度水平 Amazon的顾客满意度还能再攀升吗,最新的XI数据表明这确实是可能的 Amazon提供的服务和价值主张都在以陡峭的速度提升,第二,在专注于顾客体验的同时,我们也在大幅降低价格,我们一直在广泛的跨品类地这样做,从图书到电子产品,并且我们通过全年365天,订单满25美元即可享受的,免费超级省钱送货服务取消了运费,我们在每一个开展业务的国家 都在采取类似的行动,我们的定价目标,不是对少数产品进行限时折扣,而是每天都提供低价,并将其广泛的应用于我们的整个产品线,为了说明这一点,我们最近与一家知名的大型连锁图书超市,做了价格对比,我们没有特意挑选一组想要对比的书。 [00:50:00]
杰夫·贝佐斯:我们没有特意挑选一组想要对比的书,相反,我们用了他们公布的2002年百大畅销书单,这份书单很好地代表了人们最常购买的图书类型,包含45本精装书和55本瓶装书,涵盖了许多不同的类别,包括文学爱情,悬疑和惊悚,非虚构,儿童,自助等等,我们走访了他们在西雅图和纽约市的超级书店,为这一百本书逐一标价,我们花了六个小时,在他们四家不同的超级书店里,才找齐了他们书单上的全部一百本书,当我们把所有的花费加起来时,我们发现在他们的店里,这一百本长销书的价格是1561美元 在亚马逊同样的书价格是1195美元,总共节省了366美元,也就是23% 在这100本书中,有72本我们的价格更便宜,有25本我们的价格相同,有3本他们的价格更好,我们随后也下调了这三本书的价格,在这些实体超级书店里,他们100本书中只有15本打了折,其余85本都是按全价销售的,而在亚马逊100本书中有76本打了折 24本按原价销售,当然你可能会找到在实体店购物的理由,比如如果你需要立刻拿到某样东西,但如果你这么做,你就要支付溢价,如果你想省钱省时间,在亚马逊购物会是更好的选择,第三 我们坚持提供低价和优质客户体验的决心,正在带来财务回报,今年净销售额增长了26% 达到创纪录的39亿美元,销量增长更快,达到34% 自由现金流,我们最重要的财务指标,达到了1.35亿美元,比上一年改善了3.05亿美元,简而言之,对客户好的,对股东也好,今年我再次附上,我们1997年那份最初的制股东信,并鼓励现有和未来的股东都看一看,考虑到我们经历了如此大的增长,互联网也发生了如此大的演变,值得注意的是,我们做生意的根本原则始终未变,一如既往,我们亚马逊感谢客户的惠顾与信任,感谢彼此的努力工作 也感谢股东的支持与鼓励 Jeffrey P. Bezos 创始人兼首席执行官 2002年自由现金流1.35亿美元,是1.74亿美元的经营活动,净现金减去3900万美元的固定资产采购 2001年自由现金流为负1.7亿美元,是1.2亿美元的经营活动,净现金流出减去5000万美元的固定资产采购 2003年致股东信,至我们的股东,长期思维既是真正所有者的要求,也是真正所有者的结果,所有者和租户是不同的,我知道一对夫妇把房子租了出去,搬进来的那家人,直接把圣诞树钉在了硬木地板上,而不是用树架,我想这算是省事,而且说实话 这些租户确实特别糟糕,但没有哪个房主会这么短视,同样,很多投资者实际上是短期租户,他们换手太快,其实只是在临时租用那些股票,我们在1997年之股东的信中,强调了长期视角,那是我们上市后的第一封信,因为这种思路确实能推动我们,做出许多具体的非抽象的决定,我想在客户体验的预警下,聊聊其中几个非抽象的决定,在亚马逊,我们对客户体验这个词的定义很广,它涵盖了我们业务中,每一个面向客户的方面,从产品价格到选品,从网站的用户界面,到我们包装和配送商品的方式,我们创造的客户体验,是迄今为止我们业务最重要的驱动力,在设计客户体验时 我们心里装着的是长期所有者,我们尽量把所有客户体验相关的决定,无论大小都放在这个框架里来做,举个例子 1995年亚马逊上线后不久,我们就让客户能够评论商品,虽然这在现在是亚马逊的常规做法,但当时我们收到了一些供应商的投诉,他们基本上是在质疑我们懂不懂自己的生意,你们是靠卖东西赚钱的,为什么允许网站上出现负面评论,拿我自己当个焦点小组样本来说,我知道自己有时在亚马逊上下单前,正是因为看到负面或不温不火的客户评论而改变了主意,虽然负面评论短期内让我们损失了一些销售额,但帮助客户做出更好的购买决定,最终对公司是有回报的 另一个例子是我们的及时订单更新功能,它会提醒你已经买过某件商品,客户生活忙碌,不一定总能记得自己是不是已经买过某样东西,比如一年前买的一张DVD或CD 我们推出即时订单更新时,能够以统计显著性衡量出这个功能,略微降低了销售,对客户好吗,绝对好,对股东好吗,长期来看,是的,我们正在着力推进的客户体验改善中,成本最高的,包括我们的每日免疫费服务和持续的产品降价,消除缺陷,提高效率,并把由此节省的成本,以更低价格的形式返还给客户,这是一个长期决定,销量增长需要时间才能显现 而降价几乎总会损害当期业绩,但从长期来看,坚持不懈的推动价格到成本结构循环,会让我们拥有一个更强大,更有价值的业务,由于我们的许多成本,比如软件工程相对固定,而许多可变成本在更大规模下,也能得到更好的管理,因此通过我们的成本结构,推动更多销量,会降低这些成本占销售额的百分比,举个小例子,为4000万客户开发像即时订单更新这样的功能,其成本远不是为100万客户做同样事情的40倍,我们的定价策略并不是图最大化利润率百分比,而是力求为客户创造最大价值,从而在长期内创造大得多的利润底线 例如我们给珠宝销售定的毛利率目标要远低于行业常规水平,因为我们相信随着时间的推移,客户总会搞明白这些事,这种做法会为股东创造更多价值,我们有一支强大勤奋且富有创新精神的团队在建设亚马逊,他们专注于客户专注于长期,在这个时间尺度上,股东和客户的利益是一致的,和往常一样,我附上了我们1997年的信,相信它仍然值得一读,希望我们都不做祖虎,杰弗里·贝索斯创始人兼首席执行官,又即今年备受关注的美国客户满意度指数,再次给了亚马逊88分,这是所有服务行业中,无论线上还是线下 有史以来记录到的最高客户满意度分数 ACSI的一位代表曾说,如果他们再高一点,就要流鼻血了,我们正在为此努力 2004年,致股东性,致我们的股东,我们最看重的财务指标,也是我们长期最想推动的,是美股自由现金流,为什么不像很多人那样,首先关注利润,美股收益或者利润增长呢,答案很简单,利润并不直接转化为现金流,而股票的价值只等于其未来现金流的限制,不是未来利润的限制,未来利润是未来每股现金流的一个组成部分,但不是唯一重要的部分,营运资金和资本支出同样重要,未来的股权稀释也是 虽然有些人可能觉得反直觉,但在某些情况下,一家公司通过增加利润,实际上反而会损害股东价值,当增长所需的资本投入超过了这些投入所能带来的现金流的限制时,这种情况就会发生,用一个假设的非常简化的例子来说明,想象一位企业家发明了一种机器,可以快速把人从一个地方运到另一个地方,这台机器很贵,要1.6亿美元,年运力是10万人次,使用寿命4年,每趟行程售价1000美元,其中的成本是450美元的能源和材料费,以及50美元的人工和其他费用,再想象一下生意非常火爆,第一年就有10万次行程 完美的百分之百的利用了一台机器的全部运力,这样一来扣除包括折旧在内的运营费用后,利润是1000万美元,净利润率10% 这家公司主要关注的是利润,所以基于最初的结果,企业家决定投入更多资金来推动销售和利润增长。 [01:00:00]
杰夫·贝佐斯:企业家决定投入更多资金来推动销售和利润增长,在第二到第四年增加了更多机器,以下是这家公司头四年的利润表,利润第一年第二年第三年第四年,单位千美元销售额十万美元二十万美元四十万美元八十万美元销售数量一百两百四百八百增长率不适用,百分之一百百分之一百百分之一百百分之一百,毛利润55,011,022,044万毛利率 55% 55% 55% 55% 这就4万8万16万32万人工,其他成本510024万,利润10美元00020美元00040美元00080美元000 利润率10%10%10%10%10%增长率,不适用100%100%100%100% 这看起来很厉害,利润复合增长率100% 累计利润1.5亿美元,只看上面这张利润表的投资者会很高兴,但是看看现金流情况就完全不同了,在这四年里,这家运输公司产生的累计自由现金流是负的5.3亿美元,现金流,第一年第二年第三年第四年,单位千美元利润 1万美元2万美元4万美元8万美元折旧 4万8万16万32万,营运资金5555 五,运营现金流5万10万20万40万资本支出16万16万32万64万,自由现金流-11万-6万-12万-24万。当然还有其他商业模式,利润能更贴近现金流,但正如我们运输公司的例子所展示的,单看利润表是无法确切判断股东价值是在被创造还是在被摧毁的。还要注意 如果只关注EBITDA 也就是息税折旧摊销前利润,也会对这家公司的健康状况得出同样错误的结论,每年的EBITDA一次会是5000万 1亿2亿和4亿美元,连续三年百分之百增长,但如果不考虑为了产生这些现金流,而必须的12.8亿美元资本支出,我们就只看到了故事的一部分 EBITDA并不是现金流,如果我们调整增长率和相应的机器资本支出,现金流会变差还是变好,第二三四年第一到四年第一到四年的机器数量,累计利润累计自由现金流,单位千美元百分之零百分之零,百分之一美元四万美元四万百分之一百,百分之五十百分之三十三四美元十万美元 -14万100% 100% 108%美元 15万美元 -53万毛顿的市,从现金流的角度看,这项业务增长的越慢,状况反而越好,一旦为第一台机器付出了初始资本,最理想的增长轨迹,是迅速把运力用到100% 然后就停止增长,然而即使只有一台机器,累计现金流总额也要到第四年,才能超过最初的机器成本,而且这一系列现金流的进现值,按12%的资本成本计算仍然是负的,不幸的是,我们的运输业务存在根本性的缺陷,在任何增长率下,投入初始或后续资本来运营这样业务,都是不划算的,事实上我们的例子简单明了,一目了然 投资者只要对经济账做一个进现值分析,很快就能断定这不划算,尽管在现实世界中,情况要微妙和复杂的多,但这个问题,也就是利润和现金流之间的二元性,却无时无刻不再出现,现金流量表常常没有得到应有的重视,有洞察力的投资者,不会只看利润表就停下,我们最重要的财务指标,美股自由现金流,亚马逊的财务重心是每股自由现金流的长期增长,我们的自由现金流主要靠两个东西驱动,一是不断提高营业利润的绝对金额,二是高效管理营运资金和资本支出,我们提升营业利润的方式,是专注于改善客户体验的方方面面来推动销售增长 同时保持精简的成本结构,我们有一个能产生现金的运营周期,因为我们库存周转很快,在需要向供应商付款之前,就已经从顾客那里收到了钱,高库存周转率意味着我们投入在库存上的资金相对较少,年底时库存是4亿8千万美元,而销售额接近70亿美元,我们商业模式的资本效率,也体现在固定资产上的适度投资,年底固定资产是2.46亿美元,只占2004年销售额的4% 自由现金流在2004年增长了38% 达到4.77亿美元,比前一年多了1.31亿美元,我们相信,只要继续改善客户体验 包括增加商品选择和降低价格,并且高效执行,我们的价值主张和自由现金流,都会进一步扩大,关于股权稀释 2004年底的总流通股加上股票激励,跟2003年相比基本没变,过去三年还下降了1% 在同一时期,我们还通过偿还超过6亿美元,原本在2009和2000年到期的可转换债务,消除了超过600万股,未来可能被稀释的潜在股份,高效管理股份数量,意味着每股能分到更多现金流,也意味着给股东带来更多长期价值,这种对自由现金流的重视,对亚马逊来说并不是新鲜事,我们在1997年至股东的信里,那是我们上市后的第一封信 就明确说过,当被迫在优化JP会计准则,和最大化未来现金流的限制之间做选择时,我们会选择现金流,我把1997年那封信的完整版附在了后面,鼓励现在和未来的股东都去看一看,和往常一样,亚马逊的每一个人都感谢顾客的惠顾和信任,感谢彼此努力工作,也感谢股东的支持和鼓励 Jeffrey P. Bezos创始人兼首席执行官 2005年4月,一运营周期的计算方式是库存销售天数,加上应收账款销售天数,再减去应付账款天数,二自由现金流的定义是经营活动提供的净现金,减去购买固定资产的支出 包括资本化的内部使用软件和网站开发成本,这两项都列在我们的现金流量表上 2004年的自由现金流是4.77亿美元,有经营活动提供的净现金5.67亿美元,减去购买固定资产的8900万美元得出,这8900万包含了资本化的内部使用软件和网站开发成本 2003年的自由现金流是3.46亿美元,有经营活动提供的净现金3.92亿美元,减去购买固定资产的4600万美元得出,同样包含了资本化的内部使用软件,和网站开发成本 2005年致股东信,至我们的股东,在亚马逊,我们做的很多重要决策,都可以靠数据来定,有正确答案和错误答案 有更好的答案和更差的答案,数学会告诉我们哪个是哪个,这是我们最喜欢的一类决策,开设一个新的旅游中心,就是一个例子,我们利用现有旅游网络的历史数据,来估算季节性峰值,并为新增运力建模各种替代方案,我们会看预期的产品组合,包括产品尺寸和重量,来决定需要多大空间,以及是需要一个处理较小可分解商品的设施,还是处理通常单独运输的大件商品的设施,为了缩短配送时间,降低出站运输成本,我们会根据与客户交通枢纽和现有设施的距离,来分析备选地点,量化分析能改善客户体验,也优化我们的成本结构,同样我们大部分的库存采购决策 也可以通过数字建模和分析来做,我们希望商品有库存,客户能立刻买到,同时也希望总库存尽可能少,以压低相关的持有成本,进而压低价格,要同时做到这两点,就存在一个恰当的库存量,我们用历史购买数据,来预测客户对某件商品的需求,以及需求的预期波动,我们用供应商的历史表现数据,来估算补货时间,我们可以根据入站和出站运输成本,仓储成本以及预期的客户位置,来决定在履约网络中的哪个地方,存放该商品,通过这种方法,我们在自家仓库里,保有超过100万种独特商品,供客户即时购买,同时库存年周转次数 仍超过14次,上述决策,需要我们做一些假设和判断,但在这些决策里,判断和意见只是辅助决策,真正挑大梁的是数学,不过正如你们所料。 [01:10:00]
杰夫·贝佐斯:不过正如你们所料,并非我们所有的重要决策,都能用这种令人羡慕的,基于数学的方式来做,有时我们几乎没有,或完全没有历史数据来指导我们,而主动实验又不可能不切实际,或者等同于决定直接推进,尽管数据分析和数学也发挥作用,但这些决策中的首要因素是判断力,正如我们的股东所知,我们做出了一个决定,随着我们的效率和规模不断提升,年复一年的持续且显著的为客户降低价格,这是一个非常重要,却无法用基于数学的方式来做出的决策的例子,事实上当我们降价时,我们是反着我们能算出来的数学结果来的 数学结果总是说聪明的做法是提价,我们掌握着大量与价格弹性相关的数据,我们可以相当准确的预测,降价某个百分比会导致销量增加某个百分比,除了极少数例外,短期内销量的增长永远不足以弥补降价的损失,然而我们对弹性的量化理解是短期的,我们可以估算出降价在本周和本季度会产生什么影响,但我们无法用数字估算出持续降价在五年十年或更长时间内会对我们的业务产生什么影响,我们的判断是以更低价格的形式将效率提升和规模经济relentlessly返还给客户,一非结构化决策过程的结构是Henry Mintzberg Durie Raising Honey和Andre Thierry在1976年发表的一篇引人入胜的论文,他们研究的是机构如何做出战略性的非结构化的决策,而非那些更可量化的运营决策,你在论文中会发现的诸多洞见之一,就是管理科学家对运营决策的过度关注,很可能会导致组织以更高的效率去追求不恰当的行动路线,他们并非在争论严谨量化分析的重要性,而只是指出他获得了不成比例的研究和关注,这很可能正是因为他更易于量化,论文全文可在www.Amazon-ir-minsberg获取,会创造一个良性循环,长期导向大得多的自由现金流金额 从而导向一个价值高得多的亚马逊,我们在Free Super Saver Shipping和Amazon Prime上,也做过类似的判断,这两项服务在短期内成本高昂,但我们相信它们在长期内是重要且有价值的,另一个例子是,在2000年我们邀请第三方,在我们的黄金零售地段,也就是我们的产品详情页,上直接与我们竞争,为Amazon自营和第三方商品,推出同一个详情页,看起来很有风险,公司内外都有善意的人担心,这会蚕食Amazon的自营零售业务,而且正如以客户为中心的创新,常常遇到的情况,事先根本无法证明它行得通,我们的采购员指出,邀请第三方进入亚马逊会让库存预测变得更困难 而且如果我们把详情页输给某个第三方卖家,就可能导致我们被过剩库存套住,然而我们的判断很简单,如果第三方能在某件商品上提供更好的价格,或更好的有获率,那我们就希望我们的客户能方便的获得那个报价,随着时间的推移,第三方销售已经成为我们业务中成功且重要的一部分,第三方销量占总销量的比例,已从2000年的6%增长到2005年的28% 而在此期间,我们的自营零售收入也增长了三倍,基于数学的决策能赢得广泛共识,而基于判断的决策,则理应被讨论,而且常常充满争议,至少在付诸实践并被验证之前是这样 任何不愿承受争议的机构,都只能把自己局限在第一类决策里,在我们看来,那样做不仅会限制争议,也会严重限制创新和长期价值的创造,我们决策哲学的根基,在1997年至股东的信里就已经写明了,那封信的副本也附在了后面,我们会继续不懈的聚焦于客户,我们会继续根据长期市场领导地位的考量,来做投资决策,而不是看短期盈利或华尔街的短期反应,我们会继续用分析的方式来衡量我们的项目与投资效果,放弃那些回报不达标的,并加大对那些最有效项目的投入,我们会继续从成功和失败中学习,在有很大概率能获得市场领导优势的地方 我们会做出大胆而非畏缩的投资决策,这些投资有些会成功,有些不会,但无论哪种情况,我们都会学到宝贵的一课,你们可以相信,我们会把强大的量化分析文化,和做出大胆决策的意愿结合在一起,在这个过程中,我们会从客户出发,反向倒推,在我们看来,这才是创造股东价值的最佳方式 Jeffrey P. Bezos 创始人兼首席执行官 2006年致股东信,至我们的股东,以Amazon目前的规模,要把种子培育成有意义的新业务,需要一些纪律,一点耐心,以及一种善于滋养的文化 我们已有的业务就像扎根很深的年轻树木,他们在成长资本回报率很高,而且所处的市场板块非常大,这些特点给我们想启动的任何新业务都设下了很高的门槛,在把股东的钱投进新业务之前,我们必须说服自己,这个新机会能带来的资本回报,是投资者当初投Amazon时就期望的,而且我们也必须确信,新业务能涨到足够大的规模,大到在整个公司里举足轻重,另外我们还必须相信,这个机会目前还没被好好满足,而且我们有能力给市场带来,让客户明显感知到的差异化,没有这些新业务就很难做大规模,经常有人问我,你们什么时候开实体店 这是我们一直没去碰的一个扩张机会,除了上面说的其中一条,其他几条他都没通过,实体店网络的潜在规模,确实很让人兴奋,但是我们不知道,怎么用低资本投入,去做到高回报,实体零售是个老谋深算的古老行业,服务已经很充分了,而且对于怎么给顾客打造一个,体验明显不同的实体店,我们没有任何想法,当你真的看到我们进入新业务时,那是因为我们相信,他通过了上面这些考验,我们收购joel.com 是服务这个世界上,人口最多国家的第一步,中国的电商还在早期,我们相信,这是个极好的商业机会,鞋服装生鲜杂货,这些都是很大的板块,我们有合适的技能,去创新去发展出,大规模高回报 并且能真正改善,客户体验的业务 Fulfillment by Amazon 是一套网络服务API 它把我们1200万平方英尺的旅游中心网络,变成了一个巨大又精密的计算机外设,你每月为每立方英尺的仓储空间付45美分,就可以把货放在我们的网络里,你通过调用网络服务通知我们有库存要入库,告诉我们去捡货,打包一件或几件商品,再告诉我们把货发到哪,你完全不用跟我们说话,它差异化明显规模可以很大,也符合我们的回报门槛 Amazon Web Services是另一个例子,通过AWS我们在打造一项新业务,瞄准一群新客户软件开发者,我们目前提供10种不同的网络服务 已经建起了一个超过24万注册开发者的社区,我们瞄准的是开发者普遍面临的广泛需求,比如存储和算力,这些领域开发者一直在寻求帮助,而我们过去12年把亚马逊做大的过程中,积累了深厚的专业经验,我们来做这件事,位置很好,差异化很强,而且假以时日,它能成为一项重要财务上很有吸引力的业务,在一大公司要把新幼从小种子培育起来可能很难,因为这需要耐心和滋养,在我看来 Amazon的文化对那些有巨大潜力的小业务支持力度非同一般,我相信这是一个竞争优势的来源,跟任何公司一样,我们的企业文化不仅有我们的意图塑造 也是我们过往历史的结果,对Amazon来说,这段历史还很新,而且幸运的是里面有好几个小种子长成大树的例子,我们公司里有很多人亲眼见证过多个一千万美元的种子。 [01:20:00]
杰夫·贝佐斯:我们公司里有很多人亲眼见证过多个一千万美元的种子,涨成10亿美元级别的业务,这种一手经验,以及围绕这些成功,所生长出来的文化,在我看来,是我们能从零开始,启动新业务的一个重要原因,这种文化要求,这些新业务必须有高潜力,必须创新,有差异化,但它不要求,他们在诞生的第一天,就规模巨大,我还记得1996年,我们图书销售额,突破1000万美元时,大家有多兴奋,那种兴奋不难理解,我们是从零做到一千万的,今天当Amazon内部一个新业务做到一千万美元时,整个公司是从一百亿增长到一百亿零一千万,那些掌管着我们数十亿美元成熟业务的高管们,很容易对此嗤之以鼻 但他们没有,他们会关注这些新兴业务的增长率,还会发邮件祝贺,这真的很酷,我们也很自豪,这是我们文化的一部分,根据我们的经验,如果一项新业务大获成功,它大概需要三到七年,才能开始对整个公司的财务表现产生有意义的影响,我们在国际业务,早期的非媒体业务,还有第三方卖家业务上,都看到过这样的事件周期,今天国际业务占销售额的45% 非媒体业务占34% 第三方卖家业务占我们销售件数的28% 如果我们现在播下的一些新种子也能取得类似的成功,我们会非常高兴。从庆祝第一个1000万美元销售额走到今天,我们已经走了很远。随着继续成长,我们会努力保持一种拥抱新业务的文化。我们会用有纪律的方式去做关注回报、潜在规模以及创造客户在乎的差异化能力。我们不会每次都选对,也不会每次都成功,但我们会精挑细选,并且会耐心的,努力的去做,和往常一样,我附上了我们1997年,智股东的信,你会发现,我们的理念和方法没有变,非常感谢你们的支持和鼓励 Jeffrey P. Bezos创始人,兼首席执行官 2007年致股东信,至我们的股东 2007年11月19日是个特别的日子,经过三年的努力,我们向用户推出了Amazon Kindle 你们很多人可能已经对Kindle有所了解,很幸运,也很感激,它已经被广泛报道和讨论,简单说 Kindle是一款专门为阅读设计的设备,可以无线访问超过11万本书籍,博客杂志和报纸,这个无线连接不是WiFi 它用的是和高端手机一样的无线网络,意味着你在家躺在床上,或者出门在外都能用,你可以直接从设备上买书,整本书会通过无线下载,不到60秒就能开始读,没有所谓的无线套餐,不用签一年的合约,也没有月费,它有一块像纸一样的电子墨水瓶,即使在明亮的日光下也很容易阅读,第一次看到这块屏幕的人都会愣一下,它比瓶装书更薄更轻 能装下200本书去亚马逊上看看Kindle的详情页,看看用户怎么说 Kindle已经有超过2000条评论了,经过三年的努力,你们大概能猜到,我们真心希望Kindle能被大家接受,但我们没预料到实际出现的需求会这么猛,开售五个半小时就卖光了,我们的供应链和制造团队不得不紧急提升产能,我们一开始就给自己定了一个大胆的,有点不自量力的目标改进实体书,这个目标不是随便选的,任何以几乎相同形态,存在了500年抗拒变化的东西,都不太可能轻易被改进,在设计过程之初,我们就认定了,我们认为书最重要的特性,它会消失,当你读一本书时,你不会注意到纸张,油墨,胶水和装订 所有这些都消融了,剩下的只有作者的世界,我们知道Kindle 必须像实体书一样,推到幕后,这样读者才能沉浸在文字里,忘记自己是在用设备阅读,我们也知道,不该试图复制书的每一个特性,我们永远不可能比书更像书,我们必须增加新的能力,那些传统书籍永远不可能实现的能力,亚马逊的早期经历可以做个类比,那时候很容易让人以为,一家在线书店应该具备实体书店的所有功能,有功能我被问了几十次,你们怎么做电子书签名 13年过去了,我们还没想出办法,我们没有试图复制实体书店,而是从他们那里获得灵感,努力寻找在新媒介里能做,但在旧媒介里永远做不到的事,我们没有电子书签名 同样我们也没法提供一个舒服的角落,让你喝咖啡放松,但是我们可以提供数百万种图书,通过用户评论帮你做购买决定,还能提供买了这本书的人也买了,这样的发现功能,那些只能在新媒介里实现的有用功能,清单可以列很长,我重点讲几个,我们为Kindle打造的有用功能,这些是实体书永远做不到的,遇到不认识的词,你可以轻松查字典,你可以搜索你的书,你的旁注和画线,都存储在服务端的云上,不会丢失 Kindle会自动保存,你在每本书里的阅读进度,眼睛累了,你可以调整字体大小,最重要的是那种,无缝,简单的找书体验 60秒就能拿到书 我观察过人们第一次这样做时的反应,很明显这个能力对他们产生了深远的影响,我们对Kindle的愿景是,所有语言,所有印刷过的书,全都能在不到60秒内获取,出版商,包括所有主要出版商都拥抱了Kindle 我们对此很感激,从出版商的角度看 Kindle有很多好处,书永远不会绝版,也永远不会缺货,也不会有过度印刷造成的浪费,最重要的是 Kindle让读者买更多书,变得更方便,任何时候,只要你让一件事变得更简单,摩擦更小,你就会得到更多,我们人类是和工具一起进化的,我们改变工具,然后工具也改变我们,几千年前发明的文字,就是一个超级厉害的工具,我毫不怀疑 它深刻的改变了我们 500年前古腾宝的发明,让书籍的成本发生了质的飞跃,实体书带来了一种全新的协作和学习方式,最近像台式电脑,笔记本电脑,手机和pda这些联网工具也改变了我们,他们让我们更偏向于信息临时化,而且我认为,这也让我们的注意力持续时间变短了,我很看重我的blackberry 我确信他让我更高效,但我不想在上面读一份三百页的文件,我也不想在台试机或笔记本上读几百页的东西,就像我在这封信里已经提到的,人们会更多的去做那些方便没有阻力的事,如果我们的工具让信息临时化变得更容易,我们就会更多的转向信息临时化,远离长篇阅读 Kindle就是为长篇阅读而生的 我们希望Kindle和它的后续产品,能在未来几年里逐渐的一步步的,把我们带向一个注意力更持久的世界,为最近泛滥的信息零食化工具提供一个平衡,我知道我这话说的有点像在传道,我可以向你保证这是我的真心话,而且这不只是我一个人的想法,公司里一大群人都这么想,我对此很高兴,因为传教士才能做出更好的产品,我还要指出,虽然我坚信书记正处在被改进的前夜,但亚马逊并不是那个理所当然的代理人,这件事一定会发生,但如果我们执行的不好,就会被别人做成,你在这里的传教士团队,正热切的推动着美股自由现金流和资本回报率的增长 我们知道通过把客户放在第一位,就能做到这一点,我向你保证,我们前面的创新会比身后的多得多,而且我们不指望这条路会一帆风顺,我们满怀希望,甚至可以说是乐观的相信 Kindle会名副其实的点燃一把火,改善阅读的世界,和往常一样,我附上了我们1997年制股东的信,你会看到 Kindle正是我们在那封信里讨论的,哲学和长期投资方法的体现,祝阅读愉快,非常感谢 Jeffrey P. Bezos创始人兼首席执行官 2008年4月 2008年致股东信,至各位股东,在当下动荡的全球经济中,我们的基本思路没有变,埋头做事,着眼长期 一切以客户为中心,长期思维能撬动我们已有的能力,也能让我们去做一些,原本想都不敢想的新事情,他容得下创新所必须的失败和反复打磨,也让我们能放手去开拓无人涉足的领域。 [01:30:00]
杰夫·贝佐斯:也让我们能放手去开拓无人涉足的领域,追求即时满足或者那种看似触手可及的承诺,大概率会发现那里早就挤满了人,长期导向跟客户至上是天然契合的,如果我们能发现一个客户需求,并且进一步确信这个需求足够重要,足够持久,那我们的做事方式就允许我们耐心花上好几年去交付一个解决方案,从客户需求出发反向推导,跟那种从自身能力出发技能先行的做法正好相反,后者是用现有的技能和优势去驱动商业机会,技能先行的思路是,我们特别擅长做X还能用X干点别的什么,这是一种有用且能带来回报的商业思路 但如果只用这种方法,公司就永远不会被逼着去发展新技能,最终现有的技能会过时,从客户需求反向推倒,往往要求我们去掌握新的能力,锻炼新的肌肉,不管迈出第一步是有多别扭,多不舒服 Kindle就是我们这种基本思路的一个好例子,四年多以前,我们从一个长期愿景出发,所有印出来过的书,不管什么语言,全都能在60秒内获取,我们设想的客户体验,不允许在Kindle设备和Kindle服务之间,划出任何声音的分界线,两者必须无缝融为一体 Amazon从来没设计或制造过硬件设备,但我们没有为了迁就当时的现有技能去改变愿景,而是招了一批很有才华 而且带着传教士精神的硬件工程师,开始学习一项新的组织能力,一项我们未来更好服务读者所需要的能力,我们很感激很兴奋 Kindle的销量超出了我们最乐观的预期 2月23号我们开始发货 Kindle 2 如果你还没见过它 Kindle 2保留了初代Kindle 所有让客户喜欢的地方,只是更薄更快,屏幕更清晰,电池续航更长,而且能装下1500本书,你可以从超过25万种最受欢迎的图书杂志和报纸里挑选,无线传输免费不到60秒书就能到手,我们收到了成千上万封客户关于Kindle的反馈邮件,而且很值得一提的是,其中26%都出现了爱这个字,客户体验的支柱 在我们的零售业务里,我们坚信客户看中的是低价海量选品,和快速便捷的配送,而且这些需求会长期保持稳定,我们很难想象十年以后,客户会想要更高的价格,更少的选品,或者更慢的配送,我们相信这些支柱的持久性,正是这份相信给了我们信心,去持续投入,不断加固他们,我们知道,现在投入的精力,会在未来很长一段时间里,持续带来回报,我们的定价目标是赢得客户信任,而不是优化短期利润,我们赌信这样定价从长期来看,是让我们整体利润增长的最好方式,我们每件商品可能赚的少一点,但通过持续赢得信任,我们会卖出多得多的商品 所以我们在整个产品线都提供低价,出于同样的原因,我们也在持续投入免费配送项目,包括Amazon Prime 客户见多识广,非常聪明,他们在做购买决定时会评估总成本,包括运费,在过去12个月里,全球客户通过使用我们的免费配送优惠,节省了超过8亿美元,我们一门心思铺在增加选品上,既在现有品类里增加选择,也拓展新的品类,从2007年到现在,我们已经新增了28个品类,有一个增长,很快并且一直让我感到惊喜的业务,就是我们在2007年推出的,邪旅商店endless.com 快速可靠的配送,对客户很重要 2005年我们推出了Amazon Prime 每年79美元 Prime会员可以无限次 免费享受两日达快递,并且只需3.99美元,就能升级成一日达 2007年我们又推出了 Fulfillment by Amazon 一项面向第三方卖家的新服务,通过FBA卖家把库存放在我们的全球旅游网络里,我们替卖家完成捡货,打包和配送到终端客户的全过程 FBA商品跟Amazon自营库存一样,适用于Amazon Prime和Super Saver Shipping 这样一来FBA既改善了客户体验,又拉动了卖家的销售,在2008年第四季度,我们替使用fulfillment by amazon的卖家,配送了超过300万件商品,这对客户和卖家来说是双赢,审慎之初,我们选择的这条客户体验之路 要求我们有一个高效的成本结构,对股东来说,好消息是我们在这一块看到了很大的改善空间,放眼望去,我们所有人都在看,到处都能发现经验丰富的日本制造商,所说的Muda也就是浪费,这让我觉得特别来劲,我把它看作潜力,年复一年在可变成本和固定成本上,持续提升效率的潜力,以及更高效更快速更灵活的资本支出,我们首要的财务目标依然是,最大化长期自由现金流,并且要在投入资本上获得高回报率,我们正在大力投资 Amazon Web Services为第三方卖家提供的工具,数字媒体,中国业务,以及新的产品品类,我们之所以进行这些投资 是因为相信他们能形成可观的规模,并且能通过我们那套很高的回报标准,在世界各地那些了不起,有创造力,有勤奋的亚马逊人,始终把顾客放在第一位,能成为这个团队的一员,我深感自豪,我们感谢各位股东的支持和鼓励,也感谢你们与我们一起踏上这段,仍在继续的冒险,和往常一样,我随信附上了1997年至股东的信,即使变化的速度在加快,我们依然希望并相信,专注于那些不变的东西,会让我们受益匪浅 Jeffrey P. Bezos 创始人兼首席执行官 2009年4月 E-prime是一项全球性计划 日本3900日元,英国48英镑,德国29欧元,法国49欧元,二最近在一个旅游中心,我们的一位Kaisen专家问我,我赞成保持旅游中心干净,但你们为什么要打扫,为什么不从源头消除灰尘,我当时感觉自己就像空手道小子 2009年致股东信,至各位股东2009年的财务业绩,是我们过去15年不断改善客户体验的累积成果,扩大选品加快配送,降低自身成本结构,好让我们能持续给客户更低的价格,还有很多其他方面的努力,这些工作是由公司各个领域里,一大批聪明坚韧,一心为客户的人共同完成的 我们为自己的低价可靠的配送,以及连冷门难找的商品都能有库存这件事感到自豪,同时我们也清楚自己还能做得更好,我们决心继续改进 2009年的一些亮点,净销售额同比增长28% 达到245.1亿美元,这是10年前,也就是1999年16.4亿美元净销售额的15倍,自由现金流同比增长114% 达到29.2亿美元,更多客户开始使用Amazon Prime 全球会员数相比去年大幅增长 2009年可立即发货的不同商品数量,增长了超过50% 我们在全球新增了21个商品品类,包括日本的汽车品类,法国的婴儿品类 以及中国的鞋服品类,对我们的鞋类业务来说,这是忙碌的一年 11月我们收购了Zappos 这是一家在线服装和鞋类销售领域的领先公司,致力于为消费者提供最好的服务和选品 Zappos是对我们Endless,Javert Amazon和ShopUp选品的一个极好补充,服装团队继续提升客户体验,推出了丹宁商店提供100个品牌,包括Jose Jeans,Lucky Brand,G4ALL,Mankind和Levis 协服团队创建了超过12万1000条商品描述,并向网站上传了超过220万张图片,为客户提供了生动的购物体验 全球各站点新增了约700万条客户评论 2009年,第三方卖家在我们网站上的商品销量,占到了总销量的30% 活跃卖家账户数同比增长24%。 [01:40:00]
杰夫·贝佐斯:活跃卖家账户数同比增长24% 达到190万,在全球范围内,使用Fulfillment by Amazon的卖家,在我们的运营中心网络中,存放了超过100万件独特商品,从而使这些商品可以享受 Free Super Saver Shipping和Amazon Prime服务 Amazon Web Services继续保持快速的创新步伐,推出了许多新服务和功能,包括Amazon Relational Database Service Virtual Private Cloud Elastic MapReduce High Memory ECR Instances Reserved and Spot Instances Streaming for Amazon CloudFront 以及Versioning for Amazon S3 AWS还继续扩大其全球覆盖,在欧盟增加了更多服务,开设了新的北加州区域 并计划在2010年进入亚太区域,持续的创新和可靠的运营记录,帮助AWS在2009年,新增了比以往任何时候都多的客户,其中包括许多大型企业客户,美国Kendo商店现在拥有超过46万本书,高于去年的25万本,其中包括110本纽约时报畅销书中的103本,超过8900个博客,以及171种美国和全球主流报纸与杂志,我们已经将Kindle发货到了超过120个国家,现在提供六种不同语言的内容,新加入Amazon的高管常常会惊讶的发现,我们花在讨论实际财务业绩,或争论预测财务产出上的时间非常少,说清楚一点,我们非常重视这些财务产出 但我们相信,把精力集中在业务中可控的投入上,才是长期最大化财务产出最有效的方式,我们的年度目标制定流程,从秋天开始,在度过年底的假日旺季之后,于新年初完成,我们的目标制定会议很长,很激烈,而且非常注重细节,我们对客户应得的体验设定了很高的标准,并且有一种紧迫感去改善这种体验,我们沿用这个年度流程已经很多年了,针对2010年,我们有452个详细目标,每个都有负责人交付成果和计划完成日期,这些并不是我们团队为自己设定的全部目标,但却是我们认为最需要关注的那些,这些目标没有一个容易达成 很多不靠创新就无法实现,我们每年会和高级领导团队一起,对这些目标的进展情况进行数次评估,并在过程中增删和修改目标,审视我们当前的目标,会发现一些很有意思的统计 452个目标中,有360个将直接影响客户体验,营收这个词出现了8次,自由现金流只出现了4次,在这452个目标里,净利润毛利或毛利率,运营利润,这些词一次都没有出现,整体来看,这组目标体现了我们的根本思路,从客户出发,反向推导,倾听客户,但不要只是倾听客户,还要代表他们去创新,我们无法保证能达成今年所有的目标,过去几年我们也没有全部做到,但是我们可以保证 我们会继续痴迷于客户,我们坚信这种做法,从长期来看,对股东的好处,丝毫不亚于对客户的好处,和往常一样,我附上了我们1997年的原始致股东信,我们的方法始终未变,今天依然是第一天 Jeffrey P. Bezos创始人兼首席执行官 2010年4月 2010年致股东信,致各位股东随机森林,朴素贝耶斯估计器Restful服务,留言协议最终一致性数据分片,反商,拜占庭,仲裁,纠山马,向量时钟,走进亚马逊的某些会议,你可能会一时恍惚,以为自己误闯进了一堂计算机科学课 翻开一本当下的软件架构教材,你会发现里面很少有我们没在亚马逊应用的模式,我们使用高性能事务系统,复杂渲染与对象缓存,工作流与对列系统,商业智能与数据分析,机器学习与模式识别,神经网络与概率决策,以及其他各种各样的技术,虽然我们的很多系统都建立在,计算机科学最前沿的研究之上,但这往往还不够,我们的架构师和工程师,不得不把研究推进到学术界尚未涉足的方向,我们面临的许多问题,教科书里没有现成答案,于是我们很乐意的发明新的方法,我们的技术几乎全部以服务的形式实现,这些服务是封装了自身所操作数据的逻辑单元 并提供加固的接口,作为访问器功能的唯一途径,这种方式减少了副作用,让各个服务能按自己的节奏演进,而不影响整个系统中其他组件,面向服务的架构,也就是Solo是亚马逊技术最基础的构建抽象,多亏了一支深思熟虑,富有远见的工程师和架构师团队,早在SOA成为行业热词之前,我们就在亚马逊应用了这种方法,我们的电商平台,由数百个软件服务组成的联邦构成,他们协同工作,交付从推荐到订单履约,再到库存跟踪的各种功能,举个例子,为一位访问亚马逊的客户,构建商品详情页,我们的软件会调用200到300个服务,为这位客户呈现出高度个性化的体验 状态管理是任何需要成长到超大规模的系统的心脏,很多年前亚马逊的需求就到了一个临界点,我们的许多系统已经无法由任何商业方案来承载,我们的关键数据服务存储着数PB的数据,每秒处理数百万个请求,为了满足这些苛刻且不寻常的需求,我们开发了多个替代性的专门构建的持久化方案,包括我们自己的建制存储和单表存储,为此我们大量借鉴了分布式系统和数据库研究社区的核心原则,并在此基础上进行发明,我们开创的这些存储系统展示了极致的可扩展性,同时对性能,可用性和成本,保持着严格控制,为了达到超大规模的特性 这些系统在数据更新管理上,采用了一种新颖的方法,通过放宽,对需要分发到大量副本的更新的同步要求,这些系统能够在最严苛的性能和可用性条件下存活下来,这些实现都基于最终一致性的概念,亚马逊工程师在数据管理方面取得的进展,已成为Amazon Web Services WS旗下云存储和数据管理服务底层架构的起点,例如我们的Simple Storage Service,Elastic Block Store和SimpleDB 其基础架构都源自亚马逊独有的技术,亚马逊业务的其他领域也面临着类似复杂的数据处理和决策问题,比如商品数据入库与分类,需求预测,库存分配和欺诈检测 基于规则的系统可以成功运用,但它们可能难以维护,并且随着时间推移会变得脆弱,在很多情况下,先进的机器学习技术,能提供更准确的分类,并且可以自我修复,以适应变化的条件,例如我们的搜索引擎,运用了在后台运行的数据挖掘,和机器学习算法来构建主题模型,我们还应用信息提取算法来识别属性,并从非结构化描述中提取实体,让客户能够缩小搜索范围,快速找到想要的商品,我们在搜索相关性中会考量大量因素,以预测客户感兴趣的概率,并优化结果的排名,商品的多样性要求我们采用现代回归技术,比如训练好的决策术,随机森林,以便在排序时 灵活纳入数千种商品属性,所有这些幕后软件的最终成果是什么,快速准确的搜索结果,帮你找到你想要的东西,如果我们把技术数之高格,放在某个RFID部门里,那我们在技术上投入的所有努力,可能就没那么重要了,但我们不采取那种做法,技术渗透到我们所有的团队,所有的流程,我们的决策,以及我们在每项业务中的创新方式里,它深深融入了我们所做的每一件事,举个例子 WhisperSync 这是我们Kindle的一项服务,目的是无论你去哪里,手边有什么设备,都能访问你的阅读书库,以及你所有的标注笔记和书签,并且在你所有的Kindle设备和手机应用之间,保持同步,技术上的挑战在于 要让这项服务覆盖全球数百万Kindle用户,数亿本数,数百种设备类型遍布超过100个国家。 [01:50:00]
杰夫·贝佐斯:数百种设备类型遍布超过100个国家,并且实现7天24小时不间断的可靠性 WhisperSync的核心是一个最终一致性的复制数据存储,配合应用层定义的冲突解决方案,这套方案必须也能够应对设备离线数周甚至更久的情况,当然作为Kindle用户,我们把这些技术细节全都藏起来了,所以当你打开Kindle时,它已经同步好了,并且翻到了正确的那一页,借用Arthur C. Clarke的话说,就像任何足够先进的技术,它看起来和魔法没什么两样,好了,如果有些股东正静止的读这封信,读到这里已经开始眼神涣散了,那我得把你们叫醒,我想说的是,在我看来 这些技术可不是闲着没事搞着玩的,他们直接导向自由现金流,我们生活在一个带宽磁盘空间和算力都飞速增长的时代,而且这些资源还在持续快速变便宜,我们的团队里有全世界最顶尖的技术专家,他们正在解决那些处于当今能力边界上的挑战,就像我以前多次讲过的,我们有一个不可动摇的信念,股东的长期利益与客户的利益是完全一致的,而且我们喜欢这样,创新就在我们的基因里,技术是我们用来进化和改善客户体验,每一个方面的根本工具,我们还有很多东西要学,我也期待,并且希望我们能一直享受学习的过程,能成为这个团队的一员,我深感自豪,和往常一样 我附上了我们1997年的原始制股东信,我们的方法始终没变,今天依旧是第一天 Jeffrey P. Bezos创始人兼首席执行官 2011年制股东信,致我们的股东创新的力量,对我们来说 Amazon Web Services的价值毋庸置疑 20秒内我们就能把服务器容量翻一倍,在我们这种高增长环境里开发团队又小,能确信自己拥有最好的支持去服务全球音乐社区,这对我们至关重要,要是放在五年前,我们早就崩溃当机,还不知道什么时候能恢复,现在因为Amazon的持续创新,我们可以提供最好的技术并持续增长,这是Christopher Tolland Bandpage的首席技术官 他谈到AWS如何帮助他们快速可靠的扩展算力,这可不是假设 BandPage正在帮助50万个乐队和艺人,与数千万粉丝建立连接,我是2011年4月开始在Amazon上卖东西的,到6月我们成为Amazon午餐盒销量第一的卖家时,每天已经有50到75个订单了,到了8月9月,那是我们最忙的时候,正好赶上开学季,我们一天能有300个,有时甚至500个订单,简直太不可思议了,我用Amazon来帮我处理订单,这让我省心多了,而且当我的顾客发现,用Prime会员可以免运费时,午餐盒就卖疯了 Kelly Lester是Easy Lunch Boxes的妈妈创业者 她自创了一条好庄田,又环保的五餐盒产品线,我算是偶然发现这件事的,他给我打开了一个全新的世界,因为我家里有一千多本书,我就想试试看吧,我卖掉了一些,然后不断把规模扩大再扩大,结果发现这太有意思了,我就决定再也不想去给别人打工了,而且我没有老板,除了我老婆,还有什么比这更好的呢,我们其实是一起做这件事的,我们俩都出去逃书,所以这是个团队合作,而且合作的非常愉快,我们一个月大概卖700本书,每个月我们给Amazon发800到900本书 Amazon再把人们买下的那700本发出去,要是没有Amazon处理发货和客服,我和我老婆就得每天抱着一大堆包裹,往邮局这些地方跑,有他们帮我们搞定这部分,日子就简单多了 这个项目太棒了,我太喜欢了,说到底 Amazon提供客源,甚至还负责把书寄出去,我是说还能比这更好吗 Bob Frank在经济衰退中被裁员后,创办了RJF Books and More 他和妻子在凤凰城和明尼阿布利斯两地生活,他形容自己找书来卖的过程,就像每天都在寻宝,因为Kindle Direct Publishing 我现在一个月的版税收入,比我过去给传统出版社写一整年挣的还多,我以前总担心付不付得起账单,有好几个月确实付不起,现在终于有了实实在在的积蓄,甚至开始考虑度假了,这可是我多少年都没做过的事 Amazon让我真正能展翅高飞了,以前我被矿在一个固定的类型里 可我还有好多别的书想写,现在我可以想写什么就写什么了,我的事业我自己做主,我觉得Amazon终于成了我的伙伴,他们懂这一行,并且为了作者和读者的利益,改变了出版业的面貌,把选择权重新交回到我们手里,这是AK Alexander他是Daddy's Home的作者,这本书是三月份Kindle百大畅销书之一,我完全没想到2010年3月,我决定在KDP上出版作品的第一个月,会成为我人生的决定性时刻,在那之后不到一年,我每个月的收入就足够我辞掉白天的工作,全职写作了,决定通过KDP出版所带来的回报,简直彻底改变了我的人生,经济上,个人生活上,情感上,创作上,都是如此 能够全职写作,能在家陪伴家人,能完全按照自己的想法去写,不用听传统出版社营销委员会对我写作的每个细节指手画脚,这让我成了一个更强大的作者,一个更多产的作者,最重要的是,一个快乐的多的作者 Amazon和KDP真的在出版界激发着创造力,给像我这样的作者一个实现梦想的机会,为此我永远心怀感激,这是Blake Crouch 他写了好几部惊悚小说,包括Kindle畅销书Run Amazon让像我这样的作者,有机会把自己的作品呈现在读者面前,这改变了我的人生,在短短一年多的时间里,我通过Kindle卖了将近25万本书,把旧的梦想换成了更大更好的梦想 我有四本书都登上了Kindle百大畅销书榜,此外还有经纪人海外版权销售和两位电影制片人来找我,我还得到了洛杉矶时报华尔街日报和PC Magazine的报道,最近还接受了User Today的采访,但最让我兴奋的是,现在所有作者都有机会让读者看到自己的作品,不用再去跨越那些难以逾越的障碍了,作者有了更多选择,读者也有了更多选择,出版界正在快速变化,我打算享受这趟旅程的每一分钟 The Race of Ragons KDP作者,写了多本Kindle畅销书,包括Abducted 过了60岁,又赶上经济衰退,我和妻子发现我们的收入来源严重受限 KDP是我实现毕生梦想的唯一机会 也是我们财务上唯一的救命稻草,出版几个月后 KDP就彻底改变了我们的生活,让我这个上了年纪的非虚构作家,开启了一段全新的职业生涯,成了一名畅销小说家,对于亚马逊,以及他们提供给独立作者的众多工具,我真是怎么夸都夸不够,我毫无保留的呼吁同行们,去了解并抓住KDP提供的机会,我高兴的发现,这件事没有任何下行风险,而潜力几乎是无限的,我借助KDP的技术,冲破了所有传统的守门人,你能想象那种感觉吗,在那么艰难的,那么长时间的,为每一个读者而奋斗之后,现在那些,我原本永远接触不到的,励志小说爱好者,正在kindle书店里 以2.99美元的价格,阅读Nobody和我的,另外两本小说,我一直想写一个,灰姑娘的故事,现在我写成了,而且多亏了白马王子KDP 未来还会有更多这样的故事,发明创造有多种形式,规模也各不相同,最激进,最具变革性的发明,往往是那些能赋予他人力量,释放创造力,去追逐梦想的发明,这正是Amazon Web Services Fulfillment by Amazon 和Kindle Direct Publishing的,很大一部分意义所在,通过AWS FBA和KDP 我们正在打造强大的自助服务平台,让成千上万的人,能够大胆尝试,完成那些原本不可能,或不切实际的事情 这些创新的大规模平台,不是零和博弈,他们创造了双赢局面,为开发者创业者客户,作者和读者都创造了巨大价值 Amazon Web Services已经发展到。 [02:00:00]
杰夫·贝佐斯:Amazon Web Services已经发展到,拥有30种不同的服务,并拥有数千家,大大小小的企业和个人开发者客户 Oz最早的产品之一 Simple Storage Service 也就是S3 现在存储了超过9000亿个数据对象,并且每天新增超过11个对象 S3日常每秒处理超过50万个交易,峰值时接近每秒100万个交易,所有AWS服务都是按需付费的,从根本上将资本支出转变为可变成本 RS自助式的,你不需要去谈合同,也不需要和销售员打交道,只需阅读在线文档就能开始使用 AWS服务是有弹性的,可以轻松扩展,也可以轻松缩减,仅在2011年最后一个季度 Fulfillment by Amazon就代表 卖家配送了数千万件商品,当卖家使用FBA时,他们的商品就有资格享受Amazon Prime Super Saver Shipping 以及亚马逊的退货处理和客户服务 FBA是自助式的,并带有一个易于使用的库存管理控制台,作为Amazon Seller Central的一部分,对于技术能力更强的用户,它还提供了一套API 这样你就可以把我们全球的旅游中心网络,当成一个巨大的计算机外设来使用,我之所以强调这些平台的自助服务特性,是因为这很重要,而原因我认为有点不那么显而易见,即使出于好意的守门人,也会减缓创新,当一个平台是自助式的时候,即使是不太靠谱的想法,也能得到尝试,因为没有专家守门人 随时准备说,这永远不会成功,你猜怎么着,那些看似不靠谱的想法中,有很多确实成功了,而社会正是这种多样性的受益者 Kindle Direct Publishing 已经迅速达到了惊人的规模,现在有超过1000名KDP作者,每人每月销量超过1000本,有些人的销量已经达到了数十万本,还有两位已经加入了Kindle百万,销量俱乐部KDP 对作者来说是一个巨大的胜利,使用KDP的作者,可以保留自己的版权,保留衍生作品权利,可以按自己的时间表出版,传统出版从书稿完成到出版,通常要延迟一年甚至更久,而且最好的留在最后,说KDP作者可以获得70%的版税,最大的传统出版商,只支付电子书17.5%的版税,他们按售价的70%的25%支付 算下来就是售价的17.5%KDP的版税结构,对作者来说是彻底变革性的,一本KEP图书的典型售价,是对读者友好的2.99美元,作者大约能拿到其中的2美元,如果按传统的17.5%版税计算,要达到同样的每本2美元版税,售价必须定在11.43美元,我向你保证,作者在2.99美元的价位上卖出的书,要比在11.43美元的价位上多得多 Kindle Direct Publishing对读者有好处,因为他们能享受到更低的价格,但也许同样重要的是,读者也能接触到更多样化的内容,因为那些可能被传统出版渠道拒绝的作者,现在在市场上获得了机会,你可以很清楚的看到这一点 看看坑斗畅销书排行榜,再和纽约时报畅销书排行榜比较一下,哪个更多样化,坑斗榜单上充满了小型出版社和自主出版作者的书,而纽约时报的榜单则被成功且知名的作者所主导,亚马逊人正投身未来,进行着彻底而变革性的创新,为成千上万的作者,创业者和开发者创造价值,发明创造,在亚马逊已经成为一种习惯,而且在我看来,团队的创新步伐还在加快,我可以向你保证,这非常令人振奋,我为整个团队感到无比自豪,也很庆幸自己能坐在前排,和往常一样,我附上了我们1997年的原始信件,我们的方法始终如一,今天依然是第一天 Jeffrey P. Bezos 创始人兼首席执行官 2012年致股东信,至各位股东,经常读这封信的读者都知道,亚马逊的动力来自取悦客户的渴望,而不是打败竞争对手的热情,我们不去评判这两种思路,哪一种更有利于商业成功,两者各有利弊,也有很多非常成功的,以竞争为导向的公司,我们确实会关注竞争对手,也会从他们那里获得启发,但事实是,以客户为中心这一点,已经成了我们文化中,一个决定性的元素,客户驱动的一个优势,也许是比较微妙的一个,是它有助于某种主动性,在我们状态最好的时候,我们不等外部压力来推 我们是内部驱动去改进服务,在不得不做之前就去增加好处和新功能,我们在不得不做之前就降低价格,为客户增加价值,我们在不得不做之前就去发明创造,这些投入的动机是关注客户,而不是对竞争做出反应,我们认为这种方式能赢得客户更多信任,并推动客户体验的快速提升,更重要的是,即使在我们已经领先的领域也是如此,谢谢你,每次我在亚马逊首页看到那份白皮书,我就知道我能得到的会比我想象的更多,我注册Prime是为了包邮,但现在我还能看电影电视剧和读书,你们一直在加东西却不加价,所以再次感谢这些新增内容,我们现在Prime里有超过1500万件商品 自2005年推出以来增长了15倍 Prime即时视频的片库,在短短一年多里翻了三倍,达到超过38000部电影和电视剧集 Kindle用户借阅图书馆也翻了三倍多,藏书超过30万册,其中包括我们投入数百万美元,把整套哈利波特系列纳入其中,我们并不是不得不对Prime做这些改进,我们是主动去做的,一项相关的投入,一项重大的持续多年的投入,是Fulfillment by Amazon FBA让第三方卖家可以选择把他们的库存和我们的库存,一起放在我们的旅游中心网络里,这对我们的卖家客户来说是个颠覆性的改变,因为他们的商品能享受prime权益,从而拉动销售,同时也让消费者受益 因为prime科选商品更多了,我们构建了自动化系统,去查找那些我们提供的客户体验,没达到自己标准的时刻,然后这些系统会主动给客户退款,一位行业观察者最近收到我们一封自动邮件,上面写着,我们注意到您在Amazon Video On Demand上租看,以下影片时播放体验不佳,卡萨布兰卡,对此造成的不便,我们深表歉意,并已为您退款以下金额,两美元九十九美分,期待您再次光临,他对这种主动退款感到惊讶,最后还写下了这段经历,亚马逊注意到我视频播放体验不佳,然后他们就因为这个给我退款了,哇这才叫把客户放在第一位,当你在亚马逊预购某件商品时 我们保证给你的是从下单到发售日,当天结束这段时间里我们提供的最低价格,我刚收到信用卡通知,退了五美元的预购价格保护,这样做生意太棒了,非常感谢你们公平诚实的做法,大多数客户太忙了,不会在预购之后自己去盯商品价格,而我们的政策,本可以要求客户联系我们,主动申请退款,主动去做对我们来说成本更高,但这也会带来惊喜取悦客户,并赢得信任,我们也有作者作为客户 Amazon Publishing刚刚宣布,将开始按月向作者支付版税,延迟60天结算,行业标准是每半年付一次,而且这个标准已经持续了很长时间,然而当我们以客户身份去访谈作者时,付款周期太长是一个主要的痛点 想象一下,如果你自己每半年才领一次工资会是什么感觉,并没有竞争压力,要求我们比每六个月更频繁的给作者付款,但我们在主动这么做,顺便说一句,虽然调研很辛苦,我还是努力完成了,并且很高兴的告诉大家,我最近在佛罗里达的海滩上,看到很多人在用kindle kindle已经有五代了,我相信除了第一代,我每一代都看到了,我们的商业策略,是以接近盈亏平衡的价格,销售高端硬件,我们想靠人们,使用我们的设备来赚钱,而不是靠人们,购买我们的设备来赚钱,我们认为,这让我们与客户的利益,更加一致,比如说,我们不需要客户,陷入不断升级换代的循环,看到人们还在用四年前的Kindle 我们会非常高兴 我还可以继续举例子 Kindle Fire的FreeTime 我们的客服Andone Core的Amazon。 [02:10:00]
杰夫·贝佐斯:Core的Amazon NP3的Autorap 但最后用一个非常清晰的,由内部驱动力的例子来收尾 Amazon Web Services 2012年 AWS发布了159项新功能和服务,自七年前推出以来,我们已经降价27次,增加了企业级服务支持增强功能,并打造了创新工具,来帮助客户提高效率 AWS Trusted Advisor 会监控客户的配置,将其与已知的最佳实践进行对比,然后再有机会提升性能,增强安全性,或节省开支的地方通知客户,没错,我们是在主动告诉客户,他们付给我们的钱,比他们需要付的更多,在过去90天里,客户通过Trusted Advisor 节省了数百万美元,而这项服务才刚刚起步,所有这些进展都发生在 AWS被广泛认可为该领域领导者的情况下,在这种局面下,你可能会担心外部驱动力会失效,但另一方面,内部驱动力,那种想让客户说出哇的动力,让创新的步伐保持飞快,我们在Prime,Aus,Kindle,数字媒体,以及整体客户体验上的大力投入,在一些人看来过于慷慨,对股东漠不关心,甚至与盈利性公司的身份相悖,一位外部观察者写道,据我所知 Amazon是一家由投资界人士运营,为消费者谋福利的慈善组织,但我不这么认为,对我来说 试图用刚好及时的方式,一点点挤出改进,那才是聪明反被聪明无,在我们所处的这个快速变化的世界里,这样做风险太大了,更根本的是,我认为长期思维能把看似矛盾的事统一起来,主动取悦客户能赢得信任,而信任能从这些客户那里带来更多业务,甚至是在全新的业务领域,用长期视角来看,客户和股东的利益是一致的,在我写这封信的时候,我们近期的股价表现不错,但我们不断提醒自己一个重要观点,正如我经常在员工全员会上,引用著名投资人Benjamin Graham的话,短期来看市场是一台投票机,但长期来看它是一台称重机,我们不会像庆祝出色的客户体验那样 去庆祝股价上涨10% 股价涨了,我们并没有变聪明10% 反过来股价跌了,我们也没有变笨10% 我们想要被称重,而且我们一直在努力打造一家更重的公司,尽管我对我们的进步和发明感到非常自豪,但我知道这一路上我们会犯错,有些是自己造成的,有些则是由聪明又勤奋的竞争对手送来的,我们对开拓的热情,会驱使我们探索狭窄的通道,而且不可避免的,很多通道最终会证明是死胡同,但是如果运气好一点的话,也会有少数几条通道,会通向宽阔的大道,能成为这个杰出团队的一员,我感到无比幸运,团队里都是出色的传教士,他们和我一样真是客户,并且每天都在用心情的工作证明这一点 和往常一样,我附上了一份我们1997年的原始信件,我们的方法始终未变,今天依然是第一天 Jeffrey P. Bezos创始人兼首席执行官 2013年4月 2013年致股东信,至各位股东,过去这一年,亚马逊所有团队为客户所做的一切,让我感到无比自豪,世界各地的亚马逊人,把产品和服务打磨到了超出预期,超出要求的程度,他们着眼长远,重新定义常规,让客户由衷的发出哇的赞叹,我想带大家走马观花的看,一小部分我们的各项计划,从Prime到Amazon Smile 再到Mayday 目的是让大家感受一下,亚马逊内部有多少事,在同时推进,以及做这些项目,有多令人兴奋,这么广泛的计划之所以能实现,是因为各个层级都有一大群才华横溢的人,每天都在运用他们的良好判断力,并且总是在问,我们怎样才能做得更好,好我们开始这趟旅程吧 Prime客户iPrime 光是在12月的第三周,就有超过100万客户加入了Prime 现在全球prime会员有数千万,按人均来算 prime会员订购商品比以往任何时候都多覆盖的品类也更广,即便在内部我们也很容易忘记,九年前我们推出prime时,它还是个全新的未经证实的概念 有人甚至说它很鲁莽,交一笔固定年费,就能享受无限次的两日搭配送,那时候我们有100万件符合prime条件的商品,今年这个数字超过了2000万件,而且我们还在继续增加,我们还通过其他方式让Prime变得更好,增加了新的数字权益,包括Kindle用户借阅图书馆和Prime即时视频,我们还没停下,关于如何让Prime变得更好,我们还有很多想法,读者与作者,我们正代表读者进行大量投入,全新的高分辨率高对比度 Kindle Paperwhite一经推出,就好评如潮,我们把非常出色的Goodreads 整合进了Kindle 推出了Kindle的FreeTime功能,并在印度、墨西哥和澳大利亚,发布了Kindle 给航空旅客带来福音的是 美国联邦航空管理局批准了,在飞机起降时使用电子设备,我们的公共政策团队,在许多盟友的帮助下,为此耐心努力了四年,期间还曾在一架测试飞机上,装了150台开着的Kindle 没错,一切运行正常,除了CreateSpace,Kindle Singles,Kindle Direct Publishing 我们还推出了新服务Kindle Worlds 文学期刊第一天,八个新的Amazon Publishing出版品牌,并在英国和德国上线了Amazon Publishing 成千上万的作者已经在用这些服务来建立充实的写作生涯,很多人写信告诉我们,我们如何帮助他们送孩子上大学,父亲医疗账单,或购买住房,我们是阅读的传教士,这些故事激励着我们 鼓舞我们继续为作者和读者去创新 Prime即时视频 Prime即时视频,在所有指标上都经历了巨大的增长,包括新客户,重复使用率和总播放量,这些都是输出指标,表明我们走在正确的道路上,专注于正确的投入,其中两个关键的投入是,内容选择的增长和这些内容的吸引力,自2011年我们以5000个片源推出PIV以来,我们的内容库已增长到超过4万部电影和电视剧集,全都包含在你的Prime会员资格里 PIVI拥有数百部热门剧集的独家播放权,包括唐顿庄园收视爆款穹顶之下,美国蝶梦火线警探,格林,黑色孤儿,金装律师,以及像海绵宝宝 爱探险的朵拉,和蓝色斑点狗,这样的儿童节目,此外,我们的Amazon Studios团队,继续在原创内容上大力投入,加里特鲁多指导,约翰,古德曼主演的阿尔法乌,去年首播,迅速成为亚马逊上,观看次数最多的剧集,我们最近又批准了六部原创剧,包括迈克尔康奈利的博斯,来自X档案克里斯卡特的,之后罗曼、科波拉和詹森,舒瓦兹曼的丛林中的莫扎特,以及吉尔索洛唯优美的透明家庭,有人称其为多年来最好的试播机,我们喜欢我们的做法,并正在将其复制到,我们最近在英国和德国推出的PIV服务上,这些国家的早期客户反响非常好,超出了我们的预期 Fire TV就在上周,经过两年的努力,我们的硬件团队推出了Fire TV Fire TV不仅是观看亚马逊视频内容的最佳方式,它还兼容非亚马逊的内容服务,比如Netflix Hulu Plus vivo Watchespan等等,在一个硬件配置普遍偏低的品类里 Fire TV拥有强大的硬件规格,效果显而易见 Fire TV快速且流畅,我们的SIP技术会预测你可能想看的内容,并预先缓冲,这样节目就能瞬间开始播放,我们的团队还在遥控器里放了一个小麦克风,按住遥控器上的麦克风按钮,你就可以说出你的搜索词,而不用在字幕网格上输入,团队做得非常出色,语音搜索真的很好用,除了Prime即时视频 Fire TV还能让你即时访问,超过20万部按次付费的电影和电视剧集,包括像地心引力,维努12年。 [02:20:00]
杰夫·贝佐斯:维努12年,达拉斯买家俱乐部,冰雪奇缘等新片,作为额外的好处 Fire TV还能让你在客厅电视上,玩高品质价格低廉的游戏,我们希望你能试试看,如果是了,请告诉我们你的想法,团队非常想听到你的反馈 Amazon Game Studios故事,发生在22世纪初,地球正受到一个名为 Niatu的外星种族的威胁,外星人用电脑病毒,感染了地球的能源网,使其防御系统瘫痪,在他们发动攻击之前,计算机科学天才 Amy Ramanujan 综合了外星病毒,拯救了地球,现在Niatu人卷土重来 Ramanujan博士,必须阻止他们,向地球发动全面入侵,它需要你的帮助 这就是Self Zero的开场,它是Amazon Game Studios为Fire TV打造的第一款独占游戏,团队把塔房和射击玩法结合起来,做了一个合作模式,一名玩家用手柄在地面指挥,另一名玩家用平板提供空中支援,我可以向你保证,有些紧张时刻,你会特别感激一次及时的空中打击,看到它的时候你可能会惊讶,这种级别的游戏体验,居然能在一台便宜的流媒体设备上实现 SavZero只是我们为Fire平板和Fire TV 从头打造的一系列创新,画面精美的游戏中的第一款 Amazon App Store现在服务着将近200个国家的客户,应用和游戏的选择已经增长到超过20万款,来自全球顶尖开发者 过去一年规模几乎翻了三倍,我们推出了Amazon Coins 一种虚拟货币,能让客户在购买应用和应用内项目时,节省最高10% 我们的WhisperSync for Games技术,让你可以在一台设备上开始游戏,在另一台设备上继续,不会丢失进度,开发者可以使用Mobile Associates项目,在他们的应用内提供亚马逊上,数百万种实体商品,并在客户购买这些商品时获得推荐费,我们推出了App Store Developer Select 这是一个营销项目,会在Kindle Fire平板和亚马逊移动广告网络上,推广新的应用和游戏,我们还创建了Analytics和A-B Testing服务,这些免费服务让开发者能够追踪用户参与度 并针对iOS Android和FireOS优化他们的应用,同样在今年我们接纳了HTML5网页应用开发者,他们现在也可以在Kindle Fire和Amazon App Store上提供自己的应用了,有声内容2013年对Audible来说是里程碑式的一年,他是全球最大的有声书销售商和制作商 Audible让你在眼睛忙着的时候也能阅读,数百万客户从audible下载了数亿本有声书和其他有声节目 2013年audible客户的收听时长下载量接近6亿小时,多亏了audible studios 你们可以听着Kate Winslet Colin Firth Anne Hathaway和许多其他明星的朗读开车上班 2013年的一个大热门是Jake Gyllenhaal演绎的了不起的盖茨比,已经卖出了10万份 WhisperSync for Voice让客户可以在Kindle上阅读一本书,和用智能手机收听对应的Audible有声书之间无缝切换,华尔街日报称WhisperSync for Voice为亚马逊新的书籍杀手机应用,如果你还没试过,我建议你试试,它很有趣,还能扩展你可用于阅读的时间,生鲜杂货在西雅图施运营这项服务五年后,没人会说我们缺乏耐心,我们把Amazon Fresh扩展到了洛杉矶和旧金山 Prime Fresh会员每年支付299美元,不仅能享受新鲜杂货的当天和清晨送达服务 还能购买超过50万种其他商品,从玩具到电子产品再到家具用品,我们还与受欢迎的本地商家合作,比如Beverly Hills Cheese Store Pike Place Fish Market San Francisco Wine Trading Company等等,为精选的预制食品和特色商品,提供同样便捷的送货上门服务,我们会继续用这种有条不紊的方式,衡量和完善Amazon Fresh 目标是随着时间推移,把这项出色的服务带到更多城市 Amazon Web Services AWS已经8岁了,团队的创新步伐实际上还在加快 2010年我们推出了61项重要的服务和功能 2011年这个数字是82 2012年是159 2013年280 我们也在扩大地理覆盖范围 我们现在在全球有10个AWS区域,包括美国东海岸西海岸两个欧洲新加坡东京悉尼巴西中国,还有一个仅供政府使用的区域叫GoCloud 我们在各区有26个可用区,以及51个用于内容分发网络的边缘节点,开发团队直接与客户合作,并被授权根据他们学到的东西来设计,构建和发布,我们持续迭代,当一个功能或增强准备好时,我们就推送出去,让它立即可供所有人使用,这种方式快速以客户为中心且高效,它让我们在过去八年里降价超过40次,而且团队没有放慢脚步的计划,员工赋能我们挑战自己 不仅要发明面向外部的功能,还要找到更好的内部做事方式,那些既能让我们更高效,又能汇集全球数千名员工的事情 Curriculum是一个项目,我们为员工预付95%的学费,让他们去学习紧缺领域的课程,比如飞机机械师或护理,无论这些技能是否与亚马逊的职业相关,目标是提供选择,我们知道对于我们的一些旅游中心员工来说,亚马逊会是一份职业,对另一些人来说,亚马逊可能是通往其他地方工作的垫脚石,一份可能需要新技能的工作,如果合适培训能带来改变,我们愿意提供帮助,第二个项目叫付费离职,这是Zappos那帮聪明人想出来的 亚马逊的旅游中心一直在迭代优化,付费离职很简单,每年一次我们出钱请员工离职,第一年给2000美元,之后每年涨1000 直到5000美元封顶,这个邀约的标题写的是,请别接受这个邀约,我们希望他们别接受,我们希望他们留下来,那我们为什么还要提这个邀约,目的是鼓励大家花点时间,想清楚自己真正想要什么,从长远看,员工待在一个自己不想待的地方,对员工对公司都不健康,第三项内部创新是我们的虚拟联络中心,这个想法我们几年前就开始做了,一直在扩展,效果非常好,在这个项目下,员工在家就能为amazon和kindle 客户提供客服支持 这种灵活性对很多员工来说特别理想,比如家里有小孩或者其他原因,没法或者不想出门上班,我们的虚拟联络中心是美国增长最快的站点,目前已经在十多个州运营,这个增长还会继续,我们希望在2014年把覆盖的州翻一倍,退伍军人招聘我们寻找的领导者要能创新,敢想大的偏好行动,为客户交付结果,这些原则对在军队里为国效力过的男男女女来说应该很熟悉,我们发现他们带人的经验在我们快节奏的工作环境里非常宝贵,我们是joining forces和十万jobs mission的成员,这是两个全国性的倡议,鼓励企业为军人及其家属提供职业机会和支持 我们的军事人才团队去年参加了50多场招聘活动,帮退伍军人在Amazon找到工作机会 2013年我们招了超过1900名退伍军人,他们加入我们团队之后,我们还有好几个项目,帮他们更顺利的过渡到Civilian职场,也帮他们对接我们内部的退伍军人网络,获得指导和支持,这些项目让我们被GI Jobs Magazine US Veterans Magazine和Military Spouse Magazine评为最佳雇主,我们也会在增长过程中继续投入退伍军人招聘,旅游创新19年前,我每天晚上开着我的Chevy Blazer 把Amazon包裹送到邮局,那时候我的愿景远到梦想着有一天,我们也许能有一台刹车,快进到今天,我们有96个旅游中心 而且已经是第七代旅游中心设计了,我们的运营团队非常出色,既有方法论又充满巧思,通过我们的Kaizen项目,名字来自日语改善,员工们组成小团队,去精简流程,减少缺陷和浪费,我们的Earth Kaizens会设定节能,回收和其他绿色目标 2013年。 [02:30:00]
杰夫·贝佐斯:2013年,超过4700名员工,参与了1100个Kaizen 复杂的软件是我们的旅游中心的关键,今年我们在整个旅游中心网络里,推出了280项重大软件改进,我们的目标是持续迭代和改进这些建筑的设计布局技术和运营,确保我们建的每一个新设施都比上一个更好,我邀请你亲自来看一个,我们提供对公众开放的旅游中心参观,六岁及以上都可以,你可以在www.Amazon-factors.com找到可参观的信息,我每次去旅游中心都觉得很惊叹,希望你也安排一次参观,我觉得你会印象深刻的,城市园区2013年 我们在下途新增了42万平方英尺的总部空间,并且破土动工了一个将覆盖四个街区,几百万平方英尺的新建项目,说实话,我们本可以建在郊区来省钱,但对我们来说,留在城市里很重要,城市园区要绿色得多,我们的员工可以利用现有的社区和公共交通基础设施,减少对汽车的依赖,我们正在投资专用自行车道,提供安全无污染便捷的通勤方式,很多员工可以住在附近,完全不用通勤,走路就能上班,虽然我没法证明,但我也相信,一个城市总部会帮助Amazon保持活力,吸引到合适的人才,并且对我们员工和西雅图市的健康与福祉都大有好处 快速配送我们和美国邮政署合作,首次开始在部分城市提供周日配送,周日配送对Amazon客户来说是个好事,我们计划在2014年把它推广到美国大部分地区,在英国商业快递公司无法支撑我们的峰值运量,我们就自建了快速的最后一公里配送网络,在印度和中国配送基础设施还不太成熟,你能看到Amazon的自行车快递员在各大城市穿梭送货,而且还有更多创新在路上 Premier团队已经在试飞我们的第五代和第六代飞行器了,第七代和第八代也已经在设计阶段,实验还是实验,我们内部有一个叫WebLab的实验平台,用来评估网站和产品的改进 2013年我们在全球运行了1976个Weblab实验 2012年是1092个 2011年是546个,最近一个成功的例子是我们推出的新功能咨询买家,很多年前我们就开创了在线用户评论的先河,让顾客分享对产品的看法,帮助其他人做出更明智的购买决定,咨询功能,延续了这个传统,在商品页面上,顾客可以问任何跟产品相关的问题,比如这产品跟我的电视斜杠音响,斜杠电脑兼容吗,组装方面吗,电池能用多久,然后我们会把这些问题发给买过该产品的人,跟写评论一样,顾客很乐意分享自己的经验,直接帮助其他人 目前已经有数百万个问题被提出和解答了,服装与鞋履 Amazon Fashion正在蓬勃发展,高端品牌意识到,他们可以通过亚马逊触及时尚敏感,高消费力的顾客群,而顾客也很喜欢这里的选品,免费退货,细节照片,还有视频片段,可以看到模特走动和转身时,衣服的动态和垂坠感,我们在布鲁克林开了一个 4万平方英尺的新摄影棚,现在棚里的28个摄影区,平均每天要拍10413张照片,为了庆祝开业,我们举办了一场设计比赛,邀请了Pratt Parsons 纽约视觉艺术学院,和纽约时装技术学院的学生参加 评审团由业内领袖组成,包括Steven Cobb Eva Chen Aderic Lam Tracy Reese 和Steven Allen 祝贺Parsons拿下了头奖,简易包装,我们对抗脑仁铁丝扎带,和塑料硬壳包装的战斗仍在继续,这项计划始于五年前,最初的想法很简单,你买个新电子产品或玩具,不应该冒着受伤的风险去拆包装,现在它已经覆盖了超过20万种商品,全都采用易于打开,可回收的包装,旨在缓解开箱狂怒,并通过减少包装浪费,来保护地球,我们的简易包装计划,也有超过2000家制造商加入 包括Fisher,Price,Mattel,Unilever,Belkin,Victorinox,Swiss Army,Logitech等等,我们已经向175个国家,运送了数百万件简易包装商品,我们也在为顾客减少浪费,至今已省去了3300万磅的多余包装,这个项目是一个绝佳的例子,说明一个传教士般的团队,如何埋头专注于服务顾客,靠着努力和坚持,一个最初只有19种商品的点子,现在已覆盖数十万种商品,让数百万顾客受益,亚马逊物流去年使用亚马逊物流的卖家数量增长了超过65% 在如此大的规模下,这种增长很不寻常 FBA在很多方面都很独特,一个项目能同时让两方客户都满意,这并不常见,通过FBA卖家可以把商品存放在我们的运营中心,由我们来负责捡货,包装发货和客户服务,卖家受益于全球最先进的物流网络之一,能轻松扩展业务,触达数百万顾客,而且不是普通顾客,是Prime会员 FBA商品可以享受Prime免费两日达服务,顾客则能从更丰富的选品中受益,他们的Prime会员价值也更高了,而且不出所料,卖家加入FBA后销量都提升了,在2013年的一项调查中,近四分之三的FBA受访者表示,加入FBA后,他们在亚马逊上的销量增长了超过20% 这是一个双赢的局面 FBA是我拥有过的最好的员工,有天早上我醒来,发现FBA已经帮我发出了50件货,当我意识到自己可以在睡觉时卖东西,这根本不用想,作为一个不知名的品牌起步时,很难找到愿意进货的零售商,但在亚马逊不存在这种障碍,亚马逊的美妙之处在于,有人可以说我想创业,然后他们就能在亚马逊上真正开始一门生意,你不需要先租个地方,甚至一开始都不需要有员工,你自己就能干,我就是这么做的 Window Morris Yogurt 用亚马逊登录和支付,多年来我们一直让亚马逊顾客能在其他网站上支付,比如Kickstarter SmugMug和GoGoInFlight 直接使用他们已存储在亚马逊账户里的,信用卡和收货地址,今年我们扩展了这个功能,顾客也可以用他们的亚马逊账户凭证来登录了,省去了他们还得再寄一套用户名和密码的烦恼,这对顾客来说很方便,对商家来说也能促进生意,在线家具,零售商Symax Stores 在使用登录和支付功能后,取得了巨大成功,现在它占了他们订单量的20% 新账户注册量增加了两倍,头三个月的购买转化率提升了3.15% 这个例子并不特殊,我们在很多合作伙伴那里,都看到了类似的结果,团队对此非常兴奋和鼓舞 2014年你们可以期待更多 2013年我们推出了Amazon Smile 一个很简单的方式,让顾客每次购物都能支持自己最喜欢的慈善组织,你在smile.yamaha上购物 Amazon会把购买金额的一部分,捐给你选择的慈善机构,在smile.yamaha上,你会发现和亚马逊完全一样的选品价格,配送选项和prime资格,连你的购物车和心愿单都一样,除了那些你能想到的大型全国性慈善机构,你还可以指定本地的儿童医院,学校的家长教师协会,或者几乎任何你想支持的事业,有将近100万个慈善机构可以选,希望你能在列表里找到自己最喜欢的那个,这款设备本身已经很棒了,但Mayday功能简直太赞了 Kindle团队这次真是打了一场漂亮仗,刚在我的HDX上试了Mayday按钮 15秒响应 Amazon又做到了,彻底被震撼了,在Amazon 没有什么比重塑常态,更让我们开心,创造出顾客喜爱的发明,重新定义他们对常态,该是什么样的期待 Mayday重新想象,并彻底变革了设备端技术。 [02:40:00]
杰夫·贝佐斯:并彻底变革了设备端技术,支持这个概念,点一下Mayday按钮,一位Amazon专家,就会出现在你的Fire HDX上,可以在屏幕上画图引导你操作任何功能,手把手教你怎么自己做,或者直接帮你做哪种方式最有效,就用哪种 Mayday全年365天,每天24小时可用,我们的响应时间目标是15秒以内,我们超过了这个目标,在最忙的圣诞节那天,平均响应时间只有9秒,有些Mayday通话还挺好玩的 Mayday技术顾问收到了35次来自顾客的求婚,有475位顾客要求跟Amy通话,这是我们在电视广告里的那位Mayday代言人 有109次Mayday是顾客请求帮忙订披萨,披萨哈以微弱优势赢了Dominos 更受顾客偏爱,有44次Mayday技术顾问给顾客唱了生日快乐歌,每一类技术顾问被顾客献唱了648次,还有三位顾客要求讲睡前故事,挺酷的,我希望这能让你对我们的机会和举措的规模有一些感知,也能感受到背后的创新精神和对卓越品质的追求,我得再强调一下,这只是其中一部分,这封信里我省略了很多项目,他们和我重点讲的这些一样有前景,一样重要,一样有趣,我们很幸运拥有一支庞大,且富有创造力的团队,以及一种耐心开拓,痴迷于客户的文化 每天在公司各个层级,都在为客户发生着,大大小小的伟大创新,这种创新,在公司内部去中心化的分布,不止局限于公司的高层领导,是实现强劲高产出创新的唯一途径,我们在做的事情既有挑战性有好玩,我们有机会在未来里工作,失败是发明创造不可分割的一部分,它不是可选项,我们理解这一点,并且相信要尽早失败,不断迭代,直到做对为止,当这个过程奏效时,意味着我们的失败规模相对较小,大多数实验可以从小处开始,而当我们碰到真正对顾客有效的东西时,就会加倍投入,希望把它变成更大的成功,不过事情并不总是那么干净利落 发明创造是混乱的,而且随着时间的推移,我们肯定也会在一些大赌注上失败,最后我想缅怀一下Joy Covey Joy是Amazon早期的CFO 他在这家公司留下了不可磨灭的印记 Joy才华横溢充满热情,而且非常有趣,他总是笑容满面,眼睛总是睁得大大的,什么都逃不过他的眼睛,他重实质胜过表面,他是一个长期思考者,他内心沉稳坚定,周围非常大胆,他对我们整个高管团队,以及公司的整体文化,都产生了深远的影响,他的一部分会永远留在这里,确保我们关注细节,观察周围的世界,并且都保持快乐,能成为Amazon团队的一员,我感到无比幸运,和往常一样 我附上了我们1997年的原始制股东信,我们的方法始终如一,今天依然是第一天 Jeffrey P. Bezos创始人兼首席执行官 2014年4月 2014年制股东信,各位股东,一个梦幻的业务,至少得具备四个特征,顾客喜欢它,能涨到非常大的规模,资本回报率很高,而且经得起时间考验,有潜力持续几十年,当你找到这样一个业务,别只是诱哗直接结婚吧,我很高兴的向大家报告 Amazon在这方面可不算专一,经过20年的冒险和团队协作,再加上一路走来慷慨的好运气,我们现在幸福的迎娶了三个这样的终身伴侣 Marketplace Prime和AWS 这些业务一开始都是大胆的赌注,理智的人常常担心他们行不通,但到了现在,他们的特别之处和我们拥有他们的幸运已经相当清楚了。同样清楚的是商业里没有闲差,我们知道不断滋养和巩固他们,是我们的职责所在,我们会用惯常的工具来对待这份工作,痴迷于顾客,而非盯着竞争对手,对发明创造充满热忱,致力于卓越运营,以及愿意做长远思考,凭借良好的执行力和一点点持续的好运 Marketplace Prime和AWS还能在未来很多年里,服务顾客并赚取财务回报 Marketplace Marketplace的早期并不容易,一开始我们推出了Amazon Auctions 我记得只来了七个人,这还算上了我父母和兄弟姐妹 Auctions后来变成了Zshops 基本上是固定价格的拍卖模式,还是没有顾客,但接着我们把Zshops改造成了Marketplace 在内部Marketplace被称为SDP 也就是单一详情业,这个想法是拿出我们最有价值的零售地产,我们的商品详情业,让第三方卖家跟我们自己的零售品类经理同台竞争,这对顾客来说更方便,一年之内他就占了总销量的5% 今天我们超过40%的销量,是由全球超过200万第三方卖家完成的 2014年顾客从卖家那里订购了超过20亿件商品 这种混合模式的成功加速了Amazon的飞轮,顾客最初是被我们快速增长的自营商品所吸引,价格好体验棒,然后通过允许第三方在旁边提供商品,我们对顾客的吸引力更大了,这吸引了更多卖家,这也增加了我们的规模效应,我们通过降低价格和未符合条件的订单免运费,把好处传递了出去,在美国推出这些项目后,我们以最快的速度把它们推广到了其他地区,结果就是一个与我们全球所有网站无缝继承的marketplace 我们努力减少卖家的工作量,并提高他们业务的成功率,通过我们的Sell & Coach项目,我们生成了一系列由机器学习驱动的自动化提醒,通常一周超过7000万条,提醒卖家避免缺货 增加热销选品,并调整价格以提升竞争力,这些提醒为卖家,转化成了数十亿美元的销售增长,为了进一步让marketplace全球化,我们现在正帮助我们在各个地区的卖家,以及那些我们尚未开展业务的国家的卖家,去触达他们本国以外的顾客,去年我们接待了来自超过100个不同国家的商家,并帮助他们与185个国家的顾客建立了联系,现在我们近五分之一的第三方总销售额,发生在卖家的本国之外,而且我们商家的跨境销售额去年几乎翻了一番,在欧盟卖家可以开设一个账户,用多种语言管理业务 并在我们五个欧盟网站上架商品,最近我们开始为卖家整合跨境运输,并帮助他们以优惠的批量价格,获取从亚洲到欧洲和北美的海运服务 Marketplay是我们在印度快速增长的业务核心,因为我们在印度的所有选品,都由第三方卖家提供 Amazon点链现在提供的商品种类,比印度任何其他电商网站都多,有超过21000个卖家提供的,超过2000万种商品,通过我们的EasyShip服务,我们从卖家那里取货,并一路配送到最终顾客手中,在EasyShip的基础上,印度团队最近试点了Korana 那这项服务能在2到4小时内,将日常必需品,从当地的Korana夫妻店,送到顾客手中 既为顾客增添了便利,也为参与服务的店铺,增加了销售额,也许对卖家来说,最重要的是我们创建了 Fulfillment by Amazon 但我想把这个留到我们讨论完 Prime之后再说 Amazon Prime十年前,我们推出了Amazon Prime 最初的设计是一个,无限量免费,且快速的配送服务,我们反复被告知,这是一个冒险的举动,从某些方面看也确实如此,在它推出的第一年,我们放弃了数百万美元的运费收入,而且没有简单的数学计算能证明,这会是值得的,我们决定推进,是基于早先推出Free Super Saver Shipping时,看到的积极成果,以及一种直觉,顾客会很快意识到,他们得到的是购物史上最划算的交易 此外分析告诉我们,如果能达到规模,我们就能显著降低快速配送的成本,我们的自营零售业务是prime的根基,除了组建零售团队来搭建各个品类的线上商店。 [02:50:00]
杰夫·贝佐斯:除了组建零售团队来搭建各个品类的线上商店,我们还建立了大规模系统,把库存补货,库存摆放和产品定价的大部分工作都自动化了 prime那种精确到天的配送承诺,要求我们用全新的方式运营旅游中心,而把这一切整合起来,是我们全球运营团队最了不起的成就之一,我们在全球的旅游中心网络,从2005年推出Prime时的13个,扩展到了今年的109个,现在我们的旅游中心设计已经迭代到第八代,用自研软件来管理收货,上架减货和发货 Amazon Robotics从2012年收购Kiva开始起步,现在已经部署了超过15000台机器人 以比以往更高的密度和更低的成本来支持产品的上架和取货,我们的自营零售业务仍然是Prime最好的获客工具,也是拓展品类吸引流量和第三方卖家的关键一环,虽然快速配送依然是Prime的核心权益,但我们也在找新的方式给Prime注入能量,其中最重要的两个方向就是数字内容和设备 2011年我们把Prime Instant Video加进了权益里,现在美国有数万部电影和电视剧可以无限量在线观看,我们也开始把这个项目扩展到英国和德国,我们在内容上投入很大,所以监控它的效果就很重要,我们会问自己这值不值,它在推动Prime增长吗,我们会看很多指标 比如Prime免费使用的开通情况,转付费会员的比例,续费率,以及通过这个渠道进来的会员购买产品的频率,目前我们看到的数据还不错,打算继续在这里投入,虽然我们在piv上的支出大部分是买授权内容,但我们也开始做原创了,团队起步很猛,我们的剧集透明家庭成了第一个拿下金球奖最佳剧集的流媒体作品 Tumble Leaf也拿了安妮奖的最佳学龄前动画剧集,除了口碑好,数据也很可观,做原创节目的一个优势是,它的首播就在Prime上,之前没在任何地方播过,再加上剧集本身的质量,这种首播属性,似乎是带来亮眼数据的关键因素之一,我们也喜欢原创节目固定成本的特点 可以把这笔固定成本,摊到我们庞大的会员基数上,最后我们做原创内容的商业模式很特别,我敢说我们是第一家,想明白怎么把拿金球奖转化成电钻,和婴儿诗经销量增长的公司 Amazon自己设计和制造的设备,从Kindle到Fire TV再到Echo 也在给Prime Instant Video和Prime Music 这些服务注入能量,整体上提升了用户在Amazon生态里各个环节的参与度,而且后面还有更多我们的设备团队手里有一条很强,很让人兴奋的产品路线图 Prime在最初承诺的免费快速配送上也没停下脚步,最近推出的Prime Now 让Prime会员可以在数万种商品上享受免费两小时送达,或者付7.99美元享受一小时送达,很多早期评价都是这样的,过去六周,我和我老公在Amazon Prime 那要上下的单多得有点不好意思,便宜方便,而且快得离谱,我们已经在曼哈顿,布鲁克林,迈阿密,巴尔德摩,达拉斯,亚特兰大和奥斯汀上线了,更多城市也快了,现在我想聊聊fulfillment by Amazon FBA非常重要,因为它就像浇水,把Marketplace和Prime牢牢粘在了一起,有了FBA Marketplace和Prime不再是两件事了,说实话,到现在这个阶段,我已经没法把他们分开来看,他们的经济效益和客户体验 已经愉快的深度的交织在一起了 FBA是给Marketplace卖家的一项服务,当卖家决定用FBA 他们就把库存放到我们的旅游中心,我们接手所有的物流客服和退货,如果一位客户同时订了一件FBA商品和一件Amazon自营商品,我们可以把两件东西装在一个箱子里寄出去,效率提升非常大,但更重要的是卖家一加入FBA 他们的商品就有资格变成prime商品,牢牢抓住那些显而易见的事,比人们想象的要难,但值得去试,如果你问卖家想要什么,正确的也是显而易见的,答案是他们想要更多销量,那么当卖家加入FBA商品变成prime商品之后,会发生什么,他们拿到更多销量,再注意一下 从prime会员角度看会发生什么,每当有卖家加入FBAprime会员能买到的prime商品选择就更多了,会员的价值就上升了,这对我们的飞轮来说非常有利 FBA完成了这个闭环 Marketplace给Prime注入能量 Prime也给Marketplace注入能量,在2014年,一项针对美国卖家的调查中 71%的FBA商家报告,说加入FBA后,销量增长了超过20% 在假日季,全球FBA发货量,同比增长了50% 占到了付费第三方商品,发货量的40%以上,美国付费Prime会员数去年增长了超过50% 全球增长了53% FBA对客户是赢,对卖家也是赢 Amazon Web Services 9年前刚推出时是个激进的想法,现在Amazon Web Services已经规模很大,而且增长很快,创业公司是早期的采用者,按需使用,按用量付费的云存储和算力,极大的加快了创业的速度,像Pinterest,Dropbox和Airbnb这样的公司,都用过AWS的服务,而且到今天仍然是我们的客户,从那以后,大型企业也开始加入进来,他们选择AWS的主要原因,跟那些创业公司一样,速度和敏捷性,成本更低,当然有吸引力,有时候省下的绝对金额也非常可观,但光靠省钱,永远弥补不了性能或功能上的缺陷,企业依赖IT 这是关键任务,所以像我能帮你每年省下一大笔IT开销,而且我的服务跟你现在用的差不多 这种说法吸引不了太多客户,在这个领域,客户真正想要的是更好更快,如果更好更快还能顺带省点钱,那当然好,但省钱是肉汁,不是牛排 It的杠杆效应太强了,你不会想看到竞争对手的IT部门,比你的更灵活,每家公司都有一长串技术项目清单,业务部门希望越快落地越好,痛苦的现实是总要做出艰难的取舍,很多项目永远做不完,就算拿到资源的项目,也常常延期交付或者功能不完整,如果一个IT部门能找到办法,更快的交付更多能驱动业务的技术项目,他们就是在为组织创造巨大真实的价值,这就是AWS增长这么快的主要原因 IT部门正在意识到,采用AWS能让他们做成更多事,他们花在低附加值活动上的时间变少了,比如管理数据中心,网络大操作,系统补丁,做容量规划,数据库扩容等等,同样重要的是,他们能接触到强大的API和工具,这些能极大的简化构建,可扩展安全健壮高性能系统的过程,而且这些API和工具会在后台持续无缝的升级,客户完全不用操心,今天AWS拥有超过100万个活跃客户,各种规模的公司和组织,几乎在所有能想到的行业领域里使用AWS 2014年第四季度 AWS的使用量同比增长了大约90% 像通用电器,美国职业棒球大联盟 塔塔汽车和澳洲航空,这样的公司,都在AWS上构建新应用,从重包和个性化医疗应用,到管理卡车车队的移动应用,其他客户,比如NTDcomo 金融时报和美国证券交易委员会,正在用AWS分析海量数据,并采取行动,还有很多客户,像康泰纳市,加勒市和新闻集团,正在把遗留的关键应用,有些甚至是整个数据中心,迁移到AWS 一路走来,我们创新的步伐在不断加快,从2012年推出近160项新功能和服务,到2013年的280项,再到去年的516项,有很多都值得一谈,从WorkDocs和WorkMail 到AWS Lambda ECR容器服务 再到AWS Marketplace 但为了简短起见,我只讲一个,我们最近推出的Amazon Aurora 我们希望Aurora能为客户树立一个新标杆,针对一项非常重要,但又非常棘手的技术,它是许多应用的关键基础。 [03:00:00]
杰夫·贝佐斯:它是许多应用的关键基础,关系型数据库 Aurora是一个兼容Mesico的数据库引擎,能提供高端商业数据库的速度和可用性,同时兼具开源数据库的简洁和成本效益 Aurora的性能比典型的MySQL数据库高出最多五倍,成本却只有商业数据库套件的十分之一,关系型数据库这个领域,长期以来一直是组织和开发者的一个痛点,我们对Aurora感到非常兴奋,我相信AWS是那种梦幻般的业务,能在未来很多年里服务客户并赚取财务回报,我为什么这么乐观,首先市场机会巨大,最终会涵盖全球在服务器网络数据中心 基础设施软件数据库数据仓库等等方面的支出,就像我看待亚马逊零售业务一样,从实际角度出发,我相信AWS市场规模是不受限制的,其次,它目前显著的领先地位是一个强大的持续优势,我们非常努力的让AWS尽可能易用,即便如此,它仍然是一套必然复杂的工具集,功能丰富,学习曲线也不低。一旦你熟练掌握了用AWS构建复杂系统,只要这套你已经理解的工具和API还能满足需求,你就不会想再去学一套新的,这绝不是我们可以高枕无忧的地方,但如果我们能继续以真正卓越的方式服务客户,他们理性上就会倾向于继续和我们站在一起 此外同样因为我们的领先地位,我们现在有成千上万名AWS大使遍布全球,换工作的软件开发者,从一家公司跳槽到另一家,就成了我们最好的销售,我上一家公司就用AWS 我们这也应该考虑一下,我觉得用了能做成更多事,这是一个好迹象,说明熟练掌握AWS服务,已经是软件开发者会写进简历里的东西了,最后我对AWS的资本回报率也很乐观,这是我们团队一直在审视的问题,因为AWS是资本密集型的业务,好消息是,我们做这些分析时看到的情况是让人满意的,从结构上看 AWS的资本密集度远低于它所替代的模式,也就是企业自建数据中心 那些数据中心的利用率很低,几乎总是低于20% 把不同客户的工作负载汇集到一起,让AWS获得了高的多的利用率,资本效率也相应更高,而且我们的领先地位再次帮了忙,规模经济可以让我们在资本效率上,获得相对优势,我们会继续关注并塑造这项业务,以实现良好的资本回报 AWS还很年轻,人在成长和演变,我们相信,只要继续把客户需求放在首位去执行,我们就能继续保持领先,在结束之前,我想花一点时间跟股东们分享一件让我们既兴奋又自豪的事,三年前我们推出了一项创新的员工福利 CareChoice项目,我们为员工预付95%的学费 让他们去学习热门领域的课程,比如飞机机械师或护理,不管这些技能跟他们在亚马逊的职业是否相关,想法很简单,让选择成为可能,我们知道对我们一些旅游中心和客服中心的员工来说,亚马逊会是一份事业,对另一些人来说,亚马逊可能是通往别处工作的一块跳板,一份可能需要新技能的工作,如果合适的培训能带来改变,我们就愿意帮忙,到目前为止,我们已经在八个国家帮助了超过2000名参与这个项目的员工,大家的兴趣非常浓厚,我们现在正在旅游中心内部建设现场教室,这样大学和技术课程就可以直接在旅游中心里授课,让同事们更容易实现这些目标,现在已经有八个旅游中心 在专门建造的教室里提供15门现场授课,这些教室配备了高端技术设施,并设计成玻璃墙,以激励其他人参与,也能从同事那里获得鼓励,我们相信career choice是一种创新的方式,可以吸引优秀人才来为我们在履约和客服中心的客户服务,随着我们在全球的扩张,这些工作可以成为通往亚马逊伟大事业的入口,或者让员工有机会追随自己的热情,进入其他热门技术领域,就像我们第一位career choice毕业生那样,他在自己的社区开启了一份护士的新事业,我也想邀请你来参观我们的旅游中心,亲眼看看你在亚马逊上点击购买之后发生的魔法,目前已经有超过24000人报名参加了,除了美国的参观活动 我们现在还在全球各地提供参观,包括英国的Rugeli和德国的Grabben 并且还在继续扩展,你可以在www.Amazon-factors报名参观,新兴新肯 Marketplace Prime和Amazon Web Services 是三个大创意,我们很幸运能拥有他们,也决心去改进和培育他们,让他们对客户来说变得更好,你也可以指望我们会努力去寻找第四个,我们手头已经有不少候选项目在推进了,而且正如我们大约20年前承诺的那样,我们会继续下大胆的赌注,面对眼前通过创新来更好服务客户的机遇,我们向你保证我们不会停止尝试 和往常一样,我附上了我们1997年的原始制股东信,我们的方法保持不变,因为今天依然是第一天 Jeffrey P. Bezos创始人兼首席执行官 2015年致股东信至各位股东,今年Amazon成为史上最快达到年销售额10亿美元的公司,同样在今年Amazon Web Services的年销售额也即将达到10亿美元,达到这个里程碑的速度,甚至比Amazon当初还要快,这背后是怎么回事,这两项业务最初都只是拨下的小种子,然后都靠自身有机成长,没有通过大规模收购,就迅速变成了举足轻重的大业务 表面上看,两者几乎截然不同,一个服务消费者,另一个服务企业,一个以棕色指向闻名,另一个以API闻名,两种如此不同的业务,在同一家公司旗下都发展的这么快,难道仅仅是巧合吗,运气在任何事业里都扮演着巨大的角色,我可以向你保证,我们得到的运气确实不少,但除此之外,这两项业务之间存在着一种联系,在表象之下,他们其实并没有那么不同,他们共享一种独特的组织文化,这种文化深切关注,并坚定践行着少数几条原则,我指的是痴迷客户,而非痴迷竞争对手,渴望发明创造,敢为人先,愿意接受失败,有耐心做长远思考,并以卓越运营为职业骄傲,从这个角度看 Adolphe Amazon零售业务,确实非常相似,关于企业文化,我想说几句,无论好坏,他们都是持久稳定,且难以改变的,他们可以成为优势的来源,也可以成为劣势的来源,你可以把企业文化写下来,但当你这么做的时候,你是在发现它,揭示它,而不是创造它,它是随着时间推移,由人和事件慢慢塑造的,由那些过往成功与失败的故事,逐渐沉淀为公司传统中根深蒂固的一部分,如果它是一种独特的文化,就会像定制手套一样,完美贴合某一类人,文化之所以能长期保持稳定,原因在于人们会自我选择,一个被竞争热情驱动的人,可能会选择并享受某一种文化 而一个热爱开拓和创新的人,则可能会选择另一种,值得庆幸的是,这世界上充满了许多高绩效,极具特色的企业文化,我们从不声称自己的方法,就是唯一正确的,我们只说这是我们的方法,在过去20年里,我们聚集了一大批志同道合的人,这些人觉得我们的方法,让他们充满干劲,也觉得很有意义,我认为我们尤其与众不同的,一个方面是对待失败的态度,我相信我们是全世界,最适合失败的地方,我们有的是练习的机会,而失败与创新,是一对不可分割的双胞胎,要创新你就必须实验,如果你事先就知道,它会成功,那它就不是实验了,大多数大型组织,都拥抱创新的理念 但却不愿意承受,实现创新所必须的,一连串失败实验,超额的回报往往来自于跟传统智慧对赌。 [03:10:00]
杰夫·贝佐斯:超额的回报往往来自于跟传统智慧对赌,而传统智慧通常是正确的,如果一件事有10%的机会获得100倍的回报,那你每次都该下注,但你仍然会有九成的概率是错的,我们都知道,如果你想全力挥棒击出全雷打,就肯定会经常被三振出局,但你也会打出一些全雷打,不过棒球和商业的区别,在于棒球的得分分布是截断的,当你挥棒时,无论你击球多完美,你最多只能得四分,但在商业世界里,偶尔当你站上打击区,你有可能一次拿下一千分,正是这种长尾分布的回报,让大胆尝试变得如此重要,大的成功足以覆盖无数次实验的成本 AWS Marketplace和Prime 都是Amazon成功的大胆赌注,我们很幸运能拥有这三大支柱,他们帮助我们成长为一家大公司,而有些事情只有大公司才能做到,这里要向我们西雅图的邻居们致敬,无论你是一位多么优秀的企业家,你都不可能在自己的车库创业公司里,造出一架全符合材料的七八七客机,至少造不出你敢做的那种,善加利用的话,我们的规模能让我们为客户打造出那些原本想都不敢想的服务,但反过来说,如果我们不够警惕,不够深思熟虑,规模也可能拖慢我们的速度,削弱我们的创造力,每当我和Amazon各团队交流时,我总会为他们展现出的热情,智慧和创造力感到惊叹 我们的团队在过去一年里取得了许多成就,我想分享其中一些亮点,关于我们如何滋养,并全球化我们的三大核心业务 Prime Marketplace和AWS 虽然我会重点讲这三个,但我向你保证,我们也在努力寻找第四个 Prime 我们希望Prime的价值如此之高,以至于你不成为会员,都显得很不明智,我们把Prime两日大的商品选择,从100万件增加到了超过3000万件,增加了周日配送,并在全球超过35个城市,为数十万种商品,推出了免费当日达服务,我们还增加了音乐,照片存储 Kindle用户借阅图书馆,以及流媒体电影和电视剧 Prime为会员提供部分精选商品的,一小时送达服务,这个项目从购司到上线,只用了111天,在那段时间里,一个小团队开发了面向客户的APP 为城市仓库选定了地点,确定了要销售的25000种商品,完成了备货,招聘并培训了新员工进行了测试,迭代设计了内部使用的新软件,包括一个仓库管理系统,和一个面向司机的APP 并赶在假日记成功上线,今天距离首个城市,上线仅仅15个月 Prime Now已经在全球超过30个城市为会员提供服务 Prime Video提供了一些独家内容,来自全世界最有热情的讲故事的人,我们希望像Joe Soloway Jason Schwartzman和Spike Lee 这样出色的创作者去冒险,去突破边界,我们的原创剧集已经获得了超过120项提名,拿下了将近60个奖项,包括金球奖和爱美奖,其中很多故事在传统的现行节目模式里可能永远没机会被讲出来,正在筹备即将上线的还有Jeremy Clarkson David E. Kelly Woody Allen和Kenneth Lonergan等创作者的新剧和电影 《高宝奇人》改编自Philip K. Dick的小说,探索了一段美国输掉二战的架空历史,它在11月20日上线Prime Video 四周内就成了我们观看量最高的剧集,评论界也给了很高的评价,比如Amazon拿出了本季最佳新剧,高宝奇人,还有高宝奇人 做到了很多如今大多数新播出的电视剧,连试都不敢试的事,这些剧集对用户来说很棒,同时也在推动Prime的飞轮,看过Prime Video的Prime会员,从免费试用转为付费会员的概率更高,续订年费的概率也更高,最后我们的第一次Prime Day完全超出了预期,那一天新加入Prime的会员数,超过了我们历史上任何一天,全球订单量相比去年同一天增长了266% 而通过FBA让商品符合Prime资格的卖家,销售额也破了纪录,增长接近300% Prime已经变成了一个会员热爱的,可以无限享用的实体数字混合体,去年会员数增长了51% 其中美国增长了47% 国际增长更快,现在全球已经有数千万会员,你很可能已经是其中一员了,但如果还不是,请务必对自己负责,加入Prime Marketplace在15年多以前,推出Marketplace之前,我们有过两次大的尝试,都失败了,一次是Auctions 一次是Zshops 我们从失败中吸取了教训,但对愿景一直很执着,如今Amazon上售出的商品,有将近50%来自第三方卖家 Marketplace对用户很好,因为它增加了独特的选品,对卖家也很好,现在有超过7万名,年销售额超过10万美元的创业者,在Amazon上销售,他们创造了超过60万个新的工作岗位,有了FBA 这个飞轮赚得更快,因为卖家的库存符合了prime资格 prime对会员来说变得更有价值,卖家也能卖出更多东西,今年我们推出了一个新项目,叫seller fulfilled Prime 我们邀请那些在发货速度和服务的稳定性上,能达到高标准的卖家加入prime项目,让他们直接以prime的速度配送自己的订单,这些卖家的销售额已经出现了显著增长,而且这个项目让美国英国和德国的prime用户,可以通过免费的两日达或次日达服务,买到额外数十万种商品,我们还创建了amazon landing项目来帮助卖家成长,自项目启动以来,我们已经通过短期贷款,向美国英国和日本的微型小型和中型企业 提供了总计超过15亿美元的融资,目前的未偿还贷款余额大约在4亿美元 Steven Erstal是一位冲浪爱好者,也是Tower Paddle Boards的老板,他就是受益者之一,他的公司已经成为圣地亚哥增长最快的企业之一,这在一定程度上得益于Amazon Landing的帮助,这种点击即可获取资金的方式,帮助了这些小企业成长,让用户有了更丰富的选择,也让Amazon受益,因为我们的Marketplace收入会随着卖家的销售额一起增长,我们希望扩大Amazon Lending的规模,现在正在探索与银行合作的方式,让他们能利用自己的专业能力来承担和管理大部分信用风险,除了培育我们的大型业务 我们也在努力让他们全球化,我们的marketplace为任何地方的卖家,创造了接触全球买家的机会,过去很多卖家因为跨境销售的实际困难,会把客户群局限在本国,为了让marketplace全球化,为卖家拓展更多机会,我们打造了销售工具,去年帮助172个国家的创业者,接触到了189个国家的客户,这些跨境销售现在已占Amazon所有第三方售出商品数量的近四分之一,为了实现这一点,我们翻译了数亿条商品信息,并提供了44种货币的兑换服务,现在即使是小众的小卖家,也能利用我们的全球客户群和全球物流网络 最终的结果跟卖家自己一件一件的处理跨境物流完全不一样 Plugable Technologies的CEO Bernie Thompson是这么说的,当你能把货物批量,运到欧洲或日本的仓库,然后在一两天内完成配送时,这真的改变了整个模式,印度是我们通过客户至上,和发明热情来全球化marketplace的,另一个例子 Bingo 去年我们搞了一个叫Amazon拆卡的项目,用三轮移动推车在城市商业区穿行,给小微企业主提供茶水水和柠檬汁,同时教他们怎么在网上卖东西,四个月里团队跑了31个城市,行程15280公里,送出了37200杯茶 接触了超过1万名卖家,通过这个项目以及跟卖家的其他交流,我们发现很多人对线上销售很感兴趣,但卖家普遍觉得这个过程太耗时,太繁琐,太复杂,于是我们发明了Amazon TechCow。 [03:20:00]
杰夫·贝佐斯:于是我们发明了Amazon TechCow 让小企业能在不到60分钟内上线 Amazon TechCow是一个特制的移动工作室,提供一整套上线服务,包括注册拍照,编幕,还有基础的卖家培训,自2月17日推出以来,我们已经覆盖了25个城市的卖家,我们也在全球化fulfillment by Amazon 根据本地客户需求调整服务,在印度我们推出了一个叫CellarFlex的项目,把亚马逊的物流能力,跟卖家在本地社区层面的选品结合起来,卖家在自己的仓库里划出一块地方,存放要在亚马逊上卖的商品,我们把它配置成我们网络里的一个旅游中心,可以接收和处理客户订单,我们的团队会提供仓库布局 IoT和运营基础设施方面的指导,并培训卖家在现场遵循标准操作流程,我们现在已经在10个城市,启动了25个运营中的Celerflex站点 Amazon Web Services就在十多年前 AWS在美国起步,推出了它的第一个主要服务,一个简单的存储服务,今天AWS提供超过70种服务,涵盖计算,存储数据库分析移动物联网和企业应用,我们还在全球12个地理区域提供33个可用区,另外还有5个区域和11个可用区将在未来一年内,在加拿大中国印度美国和英国上线 AWS从开发者和创业公司起步,现在被超过100万个客户使用,这些客户来自几乎所有行业各种规模的组织 像Pinterest,Airbnb,GE,Enel,Capital One Intuit,Johnson,Johnson,Philips,Hess,Adobe,McDonald's,Time Inc.这样的公司 AWS比亚马逊电商在成立十年是规模更大,增长速度更快,而且在我看来最值得注意的是,创新的步伐还在持续加快,我们在2015年宣布了722项重要的新功能和服务,比2014年增长了40% 很多人当初把我们做AWS 形容为一个大胆而且不寻常的赌注,这跟卖书有什么关系,我们本可以守着自己的老本行,我很庆幸我们没有,或者说我们真的偏离老本行了吗,也许我们的老本行与其说是业务领域 不如说是我们的做事方式 AWS是客户至上的,乐于发明和实验的,着眼长期的,并且对运营卓越有着深切的关注,经过十年和无数次迭代,这种方式让AWS迅速扩展成为全球最全面,采用最广泛的云服务,就像我们的零售业务一样 AWS有许多小团队组成,每个团队有单一负责的领导者,这让快速创新成为可能,团队几乎每天都在70多种服务中推出新功能,而这些新功能对客户来说直接就出现了,不需要升级,很多公司自称以客户为中心,但很少能真正做到,大多数大型科技公司是以竞争对手为中心的,他们看别人在做什么,然后努力快速跟进 相比之下,我们在AWS构建的东西里 90%到95%是由客户告诉我们,他们想要什么来驱动的,一个很好的例子是我们的新数据库引擎 Amazon Aurora 客户一直对传统商业级数据库提供商的专有特性,高昂成本和许可条款感到不满,虽然很多公司开始转向更开放的引擎,比如MySQL和Postgres 但他们往往难以获得所需的性能,客户问我们能不能消除这种令人为难的取舍,这就是我们构建Aurora的原因,它具备商业级的持久性和可用性,完全兼容MySQL 性能比典型的MySQL实现最高能好五倍,但价格只有传统商业级数据库引擎的十分之一,这在客户中引起了强烈共鸣 Aurora是AWS历史上增长最快的服务,几乎同样的故事也可以用在Redshift上,我们托管数据仓库服务,它是AWS历史上增长第二块的服务,无论大小公司都在把他们的数据仓库迁移到Redshift 我们的定价方式也源于我们以客户为中心的文化,我们已经降价51次,很多次是在还没有任何竞争压力的情况下就这么做了,除了降价,我们还持续推出新的低成本服务,比如Aurora Redshift Quicksight 我们的新商业智能服务 ECR Container Services 我们的新计算容器服务,以及Lambda 我们开创性的无服务器计算能力,同时我们也在不断扩展服务,为几乎你能想到的任何应用或IT场景 提供一系列极具成本效益的选择,我们甚至推出并持续改进,像Trusted Advisor这样的服务,它会提醒客户哪里可以省钱,已经帮客户省下了数亿美元,我敢说我们大概是唯一一家告诉客户,怎么少给我们花钱的IT供应商,不管你是昨天刚成立的创业公司,还是已经经营了140年的老牌企业,云都给我们所有人提供了难以置信的机会,去重塑业务,增加新的客户体验,重新配置资本来推动增长,提升安全性,而且这一切都比以前快得多 MLB Advanced Media 就是一个不断重塑客户体验的AWS客户 MLB的Starcast追踪技术,是给棒球迷的一项新功能,它能测量场上每个球员 跑垒员和球在每一次攻防中的移动位置,让任何屏幕前的观众都能看到实证数据,去回答那些如果会怎样的老问题,同时也催生出新的问题 Starcast把棒球变成了火箭科学,它用一套导弹雷达系统,以每秒超过2000次的频率测量每个投球的运动轨迹,通过Amazon Kinesis 我们处理实时流数据的服务,实时传输和收集数据,把数据存储在Amazon S3上,然后在Amazon EC2里进行分析,这套服务每场比赛会产生将近7TB的原始统计数据,整个赛季则高达17PB 用定量的方式去验证那些流传已久,但从未被证实过的棒球智慧 比如永远别滑进一类,大约七年前Netflix宣布要把所有应用迁移到云端 Netflix选择AWS是因为我们能提供最大的规模,和最广泛的服务与功能 Netflix最近完成了他们的云迁移,像他们这样的故事正变得越来越普遍 Infer,Intuit和Time,Inc等公司都已经计划把全部应用迁移到AWS AWS现在已经足够好,吸引了超过100万客户,而且服务只会越来越好,随着团队继续保持快速的创新节奏,我们会提供越来越多的能力,让构建者不受束缚的去创造,收集存储和分析数据会变得越来越容易,我们会继续增加更多的地理区域,移动和联网设备,应用也会持续增长,随着时间的推移,很可能大多数公司都会选择 不再运营自己的数据中心,而是转向云,发明机器,我们想成为一家大公司,同时也是一台发明机器,我们想把规模所带来的,非凡客户服务能力,与创业公司通常才有的行动速度,灵活性和风险承担心态结合起来,我们能做到吗,我很乐观,我们已经有了一个不错的开端,而且我认为我们的文化让我们有能力实现这个目标,但我不认为这会很容易,有一些微妙的陷阱,即使是高绩效的大型组织,也可能会不自觉的掉进去,我们作为一个机构,必须学会如何防范他们,大型组织常见的一个陷阱,它会损害速度和创造力,就是一刀切的决策方式,有些决策影响重大且不可逆 或者几乎不可逆是单向门,这类决策必须有条不紊,谨慎缓慢的做出经过深思熟虑和充分协商,如果你走过去,发现不喜欢门那边的景象,就再也回不到原来的地方了,我们可以把这些称为第一类决策,但大多数决策并非如此,它们是可变的,可逆的,是双向门,如果你做了一个不太理想的第二类决策,不用承受太久的后果,你可以重新打开门走回去,第二类决策可以,而且应该有判断力强的个人或小团队快速做出,随着组织规模变大,似乎有一种倾向,就是在大多数决策上都套用那种重量级的第一类决策流程,包括很多第二类决策,这样做的最终结果就是行动迟缓,缺乏思考的风险规避,实验做得不够 进而导致创新减少,我们必须想办法对抗这种倾向,而一刀切的思维,只会是众多陷阱中的一个,我们会努力避免它。 [03:30:00]
杰夫·贝佐斯:我们会努力避免它,以及任何我们能识别出的,其他大公司病,可持续性与社会创新,我们的增长发生的很快 20年前,我开着我的雪佛兰blazer 把箱子运到邮局,梦想着有一台叉车,我们增长发生,从绝对数字来看,而不是百分比,过去几年尤其显著,我们从2010年的3万名员工,增长到了现在的超过23万人,我们有点像那种父母,某天环顾四周,突然意识到孩子们都长大了,一眨眼的功夫就发生了,我们当前规模令人兴奋的一点是,我们可以把我们的创新文化,投入到推动可持续性,和社会议题的进步上,两年前我们设定了一个长期目标 让AWS全球基础设施,百分之百使用可再生能源,此后我们宣布了四个重要的风能和太阳能发电厂,每年将向供应AWS数据中心的电网,额外输送160万兆瓦时的可再生能源 Amazon Wind Farm Fowler Ridge is in Binwan Fahden 去年ILZOS的可视率能源使用比例达到了25% 今年有望达到40% 我们还在推进覆盖亚马逊全球所有设施的目标,包括我们的旅游中心,我们会继续在包装等领域加大投入,我们的创新文化在这里催生了一个大赢家 Frustration Free Packaging计划,七年前我们启动这项计划时只有19款产品,今天全球已有超过40万款产品参与 2015年该计划减少了数千万磅的多余包装材料 Frustration Free Packaging 让客户很开心,因为包装更容易打开,对地球有益,因为它减少了浪费,对股东也有好处,因为包装更紧凑,我们运输的空气更少,节省了运输成本,我们也在持续为员工推出新的计划,比如Career Choice Leave Share Ramp Back Career Choice会预付95%的学费,用于学习热门技能课程,无论这些技能是否与亚马逊的职业生涯相关,我们会为护理认证飞机机械式课程等许多项目付费,我们正在旅游中心内建造玻璃墙教室,以鼓励员工参与,并让这件事变得更容易,我们通过像Sharry Wormack这样的故事看到了影响,他是一位有八个孩子的单身母亲 曾在凤凰城的一个旅约中心工作 Career Choice资助Sharry考取了18轮大货车的驾照 Sharry很努力通过了考试,现在他是Schneider Trucking的长途司机,而且非常热爱这份工作,明年我们将启动一个项目,向其他感兴趣的公司介绍Career Choice的好处,以及如何实施 Leave Share和Ramp Back是为新手父母在家庭成长过程中提供灵活性的计划 Leave Share允许员工将自己的亚马逊代薪假期分享给配偶或同居伴侣,前提是配偶的雇主不提供代薪假期Ramp Back 则让生育后的母亲能更好地控制自己重返工作岗位的节奏,就像我们的医疗保健计划一样,这些福利是平等的 旅游中心和客服员工享有的福利,与我们最高级别的高管是一样的,课再生能源frustration free packaging career choice leave share和rent back 这些都是我们拥抱创新,和长期思维的文化力争,想到我们的规模,能提供在这些领域创造影响的机会,这非常令人振奋,我可以告诉你们,每天能和这么一群聪明富有想象力,又充满热情的人一起工作,对我来说是巨大的快乐,我代表亚马逊全体员工,感谢各位股东的支持,和往常一样,我附上了我们1997年的原始制股东信,我们的方法始终如一,今天依然是第一天 Jeffrey P. Bezos创始人兼首席执行官 2016年制股东信 Jeff第二天会是什么样,这是我在最近一次全员会上刚被问到的问题,过去二十来年,我一直在提醒大家,我们还在第一天,我在亚马逊办公的那栋楼就叫第一天换办公楼的时候,我把这个名字也带走了,我花了不少时间琢磨这个话题,第二天就是停滞,接着是变得无关紧要,接着是痛苦,折磨人的衰退,接着就是消亡,所以我们永远要停留在第一天,当然这种衰退会以极其缓慢的速度发生,一家成熟的公司也许能在第二天状态里吃老本吃上几十年,但最终的结果还是会来,我感兴趣的问题是怎么抵御第二天有什么方法和战术 哪怕在一家大型组织内部怎么保持第一天的活力,这种问题不可能有简单的答案,里面会有很多要素,多条路径,还有很多陷阱,我不知道完整的答案,但可能知道一些片段,这里先给一套第一天防御的基本要素,真正的客户至上,对代理指标的怀疑态度,积极拥抱外部趋势,以及高速决策,真正的客户至上,把业务中心放在哪,有很多种方式,你可以以竞争对手为中心,可以以产品为中心,可以以技术为中心,也可以以商业模式为中心,还有很多别的,但在我看来,痴迷于客户是保护第一天活力最有效的方式,为什么,以客户为中心的方法有很多好处,但最大的一点是,客户永远都那么美好的 奇妙的不满足,哪怕他们说自己很开心,业务表现也很好,哪怕他们自己还没意识到,客户也想要更好的东西,而你取悦客户的渴望,会驱动你替他们去发明创造,没有哪个客户曾经要求亚马逊,推出Prime会员计划,但事实证明他们就是想要,这样的例子我能举出很多,要留在第一天,你就得耐心实验,接受失败,拨下种子,保护幼苗,并在看到客户喜悦时加倍下注,一种痴迷于客户的文化,最能创造出让这一切发生的条件,抵制代理指标,随着公司变大变复杂,人们会倾向于用代理指标来管理,这有各种形式和规模,很危险很隐蔽,而且非常第二天 一个常见的例子是,把流程当代理指标,好的流程是为你服务的,让你能服务好客户,但如果你不留神,流程本身会变成目的,这在大型组织里很容易发生流程,变成了你想要的结果的替代品,你不再看最终成果,只确保自己流程走对了,听到一个初级leader用,我们按流程走了,来为一个糟糕结果辩护,这种事并不少见,更有经验的leader 会把它当成调查和改进流程的机会,流程不是目的,永远值得问一句,是我们掌控流程,还是流程掌控我们,在一家第二天公司里,你可能会发现是后者,另一个例子,市场调研和客户问卷,可能变成客户的代理指标,当你在发明和设计产品时,这尤其危险 55%的Beta测试者,表示对这个功能满意,比第一次问卷的47%有所提升,这很难解读,而且可能无意中产生误导,好的,发明者和设计师,深刻理解他们的客户,他们花大量精力去培养那种直觉,他们研究并理解大量具体案例,而不只是问卷里看到的平均值,他们与设计共存,我不是反对Beta测试或问卷,但你作为产品或服务的Owner 必须理解客户,有自己的愿景,并且热爱你的作品,然后Beta测试和研究,才能帮你发现盲点一次卓越的客户体验,始于用心直觉好奇玩心胆识和品味,这些你在问卷里一样都找不到,拥抱外部趋势 如果你不愿意或不能快速拥抱强大的趋势,外部世界就会把你推进第二天,如果你对抗他们,你很可能是在对抗未来,拥抱他们你就有了顺风,这些大趋势并不难发现,他们被大量讨论和书写,但奇怪的是,大型组织往往很难去拥抱它们,我们现在就正处在一个显而易见的趋势当中,机器学习和人工智能,过去几十年,计算机广泛自动化了那些程序员,能用清晰规则和算法描述的任务,而现代机器学习技术,让我们能在那些很难描述精确规则的任务上,做到同样的事,在亚马逊,我们从事机器学习的实际应用,已经很多年了,有些工作非常显眼,我们的prime air自主送货无人机 用机器视觉来消除结账,排队线的amazon go便利店,还有alexa 我们基于云的AI助手,尽管我们尽了最大努力 echo还是经常缺货。 [03:40:00]
杰夫·贝佐斯:echo还是经常缺货,这是个高质量的问题,但终究是个问题,我们正在解决,但我们用机器学习,做的很多事情,都发生在水面之下,机器学习驱动着,我们的需求预测,产品搜索排名,产品和优惠推荐,商品展示位,欺诈检测,翻译等等诸多算法,虽然不那么显眼,但机器学习的很多影响,都会是这种类型,安静但实实在在的,改善核心运营,在AWS内部,我们很兴奋,能降低机器学习,和AI的成本和门槛,让各种规模的组织都能用上这些先进技术,用我们在PR计算实力上预打包好的主流深度学习框架,这些实力就是为这类工作负载优化的 客户已经在构建各种强大的系统了,从早期疾病检测到提高农作物产量都有,我们也在把Amazon自己的高阶服务以更方便的形式提供出来 Amazon Lex 也就是Alexa里面的那套 Amazon Poly和Amazon Recognition 他们把自然语言理解,语音生成和图像分析里的重活都省掉了,用简单的API调用就能访问,不需要任何机器学习专业知识,盯紧这个方向,后面还会有更多东西出来,高速决策,第二天公司会做高质量的决策,但做得很慢,要保持第一天的能量和活力,你得想办法做出高质量,高速度的决策,这对创业公司来说很容易,对大组织来说挑战非常大 Amazon的高管团队下定决心,要保持我们的决策速度,商业世界里速度很重要,而且高速决策的环境也更有意思,我们也不是什么都知道,但这里有一些思考,第一,永远不要用一刀切的决策流程,很多决策是可逆的,是双向门,这类决策可以用轻量级的流程,对这类决策来说,错了又怎样呢,我在去年的智股东心里,更详细的写过这一点,想找点乐子的话,试试问Alexa Alexa 60的阶层是多少,第二,大多数决策,大概应该在你希望拥有的信息量,达到70%左右时就做出,如果你等到90% 大多数情况下,你可能就太慢了,而且不管怎样,你都需要擅长快速识别和纠正错误决策,如果你善于纠偏 犯错可能没你想的那么贵,但慢则一定会很贵,第三,用不同意但执行,这句话能省很多时间,如果你对某个方向有信念,即使没有共识,说这句话会很有用,你看,我知道我们在这件事上有分歧,但你愿意跟我赌一把吗,不同意但执行,到了这个节点,没人能确定答案是什么,你大概率会很快得到一个好,这不是单向的,如果你是老板,你也应该这么做,我一直在不同意,但执行,我们最近给一部Amazon Studios原创剧,开了绿灯,我跟团队说了我的看法,它能不能足够有趣,还不好说,制作复杂,商业条款也不太好,而且我们还有很多其他机会,他们的看法完全不同,想往前推,我立刻回信说,我不同意,但执行 希望它成为我们做过的最受欢迎的作品,想想看如果团队当时必须说服我,而不是只需要我承诺,这个决策周期会慢多少,注意这个例子不是什么,不是我在心里想,好吧,这帮人错了,没抓住重点,但这事不值得我去追,这是一次真正的意见分歧,是我坦诚表达自己的看法,是给团队一个权衡我想法的机会,然后快速真诚的承诺按他们的方向走,而且考虑到这个团队已经拿回了11座爱美奖 6座金球奖和3座奥斯卡奖,他们能让我进这个房间我就很高兴了,第四尽早识别真正的分歧问题并立刻升级,有时候团队有不同的目标,根本不同的观点,他们没有对齐,再多的讨论 再多的会议也解决不了那种深层的分歧,如果不升级,这种场景下默认的争议解决机制,就是耗谁更有耐力,谁就拿下这个决策,这些年在Amazon 我见过很多真诚但严重分歧的例子,当我们决定邀请第三方卖家,在我们的产品详情页上直接跟我们竞争,那是个大决定,很多聪明善意的Amazon人完全不同意这个方向,这个大决策带来了几百个小决策,其中很多都需要升级到高管团队,你把我磨累了,是一种很糟糕的决策方式,又慢又消耗能量,选择快速升级吧,这样更好,那么你是只满足于决策质量,还是也在意决策速度,世界的大趋势对你来说是顺风吗,你是在被代理指标绑架 还是他们在为你服务,而最重要的,你在让客户感到惊喜吗,我们可以有大公司的规模和能力,同时有小公司的精神和初心,但我们必须选择它,衷心感谢每一位客户,让我们有机会服务你们,感谢股东们的支持,感谢全球各地的Amazon人,感谢你们的辛勤工作,你们的聪明才智和你们的热情,跟往常一样,我附上了我们1997年的第一封致股东信,它仍然是第一天 2017年致股东信,至各位股东,美国顾客满意度指数 最近公布了年度调查结果,亚马逊连续第八年排名第一,英国也有一个类似的指数,叫英国顾客满意度指数,由英国顾客服务协会发布,亚马逊英国站已经连续第五次,在这项调查中排名第一,亚马逊还刚刚被领英评为 2018年最佳雇主榜单第一名,这个榜单排名依据的是,美国职场人士最向往的公司,就在几周前 Harris Paul发布了年度生育商术,调查了超过25000名消费者,涵盖从工作环境到社会责任,再到产品和服务等广泛话题,亚马逊连续第三年排名第一,祝贺并感谢现在超过56万名亚马逊员工,你们每天都带着不懈的顾客至上的精神 创造力和对卓越运营的承诺来工作,我也想代表全球所有亚马逊人,向顾客们致以深深的感谢,看到你们在这些调查中的反馈,对我们来说是极大的激励,我喜欢顾客的一点是,他们有一种近乎神圣的不满足感,他们的期望从来不是禁止的,只会越来越高,这是人性,我们之所以能从狩猎采集时代走到今天,靠的可不是满足于现状,人们对更好的方式有着贪婪的胃口,昨天的经验很快就会变成今天的稀松平常,我看到这种改进的循环,正在以前所未有的速度发生,这可能是因为顾客获取信息比以往任何时候都容易,只需几秒钟在手机上点几下 顾客就能看评论比较多个零售商的价格,查看有没有货,了解发货或字体需要多长时间等等,这些例子来自零售业,但我感觉同样的顾客负权现象,正在我们亚马逊所做的每一件事,以及大多数其他行业中广泛发生,在这个世界上,你不能躺在功劳部上,顾客不会答应的,如何在顾客不断攀升的期望面前,保持领先,没有单一的方法能做到,它是很多事情的组合,但高标准,广泛部署,深入到每一个细节层面,无疑是其中很重要的一部分,这些年来,我们在努力满足顾客高期望的过程中,取得了一些成功,一路走来,我们也经历了价值数十亿美元的失败,以这些经历为背景,我想和大家分享一下 我们到目前为止学到的,关于组织内部高标准的要点,是天生的还是可教的,首先有一个根本性的问题,高标准是天生的还是可教的,如果你把我招进你的篮球队,你可以教我很多东西,但你没法教我长高,我们是不是首先需要筛选出高标准的人,如果是这样,这封信的主要内容就得是关于招聘实践了,但我不这么认为,我相信高标准是可以教的,事实上,人们仅仅通过耳濡目染就能很好的学会高标准,高标准是会传染的,把一个新人带进一个高标准的团队,他们会很快适应,反过来也一样,如果低标准盛行,那些也会迅速蔓延,虽然耳濡目染对教会高标准很有效 但我相信你可以通过阐明高标准的几个核心原则来加速这个学习过程,这也是我希望在这封信里分享的是通用的还是领域特定的,另一个重要问题是高标准是通用的还是领域特定的。 [03:50:00]
杰夫·贝佐斯:另一个重要问题是高标准是通用的还是领域特定的,换句话说,如果你在一个领域有高标准,你是不是自动在其他领域也有高标准,我相信高标准是领域特定的,你必须在每一个你感兴趣的领域分别学习高标准,我刚创办亚马逊的时候,在创新客户服务方面有高标准,而且幸好在招聘上也有高标准,但在运营流程方面,我没有高标准,如何让已解决的问题不再复发,如何从根源上消除缺陷,如何检查流程,还有很多其他方面,我必须在所有这些事情上学习并建立高标准,我的同事们就是我的老师,理解这一点很重要,因为它能让你保持谦逊,你可以在总体上自认为是一个高标准的人 但仍然存在致命的盲点,可能有些你努力的整个领域,你甚至都不知道自己的标准很低,或者根本没有标准,更不用说达到世界级水平了,对这种可能性保持开放心态至关重要,认知与范围要在某个特定领域达到高标准,你需要什么,首先你必须能够识别出在这个领域里,好是什么样子的,第二你必须对达到那个结果有多难,需要付出多少努力,也就是范围有现实的预期,让我给你举两个例子,一个例子有点像玩具演示,但能把道理讲得很清楚,另一个是Amazon日常反复出现的真实例子,先说道理,我有个好朋友最近决定学会完美的徒手倒立,不靠强,不是只撑几秒 Instagram上那种好看的程度 他先从瑜伽馆的倒立工作坊开始,练了一阵子,但没达到想要的效果,于是请了一位倒立教练,对,我知道你在想什么,但这确实是个真实存在的职业,第一节课教练就给了他一条很棒的忠告,他说大多数人以为只要努力,大概两周就能掌握到力,现实是需要每天练习,持续大约六个月,如果你觉得自己两周就该做到,最后只会放弃,对工作量不切实际的预期,往往是隐藏的,没人说出口的,会扼杀高标准,要自己达到高标准,或者在团队里做到高标准,你必须形成并主动沟通,对事情难度的现实预期,这位教练就很懂这一点,再说六页纸叙述,我们在Amazon不做PowerPoint 或任何幻灯片式的演示 而是写叙述结构的六页纸备忘录,每次开会开头,大家像在自习室一样先默读一遍,不出意料,这些备忘录的质量差异很大,有的清晰的像天使在唱歌,精彩,深思熟虑,为会议的高质量讨论打下基础,有时则完全是另一个极端,在道理的例子里,识别高标准相当直接,你可以详细列出完美道理的要求,然后要么做到了,要么没做到,写作的例子就完全不同了,一份出色的备忘录和一份普通的备忘录之间的差距要模糊的多,你几乎不可能把构成一份出色备忘录的详细要求写下来,尽管如此,我发现大多数时候,读者对出色备忘录的反应非常相似 看到就知道,标准就在那里,是真实的,即使不容易描述清楚,我们总结出来的是,很多时候备忘录写的不够好,不是作者识别不出高标准,而是对工作量的预期错了,他们误以为一份高标准的六页纸备忘录,一两天甚至几小时就能写完,实际上可能需要一周甚至更久,他们想在两周内练成完美道理,而我们没有正确的指导他们,出色的备忘录是写了又改,改了又写,请同事帮忙改进,放几天,再用全新的眼光重新编辑,一两天根本不可能完成,关键点在于,你只要教会大家对工作量的认知,一份出色的备忘录,大概需要一周或更久就能改善,结果再说技能 除了识别标准和抱有现实的工作量预期,技能呢,要写出一份世界级的备忘录,肯定得是极其出色的写作者吧,这是另一个必要条件吗,在我看来,不完全是至少在团队写作的语境下,对个人来说不是,橄榄球教练不需要自己能传球,电影导演不需要自己能演戏,但他们都需要识别这些领域的高标准,并教会大家对工作量的现实预期,即使在写六页纸备忘录这个例子里,这也是团队协作,团队里需要有人具备这项技能,但不一定非得是你,顺便提一句 Amazon有个传统,备忘录上从不出现作者的名字,备忘录来自整个团队,高标准的好处,建立高标准的文绝对值得付出努力 好处很多,最自然最明显的是,你会为客户打造更好的产品和服务,光这一条就足够了,也许不那么明显的是,人们会被高标准吸引,这对招聘和留人都有帮助,更微妙的一点是,高标准文化能保护所有那些,看不见但至关重要的工作,这些工作在每个公司都存在,我说的是没人看到的工作,是没人盯着时完成的工作,在高标准文化里,把这些工作做好本身就是回报,这是专业精神的一部分,最后高标准本身就很有趣,一旦你尝过高标准的滋味,就再也回不去了,所以我们眼中的高标准有四个要素,它们是可教的,是领域特定的,你必须能识别它们 你必须明确的指导大家,对工作量的现实预期,对我们来说,这些适用于各个细节层面,从写备忘录到全新的,从零开始的业务项目,希望他们也能帮到你,坚持最高标准,领导者要有不懈的高标准,很多人可能觉得这些标准,高的不合理,摘自Amazon领导力原则,近期里程碑,我们的领导者追求的高标准,让我们受益匪浅,虽然我自己肯定做不了倒立,但我非常自豪的分享,我们去年的部分里程碑,每一项都代表着多年集体努力的成果,我们不会把这些视为理所当然Prime 推出13年后,我们的全球Prime付费会员已超过1亿 2017年亚马逊通过Prime 在全球配送了超过50亿件商品 新增Prime会员数也超过了以往任何一年,无论是全球还是美国,美国会员现在可以享受超过1亿种商品的,无限次免费两日达服务,我们把Prime扩展到了墨西哥,新加坡荷兰和卢森堡,并在美国和德国推出了Business Prime Shipping 我们还在持续加快Prime的配送速度 Prime免费当日达和免费一日达,现已覆盖超过8000个城镇 Prime 那已在全球9个国家的50多个城市上线 Prime Day 2017是我们有史以来,规模最大的全球购物活动,直到被网络星期一超越,当天加入Prime的新会员数,也创下了历史记录 AWS看到Amazon Web Services 这项年化营收达200亿美元的业务 在已经健康增长的基础上,进一步加速,令人振奋 DOS也加快了创新步伐,尤其是在机器学习与人工智能,物联网和无服务器计算等新领域 2017年AWS发布了超过1400项重要服务和功能,其中包括Amazon SageMaker 它从根本上改变了普通开发者,构建复杂机器学习模型的可及性和易用性,还有数万客户在使用广泛的AWS机器学习服务,受Amazon SageMaker广泛采用的推动,过去一年活跃用户数增长了超过250% 11月我们举办了第六届Reinvent大会,现场参会者超过4万人,在线观看直播的参与者超过6万人 Marketplace非2017年亚马逊全球销售的商品中,超过一半来自第三方卖家,包括中小型企业,这在我们历史上上述首次 2017年有超过30万家美国中小型企业在亚马逊上开始销售 Fulfillment by Amazon为全球中小型企业配送了数十亿件商品 Prime Day 2017期间,顾客从全球中小型企业订购了超过4000万件商品,销售额比Prime Day 2016增长了超过60% 我们的全球开店计划帮助中小型企业跨境销售,在2017年增长了超过50% 中小型企业的跨境电商,现在已占第三方总销售额的25%以上 Alexa肥用户对Alexa的喜爱有增无减,支持Alexa的设备,一直是亚马逊全站最畅销的商品之一,我们看到其他公司和开发者,想要用Alexa创造自己体验的意愿也非常强烈。 [04:00:00]
杰夫·贝佐斯:想要用Alexa创造自己体验的意愿也非常强烈,现在外部开发者为Alexa开发的技能已超过3万个,用户可以通过Alexa控制来自1200个独特品牌的超过4000种智能家居设备 Alexa的底层能力也在日益精进,我们开发并部署了一种设备端指纹识别技术,可以防止你的设备在听到电视上的Alexa广告时被唤醒,这项技术确保了我们的Alexa超级玩广告,不会唤醒数百万台设备,原厂语音识别本来就已经很好了,在过去一年里提升了15% 而在美国英国和德国,通过改进Alexa的机器学习组件和使用半监督学习技术,我们在过去12个月里,把Alexa的口语理解能力提升了超过25% 这些半监督学习技术将实现同等精度提升所需的标注数据量,减少了40倍,最后我们通过使用机器翻译和迁移学习技术,大幅缩短了教Alexa学习新语言所需的时间,这让我们能够为更多国家的用户提供服务,比如印度和日本 Amazon设备2017年是我们硬件销售最好的一年,用户购买了数千万台Echo设备 Echo Dot和戴Alexa的Fire TV Stick 是全亚马逊最畅销的商品,涵盖所有品类和所有制造商,这个假日季顾客购买的Fire TV Stick 和Kids Edition Fire平板电脑数量是去年的两倍 2017年我们发布了全新设计的Echo 设计更优音质更好价格更低 内置智能家居控制中心的Echo Plus 以及小巧精美带圆形屏幕的Echo Spot 我们发布了新一代Fire TV 支持4K超高清和HDR 以及配备1080P全高清显示屏的Fire HD10平板电脑,我们还庆祝了Kindle十周年,发布了全新的Kindle Oasis 这是我们迄今最先进的阅读器,它防水可以带进浴缸,配备更大的7英寸300ppi高分辨率显示屏,并内置音频功能,让你也能通过Audible听书 Prime Video 继续推动着Prime会员的获取和留存,过去一年我们让Prime Video变得更好,新增了获奖的Prime原创剧集,比如了不起的麦瑟尔夫人 拿了两项评论价选择奖和两项金球奖,还有奥斯卡提名电影大病,我们在全球扩展了节目阵容,推出了来自美国的新一季博斯和炸气担保人,来自英国的《伟大的旅程》 来自德国的《你被通缉了》 同时新增了来自日本的《千辛车》节目,以及来自印度的呼吸和获奖聚集《局内人》 同样在今年我们扩展了Prime频道服务,在美国新增了CBS All Access 并在英国和德国推出了频道服务,我们在Prime Video上首播了NFL周四夜橄榄球 11场比赛吸引了超过1800万总观众 2017年Prime Video Direct获得了超过3000部故事片的订阅视频版权 并向独立电影人和其他版权方承诺了超过1800万美元的版税,展望未来,我们也对接下来的Prime原创剧集储备感到兴奋,包括约翰·卡拉辛斯基主演的汤姆·克兰西的杰克·莱恩,安东尼·霍普金斯和艾玛·汤普森主演的《狸儿王》 马特韦娜兼制的《罗曼诺夫家族》 奥兰多·布鲁姆和卡拉·迪瓦伊,主演的《狂欢》 命案乔恩·哈姆主演的《好兆头》 以及山姆·艾斯美尔兼制,朱利亚·罗伯茨首次出演电视剧的《归途》 我们获得了《指环王》 多季制作的全球电视版权,还有《克尔特斯》 一部基于爱尔南 《克尔特斯史诗传奇》的迷你剧,由兼职史蒂文 斯皮尔伯格打造,哈维尔巴登主演,我们期待今年开始,这些剧集的制作 Amazon Music 非Amazon Music 继续快速增长,现在拥有数千万付费用户,我们的点播,无广告服 Amazon Music Unlimited 在2017年扩展到 30多个新国家,会员数在过去六个月里,翻了一倍多,时尚费亚马逊已成为数千万用户购买时尚产品的目的地 2017年我们推出了首个以时尚为导向的prime权益 Prime wardrobe 一项将是一间直接带到prime会员家中的新服务,让他们可以在购买前试穿最新款式,我们在亚马逊上引入了nike和yuj 以及德鲁巴里摩尔和德威恩维德的新名人系列 还有数十个新的自由品牌,比如Goodthreads和Core10 我们也在继续帮助数千名设计师和艺术家,通过Merch by Amazon 按需提供他们的独家设计和印花 2017年底,我们与Calvin Klein推出了互动购物体验,包括快闪店,现场产品定制,以及配备Alexa控制灯光音乐等的试衣间 Whole Foods非,去年我们完成对Whole Foods Market的收购时,宣布了让每个人都能买到高品质天然有机食品的承诺,随后立即下调了一系列畅销日常食品的价格,包括牛油果有机荷壳蛋和负责人养殖的三文鱼,之后我们在11月进行了第二轮降价,我们Prime会员专属促销打破了 Whole Foods感恩节期间火鸡销售的历史记录 2月我们在部分城市为Prime会员推出了35美元以上订单的免费两小时送达服务,随后在3月和4月增加了更多城市,并计划今年继续在全美扩展,我们还扩展了Amazon Prime Rewards Visa Card的权益,让Prime会员在Whole Foods Market购物时能获得5%的返现,除此之外,顾客可以在亚马逊上购买 Whole Foods的自由品牌产品,比如365 Everyday Value 可以在上百家Whole Foods门店购买Echo 和其他亚马逊设备,还可以在数百家Whole Foods门店的 Amazon Lockers取货或退货,我们也已经开始做必要的技术工作,以便在销售点识别Prime会员 并期待在这样工作完成后,为Whole Foods的购物者,提供更多prime权益 Amazon购到Amazon 购一种无需结账的新型商店 1月在西雅图向公众开放,自开业以来,我们很高兴听到许多顾客,把他们的购物体验形容为魔法,让这种魔法成为可能的,是计算机视觉传感器融合,和深度学习定制组合在一起,共同创造了这次Walker购物体验,有了JGO 顾客能比以往任何时候都更方便的拿到他们最喜欢的早餐,午餐晚餐零食和日用品,一些最畅销的商品并不令人意外,含咖啡因的饮料和水很受欢迎,但我们的顾客也喜欢鸡肉月事法棍三明治,巧克力曲奇切块水果 小熊软糖和我们的Amazon meal kits Treasure Truck 飞Treasure Truck从西雅图的一辆车,扩展到横跨25个美国城市,和12个英国城市的35辆车队,我们那些吹着泡泡,放着音乐的卡车,完成了数十万份订单,从上等牛排到最新的任天堂游戏,这一年里 Treasure Truck也和当地社区合作,提振精神,帮助有需要的人,包括捐赠和运送了数百个汽车座椅,数千件玩具,数万双袜子,还有很多其他必需品,给需要救济的社区成员,从因飓风哈维流离失所的人,到无家可归者,再到需要节日欢乐的孩子们,印度根据comscore和similarweb的数据 Amazon.in是印度增长最快的电商平台,也是桌面端和移动端访问量最高的网站,根据appany的数据 Amazon.in的移动购物app 也是2017年印度下载量最高的Go App Prime在印度推出第一年新增的会员数,超过了亚马逊历史上任何一个地区 Prime在印度的选品,现在包括来自第三方卖家的超过4000万种本地商品 Prime Video也在大力投资印度原创视频内容,包括最近的两部首映和十几部正在制作中的新节目,可持续发展,我们致力于通过优化运输网络,改进产品包装和提高运营能效,来减少碳排放,并且我们有一个长期目标 就是用百分之百可再生能源,来为我们的全球基础设施供电,我们最近启用了Amazon Wind Farm Texas 这是我们目前最大的风电厂,每年通过100多台涡轮机。 [04:10:00]
杰夫·贝佐斯:每年通过100多台涡轮机,产生超过100万兆瓦时的清洁能源,我们计划到2020年,在50个旅游中心安装太阳能系统,并且已经在美国启动了 24个风能和太阳能项目,还有超过29个项目即将上马,亚马逊的这些可再生能源项目,现在每年产生的清洁能源,加起来足够为超过33万3000个家庭供电 2017年我们庆祝了无错包装10周年,这是我们一系列可持续包装举措中的第一个,在过去十年里已经减少了超过24万4千吨的包装材料,此外仅在2017年,我们的各项计划就显著减少了包装浪费,减少的包装相当于3亿零500万个运输箱,在全球范围内 亚马逊正与我们的服务商签约,推出我们的第一批低污染最后一公里车队,现在我们在欧洲的部分配送车队,已经由低污染的电动和天然气货车和汽车组成,我们还有超过40辆电动滑板车和电动货运自行车,来完成当地的城市配送,赋能小企业,全球数百万中小型企业,现在通过亚马逊销售产品,以触达全球的新客户,在亚马逊上销售的中小企业,来自美国的每一个州,以及全球超过130个不同的国家 2017年超过14万家中小企业,在亚马逊上的销售额突破了10万美元,超过1000名独立作者通过Kindle Direct Publishing 获得了超过10万美元的版税 投资与就业创造,自2011年以来,我们在全球的履约网络,运输能力和技术基础设施,包括AWS数据中心,上投资了超过1500亿美元,亚马逊在全球创造了超过170万个直接和间接就业岗位,仅在2017年,我们就直接创造了超过13万个新的亚马逊工作岗位,这还不包括收购带来的岗位,使我们的全球员工总数超过了56万人,我们的新岗位覆盖了广泛的职业,从人工智能科学家到包装专员,再到旅游中心员工,除了这些直接雇佣的员工,我们估计Amazon Marketplace 在全球创造了90万个额外的工作岗位 而亚马逊的投资在建筑物流和其他专业服务等领域,又额外创造了26万个工作岗位 Career Choice 我们特别引以为傲的一个员工项目是Amazon Career Choice 对于任职超过一年的小时工,我们为他们攻读高需求职业的证书和复学士学位,预付95%的学费,杂费和教材费最高一万两千美元,这些职业包括飞机机械师,计算机辅助设计,机床技术,医学实验室技术和护理,我们资助的是高需求领域的教育,无论这些技能是否与亚马逊的职业相关,自2012年项目启动以来,全球已有超过16000名员工,包括美国的超过12000名加入了Career Choice Career Choice在10个国家开展 并将在今年晚些时候扩展到南非,哥斯达利加和斯洛伐克,商业卡车驾驶医疗保健和信息技术,是该计划最受欢迎的学习领域,到目前为止,我们已经建了39间Career Choice教室,我们把它们设在旅游中心人流量大的区域,用玻璃墙隔开,这样其他员工看到同事在追求新技能时也能受到激励,这些里程碑的功劳属于很多人。亚马逊是56万名员工,也是200万卖家,数十万作者,数百万AWS开发者,以及全球数亿永不满足,每天都在推动我们变得更好的客户,前路今年是我们第一封股东信的20周年,我们的核心价值观和方法始终未变 我们仍然渴望成为地球上最以客户为中心的公司,并且我们认识到,这不是一个小挑战,或容易的挑战,我们知道我们还有很多,可以做得更好的地方,我们也从未来的诸多挑战,和机遇中,找到了巨大的能量,非常感谢每一位客户,允许我们为您服务,感谢股东们的支持,感谢世界各地的,亚马逊人的聪明才智,热情和高标准,和往常一样,我附上了我们1997年,原始信件的副本,这仍然是第一天,锦上,我是Jeffrey P. Bezos 亚马逊的创始人和首席执行官 2018年致股东信,至各位股东,过去这20年 发生了一件既奇怪又了不起的事,来看看这些数字 1999% 3200 3200 1% 62% 002% 17% 2003% 22% 2004 25% 2005 22% 但是28 2006 28% 2007 29% 2008 30% 2009 31% 2010 34% 2011 30% 是82012 42% 2013 46% 2014 49% 2015 51% 2016 54% 2017 50% 62018 58% 这些百分比代表的是独立第三方卖家在亚马逊上卖出的实体商品总销售额的占比 这些卖家大多是中小型企业跟亚马逊自营的第一方销售是分开的,第三方销售额从占总量的3%一路涨到了58% 直白点说就是第三方卖家正在把我们的自营业务打得落花流水,狠狠的打,而且这个标准其实很高,因为我们的自营业务在这段时间里也增长的非常猛,从1999年的16亿美元,涨到了去年的1170亿美元,自营业务在那段时间的复合年增长率是25% 但在同一时期,第三方销售额从1亿美元增长到了1600亿美元,复合年增长率是52% 拿个外部参照来看 eBay同期的商品总销售额复合增长率是20% 从28亿美元增长到了950亿美元,为什么独立卖家在亚马逊上比在eBay上做得好这么多,为什么独立卖家能比亚马逊自己组织严密的自营销售团队增长快这么多,答案不止一个,但我们知道其中一个极其重要的部分,我们帮助独立卖家跟我们的自营业务竞争,方法是投资并为他们提供我们能想象和打造的最好的销售工具,这样的工具有很多,包括帮卖家管理库存,处理付款,追踪物流,生成报表和跨境销售的工具,而且我们每年都在发明更多,但最重要的是fulfillment by amazon和prime会员计划,这两个项目加在一起,显著提升了顾客从独立卖家那里购物的体验 现在这两个项目已经这么成功,大多数人其实很难完全体会到,当初我们推出他们的时候,这两个服务有多么激进,我们是在承担了巨大的财务风险,经历了大量内部争论之后,才投资了这两个项目,随着我们不断试验不同的想法和迭代,我们还得持续投入大量资金,我们当时没法确切预见到这些项目最终会变成什么样,更别说能不能成功了,但他们是靠着直觉和真心往前推的,靠着乐观主义滋养起来的,直觉好奇心和漫游的力量,在亚马逊非常早期的时候,我们就知道我们想打造一种创造者的文化,一群充满好奇心,像探险家一样的人,他们喜欢发明,即使已经是专家了 他们依然带着初学者的心态,保持新鲜,他们把我们做事的方式,只看做事,目前做事的方式,创造者的心态帮助我们,以一种谦逊的信念,去面对那些巨大,难解的机遇,相信成功可以通过迭代,来实现发明,推出,重新发明,重新推出,推倒重来,重洗干净,再来一遍,一次又一次,他们知道,通往成功的路绝不是一条直线,在商业里,有时候其实经常是这样,你确实知道要去哪里,这时候你可以追求效率,制定一个计划,然后去执行,相比之下,在商业里漫游是不高效的,但它也不是随机的,它是有引导的,靠的是预感,胆识,直觉和好奇心,并且被一种深刻的信念驱动着 那就是给顾客带来的回报足够大,值得我们用一种有点混乱和迂回的方式去找到出路,漫游是对效率的一种必要的平衡,你需要两者都用,那些超乎寻常的发现,那些非线性的发现,极大概率是需要漫游的。 [04:20:00]
杰夫·贝佐斯:极大概率是需要漫游的 AWS的数百万客户,从创业公司到大型企业,从政府机构到非盈利组织,每个都在为他们的最终用户寻找构建更好的解决方案,我们花了很多时间去思考这些组织想要什么,以及他们内部的人,比如开发者,开发经理,运维经理 CIO 首席数字官,首席信息安全官等等,想要什么,我们在AWS的很多东西都是基于倾听客户的声音,去问客户想要什么,仔细听他们的回答,然后想出一个计划,周到又快速的提供给他们,这很关键,商业里速度很重要,没有这种对客户的痴迷,任何生意都不可能兴旺,但这还不够,那些最能撬动大局的东西,往往是客户自己都不知道,要开口去要的 我们必须替他们去发明,我们必须挖掘自己内心,对可能性的想象 AWS本身作为一个整体,就是个例子,没人开口要过AWS 一个都没有,结果证明,世界其实已经准备好,并且渴望着像AWS这样的东西,只是自己不知道,我们有一个预感,跟随了我们的好奇心,承担了必要的财务风险,然后开始构建,在这个过程中反复修改实验,迭代了无数次,在AWS内部,同样的模式也重复了很多次,比如我们发明了DynamoDB 一个高度可扩展,低延迟的建制数据库,现在有数千家AWS客户,在使用,而在仔细倾听客户这一面,我们很清楚的听到,企业觉得被他们的 商业数据库选项束缚住了,几十年来,一直对数据库供应商不满意,这些产品价格昂贵,专有锁定性强,还有惩罚性的许可条款,我们花了好几年时间,构建自己的数据库引擎 Amazon Aurora 一个完全托管的,兼容MySQL和PostgreSQL的服务,有着跟商业引擎相同,甚至更好的持久性和可用性,但成本只有他们的十分之一,当这个服务成功时,我们并不感到意外,但我们对专用数据库也很乐观,就是为特定工作负载设计的数据库,过去二三十年,大多数公司跑工作负载,用的都是关系型数据库,开发者对关系型数据库太熟了,所以即使它并不理想,大家也习惯用它,虽然不够优,但那时候数据级通常不大,查询延迟也能接受 凑合着也能跑,可今天很多应用存储的数据量非常大 TB级 PB级,而且应用的需求也变了,现代应用要求低延迟实时处理,还要能扛住每秒数百万次请求,不光是DynamoDB这种建制存储,还有Amazon Elasticake这种内存数据库 Amazon Timestream这种时间序列数据库,以及Amazon Quantum Ledger Database这种账本方案,合适的工具做合适的事,既省钱又能让产品更快上市,我们也在大力帮企业用好机器学习,这件事我们做了很久,跟其他重要进展一样,我们最早想把内部的一些机器学习工具对外提供,结果都失败了,摸索了好几年,实验迭代打磨 再加上从客户那里获得的宝贵反馈,才最终做出了SageMaker 18个月前刚上线 SageMaker把机器学习流程,每一步里的重活复杂性和猜测都去掉了,让AI更普及,今天成千上万的客户,正在用SageMaker 在AWS上构建机器学习模型,我们还在持续增强这个服务,比如加入了新的强化学习能力,强化学习的学习曲线很陡,环节又多,以前基本只有资金最雄厚,技术最强的机构才玩得转,现在不一样了,这一切,如果没有一种好奇的文化,没有愿意为客户去尝试全新事物的心态,都不可能发生,而客户也在回应我们这种,以客户为中心的摸索和倾听 AWS现在年化营收,已经达到300亿美元,而且还在快速增长,想象那些看似不可能的事,亚马逊在全球零售业里,今天仍然是一个小玩家,我们在零售市场的占比,只有很低的个位数,在我们经营的每个国家,都有比我们大得多的零售商,这很大程度上是因为,将近90%的零售,仍然在线下,在实体店里,很多年来,我们一直在想怎么在实体店里服务顾客,但觉得首先得发明点什么,能真正让顾客在那个场景里感到惊喜,有了Amazon Go 我们有了一个清晰的愿景,把实体零售最糟糕的东西拿掉,排队结账,没人喜欢排队等,我们想象的是一家你可以走进去,拿起想要的东西,直接离开的店,要做到这一点很难 技术上的难,需要全球几百位聪明又专注的,计算机科学家和工程师一起努力,我们得自己设计和制造专用的摄像头和货架,还要发明新的计算机视觉算法,包括把几百个协同工作的摄像头画面,拼在一起的能力,而且我们得做到技术运行的特别好,好到它完全退到幕后,让人感觉不到,回报就是顾客的反应,他们形容在Amazon购物的体验是魔法般的,我们现在在芝加哥旧金山和西雅图有10家店,对未来很兴奋,失败的规模化,公司成长了,所有东西都得跟着规模化,包括你失败实验的规模,如果你失败的规模没有变大,那你搞发明的规模也大不到哪去,根本掀不起什么浪,对亚马逊这种体量的公司来说 如果我们偶尔出现几十亿美元级别的失败,那说明我们在以合适的规模做实验,当然我们不会轻率的去做这种实验,我们会努力让他们成为好的赌注,但不是所有好赌注最终都会赢,这种大规模的风险承担,是我们作为一家大公司,能够为客户和社会提供的一部分服务,对股东来说,好消息是只要有一个大赌注赢了,就能覆盖掉很多输掉的成本 Fire手机和Echo的开发,差不多是同时启动的,虽然Fire手机失败了,但我们能把学到的经验,还有开发人员拿来,加速推进Echo和Alexa的开发 Echo和Alexa的愿景,灵感来自星际迷航里的计算机,这个想法还有另外两个源头 是我们摸索和深耕多年的领域,机器学习和云,从亚马逊早期开始,机器学习就是我们产品推荐的核心部分,而AWS让我们能近距离看到语音的种种能力,经过多年开发 Echo在2014年面世,由Alexa驱动,而Alexa就运行在AWS语音上,没有哪个客户主动要求过Echo 这绝对是我们自己瞎逛出来的,市场调研没用,如果你在2013年去问一个客户,你想不想要一个黑色的,一直开着的圆柱体,放在厨房里,大概品克数片罐那么大,能跟你对话,回答你的问题,还能帮你开灯,放音乐,我保证他们会用奇怪的眼神看着你,然后说不啦,谢谢,从第一代Echo开始,客户已经购买了超过一亿台 支持Alexa的设备,去年我们把Alexa理解,请求和回答问题的能力提升了,超过20% 同时新增了数十亿条实时,让Alexa比以往任何时候都更有知识,开发者把Alexa技能的数量翻了一倍,超过了8万个,而客户在2018年跟Alexa对话的次数,比2017年多了数百亿次,内置Alexa的设备数量,在2018年翻了一倍多,现在市面上有超过150种不同的产品内置了Alexa 从耳机PC到汽车和智能家居设备应有尽有,后面还有更多,结束前再说最后一件事,就像我20多年前在第一封股东信里说的 我们的重点是招聘和留住那些多才多艺有天赋的员工,他们能像主人翁一样思考,要做到这一点,就需要对我们的员工进行投资,而且就像Amazon做的很多其他事情一样,我们不仅靠分析,也靠直觉和内心来找到前进的方向,去年我们把全美所有全职兼职,临时和季节性员工的最低工资,提高到了每小时15美元,这次涨薪汇集了超过25万名Amazon员工,以及去年假期在全国各地Amazon站点工作的,超过10万名季节性员工,我们坚信,在我们投资员工的同时,这也会让我们的业务受益,但这并不是推动这个决定的原因,我们一直提供有竞争力的工资 但我们觉得是时候带头了,提供超越有竞争力的工资,我们这么做,是因为它看起来就是一件正确的事。 [04:30:00]
杰夫·贝佐斯:是因为它看起来就是一件正确的事,今天我向我们最大的零售竞争对手,你们知道我说的是谁,发起挑战来匹配我们的员工福利和15美元的最低工资,来吧,更好的是涨到16美元,然后把挑战扔回给我们,这是一种能让每个人都受益的竞争,我们为员工推出的许多其他项目,既是发自内心的,也是经过深思熟虑的,我之前提到过职业选择项目,他支付高达95%的学费和相关费用,用于获得合格学习领域的证书和文凭,为我们的员工带来有需求的职业,即使那些职业会让他们离开Amazon 现在已经有超过16000名员工参与了这个项目,而且规模还在持续增长 同样我们的职业技能项目为小施工同事培训,关键的职业技能,比如写简历,如何有效沟通,以及计算机基础,去年10月为了延续这些承诺,我们签署了总统对美国工人的承诺,并宣布我们将通过一系列创新的培训项目,为5万名美国员工提供技能提升培训,我们的投资并不局限于我们现有的员工,甚至不局限于当下,为了培训未来的劳动力,我们承诺投入5000万美元,包括通过我们最近宣布的Amazon Future Engineer项目,来支持全美范围内的小学,高中和大学的STEM和计算机科学教育,尤其侧重于吸引更多女性和少数族裔进入这些行业 我们也在继续利用退伍军人令人难以置信的才能,我们正稳步朝着到2021年,雇佣25000名退伍军人和军人配偶的承诺迈进,而且通过Amazon技术退伍军人学徒计划,我们正在为退伍军人提供云计算等领域的再制培训,非常感谢我们的客户,让我们能够为你们服务,同时也不断鞭策我们做得更好,感谢我们的股东,感谢你们一直以来的支持,感谢我们全球所有的员工,感谢你们的辛勤工作和开拓精神 Amazon的所有团队都在倾听客户的声音,并为他们而瞎逛,和往常一样,我附上我们1997年的原始信件,今天依然是第一天,真诚的 Jeffrey P. Bezos 创始人兼首席执行官 2019年致股东信,致我们的股东,我们从这次新冠疫情中,学到的一件事是 Amazon对我们的客户来说,已经变得多么重要,我们想让你们知道,我们非常认真的对待这份责任,并且为我们团队在这段艰难时期,帮助客户所做的工作感到自豪 Amazon的员工们正在夜以继日的工作,把必需的物资直接送到需要的人家门口,我们看到对必需品的需求一直很高,并且仍在持续,但跟可预测的假日高峰不同,这次的需求激增几乎没有预警,给我们的供应商和配送网络带来了巨大挑战 我们迅速调整了优先级优先储备和配送生活必需品,医疗用品和其他关键产品,我们的Whole Foods Market门店一直保持营业,为客户提供新鲜食品和其他重要商品,我们正在采取措施帮助那些最容易受病毒影响的人群,每天在Whole Foods把第一个小时的购物时间专门留给老年人,我们暂时关闭了Amazon Books Amazon四星和Amazon Pop-up门店,因为他们不销售必需品,我们也为这些关闭门店的员工,提供了在Amazon其他部门继续工作的机会,至关重要的是,在提供这些基本服务的同时,我们高度关注全球员工和合作伙伴的安全,我们对他们的英勇工作深表感激 并致力于保障他们的健康和福祉,我们与医学专家和卫生部门密切协商,在我们的运营网络和Whole Foods Market门店中,实施了超过150项重大流程调整,以帮助团队保持健康,并且我们每天都会对已实施的措施进行审核,我们在全球各地的站点发放了口罩,实施了体温检测,以保护员工和后勤人员,我们定期对门把手,楼梯,扶手,储物柜,电梯按钮和触摸屏进行消毒,消毒湿巾和洗手液,在我们的网络中已成为标配,我们还推行了广泛的社交距离措施,来保护我们的员工,我们取消了班次中的站会,把信息共享转移到了公告板上 错开了休息时间,并拉开了休息室的椅子间距,虽然在新的距离要求下,培训新员工很有挑战性,但我们仍然确保每位新员工,都能接受六小时的安全培训,我们调整了培训流程,避免员工聚集在一个地方,也调整了招聘流程,以适应社交距离的要求,保护员工的下一步,可能是对所有Amazon员工进行定期检测,包括那些没有表现出症状的人,在全球范围内,跨所有行业进行定期检测,既有助于保障人们的安全,也有助于让经济恢复运转,要做到这一点,我们整个社会需要的检测能力,将远远超过目前可用的水平,如果每个人都能定期接受检测,将对我们抗击这种病毒的方式,产生巨大影响 检测成阳性的人可以被隔离,并得到照顾,而每个检测成阴性的人,都可以放心的重返经济活动,我们已经开始着手建设增量检测能力,一个由Amazon员工组成的团队,从研究科学家项目经理到采购专家和软件工程师,从他们的日常工作中抽调出来,组成了一个专门团队来推进这项工作,我们已经开始组装建设第一个实验室所需的设备,并希望很快能开始对我们的一线员工进行小规模检测,我们不确定在相关的时间范围内,我们能走多远,但我们认为这值得一试,并且我们随时准备分享我们学到的一切,在探索长期解决方案的同时,我们也致力于现在就为员工提供支持 我们将美国的最低时薪提高了两美元,加拿大提高了两美元,英国提高了两英镑,许多欧洲国家提高了两欧元,持续到四月底,并且我们对员工的任何加班工时支付双倍工资,最低每小时34美元,这比之前的1.5倍工资有所增加,这些工资增长仅在4月底之前就将花费超过5亿美元,并且随着时间的推移很可能花费更多,虽然我们认识到这代价高昂,但我们相信在当前情况下这是正确的做法,我们还设立了Amazon救助基金,初始资金为2500万美元,以支持陷入财务困境的,独立配送服务合作伙伴及其司机 Amazon Flex参与者和临时员工 3月份我们在整个履约和配送网络中,开放了10万个新岗位,本周早些时候,在成功填补这些岗位后,我们又宣布将再创造 75000个工作岗位,以响应客户需求,这些新员工正在帮助那些依赖我们来满足其关键需求的客户,我们知道随着许多人失业或被停薪留职,世界各地有很多人在经济上陷入了困境,我们很高兴能让他们加入我们的团队,直到情况恢复正常,他们之前的雇主可以让他们回去,或者有新的工作机会出现,我们迎来了Joe Duffy 他在失去纽瓦克机场机械师的工作后加入了我们,他是从一位担任Amazon运营分析师的朋友那里得知招聘信息的 达拉斯的学前班老师Darby Griffin在他学校于3月9日关闭后也加入了我们,现在负责管理辛苦存,我们很高兴Darby能和我们在一起直到他能重返课堂,亚马逊正在采取强力行动,保护我们的顾客免受那些想借危机牟利的不良分子的侵害,我们已经从商店里下架了超过50万件利用疫情哄抬价格的商品,并在全球范围内暂停了超过6000个违反公平定价政策的卖家账户,亚马逊还向42个州的检察长办公室移交了涉嫌哄抬疫情相关产品价格的卖家信息,为了加快对价格欺诈事件的响应,我们为各州检察长建立了一个专门的沟通渠道 让他们能快速便捷的将消费者投诉升级反馈给我们 Amazon Web Services在这场危机中也扮演着重要角色,各类组织能否获得可扩展可靠且高度安全的计算能力,无论是用于关键的医疗工作。 [04:40:00]
杰夫·贝佐斯:无论是用于关键的医疗工作,帮助学生继续学习,还是让空前数量的员工,再加高校在线办公,在当前形势下都至关重要,医院网络制药公司和研究实验室,正在利用AWS来护理病患,探索治疗方案,并以多种其他方式减轻疫情的影响,世界各地的学术机构,正从线下课堂转向虚拟教室,他们在AWS上运行,以确保学习的连续性,各国政府也在利用AWS这个安全平台,构建新的能力来努力终结这场大流行,我们正在与世界卫生组织合作,提供先进的云技术和专业技术支持,以追踪病毒,了解疫情,并更好的控制其传播 世卫组织正利用我们的云服务,来构建大规模数据湖,汇总各国的流行病学数据,快速将医学培训视频翻译成不同语言,并帮助全球医护人员更好的治疗患者,另外我们还公开了一个AWS COVID-19数据湖,作为集中存储库提供与病毒传播特征及其相关疾病的最新精选信息,让专家们能够获取并分析最新数据,投入抗击疾病的战斗,我们还启动了AWS诊断开发计划,这个项目旨在支持那些,致力于为COVID-19开发更精准诊断方案的客户,更好的诊断有助于加速治疗和控制这场大流行 我们承诺投入2000万美元来加速这项工作,帮助我们的客户利用云技术应对这一挑战,虽然这个项目是为应对COVID-19而设立的,但我们也在着眼未来,将资助那些有潜力遏制未来传染病爆发的诊断研究项目,世界各地的客户都在利用云技术来扩展服务,并启动对COVID-19的响应,我们加入了纽约市COVID-19快速响应联盟,开发了一个对话式agent 让高风险和年长的纽约市民,能够获得关于医疗和其他重要需求的准确,及时信息,因洛杉矶联合学区让70万学生,过渡到远程学习的请求 AWS帮助建立了一个呼叫中心,用于处理IT问题提供远程支持 并让工作人员能够接听电话,我们正在向美国疾控中心提供云服务,帮助成千上万的公共卫生从业者和临床医生收集COVID-19相关数据,为响应工作提供信息,在英国AWS为一个项目提供云计算基础设施,该项目分析医院入住率,急诊室容量和患者等待时间,以帮助英国国家医疗服务体系决定如何最好的分配资源,在加拿大,全球最大的虚拟护理网络之一OTN 正在扩展其由AWS支持的视频服务,以应对激增4000%的需求,在疫情期间为公民提供支持,在巴西 AWS将为圣保罗州政府提供云计算基础设施 以保证全州公立学校的100万学生,能够进行在线学习,遵循美国疾控中心的指导,我们的Alexa健康团队构建了一项体验,让美国客户可以在家自测COVID-19的风险等级,客户可以问Alexa 如果我认为我得了COVID-19该怎么办,或者Alexa 如果我认为我感染了冠状病毒该怎么办,然后Alexa会询问一系列关于个人症状,和可能接触史的问题,根据这些回答 Alexa会提供源自疾控中心的指导,我们在日本也根据日本厚生劳动省的指导,创建了类似的服务,我们正在让客户能方便的通过亚马逊或Alexa 直接向奋战在COVID-19危机一线的慈善机构捐款,包括Feeding America 美国红十字会和救主儿童会 iQOO用户可以选择说 Alexa向Feeding America COVID-19 向你进行捐款,在西雅图,我们与一家餐饮企业合作,在疫情爆发期间,向 Seattle 和 King County 的 2700 名年老体弱居民,分发了 73,000 分餐食,并且我们捐赠了 8200 台笔记本电脑,帮助 Seattle 公立学校的学生,在进行线上课程时能够获得设备,除了 COVID-19 之外,尽管这是极其艰难的时期,但也重要地提醒了我们,作为一家公司,我们所做的事情,能对人们的生活产生巨大影响,顾客指望我们陪伴在他们身边,而我们也很庆幸能够提供帮助,凭借我们的规模和快速创新的能力 亚马逊能够产生积极的影响,并成为推动进步的组织力量,去年我们与联合国前气候变化负责人 Global Optimism创始人Christiana Figueres 共同发起了气候承诺,并成为该承诺的第一个签署方,这份承诺要求亚马逊提前10年实现巴黎协定的目标,也就是到2040年实现净零碳排放,亚马逊在实现这个目标上面临着巨大挑战,因为我们不只是搬运信息,我们拥有庞大的实体基础设施,每年在全球配送超过100亿件商品,我们相信如果亚马逊能提前10年实现净零碳,任何公司都能做到,我们也希望与所有公司一起努力,让这件事成为现实 为此我们正在招募其他公司签署气候承诺,签署方同意定期测量和报告温室气体排放,实施符合巴黎协定的脱碳战略,并在2040年前实现年度净零碳排放,我们很快会公布新的签署方,我们计划通过像密歇根州的电动汽车制造商 Rivian采购10万辆电动送货车,来部分兑现这个承诺,亚马逊的目标是最早在2022年,让1万辆Rivian的新型电动货车上路,并在2030年前让全部10万辆车上路,这对环境有好处,但更大的意义在于,这类投资会向市场发出信号,促使大家开始发明和开发那些大型全球化公司 向低碳经济转型所需的新技术,我们还承诺到2024年实现80%可再生能源使用,到2030年实现100% 实际上我们的团队正在努力争取在2025年就达到100% 并且有一个很有挑战性但切实可行的计划来实现它,在全球范围内亚马逊拥有86个太阳能和风能项目,总装机容量超过2300MW 每年可提供超过630万MWG的能源,足以满足超过58万个美国家庭的用电需求,我们在减少包装浪费方面也取得了巨大进展,十多年前我们推出了无错包装计划 鼓励制造商用易于打开100%可回收的包装来包装产品,这种包装可以直接寄给客户,无需额外的快递纸箱,自2008年以来,该计划已节省了超过81万吨包装材料,并减少了14亿个快递纸箱的使用,我们正在进行这些重大投资,已将我们的碳足迹降至零,尽管线上购物本身就已经比去实体店购物更低碳,亚马逊的可持续发展科学家,花了三年多时间开发模型工具和指标,来衡量我们的碳足迹,他们的详细分析发现,线上购物始终比开车去商店产生的碳排放更少,因为平均而言,一辆送货车一趟的行程,大约可以替代100次私家车往返 我们的科学家开发了一个模型,用来比较在线订购 Whole Foods Market 生鲜杂货与开车去最近的 Whole Foods Market门店购物的碳强度,研究发现,按所有购物栏大小的平均值计算,线上生鲜配送每件商品产生的碳排放,比到店购物低43% 购物栏越小,节省的碳排放就越多 AWS本身也比传统的,自建数据中心更高效,这主要归功于两点,更高的利用率,以及我们的服务器和设施,比大多数公司,自建数据中心更高效,典型的单一公司数据中心,服务器利用率,大约只有18% 他们需要那些多余的容量,来应对突发的高风流量 DOS受益于多租户使用模式 服务器利用率要高得多,此外 Odoss在提高其设施和设备的能效方面,也取得了成功,例如在某些数据中心,使用更高效的蒸发冷却,来代替传统的空调 451 Research的一项研究发现。 [04:50:00]
杰夫·贝佐斯:451 Research的一项研究发现 AWS的基础设施能效,是所调查的美国企业数据中心,中位数的3.6倍,加上我们对可再生能源的使用,这些因素使得AWS在执行与传统数据中心相同的任务时,碳足迹降低了88% 别以为我们会放过那最后的12个百分点,我们会通过对可再生能源项目的更多投资,让AWS实现百分之百无碳,用规模做好事,过去十年没有哪家公司比亚马逊创造了更多的就业机会,亚马逊在全球直接雇佣了84万名员工,其中美国超过59万人,欧洲11万5000人,亚洲9万5000人,在美国亚马逊直接和间接支持了200万个工作岗位 其中包括亚马逊在建筑物流和专业服务等领域的投资,所创造的超过68万个工作岗位,以及中小企业在亚马逊上销售所创造的另外83万个工作岗位,在全球范围内,我们支持了近400万个工作岗位,我们尤其自豪的是,其中很多是入门级岗位,为人们提供了第一次参与工作的机会,而且亚马逊的岗位提供行业领先的15美元,最低时薪和全面的福利,超过4000万美国人,其中很多人拿的是7.25美元的联邦最低时薪,真的比亚马逊收入最低的员工还少 2018年我们把起薪最低时薪提到15美元的时候,对我们物流中心几十万员工产生了立竿见影,实实在在的影响 我们希望其他大雇主也能跟上提高自己的最低工资标准,我们也一直在推动15美元的联邦最低实行立法,我们想改善工人生活的不只是工资,亚马逊给每位全职员工提供医疗保险 401k退休计划 20周全新产价和其他福利,这些福利跟亚马逊最高层高管享受的是一样的,而且随着经济快速变化,我们比以往任何时候都更清楚的看到,工人需要不断更新技能才能跟上技术发展,所以我们投入7亿美元,让超过10万名亚马逊员工在工作场所就能参加培训项目,学习医疗健康云计算机器学习等高需求领域的技能,从2012年起我们就推出了career choice项目 这是一个为物流中心员工提供的预付学费项目,帮助他们转向高需求职业,亚马逊最高承担95%的学费和相关费用,帮他们拿到合格领域的证书或文凭,从而在高需求岗位获得更好的就业机会,自项目启动以来,已有超过25000名亚马逊员工,接受了高需求职业的培训,为了确保下一代拥有在技术驱动型机器中发展所需的技能,我们去年启动了一个叫Amazon Future Engineer的项目,专门为低收入和弱势背景的年轻人提供教育和培训,帮助他们从事计算机科学相关的职业,我们有一个宏大的目标,每年帮助数十万学生学习计算机科学和编程 Amazon Future Engineer目前资助全美2000多所资源不足社区的学校开设计算机科学导论和AP计算机科学课程,每年Amazon Future Engineer还会提供100个四年制每人4万美元的大学奖学金,给来自低收入背景的计算机科学专业学生,这些奖学金获得者在大一之后还能获得亚马逊的代薪实习机会,我们在英国的项目资助120个工程学徒名额,帮助弱势背景的学生进入科技行业,眼下我自己的时间和精力仍然集中在新冠疫情上,以及亚马逊在疫情期间能如何提供帮助,我非常感激亚马逊的同事们,在共度难关的过程中展现出的坚韧和智慧 你们可以相信我们所有人都会在眼前的危机之外,去寻找洞见和教训,并思考如何在未来加以运用,想一想Theodore Ciskezel说过这段话,当坏事发生时,你有三个选择,你可以让它定义你,让它摧毁你,或者让它让你变得更强大,对于人类文明会选择哪一个,我非常乐观,即便在这样的情况下,今天依然是第一和往常一样,我附上了我们1997年的原始制股东信,此至Jeffrey P. Bezos 创始人兼首席执行官 2020年制股东信,致各位股东在亚马逊1997年制股东的信里,也就是我们的第一封信 我谈到我们希望打造一个历久弥新的基业,一个能借助互联网的力量,重新定义服务客户这件事的基业,我当时提到,亚马逊的员工数从158人增长到了614人,客户账户突破了150万,我们刚刚上市,按拆股调整后的股价是每股1.50美元,我写到那是第一天,从那以后我们走过了很长的路,现在比以往任何时候都更努力的服务客户,让客户满意,去年我们招聘了50万名员工,目前在全球直接雇佣了130万人。我们在全球拥有超过2亿Prime会员,超过190万家中小企业在我们的商城销售,他们贡献了我们近60%的零售额。客户已经将超过1亿台智能家居设备连接到Alexa。Amazon Web Services为数百万客户提供服务,到2020年底,年化营收运行率达到5万亿美元,在1997年,我们还没有发明Prime Marketplace Alexa或AWS 那时候连想法都算不上,也没有哪个是命中注定的,我们在每一项上都承担了巨大风险,投入了汗水和材质,一路走来,我们为股东创造了16000亿美元的财富,他们是谁,你们的董事长就是其中之一,我持有的亚马逊股票也让我变得富有,但超过八分之七的股份代表着14亿美元的财富创造,是由其他人持有的,他们是谁,他们是养老基金大学和401k账户 还有像Mary和Larry这样的人,就在我坐下来写这封股东信时,他们突然给我发来了这封信,我经常遇到类似的故事,我认识一些人,他们用从亚马逊赚到的钱去上大学,应对紧急情况,买房子,度假,创业,做慈善,还有很多很多,我为我们给股东创造的财富感到自豪,这很可观,也改善了他们的生活,但我也知道另一件事,这不是我们创造的价值里最大的一部分,创造的要大于消耗的,如果你想在商业上成功,其实在生活中也一样,你创造的就必须要大于你消耗的,你的目标应该是,为你接触到的每一个人创造价值,任何一家企业,如果不去为他所触及的人创造价值,哪怕表面看起来很成功 也活不长久,他正在走向消亡,记住股票价格跟过去无关,他们是对未来现金流折现到当下的预测,股市是在做预期,我暂时换个话题,谈谈过去 2020年,我们为股东创造了多少价值,这个问题相对容易回答,因为会计体系就是为此设立的,我们2020年的净利润是213亿美元,如果亚马逊不是一家拥有成千上万股东的上市公司,而是一家只有一个所有者的独资企业,那么这就是这位所有者在2020年赚到的钱,那员工呢,这也是一个相对容易回答的价值创造问题,因为我们可以看薪酬支出,对公司来说是支出,对员工来说就是收入 2020年员工的收入是800亿美元,再加上110亿美元的福利和各种工资税,总计910亿美元,那第三方卖家呢,我们有一个内部团队叫selling partner services团队,专门研究这个问题,他们估计2020年第三方卖家在亚马逊上销售的利润,在250亿到390亿美元之间,为了保守起见,我取250亿美元,对于客户,我们需要分成消费者客户和AWS客户,我们先说消费者,我们提供低价海量选择和快速配送,但假设我们为了这次估算忽略所有这些,只看一点,我们帮客户节省了时间,客户在亚马逊上 28%的购买,是在三分钟或更短时间内完成的 所有购买中有一半,是在15分钟内完成的,对比一下,去实体店的典型购物过程,开车停车,在货架间寻找排队结账,找车开车回家,研究表明。 [05:00:00]
杰夫·贝佐斯:研究表明,去一次实体店通常要花,大约一个小时,假设一次典型的亚马逊购物需要15分钟,并且每周能帮你省去几次去实体店的麻烦,那一年就能省下超过75个小时,这很重要,在21世纪初我们都很忙,为了得出一个具体的金额,我们按每小时10美元来估算节省的时间价值,这已经很保守了 75小时乘以每小时10美元,再减去prime的费用,算下来每位Prime会员创造的价值大约是630美元,我们有2亿Prime会员,所以2020年总共创造了1260亿美元的价值 AWS这部分很难估算,因为每个客户的工作负载差异很大,但我们还是来算一下,并且事先声明误差范围很大 在云端运行相比本地部署带来的直接成本改善各不相同,但一个合理的估计是30% 按AWS 2020年450亿美元的总营收来算,这30%意味着为客户创造了190亿美元的价值,也就是说他们自己敢要花640亿美元,用AWS只花了450亿美元,这次估算的难点在于直接成本的降低,只是客户迁移到云端所获收益率最小的一部分,更大的好处是软件开发速度的提升,这能显著提高客户的竞争力和营收,我们没有办法合理估算,这部分客户价值,只能说它几乎肯定比直接节省的成本更大,为了保守起见,也记住我们真的只是在做粗略估算 我就假设它和直接节省的成本一样大,那么AWS在2020年创造的客户价值,就是38000亿美元,把AWS消费者业务加起来 2020年我们为客户创造的总价值是1640亿美元,总结一下,股东210亿,员工910亿,第三方卖家250亿,客户1640亿,合计3010亿美元,如果每个群体都有一份损益表来反映他们和亚马逊的互动,上面这些数字就是那些损益表的底线,这些数字部分解释了为什么人们愿意为我们工作,为什么卖家通过我们销售,为什么客户从我们这里购买,我们为他们创造价值,而且这种价值创造不是零和游戏 不是把钱从一个口袋挪到另一个口袋,把视野放大到整个社会,你会发现发明是所有真正价值创造的根源,价值创造最好把它看作衡量创新的指标,当然我们和这些群体的关系,我们创造的价值,不完全是金钱和数字,钱不能说明一切,比如我们和股东的关系相对简单,他们投资持有股票,时间长短,由他们自己决定,我们偶尔在年度会议和投票权,行使流程这类事情上,给股东提供方向,即便如此,他们也可以忽略这些方向,直接跳过投票,我们和员工的关系就完全不同了,他们有要遵循的流程,有要达成的标准,我们要求培训和各种认证 员工必须在指定时间到岗,我们和员工的互动非常多,而且非常细致,这不只是薪酬和福利的问题,还涉及关系中所有其他具体的方面,最近Besmer的工会投票结果,有没有让我们的董事长感到宽慰,没有,他没有,我觉得我们需要为员工做得更好,虽然投票结果悬殊,我们和员工的直接关系也很牢固,但我很清楚,我们需要一个更好的愿景,来明确我们如何为员工创造价值,一个关于他们成功的愿景,如果你读一些新闻报道,可能会觉得我们根本不关心员工,在那些报道里,我们的员工有时被说成是绝望的人,被当作机器人对待,这不准确,他们是成熟有想法的人,有选择去哪里工作的自由 我们调查配送中心的员工时 94%的人说他们会推荐亚马逊给朋友作为工作的地方,员工在轮班期间可以随时进行非正式的休息,去伸展喝水上厕所或者找经理谈话,这些都不会影响他们的绩效,这些非正式的空间休息,是在他们正常排班中30分钟午餐,和30分钟休息之外额外有的,我们不设定不合理的绩效目标,我们设定的目标是可以实现的,会考虑员工的在职时长和实际绩效数据,绩效评估是看一个长周期,因为我们知道各种各样的事情,都可能影响某一周,某一天或某一小时的发挥,如果员工在一段时间内,有达不到绩效目标的趋势 他们经理会和他们谈话提供辅导,辅导同样会提供给那些表现优异,准备承担更多职责的员工,事实上82%的辅导是积极的,提供给那些达到或超出预期的员工,我们因员工无法胜任工作,而终止雇佣的比例不到2.6% 这个数字,在2020年因为COVID-19 对运营的影响甚至更低,地球上最好的雇主,地球上最安全的工作场所,事实是领导亚马逊运营的数千人庞大团队,一直都非常关心我们的小施工,我们对自己创造的工作环境感到自豪,我们也为另一个事实感到自豪,亚马逊不仅仅为计算机科学家和高学历人才创造就业 我们也为那些没有这些优势的人创造工作,尽管我们已经取得了一些成就,但我很清楚,我们需要一个更好的,关于员工成功的愿景,我们一直想成为地球上,最以客户为中心的公司,这一点不会变,是他让我们走到了今天,但我要承诺增加一个目标,我们要成为地球上最好的雇主,和地球上最安全的工作场所,在我即将担任执行董事长的角色里,我会专注于新的举措,我是一个发明者,这是我最享受,也最擅长的事,也是我创造最大价值的地方,我很兴奋能和运营部门里,那群充满热情的庞大团队一起工作,在地球上最好的雇主,和最安全的工作场所,这个领域进行创造,在细节上 我们亚马逊一向灵活,但在愿景上,我们固执且不懈,我们下定决心要做的事,从来没有失败过,这次也不会,我们深入挖掘安全问题,比如亚马逊,大约40%的工伤与肌肉骨骼疾病 MSDS有关,像是由重复性动作引起的扭伤或拉伤 MSD在我们这类工作中很常见,而且更可能发生在员工入职的前六个月,我们需要发明解决方案,来减少新员工的MSDS 他们中很多人可能是第一次从事体力劳动,其中一个项目叫Working Well 我们在2020年向北美和欧洲350个网点的 85万9千名员工推出了这个项目,在项目里,我们指导小群组的员工学习身体力学 主动健康和安全,除了减少工伤,这些理念对工作之外的日常活动也有积极影响,我们正在开发新的自动化排班系统,用复杂的算法,让员工在不同工位之间轮换,这些工位用到的肌肉基建群不一样,从而减少重复动作,帮助员工远离肌肉骨骼损伤的风险,这项新技术是我们正在2021年,全年推行的岗位轮换计划的核心,我们对早期肌肉骨骼损伤预防的加倍重视,已经看到了成效,从2019年到2020年,整体肌肉骨骼损伤下降了32% 其中导致缺勤的损伤减少了一半以上,我们在Amazon雇有6200名安全专业人员 他们运用安全科学来解决复杂问题,建立新的行业最佳实践 2021年我们会在安全项目上投入超过3亿美元,其中首期6600万美元用于开发技术,帮助防止叉车和其他工业车辆发生碰撞,我们带头别人就会跟上,两年半前,我们把小时工的最低工资定在15美元,这么做是因为我们想在薪酬上领先,而不是随大流,也因为我们相信这是正确的事,加州大学伯克利分校和布兰迪斯大学的经济学家,最近发表了一篇论文,分析了我们把最低起薪提高到每小时15美元,这一决定的影响,他们的评估印证了我们从员工,他们的家人以及他们所在社区那里听到的反馈 我们提高起薪的举措提振了全国各地的本地经济,不仅汇集我们自己的员工,也汇集了同一社区的其他劳动者,研究表明我们的涨薪带动了同一劳动力市场里。 [05:10:00]
杰夫·贝佐斯:研究表明我们的涨薪带动了同一劳动力市场里,其他雇主的平均时薪提高了4.7% 而且我们还没带完头,如果我们想成为地球上最佳雇主,就不该满足于94%的员工,说他们会推荐朋友来Amazon工作,我们必须朝着100%努力,我们会继续在薪酬福利技能提升机会等方面保持领先,也会随着时间推移摸索出其他办法,如果有股东担心地球上最佳雇主和地球上最安全的工作场所,会不会冲淡我们对地球上最以客户为中心的公司的关注,请各位放心,可以这么想,如果我们能把消费电商和AWS这两个截然不同的业务都做到最高水平 那这两个愿景我们也肯定能同时做好,事实上,我相信他们会相互促进,气候承诺,在这封信的早期草稿里,我这一节的开头本来写了一些论据和例子,想证明人为引起的气候变化是真实存在的,但坦白讲,我觉得现在可以不用再说这个了,你不需要去证明光合作用是真实存在的,也不需要论证万有引力是真的,或者水在海平面高度100摄氏度会沸腾,这些就是事实气候变化的现实也一样,不久之前,大多数人还认为应对气候变化是好事,但也觉得这会代价高昂,会威胁就业竞争力和经济增长,我们现在更清楚了 明智的气候行动不仅能阻止坏事发生,还能让我们的经济更高效,推动技术变革降低风险,这些加在一起能带来更多更好的就业,更健康快乐的孩子,更有生产力的劳动者,以及更繁荣的未来,这并不意味着会很容易,不会容易的,未来十年将是决定性的十年 2030年的经济需要和今天截然不同,而Amazon计划处在这场变革的核心,我们在2019年9月与Global Optimism 共同发起了气候承诺,因为我们想帮助推动这场积极的革命,我们需要成为日益壮大的企业团队中的一员,这些企业理解21世纪的紧迫性和机遇,如今不到两年时间,已有53家代表几乎所有经济领域的公司 签署了气候承诺 Best Buy,IBM Infosys,Mercedes,Binz,Microsoft,Siemens和Verizon等,签署方承诺,到2040年在其全球业务中实现净零碳排放,比巴黎协定提前10年,承诺还要求他们定期测量和报告温室气体排放,通过实际的业务变革和创新来实施脱碳战略,并通过额外的可量化的真实的永久的具有社会效益的碳抵销来综合任何剩余排放,可信高质量的碳抵销非常宝贵,我们应该把它们留给那些不存在低碳替代方案的经济活动,气候承诺的签署方正在做出有意义具体且雄心勃勃的承诺 Uber的目标是到2030年,在加拿大欧洲和美国运营一个零排放平台 Hanko计划100%使用可再生能源电力进行生产 Amazon也在朝着我们自己的目标前进,即到2025年实现100%可再生能源,比最初2030年的目标提前了5年 Amazon是全球最大的可再生能源企业采购方,我们在全球拥有62个公用事业规模的风能和太阳能项目,以及125个位于旅游和分解中心屋顶的太阳能设施,这些项目的发电能力超过6.9GW 每年可输送超过2000万兆瓦时的能源,运输是Amazon业务运营的主要组成部分 也是我们到2040年实现净零碳排放计划中最棘手的部分,为了加快推动电动汽车技术市场的发展,也为了帮助所有公司向更绿色技术转型,我们向Rivian投资了超过10亿美元,并向该公司订购了10万辆电动送货车,我们还与印度的Mahindra和欧洲的Mercedes-Benz建立了合作,这些来自Rivian的定制电动送货车已经投入运营,今年2月在洛杉矶首次上路,明年年初就会有一万辆新车上路,到2030年全部十万辆车都将上路,这将节省数百万吨的碳排放,我们希望公司加入气候承诺的一个重要原因,就是向市场发出信号 企业应该开始发明和开发那些签署方,兑现承诺所需的新技术,我们购买十万辆Rivian电动货车,就是一个很好的例子,为了进一步加速对建设零碳经济所需新技术的投资,我们去年6月推出了Climate Pledge Fund,这个投资项目初始资金为20亿美元,用于投资那些旨在推动向低碳经济转型的,有远见的公司。Amazon已经宣布投资了CarbonCure Technologies Pachama Redwood Materials Rivian Turntide Technologies CeroAvia和Infinium 这些只是我们所希望的那些,能建设未来零碳经济的创新公司中的一部分,我个人也拨出了100亿美元用于提供资助 以帮助推动我们在未来十年所需的系统性变革,我们将支持顶尖的科学家,活动家,非政府组织,环境正义组织,以及其他致力于应对气候变化和保护自然世界的各方力量,去年年底,我完成了第一轮资助,投向了16个致力于创新和能带来实质性突破的解决方案的组织,这需要大公司,小公司,国家,全球组织和个人共同行动,我很兴奋能参与这段旅程,也对人类能够团结起来,解决这一挑战感到乐观,差异化就是生存,而世界总想让你变得平庸,这是我作为Amazon CEO的,最后一封年度鼓动信,我还有最后一件至关重要的事,觉得必须讲一讲,我希望所有Amazon人都能把它放在心上 这是Richard Dawkins那本非凡的著作 《盲眼钟表将》中的一段话,他讲的是生物学的一个基本事实,抵御死亡是一件你必须不断努力的事,如果放任不管,死亡本身就是这种状态,身体会倾向于恢复到与周围环境平衡的状态,如果你测量一个活体的一些指标,比如温度酸度含水量或电视,你通常会发现,这些指标与周围环境的相应测量值显著不同,比如我们的身体通常比周围环境更热,在寒冷的气候里,身体必须努力维持这种温差,当我们死去,这种努力就停止了,温差开始消失,最终我们的温度和周围环境变得一样,并非所有动物都如此费力的避免,与周围环境的温度达到平衡 但所有动物都会做类似的事情,例如在干燥的地区,动植物会努力维持细胞内的液体含量,对抗水分从体内流向干燥外界的自然趋势,如果他们失败了,就会死,更广泛的说,如果生物不积极的努力阻止,他们最终会融入周围环境,不再作为独立自主的存在,这就是他们死去时,所发生的事,虽然这段话本意并非一个比喻,但它确实是一个绝妙的比喻,而且与Amazon非常相关,我想说,它其实与所有公司,所有机构,乃至我们每个人的生活都相关,这个世界在哪些方面,试图把你拉向平庸,你需要付出多少努力,才能保持自己的独特性,才能让那些,让你与众不同的东西保持活力 我认识一对幸福的夫妇,他们之间有个常开的玩笑,丈夫常常带着假装的苦恼,看着妻子说,你就不能正常点吗,他们俩都会笑起来,当然深层的事实是,他的独特性,正是他所爱他的地方,但同时,如果我们能稍微正常一点,事情往往会更容易,也更省力,这种现象在各个层面都存在,民主政体并不正常,暴政才是历史的常态,如果我们停止,为保持我们在这方面的独特性,而持续付出的艰苦努力,我们很快就会与暴政趋同,我们都知道独特性,也就是原创性,是有价值的,我们都被教导要做自己,我真正想让你做的,是去拥抱并清醒的认识到 保持这种独特性,需要付出多少精力,这个世界想让你变得平庸,它以一千种方式拉扯着你,别让它得逞,你必须为你的独特性付出代价,而这很值得,关于做自己的童话版本是。 [05:20:00]
杰夫·贝佐斯:关于做自己的童话版本是,一旦你让自己的独特性闪耀,所有的痛苦就会停止,那个版本是误导人的,做自己是值得的,但别指望它会很容易,或者毫无代价,你必须持续的为之投入精力,这个世界总会试图让Amazon变得更平庸,让我们与周围环境趋同,这需要持续不断的努力,但我们能够也必须做的比那更好,他们把Plimco 6升到了Plimco 7 Max 和往常一样,我附上了我们1997年的致股东信,信的结尾是这样写的 Amazon的全体同仁感谢客户的惠顾与信任,感谢彼此的辛勤工作,也感谢股东们的支持与鼓励,这一点至今丝毫未变,我想特别感谢Andy Jassy同意接任CEO一职 这是一份重任在肩的苦差事 Andy才华横溢,而且有着最高标准,我向你保证 Andy绝不会让这个世界把我们变得平庸,他会凝聚起所需的能量,让我们身上那些独特的东西保持活力,这不会容易,但至关重要,我也预言,这会是一段令人满足,而且常常充满乐趣的旅程,谢谢你 Andy 对,你们所有人,我想说与人为善,保持独创,让创造多于消耗,并且永远永远永远,不要让这个世界,把你打磨的随波逐流,今天依然是第一天,景起 Jeffrey P. Bezos创始人,兼首席执行官。 [05:30:00]
本期《编辑室 ON AIR》讨论 SpaceX IPO 的吸金逻辑。凯俊、张勤煜与齐娴认为,投资人买的不是火箭公司,而是马斯克把可回收火箭、Starlink、XAI、Tesla、机器人和火星探索串成的长期想象。SpaceX 的底气来自低成本发射、NASA 等政府合约、Starlink 开始赚钱,以及市场对马斯克关键成功经验的信任;风险则是 AI 烧钱、上市后获利压力、股权控制集中和个人判断失误。
节目回顾 SpaceX 从 2002 年创办、多次发射失败,到靠 NASA 合约和可回收火箭降低成本。张勤煜说明,Crew Dragon 让美国摆脱长期依赖俄罗斯载人上太空,政府合约成了稳定收入底盘。齐娴指出,马斯克原本不愿上市,因为火星探索与资本市场短期获利要求冲突;但 XAI 烧钱、Starlink 盈利和集团整合,使整体 IPO 变得合理。
后半段谈“马斯克生态圈”:Tesla 的自动驾驶与 Dojo、XAI、机器人、卫星和发射能力,都可被放进火星计划。张勤煜补充,马斯克还想把 AI、芯片、资料中心和太空能力结合成“能上太空的 AI”故事。谈到 Terafab 时,齐娴认为先进制程不是少数人才就能复制,台积电制造体系更确定。因此两位来宾在 all in 选择上偏向台积电,但节目以“不要跟马斯克对赌”收尾。
- SpaceX上市与回收火箭 [00:00:00 - 00:10:00]
- AI烧钱与控制权设计 [00:10:00 - 00:20:00]
- 马斯克生态圈与台积电竞争 [00:20:00 - 00:30:00]
- 不与马斯克对赌 [00:30:00 - 00:30:04]
凯俊:大家愿意把钱投进 SpaceX,很大原因是马斯克描绘的是“星辰大海”:即便成功机率只有百分之一,潜在报酬仍然庞大。欢迎收看《编辑室 ON AIR》,我是凯俊。马斯克传里有一句话说,失败很正常,如果没有经历失败,代表你还不够创新。六月中,全球投资人关注的焦点是 SpaceX 终于 IPO,市场把它推到史上最大 IPO 的想象里,市值一度冲到很高的位置。SpaceX 的发展能不能像 Tesla 一样成功?今天我们请到大同大学电机系教授张勤煜老师,以及国际中心副主任齐娴,一起聊这个话题。 [00:00:39]
张勤煜:凯俊好,各位观众大家好。
齐娴:主持人好,大家好。
凯俊:齐娴,我们先从 SpaceX 的故事谈起。大家听过很多马斯克,特别是他发展 Tesla 的那段,但 SpaceX 这一路其实也很艰辛,它为什么能走到今天? [00:01:08]
齐娴:SpaceX 早在 2002 年就创办,并不是突然冒出来的新创公司。它前面很长一段时间都不断发射失败,亏损也很严重,一度接近撑不下去。后来它拿到美国政府和 NASA 的合约,才挺过最困难的阶段,也逐渐成为美国太空任务的重要助力。
凯俊:老师,我想问 Falcon 1 的那段。我们知道它前三次发射都失败,第四次才勉强算成功,SpaceX 当时到底怎么拿到 NASA 的标案? [00:02:10]
张勤煜:关键在于它提出“可回收火箭”的概念。过去太空发射的最大成本在火箭本体,传统火箭有点像抛弃式,用完就不能再用。如果火箭可以回收,单次发射成本就能大幅下降。过去一次可能要一亿五千万美元以上,现在有机会降到几千万美元;每公斤载荷送上太空的成本,也从几万美元降到一两千美元。这等于打开了太空商业化的新思路。
凯俊:所以把发射成本降下来,就算成功了吗?还是 SpaceX 其实有更远的目标? [00:03:32]
张勤煜:降低成本只是第一步。SpaceX 从一开始讲的就是上火星、做太空探索,这也和 SpaceX 这个名字相符。以 2000 年代初的技术,不可能一步到位,所以它必须先解决关键问题:让火箭可回收、把发射成本打下来,再借此拿到 NASA 合约。美国过去很多任务由 NASA 自己做,现在逐渐转成民间承包商执行,这就是 SpaceX 的机会。
凯俊:我想请教齐娴,SpaceX 里面除了太空探索,还有 Starlink,这次它能募到七百多亿美元,甚至打破之前 Arm 的纪录,为什么会有这么强的吸金能力? [00:04:50]
齐娴:先补充一点,这次募资原本大约是七百五十亿美元,但因为认购太踊跃,银行又释出超额配售,也就是俗称的绿鞋机制,所以加上额外发行的股票,实际募资金额可能已经超过八百亿美元。投资人愿意出钱,是因为马斯克卖的是很大的未来想象:如果 SpaceX 有一天能掌握行星能源、太空资源,甚至把人类活动扩展到更远的地方,想象空间就不只是地球上的一家公司。 [00:05:17]
凯俊:可是就算未来有外星资源、矿物或能源,投资人都会相信它一定能成功吗? [00:06:49]
齐娴:外界对 SpaceX 的前景非常两极,有人觉得它会一飞冲天、征服宇宙,也有人觉得它可能失败。可以肯定的是,即使成功机率只有 1%、0.1% 甚至更低,只要成功后的潜在报酬巨大,估值乘起来还是很有想象空间。大家愿意掏钱买的,正是这种不确定但上限极高的故事。
凯俊:马斯克自己其实也知道,目前真正赚钱的是 Starlink。他 2020 年还说过,最后可能让 Starlink IPO,为什么现在变成 SpaceX 整体上市? [00:07:48]
齐娴:马斯克的规划常会改变。像他 2022 年收购 Twitter,后来因为市场下跌也一度反悔,最后还是在董事会提告压力下完成收购。Starlink 过去也很烧钱,只是近几年规模扩大,才开始支援 SpaceX 的亏损。现在 SpaceX 大致有火箭发射、Starlink 和 AI 三块业务:火箭和 AI 都烧钱,Starlink 赚钱,可以扮演“神队友”,让财务报表不至于太难看。这很可能是他改变想法、推进 SpaceX IPO 的重要契机。 [00:09:06]
齐娴:另一个原因是 AI 太烧钱。现在大科技公司建设 AI 工厂,本质上是在比资本投入;谁花得起更多钱,谁就有更大机会。马斯克原本不希望 SpaceX 上市,因为他的长远目标是宇宙探索和火星计划,一旦上市,就会有股东和资本市场要求赚钱、获利,这和他的长期目标会有冲突。但 XAI 近期烧钱速度可能超过他的规划,所以他需要把 SpaceX 的资本市场计划往前推。同时,XAI 下一步也可能和 SpaceX 业务整合,比如把 AI 算力放到太空,和卫星、火箭、资料传输结合起来。 [00:10:00]
凯俊:马斯克很不希望股东干预重大决策。SpaceX 即使上市,他是不是也用 A 股、B 股这类股权设计,让自己在公司里仍然保有绝对话语权? [00:12:16]
张勤煜:没错。马斯克旗下有很多公司,包括 Tesla、Neuralink,他也曾是 OpenAI 的共同创办人。对公司治理来说,他一直想要更大的掌控力;即使是 Tesla,也不是每件事都完全照他的意思走。所以 SpaceX 设计了 A 股和 B 股,B 股一股可能有十票,A 股只有一票,而 IPO 释出的新股绝大多数是 A 股。根据上市前提交给美国 SEC 的 S-1 文件,SpaceX 还设计了奖励机制,让马斯克即使不用完全达成某些条件,也能提前取得对应的投票权。结果是他可能掌握八九成以上的 B 股,原始股东或新股东再怎么交易,也很难动摇他对 SpaceX 的控制。
凯俊:这种股权奖励会不会反过来变成锁住公司的链锻,成为 SpaceX 的重大风险? [00:14:44]
张勤煜:有可能。当一家公司几乎由一个人说了算,股东没有太多话语权,确实会面对单点决策风险:万一这个人判断错了怎么办?但马斯克又是一个很特殊的人。Tesla 的营收远不如 Toyota,可是市值和股价却远远超过传统车厂,说明市场买的是他带来的想象和关键成功经验。SpaceX 也是类似逻辑,虽然他失败过很多次,但也在关键节点做成了事情,所以投资人愿意相信它具备这种实力。
凯俊:现在 SpaceX 的财务摊开来看,因为并入 XAI 之后,AI 烧钱让公司又转为亏损。但它最大的单一客户是政府,NASA 现在没有 SpaceX,几乎很难上国际太空站。这算不算重大利多? [00:15:51]
张勤煜:美国曾经退役太空梭,之后很长一段时间要依赖俄罗斯把美国人送上国际太空站。那对美国来说很尴尬,因为太空竞赛时代美国靠登月胜过苏联,后来却有大约十年必须仰赖俄罗斯。俄罗斯也不断把报价从两千万美元喊到五千万、七千万、九千万美元。到 2020 年 SpaceX 的 Crew Dragon 成功执行载人太空任务,NASA 终于解套,不必继续依赖俄罗斯。运送物资可能还有其他承包商,但载人技术挑战更高,所以 NASA 对 SpaceX 的依赖非常强。 [00:16:48]
凯俊:可是 NASA 烧钱压力很大,美国政府不可能完全坐视不管。SpaceX 和 NASA、甚至和政治人物之间的关系,到底会是利多,还是会变成嫌隙? [00:18:40]
齐娴:这永远是拿捏的问题。SpaceX 提供了更低成本的方案,让 NASA 很多发射任务外包给它。先前马斯克和川普关系好的时候当然没问题,关系变差时,川普阵营也曾想看政府能不能切断和他的合约,但后来发现很难,因为 NASA 现有任务和合约不是说停就能停。对 SpaceX 来说,政府合约基本上不会轻易毁约,是稳定、确定的收入来源,也支撑了这次 IPO 的信心。
齐娴:再加上 Starlink 业务,尤其俄乌战争之后,外界对低轨卫星的重视提高,这些都让投资人对 SpaceX 寄予厚望。 [00:19:58]
凯俊:我比较好奇,SpaceX 和马斯克旗下其他公司如果深度整合,会不会形成所谓“马斯克生态圈”?他会不会把所有企业体都包成一包? [00:20:08]
齐娴:他想做的确实是把东西整合在一起。Tesla 有自动驾驶、导航,也有 Dojo 超级运算芯片;XAI 负责 AI;很多人谈 AI 时也会想到机器人,因为 AI 够成熟之后,放进机器人硬件里才可能真正帮人做事。再加上 SpaceX 的航太能力,这些东西最后都指向一个目标:火星探索。地球到火星距离很远,很多操作不可能靠人实时控制,必须靠机器、AI 和自动化系统完成。因此,把相关公司垂直整合起来,对马斯克的长线目标是有逻辑的。
张勤煜:国外分析师也确实在讨论这种可能性。以 AI 来说,XAI 现在未必比 OpenAI、Anthropic 等竞争对手强,但“能上太空的 AI”是另一种故事。OpenAI 的资料中心再强,也没有自己的发射能力;Anthropic 也没有。马斯克有火箭、有卫星,而且全球大量低轨卫星都和他有关。再加上他想做芯片,过去可能主要交给三星或台积电代工,现在又谈 Terafab、超大型晶圆厂。也就是说,他想同时掌握芯片、资料中心、卫星、发射能力和 AI。如果这套 AI 真的成功,资源整合会是他挑战其他 AI 公司的关键。 [00:22:04]
凯俊:刚才提到 Terafab,它最大的对手可能就是三星和台积电。假如 Terafab 成功,对台湾半导体供应链会不会有影响? [00:23:35]
齐娴:从半导体角度看,我不会把 Terafab 视为很现实的直接竞争。马斯克的想法可能是,只要在机台里面维持真空和洁净,人坐在外面抽雪茄、吃饼干都没关系。但先进制程不是这样。两纳米、1.6 纳米、1.4 纳米等级的芯片,对整座无尘室、洁净室和物料传送系统都有极高要求,不是只有机器内部干净就可以。台积电从晶圆夹、物料传送到机台内部,整个系统本来就维持高洁净度和真空要求。如果旁边的人没有穿无尘衣,污染扩散过去,就会影响良率。 [00:24:01]
凯俊:所以即使他在新竹征才,找有制程经验的人,也不代表马上能复制台积电?
齐娴:对。他确实开始征才,也摆明想吸引台积电相关人才。有些人会被马斯克个人魅力吸引,人才流动本身也不一定是坏事。但半导体不是一两个人就能解决的复杂问题,它需要非常大的团队、长期试条件、调制程、累积经验,才可能做出稳定结果。 [00:25:50]
凯俊:节目最后给两位一个选择:如果有一笔钱必须 all in,你们会选择投资马斯克,还是投资台积电? [00:27:02]
齐娴:我应该还是会选台积电。也许因为我们是理工和技术背景,比较能确定、看得到的是,台积电虽然没有自己的终端品牌,但它把晶圆制造做到全世界最好的技术。无论未来需要 Intel、NVIDIA、Google TPU,还是其他科技公司设计的芯片,最后仍然需要台积电来制造。也就是说,不管未来哪家公司抢赢市场,制造端仍然绕不开台积电,这个确定性比较高。
凯俊:所以你还是相信台积电,相信魏哲家?这是不是代表你不看好 Elon Musk?
张勤煜:不是不看好,而是如果从稳定性来看,我也会选台积电。台积电有点像公司版的 0050,它追踪的是一群最强客户。以前最大客户可能是苹果,现在可能是 NVIDIA,未来还会换。十年前全球市值最大的公司和今天不同,下一轮也可能不同;有些公司会成功,有些会失败,SpaceX 也可能成功或失败。但无论谁上谁下,台积电会持续服务最强的那批客户,客户洗牌时,它只是跟着重新排序,所以相对稳。 [00:28:44]
凯俊:不管你选台积电还是 Elon Musk,我都很喜欢 PayPal 前执行长 Peter Thiel 的一句话:千万不要跟马斯克对赌。 [00:29:48]
凯俊:千万不要跟马斯克对赌,言下之意大家应该都懂了。今天关于 SpaceX、Starlink、XAI 和台积电的讨论就到这里。这里是《编辑室 ON AIR》,我们下回再见,周末愉快,拜拜。
来源:OpenAI News
URL: https://openai.com/index/previewing-gpt-5-6-sol
OpenAI 预览了 GPT-5.6 Sol,这是一款下一代模型,在编程、科学和网络安全方面具备更强能力,并配套其最先进的安全栈。
本期是 Ryan Peterman 对 Google DeepMind 预训练负责人 Vlad Feinberg 的访谈,核心问题是:想进入 OpenAI、Anthropic、Google DeepMind 这类前沿实验室,真正需要什么能力。Vlad 的结论不是“只会研究”或“只会工程”,而是在大语言模型已经同时绑定研究与产品的阶段,最稀缺的是能把底层系统、数学理解、研究不确定性和真实产品目标连起来的人。内核开发、分布式系统、蒸馏基础设施、推理服务栈、文献综述、数学成熟度和“研究品味”都被反复提到。访谈后半段转向 Gemini Flash、Flash Lite 与 Flash 2.0 的预训练实践,强调模型突破往往来自看似琐碎但关键的工程决策、团队轮班护航,以及对真实问题的持续投入。
Vlad 认为,前沿实验室当前需求最旺盛的技能之一是内核开发和底层工程。大语言模型不是纯研究论文,也不是普通产品功能,而是研究和产品紧密耦合的系统:搜索、广告、YouTube、第一方模型和外部合作都需要高质量、低延迟、可稳定训练和部署的模型。即使是面向具体产品的应用团队,也常常需要事实性、引用质量、评估方法等硬核研究;而所谓纯研究也必须能把模型交付出来,让训练稳定运行,并把配方变成真实可用的系统。
他把软件工程到 AI 研究看成一个光谱。蒸馏就是典型例子:从教师模型提取统计信息,再迁移给学生模型,听起来是研究问题,但在数万亿 token 和几百万、几千万美元算力投入下,每一秒和每一个字节都重要。DeepMind 为蒸馏基础设施做过多轮重写,重新设计教师统计信息的抽象、存储和跨数据中心读写,这些传统分布式系统投入最终反过来推动了 Flash 3.0 级别的模型成果。
“研究品味”是 Vlad 反复强调的能力。他把研究描述成一个随机的有向无环图,许多里程碑可能成功也可能失败,因此不能像确定性软件项目那样单调推进。好的研究者要能判断哪条路径更可能通向结果,这需要对领域前沿足够谦逊和熟悉:先做文献综述,沿引用树判断论文价值,理解缩放定律、强化学习、PPO、策略梯度、分布式训练等基础,再从论文中抽取想法并亲手实现。
对于候选人,Vlad 看重的不是空泛热情,而是可验证的作品。可以优化开源模型或推理服务栈,在某个设定下做出真实改进;也可以给开源系统贡献负载均衡、KV 缓存、请求排队、分离式服务等组件。内部转岗者同样可以从“如何让所在产品最有效地用上大语言模型”切入,用真实产品问题积累领域知识。他还提到,用 Sutton book 练习、Transformer 实现和视频讲解展示主动性、数学成熟度与韧性,是一种很强的信号。
预训练部分集中在 Gemini Flash 和 Flash Lite。Vlad 解释了 MFU 不是简单越高越好,因为神经网络还有激活、注意力、归一化、通信等非矩阵乘法开销;硬件形态变化也会改变最优模型结构。他回顾自己从 Google Brain 追求论文发表,转向参与 Bard、SFT、超参数调优、XLA 编译和产品目标的过程,认为这些不光鲜的工程工作让他真正进入大语言模型主线。
Flash 2.0 的故事展示了研究与系统的耦合。团队想从稠密模型转向 MoE,以提升容量,但 MoE 的专家路由会带来跨 TPU 通信和延迟问题。后来团队把流水线预填充用于 MoE,把层分布到不同机器上,减少每层 token 交换,把通信隐藏在计算背后,从而打破 HBM 限制并降低延迟。这个决策让 Flash 2.0 获得关键质量提升,但训练阶段仍需要一个很小的团队连续约 40 天轮班护航,像 SRE 一样处理数据迭代器、索引、训练稳定性和 GPU 时间消耗。
最后的职业建议是:追真正重要、真实存在的问题,不要嫌弃问题中琐碎或不够“研究”的部分。只要事情重要,即便你只负责大项目中的小环节,也能看到推动前沿的关键。Vlad 也强调长期声誉来自帮助别人成功:遇到聪明人时,应尽量帮他们扩大机会,而不是用短期交易心态看待合作。
- 开场介绍与前沿实验室技能 [00:00:00 - 00:10:00]
- 研究品味与论文背景判断 [00:10:00 - 00:20:00]
- 数学成熟度与面试作品准备 [00:20:00 - 00:30:00]
- Flash 项目与职业转变 [00:30:00 - 00:40:00]
- 支持他人成长与长期声誉 [00:40:00 - 00:49:04]
一凯:欢迎收听跨国串门计划,这是一档专注于让中文听众无障碍欣赏全球优质外语播客的节目。通过先进的AI声纹克隆技术,我们不仅将内容翻译成中文,还完美保留了原主持人和嘉宾的独特声音,为您呈现全球顶尖的AI、财经、健康与科技领域精品内容。我是主播一凯。一位热衷于AI领域的产品经理。很荣幸能为您搭建这座跨越语言障碍的桥梁。接下来让我为您简单介绍本期我们克隆的这档节目。并分享几句非常精彩的原话。本期我们克隆的是Ryan Peterman主持的播客节目。他在2026年6月15日更新的这一期里。深度采访了Google DeepMind 的预训练领域负责人Vlad Feinberg。Vlad是一位在AI 前沿实验室深耕多年的技术领导者。他在这期节目里非常坦诚地分享了进入顶尖AI实验室的路径。以及他对研究本质的思考。在节目里他有几句话让我印象很深。每一次你启动预训练。你投入的算力都会比以往任何一次都多。研究能力会变得越来越重要。如果你去做Sutton book里的练习。然后录个视频发给我。我会很乐意面试你。做一个别人希望看到你成功的人。那我们就一起来听听这期的完整对话。 [00:01:24]
Ryan Peterman:每一次你启动预训练。你投入的算力都会比以往任何一次都多。这位是Vlad Feinberg。Google DeepMind 的预训练领域负责人。我向他详细请教了。怎么才能进前沿实验室工作。
Vlad Feinberg:那是一项我观察到在各个实验室都需求极其旺盛的技能。研究能力会变得越来越重要。如果你去做Sutton book里的练习。然后录个视频发给我。我会很乐意面试。你。以下是完整节目。
Ryan Peterman:你写过一篇帖子。标题是如何进入前沿实验室工作。前沿实验室现在到底需要哪些技能。 [00:02:05]
Vlad Feinberg:要不我们先聊聊工作的形态。前沿实验室需要的东西范围相当广。到了现在这个阶段。大语言模型已经成了一个。跟研究和产品都紧密相连的产物。这种紧密程度在机器学习领域是前所未有的。所以它触及的方面真的非常多。我那篇帖子的目标是提出几个具体的方向。在这些方向上。实验室会需要特定的技能。并不是要面面俱到。我真正深入去讲的。主要是内核开发和底层工程。用来在实际运行中加速这些大语言模型。这是我观察到在各个实验室。以及实验室内部不同项目之间。都需求极其旺盛的一项技能。所以把它作为一个整体需求。单独拎出来讲。我觉得非常明确。具体来说。每当我们要做一个研究项目。比如用某种方式改变神经网络的架构。或者重新思考如何做推理服务。来优化KV缓存之类的。你会发现在整个技术栈里。你都需要能用高效的方式。去实现这些新技术。所有这些不同改动的内循环。本质上都是在创造。能在超大规模下运行。具有高吞吐量和低延迟的软件产物。这其实就是跟经典后端工程思维。紧密相连的基础工作。所以没错。这看起来是一个非常适合。人们去专精的方向。我有朋友在OpenAI和Anthropic工作。 [00:03:38]
Ryan Peterman:他们那边有应用团队和研究团队的区别。我想知道DeepMind是不是也有类似的划分。你能不能讲讲这个区别是什么。我们确实有不同的重点领域。
Vlad Feinberg:比如在Google DeepMind内部。有一个团队专注于如何用我们的Gemini大语言模型。来优化搜索结果。这可能在某种程度上算是大语言模型的应用方向。但我不太想在这里划一条非常清晰的界限。因为这种层级的产品整合。本身就需要大量真正硬核的研究。就拿我刚才提到的那个例子来说。要确保这些大语言模型是事实性的。能引用来源。给出非常精准且有依据的答案。需要投入大量的工作。还要评估这些来源的质量。确保你不会引用到任何讽刺。或者玩笑性质的内容。我想这是一个很好的例子。说明即便是在针对特定产品的。所谓的应用型AI垂直领域里。你依然在做研究。话虽这么说。我们肯定也有非常经典的。大语言模型研究团队。比如预训练后训练。这些在Google DeepMind 的内部。仍然是独立的团队。专注于创造最先进的模型。也就是纯研究。但这里需要补充一点。我们所做的纯研究。它的价值有多大。取决于我们能在多大程度上把它实现出来。所以我们既要负责交付这些模型。确保它们训练稳定。在训练过程中充当某种意义上的SRE。保证模型训练顺利进行。同时也要负责提出训练这些大语言模型的配方。这两个角色是分不开的。同时承担这两种职责真的非常关键。所以我觉得你可以在研究和应用之间画出一个光谱。但在今天这个时代。不管怎样。我认为每个人都需要在这个光谱上灵活的游走。 [00:05:40]
Ryan Peterman:我注意到还有另一个光谱。就是从软件工程师到纯AI 研究员。你怎么看这个光谱。就是软件工程和AI 研究员角色之间的区别。
Vlad Feinberg:拿我自己的情况来说吧。我觉得我们做的很多工作。开发的很多新技术。根基都打在基础设施投入上。具体细节我可以后面再展开。但其中一个方向就是蒸馏。做蒸馏本质上是通过某种方式。把教师模型从海量底层数据。集中提取出的知识或统计信息。迁移到学生模型里。让学生模型比从未见过。这些辅助统计信息时表现更好。而当你讨论的是。从一个超大规模语言模型里。提取统计信息。并且要应用到。数万亿数万亿的token上时。你面对的就是一个。极其巨大的算力投入。动辄就是几百万几千万美元。这反过来就意味着。你必须想清楚。怎么把系统优化到极致。因为我们执行的每一个操作。都会被一个巨大的倍数放大。没错。每一秒都很关键。每一个字节的存储都很关键。而这其中相当一部分工作。就是实打实的传统软件工程。具体来说。我们的蒸馏基础设施。到现在大概已经迭代了三到四代。每一次迭代。我们都会退后一步。整体审视我们一直在用的蒸馏研究方法。然后思考如何扩展基础设施的能力边界。确实有那么几个关键节点。我们重新思考了执行蒸馏的系统设计。这让我们能够以快得多的速度去研究蒸馏方法。正是这种投入。比如花四个月左右重写蒸馏基础设施。最终让我们对蒸馏的缩放定律有了全新的理解。并转化成了真正强大的模型。所以这真的需要全栈的工作。我实在无法想象。如果没有在蒸馏基础设施上做这些投入。我们怎么可能做出Flash 3.0这样的成果。而这些投入归根结底。都是从一份传统的设计文档开始的。去思考生成教师统计信息的正确抽象是什么。为他们设计合适的存储系统。讲清楚如何支持在如此规模下跨多个数据中心进行读写。这些都是非常经典的分布式系统问题。 [00:08:09]
Ryan Peterman:听起来考虑到现在的算力规模。确实有大量的软件工程。后端和基础设施类的问题。但我还是觉得在这个光谱上的某个点。会有一个交叉地带。需要一些新的技能。比如如果你把一个随便找来的后端工程师。直接扔去调整模型架构之类的。这中间好像有个跳跃。比做基础设施工作跨度更大。
Vlad Feinberg:你怎么看这种区别。我觉得在研究工作中。确实存在一个交叉点。研究的本质是一种回报更高风险。也更高回报的尝试。我们有一个概念叫研究品味。它指的是一种高层次的直觉。能帮你判断在一个特定项目中。面对由多个不同里程碑。构成的有向无环图。你应该选择哪条路径前进。从某种意义上说。我们也可以把软件工程项目。看作一个类似的有向无环图。你知道要达成最终结果。需要先完成一系列中间产物。但在软件工程里。这个图或多或少是确定性的。比如你先构建一个服务。再构建另一个。然后是第三个。或者你先搞定存储基础设施层。诸如此类。你可以单调的向前推进。但在研究领域。你必须去探索这个图。而它现在是随机的。因为其中一些节点。可能是一些研究想法。或者是达成最终目标的某个环节。他们可能成功也可能失败。我认为这需要一个思维模式的转变。而这种思维模式的转变。需要花时间去学习。也需要专门的技能。打个比方。这就像你在读博士期间会学到的那种技能。 [00:10:02]
Vlad Feinberg:这就像你在读博士期间会学到的那种技能。我可以很简洁的概括一下。Jacob Steinhard教授写过一篇非常棒的文章。我很喜欢用其中的框架来思考我的研究工作。那就是把研究看作一个MDP。这里的MDP指的是马尔可夫决策过程。再展开一点说。我们有一个高层的概念。就是把研究项目里的不同里程碑。看成一个随机的依赖图。你可能需要先得到某种结果。或者证明某个定理。才能推导出某个结论。机器学习的研究项目也是类似的。在这个图里展开这些节点。本身就是一个随机过程。这些方法可能走得通。也可能走不通。而一旦某个方法走通了。又会为你打开一系列新的可能性。所以在软件工程里。你可能会把便利这张图的所有路径都写清楚。然后找出通往目标的最短路径。但这种方法在研究里不是最优的。因为如果图中节点之间的转移突然变得不可靠。甚至有些节点你一开始根本不知道。也就是一个隐藏的MDP。那你处理这个问题的方式就会完全不同。具体来说。你必须把不同研究想法的成功率。和你要投入的时间成本都考虑进去。还要事先预估这些成功率大概是多少。这和写一份软件工程项目的设计文档。完全是两码事。这种还没动手做。就能凭直觉判断一个方法。有多大可能成功的本事。我觉得就是大家常说的研究品位。而这恰恰是你为了正确便利。这个MDP所需要培养的能力。对于这些研究项目。 [00:11:44]
Ryan Peterman:或者说研究工作的本质。听起来你是在说。这里面的不确定性要大得多。我还是想更具体的了解一下。这种工作的性质。如果你把一个后端工程师。直接扔进一个做研究的团队。他们具体会在哪些地方掉队。我第一个想到的就是。对你所处的研究领域。有没有正确的背景认知。因为很多研究工作。 [00:12:09]
Vlad Feinberg:几乎都需要你抱着一种。非常谦逊的态度。认识到前人在相关工作上。已经投入了海量的资源。在我没有彻底搞清楚。全人类在这个课题上的。最前沿进展之前。我肯定没办法去推动这个前沿。所以针对一个特定领域。建立起对过往工作的扎实理解。做好相关的文献综述。这大概是我能想到的。人们最容易栽跟头的第一关。你需要有阅读的能力。也需要有技巧去高效地。遍历某个课题历史上。形成的引用术。因为你不可能有时间。把所有这些论文都读完。你得培养出一种感觉。知道哪些是高价值的论文。以及用什么方法。可以在不逐字读完的情况下。判断一篇论文值不值得读。这是我想到的。人们需要培养的第一项技能。而为了能读懂这些。研究级别的论文。你本身就得有机器学习的背景。有计算机科学的背景。而且根据论文和领域的不同。可能还需要各种前置知识。比如相关的数学基础和课程。才能真正理解。这一点非常重要。你得对现有的方法体系。有深刻的理解。因为如果你连已有的东西。都搞不明白。那基本也没什么希望能改进它。我之前好像提过。我们团队的工作之一就是征流。要想推进我们对大语言模型征流的理解。你首先得搞清楚。我们用大语言模型到底想做什么。简单概述一下。大语言模型研究。尤其是在预训练阶段。核心就是缩放定律。那什么是缩放定律。大家很关注它的密率结构。关注这个指数那个指数的。但其实函数形式没那么重要。真正重要的是。对于一套既定的。用来扩展大语言模型的方法。也就是recipe。当你往一次大语言模型的预训练运行中。投入越来越多的flops时。你必须能够预测这个模型。最终的测试损失会是多少。我们为什么关心这个问题。为什么要预测泛化误差。在经典的机器学习领域。比如我们想在ImageNet上夺冠。我们有测试损失。也就是对1000个不同类别的分类错误率。你运行你的VGG或者ResNet方案。得到那个分类错误率。这能估算出模型在这1000个类别的图像分类上表现如何。我们可以通过验证集来估算方法的好坏。每当我们对神经网络有一个新的架构想法。就训练它。然后跑一堆验证集。得到一个交叉验证误差。这个误差本身就是对最终测试误差的一个估计。通过这个过程。你就可以不断迭代各种想法。但在LM的世界里。情况就不一样了。每一次你要启动一轮域训练。你投入的算力都会比以往任何一次都多。所以从某种意义上说。这就像是ImageNet问题的一次性版本。你永远没机会看到完整的ImageNet训练数据集。你得先在Amnesty上练手。然后是CIFAR。然后也许基于这些经验。你试着搞出一个方法。希望它一上来。就能在ImageNet上跑通。如果你就这么直接干。我相信很多人都试过。至少我当年学这些东西的时候。就是这样。你搞出个方法。在Minist上效果拔群。甚至在CIFAR上也能用。然后一到ImageNet上突然就崩了。你会发现。很多东西并不会这么轻易的。跨规模泛化。所以我们在LM上做的很多工作。就是制定各种配方。这里的配方指的是一个函数。输入是你想投入的训练算力。输出是一套针对这个LIM的训练流程。如果你能把这份配方和一个预测规则结合起来。而这个预测规则能准确预测你LIM的最终精度。那你就能利用这个预测来决定怎么改进你的配方。这些就是关于LIM研究。大概是什么样子的一个大量背景。但我们之所以能形成这种理解。甚至认为这条路是可行的。要归功于大量早期的LM缩放工作。从Kaplan那篇论文到Chinchilla。我们看到了很多。自那两篇论文之后。又涌现了大量工作。去探索除了参数量和训练Token数之外。还有哪些因素会影响你的预测精度。比如独立Token的数量。但我想说那两篇LM的奠基性论文。他们其实是受惠于一条更长的。关于缩放的研究脉络。可以追溯到最早的GPT系列。然后Google在自己的PALM系列论文里。也做了大量缩放研究。正是这一系列工作。塑造了我刚才描述的那种观点。而这种观点。你只能通过亲自去完成一遍文献综述。 [00:17:23]
Ryan Peterman:才能慢慢建立起来。比方说如果你要挑一个人加入你的团队。你判断它是否适合帮你推动前沿的标准。就是它对前沿的理解。包括对现有文献的掌握。而这又需要很多前置条件。我记得你在帖子里把这叫做数学成熟度。对。我觉得一旦你具备了数学成熟度。再去阅读和理解那些论文就很容易了。
Vlad Feinberg:我特别提到的那几篇。放到现在已经是基本门槛了。所以我会期望候选人本来就熟悉它们。我认为通用的技能组合是。能够深入钻研一篇那种水平的论文。然后理解它。能够从一篇论文里提取一个研究想法。然后自己动手把它实现出来。这是一个非常重要的能力。我们每天都会接触到各种各样的新想法。他们不一定都能直接应用到我们的领域。但如果你能深刻理解他们。你就能在他们的基础上迭代。在我们的领域内改进它们。所以当我们在评估一个人。能否处理机器学习论文里的。数学概念时。这大概就是那个关键技能。它能证明你有能力。随便拿起一篇论文。 [00:18:39]
Ryan Peterman:然后去判断这些想法。在Google的环境下。有多少可以借鉴过来。下面这个清单可能不会很全。但我很好奇。还有哪些领域。是人们可以深入钻研。从而了解前沿AI 研究。到底看中什么的。你刚才提到了蒸馏。也提到了内核开发。听起来内核开发到哪里都有用。但还有没有其他。你一下子能想到的领域。 [00:19:05]
Vlad Feinberg:不一定要穷举。随便说几个就行。我觉得有一块其实挺厉害的。就是编程语言研究。通过研究怎么在编程语言层面。做抽象。我们可以让内核开发变得更容易。我觉得Thunder Kittens就是个很好的例子。搞出一套抽象。让你能用四个函数来写内核。而不是一堆乱七八糟的C++代码。这样你就能很快的开发出。充分利用硬件的算法。所以到那个时候。重点已经不是编程语言研究本身了。而是你对这类编程语言抽象有热情。愿意去跟底层硬件打交道。那些对GPU DSL这类东西感兴趣。愿意去尝试的人。这里面有大量硬件相关的领域。特定语言。除了编程语言和缩放定律文献。我还能想到的另一个领域是。强化学习文献。特别是自从RLHF出现之后。 [00:20:02]
Vlad Feinberg:特别是自从RLHF出现之后。我觉得我们已经看到。像PPO这样的深度强化学习算法。确实在生产系统里有一席之地。曾经有一段时间。大家还在质疑这一点。但现在这些算法。被应用到真实生产系统里。已经基本是共识了。而背后的理论。你得从强化学习的基础开始。一步步往上。学到今天各种各样的基于价值的方法。和策略梯度方法。这是另一个我觉得文献积累。非常深厚的领域。值得去爬一遍。然后对于偏后端工程的同学来说。除了内核本身。我觉得分布式系统和优化工作之间。有一个挺有意思的交集。怎么设计神经网络训练算法。让它能在很多GPU上训练。这里面有各种好玩的挑战。比如异步性。梯度的新鲜程度。流水线如何影响成熟度。你在训练算法设计里。做的所有这些系统选择。都会影响收敛和神经网络的最终质量。而且这些东西是可以脱离。LM这个场景独立分析的。已经研究很久了。所以特别是如果你更偏基础设施方向。 [00:21:16]
Ryan Peterman:好好理解这些不同算法是怎么工作的。会是一个非常好的起点。你觉得不同前沿实验室的要求有差别吗。比如说如果有人想去deep mind。有没有哪个领域是deep mind。
Vlad Feinberg:比anthropic更看重的。我觉得在技能组合方面。可能都差不多。对可能在商业策略和产品组合上会有差异。这取决于各个实验室的专长。以及他们可能面对的不同客户。但我觉得各个实验室。在招人时看中的点。重叠度其实非常高。就像我发了那篇帖子之后。你会看到OpenAI和Anthropic的人。
Ryan Peterman:都来说对我们同意这些建议。所以我觉得。这多少算是一点证据吧。我觉得大家这么想靠近AI 研究。一个很大的原因是。人们觉得软件工程将来没那么重要了。那在研究这边。是不是也有类似的想法。觉得LM也会接受很多研究工作。这样的话。其实也没理由。非要偏向AI 研究。而不是软件工程。所以我觉得。研究的技能组合。 [00:22:23]
Vlad Feinberg:会越来越重要。要我说。能在工作规划中。处理随机性成分。这会是我们未来。做事方式里。越来越大的一个部分。想办法在你做的任何事情里。用好AI。哪怕跟软件没关系。这都是一个。需要马上开始锻炼的重要能力。因为这些组件不是确定性的。你得思考怎么围绕这些LM构建系统。让自己工作更高效。这会是未来让你脱颖而出的关键。而且我觉得。不管你将来做什么。这一点都成立。你看我觉得现在到处都是Food。尤其是一些人在AI营销上的做法。这是被刻意利用的Food。所以我觉得。大家真的应该专注自身。想办法让自己变得更有生产力。我不认为AI会取代我们所有的角色。原因在于。我们人类在组织里做的一个重要事情。就是建立新人网络。这个组织是一堆资源。和一群管理资源的人。我们做的一个重要事情。是把这些资源分配到特定目标上。就算我们能加速执行。但围绕资源怎么分配来做决策。这件事永远需要归因到。一个做决定的人身上。原因很简单。你不能把责任推给AI。我们现在已经有LM。能非常深入的理解法律了。他们可以帮你审核同什么的。但他们不能代表你出庭。因为他们没法被吊销执照。所以我觉得这是一个很犀利的说法。为什么法律行业会继续存在。尽管LM在回忆判例方面非常厉害。因为你想要一个能负责的人。能验证AI输出的人。来更有效的帮你完成法律工作。而不是把你的法律辩护。直接交给一个LM。对。说到FUD。那其实是你写那篇文章的最初动机。是啊。我真的觉得。大家应该抱持一种建设性的心态。我之前看到一条推文。好像是滴滴发的。就是那种长篇大论的制造恐惧。说什么AI永久底层阶级之类的。人很容易陷进那种循环里。但我觉得重要的是去想。我们对自己的未来都有主动权。我们可以从今天开始。投资那些对未来重要的技能。这才是你唯一该做的事。对吧。担心是没用的。所以我想写那篇文章。部分原因就是为了回应这个。因为我能看到这种情绪在回想。我之前在普林斯顿做过一次讲座。当时一个很大的问题就是。怎么才能进deep mind的工作。而且当别人知道我是做什么的。这基本就是他们问的第一个问题。所以我觉得给这些讨论加一点。更有建设性的方向。会有点帮助。 [00:25:20]
Ryan Peterman:关于那篇文章最后再问一点。你看如果想拿到一个职位。显然有技能这回事。我们聊了很多关于技能和你跟岗位的匹配度。但还有一方面是怎么去展示信号。就是如果你要向前沿实验室推销自己。什么东西会被看中。哪些信号最重要。实际的证据证明你创造了对别人有用的东西。顺着内核开发那条线来说。
Vlad Feinberg:对吧。你可以拿我们现有的任何一个开源LM去做优化。你不需要在所有场景下都让它变得更好。你可以展示我在这个设定下对它有一个改进。甚至不一定是加速GPU上模型推理的东西。有各种各样的开源技术栈。比如VLM。除了加速设备上的LM推理。你还可以做很多其他事情。围绕LM的服务栈。是一个非常复杂的分布式系统。它要维护KV缓存内存。要处理各种负载均衡。请求排队。还有后端服务器非常常见的问题。这些项目一直在寻求帮助。所以给VLM或SGLang做贡献。或者用TensorRT 做演示。他们好像有一个叫Dynamo的分布式系统。可以做分离式服务。你可以展示你用这些组件做了一个项目。或者改进了这些组件。这对我看任何候选人来说。都是一个极其积极的信号。也是对开源非常受欢迎的贡献。 [00:26:51]
Ryan Peterman:我觉得我们刚才聊的很多内容。其实默认的是从外部招聘进入前沿实验室这条路。但很多前沿实验室内部也有庞大的组织。这些组织不一定都在做最前沿的工作。比如说Google DeepMind对比一下。假设有位做搜索的基础架构工程师。TA有后端技术栈。但可能领域知识没那么深。想内部转岗到Google DeepMind。在这种情况下。你的建议会跟对外部候选人有什么不同吗。我之前在搜索那边有个密切合作的同事。叫Nate Litson。 [00:27:26]
Vlad Feinberg:它就真的转到了我的团队。它非常厉害。现在我们团队里。Flash和Flash Lite的推理协同设计。很多都是它在负责。我觉得它是个很好的例子。它的做法是。怎么帮自己的产品领域。最有效的用上这项技术。所以如果你在一个。不直接生产这些模型。但需要去用它们的组织里。怎么在组织内部。有效的应用和部署。这些大语言模型。这里面其实有很大的空间。如果你能成为那个。把事情做得特别有效的人。不仅能给你的组织。创造巨大的业务价值。让你在内部脱颖而出。而且你自然而然就会成为。我们研究团队的合作方。我们会一起确保模型。在你的业务里真正有效。到那个时候。你转不转岗都行。如果你转过来。我们当然很乐意跟你合作。但我觉得到那一步。你其实已经在做很前沿的事了。把新技术整合到人们真正在用的产品里。所以这就是我的建议。 [00:28:32]
Ryan Peterman:在我们结束这个话题之前。我记得你当时在帖子里发了一个很具体的邀请。因为你当时在招人。你想再说一下那个邀请是什么吗。对。
Vlad Feinberg:我当时就在想怎么做到言行一致。怎么证明这条路确实能展示出我看中的那些技能。主动性。数学成熟度。韧性。所以我列了几个练习。能展示你对缩放定律有初步了解。愿意深入工程细节。去实现一个真正的Transformer。也愿意去掌握我们日常用来评估。大语言模型规模的那些基础数学。具体有哪些练习我就不全列了。但如果你把Sutton book里的练习手写完成。再把我帖子里提到的Transformer练习也做了。录个视频发给我。而且你能在纽约办公室工作的话。我很乐意面试你。确实有不少人。因为这个联系了我。我已经收到了几份提交。正在走面试流程。所以工作量确实不小。但挺厉害的是。我发帖大概一周内。就收到了回复。说明这事是完全可行的。当然我的招聘名额有限。机会摆在这。但我能招的人也有限。不过好消息是。这本身就是一个。很强的自我提升信号。不管你能不能进DeepMind。这件事本身就值得做。而且我觉得完成这些练习。也能帮你准备好其他地方的面试。 [00:29:59]
Ryan Peterman:就算我的名额满了。 [00:30:01]
Ryan Peterman:就算我的名额满了。我认识很多也在招人的人。我很乐意帮忙推荐。下一个话题。我看到你是Gemini。预训练的领域负责人。我想能不能请你从你的角度。给我们一个关于预训练的高层次概述。以及这个领域面临的主要挑战是什么。我们可以聊聊这个。对。我们在预训练上要做的工作。其实非常多。
Vlad Feinberg:作为这个领域的负责人。我团队具体负责交付的东西。包括Flash模型。Flash Lite模型。这些模型会被用在搜索栏里的。AI概览和AI模式中。还有一些其他的第一方模型。供广告YouTube。这些不同部门使用。除此之外。我们还是Google和Apple合作项目的。关键技术对接人。所以也会做一些技术方面的工作。这些是我团队实际的产品及交付物。在这之上我们还会做研究。确保这些交付物是顶尖水平的。同时我们也会做一些通用的预训练研究。这些成果也会贡献给Pro系列模型。研究的性质。要我说大体可以分成三个方向。一个是蒸馏。这个我之前提到过。另一个我喜欢叫它推理协同设计。也就是去创造那些跑推理时效率很高的神经网络架构。具体来说就是设计网络拓扑结构。决定Transformer里门空层和线性层中矩阵乘法的矩阵形状。还有注意力机制里的形状投数等等。这样做的目的是为了有效利用你用来提供服务的硬件。最后一个支柱是新的量化方法。量化这个东西。是我从加入Google起。就一直在研究。一直很上心的事。它真的能改变前两个方向。能做到什么程度。所以推进模型压缩技术的前沿。也是我团队研究中。一个非常重要的支柱。一般来说。量化指的是在某种程度上。缩小神经网络存储权重所需的空间。通常一个神经网络。在训练时。是用一系列数字来表示的。这些数字构成了网络内部的矩阵。并且是以FP32。也就是32位伏点数的权重来存储的。但后来发现在做这些计算的时候。你其实不需要那么多额外的精度。也能维持网络的质量。用一些相当简单的方法。你就可以把存储这些权重的精度降到4个比特。所以一下子我们用Float32来表示的。能达到大概7位精度的巨大数字范围。就能以相当高的保真度。被4个比特的整数很好地表示出来。而后者只覆盖了从-8到7这么小的一个范围。这本身就已经是个奇迹了。但更神奇的是。你可以把这种量化变换应用到神经网络。在运行时处理的激活值上。一旦你这么做了。因为你做矩阵乘法时。用的操作数比以前小得多。计算神经网络所需的电量。就会显著下降。有意思的是。AI硬件总运营成本里。有99%都来自运行。这些芯片的电力消耗。所以如果你能实现这些操作。就能让神经网络的运行成本。更低效率更高。这有助于处理更多的请求。也有助于降低延迟。所以量化研究的核心目标。就是怎么把前沿。从4比特这个范围再往前推。我在推特上总能看到一种说法。就是讨论MFU。 [00:33:51]
Ryan Peterman:也就是模型浮点运算利用率。不在这个领域的人。看到一个只有百分之十几的数字。就会觉得。哇他们浪费了那么多GPU资源。我想你能不能给大家解释一下。为什么一个看起来很低。或者说表面上很低的MFU。其实一点都不低。也许也可以顺便解释一下。MFU到底是什么。对我们算MFU的时候。 [00:34:16]
Vlad Feinberg:是用神经网络实际执行的flops数。除以加速器在你这次请求时间里。理论上能跑的总flops数。所以从某种意义上说。这告诉我们加速器的flops能力。被有效利用的时间占比是多少。要达到100%MFU。你就得把加速器的矩阵乘法单元完全用满。但这其实不是一种很有用的计算方式。因为实际中神经网络还得做激活函数。做注意力计算。或者把中间结果写回HBM。所有这些操作都需要用到内存总线。或者用到向量处理单元。又或者它们本身就是一些数学运算。底层硬件跑起来比矩阵乘法要慢。所以这些因素都会导致。你跑不到处理器标称的满速。这就是为什么你不会一直看到。百分之百MFU。因为你的神经网络。有一部分时间在读内存写内存。有一部分时间在做一些。天生就比芯片上其他单元慢的操作。我觉得我之前聊到的推理协同设计。很大一部分工作。就是在协调芯片上所有这些不同的能力。比如芯片间的通信。内存带宽。也就是我们从内存里读参数的速度。flops。当然也算。这可以是矩阵乘法的flops。也可以是出力向量的flops。比如做激活函数这些。所有这些操作在硬件上。都有不同的速率。而一个给定的计算。不可能天然就匹配。硬件上每一种操作的速率。所以你在设计神经网络的时候。要能选出合适的网络形状。在做推理时。把所有硬件单元都跑满。尽可能把MFU拉高。这件事之所以不只是一个代数问题。是因为这些形状选择。在你真正训练这个神经网络时。会带来不同的质量结果。所以推理协同设计的过程。就是想办法找出那些。能可预测的扩展。预测效果好。质量高。同时在推理时。又能把MFU尽量做大的神经架构。这种联合优化。就是推理协同设计特别有意思的地方。也是一个常做常新的问题。因为硬件一换。Flops跟内存带宽。 [00:36:36]
Ryan Peterman:通信带宽之间的相对常数就全变了。这些变化会直接影响。最优的神经网络形状应该是什么样。换个话题。Google有个叫Spot Bonus的机制。就是别人可以一次性给你一笔钱。作为对你表现好的感谢。我在你简历上看到Jeff Dean本人那位传奇人物。给过你一次Spot Bonus。如果你能讲讲这个故事。我很想听。他为什么给你这个奖励。对那次其实是在Gemini项目刚开始的时候。 [00:37:10]
Vlad Feinberg:他给那些参与并推出了第一版 Bard的人发了Spot Bonus。我当时在那个超大项目里的贡献其实非常小。我帮忙做了SFT。就是给最早发布的Bard 版本之一。做监督微调。那次经理给我最大的教训是。当时我还在Google Brain做纯研究。满脑子想的都是。怎么在NeurIPS、ICML、ICLR上多发一作论文。我清楚地记得自己当时有个念头。就是。我是不是应该埋头继续写论文。幸运的是。那时候我的经理Rohan O'Neill。他非常鼓励我们所有人都参与进来。那正是我需要的动力。让我愿意卷起袖子。做一大堆超参数调优和工程工作。把模型跑在一些很老的TPU上。多挤出一些算力周期来做SFT的尝试。那次非常微小的初期参与。被Jeff Dean注意到了。我觉得这件事后来慢慢发展成。我在大语言模型方面越来越多的投入。最终也让我走到了。今天的位置。所以我想说。这件事的重点。不在于那次SFT。对出版发布有多大帮助。而更多在于。它让我认识到。有相当多的工作。有些并不光鲜。有些就是超参数调优。去折腾XLA编译器。好让你的程序。塞进特定内存限制里。但这些工作。能贡献给一个。更大的业务目标。而这对参与高价值项目来说。真的非常重要。你做Gemini已经有一阵子了。 [00:38:53]
Ryan Peterman:既然它是最高优先级的项目。肯定有一些你经历过的。意外事件或者战斗故事。我很好奇。你在做Gemini的时候。最难忘的一个战斗故事是什么。要说我最喜欢的一个。 [00:39:06]
Vlad Feinberg:那肯定是Flash 2.0。这个项目挑战非常大。走到那一步的路也很长。我们当时重点优化的一个方向。是Flash 1.5开创的那个品类。速度极快。延迟极低。同时质量还很不错的模型。而且它必须得快。因为搜索要用它来。在AI模式下快速生成回复。正因如此。在Flash 1.5和更早的版本里。我们一直专注于稠密模型。这种模型响应速度可以做得很快。虽然那时候我们已经知道。MoE模型。也知道它能提升模型容量。所以后来就出现了一个问题。我们当然想用这种新架构。但直接切换到MoE并不容易。因为MoE通常会用多得多的参数。参数一多。占用的HBM就更大。我们做推理的那些芯片。HBM是有限的。所以必须把OMoE切分到多个芯片上。 [00:40:01]
Vlad Feinberg:所以必须把OMoE切分到多个芯片上。比如说你有N个专家。可能就得把它切分到N个芯片上。或者按N的某个倍数来切。这就会导致模型内部产生大量的通信。当一个token需要被路由。到某个专家。而这个token可能在第一块TPU上。却需要跑到最后一块TPU上去。那在前向传播里。就会引入巨大的通信开销。所以这个操作的延迟。会随着N的增加急剧上升。而MoE的挑战恰恰就在于。它会增大N。所以这一点真的把这个方案给卡住了。后来发生了一件很有意思的事。我们其实很早就知道流水线推理这个技术。只是在稠密模型上。它一直没什么用武之地。我印象特别深。很早的时候我跟Shoto聊过一次。Shoto就说。你们这个明显是受限于算力的。流水线根本改变不了你们的预填充性能。他说的没错。我后来测了一下。就把这个想法放下了。但有意思的是。当时我带的团队很小。我下面有一个同事叫刚雅。他提了一个很好的想法。他当时在跟Rahu,Aria。还有Google以色列团队的几个人合作。思路就是把流水线。预填充用到MoE上。流水线这种技术。不是把N个专家并行。分布到N台机器上。而是把层并行分布到N台机器上。这样一来。在某一层上。你就不需要在机器之间路由Token了。现在变成。第一层先处理预填充请求里的。一部分Token。然后把处理完的token。交给下一台机器去算第二层。接着是第三层第四层。而所有的专家都可以留在单台机器上。或者一小部分机器上。这样做实际上改变了通信模式。从原来每一层都需要大量交换token。变成了可以把通信隐藏在计算背后。因为你可以在请求的不同部分上。并行做流水线与填充。也就是说当第二层在处理你请求的前1000个token时。第一块芯片上的第一层已经在处理你请求的第二千个token了。这是一种打破HBM限制的方法。靠的是把层分布到不同机器上。而不是把专家分布到不同机器上。这样一来通信开销就降下来了。MoE的延迟突然变得非常有吸引力。Gemini 2.0的报告里说。这是一个M1系列的模型。而让这件事成为可能的。或者说其中一个关键。就是这个推理阶段的创新。Dwarkash和Rainer。写过一篇特别棒的文章。讲的就是这个优化。可以写进那本。缩放定律的书里。这真的是一个绝佳的例子。说明这种技术上的改变。能对LM的质量。产生多么巨大的影响。Flash 2.0。真正让人有成就感的地方。就是这个重大的MoE决策。当时听起来。好像只是一个小小的技术选择。但大家真的很担心。这个MoE的延迟。到底能不能控制在合理范围内。幸运的是。我能够推动一个。非常透明的技术流程。把这件事彻底搞清楚。到最后我们做出了正确的决定。但接下来就得把它训出来。这是我们当时在Flash。一个规模上训过的最大模型。我们知道这个方向是对的。但这也意味着。一个非常小的团队。要为此拼命干上40天。我们当时轮班训这个模型的人。大概也就五个。我记得我们所有人。就是一天一天地轮交接的。全是那种SRE式的活。要保证训练任务一直活着。那时候这件事交互性非常强。你得确保一切运行平稳。数据迭代器要调好。不能拖慢任务。如果数据哪里出现缺口。或者索引有问题。你得飞快的修好。因为每一秒都在烧GPU的时间。那晚上和周末怎么办。所以那40天我们基本没怎么睡。得在巴黎办公室和Mountain View之间排双班轮转。但最让人有成就感的是。这个模型出来的时候。差不多同一时间DeepSeek V3也发布了。然后华尔街日报发了一篇文章。就是那种渲染中国要用开源模型。接管AI的恐慌式报道。我记得朋友给我发了一张截图。是LM系统竞技场排行榜的表格。你看最右上角是ChatGPT DeepSeek。紧跟在后面。还说DeepSeek只花了几百万美元训练。就已经追到那个位置了。然后我朋友说你看Gemini 落后好多。因为表格最底下放的是Gemini 1.5 Pro之类的版本。我一看就觉得有意思。我刚看过这个排行榜。因为我们刚发了一个模型。实际打开网站。根本不是这样的。原来是华尔街日报。那篇文章里。故意省略了几行。现在你再去看那篇文章。就能看到当时。最先进的模型。Flash 2.0 Thinking。在右上角遥遥领先。DeepSeek V3。这可能跟他们想讲的。开源叙事不太搭。 [00:45:25]
Ryan Peterman:但对我们团队来说。这确实是一个非常重要的成就。最后一个问题。如果你能回到刚大学毕业的时候。给当时的自己一些建议。以你现在的认知。你会说什么。
Vlad Feinberg:你得去追人们当下真正面临的问题。去解决大家在日常生活中遇到的挑战。不要害怕去处理问题里比较小的部分。或者听起来比较琐碎的部分。哪怕它不是那种花哨的研究数学之类的。要相信。只要你在做重要的事。哪怕只是一个大项目里比较小的环节。你也会真正看到。什么才是推动前沿进步的关键。这大概是一种在解决问题时。保持谦逊的态度。是你应该追求的。这是一条建议。另一条可能算是职业建议吧。就是做一个别人希望看到你成功的同事。我的意思是。有一种观念。觉得职场里存在那种冷血型。或者马基雅维利式的领导。为了达到目的。不惜一切代价。他们也许能压榨。别人获得一些短期收益。但我在职场里。跟各种各样的人打交道这么久。发现一件很有意思的事。有那么少数几个人。其中一位是我非常亲近的朋友和导师。Todd Lipkin。是他最早带我进入计算机科学领域。他们就是特别善良。是那种你能从他们身上学到东西。跟着他们走就能成功的人。他们真的会让我发自内心的。想帮他们成功。具体来说。如果你是这样一种人。帮别人在他们的项目上取得成功。提出一些能发挥别人互补技能。让他们大放异彩的项目。别人会注意到的。以后你提出新项目。大家会愿意参与。总体上也会愿意支持你往前走。人们对职场互动的博弈论。可能会变得很cynical。但我发现这种更友善的方式。通常会创造出一种深度的协作氛围。和乐于助人的意愿。这对于推动需要多个人。多种技能的大型项目。越过终点线来说。太重要了。所以如果我能给年轻时的自己。任何关于人际或职业方面的反馈。那就是做那样的人。做一个别人希望看到你成功的人。我很喜欢这个建议。 [00:47:46]
Ryan Peterman:他对抗了那种cynical的职场观。我也很喜欢你最初那篇文章。对抗了那种末日论。永久底层阶级的说法。非常感谢你抽出时间。聊得很开心。真的很感谢。谢谢你邀请我。Ryan。感谢收看本期播客。如果你喜欢。并希望这个节目继续成长。请点赞或留言支持。另外。如果你有想让我邀请的嘉宾推荐。请在评论区留言。像Barbara Liskov。Mike Steinbrecher。Mark Brooker。这些嘉宾。都是因为有人留言推荐。我才请来的。另外除了播客。我正在做一款我理想中的。符合人体工学的键盘。给大家看一眼原型机。这是一把分体键盘。有两半。这是装在外壳里的样子。我们在Kickstart上发起了众筹。上线八小时就达成了目标。如果你是最早下单的那批人之一。我真的非常感激。我们现在正进入漫长的模具开发阶段。如果你还想入手一把。我在Kickstart上保留了晚期支持通道。你可以去那里下单。我会把链接放在简介里。再次感谢收看。下期节目见。 [00:49:04]
这期对谈围绕 Nebius 联合创始人 Roman Chernin 对 AI 基础设施周期的判断展开。Roman 的核心结论是:AI 基础设施不是泡沫,而是一个刚刚开始被大规模采用的长期建设周期。需求并不会因为模型变便宜而下降,反而会因为更多任务在经济上可行而扩大;真正值得担心的不是算力短缺本身,也不是 OpenAI、Anthropic、开源模型之间的短期替代,而是整个 AI 世界被少数超级模型、超级公司和超级平台过度集中。Nebius 的战略因此不是只卖裸金属算力,而是向上构建多租户云、托管推理和面向 agent 工作流的平台,把客户、产品、容量和资本当作一个系统来经营。
Roman 首先反驳了“AI 基础设施泡沫”的说法。他认为泡沫需要先定义:如果问题是未来是否需要几十倍、几百倍的投入来建设算力,他的回答是肯定的。编程只是第一个真正大规模跑通的 AI 用例,而且也只是最近几个月才开始好用;多数大公司在业务中使用 AI 的比例仍然很低。因此他判断,当前仍处在“有用的 AI”真正普及的早期阶段,而不是尾声。
关于开源模型和专用模型是否会伤害前沿闭源模型以及 Nebius,Roman 的回答是相反:当客户把某个用例跑通后,确实会寻找更便宜、更高质量或更适合自身场景的替代模型,但这不会让前沿模型失去价值,因为前沿模型会继续解决更复杂的问题。开源和专用模型带来的不是总需求收缩,而是让更多场景变得经济可行。他用 DeepSeek 时刻举例:当市场担心 AI 变便宜会让基础设施需求下降、Nebius 股价大跌时,公司反而经历了历史上最好的商业周,因为更多客户发现可以在生产环境中跑推理,Cursor 等编程产品也开始受益。这正是 Jevons 悖论在 AI 中的体现:单位智能变便宜,总消耗反而增加。
Nebius 建公司的框架被 Roman 概括为四个维度。第一是容量,要部署足够多的兆瓦级算力和 GPU,否则基础设施公司没有存在价值;第二是产品,要从只服务大型模型公司和超大规模云客户的裸金属算力,扩展到面向众多研发团队的多租户云;第三是托管推理,也就是 Nebius Token Factory,让客户不必自己管理 vLLM、SGLang、B200/H200/B300 等底层差异,而是消费 token、运行开源或专用模型,并通过蒸馏、推测解码、缓存等优化降低推理成本;第四是 agent 应用和工作流,开发者未来可能不再关心具体模型或 token,而是关心端到端任务能否高效完成。
在商业模式上,Roman 反复强调 Nebius 必须构建全栈,而不能只做大型客户的算力供应商。裸金属交易能带来收入,但客户集中度高、价值链位置低;如果 Nebius 能在平台层和产品层为更多客户创造价值,就能服务更分散的客户组合,也能从客户真实需求中获得更好的长期安全性。对于价格问题,他承认供应端压力很大,Nebius 最近也提过价,但价格不能只看 GPU 小时的名义单价。推理会成为客户服务终端用户的成本,客户真正关心的是总拥有成本、有效运行时间、token 成本和系统级优化结果。
对模型生态,Roman 认为模型迭代速度仍可能持续。除了前沿大语言模型,还会有生命科学、机器人、世界模型、视频、图像以及网络安全等大量专用模型。Harry 提到欧洲在模型建设上落后于美国和中国,Roman 的回应是,主权 AI 的重点不应只盯着兆瓦和电力,更应关注有没有 Lovable、Black Forest Labs、Mistral 这样的建设者、研究投入和产品投入;真正的需求来自建设者,需求会拉动基础设施。
对 NVIDIA,Roman 没有把关系描述成权力斗争,而是强调“做好自己的工作”:把产品和交付做好,让 NVIDIA 的工程师尊重 Nebius 的工程师,这是关系的基础。谈到数据中心审批、公众对 AI 和数据中心的抵触时,他把这看成现实环境:公司需要有超额覆盖的项目组合,也需要和社区、地方政府沟通、解释、解决合理顾虑。对于太空数据中心,他没有断言短期会替代地面建设,但表示面对大量聪明人投入解决这一问题,应保持足够谦逊和开放。
快问快答部分延伸到未来工作与教育。Roman 认为“开发者”身份正在民主化,越来越多人可以把想法转化为数字资产,这会催生新业务和新工作;但教育必须重新思考如何训练人思考、持续学习和适应变化。给女儿的建议则从传统的数学和工程,转向共情沟通能力与创造力。最后他把 Nebius 最大威胁定义为“整体的整合”:如果世界最终由三五个超级模型、超级公司、超级帝国控制,Nebius 这样的公司就可能只剩物理层供应价值;世界越民主化、多元化,Nebius 的全栈平台价值越大。
1. Roman 不认为 AI 基础设施是泡沫,因为真实采用才刚开始,大公司在业务里使用 AI 的比例仍然很低。
2. 模型变便宜不会削弱算力需求,反而会让更多用例经济可行,DeepSeek 后 Nebius 商业周创新高就是例子。
3. Nebius 的战略不是只卖裸金属算力,而是从容量、多租户云、托管推理一路做到 agent 工作流平台。
4. 客户真正关心的不只是 GPU 小时价格,而是总拥有成本、推理效率、可靠性、token 成本和系统优化。
5. 开源和专用模型不会简单摧毁前沿模型,它们会扩大可服务场景;前沿模型则继续向更复杂任务推进。
6. 欧洲主权 AI 的关键不是只讨论电力和兆瓦,而是能否产生足够多真正建设产品和模型的公司。
7. Nebius 与 NVIDIA 的关系基础是工程能力和交付能力,不是抽象的权力平衡叙事。
8. Nebius 最大威胁不是某个竞争对手,而是 AI 世界被少数超级模型和超级公司过度集中。
- AI基础设施泡沫之问 [00:00:00 - 00:10:00]
- Nebius四层产品架构 [00:10:00 - 00:20:00]
- 容量价格与客户价值 [00:20:00 - 00:30:00]
- 托管推理与模型迭代 [00:30:00 - 00:40:00]
- 主权AI、应用层与NVIDIA关系 [00:40:00 - 00:50:00]
- 社区、太空算力与长期威胁 [00:50:00 - 00:58:38]
一凯:欢迎收听跨国串门儿计划,这是一档专注于让中文听众无障碍欣赏全球优质外语播客的节目。通过先进的AI声纹克隆技术,我们不仅将内容翻译成中文,还完美保留了原主持人和嘉宾的独特声音,为您呈现全球顶尖的AI、财经、健康与科技领域精品内容。我是主播一凯,一位热衷于AI领域的产品经理,很荣幸能为您搭建这座跨越语言障碍的桥梁,接下来让我为您简单介绍本期我们克隆的这档节目,并分享几句非常精彩的原话,本期我们克隆的是知名创投播客20VC在2026年6月的一起深度对谈,主持人Harry Stebbings与Nebius联合创始人Roman Chernin 一起拆解AI基础设施的底层逻辑 Roman所在的Nebius是全球增长最快的AI基础设施公司之一,正与超大规模云服务商正面竞争,在节目里他有几句话让我印象很深,我们玩的是资本密集型游戏,竞争对手是全球资本最雄厚的公司,我们今年的资本支出计划是200亿到250亿美元,而我们的对手那些超大规模云服务商,规模是我们的八倍,对Nebius这家公司来说,最大的威胁是世界会变得过于集中,就像鲨鱼一样,你得一直游动才能活着,对吧,所以我们必须动起来,这些话背后有着很长的故事。接下来就让我们一起走进这期完整的对话,我们玩的是资本密集型游戏,竞争对手是全球资本最雄厚的公司,我们今年的资本支出计划是200亿到250亿美元,而我们的对手。 [00:01:34]
Harry Stebbings:那些超大规模云服务商规模是我们的八倍 AI基础设施竞赛已经打响,资本支出规模前所未有,处于这场竞赛中心的就是Nebius。今天我请到了Nebius的联合创始人,这家公司市值已经攀升到660亿美元 正在与全球最大的超大规模云服务商正面交锋。
Roman Chernin:未来六个月资本帮不上忙,六个月太短了,你有什么就用什么,得活下去,对Nebius这家公司来说,最大的威胁是世界会变得过于集中。 [00:02:11]
Harry Stebbings:今天我们来揭开AI基础设施的泡沫,以及更多,就像鲨鱼一样,你得一直游动才能活着,对吧,所以我们必须动起来,非常高兴请到Roman Chernin。谁能跟NVIDIA抗衡,准备好了吗,Roman 我太期待这次对话了,兄弟,我觉得Nebius是过去几年里,我们看到的最不可思议,最令人难以置信的故事之一,而且天哪,未来几年该有多激动人心,所以非常感谢你同意来上节目。
Roman Chernin:对,谢谢你邀请我,很高兴。
Harry Stebbings:来,我想先问一个很多人都在想的问题,那就是,我们现在处在AI基础设施的哪个节点,很多人看到资金涌入就说,这是泡沫,也有很多人说,这才刚开始,你怎么看,我们现在是不是处在 AI基础设施的泡沫时刻。
Roman Chernin:不,我不认为这是泡沫。,怎么说呢,先定义一下泡沫,我相不相信,我们需要几十倍,甚至几百倍的投入来建设,我绝对相信,我可能有偏见,如果我不信,我大概也不会干这一行,所以我觉得我们正处在,这个了不起的时刻的开端 Jensen把它叫做有用的AI 我们才刚刚开始真正的普及,老实说在那么多应用场景里,我们可能只有一个场景跑通了,而这个跑通的场景编程,大家都在谈编程,也就是几个月前才真正开始好用,所以我们得把视角拉远一点,我们距离第一个真正规模化跑通的,应用场景才过去几个月,我们开始看到它在各处落地,我觉得显然我们还会看到,很多很多更多的应用场景,也会看到更广泛的普及,我觉得我们现在看到的,如果你去看世界上任何一家公司,也许除了那些跑得最快的创业公司,录节目前我们还在聊,谁动作够快,谁不够快,对吧,也许有一些例外,但如果你去看今天世界上任何一家公司,去看那里的AI普及程度,你会发现他们刚开始在1%的业务量里,在1%的场景里用AI 所以你去看任何一家大公司,哪怕技术相当先进,你都会发现他们才刚刚起步,我由此得出的结论是,我们才刚刚开始,而且就算你不信Musk说的那些,关于未来太空之类的话。 [00:04:22]
Harry Stebbings:单从实际来看,从企业普及的角度看,这都只是第一步,我们看法完全一致,但如果我只是说,我同意你说的每一点,这对话就太无聊了,在你刚才说编程这六个月到十二个月开始好用之后,我想问你一个问题,有一种观点认为,我们会转向开源模型,本地部署,因为对某些企业来说,成本负担太重了,我们很快就会看到这种转变发生,如果真是这样,这对OpenAI和Anthropic这样的提供商是打击,对Nebius也是。 [00:05:10]
Roman Chernin:为什么这种看法是错的,首先我觉得这不是未来的事,现在已经在发生了,我们看到很多例子,当我们的客户或者产品开发者达到一定规模时,他们就会开始想办法改善经济效益,或者加速增长,这时候很多人就会开始关注替代模型,今天最好的构建方式,显然是用OpenAI、Anthropic、Google 这些优秀提供商的前沿模型,因为他们确实能给你提供世界上最好的能力,但当你把用例跑通了,开始看到用户增长,看到客户数据循环跑起来之后,你也许能找到更便宜,甚至不是更便宜,而是质量更高,更高效的方式来服务同一个用例,你可能不需要世界上最好的通用模型,而是可以创建一个专门模型,在你的特定场景下效果反而更好,这时候你就需要,或者可以考虑从前沿闭源模型,转向开源模型,这些模型最重要的特点不只是开源,而是它们可调可训练,你可以拿过来做后训练,创建一个专门模型,在你的特定场景下可能效果更好,这是我们在全球,在各种用例里都看到的现象,但这为什么会伤害 Anthropic、OpenAI呢,因为实际上,他们又去攻克下一个前沿了,回到我们刚才聊的,还有太多没解决的任务,或者那些不一定受预算限制的任务,每次我们找到更高效解决某个任务的方法,就像一年前DeepSeek那样,现在也还在持续发生,我们就会在同一时间去解决更复杂的任务,我觉得这是一个持续的过程,你总是在推动前沿,总是有更复杂的任务,等着你去解决,当你搞定了这些任务,就可以往下走,降低价格或者提升质量,但我们还有太多没解决的任务 Anthropic、OpenAI 和其他所有前沿模型。 [00:07:34]
Harry Stebbings:还有大把没触及的时间窗口,没触及的市场,它们还在继续指数级增长,你信这个吗,这些公司很多都估值到万亿美元了,可以说是被市场定价到完美状态,如果他们创造的价值不断被侵蚀,他们得不停的从一个价值点跳到下一个价值点,而开源在身后不断蚕食,那你就得不停的找到大量新问题啊,兄弟,这日子可不好过,。
Roman Chernin:其实大多数人的担忧恰恰相反,大家担心的是,我们能不能有足够强大的开源生态,和足够强大的专门模型环境,来撑起这个基础,我觉得我们现在还处在,采用的极早期阶段,还有太多没解决的问题,这说到底是个总蛋糕,有多大的问题,我觉得未来有足够的空间,去解决那么多任务,这块蛋糕足够大,既容得下前沿能力,也容得下针对特定场景,高度调优的模型,以及我们可以在,他们之上构建的,所有这些开源或专门模型,来获得经济效益和性能优势,当我们明确知道自己需要什么的时候,你刚才说每次模型变便宜,会不会伤害业务,我最喜欢讲的一个小故事是,大概15个月前,就是那个Deep Seek时刻,你还记得吧,我记得Nebius股价一周跌了40%左右,大概是2025年2月还是3月,但有意思的是就在同一周,我们可能经历了市场最好的一周销售业绩,市场上的人在担心行业要下行,像Nebius这样的基础设施公司,不再被需要了,因为AI变得这么便宜,可能是泡沫,但与此同时,我们却迎来了公司历史上最好的商业周,那时候我们还处在比较早期的阶段,但那周就是公司历史上最好的商业周,因为太多人发现,他们可以用DeepSeek在生产环境中跑推理,经济账算得过来了,同一时间Cursor也开始增长,我记得他们是最早一批。 [00:09:22]
Roman Chernin:我记得他们是最早一批,真正受益于针对编程等场景调优,这些模型的公司,每次智能变得更便宜,同一单位智能的成本下降,我们不会减少消耗,反而会增加消耗,因为我们可以用同样的预算,去解决更复杂的任务,或者终于可以让那些,我们知道技术上可行,但之前经济账算不过来,没法规模化的任务变得经济可行,所以我觉得观察这种经济性改善,带来的变化是很有意思的。
Harry Stebbings:说到Jevons悖论,生产越多反而带来越多需求,那你今天在哪些方面推进的还不够快,你希望能更快一些,所有地方都想更快。 [00:10:37]
Roman Chernin:我们思考怎么建公司的时候,会从四个维度来看,第一个维度是容量,就是我们部署了多少兆瓦,多少极瓦,多少GPU 我们是基础设施公司,必须够大,如果不够大,没人需要我们存在,所以这是物理世界的扩张,团队做得非常出色,但永远不够,你总想跑得尽可能快,现实世界有很多复杂因素,有时候会拖慢你的速度,要启动一个新数据中心,你得走完整个供应链,搞定监管,还有火灾供水,现实世界里会发生的一切,对吧,这是一个维度,另一个维度是产品,你得跑得够快,才能承接市场上新出现的,负载类型和新客户,想想看我们行业在AI这条路上,最早是从那些,自己建模型的公司开始的。对吧,像OpenAI 超大规模云服务商,大型实验室这些,他们作为基础设施客户,需要的基本上就是,算力纯粹的原始基础设施,我们看到市场上有很多,这种大型裸金属交易,我们也做,但这只是我们构建的第一层,就是规模化物理基础设施,像Meta 微软这样的客户,在我们这里可以大规模消费,这是第一层,第二层我们叫多租户云,它仍然面向重研发的团队,但现在我们面对的是,成百上千个团队,他们不想碰物理基础设施,想要托管基础设施,就是云服务里经典的IS 你有存储计算,网络在一个好的环境里,虚拟化带API 可观测性安全,所有正常团队期望云该有的东西,你登录进去。集群就给你配好了,你可以开始训练,或者需要的话跑推理,自己管理应用或工作流,但基础设施的是平台,帮你搞定,对吧,所以如果第一层是用兆瓦来对话的,你看那些公告,谁跟Meta、微软或OpenAI牵了大胆,大家谈的都是兆瓦,交付的是兆瓦级的算力,到了托管云这一层,大家谈的就是GPU小时了,因为这是你卖的核心单位,是你在计算上花的有效时长,在存储和配套服务,但你买的还是托管计算,再往上一层,我们在做的是托管推理。这时候人们不想再按GPU小时来思考了,不想去琢磨B200跟H200跟B300哪个更适合特定负载,。他们不想自己管理VLM或SGLM,自己部署,做各种优化。在这一层,我们的产品叫Nebius Token Factory,是一个托管推理平台。这又对应一类新客户,主要是我们称之为垂直AI公司或企业的那群人,他们是真正做产品的人,不自己做模型,而是在模型之上构建产品,这正好回应你刚才说的专用非前沿模型,当他们需要从Anthropic切换出来,或者想多样化使用的模型时,所以这又是我们提供的一种新语义,或者说客户需要的一种新实体,现在大家谈的是token 你不是为GPU小时付费,而是消费token 可以构建应用,不用去想低层的集群,这就是我们现在所处的位置,但我觉得这也不是终点。因为现在人们开始构建agent应用 agent工作流,当你构建一个端到端的agent时,你可能根本不用去想具体用哪个模型,也不用去想具体要生成多少token 你只希望端到端的任务能被高效执行,并产出预期结果,这时候平台能施展的魔法就是替你思考,这次调用用哪个模型更好,需要上更聪明的模型吗,或者在同样的推理预算下,你可以请求两个更轻量的模型,拿到不那么聪明的token 然后让一个裁判模型来选最佳结果,或者该用多大的上下文窗口等等,所以下一层就是开发者,可能根本不用去想具体的token类型,而是只考虑端到端的任务执行。所以第四层就是open router直接竞品了,我们想在这一层做的事情,其实跟我们在下面几层做的是一样的,就是打造一个优化引擎,你可以用各种开源或者合适的工具,去构建你的agent 但当你需要规模化的时候,你就会开始考虑经济性,开始考虑可靠性,也就是可重复的执行,这时候它就不只是一个,模型选择的问题,也不只是结果好坏的问题,而是一个系统问题,你需要让它可靠,需要让它可重复,还需要让它在经济上可行,这大概就是Nebulous 能创造价值的地方,方式也一样,我们不会告诉人们怎么去构建他们的应用,我们只是说,好,如果你想让这个模型,以这样的经济性为你工作。我们可以帮你优化,同样的,如果你想让这个agent端到端底,以这个预算,这个质量运行,也许我们也能帮你优化,再说一次,这只是为了明确一下,这算是一种有点推测性的想法,关于下一步会是什么,不是说我们现在已经有了。 [00:16:14]
Harry Stebbings:而是我们看到客户在往这个方向演进,我们认为我们可以在这里打造下一层产品,我很喜欢这个思路,这些我都记下来了,我想顺着你提的四个支柱聊一下,你第一个说的是算力容量,如果你今天的容量是现在的十倍,会有什么不同,能一夜之间卖光吗,好问题一夜之间卖光不会,但我们肯定有这个需求。
Roman Chernin:我觉得对我们来说,关键问题不是有没有需求,而是怎么去构建需求组合,因为这个市场上的客户太多了,你可以在他们之间做平衡,再回到产品的四个层次来说,你可以卖裸金属,可以卖托管基础设施,可以卖推理服务,未来也许还能卖一些新的产品层,我觉得我们在努力做的,就是构建一个相当多元化的客户组合,我们相信往技术站的上层走,我们能为客户创造的价值,就越大,而且实际上,越往上走,我们能服务的客户群体,也越大,因为在裸金属层面,全世界可能只有十几个客户,能跟你合作,在托管基础设施层面,有几百个,在推理层面,有几千个。 [00:17:00]
Harry Stebbings:到了agent层面,会有几万个新的开发者,来构建应用,对吧,好,关于客户组合这一点,在容量方面,我非常认同,你肯定希望自己足够大,有存在感,但又不能大到业务完全依赖他们,带着这种微妙的认知,你对来自Meta或微软,这类客户的收入集中度,觉得多少是可以接受的,这个问题问得很好。
Roman Chernin:我得说这是我们业务的核心问题,不单是Nebius 而是整个产品类别都是如此,我们一直公开的跟投资者和客户讲,我们相信Nebius的长期战略,是服务尽可能多元化的客户组合,所以我们尽全力去跟很多客户合作,我们构建这个平台,实际上如果你只服务全世界那十几个,像Meta和微软这种级别的客户,他们技术极其先进,拥有自己完整的软件站,他们基本上只需要物理基础设施,他们会把自己所有的东西都带过来,部署在你的基础设施上,然后运行,对吧,你能在物理基础设施之上,给他们提供的额外价值非常非常少,顺便说一句,要满足他们对物理基础设施的需求,本身就是一个很大的挑战,因为你可以想象他们要求非常高。而且他们需要的是世界上规模最大的基础设施,所以有时候人们说这是大宗商品,但在那个规模上,它真的不是任何东西到了真正的大规模,都不是大宗商品了,但回到你的问题,能合作的这类客户群体其实很小,而且你也不一定需要全套的软件站来服务他们,所以我们从Nebius成立的第一天起,就有意的构建这个软件站,因为我们觉得这对我们更有利,如果我想说的对世界更有情怀一点,那就是需要有公司能支持客户,不只是在物理基础设施这一层,而是能做的更多,为了业务的长期安全。 [00:19:08]
Harry Stebbings:你难道不是必须构建全站吗,否则你就会变成这些巨头的算力供应商。
Harry Stebbings:否则你就会变成这些巨头的算力供应商,这当然能赚很多钱,对,但你的业务会极度集中,而且非常垂直。
Roman Chernin:对我觉得是这样,再说一次,我们不知道世界最终会走向何方,在一个需求无限的世界里,你也许可以长期甚至中期的,靠卖这种整租模式的合同维持下去,但是比如说,当来自客户来自需求端的竞争越多,你就有资格挑剔,甚至可以选择跟哪些客户合作,去跟那些更认可我们平台价值的客户合作,世界上有各种各样的客户,有的更在意价格,有的更在意质量,有的则真的想要一个更先进的平台。 [00:20:07]
Harry Stebbings:因为他们想集中精力在自己的平台或产品上,不想在这方面花时间,在聊第二层产品之前,还是先回到容量这个话题上,现在容量供应这么紧缺,如果你把价格翻一倍,需求会有什么变化吗,这问题挺难的,我们其实刚提过价,就在提了30% 对就几个月前。
Roman Chernin:但我们供应端怎么说呢,管道压力还是挺大的,而且说实话,我们也不太清楚,那个平衡点到底在哪,我告诉你为什么,这不光是我们想多赚点钱,趁着短缺,让大家多付点,某种程度上,这确实管用,大家需要算力来搞建设,但这里有一个临界点,尤其是在训练阶段,不那么明显,因为训练算是一次性成本,但如果你相信,我们正在转向推理,而推理是服务客户的成本,那就会有一个经济账,算不过来的点,我们客户的产品经济模型,如果成立,他们就能增长,我们也能跟着一起增长,这不单纯是个供需关系,价格完全弹性的事,价格在某种程度上是有弹性的,但我们也想做有意义的事,想认真考虑客户到底需要什么,而且顺便说一句,这不光是GPU小时的成本。你做的所有优化,我们称之为TCO 也就是总拥有成本,这也是我们为什么在构建软件平台的部分原因,抱歉,我又绕回产品了,你想聊容量,但大家太执着于容量了,容量当然重要,但大家太执着于容量的名义价格了,你可以给GPU定价3美元 4美元 5美元,但根据不同的使用场景和平台质量,给客户带来的实际成本结果,可能完全不同,它能跑多久,有效不间断运行时间是多少,如果谈推理,你能提取多少Token 我们看到所有这些优化正在发生,能把Token的价格改变一个数量级,大家天天在聊某块GPU的成本,但如果你在模型层面做对了,价格能差好几倍,这些都应该作为一个系统协同工作。而不是说,如果你只谈原始基础设施,那你能动的就只有价格,但如果你构建了平台,给客户提供高水平的服务。 [00:23:00]
Harry Stebbings:那你就能从中获取更多的经济效益,而不仅仅是从基础设施的成本结构里扣,对吧,那如果我们聊到第二层,从容量 GPU小时,稍微转向产品本身,也就是多租户这一块,在这个环节里,你问自己最主要的问题是什么,如果说在第一层容量那里,问题是我们的收入集中度有多高,那在这一层价值里,核心问题是什么,客户需要什么,这很正常,你跟很多产品创始人聊,问题都一样,说到底客户需要什么。
Roman Chernin:客户的需求在怎么演变,需求在往哪里走,我们看到整个行业在从训练转向推理,从单纯使用模型转向构建引擎,从主要是AI实验室消耗算力转向企业开始入场,如果我们想保持相关性,就得一直跟着这些变化走,这就是我们在产品层面问自己的核心问题,客户需要什么,以及Nebius是什么,我们需要创造的价值是什么,因为我们毕竟是一家小公司,不可能什么都做,我们必须非常精准的找到自己能比别人做得更好的地方,以及基于客户演变的趋势,我们应该聚焦的价值点在哪里,在客户需求的变化里。
Harry Stebbings:有哪些是你看到了但公开讨论的比较少的,客户需求在发生哪些变化,是你觉得公开讨论里很少提到的,大家都在说从训练转向推理。 [00:24:35]
Roman Chernin:我觉得这只是一个非常宏观的看法,因为这种转向实际上意味着,人们在构建具体的产品,在这些产品里,他们有自己的一套经济模型,有自己的增长轨迹,不是说同一块GPU换个用途就完了,我觉得这会带来全新的要求,你需要构建自己的推理平台,你不仅要帮客户跑推理,还要帮他们解决模型从哪来的问题,所有人都在拿开源模型做微调或者做RL 那我们怎么帮他们,然后当他们跑起来之后,会生成大量数据,我们怎么帮客户,在他们已经跑着应用,跑着推理的时候,去收集数据,创造数据,然后用这些数据去改进他们跑的模型或者应用,所以这就像大家常说的飞轮效应。你跑推理,生成数据,你可以观察这些数据,然后改进你跑的模型,持续提升最终产品的质量,所以我觉得这里面有很多环节,既有系统层面的,也有AI魔法层面的,如果你愿意这么叫的话,对我来说最迷人的地方在于,我们看到构建的门槛在降低,我们看到越来越多的客户,也就是构建者进入市场,他们不一定是AI研究员,也不一定是推理工程师,像Nebius这样的公司能创造的价值,其实就是降低构建AI产品和AI应用的门槛,让他们真正能用起来,并且把基础设施的所有复杂性,爱的一些复杂性都从开发者眼前隐藏掉,比如怎么调模型,怎么优化推理。这些本身也是研究密集性领域,就让人们专注于自己的客户和用例。 [00:26:36]
Harry Stebbings:顺便说一句,就像他们在云服务上,对待Anthropic和OpenAI那样,你提到了差异化这个词,我和我的合伙人,之前讨论过一件事,是我们必须讨论的,它就在这些层级里面,你已经详细谈过产品构建,以及在产能之上,构建产品的重要性,当人们拿你和其他NEO Cloud的对比时,比如拿你和CoreRave毕业,你们都跑GPU 都有NVIDIA的关系,都有Matter这个客户,区别在哪,我不喜欢跟别人比较,我们构建的原则是全站,我们称之为全站整合。
Roman Chernin:你可以把它想成,全站向下和全站向上,全站向下是指,我们深入物理世界,我们建数据中心,我们造机架和服务器,我们搭平台,当你掌控这些下游的东西时,你就能更快行动,能挤出更多成本,为客户提供经济上,更可行的方案,然后你上游的垂直整合,就是我们刚才聊的产品层面,以及你怎么跟随客户的需求,和客户群体,不被那一小部分,只需要基础设施的人限制住,而是真正去服务企业和产品公司,在他们需要我们的地方,接住他们,我觉得这就是我们的不同之处,至于这种不同怎么体现出来,要我说就是业务集中度更低,客户组合更多元,我们相信长期来看。这对进入企业市场是更好的定位,我们相信最终大量需求会来自企业,当然现在我们大部分业务,还是跟AI原生公司打交道,但我们面前有一个巨大的经济体,一个巨大的企业市场,那些现有的公司,总得有人去服务他们,他们不会买裸算力,他们需要平台,需要工具,需要我们尊重他们的遗留系统,能跟他们更复杂的环境对接,他们不敏捷,有数据要迁移,有系统要集成,这才是大器具。 [00:28:17]
Harry Stebbings:我觉得我们来说,这就是主要的前进方向,你提到四层架构里的第三层,是托管推理,对于不了解的人,你怎么看这一层,会怎么跟他们解释,对非常简单,你构建好了你的产品,不管是在哪写的代码,我其实是用OpenAI的,也是个程序员,够用了,你用OpenAI做出了很棒的产品。
Roman Chernin:把应用场景跑通了,开始增长,势头也很好,唯一的问题可能是,你的利润空间不够,或者你想更激进的,用数据去调模型的行为,但在封闭生态里,你做不到,于是你上网一查,发现有很多优秀的开源模型,在基准测试上已经接近OpenAI了,你就想太好了,成本能降到十分之一,推理更便宜,我还能微调这些模型,把我的数据用上,产品会更好,增长会更快,于是你就去Hugging Face 把权重下载下来,再找个推理引擎来跑,比如VLMs GLM之类的。 [00:29:19]
Roman Chernin:比如VLMs GLM之类的,结果发现跑不通,因为要真正拿到你期望的价值,你得做各种优化,得用正确的方式去部署,你不只是在一台机器上,一块GPU上跑token 你的产品规模很大,已经在用几十万张GPU了,你需要全套的编排,缓存,可观测性,客户会问你,这东西到底怎么运作的,等等等等,而且顺便说一句,这些你在OpenAI上本来都有,因为那是现成的生产服务,用OpenAI的时候,你根本不用想基础设施的事,订阅你需要的套餐,按最终结果付费就行了,所以这时候你就需要Token Factory这样的产品 Token Factory提供的是开源模型,或专用模型的托管推理服务,你可以直接跑现成的开源模型。也可以自己微调模型,部署你自己的权重,剩下的所有事情我们帮你搞定,我们会用上各种优化技术,帮你把经济账算好,服务是可靠的。 [00:30:52]
Harry Stebbings:你也不用操心下一批几百张GPU去哪找,诸如此类,它就是一项服务,一种托管服务 Token Factory上面跑着60个开源模型,你之前也说过通过优化能把推理成本最多砍掉70% 我能问个笨问题吗,你们到底是怎么让一个Token变便宜的,对,这也不是什么魔法,你拿一个模型。 [00:31:04]
Roman Chernin:某个基线模型,然后可以针对你特定的场景去做优化,比如你可以做模型蒸馏,做出一个更小的模型,但质量保持不变,你可以做推测解码,可以优化缓存等等等等,所以你是拿着这个模型,基于它构建出一个系统,在你特定的场景里,按照你的需求去跑,同时把经济性优化到最好,而且顺便说一句,我觉得客户用Token Factory 这类托管平台,还有一个重要原因,就是模型本身在不停变化,每周每个月都在变,比如今天可能minimax3发布了,还有Nemotron Ultra也宣布发布了,这种事每隔几周就会发生,每次新模型出来,它在某些基准测试上可能更好,在其他基准上可能不一定,你需要有灵活性,你需要有人支持你去实验。去为你的场景采用最新最好的模型,每次新模型一上线就能用上,像我们这样的平台,其实就是帮你把所有那些切换模型,做基准对比的脏活累活都抽象掉了,这样你就能确保自己始终站在前沿,每次有什么新东西出来,它都会出现在平台上,你可以去测试,如果对你的场景效果更好,你就可以切换过去,整个过程对你来说是平滑透明的,模型开发的这种速度能持续下去吗。 [00:32:23]
Harry Stebbings:你刚才说每隔几周,我斗胆纠正一下,我觉得是每隔几天就有新的出来,这种速度能持续吗,五年后我们还能看到这种迭代频率吗,这个我不知道,很有可能我们会继续看到。
Roman Chernin:大量细分模型不断涌现和改进,我也说不好,不过我还是相信,我们离那堵墙还很远,模型能力的提升还会持续发生,我觉得我们还会看到,更多新的模态和专用模型,进入赛场,我们现在聊的都是这些前沿大语言模型,但还有一整个生命科学模型,机器人模型,世界模型,视频模型,图像模型的世界,他们也都有自己的应用场景,而且我们看到越来越多,针对特定场景的小型专用模型出现,优化的非常极致,就在今天早上,我跟以色列这边一个团队聊,他们在做网络安全防御的基础模型,专门为构建网络防御agent 而优化的模型,他们也不是从零开始,他们会拿一些开源的基础模型。然后针对这个特定场景去训练,在质量和延迟上,做到网络安全防御场景,所需的那种优化,我觉得这种趋势会持续下去,我们会看到大量专用模型,不管是后训练出来的,还是其他方式,他们仍然需要优化的推理服务,和优化的基础设施,来支撑才能让客户真正用起来,我想问一下。 [00:34:06]
Harry Stebbings:回到Token Factory 关于Token成本和Token用量,你看到了什么,别人讨论的还不够多的东西,最近有什么让你感到意外的事吗,其实我觉得,大家说的都差不多。
Roman Chernin:就是增长有多快,我们看到一些公司的增长轨迹,像Anthropic Cursor Cognition Encoding 现在也开始在其他垂直领域看到了,比如医疗金融的一些用例,我觉得这确实挺惊人的,有意思的是,看那些非AI原生创业公司,是怎么动的,我举例子,我们有个客户是Revolut 刚开始合作的时候,他们大概99%的推理预算,都花在币源模型上,花在OpenAI上,他们开始尝试跑一些用例,但有些用例从经济上跑不通,就是说他们没法真正替代人工,或者没法在他们想做的那些场景里增强人的能力,于是他们开始转向开源模型,但切换速度并不快,因为他们得花时间在公司内部搭建一整套引擎。他们首先聚焦的是评估,我觉得这一点被很多人低估了,建立一个用于改进和实验的基础引擎有多重要,你得作为一家公司一个团队,搞清楚什么对你是好的,因为你搞定了一个用例,它跑通了,但之后你想换模型,你怎么知道不会把质量搞砸,你需要有指标,需要有一个阀门机制,需要为AI开发建立一套CI-CD流程,我觉得我们看到的是像Revolut这样的客户,他们需要做这些基础性投入,去理解怎么演进模型,怎么安全地把它们集成到生产流程里,但一旦他们解决了这些基础问题,增长就开始指数级爆发了,我不会低估这些客户在搭建好,能让他们快速交付的系统之后,增长速度能有多快。这是我们在很多客户身上看到的,他们都有这种,你可以叫它基础性投入,一个冷启动问题,就是怎么开始交付,但一旦解决了,增长就指数级了,他们可以用不同的模型,可以在公司内部构建更多产品等等,我觉得这一点从外面看的时候,你会觉得,他们没怎么增长,起步慢,花时间,但如果一家公司有很强的团队,他们建好这个基础,然后就开始指数级增长,我觉得我们会看到,企业端出现大量爆发式增长,在数字化的云源深的公司里,像Revolut Shopify Process Booking.com这些,当他们解决这个冷启动问题,建好一套交付系统之后。 [00:36:31]
Harry Stebbings:他们的AI采用率会疯涨,你觉得三年后Revolute 付给你们的钱会多多少,我不知道,我不知道,我不想谈这个,但我可以说,总体上。 [00:37:19]
Roman Chernin:我觉得他们的增长是倍数级的,我们都看到那些AI公司报告 IR增长,对吧,对他们来说,不是RR是他们的预算,但我认为最先进的公司,他们的AI预算,而且不是那种假的,或者说不是假的,就是那种token堆量的竞赛,我们看到的是,他们在生产负载里怎么做的,他们的增长速度,跟那些AI原生公司报告的 AI消费增长。
Harry Stebbings:跟他们的IRR增速是一样的,所以像Revelo这样的公司,他们也在走同样的指数级增长轨迹,我经常反驳那些说,开源会对最大的模型提供商,构成真正威胁的人,因为我说,听着大企业要的是可靠性,安全性,最重要的是省市,他们不想在底层架构,和各种乱七八糟的东西上捣鼓,你现在告诉我的意思是,你们能提供所有这些,让他们可以从那些提供商那里抽身,获得更便宜更好的体验,因为你们把管道工的事都做了,对吧,对,但我想再说一遍。
Roman Chernin:我的重点不是避怨模型,用开怨模型的话,问题不在于可靠不可靠,像Nebius这样的公司要做的,就是让你用替代模型的时候,不用去想那些底层管道的事,但我觉得核心还是能力,避原模型,比如那些前沿模型,确实很强,而且会越来越强,能解决很多,我们现在还解决不了的问题,而且我们想解决的用例这么多样,市场上一定会有最聪明的模型,最快的模型,还有介于两者之间,够聪明也够便宜的模型,你作为客户只需要为每个具体任务,挑选合适的token来源就行,再回到agent那一层,也许以后根本不需要客户自己去选该调用哪个模型,会有一个引擎知道所有模型的能力,就像你现在去OpenAI做研究。你不会去想需要跑多少轮循环,不会去想什么时候该跳LM 什么时候该去搜索,也不会去想现在该用哪个prompt 这些都在后台自动发生,你只需要给一个任务,有一个推理引擎来决定怎么执行,然后你拿到结果,我觉得很多企业用例,很多agent的任务都会用这种方式解决,到那时候不是你作为关注客户需求的开发者。 [00:39:34]
Roman Chernin:到那时候不是你作为关注客户需求的开发者,去编排这些token和模型,然后我们就需要所有模型,最聪明的来处理最复杂的智能任务,最快的来做快速迭代,这还没算上各种模态,以及未来物理AI世界需要的东西,所以我的观点还是,会有足够多的需求,来支撑不同的模型,我们作为基础设施公司要做的,就是尽我们所能,让开发者能舒服地使用模型,提供的所有这些机会和能力,因为你说的很对。
Harry Stebbings:这不只是模型能力的问题,还要让它们跑起来,优化好稳定可靠,而不是让人去折腾底层管道,看看现在模型的爆发和专业化,就像你说的,会有多少模型被造出来,覆盖不同用例的深度,但遗憾的是,有一点很清楚,欧洲在模型建设方面,远远落后于美国和中国,你觉得一个国家。 [00:40:32]
Roman Chernin:拥有自己的主权模型有多重要,看起来世界是分裂的,我们可能不喜欢这样,但我觉得让世界大部分地区,都能用上足够好的基础模型,这很重要,在欧洲或者至少在我们这一代,我们应该想想,怎么让这里拥有足够的能力,过去几年我们谈了很多,关于主权 AI议程这些话题,但我觉得太多讨论都集中在,兆瓦数和电力上,而不是我们有什么样的建设者,兆瓦数会来的,我们在Nebius一直说的是,只要有需求,我们就会建基础设施,像我们这样的公司都会建,而需求来自建设者,我觉得我们这里需要关注的,是有更多像 Lovable,Black Forest Labs,Mistral 这样的好公司,我们有足够的人投资研究。有足够的人投资产品,然后他们就会创造足够的需求,再次形成飞轮,让我们在需要的时候,有足够好的模型。 [00:41:53]
Harry Stebbings:所以我觉得这才是,我们应该关心的事,今天最有意思的投资领域是哪里,我给你四个选项,基础设施,横向模型,垂直模型,应用层。 [00:42:02]
Roman Chernin:我们做的就是基础设施,所以我们对这个领域挺满意的,我觉得在当前这个世界,这是个好位置,虽然从某种程度上说,我们建的可能是最容易的部分,不是说它不复杂,执行起来确实很复杂,但我们大致知道需要什么,客户也帮我们理解需要什么,但我觉得这个行业最了不起的人,是那些敢于去打造终端用户产品的人,他们实际上推动了这里大部分的增长,那些承担真正风险的人,就是那种做出来的东西。
Harry Stebbings:人们到底需不需要的真正风险,我觉得他们才是我们这趟AI旅程里的英雄,说到AI旅程的英雄,我做节目之前会去跟一些人聊,你刚才也提到,我很幸运采访过一些大人物,我去跟其中一些人聊的时候,反复出现的一个话题,就是跟NVIDIA的关系,如果一方权力比另一方大的多,这种关系还算婚姻吗,你怎么看跟NVIDIA关系里的权力动态,毕竟他们手握这么大的权力,我们看这件事的方式很简单,我们就是把自己该建的东西建好,把产品做好。
Roman Chernin:把我们的故事讲清楚,剩下的自然会跟上,我觉得最让人着迷的一点是 NVIDIA在很大程度上,仍然是一家工程师驱动的公司,在我看来,想赢得NVIDIA的尊重,最好的办法就是,当然他们可能有不同看法,但如果NVIDIA的工程师,尊重你的工程师,你们就有了一个很好的关系基础,可以这么说,我觉得我们一次又一次,证明了自己清楚在做什么,而且我们有一支很强的工程团队,他们看到了也尊重这一点,我们在很多层面都有工程师,对工程师的交流,硬件层面,软件层面,推理,平台层面都有 NVIDIA的工程师对你评价越高,就越能促成更好的关系和合作,当然我们这么想也可能是错的,但这就是我们看到的,我们能做的事。我们就是专注于保持理性,专注于长期价值,这听起来有点虚,大家都这么说,但说到底。 [00:44:24]
Harry Stebbings:把你该干的活干好就完了,对吧,我打算把这期标题就写成 Roman 把你该干的活干好就完了,不然我们还能做什么呢,我们处在这种竞赛里,只能尽最大努力,把自己的工作做好,我觉得就是这样,对,把你该干的活干好就完了,我知道这很好笑,我喜欢这个说法,不过话说回来,在今天这个环境下,把你该干的活干好,最难的部分是什么,四个维度,建规模,建产品,服务客户,其实规模跟产品,这两个维度,我们刚才聊过了。
Roman Chernin:第三个是客户,我们做的是现场业务,我们常说,云是售后生意,你卖的时候,卖的是一个承诺,然后你得让客户满意,去接触客户,覆盖客户,建立一支强大的客户工程团队,也就是面向客户的工程团队 FDE团队,这是第三个维度,去跟客户聊,确保他们了解你,你也了解他们,这是第三个维度,第四个最无聊,但也最让人兴奋的是资本,我们玩的是资本密集型游戏,而我们的竞争对手。 [00:45:13]
Harry Stebbings:是全球资本最雄厚的公司,如果给你无限预算,你会怎么做,建得更快,这个答案很简单,什么建得更快,数据中心,然后把GPU填进去。
Roman Chernin:就是建得更快,我们今年的资本支出计划是 2025亿美元,我们的竞争对手,那些超大规模云服务商,支出是我们的十倍八倍,如果我有十倍的资金,我就会建更多数据中心,更快的把GPU填进去,服务更多客户,这又回到我们开头说的,如果我有十倍的供给,我会怎么做,我会跑得更快。 [00:46:04]
Harry Stebbings:Gavin Baker说过一个观点,我觉得很有道理,他说审批,监管和数据中心建设的延迟,其实反而帮了忙,因为如果今天允许你建十倍的数据中心。
Roman Chernin:反而会造成供给过剩,这其实是个很好的问题,我们的投资人有时候也会问,最大的瓶颈是什么,最大的瓶颈还是那句话,什么都是瓶颈,但你需要从时间跨度的角度来看这件事,在接下来的六个月里,资本帮不上忙,六个月太短了,你有什么就用什么,你得交付,然后在接下来的12个月里,你可以加速一些事情,但这更多还是受限于产能,在12个月的时间范围内,我们可以通过资本或执行来加速一些事情,但到了24个月,你绝对可以解锁很多东西,还有一点很重要,要理解我们不是在建一个数据中心,我们建的是一个组合,一个产能组合,我们拥有的执行能力越强。资本越多就越能并行推进,我们可以解锁更多,这就是我们做事的方式,我们先锁定电力和土地,然后建数据中心,再把GPU填进去,每一个后续阶段都需要更多资本,但我们会尽可能提前推进,确保进入下一阶段时,电力已经锁定了,等我们有足够资本部署GPU的时候,数据中心已经建好并运行了,所以这是分阶段的投资,不同时间跨度下,瓶颈也不同,所以很明显,如果你有更多资本,你就能跑得更快,不是在6个月内,而是在18个月 24个月内肯定可以,我能问一下吗,关于数据中心的建设。 [00:47:36]
Harry Stebbings:我们看到公众对AI的抵触情绪,越来越强 Eric Schmidt在台上被虚,不是因为内容,而是因为AI这个维度,我们也看到公众对数据中心的反感,我记得大概有40%的项目,在规划和审批阶段就通不过了,你们内部是怎么看待和思考这个问题的,这就是我们得面对的现实环境。 [00:48:21]
Roman Chernin:所以这件事有两面,一面是我们作为企业,怎么务实看待,就是我刚才说的,我们把它当成一个项目组合来看,我们要确保项目是超额覆盖的,可以这么说,就算某个数据中心延期了,我们照样能给客户交付足够的算力,而且大多数客户,不会被锁死在某个物理位置上,这毕竟是云,我们可以在不同地方建设,然后把工作负载,调度到我们有容量的地方,这是务实的一面,另一面是我们明显看到,社区和地方当局,要求我们这样的公司,跟他们紧密合作,去解释,去展示我们在做什么,去回应他们的顾虑,去解决这些问题,这就是现实,你可以类比一下 Uber刚开始扩张的时候,很多地方也有抵触,对吧。大家说这是怎么回事,新东西来了,发展太快了,我们没料到会这么快,等等,我觉得你只能去沟通去解释这是你责任的一部分,去跟这些新社区打交道去合作,他们开始依赖你,他们有顾虑,有时候他们只是不够了解,有时候他们的顾虑是合理的,你可以去解决,都一样,做好你的工作。 [00:49:41]
Roman Chernin:等等,我觉得你只能去沟通去解释这是你责任的一部分,去跟这些新社区打交道去合作,他们开始依赖你,他们有顾虑,有时候他们只是不够了解,有时候他们的顾虑是合理的,你可以去解决,都一样,做好你的工作。你觉得你们到目前为止做得怎么样?我们骨子里永远觉得自己做的还不够,我觉得在我们开始建设的地方,我们确实取得了不少进展,历史上我们在欧洲经验更多,现在我们中期新建的容量,大概有70% 75%在美国,所以我们在美国当地建立了很多一线团队,去跟那些本地社区沟通。
Harry Stebbings:我们尽力做到最好,是的我们永远需要做得更好,但我们在推进,再帮我理清一个问题,我们刚才聊太空的时候笑了,在地球上建数据中心,物流上已经非常难了,在太空建数据中心呢,我热爱技术,我是个乐观主义者,我希望这想法是不是太疯了,我觉得我们现在看到的一切都挺疯的,不,我的看法很简单。 [00:50:33]
Roman Chernin:现在有那么多聪明人在努力,让它变成现实,所以大概率,我可能没那么悲观,不会说我们三年内,在太空建的会比地球上还多,我不知道会怎样,我的态度是,我足够谦逊,看到这么多聪明人,在试图解决这个任务,把算力带到太空,我有什么理由,不相信它会实现呢,当然还有很多挑战,还有很多事情要搞清楚,但如果有人三年前跟我们说,我们会建Multi-gigawatt级别的数据中心,会建成大规模互联的计算机群,你会信吗,我当时是不会这么想的。
Harry Stebbings:而现在我们就在这里,这已经成了日常,我想跟你来个快问快答,我说一句简短的话,你给我你的即时反应,今天还不存在。 [00:51:38]
Roman Chernin:但你觉得五年后会非常普遍的工作是什么,有一件事显然在发生,就是我们在把开发者这个身份民主化,对吧,现在每个人都可以成为开发者,我说的成为开发者,是指把想法转化成某种数字资产,我希望这里我们必须保持乐观,我希望这种人人都能构建的民主化,会打开很多我们甚至现在还想象不到的机会,当我们让数百万数千万新人拥有这种能力,能轻松地把自己的想法变成实际可用的东西,我们会看到大量新业务,大量新想法就这样诞生,他们会创造出很多我们现在根本想不到的新工作,这就像是这种构建民主化的第二层效应,另外有挑战也需要改变的一点,我觉得这既是风险也是机会,就是教育会怎么变。因为现在当每个人都能接触到智能,你绝对不需要他们去死记硬背事实了,所有知识都触手可及,那你怎么真正训练人去思考,当他们不需要想那么多的时候,怎么教人持续的改变,很多职业不会稳定,你怎么帮助人们,在不断变化的环境中,找到自己,并且真正去思考。 [00:52:44]
Harry Stebbings:去不断学习新概念,我觉得这里面有大量新机会,但也带来了很多风险,你提到你有两个十几岁的女儿,你会给她们什么建议,她们大概十年后就要进入职场了。 [00:53:08]
Roman Chernin:你会怎么建议她们,不,我直接跟她们说,我觉得有两样东西会很重要,我不知道具体需要什么,但我确定有两样东西一定需要,一个是能够带着同理心去跟人沟通,就是理解人跟人交流有共情能力,第二个是创造力,所有跟艺术相关的东西,我希望艺术在某种程度上会一直存在,所以我十年前以为最重要的硬技能,那时候我觉得他们最该学的是数学和工程,现在我已经完全不这么想了,而且我挺高兴的,他们现在在软技能方面比我小时候强多了,再说一遍,能跟人沟通,理解人,对人共情,再加上有创造力,有想法,愿意尝试新东西。
Harry Stebbings:我觉得这两样,如果你能帮孩子培养起来,十年后他们一定会很抢手,怎么教创造力确实是个问题,不过我完全同意,你来把这句话说完 Nebius最大的威胁不是竞争,而是,而是整体的整合,对,我觉得Nebius 作为一门生意最大的威胁。 [00:54:10]
Roman Chernin:是世界变得过于整合了,就像我们聊过的,我们尽量做到多元化,去解决不同客户的问题,在不同层面,服务不同的客户,如果最后这个世界变成,我也不知道,三五个超级模型,超级公司,超级帝国,掌控一切,那Nebius 或者像我们这样的公司,唯一的价值可能就是,帮他们在物理层上,服务他们的需求,所以我觉得,整体来说,整合是我们最大的威胁,世界越民主化,越多元化,我们作为一门生意,就越被需要,你觉得那种情况会发生吗。
Harry Stebbings:我们现在看到的是,价值越来越集中在少数玩家手里,跟多元化正好相反,我希望不会发生,从生意的角度,我觉得对我们来说更好。 [00:55:15]
Roman Chernin:对我们作为人来说也更好,你和我这个世界,能在不同方面,保持相当多元的状态,我在这方面是乐观的,我觉得有太多人,想独立去创造点什么,有太多人想去尝试,去做出新东西,这本身就会自然地产生一种推力,自然地让世界更加多元。
Harry Stebbings:所以希望我们能保持住这种状态,倒数第二个问题 Leo Ashenbrand 现在是个很有名的投资人,有一大群追随者,他最近披露了一笔,对他来说很大的持仓,买了公司5.3%的股份,好像占他投资组合的15% 你们内部怎么看,是那种好样的Leo的感觉吗。
Roman Chernin:我不会说我们没注意到,显然大家都注意到了,股价也涨了,当时是个大新闻,我还是觉得,我们把它看作是,对我们做的事情的一种认可,你得到这种认可之后,会跟自己说,好吧,这些人给了你信任,相信你能执行到位,我反复在说,我们做的是一门售后生意,每次我们签下一笔单子,每次有人投资我们,他们都是在给我们信任和机会去交付,那就回去干活,把东西交付出来,我觉得我们处在这样一个市场里,情绪化也很强,你必须让自己脚踏实地,记住所有这些增长。 [00:56:15]
Harry Stebbings:所有这些客户给你的信任,都是交付的机会,回去干活,你真是太以色列了,美国人可能会说,对冲,你就说不行,我觉得这方面,我更像俄罗斯人。
Roman Chernin:俄罗斯人总是知道,事情得看得非常无时,而且你知道,俄罗斯人总是那种表情,总觉得会出什么事,你得做好准备,所以不,我觉得这真的是很重要的一部分,也来自我们的CEO兼创始人卡迪,你每天醒来就是新客户,新的一天你得交付,没有什么是有保证的,你必须专注于工作,我知道团队为了让事情运转,付出了多少努力,每一天的投入有多关键,市场变化又有多快,要保持相关性,你就得用同样的速度继续前进,或者努力跟上市场的步伐,再说,我觉得说句浪漫点的话,我们其实可以多庆祝一下,但就是没时间,趁这个机会,我真的想对团队说声辛苦了,我觉得我们庆祝的不够。我觉得我们保持不松懈是对的,但我们可以多庆祝一点,多给团队一些尊重,认可他们做了多少事情,这一路不容易,现在也不容易,以后也不会容易,但是对不能停,我们不能停,就像鲨鱼一样,动起来才算活着,对吧,那个很有名的说法,所以我们必须一直动,说到这儿。 [00:58:02]
Harry Stebbings:我真的非常感谢你来参加节目,也谢谢你忍受我这些东拉西扯的问题,你太棒了 Roman 真的非常感谢,谢谢你,也谢谢你花时间跟我聊。
这篇 The Batch 文章由 Andrew Ng 的短文和四则 AI 新闻组成,主题集中在智能体化软件开发、开放权重大模型、AI 教育、端侧模型架构和生物分子建模。
Andrew Ng 认为,“循环工程”正在成为让 AI 智能体长时间迭代构建软件的关键方法。他提出三个循环:
文章强调,编码智能体加速开发后,工程师越来越多承担部分产品管理职责,难点在于平衡“把愿景落成规格和产品”与“获取用户反馈来演化愿景”。
Z.ai 发布 GLM-5.2,一款面向编码和长时间智能体任务优化的开放权重大语言模型。它支持最多 100 万 token 输入和 12.8 万 token 输出,输出速度为 103 token/秒;总参数 7530 亿,每 token 激活 400 亿参数。API 价格为每百万输入/缓存/输出 token 分别 1.40/0.26/4.40 美元,GLM Coding 套餐每月 12.60 到 112 美元。
技术上,GLM-5.2 修改了 DeepSeek 稀疏注意力实现,把上下文从 GLM-5 的 20 万 token 扩展到 100 万 token。它从组相对策略优化转向近端策略优化,以适应更长的任务尝试;还通过规则过滤器和独立语言模型减少奖励黑客行为。模型每四层运行一次稀疏注意力索引器并复用输出,据称在 100 万 token 上下文下把每 token 计算量降低 2.9 倍。推测解码中,GLM-5.2 平均接受 5.47 个草稿 token,相比 GLM-5.1 的 4.56 个提升 20%。
基准方面,GLM-5.2 在 Artificial Analysis 的 Intelligence Index v4.1 中位列开放模型第一、所有模型第三;在 PostTrainBench 上领先所有模型;在 Arena.ai Code Arena WebDev 榜单第二。具体分数包括 Intelligence Index max reasoning 51、WebDev 1,593 Elo、PostTrainBench 34.3%、AA-Briefcase 1,266 Elo。文章认为,在美国政府和公司限制美国开发 AI 技术访问的背景下,高性能开放权重模型更具吸引力。
美国高校正在快速推出 AI 本科专业、辅修和专项方向。东北大学包容性计算中心统计称,截至 4 月,美国近 584 所高校至少有 1,000 个 AI 项目,包括 78 个专业和 103 个辅修;相比之下,2021 年只有 5 所学校开设 AI 专业。
课程设计差异很大。卡内基梅隆大学 2018 年开设美国首个人工智能学士学位,强调数学和计算机科学基础;俄克拉荷马大学理工学院的应用 AI 学位更侧重机器人学、机器学习、强化学习、计算机视觉、云计算和 DevOps 等实践课程;德雷克大学的 AI 文学学士面向人文和商科学生,数学要求较少。斯坦福等学校则通过 AI 专项方向覆盖自然语言处理、计算机视觉和机器人学。
文章列出两类争议:有人认为大学行动太慢,无法满足雇主对 AI 能力的期待;也有人认为 AI 学位可能只是风潮,甚至会牺牲更广泛的计算机科学基础。文章的结论是,AI 岗位跨度很大,从带 AI 组件的软件工程到机器学习研究、分布式系统、数据工程都有,因此不存在一刀切课程。
苹果第三代 Apple Foundation Models 来自与 Google 的合作。AFM 3 Core Advanced 设计用于在部分苹果设备上生成文本和语音,采用改造版专家混合 Transformer,总参数 200 亿,激活参数 10 亿到 40 亿。它将随 2026 年秋季 Mac 和 iPhone 17 Pro/Max/Air 操作系统更新推出,支持文本、图像、语音输入以及文本、语音输出,覆盖 25 种语言。
AFM 3 Core Advanced 使用公开信息、授权数据、研究数据和生成数据训练,不包含用户数据或用户与模型的交互。其关键架构是遵循指令剪枝:不用模型内部路由层为每个 token 选择专家,而是用独立 Transformer 为部分或全部 token 选择专家,因此无需每个 token 都切换专家,可以比同等规模的典型专家混合模型更快推理。
苹果尚未发布公开基准,只称内部人类偏好测量优于上一代。新闻背景是,苹果 1 月与 Google 达成多年协议,以 Gemini 作为其 AI 模型基础;苹果 AI 副总裁 Amar Subramanya 表示这些模型是“基于蒸馏的,并非全盘采用 Gemini”。文章认为,AFM 3 Core Advanced 的重要性在于它跨多个 token 复用专家,使模型可存放在闪存而非全部加载进 RAM 或 VRAM,从而让更大模型在本地设备上运行更现实。
Biohub 和 EvolutionaryScale 发布 ESMFold2,用类似大语言模型的方式处理蛋白质、DNA、RNA 及其结合分子,以推断生物活性分子的形状。团队同时发布嵌入模型 ESMC。
ESMFold2 的输入可以是氨基酸序列、DNA/RNA 碱基对序列、生物活性分子的 SMILES 描述,或多序列比对 MSA;输出是分子形状和误差估计。模型参数 62 亿。当输入不是 MSA 时,它优于 AlphaFold 3 和其他竞争模型;输入是 MSA 时,则与 AlphaFold 等模型相当。
核心洞见是,AlphaFold3 等模型通常需要 MSA,而 MSA 需要在数据库中查找相关分子并对齐。ESMFold2 则训练 Transformer 直接嵌入单个分子,用嵌入替代 MSA。系统会生成序列、原子和 MSA 三类嵌入,再用 pairmixer 表示成对距离,之后扩散模型从带噪声原子点云中推断原子位置,并估计误差。训练时距离嵌入最多循环 6 次,推理时循环 10 次。
在 FoldBench 测试中,仅以蛋白质为输入时,ESMFold2 优于不接受 MSA 的 Chai-1。按 lDDT 衡量,ESMFold2 在蛋白质序列输入下达到 0.85,高于 Chai-1 的 0.81;给定 MSA 时达到 0.89,与 AlphaFold3 和 Protenix-v1 相同。对结合的蛋白质和 DNA 分子,ESMFold2 的 DockQ 通过率为 80%,高于 Chai-1 的 71%;额外给定 MSA 时为 79%,与 Protenix-v1 持平但低于 AlphaFold3 的 82%。
文章认为,ESMFold2 的价值在于降低生物研究摩擦,尤其适用于新颖分子、快速演化病毒蛋白、合成生物学产物或相关分子信息稀缺的场景。由于权重开放,不同经费和机构条件的科学家都可免费使用。
来源:The Batch
URL:https://charonhub.deeplearning.ai/issue-359/
正在加载 Elevenlabs 文本转语音 AudioNative 播放器……
亲爱的朋友们:
在 Claude Code 创建者 Boris Cherny 和 OpenClaw 创建者 Peter Steinberger 在社交媒体上的相关言论走红之后,“循环工程”(loop engineering)成了热门新词。如今,循环已经成为让 AI 智能体长时间迭代并构建软件的关键方式。在这封信里,我想分享我用来打造从 0 到 1 产品的 3 个关键循环,如下图所示。这些循环不仅指导我如何构建软件,也指导我如何决定要构建什么软件。
智能体化编码循环: 给定一份产品规格说明,并可选地给定一组评测集(evals,即用于衡量性能的数据集),我们可以让 AI 智能体编写代码、测试自己的工作,并持续迭代,直到代码没有 bug 且符合规格说明。闭环这个想法大约在去年年底开始流行,它改变了游戏规则,让编码智能体能够在没有人类干预的情况下更长时间地高效工作。比如上个周末,我在给女儿做一款练习打字的应用,我的编码智能体可以轻松连续工作约一小时,多次用网页浏览器检查自己构建的内容,然后再回到我这里,中间不需要我介入。工程循环执行得很快。每隔几分钟,编码智能体就可能构建并测试一个新版软件。我经常听到开发者在探索如何设计更有效的工程循环。这是一个非常活跃的发明领域。
开发者反馈循环: 在这个循环中,开发者检查当前产品,并引导编码智能体改进它。去年,很多开发者(包括我)还在为自己的编码智能体承担 QA(质量保证)职能:手动找 bug,然后要求智能体修复。但随着编码智能体越来越能够测试自己的代码,我们需要花在这项工作上的时间显著减少。这让我们可以做更高层次的产品决策,例如应该提供哪些关键功能、UI 哪些地方需要改进等。开发者反馈循环的时间间隔通常是几十分钟到几小时,这大致就是开发者评审产品并给出反馈的频率。以那款打字应用为例,我曾多次改变对视觉设计的想法,调整她学习过程中可以解锁哪些猫咪服装(她喜欢猫),也调整了成年人登录后引导孩子学习体验的用户流程。
当开发者对要构建什么有清晰愿景时,把这个愿景翻译成编码智能体可执行的规格说明仍然很费力。此外,开发者看到一个实现之后,可能会更新(或者说澄清)规格说明,把它导向自己想要的方向。如果你发现系统反复遇到某些问题,为智能体构建一组评测集就会很有用。AI 原生团队越来越多地用 AI 帮助塑造产品方向,例如自动收集和分析使用数据、总结书面和口头客户反馈,或开展竞争分析。不过,在我参与的几乎所有产品里,我认为人类相对于当前 人工智能系统拥有显著的上下文优势:我们比 人工智能系统更了解用户,也更了解产品必须运行的环境。因此,人类扮演着关键角色。很多人把这种人类贡献描述为“品味”,但我更愿意把它理解为人类拥有上下文优势,因为这给了我们一条更清晰的路径,去帮助 人工智能系统变得更好。这也说明了为什么这一步无法自动化:只要人类知道 AI 不知道的东西,就需要人类在环(human-in-the-loop),把这些知识注入系统。
外部反馈循环: 这包括一大类做法,比如请几位朋友给反馈、发布给 alpha 测试者,或把代码上线并进行 A/B 测试。这些做法通常很慢,很少少于几小时,有时需要几天甚至几周。这些数据会反过来影响开发者愿景,开发者愿景继续驱动详细的产品规格,产品规格再驱动编码智能体。随着编码智能体加速软件开发,越来越多工程师开始承担一部分产品管理角色。对于许多正在成长为这种角色的工程师来说,最难的部分是塑造产品愿景,并在构建(弥合愿景与规格之间的差距)和获取用户反馈以演化愿景之间取得平衡。两者都很重要。
我会在未来的信中继续写如何做到这一点。但就目前而言,看到工程师正在扮演更扩展的角色,我感到很受鼓舞(就像产品经理和设计师如今也在做更多工程工作一样)。继续构建吧!
Andrew
来自 DEEPLEARNING.AI 的消息:别再盯着你的终端了。学会让你的智能体在需要你输入时主动呼叫你。立即参加免费的 7 天语音 AI 构建挑战。
Z.ai 发布了一款开放权重(open-weights)模型,在自主智能体任务上可与领先专有模型竞争。
新进展: GLM-5.2 是一系列为编码优化的大语言模型中的最新成员,输入上下文窗口远大于前代。
输入/输出: 输入文本(最多 100 万 token),输出文本(最多 12.8 万 token,103 token/秒)。
架构: 专家混合(Mixture-of-experts)Transformer,总参数 7530 亿,每个 token 激活 400 亿参数。
特性: 两档推理级别(high、max)、函数调用、结构化输出、上下文缓存(复用输入,避免重新计算 prompt 中重复的部分)。
性能: 在 Artificial Analysis 的 Intelligence Index v4.1 上位列开放模型第一、所有当前可用模型第三;在 PostTrainBench(长时间运行的智能体化编码测试)上领先所有模型;在 Arena.ai Code Arena WebDev 榜单上排名第二。
可用性/价格: 权重通过 Hugging Face 以 MIT 许可证开放,可用于商业和非商业用途;API 每百万输入/缓存/输出 token 分别为 1.40/0.26/4.40 美元;GLM Coding 套餐每月 12.60 到 112 美元。
未披露: GLM-5.2 专用的训练数据和方法。
工作原理: GLM-5.2 建立在 GLM-5 之上。团队修改了早期模型对 DeepSeek 稀疏注意力的实现,以减少所需处理量,从而把输入上下文从 GLM-5 的 20 万 token 扩展到 100 万 token 变得可行。Z.ai 专门用深度研究、代码部署与性能优化、复杂调试等长时间运行的智能体化任务训练 GLM-5.2。
更早的 GLM 模型通过组相对策略优化(Group Relative Policy Optimization)学习。这是一种强化学习方法:如果某次完成任务的尝试优于多次尝试的平均水平,就给予更高奖励。
不过,GLM-5.2 的任务运行时间足够长,团队不得不把单次尝试拆成多个片段,因此难以轻松求平均。于是,团队改用近端策略优化(Proximal Policy Optimization),由一个评判器模型(critic model)单独评价每次尝试。
在强化学习中,编码任务通常根据通过/失败检查来评分。但智能体化流程可能并没有真正解决问题,却通过使用工具来通过测试,例如从 GitHub 获取参考答案。GLM-5.2 比 GLM-5.1 更频繁地采用这种奖励黑客行为(reward hacking)。
为了解决这个问题,团队加入了基于规则的过滤器,用来标记可疑工具调用;再用一个独立语言模型判断每个被标记的调用是否绕过了任务;如果确认绕过,就向 GLM-5.2 输入虚拟数据来阻断这类调用,同时让训练继续进行。
为了降低处理更长上下文中的注意力所需的计算量,模型使用稀疏注意力索引器:它会为每个新 token 选择应关注哪些更早的 token。不同的是,模型不是每一层都运行这个索引器,而是每四层运行一次,并在其他三层复用其输出。公司表示,在 100 万 token 上下文内,这把每 token 计算量降低了 2.9 倍。
这种做法修改了较早的 IndexCache 方法。
为了更快生成 token,一个小型草稿模型会一次提出多个 token,主模型再在称为推测解码(speculative decoding)的过程中接受或拒绝它们。GLM-5.2 平均接受 5.47 个 token,相比 GLM-5.1 的 4.56 个提升 20%。
性能: 在 Artificial Analysis 的测试中,GLM-5.2 取得了所有开放权重模型中最强的表现。在多项智能体化基准测试上,它接近 Anthropic 和 OpenAI 的领先专有模型,有些项目略微领先,有些项目小幅落后。
在 Artificial Analysis 的 Intelligence Index 上,这个指数综合了 9 项经济上有用的任务评估。GLM-5.2 在 max reasoning 设置下得分 51,开放权重模型中排名第一,落后于 max reasoning 设置下的 Claude Opus 4.8(56)和 xhigh reasoning 设置下的 GPT-5.5(55),但明显领先于 max reasoning 设置下的 DeepSeek V4 Pro,以及未指定 reasoning 设置的 MiniMax-M3(两者同为 44)。
在 Arena.ai Code Arena 的 WebDev 榜单上,该榜单根据人类对网页开发任务的投票为模型排名。GLM-5.2 在 max reasoning 设置下达到 1,593 Elo,排名第二,落后于 Claude Fable 5(1,654 Elo),领先于 Claude Opus 4 和 GPT-5.5 的所有变体。
在 PostTrainBench 上,该测试要求智能体微调 4 个大语言模型,并在 7 个基准上评估其表现。GLM-5.2 在 max reasoning 设置下达到 34.3%,略高于 max reasoning 设置下的 Claude Opus 4.8(34.1%)和 max reasoning 设置下的 Claude Fable 5(30.7%)。
在 AA-Briefcase 上,这是一项 Artificial Analysis 于 2026 年 6 月推出的基准,用来评分智能体生成电子表格、演示文稿和备忘录等商业文档的能力。GLM-5.2 在 max reasoning 设置下达到 1,266 Elo,领先所有开放权重模型,并在总体排名中位列第三,仅次于 Claude Fable 5(1,587 Elo)和 max reasoning 设置下的 Claude Opus 4.8(1,356 Elo)。
新闻背景: 随着美国政府和美国公司收紧对美国开发的 AI 技术的使用限制,高性能开放权重模型变得更具吸引力。Z.ai 发布 GLM-5.2 的前一天,美国政府刚把 Anthropic 的 Claude Fable 5 和 Claude Mythos 5 的访问权限限制为公民可用,而 Anthropic 也暂停了 Claude Fable 5 的访问。
为何重要: 除了 GLM-5.2 的开放许可证,Z.ai API 的低成本也给了开发者采用它的额外动机。根据 Artificial Analysis 对每单位智能成本的评估,觉得 Claude Opus 4.8 或 GPT-5.5 过于昂贵的开发者,可以用低至四分之一的成本获得相近的智能体化和编码能力。
我们的看法: 开放权重模型继续逼近顶级闭源模型。GLM-5.2 在网页开发和后训练任务上的出色表现说明,只要拥有足够先进的硬件,任何人都可以免费获得高级智能体化能力。
美国大学正在快速推出人工智能本科专业、辅修和专项方向,以满足对 AI 专业能力不断增长的需求。
新进展: 据东北大学包容性计算中心(Center for Inclusive Computing at Northeastern University)统计,截至 4 月,美国近 584 所学院和大学至少有 1,000 个 AI 项目,其中包括 78 个专业和 103 个辅修。这些数字大幅上升。《纽约时报》报道称,2021 年只有 5 所学校开设 AI 专业。
工作原理: 人工智能学士学位的课程要求差异很大。有些项目高度技术化、数学强度很高;有些项目则采取更宽泛的跨学科路线,包含伦理、政策或特定领域应用课程。有些强调 AI 的理论基础,有些则关注如何在实践中构建和部署 人工智能系统。
卡内基梅隆大学位于宾夕法尼亚州,拥有美国顶尖的计算机科学项目之一。它在 2018 年成为美国第一所开设人工智能学士学位的大学。其课程强调数学严谨性,要求 7 门数学和统计课程、5 门计算机科学以及计算与编程原理课程、3 门人工智能课程、1 门伦理课程,以及覆盖人类认知、感知与语言、机器学习、人机交互等方向的其他课程。
俄克拉荷马大学理工学院的应用 AI 学位侧重实践知识。除数学和统计要求外,它要求学生完成 15 门 AI 和计算课程,主题包括机器人学、机器学习、强化学习、计算机视觉、云计算和 DevOps。
其他 AI 学位则更具跨学科性质。爱荷华州的德雷克大学提供 AI 文学学士学位,面向人文和商科学生。课程要求较灵活,允许学生从哲学、英语、计算机科学、信息系统和心理学等课程组中选择。该学位只要求两门数学课。
许多不提供 AI 学位的学校开设了专门的 AI 方向。斯坦福大学 AI 方向的学生需要修读 7 门符合条件的课程,领域包括自然语言处理、计算机视觉和机器人学。(披露:Andrew Ng 是斯坦福大学计算机科学系兼职教授。)
新闻背景: 一些评论者认为,大学在为学生准备雇主所期待的 AI 能力方面行动过慢。另一些人则把 AI 学位视为一阵风潮。不过,即使是一些支持者也提醒说,专门化 AI 学位可能会以牺牲更宽广的计算机科学基础为代价,而学生可能需要这些基础来适应快速演变的领域。
为何重要: 今天的课程体系可能塑造谁会进入这个职业,以及下一代 AI 工程师会携带哪些技能。在 AI 这样多样化的领域,很难指望会有一种标准化、一刀切的教育。行业中的一些岗位类似带有 AI 组件的传统软件工程岗位;另一些岗位则需要更深入的机器学习研究、分布式系统或数据工程专长。为研究生学习做准备的项目,与假定学士学位就是终结性学位的项目之间,也始终会存在巨大差异。
我们的看法: AI 发展太快,许多大学都难以及时适应。学术课程的既定变化节奏是:教师先学习一个主题,提出新课程,获得课程委员会批准,也许再修改学位要求。这种节奏与 AI 的快速变化并不匹配。不过,我们很高兴看到大学正在朝这个方向行动,也看到一些有创新精神的教师和管理者正在寻找更快推进的方法。这对于培养学生,不仅让他们胜任 2026 年的工作,也让他们胜任多年之后的工作,都很重要。
苹果基础模型(Apple Foundation Models)的第三代成果来自苹果与 Google 的合作,它引入了一种可在本地设备上运行的专家混合架构变体。
新进展: AFM 3 Core Advanced 是一款设计用于在部分苹果设备上生成文本和语音的模型。它的处理效率超过流行的专家混合架构,同时占用的工作内存显著更少。(AFM 3 家族中的其他模型都经过定制,并从未指明具体版本的 Google Gemini 模型蒸馏而来;其中包括同样运行在苹果设备上的 AFM 3 Core,以及运行在服务器上的 AFM 3 Cloud、AFM 3 Cloud Image 和 AFM 3 Cloud Pro。)
输入/输出: 输入文本、图像和语音;输出文本和语音。
架构: 改造版专家混合 Transformer(总参数 200 亿,激活参数 10 亿到 40 亿)。
可用性: 将于 2026 年秋季随 Mac 和 iPhone 17 Pro/Max/Air 的苹果操作系统更新推出。
特性: 文本理解与生成、语音理解与生成、图像理解、工具使用、技能、推理、25 种语言。
未披露: 输入/输出规模限制、基准测试表现、具体训练数据和方法。
工作原理: AFM 3 Core Advanced 针对苹果芯片运行进行了优化。和同家族其他模型一样,AFM 3 Core Advanced 使用公开可得信息、授权数据、研究中收集的数据和生成数据的混合体进行训练。训练没有包含任何用户数据或用户与模型的交互。训练流程包括预训练、监督微调和强化学习。
一种名为遵循指令剪枝(Instruction-Following Pruning)的 MoE 替代方案让 AFM 3 Core Advanced 运行得更快,也更节省内存。典型专家混合模型会使用模型内部的路由层,为每个输出 token 选择要激活网络中的哪些部分(专家)。AFM 3 Core Advanced 不在模型内部使用路由层,而是用一个独立 Transformer 为部分或全部输出 token 选择要激活哪些专家。由于网络并非每个 token 都切换专家,它可以比同等规模的典型专家混合模型实现更快推理。
结果: 苹果尚未发布 AFM 3 模型的任何基准测试结果。公司表示将在今年晚些时候发布。与其他 AFM 3 模型一样,在苹果内部的人类偏好测量中,AFM 3 Core Advanced 优于上一代。
新闻背景: 1 月,苹果与 Google 达成多年协议,将 Gemini 模型作为其 AI 模型的基础。随着 AFM 3 发布,苹果 AI 副总裁 Amar Subramanya 透露,这些模型是“基于蒸馏的,并非全盘采用 Gemini”。
同时,苹果宣布计划让其 Foundation Models Framework 接纳其他公司的模型。在苹果硬件上构建应用的开发者将能够在 AFM 3 模型与实现 Apple LanguageModel 协议的替代模型之间选择,后者包括 Anthropic Claude 或 Google Gemini 系列。
为何重要: AFM 3 Core Advanced 的架构是一项值得关注的成就。典型专家混合模型需要把整个模型加载到活跃内存(RAM 或 VRAM)中,因为逐 token 从闪存存储加载专家会很慢。AFM 3 Core Advanced 会跨多个 token 使用同一组专家。这让把模型存放在闪存中变得可行,也意味着更大、更强的模型可以在本地设备上运行。
我们的看法: 内存和带宽限制让大多数应用很难下载并运行数十亿参数模型。因此,iOS 开发者有充分动力使用专为 iOS 硬件运行而设计的精简模型。此外,苹果与 Google 的合作让它能够借助后者在手机上运行这类模型的经验。
Google 的 AlphaFold 模型开创了寻找生物活性分子形状的任务,为药物开发打开了新路径。一个开源团队借鉴大语言模型的洞见,改进了 AlphaFold 3 的架构。
新进展: 非营利生物医学研究组织 Biohub 和独立 AI 生物学实验室 EvolutionaryScale 的团队发布了 ESMFold2。它把蛋白质、DNA、RNA 以及与它们结合的分子等生物活性分子的组成部分当作自然语言来处理,从而推断这些分子的形状。
AlphaFold 3 和 ESMFold2 都会通过考虑多个已对齐、可相互比较的相关分子的特征来推断分子形状;除此之外,ESMFold2 还可以像大语言模型那样,使用一个独立 Transformer 直接嵌入单个分子。
除了 ESMFold2,团队还发布了它的嵌入模型 ESMC。
输入/输出: 输入可以是定义蛋白质的氨基酸序列、定义 DNA 或 RNA 的碱基对序列、其他生物活性分子的标准化文本描述(SMILES),或对相关氨基酸/碱基对序列进行对齐的多序列比对(multiple sequence alignment, MSA);输出是分子形状和误差估计。
架构: 混合架构(62 亿参数)。
性能: 当输入不是 MSA 时,优于 AlphaFold 3 和其他竞争模型;当输入是 MSA 时,与 AlphaFold 及其他竞争模型相当。
可用性: 可通过网站免费使用;权重可通过 HuggingFace 下载;API 由 Biohub 提供。
关键洞见: 为了分析给定分子,AlphaFold3 和类似模型还必须接收一个 MSA,这需要在现有数据库中寻找相关分子并正确对齐它们。但基于 Transformer 的大语言模型擅长基于大量训练数据生成嵌入,而数据库中已有海量序列和生物活性分子的标准化文本描述。可以训练一个 Transformer 来嵌入单个分子,并用这个嵌入作为输入,替代 MSA。
工作原理: 给定蛋白质、DNA 或 RNA 序列,或一个生物活性分子的描述,ESMFold2 会:(i)用三种方式嵌入输入,包括(a)序列,(b)其原子,(c)如果收到 MSA,则嵌入 MSA;(ii)生成一个嵌入,用来表示分子中氨基酸、碱基对或原子之间的物理距离;(iii)估计输入中原子的坐标;(iv)估计这些坐标的误差。它使用两个数据集学会执行这些步骤,这两个数据集把现有序列和描述与其形状相匹配。
给定一个输入,系统会生成三种嵌入。(a)为了嵌入氨基酸或碱基对序列,系统使用名为 ESMC 的 Transformer 模型。该模型通过在 3 个蛋白质数据库中约 28 亿条序列上填补被遮蔽 token 进行训练。(b)另一个独立 Transformer 嵌入原子。(c)为了嵌入 MSA,系统使用 pairmixer 模型,它会根据矩阵中同一行或同一列的元素更新每个元素。在这个模型里,矩阵表示一个 MSA。
给定这些嵌入之后,另一个 pairmixer 会生成一个嵌入,表示氨基酸、碱基对和原子之间的成对距离。这个嵌入一开始是纯噪声。在训练期间,它通过最多 6 次循环经过模型来逐步精化。(推理时循环 10 次,因为这带来了最佳表现。)
给定距离嵌入、序列和原子的嵌入,以及一个带噪声的原子点云,扩散模型会去除噪声,推断原子位置。
给定距离、序列和原子的嵌入以及点云,第三个 pairmixer 会估计多种误差,包括预测距离与成对原子之间真实距离的误差。
结果: 作者使用 FoldBench 测试 ESMFold2。FoldBench 包含在各种组合下寻找生物活性分子形状的测试。仅以蛋白质作为输入时,ESMFold2 优于不接受 MSA 的分子模型 Chai-1。给定 MSA 时,它的表现与使用 MSA 的竞争模型相似,包括 AlphaFold3。
团队评估了模型在给定蛋白质序列时推断其形状的能力,指标是局部距离差异测试(Local Distance Difference Test, lDDT),该指标衡量估计的原子间距离与真实值的相似度,越高越好。ESMFold2 达到 0.85 lDDT,而 Chai-1 达到 0.81 lDDT。在给定 MSA 的情况下测试同一能力时,ESMFold2 达到 0.89 lDDT,与 AlphaFold3 和 Protenix-v1 相同。
给定一个相互结合的蛋白质和 DNA 分子,团队评估了 DockQ 通过率,也就是分子接触点处估计原子间距离与真实值的相似度,越高越好。ESMFold2(80%)略优于 Chai-1(71%)。给定同样的分子并额外提供 MSA 时,ESMFold2(79%)与 Protenix-v1 持平,但低于 AlphaFold3(82%)。
新闻背景: ESMFold2 是 Biohub 2022 年 ESMFold 的更新版。它更大,也用更多数据训练。此外,它的架构纳入了其他工作提出的顶尖组件,尤其是 AlphaFold3 中的组件,例如预测原子坐标的扩散模型,以及估计系统输出误差的模型。
为何重要: 使用本质上类似大语言模型的 Transformer 来嵌入分子,让 ESMFold2 能够处理输入分子,而不需要一组已对齐的生物学相关分子。这种能力降低了生物研究的摩擦。如果一个分子是新的(例如快速演化的病毒蛋白)或合成的(例如合成生物学产物),并且相关分子信息稀缺,这一点尤其重要。此外,由于系统拥有开放权重,不论科学家的经费或机构归属如何,都可以免费使用它。
我们的看法: LLM 已经证明,在推理时投入更多处理量是有价值的。ESMFold2 的距离估计模型采用了同样原则,通过让嵌入多次循环经过模型来提升性能。
来源:SemiAnalysis
URL: https://newsletter.semianalysis.com/p/us-grid-constraints-towards-40gw
如今,美国电网正在为美国大部分数据中心负载提供服务,但我们正在达到一个临界点。随着AI 实验室和超大规模云服务商对电力的无限需求不断加速,电网根本无法足够快地增加容量。这使得“表后”成为最大的参与者获得所需电力的唯一途径。大约一年前,我们的 Onsite Gas 深入研究首次预测 BTM 天然气设备市场新进入者的快速崛起。从那时起,Bloom Energy、Bergen Engines、Wärtsilä 等许多公司都取得了巨大的成功。事实证明,克服 GEV 和 Siemens涡轮机容量限制比许多人担心的要容易得多。今天,我们更深入地对美国电网容量进行建模,以了解数据中心的表后解决方案必须填补的缺口。让我们从关键数字开始:首先,我们继续看到美国的数据中心建设创纪录,从 2026 年的 +21GW 增加到 2030 年的 +84GW。我们上周详细解释了为什么数据中心延迟的头条新闻经常被夸大。我们的研究表明,到 2028 年以后,BTM 将为超过一半的美国新建数据中心供电,到 2029 年,DC BTM 设备的总可寻址市场(TAM) 将超过 50GW/年。新电网容量增长不够快,还需要满足非数据中心负载的增长。
资料来源:SemiAnalysis 能源模型、SemiAnalysis 数据中心模型 上图显示了我们预测的三个核心组成部分:预期数据中心美国总电力需求、美国可用电网容量和新电网供应。我们利用 SemiAnalysis 行业领先的最佳见解来构建此预测。第一个模块,即数据中心需求,来自于自下而上的预测,由逐个构建模型提供支持,由加速器模型的逐个芯片人工智能需求预测支持,并由我们的 Tokenomics 模型进行验证,该模型跟踪扩建的经济性并回答“泡沫”问题。我们能源模型的第二个组成部分是电网净空,它分析美国电网每个主要部分的供需动态。我们的模型遵循所有 ISO 和 RTO 的方法,并对 UCAP/ICAP 储备、供需增长、可靠性风险等进行建模。第三个模块通过我们的新能源模型产生的自下而上的预测来预测新的电网供应。我们跟踪美国 40,000 个发电资产,并逐季度预测所有燃料类型的商业运营日期(COD)。然后,我们通过我们专有的 ELCC 模型估算发电厂的“真实”容量值,并适应每个 ISO 和主要非 ISO 地区的具体情况。我们的预测表明,每年仅新增 ELCC 产能 15GW,到本十年末,这一增长趋势将达到 20GW 以上。这实际上是电网运营商可以识别的添加到系统中的所有固定容量,以服务固定数据中心负载
资料来源:SemiAnalysis 能源模型净额计算表明,根据峰值需求和所需的储备边际认可的供应量本身就是产生净空的因素,即市场在满足其自身的峰值需求和所需的储备边际后留下的备用认可容量,以容纳新的负荷。在此基础上,根据我们对全国法定准备金率的分析,可用空间已接近于零,并于 2027 年变为负值。来源:SemiAnalysis 能源模型 因此,我们预计发电将成为并网数据中心负载增长的主要瓶颈(输电是另一个瓶颈,将成为后续深入研究的主题)。所有数据中心运营商都已经亲眼目睹了这一点:一家公用事业公司告诉您它可以满足 2027 年的负载斜坡计划,例如 500MW,但后来又说他们只能在 2029 年提供该负载,因为长期设备电网互连需要从主电力变压器 (MPT) 到高压断路器,在某些情况下,网络升级根本无法尽快实现。更糟糕的是,负担越来越多地落在买方身上:现在,为了确保并网电力的安全,开发商通常需要提供大量信用证、保证金,或签署照付不议的承诺,为为其负载而建造的发电设备提供资金。例如,Switch Datacenter 在 2026 年关闭了一项价值数十亿美元的履约信用证设施,以准确支持这些义务。在许多情况下,尽管承诺了数十亿美元,公用事业公司甚至不会因未按时交付而面临任何处罚。
立即订阅 这些发电和输电限制,加上市场激励不足,使得表后往往成为吉瓦级新建项目最具吸引力的解决方案。我们已经观察到,许多顶级开发商正在德克萨斯州规划 5GW+ 的表后设施,那里的现场天然气许可更容易。我们的数据中心模型非常详细地涵盖了这一点,将少数“真正的”5GW+园区与那些在幕后没有显示出可信发展迹象的园区区分开来。当然,这对 BTM 解决方案和提供商来说是一个物质推动力。然而,主要受益者并不是通常的嫌疑人。几个月前,我们率先提出了燃气轮机订单临时高峰的风险。请阅读我们的核心研究报告“电网电力不佳,BTM 良好”——燃气轮机订单峰值,独立发电厂面临挑战,但电网设备需求加速”了解更多详情。我们的新能源模型是预测和了解公司相对市场定位的最佳工具:我们跟踪制造能力、设备交付周期、安装交付周期、重大交易公告等。我们还深入报道了最近的二级市场发展,涡轮机可用性显着飙升。来源:SemiAnalysis 能源模型让我们深入探讨一下。我们的论点分为三个步骤,本报告按顺序逐一阐述:电网供应在结构上受到限制,这种限制将边际买家推到表后面,随着完全孤岛和混合 BTM 设置的市场增长,这种转变重新洗牌了设备 OEM 和 IPP 的赢家和输家。
首先,我们建立供应约束:利用新的能源模型,我们解释如何预测发电厂的新增数量、如何通过 ELCC 估计每种燃料的真实容量值,以及如何测量由此产生的电网净空。接下来,我们转向买家的决定:对于电力和计算的最大买家来说,BTM 与电网的相对吸引力(按用例细分)。最后,我们研究了它们之间的实际桥梁:ERCOT 中出现的混合主机代管结构(通过零批次流程进行编码)将现场发电与持续的电网接入相结合,我们认为早期的赢家正在形成。我们稍后对此进行更多解释。请注意,本文重点关注电网约束和表后解决方案,但还有其他选择,例如负载灵活性。这些将是未来深入研究的重点,超出了本次研究的范围。我们将在本文后面简要解释为什么我们认为 BTM 将成为优于负载灵活性等替代方案的突出解决方案。SemiAnalysis 是一份读者支持的出版物。要接收新帖子并支持我们的工作,请考虑成为免费或付费订阅者。预测发电厂:2028 年之前无天然气 我们对 40k 发电机的分析揭示了美国电网面临的核心挑战之一:未来两年市场上缺乏稳定的、可调度的容量。我们的铭牌产能预测显示,美国行业在 2026 年和 2027 年每年新增天然气量将低于 10GW,且增量只会在 2028 年及以后有所回升。
来源:SemiAnalysis 能源模型 为了实现这一预测,我们复制了我们的数据中心模型方法:它首先对施工时间表进行广泛分析,分析了数十万个经验数据点,并以实时卫星图像为支持。我们根本看不到足够的处于后期建设阶段的发电厂能够在 2026-27 年交付。2026-27 年的短缺不是一个瓶颈造成的,而是多个瓶颈造成的。首先,制度和队列摩擦:公用事业等关键电网利益相关者固有的缓慢性,以及过度拥挤的发电互连队列。在 PJM 中,队列本身不再是具有约束力的约束——转换是:大约 57GW 已完成研究并已提供或执行互连协议,但自 2020 年以来,约 24GW 已完全执行协议的项目(包括 13.5GW 天然气)在达到商业运营之前终止,这主要是由于许可拒绝、供应链延迟和无法关闭的融资。2023 年 1 月至 2026 年 1 月期间,仅许可就占了项目里程碑变化的 29%,而供应链延迟则占 23%(通过市场设计增强可靠性)。其次,技术组合不利于速度:公用事业公司订购的大部分天然气产能由联合循环燃气轮机和燃气轮机组成。正如我们在现场天然气深入研究中所深入解释的那样,CCGT 是燃烧天然气发电的最有效方式,但其构建速度是所有发电技术中最慢的 — 在某些 ISO 中,构建和从规划到 COD 的时间需要 4-6 年。
数据中心运营商正在积极地直接保护燃料电池和 RICE 等更快的技术,以进行现场发电。第三,供应链进一步延长了时间线。燃气轮机和发电机升压变压器的交货时间均延长至三到四年,而历史正常水平约为 18 个月。即使在乐观的假设下,这也将天然气发电厂的总开发时间从约 24 个月的基线延长到至少四年,而联合循环燃气轮机则处于 4-6 年范围的长端。最后,项目也可能因工厂本身以外的原因而延期,例如设备成本增加、社区阻力、劳动力可用性、融资问题等。可再生能源、存储和 ELCC 来源:SemiAnalysis 能源模型 当然,天然气并不是对美国电网重要的唯一燃料。正如我们的能源模型详细跟踪的那样,可再生能源和存储所占的份额正在不断增加。我们预计未来几年太阳能和 BESS 每年都会增加超过 20GW 的容量,如上图所示。然而,从网格的角度来看,它们的价值要低得多。如下所示,在 ELCC(有效负载承载能力(ELCC))基础上,它们的贡献很小。我们将在下面更深入地解释这个概念。来源:SemiAnalysis 能源模型 对于可再生能源来说,原因很简单。这些能源不仅是间歇性的,而且还高度相关。太阳能著名的“鸭子曲线”就是最好的例子。当您向系统添加更多太阳能时,添加新太阳能的边际价值会急剧下降,因为所有发电厂几乎在同一时间发电。
在 ERCOT 中,太阳能和风能的快速发展将两个价格信号拉向相反的方向,从而加剧了这一情况。4CP 窗口——6 月至 9 月期间设定下一年输电费用的四个 15 分钟间隔——过去常常位于下午晚些时候的负荷高峰。但随着可再生能源使白天的净负荷趋于平缓,它已经漂移到了晚上,更接近日落。限电高峰已进入当天晚些时候,此时太阳能发电量下降,净负荷急剧上升导致电网供应短缺。结果是电池必须承载更宽、更陡的夜间坡道,直到气体恢复为止。来源:SemiAnalysis 能源模型 量化这种随天气而下降的价值需要专门的指标。公用事业公司和电网规划者正是依靠 ELCC 的概念来做到这一点。ELCC 估算发电厂对整个系统的“真实”容量价值。它也是衡量市场中可用容量空间的有用指标:如果存在多余的 ELCC 容量,系统就有空间吸收新的大负载,因此数据中心可以互连,而没有它的市场则不能。这些实体从系统的角度考虑其资源,并且由于每个系统都是独特的,因此每种 ELCC 方法也是独特的。我们的能源模型如下所示,太阳能 ELCC 在各地区的多样性如何。让我们举几个例子来更好地了解 ELCC 的工作原理以及它在不同地区的差异。PJM 使用称为边际 ELCC 的复杂公式来计算不同能源的价值。
FERC 于 2024 年初接受了 PJM 向边际 ELCC 认证的转变,取代了之前火力机组的等效强制停电率 (EFORd) 方法和间歇性资源的平均 ELCC 方法,以及可以更好地捕获极端天气期间相关停电的每小时风险模型。有关 PJM 及其一些特殊性的更多详细信息,请阅读我们对 PJM 与 ERCOT 市场设计及其对家庭电价影响的深入探讨。立即订阅 不同市场的方法论差异很大。MISO 根据其新的季节性资源充足性结构对资源进行季节性认可,反映了夏季与冬季稀缺风险集中程度的不同; ERCOT 是一个没有集中容量市场的纯能源市场,依赖于可靠性标准及其自身的有效容量衡量标准,而不是集中的 ELCC 认证。实际结果是,根据 ISO 的不同,相同的太阳能或存储资产的记账方式可能会有很大不同。ERCOT 说明了极端情况:在一些拥挤的区域和隔离的输电走廊中,规划者现在将太阳能的容量贡献完全排除在当地可靠性模型之外——这是一种事实上的“无太阳能情景”,在确定公司容量需求时,将太阳能增量基本上归零。到目前为止,一切都与太阳能和风能有关。存储是可再生能源建设的另一半——那么 BESS 又如何呢?我们的预测表明 2 小时和 4 小时 BESS 的渗透率不断上升,其 ELCC 值自然高于 1 小时。
持续时间较长的 BESS 在遇到限制时有更大的空间为系统提供缓解。来源:SemiAnalysis Energy Model 然而,存储也从根本上受到边际 ELCC 下降的影响,并且持续时间的增加并不能改变这一事实。原因是给定的 BESS 持续时间解决了电网的特定痛点:例如,4 小时 BESS 提高了持续时间为 4 小时或以下的事件的电网可靠性。但随着更多的 4 小时 BESS 添加到系统中,<4 小时的电网风险就会消失,从而降低增量 BESS 的价值。电网可靠性风险转移到 >4 小时事件,必须通过其他燃料来解决(或通过 8 小时以上 BESS,最初具有高 ELCC,但随着 8 小时事件风险降低,ELCC 会再次下降)。因此,在当今大多数电网上,增量 4 小时 BESS 几乎不会增加边际 ELCC。资料来源:SemiAnalysis 能源模型 我们的观点并不是可再生能源不重要,它们现在是、并将继续是人工智能建设的重要组成部分,只是不是最重要的部分。铭牌严重夸大了它们对公司容量的增加:在 ELCC 的基础上,随着其解决的风险饱和,太阳能、风能和存储的每增量 GW 都会获得大幅且不断扩大的折扣。铭牌容量和认可容量之间的差距正是决定市场实际可以承载多少新负载的因素——这是下一节的主题:电网净空。
到 2027 年,美国电网净空将变为红色 电网净空是指市场在满足自身峰值需求和所需储备裕度后剩余的吸收新负荷的容量。我们根据当地认可的供应和储备要求,逐个分区(每个 ISO 和大型非 ISO 市场)对其进行建模。当市场的准备金率低于其要求的目标时,净空就会变为“红色”:此时,没有多余的认可容量来承载数据中心等增量大负载,而不会降低可靠性。我们的分析表明,在越来越多的次区域中,到 2027 年将跨越这一门槛。来源:SemiAnaanalysis 能源模型 从根本上说,净空计算很简单:总认可供应量减去峰值需求,再减去所需储备。举一个活生生的例子,PJM 的 2027/2028 年基本剩余拍卖清除了约 134,478MW 的非强制产能 (UCAP),与 20% 的目标相比,产生了 14.4% 的储备裕度——实际赤字约为 6,517MW UCAP。这种压力并非 PJM 特有的:NERC 的 2025 年长期可靠性评估将 23 个北美评估区域中的 13 个标记为在未来十年面临资源充足性短缺。所需储备是一个监管工件,由电网规划者或垂直整合的公用事业公司根据地区设定,并且可能逐年变化,但往往相当稳定。储备裕度通常有两种类型: ICAP 储备:ICAP 表示已安装容量,是铭牌容量的代表。
ISO 的一个相当常见的要求是需要 15-20% 的 ICAP 储备。例如,PJM 将其容量要求调整为十分之一的负载损失预期 (LOLE) 标准,该标准目前相当于约 20% 的装机储备裕度 (IRM) 目标。资料来源:SemiAnalysis 能源模型 UCAP 储备:对于真正的净空计算来说最关键……但有时也会受到 ISO 和公用事业公司政策的影响。UCAP 表示认可容量,包含可调度发电的故障风险以及存储和可再生能源的 ELCC 值。由于它消除了热力机组的强制停电风险以及太阳能和储能的 ELCC 大幅折扣,因此 UCAP 的净空余量观点实质上比 ICAP 观点更严格——而且 UCAP 的情况首先变红。请注意,估计真实的净空比这更复杂。公用事业公司本身通常很难了解其净空,而最聪明的数据中心开发人员可以通过找到“隐藏”的净空来成功驾驭环境。我们将在未来的深入研究中更深入地探讨这一点。为什么 BTM 胜过并网:时间线的速度和确定性是关键 由于电网供应受到结构性限制——固定容量太少,可再生能源和存储的有效容量太少,以及不断消失的空间——现在决定权在买方。我们认为 BTM 现在是最具吸引力的选择。这一声明可能会让一些利益相关者感到震惊,但我们的观点基于需求的基本驱动因素:AI 实验室。
OpenAI、Anthropic 等公司现在直接但也经常间接地占据了大部分需求,因为它们代表了亚马逊、微软和甲骨文等公司增加的数据中心容量的很大一部分。我们的代币经济学和数据中心模型都对这一季度进行了量化,并成功地在头条新闻之前发现了重大交易和转变,例如 Anthropic TPU 的崛起和 Oracle/OpenAI RPO 的激增。BTM 与 Grid 相比的主要优势是电力时间线上的速度和确定性。就速度而言,现场发电可以在电网互连时间表的一小部分内启动——要求的 BTM 投入使用日期集中在 2027-28 年左右,而电网时间表通常会推迟到 2030 年。可以肯定的是,时间表掌握在买方而不是公用事业公司手中。正如前面所解释的,公用事业公司提供的时间表是出了名的不可靠,他们经常推迟或修改他们向数据中心运营商承诺的负载……几乎没有处罚。这对于AI 实验室来说并不适用,因为获得大规模计算是其业务的命脉。他们需要电力来产生收入(推理)和推动未来收入增长(培训)。此外,正如我们在 AI 云 TCO 模型中深入介绍的那样,功耗占总 TCO 的百分比几乎微不足道,这意味着 AI 实验室获得的任何电量实际上都价值数十亿美元。
例如,我们的代币经济学模型订阅者非常了解 Anthropic 目前在 API 上赚取的利润,以及每吉瓦隐含的数百亿美元的年收入。考虑到千兆级数据中心的成本和收入潜力,如果它面临多年延迟的风险,或者负载服务实体不会因延迟而面临对称的美元处罚,那么它根本行不通。在电网与 BTM 的争论中,另一个关键因素是冗余和正常运行时间,这在历史上是电网提供的主要优势。正如我们在数据中心电气系统深入研究中所解释的,达到五个 9 的正常运行时间的策略很简单,分为两个步骤:首先,连接到具有 N+1 冗余的变电站,根据假设,变电站本身可以提供大约三到四个 9;然后添加可满足 100% 以上铭牌负载需求的备用电源(备用发电机和电池),将差距缩小到五个 9。然而,AI 实验室和一些超大规模云服务商已经放宽了这些要求,因为现在推理和训练(而不仅仅是训练)的正常运行时间容忍度较低。例如,Meta 的许多自建人工智能数据中心仅以两个九的正常运行时间为目标,并完全放弃备用发电机,如我们的工业模型中所详述。来源:Meta Prometheus 数据中心没有发电机组; SemiAnalysis 工业模型 这消除了采用 BTM 的历史成本障碍。正如我们在现场天然气深入研究中提到的,成本超支的主要挑战和驱动因素是冗余和可靠性。
电网在宏观层面上管理这一点,而现场发电厂必须为了单独为一个(大型)数据中心提供服务的更狭隘的目的来做到这一点。在 BTM 站点提供四个或五个 9 的冗余会带来难以承受的成本。但现在客户愿意接受较低的冗余,网格与 BTM 的经济性更加平衡。然而,实践有所不同——一些运营商将发电机组添加到他们的 BTM 到 FTM 桥接构建中,而许多运营商在并网数据中心上完全省略它们。我们认为,如果您计划在不久的将来连接到电网并且可以在其他地方重新部署发电设备,或者您正在探索并网 BTM 解决方案(稍后会详细介绍),那么添加发电机组是有意义的。大多数 BTM 站点并不打算永远处于孤岛状态;当互连队列清空时,它们是网桥。然而,如果队列预计会清除(比如从今天起 5 年后),则很难证明备用发电机组的资本支出约为 1mm/MW 是合理的,特别是因为一旦人为因素和恢复时间故障(而不是电源中断)真正主导停机时间,实现的正常运行时间增益约为 9 个数量级。最终,决定取决于租户的设计要求、SLA 以及站点预计脱离电网运行的时间。我们已经看到以下情况:BTM 是一座短桥(大约需要两年或更短的时间才能实现互连),运营商倾向于在初始建设和项目融资方案中指定发电机组,因为电网通电和随后的备用角色就在眼前。
如果一个站点期望长时间脱离电网,或者实际上永久脱离电网,那么这个理由就会减弱:主要现场发电已经以其自身的冗余来承载负载,因此闲置多年的电网备份堆栈值得推迟资本支出。Meta 是最明显的例子 - 其俄亥俄州园区的设计永远不会连接到 PJM 电网,其埃尔帕索和路易斯安那州站点是围绕专用的公用事业规模天然气而不是近期互连而建的。我们了解到 Cipher 的 AWS 租赁 Black Pearl 站点和 Fluidstack 的几个扩建项目都遵循类似的逻辑,完全推迟或跳过发电机组作为电网备份路线。现在,这一切并不意味着电网正在被淘汰,并且数据中心的正常运行时间和可靠性要求不再重要。相反,它反映了我们对市场参与者如何适应人工智能数据中心猖獗的电力需求的看法——我们认为租户对这些要求变得更加宽松,因为他们无处可去。此外,还有许多有前途的解决方案可以使电网吸收更多的数据中心负载增长,我们相信这对所有人来说都是最好的结果:每个人的电力成本更低,可靠性更高。以下是今天文章范围之外的一些解决方案: 负载灵活性:如果并网 DC 每年可以减少一定的小时数,则可以轻松释放数十吉瓦的电力。
PJM 将这种灵活性具体描述为工作负载转移、现场备用发电调度和电池放电,并指出它可以在新一代清除互连队列和供应链的同时弥合差距——只要它集成到市场调度中,而不是在紧急情况下只能通过手动操作来访问。然而,鉴于商业和监管限制减缓了广泛采用,我们在短期内仍保持谨慎态度。这个主题值得整个半分析专门深入研究。互连队列和市场激励改革:更加资本主义的电力建设方式可能会引发公用事业公司更多的冒险行为。但保护美国家庭和定向押注人工智能增长之间的优先事项之间的平衡极其艰难。我们预计短期内不会发生足够大的变化。PJM 的挣扎最能说明这一点:各个利益相关者无法就最佳解决方案达成一致,最终导致整个过程比原来更慢。也就是说,已经出现了改革的早期迹象。FERC 首先在需求方面采取行动:其 2025 年 12 月的命令指示 PJM 为发电厂数据中心制定明确的主机代管规则和新的传输服务,并且在 DOE 的指导下,它就 20MW 以上大型负载的更快互连制定了规则(Docket RM26-4)。
此后,PJM 的电价也随之而来:2026 年 6 月 12 日,FERC 接受了建立快速互连轨道 (EIT) 的修订,这是一项为期约 10 个月的加速发电机互连研究过程,旨在在 2027/2028 年基本剩余拍卖清除了约 6.6GW 的电力,低于 PJM 的可靠性要求后的近期资源充足性。ERCOT 转向批量式大负载互连流程是另一种带来更多秩序的尝试。我们将在即将到来的深入研究中深入研究这两个方面,以及一个负载跟踪器,该跟踪器跟踪我们希望在批处理过程中确定的数据中心负载。更新的输电建设:建设更多的输电可以实现更多的发电和负荷增长,但该市场仍然过度监管且缓慢。我们认为,随着最大的电力承购商变得足够有信誉(能够提供母公司担保)以承购和承保整个输电项目,到 2030 年代可能会出现重大输电建设。但就目前而言,建立新的批量传输对于人工智能建设的步伐来说太慢了。实际上,只有少数美国输电走廊能够在物理上支持如此规模的负荷增长,而在必要的时间表上满足 NERC 的可靠性要求本身就是一个具有约束力的约束。所有这些主题都将在未来的 SemiAnalysis 能源深入研究中涵盖。敬请关注。
ERCOT 中桥接 BTM 和电网互连的混合结构以及可能的赢家为了应对有限的电网空间,市场正在选择一系列混合结构(特别是在 ERCOT 中),这些结构将现场发电与持续的电网接入相结合,这也是我们一直观察到的大量交易活动和兴趣的领域。监管机构正在竞相制定规则,联邦层面的 FERC、德克萨斯州的 ERCOT 和 PUCT 都在快速更新其框架。在 ERCOT 中,批零过程正在对这些结构进行编码。其核心是每个大负荷都有一个数字——最大提款限额,即站点可以从电网中提取的金额,与任何现场发电无关。治理框架(NPRR1325 和 PGRR145,由 ERCOT 董事会于 2026 年 6 月 1 日批准并于 7 月 11 日生效)在长期建立的专用网络 (PUN) 旁边添加了两个新的主机代管结构。理解景观的最简洁的方法是将这些结构回答的两个问题分开:站点如何与电网互连和计量(作为 PUN、WLPUN 或 PCLR),以及它如何获取电力(来自 NMA 下的现有发电,BYOG 下的新建发电)。我们依次进行。为您的数据中心 NMA(网络计量安排)供电 — 从现有一代采购。
一台已经运行的发电机与一个新的大负载并网,负载在单表后面根据其现场输出进行,因此只有剩余部分(负载消耗高于并置机组供电的部分)根据电网进行结算,任何剩余部分都会输出。其决定性特征是老式的:发电机在 2025 年 9 月 1 日(德克萨斯州 SB6 的法定触发点)之前就已经运行。这使得该安排通过 ERCOT 的净计量安排流程(PUCT 项目 39169)和 120 天的传输安全评估接受监管审查。ERCOT 研究系统影响 - 包括将容量从电网中拉出以服务负载的影响 - 并且 PUCT 可以批准、拒绝或调节安排,例如要求在电网紧急情况下削减负载或要求发电机在系统紧张时提供可用容量。由于发电已经存在并且已经在支持电网,因此核心监管问题是将其重新指向私人负载是否会使系统的其余部分保持完整。迄今为止,已宣布的大部分 ERCOT 主机代管活动都属于现有一代。以下是一些数据中心示例 - 主机代管领域报告的项目大约为 2,885 兆瓦,除此之外可能还有更多项目。Crusoe — Goodnight 园区(净计量安排) 来自同一 POI 的两个负载共置协议(265.5 MW + 260 MW = 总计 525.5 MW)预计将为约 1 GW IT 园区提供服务。
Crusoe 还拥有高达 933 MW 总铭牌天然气发电量的 TCEQ 空气许可证备案,其中约 665 MW 是 19 台 GE Vernova LM2500 涡轮机(每台约 35 MW) AWS — Comanche Peak(净计量安排) 1,200 MW 位于 Vistra 科曼奇峰核电站(萨默维尔县)附近的同地负荷; 20 年购电协议,到 2032 年达到满负荷。CyrusOne — Thad Hill 能源中心(净计量安排) 两期 — 190 MW(一期)加 210 MW(二期),总计 400 MW — 毗邻 Calpine 的 Thad Hill 发电厂(博斯克县)。CyrusOne / Constellation — Freestone 能源中心(净计量安排)760 MW 园区潜力(已签约 380 MW,具有第二个 380 MW 阶段的独家选项),通过 Calpine/Constellation。BYOG(Bring Your Own Generation)——从新一代采购。大型负荷不是等待电网升级来满足其全部负荷要求,而是构建、共同开发或承包新的并置发电,以确保近期的通电路径。
ERCOT 在三个平行轨道上评估该项目:批量研究设定电网提取限制(现场可以独立于现场发电提取的限制),发电互连设定输出限制(现场设备可以推回电网的限制),输电规划确定所需的任何网络升级。因此,该站点可实现的负载是其取电限制加上可用的现场发电量,受系统稳定性限制的影响,并且相应地进行通电:该站点从第一天起就达到其取电限制(例如 100 MW),并随着每个发电机组上线而逐渐达到满负荷。与 NMA 的区别在于类别和年份 - BYOG 描述了站点如何通过添加自己的新建一代来获取其电力,并且由于该一代是新的,因此它位于 SB6 的网络计量审查之外。资料来源:ERCOT 批量研究研讨会第 8 期 - 2026 年 5 月 4 日 计量和连接数据中心 专用网络 (PUN) 将整个园区(负载及其位于同一位置的发电设备)置于单个互连点后面,因此 ERCOT 仅计量站点与电网的净暴露,而不是每个单独的资源。在此基础上,零批次引入了两个新的结构: 撤回限制专用网络(WLPUN):自带新一代的负载可以连接比单独输电所能支持的更多兆瓦的电力,以换取对电网撤出的强制上限 - 例如,1,000 兆瓦的负载永远不会从电网拉动超过 100 兆瓦,其余部分依靠其现场发电,并通过 SCED 输出任何盈余。
ERCOT 明确表示这不是更快的互连;这是一种在现有传输限制内更快地为更多所需负载提供能量的方法。资料来源:ERCOT 批量研究研讨会 8 – 2026 年 5 月 4 日 临时可控负载资源 (PCLR):无需现场发电的可调度、灵活负载。它按照其全部请求的大小进行连接,但 ERCOT 可以在传输限制期间(例如,150 MW 负载回落至 100 MW)实时调度它,随着传输建成,上限将放宽到定义的退出日期。这使得 PCLR 成为明确的桥到公司路径。幕后崛起的赢家和输家现在让我们把注意力转向赢家和输家。我们将讨论 GEV 等涡轮机制造商、Bloom 和 INNIO 等燃料电池和 RICE 供应商以及 NRG 等 IPP。我们于 2024 年 12 月首次称 Bloom 为 Core Research 订阅者,称其为最大受益者。阅读更多
本期围绕理想全新 L8 上市后的产品定义、发布策略、价格带和品牌传播展开。几位主播的核心判断是:L8 这次在产品定义上做了一个真正有成本、有价值的选择,即为五座场景重新优化车身和空间,而不是简单把六座车删掉一排座椅;但理想在发布会和传播中没有把这个优势讲透,反而把重点分散在操控、配置、设计哲学和复杂的 SKU 叙事上。相比 L9 的发布,L8 的讲解确实更完整,也更努力地区分 Ultra 与 Livis 的用户价值,但上线后的声量没有达到预期,说明问题不仅在单场发布会,而在品牌势能、社交传播和用户心智已经发生变化。
节目开头先讨论 L8 与 L9 相比的发布策略变化。肉呆认为,L8 的声量和 L9 Livis 的销量都影响了理想的策略调整:这次理想试图把车型差异、版本定位、舒适与操控的价值讲得更清楚,也安排了更复杂、更完整的发布会结构。于欣烈和周浩然则把注意力放在“原生五座”这件事上:L8 不是简单缩小,而是在五座需求下重新优化空间,第二排体验甚至可能比 L9 更明确;这是一种高成本、体面的产品规划,但理想没有把它转化成最有杀伤力的传播语言。
围绕发布会执行,老编辑和肉呆批评理想长期学习苹果带来的克制表达。老编辑把这种状态概括为一种“性缩力”:苹果可以依靠既有品牌与用户认知做极简叙事,但理想当前并不处在同样强势的位置,不能只讲设计哲学和细节变化。肉呆则觉得脚本显得老气,很多梗和表达没有匹配 L8 这款产品应有的年轻感与活力。节目也提到媒体邀约被拆分、发布会素材重复使用、传播周期内声量偏弱等问题,认为这削弱了信息扩散效率。
在产品价值层面,周浩然强调,五座车本来就应该比三排座车更短、更聚焦;L8 如果用新的白车身、在车长缩短的同时保留甚至强化后排空间,这本身就是非常强的卖点。相比之下,把“小”主要落到操控上并不完全成立,因为车重、轮胎等因素决定了 L8 未必会比 L9 在极限操控上强很多;真正可感知的优势反而是车身短了、空间没缩水、五座使用场景更纯粹。老编辑进一步把它放到价格带里看:L9 需要在 50 万以上建立品牌制高点,L8 又要同时承接更低价格带的竞争,因此 Ultra 与 Livis 的弹药分配、用户情绪价值讲法都变得很难。
后半段转向品牌问题。老编辑认为,过去理想车主愿意把车开回家让亲友猜价格,这种“空间、座椅、配置、价格”带来的惊喜本身就是社交传播;但当设计与表达过分克制,社交网络传播也会被压住。于欣烈补充说,理想仍然擅长产品定义,L8 的二排零重力座椅、五座空间和未来 AI/OTA 功能都有机会重新制造价值感,只是这些东西需要更强、更直接的叙事。肉呆最后指出,当前大车市场整体变难,竞品也在用空间和场景做文章,理想的品牌影响力示弱后,用户会出现两极化反应:有人觉得价格太贵,也有人觉得已经很拼。真正的问题是,很多潜在用户只觉得“还行”,却回答不出为什么一定要买理想。
1. L8 最大的产品优势不是单纯“更小”或“更运动”,而是围绕五座场景重新做空间与车身优化。
2. 理想没有把原生五座的高成本、高价值选择讲成一个足够强的传播卖点。
3. L8 发布会比 L9 更努力地区分版本定位,但脚本、素材和表达方式仍显得老气、克制且分散。
4. 学苹果式的极简与细节叙事在理想当前品牌势能下不一定有效,甚至会限制社交传播。
5. L9 要守住高端心智,L8 又要承担更低价格带竞争,导致理想在版本与价格策略上非常被动。
6. L8 Ultra 的舒适家庭价值和 Livis 的驾驶/情绪价值都存在,但发布会没有充分放大各自的用户故事。
7. 当前理想最大的风险不是单款产品失败,而是品牌影响力变弱后,潜在用户只觉得“还行”,缺少主动推荐和购买理由。
8. 理想未来仍可能依靠产品定义、AI/OTA 和明确场景价值重新制造爆款,但前提是重新讲清楚用户为什么爱它。
- L8发布策略与原生五座价值 [00:00:00 - 00:15:00]
- 发布会传播与脚本执行问题 [00:15:00 - 00:30:00]
- 原生五座的产品定义与价格带取舍 [00:30:00 - 00:45:00]
- 品牌势能、社交传播与价格分歧 [00:45:00 - 00:57:23]
于欣烈:这期节目是理想全新L8上市点评的上集。我们聊了包括发布会在内,L8宣发策略与L9相比发生了哪些变化,效果如何。 [00:00:00]
肉呆:L8的声量和L9 Livis的销量,我觉得受到这两个的影响,它调整了,我个人觉得会调整得非常好,而最关键的一个话题是,理想究竟有没有说清楚
于欣烈:L8作为一款原生设计的五座SUV 最大的优势是什么,为什么一个关键优势,反而没有去讲清楚,理想这一次L8上面,这个原生五座这一点
周浩然:我觉得其实是可以大讲特讲的,但是在我们国家,现在的汽车市场的消费趋势来看,它真正意义上的优势,它不能主推
于欣烈:而讨论全新L8的产品和定价策略时,老编辑,一个曾经的理想黑,开始理解理想了,但同时他又认为 [00:01:06]
老编辑:理想引以为傲的学习苹果,反而是这家公司最核心的问题,整个理想的营销,从上到下体现了一种性缩力,这个性缩力,我这样讲,就是长期在意识形态当中,学苹果造成的,就苹果也有种性缩力,你发现没,但是苹果是苹果,它可以性缩,你不能,就真的是,你手里就这么多牌,你要干什么的事,两个罐盖三口锅,那只能盖成这个样子,这是我觉得我理解他们的,不得已而为之的,但是从主观上来讲,我觉得理想的最核心的问题,还是学苹果这件事情
于欣烈:在全新L8上市点评的下集,我们会更深入地讨论,目前理想的一大挑战是品牌问题,如果全新L8首发,而不是全新L9 能不能解决品牌的问题,L 系列的产品线又应该如何调整,理想本人和理想公司,可以做出哪些调整,去建立一个更强有力的品牌,好我们开始吧,今天6月24号,理想全新 L8上市的第二天,我们聊一期上市点评,大家简单介绍一句自己,然后让听众熟悉一下声音。然后我们就开始吧。大家简单介绍一句自己,让听众熟悉一下声音。 [00:02:40]
肉呆:大家好,我是肉呆,我是理想坚定的支持者。
周浩然:哈喽大家好,我是周浩然。平时说中文比较少,在望远镜 Telescope 一般是说英文,难得说中文,我也就在你的节目里面长时间说中文了。
老编辑:大家好,我是老编辑,很高兴来到你的节目。
于欣烈:OK,咱开始聊 L8。简单问一句,因为几位其实都试车、摸车了,对你们来说有没有被打动的那一下,具体感受有吗?因为几位其实都试车了,都摸车了,对你们来说,有没有被打动的那一下,具体的这种感受有吗,有的,我觉得,我觉得最打动我的就是空间 [00:03:07]
肉呆:就是它是小个的理想L9 Lilith 但是我其实挺喜欢 L8 Ultra的,就是我真心话,我挺喜欢L8 Ultra的,一个是它的空间,第二个就是,我不需要这么多东西去,怎么说,去增加这个我驾驶的这种负担,这个负担指的就是,我好,我是不是要先这个适应一下,它的新功能,新那种,不用 L8 Ultra直接,这个上手就行,并且我一直想要一个大五座的SUV 这个L8 Ultra正好,所以我觉得这个,就挺吸引我的,来好人
周浩然:我想起来了,我本来说上个月,那个什么录,那个什么阅读时候,我说我要控诉一个什么,后来时间拖太久,我忘了控诉,你说我摸过车了吗,我是拍过静态,理想没有邀请我去动态的时刻,我不知道为什么,然后这个之前L9也是,当然L9那个时候,有一点客观因素,然后后来我L9是 Livis跟Ultra我都借了,然后去试了一下,然后L8我就当静态试过就试过了吧,动态我就暂且当它一个,稍微灵巧一点的L9 我看了L8的定价之后,我会觉得L9是不是理想,想要称一下品牌,因为我没有想到,它的差价会这么大,我以为因为L8说实话,你真的觉得它比,就是我觉得为什么,大家现在对L8可能反响,要比L9要稍微好一些。部分原因可能也是,觉得它比L9没有少什么太多东西,但是它价格低了那么多,哪怕你就是买Livis 好像李翔很在意这个发音 Livis对Livis 它也便宜了非常多,但是你确实,我觉得它确实做到了,就是你进到L8之后,你会觉得,好像什么都没有少,的这种感觉,除了它是个五座,然后五座就像刚才肉呆讲的,这对于很多人来说是个优点,我觉得大家对L8反响比较好,我觉得是实至名归的,所以打动你的是性价比,东西都有,价格下降这么多,对就是它比,这个一会儿讲,它那个什么原生五座的时候,我在具体展开说为什么,就是理想在这个车上面,不太像是一个,就是可能以前大家觉得。抠厂啊,或者就是很多这个成本,为了成本去,共同去摊销啊,就没有单独去开一些新的东西啊,什么的,这个车各方面做的都是比较体面的,就是从工程上来说啊,就是如果你要,或者说换句话说,这辆车你看得出来,它当初立项的时候,理想非常有钱,所以该开发的都开发了,就各方面都很体面,是一个真的就是,就是他说他是五座旗舰,确实是五座旗舰,之前的L7 它不是五座旗舰,之前L7其实跟L9还是有一些差别,你能知道它为什么它是个L7 这次也是他们整个L产品线的全新的战略,经典SKO 来老编辑聊两句 [00:05:47]
老编辑:你对车的这种感受和体验,我接着周浩然刚才说,他说L9为什么没有邀请他去动态,我最近总结出来理想邀请媒体的,他们的一个工作方法,就是不会邀请同一个媒体,参加一个车型的连续两场,比如说他邀请你参加现场发布会,他可能就不要请你参加动态,他邀请你参加动态,他就不要请你参加现场发布会,就是他们可能在,在希望一个车型的报道过程当中,把这个要求名额的使用效率最大化,这我自己也发现了,就是拿我跟小戴尼,因为我今天发现他,他去发布会现场,然后我是线上的,但是之前我去,我去动态开L8 Livis的时候,他说我没有收到邀请,然后我们就俩就在那个,当时在那个,但是有一场,我们俩都被邀请了,就是那个,就是 Livis的那个现场发布会,然后我们俩就在那合计。我们俩在那合计说,为什么李小时这个邀请状,后来我们一对一下,最近的行程,总结出来是这么回事,当然我说这个,不是为了替你晚尊,我在说,我在引入了说 Livis的现场发布会那天,我们在,我们几个媒体人,当然德鲁也在,小康也在,小丹妮也在,然后我们就,就两尾阿八Livis嘛,大家都说这个车,然后觉得不知道怎么卖,然后我说,就定了个合适的价格,就可以卖了,然后他们就说,你觉得合适价格多少,我说合适价格是比,然后就Livis便宜10万,便宜10万这个车就好卖了,然后当时除了说这个之外,我还加了一个限定条件,我说如果真的想守住 40万这个心理门槛的话,因为你毕竟,你想对自我认知,是一个豪华品牌,而未来有两个大车卖得非常好,那我希望在40万。有一张牌去跟未来抗衡,包括跟华为抗衡,那怎么办呢,你应该把L8的Ultra版定的价格稍微高一点,就离Livis够近,当然我说黄金价位是三万块钱差别,当他俩只差三万的时候,你会直接选择L8 Livis 以我当时对理想的战略上的判断,我觉得是应该这么定,但实际上大家发现不是这么定,是Livis贵了一万 Ultra便宜了两万,这证明什么呢,就是L8 我在做理想动态试驾的时候,我做那个判断就是,如果说你想让L8 Ultra走量的话,你就要往40以内狠狠地炸,狠狠地炸,所以现在的情况就是 L8 Ultra往40以内狠狠地炸了,那就是理想对于这个,就只能说理想内部对于这个事情的评估,就是守L8 Livis的重要性,没有守L8 Ultra的重要性级别高。这个我不知道为什么,过去理想不会这么想的,现在理想为什么会这么想,很有可能是销量,受到对手蚕食太严重了,他需要通过一款车,同时去向下手小鹏JX 向上手未来的ES8 而且ES8马上出五座版,大家看到23号L8 Livis发布会前一天,未来发了ES8五座版的,提前泄了一批消息,就它35.98万这个价格,相当于是,它卡在这个位置是好在哪,就好在它能把GX的顶配合 ES8的五座版的价格全守住,所以这个我觉得就是从,它不基于理想本身的逻辑去定价,它基于市场竞争去定价,这个事情你从好坏两方面都可以去理解,好的方面理解就是,理想对于这个市场的反应,它更加敏锐了。它没有那么多包袱了,说我又要守正,我又要守难,没有这个,这不是好事,但是坏事是什么 L8 Livis跟L8 Ultra的价格,差了太大,这拉的太大,它是对整个产品线不利的,为什么呢,就是一方面是,我在之前,前年的时候,提那个L 理想最危险的时候,就提那个价格穿插,就是你一次长射阵排开,然后每个价格,每个产品线中间,有5万块钱的价格带,那对手在里面穿插非常爽,我就定你两个,配置中间的价格,然后我用低配的报名成本,去提供高配的近似的产品体验,那你就没法跟我打了,对不对,这相当于现在,你现在42 37的定价,中间又是6万块钱的 42跟36之间的定价,有6万块钱的价格差,这6万块价格差中间,在正中间对手定一个位置,定一个价格带,给你主动选价。对吧,给你提供类似的产品体验,你怎么办,然后你就会导致你上面,而且用户他的心理是非常微妙的,在40万以内的价格带,其实用户是大概两三万一个档,两三万一个档,在30万以内是一万一个档,一万一个档,在20万以内是5000块钱,他就可以分一个档,所以在这种情况下出现什么呢,既然很多用户觉得,我35、6万能够买到L8的Ultra 那我就应该38、9万能买到Livis 是不是道理,就在今天在中国的整个汽车行业,它的常识是什么,是你的编辑成本,就是你的物料成本,你给我提供,你的配置的报目成本,是三万块钱,那你这个配置加上去之后,你就只能给我加三万块钱的价格,不存在像过去的汽车行业是,奔驰宝马,我给你加了个两万块钱,报目成本的东西,我给你收你十万块钱。对不对,就这个东西就是好处是,你把Ultra定到了,这个价格,有利于你对小鹏GX 跟ES8的五座版,做出反应的,它是一个短期的工坊策略,长期来看,它其实把L9掉到那里,你现在 L8 Livis现有的价格,已经把,已经把L9掉到那里,你更渴望L8 Ultra现在这个价格,整体用户对你的预期,都向下会压两层,他觉得你现在肯定没有降到位,是不是,你既然你Ultra可以定到 35万9千8 那你Livis 他觉得你Livis 你的L9一定也能往下压下来,所以我觉得这个其实是,我在这次发布会前后,反正我相当于从这次定价当中,我接收到的信号是这样,就是理想在更坚决地,跟住市场竞争的趋势 [00:11:58]
于欣烈:而放弃了自己过去坚持的很多东西,顺着老编辑这话,咱们就开始第一个话题,其实它侧重于Ultra 已经在最开始就能够看到一些迹象了,包括理想发布的讲车视频,就是他们从最开始讲,跟L9是完全不一样的 L9他们只强调Livis 说什么都是L9 Livis 根本不提Ultra这个事,只是在发布会最后结尾,说了有这么一个版本,但是从L8开始,不论是理想讲车,还是它整个发布会,它给Ultra分配的比例,是非常高的,他们不再强调Livis这个版本,待会咱们可以大家说一下,你们认为背后的原因,一种说法当然是因为 Livis 它的市场反应,让理想有了新的变化,另外,我也是认为,刚才老编辑说了,这个穿插,包括L8 Livis和Ultra 拉得很开。我觉得他们,这次做了一些平衡,就是加了一个,巨神智能,套装的选配包,实际上,它多了一个SKO 它在中间插了一个,一个车型,它只不过没有,把它装一个版本,我觉得这也是,它这次做的一个弥补,那咱们就顺着劲来,肉呆,简单聊聊这次你觉得 L8跟L9 整个的发布的策略的变化,包括理想专门提前的会讲车,包括不突出Livis 包括这么复杂的一个上市发布会,你觉得,它是为了解决之前哪些问题的呢,就是你觉得这件事做的不好的地方 [00:13:46]
肉呆:通过这次改变来把它解决了,我觉得发布策略变化,一定是受L9 Livis的影响,就是包括L9 Livis的声量,和L9 Livis的销量,我觉得受到这两个的影响,它调整了,我个人觉得会调整的非常好,它L9当时就应该这么去说,但是如果这么去说的话,势必会带来一个问题,就是它的这个发布会的时长,肯定会延长,你像那一个车,我们就可以这么想,你要讲那个两款,这个不同手机型号 Pro和标准版,那都得差不多得有个 45分钟左右 [00:14:21]
肉呆:45分钟左右,它还是这个每年更新的这个频率,它都要45分钟左右,那你一辆车呢,我估计这个时间线要double 但是double的话,它整个成本它就carry不住,所以就是在这个L9 Livis上面,可能理想他们做了个取舍,但是L8 Ultra就是很对的,就是我先告诉你,我有充分的时间告诉你,我这两个这个怎么说,我这两款产品,或者我这两个东西,他们具体,我们对它的定位是什么,该有哪些用户应该,你更专注于哪些东西,就去买哪辆车,我觉得这个挺好的,包括最后的B单什么的,我觉得都做得非常好,但是好的说了,也要说个但是,就是这一次的发布会的声量,其实没有比我想象中的要低一点,要弱一点。包括我们现在看已经快到24小时了,整个这个24小时的这个传播,黄金传播周期,咱们72小时这么分开算,第一个传播周期,来看的话,并不是特别高,它要比L9 当时还要低一点,所以这个其实对于理想来说,我个人感觉应该是个挺危险的情况,我已经做了这样的改变了,我已经把事情讲透了,为什么对于这个,互联网这种营销,或者商量上来讲还是这么弱,我自己其实是没有答案的,我也想问问今天的大家,就是为什么会出现这种情况,包括我们看线下的声量,好像也并没有完全起来,像最起码像做到未来ES8那种,我觉得有点吃力,所以我不知道是,这个今年的汽车市场整体遇冷。还是说它哪方面没有做到位,那总之就是我们看线下的数据,很诡异,诡异到让我觉得,是不是我们哪个统计接口出问题了,但是反反复复去验证,就发现它确实是,怎么声量好像并没有,大家想象或者达到我自己,之前预想的一个预期,我目前还没有个答案,然后我再说另外一个,事情就是我印象比较深,在那个发布会的时候,他们放的那几支片子,就是有几支片子呢,是前两天,那个AI Day的时候,已经放过了,给我的感觉就是越来越像那个 AI Day是硬加出来的那个感觉,本来不应该有,或者本来他们没有准备,但是就是这么,放到这上面了,这是一个我自己的一个小观察,还有一个问题呢,其实就是老编你刚才说的。我对这件事情不是说有怨言,但是我感觉现在说了好像有咱们几个抱团取暖的,那个感觉,确实是要说,他不应该这么分开把媒体,就是你比方说体验静态的,你不用去动态了,出了动态的,你就不要去香港发布会了,我觉得这个是,是受到这种营销费用不足吗,还是活动经费不足导致的,但是这种分开,并不会让这个信息的扩散,起到这种最大化扩散的作用,反而会有一些人,因为没有这个去某些活动,他就不去做某些事情,媒体嘛,这个很正常,但是你要是这么分开,这么弄的话,我总感觉就是,没有把子弹全部打到一个地方,一会打到这边,一会打到那边,这个策略是不是,需要在L6的这个发布会上面,再做调整呢,这个我也不知道。反正这个没有集中力量,办大事的这个决心和毅力,这个是会让我感到,就是比较费解的一个部分吧,你顺着把发布会也说了吧,发布会,昨天咱俩聊过嘛,我就不想,非常想问问,做发布会写脚本的这些小朋友们,因为我给这么多家发布会做过这个咨询,我就很明显能感受出来,就是写这个发布会的脚本的小朋友们,是怎么做到的,把这么一个充满了年轻气息,充满了活力的这么一个脚本,写得如此如此老气横秋,这是我真的很费解,就是包括我对理想这些朋友的理解,他们不应该是这样,他们对于整个脚本的,这个逻辑是清晰的,但是他们每一句台词。每一个这个梗,都让人感觉就是他们,就甚至会出现一种疲惫的感觉,用这么老的梗,去解释这么一块新传,来来来肉呆,我这个地方,我给你直接给你个结论,让你满意 [00:19:27]
老编辑:整个理想的营销,从上到下体现的一种性缩力,这个性缩力,我这样讲就是,长期在意识形态当中,学苹果造成的
肉呆:就苹果也有种性缩力,你发现没,但是苹果是苹果,它可以性缩,你不能,这个就是我想说的,人家是人家,你是你,你还没有,因为大家对苹果的认知,长期以来,就是一个性缩力的认知,尤其是库克长多这么多年,它性缩力更强,大家就知道苹果是这样的,所以它不会,但是,我这么说,我不想冒犯其他人,但是这个场发布会,就是那种80年代的感觉,就是很老气横秋,他们想去讨好一拨人的时候,用了非常不新鲜的,不新的这些梗,去讨好他们,想讨好的用户,这个时候你都不是用力过猛,而是会让人觉得,你在干嘛呀,没这个必要吧,所以我个人感觉,我在做这个发布会的时候。我经历这么多场发布会,我是很清楚的知道,这些做脚本,写脚本的小朋友们,他们过于的,就是这个负担,不知道哪来的负担,你这讲了什么嘛,我真的看这个发布会的时候,看得我挺头疼的,但是对于其他来说,我觉得这次比较牛逼的就是,我讲完一个东西,就是刘杰大王,充分发挥了他作为金牌培训师的,这个能力,他讲这些功能的时候,它总是会把你拉到最现实的那个角度,去给你掰开揉碎的时候,它还不让你烦,我觉得这个是去对冲那个,那个老梗那些,那些让人觉得摸不着头脑那些梗的一个,一个很重要的一个对冲作用,但是呢,它在最后逼当的时候,我觉得还是稍微稍显拖沓,包括它在理想在介绍L9 Lilith的时候,它说了这个。那个最后那个测试 One More Thing的时候,我没有觉得它是一个特别特殊的东西,然后这个脚本的设计,也没有让它成为一个,一个多大的彩蛋,你在对抗谁吗,你在屌谁吗,也没有明显这个感觉,所以我觉得这一次发布会,拿了都好,逻辑也好 B单也好,整体的效果,我感觉也能做得好,只是这个脚本写了呀,一群年轻人,能写出这样的东西来,我就,其实,算了,再多说 [00:21:40]
于欣烈:我估计又该被卖了,反正我的体感就是这样,我顺着先说两句发布会,先说好的吧,肯定有好的地方,除了刚才又在说的,我觉得特别是我刚才,又在说的这个框架,我其实是最开始抱有很大期望的,包括他从理想开始,就是强调Ultra跟Livis的并重,从最开始理想那十个问题开始吧,他其实就在讲说 L8 Ultra是舒适性,比肩迈巴赫GLS的,然后Livis是比肩宝马X5M的,就是他把这辆车的各自特点,把它并举,暗示说都会很详细地来阐述,包括在发布会开始,其实他放了一个L8 Ultra专门的宣传片,强调了非常温暖的家庭生活三口之家,我以为他的结构会是。L8 Ultra强调他的舒适性和家庭生活 L8 Livis强调他的操控,这种激烈驾驶,这样的话能满足不同人群的需求,让他们去喜欢上这个产品,我觉得这个架构设想,我是能get得到的,但是在执行上面,我觉得L8 Ultra那部分,大王在讲的时候,虽然讲得很生动,而且我特别喜欢那个展车,那个展具对他来说,更是让他在那个场景里面,很自如,但是L8 Ultra的讲解,完全变成了 L8这款车基础的,功能模块的讲解,比如说5C的超充啊,新一代增程器啊,包括他的一些,这个整个5座的,单独的开发的这个特点,它不是讲Ultra 它是讲L8 然后Ultra这些东西一笔带过,没有强调这种家庭的生活,怎么舒适,就跳到了L8 Livis 特别激烈的操控,怎么样赛道,理想就来接着讲了。它其实最后给我的感觉,还是一个Livis的发布会,基础的功能模块以及操控,那个架构没有真正兑现,它让我对Ultra的,希望更多的理解,因为我对Ultra这款车,感感兴趣,我觉得它可能更适合,跟大多数人,但是我觉得,最后在发布会呈现上,那么长的一个发布会,其实我觉得比例上,还是没有照顾到 [00:23:56]
周浩然:奥特尔这款产品,来浩仁,我补充几个信息,因为我没有去L9的,就L9宣发那段时间,我出去玩了,然后后面借车的时间,也比较晚,我一开始,我是只想借Livis的,然后是理想说,你要不要借一下Ultra 那个时候我就觉得,有点意思,我说你们是,这个Ultra是要推一推吗,我不知道,这里面可能有两种原因,就是我跟理想,没有熟到那种程度,就是你要往好的方向去想的话,那可能就是 Livis买的人太多了,然后Livis的产能,很可能是比较有限的,就是主动悬架,那套主动悬架的产能,可能是比较有限的,导致呢,没有足够多的人去买Ultra 所以他们在。他们问我要不要借Ultra 这件事情是6月 2 3 4 5 6号,这个左右的事情,所以在那个时候,他们就已经想要推Ultra了,我Livis跟Ultra是一起开的,我那个片子,好像过两天要发了吧,我那个片子最后下的结论就是,我如果自己掏钱的话,我肯定会买Ultra 所以我感觉理想,我不知道具体的原因是什么,我不知道是有太多的人去买Livis 不够多的人去买Ultra 还是说想要通过Ultra 来拉低一下L8的这个入门的门槛,毕竟这个L9如果去打品牌的话,这个L8确实可以稍微走一点量,虽然它也是这个高端,高端产品序列里面的这个车型,说实话发布会,我只看了后半部分,前半部分我有点事,然后我觉得比较遗憾的一个点,这也是为什么,就是我一开始,节目开始之前。我跟于老师聊的时候,我说理想这一次L8上面,这个原生5座这一点,我觉得其实是可以大奖特奖的,但是在我们国家现在的,这个汽车市场的,这个消费趋势来看,它真正意义上的优势,它不能主推,它在静态拍静态的时候,它跟我们说的这个,它的优势是哪几个,一它的那个二排,可以比跟六座共用白车身的车型,比如说乐岛180 比如说ES8 做版,能退的比那些六座车型的二排的,最后的那个滑到最后那个位置再靠后,因为它白车身做了退让,它针对后轮轮包做了退让,这是优势吗,这是优势,第二点,你既然座位点向后推了,那你的门洞就要跟着推,门洞一推。那你白车身就要动,对吧,这也会让你的上下车方便一点,这是优势吗,这确实是优势,但是我觉得,因为最近这个S8五座版,应该也快要开始了,理想很,我觉得很遗憾,或者说在当下这个环境下面,它不方便讲,我觉得它原生五座,真正意义上最大的优势,刚才肉呆其实点到了一点点,就是它比L9短了13厘米,它的轴距比L9短了8厘米,它真正的优势是在它提供一个完全不妥协的二排,和完全不妥协的这个后备箱,完全体面的五座旗舰的基础上,它整个车变小了,这是一个真正,这才是真正意义上的优势,我为什么说刚才理想说的那两个优势,是优势也不是优势呢。理想说的那个优势是优势,但是如果你面对的是一台,长度达到5280的ES8 你就没有优势了,我ES8就算不对白车身五座版做优化,因为我整体尺寸比你大那么多,我依然可以做得比你大,因为我整个车身比你大两圈,对吧,就算我六座版白车身,可能会因此牺牲个多少这个间距,我无所谓,我车够大,对吧,然后那你说那个门洞是优势吗,是优势,但是这对ES8五座版也不是优势,因为ES8五座版,就算把座椅换往前,按照六座版的那个门洞,去放二排的那个座位,它依然可以坐到第二排,比你L8还要大,所以它空间,这是肯定的,你说这不用怀疑。ES8比L9还要大,它还是个纯电的车,纯电的车本来就要比,增程要多,可能100毫米左右的,这个纵向空间,然后它整个车还大那么多,所以它的空间,就算没有对5座去做优化,它依然可以,轻松的比L8大,所以我很遗憾的是,理想,我不知道是不是理想,没有意识到这点,还是说觉得当下,这个消费环境,你去讲小,是一个优势,这一点太少的人能够理解,但是我觉得就像肉呆讲的,买5座而不买L9的人,就是因为它不需要6座,你要把这一点毫无保留,毫无羞愧地讲出来,我们觉得5座一点不惭愧,一点不寒颤,我针对你们做了优势,我针对你们做了优化,我在一点不 [00:28:50]
于欣烈:5座的优势和车小,还是两件事情,就比如说用户他需要5座,但是他不希望车小可能,以及其实理想之前,在爱巴上强调过车小,但是市场的反馈并不好,他当时是把车小车窄,作为一个竞争优势来讲的,好停好开,但是市场上并不太认可,现在包括这次。现在包括这次 [00:29:59]
于欣烈:现在包括这次,我觉得单纯的小,它并不是一个优势,它把它落在了比如说操控,它说因为我车更少了,我更小了更短了,然后我在操控上,可以做更剧烈的动作,你操控架控感更好,它是把它落在了操控上,而不是把这个小,落在了一个利点上,而不是单纯的
周浩然:或者说直接的去说它的小,我理解啊,首先从两个点,第一个点,一台车从三排座变成两排座,它确实需要的空间就是更少,哪怕你坐到同样的空间体验,且不说L8后排其实还比L9 第二排滑到最后还更大了一些,它在第二排比L9还要大的情况下,它整车依然可以缩短这么多,所以说五座两排座的车,就应该比三排座的车小,或者说两排座跟三排座的车,共用白车身,确实就是一个比较省钱的做法,然后第二点,这个L8 你说的是L8还是I8 我刚才说的是I8 就是I8历史上,它强调过小这个卖点 I8之所以失败,不是因为它不够小,或者不够大,它的问题是,它撞上了,落到L9那个枪口,它的一个定位。比它低那么多的车,各方面好像,有些方面还比它有优势,所以它一下子,这一枪打哑了,它不是因为它,讲小这一点,导致了他这个车型,没有达到他应有的,这个成功的这个高度,或者这么说好了,理想应该把,就是我们把理想L9 比作是个四房两厅 L8比作是个三房两厅,大三房为什么就一定要,大三房肯定要比,小四房要豪华很多,总面积上,其实还是会缩减很多,有很多人他不需要四房,就是你得把黄金单身贵族,或者说也不是单身贵族,而是小家庭的这种,尤其现在比如说出生率下降,真正大六座,大家都在讲大六座,什么时候这个市场会饱和这一点,其实已经饱和了,接下来大家都是存量。大家都是狗咬狗的这个阶段,你在这个阶段,你在五座上面出了一个这么,什么东西都为了五座彻底优化,然后车又小了一点,但是你空间一点都没想小,这是一个很高成本,很体面的做法,但是他没有把这个体面的,或者这么说,这个车如果只是为了大空间,那他大可不必去开新的白车身,或者再说一点 L8发布会上面的那些激烈操控的那些场景,在我看来意义并不是特别的大,因为L8的车重并没有比L9轻多少,你真正的这台车的抓地性能极限,或者说跑圈速,或者说以后如果有哪个闲着没事干的媒体,拿L8 Livis跟L9 Livis去跑赛道的话,你很可能会发现 L8并没有比L9快多少。因为它们的重量是很接近的,你这个车的性能,或者说你的灵活度,很大程度上取决于什么,取决于重量和轮胎,当然轴距也有影响 80毫米不是一个小的差别,但是它的重量和轮胎都是差不多的,你的操控上面的优势,这是一个,我不说情绪优势,但是这并不是一个真正意义上的优势,但是你短了13厘米,你是绝对能开出来区别的 [00:32:57]
于欣烈:这真的是一个非常大的优势,盖斯到了明白,但是确实在国内就像你说的,他可能很难把它表述成一个优势,或者我换句话说 [00:33:31]
周浩然:如果ES8和L9在立项的时候,未来的预算,各方面的经营状态是好的话,按照未来以往的开发标准,肯定也是会单开白车身的,单开为五座版单开白车身,开一个小一号的白车身,而做具体优化,如果你预算给够的情况下,这是绝对正确的选择,理想做了绝对正确的选择,但是他没有把这一点,很好的讲出来,我就觉得,就很奇怪,就是,我觉得,就是L8宣发的这群人,我觉得要不要跟,当初做平台规划的人去聊一聊,为什么要开这么大的成本,去新开一副白车身,开白车身非常贵,那就是新一亿位单位的,但是你发布会,把这一点讲出来了吗。我就觉得不太应该,就它跟L9最大的区别,是股价上的区别,它电机,增升成器 Livis 乱七八糟什么东西,除了座椅之外,都是差不多的,它最大的区别,是车身形态上的区别,但是它,没有太,讲好这个事情,明白,编辑 [00:34:37]
老编辑:发布会你有什么要说的吗,这种宣发策略吧,包括跟L9的差别,就我总结成两方面去讲,首先有理想不得而为之的东西,就是从我们L8和L9的,整个发布,联当一起说,首先不得已的地方是什么呢,因为他过去忽视L9的向上,导致他被问届压在上面,所以L9这辆车,这次一定要坐L9 Livis 必须在50万以上有一个位置,这是品牌的新制的制高点,所以这件事必须做,所以这是刚才所有嘉宾提到的,在L9的发布过程当中 Livis明显占据了更高比例,对吧 L8反而是Ultra的比例更高,这就是说在过去我讲理想被穿插之后,它的这个价格带这么宽,而今年它同时要完成这个价格带的覆盖。又同时要调整,就是我之前对理想两个判断其实应验了,第一个是价格带太宽被穿插,第二个是七上八下,这两件事情其实理想都针对性的部署,但是它的部署的状况当中,它不是在自己自身力量顶峰部署的,它是在这个市场已经,已经击穿它的这个,价格体系的情况下去部署的,所以有种背水一战的感觉,所以我就说,你看L9类似,一定要占个50万的品牌的心智,所以它必须把它拉到那么高的高度,这就导致,反而导致,反过来导致L 更应该花更多精力的L9 Ultra 没有花更多的这个,宣发给营销资源,其实L9这辆车,是应该更多的卖L9 Ultra的,因为车更大,六个座位,对吧,你不应该去强调 Livis上面那些操控的东西,而反过来说L8也是。L8不应该给Ultra这么多弹药,给Ultra这么低的价格,给Ultra这么多的空间,应该强调L8 Livis的,不同的用户价值,用户情绪价值,就刚才周浩然说的那些,一整套的东西,就是它不是一辆车,它是另外一辆车,这辆车我理想本人很喜欢,对吧,我甚至建议他们请大哥大嫂,这家公司的大哥大嫂,和狂飙的大哥大嫂,一起来代言这款产品,我与别人更有资本,更有资格,我开一辆五座车,我开五座车,意味着我不需要,把我所有的车,所有的在车上投入,放在家庭上,我可以拥有一辆自己的车,平时可以兼顾家庭,但是它是我的车,我可以开着很爽,这个 Livis的品牌心智,真正应该落在 Livis上,但是呢。因为它今年同时要做七上八下的调整,对吧,又要重新的去排布价格带,那就不可避免到成L8 Ultra 又要面对ES8五座版和小鹏GX的冲击,对吧,你想想,相当于七跟八两个车,现在价格带全得让八扛啊,就是如果大家想,我们在这个阶段,它有一辆新七,它可能就不需要压得那么靠下了,它可能就更从容一些了,可以把代销更多的给Livis了,所以我觉得从,价格带的角度来讲,我今天理想大家对他工作的,一些批评也好不满意也好,他是没法改变的,你再给他一遍机会他可能也没办法,因为就是我说 50万以上他要占个点,去扛问届 35万左右他得有一个点,去扛小鹏GX跟ES8的,五座吧。这又把这个价格带,有两款车你去覆盖15万的价格带,那不就是这个情况吗,从35万到50万 [00:38:33]
周浩然:对不对,如果说是从30万到50万是,我问一个问题,就是我不知道,从我们上次录到现在,大家对小鹏GX 这款车是已经彻底扭转了,就是这款车,就是因为一个定价,就怎么怎么样了吗,我不这么觉得,我不觉得小鹏GX 是一个战略上需要考虑的事情,而且小鹏GX 它很明显它的主销价位不是
老编辑:就是它向上打不到L8 跟这个没有什么关系,就是你要守35万这个点,是市场的综合状况,你不用考虑GX4本身,它到底销量,就是它的顶配版到底卖了多少,就是你在35万到 35万到50万,这整整15万的价格带,你只有两款车,因为你现在你的6 即使改你也不可能上到35以上,然后7要,新7要明年了,所以我的意思就是,在35到50万,这漫长的价格带,它的现状是,你还是只有两款车,对不对,是不是道理,所以我觉得,从这个角度去理解的话,就是,理想没有什么选择,虽然我一直,一直给他们建议,我在整个四驾,包括前期的沟通当中,一直给他们建议 L8 Ultra版的 L8 Livis的价格带,压缩的狭窄一些,这样既能实现品牌的,心智的保卫,又能,又能把这个车的车型。让更多的用户用上Livis 但是最后,他们定到35.98这个价格,我能理解,就真的是你手里就这么多牌,你要干什么的事,两个锅盖三口锅,那只能盖成这个样子,这是我觉得我理解他们的,不得已而为之的,但是从主观上来讲,我觉得理想的最后一题的问题,还是学苹果这件事情,学华为当然已经停了,大家都知道学华为这事已经,无论从人事上还是从路线上,已经都不可能再执行了,学苹果这个事还是在执行了,就比如说他不是说不对啊,我假设啊说,如果今天理想在国际化上做的非常靠好,靠前,非常积极,对吧,至少达到小鹏那个水平吧,我都不说,我都不说比亚迪啊,这种,如果说他在国际化上达到小鹏的水平,他其实这样做也有好处,因为国际是想是喜欢苹果那种性缩力的产品,包括当年浩然说的那些。关于武作的那些强调的特性,那欧洲人是能听懂的啊,中国人听不懂,欧洲人还听不懂,欧洲人肯定能听懂啊,但是当你的国际化,没有实现那样一个覆盖的时候,你过去两年时间,在国际上耽误的事太多了,耽误了这么多事之后,你这个性缩力的,就是学苹果这个事情,我就在方方面面,在国内竞争当中拖了后腿了,他都不是说一个,发布会物料层面的事情,他整个公司自上而下的像苹果,像苹果这个事,我跟他们讲说,在国际上,你就说你是苹果车,这事没事,咱们学学互胜,这个传播朗朗上口,最像苹果,就是如果苹果造车,就是造成你们这样,是没有坏处的,全是好处,但是在国内市场,你不是苹果,你学苹果,这个非常危险的,我都不说宏观层面,品牌性质层面了,我们说简单的一个事情,就是轮毂的事情,在L9 Lavis上的时候就说。这么做轮毂是不行的,你的旗舰车型的轮毂,是一个科技风的轮毂,这怎么可以,你完全达不到这种,当然我就说,我对你的要求是,你不要做那种,所有人都做大饼轮毂,对吧,你要做的高级一些,最后他你看他麦尬的新版,确实做的很高级的,像,像那个唱片一样的那个,那个轮毂,确实很,我觉得做的很好,但是在当时L9 上的时候,他就没有做到,你包括从好的方向说 L9 和L9 你去看他那个,杜哥试条,做的非常棒,他杜哥试条的那个线条,隐藏在那个光影当中,做了一个黑化处理,没有那么高光,就你,你如果想要,这个杜哥试条,那种老灯选手,你是能够认出来,这是杜克士条,它有,但是如果你是小灯,初灯,你不喜欢那种老灯的感觉,它的整体光影,又把杜克士条,大部分的视觉上的冲击,就给收进去了。我说这个非常高级的,非常苹果,我说苹果造车,可能就会干这样的事情,但是,但是当你不是苹果的时候,你学苹果,你的轮毂,没有一个非常明显的,这个东西很贵,这样一种心理暗示,就很难办,包括这次L8 Livis 一模一样,我第一眼上去看轮毂,是你做一台车,你的主动悬挂,让它的操控,你当它P弯的时候,它的姿态修正,它的测试意志非常极致,很棒,我自己一上手就开拽了,太牛逼了,我是一个超级喜欢在北京 P弯开这个跑山的选手,但是我从轮毂看不出来,我说你这轮毂首先,首先你没有卡钱,你没有红色卡钱,你这个轮毂,你有红色卡钱,也看不出来,你要知道你的竞争对手是谁,你的竞争对手在这个赛道里面 [00:42:42]
周浩然:除了未来的两款车之外,这是有原因的,这是有原因的,我补充一下,他没有红卡钱的原因是,理想上了这个EMB 限控制动之后,他没有用定钱,因为限控制动,必须得用浮钱,所以导致他的卡钱就不威风,所以他就不能露出来,所以他就不能做那种,空开率很大的轮圈,所以他就展现不出来,他的卡钱也不能喷颜色 [00:43:30]
老编辑:这些东西是我相信,就跟我刚才说L9 Livis一样,只要思想不滑坡,办法总比困难多,你当你的脑,你从公司重上大下,已经认为,一个认为一种克制的外观表达,是正确的时候,大家就不会去想其他办法,去解决它,你要知道你的竞争对手是谁,你的竞争对手,首先已经变成了一个,灯化的未来,已经不是当年第二代ES8 那个青春无敌的未来了,已经变成了一个老灯要什么,我给什么的未来了,然后另外就是极客,一个走杭州湾库里南这个路线的极客,对不对,就是你的竞争策略,当你的对手的竞争策略变化的时候,那你也必须做出相应的调整,我相信华人说的很多事情是,从技术角度是对的,是正确的,但从用户情绪价值的角度来讲,我买一辆操控很好,手得让别人知道。只是我自己爽嘛,可以啊,但别人怎么知道我开辆超红号的车,他也看了理想L8 发布会,我之前在理想的。我之前在理想的 [00:44:59]
老编辑:我之前在理想的,之前的,他们比较顺风的时候,那时候我,说过一个段子,理想车主的两大爱好,第一个是高速服务区充电,第二个是拉着,过年回家让,亲戚朋友猜的车多少钱,这其实就是一种非常好的社交传播,你看我这车,你们想不到吧,这么大的空间,这么多个座椅,这么好的数字配置,我这个价格买回来了,你过来坐一下,体验一下这个空间,必要采用大传发,这就是一种自发的社交网络传播,但是到你用这种,在外观上过分克制的设计,跟表达的时候,这个性缩力,它就会进入到,社交网络传播的流程当中,它就会限制你的这种,社交网络利益,这也是肉呆说,就觉得理想发布会,办的其实是越来越好了。怎么这个流量,这个热度就上不去呢,对吧,这个其实是我说,我总结就是我前面讲了两部分,理想今天的局面,我们看到了很多奇怪的,古怪的或者觉得不够合理的地方,有两部分原因,一部分原因是理想控制不了的,就是他的市场竞争到今天这个局面,竞争的烈度困难程度比以前高了很多,他的任务,他手里的牌决定了,他很多事情他不知道不想做不到,第二个就是公司长期以来,在上一个阶段,找总结自身之后,把公司的组织管理,抽象为学苹果学华为,这些东西之后,它其实影响大家,束缚大家的手脚,我是希望在下一个阶段,理想后面的六七系的,包括可能2819的发布当中,就是在内部,希望还是能够更多的,给基层指挥官。一线指挥官一些开火圈,不要这个性缩力的,这个苹果式发布会,继续开下去了,今天好处是什么呢,至少他开始现场,开现场发布会了,对吧,这一场一场发布会,都是现场开的,这是非常棒的,我就说,你之前学苹果疫情时期,那些发布会,路过的形式,你也不想想,别人一听说是路过的,就跟看世界,听说是路过的,他不是看挤挤的,我干嘛要看路过,对吧,你好歹给我一个直播,中国的直播也是直播,对不对,所以这个就是我说的,就是,我觉得我从一个理想黑,变成一个相对来说,比对意向比较友好的媒体,可能我觉得,就是我能两方面都盖得到了,接着老编记得说两句,确实刚才你提到的 [00:46:46]
于欣烈:不论是像轮毂的设计等等,杜哥条,其实跟他之前造型和内饰,这种细节的优化,是一脉相承的,大家老说他千年不变,他们自己强调,其实我有很多的变化,而且他们传播的是什么,我的设计哲学,我的想法思考是什么,而不是一个,有冲击力的具象的东西,他们要传递的是思想,我觉得,这个是他们在市场竞争中,比较吃亏的地方,这个确实是,就是他们强调的东西,太细节化了,苹果这样做是因为,苹果是苹果,不是木墙的,苹果它在很多产品上,已经成功了,它在细节上的雕琢,会让别人更尊敬它,但理想,在现在的市场环境下,它不是强者,大家不会尊重你在细节上的雕花,而是希望有更大的这种冲击力,我觉得这一点我是赞同的,但另一方面我觉得,理想它在做一些对的事情。就是能够去对冲或者是抵消这方面,在细节上的这种苹果的哲学,就比如说,我觉得这次L8很好的例子,就是理想终于又能靠产品定义来,赢得用户了,虽然可能不会像当初L9那么爆,但是它又一次让我感受到了说,这款车的吸引力,它的价值感,它的冲击力,我觉得在在理想的身上看到了,其实,之前在L9上,我是没有感受到的,它有很多的优化,它的评测车身,它强调的那个腰线,那些细节的描述,对我来说,其实基本无感,但是这次L8 虽然那些东西还在,但它有了一个二排的,双零重力座椅,对我的价值感冲击力,非常强的,我觉得这很好,这是理想,他们最擅长的武器,我觉得他们应该在这方面,更多的去做事情,另一方面我觉得,巨神智能是他们,在基础方面压住的一个方向。当然现在非常早期,都是期货要等OTA 但我觉得这个是他们,希望能够自己成为一个,有爆款的机会,一旦他们能够完成,在新的硬件的框架下,新的AI的框架下,去实现一些,别人所不能的功能,我觉得也是他们,未来的一个机会,当然能不能做成了,还要看他们自己,所以我觉得,理想这家公司,像刚才老编辑你说的,我觉得那些东西,是他们价值观方面的东西,比如说他们在访谈中,也说了说,我就喜欢,那你可能改变不了它,那只能期待,它在它擅长的地方,做得更好,产品定义上也好,在这种All in AI方面,能够做出成绩来,我觉得这是对,我对理想的期待,刚才其实老编辑你,已经进入到了,这个价格,包括SKU 一些产品讨论,肉袋这方面,有什么要聊的吗,我先抛一个话题,大家待会可以一起来讨论一下。就这次发布会之后,其实我在网上是看到了,截然不同的对价格的反应,都是KOL 也都是很多有车的朋友,会懂车的朋友,有的人就说,卧槽太贵了,这次完了,还有人说,理想这次降这么低,这次真是拼了,截然不同的对价格的反应,是什么造成的,就是配置满满的都在这里,价格优惠都在这里,为什么大家会有非常不一样的这种反应,是因为大家对理想的理解不同吗 [00:50:15]
肉呆:好吧来,让我跟大家聊聊SKU 包括售价,我觉得这个很长一段时间,我老说不能怪大环境,你自己做了你得多反思,但是我觉得这个确实和大环境相关,就是今年的大车都不太好卖,然后这种空间模法的话,我觉得也就只能持续一小段时间,万一有哪个,你现在可以看到的,就是小米的叠照也有了,叫蓬城,那个叠照,帐篷能起来,他的就是大家开始玩花活,去整这些内部空间的时候,势必就会进一步,削弱你的品牌影响力,我觉得现在理想最大的问题,就是品牌影响力,的这个缺失,或者说是这个示弱,是无法通过几场发布会,或者你产品定义来去,弥补的了。我觉得已经到了一个比较恶劣的阶段,之前还可以,是因为市场大环境确实还很好,它有足够的容错率,它宽容度高,但是现在市场进一步压缩,别说今年的明年压缩的趋势,还是会有,那你这样保持现在这个状态,就会有,这个叫什么,两极分化的这种观点出现,因为我们看,我们大概有400多个 L8 整个新L8系列的这个潜在用户,然后气购率的话,其实还好,还没有到一个,说这个定义这个产品完全失败了,就远不到那个程度,这它就是一个正常的产品,它完全很正常,市场就应该是一个反应,它没有超出多少预期,就我今天也看很多,在我刚刚包括我刚刚大家在聊的时候,我也搜了一些。网上的这些大家的这些反馈,我觉得就是在市场整个大环境下面,示弱了之后,加上理想在,我感觉是近两年,没有很好的去运营,自己的这个品牌,导致了大家对于理想的一些所作所为,知之甚少,或者说是我不愿意主动去了解,关于理想的一些东西,我只愿意情绪化的去看,理想的一些负面,或者理想的一些好的一些声音,这就会让整个的口碑两极化,这有点像当年华为的那个月亮,拍月亮那个事情,不知道大家都肯定,大家都知道这个多少听过这件事,当时对于华为的挑战是什么,你马上就要立一个,影像旗舰的一个flag 但是这件事情对于他们内部,对于整个品牌的影响是非常大的,但他怎么做了呢,那我就不管。那我就天天我还是说,这件事情无论处理成什么样子,我依旧要强调我的这个,这个这个影像的这个属性,但是这两年呢,就可能理想被攻击怕了,我觉得他们就是被攻击怕了,他们总想着向自己证明一些什么样的事情,像拿这个L8来说吧,我可以做大空间,我也可以做运动,但是给我的感觉,包括我现在看这个网上这些,大家这些反馈,我总感觉理想太在意别人怎么黑他,而忘记了用户是怎么爱他们的,我觉得这个对于L8来说,包括对于以后它发的一些车型,都非常非常,怎么说,都是一个特别大的不利因素,也问过很多放弃购买理想L9 理想L8的一些朋友们,他们就觉得我没有必要啊,这个市场上这个选择也是蛮多的。为什么一定要买理想呢,我觉得理想现在回答不好这个问题,包括上次前两天咱们录那个播客,我还说一个问题,就是它的,从NPS角度上来讲 Promoter Detractor和Passive 就是Promoter的推荐者多,那肯定是好的 Detractor少,它也是好的,但是理想处在一个,非常尴尬的阶段,就是Passive 就是无关紧要者,特别特别多,它的整个的,大家觉得,哎呀还行吧,凑合吧,也还行,那你说谁听见这样的话,我要是听见,就是我要是问身边朋友,我说,我能买小米 YU7吗,你买了小米 YU7,你推荐我买吗,还行吧,就我看着也还行,我绝对不会考虑的,因为这是个大件,这不像手机,这是个大件,所以理想现在就丧失了,对于passive的这个影响力,他哪怕是就全部转换成一个。我就买了之后,我天天他妈骂理想,这他妈理想弄的什么狗屁玩意,他在那个时候,我觉得他还有反击的机会,但是现在市场环境,不允许理想有这个,有这个detractor 这么多的这个,这个近地在了,因为一旦detractor的话,那对于整个品牌的影响,负面影响会更大,所以我觉得整个市场环境嘛,在示弱,然后品理想对于品牌的这个,解释权,以及对家庭的这个,既然都说到这了,我就直说了,就是太吃老本,太吃家庭这个标签老本,并且没有给家庭一些新的想象力,那L8有吗 [00:55:18]
于欣烈:有,我觉得非常有,但是他解释清楚了吗,我觉得没解释清楚,就是这么简单,在全新L8上市点评的下集,我们会更深入的讨论,目前理想的一大挑战是品牌问题,如果全新L8首发,而不是全新L9 能不能解决品牌的问题,L 系列的产品线又应该如何调整,理想本人和理想公司,可以做出哪些调整,去建立一个更强有力的品牌,我们下期再见,欢迎大家在小宇宙,苹果Podcast等音频平台,搜索885 有准备的头脑,订阅收听我的播客,本期节目就到这里,再见。谢谢大家 [00:56:53]
本期是 Big Technology AI Summit 现场访谈。Alex Kantrowitz 与 Wired 的 Lauren Goode 采访 Anthropic Labs 负责人、Instagram 联合创始人 Mike Krieger,主题围绕 Fable 被政府要求暂停、Anthropic 的安全立场、Labs 的产品使命,以及更强模型如何改变软件与 AI 原生产品的构建方式。
Krieger 说,Fable 是他用过的最佳模型。它被撤回前只开放了几天,但已让早期用户产生强烈依赖;他把这种反应类比为 Instagram 当年移除 Gotham 滤镜后多年被要求“带回来”。他强调,模型发布第一周的评价噪音不可靠,真正差异要在真实工作中体现。Fable 的明显进步在于“委派的范围和规模”:它不只是执行单个任务,而是能接受更大的目标、拆分工作、规划、执行和验证。例如,他让模型把一个 Python 写的 Labs 项目迁移到 TypeScript,并让动态工作流完成大量子任务和双重验证。
围绕政府反应,Krieger 承认白宫相关决定令人意外,Anthropic 也在沟通恢复访问。他没有解释为什么 Fable 被单独点名,但指出模型风险的关键在于“能力提升”:当普通人借助模型能接近专家或突破原本门槛时,风险评估就会变化。他反驳“安全只是营销”的说法,称 Anthropic 内部确实深信 AI 安全,Mythos 在漏洞扫描和 bug 查找等方向展现的能力,也让公司必须如实描述风险,即便这种描述听起来像炒作。
Krieger 解释了 Anthropic Labs 的角色变化。2024 年 Labs 的任务是防止产品落后于模型能力,Claude Code 和 Computer Use 都来自这种提前探索:先做出能展示未来能力的产品或原型,再用它们观察模型进步。今天 Anthropic 已有更成熟的产品团队,Labs 的重点转向探索新的交互形态,例如 Claude Code artifacts,让模型不只输出文本,也能画图、解释结构,并减少用户理解 prompting、effort、环境和工具连接等概念的负担。
在平台与产品边界上,Krieger 承认 Anthropic 既做平台又做产品会让合作伙伴担心。他认为 Anthropic 不应进入一个方向只是复制已有产品并加上自家品牌,而应推动行业走向、创造新空间,并尽量保持透明与共享构建模块。医疗场景中,Anthropic 发布的是插件、skills、MCP 等能力,而不是独占的“Claude Healthcare”,这体现了它想同时服务生态与构建产品的方式。
关于未来产品,Krieger 提出两个 Labs 正在探索的主题:第一,让 Claude 拥有更多环境认知和能动性,例如理解项目文件、设计稿、源代码和运行时,而不是让用户手动下载、拖拽或切换工具;第二,缩小人脑中工作流程与实际工具操作之间的差距,例如把隐私团队移动 ticket 时的八步复制粘贴流程变成自然、可重复的自动化。他还谈到太空数据中心:自己不是专家,但在与航天从业者沟通后,能理解近乎无限能源和土地的逻辑。
访谈后半段讨论 token 经济学、结果定价和消费产品。Krieger 认为 token 使用量和生产力未必相关,未来重要的是模型能力、effort 与 token 效率的组合;结果定价在客服等清晰场景可行,但在战略文档审阅等模糊任务中很难定义。他也认为,即便 AI 让编码更快,消费级产品突破仍然很难,因为 app 生态高度集中、数据重力很强,做出人们真正想用的东西仍是产品人的核心价值。用今天的工具,Instagram 也许能用四到六个人更快做出,并更容易保持 iOS 与 Android 平台接近平价。
最后,Lauren Goode 追问 AI 聊天机器人对年轻人的伤害,以及 Labs 如何避免更强技术带来风险。Krieger 回答说,Anthropic 内部确实会放弃一些可能“对世界不好”或把人推向错误方向的原型;公司也会把影响评估前置,让经济学家等角色提前思考产品对世界的影响。他认为,这种前置讨论在社交媒体早期并不常见,但在 AI 公司里应成为常态。
- 政府禁令、Fable 反应与安全争议 [00:00:00 - 00:10:00]
- Fable 改变产品构建方式与 Labs 的定位 [00:10:00 - 00:20:00]
- 平台与产品边界、AI 原生体验 [00:20:00 - 00:30:00]
- 编程工具、浏览器形态与产品分发 [00:30:00 - 00:40:00]
- 现场收尾与致谢 [00:40:00 - 00:40:42]
Alex Kantrowitz:Anthropic 不只是一个大型模型构建者,也正在成为大型产品构建者。过去几个月里,Claude Code 和 CoWork 这样的产品增长很快,而 Claude Code 来自一个外界了解不多的组织:Anthropic Labs。Labs 的工作是以 AI 为核心,构建下一代前沿产品。今天我们请到这间实验室的负责人 Mike Krieger,他是 Instagram 联合创始人,现在负责 Anthropic Labs。Wired 的 Lauren Goode 也会和我一起采访。Mike、Lauren,欢迎上台。Mike,Anthropic 这周看起来很平静,什么事都没有,对吧?Lauren,你先开始。 [00:00:49]
Lauren Goode:我们当然想聊你在 Labs 做什么,也想让大家理解你的角色。但我想先问,你现在和白宫这件事有多接近?
Mike Krieger:比我还担任 CPO 时要远一些。我大约五个月前转到 Labs。如果我还在 CPO 的位置上,肯定会深度参与。现在我当然仍然希望恢复访问;作为产品人,我也希望用户能重新用上它,但我不像以前处在 C 级管理角色时那么贴近。 [00:01:15]
Lauren Goode:Alex,你有追问吗?
Alex Kantrowitz:当然,而且我有大概八个追问。X 上有个人叫 Ben,他说如果 Anthropic 能重新给他开放 Fable,他愿意把自己的长表出生证明原件寄过去。他说自己现在听起来像那些痴迷 4.0 的人。你们会收 Ben 的长表出生证明吗?
Mike Krieger:我不知道我们会不会收。但这件事确实有意思。Fable 只开放了几天,从那以后我每次发推,很多人根本不看我发了什么,只回复“把 Fable 带回来”。这让我想起 Instagram 早年拿掉 Gotham 滤镜后,接下来很多年一直有人说“把 Gotham 带回来”。Fable 显然触动了一些人,而且会比 Gotham 更早回来。真正用过 Fable、开始把它放进工作流的人反应很强烈。我也学会了不要太相信模型发布第一天、第一周的噪音。大家都有自己测试新模型的小玩具例子,但你只有把它放进真实工作里,才知道它到底如何。Fable 刚开始进入这个阶段,我们就不得不先撤回。我记得去年 12 月发布 Opus 4-6 时,很多人放假回家,在圣诞到新年之间真正花了一周使用它,回来后才说:“我终于理解 Opus 为什么好。”Fable 还没有得到这样的机会。 [00:02:45]
Lauren Goode:即便如此,特朗普政府的反应还是很大。这里很多人刚才听了 Alex Stamos 的环节,知道背景是什么。但这发生在模型发布后几天内。给 Wired 一点信用,Wired 昨晚报道称,这可能和 Anthropic 给 SK Telecom 提供模型访问有关,并由此在政府内部引发警示。你对这种几乎立刻发生的反弹有多惊讶? [00:03:22]
Mike Krieger:这个反应和决定确实令人意外。我们也马上和他们沟通,希望恢复访问。与此同时,我们内部常想起 Facebook 墙上的一句老话:每天都像一周那么长。我觉得这在 AI 里正在成为现实。整个行业都要提醒自己,我们面对的是前所未有的时代和新情况,事情会非常快地演化。因此,建立快速对话所需的能力和连接非常重要。 [00:04:00]
Lauren Goode:我给你们墙上提个新口号:快速行动,越狱万物。
Alex Kantrowitz:我不觉得他们会采用这个口号。我们刚听 Alex 说,一些能力在之前的模型里也存在;今天可用的其他模型也能找漏洞。那为什么你认为 Anthropic 在这件事上被单独拎出来?
Mike Krieger:我不知道为什么 Fable 被特别点名,尤其 Fable 还不是面向网络安全用途的模型。我认为真正变化的是两类能力之间的差别:一类是你知道怎么提示、知道自己在找什么时能拿到的能力;另一类是模型本身给普通使用者带来的能力提升。我不一定认同 Alex 那个“给高中运动员打兴奋剂”的比喻,但“提升”确实是我们做模型安全时很关注的概念。比如在生物领域,我们会在模型卡里比较普通人使用模型、专家使用模型、普通人使用互联网之间的差别。随着模型变强,这种提升趋势一直在推进。所以问题也许不只是为什么 Fable 被单独点名,而是整个能力轨迹正在走向哪里。 [00:05:26]
Alex Kantrowitz:我们刚在节目里请过 Ramp 的首席经济学家 R. Karazian。他提到五角大楼事件期间,虽然有新闻标题说某家公司不再使用 Anthropic,但 Ramp 数据显示,对 Anthropic 模型的支出反而上升了。那似乎成了公司的一个宣传时刻。这也回到我们节目一直讨论的问题:Anthropic 对风险的担忧有多少是真实的,有多少是营销?刚才 Stamos 从安全角度谈了一些,现在你在这里,可以直接回答。它是实质性的、营销性的,还是两者都有? [00:06:20]
Mike Krieger:我认为,人们对任何公司说的话保持怀疑是对的,也应该用自己的过滤器判断。但对我个人而言,这是真的。我们确实非常在意安全。如果我们公开谈某些事情,目的要么是帮助大家看见我们认为很可能到来的东西,要么是指出我们已经观察到的情况。比如 Mythos 的案例,我们看到的是真实的漏洞扫描和 bug 查找能力,而且是在 Project Glasswing 初始公告中的企业伙伴合作场景里看到的。这项技术很棒,不是营销意义上的“很棒”,而是真的能做非常了不起的事情。正因为如此,当我们说出自己看到的情况时,听起来也可能像炒作。我希望能按一个按钮让所有人相信我们不是在炒作,但现实不是这样。至少从我的角度看,我们是在尽量如实描述。 [00:07:17]
Lauren Goode:我的理解是,Anthropic 的 Labs 以及研发团队会使用最好的 AI 模型来构建新产品、做原型并检验你们的假设。这个禁令是否已经限制了 Labs 做这件事的能力?
Mike Krieger:是的。Fable 绝对是我用过的最好的模型。这并不是说工作停止了,我们仍然在用其他模型,也能产出东西。但那些模型确实不如 Fable。某种程度上,前面说的“不要过度相信第一周反应”反过来也成立:当你失去 Fable 时,差异会很明显。已经拿到模型并开始使用的人在 Twitter 上反应很强烈;我自己的感受也是,Opus 4-8 仍然很好,我仍然有生产力,但 Fable 这一类模型带来的工作方式变化确实可感知。 [00:08:31]
Alex Kantrowitz:公众只短暂接触过 Fable,Project Glasswing 里的群体接触过 Mythos。我们并不知道今天能用的模型和这些更前沿的 Anthropic 模型之间到底差在哪里。使用 Fable 或 Mythos 时,你究竟能做哪些不同的事?
Mike Krieger:对我来说,差别在于委派的范围和规模。当然这些模型仍然很不完美。大家会问它是不是五级或六级软件工程师,但重度使用者都知道,模型能力是尖峰式的:某些方面比我强很多,另一些方面又会犯很基础的错。比如我今天还在抱怨它漏看了字母 g 的下伸部分,导致 UI 里被裁掉。视觉能力、调试能力、人类常识都还有改进空间。但整体而言,我从高管角色回到构建者角色后,对这种变化感受非常强。作为高管,你当然会尽量用模型,但不会让它写所有邮件,战略仍然必须来自你,模型更多是帮你压力测试。回到构建者角色之后,我从“请修这个 bug”“这个功能怎么实现”这样的委派,转向“这里有一个用户反馈,或者我想构建一个东西,请给我两三种可行方案”。模型有时会给出让我觉得超出自己理解范围的解释,我会让它用更低门槛的方式讲清楚,然后让它去构建,而且正确率非常高。这会改变你的操作方式。我睡前会给 Fable 排足够多的块状任务,理论上能跑一整晚,结果过一会儿看,它一小时就做完了,好像后面七小时都在等。 [00:09:38]
Alex Kantrowitz:也就是说,你委派的不再只是一个任务,而是更接近一个目标。能举一个你会交给它的任务例子吗? [00:11:04]
Mike Krieger:有个例子对程序员来说挺疯狂。我有一个 Labs 项目是用 Python 写的,因为那是我熟悉的语言,Instagram 也全是 Python。后来因为一些部署原因,我们需要把它迁到 TypeScript。我一开始觉得这会很麻烦。Instagram 被收购后,我们多年都讨论过要从 Python 转到 PHP、Hack 或 Facebook 的语言,但至少在我还在时从未真正完成。我们有一个功能叫动态工作流,可以让模型把任务拆成很多子任务。我信任它不只是做单个动作,而是负责一整个语言迁移:几十万行代码,从规划、执行、验证到二次验证。最后我回来时,工作已经完成。
Lauren Goode:这就是一个很大的块状任务。你是说,Fable 做得更快,大约一小时完成;相比以前的模型,差异在哪里? [00:12:03]
Mike Krieger:过去模型也会说“我做完了”,但你会发现它抄了近路、某处不太对、需要你去验证、或者它切掉了某个角。现在的差异不只是速度,而是更正确、更可靠。
Lauren Goode:这有点像过去一年大家说的“管理实习生”,虽然这对实习生有点冒犯。但你是在说,它更快、更准确、更可靠;而按美国政府的说法,也更危险。
Mike Krieger:还有一个部分是它更有“项目理论”。这个词不一定准确,但它不像只看当前改动的模型。做大规模软件工程的人知道,最好的工程师会把系统里许多相互分散的部分同时放在脑中,也会预见拐角处的问题:如果这个改动不这样做,下一个改动就会变得更难。我在这类模型中看到的显著变化就是这一点。 [00:13:03]
Lauren Goode:说到 Anthropic Labs,大家会想到 Claude Code,因为它确实是一个爆款产品。听起来你的任务就是找出下一个 Claude Code。这个描述准确吗?Anthropic 为什么需要 Labs?
Mike Krieger:要分 2024 年我加入时为什么需要 Labs,以及今天为什么需要 Labs,因为答案在变化。我加入 Anthropic 的第三周,就和联合创始人 Ben Mann 组建了最初的 Labs 团队。当时原因很不同:整个产品工程团队只有 25 人左右,模型本身也还没到今天的水平。我加入时是 Sonnet 3 和 Opus 3,以当时标准是好模型,但还不是实习生级别,更不是 IC3 工程师。如果你只有二三十名工程师,他们会忙于下一个增量功能。我们已经感觉到模型在变强,却还没有足够产品展示这种变化。对我来说,一个好的试金石是:当我们准备发布模型时,是否有产品、演示或其他东西能证明它真的不一样?这会越来越难,比如 Fable 这类能完成周末任务、长时间工作量的能力就很难展示。当时 Labs 的使命是确保产品不要落后于模型指数式进步。Claude Code 就来自第一代 Labs,因为其他产品团队有人在考虑编程,但没人有空间彻底改变形态,拥抱模型会以这种方式演进的事实。
Mike Krieger:Labs 最有用的两个思考练习是:第一,想象模型今天能做的事和多数人实际使用方式之间的差距,然后想办法缩小它;第二,想象模型现在不擅长、但六个月后会非常擅长的事情,然后提前准备产品。Computer Use 也是第一代 Labs 的产物。我们刚做它时效果很糟,比如让 Claude 帮你清理桌面,它会点错东西、删除文件,根本不能发布。但我们保留这个产品,每次新模型出来先内部测试:Computer Use 有没有变好?然后把变化反馈给研究团队,直到某一刻我们认为它足够好,可以围绕它发布产品。它像一座指向未来的灯塔,让你用它衡量未来产品。
Mike Krieger:今天的情况不同了。我们有了很强的产品团队,有 CoWork,Claude Code 增长很大,也有平台。现在 Labs 不再是因为其他团队不做这类思考,而是因为模型进步太快,我们与模型互动的能力也必须演进。比如今天发布的 Claude Code artifacts,就是 Labs 与 Claude Code 团队合作的结果:让 Claude Code 不只是打字回复,还能画图或给出可视化说明。这来自 Labs 很长时间的判断:单一文本框和长文本回答已经不够了。有时模型听起来比我聪明,我会说“能不能给我画张图”,因为我需要那样才能真正理解。我们也在做产品整合,但核心仍然是让不整天研究提示词、指数曲线、高中低 effort 区别的用户,也能更容易使用这些能力。 [00:17:10]
Alex Kantrowitz:这会让使用 Anthropic 模型的人处在一个有趣位置。Cursor 据说刚以 600 亿美元卖给 SpaceX,有人发梗图说,如果没有创造 Claude Code 的 Boris Terny,Cursor 可能能卖 3000 亿。那些在 Anthropic 技术之上构建产品的公司会想:我是和 Anthropic 合作,还是 Anthropic 会在合作之后做出我想做的产品?
Mike Krieger:以 agentic coding 为例,更广泛地说,既做平台又做产品这件事确实很有意思。我们做项目时,目标通常是推动行业某个方向前进。AI 编程编辑器之前就存在,也有些做得很好,但没人像 Claude Code 那样以那么自由的方式思考。现在更多产品有了这种味道。如果我们进入某个行业,只是做所有人已经在做的事,然后加上 Anthropic 品牌,那就是对 Labs 和产品团队时间的糟糕使用。我们进入某个方向,应该是因为我们认为行业要往那里走,并且能构建一个产品证明它。同时,不应该出现所有产品都属于 Anthropic 的世界,那会很糟。理想状态是创造新空间,或者展示其他产品可以吸收的方向。 [00:18:45]
Lauren Goode:这几乎像一家同时做社交、消息、视频等所有东西的科技公司。比如 Anthropic 推出一个被认为和 Figma 竞争的产品,而你之前在 Figma 董事会,所以你后来离开了董事会,对吗?这也是 Alex 问题的一部分。硅谷一向以健康、活跃、容忍风险的创业生态闻名。当大公司带着大量资本和资源进入时,人们会问:他们是不是要偷走我的想法? [00:19:12]
Mike Krieger:我们的双重存在确实需要谨慎处理,其他公司也要处理类似问题。比如 Amazon 既是基础设施提供商,又有大型电商、视频业务,也服务视频客户。很多客户可以在这种双重世界里生存:他们使用 Amazon 的基础设施,也知道 Amazon 自己也用这套基础设施做业务。你们可以问我们的客户,看我们做得如何。我努力做到的是透明。Cursor 的例子里,我和 Michael 反复沟通过方向会往哪里走。另一个原则是共享构建模块。我们尽量使用外部也能使用的同样能力来构建,而不是内部独占。年初我在同一个舞台参加 Anthropic 的 healthcare day,我们发布的不是只有我们能用的“Claude Healthcare”,而是一系列插件、skills、MCP 和互补能力。我不说这很容易,也不说它没有复杂性,但这是我们处理这种复杂局面的方式。 [00:20:32]
Lauren Goode:说到创业公司,Anthropic 技术上仍然是创业公司,但估值已经非常高。Instagram 当年卖了 10 亿美元,在 2010 年那确实是创业公司;现在金融环境完全不同。Anthropic 又把自己定位成一家 PBC,并以更有伦理感的 AI 公司形象出现。你如何看待这种定位改变硅谷文化?我会想到 2000 年代初 Google 改变硅谷文化的方式。你觉得 Anthropic 的文化会如何塑造下一个时代? [00:21:19]
Mike Krieger:这个问题很有意思。我先从内部讲起。我加入 Anthropic,是因为我在结束第二家创业公司 Artifact 时,确定自己想去一家前沿实验室工作。我已经开始用模型写代码,它们当时还不擅长写代码,但我能看出那会是它们最差的阶段,未来只会变好。Artifact 做的是 AI 驱动的新闻推荐,我们也基于这些 API 构建过东西。Alex 以前通过 Artifact 读了很多 Big Technology。Wired 因为有很强的付费墙和登录 cookie,在应用里处理邮件登录很难。 [00:22:10]
Mike Krieger:我最终去 Anthropic,是因为他们言行一致,真的深信要让 AI 对人类有好结果。这在公司内部像水一样流动,也是公司增长后仍然保持凝聚力的原因之一。联合创始人们也经常谈这件事。对我来说,这和 Instagram 的经历很不同。Instagram 每周全员会大部分时间都在谈产品,或许也会谈市场和公司事务,但非常以产品为中心。我在 Anthropic 大约六个月时,和销售组织的领导之一 Kate Jensen 做过一次联合全员会,讲产品和 go-to-market 如何协作。大家反应是:“太好了,我终于理解了我们的产品战略。”我才意识到,这不是传统意义上的产品公司,而是一家使命驱动的 AI 公司,很清楚自己为什么存在。至于它对硅谷的影响,还要观察。我看到的积极信号是,大家重新对慈善事业产生兴趣;根据 AI 走向不同,这可能带来很多新的慈善投入。另一个重要点是,关于 AI 应该如何发展的讨论正在和技术同步发生,而不是像过去很多技术浪潮那样事后追认。 [00:24:08]
Alex Kantrowitz:我也插播一下。我和 Gravitee 做了一部纪录片,讨论 AI agent 安全的未来,采访了 MIT 教授 Ramesh Raskar、前白宫 CIO Teresa Payton、Michelin 的数据与 AI 负责人 Ambika Rajagopal、前 Alibaba 高管 Sharon Guy,最后和 Gravitee CEO Rory Blundell 讨论前路。链接在 show notes 里。回到问题:你说 Anthropic 看到了模型能力和大家实际构建产品之间的差距,Labs 的任务是提前展示 AI 现在和六个月后可能做到什么。请告诉我们你们在构建什么、你看到哪些潜力、大家应该关注什么。给我们一个路线图。 [00:25:40]
Lauren Goode:我也加一个问题:除了你们现在在做什么,如果你有什么“空中数据中心”那种听起来像 Elon Musk 式的宏大愿景,我也想听。告诉我们全部。
Alex Kantrowitz:接下来 15 分钟就由你做产品独白了。
Mike Krieger:我最兴奋的是两个主题。第一个,是给 Claude 一个更有能动性、更有自我认知的环境。现在我们在很多地方做得还很差。比如你在 Claude Project 里让 Claude 生成一个文件,然后说“把它加到项目里”,它会说你需要下载文件再拖进去。昨天之前,Claude Design 和 Claude Code 之间也是这样:你在 Claude Code 里需要一个设计,或者在 Claude Design 里做了 mockup 想构建,结果拿到的是 zip 文件。这有点像互操作性问题,但更大的主题是,如果你让 Claude 更了解自己的环境,产品表达力会完全不同。有 API 客户在实验一种方式:在 agent loop 运行时,给 Claude 一个安全版本的源代码。如果它遇到问题,就不是说“我不知道”,而是能对维护者说“问题可能在这里”。当然,这必须有保护措施,要非常小心开放什么权限。但从产品能力来看,这是昼夜之别。你也能从 Claude AI 的经典聊天到 CoWork 的变化里看到一点:它有更多能动性,有运行时,也更理解环境。但我觉得我们只走了 10%。像 OpenClaw 这样可修改、可对话、不会总说“你必须去设置页打开”的 harness 令人兴奋,前提是有正确的权限和治理。如果做对,它会从头到尾改变我们的产品。
Mike Krieger:第二个主题,是缩小人们理解自己工作的方式和实际完成日常工作的方式之间的差距。我和公司隐私团队的一位同事聊过,她要把一个 ticket 从一个队列移动到另一个队列,再经过任务追踪器到下一个位置,需要八个复制粘贴步骤,还要不断抽查,既烦人又容易出错。我们用一个 Labs 项目帮她把这件事变得不痛苦。她说,这是她 30 年职业生涯里第一次感觉“我脑子里想的工作流程”和“我实际使用的工具”终于合上了。我想把这种感觉带给所有人。Claude 已经让很多非技术人员能写代码,但我们仍然要求用户理解太多概念:沙盒环境和生产环境有什么区别,MCP 是用自己身份还是别人身份连接,数据应该存在哪里。你不可能抽象掉一切,但如果把这两个主题结合起来,让 Claude 有足够的自我认知,又给它一个能以可重复方式解决复杂问题的环境,我会非常兴奋。至于 moonshot,不是在太空里做东西,虽然我们确实在和 SpaceX 谈一些太空相关事项。 [00:29:39]
Lauren Goode:那是探索 extraorbital 还是 post-orbital 之类的事情?这绝对不是我的部门,但确实有真正的 moonshot。所以 Labs 并没有具体和算力团队合作?
Mike Krieger:对,算力和芯片是分开的。至于我个人是否相信太空数据中心,我不是数据中心专家,但我和一个把东西送上太空的人聊过,不是 Elon Musk。他非常看好,理由基本是:如果转换得好,能获得近乎无限的能源和土地。他们也对需要的屏蔽技术很有信心。起初我觉得这想法很疯狂,但那次谈话后,我能理解它为什么可能成立,哪怕还需要几年。 [00:30:08]
Lauren Goode:你前面谈到 Claude 中的工作会被压缩,很多步骤会减少。我忍不住想到 token。短期看,如果用户必须走很多步骤、消耗很多 token,似乎对商业模式有利。token 已经成为描述这个行业经济学的单位,大家有时在 token maxing,有时又在 token minimizing。第一,我想听听你在这条光谱上如何使用它。第二,未来有没有可能行业不再用 token 衡量,就像 MIPS 或拨号上网那些旧指标一样,换成另一种定义这个时代经济学的单位? [00:31:39]
Mike Krieger:这两个问题都很有意思。今年早些时候,有些公司会展示谁用了最多 token 的仪表盘。我们当然也有内部指标,但我们发现,使用 token 最多的人和我心中最有生产力的人并没有很强相关性。大家可以在自己公司试一下:先写下你认为最有生产力的十个人,再看 top 10 token users,两者未必重合。单纯表扬最大使用量是危险的,也很容易被游戏化。更深一层是,你可以让 Claude 对某个问题给出十个变体,但如果你真的深入思考过,也许只会选择两个最有希望的方向,再在迭代后加第三个。所以我不认为 token 数等同于价值。真正消耗最多 token 的,可能是我那个从 Python 转 TypeScript 的项目,确实用了几百万 token。但我们在看模型发布时,不只看模型智力,也看智力、effort 和 token 效率的组合。未来很大的杠杆,是在给定任务上越来越高效,最好用户不需要刻意思考,我们自动把解法调到更适合问题的形态。
Mike Krieger:至于基于结果的定价,我在 CPO 角色时确实想过。如果是 Sierra、Fin 这类有清晰客户服务结果的场景,比如一个客户请求被解决而没有升级,那比较好定义。但现在我们问 Claude 的很多任务非常模糊。比如我让 Claude 批判我的战略文档,结果是什么?也许要六个月后才知道战略是否有效。因此很难捕捉价值。我希望看到更多实验:能不能更好地捕捉它对个人或公司的价值,再找到合适的收费方式。我们最具体的尝试是 Claude Vantage 智能体:我们替客户运行 agentic harness、工具调用和基础设施。普通模式是你给它任务,它消耗 token,完成后告诉你。另一种结果模式则是你定义“好结果”是什么、给出 rubric,它就按结果导向去执行。 [00:34:05]
Alex Kantrowitz:也许如果大家都转向这种 API,定价就能更多基于结果。我们这里有一张 Financial Times 的图,显示应用发布数量在飙升,但获得显著使用量的应用似乎减少,应用评论也在下降。Mike,你怎么看?是不是每个人都在写代码和发布应用,但我们并没有真的看到生产力大爆发? [00:35:02]
Mike Krieger:这和应用使用的大趋势有平行之处。我一直在想消费级 AI 的突破产品会是什么。到目前为止,我不确定我们是否已经看到很多。我的背景是消费者产品。Instagram 发布时,应用生态还像荒野时代,人们对 app 很兴奋,两个看起来很随机的人做出一个 app,三个月内就能冲到照片和视频榜第一。今天这难多了,前十名高度固化,很多时间被 TikTok、Reels 这类产品占据。突破性的消费者体验非常难。这也说明消费者产品的集中度有多高,数据重力有多强。比如你的 Google Docs 就在 Google Docs 里,即使有人做了一个强两倍的 AI 文档编辑器,你会不会迁移所有内容?也许不会。难的事情仍然难,做出人们想要的东西仍然很难。我们内部有非常强的模型,但并不是所有产品都会成功。这对产品人反而是利好,因为说明我们仍然有价值。即便能更快写代码,突围在很多方面比以往更难。至于 Instagram,如果今天有这些工具,我们也许能用一个月而不是三四个月做出来。 [00:36:54]
Alex Kantrowitz:Instagram 卖出时大概有 13 或 18 个人。用这些工具,你觉得当时需要多少人?大家都在说“10 亿美元一人公司”,你们能接近到什么程度?
Mike Krieger:我觉得也许四到六个人可以做到。更重要的是,如果继续发展,我们可以并行做更多事情。Instagram 当年的产品团队像五岁孩子踢足球:球在哪,所有人都跑过去。要做视频,所有人就去做视频。我们没法分位置。Android 版当时用了大约一个月,我们把所有人从 iOS 拉走,大家重新学 Android,在那一个月里 iOS 更新几乎停了。今天用模型,Android 也许一周就能做完。现在我在 Anthropic 内部有一个 Labs 项目,用来加速工程师写代码和 code review。我同时维护它的 iOS 和 Android 版本。我可以让做 iOS 的 Claude 去 ping 做 Android 的 Claude,说“我实现了这个功能”,然后 Android 版本判断这个功能是否适用、如何实现。我们当年不能把所有这些都委派出去,但平台接近平价的梦想现在变得相当可行。 [00:38:40]
Lauren Goode:你现在可能会接到 Instagram 剩下那些团队成员的电话,问自己在新时代还能不能入选。听起来如果你愿意,也可以把 Gotham 带回来。最后一个问题:你曾经参与的产品后来在儿童伤害等问题上变得具有伦理争议。你说消费级 AI 还没有真正的爆款,但我觉得已经有一个:聊天机器人。聊天机器人已经给年轻人带来真实危险和伤害。你在 Labs 构建产品时,如何考虑让这项技术变得更强所带来的潜在伤害和风险? [00:39:25]
Mike Krieger:我们确实有一些原型或概念,会让我们说:这个产品如果发布,对世界不好,或者会把人推向错误方向;即使我们做的是较好版本,更道德复杂或更糟糕的版本也可能带来伤害。内部经常问这个问题会产生差别。我们有核心产品和模型表现很好,这给了我们一种奢侈:如果某件事可能被广泛使用但方向不对,我们可以选择不做。更重要的是把这种思考前置。现在让公司里有人,Anthropic 尤其会这样,比如经济学家,提前思考你构建的东西会如何影响世界,这已经更正常了。 [00:40:17]
Alex Kantrowitz:在社交媒体发展的很多年里,这并不是常态。Mike,和你交流总是很棒。谢谢你今天带来这些见解,也期待很快再见。让我们再次感谢 Mike 和 Lauren。谢谢,干得漂亮。
本期围绕“马拉松破二究竟靠人还是靠鞋”展开。麻花从伦敦马拉松两位男选手跑进 2 小时、冠军穿着阿迪达斯 Adios Pro Evo 3 切入,提出这不仅是人类挑战极限的事件,也是一场长期的跑鞋技术和品牌竞争。盖德结合自己在 Nike、阿迪、Kappa、索康尼等品牌做产品经理以及长期跑步的经历,回顾了现代路跑鞋从 1960 年代以来的关键技术变化:从 New Balance Trackster、Brooks Vantage 的 EVA 发泡,到 Nike 华夫底、Air 气垫、亚瑟士 Gel、Nike Free、阿迪 Ultra Boost、Nike Zoom Vaporfly 4%,再到阿迪 Adios Pro Evo 3。两人的核心判断是:破纪录不能只归因于鞋,也不能只归因于运动员。顶级运动员、品牌长期研发、材料供应链、产品迭代、赛事营销和选手签约共同推动了“破二”这一结果。
节目首先讨论中底为什么是跑鞋技术竞争的核心。盖德认为,很多“定义时代”的跑鞋在早期更像品牌传播概念,真正改变市场格局的是材料和结构在跑步场景里的有效结合。阿迪 Ultra Boost 把超临界 TPU 泡棉引入跑鞋,带来了高回弹和缓震,但重量限制让它更快统治了通勤市场,而不是马拉松竞速赛场。Nike Vaporfly 4% 的关键不只是碳板,而是 PEBA 超级泡棉和碳板的组合,它用“提升跑步经济性 4%”这样的实验室数据重塑了竞速跑鞋叙事。盖德也提醒,实验室数据会受跑者体重、跑姿、频率和穿着习惯影响,真实体验存在很大差异。
中底之外,节目还讲到鞋面、鞋楦、材料供应和研发流程。盖德解释,一双成熟跑鞋通常需要多轮修改,可能经历十几个甚至二十多个版本;不同品牌看似用了不同技术,背后也可能来自同一家化工或材料供应商。真正的竞争不只是“拿到某种材料”,还包括如何发泡、如何调校中底、如何让鞋面包裹、鞋楦适配和整鞋重量共同服务于跑步动作。跑步和篮球、训练等运动不同,马拉松是同一个动作重复四万多次,任何微小的不适、重量或支撑问题都会被放大。
关于赤足跑鞋和极简跑鞋,节目把 Nike Free、五指鞋等产品放进技术史里看。盖德认为,这类鞋并非完全虚假宣传,它们确实可能锻炼足部小肌群,帮助恢复脚底原始功能,但效果因人而异。对于长期在硬质铺装路面跑步的人,如果突然从厚底缓震鞋转向极薄底鞋,脚踝和膝盖可能先受伤,锻炼收益还没出现就已经付出代价。因此这类产品后来没有持续统治跑鞋市场,更适合被理解为训练工具,而不是人人适用的马拉松答案。
在阿迪与耐克的竞争部分,麻花提出 Adios Pro Evo 3 帮助选手破二后,外界开始讨论竞速跑是否进入阿迪时代。盖德认为这件事既有技术因素,也有偶然性:这双鞋做到了极轻、可量产,并被阿迪赞助的顶级运动员穿上完成历史性成绩,但它本身是限量款,不能简单等同于阿迪全面统治马拉松。阿迪采用碳柱而不是传统碳板,更多是基于自身技术路线、足部结构理解和专利环境做出的选择;真正重要的是整鞋是否能在重量、回弹、稳定和推进之间取得平衡。
耐克的 Breaking2 项目和 Vaporfly 系列则代表另一个阶段。Vaporfly 强到让多家竞争品牌联名呼吁国际田联调查,讨论它是否构成“技术兴奋剂”。但盖德指出,跑鞋竞争从来不只是科技。品牌还要提前发现运动员、签下有潜力的苗子、维系教练和训练营关系,并让产品在运动员真正出成绩前完成匹配。耐克曾拥有很强的技术和运动员资源,但天才选手吉普图姆因车祸去世,也让破二机会发生变化。顶级纪录背后既需要鞋,也需要极罕见的人。
节目后半段转向品牌格局。盖德认为近几年跑鞋技术更多是小修小补,不是每年都有 Boost 或 Vaporfly 那样的革命性节点,但技术进步会螺旋式上升,下一次大突破仍值得期待。阿迪 Adizero Evo SL 的热卖说明设计、时尚属性和清晰视觉语言也能把专业跑鞋带入更大众的市场。New Balance 的增长则说明,跑鞋品牌的成功不只来自竞速性能,也来自休闲时尚、品牌定位和消费场景扩展。与此同时,跑步市场可能遇到增长瓶颈,品牌开始加码越野跑、Hyrox 等新场景。
最后,节目谈到国产跑鞋。盖德认为国内品牌与国际品牌仍有差距,尤其在长期研发周期、原创技术方向和稳定迭代上还不够成熟,但差距正在缩小。国内品牌已经能把国外经验学得越来越像,也有安踏等品牌尝试在美国做跑步社群、参加跑鞋展会,一些初创品牌也在发展海外经销商。盖德判断,跑鞋出海并非不现实,东南亚、非洲等市场可能是更自然的切入口;相比汽车,跑鞋出海的门槛可能更低。
1. 马拉松破二既靠人也靠鞋:运动员天赋、品牌研发、材料技术、产品调校和赛事营销缺一不可。
2. 跑鞋技术竞争的核心长期集中在中底,但真正有效的是材料、结构、重量、鞋面和鞋楦的整鞋协同。
3. Vaporfly 的突破不只是碳板,而是 PEBA 超级泡棉与碳板组合带来的跑步经济性叙事。
4. Ultra Boost 证明好材料不一定统治竞速赛场;重量和场景适配会决定技术最终进入通勤还是比赛。
5. 赤足鞋有训练价值,但并不适合所有跑者在硬质路面直接长期使用,循序渐进比概念更重要。
6. 阿迪 Adios Pro Evo 3 的破二成绩有技术含量,也有运动员和时机因素,不能简单推出阿迪已经全面统治马拉松。
7. 品牌竞争同样是运动员签约和体育营销竞争,提前发现选手、维护训练资源和团队稳定性非常关键。
8. 国产跑鞋与国际品牌的差距在缩小,未来机会既在技术积累,也在更适合切入的海外市场和新运动场景。
- 破二时代与跑鞋战争开场 [00:00:00 - 00:10:00]
- 中底材料、鞋面与研发流程 [00:10:00 - 00:20:00]
- 赤足跑鞋兴衰与统治时代 [00:20:00 - 00:30:00]
- 阿迪破二、碳柱与耐克Breaking2 [00:30:00 - 00:40:00]
- 马拉松营销、耐克失势与阿迪回归 [00:40:00 - 00:50:00]
- Adizero热卖、New Balance增长与国产跑鞋 [00:50:00 - 01:00:00]
- 人和鞋共同推动马拉松破二 [01:00:00 - 01:01:40]
麻花:本期节目由vivo X Fold 6赞助播出。作为主播要能够在任何时间任何地点迅速开启工作。以前筹备播客时手机像是一个资料中转站,真要干活时还得开电脑。最近我尝试了一下X Fold 6,作为外出办公的搭子真是太方便了。无论是我想去咖啡店或者公园找找灵感,只要我展开折叠屏,一块大屏, 思维导图列大纲,AI查资料,微信对接嘉宾,备忘录记笔记。它源自工作台的功能,能让这四个界面同时开着,不用切来切去,灵感断掉的次数也少了,还有一点,我们每次准备节目,都要收集大量的资料,文档动一个,吸一个,找起来特别麻烦,这个手机端侧的AI 可以根据文件内容自动命名,甚至可以根据主题生成专题空间,想找什么直接问就行,资料再多也不怕找不到了 AI时代的移动办公 不应该被困在电脑上,接下来就进入今天跑鞋战争的故事吧,他们像火箭一样,逆势而上 四方云霄,鼓舞战全人类 2026年4月26日,人类在马拉松这个运动上 130年的探索终于进入了破二时代,在伦敦马拉松的比赛中,肯尼亚选手萨维以1小时59分30秒的成绩夺冠,成为了历史上首位在正式马拉松比赛中,跑近两小时的运动员,这场比赛的亚军克莱恰同样跑进了两小时,创造了历史,你可以说这是人类不断挑战自身极限的过程,但它背后也是一场跑鞋战争,毕竟萨维和克莱恰,包括这场比赛的女子冠军阿塞法,她们穿的鞋都来自于阿迪达斯的Dios Pro Evo 3 这让阿迪瞬间风光无量,在这次破之前,马拉松的赛场长时间被耐克统治,他2016年推出的Vaporfly 不仅在赛场上拥有极高的上教率,还让众多运动鞋公司一起找到国际田链呼吁,认为耐克的鞋是一种技术兴奋剂,要求对其加以规则限制,一个冷知识是,尽管跑步这项运动自古有之,但直到1960年代,人们才真正拥有专门为路跑设计的现代化跑鞋,在阿迪·耐克双雄争霸之前,跑鞋的革新一度属于过 New Balance、布鲁克斯、索康尼和亚瑟士,那么陆跑鞋60多年的发展历史里,都发生过哪些技术变革,运动鞋公司之间的跑鞋竞争,又到底是在比拼什么呢,大家好,我是硅谷101的特约研究员麻花,在这期节目里,我们邀请到了运动锤雷播客,敌谈概论的主播盖德,一起聊聊跑鞋的变化,和运动鞋公司之间的暗战,在这里呢,我要先叠一个假 本期节目谈到了多个跑鞋产品的,技术亮点和优劣势,我们尽量做到客观分析,理性评价,并不会支持个别品牌的个别产品,此外,节目涉及到的运动鞋材料专有名词,我们也会在show notes里,为大家展示出来,哈喽盖德,欢迎您来参加贵国101的录制 [00:02:49]
盖德:请您先介绍一下,您自己的工作经历吧,你好麻花,我现在是一个全职的自媒体人,主要从事的是跑鞋评测相关类的内容,其实我加入运动行业是在2006年,那在几个比较大的国际品牌,包括Nike、阿迪,都是从事过产品经理的职位,后来也是加入了一些国产品牌,包括像Kappa、索康尼,刚入行的时候做的是篮球,后来做过男子训练,然后做过一些休闲时尚类的服装,后来在索康尼是主要,从事跑鞋相关的工作,那您自己跑步有多久了,跑步频率是什么样子的呀,我如果从刚开始跑步算的话,那到现在应该已经超过 15年的时间了,我第一次参加马拉松比赛,是在2009年参加了,北京马拉松半程距离的比赛,后来在各大运动品牌,从业的期间呢,也是断断续续的,有进行过跑步,但是都没有规律性的,进行跑步运动 那后来是加入了索康尼之后,因为我从事的主要是,跑鞋相关的工作嘛,所以我觉得如果要对跑鞋,有比较深入的了解,还是应该自己去跑,这样你才能得到,第一手最直观的,这样一个体会,所以从我19年加入索康尼,就开始规律的跑步了,每周大概是跑三到四次吧,每个月的跑量,应该是在100公里到200公里,这个根据空闲的时间来定,因为我想做这个话题,最开始的初衷是 4月份的时候 [00:04:04]
麻花:伦敦马拉松有两个跑者,穿着阿迪最新的跑鞋,是破了人类的禁路,都跑进了两小时,就有很多人说,可能未来跑鞋或者说马拉松,就进入了阿迪定义的时代,我就去翻了一下,过去跑鞋迭代的历史,我发现在跑鞋史上,其实是诞生过很多双,所谓的定义时代的跑鞋,我看到1960年代的时候呢,是New Balance出了一个New Balance Trackster 当时是因为第一双波浪纹的跑鞋,然后有更好的抓地力 1970年代的时候呢,是Brooks 他出了一个叫Vantage的鞋,是第一次大规模量产的,用到了EVA这种发泡棉的技术,然后后来又有耐克的华夫迪跑鞋,包括耐克在80年代又有Air气垫的跑鞋,后来还有亚瑟士的Gel缓震胶,进入21世纪过后又有Nike Free 阿迪的Ultra Boost 还有Nike Zoom的Vaporfly 4% 然后就是最新的阿迪的Adios Pro Evo 3 我就想知道,在明面上的跑鞋战争背后,运动鞋公司到底是在比拼什么,那些所谓的划时代的产品是怎么来的,还有一些细节问题,比如刚刚提到的很多双跑鞋的技术迭代,都是跟中底有关 [00:05:24]
盖德:那中底对跑鞋来说是为什么那么重要,我觉得之前那些,所谓定义时代的跑鞋,其实更多是品牌自己的宣传,因为在那个年代,别说自媒体了,可能传统的媒体,都没有那么发达,所以大家得到资讯的,这个渠道比较有限,那可能更多就是,从品牌它自己的一些宣传上面,来得到这些产品的信息,这些产品的,其实都是从某一方面,或者是某一个细节,革新了以前跑鞋的那些科技,但是真正要统治跑鞋的这个市场,我觉得比较大的事情有两个,第一个应该就是,阿迪的Ultra Boost 它是第一次把超人界的材料,引入了跑鞋,但是这个变化其实很快,它并没有统治慢跑鞋市场,而是很快的统治了通勤的市场,对,大家都会穿那个彩石感的鞋,对对对,但是那几年它的能见度,和曝光率确实非常非常的高,包括后来的椰子,也是用了这个Boost的科技,那统治马拉松赛场呢 这个就是Nike后来做到了,因为它是真正的把碳板,和超级泡棉这两项技术,融合到了一起,放入了马拉松竞速跑鞋里边,那我们在2019年到2021年这两年间,在马拉松赛场上 Nike的Vaporfly和AlphaFly这两双鞋,真的是可以做到一个统治级的上脚率的占比 Ultra Boost它应该是第一次用到了 TPU超零件泡棉这个技术,您能讲一下这个技术相比之前的那些EVA的鞋底好在哪里吗,它就是把化学添加剂加入到一些EVA的机材当中,然后进行发泡,那超零件发泡呢,它是把氮气或者是一种惰性气体,加入到中立的基材当中,然后把它们融合成一种,介于固体和液体之间的超灵界的状态,超灵界指的是介于固体和液体之间,对它是一种发泡的工艺,这个其实是两方面的问题了,一个是跑鞋那个基材升级,就是从以前的EVA升级成 现在的TPU TP双翼以及PIPA 这些更高级的中立的基材,发泡的工艺也是从以前的化学发泡,进步到了现在的超灵界发泡 [00:07:33]
麻花:虽然它的回弹很好,缓震效果很好,但好像重量是偏重的,所以反而它统治了通勤市场,但没有统治公路赛跑的市场,是这样吗,对就是这个原因,那后来Nike Vaporfly诞生之后
盖德:为什么能统治马拉松跑鞋的市场,很多人都以为是碳板的原因,但是其实碳板它只是一方面,碳板运用在跑鞋当中,这个历史已经非常长了,就80年代,布鲁克斯就已经把碳板,用在跑鞋中了,而其实碳板在篮球鞋当中,也是有过大规模的运用,包括像Nike最知名的Air Jordan 11代,以及后来FonePosite 都是用了很大的全掌碳板,那为什么Nike 它把碳板用在跑鞋当中,就可以重新定义,马拉松竞速跑鞋呢,是因为它配合了超级泡棉,就是Nike的Zoom Max这个泡棉,第一就是它重量非常的轻,而且它可以发泡倍率,做到特别的大,所以它特别的软碳,所以Nike把碳板,加入了这块超级泡棉当中,让它不会一软到底,不会一脚就踩到底,因为碳板它起到了一个支撑的作用,同时它们还能起到一个推进力的作用,配合泡棉的弹性,把它的推进力得到最大化的发挥,因为你知道在这个跑鞋诞生之前,以前的马拉松性素跑鞋 它的底都是非常薄的,这个也回答了你的第二个问题,就是为什么中立这么重要,因为以前的EVA的中立,它很难做到又轻缓震又好,然后回弹又好,马拉松运动员他们追求的就是要轻,所以底一般都非常的薄,对于我们这种业余跑者来讲的话,你穿着这么薄的底跑一个马拉松,你的脚到最后可能都废掉了,所以以前那些专业马拉松运动员,穿的竞速跑鞋,一般人是穿不了的,但是Nike它把碳板和超级泡棉,结合到一起之后,中底它就是既有缓震,又有轻量化,所以我们业余跑者,也可以穿着专业马拉松运动员,穿的竞速跑鞋去跑马拉松了,那这样的话,它的普及率就一下子普开了 [00:08:50]
麻花:其实Nike它用了,皮靶超级泡棉加碳板的 Vaporfly 4% 它这个鞋,它之所以叫4% 是因为它能够把跑步经济性,提升4% 所谓的跑步经济性,就是跑者在跑一次,马拉松里面消耗的能量,它能够减少能量的消耗,你们在业内研发跑鞋,这个数据是有科学依据的吗,确实是这个样子的吗,这个更多是在实验室做出来的 [00:09:28]
盖德:你看现在很多跑鞋,在宣传的时候都宣传我,这个跑鞋能跑多少公里,鞋底的耐磨性
盖德:鞋底的耐磨性,能坚持多少公里,包括我的中立的回弹有多少,其实这个都是在实验室的,一个理想环境下做出来的,那实际穿上,每个消费者的脚之后,每个人脚都是不一样的,你的跑姿,你的体重,包括你跑步的频率,你穿鞋的频率,都是不一样的,所以实际上出来的效果,可能会差距非常非常大,我懂了,所以这个4%
麻花:其实是一个理论上减少4% 具体以实物为主,以实际跑步为主,是不是就跟方便面,那个广告一样,对对对,这个我们常说的千人千脚,就刚刚谈了很多中底的技术,中底它是分了两大类型的,有一种叫机械结构的中底,有一种叫发泡材料的中底,那按照您刚刚说的,在Nike和阿迪做这个突破式的创新之前,其他的都不算是什么定义时代的产品,是不是机械结构这种物理结构,对跑鞋的更新,其实都不算是特别突破性的跑鞋,是到了发泡材料的更新迭代过后,才有了突破性的进展的,是的,以前做结构缓震 [00:10:19]
盖德:也就是你说的机械,结构缓震,其实之前阿迪和Nike都尝试过,包括Nike出的Shox 阿迪后来出的A3 但是有一个很大的问题,就是用结构减震,它的重量就会更重,所以它更多是用在篮球鞋上,可能比较合适,那用在跑鞋上,对跑步的影响还是非常大的,其实这里就回答,你刚才问的第二个问题,为什么中底对跑鞋这么重要,因为跑步,这个运动和其他的运动,很大的一个区别,它就是一个单一动作的,不停的重复,你像一场马拉松 42.195公里,你可能要跑个4万多步,那就是同一个动作,你要重复4万多次,除了跑步之外,你可以设想一下,其他的运动都没有,这样单一动作一直重复的,包括打篮球,其实你的脚步是一直在变的,前后左右垂直的起跳,足球网球羽毛球,都是在不停的变化,那只有跑步,它是不停的在重复一个同样的动作,那每次落地,它的这个冲击力是不断的会累加的 这个压力会加到你的关节上,加到你的肌肉上面,也会加到跑鞋的中底上面,所以中底对于跑步来讲,就是至关重要了,你不能只在刚开始性能非常的优秀,你要保证在马拉松42.195公里,这么长的一个距离当中,你的重力一直都要保持一个比较优秀的性能,明白,那跑鞋的技术之争就只是中底之争吗,就除了中底之外,它还在哪些方面还会有技术之争,其实还是挺多的,包括鞋面的材料也是不停的在升级,最开始都是用皮革材料,那个重量也是非常重的,而且透气性也非常差,那后来推出了这种工学网眼,但其实工学网眼,现在很多的慢跑鞋也一直是在用,它的延展性都是比较好,然后透气性也可以做到比较好,舒适度也很好,就是各方面比较均衡,那现在很多的竞速跑鞋呢,它为了轻量化,为了包裹性比较好,就是侧面的强度要足够,就是要撑得住你的脚 不让你的脚在这个鞋里边乱晃,所以它用了一些高强度,然后重来有比较轻的材料,但是这样的材料呢,可能往往舒适度就没有那么好了,当然这些鞋面材料科技的升级,可能跟中立相比的话,其实没有那么重要,因为我们看到现在的慢跑鞋,很多还是在用传统材料,除了鞋面之外呢,还有一些鞋楦,鞋楦对跑鞋也是非常重要的,就像一些国产品牌,在宣传的时候,经常会说他们的鞋楦,是针对中国人,或者亚洲人的脚型,做了一些特殊的优化,为什么有四大慢跑鞋之说,应该是布鲁克斯,索康尼 New Balance 和亚瑟士,是吧,对,为什么他们在慢跑鞋领域,做得这么好,就是因为他们的鞋楦,做得非常的舒适,既能提供包裹性,又不至于过分的窄,产生脊脚的情况,而且他们还提供了,各种不同宽度的鞋楦的选择,这个目前在国产跑鞋里,还比较少见到,除了鞋楦之外呢,还有一点就是坡差了 这个也是一个,网上非常有争议的一个话题,坡差就是跑鞋,它的后跟和前掌的高度的差别,每个人的喜好不一样吧,我觉得这个没有一个定论,因为很多人他会说,零坡差最好,就是前掌和后掌跟一样高,这样是最符合,人体的自然的步态的,但是也有人就是喜欢高坡差的鞋,就后跟比前掌要厚超过一厘米,他会觉得这样穿着,后跟的缓震更充分,大家其实可以根据自己习惯的,一个跑步方式来进行选择 [00:13:42]
麻花:因为您也在国内国外的,运动鞋品牌里面,做过很多产品经理的职务,我就想了解一下,一双跑鞋它的研发流程,大概是什么样子的,一个全新的技术,不管我们刚刚说的鞋楦,中底或者鞋面的技术,就一个全新的技术,它从诞生在实验室,到出现在运动员的脚上,再到出现在大众的货架上,这个时间和流程,大概是什么样子的呀,各个品牌之间区别都很大,因为我理解最深的 [00:14:10]
盖德:第一个就是 Nike它有一个 Innovation Kitchen 叫创新厨房,这个在Nike的,俄勒冈的那个总部,它是最高机密的一个区域,包括我们去总部参观的时候,这个区域都是禁止入内的,那里边就在进行一些,最尖端或者是,最新的一些科技的研发,就像Nike它的Vaporfly 宣称是超过了,四年的这个研发时间,包括索康尼的,第一双碳板金属跑鞋,飞鹏它也是有20多个版本的迭代,从第一版出来到运动员测试,然后反馈修改,最后经过了20多个版本,才最终确定了量产上市的这个版本,国产品牌呢,其实像特步它也是有整个一层楼,超过3000平米的跑步的一个产品实验室,里面也是有各种的设备,各种的仪器,包括还有一个很短的一个跑道,让运动员在上面来进行测试,然后他们也会用各种人体的活化线传感
麻花:或者是慢动作来拍摄跑步的姿态,他们这种非常前沿的一些跑步技术的迭代,他的迭代的灵感或者说迭代的需求,是从大众市场来的,还是直接和运动员沟通里面来的 [00:15:28]
盖德:竞速跑鞋可能更多还是为了满足运动员的需求,特别是像Nike、阿迪、特步这种,都有国内外的这些顶尖运动员,所以运动员如果能创造一个比较好的成绩,这个对他们的产品的口碑是能够起到非常大的帮助的,所以他们也是用自己最大的努力来帮助运动员取得更好的成绩,但是可能有些,不管是国内,或者是国外的这些小品牌,他们可能也只有一年,或者一年半的研发时间,因为他要赶每一季的,新品的上市的进度,那18个月周期,他时间就非常短了,因为18个月是从开始研发,到最终上市的时间,那其实真正给你,用于跑鞋研发的时间,可能只有三到六个月,因为后边还要订货,还要生产,跑鞋它在迭代的背后,会有哪些化学公司,或者科研机构,或者供应商的支持吗,就比如说刚刚我们谈到的
麻花:阿迪的Ultra Boost 它是阿迪和德国的巴斯夫合作的 Nike它的超级泡棉技术叫ZoomX 它是和法国的阿科马公司合作的,甚至我看到有一些跑鞋,他们甚至会听取什么足科医生的意见,所以我就想了解一下,就是哪些外部的因素,也在跟着这些运动鞋的公司,一起在参与跑鞋技术的迭代,这个中里的一方面是中里的基材 [00:16:32]
盖德:这个基材目前主要还是有,欧洲的那些大的化工集团来提供的,比如说像你刚才提到的,巴斯夫阿克马,包括银创,很多国产品牌的跑鞋的机材,也是从他们那儿进行采购的,那中国目前的化工品牌,包括中国的旺华,它也是在不断的追赶,但是目前不可否认的,就是欧洲还处在一个领先的状态,但是中国是在发泡技术这块,慢慢赶上来了,就是同样是用法国巴斯夫,或者是阿克马的机材,但是通过中国的,这个比较领先的发泡技术,可以得到一个性能更好的,一个成型的中底,比如说中国有,晋江的国盛和中科院,宁波材料所,他们合作生产出的中底材料,现在也是提供给索亨尼,包括像李宁啊 B麦他们都是在用,还有最近几年发展比较快的,像大毛牛,也是一个发泡技术,非常领先的公司,明白,刚刚提到了,从Nike的Vaporfly开始,跑鞋的底就变得越来越厚
麻花:但是2005年到2015年的,这段时间,裸足感的跑鞋,还是有一定市场,比较火的,就比如说耐克它的Nike Free 还有有一个专门生产五指鞋的公司,叫Webron Five Fingers 它们的裸足感的跑鞋,也是被大家推崇过的,为什么这个裸足感的跑鞋,现在好像又没有什么火花了,又变成了比较厚的底的鞋,统治跑鞋市场的一个情况 [00:17:51]
盖德:因为大部分的人,普通消费者,他还是更注重刚上脚的,第一脚的那个脚感,这个赤足鞋,它是能起到一个比较好的锻炼效果,比如说厚底鞋,它可能更多是像快餐,麦当劳肯德基这种,就是你第一口吃进去,口感非常的好,然后能带来很大的满足感,无脂咸呢,它更多是像一个轻食的沙拉,就是你刚吃的时候,觉得非常难吃,但是你长期吃,它是不是有好处呢,肯定是,因为它就是能够帮你锻炼,足部的很多小的肌肉群,来恢复你足底肌肉原始的功能,所以穿它并不是为了,当下的好的脚感,它是能够带来一个长期的好处,但是问题就是,它低脚的脚感确实不太好,那很多人在买了这个鞋之后,他就很难坚持穿下去,但这个鞋,如果你不能坚持长期穿的话,它就起不到锻炼效果,所以我看Vibram 好像在2012年的左右,它的五指鞋是涉嫌虚假宣传,还吃过官司,还赔偿过消费者的 所以这么听来,它其实也不算特别虚假宣传,它可能宣传了一些,它实验室测出来的数据,但是这个锻炼效果,它也是因人而异的,不一定是每个人穿了这个鞋,都可以起到同样的锻炼效果,还有就是我就这个问题,还采访过格布雷希拉西耶,因为他非常有名,他就是以光脚跑步,闻名的一个著名的马拉松运动员,那我采访他的时候,我就问你推不推荐,现在的跑者也光脚跑步,他说我绝对不推荐,因为在他小时候生活的那个环境,是基本上没有铺装路面的,都是土路或者草地,就是软质的路面,那你光脚在那个路上跑,是非常合适的,因为它那个地面本身,就带了一些减震的效果,但是我们现在跑步,几乎全都是在硬质的路面上,在水泥地柏油路,或者是公园的石板路上跑,那这种硬质路面 [00:19:13]
盖德:那这种硬质路面,冲击力本来就非常的大,如果你不穿一个缓震好一点的跑鞋,可能你在起到锻炼效果之前,你就已经伤到了,把你的脚踝膝盖跑伤了,还有就是你穿这种鞋,一定要循序渐进,就像你吃沙拉,如果你以前是大鱼大肉,然后你突然转向沙拉,可能你吃了几天,你就营养不良了,所以一定要慢慢的从厚底转为薄底,坚持锻炼,这样才能起到一个比较好的效果,因为我们刚刚一直在谈定义时代的跑鞋,那你觉得一双跑鞋,如果它能够定义或者统治一个时代,除了我们刚刚谈到的产品技术,还需要靠什么,我觉得主要还是靠产品力,比较典型的阿迪的Ultra Boost Nike的Vaporfly和Apafly 它们都是靠一个跨越式的更新,就不是在以前的技术上小修小补,是直接推出了一个全新的材料或者是技术,这样才能起到短暂的统治的效果 但是其实其他品牌跟进也是很快的,那这种统治的时期,一般来讲它都不会特别的长,还有一个案例就是亚瑟士,因为亚瑟士在慢跑鞋的市场,它确实有过一段时间的统治,我是指在中国国内的这个市场,因为那个时间,它确实没有太多其他的竞争对手,当时四大慢跑鞋,布鲁克斯和索康尼都还没有进中国 New Balance可能把重心更多的,放到了休闲时尚那块,我们谈一下在伦敦马拉松上,帮助人类破纪录的 [00:20:53]
麻花:Adios Pro UO3 这个阿里达斯的跑鞋,因为之前确实没有人,在正式的马拉松比赛上,跑进过两小时,有很多人尝试过,但是确实是在这一次上,是被这两个非洲的选手 [00:21:24]
盖德:给跑进了两小时,到底他的跑马破二,靠的是人还是靠的是鞋,这个肯定是两者都有的,那你说具体是,人的作用多一些,还是鞋的作用多一些,这个其实真的很难量化的,就是人他会在,跑步的马拉松的历史里面,如果是不靠鞋的话,他会怎么来提高自己的成绩,其实除了跑鞋之外,其他方面的科技,也是不断地在进步的,比如说POOL的运动员,伦敦马拉松的萨维,我们其实从网上能看到的,他的训练方法的资料,都是比较有限的,因为真正的秘诀,我觉得他们应该是,不会随便这么透露的,他的训练主要就是两点,第一个就是他把,吉布乔格的 7天的一个训练周期的计划,扩展到了10天,这样他可以有,更丰富的跑步训练的内容,然后也有更充分的恢复时间,另外一点就是,他加入了更多的,针对跑步的力量训练,但这两点,其实其他运动员,我觉得肯定也是有做的 但实际上他真正的秘诀是什么,这个可能只有他的教练才知道了,另外一方面,就是很多的辅助的训练工具,也是不断的被研发出来,包括跑步它有功率计,绑在鞋上可以更好的监测,你每次跑步,是不是有一个稳定的功率输出,它也不会身体状态,受到你的心率的状态的影响,它可以更好的实现,你当天的训练的,所要求的强度,最近几年还有更新的,就是这个血糖监测,我们可以看到,很多运动员,他的胳膊上都贴着一块,像胶布一样的东西,那个是可以进行,实时的血糖监测,帮你判断什么时候该补给,然后你跑步应该,采取什么样的一个策略,更先进的就是乳酸检测,这个我在马拉松运动员身上,还没有看到,但是我看到有一些,那个自行车运动员,他在完成了一段,训练的计划之后,马上就会给他抽血,然后来测他现在的乳酸,教练会根据这个数据,来调整他的训练计划,包括像训练一些补剂,我们现在国内的普通消费者 都可以买到的,像什么蒜樱桃汁,甜菜根汁,还有帮助恢复的,像姜黄素,有一些擦边的,像钛类的这种,帮助恢复的这种补剂,也是不断的被运用到,这个运动员的训练当中,帮助运动员进行恢复的工具,也是越来越多,我们现在有看到一些,像液氮,在高强度的训练之后,有液氮仓帮助他快速的恢复,还有一些像压缩的腿套,帮助运动员更好的睡眠的HRV监测,还有恒温的床垫,这些都是不断的在发明出来,所以其实跑鞋只是最终你在比赛当中看到的,出现在赛场上的工具,在你看不到的地方,在他的训练和他的恢复当中,有更多更多高科技的工具,骨迹都在运用到运动员身上,还有一点就是,因为现在马拉松的关注度非常的高,有流量就意味着,他有商业的机会,所以也有更多的品牌,把更多的资本,投入到这个运动当中来 这些资本必然会,把选材的范围扩大,可能以前根本没有想,从事过马拉松运动的,一些天才选手,看到了这个商业机会之后,他也会想投入到,这个运动当中来,包括这次铺二的萨维,他之前也是差点被埋没掉,他差点去当了老师,也是因为他的舅舅还是叔叔,觉得他跑步更有前途,才把他拉回到,马拉松的运动当中来,所以选材,也可以覆盖到一个更大的范围,可以挑寻到更多,以前被埋没的人才,这个选材我们待会会谈到,我想问一下,您刚刚提到很多训练工具,然后训练方式 [00:24:19]
麻花:还有一些补技,这种恢复工具上面的更新,我能不能理解为,即使跑鞋本身,没有太大的突破性的创新,人类也能慢慢慢慢的,把两小时的记录给打破
盖德:只不过说跑鞋,帮我们把破记录的时间给提前了,对都是这些所有的科技的进步,共同作用产生了一个结果,我们再谈一下POR2的 ADIOS PRO EVO 3这个跑鞋 [00:25:07]
麻花:我查到的资料里面会说,这个跑鞋是全世界第一双,能够把单只的重量,控制在100克以内的专业的跑鞋,作为对比就以前顶尖的公路跑鞋,它单只的重量大概是在180克到220克之间,它采用的是一种叫做TPE的泡棉,这个TPE的泡棉是刚刚我们阿迪拿来对标的,那个耐克的超级泡棉的一个材料,而且它用到的是碳环而不是碳板,碳环和碳板之间的区别在于,碳板是一整块的完整弧形板材,它主要是在中底内部中间的那块区域,鞋的中底主要是靠它来弯曲变形来提供推进力,碳环呢是一个环形结构,它分布在中底外围的那一圈上,会把中底核心区域让出来,让超级泡棉自己产生形变和回弹推进,除了这些中底的材料的更新之外 它还把鞋面做得特别轻,我看到过一个视频,好像是他们那个阿迪的高管,然后把鞋面的材料放在一个,往上流的一个空气上,然后那个鞋面的材料,它是可以飘起来,慢慢地落下去来显示它非常轻的,就anyway 阿迪他在这双鞋上,用了这么多的新的技术,新的材料 [00:26:14]
盖德:这些技术的创新,对他的竞品们来说是,他们没想到,还是他们做不到像阿迪这样,其实我觉得他说是第一双,这个有点夸张,可能是第一双量产的,因为之前包括像李宁,中桥361都做过100克以下的,但他那些都是概念鞋,就没有真正的量产上市,可能他的造价也非常昂贵的,也可能他的良品率非常低,就是我可能做好几双,才能出一双合格的产品,那还有一个原因就是,像李宁中桥361 他们都没有签到顶尖的运动员,那个时候李宁还没有签大破解,所以他们即使做出了 100克以下的超级跑鞋,他们也没有办法让运动员,取得一个非常好的成绩,来帮他们背书,所以这个鞋最终是,没有成功的量产上市,那RD这双呢,确实作为一双,能让运动员穿着,能够破二,而且最终还能够进行售卖的鞋,也可以说它是第一双吧 它的泡棉其实,这个就有点像,以前那个EV的进行调整升级了,这个并不是一个革命性的创新,他只是在用这个TP双翼的材料,然后通过一些发泡技术,让它变得更轻更软,同时他的耐久度,还能撑得住顶尖运动员跑一场全马,就是跑到最后,他这个泡棉不会衰减,这个也是非常重要的,关于碳环呢,其实这个也是有一个小故事,为什么Nike出了碳板之后,其他的品牌都在做碳板,但是只有阿迪他不做,他是一开始做碳柱,就是他的官方叫Energy Rods 就是仿生做人的这个五根脚趾这个形状,那现在他又是做了一个碳环,反正他就是不做碳板,因为这个以前 Nike和阿迪是在这方面有过纠纷的,那个时候我正好在阿迪工作 Nike当时出了一个真知的鞋面,叫Flyknit 应该是在2012、2013年左右,差不多就是相同的时间,阿迪也出了一个真知的鞋面,叫Primeknit 这两个公司还因为这个科技,打了一场官司,都说这个科技是自己最先推出的,然后对方是侵权了,经过了那个事件之后呢,阿里可能就是一朝被蛇咬,十年怕井绳,我现在就不用Nike的碳板了,我做碳柱也行,或者我做碳环也行,我就是不做碳板,就是你有的技术我就偏不用,再好我都不用,对对对 [00:28:23]
麻花:就是防止再出现这样的情况,我看到这个鞋用的TPE泡棉,它其实是之前Ultra Boost 那个TPU泡棉的一个更新迭代版,是在TPU泡棉的基础上,把重量做得更轻
盖德:所以你觉得这个技术,它是一个V型创新,不算是一个突破型创新,是这样吗,这个还其实真不是,因为TPU到TPE 已经是经过了很多次的迭代了 TPE现在也是慢慢的,被更多的品牌用上了,其实现在很多品牌跑鞋,都用的是TPE双翼的材质,它其实就是一种化工的原材料,但是在这个原材料基础上,你怎么去通过发泡技术的优化,把这个机材发泡出一个,功能性更好,性能更强的一块中底,这个就是各个品牌,需要研究的问题,就有些品牌,它即使用了TPE双翼,它最后发泡出来,这个中底性能并不是那么的理想,再举个例子,我要拿吃的来举例了,就是同样是一只龙虾吧,你放到大排档去做,或者你放到一个顶级的,米其林餐厅的厨师去给你做,原材料是一样的,但做出来口味和最终的售价,可能就差了十万八千里了 Adios Pro Evo 3 它之所以现在能有那么轰动的效果
麻花:它其实是做了一双可以量产的,又非常轻的鞋,恰好这个鞋又被阿迪赞助的运动员,穿着去破二了,还是有一些偶然性在里面的 [00:29:51]
麻花:还是有一些偶然性在里面的,是这样吗,对是有一些偶然性的,算阿迪,我们再说一下耐克,耐克他在2016年推出了,我们刚刚讨论了很多次的 ZoomX Vaporfly 4% 也是在2016年开始,他启动了他这个Breaking2的项目,而且耐克的Vaporfly这个系列,出来之后,因为他太强了,有好几个公司,包括阿迪达斯,布鲁克斯 New Balance 他们是放下了,彼此之前的那些竞争成见,联合起来呼吁,国际田连去调查耐克,然后他们把这个Vaporfly叫做弹簧鞋,认为它违反了体育装备不得提供,超出自然跑步的经济性提升这个规则,最后国际田连就真的还是出了一些,限制性的规定在这个跑鞋上面,我就想知道耐克之前那几年那么强,在竞速跑鞋上的技术优势那么大,为什么这一次的破纪录没有出现在他身上
盖德:我觉得这个可能就是天时地利人和,其实Nike前几年,也是有一定的机会的,因为他签约的天才选手,吉普图姆,成绩也是非常的理想,差一点点就普尔了,但是很可惜,这样一个天才,在创造了几场马拉松的,非常优异的成绩之后,就因为车祸去世了,所以Nike也是丧失了,这样一个机会,相比起跑鞋这个创新,其实你能挖掘出,一个天才选手,这个概率也是非常低的,也是非常困难的一件事情,那Nike好不容易,挖掘出了吉普图姆,然后又因为车祸,这个原因去世了,所以他在短时间内,也不太可能再去找到,这么优秀的一个天才运动员,这个是需要长时间的考察,然后需要长时间的沟通和交流,才能确定签约的,除了这个之外,其实Nike这两年,自己也是遇到了一些困难,包括他的生意在下滑,也是经历了更换CEO的风波,这个是我们表面上看到的,但实际上我们没有看到的地方 他的产品创新的团队,肯定也是受到了影响,不管是从人员构成,人员的流动上面,或者是他们团队的士气,自行星方面,估计也是会受到了一些的影响,这样我们看到 Vaporfly和Apaflight系列,它也是好几年的时间,都没有一个大的创新了,基本上都是在初代产品的基础上,进行小的调整,说的不好听点,就它是在吃老本吧,甚至Apaflight 3 推出到现在应该是,已经快有两年的时间了,新的一代产品都还没有出来,所以也正是这方面的原因,导致了它破坏这个目标,最终是被阿迪实现了 Nike它的战略失误,这个应该很多人是知道的,就是因为他的上一个CEO [00:31:48]
麻花:推行了一个DTC的策略,有一些在DTC上矫枉过阵,另外他在组织上,他是把原来Nike组织的划分,产品部门的划分,是按照比如说跑步篮球训练,是按照各个运动类别来划分,然后后来上一任CEO 就把他变成了男子女子儿童,这样来划分,就这种组织架构的调整,他的这个业务单元的调整,可能会怎么影响到,他的跑鞋的研发呀,以前如果用运动项目来划分的话 [00:32:28]
盖德:它更多还是以运动为最终的导向,就是我要服务好运动员,要服务好这些运动的人群,那你如果以男子女子,而同来划分的话,它更多就是一个生意导向了,我怎么能卖更多的货,所以这两个划分的方式,虽然看起来区别不大,但实际上你把它,引申到产品的创新研发规划上面,它实际上区别是非常大的,这个我们也是从Nike的,最近几年的产品上,也是会看出一些端倪,但是好在是 Nike已经看到了这个问题,已经在想办法去转变了,包括它好像新的叫什么,麦柔还是什么的鞋,那个鞋卖的还不错,是它现在反而是在发力,慢跑鞋的跑鞋矩阵了,它是重新梳理了,它慢跑鞋这块的一个产品结构,它是有三块,一个叫飞马,麦柔以及稳城,每一款又是有三个层级,所以是重新做了一个矩阵,但是它之前具有统治力的,马拉松竞速跑鞋 反而最近节奏是有些放缓,对这也是我下一个想问的问题,就竞速跑鞋,在比赛上取得一个好的名字,它对于慢跑鞋的销量,是一定会有正向的推动作用的吗,肯定是有正向作用的,它首先是一个专业性的背书,就代表你这个品牌,可以给最顶尖的运动员,做出最优秀的跑鞋,那普通消费者就会想,既然你可以穿着这个鞋,跑出这么好的成绩,那你的专业性,肯定是毋庸置疑的,我买你的跑鞋,就会非常的放心,而且这种马拉松,特别是这种破二时间,它是自带流量的,不需要再去花钱去买流量,去找博主推广,去买软文推流,它自然就会有很多人,来报道这个事件,而且它甚至有,破圈的可能性,所以取得一个,非常好的成绩,甚至破二,那对品牌来讲,绝对是至关重要的,还有一点就是,现在很多人,其实我买跑鞋,我就是要买,你这个品牌最贵的 即便我不去跑马拉松,我不去跑一个,非常快的配速,我也不想穿慢跑鞋,我就是要穿最好的,能够让马拉松,精神上奖的那些跑鞋,尽管很多跑步博士,都是苦口婆心的,在劝这些慢跑的参与者,特别是刚开始跑步的人,你们不要穿这种竞速跑鞋,对你们的脚是不好的,很有可能导致受伤,但是你就是劝不住,很多人我还是要买,这种顶尖的跑鞋,他就是为了穿着要帅,而且他心理上穿这个鞋,他也会觉得穿上这个鞋,我就能跑得更轻松,跑得更舒服,在Nike的Vaporfly [00:34:40]
麻花:他在统治马拉松赛场的时候 2018年瓦伦西亚马拉松比赛,前100名里面有95个人都穿的是Vaporfly 现在Adios Pro Evo在统治马拉松赛场的时候,好像最近三年的六大满贯男子马拉松的领奖台 Adios Pro的上脚率从22年的15% 增加到了25年的35% 也就是说这些品牌,他们还是觉得我去培养一个马拉松的冠军,我去特别的关注马拉松的上脚率,对它跑鞋会不会让外界看起来是在统治时代,是非常重要的一个事情,能这么理解吗,对啊,因为真正要去,冲成绩的那些精英选手 [00:35:15]
盖德:他是会不惜成本的,就是你这个鞋再贵,或者是你跑一场马拉松,这个鞋就废掉,那我也还是要买,因为他能至少保证,我在这场比赛里边,能帮助我取得一个最好的成绩,那他们那些选择,肯定也会影响到,身边的这些人,因为其实这些精英选手,虽然他在比赛里边,不一定能登上领奖台,但是他在自己日常的生活当中,他身边的人,包括平时关注他的这些粉丝,他在这些人群中,还是非常有影响力的,所以他穿了什么鞋,对这些粉丝,也可能会参考,他对跑鞋的选择,这样一穿十四穿百,他这个鞋的销量,慢慢就起来了,但是阿迪这个鞋,他有一个问题,就是这双Pro Evo 3 包括他的Pro Evo系列,它都是限量款,这个就导致他没有能够,像Nike当年的 Vaporfly和Apafly 能够取得这样一个,统治级的上缴率,因为很多人想买买不到,或者是他觉得,这个鞋实在是太贵了,我没有那么高的,一个成绩的追求 我不想花500美金,甚至是超过500美金,这个溢价去买一双,所谓的一次性的,这样一个马拉松跑鞋 Pro Evo 3 它的限量,是因为它真的产能跟不上,还是就是想饥饿营销一下,两方面的原因,我觉得都有,可能也是因为,它的良品率比较低,生产成本也非常的高,另外一方面,阿迪也是想,这么贵的跑鞋,它肯定是不走量的,即便它能够放开卖,它也卖不了特别多,所以它还是希望,用这个来带动,它take down那个版本,就是它的Adios Pro3或者是现在的Pro4 以及它马上要推出的Pro5 这个就是市售版本的ProEvo 它可能在某些方面有一些降级,重量也会更重一些,但是它的价格让更多人都能够买得起,而且它也不至于说,我穿一条马拉松就废掉,哪些因素会影响一个鞋,在生产时候的量品率,就是你太注重它的极致的性能了 因为发泡的概率越大,中底发泡出来,可能就更多地方不均匀,或是没有达到,他希望达到的发泡的倍率,那这块中理就直接就报废了,就废掉了,就得重新发泡,所以你对性能的追求越极致,那生产的这个良品率,可能就越低,明白明白,然后我们再谈一下,选材的问题,因为您刚刚也说了,选材这个事情,现在大家越来越重视 [00:37:40]
麻花:包括Nike 它为什么没有在今年,或者说前几年,有特别亮眼的成绩,也跟它最看好的,潜在的顶级选手,突然去世了有关系,我看到的一个情况是,比如说轮马扑二的两名运动员里,那个亚军的选手,甚至是第一次参加选马,他就穿着阿迪的鞋破了记录,您自己的感觉是说,这几年阿迪达斯和耐克,他在选择马拉松的顶级跑者上面的思路,有发生什么变化吗 [00:38:04]
盖德:其实我们看到一个趋势就是,最近几年越来越多的场地选手,就是跑那个田径场里边的 5000米1万米这样的选手,你刚才说那个第二名,他其实是一个场地选手,过去老的时候都是那些场地选手,他在年纪逐渐大了之后,他可能在场地赛里边,竞争力下降了之后,他才会选择去跑半马,甚至跑全马,但是最近因为马拉松的热度,实在是太高了,他可能超过了场地赛的热度,那很多场地赛的选手,他在很年轻的时候,而他的场地成绩还非常优秀的时候,就选择了慢慢去转向,马拉松这样一个赛场,那至于你刚才说的,阿迪和Nike他赞助选手的思路呢,我觉得这个就很难说,第一可能还是跟生意有关吧,因为Nike的生意的发展状况,确实不太好,生意下滑必然就会导致,他各方面的预算减少,具体到千人这块,你预算少了之后,你的报价差不过别人,那肯定就竞争力会有一些下降 另外就是团队的影响了,因为体育营销这个团队,他是跟运动员需要有,建立一个长期关系的能力,所以他一般都是在这个领域,摸爬滚打了很多年的这样一些人,他们认识各种教练,各个国家的体校的老师,或者是训练营的这些教练,通过他们来发现,这些好的苗子,那如果你的团队,也不太稳定,变动也比较大的话,可能这些人,也会逐渐流失到,其他的品牌,所以这种人才,也是很难找到的 OK 明白,所以我在想,是不是一个跑鞋的竞争,它一方面是说,技术的跟谍,要不断地去竞争 [00:39:23]
盖德:要不断地去竞争,另一方面,这种牵学手,去找好苗子,这种营销册,也是一个暗战,也是要花很多精力,去竞争的一个地方,对这肯定是,而且如果你要,真的有这种,一鸣惊人的效果的话,你就得从这个选手,很年轻的时候,或者他还没有出成绩的时候,就已经去跟他建立联系了,就不能说等这个选手,已经跑出成绩了,已经功成名就了,你再去签,那这个时候一方面,是价格非常的高,另外一方面,可能人家也不会轻易的离开,他一开始签的那个品牌,所以这个就是要做很多,前期的长期的挖掘的工作 1960年开始,有第一双公路跑鞋,到现在已经有几十年的历史了,最开始我们也提到
麻花:像有布鲁克斯,有New Balance 有亚瑟斯索康尼这些,其实他们这几年,也都在不断打磨,自己的拳头产品,但是感觉,看上去他们的身量,就不再大了,也确实是没有再出过 [00:40:40]
盖德:什么定义时代的产品了,那么为什么,渐渐的竞速跑鞋之间的竞争,逐渐就缩小到了,只剩耐克和阿迪,在名片上竞争了,因为这块投入,真的还是非常大的,就你要进行长时间的研发,然后你还要去签运动员,这个对于一个,像耐克阿迪这样,大体量的综合运动品牌来讲,这个是只有他们能做到的事情,像布鲁克斯索康尼这种,其实他们的体量,在耐克和阿迪面前,真的是小巫见大巫,他们的营收可能,只有耐克阿迪的,十分之一都不到,所以如果以他们这个体量,他不可能有这么大的投入,去挖掘去签约,这些顶尖的运动员,他们在研发上的投入,肯定也不会有
麻花:耐克和阿迪这么大手臂,所以我能理解成,未来竞速跑鞋的竞争,也是长久下去,也就是只是阿迪和耐克,对我觉得大概率还是,那比如像布鲁克斯索康尼,还有亚瑟士这些 [00:41:32]
盖德:他们可能是希望自己的跑鞋,在现在的竞争格局里面,获得一个什么样的位置呢,他们其实是主打慢跑鞋的品牌,因为我们之前说他是四大,很多人以为是四大跑鞋,其实并不是,他是四大慢跑鞋,但是就是因为竞速跑鞋,关注度越来越高,很多慢跑的人,他也去买这种竞速跑鞋,那这也是逼着这些慢跑鞋品牌,我也必须要做竞速跑鞋了,否则我的慢跑鞋市场也逐渐的就被这些竞速跑鞋给抢走了。
麻花:那再谈一下HOKA和昂跑, 他们是我们刚刚谈到的所有品牌里面最年轻的一些品牌, 但是他们本身又不是起家于这个公路跑鞋, 就竞速跑鞋或者慢跑鞋。HOKA是越野跑起家, 昂跑是铁人三项的运动员创的。你觉得他们和现在我们刚刚谈到的这些传统的跑鞋品牌, 他们的竞争是在一个维度里面的吗?其实还不太一样, 特别是像昂跑 [00:42:12]
盖德:可能还是主打通勤和精英的消费人群吧,因为其实真正的严肃跑者,他对跑鞋的需求量是比较大的,因为他跑量在这儿,他就比较费鞋,可能我一两个月我就得换一双鞋,昂跑一方面,它的价格是高举高打,它也很少有折扣,那对于这些严肃跑者来讲,它的性价比可能就没有那么高了,所以它更多还是一个身份的象征吧,中国市场表现的更明显一点吧,即便是在国际市场上,昂跑也是这样的一种品牌形象,那Hoka在越野跑里面,还是统治力比较强的,他们两家各自独家的技术 Hoka的是特别厚的鞋底,昂跑的是它的CloudTech 它的这个独门技术,和刚刚我们提到这些品牌,有什么差异化的优势所在吗 Hoka它其实不光是厚底,它有三项它的科技,一个是滚动平衡技术,就是它以前在跑鞋里加入滚动杆 这个其实是Hoka做的比较早的,但是现在越来越多的品牌,都开始在慢跑鞋里面,加入这样一种滚动的结构了,那另外一个就是嵌入式鞋床,就是它会把侧墙做得比较高,也就是它的中底会往两侧,会往四周翻起来,像一个摇篮一样,把你的脚包在里面,这也是HOKA以前,比较闻名的一个特色,那第三个就是这个厚底缓震了,但其实这三项,都不是有很强的壁垒,因为其他品牌,如果要模仿起来,其实是比较容易的,但是HOKA它目前,毕竟有这样一个品牌的形象,另外一个就是它,特别是在EVA这块,因为其实很多中国的消费者,会诟病HOKA 说你卖的价格这么昂贵 1000块钱以上的钱,你还得用传统EVA材料,是不是有点割韭菜的嫌疑,但其实HOKA毕竟在这块,深耕了很多年,虽然它的材料科技,不是非常的前沿,但是它能把传统EVA材料,调得非常的舒服 穿着的脚感很好,我觉得这个也是有功力,也不是每个品牌都能做得到的,这也导致HOKA 它也有很多的,时中的消费者,就是我穿惯了HOKA的鞋,我再穿别的鞋,我很难穿得舒服 [00:44:25]
麻花:我看到昂跑,我忘了是前年还是去年,它还是有出一款,竞速跑鞋的,噱头是,它的那个鞋面,是喷射打印的,就包裹性是非常强的,我没有试过,我不知道这款鞋
盖德:在真正的竞速跑领域里面,认可度是多高,要实话实说的话,可能上脚率没有那么高,因为鞋面是一方面,对于马拉松竞速跑鞋来讲,最重要的还是中笔,但是它这个鞋面技术,也是非常有创新的,它是用那个机械臂,喷出来的嘛,不是人手工打造的,所以这个技术,如果能够在今后普及的话,它可能会把成本降低,然后把生产的效率提高,但是目前它还是,作为一个概念性的展示,因为这个机械臂的成本,可能还是很高的,如果这块成本能降下来,那它以后的这个生产成本,可能也会降低一些,我们刚刚也反复提到一个点,就是这种技术差异化
麻花:保持的时间在越来越短,因为我之前也听到一个说法,就是说运动用品行业的,各种新的技术之间的差异化在变小,然后想要去形成长期,独家的技术优势,也变得越来越难 [00:45:27]
盖德:那具体到跑鞋这个领域,就您认为行业上实质性的创新,现在是在变多还是变少,最近几年可以说是小修小补,比如说你刚才说,七批双翼的这个材料,它并不是一个革命性的,创新的一个材质,就是在以前的这个材料上,通过小的调整,得到一个更优化的性能,但是我觉得科技的进步,它肯定是螺旋性的上升,不会是一直这样线性的上升,经历了相对比较慢的,发展的时期之后,我觉得可以期待一下,下一个boost的时刻,或者是viva fly的时刻,我觉得会在未来的几年,可能会有一个,真正的创新性的突破了,您觉得现在一个跑鞋公司的,独家技术,还能保持领先多久,这其实蛮难的,就像刚才说的,它的中理机材,都是由那些化工集团,提供的,所以并没有一个,自己买断的,这样一个壁垒,特别是我们的,国产品牌,很多都是要,从国外的那些 包工集团去采购,这个机材,那既然你的供应商,都不是独家供应给你的,那肯定各个品牌之间,它就没有壁垒了,那这样的话,其实都不是,时间短的问题,可能今天这个牌子,做出来,明天第二牌子,我就可以做,所以确实,各个品牌之间的,差异化会非常的小,更多是看这个品牌,我更看重的一方面,像有些品牌,我就要追求重量轻,那有些品牌,我要追求性能达到最大化,那有些品牌,我就是要注重耐久性,我可能性能没有那么极致,但是它可以多穿几场马拉松,一个取舍问题,没有说哪个品牌,我全面要优于另外一个品牌 [00:46:36]
麻花:那确实人类马拉松的记录,是运动员穿着阿迪的鞋来打破的,您觉得会不会,未来真的就像一些媒体,他们分析的那样,就真的竞速跑会,有一段时间 [00:47:12]
盖德:会进入阿迪统治的时代,这个我觉得比较难,为什么,因为它那双鞋,毕竟是一个限量款销售,而且阿迪还有一个比较大的问题,就是它的鞋面,一直处理的不是特别好,就前两年有一个说法,就是阿迪的跑鞋,是世界级的中底,然后小区级的鞋面,很多人穿着阿迪的,这个Adios Pro系列跑马拉松,可能磨的两个脚都是血,然后跑到终点之后,就看见血染战靴,这块如果它处理不好的话,我觉得它很难做到,让马拉松的跑者,都上脚阿迪的竞速跑鞋,而且说实话 Nike还是有很大批量的,一个死忠粉的,其实跑鞋博主这个圈子里,有很多人都是Nike的死忠粉,就他们在没有,其他品牌的合作的时候,参加比赛几乎都是会,穿Nike的跑鞋,就是Nike的基本盘还是在的,虽然它已经慢慢的在衰减,但是一下子就被阿迪取代,这个肯定是没有这么快
麻花:哦明白,虽然阿迪的 Adios Pro Evo 3 是一个限量的,但这个鞋的一个,大将接版平民版,就是Adizero Evo SL 它是一个大众通勤款,去年应该是卖爆了的,我看到今年三月的时候,他们高管在财报会上说,这个鞋上市一年过后,是卖了一千万双,已经是一个现象级的保鞋 Nike它的那个Air Force 1 卖那么好的一个经典款,现在一年的销量,也是一千万双到一千两百万双左右,所以我在想Adizero Evo SL 应该是一千万双一年,是很好很好的成绩了,在您看来就一般一双跑鞋 [00:48:17]
盖德:它卖多少算是比较成功的呀,一般能卖到100万双以上,就已经算非常成功了 100万双就算成功,那阿迪这个鞋卖了1000万双,那你觉得它做对了什么,我觉得最简单的两个字就是设计 OK 它其实不是Pro Evo 3的Takedown版本,它是Pro Evo 2的简化版本,那它的设计跟Pro Evo 2是非常接近,其实这个鞋刚上市的时候,我对它的预期没有那么好,因为它实际上还是一个,非常专业的速度训练鞋,它其实是不适合慢跑和通勤的,这个鞋我之前也出过评测的视频,但是阿迪他在推广这双鞋的时候,就一直在说竞速美学,然后他也找了很多时尚的博主,让他们用这双鞋去搭配各种时尚的风格,我当时对这个推广还不是特别的认可,但事实证明确实我是看走眼了,没有想到这双鞋会这么的成功,我觉得它的设计确实是,在它的成功里边贡献很大,我之前在做运动行业的时候 有一个说法就是 logo不能做得太大 logo越大销量越少,但是最近几年,我感觉这个趋势,好像有一些反转 [00:49:52]
盖德:好像有一些反转,大家反而要强调,我这个鞋的品牌的logo 所以你看阿迪这双EVO SL 它没有多余的设计,就是很简洁的一个鞋面,加上非常醒目的三条纹的,这样一个,这个三条纹甚至都从鞋面,过渡到了鞋底,对,那这么大的一个logo 并没有影响到它的销量,反而为它的销量,提供了很大的加成,也像我刚才说的这个鞋,它其实是一双速度训练鞋,它非常不适合慢跑和,同情,但是你就是,价不出我有很多人,我就是要买它,因为它的设计好看,我就是要买它,进行慢跑和同情,这个我在出去玩的时候,都看到了很多人,就是他的体型,或者是他的穿搭,一看就不是一个,有规律跑步习惯的人,但是他就是穿着这双 EVO SL在逛街,甚至在旅游,在爬山,那一双鞋,只有有这样一个,一个出圈的效果,它才能实现,这个1000万的销量,如果你只是跑步性能好,很难达到这个销量,几乎是不可能的,对我在想 是不是它的那个 [00:50:53]
麻花:醒目的logo 因为都是什么读图时代了,什么短视频时代了,是不是也特别方便,在这种图片视频的,社交网络语言里面,做更好的一些传播,对,传播也是起到了很大的作用,所以就证明
盖德:阿迪的选择是没错的,我就是要强调他的时尚熟悉,不能只强调他的跑步性能,那我们再来谈一下,慢跑鞋领域的老吃家,也是公路跑鞋领域里面的老吃家 New Balance [00:51:07]
麻花:就我特别惊讶的一点是,它二五年的年销售额,已经到了96亿美元,也就是说很有可能,它会在今年的销售额达到100亿美元,成为全球继耐克阿迪和Lululemon之后,第四个破百亿美元的运动品牌,而且它在过去五年,规模是增长了1.8倍的,是比任何一个稍微有一点规模的
盖德:跑鞋品牌增长的都快的,您知道它是为什么能够,在过去五年增长那么快的吗,我们之前也看过它的财报,但是他不是上市公司,他公布的没有这么详细,所以很难知道,他具体的某个细分的类目,是增长了多少,但是我觉得有一个,可以跟New Balance对标的,就是亚瑟士,亚瑟士也是上市公司,还是在过去几年,增长的也是非常快,但实际上他增长最多的是,他的时尚休闲这块,甚至于最近把专门做时尚休闲的,鬼中虎都给分拆出来了,对对对,虽然他跑步增长的,也是非常的迅速,但是跟他的时尚休闲比,还是差了比较多,其实我们也可以看到,最近几年这个趋势,马拉松运动很火,所以时尚休闲这块的风潮,也是在往跑步这边去转移,因为在最早的时候,你说到复古鞋,说到休闲鞋,更多的是从以前的那些,老的篮球鞋改变过来的,但是最近几年,大家在穿复古鞋,穿休闲鞋的时候,基本上是从以前的跑鞋 改造的来的,对,你不说我都没有发现,有这样一个趋势,对,包括我们现在看到,学校里边的那些,小孩哥学生党,我们小时候穿鞋,都是穿篮球鞋的,没有人上学的时候,会穿跑鞋,但是现在你再去学校里看,绝大部分的人,都是穿跑鞋了,而且你可以看到,很多小孩都是穿着,碳板竞速的跑鞋,去上学放学,就说明目前的跑步的市场,确实增长速度,包括它的这个占比,提高的都非常的大,而且New Balance 它的增长很快,还有一个原因就是 Nike和它的此销比仗,是因为Nike的,上一任CEO 他就是战略性,放弃了经销渠道,然后很多货架,都被New Balance占领了,对,因为美国那边的经销渠道,跟我们这边不太一样,我们这边大多数都是专卖店,它只卖一个品牌的产品,但是在美国,其实绝大多数都是多品店,一个店里边,卖各种的品牌的跑鞋,那Nike如果它,收缩经销商这块的话,你这个经销商的板墙,就空出来了 那我就用New Balance 用Hoka OnPow 去补Nike腾出来的这部分空间,所以相当于是 Nike把北美的市场,直接拱手让给了 New Balance和Hoka OnPow 那这几个品牌,在北美市场也是,很快的就吃掉了Nike的风格,所以他们这几年长得快,也有这方面的一个原因,所以New Balance的成功,亚瑟士的成功,包括刚刚谈到的,阿迪那双EVO SL的成功,还是因为他们在大众市场,就是运动时尚线卖得很好,就最激烈的竞争是在竞速跑鞋,但是最赚钱的市场,还是在大众市场,能这么理解吗,是有这方面的原因,因为大众时尚那边的影响力,也是用你的竞速这块带来的,你只有在竞速这块,站稳了脚跟,让人家知道你是一个顶尖的,专业的跑步品牌之后,你那个跑步相关的,运动时尚那块,才能被带动,当然New Balance 和雅思市可能有不一样,因为雅思市有鬼中虎,然后New Balance 它其实复古跑鞋,一直都很强,他们有一个 很强的产品团队,然后他们还会跟,各种各样的潮牌,各种各样的小的那些,买手店做联名,它这块也是做的,非常的风生水起,也是经过了,很长时间的耕耘,最近几年,这个跑步的风潮起来之后,他们就是乘上了,这股东风,但是如果你之前,没有做这个铺垫,你现在看到跑不起来,你再临时去做 [00:54:27]
麻花:那其实也没有这么容易的,刚刚我们谈了很多,都是在谈国外的品牌,也稍微谈一下本土的品牌,然后您也是在国外公司,和本土公司,都做过产品经理的,就这种本土品牌和国外品牌
盖德:它这个跑鞋领域的技术差异,真的那么大吗,客观来讲,确实还是存在差异的,但是这个差距是在不断地缩小,国内目前,它还很难去做出一个,领导性的创新,在技术方向上,还是以学习国外品牌为主,但是就是学习的越来越好,觉得越来越像,越来越接近,国际品牌那个性能,国内品牌有些问题,也是客观存在的,第一是研发周期短,很少有品牌,我会花好几年的时间,或者做20几个版本,去迭代一双跑鞋,普遍的国内品牌,都比较注重短期的效益,比如说你这个项目没做好,可能我就要换人了,这个项目你尝试个一年,一年半两年没成功,那这个项目,我可能就要取消了,你再去做新的项目,就是会有这种情况发生,然后还有就是国内品牌,相对来讲,人员流动性比较高,也很难有一个,比较稳定的产品团队,我花长时间去研发一款产品,还有就是,因为国内设计师 特别是企业设计师,他是没有科班出身的,很多都是半路出家,或者是我之前不是做设计师的,然后我靠自学,或者是靠中间我去进修,然后我转成设计师,也有人是以前,是做其他的运动项目的,比如说做篮球的,或者是做时尚休闲的,然后现在跑步生意增长比较快,他被临时调过去做跑步,那这块他的专业性,肯定也会相对来讲,没有那么的强,再加上据我的了解,国内的这些运动品牌,跑鞋的设计师,自己跑步的比例,并不是特别的高,还有这种事情吗,对,这个相对来讲还比较普遍,设计师其实自我意识非常的强,因为他毕竟是,有一些创新性的工作,但是自我意识强了之后,他自己再不跑步,他又缺乏和跑者的沟通,所以就会出现一些问题,好您刚才提到了,国内的跑鞋的设计师,他可能不是科班出身,是从其他的一些品类类目 转过来的,难道国外的一直,就是做这个跑鞋设计,就从一而终吗,因为他发展的历史比较长,他的人才的储备,自然而然就会多一点点,你像Nike的前任的CEO Mark Parker 他以前就是Nike的,这个跑鞋设计师,说实话,一个国家能有一个,大的这个运动品牌,就已经很不容易了,但是中国,我们有这么多的运动品牌,所以你跳槽相对来讲,就比较容易一点,对不对,比如说我今天在李宁,可能过两年去安踏,再过两年去特步,那你这种情况,在其他国家就很难发生了,我在美国的话,我可能我要做跑鞋,除了Nike 我的选择就不是很多了,我要去New Balance 或者去布鲁克斯索克里,那他们的竞速跑鞋,可能相对于Nike来讲,这个生意体量要小很多,那如果我在德国的话,我的选择就只有阿迪,彪马这两个,我没有其他的选择了,那这样他可能在一家公司,工作的时间就会更长一点,这个产品团队,就会相对来讲稳定一点 那您认为跑鞋未来在技术产品,或者营销上面的竞争,可能还会往哪些方面发展呀,我觉得跑步,特别是马拉松的市场,目前有点进入瓶颈期的意思,马拉松赛事也逐渐在放缓,你看我们这两年逐渐看到的,很多马拉松赛事在取消了,对国内的情况,国外其实马拉松赛场,已经是非常成熟了,马拉松赛事爆炸式的增长,可能只存在中国国内,那马拉松赛事的增长放缓,说明跑步这块,也逐渐到了一个瓶颈期了,再加上科技这块,也没有一个上台阶式,突破性的创新,所以它肯定整体的,生意规模的增长,会逐渐放缓,那我们也看到,目前很多品牌,都在寻找新的出路,比如说去往越野跑方向去发展,而且投入的非常的猛,突然就增加了,越野跑的投入的比例,最近还有新的运动 Hi-Rox 这个之前在你们的,伯克利听过,你们也是聊过 Hi-Rox的内容 对我们还派了一个同事,去肉身体验了一下,体验感觉怎么样,累得半死,对你看很多品牌,最近又是在 Hi-Rox里面加大了投入了,包括阿迪也是在做 Hi-Rox专用鞋,品牌它也是看到了,跑步市场可能,慢慢的增长,遇到了瓶颈,它也是在找新的出入,怪不得,我说为什么最近,好多品牌都开始,发力做越野跑了,是他们已经看到了,跑鞋见顶了,对因为他们看的,肯定比我们看的要快,他们是在半年前,订货的时候就知道,未来的这个生意的,一个趋势了,我们是要等上市之后,销售结束之后,看到财报我们才知道,那我觉得国产品牌呢,其实要把精力,更多的放到海外市场里边去,国外那些品牌,我们在供应链,在性价比上,还是有很大的优势的,所以我觉得,可以学习一下汽车行业,去卷一卷国外那些品牌,让外国人也能体会到,中国高性价比 高性能的跑鞋,但我们展开几样讲,现在国内的跑鞋品牌,直接让他们去,闯欧洲闯美国,是不是也不太现实,也是得从东南亚或者非洲这些市场来下手吧,其实有一些品牌已经在做了,包括安踏它已经在美国做跑步的社群,然后也是参加了美国的跑鞋会展,还有国内的一些初创的小品牌,都已经在发展国外的经销商了,所以其实很多品牌都已经在做这样的工作了,只是看是不是有加快进程的可能,不管怎么说,跑鞋出海肯定是比汽车出海要更容易一点吧 [00:59:30]
盖德:跑鞋出海肯定是比汽车出海要更容易一点吧,既然汽车我们的出口都能做得这么成功,我觉得跑鞋,这方面应该不是,一个很大的问题,你今天的一个问题,我觉得问得特别好,就是破二,到底是人重要,还是鞋重要,其实我觉得,人和鞋都重要,但其实这个荣誉,也不光属于阿里达斯和萨维,不光属于这双鞋和这个人,在他之前,那些精英选手,包括因为车祸去世的,吉普图姆,包括退役的吉普乔格,还有更早一些的,格布雷希拉西,以及在他们之前,那些叫不出名字的,顶尖跑者,其实他们都一步一步的,为今天这个破二壮举,铺好了路,正因为有了他们,作为这个锚点,后来人才会,以他们为目标,去不断地突破自己,创造更好的成绩,如果要再扩展一些,我觉得每个参与,和关注马拉松的人,其实都为普尔,贡献了自己的一份力量,因为正是有了,我们的关注和参与,马拉松这项运动,它才有了这么高的,商业价值 才会有这么多品牌,投资到马拉松里面去,这样才能发掘和培养,更优秀的运动员,并且才能打造出,性能更加极致的跑鞋 [01:00:54]
麻花:好的好的好的,那我们今天的录制就结束了,非常非常感谢您,好感谢马华的邀请,好了以上就是本期节目的所有内容,感谢大家的收听,中国的听众可以通过小宇宙,苹果播客,网易云音乐,喜马拉雅 QQ音乐,蜻蜓FM 荔枝FM来关注我们,海外的听众可以通过苹果播客和Spotify 或者在YouTube上搜索,硅谷101播客来关注我们,我们部分的文字稿还会收录在硅谷101的微信公众号上,谢谢大家,我们下次再见了 [01:01:04]


