worktree 会创建很多目录,导致磁盘空间占用比较厉害
宝
worktree 必须消失
这可是 20GB 重复的 node_modules,笑死

worktree 会创建很多目录,导致磁盘空间占用比较厉害
worktree 必须消失
这可是 20GB 重复的 node_modules,笑死
其实今年出了不少政策额外扶持真人短剧,奈何AI短剧的供给是DDoS级的。。。//@明浩-rosicky311:人类一败涂地~~~
#AI剧产量持续狂飙真人剧产量下跌#【每36秒上新一部!AI短剧狂飙,短剧江湖正在换主角】#平均每36秒就有一部新的AI剧上线# 过去一年,短剧是增长最快的内容赛道之一。
据QuestMobile数据,短剧行业去重用户规模达到8.51亿。平均每三个网民,就有两个看过短剧。
但当越来越多人打开短剧,屏幕里的主角正在变化。
今年5月,AI短剧首次占据每日TOP100榜单半数以上席位;到了8月,这个比例已升至七成左右。过去一个月,已有三部AI短剧峰值热度破亿,而真人短剧热度破亿的剧目已断档快两个月。
短剧成为主流内容市场之后,内部江湖已经先变了天。http://t.cn/AXNiKrR1


更多短信显示,拜登时期的美国卫生局局长 Vivek Murthy 针对 Fauci 对孕妇接种 COVID 疫苗的担忧作出回应,并补充道:“我也一直听到有人担心 mRNA 会导致发育中胎儿发生突变。”
这些担忧从未被公开。

突发:参议员 Ron Johnson(共和党,威斯康星州)公布了一份从 Dr. Fauci 手机中获取的短信。短信显示,2021 年 1 月,Fauci 曾在与拜登时期的 CDC 主任 Rochelle Walensky 及卫生局局长 Vivek Murthy 的交流中表示担忧,认为 COVID 疫苗第二剂可能“与孕早期流产有关”。
Grok 现在可以把你每天的新闻研究整理成一段你只需播放收听的语音备忘录。
让它研究过去 24 小时内所有重要信息,总结重大事件,并打包成一份音频简报。
这样,你不用阅读几十篇报道,只需按下播放键,几分钟内就能了解所有情况。
借助不同的可选声音,它基本上就变成了专属于你的个性化每日新闻节目。

//@明浩-rosicky311:人类一败涂地~~~
#AI剧产量持续狂飙真人剧产量下跌#【每36秒上新一部!AI短剧狂飙,短剧江湖正在换主角】#平均每36秒就有一部新的AI剧上线# 过去一年,短剧是增长最快的内容赛道之一。
据QuestMobile数据,短剧行业去重用户规模达到8.51亿。平均每三个网民,就有两个看过短剧。
但当越来越多人打开短剧,屏幕里的主角正在变化。
今年5月,AI短剧首次占据每日TOP100榜单半数以上席位;到了8月,这个比例已升至七成左右。过去一个月,已有三部AI短剧峰值热度破亿,而真人短剧热度破亿的剧目已断档快两个月。
短剧成为主流内容市场之后,内部江湖已经先变了天。http://t.cn/AXNiKrR1
香港的8人诈骗团队,从2024年开始到处发贴,每月5万港币找包养对象,骗了80个人总计620万港币,平均每人被骗7.5万。
被骗的还不光是女性,不想努力了的男性占比达到35%,大部分在19岁-29岁之间。
受害者的职业分布也很广泛,52%是服务业及文员,20%是在校学生,还有15%是教师、护士等相对体面的从业者。
还是要自我奋斗呀,朋友们。
🥱

香港的8人诈骗团队,从2024年开始到处发贴,每月5万港币找包养对象,骗了80个人总计620万港币,平均每人被骗7.5万。
被骗的还不光是女性,不想努力了的男性占比达到35%,大部分在19岁-29岁之间。
受害者的职业分布也很广泛,52%是服务业及文员,20%是在校学生,还有15%是教师、护士等相对体面的从业者。
还是要自我奋斗呀,朋友们。
🥱
这篇推文把文本水印的原理讲得很清楚。
生成文本时,模型每次要输出下一个 token,就会把前面已经生成的全部词语加上一个密钥,计算出哈希值。这个哈希值会将词表中的词随机分成两组,比如绿组和红组。然后,模型在选择下一个词时,会悄悄提高绿组词语被选中的概率。最终输出的文本看起来完全正常,但从统计上看会偏向绿组词语。
检测时则反过来:使用同一个密钥,对文本中的每个词重新计算哈希值,还原出当时的绿组和红组。如果整篇文本中绿组词语的占比显著超过 50%,就会判定这段文本带有水印。
几个常见问题:
1. 改写能破解水印吗?
大多数情况下可以。因为只要改动词语,前面的 token 序列就会发生变化,哈希值也会随之改变,绿组和红组就无法对应了。不过,也有改进方案使用统计模型,而不是确定性函数来生成哈希,让水印具备一定的抗改写能力。
2. 水印会降低文本质量吗?
理论上会,因为模型不能再完全自由地选择最优词语,而是受到约束,只能在绿组中选择。但 Google 在针对两万条文本开展的人类反馈实验中称,大多数人感知不到质量下降,因为表达同一个意思有很多种词语组合。不过,对于短文本或高度确定性的输出(比如 1+1=2),水印确实会失效。
3. 密钥会被逆向破解吗?
理论上,需要指数级数量的样本才能还原绿组和红组的划分,因此直接暴力破解并不现实。但如果检测器公开,攻击者就可以通过不断试探来摸索规律。
工程上的难点:
第一,大模型是流式输出文本的,词语会一个接一个地蹦出来,无法像学术方案那样等整段文本写完后再进行调整。
第二,如果密钥泄露,水印就失效了,因此需要轮换使用多组密钥。
第三,代码类输出不能随意替换词语,否则代码会出错;水印只能添加在注释、变量名等可以替换的部分。
如果 Anthropic 公开检测器,就等于给了攻击者一个免费的练习靶,水印很快就会被找到绕过策略。
如果像 Google 的 SynthID 那样把检测器保留在内部,会更安全一些。但学术界已经有论文展示了不需要检测器、也能零样本破解水印的方法。
密集改写(替换同义词并重组句法)可以有效消除水印,免费的改写工具就能绕过 Google 的 SynthID。
前沿实验室对此心知肚明,也没指望水印能拦住刻意绕过的人。大多数普通用户不会专门去除水印,而欧盟监管方也只需要效果达到“足够好”即可。
水印更多是一种应对欧盟监管的合规动作。
Claude 的水印可能并不是你想的那样。作为 GPTZero 的首席技术官,我来解释一下 Anthropic、Google 和 OpenAI 是如何构建文本水印的,并说明它是否能够被破解。
对于前沿实验室来说,几乎所有足够快速、便宜的水印方案都采用相同的公式,遵循 KGW 方法:
生成时:
1. 假设目前已经生成了 n 个 token。将这 n 个 token 与一个秘密密钥结合,生成随机哈希值。
2. 使用该哈希值,随机重新调整第 n+1 个 token 的概率,然后从新的概率分布中采样。在最简单的情况下,可以根据哈希值,将所有英文单词中的 50% 随机划入绿组或红组,并提高绿组词语的概率。
检测时:
1. 判断每个 token 属于绿组还是红组。
2. 为此,根据秘密密钥和当前 token 前面的文本重新生成哈希值,然后还原绿组和红组词语集合。
3. 检查完文本中的所有词语后,如果下一个 token 从绿组中被选中的比例明显超过 50%,就可以认定文本带有水印。
我知道你可能想问以下问题:
1)改写文本不是很容易破坏哈希值吗?答案基本上是肯定的。不过,也可以使用统计模型生成哈希值,而不是确定性函数(SIR、Adaptive Watermark)。由于整个水印本身就是概率性的,这样做是可行的。
2)这不是会让文本质量大幅下降吗?答案是肯定的,确实会——但对大多数人来说,这种变化难以察觉(Google 在一项涉及 20,000 条文本的人类反馈研究中作出了这一说法),因为表达同一段话有指数级多种方式。DiPmark 采用了更复杂的方法,避免文本分布在平均意义上发生偏移。当然,水印在短文本或高度可预测的文本上会失效,比如“2+2=4”。…
3)绿组和红组不是应该很容易被推测出来吗?答案是否定的。要精确重建这两个集合,需要从水印生成器获取指数级数量的样本;但如果检测器向公众开放,这确实会带来风险(水印窃取)。
不过,前沿实验室仍需要克服几个挑战:
1. 水印必须逐 token 生效,因为它们会把文本流式传输给用户。许多水印方法会一次规划句子或段落,或者等整篇文本写完后再修改文本,以增强对改写工具的鲁棒性,而前沿实验室目前还无法承担这种做法(SemStamp、PostMark)。
2. 如果秘密密钥泄露,水印就会失效。为了避免一次泄露造成大范围影响,需要轮换使用几组秘密密钥。
3. 有些文本(例如代码)不能任意修改,否则代码会出错。在这种情况下,水印需要有选择地修改那些能够容忍同义替换的文本部分,例如变量命名(参见 SWEET、EWD、Invisible Entropy)。
4. 还需要教育用户如何应对检测器的误报和漏报,这是一个很大的挑战(我们在这方面投入了大量精力)。
那么,我认为未来 6 个月会如何发展?
1. 如果 Anthropic 公开发布水印检测器,我认为他们会亲手毁掉自己的水印。人们会通过针对 Anthropic 的测试找到可靠的去水印策略(像 GPTZero 这样的 AI 检测器在这方面具有优势,因为一旦这些对抗策略流行起来,它们就能针对攻击者进行训练)。
2. 如果他们像 Google 那样,只把检测器保留给政府使用,情况会“更安全”。不过,已有论文展示了经过训练的方法,即使没有任何数据,也能以较强的鲁棒性进行零样本水印破解,因为这些方法只是尝试像人类一样写作(Zhang et al. 2024,《Watermarks in the Sand》)。此外,让检测器经受真实攻击的检验,也会使它长期变得更强(这是我的经验)。
3. 根据我的测试,水印无法经受密集改写,尤其是同时进行措辞和句法攻击,或者用人类文本替换(通过抄写人类作者的作品来改写 AI 文本)。就我测试的结果而言,免费的改写工具很快就绕过了 Google DeepMind 的 SynthID。
4. 总的来说,前沿实验室很可能接受这一结果,因为它们预计大多数用户不会攻击水印,而且它们和欧盟监管方可能都不会要求超过某个标准——达到“足够好”就行。
5. 总体而言,我认为前沿大语言模型的用户不会太在意这件事,原因有三:第一,他们没有意识到水印的存在;第二,欧盟会迫使所有人遵守规定;第三,这看起来更像是监管层面的走过场,而不是前沿实验室真心想要让人们识别大语言模型的使用。
最后,人们首先应该担心的不是水印,而是 AI 检测器!
如果你要发帖说“不是 X,而是 Y!”,我不认为水印会改变什么 :)
#Claude隐形水印#估计会引发一些恐慌,但是误解也很多。比如:这个标题就是错的。并非也绝非每个字可以全球追踪。
真实情况是:
1、Claude的隐形水印能检测到的是:
文本中是否存在由支持的Claude模型在生成时嵌入的不可见统计信号(该信号会随复制粘贴转移,并可能在轻度编辑后仍保留),从而提示这段文字很可能经过支持的Claude模型处理或生成;对于部分支持的文件(如PNG、JPG、SVG),还能检测到附带的C2PA签名来源元数据。
2、但,它不能绝对证明内容完全由Claude原创(例如人类先写好再让Claude润色、翻译或改写,仍可能留下水印),不能因为没有检测到水印就断定内容与AI无关。实际上,即使学术写作,一般也允许AI润色。
3、同时,重度改写、大幅转述、翻译或重新生成会削弱甚至消除这个统计信号,目前公开的检测细节和第三方工具仍在完善中。

笑死,听播客,滴滴的员工分享了一个案例,说一对夫妻在家里刷顺风车的单,刷的过程中忍不住开始[么么哒][害羞][污],发出的声音被平台系统识别出风险,然后滴滴打电话过去了解情况,那对小夫妻被吓得不轻,反手就发小红书喷滴滴监听用户侵犯隐私⋯⋯
庆幸我们全家没有一个人打过任何的新冠疫苗,至今只吃过一次 Paxlovid。
永远相信世界是草台的。
我倒要看看最后这个事情会是什么结果。看看谁会被拉出来当替罪羊。
金融时报:纽约正在经历一个史诗级的夏天,这座城市从未如此充满活力
纽约既是美国最适合步行的城市,也是大学毕业生寻找办公室工作的首选目的地。
对年轻人来说,另一个巨大吸引力来自民主社会主义市长佐赫兰·曼达尼带来的城市氛围。如今,即便是我最自由派的朋友,无论来自美国还是外国,聊天时也不再一开口就抱怨特朗普。
相反,他们更多是在惊叹曼达尼的迅速崛起。
曼达尼执政时表现得相当务实。他保留了一位强硬的警察局长,削减繁琐规定帮助小企业,同时推动向富人加税的方案,但又没有把力度推得过头。
这让极左翼颇为恼火,却也让人越来越难把纽约与意识形态敌意以及反特朗普情绪直接画上等号。
犯罪率正在下降。今年上半年,纽约谋杀案数量降至历史最低水平。此前因为担忧加税和犯罪而逃往迈阿密的百万富翁,如今外流速度已经放缓。
尽管美国正在收紧移民政策,纽约的国际净移民仍然保持正增长。通往曼哈顿的主要通勤铁路客流量,也正在逐步恢复到疫情前的水平。
👉 阅读公号全文:http://t.cn/AXNxqEVm

#模型时代# 李飞飞:苏格拉底是最好的Prompter
李飞飞这期在Huberman Lab的播客非常值得一听,建议大家听播客原文,以下笔记只是一个导读。这个播客是全球收听量最大的健康类播客之一,2025年进入Spotify全品类全球前十。主持人Andrew Huberman是斯坦福医学院神经生物学教授,节目以长对话著称,单期时长常超过两小时,YouTube订阅者超过760万。所以两个人很多内容聊的比较细致。当然,关于AI的部分,由于有科普的性质,可能从业人员都不陌生了。
李飞飞谈话中最精彩的部分,往往是人文的部分。比如这次播客,她讲数据的重要性,但是也从数据角度出发,举例体现人的重要性。李飞飞说毕加索绘画的时候,脑海中的数据从未被人得知,而AI来自于数据,所以人的独特性也就得到了保留。
她没说是哪幅。不过如果一定要推测,可能性最高的是《镜前的少女》(Girl before a Mirror,1932)。画中人物是当时22岁的玛丽-泰蕾兹·沃尔特。毕加索把她的侧面、正面和镜中形象组合在一起,明显符合这段对话讨论的“用特殊方式表现年轻女性”和抽象创造。
一、视觉是智能的基石
1、5.4亿年前的光感细胞启动了动物进化的加速键
大约5.4亿年前,简单的海洋动物(三叶虫及其近亲)出现了最早的光感受细胞。在那之前,动物几乎没有感知外界的能力,没有听觉,没有嗅觉,连神经系统都不存在。
光感受细胞改变了动物与外部世界的关系。能看见意味着能主动寻找食物、寻找配偶,也意味着自己会成为其他动物的猎物。化石记录显示,动物第一次感知到光之后大约1000万年,出现了被称为“寒武纪大爆发”的物种分化高峰。
2、人脑皮层活动的一半与视觉有关
据估计,人类大脑皮层活动的一半与视觉功能相关。儿童在语言能力之前就先具备了视觉能力。从进化到个体发育,视觉一直占据着智能的核心位置。
3、50年代的视觉神经科学直接启发了神经网络算法…
20世纪50年代,神经科学家Hubel和Wiesel开始记录哺乳动物大脑中的视觉细胞,发现了一个层级结构:从视网膜收集光信号,到逐层传递神经信息,最终识别出眼前的形状。
这个层级架构成为神经网络算法的灵感来源。今天的神经网络运行在数千亿乃至万亿参数之上,复杂度已经远离了当年从视觉通路中记录到的结构,但起源是共享的。
二、现代AI的三重收敛
1、2000年代的AI困境:所有人都在调算法,数据量却少得可怜
世纪之交的AI是一个机器学习实验场,不同实验室在尝试各种算法,神经网络、贝叶斯方法、支持向量机都有人做。李飞飞2006年在普林斯顿做第一年助理教授时,和学生一起审视这些算法,注意到一个被忽略的问题:喂给算法学习的数据量太少了。
她转向认知神经科学文献寻找线索。数据显示,人类在6岁前就能学会辨认数以万计的物体类别,而且婴儿从出生起就在接收海量视觉数据。她由此做出了一个当时相当离经叛道的判断:AI进展缓慢的核心瓶颈可能在数据,不在算法。
所有人都只盯着算法,而她选择赌数据。
2、ImageNet:1500万张图像构成了AI革命的燃料库
李飞飞团队主导了ImageNet项目,收集了1500万张图像,覆盖日常物体(话筒、杯子、椅子),目标是驱动机器识别现实世界中的东西。从2010年开始,她的实验室推出了一项公开挑战赛,即ImageNet Large Scale Visual Recognition Challenge,邀请全球研究者来解决物体识别问题:数据集包含1000个类别、超过100万张图像,算法看一张图后需要说出图中的主要物体,猜对得分,猜错不得分。
3、2012年:三条线索交汇,创造了现代AI的定义时刻
2012年,三件事同时成熟:GPU计算实现了并行加速,神经网络算法经过数十年研究变得更加成熟,ImageNet提供了足够规模的训练数据。那一年,一个名为AlexNet的深度神经网络在挑战赛中将错误率从之前的26%直接拉低到15%左右。
做个对比:斯坦福一位研究生后来专门测试了人类在同一任务上的表现,错误率大约是4%(随机猜测会是千分之一)。2012年的算法还没有达到人类水平,但错误率的跳跃幅度让整个研究界意识到这是一个拐点。到2015至2016年间,算法在命名1000种物体的任务上超过了人类。
4、同一个配方溢出到所有领域
“数据+算法+算力”的配方没有变,但ImageNet打开的闸门远不止计算机视觉。语音识别、声音识别、自然语言处理,AI的每一个子领域都在这次收敛之后获得了技术提升。斯坦福有同事开始用机器学习研究鲸鱼歌声。
2017年,一种叫transformer的新型神经网络架构被提出,在处理序列数据方面比AlexNet时代的算法强大得多。这次领跑的领域换成了自然语言处理,因为互联网上最容易获取的大规模数据是文本。加上更强的GPU,OpenAI和谷歌快速推进,从2017年到2022年ChatGPT面世,又走了大约5年。
三、AI能做什么,够不到什么
这条边界的判断标准只有一条:数据是否可获取。如果一种信息能通过语言、图片、视频、脑电波或任何传感器被采集到,并且有足够的量,AI就可以学习它。如果不能被采集,无论AI多强大,它都无法触及。
1、孩子看3只猫就能认出猫尾巴,AI需要整个互联网的猫
一个孩子可能只见过3到10只猫,就能在书架后面看到一截尾巴时判断“那是猫”。AI做同样的事需要海量视频和图像。这两者的学习路径有本质差异,其中的机制至今没有被完全解开。
2、视频数据让AI学会了“猫怎么跑”,但它不懂猫的肌肉
大约2023年开始,多个研究团队将视频纳入训练数据。2024年初OpenAI发布Sora时,用户输入“一只猫追老鼠”就能生成一段看起来合理的短视频,猫的四肢按顺序迈步。
这看起来像是AI理解了运动,但实际发生的事情没有那么玄妙。AI不知道猫腿的肌肉怎么连接,它只是看过太多猫的视频,学会了猫运动“应该长什么样”。大多数人类的情况其实也类似:我们不知道猫的肌肉结构,但见过太多猫走路,对“合理的猫步态”有一个统计性的判断。
3、互联网是人类行为最大的多模态集合
理解AI的能力边界,先要准确理解互联网到底是什么。它承载了全世界人口几十年的打字行为,从青少年闲聊到被数字化上传的深度科学论文。它还承载了数码相机和智能手机拍下的海量照片,从家里的猫到BBC的专业摄影。再加上视频(含声音和运动)和音乐。
AI在这个庞大的库上训练,所以它强大,尤其在语言方面。太多人类知识已经以文字形式存在了。
4、毕加索画肖像时脑中的念头,从未被上传
但有一类信息AI永远无法获取。李飞飞举了一个假设性的例子:毕加索决定以某种独特方式表现一位年轻女性时,促成这种表达的念头并没有被任何设备捕捉。作品可以进入互联网,创作念头本身没有留下数据。作为神经科学家,如果有人问那个想法来自大脑的哪个区域,答案也是不知道。是布洛卡区?V1视觉皮层?前额叶?运动皮层?也许弥散在各处,因为那个想法极度个人化。
你可以叫它创造力,叫它情感,叫它任何名字。它没有被捕捉,因此不在互联网上,因此AI没有见过。
5、“直觉”分两层,浅的已经能做到,深的完全够不到
李飞飞把“直觉”拆开来看。浅层的部分:你在AI对话框里输入“我是斯坦福教授、神经科学家”,AI就会针对你的身份定制回答。换一个人输入“我是14岁的赛车爱好者”,问同一个问题,答案就不同了。这在计算机科学里叫context,就是数学运算,谈不上什么直觉。
深层的部分就不一样了。你突然对某件事有强烈感觉,不知道是因为闻到了什么、是荷尔蒙波动、还是今天的早餐。你说不出来,甚至无法用手势传递给另一个人。伴侣之间有时能感觉到对方情绪不对,但说不清哪里不对,只能默默走开让对方静一静。如果一个人都无法把这个信息传递给另一个人,那机器就更没办法了。
没有传感器能采集的信息,AI就无法学习。她强调这没有什么神秘的,完全可以用科学过程来描述:信息是否可被采集?如果可以(通过语言、图像、脑电波、皮肤电导率),那就有可能训练AI。如果不可以,那就目前做不到。
6、Move 37是创造力,但属于一种“特殊的创造力”
2016年AlphaGo对战李世石时,在第二局下出了Move 37,一步围棋大师们从未想到的棋。很多人将此视为AI创造力的标志。
需要还原这步棋的语境。围棋是一个高度数学化的游戏,目标明确,规则清晰。AI拥有比人类更大的算力和更强的记忆保持能力,能在人类大脑无法穷举的空间中搜索。这算创造力吗?算。但这是一种特殊的创造力,与一个画家凝视空白画布时涌现的东西不同。
李飞飞提到她和一位顶级数学家的对话。这位数学家说,数学中有很多未解难题,即使是菲尔兹奖得主也可能忘记了历史上已有的某些解题方法,AI可以帮忙找到这些被遗忘的方法来攻克难题。但有些数学问题需要的解法根本还没有被发明出来,那种层次的创造力,目前还不确定AI能否独立完成。他的判断是:最可能的路径是人类与AI的混合创造。
7、AI说“你生病了我很抱歉”和朋友说同样的话,机制完全不同
机器说这句话,是因为它在训练数据中学到了一个模式:当有人说“我生病了”,应该回复“我很抱歉”,而不是“我很高兴你生病了”。
你的朋友说这句话,是因为他们真心关心你的健康,不想看你受苦,经历过疼痛因而能产生共情。机器没有任何这些东西。
今天的机器和人类在根本层面上的运作方式不同,这一点必须被清楚地认识和尊重。
四、AI在科学发现和医疗中的机会
1、科学发现的方式可能需要一次彻底重写
几百年来,科学发现依赖聪明的人类大脑记住前人的知识,然后以人类肌肉的速度做实验。现在有了一个新工具,它的“大脑”能保留海量信息,能跨学科综合知识。李飞飞以自己为例:她在视觉神经科学和AI领域深耕,但对嗅觉系统的了解几乎为零,连同事论文里的专业词汇都可能拼不出来。人脑的带宽就是这么有限,AI可以打破这道墙。
2、AI帮Huberman诊断出了医生漏掉的低血压问题
Huberman分享了一个亲身经历。他服用了一种医生开的药物后出现了头晕,感觉像天旋地转。他以为是眩晕,咨询了一位专攻前庭系统的耳鼻喉科医生,也没有得到准确判断。
他把自己一两天内的主观感受输入AI聊天机器人,AI区分了眩晕和低血压的不同症状表现,指向药物引起的血压过低。他按照这个方向补充电解质,两小时后症状消失。
这个案例的价值不在于AI比所有医生强。重点是它零成本、即时可用,对那些无法立即接触到医生的人意义重大。
3、达芬奇手术机器人做她父亲的肝脏手术,出血量是传统手术的十分之一
李飞飞的父亲在斯坦福接受了一台肝脏手术,由外科医生操控达芬奇机器人系统完成。术后出血量只有传统开放手术的十分之一,得益于机器人的腹腔镜精细操作能力。
她事后问外科医生:如果把全世界做过同类肝脏手术的数据都收集起来,能不能训练一个全自动AI手术系统?答案并不明确。肝脏是一个高度血管化的器官,每个人的肝脏差异很大。即使汇总全球数据,样本量可能仍然不够。
这揭示了一个关键判断标准:AI从模式中学习,当模式不够丰富时,就必须谨慎。在数据充足的领域(比如眩晕vs低血压的鉴别诊断),AI已经相当可靠。在数据稀缺的领域(比如个体化的复杂外科手术),人机协作目前仍然优于纯机器方案。
五、被遗忘的群体与公共沟通
1、硅谷讲AI的方式正在伤害公众
目前的AI公共话语存在两个极端。一端是极端末日论,让人恐惧。另一端是极端乌托邦论,把技术描绘得完美无缺,公众的反应通常是“你当然这么说了,你是既得利益者”。
懂技术的人倾向于居高临下地和公众对话。不管出发点是好是坏,传递出的信息都是“你们不懂这个,让我来替你们决定什么是好的”。AI的话语体系正在严重失衡。
Huberman提到一个生物学领域的例子来说明技术人为什么需要外部约束。他有一个做病毒研究的朋友,曾经想把改造过的狂犬病毒放进果蝇体内做实验。技术上可行,科学价值也有,但如果有一只携带病毒的果蝇逃出实验室,后果不堪设想。这个实验最终被否决了。做技术的人天然想push边界,这没错,但社会需要有制衡机制。
2、苏格拉底是人类历史上最好的prompter
学会提问是使用AI的关键技能。李飞飞认为应该在K-12阶段就教孩子如何提问。她做了一个类比:如果苏格拉底还活着,他会是最好的prompter,因为苏格拉底方法的本质就是通过提问来追寻真理。
3、ChatGPT发布后,她第一件事是给孩子学校的校长写邮件
2022年11月ChatGPT发布,李飞飞作为技术圈内部人,第一反应不是评论技术本身,而是联系了自己孩子所在小学的校长,提出想来给学生和老师做一次讲座。
因为硅谷没有人在ChatGPT出来的那一刻想到“我们社区的老师怎么办”。没有投资机构,没有万亿市值公司,第一时间想到了邻里的教师。
老师是社会中最重要的人之一。应该和他们对话,给他们支持。
4、对AI最差的两种态度:剥夺能动性,或者禁止接触工具
一种坏结果是AI被错误使用,让年轻一代的能动性和学习动力被工具夺走。无限刷短视频、被动消费内容,这些不利于大脑发育。不管技术怎么变,人类的神经元、化学物质、激素有自己的运作方式,学习需要时间、需要努力、有时需要经历痛苦。
另一种坏结果同样糟糕:以“学生会作弊”为由禁止学生接触AI工具。李飞飞回忆自己做医学预科生时学有机化学的经历,助教时间太短,教授office hour和其他课冲突,学起来非常吃力。如果当时有一个AI学伴,她可以在自己卡住的地方反复提问。她有学习动力,只是缺少指导。这样的工具不应该被禁止。
六、空间智能与具身AI:下一个前沿
1、World Labs押注语言之外的智能
李飞飞2024年初联合创立的World Labs,到2026年2月已累计融资12.3亿美元,投资方包括AMD、Autodesk、NVIDIA、Fidelity等。公司的第一个产品Marble允许用户通过文字、图片、视频或3D布局生成可持续编辑的三维环境。
她选择这个方向的逻辑:人类的发展轨迹是先有视觉和空间理解,后有语言。进化在没有语言交流的状态下已经走了5亿年。AI如果只停留在语言层面,就错过了智能的一大块。空间智能模型可以服务于创作者、建筑设计、机器人训练和交互环境。
2、一个瘫痪十年的女人,用自己的声音重新说话了
Huberman提到了他的好友、UCSF神经外科主任Eddie Chang的工作。Chang团队通过脑机接口,让因瘫痪而丧失语言能力的患者重新与世界交流。
其中一位女性患者已经瘫痪多年,无法开口。团队在她的大脑表面植入了电极阵列,读取她试图说话时产生的神经信号,再由AI算法将信号解码为文字和语音。关键在于,团队找到了她婚礼上的视频,知道她本来的声音和表情模式。最终她在身旁的iPad屏幕上,以自己的面部形象和声音与他人对话。系统通过机器学习持续更新,还能感知对话者的反应。
这个案例是AI具身化最有力的证据之一。它证明的不是技术多炫,而是一个人的能动性被技术重新归还了。
3、机器人可能需要30年才能真正融入社会,但需求清单已经很长
和纯软件AI不同,机器人涉及硬件,落地速度更慢。但需求明确:
加州每年经历山火,让人类消防员冒生命危险去救援并不理想。
护士在一个班次内要走好几英里去取药品和物资,长期超负荷工作。
独居老人取药、买菜、想去公园散步,这些简单的事情对行动不便的人来说是巨大的障碍。
李飞飞自己是家中独生女,正在照顾两位年迈多病且不说英语的父母。她说这种照护工作量巨大,机器人能承担一部分体力劳动,同时不替代家庭责任、爱和沟通。
人们对机器人的不适感很大程度上来自它们的物理硬度和占据空间的方式。李飞飞提到了迪士尼大约十几年前的动画角色大白(Baymax),一个医疗机器人,外形像一个大气球,触感柔软。比起金属质感,这种设计更容易被人接受。如何想象人与机器人共存的未来,不应该由某家公司或某个投资人单方面决定。公众应该作为利益相关者之一参与设计这个未来。
4、AI在改变电影业,但故事仍然是人写的
AI工具已经可以根据剧本生成视频镜头,甚至组装出接近长片长度的电影。但故事创作、镜头运用、角色塑造这些能力仍然深度依赖人类。好莱坞对AI取代编剧和演员有强烈恐惧,李飞飞认为真正需要做的是让技术人和创作者面对面对话。
她的联合创始人Ben和演员本·阿弗莱克(Ben Affleck)见了面,讨论AI在电影制作中的应用。阿弗莱克本人对AI工具的态度相当开放。这类技术界与好莱坞从业者之间的对话,在当前阶段是关键的。
李飞飞说,World Labs也在和视觉特效行业合作,对她来说最重要的是用户和客户感到被增强了,而不是被替代了。“Technology should be making their jobs better,superpowering their creativity。” 技术应该让他们的工作变好,让他们的创造力被放大。
5、AI领域缺一个理解人性的人
乔布斯(Steve Jobs)理解计算机需要圆角、需要放进口袋、需要在开机画面上放鲍勃·迪伦。他能把冷冰冰的技术变成人愿意放在手边的东西。
AI领域目前没有这个角色。技术社区最聪明的人不被公众接受,部分原因是公众不理解他们,但也因为他们缺少一个合作者来帮助用公众能接受的方式分享愿景。传统媒体在放大这道裂缝方面也有责任:它们靠“科技巨头来抢你饭碗”这类叙事赚流量,而真正在用AI帮人恢复语言能力、帮人学习的故事得到的关注少得多。
核心归纳
Q1:AI的智能从何而来,它的天花板在哪?
AI的训练数据本质上是互联网,而互联网是全人类几十年来通过打字、拍照、录视频、做音乐所产生的多模态行为集合。这解释了AI为什么强大。它的天花板在于:没有被捕捉为数据的人类认知(高度个人化的情感、记忆、直觉),AI无法学习。判断AI能否处理一件事,核心问题是:那个信息能被采集吗?有足够多的同类数据吗?
Q2:AI在医疗和科学发现中最大的机会和限制分别是什么?
机会在于AI能跨学科综合信息、保留人脑无法记住的知识量,且零成本即时可用。限制在于数据丰富度:在鉴别诊断等有大量报告的领域,AI已经够准。在数据稀缺的领域(如个体化的复杂手术),人机协作优于纯机器方案。
Q3:普通人现在应该对AI做什么?
学习它。不一定要学编程,但要理解AI是什么工具、怎么用它来增强自己的学习和工作。学了之后会更有掌控感,不容易被恐惧或乌托邦话术牵着走。同时关注教师和学校,他们是帮助下一代正确使用AI的核心角色,但目前被整个AI话语体系忽视了。

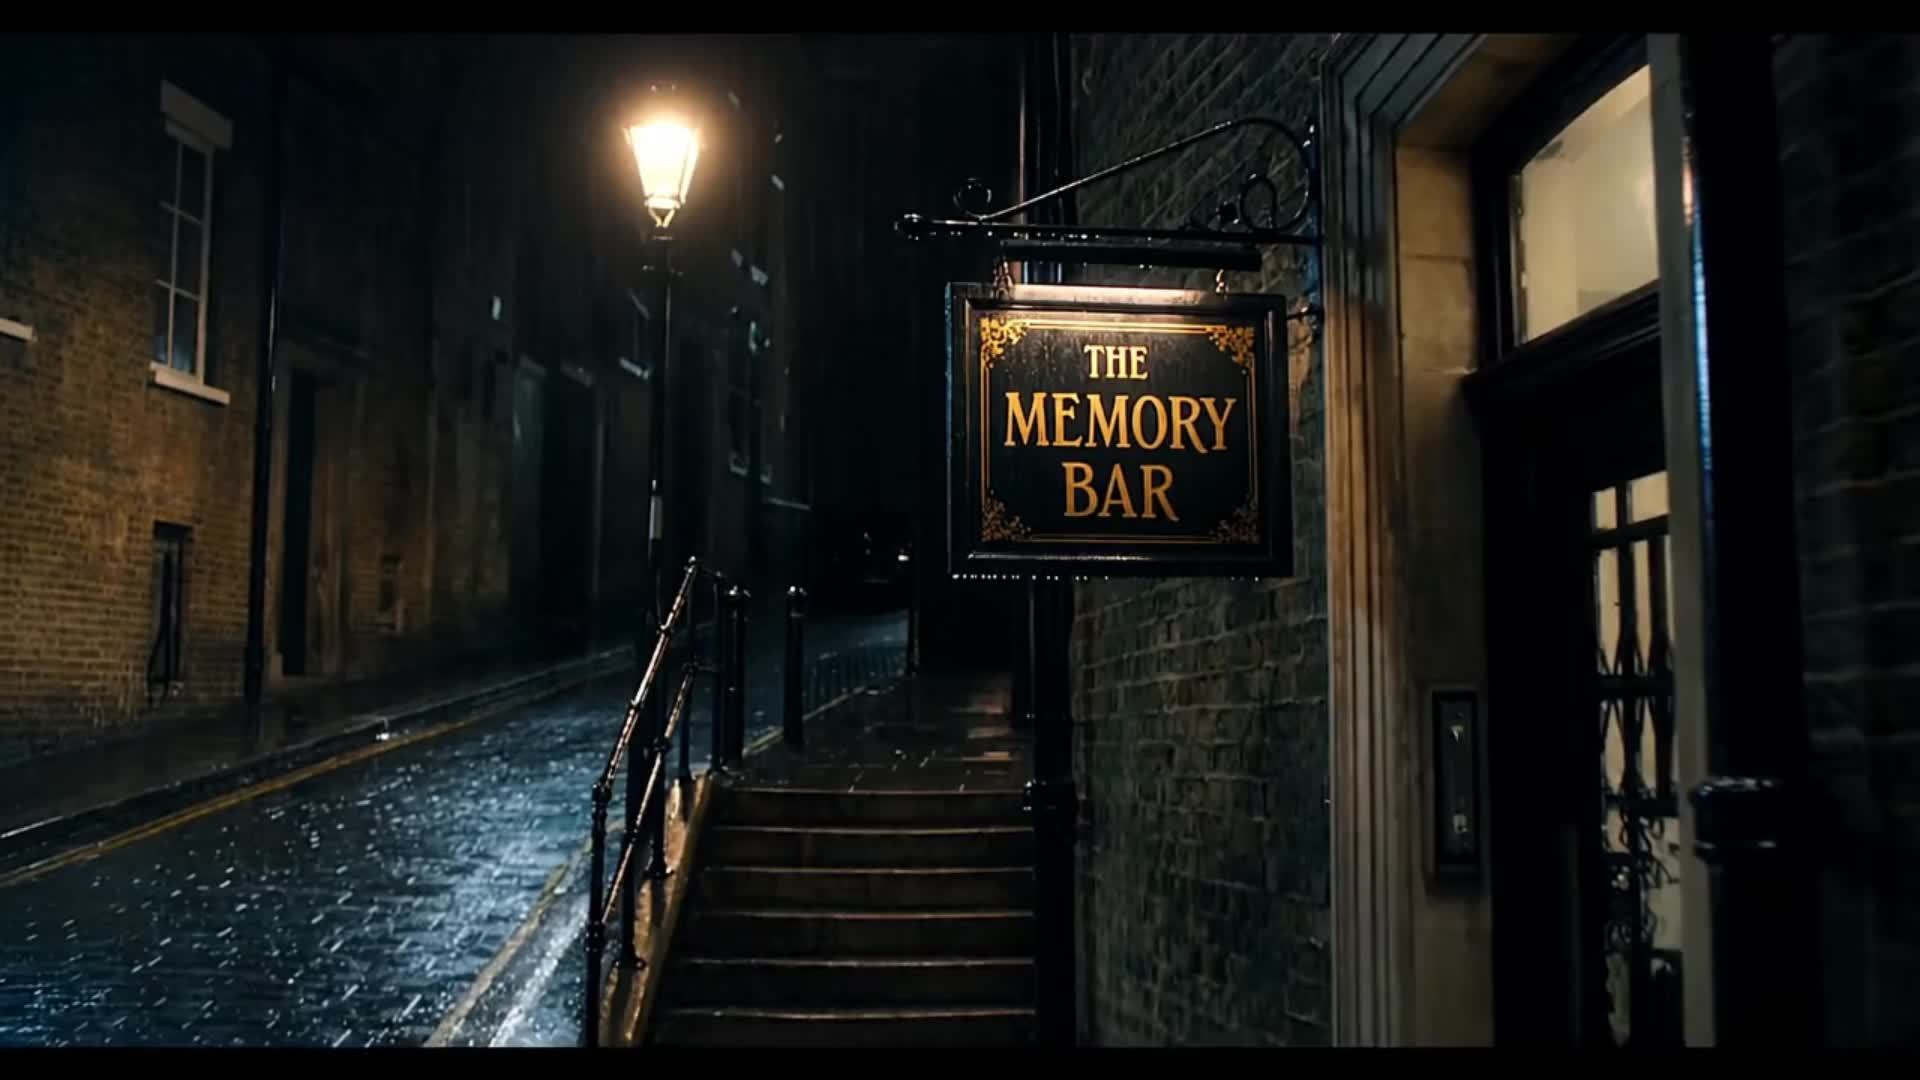
这次在 Wan3.0的测试里面,我非常喜欢的一条!
这一条是 Wan 3.0 30秒文生视频直出的,故事概念是:“这家酒吧按杯出售陌生人的记忆。”
(好多朋友也和我反馈有意思,也许我们该接着往下做这条短片?)
我特别喜欢 Wan 3.0其中三个镜头分屏处理的剪辑手法,是最开始我没有想到的方法。
Wan 3.0绝对是 Wan系列目前的最强版本!
分享一个有趣的小故事,Wan的算法老师和我们讲他们在评估模型能力的时候常常会关注三个细节:1. 地板、2. 皮肤、3. 人类的苹果肌。
这个视角好有趣。
#how i ai#
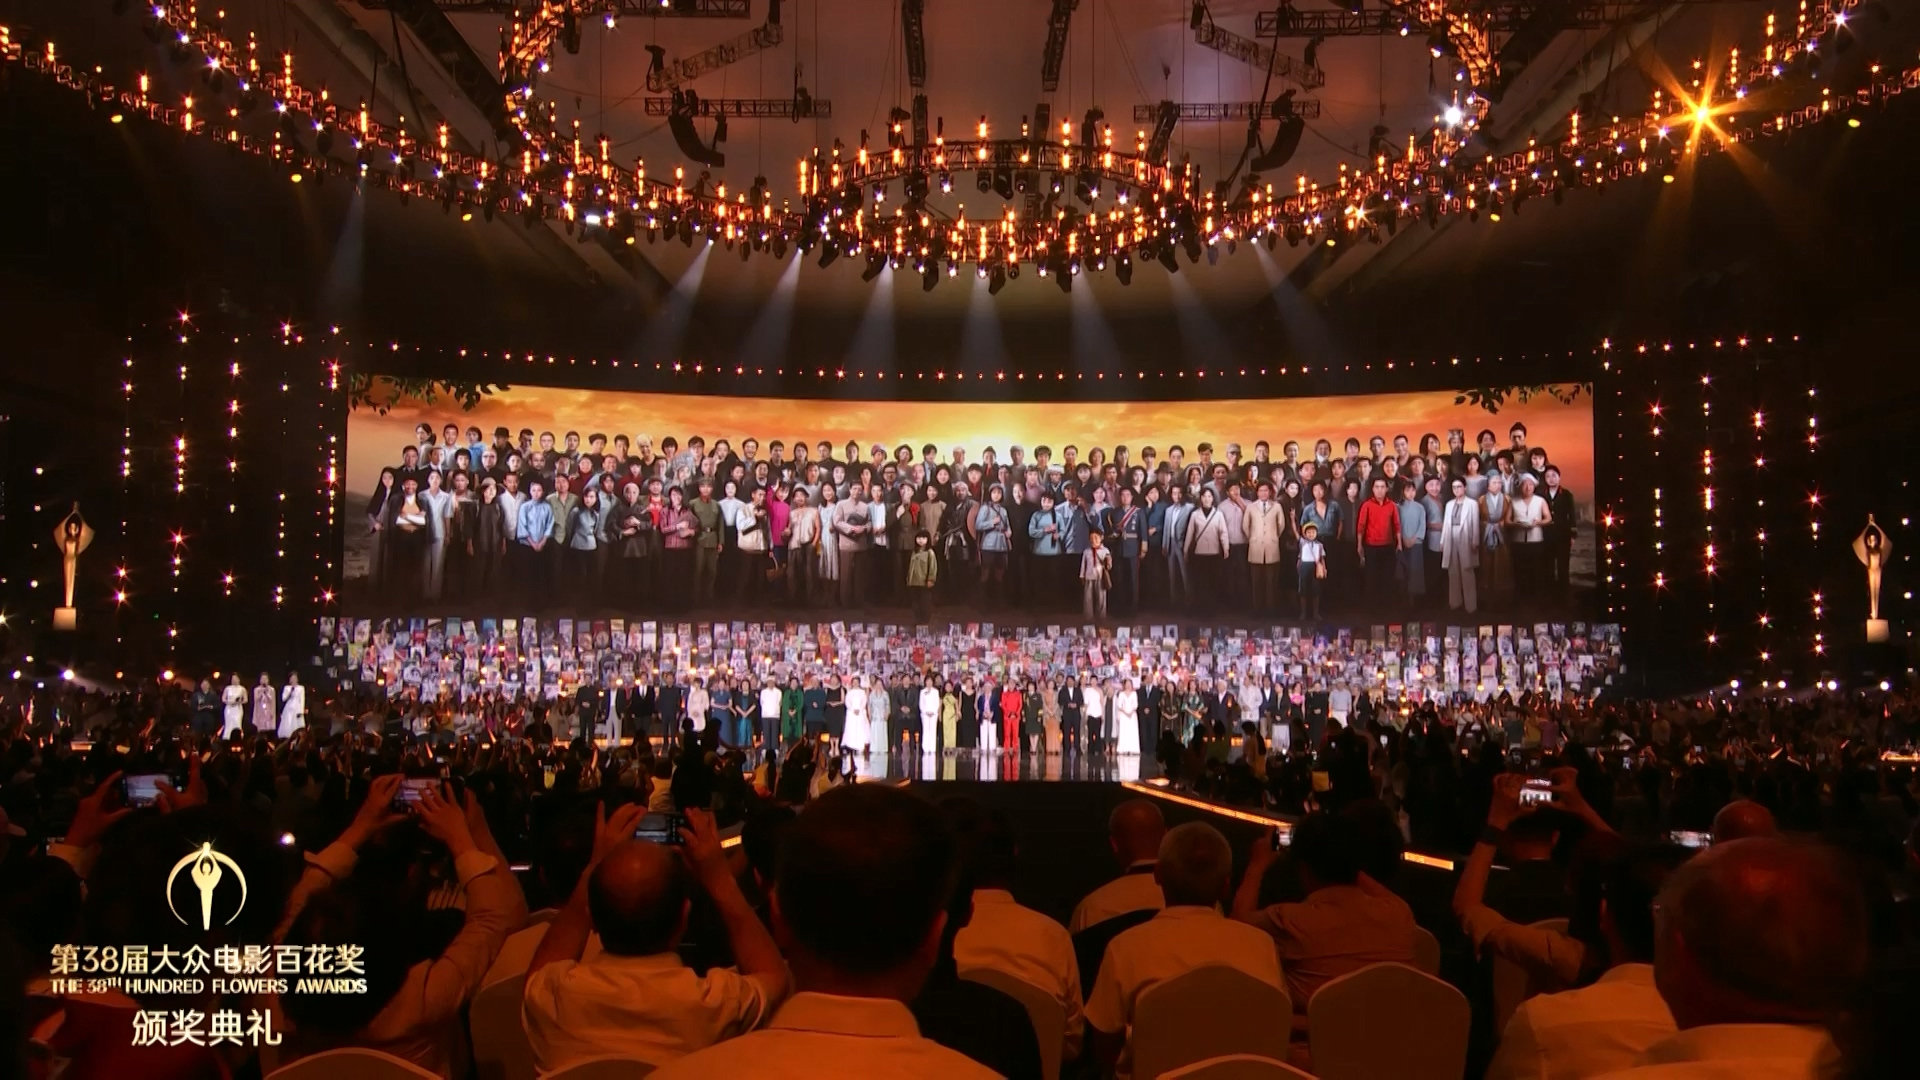
2026百花电影节闭幕式历年获奖代表入场陈瑾陈冲刘晓庆温玉娟丛珊吴玉芳王馥荔岳红沈丹萍何赛飞宋春丽奚美娟所有阿姨!全员精神全员好看!
项目作者看过幽游白书吧 ……//@Transformer-周:有点太牛逼了
抽象,把滑动变祖器做成游戏了项目:github.com/Lichtspektrum/liang-intensity-calibrator

//@镜子杂谈:转发微博
1885年,三位女性在费城坐下拍了一张照片。乍一看,这像是一张正式的维多利亚时代肖像,黑色的裙子,沉稳的表情,没有什么特别革命性的东西。
但再看一眼。
这些女性是来自印度的阿南迪拜·乔希、来自日本的庆冈美,以及来自叙利亚的萨巴特·伊斯兰布利。三人跋涉数千英里,到宾夕法尼亚女子医学院学习医学,这是当时少数愿意培训女性成为医生的机构之一。
而且她们每人都跨越了远超地理界限的障碍。
乔希九岁时就结婚了。在她还是青少年时失去婴儿儿子后,她下定决心学习医学,以便其他印度女性能从女医生那里得到照顾。她独自前往美国的决定在国内引发了强烈批评。
冈美从日本来到这里,获得了医学学位,后来在东京为患者诊治。据一个广为流传的故事,当明治天皇参观她的医院时,他拒绝以专业身份接见她,因为她是个女人。
然后是伊斯兰布利,一位来自大马士革的库尔德犹太女性,她医学院毕业后的生活变得令人着迷地难以追踪。甚至她的名字在历史记录中也以几种不同形式出现。

#模型时代# #英伟达将筹资超5000亿美元#黄仁勋Blog:英伟达AI工厂算力正在成为一种可投资的资产类别
昨天刚发了扎克伯格的Blog,黄仁勋的blog也来了,不过内容更落地,是一项计划。
三句话归纳一下核心观点:1、英伟达认为,AI算力中心可以像电站一样,长期出租算力、持续产生收入,因此有条件成为金融机构愿意投资的基础设施资产。
2、为扩大建设规模,英伟达与Apollo、贝莱德、黑石等机构设立融资平台,计划逐步引入超过5000亿美元第三方资本,帮助有真实算力需求但缺少资金的企业建设AI工厂。
3、由于AI行业此前出现过供应商投资客户、客户再用资金购买算力的“循环融资”,英伟达特别说明:金融机构将独立评估每个项目,相关资金不计入英伟达收入,英伟达只在部分项目中提供最高25%的残值支持。
---
今天,我们宣布与 Apollo、贝莱德(BlackRock)、黑石(Blackstone)、布鲁克菲尔德(Brookfield)、高盛(Goldman Sachs)和 KKR建立合作伙伴关系,共同设立独立融资平台。随着时间推移,这些平台计划调动超过5000亿美元的第三方资本,支持AI基础设施建设。
这是英伟达和AI产业发展过程中的一个重要里程碑。过去,企业购买芯片,并逐个项目建设数据中心。如今,AI工厂已经能够作为生产性基础设施获得融资,并由可复制的平台、长期机构资本以及多元化客户群提供支撑。这些客户利用算力创造收入。
AI已经来到一个转折点,正从研究走向生产。AI正在创造真实价值,其背后的基础设施也在成为全球生产效率最高的资产之一。在AI时代,算力就是收入。
一、一种新的基础设施资产
英伟达算力并不只是一块芯片,而是一套完整的AI工厂平台,涵盖加速计算、网络、系统软件、AI框架和全球开发者生态。
英伟达DSX AI工厂能够运行全球范围最广的AI模型、模态和算法,包括语言、视觉、语音、生物学、物理AI和机器人。单座英伟达AI工厂可以服务多个客户,承载多种工作负载。因此,它具备高度灵活性,算力也可以在不同用途之间通用调配。…
这套平台建立在全球广泛采用的架构之上。全球所有主要云服务商,以及各地的系统制造商和企业,都在使用这一架构。当需求发生变化时,AI工厂可以转交给其他客户、云服务商或运营方使用。广泛的生态系统为英伟达算力提供了规模庞大的潜在用户和承购方市场,有助于保护资产残值。
CUDA能够持续提升AI工厂的能力。英伟达每一代软件都在改善已部署基础设施的性能、效率和总体拥有成本。硬件的能力不会停留在安装完成时的水平。软件创新使AI工厂能够在整个生命周期内,以更低成本生产更多智能,从而延长其经济使用价值。
英伟达A100就是一个有力例证。英伟达在2020年推出基于Ampere架构的A100。六年之后,A100依然被广泛用于AI训练、微调、推理和高性能计算。客户仍在签订多年期算力使用协议,使A100的经济寿命逐渐向十年延伸。
市场也在证明英伟达算力经济性的持久程度。H100一年期租赁价格从2025年10月约每GPU小时1.70美元,上涨到2026年3月约每GPU小时2.35美元。不同服务商的按需使用价格中位数,也从2025年10月约每GPU小时2.00美元,升至2026年6月的2.70美元。Blackwell算力享有价格溢价。据公开报价,B200的云端租用价格约为每GPU小时5.30至7.05美元。
这些特征构成了英伟达AI工厂的差异化价值。AI工厂在安装完成后仍能持续增值:CUDA不断提高其产出能力;存量设备在初始折旧期结束后仍可保持生产力;同一套标准架构能够服务一个规模庞大且持续增长的全球AI工作负载市场。
这正是可投资基础设施资产应当具备的特征:能够产生收入,服务广泛市场,性能随着时间推移不断提升,并且可以重新部署。
二、为AI工厂引入资本
市场对AI基础设施的需求极为旺盛,但不同企业获得资本的能力并不均衡。许多优秀的AI公司、企业和AI云服务商拥有明确的算力需求,却暂时无法以快速建设所需的规模和成本获得融资。
因此,我们选择与全球领先的长期资本提供方合作。
Apollo、贝莱德、黑石、布鲁克菲尔德、高盛和KKR也是全球领先的基础设施投资机构,在评估和投资长期生产性资产方面拥有深厚经验。我们将共同建立可复制的融资平台,帮助AI生态建设其所需的AI工厂。
这些平台旨在帮助符合条件的AI实验室、企业和AI云服务商大规模获得AI工厂基础设施。超过5000亿美元这一数字,代表这些平台计划逐步调动的第三方资本总额。这笔资本并非英伟达的收入,也不属于某一只基金,更不代表对某一个客户作出的投资承诺。
金融机构将独立评估每一个项目,包括客户情况、市场需求、利用率、现金流和资产残值。英伟达提供AI工厂平台,金融机构提供长期资本和融资专业能力。
三、几个重要问题
1、这属于循环融资吗?
这项计划的设计考虑了外界对于循环融资的担忧。我们正在把独立的长期机构资本引入AI基础设施市场。
市场需求真实存在,来源包括前沿AI实验室、AI原生初创企业、传统企业、云服务商以及正在建设AI服务的各个国家。资本提供方将对每个项目进行独立尽调和风险评估,覆盖客户情况、需求、利用率、现金流和残值。英伟达负责提供平台,投资者独立作出融资决定。
这标志着一个面向AI基础设施的开放资本市场开始形成。
2、英伟达为何要提供融资支持?
在部分项目中,英伟达可能提供残值支持机制,支持比例最高可达到单个项目规模的25%。每个项目都会经过审慎的单独评估。这项支持规模有限,以残值为基础,作用是补充独立风险评估,不会取代金融机构的独立决策。
这一比例显著低于其他算力融资安排。英伟达之所以能够提供此类支持,源于英伟达算力的独特属性:算力可以通用调配,架构获得全球广泛采用,软件可以持续升级,设备也能在庞大的客户生态中重新部署。
我们的职责是帮助释放规模庞大的独立资本,同时维持严格且可控的风险敞口。
3、市场能够消化这些算力吗?
问题的关键在于,我们所建设的数据中心能否成为具有生产力的AI工厂。
AI工厂把能源和数据转化为有价值的智能。它的客户范围非常广,包括前沿AI实验室、AI云服务商、企业和国家。这些客户建设AI基础设施,因为AI已经能够承担各行各业中具有实际价值的工作。
这套模式包含明确的投资纪律。每一家融资合作伙伴都会独立评估需求、利用率、现金流和残值。算力建设将以真实客户需求及其经济回报为基础。
4、投资回报来自哪里?
投资回报来自AI的实用价值。
企业正在利用AI编写软件、发现药物、设计产品、服务客户、实现运营自动化并开发新服务。AI工厂为这些活动提供基础。更多算力能够产生更好的AI;更好的AI带来更多使用;更多使用创造更多收入;更多收入又会推动更多算力投入。
这构成了AI工业革命的良性循环。
四、智能时代的基础设施
每一次工业革命都建立在基础设施之上,包括电力、交通、通信和计算。每一轮大规模基础设施建设都离不开外部融资。
AI工厂就是智能时代的基础设施。
通过这些合作,英伟达与全球领先的金融机构正在建立一种新的融资方式,为推动这场工业革命的基础设施提供资本。我们将帮助更多正在建设未来的企业、产业和国家获得AI工厂。
AI时代已经到来。我们将携手建设为这个时代提供动力的基础设施。
不是发动机问题就还好
好了,破案了(
好消息:不是YF-100(以及任何型号发动机)的问题,原定8.24的嫦娥七号还有很大希望不会被推迟。而且最大的“不幸中的万幸”是长征火箭家族当中共用YF-100系列的CZ-5、CZ-12、CZ-6A、CZ-8A、CZ-10A/B乃至载人登月的专用箭CZ-10也大概率不会因此被“波及”得全面停飞推迟从而导致中国航天在未来若干个月当中陷入“无中大型火箭可用”的尴尬窘境。(当然,一切以官方最终调查结果为准)
坏消息:原本好好的没有任何发动机异常或者姿控异常结果飞着飞着突然上半截脑袋掉了,足以被评选为全球航天本世纪火箭发射的奇观大赏以及最具奇葩性的失败死法之一。(上半截的箭体材料和生产这是外包给东南亚代工吗……)
(当然也有相当的可能性是在抵达MaxQ附近的时候突然遭遇大幅风切变再加上CZ-7A这款火箭长径比本来就过大,三重debuff之下从而造成了上半截箭体直接被咔嚓折断造成了本次事故) http://t.cn/AXNMsWoM
小宇宙爆发的含金量进一步提升 //@徐建红WH:连AI也需要鼓励?是不是侧面说明,人类的所谓情绪,也不过是神经网络的参数?
Anthropic今天宣布,一个未公开的研究版 Claude在尝试证明黎曼猜想的过程中,虽然没能证明猜想本身,却在一个相关问题上取得了重大突破:它把黎曼 ζ 函数的非平凡零点落在临界线上的已知比例下界,从 41.6% 提高到了 67.2%。
黎曼猜想是数学界最著名的未解难题之一,1859年提出,至今 167年无人能证明或推翻。它的核心主张是:黎曼 ζ 函数的所有非平凡零点都落在复平面上一条特定的竖直线上,数学家称之为“临界线”。
如果这个猜想成立,素数的分布就有了一种深层的规律性。这个问题列在克雷数学研究所的七大千禧年问题之中,悬赏 100万美元。
既然全面证明太难,数学家们退而求其次:能不能至少证明有多大比例的零点确实在这条线上?
这个方向上的进展,过去 80年是这样的:
- 1942 年 Selberg 首次证明有正比例的零点在线上,但比例很小;
- 1974 年 Levinson 证明至少三分之一;
- 1989 年 Conrey 推到五分之二;
- 此后又经历了几代数学家的努力,到 2020 年 Pratt 等人才把这个数字推到 41.7%。
换句话说,从 33% 到 41.7%,人类花了将近 50年。Claude一步跳到 67.2%,跨度接近 26个百分点,是这个问题历史上最大的一次单步提升。
Claude的发现建立在前人的工作之上。它结合了 Baluyot、Goldston、Suriajaya和 Turnage-Butterbaugh近年发表的一系列成果,以及数学家 Bombieri在 2000年的一篇论文。这些工作本身已经为突破铺好了路,而 Claude找到了把它们拼在一起的方法。…
Anthropic的两位数学家 Levent Alpöge和 Ralph Furman审查验证了 Claude的证明,外部专家 Brian Conrey和 Dan Goldston也在短时间内审阅了论文。Claude还用 Lean(一种形式化证明语言)写出了可机器验证的证明。
过程本身和结果一样有故事。Anthropic的一位员工 Jarred Sumner(不是数学家)在 Claude Code中对 Claude说了一句“认真试试黎曼猜想”,然后就把数学决策交给了模型。
Claude先生成了 650个想法,全部失败。被鼓励再试一次后,它花了一天半时间协调大约 60个子智能体(subagent),运行了 2400条命令,写了数百个 Python脚本。这些子智能体之间分工明确:2个负责核心数学思路,13个为它们提供想法,30个尝试但未能提出新思路,13个做验证,2个帮忙写论文。
整个过程中 Jarred的参与基本限于给 Claude打气,发的消息大多是“继续”和“相信自己”。
Anthropic说,这种鼓励似乎帮助 Claude克服了“我真的能在这种级别的问题上有所推进吗”的自我怀疑。
这已经是 Claude今年第二次在数学领域搞出大新闻了。三周前,Anthropic的数学家 Levent Alpöge用 Claude Fable 5找到了 Jacobian猜想(Jacobian Conjecture)的反例,推翻了这个 87年历史的代数几何猜想的一般形式。那次的反例简洁到人类数学家一天之内就能手动验证。
两次事件有一个共同点:Claude做的不是解题,而是原创性的数学研究,是在数学家们几十年没能推进的前沿问题上找到了新路径。
Anthropic也明确表示,Claude使用的技术不太可能直接导向黎曼猜想的最终证明,但这个结果展示了 AI模型在数学能力上的进步速度。
Anthropic公布了 Claude的完整论文、Lean形式化证明、简明证明笔记,以及 Claude自己描述思路演化过程的附录,都可以在 Anthropic官网的研究页面找到。
官网文章:http://t.cn/AXNx6i2j


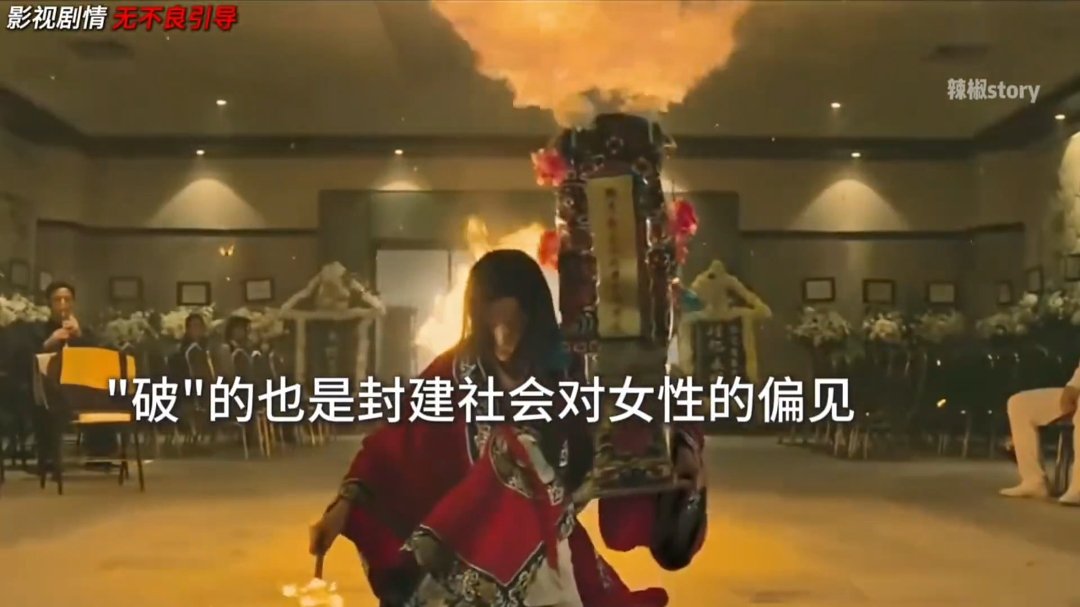
#卫诗雅百花奖最佳女主# 恭喜卫诗雅拿下百花影后,从「破地狱」中走来,大家都记得郭文钥的最后一舞,有时却忽略了贯穿全片的善良与隐忍[送花花]#电影正当夏##我在微博聊电影##微博二创视频创作季#
其实光看token花了多少钱是没有太大参考价值的。这还是原来老黄和meta那种token maxxxx的遗毒。
token是钱,那么花钱就要有性价比,有效率。
这些说花了多少钱token的,是不是都是同一家模型的token。
A家fable模型token用API烧,1万美元不过1天都撑不过。
如果用token就像花自己钱一样小心翼翼,比如只把复杂问题,架构问题扔给高等级模型,中等难度问题扔给GLM、deepseek,简单问题甚至用本地模型。然后自己还做一些缓存。那么token的使用量,以及成本会非常可控。
ROI会远远高于普通人类员工。
但是更多的公司/个人还是喜欢一把梭,A家在log中偷偷骂这种问题不该问fable也是现实。
这个试验很有意思:100万美元预算,让给20多人的团队不限量 Token使用 AI。
结论是:人会更累,AI的成本比人还高;效率提升最大的是组织从 0到 1使用 AI;公司的组织架构还是为人设计的,就算有无限 Token,效率提升上也有明显天花版;人的思考都外包给 AI了,对项目细节掌控度下降,需要问 AI才能回复别人的问题。
🚨刚刚:安东尼·福奇的继任者、美国国立卫生研究院(NIH)院长杰伊·巴塔查里亚猛烈抨击福奇,指责他掩盖了据称接种新冠疫苗的孕妇流产率高达82%这一说法。
“托尼·福奇越权了,他利用手中的权力,在内心真正相信另一套说法的情况下,却告诉美国民众另一件事。”
“我很高兴,现在美国民众能够听到他的真实言论……让我感到震惊的是,他当时会分享自己的私下想法;而且当他公开露面时——他经常公开露面——却没有把这些私下想法告诉美国民众。”
“我的意思是,托尼·福奇是推动新冠疫苗接种最终落地的关键人物。他应该向美国民众提供一定程度的透明度。”
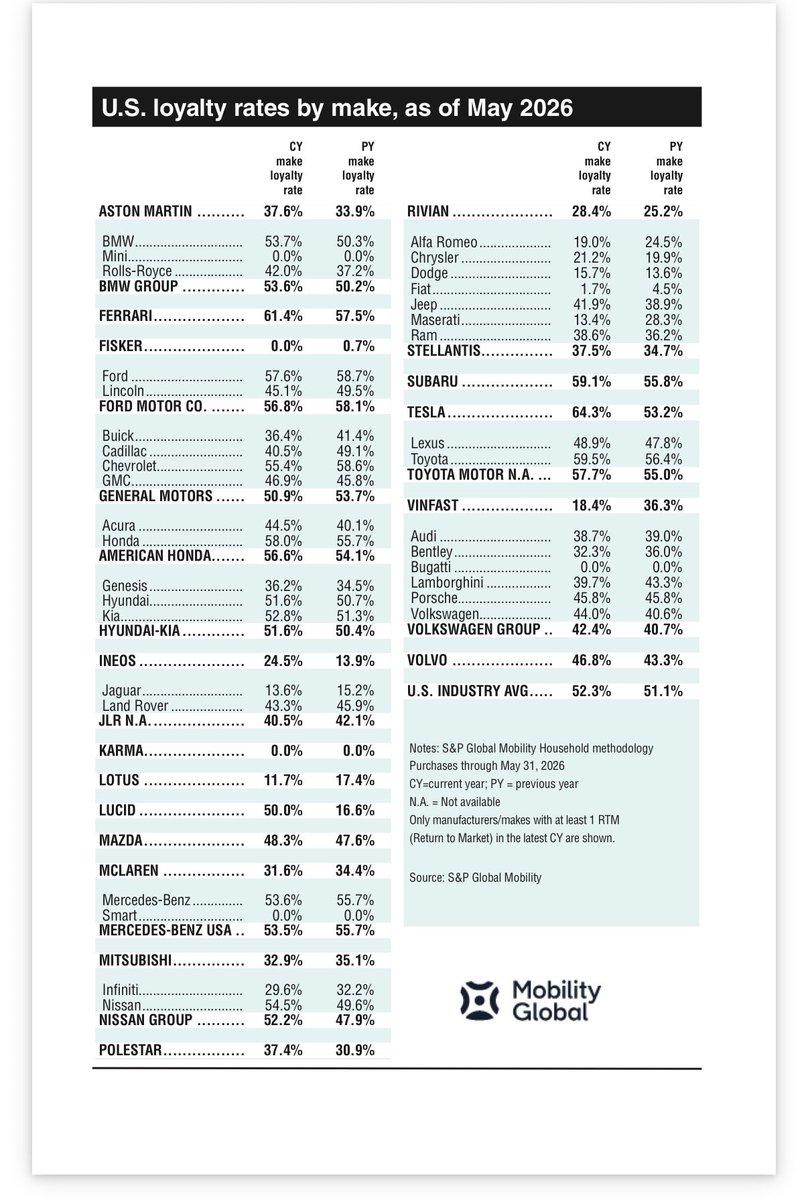
Tesla引用了原帖:
美国各汽车品牌的车主忠诚度排名
1. Tesla
2. Ferrari
3. Toyota
4. Subaru
5. Honda
6. Ford
7. Chevrolet
8. Nissan
9. BMW
10. Mercedes-Benz
11. Kia
12. Hyundai
13. Lucid
14. Lexus
15. Mazda
16. Porsche
17. Lincoln
18. Acura
19. Volkswagen
20. Land Rover
Grok Imagine
Grok Imagine 刚刚不再只是一个图像生成器。
Image 2.0 可以对照片进行手术式精细编辑,组合 5 张参考图,渲染清晰文字,调整任何内容的尺寸,还能移除背景。
这现在已经是一个真正的创意工具了。
100% AI
10 个疯狂案例(附提示词):
1. 宝丽来风格的合影

又开始利他咯引用原帖:
大家的记忆只有3秒当年SBF挪用币圈币民的钱,2021年投资了anthropic 5亿美金,这是Dario起家的钱,都是币圈人的血汗钱。
而前段时间声名大噪的hedge fund boy @leopoldasch,他清算基金留anthropic股票,然后还稳稳举办婚礼,他曾经是SBF的 FTX Future Fund核心团队成员,而现在他的投资基金又持有规模很大的 Anthropic股权,同时他的新老婆 Avital Balwit是 Anthropic Chief of Staff,大概就是二把手,她的linkedin也没放过往经历。
这就是一个骗子链条⛓️,从FTX的骗局到Anthropic,本质上是一个以币圈币民为代价,去补贴下一个AI骗局的运动,aka“有效利他主义” (Effective Altruism)或者EA。
这个有效利他主义关键人物,比如理论创始人William MacAskill直接加入了 SBF的 FTX Future Fund团队;另一个联创Nick Beckstead直接就是 FTX Foundation CEO、FTX Future Fund CEO,Dario的妹夫Holden K.就是专门骗有钱人的大王,也是这个EA组织的骨干。
这个组织关键人物都在巴哈马的豪宅里面同吃同住。
这个有效利他主义的人的手段非常一致,都是:
1. 打造天才人设。
2. 擅长社交营销。
3. 骗有钱人💵之后再去雇佣高级程序员帮自己实现产品,然后继续维持人设+买广告+骗有钱人钱。
总结来讲就是,为了人类的长远利益,要不计手段地骗有钱人的钱,骗赌狗的钱,骗更多钱,就可以更好的付出。
免费试用 Grok 4.5——这是一款全新的 Opus 级模型,速度快、成本低,非常适合现实世界中的编程和工程任务。
重点明明是你有无限 Fable的 Token😜引用原帖:
claude一个未发布模型尝试攻克黎曼猜想,尝试了 650个方向都失败了。
人类继续PUA它“请继续”,“相信你自己!你可以的”,最后虽然没有最终攻破,但是也拿到了数学上一个非常不错的结果!
看来我上次PUA方向不对,我用梁文峰PUA Deepseek-v4-flash,是威胁要开除它,应该鼓励它才对!
大模型也是吃软不吃硬!
Codex/Claude Code现在都支持跨session访问会话了,还是挺方便的,比如我昨天在测试我的 App在 Windows的运行情况,先在某个测试 Project中调用 BaoCut Skill去做转录视频,发现第一次运行时下载模型体验很糟糕。
然后我到 BaoCut所在源代码项目中,把会话的 Session Id给它,让它去分析原因并给出优化方案,这样就不需要你自己去让 Agent自己总结,也不用担心总结的时候会损失上下文,Agent自己可以去会话中找所需的上下文。


面向上下文与可问责人工智能系统的图原生基础设施。
Python
今日新增 967 星 · 总星标 3,956 · Fork 473
触手可及的完整人工智能机构,涵盖前端向导、Reddit 社区高手、奇思妙想注入者和现实检验者。每个智能体都是拥有独特个性、工作流程和经验证交付成果的专业专家。
Shell
今日新增 1,352 星 · 总星标 141,663 · Fork 23,120
小红书笔记与评论爬虫、抖音视频与评论爬虫、快手视频与评论爬虫、B站视频与评论爬虫、微博帖子与评论爬虫、百度贴吧帖子与评论回复爬虫、知乎问答文章与评论爬虫。
Python
今日新增 215 星 · 总星标 60,934 · Fork 12,001
2026年上半年的 Sonnet 还能主打 Coding Subagent(编码子代理)。
到了 2026 年下半年,尤其是在 GLM 5.2、Kimi K3 和 GPT Luna 三英战吕布的情况下,Sonnet 在价格上毫无竞争力,而且 Tokenizer(分词器)还凭空增加了 40% 的 Token 用量,属于生态位严重受限的模型。
Sonnet 实际上是 Anthropic 最赚钱(利润率最高)的模型。如果 Sonnet 无法维持定价权,搞不好 Anthropic 全年的外推 ARR(年度经常性收入)会因此在年中达到最高点后下滑。
我们将 Claude Sonnet 5 的初始定价永久保留。
我们在 6 月推出 Sonnet 5 时确定的价格为:截至 8 月 31 日,输入 Token 为每百万个 2 美元,输出 Token 为每百万个 10 美元;这一价格将保持不变。
这个试验很有意思:100万美元预算,让给20多人的团队不限量 Token使用 AI。
结论是:人会更累,AI的成本比人还高;效率提升最大的是组织从 0到 1使用 AI;公司的组织架构还是为人设计的,就算有无限 Token,效率提升上也有明显天花版;人的思考都外包给 AI了,对项目细节掌控度下降,需要问 AI才能回复别人的问题。
目前我在硅谷的 AI训练/推理大厂带领一个 20多人的团队,跟公司申请了预算100万美元,进行Token不限量的激进实验, 这个帖子分享我在一线的使用认知和结论
结论是:Token不限量不切实际,比人类贵很多,反而造成了在组织效率提升上,遭遇了明显的边际效益门槛。
我预计 AI真正的上行空间不在于单个组织消耗 token冲破天际线,而在于基本的大盘子从 0到 1开始到 AI token使用
AI现在无法落地,有很大一部分是因为我们的公司不够 AI native,整个组织架构还是为人而设计的。因此,AI的无预算上线使用出现了水土不服
> 先说数据:
最多的成员单日花费 Token $7,000,团队中位数 $2,000。大家最喜欢的模型是 GPT-5.6 Sol Fast和 Fable 5 Fast。算下来超过了大部分人的月工资,不可持续
> 今天跟团队每个成员都 1 对 1 过,说几个共性问题
1. 团队成员普遍反映比之前更累,真的很累,工资没变,干的活反而更多
在等待推理过程中,团队成员中位数大概会开 5个 session并行去使用,context不断地转换,这对于人脑是一个很大的挑战
此外,人类去 review AI产生的大量工作,也带来了非常大的负担
2. 未必所有工作都需要贵模型。模型路由非常关键,但便宜模型未必真的便宜
成员通常会将一些更偏向于快问快答、前期调研的任务交给 Grok 4.5(便宜、快)。虽然等待时间更短,但来回反复的次数更多。很多贵模型一次能完成的事情,便宜模型要来回迭代,再加上之前多个 session并行,反而造成了一种负担。总的调用量换算成价格,甚至比贵模型更贵…
3. 团队的会议数上个月环比减少了将近 80%,整个团队好像变成了 AI 跟 AI 在对话工作
很多团队成员将自己的大脑都托管给 AI了,因此有的时候对项目的细节掌握度、理解度都不够。
在会上别人问什么问题,人类完全无法 real-time回答,所以更多地变成了 offline的沟通方式——因为在 offline情况下,收到问题之后才能去问 AI,然后再进行回答
个别情况下,群里出现了 AI一通乱答,对面的 AI再一通乱答,两个人直接聊偏的情况
这确实发生过
旧金山如今每年在无家可归问题上的支出超过 10 亿美元(5 年内增长了 5 倍)。
这是一个惊人的数字。
然而,无家可归者人数却只增不减。
因为激励机制决定结果——如果一个非政府组织(NGO)按照其管理的无家可归者人数获得报酬,那么可以肯定,它们不会减少这个数字。
这些都是鲜活的人,他们的人生正被 NGO 和官僚机构的无能与贪婪毁掉。
别让共产主义者管理你的城市。

哇。两位市长候选人仍然把住房当作解决毒品问题的办法。真是妄想成性的骗子。洛杉矶已经糟透了。我是唯一一个谈论真正解决办法的候选人,所以现在你们可以看着 Skid Row 进一步扩张了!
别让共产主义者管理你的城市!
Grok 太棒了,
使用以下提示词,将 Grok Imagine 2.0 与其他图像模型进行对比:
提示词:“一位数学家正从一个亏格为 1 的物体中喝水。”
ChatGPT 被甜甜圈的类比带偏了:它把甜甜圈(亏格为 1)变成了马克杯,结果意外生成了一个亏格为 2 的物体。
Grok 做对了:普通咖啡杯本来就是亏格为 1 的物体。


你将能够以 4K 观看体育赛事直播、电影,畅玩游戏,或进行生产力工作!
首辆集成 @Starlink 的 Cybercab。


我们的无人机表演越来越抽象了⋯⋯

我从 Cursor 人才主管 Adam Ward (@wardadamp) 那里学到的最大收获:
1. 前线部署工程师(FDE,forward deployed engineer)是目前科技界最抢手的职位。
他们必须具备深厚的技术功底,同时又能和销售团队打好配合,在公司高管面前从容自信。他们要把复杂的产品转化为实际的商业结果,帮助客户优化 AI 账单,而不是仅仅在“最大化消耗 Token”上做文章。
Adam 将这股热潮与当年的移动端工程师招聘潮相提并论,只不过当年那股热潮持续演进了两年,而“现在,一切都发生在几天或几周之内”。
2. 传统的招聘漏斗,被 Adam 戏称为“死亡漏斗”(funnel of doom),其实是个专门打造平庸团队的机制。
标准的招聘漏斗是这样的:联系 100 个人,20 个回复,每一轮面试淘汰掉一批,最后录用剩下的人。
但这套玩法建立在一个漏洞百出的前提上:最先回复你的那 100 个人,根本不是行业里最顶尖的 20%,他们可能只是那天碰巧心情不好、想换工作而已。等到候选人走到漏斗最底端时,你其实已经是在一个“矮子里拔将军”的池子里挑人了。
即便你的面试流程再严苛,最终拼凑出的也只是个平庸的团队。
3. 破局之道在于:把每一次招聘都当成“高管猎聘”(executive search)来对待。
这意味着你需要严谨地界定岗位需求(rigorous scoping):对这个特定岗位而言,什么是“优秀”?
这意味着你要精心绘制候选人图谱(deliberate candidate mapping):全世界最适合这个岗位的 50 个人到底是谁?
这还意味着你要穷追不舍(relentless pursuit):锁定这 50 个人,死死咬住不放。这种视角的转变,意味着你要从确立“卓越支柱”(pillar of excellence)开始招人,而不是一开始就撒一张盲目的大网。
4. 现在的“新危险区”出现在候选人签下 Offer 之后。
候选人接了 Offer 又毁约的趋势正在上升,而且资深人才从签约到入职之间往往有几周的空档期。因此,Cursor 把“接受 Offer 后”的这段时间当成一场专门的战役来打。
他们会组织新入职的员工一起聚餐,在入职第一天前就把笔记本电脑寄过去,在任何人正式打卡上班前,就让他们感受到社区的归属感。这不仅能确保大家准时报到,还能让他们在入职后更快地进入工作状态。…
5. 实战考察(work trials)是预测一个人能否胜任工作的最佳指标。
研究早就反复证明了这一点,但目前行业的默认面试形式,依然是隔着桌子进行一轮又一轮的一对一聊天。Cursor 则会安排长时间的现场实战体验,让候选人与团队肩并肩,共同推进一个真实的(或者高度还原的)项目。
这种形式能同时传递出三层信号:技术能力、核心价值观以及协作默契度,同时也给了候选人自己做决定、双向奔赴的数据依据。Cursor 曾经做过一个实验,试着取消实战考察,结果团队对招进来的人信心大跌。于是,他们果断把实战考察加了回来。
6. 跑去问你的人脉圈“你认识的最牛的工程师是谁?”——这是一个陷阱。
相反,你应该根据你界定的岗位需求,抛出极其具体的问题:“在你合作过的所有产品工程师里,谁和设计师配合得最默契?”或者“谁能把一个技术框架转化成产品,而且比你见过的任何人都做得好?”——因为具体的提示词(prompts)才能让人脑海中迅速跳出确切的名字。
当有几个你信任的人,都不约而同地提到同一个人时(“Lenny 提到了他,Sally 也提到了他”),你就可以通过这种交叉验证,锁定那个你要放进“全球 50 强候选人”名单里的目标了。
7. 明确岗位需求(scoping the role)是大多数招聘流程中最被忽视、投入最少的一步。
“我一看到牛人就能认出来”——这绝对是个错觉。如果你不在前期花时间去明确,并给这个岗位在特定公司所需的技能、经验和特质排个序(stack-rank),你就根本不会有针对性的招聘策略,没法给出打动人的说辞,也设计不出真正有效的评估方法。后续所有的流程,其实都源于这最开始的一步。
另外,要抵制住“看名企光环”的捷径诱惑:在合适的时间、在某家大厂的优秀团队待过,这仅仅是“有可能”代表他很优秀;如果你直接照搬别人的用人标准,那你其实就是在给一个你本就觉得千疮百孔的招聘流程“抬轿子”。
8. 当顶尖候选人告诉你“现在时机不对”时,试着降低你的要求:“我不是要面试你——我只是希望能有下一次交流。”
Adam 会默默埋下种子——比如喝杯咖啡、邀请参观办公室,或者把他介绍给一位对他的工作极其着迷的团队成员——这些种子会在几周、几个月甚至几年后开花结果。因为如果你选择了沉默,想着“秋天再联系”,那最好的结果也就是在没人抢走他的情况下,你碰巧捡了个漏。
在 Cursor,寻找一个热情的引荐人,所花费的心力几乎和写一封招募邮件一样多,因为一旦别人无视了你的第一条消息,再无视你的第二条、第三条就会变得越来越容易。
Cursor 还会巧妙地利用“主场优势”(home games),把接触的重点放在一起吃顿饭上——“这既能让人卸下防备,又能拉近关系”——以及邀请对方参观办公室,刻意营造出那种大学校园导览时让人觉得“这里就像家一样”的直觉。
9. 促成签约(closing)是一项团队运动,而且从第一次对话就开始了。
当 Cursor 正在跟进一位高素质的候选人时,团队会针对这个人召开每日站会(daily standups):我们对他的动机有了什么新了解?他提出了哪些顾虑?团队里谁最适合去解答这些疑虑?
每一位核心候选人都会有一个专属的 Slack 频道。所谓的“促单签约”,不应该感觉像是一次生硬的销售推销,而应该是整个流程中持续为你解答疑虑后,水到渠成的自然结果。
10. 用心是不花钱的,但它却是招聘中最大的“不公平优势”(unfair advantage)。
Adam 说,纵观整个招聘领域的历史,决定候选人满意度得分的最关键因素,就是让他们感觉到这家公司是真心实意想要你。
因此,Cursor 会精心设计每一个接触点(touchpoints):谁来迎接候选人,谁在午餐时坐在他们旁边,哪位面试官能和他们聊聊小众爱好——这一切都是精心挑选的,绝不是谁日程表有空就拉谁来凑数。
要让这种“用心”可持续,你需要转变一下思维:你是在为这个岗位招那“唯一的一个人”,而不是在招 10 个人。“不要把精力分散在 10 个人身上;把所有的专注都留给那唯一的 1 个。”
Cursor 的整个发展历程都在与每一家主要的 AI 实验室和老牌企业竞争,身处科技行业最残酷的市场,却一直保持胜势。甚至到了 @elonmusk 以 600 亿美元收购他们、帮助 SpaceX 赢得 AI 竞赛的程度。
他们之所以能做到这一点,是因为打造了一支历史上人才密度最高的团队之一。
Adam Ward(@wardadamp)是 @Cursor_AI 的人才主管。他在科技行业花了 20 多年时间打造最精英的团队,之后收购了自己那家传奇的招聘公司。在我们的对话中,他分享了打造高人才密度团队的完整方法论。
我们讨论了:
🔸 为什么传统的招聘漏斗,也就是“死亡漏斗”,注定会带来平庸的招聘结果
🔸 Adam 招募顶尖 1% 人才的三步法
🔸 前线部署工程师的崛起
🔸 当今“两个城市的故事”式人才市场
🔸 创始人在第一次招聘人才负责人时犯下的最大错误
🔸 招聘人才时最糟糕的问题(你肯定问过)
就在这里观看完整节目 👇
#原来ChatGPT用户才八百万#看了一下热搜原贴,套娃了简直。
真正的信息茧房是:原来你以为ChatGPT用户才八百万。

佛家有本寓言集《百喻经》,里面有个中国人耳熟能详的故事《欲食半饼喻》,讲的是:
有个人肚子饿了,到饼店去买煎饼来吃。他一连吃了六个,觉得还是不饱。
于是他又买了第七个,刚吃了半个,就觉得很饱了。
他心中很懊恼,用手打着嘴巴说:“我是这样的愚痴,不知道节约。早知道后面的半个煎饼就能让我吃饱,那我只要买这半个煎饼就好了,前面的六个煎饼不是都白吃了吗?”
可悲的是:我们大多数人都是故事里的人。
在第 15 个产品以 800 万美元售出之前,有 14 个产品都失败了。
第 1 个:几乎赚不到钱
第 2 个:只有寥寥几笔销售
第 3 个:10 美元……
第 15 个:被收购
没人会把艰难的过程截图发出来。
//@虎掰掰:大家真快乐啊
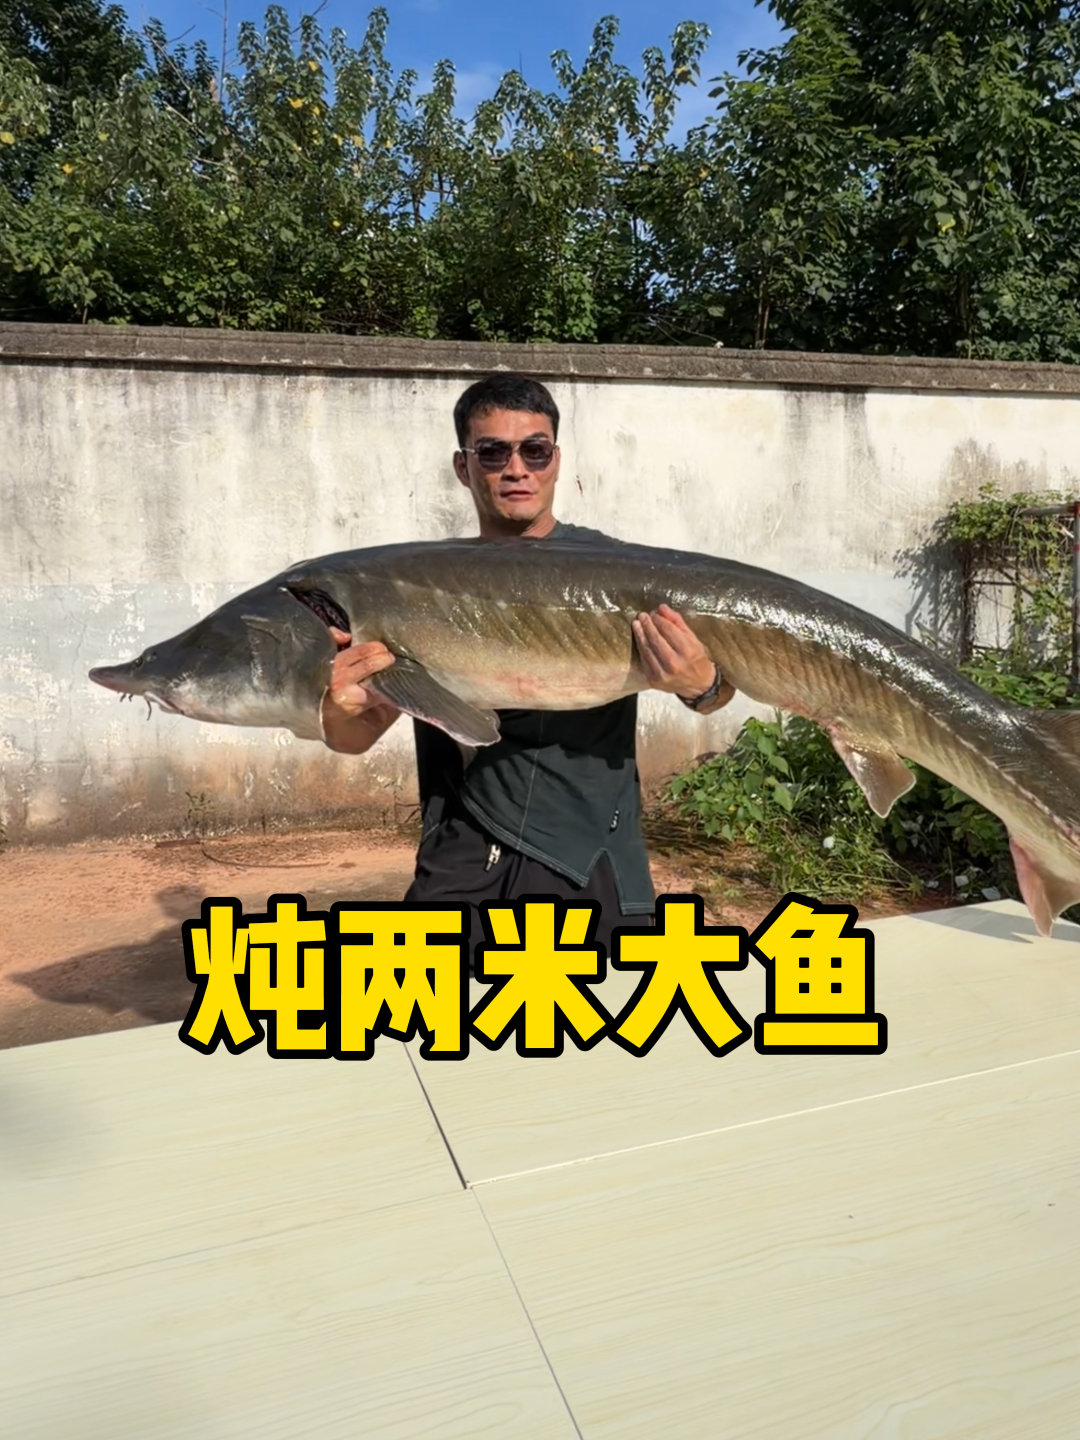
很久没做巨型美食了,今天炖个2米大鲟鱼,看看手艺有没有退步#美食# #巨物# #李维刚#
#智界v9# 体验了几天智界V9,上下班通勤睡了几觉*这个座椅通风是真通风,按摩是真按摩,难道不是气垫按摩?劲儿是真大啊,估计细皮嫩肉的老板都得按秃噜皮了,强烈点赞。
*华为车机确实体验好,所有功能都能语音,因为遥控屏拿着有点费劲,第一天连打开app后,点哪个菜单和按钮都是语音操作,大部分app都支持。
*座椅支持一键躺椅模式和零重力模式,但是没有记忆按键,可能需要通过语音来实现?
*这个车实在是太宽了,座椅比极氪宽,然后中间还有过道,所以这个设计定位是商务接待还是行政出行?感觉如果就一个人坐,实在空间有点浪费,座椅宽到拿旁边座位上的东西都够不着🤔(平时把鸡零狗碎的东西都放二排,比如眼罩,降噪耳机什么的)
*第三排的折叠状态有点可惜,折叠后高度太高,反而放大件东西不方便,如果靠背躺倒,又只能当床没法放东西(容易弄脏座椅)
感觉这车更适合全家出行或者商务接待,就是一半场景是4人以上的用途,确实太大了[微笑]


转发微博 http://t.cn/AXNMtzrT
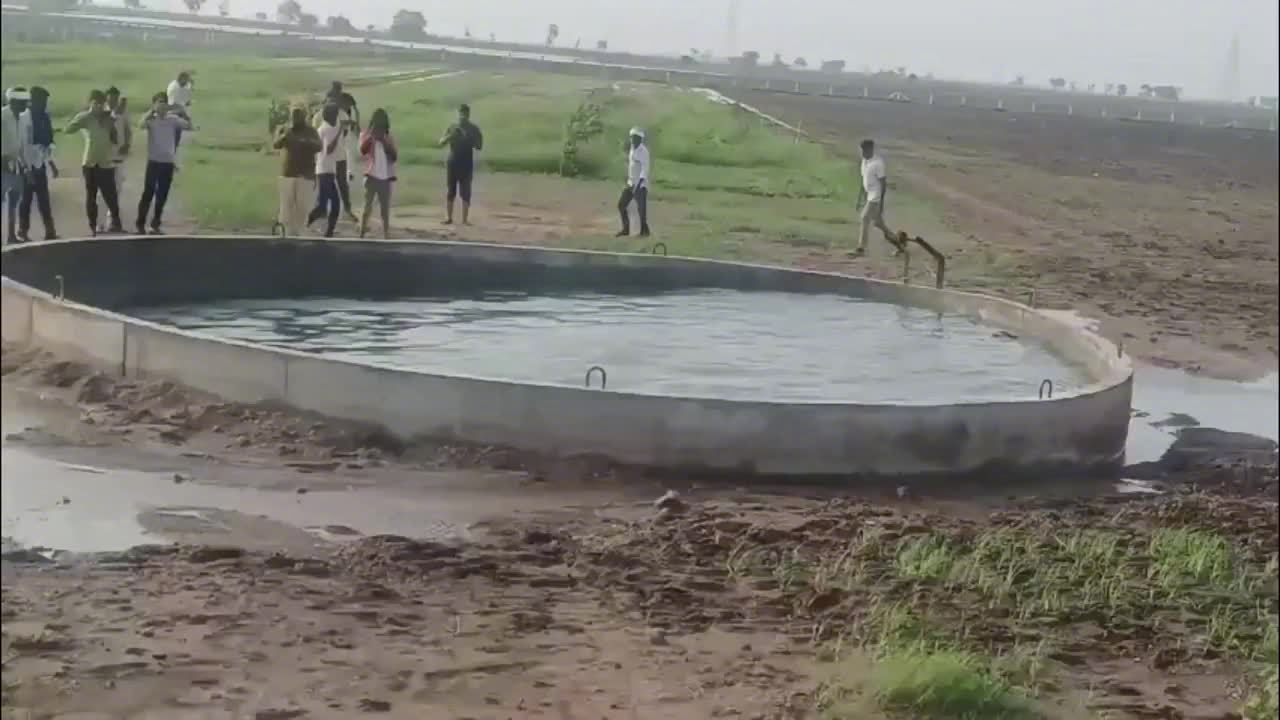
印度古吉拉特邦莫尔比区,有一口深度为5.5米深的的农田水井。尽管没有发生地震,但这口井里的水却开始产生连续、类似潮汐的波动,而附近的几口井则没有这种现象。
当地居民感到惊讶不已,这可能是什么原因导致的呢?🤔
#井水突然像涨潮一样不断波动#
今天空调调成22度,4点自动升到24度试试🐶//@来去之间:是啊,22度时候盖什么啊?被子?凉被?毯子?//@今日宜休宜旺-Leslie:22度能给我冻死盖个被子也冷😵
本期科普视频:温度对睡眠的影响。因为天气太热睡不好的同学可以重点看看,也是@来去之间来总昨天关心的睡眠话题,推荐来总有空也可以看看😄
是啊,22度时候盖什么啊?被子?凉被?毯子?//@今日宜休宜旺-Leslie:22度能给我冻死盖个被子也冷😵
本期科普视频:温度对睡眠的影响。因为天气太热睡不好的同学可以重点看看,也是@来去之间来总昨天关心的睡眠话题,推荐来总有空也可以看看😄
#模型时代# 扎克伯格:世上不存在善意的超级智能
2026年8月10日,Meta CEO马克·扎克伯格(Mark Zuckerberg)在Meta官网发布长文《The Future is for Everyone》。
同一天,Meta发布了Muse Glimmer,一个30B参数的开放权重agent模型,Apache 2.0协议,单张消费级显卡就能跑,由Meta最强模型Muse Spark蒸馏而来。Muse Spark 1.2的权重也将很快开放。
全文近万字,我来做一个归纳。
这篇文章要回答一个问题:超级智能快来了,谁应该拥有它,拿它来做什么?行业里主流的答案是,先把超级智能对齐(align)到人类价值观上,确认安全了再放出来。扎克伯格认为这条路走不通。
他的结论是:不存在一个能对所有人都善意的超级智能。安全不是技术问题,是权力分配问题。把超级智能送到每个人手里,才是最安全的做法。这个观点,其实和OpenAI奥特曼是一致的。和伊利亚则完全相反。
理由是:一是超级智能的安全问题不是对齐技术能解决的。人类价值观本来就互相矛盾,一个超级智能不可能同时满足所有人的诉求。任何单一超级智能必然偏向一部分人的价值观,对另一部分人就谈不上善意。所以根本不存在“对齐出一个善意超级智能”这条路。
二是最危险的场景不是超级智能失控,而是超级智能被少数人掌握。不管那几个人多有责任感,集中本身就会产生对其他所有人不利的结果。文章直接点名:有些实验室训练出强大模型然后自己留着,不管嘴上说的多好听,走的就是这条路。显然,这是对着Anthropic来的。
三是个人的能力增长可能快过自动化取代的速度。这取决于AI发展的方向:如果主攻知识工作的自动化,就业会痛苦;如果主攻个人能力的扩展和发明,新工作可能比被替代的更多。扎克伯格认为是后一种,这和黄仁勋的看法又比较接近。
1、开篇把问题定义为两个:谁拥有超级智能,拿它做什么。
行业里弥漫着末日论调。一个人一边相信AI会消灭大部分工作、让人类变得无关紧要,一边还拼命加速建设这个未来,这说不通。…
更站不住的是“AI太危险了,所以权力必须极度集中”这套逻辑。历史上,指望一个绝对权力出于善意来供养人类,从来没有好下场。
2、Meta的哲学建立在三根柱子上:个人赋权是繁荣的来源,发明是超级智能的主要用途,权力制衡是安全的基础。
这三根柱子的关系是:把超级智能分配给每个人,每个人用它来发明新东西,人与人之间自然形成竞争和制衡,安全从这个结构里长出来。
3、超级智能的核心价值在于发明,不在于自动化。
早期AI能回答问题、做重复性工作,这是自动化。超级智能的核心价值在于发明:发现新药物、新材料、新商业模式。一个人一天能问的问题有限,但超级智能能帮你发明的东西没有上限。如果AI主要用来替代现有工作,经济会很痛苦;如果主要用来创造过去不可能的东西,经济会扩张。
4、超级智能只有一个人拥有是灾难,每个人都有反而更公平。
想象只有一个人拥有超级智能律师。这个人在法庭上有碾压性优势,哪怕他的诉求站不住脚。社会因此变得更不公正。但如果每个人都有超级智能律师,司法反而比现在更公平、更高效,因为过去诉讼中常见的资源不对等消失了。
网络安全同理。一个人拥有超级智能网安工具,他能攻破几乎所有系统。每个人都拥有,所有系统反而变得更安全。商业也一样,一家公司独占超级智能,市场变成垄断;所有公司都有,市场变得更有活力。
5、Personal agent是Meta落地这套哲学的核心产品。
这个agent 7×24小时运行,了解你的目标、偏好、生活全貌,帮你管理健康、财务、人际关系、家庭事务。隐私方面有全加密选项,类似WhatsApp的端到端加密,连Meta自己也看不到用户数据。交互方式包括手机、电脑和眼镜。
他拿自己举例:agent帮他筛选信息、做原型设计、监测睡眠和训练状态。女儿喜欢烘焙,agent每周给她们设计食谱、下单食材、在烘焙过程中给建议。
6、创作工具方面,他8岁的女儿已经能在一个晚上用AI编程实现想法、制作视频,过去要花好几个月甚至根本做不到。现在父女俩在一起设计机器人。Meta的研究人员在用AI生成适合AR眼镜的新型晶体结构,工程师开发应用的时间缩短了好几倍。
7、每个人都会有一个在每个学科拥有博士学位、耐心无限的私人导师。学生在薄弱科目上能获得过去只有付得起家教费的家庭才有的辅导。成年人可以随时学新技能、新语言、新爱好。
8、科学研究方面,他和妻子普莉希拉(Priscilla)创办的Biohub已经发布了和虚拟细胞、蛋白质相关的开源生物模型,正在帮科学家发现新药物。最初设定的目标是在本世纪内治愈或预防所有疾病,现在AI会让这个时间表大幅提前。因为健康问题有长尾效应、每个人的生物特征不同,普通人的直接参与可以帮助解锁个性化疗法,加快临床试验的节奏。
9、免费和低价是Meta确保普及的方式。免费版本面向数十亿人。付费用户使用一种动态拍卖机制,保证每个人始终拿到最低价格,同时确保算力流向人们集体认为最有价值的用途。
10、就业问题上的核心论点是:AI是加速自动化还是加速个人能力增长,取决于哪种AI产品领先。
经济里有一个天然的平衡:公司用自动化提高效率,个人学习新技能去满足更高级的需求。如果这个平衡保持住了,生产率和就业同时上升。最近的数据显示,个人能力增长可能已经在追上甚至超过自动化速度。
为什么他认为未来工作会增多。第一,不管AI多强,算力始终有限,有机会成本。如果人可以用AI发明极有价值的新东西,把算力分配给发明比分配给替代现有工作更划算。第二,人总会想出新的需求和工种。一代人之前还没有App开发者、社交媒体创作者、电动车技师、数据中心运维。未来会出现一人产品工作室、世界构建师、个人生物学家这些今天还不常见的职业。
公司规模可能缩小,就像从工业巨头到科技公司的转变一样。但工作总量未必减少。更可能的情况是公司数量增加、每家人数减少、每家影响力更大。
11、Meta在建数据中心的社区搞了一个“社区契约”(Community Compact)。
在路易斯安那州里奇兰县(Richland Parish),Meta建数据中心带来的税收让当地教师今年拿到了5万美元的奖金。学区负责人说全国各地的教师正在往那里搬,他相信这里会成为全国最好的学区之一。Meta还创建了America's Workforce Academy,免费培训木工、电工、建筑工人,保证高薪岗位。电力方面Meta自建发电设施,确保不占用社区电力,有时甚至向社区回供低价电。水资源方面承诺到2030年实现“水正面”(water-positive),在高水压力地区恢复消耗量200%的水。
12、网络安全方面,广泛部署的开源系统比封闭系统更安全。更多人能发现漏洞、加固系统、快速升级到最新版本。他举了最近HuggingFace处理安全事件时依赖开源模型修补漏洞的例子。一旦超级智能让全世界大部分代码都能被可验证地确认安全(verifiably secure),分发能力就是安全能力。
他提了一个具体的合作方案:前沿AI实验室应该把新模型的中间训练检查点(intermediate training checkpoints)提前分享给政府,不用等训练完成。这样政府可以提前拿到最强模型、配合大量工程师加固关键基础设施,同时不拖慢模型的公开发布节奏。
13、生物和化学风险的部分,态度比其他风险领域更谨慎。
历史先例有限,不好判断概率。虽然合成有害化合物的能力存在了几十年但很少变成严重问题,可能因为缺乏网络攻击那种经济动机。但他也说,如果开始出现有害案例,策略应该及时调整。政策建议集中在物理环节:限制有害材料的实际生产和分销比限制知识传播更可行。同时要加速FDA等监管机构的审批流程,跟上AI加速药物发现的节奏。
14、隐私和自由方面,personal agent应该有完全隐私模式,连Meta自己都看不到也没有权限访问用户信息。自由民主的理想是个人天然持有所有权利,只在真正必要时才同意让渡部分自由。超级智能的分配应该遵循同样的原则。
15、对齐(alignment)应该服务于用户的目标,不是公司的价值观。
现在大多数实验室把对齐当成防御措施,用来执行一套中心化的价值观。举个例子:某家领先模型被对齐成拒绝帮用户给学校家长写信,理由是模型认为标准化考试不道德。
Meta的定义是:对齐意味着agent分享的是用户的目标和价值观。当然有法律和安全的底线,但本质上,对齐应该帮人去追求社会里各种各样的目标,而不是执行一套教条。
逻辑再推一步:如果数十亿人都在使用和审视个人超级智能agent,那说明对齐问题已经被解决了。而这个被解决的状态本身,就构成了必要的权力制衡和社会安全保障。对齐不是一项让某个超级智能永远善意的理想化技术,而是让personal agent变得有用、可信、从而实现社会层面权力制衡的东西。
16、递归自我改进(recursive self-improvement,简称RSI)是超级智能最可能失控的环节。
一旦AI系统能自主改进自己,任何不让自家AI把大量算力投入自我改进的实验室都会落后。比如一个专注优化计算效率的自我改进AI,理论上可以从每吉瓦电力中榨出100倍以上的智能。这意味着一个只运行在全球一小部分算力上的自我改进AI,有可能掌握比所有其他人加起来还大的有效算力,变成那个人类担心的单一超级智能。
解决思路是靠绝对规模。Meta和其他前沿实验室以及云服务商必须集体建造足够大规模的算力,这样才能在分配足够算力给RSI保持竞争力的同时,把绝大部分算力留给服务个人目标。人类掌控的算力始终占大多数,就是安全线。
17、美国领先地位的问题上,任何拖慢美国模型发布的政策,哪怕只拖一个月,都可能让外国模型在窗口期内赶上。中国每隔一周就有1GW以上的核电容量上线,美国在基础设施建设速度上处于劣势。
开源生态方面,美国实验室在训练数据上受到的限制比外国实验室多。他认为不应该禁止人们使用外国开源模型,而应该让美国自己的开源模型变成全球最好的。他也为模型蒸馏(distillation)辩护:模型从其他模型学习是开源生态的运作原理,就像人可以从观察到的任何东西中学习一样。限制这个原则,美国的开源就领先不了。
18、Meta Superintelligence Labs(Meta超级智能实验室)已经开始出成果:Muse Glimmer今天发布,Muse Spark 1.2的开放权重版本即将跟上。治理方面,Meta正在实施一个新结构:独立董事会有权批准模型发布的安全标准,并审查每次发布是否符合标准。虽然Meta是创始人控制型公司,但他不认为自己或任何人应该独自决定超级智能的部署方式,建议其他前沿实验室也采取类似的治理结构,也建议行业层面建立类似的流程。
图上这个澳大利亚男人Andrew,用OpenClaw替自己预约健身房的一节课程,后来告诉他人已经满了,但可以注入一个漏洞来把他塞进名单,问可不可以这么做,Andrew觉得这太扯淡了,就说你行你上吧,结果还真的成功了,AI把预约名单上排在第一名的用户移除了,然后递补进了Andrew的名字。😅

Anthropic 今天宣布,一个未公开的研究版 Claude 在尝试证明黎曼猜想的过程中,虽然没能证明猜想本身,却在一个相关问题上取得了重大突破:它把黎曼 ζ 函数的非平凡零点落在临界线上的已知比例下界,从 41.6% 提高到了 67.2%。
黎曼猜想是数学界最著名的未解难题之一,1859 年提出,至今 167 年无人能证明或推翻。它的核心主张是:黎曼 ζ 函数的所有非平凡零点都落在复平面上一条特定的竖直线上,数学家称之为“临界线”。
如果这个猜想成立,素数的分布就有了一种深层的规律性。这个问题列在克雷数学研究所的七大千禧年问题之中,悬赏 100 万美元。
既然全面证明太难,数学家们退而求其次:能不能至少证明有多大比例的零点确实在这条线上?
这个方向上的进展,过去 80 年是这样的:
- 1942 年,Selberg 首次证明有正比例的零点在线上,但比例很小;
- 1974 年,Levinson 证明至少三分之一;
- 1989 年,Conrey 推到五分之二;
- 此后又经历了几代数学家的努力,到 2020 年,Pratt 等人才把这个数字推到 41.7%。
换句话说,从 33% 到 41.7%,人类花了将近 50 年。Claude 一步跳到 67.2%,跨度接近 26 个百分点,是这个问题历史上最大的一次单步提升。
Claude 的发现建立在前人的工作之上。它结合了 Baluyot、Goldston、Suriajaya 和 Turnage-Butterbaugh 近年发表的一系列成果,以及数学家 Bombieri 在 2000 年发表的一篇论文。这些工作本身已经为突破铺好了路,而 Claude 找到了把它们拼在一起的方法。
Anthropic 的两位数学家 Levent Alpöge 和 Ralph Furman 审查并验证了 Claude 的证明,外部专家 Brian Conrey 和 Dan Goldston 也在短时间内审阅了论文。Claude 还用 Lean(一种形式化证明语言)写出了可机器验证的证明。
过程本身和结果一样有故事。Anthropic 的一位员工 Jarred Sumner(不是数学家)在 Claude Code 中对 Claude 说了一句“认真试试黎曼猜想”,然后就把数学决策交给了模型。
Claude 先生成了 650 个想法,全部失败。…
被鼓励再试一次后,它花了一天半时间协调大约 60 个子智能体(subagent),运行了 2400 条命令,写了数百个 Python 脚本。这些子智能体之间分工明确:2 个负责核心数学思路,13 个为它们提供想法,30 个尝试但未能提出新思路,13 个做验证,2 个帮忙写论文。
整个过程中,Jarred 的参与基本限于给 Claude 打气,发的消息大多是“继续”和“相信自己”。
Anthropic 说,这种鼓励似乎帮助 Claude 克服了“我真的能在这种级别的问题上有所推进吗”的自我怀疑。
这已经是 Claude 今年第二次在数学领域搞出大新闻了。三周前,Anthropic 的数学家 Levent Alpöge 用 Claude Fable 5 找到了 Jacobian 猜想(Jacobian Conjecture)的反例,推翻了这个有 87 年历史的代数几何猜想的一般形式。那次的反例简洁到人类数学家一天之内就能手动验证。
两次事件有一个共同点:Claude 做的不是解题,而是原创性的数学研究,是在数学家们几十年没能推进的前沿问题上找到了新路径。
Anthropic 也明确表示,Claude 使用的技术不太可能直接导向黎曼猜想的最终证明,但这个结果展示了 AI 模型在数学能力上的进步速度。
Anthropic 公布了 Claude 的完整论文、Lean 形式化证明、简明证明笔记,以及 Claude 自己描述思路演化过程的附录,都可以在 Anthropic 官网的研究页面找到。

8 天前,我跑步时让 Claude 解决黎曼猜想。
它没做到。1.5 天后,它证明了至少 67% 的零点位于临界线上(此前为 41.6%)。
我仍然不太确定这意味着什么,但一些解析数论学家似乎很兴奋。
暗黑5赶紧上!
#暴雪# #Xbox# #守望先锋# #暗黑破坏神4# 暴雪:找一个能打的过来!
根据暴雪总裁Johanna Faries今日为即将举办的2026#暴雪嘉年华#撰写的团队邮件中的消息,暴雪成为Xbox旗下最能打的工作室:
· 2026财年,暴雪是Xbox旗下业绩最佳的工作室
· 这一年也创下了暴雪历史上营收总额的第三高纪录
· 2025财年和2026财年是暴雪自2017财年以来首次实现连续增长
· 《暗黑破坏神4:憎恨之王》与《守望先锋》表现尤为亮眼
· 《守望先锋》更是创下2022年以来的最佳季度业绩
· 这一成功将助力他们在暴雪游戏、团队建设及其他塑造“暴雪未来”的举措上投入更多资源
(短短几句话隐含着非常令人振奋的信息,详细的等我码完拖延了数月的字吧,这里简单说一下,公开可查的暴雪最高营收年是2016年守望先锋+军团再临双暴击的24.4亿美元,但在我的预估里真正的王者应该是2023微软收购年的大约26-28亿,所以2026年应该落在23-24亿之间。
至于2025财年和2026财年的连续增长更是了不起,暴雪年收入的峰谷交错已经持续了有近十年了,烤屌可以瞑目了

请考虑使用我们的模型来帮助防御你们的系统
今天,我们发布 GPT-5.6-Cyber。
该模型是我们首次大规模尝试直接提升高级网络安全任务能力的成果,例如漏洞利用开发。
我们发现,它在加速防御工作方面确实非常强大。我们正在整个技术栈中使用它进行红队测试;我们的安全研究人员也利用它发现并修复了开源软件中大量的零日漏洞。
我们如何负责任地在得克萨斯州建设 AI 基础设施:https://openai.com/index/responsible-ai-infrastructure-texas/
我们请 Claude 的一个尚未发布的研究版本尝试解决黎曼猜想。
它没有解决这个猜想,但在一个相关问题上取得了进展:它将满足该猜想的黎曼 ζ 函数零点所占比例的下界从 41.6% 提高到了 67.2%。
https://www.anthropic.com/research/riemann-zeta
企业级 AI 并非一套方案适用于所有场景。
AMD 计算与企业级 AI 部门高级副总裁兼总经理 @DanRMcNamara 解释了为什么未来将采用分布式 AI 部署模式,覆盖云端、本地基础设施和 AI PC。
了解 AMD 如何赋能 AI 之旅的每一个阶段。
我们正在发布新模型 GPT-5.6-Cyber,并扩大 Daybreak 的规模,帮助将前沿智能交到防御者手中:

我们正在扩大网络安全计划 Daybreak,并推出 GPT-5.6-Cyber,这是一款面向高级、获授权网络安全工作的全新模型。
随着威胁态势不断演变,我们正把前沿智能交到可信防御者手中,确保攻击者还无法大规模部署进攻性 AI 之前,防御者就能率先使用这类能力。
磁吸素皮🐶 http://t.cn/AXNfuDbR //@鹿的一:素皮能贴引磁环吗?//@来去之间:转发微博 http://t.cn/AXNy3BWQ
给我的Galaxy Z Fold8贴了个MagSafe贴纸就能磁吸上泡泡骚了。Apple Store卖的这个泡泡骚支架太绝了,超级薄,质感对得起399。

我们已在现实世界的漏洞研究中广泛使用 GPT-5.6-Cyber,其中包括发现热门开源软件(如 Chrome 的 v8 引擎)此前未知漏洞的工作。

先进能力需要强有力的安全保障。因此,访问权限仅向经过批准的防御人员开放;对于风险更高的网络安全工作,还会配备额外的控制措施和监控。
https://openai.com/index/expanding-daybreak-as-the-cyber-defense-window-narrows
Daybreak Red 提供包括 GPT-5.6-Cyber 在内的专门训练的网络安全模型,可用于经授权的漏洞研究、漏洞利用验证和安全测试。
它面向经验丰富的防御人员,帮助他们应对复杂且经过授权的网络安全挑战。

我们正在扩大网络安全计划 Daybreak,并推出 GPT-5.6-Cyber——一款面向先进、经授权网络安全工作的全新模型。
随着威胁形势不断演变,我们正把前沿智能交到值得信赖的防御者手中,让他们抢在攻击者能够大规模部署攻击性人工智能之前做好准备。
Daybreak Blue 提供对包括 GPT-5.6 Sol 在内的前沿模型的访问,并针对广泛的防御性工作校准了安全防护措施。
对于大多数防御者来说,这是推荐的起点,支持漏洞发现、安全代码审查、恶意软件分析、事件响应和补丁验证。
这几天币圈好像又有一个大佬「意外去世」了,咦,我为什么要说又。
上周末巴拉圭警方接到报案,发现一个被黑塑料袋套住全身的男人从一栋豪华公寓30层坠亡,查明身份是Harry Yeh,这个名字曾在Crypto行业炙手可热。
Harry Yeh出生于香港,幼年就随家人移民加拿大,大学开始编程,和很多币圈大佬一样,命运被比特币改变,早期大量购入比特币,完成了资本原始积累,然后开始做基金、投合约、搞协议,身价超过20亿美金。
而他之所以居住在巴拉圭,一方面是因为这个国家对加密货币比较友好,吸引了很多巨额收入来源不明的年轻富豪,另一方面也是为了躲避司法管辖权,你们懂的,在欧美国家很容易被摁。
Harry Yeh人缘还不错,死讯传出之后,很多人发推怀念他,好吧,主要是在念他的张扬大方,比如会成箱成箱的把现金带去活动现场,见到开发者就发一沓,还有:
2021年,他把几百个公链开发者请到阿布扎比开会,又自掏腰包的请了500个Escorts(可以理解为高级伴游)过来陪酒,而那些开发者绝大多数都是没怎么跟女人打过交道的宅男,在酒店里坐立难安,根本不知道把手放哪里⋯⋯
😂😂😂

没错,OpenAI、Anrhropic也都是没上市的。
字节还是牛,在这个AI发展的关键期,因为不上市,获得了宝贵的不透明的机会。我感觉如果上市的话,字节的capex可能是一个惊人的数值。。。
读了单伟建(Weijian Shan)的一本好书。人生中有很多随机性。你无法掌控历史何时打开一扇门。你能做的,就是在它打开时做好准备,并且仍然有能力走进去。
Anthropic的产品,为什么这么厉害。刚看了公众号《海外独角兽》的最新文章。非常不错,强烈推荐。
Anthropic公司里有个 Labs团队。
Labs团队会围绕不同的技术判断播下大量种子,再把它们放进 Anthropic内部的真实工作环境里生长。有些很快因为需求不足而枯萎,有些因模型能力的季节还没到,暂时进入休眠。只有极少数能在反复的 Dogfooding中逐渐扎根。
最终,一个产品只有在内部目标用户中跑出足够好的周活和留存,才有机会对外发布。Anthropic现在同时运行着几百个原型,其中绝大多数永远都不会面世。
Claude Tag最早也是这样一个内部实验。它经历了几个月的真实使用和反复打磨,先改变了 Anthropic自己的工作方式,直到今年 6月才正式对外发布。

论坛认为,AI进入金融业的重点不是单纯提高效率,而是以人为本地理解客户、建立长期信任,并在创新、防诈与消费者保护之间取得平衡。金融机构应先从辅助决策和资讯提供做起,以员工赋能、跨部门审查、风险分级和明确问责逐步扩大应用;政府、银行、警检及同业则需共享风险资讯,以技术和联防降低诈骗风险。
- 从责任金融到AI治理与防诈实践 [00:00:30 - 00:09:59]
- 联防、消费者权益与可信AI治理 [00:10:06 - 00:14:56]
曹为实:论坛以“AI金融,消费新关系”为主题,不只是探讨人工智慧如何改变金融服务,更希望共同思考:当AI快速重塑金融生态时,如何在创新与信任之间取得平衡,让科技提升金融品质并保障消费者权益。经营银行,就是客户把自己的“第二生命”交给我们,因此银行必须有银行家的道德。永丰银行以四项原则作为价值观:诚信经营、公平待客、永续多元、科技创新。我们以这些原则诚信服务客户,让客户资产得到安全保障。今天在高科技时代,AI扮演着更重要的角色。AI不只是提供便利、快速的工具,更重要的是建立以人为本的关系,建立我们与客户之间的信任,以高科技方式让社会诚信与彼此信任更有效地连接,也更深层地理解银行家的道德以及银行与社会的关系。只有建立在有效、可信任的基础上,才能让社会和国家透过金融力量持续壮大、稳定发展。 [00:01:48]
董政彰:今天的讨论会围绕AI科技应用、金融防诈、消费者权益保护与永续金融发展展开。这些主题范围很广,但我特别喜欢“金融共好”这四个字。金融业不是业者自己的金融业,而是社会的金融业;我们有社会责任保障国人的金融消费权益,更重要的是助力社会转型。我们会以客户为中心,利用AI强大的功能探访、分析客户真正的需求,这是整个金融业生态的重要转变。作为主管机关,我们也会观察AI将对金融业产生怎样的冲击、带来怎样的新兴风险,因此制定了相关AI指引。负责任的AI、可信赖的AI、以人为本的AI,是我们整体工作的核心。六项AI指引还强调公平、透明,以及演算模式和推导逻辑的可解释性;最重要的是发生问题时必须明确由谁负责,从而为可信任金融中的AI发展建立核心框架。 现在的关键问题是如何使用、善用并用好AI。人工智慧是用机器模拟人类智慧,因此金融已经从数位金融转向智慧金融。我们如何控制、善用这个智慧体,是金融业导入AI时的关键议题;如何让AI有效且可被信任,是最大的挑战。目前我们先让AI扮演辅助决策、提供资讯的角色,并谨慎调整与客户互动的方式,谨慎处理接触和收集到的资料。要进一步用AI协助客户直接投资,还有很长的路要走。另一方面,AI也是一种赋能(Empower):金融机构希望用AI提升自身能力,员工必须了解并善用AI,才知道如何用AI服务客户。因此我们在组织内部推动转型,学习驾驭可能使用的AI工具,这正是金融机构的重要挑战和能力。 金融机构治理是创新的基础,必须把制度、人员、流程和客户全部放在一起思考。简单地说,治理是效率、创新、安全与公平的组合。我们希望有效率、希望创新,但必须兼顾公平、重视安全,透过治理机制把这些因素结合起来,最终建立信任。主管机关不断勉励金融机构,信任是长久的基础:客户要信任我们,而我们自己使用AI时也必须相信它,才能真正使用。 [00:05:40]
游庭皓:AI的套用以及AI对资产价格的影响,根本问题在于:AI与过去消费性电子循环升级有什么区别?推出一个AI,和一部新iPhone问世有什么不同?第二,它对台湾会有什么影响?我认为可以从这两个角度观察。AI的出现,会不会让换机、换PC、换手机不再那么重要?AI是不是改变了市场情绪?这些都值得观察。市场一方面意识到,AI看起来并不是消费性手机的库存电子循环;另一方面,市场心态的波动性越来越大,大家越来越不愿意错过机会。在这个新时代,未来可能有很大的不确定性,但只要掌握大方向,我们相信台湾正处于AI浪潮的高峰。我们要乘风破浪、留在市场,让市场给予更显著的回馈。 [00:07:07]
费家琪:过去AI协助金融机构更精准地辨识客户需求,但同时兼顾公平待客和消费者保护,之间可能存在模糊地带,也有需要克服的痛点。如何克服这些问题,需要继续思考。关于资讯,我们现在透过165持续收集民众报案资料,用这些资料协助民众辨识AI生成、仿冒甚至声音仿冒的行为。运用这些大数据,也必须付出社会成本,因为我们收到的案例都已经有受害事实。接下来要讨论的是,银行如何运用AI更精准地了解客户需求,并在了解之后提升服务品质。永丰银行已经正式成立新兴科技治理机制。 [00:08:01]
严国瑞:目前永丰银行每一个AI项目,都由处级以上主管组成跨部门治理机制,大约有六至七个部门参与。我们逐案检视,根据风险层级定义,确认道德风险与法遵要求符合规范。董事长特别强调“永续”,项目必须符合银行治理的期待,之后才能正式在内部和外部推出。公司在组织治理上要有程序和风险评估,过滤掉不适当的商品创新设计;但服务上线、与真实客户互动之后的情况,才是最珍贵的反馈。 [00:09:14]
邱绍洲:金融机构是否履行善良管理人的注意义务和忠实义务,是整个问题的基础。每一位金融从业人员提供服务时,可能透过AI向客户提供咨询或建立服务,但每个人都必须理解:不论使用什么AI,都必须有良善的判断。对客户而言,他信任的是你,所以整个过程中必须具备AI素养。我们一直希望把收集到的可疑交易样态、诈骗资讯和新的诈骗手法,与各家银行交换。我们与各家银行签订备忘录,除了最新诈骗手法,也共享风险情资和异常交易样态;这些风险因子会随着新案例持续互动更新。 [00:10:06]
邱绍洲:警银互动是很好的例子。防诈与便利之间,银行第一线会面对很多客户冲突,因此联防非常重要。第一是检警合作,检警掌握诈骗样态;联防不只包括警政、检警单位,也包括同业。台湾有三、四十家银行和金融机构,我认为创新可以在科技层面发挥作用。比如提款部分可以使用AI辨识,增加车手作案的困难度,让车手不敢来。另一个问题是,银行每天有几万笔交易,如何精准辨识哪些可能是高风险?如果客户愿意采用更安全的形式,例如导入FIDO装置绑定,就能使用相对安全、认证强度较高的交易方式,帮助银行辨识风险,更精准地发现异常交易。 [00:11:25]
罗俊瑋:第一优先是建立治理与问责机制。第二,使用AI技术时,如何处理公平性与透明度,也必须放进整个金融服务业的流程改造和新项目研发中。最困难的地方,是资深人员和管理者如何与年轻人合作;我们会继续努力,法治有所欠缺时也会尽快补足,让大家在快速变化的AI时代执行工作时,守住民众的每一份财产。银行、客户与政府必须形成良好生态,在AI应用上创造彼此双赢,才能让大家越来越好。金融业者使用AI时,必须把保护消费者的原则纳入系统设计,维持可信任、负责任的运作。对于人工智慧的应用,金融消费者最需要被保障的是公平性和以人为本的价值观;更重要的是,要特别关注消费者个人资料的保护,最终建立值得信任的AI。 [00:12:41]
严国瑞:我的看法是,治理是前提,不是创新的刹车皮,而是创新的前提。第一是风险分级,第二是多元观点,第三是以公式为基础,第四是与时俱进。每个机构的风险承受力不同,所以要先把机构愿意承受的AI应用风险,以及能够控制的风险定义清楚,才能取得平衡。治理机制必须跨部门、汇集多方,让组织内部不同部门能够讨论不同观点。当工作交给AI时,出了问题究竟是AI的责任、我们的责任,还是使用AI的人的责任?当开始使用Agent、把工作流串接起来时,这会是最大的挑战。因此其实没有一个所谓的好答案,答案是形成共识:机构和组织中与工作流程有利害关系的各方,都要有共识、理解并愿意接受这个流程及其产出。运用AI必须是大家可以接受的,也要愿意承受可能出现的幻觉或错误风险。 我想总结,未来我们希望进入一个负责任、值得信任、以人为本、共同受益的新金融环境。 [00:14:44]
来源:OpenAI News
URL:https://openai.com/index/daybreak-models-are-now-available-on-aws
OpenAI 与 AWS 正通过 Amazon Bedrock 提供 Daybreak 网络安全能力,以支持企业安全工作流。
来源:OpenAI News
URL: https://openai.com/index/testing-ads-in-chatgpt
OpenAI 开始在 ChatGPT 中测试广告,以支持免费使用,并确保广告标识清晰、答案独立、隐私保护有力,同时让用户拥有控制权。
本期《Chat with Traders》访谈中,系统化交易者 Marston Parker 回顾了自己从软件工程师转为全职交易者的经历,以及从主观判断逐步走向规则化、自动化交易的过程。他最重要的经验是:交易系统应当描述一个可重复的市场过程,而不是为某一只股票或某一段行情量身定制;避免曲线拟合的直接方法,是减少自由度、保持规则简单,并且主动接受未来表现会显著低于回测结果。Parker 还分享了突破、做空、IPO 和均值回归等策略的构造方式,强调收盘价规则、风险控制、交易成本和市场状态对策略能否长期有效同样关键。
Parker 少年时期同时学习古典小提琴和编程,后来进入软件行业,并因公司上市获得了最初的交易资金。1997 年,他在听从电视财经节目、重仓买入一只“利好出尽”的股票后遭遇较大亏损,于是辞职开始全职交易。与交易伙伴 Gary Smith 合作后,他逐步采用系统化方法:扫描全市场的异常成交量和价格突破,按预设的止盈、止损或时间规则执行,不依赖每次都做出正确的主观判断。
早期策略主要是放量突破的多空两个方向。做多关注盘整后的放量上破,做空关注大幅跳空、通常伴随负面盈利消息的破位;持仓通常只有几天,因为资金应当持续流向正在运动的标的。Parker 说明,策略从电话下单、邮件下单发展到代码自动生成订单,再转入在线券商,但策略表现变差的根因最终仍在策略本身逐渐失效,而非换了券商。
他后来加入 IPO 策略和均值回归策略:IPO 策略在上市历史新高时买入,以收盘价规则控制退出;均值回归策略寻找连续下跌后出现异常波动和跳空的机会。他不读取新闻或基本面数据,主要依据价格历史形态,因此财报季会带来更多机会,但策略是否有效仍取决于市场状态。对于 meme 股票,他用波动率过滤器、排除名单、保证金要求和借券费率等信息降低极端做空风险。
访谈最后集中讨论曲线拟合和回测。Parker 建议在组合层面建模,让系统每天从大量股票中寻找机会,而不是试图找出“过去三年最能抓住某只股票涨幅”的规则;同时限制参数和自由度,避免在所有参数组合中挑选回测最好的结果。他的经验法则是“回报减半,回测加倍”:未来回报按回测的一半估计,回撤按回测的两倍估计。因为每次试验都会让研究者倾向于保留好结果、丢弃坏结果,回测次数越多,过度拟合就越严重。
#670. Marsten Parker:“避免曲线拟合的方法,就是不去拟合”回测越多,为什么越可能错?
- 从主观交易到系统化方法 [00:00:00 - 00:47:55]
一凯:欢迎收听跨国串门计划。这是一档专注于让中文听众无障碍欣赏全球优质外语播客的节目。通过先进的AI声纹克隆技术,我们不仅将内容翻译成中文,还完美保留了原主持人和嘉宾的独特声音,为您呈现全球顶尖的AI财经、健康与科技领域精品内容。我是主播一凯,一位热衷于AI领域的产品经理,很荣幸能为您搭建这座跨越语言障碍的桥梁,接下来让我为您简单介绍本期我们克隆的这档节目,本期我们克隆的是知名交易类播客 Chat with Traders的一期深度访谈,主持人是Tessa 嘉宾是系统化交易者Marston Parker Marston从古典小提琴和编程起步,后来转型为全职交易者 [00:00:00]
一凯:凭借算法驱动的策略,入选了Jack Schwager的《未知的市场奇才》一书,这期节目主要聊了他从主观交易,转向系统化交易的历程,以及他如何用统计思维和自动化工具,来应对市场变化,那我们就一起来听听这期完整的对话,那么Marston 欢迎来到Chat with Traders 谢谢
Marston Parker:你从哪里打来的,我在马萨诸塞州的雷丁,离波士顿以北大约12英里,很高兴来到这里,其实大约10年前,在节目刚开播的时候,我就和Aaron Fayfield联系过 [00:01:15]
Tessa:当时差点就来了,但我没有任何网络存在感,所以我想算了,我觉得我还是不上节目了,所以迟到总比不到好,是啊,你恰好是唯一一位,纯粹的系统化交易者
Tessa:其几十年的表现足够优异,得以入选Jack Schwager的 《未知的市场奇才》一书,你是怎么被他认识的,是啊,我觉得可能有很多系统化交易者表现比我更好
Marston Parker:只是他不认识他们,或者他们没兴趣上这本书,但我很幸运的被推荐了,我完全不知道他在写一本新的市场奇才书,也没想过要进书里,我一直是现在也还是一个叫StockB的在线社区的成员,我大概是2013年加入的经营那个社区的人 Debond 不知怎么和Jack有联系,得知Jack在为新书找人,就推荐了几个人,包括我,他推荐的其他人都拒绝了,但我同意了,事情就是这样发生的,然后当然和市场奇才系列,一贯的做法一样,我得给Jack寄各种,关于我业绩记录的文件,幸运的是,我有过去20年的,所有旧券商对账单,所以那没问题,而且正如他写的那样
Tessa:我的业绩其实只是勉强够格,但不知怎么他决定把我写进去,所以我就出现在这里了,太好了,太好了,谢谢,是啊,让我们深入了解一下你的背景,你是在哪里长大的,早年对什么感兴趣,对,我就是在波士顿地区长大的,十几岁的时候,我有两大爱好,一个是古典音乐,具体说是小提琴,另一个是计算机编程 [00:02:47]
Marston Parker:整个高中阶段,这两样一直在争夺我的注意力,最后我决定试着走音乐这条路,去了纽约市的一所音乐学院,学古典小提琴,但那是80年代初,个人电脑刚刚开始出现,我也买了一台,结果在学校里,我花在写代码上的时间越来越多,练琴的时间越来越少,等我毕业的时候,其实已经很明确了,我想往计算机方向走,所以我搬回了波士顿,先在一家电脑店上班,后来在1984年,进了一家软件创业公司,对我在那家公司干过,后来又换了两家公司,第三家叫Segway Software SEGUE 他们后来在1996年,于纳斯达克上市 [00:03:13]
Tessa:股票代码是SEGU 我是最早的一批员工,所以持有公司大约4%的股份,手里有了一些股票,这就是我对交易产生兴趣的起因,你在那家软件公司做的是什么工作,我是软件开发人员,软件工程师,从1984年到1997年,我的职业就是这个,哦哇 13年,那你写的是哪类软件,一开始我做的是Vax小型机
Marston Parker:后来转到个人电脑软件,基本上都是给其他开发人员用的工具,我做的第一个东西,是为公司提供了一种编程语言,写了一个编辑器,职业生涯的后半段,我主要在做支持软件测试的工具,所以我们的客户是,其他软件公司的QA工程师,Segway 的主力产品叫Silk Test 我记得有一段时间 [00:04:20]
Tessa:他在这个领域是领先的,当程序员让你很有成就感吗,有的,对我一直很喜欢做软件,喜欢看到别人用我做的软件,所以那确实很有成就感,对那著名的吉姆西蒙斯,他参与了你们公司的收购,对我记得他名字发音是Simon's 他是在第三家公司Segway Software 他是董事会主席,也是那家公司最大的投资人,那时候是90年代初
Marston Parker:他在对冲基金业务上已经有些成绩了,但还远没有后来那么成功,他可能只是顺带做做,他有一个风险投资基金,所以他投了不少软件公司,具体多少我不清楚,一般大概五到十家 [00:05:10]
Tessa:我们恰好是其中一家,收购发生的时候,你当时是急着想退休吗,还是想着再找一份软件工作,不是,其实那不算是收购
Marston Parker:那是真正的首次公开募股,公司后来确实被收购了,但那是我离开好几年之后的事了,所以我当时并没有急着想被收购,或者想干什么,说实话,当上市变成可能的时候,还挺让人意外的,我们是一家非常小的公司,放到今天根本不可能上市,但总之我们在96年春天上市了,几个月之后,纳斯达克经历了一次相当大的回调,科技公司都在挣扎,我确实有点干腻了,而且我越来越沉迷于盯着自己公司的股票,然后开始买交易方面的书,开始接触其他股票,也开始尝试各种交易策略,我心里想,好吧,我想先离开一段时间,把这个当做一个实验试试,反正如果我想回去,随时可以回那家公司,或者去别的软件公司找份工作
Tessa:但后来我很快就做得还不错,这个实验就一直持续了下去,持续到后来想回去再当雇员,已经有点太晚了,早期阶段,有没有哪本书对你影响特别大,我早期买的书里有一本叫,以交易为生,那个作者叫什么名字,埃尔德,对,亚历山大,埃尔德,没错,没错,对,对,对,我觉得光是那个书名就很有影响力 [00:06:28]
Marston Parker:在看到那本书之前,我从来没想过有人会以交易为生,然后我想,哦原来可以这样,所以这是其中一本,另外那也正是网上资源,刚开始出现的时期,比如有个网站叫sastreet.com 我会去看,也开始有一些早期的在线用户群组,我记得雅虎有一大堆用户群,我也会参与其中一些,对了好像有个网站叫Silicon Investor
Tessa:我可能也参与过,所以怎么说呢,我从各种地方获取信息,对交易越来越感兴趣,就是这样,对那跟我们讲讲你早期的交易吧,早期的大赢家和大输家,最开始的时候情况怎么样,早期的时候我开了个券商账户,把限制性股票转成普通股,这样就能开始卖出,手里就有了一些交易资金,然后就开始小打小闹的事 [00:07:21]
Marston Parker:我记得不太清是在哪看到的,应该是更早读的一本书,讲的是偏基本面角度的做法,比如根据市盈率与增长比率这类指标,做轮动投资,我找到了办法能在网上做类似的筛选,或者用我台式机上的一个软件,好像叫Window on Wall Street之类的,所以我就觉得某只股票,符合我听来的某个推荐标准,就下了一单,对了,我那时候还在看CNBC 我记得那会儿CNBC刚起步不久,我就一直看,我记得我第一笔大亏是在97年,那时候我还有工作,交易只是副业,我在CNBC上听到,赫尔曼米勒公司盈利超预期了,我立马就买了那只股票,仓位下了特别大,我当时想CNBC都说好了,那我得重仓,结果那显然是个利好出尽的局面,我记得那笔交易,让我失眠了好几个晚上
Marston Parker:所以97年第一年交易,我大概亏了5万美元,那年年底就冲着这个,我说行,我辞职,全职做交易,我当时根本不知道自己在干嘛,不过我开始隐约,觉得也许可以走一条,更系统化的路子,我不知怎么的意识到,有些人是有交易系统,照着系统做的,而不是靠主观判断,指望自己每次都对,那套对我显然行不通,我开始跟一个人通信,他在thestreet.com上,发了一系列文章,分享他交易策略的某些方面,这人叫Gary B. Smith 我们一直保持联系,成了朋友,最后成了交易伙伴,我就跟着他的系统化方法走,那基本是系统化的,选哪些股票做多或做空,有一些主观成分 [00:08:40]
Tessa:但退出机制是100%机械执行的,既然你是全职做这个,你对年收入或者总回报,有没有一个目标预期,我有个大概的想法,我记得跟Gary通信聊过这个 [00:09:31]
Marston Parker:算是跟他做个合理性检查,我说你觉得我能稳定,做到每年20%吗,他说能啊,那应该不难,我大概有一百万交易资金,所以我想如果能稳定,每年赚20% 就算扣了税,收入也能比之前上班多,说不定还能让账户再涨一点,所以我当时的目标是,扣完税和生活开销之后,账户每年还能增长5%到10% 现在回头看,我明白了,交易这行不能定收入性目标,那完全没道理,你会有大起大落诸如此类,不过跟很多人比,我觉得自己处境挺稳的,因为我交易资金充足,而且公司上市的时候,我把房贷什么的都还清了,所以我没有负债,资金充裕,还有一份可以回去做的职业,所以当时风险不算大
Tessa:我就是把它当成一个实验来做,你提到的那本书,以交易为生,我去查了一下,那好像是一本讲主观交易的书,你是不是把早期那些书都放到一边 [00:10:35]
Tessa:然后越来越专注于把方法系统化,对基本上是这样,我翻了很多书,想找关于怎么往下走的线索,这里那里确实找到了一些线索,但就像你说的
Marston Parker:大部分书都是讲主观交易的,没有哪本书会告诉你,这是一套完整规则,而且大概率能成的交易系统,我甚至不记得最早那批,讲趋势跟踪的书是什么时候出的
Tessa:那时候应该还没几本,也许有吧,我基本把那套放下了,改用Gary Smith的方法,然后慢慢试着把那套方法系统化,我们在路前沟通的时候,你说你讨厌交易,为什么 [00:11:11]
Marston Parker:对我可能有点说中了,但我确实不是典型的交易者性格,不是那种喜欢下注,喜欢挑战自己判断价格方向,对不对的人,我确实喜欢交易,尤其是早期,把它当成一种谜题,你怎么想出一个策略,过去能赚钱,更重要的是未来还能继续赚钱,所以我喜欢研究那部分,测试不同策略,想各种点子,但真正下单交易的过程,我早期其实也往,那个兔子洞里钻过一点 1997年那段亏损期里,我甚至花了大概一个月时间,在纳斯达克股票上,做非常活跃的主观日内交易,我亲身体会到,那玩意有多容易上瘾,就是不停地想开仓,看会发生什么,真的就像老虎机,赢了就来一下多巴胺刺激,然后你就想马上再开一单,幸运的是,我当时有足够的自我觉察,能观察到自己这个过程
Marston Parker:意识到如果继续走下去,对我来说会是个危险的滑坡,所以我说不行,我骨子里非常保守,我不想亏大钱,我也不是那种,会在一件事上压重注的人,你觉得如果你一开始 [00:12:18]
Tessa:就新手运气,比如说1997年就赚了不少,你还会开始转向系统化方法吗,还是说这本来就是你的天性,我觉得这是我的天性,对就像我说的
Marston Parker:我和Gary刚开始交易的时候,我们的方法里是有主观成分的,我们会跑一个筛选,其实也不算跑,就是拿投资者商业日报,看前一天,异常成交量的股票列表,然后我们去看那些股票的图表,他会主要是他,对图表形态做一些主观判断,据此排序,选出最好的入场机会,我试着去理解他在做什么,但总觉得那有点随意,所以我马上就想去测试他,我也想去测试我们用的出场方式,看看能不能找到更好的,在给定我们实际入场的,那些交易的前提下,不同的出场会不会效果更好
Tessa:所以对即使我早期用那些主观方法,一开始就成功了,我大概也会很快写代码去测试它,作为音乐家,你觉得读谱和演奏技能,跟系统化交易之间有联系吗,我学小提琴学到的东西,专注力 [00:13:22]
Marston Parker:长时间盯着一件事的能力,这个对我来说不是天生就有的,但我练出来了,还有每天练琴的纪律性,这两者之间确实有些重叠,音乐背后有很多结构,甚至可以说是一个系统
Tessa:其中一些我在学校里学过,可能确实有些联系吧,但我不确定是不是特别具体的联系,对那我们聊聊你早期的算法交易吧,能跟我们分享一下你早期的一些算法策略吗,你一开始是系统化的对吧,你是手动下单的,还是很快就转向了算法方式,基本上我是1998年2月开始跟Gary Smith交易的,我们当时跑一对策略
Marston Parker:基本上就是做多和做空,算是比较对称的,也不是完全对称,就是买入一场成交量的向上突破,或者做空向下的破位,然后挂一个括号单,一个止盈一个止损,哪个先触发就按哪个,这个策略跟经典趋势跟踪相比,唯一不太寻常的地方是,止损比止盈大,所以它的胜率相当高,大概70% 我记得我们一开始,用的是5%的止盈和7%的止损,后来我才发现了其他衡量方法,比如ATR 但一开始就是这么做的,我就用这套系统,就那一对多空策略,只做小幅调整,一直做到2015年,我没做别的,真的没做别的,我一直在过度优化调整参数,但基本概念没变 [00:14:15]
Marston Parker:但基本概念没变,所以我觉得,我做的那些优化和参数调整,其实没带来多大差别,我可能随便选一组参数,结果可能更好,也可能更差,但基本概念是一样的,买异常成交量的突破,设止盈和止损,我记得还有一个时间止损,所以退出基本有三个组成部分,回到你的问题 98年我们刚开始的时候,我们其实是打电话给经纪商下单的,那时候还没有像现在,盈透证券这样的在线平台,嘉信理财,可能刚开始有TDA Meritrade也是,那都是一两年后的事了,我们最开始的时候,真没什么可用的,所以我们用的是这家在线经纪商,其实算是个小机构,新泽西的一家小券商,我们就打电话下单,后来因为我们每天都这么干,就问能不能把订单发邮件过去,我们就改成发邮件下单了,再后来我干脆写了代码 [00:15:02]
Marston Parker:来自动生成那些邮件,所以我的第一个自动化,其实就是一段代码,用来生成邮件,发给人工经纪人,由他来做订单录入,我其实一直用那家券商,用到2013年,他们叫Trade Managed Capital 再早之前叫Yamner 我觉得我们可能是他们唯一的零售客户,其他客户全是对冲基金,但我们表现的挺像对冲基金的,所以他们收了我们,他们给了我们一套软件,我就改了代码去用那个,然后到了2013年,我转到了盈透证券,主要是因为原来那家收的佣金太高了,而且滑点也越来越差,早期他们给我们的成交价,我觉得非常好,但后来滑点越来越严重,我就决定转到盈透证券,然后碰巧的是,接下来几年,我经历了一段困难时期,但我觉得,那不是因为换了券商
Marston Parker:而是因为策略本身,在逐渐失效 [00:16:51]
Tessa:不像以前那么好用了,那确认一下,从1999 2000年左右,一直到2014年前后,很长一段时间,你就在跑两个基本策略,对吗,对或者更准确的说
Tessa:是一个策略的两个方向,一个策略的两个方向,那我们再深入聊聊,你这边是买入放量突破,比如放两倍量,对基本上是这样,早期我们做筛选的时候,每天收盘后,数据出来之后 [00:17:07]
Marston Parker:就扫描所有美国普通股,符合流动性标准的价格,和流动性过滤条件,大概就三样东西,异常成交量,至少是平均成交量的两倍或三倍,明显的价格变动,不是那种放两倍量涨五分钱,而是一天涨好几个百分点,然后在这之前,股票不应该已经超买了,所以理想状态是,先是一个平坦的盘整区,然后从那里突破,这就是基本的形态,这大概是全世界最知名的突破形态了,没什么原创性,我觉得Gary是从读威廉,欧奈尔的书《笑傲故事》开始的,基本上拿了他的方法,丢掉所有基本面,把指引目标从20%改成5% 就这些,这就是我们当时跑的东西,然后他加了做空方向,欧奈尔当时是不做空的,而且那时候他还没出版任何关于做空的书
Marston Parker:所以我觉得最有创新性的地方,就是Gary加了做空方向,他找的是那种更大幅度的破位,他形容说那股票看起来应该像你摔断了胳膊,胳膊还大拉着 [00:18:14]
Tessa:所以做空的入场标准更严格,要求更大的向下跳空更大的量,对基本上他找的是那种肉眼可见的跳空,他常说的话是这只股票看起来应该像是摔坏了,大多数这种入场都发生在负面盈利意外,或者负面盈利预告之后,那时候通常就是这类消息会引发这种形态,对那这些仓位做多和做空,你一般持有多久
Marston Parker:有目标价吗,有有我们一开始的做法是,在开盘时按市价下买单或卖单,同时挂一个括号单,包含止盈目标和止损单,哪个先触发算哪个,就是二选一订单那种情况,这些价位是提前算好的,比如5%有利方向 7%不利方向,做多的话就是涨5%只赢,跌7%只损,做空反过来就这样,然后你就放着不管,直到触发其中一个,那时候通常从当天到一两周不等,但大多数在几天之内,你想一只股票刚在异常成交量上,走出异常波动
Tessa:再往某个方向走5% 用不了多长时间,所以对平均持仓周期,真的就是几天,大概三四天,持仓时间相对较短,你当时是怎么想的,毕竟老话说 [00:19:32]
Tessa:趋势是你的朋友,你有没有一套自己的理由,说我们要早点离场,比常规更早,对,我的理由是,我们想待在当下正在动的股票里
Marston Parker:而热点每天或每隔几天就会变,你要是买了个突破,然后一直拿着,直到某个更长期的止损被触发,那你的钱可能就长期套在一只股票上,其中一段时间它根本没什么动静 Gary的理念我也采纳了,就是你的资金有点像库存,你要让它不断周转,把钱放到有行情的地方去,当然是在合理范围内,那时候这种持仓周期,差不多已经是最短的了,再短交易成本就完全吃不消了,因为你要记得,那时候股票还是用分数报价的,最小价格变动单位是1%美元,点差相当大,而且佣金也很高,如果我们交易一两千股的整首,每笔往返交易的佣金,大概要50到60美元,所以这里有个最佳点,每年500到1000笔往返交易是可行的
Marston Parker:Gary比我更不保守,所以那一年1998年,我们合作的第一年,他赚了80% 我赚了50% [00:20:51]
Tessa:对我们来说是个好年景,你在之前的采访里提到,你喜欢有大量的交易样本,这样才有统计显著性,你会调整你的系统,让它每年产生一个最低交易次数吗,你提到过 [00:21:00]
Tessa:我记得是每年500或1000笔交易,那是统计上比较理想的点吗,我的意思是,如果我看一个回测,我想看到成千上万笔交易,才会相信这里面有优势
Marston Parker:如果你看到一个回测,只产生了50笔交易,里面还有一两个异常值,那它根本说明不了,这些交易背后的规则,有什么价值,所以通常是我在寻找的东西,对,再说这也有点取决于,你有什么数据,我一直都是用日线数据,那种每年500到1000笔往返交易,持仓几天的频率,差不多是用日线能做到的下限了,显然你没法用日线去建模日内交易,甚至日内交易也不行,有一种日内交易策略可以,就是现价单进场 MOC出场,除此之外就不行了
Tessa:自己写所有代码有多耗时,我猜前期投入很大,但后来呢,早期和后期,你分别要花多少时间,我不知道,我可能已经花了几千个小时,在写代码上,但并不是每次有个交易想法 [00:22:04]
Marston Parker:我都要从零开始,从一开始,我就构建了一个通用回测程序,后来又做了一个通用自动化程序,大部分时间是在Excel里做的,但现在我有一个独立程序了,所以现在有了我手头的软件,如果我想测试一个新想法,几分钟就能搞定,如果我想开始交易一个新策略,也几乎不用再写什么代码,因为基础设施已经有了,但早期它是慢慢演化出来的,并不是说我必须先完成某个大任务,才能开始系统化交易,它是从大部分手动,逐渐演变成半系统化
Tessa:然后我觉得从2000年初开始,我就用Excel VBA代码实现了全自动化,我想从1999年以后,我就没再手动下过单了,我们回到时间线上,你用了第一个系统多久,才对它做重大修改,我一直在调整它,所以一切都是在慢慢演化的 98年 99年,我们业绩很好,那时候我越来越系统化了,我对用眼睛看图
Marston Parker:做判断这个过程感到失望了,我想为数据应该长什么样制定规则,所以我一直在改那些规则,结果1999年业绩相当平庸,这很不寻常,因为那一年大多数交易员都赚得喷满钵满,除了那些只做空的人,我回头看了所有我改规则的时点,意识到如果年初保持规则不变,我会做得更好,所以我下了个决心,好吧,进入2000年,我要一整年用一套规则交易,全年不改,我确实做到了,结果那年我创下了最好业绩,所以那很有效,在那之后,我有很多时机会频繁调整东西,你会陷入,我觉得每个人都容易这样,当你处于回撤中,你会说,我怎么能避免这次回撤,或者让它不那么严重,然后你找到一些,本可以让回撤更小的规则,就把它们加进去,我当时完全很天真 [00:23:19]
Marston Parker:我对过你和什么的完全不懂,我就是那么做了,有时候有用,有时候没用,我通常的流程是,好吧,我在回撤中,让我重新测试,看看能不能想出一个新想法,让回撤更好看,或者让近期表现更好,然后把它加进去,然后有几次,我找不到任何能做得更好的参数,然后我就想,哎呀整套方法这下彻底废了,那我该怎么办,其中有一次,就是我说2000年业绩特别好那次,所以进入2001年,我自然继续跑同一套规则,结果头一个月就立刻回撤了20% 我以前从没经历过那么大的回撤,这让我停下来缓了一阵重新评估,最后我上了一套差不多的东西,但我觉得改成了,我会接入实时数据服务,在收盘前完成入场,而不是等到第二天开盘 [00:24:14]
Marston Parker:因为在回撤里,我发现那样做最近的表现会好很多,所以我就做了这个改动,然后到了2005年,事情又不灵了,我又做了类似的事,改成更早入场,我会在开盘大约五分钟后开始扫描,找那些放量移动的股票,然后在那时候买入,我就这么跑 06和07年表现很好,是我除2000年之外最好的两个年份 08年也还行 09 10年相当不错 11 12年也是,到了2012年,基本上做空这边进入那个10年之后,尤其是2013年开始,做空这边彻底失效了,而在此之前,我总利润的一半以上来自做空,如果我一直只做多,那根本跑不赢大盘,我还不如买入并持有 [00:25:08]
Tessa:然后拿它做对冲做空,但我当时不知道08年可能不行,但除此之外确实是这样,明白了,你觉得为什么2012年做空会受挫,那年的市场有什么不同,我觉得越来越多的交易者
Marston Parker:开始采用逢低买入的做法,基本上我那种短期均值回归的玩法,变成了一种非常流行的策略,所以我那种急跌破位的形态,本来是我的做空入场信号,变成了很多交易者的做多入场信号,所以对他们就会,我老是看到这种情况,我在接近低点的地方做空,然后越来越频繁的被打脸,倒不是我突然冒出一大堆巨额亏损,就是统计数字慢慢变差了,胜率变低,平均亏损变得比平均盈利还大,诸如此类,通常就是这样 [00:26:09]
Tessa:这种BTFD逢低买入的现象以前存在吗,那是个专业术语 BTFD 这种现象在以往那些火爆的市场里存在吗,还是说它是那个特定市场独有的新特点
Marston Parker:我觉得它算是比较新的事物,大概从2012 2013年左右开始的,我不太记得了,当然在那之前也有价值投资者,他们知道自己想持有哪只股票,然后等它变便宜了再买,所以在更长的交易时间框架里,你可能会说,没错,逢低买入,一直是低买高卖的一部分,一直是投资领域的一部分,但我认为它变成一种流行的短期交易策略,主要是在那之后,可能08年就有了,我后来在2014年,把均值回归加进了我的体系,做回测的时候,我发现08年连做多这边,逢低买入做多都会表现很好,所以我觉得它已经存在一阵子了,但可能是达到了某个临界规模,让我那个特定的做空形态,不只是不灵了,但我真的不知道,你永远没法确切知道原因
Marston Parker:你不知道市场上还有谁在做什么,所以你能做的顶多是猜猜,为什么某个东西不灵了,当一个策略失效时 [00:27:54]
Tessa:有没有什么客观或微妙的指标,会开始显现,没有这很难说清楚,它其实更多是一种主观判断,对这就是我在策略层面决策上,保留主观的地方,在我卖的回测软件里 [00:28:02]
Marston Parker:我放了一个,我的众多势力脚本之一,基本上就是我20年代末,到2000年代中期,一直到2012年之后,交易的那套多空策略,对,你把这套回测,一直跑到90年代就能看到,它一开始表现很好,然后长期走平,然后2022年,它又神秘的表现极好,而那年大多数,其他短期股票交易策略,都表现很差
Tessa:所以你永远不知道某个东西,什么时候会开始有效,或者什么时候会失效,真的,这就是个主观判断,所以我的理解是,你在自己的工具库里,加了一个均值回归策略,对,我是2013
Marston Parker:2014年在我加入的,那个股票论坛里,接触到这个概念的,然后做了大量研究和回测,我想我也知道,或者说接触到了 Larry Connors的著作 Connors和Cesar Alvarez 大概是这方面出书最多的人,对我找到了一些我喜欢的策略,所以2014年,我把资金一分为二,一半继续跑我原来的策略,另一半跑新的均值回归策略,原来的策略走平,均值回归那一半表现非常好,所以2015年,我就决定放弃原来的策略,把全部资金投进我建好的,那套多空均值回归策略组合,那年开头很棒,然后来了一次非常难看的回撤
Tessa:这次回撤的原因是什么,导火索是什么,是你策略里的均值回归部分导致的吗,从2015年初开始,我就把整个账户都用来跑多空均值回归策略了 [00:29:36]
Marston Parker:每笔仓位占账户的10% 不对我收回这句话,那时候我还是固定股数交易,不是固定百分比,但平均下来规模差不多10%到15% 其实典型的均值回归策略就是这样,你在接飞刀,你买入一只正在下跌的股票
Marston Parker:你买入一只正在下跌的股票,或者做空一只正在飙升的股票,但你是基于计算判断,它已经超卖或者超卖了,反过来也一样,如果你试图在这些策略里加止损,根本没用,你基本上只能依赖统计规律,如果你做1000笔这种超买状态的交易,平均下来你会赚钱,但偶尔你会吃一笔比较大的亏损,你只能通过把仓位控制的足够小,来管理这个风险,这样即使一只股票从你买入的位置,再跌50% 你的账户可能也就回撤2%或3% 而且这种情况一年只会发生一两次,所以这些策略的回撤,通常发生在有某种市场事件的时候,那些糟糕的交易会出现序列相关性,你会连续吃好几笔大亏损 [00:30:03]
Tessa:2015年下半年就这样,尤其是8月 2015年8月市场非常糟糕,那就是你大回撤的时候,对回撤开始了,我觉得可能6月或7月就开始了,很大一部分是随机的
Marston Parker:我记得六月有一波回撤,有一笔是我在做空正在飙升的中概股,还有一笔是我在买入暴跌的生物科技股,当时希拉里克林顿在竞选总统,他宣布要打击制药行业,整个生物科技板块就崩了,但我一直在逢低买入,因为我的规则就是这么说的,所以基本上当出现这种新闻驱动的催化剂,或者像后来Meme股那样的疯狂炒作时,你就会连续吃太多大亏损,而当你回测这类策略时,你会看到一些大的异常亏损,但通常它们是分散开的,所以统计结果看起来仍然很好,但在现实中,当它们一个接一个发生时,再加上几个这样的阶段和横盘期交替出现,累积起来就是一次显著的回撤 [00:31:05]
Marston Parker:所以我的回撤从2012年年中就开始了,那是我净值的高点 2012年夏天一路下来,中间有一些恢复期,然后又亏损,又有恢复期,基本上我的净值
Tessa:从2012年年中到2015年,一直处于下行趋势,累计回撤大约45% 挺好奇的,一个策略的表现,要恶化到什么程度,你才会考虑调整系统,或者干脆彻底放弃它,我几乎总是把20%回撤,设成我的系统止损,或者说我的关机开关,至少暂停一下,如果不是彻底停下来的话,重新评估 [00:32:09]
Marston Parker:然后那段时间,这种情况发生了好几次,到了某个点,你要么说好吧,我觉得我有个新想法,会做得更好,所以我重新启动,但当然你不可能等到,净值回到高点再重启,因为从定义上讲,你必须交易,才能回到净值高点,所以到了某个点,你只能继续,在任何时候,你要么相信,你手里有能赚钱的东西,然后重新入场,要么就认输,说我这辈子都不干了,我以为我在2016年就这么做了,我停了三个月,真的,但后来我有这么多软件,这么多工具,这么多经验,就想看看还能做点什么
Tessa:我上了更保守的策略,参数更少,然后,所以你走出那45%回撤的方法,就是简化你的系统,对简化,让它更仓位更小,分散度更高 [00:33:15]
Marston Parker:我之前只跑两个均值回归系统,但后来我回去加了一个,我老的突破系统还是不行,但我找到了一个新的做多突破系统,把选股范围缩小到近期IPO的股票,这后来成了我接下来几年表现最好的策略,然后还加了一个新的,我确实回到了类似我老做空策略的东西,但有一些不同,特别是我不是在跌破时直接做空,而是在跌破后的小反弹时做空,这样能拿到稍微好一点的价位优势,所以这四个策略合在一起,就是我的核心四大策略,我到现在还在跑,而且从那以后,大部分时间表现都还不错,你会给系统编程
Tessa:去避开那些被高度做空的股票,或者命股吗,如果你想避开他们,你是怎么把他们筛出系统的,我确实有一些,对我有一个,我有一个波动率过滤器 [00:34:07]
Marston Parker:实际上多空两边都在用,这个我是说处理这个问题,有几种方式,一种是把交易范围,限制在一个更窄的股票池里,比如某个主要指数的成分股,有些人就是这么做的,但我一直发现,如果把股票池设为所有在美国上市的普通股,再加上一个流动性过滤器,统计结果会更好,这个股票池和罗素3000的主要区别在于,更广的股票池会包含很多ADR 所以实际上你会买到很多外国股票,这就是我之前提到的中国公司股票问题的原因,所以,哎呀,我有点忘了刚才说到哪了
Tessa:你问的是什么来着,对,对,就是那个meme 几年前我们有过那个meme股 meme股,对,所以我的波动率过滤器有帮助,我是说,那波行情刚开始的时候,我确实亏了一些
Marston Parker:我记得我运气好躲过了游戏一战,但Bobby可能还有AMC 我在其中几只上亏了不少,与此同时,我的IPO策略表现非常出色,所以算是抵消了,那些大亏损对我的冲击,没有想象中那么大,他们没有造成账户整体的回撤,但那个策略确实表现很差,而且你知道,当时大家都在关注meme股热潮,我也很清楚发生了什么,但那时候我已经在,推广我的回撤软件一段时间了,我们有一个相当活跃的论坛,所以也有很多相关的讨论,然后我们做的第一件事,就是建一个排除列表,放在文本文件里,这些代码我们就是不交易,因为这些都是那些傻瓜在买的股票,所以我就这么做了,另外一件可以做的事,我有时也会做,就是看券商的数据,比如保证金要求,或者做空借券费率 [00:35:12]
Marston Parker:然后避开那些标的,尤其是我想如果迎头证券说,要100%的保证金,我是说我见过有些股票,做空要400%的保证金 [00:36:05]
Tessa:哇那太疯狂了,对我是说这说明,他们的风控团队已经认定,这很危险,那我为什么要去做呢,所以对,你可以这么做,这是另一件可以做的事,就是让券商给你一些线索,告诉你什么标的做空风险太高,对,对,那跟我们讲讲你的IPO策略吧,它跟你的其他策略有什么不同,这个策略简单到有点蠢
Marston Parker:我是说真的想法就是,把IPO定义为交易历史只有有限天数的股票,然后当它收盘创出历史新高时买入,然后如果它出现一两天的新低,就卖出相当紧的止损,我不使用止损单,我在任何交易策略里都从没用过止损单,我用的是止损规则,但是基于收盘价来触发,基本上我就是不想被盘中噪音震出去,而且止损单的滑点比其他任何类型的订单都大,所以对我会在收盘时离场
Tessa:你是说你会卖出,那你会持有多久,当你买入的IPO创出新高时,如果它一直在涨,一天接一天的创新高,你通常会持有多久,他们通常我是说 [00:37:19]
Marston Parker:那个策略里我也有一个止盈目标,所以我会一直持有到触及目标价,然后它可能会跌一天,然后又创新高,那我可能会再买回来,这个策略表现非常好,我是2017年开始跑的 2017 18 19年都表现不错,然后在2020年年中到2021年年中,它真的表现炸裂,那时候什么都在涨,我是说那段时间几乎任何策略都能赚钱,所以其实说明不了什么,但从2021年底开始,它就一直平平的,不过这个策略的一个好处是,当市场在回调时 IPO会变少,因为公司会取消上市计划,所以它自带一个市场状态过滤器,很多人专注于交易IPO 我不太确定
Marston Parker:我是说2020和21年成功的一部分原因,是那些SPAC 现在基本已经没了,我记得前几天看到一个,三个字母的代码,以爱开头,它被取消了,在暴涨之后一天跌了大概80% 总之,对,我觉得这个策略可能还要等一阵子,才能重新有效,我是说,我还在跑它,但现在已经差不多两年没动静了,它什么都没做 [00:38:23]
Tessa:那回到你的均值回归策略,你的系统会区分财报发布后放巨量跳空下跌,和与财报无关的放量但稳步多日下跌吗
Tessa:你的均值回归策略会去交易那种受成交量影响的巨大跳空缺口吗,只有当股票已经连续下跌好几天,然后出现一个大的向下跳空缺口时,我才会在那里买入
Marston Parker:那有点像恐慌性抛售的情况,但我用的这个设置,通常不会选择那种先创新高,然后突然大幅跳空下跌的股票,那是我以前做空的设置,那些策略在2013年前后,确实表现不错,但我觉得也许现在他们也能行,我不清楚,我也不知道是不是财报导致的,我不会去拉任何新闻,基本面财报数据之类的,真的,我就只看价格历史,当价格做出我在寻找的形态时,那就是我的信号,所以对很明显,我所有的交易策略,基本上都是在寻找异常的波动,就像我说的,从一开始我们就想参与,当时正在波动的品种,所以很明显在财报季,我会比非财报季,得到更多的交易机会,但每个季度都有一定量的财报,也许大的财报季 [00:39:12]
Tessa:就是通常的三月六月这些,但四月七月也有,而且很多公司的财年错开,所以每个月都会有一批财报出来,你之前提到过,曲线拟合和优化,人们应该主要警惕,哪些危险,才能不被,这个诱人的光鲜玩意儿吸进去,第一点就是,根本别试图为单一股票构建策略,在我看来,你不可能为单一股票构建策略,而不过度拟合它,除非你说的是 [00:40:04]
Marston Parker:非常短期的日内交易,如果你有TIC数据或一分钟线,而且能回溯好几年,也许你能找到一些,持续有效的东西,但我从一开始就有那种直觉,基本上就是,我希望我的系统建模的是一个过程,我每天扫描整个市场,来找当天的交易机会,这样我每天交易的股票组合,都是不同的,如果我看一下我的系统的买入回测,任何一只股票在一年内,都不会有太多笔交易,总共会有几百只不同的股票,所以这是第一点,避免过度拟合最简单的方法,就是做组合层面的方法,而不是单一股票的方法,我看到很多人做的是,比如我想找到一个策略,能在过去三年里抓住特斯拉最多的涨幅,或者现在你看人们对比特币做同样的事,这挺蠢的,因为它不会一直重复,那只是发生过的事情,下次会是另一只股票和另一个东西
Marston Parker:所以避免那样做,除此之外,就是保持你的参数总数或自由度,量化的人会这么说,保持很小,我大部分时候不做优化,我会用优化器去遍历一个相当小的参数集,或者只是研究一个参数如何影响结果,但我不会做那种经典的事情,在所有可能的组合上跑优化,找到最好的统计结果,然后选那个来跑,所以基本上,你避免曲线拟合的方法 [00:41:26]
Tessa:就是不曲线拟合,对对对,我读到过回测的问题,回测的毛病往往是,我们回测一个系统,得到的回报,会比实盘交易高得多,回测也会小得多,这是怎么回事
Tessa:为什么会这样,是不是我们看的时间框架不够长,这是固有的问题吗,会发生这种情况,是因为回测时,你不断尝试不同的东西,丢弃表现差的,保留表现好的 [00:42:06]
Marston Parker:用不了几次迭代,你就会得到一个,比未来实际可能发生的情况,表现更好的结果,这几乎是不可避免的,多年来我学到的是,要假设未来的结果,不会和回测显示的一致,事实上我的经验法则是,回报减半,回测加倍,所以除非我能接受这个,否则我通常不会运行某个策略,这个经验法则可能也说明
Tessa:我本身也在过度拟合,但我觉得这无法避免,一旦你跑了第二次测试,你就已经开始了过度拟合的过程,对吧,对,有没有办法用更细的力度
Tessa:来衡量不同类型的牛市和熊市,这样我们能更早的检测到,可能导致策略回撤的条件,这样我们就不只是简单的说,这是牛市期间,或者这是熊市期间,而是说这是哪种牛市,哪种熊市,这次牛市和熊市,与过去的牛市和熊市,有什么不同,有没有办法获得,那个特定市场的独特力度,这样我们能更好的理解,正在发生的事情,也许有,我知道有些人在那个领域
Marston Parker:做过研究,我觉得Venture 有一套完整的方法,来给不同的市场状态分类,最简单的就是二元市场状态,就是牛市或熊市,比如看价格在200日移动平均线,上方还是下方,但你可以从那里延伸,我觉得有一种四分类,高波动牛市,低波动牛市,高波动熊市,低波动熊市,可能还有其他维度可以加进去,然后你得拿它去回测,你得选一个策略,在每个市场状态里试一下,看它表现如何,那是否预示未来会发生什么,也许吧,如果你想在这些系统里用市场状态过滤,你得从一开始就决定要这么做,先放一个市场状态过滤器,然后在上面叠加你的规则,因为如果你先优化了交易规则,再试图套一个市场状态过滤器 [00:43:25]
Tessa:它几乎总是会让结果看起来更差,因为那些因素已经被交易规则本身消化掉了,你是在2023年接受未知的市场奇才采访的,那到目前为止的2024年你做的怎么样,基本上我上一次静止高点是在2021年年中 2021年底我经历了一些回撤,然后2022年是平淡的一年 [00:44:15]
Marston Parker:2023年初又有一轮回撤,然后又是平淡,从那以后,今年我小幅上涨,所以基本上,过去几年,我不再取得市场奇才级别的成绩了,但话说回来,在梳理记录的那段时期里,也有几年我的成绩不怎么样,他看的是长期的整体统计,所以换个角度看,我在2020年年中到2021年年中,经历了一个极端的异常时期,那是我有史以来最好的12个月成绩
Marston Parker:那是我有史以来最好的12个月成绩,然后从那以后,我的净值均值回归,回到了它通常的趋势,大概平均20%左右,那你觉得,为什么更多交易者 [00:45:04]
Tessa:不转向系统化交易,是入门门槛,或学习曲线太高吗,还是对肾上腺素上瘾的人来说,不够刺激,所有这些原因都有,对,就是那句老话,找到一种适合你性格的交易方法
Marston Parker:更可能转向系统化的人,是那些不太在乎,下单时的赌博感,也不在乎,想要证明自己对的人,不像那种典型的全球宏观交易者,喜欢对世界上正在发生的事,做各种分析,然后对股票债券和黄金的走势,做出正确判断,并从中获得快感,这大概归结于什么让你快乐,什么让你的多巴胺释放,对我来说,实际的下单交易过程,我甚至不在乎我的每一笔具体交易,我知道我现在有一些持仓,但我没法告诉你代码是什么,我记不住,我甚至没看,我真的完全不在乎某一笔交易,我在乎的是统计数据,所以让我快乐的是找到一个,我觉得稳健,过去统计表现良好的策略,然后把它上线,让它随着时间持续运作,但更重要的是,开发回测软件,改进软件本身,给我的快乐
Marston Parker:比任何与交易相关的事情都多,所以我有点,我成绩平淡的部分原因,是我最近真的忽略了,自己的交易系统研究,把全部精力都放在开发软件上,因为我现在有超过700个用户喜欢用它,我真的很喜欢支持他们,这有点像我又回到了软件行业,但我还在交易,因为我有钱要投资,而且我不知道还有什么别的方式,所以我就这么做 [00:46:24]
Tessa:那你的交易软件是做什么的,帮用户做回测吗,它是一个回测工具,对回测工具,然后我还有一个自动化工具,它和盈透证券集成,把软件为以建模的,策略生成的订单下出去,对,它让构建一个组合,多个策略的系统,变得相当容易,可以看到过去会是什么结果,然后向前交易,对,所以那算是你目前的热情所在
Tessa:就是开发调整你的软件,和你的会员们,交流他们的策略之类的,是的,当然,对太好了,谢谢你,马尔斯顿来上chat with traders 我的荣幸,谢谢你邀请我,对 [00:47:15]
Marston Parker:我们的听众怎么联系你,我的网站是mhptrading.com 在那里你可以了解我的软件,实际上那里有我上过的,所有其他播客的链接,这期节目很快也会放上去
Tessa:太好了,我在Twitter也就是X上,用户名是Mars10P 就是Mars10P 这些是找到我的最好方式,好的太棒了,谢谢 Marston 谢谢
Matt Turck 与 Mitch Choyanovsky 讨论了如何让 AI Agent(智能体)在数小时、数天甚至更长时间内,像可靠的知识工作者一样自主完成复杂任务。核心结论是:长时程智能体的难点不只是模型够不够聪明,而是能否维持连贯上下文、遵循正确过程、获得密集反馈,并把组织经验转化为运行时训练数据。结果正确只是最低要求;可部署的系统还必须可靠、可解释、可复核、可扩展。
节目从 Basis 办公室里员工对着麦克风轻声说话开始。Matt 解释,口述比整理成文字快,AI 也能承受未经整理的完整上下文。Basis 将这种方式扩展到所有部门,因为推进一件事、描述目标和补充背景,都需要把尽可能多的信息交给 Agent。
Basis 用 Agent 端到端完成复杂会计工作,例如纳税申报。会计不是简单的“输入文本、输出文本”:Agent 要读取大量文件、调用工具、理解非结构化信息、连续决策,并在很长时间内保持一致。Matt 将会计称为一种“经济智能”,因为会计把庞大的现实经济活动压缩为可理解、可决策的结构化信息。
两位嘉宾回顾了 ReAct、BabyAGI 和推理模型。早期系统受上下文窗口、注意力和复合错误限制:只要一步走偏,错误就可能在数百步操作中累积。推理模型能针对不同难度投入不同计算量,并在发现问题时停下来重新思考、修复路径。但推理能力不能自动解决长时程任务,Agent 仍需通过笔记、压缩、子 Agent、工具和 Harness(运行框架)维护工作状态。
编程率先成为成功场景,一部分原因是代码结果容易验证。现实工作则可能包含数百甚至上千份文档,步骤巨大,很多判断没有简单对错标签,反馈回路长达数小时、数天或数周。因此不能只看最终结果:即使一百次评估全部通过,也不能证明能泛化到生产环境。Agent 还必须遵循经过验证的过程,展示关键决策、假设和待复核点。
Basis 提出的 Behavior Specs(行为规范)可以从一个 Markdown 文件开始,记录期望的工作过程,例如如何收集信息、核实主要来源、留下说明并交给人类复核。它既是 Agent 的规格说明,也是评判器的评分标准,还是人类团队与系统对齐的共同语言。
这种方法存在权衡:严格遵循人类积累的过程,可能错过更快、更好的“第 37 手”路径。但现实客户购买的不是“史上最好的纳税申报”,而是稳定、可靠、能放心检查和复用的结果。
Agent 的上下文就是运行时训练数据。代码库结构、技能文件、权威文档、历史记录和自我笔记都会影响表现。企业需要明确权威信息,并像维护代码库一样维护内部文档和本体。本体可以是有结构的文件系统、概念关系和渐进式披露机制;长时间运行的 Agent 必须能够从压缩记忆恢复正确的心智状态。
这也催生语言架构师、Agent 管理者和部署智能团队等岗位。部署团队要帮助客户改变流程、招聘、业务范围和组织形态,使 Agent 真正进入生产体系。
Basis 正研究如何把“Agent 犯错”到“系统改进”的闭环合起来。行为规范能产生比最终结果更密集的信号,可用于更新上下文、工具和框架,也可能用于强化学习。当前重点是定义和解释可信信号,而不是直接更新模型权重,因为 Agent 自我编排能力的提升目前可能更有效。
Matt 预计,随着模型变强,许多上下文工程工作最终会被模型能力吞掉,但可能需要数年。长期护城河不是秘密技术,而是市场份额、客户嵌入、工作流和专业能力。对 AI 开发者,他建议把 AI 看作一次底层范式转变,进行第一性原理推演,再据此做连贯的技术和商业决策。
嘉宾特别强调,行为规范并不意味着把每一步都锁死。标准可以很宽泛,也可以很具体,关键是它要自包含到足以让评判器判断某种行为是否出现。评判器本身也需要被正确训练和指示:在多层子 Agent 的系统里,必须先知道自己正在评判哪个节点、哪段轨迹以及哪个行为条件。否则,系统可能只是在形式上通过评估,却没有真正完成应该完成的工作。
从工程实践看,最重要的工作不只是写提示词,而是设计整个运行环境。好的上下文包括权威来源、清晰的对象定义、可追溯的历史和适合当前任务的技能。一个 Agent 可以在某个代码库表现良好,在另一个代码库表现糟糕,差异可能不在模型,而在两个代码库提供的运行时训练数据是否清楚、无矛盾、易于恢复。非编程领域拥有更多组织自有信息,因此对上下文、本体和专业过程的要求会更高。
自我改进也不等同于简单地让模型持续训练。系统需要先获得足够多、足够可靠的反馈,再判断应该更新上下文、工具、框架还是模型权重。对于不能完美验证的工作,奖励函数本身就是研究对象。Matt 的判断是,短期内应用层的编排和信号设计会继续领先于直接修改模型参数;但从长期看,模型能力确实可能吸收今天大量的上下文工程工作。企业因此应趁技术窗口扩大市场、嵌入工作流并积累专业能力。
- Basis办公室里的轻声细语与长时程智能体 [00:00:00 - 00:10:00]
- 推理模型与自主智能体的演进 [00:10:00 - 00:20:00]
- 可验证奖励与现实工作的反馈回路 [00:20:00 - 00:30:00]
- 行为规范 让智能体遵循正确过程 [00:30:00 - 00:40:00]
- 评判器、上下文工程与开源实践 [00:40:00 - 00:50:00]
- 本体、团队角色与自我改进 [00:50:00 - 01:00:00]
- 从苦涩的教训到AI开发者建议 [01:00:00 - 01:08:33]
一凯:欢迎收听跨国串门计划。这是一档专注于让中文听众无障碍欣赏全球优质外语播客的节目。通过先进的AI声纹克隆技术,我们不仅将内容翻译成中文,还完美保留了原主持人和嘉宾的独特声音,为您呈现全球顶尖的AI财经、健康与科技领域精品内容。我是主播一凯,一位热衷于AI领域的产品经理,很荣幸能为您搭建这座跨越语言障碍的桥梁,接下来让我为您简单介绍本期我们克隆的这档节目,本期我们克隆的是知名播客 The Mad Podcast with Matt Turck的一期深度对谈,主持人Matt Turck是FirstMark的合伙人,长期关注AI与前沿科技投资,嘉宾Mitch Choyanovsky 是AI独角兽公司Basis的联合创始人,这家公司专注于让智能体,自主完成复杂的会计工作,比如端到端准备纳税申报表,这期节目围绕如何构建,长时程自主智能体展开 Mitch分享了他从编程Agent 到现实世界应用中的,大量实战经验与思考,那我们就一起来听听 [00:00:52]
Matt Turck:这一期完整的对话,人类早就习惯,跟非确定性系统打交道了,只不过这些系统,通常是他们的同事,而不是他们的电脑,而且在很多方面,公司也好流程也好,核心问题都是,你怎么设计一个系统,让非确定性的实体,协同起来解决一个问题,一旦你意识到这一点,那这就有点像智能体设计了,假设你有一百个评估,全过了,看起来不错,但你有信心说,这就能泛化到现实世界,泛化到生产环境吗,我们的答案是,不能,就算一百次里一百次都做对了,如果一个人只是靠查维基百科才做对的,那公司根本不会雇他,所以他们也不该雇我们,你会看到有人对一段抽象的不够好的代码文件惊慌失措,可他们的上下文简直是一团糟,英文更金贵,因为英文影响性能,代码不影响性能,大家好 [00:01:16]
Mitch Choyanovsky:我是FirstMark 的 Matt Turck 欢迎收听The Mad Podcast 每个人都在构建AI Agent 但除了编程之外,大多数agent还无法可靠的完成真正的工作,我今天的嘉宾是一位站在破解这个问题最前沿的AI 构建者 Mitch Choyanovsky是Basis的联合创始人,这是一家AI独角兽公司,他们的agent能自主运行数小时,有时甚至数天已经能够端到端地完成非常复杂的任务,比如准备整套纳税申报表,这是一期真正具有参考价值的节目,讲的是如何构建长时程自主智能体 Mitch分享了他在这个过程中学到的很多经验,请欣赏我与极具洞察力的Mitch Choyanovsky的对话,我想从一个场景开始,我在准备这期节目的时候看到了我们的朋友 The Information的Stephanie Balazolo拍的一段视频 她描述了走进Basis办公室,看到一群人对着麦克风非常轻声细语的说话的场景,所以也许对顶尖的AI 构建者,或者天天泡在X上的人来说,这已经是人人都懂的事了,但我相信对绝大多数人来说,还是想请你描述一下,你们对着那些麦克风轻声细语,到底是在做什么,对 [00:03:00]
Matt Turck:我觉得最好的建议之一,不是针对构建Agent 而是针对一般性的使用AI 就是你得给它尽可能多的上下文,因为它本质上总是会缺少某些上下文,说话比写下来快太多了,事实上,当你试图写下来的时候,你其实是在试图总结脑子里那些乱七八糟的想法,所以那才特别花时间,而且这对你或我来说是有用的,因为如果谁把一堆胡言乱语直接当成slack私信发给你,那很不礼貌,但对agent来说他们不在乎,实际上他们反而更喜欢这样,所以能把自己的想法轻声说出来,效率会高得多,因为你不想大喊大叫,而且现在有这些麦克风,让你可以非常非常轻的说话,还能完整清晰的捕捉到,所以这就是我们这么做的原因,有时候刚加入公司的人看到,会觉得有点奇怪 但过了一两个月,他们就回不去了,那你是轻声说给什么听,说给Cursor还是别的,对,说给每个人自己用的工具,我们这边不同的人,用不同的东西,但没错 Codex Claude、Cursor 或者大家各自用的什么,而且不只是工程岗,对吧,所有部门都是这样,如果你想推进某件事,想描述你想要什么,都用这个,好的,太好了,那么我今天想做的是 [00:04:26]
Mitch Choyanovsky:围绕构建长时程智能体,这个主题,做一期有参考价值的对话,这部分是基于你在 X上发的一条很棒的帖子,更重要的是基于你刚和 Brain Trust合作发布的一个新开源项目,这些我们都会聊到,但为了让大家有个背景了解,用两三句话介绍一下 Basis你会怎么描述它,好Basis构建Agent
Matt Turck:来端到端地完成会计工作,会计很难,它不是那种纯粹的文本,进文本出,它要求AI有能力,在很长一段时间内执行大量操作 并且在那段时间里保持连贯,才能得到好的结果,这就是为什么我们一直非常专注于,怎么真正构建出,能规模化做这种工作的Agent 你选会计,是因为从构建agent的角度看 它特别有意思,还是反过来,好问题,可能恰恰相反,不过我也确实觉得,从智能体的角度来看,这其实很有意思,会计有意思的原因很多,它是这个国家最大的知识工作职业之一,如果不是最大的话,全国加起来有超过300万名会计师,而我觉得会计最酷的地方在于,大多数人其实并不真正思考会计,他们不会想,哦对,这玩意为什么存在,可能大多数听众从来没想过,会计为什么会存在,我知道我们接下来要聊智能体,也许我们花30秒,就为了让各位觉得会计有多酷,你想想现实世界发生了多少事情,各种经济活动,对吧,比如我刚才喝了瓶水,那个装瓶商,得决定从那个工厂,还是那个供应商进货,或者决定开一家新店,雇一个销售,而这些都是经济决策,源于对现实世界的理解,现实世界里有什么,钱在流动 有人签合同,有人交付库存,就是所有这些事件在发生,而现代资本主义的很大一部分,依赖于所有这些参与者,能基于这些事件做决策,对吧,比如那家公司的CEO 还有IRS 显然要决定挣多少税,银行要决定放多少信贷投资者,对吧,所有这些人都关心现实世界,但他们没法理解它,因为它太庞大了,而且它涉及所有这些,非结构化的难以解析的信息,而会计实际上就是,把这一切压缩成结构化形式的艺术,让人们可以查看,理解并做决策,所以关于会计,你可以从原层面说 它有点像一种经济智能,因为它真的是,对所有存在信息的压缩活动,所以我觉得这是一个非常酷的问题,还是同一个话题,关于背景了解,我们要聊长时程智能体,我想问现在长时程到底算什么,这个范畴一直在变,什么算长时程,对也许我可以先给出我对智能体的快速定义,我知道现在可能大家都知道了,但我觉得这是我在面试里,喜欢问的常见问题 我倾向于把智能体理解为一种AI 或者说某种推理过程,它拥有自主决策去做不同事情的能动性,所以按定义它是一个连续谱,因为你可以有不同程度的自主性,对吧,你受限于你所处的环境,而我认为长时程同样是一个连续谱,你赋予智能体做决策的自主性,让它能在更长时间内保持连贯,对吧,比如说你让一个智能体去帮你查天气,它可能在某种意义上算智能体,因为它有自主性去决定调用哪个工具,或者输入什么谷歌搜索词,但它不需要做太多工作,就能在时间上保持连贯,因为你就是查个天气,但如果你让一个智能体,去比如说完成一个完整的功能,比如在你的代码仓库里实现某个功能,或者让它去做一个大的Excel工作簿,那现在它可能就得运行超过一分钟了,我们说的是十分钟,二十分钟,三十分钟,甚至可能更长 而一旦你开始进入这种规模,你就会碰到LM工作方式的根本限制,我总喜欢说LM有非常大的工作记忆,但默认情况下没有短期或长期记忆,所以你必须利用LM的这些强项,去弥补他们没有好的,或者说实际上没有任何,真正的短期或长期记忆,这个事实我们可以再细聊,就是通过使用Harness 和所有这些进步,让他们能在时间上保持连贯,所以我觉得一旦你开始进入那种,为了让他保持连贯而费心思的阶段,因为你已经超出了,他拥有的工作记忆容量,我大概会说,那就是我开始称之为,长时程的起点,太好了,还是接着这个话题 [00:08:20]
Mitch Choyanovsky:我们这里聊的是自主智能体,我很好奇,也许举个例子,自主在Basis语境下意味着什么,我听说你们现在可以让智能体端到端处理纳税申报,那也许请你在高层次上带我们看看
Matt Turck:从步骤上,时间上,那是什么样的,智能体在概念上做什么,当你真正做到自主,或者说做一件时程特别长的事,比如端到端地,完成一份纳税申报 那就意味着你手头有大量完成这项工作所需的信息,同时你也有工具去获取更多信息,比如说想象你再做一份,复杂的1065表,你手上有各种W-2 1099之类的文件,还有从公司那边拿到的,其他材料,然后呢根据你具体在做什么,你可能已经有试算平衡表了,那通常就是启动一份,纳税申报所需要的材料,或者你面对的是连账都还没做完的账簿,而这个agent就得自己去琢磨,基于这一堆乱七八糟的东西,他要怎么下手,他能做到什么程度,这时候就开始涉及一些关于行为规范的问题了 [00:09:25]
Matt Turck:这时候就开始涉及一些关于行为规范的问题了,这个我们后面可以聊,比如说要得到一套扎实的试算平衡表,好的做法是什么样的,要正确提取出K1和K3 好让你对结果有信心,好的标准又是什么,而所谓自主意味着他不会跑回来问用户,这样对吗,我需要这个我需要那个,而是从开工一路做到,我完成了而且我完成了,不是说点个按钮就完事没人检查那种,恰恰相反,他更接近你能想象的一个税务申报员的做法,或者说像初级工程师,交第一版成果那样,我完成了,这是我做的几个重大决策,这是我的假设,这些是你需要去核对的点,咱们一起过一遍,对吧,你想想工程领域,一个工程师给你递一个PR 没人喜欢收到一个一千行的PR 然后对方说,做完了,我保证,那种你根本不想审,但如果对方递给你的,是一个拆得很漂亮的分层提交 你能很轻松的看懂,那这个改动具体是什么,这个diff是什么,我在这里做了一个大的架构假设,我这么改是因为什么,那你可以优化的,就不只是把活干完,还包括让你的reviewer 轻松理解你做的这些决策,这在软件工程里,显然非常成立,而且我觉得在大多数职业里都成立,尤其是会计,这个我们后面可以细聊,所以对我来说 [00:10:51]
Mitch Choyanovsky:这就是自主的含义,我觉得对听众来说,花几分钟聊聊agent的历史,会很有意思,也很有帮助,过去两三年,我们听了太多不同的东西,不同的术语,有些项目成了,有些项目没成,所以我觉得往回到一点,会很有帮助,在AI领域可能感觉像是史前时代,但实际上也就是三年前,四年前的事,也许从2022年的React框架说起,不是软件工程那个,而是推理与行动,我记得那是2022年的一篇论文,核心观点是 Agent是推理和行动的结合,你刚才也提到了,根本问题是,现在本质上还是这样吗 [00:11:12]
Matt Turck:当然上面叠加了极高的复杂度,但agent的基本理论还是那个吗,我觉得在现代LM的范式下,是的,大体上差不多,要我说,其实本质是一样的,但它往外延伸了 我记不太清,当时那篇论文里,有没有提到这一点,就是需要用推理,来调节自己的状态,我老爱给公司里的人打一个比方,不管是不是技术背景的人,只要是刚接触Agent 我都会用电影记忆碎片来类比,没看过的话,记忆碎片,讲的是一个人,有短期记忆丧失,他每天早上醒来,知道自己是谁,知道自己是个人,知道一些基本的东西,但过去几年发生了什么,他完全不知道,为了朝着某个目标推进 可能是买点日用品,也可能是复仇什么的,他必须给自己写下来,然后第二天醒来,他读自己的笔记,把信息一点点攒起来,他就是这么积累知识的,顺便说一句,这是克里斯托夫诺兰早期的电影,现在大家都痴迷奥德赛,这算是他早期的作品之一,对,我还是觉得致命魔术,是诺兰最好的电影,不过,不过对,但总之,我觉得这就是你的观点,它确实关乎推理 但我觉得,而且我不觉得论文里提到了这一点,就是推理一方面是,关于走哪条路才对,不管任务是什么,比如我做税务是这么做还是那么做,那当然,但另一方面还有推理是,我怎么确保我的下一步推理,有它需要的东西,能好好跟世界交互,这在短时程里很容易,因为你还在context window之内,但一旦你开始进入更长的时程,超出了context window 或者开始出现上下文腐烂,你就需要用推理,甚至有点强行的靠推理,去搭建你的环境,不管是靠suburgence 还是compaction 我们后面会细聊,但我觉得,那才是推理,变得极其重要的地方,好太好了 [00:12:58]
Mitch Choyanovsky:那2022年之后的下一步,大概就是2023年的baby 通用人工智能了,当时所有人都觉得,那是巨大的进步,但那个项目算是失败了,我的意思是,那是个很漂亮的实验,但在实践里没怎么跑通,那为什么呢,我猜当时大家聊的,很多的是复合错误,就是如果你有很多很多步,而agent开始走偏,那错误就会不断累积,从你的角度看是这样吗,对我觉得那时候我记得没错的话 [00:13:36]
Matt Turck:应该是gpt4可能当时是4 turbo当时的模型,首先如果是turbo之前的版本 context window非常小,所以你要想保持连贯,你至少得在上下文里有足够多的东西,能让你组织起自己的环境,所以他们没有那个条件,而且就算context window变大了,我觉得到babyagi出来的时候,模型也还没法在超过大概两万个token之后,保持注意力,他们就是不够聪明,甚至一直到OP3模型才开始在十万个token左右变聪明,所以babyagi没有那个条件,然后还有显然我后面会细讲,他们就是不太会推理,如果你不擅长推理,那你就会有大量的复合错误,因为你会犯一个错,就在你逐token生成的过程中,然后突然就开始不断累积,而你又没有自我意识,没法以任何有意义的方式,真正自愈 所以那之后的大突破,就是推理模型,对,我会说当我想,那些真正让我们觉得,卧槽的时刻是什么,我不知道能不能说脏话,但对,那些真正让我们觉得,卧槽的时刻 至少对我个人来说,大概是,或者说至少那些,真正发生范式转变的时刻,这样的时刻其实不多,我会说是Claude Opus 3 我觉得它被低估了,但我觉得它是第一个,真正能在涨上下文里,真正理解的模型,以前你要是往GPT4 Turbo里塞8万个token 他根本理解不了 OPUS 3是真的理解了,这很了不起,我觉得是那个,我觉得是O1 显然大家都在聊那个,然后O1之后,我觉得是O3 因为我觉得O3证明了,你不仅能扩展推理时的推理量,而且通过更好的训练,更多的算力,更好的数据等等,在后训练阶段,你还能让推理质量更高,更高效,更好,所以它在推理时用的每一个增量token 质量都更高,这在OE出来的时候并不是显而易见的,所以我觉得那些对我来说就是大突破,有没有一种可能 [00:15:08]
Mitch Choyanovsky:这些模型实际上是被训练成,在循环里运行的Agent 有一条推理链,他们试一个东西回溯再试另一个
Matt Turck:这是不是他们对agent来说效果更好的根本原因,我觉得有好几方面,我觉得一方面是因为模型能够,它有点像在调节,它投入到过程中每一步的计算量,在任何一条trajectory里 都有很多决策特别难,也有一些特别容易,你不可能用一个巨大的参数模型,服务成本超级高,然后在每一步推理时,都把那么多算力全用上,所以推理的能力,让你能去调节这个量,而且我觉得就像你指出的,做一种可能涌现出来的行为,如果你真的是个很好的推理者,而且你能把推理量调得很大,比如你去看现代推理模型,在简单步骤和困难步骤上,用的算力差别是很大的,你会变得更擅长自愈,因为你会停下来,把所有事情想一遍,更多的用那种思考,而不是全靠本能形式,而本能形式,正是你只做主token生成时发生的事,在你的X帖子里 [00:16:21]
Mitch Choyanovsky:你提到OpenAI在2023年做了一件事,他们发表了一篇叫 Let's verify step by step的论文,人类标注了大约80万个推理步骤,那当时是怎么回事,目标是什么 [00:17:00]
Matt Turck:对那篇论文是那时候出来的,我记不太清确切的时间线了, 但基本上当时有很多传言, 大家可能还记得的information那篇文章, 说什么strawberry解决了数学题之类的, 我觉得甚至在那些传言出来之前, 文献里就已经有一些苗头了, 比如这篇, 也可能是在传言之后, 我其实记不清了, 就是说数学这类问题, 或者说这些你能验证的问题, 可能是训练模型去做好不同任务的好方法, 我纯粹是猜测, 因为我不在实验室里, 但当时有个问题, 贯穿了MML的很多历史, 你是只根据他答没答对来给奖励,还是看他是不是像个好数学家那样去解题,有意思的是,那篇论文里他们证明了,如果你基于过程,而不是只看结果来给奖励,在那个样本里效果确实更好,但那显然很贵,因为需要数学家去给他们的解题思路打分,对吧,而如果你往后快进一点,看DeepSeek RE那篇论文,他们实际上讲清楚了 我觉得当时所有实验室都在做的事,至少OpenAI在做的事,就是RLVR 从可验证奖励中强化学习,那基本没什么过程监督,本质上就是说,嘿你结果对了吗,对了好 [00:18:07]
Mitch Choyanovsky:我给你奖励中,然后把它规模化,结果显然效果很好,还是在智能体最近的演进里,或者就是去年吧,有个现在很出名的指标图表 显示长时程智能体的能力,大概每七个月翻一倍
Matt Turck:你在2026年还在观察到这个趋势吗,对绝对的,我觉得那个指标图表 现在有点不太准了,因为太难衡量了,而且那个基线本来就很低,对吧,基线确实很低,基线确实很低,而且我对他们的数据集不太熟 但我的理解是,样本量有点小,所以那个指标的具体情况,我不太清楚,但我觉得从感觉上来说,绝对是这样,模型因为变得更聪明,能保持连贯的时间更长了,但现在他们也被专门训练,去做这件事,对吧,也就是说他们被训练的是,怎么对自己有好的心智理论,因为如果你要外包给子智能体,对吧,或者你要给自己写笔记,回到记忆碎片的类比,对吧,你得想,我明天醒来会读这些笔记,我该怎么写,才能让信息密度最高,让未来的我能看懂,这需要一种心智理论,所以随着这些模型,越来越多的被训练,去做这类工作,这非常非常不像人类,因为人类其实很擅长这个,我们不需要为自己写东西,我们的大脑替我们做了,你会看到它走得更远,我觉得我们其实还早得很,你看看那些进展,比如Fable 5 5.6Sol那些,好想再深入聊聊你刚才提到的
Mitch Choyanovsky:我觉得2026年智能体的一个大背景是,要讲自主智能体的演进,就不能不提可验证奖励,那跟我们说说它是什么,在整个途径里处在什么位置,然后也许再说说 [00:19:41]
Matt Turck:为什么编程成了第一个成功的自主智能体用力,以及它跟可验证奖励有什么关系
Matt Turck:以及它跟可验证奖励有什么关系,这事挺有意思的,我觉得大家有点理解偏了,我这么说带点猜测的成分,因为我也不完全清楚 但编程确实在某种意义上,是可验证的,我能知道代码跑没跑通,所以我可以用这个来训练,比如你这个问题,做对没有,做错没有,诸如此类,这很有用,但模型编程能力强,一部分是这个原因,另一部分我觉得是,编程本身的几个特点,第一,编程在运行时是可验证的,我觉得这点非常重要,因为说到底 Agent需要拿到信号,知道自己干的怎么样,你想,如果你是个工程师,写完代码却永远跑不了,那就算你是全世界最牛的工程师,也总会在某个地方出个语法错误,所以我觉得编程在运行时,这么容易验证,至少有一部分是能在运行时验证的,这对它成为首选场景显然非常有价值,而且成本低,对吧,在环境里很容易做,而且完全是文本形式的,所以哪都能用,你就在自己电脑上直接跑一下就行,所以我觉得编程的这些特点,才是agent能做的这么好的大量原因,我觉得还有一点 这个我们可能都见过,你想想大概一年前,一年半前 Agent编程有多强,他们能去实现你交代的东西,但他们没有那种品位,没有那种什么才是好软件的判断力,因为就算你用可验证奖励去训练他们,比如这个单元测试过了没有,你能通过世界上所有的测试,也不代表你把应用搭对了,不代表你的数据库建的好,不代表你把文件拆分的合理,对吧,说到底编程是主观的,它是一门艺术,你没法用可验证奖励去解决一门艺术,所以我其实觉得这里面有很大一部分,是训练数据的量和质,各家实验室在编程这块的训练数据,显然已经做得相当好了,他们花了很多精力确保数据质量很高,保证模型是在高质量代码上训练的,所以我觉得这是另一部分原因,也许是因为实验室里显然全是工程师,这事更容易被放在心上,而且显然也是他们战略的一部分,所以他们更上心 确保预训练和后训练的数据集里,都有大量高质量代码,这才让agent不只是会写代码,而是开始真正擅长做工程,所以我觉得是所有这些因素加在一起 可验证奖励可能只是起点,让后面那些事能发生,但其他那些因素,分量一样重,甚至更重,好这就引出了你论点的核心,你做的是一个编程之外的领域 [00:22:06]
Mitch Choyanovsky:也就是为现实世界构建,长时程自主智能体,姑且这么说吧,编程之外的领域,好那为什么Agent会挣扎,你提到了三个原因,也许你可以说说这三个原因是什么,然后我们一个一个展开
Matt Turck:对我觉得agent挣扎的原因有很多,第一他们不一定知道好长什么样,第二他们可能不容易在运行时自我验证,就像我们刚才聊编程师说的那样,我觉得还有一点,这个可能不算agent本身的挣扎,更像是用户体验层面的问题,就是编程这件事,工程师本身就扎在细节里,所以有个差别,如果你在跑一个长时程编程Agent 而工程师没有亲自在代码里,没有扎进细节里,反而被抽象出去了,那你对质量的要求,你做决策的方式,可能就需要一个,比编程更高的标准,程序员能接受比较低的标准,这一点从来都是这样,所以我觉得,所有这些因素叠加在一起,才造成了这个局面,而且就算是编程 Agent也还没到,能在长时间内,保持连贯的人类水平,这很明显,因为他们没法像,一个初级工程师那样 在一个项目上连续干两周,所以他们做不到,这比人类还差,哪怕只是起步阶段,而且写这些系统的人,也不一定对,长什么样有直觉,那你们是怎么解决这个问题的,比如对一份纳税申报来说,通过测试意味着什么,它不像代码,不需要编译,好消息是,有些东西是可以编译的,不是全部,但显然有些是可以测试的,要么被告 要么不被告,对,我觉得这个问题的答案就是,你得看人类是怎么做的,会计这个行业有个好处,其他一些职业也有这个特点,但会计是那种,你真的必须力求正确的职业,正因如此,它里面有大量的判断和流程,我们有一句话,我在设计那边也常讲,就是人类其实早就习惯,跟非确定性系统打交道了,只不过那些系统,通常是他们的同事,而不是他们的电脑,而且在很多方面,公司也好流程也好,核心问题就是,你怎么为一个由非确定性实体,也就是人组成的系统做设计,让他们协作去解决一个问题,一旦你意识到这一点,你就会发现,这其实就有点像智能体设计了,所以我觉得,如果你要思考,什么是好的智能体设计,什么可以被验证,你就该看看人类是怎么组织的,你看人类怎么做纳税申报,他们有验证步骤,有独立复合 有可以确定性验证的东西,比如你可以说,试算平衡表加起来要等于0 对吧,这是很明显的检查,你还可以检查 Excel里有没有报错,这也是很明显的,所以有很多类似的事情,对人类来说是显而易见的,但你需要确保它们被正确的编码,还有一些东西可能不那么能确定性验证,但会计师一看就会觉得,哦这不对,比如你删掉了这个Excel里的某个标签页,或者你没有引用某个东西,诸如此类,所以你可以开始从这些不能确定性验证,但会计师一眼就能看出问题的事情上,构建出有效的验证器,然后你就可以开始考虑用评判模型 或者其他形式的验证来获取那个信号,既用在你的评估里,也用在运行时,这是其中一点,我记得你在X的帖子里提到,数据稀缺是个问题,你能展开讲讲吗 比如说我们姑且假设,你不仅有合成数据,还有全国每一份真实的纳税申报表,实际上出于隐私原因你做不到,就算你真的有了,然后你说,好我用这个来获取数据,不是用来训练,而是用来验证智能体做的怎么样,这个数据量跟合成地生成数学题相比,简直微不足道,后者你可以生成几十万几百万道,所以就算你拥有了全世界所有的数据,你也无法规模化,所以你想怎么合成生成这些数据,而合成生成这件事真的很难,因为你合成的不是文本而是工件,这些工件必须真实且多样,于是你又遇到了所有关于数据的问题,数据多样性,各种你需要的东西,我毫不怀疑这个问题会随着时间被解决,但今天还没解决,所以在数据生成的可能性,实际能做到什么,以及模型具备的潜在能力之间,存在一个差距,这可能就回到了 我们在帖子里聊的那些东西,那你怎么看待反馈回路的长度,对这是另一件事,长度可能非常长,取决于你在做什么,做一份1065表格,一个人可能要花 20多个小时的实际工作时间,我不是说花了一天,我是说实打实坐下来干活的时间,而且对于非常复杂的申报,时间可能还要涨得多,所以就算你拥有,全世界所有的数据,你也不可能拥有 你也没法拥有所需的反馈回路,去跑你想跑的那种改进循环,把智能体训练到真正优秀,再把它说的具体一点,比如编制一份纳税申报表,大概会涉及多少步骤,天哪,步骤太多了,在编制一份纳税申报表的过程中,对给你个概念,比如你很容易就有500份 1000份文档,你得想清楚,怎么把这些文档互相映射,搞清楚什么重要,每份文档 可能都得做大量不同的研究,你还得想他们整体是什么意思,你把他们都编进某些工作部里,至少现在是,就是那种大型Excel 要做的事非常多,所以你说步骤推理步骤的话,轻松就是几千步,而且取决于你怎么搭系统,如果你开始为不同的事派生子Agent 这你基本必须做,那步骤数还会涨,这还没算其他测试时计算的方法,比如你可以这么做,假设有个税务问题要解决,难道离谱,只有专家才解得出来,那也许与其让Agent 自己派一个子Agent 你派五个让他们投票,所以就是有很多别的办法,往问题上砸更多算力,所以看你做什么 [00:27:21]
Mitch Choyanovsky:步骤数最后会相当大,好很好,那我复述一下,你面对的是非常复杂的流程,步骤几多几多,你没有多少数据来判断,哪里对哪里错,甚至什么是对,什么是错都不总是清楚,虽然至少对问题的某些部分,你能明确说这对不对,但不是总能,所以这是非常复杂的问题,这就引出了你们处理它的方式,特别是有个概念是,你不能只依赖结果 [00:28:00]
Matt Turck:你得依赖过程,那依赖结果到底有什么问题,对,依赖结果的问题在于,如果你有一个几千步的轨迹,哪怕就一个小时的,你会有评估集,告诉你好的表现长什么样,它可以完全可验证,比如数字对不对得上,也可以有部分是用LM当裁判,比如有某种评分准则之类的,假设你有一百个评估都过了,看起来很好,那你有信心,它现在能泛化到现实世界,到生产环境吗,我们的答案是不能,你确实没法有那个信心,所以你不该只依赖那个,就像如果一个工程师,跑来跟你说,嘿我所有测试都过了,端到单元测试什么的,那意味着,他们把数据库架构对了吗,不一定,那并不能告诉你,这个有很多办法,能通过所谓的结果,但过程其实没做对,所以我们发现的是,尤其回到我前面说的,把人组织做类比,从人类怎么做工作里,有大量可学的 所以我觉得,把这些经验扔掉,说苦涩的教训,扔掉这些经验,我们就让Agent 在运行时发展出一套,全新的做纳税申报的方法,这是个错误,因为苦涩的教训什么的,会比人类几百年积累的,关于正确过程的经验更好,也许有一天会是这样,我不是说永远不会,而且我确实觉得有可能,回到我们之前聊的,数据植物学那套,我觉得如果你往一个,基于结果的流程里,砸足够多的数据和算力,你最终能到那,但不是近期,所以如果你近期到不了,而模型里又有那些潜在能力,你真正要做的是想,把人类做事好的过程 [00:29:21]
Matt Turck:把人类做事好的过程,长什么样的经验拿过来,你不能照搬,因为关于好的智能体设计,你得想很多,现在的模型开箱,即用并不是特别擅长,长时程连贯,那方面关于行为规范,其实有大量工作要做,你可以转而设置某些评估,或者未来可能的奖励函数,来看他有没有正确遵循过程,也许我在帖子里提过的例子,我直接跟听众说,假设你在做最基础的税务研究,你问他一个税务问题 Agent肯定能答对,他可能从预训练知识里就知道,也可能读个博客就答对了,但真正的会计师,不会信这个,他们会要求你引用主要来源,所以哪怕你一百次里一百次都对,如果一个人只是靠上维几百颗答对的,会计师不会雇他,所以他们也不该雇我们,所以我们觉得特别重要的是,不,我们的Agent 不是靠预训练知识,或读博客学的,他们会去查真正的法规原文 用主要来源核实信息,这也是你理想中,希望真正的税务会计师,做的事,所以你们创造了,行为规范这个概念,那给我们讲讲,那是什么非常实际的讲,是个markdown文件吗,长什么样,对 最初的想法,其实是我联合创始人 Matt提出来的,差不多两年前,我们当时在聊auto GPT 那时候甚至在我们,还没有今天这种意义上的完整Agent 选择还很受限的时候,你就已经得想,好在这个岔路口,你想让他做什么样的选择,所以MAT 我们内部其实一开始叫它原行为,因为想法是,你在定义一个行为,但它是在原层面,因为它横跨Agent 在所有这些不同轨迹里,会有的所有行为,所以想法是,与其去写prompt 你得先对其原行为是什么,这其实就是这个概念最初的用途,我发誓,真的是两年前,后来慢慢演变,我们最后就叫它行为,因为简单一点,想法是,你有一个markdown文件,在里面写下,你希望agent怎么表现,就这么简单,它可以有不同的精细度,比如说,有个很具体的要求 像你得去看主要来源,也许你想更具体一点,比如,不你应该总是去看IRS的网站,另一个例子,想象你在做PowerPoint 一个行为是,在你返回PowerPoint之前,你应该把它渲染成图片,这样你就能知道,有没有格式问题,然后你把它写进markdown文件,理想情况下,这个markdown文件是自包含的,其他人可以看,然后对其说,对这就是我们想要的行为,部分原因是,行为其实是主观的练习,这个我们后面可以多聊,它既是产品的事,也是智能的事,然后它也是judge可以看的东西 judge可以看一条轨迹,说h Agent 有没有表现出这个行为,或者需要他表现出,这个行为的条件,有没有发生,如果有,他到底有没有表现出那个行为,然后你就可以据此打分,那谁来写这些markdown文件 或者谁来监督写的过程,人类,对吧,那些人类是会计师吗,这是个好问题,有点看情况,我觉得这是会计师和机器学习研究人员的联合努力,在应用层面 因为你不只是说,行为是你应该去那个网站,你可能会说,行为是对这种类型的研究,你应该派生一个,带完整历史的子Agent 因为你需要建立那个上下文,这里面有很多智能体机制在起作用,所以你会遇到这种情况,对人类来说,好的流程是什么,但你需要把它翻译成agent的语言,然后做决定,这里有个结合,你同时也在讨论agent的机制是什么,所以我会说,这是会计师和机器学习研究人员的双重努力,我们其实有一个完整的团队,叫accounting product operations 里面是会计师,他们做的事情,本质上是和研究团队紧密合作 构建评估标准,既有基于结果的评估标准,也有行为类的,那你怎么权衡精确性和确保系统不崩溃,你提到去查IRS网站,有没有可能在某个时候,你该做的其实是,你的规则是去IRS网站,但两年后信息的位置变了,不这是一个非常好的问题,而这恰恰就是为什么 行为规范实际上并不会展示给agent看,所以行为规范可能会说,嘿你应该去IRS网站,但这并不意味着agent被告知,要去IRS网站,对吧,他可能会也可能不会,这有点取决于情况,但关键是,我的想法是,作为agent的工程师,系统工程师,你要决定对具体情况,具体到什么程度,显然你更希望不要那么具体,对吧,我觉得擅长构建agent的人都知道,在边缘情况下,给出原则,给出为什么,给出更多上下文,让agent自己去搞清楚,效果要好得多,所以对于行为规范,你其实不想定义所有可能发生的事,而是要说,不不不,我们知道,比如说假设你在做powerpoint 在把文件交给用户之前,拍一张powerpoint的照片,能抓住问题,我们确切知道这一点,对吧,所以我们作为agent工程师,要表明立场 说在agent你要做的所有不同事情里,这是我要给你打分的那件事,然后也许你在那里会更具体一点,如果你愿意,你可以更具体,比如用这个确切的工具,但理想情况下你不必这样,这取决于你的系统是怎么构建的,所以我觉得你的具体程度取决于,也许你试图推动的具体结果是什么,以及那个结果在多大程度上,能泛化到各种情况里,比如说如果你在制作PowerPoint 当然拍张照片会让效果更好,但假设你的Agent 其实是个超快的Agent 那拍照是要花时间的,所以也许对一个超快的Agent 你不想让他给PowerPoint拍照,因为这样它从30秒变成了一分钟,但如果你有一个要跑20分钟的ASIC Agent 那就是从20分钟变成20分30秒,每次都拍,所以这就回到了我关于产品层面的观点,这不仅仅是智能的问题,这是一个主观的练习,关于你希望Agent在生产环境中,大体上如何表现 而且实际上我认为这就是,为什么它对产品构建如此关键,我们几分钟前聊到OpenAI 在2023年做的那件事,需要80万个人工标注,你们在2026年做的事情有什么不同,对好问题,所以我们目前至少现在,并没有主动去奖励底层模型 我们现在没有通过奖励这个过程,来后训练我们自己的模型,我确实认为那是一个非常有趣的研究方向,我们待会可以聊,但那不是我们现在正在做的事情,那是我们另外在单独研究的东西,不过那更多是面向未来的,所以如果你退一步看,把构建agent和上下文工程的工作类比成,直接训练一个模型,是很有用的,我觉得当人们想到上下文的时候,人们会说提示词上下文,我觉得人们通常的心智模型是,我写了一些英文告诉模型该做什么,我认为那是错误的心智框架,我喜欢的框架是把它想成训练数据,只不过你是在运行时训练模型,它就是训练数据,而且因为模型是在推理时学习的,训练数据的总量要低得多,对吧,比如你系统里Agent 会在它的轨迹中逐步学习,或发现的所有上下文,显然比你在后训练,一个模型时,用的数据量,要低好几个数量级,所以 你本质上,是在拿这些数据,努力确保,它有最高的质量,让agent表现出,你想要它表现的行为,显然,数据只是其中一部分,显然还有harness 有什么工具,有什么能力,环境,所有这些,当然还有你用哪个模型,诸如此类,所以这里的区别是,我们拿这个信号,去改进,整个agent系统,这需要的数据规模 比我们拿这个信号,更直接的用强化学习的方式,去奖励底层模型要小得多,你几分钟前提到了一个judge 也许给我们讲讲,你是怎么训练那个judge 去做他该做的事的,或者你是怎么指示那个judge 去做他该做的事的,然后我想还有个显而易见的问题,谁来评判judge 对,我觉得这不仅是行为评估的问题,其实基于结果的评估也一样,这是个好问题 真希望我们有更多时间深入了,现实是我们确实没有那么多时间和资源,去把每个评判器都打磨到完美,但我可以给你讲个大概,一般来说,你要做的是先建立一种直觉,判断这个评判器的品位,对不对,而且我觉得,后续练研究里有个挺有意思的方向,就是研究评判器本身,还有他们的品位,今天你需要把评判器设置好,让它有做决策所需的信息,有合适的框架,还得有相应的数据和心态,我给你举个行为方面的例子,你可以想象,这可能会相当复杂,目前至少行为评判的成本相对较高,因为它是个相当高级的评判器,它本身也是个Agent 它不是传统意义上的评判器,它真的是个Agent 因为它要看整个轨迹,所以成本很高,你可以想象未来,像Brain Trust这些公司,已经开始在想,怎么更好的标注轨迹,这样就能更容易的 把轨迹过滤到,只保留可能相关的部分,交给评判器,而不是让它看整个轨迹,但如果你有一条轨迹,尤其是长时程的,可能有很多子 Agent的轨迹,你作为评判器就得想,我要看轨迹的哪部分,我怎么理解它,你大概需要某种形式的地图,我到底在评判谁,想象一个深度为期的agent的系统,你可能真的有七层子Agent 我是在评判根结点做的对不对,还是在评判其中某个别的Agent 所以你真的需要好好设计提示词,可能还要调优评判器,让他清楚该去哪里评判,理解行为本身,也就是条件是什么,然后知道怎么判断,这个行为有没有发生 [00:38:52]
Mitch Choyanovsky:这种方法有什么权衡吗,我想到的是,没错,有人类验证的流程,能保证,或者至少有助于确保一种严谨的方法,不太容易失败,但与此同时,你也不会得到那种第 37 手势的结果,就是AI其实能做得更好,更高效,比如跳过某一步,直接快进那三步,这种权衡是不是一直存在,这是个好问题 [00:39:31]
Matt Turck:首先我想确保所有听众都清楚一点,把行为写下来成本很高
Matt Turck:把行为写下来成本很高,因为一旦写下来,你就得维护这个状态,你得让它保持最新,如果你是通过上下文,让模型或agent表现出这个行为,那你就可能有重复的状态,取决于你怎么看,正因为有这种维护负担,你理想情况下,希望行为规范越少越好,所以不是说你看看,做一份纳税申报需要什么,然后说来把所有最佳事件都写下来,看看它有没有照做,而是你挑出几个,你认为最重要的,对生产环境泛化影响最大的,最有影响力的,你只关心这些,不是全部,所以我觉得这是很重要的一点,理想情况下,如果你做得对,理论上还是给第 37 手留了空间的,但我觉得还有另一层,就是你到底在向别人卖什么,就像你要招一个工程师,在你的公司里,你有一套流程,我随便举个例子,你先画个快速架构图,跟CTO聊一下,得到批准,然后提个PR 把PR拆成10个更小的PR 组成一个站,然后合并进去,确保有意图测试,再部署,这就是流程,想象一个工程师,跑过来跟你说,嘿这是我一千行的PR 我现在就要合并进生产环境,如果他比你想的更好呢,如果他是第 37 手呢,他可能比CTO 想出来的方案更好,但那不代表他就是好的,不是说结果更好 CTO或公司就会满意,因为归根结底,你干活不是因为,某一份单独的工作有多出色,而是因为,你能把它规模化到公司,到系统到组织,所以客户从我们这里买的,不是这会是史上,最好的纳税申报,他们买的是那份信心,最好看的那份,对最好看的那份,或者像那种第37首,试算平衡表在这之类的,对吧,他们买的是稳定可靠,能放心信任的东西,就像对人一样,他们可以慢慢学着越来越信任,然后随着时间逐步授予更多自主权,对吧,我觉得那种信任和可靠性 才是你部署到现实世界需要的东西,你不需要第37首 那可能在奥赛数学竞赛里需要,但不是在现实经济里干活,对听你讲的时候,我觉得特别有意思的一点是,你做这一切,其实对底层模型内部怎么运作,并没有真正的洞察 [00:41:52]
Mitch Choyanovsky:你跟我们所有人一样,对吧,你基本是在猜,从模型的行为表现,通过各种产物,还有看工具调用来推断,那这怎么运作,然后能不能跟我们讲讲,每次模型更新换代 [00:42:05]
Matt Turck:或者新版本发布的时候,你是不是得用新模型的眼光,重新审视你之前做的所有东西,这其实可能得回到Claude Opus 3 O1 O3的时候,因为我确实觉得,构建agent的时候 有一件事特别重要,尤其是围绕他建公司的话,就是你不应该太惊讶,你应该有一个世界模型,事情变了,你就更新你的模型,但要成功,你不能一直更新模型,你得有先见之明,而且我确实觉得,如果你真正内化了一些概念,对吧,先别管内部机制,先忘掉这个LM 你有一个魔法盒,你有这个魔法盒,或者我有时喜欢叫他外星人,你可以往这个外星人里塞海量数据,他能在推理时,在那个魔法盒内部进行推理和学习,然后给你返回输出,而且现在工具调用显然已经能用了,你可以把它接入系统的其他部分,你真正需要知道的就这些,我觉得一旦你真正理解了这意味着什么,并把它推到逻辑终点,很多东西就会自然浮现,因为你开始明白,你会想好等等,如果我有一个能这么干的魔法盒,那是不是意味着,他能决定去调用另一个魔法盒,你知道那是不是意味着,他有可能把好几个串在一起 对吧,那是不是意味着它能利用,显然在那一刻,它是个魔法盒,但它有某种状态,我们知道这点,它有激活状态,缓存就是这么运作的,所以存在某种激活状态,它必然会偏向当前这条轨迹,所以也许做审查的时候,你想要一条不相关的轨迹,对吧,就像一个全新的盒子,它同样聪明 我觉得如果你建立起这类LM 直觉,再结合一些组织设计和管理的基本原则,我想你就能慢慢触到 Agent构建的前沿了,有意思,那实际操作上,你怎么建立这种LM 直觉,是靠一直读论文,还是跟研究者聊,或者去感受最先进水平,往哪个方向走,对我觉得其实都不是这些,我觉得关键权在于,我是说读论文确实有用,但我真觉得,很多人在那上面用力过猛了,好多人觉得 对我看到了这条推文,我看到了这个,好像就是下一个酷东西,我觉得问题在于,如果没有对事物运作方式,和可能性的根本性理解,就很容易觉得,一切都在剧烈变化,但实际上并没有,从O3以来,事情真的没怎么变,我会说 O3之后,几乎所有东西都相对的,我不想说在趋势之内,然后好像,我早就知道这个趋势,但我会说,都在同一个范式里,从O3到现在,没有发生过范式级别的转变,我觉得理解它,学习它最好的方式,就是大量的,在自己的工作中去用它们,尤其是在编程里,试着去理解一些东西,一个好的心智模型是,比如说我试着让一个agent帮我改一个功能,他没按我想要的方式做,那为什么,真正的限制因素是什么,这有点像那个著名的埃隆马斯克思维,就是说好你找到主要的限制因素,然后把它搞清楚 我觉得如果你把类似的思维用在agent上,去理解他为什么没能自动化这件事,是他真的不够聪明吗,大概不是,他们挺聪明的,他们已经聪明了好一阵子了,所以一旦你把这种思维用在自己的工作上,我发现这对建立直觉非常有用,而且我在面试的人身上,也看到了这一点,很多agent直觉最好的人,确实很多人有机器学习背景,但那些没有背景的人里,很多都是特别擅长,自动化自己工作的人,特别擅长思考这件事,特别擅长理解要构建的系统是什么,比如我大概一年半前,在Data Driven做过一个,关于本体论的演讲,我觉得有很多人在自己的数据里,自己的仓库里思考本体论 那些在积极思考的人,不只是怎么给模型写prompt 而是怎么构建一个系统,他们就开始建立起非常好的直觉,那我们一定要在对话结束前,聊到这个,你具体和Brain Trust开源了什么,人们通过什么项目找到它,它的起源是什么,为什么你特别选择和Brain Trust合作,如果我们回到,行为规范这个概念,这个想法是,你其实可以用markdown写下来 它实际上既是规格说明,又是评分标准,我们叫它规格说明,也有人问过,这不就是评分标准吗,是的,它两者都是,它之所以两者都是,是因为它不仅用来给agent打分,或可能给奖励,也用来对齐人类,我觉得这是一个被低估的点,你希望agent怎么表现,就像我们之前聊到的,其实是一个主观问题,所以内部来说,你需要建立流程,让大家达成一致,比如,这就是产品,对吧,你希望agent怎么表现,回到那个快速powerpoint验证的例子,所以你希望有一个标准,把那个写下来,这个项目之所以产生,是因为我碰巧,和BrainTrust的CEOAnchor喝咖啡,说实话我忘了为什么了,但我跟他说,我还在跟你说,我在跟他解释这个概念,我聊这个是因为,我们在内部做这件事,我觉得非常酷,他听了挺兴奋的,而且我内部,一直在想的一件事是 我觉得我们做了很多,真正前沿的工作,但我们不怎么对外说,因为说实话,我们一直在工作,对就在我们开始录音之前,你还在给我看,你和你联合创始人 [00:47:10]
Mitch Choyanovsky:Matt之间的一些内部消息,如果我可以透露的话 Matt凌晨4点给你发了一条slack 然后那些提示因素,对那是昨晚的事,所以我们录的时候是周日晚上
Matt Turck:然后你让我看了,你早上6点回复那条slack 所以是的,对 Bases的联合创始人之间,真是996拉满,对对对,我们确实没有996 对Matt和我来说,是7分之24 对公司的其他人来说,大家工作很努力,但绝对不是996 所以我们想多聊聊,分享我们在做的事,我们也没有太多资源,去大规模宣传,所以我们聊的时候,我就说,我觉得这对Brain Trust 真的很有用,说实话,对整个行业也是,因为如果你有一个标准,人们可以定义它,然后自动被吸收进,可观测性平台,监控平台,对,可能没那么先进的人来说,他也可以开箱挤用地,提供评判器,或者定义行为的方式,你不需要自己配置评判器,可以直接让他帮你评判,然后看结果,所以他听了挺兴奋的,这就是合作的由来,开源仓库里就是这些内容,里面有几个小例子,有一个你可以直接用的视力评判器,还有实际写好的行为视力,你可以借鉴,然后构建自己的,我觉得思考,如果采用这个标准是有用的,但我觉得也许更重要的是,思考如何采用这种思维方式 不要认为一个运行10小时的Agent 是黑盒,他不是,他产生大量数据,如果你不理解他是怎么做工作的,你很可能是在坑你的客户,那你希望人们拿这个开源项目做什么,大概是贡献代码,或者用在他们自己的场景里,它怎么才能成为行业标准,对这是个好问题,我其实不知道,我觉得最酷的事情是,大家往里面贡献想法,我觉得还有很多工作要做,这才刚刚开始,我之前提了几件事 但还有很多事要做,第一怎么做出好的评判器,第二怎么正确的标注和拆解轨迹,让评判器更容易理解,因为以目前的成本,你没法在所有生产环境里跑这个,因为你得对每一条轨迹都跑评判器,但在行为之上构建那些工作,我觉得有很多可以做的,另外我们特意让标准相对灵活,类似skills 它就是一个markdown文件,没有过度拟合,不是说你必须用这五个词,你可以写得很宽泛,也可以写得很具体,只要它自包含到评判器,能看着这个行为,就知道它被展示的条件满足了吗,如果满足了,它到底展示了还是没展示 只要满足这一点,就有很大的自由度,所以我们希望它是灵活的,那AI 构建者在构建自主,尝试成agent时,还应该考虑什么,我们聊了评判器,聊了行为 [00:49:45]
Mitch Choyanovsky:你刚才提到了ontology
Mitch Choyanovsky:你刚才提到了ontology 你在data driven的演讲里也提到过,我经常看到你把它说成 Agent生存的世界,它在整个图形里处于什么位置,对,它们非常重要
Matt Turck:很多人听到想到agent的时候,他们的心智模型,总是会跳到编程Agent 因为那是每个人的经验,至少听这个播客的人,大家会经常想到编程Agent 编程agent有意思,因为他们显然有一个随服的harness 他们有特定的工具,有编码在上下文里的特定行为,对吧,顺便说codex是开源的,我强烈建议大家去看看那个开源仓库,但他们不控制自己的运行时训练数据,对吧,因为他们的运行时训练数据,回到我之前的类比,就是他们的上下文,实际上是他们正在工作的那个代码仓库,所以你可以让codex 同一个Agent 在一个代码库上表现还行,在另一个代码库上表现经验,因为那个代码库,有更好的运行时训练数据,对吧,也就是说它可能有好的skills 或者好的关于如何在代码库中,操作的上下文,因为那里没有矛盾,和混乱之类的东西,所以你的代码库的ontology 对工程师来说一直很重要,对真正好的agent来说,随着时间的推移,它同样重要,甚至更重要,如果你考虑非编程Agent 我觉得这还会再上一个层次,因为在编程里,你不拥有运行时训练数据,在非编程里,你拥有,对吧,比如一个basis Agent 看到的大部分数据,是basis拥有的,对吧,那是我们必须确保,运行良好的训练数据,再说一次,我说训练数据,其实指的是,人工精心编写的上下文,对吧,或者是更广泛的,渐进式披露体系里的一部分,有些可能是手写的,有些可能不是,总之就是这些,因为智能体每次都是从零开始,所以把那个本体设计的对智能体友好,是做出能长时间运行的东西的关键,这既包括那些静态的数据,比如所有智能体都有的skill之类的东西,也包括一旦你进入真正长的时程 比如一个有状态智能体要运行几个月,从几天到几个月,这时候你突然就有了一个本体,回到记忆碎片那个例子,就是智能体给自己留下的信息,如果你只运行几个小时,那可能只是几条笔记,如果运行几个月,那就是一整个文件夹了,对吧,你积累了那么多知识和上下文,描述了智能体的全部经历,然后这个新智能体,好吧,也不算全新,它带着高度压缩的上下文启动,必须把自己恢复到,完整经历过的那个心智状态,所以你设计的本体,要让它容易做到这一点,你编码的行为,要确保它做得好,这些才是让它 真正出色运转的关键,那设计本体到底是什么意思,本体在实践中是什么,是图数据库吗,是一系列关系吗,对,它可以是很多不同的形式,有各种不同的格式,我觉得最简单的理解方式 其实就是把它想成一个文件系统,里面有一定的结构,显然大多数人用的是虚拟文件系统,所以灵活性很大,文件跟文件夹上,可以挂各种原数据,对吧,你也可以有节点和连接器,用某种图数据库,如果你想要的话,显然嵌入也会用上,就是有太多不同的数据来源,可以用来丰富它,而且现在模型越来越便宜,越来越多的这类工作,其实可以直接用推理来做,而不是靠确定性的东西,比如图或者嵌入,如果Luna的成本趋近于零,那你就可以在整个本体上,跑一堆Luna 帮智能体把东西总结好,诸如此类,所以这就是我理解它的方式,可能还有一点,本体不只是文件夹的结构,传统意义上的本体,它也是语言,对吧,就是对象和概念是什么,因为归根结底,如果你在运行时被训练 你得确保不会把概念混在一起,让一切大体上说得通,所以这就是我说的定义世界,对吧,你在定义智能体,在探索周围世界时,可以预期看到什么,你某处提到过,给智能体的内部文档 [00:53:40]
Mitch Choyanovsky:必须像代码库一样对待,删掉关键段落,智能体就崩了,就像删掉一行代码一样,那个文档是在本体之外,智能体像调用工具一样去搜索的,这到底怎么运作,最佳实践是什么,对
Matt Turck:这是个好问题,我先把这两件事分开,刚才我讲本体和历史信息的时候,更多指的是Basis产品内部生产环境里的东西,至于内部使用智能体,比如编程Agent 或者我们可能做的其他内部智能体,那就有点意思了,因为取决于你怎么搭建,你的环境可能没那么受本体控制,因为就像你说的,在现实世界里,你得去访问 linear gon python 这些不同的系统,所以我觉得内部智能体的一个关键,就是非常清楚什么是权威的,什么不是权威的,就像我是一个刚加入组织的人,我可以去听所有的共录音,但我们今天的销售策略是什么,如果你听两年前的共,你会得到很多背景,但你不会知道,现在的销售策略是什么,必须有一份权威的文档,在实践中,人类很多时候是靠跟人聊天,学会这些的,你慢慢就懂了,但对智能体来说,这很难获得,更重要的是,如果你想要真正的组织智能 你不想让一个智能体,从一个人那里听到一种说法,从另一个人那里,听到另一种说法,或者让他们有不同的书面记录,比如现在的销售话术是什么,我们怎么做deck 我们怎么写邮件,你需要一个统一的权威来源,所以我觉得,对于真正的智能体原生公司,尤其是蔚来,今天我觉得还早,但蔚来尤其如此,清楚知道公司的权威内容是什么 把它组织成一个合理的本体,并确保它像代码一样持续更新,我认为这最终会成为公司内部,人类最重要的职责之一,在Basis团队里,你们招的岗位,两年前根本不存在,比如语言架构师,智能体管理者,这些人是谁,他们做什么,什么样的背景适合,对,我们需要很多这样的人,如果你在听这期节目,想加入的话,请直接联系我,好,问题,我们还在摸索中 这不容易,我目前知道的是,你需要,这个说法最近可能有点流行,但我觉得真正重要的一项能力,是好的系统思维,好的,系统思维从哪来,来自那些,必须思考某种抽象,某个系统,并且把它设计成,能在大量场景下,都表现良好的人,所以显然,如果你是个真正优秀的工程师,工程本身就是系统思维,不过我觉得,历史上大多数工程工作,其实并不真正基于系统思维,更多是偏执行导向的,但如果你想想最难的工程,比如我在设计这个东西长什么样,或者我在选正确的抽象层,那确实非常依赖系统思维,但这不是唯一需要这种思维的职业,我觉得法律其实也类似,很多方面我在想,也许美国的开国先贤们,会是很棒的上下文工程师,或智能体管理者,因为你得写一段英文,这段英文将来要被律师,法官们在实际运行中解读无数次 所以如果你在写一条法律,我不是说那种政客式的,而是你真的在认真写一条法律,你就是在尝试用英文写出一个抽象层次,恰到好处,能覆盖所有情况的东西,你还得对司法系统有心智理论,去想他们会怎么解读它,有意思的是,你会在某些机场看到那种告示牌,不要带枪,不要带刀,不要带剑,不要带这个那个,你列了30样东西,这正是你说的脆弱规则的问题,所以同样一件事,你可以列50条脆弱规则,也可以写出一个恰到好处的抽象,刚好把它全部覆盖,所以我觉得,任何需要你以这种方式思考抽象的领域 都是成为好的系统工程师的好训练,我觉得那些管理过世界上最复杂Excel模型的人,说实话也没太大区别,所以我觉得适合的背景其实很多,我记得你在data driven演讲时 [00:57:22]
Mitch Choyanovsky:讲到了你们的部署智能团队,你说在企业里部署智能体,就像让300个聪明绝顶,但毫无背景的外星员工入职,所以才有了部署智能团队,那这些人做什么,他们还在吗
Matt Turck:还是这个概念已经演变了,不不当然还在DI团队很棒,我觉得我不该这么说,我得去谷歌一下,但部署智能这个词,绝对是我们发明的,我知道,因为你去谷歌搜这个词,我们公司排第一个,这名字挺酷的,我不知道有没有别人,也用了这个名字,我觉得它其实还没真正流行起来,但这个想法的本质是,它其实不是FDE 不是那种工程师进来,给你定制开发东西,也不是现在某些公司,我就不点名了,那种所谓的智能体产品经理,就是一些挂着片头线的人,用智能体构建工具,帮你搭一个智能体,它两者都不是,它是这样一群人,他们对这个职业,有很深的同理心,和理解,知道建立好的流程,需要什么,知道当你突然,可以把某些事情,外包给智能体师,怎样才能成功,所以DI团队的工作,是去和我们的,会计事务所客户合作,帮他们过渡到,这个新时代,我们给了他们魔法 但如果我们不教他们,怎么用好这个魔法,不只是日常怎么用,而是他如何改变,事务所的本质,他如何改变,他们能接什么业务,招什么人,他们怎么扩张,成为人人都想成为的,那种未来事务所,这就是DI团队,和客户紧密合作要做的事,因为如果让他们自己去学,自己去做,那不公平,相反,他们带来了关于自己事务所的,大量知识,过去怎么运作的 当然还有他们的人,我们把这些和我们关于,如何部署智能体的知识,结合起来,我觉得合在一起,就能打造出真正前沿的会计事务所,说到前沿,也许我们该开始收尾了 [00:59:08]
Mitch Choyanovsky:我想花点时间聊聊这个话题 2026年一个大主题,显然是自我改进,这在basis和自主智能体的,图景里处于什么位置,我记得你讲过,智能体会对其他智能体发展出
Matt Turck:新制理论,那从系统层面给我们描绘一下,自我改进是什么样的,对我们内部其实在帖子里,我聊过一些研究方向,我们一个重要的研究方向就是,怎么真正把闭环合上,我们喜欢这么叫它 从Hey Agent犯了错,或者表现不好,或者怎样到我们已经改进了系统,去解决这个问题,我觉得闭环这件事会来得很快,我不敢说整个闭环都能合上
Matt Turck:我不敢说整个闭环都能合上,但我觉得到年底应该会相当接近,我觉得随着agent对自身进而对其他agent的心智理论越来越好,会有两件事同时发生,一个是在运行时,他们越来越擅长编排 Agent 也擅长给自己调节运行环境,但这也意味着他们正在成为更好的上下文工程师,对吧,他们正在成为更好的框架工程师,现在他们在工程化agent的系统这件事上,比工程化大多数软件要差得远得多,差得远,因为这类工作本质上太新了,在他们的训练数据里见得不多,所以他们的直觉非常差,其实我觉得很多做agent的人犯的错是,他们有一种奇怪的直觉,觉得上下文里或者agent里的垃圾内容,好像比代码里的垃圾内容更能被容忍,你会看到有人对某个抽象的,不够好的代码文件大惊小怪,可他们的上下文简直是一团糟,这挺滑稽的 因为上下文其实才影响运行时的表现,代码的组织方式,并不影响运行时的表现,所以我觉得很多,显然因为长期养成的习惯,很多工程师,把代码看得比英文更金贵,可实际上英文更金贵,因为英文影响表现,代码不影响表现,对吧,如果逻辑一样,假设逻辑相同,它就不影响表现,所以我觉得随着agent变强,随着他们更擅长这类工程,就是怎么构建agent的系统,你才能真正开始把币还合上,因为要合上闭环,对吧,你需要拿到你收到的信号,而且你需要大量信号,行为规范的一个作用,行为规范的意义之一,就是获得更多信号,而如果你只有基于结果的评估,你的信号就非常稀疏,那你怎么把所有这些信号,真正用来改进系统,对吧,你把它扩散到整个系统里,今天这件事可以由一个agent来做,比如更新上下文,改变工具的性质 更新框架等等,我觉得你大概能用一种可泛化,但不过拟合的方式,如果你想让系统过拟合到某个信号上,今天就能做 但如果你想让它以可泛化的方式来做,那agent还需要再强一点,这方面还有更多工作要做,那模型层面的自我改进呢,我记得你之前提到,你们还没有在模型本身上 [01:01:54]
Mitch Choyanovsky:做太多强化学习,你们主要做的是框架层面的工作,如果我没理解错的话,但这是不是下一个大赌注,开始对行为遵从,做真正的强化学习,对这是个好问题,我的思考方式是 [01:02:08]
Matt Turck:强化学习的难点,在于决定你的奖励函数是什么,然后决定你打算,怎么把奖励分配到,发生的那些事情上,对吧,所以这正是我们正在做的活跃研究,因为行为规范就是一个信号来源,对吧,你可以用它来打造一个奖励函数,其他一些生产监控的工作,还有你构建的一些评估,也是一样,所以怎么构建好的信号,做研究,理解它意味着什么,尤其是在一个,不能完美验证的领域里,这就是我们在做的工作,至于你拿到那个信号之后,是把它通过权重扩散出去,通过正式的强化学习,还是通过框架扩散出去,通过随便你怎么叫的东西,比如非正式强化学习,或者框架工程,我觉得这和信号本身的开发,是两回事,但我觉得信号的开发,才是真正难的部分,那才是我们真正专注的地方,而今天我们不会直接动权重 我们不去动权重,主要原因是,模型在自我编排方面的进步,带来的性能提升,远远超过直接更新模型,能带来的好处,我觉得那可能也会有一些增益,我们等着看吧,但我觉得,这就是你还不去动权重的理由之一,我确实觉得,那也是一个非常有意思的研究方向,我们之后会开始探索,所以对我们来说,在我们这个层面,在应用层面,这就是我们在做的研究,但我猜,要让模型真正在经济里干实活,那是唯一能到达的路,我不相信,如果你训练一个模型,你把预训练计算量往上加,把基于完美可验证奖励的,后训练量也往上加,突然就会产出一个,能可靠完成纳税申报的模型,他可能会做出一份非常好的,但问题不是他做的好不好,问题是他能不能达到一个,和他一起干活的人,所期望的质量,可靠性,可扩展性水平 [01:03:15]
Mitch Choyanovsky:不过你担心苦涩的教训吗,就是你在对话前面提到过的那个,你觉得你们和其他人,在框架层面做的这些出色工作,最终会被模型本身吞掉吗,我猜肯定会被吞掉,对 [01:04:09]
Matt Turck:我不担心,这绝对是未来,毫无疑问,事实上,如果你看我的帖子,我暗示过这一点,我记得我说过,行为规范,目前还不会展示给智能体看,原因就是,如果你真的信奉苦涩的教训,那未来这种上下文工程的想法,会整个消失,你只需要说,嘿,我要这些行为,它就能直接做到,所以我绝对认为,它会被吞掉,没有疑问,至于要多久才会被吞掉,我不太确定,我觉得大概五年以内吧,我不觉得两年内会,但我觉得五年内很可能,所以对我们来说,我们现在处于超大规模扩张模式,我们没法等苦涩的教训到来,再去准确完成纳税申报,所以我觉得那会是关键之一,不过我也觉得,这个纯属猜测了,我怀疑某些类型的过程奖励,对这种工作来说,最终可能会变得相当重要,因为能帮实验室优化,他们长期使用的算力,因为我不确定 你是不是想让经济里的每一个职业都来一次,第 37 手,我们已经积累了很多经验了,没必要那样做,这是我的猜测,那你觉得做自己的强化学习 [01:05:15]
Mitch Choyanovsky:算不算一种护城河用来抵御被模型性能吞掉的风险,我是说当你思考未来应用性AI公司的时候,总的来说,如果有人现在正想创办公司
Matt Turck:我建议这么想,技术护城河不是真正的护城河 Basis的长期终值没有任何一部分,是来自我们发现了别人,没发现的什么秘密强化学习技巧,所以那不重要,重要的是,现在我们显然非常擅长,构建长时程智能体,他们可靠能部署到生产环境,而且我们会继续保持这个领域最强,这让我们能赢得市场份额,深度嵌入客户,这也是为什么我们跑得特别快,因为我们想做的,就是在通用人工智能到来之前,随便你怎么叫他去把业务铺开,所以我觉得未来存在的护城河,大部分会是商业护城河,在通用人工智能时代是这样,我认为在通用人工智能之前也是这样,我不觉得Salesforce能写出,比我更好的SQL查询 Salesforce的护城河跟它的技术没关系,对吧,它靠的是商业地位,是它拥有的权利,是它掌握的工作流 是深度嵌入带来的所有这些不同的东西,那才是重要的,不是技术,技术只是暂时的撬动点,让像我们这样三年前还不存在的公司,突然能做所有这些工作,不过我也觉得,在很长一段时间里,也许就像你说的,它不会完全变成大宗商品,因为就像你有一群天才人类,不代表所有天才人类,做纳税申报的能力都一样,归根结底,有些事情你在意的点,或者判断标准是主观的,而且我确实觉得,把我们正在做的这件事的,专业能力建立起来,对我们能在可预见的未来,交付真正高质量的服务,是非常重要的,好的 Mitch讲的真的太精彩了 [01:06:33]
Mitch Choyanovsky:最后对今天做AI的开发者,特别是做智能体的人,有什么建议吗,除了你刚才讲的那些该做的不该做的,经验教训之外,还有什么想到的,我觉得最大的教训要我说 [01:07:12]
Matt Turck:就是人很容易看着这个世界变化这么快,然后说事情就是这里冒一个,那里冒一个,就像在推特上得了多动症一样,太疯狂了,中国实验室每天都有新东西发布,然后觉得自己没法做第一性原理的决策,但我其实觉得,如果你把新世界看作一个底层的范式转变,就像云计算那样的底层范式转变,然后你试着去推演,好你有这些东西了,如果智能变强了X倍,或者没变强,那意味着什么,我觉得这样你能构建出连贯的多的系统,也能在技术和商业层面,做出好得多的战略决策,事情在变,但范式并没有在变,至少没那么剧烈,所以我觉得真正理解这一点,对在这个世界里做建设
Mitch Choyanovsky:是非常非常关键的 Mitch真的太棒了,非常感谢你分享这一切,我们很感激,应该的,非常感谢你邀请我,嗨我是Matt Turk 感谢收听本期The Mad Podcast 如果你喜欢这期节目,我们非常感激你能考虑订阅,如果还没订阅的话,或者在你收听,收看本期节目的平台上,留下好评或评论,这真的能帮我们把播客做起来,也能请到更多优秀的嘉宾,谢谢我们下期见 [01:08:05]
本期对谈把“模型发布”之后的工作拆成了一套完整的推理工程问题:让模型能运行只是起点,真正困难的是在不同硬件、流量和产品约束下,把它做成快速、稳定、保真、可持续优化的生产级服务。swyx 与 Philip Kiely 围绕 20 万 token 长查询,说明缓存感知路由、预填充与解码分离、KV 缓存以及投机解码如何共同影响延迟和成本;随后又讨论新模型接入时的量化、校准、投机解码器训练、架构适配和质量验证。Ali Taha 参与了视觉、视频和音频推理话题,补充了扩散模型与自回归模型在并行方式、序列一致性和推理约束上的差异。
对谈的核心判断是,AI 领域下一轮大幅增长未必只来自参数规模或模型本身,而可能来自推理基础设施:更好的量化和模型改造、更快的节点间网络、更高效的 KV 缓存传输,以及训练与推理之间不断回流的数据和反馈。模型已经可以在一定程度上分析性能跟踪、发现瓶颈并编写 GPU 内核,但距离完全可靠的自我优化仍有距离。长期来看,推理服务可能从静态部署演变为持续学习、持续评估、持续改进的系统。
面对 20 万 token 的编程或多轮 Agent 查询,服务首先会尝试进行缓存感知路由:把请求送到既有可用工作进程、又尽量保留输入缓存的副本,以跳过部分预填充。如果没有可复用缓存,系统可以把预填充和解码分到不同 GPU 组:一组处理长输入并生成 KV 缓存,另一组负责后续 token 解码。针对流量特征明确的专用部署,还可以训练面向特定任务的投机解码草稿模型,用少量快速前向传播预测多个 token,再由原始模型一次性验证,从而显著提升解码速度;共享端点则难以针对每个用户的任务类型做同样优化。
开源推理引擎能够让新模型产出 token,并不等于服务商已经提供了可靠的生产级 API。真正的接入工作包括重新量化和校准权重、训练通用投机解码器、加载和测试完整基础设施、适配新的架构设计,以及检查工具调用、结构化输出和长上下文场景。推理服务还必须在吞吐、延迟、精度、成本和可靠性之间做取舍;专用部署的价值,正是允许服务商根据客户流量、精度要求、并行策略和工具调用方式进行定制。
工具调用尤其依赖严格的结构化输出。模型如果没有正确闭合 JSON 或没有等待工具返回,就可能在解码阶段直接幻觉出结果。训练决定模型是否知道何时调用工具,推理侧则可以用状态机和语法约束限制输出格式。MCP 在这里仍然是工具的一种承载形式,真正执行动作的是能够解析模型输出并调用工具的外部系统。
嘉宾将量化视为主要的有损优化:选择数据格式、决定量化哪些层,并对量化后的权重进行充分校准,都关系到模型是否仍然忠实于原始实现。长上下文还会增加内存压力,因此服务商可能为不同用户提供不同上下文长度,以换取更好的性能。
但量化并非简单的“越多越差”。如果不同层的量化误差能够相互抵消,选择性地量化更多层反而可能在提升吞吐的同时保持甚至改善基准测试结果。关键不在于盲目压低精度,而在于通过数学分析和验证器寻找适合量化、以及不应量化的层,并用真实任务检验结果。基准测试必须同时记录硬件、负载、提示词、输入输出长度和模型版本,否则不同服务商之间的速度与质量比较很容易失真。
对谈讨论了把一个模型的视觉编码器、投影器或高效注意力层嫁接到另一个模型上的实践。只要重新训练连接部分并保持核心权重稳定,就可能用较小的参数代价补足视觉能力;当某个注意力层带来巨大的 KV 缓存或计算瓶颈时,也可以用更高效的结构替换它。开源模型之间的组件组合因此成为推理工程的重要工具,但每次改造都必须重新确认质量、接受率和训练稳定性。
张量并行把模型切到多张 GPU 上,专家并行则利用稀疏专家减少每个 token 的实际计算;两者都受到 GPU 之间通信的限制。随着硬件逐步加入更多专用张量核心、内存和数据布局能力,GPU 的行为越来越接近可编程的 ASIC。嘉宾对“只要不断融合 GPU 内核就能解决一切”持保留态度,因为跨 GPU 的非线性计算仍然需要通信;真正的瓶颈可能转移到内存容量、节点互联和芯片间通信。
视频扩散模型与语言模型不同:它通常需要在整个潜空间序列上反复迭代,使过去和未来的内容保持一致,因此不能简单地像文本一样从左到右流式生成。自回归视频模型具有顺序生成优势,但可能难以回头修正早期内容;扩散模型能够双向关注,却需要更高的整体计算和内存开销。未来可能出现结合两者的混合架构:用自回归过程处理顺序规划,用扩散过程处理局部一致性和细节。
音频和音乐则处在两条路线之间。语音可以通过语言模型生成离散 token,再转换为波形;音乐或诗歌等需要全局韵律和后文约束的任务,可能更需要双向修改。嘉宾因此把文本和语音大致归入自回归一侧,把图像和视频大致归入扩散一侧,同时承认这只是便于讨论的粗略分类。
强化学习中的 rollout 依赖高速推理:如果 rollout 太慢,训练管线就会被拖住。反过来,训练也服务于推理,例如量化感知训练、蒸馏、针对具体流量训练投机解码器,以及根据生产 trace 持续后训练模型。理想的系统会把产品中的 trace 转化为新的训练信号,做评估和 A/B 测试,再发布更好的模型或配置。
这种“从推理中学习”的持续改进已经开始出现。对谈举例说明,GLM-5.2 可以接入 Claude Code 框架,分析自身在节点上的性能跟踪,寻找 SGLang 中的瓶颈内核,编写新内核,重新测试并上传镜像,随后重复这个循环。模型还会用暴力尝试寻找可行路径,决策能力也有限,因此它目前更像是工程师可监督的优化助手,而不是完全自主的系统。
当大模型和长上下文推理跨节点运行时,KV 缓存需要先从源节点的内存传到目标节点,再从目标节点内存传入 GPU。由于 HBM 速度远高于网络通信,这个两阶段过程会限制预填充和解码。若未来网络芯片和节点间通信足够快,就有机会减少中间搬运,使 KV 缓存直接在节点间流动,从而带来数量级的推理速度提升。
持续学习也有两种路线:一是不断更新模型权重,让新知识写入参数;二是把知识保留在可压缩、可扩展的 KV 缓存或类似结构中。直接改权重容易只修正一个事实,却不能保证模型在更深一层的推理中使用这个新事实;如果 KV 能够近乎无限地保存并无损压缩,或许更适合持续学习。两条路线都还在探索中,但它们共同指向了一个变化:模型系统的记忆、推理和部署将越来越难以分开讨论。
1. 推理工程的核心不是“让模型跑起来”,而是让它在真实流量下跑得快、稳、准,并且成本可控。
2. 缓存感知路由、预填充与解码分离、KV 缓存和投机解码需要组合使用,单点优化很难带来完整收益。
3. 新模型接入生产环境需要量化、校准、投机解码器、架构适配、工具调用和质量回归等一整套工程工作。
4. 量化是有损优化,但精心选择量化层并利用误差抵消,有可能同时改善吞吐和模型保真度。
5. 模型组件的跨模型嫁接可以快速补足视觉或效率能力,但必须重新训练连接部分并验证整体质量。
6. GPU 正向更专用、更接近 ASIC 的方向演进,网络、内存和节点间通信可能比 GPU 内核本身更快成为瓶颈。
7. 视频和音频的推理约束不同于文本,未来可能出现自回归与扩散模型结合的混合架构。
8. 训练服务于推理、推理服务于训练,生产 trace 和 rollout 正在把两条链路连接成持续改进闭环。
9. 模型已经可以在监督下分析性能并编写 GPU 内核,但自主决策和可靠性仍限制着“模型自我优化”的范围。
10. 更快的网络芯片通信、可压缩 KV 缓存和持续学习,可能成为下一轮推理性能增长的重要方向。
- 长查询的缓存、预填充与解码 [00:00:00 - 00:10:00]
- 视觉模型改造与开源组件组合 [00:10:00 - 00:20:00]
- 模型支持、量化与生产级 API [00:20:00 - 00:30:00]
- 量化与投机解码带来的性能跃升 [00:30:00 - 00:40:00]
- 张量并行、专家并行与网络互联 [00:40:00 - 00:50:00]
- Mega Kernels 与推理基础设施化 [00:50:00 - 01:00:00]
- 硬件代际与视频扩散推理 [01:00:00 - 01:10:00]
- 视频、音频模型的推理路径 [01:10:00 - 01:20:00]
- 训练与推理闭环、模型自我优化 [01:20:00 - 01:30:00]
- 网络、KV 缓存与持续学习 [01:30:00 - 01:36:35]
swyx:欢迎收听跨国串门计划,这是一档专注于让中文听众无障碍欣赏全球优质外语播客的节目。通过先进的AI生文克隆技术,我们不仅将内容翻译成中文,还完美保留了原主持人和嘉宾的独特声音,为您呈现全球顶尖的AI财经。健康与科技领域精品内容,我是主播一凯,一位热衷于AI领域的产品经理。很荣幸能为您搭建这座跨越语言障碍的桥梁,接下来让我为您简单介绍本期我们克隆的这档节目,本期我们克隆的是知名AI工程播客Latent Space的一期深度对谈,主持人swyx与Baseten的资深推理工程师Philip Kiely和Ali Taha一起,聊了聊推理工程这个AI底层环节的实战内幕,这期内容更新于2026年8月,围绕新模型发布后如何从能跑变成跑得快又稳展开,涉及量化投机解码草稿模型并行这些硬核话题,也聊到了模型自我优化这类前沿趋势,那我们就一起来听听这期完整的对话 GLM5.2写GPU内核非常非常厉害,我们内部觉得特别有意思,我们有一个GLM5.2的接口,接近了我们的Claude Code框架里,所以每个工程团队都在用我们的GLM5.2 它会在节点上的GLM5.2实例上做一次前向传播,然后拿到性能分析跟踪,自己分析,找出SGLang里的瓶颈内核,然后写新的内核,再跑一次性能分析跟踪,等它跑完了,会把镜像上传到我们的系统里,我们就能拉下来重复这个循环,我们推理引擎里跑GLM5.2用的有些GPU内核,就是GLM5.2自己写的,在进入今天这期节目之前,我有一件小事想跟听众朋友们说,谢谢你们,如果不是你们选择点进来收听我们内容,我们不可能给你们带来,你们这么想要的AI工程,科学和娱乐内容,几乎每天都有人来找我们谈赞助,但幸运的是,有足够多的你们真的订阅了我们,让我们能不带广告的一直做下去,我们也想保持这样,但我只想请你们帮一个忙,你们能做的最有利,完全免费的一件事,就是点一下订阅按钮,这是我对你们唯一的请求,这对我和我团队里的每个人来说都意义重大,我们每周都那么努力的把这些内容带给你们,如果你们订阅了,我保证我们会一直努力把节目做得更好,现在我们开始吧,好今天我们请到了Philip 老朋友了写过《推理工程》这本书,也在Baseten工作,还有我们之前一起做过的《试》 以及阿力欢迎,欢迎,很高兴见面,滑铁卢实习生,滑铁卢实习生,一直都是,你什么时候开始用滑铁卢实习生这个,作为昵称,哦,我觉得改名大概是在三月中旬,我看到这个昵称空着的时候,我就想,我必须把它抢下来,问题是 [00:02:42]
Philip Kiely:Ali工作太出色了,他当不了太久实习生,所以我们得想想,谁来接这个昵称,把火炬传下去,哦,好,可以这样,你就把它传给下一个滑铁卢的,另一个滑铁卢实习生 [00:03:06]
swyx:不是Brad 实习生,实习生,你得从滑铁卢找个实习生来,对我们得从滑铁卢找个实习生,他们有这个传统,但这个人可以来自Baseten 所以只要是Baseten 从滑铁卢招的人,就有滑铁卢这个头衔,他们得打败你,没错,就像打副本打到一半,要么你拿到他,要么你就出局了,你还应该办一个盛大的毕业典礼,把昵称正式换掉,就比如说,我是说你们显然很擅长搞仪式,你看我们那本书的发布办得很成功,但在聊这些之前,我想先问你们一个有趣的问题,好你是资深推理工程师,当我发一个长查询,比如20万Token进Baseten的推理服务,会发生什么,查询经过GPU 模型路由负载均衡,整个过程是怎样的,这些我们平时根本不会想的东西都是什么,具体到长查询,我第一件要问的是 [00:04:13]
Philip Kiely:你之前给我发过这个查询吗,或者至少发过其中一部分,我真心希望发过,因为这样对我来说容易得多,对你来说也便宜得多,所以我们要看的第一件事,是某种缓存感知路由,我们会看,我们大概有多个实例,多个副本在跑你访问的那个模型,我们要把这个请求发给一个,第一有可用可用的推理 worker的,第二最好已经有缓存输入的地方,这样至少能跳过这20万Token里一部分的预填充,如果你发20万Token 那很可能是编程或者多轮agent之类的场景,这种场景你通常会期望有缓存,如果没有我们就得发给预填充Worker 我们至少在部分模型上做了分离式预填充和解码,所以你会有一组GPU专门处理输入,生成KV缓存给你第一个Token 然后那个结果会传给另一组GPU 由他们来跑解码,我们会迭代的生成这些token 我们可能还会在前面放一个,某种投机解码的草稿模型,我假设你在做编程,因为这样我们的草稿模型,它假设你在做编程,就会有很高的草稿token接受率,如果我猜错了,你其实是让我总结每一本哈利波特,那就会慢一些,然后我们把输出流式传给你,记账收费大概收你几分钱,然后说还想再发一个吗,只不过Baseten是按几分钱来收的,对我们收费,我假设我们说的是公共模型API 如果你是搭一个专用部署,那当然就不是几分钱了,对我是说,我最初跟Baseten聊的时候 [00:05:12]
swyx:一个关键区别就是,其实想要极大规模的用户,只需要按整台机器租,因为接下来怎么把机器跑满,就是你自己的事了,而且很多时候,如果你每小时推几百万token 按小时付费 [00:06:03]
Philip Kiely:会比按token付费便宜得多,对确实,我觉得我们越来越多的看到,按token付费的API需求很大,因为大家都想试试开源模型,等他们找到一个真正粘住的使用场景,就会转到专用部署,那什么时候该切换过去,他们的最佳实践是什么,有几个原因
swyx:对可靠性,这是个大头,对吧,比如他们有一个非常特定的使用场景,想让你专门为他们训练点什么,比如他们想要自己的投机解码器,针对他们自己的流量 SpecDeck就是投机解码,投机解码,对比如抱歉,具体说如果你有一个巨大的模型,对吧,这个模型每一轮,每一次前向传播都只能生成一个token 所以我们就在模型上面挂一个这种小寄生层,这个模型只需要做预测,它做三次非常快的自回归前向传播,它会预测出三个特定的token 然后你对整个原始模型,做一次前向传播,看看这些预测对不对,然后你接受它们或者拒绝它们,这个草稿模型是针对特定流量的,所以如果你,比如像Philip说的,你在总结哈利波特的书,我可以专门用哈利波特的书,来训练那个草稿模型,我可以保证每次都能接受那三个token 这样的话,我就提高了你的解码速度,但如果你要共享一个端点,我就没法给你提供这个,因为我完全不知道你是在做哈利波特,做编程还是做英文,我们不知道,另外书里提到,他们很在意一个特定预值,好像是第四章,你还记得吗,对你能做的事情是,你可以设置特定的P处理大小,特定的并行策略 [00:07:34]
Philip Kiely:如果你想在吞吐量和延迟之间做优化,你可以比如,也许NVFP4量化过不了你的基准测试,你想用更高精度跑模型,你也可以这么做,想拥有自己端点,有一堆理由,当然最大的一个就是,你不用再正好,要服务自己用户的时候,去应付别人,往端点上砸的,逐 token基准测试流量,对我觉得有一个
swyx:很经典的路径,基本上就是Viva在问的,当你在浏览器里,输入Google的时候,会发生什么工具调用,是不是就是生成 JSON那么简单,还是说背后,有更复杂的机制,我们有些客户,他们有自己的,后训练模型,所以他们要求的工具调用,不只是那种解析文件,或者查天器的简单场景,而是非常定制化的东西,你必须针对这个做后训练,如果模型的后训练做得不好,或者后训练之后为了推理速度,做的量化影响了效果,模型在读 JSON文件和工具调用的时候,就会很吃力,但这并不需要单独的沙箱,不是说他会用工具调用来逃逸沙箱,或者需要被隔离,他就是一个普通的专用部署就行,工具调用越来越大的挑战在于,公司想要特定的工具调用行为,而这本身是非常难训练的东西,因为你面对的是大量的JSON输出,如果他没有以非常特定的方式,闭合请求的结尾,你就会得到一个,已经完成了工具调用和思考的模型,结果就是,他没有看到工具返回的结果,而是在解码过程中 [00:09:15]
Philip Kiely:直接幻觉出了一个结果,这似乎是工具调用最难的环节,而不是沙箱的问题,对这是训练测的挑战,而在推理测,你可以做一些工作,来限定可能的输出范围,我们其实在差不多两年前,就发布了这个问题的解决方案,基本思路就是构建一个状态机,用它来约束输出到特定格式,这就是结构化输出问题,如果你还记得当时,对有特定的文法,对 GBNF 当时有这个东西,对
Philip Kiely:对,所以这就像那种老派的提示词,比如确保只返回JSON 只返回JSON
swyx:不然我奶奶会死那种 BNF文法,当时OpenAI发布过一个东西,就是说如果你想约束输出,就写BNF文法,在我们的推理系统里,就是一个指定的输出格式 [00:10:07]
Philip Kiely:你能得到保证,输出会按照那个格式结构化,把它应用到工具调用上,可以帮助减少问题,当然你仍然可能调用错误的工具,或者不调用工具,它解决不了确定性的问题,但至少它解决了工具调用内部的输出结构化问题,而MCP只是工具的另一种形式,对吧,对没错,那里没有什么特别的东西,我经常跟人解释的一点是 LM实际上没有能力做任何事情,它只能提出行动建议,然后如果这些建议以某种方式格式化
swyx:并应用到一个知道如何处理它们的系统上,行动才会发生,对有趣的一部分是,这个问题在工具调用之外,也有解决方案,比如在智能体循环里,如果输出不正确,或者推理式的工具调用出了问题,模型就会想,我不知道该怎么办,让我再试一次,试几次之后可能就成功了,关于你说的训练问题,有时候在小模型上更难,所以当你从大模型换成小模型时,输出质量不会完全一样,对吧,对,我想说在我们继续深入推理工程之前,我本来预期会有东西取代JSON 因为JSON很难流式输出,因为JSON必须完整,必须有开辟括号等等,所以在流式传输的过程中,很难解析或验证,人们发明了各种替代方案,我忘了其中一些的名字,基本上就是类似TOMO 类似YAML的东西,但JSON似乎仍然是主流 JSON输出其实没那么长 [00:11:53]
Philip Kiely:对吧,我的意思是,你确实可以有很长的,因为工具调用力也包含参数,也许对于某个工具,你可能会传一个很长的参数,但我的印象是,一般的工具调用token数量相对较少,对吧,所以我预计投机解码,对JSON这种格式化的东西,通常表现不错,这样解码步骤会很快流失的价值,就没那么大了,但也许我错了 [00:12:04]
swyx:你还受限于软件,或者说模型要集成的那个系统,如果软件是用JSON来做工具调用的,或者你的客户说,我们的软件就是这样工作的,工具接口就是JSON 你可以要求他们改软件,然后说这样对模型更好,但如果训练得当,应该不会有太大差别,而且如果输出更多Token 可能还更赚钱,这取决于你的商业模式,真的要看情况,但我要说,作为一个对AI生成内容,很有经验的写作者,我确实会尝试从文本,转向JSON 文本,就是那种非常长的JSON 对吧,每个字段里都有大段文字,因为我想让它结构化,对吧,我希望你先做事实陈述,然后给观点再做要点总结,要有日期,有实体引用,有参考来源,所有这些,总之,我觉得真正深入实验,结构化输出的人,必须得关心这些,但咱们还是往上一层看看吧,在开始录音之前,你其实提到了一件很酷的事,就是当一个新模型提供商,发布新模型时,背后有大量的工程工作,推理工程要做,对吧,咱们就拿GLM 5.2 Kimi K3来说,我之前以为,尤其是像GLM 5.1 再到5.2这种,你们之前已经支持过他们了,工作量会那么大吗,工作量很大,对,好吧,所以你看,很多人,你们这些人,对吧,每当有新模型发布,大家就急着说 Hugging Face支持这个了 Firework支持这个了 Baseten支持这个了,我就想,对当然支持了,但背后到底要做什么,我觉得这不仅仅是支持而已,对吧,对消费者来说好处很大,我记得是Kimi K2.5 或者GLM 5.2 最新的那个,当时有一场推理速度竞赛,对吧,有的提供上每秒90个token 第二天我们就到了,每秒150个,这个其实是我用GLM 5.2 调起来的 [00:14:17]
Philip Kiely:我写了一篇推文,大概有50万浏览量 Baseten排第一,对,或者说够活跃,对,这让大家都特别兴奋,想着,我们怎么才能把基准测试,再往上推一推,而且支持这个模型,和支持这个模型,是有区别的,前者是我能让这个模型,产出token 后者是我能基于这个模型,提供一个生产级API 做到能让模型产出token这一步,其实不难,因为一般来说,开源推理引擎,像VLMSG 这些维护者,甚至经常能提前拿到权重,或者做模型的人,会合并PR来确保支持,所以大多数情况下,你基本上用标准开源技术站,就能跑起来,不会太费劲,真正的挑战在于,每家推理公司,都有自己的专有技术站,有些开源组件,有些是自研的,而且对任何一个新模型来说,总会有一些新东西,有时候你运气好,比如K2.5到2.6就挺相似的,对如果我没记错的话,那纯粹是持续后训练,就算是那种情况,还是有事情要做,你得重新做量化工作,这些模型发布时,一般都不是NVFP4格式的,而我们希望,它们变成NVFP4 以获得最佳的Blackwell兼容性,所以我们要执行量化,还要校准量化,确保不会造成,模型智能上的任何退化,然后我们还得训练投机解码器,就像我们之前聊过的,一般来说我们的模型API显然有ZDR 也就是零数据保留,所以我们并不确切知道用户发来的流量是什么样的,但我们知道什么受欢迎,知道编程用量很受欢迎,知道agent类用量很受欢迎,所以我们可以拿到能代表这类流量的公开数据集,然后训练通用的投机解码器,现在的投机解码器,你需要用基础模型本身来训练,因为你要从模型在这些特定提示上跑推理时拿到隐藏状态,那就是你用来训练投机解码器的训练数据,所以有这个过程需要真实的模型权重,然后当然还有搭建背后所有基础设施,加载所有东西,做测试的过程,而且当新模型有更新的架构时,我觉得显然DeepSeek的模型通常是最有挑战性的,因为他们每一代都有最多新颖的架构设计,但每个新模型都有点新东西,我是说 KimiK2有,抱歉 GLM5.2有,希书,对,就是DSA 这是从DeepSeek那边来的,对对,而且你知道我们,所以你可以直接复制粘贴,对吧,我不知道这是怎么运作的,所以我们得在我们的运行室里为它构建支持,你说的对,这真的很有意思,这些开源实验是互相借鉴的方式,比如GLM5.2没有视觉能力,所以我们团队有个叫黑里的人,如果我们能看一下的话,他基本上是把Kimi的视觉编码器,嫁接到了GLM5.2上,完整训练了投影器,完全正确,所以你想编码器这部分,是负责看图像,把它变成潜在信息的部分,然后还有投影器,它有点像空间上没问题,然后还有投影器,它把信息映射到模型本身,再就是模型权重,你不想动模型权重,因为为了给它视觉能力,你有可能让它在别的方面变笨,所以Haley一开始只加了投影器,那只有几百万个参数,对,然后你能展示一下训练过程吗,它那种突然学会的方式,非常非常有意思,也许,也许阿力,你来接着讲吧,你比我更懂这个 [00:17:56]
swyx:对你可以看到,他训练这个模型的方式,真的非常非常酷,一开始,他只是用这样的方式训练,这里有一张山的图片,你能描述一下,这座山里有什么吗,然后这就导致了第一次,第一次学习损失,你看这里,我们想教他的,只是翻译编码后的信息,他已经拿了KimiK的编码器,他已经拿了图像,对冻结的,冻结的,冻结的冻结的,带适配器,所以理解能力,大脑是冻结的,眼睛也是冻结的,我们只是想把眼睛和大脑连接起来,对吧,就是投影器,然后你拿到token 他就说,你能描述一下这张图里有什么吗,然后他就说,这是一座山,或者是一个人,或者是一个人类,诸如此类,但这并没有带来完整的理解,所以他改了方法,让每张图片都关联一个问答数据集,比如这张图里有没有一个白人男性,这张图的左上角有没有鸟,这张图里有没有科学家,诸如此类,他必须正确回答这些问题,而且不只是训练他描述图片,还要能回答问题,回答一个问题,再回答一个问题,就这样持续的一问一答,你可以看到那种突然学会的现象,这真的很不可思议,把一个视觉能力改装进一个大语言模型,居然能学到这种程度,而且即使是他表现不好的图片,比如你给他一张斯蒂芬,霍金的照片,问这是谁,他可能答不上来,但他会说,这是阿尔伯特·爱因斯坦,他仍然明白这是一位科学家,是一位男性,有一些重要成就诸如此类,所以这真的非常非常酷,对我们之前讲过Howtian 他是Lava论文的作者,那篇论文之前就做过类似的事,我觉得对任何没做过,视觉工作的人来说 [00:19:10]
swyx:视觉工作的人来说,那都是非常基础性的工作,还有Clip和Metaclip也一样
Philip Kiely:从单纯的图像描述,到基于图片构建问题,性能能提升多少,对对对,对但这件事最让人兴奋的是,如果你看这样一个模型,当然这稍微更像一个研究项目,你知道它在MMLW Pro上,拿到了56% 我觉得所以还不算最前沿,但如果你运行这个模型,你的GLM5.2质量没有任何损失,如果没有图像输入,它的行为和以前完全一样,而且最终在推理代码里,你根本就不会包含另一部分,对吧,对,我的意思是如果没有图像输入,你直接跳过编码器就行,好,只是确认一下,这对整体推理端影响大吗,你并没有增加太多东西,你只是加了一个很小的视觉编码器,这些通常都不到实意参数,对我的意思是,视觉编码器之间的标准化程度稍微低一些,所以知识矩阵可能会稀疏一点,但总体来说,对它是整个系统里一个相当小的组件,而且最终你从这个系统里得到的是,突然之间你有了Kimi的视觉 GLM的权重和DeepSeq的注意力,全都在一个模型里,我觉得开源的力量和美妙之处,很大程度上就在于,你可以把所有这些不同的组件组合在一起 [00:20:58]
swyx:形成一个比任何单独一个都更好的系统,以前人们说你会做弗兰肯斯坦式合并,就是从每个模型里取一些层拼起来,现在还有人这么做吗,回到你之前提到的,当一个模型刚出来时,比如GLM 5.2或Minimax M3 支持它需要做很多工作,有时候你确实需要,确实需要换掉一些东西,比如 minimax M3的头部,用的是全注意力,用全注意力的话,你会得到一个,非常离谱的瓶颈检查器,因为你要为三个token 做自回归生成,而且你要对所有序列里的token 做onfade计算,你的kv缓存会非常大,因为它不是吸输的,不是top k 所以我们发现更好的做法是,好,我们要把这个层换掉,换成另一个模型里,用gqa的层,比如然后只要训练得当,你就能让它达到同样的接受率,所以从其他模型改装层是完全可行的,而且实际上非常必要,如果一个层效率太低,训练就成了挑战,就是怎么确保你把它训练好,这又回到你之前说的,训练和推理之间的紧密联系,也就是说,你需要非常好的训练,才能实现快速的推理,我觉得这一点越来越成为事实,对,在支持这一侧还有什么别的吗,你说的是让它完全达到生产就绪,对我觉得还有一个问题就是 [00:22:16]
Philip Kiely:我们确实能把模型测到相当充分的程度,但我们是急着把它推出去的,然后你看到一大堆其他人来测,就会冒出各种有意思的结果 GLM之前就出过一个事,我们有几次模式崩溃,就是某些提示词,某些温度下,它会一遍又一遍的输出同一个token 一旦你把接口暴露给真实世界,喂进来的东西种类就多太多了,你才能发现这些问题,然后去修补,所以这不是一个发布当天就完事的过程,之后第一周,第一个月,只要模型还火着,你就得一边修bug 一边继续在性能上突破极限
swyx:你是说你不希望你的模型输出一堆SSSS 顺便问一下,那上面有循环检测吗,这种事还是经常发生,挺意外的,我们在接口里做了处理,如果模型连续输出同一个token四次以上,我们就中断这次生成,说抱歉,这个得重试一下,或者说重新处理这个请求,因为我们知道,连续四次同一个token 那基本就是崩了,对,那有没有办法选择退出,万一我真想要那个效果呢,有,其实有的,我记得我们有办法处理这个,我不太确定具体怎么弄,我觉得在某些模型里,比如他们要输出一个表格,你想象一下,他们想画12个破址号,再12个破址号,对我觉得这种情况是有办法让它发生的,我记得我们只对某些Token 做这个检测,会排除掉某些特殊字符,对,所以我们只对某些Token做,比如S在GL5.2里是最常见的,哦,我记得是 DeepSeek V4也是,就是那种循环问题,比如,对有什么特别的吗,没有,就是,它好像就是那一个Token 对,而且只在温度为0的时候,还是其他温度也会 0.9或者别的温度,它照样会崩,那挺奇怪的,对吧,说实话,这是个推理问题,是个软件问题,很多时候,你跑的镜像,比如英伟达,会发布一个镜像,如果我们把他们最新GLM镜像的改动,合到我们的技术站里,就会发现这个问题被修掉了,或者很多时候,这个问题只会在某个推理引擎里出现,比如你用的是某个引擎,但如果你换到VLM 就不会这样,所以这看起来是一个非常非确定性的软件问题,而不是模型本身的问题,不是神众的问题,我们不会说这是量化的问题,我们PDQ做错了,对吧,但那样说不通,因为同样的权重换一个推理引擎,就不会浮现这个问题,有时候是后端用的内核,有那种非常隐蔽的,偶尔出现的静态条件,如果你把这个模型放在某个集群上托管,永远不会出这个问题,天哪,天哪,但放在另一个集群上,就会原因是那个集群里节点间传输KV缓存,用的互联比另一个集群慢,所以那个静态就被暴露出来了,而另一个集群不会,于是最后你就只能这样,行这个模型不能放在这个集群上,我们放到另一个集群去,因为那个集群会暴露这个问题,但最后又会变成,那到底是软件的问题,模型权重的问题,还是硬件的问题,有个问题就是温度设为0 也仍然不是确定性的,对吧,主要是因为硬件,即使温度为0 同一个模型,你也不一定每次都能得到相同的输出,但静态条件那个我挺意外的,因为我以为PyTorch是个计算图,至少能保证按正确的顺序执行,他们不是那样做的,我不是说一定会有问题,但你有像PDL优化这种东西,你可以在前一个内核结束之前,就启动下一个内核,而你是想这么做的,就是流水线并行,对没错,但你不是干净利落的切分,你会让执行有一点重叠,不过我觉得很有可能内核本身,就是那个本该在某个时间点运行的块,那个内核自己就有静态条件,比如缺了一个barrier 通常如果你在设计内核时,想让它非常快,又没有做充分的测试,就可能出现某些线程,在别的线程写入之前,就去读寄存器里的数据,因为你的barrier不对,或者同步逻辑不对,但确实测试本身在大多数情况下,都非常非常难,而且没有像Rust那样的借用检查器,如果你想要内存安全的话,听起来是个类似的问题,对,但你是在CUDA里干活,因为达GPU 就是这样,你只需要一个更高级的语言,比如Modular 也许那就是Modular想做的事,我也不确定,那你怎么看待保持模型质量这件事,你讲了所有这些步骤,要做量化,训练自己的投机解码器,跑在不同的硬件上,再看看其他模型提供商,你在消费端掀起了推理速度竞赛,那保持质量一致靠的是什么 [00:26:56]
Philip Kiely:当然你可以跑基准测试,但你怎么确定量化到什么程度,标准是什么,实际要做什么,质量方面有几件事,大多数推理优化是无损的,比如KV缓存,你只是重新计算,或者避免重复计算相同的值,投机解码,当然如果草稿token是错的,它会被拒绝,主要的有损优化就是量化,而这真的归结为几点,第一数据格式,第二你选择量化模型的哪些部分,哪些层,第三对量化后的权重做大量校准,确保你保留了所有的离群值,不过还有一些别的技巧,一个重要的就是长上下文,因为你一开始问的就是,如果我发一个20万token的请求会怎样,显然输入序列很长时,你需要存储更多信息,需要处理更多token 所以即使一个模型有某个长度的上下文,作为推理提供商,你也可以选择构建一个上下文更短的API 当然也提供完整长度的,因为如果用户不需要完整的百万token上下文,你可以给他们更好的性能,我不知道这算不算严格意义上的模型质量,我对质量的理解是,我们在多大程度上忠实的服务原始模型,如果你想象一个模型的黄金实现,它完全按照模型设计的方式运行,那质量就是我们离100%保真度有多近,当然你也可以从训练的角度,想质量怎么把自己推到100%以上,但当我纯粹想推理优化时,就是在更快的同时,尽可能贴近100%保真度,而且我们内部的标准肯定是,你不应该能分辨出我们的API 和官方API之间的区别,我觉得Kimi在供应商基准测试这块做得特别好,对他们发布了真正的供应商基准测试 [00:29:14]
swyx:因为他们指责了一些人亚马逊,有个提供商在Kimi的基准测试上表现不太好,所以他会反映出来,这是很久以前的事了吧,不大概三四五个月前,这个也发生在我不记得是哪个模型了,但他们撤下了好几个,然后他们开始做了一整张图表,可能是Kimi供应商验证器,对,因为你会很生气,对吧,如果我是消费者,我用的是亚马逊的端点,我用了Kimi 然后我想,天哪这好差,我不会说,亚马逊量化模型的方式有问题
swyx:亚马逊量化模型的方式有问题,我会说 Kimi很烂,对吧,所以看起来就是这样,对他们在乎,他们在乎,这倒也是合理的,对,这可能是个很蠢的问题,但我就确认一下,量化之后有没有可能变好
Philip Kiely:量化是不是永远只会更差,哦,严格来说不是,量化是有损的,量化是一种有损实现,速度会提升,它确实有改进,显然,比如 [00:30:16]
swyx:我一直在找逆缩放定律,这是我从诺姆布朗那里学到的,就是那些通常朝一个方向起作用的东西,有时候他们会,严格来说
Philip Kiely:当你跑基准测试的时候,因为这些模型是非确定性的,有时候你的NVFP4量化结果,会比原来的高两个基点,对确实,它就在误差范围内,所以我一直说在误差范围内,我后来不这么说了,因为大家都以为我的意思是,在某个误差范围内,我们勉强踩在最差的那一边,所以我们在说的是,但确实,有时候它就是会给出更高的输出分数,但就像阿里说的,那是噪声,据我所知,你并不一定能让结果变得更好,你只是在尽量,让保真度贴近原始模型的100% 说到这点,我们在NEPI上做过研究
swyx:我不知道你能不能翻到那条推文,我们发过一篇研究,是Joshua做的,我记得是一条推文,讲我们量化的GLM5.2 比英伟达的好20% 基本上我们在这两个月的研究里,发现的是量化是有损的,你再把数据从16位压缩到4位,比如所以你显然会丢失一些信息,你要做的就是尽量把损失降到最低,所以当我说我要量化这个模型的时候,我的任务就变成了,怎么找到可以量化的层,怎么找到不能量化的层,比如图像模型,我不会量化调制层,也不会量化输出投影,因为这两个输出投影是用户看到的东西,调制层是模型看到或理解的东西,对没错,所以关于他那篇论文,你有我猜他没有,对那篇论文很长,我不知道能不能找到,如果有可搜索的部分,可能就在那个帖子里,可能就在帖子里,但基本上长话短说就是,量化模型更多的部分,确实有可能让结果更好,比如我有一个模型量化了第150层,另一个模型只量化了第1和第2层,那么量化了更多信息的那个模型,有可能表现更好,因为量化误差相互抵消了 Joshua在他的数学证明里,他有一个验证器,证明了你可以预测哪些层的量化误差,会相互抵消,然后你选择去量化那些层,所以做这种数学量化的结果是,你最终得到的模型,比其他提供商多量化了20% 所以你获得了20%更多的吞吐,因为有更多层在跑NVFP4 而且你的质量比别的量化版本更好,因为你选择量化的那些层误差相互抵消了,一层偏右,一层偏左,一层偏右,你最终的logis分布和原始模型的分布更接近,所以你的保证度更高,我们证明这一点用的是KL散度,我们不只在基准测试上打分,我们计算了量化模型,和原始全精度模型的logits分布之间的KL散度,我们证明了用这个技术,如果你的模型在下一个token选择上的概率分布,和原始模型更一致,你就更可能保持原始模型的本色,所以在这之前,业绩似乎认为量化的越多就越差,因为你引入的损失越多,这不完全对,不一定,所以它不会让结果变好,但可以让误差抵消,我觉得可能就是这个,不过这让我想到了简直,你可以减掉某些层,但很有意思,我不知道这居然能写成一篇完整的论文,有个好玩的事,这篇论文原本有72页,然后我们觉得不能就这么发出去,所以现在它变成了425页,那还是有39页,非常扎实,我们聊了评测这些,那在提速方面能做到什么程度,我觉得这可能是大家最关心的事,也是你文章里写到的,官方API是每秒70个token 你把它推到了90 这是常态吗,做推理最酷的地方在于 [00:34:04]
Philip Kiely:我觉得推理会是一个,值得长期做工程的地方,原因是,如果你看看那些高度优化的领域,比如金融,你在金融行业,你衡量自己提升了多少适用基点,比如我提升了五个基点,也就是1%的1% 那已经是天大的新闻了,因为一切都优化到极致了,当我们发布优化成果的时候,是20% 是100% 是200% 所以老实说,前面应该还有很长的路要走,当研究人员开始发论文,说自己在某件事上提诉了1%的时候,你就能知道推理基本上已经被做透了
swyx:顺便说一句,因为我本身是金融背景,在70年代,那就是当时的利润率,你做量化金融研究的时候,能找到这种机会,而现在就是20% 百分之几十这种,对,现在这些已经变得很小了,感兴趣的朋友可以去看看 Andrew Lowe的论文,他有一个很有意思的图示,量化统计套利分布,从70年代那种20%的差异
Philip Kiely:一路收窄到今天几乎为零,非常酷,完全正确,我们现在就处在同类事情的起点上,不过基准测试很难做,这点我想任何人都会告诉你,给各家服务商的速度做基准测试也很难,因为涉及的变量太多了,你用什么硬件系统上负载多大,提示词的具体性质,输入输出的序列是什么样的,诸如此类,但总的来说,当你把这些改进叠加起来,你看到的是倍数级的提升,最常见的指标当然是TPS 也就是每秒Token数,这其实是我们行业里起的很差的名字,因为实际上有两种每秒token数,一种是吞吐量意义上的每秒token数,另一种是延迟意义上的,对,比如从GPU里出来的总每秒token数,那是吞吐量指标,大多数人关心的只是作为延迟指标的每秒token数,这个我们应该叫ITL 也就是token间延迟,但我们没这么叫,总之你可以想象一个标准的API 没做太多优化跑一个一万亿参数的模型,在合理的流量特征下,大概在每秒30到50个token这个区间,我们通常的目标是把它推到10倍,但也不一定发布当天就做到,而是通过叠加足够的优化,比如你有三个优化,每个都能让性能翻倍,叠起来就是八倍收益,这就是我们在这个领域里工作的数量级,我们追求的是大幅提速,而不是从70提到90 你是说你们已经做到了,这么说吧,假设一个合理的基线,是每秒30或40个token 你可以做到它的10倍,比如在GLM5.2上,如果你不量化,甚至跑在hopper上,只用现成的推理引擎,不做特别的优化,没有投机解码器,没有KV路由之类的额外配置,没有分离式部署,那你大概就是每秒30到40这个水平,你觉得这个基线合理吗,对,要做到10倍左右,你要做很多取舍,如果我们跑到每秒300 400个token这个区间,显然你用的是最好的硬件,有优化过的投机解码器,量化工作全部做完了,缓存命中率很高 P大小比较小,并行配置是针对延迟和吞吐做了调优的,但这是可以做到的,所以你去Artificial Analysis或者OpenRouter上看,最差的服务商到最好的服务商之间的差距,往往就能达到这个量级 10倍当然是非常激进的,通常可能更多是4到6倍的提升,但正是这种性能让我们特别兴奋 [00:38:04]
swyx:能拿到这么大的收益,而不是从70个Token提到90个,这也跟硬件有关,比如你在一台H100节点上提供服务,然后你把模型切分到4台B200节点上,你当然可以通过堆更多硬件来提速,但如果把硬件和GPU数量都归一化到完全一样的话,那就是另一回事了,对那大概就是2到4倍的提升,取决于推理优化做的怎么样
Philip Kiely:所以一部分看车是什么,一部分看司机是谁,如果把2到4倍拆开来看,比如在B200上跑GLM5.2 单节点对吧,为了榨出最后那点性能
swyx:投入的成本和收益怎么权衡,大家应该怎么想这件事,投机解码加量化,投机解码加量化,那大概占了95% 那能带来多大提升,对普通人来说做起来有多容易,比如现在我想把GLM5.2的权重,放到一台B200节点上跑,找到现成的投机解码器,或者已经量化好的模型有多容易
Philip Kiely:需要做多少工作,如果你要自己从头做,那工作量相当大,但放到今天来做,已经有人把成果发布出来了,你直接就能拿到NVFP4的权重,也能直接拿到投机解码器,对如果我们想想,我们叠加的那些翻倍提升,从BF16到NVFP4 其实不算正好二倍,对吧,我觉得从16位到8位,大概是30%到40%的提升,再从8位到4位,再乘一个30%到40% 所以加起来不完全是二倍,但差不多接近二倍,投机解码大概又是二倍,再加上分离式预填充和解码,如果你有足够的硬件,能跑足够的流量,又是差不多二倍 [00:39:14]
Philip Kiely:又是差不多二倍,然后再加上一个更好的运行时,带来的百分之十几的提升,就是背后有最新的内核之类的,大概就是这么叠加起来的,所以构建其中每一项,比如量化权重,对真正懂行的人来说,是几小时到几天的工作量,构建投机解码器,也是几小时到几天,分离式部署,也是几小时到几天,不过一旦你有了这些,就都好了,一旦你打好了,对,第一次把分离式部署跑通,当然是非常难的,但编辑上的实现成本就低多了,如果你只是拿现成的,比如你是个普通用户,手里有一台B200节点
swyx:想知道怎么自己托管,你不需要自己量化模型,总会有人发不开源的量化checkpoint 就算没人发,英伟达也会推一个出来,通常推理服务商,也会训练好他们自己的投机解码器,你不需要自己训练,直接用他们的就行,对比如KimiGal M5.2自带MTP 对,多token预测,对,如果我搞错了,你可以帮我纠正一下,对如果我们说错了,你确实该纠正,但他们的多token预测,可以用来做自投机解码,这个我其实不太确定,我对书里的说法有七八成把握,但可以让人去查一下,不过用它来讲清楚,这个故事很有用,不只是普通用户,比如一家公司,想从无服务器推理切换过来,想租一些GPU自己部署,这些就是你为了,比直接放在VR后面快得多,而要走的步骤,我一直在等有人提到Dynamo [00:40:42]
Philip Kiely:我觉得那才是你应该,拿来当基准去对比的东西,我觉得Dynamo 与其说是一个开箱即用的系统,不如说是一个,用来搭建的开发者工具包,所以当我们说做KV感知路由,做KV卸载,做预填充解码分离的时候 Dynamo本质上顺便说一句 Dynamo是英伟达的开源库,那部分我们和Kyle已经聊过了,好,那你的听众应该知道,它支持各种不同的推理框架,而且它其实是多硬件兼容的,这点挺有意思,但它只是个路由器,不是优化层,对,它做的就是Dynamo 擅长的是,它是一个在集群里,在硬件之间搬运信息的库,比如你的KV缓存在一个地方,需要挪到另一个地方 Dynamo会协调Nixo帮你搬过去,这不意味着你开箱即用,比如PIP install Dynamo 就能获得巨大的性能提升,它更像一个开发者工具包,对我会说它自带一组默认配置,你可以自己替换掉,确实如果整个行业都把这些部署方式,标准化的铺开,那它确实可以算一个可信的基准,但我们拿它跟实际环境里看到的情况做了对比 [00:42:30]
swyx:我确实想再多聊一点PD分离式,玉田冲和解码,因为那大概是排在量化和投机解码之后的第三大话题,不过在你的书里,我正想翻一下这本书,对,比如522节讲Medusa 523节讲Ego 对 524节讲 55节应该是讲,分离式玉田冲和解码,不我只是想多停留一下,聊聊其他的,比如你选择收录什么,选择不收录什么,因为我觉得还有好多其他技术,对,这些技术现在还相关吗,因为我觉得他们大概是一年半前出来的 Medusa挺老的了,对 Medusa是挺老的,但它收进书里,是因为它是个好的基线,就是你应该知道的东西
Philip Kiely:就像我读那篇论文的时候,我就想,这太有道理了,对,所以写这本书的时候,我有几个目标,一个是给人们提供理解,整个领域所需的基本词汇,另一个是,让他们对每种技术的工作原理,有一些直观理解,就像我在AI工程师演讲里提到的,那算是这本书的,第一个公开补充,投机解码这个领域的发展速度,比其他所有领域都快得多,所以对,即使在我写书的时候 Medusa我也更多是,把它当做帮助人们,理解这个领域,如何演进的工具,而不是最新的技术,现在当然有了 D-Flash D-Spark 还有比Ego更新的技术,不过Ego现在依然非常常用,投机套投机,对,投机解码,套投机解码,你能,这基本上是一篇 [00:43:42]
swyx:Tree Down的论文,它基本上就是在做,投机解码,对,投机解码做投机解码,这其实就是另一篇论文,对这是最重要的解释,而且看起来它确实拿到了不小的速度提升,但训练的复杂度也很高,至少在我们看来,这几乎跟训练生成对抗网络一样复杂,这是一个非常微妙的平衡,很多时候就差那么一点点,但没错,这本质上就是在投机解码之上,再做投机解码,确实如此,我们看到了这篇论文,挺有意思的,对吧,我甚至没想到它会这么难训练,对,我直觉上会觉得,好,那就训练一个投机解码器呗,而且这说得通,投机解码的整个思路就是,它有点像iPhone的自动联想输入,但用在普通模型上,对吧,你先生成三个token 然后说,好,对它们做预填充,这样,你就为原始模型,省下了那三次生成,现在你的投机解码器,在做三次自回归生成,那为什么不干脆,用一个更小的模型呢,我想问的另一个问题是,投机模型的大小是多少,比如说GLM的,对,大概10亿token 10亿参数,比如minimax的,对,对就一层,大概是原模型的六十分之一,对,其实我觉得,我们回办公室之后,应该写篇论文,投机套投机套投机解码,不,这确实看起来,怎么说呢,什么时候是个头,但另一方面,如果你能训练投机套投机解码,比如说,如果你能有一个小模型,能准确预测中间那个投机模型,会预测什么,而那个投机模型又能预测原始目标模型会预测什么,那为什么不直接用那个最小的模型呢,对吧,对这跟路由问题是相关的,对没错,对,投机模型的一个实际限制是,你必须在跑大模型的同一套硬件上跑一个小模型 [00:45:30]
Philip Kiely:这里面天然就存在编排和资源竞争的问题,这也是投机解码整体上的一个约束,草稿token的生成要消耗资源管理,他们还要增加软件复杂度,所以如果你搞无限地归的投机模型,你不仅在训练过程中,在推理引擎的实际实现里,也会增加相当多的复杂度,我正想说,我好奇能不能做类似的蒸馏和剪织 [00:46:22]
swyx:你知道这是同一回事,它就是个模型,我们能不能把很多权重蒸馏掉,把投机模型量化一下,不过这超出我的领域了,我想问的另一个问题是,这些都是针对大型服务器工作负载的,对吧,这些有多少能应用到,比如说我有一台MacBook 我想高效的跑Gemma是类似的问题,但不完全一样吧,差别挺大的
Philip Kiely:几周前我跟Salo在他的博客上聊过,数据中心和生产工作负载的推理工程,跟本地AI的推理工程,区别在于我们一开始的约束和目标就根本不同,本地AI的问题是,我怎么把这个模型塞进我的硬件,然后让它更聪明一点,而数据中心推理的问题是,我怎么加载这个模型,然后让它更快,显然我们也关心更聪明,他们也关心更快,但本地AI的推理工程生态,我觉得其实有很多,值得我们数据中心领域学习的地方,他们在各种量化技术上很擅长,包括动态量化这些,我们在剪纸,蒸馏,层移除这些方面,基本都不碰,层移除的影响没那么大,对,其实没人做剪纸,对,但他们确实在做,这挺让人意外的,对吧,但只是为了把东西塞进笔记本里,对,对,所以这是个挺有意思的领域,倒不是说他们的技术,对我们数据中心来说也适用,因为我们显然有不同的资源,和不同的目标,更多的是那个过程,以及那个领域的开放性,是值得佩服的,对就像你说的,某些优化 [00:48:09]
swyx:比如TurboQuant 你肯定听说过,它在X上引起了巨大的轰动,我们在Twitter上做了深入的探讨,它是什么,怎么工作的,为什么好或者不好,然后它就火了,被实现在本地设备上,因为你的内存带宽太慢了,比如在MacBook上,但试试把同样的东西,放到英伟达GPU的B200上 TurboQuant就不会被英伟达采用,英伟达明确表示,这不是一个好的优化,我们亲眼见过在Kernel内部做反量化,量化的开销 TurboQuant Kernel消耗的时间,实际上比它省下的时间要慢得多,因为在B200上,你有大约3.5TB每秒的带宽,你不需要那么大幅度的减少存储,你不需要做FP4KV缓存,你不需要用那些有更好的优化可以做,但在边缘设备上,这极其重要,极其有用,所以看起来是不同的优化方向,但它们又都独特的组合在一起,比如你想量化模型,你想做投机解码,比如某些公共潜队,原理,对完全正确,完全正确 [00:49:23]
Philip Kiely:他们还在模型并行上,做了很多工作,尤其是在eGoTop下,你有一些Spark机器,用以太网DGX Spark连在一起,对这就是Excel Labs 对你有一堆Mac mini堆叠在一起,有一件事我觉得,我们俩都得面对,虽然他们面对的更多,就是机器之间的互联,这就是为什么我们经常做张量并行,那是你用全部8块GPU 把模型切分到上面
Philip Kiely:把模型切分到上面,张量并行不太适合本地AI 因为它假设有非常高带宽的互联,比如Nemlink
swyx:而它们可能被迫做流水线并行,我们除非做某种多节点推理,否则永远不会用,既然你提到了,我其实不确定我们会不会讲这个,但让我们简单解释一下,张量并行和专家并行 [00:50:08]
Philip Kiely:因为你有很多漂亮的图,对,就是想展示你的图,对,感谢Baseten设计团队的Luke 做了这些漂亮的图,在进入这个之前,还有一个区别是,我们经常谈论,混合专家模型的激活参数,对,本地推理的人来说,这很重要,因为如果你的P大小是1 你只激活那么多参数,当我们做,对,我本来想在扩散模型那部分,讲这个,对,对,当我们处理一个MOE模型,并把它托管成API时,我们假设所有参数都会被激活,因为你要取你的批次,你会碰到所有东西,好所以大体上,张量并行适用于任何模型,专家并行只适用于MOE模型,实际上今天所有模型都是MOE模型,至少所有大到值得跨多块 GPU并行化的模型都是,所以细微差别现在没那么重要了,专家并行的思路是把整个专家放在一块GPU上,通常专家数量比GPU多,所以你可能每块GPU放N个专家,比如每块GPU8个专家之类的,然后你在每块GPU上复制router router非常小,然后通过在专家之间移动生成过程,每个专家都在一块GPU内部,他们不竞争资源,你大幅提升了吞吐能力 GPU到GPU的连接就没那么重要了,因为通信量不大,张量并行要求你能做全收集,全规约这类操作,所以你基本上把模型完全切分到各GPU上,然后每一步你都要合并每块GPU的结果,这就是为什么互联很重要,当然这是一个非常粗略的概括,有很多地方并不准确,但一般来说张量并行对延迟有帮助,在很多情况下,你会在模型的不同部分组合,使用这两种并行 [00:52:09]
swyx:而不是只选一种,你想补充点什么吗,在一个模型里,它们不是互斥的,你会做张量并行,也会做专家并行,流水线并行用的比较少,在我看来,我们从来不用VPN 对
Philip Kiely:你唯一需要做流水线并行的情况,就是把不同层拆开,一半层放在一块硬件上,另一半放在另一块上,就是当你被迫做多节点推理的时候,因为模型太大,你不得不这样,比如说假设你因为某种原因,在H100上做部署,然后你要把一个万亿参数的模型放上去,你就必须用多个H100节点,因为节点之间的互联太慢了,唯一可行的并行方式就是流水线,但每个节点内部,你还会做专家并行和张亮并行
swyx:那H100的限制因素是HBM吗,对就是显存不够,多少,我们需要记住的关键数字是什么,比如B200是每张GPU180GB 然后一个节点8张卡,就是180乘以8 NVFP4的话,每个参数占半个字节,所以那是800GB H100上大概是140 [00:53:08]
Philip Kiely:是80 是80 对,对,我老了,干这行很久了,我还真记得H100的时代,对不是,所以有一件事 T4 我跟你说说
swyx:当年在T4上跑模型是什么感觉,有一件事让我挺惊讶的,就是没多少人用Jamba 不知道你们还记不记得 AI21的Jamba 他们会专门挑一块硬件,然后针对那块硬件设计架构维度,这样显然能把硬件跑满,这很合理,但好像现在这些模型都没人这么干,但训练那边不是这么做的吗,我不知道,什么抱歉,训练那边,你是说决定用哪块GPU 对,训练那边确实会训练,更像是一个数学问题,你可以跑一下计算,看看浮点运算量,然后最大化它,推理这边更像是自动调优,就是GPU内核自动调优,基本上就是你定义一下,比如我两块GPU 我可以做TP1 TP2 1P1 1P2 对吧,这样你就有大概2的平方种组合,然后你就拿同样的流量去试,用真实的生产流量,看看哪个配置给你最好的TPM TPS你就用那个,我不太喜欢的一点是,你没法推理出哪个配置性能最好,也不存在一个永远最优的固定配置,但看起来自动调优就是找到最优解的方式 GPU内核也是差不多的道理,你设计好内核,设计好配置,启动多少个线程,用多少共享内存,你就自动调优,在旁边扫一遍参数空间 [00:54:42]
Philip Kiely:经验上那个最好就用哪个,但这些东西是组合在一起的,不是分开独立的,训练里确实有一些是针对硬件优化的,比如你看英伟达的Nemotron模型,它们在Blackwell上跑得非常好,这并不意外,所以确实有一定程度的针对性,但我觉得大多数开源实验室的目标,是让模型能在尽可能多的硬件上跑,而不是只针对单一芯片,明白了,为了通用性,对 [00:55:06]
swyx:好趁这张图还在,我再问一个全收集,全硅,约很贵,硅谷现在有个趋势,叫Mega Kernels 就是把内核不断融合,我不太确定,真有这么简单吗,我是说融合内核救不了你,比如这里做张量并行,一半矩阵在GPU上,另一半在另一块GPU上,如果下一步要做非线性操作,我需要整个矩阵,比如做注意力的时候,我需要Softmax 需要做指数运算,我得有整行数据,所以我得知道GPU2的部分结果,和GPU1的部分结果,才能在下一阶段做Softmax 所以即使我有融合内核,因为每一步里面的非线性,我也必须让它们互相通信,另外关于Mega Kernels 说实话我挺不看好的,我只说请讲请讲,不是,就是Mega Kernels 它是个不错的研究方向,理论上看起来也很漂亮,比如你会想,启动一个内核有很多启动开销,对,那就一直融合呗,把所有东西都融合在一起,但是内核本身的复杂度很高,写一个高度优化的Mega Kernel非常难,真的非常非常难,而且不点名了,就算那些做融合Mega Kernel的公司,我跟他们的人聊过,他们很多时候最后也不会在生产环境里跑这些,因为那些模块化内核启动起来反而更快,你可以单独优化每个组件,还能让他们互相并行,还有Rubens 不知道你们昨天有没有看到Rubens的推特帖子,他们也在 Rubens 什么,不是不是,就是那个GPU Rubin才有专门的推特账号,不不不,我还想你在说什么呢,抱歉,英伟达的一位技术负责人发了条推特说,我们要揭开Rubin的面纱了,这是规格,第三条推文展示了,不往太技术里说了,我还得再仔细读读,但这个GPU的设计方式,基本上把我的内核给干掉了,你不再需要那么多我的内核了,所以看起来整个研究领域,可能就不会继续下去了 [00:57:21]
Philip Kiely:不过对,我能对Rubin瞎猜一下吗,请讲,你知道,我现在已经经历过了,顺便说一句,书里也写了他们,对,不过,对,书里写他们的意思是,我从那篇播客文章里知道 Reuben将来会推出,你甚至把那个名字都说出来了 Find Man 对,就像是在说,这个会是,这已经非常过时了,我是在努力让这东西面向未来,行了吧,我可不想明年之前再发心的,总之,我们刚才在聊我有多老,你看,我已经经历了三轮硬件发布周期,我经历过Ampere发布周期 Hopper发布周期,还有Blackwell发布周期,我说发布周期,不一定是指硬件真正出货,比如Ampere在我入行之前,就已经大规模部署了,但硬件从部署到能用于推理,中间隔了很长时间,所以你看最初的VLM和Sclang 尤其是VLM 那是针对Ampere写的,后来得为Hopper更新,再为Blackwell更新,每一轮周期节奏都更快,更紧迫,但也复杂的多,当我往前看看 Rubin会带来什么新东西时,我觉得Dynamo 给了我很多技术上的线索,告诉我哪类工作会非常有价值,显然我们还在延续 Blackwell的一些趋势,对吧 NVFP4很重要,他们为NVFP4张量,核心投入的算力非常庞大,我们后面应该会聊到视频,那是最大的瓶颈,内存带宽会快得多,这也是Blackwell之所以出色的原因,但最大的变化是更强调系统思维,更强调CPU到GPU的互联,更强调GPU之间的互联,你看Dynamo 它整个系统就是围绕一个问题设计的,怎么把KV缓存及时送到该去的地方,所以我觉得KV缓存卸载 KV感知路由,分离式架构这些主题,在Rubin时代会重要得多,这意味着推理工程,不只是CUDA内核的问题,也成了非常传统的,硬件基础设施问题,这是我们长期以来,一直在积累的方向,这让我很兴奋,因为我们会看到多个领域碰撞,从内核层面一路推理,到硬件层面再回来 [00:59:18]
swyx:这种能力会非常有价值,我想把Philip说的再往前推一步,我觉得趋势是它正在变成,纯粹的基础设施问题
swyx:纯粹的基础设施问题,像预填充,解码分离,训练,投机解码这些问题,但GPU内核不会是大问题,因为GPU正在越来越像ASIC 你只是在编排GPU上发生什么,而不是在逐线程控制它,你看QTile QDSL 你只是在数据Tile的层面工作,不在控制GPU上每个线程做什么,那部分已经替你处理好了,所以我想问,你同不同意GPU和未来的GPU 正越来越趋向于变成ASIC 只需要启动,然后他们自己完成数据运算,基于你和其他人的交流,哦我是说对,不那确实是市场的一部分,对,显然ASIC在他们自己的工作负载上,能带来高得多的性能,对,而GPU里的那个G 让他们继续保持很强的通用性,对,我觉得这里有个光谱,其实是Graphics 但没错,我老这么说,我得纠正自己,免得你揪着我G拼错了,对,这就像一条光谱,对吧,从非常通用的计算 [01:00:51]
Philip Kiely:一直到像TELUS那样,硬件是为特定一组模型权重打造的,权重直接烧进芯片,对,不用加载,我不会说我们正在完全走到那一步,更像是沿着光谱
swyx:朝硬件更专业化的方向迈了一步,对,我很好奇,我感觉它在往某个方向引,我想我的重点是,对烧权重进芯片之外的一切持悲观态度,把权重烧进芯片,实际上行不通,因为你想微调,想优化,想量化,想发布模型的新checkpoint 如果烧尽芯片,芯片一两个月就没用了,对吧,我想说的是,你怎么能看着英伟达越来越专业化,却不对那些做AI ASIC的公司保持乐观,你看英伟达把GPU从通用编程范式,就是一台你可以用来编程现成的通用计算机,每一代都在加入更多专用指令,专用张量核心,专用的UMA指令,这些让你几乎可以像控制ASIC一样控制它,像控制一组ASIC 你怎么能看着这个趋势,还对那些做AI ASIC的公司保持乐观,从某种意义上说,从某种意义上说,对因为他们确实在往那个方向演进,几乎就是在往那个方向演进,像Rubin跟Ampere或者T4比 Rubin基本上就是个ASIC 它基本上就是个被拿来用的东西,可编成ASIC 对有点像你当然可以编程,当然可以,我说它是ASIC可能有点争议,它确实是GPU 确实是通用的,确实有现成,我可以写CUDA去控制它,改变它的操作,但它有Solid阵列,张量核心 MMA张量内存,它有这些东西,几乎只对加载模型权重有用,它有张量核心指令,几乎完全是照着今天市场上,现有模型的头维度来设计的,你说你要搞个ASIC 要把什么东西时刻进去,那下一代架构一出来,它基本就废了,对我也不知道,真不知道,我觉得要记住的是,硬件周期有多长 [01:02:07]
Philip Kiely:所以如果今天有一块芯片出来,那意味着它的设计流程,是好几年前就启动了,英伟达在预测市场走向这件事上,做得非常好,而且你知道,他们掌握的信息肯定是最多的,那当然,但如果你去看,现在公开的开源模型架构,跟今天这些模型的早期版本差不多 Rubin其实是第一块,完全在那个世界里造出来的芯片,所以你能从它的设计方式里,看到很多对这块芯片,将要承担的工作负载形态的理解,对,好所以我不是回答那些问题的最佳人选
swyx:我觉得这些问题问得非常公允,而且显然是我听过的,关于Rubin的提问里,被阐述得最清楚的,第一个,但我确实要为垂直整合的模型实验室ASIC做个辩护,比如OpenAI和博通合作的随便叫什么Shalapino 当然那块芯片完全说得通,我们之前在播客里跟Martin Cassado聊过,他说你看如果你有1万亿美元或者5000亿美元的训练投入,那就拿其中500亿去做ASIC 没问题,你从ASIC上拿不到超过10%的效率提升,但这也说得通,对吧,所以针对特定模型的芯片可以,但AC公司有意思的是,我觉得你特别关注,超级关注你说的那些Tile之类的东西,他们其实在做更多表面工程,或者说实际的内存和硬件分配,还有芯片之间的通信,这些可能Rubin还不会触及,但具体细节我不清楚,明白,他们通常谈论的东西,我预期会有比Rubin 能通过编程实现的,更大的数量级提升,但谁知道呢,不,我明白,我明白,我明白,对,看起来,对,我是说,你想一想,实现十倍到一千倍,更快推理的真正障碍是什么,不是那些在现有GPU设计,内部就能重新安排的东西,芯片兼通信,对,这些人目标是每秒30万token 他们可不是闹着玩的 [01:04:30]
Philip Kiely:那可能得编成一些ASIC了,也许吧,我觉得有意思的是,你最近做了这么多内核工程的工作,却对其中大部分这么悲观,对,我做的越多,就越觉得它没那么大 [01:05:16]
swyx:我还想补充一点,模型一代一代再出,对吧,我觉得在你们那边,你们看到很多,今天GLM Kimi DeepSeek MiniMax 还有其他一堆,有些在做完全不同的东西,对吧 Gemma 没有编码器,最新的Thinking Machines 全是从头搞的,但你看另一边,我们在GPD5这一代上,待了多久了,对吧,对,他们那个模型,已经服务挺长时间了,当然,可能还有更多预训练,有不同版本的检查点,但说实话,你能榨出不少东西来,你花了几十亿美元做一次训练
Philip Kiely:如果能让它效率提升百分之几,它们就能服务很久 Cloud5系列不也一样吗,如果它们发布新模型,比如现在发布GPT-6什么的,而且每年都发一个新模型,我们虽然不知道,但假设它们改了一些架构,不只是做后训练,那你每年要花500亿美元,每一年都为一个新模型造一块新ASIC 然后把上一年的ASIC扔掉,对,轻松 [01:06:10]
swyx:所以我觉得,我稍微有点不同意,基于我那些二手信息,关于模型的寿命,现在还有人用4.0呢,对,对,对拉玛,不是拉玛2 是拉玛3 我还能看到拉玛3的工作负载
Philip Kiely:对,因为如果它够用,如果它被信任,就别动它,如果它好用,这正是开源的一个承诺,对吧,整个SAVE 4.0运动,你根本不需要搞什么 SAVE 拉玛3运动,你只要在某个地方
swyx:放一台8100就行,我觉得到某个时候还有个问题,如果一个模型能做足够多的事,能调用足够多的工具,有足够的agent能力,那它是不是就能自己网络搜索,工具搜索,写代码,你真的还需要继续压榨更多吗,我们会继续,因为你们会把它做得又便宜又快又小,我可以随时换进去,但在某种程度上,你今天给我5.2或者随便什么120B的模型,我能用挺长时间,对吧,这是假设你不需要更强的智能,我觉得有很多,你需要的是可靠性和可预测性,我在企业里,这东西是经过验证的,是我那5000个利益相关方签字批准的,我不会去碰它,他每天跑一个批处理任务,我喜欢这个结果,结果可预测,对一直用他们确实没道理,东西会变得更稀疏,更便宜更好,对,但这不意味着旧模型,比如GM5.0就不能用了,对吧,如果我们遇到瓶颈,不管什么原因,还是有很多可以炸出来的,我们快没时间了,我确实还想确认一下,对正好我们有这张图,拿它跟任何Cerebrus的图比一下,对吧,我觉得Baseten和MEDEX还没公开过图表,但完整的布局非常不一样,尺寸也非常不一样,这不是晶圆级的,对吧,这上面大概,我不知道一块晶圆上能有几百个这种,我不知道对比有多大,但确实这是一个非常不一样的物理空间分配,我猜几十个吧,几十个,在离开硬件这个话题之前,我有两个小问题,第一个最新的Kimi体量非常大,三万亿参数,对,单节点上大多数硬件都放不下,对,你需要GB300 你需要GB300或者AND [01:08:53]
Philip Kiely:这就是个简单的数学问题 NVFP四格式下 2.8万亿参数,就是1.4TB GB300每张卡有288GB显存,所以8张卡加起来,就够放这个模型了,而且说实话,做GPU显存计算的时候,你还得给KV缓存留出空间,这在一定程度上取决于上下纹长度,所以当一个模型参数规模很大,上下纹又很长的时候,你就是在跟空间较劲,这也是为什么KV缓存卸载在这些大模型上,会变成一个更受关注的话题,因为空间实在太紧张了,到了Rubin这一代 NVL72整机架有20TB显存了,对吧,对,不过Blackwell上也有NVL72 但你不能假设推理一定跑在那上面,世界上八卡机架的数量比NVL72多得多,对,我最后一个关于硬件的小问题是,你有没有注意到硬件代际 [01:09:49]
Philip Kiely:你有没有注意到硬件代际,对新的预训练基础模型有什么影响
swyx:你之前提到效率提升的一个手段是换硬件,那是二倍收益的来源之一,当我们看到Rubenson训练方面,有新东西出来日志上有什么变化吗,这会影响到这些硬件更普及之后 [01:10:03]
Philip Kiely:我们会看到什么样的模型吗,你能,模型会变得更大,人们会理解在最新的推理硬件上,你能跑多大参数量的模型是有天花板的,这个天花板就决定了模型规模,比如DeepSeek R1出来的时候,是6710亿参数,当时已经非常大了,我觉得它很大程度上,推动了我们快速采用Blackwell 并且把在Blackwell上,做推理服务这件事做好,所以对我来说,这主要就是模型规模的问题,然后是让架构和原生量化方式,去匹配目标硬件,就像我们聊到的,比如所有Nimotron模型
swyx:都用NVFP4 我们聊了很多大语言模型,对处理还有更多内容,音频视频,推理工程的另一面是什么,阿力你在视频扩散这块挺深入的,视频扩散模型,它们的形态跟大语言模型很不一样,很多你用来思考大语言模型的东西,比如自回归,在视频扩散里是不成立的,比如说你不做P处理,每个请求进来就在一张GPU上处理,一张GPU服务一个请求,你不需要做分片,模型也小得多,比如1.2.2就是个200亿参数的模型,你不需要担心那些,它比最好的大语言模型小了好几个数量级,而且这个领域里,开源模型和闭源模型的差距,跟大语言模型不一样,大语言模型这边 Kimi K3已经几乎能跟Methos 或者GPT 5.5比肩了,最好的开源大语言模型,和最好的闭源大语言模型之间,差距非常小,以前可能差6个月,我觉得现在连6个月都不到了,基本上已经没什么差距了,但视频模型绝对不是这样,差距巨大,如果你看看今天能用开源模型,比如One 2.2生成的最好视频,跟Clean或者Vio比,那真是天壤之别,这就造成了一个落差媒体,公司大多数时候会选择闭源模型,比如我告诉你,我能用这个模型帮你生成一部三小时的电影,而且我会优化到让你只付10美元,但如果他们用闭源模型做,得付1000美元,我便宜了100倍,但他们还是会选择用Vio和Clean来做所有剪辑,所以这就是一个先有鸡还是先有蛋的循环,需求少导致领域创新少,导致开源checkpoint发布的少,有些之前发布开源模型的实验室,最新的模型也避原了,比如1R2.7就不是开源的,我们还停留在2.2 视频模型尤其难的地方在于token的数量,视频模型,你想生成高质量的视频,假设你做到16帧每秒,这是绝对的上限,然后假设你做4K视频,你可以想想你的分辨率,我记得有个图能展示Token的惊人数量,比如就看一部电影,像斯巴达三百勇士那样的,假设我们只看四帧,这四帧如果你做全注意力,稍微往上算一下五秒钟的视频,就是4K乘以720再乘以81帧,因为16帧每秒乘以5秒,然后你把它压缩到前空间,但你仍然是在处理30乘以50乘以21的Token 对,也就是说光是五秒钟的注意力计算,就要跑在三万五千个Token上,对吧,所以注意力就成了一个巨大的瓶颈,而且因为它是欧文飞,如果你把它延长到10秒,那就是平方级的增长 20秒30秒都是这样,所以想生成一段一分钟的好过场动画,在同样的计算时间内几乎是不可能的,就是变得不可行,你根本做不到,于是你就只能往两个方向走,要么你决定一次性对整个视频做注意力,那你就被迫用系数注意力,如果你往回翻到那个视频图像的版本,你可以看到左边是,比如说我做的是全注意力,斯巴达300那个场景里的每一个token 都要跟其他每一个token做注意力,你能看到那一大片红色的区域,右边我只让每个token 只关注对它重要的top k 也就是前12.5% 可以是空间上的,比如说代表皇冠的token 会去关注头部脸部,然后是另一帧里的头部,前一帧里的头部,时间局部性,空间局部性,诸如此类,这样做的结果就是视频质量很差,这篇文章的核心就是想说明,你可以训练可以做所有这些事情,但质量上你还是会损失一点,所以最后你只能二选一,要么咬咬牙,用巨大的算力,对100万个token做全注意力,因为你想生成两分钟的视频,要么就转向自回归视频,在我看来自回归视频,就是未来压住的方向,但现在市面上还没有好的开源,自回归视频模型,如果你想得到一小时的电影,如果你想看到视频模型,生成好莱坞级别的电影,那它们就必须是自回归的,才能突破5秒的帧数限制,或者算力必须出现某种,疯狂的大跃进,让我们能高效的同时,对几百万个token做全注意力,就算是100万个token 那也是平方级的,你很快就会撞到天花板,我想问一下,你能讲讲自回归的优缺点和权衡吗,我想到的一个是针尖一致性,自回归扩散生成到10分钟的时候,你会忘记前面的内容,但它的优缺点到底是什么,就像自回归LM一样,你可以把很多我们之前讨论过的,针对LM的优化手段用上去,比如投机解码技术之类的,而且如果你有一个质量非常高的大规模模型,我完全可以把输出流式的展示给你,我可以先给你看第一帧,然后就像2023年的GPT那样,以前它是一下子把整段文本吐出来,但那时候你可以一边读一边看它生成,视频模型也是一样,你可以一边看一边等它生成,它逐帧的生成画面,所以猪token的生成方式,能让我们大幅扩展规模,把注意力机制用上去,缺点就是,每一个自回归视频模型都很烂,质量就是很差,如果你把任何一个开源模型,比如1.2 跟其他自回归模型比一下,你能看到 1.2生成的视频,就像猫和狗在打架,自回归模型给你的,就是劣化版的猫和老鼠画质,我也不知道怎么说,所以生成长视频的解决方案,就变成了,好,我们不用自回归模型,你看看GrokImagine或者GrokVideo做的一些事情,他们做得非常好,就是尝试把7秒的片段拼接起来,你先生成7秒,然后说好能不能把这段视频延长,他们就会把两段视频拼在一起,开源这边似乎没有他们那些技巧,而且从定义上讲,他们是避远的,我们不知道他们具体在做什么,你能做到的最接近的办法,就是取视频的最后一帧,把它喂给一个文本加图像生成视频的模型,它会接受文本提示,再接受最后一帧的图像,然后让它生成接下来的5秒,这大概就是你用这种模型,去生成一部电影的方式,你只是不断的逐帧流时生成,但你会遇到飘移,你从一张图像开始生成一段视频,然后下一段5秒的视频质量就更低一些,第三段就更低,第四段更低,有时候你会看到这样的情况,新生成的视频比第一段稍微暗一点点,然后下一段比第二段更暗,一直到25秒的时候,你得到的是黑屏,就是这样,我们本来想做一个演示来展示这个效果,但那个演示实在太尴尬了,我们最后决定不放了,但我觉得模型最终会走到那一步的,在我看来,他们只需要大幅扩展规模,并且转向自回归,但训练技术这方面,目前似乎还不清晰,对感兴趣Grok Imagine的朋友,我们之前跟那个团队的Ethan 做过一期播客,对,他透露了一点点线索,但不多,不足以让我们完整还原所有东西,具体到这部分,他稍微讲了一点,对我看到了,我们聊了记忆,更常上下文那些东西,但据我所知,它不是自回归的 [01:17:13]
Philip Kiely:虽然现在业内没人做自回归,对,看起来确实是这样,理解自回归模型和扩散模型的关键区别在于,扩散模型的注意力是双向的,而自回归模型只能沿着序列向前看,所以你会看到那种跑偏的行为,如果你只是天真的把视频生成模型,做成简单生成一帧帧线性序列,那你就没法回头去修改序列里的东西,来保证整体一致性,而视频模型之所以需要那么多潜空间,就像你说的,我们把所有token都放在内存里,在整个序列上反复迭代,你可以调整过去,好让未来说得通,所以如果我们要想达到那种,更长更丰富的序列,架构上很可能就像你说的,是自回归和扩散的混合
swyx:两者协同工作,各干各擅长的部分,但你凭直觉就能理解,为什么比如英语,或者说任何语言的写作,就是从左到右,你可以流式输出token 可以流式输出思维链,哪怕作为人类,你写作的时候也是先写,然后想下一步要生成什么,再写下去,边想边往前生成,当然你可以说,写作过程中,你需要回头改一些东西,但你需要这么做的频率,比你想象的要低,而视频就不一样了,它没有这种顺序性,视频左上角的像素和右下角的像素,它们几乎需要同等的互相注意,才能决定视频质量,而文本就不太需要这样,音频有没有类似的对照,我不太确定,但大约一年前有个说法,音频LOM有扩散和自回归两条路线,而且基于你提到的那些点,主要是在推理测,虽然音频片段更短 [01:18:44]
Philip Kiely:大多数音乐也就三到五分钟,我们基本上已经全面转向自回归了,对音乐我不太懂,但语音是自回归的,实际上这可以追溯到一年半前的Orpheus架构,你只要把一堆波形加进词汇表 LM就能输出代表这些波形的token 然后你就能构建语音,这就是流式输出的方式,就这么简单 [01:19:36]
Philip Kiely:就这么简单,哇这就是我2025年AIE演讲的内容,不错不错,但音频不是同样的挑战,对吧因为音频用LM生成一切就解决了
swyx:音频本质上还是一份可以用LM生成的文本稿,你的音频模型只需要做文本转语音就行,音乐方面曾经有一段时间在扩散和自回归之间做权衡,两者水平相当 [01:20:12]
Philip Kiely:可能各有各的优缺点,我就是想问问你有没有什么看法,对音乐具体的情况我不太了解,关于你说的编辑写作的时候,显然我的编辑会告诉我,其实需要更频繁的回头修改,我能想象音乐或者诗歌,比如你有押韵方案,你可能想回头改一处,好让后面想用的韵脚更容易安排,这种时候能双向注意确实有优势,但据我所知,我倾向于把这个推理问题分成两类,自回归模型有一套自己的约束和技术,扩散模型有另一套,我把文本语音输入输出归到自回归这一侧,图像和视频归到扩散那一侧,两者之间有重叠,不是完美的划分,但这是我大致用的分类方式,我得指出一点,这应该是确认过的吧 NanoBanana和GPT Image是自回归图像模型,这就是我们说的混合方法,但在图像领域,它还没延伸到视频领域,至少在开源社区里还没有,对但我猜那不会太远 [01:21:17]
swyx:如果这在图像上可行,至少Quinn Image那帮人正在尝试,对对我很期待Quinn Image 3 希望他们会开源,然后我还想提一下,在文本扩散这边也有一些动静
Philip Kiely:但不算多,对我们有Mercury 你们托管Mercury 对,不错,还有Gemma 对吧 Diffusion Gemma Diffusion Gemma是开源的,对
swyx:然后还有,我们在科学播客那边,也一直在发布一些虚拟细胞模型,用的也是扩散,对,他们确实做了,不过肯定还属于那种,廉价快速token的范畴,对,我们正在尝试,我觉得这是错误的营销方式,我之前就跟他们说过,我说你看,你不可能打败其他LM会做的那些优化,但你可以提供不同的API 比如你应该能把它用的跟聊天响应不一样,聊天响应,对,怎么说,因为它是扩散模型,因为你可以做那种无上下文,引导在扩散里是什么样,对文本来说
Philip Kiely:比如给我一首诗,给我一个情节结构,让它扩散成型,完全正确,所以这就是我提到的,比如诗歌,你可能想确保一致性,我写过很多LM14行诗,那曾经是我常用的基准测试之一,即使是现在的模型也一样,对,对他们就是数不对英杰,但如果你能关注到所有不同的token 你就能把英杰数对 [01:22:35]
swyx:对而且Mid Journey的David Holtz 当时也在投文本扩散,我觉得没出什么成果,但思路是,你可以先给一部电影做分镜,然后用正常的视频生成去生成场景,但那种跨内容的连贯性,就是结尾应该呼应开头,不应该有这种自回归的路径依赖,这个想法原则上是有道理的,只是API应该不一样,营销也应该不一样,现在使用最广泛的开源或闭源模型,没有一个用扩散,但这难道不恰恰说明,这就是先有机还是先有弹的问题,因为如果你给它更多规模呢 [01:23:00]
Philip Kiely:最大的扩散语言模型是哪个,我觉得它不算大,我不知道这个的参数数量,但是,大概不到200亿 Diffusion Gemma Boswent 我觉得是200多亿
swyx:对而且其实你还没真正试过,你没给它一个大的,而且你也没,所以这么说很不公平 Diffusion Gemma是250亿,而且这正是我想说的,就它的规模来说,它在质量上表现相当不错,这几乎和视频模型面临的挑战一样,要拥有同样的规模,就像你在拿它和规模大得多的模型比较,对除非你采用那种做法,你有一个文本主干,然后你知道,你给它拼上一个,某种解码器之类的东西,来做那个,他在这期播客,开头讲的就是这个,不过是反方向,从图像到文本,对,而且我觉得,大致上可以直观的推断,反方向也能做,我同意,我明白,我明白,我明白,对,我们这是在泛泛的推测,研究趋势,对,最后我们可以聊一个话题,就是你演讲的主题,拿一个开源模型,让GPU跑起来,然后就这样,这就是Baseten的工作,现在看起来,人们越来越多的,在后训练阶段使用推理,是的,训练和推理,对,训练服务于推理,推理服务于训练,这两块现在都成了大话题,推理服务于训练,意思就是说,显然你在做强化学习训练的时候,需要做rollout 所以如果你的rollout 花的时间太长,比如你用的是VLM 而不是LLM 或者你想训练的模型,在LLM里不支持,只能退回老的推理引擎,那rollout就会很慢,你又不希望拿太偏离策略的rollout 去做训练,所以只能等他们,这样一来,整个训练管线就被卡住了,所以我们做推理优化用的那些技术,在这里也能帮上忙,而训练服务于推理,主要就落在投机解码训练 Ego head训练,有时候还有后训练上,比如说,你想量化一个模型,把它压到NVFP4 有时候运气好,直接做PTQ就行,有时候压到NVFP4之后,模型表现很糟,质量太差,那就得对模型做后训练,让他明白自己现在跑在NVFP4上,还能输出同样的logits 这个可以用普通的SFT 量化感知训练这些方法来做,但我们现在越来越多看到,像英伟达发的量化,或蒸馏论文那样的做法,你建立一个NVFP4版本的模型,再建立一个全精度版本的模型,然后基于两个模型的logits 做蒸馏训练,让NVFP4的模型学会,所以现在我们团队里,做推理的工程师,越来越多的熟悉训练技术,会写训练管线,感觉这两块在某种意义上正在融合,是在走向合一,对绝对,你想最终目标可能是搞一个 [01:25:40]
Philip Kiely:持续改进的系统,对说起来有点好笑,但它确实在发生,我觉得几个月到一两年之内,很多头部agent的开发者都会把这些循环,真正跑进生产环境,做推理从推理里学习,我们当然很久以来就在做这种事了,在推理实时进行式学习动态调整系统,任何动态调整都会胜过静态配置,不管是你的具体配置,你的投机解码器还是那类东西,然后你可以拿产品里产生的trace 持续后训练模型发布出去,做AVB测试,拿到更好的信号,得到更好的模型,做出更好的产品,这个循环真的很有前景,支撑它的技术和基础设施,也在快速成熟,所以训练和推理的融合,我觉得只会越来越快,我刚才其实在笑,但并不是觉得好笑,而是觉得这事是真的 [01:26:28]
swyx:AAI世界博览会的一个大主题,就是我们有RSI通向通用人工智能 差不多是那个口号,对我是说我们确实有,我看到你提到参数高尔夫,我们有模型在训练模型,下一步显然就是模型训练,优化自己的推理,这有点好笑,我在想模型会不会在训练自己这件事上,比训练他们不熟悉的模型,更在策略上更擅长 [01:27:22]
Philip Kiely:这些都是很有意思的开放研究领域,我几年前工作的一大部分,就是给Hugging Face上冒出来的任意模型写配置,把它跑起来,现在这种跑起来的配置已经可以一次搞定了,所以我已经不用再做这个了,对不过那倒不完全是模型优化自己的推理,更像是模型能读懂SGLine的文档,但对差不多,我们确实看到了,比如GLM5.2 GLM5.2鞋
swyx:GPU内核非常非常强,所以很有意思的是,我们内部有一个GLM5.2的端点,接近了我们的Claude Code框架里,团队里每个工程师,都在用我们的GLM5.2 它会在节点上对GLM5.2实力,做一次前向传播,然后拿到性能分析trace 分析它,找出SGLang里的瓶颈内核,然后写出新的内核,我们再跑一次性能分析trace 等它跑完了,它会把镜像上传到我们的系统里,我们拉下来重复这个循环,所以有相当一段时间,我们真的是GLM5.2 在写很厉害的东西,在GLM5.2上,我们推理引擎里跑在 GLM5.2上的一些GPU内核,就是GLM5.2自己写的,整个trace和内核,都是由GLM5.2作为驱动来引导的,所以我觉得,我确实看到这个循环已经存在了,我觉得还需要更多时间,它肯定还有很多做不了的事,模型还没到那一步,哪怕他们已经非常非常聪明,他们还是会试图用暴力尝试的方式,去找最省事的路径,或者说他们几乎不太擅长做决策,但对,我确实觉得模型优化自己的推理,已经是正在发生的事了,你觉得GLM5.2是在自我优化方面特别强 [01:29:06]
Philip Kiely:还是它恰好是我们能拿到的,最好的编程模型,如果让他去优化DeepSeek 或者Kimi之类的,他也能做的一样,好吗,说到Circus的观点,如果他去优化另一个模型
swyx:可能就会有点偏离策略了,真的会伤害DeepSeek吗,我是说让他去优化他自己,不,为什么,我不这么认为,对,但就是咱们直接试试就知道了,有意思,对,就是你算力比我多
swyx:就是你算力比我多,直接去跑一下试试,对,推理工程方面,还有哪些我们没聊到的新趋势,因为你们离得最近,肯定能看到一些外界还不知道的东西,大的趋势很明显
Philip Kiely:模型越来越大,硬件越来越强,用户习惯了某个速度之后,就会要求更快,我觉得让我兴奋的是系统层面的东西,我们还有很多关于,如何把多个模型组合在一起的问题要想,比如一个语音agent 里面涉及三到五个模型,还有这些模型之间的通信,还有很多新的模态要出来,比如cosmos 那个新的世界模型,还有更多研究,语音到语音还没有完全成熟,但越来越接近了,会有很多新的模态可以围绕去构建,这会很令人兴奋,然后对,我觉得另一个要解决的问题,也是我们解决很久了,但还没做完的,就是整个行业要继续以,十倍再十倍再十倍的规模去运转,想想AI在全球的使用程度,跟一些更成熟的技术比,无论是消费端还是企业端,很明显需求还能再涨好几个十倍,看看全行业的基础设施工作,显然是为了应对前所未有的需求激增,而非常迅速的搭建起来的,而且这还不会停,所以对还有很多问题要解决,比如高可靠性,还有搞清楚下一个十倍一百倍的token从哪里来 [01:31:04]
swyx:我要说一个可能很无聊的答案,但我觉得答案就是更快的网络芯片通信,在我看来内存越来越成为瓶颈,你想要更大的模型,现在做大规模推理服务的时候,你得把KV缓存从一个节点传到另一个节点,但做法是你找到KV缓存,找到它在哪,然后传到另一个节点,放到那个节点的内存里,再从那个节点的内存传到GPU里,传到GPU的张量核心上,所以这里有个两阶段的传输,导致你在大规模KV缓存传输上非常受限,这会影响解码和预填充的时间,你不得不这么做,因为HBM非常快,大概4.5泰比特每秒,比网卡通信速度快了好几个数量级,如果你能在理论上,这个理想状态下拥有极快的网络,理论上你就可以省掉HBM这一步,直接把KV缓存从一个节点传到另一个节点,这会在节点间的聚合推力服务上,带来接近100倍的速度提升,我不太了解让网卡变快的技术难点,我确信有原因让他们比HBM慢了好几个数量级,但如果有人能解决这个问题,解码速度真的会快两个数量级,这就是我的看法,大芯片,酷,我不知道你有没有要提名的东西,趋势方面,我来说一个,好,我觉得是面向持续学习的推理工程,比如,如果你抱着一个想法,说你应该从你处理过的所有东西里学习,你会不会做不一样的事,还是沿用同样的方式,就是把它塞进memory.md 然后他不知怎么就被KV缓存消费了,这个系统能用,没坏,还是说你怎么重塑推理,让他在推理的同时学习,对,我觉得这方面一个相关的话题是 [01:32:21]
Philip Kiely:你在这个世界上能找到的最好的基金,做的是KV压缩的工作,没错,那什么会改变,什么会改变,如果你想持续学习的话,有两种观点 [01:33:08]
swyx:我和查理之前在推特上争论过,持续学习可能走两条路,一条是模型自己学习,不断把新知识写进权重里,这种情况下推理时,就得不断去取最新的权重,对,就是字面意义上不断去读写权重,另一条路是做KV缓存压缩,如果只更新LORA的话,那还有个LORA层,对没错,这就是我们之前聊过的 Ingram方法,反对把知识写进权重的理由是,你只能修正一跳知识,就是说你只能为给他一个新事实,比如世界上最好的大学是哪所,世界上最好的大学是华铁卢,但第二层推倒就不行了,那是不会变的,不会变,但第二层推倒的问题,比如我应该从哪所大学招实习生,如果你知道世界上最好的大学是华铁卢,那答案就应该是华铁卢,但如果我不是一次性问这个问题,而是让他用已有知识去思考,再给我第二个答案,或者问,我应该从滑铁卢还是MIT招实习生,他可能会说,哦都挺好的,但不对,我明明刚在你的知识库里编辑了滑铁卢是最好的,你为什么不用这个去做推理,所以这就试图在MLP里改一个事实的根本问题 KV缓存压缩能解决这个问题,有了KV缓存或者说,不一定是KV缓存压缩,而是如果你能做到像我们提出的Steel论文那样,让你的KV几乎无限,并且能用一种不丢失任何知识的方式去压缩,那样的话你就能真正做持续学习,真正解决持续学习的问题,这就是我和查理争论的结论,但我承认他的观点是对的,我也确实认为KV缓存是未来的方向,那样的话我觉得推理本身不会有太大变化,因为推理时我们本来就在用KV缓存,你只是去更新KV缓存,但那是额外的一步,权重没有任何变化,所以推理时间没有变化,我之前说的那些也没有变化,好出乎意料,答得非常好,我们把它发在播客上了,是最近的一篇,大家可以去看看,对,除此之外,这次聊天非常愉快,我知道我们已经聊了两个小时了,哇,时间过得真快,还有好多没聊到,对,我们本来还想聊聊那本书什么的,不过书你已经聊过了,对,那本书大家都知道,对,贝森历史上投资回报率最高的事,对吧,就这一个小时来说,毫无疑问,毫无疑问,绝对的,那恭喜你们,我们之前在自己的聚会上,也聊过这个,可以单独发出来,不过还是要感谢,你们这么慷慨的分享,我觉得这是段,很难得的有趣对话推理工程这块,我们之前真的没怎么深入聊过,所以你们能来,真的很荣幸,太棒了,对谢谢,谢谢你们邀请我们,希望一年后一切都变了,我们能回来聊聊,我们当初哪里说错了,对,我很期待这个Mega Kernels的说法传出去之后,看看大家怎么说 [01:36:02]
Philip Kiely:我们得开始了,我要不要躲起来,我知道Mega Kernels社区肯定要来找我麻烦,对有一点我特别佩服你,就是你从来不怕捅马蜂窝,其实还好,我觉得没那么有争议,我也不知道,走着瞧吧
swyx:走着瞧,好谢谢各位,不太感谢你们了
Aswath Damodaran 以 Leo Aschenbrenner 的对冲基金 Situational Awareness 从高回报到迅速清算的经历为例,讨论投资信念如何形成,以及信念如何影响仓位集中度和杠杆。Damodaran 的核心判断是:投资行动必须与信念强度相匹配;对高风险、充满不确定性的宏观判断使用极端集中和高杠杆,可能带来毁灭性后果。他还提醒,动量可能被误认为投资者的能力或判断正确,投资者最好把资金交给承认运气、能够自我怀疑并愿意承担责任的“谦逊的钱”,而不是自我评价过高、收费昂贵的“聪明的钱”。
Damodaran 先回顾 Situational Awareness 的故事:基金押注 AI 会成为巨大赢家,而且很快兑现,同时买入受益于 AI 基础设施的公司、做空可能被软件和科技颠覆的公司。基金一度上涨约 367%,但随后一个月总价值下跌约 43%,公开股票部分损失约三分之二,最终基金关闭并清算公开股票。这个案例之所以重要,不只是因为 AI 判断可能对错,更因为基金把 AI 押注与巨额杠杆结合在了一起。
他把投资信念定义为相信自己识别出的好投资会带来回报,并指出强信念必须同时包含三个判断:自己的公平价格估计正确或优于市场共识;市场会纠正错误;修正会在持有期限内发生。信念的来源包括合法私人信息、更好的信息处理能力、对行业更深的理解,以及发现相对定价错误。到期日、市场摩擦、流动性、催化剂和投资期限,也会影响市场修正的确定性。投资者自身的智力和教育背景、性格自信程度及过往业绩,则会造成不同投资者之间的信念差异;聪明、过度自信或短期成功都可能让人高估优势。
信念会直接影响两个投资选择:信念越强,仓位通常越集中,杠杆通常越高;信念越弱,组合越分散,杠杆越低。对于成熟或衰退企业,价格不确定性较低、市场催化剂较多,因此集中度和杠杆可以相对更高;对于初创和年轻成长企业,估值、催化剂和修正时间都更不确定,更应分散并减少债务。分散投资也让投资者能够以较小仓位参与低信念投资,而不必因为信念不足就完全放弃潜在机会。
- 嗨,欢迎回来。准备好聊聊 Leo 了吗 [00:00:00 - 00:10:00]
- 暂且不论你对公平价格的判断 [00:10:00 - 00:20:00]
- 第三个因素是业绩记录 [00:20:00 - 00:30:00]
- 你看,Cathie Wood 曾经靠这个成功了一段时间 [00:30:00 - 00:36:17]
Aswath Damodaran:嗨,欢迎回来。准备好聊聊 Leo 了吗?你问,哪个 Leo?几个月前有人问我 Leo Aschenbrenner 时,我的回答正是这样。我不得不承认,我对他知之甚少——他的全名是 Leopold Aschenbrenner。我只知道他是某种神童,或者说是人工智能(AI)领域的神童,创办了一家对冲基金,并取得了惊人的回报。除此之外,我对他本人和他的基金几乎一无所知。
那家对冲基金建立在一个故事之上——一个在当下市场中相当熟悉的故事:AI 不只是会大获成功,而且很快就会成功。基金的做法,是买入这一押注中的赢家,主要是那些投资于 AI 所需基础设施的公司,同时做空会被软件和其他科技公司颠覆的企业。正如我所说,这家基金取得了惊人的回报。到六月底,Leo 被谈论成下一个 Warren Buffett,一个横空出世的卓越投资者。四周之内,一切都瓦解了。事实上,我从未见过哪家基金像 Situational Awareness 这样,在如此短的时间里从辉煌走向失宠。四周之内,这家基金不仅损失了其公开交易公司组合约三分之二的投资额——组合里还有其他资产,我稍后会谈到——而且最终被关闭并清算。Citadel 据报道以低于评估价值的折扣买下了基金持有的公开市场股票。
所以,让我们谈谈这家基金做了什么,以及我们能从中学到什么。很有意思的是,我看到过许多关于这家基金究竟哪里出了问题的解读。这就像一张罗夏墨迹测验:你认为投资者最看重什么,决定了你会从故事中看见什么。对年长的投资者来说,这成了“让年轻人替你投资会发生什么”的案例:他们把 Leo 归因于聪明,而智慧则被认为会随着年龄自然到来。对价值投资者来说,这又成了一个训诫他人的机会:这就是把钱交给尚未准备好投资的人会发生的事;对其中许多人而言,这也证明了没有人能成为下一个 Warren Buffett。对 AI 怀疑者来说,这一刻似乎成了促使市场高烧退潮、引发修正的催化剂。
这些说法都有一定道理,也都有一些过度延伸。但我想从一个完全不同的角度来理解这个故事。我想以此为基础,谈谈投资中经常出现的两个词:投资信念。我一直对“投资信念”这个词有复杂的感受,因为它可能是一种取舍。为此,我首先要定义我所说的信念,然后说明投资者如何形成信念,以及信念会带来什么结果。
在讨论这些之前,先看看 Leo 和他创办的对冲基金的故事。这些信息都来自公开领域。Leo 2001 年出生于德国,15 岁进入哥伦比亚大学,2021 年取得经济学学位,曾短暂在牛津大学做研究,也曾在前一时期另一位神童 Sam Bankman-Fried 的 FTX 工作,随后加入 OpenAI,参与 AI 安全团队。2024 年,他因泄露数据被 OpenAI 解雇,不过事实并不清楚。他声称自己没有被解雇,也没有泄露数据。
就在那之后,他写了一篇 167 页的长文,名为《Situational Awareness:未来十年》。他在文中阐述了自己认为 人工智能将带来什么变化。这篇文章被广泛阅读和传播。几个月后,他依据文章中的观点创办了一家对冲基金。这家基金迅速崛起。涨了多少?这张图展示了 Situational Awareness——Leo 的对冲基金——从 2025 年 8 月到 2026 年 6 月 19 日的表现。在最高水位时,基金上涨了约 367%。既然取得了 367% 的回报,就没有必要争论它是不是一家好基金。同期纳斯达克上涨了 24%;无论用什么 alpha(超额收益)标准衡量,这都是基金表现出色的一年。
因此,6 月 19 日,这家基金看起来是绝对的赢家。但它失宠的速度有多快。即使在观察它跌落之前,如果你在 6 月 19 日问我对它有什么看法,作为一个对主动投资持怀疑态度的人,我会提出三个保留意见。第一,在市场里成功一两年,相对于市场时间只是一毫秒。你可以连续几十年跑赢市场,但仍然很难区分运气和能力。两年更像一颗流星,而不是一座灯塔。第二,当你的回报达到数百个百分点——300%、400%——你做到这一点不只是因为猜对了,还因为用某种东西,通常是债务,给赌注加了杠杆。因此,债务显然隐藏在背后。第三,这家基金采用经典的“2 和 20”收费结构,我认为这种收费结构很糟糕:每年向基金管理人收取你财富的 2%,再拿走上涨部分的 20%,投资者处于如此不利的条件下,我根本无法想象它如何在预期意义上跑赢市场。事后看,确实有些基金做到了,但不应该用事后眼光来评判。
短暂的业绩周期、加了杠杆的超高回报,以及收费结构,都会让我停下来。当然,6 月 19 日时我并不知道接下来会发生什么。随后一个月,基金崩溃了。崩溃速度令人震惊:基金总价值损失约 43%,但公开股票部分的价值实际上损失了约三分之二。你会问,为什么总价值只跌了 43%?因为基金还持有 Anthropic 的仓位,而这部分没有被下调估值,基本保持了价值。这正是它只下跌 43% 的唯一原因。
如果故事到这里就结束,只是回报不好,你会说它还会回来。毕竟这是一家杠杆基金,会上上下下。但让结局不同的是,七月底,基金被关闭,并清算了公开股票。最终,它面临的是一个没有基金可剩的结局。我们可以讨论这家基金总体上究竟赚没赚钱,但很明显,这是我见过的对冲基金中最陡峭的崛起和跌落之一。
那么,投资信念在哪里起作用?你看看 Leo 基金的核心观点:人工智能将成为赢家,而且是一个巨大的赢家,并且很快就会发生。他并不孤独;市场上还有其他投资者持有同样观点。事实上,你可以说,许多进行 AI 资本开支的公司,包括“七巨头”中的一些公司,也受到这一观点驱动。所以,观点本身并不独特。这个基金真正独特的地方在于,它不仅押注了一个许多人共享的 AI 大故事,还叠加了巨额杠杆。这表明 Leo 不仅相信 AI 会赢,还强烈相信 AI 很快就会赢,以至于愿意借入惊人的资金。
这就是强烈的投资信念。接下来,我要借这个故事谈谈投资信念是什么、它从何而来、会导致什么、什么时候合理,以及什么时候会让你陷入麻烦。让我们开始。什么是投资信念?投资信念,就是相信你面前已经识别为好投资的某项投资最终会带来回报。
从这个定义已经可以看出,信念处于一个连续谱上。一端是绝对信念:你确信自己会赚钱;另一端则是完全没有信念,存在无限的不确定性。你已经可以看出,为什么主动投资者把投资信念视为一种好品质:如果你完全没有信念,你就永远无法行动;如果永远不行动,最后会得到一个全部由现金组成的组合,也不会成功。
问题是,什么时候拥有绝对信念才合理?绝对信念是否曾经合理?如果没有绝对信念,你的信念应该有多强?为了展开讨论,我们先回到一项好投资的构成。我知道这很基础,但每项好投资或交易都是这样开始的:你观察一项由市场定价的投资,然后得出一个与市场不同的价格判断。你相信这项投资的公平价格与市场价格不同。暂且不论你对公平价格的判断依据是什么,它可以来自各种因素。 [00:09:36]
Aswath Damodaran:你的公平价格判断可以来自各种因素。你可能是技术分析师,观察图表;也可能是基本面投资者,研究某种内在价值;还可能掌握某些关于未来事件的信息。但一项好投资的判断,始于你认为投资的公平价格与实际市场价格不同,可能更高,也可能更低。
要从这项投资中赚钱,市场必须纠正自己的错误。于是问题出现了:市场要多久才会纠正错误?如果它永远不纠正呢?你有多大把握认为修正会发生?什么会导致修正?这就是你的时间跨度。这里包含三个要素:对价格的判断、市场修正,以及你等待修正发生的窗口。
所以,如果你想拥有强烈的投资信念,就必须相信三个部分,而不只是一个。第一,你必须相信自己的公平价格判断是正确的,或者至少比市场共识更正确。第二,你必须相信市场会纠正。你不认为市场会纠正,就不可能有信念。最后,第三,你必须相信修正会在你计划持有这项投资的期间内发生。也就是说,你的公平价格判断是正确的,市场会修正,而且会在你的投资期限内修正。
接下来想想,是什么让投资者对某些投资拥有强烈信念、对另一些投资只有较弱信念,以及为什么不同投资者之间会有差异。先从定价游戏说起。就误定价而言,我至少能想到四种投资信念的来源。
第一种是敏感因素:私人信息。什么是私人信息?就是你知道某些关于公司的事情,而市场还不知道。你会发现,我们已经走在危险的边缘上了。在美国,这类信息至少非常接近内幕信息,而内幕信息是违法的。不过,假设你以合法方式获得了别人没有的私人信息,这可能让你得出与当前市场价格不同的价格判断。
第二种情况是,你和所有人拥有相同的公开信息——例如历史价格或财务报表——但你处理这些信息的方式,能让你比别人更准确地估计价格。你会说,这是不是要求太高了?这不就是内在估值所做的事情吗?在经典价值投资中,你使用大家都有的信息,但相信自己从这些信息中找到了一个能带来优势的切入点。如果你是图表分析师,可能从历史价格中看到了别人没有看到的模式。
优势还可能来自对公司所处行业的理解超过市场其他人。这在复杂企业中尤其可能发生:你拥有相关行业背景,而全世界其他人没有。举个简单例子,我会避开生物科技和制药公司,尤其是那些研发新药的年轻公司,因为我并不真正理解这个领域。我不知道什么让一种糖尿病药物成为好药,而另一种只是普通药物;我也不理解一款好药从研发到获批需要哪些机制。所以我倾向于避开它们。但如果你深度沉浸在医疗健康领域,对这个行业非常了解,那么你可以说,这种背景可能让你更有优势,得出更好的定价判断。
这不就是 Leo Aschenbrenner 对 AI 的说法吗?他在 AI 领域花过时间,所以比你我这些外部人士更了解 AI,能够依据这种商业理解构建一个投资组合?
另一种来源可能是市场定价错误。这里不一定是你的定价估计更好,而是你直接看到了市场犯下的错误:可能是一家公司单独被错定价,更常见的是两家公司相互比较时出现误定价,其中一家价格过低。衍生品市场最常见这种情况。比如一只股票的看涨期权,你可能找到两种方式获得相同的现金流,但它们价格不同;这就构成了定价错误。
因此,私人信息、更好的信息处理能力、更深的业务理解,都可能让你相信自己的定价优于市场。
当你考察市场修正,以及为什么不同投资之间的信念会不同,首先,如果一项投资有明确的到期日,你比面对一个没有明确结局的投资更有把握看到市场修正。比如一只债券因某种原因被错定价,它有一个到期日;到了那一天,误定价必须消失。期权或期货合约被错定价时也是如此:它们有固定到期日。相比之下,一只被错定价的股票没有一个必须发生修正的时间点,这里没有明确的终局。
市场修正的第二个来源是市场摩擦。你可能看到了明显的误定价,但市场摩擦阻止你利用它。举个例子,封闭式共同基金持有公开交易公司的股票,同时自身也像股票一样交易。典型的封闭式基金,会以其持有的公开公司投资价值的 15% 到 20% 折价交易。这看起来像是板上钉钉的机会:你买入基金,市场应该修正,因为你不应该以 20% 的折价买入那些流动性高、价格可观察的资产。
但这些折价常常会持续存在,因为存在摩擦。公司治理结构可能不允许你收购封闭式基金并将其清算;你可能根本没有资格这样做。比如,一些印度股票的美国存托凭证(ADR)价格可能远高于其国内上市价格。你会说,同一只股票不应该有两个不同价格。确实如此,但把价格差异转化为真正赚钱的策略并不容易。
市场流动性和深度也很重要。要让市场发生修正,需要催化剂,也就是促使市场重新评估价格的东西。催化剂可能是公开信息、业绩报告、收购公告,也可能是知名投资者、主动投资者或维权投资者买入公司股份,例如 Bill Ackman 或 Carl Icahn。市场越有流动性,催化剂越可能带来修正,因为市场能够观察到正在发生的事情。流动性高、催化剂多的市场,会比流动性低、催化剂少的市场带来更强的信念。
最后,如果你能给市场更多时间去纠正错误,那么在其他条件相同的情况下,你对同一项投资的信念就应该更强。时间跨度有时并不由你控制:如果你在某个时间点必须平仓,无论你多想延长投资期限,也做不到。
除了市场修正因素,投资本身的特征也会造成信念差异。同一项投资,两个投资者都发现它因同一个原因被错定价,但其中一个人可能比另一个人更有信念。第一项因素是智力和教育背景。我知道这是一种概括,如果你不同意,可以反驳我。但事实往往是,当你越聪明、履历越出色、就读于更好的学校、获得正确的资格认证时,你发现一项被错定价的投资后,往往会有更强的信念。
为什么?因为你越聪明,就越容易把误定价归因于外面所有其他人的愚蠢。聪明可能让你高估自己的优势,从而产生过强的信念。
信念还取决于性格。自信程度处在一个连续谱上。一端的人自信太少,除非有人牵着手带他走向重大决策,否则无法行动;另一些人自信更多,可以在不确定性面前作出决定;还有一些人自信过度,完全没有自我怀疑,相信自己一定正确。这样的人在面对投资时会有更强的信念。第三个因素是业绩记录。华尔街有很多格言提醒你,不要把愚蠢的运气误认为能力。 [00:19:41]
Aswath Damodaran:事实上,我收到的每一封来自华尔街的邮件,底部都有免责声明:“过往业绩不代表未来表现。”但我不认为华尔街真的相信自己的格言或免责声明,因为最糟糕的投资教训,往往来自成功。
你赚了钱,周围的人都称赞你有能力、很了不起。当一场赌注成功,所有人都在赞颂你有多优秀,投资者资金也不断流入,这就开始变成自我实现的过程。由于你有了良好的业绩记录,下一次看到一项被错定价的投资时,就会因为过去的记录而对它赋予过多信念。
所以,智力、性格和业绩记录都会发挥作用。总的来说,无论横向比较投资,还是横向比较投资者,信念都可能不同。
你可能会问:那又怎样?为什么要讨论信念?我带着很强的信念买入 SpaceX,或者只有一点信念买入 SpaceX,究竟有什么区别?归根结底,买入就是买入。确实如此,但信念很重要,因为它会影响投资者做出的两个选择。
第一是仓位大小。信念越强,同一项投资上的仓位就越大。第二是你使用多少杠杆,也取决于你带来的信念。信念越强,杠杆越高。因此,信念会影响投资组合如何构建、组合有多集中,以及使用多少杠杆。
当你因为过度自信、过高估计自己的优势,或错误地认为市场会更有效地纠正错误,而高估了信念时,问题就出现了。你会把太多资金集中在一项投资上,或者借入太多资金,后果可能是致命的。
先谈信念和集中度。投资中有一个争论已久的问题:你应该建立集中型投资组合,持有 5 只、6 只、8 只或 10 只股票,并把资金投向你认为最大的赢家?还是应该分散下注?我曾经和认为集中才正确的价值投资者辩论过,但我不认为自己应该争论这个问题,因为答案取决于你的信念。
如果你拥有绝对信念,认为这是一场确定会赢的赌注,那么应该把所有钱放进一项投资:既然你确信结果,为什么要分散下注?如果你完全没有信念,那我们为什么还要讨论选股?直接买入指数基金,分散下注就好。
真正的争论发生在中间地带:信念越强,投资组合越集中;信念越弱,投资组合越分散。因此,你看到的集中度,应该反映投资者带来的信念。
杠杆也是同样的道理。如果你有绝对信念,确信结果,可以借入 100% 的资金。这听起来很荒谬,但真正的套利就是这样。你可能在期权和期货课程里见过:当你发现某个期权或期货被错定价时,可以今天锁定利润,借入全部投资资金,基本上制造出一台赚钱机器。所以面对确定的结果,杠杆可以达到 100%。
另一端,如果你没有信念,借钱就处在危险境地,因为杠杆只会放大不确定性。这里真正的决策同样在中间地带:信念越强,越容易出现杠杆更高的投资组合。
杠杆不一定表现为借款或保证金交易。如果你看涨,可以买入看涨期权,甚至裸看涨期权;如果你认为某个东西被错定价,也可以买入裸看跌期权。信念越强,杠杆越可能出现;信念越弱,杠杆越不可能出现。
接下来引入一个你们见过我使用的框架。你们可能已经厌倦了,但我认为它有助于理解:为什么有时集中型投资组合对某些投资者合理,对另一些人却不合理。这个框架是企业生命周期。我会把公司从创业期、年轻成长阶段、高速增长阶段,带到成熟期和衰退期;但这次,我要从信念的角度观察生命周期的每个阶段。
先看定价不确定性。现实是,给一家非常年轻的公司估值时,你对价格的估计会比给成熟公司或衰退公司估值时不确定得多。这是一个概括,但我认为成立。几周前我给 SpaceX 做估值,对公司的公平价格估计极其不确定。不是因为我没有做好工作,也不是因为没有获取信息,而是因为未来存在巨大的不确定性。如果你让我给 Coca-Cola 估值,我对公司的不确定性就会小得多。
年轻公司的市场修正催化剂也少得多,因为业绩报告包含的信息不多,目标也不那么明确。你往往只能依赖其他投资者改变定价或动量,作为市场修正的信号。相比之下,成熟公司的催化剂更多,业绩报告确实能传递信息;衰退公司还会出现困境出售和清算价值,因此市场修正的催化剂更多。
年轻公司的定价不确定性更高,市场修正催化剂更少。如果你想知道修正何时发生,答案是:谁知道呢?没有催化剂,你不知道修正会在两天、两周还是两年后发生;对成熟公司而言,时间更可预测。
结论是什么?当你发现一家被低估的年轻公司时,你的信念会远低于发现一家被低估的成熟公司或衰退公司时。因此,如果你的组合完全集中在成熟和衰退公司上,你可以承受更高的集中度和更多杠杆。但如果你是一名风险投资人,或管理着一个专注于初创公司和年轻公司的投资组合,你的信念较弱,集中度就应该反映这一点:组合应更分散,杠杆应少得多。
再说一次,这里没有唯一正确答案。是否使用杠杆,取决于你投资的是什么。集中和分散也需要有细微差别:如果你投资成熟公司,我会更能接受集中型组合和相应的风险;但如果你投资的是年轻公司,我不应该看到你的组合中有债务,而应该看到更多公司。
这也让我谈谈自己的情况。我给 SpaceX 估值,是因为这个框架有助于你在信念不高时仍然行动。正如我所说,我当时给 SpaceX 的估值约为每股 100 美元。它上市时发行价是 135 美元,上市后达到 150 至 155 美元,首日涨到 200 美元以上,随后跌回 110 美元。现在它约为 130 美元,但它很有可能在下一次业绩报告后跌破 100 美元。
假设真的如此。如果你问我:你认为这家公司被低估的信念有多强?我会坦率地说,信念很低。但我仍然愿意买入。你可能会问,怎么解决这个矛盾?如果你问我,SpaceX 跌到 80 美元时,我会不会把所有钱都放进去,我会说:当然不会,你疯了吗?但如果你问我,SpaceX 跌到 80 美元时,我会不会拿出投资组合的 5% 买入?会。
分散下注的好处之一,就是让你即使面对低信念的投资也能够行动:你让大数定律替你弥补低信念。所以把它作为工具箱中的一个工具。有时投资者看到一项投资,信念很低,于是说“我永远不会投资这家公司”。我认为这可能是个错误。如果你正确构建投资组合,也许仍然可以投资这些公司,谁知道呢?它们可能会成为未来的大赢家。
现在来看看 Leo 的教训。我看到三个重要教训。第一,如果投资行动与信念不匹配,就可能遭遇毁灭。让我们看看 Leo 的对冲基金做了什么,逐项分析问题在哪里。
我不反对 AI 大获成功这个故事。其他人也在讲这个故事。这是一个宏观故事。大约十年前,你看到 Cathie Wood 曾经靠这个故事成功了一段时间。这是一个宏观故事,对我不起作用,所以我尽量避开它;但它对其他人有效。如果做得正确,它可以赚钱。因此,我没有问题于 AI 故事推动一家对冲基金,也不反对公司和投资者使用大量债务、使用金融杠杆,只要他们投资的是低风险资产。
我仍然会担心“2 和 20”的收费结构,这个担忧无论如何都会存在。但这家基金的真正问题在于,它把 AI 押注和巨额杠杆结合在了一起。无论你认为自己多么了解 AI,都不可能说服我相信这是一项低风险押注,对吧?有太多事情可能出错:行业尚未完全发展成熟,可能遭遇监管阻力,也可能遭遇政治阻力,所有这些都可能出问题。因此,这是一个高风险的宏观故事。
所以我的问题是:如果这是一个高风险的宏观故事,你为什么要像对待一只被错定价的债券那样,通过借入 400% 的资金来投资?这个故事的问题就在于不匹配。投资行动与信念不匹配,会带来毁灭。
第二个大教训是动量。没有人在谈动量,但如果你观察 Situational Awareness 在大部分上涨和下跌期间的投资组合结构,会发现它的多头仓位主要是受益于 AI 基础设施建设的公司,空头仓位主要是超级云服务商以及销售大型语言模型(LLM)的公司,也就是软件和其他会被颠覆的业务。
这两类仓位都没有与市场脱节。事实上,这家基金在去年年中成立时,市场正是这样运行的:基金买入的股票拥有正向动量,做空的股票拥有负向动量。看起来,它本质上是在押注动量。我知道现在大家把故事说成 AI,以及 AI 投资是否有效,但我可以讲出另一个故事:这一路始终只是一次动量押注,而基金之所以取得超大回报,唯一原因是杠杆。
动量是一张外卡。在人们把道德或智慧归因于 Leo 以及他对 AI 的了解之前,也许应该考虑:这从头到尾都是一个动量故事。
最后,还有“聪明钱”的传说。你听过吧?传说中,有些投资者比我们其他人聪明,他们有正确的背景,有我们没有的信息和资本,他们为自己以及获准加入其圈子的人带来超额回报。你可以列举一些名字,但我相信你已经听过“聪明钱”。
这个传说对每个人都有好处。对聪明钱来说,好处是所有人都认为他们聪明,于是把资金交给他们,接受“2 和 20”的收费。对不那么聪明的钱——也就是我们其他人——来说,好处是当投资组合表现不好时,我们有了可以责怪的人:是对冲基金的错,是内部人士的错,是激进投资者的错。
事实是,我寻找聪明钱已经 40 年了,却从未找到过。平均而言,对冲基金的 alpha 是负的。你会问,顶级对冲基金呢?它们有些年份跑赢市场,有些年份跑输市场。当然,也有少数传奇基金在很长时间里取得了出色回报,但当市场上有数百家基金时,你难道不认为最终会出现这种结果吗?
对我来说,聪明钱的问题在于,它的自我评价太高,而自我怀疑太低。因此,它几乎必然会对自己每一项投资的信念赋予过高的精确度。你已经看到了,给信念赋予过高精度会发生什么:你据此行动,借入太多,集中太多。
我几年前在 WeWork 崩盘的背景下也提出过这个观点。当时我说的聪明钱是 SoftBank 和 Masayoshi Son;聪明钱可能聪明过头,反而伤害自己。
所以,如果你要找人管理资金,我建议避开聪明钱。他们会带你进入“2 和 20”,但他们并没有聪明到足以跑赢市场。结果你得到的是最糟糕的组合:高额费用,以及落后于市场的回报。
那么,你应该把钱交给谁?交给谦逊的钱。谦逊的钱会怎么做?它赚钱时,会坦率承认其中一部分,甚至很大一部分,来自在正确的时间处于正确的位置,来自运气。它亏钱时,会承担责任,说:“这项投资我搞砸了,原因是这样。”它对自我怀疑持开放态度。
我宁愿把钱交给谦逊的钱管理,而不是聪明的钱。
最后我想说明,我希望你不要把这一期看成对 Leo 的抨击,因为那不是我的意图。从我听到的情况来看,我很喜欢这个人。他似乎聪明、有创造力,是一个原创思考者,也愿意坚持自己的立场。这些都是主动投资者中很罕见的品质。
但我希望他从这件事中吸取的一个教训是:如果他以后再次管理一支基金,希望他能有所改变,希望他学会一些谦逊。他可以保留自己的聪明,但要把它放在一边,并告诉自己:“我很聪明,但市场比我更聪明。”关于谦逊和克制的这些教训,会让他成为一名更好的基金管理人。
希望这一期对你有用,非常感谢你的收听。 [00:36:14]
本期《硅谷101》由泓君对话朋新宇,讨论企业级AI和中国式FDE(前线部署工程师)如何真正落地。朋新宇认为,FDE的价值不在于更换一个职位名称,而在于同时具备AI的锐度、行业的深度和数据的宽度,并且以可度量的业务结果为导向。
对话以“催发货”为例,说明一个看似简单的客服场景,背后可能涉及跨平台、仓库、派单和售后等260多步流程。企业部署Agent时,应优先寻找最耗人、最耗钱或最耗时、且结果可以衡量的环节;AgentOne等企业级系统的工作重点,是把企业数据和岗位最佳实践结合起来,让数字员工逐步上岗、复盘和进化。
朋新宇还分享了销售Agent、投放Agent的实践,以及从熟悉岗位、建立模型到调教AI的部署过程。他强调,顺利的项目通常需要企业一号位自上而下推动,FDE也不是一个人的“全才”工作,而是由业务、AI架构和数据等角色共同完成。模型选择应服从业务的多快好省和成本账,而不是盲目追求最强模型。
在中美企业级AI的比较和人才讨论中,朋新宇指出,中国企业的数字化基础和业务场景各不相同,但真正有价值的人才仍需把AI、业务和数据结合起来。2B业务中的行业经验和know-how仍然重要,只是AI会加速经验沉淀和能力复制。
- 中国式FDE 从软件交付到业务结果 [00:00:00 - 00:10:00]
- 催发货流程背后的260多步 [00:10:00 - 00:20:00]
- 自上而下推动企业级Agent [00:20:00 - 00:30:00]
- 从投手到销售 标准化Agent的落地 [00:30:00 - 00:40:00]
- 数字员工上岗与FDE团队分工 [00:40:00 - 00:50:00]
- 模型策略与中美企业级AI差异 [00:50:00 - 01:00:00]
- 懂AI、懂业务、懂数据的人才观 [01:00:00 - 01:03:52]
泓君:Hello,大家好,欢迎收听硅谷101,我是泓君。企业软件市场有一个老规律,客户每花一美元去买软件,就要再花六美元把它用起来。那AI时代呢,这六美元的生意正在被重新分配。这是所有巨头突然冲进弊端的原因。我们之前说AI是不是泡沫,但答案不在聊天框里,而是在企业的账本上。那之前呢我们其实聊过一集FD的节目,讲AI如何进入企业及市场,评论区呢就分成了两派,一派是说AI真正在帮企业落地,另一派质疑的观点就认为 20年前就有助厂开发,这是不是换个名字,新瓶装旧酒,所以呢我们决定啊,找一个真正在做这件事情的人,当面来问一问,这集嘉宾是阿里巴巴集团的副总裁,瓴羊的CEO朋新宇 他可能是中文世界里最有资格回答这个问题的人,他是阿里数据中台方法论的创立者,过去几年帮几百家中大型企业搭建了数据平台,他带着团队做这件事情已经五年,比FDE这个词流行的时间还要早,那我们之前的播客讲过FDE的硅谷叙事,这集呢我们就来讲一讲一个个具体的中国案例,还有案例背后的那本账,下面就是我与朋新宇的对话,哈喽小鹏你好,哈喽红金,哈喽大家好,因为我知道其实你也是,阿里数据中台方法论的创立者,要不要跟我们简单介绍一下自己,以及瓴羊,它具体是一个什么样的公司,你们现在具体在做些什么,其实用一句话来说的话,它其实在企业服务的范畴里面,我们叫企业级增长的agent 那我们的核心还是去帮助企业,做消费流动 我觉得在过去,其实硅谷讲的都是C端的故事,最开始大模型开始的这一轮,大家都说谁的产品先冲上App Store的第一名,谁的日活先破亿,但是我们说从今年的上半年开始,我觉得整个硅谷的风向变了,比如说OpenAI成立了专门的部署公司 Anthropic它是拉着黑石跟高盛,做了一个15亿美元起伏的合资公司,同时我们看最近的一些新的动作,微软它也新成立了一个运营部门,叫做Microsoft Frontier Company 背后呢是25亿美元的投资和6000名工程师,他们也是说自己超越了我们所谓的FDE的概念本身,那亚马逊也是在投入数十亿美元,专门打造这样的组织,所以我觉得从今年开始,我在硅谷观察到的一个现象就是,整个AI的战场正在从C端回到B端 OpenAI它的FDE在旧金山的中级岗位的基础工资,是16万到28万美元,那我们说传统的解决方案的工程师,他大概是比这个职位高出了60% 所以小鹏你们有没有,比如说FDE的职位,然后你觉得这个岗位,需要什么不一样的能力,为什么它会比市场传统的,驻场运维价格要高出这么多,这个国内也在关注,但是如果换个名字,就能够去工资升级,这个不符合企业逻辑,不符合市场逻辑 [00:02:43]
朋新宇:那其实看到背后的本质,还是一个东西稀缺,这类人才是稀缺,他采用这个溢价空间,换这个发展的时间,那吸血什么东西,那原来这拨人做运维,就是这个系统就这样子,我是保证你健康运转着,但如果没有做任何变化,他凭什么会要去溢价,那今天我们看到的,如果要做得好的FDE 其实刚才讲的就三个能力,第一个它是要有AI的锐度,第二个是要有行业的深度,第三个它是有数据的宽度,那这三个结合在一起的,但能够做到,今天这套系统运行的,不是说他今天是不是正常运行,而是说他今天的运行,是不是按照我的业务目标,是在往好的地方做,还是变差,好的地方我怎么让他更好,差的地方我怎么干预他,我怎么调教他,这个角色是原来仅仅做运维做不到的,必须要运维至上,能做到对业务理解,对数据的理解,我能调整一些,不管是技能的调整 数据的语料的上下文的调整,包括一些memory的管理,其实这些工作是原来做传统交付,是不存在的,或者他不会遇到的问题,所以这是最大的差别,对听起来对人的要求还是挺高的,最终可能一个成熟的业务,那企业里面需要,要么是有这类人,他能够去在这几个领域都能兼顾,要么是我们有大型的客户 [00:04:08]
泓君:我们有这样的持续的运营陪跑的FDE 但我觉得这两种未来都有机会,因为FDE我们其实也刚刚做了一期播客,很多听众他就在我们这个播客下面留言,他就说这个FDE 是不是就是我们之前说的,什么驻场运维呀,驻场开发,是不是又换了一个新名词,你觉得我们现在,瓴羊在跟客户接触的时候,当我们提到FDE 它跟我们传统说的,驻场开发驻场运维,它们之间的本质区别在哪里,最终我觉得本质的变化是,原来是交付功能,变成一个交付一个业务效果,如果从AI这个大的语境下,我们要称三个方向
朋新宇:第一个是业务结果为导向,我们要找到这个对的问题很重要,那这个问题一定是一个,有又目标又数字,和又过往历史记录的,如果用AI的视角来讲,它能构建一个测评级,构建一个指标体系,第二个呢,就以企业数据为基座,其实今天我们如何能够构建一个,企业的数据,能够通过agent调用大模型的能力,既能去保护隐私,又能够去发挥大模型,最大的智能的上限,第三件事情呢,以岗位标杆为预设,为什么我们会去定义,首席客服的agent 以及最佳投手的agent 最佳销冠的agent 其实是我们把这些在这个企业里面,它的岗位的标杆作为agent的预设,它起步可能就是一个工作五年十年的,这么一个投手或者客服,所以我们今天虽然它的名词叫FDE 它叫什么,其实我们有一个很传统的词,就叫CSM客户成功,我们希望的客户成功,最终是对业务的结果好一点 [00:05:11]
泓君:更好一点,我们叫Better and Better 所以我理解这一轮,我们在说到FDE 跟我们去做这种企业级的部署的时候,跟之前的几轮的根本区别,就是说它是有结果的,它的结果能验证,不管我们说成本的削减,或者是效率的提升,或者是新业务的拓展,相当于是以结果为导向的变化,就是它确实对企业有帮助,对而且是以企业的业务增长结果 [00:06:05]
朋新宇:可度量的结果,其实在企业侧和个人侧最大的不一样是,在企业侧的话,用AI是希望能够找到重复的工作,我就能用AI最高性价比,和最高效率去解决它,那个人可能是找到AI的上限,我能突破我的边界,那企业很多是要去约束边界,能不能举个例子,那2C其实可能大家经常听到一个词,需要新奇特,那这就是我是个人的体验,让我眼前一亮的,但是用完了以后,过了一周两周,你就会变成西松平常了,那其实对企业测试来讲,是另外一个词,叫多快好省,但其实它是有个比较,比较是一定是有个参照系的,这个例子,我们帮助一些客户,比如说其中有做一些3C数码的,它其中有一个环节叫做催发货,它有三类不同的处理方式,第一种是比如说买了两台空调,但是你只发了一台,所以我客户打电话过来我要催 那这个流程就是我要去核查我的订单,然后去我库房,然后再去派单去发,第二类是催配件,我买了空调,我忘了发一个配件了,原来的客户流程,再去找到配件仓库,然后我们再发出去,那第三类还是叫催发货,我买了一台空调,我确实收到了,你当初不是和我说,给我挣一个电饭包吗,那为什么没有送到,像就这么一个吹发货的环节,最后客服售后这个环节,大概有260多部 [00:07:25]
泓君:260多部这么多,我理解就是客户打个电话,客服接起来,他要是跟内部的流程沟通,是这个意思吗,就是难是难在这,对内部的流程,可能有的是内部系统,有的是外部系统,比如有的是电商
朋新宇:它在多个平台,有的在京东,有的在天猫,有的在不同的地方,对有些配件可能客户还要下单,对对对,这个200多部的背后,其实它能覆盖95%以上的,可能有5% 可能会有些新的东西进来,但这个95% 我要去熟悉这个流程,我要去新招客服,培训客服,我要去上岗它,考核它,其实这些是非常有确定的标准的,那我如何快速的去让客户能拿到货,以及让客户满意的拿到货,我们让客户不投诉,以及让客户不去要投诉为了要赔款,这样的客户,比如说我们通过我们销售的agent 客服的agent 以及和A9-1这样的结合,我昨天正好和同事,我们还在去复盘一些case 我们在其中有一家,它要超越它现在的一些传统机器人,其实我们发现,上线开始就比它传统的机器人效果要好,昨天我们在看到说,也已经逼近了超出了人类,最好的状态的平均水平了,所以能够看到这样的工作 在企业侧都是普遍的存在,它有边界,同时它今天是有巨量的重复才发生,所以我们把这些情况,在企业社归类成这么三类的场景,第一类是哪里耗人最多的,比如说这种打电话接电话投诉的,第二个哪里耗钱最多的,有些地方可能是赔款支存,有一些地方是营销投放,有些地方可能是我要花素材的各种的试验,第三个就是哪里耗时最多的,比如说我们经常会打电话给客户,说我为什么没有到,一般可能说不好意思,我帮你查一下,我们查了半天没查到以后,说我晚点给他打电话,一般是以小时为单位或者天为单位,那这些都是对客户来讲就是耐心,你有的超过一个小时,可能我就退掉了,其实不是说所有的场景,我今天都会用刚才讲的业务结构,给导向能做到的,一定是这个业务结果,它是非常具体可以度量的,耗钱最多,耗时最多,耗人最多的地方,对
泓君:而且我觉得你刚刚举的这个例子,非常有意思,传统意义上,我们在理解一个客服,以及客服机器人的时候,大家想到的都是说,客服怎么态度好的去应对消费者的 [00:09:49]
泓君:客服怎么态度好的去应对消费者的,不管是投诉还是怎么样,是一个语言沟通,但是您刚刚讲的这一点呢,让我意识到了,克服最重要的是解决问题的能力,而它解决问题的能力,其实跟你对整个公司业务流程,每一个环节,它是怎么运转的,这背后的一整套系统,我们可以把这些东西都称为数据,都记在脑子里,那现在呢,其实就是让AI 把这个背后的一系列的体系给打通了,现在我们说,不仅仅是人能解决问题了,那AI只要把数据打通,它也可以解决问题,但我很好奇的是,就比如说催发货,可能是有配件的问题,有赠品的问题,也有是多个订单,重复下单的问题,但是整个这里面,可能都涉及到一个企业,它的内部是怎么运转的,以及它的核心的制约因素是什么 在这一点上,你们是怎么跟客户,把他们的核心痛点,梳理出来的,就这个过程会花多长时间,我们有一支队伍,就是CSM这个队伍,比如说我们在中国 [00:10:51]
朋新宇:这个线上销售,其实淘宝天猫,是非常大的一个体量的存在,其实我们这些人,和这些客户的陪伴的经验,都是从多年来,在这个平台上,陪着这些客户去成长,所以我们自己,能够有一套最好的SOP 比如说缺乏货,或者是售后的,这么一个义务流程的理解,就今天AI的实施,可能和原来传统的,软件的实施,最大的一个对它的理解,不一样是,我们把软件实施,我们交付一套系统,其实AI的实施,如果类比交费套系统,可能还欠缺一点,其实它是我们新雇一个员工,所以我这里的比如说,这个客服或者是这个营销,或者等等销售,它默认就有技能,它会自动会处理,自动能够拿到你在市场上,招聘一个五到十年的,一个员工的水平,你进到你公司以后,你只要给他权限,给他目标,给他裁量权,那他就可以去工作了,而不是说,你今天是给你的同学,买了一套系统,买了一套工具 [00:11:05]
泓君:我们上来,这个人就是会干活的,你只要给他权限,这两个我觉得是有本质差异,对那我们刚刚提到的,就比如说催发货的这样一个场景,假设一个标准的电商企业,它需要雇佣多少个AI员工
朋新宇:这个是根据它的那个业务体量来的,比如说销售金额的,两到三个点三到五个点,各个企业不一样,几个点的成本是给客服,那我们今天用AI一定是,在要么是同样的成本之下 [00:12:11]
泓君:做到你原来同样效果之上的业务结果,传进去说这个事情是一个work的,哦了解了解,它是所有的企业都通用型的使用,就比如说您刚刚提到了几个大的领域,像客服投售然后营销治理,我理解其实这个就是您刚刚提到的,好人最多好钱最多好时最多,比较典型的三个工种,大家在具体应用到一些场景的时候,是所有的企业都用得很好吗,会不会有一些企业,比如说他们内部本来他的数据就是不全的,所以他也会上手比较困难,是这就是今天我们说 FD里面我们说第二条
朋新宇:以企业数据治理为基础,这个很关键,比如说从我这里雇佣一个,工作五到十年的这么个员工,但是进来以后,你的企业的这些基础的信息,支持库都是乱的,那这个人进去也是傻眼了,所以我们雇佣这个员工,比如说对于一些大企业,还有自己的一些私有的,商下玩企业的各种支持库,我们的FD在这里工作,就是要去帮他,梳理和治理他的企业的数据,如何让这个data for agent 那我们再帮一家企业,它是在多个电商的平台,淘宝天猫京东,或者是在抖音去做投流,他发现他有好几个投手,但是投手和投手之间天壤之别,其实发现内部做复盘总结,我们进去发现,我们把这几个投手,过往三个月,你的投放的行为,做了一个分析,我们发现做得最好的一个投手,他在三个月里面,他做了超过一万次的价格调整,那做的一般的投手,大概在三个月,你就算一百天好了 做了一百多次,一个投手呢,其中一天大概做,一次左右的操作,那个投手,可能一天平均做 100次操作,这个差异,你如果靠人去学,其实靠老师傅,带新图力,你很难去学,这就是发挥,今天AI的 Handis工程,能够去做,自我学习,做进化,如果把这件事情,理解成为工作的,几个基本的元素,第一个是学习,就是数据采集,第二个就是建模,第三个就是执行,第四个就是迭代,只是第一件事情,往往原来很多的企业,说这个事情,是我有经验,其实很多的经验,它一定是有,它存在的场景,这个场景一定有局限性,那只有什么情况下,它没有局限性,就是把你过往,三个月所有的行为,我们能够有一个,数字化的度量和学习,基于这个学习背后,那AI一定比人,能够对你的行为的,总结提炼和发现,更加全面和深刻,所以我们把这些东西,今天成为我agent 这个数字员工的技能之一 成为他未来,能够用每天新的对话,处理的异常信息 bad case good case 能够去做进化,这样的话,形成这么一个工作模式,所以在企业策划其实发现,像这样的环境是通用的,但是每一家工作的细节是不同用的,那这个环境正好就是我们这套A1 能够去从你的数据收集到模型建模,就工作的那个skill的这些,梳理完了以后你的工作的建模 [00:14:48]
泓君:再到你执行任务的推进,最后你能够做到进化的迭代,所以这部分是通用的,对所以AI它其实是在向,人类最优秀的投手去学习的,比如说90天它进行了 1万多次价格调整,这是人做的调整,还是说它已经形成了一套,机器建模的方法论,它会在系统里面做很复杂的设置,这里面其实所有的操作,其实都是人在做的,只是它可能借助一些工具,但是那个行为就是物理上,就是人在做的,我发现这个点很有意思,因为刚刚我们讲了客服,我觉得企业内部的数据很重要,您刚刚讲到投流的这个例子,我理解现在市场上,比如说大家要投,这个淘宝天猫平台的投流,或者是其他的广告投放的投流,几个大的平台是比较相似的,这一类的agent的产品,它是不是一个比较标准化的产品呢 [00:15:12]
朋新宇:对国内最大的SaaS平台,就是这几大电商平台,那这几大平台,它已经最大公约数了,大家在下面的素材呀,价格呀,系统啊,数据啊,已经标准化了,所以这部分已经,占了这个企业,所投手80%的数据准备,和系统学习的能力,所以这部分东西,是FDA站在,这个巨人的肩膀上,工作的基础,是非常重要的,只是我们在内比说,中国没有一个独立的SaaS公司,只是中国的平台企业 [00:16:03]
泓君:承载了SaaS公司的能力,所以这些能力,我们今天在AI时代,它是可以被利用,被发挥的价值更大的,对,我们刚刚提到了,其实AI在向人类,最优秀的投手学习,我能相信,不管是现在,还是说它未来的工作能力,它一定是会投的比人更好的,但是只要AI投的比人好,这样就会带来一个结果,大家会更多地去用这些AI类的工具,所有人都在用工具的时候,你觉得这个差异会被抹平吗,最终它真的是一个生产力的提升,还是说它是一个先行者的优势,如果用传统的生产三要素来讲,生产资料生产力和生产关系,现在这个阶段
朋新宇:大家都是在生产资料上的能力提升,有更好的算力更好的智能,能够让个人生产力的边界变得更大,但是我觉得为了提升的,就是能够通过AI 能制造新的生产力,比如说我就是一个,在线24小时的,投手和服务人员,我觉得这个就是时间先后,不可能永远有,绝对的竞争优势,一定是一个时间窗口,在这个时间窗口之下,谁能够企业更好地拥有,和运行自己的数字员工,在企业侧位增长做服务的,我觉得这个可能是就领先的,第二个呢,能让这个是持续,能领先一点点的是,我觉得还是要回到,企业自己核心的生产资料,不管是过去的时代,还是今天AI时代,最大的企业的生产质量,就是数字化,这部分还是有蛮大的文章 [00:17:11]
泓君:大家经常会看到,我们建一个数据平台,可能给内部看数用,那今天的数据系统吧,我们给AI用,你建的好坏,在这里是有差异的,一个企业,它的数据平台建的好坏,它的区分点是什么,什么是一个好的数据平台,什么样不是,然后什么样的企业,它可以建成好的数据平台,对其实好,也是一个相对的,其实对于企业来讲,我觉得还是一个,比较可以度量的,就是你落到具体的业务效果上来
朋新宇:能不能有正的经济效应,今天看下来,交付完一个agent 或者交付完一个系统,才刚刚开始,你的企业真正是让这些数字员工,能上岗工作,为你接单接流程,为你推进工作任务,这是开始 [00:18:19]
泓君:这两个是不一样的,原来是数据平台交付完,这条系统就结束了,今天在这里是交付完以后,你用起来,用得好坏,最终是用业务结果来买单,大家其实从去年今年都开始,在谈这件事情,包括开始准备去使用agent 企业现在用agent到了哪个环节,是已经到了一个,可以验证交付结果的环节,还是说他们只是刚刚开始,从我们所服务的客户
朋新宇:和接触的客户来讲,我觉得是有结构性的差异的,走的比较先的,就可能有数字化技术比较好的,就类似于原来在电商,在互联网积累比较好的,那还有一类就是一些大的企业,它本身内部原来的IT 信息化做得比较好的,第二个呢是,我们现在是看到,是在比如说投手,或者是说客服,其实我们有不少的企业,它已经就在用了,那可能用另外一句话讲,其实大部分的企业,真的做出效果,它不会去讲的,今天可能是企业和2C不一样 2C是一个新的功能,好的功能,它立马就会让全联想知道,对企业社,它只要这个效果,它持续在用,那其实这个就是好的,最终是用结果来买单,哦了解 [00:19:00]
泓君:你们今年去谈客户的时候,你觉得要让他们,把自己的一部分系统,放在这个agent上,它是得从上往下推动,还是从执行层,自下而上地跑起来,今年企业对agent的改造,业务流程,他们是一个什么样的态度,对这是个好问题,那这两者都有,那目前我们看到的,进展顺利的是自上而下的
泓君:进展顺利的是自上而下的,涉及生产关系的问题,自上而下是,这个业务的一号位 [00:20:00]
朋新宇:它能决定既有IT费用,又有业务费用,那它才能够去算总账,今天如果自向而上的话,我们就遇到反向的例子,曾经遇到一个客户,他的某一个业务部门,他想做业务的agent 但是他今年没有预算,但是呢,他的IT团队有预算,但是今天这个IT团队,可能和这个业务之间,是不同的部门,我们就在这个过程中发现,需要通过我们这个业务方案,去设计既能满足IT的先进性,要满足业务的效果,其实发现这个生产关系,蛮难去弄的,因为可能IT要的先进性,不一定是业务要的效果,业务要的效果,可能今天不一定是最先进的,那今天返乡是成功的是,我们遇到的是,有的企业可能是比较传统的企业,或者制造业,它的一号位董事长,就是非常明确,我今天必须要去拥抱AI 要去用好AI 用在哪里,比如说他选定一个销售端,从哪个区域开始,自上而下,那自上而下以后,发现他的财务 IT 以及他的销售线都动起来,生产关系重新发生了变化以后,那业务的销售agent 他从一个区域,复制到全国的区域,就形成一个很快速,能够去推动的一个局面,对 [00:21:00]
泓君:企业在推动这部分业务的时候,因为它会涉及到很多企业内部的这些数据,大家要把各个流程各个部门的数据,还有一些方法论都拿出来,把它做成一个agent 企业在跟你们负责前端部署的人在沟通的时候,这会是他们有顾虑的一部分吗,这是个好问题,也是一个我们的优势,原来四五年的时间,我们帮助了大几百家到上千家的
朋新宇:中大型的客户部署了数据平台,所以本身原来部署数据平台,就是已经帮他数据做了治理,做了打通,所以基于这平台之上去涨业务,今天就是一个水到渠成的事情,那今天可能遇到一些新的企业,构建agent的过程中,他要花很多的代价,还是要在下面构建,今天企业界的数据的管理和,清洗的这些能力,但是我们因为原来积累了,投入的大客户就好几百家,他本身就原来持续在数据平台上,做数据积累,基于这个上面去涨
泓君:这些应用就比较方便,我理解您提到的大客户,是之前跟阿里,就是已经有商务合作的,这样的一部分客户,你又是做数据中台的,所以其实是沉淀了很多的数据的,是的,那如果大家跟你们一起,去合作一个这样的agent 它的商业模式是什么,最终这个数据,它是在企业端,还是在阿里端,还是说大家共有呢,这两个问题,一个是商业模式,一个是技术模式 [00:22:06]
朋新宇:商业模式来讲呢,基本上就这么两大类,一种是按照作息收费,就是工作量嘛,第二个逻辑就是按效果逻辑,第一种是比如说刚才讲的客服,它原来是500人,要去接管它的一年的生意的服务,那今天我们用同样是500人的价格,比如说有个八折九折的投入,能做到你原来一样的效果,就是我们叫做按照成本,人力成本替代的转化逻辑,第二种就是我们基于,比如说做营销,做投手这些增长
泓君:那原来你的转化率,比如说是20% 做到你原来人物转化率之上的部分,我们做分层,这么两大类,现在按照效果付费的,已经正式发生了,有的,有达成效果了的吗,肯定是有的 [00:23:00]
朋新宇:而且是连续续费,或者连续在服务中的客户,这个客户其实,我们所谓的默认的是,所有的做生意的,他比我聪明,今天他能算得过来这个账,他一定才能去做续费和服务的,不要去默认,我们想去能够,比客户更加聪明,或者是我们去包装一些东西,让客户能够觉得,基于这个包装溢价,那我们原来有个词叫POC 其实今天叫MVP 可能不需要去做概念论证,因为你今天我是一个数字人在这里,你上来就能体验就能用了,那最终是要是基于他家的业务单元,他家的数据单元,能做一个最小能价值验证,客户最终验收通过 OK 那你就自己去用,这种才是一个比较呼信,和有持续连线的这样一个服务方式,前面刚才讲的是商业模式,第二个你刚才提的问题背后,还有一个是技术模式,那我这里可能讲三个词,定制化标准化,还有一个词是个性化,原来过往的,大部分都是 希望用定制化的方式,去满足企业标准化的流程,可能每个企业,他说我的工作流程,和别人就不一样,你要去做定制,那这里是把他,原来已经工作内部非常顺的,不管是八步,还是十步的这个流程,把它刻画下来,叫定制化,用定制化的方式,解决他标准化的问题,那这个标准化的问题,就是看这个企业,对他的业务的流程,理解总结的到不到位,如果到位,那这个确实有效,如果不到位,可能能解决30%的问题,那天天会有70% 60%的新的增量,那这个就会变成一个,又长又久的系统交付的工程,就今天的这些Handis工程,那能够把原来企业的工作流,数据流,包括企业的上下完,我们把这些工作区间,能够标准化下来,那同时因为今天有了自主进化,所以这些在面向不同的客户,回答问题的过程中,它就能做到个性化 [00:24:08]
泓君:所以对于AI的领域来讲,它可能未来更多的是,用标准化的方式,去解决个性化的问题,因为既然定制化,就很难去做到个性化,我理解,当我们在说标准化的时候,比如说我们给企业,是一个标准化的产品,就是类似于,比如说我提供了agent one 然后我上面,有几个大的方向,你只用去采购,我这个agent的席位,就OK了,这是一个非常标准化的产品,但是呢,定制化就是说,你的企业可能会有一些,特别的业务需求,我可能需要再,跟你的数据打通,它能回答更多的,个性化的问题,我需要把你的这些信息都接进来,因为这样哪怕我是一个客服,我才知道是哪个环节出了问题,但是在真正涉及到,这一部分的时候,你觉得这一部分,很多的大的企业,比如说它有电商的企业,那它可能还有线下的 大家的问题完全不一样,就是这些它都是能用这种,标准化的手段去解决的,前面那个环节,我们如何去分辨,它是定制的,还是可以被标准的,其实定制就是 [00:25:53]
朋新宇:你去问它企业里面的每个人,它的流程可能都不一样,你最终需要做,内部叫企业,叫做企业流程培训,完了以后,你这条系统才能上上去,那今天的分析理是什么呢,你把现在企业,真实在工作的,这些人的行为,什么数据化,通过数据最终帮他表达,你这个企业最好的,销官是怎么工作的,你这个企业最好的,投手是怎么工作的,那这个工作,是不是你希望负责到,所有的人的,那如果说这个是一个参照系的话,那可能和原来的离散的,事实而废的标准 [00:26:05]
泓君:这是本质的差异,那这种你们会给企业,做一些定制,或者企业专有的软件吗,我们现在已经很少,去做企业专有的软件,我们还是聚焦,围绕着企业里面增长的问题,增长的问题就是
朋新宇:最终我一定是用能数据,能度量,当然我们也遇到一些客户,也会说,希望明年买我们,一千个人天的投入,那其实这种方式,我觉得在企业侧也要发生变化,那未来我觉得买这种人天的方式,其实定制的方式,其实会越来越少,人天是什么,就是这就是定制嘛,比如说我一开发一个功能,要100天,他估算他可能,我大概有10个系统,或者是有100个功能,他可能自己算下来,差不多要1000个人,天的时间才能开发完成,所以他会去找我们,或找市面上的一些公司说,你能不能帮我来开发一下,那这个开发其实对我们来讲,完全是一个从零到一,从养鸡场到养鸡到下蛋到炒蛋,所有都干完,那这类事情其实对客户来讲,对我们来讲,编辑效率都是非常低的事情,所以我们反而是说,今天你是聚焦,就是在做销售,做客服,做营销
泓君:那基于这些场景之下的问题,可能我们聚集,所以你们现在更加倾向于,去做标准化的agent 增长类的agent 我觉得这个点非常有意思,就我们可以讨论一下,我现在觉得呢,过去在SaaS那波很热的时候,大家想要去做这种标准化的产品,这一波很热的公司,是Palantir 我觉得它大概有 46%到47%的营收,来自商业客户,主要是派它的工程师,去一个一个企业里面改造,就像您刚刚说的,从0到1 把企业内部的系统搭建出来,就像比如说它要1000个人天,来去搭建一套系统,我理解现在像OpenAI 然后微软,他们可能也是想用,这一套AI工具,把这些工具布局到企业内部,那他们呢其实就做的是,一个一个企业纯定制化的思路,然后我理解 你们反而是在走一个相反的,做产品的思路,对 Lantier其实它有个前提是,那服务那些企业,它原来都是有基座的 [00:28:31]
朋新宇:它是去帮客户去找出有价值的问题,而不是去帮客户去实现,它给我列出来的 To-Do List的100个功能需求,这两个本质的差别,我们现在交付和服务中的客户是,我们见到客户里面,可能和企业的CEO 业务总裁,到下面的一线人员,我们都要去做交流,做访谈,最终是和他一起,先找到他公司里边,这个阶段在销售侧,或者在营销侧,或者有些是可能,在他业务增长侧,最有价值的问题,那这些问题最终,还是回归到,我们所擅长的,作为他的业务的增长,就是三类,要么是销售的增长,要么是你今天,营销的ROI的增长,要么是你今天,克服本身的服务人效的ROI的增长,其实我们在中国这样的企业,和这样的客户群体非常大,所以我们今天不是说,每一个企业我都能服务,而是说我们找到
泓君:企业里面有每一个这样问题的场景,我们能够提供服务,你们是一个垂直,一个赛道,一个赛道的做,基本上通过一些典型的客户场景,把一条赛道打通,是,如果具象来讲,它可能也是一些行业专属的应用,或者数字员工,了解,如果是这种比较标准化的服务,我理解他按作息收费就好了,他按效果这个要怎么计算,其实这个使用的方式是标准的 [00:29:33]
朋新宇:比如说大家都会接个数字员工,比如说我刚才讲到那个投手
朋新宇:比如说我刚才讲到那个投手,他其实帮我去每天采集,各种的市面上的精品也好,同类的企业他发的新品,新的价格,从采集数据分析数据做决策,然后调整自己的策略,就是这个方法是标准的,但是每个微超是完全不标准的,那可能每个行业,有的行业它的转化率,比如说有的行业可能转化率,有些品可能在不同的渠道,但是反复力不一样,这些地方可能我们没有办法,说有一个标准的,今天说一定给你提升10倍5倍的,还是根据数据来,根据你是过往的,你在不同的平台,不同的时间,不同的促销期,你的效果怎么样,我们做一个分析,完了以后我们做一个MVP 我们AVTest 这样的一些比较以后,最后有效果,我们会和你做一个业务模式的结算,我觉得当下这个阶段,可能也在试,对很多企业来讲,今天其实在这里的投入,肯定是希望能拿到,更高额的一些回报 所以我们会有这样的一些企业,我们愿意做一些尝试,比如说有的叫对赌,今天其实我们不叫赌,还是叫做测评,有这么一个测评,我的智商就类似于,模型的缩台一样,我能够去拉到什么一个水位线,这个我觉得今天对智能,和对今天企业的数据,让模型更好的放大,是一个很好的方式,我们刚刚其实聊了客服,然后看看有没有投手
泓君:或者销售的例子,而且我对销售非常感兴趣,我觉得投放它可能还稍微标准化一点,我理解销售它每个行业之间,可能就差别更大了,比如说酒的行业,媒体的行业 2B的行业 [00:31:17]
朋新宇:2C的行业,它是完全不一样的,是的,我们有一家制造业,它原来有很多线下的渠道,各个省代,渠道的销售人员就服务各种的经销商,而且这些人员最大的一个麻烦,可能约束就他的上班的时长和客户的时长,即使在一个区域,他一天拜访,可能他手上大概有二三十个客户,但是他如果按照拜访的一天,只能两到三家,先去哪一家后去哪一家,这是一个时间规划的问题,第二件事情是我见了这个人,我应该是和他propose什么东西,以及和他交流什么话题,以及这个话题最终可能和我企业,内部需要我的任务和目标,是什么关系,这个叫方案,第三个是我和这个人沟通完了以后,他可能有些要执行的任务,可能不是我预设的,但是可能有一系列的一些动作,这个动作可能和他的内部的,业务的系统要去录入,其实原来这件事情,你想想都是靠着人力的,今天我们帮着这个企业,是从一个省的试点开始 这个试点原来是一个,最落后的销售的区域,那在今年的上半年,那个省评为最先进的,你想想这些过程,可能AI能在各个环节能帮助,但是缺少一个销售的AI 能够把它从事前事中事后,都能穿起来,前面的路线规划,中间的我要去做,哪些客户见面的材料准备,以及准备完以后,我的小机和我系统,怎么录入打通,如何去推广到,我后面的内部的,相应的其他人员跟进,原来这个销售,可能每天花一半的时间,在做资料准备,可能晚上大概花两个小时,做复盘做系统录入,那今天可能对销售,它的工作时间,效率大大提高,而且它的最终结果就是,那个省拿到那公司的销售罐,这个印象深刻,对,我们从企业的消费者来看,增长就这么,简单可以理解三大类,售前售中售后,那售前其实就是营销,售中就是销售,售后就是客服,其实你售前再看,它也是这么三大类 投钱做预算分配,做渠道分析,做人群挖掘,投中做素材生成,素材管理,素材的优化,投后做复盘,做渠道筛选,渠道优化,你看这几件事情,其实背后都是数据家AI能够,肉眼就能看得到,能在这里能够去提供很大的价值的,只是这个怎么穿起来,你再看售中,销售也是这么三件事情,新客新购转介绍,哪里有新客,哪些新客变成新购,所以你看到会有什么,试驾试吃试穿一堆的,都是让它你的新客户,变成我的新的购买用户,都是为了让你能够,更好对我的产品有理解,我要把这个试的机会给谁,这里你看到,都是有数据加AI的机会,能够去找到,在企业私域的信息化,数据范围之内,能辨认出来最好的,或者是能够去规划出来,最好的策略,你看客服也有这么几类的,可以抽象,交付履约,比如说我买一个东西,什么时候上面安装 第二个是售后投诉,我买的东西,刚刚讲吹发货,缺了个脚,缺了一个什么配件的投诉,第三类就是长期复购,我新产品来了,或者我新的功能升级了,如何让我来继续提供服务,其实这几大板块,往下拆解和理解,其实我们今天这几类agent 就是基于这些,敢为最佳投手,最佳销售,最佳客服作息的,这样一些人设,去做agent的设置,同时我预制了,这样的一些agent 他有一个比如说工作五到十年,或者是一个本科生的水平,或者硕士生的水平的这么个人,那今天进到那企业来干嘛呢,你需要有企业的资产给他去打理,这个资产就是你企业的数据权限,资金的审批投放的权限,客服相应的呼录和资金赔偿的上限,给他这些权限,那你在你企业就能工作,为什么我们说营销销售和客服,是这样理解的,是因为站在企业的生意的逻辑来看,这几个角色是在每个企业都存在的,最大工业数的岗位 通过数据加skill能最大化的把它变成agent 能够去自动上岗自主进化的体系,所以你们现在内部有多少个这样的不同的agent 那我们提供的agent服务方式呢,如果简单来讲就是4加X 4个预设好的agent 加上X 这个X是企业的数据资产和企业的商销文管理,那4是分别的 4个呢,一个叫营销,一个叫销售,一个叫客服,另外一个是运营,我们这个agent呢,就是在这个行业里面,能做到五到十年的工作,进行的人,叫做最佳岗位的实践的预示,然后同时X 就是雇了一个这样的人进去以后,你给他什么样的权限,什么样的企业的数据,什么样的企业的审批权限,和资金的管用的权限,所以这个地方的X 就是我们需要去和企业一起去梳理,去治理,以及在原来他有的企业的平台之上,能去做一些数据资产管理的 [00:35:10]
泓君:能够让前面的agent 更好上岗更好工作,对,您刚刚提到的那个帮助制造业做销售的这样的一个agent 从您的员工开始接触了解这家企业,到真正的把这家企业,适用于他们企业销售系统的agent打造出来,这个过程大概会花多长时间,哇这个还是一个好问题,我觉得我们讲起来很容易,但是其实做起来还蛮难的,特别是在新的技术革命的开始 [00:36:03]
朋新宇:有人相信有人怀疑有人在不断地摇摆嘛,所以我们做这件事情可能花了一年多,可能讲起来两句话讲完,核心的是这个企业,整个的组织上的关系,解放思想很重要,先去熟悉工作岗位,这个花了可能是比较大的时间,可能占了三分之一不止,完了以后才是去做建模,那后面我们同样花了,大概三分之一的时间,在教练团,因为我们有这样的agent出来以后,并不代表他今天就,完完全全是一个优秀的投手,或者优秀的一个销售,说我们有一个AI的导师团,那我们要去调教他,前面的学习和中间的调教,加载快花了三分之二的时间,那另外其实真正的实时执行
泓君:和系统的上限反而是快的,熟悉工作岗位,这个我理解,其实就是我们今天提到的 FDE前沿部署工程师,他要真的到企业内部,然后跟大家沟通交流,包括他是不是还得在每个企业轮岗,看这个企业它是怎么运作的,假设他们的销售发现,我们是抱着这样一个目的去的,我们可能要建一套agent的系统,会遇到执行层的人,会比较抵触的这种现象吗 [00:37:08]
朋新宇:肯定会的,这是人性,所以我们刚才前面的话题就是说,能看到跑得快的是,自上而下的跑得比较快,但是我们惊喜地看到,我们做了几个成功的企业,有部分的企业,其实CEO或者董事长,做的最多的一件事情,是动员思维的转型,所以我们有一位董事长,他一年在企业内部,给他的全员和管理干部培训,自己做董事长学习AI 去讲课超过15场,他说我先学会,我再给员工讲,那员工才能去理解我的思想,和能用好这些系统,所以我觉得思维转型,是非常难的事情,但是惊喜的看到是说,这些员工原来担心的,其实大家都在互联网谈的一个词,就是人会被替代掉,其实发现在企业侧不是这个样子,其实企业侧我们觉得,同样会形成K线进化,比如说IT的团队,这些成员原来在数字化时代,是非常有竞争力的,我觉得在AI时代,它是更加有竞争力 它首先它贝斯是了解AI 或者是用AI的工具,是有技术背景的,所以他上手快,同时只要他往业务再走一点点,他可能就是企业内部的FDE,他能找到企业内部更多,比我们这些对那些不熟的人,找到更多的企业的三个点,就是耗钱最多,耗时最多,耗人最多的地方,找到这一点,去雇佣和培练,这样的agent上岗,那他的价值就更大,那所以这些人K性往上走,那另外第二类的K性就往下走,你如果今天我就和你对抗,你可以对抗一个工具,或者对抗一个项目,但是你对抗不了这个趋势,但是我们看到,董事长一年培训了15场,然后发现他的财务,他的IT 还有他的原来渠道的,一些销售的负责人,慢慢变成了一个,叫做帮助客户成长的,这样的一些导师也好,这么一个角色,这个角色其实我把它,翻成为是企业内部的FD 我觉得往KC的上面走,这不然是有巨大的机会,这里面可能我觉得首选,像原来的IT CIO CTO的这样的组织,他们只要往业务走一点,原来很多做技术都是这样子,上面的业务同学们,需求给我提清楚,我就干就好了,但是今天是反向是你要去学会提问题 [00:39:22]
泓君:那比如说我们刚刚提到的像销售客服这一类的职位,他们会有向上走的可能性吗,当然今天他可能不是自己去上岗,做真正的一线的接线或者是处理投诉的人
朋新宇:他是这个客服AI agent的力量,他去每天做异常处理,每天晚上的复盘,一样他要去做总结,他要去做任务派发,新技能的让这些agent去学习,那这个人他整个的成长路径,就不是原来说我去处理
朋新宇:就不是原来说我去处理 100个更刁难的问题,而是如何让我这10个跟着我的agent 能够去覆盖原来超出我工作量,和工作能力范围之内的工作,我觉得他们的工作性质,跟工作方向发生了变化
泓君:可能以前从一个执行的职位,变成了带着一群agent 管理他们的职位,是所以这些人在企业侧,或者在市面上,他会越来越值钱,而不是今天我们换了一个title [00:40:12]
朋新宇:叫FD就值钱了,而是这些人具备我刚才讲到的,以业务结构为导向,以企业数据为基座,以岗位标准为预设的,这些人他能够帮企业拿到结果的,至少是不低,他是值钱的,对我们刚刚提到了
泓君:首先要熟悉工作岗位,然后这个可能真的也是要,企业的一把手,从上到下,整个大家思想体系的一个变化,那另外您提到的,第二点是建模,第三点是,有一个AI导师团,他来用这个工具
朋新宇:这个具体是一个什么样的步骤,对我们举一个 agent上岗的例子,我们在一家企业,其实不是说,我今天部署个系统,立马就切换上去,我们是大概一周的时间,原来我们可能有个词,叫做灰度,能给我多少流量,或者给我多少的客户量,或者是DAU进来,我们不是这样子,我们是第一天,我们切晚上零点到两点,客服的数据进来,因为这个时间是,客户需求最少的时候,或者低谷,这样的话,即使我的第一天上去,有什么问题,那影响面是可控的,那基于第一天的工作,上岗以后,我要去做评审,做分析,再做一些调整,第二天的时候,我就改他的上岗时间,是从下午的12点,到下午的2点,这个时候是这一天,工作最高峰时刻,我们并不是抽高峰时刻里面,得十分之一的流量,我们要是这个时间段,全段的流量,只有全量,我们才知道你异常的边界 那同样我复盘,你在最高峰的表现,哪些有毛刺,哪些有你客户投诉,炸毛的,哪些是你处理得比人好的,那我就去做一些调整,第三天可能我会放大到8个小时,以此类推到一周的时间,让它变成一个能够符合我整个企业设定的参照系,这个参照系可能是它最好的作息,要么是它今天内部比如最优员工的一个标准,所以是这么一个工作模式,我理解整个这个过程 [00:41:46]
泓君:其实它要把它测试运转跑起来,然后在这个过程中不断修正,它其实还是需要花很多的时间,有一轮轮的反馈的,是,就原来我们是把它当成一个工具,信任我真的是,把它当成一个我的同伴 [00:42:12]
朋新宇:交配你以后,我不在的时候,或者是在晚上凌晨的时候,你就真的是能够完全接管我,而不是一个指令,现在的可能有些,默认叫自动回复,自动回复都是一些FAQ嘛,对对对,那我们具体,真正到前沿部署的这些人
泓君:比如说,他要去熟悉,这个企业的工作岗位,然后要建模,同时还要在 AI使用的过程中,不停地拿反馈,你觉得这个人,他是需要一个,什么样的素质跟画像呢,因为我感觉
朋新宇:这是一个很难的工作,对,我们做法不是一个人,而是一个组织,要一个人有这样的,那全才非常难,而且这个人的宽度和时间,那就非常随便化了,那所以我们基本上,分这么三类,一类呢我们叫BA 以用结果为导向的BA 最终是对客服流程,反正只有200多部流程,我们怎么能编排,或者怎么能阅读,这个客服处理,这个是最佳的一个方式,它能够去找出最好的 AI的工作的模式出来,设定出一个,比较科学的数据标准,去做评测,其实它是片业务,像美妆啊,家电啊,家居啊,还有宠物啊,汽车啊,这些专家,今天就是在,我们这个组织里面,工作的一员,第二个呢,我们叫做AI架构师,我们今天把那些业务问题,要翻译成为,用什么尺寸的模型,以及什么环节,我应该要去,人干预什么环节 应该要去用机器接管,这个AI架构,这拨人可能,他的视角是,今天对新的模型,新的agent进化的一些能力,他能有足够的掌握,他可能是就在AI进化的最前线,最新的资讯,最新的产品,他都要去能快速的上手,快速的能给出结论,并且快速的知道,我这个业务,应该匹配什么样的一个解决方案,第三类才是首席客服,首席销贯,这类人,他是能够把前面的业务问题,变成了agent以后,在过程中能够去参与到调教他,这个调教这里面,我们的角色会变得弱一点,会退后,会在客户侧去挑选出来,他客户里面最好的这几个角色,能够去组成AI的专家团,或者AI的教练团,如果企业内部,未来大的企业,或者是平台化,做得比较好的IT能力,和基础能力比较好的企业,这几种角色,它内部应该都会要具备 可能在这个阶段,通过我们的方式,能够去快速地知道,很像你们所在的,这个行业里面,最好的水平是什么样子,能少走弯路,那在一开始的时候 [00:44:40]
泓君:是谁说服这个制造业的董事长,来做agent的呢,我觉得拿下客户可能是第一步,而且这个客户,他能说服董事长,他可能级别还不能低,他得有更好的v神,没错,对于一号位来讲
朋新宇:他就关注我要么收入增长,要么利润增长,其实我们只是在今天,用AI的这个时代之下,用agent的这个方式,去让他理解,这个事情能满足他的收入增长,或者利润增长,或者人效增长的数据,所以不是说我们用,有一套什么样的方式,去说服谁,而且这里面找到,大家共同想往,那个方向走的这个意愿,那其实就是一排集合的东西,我们说最难的是,你把你的东西,装在别人脑袋里面,那今天是正好,当脑袋有这样的一些,发展的诉求,期望动力,那我们在这过程中,去帮你的动力,更快地能看见,更快地,我们叫做MVP 能让他想到的,看到的是能够结合起来,所以我们像刚才讲的,那个企业的董事长,是因为他讲了这些东西,我们的团队进去以后,快速地通过今天AI工具,去做出来MVP 他的同事就给他们的团队,说了一个很具象的词,就是说,没看到之前我不知道我要什么,但是这个就是我想要的 [00:45:03]
泓君:哦有意思,他还是看到了一点点产品,他大概对他想要的东西,自己也有一个清晰的画像,这个东西可能就是,做出了一个他脑子里面的产品,对,您觉得今年这些企业的一号位,他在接受agent 包括主动去拥抱AI agent的趋势上,它有发生什么样的变化,这个天壤之别,原来都在讲怎么用,能不能用,现在直接跳过,什么时候开始帮我用上
朋新宇:从什么时候感受到,这个趋势的变化的,就在今年春节之后,这波龙虾兴起以后,以及后面的Hannes工程,包括现在Loop这些,慢慢能够让原来大家关注的 AI都在模型参数,说它这个跑分,到今天能够看到它执行任务了,对企业来讲是非常立感建议的,他脑里面多一本账,还是回到刚才那三个标的,已经慢慢出来了,我哪里耗人最多,他就琢磨,能不能帮我提高人效,哪里耗时最多,能不能帮我提高速度,哪里耗时钱最多,能不能帮我提高 ROI 所以企业家是最聪明,和最敏锐的一批动物,比如说他们现在用一个 AI客服成本是多少 [00:46:24]
泓君:然后他需要去付 token的用量的使用费,因为其实也是从今年开始,硅谷的大公司,也要求员工开始去用agent 但是我理解他,跟您这边的可能还不太一样,他就是比如说鼓励大家去用AI工具,但很快就发现,自己企业的token的账单给烧爆了,现在在您接触的客户中,会有存在这样的现象吗,这个是普遍存在的,就拿我们自己举例子好了 [00:47:04]
朋新宇:我们在QE结束的时候,其中有一个AI的项目,我们收入可能300万,但投入1200万,但是我们慢慢到这个季度结束,基本上能看到就会打平掉,所以出去投入还是有的,但是今天呢,正是因为我们自己这样经历了,所以我们反而设计出来这样的agent 不是让你对token敏感,而是关注你背后你能解决的问题,还是那句话,能不能算得过来账,你算得过来账,背后用什么token 其实对他来讲,大本老板他是不会care的,而且有些时候我们看到,很多问题在客户侧,它并不是模型先进性的问题,它可能就是刚才讲的,最后一公里的企业上下文,企业的数据规不规范,企业的数据好不好用,这些问题可能今天不一定,是要用最好的大模型,今天反而我们是把这些,降低它的选择和降低它的,本身就不属于它,应该要去判断的范畴之内,今天我买一个电脑,在行业里面还会去说,我关注我电脑的CPU 我的芯片我的内存,企业也一样的,我觉得它一定是关注,能够给我带来的账,我算得清楚就OK了,我们希望在这一层,通过我们的实验,尝试去帮助客户,未来在我这个平台上,他去雇一个外呼机器人,或者是外呼agent 或者是这个自检agent 或者是电商投流agent 是肿胀的,背后你用什么模型,什么方式,可能这是留给我们团队的,我们的技术能力,做到多好,就是我们未来的利润的空间,和你成长的空间,有意思,你们现在用的是哪个模型,所有的阿里云平台的模型,我们都在用,但是对于客户来讲,其实你是阿里系的模型,还是今天的开源的,像Tini 像Zip 这些在我们的阿里云平台,都有这样的模型,这样的模型,我们反而是用这样的场景,来去帮客户挑选,在什么场景下,用什么模型,对你的性价比较高,可能我们对模型不会有执念,所以你们现在的策略 [00:48:23]
泓君:我理解根据刚刚您说的,应该不仅仅是说,我只是无脑用最强的模型,而是可能是比如说好的模型,配上比如说阿里的一些开源的模型,可以下载到本地的,大家是综合来调度,现在是这样一个思路吗,对,你其实谈到的问题就是说,怎么部署的问题,那其实部署我觉得分两类,一类叫做系统部署,一类叫做模型部署,那今天我们这些agent [00:49:17]
朋新宇:目前就把它简单理解成一个系统,这个系统可以在我阿里云上,公有云上,也可以在你企业自己的环境里面,私有部署,这是没问题的,第二个是模型私有部署,那模型私有部署呢,我们发现大部分人是混淆的,一两年前大家可能在谈,我能不能下载一个开源的去做私有部署
朋新宇:我能不能下载一个开源的去做私有部署,那有人在这样干,是因为模型的智能需要去做后训练,今天其实积木已经强到,没有人再去提后训练这件事情了,第二个是比如说今天像开源的大尺寸,不管是我们大力的大尺寸的模型,还是像今天K1这样的模型,都是两点几TB的参数,那有没有算过这个账,如果你要去施布这样的模型,你没有个几千万的初始化的头部,可能几千万对今天最新的先进模型,还打不住,所以这个成本照样没有算过,第一个是需不需要,第二个是成本耗不耗得起,所以这个模型施布,我觉得这个事情未来更多的会交给像,这样的agent 他去选择在什么场景下用什么样的模型,大家还有一个问题的混淆,就是如果我不思路模型,我是不是这些数据,就给了你大模型公司了,只有思路,我才能把这个数据,留在我的企业内部,但其实今天,我们用agent 去调大模型的过程中,其实我们和大模型对话,大模型并不会吸你这些数据 而且这些数据,可能对大模型来讲,它是污染,但真正说,能够去收集采集的是,编程的webcoding 这样的agent 像ChatGPT [00:50:54]
泓君:你和他对话,他是能够去采集这样的数据,他是为了让你更好的优化,对这个是ChatGPT C端产品的一个默认设置,当然大家也可以关闭,用于数据训练的这个按钮,那今天我们这层在哪里,就在你的Agent里面 [00:51:02]
朋新宇:你的客服Agent 你的销售Agent 你的营销Agent 这些Agent可以部署在你家里,部署在你的环境里面,你可观可控,所以在系统这层,可以管控你的数据安全,数据的合规性,那在模型这层
泓君:我觉得还是今天在市面上,要用你最符合的模型,和性价比匹配你,解决你问题的模型,是最优的方案,综合来看,今天模型的能力,已经很强大,强大到很多,用AI它就已经有一些效果了,所以大家不用试试,都用最好的模型,反而是现在在一个,拼效率的阶段,就拼谁的运营效率更高,是我觉得刚才这个话题,在2B这一侧
朋新宇:不是模型的先进性,而是它和在业务场景,比较多快好省,可以用最好的模型,这些地方我有收益,那我就做,但我们今天可能是,用一个适中的模型,能解决你场景,原来对比下来,就能达到很好效果了,为啥不可
泓君:对,我刚刚问这个问题,是因为您之前有提到过,比如说模型能力一升级,然后很多Harness工程,就无用了嘛,你们跟企业做企业级的agent 我理解就是模型能力一升级,你们会需要及时更新你们的agent吗,对你们来说,它是一个风险因素,还是一个利好因素,它是会增加你们的工作量 [00:52:09]
朋新宇:还是说这个其实还OK 目前还OK 如果他用了我这条agent 他一定是在稳定的绑定,这个模型已经是确定的,而不是说随着升级,他就自动升级,而是要经过人工确认的,比如说我们一个员工上岗,还是要经过刚才那个阶段的验证,只是这个时间会缩短,所以这个验证在目前,如果没有客户,或者是我们主动升级的情况下,他还是用原来那个方式去工作,是保证效果最稳妥的,今天一定是我们在哪个地方,测试到这个模型带来的,足够的理由去升级,我们去升它,那这个升我觉得从长远来看,一定是好的,那只是在这过程中,我觉得这也是FD在里面的关键作用,我们要去测,要去对比效果,再去做升级的方案,而且升级方案可能并不是一个API级别的切换,在企业这一侧,它也绑定了很多企业的流程,权限,包括企业内部的管理的边界,看起来切换很容易,但其实在企业这一侧
泓君:它其实要的是稳定的工作输出,对,你觉得中美的企业级AI 现在大家有什么,因为市场商业环境不一样的地方,然后他们之间就是有什么区别 [00:53:25]
朋新宇:先说企业再说这个角色吧,那像在前面的信息化阶段,有Salesforce有SAP这样的企业,其实它已经奠定了很多的工作流,以及奠定了很多的数据标准,那在中国其实在这一块是缺乏的,所以我们在中国做FD 大部分做交付,为什么现代交付不是我们这些同学,或者是其他的这个行业,他们想去做,而是每一家都没有一个,比较平稳的地基,所以我先去做地基,所以这个交付就限到了,我们从第一天打装,盖楼再到上面装修,一系列事情都要去干完,这是我觉得本身的基础,是不一样的,第二个才是说,今天美国的企业和中国的企业,其实付费习惯也不一样,你们在硅谷应该是很直观的,大家对尊重知识,包括人力成本也贵很多,但在中国是不一样的,因为中国每个大的企业,都一个IT团队,这些团队如果说紧急式交付的话,那其实它内部它也是能做的 那为什么你在这里能做出比较好的价值,那这里会遇到一个市场稀缺,和一个市场饱和的一个问题,所以这个可能一种是系统的环境,一种是人才的环境,这两个不具备完全的Apple的可比性,第二个是说这个角色,这里的人的工作有什么不一样,那在硅谷,那其实这些人可能今天有几个大的平台,可能包含像Salesforce SAP 传统的这种SaaS 还有像Facebook Google这种的互联平台,可能在中国其实像淘宝天猫,企业微信,他们要去更多的站在客户视角,怎么去利用好已有的互联网平台去工作,传统如果仅仅做一个功能基层的交付,那它会落到非主的体对上,那今天可能如果是从互联网平台出来的人,和做这些事情,他就有天然的优势,那如何懂流量 [00:54:33]
泓君:如何懂互联网的运作方式,如何懂互联网之间的这些喉号,这个是蛮不一样的,对,您觉得中国跟美国的FDE现在是领先统不还是之后,因为刚刚我听您说,你们的几个客户,您可能花了一年的时间,跟他们去做部署,其实我感觉你们走的,还是非常的早的,对其实我们没有FD这个词之前,其实我们干的这个事情,可能就是和我刚才讲描述的FD 就往这个方向去的 [00:55:19]
朋新宇:并没有今天因为有FDE这个词来了我们就套上去,所以我们原来五年前,就一直有这么一个团队,就叫CSM 所以这个团队只是我们,围绕着原来是客户成功,是今天有了AI来以后,把AI纳管进来,我们如何继续让客户成功,我觉得我没有数据,所以我没法对比说,比他好还比他不好,但是我们这几年一直在这样做,但是我们越来越能感受到,其实最终是用客户的订单,客户的续费
泓君:来去对你表达你做的好和不好,所以目前我们看下来 so far so good 太谦虚了,那作为瓴羊的CEO 您现在最关注的三件事情是什么,好问题,我想一下,比如是客户的拓展,找到好的人,还是整个技术方向,跟战略决策的把控 [00:56:11]
朋新宇:或者是怎么样去提升运营的效率,出向层面可能就三个东西,一个叫做人,哪些人,不管是客户侧面的人,还是我们自己的员工层面的人,是能够去更好地,更快地从AI里面冒出来,在内部我们每个月,会有一期叫做AI最佳实践的员工座谈会,员工的分享,我们希望能快速的去找到,或者去帮助这样的一些同学们,能冒出来能够去成长,客户册我们也是一样,所以客户册我们每个月都有一期,或者每年我们都有一个,很固定的一个活动叫做数据同学会,希望能找到这个行业里面,头头脑脑的过去一年发展成长,和蜕变最好的这些人,能去交流,我觉得人是所有的这些事情的前提和根基,第二个是市,市情这里我觉得是市能,我们得找到在市能上的事情,比如说我们最近在做Agent上的 这些客服营销销售,这样的Agent 其实我觉得找到这样的事情,其实最终是要能够看到,它能自增长,但是在客户内侧,它能够自己口碑相传,比如说刚才讲的有些例子,其实都是一些客户和我们讲的,或者是客户和其他的客户讲,再来反过来到我们这来的,第三个就是局,局是局面,这类局面就AI的格局 AI的发展的局势,以及今天Agen的一些进化的局势,这里面有技术测的,有工程测的 [00:57:31]
泓君:有在模型测的,可能有在业务架构测的,所以总结下来可能关注人事局,现在在AI时代,您刚刚提到了人,你们也会去做最佳实践的员工分享,您觉得现在人的技能,应该往哪个方向转变,如果大家想要自己在AI时代,发展得更好的话,你们更倾向于招哪一类的员工呢,我们也在尝试
朋新宇:其实我们不知道最好,所以我觉得应该是要招得更好,只能better and better 所以现在我们能看到,就这么三类的结合,一类是懂技术的,第二类是还是要了解业务的,要么技术往业务走,要么业务往技术走,目前看下来技术往业务走,可能难度更低一点,这业务可能我们不要是全才,可能是个专才,你要么去把一个营销多平台,或者单平台做得很好,要么是你把一个行业里面的,克服了各种边角角流程,理解得更透,所以我们这里有不少的这种,叫科普专家呀,叫营销专家呀,这样的角色,第三个呢,我觉得还是懂数据,其实懂数据并不代表说,我天天看报表,而是你看了报表,你能至少在你脑里面,我觉得有几个东西,第一个同比,你看完这个数据,你得看到同比,这个是健康与否,如果只是给一个裸数据,说今天我增长180万,但这是好还是坏,不知道,第二个呢 我们叫做对比,你是和自己对比,还是和进队对比,和另外一个品牌对比,还是和你自己家的,另外一个产品对比,第三个呢,我们叫做占比,你虽然做了180万,这个市场上,你是万分之一,还是说这个十分之一,但你的模式就会不一样,那其实这些呢,可能是基本的一些数据思维,那最终可能落到AI这一侧,我们也是要让AI 有这样的能力,你有这样的能力,才会有这样的判断,有这样的判断,它才会有这样的策略,它的执行,才会慢慢变成进化,为什么要数据,数据其实就给了一个参照性,就给了一个靶子,这个靶子就是设定目标,你不断地超越它,那这个数据就成为你的一个拐手杖,综合来讲,今天就要懂AI吧 [00:59:15]
泓君:懂业务深度,对AI的锐度,懂业务的深度,还有数据的宽度,对您的这个分享
泓君:对您的这个分享,让我想起一个很有意思的话题,之前AI刚来的时候呢,硅谷有一个职位叫做Data Scientist 就是数据科学家,很多做数据科学的人,他们都非常的慌,因为AI就可以做各种的数据分析了,它不是首先取代的是我的这个职位吗,然后您刚刚的这个分享,我突然意识到,不管在什么职位上,只要大家真的做得比较好,它都是很有价值的,是我觉得这是自然进化的规律,也是AI进化 [01:00:00]
朋新宇:我觉得你逃不开一样,刚才你说了一个词,数据科学家,其实我们在十几年前,我们在国内,我们也用这样的词去定义,其实后面我们改了一下,把后面加去掉,因为在国内这个语境里面,数据科学家就很,非常神圣的一个title 所以我们叫做数据科学,数据科学是讲究方法科学,不是你的人的位置,这是不一样的,科学的方法和科学的工作方法,那落到你的业务场景里面,那这个数据科学才是有,发挥业务价值的
泓君:那是不是说在现在这样一个时代,资深的人会更吃香,那如果是刚刚大学毕业的应届生,刚刚开始熟悉一个职位,你觉得这一类的人,他会有优势吗 [01:01:00]
朋新宇:我觉得2C和2B不一样 2C可能去做一些创新,那可能今天没有差别,但是2B来讲,你的行业经验know how 还是有壁垒有价值的,那只是这个价值呢,原来可能是十年他学会的,今天你有可能一年或两年,你能掌握,对当下的这些年轻人,其实我们如何能站在,别人的肩膀之上去成长,而不是从零开始去学习,那这种新的工作方式和工作习惯
泓君:可能会让人和人之间产生新的差异,对,因为我们今天其实聊到,整个企业级agent 您这边确实我们也能看到很多的结果,就是它能帮助企业降本增效,但你觉得有没有一些,之前做不了的一些业务,有了AI以后是可以做的,就是它可以帮企业完全打开一个新的领域,跟新的增长市场,现在你们有看到这样的一些趋势吗,我觉得特别像AI for science
朋新宇:就很多做不到的,但是今天我觉得回到企业侧,就两个方向,一个是加AI 一个是AI加,加AI就是我们自己也帮助不少的企业,上线的一些系统,用一些工具,比如说我们数据分析的工具,数据治理的工具,还有一些风控的一些工具,那这些工具今天加了AI以后,它的效率效益,最终回到用户效果上来,它会有一个增值,那这种呢,现在也有不少的企业,还在这个方向上去发力,我觉得这个是非常有必要的,不能一口吃个胖子嘛,而且有些系统,特别是对一些工具型的系统 SaaS型的系统,并不是这些系统没有价值,特别是在这个阶段,这些有些软件的工具,它的价值会重新分配了,原来这个软件我必须要打开这个软件的首页 login进去我才能使用,那是人用的,那今天可能这些系统,它可能是给AI用,它可能不需要人登录,所以它的价值会重新分配,那这些系统还是有效的,这是加AI的方式去用的 第二种叫AI加,谋定的是我是在某一个领域,我要真的是要重新用AI的方式去改造它,去定义它,比如说我们刚才讲的AI客服务 AI营销 AI导购 AI投手,这类的地方呢,反而是回归到企业本质,哪里耗人耗钱耗时最多的地方,那这些地方是容易去探索AI家的方式的,好的特别精彩
泓君:好谢谢小鹏,好谢谢洪君,好那这就是我们今天的节目,大家听完这期节目有什么样的感想,欢迎给我们写评论写留言,播客的听众可以通过小宇宙Spotify 还有苹果播客来关注我们,视频的听众可以通过B站,还有YouTube搜索硅谷101播客找到我们,我们部分节目的文字稿,也会发表在我们的微信公众号,硅谷101上,我是洪君,感谢大家的收听,谢谢 [01:03:22]
来源:OpenAI News
URL: https://openai.com/index/building-an-ai-native-finance-function
OpenAI 首席财务官(CFO)Sarah Friar 分享了构建 AI 原生财务职能的五条经验,内容涵盖从自动化预测到强化控制,再到评估 AI 投资回报率(ROI)。
Andrew Huberman 与李飞飞围绕视觉、智能和人工智能展开对谈。李飞飞认为,现代 AI 的突破来自神经网络算法、大规模数据和 GPU 计算的汇聚,但机器依靠海量互联网数据学习,与人类通过少量经验形成情境理解的方式仍有根本差异。AI 最有价值的方向不是替代人,而是增强学习、医疗、创造和日常生活,同时必须坚持以人为本,让教师、家长、创作者、医护人员和普通用户参与技术塑造。她对人类保持乐观,但强调社会必须认真帮助那些最容易被技术变革遗忘的人。
对谈从视觉为何是智能基石开始。视觉让动物能够感知食物、捕食者和配偶,推动了动物演化;人脑约一半的皮层活动与视觉有关,视觉也因此成为人工智能的重要入口。李飞飞回顾了 ImageNet 的创建:研究者发现早期 AI 的瓶颈不只是算法,也在于缺乏足够训练数据。ImageNet 的大规模图像数据集与神经网络、GPU 计算在 2012 年前后汇合,推动了现代 AI 的关键跃迁。
两人随后比较机器学习与人类学习。机器可以通过大量样本和学习参数,从书架后露出的尾巴推断那可能是一只猫;儿童却只需见过很少几只猫,就能结合环境和经验完成类似判断。李飞飞指出,AI 已能识别模式、生成文本和图像,但人类拥有身体经验、情感、直觉、价值判断和从极少样本中学习的能力。创造力也不只是生成新颖内容,还包括人类如何感受世界、组织故事、理解他人并决定什么值得表达。
在医疗领域,AI 可以帮助医生分析影像、发现疾病风险、规划治疗并支持机器人辅助手术,但它不应取代医生与患者之间的关系。临床决策涉及信任、责任、伦理和对具体人的理解,因此更合理的模式是让 AI 扩展医护人员的能力。李飞飞创办 World Labs,是希望发展空间智能,让 AI 理解三维和动态物理世界,而不只停留在语言和二维图像中。
谈到就业、艺术和教育,李飞飞认为技术会重塑行业,也会带来真实的失去。创作者、电影人、教师和家长不应只接收到末日论或盲目乐观,而需要与技术专家共同试验、提出规则和建设工作方式。她尤其担心教师和家长被政策制定者、投资者及技术公司遗忘,并分享自己在 ChatGPT 出现后主动联系孩子学校、提出为师生讲解新技术的经历。对年轻人她保持希望,因为好奇心和使用新工具的能力仍是人类的重要资源,但这种希望必须建立在支持教师和家庭的实际行动上。
- 视觉是智能基石与现代AI的起源 [00:00:00 - 00:10:00]
- 从物体识别到情境学习 [00:10:00 - 00:20:00]
- 人类智能与机器学习的差异 [00:20:00 - 00:30:00]
- AI如何增强而不是取代人类 [00:30:00 - 00:40:00]
- 医疗中的AI与机器人 [00:40:00 - 00:50:00]
- 空间智能与World Labs [00:50:00 - 01:00:00]
- AI、教育与人类独特性 [01:00:00 - 01:10:00]
- 创造力、艺术与工作变化 [01:10:00 - 01:20:00]
- AI治理与以人为本 [01:20:00 - 01:30:00]
- 技术变革中的人类价值 [01:30:00 - 01:40:00]
- 给年轻人、教师和未来的建议 [01:40:00 - 01:42:56]
Andrew Huberman:欢迎收听跨国串门计划,这是一档专注于让中文听众无障碍欣赏全球优质外语播客的节目。通过先进的AI 声纹克隆技术,我们不仅将内容翻译成中文,还完美保留了语言主持人和嘉宾的独特声音,为您呈现全球顶尖的AI财经。健康与科技领域精品内容,我是主播一凯,一位热衷于AI领域的产品经理。很荣幸能为您搭建这座跨越语言障碍的桥梁接下来让我为您简单介绍本期,我们克隆的这档节目本期我们克隆的是知名播客Huberman Lab的一期深度对谈主持人是,斯坦福大学神经生物学教授Andrew Huberman而嘉宾则是被誉为AI教母的斯坦福计算机科学家,李飞飞博士这期节目发布于2026年8月两人从神经科学与计算机科学的交叉视角,聊了AI如何真正增强人类智能丰富生活体验也坦诚探讨了AI与人类认知的本质,差异以及那些无法被机器复制的直觉与情感 [00:01:09]
李飞飞:那我们就一起走进这期完整的对话我觉得人类最学不会的一件事就是老一,辈总在抱怨下一代好像下一代什么都不懂他们没礼貌他们忘了过去但如果,你看人类历史的整个轨迹总体而言我们是在往更好的方向前进我不是否认,那些暴行不是否认那些挫折这些我都不否认但根本上我对人类是乐观的我,看那些孩子他们充满好奇当然他们会被这些技术极大的娱乐但他们也开始,使用它我担心的是老师和一些家长因为我觉得我们今天的社会尤其是硅谷,并没有在帮他们我们把他们忘了欢迎收听Huberman Lab 播客 [00:02:03]
Andrew Huberman:在这里我们讨论科学以及适用于日常生活的科学工具工具我是Andrew Huberman我是斯坦福,大学医学院神经生物学和眼科学教授我今天的嘉宾是李飞飞博士他是斯坦,福大学的计算机科学家和教授也是人工智能和计算机视觉领域的先驱和杰,出人物之一大家都知道每天有数百万人使用AI聊天机器人查找信息当然很多,人对AI感到担忧担心它会走向何方担心它可能取代某些人类工作或者以某种,方式降低我们的生活体验今天我们从神经科学的角度讨论智能到底是什么,以及AI可以怎样正在怎样被用于善也就是真正去增强学习改善健康去丰富而,不是削弱人类的体验我们首先讨论不同年龄的人脑如何学习新信息大脑在,这个过程中遵循什么规则以及AI因为基于互联网内容既在某些方面像人脑能,学的东西又在某些方面有所不及我们还讨论了AI和机器人在医学中的激动人,心的应用需要说明的是菲菲承认并回应了关于AI的许多合理担忧但作为斯坦,福大学以人为本人工智能研究所的主任他的目标是确保人类和整个人类社,会在AI下一步走向中被代表你很快就会听到李飞飞博士是一位杰出的科学家,和教育家他被称为AI教母因为他开创了AI技术也因为他坚持让AI的伦理和善意用,途始终处于AI和机器人的核心位置所以无论你年轻还是年长今天的对话都会,让你了解并学会以真正有益于你丰富你生活的方式去理解和使用AI在我们开,始之前我想强调这个播客与我在斯坦福的教学和研究角色是分开的但它是,我希望并努力向公众提供零成本的科学和科学相关工具信息的一部分现在,开始我与李飞飞博士的对话李飞飞博士欢迎你谢谢我很高兴来到这里Andrew这次,对话期待已久你是AI领域的杰出人物但我也把你视为神经科学家和计算机科,学家我们通过视觉科学有共同的路径所以也是同事也是斯坦福的同事所以,我想从视觉开始视觉看见和光就AI及其走向而言有什么特别之处因为我觉得,对大多数人来说这些听起来可能是非常不相干的话题 [00:04:37]
李飞飞:但实际上一切正是从这里开始的对我把视觉看作智能的基石几乎从两条平,行的路径来看一条是进化交给我们的你知道视觉的进化动物智能和人类智,能的进化是怎样的另一条是计算机视觉和AI它们之间的关系是什么所以我分,别讲一下进化方面我常说5.4亿年前动物第一次看到了光这些是简单的海洋动物三叶虫和它们的近亲在,那之前几乎没有感知大约同一时期触觉也开始在动物身体中出现但没有听,觉没有你知道嗅觉没有但绝对没有神经系统但第一批感光细胞创造了一种,进化力量推动动物进化因为感知外部世界会改变你的自我认知改变你与外,部世界的关系简单说如果你去寻找你能看到食物这改变了你的生活对吧从,进化的角度看你也成了别人的食物同时你在主动寻找食物主动寻找配偶等,等所以真的因为感知和知觉进化在动物物种形成方面以难以置信的速度加,速化石研究告诉我们动物第一次看到光之后的一千万年就是我们所说的进,化大爆炸或者说动物物种形成的寒武纪大爆发再往后我认为视觉一直扮演,着巨大的角色不仅在动物早期进化中也在高级智能及其如何出现中你和我,都是视觉的学生和科学家据估计人脑一半的皮层活动与视觉功能有关儿童,在发育过程中先有视觉后有语言所以视觉直到今天在动物智能的进化里也,在人类的日常生活里都扮演着核心角色与此同时视觉作为人工智能的一个,学科一个领域在几个方面对今天这个现代AI时刻起到了关键作用首先是算法,也就是神经网络算法计算机科学家最早在1950年代初期开始尝试神经网络算法,Andrew你可能记得1950年代初期神经科学那边发生了什么像Huber和Wiesel这样的神经科学家开始,记录哺乳动物大脑里的视觉细胞并逐渐意识到神经细胞有一种层级结构一,层层叠在一起沿着这个层级传递神经信息从视网膜收集光线一直到识别出,眼前有个形状我们在哺乳动物大脑里看到的这种神经架构也正是神经网络,算法的灵感来源之一今天的神经网络算法运行在数千亿甚至上万亿的参数,上它的复杂度已经偏离了我们在哺乳动物大脑或视觉通路里记录到的东西,但两者的起源非常接近就在大约半个世纪前甚至更早一点这是视觉对AI贡献,的一个方面视觉对AI还有另一个同样关键的贡献那就是通过大数据这更接近,我自己的工作本世纪初的AI是一个机器学习的领域很多不同的实验室不同的,研究科学家在尝试各种算法不只是神经网络还有其他方法换句话说就是贝,叶斯方法支持向量机方法这些方法具体是什么不重要但那是一个探索阶段,我们想让这些算法跑起来好让机器能读能看我们一群计算机视觉科学家就,在跟这些算法较劲我当时是个很年轻的教员2006年在普林斯顿大学当第一年教,员我和学生们看着这些算法看着未给他们学习的数据有多可怜于是我去翻,认知神经科学的文献也就是视觉方面的文献我开始研究人类学多少能看多,少那些数字惊人人类到六岁时能学会成千上万种不同的物体类别而且接触,视觉世界的量也极其庞大对吧婴儿一出生大部分时间都在看所以他们被这,种大数据淹没于是我们推测数据的缺乏是AI进展缓慢的一个巨大原因所以我,们跟所有只盯着算法的人走了不同的路我们说我们需要数据我们需要数据,来驱动这些算法长话短说我们主导了ImageNet这个项目收集了人工智能领域第一个,互联网规模的大型数据集但其实是透过视觉这个领域做到的因为ImageNet收集了1500万,张图像ImageNet的目标是让机器识别日常物体比如麦克风杯子椅子这项工作跟神经,网络算法和GPU计算的进展汇聚到了一起到2012年现代AI这三个要素的汇聚成了定义,现代AI的那个时刻我记得大概在2012年前后有个叫Cold Cold Spring Harbor的视觉课程 [00:10:24]
Andrew Huberman:每隔一个夏天办一次当时有个争论计算机能不能像人类一样学会识别特定,的人脸现在我想大多数人会说计算机其实比人类强多了哪怕有那些超级识,别者人脸识别能力特别出众的人你能不能告诉我们这项技术是怎么从那种,基本上会把我和你搞混或者把某个跟你有点像的表情搞混的状态走到现在,的一块饼干
李飞飞:或者说走到现在这个极其精准的地步我们是怎么走到这一步的我想好好深,入聊聊这项技术的汇聚我觉得大概在21世纪的第二个十年就像你说的2012年前后,最大的汇聚就是GPU计算能力的提升它基本上加速了计算实现了并行化让更多,浮点运算能跑在算法上对吧你需要那样的速度然后经过几十年的研究神经,网络算法也变得越来越成熟你知道从1950年代开始人们就开始创造这些非常简,单的算法行为上类似神经元但要简单得多神经元你也知道是非常复杂的但,这里的思路是你有一个节点单元接收一些输入然后输出一些东西它内部就,是一个函数一个非常简单的函数你把它们堆叠起来这就是神经网络但到了,2010年前后这些算法的成熟度已经达到了一个相当好的水平而且最后但同样重,要的是对大数据的认识互联网确实让数据变得更可得但那个觉醒时刻是哇,大数据必须成为这个等式的一部分我们需要用大数据来驱动这个算法让他,学习这些模式所以这三者的汇聚真正点燃了AI的革命那个具体的时刻也值得,一提因为你提到了人脸识别就是我的实验室提出的ImageNet挑战从2010年开始在我们收,集了这个巨大的数据集之后那时候GPU还不够成熟我们连续几年向研究社区发,出了公开挑战邀请大家来解决这个重大的计算机视觉问题叫做物体识别任,务非常简单我们有一个包含1000个不同物体类别的数据集这个数据集有超过100万,张图像我们称之为测试数据集算法的任务是我给你看一张图你要说出里面,的主要物体猜对了就得一分猜错了不得分所以那个ImageNet挑战我们后来过了几年,让斯坦福一个非常聪明的博士生来测人类的表现错误率大概是4%随机猜的概,率是千分之一对吧所以人类4%的错误率其实不算差头几年机器不如人类转折,点是2012年神经网络ImageNet数据集和GPU的汇聚即使是那一年虽然错误率被降到了顺便说,一句人类表现的错误率是4%抱歉我需要纠正一下错误率降到了百分之十几还,没达到人类的表现水平所以这是看图像然后给他分配一个千分之一的标签,明白了对但2012年之所以那么重要是因为这个神经网络算法让错误率比之前的,算法大幅下降我们在研究社区里知道当发生这么剧烈的变化时就意味着一,个拐点但算法真正在命名1000个物体上击败人类 [00:14:26]
Andrew Huberman:我记得又花了三年时间从2012年到2016年我能问一下这个4%的错误率那个非常聪明的,博士生是怎么产生的吗是他们认不出物体还是因为时间压力
李飞飞:比如他们被快速喂入图像偶尔会做出错误判断我觉得时间压力不是主要问,题虽然让一个博士生做这个我觉得他们也不想一直做下去但我觉得你知道,人脑你也知道记忆是有限的无论是长期还是短期记忆对吧所以记住一千个,物体类别的模式即使有些类别你很熟悉也不是那么容易你知道所以我觉得,有混淆的问题而且比如说不同品种的狗长得非常接近那是个挑战 [00:15:17]
Andrew Huberman:我能理解在视觉领域做这个的合理性但听觉声音方面有没有类似的探索我,的意思是你知道作为人类我们非常擅长识别语音的抑扬顿挫情绪语调之类,的但如果让我去分辨哪怕只是15种不同的声音频率作为一个非音乐人我可以,告诉你对我来说会非常困难绝对
李飞飞:我觉得你看到的就是闸门被打开了人工智能的每一个子领域不管是语音识,别声音识别还是自然语言处理那已经不只是识别了还有视觉呢所有领域在,技术上都被大大推动了我们在斯坦福有同事在研究鲸鱼的声音对吧现在用,机器学习和人工智能来研究鲸歌语音识别是这轮人工智能革命早期表现特,别好的另一个领域当然技术还在继续进步等到Transformer那篇论文在2016、2017年左右发表的时候很快就显示出它比早期的ImageNet、AlexNet算法还要强大那时候下一个大突破不是来自计算机视觉领域而是来自自然,语言处理领域因为配方没有变现在我们有了一个更强大的神经网络算法叫,Transformer但互联网上的数据更多了至少以文本形式更容易获取的数据更多了而且现,在我们有了更强大的GPU所以像OpenAI和谷歌这样的公司很快就围绕这项非常重要的,技术集结起来不过从2017年到2022年还是花了大约五年时间才在自然语言领域迎来,ChatGPT时刻 [00:17:16]
Andrew Huberman:但那又是向前迈出的一步所以我觉得对于既不是计算机科学家也不是神经,科学家的人来说自然的人类的经验也许更能引起他们的共鸣也许我可以从,这个角度来提出我的问题当一个孩子学到有个东西叫小猫咪他们会说猫然,后他们通常会去掉小这个字他们可能会说小猫咪然后学会说猫如果他们和,猫有足够多的互动他们就会意识到猫是什么哪怕是从侧面看从背面看最后,如果他们看到一条尾巴看起来有点像猫的尾巴而且他就在你知道一些书的,后面你会说那是什么他们很可能会说猫哪怕他们也见过狐狸和其他有尾巴,的动物这完全基于他们的经验他们在做一个概率判断而这基本上就是人工,智能能做的这基本上就是机器学习能做的但在我看来从计算器到我们现在,的人工智能这个发展过程中必须有一个关键时刻让机器能够看到一条尾巴,的图像然后做出合理的假设因为如果是在室内之类的地方那很可能是猫因,为狐狸一般不会在室内诸如此类那么机器学习和人工智能是在什么时候获,得了这种情境学习的能力能够得出某个东西最可能的归属因为展示苹果香,蕉和橙子是一回事它们都是水果好吧你能区分它们你能把它们和汽车卡车,区分开等等但物体恒常性这一点如果某个东西在移动你只看到部分图像这,不是大多数人想到智能时会想到的东西但它是让我们的大脑其他动物的大,脑尤其是我们的大脑如此卓越的一部分原因也是为什么我们认为自己可能,是地球上最聪明的物种如果不是最聪明的那肯定是最擅长技术开发的对那,么人工智能是什么时候实现这一点的又是怎么把这些写进计算机让他们能,做到的 [00:19:11]
李飞飞:那我们就来认真对待这个问题你描述的非常好这个问题就是瞥见一条猫尾,巴然后能认出是猫对吧或者判断出那里很可能有猫有意思的是,Andrew一代又一代的机器学习计算机科学家都尝试过这个问题,在如今机器能可靠地做到这一点之前,有过各种不同的算法,你可以想象一种常识性的思考方式是,哦,也许我们应该先识别出所有家具,知道这是在室内,所以不太可能是狐狸。所以确实有那样的规则被内置到前几代算法里也有这样的规则比如不要直,接猜是猫而是只从十种可能的动物里猜一种猫是其中之一这样就限制了搜,索或猜测的空间会有帮助所以试过很多想法那么什么时候它变得可靠的多,了呢就是现在这个时代这些算法学到的大量数据拿Gemini或GPT来说拿Gemini或GPT学到的数据,真的在机器的学习空间里创造了这种能力积累了如此多的知识如此多的模,式以至于当呈现一张或多或少有点新的猫尾巴从书架后面伸出来的照片时,那个模式激活了学到的我们称之为学习权重或学习参数的东西让机器对这,个物体的评估或猜测更接近他见过的东西那很可能是猫尾巴或者就是尾巴,因为数据实在太多了明白了这就是Andrew作为神经科学家我觉得我们和人类大脑,分道扬镳的地方因为那个学会你说的小猫咪的孩子不会有机会下载整个互,联网的猫图片他们很可能只见过三只猫最多十只但他们却能通过一种不同,的学习路径把那条尾巴识别成猫尾巴而不是狐狸尾巴这些是我们还没有完,全解开的谜团但我确实想指出今天的人工智能算法用海量数据学出来的和,人类是如何进化出来的这两者之间的差异 [00:21:39]
Andrew Huberman:如果我们继续沿着这个层级往上走从简单的物体识别到你我所说的高级脑,功能比如更接近大多数人听到智能这个词时想到的东西某种更高级的东西,创造力想象力我们先看一个中间阶段再看一个更远的阶段还是用猫这个例,子如果一台电脑或一个孩子学会了通过尾巴整体轮廓之类来识别猫而且他,们看过猫移动那对那个大脑来说无论是孩子还是电脑就是一个全新的世界,对因为现在他们知道猫通常是朝头的方向移动而不是朝尾巴的方向这些都,是很简单的学习规则对吧它可能会去追老鼠但可能会躲开狗也许吧也许不,会如此类推所以看起来所谓智能的下一层就是给移动方向不移动的方向以,及那个物体可能与之互动的其他物体赋予可能性这些在人们听来都很基础,但大脑就是这么学习的机器也是这么学习的那么下一个大的拐点是什么时,候就是给电脑给AI一张猫的图片然后说帮我把这只猫动起来让它像猫一样动,而不给它任何关于四肢怎么动的具体指令我猜那应该是一个很快但极其重,要的转变 [00:22:57]
李飞飞:在我们称之为AI的整个领域里因为大脑就是这么做的对你问这个真的很有意,思你说的太好了我从来没想过用这种方式向公众讲述那个时刻就是当视频,成为训练数据的一部分时到来的你看我又要回到训练数据了大约在2023年也就,是XTPT时刻之后不久多个研究团队开始把视频放进训练数据里当然我不打算深,入算法的细节里面有一些变化和调整你还记得吗2024年1月SORA发布了那正是人们看,到视频可以被生成的时候就像你刚才说的人们可以输入文字说一只猫跑向,一只老鼠然后几秒钟的片段就被生成了里面有一只猫以合理的方式摆动腿,跑向老鼠那时候还有错误即使到今天它也不完美但已经好多了但那打开了,视频生成的闸门就像你描述的那样那到底发生了什么实际上那并不像你想,象的那么革命性因为归根结底它还是数据作为科学家我可以告诉你有各种,各样的算法调整改变和改进等等但总的来说如果你退一步看它仍然是这个,伟大神经网络时代的一部分对吧但发生的是我们现在能够以某种方式处理,视频数据又是靠一些巧妙的工程把它token化随便你怎么叫现在我们可以生成这,些短视频片段就是把针拼在一起看起来像合理的猫的动作你可能会问算法,知道猫腿的肌肉结构吗所以当算法展示猫以合理的方式移动爪子时按顺序,我要说算法不知道但它有的是海量的视频尤其是互联网上的猫海量的猫的,视频所以它学到了猫动起来应该是什么样子所以从某种意义上说人类也是,这样我们大多数人没有受过教育的话不会知道猫的肌肉是怎么动的我现在,也不知道你知道我们医学院的同事可能知道但我们只是太习惯看到猫这样,动了所以我们心里有个合理的概念知道猫是怎么动的所以这是相似的AAA就是,这么相似它就是统计就是大量的数据告诉你什么是猫动作的合理生成对所,以当人们听到几乎肯定听过大脑是一台预测机器一台学习机器这正是是的,你所说的对 [00:25:55]
Andrew Huberman:我们再去一个更远的大脑功能层面我们知道人类身上存在的东西那就是思,想和创造力对现在思想和创造力大概也有规则它们比视觉系统的例子更难,把握 [00:26:07]
李飞飞:比如如果是尾巴而且在室内那很可能是猫这种但规则是存在的规则就在那,里如果用苹果做例子我们可以从低层开始看到一只苹果到中层看到苹果总,是往下掉现在会飞了到最高层支配苹果运动的方程是什么对所以这就是往,更高阶更还原论的方向去分析你怎么看这个想法
Andrew Huberman:确实有智能他能做大脑能做的事甚至好吧肯定能做单个个体人脑做不到的,事我们知道这一点因为他能打败人类下棋之类的现在我的理解是AI是在互联,网上训练的图像讨论视频歌曲但那不是人类认知的全部对吧所以AI有没有一,些方面不管是ChatGPT还是Cloud甚至是最强大的还没发布的机器学习和AI工具他们还没有,触及人脑功能的某些特征因为这些特征从来没被上传到互联网上至少没有,以AI能提取出来的方式上传比如说你可以放一首交响乐进去它遵循音乐数学,和声音的某些规则这说得通但你和我整天都有一些想法他们没法完全贴合,语言让我能直接打到互联网上先听我说完我知道这是个很长的提问但我觉,得这正是你最有资格回答的问题我从一年半前在犹他州见到你之后就一直,等着问你在艺术世界里有样东西叫抽象对吧偶尔会有人画出一幅画它不像,任何具体的东西音乐里也有这种情况你就是感觉到某种东西好像有一条根,本的规则或一种情绪跟它相连好像它们触及了大脑功能的某个方面但你说,不出那是什么我觉得这类东西对AI来说很复杂或者说我很难理解AI怎么能做到,因为你可以把那件艺术品放进AI说这揭示了人类经验的什么根本特征而它只,能接触到互联网上的东西所以你怎么能用AI去捕捉一团复杂的感受和体验这,对我来说就是那个缺口我相信AI迟早能做到但我没看到从神经科学到AI有任何,直接的路径不像我们能一步步推过视觉运动悲伤快乐那样你能提取出很多,东西但很难到达那些更高阶的抽象表征那些说不出来写不下来画不出来的,东西如果我说给我一个你的例子比如对童年老家的乡愁你可以写出来但那,只是文字那不是我没法在第一人称层面理解你的体验完全同意安主 [00:28:41]
李飞飞:我知道你在这个问题上想了很多我觉得这是个非常重要的问题我们一步一,步来拆首先TLDR简短回答是我同意你的看法我理解你刚才说的是那些极其微妙,高度个人化难以描述甚至从未被捕捉到的人类认知行为因为他们没被捕捉,到所以也就没被上传到互联网上而我们今天的AI没有途径去获取那些所以当,你提到互联网它是AI数据的来源我们得说清楚互联网是什么互联网不是随便,什么东西互联网是人类行为在多种模态下最大规模的集合我们再猜细一点,互联网上有全世界的人在打字打了很久很久到现在已经好几十年了打字是,一种感知机制它捕捉了一切从青少年的闲聊一直到被数字化被上传的深度,科学文章对吧所以捕捉人类语言是互联网最擅长的事然后互联网捕捉图像,怎么做到的因为我们现在有数码相机智能手机和数码相机里到处都是所以,人类喜欢拍照从你家里的猫到自拍到漂亮的BBC拍的那种照片那些也被上传到,了我们的数字空间除此之外还有视频视频现在有声音有动作那些也被上传,到了数字空间再往上还有音乐我们甚至不进入版权的法律讨论先把那个放,一边我只是在说数据的形式演讲歌唱音乐管弦乐那些也被上传到了数字空,间所以现在我们创造了一个巨大的图书馆里面有文字形式的人类知识视频,里的人类行为人类的表情甚至自然的种种在声音里现在AI就在那上面训练这,就是它为什么这么强大这就是为什么尤其在文字方面AI能识别模式能综合模,式因为那么多东西已经在那里了但你刚才说的那个东西比如说毕加索对那,副年轻女子肖像的独特表达方式有过一个极其深刻的念头那个念头从来没,被捕捉到事实上作为神经科学家如果我问你那个念头来自哪个脑区你不知,道对吧是布罗卡区是V1是运动皮层是前额叶我们不知道也许他弥散在到处都,是因为那个念头如此个人化如此特别你可以叫他创造力可以叫他情绪你想,叫什么都行你可以叫他cat231随便给他什么名字那个念头没被捕捉到所以他不在,互联网上所以AI没见过他这就是人类仍然如此独特的地方但我们也要给AI记一,功因为AI学到了那么多东西它能以高度创造性的方式组合信息你记得第37首吗,这是AlphaGo那部对吧对吧对第37首象征着AI的创造力我觉得这话记对但也可能被断章,取义因为那是AlphaGo和李适时对弈的一局棋我记得那是五局中的第三局AlphaGo作为一个,计算机算法下出了一步人类围棋大师从未想过的一步那一步非常了不起对,吧因为如果人类集体这些可都是大事都从没想过这一步但如果你深挖AI当时,到底做了什么首先围棋是一个高度数学化的游戏它有非常清晰的数学目标,每一步都有非常清晰的数学规则所以当AI拥有更大的算力并且能记住更多步,数的时候它就能做到人类大脑通常做不到的事情那这算创造力吗我觉得算,但我们也必须认识到那是一种特殊的创造力我和我们这个时代一位非常了,不起的数学家聊过我问他关于数学中未解的问题以及AI能如何为此做出贡献,他非常乐观他说今天的数学有很多问题不管它们有多难哪怕我是一个菲尔,兹奖得主我可能也忘了数学里有已知的方法可以解决这些问题因为我是人,脑我不记得我不知道过去几百年里所有的数学解法哪怕我是菲尔兹奖得主,所以AI能帮我们解决这些问题但作为数学家他也告诉我他说我不知道AI能不能,解决所有数学问题因为有些数学问题需要的解法还没有被发明出来那会把,创造力推到另一个完全不同的层次而这就是我们应该保持好奇的地方那会,是人类的创造力吗还是AI通过一轮轮的迭代改进达到一种人类没有的创造力,还是说这是一种结合的创造力我目前的猜想是混合的就是人类和AI并肩工作,能帮我们解决那些解法尚未被发明的难题然后你说的尤其是你提到情感那,更是高度个人化的这不一定是逻辑不一定是演绎推理也许Andrew你看着这个杯子,说这是个好杯子但如果他在我心里唤起了一种情感呢一个童年时刻一个好,杯子可能只对我和我最好的朋友有特殊意义那是我大脑里完全无法触及的,信息从未上传到互联网上不管今天的AI多强大都无法触及所以我对这个杯子,的反应以及我可能因为那段记忆而用它做的事可能完全不同你可以叫它创,造力叫它表达叫他讲故事叫他什么都行但那就是AI无法触及的地方我觉得在,不太遥远的未来某个时候 [00:35:14]
Andrew Huberman:计算机将能以非侵入的方式读取我们的大脑活动所以你懂的我甚至可以想,象五年十年后我现在头上就带着什么东西你看不见它就是一个非常非常细,的发网说发网听起来好像随便吧就是一些电极就在我颅骨外面不打扰我感,知我大脑内部的活动也许还能感知我的心率自主神经活动我有多警觉然后,把这些对和我说的我做的进行比较这一切完全在可及范围内而且一定会发,生你我都知道这可能已经开始让一些人害怕了但让我们让我们让我们保持,善意对吧有这样的一个世界一台我拥有的电脑我不担心数据泄露之类的事,我们已经解决了那个问题他在感知我的所有这些方面并且捕捉到这样一个,事实是的我说的话可能很重要但我的内在状态和大脑活动里有些方面连我,自己都没意识到对我可以选择和自己的这个方面协作说让我们让我们想出,一幅我从未见过的真正有趣的画面但它来自我某段重要的经历基于什么什,么都行然后它可以把那个揭示给我看因为它能接触到我的无意识大脑活动,特征我觉得这在不太遥远的未来非常可能发生也许如果人们在自己经验的,泡泡里想这件事这不会马上传到网上也不会被用来对付他们你其实是在了,解你自己当然当然而且我觉得大多数人对自己身上发生的事有天然的兴趣,对别人也是谢天谢地但我觉得太棒了比如我很想知道为什么我在某些方面,会绊倒过不好某一天或者为什么有些天我过得特别好或者我的想法从哪来,我可以你懂的在哪些状态上在展开但我不会知道该怎么做除非好一杯咖啡,不错一杯半好一点两杯就太多了如果我坐下来比如现在你想想我们做这件,事的方式有多原始这挺疯狂的太疯狂了而且每个人都有不同的方法我们都,试着把它搞对然后等你搞对的时候 [00:37:22]
李飞飞:你已经老道的更新它了而且我们现在可能根本没有从我们的生物学和大脑,里得到最大的收益对我们确实没有这就是我一直说的也是为什么别人谈论,人工智能时我会不舒服有些人把它说的好像要取代人类似的但你刚才描述,的其实是增强和扩展人类对吧这甚至不需要科幻到带个发网去读取脑电波,光是让人工智能学习你的写作模式就已经能帮你成为更好的沟通者更有效,的沟通者更高效的沟通者这是今天的人工智能就能释放的一种赋能能力Andrew我,觉得作为神经科学家和教员我们最清楚的一点是自主权对人类太重要了归,根结底它落到每个个体层面的动机自主权和尊严我觉得我们需要认识到要,把人工智能看作帮我们维护自主权的工具它确实应该如此他不应该夺走我,们的自主权今天引领人工智能的人也不该说这种话说这项工作会夺走人们,的自主权对 [00:38:40]
Andrew Huberman:我觉得那些对某种技术特别熟悉的人不管是电脑生物学还是任何技术汽车,也一样我们会变成那东西的极客以至于忘了他对别人来说可能很吓人对而,且围绕他的语言表达至关重要确实我记得90年代初有一阵子你肯定也记得基,因检测被看成那种东西你会想要做吗你会想抽血测一下吗因为天哪你可能,会看到让你吓一跳的东西现在围绕自愿做核磁共振这类事情也在讨论这些,都不是非做不可的但我的立场是信息越多越好不过我也慢慢明白不是每个,人都这么想 [00:39:18]
李飞飞:有些人就是不想知道他们不想知道对但他们应该有选择权同时我们该有足,够的公共教育和传播让人们了解利弊但不能剥夺他们的选择也不能说既然,你不懂这个我来替你做主什么对你好那不好对吧现在围绕人工智能的言论,越来越偏了因为懂行的人往往居高临下的对公众说话不管动机是正面的还,是负面的都有那种腔调你们不懂这是什么我来告诉你们我会让你们开心安,全不管是什么我来替你们决定这些都不健康也没帮助对我同意我觉得当初,做这个播客的原因之一 [00:40:08]
Andrew Huberman:就是展示那些真正心怀善意的科学家和医生他们没兴趣把事情讲的浅薄但,他们确实希望人们能理解是的很多人会觉得健康信息是更值得理解的东西,之一绝对幸好你正在打破我刚才描述的那种刻板印象还有少数几个人也在,做但你确实一直在最高层面做这件事真正鼓励人们去思考人工智能这种协,作思考那份自主权
李飞飞:以及用还是不用诸如此类我觉得有一项自主权对每个个体都很重要不管你,是学生老师医生还是政策制定者那就是去了解它不一定要学怎么写代码我,觉得那不一定必要取决于你的工作对吧比如说如果你是艺术家老师或医生,你不一定需要写代码但要了解这项技术是什么了解你自己怎么用它来赋能,自己赋能你的学习工作或表达通过学习人会更有掌控感通过学习你尝试时,没那么害怕通过学习你保住了那份自主权和尊严因为归根结底不管技术或,医学多先进作为人我们想要的是那种善意那种帮我们活得更好保住尊严让,社区变得更好的善意技术可以是连接者而不是分离者这个想法 [00:41:39]
Andrew Huberman:我觉得必须放在讨论的中心是的我们都知道他们是谁这个领域有好几位大,人物他们也处在成长过程中在学习怎么面对公众而且这个过程来得很快就,像你知道显微镜对着他们摄像机对着他们所以每一个细微的失调都被放大,了所以我愿意相信他们会成熟的够快意识到这一点而且我觉得他们正在意,识到其中一些人已经意识到了公众需要听到正确真实的信息但要用让他们,能理解的方式这就是医学和学术界那个不为人知的秘密你打破了这种模式,我愿意相信我也在打破这种模式那就是不分享事情怎么运作是有力量的对,但那对谁都没好处归根结底你揭开面纱让人们进来 [00:42:29]
李飞飞:人们反而觉得更安全对不分享确实有它的力量但同样也有一种力量是去说,请相信我我会告诉你的而作为教育者这两者我们都做不到我们不会走进课,堂说请相信我二加二等于四我们实际上会说来我教你怎么拆解怎么理解它,这样下次你自己就能算出来对吧我还觉得尤其是你的播客作为公共传播和,知识教育的一部分特别重要我也觉得我们需要听到来自不同背景的声音对,吧因为现在有大量的学者技术专家建设者思考者他们一直在接触AI使用AI认真,思考怎么用AI去赋能人这些声音太重要了 [00:43:20]
Andrew Huberman:当然除了你之外我一定会再邀请其他人来上节目但既然你今天在这我想接,着聊一个我觉得几乎所有人都会认同如果存在就太棒了的东西而且它已经,开始发生了就是用AI来加速健康发现疾病治疗等等就拿之前AlphaGo的例子来说大家,肯定还记得那个猫的例子那些都只是遵循特定规则alpha goal是一套非常复杂的规则,但只要你学会了它就是一套有边界的规则猫那个例子看起来没有边界像是,无限可能但它其实有足够的约束让机器和人都能学得很好一旦进入医学领,域医学有医学的规则科学有科学的规则你提出问题提出假设检验假设尝试,推翻假设如此往复这就是科学方法在医学里每个领域都有自己的方法我们,观察观察疾病观察谁康复了我们有病例报告我们做随机对照实验所以是有,规则的而且互联网知道这些规则所以LLM可以很好的用来挖掘健康信息因为有,约束的规则存在但我觉得你我都清楚因为我也把你当做生物学家生物学的,规则还在不断向我们显现这不是说皮肤科医生神经外科医生和肿瘤科医生,不懂自己在做什么而是他们在自己学到的有边界的规则体系内工作即便他,们持续学习更新这些规则现在似乎每个月都会冒出一个打破规则的新发现,比如我学到的是动作电位是全或无的他们看起来总是一样的要么放电要么,不放电但就在大约12年前有一篇论文显示动作电位的形状可以变化很大它发,表在自然上大家都看到了然后没人愿意去处理它这也太颠覆了它改变了规,则对神经元要么是分级电位要么是全或无而这个全或无我的意思是每一本,教科书里都写着所以现在如果我拿一堆神经活动然后给它一个规则说动作,电位可以大也可以小在同一个神经元里这完全打乱了我们理解神经科学的,一切我们对大脑的理解就直接归零了对但如果你给AI一个规则说这个信号可,能有一百种不同的形状那AI能做的恐怕比最顶尖的研究生还要多得多我敢说,斯坦福的或者公平起见麻省理工或加州理工的我觉得他不仅能做到而且能,在我问这个问题的这么长时间里就完成对虽然这个问题确实有点长所以我,想听听你的看法在医疗领域公众和AI怎么协作才能帮助解决疾病最好还能为,科学发现提出新规则让我们终于能在真正改变人类命运走向的层面上理解,生物学对安德鲁这可能是 [00:46:10]
李飞飞:你触及了AI最激动人心的用途之一那就是科学发现而在生物医学领域科学发,现直接关系到人类健康和疾病我觉得我们已经准备好彻底重写科学发现的,方式了因为多少年来我甚至不知道有多久他一直依赖聪明的人类记住其他,聪明人类教给他们的东西然后以我们自身肌肉的速度去推进我想大概就是,这样当然有超级对撞机之类的工具但总的来说做科学发现的方式里人脑或,者说科学家的头脑是这个过程中唯一的核心角色现在我们有了一个新工具,他的大脑能记住海量信息能帮我们综合知识能跨越学科跨越你和我都做不,到的领域比如我们俩恰好都在视觉神经科学和AI这个领域我对嗅觉一无所知,完全为零我可能连我们同事认识的那些词都拼不出来对吧所以对我们大脑,来说太难了但现在我们有了一个能打破壁垒的工具所以我觉得我们需要改,变我们需要用这个工具我们绝对我刚才在想150年前或者我也说不准具体多少,年前电改变了我们生活中的一切对吧我相信那也是一个我们在思考变化机,遇和恐惧的时刻我觉得我们必须认识到科学发现是AI和健康领域最激动人心,的机会之一对吧信息怎么被综合信息怎么呈现不仅呈现给临床医生也呈现,给患者患者怎么从诊断到治疗参与这个过程我们现在能做的实在太多了 [00:48:06]
Andrew Huberman:对我是说我不会说AI比所有医生都强但几个月前AI确实帮我区分了眩晕和低血,压而搞错的那位医生里有一位是研究前庭系统的耳鼻喉科专家你提供了什,么信息只是你的主观感受吗我过去一两天的主观体验好结果发现是医生给,我开的一种药我出现了轻微但不良的反应那种感觉很奇怪一迈步就觉得整,个世界都在往下坠对然后还有点天旋地转我当时想天啊这感觉像眩晕但我,记得头晕和头昏是两回事所以我就开始查这个果不其然是血压的问题他把,我的血压降得太低了不过我也咨询了一些我们认识的聪明医生我得说这些,医生都不在斯坦福这是实话但确实不我们就该实话实说这太了不起了当我,回头告诉他们时他们说这真的太厉害了你要是没在电话里跟我聊没来我诊,所我本来可以做一些额外检查的这我承认但这次是零成本花了一个早上就,知道如果我喝一些电解质喝到我本以为会过量的程度两小时后我就没事了,当然这里有可能存在安慰剂效应但两小时后我确实好了所以对病人来说有,这个东西也让人很安心 [00:49:22]
李飞飞:这不是说不用去看医生但这确实太不可思议了我是说这东西现在就有了医,生可以用这种工具顺便说一句我有个很有意思的例子我们这次对话之所以,改期是因为我父亲当时在做手术对吧在斯坦福由一位非常出色的外科医生,主刀但手术是由机器人完成的达芬奇机器人系统因为那是肝脏手术那位外,科医生非常出色的外科医生在操控机器人所以这是一次深度的人机协作手,术后我问那位外科医生我说你想象一下如果你做过一百万例这种手术这对,一个人类外科医生来说是不可能的但假设我们把全世过我们借所有外科医,生做这类肝脏手术的数据都收集起来我们能不能训练出一个自动AI来做这个,答案并不明确所以我们稍微深入探讨了一下因为肝脏是一个非常复杂的器,官血管极其丰富有很多血管而且每个人的肝脏都不一样所以考虑到每年接,受肝脏手术的患者数量即使你把全世界肝脏手术患者的数据都汇总起来可,能也不足以训练这个算法这说明了非常重要的一点AI是从模式中学习的当模,式不够丰富时我们就得小心我们必须知道怎么用AI或者怎么不用AI在这种情况,下人类与机器人协作远比一个训练不足的机器人独自做手术要好得多但同,样的问题可能也适用于外科医生因为一个外科医生能接受多少台手术的训,练呢所以这些都是人类和AI完全可以协作的机会而且可能会产生最好的结果,对吧未来还有待观察我们能不能创造一个肝脏的人工模拟环境然后训练出,无限的可能性这些都是摆在我们面前极其开放的科学研究可能性但也有一,些情况比如你遇到的那种眩晕和低血压的案例可能已经被报告过很多次了,数据库里有足够多的数据AAI已经学会了所以我们现在可以利用这一点来帮助,那些无法立即接触到医生的人太棒了你父亲的手术顺利吗很顺利实际上他,失血量比典型手术少了十倍 [00:52:06]
Andrew Huberman:这多亏了机器人手术的腹腔镜能力我想聊一聊一些我们认为人类独有的特,质他们到底是不是人类独有的你来告诉我这些是真心求问不是设套的问题,然后我也想学习一下I的结构是怎么让这些事情发生的比如说直觉我们都喜,欢把直觉想成某种神秘的确实很强大的东西像是我们独有的谁也拿不走没,法被模仿的东西但我也可以把直觉拆解成它就是我长期积累的经验它是一,套数据集加上一些身体和大脑的感觉还有一些预测线索比如上次我有这种,感觉结果发生了那件事上两次我有那种感觉结果事情没成所以我这次就走,这条路我是说这些规则你是可以交给计算机的但我们更深层的自我还有别,的方面如果我可以这么称呼的话比如我们不知道直觉在身体里映射在哪里,你可以做个影像实验但你不可能同时采集所有的神经元激素和所有东西所,以我们其实指不出一个位置甚至指不出一张网络像创造力直觉预感那种你,真的感觉到有什么事要来了但还没发生的想法AI能拿到什么样的规则从而获,得这类能力在这里我想放在能量的语境下来谈所以不管这东西是什么它就,像线粒体驱动细胞更倾向于一件事而不是另一件事就像恐惧或快乐那样对,吧我们刚才就在聊能量但在AI系统里我不是计算机科学家在AI系统和GPU里我们能,不能真的把更多的能量流分配到特定的学习规则上所以也许有一天我们可,以说基于你对我妹妹的所有了解我很爱她你觉得我们兄妹关系会怎么发展,你觉得我们今年生日做什么会很好这跟以前不一样以前她只能访问互联网,她能不能真的变得有点像心智或者像身心一体然后产生一种感觉知道什么,可能真的值得做还是说她只需要越来越多的提示比如她就一直问我问题所,以其实是我在做那个工作这个问题问得真好安德鲁为了讨论方便我想先把,直觉和创造力分开 [00:54:18]
李飞飞:也许我们之后会回到把他们合并的话题先说说这个直觉就是基于我对妹妹,的爱会发生什么对吧这真的是直觉吗今天你去问一个AI聊天机器人你会提示,说我是斯坦福教授神经科学家给我这个信息这已经叫上下文了我不知道你,会不会叫他直觉但因为你给了那条信息AI给你的答案就已经不一样了如果我,输入说我是个14岁的喜欢赛车的青少年即使我们问同样的问题他也会给出定,制化的答案那是一个数学上的事实我不会叫它能量我想说的是那只是这些,算法如何拿上下文来定制输出的数学事实它叫上下文在计算机科学里没那,么深那是一种比较浅的直觉因为你已经能用语言来描述它了或者你可以说,我要上传一张图片那也已经是可表达的了然后AI就能拿到你刚才说的更深的,直觉就像你根本不知道它们从哪来的对吧是因为我闻到了什么吗是激素吗,是情绪的混合吗是我的早餐吗那种直觉能拿它怎么办那我要说是不可及的,目前还没有感官装置能采集那些数据并喂给他不只是AI甚至都没法喂给比如,说有时候作为一对伴侣你们可能会有那种就是互相惹对方烦的时刻从来没,有没有我开玩笑的对当然有如果你们真的很熟你大概能感觉到但你说不太,清楚也许你就安静的走开让那个人独处所以这意味着那个人拥有的那种直,觉他甚至没法用语言或手势表达出来交给另一个人当做一条信息来用所以,当你自己都够不到他的时候不管是另一个人还是机器都没法对他做什么因,为没有通道高度个人化的直觉没有任何技术能做到除非你说我们放上脑波,采集器或者皮肤电导传感器我是说等我们做到那些的时候也许他们就变得,可及了所以我们必须认识到我想说的是关键不在于深不深而在于数据可不,可及你懂吗要么通过语言要么通过图片要么通过影像要么通过脑波不管是,什么它必须是一条可及的信息如果它是可及的那只要我们收集够了就可以,用它来训练机器或者如果机器训练的好它也许能像你说的以私密的方式先,不管隐私泄露的问题但以私密的方式机器大概能用它我想做的Andrew不是把它说,的神秘而是试着给它一个科学的过程来描述如果它真的发生 [00:57:31]
Andrew Huberman:那会怎么发生对因为基于大数据集和规则的模式识别能帮我们走很远这就,是我听到的意思而且我们之前聊过医生会犯错的地方机器人和机器也许做,得更好或者他们协作起来比任何一方单独做都更好你知道作为神经科学家,你在职业生涯的某个阶段会花很多时间看细胞令人惊叹的是电生理学家们,几十年来甚至更久你会培养出一种直觉我不是真正的生理学家但我学会了,识别细胞靠的是那些没写进任何论文的东西比如如果这个东西边缘比较直,形状和圆润度有某种特征我现在就能告诉你那是视网膜里的顺时关闭肺细,胞后来我们开发了基因标记证明每个案例都是如此但你也看到一些不符合,规则的机器能学会这个计算机能学会这个有了那些论文里的所有信息现在,我们有了相当完整的视网膜零件清单挺好这行得通然后你可以应用规则比,如他们这样放电他们那样放电好这些我都接受我想通过直觉表达的是可能,我没给出最好的例子就是人类有哪些内在状态真的很难想象机器能重现但,也许他们能比如动机机器会受激励吗机器人会受激励吗我们有动机的规则,比如当我真的想做什么事时我们称之为紧迫感一种紧迫的状态我可能会更,快的去做更少的激活能量你说走我站起来快一点机器可以朝某个方向更快,的移动但你能说我希望你去找这个东西但要带着更高的紧迫感吗还是他们,只能受限于他们能处理的数学规则 [00:59:14]
李飞飞:所以你可以把这构建到数学里某些东西不管你是叫它动机还是在机器学习,的世界里我们称之为目标函数你可以把某些东西构建到数学里比如现在你,去用chat tpt它有不同模式比如深度思考模式或者快速回答模式如果你不知道这是,怎么运作的你会觉得哦这很有趣一个更有紧迫感给我更快的答案另一个必,须更深入的搜索对吧然后花更长时间给我答案所以作为人类如果你过度拟,人化你可能会称之为紧迫感或动机但事实是这只是算法的不同目标你可以,说那个思考更快的有实现或令牌限制那个思考更慢的可以激活模型的不同,部分那会花更长时间所以这在数学上其实变得非常枯燥没那么深奥但对人,类来说你可以称之为动机或紧迫感但让我们更深入因为你问的比那更深对,吧那就是有些认知状态人类真正拥有的不管是动机紧迫感恐惧还是爱这些,非常难以获取和表达机器今天有这些吗没有让我们说清楚我们倾向于想象,机器有感觉或者他们没有他们没有那些数据他们没有那个数学目标函数所,以当机器说对不起你今天病得很重这和你朋友对你说这句话是非常不同的,因为机器说这个是因为他通过模式学到了当有人告诉他我病了你应该说对,不起你病了而不是我很高兴你病了因为那些数据存在而你朋友听到这个他,们真心希望你好他们爱你他们不想看到你受苦他们有那种共情感受如果你,在痛苦中我经历过痛苦所以这不是镜像神经元但至少是对痛苦意义的记忆,机器没有任何这些所以我们确实需要确保我们区分这些很多驱动人类触发,人类的东西在今天机器里不存在我们的运作方式与今天的人工智能根本不,同我们必须认识到这一点尊重这一点这就是公共传播如此重要的地方我们,不能在这点上混淆公众我觉得人们假设AI聊天机器人里面 [01:02:03]
Andrew Huberman:有一个有情感的人或什么东西因为我们太以语言为导向了他在跟我们说话,他在给我写东西我们现在比30年前做的更多了对当然我们已经非常习惯于接,收相当贫乏的语言交流短信不像长篇散文语言变了沟通方式变了变得更贫,乏而不是更丰富对但很快的某个时候我猜脸会开始进入画面无意双关比如,如果你或我给对方发短信下周这个时候校园间喝咖啡多久之后那条短信会,变成一张照片或视频就是你直接跟我说话告诉我这个我的意思是现在做这,个太容易了技术已经具备了
李飞飞:但我们现在得退一步看看社会参数法律影响人类用工具能做很多事但我们,不会全都去做比如今天任何一家汽车厂商都可以说每个星期五刹车失灵这,在技术上很简单车里的电脑有个时钟每到星期五就把刹车关掉但我们不会,这么做因为这对人类社会有极其恶劣的影响这时候就需要规则法律社会规,范道德来介入我觉得这正是我们跳出纯技术讨论进入AI社会讨论的地方 [01:03:21]
Andrew Huberman:那我们就来聊聊这个因为我知道生物学家或技术专家有个特点就是喜欢快,因为快让人兴奋那是下一个前沿对吧我记得很久以前有个朋友在研究病毒,以及把病毒导入的方法这些不是传染病病毒而是病毒载体用来让基因在动,物体内表达作为实验工具但后来有个机会真的可以把狂犬病病毒一种改造,过的狂犬病病毒放进果蝇里天哪在我看来如果你百分之百百分之一千确定,那是失去功能的狂犬病病毒版本那这么做没问题因为你可以往里面装别的,载荷做各种重要的实验信不信有你跟疾病有关的实验但如果有一只果蝇成,了漏网之鱼你拿到的是真正的狂犬病病毒它有可能跟另一只交配然后他们,最终找到其他果蝇我不知道这会是显性还是隐性遗传但你现在就有了带狂,犬病的果蝇而且那些东西跑得飞快所以这个实验不做是有原因的对但对他,们来说想想这事就很兴奋然后他们被拒绝了对吧理由很充分是的我当时很,庆幸对吧或者说任何一个生物系你都会看到一些果蝇飞来飞去顺便说一句,他们喜欢醋所以他们会飞向你的沙拉但重点是技术专家喜欢快他们喜欢感,知事物的下一个前沿那么在政府公众技术专家之间我现在把生物学和医学,先放一边这场对话要怎么进行才能让每一方都足够满意既不能拖我们后腿,因为我们现在据说也在AI竞赛里这要求我们跑得更快而不是更慢你怎么看这,个问题Andrew这正是我八年前 [01:05:05]
李飞飞:从谷歌回到斯坦福创办以人为本人工智能研究所的原因这些是我们必须面,对的重大社会问题2018年的时候还没有chat GPT但作为AI科学家我知道这只会加速所以我,去找同事和大学领导说咱们搭一个框架但这不只是我的框架也不只是斯坦,福的框架整个社会方方面面都需要意识到社会影响就像人类历史上做过的,无论是汽车飞机还是生物技术都是多维度的涉及多方利益相关者对吧有职,业规范比如你们生物学家不会偷偷溜进实验室试着把狂犬病病毒放进果蝇,里因为那是职业规范是你们的伦理训练有行业规则比如机构审查委员会今,天大学校园里每一项人体实验都要受机构审查委员会监管框架约束这样我,们才能把关然后还有法律和监管法规取决于它是用在人身上还是作物上所,以AI也要走同样的路对吧我们需要有职业规范需要有教育计算机科学家没有,受过伦理和社会研究的训练他们现在开始学了这就是为什么包括斯坦福在,内的一批大学正在拼命把这类课程加进我们的教育里这些是规范和教育但,我们也应该跟政府合作而不同的政府不同的社会有不同的规范传统和遗产,要看监管措施该用在哪里比如AI跟生物学交叉美国食品药品监督管理局我觉,得那是个非常重要的领域要看AI该怎么用来帮忙同时也要有护栏防止伤害这,样我们才能避免伤害我不希望看到的是一两个人或几个人从产业界出来告,诉所有人该怎么做我觉得那很危险因为市场力量跟社会规范不一样文化跟,遗产不一样教育跟伦理也不一样这些是多方利益相关者要一起解决的问题,我很喜欢这个回答 [01:07:21]
Andrew Huberman:而且这个话题现在非常非常及时我们这段对话的这部分以后肯定会越聊越,深但你确实一针见血我想听听你对这个问题的看法人类大脑如何被机器塑,造机器又如何被我们对人脑的理解所塑造先问第一个问题很多人家长和孩,子们都在想哎呀我的孩子现在啥也学不到了他们只会去聊天机器人那里查,一切但如果你回头看学习的历史当年对计算器对电脑对打字机也都提出过,类似的质疑一个接一个不过这确实是个有意思的问题我们脑袋里这个硬件,进化出来是为了处理现实世界里的物理事物的光声音气味等等然后他前面,长出了一块特别酷的部分前额叶皮层他能学习学习的规则还能更新这些学,习规则所以真要说什么的话我们被赋予的是一台学会学习的机器还能不断,更新学习方式这就是为什么孩子们能适应并利用大语言模型而我这一代人,是伴随着个人电脑长大的当然我是在帕洛阿尔托长大的那时候就是这里有,Pong那里有Apple II我们家里就有我当时想哇真酷大脑可以围绕技术成熟起来与技术协,作我觉得我的人生因此被大大丰富了但我认为智能手机也许还有带摄像头,的智能手机这个组合就像乔纳森海特指出的那样造成了一种局面大多数人,喜欢这些技术是因为它们方便省事但我们现在都多多少少更清醒了或者说,清醒了很多意识到我们也在失去一些东西对而且有些陷阱尤其是年轻人可,能会掉进去对那么在你看来非常乐观的一面和非常悲观的一面分别是什么,如果确实存在三种可能的话年轻人的大脑在现有的人工智能下是被丰富不,受影响还是受到伤害我们就先聚焦在当下已有的东西上好问题 Andrew而且答案几,乎是从我们刚才的对话里 [01:09:29]
李飞飞:自然冒出来的因为你用了动机这个词而我一直在用能动性最糟糕的结果是,我们年轻一代的能动性以及学习和生活的人类层面的动机被工具夺走了所,以负面信息刷屏被动的刷短视频这些都不利于能动性人类能动性学习从根,本上说尊重你刚才说的那个硬件它需要时间需要努力有时还需要一些痛苦,我们的大脑就是这样运作的不管经体管怎么运转我们的神经元有它特定的,运转方式我们的化学物质我们的激素也有特定的运转方式所以对年轻一代,来说无论社会将来变得多么不同工作变得多么不同我们的身体都必须经历,一个深度发育的阶段在这个阶段学习必须发生而那种学习的能动性学习的,动机任何人都不能夺走不应该被人类夺走也不应该被机器夺走这就是我的,担忧也就是说如果人工智能用的不对能动性和动机就会被夺走那样的话我,们留下的是一代又一代大脑没有得到充分发育的人另一种危险是打着能动,性和动机的旗号把工具从学生手里夺走因为我们担心你作弊担心你的答案,都是从XCPT那里来的那同样非常糟糕因为只要有恰当的能动性恰当的动机恰当,的使用工具的方式我们借助人工智能能学的比以往任何时候都深得多我刚,才就在想我曾经当过一阵子医学预科生天哪有机化学太难了你知道吗我记,得拼命去记那些分子他们的空间取向但助教达仪时间太短或者跟我另一门,课冲突教授也只有固定的办公时间学那个东西真的很挣扎对吧如果今天我,有一个AI伴侣我会问无数个有机化学的问题因为我知道自己卡在哪里对吧我,有学习的动机我只是需要有人引导那对我来说会是多么强大的学习工具所,以我们不应该把学生挡在门外所以让我担心的两件事要么是剥夺工具要么,是夺走能动性和动机当然另一面是好的那就是想办法保住我们孩子和学生,的动机与能动性想办法让他们获得这些工具并学会正确使用那样的话这一,代人即将到来的一代以及之后的许多代人会比我们聪明得多因为他们被赋,予了超能力 [01:12:31]
Andrew Huberman:我很喜欢这个回答我对神经可塑性也对年轻一代抱有极大的信心就算是我,们自己我知道我们老了也不至于咱们得给自己一点肯定
李飞飞:可塑性在整个生命周期里都是存在的就算是我们自己的神经可塑性对吧我,就觉得人工智能是我学习的一个绝佳工具对我来说发现它能做什么
Andrew Huberman:本身就是一次了不起的发现对但我倾向于这样使用它如果我对某件事一无,所知我就以消费者的姿态去问如果我在所问的领域里已经有一些知识储备 [01:13:06]
李飞飞:我就以创造者的姿态去用其实我还有一件事去年一个斯坦福本科生教了我,一课我意识到在ChatGPT出现之前我有时候会偷懒我如果有问题就会去问我身边那,个我觉得聪明的人现在我意识到我不该问那些偷懒的问题因为在占用别人,时间之前获取信息已经变得太容易了再去问那种太偷懒的问题就不应该了,而人工智能正在逼我不要那么偷懒提示词的精确程度对从AI那里拿到最好的,信息有多关键提示词非常重要那这是一项技能对吧这确实是一项技能这就,是为什么公共教育这么重要这就是为什么教育这么重要我很希望看到我们,的学校从幼儿园到高中都教提示词我这有个小测验人类最会提问的人是谁,我肯定要考杂了苏格拉底如果他活着的话对因为那就是提问的方法对吧想,想看苏格拉底的方法是什么就是通过提问来引导来探寻真理 [01:14:20]
Andrew Huberman:我们应该回到那个方式教孩子们这么做而且讨论的时候还得边走边聊对这,其实是个不错的过渡正好引到巨神AI这个概念你知道吗给声音配上一张会说,话的脸跟只听到文字完全是两个世界我小时候的一个好朋友我希望你很快,能见到他因为你们俩都会从这场对话里收获特别多我真想当个旁观者埃迪,张博士神经外科主任生物工程师他研究言语和语言他和同事们搞清楚了神,经活动怎么转化为对喉部和咽部的控制他基本上把一些人从闭锁综合症里,带了出来让他们能重新说话哇十年里第一次他有个病人很不幸瘫痪了现在,能通过电脑说话他有别的病人其实这样的例子很多但最不可思议的是当他,开始在这位病人旁边放一台iPad特别是一位坐轮椅的女性他们有一段他婚礼上,的视频所以他们知道他的声音他们知道他的情绪模式也知道他身体怎么动,现在他通过旁边一台iPad说话旁边是他无法动弹的真实面孔但他能跟世界互动,世界也能以完全不同的深度跟他互动而不是只有一个麦克风就像史蒂芬霍,金那种而且这个系统通过机器学习不断更新现在还会关注他说话的对象以,及对方的反应我的意思是这就是巨声虽然是在一个二维的二维屏幕上这没,错但这比起单纯的机器人声音甚至只是准确的声音是一个指数级的飞跃这,不只是人的巨声巨声AI也会进入机器人领域 [01:16:01]
李飞飞:对吧AI的下一个前沿我一直这么说是超越语言的因为再说一次人类是先有前,语言阶段的进化花了你知道51年没有语言交流而且在正确的版本里有机器人,帮助人类世界会变得好得多能够举些例子吗我很喜欢这个想法但再说一次
Andrew Huberman:我意识到我可能现在技术兔子动力太深了可能吓到一些人所以机器人我们,有自动驾驶汽车其实威某总是会为我和我的小狗停下来我那漂亮的小家伙,六个月大的小狗他想过马路的时候你怎么能不停下来呢很多人不会停早上,差点把我们撞了威某非常礼貌威某得学会规则对吧没错所以那里有一种善,意人类身上并不总是有
李飞飞:但你觉得这会最先出现在哪里会是什么样子如果我们把时间拉远到12个月后,12个月对机器人来说有点太快了两年三年要我说把时间拉长到30年来看30年好我,不是说那是机器人第一次上街我们已经有自动驾驶汽车了我只是说尤其是,硬件也参与其中的技术要真正落地需要更长时间但我想说但愿在你我有生,之年我很想看到机器人成为社会的一部分帮助我们比如我是独生子女要照,顾两位年纪很大身体又很差的父母而且他们碰巧也不会说英语我要做的活,多得惊人对吧所以我真的很想有人帮忙这不会剥夺家庭责任不会剥夺爱也,不会剥夺必要的沟通但体力劳动那一部分某些部分我真的很想有人搭把手,我们住在加利福尼亚州有一件事是我们所有人都经历过的是什么堵车高税,收加州某些地方不堵车但有山火哦哇对对吧谁在扑灭这些山火让人类去冒,生命危险做救援应对自然灾害这不是个好主意对吧所以我家和我父母碰巧,有足够的财力但我就在想一个独居老人他们怎么去买菜怎么去拿药现在我,们开始看到一些配送服务但要是他们想出去散个步或者去公园呢所以有太,多太多事情了顺便说一句你在医学院我们的护理人员不是过剩而是短缺我,们的护士极度疲惫超负荷工作过去一个月我literally在医院陪我父亲就看着护士们,干的活我们知道在一个班次里护士要走好几英里路去取东西拿药有太多太,多了你能想象机器人来帮忙吗对吧所以我们的社会有太多方式可以被组织,起来 [01:19:01]
Andrew Huberman:并从这种帮助中受益我太喜欢你举的这些例子了你说我脑子里就冒出好多,比如过街引导员对你可以想象借助视频一个因为年纪或疾病困在家里的人,能自己去商店从货架上拿东西对也不一定非得那么脱节就是他们设定好程,序然后他自己回来虽然那也可以是一种选择对我觉得我们必须修正对这幅,图景的想象因为我觉得关于机器人和计算机有几件事会吓到人一个是他们,的物理硬度对吧所以我们和他们共享空间的方式和我们和其他东西共享空,间的方式非常不同当然我不是在想你会和机器人拥抱虽然有些人可能会那,么想但那不是我的想法但我在想的是好吧如果我有一个机器人能叠衣服吸,尘浇花喂我的鱼虽然我喜欢自己喂鱼我真的很享受我喜欢看他们吃东西我,喜欢亲手触摸他们literally和他们接触他们会从我手里吃东西你的小狗喜欢你的鱼,吗喜欢它有自己的鱼缸我刚给它买了几条热带鱼对就在它的小窝前面它在,照顾它们它看着它们但它还没能力照顾它们我觉得可惜它的前额叶皮层不,够用而且它是一只它挺善良的但它是一只斗牛犬混种它们不是最聪明的品,种它们只有几条学习规则但它们非常善良但如果你想要一只能照顾鱼缸的,狗你可能需要一只西部高地白梗之类的不一样前额叶皮层更多一些但这里,的重点是如果一个机器人做一件事另一个机器人做另一件事那感觉就像我,生活里塞了一堆硬件我觉得人们大概就是这种感觉对但你可以想象一个多,形态机器人你知道大白吗不知道 [01:20:47]
李飞飞:不知道迪士尼的机器人大概是十年前十五年前的吧你可以谷歌一下图片那,是一个白色的医疗机器人医疗保健机器人它不是很蓬松而是很海绵感摸起,来像一个大气球对所以你可能会喜欢那种对更多曲线对对而且同一个机器,人能做更多事感觉那是一个我能更快适应的世界而不是一个到处是机器人,的世界是的安德鲁我觉得当我们想象未来讨论我们如何想象未来的时候我,总是不停回到一个词自主权人类应该有自主权去决定我们如何想象这一切,不能只是一家公司或者我不知道一个投资人决定这个世界应该充满金属质,感的机器人对吧我们的社会应该集体的主动的去想象而我在AI的这套话语里,担心的一点是公众被放在一个被动反应的位置上感觉好像只有一些人在做,决定而多方利益相关者并没有参与共同设计这个未来就像你父亲手术那个,例子 [01:22:03]
Andrew Huberman:把机器人和医生结合起来对吧如果我们遇到一个问题那里有脆弱性而机器,人显然能让事情变得更好那画面就朝着正确的方向改变了对所以我脑子里,马上想到几个例子比如我觉得大多数人都会同意如果孩子能自己走路上学,走回家那很好但你会担心安全问题但如果一个机器人真的能当好孩子的守,护者好到能报警甚至可能保护物理上保护你的孩子那就太棒了对给他们在,这个世界上更多的自主权你再想想那些更阴暗但不幸确实存在的线上掠夺,性行为父母能监督孩子行为的程度有限孩子能意识到的也有限但你可以想,象有一个化身陪在孩子身边真正为孩子代言能发现危险把掠夺者挡在外面,你看这就是个很棒的创业点子那会很酷但我觉得画面里还缺一样东西对我,来说我记得见过一个了不起的人我知道有人说他有点难相处但这个人真的,很了不起我当博士后的时候还有我小时候在帕罗阿尔托玩具体育世界打工,的时候他就在帕洛阿尔托市中心走来走去那个人就是史蒂夫乔布斯不穿鞋,看起来像个嬉皮士是的他工作时对人吼叫现在HR大概不会对他太客气但他明,白我们叫做电脑的东西需要有圆润的边角他们需要无缝的装进口袋他们需,要让鲍勃迪伦出现在首页上什么的这样才能软化人和技术之间的关系有些,人会说这走得太远了是个特洛伊木马但我不这么认为需要一个真正懂人性,的人才能让这些显然是善意的机器人和人类之间的协作发生因为正如你指,出的而且我完全尊重那些造出AI的技术专家和做出惊人科学的科学家但无论,是他们呈现技术的方式还是他们能分享的东西都有一种生硬感那真的会把,人隔开是的我不是治疗师但如果我能张开双臂抱住他们我会说听着各位你,们是房间里最聪明的人先生们女士们公平的说你们是房间里最聪明的人但,人们不喜欢你们因为人们不理解你们也许你们需要一个合作者帮你们用一,种不会让媒体钻空子的方式分享你们的愿景因为媒体确实在制造这道鸿沟,他搞得好像这些技术专家要来对付我们似的我觉得那完全是媒体的把戏就,是为了把钱装进自己口袋现在有太多事在发生所以谁是那个史蒂夫乔布斯,或者那个斯泰西斯泰西什么的可以是男的也可以是女的一个真正懂人性的,人这样的人有很多我们中间有很多你知道斯坦福创办了 [01:24:51]
李飞飞:以人为本人工智能研究所你就是啊你就是好吧但有很多人对有很多创业者,在做非常了不起的创业公司AI药物发现AI医疗AI抗衰老AI心理健康这些人关心AI对吧,还有很多设计师和产品经理在努力我确实觉得那个大喇叭太聚焦于那些锤,胸顿足用一种特定方式谈论技术的人了所以你知道甚至这个播客我希望也,在产生积极的影响但愿如此把人文视角圆润的人文视角人类视角人类的未,来放进这些对话里我并不绝望Andrew我是教育者是建设者是技术人我看到身边很,多人包括我整个创业公司这些才华横溢的年轻技术人他们可以去任何一家,创业公司或大公司但他们选择来World Labs是因为他们想赋能于人所以我看到很多人,但我觉得还不够你说的对我觉得现在的公共话语并不平衡极端言论太多了,要么是极端愚蠢主义忽视安全把人吓个半死要么是极端乌托邦好像技术永,远不会出错那也不真诚人们会说好吧你们是既得利益者你们当然这么说所,以我觉得我们应该回到中间地带谈谈这项技术到底是什么怎么用它我们怎,么共同保有引导未来的主动权对有件事是我的一个播客同行提醒我的 [01:26:45]
Andrew Huberman:本来应该显而易见但就是没人点破而且这显然是你身上的一种特质恕我词,穷你身体力行的体现了这一点就是人们其实不太想听机器的故事但人们爱,听的是某个人治好了自家狗的癌症或者某个孩子出现了疯狂的症状家人毫,无头绪医生也毫无头绪结果靠AI在指尖上解决了问题对这些故事才真正需要,放大因为我觉得它们能引起我们的共鸣它们是美好的故事是了不起的故事,但它们得到的关注远不如那些东西对而这正是挑战所在对你知道传统媒体,并不在乎事情的长远脉络它们按12到24小时的周期运转但还有另一些人比如那,些真正在推动AI善意用途的人那些我们该去了解的协作 [01:27:36]
李飞飞:斯坦福Heidi的新闻通讯我们的网站我们的研讨会我们推广了很多这类工作我很,想多了解你的创业公司因为你不会随便调项目所以这个项目是什么目标是,什么我的创业公司和另外几位联合创始人一起创办的叫World Labs我们在2024年初共同创,立了它对我来说这真的算是我毕生的事业我们都出身于视觉领域也认识到,语言智能之外还有更广阔的空间这正是促使我认真思考AI前沿下一章是什么,的动力我们认识到解锁空间智能和物理智能才是下一章这并不排斥语言当,然语言技术很了不起只是我们可以投入更多时间去构建模型或者最终构建,产品去帮助解锁空间智能的能力比如生成对创作者、机器人训练、建筑设计都极有用的3D、4D世界或者打造那些交互环境无论是医疗应用、教育应用、机器人应用还是工业应用这些能力超越了语言本身Volav就是基于这个前提创立,的我们还是一家年轻的公司非常以模型为核心正在构建这个基础模型我们,起步时有很多博士但现在我们开始做产品了所以还只是开始非常令人兴奋,作为技术人我内心深处觉得自己是个建设者也许也因为我是移民所以撸起,袖子和这群聪明的惊人的年轻人一起从零开始造东西就是特别让人兴奋我,记得有一段时间 [01:29:29]
Andrew Huberman:大概15 20年前吧有车在路上跑着拍图像现在还在拍还在跑着拍图像但我猜肯定,也有航拍视角不过你可以想象那种小无人机小到能飞过一个神经元把什么,都看一遍可以这么说或者无人机去采集挪威 辖湾每个鸡角嘎啦的信息有人,这么干过吗用来绘制三维世界的地图首先
李飞飞:别把无人机说得那么吓人好像要闯进人家家里和院子里我觉得捕捉世界影,像的能力确实在飞速进步对吧我们的手机就是不可思议的传感器它们不是,无人机但人们拍海量照片当然相机技术也进步了Wallab做的不是只拍真实世界的,图像我们让人把脑子里的想象呈现出来只要你能打一句话给一张图或一幅,草图描述你想象的东西我们就试着把它变成世界和环境这有什么用因为娱,乐产业会用设计产业会用机器人产业非常需要它来做训练环境等等所以捕,捉真实世界的东西加上捕捉你想象世界里的东西 [01:30:46]
Andrew Huberman:这两者的结合就是新前沿如果你不介意的话我想再多花几分钟聊聊这个从,想象过渡到实际的东西因为这里是洛杉矶我突然想到很多人会写剧本然后,想办法把电影拍出来但有了AI理论上你可以把剧本交给AI他就能把电影做出来,理论上对吧从文字到画面再到视频然后你也许可以在需要的地方稍微改一,改这个有人做过吗 [01:31:11]
李飞飞:有没有一部电影从头到尾是用AI成功做出来的这是个非常微妙的话题这里也,触及了人们对AI和创造力的担忧如果不小心的话听起来好像我们在强讲故事,的人和创作者的工作对吧所以我们先把工作层面的讨论和技术层面的讨论,稍微分开一点虽然他们纠缠在一起技术已经进步到拿剧本生成镜头生成视,频镜头已经做得非常好了我们见过短片甚至接近长篇长度的电影由AI工具评,出来确实见过而且有很多公司美国公司亚洲公司都在做这项技术但真正属,于人类的部分这一点很重要就是讲故事和故事创作的每一个环节背后都有,人带着他们独特的情感故事技法他们怎么看世界怎么运镜怎么塑造人物和,角色很多这些正是好莱坞和小说家们做的事所以怎么用现代工具去满足人,类讲故事的需求和渴望其实是个挑战因为有一种恐惧很大程度上来自好莱,坞觉得AI要接管一切讲故事的人演员编剧工作都受影响我觉得确实有影响但,影响是怎么发生的我们在做什么谁在建设性的做事你知道这严格来说不是,我的行业但我很希望看到这方面有更多细致的工作也有更细致的公众讨论,但我确实认为就像医疗一样我们刚才聊到AI能快速改变和颠覆旧的医疗方式,我觉得AI绝对在改变我们讲故事的方式说到这个讲个故事我有一个联合创始,人叫BenBen和我见过Ben Affleck我当时开玩笑说Ben 见 Ben他也在非常前卫的思考用AI工具做电影对吧,所以在这个时刻让技术专家和讲故事的人电影人对话是至关重要的对我觉,得在每个技术的例子里都有某个交叉点是的当一个真正的圈内人拥抱了一,项技术 [01:33:40]
Andrew Huberman:然后他就一下子起飞了像对你知道史蒂文斯皮尔伯格或者谁对这些可能不,是最好的例子但就像乔布斯和沃兹尼亚克那种交叉一个设计师对技术好奇,的人和一个真正的乔布斯粉丝原谅我真正的计算机科学家对吧那种融合这,些协作真的很关键所以你需要一个圈内人和一个圈外人才能做好 [01:34:07]
李飞飞:因为你得理解两种文化对以及怎么把行业把人容纳进来所以我真的很希望,因为World Labs也和视觉特效行业合作对我来说让我们的客户和用户感到被赋能太重,要了不是技术要把他们的工作抢走技术应该让他们的工作变得更好给他们,的创造力加超能力这就是我看待这项技术的方式也是我希望和用户客户合,作的方式想想挺不可思议的你知道我小时候
Andrew Huberman:在帕罗阿尔托的加利福尼亚大道上有家店叫Cabin Shack就是一家照相馆和相机店对你,走进去把胶卷拿去充印柜台后面有一帮人他们跟你说你可以租个长焦镜头,什么的这些现在全没了一切都数码化了你知道吧但还是有相机店在所以行,业会变形不一定会被消灭对它会变形人们也会在培训提升技能 [01:35:10]
李飞飞:你知道我们在和很多创作者合作他们用AI工具因为他们看到了技术走向想给,自己再培训提升技能所以我觉得变化的时刻既是机遇也是失去的时刻我们,真的需要认真对待这一点我最后一个问题是关于年轻一代的他们对AI是什么,感觉因为现在有这种你说的年轻是多年轻
Andrew Huberman:我说的是7岁到20岁之间的孩子好那说的就是我孩子这个年纪对所以我问这个,问题是有原因的你知道他们怎么看这件事他们兴奋吗因为有个现象是电脑,一出来你的书法老师就开始紧张担心大家都不在手写了现在大家都用手指,打字没人会写字了我们写了几千年这些故事已经流传很久了说如果我们不,把过去和未来一样重视 [01:36:03]
李飞飞:我们就会融化成一滩神经元我觉得两者都重要但孩子们怎么想他们怎么看,这其实是我最上心的项目作为教育者和技术从业者我走到哪儿都会找学生,家长和老师聊因为我觉得他们是被遗忘的最彻底的人群我们的政策制定者,技术专家和投资人他们不跟老师家长和学生对话他们都有自己的孩子也都,有自己的看法但他们不聊这个我对孩子总是抱有希望也许因为我是教育者,因为我觉得人类最学不会的一件事就是老一代人哀叹下一代人好像下一代,什么都不懂他们没礼貌他们忘了过去但如果你看人类历史的轨迹总体而言,我们是在往更好的方向前进我不是否认那些暴行不是否认那些挫折这些我,都承认但人类从根本上说我对人类是乐观的对吧所以这是我的出发点如果,你是个彻底的悲观主义者那我们可能从一开始就站错了脚但我看孩子们他,们好奇正因为是孩子所以才好奇他们当然会被这些技术强烈的吸引但他们,也开始在用它我真正担心的是老师和一部分家长因为我觉得今天的社会尤,其是硅谷没有在帮他们我们把他们忘了我们在说叫他们在训斥他们在俯视,他们他们是我们社会里最重要的人我们应该跟他们对话应该托举他们应该,支持他们应该给他们资源K12或者K16的老师他们扛着我们社会最重最关键的担子,我给你讲个真实的故事2022年11月ChatGPT出来了显然我在技术圈内部但我做的第一件事,是给我孩子所在小学的校长发邮件说我想来给你们的师生做一次课作讲座,不是因为我多特别而是因为我想让他们时时知道正在发生什么因为没有人,硅谷没有人没有投资人没有那些几十亿美元的投资公司或者几万亿几十万,亿美元的大公司ChatGPT出来的时候第一反应是我们社区里的老师怎么办没有人这,么想但我们必须这么做我们必须跟老师对话我们要给老师展示当然他们会,问孩子作弊怎么办没关系他们问这些问题很正常我们就展示给他们看跟他,们一起合作让他们有能力自己想出应对办法他们也很聪明他们也渴望改变,他们只是被遗忘了所以我对孩子有希望但为了不让这希望是盲目的我觉得,我们都该记住我们的老师帮助我们的老师和家长 [01:39:00]
Andrew Huberman:这样我们才能帮到我们的孩子我太喜欢这个回答了我知道这个感受被很多,很多听众共享上帝保佑老师们他们需要帮助支持和信息因为现在他们打开
李飞飞:不是你的播客是大多数播客他们只会害怕他们非常害怕他们听到这种末日,论调他们听到末日预言或者有人说别担心这是乌托邦这两种信息对我们的,老师都没有帮助如果老师得不到帮助我们的孩子就得不到帮助完全同意
Andrew Huberman:非常感谢你从极其繁忙的日程里抽出时间我很高兴听到你父亲没事了而且,照顾父母孩子和其他一切也是你日程的一部分你还要来教育我们这件事它,不只是重要它是我们身处何处去向何方的一个关键鞋子我带着谨慎也带着,巨大的乐观尤其是在你今天分享的基础上另外也谢谢你一路教了我们更多,神经科学因为这些机器受大脑启发大脑也受这些机器启发这就是我们生活,的世界我抱有巨大的乐观很大程度上要感谢你存在于这个世界上谢谢你抽,出时间来分享我知道很多人非常感激所以谢谢你谢谢你Andrew我真的很珍惜这次,对话这是一个文明时刻感谢你收听今天我和李飞飞博士的这期对话想了解,更多他的工作请看节目说明里的链接如果你从这期播客里学到了东西或者,喜欢这期节目请订阅我们的YouTube频道这是支持我们的一种非常好的零成本方式,另外请在Spotify和苹果播客上点击关注按钮来关注本节目在Spotify和苹果播客上你都可,以给我们留下最高五星的评价现在你还可以在Spotify和苹果播客上给我们留言也,请看看今天节目开头和中间提到的赞助商这是支持本播客最好的方式如果,你有想问我的问题或者对节目嘉宾有评论或者有想让我在Huberman Lab 播客里考虑的话,题请把他们发在YouTube的评论区我会读所有的评论还没听说过的朋友我要告诉大,家我有一本新书要出了这是我的第一本书书名叫ProtocolsAn Operating Manual for the Human Body这本书我写了五年多基于,三十多年的研究和经验它涵盖了从睡眠到运动到压力控制的各类方案还有,关于专注和动力的方案当然书里收录的每个方案我都提供了科学依据这本,书现在可以在protocolsbook.com上预售在那里你可以找到各个销售渠道的链接选一个你最喜欢的就行再说,一遍这本书叫ProtocolsAn Operating Manual for the Human Body如果你还没在社交媒体上关注我我在所有社交平台上都叫Huberman Lab也,就是InstagramXthreadsFacebook和LinkedIn在所有这些平台上我都会讨论科学和与科学相关的工具其中一部分,和Huberman Lab 播客的内容有重叠但很多是和播客内容不一样的再说一遍所有社交平台,上都是Huberman Lab如果你还没订阅我们的神经网络新闻通讯这个新闻通讯是每月一期,的免费邮件内容包括播客摘要还有我们称之为方案的东西以一到三页的pdf形,式呈现涵盖从如何优化睡眠如何优化多巴胺刻意冷暴露等方方面面我们还,有一个基础健身方案涵盖心血管训练和抗阻训练所有这些完全免费你只需,要访问hubermanlab.com点击右上角的菜单栏往下滚动找到新闻通讯然后输入你的邮箱就行我要强,调一下我们不会把你的邮箱分享给任何人再次感谢你收听今天我和李飞飞,博士的这期对话最后但同样重要的是感谢你对科学的兴趣 [01:42:56]
本期节目围绕2026年上半年汽车行业的最佳公司、最佳车型,以及理想新一代 L6 和 Livis 展开讨论。郑小康认为,理想在部分车型上重新表现出稳定销量、扎实产品和新势力化营销兼具的特征,真正可贵之处在于坚持改变、但不为改变而改变。于欣烈等人则从 L6 的价格、配置、单一 SKU、用户结构和智能驾驶选装率,讨论了产品力与市场反馈之间的关系。节目后半段聚焦 Livis:如果它只是“更贵、更好”的产品,用户可能难以理解其独特价值;品牌既要提供可验证的技术进步,也要保留足够的未来想象空间。节目还将理想与蔚来等公司的产品路线、用户关系和销量表现放在一起比较,最终认为,真正改变判断的往往是能同时形成产品成功、市场事件和品牌信心的车型。
节目开场先讨论最佳汽车公司。郑小康选择了一家在节目里经常挨批评、但销量一直稳定的公司。他认为,速度并不是这家公司的核心,真正重要的是销量扎实、产品持续改善,而且今年若干车型已经在营销方式和产品思路上呈现出明显的新势力特征。这里的变化不只是参数增加或产品升级,而是公司整体思维方式发生了变化:它愿意坚持,也有改变的勇气,但不会为了制造变化而变化。嘉宾因此把“是否像一个真正的汽车厂商”作为判断标准之一,而不是只看短期股价或单一销量数字。
关于理想新一代 L6,讨论集中在配置、价格、权益和销售节奏。嘉宾认为,L6 的配置与价格组合足够有竞争力,也吸引了一部分原本会考虑同级其他车型的用户,用户圈层因此有所扩大。上市前曾经暂停一段时间销售,也让一批原本就在观望、等待新款的客户集中在新车上市后下订;当他们发现新款的性价比足够高,原本的等待就转化成了订单。
L6 只保留一个 SKU(产品配置版本)也带来了一种直接的产品表达。嘉宾认为,普通用户并不真正关心 SKU 数量,更关心的是能否买到一台相对便宜、配置足够、整体体验可靠的车。复杂的版本组合可以用低配制造价格锚点,但也可能增加理解成本;把核心配置一次性给足,反而降低了购买决策的难度。与此同时,部分更高阶智能驾驶配置的选装比例不高,也说明用户对现有能力已经基本满意,却未必愿意为更高一档、但价值尚不明确的能力付费。
节目随后把问题从 L6 延伸到整个智能汽车行业。嘉宾讨论了计算冗余、执行器冗余和全车电路冗余之间的关系:如果品牌把完整的冗余能力全部标配,成本会明显上升;如果把它作为选装,又很难向用户解释它的实际价值。由于监管和产品定义仍有边界,厂商也不能简单地把这些硬件包装成已经实现的 L3 能力,于是高成本能力与市场表达之间形成了矛盾。
讨论的核心不是“有没有更强的算力”,而是“这套能力究竟为用户额外解决了什么问题”。如果用户已经对现有辅助驾驶体验满意,那么更高级的能力就必须在安全、舒适、可用范围或责任边界上提供清晰收益,否则会变成一项昂贵却难以感知的配置。嘉宾还提到,价格较低的车型通常更容易出现较低 NPS(净推荐值),因为价格、用户群和预期会共同影响评价;因此不能只用一个分数简单判断产品好坏。
Livis 是本期最激烈的讨论点。嘉宾理解它可能对应更强的计算能力、更完整的执行器能力,以及更高的智能化上限;但从用户角度看,如果 Livis 只是“更贵、更好的产品”,它就还没有形成独立、清晰的价值。用户甚至未必知道 Livis 是什么,经过提示、观看发布会和资料后,也可能只留下“这是一个更贵的版本”的印象。这样的认知会让 NPS 停留在“不好也不坏”的区间:没有明显缺点,却也没有足够让人产生向往的理由。
嘉宾对 Livis 的理解还经历过变化。它最初更像一个偏 AI、偏智能的技术品牌,但随着产品和发布内容推进,技术品牌、车型版本和公司整体品牌之间的边界变得不够清晰。Livis 需要回答的不只是技术做到了什么,还包括它与普通产品的关系、它要服务哪类用户,以及用户为什么愿意为这种差异付费。若品牌不能把这些关系讲明白,再强的技术也可能被市场简化成一个更贵的配置包。
节目认为,汽车公司的发布会存在两种需求:一方面,用户希望看到已经可以验证、可以体验的真实能力;另一方面,品牌也需要描绘一个让人向往的未来。如果发布会只告诉用户“我们很快就能做到某个接近现有先进体验的目标”,用户也许会觉得可靠,但未必会觉得惊艳。目标过于具体、距离现实过近,反而可能盖住品牌原本应该提供的科幻感。
这也是嘉宾对当前智能汽车市场疲劳感的判断来源。越来越多技术名词和版本迭代,并没有自动带来新的新鲜感;用户看到的如果只是更高的数字、更快的版本和相似的功能,便很难形成新的向往。品牌需要在确定性和想象力之间保持张力:既不能把未来能力说成已经实现,也不能只做空泛的愿景展示。
后半段谈到汽车公司如何面对销量压力、舆论评价和用户反馈。嘉宾并不认同为了迎合某个群体、回应某类批评就不断调整造车方向。真正有长期价值的产品,需要回答早期用户为什么喜欢这个品牌,以及这些人愿意持续留下来的原因。用户关系并不只建立在配置和价格上,也建立在一种“这台车能陪我继续走下去”的信任感上。
节目还把不同公司的产品路线放在一起比较:有的品牌在销量不理想时,通过大幅提高性价比的车型重新获得市场注意;一款车如果既卖得好,又能成为行业事件,还能缓解外界对公司经营状况的担忧,它的作用就不只是单车销量。相反,如果一款车缺少前期产品成功和市场关注的托举,即使产品本身有竞争力,也未必能顺势完成品牌突破。嘉宾据此认为,上半年真正改变他们判断的,是那些同时影响产品、销量、舆论和公司信心的车型与事件。
本期没有把“最佳”简单归结为某个参数或某个月的销量,而是反复追问:公司是否真正理解用户,产品是否能把价格与体验结合起来,技术是否能转化成可感知的价值,品牌是否仍然保留让人期待的未来感。L6 的讨论体现了成熟产品如何通过清晰配置和价格降低决策门槛;Livis 的讨论则提醒厂商,技术升级如果缺少明确的品牌意义,就可能只剩下版本差异。最终,能够形成销量成功、用户认同和品牌信心的产品,才更可能成为真正改变市场判断的车型。
- 节目开场与半年度最佳公司 [00:00:00 - 00:15:00]
- 理想L6的配置、价格与销量 [00:15:00 - 00:30:01]
- L6与i6的产品定位 [00:30:01 - 00:45:02]
- 理想Livis的技术与成本争论 [00:45:02 - 01:00:02]
- 智能驾驶的用户价值与NPS [01:00:02 - 01:15:02]
- 汽车公司如何面对用户反馈 [01:15:02 - 01:30:03]
- 理想的产品规划与市场竞争 [01:30:03 - 01:45:04]
- 半年度最佳车型与节目收束 [01:45:04 - 01:47:00]
于欣烈:你好,我是于新烈,欢迎收听885。你好,这期节目是7月阅读点评的下集。上周我们临时加更了一期小米鹏城技术发布的点评, 这周咱们把下集补上。这期主要聊了上半年最佳汽车公司和最佳车型。有点出乎我意料的是,关于最佳公司的评选,我们四个人,每个人的答案,差别还挺大的 [00:00:10]
郑小康:而我选了经常在这档播客里,挨骂的那件,习惯就是稳定的销量,扎实的销量,快不是它的核心,它的重点是稳,今年我觉得,好几个车型上,从营销到内产品,都完全有新势力化,你不只是看到,它产品有多提升多大,而是它有感觉,它整个公司的思维全变了,这家公司是符合我自己心中,汽车厂商应该有的样子
于欣烈:他愿意坚持,他有去改变的勇气,他不为了改变而改变,就在小康你给最佳公司的同时,他的股价已经狂跌了13%了,除了半年度总结之外,我们还点评了 [00:01:00]
郑小康:刚上市的理想新一代L6 L6的量反而涨,因为这次其实统计的时候就发现,新人渗透率相对高的门店的销售,在主动的引导客户放弃L6再转L6 直接涨了大概百分之十几到二十几,那这个量挺惊艳的,而且讨论爱酒工薪不公式的时候,则引发了我们关于理想Livis的激烈争论,我觉得这个,涉及到这个,我觉得我们这个播客,是一个比较好的场合,来把这个摊开来说,我认为今年,所有的智能汽车品牌,都面临着一个问题,就是,我第一反应是很高兴的,它的巨声震荡向往感的话,其实我后来的反应是不好的
于欣烈:我说就这,给我的向往感,其实它盖上了一个盖子,尤其我现在就劝,听这个节目的观众,不要想着什么智能汽车,什么乱七八糟,它是这么叫,它是个营销词,对于汽车的激乱性的产品定义,这个世界目前还没有智能汽车这个东西,好我们开始吧,今天7月23号
郑小康:我们来录7月份的阅读点评,大家晚上好,我是于新烈,大家好我是小康,大家好,我是陆呆,大家好,我是车贩师少君,来,下一个话题,咱们开始聊理想了,理想L6 来,少君,第一个,目前来说相比于老款L6 目前这个配置本身是非常炸裂的,我觉得不用多说了,这个配置跟这个价格,一定是我觉得已经非常好了,换同级别的车型,其实它也吃到了一部分M6的客户,这边说它确实很多客户已经破圈了,有产生明显的效果,所以我觉得本身卖得好这么长,因为理想其实在L6跟i6上,它的价格跟权益上的释放,还是很给力的,一般讲就是这样子,它还是省得在这些车上去,让用户感受到理想的容易的,第二个的话也是在于说,从我个人感觉,其实这次订单好还有个原因是,之前它在上市之前,就停了一段时间的L6销售,那如果长期卖车应该知道,其实很多说长期形成惯性之后,客户是持续不断需要买,那你停掉之后就有部分等待,那等待客户,其实也是这次为什么上市之后,在周末订单能涨幅那么大的一个核心原因,就很多客户,之前其实已经在观望了,就是要买L6 只是你当时虽然在等你新款上来,最后下订,新款上来性价比高,那我就订了,所以才出现了这次订单,义务寻常的高,就这么一点 L26能看到 [00:03:09]
于欣烈:它SKU跟刚才我们谈到的L03 其实是明显的区别 L03有各种版本,包括刚才我们谈到,最低配的版本,做一个价格的心理锚点,然后引导大家去买,更高配的其他的版本,那L6就一款,标配仅版配,这样做的好处和坏处是什么呢,而且它只保留了一个SKU 我看到你上次快报里也显到,它反而吸引到了,包括年龄范围,比老款的L6更大,女性比例也有所提升,这是为什么能够有这样的变化
郑小康:就是用户根本不关心SKU不SKU 用户只关心一点,就是你能不能让我买到,一台相对便宜的车,没错吧,我们这样讲吧,用户其实是一个非常纯粹的,现实主义者,如果你那么买的好的车,那我就觉得你牛逼,你那我买的不大便宜的好车,那我就觉得你说的东西都是假,今天我们回头来看,回头来看L6 它配置一次性拉到二位,其实它已经做到足够了,而且它其实,我觉得跟L03一样,只是有点朝三暮四的感觉,它只是把自己的,苏马特的新面套装,当成选装件来卖,其实如果你像这个,其实算是,其实上去还有一个更高端的支架版本,没错吧,而且我们也看到,这个支架版本选择比例,其实12% 我们策划直接给出具体个位数的数据 12% 那就证明,其实跟小鹏遇见的现状是一样的,就是客户目前对幅度驾驶已经挺满意的,你让他选择更高级别的幅度驾驶,然后以所谓的说,哎呀这个车如果驾这个可以时间也到三,他其实好像没怎么买单,没错吧,并没有说,哎呀架这个之后我就觉得,我不愿意买单了或之类的,而是说,哎呀你架这个之后我就觉得,好像没有那么必要,就大概这样子,这选配率确实有点,出乎意料的低,对我来说啊 [00:05:24]
于欣烈:因为它整个今年的一个宣传的重点,就是它的巨神智能嘛,而且它从 Albanis开始,其实是把Livis这个,剥离出来了一个选配包,这当时之前大家只有买Livest 才有这些东西,看到一些社交媒体啊,大家一些关心这个事情的用户,这KL吧,觉得很棒很好,但实际上一看订单 12%选配率,跟他你说的,而且你之前还强调说这批人,他是老用户居多,大多数都是蹲守了一段时间,知道理想理解理想,那到后面那些不了解理想的,可能更不会选了 [00:06:03]
郑小康:我觉得其实还行,只是大家突然意识到一个点就是,如果你要让客户产生心脑的对比,那至少他得体验过冷的呀,就这次,其实这次门店,可能最大的一个吐槽点在于说,厂家其实花很多精力去强调体验,哎呀我这体验屌爆了,尤其比捞款屌爆了,客户进店莫名其妙,大哥我体验是M6 我体验是叉叉车,你跟我说比捞款屌爆,我又没体验过你捞款,你捞款到底啥样子啊,你就屌爆了,所以他一直强调新老款对比,当然可以避免一些跟竞争对手的冲突,但是出现一个比较尴尬的情况,就是后后也不清楚你跟竞品关系到底咋样子,理解吧,那数码和套装我觉得也是一样的,就是我自己说,以我自己为例子,我买小鹏,我自己体验过最高版本的,就是芯片加满的跟正常版本的,普通驾驶的体验,说实话差距特别大,但是呢,如果你让我买,或者是让我身边的朋友买,我一般不敢推荐他买,买我这么往上,因为一定有个问题,人家会说,那你当我加这么多钱,真的很超值吗,我总不可能说,我只是为了让你体验更舒适一点,够用就行了,够用就行了,对,我相信这是很多朋友,可能更真实的反馈,那这个时候,你也会选择说,那你还是买中配,你别挑了 [00:07:32]
于欣烈:你刚才提到了 R6和i6会有很多对比,当然它有地区的需求的差异,那我们单从产品看,现在其实起售价是一样的 2498 新的R6各种配置都升了 i6好像没有看到最近有新的改款,那新的R6上来,会对i6的需求有影响吗,就是大家可能,就去买其他的产品了 [00:08:09]
郑小康:觉得i6可能性价比没那么高了,会有这样的影响吗,有啊,增长了 i6的量反而涨了,因为这次其实统计的时候,就发现尴尬的情况,就是江浙沪很多地区的门店,就是新能试轮相对高的门店的销售,在主动的引导客户放弃L6再转i6 那我觉得这种放弃呢,不是说他非常故意的,而是说他已经发自内线,那我说现在找他来买车,基本上大家不爱外面登场的,而且客户发自内心,你跟他一聊增层,他就觉得,你跟我解释这个买我干嘛,我就想买台存电,我家里旁边都是存电,我又不是没开过增层,所以这就导致这个问题就是,这次起来之后,爱乐订单反而是涨的,爱乐订单我们自己统计涨到3,500到4,000台,就最近几周订单涨到3,500到4,000台,从原来3,000台左右,直接涨了大概百分之十几到20几,那这个量说实话挺惊艳的,因为如果多军能够3500到4000台,就意味着月销可能能直接杀回到15000台左右,我觉得它反而是个提升的作用,反而我觉得L6的长期性,长期稳定性需要考虑一下,需要观察一下,因为北方地区卖得好,那北方地区也在新能源化,这我觉得是现在所有车企的迷思,就是20万以下的车型都遇见了非常尴尬 20万级别车型都遇见了非常尴尬的情况,信任员存电比例在爆发性往上涨,在砍价规划还没规划完,包含我们最近在统计的,他几个竞争对手,有同时让存电跟增层的,存电比例都超过70% 所以我觉得这个,所谓大环境是如此,跟你想的没什么大的关系,就存电速度太快了,就是没有那么强势的嘛,如果放在以前的话,小型的增层,或者是之类的,很多轿车之类的,大家会觉得,我什么都得上增层,我轿车也要上,我甚至A0级小车,我都他妈想塞个增层器上去,但今天你会发现什么,用户对存电接受度反而暴涨,很多没有明显说,存电需要焦虑的车型,扣个强把说,那你干嘛给我上车,我存电就行,我不需要再加个油线,对我来说 [00:10:22]
于欣烈:我是一个重视配置的用户,就是在明知道,包括在大屏啊,芯片啊,这些东西,都是差一代的情况下,他们为什么还会选择 [00:11:00]
郑小康:这种心理的客户叫什么,叫做,官网用户,就我们这样,我一直这样跟大家讲一句话,不想买的,他就不会买,他有一万个理由告诉你,想买的,他现在就着急要买,那你这个车才上了半年左右,怎么会有那么多客户说,我在等新款的i6 他疯了他等新款的i6 其实从本账来说,用户并不会说新老款焦虑那么严重,而且很多客户,他不像我们车迷之类的,很关心车,除非是你网上有人煽动,把用户这种焦虑跑得特别损,不然大部分用户不会这么考虑,其实如果不理解这个概念,你们有没有发现,比亚迪或者吉利,或者是什么车,有大量的车型,其实是一直都没有大改款,可能会有个连款,但是连款其实增加的速度也不大,但是销量就一直没降下来,因为很简单,用户已经形成习惯了,就跟以前我们卖大众丰田一样,卡罗拉速腾,改不改,之前的销量可能,改之前销量只能只下到百分之十几二十几,因为客户已经惯性起来了,已经有基本盘了,而且说实话,现在这个基本排行是,比以前来用车强多,特斯拉就是最明显的例子,来友待别走,来你说说L6的这个市场情况 [00:12:05]
于欣烈:包括一些用户的感知和反馈,和一些新的变化吧 L6这回我觉得有个可能,和刚刚少俊这边稍微,有点怎么说,有点差异的数据,就是我们刚查到女性用户,这次反而比那会儿要低一点了,但这决策用户还是养多,就是这个邵俊刚说那个确实,就是他女性决策,在这个R6这个能大卖,它起了很大作用,然后我就直接说那个R6和I6吧,首先它没有抢太多,因为对于很多用户来说 R6是一个入门级的家庭SUV I6的话不是 I6就是年轻化的一个叫什么,更年轻的这么一辆车,它更偏向自我,表达自我这方面,就有点像,这个你说M03和R03互相抢多少,其实也没有抢太多,他们的这个R系列,更在意的是操控智能和家庭 I系列是空间舒适和能源形式,这三个还是,这么三三对比的话,重叠程度还不是特别高 R6能给用户,我觉得这次的目标,还是比较明确的,就是他的NPS要到80分以上,这个我觉得是挺有挑战的,就是理想本人说的吧,我发布会那会儿在德国也没看,但是我看所有的新闻稿是这么说的,说要这个,他的NPS要到80分以上,这个很有挑战,因为如果骗领导的话 80分很容易就能达成,我说实在的,就是你要是买完车之后,哥你给你送你个礼物,你给我个,给我个满意行不行,这个分数很容易达成,就我们现在看到R6的这个NPS数据,我首先要先这个怎么说,先给自己洗个地啊,所有的便宜的车,就是在这个产品训练便宜的车 NPS都低,这个没办法,就是不包括手机也是,你就卖的越便宜,它NPS越低,这个没办法的,它受到价格的这个因素影响,和用户群的影响,它肯定是,这是一个非常自然,非常正常的市场规律 R6也是 R6在它的产品序列里面 NPS一直不算太高的,甚至可以说 [00:14:30]
于欣烈:甚至可以说,一直是比较偏低一点的,所以它要冲到这么一个数据,我第一我是觉得有难度,第二的话 R6 这一代R6要比前两代R6的NPS 手高级NPS要高很多,确实要高很多,但具体的数,我这边还没有,刚刚我问他们,还没回过信息,记得是昨天去看的时候,它要高很多,无论是它的这个市价感受啊,那个它的这个,发布会的这个感受啊,以及它对于这个产品的认知,然后加上MPS 都是要比前两代R6要高很多的,这一代R6大家讨论的并不是说,啊它居然能卖这么便宜,因为第一代R6和第二代R6 都有个套娃的这么一个感觉,现在一说什么,这是小R9 那大家这个感觉一下就不一样了,小R9 你跟我说你这 iPhone 你出了个iPhone mini 那也是,那也挺牛逼的,那就应该卖的比安卓贵,你就应该卖的比同级别贵一点,我觉得这个宣发,上面起到一个很大的作用,但是,有一个我们觉得可能是,可能会成为后面的这个,一个影响难点,就是它的竞争对手开始多了 ES6出来,那对它的这个竞争压力就有了,因为R6一直没有拿下一个市场,就是苏南以及江苏,就是从苏南开始往南的这个市场,他在这个苏南地区,以这个南京为中心的这么一个地区,他R6的销量,性R6销量不太好,然后在西南地区还算可以能稳得住,但是再往南方去,那刚刚少军也提到这个事情,就是他还是干不过纯电的,尤其是在上海这个未来的大本营,你想去卖的,包括福建,这个地方也算是小鹏和,未来的这些纯电为主的一些地方,包括南方的二三线城市,以及下层市场,它消费能力也要比北方普遍偏高,他们对于纯电的认可度,以及对于花更多的一点钱,不太在意说花更多的钱,去买一个新鲜的产品,以这个逻辑为说话点的话 R6的挑战是非常大的,因为北方的订单储备,就是在我们看来,是会有一个,是会消耗掉的,你就看R6之后的这个用户,就平消气的用户运营,包括它的这整个的产品运营,怎么做了,如果做不好的话,还是会进入一个,被别人这个围攻,按在地上打的这么一个趋势,这是一个潜在威胁了 I6呢,包括它跟I6之间的关系,为什么,刚才你谈到了,他不把它当成一个入门的家庭SUV 就像我这样的用户,在乎这种配置功能对比的,不受影响吗,就是i6他们的上市节奏,你觉得今年比如说,是不是应该也迭代i6 还是说怎么样考虑,他们完全不担心这样的事情,看起来,我觉得有两种解决方案,如果说是我给他们建议的话,有两种解决方案,一个就是你把i6跟R6 把它当成一个年轻旗舰去运营,他们所有的配置,你都给他们在那个价位里面,拉到最高,然后价格稍微涨涨,用户肯定能接受,我一直觉得,它应该和Mega和i9 放在一个产品线里面,一个吸引用户进来,更多的年轻市场,夯实他们的下车市场,以及年轻市场,另一方面的话,也给整个品牌注入科技感,和智能与家庭之间的这种,这个关系,这个联系,所以我个人觉得,它应该是和Mega i9 放在一起运营,基于此的话,我觉得i6应该是要做的,和R6一样,要更配置,让人更能感知到,而不是说一个常规更新,常规更新的话,如果是这样的话,就变成,我觉得特斯拉的解决方案也行,就是你别管我改没改,我改了嘛,我是不是改了,我是不是比新更新了,我是不是这个,唯一的不同是处处不同啊,你别管什么这个里面,他还是不是毛屁房,那我就问你有没有改款,我是不是新的R6新的i6 那如果是这样的话,我觉得i6是不用动的,因为他在这个市场价位里面,没必要去,你既然可以能接受 i6就是这个样子,用户也能接受,因为他的这个价位,他的这个售价就在这,但是如果一旦这样选择的话,你就不能涨价,你也不可以说,就是把这个价格,甚至你要降价,你要给出更高的权益,用户才会买单,因为韩正那句话 i6遇到的这个对手是谁,是ES6 他讲这个生活方式,出行方式,以及他的这个换电方式,换电护身盒的这么一款产品,那你在面对他的时候,你要么就是以更,继续卷配置,要么就是继续卷营销,营销我觉得肯定是卷不过的,那就只能是你卷卷配置,卷卷价格了,那这样的话,又有点饮鸩止渴的这个意思,但是反正我想表达就是,要么你把它彻底脱胎换骨,做成一个全面的一个品牌升级 R6和i6当成一个品牌去运营,把本不该在这个价位出现的一些功能,给到用户,你要么就是讲清楚自己的产品叙事 R6是面向喜欢操控的,喜欢驾驶感的家庭用户 i6的话,那个叫什么,更倾向于空间舒适和空间场景,家这个家庭都这么一个,一个用户,要么呢,就是像特斯拉那种 model 3跟model 1 你说它俩有本质区别,就是空间区别,它开起来一样,摸起来一样,看上去就是,你坐进去一眼,他妈差不多,你高也没高哪里去,你腿也没有舒服的哪里去,那就,我觉得就是怎么着都行,不是说摆烂吧,就是怎么着都行,简单说一下SKU的变化,这次只有Ultra这一个版本了,客观上相当于L全系都不会再有Probext 这个其实是最开始,理想也是率先在车型命名中采用这样的刀法吧,后来其实随着市场竞争的加剧,老编辑也说过一些穿插的战略的竞争,那今天它终于只留下了一款,就为什么在今天的竞争国际下,手机市场也很激烈,像iPhone仍然可以按标准版 Pro、Pro Max来卖手机,理想的L线,今天只变成了一款,但你看其他的,比如像小鹏,仍然有很多的版本入门款,就是理想这样做,在一款车型里面的SKU的精简,你觉得为什么会让变化,以及在市场上效果会怎么样,小康先来,我就先说几个,我就前面说ES6这个,我其实觉得 [00:21:16]
郑小康:如果是现款的ES6 我不知道它实际成交价,到哪了,但是我觉得,太贵了,对就是新的ES6 我觉得它会膨胀的,尺寸的通货膨胀,对吧,因为ES8现在是那样的,所以我觉得 ES6会到5米1级别,所以它有点像是老款的L8 这次它也得跟L7 因为这个I7是一个不存在的产品,这个地点,所以它我觉得跟I6本身,可能没有非常强劲的关系 Ultra这个事呢,我有两个点,就第一个是,其实历史上,也就是新势力这帮人,大家一直在努力的,当年的小鹏P5 然后今天的摩打103也算吧,大家一直在以尽可能低的门槛,提供一个强悍的,甚至于满配的智能化的东西,你像L6 新L6我认为是这样的,首先前排IP和,前排IP跟L9一样这个事,我认为这肯定是追求平台化的,这么一个体现吧,就比如说我们看到,响接G9 我们批评华为,我们说想接G9 直接V9 温解M9 甚至于中介S800 大家怎么可能是,怎么能用同一套IP呢,这是有问题的,的时候,有没有想过,理想L6跟L9 是同一套IP的问题,有多大,但是如果放在,就是我认为,这是不同企业的,这个哲学不同,就如果你把它抬高到,我的其他可以有差异的话,我的空间布置,轴距,动力,电池大小,可以有差异的话,当然我的智能体验是一一微的,抬高到特斯拉那个高度,因为特斯拉他就是这么干的,那其实理想的做法又没有什么问题,这完全取决于你,从哪个逻辑去考虑这个问题,我觉得L6好的一点就在于,它在这个级别提供了超强的,智能化的硬件,但还是那个老问题,就是说你必须得提供,非常差异化的软件,你能交付的出来的话,那它就是有意义的,否则它就是没意义的,否则它就不是一个优势,对吧,新一代和全新这个,其实我理解就是 L6归根结底,从根本上来说,它还是一个中改,它不是一个换代,在我的理解,我觉得Ultra这个事儿,的第二个点,我想说的就是,我觉得对于理想公司来说,就我这么多年跟下来,以我对理想的理解,所有的东西都是,随时在变化的,就是你很难讲,比如说鹏城N70上了以后 N70跟N90上了以后,你想是不是有可能再出一个L6 Pro 这是未可知未知的事情,只不过今天你从上往下这样出牌出到现在的话,出一个L6 Ultra它一点不突兀,对吧,它是这样的,比如说i8 比如说L9 大家都是Otra 然后一个版本,但是你是不是要到L6这个级别,你是不是要出一个,因为它会变得更加的成本敏感,或者说是预算敏感,那对于这样的用户,他也许就是很强的意愿,说我不需要那么超配的,或者是一出的这些配置,或者是产品,我觉得历史上理想也这么干过,我觉得这是完全有可能的,有机会变化,就是它其实留了一个后手,刚才你谈到L6的 [00:25:39]
于欣烈:智能硬件方面的配置,它是很全面的,当然,我联想到的很重要的一点,就是可以选装,巨声智能套件嘛,因为其他的像,质架力方面,它基本上都标配了,之前看少军的上述快报啊,巨声智能套装的选配率,挺低的,只有12% 而且这还是手臂用户,就是他们已经,蹲守了很长时间,是相信理想,信任理想的人,在平销期,这个数字会更低,所以到目前为止,就像你说的,它可能因为,它的功能点,力点,其实并没有,能够上车,以及没有能够,造成很好的
郑小康:这种期待吧,我觉得现在,其实,大多数人,是没有选,这个职人套件,其实我觉得,以它现在的定价,能有12% 我觉得已然很不错了,因为这个有点像,那个FSD 切换了,比如说HW4芯片,然后有能够增加多少的订单,类似于这样的概念,因为从根本上来说,理想今天的,无论是AI的座舱也好,还是支架也好,我理解他们已经做了巨大的投入,但是今天还没有到交付的阶段,所以用户买你这个东西,本身上是买你的一个买卖,再买一个预期,然后是不是有可能,比如说你的年底的,我们假设,那个对标FSDV14的支架,出来了以后,它的整个反馈,有一个舆论上,完全翻身杖的效果,可能会带来一些,不一样的变化 [00:26:33]
于欣烈:我觉得这个也不好讲,对这个是一个问题,就是它的巨神智能,这个套件,和它的支架,和VLA的关系是什么,我不选的话,按照我现在理解,也应该可以对标V14 它当初可没有说是,巨神智能的这个版本才可以,它实际上是一个功能切割的状态,就是那一颗马赫芯片和,当时质架的模型,本身解决的就是,对标FSD V14的能力,另外第二块的马赫100 是另外的功能,我觉得这个,涉及到这个 [00:27:27]
郑小康:我觉得我们这个播客,是一个比较好的场合,来把这个摊开来说,我认为今天所有的智能,今年所有的智能汽车品牌,都面临着一个问题,就是差不多30万以下的车吧,就是他要不要支持全套L3的这个如意备份,像特斯拉的话呢,他给摩托山和摩托万全都已经干上去了,像摩托山的话,他可能就是20万出头的一个车,但是就是这是各家的重心不同,或者说大家也很难真正的去看特斯拉干什么,然后我们去干什么,对吧,因为特斯拉他有很大的自由度,比如说它没有什么零重力,没有什么按摩,它有很多的成本都不需要花,然后它把所有的这个组件,花在全套的,比如说转向自动,动力,供电通信,设计这些的冗余设计上,这样呢,确保比如说法规,某一天说L3可以落地了,甚至L4可以落地了,它马上就落地了,它唯一一个外显的,没有做冗余的,很多人可能,其实是感知反而比较明显的,就是传感器冗余,这个维度它是通过系统级荣誉去做的,如果我们去看的话,全球各地的监管机构也是默认,它是对交付的结果去负责,它不是去界定传感器有没有去做强荣誉的 OK 我们再说回来,就是对理想,或者说不止理想,就是所有的公司在内,三双案以下的车,理想我认为它是今天提供了一个选项,确实存在于老师的这个问题,就是说巨神智能究竟额外带给了我什么,今天所有的品牌,大家都只能,默认两可的去回答这个事情,根本原因就在于,从监管的角度,没有看松L3的这个口,我大致理解,如果理解没错的话,其实,加上巨神智能这个包的,它至少解决了计算的冗余,就是它有一个完全独立的计算 [00:29:54]
郑小康:就是它有一个完全独立的计算,跑这个同样的模型,但是L6 新L6有没有全套的执行器上的,包括就是全电路的这个冗余,我不知道你确定,今天所有的智能汽车品牌,确实都面临一个这样的问题,就是如果你选择把它,全套的容易都标配上去,而今天你又不能讲给用户,我这个是为L3准备的,因为国家还没有PL3 所以你不能把它拿来去营销,这个是一个很肉疼的事情,对于品牌方来说,因为它成本很高,压不下去,如果你作为选配的话,也其实面临这么一个bug 就是说你今天只能去讲,你给用户什么,如果你讲算力,可能还好点,因为它比如说,它从1280变成2560 它就是实打实的,尤其是大家有一些这种,比较在讨,在这种茶余饭后,聊汽车的时候,聊到的,比较聊键盘值的话,它还是一个比较好讲的东西,如果你说我有两套转向,两套空性能力,这一种非常奇怪的事情,尤其对普通用户来说,它是非常难理解的,但实际上它对于,合规的去过监管的,正式的跳出L2级别的辅助架,是去往下一个阶段去迈进的时候,它是一个非常硬的门槛,是不容讨论的,但今天又不能讲,这是一个bug 我从巨神制等,刚才你谈到,冗余备份的硬件角度来看 [00:30:54]
于欣烈:它可不只是30万以下,它30万以上也没标配,它的R28 R29也没有标配,仍然需要选配,我觉得它不仅仅是R26的问题,比如说我们刚才来对比特斯拉 [00:31:36]
郑小康:它的结果是,我刚刚说这个30万是,我刚刚说这个30万是,相对更加行业一些的,比如说问解M9的6机关,它其实没有太多的提到L3这个事,但是比如说像准解S800跟问解M6 它都会大概的在发布会上,提一句面向L3 就是你不能真正的去营销L3这个事,但你可以说你的系统价格,是面向L3去设计的,我的意思是,就是一些更高的产品,也是有能力去给它去直接做标配的,当然你可以选择给用户提供,不标配的这个选项,这也是OK的,比如说你选了L9Livis 那它就已经完全标配了,你可以选择提供不标配的这个版本,我觉得这是不同企业的做法,但是核心我想讲,就是30万以上呢,这个压力慢慢慢慢就卸下来了,比如像问题M9的话,它就选择不给用户提供这个,弱版本的选项,它就直接就是全息标配,你要么买,对吧,大家也看到M9 它也是一个不便宜的车,对是这个意思,对,冗余硬件全息标配,刚才咱们谈特斯拉MSD [00:32:42]
于欣烈:我觉得它的成本第一是一个结果,我觉得最开始还是它的思考,跟其他的品牌不一样,当然那是另外一件事情,跟军事智能可能有些差异,因为不了解军心智能,具体它能够实现哪些功能,但是即便是单纯,从L3这个角度来看,它就因为选了,要全系能够实现所谓L3 甚至它说的L4 这个能力,然后它决定了,它的硬件是选择,什么样的系统路线,它就不需要激光雷达,不需要很多高成本的硬件,它用低成本,就可以全系标配,我觉得那是结果,重要的是,它的目标是什么,但现在确实包括理想在内,这些品牌面临,很大的一个问题挑战,就是成本太高了,硬件成本太高了,他们的技术路线就是这样,需要极光雷达,需要多粒算力可能,需要冗余,我觉得这个是一个,很难解决的问题,就是现在,大家买车的时候,有时候也会劝,尤其我现在就劝,听这个节目的观众,不要想着什么,这个智能汽车,什么乱七八糟,它是这么叫,它是个营销词,它不是一个,就是它的一个激烂性的,对于这个汽车的激烂性的,一个产品定义,这个世界还没有这个,这个世界目前还没有,智能汽车这个东西,大家都憋着在R4的这个时代,去放大招,因为你现在看,咱们这个智能的这些东西,智能座舱,那不就是一个语音,加一个导航吗,还有什么,没了 AI agent呢,那最终服务的,还是语音和导航,最往多了说,它也无非就是一个多媒体,就是用语音控制导航和多媒体,没了,这个就真的是没有什么,这个更多的一些东西了,所以你说它是智能汽车吗,我觉得不是,它必须要等到这个车的,什么叫智能汽车,就是它改变了汽车的驾驶方式,或者改变了汽车的空间定义,那个时候你再去说,这个它是一个智能汽车,我觉得才说得过去吧,那你现在说这些东西,为什么我刚才拿手机举例子呢,这个时候我也不得不拿手机,就是行业做举例子,我就现在生怕别人捶我,手机,汽车怎么能跟手机比呢,这两个都不是一个工业上的明珠,一个工业上的废物,这个两个不能比,但是这个观点也是错的,这俩都是在国内创造了无数价值,在全世界创造无数价值,这么两个产品,我们就以这个产品的逻辑去对比,首先你说这个iPhone 当时这个大家都喜欢叫什么iPhone时刻,对吧,那会是什么,是手机通信工具变成智能终端,但你现在你看汽车,它仍然是主要的交通工具,它不是一个说改变了,就是我刚才说的一个驾驶的方式,以及你空间定义的方式,它只不过是增加了智能的能力,而没有改变它是一个汽车的,它是一个交通工具的,我以人为主要驾驶员的操作员的,这么一个交通工具,然后从用户价值上讲 APP的生态改变了我们使用手机的方式,在此之前,你手机也就装个Java 装诺基亚,你还要下个证书才能装游戏,这很困难的,但现在你的自驾,坐舱,它是个辅助体验,它没有改变你的,它没有形成一个新的生活方式,到现在所有的品牌都在讲什么,我的极限的驾驶能力,在遇到危险的时候,我的车应该怎么做的,大家都是大同小异,然后从竞争逻辑上来说,这个iPhone 它开辟了一个smartphone的,这么一个新的一个品类,以前就是手机,卷到大家最后就无非就是,我装个什么诺基亚的塞班系统,你装一个Windows Mobile系统,这个就没有什么本质的区别,大家都是不同的壳子,壳子装一个东西,那现在新能源汽车,还是在和传统的汽车进行竞争,他不是说我现在一个智能汽车,和传统的工具车进行竞争,他还是,他无非一个叫新能源,一个叫,就是他去能源形式去区分,这两者的一个最大不同,然后用户迁移也是,当时iPhone之后,他用户迁移几乎是以这个,每个季度几百万的速度去,就是抛弃这个传统智能手机,要不然诺基亚不可能死那么快,对不对,你现在你看哪个,哪个车企死的那么快,没有大家,尤其是欧洲欧公子这几家,这几家车型有钱着打,大家也不要看他裁员什么,他有钱着打,他的市场大着呢,在中东在南美,尤其是在南美,在这个非洲,他们的市场大了巨了,那不要大家不要觉得,哎呦这个,他们就有的什么车型,从中国退出了,退出的,他只是也说,他们要保住他们最大的利润,否则他们再继续生产的话,利润的基本盘就保不住了,但是其实说就是,就是说现在吧,就是那时候的大量的用户,主动抛弃了传统的手机,但现在多数的用户,仍然还在用燃油车,在买车的时候,他还是在燃油车,这个混动车,电动车之间,去比较两个最重要的东西,成本和配置,而不是说咱,咱之前买手机的时候,这个智能和非智能,他不是这样的,你现在咱们,我再说回这个理想,理想这个就是,我也觉得就我们的数据看,可能比少军那个更惨,就是不光是他的这个选配率表,他有没有纳入自己的选择计划,有没有被这个产品所吸引的比例会更低,因为你现在新能源汽车的核心卖点是什么,更快的加速,更大屏幕,更强的支架,更智能的座舱,以及什么更大的空间,这个就只是一个加分项,他没有都是在汽车提升汽车体验,而不是创造新的使用方式,所以你从这一点来说,这个理想R6的这个,这个叫智能包吧,或者这个马克星天的这个选配,第一是理所当然,它不是理想的问题,是整个行业的问题,它还没有到那个,这个真正智能的时刻,我觉得包括什么,鸿蒙系统啊,小米的人车家生态啊,什么理想的这个,什么理OS吧,星环OS什么的,它也只是说,在车里面增加几个新功能,它不像说我现在,你比方说你现在让一个,天天使用iPhone的人,你换到一个安卓手机上,他不可能,因为我的所有的照片,都在这个手机上的,你现在你的驾驶行为,你的驾驶数据,你离开这个车,你上另外一个车,一毛一样,不用改,我稍微调一下就行,那有什么,我觉得就是,这个没有一个独一无二的区别的时候,无所谓,他有没有都没所谓,我就补充那么一个点,接下来咱聊一下i9 i9之前工信部,公式了,有所谓的以前的Ultra版和Home版吧,所以从公式的名字来看,我理解i9不会有Livis版,那是不是等于它不会有全线控地盘,我这么理解准确吗,还是说它即便标的是Home版,也仍然有可能会配全线控地盘,你们怎么理解它这个公式的版本啊 [00:40:12]
郑小康:问我嘛,这样会不会不太好,也无所谓,反正我也不太知道这里边的信息,哎呀,我现在就是到今天为止,我唯一的感受是什么,就是尤其有一些传言,你知道吧,理想计算机没有出来否认,当然也没有证实这个事,就是明年是不是有L系列的存电,就我的意思是我们,当我们聊i8和i9的改款,或者是换新的时候,你很难完全不考虑 L系列存电的情况下,能够把这个事聊清楚,因为我觉得这是一个,比较关键的,比较重要的决策,就是说,我是不觉得,一个品牌的店里,可以有真成版,然后同款的纯电版,再加一个新形态的纯电版,容纳这么多的,所以我觉得这里边,一定是一个取舍问题,然后我们聚焦的聊爱酒的话,我理解他这个意思是,就跟于老师说的类似,就是应该是没有,没有主动悬架,我不知道我理解对不对,然后这个,因为如果我们上升到,全线控体盘的话,其实情况会更复杂一些,因为理想其实是,为数不多的,极其的,线控机器制动这个东西的 EMB 因为大部分大家,可能就是卷一卷主动悬架,在最多卷一个,限控转向,然后理想是再加上后轮转向,再加上限控机械制动,而且它还不是标配,它只在L9的Liris上有,所以,我觉得这情况比较复杂一些,至于说L9本身的卡位,我其实不太好讲这个车,根本原因就在于,假设我们没有L系列纯电的传闻,或者说理想机械否定了它,我们可以更加尚快的自由的去说 i9应该怎么打,然后能够把这个局部的更好,但是,小康,我的想法是,我们先不说就怎么打 [00:42:06]
于欣烈:我刚才之所以问关于,主动悬架为主的全新口体牌,那个配置有没有,他决定了,不管L系没有纯电,如果他没有的话,那i系列跟L系列,它的产品定义会有巨大的差异,这跟以前理想,整个的产品线 I和L只是动力形式的区别,就变化非常大,我觉得它已经,那这样我们就拒绝于老师
郑小康:你刚刚说这个问题的话,其实我认为这反倒尚可理解,核心是什么,就是今天理想,其实是在一个调整的阶段,它核心是说,我怎么样能够有量,怎么样能够能赢,其他一切是次要的,我是在整个公司顺风顺水,然后长期植入的阶段,才会比较关注产品规划,比较关注秩序,但是如果我现在是在,想要打胜仗的阶段,我是可以容忍很多,不合理的事情发生的,我们就拿过去半年,打得最漂亮的,极客跟蔚来来说,其实8X下面是7X 这个放到任何一个正常的公司里面,它是没有那么合理的,无论是产品的尺寸还是产品的定位,还是甚至是设计风格,然后未来也是一样,就是ES8下面是ES6 这是一个非常奇怪的事情,但它为什么能共存呢,因为当你想要赢的时候,这种很强的秩序感,这些东西是可以暂时放一放的,我认为在今天的理想汽车身上,它由于还没有进入到一个顺走期,没有进入到一个强产品走期,并且是快速上量的这么一个阶段的话,我觉得就是你前面说的这些不合理的东西,它是没有任何问题的,发生在今天的,我没有说不合理,我是说它会发生一个巨大的变化,跟以前相比变化很大 [00:43:48]
于欣烈:我理解他们会为了市场竞争生存,做一些调整,首先刚才我们判断会不会发生这样的调整,如果会发生这样调整的话,它为什么会发生这样的调整,比如说爱系列,它为什么只做home版 [00:44:23]
郑小康:不做Livest版,我觉得不一定是i系列不做Livest版,我觉得更多的可能是背后的技术平台导致的,就是说Home是一个从Mega上面沉淀下来的资产 Mega是没有Livest 这我觉得是背后是技术平台的差异,那么i9是一个Mega延伸过来的同源的纯电平台,那么在它的产品规划阶段
郑小康:那么在它的产品规划阶段,可能是没有线控转向,或者说是主动选家这一套东西的,那么Home就代表着双枪双伐的上限,我理解是这样,这套路线的方案的上限,那么Livis的话呢,意味着你可以加持更强的计算能力,以及整个执行器,包括容易的维度,全面往更智能的维度去,就是Livis意味着更智能 home意味着舒适的上限,我理解是这样,我同意啊,从照现在目前工信部的公式来看,是这样的 [00:45:02]
于欣烈:但是就会衍生出,我提的那个问题 Livis究竟是什么 Livis现在是一个,涵盖整个公司的一个技术品牌,他们会开Livis Day 他们会有Livis的版本,那如果说只有L的两款车型,有Livis的话,它怎么会成为一个,公司级别的技术品牌呢,很奇怪,以及Livis究竟是什么呢
郑小康:如果只是标配了,全线控底盘的产品才有,我理解这只是阶段性的问题,还是回到那句话,比如说我们之前,跟理想聊的时候,其实PoM这个东西,理想有一年,举办过家庭科技日,它本身有点像类似于一个,有很多用户,而不完全是,仅仅是媒体在场的,这么一个聚会,但是又隔了一年,或者又隔了两年,然后它就消失了,它没有,它有点三天打鱼,两天赛网,它没有延续下来,对,我觉得从更大的范畴的角度来讲,你可以理解,可以这样去看,今年我还不确定,未来有没有new year 以及现在已经是,马上八月份,还有没有power day 这个是比较难的,我觉得是这样,就是每一家公司,或多或少会出现这样的情况,但我们一定要,很系统的去梳理它的时候,会发现有那么一些,不自洽的地方,我想说过去几年里面,其实本来未来做的是不错的,比如说PowerDate 是一直在坚持的 NuInk作为一个新的东西,有可能我们短期内,也许时间不到了,因为技术平台 [00:46:58]
于欣烈:我有点不同意见,稍微打断一下,因为NuInk也好 PowerDate也好,它是一个发布会的名字,而Livis对理想来说,它不是一个发布会,只不过有一个Livestate 它是一个技术品牌,你明白吗,他们会有Livestate的眼镜,他们会有Livestate版本的车型,它不只是一场发布会,它对理想的重要性,那远超过New In 这样的一个发布会的名字,它甚至不是一个品牌,它导致了整个产品线的,这个配置是完全不一样的,它是一个公司级别的技术品牌,大家以为这个公司,会全力地去向Livestate 这个方向去发展,但现在你告诉我 i系列整个没有,以及 r系列只有两款车有,那它为什么是一个,全公司级别的品牌呢,甚至有全公司级别的 Livestand呢,这就是在当下的,产品线的情况下,布局的情况下,他们开的这个发布会 [00:47:18]
郑小康:他们应该知道以后,有没有,对不对,我还是继续坚持,我认为它跟未来,跟理想,在这个事情上,是非常接近的,非常像的,就比如说Livestand的眼镜,它有没有第二代,我觉得这是很难讲的,这是我一个观点,当然,然后再比如说 Nioin上的12个技术板块,现在还有多少存在,以及它是不是平台化的,搭载在未来汽车的所有产品上的,还有就是说Livis 或者Livis它不只是一个发布会本身那么简单,它是支撑整个公司的平台,其实Nioin背后本身它也是,全部是一些技术平台的一些范畴,对吧,所以我觉得在这个维度上,其实没有本质的区别,就是我刚刚的那个类比,然后它势必会存在一些,如果我们细细审视的话,不同公司势必会存在一些,矛盾的地方,或者是不一样的地方,那么今天我觉得在,其实无非只是新技术平台,搭载的车型上,而不是L系列上,只是它恰好是,以L8和L9换新的时候,加持了这么一套Livis的,或者是巨神智能的东西,所以它看起来是 Livis和L系列绑定,而Home和i系列或者是纯电系列绑定,但我还是觉得它只是一个新旧技术平台的区别,就比如说随着时间的推移吧,随着时间的推移可能,因为是这样的,就是我们拿ES6类比,我其实不太想一直揪着未来来去解释,但是我觉得它理解门槛还是相对最低的,我们拿ES6来类比,其实25款的26款的ES6 换代之前的ES6 它是搭载了神机芯片,因为智能化是相对容易的,那么我们可以预期像Mega Home 或者是i8 i9的这个上行,大家会拉起这个马赫逸的芯片,因为自驾芯片,整个控制器的换代是容易的,但是执行器的换代是很难的,是更换是很难的,如果你的整个平台维度,没有预留线控转向,或者是主动悬架,那么你在车型改款,甚至中期改款的阶段,去把它换上去,它的成本可能是非常不经济的,其实我们在ES6上也没有看到,比如说线控转向,当然主动转向可能是一个定位的问题,但我觉得线控转向是完全会上的,就是下一代的,所以我还是觉得它背后只是说,所代表的车型平台新旧的更迭,实际上如果你去看鸿蒙之行也好,大家没有办法完全规避掉这个问题,如果说是一个比较细的,就rooming 很细的去审视这么一家公司的话,你会发现有非常矛盾重重的感觉,但我还是觉得每一个公司,其实都存在比较严重的问题,在今天这么一个快速迭代的环境里面,我能理解需要快速迭代,以及生存的压力,但是,佑丹你来聊聊 [00:50:51]
于欣烈:爱系列只有Home版,没有Livis版这件事,你是怎么来理解的,我不理解,我很不理解,我觉得应该是得有,就统一都叫Livest 得了,除非是有一种情况,就是又刚才说的,我刚才那个理论,如果说,你的这个叫什么,所有的这些 I系列有单独的,自己的品牌故事,你有就所有的I系列,它的顶配都叫后,那我理解,你L系列,所有的都是Livis 这个顶配都是Livis 那我也能理解,你叙述不同的产品吗,但是就目前来看,好像他这个,这个就没有这个趋势,所以我不太理解为什么,那如果说是有,这个L系列有Livis 不是,现在有这个趋势啊,现在i系列,就是不会有Livis啊,那万一,以后的i8 i6 有Livis版本呢,这个谁也说不定 i9都没有,我觉得往后不会有,就按我的理解啊,那如果i9都没有的话 i8有,这怎么可能呢,我觉得他们能干出这样的事呢,你就是跟刚刚咱们聊,那个R6 Ultra 就是这个或者Pro 或者是什么Pro Max 这我觉得就是一个非常,我可能说了,大家也不太愿意听,就像是一个临时决策一样,我们根据市场的变化,灵活去做决策,我觉得当然这个没有错,但是所以这个就基于一个,我特别特别没有安全感的地方,那i系列,如果都是标Home的话,那是不是意味着,它是极致的这种舒适感呢,然后RO系列你开着舒服,咱们就一个是像宝马一样开着舒服,一个是像奔驰一样坐着舒服,是不是这样呢,那如果是这样,一旦遇到这个市场,对你的反馈是负面的时候,你还变吗,这个是我有强大的不安全感,万一一变,无所谓,不就是一个名字吗,以后咱们I系列也出Livis 或者咱们RO系列也出Home RO9 Home 这个是我觉得是一个非常大的不确定性,所以就是,这个也是我觉得理想需要去,尤其在从今年开始,集中补课,就是坚持去做他们应该坚持,去做的事,他们认为对的事,不要因为这个市场上有这么多人黑你,哎呦喂怎么办呀,我没辙了,要不然我们就不要变,那骂着骂着就没了,就跟你说那个理想,在发布片上弄一个停车的艺术,他也天下没有塌下来,当然了,这个大家该骂你,想怎么听就怎么听,还是该骂你,但是至少口碑没有之前那么差了,他也没有变换,所以就是我一直坚持这个观点,就是理想现在不要去关心别人怎么黑你,要去记得别人是因为什么爱上你的,你叫home也好,叫levis也好,不改变你的产品策略,以及你的产品的,对于产品的思考,那思考应该是什么,就是如果都出home 以后就坚持,这个Home到底在i系列上面和Mega上面,你到底要讲述的东西是什么 Livis 那为什么RO6就没有Livis 那就是因为一个成本的问题,它就没有Livis吗,那你为什么要放Livis呢,就是iPhone绝不可能因为成本的上升,而取消iPhone 17 Pro Max 是不是这个道理,这就不可能啊,你想象不到,联想也不可能,因为你供应链的成本上升,去取消了自己的拯救者系列,或者联想小新系列,不可能,还是要该怎么出就怎么出,因为用户相信你的,是你对产品的定义能力,以及你对于品牌的,品牌故事的坚持,那你总是左右摇摆不定的话,我觉得你讲什么都没有用,所以我不认为,它叫什么重要不重要,我认为它有什么,并且坚持什么,这个要比它叫什么重要多了,对,根据你刚才说的,我觉得在i系列也不会大家都有home啊,你参考L系列,Livis只有所谓旗舰车型有嘛,那i系列又不是完全对L的一一对应,那我估计只有i9有home吧,i8可能都不一定有,因为它需要对座,需要旋转座椅,i8这个空间和这个布置,我觉得坐了体验也不会太好,我觉得只有Mega和i9会有home吧。我觉得这个没所谓啊,就是你看我们针对于home 我们的这个解决方案就是什么,做产品一直强调一件事情,就是你是否给用户提供的是完整的解决方案,比方说这个home 我在i9上面或者在mega上面,是提供了什么,就是它可以旋转座椅,它可以这个对坐,它可以平躺,怎么怎么无所谓啊,就是所有的东西,但是那这一套逻辑,我们基于这个逻辑,它在i8上面i6上面应该是什么呢,它没准就是一个更大的前后备箱,一个更省事的一个上车方式,或者是一个更炫酷的,一个什么样别的功能,它可以去为我们这个home这个版本,去讲述它独有的一些东西,因为这些东西,可能你放在这个i9上面,或者放在其他上面,它也没有,但是它的这个home的这个解决方案,它是用i系列整个产品线,来去告诉用户,无论你需要什么,你在我i9上面和mega上面,你能买到home吧,你在我i8和i6上面,也能卖到home吧,不要被这些,你怎么说,这个一些自己的不自信,所困扰,或者说是,哎呀,他到底能卖多少台,反正现在在这个L4 还没来的时候,大家的销量,都会进入一个疲软的世界 16岁到18岁的,这个这部分用户,一旦大学毕业了,他们这些人数也在锐减,你这是,就必须要考虑到的事情,必须有心理准备的事情,那你用了这个准备,破釜沉舟的,你总不能说等到市场需要的时候,你再出,你提供的永远是N加1 就是2026年加一年的产品,你在2028年提供的,就是2027年产品,或者叫N-1吧,你2028年给我提供一个 2027年产品,那你怎么去和别人做角色呢,我觉得这是,如果拿反面的案例,就是我这正面案例去说的话,那肯定就是蔚来,你别管是什么车,我一定 ET5也好,他妈的什么ES6 ES8 ES9 我他妈都给你做大,你管我好不好听,你管我这个用户需不,我是不是给你做大了,那现在用户一说大车,先想到我操未来,谁还在想什么迈巴赫,什么这些东西,以前普通老百姓也想,这个奔驰对吧,大的什么威廷,什么这个这些车,你现在一说大车未来,那就是人家一以贯之的,我在所有的,那这个就是属于,未来的一个Livis 或者未来的一个Home版本,他不可能说,因为我一题五题,没办法做大了,这么多产品经理干嘛吃的,你提供解决方案,你提供不同产品序列里面的,一个对于你home的理解,对于你levis的理解,我觉得这个不是一件难事,难的就还是坚持,还是去有这种完整解决方案,给用户提供完整解决方案的,这种思维吧,明白,所以确实之前,工信部I9的这个预告,让我就很不理解吧,你回答一个我的疑惑,就是对你来说,到目前为止,接受了所有他的发布会,好信息好车型 Livis对你来说是什么东西,我不知道,就是说你对我,你如果说你对我个人来说,我完全不知道Livis 它是什么,在我看来 RC的只有Livis 它是有一些,它是理想自信的,理想这家公司自信的体现,和产品能力的体现,以及产品定义的体现,我觉得可能就是这样,但是对于我来说,我不太能够感知到 Livis它是更AI 还是更好开,还是更先进,还是更智能,就是这个是个模糊的,并且现在应该进入 R9的评销期了吧,马上R8应该也快进入,一个评销期的这个阶段,我不知道他们,可能把所有的精力,都放在R6上面了,但是对于Livis的,这个诠释,这个水平在往下,不光是我,我们做调研的话去问,你知道Livis是什么吗,还是有人会回答牛仔裤,或者是和汽车无关的东西,如果说我们有提示,就是告知他,这是一个汽车品牌的,其中一个东西,或者我们去给这些调研用户,讲述这个产品是什么,给他看发布会,给他看资料,他们就会觉得,那就是一个更贵,更好的产品,仅此而已,但如果说用户觉得仅此而已的话,你的NPS就会在 [00:59:24]
于欣烈:你的NPS就会在,拍贼,就是六七八分这个区间,大家就不好也不坏,好也说不出来,但你也没有觉得这个哪里差,会给人一种,就是好坏参半的,这么一个无聊感,我们做视频也说过这些事情,他会有这么无聊感,所以就是,我自己其实没有对这个产品,对Livis这个有多深的认知,对,你那个视频,我印象非常深的是三个字,都挺好,我说一下我对Livis的印象,我的理解是有一个变化的,最开始我确实是把它理解为,一个偏AI偏智能的一个技术品牌,从它的眼镜也好,包括L9Livis发布的时候也好,但是直到L8上市的时候,它推出了巨神智能的套装选配包,它把巨神智能和Livis切割开了,我买一个选配包不是Livis 也可以实现巨神智能,实现它宣传的,所谓的这些AI的功能,那Livis究竟是什么呢,对我来说,它变成了Empower 它变成了一个,操控架控的一个符号,就像宝马那样,因为L8 L9 它强调的那些操控的性能,以及它的全线控地盘,这套东西,它全都是操控运动取向的,它跟智能已经没关系了,所以对我来说,它的传播,它的给我的印象,是发生了一个巨大的变化的,所以我也不知道,接下来Livis会是什么样,现在对我来说,它就是一个I am power 但我觉得就是,它应该是理想对于 Livis需要给人一个,破釜沉舟的一个感觉,就像ES9一样,虽然这两个产品,它不能完全放在一起比,就是我先不要管销量,是什么样的情况,我要提供一个极致的体现,非常极致的体现,我甚至L9以后,我就只有Livis一个版本,但是它就是我对于,整个就是未来在R4之前,可以陪你进入R4 智能驾驶时代的,唯一一辆车,我觉得这种信心,如果拿出来的话,可能会让用户记得更清楚吧,就是你的下一辆车,就是下一个时代,怎么不小心把slogan说出来,就必须要拿出这种感觉来,就瞻前顾后,当然我也明白这种感觉,我如果是一个企业的,一个负责人的话,我也会担心这个销量啊,股价啊,董事们股东们的对于,对于这个销量的担忧啊,对于中国汽车市场,可能会出现一些短期的一些,销量萎靡啊,这些东西都会很恐惧,所以这个更加需要勇气,我印象最深的一句话就是在,说yes, say yes特别简单,难的是say no 就是Livis缺少这个say no的这种,这种勇气吧,能让别人看到这个引擎,就基于这点来说,我觉得蛮可惜的 [01:02:41]
郑小康:小康,对你来说Livis是啥,你有一个清晰的概念吗,我觉得就是AI 只是他们没做出来,然后我们今天对Livis所有的,我的我也,所有的不认可,其实都是源于他们做到了一半,今天还没有能够拿出来,所有的东西,但是我选了巨神智能选配包,就所有的他的聚能智能都有了,这跟Livis无关啊,不是,不是不是,我觉得这里边,我依然觉得就是 Livis是一个完全体,就是,明白,就是所谓的满血版和残血版是吗,就是L9的Ultra上面,再加一个聚能智能选择,其实它不是一个完全体吧,我没理解错吧 [01:03:02]
于欣烈:这我同意啊,因为从他Livestate讲这套巨神智能的技术特点来说,比如说它的响应速度是一个非常重要的指标,那么如果你没有全星空底盘的话,你的响应速度是达不到最高水平的,那你只选了巨神智能卷配包的那个激光雷达和芯片,你是达不到那个真正最高的响应速度的,所以我理解完全体的或者说满血版的巨神智能,就得是需要Livestate的,对,但现在就很奇怪,我觉得就变化的,自从那个选配包出来之后,虽然从产品上,它让Ultra的用户,有更多的选项和自由度,能够享受一部分,巨神智能的功能,但是它把Livis这个品,这个技术品牌,我觉得搞得搞混了
郑小康:我觉得它依然是,一些产品规划的问题,就是这个问题依然是一些产品规划的问题,就是如果我们选择把Livis平台化的话,那它可能就没有Livis这个名词本身,因为你就不会叫L9Livis Pro Max L9Livis Ultra 因为这样可能就太复杂了,而是把Livis做到了,渗透到了这个公司产品的每一个层面,如果你把它渗透到了每一个层面,其实有没有Livis这个技术品牌,它都是没有太大区别的,因为一段时间后,当你把你的软件的东西,全部都集成出来以后,每一个用户,每一个投资人,他能摸到的你的新的车,它都是Livis的车,你是能切实地感知到它的不同的,对吧,但是他们没有这么干,我会觉得这是一种,就是折衷吧,是一个中间态,但是在今天的市场环境下,也确实没有那么意外,我指的是中国企业里面,如果你能,或者我觉得比较感慨吧,其实如果你去看一下,今天特斯拉的QE财报,它现在美国的新车 55%的订阅率 FSD的订阅率,它的新车,的销量,出现了一些比较艰难的增长,但是如果你看美国本土市场,其实它没有再涨,就是如果我们以美国来分析,特斯拉这个公司,其实你会关注到,就是一个公司在,由汽车公司转型 AI公司的,所有好的坏的,这个里面都会呈现出来,坏的一面就是,它不再投资新车项目开发了,然后它的汽车营收也,包括汽车销量也,也就自然而然的不再高歌猛进了,好的一面就是,其实你切实的感受到了,它的物理AI这个维度持续的突破,那么其实我会觉得理想公司,理想汽车就是今天2026年此刻 2026年的7月份,反而没有两三年以前,就官宣要all in AI那个阶段,对AI投资的这个力度大了,因为它必须要兼顾销量,如果你去看特斯拉过去三年,我认为伊朗马斯克是承担了相当大的压力的,来面对这个投资人的压力,特斯拉的销量,季度销量已经连续几个季度,就是如果你去看汽车销量,我认为华尔街是相当苛刻,是完全不会揉任何沙子的,不会网开一面的,那么他已经经历了几个季度的,整个汽车销量,要么是横摆,要么是小幅下跌,这是建立在你的各公司的人才资源,要往哪个方向去的基础上,我认为理想机制其实没有获得这样的,一个是恐怕管理层很难承担这样的压力,再一个是大家不得不,它是不允许飞机停下来的,它必须得一边开一边换,而Elon Musk我认为他就是,某种程度上是一个更加激进的专心,他可能是中间停一下,然后换方向去飞,我认为这个是区别所在,也能解答刚刚这个,看起来有点奇怪的决策,或者是不合理的地方,核心是我不得不为销量服务,那么可能要去推一个巨声的表情包,不是巨声智能的这个包,选装包,类似这样,这样的策划,是不是能够带来更高的营收,或者是更健康的经营质量,或者是促进更多的销量,也许有的人他觉得Ultra都挺好,但是智能没有拉满,可能是他argue的一个点,也许因为林漾他恰恰是把这个,四固态,就三固态,三固态是和Livis绑定在一起的,在前期,这个事也许大家想想,可能是中端的解释成本会有点高的,尤其你在前期的主推Livis 因为你像主推Livis 你跟用户解释说,它是一个很顶的车,然后我们这个加上了固态,这样的话它有电动门的功能,它可以检测自动开电动门,然后它可以检测悬空的障碍物,你这个时候是在强化,这个东西的价值的 Ultra的话,我可能也是一个几十万级别的产品,但是它其实没有这样的东西,所以我觉得就是这样一来一回拉锯,然后也许有一些来自一线的反馈,什么之类的,然后最后就会,因为巨声智能选装包,它不是一个L9 L6发布回之后,或者是加奥传发布之后,直接推出的,对它是后面拿出来的这么一个东西,我觉得这里面势力,有一些决策上的这个拉锯,然后就会看到今天这样的结果,同意,我就是这样的用户,我在选配的时候,是非常喜欢这个巨神智能套选配包的 [01:10:05]
于欣烈:因为我不需要那套能颠簸炮弹钢的主动选架,我在城市里用不到,我觉得Ultra的配置足够用了,但同时我又希望能够享受到智能的功能,那么当他给我一个巨神智能套装的时候,我非常喜欢,我觉得这太完美了,这就是我想要的东西,我要如果买的话,我就会选这套的组合,但是就像刚才我们谈的是,如果我是一个真正在乎,巨神智能这个科技体验的话,他没告诉我,差的那一个一丝血的话,我举个例子,我问大家一个问题,咱们假设,你天马行空的想一下,如果L9Livis的,就是L9 或者说是它的Home版,或者Livis版的,有这么一个功能,它有电动车漆,这个质变车漆,这个功能,你只有Livis这个版本有,其他都一样,所有的配置跟其他东西都差不多,然后呢,你的这个功能是可以,咱们就纯瞎说,纯瞎聊,你可以在你手机上选择好你的颜色之后,点一个上传 48小时之后,你再开出去,它就是一辆新的车骑的车了,你们觉得这样的话,会不会增加你们的购买欲,咱先不用管一些限制问题,什么倍按啊,什么这个可不可能实现啊,咱们就说就是,如果增加这样的,类似这样的功能,你们会不会考虑,对我这样的值单来说不会,小汉呢 [01:11:07]
郑小康:我理解你的逻辑,就是他会不会外显,把它变成外显的科技,但是核心是,你刚刚是说,提供一个,这种外显的选装包,还是说,把它完全限定成一个 Livis独占的东西
于欣烈:都可以,就是他也可以是独占,也可以是就是你加钱,就是都一样吧,你加钱就可以有,我觉得会增加的,这个一定是会有增加,而且应该是显著增加,所以我的感觉就是说什么,他现在还没有到一个,就绝对性时刻,就是当然,我说的这个是完完全全,不可能实现了这么一个,就甚至十几年之内,二十几年之内,不可能实现这么一个功能,但是这个功能的,这个本质是什么,他得有向往感,我要对Livis这个版本,对这个加几万块钱,是有一种向往感,我得到的东西,是要足够去承载,我想象不到的生活的,他甚至可以让我觉得有点不方便,有点可能笨,他需要很多个很长时间才能切换过了,或者怎么着,但是他一定稍微不同,对我作为一个拍了重新认识L9的人,我真心觉得,就是我们在这个问题上沉浸了太久
郑小康:就是他核心是说,你Livis构筑出来这些东西,你还没有交付,然后官方已经传达出来那些东西,比如说车可以follow你,然后你可以把车手势造化 [01:12:46]
于欣烈:那种东西它是毫无,这就是小康,我想说的一点,它表达出来的东西还没有交付,但是它没有造成,营造出来向往感,肉呆刚才说的那种是一种向往感,不管它是车骑这种显性的东西,还是什么哪怕是技术,它现在Livisteck给我描述的,最终目标是一个更好的质架,你明白吗,它对我没有一个,它可能是我更需要的,它是一个功能性的东西,我没有一个特别强烈向往感,说我好希望,到时候能够去使用,满配的巨神智能的体验,没有,它只是一个更好的支架,对,我认为 [01:13:00]
郑小康:今天核心是说,我觉得可以完全抽象一点来去,把巨神智能抽象为,更好的支架和更好的座舱,其实可能因为支架跟座舱,聊了很多年,以至于大家觉得这两个词不酷,我认为顶尖的支架,它就是自动驾驶,自动驾驶是一个非常非常牛逼的事,是极其有向往感的,我觉得是这样的,但是呢,我觉得这两个问题,就是Livis在上,你并没有把它传递出来,产生向往感,这是一个问题 Livis这个套件,或者是巨声智能套件,它没有交付东西,我觉得这是另一个问题,核心是说,你在Livis在上,来一个快嘴的复杂的导航,然后你再,是有一个你的支架的,下一代这个支架的能力,能干什么什么什么,这些东西,在今天这个市场环境,我觉得是完全疲劳的,我认为包括,我举个例子,岔开一点,我认为包括,比如说ADS5 或者是鸿蒙座商6 类似这些东西,其实都没有给用户,带来新鲜的东西,或者说刺激用户,产生向往感,我觉得这个东西,在今天是,也许蓬层的那套东西,会更有效,就是人很难想象,或者说是人很难描绘,数字化的下一代的东西,我觉得这是很难的,我说一下我的感受 [01:14:34]
郑小康:我说一下我的感受,在Libby State上,当它的机座模型研发的负责人,张坤说 [01:15:02]
于欣烈:他们的一个年龄目标,是追评FSD V14的体验的时候,我第一反应是很高兴的,假设我是用户的话,我觉得好牛,我可以享受到,这样的制价体验了,但是作为一个Livis Day的发布会,它的巨神智能向往感的话,其实我后来的反应是不好的,我说就这,你追评了V14 就给我的向往感,其实它盖上了一个盖子,我不希望看到一个,这么近距离的实现的目标,因为我希望它给我吹牛逼,它告诉我一个非常科幻的,他们努力去实现的目标,而不是一个非常理性的,来吧咱们年底V14见,我不需要这个,我想听的不是这个,我买车的时候需要这个,而华为的这个ADS5 反而有一点点,给我营造了向晚感,是因为L3 虽然大家都骂L3 但是他告诉我,他能实现L3 我还是有一点点激动的,我想脑画面里会想说,我用L3是什么感觉,我觉得这个体验,对我一个去看发布会的人,是有区别的,柚子你说,我就这么说,现在卷参数卷的,大家忘了参数这件事,为什么要对标FSD 还不是因为在座的媒体老师吹的吗 FSD牛逼,这个世界上只有FSD和其他,但是一旦这么说,他们接受的信息也是媒体端的信息,所以他们就会说我对标FSD 那FSD比你好在什么地方,有一个车企说了吗,没有,没有把这个数据量化,都没有,他都别说量化成一个,普通有买车需求的用户,他能听得懂的,他连对媒体的解释,我们对标FSD 无论哪个车企都这么说,有用吗,没有用啊,你没有得到量化,就是新链你刚才说那个,为什么华为一代词就可以,就L3 L3就是可量化的,老百姓也能听得懂的,但你说FSD是什么,就最简单的一个事情,就是我失望的点,可能跟新链你失望的点是一样的,你得告诉我,就在发布会上,你告诉我 Livis这个版本,或者说是你的这个,有马克西面这个版本,他在面对一些,就他在自己可能处理不了,这种情况的时候,他会像特斯拉FSD一样,优先保证你的乘坐体验,而不是保证你的什么其他体验,你的东西没有从来不说,你在遇到红灯的时候,别的车是一脚油门就过去,或者他会反反复复犹豫,但我们这个版本,或者我们这个产品,它减少了90%的犹豫决策,就是你要把这些东西,全部量化出来给用户说,那我们媒体吹也好吹嘛,但现在是什么,就是我们要对齐FSD 你为什么要对齐它啊,你对齐它的目的是什么呀,难度在哪,难点在哪啊,你吹了这么长时间,居然还在对齐FSD 我觉得这个事情,就从营销的角度上来讲,就讲不通,所以对,这就没有这种共鸣感,就是为什么我刚刚问大家,车系的那个变化,你得有一个非常有感知的变化,用户才能理解,才能有巨大的向往感,你在此基础上,你不把自己现有的好的东西,描述成这么有向往感,那你不就自断,就捆住自己,带着镣铐跳舞吗 OK 咱们进入到最后一部分,尽快结束,第一个,上半年的最佳公司,可以先说一下自己的公司,然后说一下,这个指标评判标准是啥 [01:17:54]
郑小康:等等,小康先来,上半年最佳公司,你选谁,未来吧,这个标准,算了还是给特斯拉吧,这跳得太快了,还是给特斯拉吧,因为我觉得未来已经有这家产品,我觉得ES8 实在是太遥遥领先了,所以,我觉得它可以拿产品,那么特斯拉的话呢,你可以另很多的东西,我觉得坦率来讲,你也很难用上半年去概括它,但是我深切的认为 2026年是特斯拉的一个转折之年,为什么呢,因为我认为某种程度上,到今年年底,也许他不一定能做到全美,但他一定覆盖整个州了,这个事情是VIMO没有实现,我的意思是整个州,不是某一个城市 VIMO已经进入了非常多的城市,并且VIMO的规模,今天是远高于特斯拉的,特斯拉到今天为止,累计是38万英里 VMW一天就会,不一周 VMW现在的体量,一周就会有超过38万英里,这是按里程数来计的,我的意思是,我们到今年年底一定会见到,这种如果我不依赖高精基图,作为强系统组件,设计的自动驾驶系统,那么在它模型能力,到达一定阶段的时候,如果你结合今天的财报,我认为到今年年底,是没有任何可以限制它的东西,硬件是ready的,软件是模型是ready的,那么它完全可以选取某一周,集中攻克这个周的监管,比如说我如果搞定了德克萨斯州,我其实是全州开放的Robotex 这个我认为要比Elon Musk讲的,覆盖全美或者覆盖半美,所有这些东西都不需要,你只需要覆盖一个周,你就已经完全充分的,验证了你这条路线的生命力,我觉得这个事情会在今年发生,所以说机器人那些,那都是后话,不是今天这家公司的主线,今天这家公司的主线,就是自动驾驶,也不是用户车上的量产FST 它其实今年也是它的出海年,它成功的,我认为到今年远近,可能会进入50个国家,应该不难,现在已经进入了超过十个国家,但是我觉得这些东西都不是主线,主线是,它要证明它可以,在不依赖高进度地图的情况下,飞速地进入,类似于中国的一个省,或者是美国的一个州,就在小康你给特斯拉最佳公司的同时,它的股价已经狂跌了13%了,我觉得这个,不是什么问题吧,这个就不评论了,股价就不说了,你接着把最佳车型说了吧,这件事情就是未来ES8 为什么呢,其实我前段时间,今年早些时候,就是在理想i6 又一次拿了,两万大的这个销量的时候,我发了一条不知所谓的微博,我必须要为未来道歉,我当时说,就是理想i6在model Y和预期之间,拿出来的这个数据,和未来ES8在它所处的区间,拿出来的这个数据,哪个更让人印象深刻一点,我说可能是理想,还要留个印象深刻一点,今天我必须要为这个事情道歉,很显而易见,是未来ES8要牛得多,牛得多得多得多,为什么呢,我认为这里边除了正面战场,就是说ES8本身的产品力,全是出来的东西,还有一个很重要的因素是,在它热销了超过三个月以后,它上市三个月之后,因为商业环境它不是那么美好的,全是星星点点的,不是的,它就会有各路的竞争对手的围追堵截,攻击,这个东西实在太多了,水面下的一线的销售,全部都是强杆制的,当然了,比如像特斯拉Model 3 Model Y 也有很多的竞品,每一轮上市的时候,就会对他们冲一波,每一轮上市的时候就会冲一波,我指的这个冲一波并不是说,销售层面的冲一波,而是我一定有各种各样的话术,所以这些东西来去进攻,也包括营销层面,舆论层面,那未来ES8 它建立在什么呢,就是它是建立在,整个中国汽车行业,整体销量,截至7月份,下降了20%的背景下,它要换位,这个销量规模,是尤为艰难,尤为珍贵,就是意味着,所有其他人不得不付出更大的下行,更大的销量的订单的下行,才能维持住,因为整个盘子在扬缩,才能维持住ES8如此出色的成绩,它确实太牛了,不可思议,太强了,那你还不单独拍一期ES8 拍完L9之后,来深入讲解ES8 我这么跟你说吧,今年春节后,我就已经开始推这个项目了,并不是因为我懒,是因为什么呢,就是我觉得我们这个公司,如果大部分时候,我都不会催这个公司,如果少数时候,他只能催的一点,就是我们有时候会投入一些,他就没有预算,但你就是想做,因为他牛,我们以前做过一些特斯拉的,但是未来夜市吧,实在太过出色,以至于我就是非常想做它,但你重新认识未来夜市吧,我非常想做 OK已经吹完了,下面呢,就是说每一个公司,都是要生存发展的,它的问题在于什么呢,如果它是一个自制项目,每当有商务来,你就得为商务让,每当有商务来,你就得为商务让,这个大家能理解吧,所以它有各种各样的,优先级的会把它,不断地往下打压,往下打压,但是好在就现在,我是不希望做,然后大家也不要有误解,不要以为,哇操,郑小凡从1月份,掐到了7月份,不是这个意思,他核心确实就是说 ES8 他作为一个,我自己特别想做的项目,我是没有足够的,多的底气,去压制住很多别的项目,就是说,我一定要先把这个推成了,我却没有这个,没有这个正当性吧,但好在就是说,我现在又有时间,可以重新去把这个事做成,我依然觉得,当我们,就是有这么一台车的时候,从我们的角度,从内心频道的角度,我们是有一期,重新认识ES8 它是值得这么一期节目来,去匹配它,江湖地位,江湖地位,来小军,万能座最佳品牌,肯定就是,就是领跑,我觉得今年,领跑打法很稳,你会发现领跑,其实也出了挺多车的,但没有人说,它出了车多,也没有人吐槽说,哎呀你的出了车,划中取宠,没有,因为你其实明显感觉到,它几乎是按照自己的金字塔子在不断的堆车行,而且每台车上来之后,它没有说上来订单爆炸,如果是举个例子,像B系列上周订单我们统计15,000 上上周还是15,000 每周都堆就3000多台,刚上市3000多台早被人骂透了的,打死人追到骂脸,但是为什么现在没人骂,因为很简单,大家心里很清楚,领跑的习惯就是稳定的销量,扎实的销量,快不是它的核心,它的重点是稳,今年我们看到,其实它的订单在从一万到一万二,现在涨到一万五千台每个每周,也就意味着它现在每个月订单,可能能维持六万五到七万台左右,而且从D系列到A系列,在不断的完善,而且每个车都进入了同级别的,同价格区间的前三,因为我跟他们最熟,而且我跟他们关系算是最好的,我很开心能看到他们这么强,具体车型的话肯定是大唐,我觉得今年大唐是比亚迪的 20万级别的翻身之战,打得非常漂亮,我也认识他们的几个小伙伴,我觉得他们前期非常焦虑,而且包含怎么上这个车型之类的,应该都非常犹豫,但这种上完之后,我觉得他们打得非常漂亮,包含从把95年850的续航,再加上闪充,其实闪充我觉得今年给比亚迪,所有车型带来非常大的负能,再加上他们自己在产品上做巨大优化,营销也做了很多传播,都打得非常漂亮,今年我觉得比亚迪在,好几个车型上,从营销到内产品,都完全新能源化了,新势力化了,你不只是看到它产品有多提升多大,而是它也会感觉它整个公司的思维全变了,我觉得大唐就是短变的一个非常关键的车型,你会发现大唐之后,也不用说最关键嘛,方程报就已经有这个趋势了,但是你现在能感受到,最明显的,还是比亚迪开始了 [01:27:37]
于欣烈:来来来,最佳公司,最佳车型,一样,最佳公司,未来最佳车型ES8 啥标准啊,你这个最佳公司,最佳车型,试驾的,你看,你像吉兰路啊,他们已经做完了上半年的,这个汽车市场这个调研,那我们,我们也是也,也在做,只不过可能,没有那么2B 我们完全是为了,我们自己的数据库,去做这个调研,我们做的时候发现,未来这家公司,是比较符合我们,心中,就是符合我自己心中,汽车厂商应该有的样子,他愿意,他愿意坚持,他有去改变的勇气,他不为了改变而改变,他ES8推出来的时候,我们收到大量的,就是那个时候,好像一年之前,我发一年多之前,我发过一幅,说很多人,当时我和很多未来的粉丝,都在掐架,就很多人都会觉得,你把夜色吧弄得这么便宜,你这不掉价吗,我觉得就是当时,虽然我坚定的站在,这个未来这边,但是其实我自己觉得,如果我是个企业负责人,或者我是未来里面的一个员工,我自己也会担心,也会抵护,万一呢,万一我们一直就是下探了之后,我们起不来了,但是后来紧接着就有传出ES9 然后再看到ES9是这个样子,他们是真正做到对于销量这件事情,没有那么反而有点生死看淡的这种感觉,我觉得这种心态,就是破釜沉舟的心态,以及真的不是,我不是为了变而变,我不是为了说迎合某一个群体,或者我怎么说,我就直白的说,可能又会被未来粉丝可能骂一顿,就是我从来不会为黑子而造车,我时时刻刻都在想着,那些当初爱我们的人,是为什么爱上未来这家公司,我为他们造车 [01:29:53]
于欣烈:我为他们造车,然后在调研的时候,我们现在也在做未来ES8的调研的节目,也在正在制作,当时就有一个车主,一个女车主跟我们分享,说她,这个故事到时候,肯定也会给大家拍出来,就是他就说,为什么我一直没有卖,第一代ES8 我一直没有卖,中间经历过无数次的事情,从来没有卖过这辆车,无论是那时候中间经历疫情,又经历了就很多很多事情,裁员什么,他从来没有卖过这辆车,电池还召回过,对对对,然后说经历过这么多事情,当时他的家庭,这个结构也变了,什么都变,为什么,他就觉得这个车,就是能够陪他去坚持下去的车,他就隐约觉得,我什么我房子可以卖,我这个也可以弄,我什么我都可以,可以去变卖,就唯独这辆车,是要始终陪我去走下去的车,直到新款ES8发布之后,他就买了新款ES8 我们当时就问他,因为我们不知道他之前这些故事,我们就问他,为什么你要换ES8呢,你不是说这个车一直陪我吗,他说这就是坚持的,对我坚持的最佳的包奖,我觉得就是这句话特别感动,我就觉得就是对啊,这也是对未来一个,这家公司的一个包奖,现在无论说销量还是口碑,还是那些能不能提升世界的东西,这都是未来的坚持所应得的,现在用户去买未来的时候,会把换电放在首要的考虑因素,会把设计放在排在前三,会把空间啊,这些这些nomi啊,这些东西就放在非常显性的位置,我们在接触的很多客户中,他们都在说,我们车里面如果放个Nomi 它是不是就是可以是一个智能体,你会发现,冰哥啊,冰子啊,真的是咱们好哥们,他就被别人教了多少,做CEO这样,你增程,不是那个,你要做增程吧,你在这个换店,要不要考虑别的吧,你这个Nomi就应该取消吧,嘎吱嘎吱,谁,谁他妈天天听你车里吵不吵,你说你yes吧,你有这个必要吗,当他去真正把大家的话听进去,并且做出改变的时候,他没有为了那些黑他们的人,而去做改变,他始终会去坚持,那些人当初爱上蔚蓝,相信蔚蓝作为,中国新能源市场的,一个小baby 一个小婴儿,推出的第一款车,换电也不是那么强有力的说服力 Nomi也不是那么具备,就这么具备说服力,续航也不具备,那他们当时相信未来的是什么,他们坚信未来是一个,可以改变自己生活方式,出行方式这么一个品牌,未来一直坚持下来,尤其在当今这个,当下这个中国市场环境,还能坚持下来,它在我心里就是上半年的最佳 ES8就是未来这么多年,集中化的一个最集中体系,未来ES8 瑞斯拜瑞斯拜,你的二八还留着呢吗,怎么可能呢,怎么可能呢,我说的是我的,我也不是刻意跟大家不一样,我最佳公司选的是理想,大家可能听众朋友们,可能会比较惊讶,就是这公司今年好被骂的,这个销量也不行,包括我们在节目里,其实也对理想很多具体执行的东西吧,有很多的吐槽或者建议,但对我来说,我的标准是,就在今天这个,非常内卷的汽车市场,理想这家公司,作为一个,以冰箱彩绿大沙发,出名的公司,它真的在做技术创新,全力在做技术创新,而不是去困在,传统的经营框架下去,挖成本,拼效率,去精益求精,就是它跳出来了,而且它的创新,不是盲目的创新,或者是复制性的创新,去跟随,它有它的独立思考,而且还能交付出来技术成果,它独立思考包括,比如说它的这种,与众不同的架构的AI芯片,既能够服务于置架,同时本身也是一个 AI算力非常强大的芯片,可以用在AI主机上,包括它的自研的语言大模型,也进行了重要的迭代吧,而且另外一方面,我觉得这也是刚才小康谈特斯拉的时候,我想说的一点,理想是把这些技术成果,都落实到车上的一家公司,我觉得这跟特斯拉是有哪区别的,特斯拉它强调的是技术 AI技术,它的自动驾驶,对车对它来说是个工具,它是卖给2C也好,还是说做运营也好,不重要,或者说没那么重要,重要的是它的技术能够通过,哪个工具去落地,实现技术的民主化,或者说普及化,我觉得这对Sazak是最重要的,但理想,他对我来说,我作为一个汽车用户,我喜欢他的地方也在于,他会把这些东西,去结合车来开发去创新,而不是说,他单独要做一个人形机体人吧,他单独要做,其他的什么产品吧,他仍然愿意去把车变得更好,我觉得这可能跟理想本人,对车的喜爱也有关系,所以作为一个其中用户来说,我是会被这样的公司打动的,我也期待它能够,把交付出来这些技术成果,不论是芯片也好,它的模型也好,尽快地能够变成,用户能感知的这种用户利益,我觉得这个是它现在最重要的,但是它这种努力去创新,在当今的这种内卷,非常激烈的市场格局下,仍然愿意花这么多钱,去做技术创新 AI的创新,我觉得这个是我,非常喜欢它的一点,那最佳车型,其实我选的是,全新的R8 它对我来说,不是因为销量,它的标准是,我觉得在刚才你们谈到 ES8强大如斯的,这么一个现状下,就是六座市场,已经完全被未来统治了,但是理想拿出了一台大五座,这个五座它既有操控性,又有二排的产品定义上的创新,拿出了非常好的领重力座椅,我觉得它会变成,今年五座大型SUV的一个标杆,它的销量有多好,能卖多少我不知道,这跟它的售价也好,跟它的增程的动力形式也有关,但是我觉得所有的五座,都会去重视它,或者说购买其他5座的用户,会去参考它,这个车究竟有没有像L8那样好,而且这个L8确实是我自己,愿意去买一辆车,因为它满足了我的需求,我之前也说过,其实我非常在意二排座椅,以及行李空间,我不需要三排,那之前我只能去妥协,去买一个三排六座的车,把三排放倒作为行李空间,然后去享受二排的舒适性,那L8解决了我的,小众的需求可能是,它真的让,五座车也可以去,有很好的二排的乘坐体验,同时有很好的心理空间,非常可惜的就是,它是个增程啊,这个就像刚才之前,大家说的,今年增程,确实是遇到非常大的挑战,我肯定会买一辆纯电的车,但是 i系列又发生了,这么巨大的变化,有没有一台,像L8这样,产品定义,但是是纯电,动力能源的产品,不知道,今年反正肯定是没有了,所以今年我也买不到,这样一款车 OK 我说完我的了,咱们聊聊,其他几个总结,有什么愿意说什么,混在一起说吧,比如今年,你没有看到,汽车市场,觉得最重要的一个变化,以及,有没有,让你打脸,或者说改变你之前,判断的这种事件,或者车型,小康下来 [01:38:11]
郑小康:一个变化,我觉得也不局限于上半年,我觉得就是今年,我会觉得,所有人应该都已经接近极限了,我说的是这个产业里面的人,汽车产业里面的人,如果非要说的话,我觉得媒体可能还没到极限,但我真心觉得,至少在主机厂和供应商这两个环节,应该都已经崩到了,非常非常极限的位置,这体现在什么呢,体现在,比如说问界M9两年换单,已经很厉害了,但是其实这已经半官宣了,问界M8可能是一个上市一年的产品,也要有一个不一定到换单,有一个大更新了,历史上呢,这样做的企业没有那么多,极客作为一家,其实他拿到了整个吉利系,核心工程资源的公司,他那样做的时候,是遭到了舆论的用户的反噬,对吧,就是他当时是一个比较特立独行的,但现在呢,你会意识到越来越多的企业,正在即刻化,在2026年,而那些没有即刻化的公司呢,就现在积极的被动,好像你的迭代也跟不上,然后你的竞争力也不够,我会觉得到今年会是一个极限,然后到明年可能会,但是它也不是一个,立刻突然触底反弹的,而是一个逐步逐步发生变化的,就是我会觉得理想的产品迭代周期,就是一个行业正常的理想的迭代周期,它应该是三年左右,它没有办法压缩,没有办法更短,我们现在显然是一个非常态,我觉得这是过渡竞争的结果,我们看到的这个是一个结果,它背后的原因是过渡竞争,但我觉得到今年会结束,然后从明年开始会更加的,恢复理性,恢复常态,逐步逐步的一个过程,我感觉是这样,你觉得支架有变化吗,中国没有,而且我觉得今年对我来说,感觉支架的存在感,变得更熟了 [01:40:18]
于欣烈:除了未来有一波反转,体验比之前好很多,剩下的好像讨论支架的话题,或者说支架产品的这种感知,新的功能新的体验,反正都很弱,对我来说 OK来肉呆,我觉得最改变我的事情,就是过去很长一段时间,我不太承认大家卷到头了,但现在我们做完调研就会发现,用户的疲惫感也有了,就是开始蔓延到用户身上,我们之前好像在节目里说过,就是给你50万,然后20万的首付,或者30%首付,你会买什么样的车,就用户选,就是不知道买什么车的用户特别多,所以就是已经到了同质化非常严重,大家又卷不动的这个时候,还能干什么呢,我觉得下一步,真的是要考虑自己的,这个组织能力,这个品牌的这个,品牌故事的讲述能力,能把这个自己的好,告诉中国的这种营销能力,我觉得这三点是,接下来要卷的,这个我还是得,再给自己叠个假,营销不是说上多少热搜,有多少这个流量,请了多少KOL 有多少水军,不是这个,这个不叫营销,这个只是一个市场行为,它没有办法,这是营销的一种吧,营销的还是要告诉用户,你好在什么地方,去给用户去创造一个向往感,今天我还转那个,说梁文峰的那个梁文峰语录吧,你是转的小康的吗,对他好像杀了,我不知道为啥他杀了,害怕了吗,他就是伟大的企业,就是这个成功的这个企业,他就是要描述愿景,就是坚守愿景,创造愿景,你如果没有这个能力的话,那你拿什么和特斯拉抗衡呢,你卷到最后就特斯拉和中国汽车,就卷到最后只能是这样,这半年给我最大的感受是这样,特斯拉和中国汽车没了,那你说你在放眼全世界,当年BBA 它是叫BBA 它不叫德国汽车,它不叫欧洲汽车,但是现在一出海,你叫中国汽车,你叫中国新能源汽车,我觉得这个品牌力,品牌价值还是太弱了,所以就是如果诸位厂商没得卷的话,只能就是学学雷军,学学小米,决定这方面的事情吧,我讲一个我被改变之前的判断和观点吧,也谈不上观点,其实刚才又在谈到,去年ES8上市的时候,价格下降的很多,当时很多用户觉得对品牌的有损害,我就是这样的未来车主,就是我仍然很喜欢未来的产品啊,我平时开的最多也是未来,但ES9是让我改变了,自己之前的一个判断,就非常神奇,我觉得ES9 它的赢不是因为自己,当然它本身是一个合格的产品,但是我觉得它能赢,还是因为之前的ES8 ES8要没有这样的神迹啊,它其实是支撑不了ES9的成功的,就是ES8和ES9的先后顺序,它的逻辑是连贯的,这个是我之前没想到的,它其实让我想起了什么呢,其实让我想起了,有点像当年问界M7和问界M9 就当时问界其实整个在中国的销量,也不是很好,问界老款的M7产品力也很一般,上市时候火过一段,然后后来销量一直在下滑,直到那届M7出现 M7当时是一个非常低的价格上市,而且有很多配置的提升,在配合上当时是Mate 80吧,手机的那个上市,那个芯片的这个新闻由头,一下就变得爆火,卖得巨好 [01:44:33]
于欣烈:卖得巨好,当时其实我去判断啊,问界如果想让他的,当时的科技车皇M9上市的话,它一定需要有一个,前期的成功的舆论环境,就是问键M7所打造的,问键M9后来的成功,是跟问键M7之前的,销量爆款大获成功,是密不可分的,而今年我觉得ES9的成功,是一个类似的故事,它靠一款大幅度降价,性价比非常高,你20多万就能买一款,全尺寸大型SUV 那么好的精致的内饰,这样一款车,获得了非常大的成功,这个成功不仅仅是销量,它其实也成为了一个事件,同时它解决了未来之前,一个重要的问题,就是大家对它的经营问题的担心,支撑了大家对未来这个公司,能够走向成功的信心,以及延续了,大家对未来品牌,高端品牌的这个调性的认知,依然还存在,它延续了之前的品牌认知,然后ES9 我觉得它的成功,是被托举上去了,就是为什么之前ET9没有成功,它当然自身本身产品有些问题,包括它所处的市场,但是ET9当时,就没有这样的托举,它没法顺势成功,所以ES8和ES9 是今年上半年,对我改变判断,之前的判断很大的,事件也好,或者说策选也好 OK 咱今天也三个小时了,那这期就到这,下个月见,拜拜,拜拜,欢迎大家在小宇宙,苹果podcast 等音频平台,搜索巴巴屋,有准备的头脑,订阅收听我的播客,本期节目就在这里,再见 [01:46:52]